
L’analyse statistique moderne repose sur une tension fondamentale entre la simplification descriptive des données et la préservation de leur complexité intrinsèque. Dans la pratique scientifique comme dans l’ingénierie décisionnelle, résumer une série d’observations par une simple mesure de tendance centrale constitue un geste analytique à la fois indispensable et périlleux. Qu’il s’agisse de mesurer la latence cognitive dans un protocole expérimental de psychologie, d’évaluer la dispersion des rendements d’un portefeuille d’actifs ou de quantifier la tolérance dimensionnelle dans une chaîne de production industrielle, la moyenne arithmétique ne délivre qu’un point d’ancrage incomplet. Deux distributions peuvent partager une moyenne rigoureusement identique tout en décrivant des réalités empiriques diamétralement opposées, l’une témoignant d’une remarquable homogénéité tandis que l’autre dissimule une variance critique et des risques de déviation considérables.
Face à cette limite structurelle, la modélisation de la dispersion s’impose comme le pivot méthodologique de toute entreprise d’inférence quantitative. Parmi les métriques disponibles, l’écart-type occupe une position prééminente en raison de son élégance algébrique et de sa conservation directe de l’unité de mesure initiale des variables observées. Toutefois, l’opérationnalisation de ce concept ne se réduit pas à une banale formule mathématique appliquée mécaniquement. Elle exige une distinction conceptuelle radicale entre le traitement d’une population exhaustive et l’estimation réalisée à partir d’un échantillon fini, une frontière que la statistique inférentielle formalise notamment à travers la correction de Bessel et la théorie des estimateurs non biaisés.
L’avènement des plateformes de calcul collaboratif dans le cloud, au premier rang desquelles figure Google Sheets, a démocratisé l’accès à ces formalismes statistiques de pointe tout en introduisant de nouveaux défis de gouvernance méthodologique. La cohabitation de multiples fonctions natives au sein du tableur—telles que STDEV.S, STDEV.P, STDEV ou encore STDEVA—reflète l’évolution historique des standards informatiques internationaux et exige du praticien une compréhension lucide des hypothèses sous-jacentes. Ce guide exhaustif a pour vocation d’analyser en profondeur les soubassements théoriques, la dérivation mathématique et l’implémentation opérationnelle de l’écart-type au sein de Google Sheets, guidant le chercheur, l’analyste et l’étudiant à travers les subtilités du calcul univarié, du filtrage conditionnel dynamique et du reporting scientifique conforme aux normes académiques.
1. Introduction aux mesures de dispersion statistique et utilité dans Google Sheets
1.1 Rôle épistémologique de la dispersion dans l’analyse de données
D’un point de vue épistémologique, la quantification de l’incertitude et de la variabilité constitue le cœur battant de la méthode scientifique. Dans toute démarche empirique, l’illusion d’une régularité absolue est immédiatement battue en brèche par la nature stochastique des phénomènes observés. Réduire une distribution statistique à ses seuls indicateurs de tendance centrale, tels que la moyenne arithmétique, la médiane ou le mode, revient à postuler implicitement que les observations s’agglomèrent étroitement autour d’un barycentre idéal. Or, cette simplification efface la dimension la plus informative du réel : l’amplitude des fluctuations, l’hétérogénéité des sous-populations et la présence éventuelle de trajectoires atypiques.
La nécessité de quantifier la variabilité intra-groupe s’avère particulièrement criante dans les disciplines du vivant et les sciences sociales. En psychométrie, par exemple, lorsqu’un chercheur évalue les scores d’anxiété préopératoire au sein d’une cohorte de patients, deux groupes distincts peuvent afficher un score moyen de 50 sur une échelle standardisée. Pourtant, si le premier groupe présente une dispersion resserrée entre 48 et 52, tandis que le second s’échelonne de 10 à 90, les implications cliniques et thérapeutiques sont radicalement dissemblables. Dans le second cas, la moyenne ne représente presque aucun patient individuel et masque l’existence de profils pathologiques critiques nécessitant une intervention urgente. La modélisation de la dispersion n’est donc pas un simple raffinement descriptif ; elle constitue une condition sine qua non de la validité écologique des inférences psychologiques et comportementales.
De surcroît, la dispersion informe directement sur la stabilité et la reproductibilité des systèmes sous observation. En physique expérimentale ou en contrôle qualité industriel, une mesure dont la dispersion est mal maîtrisée traduit soit une imprécision structurelle de l’appareil de mesure, soit une instabilité thermodynamique ou cinématique du dispositif expérimental. En formalisant mathématiquement l’étendue des résidus par rapport au centre de gravité de la série, la statistique descriptive permet de discriminer le signal du bruit de fond, condition préalable à toute tentative ultérieure d’explication causale ou de régression modélisatrice.
1.2 Place de Google Sheets dans l’analyse statistique moderne
Longtemps cantonnés aux logiciels de calcul intensif autonomes ou aux progiciels propriétaires spécialisés tels que SAS, SPSS ou Stata, les calculs statistiques fondamentaux ont connu une transition majeure vers des environnements infonuagiques décentralisés. Google Sheets s’est affirmé comme l’un des vecteurs privilégiés de cette mutation analytique en offrant un environnement de calcul ubiquitaire, hautement collaboratif et nativement intégré aux architectures de données web contemporaines. Cette accessibilité sans friction transforme en profondeur la reproductibilité des protocoles de recherche et d’évaluation organisationnelle.
L’intérêt de Google Sheets réside dans sa capacité à héberger des chaînes de traitement quantitatives complexes sans exiger le déploiement d’infrastructures informatiques locales lourdes ni l’apprentissage ardu de langages de programmation dédiés comme R ou Python. Pour des équipes de recherche réparties géographiquement ou des cellules de veille décisionnelle en entreprise, la possibilité de partager une même matrice d’observations brutes, d’y appliquer des fonctions de réduction statistique standardisées et de visualiser instantanément les mises à jour dynamiques représente un gain d’efficience méthodologique considérable. La manipulation simultanée d’un même jeu de données par plusieurs pairs réduit substantiellement les risques de divergence de versions de fichiers, un écueil récurrent dans la gestion documentaire classique.
Cependant, cette facilité d’accès apparente impose un devoir de rigueur algorithmique décuplé. Le fait qu’un tableur permette d’obtenir un résultat numérique en quelques millisecondes via une commande intuitive ne dispense aucunement l’opérateur de comprendre les hypothèses axiomatiques régissant la formule mobilisée. La simplicité opérationnelle de Google Sheets peut agir comme un piège épistémologique si le statisticien traite le tableur comme une boîte noire bienveillante. Il est impératif de maîtriser la gestion implicite des données manquantes, le typage des chaînes textuelles au sein des plages numériques et l’adéquation exacte entre l’objectif de recherche et la variante algorithmique de la fonction de dispersion sélectionnée.
1.3 Objectifs méthodologiques de la modélisation de la dispersion
L’investigation systématique de la variabilité poursuit trois finalités méthodologiques cardinales dans l’architecture d’un protocole quantitatif. La première réside dans la caractérisation objective de la précision et de la fidélité d’une série de mesures. Dans le cadre de protocoles répétés, la dispersion quantifie l’erreur de mesure aléatoire inhérente à l’instrument ou à la variabilité biologique de l’organisme étudié. Un écart-type minimaliste atteste d’une constance métrologique élevée, permettant de resserrer les marges d’incertitude et de conférer aux indices dérivés une crédibilité expérimentale renforcée.
Le second objectif méthodologique concerne la standardisation des grandeurs empiriques. Dans une multitude de contextes comparatifs, le chercheur est confronté à des variables mesurées selon des échelles physiques ou psychométriques hétérogènes : comparer le temps de réaction en millisecondes avec le nombre d’erreurs commises lors d’une tâche d’attention divisée requiert une conversion métrique. L’écart-type constitue l’étalon par excellence permettant de transformer des scores bruts en valeurs réduites sans dimension, connues sous le nom de scores z. Cette opération normalise la distance de chaque observation à la moyenne en fractions d’écart-type, rendant commensurables des grandeurs initialement incomparables.
Enfin, la modélisation rigoureuse de la dispersion constitue le prérequis absolu à l’inférence statistique classique et à la vérification d’hypothèses probabilistes. Qu’il s’agisse de déployer un test t de Student pour comparer deux conditions expérimentales ou de structurer une analyse de variance factorielle (ANOVA), l’estimation de la variance d’échantillonnage représente le dénominateur fondamental qui pondère l’amplitude des effets observés. Sans une appréhension mathématiquement intègre de l’écart-type, le calcul des intervalles de confiance devient vicié, exposant l’analyste au risque inacceptable de commettre des erreurs de type I (faux positifs) ou de type II (faux négatifs) lors du test des hypothèses nulles.
2. Distinction théorique fondamentale : Population versus Échantillon
2.1 Caractérisation formelle de la population statistique
En théorie statistique, la population représente la totalité absolue et exhaustive des entités, unités d’échantillonnage ou événements satisfaisant un ensemble strict de critères d’inclusion prédéfinis. Cet ensemble universel, traditionnellement désigné par la lettre majuscule $N$ pour qualifier sa taille cardinale, constitue l’horizon indépassable de l’enquête lorsqu’un recensement intégral est mené. Dans une telle configuration, la mesure observée ne souffre d’aucune incertitude probabiliste liée à l’omission d’un sous-ensemble d’individus, puisque chaque composante élémentaire du système est scrutée et intégrée dans le calcul global.
Dans la pratique de la recherche empirique, l’accès à une population authentiquement fermée demeure une occurrence exceptionnelle en raison des coûts logistiques, temporels et financiers exorbitants qu’impliquerait une collecte exhaustive. Néanmoins, certaines situations concrètes circonscrivent des populations strictes : l’ensemble des dossiers médicaux d’un essai clinique de phase I clos, la totalité des étudiants inscrits à une session d’examen universitaire donnée, ou encore l’intégralité des transactions financières exécutées par une succursale bancaire au cours d’un exercice comptable verrouillé. Dans ces cas délimités, le champ de l’investigation coïncide parfaitement avec le domaine de définition de la variable, éliminant tout besoin d’inférence inductive.
Sur le plan notationnel et conceptuel, les propriétés numériques caractérisant une population complète sont dénommées des « paramètres ». Ces grandeurs sont considérées comme des constantes déterministes fixes bien que souvent inconnues dans la nature. La moyenne d’une population est universellement symbolisée par la lettre grecque $\mu$ (mu), tandis que son écart-type est immuablement formalisé par la lettre grecque minuscule $\sigma$ (sigma). L’application d’un calcul de dispersion sur une population ne laisse place à aucun biais d’échantillonnage, la variance mesurée reflétant l’intégralité de la variabilité biologique, physique ou comportementale inhérente au système clos étudié.
2.2 Théorie de l’échantillonnage et représentativité
Dès lors que la population d’intérêt excède la capacité d’investigation exhaustive de l’observateur—ce qui est le cas général en épidémiologie, en sociologie, en neurosciences ou en étude de marché—, la méthodologie doit recourir à la théorie de l’échantillonnage. Un échantillon constitue un sous-ensemble fini d’unités d’observation, de taille cardinale notée $n$, extrait méthodiquement de la population mère $N$. L’ambition de cette manœuvre épistémologique réside dans la capacité à formuler des énoncés généralisables sur le tout à partir de l’observation minutieuse de la partie, un processus fondé sur les lois du calcul des probabilités.
La validité de cette démarche inductive repose intégralement sur le concept de représentativité. Un échantillon n’est qualifié de représentatif que si chaque unité de la population cible a disposé d’une probabilité d’inclusion connue et non nulle dans le processus de sélection, idéalement à travers des procédures d’échantillonnage aléatoire simple, stratifié ou en grappes. Même au sein d’un échantillon parfaitement probabiliste, le chercheur fait face à la « variabilité d’échantillonnage » : par le simple jeu du hasard stochastique, deux échantillons distincts de taille identique $n$ prélevés dans la même population afficheront des distributions numériques et des moyennes légèrement discordantes.
Cette fluctuation intrinsèque pose des contraintes sévères sur l’interprétation des données. Si le protocole expérimental est entaché d’un biais de sélection—par exemple, le recours exclusif à des volontaires rémunérés dans une étude cognitive ou l’attrition sélective de participants fragiles dans une étude longitudinale—, l’échantillon cesse de refléter la structure sous-jacente de la population cible. Les indices statistiques dérivés ne constituent plus alors des approximations fidèles des paramètres généraux, mais des estimations décalées et fallacieuses, amplifiant les déviances d’inférence indépendamment des raffinements de calcul algorithmique opérés en aval dans le tableur.
2.3 Implications mathématiques du statut des données
La frontière épistémologique séparant la population de l’échantillon impose une bifurcation mathématique irréductible lors du calcul de la dispersion. Lorsqu’on travaille sur une population, le statisticien calcule un paramètre vrai et exhaustif. En revanche, lorsqu’on opère sur un échantillon, le calcul ne produit qu’une « statistique », c’est-à-dire une variable aléatoire destinée à servir d’estimateur du paramètre inconnu de la population parente. Cette statistique est notée traditionnellement par des caractères de l’alphabet latin : $\bar{x}$ pour la moyenne de l’échantillon et $s$ pour son écart-type.
La distinction cruciale réside dans la perte d’un degré de liberté lors du passage à l’échantillon. Pour calculer la dispersion des observations d’un échantillon, le praticien est contraint d’utiliser la moyenne empirique $\bar{x}$ comme substitut provisoire de la moyenne populationnelle vraie $\mu$, qui demeure irrémédiablement inaccessible. Or, par définition mathématique de la moyenne arithmétique, les observations individuelles d’un échantillon sont mécaniquement plus proches de leur propre moyenne $\bar{x}$ qu’elles ne le sont de la moyenne théorique globale $\mu$. Si l’on applique naïvement la formule de dispersion populationnelle à un échantillon, la dispersion calculée aura tendance à être systématiquement trop petite.
Cette sous-estimation structurelle nécessite une compensation algébrique délibérée. Le dénominateur de la formule de variance doit être ajusté pour compenser l’information absorbée lors de l’estimation préalable de la moyenne de l’échantillon. Cette rectification, formalisée par la substitution du diviseur $N$ par $n – 1$, dicte l’ensemble de l’architecture logicielle des tableurs modernes. Choisir entre une modélisation de population et une modélisation d’échantillon dans Google Sheets ne relève pas d’une préférence cosmétique, mais d’une conformité rigoureuse aux lois mathématiques de l’estimation non biaisée.
3. L’écart-type de la population (σ) : Fondements et modélisation mathématique
3.1 Décomposition algébrique de la formule de population
L’écart-type d’une population statistique fermée, universellement désigné par le symbole $\sigma$, représente l’expression quantitative de la dispersion moyenne quadratique des observations individuelles autour du centre de gravité théorique du système. Sa dérivation formelle procède d’une construction algébrique méthodique et élégante, régie par l’équation canonique suivante :
$$\sigma = \sqrt{\frac{\sum_{i=1}^{N} (x_i – \mu)^2}{N}}$$
Dans cette formulation intégrale, le terme $x_i$ désigne la valeur observée pour la $i$-ème unité d’observation élémentaire du système clos, tandis que la constante $\mu$ représente la moyenne arithmétique vraie de l’intégralité de la population, elle-même définie par le quotient $\frac{\sum_{i=1}^{N} x_i}{N}$. La différence fondamentale $(x_i – \mu)$ constitue l’écart individuel ou résidu, mesurant la distance directionnelle séparant chaque observation particulière de la valeur attendue globale. La sommation explicite de ces déviations, indexée de $i = 1$ jusqu’au cardinal absolu $N$, agrège l’ensemble des fluctuations individuelles du collectif étudié.
Le dénominateur $N$ traduit le principe d’une moyenne arithmétique simple appliquée aux déviations quadratiques. Étant donné que chaque membre de la population a été recensé de manière exhaustive et sans omission, aucune pondération corrective n’est requise à ce stade. La somme des carrés des écarts est rigoureusement partagée entre l’ensemble des $N$ entités constitutives du domaine d’étude, assurant une description statistique géométriquement exacte et déterministe de la structure dispersive du groupe.
3.2 Propriétés mathématiques de la variance populationnelle (σ²)
Avant d’extraire la racine carrée permettant d’obtenir l’écart-type, l’expression interne correspond à la variance populationnelle, notée $\sigma^2$. L’opération d’élévation au carré des résidus, $(x_i – \mu)^2$, remplit une double fonction analytique primordiale. D’une part, elle neutralise le problème structurel de la compensation algébrique des signes. En vertu des propriétés fondamentales du barycentre statistique, la somme arithmétique simple des écarts bruts à la moyenne est toujours rigoureusement égale à zéro ($\sum (x_i – \mu) = 0$). L’élévation au carré garantit que toutes les déviations, qu’elles soient positives ou négatives, se cumulent cumulativement sous forme de grandeurs strictement positives.
D’autre part, cette transformation quadratique confère à la mesure de dispersion une sensibilité hautement non linéaire face aux déviations de grande magnitude. Un écart de 4 unités par rapport à la moyenne contribue pour une valeur de 16 au numérateur de la variance, tandis qu’un écart de 8 unités y contribue pour une valeur de 64. Cette disproportion mathématique fait de la variance une fonction d’évaluation pénalisant fortement les valeurs extrêmes et les distributions à queues lourdes. La dispersion capture ainsi prioritairement l’instabilité induite par les points distants, ce qui constitue une propriété recherchée dans les protocoles d’assurance qualité industrielle ou d’évaluation des risques financiers extrêmes.
L’extraction terminale de la racine carrée principale rétablit l’isomorphisme dimensionnel entre l’indicateur de dispersion et la grandeur physique ou psychométrique primitivement recueillie. La variance s’exprime dans des unités au carré—telles que des milligrammes par litre au carré, des secondes au carré ou des points d’échelle au carré—ce qui la rend intrinsèquement abstraite et difficile à interpréter sur le plan clinique ou opérationnel. L’application de l’opérateur racine carrée $\sqrt{\cdot}$ ramène l’écart-type dans l’échelle originelle de l’observation brute, restaurant une métrique intuitive et directement superposable aux représentations graphiques univariées.
3.3 Critères d’application rigoureuse du paramètre σ
L’utilisation légitime de la formule de l’écart-type de population $\sigma$ est conditionnée par des impératifs méthodologiques d’une grande rigueur. La condition première et incontournable stipule que l’analyste doit impérativement avoir mesuré ou recensé 100 % des unités statistiques appartenant au cadre d’échantillonnage cible. Dès l’instant où une seule observation fait défaut, est omise par négligence ou s’avère inaccessible pour des raisons expérimentales, la matrice de données cesse d’être une population pour devenir de facto un échantillon amputé, invalidant formellement l’emploi déterministe de la division par $N$.
En second lieu, la formule de population est conceptuellement inadéquate dès lors que le dessein de l’étude implique une portée inférentielle, c’est-à-dire une ambition de généraliser les conclusions au-delà du groupe immédiatement scruté. Même si l’on dispose de l’intégralité des scores d’une promotion académique de 250 étudiants inscrits en première année de médecine dans une faculté spécifique pour l’année universitaire 2024, le statut mathématique de ces scores dépend étroitement de la problématique posée. Si l’objectif est d’archiver la performance finale de cette promotion spécifique sans aucune autre prétention, le groupe constitue une population intégrale et $\sigma$ s’applique rigoureusement.
En revanche, si le chercheur utilise les résultats de cette même cohorte pour valider un nouveau paradigme pédagogique et postule que ses observations s’étendent aux promotions futures ou aux étudiants d’autres universités francophones, alors ces 250 étudiants ne représentent plus une population close, mais un échantillon d’opportunité tiré d’une métapopulation temporelle et géographique beaucoup plus vaste. Dans cette perspective d’induction scientifique, l’usage de $\sigma$ induit une confiance excessive et trompeuse dans la précision du paramètre en ignorant le bruit d’échantillonnage inhérent à l’expérimentation pédagogique.
4. L’écart-type de l’échantillon (s) et la correction de Bessel
4.1 Formulation mathématique de l’échantillon
Lorsqu’une investigation quantitative est conduite à partir d’un sous-ensemble aléatoire de taille finie $n$, l’écart-type de l’échantillon, noté universellement par la lettre latine minuscule $s$, se substitue au paramètre théorique $\sigma$. L’architecture algébrique de cet indicateur empirique répond à l’équation conventionnelle suivante :
$$s = \sqrt{\frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n – 1}}$$
Cette expression intègre deux modifications conceptuelles profondes comparativement à l’équation de population. D’une part, la moyenne théorique $\mu$ est évincée au profit de la moyenne empirique de l’échantillon, $\bar{x}$, calculée exclusivement à partir des $n$ observations disponibles ($\bar{x} = \frac{1}{n} \sum_{i=1}^n x_i$). D’autre part, le diviseur cardinal $n$ est systématiquement amputé d’une unité pour devenir $n – 1$.
L’utilisation de $\bar{x}$ à la place de $\mu$ modifie structurellement la dynamique des écarts individuels. Par définition algébrique du barycentre d’un nuage de points univarié, la somme quadratique des résidus d’une série de valeurs est minimale lorsqu’elle est calculée par rapport à leur propre moyenne arithmétique. Mathématiquement, pour toute valeur constante $c \neq \bar{x}$, on vérifie rigoureusement l’inégalité stricte :
$$\sum_{i=1}^n (x_i – \bar{x})^2 < \sum_{i=1}^n (x_i – c)^2$$
Par conséquent, puisque la moyenne empirique $\bar{x}$ est calculée directement à partir des observations recueillies, elle se positionne inévitablement au barycentre exact de cet échantillon particulier. Sauf dans l’hypothèse statistiquement infiniment improbable où $\bar{x}$ coïnciderait à l’identique avec la moyenne populationnelle vraie $\mu$, la somme des résidus calculée autour de $\bar{x}$ sera systématiquement inférieure à la somme théorique des résidus qui aurait été mesurée autour de $\mu$. L’échantillon a tendance à se regrouper artificiellement autour de son propre centre de gravité immédiat.
4.2 Origine et démonstration du facteur de correction de Bessel
Ce phénomène de sous-estimation systématique de la variance globale constitue un biais statistique majeur, formellement mis en lumière par l’astronome et mathématicien allemand Friedrich Wilhelm Bessel. Si l’on définissait la variance de l’échantillon en conservant le diviseur intuitif $n$, l’espérance mathématique de cet estimateur naïf—souvent noté $S_n^2$—ne convergerait pas vers la variance populationnelle vraie $\sigma^2$, mais souffrirait d’une distorsion proportionnelle à la taille du groupe, comme le montre le développement algébrique de son espérance :
$$\mathbb{E}[S_n^2] = \mathbb{E}\left[ \frac{1}{n} \sum_{i=1}^n (x_i – \bar{x})^2 \right] = \frac{n – 1}{n} \sigma^2$$
L’espérance de la variance non corrigée démontre avec limpidité que l’estimateur naïf n’atteint qu’une fraction $\frac{n – 1}{n}$ de la variance authentique de la population d’origine. Pour un très petit échantillon expérimental comportant par exemple 4 observations ($n = 4$), la variance naïve ne capture que les trois quarts ($\frac{3}{4} = 75%$) de la variabilité réelle du phénomène, introduisant un biais réducteur massif de 25 % dans l’appréciation du risque ou de la dispersion des données.
Pour neutraliser ce biais structurel et transformer cet estimateur en un estimateur parfaitement non biaisé (ou « sans biais »), il est nécessaire de multiplier l’expression naïve par l’inverse exact du coefficient d’atténuation, à savoir le facteur de correction de Bessel $\frac{n}{n – 1}$. En appliquant cette rectification multiplicative, le diviseur $n$ se simplifie rigoureusement :
$$\mathbb{E}[s^2] = \mathbb{E}\left[ \frac{n}{n – 1} S_n^2 \right] = \frac{n}{n – 1} \cdot \left( \frac{n – 1}{n} \sigma^2 \right) = \sigma^2$$
Cette démonstration prouve sans équivoque que la substitution de $n$ par $n – 1$ au dénominateur assure que l’espérance mathématique de la variance corrigée $s^2$ équivaut rigoureusement à la variance de la population $\sigma^2$. Sur le plan conceptuel, ce dénominateur $n – 1$ incarne le nombre de « degrés de liberté » résiduels au sein du système. Lorsque l’on a calculé la moyenne de l’échantillon $\bar{x}$, les $n$ écarts $(x_i – \bar{x})$ sont liés par la contrainte linéaire stricte $\sum (x_i – \bar{x}) = 0$. Dès lors que $n – 1$ écarts sont connus, le $n$-ième écart est entièrement prédéterminé et n’apporte aucune information indépendante supplémentaire. L’information libre disponible pour estimer la variabilité se résume donc mathématiquement à $n – 1$ dimensions vectorielles.
4.3 Propriétés de l’estimateur sans biais en recherche expérimentale
L’utilisation de la variance corrigée $s^2$ confère des garanties théoriques fondamentales pour la recherche expérimentale et la modélisation statistique avancée. La première de ces propriétés est la convergence asymptotique. À mesure que la taille de l’échantillon $n$ croît vers l’infini, la fraction $\frac{n – 1}{n}$ tend inexorablement vers 1. Par voie de conséquence, l’écart numérique absolu entre la formule non corrigée et la formule corrigée s’amenuise pour devenir négligeable dans les très grands jeux de données : sur un échantillon de 10 000 enregistrements, l’écart entre les deux diviseurs n’est plus que de 0,01 %.
Toutefois, en recherche biomédicale, en psychophysique ou lors d’essais cliniques pilotes, la réalité expérimentale impose fréquemment de travailler sur des cohortes restreintes, oscillant souvent entre 10 et 30 sujets par condition expérimentale. Dans cette zone de faible puissance statistique, l’impact de la correction de Bessel est substantiel. Négliger le facteur $n – 1$ sur une cohorte de 10 participants sous-estimerait la variance de 10 %, ce qui fausserait dramatiquement les inférences déduites des tests d’hypothèses subséquents en comprimant indûment la taille estimée des erreurs standards.
Il importe néanmoins de souligner une subtilité mathématique souvent occultée dans l’enseignement élémentaire : si la variance corrigée $s^2$ est un estimateur rigoureusement sans biais de $\sigma^2$, l’écart-type de l’échantillon $s$—obtenu par extraction de la racine carrée—demeure, quant à lui, un estimateur légèrement biaisé de l’écart-type de population $\sigma$. En vertu de l’inégalité de Jensen, la racine carrée étant une fonction strictement concave, l’espérance de la racine carrée d’une variable aléatoire est strictement inférieure à la racine carrée de son espérance ($\mathbb{E}[\sqrt{s^2}] \leq \sqrt{\mathbb{E}[s^2]} = \sigma$). Bien qu’il sous-estime infimement l’écart-type réel dans les micro-échantillons, $s$ constitue le standard universel retenu par la communauté scientifique internationale et les revues à comité de lecture en raison de sa tractabilité analytique optimale.
5. Fonctions natives de Google Sheets pour l’écart-type de population
5.1 La formule moderne : ECARTYPE.STANDARD.P / STDEV.P
Dans l’écosystème algorithmique contemporain de Google Sheets, l’instruction de référence absolue destinée au calcul de la dispersion d’une population intégrale est la fonction STDEV.P, traduite sous la nomenclature francophone officielle ECARTYPE.STANDARD.P. L’adjonction explicite du suffixe .P marque sans ambiguïté son ancrage mathématique dans la modélisation de population et garantit la conformité de Google Sheets avec les standards internationaux de l’ISO/IEC 29500 régissant les formats de documents informatiques ouverts et l’interopérabilité des métadonnées de feuilles de calcul.
La syntaxe canonique de cette fonction répond à la formulation générale suivante :
=STDEV.P(valeur1; [valeur2; ...]) ou en interface française =ECARTYPE.STANDARD.P(valeur1; [valeur2; ...])
Les arguments acceptés par cette formule peuvent adopter une diversité de typologies structurelles : des références directes à des cellules individuelles (par exemple A1; B4; C9), des constantes scalaires insérées manuellement (=STDEV.P(12; 15; 22; 29)), ou, plus fréquemment, des plages matricielles continues ou discontinues (A2:A500 ou A2:A100; C2:C100). L’algorithme interne de STDEV.P procède mécaniquement en identifiant l’ensemble des valeurs numériques éligibles, en calculant leur moyenne arithmétique $\mu$, puis en divisant la somme cumulée de leurs résidus quadratiques par la cardinalité totale $N$ des observations valides recensées.
Sur le plan du filtrage algorithmique sous-jacent, STDEV.P adopte un comportement strictement conservateur vis-à-vis des types de données non numériques. Si la plage matricielle désignée comprend des cellules vides, des chaînes textuelles descriptives ou des arguments logiques résultant de formules booléennes non typées, la fonction les ignore silencieusement sans corrompre le calcul, pourvu qu’il subsiste au moins une valeur numérique exploitable. Cette étanchéité prévient les ruptures de flux lors du traitement de registres de données administratives hétérogènes.
5.2 La formule héritée : ECARTYPEP / STDEVP
Au sein des versions initiales des tableurs informatiques—notamment lors de l’essor des premières moutures de Microsoft Excel dans les années 1990 et 2000, standards qui ont ensuite été intégrés par mimétisme logiciel lors de la genèse de Google Sheets—, l’instruction vouée au calcul de dispersion de population portait l’identifiant contracté STDEVP, adapté en français sous la dénomination ECARTYPEP. Cette formulation classique ne comportait aucune segmentation typographique par point séparateur.
D’un point de vue strictement arithmétique et algorithmique, la formule héritée STDEVP délivre un résultat rigoureusement identique à celui généré par STDEV.P. Les deux fonctions exploitent le même moteur de calcul, appliquent la même sommation des carrés des écarts et divisent invariablement le numérateur par la taille totale $N$ de la population sélectionnée. Google Sheets assure une compatibilité ascendante et descendante intégrale de ces syntaxes, garantissant que d’anciennes feuilles de calcul scientifiques conçues il y a plus de quinze ans continuent de s’exécuter avec une fidélité numérique parfaite.
Néanmoins, sur le plan des bonnes pratiques contemporaines en ingénierie des données et en gestion de la reproductibilité scientifique, l’usage de la fonction héritée STDEVP est formellement déconseillé dans les nouveaux projets de recherche. Bien que Google n’ait émis aucun calendrier de dépréciation contraignant, les consortiums académiques préconisent l’adoption exclusive de la nomenclature STDEV.P. Cette syntaxe explicite clarifie immédiatement la nature populationnelle de l’opérateur dans la formule, prévenant les ambiguïtés d’audit lors des revues de code ou de l’évaluation méthodologique par des pairs.
5.3 Prise en compte des types mixtes avec STDEVPA
Google Sheets propose une variante algorithmique spécialisée conçue pour le traitement matriciel des collections d’arguments de population comportant des typologies de données mixtes : la fonction STDEVPA (dont l’acronyme intègre le suffixe « A » pour All, traduisant sa propension à inclure l’ensemble des entrées non numériques). Cette instruction singulière obéit aux mêmes fondements algébriques que STDEV.P, appliquant le diviseur $N$, mais modifie profondément le protocole d’ingestion des types de variables.
Contrairement à STDEV.P qui élague automatiquement les chaînes textuelles et les valeurs booléennes, STDEVPA applique une conversion typologique forcée :
- Les valeurs booléennes logiques
VRAI(ouTRUE) sont systématiquement converties en l’entier numérique1. - Les valeurs booléennes logiques
FAUX(ouFALSE) sont systématiquement converties en l’entier numérique0. - Toute chaîne de texte brute insérée au sein d’une cellule—qu’il s’agisse d’un mot descriptif, d’une mention d’absence de données telle que
"Non disponible"ou d’une faute de saisie alphabétique—est automatiquement coercée et interprétée comme la valeur numérique0. - Seules les cellules entièrement vides échappent à cette conversion et demeurent exclues de la cardinalité $N$.
Cette coercition automatique expose le chercheur à des risques d’artéfacts méthodologiques dévastateurs. Si une feuille de calcul contient une colonne combinant des mesures psychométriques continues s’échelonnant de 50 à 100 et que des omissions expérimentales ont été documentées textuellement par la mention "Manquant", la fonction STDEVPA intégrera ces occurrences comme des scores effectifs de 0. Cette inclusion fallacieuse provoquera un effondrement artificiel de la moyenne apparente et une explosion spectaculaire de l’écart-type, générant une modélisation totalement viciée. Par conséquent, l’usage de STDEVPA doit être restreint aux rares protocoles formalisant explicitement des variables dichotomiques ou indicatrices d’état encodées sous forme textuelle ou booléenne.
6. Fonctions natives de Google Sheets pour l’écart-type d’échantillon
6.1 La formule standardisée : ECARTYPE.STANDARD / STDEV.S
Dès lors que l’analyste évolue dans le cadre normatif de la statistique inférentielle et manipule des données issues d’un protocole d’échantillonnage, la fonction de référence absolue au sein de Google Sheets est STDEV.S, accessible dans la localisation française du tableur sous l’intitulé ECARTYPE.STANDARD. Le suffixe typographique .S indique sans ambiguïté son affiliation conceptuelle à l’échantillon (Sample) et son assise sur la correction de Bessel.
L’exécution de cette formule repose sur une syntaxe directe et normalisée :
=STDEV.S(valeur1; [valeur2; ...]) ou =ECARTYPE.STANDARD(valeur1; [valeur2; ...])
Sur le plan computationnel, STDEV.S isole l’ensemble des entrées quantitatives présentes dans la plage désignée, dénombre la taille de l’échantillon $n$, calcule la moyenne arithmétique empirique $\bar{x}$, détermine la sommation cumulée des carrés des déviations individuelles $\sum (x_i – \bar{x})^2$, puis divise impérativement cette somme par les degrés de liberté résiduels, soit $n – 1$, avant d’en extraire la racine carrée positive. Ce processus algorithmique garantit la neutralisation exacte du biais de sous-estimation structurel.
Dans la gestion des exceptions et des typologies hétérogènes, STDEV.S fait preuve d’une étanchéité méthodologique rigoureuse. Les cellules dépourvues de contenu (cellules vides), les expressions textuelles typées comme telles et les états logiques purs ne sont sous aucun prétexte convertis en zéros arithmétiques ; ils sont purement et simplement écartés du calcul du numérateur et du dénombrement cardinal du diviseur $n – 1$. Cette caractéristique en fait l’outil algorithmique d’élection pour les protocoles de recherche biomédicale, psychométrique ou expérimentale où les données manquantes ne doivent en aucun cas altérer l’estimation de la dispersion intrinsèque des observations valides.
6.2 La fonction historique : ECARTYPE / STDEV
Présente depuis les premières versions logicielles de Google Sheets pour assurer la continuité opérationnelle avec le patrimoine algorithmique des suites bureautiques traditionnelles, la formule générique STDEV (traduite classiquement par ECARTYPE sans suffixe) demeure incontestablement la plus répandue dans les usages d’entreprise ordinaires. Son ancienneté et sa brièveté mnémonique expliquent son ancrage profond dans les habitudes des praticiens du tableur à travers le monde.
Il est capital d’expliciter une réalité mathématique fondamentale souvent méconnue des utilisateurs occasionnels : la fonction historique STDEV applique par défaut la formule de l’écart-type d’échantillon. Son algorithme interne mobilise rigoureusement le diviseur $n – 1$ et ne calcule en aucun cas l’écart-type de population. Il existe donc une stricte équivalence numérique entre =STDEV(A1:A100) et =STDEV.S(A1:A100), les deux fonctions produisant des résultats au bit près identiques sur n’importe quel ensemble de données numériques.
La transition de la communauté académique vers la nomenclature explicite STDEV.S ne relève donc pas d’une disparité computationnelle, mais d’une exigence de transparence épistémologique et de rigueur documentaire. L’emploi du terme indifférencié STDEV laisse planer un doute formel sur la conscience méthodologique de l’analyste, suggérant qu’il pourrait avoir ignoré l’existence de la dualité population/échantillon. En consignant explicitement STDEV.S dans un protocole d’analyse ou un rapport technique, le chercheur atteste formellement qu’il a identifié ses données comme un échantillon probabiliste et qu’il a intentionnellement mobilisé la correction de Bessel pour estimer la variabilité du phénomène sous observation.
6.3 Variante pour données hétérogènes : STDEVA
À l’instar de la variante populationnelle STDEVPA examinée précédemment, Google Sheets intègre pour les échantillons une fonction spécialisée acceptant les types de variables composites : la fonction STDEVA. Cette instruction calcule l’écart-type d’échantillon sur la base du diviseur corrigé $n – 1$, tout en appliquant les règles d’évaluation élargie aux données non purement quantitatives situées dans la plage référencée.
Sous l’empire de l’algorithme STDEVA, la matrice de calcul subit un traitement coercitif strict :
- Chaque chaîne textuelle brute contenue dans une cellule comprise dans l’intervalle est convertie en une observation numérique de valeur
0et incrémente le cardinal total $n$ d’une unité. - La constante logique
VRAIest convertie en la valeur numérique1et contribue au dénombrement de l’échantillon. - La constante logique
FAUXest convertie en la valeur numérique0et contribue également à l’accroissement de $n$. - Seules les cellules entièrement vierges de tout caractère ou formule sont exclues de l’agrégation.
Cette particularité algorithmique confère à STDEVA une utilité restreinte, quasi exclusivement circonscrite à des cas de figure très spécifiques d’analyse de données booléennes ou de variables dichotomiques indicatrices. Par exemple, si l’on souhaite quantifier la variabilité des réponses à un sondage codé sous forme de drapeaux logiques (succès/échec, présence/absence), STDEVA permet d’extraire la dispersion de cet échantillon sans exiger de colonne intermédiaire de conversion numérique binaire. Cependant, en dehors de ces scénarios rigoureusement maîtrisés, son application aveugle sur des jeux de données quantitatifs contaminés par du texte engendre des distorsions mathématiques majeures qu’aucune méthodologie saine ne saurait tolérer.
7. Tutoriel pas-à-pas : Calcul pratique de l’écart-type d’échantillon sur Google Sheets
7.1 Structuration et assainissement préalable de la feuille de calcul
L’implémentation rigoureuse d’un calcul statistique sous Google Sheets commence impérativement par une phase d’assainissement (data cleaning) et de structuration normalisée de l’espace matriciel de travail. Toute négligence dans l’ordonnancement initial des colonnes ou la validation des types de cellules compromet la reproductibilité du traitement et ouvre la porte à des erreurs silencieuses d’une extrême gravité. Il convient de respecter une architecture d’organisation tabulaire univariée où chaque ligne représente une unité d’observation unique et chaque colonne une variable méthodologique distincte.
La première vérification porte sur le formatage numérique des données. Dans les versions linguistiques de Google Sheets adaptées aux conventions francophones, le séparateur décimal standard est la virgule (,), alors que la norme anglo-saxonne recourt au point (.). Si des données quantitatives sont importées depuis un fichier CSV international avec des séparateurs sous forme de points, Google Sheets peut échouer à les reconnaître comme des grandeurs scalaires et les interpréter silencieusement comme des chaînes de texte statiques, alignées par défaut sur la gauche des cellules. Pour remédier à cet écueil, l’opérateur doit sélectionner la colonne concernée, accéder au menu Format > Nombre > Nombre et valider que l’alignement typographique bascule organiquement sur la droite, attestant de la reconnaissabilité mathématique des entrées.
Enfin, l’étiquetage des variables doit faire l’objet d’une standardisation rigoureuse. La première ligne de la feuille doit être exclusivement réservée aux en-têtes explicites—tels que Participant_ID, Temps_Reaction_ms ou Score_Anxiete_Pre—en évitant les caractères diacritiques complexes ou les espaces superflus qui compliqueraient l’injection ultérieure de formules conditionnelles. Les données manquantes avérées doivent impérativement demeurer sous forme de cellules strictement vides ou être temporairement encodées selon un protocole strict, sans introduire de mentions textuelles informelles au cœur de la colonne quantitative.
7.2 Application concrète de la formule STDEV.S
Une fois la matrice assainie et les observations isolées dans une plage continue—considérons, à titre d’exemple pédagogique, que nos données empiriques de temps de réaction sont réparties dans la plage verticale B2:B85 pour un échantillon de 84 participants—, l’insertion de l’opérateur d’écart-type d’échantillon s’opère directement dans la barre d’édition des formules du tableur.
L’analyste sélectionne une cellule de synthèse dédiée, idéalement située en dehors de la plage de données brutes (par exemple en D2), puis saisit la commande interactive :
=STDEV.S(B2:B85) ou =ECARTYPE.STANDARD(B2:B85)
Dès la saisie du premier parenthésage, l’analyseur syntaxique de Google Sheets déploie une infobulle contextuelle dynamique affichant la syntaxe attendue, la définition des paramètres requis et un aperçu instantané du résultat numérique calculé. Il est fortement recommandé d’utiliser des références absolues si la formule est destinée à être recopiée ou propagée vers d’autres compartiments de l’analyse, en ancrant la plage au moyen de l’opérateur dollar : =STDEV.S($B$2:$B$85). Cette précaution syntaxique neutralise tout risque de glissement dimensionnel accidentel lors des manipulations structurelles de la feuille.
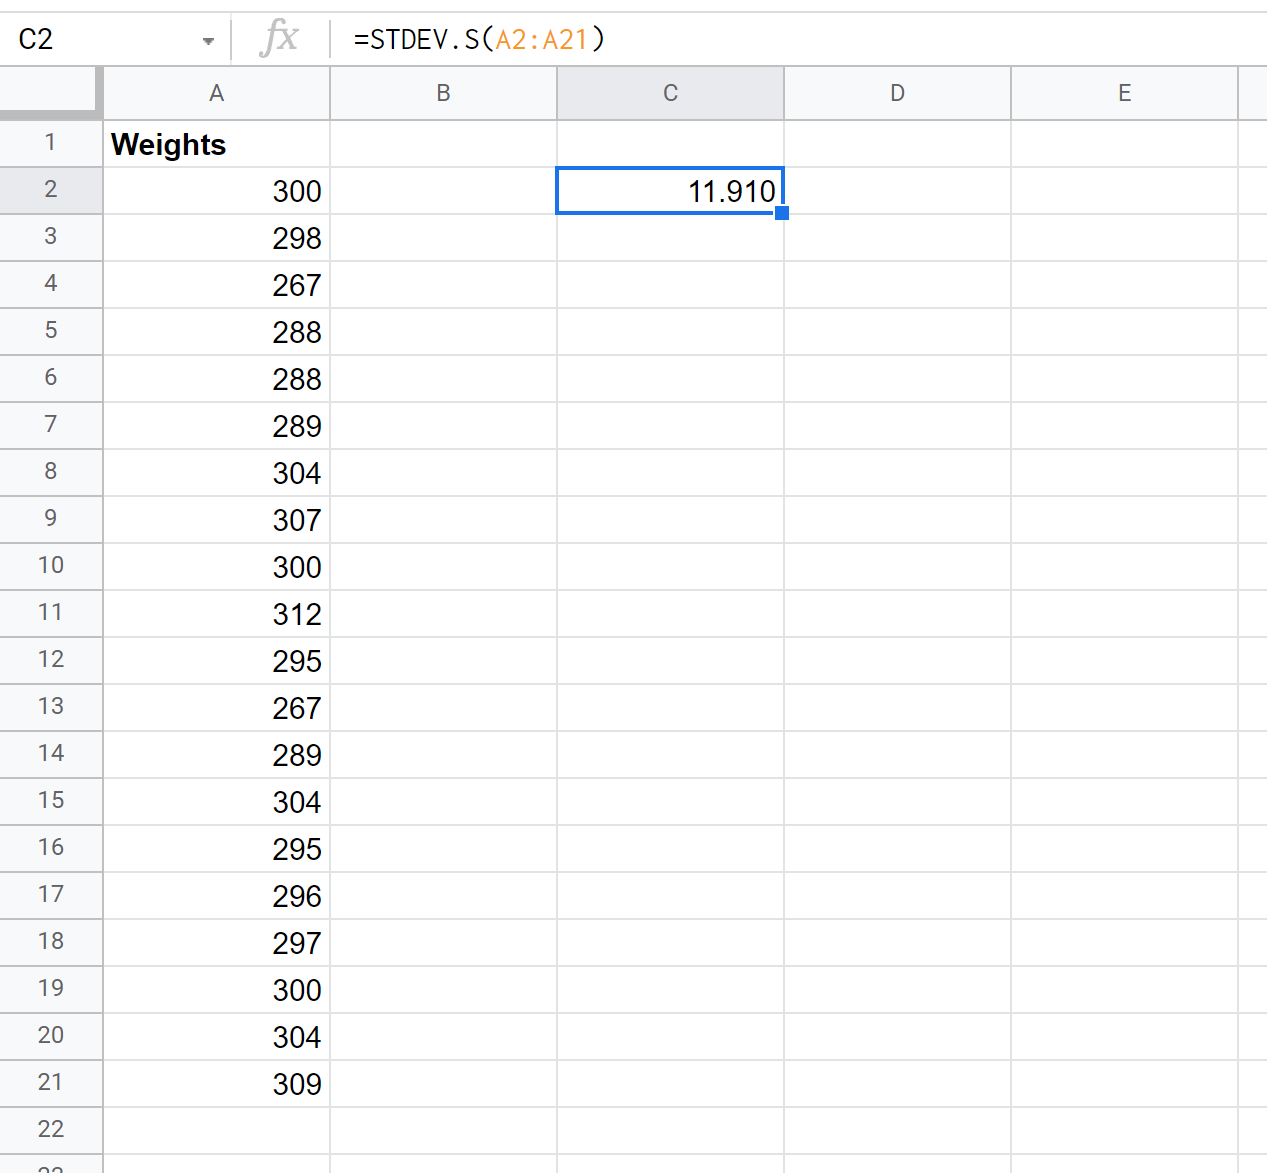
Un atout fondamental de cette implémentation réside dans sa réactivité algorithmique dynamique. Si de nouveaux sujets expérimentaux viennent s’adjoindre à l’échantillon initial, il est possible d’anticiper cette expansion matricielle en recourant à des plages ouvertes, sous la forme syntaxique =STDEV.S(B2:B). Dans cette configuration, Google Sheets calcule l’écart-type sur l’ensemble de la colonne B à partir de la ligne 2, intégrant instantanément au dénominateur $n – 1$ et au numérateur chaque nouvelle saisie numérique, tout en ignorant automatiquement les cellules résiduelles vides situées en aval de la dernière entrée.
7.3 Vérification manuelle des étapes intermédiaires de calcul
Dans un contexte d’audit statistique ou d’enseignement universitaire, la confiance aveugle accordée aux fonctions encapsulées peut générer un détachement préjudiciable par rapport aux mécanismes de la correction de Bessel. Pour consolider la compréhension mathématique et valider la conformité de l’algorithme de Google Sheets, il est hautement formateur de décomposer manuellement les étapes séquentielles du calcul de dispersion au moyen de colonnes d’appui dédiées.
Cette vérification méthodique s’articule selon le protocole de décomposition suivant :
- Étape 1 : Calcul de la moyenne arithmétique de l’échantillon. Dans une cellule isolée (par exemple
E1), implémenter la formule=AVERAGE(B2:B85)pour dériver la constante empirique $\bar{x}$. - Étape 2 : Extraction des déviations individuelles (résidus). Dans la cellule
C2d’une colonne adjacente, saisir la formule vectorielle=B2-$E$1, puis propager cette formule par double-clic sur le coin inférieur droit de la cellule jusqu’àC85. Cette colonne consigne chaque écart $(x_i – \bar{x})$. - Étape 3 : Élévation des écarts au carré. Dans la cellule
D2, introduire la relation quadratique=C2^2, puis étendre la projection jusqu’àD85afin d’obtenir l’ensemble des déviations positives $(x_i – \bar{x})^2$. - Étape 4 : Sommation et pondération par les degrés de liberté. Dans une cellule terminale de contrôle (par exemple
E2), agréger la somme quadratique et appliquer la correction de Bessel :=SUM(D2:D85)/(COUNT(B2:B85)-1). Ce résultat intermédiaire livre la variance sans biais de l’échantillon $s^2$. - Étape 5 : Extraction de la racine carrée. Enfin, en
E3, appliquer l’opérateur de racine carrée :=SQRT(E2).
La confrontation du résultat obtenu manuellement en E3 avec la valeur générée directement par la commande automatisée =STDEV.S(B2:B85) en D2 met en évidence une identité numérique absolue, confirmant rigoureusement la parfaite transparence du moteur de calcul sous-jacent de Google Sheets.
8. Tutoriel pas-à-pas : Calcul pratique de l’écart-type de population sur Google Sheets
8.1 Délimitation d’un jeu de données populationnel
L’exécution licite de l’écart-type de population requiert, comme préalablement établi, l’assurance formelle que la matrice de données observée circonscrit l’intégralité d’un univers statistique fermé. Pour illustrer cette situation empirique, modélisons un cas d’étude organisationnel strict : l’audit exhaustif des salaires mensuels de l’ensemble des 45 collaborateurs d’une jeune entreprise technologique au 31 décembre d’un exercice fiscal donné, ou le recensement intégral des notes d’examen attribuées aux 120 élèves d’un internat lors d’une épreuve commune dont le cadre d’analyse est strictement restreint à cet établissement.
Dans un tel contexte, chaque ligne correspond à un membre inaliénable du collectif, et aucune omission n’est méthodologiquement tolérable. Le statisticien doit vérifier avec une méticulosité absolue qu’aucun individu n’a été écarté et qu’aucune procédure d’inférence vers une population extrapolée n’est visée par le livrable final. Les observations représentent des faits historiques complets et fermés, définissant un domaine d’investigation dont la cardinalité $N$ est déterministe et fixe.
La feuille de calcul est configurée selon une nomenclature univoque : la colonne A recense les identifiants d’inventaire ou matricules institutionnels (ID_Employe), tandis que la colonne B consigne les montants nominaux bruts correspondants (Salaire_Brut_EUR), s’étendant exactement de la cellule B2 jusqu’à la cellule B46 pour un effectif global $N = 45$.
8.2 Exécution méthodique de la formule STDEV.P
L’application du modèle de dispersion de population s’effectue au sein d’une cellule de synthèse dédiée en invoquant formellement l’instruction standardisée :
=STDEV.P(B2:B46) ou =ECARTYPE.STANDARD.P(B2:B46)
L’algorithme analyse l’ensemble de la série, calcule la moyenne arithmétique globale $\mu = \frac{\sum x_i}{45}$, cumule la totalité des écarts quadratiques à cette moyenne, puis divise le numérateur ainsi obtenu rigoureusement par le cardinal complet $N = 45$, sans appliquer la soustraction unitaire de Bessel. L’opérateur racine carrée final fournit la valeur exacte de $\sigma$, caractérisant la variabilité absolue du groupe considéré.
Dans l’éventualité où l’audit porterait sur des matrices multidimensionnelles comportant plusieurs colonnes d’analyse simultanées—par exemple l’évaluation concomitante des rémunérations fixes (colonne B), des primes de performance (colonne C) et des avantages en nature monétarisés (colonne D)—, Google Sheets autorise l’injection matricielle directe d’un bloc bidimensionnel continu :
=STDEV.P(B2:D46)
Dans cette configuration unifiée, le tableur consolide l’ensemble des $45 \times 3 = 135$ observations au sein d’une distribution univariée globale unique et calcule la dispersion populationnelle totale en divisant la somme des déviations quadratiques par 135. Le résultat numérique produit doit ensuite être convenablement formaté : via la barre d’outils de Google Sheets, l’opérateur active l’option Diminuer le nombre de décimales pour fixer un affichage standardisé à deux chiffres après la virgule, conformément aux standards de précision métrologique de la comptabilité analytique.
8.3 Comparaison chiffrée directe des deux estimateurs
Pour appréhender concrètement la distorsion numérique induite par une mauvaise sélection de fonction au sein du tableur, il est particulièrement instructif de confronter en temps réel les résultats dérivés de STDEV.P et de STDEV.S sur une même plage expérimentale dont on fait fluctuer artificiellement la cardinalité d’observation.
Considérons un micro-ensemble de test composé de seulement 5 mesures biomécaniques consignées dans les cellules A1:A5 : {10, 14, 15, 18, 23}. La moyenne de cette série s’établit exactement à $\bar{x} = \mu = 16$. Calculons concomitamment les deux estimateurs :
- L’écart-type de population généré par
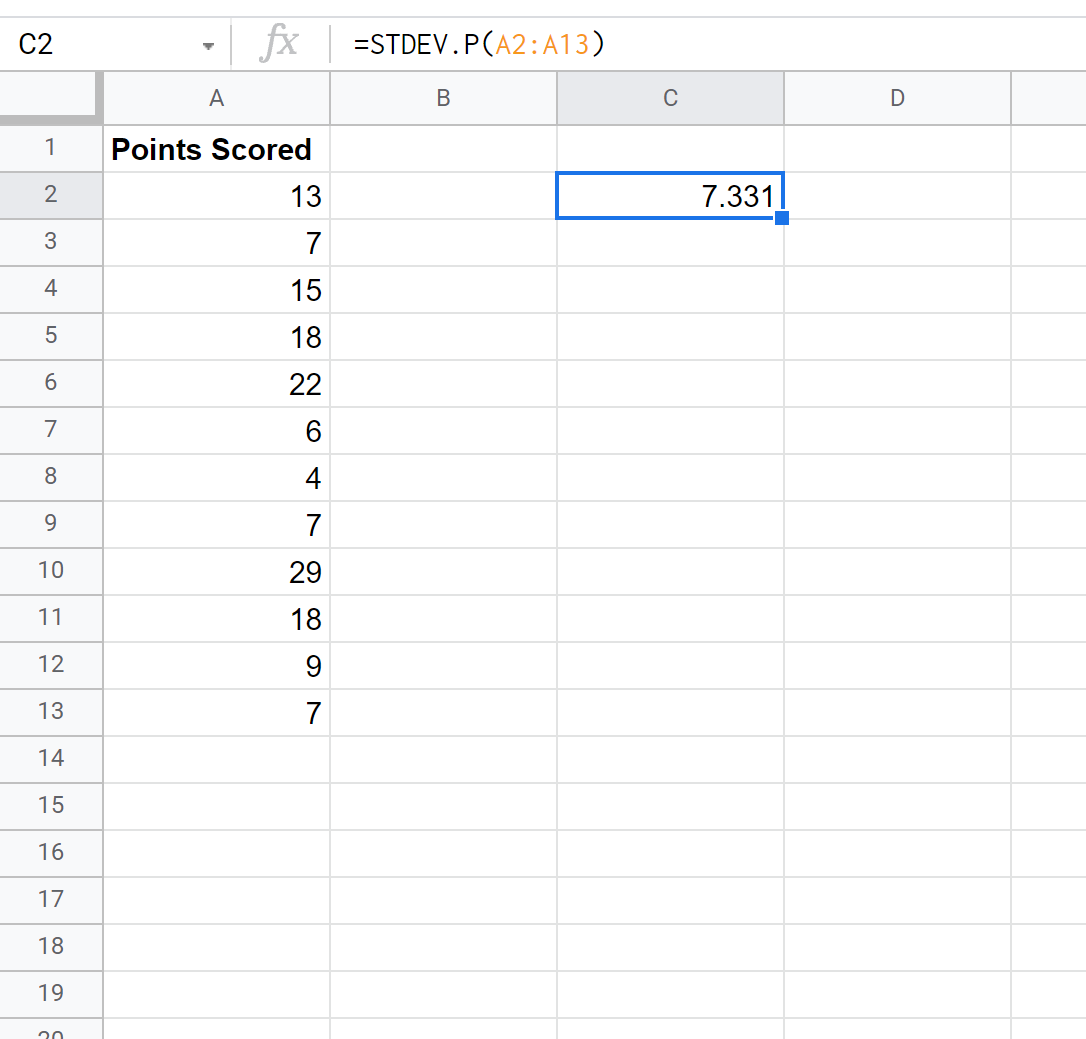
=STDEV.P(A1:A5)applique un diviseur de $N = 5$. La somme des carrés des écarts s’élevant à $(10-16)^2 + (14-16)^2 + (15-16)^2 + (18-16)^2 + (23-16)^2 = 36 + 4 + 1 + 4 + 49 = 94$. La variance de population est de $\frac{94}{5} = 18{,}80$, d’où un écart-type de population $\sigma = \sqrt{18{,}80} \approx 4{,}3359$. - L’écart-type d’échantillon généré par
=STDEV.S(A1:A5)applique quant à lui un diviseur corrigé de $n – 1 = 4$. La variance corrigée s’élève à $\frac{94}{4} = 23{,}50$, délivrant un écart-type empirique $s = \sqrt{23{,}50} \approx 4{,}8477$.
La confrontation de ces deux résultats met en relief un écart relatif substantiel de près de 11,8 % entre les deux valeurs. Si un chercheur manipulant cet échantillon commettait l’erreur de mobiliser par inadvertance la fonction STDEV.P, il publierait une sous-estimation artificielle massive de la dispersion de ses observations, distordant sévèrement la perception de la variabilité de son protocole. En revanche, si l’on étend cette même simulation à une série de 1 000 observations affichant une somme quadratique proportionnelle, le ratio multiplicateur de Bessel $\sqrt{\frac{1000}{999}} \approx 1{,}0005$ ne produirait plus qu’un décalage marginal de 0,05 %, illustrant concrètement l’amortissement asymptotique de la correction dans les environnements de données massives.
9. Utilisation avancée : Fonctions conditionnelles et filtrage dynamique
9.1 Calcul de dispersion conditionnelle avec FILTER et STDEV.S
Dans l’analyse de données réelles, il est très rare que l’ensemble des observations d’une colonne appartienne à une cohorte homogène. Les protocoles factoriels requièrent quasi systématiquement d’évaluer la dispersion de sous-groupes catégoriels : comparer l’écart-type des temps de réaction du groupe témoin versus le groupe expérimental, ou ventiler la dispersion des salaires par genre ou département fonctionnel. Contrairement aux mesures de tendance centrale qui disposent d’instructions conditionnelles natives directes telles que MOYENNE.SI ou AVERAGEIF, Google Sheets ne comporte aucune fonction native directe de type STDEV.IF.
Pour combler cette absence structurelle sans recourir à des scripts externes complexes, la méthodologie la plus élégante et performante consiste à imbriquer l’opérateur de dispersion au sein de la puissante fonction matricielle FILTER. La formule s’articule selon l’architecture canonique suivante :
=STDEV.S(FILTER(plage_valeurs; plage_critère = "Condition"))
Considérons une feuille de recherche clinique où la colonne A spécifie la condition expérimentale assignée au sujet ("Controle" ou "Traitement") et la colonne B consigne la baisse de la pression artérielle systolique en millimètres de mercure. Pour calculer l’écart-type d’échantillon restreint exclusivement aux sujets ayant reçu le traitement actif, l’analyste inscrira en toute sécurité la formule imbriquée :
=STDEV.S(FILTER(B2:B100; A2:A100 = "Traitement"))
L’algorithme de FILTER procède en évaluant ligne par ligne l’assertion logique contenue dans le second argument. Il génère en mémoire vive un vecteur numérique temporaire composé uniquement des valeurs de la colonne B pour lesquelles la cellule correspondante en colonne A vérifie rigoureusement l’égalité textuelle. Ce vecteur dynamique est ensuite instantanément transmis à la fonction STDEV.S, qui applique la correction de Bessel sur le sous-ensemble extrait, sans nécessiter aucune manipulation manuelle de tri préalable ni d’extraction physique des données.
Cette approche excelle également lors du déploiement de conditions booléennes multifactorielles complexes. Si l’on souhaite restreindre le calcul aux sujets appartenant au groupe "Traitement" ET présentant un âge (colonne C) strictement supérieur à 60 ans, il suffit de composer les critères au sein de la commande de filtrage par le produit d’opérateurs logiques :
=STDEV.S(FILTER(B2:B100; (A2:A100 = "Traitement") * (C2:C100 > 60)))
9.2 Exploitation de la fonction de base de données BDÉCARTYPE / DSTDEV
Pour les environnements analytiques massifs et fortement structurés obéissant aux principes des bases de données relationnelles tabulaires, Google Sheets propose une famille d’instructions d’ingénierie statistique avancée : les fonctions de base de données, représentées par DSTDEV (en français BDÉCARTYPE) pour l’échantillon, et DSTDEVP (en français BDÉCARTYPEP) pour la population.
L’exploitation de ces fonctions exige la formalisation préalable de trois composants matriciels distincts :
- La base de données source intégrale, incluant obligatoirement sa ligne d’en-têtes textuels (par exemple
A1:D500). - Le champ de référence désignant la colonne numérique sur laquelle doit porter l’évaluation de dispersion, spécifié soit par son intitulé exact entre guillemets (
"Temps_Reaction"), soit par son index ordinal numérique (par exemple2pour la seconde colonne du tableau). - Une plage de critères externe physiquement délimitée dans la feuille de calcul (par exemple
F1:G2), reproduisant à l’identique les en-têtes cibles avec, sur la ligne immédiatement inférieure, les contraintes logiques de filtrage souhaitées.
La syntaxe opérationnelle s’énonce alors comme suit :
=DSTDEV(A1:D500; "Temps_Reaction"; F1:G2)
L’avantage comparatif prééminent de la fonction DSTDEV réside dans sa puissance de modélisation pour les scénarios de recherche multivariés complexes. Au lieu d’écrire des formules imbriquées interminables et difficiles à relire, l’analyste peut piloter l’ensemble de ses extractions statistiques à partir d’un tableau de bord de critères visuel. Modifier un critère d’inclusion dans la cellule F2 (par exemple substituer ">= 50" à "< 30") met à jour instantanément la valeur de l’écart-type sans altérer la syntaxe de la formule de calcul, garantissant une ergonomie d’audit inégalée dans les systèmes de reporting complexes.
9.3 Calcul matriciel et automatisation avec ARRAYFORMULA
L’optimisation des flux de travail dans Google Sheets implique fréquemment d’automatiser des opérations statistiques le long de séries chronologiques ou de cohortes sans devoir étendre manuellement des formules sur des milliers de lignes. Bien que les fonctions de réduction globale telles que STDEV.S ne puissent pas être directement « étirées » le long d’une matrice via ARRAYFORMULA pour produire une dérivation ligne par ligne—dans la mesure où leur fonction intrinsèque est précisément d’agréger un vecteur en un scalaire unique—, le calcul matriciel s’avère indispensable pour dériver les résidus ou des écarts-types glissants longitudinaux.
Considérons la nécessité de calculer simultanément, pour chaque observation d’une série longitudinale de 1 000 participants, l’écart absolu normalisé par rapport à la moyenne globale du groupe, une étape clé dans le calcul d’indices de dispersion personnalisés. Au lieu de copier une formule individuelle sur 1 000 rangées, la commande matricielle encapsulée permet de vectoriser l’opération instantanément :
=ARRAYFORMULA(IF(ISBLANK(A2:A); ""; (A2:A - AVERAGE(A2:A))^2))
Cette instruction unique injectée en tête de colonne B2 projette dynamiquement le calcul du carré des écarts sur l’intégralité de la colonne active, en suspendant son évaluation dès qu’une cellule sous-jacente est vide grâce au test logique ISBLANK. Pour des applications de séries temporelles en finance de marché ou en monitoring physiologique continu, la modélisation d’écarts-types glissants (sur une fenêtre mobile standard de 20 jours ou 20 cycles) peut être instrumentée de manière hautement performante en combinant MAP, LAMBDA et STDEV.S, évitant la dégradation des temps de réponse du navigateur face à des volumétries massives.
10. Visualisation graphique de l’écart-type et barres d’erreur dans Google Sheets
10.1 Configuration des graphiques à barres avec barres d’erreur
La communication scientifique des résultats quantitatifs requiert une transcription visuelle rigoureuse où les mesures de dispersion sont intimement associées aux représentations de tendance centrale. Présenter un graphique à barres (histogramme de comparaison) illustrant les moyennes de plusieurs groupes expérimentaux sans y accoler des barres d’erreur quantifiant l’écart-type constitue une lacune méthodologique majeure, souvent qualifiée péjorativement de « graphique de décontextualisation » dans la littérature scientifique contemporaine.
Pour implémenter des barres d’erreur basées sur l’écart-type au sein de Google Sheets, l’analyste procède selon les étapes suivantes :
- Générer un tableau récapitulatif synthétisant les conditions expérimentales en colonnes et les moyennes arithmétiques respectives calculées via
AVERAGE. - Sélectionner ce tableau d’agrégation, cliquer sur Insertion > Graphique, et configurer le type de visualisation sur Graphique à colonnes standard.
- Dans le panneau latéral de configuration de l’éditeur de graphiques, basculer sur l’onglet Personnaliser, puis ouvrir la section déroulante intitulée Série.
- Faire défiler les options jusqu’à localiser la case à cocher Barres d’erreur et l’activer.
- Dans le menu déroulant sous-jacent Type, modifier la sélection par défaut pour choisir formellement Écart type (ou Standard Deviation en version anglophone).
Une fois cette option validée, Google Sheets trace automatiquement sur chaque colonne un segment vertical centré sur le sommet de la barre, s’étendant symétriquement vers le haut et vers le bas d’une amplitude correspondant à la dispersion des données sous-jacentes. L’observateur dispose ainsi d’un indicateur visuel immédiat : des barres de dispersion qui se chevauchent largement suggèrent intuitivement une variance intra-groupe substantielle comparativement à l’écart inter-groupes, modérant les conclusions hâtives quant à l’efficacité du traitement évalué avant même l’exécution des tests inférentiels formels.
10.2 Personnalisation avancée des barres d’erreur asymétriques
Bien que le module automatisé de barres d’erreur basé sur l’option native « Écart type » soit commode pour des explorations visuelles préliminaires, il souffre d’une limitation algorithmique interne : dans certains contextes d’agrégation, Google Sheets calcule l’écart-type de manière globale ou applique une proportion mécanique uniforme qui ne reflète pas fidèlement les écarts-types d’échantillon empiriques individuels calculés rigoureusement via STDEV.S pour chaque groupe distinct.
Pour atteindre une rigueur académique irréprochable, il est vivement préconisé de recourir à des barres d’erreur configurées à partir d’une série de données explicite. Cette méthode avancée exige de structurer au préalable, dans la feuille de calcul, une colonne consignant avec précision les écarts-types empiriques calculés via STDEV.S en regard de chaque condition expérimentale. Ensuite, dans l’éditeur de graphique, sous l’onglet Personnaliser > Série > Barres d’erreur, le statisticien sélectionne le type Constante ou importe une plage personnalisée.
Cette démarche permet d’éviter la confusion visuelle fréquente entre l’écart-type de l’échantillon ($s$), qui illustre la variabilité brute des individus composant le groupe, et l’erreur-type de la moyenne ($SEM$), qui modélise la précision de l’estimation du barycentre. Lorsque les données présentent des contraintes physiques unilatérales—par exemple des temps de réponse ou des concentrations enzymatiques qui ne peuvent théoriquement pas descendre sous le seuil de zéro—, cette personnalisation avancée garantit la documentation transparente des limites de dispersion, prévenant la projection de barres d’erreur absurdes dans les quadrants négatifs de l’axe géométrique.
10.3 Représentation de la loi normale et des intervalles empiriques
L’écart-type prend toute sa dimension géométrique lorsqu’il est articulé aux propriétés probabilistes de la loi normale (ou distribution gaussienne). Dans un jeu de données quantitatives continues répondant de manière acceptable à l’hypothèse de normalité, l’écart-type dicte la morphologie exacte de la « courbe en cloche » et délimite des pourcentages d’observations hautement prévisibles en vertu de la célèbre règle empirique 68-95-99,7.
Cette règle empirique postule mathématiquement les proportions suivantes :
- L’intervalle délimité par $\mu \pm 1\sigma$ (ou $\bar{x} \pm 1s$) englobe approximativement 68,27 % de l’ensemble des observations de la distribution.
- L’intervalle délimité par $\mu \pm 2\sigma$ (ou $\bar{x} \pm 2s$) regroupe environ 95,45 % des unités statistiques analysées.
- L’intervalle délimité par $\mu \pm 3\sigma$ (ou $\bar{x} \pm 3s$) absorbe la quasi-totalité des données, soit 99,73 % de la distribution empirique.
Pour modéliser visuellement cette loi au sein de Google Sheets, l’analyste peut générer un vecteur théorique d’abscisses régulières s’étendant de $-3{,}5s$ à $+3{,}5s$ autour de la moyenne, puis appliquer dans une colonne parallèle la fonction de densité de probabilité normale via l’instruction NORMDIST (en français LOI.NORMALE) configurée avec l’argument cumulatif FAUX :
=NORMDIST(x; moyenne; ecart_type; FAUX)
En projetant ces deux colonnes au sein d’un graphique à lignes lissées (graphique cartésien), la distribution gaussienne se déploie harmonieusement. En y adjoignant des lignes verticales d’annotation marquant les frontières d’écarts-types successifs, le chercheur offre à ses pairs une appréciation intuitive remarquable de la dispersion de ses observations, permettant de confronter la distribution empirique réelle à son idéal théorique asymptotique.
11. Erreurs fréquentes, pièges numériques et dépannage dans Google Sheets
11.1 Gestion des erreurs de syntaxe et d’exécution (#DIV/0!, #VALEUR!, #NOMBRE!)
Lors de l’implémentation opérationnelle de formules statistiques dans Google Sheets, le moteur de calcul peut interrompre son exécution et renvoyer divers codes d’erreur explicites. Comprendre les fondements algébriques et typologiques de ces interruptions est indispensable pour diagnostiquer et assainir rapidement les modèles défaillants.
L’écueil le plus emblématique rencontré lors de l’application de STDEV.S est l’apparition brutale de l’erreur #DIV/0!. Dans l’esprit des praticiens débutants, ce code est traditionnellement associé à une division explicite d’un nombre par zéro au sein d’une cellule. Or, dans le cadre de STDEV.S, cette anomalie se produit inévitablement dès lors que la plage référencée ne comporte qu’une seule et unique observation numérique valide ($n = 1$). En vertu de la correction de Bessel, le dénominateur de la formule est égal à $n – 1$. Si $n = 1$, le dénominateur devient $1 – 1 = 0$. Le tableur se trouve dans l’impossibilité d’exécuter la division par zéro requise pour dériver la variance sans biais, ce qui déclenche immédiatement l’interruption logicielle. La survenue de #DIV/0! sur une formule d’écart-type est donc le signal direct d’une sous-alimentation critique de l’échantillon.
Le code d’erreur #VALEUR! (ou #VALUE!) se manifeste quant à lui lorsqu’une incompatibilité structurelle de typage est injectée directement en argument scalaire dans la fonction, par exemple si un opérateur saisit =STDEV.S(10; 20; "Trente"). Alors que les chaînes textuelles situées à l’intérieur d’une plage matricielle de cellules (ex: A1:A50) sont ignorées pacifiquement par STDEV.S, l’incorporation explicite d’une chaîne alphabétique au sein de la liste des arguments directs provoque un blocage immédiat de l’analyseur lexical. Enfin, le code #NOMBRE! signale des aberrations de calcul arithmétique interne, telles qu’une tentative de traitement de valeurs numériques dépassant les seuils de représentation en virgule flottante standard (nombres supérieurs à $1{,}79 \times 10^{308}$).
Pour prémunir les tableaux de bord automatisés contre ces ruptures d’affichage inesthétiques, il est vivement recommandé d’encapsuler préventivement les calculs de dispersion sensibles au sein de la fonction défensive IFERROR (en français SIERREUR) :
=IFERROR(STDEV.S(A2:A100); "Taille d'échantillon insuffisante")
11.2 Distorsions induites par les cellules vides et les zéros explicites
L’un des pièges méthodologiques les plus pernicieux dans l’utilisation des tableurs numériques concerne la confusion conceptuelle entre une absence de mesure (représentée par une cellule vide) et une mesure de magnitude nulle (représentée par la saisie du chiffre 0). Bien que ces deux états puissent paraître visuellement similaires dans une feuille de calcul mal configurée, leur impact mathématique sur le calcul de la dispersion est diamétralement opposé.
Comme souligné antérieurement, les fonctions standardisées STDEV.S et STDEV.P excluent totalement les cellules vides de leur dynamique de calcul. Ni le numérateur quadratique ni le décompte cardinal des diviseurs ($n$ ou $n – 1$) ne sont modifiés par l’existence d’une cellule vide. En revanche, dès lors qu’un opérateur ou un script automatisé inscrit la valeur numérique 0 dans une cellule pour marquer un participant non venu ou un test manqué, ce zéro est traité par l’algorithme comme une observation empirique authentique.
L’incorporation inopportune d’un ou plusieurs zéros altère lourdement les statistiques :
- Elle tire mécaniquement la moyenne arithmétique vers le bas, augmentant artificiellement la distance résiduelle de toutes les observations élevées.
- Elle introduit des déviations quadratiques considérables au numérateur ($(0 – \bar{x})^2$), injectant une variance artificielle massive dans la distribution.
- Elle incrémente indûment le diviseur d’une unité supplémentaire, faussant l’évaluation des degrés de liberté.
Un danger connexe provient de l’usage archaïque de codes de remplacement pour désigner les valeurs manquantes, tels que -999 ou 9999, hérités des anciens systèmes de cartes perforées ou des formats Fortran historiques. Si de tels codes sentinelles subsistent dans une colonne sans être expurgés avant l’application de STDEV.S, ils agissent comme des bombes numériques, propulsant l’écart-type à des magnitudes démesurées sans aucun rapport avec la variabilité biologique ou physique réelle du phénomène étudié.
11.3 Influence démesurée des valeurs aberrantes (outliers)
Sur le plan des fondements de la statistique mathématique, l’écart-type appartient à la catégorie des estimateurs non robustes. Sa structure algébrique reposant intégralement sur la moyenne arithmétique et sur l’élévation des résidus au carré lui confère un point de rupture (breakdown point) formellement égal à zéro : il suffit d’une seule observation erronée de magnitude arbitrairement disproportionnée au sein d’une série de données pour contaminer irrémédiablement l’indice et lui faire prendre une valeur totalement aberrante.
Pour diagnostiquer formellement la contamination de la dispersion par des valeurs aberrantes, la méthode classique repose sur le calcul des scores $z$ pour chaque unité de la distribution :
$$z_i = \frac{x_i – \bar{x}}{s}$$
Au sein d’un échantillon unimodal raisonnablement symétrique, toute observation affichant une valeur absolue $|z_i| > 3$ (située à plus de trois écarts-types de la moyenne) doit être soumise à une inspection méthodique afin de discriminer une erreur matérielle de saisie (par exemple, la frappe accidentelle d’une virgule décalée transformant 12,5 en 125) d’une fluctuation empirique extrême mais authentique.
Lorsque la distribution des données se révèle structurellement asymétrique, fortement étirée vers les valeurs positives (comme les salaires ou les temps de survie) ou lourdement contaminée, l’écart-type cesse d’être l’indicateur de dispersion le plus informatif. Le praticien gagne alors à lui adjoindre, ou à lui substituer, des indices de dispersion d’une robustesse mathématique éprouvée :
- L’écart interquartile (IQR) : calculé via
=QUARTILE(A2:A100; 3) - QUARTILE(A2:A100; 1), qui mesure l’étendue occupée par les 50 % centraux des données et demeure parfaitement insensible aux déformations survenant aux extrémités de la distribution. - La médiane absolue des écarts (MAD) : définie formellement comme la médiane des déviations absolues par rapport à la médiane de la série, formulable dans Google Sheets via
=MEDIAN(INDEX(ABS(A2:A100 - MEDIAN(A2:A100)))). La MAD constitue l’estimateur de variabilité le plus résistant face aux contaminations extrêmes, offrant une alternative d’une robustesse méthodologique remarquable dans les environnements de données bruitées.
12. Synthèse méthodologique et recommandations pour le reporting académique
12.1 Arbre de décision logique pour le choix de la formule appropriée
Afin de guider avec une clarté infaillible l’analyste, le chercheur ou le gestionnaire de données dans le labyrinthe des fonctions de dispersion sous Google Sheets, la démarche d’arbitrage méthodologique peut être synthétisée sous la forme d’un protocole décisionnel séquentiel fondé sur trois critères logiques hiérarchisés :
-
Critère 1 : Accès absolu à la population versus échantillonnage représentatif
- Ai-je mesuré rigoureusement 100 % des unités composant un ensemble clos et délimité, sans aucune omission et sans aucune intention d’extrapoler les conclusions au-delà de ces observations historiques ?
- Si OUI : La modélisation relève de l’écart-type de population. S’orienter vers la famille de formules
.P. - Si NON (cas de la quasi-totalité des protocoles de recherche et d’expérimentation) : Les données constituent un sous-ensemble empirique visant l’induction statistique. S’orienter impérativement vers la famille de formules
.Savec correction de Bessel.
- Si OUI : La modélisation relève de l’écart-type de population. S’orienter vers la famille de formules
- Ai-je mesuré rigoureusement 100 % des unités composant un ensemble clos et délimité, sans aucune omission et sans aucune intention d’extrapoler les conclusions au-delà de ces observations historiques ?
-
Critère 2 : Typologie des données matricielles
- La plage contient-elle exclusivement des valeurs quantitatives continues ou discrètes nettoyées, ou intègre-t-elle des variables logiques booléennes ou indicatrices d’état textuelles qui doivent obligatoirement être converties numériquement ?
- Si les données sont purement quantitatives standard : Employer exclusivement
STDEV.S(ouSTDEV.Pselon l’arbitrage du Critère 1). - Si une conversion forcée des arguments textuels et booléens en zéros et uns est explicitement exigée par le protocole : Employer
STDEVA(ouSTDEVPA).
- Si les données sont purement quantitatives standard : Employer exclusivement
- La plage contient-elle exclusivement des valeurs quantitatives continues ou discrètes nettoyées, ou intègre-t-elle des variables logiques booléennes ou indicatrices d’état textuelles qui doivent obligatoirement être converties numériquement ?
-
Critère 3 : Architecture computationnelle et structure de filtrage
- L’analyse s’applique-t-elle à une plage inconditionnelle continue, ou doit-elle être segmentée dynamiquement selon des facteurs d’inclusion catégoriels ?
- Calcul global standard : Invoquer directement
=STDEV.S(plage). - Calcul conditionnel dynamique : Combiner
=STDEV.S(FILTER(plage_valeurs; critere)). - Intégration au sein d’une base de données tabulaire à critères externes : Exploiter
=DSTDEV(base; champ; criteres).
- Calcul global standard : Invoquer directement
- L’analyse s’applique-t-elle à une plage inconditionnelle continue, ou doit-elle être segmentée dynamiquement selon des facteurs d’inclusion catégoriels ?
En recherche scientifique et expérimentale, la règle empirique de prudence méthodologique impose de faire de STDEV.S le choix algorithmique par défaut. Sauf justification épistémologique expresse d’un recensement universel clos, toute démarche quantitative publiée doit s’appuyer sur la formule corrigée de Bessel afin d’honorer les exigences de neutralité de l’estimation statistique.
12.2 Articulation conceptuelle entre écart-type et erreur-type de la moyenne
L’une des confusions les plus dommageables observées dans la littérature académique et les rapports d’études réside dans l’assimilation erronée de l’écart-type de l’échantillon ($s$) avec l’erreur-type de la moyenne (universellement désignée par le sigle anglo-saxon SEM pour Standard Error of the Mean). Bien que ces deux indices quantifient formellement une variabilité et partagent la même unité métrique que la variable analysée, leurs objets statistiques sous-jacents sont fondamentalement discordants.
L’écart-type ($s$) est un indice descriptif. Il quantifie l’amplitude des variations interindividuelles réelles au sein de l’échantillon, décrivant la manière dont les observations concrètes s’éparpillent autour du centre de gravité empirique. Sa valeur reflète une propriété intrinsèque du phénomène mesuré : augmenter la taille de l’échantillon de $n = 30$ à $n = 3,000$ ne réduira pas l’écart-type d’une variable biologique stable comme la taille adulte, car la variabilité biologique de la population sous-jacente demeure invariante.
À l’inverse, l’erreur-type de la moyenne ($SEM$) est un indice inférentiel. Elle ne mesure pas la dispersion des individus, mais la précision théorique avec laquelle la moyenne de l’échantillon $\bar{x}$ estime la moyenne inconnue de la population parente $\mu$. Elle correspond à l’écart-type théorique de la distribution d’échantillonnage des moyennes qui serait obtenue si l’on répétait l’expérience une infinité de fois. Sa dérivation mathématique s’exprime par le quotient :
$$SEM = \frac{s}{\sqrt{n}}$$
L’implémentation pratique de l’erreur-type sous Google Sheets s’effectue aisément en combinant les fonctions natives élémentaires :
=STDEV.S(A2:A100) / SQRT(COUNT(A2:A100))
Par construction algébrique, le dénominateur $\sqrt{n}$ implique que le $SEM$ décroît asymptotiquement à mesure que la taille de l’échantillon s’accroît. Présenter un $SEM$ à la place d’un écart-type dans une table de statistiques descriptives constitue un artifice cosmétique classique—souvent dénoncé par les éditeurs scientifiques—visant à faire paraître les barres d’erreur artificiellement étroites afin de donner une illusion trompeuse d’homogénéité des données brutes. Le reporting académique rigoureux exige d’associer systématiquement la moyenne à l’écart-type lorsqu’il s’agit de décrire une cohorte, et de réserver l’erreur-type ou les intervalles de confiance à 95 % aux contextes d’estimation inférentielle de paramètres.
12.3 Normes de présentation académique des indices de dispersion (normes APA)
La transcription écrite des résultats statistiques dans les mémoires universitaires, thèses de doctorat et articles soumis aux revues internationales à comité de lecture est régie par des conventions éditoriales strictes, dont les standards de l’American Psychological Association (normes APA, actuellement en 7e édition) constituent la référence dominante à l’échelle planétaire.
Les prescriptions stylistiques fondamentales relatives à l’écart-type imposent les règles suivantes :
- Typographie des symboles : Les lettres alphabétiques désignant des statistiques d’échantillon doivent impérativement être composées en caractères italiques. L’écart-type d’échantillon s’abrège formellement par la lettre majuscule SD (pour Standard Deviation) ou parfois s, tandis que la moyenne arithmétique s’abrège par la lettre majuscule M. Les paramètres grecs de population ($\mu$ et $\sigma$) ne s’italisent jamais.
- Formatage au sein du corps de texte : Lorsqu’ils sont intégrés dans une phrase narrative, les indices de tendance centrale et de dispersion s’insèrent préférentiellement entre parenthèses sous une forme standardisée : « Les participants du groupe expérimental ont manifesté une latence de réponse significativement plus brève (M = 423,15 ms ; SD = 45,82 ms) que ceux du groupe témoin (M = 512,80 ms ; SD = 78,34 ms)… ».
- Règle de précision décimale : Les normes académiques stipulent que les statistiques descriptives telles que M et SD doivent être rapportées avec un degré de précision cohérent, généralement borné à une ou deux décimales significatives au-delà de la précision native des instruments de collecte brute. Dans Google Sheets, il convient de calibrer uniformément la présentation des cellules récapitulatives via le menu décimal pour éviter la juxtaposition disparate d’estimations affichant dix chiffres après la virgule.
- Documentation des feuilles de calcul ouvertes : Dans le cadre du mouvement contemporain pour la science ouverte (Open Science), les tableurs Google Sheets versés dans les entrepôts de données publics (tels que l’Open Science Framework ou Zenodo) en soutien d’un article publié doivent faire l’objet d’une documentation méthodologique transparente. Les en-têtes doivent être annotés au moyen de métadonnées précisant la fonction exacte mobilisée (ex:
STDEV.S), attestant de l’exclusion des valeurs manquantes et garantissant la réplication computationnelle intégrale des calculs par n’importe quel auditeur indépendant à travers le globe.
Références
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Bessel, F. W. (1816). Untersuchungen über die scheinbare und wahre Bahn des im Jahre 1807 erschienenen grossen Kometen. Königsberger Archiv für Naturwissenschaften und Mathematik, 1, 1-52.
- Google Support. (2024). Fonction STDEV.S (ECARTYPE.STANDARD) dans Google Sheets. Google Documentation. https://support.google.com/docs/answer/3094054
- Google Support. (2024). Fonction STDEV.P (ECARTYPE.STANDARD.P) dans Google Sheets. Google Documentation. https://support.google.com/docs/answer/3094053
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- National Institute of Standards and Technology. (2023). NIST/SEMATECH e-Handbook of Statistical Methods. NIST. https://www.itl.nist.gov/div898/handbook/
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2014). Mathematical statistics with applications (7th ed.). Cengage Learning.