
Dans le champ de l’analyse quantitative, de la modélisation statistique et des sciences du comportement, la distribution des données constitue la structure fondamentale sur laquelle repose toute tentative d’interprétation empirique. Qu’il s’agisse de mesurer des variables psychométriques telles que le quotient intellectuel, d’évaluer les temps de réaction dans des paradigmes cognitifs ou d’analyser les erreurs de mesure au sein de protocoles expérimentaux stricts, la forme géométrique adoptée par les observations conditionne directement la validité des conclusions scientifiques. Parmi l’ensemble des configurations théoriques concevables, la distribution symétrique occupe une position prééminente, agissant à la fois comme un idéal analytique, un étalon de référence et une hypothèse sous-jacente à la vaste majorité des méthodes d’inférence paramétrique.
L’étude approfondie de la symétrie distributionnelle dépasse largement la simple constatation visuelle d’un équilibre esthétique. Elle engage des principes mathématiques rigoureux liés à l’invariance par réflexion, à la convergence des indicateurs de tendance centrale et à l’annulation systématique des moments d’ordre impair. Comprendre la mécanique d’une variable aléatoire symétrique permet non seulement d’optimiser l’estimation des paramètres de population, mais offre également un cadre d’évaluation critique face aux distorsions empiriques causées par des biais d’échantillonnage, des effets de seuil ou des particularités structurelles inhérentes aux traits mesurés. Dans des disciplines telles que la psychologie différentielle, la neuropsychologie et la psychométrie contemporaine, la maîtrise de ces dynamiques est indispensable pour garantir l’équité diagnostique et la robustesse des modèles prédictifs.
Le présent article propose une exploration exhaustive et systématique de la distribution symétrique sous l’ensemble de ses facettes conceptuelles, mathématiques et opérationnelles. Depuis les fondements axiomatiques établis par les pionniers de la théorie des probabilités jusqu’aux arbres décisionnels guidant le choix entre approches paramétriques et non paramétriques, chaque section détaillera les propriétés formelles, les manifestations canoniques — à l’instar de la courbe de Gauss ou de la loi de Student —, les atypies multimodales, ainsi que les protocoles diagnostiques visuels et inférentiels permettant d’attester de la symétrie des données empiriques.
1. Définition fondamentale de la distribution symétrique
1.1 Concept théorique et miroir bilatéral
Au sens probabiliste formel, une variable aléatoire continue $X$ admet une distribution symétrique autour d’une constante réelle centrale, conventionnellement notée $c$, si sa fonction de densité de probabilité $f(x)$ demeure rigoureusement invariante sous l’effet d’une transformation géométrique de réflexion orthogonale par rapport à l’axe vertical d’équation $x = c$. Sur le plan analytique, cette condition fondamentale s’exprime par l’identité d’équité fonctionnelle $f(c – x) = f(c + x)$ pour tout nombre réel $x$. Lorsque la distribution est centrée sur l’origine du repère, c’est-à-dire lorsque $c = 0$, la fonction de densité devient une fonction paire vérifiant l’égalité classique $f(-x) = f(x)$. Cette parité confère à la courbe de densité une morphologie en miroir bilatéral, signifiant que chaque point situé à une distance déterminée à gauche de la valeur centrale possède un équivalent infinitésimal de densité strictement identique à égale distance sur la droite.
Cette propriété géométrique se répercute avec une exactitude identique sur le plan cumulatif et décisionnel. Si l’on s’intéresse à la fonction de répartition $F(x) = P(X le x)$, la symétrie autour du point $c$ impose que, pour toute déviation positive ou négative $t ge 0$, la probabilité conditionnelle que la variable $X$ s’écarte vers la gauche soit rigoureusement égale à la probabilité qu’elle dévie vers la droite. Ainsi, l’équation $P(X le c – t) = P(X ge c + t)$ s’applique universellement, ce qui implique par corollaire direct que $F(c – t) = 1 – F(c + t)$. Cette configuration garantit que la masse de probabilité totale, d’une valeur unitaire de 1, se scinde de façon parfaitement équilibrée en deux moitiés distinctes de part et d’autre de $c$, faisant de cette valeur la médiane théorique incontestable de la variable considérée.
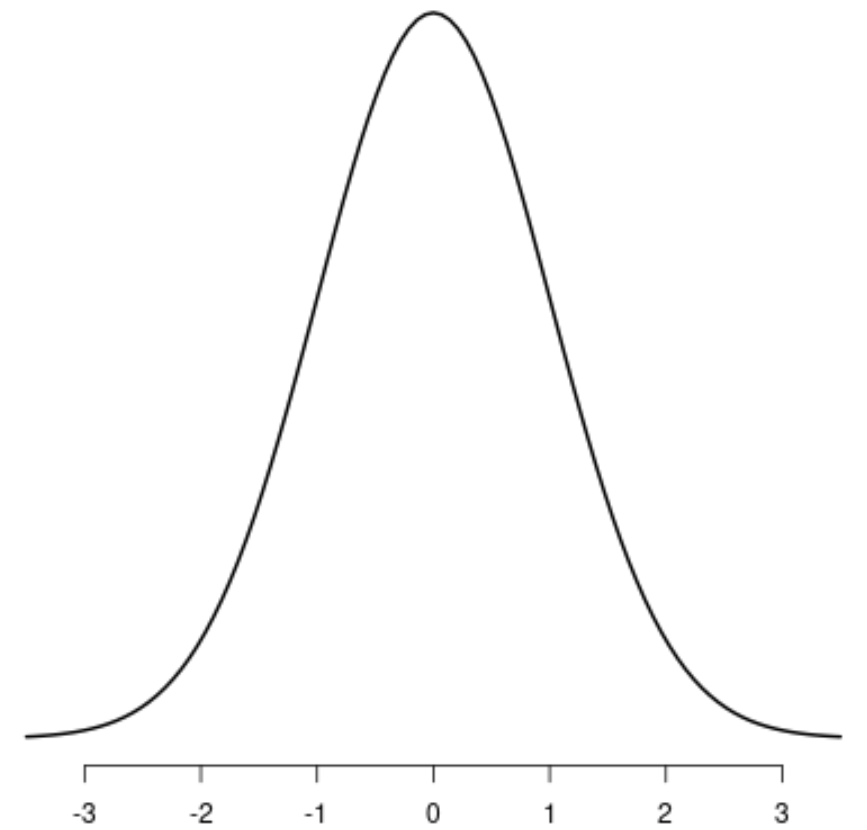
D’un point de vue géométrique et structural, ce miroir bilatéral signifie que la surface sous la courbe de la fonction de densité sur l’intervalle $]-\infty, c]$ est l’exact reflet géométrique de la surface délimitée sur l’intervalle $[c, +\infty[$. Les variations de la pente, les accélérations mesurées par la dérivée seconde et les éventuels points d’inflexion se manifestent par paires parfaitement ordonnées. Dès lors, toute perturbation unilatérale, qu’elle résulte d’une accumulation anormale de mesures sur une queue de distribution ou d’un affaissement asymétrique, détruit instantanément cette invariance par réflexion, faisant basculer le profil probabiliste dans le registre de l’asymétrie.
1.2 Importance de la symétrie en théorie des probabilités
En théorie pure des probabilités ainsi qu’en statistique mathématique, l’hypothèse de symétrie représente un levier de calcul d’une puissance exceptionnelle, permettant la simplification directe d’équations intégrales souvent insolubles par d’autres voies. En vertu des règles fondamentales d’intégration des fonctions impaires sur un domaine symétrique, toute intégrale de la forme $\int_{-a}^{a} g(u) du$ s’annule immédiatement si la fonction $g(u)$ vérifie $g(-u) = -g(u)$. Dans le contexte d’une densité symétrique centrée en zéro, le calcul des espérances mathématiques, des moments polynomiaux et de diverses fonctions génératrices se trouve radicalement épuré, éliminant des termes exponentiels complexes et facilitant les démonstrations asymptotiques nécessaires aux grands théorèmes de convergence.
Au-delà de ces facilités opératoires, la symétrie constitue le socle ontologique du théorème central limite, l’une des pierres angulaires de la science statistique moderne. Ce théorème stipule que la somme d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées tend asymptotiquement vers une loi normale — archétype par excellence de la distribution symétrique —, et ce, quelle que soit la forme originelle des lois sous-jacentes pourvu que leur variance demeure finie. La symétrie agit ici comme un attracteur probabiliste universel, conférant aux méthodes d’inférence paramétrique (telles que le test de Student ou l’analyse de variance de Fisher) une pertinence et une applicabilité ubiquitaires dans l’analyse de phénomènes complexes.
Enfin, sur le plan de l’estimation ponctuelle, la présence d’une structure symétrique assure une stabilité exceptionnelle aux estimateurs statistiques gravitant autour du paramètre de position. Sous des conditions de symétrie stricte, l’estimateur de la moyenne arithmétique coïncide idéalement avec le centre de symétrie, minimisant les fonctions de perte quadratique tout en conférant aux M-estimateurs une robustesse théorique face à certaines formes d’incertitude. L’absence de distorsion directionnelle élimine le biais structurel systématique, garantissant que l’échantillonnage aléatoire produise des estimations non biaisées et asymptotiquement efficaces, deux qualités indispensables à la validation des hypothèses scientifiques.
1.3 Origine historique et conceptualisation empirique
L’émergence formelle du concept de distribution symétrique est intimement liée aux défis méthodologiques posés par l’astronomie de précision et la géodésie au tournant des XVIIIe et XIXe siècles. Confrontés aux divergences inévitables entre les relevés d’observation des corps célestes, Carl Friedrich Gauss et Pierre-Simon de Laplace ont théorisé de manière indépendante la « loi des erreurs ». Selon cette approche novatrice, les erreurs accidentelles commises lors des mesures ne sont pas anarchiques, mais obéissent à un ordre probabiliste intrinsèque où les déviations positives et négatives de même amplitude ont exactement la même probabilité de se produire, tandis que les écarts d’amplitude colossale deviennent exponentiellement rares. Cette intuition fondamentale a donné naissance à la courbe en cloche, baptisée par la suite distribution gaussienne ou loi normale.
Au milieu du XIXe siècle, le sociologue et astronome belge Adolphe Quetelet a franchi une étape conceptuelle déterminante en transposant ce formalisme mathématique des sciences physiques aux sciences humaines. Par l’introduction du concept de « l’homme moyen », Quetelet postula que les caractéristiques morphologiques, anthropométriques et morales des populations humaines se structurent autour d’un pivot moyen selon une distribution symétrique analogue à la loi des erreurs astronomiques. Pour la première fois, la variabilité individuelle cessait d’être perçue comme un désordre fortuit ou une dégénérescence pour être reconnue comme une régularité statistique mesurable, symétriquement articulée autour d’un idéal typologique central.
Cette conceptualisation a ensuite trouvé son prolongement le plus abouti dans les travaux de Francis Galton et l’avènement subséquent de la psychologie différentielle. Galton s’attacha à démontrer que les facultés intellectuelles, les traits comportementaux et les aptitudes perceptives se distribuaient au sein de l’espèce humaine selon le modèle de la loi normale symétrique. Ce postulat a constitué l’armature épistémologique sur laquelle reposent les développements de la psychométrie contemporaine, de Charles Spearman à Alfred Binet, instituant la symétrie distributionnelle comme paradigme dominant pour la standardisation des instruments d’évaluation cognitive et la modélisation de la psyché humaine.
2. Propriétés mathématiques et indicateurs de tendance centrale
2.1 L’égalité parfaite : Moyenne, Médiane et Mode
L’une des propriétés les plus remarquables et les plus élégantes d’une distribution symétrique unimodale continue réside dans la coïncidence mathématique absolue de ses trois principaux indicateurs de tendance centrale : la moyenne arithmétique ($\mu$), la médiane ($Me$) et le mode ($Mo$). Dans une configuration où la fonction de densité $f(x)$ est symétrique par rapport à un axe central $c$ et ne présente qu’un unique sommet, ce sommet coïncide inévitablement avec la valeur modale où la dérivée première de la fonction s’annule, soit $f'(c) = 0$, avec une dérivée seconde négative $f »(c) < 0$. Dès lors, le mode s'établit avec une rigueur absolue au point $Mo = c$.
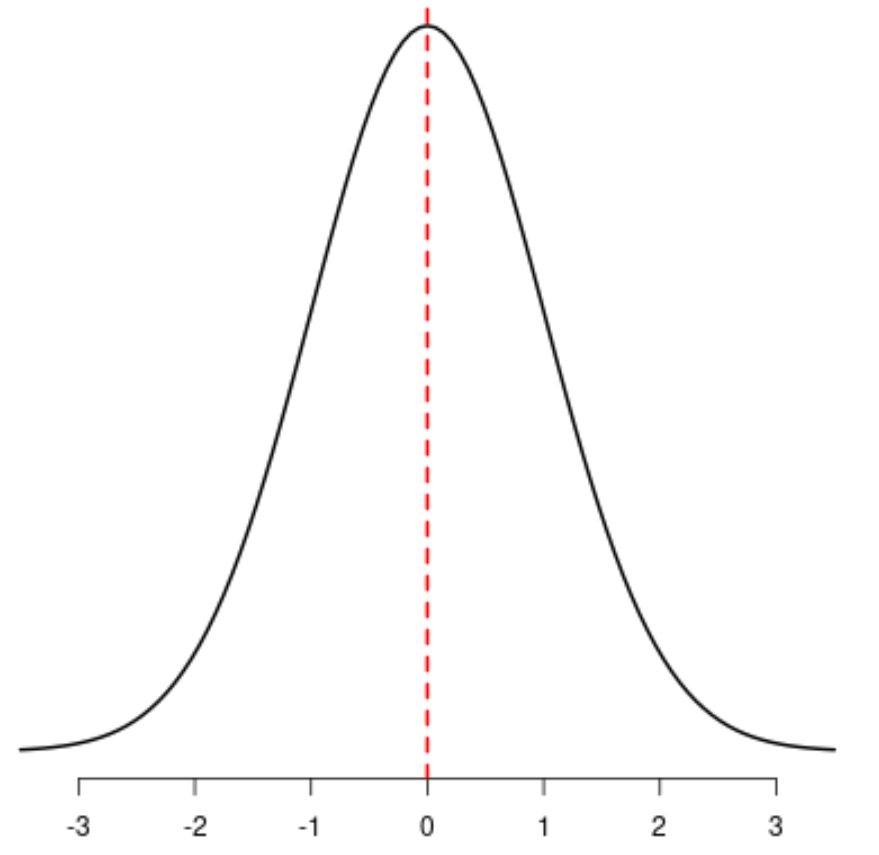
Parallèlement, la définition de la médiane stipule qu’elle sépare l’aire totale délimitée par la courbe de densité en deux régions d’égale probabilité, telles que $P(X le Me) = P(X ge Me) = 0{,}5$. En vertu de la symétrie bilatérale stricte qui impose que $\int_{-\infty}^{c} f(x) dx = \int_{c}^{+\infty} f(x) dx = 0{,}5$, la constante $c$ endosse immédiatement et sans équivoque le rôle de médiane, garantissant $Me = c$. Enfin, l’espérance mathématique ou moyenne de la distribution se formalise par l’intégrale $\mu = \int_{-\infty}^{+\infty} x f(x) dx$. En effectuant le changement de variable $u = x – c$, l’expression devient $\mu = \int_{-\infty}^{+\infty} (u + c) f(u + c) du = \int_{-\infty}^{+\infty} u f(u + c) du + c \int_{-\infty}^{+\infty} f(u + c) du$. La fonction $u f(u + c)$ étant strictement impaire, son intégrale sur un domaine symétrique est nulle, tandis que l’intégrale de la densité vaut 1, démontrant ainsi de manière irréfutable que $\mu = c$. On aboutit dès lors à la fameuse trilogie d’égalité paramétrique :
$$\mu = Me = Mo$$
Cette convergence parfaite illustre le comportement idéal de la moyenne arithmétique face aux variations équilibrées des queues de distribution. Contrairement aux distributions asymétriques où la moyenne se trouve irrémédiablement aspirée vers l’extrémité la plus étalée, la symétrie neutralise mutuellement l’influence gravitationnelle des valeurs extrêmement basses et des valeurs extrêmement élevées. Chaque observation située à plusieurs écarts-types en deçà du centre est mathématiquement contrebalancée par une observation de magnitude strictement équivalente située au-delà du centre. Ainsi, le point d’équilibre physique de la courbe coïncide rigoureusement avec son point de découpage médian et son sommet de densité maximale, simplifiant considérablement le travail d’inférence.
2.2 Moments statistiques d’ordre impair
Dans le formalisme de la théorie des probabilités, les moments d’une variable aléatoire capturent les subtilités morphologiques de sa fonction de densité. Le moment centré d’ordre $k$, couramment noté $\mu_k$, est formellement défini par l’espérance de l’écart à la moyenne élevé à la puissance $k$ :
$$\mu_k = E\left[(X – \mu)^k\right] = \int_{-\infty}^{+\infty} (x – \mu)^k f(x) dx$$
Lorsque la distribution est symétrique autour de son espérance $\mu$, le terme $(x – \mu)^k$ adopte un comportement strictement fonctionnel selon la parité de l’exposant $k$. Lorsque l’entier $k$ est impair (pour $k = 1, 3, 5, 7, dots$), l’expression $(x – \mu)^k$ devient une fonction impaire par rapport à l’axe de réflexion $x = \mu$. Le produit d’une fonction impaire et d’une fonction paire — en l’occurrence la densité symétrique $f(x)$ — génère invariablement une fonction impaire. Par conséquent, l’intégration de ce produit sur l’ensemble de l’espace réel s’annule obligatoirement :
$$\mu_{2k+1} = 0 \quad \text{pour tout } k in \mathbb{N}$$
Cette annulation systématique engendre des conséquences théoriques de premier ordre. Le premier moment centré, $\mu_1 = E[X – \mu]$, est identiquement nul pour toute distribution par définition, mais c’est l’annulation du troisième moment centré ($\mu_3 = E[(X – \mu)^3] = 0$) qui constitue la marque distinctive de la symétrie. Ce troisième moment centré quantifie directement la distorsion asymétrique de la masse probabiliste. Son extinction indique que les déviations cubiques négatives et positives s’annulent de façon exhaustive, attestant de l’absence totale de traînée directionnelle. Ce principe s’étend identiquement aux moments d’ordre supérieur impair, tels que le cinquième moment centré ($\mu_5$) et le septième moment centré ($\mu_7$), lesquels s’avèrent indispensables pour étudier les déformations ultra-périphériques des queues de distribution sans altérer l’équilibre symétrique.
L’élimination des moments d’ordre impair clarifie considérablement les calculs liés à la variance ($\mu_2 = \sigma^2$) et à l’estimation des erreurs-types d’échantillonnage. En l’absence de covariance entre les estimateurs de position (moyenne) et d’échelle (variance), la matrice d’information de Fisher devient fréquemment diagonale ou bloc-diagonale dans les familles de lois symétriques. Cette indépendance structurelle réduit substantiellement les biais d’estimation et protège le chercheur contre les corrélations parasites qui parasitent couramment l’analyse de variables fortement dissymétriques.
2.3 Quantiles et dispersion symétrique
L’empreinte mathématique d’une distribution symétrique se reflète également avec une élégance parfaite dans la répartition de ses quantiles et de ses valeurs de dispersion ordinale. Par définition, le quantile d’ordre $p$ (avec $0 < p < 1$), noté $Q(p)$ ou $x_p$, est la valeur telle que $P(X le x_p) = p$. Dans une configuration symétrique autour de son centre $\mu = Me$, l'invariance par réflexion impose une équidistance stricte entre les quantiles complémentaires situés de part et d'autre de la médiane :
$$\mu – Q(p) = Q(1 – p) – \mu$$
Cette relation générale prend un relief concret lorsque l’on examine les quartiles de la distribution. Le premier quartile ($Q_1 = Q(0{,}25)$) délimite les 25 % inférieurs des observations, tandis que le troisième quartile ($Q_3 = Q(0{,}75)$) borne les 75 % inférieurs, laissant 25 % de l’effectif au-dessus de lui. Sous condition de symétrie, l’intervalle séparant le premier quartile de la médiane est rigoureusement identique à l’intervalle séparant la médiane du troisième quartile, ce qui se traduit par l’égalité arithmétique :
$$Me – Q_1 = Q_3 – Me$$
L’écart interquartile ($IQR = Q_3 – Q_1$) se trouve ainsi scindé en deux segments d’amplitudes strictement équivalentes à partir de la médiane, soit $IQR/2$. Cette équidistance absolue constitue un outil diagnostique fondamental en analyse exploratoire de données. Toute déviation empirique significative entre le segment inférieur ($Me – Q_1$) et le segment supérieur ($Q_3 – Me$) apporte l’indice irréfutable d’une distorsion asymétrique locale ou globale.
Cette propriété de symétrie géométrique se répercute de manière analogue sur l’ensemble des percentiles de la distribution. Si l’on considère le cinquième centile ($P_5$) et le quatre-vingt-quinzième centile ($P_{95}$), ou encore le dixième ($P_{10}$) et le quatre-vingt-dixième centile ($P_{90}$), leur éloignement par rapport au cinquantième centile ($P_{50} = Me$) est invariant :
$$P_{50} – P_{50 – k} = P_{50 + k} – P_{50} \quad \text{pour tout } k in ]0, 50[$$
Dans le domaine de l’étalonnage psychométrique, cette équidistance garantit que les zones d’exception diagnostique, qu’elles concernent la déficience cognitive ou l’exception intellectuelle, se positionnent à des distances ordinales strictement comparables du standard moyen, autorisant des comparaisons normatives exemptes d’asymétrie de structure.
3. L’asymétrie statistique (Skewness) et son rôle dans la symétrie
3.1 Définition mathématique du coefficient d’asymétrie
Pour mesurer quantitativement le degré de déformation ou de symétrie d’une distribution sans dépendre de son unité de mesure, la statistique mathématique recourt aux coefficients d’asymétrie, universellement désignés sous l’anglicisme de skewness. La formulation la plus canonique et la plus rigoureuse est le coefficient de Fisher-Pearson, noté $\gamma_1$ au niveau populationnel. Ce paramètre correspond au troisième moment centré normalisé ou standardisé par la troisième puissance de l’écart-type :
$$\gamma_1 = \frac{\mu_3}{\sigma^3} = \frac{E\left[(X – \mu)^3\right]}{\left(E\left[(X – \mu)^2\right]\right)^{3/2}}$$
Cette adimensionnalisation confère au coefficient une indépendance absolue vis-à-vis des translations d’échelle et des changements d’unités de mesure. À côté de cette approche fondée sur les moments, Karl Pearson a formulé des indicateurs empiriques alternatifs basés sur l’écartement des paramètres de tendance centrale. Le premier coefficient d’asymétrie de Pearson, défini par $Sk_1 = \frac{\mu – Mo}{\sigma}$, et le second coefficient, souvent appelé coefficient d’asymétrie médiane de Pearson, formulé comme suit :
$$Sk_2 = \frac{3(\mu – Me)}{\sigma}$$
Ces coefficients capturent l’intensité de la dérive de la moyenne par rapport au pivot médian ou modale sous l’influence des valeurs distales.
Lors de l’application de ces formules à des échantillons de taille finie $n$, le coefficient d’échantillon brut $g_1 = \frac{m_3}{m_2^{3/2}}$ souffre d’un biais systématique qui sous-estime généralement l’asymétrie réelle de la population parentale. Pour pallier cette distorsion méthodologique, les logiciels statistiques modernes calculent le coefficient d’asymétrie corrigé non biaisé, généralement dénoté $G_1$ :
$$G_1 = \frac{n}{(n – 1)(n – 2)} \sum_{i=1}^n \left(\frac{x_i – \bar{x}}{s}\right)^3 = \frac{\sqrt{n(n – 1)}}{n – 2} g_1$$
Cette correction analytique s’avère particulièrement cruciale lors du traitement de petits échantillons ($n < 30$), où l'absence de correction conduirait à déclarer à tort la symétrie d'une distribution qui présente en réalité une asymétrie populationnelle substantielle.
3.2 La valeur zéro comme critère d’absence d’asymétrie
Sur le plan purement théorique, une distribution symétrique se caractérise par une annulation stricte du coefficient d’asymétrie : $\gamma_1 = 0$. Cette valeur zéro marque l’équilibre parfait de la balance probabiliste, signalant l’absence totale de déport de la masse vers la gauche ou vers la droite. Dès que la condition fonctionnelle de réflexion $f(c – x) = f(c + x)$ est vérifiée, le troisième moment centré s’éteint rigoureusement dans l’intégrale, entraînant de facto la nullité du ratio de Fisher-Pearson. Dans les manuels théoriques, le skewness nul est donc couramment assimilé à la condition nécessaire et suffisante de la symétrie distributionnelle.
Néanmoins, dans le cadre de la pratique de la recherche et de l’analyse empirique de données réelles, une valeur de $G_1$ strictement égale à 0,000 est une chimère statistique qui ne se rencontre quasiment jamais en raison des fluctuations aléatoires d’échantillonnage. Les méthodologistes et psychométriciens adoptent donc des plages de tolérance pragmatiques. Selon les recommandations largement acceptées de George et Mallery, un coefficient d’asymétrie compris dans l’intervalle $[-0{,}5 ; +0{,}5]$ reflète une distribution approximativement symétrique qui n’altère pas significativement la robustesse des tests inférentiels linéaires. Des valeurs oscillant entre $[-1{,}0 ; -0{,}5]$ ou $[+0{,}5 ; +1{,}0]$ indiquent une asymétrie modérée, tandis que des scores excédant les bornes $[-1{,}0 ; +1{,}0]$ ou $[-2{,}0 ; +2{,}0]$ imposent d’abandonner l’hypothèse de symétrie au profit de transformations correctrices ou de méthodes non paramétriques.
Il importe toutefois de souligner un piège méthodologique fondamental : si toute distribution continue symétrique possède obligatoirement un skewness théorique de zéro, la réciproque n’est pas rigoureusement vraie d’un point de vue axiomatique. Il existe des distributions pathologiques, construites mathématiquement ou résultant de la juxtaposition de sous-échantillons discordants, qui affichent un coefficient $\gamma_1 = 0$ alors même que leur géométrie interne n’est pas invariante par réflexion. Ce phénomène de « fausse symétrie » survient lorsqu’une queue de distribution exceptionnellement longue mais très peu peuplée d’un côté compense arithmétiquement une queue plus courte mais nettement plus dense du côté opposé. L’analyste rigoureux ne saurait donc se contenter de la simple lecture du skewness numérique sans l’étayer par une vérification graphique scrupuleuse de la morphologie de la courbe.
3.3 Comparaison avec l’asymétrie positive et négative
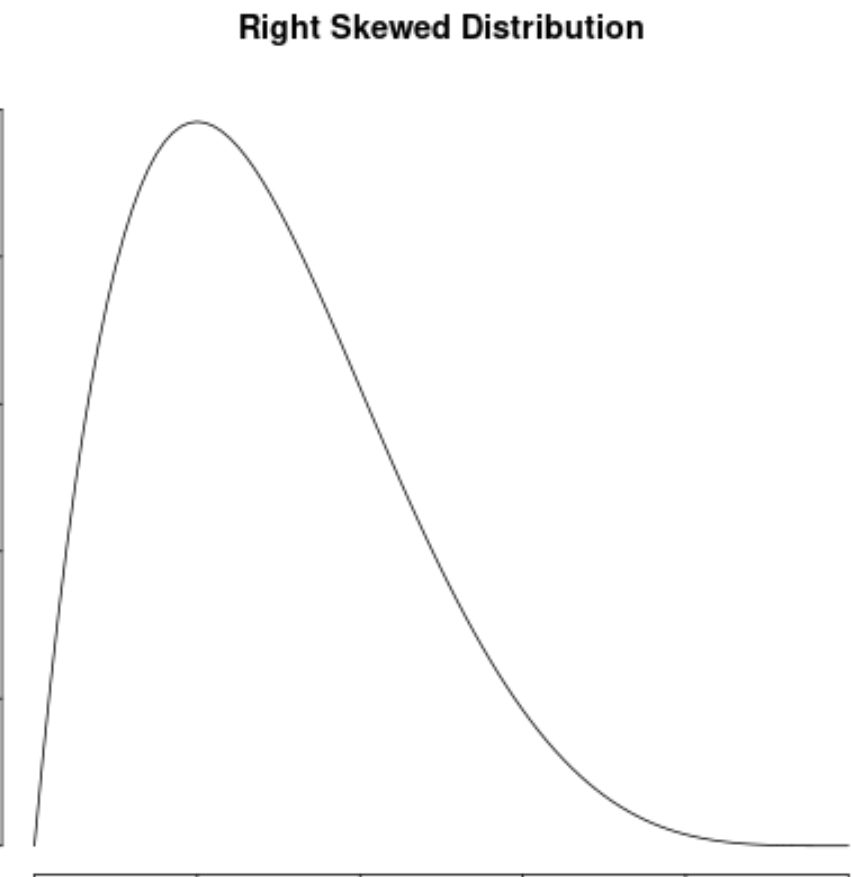
Pour appréhender pleinement l’équilibre inhérent à la distribution symétrique, il convient d’examiner ses altérations directionnelles que sont l’asymétrie positive et l’asymétrie négative. L’asymétrie positive, également qualifiée d’asymétrie droite ou right-skewed, se manifeste par un étalement prononcé de la traînée de distribution vers les valeurs numériques élevées de l’axe des abscisses. La masse probabiliste principale reste concentrée sur la gauche, mais quelques observations extrêmes viennent étirer la queue droite de la fonction de densité. Sur le plan des indicateurs de tendance centrale, cette configuration engendre un glissement différentiel hautement caractéristique, où la moyenne est tractée vers le sommet de la queue par la force des extrêmes, tandis que le mode reste ancré au sommet de fréquence, reléguant la médiane dans une position intermédiaire :
$$Mo < Me 0)$$
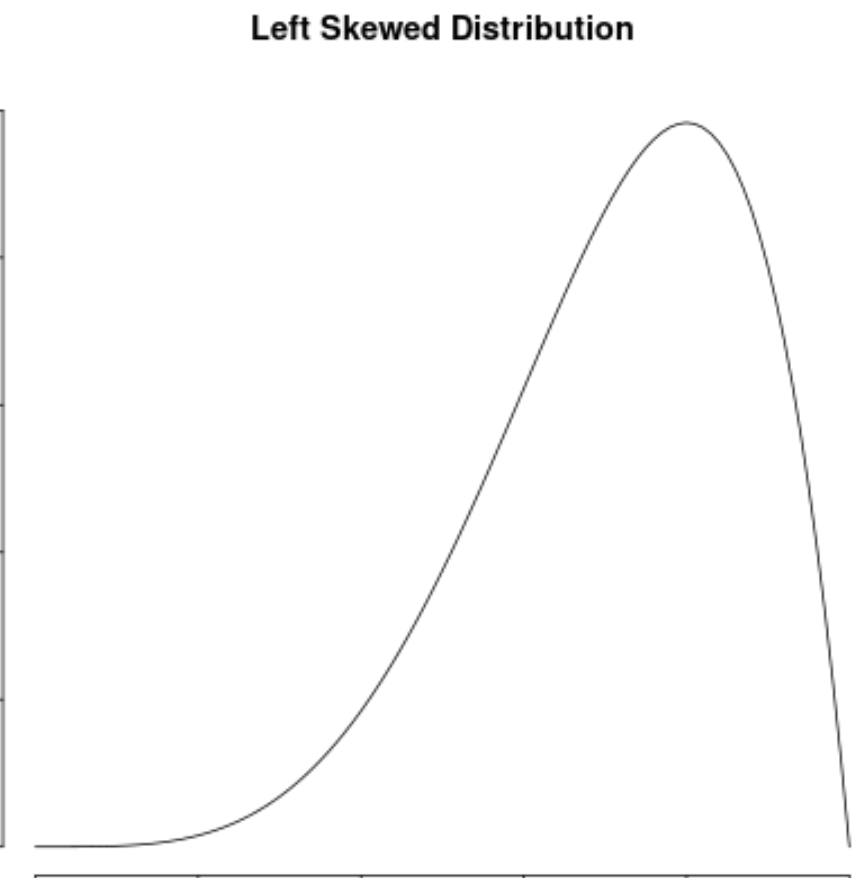
À l’opposé, l’asymétrie négative, ou asymétrie gauche (left-skewed), se traduit par une longue traînée descendant vers les valeurs négatives ou infinitésimales de l’échelle, tandis que la concentration majeure des observations se situe à droite du graphique. Dans ce scénario, ce sont les scores exceptionnellement bas qui attirent l’espérance arithmétique vers le bas, générant un ordre hiérarchique inverse des paramètres centraux :
$$\mu < Me < Mo \quad (\text{Asymétrie négative}, \gamma_1 < 0)$$
La distribution symétrique se pose ainsi en arbitre neutre et immuable entre ces deux polarités morphologiques. Elle constitue l’exact point d’inflexion où les forces d’attraction droite et gauche se neutralisent intégralement, contraignant la moyenne, la médiane et le mode à s’agréger en un point focal unique. Alors que les asymétries orientent artificiellement les erreurs de prédiction selon le signe de la déviation, la symétrie pure garantit une homoscédasticité théorique idéale des résidus d’estimation de chaque côté du centre de gravité des données.
4. La distribution normale : Archétype de la distribution symétrique unimodale
4.1 Structure analytique de la courbe en cloche
Dans l’univers des distributions symétriques, la distribution normale, ou loi de Gauss-Laplace, incarne le standard universel de référence. Définie de façon continue sur l’ensemble du domaine réel $]-\infty, +\infty[$, sa fonction de densité de probabilité est régie par une formulation mathématique hautement formalisée qui ne dépend que de deux paramètres fondamentaux : son espérance mathématique ou moyenne $\mu in \mathbb{R}$, qui détermine son paramètre de position centrale, et sa variance $\sigma^2 > 0$ (ou son écart-type $\sigma$), qui en constitue le paramètre d’échelle et de dispersion :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right)$$
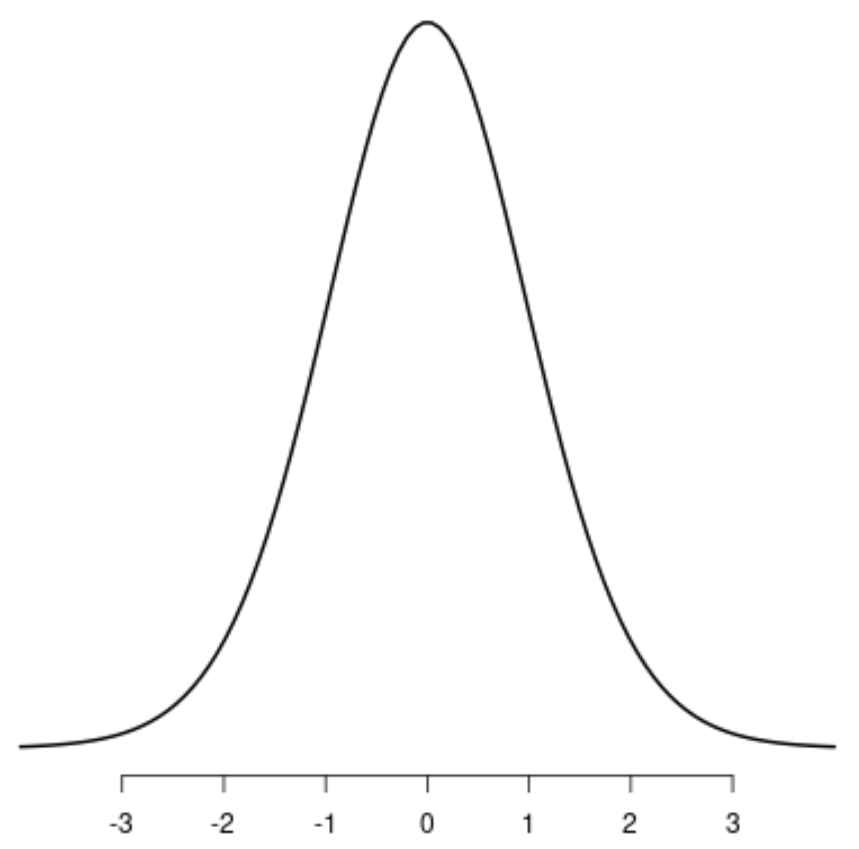
L’examen de cette fonction révèle immédiatement son invariance par rapport à la valeur centrale $\mu$. En effet, le terme quadratique $\left(\frac{x – \mu}{\sigma}\right)^2$ produit une valeur strictement identique que l’on évalue la fonction au point $x = \mu + \Delta$ ou au point $x = \mu – \Delta$, puisque $(\Delta)^2 = (-\Delta)^2$. Cette caractéristique assure la parité et la symétrie bilatérale parfaite de la courbe en forme de cloche, son point sommital culminant à l’ordonnée $f(\mu) = \frac{1}{\sigma \sqrt{2\pi}}$.
Une particularité géométrique essentielle de la loi normale réside dans la position de ses deux points d’inflexion, c’est-à-dire les coordonnées où la courbure change de convexité pour devenir concave. Ces points s’obtiennent analytiquement en annulant la dérivée seconde de la fonction de densité, $f »(x) = 0$, et se situent avec une rigueur absolue à exactement un écart-type de part et d’autre de la moyenne :
$$x_{\text{inflexion}} = \mu \pm \sigma$$
Au-delà de ces bornes d’inflexion, les queues de la distribution adoptent une trajectoire asymptotique descendante qui se rapproche de l’axe des abscisses de façon exponentielle sans jamais l’intercepter, illustrant le fait que l’étendue théorique des événements modélisés couvre l’infinité de la droite réelle tout en confinant l’immense majorité de la probabilité dans une région centrale étroitement circonscrite.
4.2 La règle empirique 68-95-99.7
Conséquence directe de son équilibre symétrique et de sa formulation mathématique exponentielle, la distribution normale obéit à des propriétés volumétriques remarquables couramment désignées sous l’appellation de règle empirique 68-95-99.7, ou règle des trois sigmas. En intégrant la fonction de densité de probabilité sur des intervalles standardisés symétriquement ancrés autour du paramètre de position $\mu$, on dérive des constantes probabilistes invariantes qui confèrent à cette distribution une prévisibilité exceptionnelle.
En premier lieu, l’aire circonscrite sous la courbe sur le segment délimité par $\mu – \sigma$ et $\mu + \sigma$ correspond approximativement à 68,27 % de la masse de probabilité totale :
$$P(\mu – \sigma le X le \mu + \sigma) = \frac{1}{\sigma \sqrt{2\pi}} \int_{\mu – \sigma}^{\mu + \sigma} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right) dx \approx 0{,}6827$$
En vertu de la symétrie parfaite, cette proportion se décompose en deux portions de 34,13 % de part et d’autre de la moyenne arithmétique. Lorsqu’on élargit la fenêtre d’observation à deux écarts-types ($\mu \pm 2\sigma$), l’intervalle absorbe approximativement 95,45 % de l’ensemble des observations empiriques, ne laissant que 4,55 % de données réparties de façon équitablement partagée (soit environ 2,275 % sur chaque aile périphérique) :
$$P(\mu – 2\sigma le X le \mu + 2\sigma) \approx 0{,}9545$$
Enfin, l’intervalle délimité par trois écarts-types ($\mu \pm 3\sigma$) englobe pas moins de 99,73 % du volume global des données, reléguant les événements extrêmes à une proportion marginale de 0,27 % (soit 0,135 % à chaque extrémité) :
$$P(\mu – 3\sigma le X le \mu + 3\sigma) \approx 0{,}9973$$
Cette décroissance probabiliste strictement calibrée fait de la règle empirique un instrument opérationnel fondamental en statistique descriptive et en contrôle qualité, autorisant le repérage instantané des observations déviantes ou suspectes par simple comparaison avec les écarts-types théoriques.
4.3 Kurtosis et profil d’aplatissement de la distribution normale
Si la symétrie régit la balance latérale d’une distribution, l’indicateur de kurtosis (ou coefficient d’aplatissement) renseigne sur son profil vertical, décrivant la propension de la distribution à concentrer sa masse soit autour de son centre, soit dans ses queues distales. Le kurtosis standard de Pearson se définit formellement par le quatrième moment centré standardisé :
$$\beta_2 = \frac{\mu_4}{\sigma^4} = \frac{E\left[(X – \mu)^4\right]}{\left(E\left[(X – \mu)^2\right]\right)^2}$$
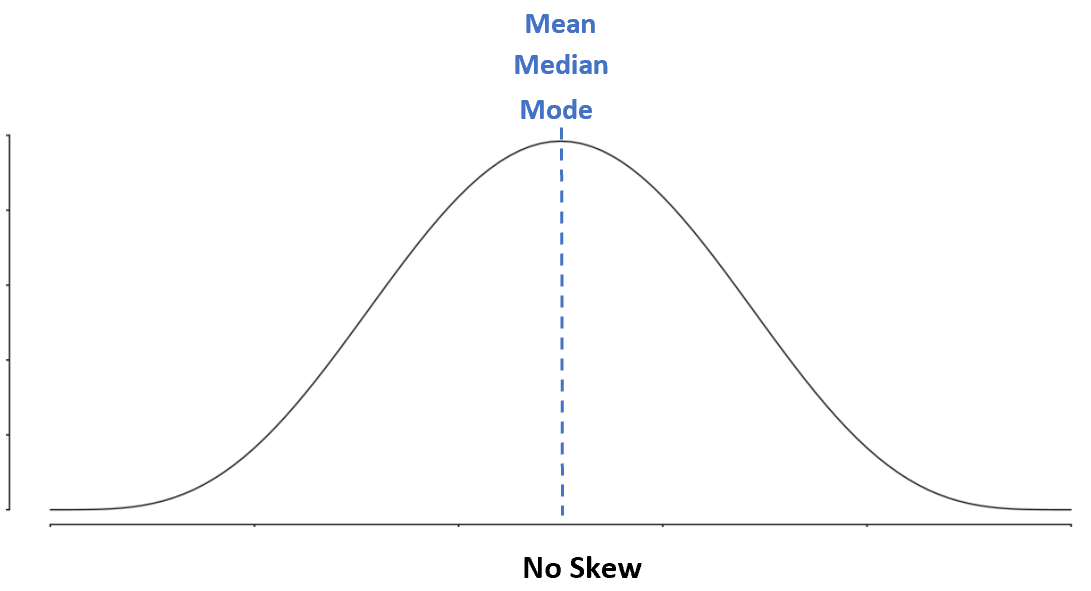
Pour la distribution normale symétrique, la résolution analytique de cette intégrale aboutit invariablement à la valeur $\beta_2 = 3$. Afin de simplifier les interprétations comparatives, les statisticiens privilégient couramment l’utilisation de l’excès de kurtosis, noté $\gamma_2 = \beta_2 – 3$. Dans cette perspective réétalonnée, la loi normale présente un excès de kurtosis rigoureusement nul ($\gamma_2 = 0$), une condition qualifiée de mésokurtique. Cette structure mésokurtique incarne l’équilibre canonique entre la hauteur du sommet central et l’épaisseur asymptotique des queues.
Toutefois, une distribution peut demeurer rigoureusement symétrique tout en adoptant des profils d’aplatissement radicalement distincts de celui de la gaussienne :
- Une distribution symétrique leptokurtique ($\gamma_2 > 0$) arbore un pic central plus élancé et aiguisé, accompagné de « queues lourdes » ou épaisses (fat tails), signifiant que les probabilités associées aux événements extrêmes sont substantiellement supérieures à celles dictées par la loi normale.
- À l’inverse, une distribution symétrique platykurtique ($\gamma_2 < 0$) présente un dôme central écrasé, émoussé, et des queues particulièrement légères et effilées (thin tails), indiquant que les observations s’étendent de façon plus homogène sur la zone péri-centrale sans générer de points aberrants distaux.
Il importe de souligner que le kurtosis est particulièrement sensible aux déviations situées aux extrémités de la distribution en raison de l’élévation des écarts à la puissance quatre. Dès lors, deux distributions peuvent posséder une symétrie parfaite et un skewness strictement nul, mais présenter des dynamiques inférentielles totalement divergentes selon que leur profil est leptokurtique ou platykurtique, altérant le risque d’erreur de première espèce dans les tests statistiques classiques.
5. Distributions symétriques non standard : Multimodales et uniformes
5.1 La distribution uniforme continue
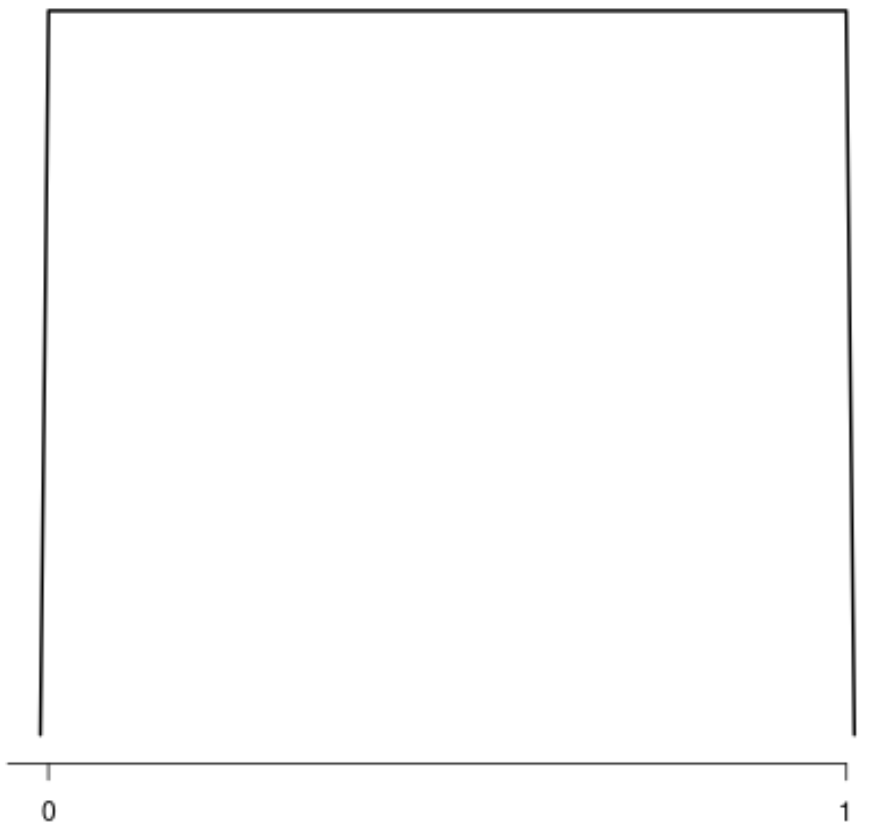
Il est fréquent de commettre l’erreur conceptuelle d’assimiler systématiquement la distribution symétrique à une silhouette en forme de cloche dotée d’un sommet unique bien individualisé. La distribution uniforme continue apporte un contre-exemple mathématique flagrant, démontrant qu’une distribution peut posséder une symétrie rigoureuse tout en étant totalement dénuée de point focal sommital. Définie sur un intervalle borné $[a, b]$, sa fonction de densité de probabilité est strictement constante sur toute l’étendue du support :
$$f(x) = \begin{\cases} \frac{1}{b – a} &a\mp; \text{pour } a le x le b 0 &a\mp; \text{sinon} \end{\cases}$$
La symétrie de la distribution uniforme s’opère par rapport au milieu géométrique de l’intervalle support, à savoir la valeur médiane $c = \frac{a + b}{2}$. En substituant cette coordonnée dans la fonction d’invariance, on observe que pour tout écart $x$, $f\left(\frac{a + b}{2} – x\right) = f\left(\frac{a + b}{2} + x\right)$, l’ordonnée demeurant fixée à $\frac{1}{b-a}$ à l’intérieur du segment et à zéro au-delà. La géométrie de la courbe ne décrit plus une cloche mais un rectangle parfait, dont l’axe vertical médian divise la boîte probabiliste en deux rectangles isométriques d’aires équivalentes à 0,5.
Sur le plan des indicateurs de tendance centrale, la distribution uniforme matérialise une situation singulière : la moyenne arithmétique et la médiane coïncident parfaitement en $c = \frac{a + b}{2}$, confirmant la règle inhérente aux structures symétriques. En revanche, le concept de mode strict s’effondre, car chaque point de l’intervalle $[a, b]$ présente la même densité de probabilité que ses voisins. La distribution est dite achronique ou sans mode unique, illustrant avec force que la présence d’un pic sommital n’est nullement une condition nécessaire à l’existence d’une symétrie probabiliste fondamentale.
5.2 Distributions bimodalement symétriques
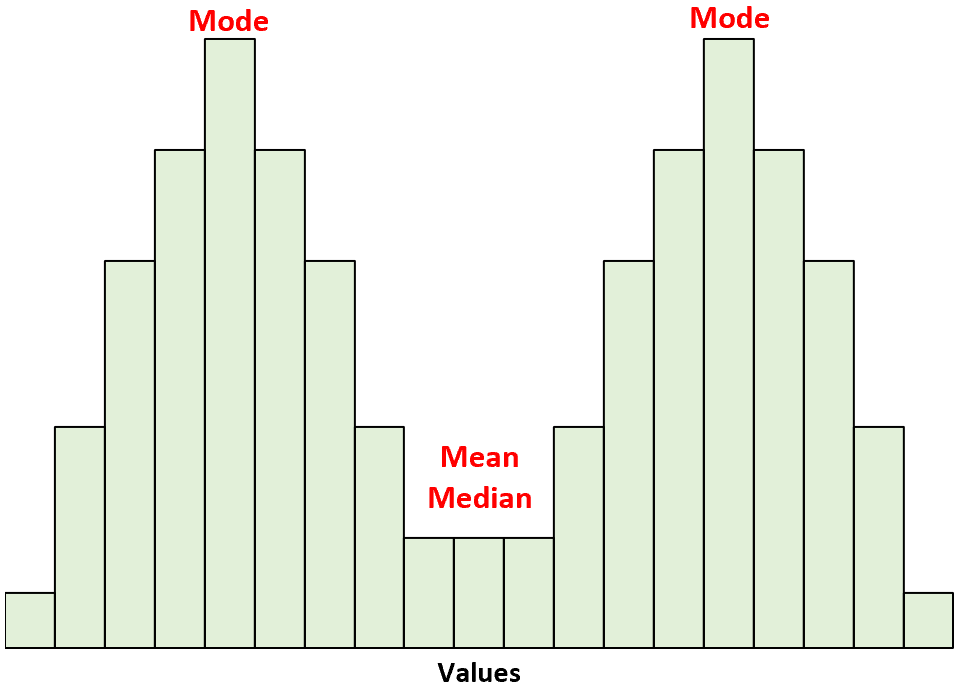
Une autre configuration non standard de grand intérêt théorique et appliqué est représentée par les distributions bimodales symétriques. Contrairement à la courbe normale qui concentre sa masse au centre, une distribution bimodale présente deux sommets distincts (modes locaux) séparés par une dépression centrale ou un creux de fréquence. Pour que cette structure demeure symétrique au sens formel, deux critères morphologiques stricts doivent être simultanément réunis : les deux modes doivent être situés à équidistance exacte de l’axe central de réflexion $c$, et ils doivent afficher une amplitude (hauteur de densité) rigoureusement identique.
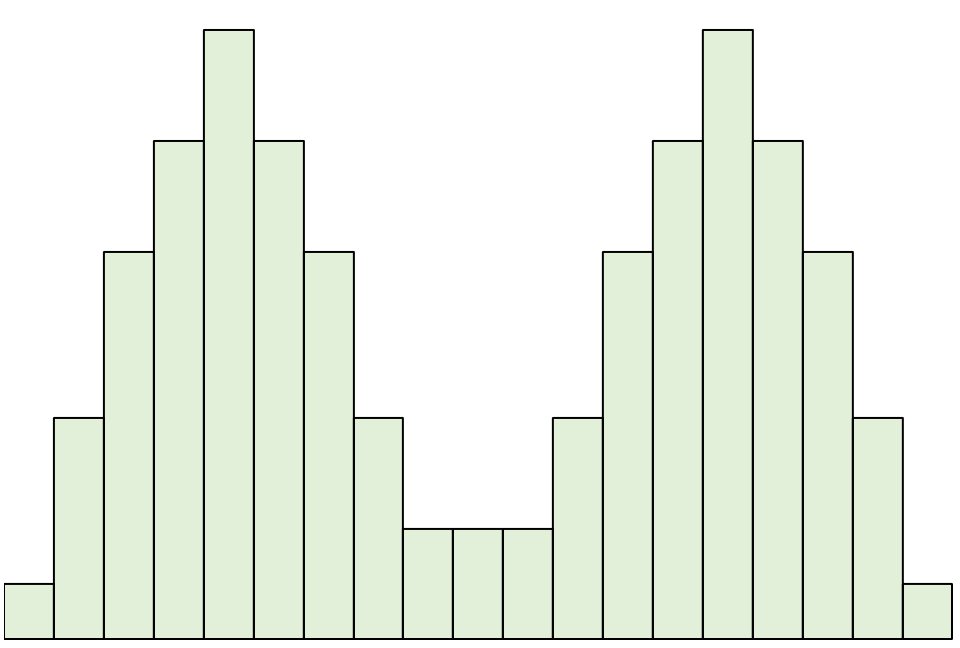
Dans un tel contexte, la position centrale $c$ endosse un statut fonctionnel paradoxal : elle constitue simultanément la moyenne arithmétique et la médiane de l’ensemble de la distribution, mais correspond au point de plus basse probabilité relative entre les deux pics d’accumulation (antimode local). Ce phénomène s’exprime couramment lorsqu’une variable aléatoire résulte du mélange additif équilibré de deux sous-populations sous-jacentes identiquement dispersées mais décalées par leurs moyennes respectives, selon la formule d’un mélange gaussien équiprobable :
$$f(x) = 0{,}5 \cdot \mathcal{N}(\mu_1, \sigma^2) + 0{,}5 \cdot \mathcal{N}(\mu_2, \sigma^2) \quad \text{a\vec } c = \frac{\mu_1 + \mu_2}{2}$$
L’observation d’une symétrie bimodale en psychologie différentielle ou en épidémiologie constitue un signal diagnostique majeur. Elle révèle que le phénomène mesuré ne reflète pas une homogénéité fondamentale, mais cache deux groupes distincts (tels que deux cohortes d’apprentissage aux dynamiques opposées ou des réponses différenciées selon une caractéristique biologique binaire) dont les dispersions sont équivalentes. L’indicateur central moyen demeure stable et non biaisé, mais s’avère totalement non représentatif des individus réels, ces derniers se concentrant massivement autour des deux sommets périphériques.
5.3 Distributions multimodales équilibrées
En poussant la décomposition structurelle à un degré supérieur, il est tout à fait possible d’observer des distributions multimodales équilibrées, comportant trois, quatre sommets ou davantage, qui préservent une invariance par réflexion rigoureuse. Les exigences mathématiques pour le maintien de la symétrie imposent une organisation paritaire de la morphologie distributionnelle. Si le nombre de modes est pair, ils doivent s’ordonner en paires bilatérales parfaitement jumelées en abscisse et en ordonnée : pour chaque mode culminant à $c – \delta_k$ avec une hauteur $\alpha_k$, il doit exister un mode symétrique culminant à $c + \delta_k$ avec une amplitude strictement égale à $\alpha_k$.
Si la distribution présente un nombre impair de modes, l’un des sommets doit obligatoirement être ancré sur l’axe central de réflexion $x = c$, tandis que l’ensemble des modes secondaires satellites doit se répartir par paires symétriques de part et d’autre de ce point focal. Ce type de structure distributionnelle s’observe notamment dans l’analyse de signaux oscillatoires, de dynamiques comportementales rythmées par des cycles circadiens alternés, ou encore dans des tâches de discrimination psychophysique complexe où des choix multiples équilibrés fractionnent l’éventail des réponses.
L’invariance par translation et inversion de ces composantes modales garantit que, malgré la complexité et les ondulations sinueuses de la densité, les moments d’ordre impair demeurent strictement nuls ($\mu_3 = \mu_5 = 0$). Ces distributions rappellent que la symétrie n’est pas synonyme de simplicité ou de monotonie fonctionnelle, mais renvoie fondamentalement à une règle d’équilibre géométrique bilatéral qui peut s’incarner dans des paysages probabilistes aux reliefs hautement sophistiqués.
6. Typologie des lois de probabilité symétriques continues et discrètes
6.1 Distribution t de Student
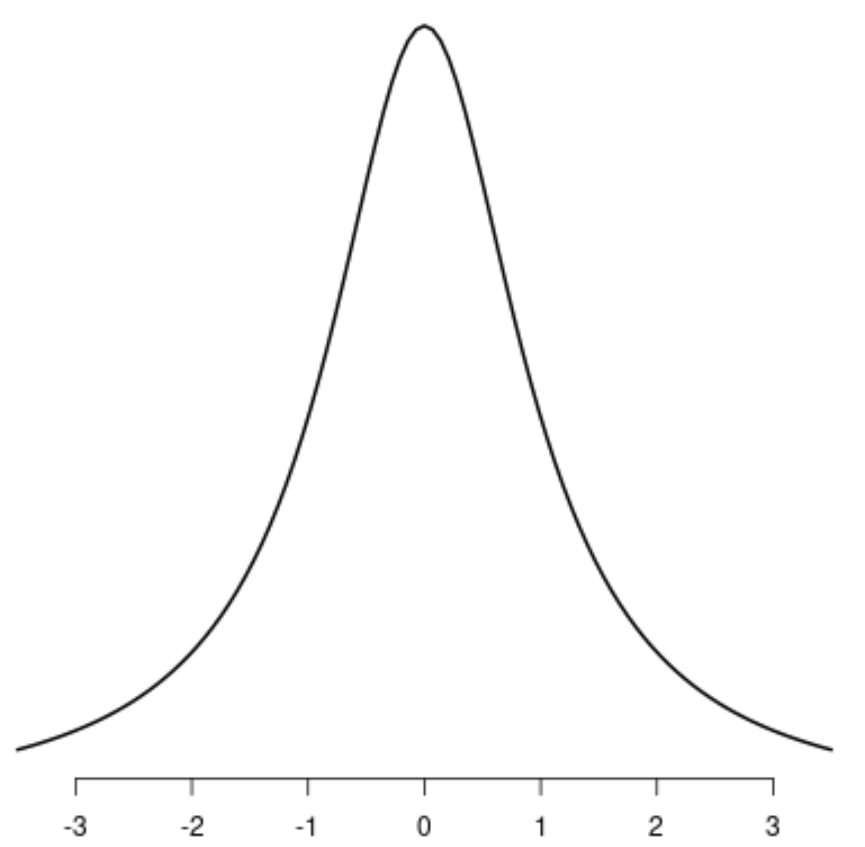
Parmi les lois de probabilité continues symétriques, la distribution t de Student se positionne immédiatement aux côtés de la loi normale comme un outil inférentiel indispensable. Conçue à l’origine par William Sealy Gosset sous le pseudonyme de Student pour traiter des données brassicoles reposant sur de petits échantillons, cette loi modélise le ratio d’une variable normale standardisée par la racine carrée d’une variable distribuée selon un khi-deux divisé par ses degrés de liberté : $T = \frac{Z}{\sqrt{U / \nu}}$. Sa densité de probabilité dépend exclusivement du paramètre des degrés de liberté $\nu > 0$ :
$$f(t) = \frac{\Gamma\left(\frac{\nu + 1}{2}\right)}{\sqrt{\pi \nu} , \Gamma\left(\frac{\nu}{2}\right)} \left(1 + \frac{t^2}{\nu}\right)^{-\frac{\nu + 1}{2}}$$
La présence du terme quadratique $t^2$ au dénominateur assure instantanément la parité de la fonction $f(-t) = f(t)$, ancrant la distribution dans une symétrie unimodale rigoureuse centrée sur l’origine $\mu = Me = Mo = 0$. Morphologiquement, la loi de Student présente une silhouette en cloche qui rappelle visuellement celle de la distribution normale standard, mais avec une différence capitale : ses queues de distribution sont considérablement plus épaisses et lourdes, signifiant qu’elle accorde une probabilité beaucoup plus élevée aux observations distales et extrêmes.
Cette particularité confère à la distribution t de Student une pertinence exceptionnelle lors de l’analyse d’échantillons de taille réduite ($n < 30$), où l'écart-type réel de la population $\sigma$ demeure inconnu et doit être estimé par la variance d'échantillon $s^2$. Au fur et à mesure que les degrés de liberté progressent ($\nu to \infty$), la distribution converge asymptotiquement vers la loi normale standard. En dessous de cette limite, elle offre un bouclier méthodologique robuste, évitant de rejeter à tort des hypothèses nulles en intégrant l'incertitude additionnelle issue de l'estimation de la dispersion échantillonnale.
6.2 Distribution logistique et loi de Laplace
Deux autres lois de probabilité continues méritent une attention particulière en raison de leur morphologie symétrique et de leurs fonctionnalités analytiques spécifiques : la distribution logistique et la loi de Laplace (souvent désignée sous le nom de distribution double exponentielle).
La distribution logistique présente une densité symétrique dont l’expression générale s’articule autour de la fonction sécante hyperbolique carrée ou du ratio exponentiel :
$$f(x) = \frac{\exp\left(-\frac{x – \mu}{s}\right)}{s \left(1 + \exp\left(-\frac{x – \mu}{s}\right)\right)^2}$$
Elle ressemble à s’y méprendre à la courbe normale, au point d’être fréquemment substituée à celle-ci dans les modèles de régression logistique et la théorie de réponse aux items (TRI) en psychométrie. La distribution logistique affiche cependant un excès de kurtosis fixe de $\gamma_2 = 1{,}2$, traduisant une concentration légèrement plus marquée sur son centre et des queues plus étalées que la gaussienne, tout en offrant l’avantage d’une fonction de répartition fermée calculable sans intégration numérique.
La loi de Laplace, quant à elle, se structure à partir de la valeur absolue des écarts au centre de position, adoptant la formulation analytique :
$$f(x) = \frac{1}{2b} \exp\left(-\frac{|x – mu|}{b}\right)$$
Cette loi se distingue visuellement par une symétrie unimodale non différentiable en son centre : elle arbore un sommet aigu en pointe (ou cuspide) au point $x = \mu$, où sa dérivée n’est pas continue, et des flancs décroissant de façon purement exponentielle. Sur le plan de la théorie statistique, la distribution de Laplace est intimement liée à la minimisation des déviations absolues (médiane) plutôt qu’au modèle des moindres carrés (moyenne), offrant un cadre d’estimation paramétrique hautement résistant face aux valeurs aberrantes modérées.
6.3 Cas des distributions discrètes symétriques
L’univers de la symétrie ne se limite pas au continuum réel ; il englobe de nombreuses variables aléatoires discrètes, pour lesquelles la fonction de masse de probabilité $P(X = k)$ vérifie une invariance stricte autour d’un pivot entier ou demi-entier $c$, telle que $P(X = c – k) = P(X = c + k)$. L’exemple le plus emblématique est fourni par la distribution binomiale $\mathcal{B}(n, p)$, qui dénombre les succès au cours de $n$ épreuves de Bernoulli indépendantes à probabilité unitaire de succès $p$. Lorsque le paramètre de succès est rigoureusement équilibré, soit :
$$p = 0{,}5$$
la distribution binomiale devient parfaitement symétrique autour de son espérance $\mu = n/2$. Les coefficients binomiaux $\binom{n}{k} = \frac{n!}{k!(n-k)!}$ garantissent en effet une égalité arithmétique absolue entre $\binom{n}{k}$ et $\binom{n}{n-k}$, matérialisant une symétrie combinatoire pure qui reflète les tirages équitables à pile ou face ou les paradigmes de choix forcés bivalents.
Un autre cas fondamental est celui de la distribution uniforme discrète sur un ensemble fini de valeurs équidistantes, comme le jet d’un dé cubique non pipé à six faces où $P(X = k) = 1/6$ pour $k in {1, 2, 3, 4, 5, 6}$. Ici, la symétrie s’opère autour du point non entier $c = 3{,}5$, qui correspond exactement à la médiane et à la moyenne arithmétique de la variable. Les propriétés combinatoires de ces distributions discrètes symétriques constituent l’assise probabiliste de nombreux tests non paramétriques exacts, à l’instar du test des signes ou du test de permutation de Fisher.
7. Applications et pertinence dans les sciences psychologiques
7.1 Théorie classique des tests et modèle du score vrai
Au cœur des sciences de la mesure psychologique, la théorie classique des tests (TCT), initiée par Charles Spearman et formalisée par Lord et Novick, repose sur un postulat structural indissociable de la notion de symétrie. Le modèle décompose le score observé $X$ obtenu par un individu à une épreuve psychométrique en deux entités additives fondamentales : le score vrai latent $V$ et une composante d’erreur de mesure aléatoire $E$ :
$$X = V + E$$
L’axiome central de ce modèle stipule que l’erreur de mesure $E$ est une variable aléatoire continue dont la distribution conditionnelle est symétrique et normale, possédant une espérance mathématique strictement nulle :
$$E[E] = 0 \quad \text{et} \quad E \sim \mathcal{N}(0, \sigma_e^2)$$
Cette hypothèse de symétrie des erreurs est conceptuellement primordiale. Elle signifie qu’à chaque passation d’un test, la probabilité que des facteurs parasites imprévisibles (fatigue passagère, baisse d’attention, bruit ambiant) dégradent le score réel est rigoureusement identique à la probabilité que des éléments fortuits (devinette heureuse, facilitation contextuelle temporaire) majorent artificiellement le score d’une ampleur équivalente. L’absence de biais systématique garantit que la moyenne arithmétique de passations répétées théoriquement indépendantes converge directement vers le score vrai non biaisé de l’individu, préservant ainsi l’équité de la mesure et l’exactitude des inférences diagnostiques.
7.2 Mesure des traits de personnalité selon le modèle en Big Five
Dans l’évaluation psychologique moderne de la personnalité, le modèle canonique des Big Five (ou modèle OCEAN : Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme) génère des distributions de scores qui épousent de façon remarquable la symétrie de la courbe en cloche au sein de la population générale adulte. Contrairement aux nosographies psychiatriques qui recherchent des signes catégoriels pathologiques discrets, la psychologie différentielle appréhende la personnalité comme un ensemble de continuums dimensionnels où chaque individu se positionne de manière relative.
L’observation d’une distribution symétrique pour des dimensions telles que l’Extraversion ou la Conscienciosité engendre des répercussions cliniques et théoriques majeures. D’une part, elle indique que l’immense majorité des sujets se situe dans une zone médiane tempérée, manifestant un répertoire comportemental flexible et équilibré — par exemple, un individu ni excessivement extraverti ni pathologiquement introverti, capable d’adapter son expressivité sociale aux impératifs du contexte relationnel.
D’autre part, la symétrie bilatérale permet de conceptualiser les deux extrémités de l’échelle non pas comme des entités asymétriques où l’une représenterait le pôle de santé et l’autre la déviance, mais comme des polarités phénotypiques d’ampleur quantitative identique. L’extrême extraversion et l’introversion profonde constituent deux écarts standardisés de même magnitude par rapport au centre de gravité de la population générale. Cette structure symétrique facilite l’application d’échelles standardisées sans nécessiter de transformations correctrices d’échelle, tout en fournissant une matrice probabiliste stable pour évaluer les corrélations entre traits et déterminants biopsychosociaux.
7.3 Psychologie cognitive et temps de réaction normalisés
S’il est un domaine de la psychologie où l’exigence de symétrie se heurte à la résistance de la réalité biologique brute, c’est bien la chronométrie mentale et l’étude des temps de réaction (TR). Lors d’une tâche de décision lexicale, de détection de signal ou d’inhibition de type Stroop, les temps de réaction bruts affichent invariablement une asymétrie positive prononcée. Cette morphologie dissymétrique découle d’une contrainte physiologique incompressible : il existe un plancher chronologique infranchissable (la vitesse minimale de transmission synaptique et neuromusculaire, rarement inférieure à 150-200 millisecondes), alors qu’il n’existe théoriquement aucun plafond strict aux latences induites par des distractions cognitives momentanées, étirant démesurément la queue droite de la distribution.
L’exploitation directe de ces données asymétriques pose un obstacle méthodologique redoutable, car l’application de modèles statistiques linéaires généraux (tels que la régression linéaire, l’ANOVA ou les modèles mixtes à effets fixes et aléatoires) exige expressément l’homoscédasticité et la normalité symétrique des résidus d’estimation. Pour résoudre ce conflit, les chercheurs en psychologie cognitive mobilisent des transformations mathématiques non linéaires stabilisatrices conçues pour restaurer artificiellement la symétrie des distributions :
- La transformation logarithmique : $y = log(TR)$ ou $y = ln(TR)$, qui compresse considérablement l’échelle des valeurs distales droites tout en étirant les intervalles des valeurs faibles.
- La transformation réciproque (ou inverse) : $y = -1/TR$ (parfois exprimée en vitesse de traitement $1/TR$), qui s’avère fréquemment optimale pour réaligner les distributions de temps de réponse vers un profil rigoureusement symétrique.
- La transformation de Box-Cox, qui recherche algorithmiquement la puissance mathématique $lambda$ optimale pour minimiser le skewness résiduel de la série de données.
Une fois cette symétrie recouvrée, la moyenne arithmétique des temps transformés redevient un estimateur fiable et robuste de la performance cognitive centrale de l’individu, permettant d’effectuer des inférences comparatives exemptes des distorsions induites par la dérive asymétrique brute.
8. Exemples concrets de distributions symétriques en psychométrie
8.1 L’échelle d’intelligence standardisée (QI de Wechsler)
L’archétype par excellence de la distribution symétrique intentionnellement calibrée en psychométrie appliquée est incarné par l’échelle d’intelligence standardisée issue des matrices de David Wechsler, déclinée contemporainement dans le WISC pour les enfants et le WAIS pour les adultes. Lors de l’étalonnage de ces instruments psychométriques, les scores bruts issus des différentes épreuves cognitives font l’objet d’une standardisation normalisante rigoureuse qui force explicitement la distribution du quotient intellectuel (QI) à épouser une loi normale symétrique dotée de paramètres mathématiques fixés par convention universelle : une moyenne arithmétique de 100 et un écart-type de 15 :
$$\text{QI} \sim \mathcal{N}(100, 15^2)$$
Cette armature mathématique impose une équité diagnostique et classificatoire d’une symétrie parfaite. En vertu des propriétés géométriques de la courbe en cloche de Gauss, les proportions théoriques de la population générale situées à des distances équidistantes de la moyenne de 100 sont strictement équivalentes :
- La zone qualifiée de déficience intellectuelle (traditionnellement bornée à un QI inférieur ou égal à 70, soit $\mu – 2\sigma$) regroupe théoriquement environ 2,27 % de la population.
- La zone symétrique qualifiée de haut potentiel intellectuel (définie par un QI supérieur ou égal à 130, soit $\mu + 2\sigma$) intègre avec une précision probabiliste identique exactement 2,27 % de cette même population.
Le maintien de cette symétrie impeccable exige toutefois une rigueur méthodologique colossale lors des phases de réétalonnage périodique. Si l’échantillon normatif présente le moindre biais de représentativité sociologique, économique ou générationnelle — ou si l’on ne corrige pas l’effet Flynn (progression séculaire tendancielle des performances aux tests d’intelligence) —, la distribution empirique subit un glissement asymétrique qui fausse instantanément les seuils diagnostiques. La symétrie du QI n’est donc pas un phénomène naturel spontané, mais une construction métrologique sophistiquée requérant une vigilance statistique permanente.
8.2 Échelles de réponse de type Likert équilibrées
Dans la recherche par questionnaires en psychologie sociale, en psychologie des organisations et en sociologie quantitative, l’échelle de Likert représente le format prédominant pour quantifier les attitudes, les opinions et les croyances individuelles. L’obtention d’une distribution symétrique à partir d’un inventaire d’auto-évaluation repose sur une architecture méthodologique minutieuse lors de la conception des ancres de réponse. Pour favoriser l’émergence d’une symétrie métrique, l’instrument doit obligatoirement proposer un nombre impair d’échelons (généralement 5 ou 7 points) articulés autour d’un point pivot central authentiquement neutre (« Ni en accord, ni en désaccord »).
En outre, les ancres sémantiques doivent être sélectionnées de façon à créer une balance verbale bilatérale d’intensités rigoureusement équivalentes de part et d’autre de ce pivot neutre :
| Niveau | Ancre sémantique | Rôle psychométrique |
|---|---|---|
| 1 | Pas du tout d’accord | Désaccord maximal ($\mu – 2\Delta$) |
| 2 | Pas d’accord | Désaccord modéré ($\mu – \Delta$) |
| 3 | Neutre / Sans avis | Pivot central de réflexion ($\mu$) |
| 4 | D’accord | Accord modéré ($\mu + \Delta$) |
| 5 | Tout à fait d’accord | Accord maximal ($\mu + 2\Delta$) |
Lorsque ces précautions sont respectées et que les items portent sur des construits non stigmatisants et non controversés, l’agrégation des scores à l’échelle produit généralement une distribution de scores totaux remarquablement symétrique. Néanmoins, l’émergence de cette symétrie peut être entravée par des biais de réponse psychologiques délétères, tels que le biais d’acquiescement (tendance systématique à approuver les énoncés) ou les biais de désirabilité sociale. Ces distorsions déplacent artificiellement le centre de masse vers l’extrémité positive, détruisant l’invariance par réflexion et imposant l’usage de scores ipsatifs ou d’équilibrages d’items polarisés inversement pour restaurer la symétrie de l’instrument.
8.3 Scores factoriels issus d’analyses factorielles confirmatoires
Dans le domaine avancé de la modélisation par équations structurelles (SEM) et de l’analyse factorielle confirmatoire (CFA), les chercheurs s’efforcent d’extraire des variables latentes non observables (par exemple le niveau d’Anxiété-Trait ou la Charge Cognitive Globale) à partir d’un faisceau d’indicateurs manifestes observés. Lors de l’estimation des scores factoriels individuels via la méthode de régression de Thurstone ou la méthode de Bartlett, les algorithmes procèdent classiquement à une standardisation contrainte qui impose à la variable latente une espérance théorique nulle et une variance unitaire :
$$\eta \sim (0, 1)$$
Sous l’hypothèse de multinormalité des variables observables, les scores factoriels générés adoptent une distribution symétrique centrée en zéro. Cette symétrie s’étend aux résidus structuraux du modèle factoriel, c’est-à-dire aux fractions de variance spécifiques à chaque item qui échappent à l’explication par le facteur commun. Les théorèmes d’ajustement du modèle exigent que ces résidus se comportent comme un bruit blanc gaussien d’espérance nulle, dénué de toute asymétrie systématique :
$$\epsilon_i \sim \mathcal{N}(0, \theta_i)$$
L’observation d’une symétrie parfaite dans la distribution des scores factoriels permet aux psychométriciens de cartographier les dimensions de l’esprit humain sous une forme vectorielle équilibrée. Les profils psychologiques individuels ne sont plus évalués sur une métrique brute arbitraire, mais projetés comme des déviations positives ou négatives rigoureusement comparables autour de l’axe central du continuum théorique.
9. Différenciation approfondie avec les distributions asymétriques
9.1 Distributions asymétriques positives en santé mentale
Tandis que la distribution symétrique prévaut dans l’évaluation des aptitudes intellectuelles et des traits généraux de la personnalité, le champ de la psychopathologie et de la santé mentale est massivement dominé par des distributions asymétriques positives (orientées vers la droite). Si l’on administre un instrument de dépistage standardisé au sein d’une population non clinique générale — tel que l’Inventaire de Dépression de Beck (BDI) ou l’échelle d’anxiété généralisée GAD-7 —, la morphologie du profil empirique défie radicalement l’idéal de la courbe en cloche symétrique.
Dans ces conditions, l’immense majorité des participants asymptomatiques déclare une absence totale ou une présence infinitésimale de symptômes cliniques, générant une accumulation massive et abrupte des observations au niveau du score zéro ou des valeurs planchers de l’échelle. Parallèlement, une minorité décroissante d’individus souffrant de troubles légers, modérés puis sévères vient alimenter une longue queue descendante qui s’étire vers les scores maximaux de souffrance psychique. Cette déconnexion morphologique provoque une dissociation béante entre les indicateurs de tendance centrale :
$$\text{Mode} = 0 \quad < \quad \text{Médiane} \approx 2 \quad < \quad \text{Moyenne} \approx 6{,}8$$
Dans un tel contexte, traiter la moyenne arithmétique comme un indicateur représentatif de la population générale constitue une erreur clinique majeure. La queue clinique attire mécaniquement la moyenne vers le haut, créant l’illusion statistique trompeuse d’un niveau moyen de pathologie généralisé qui n’existe en réalité chez aucun individu modal. L’abandon de l’hypothèse de symétrie devient alors impératif, imposant aux cliniciens de se référer exclusivement aux rangs percentiles ou à des modèles de lois de Poisson ou binomiales négatives spécialement calibrés pour les données de comptage asymétriques.
9.2 Distributions asymétriques négatives et effets de plafond
À l’opposé des inventaires cliniques, les distributions asymétriques négatives (étirées vers la gauche) se manifestent fréquemment dans les contextes éducatifs, professionnels ou neuropsychologiques marqués par l’apparition d’un effet de plafond (ceiling effect). Ce phénomène survient lorsqu’un instrument d’évaluation cognitive se révèle d’une difficulté globale manifestement trop modeste au regard du niveau d’aptitude de la population examinée.
Un exemple paradigmatique est fourni par le Mini-Mental State Examination (MMSE) lorsqu’il est administré à des adultes âgés autonomes indemnes de détérioration neurocognitive. Le test étant initialement paramétré pour déceler des altérations cognitives majeures chez des patients cérébrolésés, les sujets sains obtiennent quasi systématiquement des scores parfaits ou proches du score maximal de 30 points. Il en résulte un empilement artificiel des observations à l’extrémité supérieure de l’échelle, prolongé vers la gauche par une traînée descendante constituée des rares individus manifestant des déficits cognitifs débutants :
$$\text{Moyenne} \approx 28{,}2 \quad < \quad \text{Médiane} = 29 \quad < \quad \text{Mode} = 30$$
Cette troncature artificielle de la distribution engendre une restriction sévère de la variance des aptitudes élevées, compressant les écarts entre les individus performants et annihilant la validité discriminante du test à ce niveau. La symétrie distributionnelle se trouve brisée, interdisant formellement l’exploitation des scores bruts au sein de modèles de corrélation de Bravais-Pearson ou d’analyses de régression paramétrique classiques, sous peine de sous-estimer dramatiquement la force des liens unissant le fonctionnement cognitif aux variables d’intérêt.
9.3 Comparaison synthétique des trois formes de distribution
Pour clarifier de façon synthétique les distinctions fondamentales régissant les équilibres et déséquilibres distributionnels, le tableau analytique ci-dessous récapitule les positions relatives des indicateurs centraux, le comportement des moments statistiques ainsi que les recommandations méthodologiques associées à chaque profil :
| Propriété / Critère | Asymétrie négative (Gauche) | Distribution symétrique | Asymétrie positive (Droite) |
|---|---|---|---|
| Relations centrales | Moyenne < Médiane < Mode | Moyenne = Médiane = Mode | Mode < Médiane < Moyenne |
| Coefficient d’asymétrie ($\gamma_1$) | $\gamma_1 < 0$ | $\gamma_1 = 0$ | $\gamma_1 > 0$ |
| Troisième moment centré ($\mu_3$) | Négatif ($\mu_3 < 0$) | Strictement nul ($\mu_3 = 0$) | Positif ($\mu_3 > 0$) |
| Allure visuelle des queues | Traînée allongée vers la gauche | Queues équilibrées bilatérales | Traînée allongée vers la droite |
| Exemples psychologiques types | Tests cognitifs faciles (Effet plafond) | QI de Wechsler, Traits Big Five | Scores cliniques de dépression (BDI) |
| Indicateur central privilégié | Médiane et Quantiles | Moyenne arithmétique | Médiane et Mode |
| Approche statistique requise | Non paramétrique / Transformations | Paramétrique classique (GLM) | Non paramétrique / Modèles GLM |
Cette mise en parallèle souligne que le choix entre approches paramétriques et non paramétriques ne procède pas d’une simple préférence computationnelle, mais s’enracine dans la structure géométrique intrinsèque des données recueillies. Ignorer l’asymétrie pour plaquer artificiellement des indices paramétriques symétriques expose l’analyste à des distorsions méthodologiques majeures susceptibles d’invalider ses inférences scientifiques.
10. Méthodes graphiques et visuelles pour identifier la symétrie
10.1 Histogramme et courbe de densité estimée
L’inspection visuelle représente la première étape incontournable de tout protocole d’analyse exploratoire visant à statuer sur la symétrie d’un jeu de données. L’instrument graphique le plus usuel demeure l’histogramme, qui agrège les effectifs observés au sein de classes de valeurs disjointes adjacentes. L’évaluation visuelle de la symétrie via l’histogramme exige néanmoins une vigilance technique extrême quant au paramétrage de la largeur de classe (ou bin width). Un découpage arbitraire trop grossier masque les asymétries locales en lissant excessivement la distribution, tandis qu’un découpage trop fragmenté génère des oscillations stochastiques parasites mimant une multimodalité factice.
Pour prévenir ces artefacts visuels, il est vivement recommandé d’adopter des règles de discrétisation éprouvées, telles que la formule de Scott :
$$h = \frac{3{,}49 \cdot s}{\sqrt[3]{n}}$$
ou l’algorithme robuste de Freedman-Diaconis fondé sur l’écart interquartile :
$$h = 2 \cdot \frac{IQR}{\sqrt[3]{n}}$$
Afin de transcender les limites de l’histogramme discrétisé, la pratique contemporaine superpose une courbe d’estimation de densité par noyau (Kernel Density Estimation ou KDE). L’approche KDE lisse l’information empirique en appliquant une fonction de noyau gaussienne centrée sur chaque point d’observation :
$$\hat{f}_h(x) = \frac{1}{nh} \sum_{i=1}^n K\left(\frac{x – x_i}{h}\right)$$
Ce procédé fait émerger la silhouette continue sous-jacente des données, permettant à l’analyste de vérifier si la pente ascendante de gauche réplique fidèlement la trajectoire descendante de droite, et si l’axe vertical médian scinde la surface en deux lobes d’aspect parfaitement symétrique.
10.2 Diagramme en boîte (Boxplot) et symétrie des moustaches
Conçu par John Tukey, le diagramme en boîte (ou boîte à moustaches / boxplot) constitue un dispositif graphique synthétique exceptionnellement performant pour diagnostiquer en un coup d’œil l’absence ou la présence d’une symétrie dans une distribution continue. Le corps central de la boîte est circonscrit par le premier quartile ($Q_1$) à sa base et par le troisième quartile ($Q_3$) à son sommet, matérialisant visuellement l’écart interquartile ($IQR = Q_3 – Q_1$), au sein duquel est tracée la barre transversale représentant la médiane ($Me = Q_2$).
Dans le cadre d’une distribution symétrique, le diagramme en boîte doit obligatoirement arborer trois éléments de géométrie interne invariante :
- La ligne médiane doit être rigoureusement localisée au centre géométrique exact de la boîte interquartile, illustrant l’égalité des distances $Q_2 – Q_1 = Q_3 – Q_2$.
- Les moustaches inférieure et supérieure — qui s’étendent généralement jusqu’à la valeur observée la plus éloignée ne dépassant pas 1,5 fois l’écart interquartile depuis les charnières — doivent présenter des longueurs rigoureusement identiques.
- Les éventuelles valeurs aberrantes ou extrêmes (outliers), positionnées au-delà des barrières de Tukey, doivent se distribuer de manière harmonieusement appariée en nombre et en distance de part et d’autre de la boîte.
Tout désaxement sensible de la barre médiane vers le plancher ou le plafond de la boîte, ou toute disproportion manifeste dans l’allongement d’une moustache par rapport à l’autre, offre la signature visuelle immédiate d’une distorsion asymétrique unilatérale qu’aucun test numérique sommaire ne saurait occulter.
10.3 Diagramme quantile-quantile (Q-Q Plot)
Pour pousser l’investigation diagnostique au plus haut degré de précision visuelle, le diagramme quantile-quantile (Q-Q Plot) s’impose comme la méthode de référence absolue. Ce graphique confronte de manière bidimensionnelle les quantiles calculés sur l’échantillon de données empiriques aux quantiles théoriques attendus d’une loi symétrique de référence — le plus fréquemment la loi normale standard. Si la série empirique présente une symétrie normale idéale, les points de dispersion s’alignent rigoureusement le long de la ligne diagonale de référence bissectrice d’équation $y = x$.
L’intérêt diagnostique majeur du Q-Q Plot réside dans sa capacité à traduire visuellement les moindres entorses à la symétrie par des courbures géométriques hautement typées et immédiatement identifiables :
- Une asymétrie positive (déport vers la droite) génère une courbure globale en forme de « U » ou de parabole creuse ascendante : les points s’écartent au-dessus de la droite diagonale aux deux extrémités du graphique, révélant que les valeurs élevées de l’échantillon sont beaucoup plus dispersées que prédit par le modèle symétrique.
- Une asymétrie négative (déport vers la gauche) produit une courbure inversée en dôme (forme de « parapluie » ou de « n »), où les observations empiriques fléchissent sous la ligne théorique aux deux confins de l’échelle.
- Des écarts symétriques de kurtosis provoquent des figures en « S » ou en « S inversé », trahissant un profil leptokurtique ou platykurtique sans rompre l’équilibre de rotation autour du centre médian.
L’analyse minutieuse des extrémités supérieure et inférieure du Q-Q Plot permet ainsi de dissocier instantanément les altérations pures d’asymétrie des simples variations d’aplatissement de la distribution.
11. Tests statistiques d’adéquation et d’évaluation de la symétrie
11.1 Tests de normalité et de symétrie paramétrique
Au-delà de l’appréciation graphique qualitative, l’évaluation de la symétrie recourt à des tests d’hypothèse formels conçus pour quantifier la probabilité que les déviations observées résultent de simples aléas d’échantillonnage. Dans le cadre paramétrique, le test le plus largement déployé est le test de Shapiro-Wilk ($W$), réputé pour sa remarquable puissance statistique face à une vaste gamme d’alternatives non gaussiennes. Il convient néanmoins de garder à l’esprit une limitation inhérente à la taille de l’échantillon : sur de très grands effectifs ($n > 500$), le test de Shapiro-Wilk acquiert une sensibilité ultra-fine qui le conduit à rejeter l’hypothèse nulle ($p < 0{,}05$) pour des micro-déviations morphologiques sans aucune conséquence pratique sur l'inférence.
Pour isoler spécifiquement la composante d’asymétrie sans la confondre avec d’autres altérations distributionnelles, le test omnibus de D’Agostino-Pearson $K^2$ s’avère particulièrement pertinent. Ce test combine de manière quadratique le score normalisé d’asymétrie $Z(g_1)$ et le score d’aplatissement $Z(g_2)$ :
$$K^2 = Z(g_1)^2 + Z(g_2)^2 \sim \chi^2(2)$$
Il autorise l’analyste à évaluer indépendamment le terme $Z(g_1)^2$, lequel suit asymptotiquement une loi du khi-deux à un degré de liberté sous l’hypothèse nulle de symétrie, fournissant une estimation probabiliste directe de l’absence de skewness.
Enfin, le test d’adéquation de Kolmogorov-Smirnov, lorsqu’il intègre la correction de Lilliefors pour compenser l’estimation des paramètres $\mu$ et $\sigma^2$ à partir des données d’échantillon, compare la distance verticale maximale $D$ entre la fonction de répartition empirique $F_n(x)$ et la fonction théorique normale $F_0(x)$ :
$$D = \sup_x |F_n(x) – F_0(x)|$$
Bien que moins puissant que le test de Shapiro-Wilk pour détecter les asymétries fines, il offre un test d’adéquation global souvent exigé dans les protocoles réglementaires et industriels.
11.2 Tests d’hypothèse dédiés à la symétrie non normale
Une confusion méthodologique fréquente consiste à réduire le test de symétrie à un simple test de normalité. Une distribution peut parfaitement dévier de la courbe de Gauss tout en maintenant une symétrie non paramétrique absolue. Lorsque l’objectif est d’éprouver formellement l’invariance par réflexion autour d’un centre inconnu $\theta$ sans postuler la normalité des données, il est indispensable de faire appel à des tests non paramétriques dédiés.
Le test de symétrie de Wilcoxon pour échantillon unique évalue l’hypothèse nulle selon laquelle la distribution continue sous-jacente est symétrique autour d’une médiane spécifiée $\theta_0$. En classant les valeurs absolues des écarts $|x_i – \theta_0|$ et en sommant les rangs associés aux déviations positives, le test détecte tout déséquilibre systématique dans la dispersion bilatérale des observations. Lorsque le centre de symétrie n’est pas connu a priori mais doit être estimé par la médiane empirique, des développements récents ont donné naissance à des procédures plus sophistiquées, à l’instar du test de symétrie de Miao, Gel et Gastwirth (MGG) :
$$T_{\text{MGG}} = \frac{\bar{X} – Me}{\frac{1}{n} \sum_{i=1}^n |x_i – Me|}$$
Ce test robuste fonde son ratio sur l’écart standardisé entre la moyenne arithmétique et la médiane, pondéré par la déviation absolue médiane (MAD). L’interprétation de la p-valeur sous l’hypothèse nulle $H_0: f(\theta – x) = f(\theta + x)$ permet d’attester de la symétrie intrinsèque de distributions fortement aplaties ou multimodales pour lesquelles les tests de normalité échouent systématiquement.
11.3 Approches par rééchantillonnage (Bootstrap)
Lorsque la taille de l’échantillon est restreinte ou que les données empiriques proviennent de contextes cliniques à fort niveau de bruit métrologique où les hypothèses asymptotiques sont inopérantes, les techniques de rééchantillonnage non paramétrique par bootstrap représentent la solution computationnelle la plus robuste. Initiée par Bradley Efron, cette démarche consiste à tirer avec remise un nombre élevé $B$ de pseudo-échantillons (typiquement $B = 2,000$ ou $B = 10,000$) de même taille $n$ à partir du jeu de données originel.
Pour chaque tirage itératif $b$, le coefficient d’asymétrie non biaisé $G_1^{(b)}$ est recalculé, générant une distribution empirique d’échantillonnage du paramètre d’asymétrie. À partir de cette distribution rééchantillonnée, le chercheur calcule l’intervalle de confiance bootstrap corrigé et accéléré (BCa) au seuil de 95 % :
$$IC_{95%}^{\text{BCa}} = [G_{1, \alpha_1}^* ,;, G_{1, \alpha_2}^*]$$
Le diagnostic de symétrie devient alors immédiat et rigoureux : si la valeur zéro est clairement incluse à l’intérieur de l’intervalle de confiance bootstrap $[G_{1, \text{\inf}} ,;, G_{1, \text{\sup}}]$, l’hypothèse de symétrie ne peut être rejetée, garantissant que les fluctuations d’asymétrie de l’échantillon initial sont compatibles avec une variabilité purement aléatoire. Cette approche offre une assise empirique solide pour justifier le maintien d’analyses paramétriques dans des protocoles de recherche en psychologie clinique ou en neuro-imagerie où les effectifs disponibles sont structurellement limités.
12. Implications cliniques, diagnostiques et prise de décision méthodologique
12.1 Normalisation et étalonnage des instruments psychologiques
Les propriétés morphologiques d’une distribution conditionnent de façon décisive le processus d’étalonnage et de standardisation des instruments de mesure en psychologie, en éducation et en santé comportementale. Lorsqu’un outil psychométrique génère des données empiriques symétriques, la conversion des scores bruts en notes standardisées linéaires (telles que les notes Z centrées-réduites, les notes T de moyenne 50 et d’écart-type 10, ou les scores de QI standardisés) s’avère parfaitement légitime et mathématiquement transparente :
$$Z = \frac{X – \mu}{\sigma} \quad \text{et} \quad T = 50 + 10 \cdot Z$$
Cette linéarité garantit que les distances métriques relatives séparant les individus sont rigoureusement préservées sur l’ensemble du spectre de performance.
En revanche, lorsque la distribution originelle d’un test manifeste une asymétrie marquée mais que les exigences de standardisation imposent un profil symétrique pour des motifs d’homogénéisation diagnostique, les métriciens ont recours à la normalisation par aires (méthode de McCall). Cette technique substitue à la transformation linéaire une conversion ordinale non linéaire : chaque score brut est d’abord transformé en son rang percentile empirique, lequel est ensuite converti en la coordonnée correspondante de la fonction quantile de la loi normale standard :
$$Z_{\text{normalisé}} = \Phi^{-1}(F_n(X))$$
Si ce processus restaure artificiellement la symétrie fonctionnelle de l’échelle, il soulève des enjeux éthiques et interprétatifs majeurs. En étirant les écarts au sein des zones clairsemées de la distribution et en compactant les différences au cœur des zones de forte densité, la normalisation artificielle peut distordre la compréhension clinique des progressions individuelles. Le praticien éclairé doit donc toujours discerner si la symétrie de son échelle d’évaluation reflète la dynamique intrinsèque du trait mesuré ou procède d’un artifice de calibrage mathématique.
12.2 Robustesse des modèles linéaires face aux écarts de symétrie
L’un des débats méthodologiques les plus constants en statistique appliquée concerne le niveau de tolérance des modèles linéaires classiques — à l’instar de l’analyse de variance (ANOVA), des régressions linéaires multiples et des modèles mixtes — face aux violations de l’hypothèse de symétrie et de normalité. Un consensus scientifique robuste, étayé par de vastes simulations de Monte Carlo, démontre que l’ANOVA et les tests de Student possèdent une résilience statistique remarquable face aux distributions présentant des asymétries modérées ($|\gamma_1| < 1{,}0$), pourvu que la taille des échantillons soit équilibrée entre les groupes ($n_1 = n_2 = dots = n_k$) et d'un volume suffisant ($n ge 30$ par cellule) en vertu du théorème central limite.
Néanmoins, dès lors que l’asymétrie devient sévère ($|\gamma_1| > 1{,}5$ ou $2{,}0$) — tout particulièrement lorsqu’elle s’accompagne d’une hétéroscédasticité des variances d’erreur et de tailles de groupes inégales —, les fondements mathématiques des moindres carrés ordinaires s’effondrent. Les conséquences sont immédiates :
- Inflation incontrôlée du taux d’erreur de première espèce ($\alpha$), conduisant à déceler des effets de traitement statistiquement significatifs qui ne sont que des artefacts d’échantillonnage ;
- Perte catastrophique de puissance statistique ($1 – \beta$), masquant de réelles différences cliniques sous un voile de variance résiduelle hypertrophiée ;
- Biais systématique dans l’estimation des intervalles de confiance paramétriques, dont la symétrie artificielle ne recouvre plus les véritables limites de certitude empirique.
Dans ces configurations réfractaires, le recours aux modèles linéaires généralisés (GLM) s’impose comme l’alternative méthodologique de premier choix. En autorisant la modélisation directe des variables via des distributions d’adhésion spécifiques (telles que la loi gamma pour les données positives étirées ou la loi quasi-Poisson pour les comptages asymétriques), les modèles GLM affranchissent l’analyste de l’obligation de symétrie tout en préservant la richesse interprétative des modélisations linéaires complexes.
12.3 Arbre décisionnel pour le chercheur et le praticien
Pour guider de manière opérationnelle l’investigateur, le biostatisticien et le psychologue dans le dédale des choix méthodologiques liés à la forme de leurs distributions, un protocole séquentiel d’évaluation analytique s’avère indispensable. Cet arbre décisionnel structure l’évaluation de la symétrie et oriente vers la démarche inférentielle la plus adéquate :
- Étape 1 : Exploration visuelle multi-angle
- Générer conjointement l’histogramme lissé par estimation de densité par noyau (KDE), le diagramme en boîte et le diagramme quantile-quantile (Q-Q Plot).
- Rechercher visuellement la présence d’asymétries évidentes (forme en U sur le Q-Q Plot, moustaches asymétriques) ou de configurations multimodales prononcées.
- Étape 2 : Quantification numérique des moments
- Calculer le coefficient d’asymétrie non biaisé d’échantillon ($G_1$) et l’excès de kurtosis ($G_2$).
- Si $|G_1| le 0{,}5$, la symétrie distributionnelle est considérée comme excellente pour toutes les applications paramétriques.
- Si $0{,}5 < |G_1| le 1{,}0$, la symétrie est modérée ; vérifier l'équilibre des effectifs de sous-groupes ($n_i$).
- Si $|G_1| > 1{,}0$, la distribution est asymétrique ; abandonner la confiance aveugle dans les indicateurs de tendance moyenne.
- Étape 3 : Inférence formelle et vérification d’adéquation
- Sur petits et moyens échantillons ($n < 300$) : exécuter le test omnibus de D'Agostino-Pearson ($Z(g_1)$) ou de Shapiro-Wilk.
- Sur très grands échantillons ($n ge 500$) : privilégier l’intervalle de confiance bootstrap BCa à 95 % du coefficient d’asymétrie pour neutraliser l’hyper-sensibilité des p-valeurs.
- Si l’hypothèse de symétrie sans normalité est privilégiée : déployer le test non paramétrique de Miao-Gel-Gastwirth.
- Étape 4 : Sélection méthodologique et communication scientifique
- Scénario Symétrique Validé : Appliquer les modèles linéaires paramétriques usuels (ANOVA, régressions, corrélations de Pearson). Communiquer systématiquement la moyenne arithmétique accompagnée de son écart-type ($\mu \pm \sigma$) et de l’intervalle de confiance standard.
- Scénario Asymétrique Modéré : Procéder à une transformation stabilisatrice de variable ($log$, Box-Cox) ou utiliser des estimateurs robustes (moyennes tronquées ou winsorisées).
- Scénario Asymétrique Sévère : Basculer résolument vers des tests statistiques non paramétriques (Mann-Whitney, Kruskal-Wallis, régressions quantiles) ou des modèles GLM adaptés à la famille distributionnelle réelle. Présenter impérativement la médiane et l’écart interquartile ($Me ; [IQR]$) comme mesures de référence centrale.
Ce cheminement méthodologique garantit que le traitement mathématique des données demeure en harmonie constante avec leur substrat géométrique et empirique réel, évitant les inférences erronées et assurant la reproductibilité des découvertes scientifiques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- D’Agostino, R. B., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of $b_2$ and $\sqrt{b_1}$. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press. https://doi.org/10.1201/9780429246593
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Galton, F. (1889). Natural inheritance. Macmillan and Co. https://doi.org/10.1037/11696-000
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- George, D., & Mallery, P. (2019). IBM SPSS Statistics 26 step by step: A simple guide and reference (16th ed.). Routledge. https://doi.org/10.4324/9780429056765
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Miao, W., Gel, Y. R., & Gastwirth, J. L. (2006). A new test of symmetry about an unknown median. In Random walk, sequential analysis and related topics: A Festschrift in honor of Yuan-Shih Chow (pp. 199–214). World Scientific. https://doi.org/10.1142/9789812772558_0013
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Quetelet, A. (1835). Sur l’homme et le développement de ses facultés, ou Essai de physique sociale. Bachelier.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson. https://doi.org/10.1037/t15169-000