
Dans le domaine de l’analyse quantitative et de la méthodologie de recherche en sciences humaines, la structuration des variables constitue une étape déterminante qui conditionne l’ensemble de la chaîne de traitement statistique. Parmi les configurations de groupement de données, la distribution ouverte (ou distribution à classes ouvertes) occupe une place singulière, à la croisée de nécessités pragmatiques de collecte et d’exigences formelles d’analyse. Utilisée de manière récurrente dans les enquêtes épidémiologiques, les bilans psychométriques et les études sociologiques menées par de grands instituts tels que l’Institut national de la statistique et des études économiques, cette modalité d’organisation des observations permet de catégoriser des phénomènes dont les bornes extrêmes s’avèrent indéterminées, infinies ou méthodologiquement inaccessibles.
Pourtant, si le recours à une modalité dépourvue de seuil inférieur ou supérieur résout d’importantes difficultés de passation d’épreuves ou de questionnaires, il introduit des contraintes calculatoires majeures. L’absence de délimitation stricte pour certaines classes remet en cause l’application des paramètres statistiques descriptifs les plus élémentaires, au premier rang desquels figurent la moyenne arithmétique et la variance. La modélisation mathématique se trouve alors confrontée à une indétermination structurelle : comment calculer le centre d’une classe qui s’étend vers l’infini négatif ou positif ? Cette aporie théorique impose le recours à des mesures non paramétriques robustes et à des modèles de régression spécifiquement adaptés aux phénomènes censurés.
Le présent article propose une analyse épistémologique et méthodologique exhaustive de la distribution ouverte. En explorant ses fondements théoriques, sa typologie, ses répercussions sur les indicateurs de tendance centrale et de dispersion, ainsi que ses modélisations computationnelles avancées, cette synthèse ambitionne de fournir aux chercheurs, cliniciens et analystes de données un cadre de référence rigoureux pour appréhender ces structures de données non conventionnelles sans compromettre la validité de leurs inférences empiriques.
1. Fondements théoriques et définition d’une distribution ouverte
1.1 Définition statistique de la distribution à classes ouvertes
En statistique descriptive, une distribution à classes ouvertes (ou open-ended distribution) se caractérise formellement par un tableau de fréquences ou une partition d’intervalles dans lequel au moins une classe périphérique ne comporte pas de limite finie. Dans le cas canonique d’une variable quantitative continue préalablement discrétisée, les données sont généralement regroupées au sein d’intervalles contigus d’amplitudes fixes ou variables. Cependant, dès lors qu’un intervalle est désigné par une formule d’exclusion telle que « moins de k » ou « supérieur ou égal à K », la classe correspondante ne présente plus de borne inférieure ou supérieure mesurable.
Ce concept introduit une rupture épistémologique fondamentale par rapport aux distributions classiques. L’absence de limite assigne à la classe concernée une largeur mathématiquement infinie ou indéterminée, ce qui interdit d’emblée la définition d’un centre de classe (ou milieu d’intervalle) sur la base de la simple demi-somme des bornes. Il convient d’opérer une distinction rigoureuse entre une variable continue discrétisée artificiellement par commodité de recueil et une variable ordinale intrinsèque. Dans une variable continue partitionnée en classes ouvertes, le sous-jacent métrique demeure actif, mais l’observation empirique subit un mécanisme de groupement qui tronque l’information spatiale dans la queue de la distribution.
Les propriétés mathématiques de ces intervalles non bornés impliquent des singularités de traitement dans l’espace probabiliste. Si l’espace fondamental des événements reste exhaustif — c’est-à-dire que l’union de toutes les classes, ouvertes et fermées, englobe rigoureusement l’ensemble des réalisations possibles de l’échantillon —, l’absence de compacité topologique sur la droite réelle empêche toute intégration classique de densité de probabilité sans l’introduction d’hypothèses auxiliaires sur la forme fonctionnelle régissant l’extrême de la distribution.
1.2 Comparaison structurelle avec la distribution fermée
À l’opposé des architectures ouvertes, une distribution statistique fermée impose des bornes d’inclusion strictes, finies et mesurables pour chacun de ses intervalles constitutifs. Dans une partition fermée, chaque classe i est rigoureusement définie par un doublet $[a_i, b_i[$, où $a_i$ et $b_i$ appartiennent à l’ensemble des nombres réels $\mathbb{R}$. Cette clôture topologique garantit que l’amplitude de chaque catégorie, exprimée par $h_i = b_i – a_i$, est une valeur strictement positive et finie, autorisant immédiatement le calcul du point central $c_i = (a_i + b_i) / 2$, pierre angulaire des calculs momentanés de premier et second ordres.
En recherche empirique, la comparaison entre ces deux approches se manifeste fréquemment lors de la mise en place d’un protocole expérimental. Considérons par exemple une étude mesurant le temps de réaction cognitive face à un stimulus perceptif complexe : une distribution fermée segmentera les latences en tranches fixes, telles que $[200, 300[$, $[300, 400[$, et $[400, 500[\text{ ms}]$, tout en écartant ou en consignant à part les réponses excédant 500 ms. À l’inverse, une distribution ouverte introduira une classe ultime désignée par « $ge 500\text{ ms}$ », englobant indistinctement les participants ayant réagi en 505 ms et ceux ayant manifesté un temps d’hésitation pathologique de 3 000 ms.
Cette divergence structurelle produit des conséquences profondes sur les fonctions de répartition. Si le calcul des fréquences relatives simples ($f_i = n_i / N$) et des fréquences cumulées ascendantes demeure arithmétiquement licite dans les deux configurations, la distribution fermée autorise une interpolation linéaire continue sur l’intégralité du domaine de définition. En revanche, la distribution ouverte crée une zone d’opacité terminale : le tracé de la fonction de répartition cumulée s’interrompt ou plafonne brutalement dès l’amorce de la classe ouverte, interdisant toute déduction sur la répartition interne des effectifs au-delà du seuil critique.
1.3 Pertinence méthodologique en sciences du comportement
L’usage des distributions à classes ouvertes répond à des impératifs méthodologiques cruciaux au sein des sciences cognitives, de la psychologie clinique et de la neuropsychologie. Le comportement humain, par sa nature adaptative et multivariée, génère régulièrement des réponses extrêmes qui défient les tentatives de standardisation linéaire. L’évaluation de traits psychologiques sous-tendus par des échelles quantitatives — tels que l’intensité des symptômes dépressifs évaluée par des inventaires normalisés, la réactivité émotionnelle ou encore les compétences en mémoire de travail — met souvent en évidence des dynamiques asymétriques où une faible proportion d’individus déploie des performances atypiques.
Dans les questionnaires psychométriques contemporains élaborés selon les standards de l’American Psychological Association, l’aménagement d’intervalles ouverts représente une flexibilité nécessaire. Il s’avère particulièrement complexe de délimiter a priori une frontière supérieure ou inférieure stricte à des processus psychobiologiques hautement distribués. Vouloir imposer une clôture absolue à un questionnaire évaluant, par exemple, la fréquence hebdomadaire des compulsions alimentaires ou des ruminations anxieuses reviendrait soit à artificiellement contraindre le spectre d’expression du patient, soit à multiplier des dizaines de classes unitaires résiduelles qui resteraient désespérément vides pour l’immense majorité de la cohorte.
Cette pertinence méthodologique procède également d’une reconnaissance pragmatique des limites de la mesure psychologique. Face à l’impossibilité pratique et théorique d’isoler un plafond biologique indépassable pour certaines aptitudes cognitives supérieures ou, a contrario, d’établir un plancher absolu sans fausser la métrique sous-jacente, la classe ouverte constitue une convention épistémique élégante : elle prend acte de la présence de valeurs singulières sans pour autant contraindre indûment l’instrument de mesure dans des limites arbitraires.
2. Typologie et configurations des distributions ouvertes
2.1 Distributions ouvertes par la borne inférieure
Une distribution est dite ouverte par la borne inférieure lorsqu’elle intègre une classe inaugurale dépourvue de frontière minimale déterminée. Dans les répertoires statistiques et les instruments d’enquête, ce type de catégorie est traditionnellement désigné par des formules lexicales telles que « inférieur à $X$ », « strictement moins de $X$ » ou mathématiquement par l’intervalle $]-\infty, X[$. La classe de base capture ainsi l’ensemble des occurrences dont l’amplitude numérique se situe en deçà du seuil critique $X$, sans qu’aucune limite opérationnelle ne vienne borner le domaine de mesure vers le bas.
Les cas d’usage typiques abondent en chronométrie mentale et en neuropsychologie clinique. L’analyse des temps de latence cognitive ultra-courts en fournit une illustration emblématique : lors d’épreuves d’attention sélective informatisées, les réponses enregistrées sous la barre physiologique des 150 millisecondes sont couramment regroupées au sein d’une modalité unique « $< 150\text{ ms}$ ». Ces temps de réaction infinitésimaux, souvent assimilés à des réponses anticipatoires pré-motrices ou à des artéfacts moteurs, ne nécessitent pas une décomposition unitaire fine mais doivent impérativement être quantifiés pour apprécier l'impulsivité du sujet ou filtrer le bruit expérimental.
Sur le plan distributionnel, l’ouverture par la borne inférieure induit un effet direct de troncature à gauche sur les données observées. Cette condensation forcée de l’extrémité inférieure engendre une dissymétrie mécanique de la courbe de densité empirique. Le rassemblement des valeurs planchers dans une catégorie unique comprime artificiellement la traîne gauche, masquant d’éventuelles sous-populations cliniques qui se distingueraient uniquement par des niveaux de déficit sévères situés profondément en deçà de la normale métrique établie.
2.2 Distributions ouvertes par la borne supérieure
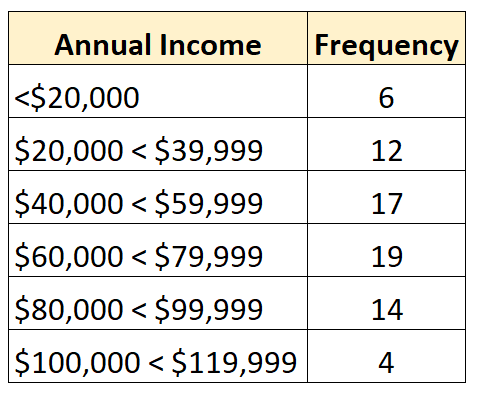
La distribution ouverte par la borne supérieure représente la configuration la plus fréquemment répertoriée dans la littérature scientifique et économique. Elle se matérialise par l’introduction d’un intervalle terminal dépourvu de plafond, habituellement formalisé sous la notation $[Y, +\infty[$ ou identifié par des intitulés pragmatiques tels que « supérieur ou égal à $Y$ », « $Y$ et plus » ou « au-delà de $Y$ ». Dans cette structure, l’ensemble des observations excédant le seuil de basculement $Y$ sont agrégées indistinctement au sein d’une unique entité catégorielle.
Cette typologie constitue la règle prévalente dans l’exploration des variables socio-économiques, telles que la répartition des tranches de revenu ou du patrimoine net des ménages, domaines amplement étudiés par l’Organisation de coopération et de développement économiques. En psychopathologie et en addictologie, cette approche est également systématique : l’évaluation de la consommation compulsive de substances psychoactives (par exemple, le nombre d’unités d’alcool ou de cigarettes consommées quotidiennement) recourt de manière quasi universelle à des bornes supérieures ouvertes, à l’image des catégories « plus de 40 cigarettes par jour ». Les scores cliniques plafonds, mesurant par exemple des épisodes d’automutilation ou des attaques de panique mensuelles, sont similairement capturés par ce mécanisme.
L’introduction d’une classe supérieure indéterminée suscite l’apparition de phénomènes statistiques complexes associés à la censure à droite et aux queues de distribution épaisses (heavy-tailed distributions). L’écrasement de toute l’information située au-delà de $Y$ élimine la variabilité intrinsèque des profils ultra-atypiques. Les sujets affichant des niveaux comportementaux exceptionnellement élevés se trouvent confondus avec ceux qui ne franchissent que marginalement le palier d’inclusion, ce qui entraîne une distorsion substantielle de la forme globale du polygone de fréquence.
2.3 Distributions bilatéralement ouvertes
La configuration bilatéralement ouverte survient lorsqu’une série statistique combine de manière simultanée une classe initiale non bornée inférieurement et une classe terminale non bornée supérieurement. La partition des données prend alors la forme canonique : $]-\infty, a[$, $[a, b[$, $[b, c[$, …, $[k, +\infty[$. Cette structure duale encadre une zone centrale d’intervalles parfaitement fermés et quantifiables par deux extrémités amples et indéterminées.
La complexité analytique d’une telle distribution s’avère particulièrement élevée en raison de la perte symétrique d’information quantitative. Cette organisation est fréquemment adoptée dans les études épidémiologiques employant des scores standardisés composites, tels que les scores Z centrés réduits ou les quotients intellectuels déviants, dès lors que l’on souhaite isoler les tranches modérées tout en regroupant les phénotypes d’extrême sous-performance et de surperformance remarquable. On la rencontre également dans les modélisations économétriques des rendements d’actifs financiers ou des variations de température résiduelles en psychophysique environnementale.
La gestion de variables standardisées présentant des résidus très dispersés impose parfois cette bilatéralité pour préserver la lisibilité synthétique des bilans diagnostiques. Néanmoins, l’analyste se trouve alors privé de repères métriques sur les deux ailes de la population. Les déviations extrêmes négatives et positives se trouvant soustraites à toute quantification paramétrique directe, le traitement mathématique de ces distributions exige l’emploi exclusif d’approches ordonnées ou de techniques avancées de vraisemblance conditionnelle.
3. Causes méthodologiques et psychologiques des distributions ouvertes
3.1 Biais de désirabilité sociale et préservation de l’anonymat
L’adoption de classes ouvertes lors de la collecte de données ne découle pas uniquement de contraintes mathématiques ; elle relève d’une fine compréhension des processus socio-cognitifs qui animent le répondant face à un protocole d’évaluation. La divulgation d’informations quantitatives exactes relatives à des aspects intimes, transgressifs ou hautement valorisés de l’existence active inévitablement le biais de désirabilité sociale. Qu’il s’agisse du revenu individuel, du patrimoine financier, du nombre de partenaires sexuels ou de la fréquence d’actes déviants, l’obligation de renseigner une valeur numérique précise peut être vécue comme une intrusion menaçante pour l’image de soi.
La mise à disposition d’une classe terminale ouverte telle que « 100 000 euros et plus » ou « plus de 10 verres par occasion » agit comme un bouclier psychologique et un préservateur d’anonymat. En choisissant une catégorie collective large, le répondant n’a pas le sentiment d’exposer sa singularité au regard inquisiteur du chercheur. Il dilue sa réalité individuelle dans une cohorte indifférenciée, ce qui réduit significativement l’anxiété d’évaluation et la réactance psychologique.
De multiples investigations en méthodologie d’enquête ont corroboré que l’usage de catégories ouvertes pour des domaines sensibles permet de minimiser substantiellement l’attrition des données. Les taux de non-réponse partielle chutent drastiquement lorsque les participants ont la possibilité de s’affilier à une classe non limitative plutôt que d’être contraints de consigner une valeur chiffrée exacte. Ce dispositif concilie ainsi le respect de la sphère privée du sujet avec l’exigence de complétude de l’échantillonnage empirique.
3.2 Contraintes de conception des instruments psychométriques
L’architecture des questionnaires psychométriques contemporains est gouvernée par le principe d’économie cognitive. La multiplication effrénée des modalités de réponse au sein d’un instrument d’évaluation majore considérablement la charge mentale du sujet testé, induisant un phénomène d’épuisement attentionnel et de désengagement progressif. Dans le cadre de protocoles standardisés administrés à de larges cohortes épidémiologiques, tels que ceux supervisés par l’Organisation mondiale de la Santé, la simplification de la structure des échelles constitue un impératif de fidélité métrologique.
Si un concepteur de test devait provisionner des classes fermées d’amplitude constante pour couvrir l’intégralité des spectres de comportement imaginables, les formulaires comporteraient une prolifération de modalités résiduelles. Pour une question évaluant le nombre d’heures consacrées aux jeux vidéo chaque semaine, calibrer des tranches régulières de deux heures jusqu’à un maximum théorique de 100 heures engendrerait une échelle de 50 modalités. Une telle démesure saturerait la perception visuelle du sujet tout en générant un nombre considérable de classes vides au plan statistique.
L’introduction délibérée d’une classe ouverte terminale (par exemple, « plus de 30 heures par semaine ») permet de compacter l’instrument tout en conservant une discrimination fine sur la majeure partie de la courbe de Gauss. Les événements rares mais extrêmes sont ainsi recueillis de façon opérationnelle, sans surcharger cognitivement les participants ordinaires ni diluer la robustesse de l’instrument d’évaluation au sein d’une matrice inutilement complexe.
3.3 Variabilité extrême et queues de distribution lourdes
L’expérience empirique démontre que de nombreuses manifestations psychologiques, psychopathologiques et comportementales ne se conforment nullement à la symétrie prévisible de la courbe normale de Gauss-Laplace. De nombreuses variables humaines exhibent une variabilité extrême dominée par des phénomènes de lois de puissance ou de distributions à queues lourdes. Dans ces contextes, une infime minorité d’individus présente des comportements dont l’amplitude excède de plusieurs ordres de grandeur la moyenne de l’échantillon général.
Considérons l’intensité des comportements d’achat compulsif, les vérifications obsessionnelles dans le cadre d’un trouble obsessionnel-compulsif (TOC), ou le temps quotidien passé sur les réseaux sociaux. Alors que 95 % des répondants vont osciller entre des valeurs modérées, quelques profils pathologiques peuvent rapporter des scores vertigineux. Face à cette hétérogénéité radicale, les échelles linéaires conventionnelles révèlent leur incapacité structurelle à capter conjointement la nuance des variations standard et la démesure des cas marginaux.
La classe ouverte opère ici comme une barrière régulatrice protectrice contre les erreurs de mesure associées aux valeurs aberrantes individuelles (outliers). En absorbant l’ensemble des dérives massives au sein d’une catégorie non bornée, l’expérimentateur évite que des valeurs numériques isolées — parfois consécutives à des erreurs de saisie, des affabulations ou des manifestations cliniques paroxystiques — ne viennent déstabiliser de manière disproportionnée les moments statistiques de l’échantillon global.
4. Impact sur les mesures de tendance centrale
4.1 L’inapplicabilité de la moyenne arithmétique conventionnelle
L’incidence la plus immédiate et la plus problématique de la distribution ouverte réside dans l’inapplicabilité formelle de la moyenne arithmétique conventionnelle. Par définition, le calcul de la moyenne arithmétique pondérée au sein d’un tableau groupé s’exprime selon la formule mathématique rigoureuse :
$$\bar{x} = \frac{1}{N} \sum_{i=1}^{k} n_i c_i$$
où $n_i$ désigne l’effectif de la classe $i$, $N$ l’effectif total de l’échantillon, et $c_i$ le centre de la classe considérée. Dans le cadre d’une classe ouverte, telle que $[Y, +\infty[$, l’infinité de l’amplitude rend le centre de classe $c_i$ indéfini dans le corps des réels :
$$c_k = \frac{Y + \infty}{2} = \text{Indéfini}$$
Cette impossibilité algébrique interdit toute détermination directe de la moyenne sans violer les axiomes du calcul statistique élémentaire. Tenter de contourner cet obstacle par la fixation discrétionnaire d’un point médian arbitraire (par exemple, en décidant unilatéralement que le centre de la classe « 60 ans et plus » sera fixé à 70 ans) expose l’analyste à un risque sévère d’erreur systématique de mesure. L’estimation qui en découle ne reflète plus la structure empirique des données, mais traduit uniquement le postulat arbitraire de l’expérimentateur.
De surcroît, la moyenne arithmétique est unanimement reconnue pour sa vulnérabilité intrinsèque à l’attraction des scores extrêmes. Dans une distribution ouverte à droite, l’inclusion d’individus situés profondément dans la queue de distribution tire mécaniquement la moyenne vers le haut. Faute de pouvoir situer précisément ces observations sur l’axe numérique, tout calcul paramétrique traditionnel devient spéculatif et scientifiquement indéfendable.
4.2 La médiane comme indicateur privilégié
Face à la défaillance structurelle de la moyenne arithmétique, la médiane ($Me$) s’impose comme l’indicateur d’élection de la tendance centrale au sein des distributions ouvertes. Fondée sur le rang ordonné des observations et non sur leur amplitude métrique directe, la médiane correspond à la valeur du caractère qui scinde l’échantillon ordonné en deux sous-groupes d’effectifs strictement égaux, de sorte que 50 % des observations lui sont inférieures et 50 % lui sont supérieures.
La validité et l’élégance de la médiane reposent sur son insensibilité mathématique totale à l’indétermination des bornes extrêmes. Pourvu que la classe médiane — celle qui contient la cinquantième unité centésimale de l’effectif cumulé — soit une classe fermée, le calcul procède classiquement par interpolation linéaire intra-classe selon la formule standard :
$$Me = L_m + \left( \frac{\frac{N}{2} – F_{m-1}}{f_m} \right) \times h_m$$
où $L_m$ représente la borne inférieure de la classe médiane, $N$ la taille de l’échantillon, $F_{m-1}$ la fréquence cumulée absolue précédant la classe médiane, $f_m$ l’effectif de la classe médiane, et $h_m$ son amplitude fermée. L’indétermination de la borne de la première ou de la dernière classe n’intervient à aucun moment dans cette relation analytique.
La seule réserve méthodologique formelle concerne les situations pathologiques où l’effectif d’une classe ouverte périphérique excède 50 % de l’échantillon total. Dans cette hypothèse rarissime d’un effondrement massif des données dans l’intervalle non borné, la classe médiane devient elle-même ouverte, ce qui empêche l’interpolation linéaire et restreint la conclusion à l’énoncé d’une inégalité ordinale (par exemple, $Me ge Y$). En dehors de ce cas singulier, la médiane demeure l’estimateur de localisation le plus stable et le plus scientifiquement fondé.
4.3 Le mode et la classe modale
Le mode statistique, défini comme la valeur ou la modalité accusant la fréquence d’apparition la plus élevée au sein de l’échantillon, présente une résistance théorique appréciable face aux distributions ouvertes. Lorsque les données sont regroupées en classes fermées d’amplitudes strictement égales, la détermination de la classe modale s’effectue sans aucune ambiguïté par la simple identification du sommet de l’histogramme des fréquences.
Cependant, la situation se complique considérablement lorsque les classes présentent des largeurs inégales, ce qui est structurellement le cas en présence d’intervalles ouverts. Dans ces conditions, l’identification de la classe modale ne peut reposer sur l’effectif brut ($n_i$), mais doit impérativement faire appel à la densité de fréquence ($d_i$), définie par le rapport entre l’effectif et l’amplitude de l’intervalle :
$$d_i = \frac{n_i}{h_i}$$
Or, pour une classe ouverte dont l’amplitude $h_i$ tend formellement vers l’infini, la densité de fréquence tend corrélativement vers zéro ($d_k = n_k / \infty to 0$). Par conséquent, une classe ouverte ne peut jamais être rigoureusement déclarée comme classe modale sur le plan de la densité probabiliste continue, bien qu’elle puisse concentrer un nombre brut d’observations substantiel en raison de son immensité spatiale.
Dans l’interprétation des profils de réponse fortement polarisés en psychologie comportementale, il convient donc de distinguer avec acuité la mode au sens catégoriel brut (la modalité nominative la plus cochée sur le formulaire) de la classe modale continue corrigée pour l’amplitude. Cette vigilance épistémologique prévient des contresens diagnostiques majeurs lors de l’analyse des regroupements cliniques terminaux.
5. Analyse de la dispersion et de la variabilité
5.1 Limites de la variance et de l’écart-type
À l’instar de la moyenne arithmétique, les métriques traditionnelles de dispersion que constituent la variance ($\sigma^2$ ou $s^2$) et l’écart-type ($\sigma$ ou $s$) s’avèrent inopérantes dans l’espace formel d’une distribution à classes ouvertes. L’expression canonique de la variance au sein d’une population regroupée :
$$s^2 = \frac{1}{N} \sum_{i=1}^{k} n_i (c_i – \bar{x})^2$$
témoigne d’une double dépendance critique à l’égard de l’information non bornée. D’une part, le paramètre $\bar{x}$ étant lui-même indéterminé en raison de l’ouverture de l’intervalle, le calcul des écarts quadratiques à la moyenne ne repose sur aucun ancrage certifié. D’autre part, la détermination du centre de classe $c_i$ pour la modalité ouverte fait structurellement défaut.
La pratique déconseillée consistant à imputer une amplitude arbitraire pour fermer artificiellement la classe introduit un biais quadratique exponentiel. Étant donné que la distance $(c_i – \bar{x})$ est élevée au carré, toute sous-estimation ou surestimation de l’étalement de la queue de distribution déforme de manière colossale la variance globale de l’échantillon. Une imputation conservatrice minimisera artificiellement l’hétérogénéité intra-groupe, tandis qu’une fermeture trop distante projettera la variance vers des sommets factices.
Ces instabilités disqualifient l’usage de l’écart-type pour normaliser des résultats cliniques ou calculer des tailles d’effet paramétriques, telles que le d de Cohen, dès lors que les données sous-jacentes procèdent d’un découpage comportant des classes ouvertes. Le maintien de telles pratiques compromet la reproductibilité des inférences scientifiques et fausse la comparabilité entre études indépendantes.
5.2 L’écart interquartile comme alternative robuste
Pour contourner l’écueil de la variance, la méthodologie statistique préconise sans réserve le déploiement de l’écart interquartile (Interquartile Range ou $IQR$). Défini comme la différence algébrique séparant le troisième quartile ($Q_3$, 75e percentile) du premier quartile ($Q_1$, 25e percentile) :
$$IQR = Q_3 – Q_1$$
cet indicateur mesure l’empan spatial au sein duquel se concentrent les 50 % centraux de la population étudiée. Parallèlement, l’écart semi-interquartile ($SIQR = IQR / 2$) offre une appréciation normalisée de la dispersion autour de la médiane.
L’insensibilité opératoire de l’écart interquartile face aux classes ouvertes périphériques est absolue, sous réserve que la classe ouverte inférieure contienne strictement moins de 25 % des données ($F_1 < 0,25$) et que la classe ouverte supérieure en concentre strictement moins de 25 % ($1 – F_{k-1} < 0,25$). Dans ce cadre standard, tant $Q_1$ que $Q_3$ sont localisés au sein de catégories intermédiaires parfaitement fermées, ce qui autorise une interpolation linéaire rigoureuse de leurs valeurs métriques respectives :
$$Q_p = L_p + \left( \frac{p \cdot N – F_{p-1}}{f_p} \right) \times h_p \quad \text{pour } p in {0,25 ; 0,75}$$
L’étalement des scores psychologiques ou comportementaux peut ainsi être restitué fidèlement sans qu’aucune hypothèse spéculative relative aux extrémités ne doive être formulée. En complément, l’usage des intervalles inter-déciles ($D_9 – D_1$) ou d’empans percentiles plus larges demeure licite, pourvu que les rangs centésimaux ciblés n’empiètent pas sur les tranches ouvertes de la distribution.
5.3 Indicateurs d’asymétrie et d’aplatissement
L’analyse approfondie de la morphologie d’une distribution exige l’estimation de ses coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Les coefficients classiques d’asymétrie de Fisher-Pearson, fondés sur les moments centrés d’ordres trois et quatre :
$$\gamma_1 = \frac{m_3}{s^3} = \frac{\frac{1}{N}\sum n_i (c_i – \bar{x})^3}{\left[\frac{1}{N}\sum n_i (c_i – \bar{x})^2\right]^{3/2}}$$
partagent l’inapplicabilité totale de la moyenne et de la variance au sein des structures ouvertes. L’impossibilité de calculer les moments d’ordre élevé par rapport à une origine centrale indéterminée contraint le statisticien à renoncer à ces métriques paramétriques sous peine d’obtenir des résultats dénués de toute signification formelle.
En substitution, les sciences du comportement recourent aux indices non paramétriques de forme, au premier rang desquels figure le coefficient d’asymétrie quartile de Bowley (ou indice de Yule) :
$$B = \frac{(Q_3 – Me) – (Me – Q_1)}{Q_3 – Q_1} = \frac{Q_3 + Q_1 – 2Me}{Q_3 – Q_1}$$
Ce coefficient adimensionnel, strictement borné entre $-1$ et $+1$, évalue la position relative de la médiane par rapport aux quartiles supérieur et inférieur. Un indice $B > 0$ témoigne d’une asymétrie positive (queue étirée vers la droite), tandis qu’un indice $B < 0$ traduit une asymétrie négative.
L’interprétation clinique de cet indicateur s’avère particulièrement féconde lors de l’étude d’échelles de détresse psychologique ou de symptomatologie névrotique. En mesurant la dissymétrie interne du cœur de la distribution par l’indice de Bowley, le praticien s’affranchit des distorsions périphériques inhérentes à la classe ouverte terminale tout en qualifiant précisément le sens de basculement de la majorité des patients de la cohorte.
6. Représentation graphique des distributions ouvertes
6.1 Limites et adaptations de l’histogramme
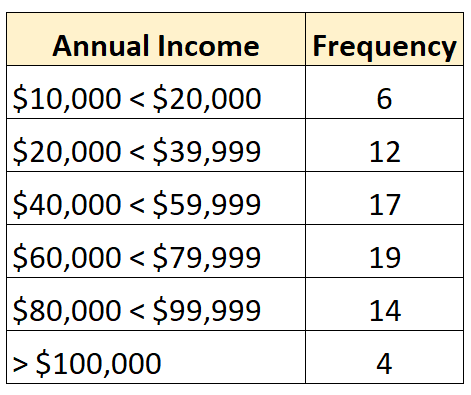
L’histogramme constitue la représentation graphique fondamentale des distributions quantitatives continues regroupées en classes. Son principe fondamental repose sur la proportionnalité de l’aire des rectangles à l’effectif des tranches associées : pour chaque intervalle $i$, l’aire du rectangle érigé vaut $A_i = h_i \times d_i propto n_i$, où la base correspond à l’amplitude $h_i$ et la hauteur à la densité de fréquence $d_i$. Ce principe visuel universel se heurte à une contradiction géométrique insurmontable dès lors qu’il est appliqué à une classe ouverte.
En effet, attribuer à une classe non bornée supérieurement une base de largeur infinie exigerait, pour maintenir une aire finie représentative de son effectif $n_k$, de lui assigner une hauteur infinitésimale tendant vers zéro ($d_k to 0$), ce qui rend la barre imperceptible sur le plan graphique. Inversement, si le concepteur trace arbitrairement un rectangle de largeur standard tout en lui conférant une hauteur proportionnelle à son effectif brut, il fausse dramatiquement la lecture géométrique de la distribution : l’aire de ce rectangle terminal surestime de manière extravagante la densité locale d’individus.
Pour remédier à cette distorsion perceptuelle majeure, les normes de sémiologie graphique recommandent plusieurs artifices conventionnels :
- La rupture d’axe graphique : Elle s’illustre par un double trait oblique barrant l’axe des abscisses immédiatement avant l’amorce de la classe ouverte, signalant visuellement au lecteur une discontinuité métrique infranchissable.
- La barre isolée avec flèche directionnelle : La modalité ouverte est représentée à l’écart du corps continu de l’histogramme, surmontée d’une flèche pointant vers l’infini pour expliciter l’absence de borne supérieure.
- L’imposition d’une largeur conventionnelle standardisée : L’amplitude de la classe ouverte est arbitrairement alignée sur celle de la classe fermée adjacente, mais la colonne fait l’objet d’un hachurage distinctif et d’une mention textuelle explicite interdisant l’interprétation de son aire comme une densité probabiliste.
6.2 Diagrammes en boîte et représentations par quantiles
Contrairement aux histogrammes, les diagrammes en boîte (ou boîtes à moustaches de Tukey, boxplots) s’adaptent avec une fidélité graphique remarquable aux contraintes spatiales des distributions ouvertes. Dans sa conception canonique, le corps central de la boîte matérialise l’intervalle interquartile ($[Q_1, Q_3]$) au sein duquel la médiane ($Me$) est figurée par un trait transversal proéminent. Dans la mesure où les quartiles demeurent cantonnés dans les tranches fermées de la distribution, le tracé du cœur de la boîte n’est en rien altéré par l’indétermination des bornes périphériques.
L’adaptation graphique requise porte exclusivement sur la configuration des « moustaches » (whiskers) et la désignation des valeurs aberrantes ou extrêmes. Si la distribution est ouverte par la borne supérieure, la moustache s’étendant vers le haut ne peut être raccordée à un extremum déterminé ($X_{\max}$). La convention méthodologique impose alors de prolonger la moustache jusqu’à la borne inférieure de la classe ouverte, puis de symboliser la présence des effectifs non bornés au moyen d’un chapeau fléché ou d’une grappe d’indicateurs géométriques génériques disposés au-delà du seuil critique sans graduation métrique fine.
Le diagramme en boîte offre un atout heuristique de premier plan pour comparer graphiquement deux groupes cliniques distincts — par exemple, un groupe contrôle et un groupe souffrant de phobie sociale — soumis à une échelle de retrait comportemental comportant une catégorie ouverte supérieure. Sans exiger d’imputation paramétrique contestable, la confrontation des boîtes permet d’apprécier d’un coup d’œil les divergences de tendances médianes et de dispersions interquartiles entre les cohortes.
6.3 Polygones de fréquences et courbes cumulatives
Le tracé du polygone de fréquences simples rencontre les mêmes écueils que l’histogramme, car il requiert de relier les centres de chaque classe par des segments rectilignes continus. La classe terminale ouverte étant privée de centre de classe identifiable, le tracé se trouve incapable de refermer la ligne brisée sur l’axe des abscisses à l’extrémité droite du graphique. Toute fermeture unilatérale arbitraire dénature la géométrie intrinsèque du polygone.
En revanche, la courbe des fréquences cumulées ascendantes — traditionnellement désignée sous le terme d’ogive de Galton — offre une excellente opérabilité descriptive. L’ogive associe à chaque borne supérieure de classe la proportion cumulée correspondante d’observations. Pour une distribution ouverte par la borne supérieure, la courbe cumulative peut être rigoureusement tracée jusqu’à la limite inférieure de ladite classe terminale, atteignant le niveau cumulé précis $F(Y) = 1 – (n_{\text{ouvert}} / N)$.
Au-delà de cette coordonnée ultime déterminée, la courbe adopte un comportement d’asymptote horizontale discontinue convergeant formellement vers 1,00 (ou 100 %) sans qu’aucune trajectoire fonctionnelle ne puisse être dessinée avec certitude. Cette représentation graphique présente un intérêt diagnostique et pronostique de premier ordre en psychométrie clinique : elle permet de situer avec une précision absolue le rang percentile de n’importe quel patient s’inscrivant dans la plage fermée de l’échelle, tout en visualisant nettement la part globale de l’échantillon basculant dans l’extrême non borné.
7. Applications pratiques en psychologie et psychométrie
7.1 Variables sociodémographiques en recherche clinique
L’inclusion de variables sociodémographiques constitue le socle préliminaire de toute investigation épidémiologique et clinique en sciences du comportement. Parmi ces variables, l’âge chronologique des participants illustre parfaitement la persistance des distributions ouvertes. Dans les études gérontologiques ou de neurodégénérescence (portant par exemple sur la maladie d’Alzheimer), il est d’usage courant de segmenter la population âgée en tranches quinquennales jusqu’à un palier terminal désigné par « 85 ans et plus » ou « 90 ans et plus ».
Cette condensation terminale procède d’une réalité démographique : au-delà de 85 ou 90 ans, les effectifs s’amenuisent drastiquement, rendant toute catégorisation unitaire instable lors des analyses d’échantillonnage. Toutefois, regrouper tous les nonagénaires et centenaires au sein d’une même classe ouverte occulte l’extraordinaire hétérogénéité biologique et cognitive caractérisant ces décennies avancées, ce qui impose aux épidémiologistes une prudence interprétative majeure lors de l’estimation de l’impact du vieillissement terminal sur les fonctions exécutives.
Le revenu disponible du ménage et le statut socio-économique constituent une autre illustration canonique de variable continue discrétisée avec classe ouverte supérieure. Les enquêtes en psychiatrie sociale explorent intensivement la corrélation existant entre le gradient de revenus et la prévalence des troubles anxio-dépressifs. Les barèmes proposés culminent invariablement par une catégorie ouverte (« plus de 6 000 euros mensuels »). De même, le niveau d’instruction, souvent approché par le nombre cumulé d’années de scolarisation post-secondaire, s’achève fréquemment sur la modalité générique « 8 années et plus ».
7.2 Mesure des fréquences comportementales
L’évaluation des habitudes de vie et des comportements additifs repose massivement sur des formats de distribution ouverte. En addictologie clinique, le recueil de la consommation moyenne d’alcool via des instruments standardisés tels que le test AUDIT (Alcohol Use Disorders Identification Test) préconisé par l’INSERM segmente les prises de boissons alcoolisées en unités réparties dans des catégories prédéfinies se terminant invariablement par « 10 unités standard ou plus par jour » ou « 4 fois ou plus par semaine ».
L’analyse contemporaine des cyberaddictions et de l’exposition aux écrans numériques chez les adolescents reproduit fidèlement ce schéma méthodologique. Les protocoles quantifient le temps hebdomadaire consacré aux jeux en réseau ou aux plateformes sociales par des échelles dont la classe terminale affiche « plus de 40 heures par semaine » ou « plus de 8 heures par jour ». Ce groupement permet d’isoler rapidement les usagers à haut risque sans contraindre le protocole à dénombrer les heures précises d’engagement nocturne.
Dans le domaine de la psychopathologie sévère, la quantification des événements paroxystiques — tels que les attaques de panique chez les patients souffrant de trouble panique, les accès boulimiques ou les gestes d’automutilation non suicidaire chez les personnalités borderline — exige une telle architecture. Les cliniciens recourent à des items de fréquence hebdomadaire calibrés de « 0 fois » à « 5 fois ou plus ». Le dépassement du seuil de 5 manifestations traduit un seuil d’alerte clinique aigu, où la variabilité métrique fine au-delà du seuil devient secondaire par rapport à l’urgence thérapeutique de la prise en charge.
7.3 Échelles de réponse semi-quantitatives
Les échelles psychométriques d’auto-évaluation mobilisent fréquemment des échelles de type Likert étendues qui s’apparentent structurellement à des distributions ouvertes à leurs terminaisons. Bien qu’une échelle de Likert standard comporte des ancres nominales ordonnées symétriques (« Fortement en désaccord » à « Fortement d’accord »), certaines déclinaisons quantitatives sollicitent l’évaluation de l’intensité subjective d’un symptôme avec une ancre terminale non bornée.
Dans l’évaluation clinique de la douleur chronique au moyen d’échelles visuelles analogiques (EVA) ou d’échelles semi-quantitatives en 10 points, le palier supérieur peut être désigné comme « Douleur intolérable / Incommensurable ». Cette formulation transforme le pôle supérieur en un puits d’absorption conceptuel où viennent se loger des états sensoriels d’intensité subjective infinie. Le patient ne cote plus une grandeur finie, mais s’inscrit dans une classe ouverte traduisant le débordement de ses capacités de tolérance psychophysiologique.
Cette organisation semi-quantitative met en lumière la sensibilité différentielle des patients aux ancres numériques extrêmes. Certains sujets déploient une réticence psychologique prononcée à mobiliser la dernière catégorie d’une échelle, assimilée à une perte de contrôle absolue, tandis que d’autres s’y réfugient de manière précoce pour dramatiser leur détresse. L’analyste psychométricien doit ainsi demeurer conscient que les classes terminales ouvertes captent autant l’attitude expressive du patient face au dispositif de mesure que la magnitude neurophysiologique réelle du symptôme ressenti.
8. Enjeux psychologiques de la collecte de données ouvertes
8.1 Pression évaluative et effet d’intrusion perçue
La passation d’un test psychométrique ou la réponse à une enquête sociologique n’est jamais un acte neutre sur le plan affectif ; elle confronte l’individu à un miroir évaluatif susceptible de fragiliser son équilibre narcissique. Lorsqu’un formulaire exige la saisie exacte d’une métrique personnelle — comme le nombre d’heures passées au travail, le montant des dettes accumulées ou le poids corporel exact —, des mécanismes de défense psychologique s’activent instantanément, notamment la rationalisation, le refoulement ou le déni.
L’effet protecteur d’une classe ouverte réside dans la modulation de l’intrusion perçue. Proposer à une personne souffrant d’anorexie ou d’obésité morbide de cocher une classe ouverte de type « indice de masse corporelle supérieur à 35 » ou « inférieur à 16 » atténue la violence symbolique de la confrontation au chiffre brut précis. La catégorie large offre un sas de dépersonnalisation qui préserve l’estime de soi du répondant tout en délivrant au chercheur l’information nosographique nécessaire.
L’impact pratique sur l’adhésion au protocole d’évaluation est considérable. Les recherches en psychologie de la mesure indiquent que la présence de classes ouvertes sur les dimensions émotionnellement sensibles jugule de façon déterminante l’abandon prématuré du questionnaire en cours de route. Le répondant ne se heurte pas à une injonction d’exactitude humiliante, ce qui favorise le maintien d’une alliance collaborative tout au long de la passation de l’épreuve.
8.2 Effets de cadrage cognitif induits par les seuils
L’architecture des catégories de réponse proposées au sein d’un questionnaire ne se borne pas à enregistrer passivement les comportements des individus ; elle exerce une influence rétroactive puissante sur le jugement cognitif du répondant à travers des effets de cadrage (framing effects) et des phénomènes d’ancrage heuristique. Théorisée par les psychologues cognitivistes, la théorie des normes conversationnelles postule que les participants interprètent les intervalles fournis par l’expérimentateur comme le reflet implicite de la distribution normale du phénomène au sein de la société.
Dès lors, le positionnement de la borne d’une classe ouverte modifie directement la perception de la normalité sociale :
- Si une enquête sur la consommation d’alcool propose pour classe terminale « Plus de 3 verres par jour », le répondant déduit que dépasser 3 verres constitue une pratique exceptionnelle et socialement stigmatisante. Les consommateurs de 4 verres auront alors une propension accrue à sous-déclarer leur prise pour se conformer à la norme perçue.
- À l’inverse, si l’échelle s’achève par la classe ouverte « Plus de 10 verres par jour », le consommateur de 4 verres relativise immédiatement son comportement, se percevant au sein de la moyenne acceptable, ce qui favorise une déclaration spontanée dénuée d’inhibition.
Ce biais d’inférence statistique induit par un mauvais calibrage des intervalles d’échelle altère la validité interne des recherches. L’expérimentateur qui fixe maladroitement les bornes de ses classes ouvertes risque d’induire artificiellement des surdéclarations ou des sous-déclarations massives, imputables non à la dynamique comportementale des sujets mais à la structure sémiotique de l’instrument de mesure.
8.3 Éthique et consentement éclairé en recherche comportementale
L’élaboration de questionnaires quantitatifs s’inscrit aujourd’hui dans un cadre juridique et déontologique hautement contraignant, gouverné notamment par le Règlement Général sur la Protection des Données (RGPD) en Europe et les préceptes éthiques de la déclaration d’Helsinki. Le principe fondamental de minimisation des données prescrit formellement de ne collecter que les informations strictement nécessaires à la finalité de la recherche, en s’abstenant de requérir des détails biométriques ou biographiques superflus.
Dans cette optique, l’utilisation délibérée de distributions à classes ouvertes pour les variables sensibles constitue une mesure de protection de la vie privée parfaitement alignée sur l’éthique de la recherche. Renseigner qu’un participant gagne « plus de 100 000 euros par an » ou a subi « plus de 5 traumatismes durant l’enfance » s’avère amplement suffisant pour la modélisation épidémiologique, tout en réduisant considérablement le risque de ré-identification malveillante du sujet au sein de bases de données ouvertes (open data).
Toutefois, cette précaution éthique doit être méticuleusement conciliée avec l’impératif de représentativité des populations vulnérables ou marginalisées. Si la borne d’une classe ouverte inférieure ou supérieure est définie de manière trop inclusive ou réductrice, elle risque d’invisibiliser des sous-groupes démographiques singuliers au sein d’une catégorie fourre-tout. La justice distributive de la recherche exige donc une calibration éthique rigoureuse des seuils d’inclusion afin de ne sacrifier ni la granularité scientifique ni l’impératif de protection des données individuelles.
9. Méthodes statistiques avancées pour traiter les classes ouvertes
9.1 Techniques d’imputation et d’estimation paramétrique
Face à l’impossibilité de calculer directement la moyenne et la variance au sein d’une distribution à classes ouvertes, les statisticiens ont développé des démarches paramétriques avancées fondées sur la modélisation probabiliste de la variable sous-jacente continue. Si l’on dispose de fondements théoriques robustes autorisant à formuler une hypothèse sur la loi de probabilité régissant le phénomène, il devient possible d’estimer rigoureusement le centre de la classe ouverte par des méthodes de maximum de vraisemblance.
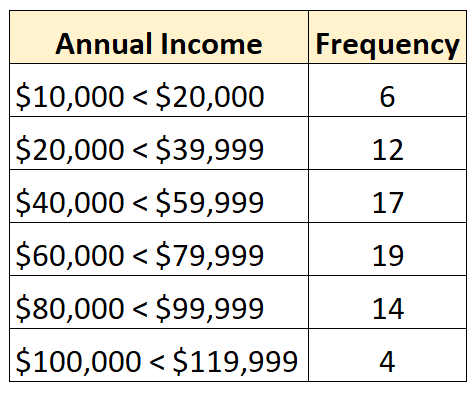
Pour les variables économiques et sociologiques présentant une asymétrie droite marquée (comme le revenu ou le patrimoine), la modélisation par la loi de Pareto représente l’approche de référence. Selon cette distribution, le centre conditionnel d’une classe ouverte supérieure $[Y, +\infty[$ s’exprime par la relation élégante :
$$\bar{x}_{\text{ouvert}} = Y \left( \frac{\alpha}{\alpha – 1} \right) \quad \text{pour } \alpha > 1$$
où $\alpha$ désigne le paramètre d’élasticité de Pareto, déterminé à partir des fréquences cumulées des classes fermées immédiatement antérieures. Lorsque le phénomène obéit plutôt à une cinétique de diffusion continue (comme les temps de réaction ou les concentrations biométriques), l’application de distributions log-normales, gamma ou exponentielles permet similairement d’inférer la localisation théorique de la masse de probabilité masquée.
Dans les cohortes contemporaines de grande envergure, ces approches sont avantageusement relayées par les techniques d’imputation multiple adaptées aux données censurées (méthodes MICE censurées). Au lieu d’assigner une valeur centrale unique déterministe, l’algorithme génère une pluralité de jeux de données complets en tirant stochastiquement des valeurs plausibles au sein du domaine ouvert $[Y, +\infty[$, sous contrainte de la loi de densité globale de l’échantillon. Cette démarche préserve fidèlement l’incertitude d’échantillonnage lors des modélisations ultérieures.
9.2 Modèles de régression pour variables censurées
L’analyse inférentielle multivariée est fréquemment compromise lorsque la variable dépendante (le critère à prédire) présente une structure ouverte. L’application des Moindres Carrés Ordinaires (MCO) sur une variable comportant une troncature ou une censure terminale viole directement les hypothèses de normalité et d’homoscédasticité des résidus, aboutissant à une sous-estimation systématique et sévère de la magnitude des coefficients de régression (biais d’atténuation).
Pour dépasser cette aporie, l’économétrie et la biométrie recourent au modèle de régression Tobit (ou modèle de régression censurée standard), développé initialement par James Tobin. Dans un modèle Tobit censuré à droite au seuil $Y$, la variable latente sous-jacente $y^*$ est supposée obéir à une dynamique linéaire normale :
$$y_i^* = X_i \beta + \varepsilon_i, \quad \varepsilon_i \sim \mathcal{N}(0, \sigma^2)$$
tandis que la variable effectivement observée $y_i$ s’écrit :
$$y_i = \begin{\cases} y_i^* &a\mp; \text{si } y_i^* < Y Y &a\mp; \text{si } y_i^* ge Y \end{\cases}$$
L’estimation des coefficients $\beta$ s’opère par maximisation d’une fonction de log-vraisemblance hybride qui combine une densité continue normale pour les classes fermées et une probabilité cumulative pour la classe ouverte :
$$\ln L = \sum_{y_i < Y} \ln \left[ \frac{1}{\sigma} \phi\left( \frac{y_i – X_i \beta}{\sigma} \right) \right] + \sum_{y_i = Y} \ln \left[ 1 – \Phi\left( \frac{Y – X_i \beta}{\sigma} \right) \right]$$
Une alternative encore plus robuste est constituée par la régression par intervalles (interval regression). Cette méthode généralise l’approche Tobit en considérant chaque intervalle, fermé ou ouvert, comme une fenêtre d’incertitude $[a_i, b_i]$, modélisant directement la probabilité que la valeur latente appartienne à ladite fenêtre. Ces modèles de régression censurée délivrent des estimations non biaisées des relations explicatives, restaurant pleinement la puissance statistique sans déformer artificiellement la structure des données ouvertes.
9.3 Approches non paramétriques
Lorsque le chercheur ne dispose d’aucune garantie empirique relative à la forme paramétrique sous-jacente de la distribution ou que la taille de l’échantillon demeure trop modeste pour autoriser des ajustements de vraisemblance fiables, les méthodes statistiques non paramétriques fondées sur les rangs constituent la trajectoire analytique la plus sûre et la plus élégante.
L’application du test de somme des rangs de Wilcoxon-Mann-Whitney (pour la comparaison de deux groupes indépendants) ou du test de Kruskal-Wallis (pour la confrontation de plusieurs cohortes) résout spontanément le problème de l’amplitude infinie des classes ouvertes. Dans ces protocoles, les observations sont substituées par leur rang dans la hiérarchie globale ordonnée. Dès lors que l’ensemble des individus appartenant à la classe terminale ouverte $[Y, +\infty[$ partagent des valeurs supérieures à celles de toutes les autres classes, ils se voient simplement attribuer le rang moyen ex æquo lié à leur groupe d’inclusion :
$$\text{Rang moyen} = \frac{(N – n_{\text{ouvert}} + 1) + N}{2}$$
La robustesse des méthodes ordonnales face à l’imprécision métrique périphérique est totale : le résultat du test de rang demeure rigoureusement identique, que les sujets de la classe terminale aient franchi la borne supérieure d’un millième de point ou de plusieurs dizaines d’unités de variance. Cette immunité contre les dérives spatiales des queues de distribution confère aux approches non paramétriques une puissance de test remarquable, exempte de tout biais d’arbitraire ou d’inférence fallacieuse.
10. Comparaison empirique : analyse d’une distribution ouverte vs fermée
10.1 Étude de cas : évaluation des heures d’exposition aux écrans
Afin de concrétiser les répercussions empiriques du groupement à classes ouvertes, examinons un échantillon expérimental de $N = 1,000$ adolescents évalués sur leur temps quotidien d’exposition aux écrans numériques récréatifs. Dans une collecte initiale continue non groupée, la moyenne empirique exacte de l’échantillon s’élève à 4,82 heures par jour, avec une médiane de 4,20 heures et un écart-type de 2,35 heures, révélant une queue de distribution étirée vers les grands usagers dont certains atteignent 14 heures quotidiennes.
Supposons que ce même échantillon soit recodé au sein d’une distribution en classes fermées régulières : $[0, 2[$, $[2, 4[$, $[4, 6[$, $[6, 8[$, et une classe supérieure ouverte $[8, +\infty[$ regroupant 95 adolescents (soit 9,5 % de la cohorte). Si un analyste tente d’appliquer la moyenne arithmétique conventionnelle en fermant arbitrairement la dernière classe à l’amplitude conventionnelle des classes précédentes (soit $[8, 10[$ avec un centre de classe assigné à 9,0 heures), la moyenne calculée s’effondre à 4,38 heures. Cette fermeture forcée comprime artificiellement la queue supérieure et sous-estime de près de 10 % l’exposition effective des jeunes les plus à risque.
Cette altération se répercute drastiquement sur les coefficients d’association bivariée. En calculant la corrélation de Pearson entre ce temps d’écran faussement tronqué et un inventaire de dépressivité clinique, le coefficient r chute de $r = 0,38$ (valeur continue réelle) à $r = 0,27$. Cette réduction artificielle de près de 30 % de la taille d’effet démontre le danger méthodologique consistant à masquer la variabilité des données ouvertes par des fermetures paramétriques hâtives.
10.2 Étude de cas : revenu du ménage et détresse psychologique
L’impact de la structure des distributions se manifeste avec une acuité particulière dans la modélisation de la relation non linéaire entre les ressources financières du foyer et les indicateurs de détresse psychologique ou de bien-être subjectif. Dans la littérature épidémiologique, cette relation prend une forme logarithmique classique : une hausse de revenu produit un bénéfice substantiel sur la santé mentale aux échelons de précarité, avant d’atteindre un plateau de rendement décroissant au-delà d’un certain seuil d’aisance financière.
Lorsqu’une enquête partitionne le revenu mensuel en tranches fermées de 1 000 euros jusqu’à un palier terminal ouvert « 8 000 euros et plus », l’information relative à l’extrême richesse (ménages percevant 15 000, 30 000 euros ou davantage) est totalement écrasée dans une unique classe représentative. Si le statisticien modélise cette relation par une régression linéaire standard en affectant arbitrairement à cette dernière classe un revenu imputé de 9 000 euros, il s’expose à un phénomène d’illusion statistique : l’aplatissement de la courbe logarithmique se trouve faussé par un effet de levier artificiel exercé par le point terminal.
Pour redresser adéquatement cette relation, la stratégie méthodologique consiste à mobiliser une régression par intervalles couplée à un ajustement de Pareto pour l’extrémité supérieure. En intégrant formellement le fait que la classe terminale abrite une distribution à queue lourde étirée sur un empan financier étendu, l’estimation préserve l’intégrité de la courbure fonctionnelle réelle et restitue avec fidélité la saturation asymptotique du bien-être subjectif au sommet de l’échelle des revenus.
10.3 Analyse de sensibilité des résultats de recherche
L’évaluation rigoureuse d’une recherche impliquant des distributions à classes ouvertes exige la réalisation systématique d’une analyse de sensibilité (sensitivity analysis). Cette démarche méthodologique cardinale consiste à tester la stabilité des conclusions scientifiques et des inférences statistiques face à des variations contrôlées des postulats de traitement des classes non bornées.
Dans un protocole transparent, le chercheur doit calculer et publier les résultats d’estimation selon une pluralité de scénarios :
- Scénario conservateur : Le centre de la classe ouverte est fixé à la valeur de sa borne inférieure immédiate (hypothèse de dispersion minimale).
- Scénario d’amplitude adjacente : La classe ouverte est complétée en lui attribuant l’amplitude de la classe fermée précédente.
- Scénario paramétrique lourd : Modélisation par distribution de Pareto ou log-normale dérivée des classes antérieures.
- Scénario non paramétrique pur : Analyse exclusive par les rangs et les médianes interquartiles.
Si la significativité statistique ($p\text{-value} < 0,05$) ou la taille d'effet estimée d'une intervention thérapeutique ou d'un facteur d'exposition fluctue substantiellement d'un scénario à l'autre, les conclusions de l'étude doivent être considérées comme fragiles et fortement dépendantes des choix arbitraires du modélisateur. Les principes de la science ouverte imposent d'expliciter cette incertitude structurelle afin d'éviter la propagation de résultats d'artefacts au sein de la communauté scientifique.
11. Bonnes pratiques de conception d’enquêtes et d’échelles
11.1 Critères de décision pour adopter ou éviter une classe ouverte
Le choix d’introduire ou de proscrire une classe ouverte au sein d’un instrument de mesure ne doit jamais résulter du hasard ou de la simple commodité bureautique. Il requiert un arbitrage rigoureux entre deux impératifs méthodologiques antagonistes : la précision fine de l’analyse métrique quantitative continue d’une part, et l’acceptabilité ergonomique ainsi que la complétude de réponse du participant d’autre part.
Les critères décisionnels peuvent être synthétisés au sein d’une grille d’orientation épistémologique :
- Adopter le recueil continu direct (évitement de la classe ouverte) : Lorsque la variable mesurée possède une unité physique claire, stable et facilement mémorisable par le sujet (par exemple l’âge exact en années, le nombre d’enfants à charge, la taille corporelle en centimètres), et que la collecte se déroule dans un climat de confiance garantissant l’absence de réactance psychologique. Le recueil direct préserve l’intégralité de l’information mathématique et autorise a posteriori tous les regroupements souhaités.
- Adopter une classe ouverte unilatérale : Lorsque la variable présente une asymétrie extrême prévisible avec une traîne infinie (heures de jeu vidéo, consommation compulsive de tabac), que les valeurs extrêmes sont suspectes de distorsion mnésique ou d’exagération, et que l’objectif premier de l’instrument est le dépistage clinique ou la stratification épidémiologique générale.
- Proscrire formellement la classe ouverte : Dans les protocoles expérimentaux fondamentaux de psychologie cognitive et de neurosciences où la modélisation mathématique repose sur l’ajustement précis de distributions théoriques de temps de réponse (comme les modèles de diffusion ou d’ex-Gaussienne), pour lesquels la censure d’une extrémité anéantirait la testabilité des hypothèses computationnelles.
11.2 Optimisation du positionnement des seuils limites
Lorsque le recours à une distribution à classes ouvertes est jugé indispensable, l’emplacement du seuil critique de basculement ($X$ ou $Y$) conditionne l’ensemble de la qualité métrique ultérieure. Une erreur fréquente de conception consiste à positionner ce seuil trop bas par rapport à la distribution empirique réelle, ce qui a pour conséquence fâcheuse d’engloutir une part démesurée de la cohorte au sein de la modalité ouverte.
La règle d’or méthodologique préconise de s’appuyer sur des études pilotes rigoureuses ou des données de recensement fiables afin de calibrer les seuils. Une classe ouverte terminale ne devrait idéalement jamais capturer plus de 5 % à 10 % de la population d’échantillonnage globale. En cantonnant la classe ouverte à cette marge périphérique étroite, le chercheur s’assure que la médiane ($P_{50}$) et le troisième quartile ($P_{75}$) demeurent fermement ancrés dans les intervalles réguliers fermés, préservant ainsi l’intégralité des analyses de dispersion interquartile.
De surcroît, le seuil retenu doit correspondre à une frontière sémiotique cliniquement ou scientifiquement signifiante. En psychométrie de l’anxiété, placer un seuil ouvert à « 15 crises de panique ou plus par mois » isole une sous-population pathologique sévère justifiant une intervention psychiatrique urgente. Placer ce seuil arbitrairement à « 3 crises ou plus » agglomérerait de manière confuse des états névrotiques modérés et des tableaux d’invalidation clinique majeure, détruisant tout pouvoir discriminant à l’instrument d’évaluation.
11.3 Documentation méthodologique et archivage des protocoles
La transparence méthodologique constitue le pilier fondamental de la reproductibilité scientifique. Face aux ambiguïtés intrinsèques qu’engendrent les distributions à classes ouvertes, les chercheurs se doivent de consigner avec une méticulosité absolue chaque étape de la chaîne de traitement au sein de leurs rapports d’évaluation et de leurs publications académiques.
Cette documentation rigoureuse doit impérativement stipuler :
- Le libellé textuel exact et exhaustif des modalités de réponse soumises aux participants lors de la passation du test ou de l’enquête.
- La justification scientifique et bibliographique ayant présidé à la sélection des seuils d’ouverture supérieure ou inférieure.
- Les algorithmes précis et les formules de recodage adoptés pour le calcul des indicateurs de tendance centrale et de dispersion.
- Les scripts computationnels intégraux (exécutés sous des environnements tels que R, Python ou SAS) attestant de l’utilisation de modèles de régression censurée (Tobit, régression par intervalles) ou de tests non paramétriques sur les rangs.
Conformément aux principes directeurs de la science ouverte (Open Science Framework), le dépôt des protocoles de recodage dans des entrepôts de données certifiés permet aux équipes indépendantes de réanalyser les cohortes en éprouvant d’autres hypothèses d’imputation. Cette rigueur garantit que la présence inévitable de classes ouvertes ne se transforme jamais en un vecteur d’opacité statistique ou de contestabilité scientifique.
12. Synthèse critique et perspectives en modélisation computationnelle
12.1 Les distributions ouvertes à l’ère du Big Data et du traçage numérique
L’essor fulgurant des technologies d’enregistrement numérique continu et l’avènement du Big Data transforment profondément l’écologie de la collecte de données en sciences du comportement. L’utilisation croissante de capteurs passifs embarqués — montres connectées mesurant la fréquence cardiaque et l’activité motrice, actigraphes évaluant le sommeil, journaux de bord numériques automatisés traçant le temps d’exposition aux écrans à la milliseconde près — tend à rendre obsolète le recours aux questionnaires statiques partitionnés à classes ouvertes.
Désormais, les analystes de données ont accès à des trajectoires continues exhaustives où chaque seconde d’engagement comportemental est répertoriée de façon brute sans nécessiter de regroupement a priori en tranches verbales floues. Toutefois, cette mutation technologique n’éradique nullement la problématique des distributions ouvertes ; elle la déplace sur un autre plan épistémologique. D’une part, les bases de données administratives et médico-sociales consolidées continuent d’agréger massivement leurs archives sous des formats de classes ouvertes pour des motifs d’anonymisation et de protection légale des données privées.
D’autre part, les algorithmes contemporains d’apprentissage automatique (machine learning) se heurtent de plein fouet à ces architectures hybrides lors de l’entraînement de réseaux neuronaux ou de modèles de gradient boosting. L’intégration de variables catégorielles ordinales se terminant par une classe ouverte non bornée exige le développement de pipelines de prétraitement sophistiqués combinant quantification par plongement (embeddings) et contraintes de régularisation pour éviter que les modèles d’intelligence artificielle ne prédisent des aberrations sur les ailes de la distribution.
12.2 Approches bayésiennes de la censure d’intervalles
Dans le champ de la statistique computationnelle contemporaine, l’inférence bayésienne propose sans conteste le cadre théorique le plus unifié et le plus puissant pour surmonter les limites des distributions ouvertes. Dans le paradigme bayésien, l’incertitude entourant la valeur métrique exacte masquée par une classe ouverte $[Y, +\infty[$ n’est plus traitée par une imputation déterministe fixe, mais est formalisée comme une distribution de probabilité a posteriori sur une variable latente non observée.
Grâce aux algorithmes d’échantillonnage par chaînes de Markov Monte Carlo (MCMC, tels que le No-U-Turn Sampler implémenté dans le langage probabiliste Stan), le chercheur formule un modèle génératif complet où les observations de la classe ouverte sont traitées comme des données manquantes informatives conditionnées par une fonction de vraisemblance tronquée :
$$p(y_i mid \theta) = \int_{Y}^{+\infty} p(y^* mid \theta) , dy^* \quad \text{pour } y_i in [Y, +\infty[$$
Ce formalisme intègre avec une flexibilité inégalée des distributions a priori informatives fondées sur la littérature épidémiologique antérieure pour contraindre le comportement asymptotique de la queue de distribution. Les chaînes d’échantillonnage simulent des milliers de configurations conjointes des paramètres, délivrant des intervalles de crédibilité d’une rigueur absolue pour la médiane, la dispersion et les coefficients de régression, tout en quantifiant avec précision l’incertitude épistémique générée par l’ouverture de l’intervalle.
12.3 Recommandations finales pour les chercheurs en sciences humaines
Au terme de cette exploration transversale de la distribution ouverte, il apparaît manifeste que cette structure de données, loin de constituer une simple anomalie descriptive, incarne un pont méthodologique pragmatique entre les exigences de simplicité de collecte psychologique et la complexité des manifestations humaines extrêmes. Pour manier ces instruments avec une rigueur scientifique irréprochable, les praticiens et chercheurs en sciences humaines et du comportement sont invités à adopter une discipline méthodologique articulée autour de préceptes cardinaux :
- Priorité inconditionnelle aux statistiques robustes : Bannir formellement l’usage de la moyenne arithmétique et de l’écart-type dès lors qu’une variable comporte au moins une classe ouverte. Adopter systématiquement la médiane comme paramètre d’ancrage central et l’écart interquartile (IQR) comme mesure étalon de la variabilité.
- Récusation de toute fermeture arbitraire simpliste : Proscrire l’imputation discrétionnaire d’amplitudes fixes pour forcer la fermeture des intervalles périphériques dans le dessein d’appliquer des tests paramétriques élémentaires. Recourir sans réserve aux tests non paramétriques sur les rangs (Mann-Whitney, Kruskal-Wallis) ou aux modèles formalisés pour variables censurées (régression Tobit, régression par intervalles).
- Optimisation précoce lors de la conception : Calibrer judicieusement les seuils de rupture au cours de phases pré-expérimentales afin de cantonner l’effectif des classes ouvertes sous le plafond critique de 5 % à 10 % de la cohorte, garantissant ainsi l’intégrité de l’empan interquartile central.
- Vigilance interprétative clinique : Sensibiliser les équipes soignantes et les évaluateurs au fait que les catégories ouvertes terminales créent un effet de condensation visuelle qui égalise artificiellement des profils comportementaux ou émotionnels dont la gravité sous-jacente peut différer de plusieurs ordres de grandeur.
- Transparence computationnelle absolue : Expliciter sans réserve dans les publications scientifiques les protocoles mathématiques appliqués au traitement des classes ouvertes et publier les codes analytiques selon les standards internationaux de la science ouverte reproductible.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bowley, A. L. (1920). Elements of statistics (4th ed.). P.S. King & Son.
- Babbie, E. R. (2021). The practice of social research (15th ed.). Cengage Learning.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
- Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
- Institut national de la statistique et des études économiques. (2022). Guide des pratiques d’échantillonnage et de traitement des données d’enquêtes. Insee Méthodes. https://www.insee.fr
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Organisation de coopération et de développement économiques. (2013). OECD guidelines on measuring subjective well-being. OECD Publishing. https://doi.org/10.1787/9789264191655-en
- Organisation mondiale de la Santé. (2001). The Alcohol Use Disorders Identification Test (AUDIT): Guidelines for use in primary care (2nd ed.). World Health Organization. https://www.who.int
- Pareto, V. (1896). Cours d’économie politique. F. Rouge.
- Tobin, J. (1958). Estimation of relationships for generalized truncated dependent variables. Econometrica, 26(1), 24–36. https://doi.org/10.2307/1907382
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2022). Introduction to robust estimation and hypothesis testing (5th ed.). Academic Press. https://doi.org/10.1016/C2019-0-04332-9