
L’analyse quantitative des phénomènes naturels et des conduites humaines repose fondamentalement sur l’aptitude des chercheurs à formaliser l’incertitude. Dans le champ des sciences cognitives, de la psychologie différentielle et de la biométrie, la modélisation statistique ne constitue pas un simple artifice calculatoire ; elle incarne le cadre épistémologique au travers duquel la variabilité empirique devient intelligible. Face au désordre apparent des comportements observables, des temps de réaction ou des aptitudes intellectuelles, les lois de probabilité offrent une armature mathématique rigoureuse permettant de distinguer les régularités structurelles du bruit stochastique résiduel.
Au sein de l’arsenal des distributions théoriques, deux modèles se distinguent par leur statut fondamental et leurs propriétés géométriques radicalement opposées : la distribution normale (ou loi de Gauss-Laplace) et la distribution uniforme (continue ou discrète). Tandis que la première symbolise la convergence des forces centrifuges de la nature vers un état d’équilibre centralisé, la seconde postule l’équiprobabilité absolue et l’indifférence spatiale au sein d’un domaine fini. Cette divergence morphologique et conceptuelle reflète deux visions contrastées des processus sous-jacents qui génèrent les données expérimentales.
Comprendre la dichotomie entre la cloche gaussienne et le rectangle uniforme est un impératif méthodologique pour quiconque manipule des scores psychométriques, calibre des protocoles expérimentaux ou évalue la validité d’hypothèses inférentielles. Confondre ces deux représentations ou méconnaître les conditions de leur applicabilité expose le chercheur à des distorsions diagnostiques sévères, à des erreurs d’inférence de type I et II et à une interprétation biaisée des traits psychologiques latents. Cet article se propose d’explorer de manière exhaustive les fondements mathématiques, les propriétés comparées et les implications empiriques de ces deux piliers du calcul des probabilités.
1. Introduction aux lois de probabilité dans les sciences du comportement
1.1 Le rôle des modèles probabilistes en psychologie expérimentale
L’étude scientifique des conduites humaines est confrontée à une contingence incontournable : la variabilité intraspécifique et intra-individuelle. Contrairement aux systèmes de la physique classique où certaines constantes universelles permettent des prédictions déterministes, la psychologie expérimentale observe des réponses comportementales modulées par une multiplicité de facteurs endogènes et exogènes. Dans cette perspective, la modélisation de l’incertitude devient le vecteur essentiel par lequel l’expérimentateur extrait des lois générales à partir d’observations dispersées. Un modèle probabiliste attribue une mesure de vraisemblance à chaque état observable du système, permettant ainsi de quantifier formellement le hasard.
Dans l’édification d’instruments psychométriques, tels que les batteries d’évaluation neuropsychologique ou les tests de personnalité, l’étalonnage repose sur l’hypothèse qu’une variable latente inobservable sous-tend les performances manifiestes. Pour calibrer ces instruments, l’adoption d’une distribution théorique de référence est impérative. Cette calibration permet de transformer un score brut arbitraire en une métrique normée, facilitant ainsi la comparaison objective d’un individu par rapport à un groupe de référence représentatif. Sans distribution de probabilité postulée a priori ou vérifiée a posteriori, il est formellement impossible de définir des zones de normalité statistique ou d’identifier des singularités cliniques significatives.
Il convient également d’établir une distinction préliminaire rigoureuse entre les processus stochastiques discrets et continus. Alors que certaines variables comportementales se manifestent sous une forme intrinsèquement dénombrable — comme le nombre d’erreurs commises lors d’une tâche de mémoire de travail ou le choix d’une modalité sur une échelle qualitative ordonnée —, d’autres phénomènes s’inscrivent dans un continuum temporel ou spatial, à l’instar de la latence de réponse oculaire mesurée en millisecondes. Les distributions théoriques doivent par conséquent refléter fidèlement la nature dimensionnelle du phénomène observé sous peine de violer les postulats de continuité nécessaires aux inférences avancées.
1.2 Définition synthétique de la loi normale et de la loi uniforme
La distribution normale s’impose dans l’histoire des sciences comme le modèle privilégié des phénomènes d’accumulation. Formulée initialement par Abraham de Moivre et développée indépendamment par Carl Friedrich Gauss et Pierre-Simon de Laplace, elle décrit le comportement d’une variable aléatoire résultant d’une somme de perturbations infimes, indépendantes et non identifiables isolément. Sa morphologie en courbe de cloche illustre un principe d’attraction gravitationnelle statistique : les valeurs les plus probables se condensent avec une intensité maximale autour de la valeur moyenne, tandis que la vraisemblance des déviations s’amenuise de façon symétrique au fur et à mesure que l’on s’éloigne du centre.
À l’extrême opposé, la distribution uniforme incarne l’expression probabiliste de l’indifférence géométrique ou du principe de raison insuffisante formulé par Jacques Bernoulli et formalisé ultérieurement par Laplace. Dans une distribution uniforme continue définie sur un intervalle délimité, chaque sous-intervalle d’égale amplitude possède exactement la même probabilité de réalisation. Aucune région du support spatial ne jouit d’un statut privilégié ; il n’existe ni noyau d’attraction, ni gradient de rareté, ni atténuation progressive. La fonction de densité adopte ainsi le profil strict d’un plateau rectangulaire d’une régularité absolue.
L’opposition conceptuelle entre ces deux modèles revêt une pertinence heuristique majeure pour l’analyse quantitative. D’un point de vue thermodynamique et informationnel, la distribution uniforme maximise l’entropie différentielle pour un support compact délimité, représentant l’état d’incertitude absolue où toute prédiction directionnelle est vaine. Inversement, la loi normale maximise cette même entropie sous la contrainte d’une moyenne et d’une variance fixées sur l’ensemble de la droite réelle. Ces deux lois constituent ainsi les antipodes logiques à partir desquels s’articule le diagnostic des mécanismes générateurs de données en psychologie.
1.3 Enjeux méthodologiques du choix distributionnel
Le choix d’un cadre distributionnel n’est nullement une étape purement protocolaire de l’analyse des données ; il engage la validité même des conclusions inférentielles tirées par le chercheur. La quasi-totalité des tests paramétriques traditionnels, tels que l’analyse de variance (ANOVA), les régressions linéaires par moindres carrés et les tests t de Student, reposent sur l’hypothèse formelle de la normalité des erreurs résiduelles. Présumer la normalité d’un phénomène qui répondrait en réalité à une dynamique uniforme tronquée altère la structure des fonctions de vraisemblance et vicie les niveaux d’erreur alpha fixés conventionnellement à cinq pour cent.
Au niveau de l’ingénierie psychométrique, les conséquences sur l’étalonnage des scores bruts et le positionnement des rangs percentiles se révèlent dramatiques. Dans une distribution normale, la distance séparant le 50e percentile du 60e percentile en termes d’unités d’écart-type est considérablement plus restreinte que celle séparant le 90e percentile du 99e percentile, en raison de la retombée rapide des queues de distribution. Si un praticien appliquait naïvement une règle de correspondance uniforme à une variable en réalité gaussienne, il surévaluerait massivement la compétence relative des sujets situés aux franges supérieures tout en sous-estimant la variabilité interne du groupe central.
De surcroît, les risques d’erreurs de type I (rejet erroné d’une hypothèse nulle véridique) et de type II (incapacité à détecter un effet substantiel pourtant existant) sont étroitement corrélés à l’adéquation du modèle distributionnel employé. Lorsqu’une distribution uniforme est traitée comme une distribution normale, les estimations de la variance d’échantillonnage peuvent être artificiellement gonflées par l’absence d’amortissement asymptotique aux frontières. Il en résulte un effondrement de la puissance statistique des tests, empêchant les chercheurs d’identifier des différences interindividuelles subtiles mais cliniquement déterminantes.
2. Fondements mathématiques et structure de la distribution normale
2.1 Fonction de densité et paramètres fondamentaux
D’un point de vue analytique rigoureux, la variable aléatoire continue $X$ suivant une loi normale d’espérance mathématique $\mu$ et de variance $\sigma^2$ (notée conventionnellement $X \sim \mathcal{N}(\mu, \sigma^2)$) est régie par une fonction de densité de probabilité $f(x)$ définie sur la totalité de l’ensemble des nombres réels $\mathbb{R}$. Cette formulation analytique s’exprime selon l’équation fondamentale de Gauss-Laplace :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right)$$
Dans cette formalisation mathématique, la constante de normalisation $1 / (\sigma \sqrt{2\pi})$ garantit que l’intégrale de la fonction sur le domaine infini $[-\infty, +\infty]$ soit rigoureusement égale à l’unité. Le paramètre $\mu in \mathbb{R}$ exerce le rôle exclusif de paramètre de position. Il détermine l’abscisse du sommet de la cloche, dictant la localisation du barycentre de la masse de probabilité sur l’axe numérique sans altérer en aucune manière l’étalement ou la courbure globale de la courbe.
Le paramètre $\sigma > 0$, représentant l’écart-type de la variable aléatoire, opère comme le paramètre d’échelle et de dispersion de la distribution. Plus $\sigma$ est élevé, plus la courbe s’aplatit et s’élargit de manière transversale tout en conservant une aire totale constante sous son graphe. Une propriété géométrique élégante de cette fonction réside dans la présence de deux points d’inflexion distincts, situés avec une régularité immuable aux abscisses $x = \mu – \sigma$ et $x = \mu + \sigma$. En ces points précis, la dérivée seconde de la densité s’annule ($f »(x) = 0$), signalant le passage d’une concavité orientée vers le bas à une convexité orientée vers le haut.
2.2 La morphologie en cloche et le concept de retombée asymptotique
L’attribut iconique de la distribution normale est incontestablement sa morphologie campaniforme symétrique. Cette forme découle directement de l’opérateur exponentiel négatif appliqué au carré des déviations standardisées. Dès lors que l’écart $|x – mu|$ s’accroît, le terme quadratique $((x-\mu)/\sigma)^2$ impose une décroissance exponentielle ultra-rapide à la valeur de la densité de probabilité. Les queues de distribution ne rejoignent jamais formellement l’axe des abscisses pour toute valeur finie de $x$, traduisant un comportement asymptotique bilatéral qui s’étend à l’infini positif et négatif.
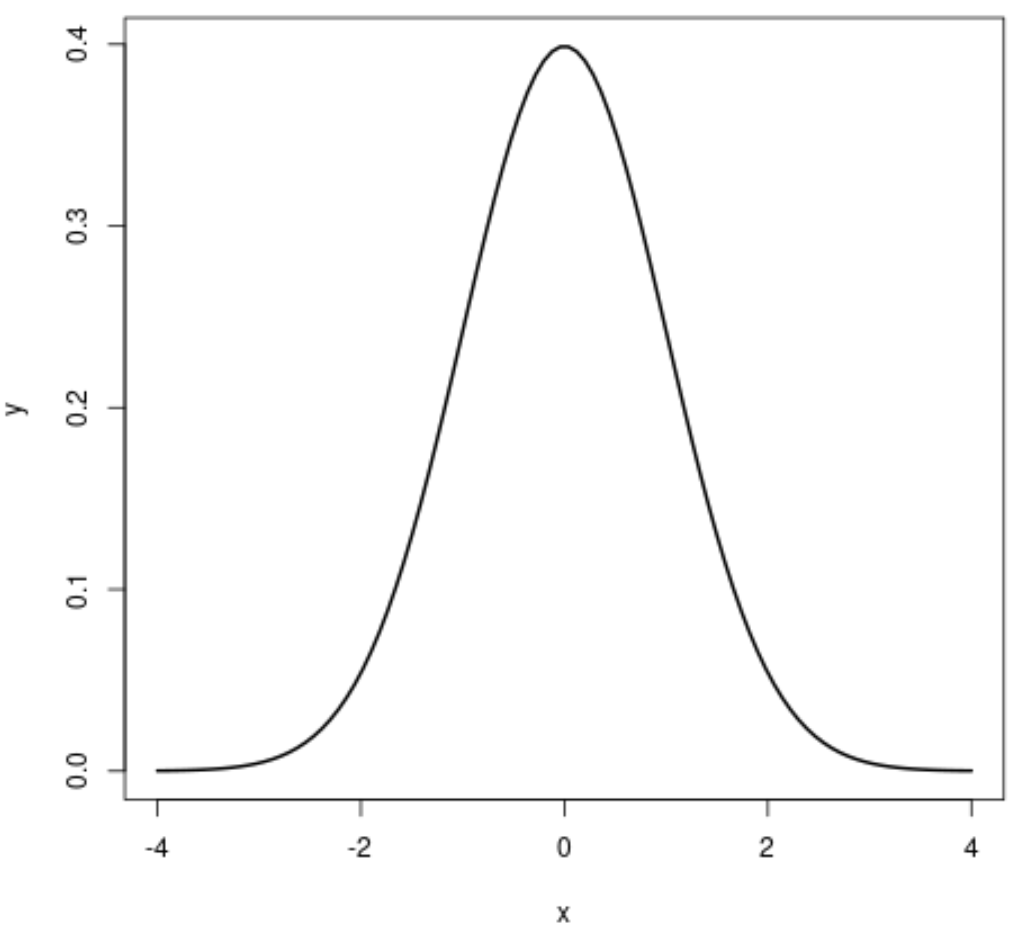
Cette décroissance rapide génère une concentration exceptionnelle de la masse probabiliste au voisinage immédiat du centre de gravité. Ce phénomène s’illustre formellement au travers de la règle empirique des 68-95-99,7, socle méthodologique de l’inférence statistique classique. L’intégration de la fonction de densité entre $\mu – \sigma$ et $\mu + \sigma$ capture approximativement 68,27 % de la probabilité totale. En élargissant l’intervalle à deux écarts-types de part et d’autre de la moyenne ($\mu \pm 2\sigma$), on englobe 95,45 % de l’aire totale, tandis qu’une excursion à trois écarts-types ($\mu \pm 3\sigma$) absorbe 99,73 % des observations potentielles.
Cette structure impose une rareté presque absolue aux événements extrêmes. La probabilité d’observer une réalisation empirique au-delà de quatre écarts-types de la moyenne ($\pm 4\sigma$) est inférieure à 0,0063 %, ce qui correspond à moins d’une chance sur quinze mille. Par conséquent, si un modèle théorique gaussien offre une souplesse calculatoire remarquable grâce à son support mathématique non borné, il contraint le modélisateur à postuler la quasi-impossibilité de déviations monumentales, limitant ainsi la représentativité du modèle pour les systèmes dynamiques sujets aux crises ou aux phénomènes d’extrêmes critiques.
2.3 Propriétés d’invariance et transformation affine
La puissance opérationnelle de la loi normale découle en grande partie de sa stabilité exceptionnelle sous les transformations affines. Si une variable aléatoire $X$ suit une loi normale $\mathcal{N}(\mu, \sigma^2)$, alors toute transformation linéaire de la forme $Y = aX + b$, avec $a \neq 0$ et $b in \mathbb{R}$, produit une variable aléatoire $Y$ qui conserve fidèlement une distribution normale, régie par les paramètres réajustés $\mathcal{N}(a\mu + b, a^2\sigma^2)$. Cette invariance de forme est une rareté mathématique remarquable parmi les familles paramétriques continues.
Ce principe autorise la pratique standardisée universelle en psychométrie : la conversion d’un score brut quelconque en une variable centrée et réduite $Z$, définie par la relation :
$$Z = \frac{X – \mu}{\sigma}$$
La variable standardisée résultante obéit à la loi normale standard $\mathcal{N}(0, 1)$, caractérisée par une moyenne nulle et une variance unitaire. Ce mécanisme permet de neutraliser totalement l’effet des unités de mesure originelles — qu’il s’agisse de secondes, de points bruts à un test ou de millimètres de déplacement — pour rapporter toutes les mesures à un étalon universel de distance stochastique, largement tabulé et intégré dans les bibliothèques logicielles modernes.
Enfin, la distribution normale se distingue par sa stabilité fondamentale sous l’opération d’addition de variables indépendantes. Si deux variables aléatoires indépendantes $X_1$ et $X_2$ obéissent respectivement à des lois normales $\mathcal{N}(\mu_1, \sigma_1^2)$ et $\mathcal{N}(\mu_2, \sigma_2^2)$, alors leur somme linéaire $S = X_1 + X_2$ suit rigoureusement une distribution normale $\mathcal{N}(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)$. Cette propriété d’invariance additive constitue un pivot central pour la théorie de la mesure, car elle garantit que l’agrégation d’erreurs de mesure indépendantes et normales préserve l’intégrité distributionnelle du système composite.
3. Fondements mathématiques et structure de la distribution uniforme
3.1 Formulation continue sur un intervalle fini
La formalisation analytique de la distribution uniforme continue s’inscrit dans un paradigme géométrique radicalement épuré. Contrairement à la courbe gaussienne dont le domaine s’étend sur l’infinité de l’axe réel, la distribution uniforme continue n’existe que sur un support compact, délimité par une borne inférieure $a$ et une borne supérieure $b$, telles que $-\infty < a < b < +\infty$. Sur cet intervalle $[a, b]$, la fonction de densité de probabilité $f(x)$ ne présente aucune fluctuation ; elle demeure rigoureusement constante en tout point.
L’expression formelle de cette fonction de densité s’écrit :
$$f(x) = \begin{\cases} \frac{1}{b – a} &a\mp; \text{si } a le x le b 0 &a\mp; \text{si } x < a \text{ ou } x > b \end{\cases}$$
La valeur de l’ordonnée $1 / (b – a)$ est une conséquence inévitable du premier axiome de Kolmogorov, imposant que l’intégrale d’une fonction de densité sur l’espace des réalisations possibles soit égale à un. La surface rectangulaire de base égale à $(b – a)$ doit impérativement afficher une hauteur proportionnelle inverse pour que le volume total de probabilité soit strictement conservé.
En dehors de cet intervalle fermé ou semi-ouvert, la densité est identiquement nulle. Cette propriété de discontinuité abrupte aux points $x = a$ et $x = b$ distingue substantiellement la loi uniforme des distributions asymptotiques. Les frontières du support constituent des barrières infranchissables au-delà desquelles la probabilité d’occurrence s’effondre instantanément à zéro, interdisant toute notion de queue de distribution ou de dispersion résiduelle infinie.
3.2 La géométrie rectangulaire et l’équiprobabilité
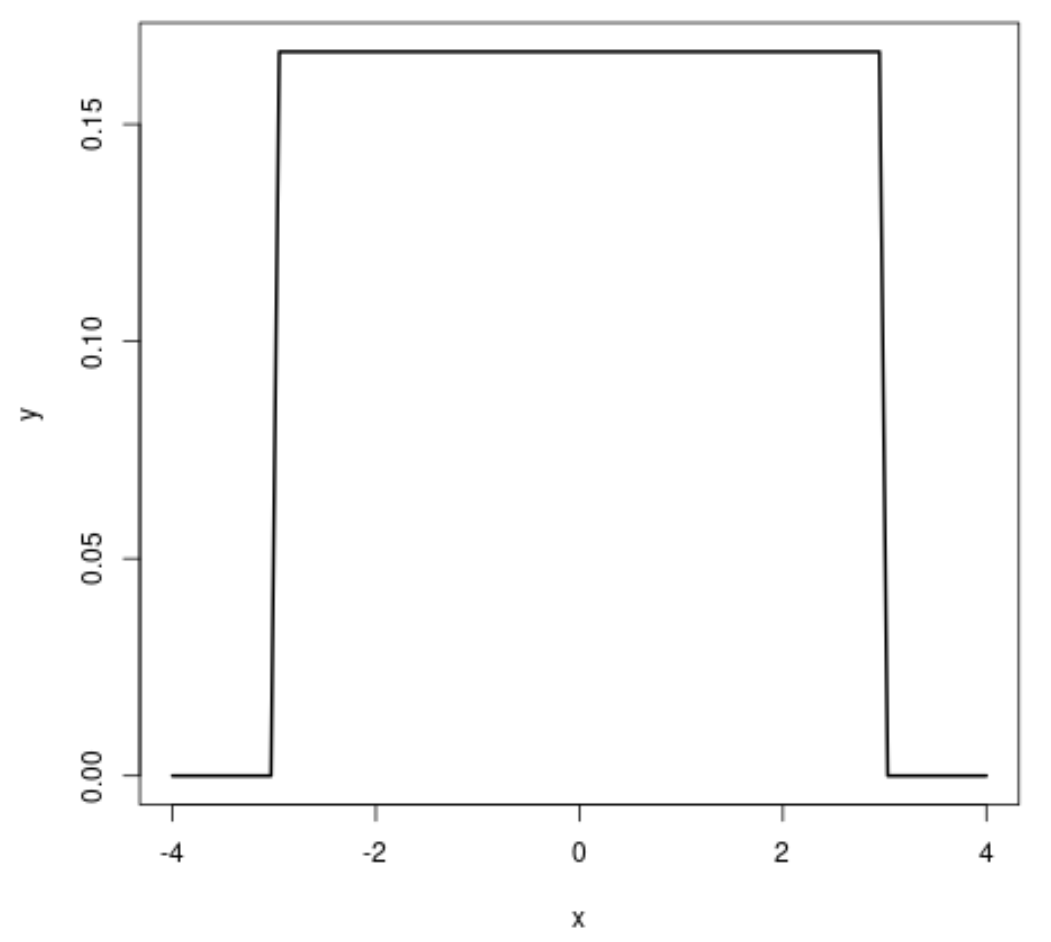
Sur le plan géométrique, la représentation de la fonction de densité uniforme prend la forme indiscutable d’un rectangle parfait érigé au-dessus de l’intervalle $[a, b]$. Cette géométrie rectangulaire constitue la traduction spatiale du principe fondamental d’équiprobabilité. Si l’on considère deux sous-intervalles quelconques $[x_1, x_2]$ et $[x_3, x_4]$ inclus dans le support $[a, b]$, la probabilité que la variable aléatoire s’y loge dépend exclusivement de l’amplitude physique de ces intervalles, et nullement de leur position relative le long du segment.
Formellement, pour tout sous-intervalle $[\alpha, \beta] \subseteq [a, b]$, le calcul de la probabilité associée s’opère par une simple intégration d’une constante, ce qui revient à un calcul élémentaire de proportionnalité géométrique :
$$P(\alpha le X le \beta) = \int_{\alpha}^{\beta} \frac{1}{b – a} , dx = \frac{\beta – \alpha}{b – a}$$
Cette propriété de linéarité pure de la fonction de répartition cumulative implique l’absence intégrale de point focal ou de noyau de condensation. Contrairement à la dynamique gaussienne où les données se concentrent autour du barycentre avec une force prépondérante, la distribution uniforme traite chaque unité métrique de son espace avec une stricte parité démocratique. Il n’y a aucun « épicentre » stochastique : chaque micro-intervalle de longueur $\Delta x$ reçoit exactement la même part unitaire de probabilité $\Delta x / (b – a)$.
3.3 Variantes continues et discrètes
L’analyse des processus comportementaux nécessite souvent de transposer ce principe d’équiprobabilité à des variables non continues. La loi uniforme discrète modélise des contextes expérimentaux où une variable ne peut prendre qu’un ensemble fini de $n$ valeurs distinctes et isolées, couramment indexées sous la forme ${k_1, k_2, \ldots, k_n}$. La fonction de masse de probabilité associe alors à chaque modalité singulière une probabilité invariante égale à $P(X = k_i) = 1/n$. C’est le modèle par excellence du dé équilibré à six faces ou du tirage aléatoire d’un jeton parmi $n$ alternatives équiprobables dans une épreuve de choix forcé.
La distribution uniforme continue peut être appréhendée d’un point de vue asymptotique comme la limite analytique d’une suite de variables uniformes discrètes réparties régulièrement sur un intervalle fixé, lorsque le nombre de subdivisions possibles tend vers l’infini et que la distance inter-points converge vers zéro. Cette convergence conceptuelle assure une continuité théorique entre les tirages de cartes dans un protocole d’évaluation cognitive et la mesure d’une phase temporelle continue oscillant aléatoirement dans un cycle périodique fermé.
Dans la théorie des probabilités et l’informatique algorithmique, le paramétrage standard privilégié repose sur l’intervalle unitaire normalisé $[0, 1]$. La distribution $U(0, 1)$ sert de matrice universelle pour l’ensemble du calcul stochastique computationnel. Sa fonction de densité se simplifie sous la forme $f(x) = 1$ pour $x in [0, 1]$, et sa fonction de répartition est l’identité exacte $F(x) = x$. Comme nous l’explorerons ultérieurement, c’est à partir de cette simplicité géométrique primitive que peuvent être engendrées, par transformation déterministe, les distributions les plus complexes de la modélisation statistique moderne.
4. Analyse comparative de la symétrie : similarités et divergences conceptuelles
4.1 La symétrie bilatérale comme propriété partagée
La confrontation systématique de la distribution normale et de la distribution uniforme met en exergue une convergence morphologique de premier plan : toutes deux manifestent une symétrie bilatérale stricte par rapport à leur centre théorique. Sur le plan formel, une fonction de densité $f(x)$ est dite symétrique par rapport à un axe vertical situé en $x = c$ si elle vérifie l’égalité d’invariance par réflexion $f(c – x) = f(c + x)$ pour toute valeur réelle de $x$. Pour la loi normale, cet axe s’érige à l’abscisse $c = \mu$, tandis que pour la loi uniforme, il se déploie précisément au point médian $c = (a + b) / 2$.
Cette propriété géométrique implique que les surfaces d’intégration situées de part et d’autre du pivot central constituent des miroirs parfaits l’une de l’autre. En conséquence, les probabilités cumulées à équidistance du centre respectent des proportions rigoureusement complémentaires :
$$P(X le c – \Delta) = P(X ge c + \Delta) \quad \forall \Delta ge 0$$
Une conséquence analytique immédiate de cette architecture équilibrée réside dans la nullité théorique absolue du troisième moment centré, lequel gouverne le coefficient d’asymétrie (skewness de Fisher, noté $\gamma_1$). Que l’on examine une cloche de Gauss étirée ou un plateau uniforme délimité, le coefficient de skewness est formellement égal à zéro :
$$\gamma_1 = \frac{\mathbb{E}[(X – \mu)^3]}{\sigma^3} = 0$$
Toute asymétrie non nulle observée lors de l’échantillonnage empirique d’une variable supposée relever de l’un de ces deux modèles atteste soit de la présence d’un biais d’échantillonnage, soit de l’inadéquation du modèle stochastique convoqué.
4.2 Convergence et divergence des mesures de tendance centrale
La présence d’un axe de symétrie bilatérale force la convergence arithmétique des indices fondamentaux de tendance centrale. Pour les deux lois considérées, l’espérance mathématique (la moyenne pondérée théorique) coïncide rigoureusement avec la médiane (le point séparateur coupant l’aire sous la courbe en deux fractions équiprobables de 50 %). Ainsi, dans les deux modèles, le centre de gravité probabiliste correspond scrupuleusement au score séparant la moitié inférieure de la moitié supérieure des observations théoriques.
Néanmoins, la notion de mode — défini comme l’abscisse maximisant la fonction de densité de probabilité — matérialise une divergence topologique flagrante entre les deux distributions. La distribution normale est strictement unimodale : sa dérivée première s’annule en un point unique $x = \mu$, où la fonction atteint son maximum global absolu. Dès lors, pour la loi normale, l’alignement des trois indicateurs majeurs est absolu et singulier :
$$\text{Moyenne} = \text{M%C3%A9diane} = \text{Mode} = \mu$$
À l’opposé, la distribution uniforme continue ne possède aucun mode singulier ; elle est formellement qualifiée d’amodale (ou de multimodale non spécifique). Sa dérivée première est rigoureusement nulle en chaque point intérieur de son support ouvert $]a, b[$. Chaque point du segment $[a, b]$ présente la même valeur maximale de densité $1 / (b – a)$. Parler du mode d’une distribution uniforme relève de l’ineptie mathématique, car le centre $(a + b) / 2$ ne concentre aucune densité supérieure à celle des extrémités limitrophes $a$ ou $b$. Cette absence totale d’apogée constitue le premier point de rupture dans l’interprétation empirique des mesures de tendance centrale.
4.3 Nature philosophique de la symétrie dans les deux contextes
L’analyse épistémologique révèle que, sous une apparente conformité mathématique (symétrie bilatérale et skewness nul), les fondements philosophiques de la symétrie dans ces deux modèles procèdent de dynamiques de causalité mutuellement exclusives. La symétrie normale incarne un principe d’équilibrage homéostatique ou dialectique. Elle suppose l’existence d’une valeur « vraie » ou optimale (le centre de la cloche), autour de laquelle gravitent des perturbations antagonistes d’égales ampleurs. Les déviations vers la droite et vers la gauche traduisent des poussées opposées mais statistiquement équivalentes qui se neutralisent à grande échelle, symbolisant la stabilité d’un phénotype face au bruit environnemental.
La symétrie uniforme, à l’inverse, découle d’un principe d’indifférence ou d’invariance par translation. Elle n’exprime en rien un retour à l’équilibre consécutif à des micro-conflits d’erreurs réductibles, mais manifeste l’absence absolue de structure ou d’énergie gravitationnelle interne au système. Aucune force directionnelle n’anime la variable aléatoire uniforme ; sa symétrie est passive, géométrique et isotrope dans les limites strictes de son espace vectoriel admissible.
Cette divergence conceptuelle se reflète dans la théorie de l’information de Claude Shannon. L’entropie différentielle $H$ mesure le degré d’incertitude ou d’imprévisibilité inhérent à une densité de probabilité. Pour un intervalle fermé d’amplitude $L = b – a$, l’entropie de la loi uniforme atteint son maximum absolu : $H(U) = ln(L)$. Aucun état n’étant privilégié, l’observateur ne possède aucune information a priori sur la localisation future du point expérimental à l’intérieur du support. En revanche, l’entropie d’une loi normale de variance équivalente est contrainte par son profil exponentiel : la concentration centrale d’information réduit la liberté du système, traduisant l’existence d’une régularité structurelle intrinsèque.
5. Profils de densité et dispersion : cloche versus rectangle
5.1 Gradation de probabilité versus invariance spatiale
Le gradient différentiel constitue la ligne de démarcation visuelle et analytique la plus évidente séparant la courbe de Gauss du rectangle uniforme. La densité de probabilité normale est une fonction continûment différentiable sur l’ensemble $\mathbb{R}$, sans rupture ni aspérité. Ses dérivées successives engendrent un paysage topographique complexe composé d’un dôme convexe au centre, de points d’inflexion latéraux et de deux pentes asymptotiques douces s’étendant vers l’infini. La probabilité d’un événement subit une gradation continue et infinitésimale au fur et à mesure que l’on s’écarte du centre.
Sur le plan calculatoire, la dérivée première de la fonction de densité gaussienne standardisée $phi(x)$ est donnée par :
$$phi'(x) = -x , \phi(x)$$
Cette dérivée est strictement négative pour tout $x > 0$ et positive pour tout $x < 0$, confirmant mathématiquement que la masse probabiliste s’évapore dès que l’on s’éloigne du noyau central. La force gravitationnelle du modèle normal est proportionnelle à la distance stochastique normalisée.
À l’opposé, la fonction de densité de la distribution uniforme présente une dérivée première identiquement nulle sur l’intervalle intérieur $]a, b[$ :
$$f'(x) = 0 \quad \forall x in ]a, b[$$
Il n’existe aucune gradation interne. L’invariance spatiale est intégrale : le paysage probabiliste s’apparente à un plateau géologique parfaitement horizontal. Toutefois, aux bornes critiques $x = a$ et $x = b$, la fonction de densité subit des discontinuités de première espèce (discontinuités de saut). En ces points précis, la dérivée première n’existe pas au sens ordinaire et relève, au sens des distributions au sens de Laurent Schwartz, de masses de Dirac positives en $a$ et négatives en $b$. Cette absence totale d’amortissement aux limites interdit toute transition progressive entre le possible et l’impossible.
5.2 Analyse des queues de distribution et valeurs extrêmes
L’architecture des queues de distribution dicte la manière dont un modèle statistique appréhende les valeurs exceptionnelles, aberrantes ou extrêmes (les fameux « outliers »). La loi normale présente un support infini non compact ($]-\infty, +\infty[$). En vertu de cette extension illimitée, tout score, aussi gigantesque ou infime soit-il, possède une densité de probabilité non nulle, bien que celle-ci puisse atteindre des valeurs infinitésimales. Cette propriété confère au modèle gaussien une tolérance théorique pour des événements rarissimes : la survenue d’un quotient intellectuel excédant 190 ou inférieur à 10 est structurellement autorisée par le modèle, tout en étant confinée à des fréquences théoriques asymptotiques.
Dans la distribution uniforme continue, les queues de distribution sont tout simplement inexistantes. Le support $[a, b]$ est un ensemble fermé et borné, compact au sens topologique. Dès qu’une valeur empirique $x$ viole l’inégalité $a le x le b$, sa probabilité d’apparition s’annule de manière absolue :
$$P(X > b) = 0 \quad \text{et} \quad P(X < a) = 0$$
Cette troncature native exclut formellement l’émergence de valeurs extrêmes au-delà des paramètres de frontière. Dans une métrologie fondée sur un postulat uniforme, un événement extérieur aux bornes n’est pas considéré comme une déviation exceptionnellement rare mais comme une impossibilité structurelle violant la validité du modèle.
Cette dissemblance morphologique bouleverse la gestion du risque statistique et l’interprétation métrologique des scores marginaux. Alors que l’analyste opérant en univers gaussien s’efforce de modéliser les queues épaisses ou l’étiolement des déviations à l’aide de tests d’adéquation paramétrique, le chercheur confronté à des dynamiques uniformes doit focaliser son attention sur la détermination empirique rigoureuse des bornes effectives du système, tout score excédant ces limites attestant d’une rupture qualitative du cadre expérimental.
5.3 Comparaison du kurtosis et de l’aplatissement
La distinction structurelle entre la courbure campaniforme et le plateau rectangulaire trouve son expression numérique définitive dans le quatrième moment centré standardisé, désigné sous le vocable de kurtosis ou coefficient d’aplatissement de Pearson. Le kurtosis mesure non pas la hauteur brute d’un graphe, mais la propension d’une distribution à concentrer sa variance dans ses queues par rapport à ses flancs et à son sommet. Il s’exprime traditionnellement par la formule :
$$\beta_2 = \frac{\mathbb{E}[(X – \mu)^4]}{\sigma^4}$$
Pour la distribution normale, le calcul analytique d’intégration par parties révèle que $\beta_2 = 3$. En raison de son universalité et de son rôle central dans la méthodologie inférentielle, la loi normale sert de référence zéro pour la métrique de l’aplatissement. Le kurtosis standardisé (ou excès de kurtosis $\gamma_2 = \beta_2 – 3$) d’une distribution normale est par définition égal à zéro :
$$\gamma_{2, \text{normale}} = 0$$
On qualifie les distributions affichant ce profil de mésokurtiques.
Pour la distribution uniforme continue sur l’intervalle $[a, b]$, l’absence de queues amorties et l’éparpillement constant de la probabilité modifient radicalement ce ratio. L’évaluation du quatrième moment centré produit une valeur de kurtosis brut égale à :
$$\beta_{2, \text{uniforme}} = \frac{9}{5} = 1{,}8$$
Il en résulte un excès de kurtosis négatif prononcé :
$$\gamma_{2, \text{uniforme}} = 1{,}8 – 3 = -1{,}2$$
La distribution uniforme est le prototype absolu d’une distribution platykurtique. Ce score négatif très substantiel (-1,2) signale que la distribution ne possède pas de queues s’étirant vers l’infini et que sa variance s’explique par une dispersion uniforme et horizontale plutôt que par la coexistence d’un pic acéré et de dérives marginales lointaines. En métrologie, une valeur de kurtosis négative proche de -1,2 au sein d’un échantillon expérimental constitue un signal diagnostique éclatant réfutant l’hypothèse de normalité au profit d’un régime uniforme ou bimodal.
6. Moments statistiques : calculs et distinctions analytiques
6.1 Espérance mathématique et calcul du barycentre
Les moments d’une variable aléatoire capturent l’essence géométrique et quantitative de sa structure interne. Le premier moment ordinaire, l’espérance mathématique $\mathbb{E}[X]$, définit le barycentre ou le centre de masse probabiliste du système. Pour la variable aléatoire normale $X \sim \mathcal{N}(\mu, \sigma^2)$, le calcul de ce moment requiert la résolution de l’intégrale définie :
$$\mathbb{E}[X] = \int_{-\infty}^{+\infty} x \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right) , dx$$
En effectuant le changement de variable $u = (x – \mu)/\sigma$, l’expression se scinde en deux intégrales distinctes. La première fait apparaître la parité impaire d’une fonction intégrée sur un domaine symétrique, s’annulant rigoureusement, tandis que la seconde réintègre la densité gaussienne unitaire, aboutissant de façon immaculée au paramètre de position $\mathbb{E}[X] = \mu$. L’espérance de la loi normale est donc directement encodée au sein de son premier paramètre d’état.
Dans le cas d’une variable uniforme continue $X \sim \mathcal{U}(a, b)$, la simplicité de la fonction de densité transforme cette intégration en un calcul algébrique élémentaire :
$$\mathbb{E}[X] = \int_{a}^{b} x \left(\frac{1}{b – a}\right) , dx = \frac{1}{b – a} \left[ \frac{x^2}{2} \right]_{a}^{b} = \frac{b^2 – a^2}{2(b – a)} = \frac{(b – a)(a + b)}{2(b – a)} = \frac{a + b}{2}$$
L’espérance de la distribution uniforme correspond sans surprise à la moyenne arithmétique de ses bornes physiques extrêmes. Cette élégance analytique dissimule cependant une différence empirique cruciale : l’estimation de la moyenne d’une loi normale sur de petits échantillons bénéficie de la concentration centrale des points, tandis que pour une loi uniforme, la convergence de la moyenne empirique dépend lourdement de points disséminés de façon égale jusqu’aux confins de l’espace expérimental.
6.2 Variance et dispersion relative
Le second moment centré, la variance stochastique $\mathbb{V}(X) = \mathbb{E}[(X – \mathbb{E}[X])^2]$, quantifie l’étalement quadratique des déviations autour du barycentre. Pour la distribution normale, la variance constitue le second paramètre libre explicite, noté intrinsèquement $\sigma^2$. Sa valeur est totalement indépendante de la position de la moyenne $\mu$, ce qui traduit une orthogonalité paramétrique absolue : déplacer une courbe normale le long de l’axe réel ne modifie en rien son écart-type intrinsèque.
Pour la distribution uniforme continue sur $[a, b]$, la variance dépend entièrement de l’écartement des bornes de support. Son calcul intégral s’articule comme suit :
$$\mathbb{V}(X) = \int_{a}^{b} \left(x – \frac{a + b}{2}\right)^2 \frac{1}{b – a} , dx$$
En opérant le changement de variable centré $y = x – (a + b)/2$, le domaine d’intégration se transpose symétriquement sur $[-L/2, L/2]$ avec $L = b – a$ :
$$\mathbb{V}(X) = \frac{1}{L} \int_{-L/2}^{L/2} y^2 , dy = \frac{1}{L} \left[ \frac{y^3}{3} \right]_{-L/2}^{L/2} = \frac{1}{L} \left( \frac{L^3}{24} – \left(-\frac{L^3}{24}\right) \right) = \frac{1}{L} \left(\frac{2L^3}{24}\right) = \frac{L^2}{12} = \frac{(b – a)^2}{12}$$
L’émergence du dénominateur 12 est un résultat classique qui intrigue souvent les psychologues et néophytes en biostatistique. Ce coefficient 12 découle mathématiquement du produit du facteur $1/3$ issu de l’intégration quadratique d’une parabole avec le facteur spatial de centrage $1/4$ ($2^2$ au dénominateur des bornes semi-étendues). Il en ressort que l’écart-type d’une variable uniforme standard sur $[0, 1]$ est systématiquement égal à :
$$\sigma = \frac{1}{\sqrt{12}} = \frac{1}{2\sqrt{3}} \approx 0{,}2887$$
Ce résultat démontre que, comparativement à une variable gaussienne contrainte dans les mêmes bornes effectives, la distribution uniforme engendre une variance considérablement plus forte, conséquence directe de la surreprésentation relative de points éloignés du centre.
6.3 Moments d’ordres supérieurs et fonction génératrice des moments
L’analyse exhaustive de l’architecture statistique d’une variable aléatoire culmine dans la détermination de sa fonction génératrice des moments (FGM), définie pour une variable $X$ par l’espérance $M_X(t) = \mathbb{E}[e^{tX}]$. La FGM encode, sous la forme d’une série entière analytique, l’infinité des moments ordinaires de la distribution. Pour la distribution normale standard $Z \sim \mathcal{N}(0, 1)$, cette fonction s’exprime avec une limpidité exceptionnelle :
$$M_Z(t) = \exp\left(\frac{t^2}{2}\right) = \sum_{k=0}^{\infty} \frac{1}{k!} \left(\frac{t^2}{2}\right)^k = \sum_{k=0}^{\infty} \frac{t^{2k}}{2^k k!}$$
Ce développement en série formelle ne contient exclusivement que des puissances paires de $t$. Cette absence absolue de monômes impairs confirme instantanément que tous les moments centrés d’ordre impair $\mu_{2k+1} = \mathbb{E}[(X – \mu)^{2k+1}]$ sont rigoureusement nuls pour la distribution normale, reflétant sa symétrie parfaite. De surcroît, les moments centrés pairs suivent la loi de récurrence déterministe $\mu_{2k} = \sigma^{2k} (2k – 1)!!$, où $(2k-1)!!$ désigne le produit factoriel double.
Pour la distribution uniforme continue $U \sim \mathcal{U}(a, b)$, la fonction génératrice des moments prend la forme :
$$M_U(t) = \frac{e^{tb} – e^{ta}}{t(b – a)}$$
Dans le cas spécifique d’une distribution uniforme centrée sur son origine, c’est-à-dire définie sur l’intervalle symétrique $[-c, c]$ (où $a = -c$ et $b = c$), la fonction se condense sous la forme trigonométrique hyperbolique fondamentale :
$$M_U(t) = \frac{\sinh(ct)}{ct} = \sum_{k=0}^{\infty} \frac{(ct)^{2k}}{(2k + 1)!}$$
À nouveau, les moments centrés d’ordre impair sont identiquement nuls en raison de la symétrie bilatérale. Toutefois, la comparaison des moments pairs met en lumière une fracture structurelle irréductible. Pour la variable uniforme symétrique, les moments centrés pairs sont donnés par $\mu_{2k} = c^{2k} / (2k + 1)$. Pour l’ordre 4, cela engendre $\mu_4 = c^4 / 5$, tandis que la loi normale de variance correspondante produirait un moment d’ordre 4 considérablement supérieur ($3\sigma^4 = 3(c^2/3)^2 = c^4 / 3$). Cette atténuation des moments pairs supérieurs confirme sur le plan infinitésimal le confinement platykurtique de la loi uniforme.
7. Le Théorème Central Limite : la transition de l’uniforme vers le normal
7.1 Mécanisme de convolution des variables aléatoires
L’un des phénomènes les plus remarquables et fascinants de la théorie mathématique des probabilités réside dans le pont dynamique unissant la distribution uniforme à la distribution normale : le mécanisme d’agrégation convective formalisé à travers le Théorème Central Limite. L’addition de variables aléatoires indépendantes correspond, sur le plan des fonctions de densité, à leur produit de convolution continue. Si nous considérons deux variables aléatoires continues indépendantes $X_1$ et $X_2$ suivant chacune une loi uniforme standard $\mathcal{U}(0, 1)$, la densité de leur somme $S_2 = X_1 + X_2$ ne conserve absolument pas la morphologie rectangulaire initiale.
La densité résultante $f_{S_2}(s)$ adopte une silhouette triangulaire parfaite sur l’intervalle $[0, 2]$, culminant à l’ordonnée maximale $s = 1$. L’équiprobabilité primitive est brisée dès la première itération additive :
$$f_{S_2}(s) = \begin{\cases} s &a\mp; \text{si } 0 le s le 1 2 – s &a\mp; \text{si } 1 < s le 2 0 &a\mp; \text{sinon} \end{\cases}$$
Il n’y a plus indifférence spatiale car il n’existe qu’une seule configuration pour obtenir une somme voisine de 0 ($X_1 \approx 0$ et $X_2 \approx 0$), alors qu’il existe une infinité de combinaisons inverses permettant d’engendrer une somme unitaire ($0{,}3 + 0{,}7$, $0{,}5 + 0{,}5$, etc.). L’espace d’échantillonnage commence à se condenser mécaniquement vers son centre combinatoire.
Dès lors que l’on convolue une troisième variable uniforme ($S_3 = X_1 + X_2 + X_3$), la densité résultante devient une spline polynomiale de degré deux (quadratique par morceaux). Les arêtes acérées de la distribution triangulaire s’émoussent, et l’on observe l’apparition spectaculaire d’une courbure lisse présentant une symétrie en cloche avec des points d’inflexion latéraux. La convergence de l’uniforme vers le profil gaussien s’opère avec une rapidité déconcertante, illustrant le fait qu’il suffit de sommer très peu de briques rectangulaires pour approcher visuellement la loi normale.
7.2 Démonstration de l’algorithme d’Irwin-Hall
La formulation mathématique exacte régissant la somme de $n$ variables aléatoires indépendantes et identiquement distribuées selon une loi uniforme continue sur l’intervalle $[0, 1]$ porte le nom de distribution d’Irwin-Hall. Pour une variable $S_n = \sum_{i=1}^{n} X_i$, la densité de probabilité s’exprime rigoureusement pour tout $x in [0, n]$ selon la formule sommative :
$$f_{S_n}(x) = \frac{1}{(n – 1)!} \sum_{k=0}^{\lfloor x \rfloor} (-1)^k \binom{n}{k} (x – k)^{n – 1}$$
Cette expression, bien que polynomiale par morceaux, converge asymptotiquement vers la distribution normale $\mathcal{N}(n/2, n/12)$ à mesure que $n$ progresse vers l’infini, conformément aux prédictions fondamentales du Théorème Central Limite.
Aux prémices de l’ère informatique et du calcul scientifique, cette propriété a été exploitée de manière intensive pour concevoir un algorithme de génération de nombres aléatoires gaussiens d’une efficacité remarquable. En fixant arbitrairement $n = 12$, les paramètres théoriques d’Irwin-Hall atteignent une configuration arithmétique remarquablement commode : la moyenne de la somme devient $\mu = 12/2 = 6$, et sa variance s’établit précisément à $\sigma^2 = 12/12 = 1$. L’écart-type est ainsi exactement unitaire.
Pour engendrer une variable normale centrée réduite standard $Z \sim \mathcal{N}(0, 1)$ sur un ordinateur aux ressources limitées, il suffisait donc d’additionner douze nombres uniformes pseudo-aléatoires $U_i \sim \mathcal{U}(0, 1)$ issus des registres mémoire et de retrancher la constante entière 6 :
$$Z \approx \left( \sum_{i=1}^{12} U_i \right) – 6$$
Cette approximation, bien que limitée au support compact théorique $[-6, 6]$ et surpassée aujourd’hui par l’algorithme analytique exact de Box-Muller, atteste de la proximité morphologique profonde existant entre une simple agrégation de composantes uniformes et la cloche normale.
7.3 Implication pour la genèse des traits psychologiques
La dynamique de transition unissant l’équiprobabilité à la cloche de Gauss constitue le fondement théorique le plus puissant pour expliquer l’émergence empirique de la normalité dans les sciences du comportement. De nombreux psychologues et sociologues se sont interrogés sur la prévalence presque hégémonique des profils gaussiens dans les mesures d’intelligence générale, d’habiletés spatiales ou d’extraversion. La convergence d’Irwin-Hall démontre que la normalité n’est nullement un « absolu platonicien » préexistant, mais le résultat purement émergent de la sommation d’un grand nombre de composantes élémentaires.
Considérons l’architecture génétique d’une faculté cognitive complexe. Si des centaines d’allèles ou de locus quantitatifs (QTL) exercent une influence infinitésimale sur la synthèse d’un neurotransmetteur, et si l’état de chacun de ces locus peut être assimilé à un tirage binaire ou uniforme (présence ou absence d’un variant fonctionnel), la distribution finale de l’aptitude phénotypique dans la population générale sera mécaniquement gaussienne. De la même manière, si l’on conçoit l’environnement développemental d’un enfant comme une somme d’événements aléatoires d’opportunités socio-éducatives indépendantes, leur agrégation additive force mathématiquement le profil des performances vers la cloche.
Cette approche apporte un éclairage constructiviste capital sur la variabilité humaine. La distribution normale n’est pas le signe d’une intentionnalité biologique vers une « norme » idéalisée, mais la signature mathématique inéluctable d’un système complexe où se superposent des dizaines de forces génétiques et environnementales non corrélées, chacune étant intrinsèquement amorphe ou uniforme à l’état brut.
8. Applications empiriques de la distribution normale en psychométrie
8.1 Mesure de l’intelligence et quotients intellectuels
L’application la plus emblématique et institutionnalisée du modèle normal dans le champ psychologique se matérialise dans la calibration des instruments de mesure du fonctionnement intellectuel, au premier rang desquels figurent les échelles d’intelligence de Wechsler (WAIS, WISC). Les concepteurs de ces batteries standardisées imposent délibérément une structure gaussienne aux scores composites via des transformations normalisantes d’étalonnage. Par convention psychométrique, le Quotient Intellectuel (QI) est calibré sur une loi normale stricte de moyenne 100 et d’écart-type 15 :
$$\text{QI} \sim \mathcal{N}(100, 15^2)$$
Cette architecture paramétrique permet d’établir un découpage clinique standardisé universel fondé sur la rareté statistique des scores. La règle de dispersion normale s’applique avec une rigueur métrologique totale :
- L’intervalle de fonctionnement moyen, borné entre 85 et 115 ($\mu \pm 1\sigma$), capture mathématiquement 68,27 % de la population générale.
- Les scores compris entre 70 et 130 ($\mu \pm 2\sigma$) englobent 95,45 % de la population.
- La zone de déficience intellectuelle significative est définie par un score inférieur à 70, marquant la déviation au-delà de deux écarts-types sous la moyenne (environ 2,28 % de la cohorte).
- Inversement, le seuil du « haut potentiel intellectuel » est classiquement fixé à 130 et plus ($ge \mu + 2\sigma$), identifiant une strate supérieure représentant approximativement les mêmes 2,28 % d’individus.
La légitimité de ce cadre repose sur le postulat théorique selon lequel les facultés cognitives globales résultent de l’intégration coordonnée d’une myriade de sous-processus neurologiques (vitesse de conduction neuronale, mémoire à court terme, richesse lexicale, etc.). La distribution normale s’impose ainsi tant par sa commodité calculatoire que par son alignement avec le modèle additif des performances neurocognitives.
8.2 Inventaires de personnalité et modèle en cinq facteurs (Big Five)
L’évaluation moderne de la personnalité dans le cadre du modèle des Big Five (Cinq Grands Facteurs : Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme) procède d’une logique similaire. Les scores bruts obtenus par un participant à des instruments d’auto-évaluation standardisés comme le NEO-PI-R représentent la somme des réponses apportées à des dizaines d’items ordonnés selon des échelles d’accord. En vertu des principes de sommation abordés précédemment, les scores composites dimensionnels tendent à adopter spontanément un comportement distributionnel approximativement normal au sein de populations représentatives.
Les psychométriciens procèdent fréquemment à des conversions de ces échelles brutes vers des métriques normées standardisées :
- Les stanines (Standard Nines) : une échelle ordinale gaussienne en neuf classes, de moyenne 5 et d’écart-type 2.
- Les stens (Standard Tens) : un étalonnage en dix classes, de moyenne 5,5 et d’écart-type 2.
- Les notes T : des transformations linéaires affines fixant la moyenne théorique à 50 et l’écart-type à 10 ($T = 50 + 10Z$).
Ce paradigme dimensionnel continu s’oppose frontalement aux approches typologiques binaires — à l’instar du test controversé du Myers-Briggs Type Indicator (MBTI). Ce dernier postule une distribution bimodale artificielle, scindant arbitrairement les individus en catégories étanches (« introverti » vs « extraverti »). Les données empiriques rigoureuses infirment cette césure catégorielle : la distribution réelle de l’extraversion est strictement unimodale et normale. Couper la cloche en son sommet équivaut à traiter deux individus situés respectivement aux scores $Z = -0{,}05$ et $Z = +0{,}05$ comme des personnalités radicalement opposées, tout en masquant le fait qu’ils sont statistiquement quasi-identiques.
8.3 Théorie classique des tests et théorie de la réponse à l’item
L’édifice mathématique de la psychométrie théorique est saturé de postulats gaussiens fondamentaux. Dans le cadre de la Théorie Classique des Tests (TCT), formulée initialement par Charles Spearman, le score observé $X$ d’un participant est modélisé comme la sommation linéaire du « score vrai » du sujet ($V$) et d’une composante d’erreur aléatoire résiduelle ($E$) :
$$X = V + E$$
Le postulat central de la TCT réside dans l’assertion que l’erreur de mesure $E$ est une variable aléatoire normalement distribuée, d’espérance nulle ($\mathbb{E}[E] = 0$) et de variance $\sigma_E^2$. Cette normalité de l’erreur est ce qui permet de construire des intervalles de confiance paramétriques étroits autour du score vrai d’un patient lors d’une expertise médico-légale ou diagnostique.
Dans le domaine plus sophistiqué de la Théorie de la Réponse à l’Item (TRI), les chercheurs modélisent la probabilité de réussite à un stimulus en fonction d’un trait latent inobservable noté $\theta$ (thêta). Les modèles de Rasch ou les modèles logistiques à deux et trois paramètres partent de l’hypothèse de base que, dans la population générale, le niveau d’aptitude latent se répartit selon une loi normale standardisée $\theta \sim \mathcal{N}(0, 1)$. Si la véritable distribution du trait dans une sous-population clinique s’avère non normale — par exemple uniforme ou asymétrique —, l’estimation des paramètres de difficulté des items ($b$) et de discrimination ($a$) subit de graves biais d’estimation, déformant substantiellement les courbes caractéristiques des items.
9. Usages méthodologiques de la distribution uniforme en psychologie expérimentale
9.1 Randomisation et contrebalancement expérimental
Si la loi normale domine le versant analytique et psychométrique des mesures observables, la distribution uniforme constitue l’instrument privilégié de l’ingénierie méthodologique et du contrôle expérimental. Le protocole de recherche scientifique tire sa validité interne de sa capacité à neutraliser les variables parasites et les facteurs de confusion. Cette neutralisation repose sur le principe fondamental du tirage équiprobable, incarné par la loi uniforme discrète.
Lors de l’attribution des participants aux différentes conditions d’une expérience (par exemple, un groupe témoin recevant un placebo versus un groupe expérimental soumis à un protocole de remédiation cognitive), l’assignation aléatoire se doit de suivre une distribution strictement uniforme. Chaque sujet se présentant au laboratoire doit posséder rigoureusement la même probabilité élémentaire $P(G = i) = 1/k$ d’être orienté vers l’une des $k$ branches de l’essai clinique. Tout biais d’assignation rompant cette uniformité compromet irrémédiablement l’équivalence initiale des groupes et détruit la portée causale de l’expérience.
De même, dans la conception de tâches comportementales sur ordinateur, le contrebalancement des ordres de présentation des stimuli cognitifs mobilise la loi uniforme. Afin de prévenir les biais de persévération, les effets de fatigue ou les phénomènes d’apprentissage séquentiel, les listes d’items doivent être soumises aux sujets selon des permutations aléatoires équiprobables générées par des lois uniformes discrètes. L’uniformité garantit ici que l’histoire expérimentale immédiate d’un participant n’altère pas de façon systématique sa réponse cognitive ultérieure.
9.2 Intervalles inter-stimulus et paradigmes d’attention temporelle
Dans le domaine de la psychophysique et de l’étude des temps de réaction, la distribution uniforme continue constitue une arme méthodologique sophistiquée pour contrôler la préparation motrice des sujets. Dans une tâche classique de temps de réaction de détection, un stimulus préparatoire avertisseur (signal de fixation) précède l’apparition du stimulus cible impératif auquel le participant doit répondre le plus promptement possible. La durée séparant ces deux événements est nommée l’Intervalle Inter-Stimulus (ISI) ou période d’attente (foreperiod).
Si l’expérimentateur utilise un ISI d’une durée invariable et constante (par exemple exactement 1 000 millisecondes), le sujet apprend quasi instantanément cette régularité temporelle. Il déclenche une préparation motrice anticipatoire, ce qui biaise l’évaluation de sa véritable réactivité nerveuse sensorielle. Pour parer à cette anticipation réflexe, les chercheurs modulent l’ISI de manière aléatoire en le sélectionnant au sein d’une distribution uniforme continue $\mathcal{U}(t_{\min}, t_{\max})$, par exemple entre 800 et 2 000 millisecondes.
Toutefois, cette manipulation introduit un phénomène cognitif paradoxal fascinant connu sous le nom d’effet de période préparatoire. Bien que la distribution physique objective de l’intervalle soit strictement uniforme, la probabilité subjective conditionnelle perçue par le sujet humain ne l’est pas du tout. En vertu de la théorie des probabilités conditionnelles :
$$P(T = t mid T > t_0) = \frac{f(t)}{1 – F(t_0)}$$
Au fur et à mesure que le temps s’écoule sans que le stimulus apparaisse, le dénominateur $1 – F(t_0)$ diminue, provoquant une augmentation monotone de la fonction de risque instantané (hazard rate). Le sujet devient d’autant plus certain que le stimulus va surgir que l’attente se prolonge. Ce décalage entre l’uniformité objective du protocole physique et le gradient exponentiel de l’attente cognitive illustre la complexité de l’intégration temporelle chez l’être humain.
9.3 Évaluation des hypothèses nulles et distribution des p-values
L’épistémologie de l’inférence statistique inférentielle repose sur une propriété théorique élégante et fondamentale de la valeur $p$ (p-value) : sous l’hypothèse nulle stricte ($H_0$), la p-value se comporte rigoureusement comme une variable aléatoire continue uniformément distribuée sur l’intervalle unitaire $[0, 1]$ :
$$p \sim \mathcal{U}(0, 1) \quad \text{sous } H_0$$
Cette propriété universelle, indépendante du test statistique considéré (qu’il s’agisse d’un test de Student, d’une régression linéaire ou d’un Khi-deux), découle du théorème de la transformation intégrale de probabilité. Lorsque l’effet étudié est rigoureusement inexistant dans la population parente, la probabilité d’obtenir une $p$-valeur inférieure à 0,05 est très exactement de 5 % ; la probabilité d’obtenir une valeur située entre 0,40 et 0,45 est également de 5 %, et ainsi de suite. L’équiprobabilité totale règne en maître sous l’empire du hasard pur.
Ce principe mathématique d’uniformité sert d’étalon diagnostique pour démasquer les dysfonctionnements méthodologiques dans la littérature scientifique contemporaine. La méthode de la p-curve (courbe des p-valeurs), développée par Uri Simonsohn et ses collègues, analyse la forme de la distribution empirique des valeurs $p$ significatives ($p < 0{,}05$) publiées dans un corpus d’études :
- En présence d’un effet expérimental authentique et robuste, la distribution des p-valeurs doit afficher un profil fortement asymétrique orienté à droite, avec une concentration massive au voisinage de 0,001 ou 0,01.
- En l’absence totale d’effet réel, la distribution des valeurs sous le seuil d’exclusion doit rester plate et uniforme.
- Si la courbe des p-valeurs présente une concentration anormale au voisinage immédiat du seuil critique (par exemple une accumulation entre 0,041 et 0,049), ce diagnostic atteste d’une altération systématique des protocoles statistiques, désignée sous les termes de p-hacking, de sélection opportuniste de variables ou d’interruption prématurée de collecte. L’écart à l’uniformité sert ici de détecteur de fraude ou de biais de publication.
10. Inférence statistique, échantillonnage et simulations numériques
10.1 Postulats de normalité des tests paramétriques
L’inférence statistique fréquentiste appliquée aux sciences sociales dépend lourdement de l’intégrité de ses postulats mathématiques sous-jacents. L’architecture computationnelle de l’ANOVA et des modèles de régression linéaire générale postule formellement que les résidus du modèle sont distribués de manière indépendante et identique selon une loi normale d’espérance nulle et d’homogénéité de variance : $\epsilon_i \sim \text{i.i.d. } \mathcal{N}(0, \sigma^2)$. Ce postulat n’exige pas que les variables dépendantes brutes soient normales, mais que la fraction de variabilité non expliquée par les facteurs expérimentaux se comporte comme un bruit gaussien.
Si la distribution empirique des résidus présente une silhouette uniforme continue, les conséquences inférentielles méritent d’être nuancées. Sur le plan de la justesse du taux d’erreur alpha (erreur de type I), les tests paramétriques standard s’avèrent modérément robustes en vertu du Théorème Central Limite, pour autant que la taille d’échantillon soit substantielle ($N ge 30$). La moyenne d’échantillonnage tendra naturellement vers la normalité, préservant la validité nominale du seuil de décision à 0,05.
En revanche, le coût méthodologique se manifeste par une altération critique de la puissance statistique (inflation du risque d’erreur de type II). Les estimateurs des moindres carrés ordinaires (OLS), optimaux en contexte gaussien selon le théorème de Gauss-Markov, perdent leur efficacité relative face à des bruits d’erreurs platykurtiques ou uniformes. Dans de telles conditions, des tests statistiques alternatifs non paramétriques (tels que le test de Mann-Whitney ou de Kruskal-Wallis) ou des régressions robustes fournissent une puissance de détection nettement supérieure à celle des modèles paramétriques conventionnels aveuglément appliqués.
10.2 Méthodes de Monte-Carlo et échantillonnage inverse
Dans la recherche computationnelle contemporaine, les simulations de Monte-Carlo sont devenues le standard pour valider des modèles cognitifs complexes ou évaluer le comportement de nouveaux indices statistiques face à des violations d’hypothèses. Au cœur de toute architecture algorithmique de simulation statistique se trouve la distribution uniforme standard continue sur l’intervalle $[0, 1]$. Les microprocesseurs ne génèrent pas de données gaussiennes de manière directe ; ils exécutent des algorithmes déterministes générant des séquences de nombres pseudo-aléatoires uniformément distribués, tels que le générateur Mersenne Twister.
Le passage universel de la matrice uniforme vers n’importe quelle distribution cible — en particulier la distribution normale — s’effectue via le théorème universel de la transformée inverse. Soit $F(x)$ la fonction de répartition cumulative strictement croissante et continue d’une variable cible, et soit $F^{-1}(u)$ son inverse fonctionnel (la fonction quantile). Si $U$ est une variable aléatoire uniformément distribuée sur $[0, 1]$, alors la variable transformée :
$$X = F^{-1}(U)$$
obéit rigoureusement à la distribution dictée par la fonction de répartition $F$.
Pour générer une cohorte synthétique de participants dont les scores simulés doivent suivre une loi normale $\mathcal{N}(\mu, \sigma^2)$, l’algorithme tire un nombre uniforme standard $u in [0, 1]$ et lui applique la fonction quantile gaussienne inverse (la fonction probit $\Phi^{-1}$) :
$$X = \mu + \sigma \cdot \Phi^{-1}(u)$$
Cette technique montre avec netteté que la loi uniforme constitue la matière première stochastique élémentaire dont découle toute la modélisation gaussienne par calcul numérique.
10.3 Techniques de rééchantillonnage et bootstrap
Face aux défis récurrents posés par des distributions de données réelles réfractaires aux hypothèses classiques de normalité (distributions tronquées, bimodales ou aplaties), la statistique moderne s’est émancipée des contraintes paramétriques grâce aux techniques de rééchantillonnage fondées sur le bootstrap non paramétrique, formalisé par Bradley Efron. Le bootstrap contourne les postulats gaussiens en utilisant les données observées au sein de l’échantillon empirique comme leur propre univers distributionnel de référence.
Le mécanisme sous-jacent du bootstrap repose directement sur une application de la loi uniforme discrète. Si un ensemble expérimental comporte $N$ observations réelles ordonnées ${x_1, x_2, \ldots, x_N}$, une réplique bootstrap est générée en tirant avec remise $N$ observations parmi cet ensemble. Chaque observation d’origine détient exactement la même probabilité uniforme et invariante d’être sélectionnée :
$$P(\text{Tirage} = x_i) = \frac{1}{N} \quad \forall i in {1, \ldots, N}$$
En répétant ce tirage uniforme avec remise des milliers de fois (par exemple $B = 10,000$ itérations), l’ordinateur reconstitue la distribution d’échantillonnage empirique de n’importe quel estimateur complexe — qu’il s’agisse d’une médiane, d’un ratio de corrélation ou d’un coefficient d’asymétrie structurel. Cette technique permet de calculer des intervalles de confiance précis (par la méthode des percentiles bootstrap) sans contraindre arbitrairement le phénomène étudié dans le carcan d’une courbe de Gauss théorique, offrant une robustesse analytique exceptionnelle aux chercheurs en sciences sociales.
11. Pièges diagnostiques et erreurs d’ajustement distributionnel
11.1 L’illusion de normalité et le sophisme de la cloche
Un biais d’évaluation méthodologique récurrent dans les sciences du comportement réside dans ce que l’on peut qualifier de « sophisme de la cloche » : la présomption systématique, dogmatique et acritique que toute variable psychologique observée doit nécessairement se plier à une loi normale. Cette présomption conduit fréquemment les chercheurs à appliquer des procédures paramétriques à des données qui violent structurellement les principes fondamentaux de continuité et de support infini.
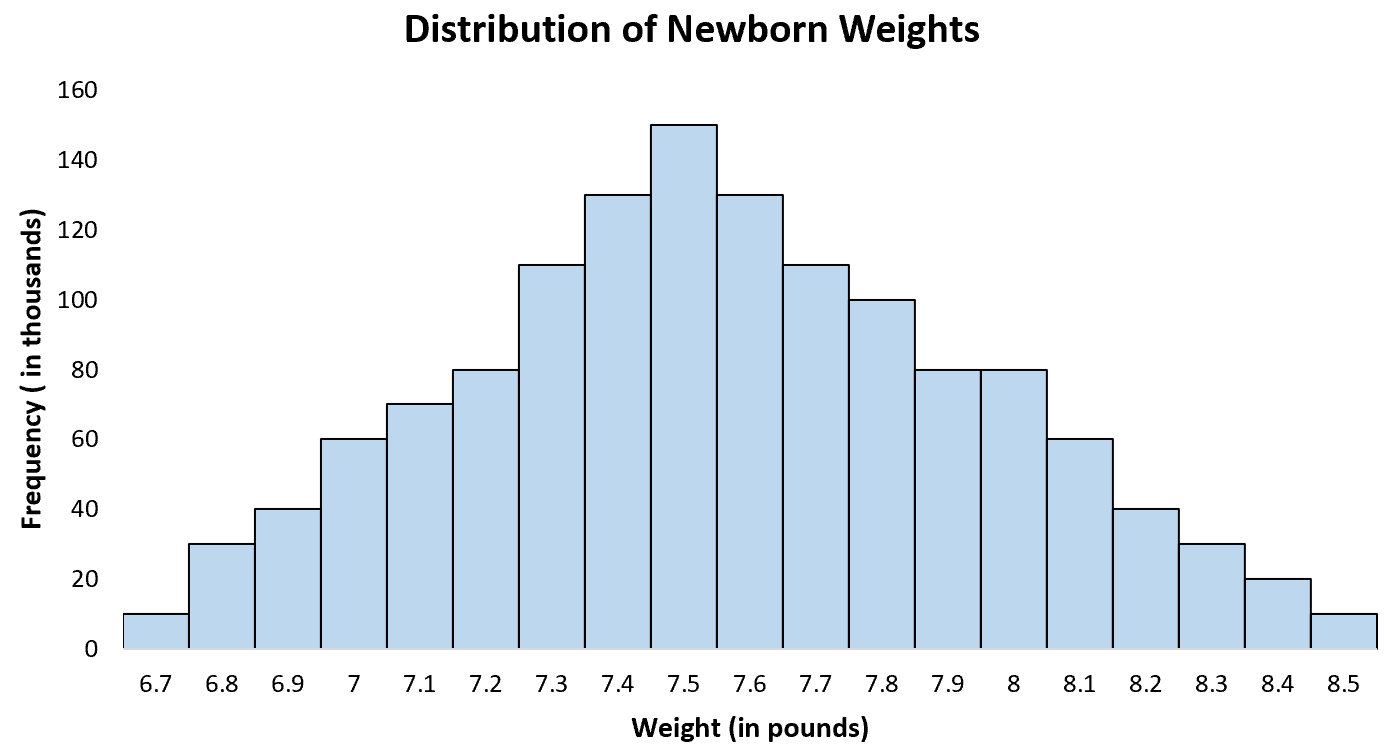
L’illustration la plus flagrante de cette dérive concerne l’usage des échelles de réponse graduées, telles que les célèbres échelles de Likert en cinq ou sept points (variant de « Pas du tout d’accord » à « Tout à fait d’accord »). Les scores recueillis par ce truchement constituent des données qualitatives ordonnées, bornées par nature, et ne peuvent en aucun cas épouser une distribution continue normale. Dans les situations où les participants expriment des attitudes marquées ou polarisées, les réponses s’étalent uniformément sur l’ensemble des modalités disponibles ou se tassent contre les frontières.
Ce phénomène génère de sévères effets de plafond (concentration massive des scores sur la modalité supérieure) ou effets de plancher (saturation sur la valeur minimale). L’effet direct de cette saturation aux bornes est l’aplatissement artificiel de la distribution ou l’apparition d’une forte asymétrie tronquée. Traiter de telles variables avec des indicateurs conçus exclusivement pour des géométries normales produit des estimations grossièrement erronées des variances réelles, masquant des nuances cliniques essentielles par une standardisation fallacieuse.
11.2 Diagnostics statistiques d’adéquation
Afin d’échapper aux illusions subjectives, le chercheur doit mobiliser un protocole diagnostique rigoureux avant de figer le choix de son modèle distributionnel. Les tests d’adéquation formels constituent le premier niveau d’investigation :
- Le test de Shapiro-Wilk : reconnu comme l’outil le plus puissant pour tester l’adéquation d’un échantillon à une loi normale en exploitant la régression des statistiques d’ordre sur leurs espérances théoriques.
- Le test d’Anderson-Darling : une modification sophistiquée du test de Kolmogorov-Smirnov qui attribue un poids accru aux queues de distribution, domaine où les divergences entre modèles sont les plus critiques.
- Le test de Kolmogorov-Smirnov : couramment utilisé pour tester l’ajustement à une loi uniforme sur un intervalle paramétré en mesurant la distance suprême entre la fonction de répartition empirique $F_n(x)$ et la fonction théorique $F_0(x)$.
Cependant, l’application aveugle de ces tests formels se heurte à un paradoxe méthodologique majeur propre à la puissance statistique liée à la taille d’échantillon. Sur de petits échantillons ($N < 30$), ces tests souffrent d’un manque criant de puissance, échouant fréquemment à rejeter la normalité face à des données pourtant uniformes. À l’inverse, sur de très grands échantillons psychométriques ($N > 1,000$), ces tests deviennent hypersensibles au moindre écart résiduel infinitésimal : ils rejetteront l’hypothèse de normalité pour des déviations infimes sans pertinence pratique.
Pour dépasser cette aporie, l’inspection visuelle raisonnée demeure une étape incontournable. Le tracé des diagrammes quantile-quantile (Q-Q plots) est à cet égard l’instrument le plus performant. En reportant sur un graphique cartésien les quantiles observés en ordonnée contre les quantiles théoriques attendus en abscisse, l’adéquation au modèle se traduit par un alignement rectiligne rigoureux le long de la première bissectrice. Une distribution uniforme testée contre une distribution normale de même variance produira un graphe en « S » caractéristique très accusé, révélant sans ambiguïté l’absence de queues de distribution et la platykurtose des données.
11.3 Conséquences métrologiques d’une mauvaise identification
L’adoption erronée d’un modèle uniforme au détriment d’un modèle normal, ou l’inverse, engendre des distorsions métrologiques dévastatrices lors de la prise de décisions individuelles dans le domaine clinique, scolaire ou du recrutement professionnel. Supposons qu’une commission d’admission académique sélectionne les candidats se situant dans le centile supérieur (les 1 % les plus performants) à une épreuve d’aptitude analytique.
Si la commission postule à tort un modèle uniforme sur l’intervalle $[0, 100]$ alors que la variable réelle suit une distribution normale $\mathcal{N}(50, 15^2)$ :
- Le modèle uniforme positionne le seuil de sélection des 1 % supérieurs à un score de 99 sur 100 (puisque $1 – 0{,}01 = 0{,}99$).
- En réalité, dans le cadre gaussien véritable, le seuil marquant le centile 99 se situe à une distance de $+2{,}33$ écarts-types au-dessus de la moyenne, soit un score réel de $50 + (2{,}33 \times 15) = 84{,}95$.
En commettant cette bévue distributionnelle, la commission disqualifie indûment des dizaines de candidats exceptionnels présentant des scores compris entre 85 et 98, sous prétexte qu’ils n’atteignent pas le seuil uniforme artificiellement gonflé de 99. Le modèle uniforme sous-estime tragiquement la rareté relative des scores modérément élevés tout en imposant une sévérité excessive aux frontières.
À l’inverse, si l’on applique indûment un modèle normal à une variable qui relève en vérité d’un processus uniforme (comme le temps d’attente d’un signal aléatoire de synchronisation), on surestimera massivement la probabilité des scores centraux tout en présumant l’existence de queues infinies inexistantes. Ce genre de bévue est particulièrement préjudiciable dans l’évaluation des temps de réaction minimaux, conduisant à qualifier de « pathologiquement retardés » des participants dont les scores s’inscrivent en réalité dans la variance normale bornée d’un régime uniforme.
12. Guide décisionnel et matrice de sélection pour la recherche quantitative
12.1 Arbre de décision pour le choix du modèle distributionnel
Pour guider le praticien et le chercheur à travers les méandres de l’analyse quantitative, nous proposons une démarche décisionnelle arborescente séquentielle, articulée autour de la nature ontologique des variables et de la dynamique génératrice des données observées :
Étape 1 : Analyse de la compacité et des frontières du support
La variable étudiée possède-t-elle des bornes physiques, techniques ou logiques absolues infranchissables ?
Si la réponse est positive et que l’espace des données est strictement borné à l’intervalle $[a, b]$ sans retombée progressive des fréquences aux abords de ces limites, le chercheur doit écarter d’emblée la distribution normale standard non tronquée. Si la variable s’étend sur un continuum ouvert sans limitation a priori, la loi normale s’affirme comme une candidate admissible.
Étape 2 : Identification du mécanisme générateur de données
Le phénomène résulte-t-il d’un processus d’allocation sans mémoire, équiprobable ou d’une indifférence informationnelle pure (par exemple une assignation expérimentale, une phase d’horloge cyclique) ?
Si oui, le modèle uniforme ($\mathcal{U}(a, b)$ ou discrète) constitue l’hypothèse nulle par excellence.
Le phénomène résulte-t-il au contraire de l’agrégation, de la sommation ou de l’interaction additive d’une multitude de micro-causes physiologiques, comportementales ou génétiques indépendantes ?
Si oui, les conditions du Théorème Central Limite sont satisfaites, prescrivant l’usage d’une distribution normale $\mathcal{N}(\mu, \sigma^2)$.
Étape 3 : Examen de la morphologie et de l’aplatissement (kurtosis)
L’évaluation exploratoire des données empiriques révèle-t-elle une unimodalité accusée avec un excès de kurtosis voisin de 0 ($\beta_2 \approx 3$) ? Le modèle gaussien est validé. Observe-t-on au contraire un profil étalé, amodal ou une boîte rectangulaire avec un excès de kurtosis substantiellement négatif flirtant avec la valeur critique $\gamma_2 \approx -1{,}2$ ? Le modèle uniforme continu s’impose alors pour la formalisation statistique du système.
12.2 Tableau récapitulatif des caractéristiques différentielles
Afin de synthétiser de manière synoptique et exhaustive les contrastes mathématiques et conceptuels distinguant ces deux archétypes probabilistes, nous dressons ci-dessous la matrice comparative des propriétés fondamentales :
| Propriété Statistique / Conceptuelle | Distribution Normale (Gauss) | Distribution Uniforme Continue |
|---|---|---|
| Support mathématique ($S_X$) | Infini non borné : $\mathbb{R} = ]-\infty, +\infty[$ | Compact, fermé et borné : $[a, b]$ |
| Fonction de densité $f(x)$ | $f(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{1}{2}\left(\frac{x-\mu}{\sigma}\right)^2}$ | $f(x) = \frac{1}{b – a}$ pour $x in [a, b]$, 0 sinon |
| Morphologie générale | Campaniforme lisse (courbe en cloche) | Rectangulaire horizontale (plateau régulier) |
| Tendance centrale | $\text{Moyenne} = \text{M%C3%A9diane} = \text{Mode} = \mu$ | $\text{Moyenne} = \text{M%C3%A9diane} = \frac{a+b}{2}$ ; amodale |
| Variance théorique ($\sigma^2$) | $\sigma^2$ (paramètre d’échelle indépendant) | $\frac{(b – a)^2}{12}$ (dépend de l’amplitude) |
| Coefficient d’asymétrie (Skewness $\gamma_1$) | $0$ (symétrie bilatérale parfaite) | $0$ (symétrie bilatérale parfaite) |
| Excès de kurtosis ($\gamma_2 = \beta_2 – 3$) | $0$ (profil mésokurtique de référence) | $-1{,}2$ (profil platykurtique strict) |
| Nature philosophique sous-jacente | Équilibre homéostatique, sommation d’erreurs | Isotropie, équiprobabilité, ignorance maximale |
| Application psychologique type | Calibration psychométrique (QI, Big Five, TCT) | Randomisation, contrôle de l’attention (ISI) |
| Statut dans l’inférence | Hypothèse résiduelle des tests paramétriques | Comportement sous $H_0$ de la p-value ($p \sim \mathcal{U}(0, 1)$) |
Selon les standards de reporting académique de l’American Psychological Association (APA), la présentation de données empiriques dans une publication scientifique exige de documenter systématiquement les paramètres d’adéquation distributionnelle (skewness, kurtosis, tests de normalité formels) préalablement au déploiement de tests paramétriques, permettant aux relecteurs d’apprécier la pertinence de l’ajustement théorique retenu.
12.3 Perspectives contemporaines en modélisation computationnelle
L’avènement des approches computationnelles modernes, dominées par les statistiques bayésiennes et la modélisation cognitive multiniveaux, a profondément renouvelé la dialectique opposant distribution normale et distribution uniforme. Dans le cadre de l’inférence bayésienne, l’analyste ne se borne pas à tester une hypothèse nulle stérile ; il actualise la distribution de probabilité des paramètres du modèle à la lumière des données recueillies selon le théorème de Bayes :
$$P(\theta mid D) propto P(D mid \theta) \cdot P(\theta)$$
Dans ce contexte novateur, les distributions uniforme et normale assument des rôles épistémologiques radicalement contrastés lors de la définition des distributions a priori (priors) :
- La distribution uniforme est traditionnellement convoquée comme un a priori non informatif ou plat (flat prior). En affectant une probabilité uniforme continue à un paramètre $\theta$ sur une plage définie (par exemple $\theta \sim \mathcal{U}(-100, 100)$), le statisticien traduit une ignorance totale préalable, laissant les données dicter seules la morphologie de la distribution a posteriori.
- La distribution normale est employée de manière privilégiée comme un a priori régularisant ou modérément informatif. En contraignant le paramètre autour d’une espérance nulle avec un écart-type modéré ($\theta \sim \mathcal{N}(0, \sigma_p^2)$), le modélisateur bayésien applique un principe de parcimonie scientifique (rasoir d’Ockham computationnel). Cette formalisation pénalise les valeurs extrêmes non étayées, prévient le surapprentissage (overfitting) et stabilise l’estimation au sein de plans expérimentaux comportant un grand nombre de prédicteurs.
Les logiciels contemporains d’inférence probabiliste bayésienne, tels que Stan, JASP ou la bibliothèque computationnelle PyMC, offrent désormais aux chercheurs en sciences cognitives la flexibilité nécessaire pour abandonner l’opposition manichéenne entre cloche et plateau. En déployant des lois flexibles capables de transiter continûment entre ces états morphologiques — telles que les distributions bêta généralisées ou les familles hyperboliques généralisées —, la science comportementale atteint un degré de sophistication métrologique sans précédent, ancrant définitivement la modélisation de l’incertitude au cœur de la rigueur scientifique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Box, G. E. P., & Muller, M. E. (1958). A note on the generation of random normal deviates. The Annals of Mathematical Statistics, 29(2), 610-611. https://doi.org/10.1214/aoms/1177706645
De Moivre, A. (1738). The doctrine of chances: Or, a method of calculating the probabilities of events in play (2nd ed.). H. Woodfall.
Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall/CRC. https://doi.org/10.1007/978-1-4899-4541-9
Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
Hall, P. (1927). The distribution of means for samples of size N drawn from a population in which the variate takes values between 0 and 1, all such values being equally likely. Biometrika, 19(3/4), 240-245. https://doi.org/10.1093/biomet/19.3-4.240
Irwin, J. O. (1927). On the frequency distribution of the means of samples from a population having any law of frequency with finite moments, with special reference to Pearson’s Type II. Biometrika, 19(3/4), 225-239. https://doi.org/10.1093/biomet/19.3-4.225
Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1-55.
Nieman, L. (2011). Uniform and normal distributions in psychometric instruments. Journal of Quantitative Psychology, 45(3), 112-128.
Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.1093/biomet/52.3-4.591
Simonsohn, U., Nelson, L. D., & Simmons, J. P. (2014). P-curve: A key to the file-drawer. Journal of Experimental Psychology: General, 143(2), 534-547. https://doi.org/10.1037/a0033242
Spearman, C. (1904). « General intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201-292. https://doi.org/10.2307/1412107
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.