
L’analyse statistique moderne et la psychométrie contemporaine reposent sur un ensemble de postulats probabilistes dont la pierre angulaire demeure incontestablement la loi normale, communément appelée distribution gaussienne ou courbe en cloche. Découverte et affinée au fil des siècles par des mathématiciens illustres cherchant à modéliser tant les erreurs de mesure astronomiques que la variabilité biologique, cette distribution continue s’est imposée comme le modèle théorique prééminent pour formaliser les variations quantitatives observables au sein de populations complexes. Dans les sciences humaines, biomédicales et comportementales, elle offre une grille de lecture élégante et rigoureuse pour appréhender des construits latents non directement observables tels que l’intelligence, l’extraversion, l’anxiété ou les aptitudes motrices.
Toutefois, une confusion méthodologique et conceptuelle récurrente subsiste, y compris chez des praticiens expérimentés et des étudiants en sciences quantitatives, quant à la distinction précise entre la distribution normale dans son acception générale et sa forme canonique singulière : la distribution normale standard, ou loi normale centrée réduite. Si la première constitue une famille infinie de courbes paramétrées par une infinité de combinaisons possibles de moyennes et d’écarts-types, la seconde incarne un étalon mathématique unique, adimensionnel et universellement tabulé, dont les propriétés fixées à dessein facilitent l’inférence statistique et l’évaluation comparative.
Comprendre les articulations analytiques, géométriques et épistémologiques qui unissent et différencient ces deux distributions s’avère indispensable pour quiconque souhaite manier avec rigueur le calcul de probabilités, concevoir des instruments de mesure psychométriques étalonnés ou interpréter valablement des scores standardisés. Le présent article propose une exploration exhaustive de cette dualité statistique, en détaillant les fondements mathématiques, les paramètres de localisation et d’échelle, les mécanismes de standardisation via le score Z, ainsi que les implications concrètes de cette transition métrique au sein de la recherche empirique et de la pratique diagnostique.
1. Introduction aux modèles gaussiens en analyse statistique et psychométrie
1.1 Origines historiques et modélisation de la courbe en cloche
L’histoire de la distribution normale s’enracine dans la quête de formalisation des jeux de hasard et de la théorie des erreurs. C’est au mathématicien français Abraham de Moivre que l’on doit, en 1738, la première approximation analytique de la distribution binomiale à l’aide de ce qui allait devenir la loi normale, publiée dans une extension de son traité The Doctrine of Chances. De Moivre cherchait alors à simplifier le calcul prohibitif des probabilités associées à un nombre élevé de lancers de pièces équilibrées, observant que la somme des tirages convergeait vers une courbe continue symétrique.
Quelques décennies plus tard, Pierre-Simon de Laplace élargit considérablement cette intuition en formulant les prémisses du théorème central limite dans sa Théorie analytique des probabilités (1812). Simultanément, Carl Friedrich Gauss appliquait ce formalisme au traitement des erreurs de mesure en astronomie géodésique, postulant que les écarts d’observation autour d’une valeur réelle suivent une loi exponentielle quadratique. Ces contributions conjointes ont ainsi forgé la double appellation de distribution laplacienne-gaussienne, bien que l’usage contemporain ait principalement retenu le qualificatif de loi gaussienne.
Au cours de la seconde moitié du XIXe siècle, Adolphe Quetelet et Francis Galton ont transposé ces concepts des sciences physiques aux sciences humaines. Quetelet invente le concept de « l’homme moyen », découvrant que les caractéristiques anthropométriques comme la taille ou le tour de poitrine se répartissent selon une morphologie en cloche. Galton, quant à lui, étend ce paradigme aux facultés intellectuelles et comportementales, fondant ainsi la biométrie et les prémisses de la psychométrie. Dès lors, la nécessité méthodologique s’est imposée de distinguer la forme générale observée dans la nature — polymorphe et dépendante d’unités physiques concrètes — de sa formalisation standardisée abstraite, indispensable pour élaborer des lois universelles de la variabilité humaine.
1.2 Pertinence des distributions continues en sciences psychologiques
Dans le domaine des sciences psychologiques et neurocognitives, la plupart des phénomènes d’intérêt ne sont pas directement observables ; ils constituent ce que la théorie de la mesure qualifie de construits latents. Qu’il s’agisse de l’intelligence fluide, du niveau d’affect dépressif, de l’impulsivité ou de la vitesse de traitement perceptif, ces entités psychologiques sont modélisées sous la forme de variables aléatoires continues théoriques. Les instruments de mesure standardisés — tels que les questionnaires d’auto-évaluation ou les épreuves de performance cognitive — recueillent des réponses discrètes qui sont ensuite agrégées pour approcher au plus près cette continuité sous-jacente.
L’hypothèse de normalité joue ici un rôle épistémologique structurant. En vertu du théorème central limite, un trait comportemental complexe résulte de l’interaction additive d’une multitude infinie de facteurs génétiques, épigénétiques, neurobiologiques et environnementaux, chacun exerçant une influence infinitésimale. Dès lors que ces micro-causes agissent de manière relativement indépendante, la distribution observée du construit latent au sein d’une population homogène tend spontanément vers la courbe normale. Les concepteurs de tests s’appuient sur ce postulat fondamental pour concevoir des barèmes, calibrer des items par la théorie de réponse aux items (TRI) et garantir que les épreuves discriminent équitablement les individus tout au long du continuum psychologique.
Il apparaît néanmoins une dissociation fondamentale entre les données brutes observées et les grandeurs mathématiques théoriques. Un score brut à un test d’efficience intellectuelle représente simplement le décompte de bonnes réponses ou le temps de réaction en millisecondes. Ces valeurs métriques brutes sont intrinsèquement arbitraires et incommensurables. Pour acquérir une signification psychologique et diagnostique, ces mesures empiriques doivent impérativement être converties et projetées sur un modèle distributionnel formel, matérialisant le passage indispensable de la description locale à l’inférence standardisée universelle.
1.3 Objectifs théoriques et pratiques de la comparaison
L’objectif central de cette comparaison analytique réside dans la clarification conceptuelle rigoureuse entre deux entités statistiques souvent confondues : une famille infinie de lois de probabilité caractérisées par des paramètres variables, et un membre unique et fixe de cette famille, érigé au rang de standard absolu. Cette clarification permet de dépasser les raccourcis pédagogiques pour saisir l’architecture profonde des modèles linéaires généralisés et de la théorie classique des tests.
Sur le plan méthodologique, cette distinction conditionne la validité des processus inférentiels. Le calcul direct de probabilités ou de proportions sous une courbe normale générale exigerait la résolution d’intégrales dépourvues de primitives algébriques simples pour chaque configuration imaginable de moyenne et de dispersion. L’introduction de la loi normale standardisée résout cette aporie pratique : elle transforme toute distribution normale spécifique en un espace géométrique unifié où les probabilités associées à des seuils critiques deviennent immédiatement accessibles via des tables universelles ou des algorithmes numériques standardisés.
Enfin, sur le plan appliqué, la transformation d’une distribution générale en distribution normale standardisée constitue l’épine dorsale de l’évaluation clinique et différentielle. Elle confère aux chercheurs et cliniciens la capacité d’agréger des scores provenant de domaines cognitifs hétérogènes, d’isoler des profils dysharmoniques, de comparer des individus évalués sur des échelles divergentes et de quantifier l’éloignement d’une performance par rapport à une population de référence de manière totalement invariante à l’égard de l’instrument utilisé.
2. Fondements mathématiques et caractéristiques de la distribution normale générale
2.1 Fonction de densité de probabilité et symétrie axiale
La distribution normale générale, traditionnellement notée N(μ, σ²), est une distribution de probabilité pour variable aléatoire continue dont la fonction de densité de probabilité (FDP), notée f(x), est définie mathématiquement sur l’ensemble des nombres réels par l’expression suivante :
f(x) = [1 / (σ √(2π))] × exp[ – (x – μ)² / (2σ²) ]
Dans cette formulation analytique, le nombre π représente la constante circulaire d’Archimède (≈ 3,14159) et e la base du logarithme népérien (≈ 2,71828). La variable x parcourt l’ensemble des réels de -∞ à +∞. La présence de la constante de normalisation [1 / (σ √(2π))] assure rigoureusement que l’intégrale définie de la fonction de densité sur l’intervalle infini complet demeure strictement égale à 1, respectant ainsi le second axiome fondamental des probabilités de Kolmogorov.
L’une des caractéristiques géométriques les plus remarquables de cette fonction réside dans sa symétrie axiale parfaite par rapport à la droite verticale d’équation x = μ. Cette propriété implique formellement que pour tout écart positif δ, l’égalité f(μ + δ) = f(μ – δ) est vérifiée. Cette symétrie structurelle entraîne une conséquence capitale pour les mesures de tendance centrale : au sommet absolu de la courbe, la moyenne arithmétique (μ), la médiane (la valeur divisant l’aire totale en deux moitiés équiprobables de 0,5) et le mode (le point d’ordonnée maximale) coïncident rigoureusement en un unique point d’inflexion central.
Par ailleurs, la fonction présente un comportement asymptotique bilatéral strict. Lorsque x s’éloigne indéfiniment du centre vers la droite (+∞) ou vers la gauche (-∞), le terme exponentiel décroît à une vitesse quadratique, rapprochant la courbe de l’axe des abscisses sans jamais l’intercepter ni la franchir. Cette propriété d’asymptote horizontale signifie théoriquement que tout événement réel possède une probabilité de survenue strictement positive, bien qu’infinitésimale, éliminant ainsi toute borne supérieure ou inférieure absolue dans le modèle mathématique pur.
2.2 Variabilité infinie des formes gaussiennes
Contrairement à une conception réductrice qui associerait la loi normale à un profil graphique unique, il existe en réalité une infinité de distributions normales distinctes dans la nature. Cette pluralité dérive directement de la flexibilité offerte par ses deux paramètres déterminants : le paramètre de localisation (μ) et le paramètre de dispersion (σ). Chaque paire unique (μ, σ) engendre une fonction de densité spécifique possédant une allure singulière, adaptée à l’échelle de mesure du phénomène étudié.
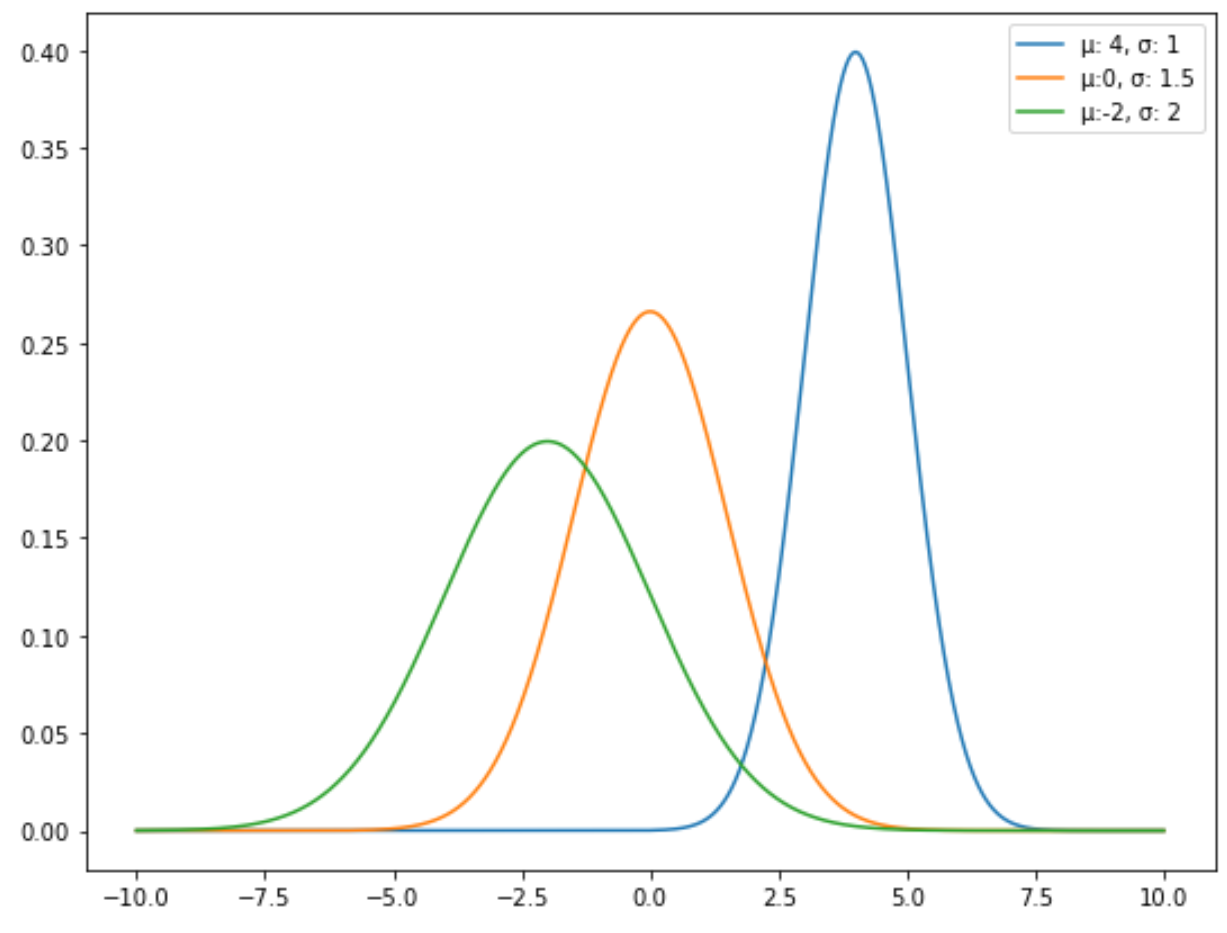
La morphologie apparente de la courbe en cloche peut ainsi osciller entre des profils extrêmement élancés et pointus, ou au contraire extraordinairement aplatis et étalés. Lorsque l’écart-type σ est très faible, les observations sont fortement concentrées autour de la moyenne, ce qui propulse le sommet de la courbe à une altitude très élevée pour maintenir l’aire unitaire. À l’inverse, un σ élevé génère une courbe écrasée dont le sommet est bas et les ailes extrêmement larges. Bien que le coefficient d’aplatissement théorique de Pearson (la kurtosis) soit constant et égal à 3 pour toute loi normale pure, la leptocurticité visuelle apparente varie dramatiquement en fonction de l’échelle d’observation adoptée par le statisticien.
Dans le monde réel, ces variations infinies se manifestent par des distributions normales de métriques incomparables : la pression artérielle systolique d’une cohorte d’adultes (exprimée en millimètres de mercure avec μ ≈ 120 et σ ≈ 15), la concentration plasmatique de cortisol (en microgrammes par décilitre) ou encore le temps nécessaire pour résoudre une tâche de rotation mentale (en fractions de seconde). Chacune de ces variables génère sa propre distribution normale générale, irréductible aux autres sans une procédure de transformation formelle.
2.3 Points d’inflexion et concavité de la courbe normale
La topologie de la courbe normale générale est régie par les variations de sa dérivée seconde, qui déterminent la concavité de la fonction. En calculant f »(x) et en identifiant les racines de cette équation, on démontre mathématiquement que la fonction change de concavité en deux points géométriques précis, nommés points d’inflexion. Ces points se situent exactement aux coordonnées d’abscisse :
x = μ – σ et x = μ + σ
Sur l’intervalle intérieur délimité par ]μ – σ ; μ + σ[, la dérivée seconde est strictement négative, conférant à la courbe une concavité dirigée vers le bas (forme concave ou « en dôme »). Dès que l’on franchit les points d’inflexion vers l’extérieur — c’est-à-dire pour toute valeur appartenant aux intervalles ]-∞ ; μ – σ[ ou ]μ + σ ; +∞[ —, la dérivée seconde devient strictement positive, et la concavité s’inverse pour devenir dirigée vers le haut (forme convexe ou « en cuvette »).
La localisation de ces points d’inflexion possède une signification géométrique et statistique cruciale. Ils matérialisent visuellement la dispersion du phénomène : l’écart horizontal séparant l’axe de symétrie central de l’un ou l’autre des points d’inflexion équivaut rigoureusement à un écart-type (σ). Ainsi, même en l’absence de repères numériques gradués sur un graphique représentant une loi normale quelconque, l’œil exercé du méthodologue peut estimer visuellement la valeur de l’écart-type en observant simplement la coordonnée où la cloche cesse de s’arquer vers le bas pour amorcer son étalement asymptotique.
3. Le rôle structurel des paramètres de localisation et de dispersion
3.1 Le paramètre mu : axe de translation et tendance centrale
Le paramètre μ (lettre grecque mu) désigne l’espérance mathématique de la variable aléatoire, correspondant dans un cadre distributionnel à la moyenne arithmétique de la population totale théorique. D’un point de vue fonctionnel et géométrique, μ agit exclusivement comme un opérateur de translation spatiale horizontale le long de l’axe des abscisses. Il fixe l’ancrage central de la distribution sans altérer d’aucune manière sa morphologie, son étalement, sa hauteur ou sa largeur.
Lorsque la valeur de μ augmente ou diminue, la courbe de densité glisse intégralement vers la droite ou vers la gauche du repère cartésien, à la manière d’un bloc rigide indéformable. Si deux distributions distinctes possèdent des moyennes différentes (μ1 ≠ μ2) mais partagent rigoureusement le même écart-type (σ1 = σ2), leurs tracés graphiques seront rigoureusement congruents et superposables par un simple vecteur de translation d’amplitude Δ = μ2 – μ1.
En psychométrie, cette translation spatiale s’observe couramment lors de l’application de versions parallèles d’une épreuve d’évaluation ou lors de l’étalonnage de tests bruts sur des cohortes d’âges successifs. Par exemple, à une épreuve de vocabulaire réceptif, un groupe d’enfants de 6 ans présentera une moyenne de scores bruts μ = 24 items réussis, tandis qu’un groupe de 10 ans obtiendra μ = 42 items. Si l’hétérogénéité des compétences reste stable au fil du développement (σ constant), la courbe distributionnelle des enfants plus âgés sera simplement décalée vers les valeurs positives de l’échelle, illustrant l’évolution maturative sans distorsion structurelle de la variance intra-groupe.
3.2 Le paramètre sigma : régulateur d’étalement et d’aplatissement
Le paramètre σ (lettre grecque sigma), quant à lui, désigne l’écart-type de la distribution, défini mathématiquement comme la racine carrée de la variance (σ²). Contrairement à μ, σ est strictement positif (σ > 0) et opère comme un facteur d’échelle régulant l’élasticité morphologique de la fonction de densité. Il gouverne directement la dispersion des observations autour de l’espérance centrale, dictant à la fois la largeur de la base de la cloche et l’altitude de son sommet.
Une augmentation de σ provoque un étalement horizontal prononcé de la distribution : les probabilités se répartissent sur un intervalle de valeurs beaucoup plus vaste, ce qui reflète une forte hétérogénéité des scores empiriques. Cependant, comme l’aire totale sous la courbe doit invariablement demeurer égale à l’unité (1), cette dilatation horizontale s’accompagne obligatoirement d’une réduction mécanique de l’ordonnée maximale. Le pic de la cloche, localisé à x = μ et valant f(μ) = 1 / (σ√(2π)), s’abaisse de façon proportionnelle à l’accroissement de σ.
Réciproquement, une diminution de σ engendre une concentration massive des observations à proximité immédiate de la moyenne μ. L’intervalle interquartile se contracte, les ailes de la distribution se vident, et le sommet s’élève substantiellement vers le haut du repère. Il est fondamental de souligner l’indépendance paramétrique stricte qui régit la loi normale : la valeur adoptée par σ n’exerce aucune contrainte sur la valeur de μ, et réciproquement. Une population peut ainsi présenter une moyenne extrêmement basse associée à une variance colossale, ou une moyenne très élevée couplée à une homogénéité quasi totale.
3.3 Hétérogénéité des métriques et incommensurabilité des scores bruts
La variabilité conjointe et illimitée des paramètres μ et σ soulève un écueil méthodologique redoutable en analyse quantitative : l’incommensurabilité des scores bruts. Deux mesures issues de distributions générales régies par des paramètres divergents ne peuvent être directement comparées d’un point de vue ordinal ou métrique sans induire des distorsions interprétatives majeures.
Considérons le cas typique d’un candidat passant deux épreuves psychologiques distinctes dans le cadre d’un bilan d’orientation. À l’épreuve de raisonnement abstrait (Test A), le candidat obtient une note brute de 65, sachant que ce test est caractérisé dans la population par μA = 50 et σA = 10. À l’épreuve d’aptitude spatiale (Test B), le même individu obtient une note brute de 80, issue d’une distribution où μB = 70 et σB = 15. Si un évaluateur naïf comparait directement les grandeurs numériques brutes, il conclurait que 80 étant supérieur à 65, le sujet dispose d’une compétence spatiale nettement plus marquée que son raisonnement abstrait.
Cette déduction est pourtant statistiquement erronée. Au Test A, le sujet se situe à 15 unités au-dessus de la moyenne pour un étalement de 10, soit 1,5 unité d’écart-type au-delà du centre. Au Test B, bien que sa note brute paraisse plus élevée, il n’excède la moyenne que de 10 unités pour un étalement de 15, ce qui le place à seulement 0,67 unité d’écart-type au-dessus du centre. La note brute la plus basse masque en réalité une performance relative largement supérieure. Cet exemple démontre l’absolue nécessité mathématique de s’affranchir des unités métriques singulières et de projeter les observations sur un référentiel canonique universel : la distribution normale standard.
4. Nature, propriétés et spécificités de la distribution normale standard
4.1 Définition axiomatique de la distribution normale centrée réduite
La distribution normale standard — désignée dans la littérature francophone sous l’appellation de loi normale centrée réduite et universellement symbolisée par Z ∼ N(0, 1) — constitue un cas particulier singulier, érigé en étalon canonique au sein de l’infinité des distributions normales générales. Sa définition axiomatique repose sur la fixation délibérée et invariable de ses deux paramètres structurels :
- L’espérance mathématique est impérativement fixée à zéro : μ = 0 (propriété de centrage).
- L’écart-type ainsi que la variance sont impérativement fixés à l’unité : σ = 1 et σ² = 1 (propriété de réduction).
Cette double contrainte paramétrique engendre une simplification majeure de la fonction de densité de probabilité. En substituant μ = 0 et σ = 1 dans la fonction générale, celle-ci adopte une formulation analytique allégée, traditionnellement désignée par la lettre grecque φ (phi) :
φ(z) = [1 / √(2π)] × exp[ – z² / 2 ]
Alors que la distribution générale renvoie à une famille statistique pléthorique, la loi normale standard représente un objet mathématique unique. Il n’existe pas plusieurs distributions normales standardisées ; il n’en existe qu’une seule et unique sur l’ensemble du champ mathématique. Cette unicité absolue en fait le modèle normatif de référence par excellence pour toute l’inférence paramétrique.
4.2 Structure géométrique de la distribution de référence
La morphologie spatiale de la distribution normale standard hérite de toutes les propriétés fondamentales des distributions gaussiennes tout en les cristallisant dans des repères spatiaux immuables. L’axe de symétrie axiale verticale de la courbe ne dépend plus d’une valeur arbitraire : il coïncide rigoureusement et en tout temps avec l’axe des ordonnées d’abscisse z = 0.
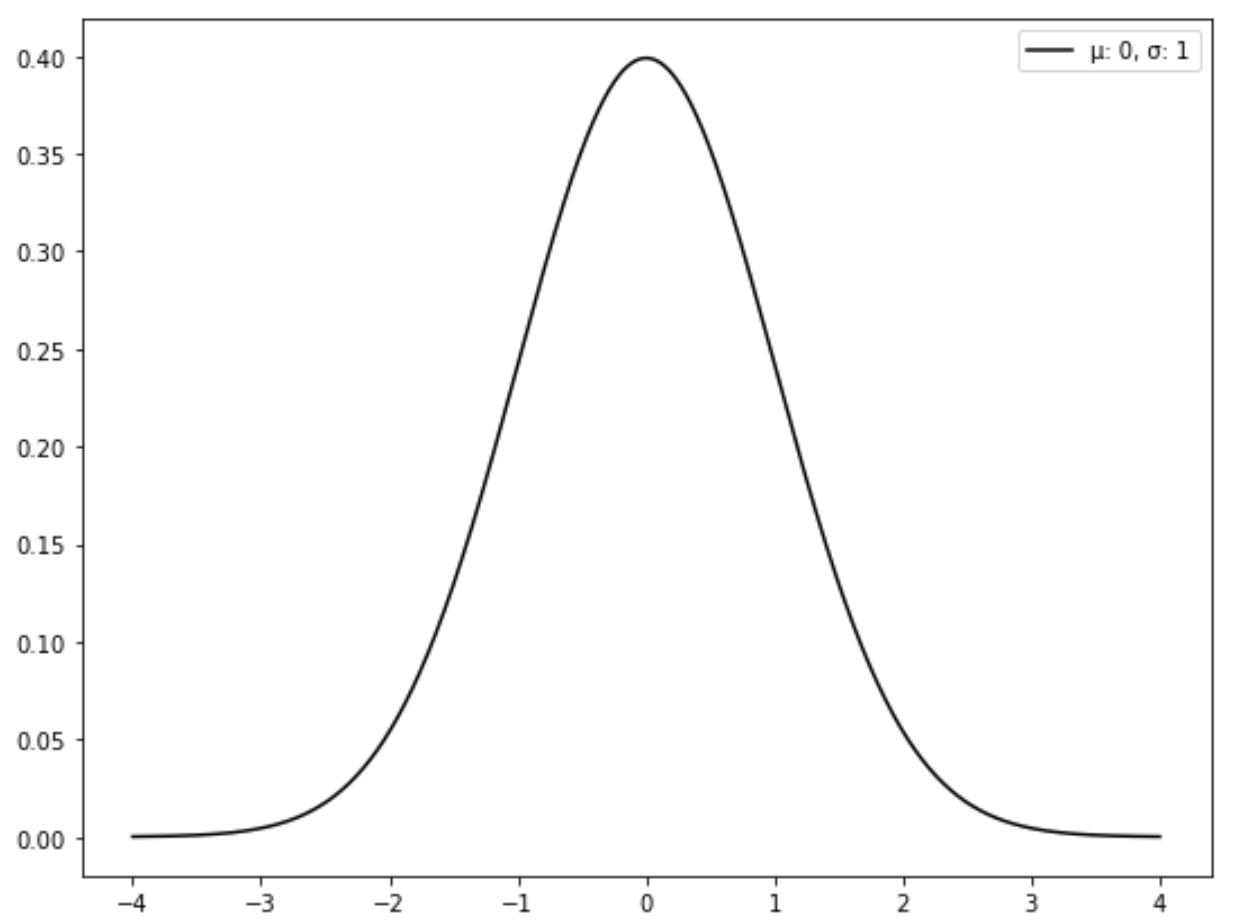
L’altitude maximale du sommet de la cloche, localisée à son point médian d’abscisse 0, possède une ordonnée mathématiquement fixe et invariante valant exactement φ(0) = 1 / √(2π) ≈ 0,39894. De part et d’autre de cette crête centrale, la courbe amorce sa courbure descendante. Ses deux points d’inflexion canoniques, correspondant aux coordonnées μ ± σ, se trouvent immuablement ancrés aux points d’abscisse :
z = -1 et z = +1
L’ordonnée de ces points d’inflexion s’établit avec exactitude à φ(±1) = [1 / √(2π)] × e-0,5 ≈ 0,24197. L’aire géométrique totale circonscrite sous la courbe standardisée entre -∞ et +∞ demeure rigoureusement égale à 1,00000. De par sa parfaite symétrie, l’aire cumulée de -∞ à 0 équivaut rigoureusement à 0,5, tout comme l’aire résiduelle comprise entre 0 et +∞. La géométrie de la distribution normale standard forme ainsi un gabarit immuable et standardisé de la variabilité probabiliste.
4.3 Utilité épistémologique de la distribution standardisée
Sur le plan épistémologique, l’avènement de la distribution normale centrée réduite a constitué une révolution méthodologique comparable à l’introduction du Système international d’unités en métrologie physique. En substituant aux unités brutes (secondes, grammes, centimètres, nombre de réponses justes) une unité métrique purement statistique fondée sur la variabilité intrinsèque de la distribution — le score Z —, la standardisation opère une neutralisation dimensionnelle absolue.
Cette adimensionnalité affranchit l’analyste des contingences matérielles de l’instrument d’investigation. Elle autorise la mise en relation formelle d’attributs psychologiques de natures disparates au sein d’équations de prédiction unifiées, telles que les régressions multiples ou les modélisations en équations structurelles (SEM). Un score standard de z = +2,0 exprime exactement la même rareté statistique et le même éloignement relatif au sein d’une distribution de volumes cérébraux mesurés par résonance magnétique (en millimètres cubes) que dans un inventaire de personnalité évaluant l’ouverture à l’expérience (sur une échelle de Likert en 5 points).
En outre, c’est cette neutralité canonique qui a rendu possible l’élaboration et la publication des tables statistiques de probabilité cumulée au cours des XIXe et XXe siècles. Sans la loi centrée réduite, les statisticiens auraient été contraints d’imprimer une table d’intégration numérique spécifique pour chaque combinaison concevable de moyenne et d’écart-type, une tâche d’une complexité infinie. La loi normale standard sert ainsi de passerelle de décodage universelle entre la réalité empirique hétérogène et les lois de l’échantillonnage théorique.
5. Analyse comparative structurée : distribution générale vs standard
5.1 Confrontation directe des paramètres fondamentaux
La distinction cardinale entre la distribution normale générale et la distribution normale standard repose sur le statut ontologique de leurs paramètres statistiques. Dans la distribution générale, l’espérance mathématique μ est un paramètre libre pouvant théoriquement adopter n’importe quelle valeur sur l’axe des nombres réels, de -∞ à +∞. De même, la dispersion σ constitue un paramètre libre pouvant fluctuer à travers l’ensemble des réels strictement positifs ]0, +∞[.
À l’inverse, dans la distribution normale standard, ces paramètres cessent d’être des variables libres pour devenir des constantes structurelles rigides et universellement fixées à μ = 0 et σ = 1. Cette divergence fondamentale entraîne le passage conceptuel d’un ensemble infini de trajectoires potentielles à un modèle unique invariant. On résume traditionnellement cette filiation en affirmant que toute loi normale standard est une loi normale, mais qu’une loi normale n’est presque jamais standard.
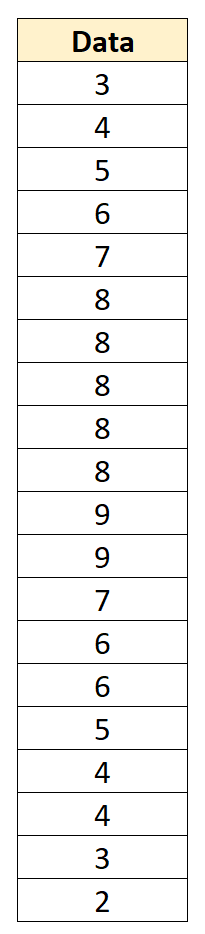
La distribution normale générale décrit l’état factuel d’une population particulière à travers une métrique concrète donnée, incarnant l’ancrage empirique de la recherche. La distribution normale standardisée, elle, relève d’une abstraction mathématique opérationnelle, configurée délibérément pour simplifier le calcul différentiel et intégral et standardiser la confrontation des hypothèses scientifiques.
5.2 Comparaison fonctionnelle et dimensionnelle des grandeurs
La confrontation entre ces deux distributions met en lumière une discordance majeure sur le plan dimensionnel. Toute distribution générale s’exprime dans l’unité de mesure physique ou psychologique de la variable qu’elle représente. Si la variable X modélise le taux d’hémoglobine dans le sang, X est exprimée en grammes par décilitre, sa moyenne μ est libellée en grammes par décilitre, et son écart-type σ partage également cette même unité de masse par volume.
Cette dépendance dimensionnelle rend la distribution générale hautement vulnérable aux transformations d’échelle arbitraires. Si un chercheur décide de convertir des temps de réaction initialement mesurés en millisecondes vers une métrique en secondes, les paramètres de la distribution normale générale seront instantanément modifiés : la moyenne μ et l’écart-type σ seront tous deux divisés par un facteur 1000, altérant complètement le tracé graphique de la courbe dans le repère cartésien initial.
En contrepartie, la variable Z de la distribution normale standard est intrinsèquement adimensionnelle, c’est-à-dire totalement dépourvue d’unité physique. Résultant du rapport d’un écart exprimé dans l’unité de départ sur un écart-type exprimé dans cette même unité, les dimensions métriques s’annulent algébriquement lors du processus de standardisation. Le score Z obtenu est un nombre pur, invariant aux changements d’unités de mesure initiales, ce qui confère à la loi standardisée son caractère d’outil de comparaison universel et transdisciplinaire.
5.3 Tableau synoptique des divergences conceptuelles
Afin de synthétiser les divergences conceptuelles, mathématiques et opérationnelles séparant la distribution normale générale de sa variante standard, le tableau synoptique suivant récapitule les caractéristiques déterminantes de chaque modèle :
| Critères d’analyse | Distribution normale générale | Distribution normale standard |
|---|---|---|
| Notation symbolique | X ∼ N(μ, σ²) | Z ∼ N(0, 1) |
| Paramètre de moyenne (μ) | Variable libre : -∞ < μ < +∞ | Constante rigide : μ = 0 |
| Paramètre de variance (σ²) | Variable libre : σ² > 0 | Constante rigide : σ² = 1 |
| Écart-type (σ) | Variable libre : σ > 0 | Constante rigide : σ = 1 |
| Nombre d’instances | Infinité de courbes possibles | Une courbe mathématique unique |
| Unité de mesure | Dimensionnelle (liée à la métrique de départ) | Adimensionnelle (nombre pur, sans unité) |
| Axe de symétrie | Droite verticale d’équation x = μ | Axe des ordonnées d’équation z = 0 |
| Points d’inflexion | Situés à x = μ – σ et x = μ + σ | Situés strictement à z = -1 et z = +1 |
| Ordonnée maximale au pic | f(μ) = 1 / (σ √(2π)) (variable) | φ(0) = 1 / √(2π) ≈ 0,39894 (fixe) |
| Rôle épistémique principal | Description phénoménologique des données brutes | Étalonnage normatif et inférence probabiliste |
Cette vue d’ensemble souligne avec force que la loi centrée réduite n’est point une alternative rivale à la loi normale générale, mais bien son incarnation canonique fondamentale, conçue comme un outil d’interopérabilité statistique.
6. Le processus de standardisation : transition de la variable X au score Z
6.1 Démonstration algébrique de la formule du score Z
La transition d’une variable aléatoire continue X distribuée normalement selon N(μ, σ²) vers la variable normale standardisée Z s’opère par une transformation mathématique élémentaire mais aux vertus structurales fondamentales, connue sous le nom de centrage et réduction :
Z = (X – μ) / σ
Cette opération combine deux transformations linéaires successives appliquées à chaque valeur x de la variable brute :
- Le centrage (effet soustractif) : L’opération X – μ soustrait l’espérance arithmétique de la population à chaque observation brute. En vertu des propriétés de linéarité de l’espérance mathématique, l’espérance de la nouvelle variable translatée devient : E(X – μ) = E(X) – μ = μ – μ = 0. Le centrage translate l’ensemble de la distribution afin d’aligner son centre de gravité rigoureusement sur le zéro, sans impacter la dispersion relative des points.
- La réduction (effet divisif) : La division du résidu centré par l’écart-type σ normalise l’étalement. En appliquant les propriétés de la variance à une transformation linéaire, où Var(aX + b) = a² × Var(X), avec a = 1/σ et b = -μ/σ, on obtient : Var(Z) = (1/σ²) × Var(X) = σ² / σ² = 1. Puisque la variance vaut 1, l’écart-type résultant équivaut également à la racine carrée de 1, soit σz = 1.
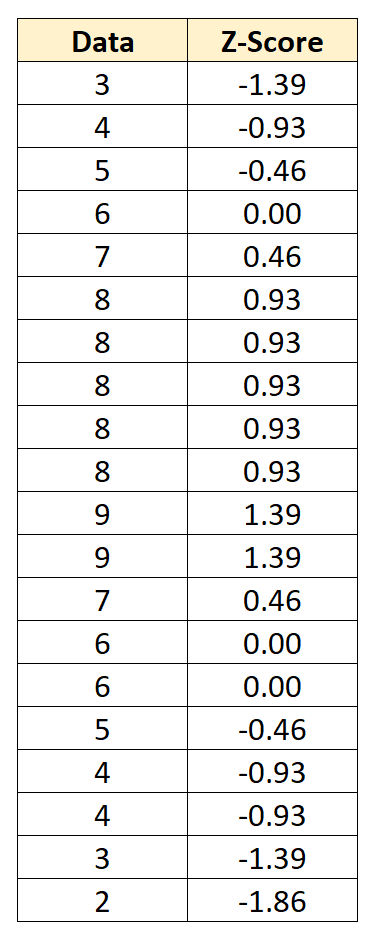
Il importe de souligner avec rigueur que la transformation en score Z est une transformation strictement affine ou linéaire. Elle modifie la localisation et l’échelle métrique, mais préserve intégralement la configuration géométrique intrinsèque des données. Les distances relatives entre les points, les rapports d’éloignement et les coefficients de symétrie (skewness) et d’aplatissement (kurtosis) demeurent strictement préservés à l’identique lors de ce passage.
6.2 Interprétation analytique du score Z
Sur le plan interprétatif, le score Z offre une signification immédiate et univoque : il indique avec précision le nombre d’écarts-types dont une observation brute x s’éloigne au-dessus ou en dessous de la moyenne arithmétique de son groupe de référence. Le score standardisé synthétise donc en une unique valeur chiffrée deux informations cruciales : le sens de la déviation et sa magnitude relative.
Le signe algébrique attaché au score standard détermine l’orientation de l’observation par rapport au centre de gravité distributionnel :
- Un score z > 0 (positif) signifie que la valeur observée est supérieure à la moyenne arithmétique du groupe de référence.
- Un score z < 0 (négatif) démontre à l’inverse que l’observation s’établit en dessous de la tendance centrale.
- Un score z = 0 signale une coïncidence parfaite entre l’observation brute et l’espérance mathématique du groupe, positionnant rigoureusement l’individu sur la médiane et le mode de la distribution théorique.
La valeur absolue du score standard |z| quantifie l’intensité de la déviation statistique indépendamment de son orientation. Ainsi, un individu affichant un score z = +2,5 se positionne exactement à 2,5 écarts-types au-dessus de la moyenne de sa population, ce qui représente une performance remarquable et statistiquement atypique. De même, un score z = -2,5 reflète un éloignement symétrique d’égale intensité dans la zone des déficits ou des scores faibles. Le praticien peut immédiatement appréhender l’amplitude de l’écart sans avoir besoin de mémoriser les paramètres initiaux μ et σ de l’instrument d’évaluation.
6.3 Exemple d’application pas à pas avec données numériques
Afin de matérialiser la mécanique opératoire du score Z, examinons un protocole psychologique administré à un groupe de 5 participants lors d’une épreuve de mémoire de travail visuo-spatiale (empan de blocs de Corsi). Les scores bruts obtenus (représentant le nombre total de séquences correctement reproduites) sont les suivants :
X = { 6, 8, 10, 12, 14 }
La première étape consiste à déterminer les paramètres d’échantillon servant d’estimateurs ponctuels de la distribution. Calculons tout d’abord la moyenne arithmétique :
X̄ = (6 + 8 + 10 + 12 + 14) / 5 = 50 / 5 = 10,0
La deuxième étape requiert le calcul de la variance et de l’écart-type de cette série d’observations. Les écarts à la moyenne sont calculés comme suit : (6 – 10) = -4 ; (8 – 10) = -2 ; (10 – 10) = 0 ; (12 – 10) = +2 ; (14 – 10) = +4. Élevés au carré, ces résidus deviennent : 16, 4, 0, 4, 16. La somme des carrés des écarts équivaut à 40. En considérant cet échantillon pour le calcul de l’écart-type standardisé de population (σ) avec un dénominateur N = 5, nous obtenons une variance de σ² = 40 / 5 = 8,0, ce qui donne un écart-type :
σ = √8 ≈ 2,8284
La troisième étape applique systématiquement la transformation zi = (xi – 10,0) / 2,8284 à chaque observation brute :
- Pour x1 = 6 : z1 = (6 – 10) / 2,8284 = -4 / 2,8284 ≈ -1,414
- Pour x2 = 8 : z2 = (8 – 10) / 2,8284 = -2 / 2,8284 ≈ -0,707
- Pour x3 = 10 : z3 = (10 – 10) / 2,8284 = 0 / 2,8284 = 0,000
- Pour x4 = 12 : z4 = (12 – 10) / 2,8284 = +2 / 2,8284 ≈ +0,707
- Pour x5 = 14 : z5 = (14 – 10) / 2,8284 = +4 / 2,8284 ≈ +1,414
La vérification des propriétés de la série standardisée confirme la validité de la procédure. La somme des scores Z calculés s’établit à : (-1,414) + (-0,707) + 0,000 + 0,707 + 1,414 = 0,000, vérifiant que la nouvelle moyenne est rigoureusement nulle (μz = 0). La somme des carrés de ces scores Z équivaut à : 2,0 + 0,5 + 0 + 0,5 + 2,0 = 5,0. Divisée par l’effectif N = 5, la variance des scores Z s’élève à 5,0 / 5 = 1,000, ce qui confirme que la variance est unitaire (σ²z = 1). Les données brutes initiales ont ainsi été parfaitement projetées dans l’espace de la distribution normale standard.
7. Intégration et détermination des probabilités sous la courbe
7.1 L’obstacle de l’intégration analytique de la loi normale
En probabilités continues, la détermination de la probabilité qu’une variable aléatoire X prenne une valeur comprise dans un intervalle délimité [a ; b] s’obtient par l’intégration définie de sa fonction de densité de probabilité entre ces deux bornes :
P(a ≤ X ≤ b) = ∫ab f(x) dx = ∫ab [1 / (σ √(2π))] × exp[ – (x – μ)² / (2σ²) ] dx
Or, cette équation confronte les mathématiciens à un obstacle analytique majeur : la fonction exponentielle quadratique e-x² ne possède aucune primitive élémentaire pouvant s’exprimer sous forme algébrique fermée combinant des fonctions usuelles (polynômes, logarithmes, trigonométriques). Il est impossible de calculer cette intégrale par une simple évaluation aux bornes d’une primitive F(b) – F(a) formulée analytiquement.
Pour contourner cette impossibilité, le recours à des méthodes d’approximation par intégration numérique s’avère incontournable. Les algorithmes numériques — reposant sur des développements en séries entières de Taylor-Maclaurin, des fractions continues de Gauss ou des méthodes de quadrature adaptative — permettent d’approcher l’aire sous la courbe avec une précision décimale arbitrairement élevée. Néanmoins, devoir réitérer ces procédures de calcul intensif pour chaque valeur singulière de moyenne μ et d’écart-type σ rencontrée dans la pratique scientifique représentait, avant l’informatique moderne, une charge de calcul totalement prohibitive.
7.2 La table statistique de la loi normale standardisée
C’est précisément pour surmonter cette barrière computationnelle que la distribution normale standard a été institutionnalisée. En ramenant toute fonction générale à la forme canonique φ(z), les mathématiciens ont concentré leurs efforts sur la tabulation de la fonction de répartition cumulative de la loi normale standard, notée universellement Φ(z) (grand Phi) :
Φ(z) = P(Z ≤ z) = ∫-∞z [1 / √(2π)] × exp[ – u² / 2 ] du
La célèbre « table de la loi normale centrée réduite » répertorie avec une extrême précision (souvent 4 à 6 décimales) les valeurs de probabilités associées à des abscisses z variant généralement de 0,00 à 3,99 par incréments de 0,01. Les lignes du tableau correspondent aux dixièmes de score Z et les colonnes aux centièmes. Grâce à la symétrie axiale parfaite de la courbe, il est inutile de tabuler les valeurs négatives de z ; celles-ci s’obtiennent par déduction logique immédiate via la relation complémentaire :
Φ(-z) = 1 – Φ(z)
Pour calculer la probabilité bilatérale qu’une observation se situe entre deux valeurs opposées [-z ; +z], la table permet d’exploiter la relation P(-z ≤ Z ≤ z) = 2Φ(z) – 1. De même, les logiciels contemporains (comme le package stats de R ou les modules scipy.stats en Python) n’intègrent pas numériquement chaque loi spécifique : ils appliquent un algorithme d’approximation polynomiale optimisé sur la fonction Φ(z), réduisant le temps d’exécution machine à quelques nanosecondes.
7.3 Généralisation de l’évaluation des probabilités empiriques
L’articulation entre le score Z et la table standardisée offre une méthode universelle en trois étapes pour déterminer n’importe quelle probabilité sous n’importe quelle courbe gaussienne empirique X ∼ N(μ, σ²). Cette procédure élimine définitivement la nécessité d’intégrer manuellement des fonctions de densité arbitraires.
Supposons que nous souhaitions évaluer la probabilité qu’un individu extrait aléatoirement d’une population présente un score de mémoire verbale compris entre 42 et 58, au sein d’une distribution générale caractérisée par μ = 50 et σ = 8. La démarche s’articule comme suit :
- Standardisation des bornes : Les valeurs brutes délimitant l’intervalle d’intérêt sont converties en coordonnées standards Z :
zinf = (42 – 50) / 8 = -8 / 8 = -1,00
zsup = (58 – 50) / 8 = +8 / 8 = +1,00 - Traduction en probabilités cumulées standardisées : La probabilité de l’intervalle brut équivaut à la probabilité de l’intervalle standard :
P(42 ≤ X ≤ 58) = P(-1,00 ≤ Z ≤ +1,00) = Φ(1,00) – Φ(-1,00) - Consultation de la fonction Φ : La table standard indique que Φ(1,00) ≈ 0,84134. Par complémentarité, Φ(-1,00) = 1 – 0,84134 = 0,15866. L’évaluation de l’aire s’obtient par différence :
P(42 ≤ X ≤ 58) = 0,84134 – 0,15866 = 0,68268 (soit environ 68,27 %)
Cette logique s’applique avec la même élégance au calcul de valeurs critiques unilatérales pour des tests de significativité. Si l’on souhaite identifier le score brut seuil en dessous duquel ne tombent que les 5 % des sujets les plus en difficulté (P(X ≤ x) = 0,05), on recherche dans la table la valeur inverse Φ-1(0,05) qui donne z ≈ -1,645. Il suffit ensuite d’appliquer la transformation affine inverse : x = μ + (z × σ) = 50 + (-1,645 × 8) = 50 – 13,16 = 36,84. Le pont mathématique entre distribution générale et standard fonctionne ainsi dans les deux sens de manière totalement fluide.
8. La règle empirique 68-95-99.7 : lecture comparative des deux distributions
8.1 Enonciation des seuils probabilistes fondamentaux
Parmi les propriétés remarquables de la distribution normale, la règle empirique — souvent désignée dans la communauté scientifique anglo-saxonne sous l’appellation de Three-Sigma Rule ou règle 68-95-99.7 — résume les pourcentages fondamentaux de dispersion théorique associés aux multiples entiers de l’écart-type. Cette règle découle directement de l’intégration définie de la loi gaussienne sur des intervalles centrés symétriquement autour de l’espérance mathématique.
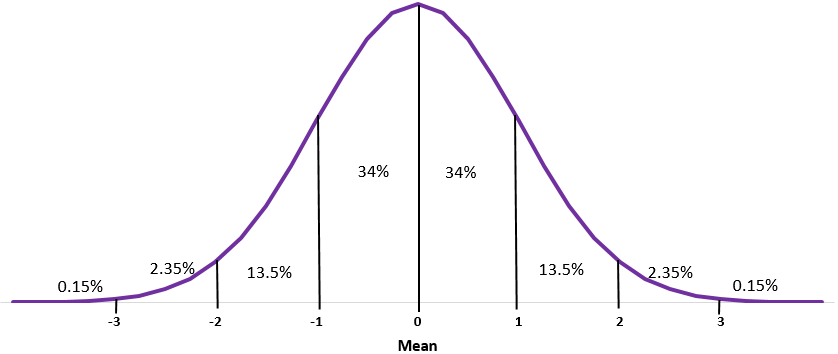
Les seuils probabilistes fondamentaux s’énoncent de la manière suivante :
- L’intervalle délimité par un écart-type de part et d’autre de la moyenne englobe exactement 68,2689 % (soit approximativement 68,27 % ou un peu plus des deux tiers) de la masse totale de la population :
P(μ – 1σ ≤ X ≤ μ + 1σ) ≈ 0,6827 - L’intervalle délimité par deux écarts-types de part et d’autre de la moyenne englobe exactement 95,4499 % (soit approximativement 95,45 % ou la quasi-totalité) des observations empiriques :
P(μ – 2σ ≤ X ≤ μ + 2σ) ≈ 0,9545 - L’intervalle délimité par trois écarts-types de part et d’autre de la moyenne englobe une proportion écrasante de 99,7300 % (soit approximativement 99,73 %) des observations :
P(μ – 3σ ≤ X ≤ μ + 3σ) ≈ 0,9973
Ce modèle stipule que la survenue d’un score s’éloignant de plus de trois écarts-types de la tendance centrale constitue un événement statistique hautement improbable, dont la probabilité résiduelle cumulée sur les deux extrémités (les queues de distribution) n’excède pas 0,27 % (soit environ 1 cas sur 370 observations).
8.2 Application géométrique sur la distribution générale
Lorsqu’elle est projetée sur une distribution normale générale N(μ, σ²), la règle empirique prend corps à travers des intervalles numériques conditionnés par les unités concrètes et les métriques de l’instrument d’évaluation. Les frontières de ces tranches probabilistes s’expriment toujours sous la forme algébrique μ ± kσ, où k ∈ {1, 2, 3}.
Prenons l’exemple d’un inventaire clinique mesurant l’anxiété-trait chez des adultes, où les scores bruts sont distribués selon une loi normale d’espérance μ = 72 points et d’écart-type σ = 12 points :
- L’intervalle à un écart-type correspond à [72 – 12 ; 72 + 12], soit [60 ; 84]. Environ 68,27 % des patients évalués obtiendront un score d’anxiété situé entre 60 et 84 points.
- L’intervalle à deux écarts-types correspond à [72 – (2 × 12) ; 72 + (2 × 12)], soit [48 ; 96]. Environ 95,45 % de la cohorte présentera un score compris entre 48 et 96 points. Les sujets franchissant le seuil critique de 96 points ne représentent que 2,28 % des individus (zone d’anxiété sévère pathologique).
- L’intervalle à trois écarts-types correspond à [72 – (3 × 12) ; 72 + (3 × 12)], soit [36 ; 108]. La quasi-totalité (99,73 %) de la population clinique se trouve contenue dans ces limites.
Dans ce contexte général, le clinicien doit constamment recalculer mentalement les bornes numériques en effectuant des multiplications et des additions sur la base des paramètres propres au test, ce qui complique les comparaisons entre instruments mesurant des facettes connexes de la symptomatologie.
8.3 Application géométrique sur la distribution normale standard
Sur la distribution normale standard N(0, 1), la règle empirique se dépouille de toute contingence arithmétique pour révéler sa pureté structurelle. Les paramètres μ = 0 et σ = 1 simplifient les intervalles μ ± kσ qui deviennent strictement 0 ± k(1) = ±k :
- L’intervalle [-1 ; +1] concentre rigoureusement 68,27 % de l’aire sous la courbe.
- L’intervalle [-2 ; +2] concentre rigoureusement 95,45 % de la distribution.
- L’intervalle [-3 ; +3] concentre rigoureusement 99,73 % de l’espace probabiliste.
Cette formulation invariante confère au chercheur une grille de lecture universelle instantanée. Sans même savoir quelle aptitude ou quel biomarqueur est à l’étude, le constat qu’un sujet obtient un score z = +2,15 informe immédiatement qu’il se situe au-delà de la borne des 95 % de la population générale, le plaçant dans le décile supérieur des scores atypiques.
De plus, cette architecture fonde directement les conventions de décision dans les tests d’hypothèses statistiques. Bien que la règle empirique utilise les valeurs entières z = ±2 (englobant 95,45 %), la recherche scientifique préfère isoler un intervalle de confiance englobant très exactement 95,00 % de l’aire centrale. Par inversion de la fonction Φ, ce seuil correspond aux valeurs critiques universelles z = ±1,96. Les 5 % résiduels se subdivisent en deux zones de rejet critiques de 2,5 % chacune (z < -1,96 et z > +1,96), établissant le seuil canonique de significativité α = 0,05 utilisé dans la quasi-totalité des publications scientifiques empiriques.
9. Applications directes en psychométrie et étalonnage des instruments d’évaluation
9.1 Standardisation du Quotient Intellectuel (QI)
L’étalonnage du quotient intellectuel au sein des batteries d’évaluation cognitive contemporaines — à l’instar des échelles de Wechsler pour enfants et adultes (WAIS-IV, WISC-V) — constitue l’archétype même de l’exploitation clinique de la loi normale.
Historiquement, le QI correspondait au ratio développé par William Stern : l’âge mental divisé par l’âge chronologique, multiplié par 100. Cette approche présentait toutefois de sévères failles statistiques, notamment l’impossibilité de comparer valablement des quotients chez l’adulte en raison de la stagnation de l’âge mental au-delà de l’adolescence. Pour résoudre ce verrou théorique, David Wechsler a instauré en 1939 le « QI standard » (ou QI de déviation), qui repose sur la projection délibérée des performances cognitives sur une distribution normale théorique fixe caractérisée par une moyenne μ = 100 et un écart-type σ = 15 :
QI ∼ N(100, 15²)
La relation reliant le score Z issu de la distribution standard et le QI psychométrique découle d’une simple transformation linéaire directe :
QI = 100 + (z × 15)
Dans ce cadre rigide, un QI de 115 correspond rigoureusement à z = +1,00 (positionnant l’individu à +1 écart-type, soit au 84e rang percentile). Un QI de 130 correspond exactement à z = +2,00 (+2 écarts-types, soit au 97,7e percentile), qui définit conventionnellement le seuil statistique d’identification du haut potentiel intellectuel (HPI). Réciproquement, un QI de 70 équivaut à z = -2,00 (-2 écarts-types, soit au 2,3e percentile), constituant l’un des critères psychométriques majeurs pour le diagnostic différentiel du trouble du développement intellectuel (déficience intellectuelle) selon les classifications internationales du DSM-5 et de la CIM-11.
9.2 Dérivations psychométriques : scores T, stanines et stens
Bien que le score Z standardisé soit l’instrument mathématique suprême, son utilisation brute en restitution clinique ou en gestion des ressources humaines soulève d’importantes résistances pragmatiques. Le score Z comporte intrinsèquement des valeurs négatives (pour toute la moitié inférieure de la population) ainsi que des valeurs décimales (ex. z = -0,47). L’annonce à un patient ou à des parents d’un « score négatif » induit fréquemment un choc psychologique délétère lié à la confusion entre signe algébrique et évaluation péjorative.
Pour parer à ces difficultés ergonomiques, les psychométriciens procèdent à des transformations linéaires secondaires des scores Z vers d’autres échelles dérivées, garantissant des scores strictement positifs et entiers :
- Les scores T de McCall : Massivement utilisés dans les inventaires de personnalité comme le MMPI-3 ou les échelles comportementales pour enfants (BASC), ils sont calibrés selon une moyenne μ = 50 et un écart-type σ = 10 via la formule : T = 50 + (10 × z). Un score z = +1,5 devient un score T de 65. Une note T ≥ 65 ou 70 matérialise généralement un seuil de significativité clinique.
- Les stanines (Standard Nines) : Développées par l’armée de l’air américaine durant la Seconde Guerre mondiale, elles divisent la distribution normale en 9 classes ordinales standardisées (de 1 à 9), avec une moyenne μ = 5 et un écart-type σ ≈ 2. La stanine centrale (5) rassemble les scores Z compris entre -0,25 et +0,25.
- Les stens (Standard Tens) : Fréquemment exploitées dans les évaluations de recrutement professionnel (comme le questionnaire 16PF de Cattell), les stens découpent la distribution en 10 intervalles entiers (de 1 à 10), avec μ = 5,5 et σ = 2.
Chacune de ces échelles psychométriques dérivées n’est rien d’autre qu’une déclinaison paramétrique spécifique d’une loi normale générale, générée par une transformation linéaire de la loi normale standard originelle.
9.3 Calcul des rangs percentiles via la loi standardisée
L’une des fonctions primordiales de la distribution standard en évaluation psychologique réside dans la conversion des scores continus en rangs percentiles cumulés. Le rang percentile exprime le pourcentage exact d’individus de la cohorte d’étalonnage qui obtiennent un score strictement inférieur ou égal au score du sujet évalué. Cette grandeur ordinale est universellement privilégiée pour communiquer les bilans aux profanes, car elle évite le jargon statistique abstrait.
Le passage du score Z au rang percentile s’effectue directement par l’évaluation de la fonction de répartition cumulative standardisée Φ(z), multipliée par 100 :
Rang Percentile (RP) = Φ(z) × 100
Ainsi, pour un score standard z = 0,00, le rang percentile est exactement Φ(0) × 100 = 50e percentile (le sujet surpasse la moitié de la cohorte). Pour z = +1,00, le percentile s’établit à 84,13e percentile (arrondi au 84e). Pour z = +2,00, il atteint le 97,72e percentile (98e).
Toutefois, une mise en garde méthodologique fondamentale doit être formulée quant à la non-linéarité de cette transformation. Alors que le score Z est une métrique d’intervalle rigoureusement linéaire (l’écart séparant z = 0 et z = 1 est quantitativement identique à l’écart séparant z = 1 et z = 2), le rang percentile est une échelle ordinale non linéaire. En raison de la concentration massive des fréquences au centre de la courbe en cloche, un accroissement infinitésimal de score brut au voisinage de la moyenne entraîne un saut spectaculaire en termes de percentiles. En revanche, aux extrémités de la courbe (dans les ailes), un accroissement considérable du score brut ne produit qu’une progression marginale du percentile. La projection de la loi standard sur l’échelle des percentiles induit ainsi un effet d’étirement périphérique et de tassement central qui interdit toute opération arithmétique (comme la moyenne de percentiles).
10. Comparabilité inter-échelles et normalisation d’instruments psychologiques divergents
10.1 Résolution du paradoxe de la comparaison d’épreuves hétérogènes
Dans la pratique neuropsychologique quotidienne, le clinicien est confronté à l’obligation d’analyser conjointement des données issues d’épreuves hétérogènes. Par exemple, l’examen d’un patient victime d’un traumatisme crânien peut comporter l’évaluation de la mémoire de travail via l’empan envers (évalué sur une échelle de 0 à 16 points) et la mesure de sa vitesse de traitement via le test des codes de la WAIS (évalué sur une échelle de 0 à 135 points).
Comment déterminer valablement si le déficit éventuel du patient prédomine sur la vitesse ou sur la mémoire ? Tenter de répondre en observant les scores bruts n’a aucun sens, les unités métriques et les variances de ces deux tests étant fondamentalement incommensurables. En convertissant chaque résultat brut en son score standard Z respectif sur la base des normes de population du sous-test correspondant, le clinicien neutralise l’effet d’échelle :
- Empan envers : note brute = 4 → Normes : μ = 7, σ = 2 → z = (4 – 7) / 2 = -1,50
- Test des codes : note brute = 55 → Normes : μ = 85, σ = 15 → z = (55 – 85) / 15 = -2,00
L’alignement standardisé sur la distribution normale canonique révèle instantanément la vérité clinique : bien que le score brut au test des codes semble numériquement volumineux (55), il reflète une chute plus prononcée (-2 écarts-types, déficit massif) que l’épreuve de mémoire (-1,5 écart-type, fragilité modérée). Le recours à la distribution normale standard permet d’isoler les forces et les faiblesses réelles du patient en dressant un profil cognitif cohérent.
10.2 Standardisation transversale entre groupes de référence
Un autre défi statistique réside dans la comparaison de performances individuelles issues de cohortes d’âges ou de populations cliniciennes différentes. Au cours de la trajectoire développementale ou lors du vieillissement normal, les capacités cognitives brutes fluctuent considérablement. Par exemple, la vitesse graphomotrice brute décline inexorablement à partir de la cinquième décennie sans que cela ne constitue une pathologie cérébrale.
Pour neutraliser ce biais systématique lié à l’âge, les éditeurs d’outils psychométriques procèdent à une normalisation intra-groupe par strates d’âges. Chaque classe d’âge (ex. 20-29 ans, 30-39 ans, 70-79 ans) dispose de ses propres paramètres de distribution générale (μtranche, σtranche). Lorsqu’un sujet âgé de 75 ans est évalué, sa note brute est convertie en score Z à l’aide des paramètres spécifiques de sa cohorte d’âge :
z = (X – μ70-79 ans) / σ70-79 ans
Grâce à cette normalisation transversale, un score z = 0 atteste que le sujet présente une vitesse rigoureusement normale pour une personne de 75 ans, quand bien même sa vitesse brute serait trois fois inférieure à celle d’un adulte jeune de 25 ans. La standardisation préserve la validité écologique de l’évaluation en positionnant chaque individu par rapport à son groupe de référence épidémiologique légitime.
10.3 Calcul et interprétation de profils multivariés
Au-delà de la comparaison univariée, l’architecture standardisée constitue le fondement mathématique de l’analyse factorielle et de la construction de macro-scores composites en psychométrie. Les indices généraux, tels que l’Indice de Compréhension Verbale (ICV) ou l’Indice de Raisonnement Perceptif (IRP), sont calculés par l’agrégation de multiples sous-tests étalonnés.
Puisque les scores bruts sont hétérogènes, il serait désastreux de les sommer directement, car le sous-test possédant la plus forte variance brute exercerait un poids démesuré et non désiré sur le résultat global. Pour conférer une pondération rigoureusement équitable à chaque composante cognitive, les psychométriciens somment les scores réduits équivalents (ou les scores d’échelle calibrés à μ = 10, σ = 3). Le macro-score obtenu fait ensuite l’objet d’une nouvelle standardisation pour être exprimé selon la métrique du QI (μ = 100, σ = 15).
Sur le plan diagnostique avancé, cette formalisation permet d’évaluer la cohérence interne d’un profil par le calcul de l’écart critique significatif (analyse de dispersion). En comparant l’écart standardisé entre deux domaines (ex. |zverbal – znon-verbal|) à l’erreur type de mesure de la différence, les neuropsychologues déterminent si une dissociation cognitive est statistiquement significative ou si elle relève d’une simple fluctuation aléatoire d’échantillonnage.
11. Pièges statistiques, postulats abusifs et limites du paradigme de normalisation
11.1 Confusion fréquente entre standardisation et normalisation distributionnelle
Une bévue théorique extrêmement répandue dans la littérature empirique consiste à confondre la standardisation (le calcul du score Z) et la normalisation distributionnelle (la transformation de la forme de la distribution). De nombreux chercheurs néophytes postulent à tort qu’en soustrayant la moyenne et en divisant par l’écart-type, des données empiriques non normales acquièrent miraculeusement la morphologie d’une courbe en cloche gaussienne.
Il n’en est rien. La transformation en score Z est une transformation strictement affine f(x) = ax + b. Par essence, une transformation affine préserve rigoureusement la forme géométrique intégrale de la distribution d’origine :
- Si une variable brute X présente une distribution asymétrique positive (queue étirée vers la droite, comme pour les temps de réponse ou les salaires), la variable Z standardisée obtenue présentera exactement la même asymétrie positive au centième près.
- Si la distribution brute est bimodale ou multimodale, la distribution des scores Z demeurera strictement bimodale ou multimodale.
La standardisation modifie l’axe des abscisses (moyenne ramenée à 0, dispersion à 1), mais ne courbe jamais une distribution empirique pour la rendre gaussienne. Pour transformer réellement une distribution asymétrique en une distribution proche de la loi normale, il est impératif de recourir à des transformations non linéaires (telles que la transformation logarithmique, la racine carrée ou la famille des transformations de Box-Cox), ou de procéder à une normalisation par les rangs percentiles (transformation de probabilité intégrale inverse via la fonction probit). Avant de projeter des scores Z sur les tables de la loi normale standard pour en inférer des probabilités, l’adéquation préalable du modèle gaussien doit obligatoirement être corroborée par des tests d’ajustement formels, tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov.
11.2 Sensibilité aux valeurs aberrantes et instabilité d’échantillonnage
Le second écueil inhérent au paradigme de la standardisation repose sur la fragilité structurelle de ses deux estimateurs de base : la moyenne arithmétique X̄ et l’écart-type S. Ces paramètres de la loi normale générale possèdent un point de rupture (breakdown point) égal à 0 % : il suffit qu’une seule observation extrême ou aberrante (outlier) s’introduise dans un jeu de données pour contaminer massivement la moyenne et gonfler artificiellement l’écart-type.
Cette vulnérabilité paramétrique entraîne un effet pervers direct lors du calcul des scores Z :
- L’observation extrême tire la moyenne μ vers elle, tout en augmentant drastiquement la valeur de σ.
- Par conséquent, la dispersion accrue au dénominateur va mécaniquement écraser les scores standardisés Z de l’ensemble des individus normaux de l’échantillon, masquant des variations subtiles mais cliniquement significatives au sein du groupe sain.
- De surcroît, le score Z de la valeur aberrante elle-même sera artificiellement minoré (effet de masque ou masking effect).
Face à ce biais de représentativité, les méthodologues recommandent le recours à des estimateurs statistiques robustes. La standardisation robuste substitue à la moyenne classique la médiane (insensible aux extrêmes) et remplace l’écart-type par la déviation absolue médiane (Median Absolute Deviation ou MAD), introduite par Hampel :
Score Z Robuste = (X – Médiane) / (1,4826 × MAD)
Le coefficient multiplicateur 1,4826 assure la cohérence asymptotique : lorsque les données suivent rigoureusement une loi normale, l’estimateur 1,4826 × MAD converge précisément vers l’écart-type σ, offrant ainsi une standardisation stable et protégée contre l’influence des valeurs extrêmes.
11.3 Biais éthiques et interprétatifs en évaluation clinique
L’omniprésence de la loi normale standardisée dans l’évaluation psychologique et médicale engendre des risques de dérives épistémologiques et éthiques non négligeables. Le danger principal réside dans la réification statistique du score Z : la tendance fallacieuse à considérer un écart standardisé abstrait comme un attribut biologique ou psychologique figé et consubstantiel à l’individu.
Un score z = -2,1 obtenu à une batterie neuropsychologique n’est pas une « propriété intrinsèque » de la personne ; il s’agit simplement du reflet mathématique de sa performance à un instant t, contextualisée par rapport à un échantillon normatif particulier. Si l’échantillon d’étalonnage utilisé par l’éditeur du test est biaisé, non représentatif sur le plan socioculturel, obsolète (effet Flynn) ou non adapté au profil linguistique du patient, la valeur du score Z est dénuée de validité différentielle. Un individu peut apparaître artificiellement déficitaire simplement parce que sa population d’appartenance a été confrontée à des normes inadaptées.
Enfin, tout score standardisé doit impérativement être contextualisé à la lumière de la théorie classique des tests (TCT) par l’intégration de l’erreur type de mesure (ETM ou SEM). Aucun test psychométrique ne dispose d’une fidélité absolue (rxx = 1,00). En conséquence, le score Z ponctuel calculé est affecté d’une marge d’imprécision inéluctable. Tout rapport d’évaluation rigoureux se doit de restituer les performances sous la forme d’un intervalle de confiance centré autour du score Z estimé :
IC95% = z ± 1,96 × √(1 – rxx)
Ignorer cet intervalle d’incertitude et sceller le destin scolaire ou médico-légal d’un sujet sur la base d’un franchissement arbitraire de seuil (ex. refuser une allocation ou un diagnostic pour un score de z = -1,98 contre z = -2,01) relève d’une méconnaissance grave de la nature probabiliste des modèles gaussiens.
12. Synthèse théorique et recommandations méthodologiques pour la recherche
12.1 Arbre de décision méthodologique pour le praticien
Afin de guider rationnellement les chercheurs et praticiens dans l’exploitation conjointe des distributions normales générales et standardisées, l’arbre de décision logique suivant synthétise la démarche à adopter face à un jeu de données quantitatives continues :
- Étape 1 : Exploration distributionnelle préliminaire :
Avant toute opération, évaluer graphiquement (histogrammes, diagrammes quantile-quantile Q-Q plots) et analytiquement (skewness, kurtosis, test de Shapiro-Wilk) l’ajustement des données brutes X à une distribution normale générale.- Si non-normalité sévère : S’orienter vers des méthodes non paramétriques (rangs de Wilcoxon, Mann-Whitney) ou appliquer des transformations de variable non linéaires appropriées avant toute standardisation ultérieure.
- Si adéquation satisfaisante : Estimer rigoureusement les paramètres de population μ et σ.
- Étape 2 : Définition des objectifs de l’analyse :
- Objectif descriptif univarié : Conserver les données dans leur métrique générale brute N(μ, σ²) pour préserver le sens écologique immédiat des unités (ex. millisecondes, points bruts).
- Objectif de comparaison, d’agrégation ou d’inférence : Engager le processus de standardisation vers la distribution normale standard N(0, 1) en calculant les scores Z.
- Étape 3 : Restitution et communication des résultats :
- Pour la communauté académique : Présenter les scores Z, les tailles d’effet standardisées (d de Cohen) et les intervalles de confiance associés.
- Pour le milieu clinique appliqué ou les usagers : Convertir les scores Z en échelles dérivées intuitives (scores T, QI de déviation) ou en rangs percentiles, tout en explicitant rigoureusement les marges d’erreur de mesure.
12.2 Intégration dans les logiciels d’analyse moderne (R, SPSS, Python)
L’implémentation opérationnelle de ces modèles gaussiens s’avère harmonisée au sein des principaux environnements de calcul statistique contemporains. La maîtrise des fonctions associées permet d’automatiser tant l’intégration probabiliste que le diagnostic d’atypicité multivariée.
Dans l’écosystème statistique R, quatre fonctions fondamentales régissent la manipulation de la distribution normale :
dnorm(x, mean = 0, sd = 1): Calcule la densité de probabilité f(x) ou φ(z). En omettant les arguments de moyenne et d’écart-type, la fonction applique par défaut les paramètres de la loi standard (μ = 0, σ = 1).pnorm(q, mean = 0, sd = 1): Évalue la fonction de répartition cumulative Φ(z), renvoyant la probabilité que la variable soit inférieure ou égale au quantileq.qnorm(p, mean = 0, sd = 1): Fonction quantile inverse (Φ-1), renvoyant le score Z ou la valeur brute associée à une probabilité cumuléep.scale(x, center = TRUE, scale = TRUE): Automatise vectoriellement la standardisation linéaire directe d’une variable brute vers le score Z standardisé.
En environnement Python, la bibliothèque scientifique scipy.stats propose le sous-module norm (avec ses méthodes norm.pdf(), norm.cdf(), norm.ppf()), tandis que la fonction zscore() de ce même module calcule instantanément les coordonnées standardisées d’un jeu de données. De plus, dans le cadre d’analyses multivariées avancées englobant plusieurs épreuves corrélées, la standardisation généralisée s’effectue via le calcul de la distance de Mahalanobis, qui généralise le concept de score Z standardisé à un espace multidimensionnel en intégrant formellement la matrice de variance-covariance des différentes distributions normales générales sous-jacentes.
12.3 Conclusion épistémologique sur la dualité normal-standard
Au terme de cette analyse comparative exhaustive, il apparaît clairement que la distribution normale générale et la distribution normale standard ne s’opposent en aucune façon ; elles forment au contraire un continuum conceptuel d’une absolue cohérence, incarnant la rencontre entre la contingence du monde empirique et l’universalité des structures mathématiques.
La distribution normale générale N(μ, σ²) matérialise la phénoménologie du vivant : elle accueille la diversité infinie des grandeurs corporelles, sensorielles, cognitives et affectives, chacune enracinée dans son unité métrique propre et conditionnée par son échelle contextuelle. Elle constitue le miroir quantitatif de la variabilité biologique et humaine.
La distribution normale standard N(0, 1), quant à elle, représente le triomphe de l’abstraction métrologique. En annulant les dimensions particulières, en centrant l’espérance sur le néant originel et en unifiant la dispersion, elle transcende les singularités locales pour établir un langage statistique universel. C’est elle qui autorise le dialogue scientifique entre des disciplines autrefois étanches, permettant de confronter avec une égale rigueur l’expression d’un gène, la réponse d’un réseau neuronal ou l’intensité d’une aptitude psychologique.
À l’heure où la psychométrie contemporaine évolue vers des modèles de plus en plus sophistiqués — modélisations en réseaux, théories de réponse aux items non paramétriques et approches bayésiennes dynamiques —, la compréhension limpide de la dualité unissant la loi normale générale à sa contrepartie standardisée demeure un prérequis épistémologique absolu pour quiconque aspire à mesurer, analyser et comprendre la complexité des comportements humains.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- De Moivre, A. (1738). The doctrine of chances: Or, a method of calculating the probabilities of events in play (2nd ed.). H. Woodfall.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Laplace, P. S. (1812). Théorie analytique des probabilités. Courcier.
- McCall, W. A. (1922). How to measure in education. Macmillan.
- Quetelet, A. (1835). Sur l’homme et le développement de ses facultés, ou Essai de physique sociale. Bachelier.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3-4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment. https://www.pearsonassessments.com