
Dans le champ de l’analyse statistique contemporaine, de la psychométrie appliquée et des neurosciences computationnelles, la modélisation des phénomènes stochastiques repose de manière prépondérante sur la loi normale, ou distribution de Gauss-Laplace. Si la majorité des praticiens et des chercheurs maîtrisent le calcul direct consistant à évaluer la probabilité qu’une variable aléatoire continue prenne une valeur inférieure ou égale à un seuil empirique déterminé, la démarche réciproque s’avère tout aussi déterminante dans la démarche d’inférence scientifique. Cette approche inverse consiste à déterminer avec précision la valeur critique ou le score frontière correspondant à une probabilité cumulée préalablement spécifiée.
Cette opération mathématique est rendue possible par la fonction quantile de la loi normale, plus communément désignée sous le vocable de distribution normale inverse. Loin de constituer un simple artifice d’algèbre statistique, cette fonction permet de résoudre des problèmes fondamentaux tels que l’étalonnage normatif des épreuves psychologiques standardisées, la fixation des seuils de significativité clinique lors d’évaluations neuropsychologiques, ou encore la décomposition des processus décisionnels à travers la théorie de détection du signal. Comprendre ses mécanismes sous-jacents, sa dérivation analytique ainsi que ses incarnations algorithmiques au sein des logiciels scientifiques contemporains constitue une compétence méthodologique indispensable pour tout chercheur en sciences quantitatives.
Le présent traité propose une analyse exhaustive et rigoureuse de la distribution normale inverse. À travers un parcours alliant fondements théoriques, modélisations mathématiques, différentiations conceptuelles cruciales — notamment vis-à-vis de la loi de Wald —, résolutions algorithmiques et études de cas cliniques détaillées, cet article a pour vocation de fournir aux psychologues, métrologues, biostatisticiens et chercheurs en sciences du comportement l’ensemble des clés analytiques nécessaires à son exploitation raisonnée et méthodologiquement irréprochable.
1. Fondements conceptuels et définition de la distribution normale inverse
1.1 Définition rigoureuse et principe de la fonction inverse
Pour appréhender la nature exacte de la distribution normale inverse, il est impératif d’examiner au préalable la fonction de répartition cumulative, traditionnellement désignée par la lettre grecque majuscule Phi, notée Φ(z), dans le cadre de la loi normale centrée réduite dont la moyenne est nulle (μ = 0) et l’écart-type unitaire (σ = 1). La fonction de répartition associe à toute valeur réelle z, appartenant à l’intervalle des nombres réels ]-∞, +∞[, une probabilité cumulée p comprise strictement dans l’intervalle ouvert ]0, 1[. Cette probabilité formalise l’intégrale de la fonction de densité de probabilité gaussienne depuis l’infini négatif jusqu’au point critique z. Dès lors, le problème fondamental posé par l’analyse inverse consiste à inverser cette relation fonctionnelle : connaissant une probabilité cible p, comment retrouver la coordonnée z correspondante telle que Φ(z) = p ?
La formalisation mathématique de cette opération s’exprime à travers la fonction quantile, rigoureusement notée Φ-1(p) ou F-1(p). Cette fonction quantile réalise une bijection stricte de l’intervalle des probabilités ]0, 1[ vers l’ensemble des réels ]-∞, +∞[. La légitimité théorique de cette inversion repose sur les propriétés fondamentales de la fonction de répartition Φ(z) : celle-ci est de classe C∞ (infiniment dérivable), continue en tout point, et strictement croissante sur l’ensemble de son domaine de définition en raison de la positivité stricte de la densité gaussienne. En vertu du théorème de la bijection, Φ admet donc une fonction réciproque unique, continue et strictement croissante sur ]0, 1[.
Il importe d’insister sur la différenciation conceptuelle majeure entre la probabilité a priori p et la variable quantile z résultante. La probabilité p est un scalaire sans dimension physique ou métrique, représentant une proportion surfacique sous la courbe de Gauss ou une fréquence théorique d’occurrence. À l’inverse, le quantile z (ou le score x dénormalisé) s’exprime dans l’unité de mesure de la variable sous étude ou sous forme d’unités d’écart-type. La fonction normale inverse n’est donc pas une densité de probabilité au sens usuel, mais bien un opérateur mathématique de projection inverse permettant de traduire un impératif probabiliste en un seuil métrologique concret.
1.2 Importance statistique dans l’inférence paramétrique
Dans l’arsenal de l’inférence statistique paramétrique, la distribution normale inverse occupe une position nodale pour la construction des intervalles de confiance tant bilatéraux qu’unilatéraux. Lorsqu’un chercheur souhaite estimer la moyenne d’une population parente avec un niveau de confiance fixé à (1 – α), l’étendue de cet intervalle est directement conditionnée par le quantile z1 – α/2 obtenu par l’évaluation de Φ-1(1 – α/2). Sans cette transformation inverse, il serait rigoureusement impossible d’établir les marges d’erreur associées aux estimateurs sans biais issus d’échantillons probabilistes régis par le théorème central limite.
De manière analogue, la démarche de décision statistique régissant les tests d’hypothèses — qu’il s’agisse de comparer des moyennes, des proportions ou des coefficients de régression linéaire — dépend intrinsèquement de la détermination précise des régions critiques de rejet. Pour un seuil d’erreur de première espèce α unilatéral, la valeur critique marquant la frontière au-delà de laquelle l’hypothèse nulle H0 est rejetée est obtenue via Φ-1(1 – α) pour un test unilatéral supérieur, ou via Φ-1(α) pour un test unilatéral inférieur. L’inversion normale garantit ainsi le contrôle nominal des erreurs décisionnelles au sein de la démarche formelle de Neyman-Pearson.
Au-delà de la stricte théorie des tests, la transformation inverse constitue le mécanisme universel permettant d’interpréter les fractiles, quartiles, déciles et percentiles au sein des distributions de données. Elle permet d’ordonner et de hiérarchiser les observations empiriques en les confrontant à un modèle probabiliste théorique robuste. En associant à tout rang percentile une distance mesurable à la tendance centrale, la fonction quantile déploie une métrique d’intervalle continue à partir de rangs cumulés, facilitant ainsi l’analyse comparative de populations diverses sur un continuum d’aptitudes ou de caractéristiques biologiques.
1.3 Contexte d’application en sciences psychologiques et comportementales
L’introduction de la distribution normale inverse a constitué une véritable révolution méthodologique au sein des sciences psychologiques, de la psychiatrie quantitative et des sciences comportementales. La discipline psychométrique se heurte de manière récurrente au caractère ordinal et asymétrique des scores bruts obtenus par le biais d’échelles de mesure psychologiques, qu’il s’agisse de questionnaires d’auto-évaluation, de batteries neuropsychologiques ou de tests d’efficience intellectuelle. Afin d’autoriser des comparaisons interindividuelles et intra-individuelles rigoureuses, la normalisation des scores bruts exige un passage méthodique des distributions empiriques vers une métrique standardisée unifiée.
Cette standardisation s’opère cliniquement par le biais de la fonction normale inverse : en calculant dans un premier temps le rang centile cumulé d’un individu au sein d’un échantillon d’étalonnage représentatif, le psychologue applique ensuite la fonction Φ-1 afin de dériver le score d’écart-type z correspondant. Cette procédure, connue sous le nom de normalisation de surface ou transformation de McCall, transforme des rangs ordinaires en unités d’écart-type réparties selon une loi gaussienne théorique idéale. Les seuils de significativité clinique lors de diagnostics différentiels — par exemple pour identifier un trouble déficitaire de l’attention ou un déclin cognitif léger — s’adossent de façon univoque à ces valeurs seuils dérivées par inversion.
En pratique clinique, l’exploitation des rangs centiles bruts présente l’inconvénient majeur de masquer l’espacement réel entre les individus : les écarts entre centiles sont considérablement compressés aux extrémités de la distribution et dilatés au centre. Le recours systématique à la distribution normale inverse restaure la linéarité métrique sous-jacente en projetant ces centiles sur une échelle de Gauss. Dès lors, le chercheur ou le clinicien dispose d’un outil d’une remarquable fidélité métrologique, garantissant que chaque unité de distance le long de l’échelle d’évaluation reflète un écart standardisé constant par rapport à la moyenne du groupe de référence.
2. Distinction essentielle : distribution normale inverse versus loi de Wald
2.1 Clarification terminologique et ambiguïtés récurrentes
Dans la littérature statistique francophone et internationale, une confusion terminologique tenace et délétère persiste quant à l’usage de l’expression « distribution normale inverse ». Nombre d’étudiants, d’ingénieurs et de praticiens assimilent par erreur l’action d’inverser la fonction de répartition de la loi normale à une loi de probabilité spécifique et autonome dénommée en anglais Inverse Gaussian distribution ou loi de Wald. Il est indispensable, sur le plan épistémologique et mathématique, de dissiper immédiatement cette ambiguïté sémantique qui altère l’application rigoureuse des modèles théoriques.
D’une part, l’objet principal du présent article est la fonction quantile de la loi normale, c’est-à-dire l’inverse mathématique de la fonction de répartition d’une variable aléatoire gaussienne standard ou générale. Il ne s’agit nullement d’une nouvelle distribution statistique disposant de sa propre densité intégrable à l’infini sur son domaine de définition, mais de l’application inverse de la loi de Gauss classique. D’autre part, la distribution gaussienne inverse (ou loi de Wald) est une véritable loi de probabilité continue, régie par deux paramètres distincts, dont le support est strictement restreint à l’ensemble des réels strictement positifs ]0, +∞[.
Cette confusion provient historiquement du fait que la loi de Wald émerge de l’inversion de la relation fonctionnelle gouvernant les temps de passage dans un mouvement brownien, ce qui lui a valu le qualificatif d’inverse. Ainsi, tandis que la distribution normale inverse réfère à l’opérateur x = Φ-1(p), la loi gaussienne inverse renvoie à une variable stochastique asymétrique caractérisée par une forme fonctionnelle radicalement différente. La méconnaissance de ce distinguo conduit fréquemment à des implémentations logicielles aberrantes lors du traitement des données comportementales.
2.2 Propriétés structurales de la loi Gaussienne inverse (loi de Wald)
Pour parfaire la distinction, il convient de caractériser succinctement l’architecture mathématique de la loi de Wald. Introduite formellement par le statisticien Abraham Wald au cours de ses travaux sur les tests séquentiels, cette loi décrit avec élégance le temps nécessaire à un mouvement brownien standard, doté d’une dérive positive constante notée γ, pour franchir pour la première fois un seuil ou une barrière déterminée d’ordonnée a > 0. Ce problème du premier temps de passage engendre une distribution de probabilité continue intrinsèquement asymétrique positive, caractérisée par une traîne droite étirée vers les valeurs élevées.
La densité de probabilité associée à une variable aléatoire X suivant une loi gaussienne inverse de paramètres de position μ > 0 et d’échelle λ > 0 s’écrit formellement pour tout x > 0 :
f(x; μ, λ) = [ λ / (2 π x3) ]1/2 × exp[ – λ (x – μ)2 / (2 μ2 x) ]
Il apparaît de manière manifeste que cette formulation analytique ne présente aucune équivalence fonctionnelle avec l’inversion d’une intégrale de Gauss. Alors que la loi normale classique et sa fonction quantile sont intrinsèquement symétriques par rapport à leur paramètre central de localisation μ, la loi de Wald présente un coefficient d’asymétrie (skewness) structurellement positif égal à 3(μ/λ)1/2 et une kurtosis supérieure à 3. Elle est donc structurellement incompatible avec une inversion symétrique des quantiles gaussiens.
2.3 Critères de sélection du modèle approprié pour le psychologue
Le choix raisonné entre l’emploi de la fonction normale inverse et le recours à la loi gaussienne inverse de Wald s’opère sur la base de critères conceptuels et expérimentaux rigoureusement délimités. Dans le vaste champ de la psychologie cognitive et de la chronométrie mentale, l’enregistrement des temps de réaction (TR) lors de tâches de décision lexicale ou de discrimination perceptive produit systématiquement des distributions fortement asymétriques à étalement positif, incompatibles avec l’hypothèse de symétrie gaussienne. Dans ce cadre précis, c’est la loi de Wald — souvent formalisée au sein des modèles de diffusion d’accumulateurs de type Ratcliff — qui constitue le modèle probabiliste optimal pour caractériser la vitesse d’accumulation de l’information perceptive.
En revanche, dès lors que l’objectif du chercheur ou du psychométricien relève de la calibration psychométrique, de l’étalonnage normatif d’un test, ou de la transformation de scores composites issus d’épreuves composites (comme les sous-tests d’une batterie cognitive où le théorème central limite s’applique de par l’agrégation de multiples items indépendants), c’est la distribution normale inverse qui doit être impérativement mobilisée. Celle-ci permet de situer la performance relative d’un individu par rapport aux fractiles de la population parente de manière parfaitement symétrique et standardisée.
Les conséquences méthodologiques d’une confusion entre ces deux approches mathématiques s’avèrent délétères. Utiliser un algorithme calculant la fonction quantile normale sur des données de temps de réaction sans normalisation préalable aboutira à une estimation biaisée des temps limites et à une prédiction erronée des performances extrêmes, sous-estimant la longue traîne des latences cognitives. Inversement, ajuster une loi de Wald sur des scores standardisés préalablement symétrisés introduira une asymétrie artificielle qui faussera irrémédiablement l’interprétation des rangs centiles et la comparabilité internationale des étalonnages cliniques.
3. Formulation mathématique et dérivation de la fonction quantile
3.1 Intégrale de Gauss et fonction d’erreur (erf)
La dérivation mathématique rigoureuse de la fonction quantile normale nécessite d’examiner la structure fonctionnelle de l’intégrale de Gauss. Pour une variable aléatoire Z distribuée selon la loi normale centrée réduite N(0, 1), la fonction de répartition cumulative Φ(z) est définie de manière explicite par l’expression intégrale suivante :
Φ(z) = (1 / √(2π)) ∫-∞z exp(-t2 / 2) dt
Il est universellement établi en analyse mathématique, depuis les travaux fondamentaux de Joseph Liouville sur l’intégration en termes finis, que la primitive de la fonction exp(-t2/2) ne peut être formulée à l’aide des fonctions élémentaires usuelles (algébriques, trigonométriques ou exponentielles). Par conséquent, Φ(z) constitue une fonction transcendante spéciale. Afin de faciliter son étude analytique et son calcul, la théorie des probabilités établit un pont structurel direct entre la fonction Φ(z) et la célèbre fonction d’erreur de Gauss, notée erf(x), largement exploitée en physique mathématique et en analyse de la diffusion thermique.
La fonction d’erreur standard erf(x) est définie pour tout réel x par :
erf(x) = (2 / √π) ∫0x exp(-u2) du
Par un changement de variable rigoureux posant u = t / √2 au sein de l’intégrale de Gauss, il est aisé d’établir la relation d’équivalence universelle reliant Φ(z) et la fonction d’erreur :
Φ(z) = 1/2 [ 1 + erf( z / √2 ) ]
Dès lors, la résolution formelle de l’équation Φ(z) = p pour déterminer le quantile z = Φ-1(p) s’opère par inversion directe de cette équation algébrique. En isolant la fonction d’erreur, il advient successivement :
2p – 1 = erf( z / √2 )
z / √2 = erfinv( 2p – 1 )
z = Φ-1(p) = √2 × erfinv( 2p – 1 )
Où erfinv désigne la fonction d’erreur inverse. Cette formulation met en lumière le verrou analytique fondamental : la détermination exacte de la normale inverse est intimement subordonnée à l’évaluation de erfinv. L’absence de forme close élémentaire pour cette intégrale impose impérativement le recours à des développements en séries de Taylor locales ou à des algorithmes d’approximation numérique de haute précision pour concrétiser numériquement la valeur du quantile z.
3.2 Méthodes d’approximation numérique de la valeur z
Face à l’impossibilité d’évaluer analytiquement la fonction quantile en temps fini, les mathématiciens appliqués et les informaticiens ont conçu des algorithmes d’approximation rationnelle d’une prodigieuse précision. Parmi les architectures pionnières, l’algorithme d’Odeh et Evans, développé dans les années 1970, a longtemps fait référence en approximant la fonction quantile par des fractions rationnelles minimax sur des sous-intervalles distincts du domaine de probabilité, garantissant une erreur maximale bornée à 10-7.
Dans les moteurs de calcul statistique contemporains, tels que ceux intégrés au cœur du langage R, des bibliothèques SciPy sous Python ou des progiciels industriels de biostatistique, c’est principalement l’algorithme AS 241 conçu par Michael J. Wichura (1988) qui est systématiquement implémenté. L’algorithme de Wichura partitionne l’intervalle ]0, 1[ en plusieurs régions critiques : la zone centrale [0.15, 0.85] et les régions correspondant aux queues de distribution distales ]0, 0.15[ et ]0.85, 1[. Il applique ensuite des polynômes de Tchebychev et des fractions rationnelles de degrés élevés dont les coefficients ont été optimisés pour minimiser l’erreur relative.
Cette méthodologie d’approximation rationnelle assure un contrôle absolu de l’erreur résiduelle, plafonnant celle-ci à la limite de précision des nombres flottants en double précision (environ 16 chiffres significatifs, soit une erreur inférieure à 10-15). Un tel degré d’exactitude algorithmique s’avère indispensable en recherche clinique et génétique, où l’évaluation des seuils statistiques extrêmes (par exemple p = 10-8 pour les études d’association pangénomique GWAS) requiert une fidélité absolue dans le calcul des quantiles distaux sans risquer de dérive d’arrondi numérique.
3.3 Transformation des scores standardisés vers des échelles arbitraires
Une fois le quantile z dérivé de la loi normale centrée réduite par l’intermédiaire de Φ-1(p), il demeure nécessaire d’adapter cette métrique abstraite aux distributions empiriques réelles caractérisées par une moyenne μ et un écart-type σ arbitraires. La loi normale possède la remarquable propriété d’invariance d’échelle sous les transformations affines : si Z suit une loi N(0, 1), alors la variable X = μ + (Z × σ) suit rigoureusement une loi normale N(μ, σ2).
Cette propriété fondamentale permet de formuler l’adaptation linéaire universelle de la valeur z vers tout score x spécifique :
x = F-1(p; μ, σ) = μ + σ × Φ-1(p)
Cette relation affine démontre que le comportement mathématique de la distribution normale inverse est invariant par changement d’échelle et translation d’origine. Quel que soit le système métrologique retenu, la dynamique des distances percentiles relatives reste totalement préservée. Il convient en outre d’examiner le comportement asymptotique de cette fonction quantile aux frontières du domaine :
limp → 0+ Φ-1(p) = -∞
limp → 1– Φ-1(p) = +∞
Ce comportement asymptotique illustre l’étendue théorique infinie du support de la courbe de Gauss. Il rappelle au psychologue praticien qu’une probabilité théorique de 0 ou de 1 ne peut jamais correspondre à un score réel fini : aucune performance psychologique ne saurait être située à l’infini absolu. Dans toute étude empirique, l’utilisation de quantiles extrêmes impose dès lors une prudence métrologique rigoureuse, les valeurs calculées devenant hautement instables à mesure que p converge vers les limites asymptotiques du domaine.
4. Applications psychométriques : étalonnage et standardisation des tests
4.1 Normalisation des scores bruts et calcul des rangs centiles
Dans la construction des instruments de mesure psychométrique, l’obtention de scores bruts issus d’épreuves de performance cognitive ou d’inventaires de personnalité présente fréquemment une distribution empirique marquée par une forte asymétrie ou un aplatissement non conforme à la loi théorique de Gauss. Pour pallier cette anomalie structurelle qui vicie les comparaisons normatives, les spécialistes de la métrologie humaine déploient la méthode de normalisation non linéaire de McCall, fondée précisément sur la fonction normale inverse.
Le processus opératoire s’articule en étapes successives rigoureusement standardisées. Dans un premier temps, les scores bruts sont ordonnés de manière croissante afin de calculer pour chaque performance le rang centile cumulé pi au sein de la cohorte d’étalonnage. Afin d’éviter les biais de bord et l’assignation de probabilités unitaires incompatibles avec l’inversion gaussienne, la correction de continuité classique de Blom ou de Hazen est fréquemment appliquée :
pi = (Ri – 3/8) / (N + 1/4)
où Ri représente le rang moyen attribué à l’observation et N la taille totale de l’échantillon normatif. Dans un second temps, chaque rang centile empirique pi est soumis à la fonction de distribution normale inverse zi = Φ-1(pi). Cette transformation non linéaire a pour vertu de redistribuer artificiellement mais mathématiquement les observations brutes selon les proportions idéales de la distribution normale. À partir de ces z normalisés, il devient aisé de transposer les résultats vers des échelles d’intervalles plus intuitives pour les praticiens, telles que les stanines (moyenne 5, écart-type 2) ou les stens (moyenne 5.5, écart-type 2), atténuant drastiquement les biais d’échantillonnage par redistribution gaussienne équivalente.
4.2 Étalonnage des échelles d’intelligence et de personnalité
L’application clinique la plus répandue de la distribution normale inverse réside sans conteste dans l’étalonnage des grandes échelles d’intelligence contemporaines, telles que les échelles de David Wechsler (WAIS-IV pour adultes, WISC-V pour enfants). Historiquement calculé comme un quotient d’âge mental sur l’âge chronologique, le quotient intellectuel a été refondé par Wechsler sous la forme d’un QI de déviation standardisé, dont la distribution théorique est fixée à une moyenne μ = 100 et un écart-type σ = 15. La correspondance entre un rang percentile de performance p et le QI de déviation associé est établie mathématiquement par la formule d’inversion directe :
QI = 100 + 15 × Φ-1(p)
Dans le domaine de l’évaluation de la personnalité et de la psychopathologie clinique, les inventaires standardisés tels que le Minnesota Multiphasic Personality Inventory (MMPI) font quant à eux appel aux scores T normalisés. Cette échelle présente conventionnellement une moyenne de 50 et un écart-type de 10. La dérivation d’un score T s’effectue rigoureusement via T = 50 + 10 × Φ-1(p). L’établissement des seuils d’inclusion pour la qualification de profils déficitaires (définis par exemple par un score situé à deux écarts-types sous la moyenne, soit un QI ≤ 70 correspondant à Φ-1(0.0227)) ou pour l’identification de profils à haut potentiel intellectuel (deux écarts-types au-dessus de la moyenne, soit un QI ≥ 130 correspondant au quantile p ≥ 0.9772) dépend exclusivement de cette transformation.
Cette standardisation offre une stabilité métrologique remarquable dans le temps. En ancrant les métriques diagnostiques sur les quantiles de la courbe de Gauss, elle assure que les proportions théoriques d’individus diagnostiqués demeurent parfaitement constantes indépendamment des variations de métriques brutes, fournissant un langage quantitatif universel pour le dialogue interdisciplinaire entre neuropsychologues, pédopsychiatres et autorités médico-légales.
4.3 Théorie de la réponse aux items (TRI) et fonction d’ogive normale
La théorie de la réponse aux items (TRI) constitue le socle contemporain de la psychométrie computationnelle et des tests adaptatifs informatisés. Dans le modèle historique à deux paramètres formalisé par Frederic M. Lord, la probabilité conditionnelle P(Xij = 1 | θi) qu’un individu doté d’un niveau de trait latent θi réussisse un item donné j de difficulté bj et de pouvoir discriminant aj est modélisée par la fonction d’ogive normale :
P(Xij = 1 | θi) = Φ[ aj (θi – bj) ]
Cette modélisation place la distribution normale et son inversion au cœur même de l’estimation des compétences cognitives sous-jacentes. Pour étalonner les paramètres d’un item, la procédure inverse s’avère immédiatement nécessaire. Si une proportion spécifique p d’une sous-population homogène résout avec succès un item dont la discrimination est supposée unitaire, la valeur du trait latent sous-jacent ou la difficulté de l’item se dérive directement par inversion :
θ – b = Φ-1(p)
Bien que les modèles logistiques de Rasch et de Birnbaum soient souvent privilégiés en pratique computationnelle pour des raisons de tractabilité analytique (les fonctions logistiques disposant d’une forme close élémentaire), l’ogive normale demeure la référence conceptuelle fondamentale en raison de son ancrage direct dans l’hypothèse de distributions d’aptitudes sous-jacentes normales. Une constante d’échelle d’ajustement empirique D ≈ 1.702 est d’ailleurs universellement utilisée pour convertir les paramètres des modèles logistiques en équivalents gaussiens inverses, attestant du rôle pivot de la fonction Φ-1 dans la théorie unifiée de la mesure psychologique.
5. Utilisation dans la théorie de détection du signal (TDS) en psychophysique
5.1 Architecture conceptuelle de la théorie de détection du signal
Développée originellement dans le cadre des télécommunications et de l’ingénierie radar au cours des années 1950, puis introduite magistralement en psychologie expérimentale par David M. Green et John A. Swets, la théorie de détection du signal (TDS) constitue l’un des paradigmes expérimentaux les plus féconds de la psychophysique contemporaine. Ce modèle s’applique à toute situation expérimentale dans laquelle un observateur humain ou animal doit déterminer si un stimulus sensoriel faible (le signal) a été présenté sur un fond d’activité spontanée aléatoire (le bruit), ou si seul le bruit était présent.
Le paradigme repose sur une matrice de confusion expérimentale croisant l’état du monde avec la décision de l’observateur, générant quatre catégories d’événements fondamentaux : les détections correctes (Hits), les omissions (Misses), les fausses alarmes (False Alarms) et les rejets corrects (Correct Rejections). L’hypothèse structurante de la TDS postule que l’activité sensorielle interne générée par le bruit seul se distribue selon une loi normale N(0, σ2), tandis que l’activité suscitée par le signal s’additionne linéairement au bruit pour former une seconde distribution normale décalée, notée N(μs, σ2). L’évaluation des seuils perceptifs purs exige alors de déconvoluer mathématiquement la sensibilité biologique du sujet de ses biais stratégiques de réponse par l’emploi direct de la fonction normale inverse.
5.2 Calcul de l’indice de sensibilité d-prime (d’)
L’indice de sensibilité, universellement désigné par le symbole d-prime (d’), quantifie la distance métrique séparant les centres de gravité des deux distributions gaussiennes sous-jacentes, exprimée en unités de leur dispersion commune σ. En posant par convention σ = 1 pour la distribution du bruit centrée sur zéro, la probabilité d’une fausse alarme correspond à la queue de distribution de la loi normale centrée réduite au-delà d’un critère décisionnel fixé, tandis que le taux de détection correcte représente la surface équivalente sous la distribution signal plus bruit.
Par une dérivation immédiate s’appuyant sur la symétrie de la courbe de Gauss, l’indice d’ s’exprime rigoureusement comme la différence entre deux quantiles issus de la distribution normale inverse :
d’ = Φ-1(Taux de Détections) – Φ-1(Taux de Fausses Alarmes)
ou, selon la notation internationale : d’ = Φ-1(H) – Φ-1(FA).
L’élégance de cette formulation réside dans son indépendance absolue vis-à-vis des tendances subjectives du sujet. Que l’observateur se montre excessivement téméraire ou extrêmement précautionneux dans ses réponses, la valeur de d’ demeure invariable pour une qualité sensorielle donnée. Cependant, un écueil analytique surgit lorsque les taux empiriques de détection ou de fausses alarmes atteignent les bornes extrêmes 0 ou 1, puisque Φ-1(0) = -∞ et Φ-1(1) = +∞. La méthodologie psychophysique contemporaine résout ce blocage par la correction log-linéaire standard de Hautus, consistant à ajouter 0.5 à chaque cellule d’observation et 1 au nombre total d’essais, préservant ainsi la stabilité numérique des calculs de quantiles inverses.
5.3 Détermination du critère de décision (C) et du biais de réponse
Le second apport capital de la TDS réside dans la quantification explicite du critère de décision individuel, noté C, lequel formalise la position absolue du seuil décisionnel choisi par le sujet sur l’axe des sensations internes. Contrairement à la sensibilité d’ qui mesure une capacité discriminative neurosensorielle passive, le critère C évalue une disposition cognitive ou motivationnelle, reflétant la tendance stratégique d’un individu à répondre préférentiellement « oui » (biais libéral) ou « non » (biais conservateur).
Le critère C, défini comme la distance séparant le seuil décisionnel du point d’intersection neutre des deux distributions gaussiennes, s’obtient directement par la moyenne arithmétique négative des deux valeurs inverses :
C = – 0.5 × [ Φ-1(H) + Φ-1(FA) ]
Lorsque le critère C est égal à zéro, le sujet ne présente aucun biais systématique : il adopte une stratégie décisionnelle rigoureusement optimale minimisant les erreurs globales si les événements sont équiprobables. Une valeur négative de C dénote un biais libéral (le sujet requiert peu d’évidence perceptive pour affirmer la présence du signal), tandis qu’une valeur strictement positive révèle un comportement décisionnel conservateur (le sujet exige une certitude élevée avant de se prononcer).
Cette dissociation quantitative fondée sur la fonction normale inverse trouve des applications majeures en neuropsychologie clinique, notamment dans l’exploration des agnosies visuelles, de l’anosognosie ou de la reconnaissance des visages dans la maladie d’Alzheimer, ainsi qu’en ergonomie cognitive pour optimiser la vigilance des opérateurs de surveillance radar et des praticiens analysant des clichés mammographiques.
6. Méthodologie de calcul manuel à l’aide des tables statistiques
6.1 Structure et lecture à rebours des tables de la loi normale centrée réduite
Avant la démocratisation des calculatrices graphiques et des ordinateurs personnels, la détermination des quantiles z reposait exclusivement sur l’utilisation minutieuse des tables de probabilités cumulées de Gauss-Laplace imprimées en annexe des manuels académiques. La compréhension de la structure de ces documents statistiques demeure un impératif didactique essentiel pour visualiser la géométrie des surfaces sous la courbe normale et prévenir les erreurs d’orientation conceptuelle.
Une table statistique standard présente une disposition matricielle bidimensionnelle. Les en-têtes de lignes affichent la partie entière et la première décimale de la coordonnée z (par exemple de 0.0 à 3.4), tandis que les colonnes indiquent la seconde décimale (de 0.00 à 0.09). L’intersection d’une ligne et d’une colonne abrite la valeur de probabilité cumulée Φ(z). Pour exécuter une distribution normale inverse de manière manuelle, l’opérateur doit adopter une stratégie de lecture à rebours : au lieu de partir des marges extérieures pour converger vers une cellule centrale, il explore le corps intérieur de la table afin de localiser la probabilité la plus proche possible de la probabilité cible p recherchée.
Lorsque la probabilité cible est inférieure à 0.50, les tables classiques positives n’affichent pas directement les valeurs requises. Le praticien doit alors impérativement exploiter la propriété fondamentale de symétrie centrale de la fonction de densité gaussienne autour de zéro :
Φ(-z) = 1 – Φ(z) &implies; Φ-1(p) = – Φ-1(1 – p)
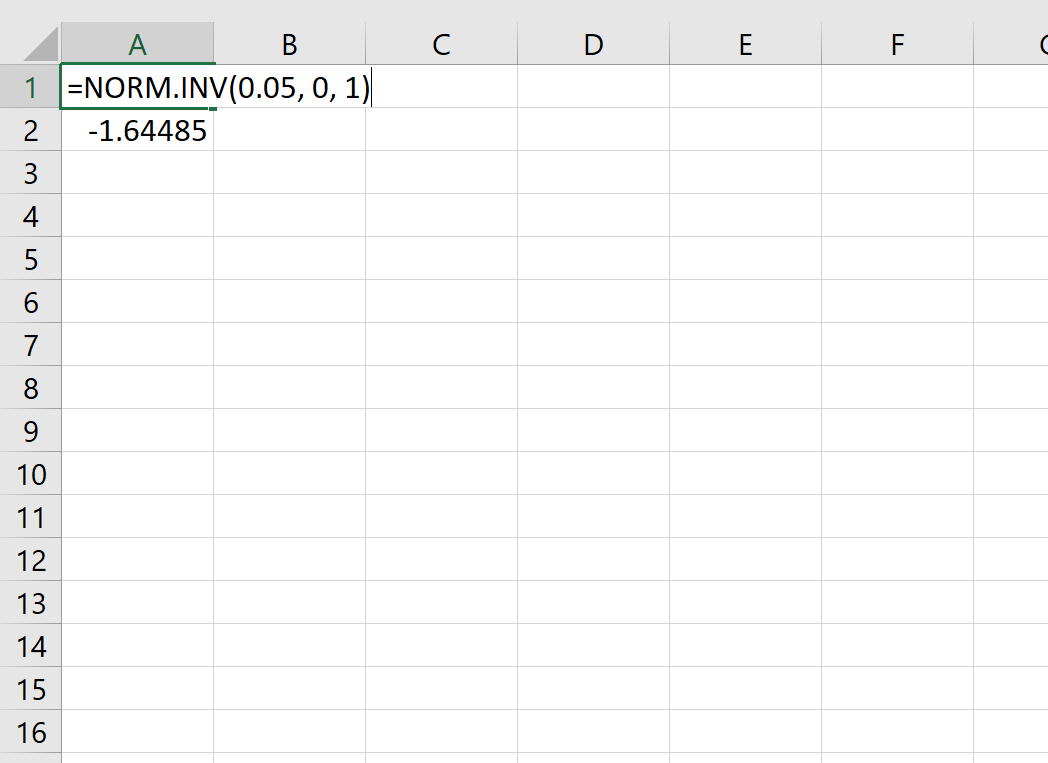
Dès lors, pour une probabilité p = 0.05, l’opérateur recherche au sein de la table la probabilité complémentaire 1 – p = 0.95, identifie la valeur critique correspondante (située entre z = 1.64 et z = 1.65), puis applique le signe négatif pour conclure rigoureusement que z ≈ -1.645.
6.2 Techniques d’interpolation linéaire pour une précision accrue
Dans la grande majorité des situations d’analyse empirique, la probabilité cible p ne coïncide pas exactement avec l’une des valeurs discrètes tabulées. Pour obtenir une précision décimale supérieure sans recourir au calcul numérique lourd, la méthode de l’interpolation linéaire locale est traditionnellement mobilisée. Elle repose sur l’hypothèse simplificatrice selon laquelle la courbe de répartition Φ(z) peut être assimilée à un segment de droite rectiligne sur un intervalle d’abscisse extrêmement restreint [z1, z2].
Soient p1 et p2 les probabilités immédiatement adjacentes répertoriées dans la table telles que p1 ≤ p ≤ p2, et soient z1 et z2 leurs quantiles correspondants respectifs. La formulation analytique de l’ajustement linéaire s’exprime par :
z = z1 + [ (p – p1) / (p2 – p1) ] × (z2 – z1)
Illustrons cette procédure par un exemple numérique pas à pas. Supposons que l’on recherche le quantile associé à une probabilité exacte de p = 0.9755. En consultant une table normale standard, on identifie :
- Pour z1 = 1.96, p1 = 0.9750
- Pour z2 = 1.97, p2 = 0.9756
L’écart de probabilité total sur l’intervalle est de p2 – p1 = 0.0006, tandis que l’écart entre notre cible et la borne inférieure est p – p1 = 0.9755 – 0.9750 = 0.0005. En appliquant la formule d’interpolation :
z = 1.96 + (0.0005 / 0.0006) × (1.97 – 1.96) = 1.96 + (0.8333 × 0.01) ≈ 1.9683
Bien que l’interpolation linéaire réduise significativement l’erreur par rapport à un arrondi brutal, elle présente des limites intrinsèques évidentes lorsque p se situe dans les queues de distribution extrêmes, zones où la courbure de la fonction de répartition s’accentue de manière vertigineuse, invalidant l’approximation par un segment linéaire.
6.3 Détermination des valeurs critiques unilatérales et bilatérales classiques
L’utilisation pratique des tables statistiques pour le calcul de la distribution normale inverse est indissociable de la recherche des seuils de significativité conventionnels encadrant les décisions statistiques. Ces valeurs critiques z constituent des bornes immuables dans la pratique scientifique quotidienne, conditionnant l’acceptation ou le rejet des hypothèses d’étude.
Dans le cadre d’un test bilatéral au seuil conventionnel d’erreur de première espèce α = 0.05, la région critique de rejet est scindée équitablement entre les deux extrémités de la distribution, attribuant une aire de probabilité de α/2 = 0.025 à chaque queue. L’inversion normale fournit :
zcritique = ± Φ-1(1 – 0.025) = ± Φ-1(0.975) = ± 1.95996 ≈ ± 1.96
Pour un test unilatéral au même seuil global α = 0.05, l’intégralité du risque d’erreur est concentrée dans une seule direction. La lecture inverse cible alors directement la probabilité cumulée p = 0.95 (pour la queue droite) ou p = 0.05 (pour la queue gauche) :
zcritique unilatéral = Φ-1(0.95) ≈ 1.64485 ≈ 1.645
Lorsque les exigences de puissance et de sécurité méthodologique imposent des seuils d’erreur plus drastiques, notamment pour pallier les problèmes d’inflation de l’erreur globale lors de comparaisons multiples, les seuils critiques α = 0.01 et α = 0.001 sont couramment adoptés :
- Pour α = 0.01 bilatéral : p = 0.995 &implies; z = ± 2.5758 ≈ ± 2.58
- Pour α = 0.01 unilatéral : p = 0.990 &implies; z = 2.3263 ≈ 2.33
- Pour α = 0.001 bilatéral : p = 0.9995 &implies; z = ± 3.2905 ≈ ± 3.29
La représentation graphique systématique de ces seuils sur la cloche de Gauss, accompagnée du hachurage minutieux des surfaces correspondant aux probabilités rejetées, constitue le rempart méthodologique le plus efficace pour éviter toute confusion directionnelle entre tests unilatéraux et bilatéraux.
7. Mise en œuvre pratique sur calculatrices graphiques TI-83 et TI-84
7.1 Accès et syntaxe de la fonction invNorm()
Dans l’enseignement supérieur, les concours d’ingénierie et la pratique des laboratoires de psychologie, les calculatrices graphiques des gammes Texas Instruments (TI-83 Plus, TI-84 Plus, TI-84 Plus CE) demeurent des instruments de calcul de référence. L’architecture logicielle de ces machines intègre nativement l’approximation numérique de la fonction quantile normale par l’intermédiaire de la commande programmée invNorm(.
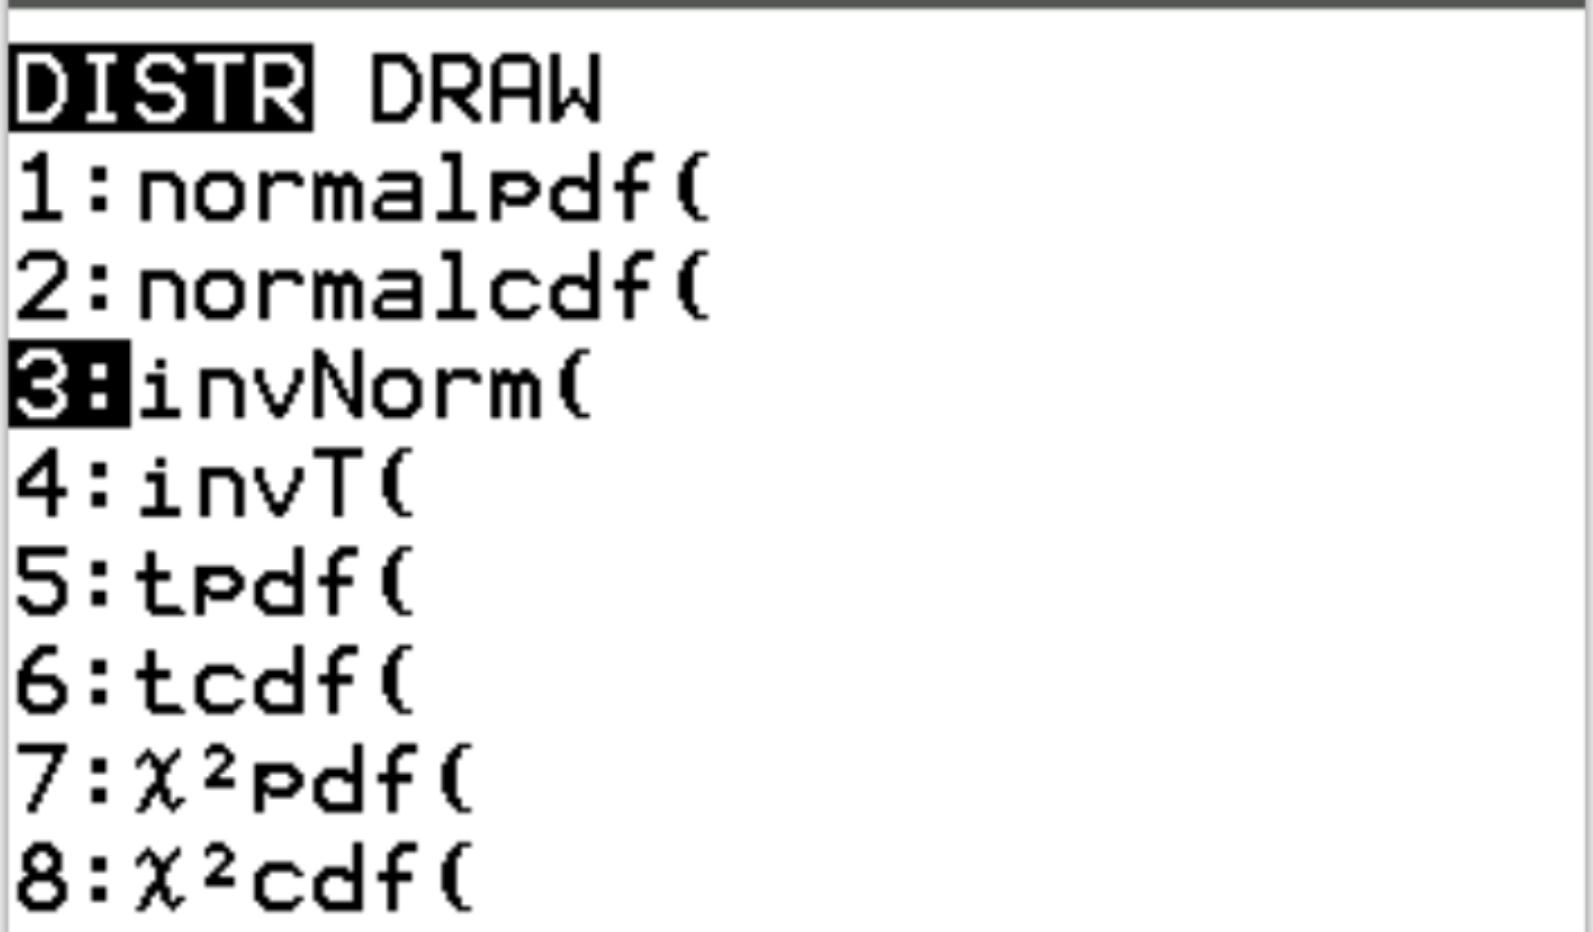
Pour accéder à cette fonction sous l’environnement matériel TI, la séquence des commandes physiques s’opère comme suit : l’utilisateur presse la touche secondaire bleue ou jaune [2nd], puis active la touche [VARS], ce qui permet d’accéder au menu spécialisé [DISTR] (pour Distributions statistiques). Au sein de la liste déroulante qui se déploie à l’écran, le troisième choix, généralement libellé 3: invNorm(, correspond précisément à l’algorithme d’inversion normale.
La syntaxe de base de la fonction accepte jusqu’à quatre paramètres positionnels, structurés comme suit :
invNorm(aire, [mu, sigma, zone])
Sur les calculatrices d’ancienne génération (telles que la TI-83 standard), seuls les trois premiers arguments sont reconnus : invNorm(aire, μ, σ). Si l’opérateur omet de spécifier les arguments d’échelle et de position, la calculatrice assigne par défaut les valeurs normalisées d’une loi centrée réduite, soit μ = 0 et σ = 1. Sur les modèles TI-84 Plus dotés du système d’exploitation MathPrint, un assistant visuel interactif apparaît à l’écran, demandant successivement la saisie de l’aire (Area), de la moyenne (μ), de l’écart-type (σ) et enfin du positionnement de l’aire.
7.2 Paramétrage des zones de rejet : Gauche, Centre et Droite
L’introduction du système d’exploitation actualisé sur la TI-84 Plus CE a apporté une avancée fonctionnelle majeure en permettant de spécifier géométriquement l’argument de positionnement spatial de l’aire intégrée : LEFT (Gauche), CENTER (Centre), et RIGHT (Droite). Cette flexibilité conceptuelle dissipe nombre d’erreurs récurrentes chez les praticiens.
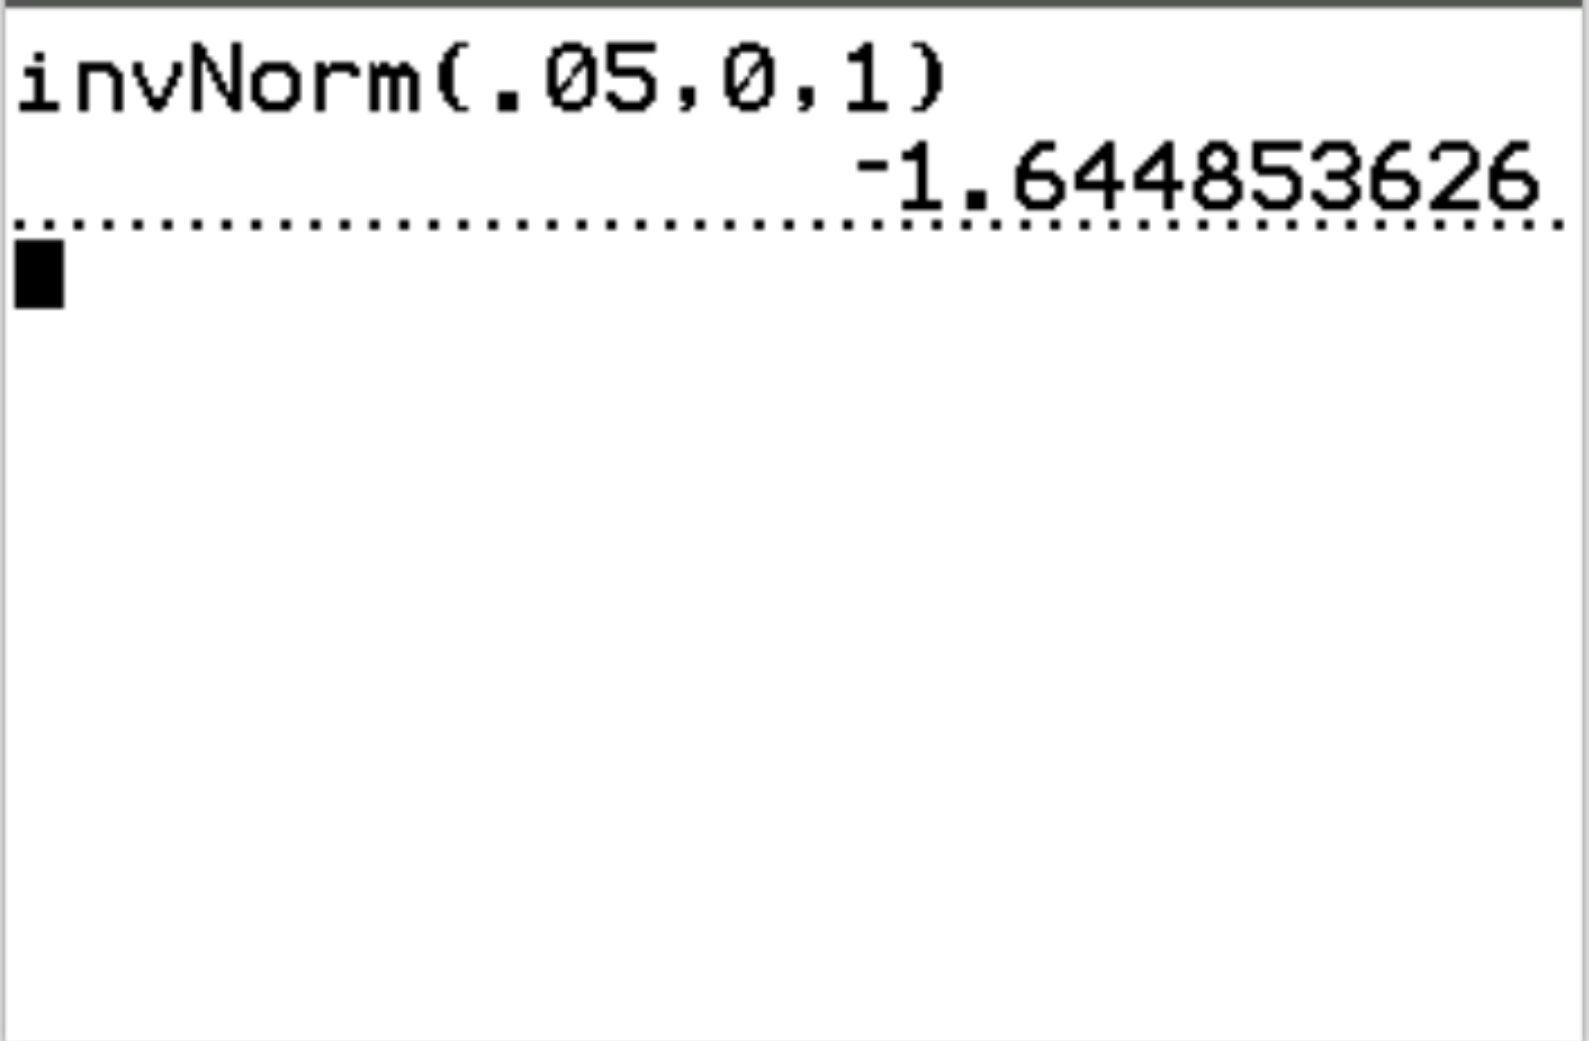
Le paramétrage conventionnel par défaut est l’option LEFT. Sous ce mode, la calculatrice effectue le calcul standard de la fonction quantile cumulative depuis l’infini négatif : elle recherche la valeur x telle que P(X ≤ x) = aire. C’est l’équivalent direct de la formule mathématique Φ-1(aire).
L’option RIGHT inverse l’orientation géométrique en intégrant depuis l’infini positif vers la gauche : elle identifie le seuil x tel que P(X ≥ x) = aire. Par exemple, appeler invNorm(0.05, 0, 1, RIGHT) retournera immédiatement +1.64485 sans nécessiter de conversion préalable vers le complémentaire 0.95.
L’option CENTER s’avère particulièrement puissante pour l’établissement direct des intervalles de confiance symétriques. En indiquant une aire centrale de 0.95 via invNorm(0.95, 0, 1, CENTER), la calculatrice ne retourne pas un scalaire unique mais une liste de deux nombres réels {-1.95996, 1.95996}. Sur les modèles plus anciens ne disposant pas de cette sélection visuelle, le chercheur doit obligatoirement convertir l’intervalle d’acceptation bilatéral en une probabilité cumulée unilatérale gauche en calculant au préalable : aire_gauche = (1 – aire_centrale) / 2.
7.3 Résolution d’un exemple concret de psychologie cognitive sur calculatrice
Considérons une situation d’expérimentation concrète en laboratoire de psychologie cognitive. Un groupe de chercheurs analyse les temps de réponse verbale lors d’une tâche de dénomination rapide d’images chez des patients atteints de séquelles d’accidents vasculaires cérébraux. Les données de référence chez les sujets contrôles sains indiquent que la latence de verbalisation suit une distribution normale de moyenne μ = 450 millisecondes (ms) et d’écart-type σ = 50 ms.
La question posée par le protocole expérimental est la suivante : au-delà de quel temps de réaction précis un patient doit-il être classé parmi les 5% des individus les plus lents de la population de référence, justifiant une notification clinique de ralentissement pathologique ?
Sur le plan mathématique, nous recherchons le quantile x délimitant les 5% supérieurs de la distribution normale N(450, 502). Deux démarches rigoureusement équivalentes peuvent être exécutées sur la calculatrice :
- Via l’option classique (intégration à gauche) : être dans les 5% les plus lents équivaut à avoir un temps supérieur à 95% de la population. L’opérateur saisit :
invNorm(0.95, 450, 50) - Via l’option droite (sur TI-84 Plus CE) : l’opérateur configure l’aire supérieure directe :
invNorm(0.05, 450, 50, RIGHT)
L’exécution de la commande produit instantanément le résultat :
ans = 532.24268...
Le chercheur conclut ainsi que tout patient présentant une latence verbale supérieure ou égale à 532.24 ms se situe dans la queue distale critique des 5% les plus lents. La calculatrice permet en outre de tracer le graphique interactif via le menu [DRAW] en superposant la cloche de Gauss et le hachurage de l’aire distale, garantissant un contrôle visuel immédiat de la validité de la solution numérique obtenue.
8. Calcul et programmation sous Microsoft Excel et feuilles de calcul
8.1 Syntaxe et distinction des fonctions LOI.NORMALE.INVERSE
Dans l’environnement professionnel des entreprises, des hôpitaux et des cabinets d’audit clinique, Microsoft Excel ainsi que ses homologues libres (LibreOffice Calc) et en ligne (Google Sheets) constituent les tableurs matriciels les plus couramment sollicités pour le traitement quantitatif. Toutefois, la nomenclature des fonctions de distribution statistique dans Excel a subi une refonte structurelle majeure à partir de la version 2010, imposant une connaissance claire des syntaxes modernes et de leur compatibilité ascendante.
Dans les versions actuelles d’Excel, deux fonctions standardisées doivent être impérativement mobilisées :
LOI.NORMALE.STANDARD.INVERSE.N(probabilité): Cette fonction calcule le quantile z pour une distribution normale centrée réduite N(0, 1). Elle requiert un argument unique correspondant à la probabilité cumulée, lequel doit être strictement compris dans l’intervalle ouvert ]0, 1[.LOI.NORMALE.INVERSE.N(probabilité; moyenne; écart_type): Cette fonction plus polyvalente calcule directement le score x pour une distribution normale générale définie par sa moyenne empirique et son écart-type.
À des fins de rétrocompatibilité, Excel conserve les anciennes fonctions LOI.NORMALE.STANDARD.INVERSE() et LOI.NORMALE.INVERSE(). Cependant, l’usage de la nouvelle syntaxe suffixée par .N est vivement préconisé par l’éditeur car elle bénéficie d’algorithmes d’inversion numérique révisés offrant une fidélité accrue dans les queues de distribution. Si l’argument de probabilité saisi est inférieur ou égal à 0, ou supérieur ou égal à 1, Excel génère immédiatement le code d’erreur #NOMBRE!. Si un paramètre texte non convertible est injecté, l’erreur #VALEUR! s’affiche, imposant une validation stricte des cellules sources lors de la conception de feuilles de calcul partagées.
8.2 Automatisation du traitement de grands jeux de données psychologiques
L’avantage cardinal d’un tableur réside dans son aptitude à appliquer des formules vectorisées sur de vastes cohortes de données psychométriques. Pour transformer un ensemble de scores bruts issus d’un protocole expérimental comprenant plusieurs centaines de participants en scores z ou T parfaitement normalisés, la combinaison de plusieurs fonctions analytiques s’avère extrêmement productive.
Supposons une cohorte clinique dont les scores bruts à une épreuve d’efficience mnésique sont consignés dans la plage de cellules A2:A500. Pour déterminer le rang centile normalisé de chaque sujet selon la formulation de Hazen, on insère en colonne B la formule suivante :
= (RANG.POURCENTAGE.EXCLURE($A$2:$A$500; A2) )
Pour convertir immédiatement cette probabilité cumulée en un score d’écart-type z normalisé, on applique en colonne C la formule imbriquée :
= LOI.NORMALE.STANDARD.INVERSE.N(B2)
Enfin, si l’on souhaite transformer ce score z en une note d’échelle standardisée de type QI de Wechsler (moyenne 100, écart-type 15), la cellule D2 reçoit simplement l’expression :
= 100 + 15 * C2
L’étalonnage instantané d’une cohorte clinique s’accomplit ainsi de manière transparente. En outre, la création d’un graphique Quantile-Quantile (Q-Q plot) sous Excel — consistant à porter les quantiles empiriques ordonnés en abscisse et les quantiles théoriques issus de la fonction LOI.NORMALE.STANDARD.INVERSE.N en ordonnée — permet de contrôler instantanément la linéarité des observations et d’authentifier la normalité de la distribution avant de valider l’étalonnage normatif.
8.3 Simulations stochastiques selon la méthode de Monte-Carlo
Au-delà du calibrage statique de bases de données, la distribution normale inverse constitue le moteur mathématique fondamental de la méthode d’échantillonnage par transformation inverse (Inverse Transform Sampling), employée dans les simulations stochastiques de Monte-Carlo sous Excel. Cette approche permet de générer des variables aléatoires artificielles mais réalistes distribuées rigoureusement selon une loi normale, à partir d’un générateur de nombres pseudo-aléatoires uniformes.
La fonction ALEA() d’Excel produit des valeurs stochastiques distribuées uniformément sur l’intervalle ouvert ]0, 1[. En composant cette fonction avec la normale inverse, on réalise une projection probabiliste directe :
= LOI.NORMALE.INVERSE.N(ALEA(); 100; 15)
Cette simple formule génère une observation simulée d’un score de QI suivant parfaitement la loi N(100, 152). En étendant cette syntaxe sur 10 000 lignes, un chercheur peut modéliser des populations théoriques complexes, simuler la trajectoire de dégradation cognitive au fil du temps ou réaliser des analyses de puissance a priori pour des protocoles d’expérimentation complexes avant le déploiement effectif d’une recherche hospitalière.
Néanmoins, les analystes de données quantitatives doivent garder à l’esprit les limitations algorithmiques des tableurs grand public : le générateur pseudo-aléatoire d’Excel et ses algorithmes d’inversion peuvent manifester de légères instabilités de traîne pour des écarts-types extrêmes supérieurs à 6σ, seuil au-delà duquel des logiciels statistiques spécialisés (comme R ou Python) doivent être formellement privilégiés.
9. Traitement computationnel sous R et Python pour les neurosciences
9.1 Modélisation statistique sous l’environnement R
Dans l’écosystème de la recherche internationale en neurosciences, en psychologie mathématique et en biostatistique, le langage open source R s’impose comme le standard académique prééminent. Au sein de cet environnement, la famille des fonctions associées à la loi normale comprend quatre commandes fondatrices : dnorm (densité), pnorm (répartition cumulative), rnorm (génération aléatoire) et qnorm (fonction quantile, incarnant la distribution normale inverse).
La syntaxe canonique de la fonction qnorm se présente comme suit :
qnorm(p, mean = 0, sd = 1, lower.tail = TRUE, log.p = FALSE)
Une caractéristique informatique remarquable de cette implémentation réside dans la gestion de l’argument booléen lower.tail. Par défaut (TRUE), la fonction évalue la probabilité cumulée depuis la gauche : P(X ≤ x) = p. Si cet argument est assigné à FALSE, la fonction calcule directement la valeur critique relative à la queue supérieure droite : P(X > x) = p. Cette architecture permet d’éviter l’opération arithmétique 1 - p, laquelle engendre un phénomène catastrophique de perte de précision numérique par arrondi flottant lorsque p est extrêmement proche de 1 (par exemple pour p = 0.999999999999).
L’exploitation de qnorm s’articule de manière puissante avec la suite de packages du Tidyverse. Par exemple, pour normaliser instantanément un vecteur de données cliniques massives au sein d’un dataframe tout en calculant des intervalles de crédibilité bayésiens basés sur les distributions a posteriori d’un paramètre neurophysiologique, R déploie une efficience vectorielle optimale permettant de traiter plusieurs centaines de milliers d’observations en quelques fractions de seconde.
9.2 Déploiement sous Python avec SciPy et NumPy
Dans les pipelines d’apprentissage automatique, de neuro-imagerie computationnelle et de science des données appliquées au comportement, le langage de programmation Python domine l’ingénierie statistique. L’évaluation de la distribution normale inverse y est implémentée au sein de la célèbre bibliothèque scientifique SciPy, plus particulièrement dans le module scipy.stats.
Sous Python, la fonction quantile est conventionnellement désignée sous le terme de Percent Point Function, abrégée par la méthode ppf. L’architecture d’importation et d’exécution se structure rigoureusement comme suit :
from scipy.stats import norm
# Calcul du quantile z pour une probabilité cumulée p = 0.975
z = norm.ppf(0.975, loc=0, scale=1)
Les paramètres formels loc et scale correspondent respectivement à l’espérance mathématique (μ) et à l’écart-type (σ) de la distribution. En symbiose étroite avec la bibliothèque vectorielle NumPy, la méthode norm.ppf traite des matrices multidimensionnelles (tenseurs) d’une grande complexité sans nécessiter de boucles itératives manuelles. Cela permet d’intégrer des seuils d’activation statistiques inverses directement au sein de pipelines de machine learning prédisant des trajectoires cognitives ou décodant des matrices de signaux électoencéphalographiques (EEG).
De surcroît, la combinaison de SciPy avec les modules de rendu graphique Matplotlib et Seaborn permet d’automatiser la génération de figures scientifiques de qualité publiable, visualisant avec une exactitude chirurgicale les surfaces de rejet et les fractiles théoriques sur les distributions expérimentales observées.
9.3 Reproductibilité et gestion des valeurs extrêmes en programmation
La recherche translationnelle et ouverte exige une reproductibilité absolue des calculs statistiques. Lors de la manipulation computationnelle de la distribution normale inverse aux frontières du support continu, les environnements R et Python peuvent être confrontés au phénomène d’extinction de virgule flottante (floating-point underflow). Lorsqu’une probabilité cumulée p s’abaisse en-deçà de 10-308 (la limite des nombres double précision sous la norme IEEE 754), l’ordinateur assimile p à zéro absolu, conduisant à une divergence non gérée vers -Inf.
Pour conjurer cette instabilité, les fonctions modernes permettent d’opérer directement dans l’espace des log-probabilités. Sous R, le paramètre log.p = TRUE au sein de qnorm() accepte en argument le logarithme népérien de la probabilité cumulée ln(p). De façon parfaitement analogue, la bibliothèque SciPy met à disposition la méthode spécialisée norm.logppf(). Ces implémentations évaluent les asymptotes distales sans jamais convertir les valeurs en probabilités brutes, repoussant les limites du calcul computationnel jusqu’à des ordres de grandeur de plusieurs centaines d’écarts-types.
La rigueur méthodologique impose en outre de documenter systématiquement au sein des scripts de recherche la version précise des bibliothèques employées (ex. SciPy 1.11.x, R 4.3.x) ainsi que les graines de génération aléatoire (via set.seed() sous R ou numpy.random.seed() sous Python). Cette discipline de programmation garantit que l’inversion numérique de chaque quantile expérimental pourra être auditée et reproduite à l’identique par l’ensemble de la communauté scientifique internationale.
10. Exemples cliniques empiriques et résolutions pas à pas
10.1 Exemple 1 : Identification du déficit attentionnel dans une échelle clinique
Mise en situation clinique : Une équipe de neuropsychologie hospitalière évalue les capacités d’inhibition cognitive chez des adolescents suspectés de présenter un Trouble Déficitaire de l’Attention avec ou sans Hyperactivité (TDAH). La batterie informatisée utilisée délivre un score standard d’attention soutenue distribué de manière normale dans la population générale de référence, avec une moyenne clinique μ = 50 et un écart-type σ = 10 (échelle de type T).
Question clinique : Le protocole diagnostique international stipule qu’une performance est reconnue comme significativement déficitaire si elle se positionne parmi les 2,5% des résultats les plus faibles enregistrés dans la population du même âge. Quel est le score plancher précis en-deçà duquel un adolescent répond aux critères cliniques d’un déficit d’inhibition ?
Résolution analytique détaillée :
- Identification de la probabilité cumulée : Le seuil unilatéral inférieur correspond à p = 0.025.
- Détermination du quantile z de la loi normale centrée réduite :
z = Φ-1(0.025).
En exploitant la symétrie de la loi normale, nous savons que Φ-1(0.025) = – Φ-1(0.975).
La valeur tabulée pour 0.975 étant exactement 1.95996, nous obtenons :
z = -1.960. - Transposition à la distribution clinique de l’épreuve :
x = μ + (z × σ)
x = 50 + (-1.95996 × 10)
x = 50 – 19.5996 = 30.4004.
Conclusion et décision clinique : Le score seuil d’alerte s’établit rigoureusement à 30.4 points. En pratique clinique, tout patient obtenant un score brut inférieur ou égal à 30 points est formellement catégorisé comme présentant un déficit d’inhibition significatif au seuil α = 0.025. Ce résultat constitue un élément biométrique probant orientant la décision d’un aménagement pédagogique ou d’une prise en charge pharmacologique adaptée.
10.2 Exemple 2 : Sélection des profils à très haut potentiel intellectuel
Mise en situation clinique : Dans le cadre d’un programme d’accompagnement éducatif spécifique pour enfants intellectuellement précoces, un établissement spécialisé souhaite définir les critères d’admission sur la base de l’échelle d’intelligence WISC-V. L’indice d’efficience globale se distribue selon une loi normale caractérisée par une moyenne théorique μ = 100 et un écart-type σ = 15.
Question clinique : Le comité pédagogique restreint l’accès à ce programme aux seuls candidats se situant rigoureusement au 98e percentile supérieur de la population générale (soit les 2% des enfants les plus efficients). Quel doit être le score de QI minimal requis lors du bilan psychologique pour valider l’éligibilité du candidat ?
Résolution analytique détaillée :
- Identification de la probabilité cumulée : Le 98e percentile correspond à une probabilité cumulée à gauche de p = 0.98.
- Extraction du quantile z critique :
z = Φ-1(0.98).
La consultation de la fonction d’approximation ou de la table normale indique qu’entre z = 2.05 (Φ(2.05) = 0.9798) et z = 2.06 (Φ(2.06) = 0.9803), la valeur interpolée avec précision est :
z ≈ 2.05375. - Conversion métrique vers l’échelle de Wechsler :
QIseuil = μ + (z × σ)
QIseuil = 100 + (2.05375 × 15)
QIseuil = 100 + 30.80625 = 130.806.
Interprétation psychométrique : Les échelles de Wechsler ne délivrant que des scores de QI sous forme d’entiers discrets, la règle d’arrondi méthodologique impose de retenir un seuil d’admissibilité fixé à un score de QI standard de 131. Tout score égal ou supérieur à 131 certifie que l’enfant surpasse au moins 98% des pairs de son groupe d’âge. Le psychologue veillera toutefois à adosser cette conclusion à l’analyse de l’intervalle de confiance du score composite afin de neutraliser l’aléa lié à l’erreur type de mesure du test.
10.3 Exemple 3 : Évaluation psychophysique du temps de discrimination auditive
Mise en situation clinique : Un laboratoire d’audiologie et de psychophysique explore les anomalies du traitement auditif central. L’épreuve consiste à mesurer le temps de discrimination (en millisecondes) séparant la détection de deux sons purs présentés de manière dichotique. Les données normatives démontrent que cette latence se distribue selon une loi normale N(μ = 180 ms, σ2 = 252 ms).
Question clinique : Les cliniciens souhaitent délimiter l’intervalle interquartile de la population normale, c’est-à-dire l’étendue délimitée par le premier quartile (Q1, soit p = 0.25) et le troisième quartile (Q3, soit p = 0.75), afin de définir la zone de performance cognitive typique.
Résolution analytique détaillée :
- Calcul du premier quartile Q1 (p = 0.25) :
z0.25 = Φ-1(0.25) = – Φ-1(0.75).
Le quantile canonique associé au troisième quart de la courbe de Gauss est universellement connu : z ≈ 0.67449.
Par symétrie : z0.25 = -0.67449.
Q1 = 180 + (-0.67449 × 25) = 180 – 16.862 = 163.138 ms. - Calcul du troisième quartile Q3 (p = 0.75) :
z0.75 = +0.67449.
Q3 = 180 + (0.67449 × 25) = 180 + 16.862 = 196.862 ms. - Détermination de l’intervalle interquartile :
IIQ = Q3 – Q1 = 196.862 – 163.138 = 33.724 ms.
Implications fonctionnelles : La zone de dispersion typique abritant les 50% centraux des individus sains s’étend de 163.14 ms à 196.86 ms. Si un patient présente une latence excédant largement la borne supérieure du troisième quartile majorée de 1.5 fois l’intervalle interquartile (règle des valeurs aberrantes de Tukey), il pourra être orienté vers un bilan otoneurologique approfondi visant à investiguer une éventuelle neuropathie auditive démyélinisante.
11. Erreurs fréquentes, hypothèses sous-jacentes et diagnostics de validité
11.1 Violation de l’hypothèse de normalité et conséquences statistiques
L’utilisation de la distribution normale inverse pour dériver des seuils critiques ou normaliser des échelles d’évaluation repose intégralement sur une hypothèse fondamentale : la variable aléatoire empirique sous-jacente doit suivre de manière stricte, ou au moins hautement approximative, une distribution normale de Gauss. Si cette condition sine qua non est violée, l’ensemble des déductions quantitatives et diagnostiques qui en découlent se trouve irrémédiablement faussé.
Deux déviations majeures corrompent fréquemment la validité de l’inversion :
- L’asymétrie structurelle (skewness) : Lorsqu’une distribution empirique présente une asymétrie positive marquée (longue traîne vers la droite, fréquente dans les mesures d’anxiété ou de temps de réaction), l’application de la fonction symétrique Φ-1 comprime artificiellement la queue supérieure. Les valeurs critiques théoriques sous-estiment alors substantiellement les véritables seuils observés, multipliant le taux de diagnostics de faux positifs dans l’extrémité étirée.
- L’aplatissement anormal (kurtosis) : Les distributions leptokurtiques (à queues épaisses) abritent beaucoup plus d’observations extrêmes qu’une distribution gaussienne idéale. Si un chercheur applique une inversion gaussienne standard sur de telles données, il commettra une sous-estimation dramatique de la probabilité d’occurrence des événements extrêmes, assignant par exemple un niveau de rareté exceptionnel à des performances qui surviennent en réalité fréquemment dans la population.
Avant d’engager toute inversion formelle, il est donc impératif de procéder à un diagnostic de normalité rigoureux par le biais de tests d’adéquation robustes tels que le test de Shapiro-Wilk (pour des échantillons N ≤ 50), le test d’Anderson-Darling (particulièrement sensible aux déviations dans les queues de distribution) ou le test de Kolmogorov-Smirnov corrigé par Lilliefors. En présence d’une non-normalité avérée et incorrigible par transformation mathématique (Box-Cox ou logarithmique), l’analyste doit impérativement abandonner l’inversion paramétrique au profit de l’extraction des quantiles empiriques purs basée sur la fonction de répartition empirique ÊN(x).
11.2 Erreurs d’orientation des probabilités cumulées
L’erreur la plus banale mais aux répercussions cliniques les plus préjudiciables réside dans la confusion entre l’aire cumulée à gauche (probabilité inférieure P(X ≤ x)) et l’aire de rejet unilatérale supérieure (P(X ≥ x)). Les logiciels statistiques et les tables standard intègrent invariablement depuis l’infini négatif jusqu’à la valeur critique z. Par conséquent, si un praticien souhaite identifier le seuil correspondant aux « 5% des individus les plus performants » et saisit par inadvertance p = 0.05 au sein de la fonction inverse, il n’obtiendra pas le seuil supérieur convoité mais la frontière marquant les 5% des scores les plus faibles (soit z = -1.645 au lieu de +1.645).
Cette méprise s’avère particulièrement insidieuse lorsque la valence clinique de l’échelle d’évaluation s’oppose au sens arithmétique des scores. Par exemple, sur une échelle de dépression où un score élevé traduit une pathologie sévère, les individus cliniquement les plus vulnérables se trouvent dans la queue supérieure droite de la distribution. Inversement, sur une échelle de fluidité verbale, les performances déficitaires sont logées dans la queue inférieure gauche. L’analyste doit constamment clarifier le sens substantiel des scores avant d’assigner une probabilité p ou son complémentaire 1 – p.
Sur le plan éthique et déontologique, un faux positif consécutif à une erreur de directionnalité mathématique peut conduire à déclarer déficitaire un individu parfaitement sain, ou à priver un enfant présentant des difficultés majeures d’un accès à un programme de remédiation spécialisé. La stratégie de contrôle méthodologique la plus élémentaire et la plus efficace consiste à esquisser systématiquement un schéma visuel de la courbe de Gauss, en y plaçant manuellement la moyenne et la zone cible afin de valider sans équivoque le signe algébrique (+ ou -) attendu pour la valeur z.
11.3 Fluctuations d’échantillonnage et instabilité des quantiles extrêmes
Une illusion statistique tenace consiste à croire que la précision d’un quantile calculé par inversion normale est équivalente tout au long de la distribution. Sur le plan mathématique, l’erreur type asymptotique d’un estimateur de quantile xp d’une loi normale basé sur un échantillon de taille N s’exprime rigoureusement par :
SE(xp) = [ σ / √N ] × [ √( p (1 – p) ) / φ( Φ-1(p) ) ]
où φ désigne la fonction de densité normale standard. L’analyse analytique de cette formulation révèle un comportement asymptotique redoutable : à mesure que la probabilité p converge vers 0 ou vers 1, la densité φ(Φ-1(p)) au dénominateur décroît de manière exponentielle vers zéro, bien plus rapidement que le terme √(p(1-p)) au numérateur. Par conséquent, l’erreur type des quantiles augmente vertigineusement à mesure que l’on s’aventure dans les queues de la distribution.
Dans un échantillon de taille modeste (par exemple N = 100), l’estimation de la moyenne ou de la médiane (p = 0.50) bénéficie d’une excellente stabilité métrologique. En revanche, l’estimation d’un seuil critique situé au 99e percentile (p = 0.99) au sein du même échantillon est frappée d’une variance d’échantillonnage considérable : de simples fluctuations aléatoires de quelques sujets peuvent décaler la valeur z critique de plusieurs dixièmes d’écart-type. Les manuels de métrologie recommandent ainsi d’asseoir l’étalonnage des quantiles cliniques extrêmes (au-delà de ±2σ) sur des cohortes d’au minimum 500 à 1 000 participants par tranche d’âge.
Pour jauger la robustesse empirique des seuils déterminés par inversion normale, le déploiement de techniques de rééchantillonnage stochastique par bootstrap non paramétrique est vivement recommandé. En générant plusieurs milliers d’itérations rééchantillonnées de la base de données clinique, le chercheur peut dériver l’intervalle de confiance empirique entourant le quantile critique calculé, évitant ainsi d’attribuer une certitude déterministe excessive à un score seuil intrinsèquement soumis à l’aléa de l’échantillonnage.
12. Synthèse épistémologique et recommandations pour la pratique quantitative
12.1 Règles de bonne conduite méthodologique pour les praticiens
Au terme de cette analyse approfondie, l’emploi de la distribution normale inverse en psychologie, en médecine et en sciences du comportement doit être encadré par des règles méthodologiques intangibles, garantissant la validité écologique et scientifique des inférences posées :
- Justification formelle de la normalité : L’inversion normale ne doit jamais être exécutée de manière aveugle ou automatisée. Le chercheur est tenu de documenter explicitement la forme distributionnelle de ses données (indices d’asymétrie, kurtosis, tests formels d’adéquation et graphiques Q-Q) avant de revendiquer la légitimité théorique des quantiles dérivés.
- Transparence algorithmique : Les articles scientifiques doivent spécifier avec exactitude l’environnement logiciel mobilisé (ex. fonction
qnormsous R, modulescipy.statssous Python) et la méthode d’inversion employée, en explicitant si les corrections de continuité ou les options de queue unilatérale/bilatérale ont été sollicitées. - Encadrement par les erreurs types : Tout score seuil déterminé par la distribution normale inverse doit être systématiquement rapporté avec son intervalle de confiance à 95%, afin de rappeler aux cliniciens et aux décideurs qu’une frontière statistique n’est pas un point mathématique fixe, mais une zone d’estimation stochastique.
- Intégration de l’erreur de mesure du test : En psychométrie clinique, le score d’un individu est entaché d’une imperfection de mesure inhérente à la fidélité de l’instrument (coefficient alpha de Cronbach ou oméga de McDonald). La fixation d’un seuil critique via Φ-1 doit être confrontée à l’erreur type de mesure (SEM = σ √(1 – rxx)), de sorte qu’une décision diagnostique lourde de conséquences ne dépende pas d’une fluctuation de quelques points imputable au manque de fidélité intrinsèque du test.
12.2 Arbre de décision pour le choix du calcul inverse approprié
Afin de guider rationnellement le praticien dans la sélection de la procédure d’inversion adaptée à la nature de ses données, l’arbre de décision conceptuel suivant formalise les arbitrages méthodologiques requis :
- Situation 1 : La variable observée est continue, symétrique et sa normalité est confirmée.
- Objectif : Étalonnage d’une échelle ou détermination de seuils d’inclusion critiques.
- Solution : Mobiliser la transformation linéaire standard x = μ + σ × Φ-1(p) via la fonction quantile normale paramétrique.
- Situation 2 : La variable est intrinsèquement asymétrique positive (ex. temps de réaction, latences).
- Option A (Modélisation de processus) : Si l’on souhaite modéliser l’accumulation d’information perceptive dans le temps, rejeter la normale inverse et modéliser directement les données via la loi de Wald (loi gaussienne inverse).
- Option B (Standardisation normative) : Si l’on souhaite normaliser ces scores pour un étalonnage normatif, exécuter la normalisation de McCall (conversion des scores bruts en rangs centiles pi corrigés, puis projection par Φ-1(pi)).
- Situation 3 : La distribution viole sévèrement la normalité et N est trop faible pour une normalisation robuste.
- Solution : Renoncer à la fonction normale inverse et adopter une méthode non paramétrique d’estimation empirique directe des quantiles, ou procéder à un rééchantillonnage par bootstrap pour fixer des intervalles empiriques sans a priori de distribution.
12.3 Perspectives futures dans le diagnostic psychologique assisté par ordinateur
L’avènement de l’intelligence artificielle, des technologies d’évaluation écologique momentanée (EMA) sur smartphones et des tests adaptatifs informatisés de nouvelle génération transforme radicalement l’exploitation de la distribution normale inverse. Dans les plateformes d’évaluation cognitive dynamique, l’estimation du trait latent du patient ne s’effectue plus de manière statique après la passation de l’intégralité du test, mais de façon séquentielle item par item.
Après chaque réponse enregistrée, l’algorithme met à jour la distribution a posteriori du niveau de compétence de l’individu via les équations de filtrage bayésien. La fonction de distribution normale inverse est alors continuellement sollicitée pour réajuster en temps réel les intervalles de crédibilité du trait θ et sélectionner instantanément l’item suivant dont l’information de Fisher est maximale au niveau du quantile estimé. Cette symbiose entre inversion analytique classique et puissance computationnelle moderne réduit la durée de passation des épreuves de plus de 50% tout en augmentant la fidélité métrologique de la mesure aux extrêmes de la distribution.
Enfin, les consortiums internationaux de neuropsychologie et d’épidémiologie psychiatrique travaillent activement à l’harmonisation des algorithmes d’inversion au sein des dossiers médicaux électroniques partagés. L’objectif est d’assurer que l’application de la fonction quantile normale sur des données massives hétérogènes (mélangeant marqueurs génomiques, données d’imagerie par résonance magnétique et scores comportementaux) réponde à des protocoles mathématiques universels, fiables et éthiquement éprouvés, consolidant ainsi le rôle impérissable de la distribution normale inverse au cœur de la science quantitative contemporaine.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Green, D. M., & Swets, J. A. (1966). Signal Detection Theory and Psychophysics. John Wiley & Sons.
- Hautus, M. J. (1995). Corrections for extreme proportions and their biasing effects on estimated values of d’. Behavior Research Methods, Instruments, & Computers, 27(1), 46–51. https://doi.org/10.3758/BF03203619
- Lord, F. M., & Novick, M. R. (1968). Statistical Theories of Mental Test Scores. Addison-Wesley.
- Macmillan, N. A., & Creelman, C. D. (2005). Detection Theory: A User’s Guide (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9781410611147
- Odeh, R. E., & Evans, J. O. (1974). Algorithm AS 70: The Percentage Points of the Normal Distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 23(1), 96–97. https://doi.org/10.2307/2347061
- Ratcliff, R. (1978). A theory of memory retrieval. Psychological Review, 85(2), 59–108. https://doi.org/10.1037/0033-295X.85.2.59
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Wald, A. (1947). Sequential Analysis. John Wiley & Sons.
- Wechsler, D. (2014). Wechsler Intelligence Scale for Children—Fifth Edition (WISC-V): Technical and interpretive manual. NCS Pearson.
- Wichura, M. J. (1988). Algorithm AS 241: The Percentage Points of the Normal Distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 37(3), 477–484. https://doi.org/10.2307/2347330