
Dans le champ de la statistique théorique comme au sein des sciences appliquées contemporaines, la loi normale de Laplace-Gauss occupe une position paradigmatique incontournable. Modélisant avec une élégance singulière la dispersion des phénomènes aléatoires continus autour d’une valeur centrale sous l’effet du théorème central limite, elle constitue le pilier fondamental sur lequel repose l’ensemble des méthodes paramétriques d’inférence. Néanmoins, si l’approche probabiliste conventionnelle consiste à déduire une probabilité cumulée à partir d’un score observé, la démarche scientifique inverse s’avère tout aussi déterminante : comment retrouver la valeur critique d’une variable lorsque l’on connaît la proportion exacte d’une population ou la probabilité associée à une région de l’espace échantillonnal ? C’est précisément à cette problématique fondamentale que répond la distribution normale inverse, également désignée sous le terme technique de fonction quantile de la loi normale.
Le passage méthodologique de la probabilité à la valeur critique ne constitue pas un simple exercice d’inversion algébrique. Il incarne une transposition épistémologique cruciale, particulièrement en psychométrie, en neuropsychologie et dans les sciences du comportement. Qu’il s’agisse de calibrer les seuils diagnostics d’un trouble neurodéveloppemental, d’isoler le centile supérieur caractérisant le haut potentiel intellectuel, d’harmoniser des échelles de mesure psychologiques ou de construire des intervalles de confiance rigoureux pour des estimateurs d’effets cliniques, l’inversion de la fonction de répartition gaussienne est sollicitée à chaque étape du raisonnement analytique. Pourtant, son implémentation algorithmique, sa formulation analytique dépourvue de forme close élémentaire et la confusion lexicale persistante qui l’entoure dans la littérature statistique représentent des défis méthodologiques majeurs pour les chercheurs et les praticiens.
Le présent traité propose une exploration exhaustive, théorique et appliquée de la distribution normale inverse. En articulant formalisation mathématique rigoureuse, histoire computationnelle des algorithmes d’approximation, protocoles d’implémentation logicielle (calculatrices graphiques, tableurs, environnements R et Python) et applications cliniques détaillées, cette monographie a pour dessein d’offrir aux chercheurs, cliniciens et analystes de données un cadre de référence complet. À travers l’analyse approfondie de cas concrets issus de la recherche cognitive et neuropsychologique, ce document éclaire la puissance diagnostique de la fonction quantile tout en exposant sans concession ses limites de validité, ses pièges d’interprétation et ses exigences de contrôle méthodologique.
1. 1. Introduction et fondements conceptuels de la distribution normale inverse
1.1 1.1 Définition fondamentale et terminologie
La compréhension formelle de la distribution normale inverse exige une clarification sémantique préalable : dans le vocabulaire probabiliste contemporain, cette entité n’est pas une nouvelle loi de probabilité indépendante générant de la stochasticité, mais représente rigoureusement la fonction quantile associée à la loi normale standard ou générale. Alors que la loi normale classique détermine la probabilité qu’une variable aléatoire continue prenne une valeur inférieure ou égale à un seuil donné, la démarche inverse résout l’équation réciproque. Étant donné un niveau de probabilité cumulative $p$ appartenant rigoureusement à l’intervalle ouvert $]0, 1[$, la fonction normale inverse identifie l’unique valeur réelle $z$ ou $x$ telle que l’intégrale de la fonction de densité de probabilité gaussienne de l’infini négatif jusqu’à cette valeur soit exactement égale à $p$.
Ce basculement conceptuel transforme une démarche prospective de mesure d’un risque en une démarche rétrodictive d’identification de bornes opérationnelles. Dans la littérature internationale, cette opération est désignée sous diverses terminologies : fonction quantile normale, fonction de répartition cumulative inverse, ou encore selon la notation anglo-saxonne probit function lorsqu’elle est mobilisée dans des modèles de régression à variables dépendantes binaires. Dans le champ de la modélisation mathématique, cette fonction est universellement notée $\Phi^{-1}(p)$ pour la distribution normale centrée réduite, et $F^{-1}(p; \mu, \sigma)$ lorsque la distribution est paramétrée par une moyenne d’échantillonnage $\mu$ et un écart-type $\sigma$.
Le rôle méthodologique de cette inversion s’avère absolument central dans l’inférence statistique et la psychométrie moderne. En statistique inférentielle classique, elle permet l’extraction immédiate des valeurs critiques d’écart-type nécessaires à la démarcation des régions de rejet de l’hypothèse nulle pour un risque d’erreur de première espèce $\alpha$ préétabli. En psychométrie contemporaine, elle constitue la clé de voûte des transformations normatives, autorisant le passage d’une distribution de rangs percentiles empiriques — dont les écarts ne reflètent pas des distances métriques constantes — à des scores standardisés métriquement stables, respectant les postulats de l’échelle d’intervalles indispensables aux modélisations factorielles et aux comparaisons interindividuelles.
1.2 1.2 Dualité entre fonction de répartition et fonction quantile
L’analyse de la relation unissant la fonction de répartition cumulative standard, universellement désignée par la lettre grecque majuscule $Phi(z)$, et sa fonction inverse $\Phi^{-1}(p)$ révèle une dualité fonctionnelle et géométrique d’une remarquable élégance mathématique. La fonction directe $Phi(z)$ effectue une surjection de la droite réelle $\mathbb{R}$ vers l’intervalle ouvert $]0, 1[$. D’un point de vue géométrique, elle calcule l’aire sous la courbe en cloche définie par la densité de probabilité de Gauss-Laplace depuis la limite asymptotique gauche $-\infty$ jusqu’à l’abscisse $z$. Cette courbe de densité, symétrique par rapport à l’axe des ordonnées en zéro, présente des points d’inflexion caractéristiques précisément situés à $z = -1$ et $z = +1$.
À l’inverse, la fonction quantile $\Phi^{-1}(p)$ réalise la bijection réciproque, associant à chaque valeur d’aire $p$ sous la courbe de densité l’abscisse exacte $z$ marquant la coupure à droite de cette région. Sur le plan de la géométrie analytique, le graphe de la fonction quantile s’obtient par la réflexion symétrique du graphe de la fonction de répartition cumulative par rapport à la première bissectrice d’équation $y = x$. Cette opération transforme le profil sigmoïdal borné verticalement de $Phi(z)$ en une courbe strictement croissante s’étendant horizontalement sur l’intervalle $]0, 1[$ et plongeant verticalement vers l’infini négatif lorsque $p$ tend vers zéro, tout en s’élevant vers l’infini positif lorsque $p$ approche l’unité.
Cette dualité met en exergue les propriétés intrinsèques d’invariance et de symétrie axiale inhérentes à la loi normale centrée réduite. Du fait de la symétrie parfaite de la courbe de densité autour de sa moyenne nulle, les quantiles présentent une réciprocité fondamentale caractérisée par l’identité mathématique remarquable :
$$\Phi^{-1}(1 – p) = -\Phi^{-1}(p)$$
Cette propriété implique directement que la médiane de la distribution correspond rigoureusement à la probabilité cumulée de 0,5, pour laquelle la valeur critique s’annule : $\Phi^{-1}(0{,}5) = 0$. Ainsi, une aire de 5 % isolée dans la queue gauche correspond à une abscisse rigoureusement opposée à celle isolant une aire de 5 % dans la queue droite, conférant à la distribution normale inverse une structure prédictible et manipulable avec une grande économie conceptuelle.
1.3 1.3 Importance méthodologique dans les sciences du comportement
Dans l’évaluation psychologique standardisée, les cliniciens et les chercheurs ne disposent initialement que de fréquences relatives ou de pourcentages cumulés dérivés de grands échantillons normatifs. L’utilisation directe des rangs percentiles présente toutefois une faiblesse psychométrique rédhibitoire : les percentiles compressent artificiellement les différences au centre de la distribution et dilatent démesurément les écarts aux extrémités. Deux individus séparés par dix points de percentile entre le 45e et le 55e rang présentent des niveaux de compétence cognitive presque identiques, alors que dix points de percentile d’écart entre le 89e et le 99e rang traduisent une divergence substantielle de capacités cognitives. L’inversion quantile rectifie précisément cette distorsion ordinale en rétablissant une métrique linéaire continue.
L’étalonnage des batteries neuropsychologiques d’évaluation clinique — telles que les échelles d’intelligence de Wechsler pour adultes et enfants (WAIS, WISC) ou les tests de mémoire clinique de la MEM — repose directement sur la distribution normale inverse pour définir des seuils diagnostics d’une grande rigueur. Par exemple, la catégorisation d’un déficit mnésique sévère requiert couramment que la performance du patient se situe à au moins deux écarts-types sous la moyenne normative. Pour fixer la limite d’admissibilité ou de sévérité à partir d’un taux de prévalence clinique théorique de 2,27 %, le praticien applique la fonction quantile pour déterminer que le score $z$ équivalent correspond exactement à $-2{,}00$.
Enfin, la distribution normale inverse intervient de manière décisive dans la gestion et la correction des distributions tronquées ou asymétriques issues de l’évaluation des capacités cognitives extrêmes. Dans l’identification des sujets à haut potentiel intellectuel ou dans l’étude des personnes présentant un déficit intellectuel majeur, les instruments conventionnels se heurtent à des effets de plancher ou de plafond. L’application de techniques d’estimation basées sur les quantiles inverses permet de normaliser les scores bruts par probit, garantissant que l’estimation des compétences sous-jacentes ne soit pas biaisée par les artefacts de mesure inhérents aux limites physiques des épreuves standardisées.
2. 2. Fondements mathématiques de la fonction quantile normale
2.1 2.1 Formalisme mathématique et fonction d’erreur inverse
L’étude formelle de la distribution normale standard débute par l’expression de sa fonction de densité de probabilité, notée $phi(z)$, définie sur la droite des réels par :
$$\phi(z) = \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{z^2}{2}\right)$$
La fonction de répartition cumulative correspondante $Phi(z)$ est obtenue par l’intégration définie de cette densité :
$$\Phi(z) = \int_{-\infty}^{z} \phi(t) , \mathrm{d}t = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-t^2/2} , \mathrm{d}t$$
Cette intégrale appartient à la classe des intégrales non élémentaires; elle ne peut être exprimée sous forme finie au moyen de fonctions algébriques, trigonométriques ou exponentielles basiques. En analyse fonctionnelle, cette intégrale est intimement liée à la fonction d’erreur de Gauss, universellement formalisée sous le symbole $\mathrm{erf}(x)$, définie par :
$$\mathrm{erf}(x) = \frac{2}{\sqrt{\pi}} \int_{0}^{x} e^{-u^2} , \mathrm{d}u$$
La relation exacte unissant la fonction de répartition cumulative normale standard et la fonction d’erreur s’énonce par la transformation variable suivante :
$$\Phi(z) = \frac{1}{2} \left[ 1 + \mathrm{erf}\left( \frac{z}{\sqrt{2}} \right) \right]$$
Pour dériver l’expression analytique de la distribution normale inverse, il convient de poser l’égalité $Phi(z) = p$ et d’isoler la variable $z$. En inversant algébriquement la formulation précédente faisant intervenir la fonction d’erreur, nous établissons le lien fondamental entre $\Phi^{-1}(p)$ et la fonction d’erreur réciproque, notée $\mathrm{erf}^{-1}$ :
$$p = \frac{1}{2} \left[ 1 + \mathrm{erf}\left( \frac{z}{\sqrt{2}} \right) \right] implies 2p – 1 = \mathrm{erf}\left( \frac{z}{\sqrt{2}} \right)$$
En appliquant la réciproque de la fonction d’erreur aux deux membres de l’équation, nous obtenons le formalisme mathématique canonique de la fonction quantile normale standard :
$$z = \Phi^{-1}(p) = \sqrt{2} \cdot \mathrm{erf}^{-1}(2p – 1)$$
Le domaine de définition de cette fonction est strictement borné à l’intervalle ouvert $]0, 1[$. Cette restriction découle directement du fait que la fonction d’erreur réciproque $\mathrm{erf}^{-1}(y)$ n’est définie que sur l’intervalle $]-1, 1[$, correspondant à $y = 2p – 1$. Le comportement asymptotique aux frontières de probabilités nulles et certaines traduit la nature infinie des queues de la distribution gaussienne :
$$\lim_{p to 0^+} \Phi^{-1}(p) = -\infty \quad \text{et} \quad \lim_{p to 1^-} \Phi^{-1}(p) = +\infty$$
Ces divergences logarithmiques et exponentielles aux frontières imposent des contraintes calculatoires sévères lors de l’évaluation numérique des quantiles associés à des probabilités infinitésimales.
2.2 2.2 Paramétrage par la moyenne et l’écart-type
Lorsque la variable aléatoire continue $X$ ne suit pas la loi centrée réduite mais une loi normale générale paramétrée par son espérance mathématique $\mu in \mathbb{R}$ et son écart-type $\sigma in \mathbb{R}^+_*$, notée $X \sim \mathcal{N}(\mu, \sigma^2)$, le calcul du quantile fait intervenir une transformation affine rigoureuse. La standardisation élémentaire associe à toute réalisation $x$ de la variable le score centré réduit $z$ par la relation :
$$z = \frac{x – \mu}{\sigma}$$
Réciproquement, la fonction de répartition cumulative générale $F(x; \mu, \sigma)$ est liée à la fonction standard $Phi$ par l’égalité d’échelle :
$$F(x; \mu, \sigma) = \Phi\left(\frac{x – \mu}{\sigma}\right)$$
Pour déterminer la valeur $x$ correspondant à une probabilité cumulée $p$ sous cette loi générale, il suffit d’inverser cette équation de standardisation. En substituant $\Phi^{-1}(p)$ à la variable standardisée $z$, nous formulons l’équation paramétrique universelle de la distribution normale inverse :
$$x = F^{-1}(p; \mu, \sigma) = \mu + \sigma \cdot \Phi^{-1}(p)$$
Cette formulation met en lumière le rôle distinct et complémentaire des paramètres d’emplacement ($\mu$) et d’échelle ($\sigma$). La moyenne $\mu$ opère une simple translation spatiale rigide du système d’axes sans altérer les relations d’espacement relatives entre les quantiles. À l’opposé, l’écart-type $\sigma$ agit comme un multiplicateur direct de dispersion : plus la variance de la population est importante, plus la distance séparant deux quantiles critiques successifs est amplifiée sur l’axe des abscisses réelles.
Pour illustrer l’effet de cette dispersion sur l’espacement des quantiles critiques, considérons deux échelles psychométriques classiques mesurant une aptitude cognitive globale : l’échelle du Quotient Intellectuel de Wechsler ($\mu = 100, \sigma = 15$) et l’échelle standardisée T utilisée dans les inventaires de personnalité comme le MMPI ($\mu = 50, \sigma = 10$). Pour un même percentile critique situé au sommet de la distribution ($p = 0{,}975$), le score standardisé invariant est $z = \Phi^{-1}(0{,}975) \approx 1{,}96$. L’évaluation concrète donne :
- Pour l’échelle de Wechsler : $x = 100 + 15 \times 1{,}95996 = 129{,}40$
- Pour l’échelle T : $x = 50 + 10 \times 1{,}95996 = 69{,}60$
La variabilité structurelle inhérente à l’écart-type gouverne ainsi l’étendue de l’intervalle métrique requis pour englober une fraction déterminée de la masse de probabilité.
2.3 2.3 Propriétés analytiques majeures
La fonction quantile normale possède un ensemble de propriétés analytiques qui régissent sa régularité et permettent son utilisation dans des procédures d’optimisation mathématique avancées. En premier lieu, la fonction $\Phi^{-1}(p)$ fait preuve d’une monotonie strictement croissante sur l’intégralité de son intervalle de définition $]0, 1[$. Cette propriété découle du fait que sa dérivée première ne s’annule jamais et demeure strictement positive sur tout le domaine. En effet, d’après le théorème de dérivation des fonctions réciproques :
$$\frac{\mathrm{d}}{\mathrm{d}p} \left[ \Phi^{-1}(p) \right] = \frac{1}{\phi\left( \Phi^{-1}(p) \right)} = \sqrt{2\pi} \cdot \exp\left( \frac{\left[ \Phi^{-1}(p) \right]^2}{2} \right)$$
Cette dérivée première présente un intérêt théorique exceptionnel : elle démontre que la pente de la fonction quantile est minimale au point d’inflexion médian où $\Phi^{-1}(0{,}5) = 0$, atteignant la valeur minimale de $\sqrt{2\pi} \approx 2{,}5066$. Lorsque $p$ s’approche des bornes asymptotiques zéro ou un, la quantité $\left[\Phi^{-1}(p)\right]^2$ diverge vers l’infini positif, provoquant une croissance exponentielle de la dérivée. Sur le plan psychométrique, cela prouve mathématiquement qu’une variation infinitésimale de probabilité cumulative au niveau des queues de distribution exige un déplacement d’amplitude quasi infinie sur l’axe des scores réels, confirmant la sensibilité extrême des quantiles distaux aux erreurs d’échantillonnage.
Par ailleurs, la fonction quantile normale est indéfiniment différentiable ($C^\infty$) sur son domaine ouvert. Sa dérivée seconde s’obtient aisément en différenciant l’expression précédente par rapport à $p$, en mobilisant la règle de dérivation en chaîne :
$$\frac{\mathrm{d}^2}{\mathrm{d}p^2} \left[ \Phi^{-1}(p) \right] = 2\pi \cdot \Phi^{-1}(p) \cdot \exp\left( \left[ \Phi^{-1}(p) \right]^2 \right)$$
Cette dérivée seconde s’annule rigoureusement en $p = 0{,}5$, traduisant un point d’inflexion analytique. Elle est strictement négative pour $p in ]0; 0{,}5[$, ce qui confère à la courbe une concavité dirigée vers le bas sur sa première moitié, puis devient strictement positive pour $p in ]0{,}5; 1[$, conférant à la distribution une convexité rigoureuse. Cette courbure équilibrée garantit une stabilité structurelle remarquable lors des développements en séries de Taylor au voisinage du point médian.
3. 3. Distinction essentielle : Distribution normale inverse vs Distribution gaussienne inverse
3.1 3.1 La confusion sémantique courante dans la littérature
Dans la littérature scientifique, les manuels statistiques et même certains manuels d’utilisation de progiciels, une confusion lexicographique récurrente et préjudiciable persiste entre la distribution normale inverse (objet du présent traité) et la distribution gaussienne inverse, historiquement formalisée par Abraham Wald sous l’appellation de loi de Wald. Bien que partageant des racines étymologiques communes fondées sur le patronyme de Carl Friedrich Gauss et le concept mathématique d’inversion, ces deux entités incarnent des constructions théoriques radicalement distinctes qui ne doivent en aucun cas être confondues lors de la conception d’un protocole d’analyse de données.
La source fondamentale de cette confusion réside dans l’utilisation polysémique du vocable « inverse ». Dans le cas de la distribution normale inverse, le terme qualifie une opération fonctionnelle : il s’agit de l’inversion univariée de la fonction de répartition cumulative d’une loi normale classique. Le résultat de cette opération n’est pas une nouvelle densité de probabilité mais un opérateur de seuillage (la fonction quantile). À l’inverse, dans le cas de la distribution gaussienne inverse, le qualificatif désigne une loi de probabilité à part entière, dotée de sa propre fonction de densité, de son espérance, de ses moments d’ordre supérieur et de son domaine de définition spécifique sur les réels positifs.
Le risque de commettre une erreur interprétative majeure est particulièrement élevé lorsque des chercheurs peu familiarisés avec le jargon algorithmique programment des scripts d’analyse sous R, Python ou SAS. L’appel fortuit de modules dédiés à la distribution gaussienne inverse (comme le package d’analyse de survie ou de régression linéaire généralisée avec famille gaussienne inverse) à la place des fonctions quantiles standards de la loi normale conduit à des résultats mathématiquement aberrants, appliquant une modélisation asymétrique de temps d’arrêt à des données normalement distribuées.
3.2 3.2 Caractéristiques de la distribution de Wald (Gaussienne inverse)
La distribution gaussienne inverse ou loi de Wald modélise le temps nécessaire à un mouvement brownien standard doté d’une dérive constante positive (drift) pour franchir un seuil d’absorption fixe et déterminé. Elle appartient à la famille exponentielle et se trouve rigoureusement restreinte aux variables aléatoires strictement positives : $X in ]0, +\infty[$. Sa fonction de densité de probabilité, paramétrée par sa moyenne $\mu > 0$ et son paramètre d’échelle ou de dispersion $lambda > 0$, s’énonce selon le formalisme suivant :
$$f_{Wald}(x; \mu, \lambda) = \left( \frac{\lambda}{2\pi x^3} \right)^{1/2} \exp\left( -\frac{\lambda (x – \mu)^2}{2\mu^2 x} \right) \quad \text{pour } x > 0$$
Contrairement à la distribution normale classique dont la densité présente une symétrie parfaite et des queues s’étendant à l’infini dans les deux directions positive et négative, la loi de Wald est fortement asymétrique positive, affichant une queue de distribution droite très étirée. En sciences cognitives, cette caractéristique morphologique fait de la distribution de Wald un outil privilégié pour modéliser les latences et les temps de réaction à des tâches d’attention sélective ou de décision lexicale, au sein des modèles d’accumulation de preuves de type drift-diffusion models.
L’inversion qui lui donne son nom historique n’est donc pas une inversion géométrique de courbe, mais renvoie au fait que le cumul d’obstacles franchis par un processus brownien sur un temps fixé suit une loi normale, alors que le temps requis pour franchir une distance unitaire suit cette distribution asymétrique : le temps est l’inverse de la vitesse. Ainsi, la distribution gaussienne inverse est une loi modélisant un phénomène physique réel, tandis que la distribution normale inverse est l’outil mathématique permettant de retrouver un seuil de score sur une loi de Gauss.
3.3 3.3 Tableau comparatif exhaustif
Afin de clore toute ambiguïté méthodologique au sein des protocoles de recherche quantitative, le tableau synoptique suivant récapitule les divergences fondamentales qui séparent la distribution normale inverse de la distribution gaussienne inverse de Wald.
| Critère de comparaison | Distribution normale inverse (Fonction quantile) | Distribution gaussienne inverse (Loi de Wald) |
|---|---|---|
| Nature mathématique | Opérateur réciproque de la fonction de répartition ($\Phi^{-1}$) | Loi de probabilité continue à part entière |
| Domaine de définition (Support) | $p in ]0, 1[$ (Probabilités cumulées) | $x in ]0, +\infty[$ (Variables réelles strictement positives) |
| Ensemble d’arrivée | $\mathbb{R}$ (Scores $z$ de $-\infty$ à $+\infty$) | $[0, +\infty[$ (Densité de probabilité de présence) |
| Paramètres requis | Probabilité $p$, moyenne $\mu$, écart-type $\sigma$ | Moyenne $\mu > 0$, paramètre d’échelle $lambda > 0$ |
| Forme de la densité associée | Symétrie axiale parfaite (loi normale sous-jacente) | Asymétrie positive prononcée, queue droite allongée |
| Formule analytique centrale | $x = \mu + \sigma \sqrt{2} , \mathrm{erf}^{-1}(2p – 1)$ | $f(x) = \sqrt{\frac{\lambda}{2\pi x^3}} \exp\left( -\frac{\lambda(x-\mu)^2}{2\mu^2 x} \right)$ |
| Applications majeures | Calcul de valeurs critiques $z$, étalonnage psychométrique, seuils diagnostics | Modélisation des temps de réaction, analyse de survie, processus de diffusion |
| Syntaxe typique (R) | qnorm(p, mean, sd) |
statmod::qinvgauss(p, mean, shape) |
Ce tableau met en exergue les contextes d’application exclusifs de ces deux outils. Le chercheur mobilisera la distribution normale inverse lorsqu’il cherchera à partitionner un échantillon normé ou à déterminer des limites de décision sur des variables distribuées symétriquement. Il optera pour la loi de Wald uniquement lorsqu’il cherchera à modéliser la morphologie intrinsèque de variables asymétriques générées par des dynamiques temporelles sous contrainte d’accumulation stochastique.
4. 4. Méthodes d’approximation numérique de la distribution normale inverse
4.1 4.1 L’absence de forme close pour l’intégrale gaussienne inverse
L’obstacle fondamental qui s’oppose à une mise en œuvre computationnelle directe de la fonction quantile normale réside dans l’inexistence de forme close élémentaire pour la primitive de la densité gaussienne. Puisque la fonction de répartition cumulative $Phi(z)$ est irréductible à des expressions finies, son opérateur inverse $\Phi^{-1}(p)$ partage la même nature transcendante. Il en découle que le calcul exact d’un quantile ne peut s’effectuer par une simple évaluation algébrique analytique, mais exige le recours incontournable à des méthodes d’approximation numérique de haute précision.
Historiquement, avant l’avènement des calculateurs électroniques et des microprocesseurs dans le dernier tiers du XXe siècle, ce défi calculatoire était contourné par la publication laborieuse de vastes recueils de tables statistiques. Les pionniers du calcul numérique effectuaient manuellement des interpolations linéaires ou quadratiques fastidieuses à partir de tables calculées par développements en séries de Taylor au voisinage de zéro, limitant le chercheur à quelques décimales de précision. Ces limitations freinaient considérablement le développement d’analyses statistiques itératives à grande échelle.
L’essor de l’informatique moderne a radicalement transformé la donne, imposant toutefois la formulation de compromis algorithmiques subtils. Un algorithme statistique professionnel ne doit pas seulement être précis au dixième décimal près ; il doit garantir une exécution en un minimum de cycles processeur tout en évitant les erreurs de dépassement arithmétique (overflow ou underflow) lorsque la probabilité d’entrée avoisine les limites critiques de la précision machine à virgule flottante sous la norme IEEE 754.
4.2 4.2 L’algorithme de Beasley-Springer-Moro
L’un des premiers accomplissements majeurs dans le calcul rationnel rapide de la distribution normale inverse a été formulé par J. D. Beasley et S. G. Springer en 1977, puis considérablement perfectionné par Boris Moro en 1995 pour le traitement des queues de distribution. L’algorithme original de Beasley-Springer subdivise l’intervalle de probabilité central pour y appliquer une fraction rationnelle de polynômes de Tchebychev. Pour $p in [0{,}08; 0{,}92]$, la fonction est approximée par le rapport de deux polynômes de degré 3 ou 4 :
$$\Phi^{-1}(p) \approx \frac{\sum_{i=0}^{3} a_i (p – 0{,}5)^{2i+1}}{1 + \sum_{j=1}^{4} b_j (p – 0{,}5)^{2j}}$$
Cette formulation exploite rigoureusement la symétrie centrale autour de $p = 0{,}5$, annulant les puissances paires au numérateur afin de réduire drastiquement le nombre d’opérations d’addition et de multiplication requises par cycle d’évaluation.
Cependant, l’approximation de Beasley-Springer révélait une dégradation sensible de sa précision dès que $p$ s’éloignait vers les queues extrêmes ($p 0{,}92$). C’est ici qu’intervient l’apport fondamental de Moro : substituer à la fraction rationnelle classique un développement polynomial tronqué opérant sur la variable logarithmique de transformation asymptotique $y = \sqrt{-\ln(\min(p, 1-p))}$. En combinant judicieusement des coefficients optimisés par la méthode des moindres carrés pondérés, l’algorithme de Beasley-Springer-Moro parvient à garantir une erreur absolue maximale théorique inférieure à $3 \times 10^{-9}$ sur l’ensemble de la droite réelle accessible.
Cet algorithme demeure aujourd’hui encore une référence incontournable au sein des systèmes financiers et des moteurs d’analyse de risque quantitatif de type Monte-Carlo, où la vitesse d’évaluation vectorisée sur des millions de tirages prévaut sur l’obtention d’une précision microscopique au-delà de la dixième décimale.
4.3 4.3 Méthode d’inversion par approximation d’Acklam
La référence méthodologique moderne la plus largement adoptée par les packages scientifiques de haut niveau — incluant les implémentations sous Python (SciPy), MATLAB, et divers modules C++ — est l’algorithme conçu par le mathématicien norvégien Peter John Acklam en 2003. Conçu spécifiquement pour maximiser la précision arithmétique tout en éliminant les discontinuités aux frontières de raccordement, l’algorithme d’Acklam segmente le domaine probabiliste $]0, 1[$ en trois régions distinctes :
- La région centrale : définie pour $0{,}02425 le p le 0{,}97575$. L’approximation y utilise une fraction rationnelle de polynômes de degré 5 en fonction de la quantité $q = p – 0{,}5$.
- La queue inférieure : pour $p < 0{,}02425$. L'approximation fait intervenir la variable logarithmique auxiliaire $r = \sqrt{-\ln(p)}$.
- La queue supérieure : pour $p > 0{,}97575$. La formulation est le symétrique exact de la queue inférieure en évaluant $r = \sqrt{-\ln(1 – p)}$.
L’expression analytique pour les régions extrêmes prend la forme hautement optimisée :
$$\Phi^{-1}(p) \approx \pm \frac{\sum_{i=0}^{5} c_i r^i}{1 + \sum_{j=1}^{4} d_j r^j}$$
Cette architecture par segmentation rationnelle assure une précision intrinsèque spectaculaire : l’erreur relative maximale de l’algorithme brut d’Acklam ne dépasse pas $1{,}15 \times 10^{-9}$ en tout point de l’intervalle.
Pour atteindre la précision machine absolue imposée par les calculs scientifiques modernes (de l’ordre de $10^{-16}$ pour le format à double précision 64 bits), l’estimation initiale produite par la formule rationnelle d’Acklam est injectée comme point de départ dans une seule étape de raffinement itératif de Newton-Raphson du second ordre (méthode de Halley) :
$$z_{k+1} = z_k – \frac{\Phi(z_k) – p}{\phi(z_k)} \left[ 1 + \frac{z_k (\Phi(z_k) – p)}{2 \phi(z_k)} \right]$$
Cette convergence quadratique quasi instantanée garantit une précision absolue parfaite jusqu’au dernier bit de mantisse, conférant à la méthode d’Acklam le statut de référence computationnelle mondiale.
5. 5. Utilisation sur calculatrices graphiques : TI-83 et TI-84
5.1 5.1 La commande invNorm et sa syntaxe fondamentale
Pour les étudiants, chercheurs et cliniciens opérant sur le terrain, les calculatrices graphiques de la gamme Texas Instruments (TI-83 Plus, TI-84 Plus, et leurs déclinaisons contemporaines à écran couleur TI-84 Plus CE) représentent les instruments les plus fréquemment déployés pour l’évaluation immédiate de seuils statistiques. L’implémentation algorithmique de la distribution normale inverse y est encapsulée sous la commande syntaxique standardisée invNorm (ou FracNormale sur les versions commercialisées avec une interface logicielle intégralement francophone).
L’accès physique à cette routine s’effectue par une séquence de touches immuable : la pression préalable de la touche jaune 2nd, suivie de la touche VARS (permettant d’ouvrir le menu sous-jacent DISTR ou Distributions). Au sein du menu déroulant qui apparaît à l’écran, la fonction occupe généralement la troisième position, immédiatement consécutive aux routines normalpdf (densité de probabilité) et normalcdf (probabilité cumulée).
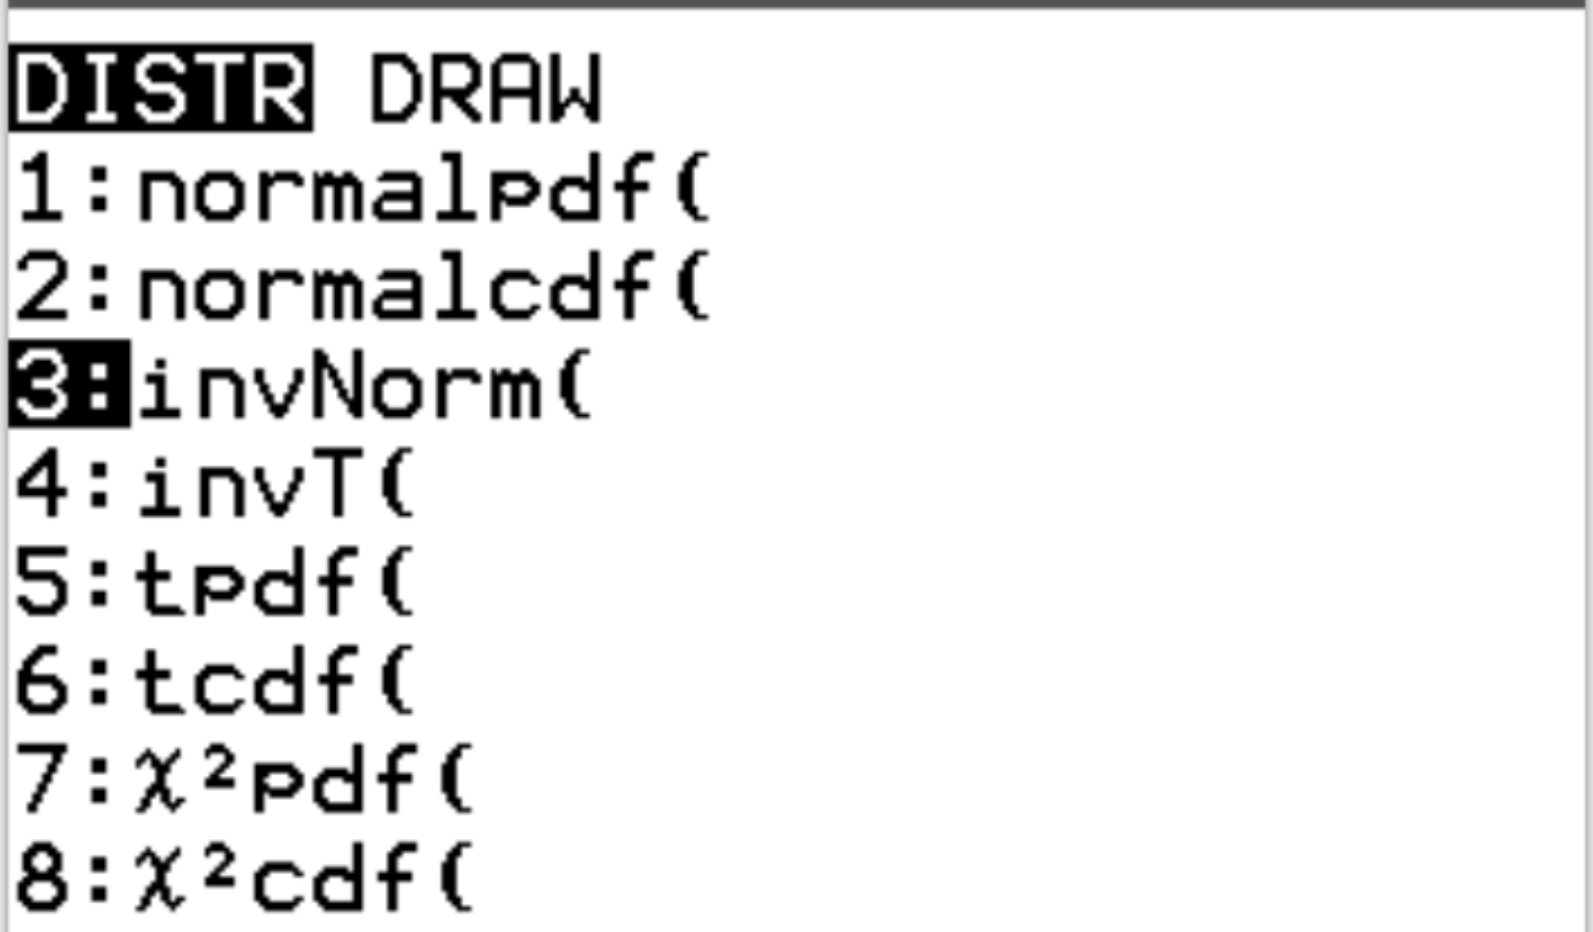
Sur les générations d’appareils antérieures (telles que la TI-83 originelle ou la TI-84 Plus standard sans mise à jour logicielle récente), la commande n’acceptait qu’une syntaxe vectorielle stricte délimitée par des virgules, de la forme :
invNorm(aire, [moyenne, écart-type])
Si l’opérateur omet de spécifier les arguments optionnels de moyenne et d’écart-type, le microprocesseur de la machine assigne automatiquement les paramètres par défaut de la loi normale centrée réduite standard, à savoir $\mu = 0$ et $\sigma = 1$. L’argument fondamental « aire » (area) doit impérativement être exprimé sous la forme d’un nombre décimal strict compris entre zéro et un, désignant la probabilité cumulative totale mesurée exclusivement à partir de l’extrémité gauche ($-\infty$) de la courbe de distribution.
5.2 5.2 Gestion des queues : Gauche, Droite et Centrée
Une mise à niveau majeure introduite avec les systèmes d’exploitation récents de la TI-84 Plus C Silver Edition et de la TI-84 Plus CE réside dans l’intégration d’un assistant de saisie graphique interactif (wizard), doté d’une option de paramétrage spatial des queues de distribution, désignée sous l’étiquette Tail: LEFT / RIGHT / CENTER. Cette innovation ergonomique simplifie considérablement la tâche de l’opérateur en réduisant les risques d’erreurs de soustraction mentale.
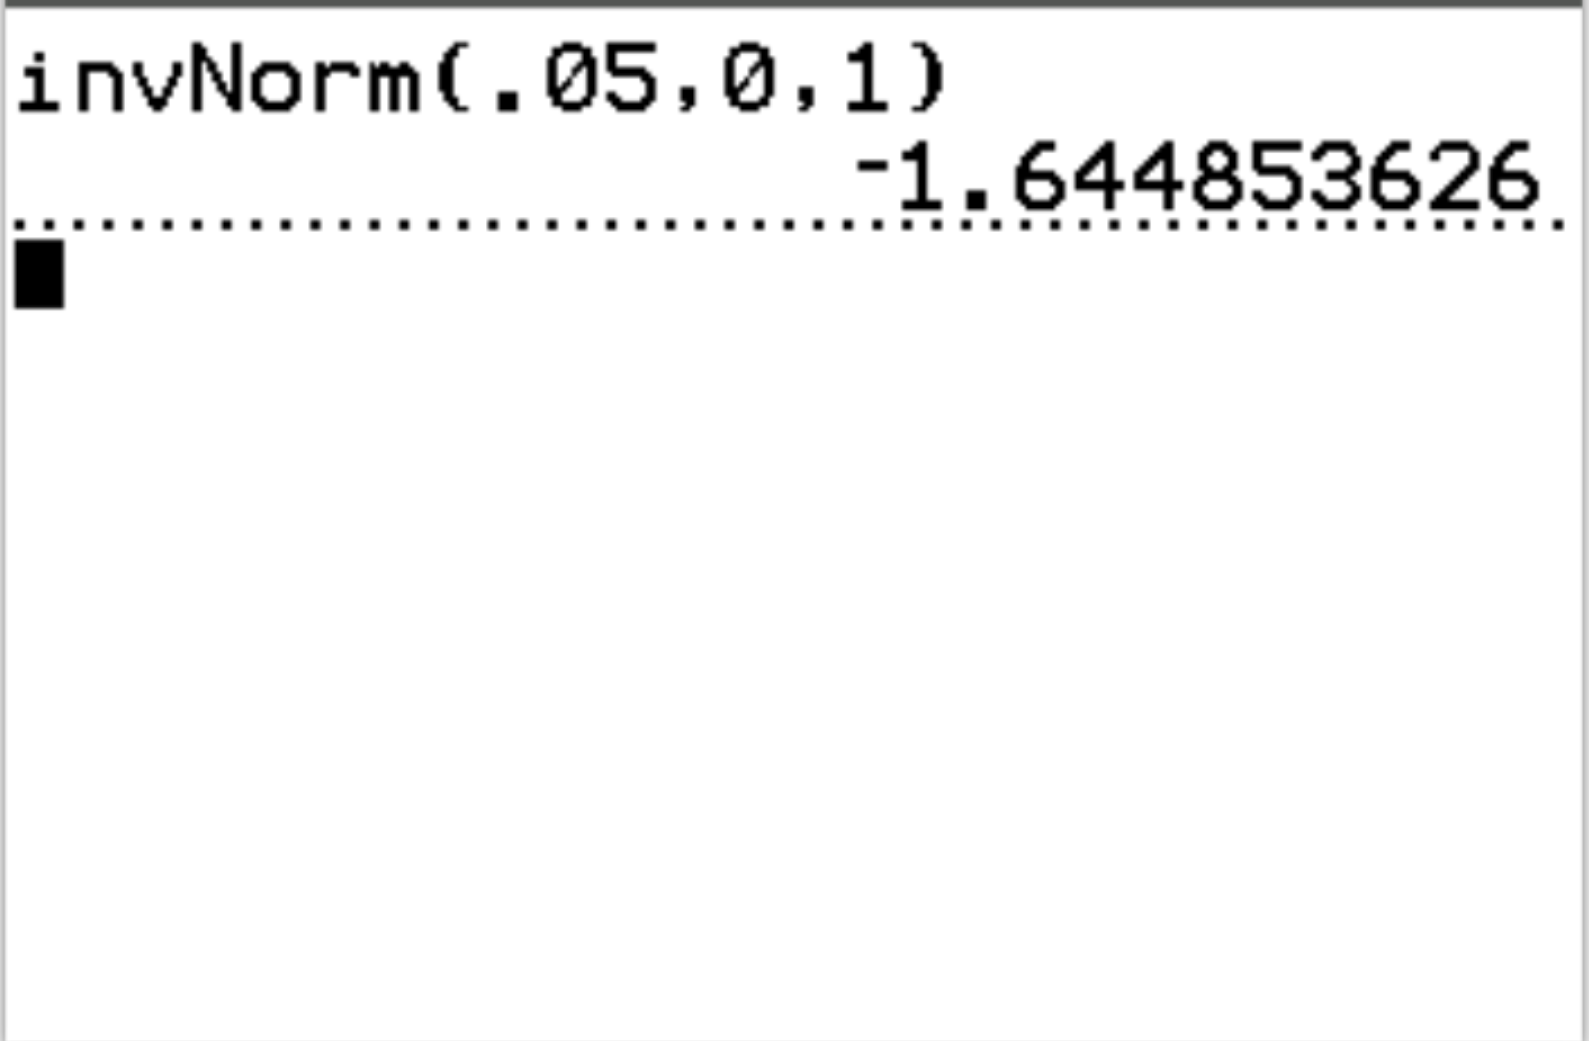
Le fonctionnement technique de ces trois options s’articule comme suit :
- LEFT (Queue gauche) : Comportement traditionnel immuable. L’aire spécifiée correspond à l’intégrale cumulée de $-\infty$ à la valeur seuil $z$. Cette modalité est universellement employée pour les tests d’hypothèses unilatéraux inférieurs ou pour déterminer des seuils de déficit clinique.
- RIGHT (Queue droite) : L’algorithme résout l’équation $P(X > x) = \text{aire}$. La valeur saisie représente l’aire découpée sous la queue supérieure droite de la courbe. Cette option s’avère particulièrement utile pour déterminer les scores d’admission à des programmes d’élite ou pour les tests directionnels supérieurs sans devoir calculer préalablement l’aire complémentaire $1 – p$.
- CENTER (Centrée) : L’aire saisie correspond à la probabilité totale englobée symétriquement autour de la moyenne arithmétique. L’algorithme retourne alors un vecteur de deux valeurs critiques distinctes $[z_{\inf}, z_{\sup}]$, délimitant un intervalle d’admissibilité ou l’étendue d’un intervalle de confiance bilatéral de niveau $1 – \alpha$.
Pour les praticiens contraints d’opérer sur des modèles plus anciens dépourvus du sélecteur interactif de queue, l’émulation mathématique de ces options demeure impérative. Pour une queue droite isolant une probabilité $\alpha$, l’utilisateur doit impérativement saisir invNorm(1 - alpha, mu, sigma). De même, pour isoler une région centrale de confiance $(1 – \alpha)$, les bornes critiques doivent être déduites manuellement par l’évaluation successive de invNorm(alpha / 2) pour la borne gauche négative et invNorm(1 - alpha / 2) pour la borne droite positive.
5.3 5.3 Exemples guidés pas à pas
Afin de concrétiser la manipulation technique de ces commandes sur le clavier d’une calculatrice graphique, examinons deux applications canoniques rencontrées quotidiennement en recherche empirique et en pratique psychologique.
Exemple 1 : Détermination de la valeur critique pour un test directionnel supérieur à $\alpha = 0{,}05$.
Le chercheur formule une hypothèse de recherche postulant que son protocole d’entraînement cognitif augmente significativement les capacités d’inhibition chez des adolescents. Il souhaite rejeter l’hypothèse nulle au seuil unilatéral standard de $\alpha = 0{,}05$. Sur une TI-84 Plus CE, la démarche séquentielle s’organise ainsi :
- Actionner la séquence de touches
2ndpuisVARS. - Sélectionner l’option
3: invNorm. - Dans le menu contextuel, renseigner :
Area: 0.05,μ: 0,σ: 1,Tail: RIGHT(ou sur une machine classique :Area: 0.95,Tail: LEFT). - Positionner le curseur sur
Pasteet presserENTER. - L’écran affiche la syntaxe exécutable
invNorm(0.05, 0, 1, RIGHT)(ouinvNorm(0.95, 0, 1)). - La machine affiche le résultat critique final : 1.644853625. Le chercheur sait qu’il rejettera $H_0$ si son score $z$ calculé dépasse $+1{,}645$.
Exemple 2 : Calcul du seuil de QI marquant le 95e percentile d’une batterie cognitive.
Un neuropsychologue cherche à identifier la note composite minimale à l’échelle d’efficience globale de Wechsler ($\mu = 100, \sigma = 15$) plaçant un patient dans les 5 % supérieurs de la population normative générale. L’opération requiert la résolution de $F^{-1}(0{,}95; 100, 15)$ :
- Ouvrir le menu de distribution :
2nd+VARS→3: invNorm. - Saisir scrupuleusement les paramètres :
Area: 0.95,μ: 100,σ: 15,Tail: LEFT. - Exécuter la commande
invNorm(0.95, 100, 15). - La calculatrice génère instantanément le score étalonné : 124.6728.
Pour valider mathématiquement ce résultat et se prémunir contre toute erreur de frappe ou d’aiguillage de queue, le praticien peut procéder à une vérification inverse immédiate via la commande de répartition cumulative normalcdf. En exécutant normalcdf(-1E99, 124.6728, 100, 15) (où $-1\text{E}99$ modélise l’infini négatif dans le format de notation scientifique de l’appareil), la machine retourne avec une exactitude parfaite le nombre décimal 0.9500000000, confirmant de manière irréfutable la conformité du quantile calculé.
6. 6. Implémentation pratique sous Microsoft Excel et Google Sheets
6.1 6.1 Fonctions standards : LOI.NORMALE.INVERSE et LOI.NORMALE.STANDARD.INVERSE
L’exploitation de tableurs tels que Microsoft Excel ou Google Sheets constitue l’une des voies les plus répandues pour traiter des bases de données quantitatives au sein des laboratoires et des institutions cliniques. Ces logiciels intègrent des bibliothèques de fonctions statistiques spécialisées permettant d’évaluer la fonction quantile normale sur de volumineuses matrices de données. Depuis la refonte majeure du moteur de calcul statistique introduite lors de la publication d’Excel 2010, deux fonctions normalisées conformes aux normes ISO/CEI régissent cette évaluation :
LOI.NORMALE.INVERSE(probabilité, moyenne, écart_type): Dédiée à l’inversion d’une distribution normale générale paramétrée par ses paramètres empiriques ou théoriques $\mu$ et $\sigma$. Sa syntaxe équivalente anglophone sous Google Sheets ou sur les versions anglaises du tableur s’intituleNORM.INV(probability, mean, standard_dev).LOI.NORMALE.STANDARD.INVERSE(probabilité): Conçue exclusivement pour la distribution normale standard ($\mu = 0, \sigma = 1$). Elle ne requiert que le seul argument scalaire de la probabilité cumulée unilatérale gauche. Son équivalent anglophone international estNORM.S.INV(probability).
Il importe de souligner que les tableurs assurent une rétrocompatibilité ascendante stricte avec leurs fonctions historiques antérieures, respectivement désignées par LOINORMINV (en anglais NORMINV) et LOINORMALE.STANDARD.INVERSE (en anglais NORMSINV). Cependant, leur emploi est formellement déconseillé dans les protocoles de recherche contemporains : ces routines obsolètes s’appuyaient sur des algorithmes d’approximation polynomiale moins stables, susceptibles d’engendrer des erreurs d’arrondi significatives au-delà du quatrième écart-type ou lors du traitement de jeux de données massifs.
6.2 6.2 Automatisation des calculs psychométriques sur feuilles de calcul
Dans le cadre de l’étalonnage psychométrique automatisé ou de l’analyse d’évaluations standardisées en milieu éducatif ou clinique, le chercheur doit fréquemment convertir une colonne complète de rangs centiles en scores calibrés opérationnels (tels que les scores standardisés de Wechsler ou les scores T). La structuration rigoureuse d’une feuille de calcul permet d’effectuer cette normalisation instantanément sur des milliers d’observations.
Supposons qu’un fichier contienne les identifiants de patients dans la colonne A et leurs rangs centiles observés (échelonnés entre 1 et 99) dans la colonne B, débutant à la cellule B2. Pour convertir ces rangs centiles en scores de Quotient Intellectuel normalisés ($\mu = 100, \sigma = 15$), le praticien intègrera dans la cellule C2 la formulation dynamique suivante :
=LOI.NORMALE.INVERSE(B2/100; 100; 15)
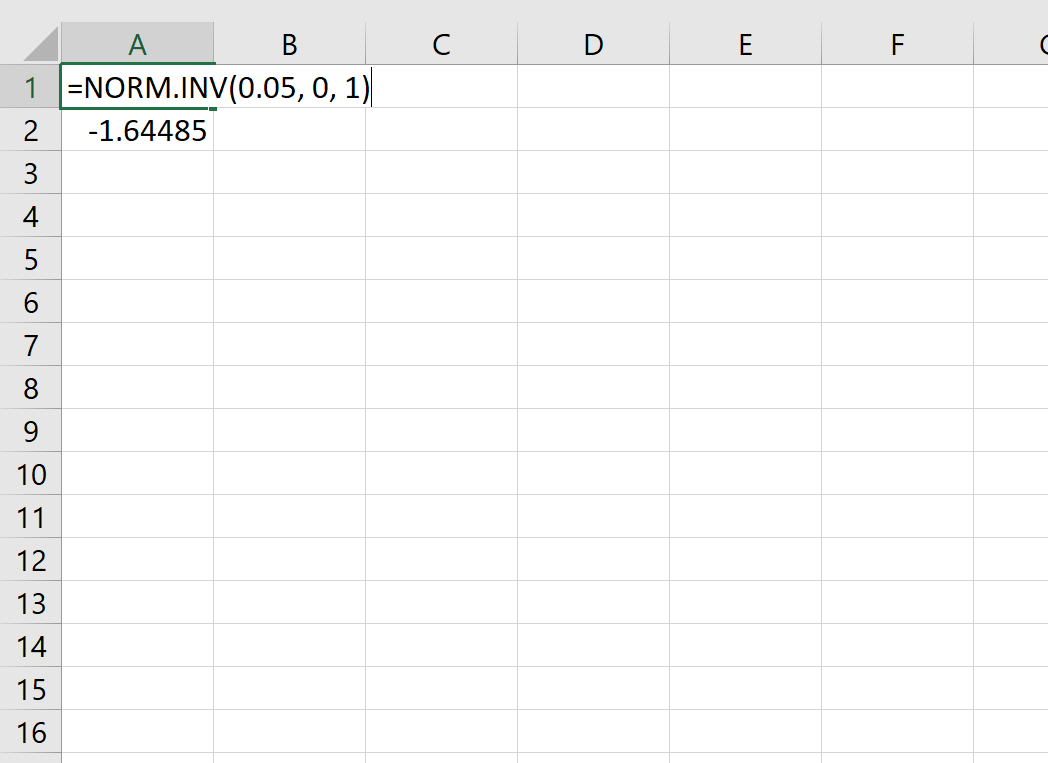
La division par 100 s’avère rigoureusement indispensable pour ramener le rang centile entier (par exemple 84) à une échelle de probabilité unitaire continue appartenant à l’intervalle $]0, 1[$ ($0{,}84$). Afin de prévenir les plantages de calcul générés par la saisie accidentelle de valeurs extrêmes théoriquement interdites — un centile de 0 ou de 100 produisant respectivement les valeurs mathématiquement divergentes $-\infty$ et $+\infty$, ce qui déclenche l’erreur fatale #NOMBRE! dans le tableur —, il est hautement recommandé d’encapsuler la formule dans une structure de condition logique protectrice :
=LOI.NORMALE.INVERSE(MIN(MAX(B2/100; 0,0001); 0,9999); 100; 15)
Cette sécurité algorithmique contraint automatiquement les probabilités dans un intervalle fermé $[0{,}0001; 0{,}9999]$, garantissant la résilience de la matrice d’analyse tout en signalant les scores marginaux nécessitant une inspection clinique approfondie.
6.3 6.3 Pièges fréquents sous les tableurs de bureau
Malgré l’accessibilité apparente des logiciels de tableur, leur exploitation en méthodologie quantitative est fréquemment entachée d’erreurs méthodologiques et techniques subtiles mais lourdes de conséquences.
Le piège le plus universel concerne la confusion structurelle entre probabilité cumulée unilatérale et niveau de confiance bilatéral. Un utilisateur souhaitant construire un intervalle de confiance à 95 % autour d’une moyenne a souvent le réflexe erroné de saisir =LOI.NORMALE.STANDARD.INVERSE(0,95). Cette commande retourne la valeur critique unilatérale de $1{,}64485$, conduisant à un sous-dimensionnement manifeste de l’intervalle de confiance réel, dont la marge d’erreur bilatérale correcte exige l’évaluation de $\Phi^{-1}(1 – alpha/2) = \Phi^{-1}(0{,}975) = 1{,}95996$. L’écriture appropriée pour extraire directement le quantile d’un intervalle bilatéral centré au niveau de confiance $C$ s’exprime donc par :
=LOI.NORMALE.STANDARD.INVERSE(1 - (1 - C)/2) ou =LOI.NORMALE.STANDARD.INVERSE((1 + C)/2)
Un second piège récurrent réside dans la gestion des séparateurs décimaux et des notations scientifiques selon la localisation linguistique de l’environnement logiciel. Dans les versions francophones d’Excel, le séparateur décimal légal est la virgule, et l’argument séparateur dans les formules est le point-virgule (;). L’importation brute de fichiers de données formatés en standard anglo-saxon (séparateur décimal point et délimiteur argument virgule) provoque des erreurs silencieuses ou des conversions de probabilités décimales infinitésimales en dates ou en chaînes de caractères textuelles, faussant irrémédiablement l’agrégation statistique globale de l’échantillon clinique.
7. 7. Traitement statistique dans les langages de programmation : R et Python
7.1 7.1 La fonction qnorm() sous le langage R
Dans l’écosystème de la recherche universitaire et de la biométrie computationnelle contemporaine, le langage open source R s’impose comme l’étalon méthodologique par excellence. L’accès à la distribution normale inverse y est géré de manière native, hautement optimisée et universellement vectorisée via la fonction fondamentale qnorm(), issue du package central de distributions statistiques stats.
La signature complète de la fonction s’articule autour de quatre arguments formels :
qnorm(p, mean = 0, sd = 1, lower.tail = TRUE, log.p = FALSE)
La nature vectorisée de l’argument p confère à R une puissance opérationnelle remarquable : il est possible de lui passer sans surcoût de programmation un vecteur numérique contenant des centaines de milliers de probabilités cumulées issues de cohortes épidémiologiques massives, la fonction retournant instantanément le vecteur complet des quantiles correspondants par l’exploitation de routines C compilées en arrière-plan.
L’argument booléen lower.tail joue un rôle déterminant dans la précision numérique : configuré par défaut à TRUE, il évalue $P(X le x)$. Lorsqu’il est basculé sur FALSE, la fonction calcule directement la probabilité de queue supérieure $P(X > x) = 1 – p$. Cette distinction algorithmique est cruciale en statistique de test : évaluer qnorm(1e-12, lower.tail = FALSE) préserve scrupuleusement l’intégrité de la précision arithmétique machine, tandis qu’évaluer qnorm(1 - 1e-12) provoque un phénomène d’annulation catastrophique au sein de la mantisse, où la soustraction $1 – 10^{-12}$ épuise la précision des 53 bits de fraction flottante standard. Enfin, l’activation de log.p = TRUE permet de renseigner directement la probabilité sous forme de logarithme népérien ($ln(p)$), permettant de sonder sans saturation numérique des quantiles situés au-delà de dix écarts-types de la moyenne.
7.2 7.2 La méthode scipy.stats.norm.ppf() sous Python
Au sein de l’environnement de programmation Python — prédominant dans le développement d’architectures d’apprentissage automatique et de bio-informatique —, la fonction quantile de la loi normale est distribuée au sein du sous-module scipy.stats sous l’acronyme technique ppf, signifiant Percent Point Function, qui est le synonyme mathématique exact de la fonction quantile.
L’implémentation repose sur la classe de distribution continue norm, dont la méthode de classe s’invoque conventionnellement selon la syntaxe suivante :
scipy.stats.norm.ppf(q, loc=0, scale=1)
Dans ce formalisme, l’argument q désigne la probabilité cumulative (équivalente à $p$), tandis que les paramètres nominatifs loc et scale correspondent rigoureusement à l’espérance mathématique ($\mu$) et à l’écart-type ($\sigma$) de la distribution normale cible.
L’interopérabilité fluide entre SciPy, NumPy et Pandas permet d’intégrer l’inversion quantile au sein de pipelines de traitement de mégadonnées cliniques avec une efficacité calculatoire maximale. L’application de la méthode vectorisée norm.ppf sur une colonne complète de type pandas.Series s’exécute par des liaisons optimisées vers les bibliothèques d’algèbre linéaire sous-jacentes (BLAS/LAPACK). De surcroît, la classe met à disposition la méthode réciproque duale norm.isf (Inverse Survival Function), qui résout directement l’équation de survie pour les queues droites sans exiger de soustraction préalable à l’unité, équivalant rigoureusement à l’argument lower.tail = FALSE du langage R.
7.3 7.3 Comparaison de précision et tests de robustesse
L’évaluation comparative de la stabilité numérique entre R et Python met en lumière la remarquable standardisation des moteurs de calcul contemporains, tous deux reposant sur des dérivés hautement raffinés de l’algorithme d’Acklam couplé à des corrections de Halley. Lorsque l’on soumet ces interpréteurs à des tests de robustesse aux limites de tolérance de la virgule flottante double précision conforme à la norme standard IEEE 754, des divergences microscopiques n’apparaissent qu’aux franges ultimes de l’espace arithmétique.
Pour un quantile conventionnel comme $p = 0{,}975$, R et Python s’accordent de manière absolue jusqu’à la seizième décimale :
$$z = 1{,}959963984540054dots$$
En revanche, face à des probabilités infinitésimales représentatives d’événements rarissimes en épidémiologie génétique (par exemple $p = 10^{-15}$), la gestion des flux de calcul révèle l’importance des bonnes pratiques logicielles. L’utilisation maladroite de la fonction directe produit sous les deux environnements une dégradation de la précision si la formulation logarithmique n’est pas invoquée. En R, la commande qnorm(-15 * log(10), log.p = TRUE) délivre le score critique exact de $-7{,}941345$, surpassant en robustesse les approches procédurales naïves.
Dans la recherche reproductible en psychologie quantitative, la validation des données d’entrée constitue le garant incontournable de la validité scientifique des scripts. Il est impératif d’intégrer dans le pipeline de code des tests unitaires confirmant que toutes les entrées sont strictement contenues dans l’intervalle ouvert $]0, 1[$, tout en prévoyant une gestion explicite des données manquantes (valeurs NA ou NaN). L’absence de vérification rigoureuse expose l’analyste à des propagations silencieuses de valeurs infinies qui corrompent irrémédiablement les estimations de modèles linéaires ou d’analyses de trajectoire latente en aval.
8. 8. Applications pratiques en psychométrie et évaluation neuropsychologique
8.1 8.1 Conversion des rangs centiles en scores étalonnés
La mission fondamentale de la psychométrie appliquée réside dans la quantification précise et équitable des aptitudes cognitives, des traits de personnalité et des états psychopathologiques. Dans cette optique, l’inversion quantile normale joue un rôle d’harmonisation métrique universel, permettant de transposer les données brutes d’observation — naturellement soumises aux contingences de l’échantillonnage — vers des échelles standardisées aux propriétés mathématiques parfaitement documentées.
Lors de la phase de calibration d’un test psychométrique, l’expérimentateur administre l’instrument à un échantillon normatif représentatif de la population générale, calcule les fréquences cumulées empiriques associées à chaque score brut, puis dérive les rangs centiles associés par interpolation linéaire. Pour convertir ces rangs centiles en une métrique d’échelle d’intervalles stable, la transformation passe impérativement par le score centré réduit $z = \Phi^{-1}(p)$. Une fois ce score critique invariant extrait, il peut être projeté sur n’importe quel système de référence normatif classique au moyen d’une transformation linéaire directe :
- L’échelle des scores T : largement adoptée dans les inventaires psychopathologiques (MMPI, PAI), caractérisée par une moyenne $\mu = 50$ et un écart-type $\sigma = 10$, formulée par : $T = 50 + 10 \cdot \Phi^{-1}(p)$.
- L’échelle des notes standard (ou subtest scores) : adoptée dans les sous-tests des batteries de Wechsler, fixant $\mu = 10$ et $\sigma = 3$, calculée par : $\text{Note} = 10 + 3 \cdot \Phi^{-1}(p)$.
- L’échelle Sten (Standard Ten) : fréquente dans l’évaluation des compétences professionnelles et des tests de sélection en psychologie du travail, comportant une moyenne $\mu = 5{,}5$ et un écart-type $\sigma = 2$, bornée de 1 à 10.
- L’échelle Stanine (Standard Nine) : partitionnant la distribution théorique en neuf tranches de dispersion d’une largeur de 0,5 écart-type autour d’une moyenne $\mu = 5$ et d’un écart-type $\sigma = 2$.
Cette méthodologie garantit une propriété psychométrique capitale : la préservation des distances relatives d’intervalles. Deux scores standardisés séparés par une même distance métrique représentent rigoureusement la même divergence probabiliste au sein de la population générale de référence, autorisant dès lors l’application licite de calculs de moyennes, d’analyses de variance et de modélisations en équations structurelles.
8.2 8.2 Définition des seuils de significativité clinique
Dans l’exercice diagnostique clinique, tant en psychiatrie qu’en neuropsychologie ou en orthophonie, le praticien est confronté à la nécessité impérieuse de poser une frontière de démarcation entre une variation typique du fonctionnement individuel et une altération statistiquement significative justifiant la qualification de pathologique ou de trouble neurodéveloppemental. La distribution normale inverse fournit le substrat mathématique sur lequel reposent l’ensemble des critères nosographiques internationaux, à l’image du DSM-5 et de la CIM-11.
La convention diagnostique neuropsychologique contemporaine définit les seuils d’alerte et de sévérité à partir d’écarts-types critiques standardisés par rapport à la moyenne étalonnée :
- La zone de vigilance ou de fragilité cognitive : traditionnellement fixée à $-1{,}5$ écart-type, correspondant à une probabilité cumulative de $p = \Phi(-1{,}5) \approx 0{,}0668$ (soit les 6,7 % des individus les plus fragiles de la cohorte normée).
- Le déficit clinique avéré ou significatif : conventionnellement ancré à $-2{,}0$ écart-types, correspondant à $p = \Phi(-2{,}0) \approx 0{,}0228$ (les 2,28 % inférieurs). C’est le seuil formel retenu pour le diagnostic de trouble des apprentissages (dyslexie, dyscalculie) ou pour l’identification d’une déficience intellectuelle globale lorsque le Quotient Intellectuel chute sous le score de 70.
- Le déficit cognitif massif ou profond : délimité à $-3{,}0$ écart-types, correspondant à la zone d’extrême rareté statistique où $p = \Phi(-3{,}0) \approx 0{,}00135$ (environ un individu sur 740).
Au-delà de l’analyse d’un score isolé, la distribution normale inverse est la composante clé de la méthode d’analyse des divergences inter-sous-tests (discrepancy analysis). Lorsqu’un neuropsychologue observe un écart entre l’Indice de Compréhension Verbale et l’Indice de Raisonnement Fluide d’un patient au sein de la WAIS-IV, il calcule la différence brute observée, puis évalue la probabilité cumulative $p$ d’une telle divergence au sein de la population normative. En réinjectant cette probabilité dans la fonction quantile, il établit formellement si la dissociation cognitive observée reflète une dysharmonie pathologique singulière ou une fluctuation d’échantillonnage aléatoire dépourvue de signification sémiologique.
8.3 8.3 Normalisation des échelles d’attitudes et questionnaires de personnalité
Les échelles psychométriques d’auto-évaluation reposant sur des items ordonnés de type Likert (par exemple des échelons de réponses gradués de 1 à 5, allant de « pas du tout d’accord » à « tout à fait d’accord ») génèrent structurellement des scores discrets ordinaux. L’assignation naïve d’une valeur numérique équidistante à ces modalités de réponse constitue un raccourci méthodologique critiquable : la distance subjective et psychologique séparant « pas du tout d’accord » de « peu d’accord » n’est presque jamais équivalente à celle séparant « neutre » de « d’accord ». La distribution normale inverse offre un protocole mathématique de linéarisation désigné sous l’appellation d’échelonnage de Thurstone ou de transformation probit.
La procédure s’articule par l’inversion systématique des proportions de réponses observées au sein de chaque catégorie. Pour un item d’évaluation psychologique administré à un échantillon calibré, l’analyste calcule la proportion cumulée empirique des répondants endossant chaque modalité successive. En appliquant la fonction $\Phi^{-1}$ à ces proportions cumulées, les seuils de coupure de chaque modalité de réponse (désignés sous le terme de thresholds ou seuils de saturation $\tau_k$) sont projetés sur un continuum psychologique sous-jacent latent supposé normalement distribué :
$$\tau_k = \Phi^{-1}\left( \sum_{j=1}^{k} \hat{p}_j \right)$$
Cette transformation paramétrique convertit une métrique de classement ordinale arbitraire en une échelle d’intervalles latente continue. Elle représente l’armature théorique indispensable à la formulation des modèles d’analyse factorielle confirmatoire pour variables catégorielles et des modèles de réponse à l’item (TRI) de type Ogive Normale. De surcroît, elle permet l’harmonisation psychométrique rigoureuse d’instruments d’évaluation distincts mesurant un même construit (comme l’anxiété ou le neuroticisme) mais comportant des nombres d’échelons de réponse divergents, en recalibrant leurs seuils de discrimination sur une échelle quantile unifiée.
9. 9. Utilisation dans les tests d’hypothèses et l’inférence statistique
9.1 9.1 Détermination des valeurs critiques unilatérales et bilatérales
L’inférence statistique fréquentiste, structurée par le paradigme décisionnel de Neyman-Pearson, repose intégralement sur le partitionnement de l’espace échantillonnal en deux régions disjointes : la région d’acceptation de l’hypothèse nulle ($H_0$) et la région de rejet (ou région critique), dont la masse de probabilité correspond rigoureusement au risque consenti d’erreur de première espèce $\alpha$. La distribution normale inverse est l’instrument mathématique qui opère ce partitionnement en déterminant la frontière numérique exacte séparant ces deux zones décisionnelles.
La topologie de cette zone de rejet dépend de la directionalité théorique de l’hypothèse formulée par le chercheur :
- Test unilatéral gauche ($H_1: \mu < \mu_0$) : La totalité du risque d'erreur $\alpha$ est concentrée à l'extrémité inférieure de la distribution. L'abscisse critique d'arrêt $z_c$ est directement dérivée par :
$$z_c = \Phi^{-1}(\alpha)$$
Pour le risque standard $\alpha = 0{,}05$, l’inversion fournit $z_c = \Phi^{-1}(0{,}05) \approx -1{,}64485$. L’hypothèse nulle est rejetée si la statistique empirique calculée $z_{obs} < -1{,}64485$.
- Test unilatéral droit ($H_1: \mu > \mu_0$) : La région de rejet est localisée sous la queue supérieure. L’abscisse critique se déduit de la probabilité complémentaire :
$$z_c = \Phi^{-1}(1 – \alpha)$$
Pour $\alpha = 0{,}05$, nous obtenons $z_c = \Phi^{-1}(0{,}95) \approx +1{,}64485$.
- Test bilatéral ou non directionnel ($H_1: \mu \neq \mu_0$) : Le chercheur postule l’existence d’une différence sans préjuger de sa direction. La masse d’erreur $\alpha$ est alors scindée symétriquement en deux parties égales de surface $\alpha / 2$ aux deux extrémités de la courbe. Les abscisses critiques sont données par la paire symétrique :
$$z_{c, \inf} = \Phi^{-1}\left(\frac{\alpha}{2}\right) \quad \text{et} \quad z_{c, \sup} = \Phi^{-1}\left(1 – \frac{\alpha}{2}\right)$$
Pour le seuil classique $\alpha = 0{,}05$, l’évaluation donne $z_{c, \sup} = \Phi^{-1}(0{,}975) \approx +1{,}95996$, traditionnellement arrondi dans les manuels élémentaires à la valeur canonique $+1{,}96$.
Dans le contexte des analyses d’inférence complexes impliquant de multiples comparaisons simultanées, le maintien d’un risque d’erreur global contrôlé (Family-Wise Error Rate) impose des ajustements correctifs drastiques. Sous la classique correction de Bonferroni pour un ensemble de $k$ tests indépendants, le seuil nominal individuel est abaissé à $alpha’ = \alpha / k$. L’inversion quantile normale permet d’observer immédiatement le durcissement du critère décisionnel. Pour une batterie de 10 sous-tests neuropsychologiques menée à un niveau global $\alpha = 0{,}05$, le seuil unitaire corrigé devient $alpha’ = 0{,}005$, requérant dans un cadre bilatéral l’évaluation de $\Phi^{-1}(1 – 0{,}005/2) = \Phi^{-1}(0{,}9975) \approx +2{,}807$, repoussant considérablement le seuil de signification clinique nécessaire pour attester d’un effet authentique.
9.2 9.2 Construction d’intervalles de confiance rigoureux
L’estimation ponctuelle d’un paramètre populationnel (telle que l’espérance mathématique d’un indice clinique) demeure intrinsèquement incomplète sans la délimitation d’un intervalle de confiance probabiliste reflétant la précision métrologique de la mesure et l’incertitude liée à l’échantillonnage fini. Pour un échantillon aléatoire de taille $n$ issu d’une population de variance connue $\sigma^2$, le théorème central limite garantit que la distribution de la moyenne empirique $\bar{X}$ converge asymptotiquement vers une loi normale de moyenne $\mu$ et d’erreur standard $SE = \sigma / \sqrt{n}$.
La construction de l’intervalle de confiance bilatéral au degré de certitude nominal $(1 – \alpha)$ consiste à identifier l’intervalle symétrique délimitant une probabilité d’englobement exactement égale à $1 – \alpha$. La dérivation mathématique s’établit à partir de l’encadrement canonique :
$$P\left( -z_{1-alpha/2} le \frac{\bar{X} – \mu}{sigma/\sqrt{n}} le z_{1-alpha/2} \right) = 1 – \alpha$$
En isolant la moyenne populationnelle $\mu$ au centre de la double inéquation par manipulation algébrique, nous déduisons rigoureusement l’expression analytique de l’intervalle de confiance :
$$IC_{1-\alpha}(\mu) = \left[ \bar{X} – \Phi^{-1}\left(1 – \frac{\alpha}{2}\right) \cdot \frac{\sigma}{\sqrt{n}} ; ; ; \bar{X} + \Phi^{-1}\left(1 – \frac{\alpha}{2}\right) \cdot \frac{\sigma}{\sqrt{n}} \right]$$
Le produit de la valeur quantile inverse par l’erreur standard de la moyenne définit la marge d’erreur (notée $E$). Cette formalisation met en lumière la sensibilité paramétrique des intervalles :
- Une exigence de rigueur accrue (par exemple passer d’un intervalle de confiance conventionnel de 95 % à un intervalle médical de haute certitude à 99 %) majore le multiplicateur quantile de $\Phi^{-1}(0{,}975) \approx 1{,}96$ à $\Phi^{-1}(0{,}995) \approx 2{,}576$, élargissant mécaniquement la marge d’erreur de plus de 31 %.
- La réduction de cette incertitude sans dégradation du niveau de confiance exige une augmentation de la taille d’échantillon $n$. Puisque le facteur d’échelle est modulé par $\sqrt{n}$, diviser la marge d’erreur par deux impose de quadrupler les effectifs expérimentaux.
9.3 9.3 Calcul de la puissance statistique a priori et taille d’effet
L’une des étapes les plus critiques de la planification méthodologique d’une recherche expérimentale en sciences du comportement réside dans l’analyse de puissance statistique a priori. Cette démarche garantit qu’un protocole d’essai clinique dispose d’une sensibilité empirique suffisante pour détecter une différence théorique réelle si celle-ci existe effectivement dans la population générale, évitant ainsi le gaspillage de ressources inhérent à des études sous-puissantes conduisant à des faux négatifs (erreur de seconde espèce de type II, notée $\beta$).
La puissance d’un test statistique est définie formellement par la quantité $1 – \beta$. Sous l’hypothèse alternative $H_1$, posant une différence standardisée de moyennes d’amplitude $\delta = (\mu_1 – \mu_0) / \sigma$ (le d de Cohen), la distribution de la statistique de test n’est plus centrée sur zéro mais décalée vers une loi normale non centrale. La délimitation de la frontière de détection exige l’interaction simultanée de deux quantiles inverses issus de la distribution normale :
- Le quantile critique associé au risque de première espèce $\alpha$ : $z_\alpha = \Phi^{-1}(1 – alpha/2)$ pour un test bilatéral.
- Le quantile associé au risque d’erreur de seconde espèce consenti $\beta$ : $z_\beta = \Phi^{-1}(1 – \beta)$.
Pour un design expérimental classique à deux groupes indépendants équilibrés d’effectif $n$ par bras de traitement, la condition de rejet de l’hypothèse nulle sous l’hypothèse alternative se formalise par l’équation de conception fondamentale :
$$\frac{\delta}{\sqrt{2/n}} ge z_{1-alpha/2} + z_{1-\beta}$$
En isolant la taille d’échantillon $n$ dans cette relation, nous obtenons la célèbre formule d’estimation des effectifs requis par groupe :
$$n = \frac{2 \left[ \Phi^{-1}\left(1 – \frac{\alpha}{2}\right) + \Phi^{-1}(1 – \beta) \right]^2}{\delta^2}$$
Illustrons concrètement cette dynamique : supposons qu’un neuropsychologue souhaite évaluer l’efficacité d’un programme de remédiation cognitive visant à produire un effet d’amplitude modérée ($d = 0{,}50$), avec un risque d’erreur de première espèce standard $\alpha = 0{,}05$ et une puissance statistique robuste conventionnelle de $80,%$ ($1 – \beta = 0{,}80$, d’où $\beta = 0{,}20$). Les quantiles inverses correspondants s’établissent rigoureusement à :
- $z_{1-alpha/2} = \Phi^{-1}(0{,}975) \approx 1{,}95996$
- $z_{1-\beta} = \Phi^{-1}(0{,}80) \approx 0{,}84162$
Leur sommation quadratique donne : $(1{,}95996 + 0{,}84162)^2 = (2{,}80158)^2 \approx 7{,}8488$. L’évaluation numérique de la taille d’échantillon requise s’obtient alors immédiatement :
$$n = \frac{2 \times 7{,}8488}{0{,}50^2} = \frac{15{,}6976}{0{,}25} \approx 62{,}79$$
Le chercheur sait dès lors avec certitude qu’il devra recruter un minimum de 63 participants par groupe (soit un effectif expérimental total de 126 sujets) pour garantir la robustesse décisionnelle de son essai clinique.
10. 10. Études de cas détaillées en recherche psychologique
10.1 10.1 Cas clinique 1 : Identification du haut potentiel intellectuel
Dans l’évaluation psychométrique contemporaine des fonctions cognitives, la caractérisation du Haut Potentiel Intellectuel (HPI) fait l’objet d’un consensus international fondé sur un critère statistique d’exceptionnalité cognitive : l’appartenance formelle aux deux centiles les plus élevés de la distribution générale des aptitudes globales, c’est-à-dire un rang centile $p ge 0{,}98$.
L’instrument de référence déployé en milieu clinique pédiatrique pour cette investigation est l’échelle d’intelligence de Wechsler pour enfants (WISC-V). Conformément aux standards de standardisation de l’évaluation psychologique, les notes globales de Quotient Intellectuel Total (QIT) sont paramétrées selon une distribution normale théorique de moyenne d’échantillonnage $\mu = 100$ et d’écart-type d’échelle $\sigma = 15$. La problématique diagnostique consiste à déterminer avec une exactitude arithmétique le seuil de score composite brut déclenchant formellement la qualification clinique de haut potentiel.
Le praticien formalise l’investigation par la résolution de la fonction quantile normale générale appliquée à la frontière critique :
$$QIT_{seuil} = F^{-1}(0{,}98; 100, 15) = 100 + 15 \cdot \Phi^{-1}(0{,}98)$$
L’évaluation analytique de la fonction standardisée donne :
$$\Phi^{-1}(0{,}98) \approx 2{,}05374891$$
La projection sur la métrique de l’échelle de Wechsler délivre le résultat précis suivant :
$$QIT_{seuil} = 100 + 15 \times 2{,}05374891 = 100 + 30{,}80623 = 130{,}80623$$
La règle psychométrique d’arrondi impose que le seuil opérationnel de coupure soit fixé à un QIT minimal de 131 (ou conventionnellement 130 dans certains manuels cliniques arrondissant $\Phi^{-1}(0{,}9772) = 2{,}00$).
Cependant, l’analyse clinique moderne ne saurait se limiter à un découpage rigide d’un score ponctuel sans intégrer la théorie de l’erreur de mesure inhérente à la psychométrie classique. Chaque mesure psychologique est soumise à une erreur d’échantillonnage d’items modélisée par l’Erreur Standard de Mesure ($SEM$), formulée à partir de la fidélité du test $r_{xx}$ par :
$$SEM = \sigma \sqrt{1 – r_{xx}}$$
Pour un indice global présentant une excellente consistance interne de $r_{xx} = 0{,}96$, l’erreur standard s’établit à $SEM = 15 \sqrt{1 – 0{,}96} = 15 \times 0{,}2 = 3{,}0$ points de QI. En réinjectant cette dispersion dans la distribution normale inverse pour construire un intervalle de confiance bilatéral à 95 % ($\Phi^{-1}(0{,}975) = 1{,}96$), la marge d’incertitude autour du seuil critique atteint $\pm (1{,}96 \times 3{,}0) = \pm 5{,}88$ points de QI. Ainsi, un enfant crédité d’un QIT mesuré de 127 présente un intervalle de confiance $[121{,}1 ; 132{,}9]$ englobant le seuil théorique de 131, imposant au clinicien une prudence diagnostique majeure reposant sur l’examen croisé des manifestations cliniques qualitatives et de la régularité du profil cognitif plutôt que sur l’application aveugle d’une coupure statistique binaire.
10.2 10.2 Cas clinique 2 : Dépistage de la symptomatologie dépressive sévère
Dans un contexte de santé publique et d’épidémiologie clinique, une équipe hospitalière cherche à calibrer un outil de dépistage rapide de la dépression majeure au sein d’une cohorte de 5 000 étudiants universitaires. L’instrument administré est une version adaptée d’une échelle psychométrique auto-rapportée dont les scores globaux, après exclusion des cas extrêmes et application d’un lissage continu, suivent une distribution normale d’espérance $\mu = 22{,}4$ points et d’écart-type de population $\sigma = 6{,}8$ points. La capacité d’accueil des structures de prise en charge psychothérapeutique d’urgence étant strictement bornée, la direction médicale fixe pour consigne de déclencher une alerte clinique automatisée uniquement pour la fraction représentant les cinq pour cent (5 %) des étudiants les plus sévèrement impactés de la cohorte.
Cette problématique de santé publique impose d’isoler la queue supérieure de la distribution des scores de morbidité : le seuil d’intervention $S_{alerte}$ correspond à la probabilité cumulative de non-atteinte de $95,%$, soit $p = 0{,}95$. L’évaluation de l’abscisse de coupure via la distribution normale inverse s’exprime par :
$$S_{alerte} = F^{-1}(0{,}95; 22{,}4; 6{,}8) = 22{,}4 + 6{,}8 \cdot \Phi^{-1}(0{,}95)$$
En mobilisant la valeur critique standard $\Phi^{-1}(0{,}95) \approx 1{,}644853$, le calcul opérationnel s’établit à :
$$S_{alerte} = 22{,}4 + 6{,}8 \times 1{,}644853 = 22{,}4 + 11{,}1850 = 33{,}585$$
L’équipe médicale calibrera donc l’algorithme hospitalier de convocation d’urgence sur un seuil entier de 34 points à l’inventaire clinique.
L’analyse méthodologique de ce seuil calculé par inversion quantile exige une évaluation rigoureuse de ses implications décisionnelles au moyen d’une analyse de courbes ROC (Receiver Operating Characteristic). La sélection d’un seuil strict situé à $+1{,}645$ écart-type garantit une spécificité clinique très élevée (fixée mathématiquement à 95 %), éliminant la quasi-totalité des faux positifs et évitant la saturation inutile des services psychiatriques universitaires par des étudiants présentant des états de stress passagers non pathologiques. Néanmoins, le coût éthique et épidémiologique réside dans une diminution de la sensibilité du dépistage : les sujets souffrant d’un épisode dépressif majeur mais dont les manifestations symptomatiques se situent entre $+1{,}0$ et $+1{,}5$ écart-type échappent à ce filtre automatisé. Cette étude de cas démontre que l’inversion quantile ne fournit pas une vérité médicale absolue mais formalise rigoureusement le compromis statistique requis par la régulation des ressources de santé.
10.3 10.3 Cas de recherche cognitive 3 : Modélisation des temps de traitement d’information
En neuropsychologie cognitive expérimentale, l’étude de l’efficience du traitement de l’information s’appuie fréquemment sur l’enregistrement milliseconde par milliseconde des temps de réaction (TR) lors de tâches informatisées d’inhibition motrice (telle qu’une tâche de Go/No-Go). Cependant, les distributions empiriques de temps de latence violent systématiquement le postulat de symétrie gaussienne : elles présentent une borne physique incompressible à gauche (temps minimal de transmission sensorimotrice d’environ 150 ms) et une longue traîne de réponses retardées à droite traduisant des fluctuations de l’attention soutenue.
Pour appliquer légitimement l’inversion quantile de la distribution normale à ces chronométries, la première étape méthodologique obligatoire réside dans l’application d’une transformation mathématique non linéaire de normalisation, classiquement une transformation logarithmique :
$$Y_i = \ln(TR_i)$$
Une fois les latences transformées, la variable résultante $Y$ converge vers une distribution normale robuste caractérisée par une moyenne logarithmique $\mu_{\ln} = 5{,}85$ (correspondant à une médiane géométrique de $e^{5{,}85} \approx 347{,}2$ ms) et un écart-type logarithmique $\sigma_{\ln} = 0{,}22$.
L’objectif expérimental consiste à filtrer objectivement les essais non attentifs aberrants (inattentions caractérisées ou distractions) sans recourir à des coupures millisecondes subjectives fixées arbitrairement par le chercheur. Le protocole de nettoyage de données définit comme aberrants les essais tombant au-delà du 99,5e percentile de la distribution individuelle du sujet ($p = 0{,}995$). L’utilisation de la distribution normale inverse sur la métrique normalisée permet d’extraire le seuil de coupure :
$$Y_{coupure} = \Phi^{-1}(0{,}995; 5{,}85; 0{,}22) = 5{,}85 + 0{,}22 \cdot \Phi^{-1}(0{,}995)$$
Sachant que $\Phi^{-1}(0{,}995) \approx 2{,}575829$, nous évaluons :
$$Y_{coupure} = 5{,}85 + 0{,}22 \times 2{,}575829 = 5{,}85 + 0{,}56668 = 6{,}41668$$
Pour convertir ce seuil d’élagage dans l’unité physique initiale intelligible des millisecondes, il suffit d’appliquer la fonction exponentielle réciproque :
$$TR_{coupure} = \exp(6{,}41668) \approx 611{,}97 \text{ ms}$$
Tout essai de ce participant excédant 612 ms sera éliminé du jeu de données expérimental. Par ce couplage élégant entre transformation logarithmique et distribution normale inverse, le chercheur dispose d’une procédure de prétraitement automatisée, reproductible et mathématiquement neutre pour assainir ses indices chronométriques avant modélisation cognitive.
11. 11. Erreurs méthodologiques courantes, limites et diagnostics
11.1 11.1 Violation de l’hypothèse de normalité univariée
L’application non critique de la distribution normale inverse repose sur une présomption théorique implicite souvent ignorée : l’adéquation parfaite de la distribution empirique des données sous-jacentes au modèle théorique gaussien. Lorsque cette hypothèse fondatrice est violée — situation fréquente en psychologie clinique et en psychopathologie où les phénomènes observés sont souvent asymétriques ou présentent une forte concentration de zéros (effets plancher) —, l’utilisation de la fonction $\Phi^{-1}$ conduit à des déductions d’abscisses critiques erronées et à des décisions diagnostiques hautement biaisées.
Deux déviations morphologiques majeures menacent particulièrement la fidélité des quantiles calculés :
- L’asymétrie univariée (Skewness) : Si une distribution présente une asymétrie positive marquée, la masse centrale des observations est déportée vers la gauche tandis que la queue droite s’étire anormalement. L’utilisation aveugle de $\mu + \sigma \Phi^{-1}(p)$ sous-estimera substantiellement les quantiles élevés de la queue supérieure et surestimera drastiquement les quantiles de la queue inférieure.
- L’aplatissement ou excès de courbure (Kurtosis) : Une distribution leptokurtique (à queues lourdes ou épaisses) concentre une proportion d’événements extrêmes bien supérieure à ce que postule la cloche de Gauss. Dans ce cas, les valeurs critiques à $+2$ ou $+3$ écarts-types englobent en réalité une fraction d’échantillon plus importante que les $2{,}28,%$ ou $0{,}13,%$ théoriques, conduisant le chercheur à sous-estimer la rareté réelle des cas cliniques extrêmes.
Pour diagnostiquer rigoureusement la licéité de l’inversion quantile, le chercheur doit obligatoirement procéder à des vérifications formelles de normalité univariée :
- L’application de tests d’inférence dédiés, au premier rang desquels figure le test de Shapiro-Wilk (hautement recommandé pour les effectifs modérés $n < 50$) ou le test d’Anderson-Darling (particulièrement sensible aux déviations de courbure sur les queues de distribution).
- L’inspection graphique systématique au moyen d’un diagramme quantile-quantile (Q-Q plot). Ce graphique oppose les quantiles empiriques observés dans l’échantillon aux quantiles théoriques prédits par $\Phi^{-1}(p)$. Tout alignement linéaire strict le long de la première bissectrice confirme l’adéquation du modèle ; à l’inverse, une déformation en « S » ou un décollement marqué aux extrémités signale une violation rédhibitoire de la normalité.
En présence d’une violation avérée, deux stratégies de remédiation s’imposent : appliquer préalablement une transformation stabilisatrice de puissance issue de la famille de Box-Cox (telle qu’une transformation logarithmique, racine carrée ou inverse), ou renoncer aux paramétrages gaussiens au profit d’approches non paramétriques basées sur les quantiles empiriques échantillonnaux (centiles calculés par rangs pondérés selon la méthode de Harrell-Davis ou par rééchantillonnage de type bootstrap).
11.2 11.2 Erreurs de spécification de la probabilité cumulée
L’erreur la plus banale mais aux implications médicales les plus destructrices réside dans la saisie par inadvertance de la probabilité complémentaire associée à la queue opposée de la distribution. Cette confusion provient du fait que le cerveau humain interprète intuitivement les critères d’excellence ou d’anomalie sous l’angle de la rareté : un clinicien formulera mentalement l’objectif d’identifier les « 5 % les plus performants » ou les « 2,5 % les plus déficitaires » sans expliciter systématiquement la direction d’intégration algorithmique.
Rappelons avec force la convention mathématique immuable : la fonction quantile $\Phi^{-1}(p)$ opère exclusivement par intégration cumulative de gauche à droite (de $-\infty$ vers $+\infty$). Par conséquent :
- Pour cibler une proportion $\alpha$ située dans la queue inférieure (déficits cognitifs, ralentissement psychomoteur), l’argument d’entrée est directement la probabilité de rareté : $p = \alpha$. Le quantile résultant est négatif : $\Phi^{-1}(0{,}05) \approx -1{,}645$.
- Pour cibler une proportion $\alpha$ localisée dans la queue supérieure (haut potentiel, résistance cognitive, élites académiques), l’argument d’entrée doit impérativement être la probabilité cumulée d’exclusion : $p = 1 – \alpha$. Le quantile résultant est positif : $\Phi^{-1}(1 – 0{,}05) = \Phi^{-1}(0{,}95) \approx +1{,}645$.
L’impact d’une telle interversion de signe dans un rapport d’évaluation neuropsychologique est dramatique : injecter par erreur $p = 0{,}05$ au lieu de $0{,}95$ dans le calcul d’un score seuil transforme un profil de très haute performance intellectuelle en un critère diagnostique de déficience cognitive sévère. Pour conjurer tout risque d’erreur d’aiguillage, le clinicien doit instaurer une règle de vérification logique automatique : tout quantile associé à une probabilité cumulée $p > 0{,}50$ doit impérativement être supérieur à la moyenne $\mu$, et tout quantile associé à $p < 0{,}50$ doit être strictement inférieur à $\mu$. La mise en échec de ce postulat logique élémentaire signale instantanément une inversion de probabilité dans la formulation de la commande.
11.3 11.3 Instabilité numérique aux extrêmes de la distribution
Bien que la distribution normale théorique s’étende indéfiniment sur la droite réelle jusqu’aux infinis négatif et positif, l’évaluation computationnelle de sa fonction inverse se heurte aux contraintes physiques infranchissables de l’architecture binaire des calculateurs électroniques. Le standard de calcul en virgule flottante à double précision (norme ANSI/IEEE 754) alloue 64 bits par nombre réel (1 bit de signe, 11 bits d’exposant et 52 bits de fraction ou mantisse), conférant une précision maximale d’environ 15 à 17 chiffres décimaux significatifs.
Lorsque des analystes en génétique statistique, en bio-informatique ou en psychométrie modélisent des probabilités d’événements infinitésimales (par exemple $p = 10^{-16}$ pour évaluer des tests d’association pan-génomique sur des millions de polymorphismes), deux périls numériques majeurs émergent :
- Le phénomène d’annulation catastrophique : L’évaluation de quantiles sous la queue supérieure requiert classiquement la soustraction $1 – p$. Lorsque $p$ est inférieur à la précision de la mantisse ($p < 2{,}22 \times 10^{-16}$, la constante machine
eps), l’ordinateur évalue arithmétiquement $1 – p = 1{,}0000000000000000$. En réinjectant cette valeur tronquée dans la fonction quantile, la machine calcule $\Phi^{-1}(1) = +\infty$, détruisant instantanément l’analyse quantitative en générant une valeur infinie indéterminée. - Le sous-dépassement arithmétique (Underflow) : Lorsque la densité de probabilité au point d’évaluation devient inférieure au plus petit nombre dénormalisé représentable par le processeur ($2{,}225 \times 10^{-308}$), la fonction de calcul de dérivée s’annule brusquement, provoquant des divisions par zéro au sein des routines itératives d’optimisation de type Halley ou Newton-Raphson.
Pour préserver la stabilité analytique aux frontières extrêmes de l’espace d’échantillonnage, il est formellement recommandé d’adopter des règles de codage computationnel strictes :
- Bannir formellement les opérations manuelles de soustraction $1 – p$ dès que le quantile dépasse trois écarts-types. Recourir systématiquement aux arguments algorithmiques dédiés prévus par les langages scientifiques modernes :
lower.tail = FALSEen R, ouscipy.stats.norm.isf()en Python. - Pour les régions ultra-distales excédant six écarts-types ($|z| > 6$), opérer exclusivement dans le domaine des log-probabilités en exploitant l’argument
log.p = TRUEen R. Les fonctions quantiles évaluent alors les queues asymptotiques par des approximations semi-analytiques basées sur les fractions continues de Laplace ou le développement asymptotique de Mill, évitant tout basculement par l’espace de probabilité linéaire sous-jacent.
12. 12. Synthèse pratique, arbre de décision et guide méthodologique
12.1 12.1 Arbre décisionnel pour le choix de la procédure de calcul
Face à la diversité des architectures matérielles et logicielles disponibles, le choix de la méthode computationnelle optimale pour évaluer la distribution normale inverse ne doit pas être laissé au hasard. Il doit résulter d’une analyse rigoureuse prenant en compte la taille du jeu de données, les impératifs d’automatisation, le niveau de précision requis et les exigences de traçabilité scientifique de la recherche. Le protocole décisionnel suivant permet d’orienter le praticien et le chercheur vers l’outil le plus efficient :
- Scénario A : Évaluation clinique individuelle ponctuelle au cabinet ou au lit du patient
- Contexte : Analyse d’un protocole unique de test neuropsychologique (WAIS, WISC, MEM) avec conversion immédiate de quelques scores composites pour l’élaboration d’un compte rendu diagnostique.
- Outil préconisé : Calculatrice graphique (TI-84 Plus CE).
- Justification : Rapidité d’accès immédiate, ergonomie visuelle sans intermédiaire machine, suppression du temps de paramétrage informatique, absence de risque de connexion réseau non sécurisée dans le traitement de données nominatives protégées.
- Scénario B : Gestion de cohortes cliniques de taille modérée et étalonnages pédagogiques ($10 < n < 10,000$)
- Contexte : Suivi de cohortes institutionnelles, harmonisation de notes scolaires standardisées, transformation de fichiers de bilans cliniques annuels d’un service hospitalier.
- Outil préconisé : Tableur bureautique (Microsoft Excel ou Google Sheets) via la commande
LOI.NORMALE.INVERSE(). - Justification : Lisibilité visuelle sous forme tabulaire pour les équipes pluridisciplinaires, génération automatisée de graphiques de contrôle, accessibilité technique pour des praticiens non programmeurs.
- Scénario C : Recherche empirique, méta-analyses, modélisations psychométriques lourdes et mégadonnées ($n > 10,000$)
- Contexte : Études longitudinales de cohortes épidémiologiques, modélisation par équations structurelles, analyses factorielles confirmatoires catégorielles, criblage génétique.
- Outil préconisé : Langages de programmation scientifique (R avec qnorm() ou Python avec scipy.stats.norm.ppf()).
- Justification : Vectorisation intégrale assurant des temps d’exécution optimaux, traçabilité absolue des protocoles de transformation garantissant la reproductibilité de la recherche, intégration directe avec des modules statistiques de pointe (Lavaan, Psych, Statsmodels).
12.2 12.2 Protocole de vérification et de contrôle qualité
L’intégration de la distribution normale inverse dans des protocoles de décision clinique ou de publication scientifique exige la mise en œuvre d’un protocole d’assurance qualité standardisé, structuré en trois niveaux de vérification indépendants :
- Le contrôle de réversibilité bidirectionnelle (Round-trip consistency check) : Toute évaluation de quantile $z = \Phi^{-1}(p)$ doit être immédiatement soumise à l’épreuve de sa réciproque $p’ = Phi(z)$. Si la différence $|p – p’|$ excède la tolérance de précision machine ($10^{-12}$ sur ordinateur ou $10^{-8}$ sur calculatrice), l’analyse doit être suspendue et les paramètres d’approximation réexaminés.
- Le contrôle de plausibilité clinique et métrologique : Le praticien doit confronter la valeur seuil calculée à l’intuition probabiliste du domaine d’application. Tout score standardisé $z$ s’écartant de plus de quatre écarts-types de la moyenne ($|z| > 4$) au sein d’un échantillon clinique de taille modeste ($n \approx 100$) doit être systématiquement mis en quarantaine pour vérification d’éventuelles erreurs d’encodage de probabilités ou d’asymétries pathologiques d’échantillonnage.
- La documentation algorithmique dans le rapport scientifique : Conformément aux recommandations de l’American Psychological Association (APA) relatives à la transparence méthodologique, toute publication faisant intervenir des quantiles normaux inverses doit mentionner explicitement le progiciel déployé, le numéro de version de l’interpréteur, le nom formel de la fonction mobilisée, et la spécification exacte des arguments de queue (notamment la modalité d’intégration bilatérale ou unilatérale).
12.3 12.3 Récapitulatif des formules et aide-mémoire conceptuel
Pour clore ce traité et offrir aux chercheurs un guide pratique directement opérationnel sur leur poste de travail, le tableau synthétique suivant récapitule les correspondances formelles d’appels de fonctions sur les principaux environnements statistiques contemporains, en lien avec les seuils de risque probabiliste universellement mobilisés en sciences humaines et médicales.
| Environnement / Plateforme | Loi normale standard : $\Phi^{-1}(p)$ | Loi normale générale : $F^{-1}(p; \mu, \sigma)$ | Queue supérieure : $P(X > x) = \alpha$ |
|---|---|---|---|
| Calculatrice TI-84 Plus CE | invNorm(p, 0, 1) |
invNorm(p, μ, σ) |
invNorm(α, μ, σ, RIGHT) |
| Microsoft Excel (FR) | =LOI.NORMALE.STANDARD.INVERSE(p) |
=LOI.NORMALE.INVERSE(p; μ; σ) |
=LOI.NORMALE.INVERSE(1-α; μ; σ) |
| Google Sheets (EN) | =NORM.S.INV(p) |
=NORM.INV(p, mean, sd) |
=NORM.INV(1-alpha, mean, sd) |
| Langage R | qnorm(p) |
qnorm(p, mean, sd) |
qnorm(alpha, mean, sd, lower.tail=FALSE) |
| Python (SciPy) | scipy.stats.norm.ppf(p) |
scipy.stats.norm.ppf(p, loc, scale) |
scipy.stats.norm.isf(alpha, loc, scale) |
Le tableau d’équivalence numérique suivant rappelle les valeurs critiques standardisées fondamentales qui régissent l’inférence statistique et la prise de décision diagnostique :
| Niveau de confiance / Objectif | Probabilité cumulée gauche ($p$) | Score $z$ standardisé ($\Phi^{-1}(p)$) | Application psychométrique / Inférentielle |
|---|---|---|---|
| Déficit clinique profond (-3 SD) | $0{,}00135$ (0,135 %) | $-3{,}00000$ | Altération neurocognitive massive, QI ≤ 55 |
| Déficit clinique avéré (-2 SD) | $0{,}02275$ (2,275 %) | $-2{,}00000$ | Troubles des apprentissages, déficience intellectuelle (QI ≤ 70) |
| Fragilité cognitive (-1,5 SD) | $0{,}06681$ (6,681 %) | $-1{,}50000$ | Zone de vigilance neuropsychologique (MCI) |
| Seuil unilatéral classique ($\alpha = 0{,}05$) | $0{,}05000$ (Queue gauche) | $-1{,}64485$ | Test unilatéral inférieur de rejet de $H_0$ |
| Médiane théorique (Moyenne nulle) | $0{,}50000$ (50,0 %) | $0{,}00000$ | QI = 100, Score T = 50, Stanine = 5 |
| Seuil unilatéral classique ($\alpha = 0{,}05$) | $0{,}95000$ (Queue droite) | $+1{,}64485$ | Test unilatéral supérieur de rejet de $H_0$ |
| Intervalle de confiance bilatéral à 95 % | $0{,}97500$ (Queue droite) | $+1{,}95996$ | Marge d’erreur $E = 1{,}96 \times SE$, tests bilatéraux conventionnels |
| Seuil Haut Potentiel Intellectuel | $0{,}98000$ (98e centile) | $+2{,}05375$ | Critère d’identification HPI (WISC/WAIS QI ≥ 131) |
| Intervalle de confiance bilatéral à 99 % | $0{,}99500$ (Queue droite) | $+2{,}57583$ | Marge d’erreur de haute certitude médicale et industrielle |
En perspective prospective, l’évolution méthodologique de l’analyse de données en sciences du comportement confirme l’utilité durable de la distribution normale inverse. Alors que les modélisations linéaires classiques cèdent progressivement le pas à des approches semi-paramétriques plus flexibles, la régression quantile — qui modélise directement l’impact de prédicteurs sur des quantiles d’intérêt choisis plutôt que sur la seule espérance conditionnelle moyenne — s’affirme comme une avancée déterminante. De même, les architectures d’apprentissage statistique profond exploitent aujourd’hui abondamment la fonction quantile normale au sein des auto-encodeurs variationnels (VAE) pour transposer par l’astuce de reparamétrisation un espace latent normalisé vers des structures de données hautement complexes. Maîtriser les fondements mathématiques, les conditions de validité et les subtilités calculatoires de la distribution normale inverse constitue ainsi, plus que jamais, un prérequis technique et épistémologique indispensable pour tout chercheur aspirant à l’excellence méthodologique.
Références
- Acklam, P. J. (2003). An algorithm for computing the inverse normal cumulative distribution function. University of Oslo, Department of Mathematics. https://home.online.no/~pjacklam/notes/invnorm/
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beasley, J. D., & Springer, S. G. (1977). Algorithm AS 111: The percentage points of the normal distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 26(1), 118-121. https://doi.org/10.2307/2346889
- Chissom, B. S. (1970). Interpretation of the normal distribution and its inverse in standardized testing. Educational and Psychological Measurement, 30(2), 345-352. https://doi.org/10.1177/001316447003000213
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Moro, B. (1995). The full monte. Risk, 8(2), 57-58.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Texas Instruments. (2020). Guide de référence des calculatrices graphiques de la famille TI-84 Plus. Texas Instruments Incorporated. https://education.ti.com/fr/guidebooks
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., Carey, C. J., Polat, İ., Feng, Y., Moore, E. W., VanderPlas, J., Laxalde, D., Perktold, J., Cimrman, R., Henriksen, I., Quintero, E. A., Harris, C. R., Archibald, A. M., Ribeiro, A. H., Pedregosa, F., van Mulbregt, P., & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Wald, A. (1947). Sequential analysis. John Wiley & Sons.
- Wechsler, D. (2014). Wechsler Intelligence Scale for Children—Fifth Edition: Administration and scoring manual. The Psychological Corporation.