
Dans l’édifice complexe de la statistique contemporaine et de l’analyse multivariée, la notion de distribution marginale constitue l’une des pierres angulaires les plus déterminantes pour la modélisation des phénomènes empiriques. Lorsque des chercheurs observent des systèmes complexes, qu’il s’agisse des interactions neuronales, des comportements humains au sein de groupes sociaux ou des dynamiques cognitives mesurées par des batteries de tests psychométriques, les données recueillies se présentent presque invariablement sous la forme de vecteurs multidimensionnels. L’observation conjointe de plusieurs variables, si elle permet de capturer la structure de covariance et les dépendances mutuelles, pose un défi analytique immédiat : la complexité géométrique de l’espace des données croît de manière exponentielle avec le nombre d’attributs mesurés. C’est dans ce cadre que s’impose la nécessité d’isoler le comportement stochastique individuel de chaque composante sans pour autant oblitérer le contexte probabiliste global d’où elle provient.
La distribution marginale répond précisément à cet impératif épistémologique et méthodologique. Elle désigne la loi de probabilité régissant une sous-partie ou une variable unique extraite d’un ensemble plus large de variables aléatoires conjointes, en agrégeant mathématiquement l’ensemble des variations possibles des autres dimensions. Loin de correspondre à une simple mesure isolée effectuée en vase clos, la marginalisation est une opération formelle de projection, comparable à l’ombre portée d’un objet tridimensionnel sur un plan bidimensionnel ou unidimensionnel. Cette opération de réduction dimensionnelle est régie par des axiomes probabilistes rigoureux, garantissant la cohérence interne des modèles statistiques. Comprendre les distributions marginales est indispensable pour quiconque souhaite explorer les données en psychométrie, en épidémiologie, en sociologie quantitative ou en sciences cognitives, car elle constitue le prérequis absolu à toute évaluation de l’indépendance, de la corrélation et des effets conditionnels.
Le présent traité propose une analyse exhaustive, rigoureuse et approfondie de la distribution marginale, depuis ses origines historiques et ses fondements conceptuels jusqu’à ses implémentations numériques les plus avancées dans les environnements informatiques modernes. À travers l’exploration des structures matricielles discrètes, du calcul intégral dans les espaces continus, des théorèmes de décomposition copulaire et des applications cliniques en psychopathologie, ce document met en lumière l’omniprésence de la marginalisation. Nous examinerons également les pièges méthodologiques redoutables qui guettent les praticiens, tels que le paradoxe de Simpson ou la confusion entre probabilités marginales et conditionnelles, tout en fournissant les repères formels nécessaires à une interprétation irréprochable des données issues de la recherche sur le comportement humain.
1. Introduction et fondements conceptuels de la distribution marginale
1.1 Définition théorique et origine du terme
L’étymologie du vocable « marginal » au sein de la discipline statistique plonge ses racines dans les pratiques concrètes de l’arithmétique commerciale et des premiers relevés démographiques des dix-huitième et dix-neuvième siècles. À l’origine, les calculateurs et les statisticiens pionniers, à l’instar de Karl Pearson et de ses contemporains, disposaient les données observées sous la forme de tableaux à double entrée tracés manuellement sur des feuilles de registre. Afin d’obtenir les totaux de chaque modalité indépendamment des autres facteurs, ils inscrivaient naturellement les sommes arithmétiques dans les marges physiques — c’est-à-dire le bord droit pour les lignes et la bordure inférieure pour les colonnes — de ces documents cartacés. Ce qui n’était initialement qu’une commodité spatiale d’inscription graphique est devenu, au fil de la formalisation des théories probabilistes modernes, un concept mathématique unifié désignant la loi univariée d’une variable extraite d’un système multivarié.
D’un point de vue théorique formel, la distribution marginale représente la loi de probabilité d’une variable aléatoire considérée individuellement, indépendamment des valeurs prises par les autres variables aléatoires intégrées au système conjoint étudié. Soit un vecteur aléatoire défini sur un espace de probabilité donné ; la marginalisation consiste à calculer la probabilité d’occurrence d’un sous-ensemble d’événements en sommant ou en intégrant la fonction de distribution conjointe sur l’ensemble de l’espace d’états des variables non ciblées. Cette opération de réduction dimensionnelle est cruciale en sciences psychologiques et comportementales, où l’on observe simultanément de multiples facettes d’un construit psychologique, telles que l’anxiété, l’extraversion ou la mémoire de travail. Elle permet de simplifier l’analyse en ramenant l’attention sur les propriétés distributives intrinsèques d’un trait singulier.
Il importe de distinguer rigoureusement la distribution marginale d’une simple mesure univariée isolée. Lorsqu’une variable est mesurée en dehors de tout cadre multivarié, elle ignore totalement la présence d’autres covariables. En revanche, la projection marginale d’une variable au sein d’une distribution conjointe préserve l’empreinte de la population parente et conserve une cohérence mathématique stricte avec les covariances sous-jacentes. La marginale n’est donc pas une variable recueillie isolément, mais bien le résultat d’un processus délibéré d’agrégation stochastique qui intègre l’ensemble des scénarios possibles offerts par les autres dimensions comportementales ou biologiques mesurées lors du protocole expérimental.
1.2 Importance de l’approche marginale en sciences du comportement
Dans l’exploration quantitative des conduites humaines et des processus psychiques, l’analyse marginale remplit plusieurs fonctions épistémologiques et pratiques de premier ordre. En premier lieu, elle offre la possibilité de caractériser les traits de personnalité, les aptitudes cognitives ou les états émotionnels indépendamment des variables sociodémographiques qui composent fréquemment l’arrière-plan des études cliniques. Par exemple, lorsqu’un chercheur analyse l’échelle d’un inventaire de personnalité administré à une cohorte hétérogène comprenant divers groupes d’âge, de milieux socio-économiques et de genres, l’évaluation de la distribution marginale du score d’extraversion permet d’observer la dispersion globale de ce trait au sein de la population générale avant d’examiner ses modulations en fonction des sous-groupes démographiques.
De surcroît, la marginalisation est un instrument d’évaluation critique de la représentativité des échantillons en recherche clinique et expérimentale. En confrontant les distributions marginales observées au sein d’une cohorte (par exemple, la répartition marginale des âges ou des niveaux de scolarité) aux données de recensement publiées par les instituts officiels de statistique, le psychométricien peut immédiatement quantifier les dérives de recrutement et identifier d’éventuels biais de sélection. Si la distribution marginale de l’âge d’un échantillon expérimental présente un écart structurel avec la pyramide des âges nationale, la validité externe des inférences ultérieures s’en trouve compromise, indépendamment de la robustesse des corrélations internes observées.
Enfin, l’examen des marges conditionne l’identification des taux de réponse globaux et des prévalences de base avant toute tentative d’exploration des interactions comportementales complexes. En psychologie sociale ou en psychopathologie expérimentale, il est indispensable de connaître la proportion brute d’individus manifestant un symptôme ou adhérant à une attitude donnée — ce que traduit précisément la probabilité marginale — avant d’émettre des hypothèses causales sur les corrélations reliant ces manifestations à des déclencheurs situationnels ou à des prédispositions génétiques spécifiques.
1.3 Principes d’invariance et axiomes probabilistes associés
L’analyse des distributions marginales repose sur un ensemble d’axiomes fondamentaux issus de l’axiomatisation de Kolmogorov. Le premier de ces principes est l’axiome de sommation unitaire, qui stipule impérativement que la somme — ou l’intégrale selon que l’espace considéré est discret ou continu — de l’ensemble des probabilités ou des densités marginales associées à toutes les modalités possibles d’une variable doit être rigoureusement égale à l’unité (soit 1, ou 100 % de la masse de probabilité). Cette contrainte n’est pas une simple convention formelle ; elle découle directement du fait que l’union de tous les événements marginaux possibles reconstitue l’univers certain Ω de l’expérience aléatoire.
Un deuxième principe fondamental réside dans la conservation de l’information univariée lors de la marginalisation. Bien que le passage d’une distribution conjointe bidimensionnelle ou multidimensionnelle à une distribution marginale entraîne une perte définitive d’information concernant les corrélations, covariances et associations conditionnelles unissant les variables, la marginale conserve intacte l’intégralité de la structure statistique propre à la variable projetée. Sa moyenne marginale, sa variance marginale ainsi que tous ses moments d’ordres supérieurs (asymétrie, aplatissement) demeurent rigoureusement exacts et fidèles à la dynamique qu’elle présentait au sein de l’espace multidimensionnel originel.
D’un point de vue géométrique et fonctionnel, l’opération de marginalisation peut être modélisée comme une projection orthogonale au sein d’un espace de Hilbert formé par les variables aléatoires de carré intégrable. Lorsque l’on projette la mesure de probabilité conjointe sur le sous-espace vectoriel engendré par une seule coordonnée, on applique un opérateur linéaire qui fait abstraction des coordonnées orthogonales. Cette perspective géométrique clarifie pourquoi la marginalisation est une transformation irréversible : à l’instar d’une ombre projetée dont on ne peut déduire la forme tridimensionnelle exacte sans informations stéréoscopiques supplémentaires, une distribution marginale ne contient pas en elle-même les données nécessaires à la reconstruction de la matrice de covariance conjointe.
2. Le tableau de contingence : structure matricielle et lecture marginale
2.1 Anatomie d’une table à double entrée en psychométrie
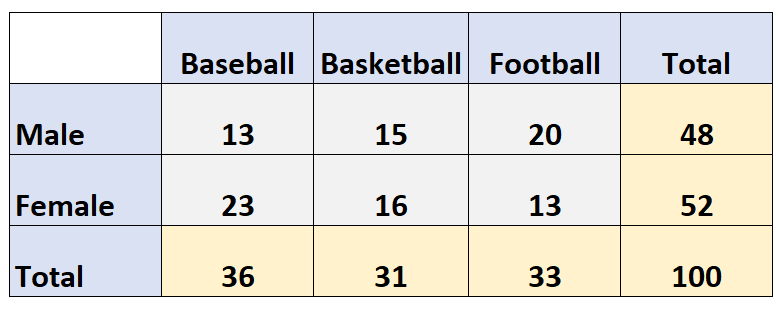
En psychométrie et en analyse des données qualitatives, le tableau de contingence (ou table à double entrée) représente la structure matricielle classique permettant de modéliser simultanément deux variables catégorielles ou discrétisées. Ce tableau s’organise rigoureusement sous la forme d’une matrice comportant r lignes (représentant les modalités d’une première variable notée X) et c colonnes (représentant les modalités d’une seconde variable notée Y). À l’intersection de chaque ligne i (avec i allant de 1 à r) et de chaque colonne j (avec j allant de 1 à c) se trouve une cellule conjointe qui héberge l’effectif observé, communément noté nij. Cet effectif correspond au dénombrement absolu des sujets de l’échantillon présentant simultanément la modalité xi de la première variable et la modalité yj de la seconde.
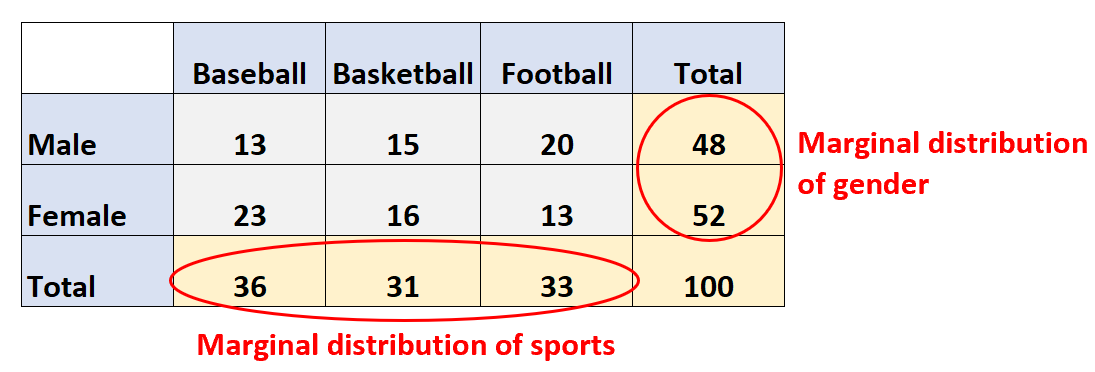
L’anatomie d’une table de contingence ne se limite pas à ces cellules internes qui captent la coexistence des attributs. Elle comprend obligatoirement des vecteurs de bordure dédiés, situés à l’extrémité droite de chaque ligne et à la partie inférieure de chaque colonne. Ces vecteurs hébergent les effectifs marginaux, formellement notés ni. pour les totaux des lignes et n.j pour les totaux des colonnes. Le point placé en indice remplace conventionnellement la dimension sur laquelle la sommation a été opérée, signifiant de manière explicite que l’indice correspondant a été agrégé sur l’ensemble de son domaine de définition.
Dans les applications psychométriques courantes, ce dispositif matriciel permet de croiser, par exemple, le statut diagnostique d’un patient (Dépression sévère, Dépression modérée, Témoin sain) avec son profil d’adhésion à une psychothérapie (Adhésion forte, Adhésion partielle, Abandon). Les cellules centrales de la table illustrent la manière dont les patients se distribuent dans les combinaisons spécifiques de ces deux dimensions, tandis que les vecteurs marginaux situés sur les pourtours du tableau décrivent séparément la prévalence globale de chaque classe diagnostique d’une part, et les taux globaux d’adhésion thérapeutique d’autre part.
2.2 Calcul des effectifs marginaux absolus
Le passage des effectifs conjoints aux effectifs marginaux s’effectue au moyen d’une règle de sommation arithmétique simple mais systématique. Pour obtenir l’effectif marginal absolu associé à une modalité spécifique xi de la variable en ligne, le statisticien procède à la sommation de tous les effectifs observés le long de la ligne i, en faisant varier l’indice de colonne j sur la totalité de ses valeurs possibles. L’expression mathématique formelle de ce total marginal en ligne s’écrit :
ni. = ∑j=1c nij
De façon symétrique, l’obtention de l’effectif marginal absolu lié à une modalité donnée yj de la variable disposée en colonne implique de sommer l’intégralité des cellules de la colonne j en faisant défiler l’indice de ligne i sur l’ensemble des r modalités. L’expression du total marginal en colonne s’énonce ainsi :
n.j = ∑i=1r nij
La validité structurelle de la matrice repose sur une règle de fermeture universelle : la sommation de l’ensemble des totaux marginaux de ligne doit être strictement égale à la sommation de tous les totaux marginaux de colonne, cette somme commune coïncidant parfaitement avec l’effectif global N de l’échantillon expérimental. Cette égalité fondamentale s’exprime par la relation bilatérale suivante :
N = ∑i=1r ni. = ∑j=1c n.j = ∑i=1r ∑j=1c nij
Toute discordance observée entre ces différentes sommations marginales et le grand total dénote inévitablement une anomalie méthodologique, telle que la présence de données manquantes non imputées, une double comptabilisation d’individus ou des erreurs matérielles de saisie au cours de la collecte des données expérimentales.
2.3 Conversion des effectifs en fréquences relatives marginales
Bien que les effectifs absolus soient indispensables pour réaliser des tests inférentiels paramétriques ou non paramétriques, la comparaison d’échantillons de tailles divergentes exige la normalisation de ces quantités sous la forme de fréquences relatives marginales. Cette conversion s’obtient simplement en divisant chaque effectif marginal absolu par le grand total N de la cohorte évaluée. La fréquence relative marginale de la modalité xi s’exprime par le rapport :
fi. = ni. / N
De même, la fréquence relative marginale associée à la modalité yj de la variable en colonne répond à la formulation mathématique :
f.j = n.j / N
Ces fréquences relatives peuvent être converties sans ambiguïté en pourcentages marginaux par simple multiplication par 100. Elles remplissent une fonction essentielle dans les protocoles d’enquête et les sondages d’opinion, car elles matérialisent ce que la théorie bayésienne qualifie de probabilités marginales a priori. En l’absence de toute information concernant la valeur prise par la variable Y pour un participant tiré au sort au sein de la population, la fréquence fi. constitue la meilleure estimation empirique de la probabilité que cet individu présente le trait ou le statut xi.
Ces distributions relatives marginales obéissent sans dérogation aux propriétés de normalisation probabiliste : la somme des fréquences de la marge horizontale égale 1 (∑ fi. = 1,00), et il en va rigoureusement de même pour la marge verticale (∑ f.j = 1,00). Ces vecteurs marginaux constituent donc de véritables lois de probabilité discrètes univariées, autonomes dans leur lecture descriptive mais articulées à la loi conjointe dont elles proviennent.
3. Formalisation mathématique des distributions marginales discrètes
3.1 Notation mathématique et loi de probabilité marginale
L’étude formelle des distributions marginales discrètes s’appuie sur le formalisme des probabilités discrètes appliqué aux couples de variables aléatoires. Soient deux variables aléatoires discrètes X et Y définies sur un même univers d’événements probabilisé (Ω, A, P), prenant leurs valeurs respectives dans des ensembles dénombrables SX = {x1, x2, …, xr} et SY = {y1, y2, …, yc}. La loi conjointe de ces deux variables est déterminée par la fonction de masse conjointe définie pour tout couple (xi, yj) par la probabilité d’intersection :
pXY(xi, yj) = P(X = xi ∩ Y = yj)
La fonction de masse marginale de la variable X, notée pX(xi) ou simplement P(X = xi), est obtenue en invoquant formellement le théorème des probabilités totales. Ce théorème énonce que si un ensemble d’événements constitue une partition finie ou dénombrable de l’univers, la probabilité d’un événement quelconque s’obtient en sommant les probabilités des intersections de cet événement avec chaque élément de la partition. En considérant les événements {Y = yj} comme formant une partition de Ω, la loi marginale s’exprime selon la formule :
P(X = xi) = ∑j P(X = xi ∩ Y = yj) = ∑j pXY(xi, yj)
Symétriquement, la fonction de masse de probabilité marginale de la variable Y s’écrit formellement en agrégeant les modalités de la variable X :
P(Y = yj) = ∑i P(X = xi ∩ Y = yj) = ∑i pXY(xi, yj)
Les conditions de validité statistique de ces fonctions marginales imposent que pour tout xi ∈ SX, on ait 0 ≤ P(X = xi) ≤ 1, et que la série convergente des masses marginales vérifie la condition d’égalisation : ∑i P(X = xi) = 1. Ce domaine de définition s’étend sans difficulté théorique aux vecteurs multivariés de dimension supérieure, où la marginalisation sur un sous-ensemble de variables implique une sommation multidimensionnelle sur l’ensemble des coordonnées complémentaires.
3.2 Moments statistiques de la distribution marginale
Une fois la fonction de masse marginale établie, la variable aléatoire univariée qui en découle possède son propre système de moments statistiques, qui décrivent synthétiquement la tendance centrale, la dispersion et la morphologie de sa distribution. L’espérance mathématique marginale — qui équivaut à la moyenne théorique de la variable X considérée isolément au sein du modèle — se calcule exclusivement à partir des masses marginales pondérant chaque valeur possible :
E[X] = μX = ∑i xi · P(X = xi)
Cette moyenne marginale possède une propriété d’invariance fondamentale : elle coïncide rigoureusement avec la composante correspondante du vecteur d’espérance multivarié du couple aléatoire originel. En second lieu, la variabilité propre à la variable est quantifiée par la variance marginale, notée Var(X) ou σX2, laquelle mesure la dispersion quadratique moyenne des observations individuelles autour de l’espérance marginale :
Var(X) = σX2 = E[(X – μX)2] = ∑i (xi – μX)2 · P(X = xi) = ∑i xi2 · P(X = xi) – μX2
L’analyse distributionnelle approfondie nécessite fréquemment l’évaluation des moments centrés d’ordre supérieur. Le coefficient d’asymétrie marginal (skewness), γ1, permet de déterminer si la distribution marginale des scores s’étire vers les valeurs positives ou négatives :
γ1 = E[(X – μX)3] / σX3
De même, le coefficient d’aplatissement marginal (kurtosis), γ2, évalue le caractère leptocurtique ou platycurtique de la variable en jaugeant l’épaisseur de ses queues de distribution par rapport à une loi de référence :
γ2 = (E[(X – μX)4] / σX4) – 3
Ces indicateurs statistiques univariés, dérivés intégralement des masses marginales, permettent au psychologue chercheur de qualifier avec une grande précision la métrique de ses outils de mesure avant d’étudier leurs liens d’association avec d’autres dimensions cliniques.
3.3 Exemple formalisé appliqué à une étude psychométrique
Afin d’ancrer ces développements théoriques dans la réalité concrète de l’évaluation empirique, considérons une recherche menée auprès d’une cohorte clinique de N = 200 sujets adultes, évaluant le niveau d’anxiété situationnelle (variable X discrétisée en trois modalités : x1 = Faible, x2 = Moyen, x3 = Élevé) croisé avec la qualité subjective du sommeil au cours du mois écoulé (variable Y découpée en deux modalités : y1 = Perturbé, y2 = Réparateur). La matrice conjointe des effectifs observés se présente selon la répartition suivante :
- Pour un niveau d’anxiété Faible (x1) : 15 participants rapportent un sommeil Perturbé (y1) et 65 un sommeil Réparateur (y2).
- Pour un niveau d’anxiété Moyen (x2) : 40 participants rapportent un sommeil Perturbé (y1) et 40 un sommeil Réparateur (y2).
- Pour un niveau d’anxiété Élevé (x3) : 35 participants rapportent un sommeil Perturbé (y1) et 5 un sommeil Réparateur (y2).
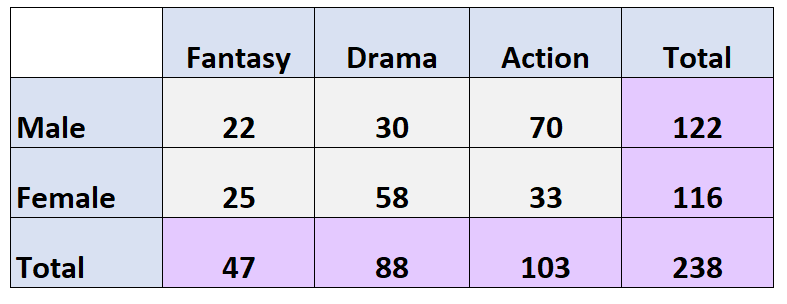
Le calcul des effectifs marginaux de la variable anxiété s’effectue en appliquant la formule de sommation horizontale sur les colonnes. Pour l’anxiété faible, le total marginal absolu est égal à n1. = 15 + 65 = 80 participants. Pour l’anxiété moyenne, nous obtenons n2. = 40 + 40 = 80 participants. Enfin, pour l’anxiété élevée, le calcul donne n3. = 35 + 5 = 40 participants. La somme de ces effectifs marginaux vérifie bien le grand total : 80 + 80 + 40 = 200.
La conversion en probabilités marginales s’obtient immédiatement en divisant chaque effectif marginal par la taille totale de l’échantillon N = 200. Nous déduisons ainsi les masses de probabilité marginales suivantes :
- P(X = Faible) = 80 / 200 = 0,40 (soit 40 %)
- P(X = Moyen) = 80 / 200 = 0,40 (soit 40 %)
- P(X = Élevé) = 40 / 200 = 0,20 (soit 20 %)
La contrainte d’égalisation unitaire est vérifiée puisque 0,40 + 0,40 + 0,20 = 1,00. Parallèlement, nous pouvons déduire la distribution marginale de la qualité du sommeil : le total marginal des dormeurs perturbés est de n.1 = 15 + 40 + 35 = 90, soit une probabilité marginale P(Y = Perturbé) = 90 / 200 = 0,45 (45 %), tandis que le total pour le sommeil réparateur est de n.2 = 65 + 40 + 5 = 110, générant une probabilité marginale P(Y = Réparateur) = 110 / 200 = 0,55 (55 %). Ces calculs établissent avec clarté les profils globaux de chaque variable considérée séparément de l’autre.
4. Extension au cas continu : densités de probabilité marginales
4.1 Intégration et fonction de densité marginale
Lorsque les variables psychologiques ou biologiques ne sont plus modélisées sous une forme discrète mais sont conceptualisées comme des variables aléatoires continues prenant leurs valeurs sur le continuum des réels ℝ — comme les temps de réaction en millisecondes, les concentrations d’hormones de stress ou les scores continus standardisés —, la sommation arithmétique cède la place à l’intégration au sens de Riemann ou de Lebesgue. Soit un couple de variables aléatoires continues (X, Y) défini par une fonction de densité de probabilité conjointe continue fXY(x, y). La fonction de densité de probabilité marginale de la variable X, désignée par fX(x), est obtenue par intégration de la densité conjointe sur la totalité du domaine de support de la variable Y :
fX(x) = ∫-∞+∞ fXY(x, y) dy
Symétriquement, la fonction de densité marginale de la seconde variable continue Y s’obtient en intégrant la distribution conjointe par rapport à la variable X :
fY(y) = ∫-∞+∞ fXY(x, y) dx
L’interprétation géométrique de cette formulation offre une excellente intuition de la marginalisation continue. La fonction de densité conjointe fXY(x, y) peut être visualisée dans un espace tridimensionnel comme une surface dont le volume sous-jacent représente la probabilité totale, égale à 1. Lorsque l’on intègre par rapport à y pour une coordonnée x fixée, on calcule la surface d’une tranche infiniment fine coupant cette montagne tridimensionnelle parallèlement à l’axe des ordonnées. En agrégeant la totalité de ces sections, on déploie la courbe de densité univariée fX(x) sur l’axe des abscisses. La probabilité que la variable X appartienne à un intervalle réel fermé [a, b] s’exprime alors comme l’aire sous la courbe marginale :
P(a ≤ X ≤ b) = ∫ab fX(x) dx = ∫ab (∫-∞+∞ fXY(x, y) dy) dx
Ce formalisme illustre le passage mathématique rigoureux des sommes partielles de Riemann aux intégrales définies, garantissant que les propriétés de positivité (fX(x) ≥ 0) et de normalisation intégrale (∫ fX(x) dx = 1) sont rigoureusement respectées.
4.2 Cas des distributions bivariées normales en psychométrie
L’une des configurations théoriques et empiriques les plus prégnantes en psychométrie concerne la loi normale bivariée, qui modélise fréquemment deux variables continues corrélées au sein d’une population, comme le quotient intellectuel et les capacités de mémoire de travail. Une loi normale bidimensionnelle est totalement paramétrée par cinq grandeurs : les moyennes théoriques μX et μY, les écarts-types σX et σY, et le coefficient de corrélation linéaire de Pearson ρ. Sa fonction de densité conjointe prend la forme :
fXY(x, y) = (1 / (2πσXσY√(1 – ρ2))) · exp(-z / (2(1 – ρ2)))
où l’argument quadratique z s’exprime selon :
z = ((x – μX) / σX)2 – 2ρ((x – μX) / σX)((y – μY) / σY) + ((y – μY) / σY)2
Cette distribution conjointe jouit d’une propriété mathématique remarquable d’invariance structurelle, connue sous le terme de stabilité distributionnelle : les distributions marginales issues d’une loi normale multivariée sont elles-mêmes rigoureusement et invariablement des lois normales univariées. En effectuant l’intégration de fXY(x, y) sur l’ensemble de l’axe réel des y, le terme de dépendance impliquant le coefficient de corrélation ρ se résorbe intégralement lors de l’application de la factorisation gaussienne. La densité marginale obtenue pour X est tout simplement :
fX(x) = (1 / (σX√(2π))) · exp(-((x – μX)2 / (2σX2)))
Cette caractéristique présente des conséquences majeures pour l’étalonnage des échelles psychologiques. Lorsque deux dimensions cognitives ou conatives suivent une loi normale bivariée, chaque dimension peut être calibrée et normalisée de façon strictement univariée (avec par exemple une moyenne standardisée de 100 et un écart-type de 15 pour le QI) sans que la structure de dépendance ρ ne vienne distordre la morphologie de la courbe de référence individuelle.
4.3 Contre-exemples et limites de réciprocité
Bien que la propriété précédente assure que la marginalisation d’une loi normale conjointe donne toujours des lois marginales univariées normales, une méprise méthodologique très répandue — qualifiée de sophisme de réciprocité — consiste à supposer l’implication inverse vraie. Il est en réalité formellement faux d’affirmer que si deux variables continues X et Y possèdent chacune une distribution marginale normale, alors leur distribution conjointe est nécessairement une loi normale bivariée.
Pour démontrer mathématiquement cette absence de réciprocité, les statisticiens ont développé plusieurs contre-exemples élégants. Soit X une variable aléatoire suivant une loi normale standard N(0, 1). Définissons une seconde variable Y par la relation fonctionnelle Y = S · X, où S est une variable aléatoire discrète indépendante de X, prenant les valeurs +1 ou -1 avec une probabilité égale de 1/2. La distribution marginale de Y est elle aussi une loi normale standard parfaite N(0, 1), car sa densité s’exprime comme une combinaison linéaire pondérée de densités normales identiques. Pourtant, le couple conjoint (X, Y) ne suit aucunement une distribution normale bivariée : la probabilité conjointe se concentre exclusivement le long de deux droites sécantes (y = x et y = -x), et la densité conjointe est nulle partout ailleurs dans le plan ℝ2, ce qui est incompatible avec la morphologie en cloche d’une surface gaussienne bidimensionnelle standard.
Ces cas limites ont des conséquences profondes pour les psychométriciens. Il ne suffit jamais de vérifier la normalité marginale des scores (par exemple à l’aide de tests d’adéquation univariés tels que le test de Shapiro-Wilk ou de Kolmogorov-Smirnov sur chaque variable prise séparément) pour pouvoir valider l’utilisation de méthodes statistiques exigeant la normalité multivariée, comme les régressions linéaires multiples, les analyses discriminantes ou la modélisation par équations structurelles. L’évaluation de la normalité multivariée requiert des indicateurs spécifiques, tels que le coefficient d’asymétrie et de kurtosis multivariés de Mardia ou l’examen des distances de Mahalanobis au regard d’une distribution du Chi-deux.
5. Distinction fondamentale : distributions marginales, conjointes et conditionnelles
5.1 Distribution conjointe vs distribution marginale
L’articulation entre distribution conjointe et distribution marginale repose sur un changement de granularité analytique qui modifie la nature de l’information statistique accessible à l’investigateur. La distribution conjointe caractérise la probabilité d’intersection formelle de plusieurs événements stochastiques :
P(X = xi ∩ Y = yj)
Elle documente le degré de coexistence de deux ou plusieurs attributs au sein d’une même unité d’observation. À l’inverse, la distribution marginale P(X = xi) fait délibérément abstraction de toute information relative aux autres variables du système.
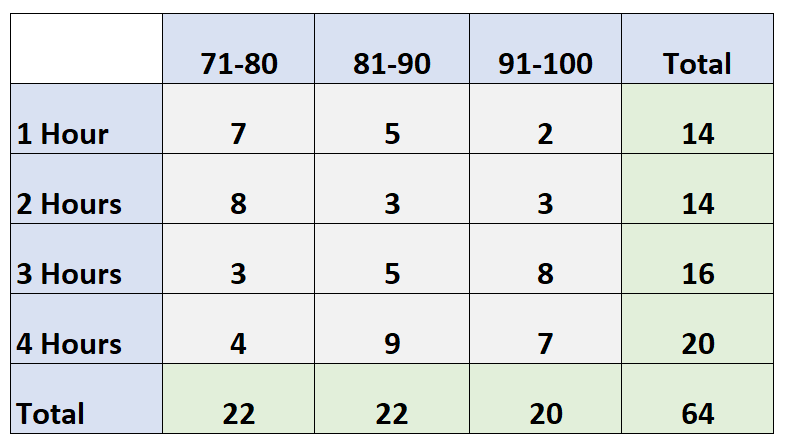
Le passage de la loi conjointe à la loi marginale entraîne une perte d’information structurelle irréversible. Pour illustrer cette asymétrie, imaginons deux variables dichotomiques X et Y. Une infinité de configurations de distributions conjointes — présentant des corrélations allant de la dépendance linéaire parfaite positive (r = +1) jusqu’à la dépendance négative absolue (r = -1) — peuvent générer rigoureusement les mêmes distributions marginales pour chaque variable. Par conséquent, il est mathématiquement impossible de reconstituer la matrice de covariance conjointe à partir de la seule connaissance des marges statistiques d’une table, à moins de poser l’hypothèse très restrictive d’indépendance stochastique totale.
Ce constat implique que le statisticien ou le psychologue clinicien doit déterminer le niveau d’observation adapté à ses interrogations scientifiques : l’analyse conjointe est requise pour modéliser des dynamiques associatives, interactives ou prédictives, tandis que l’analyse marginale est l’outil approprié pour caractériser la démographie globale, l’étalonnage normatif individuel et les charges épidémiologiques globales.
5.2 Distribution conditionnelle vs distribution marginale
Tandis que la distribution marginale caractérise le comportement d’une variable au sein de l’univers probabilisé général Ω, la distribution conditionnelle examine le comportement de cette même variable après qu’une information additionnelle est venue restreindre l’univers des possibles à un sous-ensemble spécifique. La loi de probabilité conditionnelle de X sachant que l’événement {Y = yj} s’est réalisé est formellement définie, sous réserve que P(Y = yj) > 0, par le ratio de la probabilité conjointe sur la probabilité marginale de conditionnement :
P(X = xi | Y = yj) = P(X = xi ∩ Y = yj) / P(Y = yj)
La distinction entre probabilité marginale et conditionnelle s’éclaire au moyen du théorème de Bayes, qui tisse un lien mathématique direct entre ces grandeurs :
P(X = xi | Y = yj) = (P(Y = yj | X = xi) · P(X = xi)) / P(Y = yj)
Dans cette formulation canonique, P(X = xi) représente la probabilité marginale a priori de l’état xi, tandis que P(X = xi | Y = yj) correspond à la probabilité conditionnelle actualisée (ou a posteriori) suite à l’observation de l’indice yj. Le terme du dénominateur, P(Y = yj), est précisément la probabilité marginale de cet indice, obtenue par la loi des probabilités totales : ∑k P(Y = yj | X = xk) · P(X = xk).
La distribution conditionnelle est donc une loi de probabilité à part entière, mais dont l’espace d’échantillonnage a été amputé de toutes les réalisations où Y n’est pas égal à yj. Cela explique pourquoi la forme d’un profil conditionnel peut diverger radicalement de l’allure de la distribution marginale globale de la même variable.
5.3 Arbre de décision conceptuel pour les chercheurs en psychologie
Afin de structurer le choix méthodologique entre distribution marginale et distribution conditionnelle dans les protocoles de recherche en sciences humaines, les investigateurs peuvent s’appuyer sur un arbre de décision conceptuel guidé par la nature de l’hypothèse mise à l’épreuve :
- Objectif 1 : Évaluation de la représentativité ou de la prévalence globale. Si la question de recherche vise à quantifier la proportion globale d’un trouble au sein d’une population ou à valider l’adéquation d’un échantillon aux données censitaires sans égard aux sous-groupes, la métrique pertinente est la distribution marginale.
- Objectif 2 : Étude comparative ou recherche d’hétérogénéité sous-jacente. Si la question vise à déterminer si la manifestation d’un construit psychologique varie en fonction de l’appartenance à un groupe ou de l’exposition à une condition expérimentale, l’analyse doit se focaliser sur les distributions conditionnelles.
- Objectif 3 : Analyse des structures de contingence complexes. Si l’on souhaite déceler d’éventuelles associations ou des motifs d’indépendance, la comparaison systématique des distributions conditionnelles à la distribution marginale de référence constitue la démarche d’inférence appropriée.
Considérons l’exemple illustratif du diagnostic de l’épisode dépressif caractérisé (EDC) en fonction du genre. Dans une étude épidémiologique, la probabilité marginale P(EDC = Présent) documente la prévalence globale du trouble au sein de la société, fournissant aux autorités de santé publique les effectifs nécessaires pour allouer les ressources hospitalières. En revanche, les probabilités conditionnelles P(EDC = Présent | Genre = Femme) et P(EDC = Présent | Genre = Homme) répondent à une question psychopathologique et étiologique distincte, à savoir l’identification d’une vulnérabilité différentielle selon le genre biologique ou les rôles sociaux associés. Confondre ces deux niveaux d’analyse mènerait à une appréciation erronée de l’épidémiologie clinique.
6. Le rôle des distributions marginales dans les tests d’indépendance statistique
6.1 Définition stochastique de l’indépendance
Le concept d’indépendance stochastique entre deux variables constitue l’un des piliers de l’inférence statistique. Deux variables aléatoires X et Y sont dites mutuellement indépendantes si, et seulement si, la réalisation de l’une n’apporte aucune information prédictive sur la probabilité de survenue de l’autre. Dans le formalisme des probabilités discrètes, cette propriété se traduit par l’égalité universelle selon laquelle la probabilité conjointe de tout événement composé est strictement égale au produit de leurs probabilités marginales respectives :
P(X = xi ∩ Y = yj) = P(X = xi) · P(Y = yj), ∀ (i, j)
En termes de distributions conditionnelles, cette définition implique directement que la loi de X conditionnée par Y se réduit simplement à sa loi marginale univariée :
P(X = xi | Y = yj) = P(X = xi), ∀ j tel que P(Y = yj) > 0
Dans les sciences comportementales, l’indépendance statistique signifie l’absence de tout lien structurel ou fonctionnel direct ou indirect entre deux construits mesurés. La structure marginale joue ici un rôle normatif fondamental : elle détermine la référence théorique idéale à laquelle la distribution empirique conjointe doit être comparée pour quantifier le degré d’association ou d’écart à l’indépendance.
6.2 Calcul des effectifs théoriques (attendus) pour le test du Chi-deux
Cette définition probabiliste de l’indépendance sous-tend la construction opérationnelle du test d’indépendance du Chi-deux de Pearson (χ2). L’hypothèse nulle (notée H0) de ce test postule l’indépendance stochastique stricte des deux variables catégorielles étudiées dans la population parente. Sous cette hypothèse H0, la probabilité théorique conjointe de chaque case (i, j) s’écrit comme le produit des probabilités marginales de ligne et de colonne : P(X = xi) · P(Y = yj).
En substituant les probabilités marginales par leurs estimateurs empiriques sans biais — à savoir les fréquences relatives marginales observées fi. = ni. / N et f.j = n.j / N —, l’effectif théorique attendu (souvent désigné par la notation Eij pour Expected frequency) dans la cellule conjointe (i, j) est obtenu par le produit de cette probabilité théorique par l’effectif global de l’échantillon N :
Eij = N · (ni. / N) · (n.j / N) = (ni. · n.j) / N
Cette formulation classique démontre que la distribution conjointe théorique sous l’hypothèse nulle est entièrement contrainte par les totaux marginaux du tableau de contingence. Le calcul de la statistique de test du Chi-deux évalue précisément l’ampleur de la divergence quadratique entre les effectifs empiriques observés nij et ces effectifs théoriques Eij dictés par les marges :
χ2 = ∑i=1r ∑j=1c ((nij – Eij)2 / Eij)
Une conséquence méthodologique immédiate de cette formule concerne la vulnérabilité des effectifs théoriques aux déséquilibres marginaux. Si l’un des totaux marginaux ni. ou n.j est très restreint (par exemple dans le cas d’une modalité rare représentant moins de 5 % des répondants), certains effectifs théoriques Eij peuvent chuter sous le seuil critique conventionnel de 5. Une telle violation invalide l’approximation asymptotique continue de la loi du Chi-deux et impose le recours à des alternatives comme le regroupement de modalités ou des tests exacts.
6.3 Influence des marges fixes versus marges libres
L’interprétation statistique et le traitement mathématique des tables de contingence dépendent fondamentalement de la nature du plan expérimental ayant présidé à la collecte des données, et plus spécifiquement du statut déterministe ou stochastique des marges. On distingue à cet égard les plans à marges aléatoires (ou libres) des plans à marges fixées par protocole.
Dans une enquête observationnelle transversale standard où un échantillon global de taille N est prélevé au hasard dans une population générale sans quota prédéfini, l’ensemble des effectifs marginaux de ligne ni. et de colonne n.j constitue des variables aléatoires libres d’osciller d’une réplication à l’autre de l’expérience. Le modèle d’échantillonnage sous-jacent relève d’une loi multinomiale globale. À l’opposé, dans une étude clinique contrôlée où le chercheur assigne arbitrairement 50 patients au groupe recevant un traitement actif et 50 patients au groupe placebo, le vecteur marginal des lignes est fixé a priori par le protocole (n1. = 50, n2. = 50) ; seuls les effectifs marginaux de colonne demeurent libres de fluctuer.
Lorsque les deux marges (lignes et colonnes) sont fixées ou conditionnées mathématiquement — comme c’est le cas lors de l’application du test exact de Fisher fondé sur la loi hypergéométrique —, l’espace d’échantillonnage se contracte de manière drastique. Le nombre de degrés de liberté de la table de contingence découle directement de ces contraintes de bordure : pour une matrice de dimensions r × c soumise à la connaissance de ses marges et du grand total, seuls (r – 1)(c – 1) effectifs de cellules conjointes peuvent varier librement. Dès lors que ces (r – 1)(c – 1) cases sont remplies, toutes les autres cellules sont mécaniquement déterminées par les contraintes arithmétiques de sommation marginale.
7. Applications pratiques en psychologie clinique et psychopathologie
7.1 Évaluation de la prévalence marginale des troubles mentaux
En psychopathologie quantitative et en épidémiologie psychiatrique, l’estimation des prévalences marginales est un outil central pour la planification sanitaire et l’évaluation diagnostique. La prévalence marginale correspond au taux global de prévalence d’un trouble au sein d’une cohorte ou d’une communauté, calculé sur la marge sans tenir compte de la présence simultanée d’autres pathologies. Par exemple, au sein d’une population clinique donnée, déterminer que la probabilité marginale du trouble anxieux généralisé (TAG) s’élève à P(TAG) = 0,18 permet de quantifier le volume absolu de soins nécessaires pour cette catégorie diagnostique singulière.
Il convient de dissocier formellement la prévalence marginale des indices de comorbidité conjointe. La comorbidité entre le TAG et le trouble dépressif majeur (TDM) s’exprime par leur probabilité conjointe P(TAG ∩ TDM), qui est le dénombrement des patients répondant simultanément aux critères des deux entités nosologiques. L’écart entre cette probabilité conjointe observée et le produit des prévalences marginales P(TAG) · P(TDM) mesure l’intensité du chevauchement psychopathologique : un rapport supérieur à 1 indique une comorbidité positive élevée, suggérant un facteur de vulnérabilité partagé (tel que le névrosisme ou l’affectivité négative).
En outre, le suivi longitudinal des distributions marginales offre un instrument de surveillance épidémiologique performant. En traquant l’évolution temporelle des marges de prévalence au fil des années ou des phases de développement de l’enfant et de l’adolescent, les cliniciens peuvent observer des trajectoires d’émergence ou d’extinction symptomatique indépendamment des fluctuations associées aux covariables environnementales fluctuantes.
7.2 Gestion des biais d’échantillonnage clinique
Les protocoles de recherche clinique et d’évaluation psychologique souffrent de manière quasi systématique de biais de sélection et d’asymétries de recrutement. L’inspection des distributions marginales démographiques de l’échantillon d’étude constitue la première méthode de contrôle qualité de la collecte de données. Lorsqu’un protocole expérimental sur les troubles cognitifs liés au vieillissement affiche une distribution marginale du niveau de diplôme où 70 % des sujets possèdent un diplôme de l’enseignement supérieur, le statisticien constate un biais de sélection sévère par rapport à la distribution marginale réelle de la population cible des seniors.
Pour remédier à ces distorsions qui menacent la validité des conclusions, les chercheurs déploient des techniques de redressement d’échantillon par pondération ou post-stratification. La méthode repose sur le calage sur marges (algorithme d’itérations proportionnelles ou raking ratio). Cette procédure algorithmique ajuste les pondérations individuelles des sujets de manière itérative jusqu’à ce que les distributions marginales de l’échantillon pour l’âge, le genre et la catégorie socio-professionnelle coïncident avec les distributions marginales issues des recensements officiels de population.
Ces corrections marginales jouent un rôle déterminant dans les cohortes longitudinales en santé mentale, où l’attrition sélective (la défection progressive de participants au fil des vagues de mesure) altère les marges démographiques et symptomatiques initiales. La réinjection des marginales d’origine par le biais d’équations de pondération permet d’atténuer substantiellement les biais de survie ou de compliance dans l’estimation de l’efficacité à long terme des interventions thérapeutiques.
7.3 Analyse de concordance inter-juges et diagnostic différentiel
L’analyse de l’accord inter-juges est une étape indispensable lors de la mise au point de nouveaux outils d’évaluation nosologique ou d’échelles d’observation comportementale. Deux cliniciens évaluent indépendamment les mêmes patients en assignant des catégories diagnostiques (par exemple, Présence ou Absence d’un trouble de la personnalité). Les données sont synthétisées dans une table de contingence carrée où les diagnostics du premier clinicien forment les lignes et ceux du second forment les colonnes. Pour quantifier cet accord au-delà de la chance, le coefficient Kappa de Cohen (κ) est classiquement utilisé :
κ = (Po – Pe) / (1 – Pe)
Dans cette équation, l’accord observé Po est la proportion d’individus classés dans les cases diagonales (accord effectif), tandis que l’accord attendu par le hasard Pe est calculé directement à partir du produit des distributions marginales des deux juges : Pe = ∑i (ni. / N) · (n.i / N). Cependant, cette sensibilité directe aux totaux marginaux engendre ce que la littérature nomme le paradoxe de Kappa. Lorsque la distribution marginale d’un trouble est fortement asymétrique (prévalence très faible ou très forte dans l’échantillon), la valeur de Pe devient mécaniquement très élevée, comprimant artificiellement la valeur de κ à des niveaux dérisoires, même en présence d’un taux d’accord brut Po dépassant 90 %.
Pour dépasser les impasses induites par ces contraintes marginales extrêmes, la biométrie contemporaine propose des coefficients alternatifs plus robustes, tels que l’indice de Gwet (AC1). Ce coefficient intègre une modélisation probabiliste de la chance moins sensible aux déséquilibres des marges, préservant une quantification fidèle de la fidélité inter-évaluateurs même face à des pathologies à faible prévalence marginale.
8. Utilisation en psychométrie et théorie de la mesure
8.1 Analyse d’items et taux de réussite marginal
Dans le paradigme de la théorie classique des tests (TCT), le développement d’échelles de mesure — qu’il s’agisse de tests d’efficience intellectuelle, d’épreuves de connaissances ou de questionnaires d’auto-évaluation — débute systématiquement par une analyse fine des propriétés univariées de chaque item. Le paramètre central de cette étape est le taux de réussite marginal (ou indice de difficulté, conventionnellement noté p pour un item dichotomique noté 0 ou 1). Cet indice est déterminé par la distribution marginale de réussite de l’item considéré individuellement au sein du groupe d’étalonnage :
p = n1 / N
où n1 est le total marginal d’individus ayant validé l’item et N le nombre total de répondants. La distribution marginale de cet item fournit immédiatement des indicateurs sur sa qualité métrologique. Un item affichant une probabilité marginale de réussite p > 0,95 présente un effet de plafond critique, signifiant qu’il est incapable de discriminer les participants situés dans les niveaux d’aptitude élevés. Réciproquement, un item dont le taux marginal de réussite est inférieur à p < 0,10 manifeste un effet de plancher sévère.
La variance marginale d’un item dichotomique est régie par la relation σ2 = p(1 – p). Elle atteint son maximum statistique strict lorsque le taux marginal de réussite est de p = 0,50. Dans la mesure où la variance du score total à un test psychologique est égale à la somme des variances marginales de chaque item augmentée de la double somme de leurs covariances mutuelles, le choix d’items dont les distributions marginales se situent autour de 0,50 constitue la stratégie de référence en psychométrie pour maximiser la fidélité et le pouvoir discriminant de l’instrument.
8.2 Théorie de la réponse à l’item (TRI) et marginalisation
La théorie moderne de la mesure s’appuie largement sur les modèles de la théorie de la réponse à l’item (TRI), qui dépassent le cadre descriptif de la théorie classique des tests en postulant l’existence d’une variable latente continue non observable, notée θ (représentant le niveau d’aptitude cognitive ou l’intensité du trait de personnalité d’un individu). Dans ce cadre probabiliste, la fonction de réponse à l’item décrit la probabilité conditionnelle P(Ui = 1 | θ) qu’un sujet réponde positivement à l’item i étant donné son niveau θ.
Cependant, lors de l’étalonnage d’un test psychométrique, le niveau de trait latent θ des répondants n’est pas connu d’avance. Pour estimer rigoureusement les paramètres de l’item (son seuil de difficulté bi, son pouvoir discriminant ai et son éventuel paramètre de pseudo-chance ci), les statisticiens recourent à la méthode de la vraisemblance maximale marginale (Marginal Maximum Likelihood, MML), formalisée de manière décisive par Darrell Bock et Murray Aitkin en 1981. Cette approche marginalise la variable latente θ en intégrant la fonction de vraisemblance conjointe sur la distribution de densité a priori de cette aptitude, habituellement fixée comme une loi normale standard g(θ) ~ N(0, 1) :
Lmarginal = ∏k=1N ∫-∞+∞ [∏i=1M P(Uik | θ) ] g(θ) dθ
La mise en œuvre de cette marginalisation repose sur des méthodes d’approximation numérique par quadrature de Gauss-Hermite. L’intégration de la variable latente hors de la fonction de vraisemblance permet d’estimer les paramètres des items de manière stable et cohérente, indépendamment des scores des individus spécifiques composant l’échantillon d’étalonnage, conférant ainsi aux échelles psychométriques standardisées leur propriété fondamentale d’invariance de mesure.
8.3 Invariance de mesure et équivalence structurelle
La validité transculturelle et intergroupe des instruments d’évaluation constitue une exigence éthique et scientifique majeure de la psychométrie. L’invariance de mesure teste si un instrument psychologique évalue le même construit sous-jacent avec la même précision au sein de populations distinctes (par exemple, entre groupes linguistiques, ethniques ou entre genres). Cette exploration nécessite une analyse prudente des distributions marginales des scores observés.
Une discordance observée entre les distributions marginales de deux sous-populations (par exemple, un groupe présentant une moyenne marginale significativement inférieure à l’autre) peut refléter une véritable différence substantive du niveau moyen du trait dans la population, mais elle peut également trahir un artéfact de mesure qualifié de fonctionnement différentiel d’item (Differential Item Functioning, DIF). Un item présente un DIF lorsque des individus issus de groupes différents mais disposant d’un même niveau réel de trait latent possèdent des probabilités conditionnelles inégales de réussir cet item.
La vérification de l’invariance structurelle exige donc de dissocier les variations de la distribution marginale globale du construit des distorsions locales introduites par chaque item. Ce n’est qu’en garantissant l’invariance des paramètres conditionnels de réponse au niveau des items que les comparaisons entre distributions marginales de groupes socioculturels distincts acquièrent une validité interprétative robuste, exempte de biais discriminatoires dans les contextes d’orientation scolaire ou de sélection professionnelle.
9. Représentation graphique et visualisation des distributions marginales
9.1 Techniques de visualisation multivariée avec projections marginales
La visualisation des données quantitatives est un vecteur fondamental d’exploration statistique et de transmission des résultats scientifiques. Pour retranscrire la nature duale des distributions bivariées — qui articulent une structure de dépendance interne et deux distributions univariées externes —, la science graphique a conçu des dispositifs visuels combinant nuages de points et projections marginales (les marginal plots). Le cœur du graphique est constitué d’un diagramme de dispersion traditionnel où chaque individu est projeté dans l’espace cartésien défini par les variables X et Y, permettant d’apprécier la forme de la corrélation (linéaire, non linéaire, hétéroscédastique).
Sur les bordures extérieures de cette zone cartésienne — le long de l’axe supérieur ou inférieur pour la variable X, et sur le flanc droit pour la variable Y —, sont disposés des graphiques univariés synchronisés représentant les lois marginales. Ces projections périphériques prennent le plus souvent la forme d’histogrammes discrets, de diagrammes en boîte (boxplots) ou d’estimations de densité par noyau lissé (courbes de densité gaussienne). Cette disposition permet au chercheur d’inspecter simultanément la relation d’association globale et la présence éventuelle d’asymétries, de bimodalités ou de valeurs aberrantes sur les composantes individuelles.
Une innovation récente en visualisation psychologique est le diagramme en nuage de pluie (raincloud plot). Cette représentation combine une courbe de densité marginale semi-violon (qui figure le « nuage »), un boxplot horizontal condensé et la dispersion brute des points individuels (les « gouttes de pluie » avec un léger bruit aléatoire de dispersion). Cette technique offre une transparence absolue sur les distributions marginales continues en révélant à la fois les propriétés paramétriques globales et les irrégularités locales des données empiriques sans recourir à des agrégations trompeuses.
9.2 Représentation visuelle des tables de contingence
Pour les variables catégorielles et les matrices discrètes, les histogrammes continus sont inapplicables et doivent être remplacés par des structures graphiques adaptées à la géométrie des tableaux de contingence. Le diagramme en barres empilées et normalisées constitue la solution descriptive la plus élémentaire : chaque barre représente une modalité d’une variable dont la hauteur totale atteint 100 %, tandis que les segments internes illustrent les fréquences conditionnelles. Toutefois, cette représentation présente la faiblesse d’occulter les effectifs marginaux de la variable principale, toutes les barres affichant artificiellement une largeur identique indépendamment du nombre de sujets composant chaque groupe.
Pour pallier cette limitation graphique, le diagramme en mosaïque (mosaic plot) s’impose comme la référence pour l’analyse des distributions marginales et conjointes qualitatives. Dans un graphique en mosaïque, l’axe horizontal est tout d’abord divisé en bandes de largeurs proportionnelles aux fréquences relatives de la distribution marginale de la variable en ligne. Puis, chacune de ces colonnes est découpée verticalement en tuiles dont les hauteurs sont strictement proportionnelles aux fréquences conditionnelles de la variable en colonne.
Cette construction confère une propriété visuelle intuitive fondamentale : la surface géométrique de chaque tuile rectangulaire est directement proportionnelle à l’effectif conjointe observé dans la cellule correspondante. De plus, la comparaison de l’alignement des bordures horizontales entre les colonnes met immédiatement en évidence les écarts à l’indépendance statistique : sous l’hypothèse nulle d’indépendance, les bordures des tuiles se prolongent de façon rectiligne sur toute la largeur du graphique, reproduisant la géométrie des marges théoriques.
9.3 Bonnes pratiques ergonomiques dans les rapports scientifiques
La restitution visuelle des distributions marginales dans les publications académiques répond à des impératifs d’intelligibilité et de rigueur formelle codifiés, entre autres, par les normes de l’American Psychological Association (normes APA 7e édition). Une erreur récurrente consiste à superposer sur un même axe graphique des effectifs conjoints et des totaux marginaux sans différencier les échelles de mesure, ce qui introduit une confusion majeure pour le lecteur.
Les recommandations ergonomiques exigent que toute représentation graphique bivariée intégrant des projections marginales spécifie clairement les unités métriques sur chaque sous-axe. Lorsque des fréquences ou proportions marginales sont rapportées, il est fortement préconisé d’y adjoindre des barres d’erreur matérialisant les intervalles de confiance à 95 % calculés sur la marge univariée (selon la méthode de Wilson ou de Clopper-Pearson pour les proportions binomiales), afin de donner à voir l’incertitude liée à l’échantillonnage.
Enfin, le choix de la palette graphique doit être opéré avec soin pour éviter les distorsions d’interprétation. L’utilisation de dégradés continus perceptuellement uniformes (comme la palette viridis ou plasma) garantit une lisibilité optimale, y compris pour les lecteurs présentant des déficits de la vision des couleurs, et assure la reproductibilité du graphique lors de son impression en niveaux de gris au sein des périodiques scientifiques.
10. Modélisation avancée : copules et distributions marginales multivariées
10.1 Le théorème de Sklar et la séparation des marges
Dans le domaine de la modélisation statistique avancée et de l’économétrie appliquée aux sciences du comportement, l’analyse multivariée a été profondément renouvelée par l’introduction des copules, fondées sur le théorème d’Abe Sklar publié en 1959. Le théorème de Sklar établit un principe fondamental : toute fonction de distribution conjointe multivariée FXY(x, y) peut être décomposée de façon exacte et univoque en deux composantes entièrement disjointes : d’une part, les fonctions de distribution marginales univariées FX(x) et FY(y), et d’autre part, une fonction de couplage appelée copule, notée C :
FXY(x, y) = C(FX(x), FY(y))
Si les distributions marginales sont continues, la copule C est unique et définie sur l’hypercube unité [0, 1]2. L’intérêt méthodologique de cette séparation est considérable : elle permet de dissocier intégralement la modélisation du comportement marginal individuel de chaque variable (ses moments, sa morphologie en cloche ou asymétrique) de la modélisation de la structure de dépendance et de covariance qui les relie. Deux variables présentant des distributions marginales très dissemblables — par exemple une variable marginale suivant une loi log-normale et une autre suivant une loi de Poisson — peuvent ainsi être articulées sans difficulté théorique au sein d’un modèle conjoint grâce au choix d’une copule appropriée (copule de Clayton, de Gumbel ou gaussienne).
Cette souplesse est exploitée en psychologie cognitive pour lier le temps de réaction et la précision décisionnelle au sein de modèles de diffusion. Alors que les temps de réponse marginaux suivent des distributions fortement asymétriques à queue lourde (lois Ex-Gaussiennes ou de Wald), la précision des réponses est une variable binaire ou ordinale. L’application des copules permet de capturer la dépendance fine dans les queues de distribution (la corrélation extrême entre réponses très lentes et baisse de précision) sans contraindre arbitrairement les distributions marginales à adopter une forme normale non réaliste.
10.2 Modélisation par équations structurelles et marges non normales
La modélisation par équations structurelles (Structural Equation Modeling, SEM) constitue le cadre statistique dominant pour valider des modèles théoriques complexes comprenant des variables latentes, des structures factorielles et des réseaux de dépendances causales. Historiquement, l’estimation des modèles SEM repose sur la méthode du maximum de vraisemblance standard (ML), laquelle formule l’hypothèse contraignante que les distributions conjointes et marginales des variables manifestes observées suivent une loi normale multivariée.
Dans la pratique psychométrique, cette hypothèse est systématiquement mise en défaut : les scores cliniques de dépression, les consommations de substances psychoactives ou les indices de comportement antisocial présentent quasi exclusivement des distributions marginales tronquées avec de fortes asymétries positives et des amas majeurs au niveau du zéro (effets de plancher). L’ignorance de ces profils marginaux non normaux lors de l’application aveugle du maximum de vraisemblance standard conduit à des biais sévères : sous-estimation des erreurs-types, inflation artificielle de la statistique de test du Chi-deux de conformité du modèle (conduisant à rejeter abusivement des modèles théoriquement justes) et fausses estimations des indices d’ajustement global tels que le RMSEA ou le CFI.
Pour surmonter ces distorsions induites par la non-normalité marginale, la psychométrie moderne emploie des estimateurs robustes adaptés. L’estimateur MLR (Maximum Likelihood Robust, ou correction de Satorra-Bentler) réajuste la statistique de test et les erreurs-types en calculant une matrice asymptotique basée sur les kurtosis marginaux empiriques des données. Lorsque les données sont intrinsèquement ordinales, les méthodes fondées sur les matrices de corrélations polychoriques avec estimateurs de moindres carrés pondérés et corrigés (WLSMV) modélisent explicitement les distributions marginales sous-jacentes via des fonctions de seuil (thresholds), préservant la validité des paramètres de régression latente.
10.3 Approches bayésiennes et lois a priori marginales
Dans le paradigme de l’inférence bayésienne — dont l’adoption croît de manière exponentielle en sciences comportementales —, la marginalisation joue un rôle technique et conceptuel fondamental. Lors de la formulation d’un modèle bayésien, l’investigateur définit la distribution de probabilité conjointe a priori de l’ensemble des paramètres du modèle θ et des hyperparamètres φ. La loi a priori marginale d’un paramètre d’intérêt individuel (par exemple la taille d’effet d’une psychothérapie) s’obtient en intégrant la distribution conjointe sur le domaine de tous les paramètres de nuisance du modèle.
Cette logique s’applique symétriquement à la distribution a posteriori des paramètres après actualisation par les données empiriques observées D. La distribution conjointe a posteriori P(θ, φ | D) est couramment d’une dimension trop élevée pour autoriser un calcul analytique direct. Les méthodes d’échantillonnage stochastique fondées sur les chaînes de Markov Monte Carlo (MCMC), notamment l’échantillonneur de Gibbs et l’algorithme de Metropolis-Hastings implémentés dans des moteurs comme Stan ou JAGS, résolvent ce problème en générant des échantillons successifs convergeant vers la distribution a posteriori cible.
Pour extraire la distribution a posteriori marginale du paramètre d’effet θ, le praticien isole simplement les tirages simulés de ce paramètre spécifique, ignorant les coordonnées des autres variables générées au cours des itérations de la chaîne. C’est sur cette distribution marginale a posteriori que sont calculés les estimateurs ponctuels bayésiens (médiane ou moyenne a posteriori) ainsi que les intervalles de crédibilité à 95 %, fournissant une quantification intuitive et directement probabilisable de l’ampleur du paramètre clinique mesuré.
11. Pièges d’interprétation et erreurs méthodologiques fréquentes
11.1 Le paradoxe de Simpson et l’occultation des relations internes
Le piège méthodologique le plus notoire lié à l’analyse exclusive des distributions marginales est sans conteste le paradoxe de Simpson (ou effet Yule-Simpson). Ce paradoxe désigne une situation où une association statistique, une corrélation ou une différence observée au niveau de la distribution marginale globale d’un ensemble de données s’atténue, disparaît, ou pire, s’inverse complètement lorsque les données sont désagrégées en sous-groupes conditionnels définis par une troisième variable de confusion.
Le mécanisme sous-jacent à ce paradoxe découle de la perte de l’information structurelle propre à l’opération de marginalisation. En agrégeant brutalement les sous-populations au sein d’une table de contingence marginale globale, les poids relatifs des différentes strates démographiques ou expérimentales viennent distordre l’association sous-jacente. L’exemple historique classique concerne les admissions à l’Université de Berkeley en 1973 : l’examen de la distribution marginale globale des taux d’admission indiquait que les candidats masculins présentaient un taux marginal d’acceptation substantiellement supérieur à celui des candidates féminines, soulevant un soupçon de discrimination systémique. Cependant, lorsque l’analyse fut décomposée conditionnellement par département d’enseignement, il apparut que dans la quasi-totalité des filières, les femmes affichaient un taux d’admission égal ou supérieur à celui des hommes. L’effet marginal global était causé par une variable cachée : les candidates postulaient préférentiellement dans des filières très sélectives à faible taux global d’acceptation, alors que les hommes postulaient massivement dans des départements disposant de capacités d’accueil étendues.
Ce phénomène se manifeste fréquemment dans les études d’efficacité thérapeutique. Un traitement médical ou psychologique peut afficher un taux marginal de rémission supérieur au groupe contrôle au niveau global, alors même qu’il se révèle inférieur pour les patients jeunes et pour les patients âgés pris séparément, en raison d’une affectation déséquilibrée de la sévérité initiale de la maladie entre les groupes de traitement. Il est donc méthodologiquement hasardeux d’émettre des inférences causales à partir de distributions de bordure sans avoir exploré les structures conditionnelles internes.
11.2 L’erreur de substitution entre probabilité conditionnelle et marginale
L’évaluation clinique et la pose de diagnostics psychiatriques sont très régulièrement exposées à un biais de raisonnement probabiliste critique : l’erreur de substitution entre probabilité conditionnelle et probabilité marginale. Cette confusion — intimement reliée à l’erreur du procureur et à la négligence de la taille de base (base-rate fallacy) — survient lorsqu’un praticien identifie la probabilité de présenter un symptôme sachant qu’un patient souffre d’un trouble P(Symptôme | Trouble) avec la probabilité marginale de survenue du symptôme dans la population P(Symptôme), ou avec la probabilité conditionnelle inverse P(Trouble | Symptôme).
Imaginons un symptôme cognitif rare (noté S), comme une agnosie visuelle spécifique, présent chez 90 % des patients souffrant d’une pathologie neurologique sévère mais exceptionnelle (notée M, dont la prévalence marginale a priori dans la population est de P(M) = 0,001, soit 1 patient sur 1000). Supposons par ailleurs que ce symptôme apparaisse également de manière bénigne et transitoire chez 1 % des personnes saines (taux de faux positifs : P(S | Sain) = 0,01). Si un clinicien reçoit un patient manifestant le symptôme S et conclut intuitivement que ce patient a 90 % de chances d’être atteint de la pathologie M, il commet une erreur d’inférence majeure.
En vertu de la règle de Bayes et de l’analyse conjointe des probabilités marginales, la probabilité réelle que ce patient soit atteint sachant son symptôme s’établit selon le calcul :
P(M | S) = (P(S | M) · P(M)) / [P(S | M) · P(M) + P(S | Sain) · P(Sain)]
P(M | S) = (0,90 · 0,001) / [(0,90 · 0,001) + (0,01 · 0,999)] = 0,0009 / (0,0009 + 0,00999) ≈ 0,0826
La probabilité réelle n’est donc que de 8,26 %. L’ignorance de la faible prévalence marginale a priori du trouble conduit le praticien à surestimer le risque diagnostique d’un facteur 10. La formation méthodologique continue des psychologues cliniciens et des médecins exige un apprentissage systématique de la manipulation des distributions marginales de base pour désamorcer ces illusions cognitives préjudiciables aux patients.
11.3 Perte de covariation et fausses équivalences
Une dernière défaillance interprétative consiste à postuler l’équivalence de deux jeux de données empiriques sur la seule base de l’égalité observée de leurs distributions marginales. Deux cohortes cliniques ou expérimentales peuvent présenter des caractéristiques marginales strictement superposables — mêmes moyennes, mêmes écarts-types, mêmes proportions de classes sociodémographiques — tout en dissimulant des structures de covariation radicalement dissemblables.
Ce principe peut être aisément illustré par une table de contingence 2 × 2 croisant deux variables dichotomiques au sein de deux échantillons distincts de taille N = 100 :
- Échantillon A : La cellule conjointe (1,1) contient 50 individus, la cellule (2,2) contient 50 individus, et les cellules hors-diagonales (1,2) et (2,1) contiennent 0 individu. Les marges pour la première variable sont de 50/50, et les marges pour la seconde sont de 50/50. La corrélation entre les deux variables est de φ = +1,00 (dépendance linéaire déterministe positive).
- Échantillon B : La cellule conjointe (1,2) contient 50 individus, la cellule (2,1) contient 50 individus, et les cellules diagonales (1,1) et (2,2) contiennent 0 individu. Les totaux marginaux restent rigoureusement identiques : 50/50 pour la variable 1, et 50/50 pour la variable 2. Cependant, la corrélation est ici de φ = -1,00 (dépendance linéaire déterministe négative).
Les marges sont indiscernables, mais les dynamiques psychologiques ou comportementales mesurées sont diamétralement opposées. Par conséquent, les protocoles expérimentaux procédant à un appariement d’échantillons sur des bases purement univariées ou marginales s’exposent à des biais de confusion résiduels massifs. L’équivalence de deux groupes ne peut être rigoureusement garantie que par le contrôle de la distribution conjointe multivariée complète.
12. Mise en œuvre pratique et calculs via les logiciels statistiques
12.1 Extraction et analyse sous R
L’environnement de programmation statistique R constitue l’un des écosystèmes informatiques les plus performants pour le calcul, la manipulation et la modélisation des distributions marginales univariées et multivariées. Le système de base de R intègre nativement des fonctions vectorisées optimisées pour extraire les marges de tableaux de contingence matriciels de dimension quelconque. Soit une matrice ou une table de données nommée table_contingence créée via la commande table() ; l’extraction des sommes marginales s’opère de façon classique via la fonction marginSums() ou la fonction plus générale margin.table() :
Pour calculer les totaux marginaux en ligne :
marginSums(table_contingence, margin = 1)
Pour calculer les totaux marginaux en colonne :
marginSums(table_contingence, margin = 2)
La conversion de ces totaux absolus en fréquences relatives marginales repose sur l’instruction prop.table(), en omettant l’argument dimensionnel afin de diviser l’ensemble de la structure par le grand total N, ou en l’appliquant aux vecteurs marginaux préalablement extraits. L’enrichissement visuel d’une table par l’affichage simultané des cases conjointes et des marges de bordure s’obtient élégamment par la commande intégrée addmargins(table_contingence).
En matière d’analyse graphique avancée, le package de référence ggplot2, associé à l’extension spécialisée ggExtra, permet d’adjoindre des représentations marginales directes à un diagramme de dispersion bivarié. L’utilisateur construit préalablement un objet graphique unissant les deux variables continues :
p <- ggplot(donnees_psy, aes(x = score_anxiete, y = temps_reaction)) + geom_point()
Puis, l’appel de la fonction ggMarginal() injecte automatiquement les projections périphériques sous la forme choisie :
ggMarginal(p, type = "density", margins = "both", fill = "skyblue")
Pour la modélisation psychométrique approfondie, le package psych — conçu par William Revelle — met à disposition des chercheurs des fonctions dédiées telles que marginal(), describe() et polychoric(), qui calculent de manière automatisée les distributions marginales empiriques, les seuils multivariés et les coefficients de normalité requis lors de l’évaluation d’échelles de mesure complexes.
12.2 Traitement automatisé sous Python
Au sein du langage de programmation Python, l’écosystème scientifique formé par les bibliothèques open-source Pandas, SciPy et Seaborn offre des fonctionnalités pour l’automatisation des flux d’ingénierie et d’analyse des distributions marginales. La structure de données centrale de Pandas, le DataFrame, propose une méthode dédiée aux tableaux croisés via la fonction globale pd.crosstab(). L’activation de l’argument booléen margins=True calcule et insère automatiquement les effectifs marginaux de bordure ainsi que le total global :
tableau = pd.crosstab(df['Diagnostic'], df['Traitement'], margins=True, margins_name="Total Marginal")
Pour transformer ces effectifs en probabilités marginales ou conditionnelles, l’utilisateur paramètre l’argument normalize selon ses objectifs analytiques : la valeur normalize='all' génère la loi conjointe et les masses marginales rapportées au grand effectif N, tandis que normalize='index' ou normalize='columns' engendre respectivement les distributions conditionnelles en ligne ou en colonne.
Sur le plan du calcul numérique continu, le module scipy.stats permet d’ajuster des fonctions de densité marginale empiriques à l’aide de l’estimateur par noyau gaussien univarié scipy.stats.gaussian_kde. Cet outil permet d’évaluer la fonction marginale estimée f_estime(x) en n’importe quel point du continuum en intégrant numériquement les données sans formuler d’hypothèse paramétrique rigide sur la loi génératrice sous-jacente.
Enfin, la librairie de visualisation statistique Seaborn matérialise l’intégration visuelle conjointe-marginale à travers sa fonction de haut niveau sns.jointplot(). L’instruction s’exécute avec une grande simplicité syntaxique :
sns.jointplot(data=df, x='Score_Depression', y='Qualite_Sommeil', kind='kde', marginal_kws=dict(fill=True))
Cette commande génère automatiquement une cartographie bidimensionnelle des contours de densité conjointe au centre de la figure, flanquée au-dessus et à droite des courbes de densité marginales respectives des deux variables comportementales, fournissant un bilan distributionnel complet en une seule restitution graphique.
12.3 Utilisation dans les logiciels graphiques dédiés : SPSS et JASP
Pour les praticiens, cliniciens et étudiants recourant à des environnements logiciels pilotés par interface graphique sans programmation textuelle, des solutions institutionnelles telles qu’IBM SPSS Statistics ou des alternatives open-source modernes orientées vers la recherche comme JASP fournissent des procédures rigoureuses pour inspecter les distributions marginales.
Dans IBM SPSS Statistics, le calcul et l’affichage des marges s’articulent autour de la procédure des Tableaux croisés accessible via le cheminement de menus : Analyser > Statistiques descriptives > Tableaux croisés (ou via la syntaxe CROSSTABS). Dans la sous-boîte de dialogue « Cellules », l’analyste peut cocher les cases correspondant aux pourcentages : « Ligne », « Colonne » et « Total ». La sélection de l’option « Total » affiche les fréquences relatives marginales univariées au niveau des bordures extrêmes du tableau, tandis que le choix de « Ligne » ou « Colonne » restitue les profils de distributions conditionnelles. Il est primordial pour l’utilisateur de maîtriser cette distinction afin de ne pas interpréter par mégarde un pourcentage conditionnel intra-classe comme une probabilité marginale de population.
Dans le logiciel JASP — développé par l’Université d’Amsterdam pour promouvoir les standards de l’évaluation bayésienne et fréquentiste —, l’analyse des distributions marginales s’intègre au sein du module Frequencies > Contingency Tables. JASP propose un affichage dynamique et synchronisé où chaque modification des options d’affichage des marges actualise en temps réel la table des résultats ainsi que les visualisations en mosaïque associées.
De surcroît, JASP excelle dans la mise en œuvre des tests d’indépendance bayésiens. En cochant l’option de modélisation par facteurs de Bayes, le logiciel permet de spécifier des lois a priori de Dirichlet sur les distributions marginales (modèle de Poisson indépendant ou modèle multinomial conjoint conditionné sur les marges), permettant au psychologue de tester formellement si les données observées apportent un soutien empirique en faveur de l’hypothèse nulle d’indépendance (H0) ou de l’hypothèse alternative d’association (H1), fournissant une alternative méthodologique solide aux tests traditionnels du Chi-deux et facilitant l’exportation des tableaux conformes aux normes éditoriales académiques internationales.
Références
Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Categorical+Data+Analysis%2C+3rd+Edition-p-9780470463635
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bock, R. D., & Aitkin, M. (1981). Marginal maximum likelihood estimation of item parameters: Application of an EM algorithm. Psychometrika, 46(4), 443–459. https://doi.org/10.1007/BF02293801
Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press. https://www.cengage.com
Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
Gwet, K. L. (2014). Handbook of inter-rater reliability: The definitive guide to measuring the extent of agreement among raters (4th ed.). Advanced Analytics, LLC. https://agreestat.com/book4/
Nelsen, R. B. (2006). An introduction to copulas (2nd ed.). Springer. https://doi.org/10.1007/0-387-28678-0
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
Sklar, A. (1959). Fonctions de répartition à n dimensions et leurs marges. Publications de l’Institut de Statistique de l’Université de Paris, 8, 229–231. https://gallica.bnf.fr