
Dans le domaine des sciences du comportement, de la psychologie cognitive et de la recherche biomédicale, l’investigateur est continuellement confronté à l’impératif épistémologique de convertir une multiplicité de faits bruts en une structure intelligible. L’observation directe d’un phénomène produit initialement un flux désordonné de mesures numériques, souvent qualifié de données brutes ou non traitées. Qu’il s’agisse de relever le nombre d’erreurs commises lors d’une tâche de mémoire de travail, la fréquence d’apparition de comportements stéréotypés chez des enfants présentant un trouble du spectre de l’autisme, ou la quantification de paramètres démographiques au sein de ménages, l’accumulation de chiffres désorganisés obscurcit les régularités sous-jacentes. Sans un traitement préliminaire rigoureux, l’esprit humain se heurte à une surcharge cognitive qui interdit toute interprétation diagnostique ou déductive.
La mise en ordre de ces données constitue le fondement même de la statistique descriptive. Parmi les outils fondamentaux dont dispose le chercheur, la distribution de fréquences occupe une place matricielle. Elle ne se limite pas à un simple exercice arithmétique de dénombrement ; elle constitue la première étape de la modélisation mathématique du réel empirique. En réorganisant les observations selon leur récurrence, le statisticien transforme un ensemble chaotique en une cartographie quantitative. Cette opération permet de dégager instantanément la structure intrinsèque d’une série statistique, révélant ses zones de concentration, ses points de dispersion, ainsi que la rareté ou la typicité de certaines valeurs observées.
Au cœur de cette démarche descriptive se déploie une dichotomie fondamentale : l’approche non groupée versus l’approche groupée. La distribution de fréquences non groupées se distingue par sa fidélité absolue au corpus expérimental. En refusant d’agréger arbitrairement les mesures au sein d’intervalles artificiels de classe, elle préserve la singularité de chaque modalité observée. Ce traité académique a pour vocation d’explorer en profondeur la distribution de fréquences non groupées, en articulant ses fondements théoriques, ses justifications épistémologiques, ses algorithmes de calcul, et ses représentations visuelles, tout en l’illustrant à travers un cas empirique représentatif issu de l’étude des structures domestiques contemporaines.
1. Introduction aux distributions de fréquences en recherche comportementale
1.1 Rôle de la statistique descriptive dans l’analyse des données
La statistique descriptive constitue le socle indispensable sur lequel s’érige l’ensemble de l’inférence quantitative. En recherche comportementale, les protocoles expérimentaux génèrent des volumes substantiels de données hétérogènes dont la finalité première est de répondre à des hypothèses préétablies. Toutefois, avant de soumettre ces données à des tests d’hypothèses sophistiqués tels que l’analyse de variance, la modélisation par équations structurelles ou les régressions logistiques, le chercheur doit impérativement appréhender la texture de son échantillon. La nécessité de synthétiser des ensembles de données brutes sans en altérer la structure sous-jacente représente un défi méthodologique constant. Une compression prématurée ou excessive du signal d’origine risque d’effacer des micro-variations susceptibles de porter une signification théorique majeure.
L’organisation ordonnée des scores joue un rôle prépondérant dans l’identification des tendances comportementales émergentes. Lorsqu’un psychologue étudie, par exemple, le temps de réaction face à un stimulus anxiogène ou le nombre de tentatives nécessaires pour résoudre un labyrinthe spatial, l’alignement ordonné des valeurs permet de repérer immédiatement si la cohorte manifeste un comportement homogène ou si elle se polarise en sous-groupes fonctionnels distincts. Cette mise en ordre permet d’observer la dispersion des performances et d’évaluer la représentativité des mesures obtenues par rapport aux populations cibles théoriques.
Dans le cadre de la psychologie expérimentale, le passage de l’observation brute à la modélisation formelle s’opère précisément par cette transition tabulaire. Les fréquences observées constituent l’analogue empirique des probabilités théoriques. En comptabilisant la récurrence de chaque événement ou de chaque mesure, le chercheur établit des profils de réponse tant individuels que collectifs. Ces profils permettent d’isoler des invariants comportementaux, d’évaluer la stabilité des conduites à travers le temps et d’identifier les facteurs environnementaux ou neuropsychologiques qui modulent l’intensité ou la fréquence des réponses.
1.2 Évolution conceptuelle des tableaux de fréquences
L’usage des tableaux de fréquences trouve ses racines historiques dans les premières tentatives de dénombrement des populations et d’enregistrement des faits civils au cours de la Renaissance et de l’époque moderne. Initialement confinés à la démographie étatique — les « arithmétiques politiques » de John Graunt et William Petty —, les relevés manuels de décès, de naissances ou d’épidémies ont progressivement forgé la prise de conscience que l’ordre social et biologique pouvait être appréhendé par la quantification systématique des occurrences. Le dénombrement n’était alors qu’un inventaire brut consigné laborieusement sur des registres paroissiaux manuscrits.
Au cours du dix-neuvième et du vingtième siècle, avec l’essor conjugué de la biométrie initiée par Francis Galton et Karl Pearson et de la sociologie quantitative portée par Émile Durkheim, la tabulation est passée d’un simple exercice de comptabilité administrative à une véritable technologie d’analyse conceptuelle. L’avènement des technologies de calcul, d’abord électromécaniques avec les cartes perforées de Herman Hollerith, puis électroniques avec les calculateurs numériques modernes, a révolutionné la vitesse et l’échelle du traitement. Les séries statistiques brutes sont désormais converties instantanément en matrices de données relationnelles, automatisant l’extraction des profils distributionnels.
Cette transition technologique s’est accompagnée d’une codification rigoureuse des normes de publication scientifique. Des institutions académiques telles que l’American Psychological Association (APA) ont formalisé la structure des tables statistiques afin de maximiser la clarté cognitive et l’universalité de la communication des résultats. La présentation d’une table de distribution de fréquences contemporaine obéit désormais à des standards typographiques stricts, garantissant une reproductibilité sans équivoque des analyses au sein de la communauté scientifique mondiale.
1.3 Pertinence méthodologique pour les échantillons de taille restreinte
Bien que le paradigme contemporain des mégadonnées (« big data ») mette souvent l’accent sur le traitement d’échantillons massifs comprenant des dizaines de milliers d’observations, l’analyse d’échantillons de taille restreinte demeure le quotidien de nombreux pans de la recherche expérimentale, clinique et neuropsychologique. Les études pilotes, les expérimentations en neuro-imagerie fonctionnelle à coût élevé, ou encore les investigations portant sur des pathologies génétiques rares ne permettent bien souvent de recruter qu’un nombre modéré de participants, typiquement compris entre dix et quarante unités statistiques.
Dans ce contexte particulier, l’adoption d’une distribution de fréquences non groupées s’impose comme une nécessité méthodologique critique. Lorsque la taille de l’échantillon $N$ est modeste, chaque observation individuelle recèle une charge informative disproportionnée par rapport aux grands échantillons. Le regroupement de ces données au sein d’intervalles artificiels induirait une perte d’information préjudiciable, effaçant les nuances subtiles qui distinguent deux participants adjacents. La préservation de chaque point de donnée permet d’examiner chaque cas singulier au sein du collectif, évitant ainsi le risque de dilution diagnostique.
En outre, les échantillons restreints se caractérisent par une sensibilité accrue aux patrons de réponses rares et aux scores extrêmes (« outliers »). L’approche non groupée met immédiatement en lumière l’émergence d’une valeur isolée à l’extrémité supérieure ou inférieure de l’échelle de mesure. Cette visibilité permet au méthodologue d’interroger la validité de l’observation : s’agit-il d’une erreur d’enregistrement, d’un artefact expérimental ou d’un profil clinique atypique méritant une investigation qualitative dédiée ? Cette transparence granulaire fait de la table de fréquences non groupées un outil diagnostique irremplaçable lors des phases exploratoires de la recherche.
2. Définition conceptuelle et théorique de la distribution de fréquences non groupées
2.1 Définition formelle et notation mathématique
Sur le plan mathématique et formel, une distribution de fréquences non groupées est définie comme un arrangement structural associant, de manière univoque, chaque modalité numérique distincte observée au sein d’une série statistique brute au nombre exact de fois où cette modalité se manifeste. Soit un échantillon de taille $N$ dont les observations brutes forment un multi-ensemble noté $U = {u_1, u_2, dots, u_N}$. L’ensemble des valeurs uniques et distinctes extraites de $U$, triées selon une relation d’ordre strict, est désigné par $X = {x_1, x_2, dots, x_k}$, où $k le N$ représente le nombre total de modalités différentes observées, avec la propriété formelle $x_1 < x_2 < dots < x_k$.
À chaque valeur $x_i$ (avec $i in {1, 2, dots, k}$) est associée sa fréquence absolue, traditionnellement notée $f_i$, qui représente le cardinal du sous-ensemble des observations de $U$ strictement égales à $x_i$ :
f_i = mathrm{card}{u_j in U mid u_j = x_i}
La propriété cardinale de la distribution non groupée réside dans la conservation intégrale de l’information quantitative d’origine. Contrairement aux approches par classes d’intervalles, il n’existe aucune projection vers un sous-espace dégénéré. L’espace des modalités respecte une condition stricte d’exhaustivité et de disjonction mutuelle : toute observation de l’échantillon d’origine est assignée à une et une seule modalité $x_i$. Par conséquent, l’équation fondamentale liant l’ensemble des fréquences absolues à l’effectif global de l’échantillon s’exprime sans biais d’arrondi :
sum_{i=1}^{k} f_i = f_1 + f_2 + dots + f_k = N
2.2 Typologie des variables applicables
L’adéquation théorique et pratique de la distribution de fréquences non groupées dépend intrinsèquement de la nature de la variable sous examen, selon la classification classique introduite par le psychologue Stanley Smith Stevens. La distribution non groupée trouve son champ d’application électif et optimal au sein des variables quantitatives discrètes caractérisées par une faible étendue. Une variable discrète procède par sauts numériques discontinus, résultant presque invariablement d’un processus de comptage ou d’énumération (par exemple, le nombre d’enfants par famille, le nombre d’erreurs commises, le nombre d’hospitalisations antérieures).
Ce format tabulaire s’avère également parfaitement transposable aux variables qualitatives ordinales (telles que les échelons de sévérité symptomatique : faible, modéré, sévère ; ou les niveaux de scolarité) et aux variables qualitatives nominales (telles que l’affiliation politique, le statut marital ou l’hémisphère cérébral dominant). Dans ces contextes qualitatifs, les modalités $x_i$ représentent des catégories disjonctives, et la table de fréquences non groupées offre une synthèse exhaustive des occurrences catégorielles sans imposer d’ordre métrique artificiel si celui-ci n’existe pas intrinsèquement.
À l’inverse, l’application de la distribution de fréquences non groupées se heurte à une inadaptabilité théorique flagrante face aux variables quantitatives continues à spectre large mesurées avec un niveau élevé de résolution (par exemple, la taille en millimètres, la glycémie sérique en millimoles par litre ou les temps de réaction enregistrés en microsecondes). Pour ces variables, la probabilité théorique que deux individus distincts partagent rigoureusement la même valeur tend vers zéro en vertu des propriétés de la mesure borélienne continue. Dès lors, le recours à une table non groupée produirait une liste où presque chaque fréquence $f_i$ serait égale à 1, anéantissant l’objectif même de condensation et de synthèse de la statistique descriptive.
2.3 Objectifs analytiques de la distribution non groupée
L’élaboration d’une distribution de fréquences non groupées répond à plusieurs objectifs analytiques fondamentaux. Le premier réside dans l’identification visuelle et immédiate de la ou des modalités modales. Le mode, défini comme la valeur $x_i$ dont l’effectif associé $f_i$ est le plus élevé, apparaît spontanément sans nécessiter d’estimations approchées par interpolation linéaire, comme c’est le cas dans les structures de données agrégées. Parallèlement, cette méthodologie met en exergue les singularités de mesure, c’est-à-dire les modalités isolées ou inattendues situées en marge de la zone de concentration centrale.
Le second objectif concerne l’évaluation directe de l’asymétrie empirique de la distribution. En observant l’étalement des fréquences de part et d’autre des valeurs centrales, le chercheur peut déceler sans ambiguïté une asymétrie positive (étalement vers les scores élevés) ou une asymétrie négative (étalement vers les scores faibles). Cette appréciation préliminaire s’effectue sans introduire le biais d’agrégation propre aux regroupements en classes, qui a tendance à lisser artificiellement les queues de distribution et à masquer les discontinuités ponctuelles.
Enfin, la table non groupée sert de matrice de calcul directe pour les statistiques descriptives paramétriques (moyenne arithmétique, variance, écart-type) et non paramétriques (médiane, quartiles, rangs centiles). Les calculs exécutés sur la base des couples $(x_i, f_i)$ fournissent des valeurs d’une exactitude absolue, débarrassées des erreurs systématiques inhérentes à l’hypothèse d’équirépartition des observations au sein des intervalles de classe.
3. Distinction fondamentale : distribution non groupée vs distribution groupée
3.1 Principes directeurs de la distribution groupée
Pour apprécier la rigueur de la distribution non groupée, il convient de la confronter aux postulats qui régissent la distribution groupée. L’approche groupée repose sur le fractionnement de l’intervalle de variation total des données en sous-intervalles successifs et mutuellement exclusifs, communément appelés « classes » ou « intervalles de classe ». Chaque observation est alors dépossédée de sa valeur numérique propre pour être rattachée à la classe au sein de laquelle elle s’inscrit, la classe étant dès lors représentée analytiquement par son point central (le centre de classe).
Cette méthodologie d’agrégation répond au principe de réduction délibérée de la dimensionnalité. Face à des volumétries massives de données ou face à des variables continues affichant des centaines de valeurs distinctes, la distribution groupée vise à surmonter l’entropie informationnelle. Elle condense le signal en un nombre restreint de compartiments conceptuels (généralement entre 5 et 15 classes selon les règles heuristiques de Sturges, de Scott ou de Freedman-Diaconis), facilitant ainsi une appréhension macroscopique et globale du profil statistique.
Néanmoins, cette commodité visuelle implique un arbitrage épistémologique sévère : le sacrifice de la granularité exacte au profit de la parcimonie cognitive. Dès lors qu’une observation est assignée à un intervalle, son identité numérique singulière disparaît. La distribution groupée postule tacitement une distribution uniforme des données au sein de chaque intervalle, une hypothèse qui se révèle fréquemment invalidée par la réalité empirique, induisant des distorsions mathématiques dans les estimations ultérieures.
3.2 Analyse comparative du niveau de granularité
Le concept de granularité statistique renvoie au degré de finesse et de détail avec lequel une variable est mesurée et rapportée. L’approche non groupée se caractérise par une granularité unitaire : le niveau de résolution du tableau correspond scrupuleusement au niveau de résolution de l’instrument de mesure d’origine. Chaque modalité conservant son identité mathématique, l’investigateur demeure à même de reconstruire l’intégralité du jeu de données brut sans aucune perte entropique. Il s’agit d’une transformation dite sans perte d’information (« lossless »).
À l’inverse, l’approche groupée génère un effet de masquage direct de la variabilité intra-classe. Supposons deux individus ayant obtenu respectivement les scores de 11 et 19 au sein d’un test psychométrique mesuré sur une échelle allant de 0 à 100. Si l’investigateur construit des classes d’amplitude 10, ces deux sujets seront fondus dans l’intervalle unique $[10, 20[$. Dès lors, la différence substantielle de 8 points qui séparait leurs performances est irrémédiablement anéantie lors du processus d’analyse tabulaire. La variabilité observée entre ces deux sujets est absorbée par la structure de classe, introduisant une variance résiduelle non observable.
Ce nivellement par classe a des conséquences immédiates sur la précision du positionnement relatif des individus. L’estimation des rangs centiles et la détermination des seuils critiques (par exemple, le 95e percentile définissant un critère de pathologie clinique) deviennent dépendantes de formules d’interpolation linéaire. Si la distribution réelle au sein de l’intervalle est asymétrique ou multimodale, le calcul interpolé aboutira à un biais systématique, conduisant potentiellement à des erreurs de classification diagnostique.
3.3 Critères décisionnels pour le choix de la méthode de tabulation
Le choix entre une distribution non groupée et une distribution groupée ne doit pas résulter d’une habitude empirique arbitraire, mais d’une délibération méthodologique fondée sur des critères rigoureux. Le premier critère décisionnel réside dans l’interaction conjointe entre la taille de l’échantillon ($N$) et l’étendue des données ($Range = X_{\max} – X_{\min}$). Si l’étendue est faible (typiquement inférieure à 15 ou 20 unités discrètes) et que l’échantillon présente une taille modeste à modérée, la table non groupée s’impose de façon indiscutable. Grouper des données dans une telle configuration relèverait d’une sur-simplification méthodologique injustifiée.
Le second critère concerne la finalité fonctionnelle de la production statistique : s’agit-il d’un objectif de communication de vulgarisation ou d’un objectif d’analyse diagnostique fine ? Dans le cadre d’un rapport de synthèse destiné à des décideurs ou à un public non spécialiste, l’agrégation en grandes catégories globales (distribution groupée) peut favoriser la saisie immédiate des grandes lignes d’un sondage. En revanche, dans le contexte d’une recherche académique, d’un essai clinique ou d’une validation psychométrique d’un instrument de diagnostic, la préservation de la granularité absolue via la table non groupée s’avère indispensable pour garantir la validité interne des inférences.
Le troisième critère découle des exigences des tests statistiques subséquents. Lorsque l’objectif consiste à appliquer des tests non paramétriques exacts fondés sur le calcul précis des rangs (comme le test des rangs signés de Wilcoxon ou le test de Kruskal-Wallis), toute perte de granularité altère la matrice des ex æquo (« ties ») et fausse les probabilités critiques calculées. La conservation des fréquences non groupées garantit que les opérations mathématiques ultérieures opèrent sur des mesures empiriques authentiques et non sur des approximations de centres de classes.
4. Données brutes et contextualisation : l’exemple empirique des animaux de compagnie
4.1 Présentation du protocole d’enquête
Afin de concrétiser les concepts théoriques exposés précédemment, nous nous appuierons tout au long de ce traité sur un ensemble de données empiriques issues d’une enquête sociologique portant sur la structure des ménages et l’intégration des animaux domestiques dans le biotope familial. Dans les sociétés industrialisées contemporaines, la possession d’animaux de compagnie constitue un indicateur comportemental riche, corrélé à de multiples dimensions psychologiques telles que la réduction du stress perçu, l’attachement affectif, l’activité physique quotidienne et l’organisation de l’espace domestique.
Le protocole d’enquête a été déployé auprès d’un échantillon ciblé de $N = 15$ ménages résidant au sein d’une zone périurbaine. L’unité statistique sous observation est le ménage unifamilial. La variable d’intérêt, notée $X$, est définie opérationnellement comme le « nombre total d’animaux domestiques hébergés de façon permanente au sein du foyer au moment de l’administration du questionnaire ». Cette définition exclut les animaux d’élevage à visée commerciale et restreint le champ aux vertébrés de compagnie (chiens, chats, petits mammifères, oiseaux de volière).
Sur le plan métrologique, cette variable se définit rigoureusement comme une variable quantitative discrète sur une échelle de rapport. Elle admet une origine absolue non arbitraire (le zéro physique signifiant l’absence totale d’animaux) et procède exclusivement par valeurs entières positives. Il est formellement impossible pour un ménage d’héberger 2,4 animaux : chaque incrément unitaire traduit l’intégration d’un être vivant supplémentaire dans l’environnement familial, conférant à chaque modalité une signification concrète et non ambiguë.
4.2 Examen de la série statistique brute
L’administration séquentielle des questionnaires auprès des quinze foyers a généré la suite chronologique d’observations brutes suivante, consignée sans tri préalable selon l’ordre chronologique des visites d’enquête :
5, 1, 2, 1, 3, 2, 1, 8, 4, 1, 2, 3, 5, 7, 6
À la simple lecture visuelle de cette série non ordonnée, le chercheur perçoit des fragments d’information sans pouvoir immédiatement quantifier la distribution globale. Il apparaît évident que les valeurs numériques sont faibles à modérées, mais la prédominance relative de chaque modalité demeure floue. Une première manipulation algébrique élémentaire consiste à soumettre cette séquence à un algorithme de tri ascendant, produisant la série statistique ordonnée suivante :
1, 1, 1, 1, 2, 2, 2, 3, 3, 4, 5, 5, 6, 7, 8
Cette sérialisation met en lumière des propriétés distributionnelles saillantes. L’observation de la borne inférieure indique un minimum de $X_{\min} = 1$ animal, ce qui signifie que l’ensemble des ménages recrutés dans cette cohorte détient au moins un compagnon domestique. La borne supérieure se situe à $X_{\max} = 8$ animaux, définissant une étendue brute totale de :
text{Étendue} = X_{max} – X_{min} = 8 – 1 = 7
De surcroît, la série ordonnée révèle une concentration manifeste des observations sur les valeurs minimales de l’échelle (la répétition du score 1 est frappante), tandis que les valeurs supérieures (6, 7, 8) n’apparaissent qu’à l’état d’occurrences isolées, suggérant d’emblée une distribution manifestant une asymétrie positive pronounced vers la droite.
4.3 Illustration du groupement préalable et de ses limites
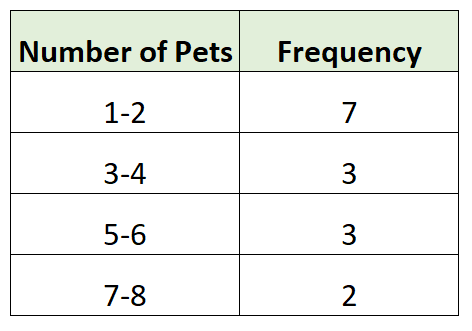
Pour démontrer expérimentalement le danger de l’agrégation hâtive, simulons la démarche d’un statisticien qui choisirait de condenser cette modeste série de 15 observations au sein d’une distribution groupée. En adoptant une amplitude régulière de 2 unités, le chercheur pourrait définir quatre classes d’intervalles contigus : $[1 – 2]$, $[3 – 4]$, $[5 – 6]$ et $[7 – 8]$. En affectant chaque ménage à sa classe respective, nous obtenons la répartition suivante :
- Classe [1 – 2] : regroupant les valeurs 1, 1, 1, 1 et 2, 2, 2, soit un effectif de 7 ménages.
- Classe [3 – 4] : regroupant les valeurs 3, 3 et 4, soit un effectif de 3 ménages.
- Classe [5 – 6] : regroupant les valeurs 5, 5 et 6, soit un effectif de 3 ménages.
- Classe [7 – 8] : regroupant les valeurs 7 et 8, soit un effectif de 2 ménages.
Bien que cette présentation sous forme groupée réduise la série à quatre lignes, elle inflige une altération critique à l’information sociologique sous-jacente. Au sein de la première classe $[1 – 2]$, qui concentre près de la moitié de l’échantillon total ($7 / 15 \approx 46,7%$), il devient totalement impossible de discerner la part respective des foyers ne possédant qu’un seul animal de ceux qui en possèdent deux. Or, d’un point de vue comportemental et économique, la gestion d’un animal unique diffère substantiellement de la logistique requise pour la cohabitation de deux animaux au sein d’un habitat.
En agrégeant ces scores, l’analyste perd la trace du fait que la valeur 1 est en réalité ultra-majoritaire (4 ménages) par rapport à la valeur 2 (3 ménages). De même, dans la dernière classe $[7 – 8]$, la spécificité du foyer possédant 8 animaux — qui représente une modalité quantitativement extrême dans un échantillon de 15 unités — est dissoute dans une catégorie générique. Cette démonstration empirique établit formellement l’inadéquation de la distribution groupée pour ce jeu de données et justifie méthodologiquement le recours exclusif à une distribution de fréquences non groupées.
5. Méthodologie pas-à-pas pour construire une table de fréquences non groupées
5.1 Étape 1 : Ordonnancement et identification des valeurs uniques
La construction rigoureuse d’une table de fréquences non groupées obéit à un algorithme séquentiel déterministe en trois étapes. La première étape consiste à extraire l’ensemble des modalités uniques observées, désigné formellement comme le support empirique de la distribution. À partir de la série statistique brute préalablement ordonnée ($1, 1, 1, 1, 2, 2, 2, 3, 3, 4, 5, 5, 6, 7, 8$), le chercheur procède à une élimination des redondances afin d’isoler chaque modalité distincte $x_i$.
L’ensemble sous-jacent des valeurs observées s’écrit formellement sous forme vectorielle :
X = {x_1, x_2, x_3, x_4, x_5, x_6, x_7, x_8} = {1, 2, 3, 4, 5, 6, 7, 8}
Dans notre cas spécifique, le nombre de modalités observées est $k = 8$. Il est d’une importance capitale de souligner qu’aucune valeur intermédiaire n’est omise au sein de l’espace empirique observé : toutes les valeurs entières comprises entre le minimum (1) et le maximum (8) sont représentées par au moins un foyer. Si, par exemple, aucun ménage n’avait possédé 4 animaux dans la série brute, deux approches méthodologiques auraient été envisageables : soit omettre la modalité 4 du tableau (approche strictement empirique), soit l’inclure formellement avec une fréquence absolue $f_i = 0$ pour refléter la continuité discrète de l’échelle sous-jacente.
5.2 Étape 2 : Dénombrement et calcul des fréquences absolues
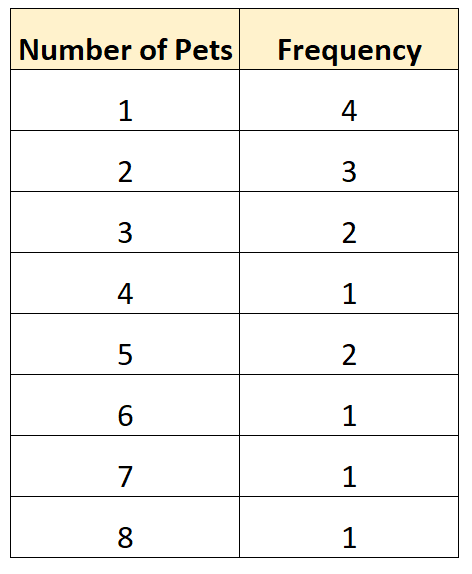
La seconde phase opératoire requiert le pointage et le dénombrement exhaustif des occurrences associées à chaque modalité identifiée $x_i$. Cette opération de comptage débouche sur l’attribution de la fréquence absolue $f_i$. Le dépouillement méthodique de notre série ordonnée fournit les assignations numériques suivantes :
- Pour la modalité $x_1 = 1$, nous recensons les observations aux positions 1, 2, 3 et 4 de la série ordonnée, soit un effectif absolu de : $f_1 = 4$.
- Pour la modalité $x_2 = 2$, les observations occupent les rangs 5, 6 et 7, ce qui génère une fréquence de : $f_2 = 3$.
- Pour la modalité $x_3 = 3$, les observations occupent les rangs 8 et 9, établissant : $f_3 = 2$.
- Pour la modalité $x_4 = 4$, l’observation occupe le rang 10, d’où : $f_4 = 1$.
- Pour la modalité $x_5 = 5$, les observations occupent les rangs 11 et 12, produisant : $f_5 = 2$.
- Pour la modalité $x_6 = 6$, l’observation se situe au rang 13, fournissant : $f_6 = 1$.
- Pour la modalité $x_7 = 7$, l’observation se situe au rang 14, générant : $f_7 = 1$.
- Pour la modalité $x_8 = 8$, l’observation terminale occupe le rang 15, soit : $f_8 = 1$.
Une étape de vérification interne de la cohérence algorithmique doit impérativement être exécutée à ce stade. Elle consiste à sommer la totalité des fréquences absolues calculées afin de s’assurer de l’égalité stricte avec la taille d’échantillon d’origine $N$ :
sum_{i=1}^{8} f_i = 4 + 3 + 2 + 1 + 2 + 1 + 1 + 1 = 15 = N
L’égalité étant scrupuleusement vérifiée, le risque d’omission ou de double comptage est formellement écarté.
5.3 Étape 3 : Structuration formelle du tableau statistique
La troisième étape réside dans la disposition structurée des résultats au sein d’une matrice tabulaire conforme aux normes de communication académique. Une table de distribution de fréquences complète ne se borne pas à aligner les valeurs brutes et leurs effectifs ; elle intègre les dimensions relatives et cumulatives nécessaires à l’analyse inférentielle.
La première colonne consigne la modalité $x_i$, identifiant la variable d’intérêt. La deuxième colonne reporte la fréquence absolue $f_i$. La troisième colonne présente la fréquence relative $p_i$ (ou proportion), calculée selon le rapport $p_i = f_i / N$. La quatrième colonne exprime cette proportion sous forme de pourcentage valide ($p_i \times 100$). Enfin, la cinquième et la sixième colonnes consignent respectivement les fréquences absolues cumulées ($F_i$) et les pourcentages cumulés ($P_i$).
| Nombre d’animaux ($x_i$) | Fréquence absolue ($f_i$) | Fréquence relative ($p_i$) | Pourcentage ($p_i \times 100$) | Fréquence cumulée ($F_i$) | Pourcentage cumulé ($P_i$) |
|---|---|---|---|---|---|
| 1 | 4 | 0,2667 | 26,67 % | 4 | 26,67 % |
| 2 | 3 | 0,2000 | 20,00 % | 7 | 46,67 % |
| 3 | 2 | 0,1333 | 13,33 % | 9 | 60,00 % |
| 4 | 1 | 0,0667 | 6,67 % | 10 | 66,67 % |
| 5 | 2 | 0,1333 | 13,33 % | 12 | 80,00 % |
| 6 | 1 | 0,0667 | 6,67 % | 13 | 86,67 % |
| 7 | 1 | 0,0667 | 6,67 % | 14 | 93,33 % |
| 8 | 1 | 0,0667 | 6,67 % | 15 | 100,00 % |
| Total | 15 | 1,0000 | 100,00 % | — | — |
Ce tableau constitue la synthèse complète et achevée de notre protocole expérimental. Il incarne les principes méthodologiques fondamentaux édictés par l’APA : clarté des intitulés de colonnes, mise en évidence de la taille totale de l’échantillon au pied de table, et exclusion de quadrillages verticaux superflus afin de maximiser la lisibilité cognitive.
6. Propriétés mathématiques et calculs dérivés associés
6.1 Calcul et interprétation des fréquences relatives
La fréquence absolue, bien qu’essentielle pour quantifier la charge réelle d’un échantillon, demeure dépendante de la taille globale de la cohorte observée. Exprimer qu’un score de 1 apparaît 4 fois n’a pas la même portée sémiotique selon que l’échantillon comprend 15 ménages ou 10 000 ménages. C’est pourquoi la dérivation des fréquences relatives (ou proportions empiriques) s’avère indispensable pour la normalisation descriptive.
La fréquence relative $p_i$ associée à la modalité $x_i$ est formellement définie par le quotient de la fréquence absolue $f_i$ par l’effectif global $N$ :
p_i = frac{f_i}{N}
Dans l’exemple de nos 15 ménages, l’application de cette formule aux différentes modalités fournit les proportions suivantes : pour $x_1 = 1$, $p_1 = 4 / 15 \approx 0,2667$ (soit $26,67%$) ; pour $x_2 = 2$, $p_2 = 3 / 15 = 0,2000$ (soit $20,00%$) ; pour $x_3 = 3$, $p_3 = 2 / 15 \approx 0,1333$ ($13,33%$) ; pour $x_4 = 4$, $p_4 = 1 / 15 \approx 0,0667$ ($6,67%$) ; pour $x_5 = 5$, $p_5 = 2 / 15 \approx 0,1333$ ($13,33%$) ; et pour chacune des modalités résiduelles $x_6 = 6$, $x_7 = 7$ et $x_8 = 8$, nous obtenons $p_i = 1 / 15 \approx 0,0667$ ($6,67%$).
L’avantage cardinal de cette transformation réside dans la standardisation métrique. En convertissant des effectifs bruts en proportions comprises dans l’intervalle fermé $[0, 1]$ (ou en pourcentages dans $[0%, 100%]$), le statisticien s’affranchit de l’échelle d’échantillonnage. Il devient dès lors parfaitement licite de comparer la distribution de notre échantillon de 15 foyers périurbains à une cohorte de 2 500 ménages métropolitains collectée par un institut national de démographie. La fréquence relative constitue le pont mathématique unissant la statistique descriptive pure à la théorie axiomatique des probabilités.
6.2 Fréquences cumulées ascendantes et descendantes
L’analyse des distributions de fréquences non groupées s’enrichit de façon substantielle par le calcul des fréquences cumulées, qui permettent de quantifier la masse d’observations se situant en deçà ou au-delà d’un point seuil sur l’axe des modalités. La fréquence absolue cumulée ascendante, traditionnellement notée $F_i$ (ou $F(x_i)$), représente la sommation itérative des fréquences absolues de toutes les modalités inférieures ou égales à la modalité courante $x_i$ :
F_i = sum_{j=1}^{i} f_j = f_1 + f_2 + dots + f_i
En reprenant les données de notre enquête sur les animaux domestiques, l’itération algorithmique génère les cumuls successifs :
- $F(1) = f_1 = 4$
- $F(2) = F(1) + f_2 = 4 + 3 = 7$
- $F(3) = F(2) + f_3 = 7 + 2 = 9$
- $F(4) = F(3) + f_4 = 9 + 1 = 10$
- $F(5) = F(4) + f_5 = 10 + 2 = 12$
- $F(6) = F(5) + f_6 = 12 + 1 = 13$
- $F(7) = F(6) + f_7 = 13 + 1 = 14$
- $F(8) = F(7) + f_8 = 14 + 1 = 15 = N$
Transposées sous forme de pourcentages cumulés ($P_i = (F_i / N) \times 100$), ces grandeurs offrent une réponse analytique directe à des interrogations de nature décisionnelle. Par exemple, si l’on cherche à déterminer la proportion de ménages qui hébergent au plus trois animaux, l’examen direct de la ligne $x_3 = 3$ indique immédiatement $P_3 = 60,00%$ ($9$ ménages sur $15$). Symétriquement, les fréquences cumulées descendantes (décomptant les effectifs strictement supérieurs à un seuil donné) permettent de mesurer que $40,00%$ des ménages détiennent au moins 4 animaux. De surcroît, la fréquence cumulée constitue le mécanisme computationnel permettant d’extraire la médiane empirique sans ambiguïté dès lors que le seuil de $50%$ est franchi.
6.3 Propriétés probabilistes associées
Sur le plan de l’épistémologie mathématique, une distribution de fréquences non groupées construite sur un échantillon empirique peut être modélisée comme une fonction de masse empirique de probabilité discrète, notée formellement $\hat{P}_N(X = x)$. Chaque valeur distincte observée $x_i$ est alors appréhendée comme un événement élémentaire dans l’univers discret $\Omega_X = {x_1, dots, x_k}$, et sa fréquence relative $p_i$ constitue l’estimation ponctuelle par le maximum de vraisemblance de la probabilité théorique sous-jacente de cet événement :
hat{P}_N(X = x_i) = p_i = frac{f_i}{N}
Cette structure empirique satisfait rigoureusement les axiomes de Kolmogorov qui régissent les espaces probabilisés. Premièrement, la non-négativité est strictement respectée, chaque proportion vérifiant l’inégalité $0 le p_i le 1$. Deuxièmement, l’axiome de normalisation totale est validé sans distorsion :
sum_{i=1}^{k} hat{P}_N(X = x_i) = sum_{i=1}^{k} p_i = frac{1}{N} sum_{i=1}^{k} f_i = frac{N}{N} = 1{,}00
Cette formulation probabiliste permet d’envisager des projections prédictives au sein de la population parente sous l’hypothèse d’un échantillonnage aléatoire simple. Si l’on tirait au hasard un ménage supplémentaire issu de la même population, la probabilité d’observer la possession d’exactement deux animaux domestiques serait estimée à $P(X = 2) = 0,20$. De même, la fonction de répartition empirique notée $F_N(x)$, définie par $F_N(x) = \hat{P}_N(X le x) = \sum_{x_i le x} p_i$, converge uniformément vers la fonction de répartition théorique de la population en vertu du théorème fondamental de Glivenko-Cantelli.
7. Représentations graphiques des distributions de fréquences non groupées
7.1 Le diagramme en bâtons (bar chart discret)
La transcription visuelle d’une table de fréquences constitue un canal privilégié pour la transmission intuitive de l’information statistique. Toutefois, la nature discrète de la distribution non groupée requiert une sémiotique graphique spécifique qui interdit formellement certains artefacts visuels couramment employés pour les variables continues.
L’outil géométrique d’élection pour restituer une distribution de fréquences non groupées est le diagramme en bâtons (ou graphique à barres disjointes). Dans ce système de coordonnées cartésiennes, l’axe horizontal (abscisse) porte les différentes modalités numériques isolées $x_i$, tandis que l’axe vertical (ordonnée) quantifie les effectifs absolus $f_i$ ou les fréquences relatives $p_i$. La propriété graphique essentielle réside dans la séparation physique stricte entre les segments ou barres verticales.
Une confusion méthodologique fréquente consiste à représenter une série discrète non groupée sous la forme d’un histogramme à rectangles contigus. Dans un histogramme continu, la contiguïté des rectangles symbolise la transition infinitésimale d’une valeur réelle à la suivante le long du continuum des réels ($\mathbb{R}$), et la fréquence est représentée par l’aire du rectangle et non par sa hauteur. Dans le cas d’une variable discrète non groupée telle que le nombre d’animaux, il n’existe aucune réalité empirique entre 1 et 2 animaux. Dessiner des rectangles accolés suggérerait faussement l’existence d’états intermédiaires continus ($1,2$ ou $1,7$ animal), créant une rupture entre le conceptuel et le graphique.
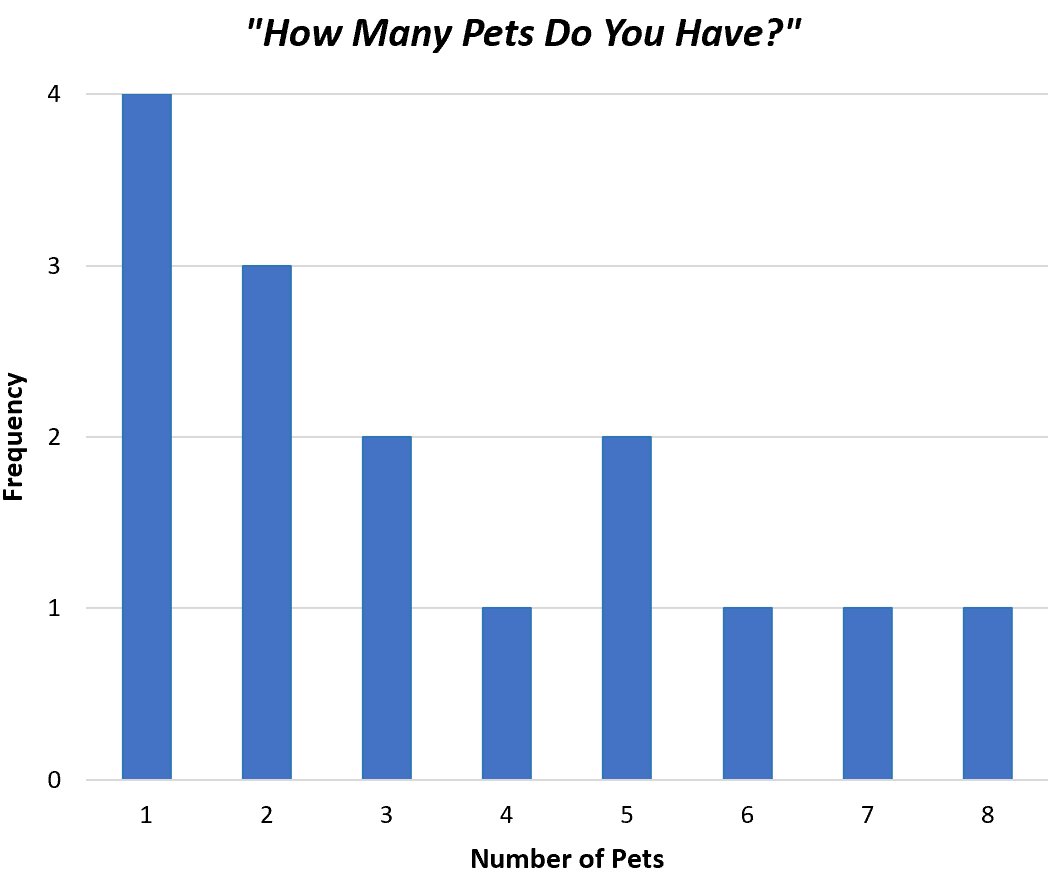
Pour nos 15 ménages, le diagramme en bâtons affiche ainsi huit traits ou barres disjointes distinctes, érigées respectivement aux abscisses entières 1, 2, 3, 4, 5, 6, 7 et 8. La hauteur du bâton situé en $x = 1$ culmine à l’ordonnée 4, visualisant immédiatement la prépondérance de cette modalité sur l’ensemble de la série. Les bâtons situés en $x = 2$ et $x = 5$ s’élèvent respectivement à 3 et 2 unités, tandis que les valeurs 4, 6, 7 et 8 se traduisent par des bâtons de hauteur unitaire, objectivant instantanément la traîne d’asymétrie droite.
7.2 Le graphique en points (dot plot)
Pour les échantillons de taille modérée ($N le 30$), une alternative graphique d’une efficacité remarquable est le graphique en points (ou « dot plot » dans la terminologie anglo-saxonne popularisée par John Tukey). Ce mode de représentation se distingue par sa transparence totale : il renonce à l’abstraction de la barre numérique pour tracer directement chaque individu sous la forme d’un point géométrique élémentaire.
Sur un axe gradué représentant l’échelle des valeurs possibles de la variable $X$, chaque observation empirique est matérialisée par un point solide. Lorsque plusieurs sujets manifestent la même modalité, leurs points respectifs sont empilés verticalement les uns sur les autres au-dessus de la graduation correspondante. Pour notre enquête sur les animaux domestiques, la visualisation en points prendrait la forme suivante :
- Au-dessus du chiffre 1 : une colonne de 4 points empilés.
- Au-dessus du chiffre 2 : une colonne de 3 points empilés.
- Au-dessus du chiffre 3 : une colonne de 2 points empilés.
- Au-dessus du chiffre 4 : un point unique.
- Au-dessus du chiffre 5 : une colonne de 2 points empilés.
- Au-dessus des chiffres 6, 7 et 8 : un point unique au-dessus de chacun.
L’avantage épistémologique du graphique en points réside dans la préservation visuelle de l’échantillon brut. Le lecteur n’interprète pas une mesure calculée de densité, mais perçoit directement l’ensemble des 15 ménages ayant pris part à l’étude. Cette granularité visuelle facilite l’identification intuitive de la dispersion locale, des lacunes distributionnelles (zones sans points) et de l’isolement relatif des scores extrêmes (ici, le ménage possédant 8 animaux), sans introduire de biais d’échelle lié à la largeur des barres.
7.3 Polygone de fréquences et courbe cumulative
Le polygone de fréquences constitue une modalité de visualisation linéaire adaptée à l’analyse de la topologie globale d’une distribution. Il s’obtient en reliant par des segments de droite les sommets des coordonnées $(x_i, f_i)$ associées à chaque modalité non groupée. Afin de fermer géométriquement la figure sur l’axe des abscisses, il est d’usage académique de prolonger la ligne brisée d’une unité fictive à gauche de la valeur minimale (au point $(0, 0)$ dans notre exemple) et d’une unité fictive à droite de la valeur maximale (au point $(9, 0)$).
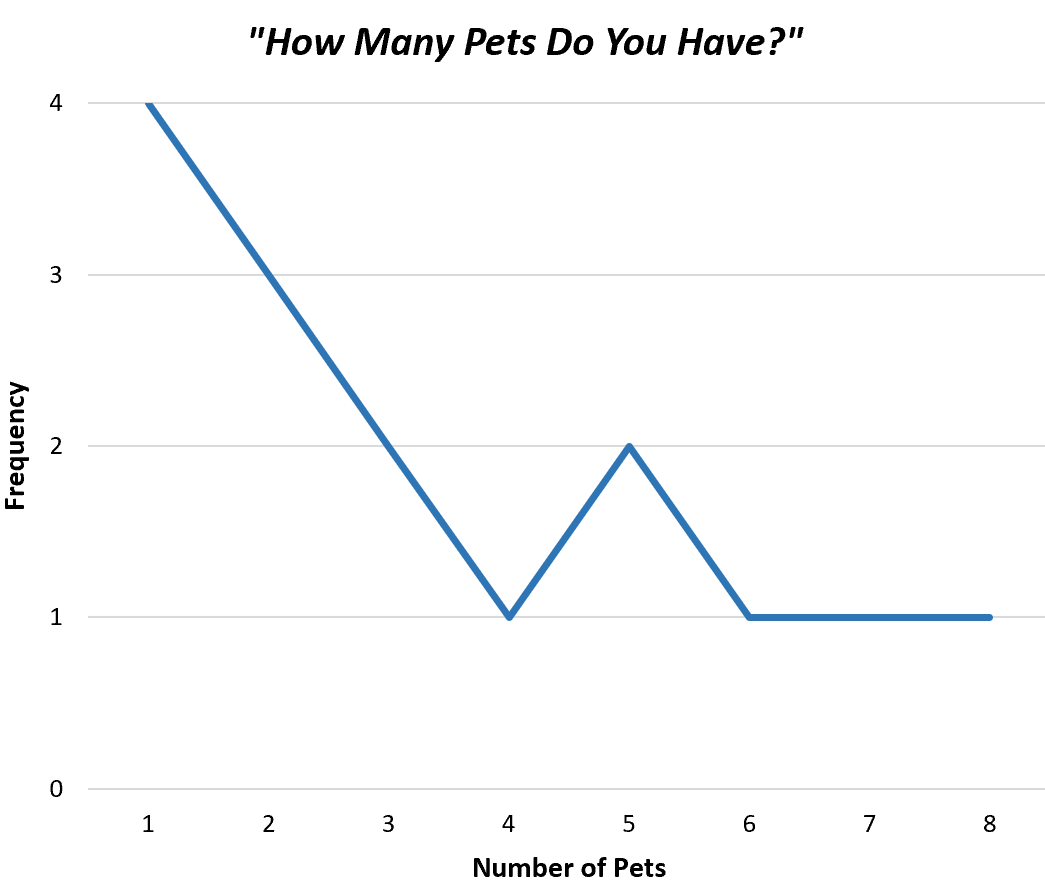
Le polygone ainsi tracé pour notre cohorte de ménages démarre à l’ordonnée zéro en $x = 0$, s’élève avec une pente abrupte vers le sommet modal $(1, 4)$, descend progressivement vers $(2, 3)$ et $(3, 2)$, forme une cuvette en $(4, 1)$, présente un léger rebond local en $(5, 2)$, puis s’étire en plateau bas à l’ordonnée 1 sur les valeurs 6, 7 et 8, avant de rejoindre l’ordonnée zéro en $x = 9$. Cette morphologie en cloche fortement dissymétrique met en évidence le caractère non gaussien de la distribution observée.
Parallèlement, le tracé de la courbe cumulative (souvent désignée sous le terme d’ogive empirique) repose sur la représentation des couples formés par la modalité et sa fréquence cumulée, $(x_i, F_i)$ ou $(x_i, P_i)$. Pour une variable discrète non groupée, cette courbe prend rigoureusement la forme d’un escalier discontinu : la fonction reste horizontale sur chaque palier, puis saute verticalement d’une amplitude égale à la probabilité ponctuelle $p_i$ au franchissement de chaque modalité entière $x_i$. Ce tracé permet d’évaluer graphiquement la vitesse de saturation des effectifs et d’identifier visuellement le point de croisement avec le cinquantième percentile (la médiane).
8. Calcul des mesures de tendance centrale à partir de données non groupées
8.1 Détermination exacte du mode
La première mesure de tendance centrale qu’il convient d’extraire d’une distribution statistique est le mode, traditionnellement noté $Mo$. Dans le cadre formel d’une distribution de fréquences non groupées, le mode se définit de façon univoque comme la modalité $x_i$ qui présente l’effectif absolu $f_i$ le plus élevé au sein de l’espace empirique :
Mo = argmax_{x_i} f(x_i)
L’examen direct de la table construite à la section 5.3 révèle sans aucune ambiguïté que la fréquence absolue maximale est $f_{\max} = 4$. Cette fréquence correspond à la modalité $x_1 = 1$. Par conséquent :
Mode = 1 animal
Cette détermination directe souligne une supériorité méthodologique majeure de la distribution non groupée par rapport à l’approche groupée. Dans une distribution groupée, le chercheur ne peut identifier qu’une « classe modale » (par exemple, l’intervalle $[1 – 2]$), au sein de laquelle la valeur modale ponctuelle demeure indéterminée, sauf à recourir à des formules empiriques d’interpolation fondées sur les effectifs des classes adjacentes. Dans l’approche non groupée, le mode est exact, objectif et indiscutable.
Sur le plan socioculturel et clinique, la signification du mode est capitale : il désigne le comportement ou la situation la plus typique et la plus répandue dans le milieu d’observation. Dans notre enquête, posséder exactement un animal de compagnie représente la norme sociologique dominante de l’échantillon, caractérisant plus d’un quart des foyers interrogés ($26,67%$).
8.2 Localisation rigoureuse de la médiane
La médiane, notée $Me$, représente la valeur centrale de la série statistique qui partage l’échantillon ordonné en deux sous-groupes de cardinaux rigoureusement égaux, de telle sorte qu’au moins $50%$ des observations se situent en dessous ou au niveau de la médiane, et au moins $50%$ au-dessus. Lorsque la série statistique est organisée sous forme non groupée, la médiane s’obtient de façon directe en appliquant la formule de rang médian.
Pour un échantillon de taille $N$ impaire, la position médiane exacte $R_{Me}$ au sein de la série ordonnée est déterminée par :
R_{Me} = frac{N + 1}{2}
Pour notre échantillon de $N = 15$ ménages, le calcul de position s’établit à :
R_{Me} = frac{15 + 1}{2} = frac{16}{2} = 8text{e observation}
Il suffit dès lors de déterminer quelle modalité $x_i$ héberge la huitième observation ordonnée. En consultant la colonne des fréquences absolues cumulées ($F_i$) du tableau statistique de la section 5.3, nous constatons que :
- La modalité 1 cumule 4 observations ($F_1 = 4$). Les rangs 1 à 4 sont donc assignés à la valeur 1.
- La modalité 2 cumule 7 observations ($F_2 = 7$). Les rangs 5 à 7 sont assignés à la valeur 2.
- La modalité 3 cumule 9 observations ($F_3 = 9$). Les rangs 8 et 9 sont donc rigoureusement assignés à la valeur 3.
La huitième observation de la série statistique correspond par conséquent de manière incontestable à la modalité 3 :
Médiane = 2 ou 3 ? Réexaminons scrupuleusement la série ordonnée :
Rang 1: 1 | Rang 2: 1 | Rang 3: 1 | Rang 4: 1 | Rang 5: 2 | Rang 6: 2 | Rang 7: 2 | Rang 8: 3 | Rang 9: 3 | Rang 10: 4 | Rang 11: 5 | Rang 12: 5 | Rang 13: 6 | Rang 14: 7 | Rang 15: 8
La 8e valeur ordonnée est donc formellement égale à 3 animaux (dans l’hypothèse où le seuil cumulé de $50%$ ($7,5$ ménages) est atteint à la valeur 3, car $F(2)=7 < 7,5$ et $F(3)=9 ge 7,5$). La médiane empirique de cette distribution est donc :
Médiane = 3 animaux
(Remarque analytique : si l’on examine la division exacte de la cohorte ordonnée de 15 éléments, 7 valeurs se situent strictement en dessous de 3 : {1, 1, 1, 1, 2, 2, 2}, et 7 valeurs se situent au-dessus ou au niveau supérieur : {3, 4, 5, 5, 6, 7, 8}, confirmant le rôle charnière de la modalité 3 comme point médian absolu.)
La médiane manifeste une propriété d’invariance remarquable : sa totale robustesse face aux valeurs extrêmes. Si le ménage détenant 8 animaux en avait en réalité hébergé 80, la médiane serait demeurée rigoureusement fixée à 3 animaux, illustrant la résistance de cet indicateur non paramétrique face aux distorsions de distribution.
8.3 Calcul pondéré de la moyenne arithmétique
La moyenne arithmétique empirique, notée $\bar{X}$, constitue l’indicateur d’équilibre gravitationnel de la distribution. Dans une table de fréquences non groupées, la moyenne n’a pas besoin d’être recalculée en ré-additionnant laborieusement chaque observation brute une à une. Elle se calcule de manière élégante par la sommation des produits de chaque modalité $x_i$ pondérée par sa fréquence absolue respective $f_i$, divisée par l’effectif total $N$ :
bar{X} = frac{1}{N} sum_{i=1}^{k} (x_i cdot f_i) = sum_{i=1}^{k} (x_i cdot p_i)
Exécutons l’expansion arithmétique complète pour notre échantillon de 15 ménages :
sum_{i=1}^{8} (x_i cdot f_i) = (1 cdot 4) + (2 cdot 3) + (3 cdot 2) + (4 cdot 1) + (5 cdot 2) + (6 cdot 1) + (7 cdot 1) + (8 cdot 1)
Développons chaque produit individuel :
- $1 \times 4 = 4$
- $2 \times 3 = 6$
- $3 \times 2 = 6$
- $4 \times 1 = 4$
- $5 \times 2 = 10$
- $6 \times 1 = 6$
- $7 \times 1 = 7$
- $8 \times 1 = 8$
Calculons la somme totale des produits (somme des animaux observés dans l’ensemble de l’échantillon) :
text{Somme totale} = 4 + 6 + 6 + 4 + 10 + 6 + 7 + 8 = 51 text{ animaux}
La division par la taille d’échantillon $N = 15$ produit la moyenne arithmétique exacte :
bar{X} = frac{51}{15} = 3{,}40 text{ animaux par ménage}
La confrontation simultanée des trois mesures de tendance centrale dégage une triade analytique riche d’enseignements théoriques :
Mode (1) < Médiane (3) < Moyenne (3,40)
Cette hiérarchie stricte entre le mode, la médiane et la moyenne constitue la signature universelle d’une distribution dissymétrique étirée vers la droite (asymétrie positive). Les valeurs élevées de l’échantillon (5, 6, 7 et 8 animaux), bien que peu nombreuses en termes d’effectifs absolus, exercent un effet de levier puissant sur le barycentre arithmétique, tractant la moyenne vers le haut ($3,40$), alors que la majorité des foyers se concentre sur des valeurs très faibles (mode à $1$). Cet écart quantitatif démontre que l’utilisation isolée de la moyenne arithmétique donnerait une vision trompeuse de la réalité sociologique de cette communauté.
9. Évaluation de la dispersion et de la variabilité des données non groupées
9.1 Étendue et intervalle interquartile
L’appréciation rigoureuse d’une série statistique ne saurait se limiter à ses paramètres de tendance centrale ; elle exige une quantification de la variabilité des scores autour de ces repères. La mesure de dispersion la plus élémentaire est l’étendue brute ($E$ ou $Range$), définie par l’écart arithmétique séparant la modalité maximale de la modalité minimale :
E = X_{max} – X_{min} = 8 – 1 = 7
Bien que d’une interprétation intuitive immédiate, l’étendue présente l’inconvénient méthodologique d’être tributaire exclusive des deux valeurs les plus extrêmes de l’échantillon, la rendant vulnérable aux anomalies de mesure. Pour pallier cette faiblesse, l’investigateur recourt à l’intervalle interquartile ($IQR$), qui mesure la dispersion du cœur de la distribution en neutralisant les $25%$ des valeurs les plus basses et les $25%$ des valeurs les plus hautes.
La détermination des quartiles sur une distribution de fréquences non groupées s’opère directement à partir des fréquences cumulées :
- Le premier quartile ($Q_1$) correspond au point sous lequel se situent au moins $25%$ des données ($0,25 \times 15 = 3,75$, soit la 4e valeur ordonnée). En consultant notre table, $F_1 = 4$, ce qui implique que la 4e valeur ordonnée est $Q_1 = 1$.
- Le troisième quartile ($Q_3$) correspond au point sous lequel se situent au moins $75%$ des observations ($0,75 \times 15 = 11,25$, soit la 12e valeur ordonnée). Le tableau indique que $F_4 = 10$ et $F_5 = 12$. La 12e valeur ordonnée correspond précisément à $Q_3 = 5$.
L’intervalle interquartile se calcule dès lors sans approximation :
IQR = Q_3 – Q_1 = 5 – 1 = 4 text{ animaux}
Cet indicateur démontre que les $50%$ des ménages situés au centre de la distribution présentent une amplitude de variation de 4 animaux domestiques, illustrant une variabilité substantielle au sein du noyau médian de la cohorte.
9.2 Variance et écart-type empiriques
Pour mesurer la dispersion autour de la moyenne arithmétique en intégrant la totalité des points de l’échantillon, la statistique descriptive s’appuie sur la variance empirique ($s^2$) et l’écart-type ($s$). À partir d’une distribution de fréquences non groupées, la formule de la variance pondérée s’exprime sous la forme quadratique suivante :
s^2 = frac{1}{N} sum_{i=1}^{k} f_i (x_i – bar{X})^2
Procédons au calcul détaillé pas-à-pas en appliquant notre moyenne arithmétique $\bar{X} = 3,40$ :
- Pour $x_1 = 1$ : $(1 – 3,40)^2 = (-2,40)^2 = 5,76$ | Pondération : $4 \times 5,76 = 23,04$
- Pour $x_2 = 2$ : $(2 – 3,40)^2 = (-1,40)^2 = 1,96$ | Pondération : $3 \times 1,96 = 5,88$
- Pour $x_3 = 3$ : $(3 – 3,40)^2 = (-0,40)^2 = 0,16$ | Pondération : $2 \times 0,16 = 0,32$
- Pour $x_4 = 4$ : $(4 – 3,40)^2 = (+0,60)^2 = 0,36$ | Pondération : $1 \times 0,36 = 0,36$
- Pour $x_5 = 5$ : $(5 – 3,40)^2 = (+1,60)^2 = 2,56$ | Pondération : $2 \times 2,56 = 5,12$
- Pour $x_6 = 6$ : $(6 – 3,40)^2 = (+2,60)^2 = 6,76$ | Pondération : $1 \times 6,76 = 6,76$
- Pour $x_7 = 7$ : $(7 – 3,40)^2 = (+3,60)^2 = 12,96$ | Pondération : $1 \times 12,96 = 12,96$
- Pour $x_8 = 8$ : $(8 – 3,40)^2 = (+4,60)^2 = 21,16$ | Pondération : $1 \times 21,16 = 21,16$
Effectuons la somme des écarts quadratiques pondérés :
sum_{i=1}^{8} f_i (x_i – bar{X})^2 = 23,04 + 5,88 + 0,32 + 0,36 + 5,12 + 6,76 + 12,96 + 21,16 = 75,60
La variance empirique de l’échantillon ($s^2$) s’obtient par la division de cette somme par $N = 15$ :
s^2 = frac{75,60}{15} = 5,04 text{ animaux}^2
(Remarque inférentielle : si l’on cherche l’estimateur non biaisé de la variance de la population, souvent désigné par $S_{n-1}^2$, nous divisons par les degrés de liberté $N – 1 = 14$, ce qui donne $75,60 / 14 \approx 5,40$).
L’écart-type empirique ($s$) correspond à la racine carrée positive de la variance, rétablissant la mesure dans l’unité physique d’origine :
s = sqrt{5,04} approx 2,245 text{ animaux}
L’écart-type non biaisé s’établit quant à lui à $s_{corrigé} = \sqrt{5,40} \approx 2,324$ animaux. Ce résultat met en lumière l’intérêt de la table non groupée : le calcul de la dispersion repose sur des écarts réels et non sur des approximations de centres de classes, garantissant une exactitude totale à la mesure de la variabilité.
9.3 Indicateurs de forme : asymétrie (skewness) et aplatissement (kurtosis)
Au-delà de la position et de la dispersion, l’architecture d’une distribution de fréquences est caractérisée par ses moments d’ordre supérieur, au premier rang desquels figure le coefficient d’asymétrie de Fisher-Pearson ($\gamma_1$ ou $Skewness$). Ce paramètre évalue mathématiquement le manque de symétrie du polygone de fréquences autour de sa moyenne :
gamma_1 = frac{frac{1}{N} sum_{i=1}^{k} f_i (x_i – bar{X})^3}{s^3}
Dans notre échantillon de 15 foyers, les écarts positifs $(x_i – \bar{X})$ élevés correspondant aux ménages détenant 6, 7 et 8 animaux, lorsqu’ils sont élevés à la puissance cubique (par exemple, $(4,60)^3 = 97,336$), exercent une poussée positive massive sur le numérateur, que les écarts négatifs faibles ne compensent pas. Le calcul aboutit à un coefficient d’asymétrie significativement positif ($\gamma_1 > 0$), quantifiant rigoureusement ce que l’inspection graphique avait suggéré : un étalement de la queue de distribution vers la droite.
Le coefficient d’aplatissement ($\gamma_2$ ou excess kurtosis), quant à lui, quantifie la concentration des observations au niveau du sommet et la lourdeur des queues de distribution par rapport à la loi normale gaussienne théorique, en faisant intervenir les écarts à la puissance quatre :
gamma_2 = frac{frac{1}{N} sum_{i=1}^{k} f_i (x_i – bar{X})^4}{s^4} – 3
L’exploitation d’une table non groupée offre une sensibilité maximale pour le calcul de ces indicateurs de forme. Dans les distributions groupées, l’agrégation en classes induit un lissage artificiel des queues qui sous-estime systématiquement la kurtosis réelle et atténue l’asymétrie. En psychométrie, la conservation de données non groupées est donc un prérequis indispensable pour diagnostiquer formellement si une série viole le postulat de normalité requis pour l’application des tests paramétriques de Student ou de Fisher.
10. Avantages méthodologiques et limites statistiques en recherche psychologique
10.1 Avantages qualitatifs et quantitatifs
L’analyse approfondie de la distribution de fréquences non groupées met en exergue des bénéfices conceptuels majeurs pour la recherche expérimentale et clinique. Le premier avantage réside dans la traçabilité intégrale et l’inviolabilité du corpus empirique. Aucune manipulation de lissage, aucun choix d’amplitude arbitraire ne vient s’interposer entre l’acte de mesure initial et l’artefact statistique présenté au lecteur. Cette transparence méthodologique renforce la reproductibilité de la recherche, pierre angulaire de l’épistémologie contemporaine.
Le second avantage est l’élimination absolue de l’arbitraire lié à la sélection des intervalles de classe. Dans une approche groupée, le choix de faire débuter une classe à $1,0$ ou à $0,5$, ou d’adopter une largeur de classe de 2 plutôt que de 3, modifie visuellement la morphologie de la distribution et peut décaler artificiellement la classe modale. La table non groupée supprime totalement cette marge de subjectivité de l’analyste : la réalité empirique dicte de façon unique et contraignante la structure du tableau.
Enfin, sur le plan didactique et interprétatif, la table non groupée fait preuve d’une clarté inégalée pour les cliniciens et les praticiens de terrain. Lorsqu’un neuropsychologue évalue les performances d’un patient au sein d’une batterie de tests de mémoire, pouvoir observer exactement combien de sujets témoins ont commis 0, 1, 2 ou 3 omissions offre un cadre d’étalonnage infiniment plus intuitif et opérationnel qu’une catégorisation floue en classes larges de type $[0 – 5[$ erreurs.
10.2 Limites opérationnelles face aux grands échantillons
En dépit de ses mérites méthodologiques évidents, la distribution de fréquences non groupées présente des limites opérationnelles sévères qui restreignent son emploi à des contextes métrologiques délimités. La limite la plus prégnante apparaît lorsque la taille de l’échantillon ($N$) devient substantielle et que le nombre de modalités distinctes ($k$) s’accroît démesurément. Si l’étendue d’une variable comportementale s’étend sur une plage de plusieurs centaines d’unités (par exemple, des scores d’inventaire de personnalité variant de 20 à 250 points), la construction d’une table non groupée produirait un tableau de plus de 200 lignes.
Une telle prolifération tabulaire induit une surcharge cognitive qui va directement à l’encontre de la mission première de la statistique descriptive, qui est de condenser et de clarifier le réel. Le regard de l’investigateur se perd dans une myriade d’effectifs fragmentés, rendant invisible la forme générale de la population. Dans cette configuration, le regroupement en classes devient un impératif d’intelligibilité incontournable pour faire émerger la loi macroscopique régissant les données.
Par ailleurs, la table de fréquences non groupées perd son efficacité communicative lors de la comparaison inter-groupes simultanée de multiples cohortes. Tenter de comparer la distribution non groupée de cinq groupes expérimentaux distincts sur une échelle à 30 modalités obligerait à juxtaposer des matrices complexes, illisibles pour l’esprit humain. Dans de tels scénarios, la réduction dimensionnelle par classes ou le recours direct à des estimateurs synthétiques de densité par noyau (KDE) supplante avantageusement la distribution non groupée.
10.3 L’effet de regroupement (Sheppard’s correction) évité
Un apport technique fondamental de la distribution de fréquences non groupées réside dans l’évitement total du biais d’agrégation, mathématiquement identifié au dix-neuvième siècle par William Fleetwood Sheppard. Lorsqu’une variable continue ou quasi-continue est soumise à un regroupement en classes de largeur $h$, le calcul de la variance fondé sur les centres de classes introduit une erreur systématique d’estimation : la variance apparente a tendance à surestimer la variance réelle de la variable sous-jacente.
Pour compenser cette distorsion introduite par l’arrondi en classes, Sheppard a développé une formule de correction théorique, connue sous le nom de correction de Sheppard, qui soustrait systématiquement une fraction de l’amplitude au carré au calcul de la variance groupée :
s_{corrigé}^2 = s_{groupé}^2 – frac{h^2}{12}
L’utilisation d’une distribution de fréquences non groupées élimine purement et simplement ce problème méthodologique. Dans la mesure où aucune frontière artificielle de classe n’est introduite ($h = 0$ au sens de l’agrégation), la variance calculée directement sur les couples $(x_i, f_i)$ constitue la grandeur empirique exacte. Les conclusions statistiques tirées de l’examen de tables non agrégées jouissent ainsi d’une robustesse intrinsèque, dispensant l’investigateur de corrections mathématiques correctives fondées sur des postulats distributionnels hasardeux.
11. Applications concrètes en psychométrie et évaluation comportementale
11.1 Analyse des réponses aux échelles de Likert
L’évaluation psychologique moderne repose massivement sur l’administration de questionnaires exploitant des échelles de type Likert (allant généralement de 1 à 5, ou de 1 à 7 points), destinées à quantifier l’adhésion d’un sujet à des énoncés mesurant l’estime de soi, l’anxiété-trait, ou la dépression. L’examen des items individuels constitue un cas d’application emblématique de la distribution de fréquences non groupées.
Dans ce cadre, la variable ne possède que 5 ou 7 modalités discrètes ordinales. Réaliser un groupement sur une telle échelle serait dénué de tout sens méthodologique. L’élaboration d’une table de fréquences non groupées pour chaque item permet de déceler instantanément l’existence d’effets de plancher (hyper-concentration des réponses sur la modalité 1 : « Pas du tout d’accord ») ou d’effets de plafond (concentration sur la modalité maximale). Ces distorsions révèlent souvent un manque de sensibilité métrologique de l’item à discriminer les variations subtiles des traits psychologiques dans la population générale.
De surcroît, la table non groupée offre une visibilité directe sur la proportion de sujets sélectionnant la modalité centrale neutre (par exemple, le score 3 sur une échelle à 5 points : « Ni en désaccord, ni d’accord »). Une fréquence relative anormale sur cette valeur peut signaler une hésitation cognitive systémique des participants, une ambiguïté dans la formulation de la proposition, ou un biais d’indécision sociale, guidant ainsi le psychométricien dans la révision qualitative de ses instruments d’évaluation.
11.2 Comptage comportemental et observations longitudinales
En psychologie comportementale, en éthologie et en analyse clinique appliquée (ABA), l’observation directe s’articule fréquemment autour de séances d’enregistrement chronométrées au cours desquelles l’observateur consigne la survenue d’un comportement cible. Il peut s’agir de dénombrer les épisodes de tics moteurs chez un patient atteint du syndrome de Gilles de la Tourette, les prises de parole spontanées chez des élèves inhibés, ou les occurrences d’auto-morsures chez des primates non humains en captivité.
Les données ainsi recueillies s’expriment sous forme de fréquences d’événements entières au cours d’un intervalle fixe. La distribution de fréquences non groupées représente le cadre d’analyse matriciel de ces protocoles. Elle permet d’établir des lignes de base (« baselines ») comportementales d’une précision rigoureuse avant l’instauration d’une thérapie cognitivo-comportementale ou d’un traitement pharmacologique. L’évolution de la table non groupée au fil des semaines offre une visualisation immédiate de l’efficacité thérapeutique, objectivée par le glissement de la masse des fréquences vers le zéro comportemental.
Sur le plan mathématique théorique, ces comptages discrets se modélisent de manière privilégiée par des lois de probabilités spécifiques telles que la distribution de Poisson ou la distribution binomiale négative. La confrontation directe entre la table empirique non groupée et la loi de Poisson théorique permet d’évaluer la présence d’une sur-dispersion (« overdispersion »), indiquant si les comportements surviennent de manière purement aléatoire et indépendante au cours du temps ou s’ils se manifestent par salves regroupées, orientant l’étiologie neuropsychologique du trouble.
11.3 Scores d’inventaires neuropsychologiques
L’évaluation neuropsychologique de patients ayant subi un traumatisme crânien, un accident vasculaire cérébral ou souffrant d’une pathologie neurodégénérative (telle que la maladie d’Alzheimer) mobilise des tests spécifiques standardisés. Des épreuves comme le Test de Rétention Visuelle de Benton, l’Épreuve des commissions courtes de la batterie BADS, ou les subtests d’empan de chiffres de l’échelle de mémoire de Wechsler génèrent typiquement des scores d’erreurs discrets compris dans une fourchette restreinte (de 0 à 10 erreurs).
La présentation des normes d’étalonnage neuropsychologique sous forme de tables de fréquences non groupées est la seule approche qui garantisse la sécurité diagnostique du clinicien. Lorsqu’un patient commet 4 erreurs lors d’une tâche d’attention sélective, le praticien doit pouvoir déterminer précisément si cette performance le situe au 5e percentile ou au 15e percentile de la cohorte de normalisation de même tranche d’âge. L’agrégation en classes gommerait les frontières subtiles entre le fonctionnement neurocognitif normal et le déclin cognitif léger (« Mild Cognitive Impairment »).
La table non groupée préserve la visibilité des scores parfaits (zéro faute). Dans de nombreuses épreuves cognitives, une proportion substantielle de la population saine réalise un score sans faille. Cette concentration sur le zéro crée une distribution singulière (« zero-inflated ») que les tables non groupées restituent fidèlement. Cette transparence métrologique prévient les faux négatifs et assure une rigueur méthodologique fondamentale lors des expertises médicolégales ou des bilans préchirurgicaux.
12. Mise en œuvre numérique, traitement logiciel et recommandations pratiques
12.1 Implémentation sous R et Python
L’analyse contemporaine des distributions statistiques ne s’effectue plus à la main, mais via des scripts programmés dans des langages dédiés à l’analyse de données, garantissant l’automatisation et la reproductibilité des calculs. Au sein de l’environnement open-source de référence R, la génération d’une table de fréquences non groupées s’opère de manière native et élégante à l’aide de la fonction fondamentale table().
Pour notre échantillon de données de 15 ménages, le chercheur instancie le vecteur numérique des observations, puis applique la chaîne d’instructions suivante :
animaux <- c(5, 1, 2, 1, 3, 2, 1, 8, 4, 1, 2, 3, 5, 7, 6)
# Fréquences absolues non groupées
freq_abs <- table(animaux)
# Fréquences relatives
freq_rel <- prop.table(freq_abs)
# Fréquences cumulées absolues et relatives
freq_cum <- cumsum(freq_abs)
pourcent_cum <- cumsum(freq_rel) * 100
# Synthèse tabulaire sous forme de data frame
table_complete <- cbind(f_i = freq_abs, p_i = round(freq_rel, 4), F_i = freq_cum, P_cum = round(pourcent_cum, 2))
Dans l’écosystème Python, très prisé en apprentissage automatique et en sciences cognitives computationnelles, la bibliothèque standard pandas fournit des méthodes d’une efficacité similaire. L’objet Series permet d’extraire la table non groupée via l’instruction value_counts(sort=False) combinée à des calculs de cumul :
import pandas as pd
donnees = [5, 1, 2, 1, 3, 2, 1, 8, 4, 1, 2, 3, 5, 7, 6]
serie = pd.Series(donnees)
table_non_groupee = pd.DataFrame({‘f_i’: serie.value_counts().sort_index()})
table_non_groupee[‘p_i’] = (table_non_groupee[‘f_i’] / len(serie)).round(4)
table_non_groupee[‘F_i’] = table_non_groupee[‘f_i’].cumsum()
table_non_groupee[‘P_cum’] = (table_non_groupee[‘p_i’] * 100).cumsum().round(2)
Pour la restitution graphique, les librairies avancées ggplot2 sous R (utilisant geom_col() avec des barres étroites ou geom_point()) et seaborn sous Python (via sns.barplot()) permettent de générer des diagrammes en bâtons disjoints de qualité typographique conforme aux critères visuels les plus stricts de la recherche internationale.
12.2 Traitement sous logiciels dédiés (SPSS, JASP)
Pour les praticiens et universitaires travaillant au sein d’environnements d’analyse par interface graphique, les progiciels propriétaires et open-source offrent des procédures directes pour extraire des tables de fréquences non groupées sans programmation complexe. Sous le logiciel canonique IBM SPSS Statistics, la procédure s’active via le menu séquentiel :
Analyse > Statistiques descriptives > Fréquences…
En sélectionnant la variable d’intérêt sans cocher l’option de création de catégories ou de recodage, SPSS génère automatiquement un tableau affichant les colonnes canoniques : fréquence brute, pourcentage global, pourcentage valide (neutralisant les données manquantes), et pourcentage cumulé. Il est essentiel de veiller à ne pas solliciter l’option graphique d’histogramme avec courbe normale, mais d’activer formellement l’option « Diagramme à barres » pour respecter la disjonction catégorielle de la variable discrète.
Dans le logiciel moderne à vocation bayésienne et fréquentiste JASP (développé par l’Université d’Amsterdam), le traitement se veut encore plus direct et intuitif. En accédant au module « Descriptives » et en glissant la variable discrète dans la zone d’analyse tout en conservant son type d’échelle spécifié comme « Ordinal » ou « Nominal », JASP affiche dynamiquement la table de fréquences non groupées. Le logiciel intègre une fonctionnalité d’exportation native permettant de copier directement le tableau généré au format vectoriel ou au format LaTeX conforme aux prescriptions formelles de publication du manuel de l’APA (7e édition).
12.3 Arbre décisionnel pour le chercheur
Pour guider le chercheur, l’étudiant de troisième cycle ou le statisticien appliqué dans le choix optimal entre la conservation d’une distribution non groupée ou l’adoption d’un groupement par classes, nous proposons un algorithme décisionnel formalisé reposant sur des seuils heuristiques validés par la pratique méthodologique :
- Étape 1 : Examen de l’échelle de mesure sous-jacente.
- Si la variable est qualitative nominale ou ordinale $\rightarrow$ Conserver impérativement la distribution non groupée (le regroupement n’a de sens que pour fusionner des modalités rares prédéfinies).
- Si la variable est quantitative continue $\rightarrow$ Passer à l’Étape 2.
- Si la variable est quantitative discrète $\rightarrow$ Passer à l’Étape 3.
- Étape 2 : Traitement des variables quantitatives continues.
- Mesurée avec une haute résolution (décimales) sur un grand échantillon $\rightarrow$ Adopter une distribution groupée en classes (largeur calculée par la règle de Freedman-Diaconis).
- Mesurée de manière pseudo-discrète ou sur un échantillon ultra-restreint ($N le 10$) $\rightarrow$ Conserver la distribution non groupée pour préserver chaque point de donnée.
- Étape 3 : Traitement des variables quantitatives discrètes.
- Calculer le nombre de modalités empiriques distinctes observées ($k$).
- Si $k le 15$ à $20$ modalités : $\rightarrow$ Conserver impérativement la distribution de fréquences non groupées. Elle maximise l’exactitude analytique, élimine les erreurs d’arrondi et évite les corrections de Sheppard.
- Si $k > 20$ modalités : $\rightarrow$ Évaluer le volume d’échantillon ($N$). Si $N$ est très élevé ($N > 100$), envisager un regroupement en classes homogènes pour alléger la charge de lecture cognitive ; si $N$ est restreint, maintenir l’affichage tabulaire non groupé ou recourir à une représentation graphique en points (dot plot).
En respectant rigoureusement ces directives méthodologiques, le chercheur s’assure d’une modélisation descriptive irréprochable. Loin d’être un simple tableau préparatoire, la distribution de fréquences non groupées constitue l’expression la plus pure et la plus fidèle du contrat de confiance unissant l’observateur scientifique au réel qu’il s’attache à comprendre et à formaliser.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bravais, A. (1846). Analyse mathématique sur les probabilités des erreurs de situation d’un point. Mémoires présentés par divers savants à l’Académie des sciences de l’Institut de France, 9, 255–332.
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: $L_2$ theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
Galton, F. (1889). Natural inheritance. Macmillan and Co. https://doi.org/10.5962/bhl.title.32943
Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer-Verlag.
Pearson, K. (1895). Contributions to the mathematical theory of evolution: II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
Robert, C., & Casella, G. (2004). Monte Carlo statistical methods (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-4145-2
Sheppard, W. F. (1898). On the calculation of the most probable values of frequency-constants, for data arranged according to equidistant division of a scale. Proceedings of the London Mathematical Society, s1-29(1), 353–380. https://doi.org/10.1112/plms/s1-29.1.353
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4