
Dans le vaste édifice du calcul des probabilités et de la statistique inférentielle, peu de concepts s’avèrent aussi fondamentaux, et pourtant aussi fréquemment confondus dans la pratique expérimentale, que la relation unissant la loi de Bernoulli à la distribution binomiale. Ces deux modèles stochastiques constituent la pierre angulaire de l’analyse des phénomènes discrets où la nature impose une bifurcation : succès ou échec, activation ou repos, adhésion ou rejet, présence ou absence d’un trait psychopathologique. Bien que les manuels introductifs traitent souvent cette distinction de manière expéditive en réduisant la loi de Bernoulli à un simple « cas particulier » de la distribution binomiale où le nombre d’essais serait égal à un, cette simplification pédagogique occulte les singularités mathématiques, les implications épistémologiques et les conséquences méthodologiques majeures qui découlent de l’analyse d’un événement élémentaire isolé comparativement à son agrégation au sein d’un collectif d’expériences répétées.
Comprendre en profondeur la frontière conceptuelle et formelle entre ces deux lois de probabilité est d’autant plus crucial dans les sciences contemporaines que la recherche quantitative, la psychométrie computationnelle, les neurosciences cognitives et la modélisation statistique avancée s’appuient continuellement sur ces distributions pour formaliser des dynamiques décisionnelles, calibrer des tests standardisés ou concevoir des modèles de régression logistique et linéaire généralisée (Wolfram MathWorld). Dès lors qu’un chercheur observe la réponse dichotomique d’un participant face à un stimulus perceptif, enregistre la réussite d’un patient à un item clinique ou mesure le taux global de mémorisation au sein d’une cohorte, il navigue nécessairement entre l’échelle atomique de l’épreuve de Bernoulli et l’échelle synthétique de la variable binomiale.
Cet article propose une analyse exhaustive et rigoureuse de la distribution de Bernoulli et de la distribution binomiale, depuis leurs fondements axiomatiques et leurs développements historiques jusqu’à leurs implémentations computationnelles et leurs applications diagnostiques de pointe. En examinant leurs propriétés analytiques respectives, leurs fonctions génératrices, leurs comportements asymptotiques ainsi que les pièges méthodologiques liés à la violation de leurs postulats constitutifs, nous fournirons au chercheur et au statisticien les clés théoriques indispensables pour maîtriser ces deux piliers de l’incertitude quantifiée.
1. Introduction aux fondements probabilistes : de l’événement unique à la répétition
1.1 Origines historiques et contributions de Jacques Bernoulli
L’émergence formelle de l’analyse probabiliste des variables binaires trouve son acte de naissance dans le chef-d’œuvre posthume du mathématicien suisse Jacques Bernoulli, l’Ars Conjectandi (« L’Art de conjecturer »), publié en 1713 sous les soins de son neveu Nicolas Bernoulli, huit années après le décès de son auteur. Jusqu’au tournant du XVIIIe siècle, la quantification des jeux de hasard, inaugurée par des érudits tels que Gerolamo Cardano, Blaise Pascal et Pierre de Fermat, s’était principalement cantonnée à l’analyse de situations combinatoires symétriques, à l’instar des tirages dans une urne ou des lancers de dés équilibrés. Jacques Bernoulli opéra une rupture conceptuelle majeure en formalisant l’épreuve dichotomique non plus comme une simple curiosité récréative, mais comme une unité de mesure fondamentale de la certitude philosophique et empirique.
Dans la quatrième partie de l’Ars Conjectandi, Bernoulli introduisit ce qui allait devenir le premier théorème limite de l’histoire des mathématiques : la Loi faible des grands nombres. Pour asseoir cette démonstration monumentale, il théorisa l’abstraction d’une expérience isolée ne pouvant comporter que deux issues mutuellement exclusives et collectivement exhaustives. Son ambition transcendait largement les tables de jeu ; il s’agissait de doter la médecine légale, la jurisprudence et les sciences naissantes du comportement humain d’un cadre objectif permettant d’inférer la probabilité intrinsèque d’un événement sous-jacent à partir de la fréquence relative de ses manifestations observées.
Cette transition de l’interrogation philosophique sur la certitude subjective vers la formalisation quantitative du hasard posa les bases de la statistique moderne. Les sciences comportementales contemporaines, et plus particulièrement la psychométrie et la psychologie expérimentale, sont les héritières directes de cette révolution bernoullienne. Lorsque nous examinons aujourd’hui si un sujet réussit ou échoue à une épreuve cognitive, nous réactivons la mécanique théorique imaginée il y a plus de trois siècles par le maître de Bâle, articulant le passage de l’inconnaissable ponctuel à la régularité statistique globale.
1.2 Définition axiomatique d’une variable aléatoire discrète
D’un point de vue formel, l’ancrage de ces distributions dans la théorie moderne des probabilités requiert le cadre axiomatique institué par Andreï Kolmogorov en 1933. Considérons un espace probabilisé défini par le triplet fondamental $(\Omega, \mathcal{F}, P)$, où $\Omega$ représente l’univers des états de la nature (l’espace d’échantillonnage), $\mathcal{F}$ est une tribu ou une $\sigma$-algèbre de parties de $\Omega$ définissant l’ensemble des événements mesurables, et $P$ est une mesure de probabilité assignant à chaque événement de $\mathcal{F}$ une valeur comprise dans l’intervalle réel $[0, 1]$, satisfaisant les axiomes de non-négativité, de normalisation ($P(\Omega) = 1$) et de $\sigma$-additivité.
Une variable aléatoire discrète $X$ est une application mesurable définie sur $\Omega$ à valeurs dans un sous-ensemble dénombrable ou fini de l’espace des nombres réels $\mathbb{R}$. Dans l’étude des phénomènes psychologiques et comportementaux, une immense majorité de situations empiriques se manifeste par des données qualitatives nominales binaires. L’expérimentateur n’observe pas directement un nombre continu, mais un état ontologique : une personne choisit de coopérer ou de faire défection dans un dilemme du prisonnier ; un participant détecte ou non un flash lumineux en vision périphérique ; un patient répond par l’affirmative ou la négative à une question évaluant la symptomatologie dépressive.
Le traitement analytique de ces manifestations impose une assignation numérique standardisée. Par convention canonique universelle, les modalités qualitatives hétérogènes sont projetées sur l’ensemble binaire discret ${0, 1}$, où la modalité d’intérêt ou « succès » se voit assigner la valeur numérique 1, tandis que son complémentaire ou « échec » reçoit la valeur numérique 0. Cette opération d’arithmétisation transforme l’observation phénoménologique en une variable indicatrice mesurable. La distinction mathématique liminaire se dessine alors avec netteté : sommes-nous en présence d’une mesure isolée sur un unique tirage expérimental, ou devons-nous caractériser la composition d’un vecteur ou d’une suite séquentielle de telles réalisations ? C’est dans cet interstice méthodologique que s’établit la frontière séparant l’épreuve de Bernoulli de sa généralisation binomiale.
1.3 Importance de la distinction en recherche quantitative et psychologique
La confusion entre l’unité expérimentale élémentaire et l’agrégat séquentiel n’est pas qu’une simple imprécision terminologique ; elle engendre des conséquences méthodologiques délétères lors du traitement statistique des données empiriques. En recherche quantitative, la nature du support de la variable dépendante dicte impérativement le choix de la famille exponentielle à mobiliser dans le cadre des modèles linéaires généralisés (GLM). Modéliser une issue binaire unique observée au niveau du sujet ou de l’item requiert une formulation logistique ou probit stricte reposant sur une vraisemblance de Bernoulli. À l’inverse, l’analyse d’un total d’occurrences positives cumulées sur un bloc expérimental structuré exige la spécification d’un modèle binomial prenant explicitement en considération le dénominateur correspondant au nombre total d’essais.
Une mauvaise identification de cette échelle engendre des distorsions graves dans l’estimation des erreurs types, augmentant dramatiquement le risque d’erreurs de type I (faux positifs) par l’omission des dépendances hiérarchiques ou la génération artificielle d’une surdispersion statistique non contrôlée. Dans l’administration des questionnaires psychométriques, postuler implicitement qu’une série de dix items dichotomiques équivaut à un processus binomial parfait conduit souvent les cliniciens à ignorer les variations idiosyncrasiques de difficulté d’un item à l’autre, biaisant l’estimation de la fidélité et de l’erreur type de mesure.
En outre, cette distinction s’avère centrale en psychophysique et dans la théorie de la détection du signal. L’analyse ne saurait traiter de manière équivalente la dynamique temporelle d’un essai perceptif isolé — influencé par l’attention momentanée du sujet et mesuré par une variable de Bernoulli — et le taux agrégé de détections correctes sur une session d’essais multiples, gouverné par une structure binomiale composite. Maîtriser cette frontière méthodologique constitue donc une condition sine qua non de validité pour quiconque aspire à produire des résultats reproductibles en sciences comportementales.
2. La distribution de Bernoulli : formalisation théorique et caractéristiques
2.1 Définition mathématique et support de la variable
La distribution de Bernoulli représente le modèle probabiliste le plus dépouillé et le plus élémentaire applicable à une expérience aléatoire ne comportant que deux éventualités possibles. Formellement, soit une variable aléatoire discrète $X$ définie sur l’espace d’échantillonnage $\Omega$. On dit que $X$ suit une loi de Bernoulli, ce que l’on note conventionnellement $X \sim \mathcal{B}(p)$ ou $X \sim \text{Bernoulli}(p)$, si son support $\mathcal{X}$ est strictement restreint au sous-ensemble des entiers :
$$\mathcal{X} = {0, 1}$$
Cette distribution est entièrement caractérisée par un unique paramètre scalaire continu, $p$, appartenant à l’intervalle réel fermé :
$$p in [0, 1]$$
Le paramètre $p$ quantifie la probabilité intrinsèque d’observer l’événement qualifié conventionnellement de « succès », soit $P(X = 1) = p$. En vertu du principe de complémentarité absolue et du troisième axiome de Kolmogorov, la probabilité d’observer l’événement qualifié d’« échec », notée fréquemment $q$, est déterminée univoquement par la relation :
$$q = P(X = 0) = 1 – p$$
Pour exprimer la distribution de probabilité sous une forme analytique unifiée et élégante, permettant des manipulations algébriques directes notamment lors de l’écriture des fonctions de vraisemblance, la fonction de masse de probabilité (PMF, pour Probability Mass Function) de la loi de Bernoulli s’écrit sous la forme multiplicative compacte suivante, valide pour tout $x in {0, 1}$ :
$$P(X = x) = p^x (1 – p)^{1 – x}$$
Lorsque l’on substitue $x = 1$ dans cette expression, le second terme s’élève à la puissance zéro ($(1 – p)^0 = 1$), restituant immédiatement $P(X = 1) = p$. Inversement, en posant $x = 0$, le premier terme s’annule à l’exposant ($p^0 = 1$), ne laissant subsister que $P(X = 0) = 1 – p$. La fonction de répartition cumulative (CDF, pour Cumulative Distribution Function) correspondante, $F(x) = P(X le x)$, présente une structure d’escalier discontinue avec un saut discret d’amplitude $1 – p$ en $x = 0$ et un second saut discret d’amplitude $p$ en $x = 1$, atteignant ainsi son asymptote unitaire pour toute valeur supérieure ou égale à 1.
2.2 Moments statistiques de la loi de Bernoulli
L’étude des moments statistiques d’une variable aléatoire permet de résumer rigoureusement ses propriétés structurales fondamentales que sont sa tendance centrale, sa dispersion, son asymétrie et son aplatissement. Pour une variable aléatoire de Bernoulli $X \sim \mathcal{B}(p)$, le calcul du premier moment ordinaire, correspondant à l’espérance mathématique $E(X)$, s’opère par l’application directe de la définition du produit des valeurs du support par leurs probabilités respectives :
$$E(X) = \sum_{x in {0, 1}} x \cdot P(X = x) = (0 \cdot P(X = 0)) + (1 \cdot P(X = 1)) = (0 \cdot (1 – p)) + (1 \cdot p) = p$$
L’espérance mathématique d’une loi de Bernoulli coïncide donc strictement avec son paramètre fondamental $p$. Pour dériver la variance $\text{Var}(X)$, mesurant la dispersion stochastique autour de cette moyenne théorique, nous utilisons le théorème de König-Huygens selon lequel $\text{Var}(X) = E(X^2) – [E(X)]^2$. En évaluant d’abord le moment non centré d’ordre deux :
$$E(X^2) = (0^2 \cdot (1 – p)) + (1^2 \cdot p) = p$$
Il en découle immédiatement l’expression canonique de la variance :
$$\text{Var}(X) = p – p^2 = p(1 – p) = pq$$
Cette expression parabolique révèle une caractéristique essentielle : la variance d’une distribution de Bernoulli est une fonction concave de $p$, atteignant son maximum absolu théorique pour $p = 0{,}5$, où $\text{Var}(X) = 0{,}25$. Lorsque $p$ tend vers ses bornes déterministes 0 ou 1, la variance s’annule inexorablement, matérialisant l’absence totale d’incertitude sur l’issue de l’épreuve.
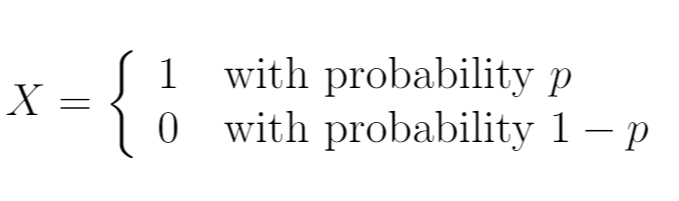
Au-delà de la moyenne et de la variance, les moments d’ordre supérieur fournissent des informations capitales sur la morphologie de la distribution. Le coefficient d’asymétrie de Fisher (skewness), dénoté $\gamma_1$, se déduit à partir du troisième moment centré normalisé par l’écart-type $\sigma = \sqrt{p(1-p)}$ :
$$\gamma_1 = \frac{E[(X – p)^3]}{\sigma^3} = \frac{1 – 2p}{\sqrt{p(1 – p)}}$$
Cette formule met en exergue le fait que la loi de Bernoulli n’est parfaitement symétrique ($\gamma_1 = 0$) que si et seulement si $p = 0{,}5$. Si $p 0$, signifiant que la masse probabiliste s’étire vers la droite avec une queue positive représentée par le succès rare. Réciproquement, si $p > 0{,}5$, l’asymétrie devient négative ($\gamma_1 < 0$).
Enfin, le coefficient d’aplatissement de Fisher ou kurtosis d’excès, noté $\gamma_2$, qui évalue la propension de la distribution à générer des valeurs extrêmes comparativement à une loi normale standard, s’établit formellement comme :
$$\gamma_2 = \frac{E[(X – p)^4]}{\sigma^4} – 3 = \frac{1 – 6p(1 – p)}{p(1 – p)}$$
Ce résultat démontre la sensibilité aiguë de la distribution de Bernoulli aux événements atypiques : à mesure que $p$ s’écarte de 0,5 pour converger vers 0 ou 1, le kurtosis tend vers l’infini positif, traduisant une hyper-leptokurticité structurelle caractéristique des processus stochastiques gouvernés par des occurrences exceptionnelles.
2.3 Exemples canoniques et illustrations empiriques
L’archétype universellement invoqué pour illustrer la variable de Bernoulli réside dans le lancer unique d’une pièce de monnaie. Si la pièce est rigoureusement équilibrée, le paramètre prend la valeur théorique $p = 0{,}5$, traduisant une situation d’entropie informationnelle maximale où l’incertitude prédictive est totale. Si la pièce présente une dissymétrie matérielle ou est volontairement lestée, le paramètre $p$ s’éloigne de cette valeur médiane, configurant une épreuve biaisée tout en demeurant strictement dans le formalisme bernoullien.
Dans le domaine de l’évaluation psychométrique et pédagogique, la réponse fournie par un individu à un item isolé d’un test d’aptitude constitue une réalisation empirique pure d’une variable de Bernoulli. Face à une question standardisée à choix multiple (QCM) ou à une tâche de résolution de problème, l’examinateur consigne une réponse dichotomique : la réponse est soit strictement exacte ($X = 1$), soit erronée ($X = 0$). Le paramètre $p$ ne représente pas ici une propriété mécanique de l’objet de test, mais l’interaction stochastique complexe entre le niveau d’habileté cognitive du candidat et le degré d’exigence ou de difficulté intrinsèque de l’item considéré.
En neurosciences computationnelles et en électrophysiologie cellulaire, la loi de Bernoulli trouve une incarnation biologique fascinante dans la modélisation du potentiel d’action neuronal. À l’intérieur d’une micro-fenêtre temporelle d’observation discrétisée (typiquement de l’ordre de 1 à 2 millisecondes, correspondant à la période réfractaire absolue du neurone), l’axone neuronal obéit à la loi du « tout ou rien » établie par Edgar Adrian. Le neurone ne peut émettre un demi-potentiel d’action : soit le dépolarisation membranaire franchit le seuil d’excitabilité critique et déclenche une décharge électrique complète ($X = 1$), soit la membrane demeure dans un état sous-liminaire ($X = 0$). La probabilité $p$ traduit alors la sensibilité synaptique locale instantanée en réponse aux afférences dendritiques excitatrices et inhibitrices.
3. La distribution binomiale : extension multidimensionnelle de l’épreuve élémentaire
3.1 Cadre théorique et conditions de réalisation
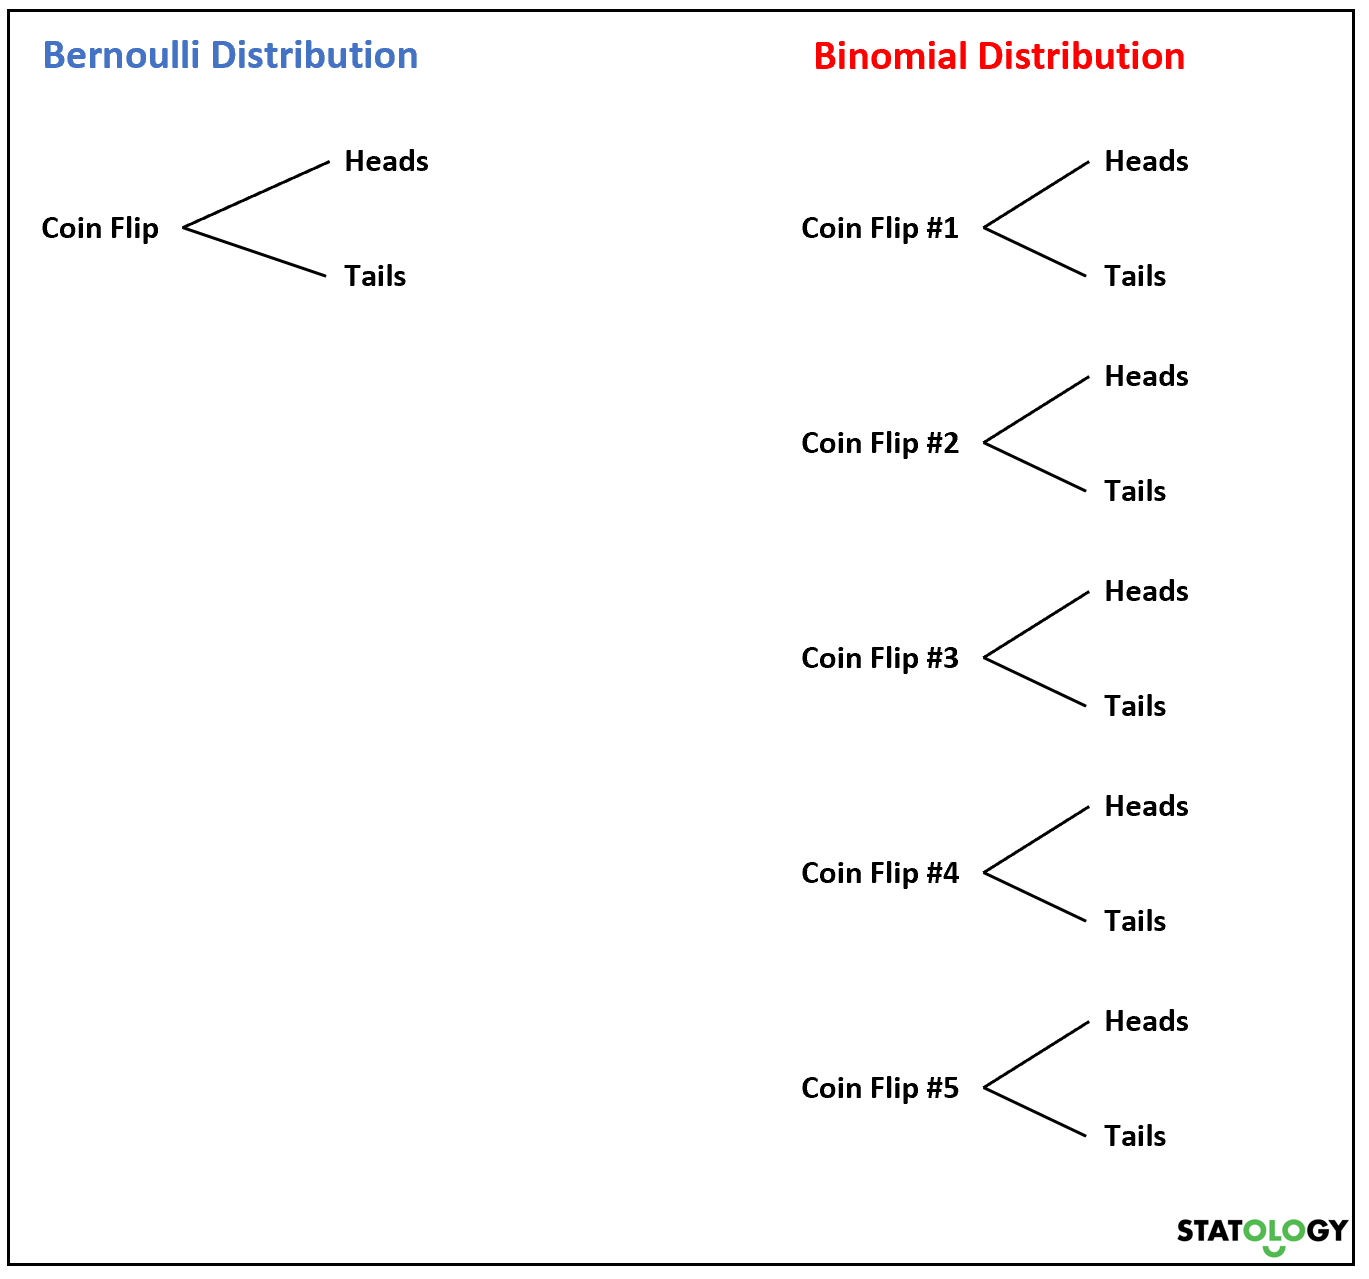
Tandis que la distribution de Bernoulli capture l’état d’un système à l’échelle d’une transaction événementielle isolée, la distribution binomiale opère un changement de paradigme fondamental en modélisant le comportement cumulatif d’une pluralité d’épreuves. La distribution binomiale, conventionnellement notée $B(n, p)$, formalise la loi de probabilité régissant le nombre total de succès observés au cours d’une série finie de $n$ épreuves de Bernoulli.
Pour que cette modélisation binomiale conserve une rigueur axiomatique irréprochable, l’expérience composite doit satisfaire de manière inconditionnelle à quatre postulats fondamentaux, collectivement désignés sous le concept de schéma de Bernoulli :
- La nature dichotomique de chaque essai : chaque épreuve élémentaire constitutive de la séquence ne peut aboutir qu’à deux résultats mutuellement exclusifs et exhaustivement définis, étiquetés de manière invariante « succès » ($1$) et « échec » ($0$).
- La finitude de l’expérience : le nombre total d’essais réalisés, désigné par la lettre $n$, est un entier naturel strictement fixé a priori par le protocole expérimental avant la collecte des données ($n in \mathbb{N}^*$).
- La constance absolue de la probabilité de succès : le paramètre $p in [0, 1]$ demeure strictement stationnaire tout au long des $n$ épreuves consécutives. La propension du système à générer un succès ne subit aucune dérive temporelle, aucune usure, aucun effet d’apprentissage ni aucune modification de contexte expérimental.
- L’indépendance stochastique totale : l’issue de n’importe quelle épreuve de la série n’exerce aucune influence causale ou statistique sur l’issue des autres épreuves, passées ou futures. En termes probabilistes formels, la probabilité conjointe de toute séquence spécifique correspond rigoureusement au produit direct des probabilités marginales de chaque essai individuel composant cette chaîne.
Sous ces conditions rigoureuses, si nous définissons une suite de $n$ variables aléatoires indépendantes et identiquement distribuées (i.i.d.) selon une loi de Bernoulli, soit $X_1, X_2, dots, X_n \overset{\text{i.i.d.}}{\sim} \mathcal{B}(p)$, la variable aléatoire binomiale $Y$ se définit ontologiquement comme la somme arithmétique globale de ces épreuves individuelles :
$$Y = \sum_{i=1}^n X_i$$
Le support de cette nouvelle variable aléatoire $Y$, noté $\mathcal{Y}$, s’étend désormais à l’ensemble discret fini des entiers compris entre zéro et $n$ inclus :
$$\mathcal{Y} = {0, 1, 2, dots, n}$$
3.2 La formule binomiale et le coefficient combinatoire
La dérivation de la fonction de masse de probabilité d’une variable binomiale $Y sim B(n, p)$ répond à un problème fondamental de dénombrement combinatoire. Supposons que nous souhaitions déterminer la probabilité d’obtenir exactement $k$ succès au terme des $n$ épreuves (où $k in {0, 1, dots, n}$), ce qui implique nécessairement l’occurrence simultanée de $(n – k)$ échecs. Considérons dans un premier temps une configuration séquentielle particulière fixée, par exemple celle où tous les $k$ succès surviennent au début de la séquence, suivis par tous les $(n – k)$ échecs :
$$\underbrace{(1, 1, dots, 1)}_{k \text{ fois}}, \underbrace{(0, 0, dots, 0)}_{(n – k) \text{ fois}}$$
En vertu de l’axiome d’indépendance stochastique, la probabilité d’occurrence conjointe de cet arrangement ordonné spécifique équivaut au produit multiplicatif de leurs probabilités unitaires, soit :
$$P(\text{séquence particulière}) = \prod_{i=1}^k p \times \prod_{j=1}^{n-k} (1 – p) = p^k (1 – p)^{n – k}$$
Cependant, l’expérimentateur ne s’intéresse généralement pas à l’ordre d’apparition chronologique des succès et des échecs, mais uniquement à leur décompte total au sein du bloc expérimental. Il convient dès lors de déterminer combien d’arrangements distincts et équiprobables permettent d’obtenir précisément $k$ succès parmi $n$ positions temporelles distinctes. Ce nombre correspond mathématiquement au nombre de combinaisons de $k$ éléments choisis parmi $n$, formellement désigné sous le terme de coefficient binomial :
$$C_n^k = \binom{n}{k} = \frac{n!}{k!(n – k)!}$$
Dans cette formulation, la notation $n!$ désigne la factorielle de l’entier $n$, définie par le produit $n \times (n – 1) \times dots \times 2 \times 1$, avec la convention axiomatique $0! = 1$. Les coefficients combinatoires $\binom{n}{k}$ peuvent être extraits manuellement grâce aux symétries additives du célèbre triangle arithmétique de Pascal, fondé sur la relation de récurrence $\binom{n}{k} = \binom{n-1}{k-1} + \binom{n-1}{k}$.
Puisque chaque agencement spécifique possède la probabilité invariable $p^k (1 – p)^{n – k}$ et que tous ces agencements constituent des événements élémentaires incompatibles deux à deux, la probabilité globale d’enregistrer exactement $k$ succès s’obtient en sommant ces probabilités disjointes, ce qui livre la célèbre fonction de masse binomiale :
$$P(Y = k) = \binom{n}{k} p^k (1 – p)^{n – k} \quad \text{pour tout } k in {0, 1, dots, n}$$
La validité axiomatique de cette distribution découle directement du théorème d’expansion du binôme de Newton. En effet, la somme de toutes les probabilités sur le support complet de la variable restitue rigoureusement l’unité :
$$\sum_{k=0}^n P(Y = k) = \sum_{k=0}^n \binom{n}{k} p^k (1 – p)^{n – k} = [p + (1 – p)]^n = 1^n = 1$$
3.3 Moments théoriques de la distribution binomiale
L’évaluation des moments analytiques de la loi binomiale s’avère particulièrement fluide et élégante dès lors que l’on exploite sa structure générative additive plutôt que d’entreprendre des sommations combinatoires algébriquement lourdes. Considérant la variable binomiale comme la résultante sommatoire de $n$ variables de Bernoulli i.i.d., $Y = \sum_{i=1}^n X_i$, nous pouvons faire appel à la propriété fondamentale de linéarité de l’opérateur d’espérance mathématique. Quel que soit le degré d’indépendance des composantes, l’espérance d’une somme équivaut toujours à la somme des espérances :
$$E(Y) = E\left(\sum_{i=1}^n X_i\right) = \sum_{i=1}^n E(X_i) = \sum_{i=1}^n p = n \cdot p$$
Ainsi, la moyenne théorique d’une loi binomiale s’exprime très intuitivement comme le produit direct du volume de l’échantillon d’essais $n$ par la probabilité unitaire de succès $p$.
Pour le calcul de la variance théorique $\text{Var}(Y)$, l’hypothèse d’indépendance stochastique mutuelle devient indispensable. En vertu du théorème de Bienaymé, la variance d’une somme de variables aléatoires indépendantes est rigoureusement égale à la somme de leurs variances respectives, les termes de covariance bilatérale s’annulant strictement :
$$\text{Var}(Y) = \text{Var}\left(\sum_{i=1}^n X_i\right) = \sum_{i=1}^n \text{Var}(X_i) = \sum_{i=1}^n p(1 – p) = n \cdot p(1 – p) = n \cdot p \cdot q$$
L’écart-type théorique $\sigma_Y$, quantifiant l’échelle de dispersion absolue autour de la moyenne, est obtenu par la racine carrée de cette variance :
$$\sigma_Y = \sqrt{n \cdot p(1 – p)}$$
Une observation mathématique remarquable s’impose ici : alors que la variance et l’espérance croissent de façon strictement linéaire par rapport à $n$, l’écart-type ne progresse qu’au rythme sous-linéaire de la racine carrée de la taille d’échantillon ($\sqrt{n}$). Il en résulte que le coefficient de variation de la distribution, défini par le ratio de la dispersion sur la tendance centrale, évolue de manière inversement proportionnelle à $\sqrt{n}$ :
$$\text{CV} = \frac{\sigma_Y}{E(Y)} = \frac{\sqrt{n \cdot p(1 – p)}}{n \cdot p} = \sqrt{\frac{1 – p}{n \cdot p}} propto \frac{1}{\sqrt{n}}$$
Cette propriété structurelle explique pourquoi, lorsque la séquence expérimentale s’allonge considérablement ($n to \infty$), la distribution binomiale subit une concentration relative spectaculaire de sa densité autour de son ratio moyen $p$. Ce phénomène constitue la base de la convergence stochastique formalisée par la loi des grands nombres et préfigure le comportement gaussien asymptotique de la distribution.
4. Analyse comparative directe : divergences conceptuelles et formelles
4.1 Le rôle du paramètre n : cas limite et généralisation
La distinction nodale entre la loi de Bernoulli et la loi binomiale cristallise le problème mathématique classique du passage du cas particulier à la généralisation structurelle. La distribution de Bernoulli ne constitue pas une entité ontologiquement disjointe de la distribution binomiale ; elle en représente l’expression limite absolue lorsque le paramètre de répétition $n$ est contraint à sa plus petite valeur positive non triviale, à savoir l’unité :
$$\mathcal{B}(p) \equiv B(n = 1, p)$$
Si l’on injecte la valeur $n = 1$ dans la formulation générale de la fonction de masse binomiale, les coefficients combinatoires se simplifient instantanément puisque $\binom{1}{0} = 1$ et $\binom{1}{1} = 1$. L’expression se réduit alors terme à terme :
- Pour $k = 0$ : $P(Y = 0) = \binom{1}{0} p^0 (1 – p)^{1 – 0} = 1 \cdot 1 \cdot (1 – p)^1 = 1 – p$
- Pour $k = 1$ : $P(Y = 1) = \binom{1}{1} p^1 (1 – p)^{1 – 1} = 1 \cdot p \cdot (1 – p)^0 = p$
Le support de la variable aléatoire subit une métamorphose conceptuelle majeure : alors que pour $n = 1$, le support $\mathcal{X} = {0, 1}$ ne tolère aucune graduation intermédiaire et matérialise une simple polarité d’état, l’espace d’échantillonnage de la binomiale pour $n > 1$ explore une granularité arithmétique ordonnée $\mathcal{Y} = {0, 1, dots, n}$. Cette transition entraîne une démultiplication de la complexité computationnelle. Évaluer la probabilité ponctuelle d’un événement de Bernoulli ne requiert aucune opération combinatoire ; en revanche, le calcul d’une probabilité binomiale ou de sa fonction de répartition cumulative pour des valeurs substantielles de $n$ nécessite le traitement d’expressions factorielles colossales, exigeant des approximations asymptotiques sophistiquées ou l’usage de logarithmes factoriels (fonction log-gamma) pour conjurer les erreurs de dépassement arithmétique sur ordinateur.
4.2 Tableau récapitulatif des divergences statistiques
Afin de synthétiser avec une rigueur formelle absolue les divergences mathématiques et opérationnelles séparant ces deux paradigmes probabilistes, le tableau synoptique suivant dresse un comparatif analytique de leurs propriétés intrinsèques respectives :
| Propriété Mathématique | Distribution de Bernoulli | Distribution Binomiale |
|---|---|---|
| Notation standard | $X \sim \mathcal{B}(p)$ ou $\text{Bernoulli}(p)$ | $Y sim B(n, p)$ ou $\text{Binomial}(n, p)$ |
| Espace des paramètres | $p in [0, 1]$ (uniparamétrique) | $n in \mathbb{N}^*,, p in [0, 1]$ (biparamétrique) |
| Support de la variable | $\mathcal{X} = {0, 1}$ | $\mathcal{Y} = {0, 1, 2, dots, n}$ |
| Fonction de masse (PMF) | $P(X = x) = p^x (1 – p)^{1 – x}$ | $P(Y = k) = \binom{n}{k} p^k (1 – p)^{n – k}$ |
| Espérance mathématique | $E(X) = p$ | $E(Y) = n \cdot p$ |
| Variance théorique | $\text{Var}(X) = p(1 – p)$ | $\text{Var}(Y) = n \cdot p(1 – p)$ |
| Écart-type | $\sigma = \sqrt{p(1 – p)}$ | $\sigma = \sqrt{n \cdot p(1 – p)}$ |
| Coefficient d’asymétrie | $\gamma_1 = \frac{1 – 2p}{\sqrt{p(1 – p)}}$ | $\gamma_1 = \frac{1 – 2p}{\sqrt{n \cdot p(1 – p)}}$ |
| Kurtosis d’excès | $\gamma_2 = \frac{1 – 6p(1 – p)}{p(1 – p)}$ | $\gamma_2 = \frac{1 – 6p(1 – p)}{n \cdot p(1 – p)}$ |
| Nature phénoménologique | Observation isolée, état ponctuel binaire | Agrégation quantitative, fréquence de comptage |
| Typologie de variable | Variable indicatrice, variable dummy | Score d’échelle discrète, dénombrement borné |
4.3 Additivité et convolution de variables indépendantes
L’articulation la plus profonde reliant la distribution de Bernoulli à la distribution binomiale s’incarne dans le concept mathématique d’additivité stochastique par convolution de probabilités. En analyse probabiliste, la distribution de probabilité gouvernant la somme arithmétique de deux variables aléatoires discrètes et indépendantes est formellement égale au produit de convolution de leurs distributions discrètes respectives.
Soient deux variables aléatoires de Bernoulli indépendantes partageant rigoureusement le même paramètre de succès, $X_1 \sim \mathcal{B}(p)$ et $X_2 \sim \mathcal{B}(p)$. Définissons leur somme $S_2 = X_1 + X_2$. La probabilité que $S_2$ prenne une valeur donnée $k in {0, 1, 2}$ s’écrit sous forme de la série de convolution :
$$P(S_2 = k) = (P_{X_1} * P_{X_2})(k) = \sum_{j} P(X_1 = j) \cdot P(X_2 = k – j)$$
En développant cette somme discrète pour $k = 1$, les configurations disjointes envisageables correspondent soit au vecteur $(X_1 = 1, X_2 = 0)$, soit au vecteur $(X_1 = 0, X_2 = 1)$. Le calcul de convolution déploie :
$$P(S_2 = 1) = [p \cdot (1 – p)] + [(1 – p) \cdot p] = 2p(1 – p) = \binom{2}{1} p^1 (1 – p)^1$$
Ce résultat coïncide rigoureusement avec la loi binomiale $B(2, p)$. Par extension par récurrence finie à un ensemble de $n$ variables de Bernoulli i.i.d., la convolution d’ordre $n$ de la loi élémentaire génère identiquement et nécessairement la distribution binomiale $B(n, p)$.
Il est impératif de souligner l’extrême sensibilité de cette propriété d’équivalence au postulat d’indépendance. Si les variables de Bernoulli $X_i$ présentent une corrélation interne mutuelle — qu’elle soit induite par un processus markovien temporel, une transmission d’information en réseau ou une contrainte contextuelle partagée —, leur convolution échoue formellement à engendrer une loi binomiale standard. La somme de telles variables engendre une distribution déformée pouvant manifester une surdispersion critique, explorée plus loin dans nos développements, illustrant combien la binomiale constitue un édifice mathématiquement fragile suspendu à la stricte orthogonalité stochastique de ses composantes élémentaires.
5. Propriétés mathématiques avancées : fonctions génératrices et moments
5.1 Fonctions génératrices des probabilités (PGF)
L’analyse des propriétés structurales des variables aléatoires discrètes trouve son instrument analytique le plus puissant dans le formalisme des fonctions génératrices des probabilités (PGF, pour Probability Generating Function). Pour une variable aléatoire discrète $X$ à valeurs entières positives, la PGF, conventionnellement notée $G_X(s)$, est définie pour tout nombre réel ou complexe $s$ satisfaisant la convergence de la série comme l’espérance mathématique de la transformation $s^X$ :
$$G_X(s) = E(s^X) = \sum_{k=0}^\infty P(X = k) \cdot s^k$$
Dans le cas spécifique d’une épreuve élémentaire de Bernoulli $X \sim \mathcal{B}(p)$, cette série ne comporte que deux termes finis correspondant aux états $x = 0$ et $x = 1$ :
$$G_X(s) = P(X = 0) \cdot s^0 + P(X = 1) \cdot s^1 = (1 – p) + p \cdot s = q + ps$$
La dérivation des moments statistiques s’opère alors de manière purement différentielle à travers les dérivées d’ordre successif évaluées au point singulier $s = 1$. La première dérivée fournit directement l’espérance arithmétique :
$$G’_X(s) = \frac{d}{ds}(q + ps) = p implies E(X) = G’_X(1) = p$$
La seconde dérivée fournit le moment factoriel d’ordre 2, $E[X(X – 1)] = G »_X(1) = 0$, d’où l’on réextrait instantanément la variance $\text{Var}(X) = G »_X(1) + G’_X(1) – [G’_X(1)]^2 = 0 + p – p^2 = p(1 – p)$.
La puissance conceptuelle de la fonction génératrice culmine lorsqu’on examine la distribution d’une variable binomiale $Y = \sum_{i=1}^n X_i$. En vertu du théorème de factorisation des fonctions génératrices, la PGF d’une somme de variables aléatoires indépendantes équivaut au produit algébrique direct de leurs fonctions génératrices individuelles. Par conséquent, pour une suite de $n$ variables de Bernoulli i.i.d., nous obtenons immédiatement :
$$G_Y(s) = \prod_{i=1}^n G_{X_i}(s) = [G_X(s)]^n = (q + ps)^n = [(1 – p) + ps]^n$$
Cette factorisation élégante démontre sans ambiguïté l’isomorphisme parfait reliant la somme de processus bernoulliens indépendants au modèle binomial unifié. Le développement binomial de Newton de cette fonction génératrice fait réémerger naturellement les coefficients de masse combinatoires comme les coefficients des monômes $s^k$, prouvant que chaque puissance de $s$ encode de manière synthétique la probabilité $P(Y = k)$.
5.2 Fonctions caractéristiques et moments d’ordre supérieur
Bien que la fonction génératrice des probabilités s’avère remarquable pour les variables entières, la fonction caractéristique $phi(t)$ transcende le domaine discret pour offrir un cadre d’analyse harmonique universel, continuellement défini sur l’axe des réels grâce aux propriétés des exponentielles imaginaires. Pour une variable aléatoire $X$, elle est définie par :
$$\phi_X(t) = E(e^{itX})$$
où $i$ représente l’unité imaginaire pure telle que $i^2 = -1$ et $t in \mathbb{R}$. Pour la distribution de Bernoulli, l’application immédiate de la formule d’Euler déploie :
$$\phi_X(t) = (1 – p)e^{it \cdot 0} + p e^{it \cdot 1} = 1 – p + p e^{it}$$
Par application de la propriété de convolution dans le domaine spectral, la fonction caractéristique de la distribution binomiale $Y sim B(n, p)$ prend la forme factorisée suivante :
$$\phi_Y(t) = [\phi_X(t)]^n = (1 – p + p e^{it})^n$$
Cette fonction caractéristique constitue le pivot analytique permettant d’examiner le comportement des moments d’ordre supérieur, particulièrement l’asymétrie ($\gamma_1$) et l’aplatissement ou kurtosis ($\gamma_2$). Les expressions analytiques exactes de ces moments réduits pour la distribution binomiale s’écrivent :
$$\gamma_{1, Y} = \frac{1 – 2p}{\sqrt{n \cdot p(1 – p)}} = \frac{1}{\sqrt{n}} \cdot \gamma_{1, X}$$
$$\gamma_{2, Y} = \frac{1 – 6p(1 – p)}{n \cdot p(1 – p)} = \frac{1}{n} \cdot \gamma_{2, X}$$
L’analyse asymptotique de ces deux équations révèle un fait fondamental : à mesure que le paramètre de taille $n$ progresse vers des valeurs arbitrairement élevées ($n to \infty$), le coefficient d’asymétrie décroît proportionnellement à $n^{-1/2}$, tandis que le kurtosis d’excès s’évanouit au rythme quadratique de $n^{-1}$. Il s’ensuit que, quelles que soient l’asymétrie initiale et l’hyper-leptokurticité d’une épreuve de Bernoulli sous-jacente (pourvu que $p$ demeure strictement non nul et non unitaire), la distribution binomiale composite se régularise progressivement pour adopter un profil parfaitement symétrique et mésokurtique ($\gamma_1 to 0$ et $\gamma_2 to 0$). Cette morphologie spectrale démontre la convergence asymptotique de la distribution binomiale vers la distribution normale standard, pierre angulaire de l’inférence statistique sur grands effectifs.
6. Applications en psychométrie et théorie de la mesure
6.1 Modélisation de l’item individuel par la loi de Bernoulli
Dans l’architecture de la théorie moderne de la mesure en sciences comportementales, l’item individuel constituant une batterie d’évaluation psychologique représente le capteur phénoménologique de base. Lorsque cet item adopte un format de réponse dichotomique (tel que Présence/Absence d’un symptôme clinique dans une échelle d’évaluation, ou Réussite/Échec à une tâche d’intelligence fluide), son observation empirique pour un sujet $j$ donné face à un item $i$ s’exprime rigoureusement sous la forme d’une variable de Bernoulli :
$$U_{ij} \sim \mathcal{B}(p_{ij})$$
Contrairement au modèle de Bernoulli classique où le paramètre $p$ est tenu pour constant à travers toute l’observation, la théorie psychométrique contemporaine, formalisée par la théorie de la réponse à l’item (TRI) et plus particulièrement par le modèle logistique fondamental de Georg Rasch (1960), paramètre la probabilité d’occurrence $p_{ij}$ comme une fonction non linéaire dépendant d’attributs latents inobservables.
Dans le modèle de Rasch unidimensionnel, la probabilité que l’individu $j$, doté d’un niveau de trait latent $\theta_j$ (par exemple, son niveau de compétence verbale ou son intensité d’anxiété), produise une réponse codée 1 face à l’item $i$ caractérisé par un paramètre de difficulté intrinsèque $b_i$, s’exprime par la fonction logistique :
$$p_{ij} = P(U_{ij} = 1 mid \theta_j, b_i) = \frac{e^{\theta_j – b_i}}{1 + e^{\theta_j – b_i}} = \frac{1}{1 + e^{-(\theta_j – b_i)}}$$
Ce formalisme élégant préserve la nature bernoullienne de l’observation unitaire tout en ancrant sa dynamique dans un continuum psychologique sous-jacent. Une condition épistémologique et méthodologique fondamentale pour la validité de cette approche réside dans l’axiome d’indépendance locale de Lord : conditionnellement au niveau de trait latent du sujet $\theta_j$, les réponses aux différents items doivent être stochastiquement indépendantes les unes des autres. L’observation composite d’un test psychométrique s’analyse ainsi comme un vecteur de réalisations indépendantes de variables de Bernoulli hétérogènes en leurs paramètres $p_{ij}$.
6.2 Score global à un test et distribution binomiale
Dans la pratique clinique standardisée et en psychologie de l’éducation, les praticiens recourent massivement à l’usage du score brut composite, obtenu par l’agrégation arithmétique simple des réponses positives accordées au fil de l’inventaire psychométrique :
$$S_j = \sum_{i=1}^k U_{ij}$$
Pour qu’un tel score total puisse être légitimement modélisé par une distribution binomiale $B(k, p)$, une hypothèse théorique extrêmement contraignante doit être postulée : l’hypothèse de parallélisme strict des items. Cette condition impose non seulement l’indépendance locale mutuelle des épreuves, mais également l’égalité parfaite des paramètres de difficulté de tous les items composant l’instrument ($b_1 = b_2 = dots = b_k = b$), induisant une probabilité de succès invariante $p_j$ pour un niveau de trait donné.
Cependant, cette exigence d’homogénéité est quasi systématiquement violée dans les contextes empiriques réels. Les instruments de mesure comportent délibérément des items échelonnés du plus accessible au plus discriminant afin de cartographier l’intégralité du continuum psychologique. Lorsque les paramètres $p_i$ diffèrent substantiellement d’un item à l’autre, la variable composite $S_j$ cesse rigoureusement d’obéir à une loi binomiale standard ; elle se déploie selon une distribution binomiale de Poisson (aussi dénommée loi binomiale hétérogène).
Cette déviation structurelle exerce un impact direct sur les métriques classiques de consistance interne. La variance théorique de cette somme de variables de Bernoulli non identiques s’exprime formellement comme :
$$\text{Var}(S) = \sum_{i=1}^k p_i(1 – p_i) = k \bar{p}(1 – \bar{p}) – \sum_{i=1}^k (p_i – \bar{p})^2$$
où $\bar{p}$ désigne la probabilité moyenne des items. Cette équation démontre que la variance d’un score composite constitué d’items hétérogènes est intrinsèquement inférieure à la variance d’un modèle binomial parfait qui postulerait une probabilité uniforme égale à $\bar{p}$. Ignorer cette divergence méthodologique induit des distorsions notables dans le calcul du coefficient alpha de Cronbach ou de la fidélité composite de McDonald, conduisant potentiellement à sous-estimer la précision diagnostique réelle de l’outil psychométrique.
6.3 Standardisation et calibrage des outils diagnostiques
L’utilisation de la distribution binomiale cumulative s’avère indispensable pour la standardisation rigoureuse des seuils d’intervention clinique et diagnostique, particulièrement dans les protocoles de dépistage des troubles neurocognitifs ou psychopathologiques. Considérons une batterie neuropsychologique standardisée comportant $n = 20$ items de mémoire épisodique, administrée à une vaste population de contrôle normonégative caractérisée par une probabilité de réussite moyenne attendue de $p = 0{,}85$.
Pour statuer sur le caractère pathologique de la performance d’un patient ayant obtenu un score anormalement faible de $k le 12$ réussites, le clinicien doit évaluer la probabilité critique sous l’hypothèse nulle d’un fonctionnement cognitif préservé. Cette quantification s’obtient par l’intégration de la queue inférieure de la fonction de répartition cumulative binomiale :
$$P(Y le 12) = \sum_{k=0}^{12} \binom{20}{k} (0{,}85)^k (0{,}15)^{20 – k}$$
Si cette valeur p-valeur cumulative s’avère inférieure au seuil critique préétabli (par exemple, $\alpha = 0{,}01$ ou un rang centile de 1 %), le neuropsychologue peut légitimement inférer la présence d’un déficit cognitif cliniquement significatif, rejetant l’hypothèse d’une simple fluctuation stochastique.
Une complexification méthodologique supplémentaire survient lors de l’évaluation des tests d’aptitude intégrant un format à choix multiples fermé. Dans cette configuration, le paramètre plancher de réussite à l’item $p$ se trouve artificiellement contaminé par le phénomène de devinette aléatoire (guessing). Si un item propose $m$ alternatives de réponse équiprobables, un individu dénué de toute compétence relative à la tâche possède néanmoins une probabilité de réussite par simple conjecture mécanique égale à $c = 1/m$. Le modèle probabiliste doit dès lors ajuster la loi de Bernoulli élémentaire en introduisant ce pseudo-paramètre de chance, transitionnant vers des formulations de TRI à trois paramètres (3PL), altérant directement la distribution binomiale globale des scores seuils et imposant des corrections de barème spécifiques pour pénaliser les erreurs aléatoires.
7. Psychologie cognitive, neurosciences et théorie de la décision
7.1 Théorie de la détection du signal (TDS)
L’analyse des processus perceptifs et cognitifs a été profondément révolutionnée par l’introduction de la théorie de la détection du signal (TDS), initialement conceptualisée par Green et Swets en 1966. Au cœur de ce paradigme expérimental, le traitement sensoriel est modélisé comme une succession d’essais élémentaires où l’observateur humain ou animal doit décider si une information sensorielle cible est présente (« signal + bruit ») ou absente (« bruit seul »).
Chaque essai expérimental isolé constitue l’incarnation parfaite d’un tirage de Bernoulli. Face à la présentation d’un stimulus, la décision du sujet se condense en une réponse dichotomique : affirmation (« stimulus détecté », $X = 1$) ou dénégation (« stimulus non détecté », $X = 0$). Lorsque l’on soumet l’observateur à un bloc d’essais standardisé comportant $n_s$ présentations du signal et $n_b$ présentations du bruit seul, les réponses comportementales agrégées se structurent selon deux distributions binomiales disjointes :
- Le nombre total de détections correctes ou « succès » (Hits, $H$) suit une distribution binomiale conditionnelle au signal : $H \sim B(n_s, p_H)$.
- Le nombre total d’identifications erronées ou « fausses alarmes » (False Alarms, $FA$) suit une distribution binomiale conditionnelle au bruit : $FA \sim B(n_b, p_{FA})$.
La puissance du formalisme probabiliste intervient alors pour dissocier deux processus cognitifs orthogonaux que la simple observation empirique confond inévitablement : la sensibilité perceptive sensorielle de l’observateur, quantifiée par l’indice métrique $d’$, et son biais de décision motivationnel, indexé par le critère décisionnel $c$ ou $\beta$. L’indice de sensibilité $d’$ s’exprime mathématiquement comme la distance séparant les moyennes des distributions sous-jacentes sous forme de scores z :
$$d’ = \Phi^{-1}(p_H) – \Phi^{-1}(p_{FA})$$
où $\Phi^{-1}$ désigne la fonction quantile de la distribution normale standard. Puisque les fréquences empiriques de hits ($\hat{p}_H = H / n_s$) et de fausses alarmes ($\hat{p}_{FA} = FA / n_b$) sont issues de processus binomials générateurs, elles portent en elles une variance d’échantillonnage intrinsèque $\text{Var}(\hat{p}) = p(1 – p)/n$. L’estimation expérimentale de la sensibilité $d’$ requiert par conséquent la propagation rigoureuse de ces variances binomiales d’échantillonnage pour calculer les intervalles de confiance exacts du pouvoir de discrimination perceptuelle de l’individu.
7.2 Paradigmes de temps de réaction et choix binaire
L’exploration chronométrique des architectures de prise de décision rapide utilise massivement les protocoles d’expérimentation à choix forcé à deux alternatives (tâches dites 2-AFC, pour Two-Alternative Forced Choice). Qu’il s’agisse de catégoriser la direction globale d’un champ cinétique de points en mouvement aléatoire ou de juger si une séquence de lettres forme un mot valide dans une tâche de décision lexicale, chaque essai individuel produit un couple d’observations composé d’une variable continue (le temps de réaction, TR) et d’une variable de Bernoulli (l’exactitude de la réponse, $X in {0, 1}$).
Dans les modèles mathématiques contemporains de diffusion neuronale (DDM, pour Drift-Diffusion Model), théorisés par Roger Ratcliff, le processus décisionnel s’analyse comme une accumulation continue d’évidences neuronales bruitées modélisée par un mouvement brownien avec dérive (drift rate, $v$), oscillant entre deux frontières absorbantes discrètes situées à 0 et $a$. L’atteinte de la frontière supérieure déclenche la réponse correcte ($X = 1$), tandis que la frontière inférieure sanctionne l’erreur décisionnelle ($X = 0$). L’issue dichotomique finale de chaque essai constitue ainsi une réalisation de Bernoulli dont le paramètre de succès $p$ émerge directement de la dynamique différentielle continue régie par les paramètres du modèle :
$$p = \frac{1}{1 + e^{-2va/\sigma^2}}$$
Lorsque ces essais élémentaires sont sommés au sein de blocs de conditions expérimentales équivalentes, le profil d’exactitude agrégé converge vers une loi binomiale $B(n, p)$. Cette passerelle structurelle permet de formaliser quantitativement le célèbre compromis vitesse-précision (speed-accuracy trade-off) : lorsque le protocole expérimental impose une forte contrainte temporelle, les sujets abaissent stratégiquement leurs frontières décisionnelles $a$, ce qui compresse les temps de réaction mais dégrade structurellement le paramètre bernoullien $p$ vers 0,5, aplatissant consécutivement la distribution binomiale agrégée des réussites vers une incertitude accrue.
7.3 Décharge neuronale et codage probabiliste
À l’échelle de la micro-physiologie corticale, les assemblées de neurones communiquent par l’émission stochastique de potentiels d’action forming ce que la neurophysiologie désigne sous le vocable de trains d’impulsions (spike trains). Pour déchiffrer le code neuronal sous-jacent, les chercheurs discrétisent l’axe temporel continu en micro-intervalles successifs de durée $\Delta t$ suffisamment ténue ($\Delta t \approx 1\text{ ms}$) pour qu’aucun événement multipotentiel ne puisse survenir à l’intérieur d’une même fenêtre d’analyse en raison de la période réfractaire absolue.
Sous ce découpage temporel rigoureux, chaque fenêtre infinitésimale se comporte strictement comme un essai de Bernoulli stochastique : la probabilité qu’un spike apparaisse à l’intérieur de l’intervalle est donnée par $p \approx r \cdot \Delta t$ (où $r$ figure le taux moyen instantané de décharge du neurone en Hertz), tandis que la probabilité d’absence de spike s’établit à $1 – p$. Lorsque l’analyse étend sa focale sur une époque d’intégration sensorielle élargie de durée totale $T$, subdivisée en $n = T / \Delta t$ micro-intervalles disjoints, le dénombrement global des potentiels d’action émis par la cellule pyramidale se formalise sous l’égide de la distribution binomiale :
$$N(T) \sim B(n, p) \equiv B\left(\frac{T}{\Delta t}, r \cdot \Delta t\right)$$
Cette modélisation binomiale du codage en fréquence (rate coding) fournit une explication mécanique à la variabilité du signal observée expérimentalement dans les aires visuelles primaires (V1) ou auditives (A1) face à des stimulations sensorielles rigoureusement identiques. La variance de la décharge neuronale enregistrée sur une fenêtre $T$ présente une dépendance intrinsèque au produit binomial $n \cdot p(1 – p)$. Lorsque le stimulus devient extrêmement intense, saturant le taux de décharge $r$, le terme $(1 – p)$ exerce un effet modérateur, induisant une régularité accrue du train d’impulsions comparativement aux régimes de décharge spontanée de faible intensité.
8. Approximations asymptotiques et théorèmes limites
8.1 Théorème central limite et approximation normale
L’une des manifestations les plus spectaculaires de l’universalité mathématique réside dans la convergence structurelle de la distribution binomiale vers le continuum de la loi normale lorsque le volume des essais $n$ croît vers l’infini. Ce phénomène asymptotique, historiquement démontré par Abraham de Moivre en 1738 pour le cas symétrique $p = 0{,}5$, puis généralisé par Pierre-Simon de Laplace en 1812 pour toute valeur rationnelle de $p$, est formalisé sous le célèbre théorème de De Moivre-Laplace, expression pionnière du théorème central limite pour les variables discrètes.
Le théorème énonce formellement que si $Y_n \sim B(n, p)$, la variable aléatoire standardisée construite en soustrayant l’espérance arithmétique et en divisant par l’écart-type théorique converge en loi (distribution) vers la loi normale standard $\mathcal{N}(0, 1)$ lorsque $n$ tend vers l’infini :
$$Z_n = \frac{Y_n – n \cdot p}{\sqrt{n \cdot p(1 – p)}} x\rightarrow{\mathcal{L}} \mathcal{N}(0, 1) \quad \text{lorsque } n to \infty$$
Dans la pratique de la recherche expérimentale et des statistiques inférentielles appliquées, cette approximation par une densité continue d’espérance $\mu = np$ et de variance $\sigma^2 = np(1-p)$ s’avère opérationnellement valide dès lors que les critères empiriques de robustesse d’asymétrie sont pleinement satisfaits. Les canons méthodologiques traditionnels imposent l’observation simultanée des inégalités suivantes :
$$n \cdot p ge 5 \quad \text{et} \quad n(1 – p) ge 5$$
Certains auteurs plus conservateurs préconisent d’élever ce seuil à $np ge 10$ et $n(1-p) ge 10$, particulièrement lorsque la probabilité unitaire $p$ s’écarte substantiellement de la zone médiane 0,5, afin d’atténuer l’impact de l’asymétrie résiduelle.
Une précaution méthodologique cardinale lors de l’application de cette convergence repose sur la mise en œuvre de la correction de continuité de Yates. Puisque l’analyste utilise une distribution continue pour approximer un phénomène fondamentalement discret opérant sur des paliers entiers unitaires, la probabilité ponctuelle d’une valeur discrète $k$ doit être appréhendée comme l’intégrale de la courbe gaussienne sur l’intervalle réel $[k – 0{,}5,;, k + 0{,}5]$. De manière analogue, la probabilité cumulative s’ajuste par un décalage d’un demi-point :
$$P(Y le k) \approx \Phi\left(\frac{k + 0{,}5 – n \cdot p}{\sqrt{n \cdot p(1 – p)}}\right)$$
L’omission de cette correction d’un demi-palier dans l’analyse de cohortes expérimentales de taille modeste engendre des erreurs systématiques d’estimation des valeurs p, compromettant la rigueur des inférences cliniques.
8.2 Événements rares et approximation par la loi de Poisson
Lorsque le paramètre de taille $n$ tend vers l’infini tandis que simultanément la probabilité d’occurrence $p$ s’effondre vers zéro de telle sorte que leur produit arithmétique demeure constant et égal à une valeur finie strictement positive $lambda$ ($\lim_{n to \infty, p to 0} n \cdot p = \lambda > 0$), l’approximation normale s’avère totalement inopérante en raison d’une asymétrie positive extrême. Dans cette configuration asymptotique singulière, la distribution binomiale converge en loi vers la distribution de Poisson de paramètre $lambda$, un résultat fondamental formalisé par le théorème limite de Poisson (ou loi des événements rares).
La démonstration analytique s’opère en examinant le comportement asymptotique de la fonction de masse binomiale sous la substitution $p = lambda / n$. En réécrivant les termes factoriels et exponentiels pour une valeur fixée $k$ :
$$P(Y = k) = \frac{n!}{k!(n – k)!} \left(\frac{\lambda}{n}\right)^k \left(1 – \frac{\lambda}{n}\right)^{n – k} = \frac{\lambda^k}{k!} \left[\frac{n(n – 1)dots(n – k + 1)}{n^k}\right] \left(1 – \frac{\lambda}{n}\right)^n \left(1 – \frac{\lambda}{n}\right)^{-k}$$
Lorsque $n to \infty$, le ratio polynomial entre crochets converge rigoureusement vers 1. Par ailleurs, par définition fondamentale de l’exponentielle, $\lim_{n to \infty} (1 – lambda/n)^n = e^{-\lambda}$, tandis que le terme $(1 – lambda/n)^{-k}$ converge unitairement vers 1. L’expression se transmute alors parfaitement en la fonction de masse de Poisson :
$$P(Y = k) to \frac{\lambda^k e^{-\lambda}}{k!}$$
En psychopathologie quantitative et en modélisation comportementale, cette approximation binomiale-poissonnienne trouve un terrain d’application fécond dans l’analyse des manifestations comportementales à prévalence extrêmement sporadique. L’évaluation de l’occurrence annuelle des épisodes psychotiques aigus chez des patients vulnérables, les passages à l’acte suicidaires au sein d’une unité de soins ou les réactions indésirables rarissimes à un traitement psychopharmacologique constituent des événements caractérisés par un effectif de personnes à risque colossal ($n$ très grand) mais une probabilité individuelle infime ($p to 0$).
La distinction structurelle entre les deux lois réside dans la mécanique de dispersion : alors que la distribution binomiale présente une sous-dispersion structurelle ($\text{Var}(Y) = n p (1 – p) < E(Y)$), la loi de Poisson impose une équidispersibilité parfaite ($\text{Var}(Y) = E(Y) = \lambda$). Lorsque $p$ est négligeable, le facteur correctif binomial $(1 – p)$ converge vers 1, scellant la fusion stochastique des deux distributions.
9. Inférence statistique et estimation de paramètres
9.1 Estimation par le maximum de vraisemblance (EMV)
L’estimation ponctuelle du paramètre inconnu de probabilité de succès $p$ à partir de données empiriques constitue l’un des piliers de la modélisation statistique. La méthode standard de référence repose sur le principe du maximum de vraisemblance institué par Ronald Fisher. Considérons en premier lieu un échantillon de $n$ observations indépendantes issues d’une loi de Bernoulli, représentées par le vecteur d’observations binaires $\mathbf{x} = (x_1, x_2, dots, x_n)$ où chaque $x_i in {0, 1}$.
La fonction de vraisemblance $L(p mid \mathbf{x})$, exprimant la probabilité conjointe d’observer cet échantillon empirique sous la valeur hypothétique du paramètre $p$, s’écrit comme le produit des fonctions de masse individuelles :
$$L(p mid \mathbf{x}) = \prod_{i=1}^n p^{x_i} (1 – p)^{1 – x_i} = p^{\sum_{i=1}^n x_i} (1 – p)^{n – \sum_{i=1}^n x_i}$$
En posant $k = \sum_{i=1}^n x_i$, représentant le nombre empirique total de succès observés, la log-vraisemblance $ell(p) = \ln L(p mid \mathbf{x})$ se formule additivement :
$$ell(p) = k \ln(p) + (n – k) \ln(1 – p)$$
Pour déterminer la valeur maximisant cette surface de vraisemblance, nous dérivons cette fonction par rapport au paramètre $p$ afin d’établir la fonction de score $S(p)$ et annulons celle-ci :
$$S(p) = \frac{dell(p)}{dp} = \frac{k}{p} – \frac{n – k}{1 – p} = 0 implies k(1 – p) – p(n – k) = 0 implies k – n p = 0$$
La résolution de cette équation différentielle livre l’estimateur canonique du maximum de vraisemblance (EMV) :
$$\hat{p} = \frac{k}{n} = \frac{1}{n}\sum_{i=1}^n x_i = \bar{x}$$
Il convient de remarquer que si nous avions formulé la vraisemblance à partir de la loi binomiale globale régissant le décompte agrégé $Y = k$, l’équation de vraisemblance aurait intégré la constante multiplicative combinatoire $\binom{n}{k}$. Toutefois, lors du passage au logarithme népérien, cette constante devient un terme additif indépendant du paramètre $p$ dont la dérivée première s’annule purement, conduisant à une identité rigoureuse du résultat analytique de l’estimateur.
Cet estimateur $\hat{p}$ jouit de propriétés statistiques optimales : il est strictement non biaisé ($E(\hat{p}) = p$), convergent au sens stochastique (la variance tendant vers zéro lorsque $n to \infty$) et efficace au sens de Cramér-Rao. L’information de Fisher attendue pour $n$ observations de Bernoulli s’établit comme :
$$I_n(p) = -E\left(\frac{d^2ell(p)}{dp^2}\right) = E\left(\frac{k}{p^2} + \frac{n – k}{(1 – p)^2}\right) = \frac{np}{p^2} + \frac{n(1 – p)}{(1 – p)^2} = \frac{n}{p(1 – p)}$$
Puisque la variance de notre estimateur vérifie $\text{Var}(\hat{p}) = \text{Var}(k / n) = \frac{1}{n^2}\text{Var}(k) = \frac{np(1-p)}{n^2} = \frac{p(1-p)}{n}$, elle atteint rigoureusement la borne inférieure de Cramér-Rao ($1 / I_n(p)$), certifiant que $\hat{p}$ est l’estimateur à variance minimale absolue parmi tous les estimateurs sans biais.
9.2 Intervalles de confiance pour une proportion
L’estimation ponctuelle $\hat{p}$ demeurant soumise aux aléas d’échantillonnage, la quantification de l’incertitude exige la dérivation d’intervalles de confiance rigoureux à un niveau d’assurance $1 – \alpha$ préétabli. L’approche historiquement la plus répandue dans les progiciels statistiques introductifs est l’intervalle asymptotique standard de Wald :
$$\text{IC}_{\text{Wald}} = \hat{p} \pm z_{1 – alpha/2} \sqrt{\frac{\hat{p}(1 – \hat{p})}{n}}$$
Toutefois, une abondante littérature méthodologique (par exemple, les travaux fondateurs d’Agresti et Coull en 1998) a formellement démontré que l’intervalle de Wald présente des défaillances critiques et une instabilité pathologique. Lorsque la taille d’échantillon $n$ est modeste ou lorsque le paramètre $p$ s’approche des frontières 0 ou 1, le taux de couverture effectif de l’intervalle s’effondre dramatiquement bien en deçà du seuil nominal conventionnel de 95 %, atteignant parfois des niveaux inacceptables de 80 %. Pire encore, en l’absence de succès ($k = 0$) ou d’échec ($k = n$), l’intervalle de Wald dégénère en s’effondrant sur une largeur nulle ($[0, 0]$), une absurdité inférentielle patente.
Pour remédier à ces distorsions, deux approches supérieures doivent être impérativement privilégiées :
- L’intervalle de score de Wilson : dérivé de l’inversion analytique du test de score de Rao, cet intervalle résout une équation quadratique encadrant la statistique gaussienne. Sa borne centrale subit une pondération bayésienne implicite vers 0,5, garantissant un comportement optimal même sur des micro-échantillons :
$$\text{IC}_{\text{Wilson}} = \frac{\hat{p} + \frac{z^2}{2n} \pm z \sqrt{\frac{\hat{p}(1 – \hat{p})}{n} + \frac{z^2}{4n^2}}}{1 + \frac{z^2}{n}}$$ - L’intervalle exact de Clopper-Pearson : ancré directement dans la distribution binomiale cumulative sans recourir à aucune approximation asymptotique, il détermine les bornes d’intervalle à partir des quantiles exacts de la distribution Bêta ou de la loi de Fisher-Snedecor. Cet intervalle garantit de manière inconditionnelle un taux de couverture d’au moins $1 – \alpha$, bien qu’il s’avère légèrement conservateur.
En recherche quantitative, l’impact direct de la taille d’échantillon $n$ se matérialise par la compression de la largeur de ces intervalles selon un ordre de grandeur en $\mathcal{O}(1/\sqrt{n})$. Pour diviser par deux la marge d’incertitude entourant l’estimation d’une proportion diagnostique en psychologie, le protocole expérimental doit impérativement quadrupler son effectif de participants.
9.3 Tests d’hypothèses sur des données dichotomiques
L’inférence statistique sur données dichotomiques requiert souvent d’opposer formellement une hypothèse nulle $H_0: p = p_0$ (où $p_0$ figure une constante théorique de référence, tel que $0{,}5$ dans une épreuve de choix aléatoire) à une hypothèse alternative bilatérale $H_1: p \neq p_0$ ou unilatérale. Deux grandes familles de tests structurent cette démarche :
- Le test binomial exact : ce test non paramétrique calcule directement la probabilité cumulative exacte d’observer sous $H_0$ un nombre de succès au moins aussi extrême que la valeur empirique $k$ recueillie dans l’expérience. En s’appuyant directement sur la fonction de masse $B(n, p_0)$, il élimine tout biais d’approximation continue et s’impose comme l’étalon-or absolu dès lors que les effectifs observés sont restreints.
- Le test d’adéquation du $\chi^2$ de Pearson : ce test asymptotique évalue l’écart quadratique normalisé entre les fréquences empiriques observées ($O_i$) et les fréquences théoriques attendues ($E_i = n \cdot p_0$ et $n(1 – p_0)$) sur les deux catégories du support :
$$\chi^2 = \sum \frac{(O_i – E_i)^2}{E_i} = \frac{(k – n p_0)^2}{n p_0} + \frac{((n – k) – n(1 – p_0))^2}{n(1 – p_0)}$$
Sous $H_0$, cette statistique suit asymptotiquement une distribution du Khi-deux à un degré de liberté ($\chi^2 \sim \chi^2_1$), dont la valeur coïncide rigoureusement avec le carré de la statistique de Wald standardisée ($z^2$).
Une application clinique emblématique de ce formalisme réside dans le test du signe appliqué aux protocoles pré-post interventionnels en psychothérapie. Lorsque les postulats de normalité des scores continus sont radicalement violés ou que les instruments ne fournissent que des classements ordinaux, le chercheur évalue pour chaque patient si son état s’est amélioré ($+$) ou dégradé ($-$). Sous l’hypothèse nulle d’une stricte inefficacité du traitement thérapeutique, la probabilité d’amélioration correspond à un tirage équiprobable de Bernoulli ($p = 0{,}5$). L’analyse globale du nombre de guérisons au sein de la cohorte s’exécute alors via un test binomial exact, garantissant une décision inférentielle exempte d’artefacts distributionnels.
10. Approche bayésienne comparée : du tirage individuel à l’agrégation
10.1 Distributions a priori conjuguées et modèle Bêta-Binomial
L’inférence bayésienne substitue à la vision fréquentiste d’un paramètre $p$ fixe mais inconnu une conceptualisation épistémologique où $p$ est lui-même appréhendé comme une variable aléatoire continue sur l’intervalle $[0, 1]$, régie par une distribution de probabilité reflétant l’état de croyance ou de connaissance préalable de l’analyste. Dans ce cadre paradigmatique, la loi a priori naturelle pour modéliser le paramètre de succès d’épreuves de Bernoulli ou d’un processus binomial est la distribution Bêta, en raison de son statut de loi conjuguée pour la famille exponentielle binomiale.
Une loi Bêta de paramètres continus d’hyper-forme $\alpha > 0$ et $\beta > 0$, notée $\text{B\eta}(\alpha, \beta)$, présente une fonction de densité s’écrivant pour tout $p in [0, 1]$ :
$$f(p mid \alpha, \beta) = \frac{1}{\text{B}(\alpha, \beta)} p^{\alpha – 1} (1 – p)^{\beta – 1}$$
où $\text{B}(\alpha, \beta) = \frac{\Gamma(\alpha)\Gamma(\beta)}{\Gamma(\alpha + \beta)}$ figure la fonction Bêta d’Euler, assurant la normalisation unitaire de l’intégrale. La mise à jour bayésienne en présence de données empiriques binomiales déploie une harmonie mathématique singulière. Si l’on recueille $k$ succès au terme de $n$ épreuves de Bernoulli indépendantes (ou sur une variable globale binomiale $Y sim B(n, p)$), la règle de Bayes stipule que la densité a posteriori $f(p mid Y = k)$ est proportionnelle au produit de la vraisemblance par la densité a priori :
$$f(p mid Y = k) propto L(p mid k) \times f(p mid \alpha, \beta) propto \left[ p^k (1 – p)^{n – k} \right] \times \left[ p^{\alpha – 1} (1 – p)^{\beta – 1} \right] = p^{(\alpha + k) – 1} (1 – p)^{(\beta + n – k) – 1}$$
Cette forme algébrique résultante appartient de manière transparente à la même famille fonctionnelle : il s’agit identiquement d’une loi Bêta actualisée, de paramètres recalculés :
$$p mid Y = k \sim \text{B\eta}(\alpha + k, , \beta + n – k)$$
Cette propriété de conjuguité offre une interprétation psychologique et cognitive extrêmement puissante des hyperparamètres $\alpha$ et $\beta$ : ils fonctionnent comme des pseudo-observations historiques. Le paramètre $\alpha$ symbolise un capital initial de pseudo-succès fictifs préalablement intégrés par l’expérimentateur, tandis que $\beta$ matérialise son équivalent en pseudo-échecs. Si le chercheur adopte une posture d’indifférence totale ou d’ignorance préalable, il spécifie une loi a priori uniforme $\text{B\eta}(1, 1)$, auquel cas la moyenne de la distribution a posteriori converge vers l’estimateur de Laplace-Bayes corrigé $\hat{p}_{\text{Bayes}} = \frac{k + 1}{n + 2}$, conjurant nativement le risque d’assignation de probabilités nulles aux événements extrêmes.
10.2 Raisonnement bayésien face aux biais cognitifs humains
Si le formalisme mathématique de l’inversion bayésienne se déploie avec une remarquable limpidité computationnelle, le système cognitif humain démontre en situation naturelle une incapacité structurelle à traiter spontanément ces dynamiques probabilistes. Les travaux séminaux d’Amos Tversky et Daniel Kahneman ont documenté une série d’aberrations systématiques caractérisant la manière dont les individus profanes et les professionnels de santé interprètent les séquences de Bernoulli et leur agrégation.
Le biais le plus prégnant en pratique diagnostique réside dans la négligence du taux de base (base rate fallacy). Face à un résultat diagnostique dichotomique positif émis par un dispositif de détection, les praticiens surestiment massivement la probabilité que le patient soit effectivement porteur de la pathologie en omettant de pondérer la vraisemblance par la probabilité a priori marginale de l’affection dans la population générale. Cette distorsion cognitive s’explique par l’heuristique de représentativité : l’esprit humain traite la réponse positive issue d’une épreuve de Bernoulli diagnostique comme un archétype clinique complet, ignorant la mécanique combinatoire sous-jacente régissant les faux positifs dans de larges cohortes.
Parallèlement, lorsque des sujets humains sont exposés à une suite séquentielle d’épreuves de Bernoulli courtes, ils tendent à projeter une symétrie binomiale idéale sur des fenêtres d’échantillonnage infimes. Face à une séquence de pile ou face de six lancers, une configuration alternée ordonnée telle que $(P, F, P, F, P, F)$ est subjectivement perçue comme substantiellement « plus probable » et « plus représentative du hasard » qu’une suite présentant un agrégat local comme $(P, P, P, P, F, F)$, bien que chaque trajectoire permutationnelle spécifique possède exactement la même probabilité élémentaire $p^6 = (0{,}5)^6 = 1/64 \approx 0{,}0156$. Cette défaillance métacognitive témoigne de la confusion chronique opérée par le cerveau entre la probabilité de l’événement individuel (Bernoulli) et la multiplicité combinatoire des permutations globales (Binomiale).
11. Erreurs courantes, pièges méthodologiques et violations des postulats
11.1 L’illusion du joueur et la perception erronée du hasard
L’illusion du joueur (gambler’s fallacy) constitue sans doute la pathologie cognitive la plus célèbre découlant de l’incompréhension radicale des propriétés d’indépendance de la loi de Bernoulli. Cette erreur épistémique se caractérise par la croyance tenace et irrationnelle selon laquelle un résultat stochastique passé modifie la probabilité de l’issue d’une épreuve de Bernoulli future, le système stochastique étant censé « corriger » une asymétrie temporaire pour rééquilibrer ses totaux vers l’espérance binomiale théorique.
Si une pièce équilibrée atterrit sur la face pile dix fois consécutivement ($X_1 = dots = X_{10} = 1$), le joueur victime de cette distorsion jugera que l’apparition de la face face au onzième lancer ($X_{11} = 0$) est désormais « hautement probable », voire « inéluctable ». Cette illusion repose sur une confusion dramatique entre la structure ex post d’un collectif binomial fini et l’amnésie structurelle inconditionnelle d’une épreuve de Bernoulli élémentaire :
$$P(X_{11} = 1 mid X_1 = 1, X_2 = 1, dots, X_{10} = 1) = P(X_{11} = 1) = p = 0{,}5$$
Le processus génératif physique d’une pièce n’enregistre aucune mémoire de ses états cinétiques antérieurs. La loi des grands nombres n’opère aucunement par « compensation mécanique » ou « équilibrage rétroactif » ; elle agit par dilution progressive. À mesure que le nombre total d’essais $n$ progresse vers des millions de tirages, la grappe initiale de dix piles consécutifs demeure inchangée mais se trouve mathématiquement noyée et rendue infinitésimale dans la masse globale du dénominateur d’échantillon.
Cette incompréhension génère une distorsion comportementale symétrique dans les protocoles où des sujets doivent générer des séquences aléatoires fictives. Incapables d’émuler la véritable liberté stochastique d’un processus bernoullien i.i.d., les êtres humains produisent une sur-alternance artificielle entre les modalités, évitant scrupuleusement les regroupements d’états identiques pourtant inhérents au hasard pur, trahissant une perception idéalisée et faussée du comportement de l’incertitude quantifiée.
11.2 Violation de l’indépendance et surdispersion
Le piège méthodologique le plus redoutable guettant le chercheur dans l’analyse de données expérimentales agrégées réside dans la violation clandestine du troisième et du quatrième postulat de la distribution binomiale : la stationnarité du paramètre $p$ et l’indépendance stochastique des essais constitutifs. Dans la recherche en psychologie comportementale, en éducation et en psychopharmacologie, les unités d’observation individuelles sont rarement imperméables les unes aux autres.
Des phénomènes endogènes tels que la fatigue progressive d’un sujet au cours d’une longue session expérimentale dégradent insidieusement la valeur de $p$ au fil des essais. Inversement, l’apprentissage perceptif ou l’entraînement procédural accroît ce paramètre au cours de la tâche. De surcroît, les effets d’émulation collective, la contamination par les pairs ou la présence de variables de confusion environnementales partagées au sein d’une même grappe d’individus créent des corrélations intra-grappes positives entre les observations binaires.
Lorsque des données présentant de telles dépendances structurelles sont agrégées et injectées dans un modèle binomial classique, l’analyse subit le phénomène de surdispersion (overdispersion). La variance empiriquement observée excède substantiellement la variance théorique sous-jacente prescrite par le modèle :
$$\text{Var}_{\text{empirique}}(Y) > n \cdot p(1 – p)$$
Si l’analyste persiste à appliquer une régression logistique standard ou un test binomial en ignorant cette divergence, le modèle statistique calcule des erreurs types drastiquement sous-estimées. Cette anomalie engendre une inflation dévastatrice du taux de fausses découvertes (taux d’erreur de type I, $\alpha$), validant faussement l’existence d’effets expérimentaux ou thérapeutiques purement fictifs.
Pour contrer cette défaillance méthodologique, l’analyse doit recourir à des modèles de régression quasi-binomiaux (intégrant un facteur scalaire d’hétérogénéité $phi > 1$ élargissant proportionnellement les erreurs types) ou transiter vers des modélisations hiérarchiques avancées telles que la distribution bêta-binomiale ou les modèles linéaires généralisés à effets mixtes (GLMM), capables de modéliser séparément la stochasticité intra-sujet et la variabilité inter-sujets.
11.3 Échantillonnage sans remise : dérive vers la loi hypergéométrique
Une confusion formelle fréquente concerne le mode de sélection des unités d’échantillonnage au sein d’une population finie. La distribution binomiale requiert impérativement un protocole de tirage avec remise (ou l’hypothèse d’une population source de taille asymptotiquement infinie), de sorte que le prélèvement d’une observation n’altère en rien la composition probabiliste des tirages subséquents.
Or, en recherche biomédicale, en psychologie clinique et en neuro-épidémiologie, les protocoles expérimentaux opèrent fréquemment des échantillonnages exhaustifs sans remise au sein de populations restreintes (par exemple, une cohorte fermée de $N = 50$ patients atteints d’un syndrome génétique neurodéveloppemental rarissime répertoriés dans un hôpital). Supposons que cette population contienne $M$ individus présentant une anomalie comportementale spécifique.
Lorsque l’examinateur extrait un échantillon aléatoire de $n$ sujets sans les remettre dans le pool, la probabilité de succès $p$ fluctue dynamiquement à chaque tirage en fonction des individus préalablement sélectionnés. La loi de probabilité exacte régissant le décompte $k$ d’individus symptomatiques dans l’échantillon cesse dès lors d’être binomiale pour basculer dans le formalisme strict de la distribution hypergéométrique :
$$P(Y = k) = \frac{\binom{M}{k} \binom{N – M}{n – k}}{\binom{N}{n}}$$
L’espérance arithmétique de cette loi coïncide avec celle de la binomiale ($E(Y) = n \cdot \frac{M}{N} = np$), mais sa variance théorique intègre un multiplicateur de contraction fondamental, nommé le facteur de correction pour population finie (FPCF) :
$$\text{Var}_{\text{Hyper}}(Y) = n \cdot p(1 – p) \cdot \left(\frac{N – n}{N – 1}\right)$$
La règle empirique généralement admise en méthodologie quantitative établit que l’approximation de la distribution hypergéométrique par la distribution binomiale demeure recevable sans correction substantielle tant que le ratio d’échantillonnage ne franchit pas le seuil critique de 5 à 10 % de la population globale :
$$\frac{n}{N} le 0{,}05$$
Dès lors que la fraction sondée excède cette limite, ignorer la structure hypergéométrique conduit à surévaluer la variance réelle de l’échantillonnage, induisant une perte regrettable de puissance statistique lors du test des hypothèses expérimentales.
12. Guide décisionnel pratique et synthèse pour la recherche empirique
12.1 Arbre de décision méthodologique pour le chercheur
Afin de guider de manière pragmatique le chercheur, le biostatisticien et l’analyste de données dans l’arbitrage distributionnel au moment de concevoir son plan d’analyse ou de calibrer son modèle statistique, la matrice décisionnelle séquentielle suivante articule les critères diagnostiques clés :
Étape 1 : Analyse de la granularité de l’unité d’observation (Support)
- La variable dépendante enregistre-t-elle une issue unique et indivisible pour chaque ligne de données de votre jeu d’expérimentation ($y_i in {0, 1}$) ?
$to$ Modélisation de Bernoulli impérative. Le modèle statistique de choix est la régression logistique binaire (modèle à réponse dichotomique avec fonction de lien logit ou probit). - La variable dépendante représente-t-elle la somme consolidée de succès $k$ enregistrés sur un total fixe de $n$ essais structurés ($y_i in {0, 1, dots, n}$ avec $n > 1$) ?
$to$ Poursuivre vers l’Étape 2.
Étape 2 : Vérification de la constance et de l’indépendance (Postulats fondamentaux)
- Les $n$ essais constitutifs de chaque bloc sont-ils stochastiquement indépendants et régis par une probabilité unitaire de succès stationnaire ?
$to$ Modélisation Binomiale standard. Recourir au modèle linéaire généralisé (GLM) binomial avec spécification conjointe du numérateur $k$ et du dénominateur $n$. - Existe-t-il des corrélations intra-sujets, des effets de grappes ou une hétérogénéité non contrôlée induisant une variance excessive ?
$to$ Transiter vers un modèle quasi-binomial (ajustement scalaire de surdispersion) ou vers un modèle bêta-binomial hiérarchique (effets mixtes GLMM).
Étape 3 : Examen du mode d’échantillonnage (Finitude de la population)
- L’échantillonnage s’opère-t-il sans remise au sein d’une population close de faible volume telle que $n / N > 0{,}05$ ?
$to$ Abandonner la distribution binomiale et appliquer le formalisme de la loi hypergéométrique. - Le paramètre $p$ est-il extrêmement ténu ($p to 0$) sur une série temporelle prolongée ($n to \infty$) ?
$to$ Transiter vers une régression de Poisson ou un modèle binomial négatif en cas de surdispersion.
12.2 Implémentation computationnelle sous R et Python
L’exécution computationnelle des analyses probabilistes requiert une maîtrise rigoureuse de la syntaxe des environnements informatiques spécialisés que sont R et Python. Ces deux plateformes proposent des bibliothèques hautement optimisées structurées autour de conventions fonctionnelles précises.
Sous l’environnement statistique R, les distributions de Bernoulli et binomiales sont nativement intégrées au package de base stats via le radical binom, complété par les préfixes fonctionnels universels :
dbinom(x, size, prob): calcule la fonction de masse de probabilité (PMF) $P(Y = k)$. Pour une loi de Bernoulli, il suffit de fixersize = 1.pbinom(q, size, prob): calcule la probabilité cumulative unilatérale (CDF) $P(Y le q)$, fondamentale pour l’extraction des valeurs p.qbinom(p, size, prob): fonction quantile extrayant le score $k$ correspondant à un centile de coupure théorique.rbinom(n, size, prob): générateur stochastique de nombres pseudo-aléatoires selon un schéma binomial ou bernoullien (sisize = 1), pilier incontournable des simulations de Monte-Carlo.
Au niveau de la modélisation statistique avancée, la spécification d’une régression logistique sous R pour une variable de Bernoulli $Y in {0, 1}$ s’exécute via la syntaxe :
modele_bernoulli <- glm(Y ~ X1 + X2, family = binomial(link = "logit"), data = donnees)
Tandis que pour des données binomiales agrégeant les succès et les échecs par bloc d’essais, la syntaxe exploite soit le ratio pondéré par le dénominateur total, soit une matrice bivariée succès/échecs en variable réponse :
modele_binomial <- glm(cbind(succes, echecs) ~ Traitement, family = binomial, data = synthese)
Sous l’écosystème Python, les calculs analytiques s’articulent autour du module d’élite scipy.stats :
- Pour la distribution de Bernoulli : la classe
scipy.stats.bernoullifournit les méthodespmf(k, p),cdf(k, p), etrvs(p, size=N). - Pour la distribution binomiale : la classe
scipy.stats.binompropose les méthodes équivalentespmf(k, n, p),cdf(k, n, p), etrvs(n, p, size=N).
La modélisation inférentielle s’exécute couramment via la bibliothèque statsmodels, à travers les classes Logit ou GLM(family=sm.families.Binomial()), permettant une extraction exhaustive des matrices de covariance hessiennes et des rapports de cotes (odds ratios) associés à leurs intervalles de confiance robustes.
12.3 Synthèse conceptuelle globale
Au terme de cette exploration transversale approfondie, la relation unissant la distribution de Bernoulli à la distribution binomiale s’éclaire sous toute sa puissance conceptuelle et mathématique. Bien loin de constituer deux modèles probabilistes étanches ou concurrents, elles incarnent les deux échelles symbiotiques d’un même phénomène génératif sous-jacent :
- La distribution de Bernoulli opère à l’échelle atomique de l’instant : elle formalise la phénoménologie de la rupture binaire singulière, constituant le brique élémentaire irréductible de toute manifestation qualitative discrète.
- La distribution binomiale opère à l’échelle macroscopique de l’agrégation : elle orchestre la sommation combinatoire d’une multiplicité d’épreuves élémentaires stables et orthogonales, déployant une morphologie prévisible et géométrique qui annonce et préfigure, au fil de sa progression asymptotique, l’harmonieuse régularité de la loi normale.
Pour le chercheur en sciences quantitatives, maîtriser intimement les hypothèses de réalisation, les formulations mathématiques, les modes d’estimation et les points de rupture structurels de ces distributions ne relève pas du simple perfectionnisme théorique. Il s’agit d’une condition méthodologique impérative pour garantir la validité interne des mesures psychométriques, préserver la robustesse des modèles prédictifs et conjurer les crises de reproductibilité qui menacent les sciences empiriques contemporaines. En identifiant rigoureusement si une donnée comportementale constitue l’écho d’une étincelle bernoullienne unique ou le reflet d’une dynamique binomiale collective, le statisticien s’assure d’inscrire son édifice inférentiel sur les fondations inébranlables de la rigueur probabiliste.
Références
- Agresti, A., & Coull, B. A. (1998). Approximate is better than « exact » for interval estimation of binomial proportions. The American Statistician, 52(2), 119-126. https://doi.org/10.1080/00031305.1998.10480550
- Bernoulli, J. (1713). Ars conjectandi, opus posthumum. Accedit Tractatus de seriebus infinitis, et epistola gallice scripta de ludo pilae reticularis. Basileae: Impensis Thurnisiorum, Fratrum.
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404-413. https://doi.org/10.1093/biomet/26.4.404
- De Moivre, A. (1738). The Doctrine of Chances: Or, A Method of Calculating the Probabilities of Events in Play (2nd ed.). London: H. Woodfall.
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. New York: John Wiley & Sons.
- Kahneman, D., & Tversky, A. (1972). Subjective probability: A judgment of representativeness. Cognitive Psychology, 3(3), 430-454. https://doi.org/10.1016/0010-0285(72)90016-3
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Berlin: Julius Springer.
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Paris: Vve Courcier.
- Lord, F. M. (1980). Applications of item response theory to practical testing problems. Mahwah, NJ: Lawrence Erlbaum Associates.
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Copenhagen: Danmarks Paedagogiske Institut.
- Ratcliff, R. (1978). A theory of memory retrieval. Psychological Review, 85(2), 59-108. https://doi.org/10.1037/0033-295X.85.2.59
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209-212. https://doi.org/10.1080/01621459.1927.10502953