
Dans le vaste champ des sciences quantitatives et plus particulièrement des sciences du comportement, la notion d’association statistique constitue la pierre angulaire de l’inférence empirique. Face à un monde physique et psychologique d’une complexité vertigineuse, les chercheurs cherchent inlassablement à quantifier le degré selon lequel deux phénomènes varient de concert. Qu’il s’agisse de mesurer l’impact du stress chronique sur la mémoire de travail, d’évaluer la concordance entre traits de personnalité et réussite académique, ou d’estimer l’efficacité d’un protocole psychothérapeutique, le calcul d’un indice de corrélation apparaît comme l’outil diagnostique par excellence. Cependant, l’obtention d’un coefficient chiffré ne représente que la première étape d’un processus interprétatif ardu. Que signifie réellement qualifier un lien de « modeste », d’« intermédiaire » ou, plus décisivement, de « fort » ?
La réponse à cette interrogation fondamentale est trop souvent réduite à l’application mécanique de barèmes arbitraires. Héritée de conventions établies au cours du siècle dernier, l’habitude d’attribuer des étiquettes sémantiques rigides à des grandeurs continues a forgé un confort intellectuel trompeur au sein de la communauté scientifique. Qualifier une corrélation de « forte » engage en réalité un ensemble complexe de présupposés métrologiques, d’exigences contextuelles et de réalités statistiques. Ce qui constitue une association impressionnante dans l’étude des processus affectifs et sociaux peut s’avérer dérisoire dans le cadre de la psychophysique ou de la physique fondamentale. Inversement, négliger des corrélations en apparence ténues peut conduire à méconnaître des leviers d’action d’une portée sociétale et clinique majeure.
Cet article propose un examen exhaustif, théorique et appliqué, de la qualification d’une corrélation dite « forte ». En explorant les fondations mathématiques du coefficient produit-moment, les grilles conventionnelles de référence et leurs réévaluations empiriques contemporaines, nous mettrons en lumière la tension constante entre standardisation théorique et réalité écologique de la recherche. De l’impact corrosif de l’erreur de mesure aux distorsions induites par les artefacts méthodologiques, en passant par la nécessaire dissociation entre significativité statistique et amplitude de l’effet, cette réflexion vise à fournir aux chercheurs, cliniciens et étudiants les clés d’une lecture épistémologique et critique du concept d’intensité corrélationnelle.
1. Introduction et fondements théoriques du coefficient de corrélation
1.1 Définition mathématique et conceptuelle du r de Pearson
Le coefficient de corrélation produit-moment, universellement désigné par la lettre minuscule r, trouve son ancrage formel dans les travaux fondateurs de Karl Pearson à la fin du XIXe siècle, prolongeant les intuitions géométriques et héréditaires de Sir Francis Galton. Sur le plan mathématique, le r de Pearson est défini comme le rapport entre la covariance des deux variables aléatoires considérées et le produit de leurs écarts-types respectifs. Cette opération de division par les dispersions individuelles joue un rôle capital : elle standardise la mesure de covariance en éliminant les unités d’échelle d’origine. Qu’une variable soit mesurée en millisecondes, en points sur une échelle d’évaluation de la dépression ou en euros de revenu mensuel, le coefficient résultant se trouve contraint dans un intervalle adimensionnel strict s’étendant invariablement de -1,00 à +1,00.
L’interprétation du signe arithmétique gouverne la direction de la covariation observée. Une valeur positive dénote une concordance monotone : lorsque les scores de la première variable s’élèvent au-dessus de leur moyenne, ceux de la seconde variable manifestent une tendance concomitante à l’accroissement. Réciproquement, un coefficient négatif traduit une opposition discordante, où les valeurs élevées d’un construit s’associent aux valeurs basses du second, sans que cette polarité inverse ne préjuge en rien d’une faiblesse du lien. Un r de -0,75 traduit une intensité associative rigoureusement équivalente à celle d’un r de +0,75, la directionalité n’étant qu’un artefact du sens de codage des indicateurs opérationnels.
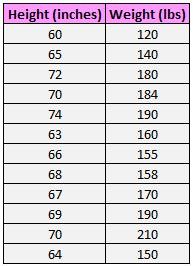
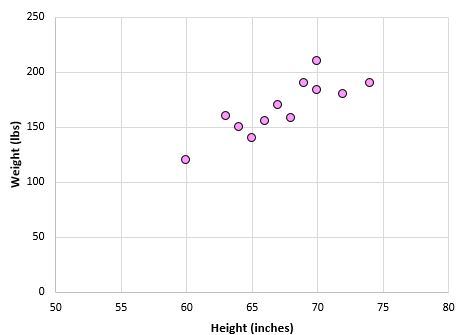
Néanmoins, le modèle mathématique sous-jacent repose sur un postulat inflexible souvent occulté par la pratique routinière : l’hypothèse d’une association strictement linéaire. Le calcul de Pearson postule que la fonction d’espérance conditionnelle d’une variable par rapport à l’autre peut être adéquatement représentée par une ligne droite. Toute déviation morphologique par rapport à cette linéarité implique que le coefficient sous-estimera l’ampleur de la dépendance véritable. Dès lors, assimiler la proximité du coefficient par rapport aux valeurs extrêmes (+1 ou -1) à l’intensité absolue de la relation présuppose que le nuage de points sous-jacent ne dissimule aucune structure fonctionnelle supérieure.
1.2 La notion d’association linéaire entre deux variables psychologiques
Dans l’écosystème conceptuel de la psychologie scientifique, la transposition du modèle linéaire exige une rigueur épistémologique accrue. Il convient d’opérer une différenciation catégorique entre association, covariance et causalité directe. L’association linéaire indique simplement que la position relative d’un individu au sein de la distribution d’une variable X permet d’anticiper linéairement sa position sur la distribution d’une variable Y. La covariance quantifie l’étendue conjointe de cette dispersion partagée, mais ne renseigne aucunement sur l’architecture génératrice des données. Observer qu’un niveau élevé d’anxiété état s’associe linéairement à une baisse de performance lors d’épreuves de raisonnement abstrait n’autorise pas à déduire que l’anxiété détériore mécaniquement l’efficience cognitive ; une tierce variable, telle qu’une privation de sommeil ou un profil neurobiologique partagé, peut orchestrer simultanément ces deux manifestations.
Considérons l’exemple paradigmatique du lien entre la qualité perçue du sommeil et la régulation de l’humeur matinale. Les observations colligées dans les études de journal de bord révèlent fréquemment une covariation linéaire robuste. Sur le plan géométrique, cette dynamique se visualise par un nuage de points elliptique au sein d’un plan cartésien bivarié. Plus l’ellipse s’étire et se resserre le long de sa droite de régression des moindres carrés, plus l’incertitude prédictive diminue, traduisant un alignement géométrique serré des observations individuelles autour du vecteur de tendance générale.
Toutefois, la modélisation de construits psychologiques via l’association linéaire se heurte à la nature latente des variables étudiées. Contrairement aux grandeurs physiques directement appréhensibles, les attributs psychologiques (extraversion, résilience, biais attentionnel) ne sont accessibles qu’au travers d’indicateurs imparfaits. La linéarité n’est souvent qu’une approximation opérationnelle commode, choisie pour sa parcimonie mathématique plutôt que pour sa fidélité ontologique aux dynamiques sous-jacentes du fonctionnement psychique humain.
1.3 L’évolution historique de l’évaluation de la force statistique
L’évaluation de ce qui constitue une corrélation substantielle ou remarquable a profondément évolué au cours du XXe siècle. Durant les premières décennies suivant les propositions de Karl Pearson et de Charles Spearman, la communauté scientifique naviguait dans une subjectivité interprétative manifeste. Les approches pré-statistiques qualifiaient les liens de manière purement intuitive, les chercheurs s’appuyant sur leur intime conviction ou sur les normes tacites de leurs laboratoires respectifs. Un coefficient de 0,40 pouvait être célébré comme une découverte majeure par un psycho-physiologiste ou dédaigné par un biométricien habitué aux corrélations anatomiques frôlant l’unité.
Avec l’essor de la psychologie différentielle et le déploiement massif de tests psychométriques standardisés durant l’entre-deux-guerres, la nécessité d’une harmonisation s’est imposée. La transition vers la formalisation des tailles d’effet a été catalysée par la volonté d’émanciper l’évaluation scientifique de la seule dictature du test d’hypothèse nulle. Les pionniers de la méthodologie ont rapidement compris qu’un échantillon gigantesque pouvait conférer une aura de certitude statistique à une association insignifiante dans le monde réel, tandis qu’un échantillon restreint risquait d’occulter une dynamique puissante.
Cette quête de standardisation a culminé avec le mouvement d’institutionnalisation des sciences comportementales dans la seconde moitié du siècle. Les statisticiens ont cherché à bâtir des cadres de référence universels permettant de comparer des études hétérogènes employant des métriques divergentes. La standardisation n’était plus seulement un outil technique de réduction des données, mais un impératif épistémologique visant à instaurer un langage commun, gage de crédibilité pour une psychologie aspirant au statut de science cumulative rigoureuse.
2. La grille conventionnelle de Jacob Cohen : Le standard académique classique
2.1 Les seuils de Cohen (1988) dans la littérature psychologique
C’est dans cet esprit de rationalisation que le statisticien et psychologue américain Jacob Cohen a publié son ouvrage séminal, Statistical Power Analysis for the Behavioral Sciences, dont l’édition de 1988 demeure encore aujourd’hui la référence la plus citée au monde en matière de calibrage des tailles d’effet. Conscient du désarroi des chercheurs confrontés à l’absence de repères objectifs pour planifier la puissance statistique de leurs devis expérimentaux, Cohen a formalisé une taxonomie devenue canonique :
- Effet faible (r = 0,10) : Ce seuil dénote une relation ténue mais non négligeable, imperceptible à l’œil nu lors de l’observation quotidienne et exigeant des outils méthodologiques sensibles pour être détectée.
- Effet modéré (r = 0,30) : Considéré par Cohen comme le pivot représentatif typique des phénomènes psychologiques et sociaux, visible lors d’observations contrôlées et captant des associations substantielles dans le champ de la personnalité ou de l’évaluation clinique.
- Effet fort (r = 0,50 ou plus) : Réservé aux relations particulièrement marquées, perceptibles sans artifice statistique sophistiqué, traduisant une proximité manifeste entre deux construits mesurés.
Malgré le succès planétaire de cette triade, un malentendu fondamental persiste. Jacob Cohen a lui-même assorti sa classification de mises en garde explicites et répétées. Il a expressément souligné que ces valeurs n’avaient été avancées qu’à titre indicatif, dans le but d’orienter les analyses de puissance a priori lorsque le chercheur ne disposait d’absolument aucune littérature préalable. Cohen a vigoureusement mis en garde la communauté contre une réification dogmatique de ses bornes, affirmant que qualifier mécaniquement un coefficient de faible, moyen ou fort sans scruter la nature de la variable, la fidélité de l’instrumentation et le contexte théorique relevait d’une dérive épistémologique dommageable.
2.2 Comparaison avec d’autres taxonomies classiques
L’omniprésence du barème de Cohen a eu tendance à éclipser d’autres systèmes de classification pourtant développés par des figures éminentes de la psychométrie et des statistiques appliquées. Dès les années 1950, J. P. Guilford proposait une grille d’une sévérité bien plus prononcée dans ses manuels d’évaluation psychologique. Pour Guilford, un r inférieur à 0,20 représentait une relation presque négligeable ; les coefficients compris entre 0,20 et 0,40 étaient qualifiés de faibles ; la tranche 0,40 à 0,70 incarnait une relation modérée ; et seule une valeur franchissant le cap de 0,70 pouvait légitimement prétendre au statut d’association « forte » ou marquée.
Quelques décennies plus tard, James Evans (1996) introduisait une taxonomie intermédiaire, fréquemment relayée dans l’enseignement des statistiques appliquées aux sciences sociales. Selon Evans, un r de 0,50 ne constitue nullement l’orée d’une corrélation forte, mais demeure dans le spectre moyen supérieur. Pour mériter le qualificatif de « fort », le coefficient doit obligatoirement atteindre ou dépasser 0,60, tandis qu’un coefficient excédant 0,80 est qualifié de « très fort ». Ces divergences historiques illustrent à quel point la qualification sémantique d’un nombre abstrait reflète des conventions académiques fluctuantes plutôt que des frontières naturelles immuables.
Le tableau suivant résume ces disparités taxonomiques classiques, mettant en évidence les variations de rigueur entre auteurs :
- Jacob Cohen (1988) : Faible (0,10) | Modéré (0,30) | Fort (0,50)
- Paul Guilford (1956) : Négligeable (<0,20) | Faible (0,20 – 0,39) | Modéré (0,40 – 0,69) | Fort (≥ 0,70)
- James Evans (1996) : Très faible (<0,20) | Faible (0,20 – 0,39) | Modéré (0,40 – 0,59) | Fort (0,60 – 0,79) | Très fort (≥ 0,80)
3. La relativité disciplinaire : Pourquoi le seuil « fort » varie selon le domaine
3.1 Sciences dures versus sciences du comportement
L’exigence relative à ce qui constitue une corrélation forte s’articule directement autour du degré de contrôle expérimental et de la nature ontologique des objets d’étude. Dans les sciences dites « dures », telles que la physique ondulatoire, la chimie thermodynamique ou même certains pans de l’astronomie, l’obtention d’un r de 0,50 serait accueillie non comme une victoire théorique, mais comme un symptôme d’échec méthodologique cuisant. Dans ces disciplines, les protocoles s’opèrent au sein de systèmes hautement isolés, où les sources de bruit thermique ou instrumental sont rigoureusement jugulées. Une association valide entre la température et la pression d’un gaz parfait, ou entre la résistance électrique et la longueur d’un conducteur, s’établit régulièrement à des niveaux dépassant r = 0,95 ou 0,99.
À l’opposé, les sciences du comportement affrontent l’organisme humain, structure d’une indétermination et d’une complexité multifactorielle sans commune mesure avec la matière inanimée. Un comportement individuel, qu’il s’agisse de l’adhésion à une thérapie, de l’apprentissage de la lecture ou d’un acte de violence impulsif, ne procède jamais d’une chaîne causale unique et isolée. Il résulte de l’interaction dynamique de prédispositions génétiques, de facteurs épigénétiques, d’expériences biographiques précoces, d’états physiologiques transitoires et de contingences environnementales immédiates.
Dans ce contexte systémique saturé de variables régulatrices et médiatrices, exiger d’une seule dimension psychologique qu’elle explique le fonctionnement global d’un individu avec une corrélation de 0,80 relève d’une illusion méthodologique. Attendre un tel seuil témoigne d’une méconnaissance de l’écologie propre aux sciences humaines, où les effets majeurs se déploient sous forme d’influences diffuses et cumulatives plutôt que de déterminismes linéaires univoques.
3.2 Psychologie clinique versus psychologie cognitive
Même au sein du périmètre disciplinaire de la psychologie, des fractures épistémologiques et méthodologiques profondes imposent des grilles de lecture asymétriques. En psychologie cognitive expérimentale, les dispositifs exploitent des paradigmes hautement standardisés administrés sur ordinateur. Les chronométries mentales mesurent des temps de réaction à la milliseconde près, et les tâches de détection de signaux bénéficient de centaines d’essais répétés au sein d’environnements insonorisés. Dans ce cadre d’optimisation du rapport signal/bruit, les corrélations test-retest des capacités de traitement de base peuvent fréquemment osciller entre 0,60 et 0,80, ce qui permet aux chercheurs de considérer qu’une association entre deux processus cognitifs fondamentaux n’est véritablement forte que si elle franchit le seuil de 0,55 ou 0,60.
Le paradigme de la psychologie clinique offre un contraste saisissant. Lorsqu’un praticien ou un chercheur cherche à relier la sévérité d’une symptomatologie dépressive à des biais d’interprétation cognitive ou à des marqueurs de stress post-traumatique, les données proviennent d’outils d’auto-évaluation déclaratifs ou d’entretiens diagnostiques semi-structurés, appliqués à des populations affichant une immense hétérogénéité biopsychosociale (comorbidités, polymédication, ruptures de vie). Dans cette arène clinique chaotique, un coefficient de corrélation de 0,35 ou 0,40 possède déjà une force clinique extraordinaire, car il permet de dégager des orientations pronostiques et thérapeutiques indispensables à la pratique de soin.
4. La réalité empirique en psychologie : Réévaluations contemporaines
4.1 Les conclusions de l’étude empirique de Hemphill (2003)
Face à la persistance du dogme issu des préconisations de Cohen, plusieurs méthodologistes ont éprouvé le besoin d’ancrer les qualificatifs d’intensité corrélationnelle dans la réalité observable des données publiées, plutôt que dans des intuitions spéculatives. Dans un article pionnier devenu classique, James F. Hemphill (2003) a entrepris une méta-évaluation systématique de la littérature psychologique. En disséquant plus de 380 méta-analyses englobant des milliers d’études primaires réparties dans tous les sous-domaines de la discipline, Hemphill a dressé la distribution empirique exacte des coefficients de corrélation.
Ses constatations ont immédiatement révélé un gouffre entre les standards académiques et la production concrète du savoir scientifique. Hemphill a mis en évidence que les corrélations observées en psychologie se scindent naturellement en tiers distributifs bien distincts :
- Le tiers inférieur rassemble les coefficients inférieurs à 0,20.
- Le tiers moyen englobe les corrélations s’étendant de 0,20 à 0,30.
- Le tiers supérieur, incarnant le peloton de tête des associations documentées, est constitué des valeurs dépassant r = 0,30.
Sur la base de cette cartographie empirique rigoureuse, Hemphill a proposé une révision pragmatique des seuils : un r de 0,10 doit continuer d’être vu comme faible, un r de 0,20 à 0,30 incarne la moyenne exacte de la discipline, et une corrélation atteignant ou dépassant r = 0,35 doit être considérée comme résolument « forte » au regard de la réalité descriptive de la recherche en psychologie. Ce travail a assené un coup décisif au précepte selon lequel un chercheur devrait rougir d’un coefficient n’atteignant pas le cap de 0,50.
4.2 L’actualisation méthodologique de Gignac et Szodorai (2016)
Plus d’une décennie après Hemphill, une actualisation d’une envergure méthodologique sans précédent a été conduite par Gilles E. Gignac et Eva T. Szodorai (2016). Les auteurs ont extrait et analysé 708 coefficients de corrélation issus d’une méta-synthèse exhaustive couvrant l’ensemble de la recherche en psychologie individuelle, sociale, clinique et cognitive. Leur démarche visait à établir des percentiles normatifs indiscutables pour fonder des lignes directrices fondées sur les preuves pour le calibrage des tailles d’effet.
Les conclusions de Gignac et Szodorai ont définitivement scellé l’obsolescence normative des propositions de 1988 de Cohen. L’analyse révèle que le 25e percentile de la distribution des coefficients se situe précisément à r = 0,11 ; la médiane exacte (le 50e percentile) culmine modestement à r = 0,19 ; et le 75e percentile se matérialise dès r = 0,29. Moins de 3 % de l’ensemble des études publiées en psychologie rapportent des coefficients supérieurs à r = 0,50.
Sur le fondement de cette métrologie actualisée, Gignac et Szodorai ont formulé de nouveaux seuils empiriques tripartites pour la discipline psychologique :
- Faible : r = 0,11 (25e percentile de la recherche publiée)
- Moyen : r = 0,19 (valeur médiane de la psychologie scientifique)
- Fort : r = 0,29 (franchissement du 75e percentile des publications les plus prédictives)
Dès lors, désigner un coefficient d’environ 0,30 comme modéré, voire secondaire, relève d’une profonde aberration normative. Dans la réalité empirique du champ, un lien de cette magnitude surpasse les trois quarts des associations jamais documentées par la science psychologique contemporaine. Le consensus moderne exige donc de qualifier un r voisin de 0,30 de véritablement « fort » à l’échelle de la vie mentale et comportementale humaine.
5. Le coefficient de détermination (r²) et la variance partagée
5.1 Calcul et signification épistémologique du r²
Bien que le coefficient r de Pearson demeure l’indicateur standard le plus disséminé, son interprétation intuitive dissimule une distorsion métrique majeure que seul le calcul du coefficient de détermination, noté r², permet de dissiper. Obtenu par l’élévation au carré de la corrélation bivariée, le r² quantifie la proportion de la variance totale d’une variable qui peut être statistiquement expliquée ou prédite par la variation de l’autre variable. Sur le plan épistémologique, le passage de r à r² marque la transition d’un indice ordinal d’alignement vectoriel à une mesure cardinale d’information partagée.
Cette transformation exponentielle introduit un effet non linéaire capital : la progression de la quantité d’information explicative n’est pas proportionnelle à l’augmentation arithmétique de r. Considérons les deux transitions suivantes :
- Le passage d’un r de 0,20 à un r de 0,30 fait progresser la variance expliquée de 0,04 (4 %) à 0,09 (9 %), soit un gain net modeste de 5 points de pourcentage de variance commune.
- À l’inverse, l’élévation d’un r de 0,70 à un r de 0,80 propulse la variance expliquée de 0,49 (49 %) à 0,64 (64 %), matérialisant un bond phénoménal de 15 points de pourcentage d’information résolue.
Cette dynamique mathématique se conceptualise aisément par des diagrammes de Venn superposant deux cercles représentant la variabilité totale des deux construits. La zone d’intersection centrale incarne la variance partagée (r²), tandis que les croissants extérieurs représentent l’inconnu, c’est-à-dire le coefficient d’aliénation équivalent à (1 – r^2). L’intersection ne croît de manière spectaculaire qu’aux confins des valeurs supérieures du coefficient de Pearson.
5.2 Réalité concrète de la variance expliquée
L’application rigoureuse du prisme du r² impose une salutaire cure de modestie aux analystes des données psychologiques. Lorsque nous mobilisons le barème historique de Jacob Cohen, une corrélation dite « forte » de r = 0,50 se traduit mécaniquement par un r² de 0,25. Cela signifie qu’une association canoniquement considérée comme l’étalon de la robustesse laisse subsister 75 % de variance totalement inexpliquée au sein du modèle univarié.
Dans un contexte d’intervention clinique ou d’évaluation pronostique, cette proportion résiduelle de trois quarts d’indétermination implique qu’un individu peut parfaitement afficher un résultat discordant par rapport à la prédiction linéaire. Prenons le cas d’une corrélation d’une force reconnue de r = 0,50 liant les distorsions cognitives dépressives à la sévérité d’un épisode dépressif caractérisé. Bien que la liaison soit indéniable au plan populationnel, une telle métrique reste insuffisante pour sceller à elle seule un diagnostic catégoriel individuel, car la trajectoire d’un patient donné demeure gouvernée à 75 % par des facteurs non pris en compte dans ce modèle bivarié simple (soutien social, vulnérabilité biologique, stress aigu, régulation émotionnelle implicite).
5.3 Le risque de surestimation de la puissance explicative
L’esprit humain est naturellement enclin aux raccourcis heuristiques, et les chercheurs n’échappent pas à ce biais cognitif. L’une des erreurs les plus ubiquitaires dans l’interprétation des corrélations réside dans l’illusion de proportionnalité directe, par laquelle un récepteur associe inconsciemment un r de 0,50 à une explication de « 50 % » du phénomène étudié. Ce glissement sémantique fallacieux conduit fréquemment à des conclusions hyperboliques dans les synthèses d’études, où une variable est promue au rang de pivot déterministe central alors qu’elle ne capte en réalité qu’un quart de la variance de l’attribut cible.
Ce mirage de l’explication amplifiée s’avère particulièrement toxique lorsqu’il contamine les décisions politiques ou médico-légales. Si l’on affirme prématurément qu’un test psychologique est « fortement » corrélé à l’inadaptation professionnelle ou au risque de récidive délinquante sur la base d’un r de 0,45, les décideurs non aguerris aux statistiques peuvent croire que le test fournit une certitude quasi-binaire. En réalité, un r de 0,45 correspond à un r² d’environ 0,20 : 80 % des trajectoires individuelles échappent totalement au pouvoir de prédiction du score. Confondre corrélation substantielle et déterminisme strict engendre des erreurs d’orientation thérapeutique, des discriminations à l’embauche et des erreurs judiciaires fondées sur une mauvaise appréciation mathématique de la force associative.
6. L’impact des propriétés psychométriques : L’atténuation due à l’erreur de mesure
6.1 La théorie classique des tests et la fidélité
L’évaluation brute d’une corrélation ne peut jamais être dissociée de la qualité instrumentale des mesures dont elle est issue. Au sein de la Théorie Classique des Tests (TCT), tout score obtenu par un participant à une épreuve psychométrique ((X)) se décompose formellement en deux composantes inaliénables : le score vrai ((V)), qui correspond à l’ampleur ontologique réelle de l’attribut latent chez l’individu, et une erreur de mesure aléatoire ((E)), non corrélée au score vrai :
[X = V + E]
La fidélité d’un instrument, souvent estimée par le coefficient alpha de Cronbach ((alpha)) ou le coefficient oméga de McDonald ((omega)), quantifie la proportion de la variance observée attribuable à la variance du score vrai. Lorsque les instruments souffrent d’une fidélité médiocre, l’erreur aléatoire vient parasiter et noyer le signal véritable. Un théorème cardinal de la psychométrie démontre que la corrélation observable maximale possible entre deux mesures est plafonnée par la racine carrée du produit de leurs fidélités respectives :
[r_{max} = sqrt{r_{xx} cdot r_{yy}}]p>
Si deux échelles psychologiques affichent chacune un coefficient de fidélité modeste de 0,70, la corrélation observable entre ces deux instruments ne pourra jamais mathématiquement dépasser 0,70, même si les deux construits psychologiques sous-jacents sont en vérité parfaitement identiques et indissociables ((r_{text{vrai}} = 1,00)). Par conséquent, tout coefficient de corrélation empirique observé subit une compression réductrice systématique, désignée sous le terme d’atténuation statistique due à l’erreur de mesure.
6.2 La formule de correction pour atténuation de Spearman
Dès 1904, le psychologue et statisticien Charles Spearman a résolu ce verrou méthodologique en élaborant la célèbre formule de correction pour atténuation. Cette équation offre la possibilité d’estimer la corrélation latente théorique entre deux variables en purgeant mathématiquement l’influence parasite des erreurs de mesure aléatoires :
[r_{v_x v_y} = frac{r_{xy}}{sqrt{r_{xx} cdot r_{yy}}}]
Considérons un scénario de recherche fréquent où un investigateur analyse l’association entre l’épuisement émotionnel et l’engagement au travail. Le coefficient brut observé se chiffre à r = 0,40, ce qui correspond, selon la grille de Cohen, à une corrélation modérée. Cependant, l’échelle d’épuisement utilisée affiche une consistance interne perfectible ((r_{xx} = 0,65)) et l’indicateur d’engagement présente une fidélité similaire ((r_{yy} = 0,60)). L’application de la correction de Spearman produit le résultat suivant :
[r_{v_x v_y} = frac{0,40}{sqrt{0,65 cdot 0,60}} = frac{0,40}{sqrt{0,39}} = frac{0,40}{0,624} approx 0,64]
Par cette décontamination métrique, la corrélation véritable entre les construits psychologiques purs passe subitement de 0,40 à 0,64. Ce saut conceptuel propulse la relation au-delà du seuil classique des associations hautement robustes. Ainsi, négliger d’évaluer la fidélité des échelles conduit inexorablement à mépriser des liens théoriques profonds, masqués sous la rugosité métrologique d’instruments imparfaits.
6.3 Limites et dérives de la correction pour atténuation
L’utilisation de la correction de Spearman impose des garde-fous rigoureux. L’une des dérives les plus déroutantes survient lorsque la formule engendre un coefficient corrigé supérieur à l’unité théorique ((r > 1,00)), ce que l’on qualifie d’anomalie d’Heywood en modélisation structurelle. Cet artefact incongru découle généralement d’une sous-estimation de la fidélité des outils, provoquée par l’emploi erroné de l’alpha de Cronbach en violation de l’hypothèse de tau-équivalence, ou d’erreurs d’échantillonnage instables.
De surcroît, le score corrigé pour atténuation constitue une abstraction mathématique : il modélise le lien qui existerait dans un univers utopique dépourvu de toute imperfection de mesure. Or, le praticien de terrain ne dispose jamais de construits parfaits ; il doit impérativement intervenir auprès d’individus réels au moyen d’outils réels. Communiquer exclusivement sur les corrélations corrigées sans rappeler la magnitude des coefficients bruts observables engendre un optimisme illusoire quant à l’utilité prédictive effective des évaluations psychologiques au chevet du patient ou dans l’organisation.
7. Artefacts méthodologiques pouvant gonfler artificiellement une corrélation
7.1 La variance commune de méthode (Common Method Variance)
Si certains artefacts réduisent indûment la taille des effets, d’autres pièges méthodologiques concourent à gonfler artificiellement les coefficients, fabricant l’illusion d’une corrélation extraordinairement forte là où ne règne qu’un artefact d’instrumentation. Le principal fléau contemporain des sciences comportementales réside dans la variance commune de méthode (Common Method Variance ou CMV). Ce phénomène survient de manière omniprésente lorsque les données mesurant deux construits prétendument distincts sont recueillies simultanément, auprès de la même source humaine, à l’aide du même format instrumental (par exemple, un auto-questionnaire numérique utilisant exclusivement des échelles de Likert en 5 ou 7 points).
Dans ce protocole naïf, une vaste fraction de la covariation observée ne relève pas de la dynamique psychologique entre les variables, mais découle de biais internes au sujet réagissant à l’épreuve. On recense parmi ceux-ci :
- Le biais de désirabilité sociale, qui incite le répondant à aligner positivement ou négativement tous ses énoncés pour préserver une cohérence narcissique face au chercheur.
- Le besoin de cohérence cognitive, poussant l’individu à déduire logiquement ses réponses ultérieures des affirmations précédentes afin de ne pas paraître contradictoire.
- Des styles de réponse idiosyncrasiques, tels que la complaisance passive (l’assentiment systématique) ou l’inclination compulsive pour les ancres extrêmes de l’échelle.
Ces facteurs parasites injectent une variance non substantielle uniforme qui gonfle le coefficient de Pearson de 0,20 à 0,30 point au-dessus de sa magnitude réelle. Pour démasquer cette distorsion et éprouver la robustesse authentique d’une corrélation « forte », les méthodologistes recommandent la triangulation multi-méthodes : coupler les auto-questionnaires à des évaluations par les pairs, à des données comportementales objectives ou à des temps de latence expérimentaux.
7.2 L’hétérogénéité d’échantillon et le paradoxe de Simpson
Un autre mécanisme d’inflation artificielle, redoutablement contre-intuitif, réside dans l’hétérogénéité non contrôlée de l’échantillon et sa manifestation la plus toxique : le paradoxe de Simpson. Lorsqu’un chercheur regroupe au sein d’une analyse bivariée globale des participants issus de sous-groupes structurellement distincts (par exemple selon le sexe, la tranche d’âge, le niveau socio-économique ou la nationalité), l’agrégation aveugle des sous-populations peut créer de toutes pièces une association vigoureuse qui n’existe absolument pas au niveau local.
Supposons que l’on étudie le lien entre la dépense énergétique physique et l’espérance de vie au sein d’une vaste cohorte réunissant des adolescents de 15 ans et des aînés de 80 ans. L’agrégation fera surgir une corrélation positive immense entre dépense sportive et survie, uniquement parce que les jeunes bougent plus et affichent une probabilité de décès immédiate quasi-nulle par rapport aux personnes âgées. Plus pervers encore, le paradoxe de Simpson peut dévoiler un coefficient globalement très fort et positif, alors même qu’à l’intérieur de chaque sous-groupe stratifié, la corrélation s’avère rigoureusement négative. Omettre de vérifier l’invariance et l’homogénéité des cohortes expose l’analyste au risque d’ériger des corrélations fortes qui ne sont que des mirages d’agrégation démographique.
7.3 L’influence disproportionnée des valeurs aberrantes (outliers)
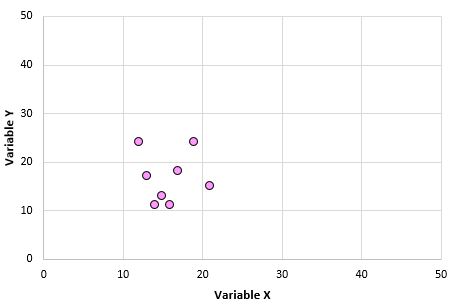
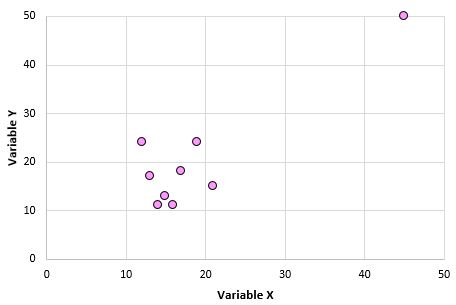
Le calcul du r de Pearson s’effectue sur le fondement de la minimisation de la somme des carrés des écarts à la moyenne. Cette structure quadratique confère au coefficient une hypersensibilité aux observations extrêmes situées en marge de la distribution bivariée. Une valeur aberrante isolée, déviant simultanément sur les axes X et Y en s’éloignant massivement du barycentre du nuage de points, exerce un effet de levier statistique considérable.
Dans un échantillon de taille modeste ((N = 30) ou (40)), la présence d’un seul individu atypique (par exemple un sujet ayant mal encodé ses réponses, ou présentant une pathologie neurologique sous-jacente non détectée) peut suffire à transformer un nuage parfaitement circulaire sans aucune association ((r = 0,05)) en une corrélation statistiquement significative estampillée « forte » ((r = 0,55)). À l’inverse, une valeur aberrante asymétrique peut détruire instantanément une corrélation robuste préexistante.
L’assainissement préliminaire des matrices de données ne constitue donc pas une formalité d’intendance, mais un impératif méthodologique de premier ordre. L’identification des points atypiques univariés via les scores standardisés (scores Z supérieurs à 3,29), complétée par la détection des outliers multivariés via le calcul de la distance de Mahalanobis et de la distance de Cook, conditionne la légitimité même de tout qualificatif accordé à la force d’une corrélation.
8. Artefacts méthodologiques pouvant masquer une corrélation forte
8.1 La restriction de l’étendue (Range Restriction)
À l’autre extrémité du spectre métrologique se dressent des artefacts pernicieux dont l’action systématique consiste à briser artificiellement les corrélations, reléguant des relations organiquement très puissantes au rang d’associations anémiques ou non significatives. Le phénomène le plus documenté en psychométrie différentielle et organisationnelle est sans conteste la restriction de l’étendue (Range Restriction).
Ce biais se matérialise chaque fois que l’échantillon analysé subit une sélection préalable directe ou indirecte sur l’une des variables d’intérêt. L’illustration d’école demeure la validité prédictive des concours d’entrée aux grandes écoles ou des tests d’intelligence générale (QI) sur les performances universitaires ultérieures. Lorsque les études corrèlent les scores au test d’admission avec les notes obtenues à la fin du cycle académique, les coefficients observés oscillent fréquemment autour d’un modeste r = 0,20 ou 0,30, incitant les commentateurs néophytes à décréter l’inutilité de l’épreuve de sélection.
Cette déduction est méthodologiquement erronée. Les candidats admis ne constituent aucunement un échantillon aléatoire représentatif de la population générale : seuls les 5 % ou 10 % ayant obtenu les scores les plus éclatants ont été admis au sein de l’institution. En amputant ainsi 90 % de la distribution des compétences, on compresse drastiquement la variance de la variable prédictive. Or, sans variabilité conjointe, le calcul de Pearson est mathématiquement bridé. Si l’on recalcule la corrélation sur la population globale des candidats à l’aide des formules de correction de Pearson et de Thorndike, le r originellement de 0,25 grimpe régulièrement au-delà de 0,65, révélant une puissance prédictive fondamentale exceptionnellement élevée.
8.2 Les relations non linéaires méconnues
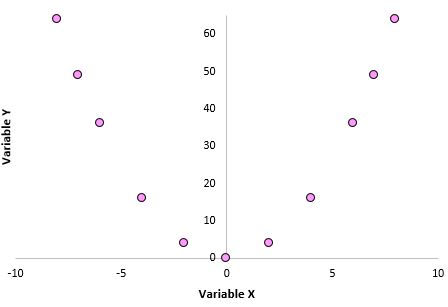
L’inféodation aveugle au coefficient produit-moment expose le chercheur à ignorer des dépendances fonctionnelles majeures du fait de leur géométrie non rectiligne. Comme explicité au premier chapitre, le r de Pearson est aveugle aux variations curvilignes. L’exemple le plus éclatant en sciences comportementales est incarné par la vénérable loi de Yerkes-Dodson (1908), qui régit les relations dynamiques unissant l’activation psychophysiologique (l’arousal ou le stress) et l’efficience de la performance cognitive.
Cette relation adopte la morphologie d’une cloche inversée (un U inversé) :
- À un niveau de stress trop bas, l’apathie et le déficit attentionnel induisent une performance faible.
- À mesure que la vigilance s’accroît, la performance s’améliore pour atteindre un optimum d’efficience au sommet de la courbe.
- Lorsque l’activation franchit ce seuil optimal pour sombrer dans l’angoisse panique, la surcharge mentale dégrade brutalement la performance motrice et exécutive.
Si un analyste applique machinalement le r de Pearson sur un jeu de données balayant la totalité du spectre de cette loi, la trajectoire ascendante de la première phase viendra annuler rigoureusement la pente descendante de la seconde. Le résultat statistique délivrera un coefficient r avoisinant 0,00, concluant faussement à une absence totale de relation. Il existe pourtant un déterminisme fonctionnel quasi-parfait entre stress et performance. Cet écueil illustre l’obligation absolue d’examiner attentivement les diagrammes de dispersion bivariés avant tout calcul algorithmique formel.
8.3 L’asymétrie de distribution et effets de plancher/plafond
L’architecture mathématique de Pearson postule implicitement que les variables distribuées partagent des formes symétriques, idéalement conformes à la normalité bivariée. Lorsque les instruments souffrent d’une asymétrie de distribution prononcée, la corrélation empirique maximale théoriquement atteignable s’effondre bien en deçà du plafond de 1,00.
Ces asymétries prévalent particulièrement lors de l’investigation de phénomènes psychopathologiques ou adaptatifs rares au sein de la population générale (idéations suicidaires, comportements agressifs extrêmes, dons intellectuels exceptionnels). Les distributions résultantes manifestent une asymétrie positive abrupte : la quasi-totalité des participants s’accumulent au score zéro ou un, déclenchant un effet de plancher massif, tandis qu’une infime minorité s’étire en une longue queue de comète.
Lorsque deux variables présentent des distributions aux formes opposées (l’une marquée par un effet de plancher et l’autre par un effet de plafond avec accumulation aux scores maximaux), les contraintes marginales interdisent géométriquement à la covariance d’atteindre son plein déploiement. Le coefficient de corrélation se retrouve bridé à des magnitudes maximales ne pouvant dépasser 0,30 ou 0,40, quand bien même la synchronie entre les deux processus serait absolue. Le recours à des transformations mathématiques correctrices (transformation logarithmique, racine carrée ou modélisation semi-paramétrique) devient alors indispensable pour restaurer la pleine expressivité de la corrélation.
9. Significativité statistique (valeur p) versus magnitude de l’effet (valeur r)
9.1 La dépendance critique de la valeur p à la taille de l’échantillon
Dans l’arsenal de l’inférence statistique, la confusion récurrente entre la significativité statistique opérationnalisée par la valeur p et la magnitude concrète de l’effet captée par le coefficient r demeure l’une des impasses épistémologiques les plus tenaces de la psychologie contemporaine. La valeur p ne mesure en aucune manière la force d’une corrélation ; elle quantifie exclusivement la probabilité conditionnelle d’observer un coefficient au moins aussi extrême que celui calculé, sous l’hypothèse nulle d’une absence absolue de relation dans la population d’origine ((rho = 0)).
La statistique de test de Student associée à un coefficient de Pearson s’énonce selon la formule suivante :
[t = r sqrt{frac{N – 2}{1 – r^2}}]
L’examen de cette équation révèle la dépendance mathématique directe du test envers la taille de l’échantillon ((N)). Plus (N) s’amplifie, plus le dénominateur s’effondre et plus la valeur de (t) explose, comprimant la valeur p vers des seuils infinitésimaux. Considérons deux situations expérimentales diamétralement opposées :
- Dans une méga-cohorte de bio-banque regroupant (N = 50,000) participants, une corrélation minuscule et cliniquement insignifiante de r = 0,03 obtiendra une valeur de (p < 0,0000000001). Déclarer cette association « hautement significative » relève d'une exactitude statistique formelle, mais d'une imposture pratique : elle n'explique qu'un dérisoire millième de la variance du comportement.
- Inversement, dans une recherche pilote en neuropsychologie clinique portant sur une pathologie rare mobilisant (N = 12) patients cérébrolésés, un coefficient robuste et théoriquement impressionnant de r = 0,52 échouera lamentablement au seuil canonique de significativité ((p approx 0,08)). Le chercheur non averti rejettera l’observation, passant à côté d’un effet potentiellement majeur.
9.2 L’utilisation systématique des intervalles de confiance
Pour s’émanciper de la tyrannie stérile du test dichotomique par valeur p, les instances internationales d’accréditation scientifique préconisent l’adoption universelle des intervalles de confiance (IC). La construction d’un intervalle de confiance autour d’un coefficient r de Pearson ne peut s’effectuer par simple ajout symétrique d’erreurs-types, car la distribution d’échantillonnage de r devient hautement asymétrique à mesure qu’elle s’écarte de zéro. Il est requis d’opérer la transformation z de Ronald Fisher :
[z’ = frac{1}{2} lnleft(frac{1 + r}{1 – r}right) = operatorname{arctanh}(r)]
Cette métrique normalisée permet de calculer l’erreur-type théorique fixe (sigma_{z’} = frac{1}{sqrt{N – 3}}), d’ériger les bornes de l’intervalle au seuil de confiance désiré (généralement 95 %), puis d’effectuer la transformation inverse pour rapatrier les limites dans l’espace métrique du r originel. Cette démarche modifie radicalement l’évaluation de la force statistique. Imaginons une étude rapportant un coefficient r = 0,55, promptement qualifié de corrélation forte par les auteurs. L’observation attentive de l’échantillon ((N = 25)) révèle un intervalle de confiance à 95 % s’étendant de 0,19 à 0,78.
Cette dispersion colossale de l’estimation signifie que les données collectées sont compatibles aussi bien avec une relation marginale et banale ((r = 0,19)) qu’avec une concordance structurelle quasi-déterministe ((r = 0,78)). Dès lors, qualifier péremptoirement ce résultat ponctuel d’association « forte » relève d’une audace injustifiée. L’amplitude de l’intervalle de confiance rappelle que la force d’un lien statistique ne réside pas seulement dans son estimation centrale ponctuelle, mais dans la précision de son ancrage au sein de la population cible.
10. Au-delà de Pearson : Évaluer la force via des métriques alternatives
10.1 Les coefficients de rang : Spearman et Kendall
L’hégémonie du r de Pearson ne doit pas occulter la présence d’alternatives non paramétriques robustes, requises dès lors que les données violent l’hypothèse de normalité bivariée ou relèvent d’échelles de mesure purement ordinales. Les deux approches les plus établies reposent sur les statistiques d’ordre : le rhô ((rho)) de Spearman et le tau ((tau)) de Kendall.
Le rhô de Spearman consiste simplement à convertir au préalable les valeurs métriques continues en rangs hiérarchiques ordinaux, puis à appliquer l’algorithme standard de Pearson sur ces classements sériels. Il évalue la monotonicité stricte de la relation : une association est réputée parfaite ((rho = 1,00)) dès lors que l’élévation d’une variable s’accompagne systématiquement de l’élévation de la seconde, sans exiger que cette synchronie obéisse à un ratio linéaire constant. Toutefois, en cas d’égalités de rangs (ties) nombreuses, Spearman tend à perdre de sa précision.
Le tau de Kendall, particulièrement décliné sous sa version tau-b pour gérer les ex-aequo, offre une élégance mathématique supérieure. Il s’édifie sur la comptabilité combinatoire des paires d’observations concordantes et discordantes :
[tau = frac{P – Q}{frac{1}{2} n (n – 1)}]
Le tau de Kendall présente des propriétés distributionnelles remarquables et une convergence normale bien plus rapide dans les petits échantillons que le coefficient de Spearman. Cependant, les analystes commettent souvent l’erreur d’appliquer les seuils de Cohen au tau de Kendall. De par sa construction probabiliste combinatoire, les valeurs numériques de Kendall sont structurellement inférieures à celles de Pearson. Un (tau) de 0,35 équivaut conceptuellement à un r de Pearson d’environ 0,50 à 0,55. Dès lors, pour Kendall, une association franchissant le seuil de (tau = 0,35) doit être reconnue comme résolument « forte ».
10.2 Corrélations bisériales et polychoriques
Dans de vastes pans de la psychométrie appliquée et de l’évaluation diagnostique, les variables d’intérêt ne sont pas encodées sous forme continue, mais sous forme discrète : items de personnalité dichotomiques (Vrai/Faux), validation catégorielle d’un symptôme (Présent/Absent), ou échelles de sévérité graduées de type Likert ordonnées. L’application erronée du r de Pearson à ces formats discrets engendre une sévère sous-estimation de la liaison sous-jacente.
Deux coefficients majeurs permettent de corriger cette mutilation métrique :
- La corrélation bisériale de points (et bisériale pure) : Mobilisée lorsqu’une variable continue normale est mise en regard d’une variable dichotomique réelle ou artificiellement tronquée. La corrélation bisériale reconstitue mathématiquement la distribution gaussienne latente supposée sous-tendre la dichotomie observable.
- La corrélation tétrachorique (pour deux variables binaires) et polychorique (pour deux variables ordinales) : Ces formulations sophistiquées estiment quelle serait la corrélation bivariée normale de Pearson si les deux traits latents avaient été mesurés avec une précision continue infinie, plutôt qu’à travers le prisme déformant de seuils de réponse catégoriels.
Les seuils de qualification de la force doivent être modulés en conséquence : les corrélations polychoriques étant par nature décontaminées du tassement provoqué par le format de réponse catégoriel, leurs valeurs sont systématiquement plus élevées que les corrélations de Pearson calculées sur les mêmes données brutes. Une corrélation polychorique forte réclamera ainsi fréquemment un ancrage au-delà de 0,60 pour signaler une convergence substantielle indiscutable.
10.3 Les coefficients de corrélation de distance et d’information mutuelle
Les avancées récentes en science des données et en biostatistique computationnelle ont donné naissance à des métriques affranchies des contraintes restrictives de la famille de Pearson. La plus remarquable est la corrélation de distance (distance correlation ou dCor), formalisée par Székely et ses collaborateurs au XXIe siècle. Contrairement au r de Pearson qui ne scrute que l’alignement rectiligne, la corrélation de distance capture toute forme de dépendance fonctionnelle, qu’elle soit linéaire, exponentielle, sinusoïdale ou circulaire. Une valeur de dCor égale à 0 prouve l’indépendance statistique absolue des variables.
Parallèlement, les neurosciences computationnelles et la psychologie cognitive de pointe exploitent de plus en plus l’information mutuelle ((I(X; Y))), issue des concepts de la théorie de l’information développée par Claude Shannon. Fondée sur la métrique de l’entropie, l’information mutuelle quantifie le volume d’incertitude sur la variable X qui se trouve éliminé par la connaissance préalable de la variable Y :
[I(X; Y) = iint p(x,y) log left( frac{p(x,y)}{p(x),p(y)} right) dx,dy]
L’information mutuelle ne se limite à aucun intervalle préétabli et transcende les limites de la géométrie euclidienne. L’émergence de ces métriques redéfinit la conception contemporaine de la force associative : un lien n’a plus besoin d’être rectiligne pour être qualifié de puissant. Une dynamique chaotique ou curvilinéaire complexe reliant deux assemblées neuronales peut manifester une information mutuelle colossale, signalant un lien d’une force déterminante que les outils gaussiens traditionnels classaient au rang de bruit stochastique nul.
11. Exemples concrets et contextuels en recherche psychologique
11.1 Quand un r modeste (0,20 – 0,30) possède un impact sociétal massif
L’une des erreurs d’appréciation les plus dommageables consiste à juger de l’utilité pratique d’une corrélation à l’aune exclusive de son étiquette numérique abstraite. L’histoire de l’épidémiologie médicale offre à ce propos un rappel saisissant : lors du retentissant essai clinique américain Physicians’ Health Study évaluant l’efficacité de l’aspirine dans la prévention des infarctus du myocarde, l’association observée entre la prise d’aspirine et la réduction des événements coronariens aigus affichait un coefficient de corrélation de Pearson de seulement r = 0,03 ((r^2 = 0,0009)).
Selon les canons de n’importe quel manuel de statistiques élémentaires, un tel coefficient relève du néant explicatif. Pourtant, le comité d’éthique a ordonné l’interruption prématurée immédiate de l’essai clinique : ce dérisoire r de 0,03 représentait l’épargne avérée de centaines de vies humaines au sein du bras expérimental. Traiter par le mépris un coefficient faible constitue donc une faute professionnelle lourde lorsque l’intervention s’applique de manière universelle à une échelle démographique massive.
Cette leçon s’applique rigoureusement à la psychologie sociale et différentielle. La méta-analyse fondatrice de Bushman et Anderson (2001) sur l’impact de l’exposition aux jeux vidéo violents sur les comportements agressifs a établi un coefficient de corrélation moyen oscillant entre r = 0,15 et 0,25. Bien que modeste, cette taille d’effet équivaut à celle unissant le tabagisme passif à l’apparition du cancer du poumon. De même, la prédiction de la performance managériale et professionnelle à long terme par le trait de Consciencieusité issu du modèle du Big Five se stabilise méta-analytiquement autour de r = 0,22. Déployé sur une population active de plusieurs dizaines de millions de travailleurs, ce coefficient génère des différentiels de productivité et de bien-être économique qui se chiffrent en dizaines de milliards d’euros.
11.2 Les rares occurrences de corrélations réellement fortes (> 0,60) en psychologie
En contrepoint de ces effets diffus, les occurrences où la recherche comportementale isole des corrélations franchissant véritablement le seuil de r = 0,60 sont exceptionnellement rares et circonscrites à des topologies métrologiques très spécifiques. Le cas le plus documenté concerne la fidélité test-retest à court terme et la convergence des instruments d’intelligence générale fluide et cristallisée (QI). Lorsque l’on corrèle les scores obtenus à l’échelle de Wechsler (WAIS) à ceux des Matrices Progressives de Raven au sein d’un échantillon normatif non restreint, le coefficient s’élève régulièrement entre 0,70 et 0,80, traduisant le partage indiscutable d’un facteur g commun puissant.
Cependant, dans la majorité des autres domaines psychologiques, l’observation d’un coefficient dépassant 0,65 ou 0,70 doit susciter la circonspection méthodologique plutôt que l’euphorie. Très souvent, une corrélation aussi spectaculaire entre deux échelles distinctes dissimule un chevauchement conceptuel redondant, voire une tautologie métrologique. Considérons le cas classique des corrélations massives souvent observées entre les échelles d’anxiété généralisée et les inventaires de dépression majeure, qui dépassent couramment r = 0,75.
Une inspection clinique minutieuse du contenu des items dissipe l’illusion d’une relation fonctionnelle surpuissante : les deux échelles administrent en vérité les mêmes questions sous des formulations quasi-synonymes (fatigue chronique, troubles de la concentration, rumination négative, perturbations du sommeil). Le coefficient géant ne capture pas une dynamique causale fascinante entre deux entités psychologiques autonomes ; il enregistre simplement la redondance lexicale d’une même dimension latente sous-jacente de détresse psychologique générale ou d’affectivité négative.
11.3 L’évaluation de la validité discriminante
Cette problématique des corrélations excessives est au cœur des protocoles de validation d’outils, formalisés dès 1959 par Campbell et Fiske dans leur célèbre Matrice Multi-Traits Multi-Méthodes (MTMM). Selon cette méthodologie cardinale de la psychométrie, un nouvel instrument doit simultanément attester d’une validité convergente (corréler fortement avec des instruments éprouvés captant le même attribut) et d’une validité discriminante (démontrer des corrélations faibles ou modérées avec des construits théoriquement distincts).
Dans ce paradigme, une corrélation trop forte devient pathologique :
- Si un chercheur développe une nouvelle échelle d’évaluation de l’« intelligence émotionnelle » et observe une corrélation de r = 0,82 avec un test de compréhension verbale préexistant, la validité discriminante est anéantie. Le nouvel outil n’apporte aucune plus-value incrémentale et ne fait que mesurer le facteur verbal sous une fausse étiquette commerciale.
- De plus, au sein des analyses statistiques multivariées et des modélisations par équations structurelles (SEM), l’émergence de corrélations bivariées inter-items ou inter-facteurs excédant 0,80 ou 0,85 déclenche le piège destructeur de la multicolinéarité. Cette saturation artificielle déstabilise les matrices de covariance, fait exploser les erreurs-types des paramètres estimés et produit des signes de régression inversés aberrants. Paradoxalement, dans la modélisation structurelle avancée, une corrélation « trop forte » n’est plus un signe de puissance théorique, mais un symptôme d’invariance mal calibrée et de parasitage paramétrique.
12. Recommandations méthodologiques pour rapporter et interpréter une corrélation
12.1 Directives de publication de l’APA (7e édition)
Face à la persistance des interprétations dévoyées et aux défis de la crise de la réplicabilité qui secoue les sciences empiriques, l’American Psychological Association a considérablement durci ses directives de diffusion des résultats au sein du manuel de publication APA 7e édition. La transcription d’une analyse corrélationnelle dans une revue scientifique à comité de lecture ne peut plus se réduire à la simple juxtaposition d’une valeur estimée et d’un astérisque de significativité.
Les normes contemporaines imposent dorénavant les prescriptions suivantes :
- Rapporter la taille d’effet exacte : Le coefficient d’échantillon doit être renseigné avec sa précision exacte (généralement deux décimales, sans zéro devant la virgule selon l’usage typographique anglo-saxon : par exemple, r = .34).
- Associer la valeur p exacte : Les expressions archaïques telles que « p < .05 » ou « p = NS » sont proscrites au profit des valeurs précises (ex. p = .003), à l’exception unique des seuils infinitésimaux (p < .001).
- Fournir systématiquement l’intervalle de confiance : Les auteurs ont l’obligation stricte d’adjoindre l’intervalle de confiance à 95 % entourant le coefficient (ex. r = .34, IC 95 % [.12, .53]), offrant aux pairs une évaluation transparente de la précision d’échantillonnage.
- Expliciter les procédures d’assainissement : Le texte doit documenter la façon dont les valeurs extrêmes ont été détectées, les méthodes de gestion des données manquantes (imputation multiple ou FIML) et les vérifications d’invariance menées.
- Bannir les adjectifs dogmatiques : Les directives incitent formellement les chercheurs à ne plus qualifier un coefficient de « fort », « faible » ou « négligeable » sur la base des seuils génériques et désuets de Cohen, mais à discuter l’amplitude de l’effet en relation directe avec les méta-analyses antérieures publiées dans le champ spécifique.
12.2 La matrice d’aide à la décision pour le chercheur et le praticien
Afin de synthétiser ces enseignements dans une démarche opératoire, nous proposons une matrice séquentielle d’aide à la décision méthodologique, articulée en quatre étapes cardinales :
Étape 1 : Inspection graphique et diagnostic des postulats fondamentaux
Avant tout calcul numérique, le chercheur doit générer un diagramme de dispersion bivarié. Cette inspection vérifie l’absence de non-linéarité flagrante (relations en cloche ou asymptotiques), examine l’homoscédasticité de la distribution des résidus, et recherche d’éventuels points extrêmes aberrants par l’analyse des distances statistiques standardisées.
Étape 2 : Évaluation et correction de la qualité métrologique
L’analyste consigne les indices de fidélité des mesures engagées (oméga de McDonald ou consistance interne). Si la fidélité s’avère imparfaite, il convient de calculer conjointement le coefficient brut observable et le coefficient théorique corrigé pour atténuation de Spearman, afin de distinguer l’association réelle sur le terrain de la puissance relationnelle latente.
Étape 3 : Contextualisation normative et méta-analytique
L’évaluation sémantique de l’intensité corrélationnelle doit délaisser les grilles de 1988 pour s’aligner sur les distributions empiriques contemporaines (Gignac & Szodorai, 2016). Un coefficient situé autour de r = 0,30 doit être légitimement reconnu comme un effet fort au regard des standards empiriques des sciences humaines, pour peu que la variance commune de méthode ait été préalablement jugulée.
Étape 4 : Dérivation de l’utilité clinique et sociétale
L’interprétation finale s’opère par le calcul du coefficient de détermination ((r^2)) pour mesurer la part de variance expliquée face à l’incertitude résiduelle. Cette métrique est confrontée au coût de l’intervention et à la portée collective du phénomène : un effet modeste sur un résultat vitale ou à très grande échelle prévaut toujours méthodologiquement sur un effet fort mais restreint à une relation tautologique triviale.
En définitive, statuer sur ce qui est considéré comme une corrélation « forte » requiert l’abandon définitif des catéchismes statistiques simplificateurs. Loin de représenter un attribut numérique statique, la force d’une corrélation s’avère une construction contextuelle, psychométrique et épistémologique. Elle est la résultante d’un dialogue exigeant entre la rigueur métrologique de la collecte, l’humilité face à la complexité des conduites humaines, et la lucidité analytique d’un chercheur capable de voir au-delà du chiffre abstrait la réalité concrète des phénomènes qu’il s’est donné pour mission de comprendre.
Références
- Bushman, B. J., & Anderson, C. A. (2001). Media violence and the American public: Scientific facts versus media misinformation. American Psychologist, 56(6-7), 477–489. https://doi.org/10.1037/0003-066X.56.6-7.477
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Evans, J. D. (1996). Straightforward Statistics for the Behavioral Sciences. Brooks/Cole Publishing Company.
- Fisher, R. A. (1921). On the ‘probable error’ of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74–78. https://doi.org/10.1016/j.paid.2016.06.042
- Guilford, J. P. (1956). Fundamental Statistics in Psychology and Education (3rd ed.). McGraw-Hill.
- Hemphill, J. F. (2003). Interpreting the magnitudes of correlation coefficients. American Psychologist, 58(1), 78–79. https://doi.org/10.1037/0003-066X.58.1.78
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Székely, G. J., Rizzo, M. L., & Bakirov, N. K. (2007). Measuring and testing dependence by correlation of distances. The Annals of Statistics, 35(6), 2769–2794. https://doi.org/10.1214/009053607000000505
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503