
Dans le domaine de l’analyse quantitative et de la recherche empirique, particulièrement au sein des sciences comportementales, de la psychométrie et de l’épidémiologie, la représentation visuelle fidèle des distributions constitue un impératif méthodologique incontournable. L’exploration de données ne peut se limiter à l’inspection de métriques paramétriques classiques telles que la moyenne arithmétique et l’écart-type, souvent trompeuses lorsqu’elles sont confrontées à des distributions asymétriques, multimodales ou contaminées par des valeurs aberrantes. À cet égard, la boîte à moustaches, formalisée par John Tukey dans son ouvrage fondateur sur l’analyse exploratoire des données en 1977, demeure l’un des artefacts graphiques les plus denses et efficients de la statistique moderne. Elle offre une synthèse non paramétrique immédiate de la tendance centrale, de la dispersion et des extrêmes sans formuler la moindre supposition préalable sur la gaussianité de la population sous-jacente.
Le logiciel statistique Stata s’impose depuis plusieurs décennies comme l’une des plateformes de référence pour le traitement de données volumineuses, l’économétrie et la biostatistique. Son moteur graphique, particulièrement rigoureux et modulaire, intègre une suite de commandes dédiées à l’élaboration de diagrammes en boîte d’une précision analytique et typographique absolue. Si les commandes élémentaires de Stata permettent de produire des ébauches visuelles en quelques frappes de clavier, l’exploitation optimale de ses sous-routines de paramétrage requiert une compréhension intime de sa syntaxe par couches, du comportement de ses algorithmes de partitionnement et de la manipulation fine de ses métadonnées. L’objectif de ce manuel exhaustif est de décortiquer pas à pas chaque composant structurel, esthétique et programmatique de la création de boîtes à moustaches dans Stata, afin d’élever vos visualisations au niveau des exigences de publication les plus strictes des revues internationales.
De la dérivation mathématique des charnières de Tukey jusqu’à l’automatisation de séries complexes de graphiques factoriels emboîtés au moyen de scripts de commande reproductibles, ce guide explore l’intégralité du cycle de vie de la donnée visuelle. Que vous soyez chercheur en psychologie cognitive confronté à des temps de réaction fortement asymétriques, biostatisticien évaluant la réponse clinique différentielle de biomarqueurs sanguins, ou analyste de politiques publiques soucieux de respecter scrupuleusement les chartes graphiques académiques comme celles de l’American Psychological Association, vous trouverez ici les fondements théoriques, les explications syntaxiques détaillées et les conseils ergonomiques nécessaires pour maîtriser l’art de la boîte à moustaches sous Stata.
1. Introduction aux boîtes à moustaches et fondements statistiques dans Stata
1.1 Définition mathématique du résumé à cinq nombres
Le diagramme en boîte à moustaches repose fondamentalement sur le concept de résumé à cinq nombres (five-number summary), une approche d’estimation non paramétrique conceptualisée pour synthétiser l’information essentielle d’une variable continue ordonnée sans faire d’hypothèse sur sa loi de distribution. Les cinq valeurs scalaires qui constituent l’armature de ce tracé sont le minimum empirique, le premier quartile (marquant le vingt-cinquième centile, noté Q1), la médiane (le cinquantième centile ou Q2), le troisième quartile (le soixante-quinzième centile, noté Q3) et le maximum empirique. L’évaluation de ces centiles dans un échantillon de taille finie nécessite le tri préalable des observations par ordre croissant. La médiane représente la valeur centrale séparant l’échantillon en deux moitiés égales, minimisant ainsi la somme des écarts absolus des observations, ce qui lui confère une insensibilité totale aux déformations induites par les valeurs exceptionnellement éloignées.
L’espace compris entre le premier et le troisième quartile constitue l’écart interquartile (communément désigné sous l’acronyme IQR pour Interquartile Range). Mathématiquement défini par la différence stricte Q3 moins Q1, l’écart interquartile mesure la dispersion des cinquante pour cent centraux de la population observée. Contrairement à la variance ou à l’écart-type, dont les calculs reposent sur les déviations quadratiques par rapport à la moyenne arithmétique, l’IQR possède un point de rupture élevé, atteignant vingt-cinq pour cent : cela signifie qu’un quart des observations peuvent être arbitrairement altérées ou corrompues sans que cette mesure de dispersion ne bascule vers l’infini. Cette propriété de robustesse s’avère particulièrement cruciale dans les disciplines expérimentales où les contaminations de mesure ou les erreurs d’encodage sont fréquentes.
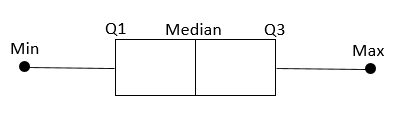
Dans la formalisation standard de Tukey implémentée nativement par Stata, les délimitations extrêmes de la boîte centrale matérialisent directement le premier et le troisième quartile. La ligne traversant la boîte correspond à la médiane. En revanche, les moustaches (ou whiskers) ne s’étendent pas nécessairement jusqu’aux valeurs minimale et maximale absolues du jeu de données. Elles sont bornées par des barrières de calcul spécifiques, établies conventionnellement à une fois et demie l’écart interquartile au-delà des quartiles inférieur et supérieur. Les données situées en deçà de la barrière inférieure ou au-delà de la barrière supérieure sont classées comme des valeurs aberrantes ou atypiques et représentées sous forme de points individualisés, prévenant ainsi toute distorsion visuelle de l’échelle d’analyse.
1.2 Importance de la visualisation robuste en psychométrie
Dans le domaine de la psychométrie contemporaine et de l’évaluation comportementale, la structure empirique des données s’éloigne fréquemment de la courbe théorique de Gauss. Les variables telles que les scores de dépression clinique, les inventaires de traumatismes, ou les temps de latence cognitive manifestent une asymétrie de distribution (skewness) positive prononcée, caractérisée par une longue traîne vers les valeurs élevées et une forte concentration vers le bas. À l’inverse, des tests d’aptitude cognitive standardisés appliqués à des cohortes sélectionnées peuvent générer une asymétrie négative marquée. La boîte à moustaches permet d’évaluer visuellement cette dissymétrie d’un simple coup d’œil : une médiane non centrée à l’intérieur de la boîte centrale et des longueurs inégales de moustaches signalent sans équivoque une violation de l’hypothèse de symétrie.
De surcroît, les échelles d’évaluation psychologique souffrent régulièrement de contraintes de mesure intrinsèques, telles que l’effet de plancher (floor effect) ou l’effet de plafond (ceiling effect). L’effet de plancher survient lorsqu’un instrument de mesure est incapable de distinguer les variations chez les individus présentant des niveaux extrêmement faibles du trait latent, comprimant artificiellement une fraction notable de l’échantillon sur le score minimal admissible. L’effet de plafond produit la distorsion inverse à l’extrémité supérieure de l’échelle. Dans un diagramme en boîte, ces artefacts se manifestent par un aplatissement complet de la moustache inférieure ou supérieure et par la coalescence de la ligne médiane avec l’une des bordures du rectangle interquartile, avertissant immédiatement l’expérimentateur de la troncation des scores.
Enfin, la comparaison non paramétrique entre des cohortes cliniques et des groupes témoins sains trouve dans la boîte à moustaches un vecteur de communication d’une clarté inégalée. Lorsque les postulats d’homoscédasticité et de normalité requis par le test t de Student ou l’analyse de variance classique sont violés, la juxtaposition de boîtes à moustaches permet de comparer la tendance centrale par le décalage des médianes et la variabilité intrinsèque par la hauteur relative des boîtes, fournissant ainsi une base solide et intuitive pour appuyer des tests inférentiels non paramétriques tels que le test de Wilcoxon-Mann-Whitney ou le test de Kruskal-Wallis.
1.3 Architecture du moteur graphique de Stata
L’environnement logiciel Stata dispose d’un sous-système graphique hautement spécialisé, doté d’une grammaire logique qui structure chaque élément géométrique sous forme d’une couche superposable et paramétrable. Pour le traçage des distributions condensées, Stata distingue fondamentalement deux commandes sœurs : la commande graph box, conçue pour produire des visualisations à orientation verticale, et la commande graph hbox, dédiée aux projections à orientation horizontale. Bien que ces deux commandes partagent une quasi-totalité de leurs arguments syntaxiques et de leurs sous-options de formatage, leur divergence directionnelle modifie l’attribution spatiale des axes et l’ergonomie de lecture des sorties textuelles.
Contrairement aux commandes graphiques génériques de type bidimensionnel, regroupées sous l’instruction twoway, les commandes de boîtes à moustaches de Stata fonctionnent sous un paradigme d’agrégation statistique directe. L’utilisateur ne transmet pas au moteur graphique des coordonnées cartésiennes précalculées ; il spécifie les variables analytiques brutes ainsi que d’éventuelles variables de stratification catégorielle. C’est le compilateur interne de Stata qui exécute en mémoire vive le tri des rangs, le calcul matriciel des quantiles et l’évaluation des seuils d’exclusion avant de dessiner les polygones et les marqueurs.
Cette architecture intégrée permet une flexibilité remarquable. L’utilisateur peut simultanément définir la géométrie des boîtes, personnaliser la typographie des axes, calibrer les échelles numériques et filtrer les sous-populations au sein d’une seule ligne d’instruction. L’intégration de la syntaxe par couches garantit en outre que chaque modification d’aspect, qu’il s’agisse de l’épaisseur d’un trait, du motif d’une trame ou de la teinte d’un point aberrant, s’applique de façon déterministe et reproductible au sein de scripts de traitement automatisés.
2. Préparation de l’environnement Stata et manipulation des données
2.1 Chargement et inspection préliminaire du jeu de données
Toute initiative de visualisation graphique rigoureuse dans Stata commence impérativement par une phase d’audit structurel des données importées en mémoire vive. L’acquisition du jeu de données s’effectue couramment via l’instruction use, suivie du chemin d’accès absolu ou relatif vers le fichier de format propriétaire, complétée si nécessaire par l’option clear afin de purger les données résiduelles préalablement chargées. Pour illustrer des manipulations méthodologiquement reproductibles, les chercheurs s’appuient fréquemment sur les jeux de données hébergés directement sur les dépôts distants de StataCorp, tels que les inventaires de santé publique ou les bases automobiles d’apprentissage.
Dès le chargement complété, la phase d’inspection préliminaire s’ouvre par l’exécution de la commande describe. Cette directive fournit un état des lieux exhaustif de la table : nombre total de lignes (observations), nombre de colonnes (variables), typage machine de chaque champ (entiers sous formats byte ou int, réels à virgule flottante sous formats float ou double, et chaînes de caractères de type str). Il est capital de vérifier que les variables psychométriques ou cliniques continues destinées à figurer dans le diagramme sont bel et bien encodées sous forme de variables numériques réelles, faute de quoi le moteur de graph box rejettera la commande avec une notification d’incompatibilité de type.
Par la suite, l’opérateur déploie les instructions summarize (souvent assortie du modificateur detail pour dévoiler l’intégralité des centiles) et codebook. La sous-routine summarize, detail constitue un prélude essentiel au tracé graphique : elle affiche textuellement les valeurs précises de Q1, de la médiane et de Q3, permettant au statisticien de disposer des valeurs numériques exactes qui serviront d’étalons de vérification lors de l’examen visuel de la boîte générée par Stata.
2.2 Nettoyage et filtrage préalable des observations
L’intégrité de la boîte à moustaches dépend étroitement de la salubrité du jeu de données sous-jacent. L’un des écueils majeurs dans l’écosystème Stata réside dans le traitement des valeurs manquantes système (représentées par un simple point typographique) et des valeurs manquantes étendues (allant de .a jusqu’à .z). Dans la hiérarchie computationnelle de Stata, les valeurs manquantes numériques sont assimilées à des grandeurs positives infiniment plus élevées que le plus grand nombre réel encodable. Bien que la commande graph box possède des filtres internes pour ignorer par défaut les observations manquantes sur la variable continue tracée, la prudence dicte un assainissement préalable explicite pour éviter toute contamination lors d’analyses combinées.
Le chercheur utilise judicieusement la clause conditionnelle if pour délimiter les sous-échantillons analytiques. Dans le cadre d’un protocole d’investigation en sciences comportementales, il peut s’avérer nécessaire d’exclure les participants n’ayant pas satisfait aux critères d’attention ou présentant des profils cliniques aberrants. L’expression prendra la forme d’un filtrage direct au sein de l’instruction graphique, ou passera par la création préalable d’une variable binaire d’inclusion via la commande generate et l’assignation de valeurs logiques.
Le recodage systématique des variables d’identification et des modalités catégorielles fait également partie de cette phase préparatoire. L’utilisation de l’utilitaire recode permet de redéfinir les scores hors normes, de fusionner des cohortes marginales ou de transformer des valeurs sentinelles (telles que -99 ou 999, fréquemment utilisées dans les questionnaires papier pour signifier l’absence de réponse) en valeurs manquantes formelles reconnues par le système, écartant ainsi tout risque de distorsion monumentale de l’échelle des ordonnées.
2.3 Attribution d’étiquettes de variables et de valeurs
La dimension communicante d’un graphique repose pour une large part sur la précision de sa sémiologie textuelle. L’un des atouts déterminants de Stata réside dans son architecture de métadonnées, qui permet de greffer des descriptions littérales sur les objets mathématiques. Lors de l’exécution de graph box, le logiciel utilise prioritairement l’étiquette de la variable (variable label) pour nommer l’axe de mesure. Si aucune étiquette n’a été spécifiée, Stata se résout à afficher le nom technique abrégé de la variable, ce qui dégrade considérablement la lisibilité du document scientifique.
L’attribution de cette métadonnée descriptive s’opère via la commande label variable, suivie du nom de la variable et de la chaîne de caractères correspondante, qui doit idéalement expliciter la métrique employée ainsi que l’unité de mesure (par exemple : « Temps de réaction moyen (en millisecondes) » ou « Score total d’anxiété (inventaire de Beck) »). Cette précaution garantit que l’axe métrique du futur tracé sera immédiatement compréhensible sans nécessiter d’annotations correctives ultérieures.
Pour les variables catégorielles destinées à former les sous-groupes de comparaison, l’assignation d’étiquettes de valeurs (value labels) est un prérequis absolu. Ce processus se déploie en deux temps distincts : la création d’une table d’association au moyen de l’instruction label define, qui lie chaque code numérique discret à une chaîne explicative claire, suivie de l’attachement effectif de cette nomenclature à la variable cible grâce à label values. Grâce à cette discipline préparatoire, les modalités apparaîtront sous forme d’intitulés explicites sur l’axe catégoriel plutôt que sous des codes cryptiques réclamant un effort de décodage cognitif superflu de la part du lecteur.
3. Création de boîtes à moustaches verticales fondamentales
3.1 Syntaxe de base de la commande graph box
La production d’un diagramme en boîte univarié représente l’opération fondamentale à partir de laquelle s’articulent toutes les extensions ultérieures du moteur graphique de Stata. La syntaxe la plus élémentaire s’énonce en saisissant le terme graph box, suivi immédiatement du nom de la variable numérique continue dont on cherche à inspecter la dispersion. Dès la validation de cette consigne, Stata sollicite son compilateur, exécute le calcul du résumé à cinq nombres en arrière-plan, ouvre la fenêtre de rendu graphique dédiée et affiche la silhouette caractéristique du diagramme de Tukey dressé à la verticale.
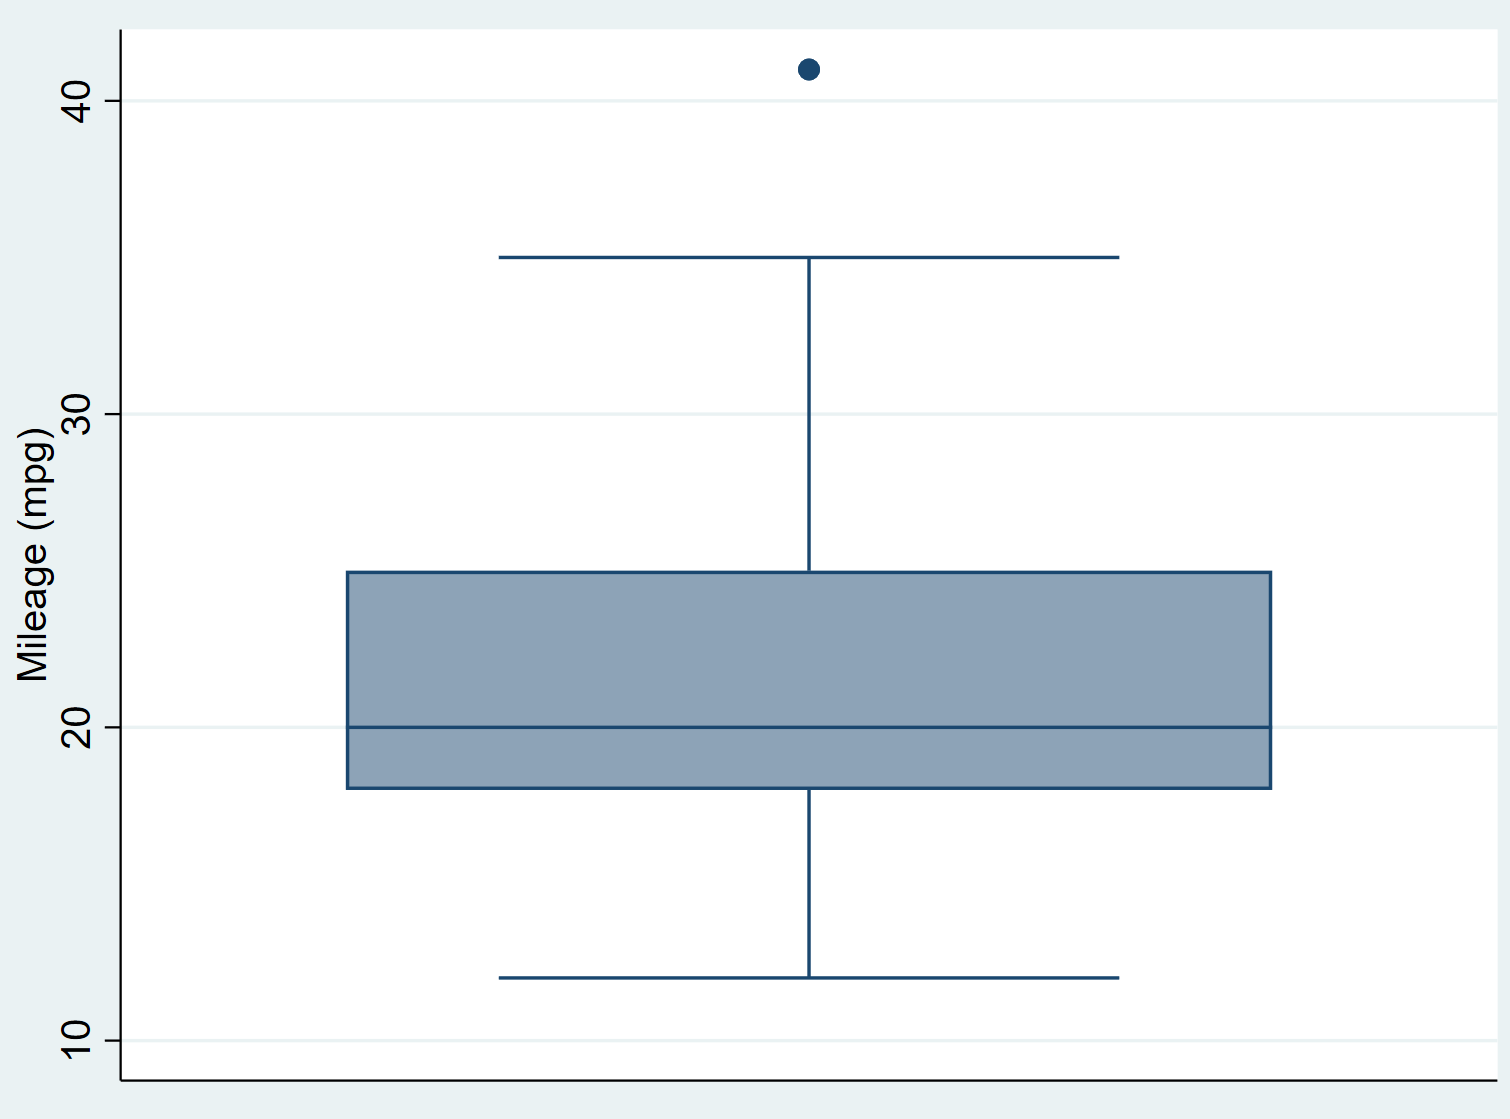
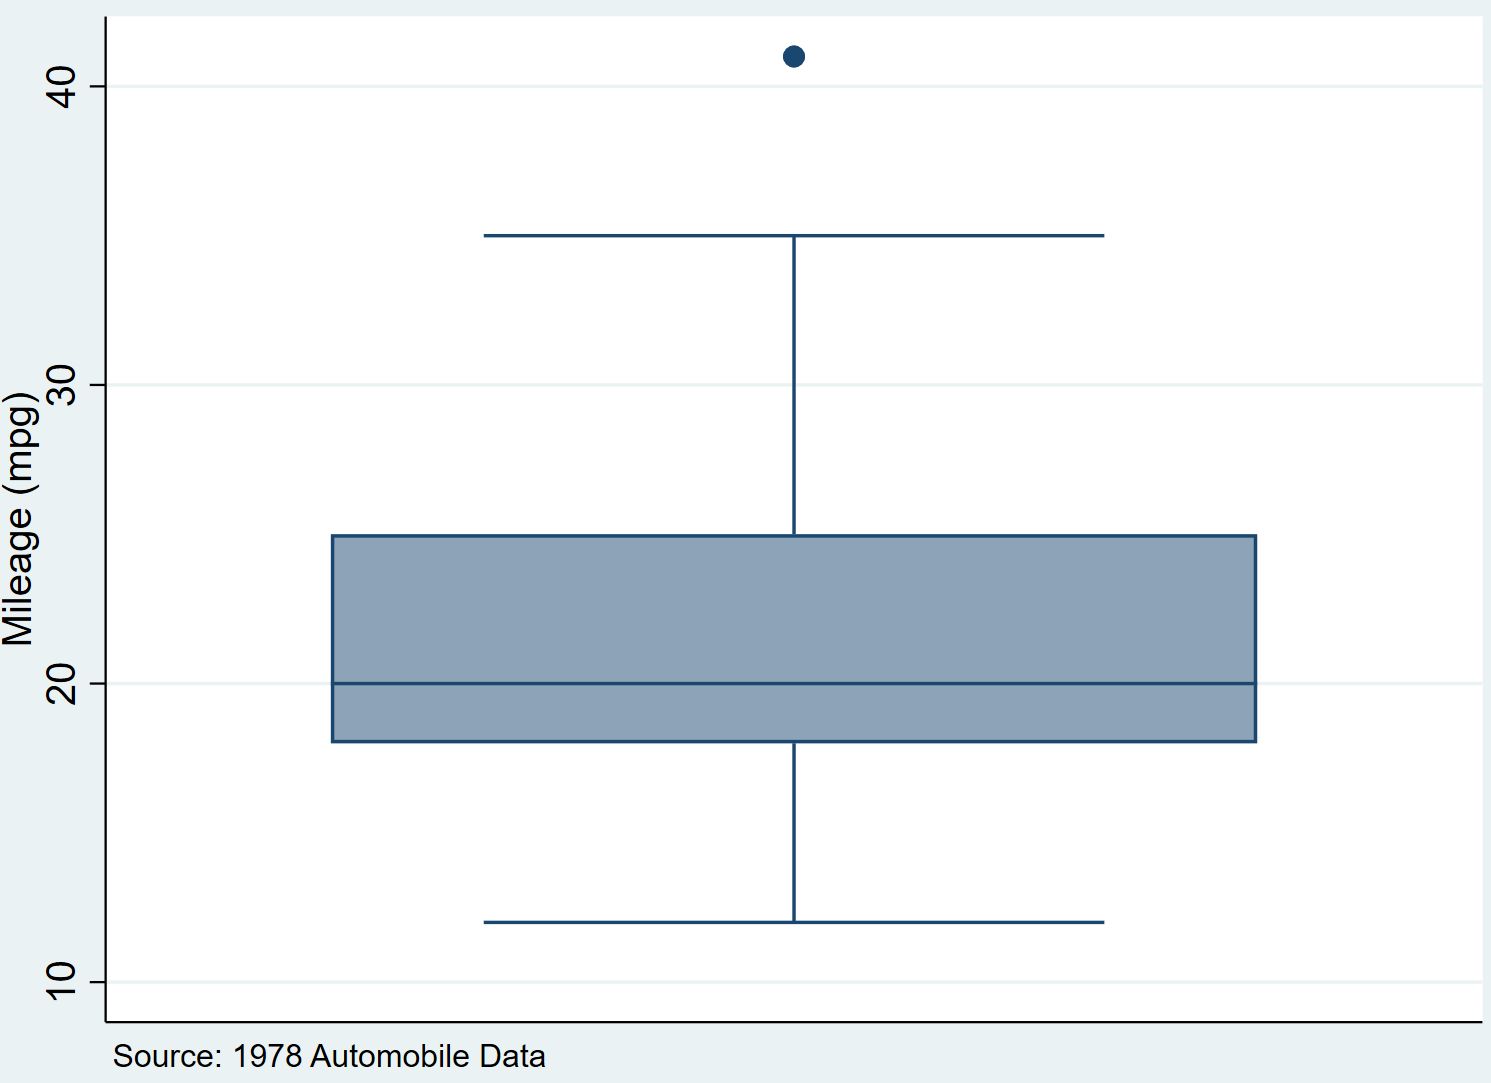
Dans ce mode d’affichage par défaut, la structure géométrique obéit à un ensemble de conventions standardisées. Le corps central de la boîte est constitué d’un rectangle bleu ardoise (selon le schéma graphique d’usine par défaut), délimité en bas par le premier quartile et en haut par le troisième quartile. La hauteur de ce rectangle représente exactement l’écart interquartile. Une ligne transversale blanche ou sombre traverse le parallélépipède à hauteur exacte de la médiane empirique, permettant d’apprécier la symétrie locale des cinquante pour cent centraux de la distribution.
Les moustaches s’étendent verticalement à partir des arêtes de la boîte centrale jusqu’aux valeurs adjacentes les plus éloignées qui respectent la barrière de Tukey de 1,5 fois l’écart interquartile. Toutes les observations tombant en dehors de ces bornes de tolérance sont matérialisées par des points isolés suspendus au-dessus ou au-dessous des moustaches. L’axe vertical (ordonnée) reçoit automatiquement une graduation arithmétique couvrant l’intervalle complet des données observées, tandis que l’axe horizontal ne comporte aucune graduation métrique, servant uniquement de support d’ancrage pour l’unique boîte tracée.
3.2 Analyse univariée de variables psychométriques continues
L’application directe de la commande graph box univariée prend tout son sens lors de la phase initiale d’évaluation des propriétés d’une échelle psychométrique nouvellement administrée. Considérons l’examen des scores bruts obtenus par un groupe d’individus à un test d’aptitude spatiale. Le chercheur lance le tracé de la boîte à moustaches afin d’évaluer la dispersion globale des compétences au sein de sa cohorte. La hauteur de la boîte offre une appréciation instantanée de l’hétérogénéité des sujets : une boîte étirée traduit une forte divergence interindividuelle, tandis qu’une boîte comprimée témoigne d’une grande cohésion des performances.
Cette appréciation visuelle permet de confronter les observations aux hypothèses sous-jacentes de la modélisation statistique. Si la ligne médiane est collée contre le plancher du premier quartile et que la moustache supérieure est considérablement plus longue que la moustache inférieure, le psychométricien diagnostique immédiatement une distribution fortement étalée vers la droite. Dans une telle configuration, l’hypothèse de normalité univariée est manifestement compromise, ce qui incite le chercheur à la prudence quant à l’application prématurée de modèles paramétriques linéaires.
Il est de bonne pratique académique de confronter ce diagnostic graphique aux résultats des tests statistiques inférentiels de normalité, tels que le test de Shapiro-Wilk (exécuté via la commande swilk) ou le test de symétrie et d’aplatissement de D’Agostino et Pearson (accessible par sktest). Si la p-valeur de ces tests s’avère inférieure au seuil critique conventionnel de cinq pour cent, le rejet de l’hypothèse nulle de normalité trouve dans la boîte à moustaches une justification empirique irréfutable, fournissant la documentation visuelle nécessaire pour étayer le choix de recourir à des méthodes statistiques robustes ou à des transformations mathématiques préalables.
3.3 Comparaison simultanée de plusieurs variables sur la même échelle
Une fonctionnalité particulièrement puissante de la commande graph box réside dans sa faculté d’accueillir simultanément plusieurs variables continues distinctes au sein de la même ligne d’instruction. Pour générer un affichage comparatif juxtaposé, il suffit d’énumérer les variables d’intérêt à la suite du mot-clé initial, par exemple en spécifiant graph box score_anxiete score_depression score_stress. Stata engendre alors un graphique unifié où chaque variable se voit assigner une boîte à moustaches dédiée, positionnée parallèlement sur le plan visuel.
Cette approche implique cependant une contrainte méthodologique capitale : l’ensemble des variables appelées doit impérativement partager une échelle de mesure identique ou du moins parfaitement standardisée. Si un analyste tente de superposer sur le même graphique un temps de réaction exprimé en millisecondes (dont les grandeurs oscillent couramment entre trois cents et douze cents unités) et un score d’exactitude borné entre zéro et un, la seconde distribution se trouvera écrasée de manière illisible contre l’axe de référence sous l’effet de l’étirement excessif de l’échelle des ordonnées.
Lorsque cette condition d’homogénéité métrique est respectée — comme dans le cas de sous-échelles d’un inventaire psychologique toutes notées sur une échelle de Likert de 1 à 7, ou de scores standardisés en notes Z (de moyenne nulle et d’écart-type unitaire) —, la juxtaposition visuelle permet d’établir des comparaisons de profils immédiates. Le chercheur peut observer en un regard quelle dimension clinique présente la dispersion la plus prononcée, quelle facette de la personnalité se caractérise par la médiane la plus élevée, et quelles échelles génèrent des distributions asymétriques au sein de la population ciblée.
4. Création de boîtes à moustaches horizontales avec graph hbox
4.1 Spécificités et syntaxe de la commande graph hbox
Bien que la disposition verticale soit historiquement la plus répandue dans les publications scientifiques, Stata propose une alternative ergonomique majeure au travers de sa commande spécialisée graph hbox. Le préfixe « h » signale sans ambiguïté la translation vers une orientation horizontale (horizontal box plot). D’un point de vue fonctionnel et algorithmique, graph hbox opère une permutation cartésienne rigoureuse : l’axe métrique, habituellement attribué aux ordonnées verticales, est désormais déployé sur l’axe des abscisses horizontales, tandis que l’axe catégoriel ou l’espace de répartition des variables prend place sur l’axe vertical.
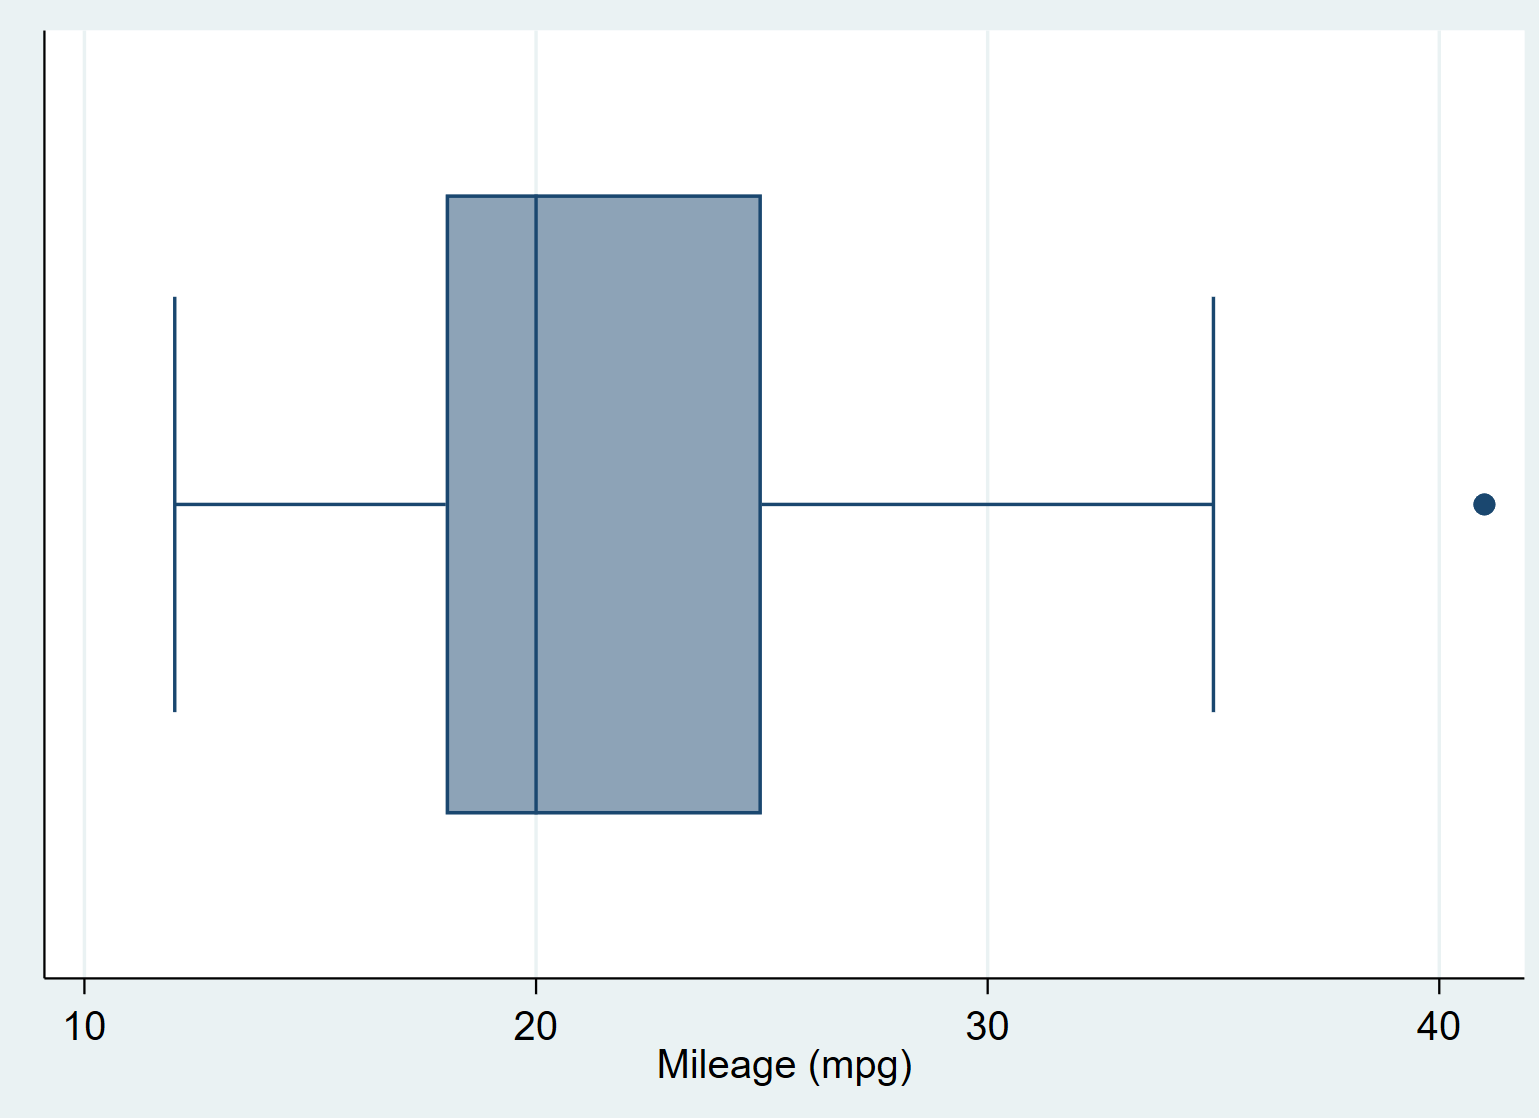
Toutes les options de personnalisation, d’ajustement de calcul, de coloration des trames et de contrôle des valeurs aberrantes développées pour la commande verticale s’appliquent avec une interchangeabilité syntaxique parfaite à la commande horizontale. L’utilisateur peut ainsi transposer l’intégralité de ses scripts d’une orientation à l’autre en remplaçant simplement le mot-clé graph box par graph hbox, sans risquer de corrompre les arguments de mise en forme ou les conditions logiques sous-jacentes.
Le comportement de l’échelle métrique sur l’axe horizontal offre une lecture intuitive similaire à celle d’une règle graduée ou d’une frise temporelle, progressant classiquement de la gauche (valeurs minimales) vers la droite (valeurs maximales). Les moustaches s’étendent latéralement, et la ligne médiane traverse désormais la boîte de façon verticale. Cette disposition est particulièrement prisée pour représenter des grandeurs physiques unidirectionnelles ou des scores continus s’inscrivant naturellement dans une perspective d’accroissement progressif de la gauche vers la droite.
4.2 Avantages ergonomiques pour les libellés textuels longs
Le recours à la projection horizontale répond avant tout à un problème fréquent d’affichage graphique : la gestion de l’encombrement spatial des étiquettes de texte. Dans une configuration verticale standard utilisant graph box, l’axe horizontal accueille les noms des variables ou les libellés des modalités expérimentales. Lorsque ces libellés comportent un nombre élevé de caractères, leur alignement horizontal classique conduit inévitablement à des collisions typographiques désastreuses, où les mots se chevauchent et deviennent indéchiffrables, à moins d’imposer une rotation angulaire des textes qui altère le confort de lecture.
La commande graph hbox résout ce défi avec élégance. En déportant les étiquettes sur l’axe vertical gauche, le graphique dégage une hauteur de ligne généreuse pour chaque modalité. Les libellés textuels, qu’il s’agisse de dénominations cliniques complexes telles que « Troubles obsessionnels compulsifs avec composante dépressive majeure » ou d’intitulés de postes organisationnels étendus, peuvent ainsi s’écrire horizontalement et dans leur intégralité, dans le sens naturel de la lecture occidentale.
Cette caractéristique fait de graph hbox l’outil privilégié pour la restitution des grands inventaires de personnalité, tels que les tests évaluant les facettes du Big Five ou le MMPI (Minnesota Multiphasic Personality Inventory). Lorsque l’on souhaite représenter simultanément une douzaine de sous-dimensions comportementales distinctes, l’empilement vertical permis par graph hbox produit une structure visuelle aérée et aplanit toute friction cognitive lors de la lecture des rapports d’expertise ou des mémoires universitaires.
4.3 Cas d’usage appliqués aux données comportementales
L’analyse des chronométries mentales et des latences de réponse expérimentales constitue un champ d’élection remarquable pour les boîtes à moustaches horizontales. Dans les protocoles de psychologie cognitive explorant des tâches de Stroop, d’écoute dichotique ou de détection de signaux visuels, les temps de réaction sont structurellement bornés à gauche par un seuil physiologique infranchissable (environ cent millisecondes) et présentent une queue de distribution extrêmement étirée vers les latences lentes, causée par des défaillances attentionnelles transitoires.
L’alignement horizontal de ces distributions permet d’aligner le regard de l’observateur avec la flèche naturelle du temps. Les latences rapides se massent sur le côté gauche du repère, tandis que les valeurs atypiques et les moustaches distendues pointent vers la droite, traduisant visuellement la dynamique d’échappement temporel. L’observateur compare avec une précision accrue les écarts d’étendue interquartile entre des conditions congruentes et incongruentes, percevant immédiatement la robustesse de l’effet expérimental.
Le choix entre une orientation verticale et horizontale doit également être dicté par la mise en page finale du support de diffusion. Dans un article scientifique à deux colonnes, une boîte verticale étroite calibrée sur la largeur exacte d’une seule colonne optimise l’occupation de l’espace typographique. En revanche, pour un rapport technique de format paysage, une présentation sur écran de conférence ou une planche d’annexes transversales, l’amplitude offerte par la commande graph hbox assure un déploiement spatial bien plus harmonieux.
5. Segmentation et comparaison univariée par variable catégorielle
5.1 Utilisation de l’option over() pour l’analyse intergroupe
L’une des opérations les plus fécondes en analyse exploratoire des données consiste à désagréger la distribution d’une variable quantitative continue à travers les niveaux successifs d’une variable nominale ou ordinale. Dans le langage de commande de Stata, cette opération de partitionnement s’effectue au moyen de l’option fondamentale over(). La syntaxe requiert de déclarer la variable continue principale, puis de spécifier entre les parenthèses de l’option le nom de la variable catégorielle qui servira de facteur de regroupement, par exemple : graph box temps_reaction, over(condition_experimentale).
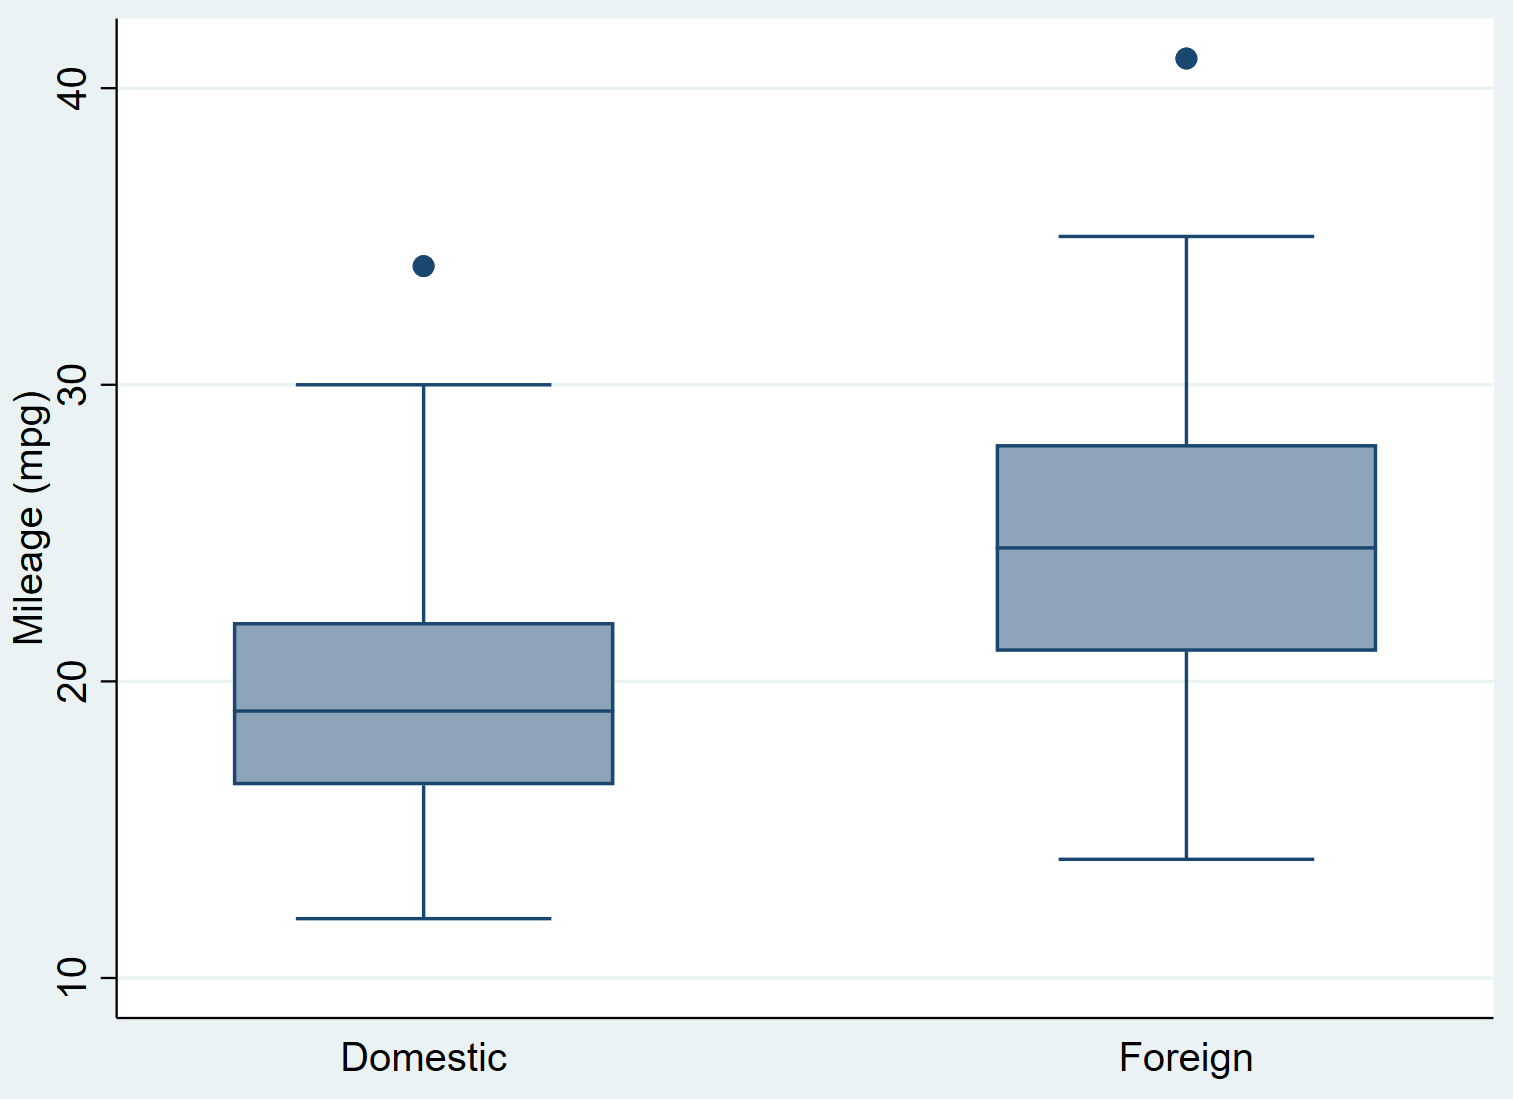
L’algorithme de Stata calcule alors le résumé à cinq nombres de manière entièrement indépendante pour chaque sous-groupe identifié au sein de la variable de stratification. Le moteur graphique génère autant de boîtes à moustaches individuelles qu’il existe de modalités effectives, et les dispose les unes à côté des autres le long de l’axe catégoriel. L’écartement entre les boîtes et leur centrage par rapport aux marques de graduation sont automatiquement gérés par le système pour préserver une symétrie visuelle optimale.
Cette mise en regard permet une interprétation clinique et expérimentale immédiate. Dans un essai contrôlé randomisé comparant un placebo, une thérapie standard et un protocole innovant, la juxtaposition des trois boîtes associées au score symptomatique final dévoile sans détour l’ampleur du déplacement de la médiane du traitement expérimental vers des zones d’amélioration clinique, tout en mettant en lumière d’éventuelles modifications de dispersion au sein des cohortes traitées.
5.2 Tri et agencement logique des modalités catégorielles
Par défaut, Stata ordonne les boîtes à moustaches le long de l’axe catégoriel selon l’ordre numérique croissant des codes sous-jacents de la variable de groupement. Cependant, cet agencement chronologique ou arbitraire n’est pas toujours le plus pertinent sur le plan narratif ou théorique. Pour conférer une réelle force démonstrative à un tracé comparatif, il est souvent souhaitable d’ordonner les catégories selon l’intensité croissante ou décroissante de la métrique observée.
L’option over() embarque à cet effet une riche collection de sous-arguments de contrôle. L’introduction de la sous-option sort() permet de trier les catégories en fonction de la valeur prise par la variable dépendante. Par exemple, la commande rédigée sous la forme graph box salaire, over(secteur_activite, sort(1)) réordonnera automatiquement l’ensemble des secteurs d’activité de telle façon que les médianes des salaires progressent de gauche à droite sur le graphique, transformant un assemblage chaotique en une progression linéaire facile à analyser.
Si la logique démonstrative impose une hiérarchie inversée, il suffit d’adjoindre le modificateur descending à l’intérieur de la clause de tri de l’option over(). Cette flexibilité permet aux chercheurs engagés dans des études épidémiologiques transversales de sérier instantanément les groupes de patients du plus vulnérable au plus résilient, guidant le regard des évaluateurs vers les contrastes les plus remarquables sans exiger de recodage laborieux des identifiants catégoriels dans la base de données brute.
5.3 Gestion fine des étiquettes de catégories
L’esthétique globale d’un graphique factoriel repose pour une grande part sur la lisibilité des libellés décrivant chaque groupe d’échantillonnage. Lorsque l’axe des abscisses accueille un nombre substantiel de catégories, les textes peuvent se chevaucher ou empiéter sur les marges du cadre graphique. Pour pallier cet inconvénient sans recourir systématiquement à l’orientation horizontale, l’option over() permet d’ajuster l’apparence des étiquettes via la sous-option label().
À l’intérieur de cette clause, le chercheur peut moduler l’orientation angulaire du texte au moyen de l’argument angle(). La déclaration de valeurs angulaires courantes comme angle(45) ou angle(90) incline les libellés, évitant ainsi les collisions typographiques entre catégories contiguës. De même, la taille des caractères peut être finement recalibrée via l’argument labsize(), acceptant des modificateurs standardisés de Stata tels que small, vsmall ou medium pour préserver l’équilibre visuel.
Un autre défi fréquent concerne la présence de modalités catégorielles théoriquement définies dans la nomenclature mais totalement absentes des données observées. Par défaut, Stata réserve un espace vide sur l’axe pour ces catégories sans observation, ce qui crée des discontinuités inesthétiques. L’introduction de la sous-option nofill commande au logiciel de supprimer immédiatement ces espaces orphelins, condensant le graphique sur les seuls groupes réellement documentés pour maintenir une haute densité d’information visuelle.
6. Conception de boîtes à moustaches factorielles complexes et emboîtées
6.1 Combinaisons de facteurs multiples avec double over()
Dans la recherche empirique contemporaine, les protocoles d’investigation se limitent rarement à des comparaisons univariées simples ; ils mettent fréquemment en scène des dispositifs expérimentaux croisés, tels que les plans factoriels 2×2 ou les protocoles à mesures répétées entre groupes indépendants. L’environnement Stata répond à ces exigences en autorisant la déclaration simultanée de deux instructions over() au sein de la même commande graph box.
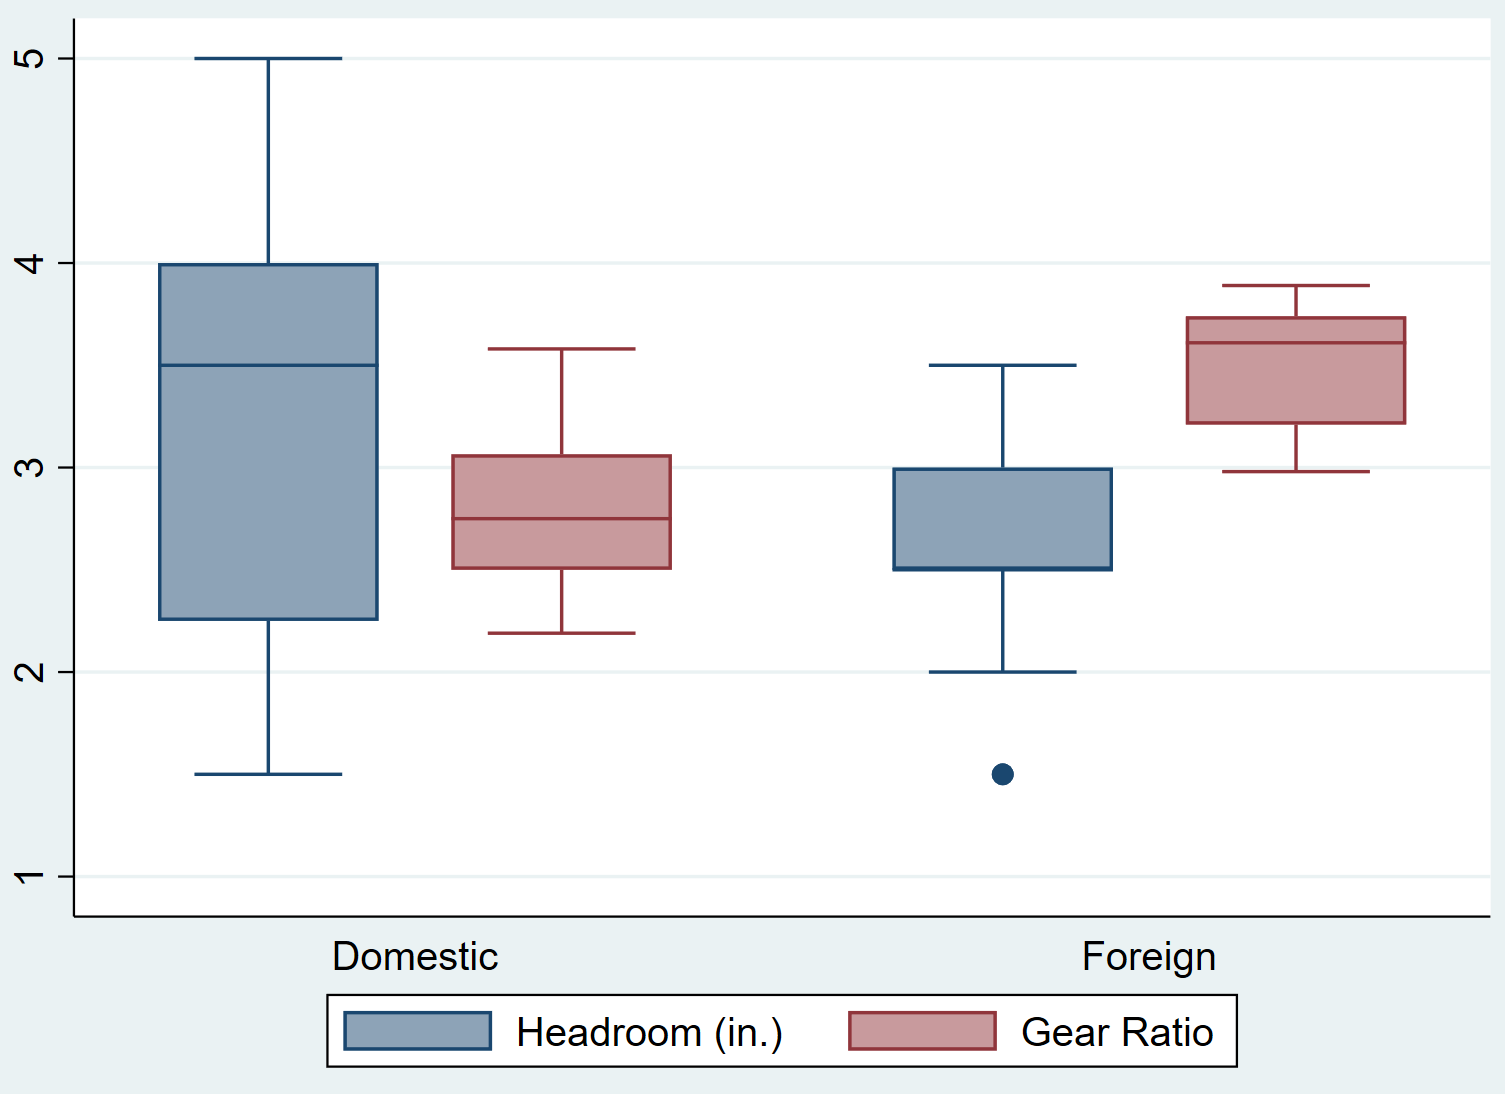
La hiérarchie spatiale obéit scrupuleusement à l’ordre d’énonciation séquentielle des options dans la ligne d’instruction. Si l’on saisit graph box score_stress, over(statut_clinique) over(genre), Stata interprète la première variable comme le facteur de regroupement interne primaire et la seconde variable comme le facteur de regroupement externe majeur. Visuellement, le graphique regroupera les catégories de statut clinique (par exemple témoin versus pathologique) à l’intérieur de chaque compartiment délimité par le genre (féminin versus masculin).
Cette modélisation visuelle emboîtée s’avère remarquable pour dépister d’éventuels effets d’interaction entre deux variables indépendantes. Si l’amplitude du décalage des boîtes à moustaches entre témoins et sujets cliniques est marginale chez les hommes mais s’avère monumentale chez les femmes, l’observateur détecte immédiatement la présence d’une interaction croisée. Ce diagnostic graphique orientera judicieusement la formulation des termes de contraste lors de l’estimation ultérieure de modèles linéaires généralisés ou d’analyses de variance factorielles.
6.2 Compartimentation par panneaux avec l’option by()
Bien que la répétition des clauses over() permette des comparaisons élégantes au sein d’un repère cartésien unique, cette stratégie peut saturer l’espace visuel dès lors que les facteurs multiplient leurs modalités respectives. Pour aérer la présentation tout en isolant l’effet d’une tierce variable modératrice ou de confusion, l’architecture graphique de Stata propose l’option de compartimentation en panneaux séparés via l’instruction by().
La distinction conceptuelle entre over() et by() est fondamentale. L’option over() dispose les sous-groupes sur un même espace d’axes partageant les mêmes graduations au sein d’une seule fenêtre de coordonnées. À l’opposé, la commande graph box score, over(groupe) by(tranche_age) va scinder la toile graphique globale en une matrice de sous-graphiques autonomes, chacun représentant une classe d’âge spécifique et abritant ses propres boîtes relatives aux groupes expérimentaux.
L’utilisation de by() assure une standardisation automatique des échelles d’ordonnées à travers l’ensemble des panneaux matriciels, garantissant une comparabilité visuelle sans distorsion d’un cadran à l’autre. En outre, la commande supporte des sous-arguments d’agencement tels que cols() ou rows() pour prescrire le nombre exact de colonnes ou de rangées de la matrice, ainsi que rescale lorsque l’on souhaite déroger à l’égalisation des échelles pour mettre en exergue des variations purement internes à chaque facette.
6.3 Affichage de plusieurs variables dépendantes à travers plusieurs facteurs
Le degré ultime de complexité dans la structuration des boîtes à moustaches sous Stata réside dans la conjonction de plusieurs variables métriques continues projetées à travers une ou plusieurs dimensions catégorielles. Considérons un cas où un chercheur désire inspecter conjointement l’anxiété cognitive et l’anxiété somatique à travers trois conditions de traitement pharmacologique. La commande prendra alors la configuration graph box anxiete_cognitive anxiete_somatique, over(traitement).
Face à cette consigne, Stata adopte une typologie de regroupement sophistiquée : pour chaque niveau du facteur catégoriel spécifié dans l’option over(), il génère une paire de boîtes adjacentes, l’une figurant l’anxiété cognitive et l’autre l’anxiété somatique. Afin de différencier clairement les deux variables continues sans confusion possible, le moteur graphique applique des teintes contrastées distinctes à chacune des boîtes et génère automatiquement une légende explicative en bas de figure.
Face à une telle profusion d’informations graphiques, le risque de saturation cognitive pour le lecteur devient tangible. Le statisticien doit veiller à calibrer minutieusement l’espacement inter-boîtes et inter-groupes en mobilisant les options de formatage telles que boxgap() (qui module la distance entre les boîtes d’un même groupe) et outergap() (qui ajuste l’intervalle séparant les différents blocs factoriels). Une aération bien dosée prévient l’effet d’entassement et permet aux contrastes pertinents d’émerger clairement.
7. Personnalisation avancée de l’esthétique et des couleurs de la boîte
7.1 Modification des couleurs de remplissage et d’opacité
L’apparence visuelle des boîtes à moustaches produites par Stata peut être entièrement modifiée pour répondre aux exigences esthétiques des revues académiques ou aux chartes graphiques institutionnelles. Par défaut, la boîte centrale se pare d’une teinte uniforme dictée par le schéma graphique actif de votre session. Pour modifier délibérément la couleur intérieure du polygone, on fait appel à l’option box() combinée avec la directive de couleur de remplissage fcolor() (fill color).
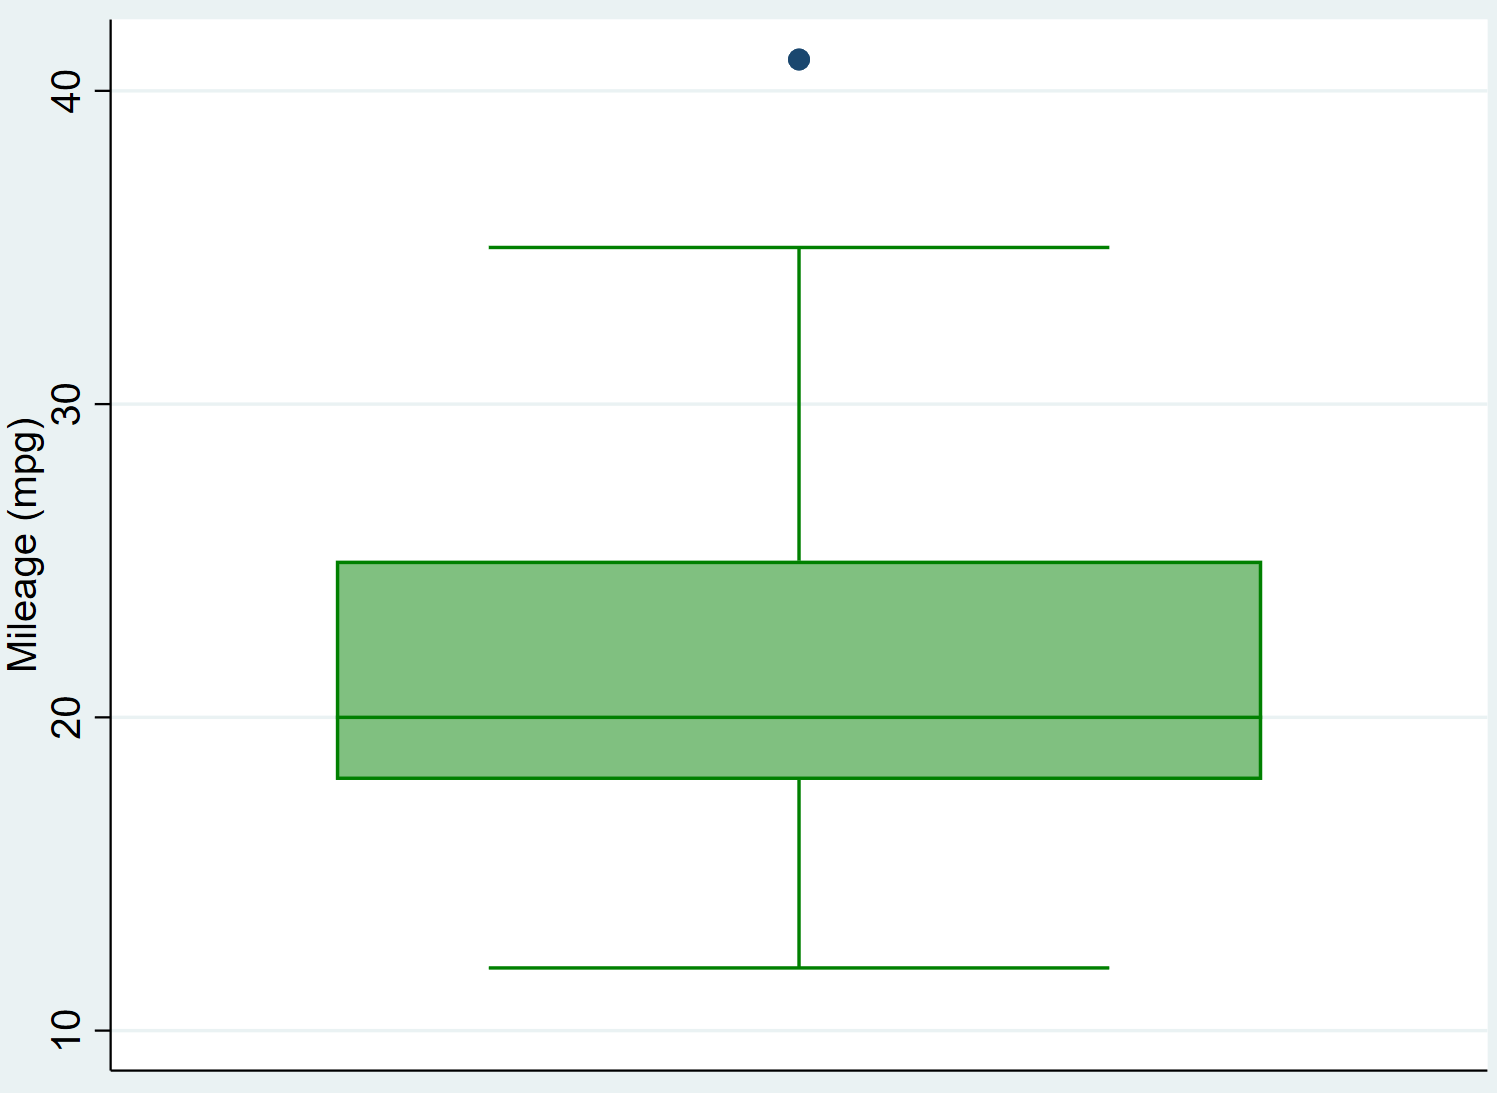
Stata reconnaît un lexique exhaustif de noms de couleurs élémentaires (tels que navy, maroon, forest_green, cranberry ou gs10 pour les nuances d’échelle de gris), mais permet également l’incorporation directe de triplets chromatiques au format RGB. Par exemple, la syntaxe box(1, fcolor(« 120 180 220 »)) permet de styliser le premier élément de la figure avec une précision de nuance remarquable, idéale pour concevoir des visualisations conformes aux palettes scientifiques modernes comme ColorBrewer, optimisées pour être lisibles par les personnes atteintes de daltonisme.
En outre, les versions modernes de Stata prennent en charge la gestion du niveau d’opacité (canal alpha) au sein même de la déclaration chromatique. En adjoignant un pourcentage d’intensité via la syntaxe fcolor(« navy%60 »), le statisticien confère une semi-transparence élégante au corps de la boîte. Cette technique s’avère particulièrement utile lorsque le graphique est superposé à un quadrillage d’arrière-plan dense, car elle préserve la lisibilité des repères arithmétiques tout en offrant une texture visuelle raffinée.
7.2 Stylisation des bordures et contours de boîte
Si la couleur de remplissage détermine la masse visuelle dominante de la boîte, la netteté de son périmètre conditionne sa clarté géométrique. Le contrôle des bordures s’effectue au travers de la famille d’options de contour lcolor() (line color), lwidth() (line width) et lpattern() (line pattern), encapsulées au sein de la clause générale de paramétrage de la boîte.
Dans de nombreuses situations d’impression académique, les contraintes budgétaires ou éditoriales imposent une diffusion en noir et blanc strict. Dans ce contexte, l’emploi de couleurs contrastées pour différencier des sous-groupes devient caduc. Le chercheur utilise alors la personnalisation des bordures pour créer des contrastes distinctifs : une première boîte présentera un contour noir épais continu (lcolor(black) lwidth(medium)), tandis qu’une boîte comparative présentera une bordure pointillée ou tiretée (lpattern(dash)) ou un remplissage tramé neutre.
Cette granularité de réglage permet également de mettre en valeur un groupe expérimental cible par rapport à des cohortes de référence passives. En conservant des bordures fines et délavées (par exemple lcolor(gs12)) pour l’ensemble des groupes témoins et en appliquant un contour noir vigoureux (lwidth(thick) lcolor(black)) sur le groupe clinique traité, l’analyste crée un appel d’attention visuel puissant qui guide le regard de son audience vers le résultat phare de la publication.
7.3 Personnalisation poussée de la ligne médiane
La ligne médiane constitue le cœur battant de la boîte à moustaches, matérialisant l’estimateur fondamental de la tendance centrale non paramétrique de la population échantillonnée. Par défaut, Stata trace cette ligne sur toute la largeur interne de la boîte sous forme d’un trait plein de couleur neutre. Toutefois, le moteur graphique propose des options poussées pour reconfigurer l’apparence et le type de cette délimitation vitale via l’option medtype() et ses modificateurs associés.
L’option medline() permet d’ajuster spécifiquement la couleur, l’épaisseur et le motif de la médiane sans affecter le reste de la bordure extérieure. Une directive telle que medline(lcolor(cranberry) lwidth(thick)) transforme la ligne médiane en un repère rouge écarlate très visible, ce qui facilite la comparaison visuelle des niveaux d’ordonnées entre plusieurs boîtes dispersées le long d’un vaste axe horizontal.
Stata permet également d’altérer la nature morphologique de la médiane. Par le biais de l’argument medtype(marker), il est possible de substituer à la ligne transversale continue un symbole ponctuel discret, tel qu’un cercle ou un losange rigoureusement positionné à la coordonnée du cinquantième centile. Plus intéressant encore, bien que la boîte à moustaches soit une construction résolument non paramétrique, certains chercheurs choisissent de superposer un point symbolisant la moyenne arithmétique. Cette pratique permet de mettre immédiatement en relief la divergence entre moyenne et médiane : un écart vertical prononcé entre les deux indicateurs offre une démonstration flagrante de l’asymétrie de la distribution analysée.
8. Traitement rigoureux des moustaches et détection des valeurs aberrantes
8.1 Règles de calcul et ajustement de l’étendue des moustaches
L’algorithme de déploiement des moustaches appliqué nativement par Stata repose sur la règle classique des moustaches de Tukey. Selon cette convention, la moustache supérieure s’étend jusqu’à la plus grande valeur observée qui demeure inférieure ou égale au troisième quartile majoré de 1,5 fois l’écart interquartile (Q3 + 1,5 * IQR). Symétriquement, la moustache inférieure rejoint la plus petite valeur empirique supérieure ou égale au premier quartile minoré de 1,5 fois ce même écart (Q1 – 1,5 * IQR). Ces bornes théoriques portent la désignation canonique de barrières internes de Tukey.
Néanmoins, Stata offre une latitude méthodologique complète pour moduler ce coefficient multiplicateur d’étalement au moyen de l’option crule() (calculation rule). Si un protocole d’assurance qualité particulièrement strict exige de ne tolérer aucun dépassement de dispersion sans inspection individuelle, l’analyste peut abaisser ce seuil, par exemple à une fois l’écart interquartile. Inversement, pour circonscrire l’examen aux seules déviations exceptionnelles et rarissimes, le multiplicateur peut être rehaussé à trois fois l’IQR, seuil délimitant les valeurs traditionnellement qualifiées d’aberrantes sévères (extreme outliers).
Il existe également des scénarios de recherche où le chercheur souhaite affranchir le tracé des moustaches de la dépendance exclusive à l’IQR pour adopter des définitions fondées sur les centiles conventionnels de la distribution complète. Stata permet ainsi de caler les moustaches sur le cinquième et le quatre-vingt-quinzième centile, ou de les contraindre à s’étendre jusqu’aux minima et maxima absolus de l’échantillon. Cette dernière configuration offre l’avantage de faire visualiser l’étendue totale du jeu de données, éliminant de fait tout affichage de points isolés au-delà des moustaches.
8.2 Stylisation et étiquetage des valeurs aberrantes (outliers)
Les données isolées rejetées au-delà des barrières de calcul de Tukey font l’objet d’un traitement visuel spécifique sous forme de marqueurs individuels. Stata donne le plein contrôle sur la géométrie et la signature visuelle de ces observations périphériques au travers de la commande globale marker(), laquelle se décline en une suite de sous-options telles que msymbol() (forme du glyphe), msize() (dimension spatiale du point) et mcolor() (teinte chromatique).
Par défaut, ces valeurs déviantes sont restituées sous forme de cercles évidés ou de disques pleins de dimension standard. Dans une démarche de diagnostic clinique approfondi, il peut être judicieux de substituer à cette forme neutre un symbole plus incisif, tel qu’un triangle ou une croix rougeoyante (msymbol(X) mcolor(red)), afin d’alerter instantanément le comité de lecture sur la présence de sujets manifestant des comportements ou des réponses physiologiques hors normes.
L’un des apports fonctionnels les plus remarquables de Stata réside dans sa capacité à identifier individuellement ces données atypiques directement sur le canevas graphique au moyen de la directive mlabel(). En associant cette option à la variable d’identification de votre base de données (par exemple marker(1, mlabel(id_patient))), le numéro d’anonymat du participant concerné vient s’inscrire à côté de son point aberrant respectif. Ce mécanisme permet de repérer immédiatement les cas déviants pour procéder à un audit approfondi de leurs données dans le tableur d’origine.
8.3 Considérations éthiques et méthodologiques sur le masquage des extrêmes
Le moteur graphique de Stata met à la disposition des utilisateurs une option redoutablement expéditive : le mot-clé noouts (contraction de no outliers). Lorsque cette consigne est insérée dans la commande graph box, le logiciel supprime purement et simplement la représentation graphique de toutes les observations situées au-delà de l’étendue des moustaches de Tukey. La boîte centrale, la ligne médiane et les moustaches conservent scrupuleusement leurs positions arithmétiques initiales, mais les points déviants deviennent invisibles sur la figure.
Le recours à cette option soulève des enjeux déontologiques et méthodologiques capitaux dans la pratique scientifique. Masquer les valeurs atypiques sur un graphique destiné à la publication peut être assimilé à une tentative d’édulcoration des résultats si cette démarche n’est pas explicitée de façon transparente. Dans les sciences biomédicales et psychologiques, les cas aberrants constituent fréquemment les observations les plus informatives, témoignant d’une réponse clinique idiosyncrasique, d’un effet indésirable rare ou d’un profil cognitif singulier méritant une discussion théorique approfondie.
Si l’analyste décide d’utiliser l’option noouts — par exemple pour éviter qu’une valeur aberrante excessivement éloignée n’écrase la boîte centrale en étirant démesurément l’axe des ordonnées —, cette décision doit être impérativement documentée dans la note de bas de figure ou dans la section méthodologique du manuscrit. Il conviendra de préciser sans ambiguïté le nombre exact d’observations masquées, leurs valeurs précises et les justifications analytiques étayant le fait qu’elles n’invalident pas les conclusions présentées.
9. Contrôle des axes, des échelles numériques et du quadrillage
9.1 Calibration fine de l’axe métrique avec yscale() et xscale()
Dans Stata, la commande graph box érige ses axes selon des algorithmes d’ajustement automatique calculés pour englober la totalité des observations réelles et des barrières de calcul. Toutefois, ce calibrage automatique ne coïncide pas nécessairement avec les exigences théoriques du protocole de mesure. Le contrôle de l’axe quantitatif s’opère par le truchement de la directive yscale() (ou xscale() dans le cas d’une boîte horizontale générée par graph hbox).
L’une des interventions les plus fréquentes consiste à fixer manuellement l’étendue visible de l’axe à l’aide du sous-argument range(). Par exemple, lors de la restitution d’un questionnaire standardisé dont les scores sont théoriquement bornés entre 0 et 100, si l’échantillon observé n’obtient que des valeurs comprises entre 35 et 70, Stata bornera naturellement son axe sur cet intervalle restreint. L’injection de la commande yscale(range(0 100)) force l’axe vertical à se déployer sur l’intégralité du continuum théorique de l’instrument psychométrique, fournissant ainsi une lecture proportionnée qui prévient tout risque d’exagération visuelle des écarts observés.
Il importe de souligner avec force la différence fondamentale existant entre l’extension de l’axe via yscale(range()) et le filtrage d’échantillon via une clause if. L’option range() ne modifie en aucun cas le corpus des observations : elle se contente d’élargir le champ de vision du graphique. Si vous spécifiez une borne inférieure supérieure au minimum empirique de votre base, Stata refusera de tronquer la boîte et adaptera l’axe pour préserver l’intégrité de la distribution, réaffirmant sa philosophie de protection contre les erreurs d’interprétation statistique involontaires.
9.2 Graduation personnalisée et étiquetage des seuils critiques
La précision avec laquelle un lecteur évalue la position d’une médiane dépend étroitement de la qualité des graduations apposées sur l’axe continu. L’instruction ylabel() (ou xlabel() pour les figures horizontales) permet de maîtriser avec exactitude le positionnement, l’intervalle et la typographie des repères numériques. Au lieu de laisser le logiciel choisir des incréments arbitraires, le chercheur peut déclarer une séquence d’échelonnage explicite au travers de la syntaxe ylabel(min(step)max), par exemple ylabel(0(10)100) pour positionner un repère tous les dix points.
De surcroît, cette commande permet de formater l’affichage des valeurs numériques pour répondre aux normes de publication. L’introduction de l’argument format(%9.1f) arrondit la graduation au dixième le plus proche, tandis que l’argument angle(horizontal) assure que les nombres associés aux graduations verticales soient orientés parallèlement au plan de lecture, supprimant ainsi la nécessité pour le lecteur d’incliner la tête pour déchiffrer les valeurs de l’ordonnée.
Dans un contexte de recherche clinique ou de diagnostic psychologique, l’insertion de repères normatifs revêt une importance capitale. L’option yline() permet de tracer une ou plusieurs lignes de référence transversales barrant l’intégralité du graphique à une ordonnée précise. En saisissant par exemple yline(50, lcolor(red) lpattern(dash)), le chercheur superpose une ligne rouge pointillée matérialisant un seuil de significativité pathologique ou la norme standard d’une population de référence, facilitant l’évaluation immédiate de la proportion de chaque groupe franchissant cette limite critique.
9.3 Intégration d’un quadrillage ergonomique
La présence d’une grille ou d’un quadrillage d’arrière-plan sur un graphique scientifique fait l’objet de vifs débats au sein de la communauté de la visualisation de données. Suivant les préceptes pionniers d’Edward Tufte sur l’optimisation du ratio encre/données (data-ink ratio), tout élément graphique n’apportant pas une information analytique directe doit être minimisé ou éliminé afin de ne pas parasiter l’attention de l’observateur. Un quadrillage lourd et sombre encombre inutilement l’espace et complique la distinction des moustaches et des valeurs aberrantes.
Cependant, un quadrillage subtil et discret rend de précieux services pour évaluer précisément la hauteur des médianes lorsque les boîtes à moustaches sont multiples et espacées. Dans Stata, l’activation du quadrillage s’effectue directement à l’intérieur de l’option ylabel() par l’adjonction de l’argument grid. Pour éviter toute distraction visuelle préjudiciable, il est vivement recommandé d’atténuer la présence de ce carroyage en lui appliquant une teinte neutre très pâle, comme glcolor(gs14), et un motif fin en pointillés via glpattern(dot).
L’articulation harmonieuse entre des bordures de boîtes aux tracés affirmés et un réseau de repères de fond délicatement estompé produit un résultat professionnel conforme aux exigences des meilleures revues internationales. Cette approche garantit une lecture précise des grandeurs métriques sans que l’œil de l’observateur ne soit distrait par un carcan géométrique inutilement pesant.
10. Titres, légendes, annotations et conformité aux normes APA
10.1 Hiérarchie des titres, sous-titres et notes explicatives
L’autonomie narrative d’un graphique constitue un critère de qualité incontournable dans la rédaction d’articles scientifiques : la figure doit pouvoir être comprise par le lecteur sans qu’il soit contraint de se référer constamment au corps du texte. L’environnement Stata fournit un ensemble structuré de commandes pour établir une hiérarchie textuelle exhaustive : title(), subtitle(), note() et caption().
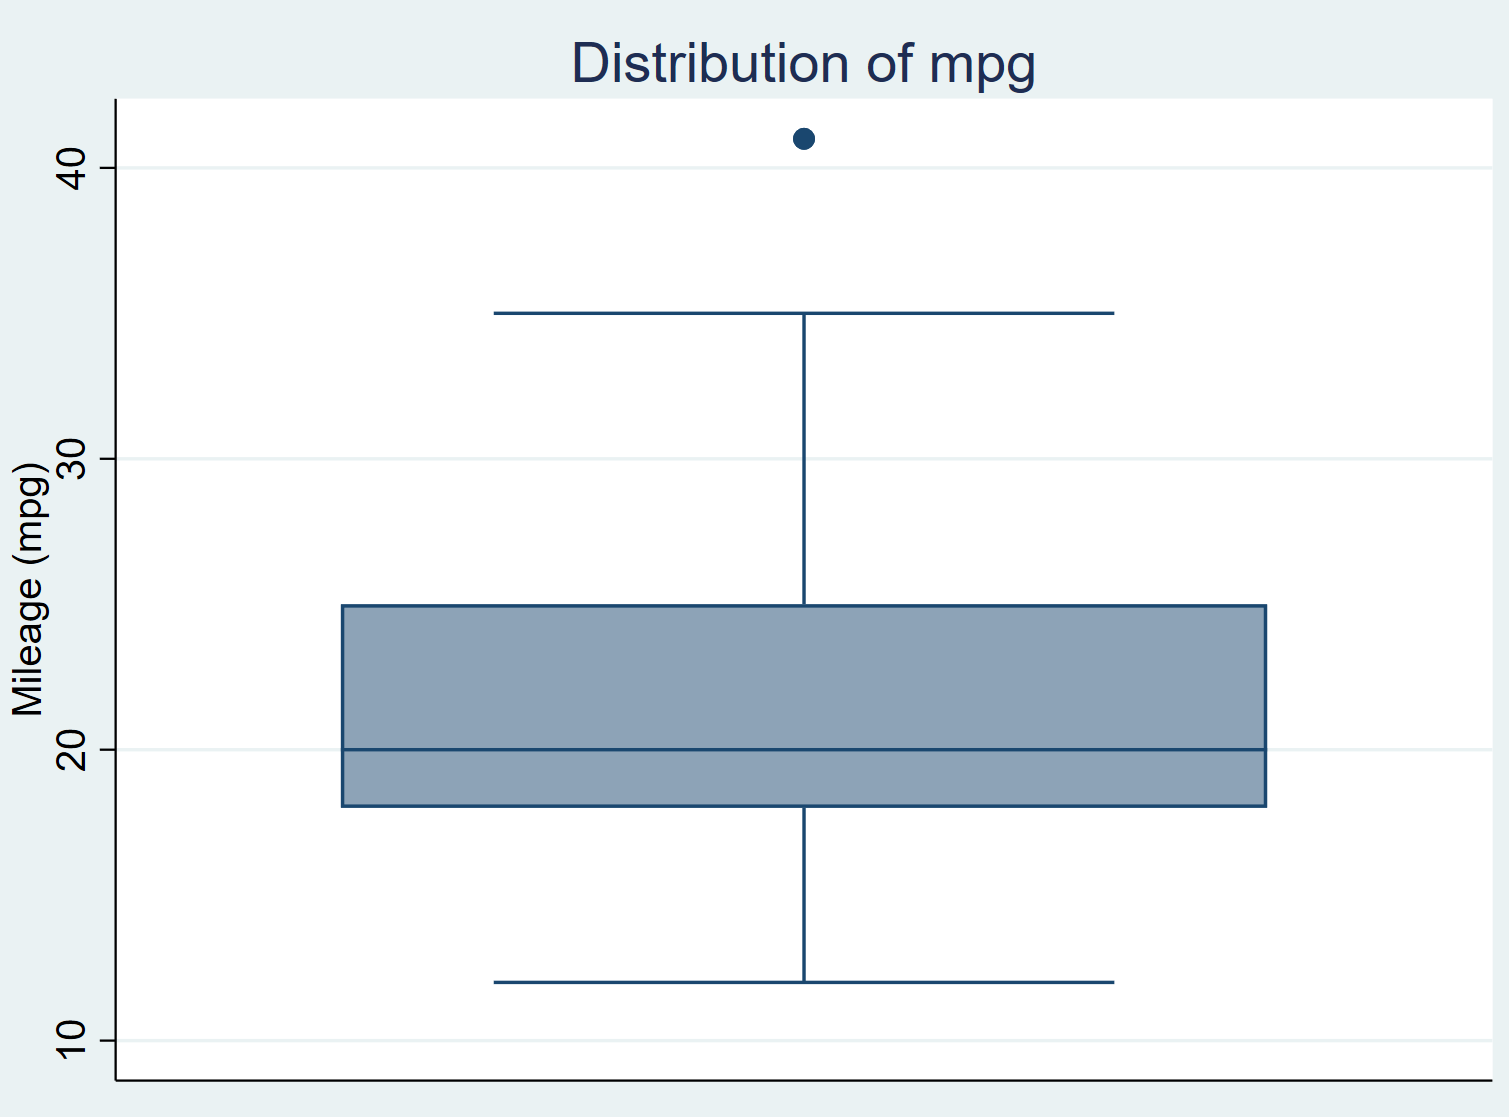
L’option title() introduit l’intitulé principal au sommet du canevas, rédigé dans une typographie valorisante et synthétisant l’objet fondamental de la visualisation (par exemple « Distribution comparée des temps de réaction selon le paradigme expérimental »). La commande subtitle() permet d’ajouter en corps de texte inférieur une précision contextuelle, telle que la description de la population cible ou la nature du traitement administré.
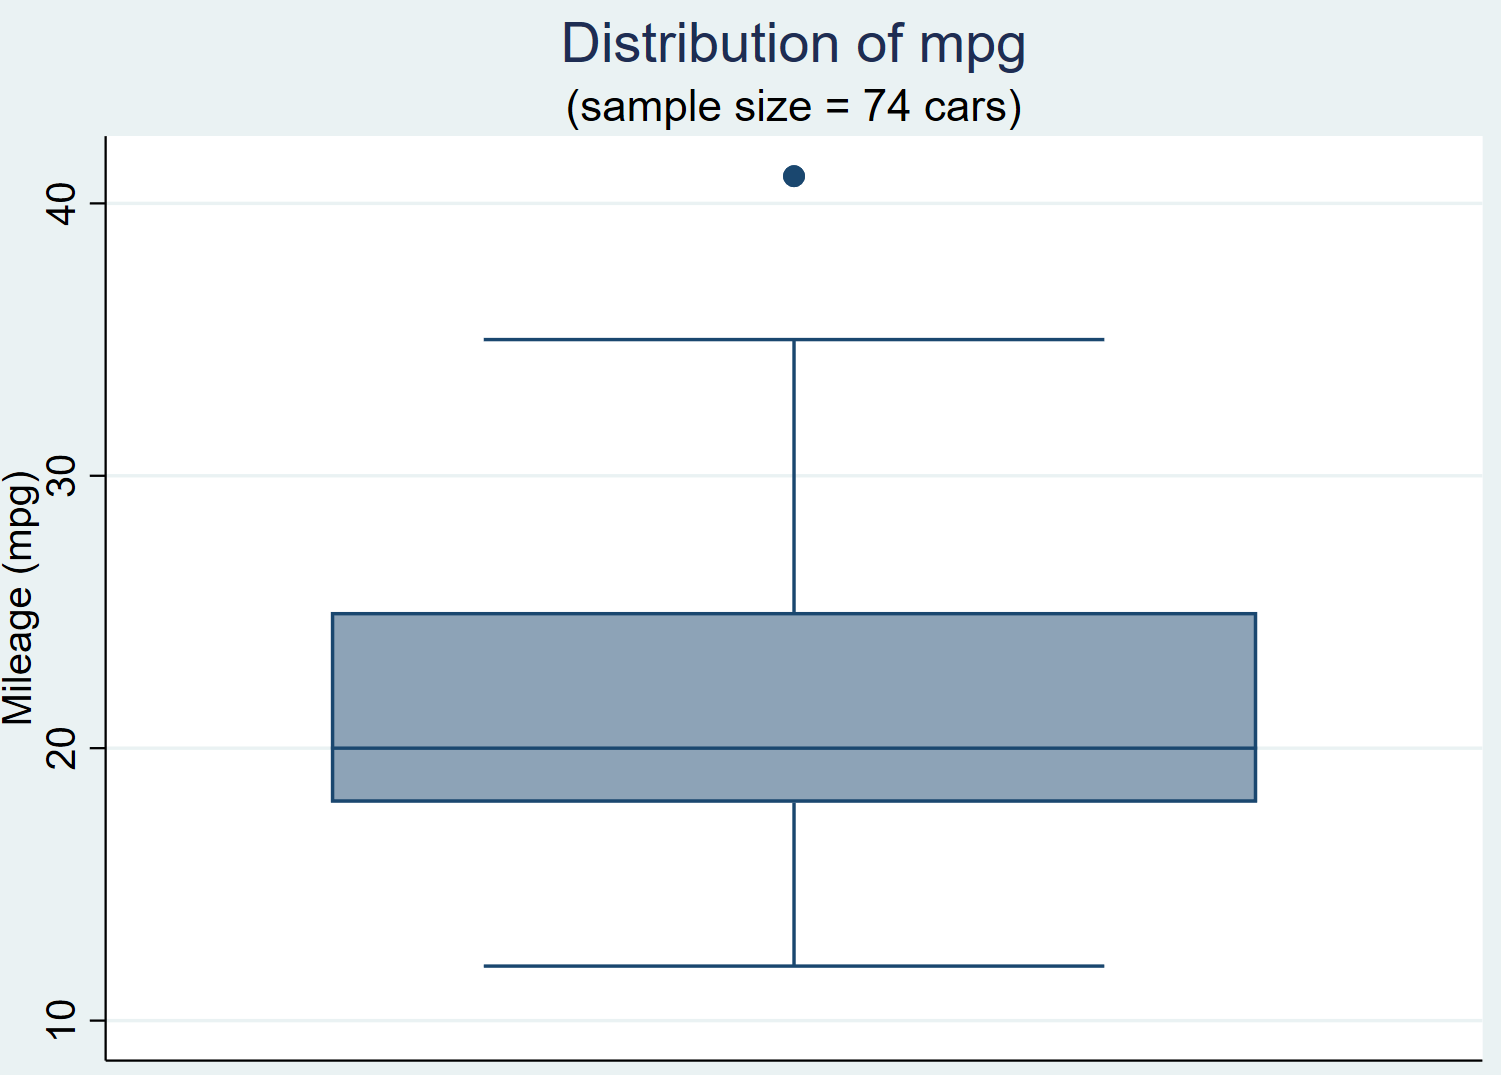
À la base de la composition graphique, l’option note() remplit une fonction documentaire essentielle. Elle accueille traditionnellement les précisions relatives à l’effectif échantillonnal (noté N), la signification exacte des abréviations utilisées, les éventuelles exclusions d’observations atypiques réalisées pour des motifs méthodologiques, ainsi que la définition formelle de l’étendue des moustaches (rappelant la convention de Tukey à 1,5 fois l’écart interquartile). L’alignement de cette note peut être calé sur le bord gauche du cadre au moyen de la sous-option position(6) ring(1) span, assurant une finition typographique rigoureuse.
10.2 Configuration précise de la légende
Lors de la production de boîtes à moustaches factorielles complexes impliquant plusieurs variables continues ou des emboîtements multiples via over(), la présence d’une légende explicative s’avère indispensable pour identifier les sous-ensembles représentés. L’instruction legend() de Stata constitue une boîte à outils modulable permettant d’ajuster chaque paramètre d’identification symbolique et textuelle.
Par défaut, Stata positionne la légende au bas de l’espace graphique, dans un encadré rectangulaire parfois encombrant. Le chercheur peut optimiser cet agencement en modifiant son orientation spatiale au travers de l’argument rows() ou cols(), imposant un déploiement sur une seule ligne horizontale pour épargner la hauteur de la page. Le contenu textuel de chaque entrée de légende se personnalise via la syntaxe label(numéro « Nouveau texte »), autorisant le remplacement des identifiants techniques des variables par des formulations claires et professionnelles.
Dans les configurations univariées simples segmentées par une seule variable catégorielle ordonnée le long de l’axe des abscisses, la présence d’une légende est totalement redondante, puisque les étiquettes de catégories situées sous les boîtes apportent déjà toute l’information nécessaire. Dans cette situation, l’application de la directive catégorique legend(off) s’impose : elle supprime purement et simplement le bloc de légende superfétatoire, libérant ainsi un espace vertical précieux pour agrandir l’échelle de mesure et aérer le corps du graphique.
10.3 Application des chartes graphiques académiques et styles APA
L’American Psychological Association (normes APA, 7e édition) impose des directives formelles rigoureuses concernant l’esthétique des figures destinées aux revues affiliées. Ces règles préconisent une sobriété absolue : proscription des fonds colorés ou grisés, suppression des effets de relief ou d’ombrage superflus, réduction des traits de grille à leur strict minimum, et recours prioritaire à une typographie sans empattement (telle que Arial ou Helvetica) de taille uniforme et immédiatement lisible.
Pour aligner instantanément les rendus graphiques de Stata sur ces standards éditoriaux internationaux, la méthode la plus rapide consiste à exploiter le système des schémas graphiques au moyen de l’option scheme(). L’instruction scheme(s2mono) convertit la totalité du graphique dans une palette monochrome en niveaux de gris d’une sobriété exemplaire. Pour une esthétique encore plus épurée, le schéma scheme(sj) (recommandé par le Stata Journal) applique un arrière-plan blanc immaculé, supprime les boîtes de contour superflues et calibre l’épaisseur des traits selon les meilleurs standards typographiques académiques.
Il est également possible de désactiver explicitement les aplats de fond par l’intermédiaire des commandes plotregion(color(white)) et graphregion(color(white)). Cette mise en conformité garantit que la figure s’insérera naturellement sur la page d’un article ou d’un mémoire sans faire apparaître de rectangles grisâtres parasites, assurant ainsi un rendu optimal tant pour l’affichage numérique que pour l’impression finale sur papier.
11. Automatisation, programmation via scripts .do et reproductibilité
11.1 Structuration modulaire du script de génération graphique
Dans un contexte de recherche scientifique guidé par les principes de science ouverte et de reproductibilité computationnelle des résultats, la création manuelle d’artefacts graphiques au moyen de menus déroulants interactifs doit être proscrite. Chaque figure incorporée dans un manuscrit de recherche doit être entièrement codée au sein d’un fichier de commandes exécutable (un script au format .do), permettant de régénérer le tracé à l’identique à partir de la base de données brute en une fraction de seconde.
Pour assurer la pérennité et la maintenabilité de vos programmes de visualisation, il est vivement recommandé d’adopter une programmation modulaire articulée autour de variables locales (les macros local de Stata). En regroupant en tête de script l’assignation de paramètres fondamentaux — tels que le nom de la variable dépendante d’intérêt, les couleurs de référence, la sélection des seuils cliniques ou les chaînes textuelles des titres —, il devient aisé de reconfigurer l’ensemble de la figure en ne modifiant que quelques déclarations centralisées, sans avoir à parcourir de longues lignes de code graphique.
L’insertion systématique de commentaires textuels structurés au moyen de barres obliques doubles (//) ou d’astérisques consolide la dimension collaborative de votre travail de recherche. Ces notes internes documentent la justification théorique des choix de recodage, le rationnel guidant l’application d’un seuil particulier d’élimination des moustaches, et les références documentaires associées aux données visualisées, facilitant ainsi les futurs audits méthodologiques lors des phases de révision par les pairs.
11.2 Génération dynamique de séries de boîtes à moustaches avec des boucles
Les investigations psychométriques ou biomédicales contemporaines requièrent couramment l’évaluation simultanée de dizaines, voire de centaines de variables phénotypiques ou de biomarqueurs à travers les mêmes cohortes cliniques. Écrire à la main une instruction graphique individualisée pour chaque variable constitue une tâche fastidieuse, sujette à d’inévitables erreurs de copier-coller. L’environnement programmatique de Stata résout ce problème d’échelle grâce à ses structures de boucles algorithmiques foreach et forvalues.
L’utilisation d’une boucle itérative permet d’exécuter une séquence d’instructions graphiques en substituant dynamiquement les variables cibles à chaque passage. Considérons la commande foreach var of varlist score_memoire score_attention score_vitesse { … } : à l’intérieur de ce bloc itératif, le programme compile successivement le diagramme en boîte pour chacune des dimensions désignées, ajuste automatiquement le titre en fonction des métadonnées intégrées de la variable en cours de traitement, et exporte la figure sur le disque dur avec un nom de fichier indexé de façon prédictible.
Ce flux de traitement dynamique peut également comporter des branchements conditionnels (instructions if/else) permettant d’adapter le tracé à la nature des variables itérées. Si une variable présente une amplitude de valeurs particulièrement étendue, la boucle peut lui adjoindre une échelle spécifique, tout en maintenant une identité visuelle homogène (même typographie, même schéma de couleurs, même hiérarchie des moustaches) à travers l’ensemble de la série graphique produite.
11.3 Sauvegarde dans le format natif Stata et gestion de mémoire
Lors de la production automatisée de vastes collections de graphiques, la gestion rigoureuse des ressources graphiques en mémoire vive constitue un enjeu technique non négligeable. Par défaut, Stata conserve en mémoire les fenêtres graphiques ouvertes, ce qui peut saturer l’espace de travail lors d’itérations massives. Il est donc recommandé d’insérer régulièrement l’instruction graph drop _all ou de purger sélectivement les identifiants d’affichage au fur et à mesure de l’avancement des sauvegardes sur support physique.
Au-delà des formats d’exportation d’images finies, la sauvegarde dans le format natif propriétaire de Stata, reconnaissable à son extension .gph, offre des avantages remarquables. Cette sauvegarde s’opère au moyen de la directive graph save « chemin/nom_figure.gph », replace. Contrairement à une image matricielle figée, un fichier .gph encapsule l’intégralité de la structure vectorielle et des données géométriques ayant servi à générer le tracé.
Cette conservation vectorielle dynamique permet d’ouvrir ultérieurement la figure dans le puissant éditeur graphique interactif de Stata (Graph Editor) pour procéder à des retouches cosmétiques ponctuelles de dernière minute. De plus, la conservation des graphiques au format .gph est un prérequis indispensable pour utiliser la commande d’assemblage matriciel graph combine, qui permet de fusionner des boîtes à moustaches indépendantes produites lors de sessions de calcul séparées au sein d’une seule et même grande planche de publication.
12. Exportation haute résolution et intégration dans les publications
12.1 Sélection des formats d’exportation matriciels et vectoriels
L’ultime étape du processus de création d’une boîte à moustaches réside dans son exportation hors de l’environnement Stata en vue de son incorporation dans un traitement de texte scientifique ou sa soumission à une revue à comité de lecture. La commande standard consacrée à cette opération est graph export, dont la syntaxe requiert le chemin de destination assorti de l’extension de fichier souhaitée, laquelle dicte automatiquement le convertisseur logiciel utilisé par le système.
Le choix du format d’exportation repose sur la dichotomie fondamentale entre formats matriciels (ou raster) et formats vectoriels. Les formats matriciels (tels que PNG, TIFF ou JPEG) fixent la figure sous forme d’une grille finie de pixels : tout agrandissement ultérieur lors de la mise en page imprimée produit une dégradation de la netteté et une pixellisation des textes. Les formats vectoriels (tels que PDF et Encapsulated PostScript – EPS), quant à eux, ne stockent pas des points colorés mais des équations géométriques décrivant les segments de droite, les courbes, les polygones et les polices de caractères.
Pour toute publication scientifique de premier plan, le recours aux formats vectoriels (PDF sous environnement d’édition moderne ou EPS pour les chaînes de publication traditionnelles) doit être la priorité absolue. L’incorporation d’une boîte à moustaches exportée en PDF dans un document garantit que les lignes médianes, les délimitations des moustaches et les étiquettes textuelles conserveront une netteté absolue, quel que soit le niveau de grossissement ou la résolution d’impression adoptée par l’éditeur.
12.2 Ajustement de la résolution DPI et des dimensions physiques
Lorsqu’un éditeur exige impérativement un format d’image matriciel — le format TIFF non compressé constituant souvent la norme éditoriale en sciences de la vie —, le chercheur doit maîtriser scrupuleusement la résolution géométrique de sortie pour éviter tout rejet du manuscrit. La norme internationale pour les figures au trait (line art), catégorie dont relèvent les diagrammes en boîte, prescrit une résolution minimale de 300 à 600 DPI (dots per inch ou points par pouce).
Dans Stata, la calibration de cette finesse d’échantillonnage s’opère par l’adjonction de l’argument width() ou de la commande d’échelle de rendu lors de l’exportation matricielle. Par exemple, la commande rédigée sous la forme graph export « figure1.tif », as(tif) width(3600) replace génère une image de 3600 pixels de largeur, garantissant qu’une impression sur une largeur utile de six pouces maintiendra une résolution effective irréprochable de 600 DPI.
Il convient également de définir en amont les dimensions physiques de la boîte à moustaches en fonction de la maquette de la revue cible (largeur simple colonne équivalente à environ 8,5 centimètres, ou double colonne d’environ 17,5 centimètres). La régulation des dimensions d’exportation évite les redimensionnements ultérieurs brutaux au sein du logiciel de traitement de texte, préservant ainsi le ratio visuel calculé entre la taille des caractères des étiquettes et l’épaisseur des traits des boîtes.
12.3 Intégration transparente dans LaTeX, Word et plateformes d’édition
L’intégration de figures Stata dans la suite logicielle Microsoft Office (Word, PowerPoint) ou dans des environnements de composition typographique spécialisés comme LaTeX requiert quelques ajustements techniques spécifiques. Pour les utilisateurs de Word, l’exportation au format vectoriel EMF (Enhanced Metafile, sous plateforme Windows) ou au format PDF vectoriel moderne assure une intégration directe sans perte de qualité lors de la pagination.
Pour les chercheurs qui rédigent leurs articles scientifiques sous LaTeX, l’utilisation conjointe de graphiques exportés en PDF natif via la commande graph export « figure.pdf », as(pdf) replace et de l’environnement typographique standardisé constitue la solution de référence. Cette approche élimine toute pixellisation et assure une restitution géométrique fidèle des boîtes de distribution. En outre, elle permet de gérer les légendes et la numérotation automatique des figures directement via le moteur de composition typographique de LaTeX, maintenant une cohérence esthétique absolue sur l’ensemble de l’ouvrage.
Avant la soumission finale de votre manuscrit, une ultime vérification s’impose : l’audit de lisibilité en niveaux de gris. Même si votre publication est diffusée en ligne en couleurs, de nombreux confrères continueront d’imprimer les tirés à part sur des imprimantes laser monochromes. S’assurer que les contrastes choisis au sein de vos boîtes à moustaches Stata demeurent parfaitement distincts une fois désaturés en nuances de gris garantit que votre travail demeurera accessible, équitable et intelligible pour l’ensemble de la communauté scientifique mondiale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cox, N. J. (2009). Speaking Stata: Creating and varying box plots. The Stata Journal, 9(3), 478-496. https://doi.org/10.1177/1536867X0900900308
- Friendly, M. (2008). A brief history of data visualization. In C. Chen, W. Härdle, & A. Unwin (Eds.), Handbook of data visualization (pp. 15-56). Springer. https://doi.org/10.1007/978-3-540-33037-0_2
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12-16. https://doi.org/10.2307/2683468
- Mitchell, M. N. (2012). A visual guide to Stata graphics (3rd ed.). Stata Press.
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
- StataCorp. (2023). Stata graphics reference manual: Release 18. Stata Press. https://www.stata.com/manuals/g.pdf
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0