
L’étude scientifique des processus mentaux, des conduites humaines et des structures sous-jacentes de la personnalité repose fondamentalement sur la capacité des chercheurs à appréhender, modéliser et interpréter la variabilité. Dans le champ des sciences humaines et du comportement, aucun individu n’est strictement identique à un autre, et aucune mesure psychologique ne se reproduit de manière invariante à travers le temps ou les contextes. Cette fluctuation inhérente aux phénomènes psychologiques constitue à la fois le défi majeur et l’objet d’étude premier de la psychométrie contemporaine. Pour dépasser le stade de la simple narration clinique et accéder au rang de science empirique robuste, la psychologie a dû développer un outillage quantitatif sophistiqué, ancré dans la théorie des probabilités et l’analyse statistique multidimensionnelle.
Au cœur de cet édifice méthodologique trônent deux concepts cardinaux souvent confondus par les étudiants et les praticiens : la variance et la covariance. Si toutes deux partagent une ascendance mathématique commune fondée sur la notion de déviation par rapport à une valeur centrale, leurs objectifs épistémologiques et leurs implications opérationnelles divergent radicalement. La variance s’attache à capturer l’ampleur de l’étalement d’une grandeur unique autour de son espérance mathématique, agissant comme le baromètre de l’hétérogénéité d’un groupe ou de l’incertitude d’une mesure. À l’inverse, la covariance explore la dynamique conjointe de deux grandeurs distinctes, traquant la manière dont les fluctuations de l’une s’articulent avec les oscillations de l’autre au sein d’un même système d’observation.
Comprendre avec rigueur la distinction entre ces deux métriques n’est pas une simple coquetterie académique réservée aux spécialistes de la biométrie. Il s’agit d’une compétence fondamentale pour quiconque souhaite concevoir des tests psychologiques valides, tester des modèles d’équations structurelles, évaluer des protocoles de psychothérapie ou décrypter les interactions complexes gouvernant la cognition et les émotions. Cet article propose une exploration approfondie, mathématique et pratique de la variance et de la covariance, en examinant pas à pas leurs fondements théoriques, leurs protocoles de calcul, leurs représentations matricielles et leurs applications incontournables dans la recherche clinique, cognitive et sociale.
1. Introduction aux mesures de dispersion et d’association en psychologie
1.1 Le rôle des statistiques descriptives et inférentielles en sciences du comportement
Les sciences du comportement évoluent dans un univers probabiliste où la certitude déterministe fait figure d’exception. Contrairement aux sciences physiques fondamentales, où certaines constantes universelles permettent des prédictions d’une exactitude spectaculaire, la psychologie étudie des entités biologiques et phénoménologiques sujettes à une infinité d’influences interactives. La variabilité interindividuelle, loin d’être un bruit parasite qu’il conviendrait d’éliminer mécaniquement, représente l’essence même de l’investigation psychométrique. Qu’il s’agisse des temps de réaction lors d’une tâche d’attention divisée, des scores de névrosisme sur l’inventaire des cinq grands facteurs de personnalité, ou des niveaux de cortisol salivaire en réponse à un stress aigu, la dispersion des données reflète l’architecture de la diversité humaine.
Le passage historique de l’observation clinique qualitative à la modélisation statistique formelle a nécessité l’élaboration d’indicateurs standardisés capables de résumer des distributions complexes sans en perdre la substance informationnelle. Si les mesures de tendance centrale, à l’instar de la moyenne arithmétique ou de la médiane, offrent un premier point d’ancrage indispensable en indiquant la localisation globale d’un groupe, elles s’avèrent tragiquement insuffisantes lorsqu’elles sont utilisées isolément. Deux cohortes de patients psychiatriques peuvent présenter rigoureusement le même score moyen à une échelle de dépression tout en reflétant des dynamiques cliniques totalement divergentes : l’une peut être caractérisée par une homogénéité remarquable autour de troubles modérés, tandis que l’autre rassemble des profils bipolaires extrêmes, juxtaposant des états de rémission totale et des phases de crise mélancolique aiguë.
Les statistiques descriptives fournissent ainsi le cadre d’évaluation initiale permettant de quantifier la morphologie d’une distribution. Elles ouvrent immédiatement la voie aux statistiques inférentielles, dont la vocation est d’extrapoler les caractéristiques observées sur un échantillon restreint à l’ensemble de la population parente. Dans cette perspective, la rigueur de l’inférence dépend directement de la précision avec laquelle la dispersion des mesures a été quantifiée. L’estimation des erreurs types, la détermination des intervalles de confiance et le calcul de la puissance statistique d’une étude clinique reposent de manière indéfectible sur la prise en compte intégrale de la variabilité des données empiriques recueillies auprès des participants.
1.2 Distinction préliminaire entre variabilité univariée et relation bivariée
Pour appréhender la mécanique quantitative sous-jacente aux données psychologiques, il convient d’opérer une distinction conceptuelle nette entre le traitement univarié et le traitement bivarié. L’approche univariée s’intéresse à une dimension singulière du comportement ou de la cognition. Lorsqu’un psychologue scolaire administre un subtest de mémoire de travail à une classe d’élèves, il observe une seule variable aléatoire. Dans ce contexte, la préoccupation analytique majeure réside dans la quantification de la dispersion : les performances se concentrent-elles étroitement autour de la moyenne, ou observe-t-on un étalement considérable des scores, témoignant d’une disparité substantielle des capacités cognitives au sein du groupe ? C’est précisément ici qu’intervient la variance, indicateur par excellence de la variabilité univariée, mesurant l’énergie d’écartement des observations individuelles vis-à-vis de leur barycentre mathématique.
À l’opposé, l’approche bivariée fait basculer le chercheur dans le domaine des relations et des contingences. L’attention ne se focalise plus sur une grandeur isolée, mais sur la dynamique synchronique de deux vecteurs de données distincts observés chez les mêmes sujets d’expérience. Par exemple, si l’on évalue simultanément la mémoire de travail et la réussite à un test de raisonnement fluide, la question centrale devient relationnelle : les participants manifestant une mémoire de travail supérieure à la moyenne ont-ils également tendance à exceller en raisonnement fluide ? Existe-t-il une coordination ou, au contraire, une discordance systématique entre ces deux construits théoriques ? La covariance constitue la première réponse mathématique à cette interrogation bivariée, en évaluant dans quelle mesure les déviations observées sur une première variable s’associent de manière linéaire aux déviations enregistrées sur une seconde variable.
D’un point de vue épistémologique, cette dichotomie traduit deux manières complémentaires d’interroger le fonctionnement psychique. L’étude de la variance univariée relève d’une logique ontologique de la mesure : elle renseigne sur la distribution intrinsèque d’une caractéristique psychologique au sein d’une espèce ou d’une population définie. L’examen de la covariance bivariée relève d’une logique relationnelle ou fonctionnelle : elle permet d’échafauder des réseaux nomologiques, d’élaborer des théories causales et d’identifier les régularités structurelles qui lient les différents étages de l’appareil cognitif, affectif et comportemental. Confondre ces deux niveaux d’analyse revient à ignorer la différence entre l’étendue spatiale d’un territoire et le réseau routier qui le relie à une province voisine.
1.3 Enjeux méthodologiques pour la recherche clinique et expérimentale
La maîtrise conceptuelle et opérationnelle de la variance et de la covariance soulève des enjeux considérables dans les protocoles de recherche contemporains, qu’ils soient fondamentaux ou appliqués. En psychologie clinique, l’identification précise des facteurs de vulnérabilité repose presque exclusivement sur la décomposition de la variabilité. Lorsqu’une équipe de recherche tente d’isoler les marqueurs prédictifs du trouble de stress post-traumatique (TSPT) chez des victimes d’agression, l’objectif consiste à déterminer quelle portion de la variance des symptômes cliniques peut être légitimement attribuée à des facteurs antérieurs (comme des traumatismes infantiles), à des caractéristiques péritraumatiques (comme la dissociation perçue lors de l’événement) ou à des facteurs génétiques. Ignorer la structure de cette variance compromet gravement la capacité des cliniciens à hiérarchiser les cibles d’intervention thérapeutique prioritaire.
Sur le plan de la validation des instruments psychométriques, la covariance joue un rôle tout aussi déterminant. Selon les lignes directrices des standards de mesure en éducation et psychologie, tout nouvel outil d’évaluation diagnostique doit prouver sa validité de construit à travers les concepts de validité convergente et discriminante. La validité convergente exige que les scores au nouvel instrument démontrent une forte covariance positive avec les outils préexistants mesurant des entités théoriquement similaires. Simultanément, la validité discriminante impose que la covariance mesurée entre ce nouvel instrument et des échelles évaluant des construits orthogonaux demeure minimale, voire nulle. Sans une compréhension rigoureuse de la mécanique de la covariance, le psychologue risque de valider des échelles redondantes ou d’attribuer fallacieusement une valeur novatrice à des outils capturant de simples artefacts de mesure.
Enfin, une mauvaise interprétation de la dispersion empirique expose les praticiens à des erreurs diagnostiques préjudiciables. Une variance artificiellement restreinte au sein d’un groupe d’étalonnage – souvent consécutive à un échantillonnage de convenance restreint à des étudiants d’université – conduit inévitablement à sous-estimer la dispersion réelle des pathologies dans la population générale. De telles dérives méthodologiques faussent les seuils cliniques critiques, générant des faux négatifs préjudiciables ou des faux positifs induisant des prises en charge psychiatriques indues. La rigueur statistique se présente donc non comme une contrainte bureaucratique, mais comme le garant éthique de l’intégrité de la recherche et de la prise en charge humaine.
2. Fondements théoriques et définition mathématique de la variance
2.1 Définition conceptuelle de la variance en tant que dispersion
Sur le plan purement conceptuel, la variance peut être définie comme la moyenne arithmétique du carré des écarts à la moyenne. Pour en saisir la quintessence géométrique et physique, il est utile de se représenter l’ensemble des scores obtenus par un échantillon de sujets sur un continuum unidimensionnel. Le centre de gravité de cette distribution de points matériels correspond rigoureusement à l’espérance mathématique ou moyenne de la série. Si chaque observation individuelle est reliée au centre de gravité par un vecteur d’écart, la somme arithmétique simple de ces vecteurs s’annule toujours obligatoirement, les déviations positives compensant exactement les déviations négatives.
Pour surmonter cette neutralisation algébrique et mesurer véritablement la force d’éloignement globale des données, il est nécessaire d’appliquer une transformation éliminant les signes négatifs. Le choix de l’élévation au carré, théorisé initialement par Carl Friedrich Gauss et consolidé par Ronald Fisher, possède des propriétés analytiques admirables en comparaison de la valeur absolue. L’élévation au carré pénalise de manière géométrique les déviations importantes : plus un score individuel s’éloigne du consensus central du groupe, plus son poids dans le calcul final croît de façon exponentielle. La variance mesure ainsi la dispersion globale non pas sous l’angle d’une simple distance métrique linéaire, mais sous l’angle d’une inertie distributionnelle.
Dans l’analyse psychologique, une variance faible traduit un phénomène de standardisation ou d’homogénéité comportementale. Un échantillon de candidats à une formation d’élite manifestant une variance quasi nulle à un test de stabilité émotionnelle indique un profil psychologique extrêmement resserré, où presque tous les sujets partagent un niveau de régulation affective similaire. À l’inverse, une variance élevée signale une hétérogénéité marquée, suggérant la présence de profils atypiques, de sous-populations différenciées ou d’une forte sensibilité différentielle aux stimuli environnementaux.
2.2 Formulation mathématique : populationnelle versus échantillonnaire
L’expression mathématique formelle de la variance se décline sous deux formes distinctes selon que l’analyse s’applique à une population exhaustive ou à un échantillon probabiliste extrait de celle-ci. Lorsque l’investigateur a le privilège rare de mesurer l’intégralité des individus d’une population cible, notée par la taille $N$, la variance populationnelle, traditionnellement symbolisée par la lettre grecque $\sigma^2$ (sigma carré), s’exprime par la formule canonique suivante :
$$\sigma^2 = \frac{1}{N} \sum_{i=1}^{N} (X_i – \mu)^2$$
Dans cette équation fondamentale, $X_i$ représente le score individuel de la $i$-ième unité statistique, $\mu$ symbolise la moyenne paramétrique véritable de la population parente, et le symbole sommatoire $\sum$ agrège la totalité des écarts au carré depuis le premier participant jusqu’au $N$-ième. Cette formule fournit la mesure exacte, sans incertitude stochastique, de la dispersion du paramètre d’intérêt.
Néanmoins, dans la pratique empirique des sciences humaines, les chercheurs travaillent quasi exclusivement avec des échantillons d’une taille finie notée $n$. Lorsque l’on tente d’estimer la variance d’une vaste population à partir des données d’un échantillon modeste, l’utilisation directe de la formule populationnelle – en substituant simplement la moyenne d’échantillon $\bar{X}$ à la moyenne théorique inconnue $\mu$ et en divisant par $n$ – produit une distorsion systématique connue sous le nom de biais d’estimation. Ce biais découle du fait que les données de l’échantillon ont naturellement tendance à se regrouper plus étroitement autour de leur propre moyenne observée $\bar{X}$ qu’autour de la moyenne théorique $\mu$. La variance calculée avec un diviseur égal à $n$ sous-estime donc systématiquement la variance populationnelle réelle.
Pour corriger ce déficit d’estimation, la théorie statistique moderne adopte la célèbre correction de Bessel, qui consiste à substituer au diviseur $n$ la quantité $(n – 1)$. La formule de la variance échantillonnaire sans biais, notée conventionnellement $s^2$, se structure ainsi :
$$s^2 = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})^2$$
Le terme $(n – 1)$ représente mathématiquement les degrés de liberté du système statistique. Puisque la somme des résidus par rapport à la moyenne d’échantillon est contrainte d’être égale à zéro, une fois que $(n – 1)$ écarts sont librement fixés, le $n$-ième écart est mathématiquement déterminé d’avance et n’apporte plus aucune information indépendante. La division par ces degrés de liberté résiduels restaure rigoureusement l’exactitude de l’estimateur, assurant que l’espérance mathématique de $s^2$ est rigoureusement égale à $\sigma^2$.
2.3 Propriétés mathématiques fondamentales de la variance
La variance possède plusieurs axiomes et propriétés algébriques remarquables qui dictent son utilisation dans les modèles quantitatifs complexes. La première de ces caractéristiques réside dans sa non-négativité absolue : pour toute variable aléatoire réelle $X$, la condition $\mathrm{Var}(X) ge 0$ est impérativement vérifiée. Cette propriété découle mécaniquement de l’élévation au carré de chaque déviation individuelle, tout nombre réel élevé au carré étant nécessairement positif ou nul. Une variance strictement égale à zéro correspond au cas dégénéré d’une constante parfaite, où chaque individu présente exactement le même score que ses pairs, annulant toute divergence au sein des données.
Une deuxième série de propriétés concerne le comportement de la variance face aux transformations affines et linéaires des variables aléatoires. Si l’on applique une translation à une distribution de données en y ajoutant une constante scalaire $a$ (par exemple en ajoutant 5 points de bonus à tous les scores d’un examen), la variance demeure strictement invariante :
$$\mathrm{Var}(X + a) = \mathrm{Var}(X)$$
Sur le plan conceptuel, déplacer l’ensemble des scores sur l’axe des réels décale la moyenne arithmétique de la même quantité mais ne modifie en aucun cas l’espacement relatif séparant les différents participants. En revanche, si la distribution subit un changement d’échelle multiplicative par un scalaire $b$ (par exemple en convertissant des temps de réaction de secondes en millisecondes en multipliant par 1000), la variance réagit de manière quadratique :
$$\mathrm{Var}(bX) = b^2 \mathrm{Var}(X)$$
Cette amplification quadratique met en exergue l’une des contraintes majeures de l’indicateur : la variance n’est pas exprimée dans l’unité de mesure initiale de la variable étudiée, mais dans le carré de cette unité. Si un clinicien évalue les scores d’anxiété sur une échelle graduée en points de sévérité, la variance s’exprime en « points au carré », une dimension géométrique dépourvue d’ancrage sémantique intuitif dans le discours médical standard. Pour pallier cette abstraction de l’échelle, les chercheurs procèdent universellement à l’extraction de la racine carrée de la variance, obtenant ainsi l’écart-type :
$$s = \sqrt{s^2}$$
L’écart-type réintègre la mesure de dispersion dans la métrique native de la variable observée, permettant une interprétation directe et intuitive de l’amplitude de l’étalement des scores individuels autour de la moyenne.
3. Calcul pas à pas et interprétation empirique de la variance
3.1 Protocole de calcul manuel sur un échantillon psychométrique
Afin de maîtriser l’architecture calculatoire de la variance et de comprendre intimement chaque composante de sa structure analytique, il s’avère hautement formateur de décomposer manuellement son algorithme sur une série clinique réduite. Imaginons une étude pilote menée au sein d’un service de neuropsychologie auprès d’une cohorte de $n = 6$ patients cérébro-lésés soumis à un subtest de flexibilité cognitive. Les scores bruts obtenus par ces six individus sur l’échelle psychométrique se déclinent comme suit : $X = {12, 16, 14, 10, 18, 20}$.
La première étape indispensable consiste à déterminer avec une précision maximale le barycentre de la distribution, à savoir la moyenne arithmétique empirique :
$$\bar{X} = \frac{\sum X_i}{n} = \frac{12 + 16 + 14 + 10 + 18 + 20}{6} = \frac{90}{6} = 15$$
La moyenne du groupe s’établit précisément à 15 unités. La seconde étape requiert le calcul individuel des écarts à cette moyenne pour chaque patient de l’échantillon. Cette démarche met immédiatement en évidence la neutralisation systématique des valeurs positives et négatives :
- Patient 1 : $(12 – 15) = -3$
- Patient 2 : $(16 – 15) = +1$
- Patient 3 : $(14 – 15) = -1$
- Patient 4 : $(10 – 15) = -5$
- Patient 5 : $(18 – 15) = +3$
- Patient 6 : $(20 – 15) = +5$
Si l’on calcule la somme de ces écarts résiduels, on constate immédiatement que $(-3) + (+1) + (-1) + (-5) + (+3) + (+5) = 0$, illustrant parfaitement le principe théorique selon lequel la somme des résidus par rapport à la moyenne arithmétique est invariablement nulle.
La troisième étape opérationnelle réside dans l’élévation au carré de chacun de ces écarts individuels, convertissant l’ensemble des distances en grandeurs strictement positives :
- Patient 1 : $(-3)^2 = 9$
- Patient 2 : $(+1)^2 = 1$
- Patient 3 : $(-1)^2 = 1$
- Patient 4 : $(-5)^2 = 25$
- Patient 5 : $(+3)^2 = 9$
- Patient 6 : $(+5)^2 = 25$
La somme de ces carrés d’écarts, désignée dans la littérature méthodologique sous le vocable fondamental de « Somme des Carrés » (notée couramment *SS* pour *Sum of Squares*), constitue le numérateur de l’équation :
$$SS = \sum (X_i – \bar{X})^2 = 9 + 1 + 1 + 25 + 9 + 25 = 70$$
La quatrième et ultime étape nécessite d’ajuster cette somme par les degrés de liberté appropriés afin d’assurer l’absence de biais statistique. L’échantillon comptant $n = 6$ participants, le diviseur est égal à $(n – 1) = 6 – 1 = 5$ :
$$s^2 = \frac{SS}{n – 1} = \frac{70}{5} = 14$$
La variance échantillonnaire non biaisée des scores de flexibilité cognitive pour ce groupe de patients est donc de 14 unités au carré. Si l’on souhaite extraire l’écart-type pour interpréter cette dispersion dans l’unité originelle du test, il suffit de poser $s = \sqrt{14} \approx 3{,}74$ points.
3.2 Étude de cas : dispersion des scores à une échelle d’anxiété
Pour illustrer les implications pratiques de cette mesure univariée, analysons une situation clinique concrète opposant deux cohortes de sujets évalués au moyen du questionnaire d’anxiété-état de Spielberger (STAI), dont les scores peuvent osciller théoriquement entre 20 et 80 points. Deux services psychiatriques évaluent chacun un échantillon de dix patients admis consécutivement pour un motif d’anxiété diffuse. Les scores bruts enregistrés se structurent de la façon suivante :
- Groupe Clinique A (Cohorte ambulatoire) : ${48, 50, 49, 52, 51, 49, 50, 53, 48, 50}$
- Groupe Clinique B (Service d’urgence psychiatrique) : ${25, 75, 30, 70, 22, 78, 35, 65, 80, 20}$
Procédons à l’analyse comparée des propriétés descriptives de ces deux collectifs. Le calcul de la moyenne arithmétique pour le Groupe A donne une somme de 500 divisée par 10, soit une moyenne $\bar{X}_A = 50$ points. Pour le Groupe B, l’agrégation des scores génère également une somme globale de 500, aboutissant à une moyenne identique $\bar{X}_B = 50$ points. Sur la foi d’un rapport synthétique restreint à la seule mesure de tendance centrale, un évaluateur externe pourrait conclure hâtivement à une équivalence clinique absolue entre les deux services hospitaliers.
L’évaluation de la variance et de l’écart-type révèle pourtant une réalité diamétralement opposée. Pour le Groupe A, la somme des carrés des écarts à la moyenne s’établit à un niveau minimal :
$$SS_A = (-2)^2 + 0^2 + (-1)^2 + 2^2 + 1^2 + (-1)^2 + 0^2 + 3^2 + (-2)^2 + 0^2 = 24$$
$$s^2_A = \frac{24}{10 – 1} = \frac{24}{9} \approx 2{,}67 \quad Long\rightarrow \quad s_A \approx 1{,}63 \text{ p\oint}$$
Pour le Groupe B, le calcul de la somme des carrés dévoile une dynamique d’éclatement distributionnel massif :
$$SS_B = (-25)^2 + 25^2 + (-20)^2 + 20^2 + (-28)^2 + 28^2 + (-15)^2 + 15^2 + 30^2 + (-30)^2 = 5798$$
$$s^2_B = \frac{5798}{10 – 1} = \frac{5798}{9} \approx 644{,}22 \quad Long\rightarrow \quad s_B \approx 25{,}38 \text{ points}$$
Ces résultats quantitatifs modifient radicalement le diagnostic organisationnel et clinique. Le Groupe A représente une population remarquablement homogène, où tous les individus présentent une symptomatologie modérée étroitement calibrée autour du seuil de 50 points, ce qui autorise la mise en place d’un protocole standardisé de thérapie de groupe. En revanche, le Groupe B présente une variance vertigineuse de $644{,}22$, couplée à un écart-type de plus de 25 points. Cette dispersion extrême démontre la coexistence de deux sous-groupes pathologiques irréconciliables : des individus en souffrance cataclysmique flirtant avec le plafond de l’échelle (scores de 75 à 80) et des patients ne présentant quasiment aucun symptôme d’anxiété pathologique (scores de 20 à 25). Dans un tel contexte de dispersion massive, tenter d’appliquer une thérapie générique calquée sur la moyenne de 50 s’avérerait totalement inadapté pour les deux extrêmes de la cohorte.
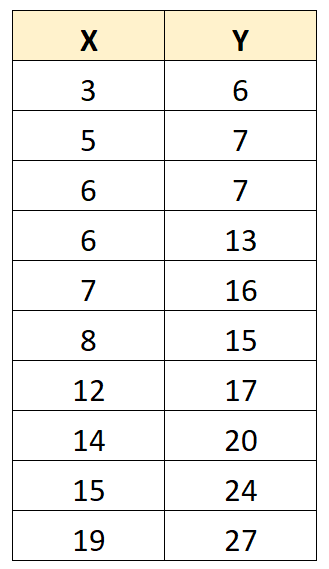
3.3 Sensibilité de la variance aux valeurs extrêmes
Bien que la variance présente des propriétés mathématiques optimales pour l’estimation paramétrique, son utilisation aveugle en recherche clinique comporte un écueil méthodologique majeur : son extrême vulnérabilité face aux valeurs aberrantes ou extrêmes (*outliers*). Cette hypersensibilité découle directement du choix constitutif de l’élévation au carré des déviations individuelles. Si une observation s’éloigne modérément du centre de la distribution, sa contribution à la variance reste proportionnée ; mais dès lors qu’un score s’écarte substantiellement de la norme collective, son résidu quadratique explose de façon disproportionnée.
Imaginons une évaluation du temps de réaction psychomoteur mesuré en millisecondes chez dix participants sains : neuf sujets réalisent des temps d’environ 300 ms, tandis qu’un dixième participant subit une absence cognitive transitoire et produit un temps aberrant de 2500 ms. L’écart de 2200 ms généré par ce seul individu, une fois élevé au carré, produit une valeur de $4,840,000$, qui dominera l’intégralité de la somme des carrés, écrasant littéralement l’information apportée par les neuf autres sujets. La variance obtenue ne reflétera en aucune façon la dispersion typique du processus cognitif investigué, mais traduira simplement l’accident méthodologique causé par une observation unique non représentative.
Dans les contextes cliniques où les distributions sont naturellement asymétriques – ce qui est fréquemment le cas pour la consommation d’alcool, les comportements auto-agressifs ou les scores de dépression majeure –, le recours exclusif à la variance paramétrique classique peut dénaturer gravement l’analyse des faits. Les méthodologistes préconisent alors de recourir à des mesures de dispersion robustes, moins sensibles aux queues de distribution. L’écart interquartile (différence entre le troisième quartile $Q_3$ et le premier quartile $Q_1$) ou la déviation absolue médiane (*Median Absolute Deviation* ou MAD) constituent des alternatives robustes précieuses. La MAD, notamment, calculée comme la médiane des déviations absolues par rapport à la médiane du groupe, offre une résistance exceptionnelle aux contaminations extrêmes, permettant de caractériser la dispersion comportementale sans que l’indicateur ne soit capturé par quelques valeurs aberrantes.
4. Fondements théoriques et conceptuels de la covariance
4.1 Définition théorique de la covariation conjointe
Alors que la variance circonscrit son analyse à l’étalement spatial d’un seul attribut, la covariance s’aventure dans le domaine fondamental de l’association statistique en quantifiant la coordination simultanée de deux variables aléatoires distinctes. Le concept central qui sous-tend la covariance est celui de la tendance partagée ou de la covariation bivariée. En psychologie, presque aucune fonction biologique ou mentale n’opère en autarcie absolue : les mécanismes de l’inhibition cognitive s’articulent avec les systèmes de régulation de l’affect, la motivation intrinsèque interagit avec le sentiment d’auto-efficacité, et l’exposition prolongée aux facteurs de stress environnementaux s’associe à l’apparition de désordres psychosomatiques.
La covariance fournit l’outil analytique élémentaire permettant d’évaluer dans quelle mesure les écarts à la moyenne constatés sur une variable $X$ sont synchronisés avec les écarts à la moyenne relevés sur une variable $Y$ chez les mêmes sujets. La question n’est plus seulement de savoir si un individu s’éloigne du centre de gravité de son groupe sur une dimension $A$, mais de déterminer si cet éloignement s’accompagne systématiquement, chez ce même individu, d’un écart prévisible par rapport au centre de gravité sur une dimension $B$. Il s’agit en quelque sorte d’une mesure de l’alignement directionnel des déviations individuelles dans un plan bidimensionnel.
Cette covariation conjointe peut être appréhendée comme la projection géométrique de nuages de points dans un repère cartésien dont l’origine a été translatée au point moyen $(\bar{X}, \bar{Y})$. Les quatre quadrants délimités par ces axes moyens reflètent les différentes configurations possibles de l’association : les quadrants supérieur-droit et inférieur-gauche rassemblent les concordances (scores conjointement supérieurs ou conjointement inférieurs aux moyennes respectives), tandis que les quadrants supérieur-gauche et inférieur-droit rassemblent les discordances. La covariance agrège l’ensemble de ces positions relatives pour déterminer le barycentre relationnel des deux construits psychologiques explorés.
4.2 Formulation algébrique de la covariance
Sur le plan mathématique formel, la covariance populationnelle unissant deux variables aléatoires $X$ et $Y$, désignée par $\mathrm{Cov}(X,Y)$ ou par le symbole grec $\sigma_{XY}$, correspond à l’espérance mathématique du produit croisé de leurs déviations respectives par rapport à leurs moyennes théoriques. Pour une population complète de taille $N$, l’équation s’écrit :
$$\mathrm{Cov}(X,Y) = \sigma_{XY} = \frac{1}{N} \sum_{i=1}^{N} (X_i – \mu_X)(Y_i – \mu_Y)$$
Lorsque cette métrique doit être estimée à partir d’un échantillon empirique représentatif de taille $n$, la démarche inférentielle impose, à l’instar de la variance, l’intégration des degrés de liberté résiduels au diviseur pour corriger le biais stochastique induit par l’estimation conjointe de $\bar{X}$ et $\bar{Y}$. La formule de la covariance échantillonnaire sans biais, notée $s_{XY}$ ou $\mathrm{cov}(X,Y)$, prend alors l’expression analytique suivante :
$$s_{XY} = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})$$
Le numérateur de cette équation joue un rôle fondamental dans la littérature psychométrique et statistique. Il est universellement dénommé la « Somme des Produits Croisés » (souvent abrégé en *SP* pour *Sum of Products*). La structure de cette somme des produits croisés éclaire la nature profonde de l’indice : chaque participant $i$ contribue au numérateur non pas par un terme quadratique unilatéral, mais par le produit direct de son résidu sur la première dimension $(X_i – \bar{X})$ multiplié par son résidu sur la seconde dimension $(Y_i – \bar{Y})$.
Il est capital de remarquer la symétrie algébrique parfaite de la formule : permuter les variables $X$ et $Y$ n’altère en rien la valeur du produit algébrique au numérateur. De fait, la covariance est une fonction strictement commutative :
$$\mathrm{Cov}(X,Y) = \mathrm{Cov}(Y,X)$$
Cette commutativité implique une conséquence théorique de premier ordre : la covariance est un indicateur purement symétrique qui quantifie une association bidirectionnelle sans préjuger d’un quelconque sens de causalité unilatérale entre les deux dimensions psychologiques investiguées.
4.3 Signe et orientation de la covariance
Contrairement à la variance, dont l’élévation au carré impose une non-négativité inconditionnelle, la covariance est une quantité algébriquement signée. Elle peut adopter une valeur positive, une valeur négative ou s’annuler totalement. La polarité du signe constitue une indication directe de l’orientation de l’association conjointe entre les deux construits psychologiques analysés.
Une covariance positive ($\mathrm{Cov}(X,Y) > 0$) survient lorsque les produits croisés positifs dominent la somme des déviations. Cela se produit lorsque les individus affichant un score supérieur à la moyenne sur la variable $X$ ont également tendance à manifester un score supérieur à la moyenne sur la variable $Y$ (produit de deux nombres positifs, donnant un résultat positif), ou réciproquement, lorsque les participants situés en deçà de la moyenne sur $X$ se positionnent également en deçà de la moyenne sur $Y$ (produit de deux déviations négatives, donnant également un résultat arithmétique strictement positif). Sur le plan psychologique, la covariance positive traduit une synergie comportementale ou cognitive, comme celle observée entre l’estime de soi globale et le niveau d’optimisme dispositionnel : les sujets optimistes ont tendance à s’évaluer positivement, tandis que les individus pessimistes ont tendance à déprécier leur valeur personnelle.
À l’inverse, une covariance négative ($\mathrm{Cov}(X,Y) < 0$) traduit une dynamique d'opposition systématique ou d'antagonisme fonctionnel entre les deux dimensions comportementales. Elle émerge mathématiquement lorsque les écarts individuels présentent des orientations divergentes : les individus manifestant un niveau élevé sur la variable $X$ enregistrent un niveau faible sur la variable $Y$ (produit d'un écart positif par un écart négatif, produisant un terme négatif), et vice versa. En clinique différentielle, ce patron illustre typiquement les phénomènes d'inhibition comportementale ou de compromis cognitif, telle que la relation fréquemment mise en évidence entre l'anxiété d'évaluation et l'efficience de la mémoire de travail : à mesure que le stress situationnel excède les capacités régulatrices du sujet, les ressources exécutives mobilisables pour la rétention d'information s'effondrent.
Enfin, une covariance théoriquement nulle ($\mathrm{Cov}(X,Y) = 0$) signale une absence totale d'association linéaire conjointe entre les deux séries de données. Dans une telle configuration géométrique, les contributions positives issues des quadrants de concordance sont exactement compensées et neutralisées par les contributions négatives issues des quadrants de discordance. Les variations d'un individu autour de la moyenne de la première variable n'offrent aucune prise prédictive linéaire sur la trajectoire de son score par rapport à la moyenne de la seconde variable. On observe par exemple une covariance proche de zéro entre l'extraversion sociale et la précision temporelle lors d'une tâche d'horloge motrice fondamentale.
5. Calcul pas à pas et interprétation pratique de la covariance
5.1 Procédure algorithmique de calcul de la covariance bivariée
La réalisation du calcul manuel de la covariance sur un protocole expérimental requiert une démarche rigoureuse et séquentielle. Il est essentiel d’associer précisément chaque score individuel à son homologue apparié chez le même sujet, toute rupture dans l’appariement des paires de données corrompant irrémédiablement le sens du produit croisé.
L’algorithme formel s’articule autour des étapes suivantes :
1. Calcul préalable et simultané des deux moyennes arithmétiques du groupe, notées respectivement $\bar{X}$ et $\bar{Y}$.
2. Détermination, pour chaque participant $i$ de l’étude, de sa déviation par rapport à la moyenne sur la première variable, $(X_i – \bar{X})$.
3. Détermination, pour ce même participant, de sa déviation par rapport à la moyenne sur la seconde variable, $(Y_i – \bar{Y})$.
4. Multiplication des deux déviations obtenues pour chaque sujet afin de former le produit croisé individuel $CP_i = (X_i – \bar{X})(Y_i – \bar{Y})$.
5. Sommation arithmétique de l’ensemble des produits croisés individuels sur la totalité de l’échantillon pour générer la Somme des Produits Croisés ($SP$).
6. Division finale de cette quantité $SP$ par le nombre total de degrés de liberté résiduels, soit $(n – 1)$, pour extraire la covariance échantillonnaire non biaisée.
Cette séquence montre avec limpidité que la covariance ne traite pas les deux variables dans des silos séparés pour ne fusionner leurs indices qu’au terme du protocole ; elle fusionne les informations au niveau microscopique de chaque individu avant de procéder à l’agrégation distributionnelle globale.
5.2 Exemple pratique : relation entre temps d’écran et niveau de dépression
Pour donner corps à cette procédure, considérons une recherche menée en psychologie de l’adolescence portant sur la corrélation potentielle entre l’exposition quotidienne aux écrans de loisir et la sévérité des symptômes dépressifs. Un échantillon de $n = 5$ adolescents volontaires a été suivi durant un trimestre. La variable $X$ mesure le temps moyen passé devant les écrans récréatifs exprimé en heures par jour. La variable $Y$ mesure le niveau de symptomatologie dépressive évalué par l’inventaire de Beck (BDI-II), avec des scores pouvant aller de 0 à 63 points.
Les données empiriques recueillies auprès des cinq participants se déclinent ainsi :
- Participant 1 : $X_1 = 2$ heures, $Y_1 = 10$ points
- Participant 2 : $X_2 = 4$ heures, $Y_2 = 20$ points
- Participant 3 : $X_3 = 6$ heures, $Y_3 = 18$ points
- Participant 4 : $X_4 = 8$ heures, $Y_4 = 32$ points
- Participant 5 : $X_5 = 10$ heures, $Y_5 = 40$ points
Procédons méthodiquement au traitement algorithmique de ces scores appariés.
Étape 1 : Calcul des moyennes des variables
$$\bar{X} = \frac{2 + 4 + 6 + 8 + 10}{5} = \frac{30}{5} = 6 \text{ heures}$$
$$\bar{Y} = \frac{10 + 20 + 18 + 32 + 40}{5} = \frac{120}{5} = 24 \text{ points}$$
Étape 2 et 3 : Calcul des écarts individuels aux moyennes
- Participant 1 : $(X_1 – \bar{X}) = 2 – 6 = -4$ ; $(Y_1 – \bar{Y}) = 10 – 24 = -14$
- Participant 2 : $(X_2 – \bar{X}) = 4 – 6 = -2$ ; $(Y_2 – \bar{Y}) = 20 – 24 = -4$
- Participant 3 : $(X_3 – \bar{X}) = 6 – 6 = 0$ ; $(Y_3 – \bar{Y}) = 18 – 24 = -6$
- Participant 4 : $(X_4 – \bar{X}) = 8 – 6 = +2$ ; $(Y_4 – \bar{Y}) = 32 – 24 = +8$
- Participant 5 : $(X_5 – \bar{X}) = 10 – 6 = +4$ ; $(Y_5 – \bar{Y}) = 40 – 24 = +16$
Étape 4 : Calcul des produits croisés individuels
- Participant 1 : $(-4) \times (-14) = +56$
- Participant 2 : $(-2) \times (-4) = +8$
- Participant 3 : $(0) \times (-6) = 0$
- Participant 4 : $(+2) \times (+8) = +16$
- Participant 5 : $(+4) \times (+16) = +64$
Étape 5 : Sommation des produits croisés (SP)
$$SP = \sum (X_i – \bar{X})(Y_i – \bar{Y}) = 56 + 8 + 0 + 16 + 64 = 144$$
Étape 6 : Division par les degrés de liberté $(n – 1)$
L’échantillon comptant 5 participants, le dénominateur est égal à $5 – 1 = 4$ :
$$s_{XY} = \frac{SP}{n – 1} = \frac{144}{4} = 36$$
Le résultat final fournit une covariance de $+36$. Ce chiffre positif confirme empiriquement que, dans cet échantillon, le temps d’exposition aux écrans et le niveau de dépression co-évoluent dans une direction concordante. Les adolescents passant significativement plus de temps que la moyenne collective devant leurs écrans ont également tendance à afficher une symptomatologie dépressive plus marquée que la moyenne du groupe.
5.3 La dépendance de la covariance aux échelles de mesure
Si le signe positif du résultat précédent (+36) renseigne avec netteté sur l’orientation de la dynamique conjointe, la valeur numérique brute de cette covariance recèle une vulnérabilité théorique déterminante : son amplitude dépend intégralement et servilement des unités de mesure utilisées pour calibrer les variables $X$ et $Y$. L’unité formelle de notre résultat de 36 n’est pas un pourcentage ni un ratio sans dimension, mais le produit hybride « heures $\times$ points ».
Pour saisir concrètement cette dépendance à la métrique, supposons que le chercheur décide d’exprimer le temps d’écran non plus en heures quotidiennes, mais en minutes journalières, afin de s’aligner sur des standards ergonomiques internationaux. La conversion mathématique s’opère par multiplication de la variable $X$ par une constante scalaire $c = 60$. Les temps d’écran des cinq sujets deviennent alors : ${120, 240, 360, 480, 600}$ minutes. La nouvelle moyenne s’élève à $\bar{X} = 360$ minutes, et les déviations individuelles en minutes sont toutes multipliées par 60.
Reprenons le calcul de la somme des produits croisés avec cette nouvelle échelle temporelle :
- Participant 1 : $(-240) \times (-14) = +3360$
- Participant 2 : $(-120) \times (-4) = +480$
- Participant 3 : $(0) \times (-6) = 0$
- Participant 4 : $(+120) \times (+8) = +960$
- Participant 5 : $(+240) \times (+16) = +3840$
La nouvelle somme des produits croisés s’élève à $SP_{\mathrm{minutes}} = 3360 + 480 + 0 + 960 + 3840 = 8640$. En divisant par les 4 degrés de liberté, nous obtenons :
$$s_{XY(\mathrm{minutes})} = \frac{8640}{4} = 2160 \text{ minutes}\cdot\text{points}$$
En modifiant uniquement l’unité de mesure du temps, la covariance a bondi numériquement de 36 à 2160, soit une multiplication exacte par 60. La relation psychologique de fond unissant l’usage des écrans à la dépression a-t-elle pour autant changé de nature, d’intensité ou de force prédictive ? Absolument pas : le phénomène humain sous-jacent est resté strictement identique.
Cette sensibilité aux échelles engendre une impossibilité méthodologique majeure : il est totalement impossible de comparer directement des covariances issues de couples de variables différents pour en déduire laquelle présente l’association la plus puissante. Une covariance de 2160 reliant des minutes d’écran et des scores de dépression ne traduit pas un lien plus puissant ou plus intime qu’une covariance de 0,85 mesurée entre la concentration d’une hormone dans le sang (en milligrammes par litre) et la fréquence cardiaque (en battements par minute). L’absence de bornes finies standards empêche d’utiliser la magnitude brute de la covariance comme baromètre de l’intensité d’une relation, nécessitant une normalisation que nous aborderons ultérieurement.
6. Analyse comparative directe : Variance versus Covariance
6.1 Dimensionnalité et nombre de variables impliquées
L’analyse comparée de la variance et de la covariance met en lumière des lignes de clivage conceptuel et mathématique majeures, tout en révélant une filiation théorique fascinante. La première différence évidente concerne la dimensionnalité du problème statistique traité. La variance est une métrique fondamentalement univariée : elle s’enracine dans un espace géométrique à une seule dimension et quantifie l’énergie de dispersion autour d’un point scalaire unique. Elle ne nécessite pour son exécution qu’une seule distribution de données et un seul opérateur de centrage.
À l’opposé, la covariance est structurellement bivariée : elle opère nécessairement à l’intersection de deux espaces géométriques distincts. Elle ne cherche pas à savoir comment une grandeur s’étale sur son propre axe, mais comment les positions relatives d’un nuage d’individus sur un premier axe s’articulent avec leurs positions relatives sur un second axe. Elle exige l’existence d’une observation appariée pour chaque unité d’analyse, reliant structurellement deux dimensions au sein d’un même espace vectoriel.
Néanmoins, cette dualité apparente masque une unité mathématique remarquable. En réalité, la variance peut être modélisée comme un cas particulier de la covariance. Si l’on calcule formellement la covariance d’une variable aléatoire continue $X$ avec elle-même, l’application de la formule analytique donne :
$$\mathrm{Cov}(X,X) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})(X_i – \bar{X}) = \frac{1}{n – 1} \sum_{i=1}^{n} (X_i – \bar{X})^2$$
Cette expression mathématique redonne précisément la formule de la variance échantillonnaire sans biais $s^2$. La variance n’est donc rien d’autre que l’autocovariance d’une variable avec son propre tracé empirique. Lorsque l’on passe de l’analyse conjointe de deux grandeurs hétérogènes à l’évaluation de la redondance d’une grandeur avec son propre signal, la covariance se replie géométriquement sur elle-même pour devenir la variance.
6.2 Interprétabilité des échelles et des amplitudes numériques
La question de l’interprétabilité des métriques constitue le deuxième point d’achoppement distinctif entre ces deux indicateurs. Pour la variance, la limitation sémantique découle de la quadrature unilatérale de l’unité de mesure d’origine. Si un neuropsychologue évalue le temps nécessaire pour compléter un labyrinthe en secondes, la variance s’exprimera en « secondes au carré ». Cette distorsion dimensionnelle rend impossible toute lecture intuitive directe de la dispersion moyenne, forçant quasi systématiquement le chercheur à convertir la variance en écart-type afin de restaurer l’intelligibilité descriptive de la dispersion.
La situation s’avère encore plus complexe pour la covariance. Puisqu’elle résulte de la multiplication croisée des déviations issues de deux grandeurs différentes, son unité d’expression est le produit composite des deux unités natives. Dans notre exemple précédent, la mesure oscillait en « heures-points », mais dans une étude de neurobiologie cognitive, elle pourrait se formaliser en « micromoles par litre $\times$ millisecondes ». Ce type d’unité composite n’a aucune réalité phénoménologique directe dans l’expérience du clinicien ou du chercheur.
De surcroît, les échelles numériques de la variance et de la covariance obéissent à des contraintes de bornage asymétriques. La variance d’un échantillon réel est strictement confinée au demi-espace positif $[0, +\infty[$. Elle dispose d’une borne inférieure absolue et universelle (le zéro), qui correspond à l’homogénéité parfaite où toute variabilité est éteinte. En revanche, la covariance n’est bornée ni inférieurement ni supérieurement : son amplitude oscille théoriquement dans l’intervalle ouvert $]-\infty, +\infty[$. Cette absence totale de repères fixes interdit non seulement de déterminer à la simple lecture du chiffre si l’association est robuste ou fragile, mais empêche également toute tentative de juxtaposer directement une variance et une covariance pour tenter d’en hiérarchiser l’impact statistique.
6.3 Tableau comparatif exhaustif des propriétés fondamentales
Pour synthétiser de manière didactique et synoptique les propriétés croisées de ces deux instruments majeurs de la modélisation statistique, le tableau analytique ci-dessous résume leurs attributs théoriques, algébriques et opérationnels essentiels :
| Caractéristique Méthodologique | Variance ($s^2$ ou $\sigma^2$) | Covariance ($s_{XY}$ ou $\sigma_{XY}$) |
|---|---|---|
| Nature de l’investigation | Univariée (dispersion d’une dimension unique) | Bivariée (association conjointe de deux dimensions) |
| Formule d’échantillon sans biais | $\frac{1}{n-1} \sum (X_i – \bar{X})^2$ | $\frac{1}{n-1} \sum (X_i – \bar{X})(Y_i – \bar{Y})$ |
| Intervalle de variation théorique | $[0, +\infty[$ (Strictement non-négative) | $]-\infty, +\infty[$ (Signée : négative, nulle, positive) |
| Unité formelle du résultat | Carré de l’unité originale de la variable ($U^2$) | Produit des deux unités distinctes ($U_X \times U_Y$) |
| Interprétation du zéro | Absence totale de variabilité (scores identiques) | Absence d’association linéaire conjointe |
| Impact d’une translation ($+ a$) | Totalement invariante : $\mathrm{Var}(X + a) = \mathrm{Var}(X)$ | Invariante : $\mathrm{Cov}(X + a, Y + b) = \mathrm{Cov}(X,Y)$ |
| Impact d’une mise à l’échelle ($\times b$) | Quadratique : $\mathrm{Var}(bX) = b^2 \mathrm{Var}(X)$ | Multiplicative bilatérale : $\mathrm{Cov}(aX, bY) = ab , \mathrm{Cov}(X,Y)$ |
| Relation de réciprocité mathématique | Cas particulier : $\mathrm{Var}(X) = \mathrm{Cov}(X,X)$ | Généralisation bivariée de la notion d’autovariation |
| Propriété de symétrie | Non applicable (opérateur univarié) | Strictement commutative : $\mathrm{Cov}(X,Y) = \mathrm{Cov}(Y,X)$ |
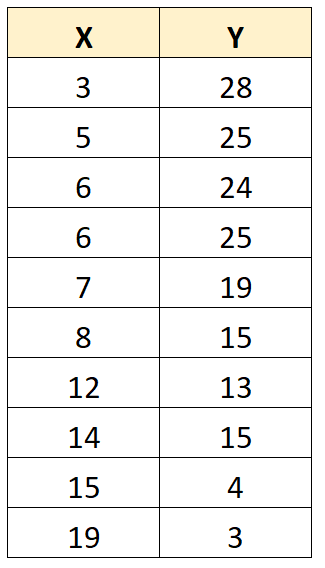
7. La matrice de variance-covariance : architecture et applications psychométriques
7.1 Structure matricielle et organisation géométrique
Lorsque les investigations en sciences cognitives ou en psychologie sociale franchissent le cap de l’analyse bivariée pour embrasser des designs expérimentaux complexes englobant trois, dix ou cent variables simultanément, le traitement isolé de chaque couple scalaire devient rapidement ingérable. Les statisticiens ont donc conçu un opérateur d’une élégance et d’une puissance remarquables : la matrice de variance-covariance, universellement désignée par la lettre grecque majuscule $boldsymbol{\Sigma}$ (Sigma) au niveau populationnel ou $\mathbf{S}$ au niveau échantillonnaire.
Considérons un vecteur aléatoire $\mathbf{X}$ composé de $p$ variables psychométriques distinctes collectées auprès d’un large échantillon clinique, noté $\mathbf{X} = [X_1, X_2, dots, X_p]^T$. La matrice de variance-covariance associée est un tableau carré régulier d’ordre $p \times p$ qui consolide en une entité computationnelle unique l’intégralité des informations relatives à la dispersion interne de chaque variable ainsi qu’à leurs associations croisées mutuelles.
Sa structure interne obéit à un ordonnancement géométrique strict et invariant :
- La diagonale principale de la matrice, qui relie le coin supérieur gauche au coin inférieur droit (les coordonnées matricielles où la ligne $j$ est égale à la colonne $k$), accueille les variances individuelles de chacune des $p$ variables observées. L’élément situé en position $(1,1)$ est la variance de $X_1$, l’élément $(2,2)$ est la variance de $X_2$, et l’élément $(p,p)$ consigne la variance de $X_p$.
- Les éléments hors-diagonale (situés au-dessus et en dessous de la trajectoire diagonale, où $j \neq k$) rassemblent l’ensemble exhaustif des covariances bivariées unissant chaque paire possible de dimensions. L’élément situé à l’intersection de la ligne 1 et de la colonne 2 consigne ainsi la covariance $\mathrm{Cov}(X_1, X_2)$.
Une propriété géométrique fondamentale de cette matrice réside dans sa symétrie parfaite par rapport à la diagonale principale. En vertu de la commutativité inconditionnelle de la covariance démontrée précédemment, l’élément situé à la coordonnée $(j, k)$ est rigoureusement identique à l’élément logé en position $(k, j)$, ce qui se résume par la relation d’algèbre linéaire $\mathbf{S} = \mathbf{S}^T$, où $\mathbf{S}^T$ représente la matrice transposée. De surcroît, toute matrice empirique de variance-covariance issue de données psychologiques réelles doit respecter la propriété de semi-définition positive, ce qui garantit qu’aucune combinaison linéaire de ces variables ne pourra générer une variance négative impossible.
7.2 Utilité dans l’analyse de fidélité et de consistance interne
La matrice de variance-covariance constitue le moteur algorithmique sous-jacent à l’évaluation de la qualité psychométrique des instruments de mesure, et plus particulièrement à l’estimation de leur fidélité via la consistance interne. Lorsqu’un psychomètre conçoit un questionnaire destiné à évaluer une dimension clinique comme l’épuisement professionnel (*burnout*), l’échelle est classiquement découpée en une batterie d’items ordonnés (par exemple 10 questions spécifiques). Chaque item constitue en lui-même une variable psychométrique distincte.
L’indicateur le plus célèbre de la fidélité d’une échelle composite, le coefficient alpha de Cronbach (couramment noté $\alpha$), s’extrait directement des sommations internes de cette matrice de covariance $\mathbf{S}$ d’ordre $k \times k$ formée par l’ensemble des $k$ items du test. La formule canonique d’estimation s’exprime ainsi :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^{k} \sigma_{i}^2}{\sigma_{\mathrm{Total}}^2} \right)$$
Pour comprendre la mécanique intime de cet indice, il suffit d’analyser les deux composantes de son ratio intérieur. Le terme $\sum_{i=1}^{k} \sigma_{i}^2$ correspond rigoureusement à la trace de la matrice de variance-covariance, c’est-à-dire à la somme arithmétique simple de tous les éléments situés sur la diagonale principale (les variances propres de chaque item pris individuellement). À l’inverse, le terme au dénominateur $\sigma_{\mathrm{Total}}^2$, qui représente la variance du score total obtenu par les sujets en sommant l’intégralité des questions de l’échelle, intègre à la fois la somme des variances diagonales et l’intégralité de la somme de toutes les covariances hors-diagonale.
Si les items de l’échelle ne mesurent pas un construit commun et fluctuent de manière anarchique, les covariances hors-diagonale seront proches de zéro. Dans cette hypothèse défavorable, la variance du score total sera approximativement égale à la somme des variances individuelles des items. Le ratio $\frac{\sum \sigma_i^2}{\sigma_{\mathrm{Total}}^2}$ approchera la valeur de 1, faisant s’effondrer le coefficient $\alpha$ vers zéro. Si, en revanche, les items partagent une forte consistance interne et capturent avec précision le même processus psychologique, ils produiront des covariances positives massives dans l’ensemble des cases hors-diagonale. Le dénominateur surpassera alors très largement le numérateur, le ratio approchera de zéro, et l’alpha de Cronbach grimpera vers sa valeur maximale d’excellence méthodologique, traditionnellement attendue au-delà de 0,80 ou 0,85.
7.3 Application au calcul de la variance d’une somme de variables
Un autre domaine théorique où la covariance démontre son caractère indispensable concerne le calcul de la dispersion résultant de l’addition de deux ou plusieurs scores distincts. Dans la pratique psychologique quotidienne, il est fréquent d’agréger différentes épreuves pour bâtir un indice global composite, comme l’addition des scores d’anxiété et de dépression pour établir un score général de détresse psychologique.
Une erreur statistique courante consiste à présumer naïvement que la variance de la somme de deux variables équivaut simplement à la somme de leurs variances respectives. L’algèbre statistique démontre que ce postulat n’est rigoureusement vrai que dans le cas particulier et rarissime où les deux variables sont totalement orthogonales et indépendantes. Dans la réalité empirique, dès lors que les deux dimensions manifestent une association conjointe, le théorème fondamental de la variance d’une somme de variables aléatoires impose l’intégration du terme de covariance :
$$\mathrm{Var}(X + Y) = \mathrm{Var}(X) + \mathrm{Var}(Y) + 2,\mathrm{Cov}(X, Y)$$
L’apparition du coefficient d’amplification $2,\mathrm{Cov}(X,Y)$ modifie substantiellement le paysage quantitatif. Si deux variables sont positivement corrélées – ce qui est la règle quasi universelle au sein des tests cognitifs ou psychopathologiques en vertu du phénomène de variance commune –, leur covariance est positive. En conséquence, la variance du score total obtenu par les participants sera substantiellement plus élevée que la simple juxtaposition de leurs dispersions individuelles. Cette amplification de la variance composite reflète la synergie constructive des déviations individuelles : un sujet performant sur $X$ ayant tendance à performer également sur $Y$, ses écarts se cumulent pour projeter son score global aux franges extrêmes de la distribution sommative.
Réciproquement, si deux variables affichent une covariance négative prononcée (par exemple une mesure d’autonomie émotionnelle et une mesure de dépendance affective), l’injection du terme négatif $2,\mathrm{Cov}(X,Y)$ exerce un effet modérateur et tampon. La variance du score combiné se trouvera considérablement compressée par rapport à la somme des variances d’origine, car les forces centrifuges s’exerçant dans une direction sur la variable $X$ seront systématiquement absorbées et compensées par des mouvements contraires sur la variable $Y$. Ignorer la covariance lors de la construction d’indices composites cliniques conduit immanquablement à des estimations faussées de l’erreur type de mesure et des intervalles de confiance associés.
8. De la covariance à la corrélation : la normalisation statistique
8.1 Pourquoi la covariance nécessite une standardisation
Malgré sa rigueur mathématique et sa centralité dans l’algèbre matricielle, la covariance brute demeure un outil incomplet pour l’analyse descriptive directe et la communication scientifique vulgarisée. Le problème fondamental qui limite son emploi direct dans l’évaluation empirique quotidienne des résultats de recherche réside dans son insolubilité face à la relativité des échelles de mesure. Comme nous l’avons mis en exergue lors de l’expérimentation bivariée sur le temps d’écran, modifier artificiellement la métrique d’un instrument suffit à multiplier ou diviser l’amplitude chiffrée de la covariance par un facteur gigantesque sans que le lien phénoménologique n’ait varié d’un iota.
En l’absence d’une borne supérieure absolue et standardisée, comment un neuropsychologue peut-il déterminer si une covariance de $+12{,}4$ constatée entre l’âge chronologique des patients et leur nombre d’erreurs au test de Stroop reflète une association majeure ou une liaison ténue ? La valeur numérique brute est rigoureusement muette sur cette question. Elle dépend intrinsèquement de l’étalement propre à la distribution des âges et de la dispersion propre à l’échelle des erreurs.
Pour conférer à la mesure de covariation un pouvoir d’évaluation universel et intuitif, la méthodologie quantitative doit s’affranchir des unités métriques arbitraires spécifiques aux instruments mobilisés. Cette émancipation nécessite le déploiement d’un procédé de normalisation ou de standardisation, permettant de convertir les scores bruts en déviations relatives sans dimension. Il convient pour cela d’opérer une transition topologique depuis l’espace non standardisé des variables brutes vers l’espace standardisé des variables centrées réduites (les fameux scores $Z$), où chaque déviation est systématiquement divisée par l’écart-type de sa propre distribution.
8.2 La dérivation du coefficient r de Pearson
La formulation canonique de cette normalisation statistique a été formalisée à la fin du dix-neuvième siècle par le polymathe Karl Pearson, prolongeant les travaux initiaux de Sir Francis Galton. Pearson a démontré qu’en divisant la covariance conjointe de deux variables par le produit géométrique de leurs écarts-types respectifs, on obtient un indice d’association pur, parfaitement invariant aux transformations linéaires d’échelle : le célèbre coefficient de corrélation linéaire produit-moment, universellement symbolisé par la lettre $r$ pour un échantillon, ou par la lettre grecque $rho$ (rhô) pour la population.
L’équation reliant directement la covariance à la corrélation s’énonce ainsi :
$$r_{XY} = \frac{\mathrm{Cov}(X, Y)}{s_X , s_Y} = \frac{\sum (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum (X_i – \bar{X})^2} \sqrt{\sum (Y_i – \bar{Y})^2}}$$
La beauté analytique de cette normalisation réside dans l’émergence de bornes finies, fixes et universelles. Alors que la covariance s’étendait de façon illimitée sur l’ensemble de la droite réelle, le coefficient $r$ de Pearson est mathématiquement contraint de résider strictement dans l’intervalle fermé $[-1, +1]$ :
$$-1 le r_{XY} le +1$$
La démonstration mathématique rigoureuse de ce confinement entre les valeurs extrêmes $-1$ et $+1$ découle de l’inégalité de Cauchy-Schwarz, un théorème fondamental de l’analyse vectorielle. En géométrie euclidienne, le produit scalaire de deux vecteurs ne peut jamais excéder en valeur absolue le produit de leurs normes respectives. Dans l’espace vectoriel des variables centrées, le coefficient de corrélation linéaire s’interprète rigoureusement comme le cosinus de l’angle géométrique $\theta$ formé par les deux vecteurs de scores dans l’espace des sujets :
$$r_{XY} = \cos(\theta)$$
Une corrélation parfaite de $+1$ indique que les deux vecteurs sont strictement colinéaires et pointent dans la même direction ($\theta = 0^circ$). Une corrélation de $-1$ indique qu’ils pointent dans des directions diamétralement opposées ($\theta = 180^circ$). Une absence totale de corrélation ($r = 0$) révèle que les deux vecteurs sont rigoureusement orthogonaux à angle droit ($\theta = 90^circ$). Par cette opération de division par les écarts-types, la covariance brute acquiert un cadre d’interprétation universel immédiatement lisible par l’ensemble de la communauté scientifique mondiale.
8.3 Comparaison fonctionnelle : covariance versus coefficient de corrélation
L’existence de cette forme standardisée soulève une question méthodologique centrale : pourquoi la communauté statistique et psychométrique continue-t-elle à mobiliser la covariance brute si le coefficient de corrélation de Pearson apporte une normalisation aussi élégante et intuitive ? La réponse tient à la distinction fondamentale entre la description empirique d’un lien d’une part, et la modélisation mathématique causale d’autre part.
Le coefficient de corrélation constitue indéniablement l’outil d’excellence pour l’évaluation descriptive et le diagnostic immédiat de la magnitude d’un lien. Lorsque l’objectif d’une publication consiste à rapporter la force d’une association à des confrères ou à des cliniciens, le coefficient de corrélation apporte une clarté indiscutable. Dire que la corrélation entre la régulation de l’effort et la performance scolaire est de $r = 0{,}52$ situe immédiatement l’intensité de la relation au regard des conventions empiriques de la psychologie, sans exiger du lecteur qu’il connaisse par cœur les unités de mesure baroques des questionnaires administrés.
Toutefois, la normalisation induite par le coefficient de corrélation présente le défaut majeur de dépouiller les variables de leurs unités métriques réelles. En convertissant toutes les données en scores centrés réduits dénués de dimension, le chercheur perd toute visibilité sur l’ampleur absolue des effets observés. Or, dans les modélisations explicatives avancées, comme les analyses de régression ou les modélisations causales, l’amplitude réelle de l’effet dans l’unité de mesure native revêt un rôle décisif. La covariance conserve scrupuleusement la métrique d’origine, permettant de quantifier exactement la variation attendue sur une échelle physique ou psychométrique lors d’une modification unitaire sur une autre échelle.
C’est la raison pour laquelle les moteurs algorithmiques des progiciels de statistiques avancées opèrent quasi exclusivement à partir des matrices de variance-covariance non standardisées, n’effectuant la conversion vers les corrélations qu’au stade final de la présentation visuelle pour faciliter la restitution ergonomique des données aux analystes.
9. Applications pratiques en psychologie clinique, cognitive et sociale
9.1 Psychométrie différentielle : intelligence et aptitudes cognitives
L’histoire de la psychologie différentielle et de l’étude quantitative de l’intelligence humaine s’est littéralement édifiée sur l’exploitation méthodologique conjointe de la variance et de la covariance. Au tournant du vingtième siècle, lorsque Charles Spearman posa les bases de la théorie moderne des aptitudes intellectuelles, son attention se concentra sur une énigme empirique récurrente : pourquoi des individus qui obtiennent des scores élevés à des tests d’aptitude verbale tendent-ils également à manifester des scores supérieurs à la moyenne sur des épreuves de géométrie spatiale, de calcul arithmétique ou de discrimination auditive ?
Sur le plan computationnel, Spearman constata que l’ensemble des subtests cognitifs présentaient invariablement des covariances positives mutuelles au sein de la population générale, un phénomène empirique universel connu sous le vocable historique de « collectivité positive » (*positive manifold*). En appliquant une analyse fine à la structure de cette matrice de covariances, Spearman découvrit qu’il était possible d’extraire un facteur latent d’ordre supérieur rendant compte de l’ensemble de ces covariations partagées : le célèbre facteur général d’intelligence, ou facteur $g$. Dans ce cadre psychométrique classique, la variance globale manifestée par un individu sur un subtest spécifique est rigoureusement décomposée en deux segments fonctionnels :
- Une portion de variance commune, capturée par la forte covariance que l’épreuve entretient avec le facteur général $g$.
- Une portion de variance spécifique (souvent désignée par la lettre $s$), qui reflète la dispersion unique propre aux exigences mécaniques de la tâche particulière explorée, additionnée à la variance de l’erreur de mesure aléatoire.
Parallèlement, la psychologie cognitive expérimentale contemporaine s’appuie massivement sur l’analyse fine de la variance intra-individuelle pour évaluer les processus d’attention soutenue et de contrôle exécutif. Lorsqu’un participant est soumis à une batterie chronométrique impliquant des centaines d’essais successifs, la moyenne de ses temps de réaction informe sur sa vitesse de traitement brute globale. En revanche, l’analyse de la variance de ses temps de réaction d’un essai à l’autre – c’est-à-dire l’instabilité de sa performance temporelle au fil des blocs de tâches – fournit un biomarqueur cognitif infiniment plus sensible. Une variance intra-individuelle anormalement élevée est aujourd’hui reconnue comme une signature neuropsychologique cardinale du Trouble du Déficit de l’Attention avec ou sans Hyperactivité (TDAH), ainsi que des phases précoces de déclin neurodégénératif dans la démence de type Alzheimer.
9.2 Psychopathologie quantitative : comorbidité et profils symptomatiques
Dans le champ de la psychopathologie clinique et de la nosologie psychiatrique moderne, la distinction entre variance et covariance révolutionne en profondeur la conceptualisation traditionnelle des maladies mentales. Historiquement structuré par les manuels de diagnostic catégoriels de type DSM ou CIM, le discours psychiatrique a longtemps appréhendé les troubles mentaux comme des entités catégorielles fermées et étanches. Pourtant, la pratique clinique quotidienne se heurte invariablement au phénomène ubiquitaire de la comorbidité : un patient consultant pour un épisode dépressif caractérisé présente, dans une écrasante majorité des cas, des symptômes sévères d’angoisse panique, de somatisation ou de phobie sociale.
La modélisation quantitative contemporaine dépasse ces apories diagnostiques en abordant la comorbidité non plus comme la coexistence malheureuse de deux pathologies distinctes chez un même hôte, mais comme l’expression d’une covariance phénoménologique massive entre constellations de symptômes. Les cohortes analysées dans le cadre du consortium HiTOP (*Hierarchical Taxonomy of Psychopathology*) révèlent que les covariances entre les symptômes dépressifs et les manifestations anxieuses ne relèvent pas du hasard stochastique : elles structurent un spectre sous-jacent dimensionalisé appelé « spectre d’internalisation ».
De façon encore plus novatrice, l’approche de la psychopathologie en réseau (*Network Approach to Psychopathology*), théorisée initialement par Denny Borsboom, fait de la matrice de variance-covariance le cœur battant de la modélisation clinique. Dans ce paradigme scientifique novateur, un trouble mental n’est plus considéré comme l’émanation d’une cause sous-jacente invisible (comme un prétendu déséquilibre chimique latent), mais comme un système complexe d’éléments auto-entretenus en interaction dynamique directe. Les nœuds du réseau représentent les symptômes individuels (insomnie, rumination, fatigue, anhédonie), et la force des arêtes connectant ces nœuds dérive directement de leurs covariances partielles.
L’analyse de la variance intracatégorielle des symptômes permet parallèlement de mesurer la résistance ou la fragilité du système émotionnel d’un patient : un réseau clinique où les symptômes manifestent des variances excessives couplées à de fortes covariances mutuelles signale un système psychopathologique hyper-réactif, prêt à s’embraser dans une boucle de rétroaction délétère au moindre stress déclencheur environnemental.
9.3 Psychologie sociale : dynamiques de groupe et attitudes
Les investigations en psychologie sociale expérimentale offrent un champ d’illustration complémentaire de l’application de ces deux grandeurs d’écartement et de liaison. Considérons l’étude des attitudes intergroupes et de la formation des stéréotypes. Lorsqu’une équipe de recherche évalue la manière dont les membres d’un groupe d’appartenance (*in-group*) perçoivent les membres d’un groupe extérieur (*out-group*), l’un des phénomènes les plus robustes documentés expérimentalement est le « biais d’homogénéité de l’exogroupe ».
Ce biais cognitif et perceptif s’opérationnalise précisément par une étude comparative des variances distributionnelles : les participants attribuent systématiquement une variance significativement plus restreinte aux traits de personnalité des membres de l’exogroupe (« ils sont tous pareils »), alors qu’ils accordent spontanément une variance très étendue, synonyme de richesse et de diversité individualisée, aux membres de leur propre groupe d’appartenance. La quantification mathématique des variances attribuées permet de chiffrer l’intensité du préjugé sans recourir à des questions directes hautement sensibles à la désirabilité sociale.
Sur le plan des relations inter-variables, la psychologie sociale mobilise intensément la covariance pour mesurer la congruence ou le décalage séparant les attitudes déclarées et les comportements réels. L’une des controverses fondatrices de la discipline a résidé dans la mise en évidence d’une covariance étonnamment modeste entre les scores obtenus à des échelles d’attitudes morales ou écologiques explicites et la réalisation effective d’actes prosociaux ou éco-responsables dans la vie quotidienne.
Pour disséquer ce paradoxe, les chercheurs utilisent des protocoles d’invariance de mesure basés sur l’équivalence des matrices de variance-covariance à travers différents sous-groupes démographiques. Si la structure interne de la matrice de covariance reliant l’empathie perçue et le don caritatif s’avère non invariante entre les populations adolescentes et les cohortes de personnes âgées, toute comparaison brute de leurs moyennes respectives est méthodologiquement frappée de nullité scientifique. La covariance agit ici comme le testeur d’intégrité garantissant que les concepts mesurés conservent rigoureusement la même signification fonctionnelle à travers les divers groupes composant le tissu social.
10. Rôle de la variance et de la covariance dans la modélisation avancée
10.1 Analyse en composantes principales (ACP) et réduction de dimensionnalité
Dans la recherche contemporaine, la masse phénoménale de données générée par les technologies numériques, les systèmes d’imagerie cérébrale fonctionnelle ou les questionnaires en ligne confrontent les scientifiques au défi de la haute dimensionnalité. Lorsqu’une étude neurocognitive collecte simultanément les signaux électroencéphalographiques (EEG) sur 128 électrodes crâniennes au fil de multiples conditions expérimentales, l’analyste se trouve submergé par des matrices gigantesques où le risque de bruit aléatoire domine. C’est ici qu’intervient l’Analyse en Composantes Principales (ACP), une technique multivariée de premier plan dont le fonctionnement intime repose sur la manipulation vectorielle directe de la matrice de variance-covariance.
Le postulat épistémologique fondamental de l’ACP s’énonce comme suit : l’information scientifique substantielle réside dans la variabilité des données, tandis que la redondance entre canaux de mesure s’exprime par leurs covariances mutuelles. L’ACP se propose de réorganiser géométriquement l’espace des données pour concentrer le maximum de variance possible sur un nombre minimal d’axes orthogonaux synthétiques non corrélés, appelés les « composantes principales ».
Sur le plan de l’algèbre computationnelle, ce processus s’accomplit par l’opération mathématique de diagonalisation de la matrice de variance-covariance empirique $\mathbf{S}$. Trouver les composantes principales consiste à résoudre l’équation canonique aux valeurs propres :
$$\mathbf{S} , \mathbf{v}_i = \lambda_i , \mathbf{v}_i$$
Dans cette formulation géométrique fondamentale :
- Les vecteurs $\mathbf{v}_i$ constituent les « vecteurs propres » (*eigenvectors*) de la matrice de covariance. Ils définissent l’orientation spatiale précise des nouveaux axes dimensionnels dans l’espace multidimensionnel.
- Les scalaires $\lambda_i$ représentent les « valeurs propres » (*eigenvalues*) associées à chaque vecteur. La valeur propre $\lambda_i$ quantifie rigoureusement la quantité absolue de variance capturée par la $i$-ième composante principale.
Puisque la matrice de variance-covariance empirique est symétrique et semi-définie positive, la somme totale de l’ensemble des valeurs propres est rigoureusement équivalente à la trace de la matrice initiale, c’est-à-dire à la somme intégrale des variances de toutes les variables de départ. En extrayant les deux ou trois premiers vecteurs propres associés aux plus fortes valeurs propres $lambda$, le chercheur parvient à compresser un système hautement complexe tout en retenant la majeure partie de la variance signifiante du système psychologique. La covariance joue ici le rôle de guide d’élimination de la redondance, permettant aux composantes résultantes d’être parfaitement décorrélées (covariance nulle entre composantes).
10.2 Modélisation par équations structurelles (SEM)
S’il est un domaine où la suprématie méthodologique de la covariance sur les simples statistiques descriptives se manifeste avec une éclatante souveraineté, c’est bien celui des Modèles d’Équations Structurelles (*Structural Equation Modeling* ou SEM). Désignée fréquemment sous l’appellation d’analyse de structures de covariance, cette famille méthodologique avancée fusionne au sein d’un cadre statistique unifié l’analyse factorielle confirmatoire et la régression linéaire multivariée sur variables latentes.
L’hypothèse fondatrice des modèles par équations structurelles consiste à poser qu’une théorie psychologique donnée (par exemple, le postulat affirmant que le sentiment d’aliénation parentale médiatise la relation unissant la précarité socio-économique et l’émergence de conduites délinquantes à l’adolescence) implique une configuration structurelle hautement spécifique de la matrice de variance-covariance des indicateurs empiriques observables.
L’algorithme de modélisation procède à une confrontation directe entre deux matrices mathématiques :
1. D’une part, la matrice de variance-covariance empirique d’échantillon, conventionnellement symbolisée par $\mathbf{S}$, qui reflète fidèlement la réalité brute constatée sur le terrain.
2. D’autre part, la matrice de variance-covariance théorique implicite, notée $boldsymbol{\Sigma}(boldsymbol{\theta})$, dont chaque élément est calculé mathématiquement comme une fonction algébrique des paramètres libres du modèle théorique spécifié par le chercheur (coefficients de régression causaux, saturations factorielles, variances des erreurs de mesure).
L’estimation statistique – fréquemment réalisée via le critère du Maximum de Vraisemblance (*Maximum Likelihood*) – vise à minimiser une fonction de discordance multivariée $F_{\mathrm{ML}}$, qui évalue l’écart numérique résiduel séparant la matrice empirique $\mathbf{S}$ de la matrice théorisée $boldsymbol{\Sigma}(boldsymbol{\theta})$ :
$$F_{\mathrm{ML}} = ln|boldsymbol{\Sigma}(boldsymbol{\theta})| – ln|\mathbf{S}| + \mathrm{tr}\left(\mathbf{S}boldsymbol{\Sigma}(boldsymbol{\theta})^{-1}\right) – p$$
Si la théorie psychologique articulée par le modèle est correcte et bien spécifiée, la matrice déduite de la théorie reproduira avec une fidélité presque chirurgicale la trame des covariances empiriques observées, aboutissant à des indices d’adéquation (*fit indices* tels que le RMSEA ou le CFI) attestant de l’ajustement structurel. Si la théorie clinique est invalide, les disparités criantes entre les covariances attendues et les covariances observées rejetteront sans appel le modèle. L’ensemble de la causalité non expérimentale en psychologie dépend donc de l’art d’ajuster des réseaux théoriques de covariances.
10.3 Régression linéaire multiple et analyse de la variance (ANOVA)
Dans les analyses inférentielles plus classiques que constituent la régression linéaire multiple et l’Analyse de la Variance (ANOVA), la variance et la covariance opèrent de concert sous l’égide du Modèle Linéaire Général (GLM). Le terme même « d’analyse de la variance » illustre de manière transparente la philosophie épistémologique de Ronald Fisher : pour tester l’efficacité d’un traitement thérapeutique ou d’une manipulation expérimentale sur des groupes de sujets, la démarche ne consiste pas à comparer directement les moyennes de façon isolée, mais à partitionner la somme des carrés de la variance totale des données en blocs fonctionnels indépendants.
Dans l’ANOVA factorielle, la variance globale de la variable dépendante est mathématiquement scindée en deux composantes fondamentales :
- La variance inter-groupes (*between-groups variance*), qui mesure la dispersion des moyennes de chaque condition expérimentale autour de la moyenne générale de l’étude. Elle reflète l’amplitude systématique générée par la manipulation de la variable indépendante.
- La variance intra-groupe ou résiduelle (*within-groups variance* ou *error variance*), qui quantifie la dispersion des scores individuels des participants autour de la moyenne de leur propre groupe d’assignation. Elle incarne le bruit de fond stochastique, la variabilité biologique aléatoire et les erreurs de mesure non contrôlées.
Le test statistique de décision repose alors sur le ratio de Fisher $F$, qui n’est autre que le rapport direct de ces deux variances (plus exactement des carrés moyens correspondants) :
$$F = \frac{\mathrm{Variance}_{\mathrm{inter}}}{\mathrm{Variance}_{\mathrm{intra}}}$$
Toutefois, dès lors que l’on complexifie le modèle expérimental par l’introduction de covariables continues, le traitement franchit le seuil de l’Analyse de Covariance (ANCOVA). L’objectif de l’ANCOVA est d’accroître la puissance statistique du test expérimental en purgeant artificiellement la variance dépendante de la portion de variance expliquée par une variable parasite non contrôlée directement (par exemple, le quotient intellectuel préalable des sujets dans une recherche testant une nouvelle méthode mnémotechnique).
L’ANCOVA exploite précisément la covariance mesurée entre la covariable continue et la variable dépendante pour soustraire de la somme des carrés résiduelle toute la variabilité prévisible. En réduisant drastiquement le dénominateur du ratio $F$ (la variance d’erreur), l’analyse permet à l’effet thérapeutique principal d’émerger avec une significativité statistique éclatante, là où le bruit parasite initial aurait masqué le résultat. La covariance agit ici comme un filtre de nettoyage statistique des données de dispersion univariée.
11. Erreurs courantes, pièges méthodologiques et limites statistiques
11.1 Confusions conceptuelles fréquentes entre covariance et corrélation
L’un des pièges méthodologiques les plus insidieux réside dans la confusion cognitive persistante chez de nombreux analystes entre l’amplitude absolue d’une covariance et la force réelle de l’association stochastique existant entre deux entités mesurées. Confronté à une covariance positive substantielle – par exemple $+350$ constatée entre l’âge exprimé en mois et le vocabulaire passif chez de jeunes enfants –, l’évaluateur novice conclut spontanément à l’existence d’une corrélation d’une intensité exceptionnelle.
Cette déduction est méthodologiquement erronée. Comme souligné précédemment, la magnitude chiffrée de la covariance est entièrement tributaire des unités de mesure locales. Si la variable de vocabulaire s’exprime sur une échelle s’étendant de 0 à 10 000 mots, une covariance de 350 peut en réalité correspondre à un coefficient de corrélation normalisé de Pearson ridiculement bas, de l’ordre de $r = 0{,}08$, signalant une association quasi inexistante et dépourvue de toute pertinence prédictive. L’intuition humaine peinant à manipuler des métriques combinées hétérogènes, la covariance brute ne doit en aucun cas servir de substitut direct à l’évaluation de la taille de l’effet (*effect size*).
Un autre écueil méthodologique fréquent consiste à confondre l’indépendance statistique au sens probabiliste strict et la nullité de la covariance. Si deux variables aléatoires sont rigoureusement indépendantes au sens de la théorie des probabilités (c’est-à-dire si leur distribution conjointe vérifie $P(X cap Y) = P(X)P(Y)$ pour tout point de l’espace d’échantillonnage), alors leur covariance linéaire est indiscutablement égale à zéro. Cependant, la réciproque n’est absolument pas universelle : une covariance empirique rigoureusement égale à zéro ne prouve en aucun cas l’absence de lien ou l’indépendance de ces deux variables. Elle prouve uniquement et exclusivement l’absence d’association de nature strictement linéaire, masquant potentiellement des dépendances fonctionnelles déterministes d’une autre forme morphologique.
11.2 Hypothèse de linéarité et vulnérabilité aux relations non linéaires
L’ancrage fondamental de la covariance dans l’algèbre des produits croisés linéaires constitue à la fois sa force computationnelle et sa plus grande limite heuristique face à la complexité des phénomènes psychologiques réels. L’algorithme standard présume implicitement que toute déviation positive sur la variable $X$ est associée de manière constante et monotone à une déviation d’orientation fixe sur la variable $Y$. Dès lors que la réalité biologique ou cognitive emprunte une trajectoire curviligne ou polymorphe, la covariance devient aveugle.
Le cas d’école le plus célèbre en sciences du comportement est illustré par la célèbre loi de Yerkes-Dodson, qui théorise la relation reliant l’activation physiologique ou le niveau de stress (variable $X$) et la performance à une tâche cognitive complexe (variable $Y$). Cette relation dessine une trajectoire morphologique en « U inversé » :
- Dans la première moitié du continuum (niveaux faibles à modérés de stress), l’élévation de l’activation neurovégétative stimule la vigilance et amplifie proportionnellement la performance : les produits croisés sont dominés par des concordances positives.
- Passé un niveau d’activation optimal, le stress bascule dans la détresse toxique : l’excès d’angoisse sature les fonctions exécutives et dégrade dramatiquement l’efficacité cognitive. Sur ce second segment, les déviations de stress deviennent fortement positives tandis que les déviations de performance plongent en territoire négatif, générant des produits croisés massivement négatifs.
Si l’analyste procède au calcul global de la covariance sur l’ensemble de la cohorte d’étude, les produits croisés positifs de la phase ascendante compenseront et neutraliseront presque mathématiquement les produits croisés négatifs de la phase descendante. La somme totale des produits croisés s’effondrera à proximité de zéro, aboutissant à une covariance nulle ou insignifiante. Un chercheur concluant sur la seule base de cette covariance déclarerait fallacieusement que « le stress n’a aucun impact sur la performance cognitive », passant à côté d’une loi psychologique universelle. Ce biais tragique rappelle la consigne méthodologique absolue de toujours coupler l’analyse matricielle des covariances à une inspection visuelle exhaustive des diagrammes de dispersion bivariés (*scatter plots*).
11.3 Échantillonnage biaisé, restriction de variance et paradoxes
La validité des conclusions tirées des calculs de variance et de covariance dépend de l’intégrité de l’échantillonnage expérimental. Parmi les distorsions qui menacent la recherche quantitative, le phénomène d’atténuation consécutif à la restriction de variance figure au premier rang. Ce phénomène survient lorsque l’échantillon analysé est sélectionné de manière telle que la variabilité réelle de l’une des dimensions étudiées se trouve artificiellement rabotée par rapport à sa véritable distribution dans la population parente.
Considérons une étude cherchant à évaluer le lien prédictif existant entre le quotient intellectuel mesuré par la WAIS-IV et la réussite académique au sein d’une prestigieuse faculté de médecine. Les étudiants intégrant ce cursus de très haut niveau ont tous franchi un concours hautement sélectif requérant des aptitudes cognitives de premier ordre : la quasi-totalité de la cohorte affiche un QI oscillant étroitement entre 125 et 135 points. La variance du QI au sein de cet échantillon est donc extrêmement comprimée par rapport à la variance de la population générale (où l’écart-type est de 15 points).
Cette compression drastique de la variance entraîne mécaniquement l’effondrement proportionnel de la covariance que le QI peut entretenir avec toute autre variable académique. L’analyste constatera avec stupeur une covariance et une corrélation proches de zéro, ce qui pourrait l’amener à conclure absurde que les aptitudes intellectuelles n’ont aucun rapport avec la maîtrise des études médicales. La formule de correction pour restriction de variance développée par Robert Thorndike démontre formellement que lorsque la variance d’un prédicteur tend vers zéro, sa covariance avec n’importe quel critère clinique ou cognitif tend asymptotiquement vers zéro, indépendamment de la force causale réelle du phénomène dans l’univers macroscopique.
Un autre écueil redoutable réside dans le paradoxe de Simpson, qui émerge lorsque l’agrégation non contrôlée de différents sous-groupes cliniques inverse purement et simplement le signe de la covariance globale. Imaginons l’analyse de deux variables psychologiques mesurées au sein de deux cohortes distinctes (par exemple des patients souffrant de troubles bipolaires d’une part, et des sujets témoins sains d’autre part). Au sein du sous-groupe bipolaire, la covariance entre l’impulsivité et la capacité d’adaptation est strictement négative. Au sein du sous-groupe sain, cette même covariance intra-groupe est également strictement négative.
Toutefois, si les moyennes des deux sous-groupes sont très distantes l’une de l’autre sur les deux axes (les bipolaires ayant globalement une très forte impulsivité et une faible adaptation, tandis que les témoins manifestent le profil inverse), la fusion imprudente des deux cohortes dans une matrice de covariance commune unique générera artificiellement une covariance globale positive trompeuse. La négligence de la structure emboîtée des données conduit alors à formaliser une loi statistique globale dont le signe algébrique est rigoureusement opposé à la réalité psychologique de chaque individu composant les sous-systèmes.
12. Synthèse méthodologique et recommandations pour les chercheurs
12.1 Arbre décisionnel pour le choix des paramètres d’analyse
Pour guider les chercheurs, psychologues cliniciens et étudiants en sciences cognitives face à la multiplicité des options quantitatives, il est indispensable de structurer un arbre décisionnel méthodologique clair régissant la sélection des indicateurs statistiques de dispersion et d’association. Ce choix ne doit jamais être guidé par la facilité informatique, mais par l’adéquation ontologique entre la question de recherche et la métrique mathématique.
L’organigramme logique suivant permet de formaliser cette sélection rigoureuse :
- Interrogation de recherche portant sur une dimension unique (Univariée) :
- La distribution des données est-elle approximativement symétrique et dépourvue de cas extrêmes massifs ?
- Si Oui : Mobiliser la Variance ($s^2$) pour toutes les étapes de décomposition computationnelle matricielle, et communiquer l’Écart-type ($s$) pour restituer la dispersion dans l’unité de mesure intelligible de l’instrument.
- Si Non (asymétrie forte, échelle ordinale, valeurs aberrantes) : Rejeter la variance paramétrique standard et adopter des estimateurs de dispersion robustes non paramétriques, tels que l’Écart interquartile ($IQR$) ou la Déviation absolue médiane ($MAD$).
- La distribution des données est-elle approximativement symétrique et dépourvue de cas extrêmes massifs ?
- Interrogation de recherche portant sur la relation entre deux dimensions (Bivariée) :
- L’inspection préalable du diagramme de dispersion confirme-t-elle une trajectoire approximativement linéaire sans courbure en cloche ?
- Si Non : Proscrire la covariance classique. Recourir à des méthodes non paramétriques basées sur les rangs (comme le tau de Kendall ou le rhô de Spearman) ou ajuster des modèles de régression polynomiale ou non linéaire (splines).
- Si Oui (linéarité validée) : Définir l’objectif de l’analyse :
- L’objectif est-il d’alimenter un algorithme de modélisation causale avancée (SEM, régression multivariée, matrice d’équations structurelles, calcul de variance d’un score composite) tout en préservant scrupuleusement les unités physiques ou psychométriques réelles ? $Long\rightarrow$ Mobiliser sans hésitation la Covariance non standardisée ($s_{XY}$).
- L’objectif est-il de décrire la force intrinsèque de la relation, de communiquer un résultat clair dans une publication internationale, de comparer des instruments calibrés sur des métriques hétérogènes ou d’évaluer la taille d’effet ? $Long\rightarrow$ Procéder à la normalisation de la covariance pour extraire le Coefficient de corrélation linéaire ($r$ de Pearson).
- L’inspection préalable du diagramme de dispersion confirme-t-elle une trajectoire approximativement linéaire sans courbure en cloche ?
12.2 Directives de rédaction et de communication scientifique des résultats
La diffusion des données quantitatives dans les revues académiques de premier rang obéit à des normes typographiques et déontologiques d’une grande rigueur, principalement encadrées par le manuel de style de l’American Psychological Association (APA, 7e édition). Trop souvent, les manuscrits soumis pèchent par omission méthodologique, privant les lecteurs des informations brutes indispensables pour vérifier l’exactitude des modélisations ou procéder à de futures méta-analyses.
Sur le plan formel, la première directive déontologique consiste à ne jamais se limiter à rapporter de simples corrélations ou des valeurs de probabilité ($p$-values) isolées dans les études multivariées. Les auteurs de recherches mobilisant des régressions, des analyses factorielles ou des équations structurelles doivent impérativement publier l’intégralité de la matrice de variance-covariance empirique, soit au cœur du corps du texte (pour les modèles compacts), soit au sein des annexes ou des dépôts de données ouvertes (*Open Science Framework*). La matrice doit afficher distinctement les variances sur la diagonale et les covariances hors-diagonale, en précisant la taille de l’échantillon $n$ associé à chaque cellule en cas de données manquantes gérées par élimination par paires (*pairwise deletion*).
Sur le plan sémantique et discursif, la vigilance terminologique doit être totale pour éviter les glissements langagiers frauduleux vers la causalité. Qu’il s’agisse de la variance d’un subtest ou de la covariance mesurée entre un profil d’attachement précoce et un trouble de la personnalité à l’âge adulte, ces grandeurs demeurent des constats observationnels de covariation synchronique. Elles ne permettent en aucune façon, à elles seules, d’affirmer que la première dimension « produit », « déclenche » ou « cause » la trajectoire de la seconde. Les chercheurs doivent scrupuleusement privilégier un vocabulaire rigoureusement associatif (« s’associe positivement », « co-varie conjointement », « explique une portion substantielle de variance »), réservant les inférences de causalité directe aux stricts protocoles expérimentaux contrôlés avec randomisation totale et manipulation de variables indépendantes.
12.3 Perspectives contemporaines et développements computationnels
À l’ère contemporaine des mégadonnées comportementales (*big data*), de l’intelligence artificielle et de la psychiatrie computationnelle, l’exploitation de la variance et de la covariance connaît un renouveau méthodologique spectaculaire, catalysé par la puissance des environnements de programmation statistique ouverts comme R et Python. Les scripts modernes abandonnent les calculs manuels laborieux au profit de pipelines de traitement automatisés capables de manipuler instantanément des matrices de covariances géantes comptant des millions de dimensions.
Dans l’environnement de programmation statistique open source R, les fonctions natives `var()` et `cov()` permettent d’extraire en une fraction de milliseconde les matrices complètes sur des dataframes complexes, tandis que des packages de référence comme **lavaan** permettent d’estimer des modèles de covariance structurelle d’une sophistication inimaginable il y a quelques décennies. Sous Python, les bibliothèques scientifiques fondamentales telles que **NumPy** (via sa fonction `numpy.cov()`), **SciPy** et **Pandas** assurent des intégrations transparentes au sein d’architectures d’apprentissage automatique supervisé et non supervisé gérées par **scikit-learn**.
Parallèlement, la statistique moderne s’émancipe de plus en plus du postulat restrictif de normalité multivariée qui conditionnait historiquement la fiabilité des estimations paramétriques de la variance et de la covariance. Les méthodologistes déploient aujourd’hui à grande échelle des approches non paramétriques computationnelles de rééchantillonnage de type bootstrap : en tirant des milliers de sous-échantillons avec remise au sein des données initiales, le bootstrap permet de construire des intervalles de confiance empiriques robustes pour les covariances et les variances, y compris face à des données hautement asymétriques ou contaminées par des profils extrêmes.
Bien loin d’être des reliques du passé pré-informatique, la variance et la covariance constituent plus que jamais les briques de base de la science des données appliquées à l’esprit humain, prouvant que la quantification méthodique de la variabilité demeure le moyen le plus sûr de percer les lois profondes de notre fonctionnement psychologique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7e éd.). https://doi.org/10.1037/0000165-000
- Borsboom, D. (2017). A network approach to psychopathology. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4e éd.). Guilford Press.
- Kotz, S., & Johnson, N. L. (Éds.). (1992). Breakthroughs in statistics: Foundations and basic theory. Springer-Verlag. https://doi.org/10.1007/978-1-4612-0919-5
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Spearman, C. (1904). « General intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7e éd.). Pearson.
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.