
Dans le paysage contemporain de la recherche quantitative en sciences humaines et comportementales, l’analyse des données empiriques constitue le socle sur lequel s’érigent les théories psychologiques les plus robustes. Qu’il s’agisse de mesurer l’impact de l’anxiété sur les performances cognitives, d’évaluer la trajectoire développementale de la mémoire de travail ou d’examiner les interactions dynamiques entre les traits de personnalité et l’épuisement professionnel, le chercheur se trouve inlassablement confronté à une problématique cardinale : caractériser avec précision la nature des relations qui unissent deux ou plusieurs dimensions mesurables. Au cœur de cette entreprise analytique, deux outils méthodologiques dominent la pratique scientifique depuis plus d’un siècle : la corrélation et la régression linéaire. Si ces deux approches partagent des origines mathématiques communes et reposent sur l’examen conjoint de la variabilité au sein d’échantillons, elles répondent à des desseins épistémologiques, conceptuels et pragmatiques fondamentalement divergents.
Trop souvent, une confusion pernicieuse persiste dans la littérature académique et clinique, conduisant praticiens et étudiants à employer indifféremment ces deux démarches, ou à déduire des propriétés prédictives là où seule une simple covariation a été formellement établie. La corrélation, par essence non directionnelle et symétrique, se borne à quantifier le degré d’association linéaire unissant deux variables sans postuler de hiérarchie ni d’antériorité. À l’inverse, la régression linéaire engage une modélisation structurelle et asymétrique, assignant à une variable le statut d’explication fonctionnelle ou de prédicteur, et à l’autre celui de critère à pronostiquer. Confondre ces deux paradigmes revient à brouiller la frontière entre la simple observation descriptive d’une concomitance phénotypique et la formulation d’un modèle fonctionnel capable de projeter l’état futur d’un sujet ou d’une population.
Cet article propose une exploration approfondie, exhaustive et critique de la dichotomie entre corrélation et régression dans le cadre spécifique de la recherche et de la pratique en psychologie scientifique. En articulant rigueur mathématique, ancrage épistémologique et contextualisation clinique, nous examinerons les fondements théoriques, les postulats d’application, les indices statistiques associés, ainsi que les pièges interprétatifs majeurs qui jalonnent l’analyse des données bivariées et multivariées. À travers un parcours didactique rigoureux, jalonné d’exemples empiriques concrets issus de la psychométrie, de la neuropsychologie et de la psychologie sociale, ce guide exhaustif entend armer le chercheur, l’analyste de données et le clinicien d’une grille de lecture définitive pour arbitrer judicieusement entre ces deux puissants instruments de la statistique inférentielle.
1. Fondements épistémologiques des relations bivariées en psychologie
1.1 La quête de régularités dans les sciences du comportement
L’émergence de la psychologie comme science autonome à la fin du dix-neuvième siècle a été indissociable d’un impératif méthodologique fondamental : substituer à l’introspection spéculative des mesures quantitatives précises, objectives et reproductibles des phénomènes mentaux. Dès lors que des pionniers tels que Francis Galton, Wilhelm Wundt et James McKeen Cattell ont entrepris d’enregistrer des temps de réaction, des seuils de discrimination sensorielle ou des aptitudes cognitives générales, la question de l’interdépendance des construits psychiques s’est imposée avec acuité. Il ne suffisait plus de constater qu’un individu présentait un score élevé à une épreuve de mémorisation ; il devenait indispensable de déterminer si cette performance s’accompagnait systématiquement d’aptitudes verbales supérieures, ou si elle évoluait de concert avec l’âge chronologique.
Cette quête de régularités a rapidement conduit à une rupture épistémologique majeure : le passage de la simple observation naturaliste et passive à l’inférence probabiliste formelle. Dans le domaine complexe des sciences du comportement, où les sources de variabilité individuelle et environnementale sont infinies, les lois déterministes strictes de la physique classique se révèlent inapplicables. La psychologie a ainsi dû forger des outils probabilistes capables d’isoler des tendances stables au milieu du bruit de mesure. Dans ce contexte, les plans corrélationnels ont acquis un statut privilégié au sein de la recherche quasi-expérimentale. Lorsque la manipulation directe et contrôlée de variables indépendantes s’avère éthiquement proscrite ou matériellement irréalisable — comme dans l’étude des traumatismes infantiles, des troubles de la personnalité ou des prédispositions génétiques —, l’analyse statistique des covariations naturelles demeure l’unique vecteur d’investigation empirique rigoureuse.
1.2 Définition synthétique et intuitive des deux concepts
Pour appréhender avec clarté la ligne de démarcation entre corrélation et régression, il convient d’en poser d’emblée les définitions canoniques. La corrélation se définit formellement comme une mesure d’association bidirectionnelle et adimensionnelle entre deux variables aléatoires. Elle cherche exclusivement à répondre à la question suivante : « Dans quelle mesure ces deux dimensions varient-elles conjointement, et quelle est l’intensité ainsi que la direction de cette covariation ? » Aucune variable ne se voit attribuer de primauté théorique, temporelle ou mathématique sur l’autre. Le traitement accordé aux deux grandeurs est rigoureusement interchangeable, traduisant un statut épistémique d’égalité parfaite.
À l’opposé, la régression linéaire se structure autour d’une fonction mathématique asymétrique destinée à modéliser et à quantifier la dépendance structurelle d’une variable réponse — traditionnellement qualifiée de dépendante, d’expliquée ou de critère — vis-à-vis d’une ou plusieurs variables explicatives, dites indépendantes ou prédictrices. L’interrogation fondamentale de la régression s’énonce ainsi : « De combien d’unités la variable critère se modifie-t-elle en moyenne lorsque la variable prédictrice augmente d’une unité, et quelle précision accorde ce modèle fonctionnel à l’estimation de valeurs non observées ? »
Prenons l’illustration classique du lien unissant l’anxiété pré-examen et la performance académique chez des étudiants universitaires. Dans une approche corrélationnelle, le psychologue calcule un indice d’association pour vérifier si des niveaux accrus d’anxiété tendent à coexister avec des notes inférieures au test, concluant par exemple à l’existence d’une relation négative modérée. Dans une perspective de régression, le chercheur pose explicitement l’anxiété comme prédicteur explicatif de la note d’examen ; il estime une équation formelle permettant d’anticiper avec précision la chute de points prévisible sur l’échelle académique pour chaque incrément d’un point sur l’inventaire clinique d’anxiété. L’une quantifie l’intensité d’une coexistence phénoménale ; l’autre construit un modèle fonctionnel de projection.
2. La corrélation : Mesure, interprétation et propriétés mathématiques
2.1 Le coefficient r de Pearson et la covariance
La mesure standard de l’association linéaire entre deux variables quantitatives continues repose sur le célèbre coefficient de corrélation produit-moment développé par Karl Pearson. Sur le plan mathématique, ce coefficient constitue la version standardisée de la covariance. La covariance brute entre deux distributions $X$ et $Y$, calculée pour un échantillon de taille $N$, s’exprime comme la moyenne arithmétique des produits des écarts à leurs moyennes respectives :
$$Cov(X, Y) = \frac{\sum_{i=1}^{N} (X_i – \bar{X})(Y_i – \bar{Y})}{N – 1}$$
Bien que la covariance fournisse une indication immédiate sur le sens de la relation — une valeur positive révélant que les individus au-dessus de la moyenne en $X$ tendent également à se situer au-dessus de la moyenne en $Y$ —, son amplitude absolue demeure dépendante des unités métriques arbitraires dans lesquelles les variables sont exprimées. Pour s’émanciper de cette contrainte dimensionnelle, Pearson a normalisé la covariance en la divisant par le produit des écarts-types marginaux des deux variables :
$$r_{XY} = \frac{Cov(X, Y)}{s_X s_Y} = \frac{\sum (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum (X_i – \bar{X})^2 \sum (Y_i – \bar{Y})^2}}$$
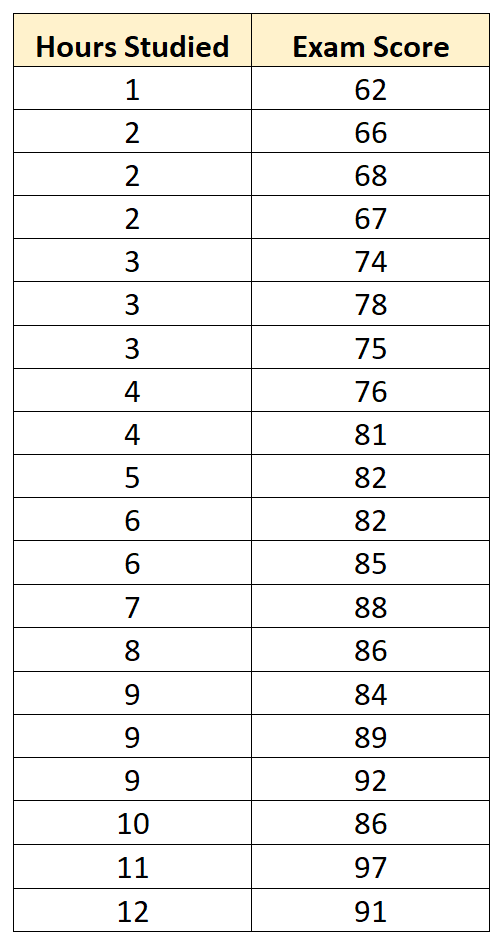
Cette standardisation confine mathématiquement l’indice résultant dans un intervalle strict oscillant entre $-1$ et $+1$. Un coefficient de $+1$ dénote une concordance linéaire positive déterministe parfaite, où tous les points se positionnent rigoureusement sur une droite ascendante ; à l’inverse, un coefficient de $-1$ traduit une discordance linéaire négative absolue. Sur le plan géométrique, lorsque les distributions de $X$ et $Y$ suivent une loi normale bivariée, le nuage de points affecte la forme d’une ellipse de dispersion. L’orientation de l’axe majeur de cette ellipse reflète le signe de $r$, tandis que sa compacité ou son aplatissement traduit la force du coefficient : plus l’ellipse est effilée et étroite, plus la valeur absolue de $r$ approche de l’unité.
Un aspect méthodologique névralgique en psychométrie concerne l’impact de la restriction d’amplitude (ou sélection sur la variance). Si un chercheur évalue la corrélation entre les scores à un test d’aptitude intellectuelle et la réussite professionnelle uniquement auprès de cadres supérieurs préalablement recrutés sur la base de ce même test, la variance observée sur $X$ se trouve drastiquement tronquée. Cette contraction artificielle de la dispersion entraîne inéluctablement une sous-estimation sévère de la véritable valeur du coefficient $r$ dans la population générale, un artefact formellement décrit par les formules de correction de Thorndike.
2.2 Nuances d’intensité et conventions de taille d’effet
L’interprétation de la magnitude d’un coefficient de corrélation nécessite une vigilance épistémologique constante, afin de ne point confondre la présence d’une association statistiquement décelable avec un effet cliniquement ou théoriquement substantiel. Dans son ouvrage de référence sur l’analyse de puissance, Jacob Cohen a formalisé des repères opérationnels largement adoptés en psychologie différentielle : un coefficient de $r = 0,10$ correspond à un effet de faible ampleur ; $r = 0,30$ représente un effet d’intensité moyenne ; enfin, $r = 0,50$ et au-delà qualifie une association de forte intensité. Toutefois, ces seuils conventionnels ne doivent jamais être appliqués de manière dogmatique ou décontextualisée.
Il est crucial de dissocier la significativité statistique (quantifiée par la valeur $p$) de la pertinence clinique de l’association. Étant donné que l’erreur standard du coefficient de corrélation est inversement proportionnelle à la racine carrée de la taille d’échantillon ($SE_r \approx \frac{1 – r^2}{\sqrt{N – 2}}$), une cohorte épidémiologique massive de dix mille individus permettra d’obtenir une valeur $p < 0,001$ pour un coefficient infinitésimal de $r = 0,04$. Si ce résultat confirme avec une certitude probabiliste que la corrélation n'est pas strictement nulle dans la population parente, l'effet mesuré ne rend compte que de $0,16,%$ de variance commune, ce qui s'avère dénué de toute utilité diagnostique ou prédictive à l'échelle de l'évaluation individuelle.
Par ailleurs, le coefficient de Pearson se caractérise par une vulnérabilité pathologique à la présence de valeurs aberrantes bivariées et aux configurations relationnelles non linéaires. L’adjonction d’un seul individu présentant des valeurs atypiques distantes du barycentre peut suffire à gonfler artificiellement un coefficient proche de zéro jusqu’à des niveaux atteignant $0,60$, ou inversement à anéantir une association robuste présente chez l’ensemble des autres sujets. De surcroît, le coefficient de Pearson mesure exclusivement le degré d’alignement linéaire : une relation curviligne déterministe parfaite, telle que la loi de Yerkes-Dodson reliant l’éveil attentionnel à la performance cognitive sous la forme d’un U inversé, produira un coefficient $r$ voisin de zéro, dissimulant complètement la véritable interdépendance fonctionnelle des variables.
3. Typologie des corrélations adaptées aux données psychométriques
3.1 Approches non paramétriques pour échelles ordinales
Les instruments d’évaluation psychologique génèrent fréquemment des données qui s’écartent des postulats stricts de la mesure par intervalles égaux et de la normalité multivariée. Face à des inventaires cliniques composés d’échelles de Likert ordonnées, de classements hiérarchiques de préférences ou d’évaluations psychiatriques graduées selon des stades de sévérité discrets, le recours au coefficient de Pearson s’avère formellement proscrit. Deux alternatives non paramétriques prédominent alors dans l’arsenal psychométrique : le coefficient rhô de Spearman ($rho$) et le tau de Kendall ($tau$).
Le rhô de Spearman repose sur un principe algébrique élégant : les scores bruts continus ou discrets sont préalablement convertis en rangs croissants pour chaque variable séparément, après quoi la formule classique de Pearson est appliquée directement à ces rangs. En l’absence d’ex æquo au sein des distributions, la formulation analytique se simplifie comme suit :
$$\rho = 1 – \frac{6 \sum d_i^2}{N(N^2 – 1)}$$
où $d_i$ représente la différence arithmétique entre les rangs attribués à l’individu $i$ sur les deux dimensions étudiées. Cette méthode présente l’avantage considérable d’évaluer la monotonicité d’une relation plutôt que sa stricte linéarité. Dès lors qu’une variable croît continuellement en même temps que l’autre — quelle que soit la forme exacte de la concavité ou de la convexité de la courbe d’association —, le rhô de Spearman conservera une valeur de $+1$.
De son côté, le tau de Kendall repose sur l’analyse combinatoire du nombre de paires dites concordantes et discordantes formées par l’ensemble des observations. Pour toute paire de sujets $(i, j)$, la relation est déclarée concordante si le sujet dont le score en $X$ est supérieur présente également un score plus élevé en $Y$. Le coefficient $tau$ évalue la proportion nette de paires concordantes par rapport au total des combinaisons possibles. Moins sensible aux fluctuations d’échantillonnage et mathématiquement supérieur pour traiter les cas d’ex æquo omniprésents dans les questionnaires psychologiques à modalités restreintes, le tau de Kendall doit systématiquement être privilégié lorsque la taille d’échantillon est modeste ($N < 30$).
3.2 Corrélations spécifiques aux variables dichotomiques
Dans les phases d’élaboration, d’étalonnage et de validation des tests standardisés, les psychométriciens sont continuellement conduits à évaluer le comportement d’items individuels cotés de manière binaire (réussite/échec, présence/absence d’un symptôme) par rapport au score global du test ou par rapport à d’autres items discrets. Ces configurations spécifiques exigent des adaptations mathématiques rigoureuses de la formulation corrélationnelle générale.
Le coefficient de corrélation point-bisérial ($r_{pb}$) constitue la variante algébrique exacte du $r$ de Pearson dédiée à l’étude conjointe d’une variable quantitative continue et d’une variable dichotomique authentique ou naturelle (comme l’appartenance à un groupe témoin versus un groupe clinique). Sa formulation s’énonce :
$$r_{pb} = \frac{\bar{Y}_1 – \bar{Y}_0}{s_Y} \sqrt{p (1 – p)}$$
où $\bar{Y}_1$ et $\bar{Y}_0$ désignent les moyennes de la variable continue obtenues respectivement par les sous-groupes définis par les modalités $1$ et $0$ de la variable dichotomique, $s_Y$ représente l’écart-type global de la variable continue sur l’échantillon réuni, et $p$ matérialise la proportion d’individus appartenant à la catégorie $1$. En psychométrie, le coefficient point-bisérial représente l’indice de discrimination par excellence d’un item : il démontre si la probabilité de réussir une question spécifique corrèle positivement avec l’aptitude globale mesurée par l’ensemble de l’instrument.
Lorsque les deux dimensions investiguées sont intrinsèquement dichotomiques — par exemple, dans l’analyse de contingence croisant le diagnostic formel d’un trouble panique ($0/1$) avec la présence d’une agoraphobie comorbide ($0/1$) —, la métrique idoine est le coefficient phi ($phi$). Isomorphe au coefficient de Pearson calculé sur deux variables indicatrices ne prenant que les valeurs $0$ et $1$, il se déduit directement de la statistique du chi-deux ($\chi^2$) d’indépendance calculée sur le tableau de contingence à quatre cases ($2 \times 2$) :
$$\phi = \sqrt{\frac{\chi^2}{N}}$$
Le psychométricien doit toutefois veiller à ne pas confondre le coefficient phi avec la corrélation tétrachorique. Cette dernière intervient lorsque les variables dichotomiques observées sont présumées découler de la binarisation artificielle de construits sous-jacents continus et normalement distribués (comme la propension latente à l’anxiété), offrant une estimation non biaisée du coefficient de Pearson qui aurait été observé si les continuums avaient été mesurés directement.
4. La régression linéaire : Modélisation mathématique et visée prédictive
4.1 Formalisation de l’équation de la droite
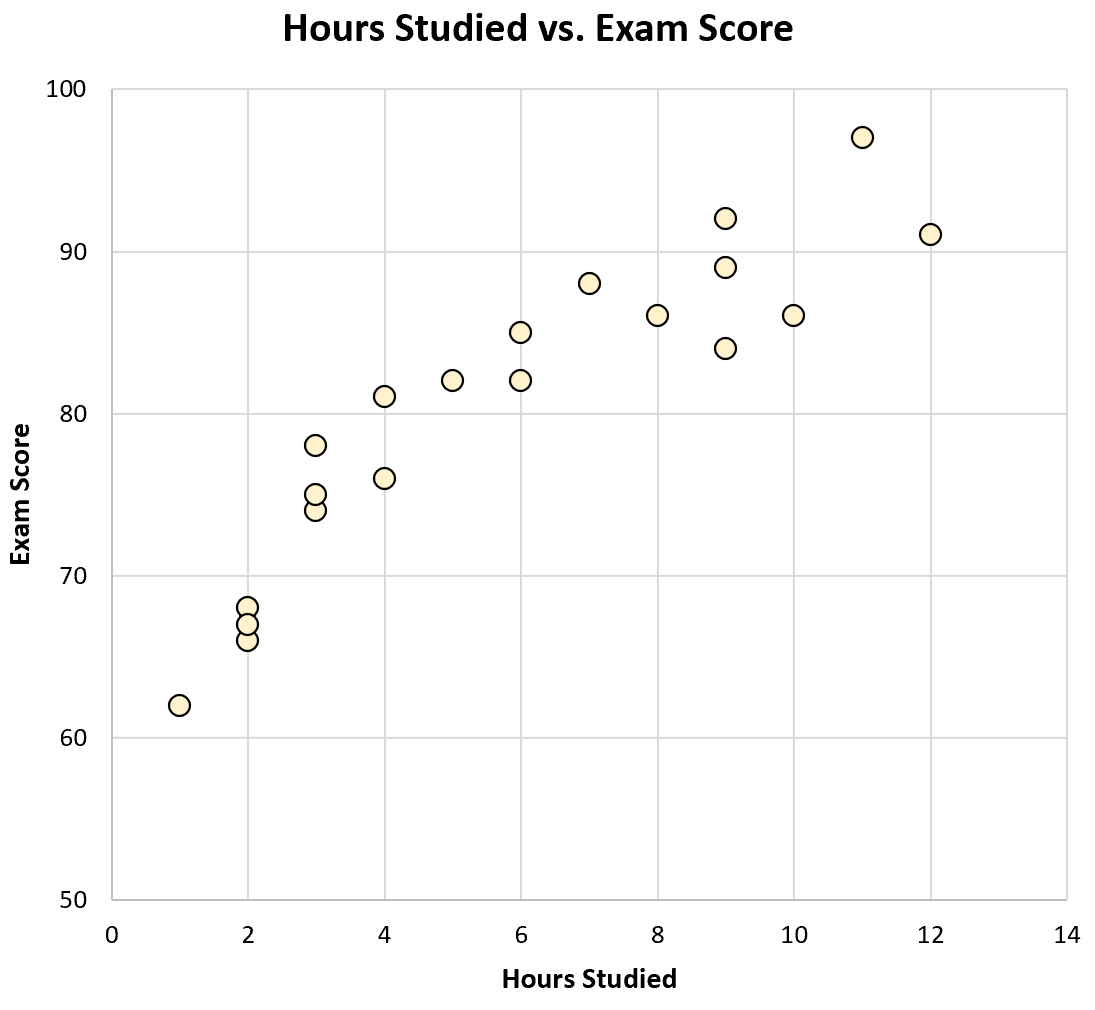
Tandis que la corrélation s’attache à synthétiser l’intensité d’une relation partagée en un scalaire invariant, la régression linéaire simple s’attelle à formaliser une fonction mathématique explicite capable de décrire la trajectoire moyenne d’un critère $Y$ conditionnellement aux fluctuations d’un prédicteur $X$. Dans le modèle stochastique univarié classique, cette relation s’exprime au moyen de l’équation algébrique suivante :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Dans cette formalisation structurelle, chaque composante assume une signification conceptuelle fondamentale pour la psychologie quantitative :
- L’ordonnée à l’origine ($\beta_0$, ou constante) : Représente l’espérance mathématique de la variable dépendante $Y$ lorsque la valeur du prédicteur $X$ est rigoureusement égale à zéro ($E[Y | X = 0]$). Dans de nombreuses applications psychométriques, le point zéro du prédicteur n’a aucune réalité psychologique (par exemple, un score de zéro de Quotient Intellectuel ou de température corporelle). Les chercheurs recourent fréquemment au centrage de la variable prédictrice ($X_i – \bar{X}$) afin que l’ordonnée à l’origine corresponde à la moyenne marginale du critère pour un individu représentatif de l’échantillon.
- La pente de régression ($\beta_1$, coefficient angulaire) : Quantifie le taux de changement marginal théorique. Elle exprime très précisément de combien d’unités d’échelle métrique la variable dépendante $Y$ varie, en moyenne, pour chaque accroissement unitaire d’une unité de mesure sur l’échelle de la variable indépendante $X$. La pente incarne ainsi la métrique fonctionnelle du modèle.
- Le terme d’erreur stochastique ($\varepsilon_i$, ou résidu) : Reconnaît explicitement qu’aucun modèle déterministe ne saurait prédire exhaustivement les conduites humaines. Il agrège l’ensemble des déterminants non observés du comportement, les erreurs instrumentales inhérentes aux questionnaires psychologiques et les fluctuations aléatoires idiosyncrasiques propres à chaque sujet.
4.2 La méthode des moindres carrés ordinaires (MCO)
L’estimation empirique des paramètres populationnels inconnus ($\beta_0$ et $\beta_1$) à partir des données échantillonnées ($b_0$ et $b_1$) est quasi universellement accomplie via la méthode séculaire des moindres carrés ordinaires (MCO, ou Ordinary Least Squares). Le principe géométrique sous-jacent est d’une remarquable simplicité conceptuelle : le modèle cherche à tracer une ligne droite à travers le nuage de points de telle sorte que la somme globale des résidus verticaux portés au carré soit mathématiquement minimale.
Le résidu empirique individuel $e_i$ se définit comme l’écart vertical strict séparant le point observé de la valeur ajustée par le modèle sur la droite : $e_i = Y_i – \hat{Y}_i$, où $\hat{Y}_i = b_0 + b_1 X_i$. Dès lors, la fonction de coût à minimiser s’énonce :
$$S(b_0, b_1) = \sum_{i=1}^{N} e_i^2 = \sum_{i=1}^{N} (Y_i – (b_0 + b_1 X_i))^2$$
Il est fondamental de noter que l’optimisation des moindres carrés opère une minimisation des distances exclusivement le long de l’axe vertical des ordonnées ($Y$), et non pas des distances orthogonales perpendiculaires à la droite de régression (ce dernier cas relevant de l’analyse en composantes principales de Pearson). Cette spécificité découle de la prémisse théorique fondamentale assignée à la régression : on considère la variable explicative $X$ comme fixée par le protocole ou observée sans erreur de mesure, toute l’incertitude aléatoire résiduelle étant projetée unilatéralement sur la variable critère $Y$.
Par l’annulation des dérivées partielles de la fonction de coût vis-à-vis des deux paramètres d’intérêt, le calcul infinitésimal conduit directement aux formules canoniques des estimateurs des moindres carrés :
$$b_1 = \frac{\sum (X_i – \bar{X})(Y_i – \bar{Y})}{\sum (X_i – \bar{X})^2} = \frac{Cov(X, Y)}{Var(X)}$$
$$b_0 = \bar{Y} – b_1 \bar{X}$$
En vertu du théorème de Gauss-Markov, lorsque les hypothèses classiques de la régression sont respectées, ces estimateurs possèdent la propriété mathématique d’être BLUE (Best Linear Unbiased Estimators) : parmi tous les estimateurs linéaires sans biais envisageables, ils présentent la variance d’échantillonnage la plus faible possible, garantissant ainsi une efficience statistique maximale.
5. Décomposition de la variance et ajustement du modèle de régression
5.1 Partitionnement de la somme des carrés
Le génie conceptuel de la modélisation linéaire réside dans sa capacité à découper la variabilité totale d’un phénomène comportemental en composantes élémentaires mutuellement exclusives et parfaitement interprétables. Ce processus repose sur le partitionnement de la somme des carrés, pierre angulaire partagée par la régression et l’analyse de variance (ANOVA). Considérons la distance totale séparant le score observé d’un participant individuel $Y_i$ de la moyenne marginale globale de l’échantillon $\bar{Y}$. Cet écart peut être scindé algébriquement en deux composantes distinctes :
$$(Y_i – \bar{Y}) = (\hat{Y}_i – \bar{Y}) + (Y_i – \hat{Y}_i)$$
En élevant ces écarts au carré et en sommant sur l’ensemble des $N$ observations, les termes de produits croisés s’annulent sous l’action des conditions de premier ordre des moindres carrés ordinaires, produisant l’identité fondamentale :
$$SST = SSM + SSR$$
où ces termes correspondent à des entités fondamentales :
- $SST$ (Somme Totale des Carrés – Total Sum of Squares) : $\sum (Y_i – \bar{Y})^2$. Elle quantifie la dispersion globale brute de la variable dépendante dans l’échantillon, c’est-à-dire l’ignorance initiale du chercheur avant toute tentative d’explication par le prédicteur.
- $SSM$ (Somme des Carrés du Modèle ou de la Régression – Model Sum of Squares) : $\sum (\hat{Y}_i – \bar{Y})^2$. Elle mesure la part de la variabilité globale qui est formellement capturée, modélisée et réduite par l’introduction du prédicteur $X$ au sein de l’équation linéaire.
- $SSR$ (Somme des Carrés Résiduels – Residual Sum of Squares) : $\sum (Y_i – \hat{Y}_i)^2 = \sum e_i^2$. Elle représente la variabilité résiduelle inexpliquée, correspondant à la divergence inévitable entre les projections de l’équation et la réalité phénoménologique brute des sujets.
5.2 Le coefficient de détermination R-deux
À partir du partitionnement de la somme des carrés émerge le paramètre d’ajustement global le plus universellement rapporté en sciences psychologiques : le coefficient de détermination, noté $R^2$. Cet indice sans dimension évalue formellement la proportion de la variance de la variable critère directement expliquée par la droite de régression :
$$R^2 = \frac{SSM}{SST} = 1 – \frac{SSR}{SST}$$
Dans le cadre strict d’un modèle de régression linéaire bivariée (impliquant une seule variable prédictrice continue), une équivalence mathématique remarquable lie ce paramètre au coefficient de corrélation produit-moment : le coefficient de détermination est rigoureusement égal au carré du coefficient de corrélation de Pearson :
$$R^2 = (r_{XY})^2$$
Ainsi, si un protocole neuropsychologique observe une corrélation bivariée de $r = 0,40$ entre la vitesse de traitement de l’information et le score à un test de raisonnement fluide, la modélisation par régression de ce même raisonnement fluide sur la vitesse de traitement produira un coefficient de détermination $R^2 = 0,16$. Cela signifie rigoureusement que $16,%$ de la variabilité interindividuelle observée dans les facultés de raisonnement fluide est imputable aux variations de la vitesse de traitement dans la cohorte étudiée, laissant $84,%$ de la variance sous la dépendance d’autres facteurs non mesurés ou d’erreurs stochastiques.
Cependant, dans les contextes de modélisation complexe impliquant des prédicteurs multiples, l’adjonction purement opportuniste de variables additionnelles dans l’équation a pour conséquence mécanique d’augmenter inéluctablement le $R^2$ brut, même si ces prédicteurs n’apportent aucun pouvoir explicatif substantiel. Pour parer à cette dérive, on calcule le $R^2$ ajusté ($R^2_{adj}$), qui pénalise mathématiquement l’estimation en intégrant le nombre de prédicteurs $k$ au regard des degrés de liberté résiduels ($N – k – 1$) :
$$R^2_{adj} = 1 – \left[ \frac{(1 – R^2)(N – 1)}{N – k – 1} \right]$$
Cette correction préserve le statisticien du surajustement (overfitting) et offre une estimation non biaisée du véritable pouvoir explicatif du modèle au sein de la population générale.
6. Divergences conceptuelles majeures : Symétrie versus Asymétrie
6.1 L’invariance de rôle dans la corrélation
L’abîme conceptuel qui sépare la corrélation de la régression s’articule prioritairement autour de la notion de symétrie mathématique et opérationnelle. Le coefficient de corrélation de Pearson est une fonction algébrique commutative. En vertu de la commutativité inhérente à la formule du produit des écarts centrés, la relation suivante s’impose rigoureusement :
$$r_{XY} = r_{YX}$$
Dans l’univers de la corrélation, aucune variable ne possède de préséance structurelle, d’antériorité temporelle ou de prééminence explicative. Que l’on corrèle le niveau de stress parental avec les troubles du sommeil de l’enfant ou, à l’inverse, les troubles du sommeil de l’enfant avec le stress parental, le chiffre obtenu sera rigoureusement identique jusqu’à sa dernière décimale. Le coefficient demeure totalement insensible au sens de l’interrogation clinique.
Cette stricte invariance de rôle traduit l’indifférence absolue de la corrélation vis-à-vis du sens temporel ou fonctionnel du recueil des données. La corrélation traite la relation comme une propriété émergente bilatérale d’une distribution conjointe. Elle est un descripteur d’état global, un thermomètre de la proximité linéaire de deux vecteurs au sein d’un espace vectoriel normé, sans jamais assigner à l’un le rôle d’agent modulateur et à l’autre celui d’élément modulé.
6.2 La directionnalité structurelle de la régression
À l’extrême opposé de cette équipotence, la régression linéaire engage une démarche résolument asymétrique et orientée. La régression de $Y$ sur $X$ constitue un modèle mathématique radicalement différent de la régression de $X$ sur $Y$. Cette disparité apparaît immédiatement lorsque l’on examine l’expression algébrique des pentes respectives de ces deux droites d’ajustement :
$$b_{Y|X} = \frac{Cov(X, Y)}{Var(X)} = r_{XY} \frac{s_Y}{s_X}$$
$$b_{X|Y} = \frac{Cov(X, Y)}{Var(Y)} = r_{XY} \frac{s_X}{s_Y}$$
Sauf dans le cas exceptionnel et improbable où les variances marginales des deux distributions seraient rigoureusement identiques ($s_X^2 = s_Y^2$), ces deux pentes seront systématiquement dissemblables ($b_{Y|X} \neq b_{X|Y}$).
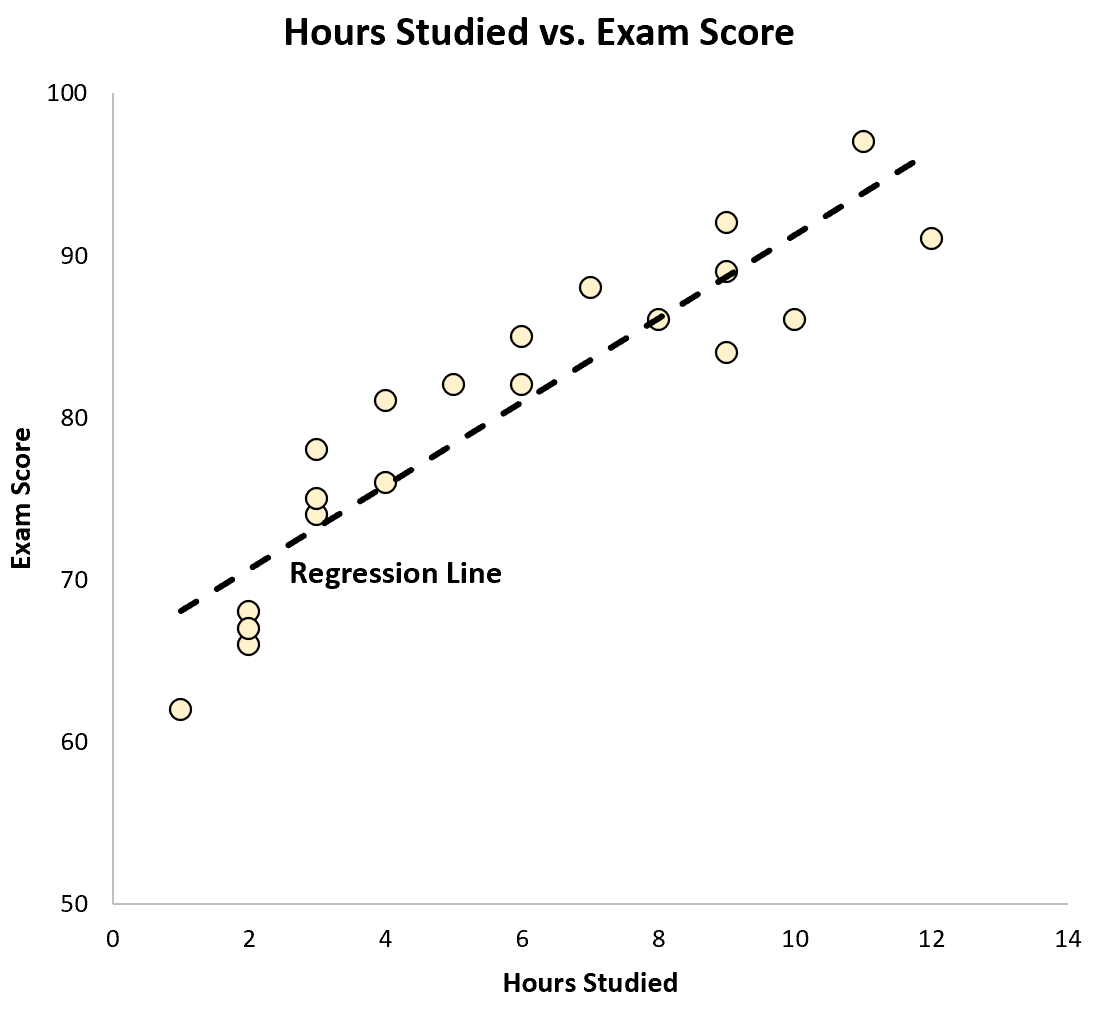
Une distinction fondamentale réside dans l’intégration des unités métriques de mesure. Alors que le coefficient de corrélation $r$ est un nombre pur adimensionnel — une métrique standardisée affranchie de toute échelle —, la pente de régression $b_1$ est une quantité physiquement dimensionnée. Elle s’exprime dans le rapport formel des unités de la variable dépendante par unité de la variable indépendante ($[Unité_Y] / [Unité_X]$).
Supposons que l’on étudie l’effet de l’entraînement cognitif (mesuré en heures d’exercices hebdomadaires) sur le niveau de sévérité dépressive (quantifié par le score au questionnaire de Beck, variant de $0$ à $63$ points). Un coefficient de corrélation $r = -0,45$ décrira une association négative appréciable, mais demeurera muet sur les conséquences pragmatiques directes d’une prescription thérapeutique. En revanche, la pente de régression issue de la modélisation de la dépression sur le temps d’entraînement ($b_{Y|X} = -1,85$) transmettra une information clinique cruciale : pour chaque tranche supplémentaire d’une heure d’entraînement par semaine, on observe une réduction attendue moyenne de 1,85 point sur l’échelle de Beck. Si l’on inversait le modèle en régressant les heures d’entraînement sur la dépression, la pente ($b_{X|Y}$) traduirait des « heures par point de dépression », illustrant l’incompatibilité clinique de l’inversion sans réflexion théorique préalable.
6.3 Synthèse des critères différentiels techniques
Afin de synthétiser les divergences méthodologiques fondamentales qui délimitent ces deux paradigmes, il convient de confronter systématiquement leurs propriétés algorithmiques, structurelles et interprétatives.
Sur le plan de l’objectif d’analyse, la corrélation vise la quantification descriptive standardisée d’une association covariante, tandis que la régression cherche la prédiction algorithmique, l’estimation de paramètres fonctionnels et l’élaboration de modèles contrefactuels simulant l’effet d’une variation marginale. Graphiquement, la corrélation s’illustre par un nuage de points centré entouré de ses contours d’équidensité (l’ellipse de corrélation), au sein duquel aucune direction de projection préférentielle n’est privilégiée. La régression, elle, matérialise une droite optimale sur laquelle viennent s’écraser orthogonalement les résidus verticaux issus des observations réelles.
Un autre contraste réside dans la réaction de ces estimateurs face aux transformations linéaires admissibles des variables (multiplication par une constante positive ou addition d’une constante). Le coefficient de corrélation $r$ de Pearson est invariant sous toute transformation affine positive appliquée à $X$ ou $Y$ : convertir des temps de réaction de secondes en millisecondes n’altérera pas d’un iota le coefficient $r$. En régression, si l’ordonnée à l’origine et le coefficient angulaire se transforment de manière prévisible pour préserver l’équivalence physique de la fonction, la pente brute $b_1$ est modifiée d’un facteur d’échelle exact. Cette flexibilité métrique de la pente de régression constitue sa plus grande force en recherche appliquée : elle ancre le résultat statistique dans l’épaisseur concrète et opérationnelle des instruments de mesure mobilisés.
7. Le dilemme de la causalité en psychologie scientifique
7.1 La maxime méthodologique : ‘Corrélation n’est pas causalité’
Aucun adage épistémologique n’est plus célèbre ni plus fréquemment violé dans l’arène des sciences humaines que l’injonction canonique : « Corrélation n’est pas causalité » (Cum hoc ergo propter hoc). Ce rappel méthodologique ne relève pas d’une coquetterie rhétorique, mais d’une barrière logique infranchissable. La présence attestée d’une corrélation statistiquement significative entre deux variables $X$ et $Y$ ne constitue qu’un indice empirique nécessaire, mais absolument jamais suffisant, pour inférer que les variations de $X$ induisent mécaniquement les fluctuations de $Y$.
L’écueil primordial réside dans le problème classique de la variable confondante non observée (ou facteur tiers $Z$). Lorsqu’une troisième dimension structurelle non intégrée au recueil de données corrèle simultanément avec les deux variables analysées, elle engendre une covariation apparente purement artificielle, qualifiée de corrélation fallacieuse (spurious correlation). Considérons l’exemple paradigmatique étudié en psychologie sociale : la corrélation positive substantielle systématiquement documentée entre le niveau d’estime de soi chez l’adolescent et ses résultats scolaires. Durant des décennies, cette relation linéaire a nourri des programmes pédagogiques coûteux visant à gonfler artificiellement l’amour-propre des élèves dans l’espoir de doper leurs notes académiques. Comme l’ont démontré les analyses critiques conduites par Roy Baumeister et ses collaborateurs, cette corrélation est largement imputable à des facteurs environnementaux confondants : un statut socio-économique familial favorisé et un soutien parental stimulant augmentent simultanément l’estime de soi et facilitent le succès scolaire, sans que l’estime de soi n’exerce de causalité directe majeure sur les performances académiques.
À cet obstacle s’ajoute l’énigme de la causalité inverse et des boucles de rétroaction bidirectionnelles. Dans l’exemple précédent, il est tout aussi plausible que ce soient les réussites académiques répétées qui renforcent ultérieurement l’estime de soi de l’apprenant, inversant la flèche explicative. Dans les systèmes cognitifs et comportementaux humains décrits par la théorie de l’apprentissage social d’Albert Bandura, la causalité s’avère quasi continuellement circulaire et dynamique : le comportement, les facteurs internes cognitifs et les influences environnementales agissent les uns sur les autres comme des déterminants en interaction réciproque. La simple observation d’un coefficient de corrélation est incapable d’éclairer cette dynamique processuelle.
7.2 La régression implique-t-elle une causalité fonctionnelle ?
L’asymétrie structurelle et la nomenclature même de la régression linéaire — qui qualifie traditionnellement les prédicteurs de « variables explicatives » ou de « variables indépendantes » — entretiennent une confusion pernicieuse. De nombreux analystes succombent à l’illusion qu’en configurant formellement une équation de régression orientée de $X$ vers $Y$, ils ont franchi le rubicon méthodologique les autorisant à inférer une causalité mécanique directe.
Il est impératif d’affirmer avec la plus grande rigueur que la régression linéaire n’est pas plus causale par essence que la corrélation. L’ajustement mathématique des moindres carrés ordinaires demeure une opération purement computationnelle d’association géométrique. Si l’on assigne arbitrairement le statut de prédicteur au nombre de parapluies ouverts dans une ville et celui de critère au volume de précipitations atmosphériques, l’algorithme des moindres carrés produira sans hésitation une pente positive hautement significative et un coefficient $R^2$ élevé, permettant de « prédire » avec une remarquable efficience la pluie à partir du déploiement des toiles cirées. Il est évident que refermer les parapluies n’interrompra pas l’orage. Le modèle capture une dépendance statistique fonctionnelle prédictive, non un mécanisme générateur causal.
Pour qu’un modèle de régression puisse prétendre à une interprétation causale légitime, le chercheur doit obligatoirement ancrer son analyse dans l’architecture formelle de l’inférence causale, telle que conceptualisée par le modèle des résultats potentiels de Donald Rubin ou les graphes acycliques dirigés (DAGs) de Judea Pearl. Une telle inférence n’est autorisée que sous deux conditions impératives :
- Le protocole expérimental avec assignation aléatoire : Si les niveaux de la variable prédictrice $X$ ont été manipulés activement par l’expérimentateur et alloués aux sujets par randomisation stricte (comme dans un essai clinique évaluant l’efficacité d’une psychothérapie comportementale face à un placebo), la randomisation désamorce l’influence des variables confondantes non observées. Dans ce cadre précis, la pente de régression $b_1$ estime sans biais l’effet causal moyen du traitement.
- L’ajustement structurel exhaustif en contexte observationnel : En l’absence de randomisation, l’affirmation causale exige la formulation d’hypothèses fortes et non testables d’échangeabilité conditionnelle (unconfoundedness) : tous les facteurs confondants communs au prédicteur et au critère doivent être parfaitement identifiés, fidèlement mesurés et statistiquement neutralisés au sein du modèle multivarié. Une exigence que la pratique de la psychologie observationnelle ne parvient que très rarement à honorer pleinement.
8. Postulats statistiques sous-jacents et diagnostics de validité
8.1 Conditions d’application de la corrélation bivariée
L’usage inférentiel légitime du coefficient de corrélation linéaire de Pearson — singulièrement lors du calcul des intervalles de confiance et de l’exécution des tests de significativité de l’hypothèse nulle ($H_0 : \rho = 0$) — repose sur un ensemble d’hypothèses distributionnelles restrictives qu’il convient de vérifier méthodiquement préalablement à toute interprétation clinique :
- La normalité bivariée : L’hypothèse mathématique requise stipule que le couple de variables aléatoires $(X, Y)$ suit une loi normale conjointe à deux dimensions. Cette condition implique non seulement que chaque variable marginale considérée isolément présente une distribution gaussienne (asymétrie et aplatissement conformes aux standards), mais également que pour chaque tranche de score sur la variable $X$, la distribution conditionnelle de $Y$ est parfaitement normale et homogène. La violation sévère de cette hypothèse fausse le calcul de la statistique de Student $t = \frac{r \sqrt{N – 2}}{\sqrt{1 – r^2}}$ et altère le taux d’erreur de première espèce ($\alpha$).
- La linéarité intrinsèque : Le modèle assume que la relation entre les deux construits se déploie fidèlement selon une droite géométrique. L’inspection attentive d’un nuage de points (scatterplot) constitue une obligation déontologique incontournable pour détecter précocement d’éventuelles saturations de seuil (effets plancher ou plafond) ou des dynamiques non linéaires complexes.
- L’homogénéité de la population sous-jacente : Le mélange non contrôlé au sein de l’échantillon de sous-groupes structurellement distincts (par exemple, agréger sans distinction des patients souffrant de dépression mélancolique et des sujets sains au sein d’une même analyse de connectivité cérébrale) peut scinder artificiellement le nuage en deux amas distants, créant une corrélation globale fallacieuse qui ne reflète aucune régularité clinique au sein de l’un ou l’autre groupe.
8.2 Diagnostics approfondis pour la régression linéaire
La théorie de la régression linéaire classique des moindres carrés ordinaires repose sur un ensemble plus étendu de postulats formels, connus sous le nom d’hypothèses standard de Gauss-Markov complétées par la normalité des erreurs. La validité des prédictions, la justesse des erreurs-types des coefficients et la pertinence des tests de Student et de Fisher ($F$) reposent entièrement sur la vérification des conditions suivantes, centrées sur le comportement du terme d’erreur résiduelle :
- L’espérance nulle des erreurs : $E[\varepsilon_i | X_i] = 0$. En moyenne, le modèle ne doit ni sous-estimer ni surestimer systématiquement la réalité clinique. Ce postulat est mathématiquement garanti dès lors qu’une constante ($\beta_0$) est incluse dans l’équation.
- L’homoscédasticité des résidus : $Var(\varepsilon_i | X_i) = \sigma^2$. La dispersion des erreurs résiduelles doit demeurer rigoureusement constante à travers tous les niveaux de la variable prédictrice $X$. L’hétéroscédasticité — situation où la variance des erreurs s’évase en entonnoir, devenant par exemple beaucoup plus large pour les valeurs élevées de $X$ — constitue un problème fréquent en psychopathologie : les scores d’anxiété peuvent être prédits avec une grande précision chez les individus calmes, tandis que les prédictions deviennent extrêmement divergentes et erratiques chez les individus instables. Ce manquement invalide le calcul des erreurs-types conventionnelles, imposant le recours à des estimateurs de variance robustes (tels que l’estimateur de Huber-White ou sandwich).
- L’indépendance des résidus (absence d’autocorrélation) : $Cov(\varepsilon_i, \varepsilon_j) = 0$ pour tout $i \neq j$. Les erreurs associées à deux participants distincts doivent être totalement décorrélées. Cette hypothèse est systématiquement enfreinte dès lors que le protocole intègre des mesures répétées dans le temps chez un même sujet (séries temporelles) ou recueille des données nichées dans des structures hiérarchiques (patients suivis par un même thérapeute, élèves regroupés dans une même classe d’école). Ce type de violation impose impérativement le basculement vers des modèles mixtes ou hiérarchiques linéaires (HLM).
- La normalité des erreurs résiduelles : $\varepsilon_i \sim \mathcal{N}(0, \sigma^2)$. Les résidus doivent suivre une distribution normale. Contrairement à une idée faussement répandue, il n’est nullement requis que la variable dépendante $Y$ soit marginalement normale : seule la distribution des erreurs conditionnelles non expliquées par le modèle doit adopter cette allure gaussienne, ce que l’on évalue à l’aide d’un diagramme quantile-quantile (Q-Q plot) ou du test de Shapiro-Wilk.
Le diagnostic de la régression exige enfin la recherche méticuleuse des observations influentes. Un participant atypique peut altérer de façon disproportionnée l’orientation de la droite des moindres carrés. On évalue cette menace au moyen de trois métriques complémentaires : la mesure de l’effet de levier (leverage, noté $h_{ii}$), qui évalue la distance d’un sujet par rapport à la moyenne du prédicteur ; les résidus studentisés, qui mesurent la grandeur de l’erreur d’ajustement ; et la distance de Cook ($D_i$). Tout individu présentant une distance de Cook excédant le seuil conventionnel de $4 / (N – k – 1)$ ou approchant la valeur critique de $1,0$ modifie de manière critique l’ensemble du vecteur des coefficients $b$ dès lors qu’il est retiré de l’analyse, requérant une investigation clinique ciblée pour déceler d’éventuelles erreurs d’encodage ou des profils psychopathologiques hautement singuliers.
9. Études de cas en psychologie : Arbitrer entre corrélation et régression
9.1 Cas pratique 1 : Analyse psychométrique d’un nouvel inventaire de personnalité
Imaginons une équipe de chercheurs spécialisés en psychométrie s’attelant à valider un nouvel outil d’évaluation de la résilience psychologique : l’Inventaire Multidimensionnel de Résilience (IMR). Dans ce contexte méthodologique bien précis, l’arbitrage entre corrélation et régression se tranche sans ambiguïté en faveur de la corrélation.
Lors de l’étape fondamentale de l’évaluation de la fidélité test-retest, les expérimentateurs administrent l’IMR à une cohorte de cent cinquante participants à un intervalle de quatre semaines de distance, dans des conditions environnementales standardisées et stables. L’objectif analytique consiste exclusivement à mesurer la stabilité temporelle des scores individuels. Pourquoi la régression linéaire s’avère-t-elle ici totalement inappropriée ? Régresser le score au temps 2 sur le score au temps 1 produirait certes une estimation de pente, mais cette procédure masquerait de potentielles dérives d’étalonnage systématiques. Une régression peut afficher un ajustement linéaire parfait alors même que tous les sujets ont vu leur score augmenter uniformément de dix points au retest (effet d’apprentissage ou de sensibilisation). Le psychométricien recourt donc à la corrélation — idéalement sous la forme d’un coefficient de corrélation intra-classe (ICC) ou d’un coefficient produit-moment de Pearson —, afin de vérifier l’intensité de la convergence stricte des positions relatives des sujets dans la distribution.
Il en va rigoureusement de même pour l’analyse de la validité convergente. L’IMR doit être confronté à des échelles de référence bien établies, telles que l’Échelle de Résilience de Connor-Davidson (CD-RISC) et l’Inventaire d’Optimisme Dispositionnel (LOT-R). Les chercheurs calculent la matrice des coefficients de corrélation bivariés unissant ces outils, synthétisée selon l’architecture canonique de la matrice multitrait-multiméthode élaborée par Campbell et Fiske. L’introduction d’un modèle de régression linéaire à cette étape serait théoriquement aberrante : les construits coexistent au sein du paysage psychique sans qu’aucun ne prétende réguler fonctionnellement ou engendrer structuralement l’autre. Il s’agit purement de valider l’étendue du recouvrement sémantique et métrologique de deux instruments évaluant un même espace latent.
9.2 Cas pratique 2 : Pronostic du burn-out chez les soignants
Envisageons à présent une problématique diamétralement opposée, ancrée dans la psychologie du travail et des organisations : une intervention menée au sein d’un centre hospitalier universitaire pour prévenir l’émergence du syndrome d’épuisement professionnel (burn-out) parmi les équipes infirmières et médicales des services d’urgence.
Dans ce scénario pragmatique, les chercheurs opérationnalisent la charge de travail subjective via l’indice multidimensionnel NASA-TLX (mesurant les exigences mentales, physiques et temporelles) comme variable prédictrice ($X$). La variable dépendante à expliquer ($Y$) est le score de dépersonnalisation et d’épuisement émotionnel quantifié par l’Inventaire d’Épuisement de Maslach (MBI). Si le calcul initial d’une corrélation atteste d’une liaison positive substantielle ($r = 0,55$), cette seule information demeure d’une affligeante stérilité pour les décideurs hospitaliers et la médecine du travail. Elle ne répond à aucune des exigences opérationnelles du milieu clinique.
L’application d’un modèle de régression linéaire s’impose alors comme la seule démarche méthodologique pertinente et féconde. L’estimation des moindres carrés fournit une équation formelle concrète, par exemple :
$$\widehat{MBI} = 12,4 + 0,42 \times (NASA\text{-}TLX)$$
Cette formalisation offre deux atouts pragmatiques incomparables :
- Le pronostic individualisé et le dépistage précoce : En injectant le score NASA-TLX renseigné par un infirmier lors de sa visite annuelle, le médecin du travail peut calculer instantanément un score d’épuisement prévisionnel individualisé. Si ce score projeté franchit le seuil critique d’alerte clinique (fixé par exemple à un score MBI de $30$), des protocoles d’accompagnement psychologique peuvent être déployés avant même la décompensation fonctionnelle du professionnel de santé.
- L’étalonnage des politiques organisationnelles préventives : Grâce à la valeur tangible de la pente de régression ($b_1 = 0,42$), la direction de l’établissement dispose d’une métrique d’impact opérationnelle. Elle sait précisément que pour abaisser en moyenne de quatre points le niveau d’épuisement émotionnel au sein du service, il est nécessaire de mettre en œuvre des aménagements organisationnels capables de comprimer la charge de travail perçue d’environ dix points sur l’échelle NASA-TLX. La régression devient alors un authentique instrument d’ingénierie comportementale et d’aide à la décision managériale.
10. Extensions multivariées et complexification des modèles
10.1 Corrélations partielles et semi-partielles
Dès lors que l’on abandonne le cadre simplificateur de l’analyse bivariée pour embrasser la complexité pluridimensionnelle des phénomènes cognitifs et affectifs, la nécessité d’isoler des relations pures s’impose. Deux outils corrélationnels sophistiqués constituent la passerelle naturelle unissant la corrélation bivariée à la modélisation par régression : la corrélation partielle et la corrélation semi-partielle (ou partitive).
La corrélation partielle ($r_{XY.Z}$) quantifie l’association linéaire résiduelle subsistant entre deux variables d’intérêt, $X$ et $Y$, après avoir préalablement extrait, purgé et neutralisé la variance partagée commune avec une ou plusieurs variables de contrôle tierces ($Z$). Sur le plan algorithmique, calculer la corrélation partielle entre la flexibilité mentale ($X$) et la créativité divergente ($Y$) en contrôlant pour l’âge ($Z$) revient rigoureusement à :
- Régresser la flexibilité ($X$) sur l’âge ($Z$) et en extraire les erreurs résiduelles $e_{X|Z}$.
- Régresser la créativité ($Y$) sur ce même âge ($Z$) et en extraire les résidus $e_{Y|Z}$.
- Calculer le coefficient de corrélation de Pearson standard directement entre ces deux séries de résidus non expliqués par l’âge : $r(e_{X|Z}, e_{Y|Z})$.
Sa formulation algébrique directe s’exprime ainsi :
$$r_{XY.Z} = \frac{r_{XY} – r_{XZ} r_{YZ}}{\sqrt{(1 – r_{XZ}^2)(1 – r_{YZ}^2)}}$$
À la différence de la corrélation partielle, la corrélation semi-partielle ($r_{Y(X.Z)}$) ne purge l’effet perturbateur de la variable confondante $Z$ que sur une seule des deux variables analysées (traditionnellement le prédicteur $X$), laissant le critère $Y$ intact dans son unité de variance globale d’origine. Cette statistique fondamentale reflète très exactement la contribution marginale unique apportée par l’inclusion du prédicteur $X$ à l’augmentation du coefficient de détermination global lors de son adjonction dans un modèle de régression multiple ($r_{Y(X.Z)}^2 = \Delta R^2$).
10.2 De la régression simple à la régression multiple et aux modèles d’équations structurelles
L’expansion du modèle bivarié vers la régression linéaire multiple permet d’appréhender le comportement humain dans sa véritable nature multifactorielle. L’équation se généralise à un ensemble de $p$ variables explicatives :
$$Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + dots + \beta_p X_{\pi} + \varepsilon_i$$
Dans cette architecture, les coefficients de régression partiels non standardisés ($\beta_j$) traduisent l’effet marginal spécifique du prédicteur $X_j$ sur le critère $Y$, toutes choses étant égales par ailleurs (c’est-à-dire en maintenant rigoureusement constants les scores sur l’ensemble des autres variables indépendantes incorporées au modèle). Lorsque les prédicteurs sont standardisés en scores réduits ($Z$), les coefficients bêta standardisés ($\beta^*_j$) autorisent une comparaison directe de la magnitude relative des différents déterminants comportementaux sur une échelle adimensionnelle commune.
Cette complexification méthodologique expose toutefois le chercheur au péril majeur de la multicolinéarité. Lorsque deux ou plusieurs variables prédictrices sont intensément corrélées entre elles au sein d’une même équation, leurs espaces de variance se chevauchent de manière redondante. En conséquence mathématique, l’inversion de la matrice d’information $(X^T X)^{-1}$ devient instable, provoquant une explosion artificielle de l’erreur standard des coefficients. Les tests de Student perdent dramatiquement en puissance, et les estimations de pente oscillent de façon erratique sous l’effet de variations infinitésimales des données. La colinéarité se surveille rigoureusement au moyen du facteur d’inflation de la variance ($VIF = \frac{1}{1 – R_j^2}$), où un seuil excédant la valeur de $5$ ou $10$ exige le remaniement structurel du modèle par agrégation ou sélection parcimonieuse de prédicteurs.
Enfin, le couronnement contemporain de la régression linéaire s’incarne dans les modèles d’équations structurelles (Structural Equation Modeling, SEM). Cette méthodologie hybride réunit l’analyse factorielle confirmatoire et la régression linéaire multivariée en un canevas unique. Les SEM permettent de tester des chaînes causales complexes articulées autour de mécanismes de :
- Médiation statistique : Déterminer si l’impact d’un prédicateur initial $X$ sur un critère comportemental $Y$ transite de manière indirecte par le truchement d’une variable intermédiaire intervenante $M$ ($X to M to Y$), évalué traditionnellement via la procédure de rééchantillonnage (bootstrapping) des effets indirects standardisée par Andrew Hayes.
- Modération statistique : Évaluer si l’intensité ou la polarité de la relation de régression entre $X$ et $Y$ varie de manière conditionnelle selon la valeur assumée par un tiers facteur modérateur $W$, formalisé mathématiquement par l’introduction d’un terme de produit croisé interactif ($X \times W$).
11. Pièges méthodologiques et biais interprétatifs fréquents
11.1 Le paradoxe de Simpson dans les cohortes cliniques
L’un des phénomènes statistiques les plus troublants et les plus périlleux auxquels un psychologue puisse être confronté dans le traitement de données corrélationnelles et de régression est le célèbre paradoxe de Simpson (ou effet Yule-Simpson). Ce paradoxe désigne une anomalie mathématique au sein de laquelle une tendance statistique robuste — qu’il s’agisse d’un signe de corrélation ou d’une pente de régression — observée de manière systématique et concordante au sein de plusieurs sous-groupes indépendants se retrouve totalement inversée lorsque les données de l’ensemble de ces cohortes sont brutalement agrégées dans une analyse globale indifférenciée.
Illustrons ce mécanisme par une recherche clinique portant sur le lien unissant le niveau de stress physiologique chronique (mesuré par le taux de cortisol salivaire matinal) et les performances à une batterie de mémoire prospective. Si l’échantillon réunit des adultes jeunes (vingt à trente ans) et des aînés (soixante-dix à quatre-vingts ans), l’analyse interne conduite séparément au sein de chaque tranche d’âge révélera une corrélation négative et une pente de régression descendante : aussi bien chez les jeunes que chez les personnes âgées, un stress plus élevé altère les scores mnésiques. Pourtant, si le statisticien fusionne naïvement les deux groupes dans un modèle de régression global bivarié sans introduire la variable âge, il risque d’observer avec stupéfaction une corrélation positive hautement significative !
La mécanique sous-jacente s’explique par l’action d’une variable de confusion non contrôlée agissant comme médiateur masqué. Si la cohorte âgée présente structurellement des scores mnésiques de base inférieurs en raison du déclin cognitif normal mais manifeste simultanément une réactivité biologique au stress différente, le nuage global s’organisera selon deux grappes de points distantes sur le plan cartésien. La ligne d’ajustement globale des moindres carrés cherchera simplement à relier le centre de gravité du groupe âgé au centre de gravité du groupe jeune, adoptant une inclinaison ascendante factice. Pour prévenir ce biais interprétatif catastrophique, le chercheur doit obligatoirement procéder à des diagnostics préliminaires par sous-populations homogènes et intégrer formellement les caractéristiques démographiques et cliniques majeures comme covariables d’ajustement ou variables de stratification.
11.2 La régression vers la moyenne
Découvert et théorisé par Francis Galton en 1886 à l’occasion de ses recherches pionnières sur l’hérédité de la taille humaine, le phénomène de régression vers la moyenne (regression toward the mean) représente l’un des pièges inférentiels les plus retors de la psychologie clinique et des neurosciences. Ce principe découle de la nature imparfaite de la fidélité des mesures psychologiques ($r_{XX’} < 1,0$). Toute mesure psychométrique $X$ est une résultante stochastique agrégeant le score vrai d'un individu ($tau$) et une composante d'erreur aléatoire d'échantillonnage ou d'état ($varepsilon$) : $X = tau + varepsilon$.
Lorsqu’un clinicien sélectionne au pré-test une sous-cohorte de patients spécifiquement parce qu’ils manifestent des scores extraordinairement extrêmes — par exemple, les participants affichant des niveaux de dépression clinique situés dans les centiles les plus élevés d’une distribution —, il sélectionne inévitablement des individus dont l’erreur aléatoire $varepsilon$ était momentanément positive et maximale lors de la première passation. Lors d’une seconde mesure (post-test) administrée quelques semaines plus tard, ces erreurs d’échantillonnage aléatoires tendent statistiquement à se redistribuer autour de leur espérance nulle. En conséquence purement mathématique, les scores extrêmes au post-test vont mécaniquement se rapprocher du barycentre moyen de la population générale, donnant l’illusion trompeuse d’un changement substantiel chez les sujets.
Ce mécanisme statistique a historiquement induit en erreur d’innombrables praticiens. Un psychologue évaluant l’efficacité d’une thérapie novatrice sur des patients sévèrement traumatisés constatera presque inévitablement une diminution de leurs scores de détresse lors du bilan de contrôle. Attribuer spontanément cette évolution positive à l’efficience intrinsèque des protocoles thérapeutiques relève d’une illusion méthodologique naïve si l’effet de régression vers la moyenne n’a pas été parfaitement circonscrit. Le seul rempart scientifique face à ce biais cognitif de confirmation réside dans l’intégration impérative d’un groupe témoin randomisé (ou contrôle sur liste d’attente) : la part d’amélioration imputable à la régression vers la moyenne se manifestera à une amplitude rigoureusement identique au sein du groupe contrôle, permettant d’isoler l’effet thérapeutique spécifique par la comparaison des pentes de régression ou par une analyse de covariance (ANCOVA) ajustant le score post-test sur le score pré-test.
11.3 Extrapolations abusives et surajustement
L’illusion du pouvoir prédictif constitue le troisième écueil cardinal guettant l’utilisateur de modèles de régression en sciences du comportement. Deux dérives analytiques méritent une attention toute particulière :
- L’extrapolation au-delà des bornes empiriques observées : Une équation de régression des moindres carrés ordinaires n’est mathématiquement valide et stable qu’à l’intérieur du domaine de convexité restreint défini par l’éventail des scores observés au sein de l’échantillon d’étalonnage. Projeter l’équation au-delà de ces frontières phénoménologiques pour anticiper le comportement de sujets aux profils inédits constitue une faute méthodologique majeure. Si une modélisation par régression démontre que l’augmentation de doses d’un psychostimulant améliore linéairement les performances de concentration chez des enfants présentant un TDAH pour des posologies oscillant entre $5$ et $20,\text{mg}$, en déduire mathématiquement qu’une dose de $100,\text{mg}$ quintuplera leurs capacités cognitives ignore les réalités biologiques élémentaires : au-delà du domaine exploré, la fonction bascule inéluctablement vers une toxicité neurovégétative et un effondrement des fonctions exécutives.
- Le surajustement statistique (overfitting) et la perte de validité externe : À mesure que le chercheur multiplie les prédicteurs, intègre des termes polynomiaux d’ordre élevé ou tolère des interactions complexes pour maximiser coûte que coûte son $R^2$ empirique, son modèle commence à ajuster le bruit idiosyncrasique de l’échantillon d’entraînement plutôt que le signal structurel généralisable de la population parente. L’équation présentera une adéquation spectaculaire sur les données natives, mais s’effondrera de manière catastrophique dès qu’elle sera déployée sur un échantillon clinique indépendant. La parade contemporaine absolue impose la systématisation des protocoles de validation croisée (k-fold cross-validation ou division train/test) afin de garantir l’étanchéité et la robustesse prédictive réelle des équations comportementales.
12. Guide décisionnel pragmatique pour le chercheur et le praticien
12.1 Arbre de décision statistique étape par étape
Face à un jeu de données psychométriques ou cliniques bivariées, le chercheur doit adopter une démarche algorithmique rigoureuse pour déterminer si le recours à une analyse de corrélation ou à un modèle de régression est méthodologiquement indiqué. L’arbre décisionnel suivant formalise les étapes successives d’arbitrage :
- Évaluation de la finalité épistémologique fondamentale :
- L’interrogation clinique ou théorique porte-t-elle exclusivement sur l’existence, le signe et l’intensité d’un lien d’interdépendance sans hiérarchie entre deux dimensions mesurées ? $to$ Orientez-vous impérativement vers la corrélation.
- L’objectif implique-t-il explicitement d’anticiper la valeur numérique d’un critère, d’estimer un taux d’évolution fonctionnel marginal ou d’élaborer une politique d’intervention graduée ? $to$ Orientez-vous vers la modélisation par régression.
- Examen du statut fonctionnel des variables :
- Les statuts des deux grandeurs sont parfaitement commutables et dénués d’antériorité théorique claire. $to$ Corrélation.
- Une variable est clairement désignée comme déterminant structurel, traitement ou antécédent temporel, et l’autre comme résultat ou critère phénoménologique. $to$ Régression.
- Vérification de la nature métrique des instruments de mesure :
- Deux variables strictement quantitatives continues répondant à la normalité bivariée. $to$ Corrélation de Pearson ou Régression linéaire MCO.
- Variables ordinales, scores d’échelles de Likert ou distributions asymétriques résistantes aux transformations. $to$ Corrélation non paramétrique (Rhô de Spearman ou Tau de Kendall).
- Une variable binaire et une variable continue. $to$ Corrélation point-bisériale ou Régression logistique / Régression linéaire simple par codage indicatif.
- Deux variables binaires. $to$ Coefficient Phi ou analyse de contingence.
- Audit rigoureux des diagnostics résiduels (si la régression est envisagée) :
- L’inspection des nuages de résidus met en lumière une hétéroscédasticité patente, une dépendance temporelle ou une non-linéarité sévère non réductible par transformation de variables. $to$ Abandon de la régression MCO classique au profit d’estimateurs robustes, de régressions non paramétriques (splines, GAM) ou de modèles généralisés adaptés.
12.2 Normes de restitution des résultats selon les standards académiques
La communication scientifique des résultats au sein de revues à comité de lecture doit obéir à des exigences formelles scrupuleuses, codifiées à l’échelle internationale par le manuel de style de l’American Psychological Association (APA, 7e édition). Une restitution transparente, reproductible et éthique exige la présentation rigoureuse d’indices précis, tant pour les analyses corrélationnelles que pour les modèles de régression.
Lors de la rédaction des résultats d’une matrice de corrélation, le chercheur s’astreint à rapporter systématiquement :
- La nature exacte du coefficient utilisé (par exemple, r de Pearson, rho de Spearman).
- La taille exacte de l’échantillon d’analyse ou les degrés de liberté ($N – 2$).
- L’estimation ponctuelle du coefficient arrondie à deux décimales, obligatoirement accompagnée de son intervalle de confiance à $95,%$ (calculé via la transformation en $Z$ de Fisher), afin de renseigner sur la précision de la mesure.
- La valeur $p$ exacte (par exemple, $p = 0,012$, et non la formulation désuète $p < 0,05$), sauf en deçà du seuil millième où l'on reporte $p < 0,001$.
- Exemple de formulation académique textuelle : « Le score d’anxiété état présente une corrélation bivariée positive et modérée avec les temps de réaction à la tâche de Stroop émotionnel, $r(118) = 0,38$, IC $95,% [0,21 ; 0,53]$, $p < 0,001$. »
Pour un modèle de régression linéaire, la restitution ne saurait se limiter à la mention globale de la significativité du modèle. Les standards APA préconisent la construction d’un tableau exhaustif articulant méticuleusement :
- Les coefficients de régression non standardisés ($B$), garantissant l’interprétabilité physique dans l’échelle de mesure native.
- Les erreurs-types associées ($SE_B$), indispensables pour apprécier la variance d’échantillonnage de chaque estimateur.
- Les coefficients de régression standardisés ($\beta$), permettant la hiérarchisation relative des prédicteurs.
- Les statistiques inférentielles associées : valeur de la statistique $t$ de Student et son niveau de probabilité associé ($p$).
- Les indices d’ajustement globaux du modèle : statistique de Fisher ($F$) avec ses degrés de liberté ($df_1, df_2$), le coefficient de détermination global $R^2$, ainsi que le $R^2$ ajusté.
- Exemple de formulation textuelle canonique : « L’analyse de régression linéaire simple montre que la charge mentale perçue prédit de manière significative le niveau d’épuisement émotionnel des soignants, $F(1, 148) = 63,42$, $p < 0,001$. L'équation indique que pour chaque augmentation d'une unité sur l'échelle NASA-TLX, le score d'épuisement augmente de $0,42$ point ($B = 0,42$, $SE = 0,05$, $\beta = 0,55$, $t = 7,96$, $p < 0,001$). Le modèle rend compte de $30,%$ de la variance totale du construit ($R^2 = 0,30$, $R^2_{adj} = 0,29$). »
Enfin, le chercheur veillera rigoureusement à proscrire tout vocabulaire fallacieusement causal dans le corps du texte (tels que « impacte », « modifie », « produit » ou « engendre ») dès lors que l’architecture du protocole repose sur des devis corrélationnels observationnels dénués de manipulation expérimentale aléatoire, préservant ainsi l’intégrité épistémologique de ses conclusions.
Références
- Baumeister, R. F., Campbell, J. D., Krueger, J. I., & Vohs, K. D. (2003). Does high self-esteem cause better performance, interpersonal success, happiness, or healthier lifestyles? Psychological Science in the Public Interest, 4(1), 1-44. https://doi.org/10.1111/1529-1006.01431
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81-105. https://doi.org/10.1037/h0046016
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Cronbach, L. J. (1957). The two disciplines of scientific psychology. American Psychologist, 12(11), 671-684. https://doi.org/10.1037/h0043943
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246-263. https://doi.org/10.2307/2841583
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearson, K. (1895). VII. Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240-242. https://doi.org/10.1098/rspl.1895.0041
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688-701. https://doi.org/10.1037/h0037350
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238-241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72-101. https://doi.org/10.2307/1412159
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.