
Dans l’arsenal méthodologique des sciences contemporaines, et tout particulièrement en psychologie, en neurosciences cognitives et en épidémiologie comportementale, la quantification des relations entre phénomènes constitue le socle fondamental de la découverte empirique. Pourtant, un gouffre épistémologique sépare fréquemment l’intuition conceptuelle du chercheur de l’outil statistique déployé. Au cœur de cette tension réside une équivoque récurrente, parfois délétère pour la validité des conclusions scientifiques : la confusion conceptuelle, terminologique et pratique entre les notions d’association et de corrélation. Si ces termes sont régulièrement employés comme des synonymes interchangeables dans les vulgarisations académiques ou les discussions informelles, ils renvoient à des réalités mathématiques et théoriques profondément distinctes.
L’enjeu de cette distinction dépasse largement une simple querelle sémantique réservée aux puristes de la biométrie. Confondre une association globale avec une corrélation spécifique expose le chercheur à des erreurs systématiques d’interprétation : occultation de relations fonctionnelles non linéaires complexes, inférences erronées sur la nature des dynamiques psychologiques, ou encore modélisations prédictives défaillantes. Comprendre l’architecture formelle de la dépendance entre variables requiert une décomposition rigoureuse des propriétés d’invariance, des niveaux d’échelle de mesure et des topologies de distribution. Cet article propose une exploration exhaustive de cette frontière méthodologique, depuis les théorèmes probabilistes de base jusqu’aux applications psychométriques de pointe.
À travers ce guide approfondi, nous analyserons pourquoi toute corrélation constitue une forme singulière d’association, tandis que la réciproque est fondamentalement fausse. En explorant la géométrie des nuages de points, les contraintes paramétriques des estimateurs classiques de Pearson, les alternatives non paramétriques, ainsi que les avancées récentes issues de la théorie de l’information et des modèles graphiques probabilistes, nous fournirons aux chercheurs et aux praticiens les clés analytiques indispensables pour naviguer avec rigueur dans l’univers complexe des dépendances statistiques bivariées et multivariées.
1. Introduction conceptuelle : Définir l’association et la corrélation en psychologie
1.1 L’ambiguïté sémantique dans le discours scientifique
L’usage du langage au sein des publications scientifiques relatives aux sciences humaines et sociales souffre fréquemment d’un manque de rigueur terminologique. Dans les comptes rendus empiriques, les locutions « être associé à », « être corrélé avec » et « covarier avec » sont couramment mobilisées de manière indistincte pour signaler que deux construits psychologiques ne sont pas indépendants. Cette porosité lexicale découle en grande partie de l’histoire même des statistiques appliquées. À la fin du XIXe siècle, sous l’impulsion de pionniers tels que Sir Francis Galton et Karl Pearson, le concept de corrélation a été formulé initialement pour traduire l’idée générale de « co-relation » organique ou héréditaire observée dans la nature, avant de se figer dans un formalisme mathématique hautement spécifique centré sur la droite des moindres carrés.
La persistance de cette ambiguïté dans la littérature contemporaine pose des défis méthodologiques considérables. Lorsqu’un investigateur affirme que le niveau d’anxiété est « corrélé » au rendement mnésique, le lecteur averti postule immédiatement l’existence d’une fonction linéaire caractérisée par un taux de changement proportionnel et constant. Or, si l’investigateur utilise ce terme pour désigner une dépendance générale — par exemple un effondrement des performances aux deux extrêmes de l’anxiété —, l’usage du vocable « corrélation » s’avère techniquement erroné et inducteur d’erreur. Cette confusion nuit gravement à la méta-analyse, à la réplication des études et à l’élaboration de théories cumulatives en psychologie différentielle.
Pour restaurer une communication scientifique irréprochable, il convient de tracer une ligne de démarcation épistémologique stricte. L’imprécision terminologique ne constitue pas seulement un défaut stylistique ; elle masque des propriétés structurales des données empiriques qui, si elles étaient correctement identifiées à travers le vocabulaire adéquat, orienteraient les chercheurs vers des protocoles analytiques radicalement différents, préservant ainsi l’intégrité de la démarche déductive.
1.2 L’association comme concept parapluie
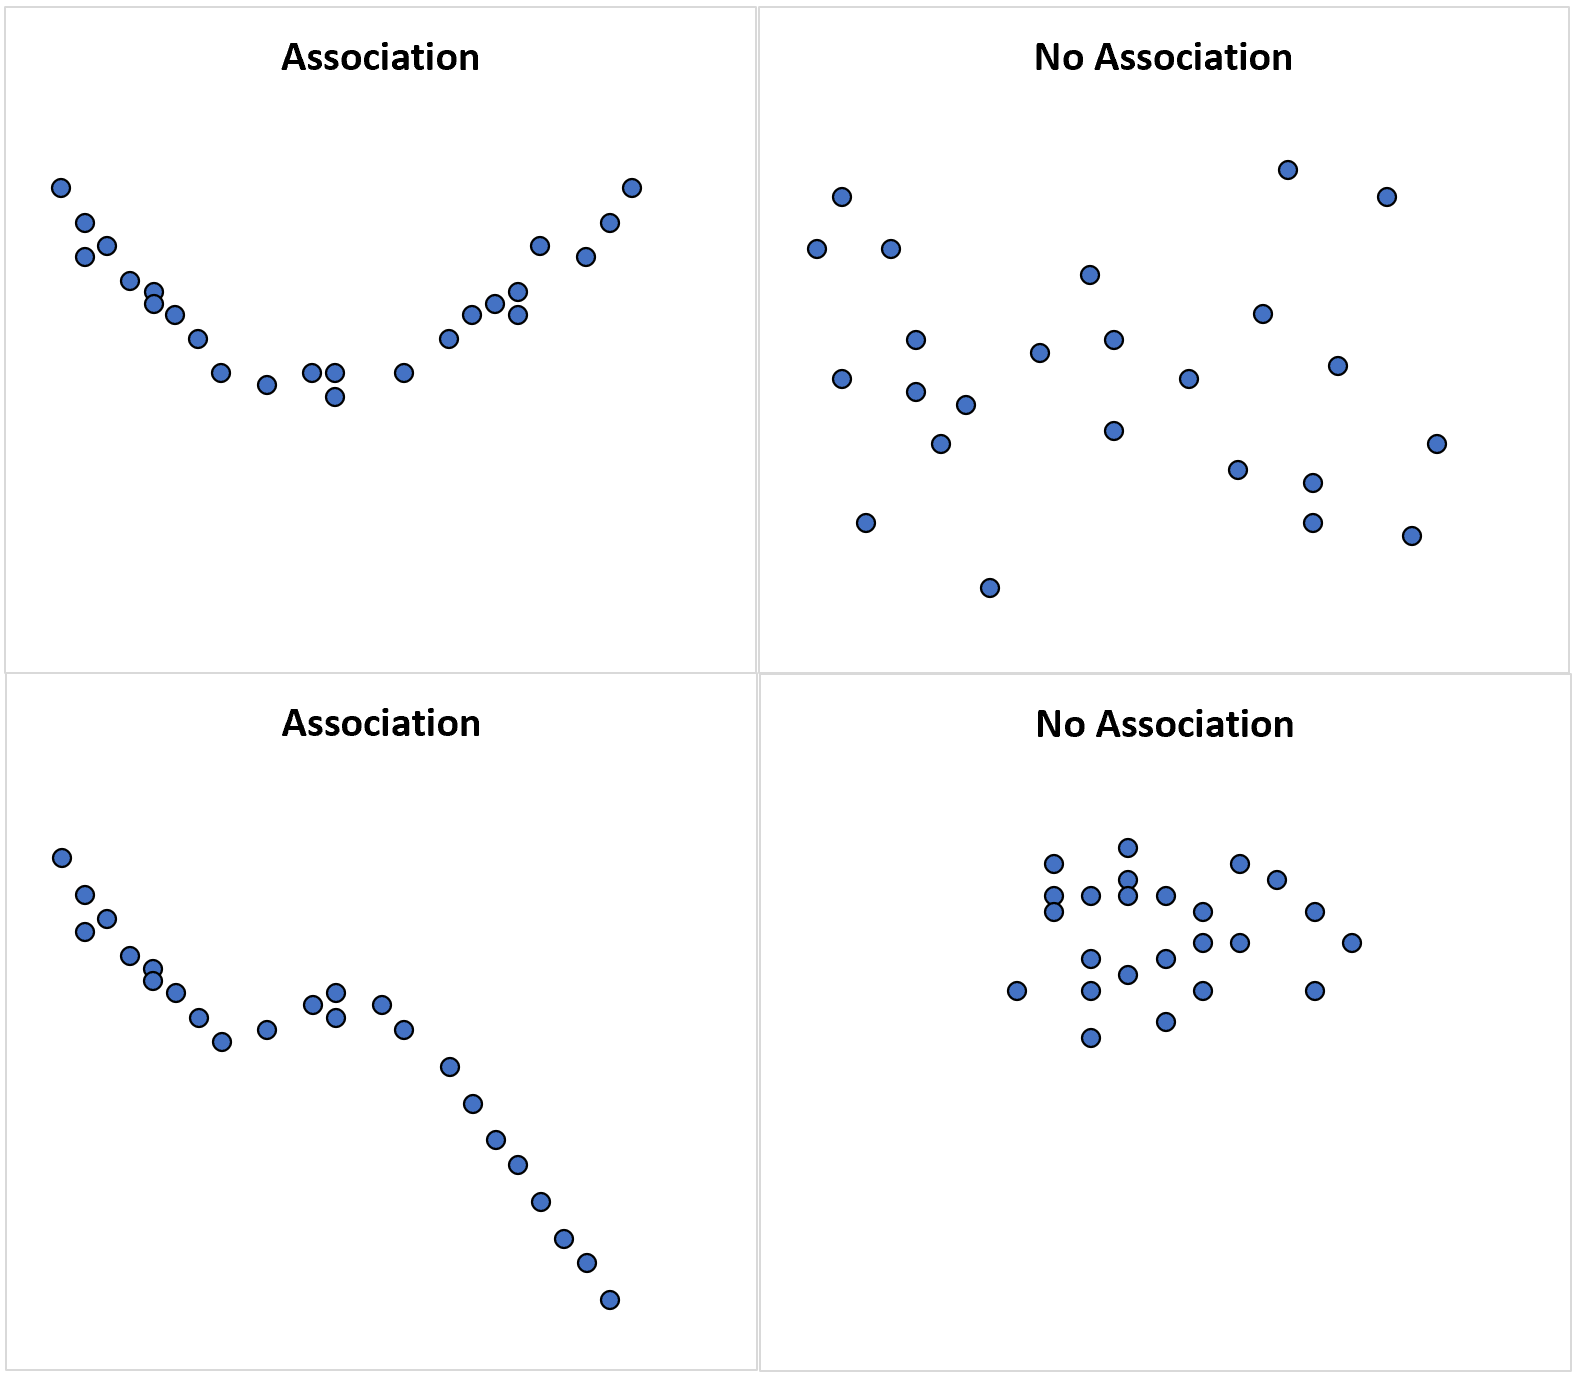
D’un point de vue axiomatique, le concept d’association statistique représente la notion la plus vaste et la plus inclusive pour qualifier le lien entre deux ou plusieurs variables aléatoires. Deux variables, désignées formellement par $X$ et $Y$, sont dites associées dès lors qu’elles violent le principe d’indépendance stochastique. En d’autres termes, il existe une association si la distribution de probabilité conditionnelle de $Y$ sachant $X$ diffère de la distribution marginale de $Y$. L’association incarne ainsi un concept parapluie qui englobe toutes les formes imaginables de dépendance, indépendamment de la forme géométrique que peut revêtir cette relation dans l’espace des phases.
Cette universalité confère à l’association la capacité d’intégrer des relations qualitatives, ordinales, non monotones, périodiques ou chaotiques. Par exemple, si l’on examine l’interaction entre le type d’attachement développemental (sécurisant, insécure-évitant, insécure-anxieux, désorganisé) et la modalité préférentielle de régulation émotionnelle, nous nous trouvons en présence de variables purement catégorielles. Les variations observées dans les fréquences conjointes signalent une association indiscutable, bien qu’aucun calcul de pente ou d’alignement vectoriel continu ne puisse faire sens dans ce contexte précis.
L’association ne présuppose aucun ordre sous-jacent, aucune continuité dimensionnelle et aucune constance dans les variations relatives. Elle atteste simplement que la connaissance de l’état d’une variable apporte une information non nulle sur l’état le plus probable de la seconde variable. Dans l’exploration des traits de personnalité et des phénotypes comportementaux, reconnaître l’association comme un cadre générique permet de s’affranchir des contraintes restrictives imposées par les modèles mathématiques plus exigeants, tout en appréhendant la complexité des systèmes psychologiques ouverts.
1.3 La corrélation comme sous-ensemble spécifique et standardisé
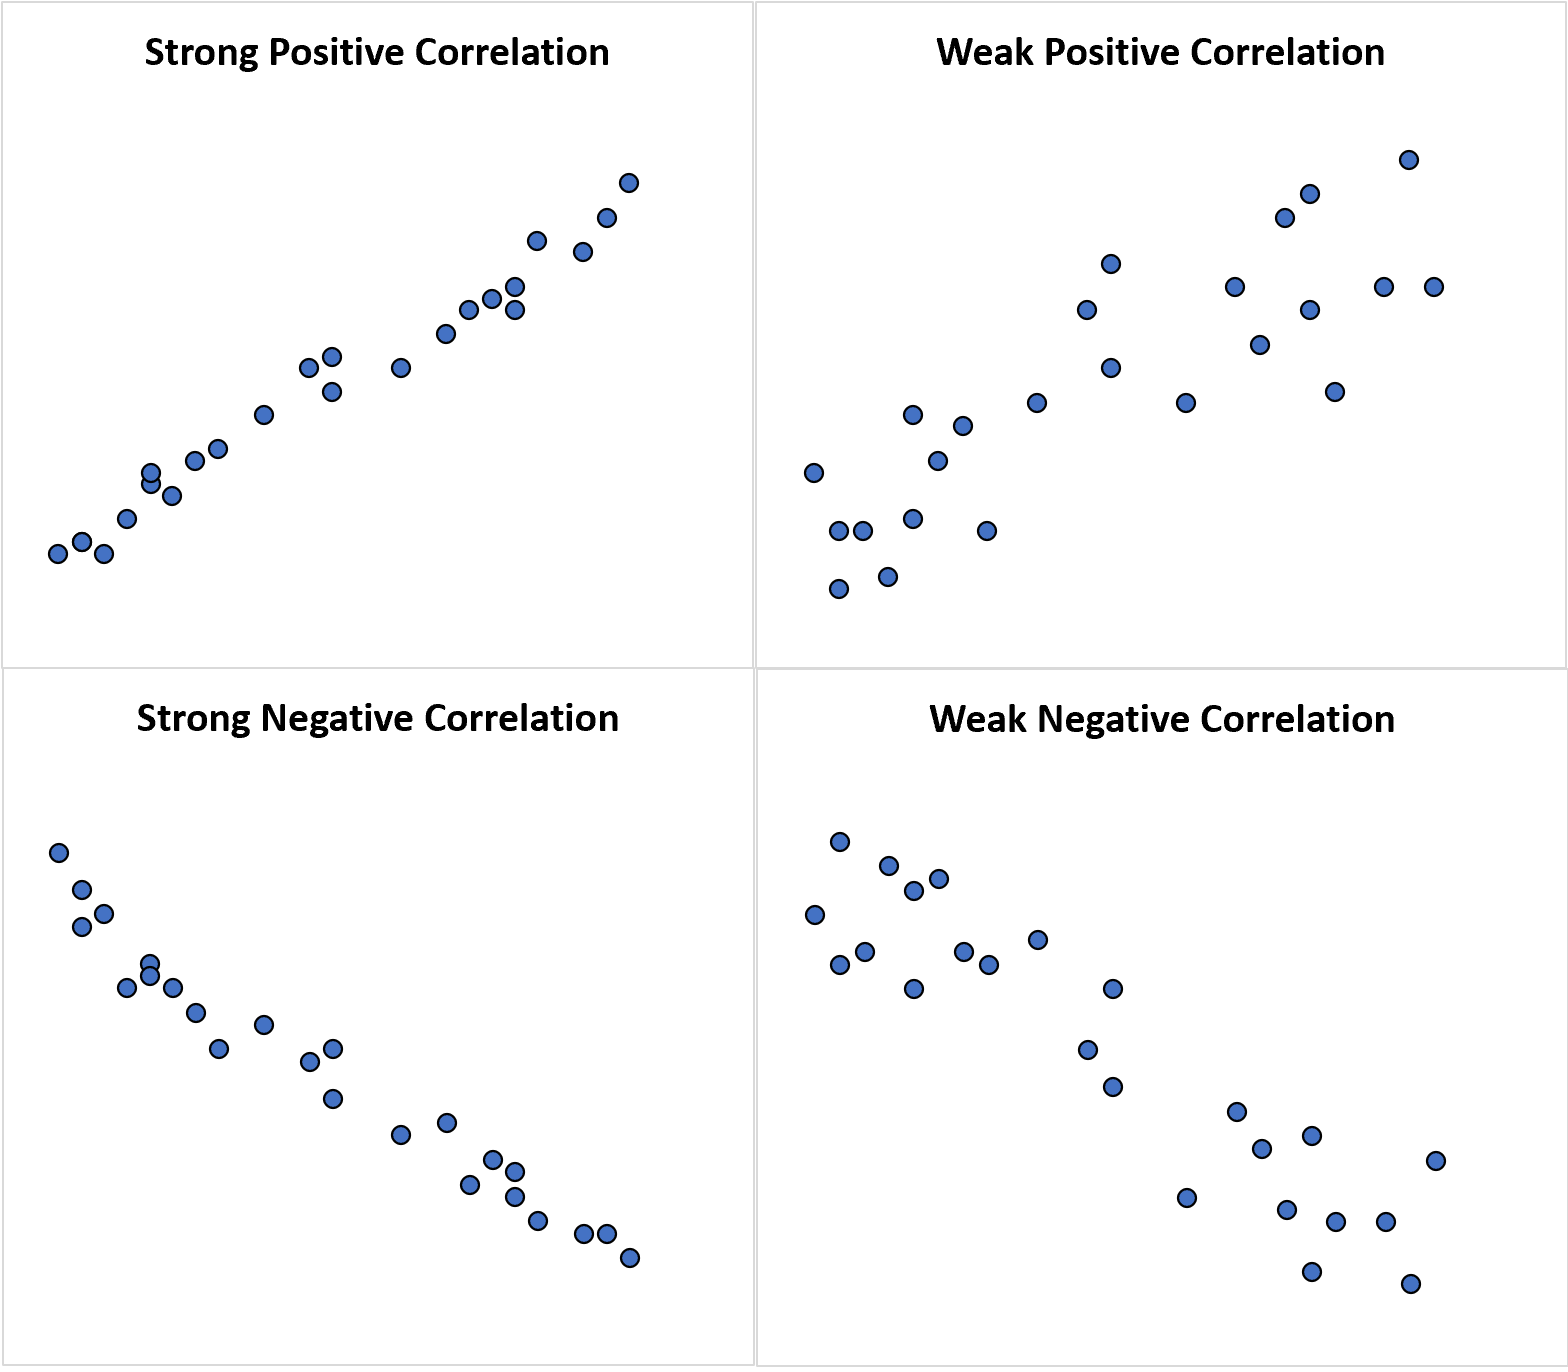
La corrélation ne doit pas être perçue comme un synonyme de l’association, mais rigoureusement comme l’un de ses sous-ensembles méthodologiques les plus sophistiqués et contraints. Si toute corrélation valide sans équivoque l’existence d’une association, l’inverse n’est absolument pas garanti. Historiquement et techniquement, le concept classique de corrélation — incarné par le coefficient produit-moment — restreint son champ d’action à la quantification de la force et de la direction d’une relation strictement linéaire unissant deux variables continues.
Cette spécification exigeante repose sur des impératifs métrologiques précis. Alors que l’association peut être documentée sur des échelles nominales ou ordinales à l’aide de tests de contingence, le calcul d’une corrélation paramétrique nécessite obligatoirement des variables mesurées au minimum sur une échelle d’intervalles égaux, voire sur une échelle de rapports. La corrélation opère une standardisation mathématique de la covariance : elle transforme la mesure brute de la variation conjointe, tributaire des unités de mesure empiriques (comme des millisecondes, des scores à un inventaire psychométrique ou des concentrations hormonales), en un indice adimensionnel borné dans un intervalle normalisé de $-1$ à $+1$.
La corrélation fournit donc deux paramètres cardinaux que l’association générique ne formule pas intrinsèquement : un vecteur directionnel univoque (positif ou négatif) et une métrique d’intensité standardisée fondée sur la proximité des points observés par rapport à une droite idéale tracée par les moindres carrés ordinaires. Assimiler la richesse polymorphe de l’association à ce seul cas particulier de rectilinéarité constitue l’un des réductionnismes les plus fréquents de l’analyse quantitative contemporaine.
2. Les fondements mathématiques de l’association statistique
2.1 La dépendance statistique probabiliste
La définition formelle de l’association statistique s’ancre dans les axiomes de la théorie des probabilités formulés par Andreï Kolmogorov. Soient deux variables aléatoires discrètes ou continues, notées respectivement $X$ et $Y$, définies sur un espace probabilisé commun $(\Omega, \mathcal{F}, P)$. Ces deux variables sont déclarées strictement indépendantes au sens stochastique si, et seulement si, leur fonction de distribution conjointe est égale au produit exact de leurs fonctions de distribution marginales respectives pour tout couple de valeurs possibles :
$$P(X = x \cap Y = y) = P(X = x) \cdot P(Y = y)$$
Dans le domaine continu, cette condition se traduit par l’égalité des densités de probabilité : $f_{X,Y}(x,y) = f_X(x) \cdot f_Y(y)$. Dès l’instant où cette égalité stricte est violée pour au moins un sous-ensemble mesurable de l’espace échantillonnal, les variables $X$ et $Y$ cessent d’être indépendantes ; elles entrent dans un état de dépendance statistique, ce qui équivaut par définition exacte à l’existence d’une association. La déviation observée entre la loi conjointe empirique et le produit des lois marginales constitue l’empreinte mathématique brute de l’association.
L’association statistique jouit de propriétés invariantes fondamentales. Contrairement aux mesures paramétriques qui peuvent être lourdement affectées par des transformations non linéaires des variables, la dépendance stochastique générale demeure invariante sous n’importe quelle transformation strictement monotone et bijective des variables aléatoires considérées. Cette propriété souligne la robustesse conceptuelle de l’association : elle signale une imbrication structurelle d’informations qui transcende le système de coordonnées ou l’échelle de mesure arbitrairement adoptée par l’expérimentateur.
2.2 Mesures de contingence pour variables qualitatives
Lorsque les phénomènes psychologiques sont saisis à travers des catégories discrètes — telles que les diagnostics psychiatriques structurés selon le DSM-5 ou les typologies comportementales en psychologie sociale —, l’évaluation de l’association mobilise des matrices de données spécifiques appelées tableaux de contingence bivariés. Pour une table croisant $r$ modalités d’une variable $X$ et $c$ modalités d’une variable $Y$, l’outil fondamental de détection de l’association demeure le test d’indépendance du Chi-deux ($\chi^2$), initialement théorisé par Karl Pearson en 1900.
La statistique du $\chi^2$ quantifie l’écart quadratique global entre les effectifs observés ($O_{ij}$) dans chaque cellule de la table et les effectifs théoriques attendus sous l’hypothèse nulle d’indépendance stochastique ($E_{ij}$) :
$$\chi^2 = \sum_{i=1}^{r} \sum_{j=1}^{c} \frac{(O_{ij} – E_{ij})^2}{E_{ij}}$$
Cependant, la valeur brute du $\chi^2$ est directement proportionnelle à la taille de l’échantillon $N$, ce qui interdit son interprétation directe comme indice de force d’association. Pour contourner cette limite, la métrologie statistique fait appel à des coefficients normalisés. Le coefficient $Phi$ (Phi), adapté pour les tables $2 \times 2$, et le $V$ de Cramér, applicable à des dimensions arbitraires $r \times c$, permettent de cartographier la force de l’association nominale sur une échelle standardisée variant de 0 (absence totale d’association) à 1 (association parfaite). Le calcul du $V$ de Cramér s’exprime par la relation :
$$V = \sqrt{\frac{\chi^2}{N \cdot \min(r – 1, c – 1)}}$$
Ces métriques illustrent parfaitement la nature de l’association non corrélative : elles confirment avec précision la magnitude de l’interdépendance sans jamais introduire de notion d’orientation vectorielle, de croissance conjointe ou d’élasticité marginale.
2.3 Associations monotones et non linéaires
L’association statistique dépasse également les contraintes de distribution continue grâce au concept de monotonie. Une relation entre deux variables continues ou ordinales est qualifiée de strictement monotone si une augmentation de la variable $X$ s’accompagne systématiquement d’une variation dans une seule et unique direction de la variable $Y$ (soit toujours croissante, soit toujours décroissante), sans que le taux de changement n’ait besoin d’être constant le long du continuum.
En psychophysique et en neurobiologie comportementale, de nombreuses lois fondamentales illustrent ce type d’association non linéaire mais rigoureusement monotone. Considérons la loi de Weber-Fechner ou la loi de puissance de Stevens reliant l’intensité physique d’un stimulus (luminosité, pression acoustique) à l’intensité de la sensation subjective perçue. De même, les phénomènes de saturation enzymatique ou synaptique, ainsi que les effets de plafonnement cognitif dans les tâches d’apprentissage intensif, génèrent des profils asymptotiques ou logarithmiques. Dans ces configurations, l’association entre l’effort consenti et le gain de performance est totale et déterministe au niveau théorique.
Pourtant, si un statisticien applique un modèle de régression linéaire standard à de telles dynamiques, le coefficient de corrélation linéaire enregistrera une sous-estimation systématique de la force réelle du lien en raison de la courbure intrinsèque de la fonction. Les chercheurs recourent souvent à des transformations d’échelles (logarithmiques, exponentielles ou transformations de Box-Cox) pour rétablir artificiellement la linéarité. Cette pratique démontre avec éclat que la non-linéarité n’est pas une absence de relation, mais une modalité complexe d’association que les métriques classiques échouent à capturer dans leur état brut.
3. La corrélation linéaire : Le coefficient de Pearson
3.1 Dérivation mathématique et formule du r de Pearson
Le coefficient de corrélation produit-moment de Pearson, universellement désigné par la lettre latine $r$ pour un échantillon et par la lettre grecque $rho$ pour le paramètre populationnel, constitue l’étalon-or de la quantification des relations bivariées paramétriques. Mathématiquement, le coefficient de Pearson est défini comme le rapport normalisé entre la covariance de deux variables aléatoires et le produit géométrique de leurs écarts-types respectifs :
$$r_{XY} = \frac{\mathrm{Cov}(X,Y)}{s_X s_Y} = \frac{\sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum_{i=1}^{n} (X_i – \bar{X})^2} \sqrt{\sum_{i=1}^{n} (Y_i – \bar{Y})^2}}$$
Cette dérivation élégante met en lumière le principe sous-jacent : la covariance capture la somme des produits croisés des écarts à la moyenne arithmétique. Si les scores individuels tendent à se situer simultanément au-dessus de leur moyenne respective pour $X$ et pour $Y$, les produits croisés sont positifs, conférant à la covariance un signe positif. Inversement, si un score supérieur à la moyenne sur $X$ coïncide systématiquement avec un score inférieur à la moyenne sur $Y$, les produits croisés deviennent négatifs.
La division par le produit des écarts-types opère une standardisation dimensionnelle complète, libérant l’indice de toute unité de mesure originale. Par application de l’inégalité de Cauchy-Schwarz, la valeur de $r$ est mathématiquement confinée à l’intervalle fermé $[-1, +1]$. Un coefficient de $+1$ indique un alignement géométrique positif parfait sur une droite vectorielle ; une valeur de $-1$ reflète une colinéarité négative parfaite. Cependant, cette sensibilité mathématique aux distances algébriques rend le coefficient de Pearson extraordinairement vulnérable à la présence de valeurs aberrantes (outliers), une seule observation extrême pouvant à elle seule inverser artificiellement le signe ou gonfler l’amplitude de $r$.
3.2 Postulats fondamentaux de la corrélation de Pearson
L’inférence statistique valide à partir du coefficient de Pearson ne repose pas uniquement sur l’application mécanique de sa formule algébrique ; elle exige le respect scrupuleux d’un ensemble de postulats distributionnels contraignants. Le premier d’entre eux stipule que les deux variables doivent être mesurées sur une échelle métrique continue, c’est-à-dire au minimum sur une échelle d’intervalles (comme les scores standardisés de quotient intellectuel) ou d’intervalles de rapports (comme les temps de réaction en millisecondes).
Le postulat le plus exigeant concerne l’hypothèse de normalité bivariée dans la population source. Cette condition n’implique pas seulement que la variable $X$ et la variable $Y$ suivent chacune isolément une distribution gaussienne univariée, mais que pour chaque valeur conditionnelle de $X$, la distribution de $Y$ soit normale, et réciproquement. La densité conjointe dans l’espace tridimensionnel doit épouser la forme d’une cloche ellipsoïdale symétrique. Associée à cette exigence, la condition d’homoscédasticité postule que la dispersion ou la variance des résidus le long de la droite d’ajustement doit demeurer strictement constante sur l’ensemble de l’étendue des valeurs prédictives.
Enfin, la distribution empirique ne doit présenter ni effets de plancher ni effets de plafond. La présence de tels artéfacts psychométriques — fréquents lorsque les épreuves d’évaluation cognitive s’avèrent trop ardues ou excessivement élémentaires — tronque arbitrairement la variance observée aux extrémités du spectre. Cette amputation de la variabilité réelle entraîne une compression artificielle de la covariance empirique, faussant irrémédiablement l’estimation du paramètre populationnel $rho$.
3.3 Interprétation de la variance partagée
Une précaution interprétative majeure relative au coefficient de Pearson concerne sa relation non linéaire avec l’amplitude du phénomène qu’il décrit. Si $r$ est un estimateur linéaire de l’alignement des points, il ne constitue en aucun cas une échelle proportionnelle de la magnitude de l’association. Pour quantifier la part d’information mutuellement partagée par les deux construits psychologiques, il est impératif d’élever ce coefficient au carré, calculant ainsi le coefficient de détermination ($r^2$).
Le coefficient $r^2$ exprime la proportion exacte de la variance totale de la variable dépendante qui peut être expliquée, prédite ou comptabilisée par la variance de la variable indépendante dans le cadre du modèle linéaire :
$$r^2 = \frac{\mathrm{Variance expliquacute{e}e}}{\mathrm{Variance totale}} = 1 – \frac{\mathrm{SS}_{\mathrm{racute{e}siduelle}}}{\mathrm{SS}_{\mathrm{totale}}}$$
Cette conversion met en relief une réalité statistique souvent négligée : une corrélation empirique de $r = 0{,}30$, fréquemment qualifiée d’effet moyen dans la recherche psychologique, n’explique en réalité que $0{,}30^2 = 0{,}09$, soit seulement $9,%$ de la variance partagée entre les deux variables. Les $91,%$ restants relèvent de la variance d’erreur, de fluctuations stochastiques ou de déterminants psychologiques alternatifs non pris en compte dans le modèle bivarié. La distinction entre l’intensité statistique d’un coefficient significatif ($p < 0{,}05$) et son utilité pratique dans la prédiction clinique individuelle est ici criante : un $r^2$ modeste interdit toute extrapolation diagnostique catégorique à l'échelle d'un patient isolé.
4. La nature de la relation : Linéarité versus non-linéarité
4.1 La courbe en U inversé et la loi de Yerkes-Dodson
L’une des illustrations les plus paradigmatiques de la divergence fondamentale entre association et corrélation est incarnée en psychologie expérimentale par la célèbre loi de Yerkes-Dodson (1908). Cette loi postule une relation curviligne, prenant la forme d’un U inversé (ou parabole concave), entre le niveau d’éveil physiologique ou d’activation corticale (arousal) et l’efficacité de la performance cognitive dans des tâches complexes.
D’un point de vue physiologique, un niveau d’éveil excessivement faible (somnolence, apathie) hypostimule les réseaux attentionnels et engendre des performances médiocres. À mesure que l’éveil augmente, l’efficience cognitive s’accroît jusqu’à atteindre un optimum fonctionnel optimal. Cependant, au-delà de ce point critique, une activation physiologique excessive (anxiété aiguë, panique motrice, surcharge catécholaminergique) dégrade de façon spectaculaire les capacités de la mémoire de travail et de la flexibilité mentale, précipitant un déclin symétrique des performances.
Si l’on soumet un échantillon complet couvrant l’ensemble du continuum d’éveil à un calcul standard de corrélation linéaire de Pearson, le résultat produit une anomalie déconcertante : le coefficient $r$ converge vers une valeur proche de $0{,}00$. Un observateur candide se fiant uniquement à cet indice numérique déclarerait péremptoirement l’absence totale de relation entre l’état physiologique et l’efficience cognitive. Pourtant, l’association entre ces deux variables est quasi-déterministe : la connaissance du niveau d’éveil prédit remarquablement la performance, à condition de recourir à une régression polynomiale quadratique ($Y = \beta_0 + \beta_1 X + \beta_2 X^2 + \epsilon$) plutôt qu’à un modèle linéaire borné.
4.2 Les relations bimodales et cycliques
Les dynamiques comportementales et psychobiologiques contemporaines abondent en processus oscillatoires qui échappent intégralement au cadre de la corrélation linéaire. Les rythmes circadiens de la température corporelle centrale, les sécrétions пульsatiles de cortisol ou de mélatonine, ainsi que les fluctuations nycthémérales de la vigilance attentionnelle et des états affectifs suivent des cinétiques périodiques modélisables par des fonctions trigonométriques (sinusoïdales ou cosinusoïdales).
Prenons l’exemple de l’évaluation de l’humeur positive mesurée à intervalles réguliers sur un cycle complet de 24 heures. Aux premières heures de la matinée et en fin d’après-midi, des pics de vitalité peuvent être enregistrés, entrecoupés par le creux postprandial du début d’après-midi et l’effondrement nocturne. Dans une telle structure de données, la variable temporelle continue (l’heure de la journée) est intensément associée à l’état affectif auto-rapporté. Néanmoins, tenter d’ajuster une droite de régression linéaire classique à travers ce cycle harmonique conduit à une impasse analytique majeure, le terme de covariance globale tendant à s’annuler en raison de l’alternance cyclique des phases ascendantes et descendantes.
La présence incontestable d’une association fonctionnelle robuste coexiste ici avec une corrélation linéaire de Pearson rigoureusement nulle. Pour modéliser adéquatement ces données chronobiologiques, les chercheurs doivent faire appel à l’analyse harmonique de Fourier ou à des modèles de régression non linéaire de type cosinor :
$$Y(t) = M + A \cos(\omega t + \phi) + \epsilon(t)$$
où $M$ représente le méser (valeur moyenne ajustée), $A$ l’amplitude de l’oscillation, $\omega$ la fréquence angulaire et $phi$ l’acrophase (le moment du pic). Cet exemple démontre une fois encore l’incapacité principielle de la corrélation de Pearson à sonder les géométries non linéaires.
4.3 La détection visuelle vs numérique des relations
L’extrême vulnérabilité des coefficients synthétiques globaux face aux topologies hétérogènes a été brillamment mise en exergue par le statisticien britannique Francis Anscombe en 1973 à travers son célèbre Quartet d’Anscombe. Ce dispositif pédagogique fondamental est constitué de quatre jeux de données synthétiques bivariés distincts présentant des propriétés numériques rigoureusement identiques : une moyenne de $X$ égale à $9$, une moyenne de $Y$ égale à $7{,}50$, des variances identiques, une même droite de régression par les moindres carrés ($Y = 3{,}00 + 0{,}50X$), et un coefficient de corrélation linéaire strictement invariable fixé à $r = 0{,}816$.
Toutefois, dès que le statisticien procède à l’inspection visuelle des nuages de points correspondants, la réalité structurale sous-jacente révèle des architectures radicalement dissemblables :
- Le premier jeu de données décrit une relation linéaire classique, homoscédastique, répondant parfaitement au modèle théorique de Pearson.
- Le deuxième jeu trace une courbe parabolique lisse et déterministe (association quadratique parfaite), pour laquelle le modèle linéaire est totalement inadapté.
- Le troisième jeu illustre une relation linéaire rigoureuse perturbée par un unique point aberrant vertical qui tire la pente et affaiblit le coefficient réel.
- Le quatrième jeu démontre un cas extrême de levier : l’ensemble des observations se superpose sur une ligne verticale ($X = 8$), tandis qu’une unique valeur aberrante située à l’extrême droite ($X = 19, Y = 12{,}5$) génère artificiellement à elle seule l’intégralité du coefficient de corrélation de $0{,}816$.
Cet écueil méthodologique réaffirme l’impératif absolu de l’exploration graphique préalable des données (EDA, Exploratory Data Analysis). Se fier exclusivement à une sortie logicielle automatisée affichant un $r$ ou une $p$-valeur sans visualiser la distribution géométrique bivariée expose le chercheur à valider des illusions mathématiques ou à ignorer des associations fonctionnelles d’une importance clinique capitale.
5. Direction et intensité : Paramétrer la corrélation
5.1 Le vecteur de directionnalité
L’un des apports majeurs de la standardisation corrélative réside dans l’attribution d’un signe algébrique sans équivoque qui détermine le vecteur directionnel du lien bivarié. Une corrélation positive ($rho > 0$) traduit une dynamique de covariation synchrone : les individus manifestant un score élevé sur le premier construit cognitif ou psychologique ont une probabilité accrue de présenter un score proportionnellement élevé sur le second construit. C’est typiquement le cas de la relation linéaire unissant le volume de vocabulaire réceptif et la vitesse de traitement de l’information sémantique chez l’enfant d’âge scolaire.
À l’opposé, une corrélation négative ou inverse ($rho < 0$) modélise un compromis fonctionnel (trade-off) ou un mécanisme homéostatique de compensation. Un exemple classique en psychologie clinique est fourni par l'association linéaire inverse unissant l'estime de soi globale et les scores de rumination dépressive sur des échelles validées : plus la capacité d'auto-évaluation positive se consolide, plus la fréquence des boucles de pensées automatiques négatives tend à s'atténuer de façon proportionnelle.
Cependant, le signe mathématique dépend entièrement du codage arbitraire adopté par le chercheur. Dans la construction d’outils psychométriques, l’inversion d’items formulés négativement au sein d’une échelle de Likert commute instantanément le signe de la corrélation sans en altérer d’un iota l’intensité structurale sous-jacente. Il importe de souligner qu’une corrélation nulle ($r = 0$) ne signale que l’absence de composante linéaire partagée (orthogonalité géométrique dans l’espace euclidien), et ne doit en aucun cas être assimilée hâtivement à une indépendance probabiliste générale.
5.2 L’intensité de la relation selon les standards académiques
Pour calibrer l’intensité des coefficients dans la recherche en sciences du comportement, Jacob Cohen a proposé en 1988 des seuils conventionnels qui sont rapidement devenus canoniques dans les sciences sociales : un coefficient de $r = 0{,}10$ est considéré comme signalant une taille d’effet faible, $r = 0{,}30$ une intensité moyenne, et $r = 0{,}50$ un effet de forte amplitude. Bien que ces repères aient fourni une grille de lecture standardisée indispensable pour le calcul de puissance statistique a priori, ils ont fait l’objet de réévaluations contemporaines critiques, notamment par David Funder et Daniel Ozer (2019).
Ces derniers ont démontré qu’en psychologie de la personnalité et en psychologie sociale, un coefficient de corrélation de $r = 0{,}40$ ou supérieur constitue une rareté empirique extrême et reflète souvent une redondance conceptuelle entre les items des échelles administrées (par exemple, corréler deux mesures évaluant presque la même définition de l’extraversion). Dans les faits empiriques réels :
- Un effet de $r = 0{,}10$ s’avère hautement informatif à l’échelle sociétale lorsqu’il s’applique de façon cumulative à des populations massives (ex. impact d’une micro-intervention préventive sur la santé publique).
- Un effet de $r = 0{,}20$ représente une magnitude typique dans la prédiction des comportements individuels complexes.
- Un coefficient de $r = 0{,}30$ doit être interprété comme une association robuste ayant des conséquences tangibles à court et moyen terme sur le fonctionnement psychologique.
Par ailleurs, l’avènement des mégadonnées (Big Data) et des études fondées sur de gigantesques cohortes épidémiologiques (ex. UK Biobank comprenant plusieurs centaines de milliers de participants) induit un risque majeur de surinterprétation. Dans de tels échantillons, une corrélation infime de $r = 0{,}02$ atteint sans difficulté un seuil de significativité statistique infinitésimal ($p < 10^{-6}$), alors même que sa pertinence explicative ou clinique est rigoureusement négligeable. L'attention du chercheur doit dès lors impérativement se déplacer de la seule $p$-valeur vers l'estimation de la précision du paramètre, documentée par des intervalles de confiance à $95,%$ étroits.
5.3 Facteurs limitant artificiellement l’intensité
L’intensité observée d’un coefficient de corrélation de Pearson dans un échantillon de recherche reflète rarement la pureté théorique du lien latent unissant les deux construits psychologiques. Plusieurs facteurs méthodologiques et artéfacts d’échantillonnage dégradent systématiquement cette valeur. Le mécanisme le plus insidieux est sans conteste la restriction de variance (ou restriction d’étendue, restriction of range).
Si un psychologue chercheur évalue la corrélation entre les capacités de raisonnement fluide (mesurées par les Matrices de Raven) et la réussite académique au sein d’un échantillon constitué exclusivement d’étudiants admis dans un cursus d’élite ultra-sélectif, la variance du prédicteur se trouve drastiquement tronquée vers le haut. Cette homogénéité artificielle du groupe sélectionné comprime mathématiquement la covariance observée, réduisant un coefficient populationnel potentiel de $\rho = 0{,}55$ à une valeur empirique anémique de $r = 0{,}18$. Si le chercheur ignore la formule de correction pour restriction d’étendue de Thorndike, il conclura faussement à l’inefficacité prédictive du raisonnement fluide.
Un deuxième facteur universel d’altération réside dans l’atténuation due à l’erreur de mesure. Aucun instrument psychométrique ne jouit d’une fidélité parfaite ($\alpha = 1{,}00$). Selon la théorie classique des tests formalisée par Charles Spearman (1904), le score observé est la résultante de la somme du score vrai et d’une composante d’erreur aléatoire : $X = T_X + E_X$. Cette erreur non corrélée dilue la covariance observable. La formule de correction pour佻atténuation de Spearman permet d’estimer la corrélation réelle théorique entre les scores vrais latents ($\rho_{T_X T_Y}$) à partir des indices de fidélité observés ($r_{XX’}$ et $r_{YY’}$) :
$$r_{T_X T_Y} = \frac{r_{XY}}{\sqrt{r_{XX’} \cdot r_{YY’}}}$$
Enfin, la fâcheuse tendance historique consistant à dichotomiser des variables continues (par exemple via une séparation par la médiane pour constituer des groupes dits « d’anxiété basse » et « d’anxiété haute ») supprime purement et simplement une part massive de la variance continue, induisant une dégradation immédiate de l’amplitude du coefficient pouvant atteindre $30,%$ à $40,%$.
6. Représentation graphique : Nuages de points et géométrie des données
6.1 Anatomie d’un nuage de points bivarié
L’exploration d’une association ou d’une corrélation trouve son accomplissement méthodologique dans la projection des observations sous forme d’un nuage de points (scatter plot) dans un repère cartésien orthogonal bi-dimensionnel. Chaque individu statistique $i$ de l’échantillon est représenté par une dyade de coordonnées $(x_i, y_i)$. La morphologie globale de cette constellation spatiale révèle instantanément la structure de dépendance sous-jacente.
Lorsque deux variables continues se conforment à une distribution normale bivariée, le nuage de points adopte la morphologie caractéristique d’une ellipse de confiance. L’excentricité de cette ellipse (son aplatissement) traduit directement la magnitude de la corrélation linéaire : plus l’ellipse est étirée le long de son grand axe, plus $|r|$ tend vers l’unité ($1{,}0$). À l’inverse, une distribution sphéroïdale circulaire dénote une absence totale de corrélation linéaire ($r \approx 0$). L’inclinaison de l’axe principal d’inertie de l’ellipse renseigne visuellement sur la direction (pente positive ou négative) de la covariation.
L’inspection du nuage de points constitue également le mécanisme diagnostique privilégié pour traquer l’hétéroscédasticité. Si la dispersion des points s’élargit en forme d’entonnoir (funnel shape) ou d’éventail à mesure que les valeurs de l’abscisse augmentent, cela trahit une instabilité majeure de la variance résiduelle, violant le postulat d’homoscédasticité. De surcroît, le tracé permet d’isoler visuellement les points de fort levier (leverage points), c’est-à-dire les observations isolées sur l’axe horizontal qui, combinées à un résidu substantiel, exercent une attraction démesurée sur l’orientation de la droite de régression des moindres carrés.
6.2 Visualiser la différence entre association et corrélation
La puissance de la géométrie des données s’illustre avec acuité lorsqu’on confronte des tracés représentant des structures d’association pure face à des patterns strictement corrélatifs. Considérons une distribution synthétique de points disposés selon un cercle parfait centré sur l’origine du repère :
$$X_i^2 + Y_i^2 = R^2$$
Dans cette configuration, l’association entre $X$ et $Y$ est absolue, déterministe et rigoureuse : si l’on connaît la valeur de $x_i$, la valeur absolue de $y_i$ est rigoureusement déterminée par $\sqrt{R^2 – x_i^2}$. Il existe donc une dépendance structurelle totale. Pourtant, si l’on applique la machinerie algorithmique de Pearson à cet anneau parfait, les produits croisés positifs dans les premier et troisième quadrants sont méticuleusement annulés par les produits croisés négatifs dans les deuxième et quatrième quadrants. Le coefficient $r$ résultant est exactement de $0{,}00$. Superposer sur ce tracé la droite de régression horizontale plate ($Y = \bar{Y}$) illustre la cécité du formalisme linéaire face à une telle association géométrique.
De façon analogue, l’intégration conjointe sur un graphique de dispersion d’une droite linéaire des moindres carrés ordinaires et d’un lisseur non paramétrique local de type LOESS (Locally Estimated Scatterplot Smoothing) ou d’une spline cubique permet de matérialiser instantanément les écarts à la linéarité. Si le lisseur LOESS ondule de façon significative en s’écartant du vecteur rectiligne, il signale visuellement au chercheur que la relation observée relève d’une association curviligne ou saturée que le calcul d’un simple $r$ de Pearson réduirait à une caricature statistique appauvrie.
6.3 Techniques graphiques avancées en psychométrie
À mesure que les protocoles psychométriques montent en complexité et intègrent des dimensions observationnelles multiples, le simple nuage de points bivarié s’avère insuffisant. Les chercheurs déploient alors des matrices de nuages de points (scatterplot matrices ou SPLOM), qui projettent simultanément l’ensemble des combinaisons bivariées d’un vecteur multivarié de variables continues, adossées à des estimations de densité univariées par noyau (KDE) sur la diagonale principale.
Un défi majeur rencontré lors du traitement de volumineuses cohortes réside dans le phénomène de sur-tracé (overplotting), où l’accumulation de dizaines de milliers de points superposés transforme le centre du graphique en une masse d’encre opaque indéchiffrable, dissimulant la véritable concentration des densités bivariées. Pour surmonter cet écueil technique, la psychométrie computationnelle utilise des graphiques de densité bidimensionnelle par contours (isolignes de probabilité) ou des représentations par pavage hexagonal (hexbinning), où l’espace cartésien est segmenté en cellules hexagonales dont la chromaticité reflète la fréquence exacte des observations.
Ces représentations sophistiquées sont indispensables pour identifier l’existence de sous-groupes latents non documentés a priori. L’apparition d’un nuage de points présentant une morphologie bimodale ou séparé en deux sous-ellipses distinctes trahit immédiatement l’action d’une variable modératrice catégorielle cachée (par exemple, un dimorphisme sexuel marqué ou une hétérogénéité étiologique dans un phénotype psychiatrique) qui rend caduque l’interprétation d’un coefficient de corrélation agrégé global.
7. Mesures alternatives : De l’association ordinale à la corrélation non paramétrique
7.1 Le rho de Spearman pour relations monotones
Pour s’émanciper de l’impératif rigide de normalité bivariée et de métrique linéaire continue, Charles Spearman a développé une alternative non paramétrique pionnière : le coefficient de corrélation de rangs, universellement désigné par $rho$ (rho) ou $r_s$. L’algorithme de Spearman opère une transformation fondamentale : il substitue aux valeurs numériques brutes des variables continues leur rang ordinal respectif au sein de la série statistique ordonnée, variant de $1$ pour la plus petite observation à $n$ pour la plus élevée.
Le calcul mathématique du $rho$ de Spearman équivaut rigoureusement à l’application de la formule de corrélation produit-moment de Pearson directement sur les variables transformées en rangs. En l’absence d’ex-æquo, il s’exprime par la formule simplifiée remarquable :
$$r_s = 1 – \frac{6 \sum_{i=1}^n d_i^2}{n(n^2 – 1)}$$
où $d_i = \mathrm{Rang}(X_i) – \mathrm{Rang}(Y_i)$ représente la différence arithmétique entre les rangs attribués à chaque sujet sur les deux dimensions étudiées.
Ce changement de référentiel apporte une flexibilité méthodologique déterminante : le $rho$ de Spearman ne mesure plus la conformité à une droite linéaire stricte, mais la conformité globale à n’importe quelle fonction monotone arbitraire, qu’elle soit exponentielle, logarithmique ou sigmoïde. Dès lors que $Y$ croît continuellement quand $X$ croît, le coefficient de Spearman culminera à $+1{,}00$, alors même que le $r$ de Pearson sera substantiellement inférieur à l’unité en raison de la courbure fonctionnelle. De plus, la conversion en rangs neutralise l’impact destructeur des valeurs aberrantes univariées, conférant à cette métrique une robustesse exceptionnelle lors du traitement de données psychologiques asymétriques issues de questionnaires d’auto-évaluation.
7.2 Le tau de Kendall pour échantillons restreints et ex-aequo
Bien que le coefficient de Spearman soit largement usité, les théoriciens de la statistique non paramétrique lui préfèrent souvent le coefficient $tau$ (tau) de Maurice Kendall (notamment la variante $\tau_b$ de Kendall), particulièrement lorsque la taille des échantillons étudiés est modeste ($n < 30$) ou lorsque les données ordinales présentent une forte concentration de rangs ex-æquo (tied ranks), une configuration ubiquitaire dans les échelles de Likert comptant de 5 à 7 points d’ancrage.
L’assise mathématique du tau de Kendall repose sur une approche probabiliste combinatoire élégante axée sur l’analyse comparative de l’ensemble des $\binom{n}{2} = \frac{n(n-1)}{2}$ paires d’observations possibles dans l’échantillon. Une paire de sujets $(i, j)$ est qualifiée de concordante si le sujet présentant le score le plus élevé sur $X$ présente également le score le plus élevé sur $Y$ :
$$(X_i – X_j)(Y_i – Y_j) > 0$$
À l’inverse, elle est dite discordante si l’orientation relative des rangs s’inverse : $(X_i – X_j)(Y_i – Y_j) < 0$. Le coefficient fondamental $\tau_a$ est défini comme la différence standardisée entre la proportion de paires concordantes ($C$) et la proportion de paires discordantes ($D$) :
$$\tau = \frac{C – D}{\frac{1}{2} n (n – 1)}$$
Le tau de Kendall offre une interprétation cognitive directe et intuitive : il quantifie la différence nette de probabilité entre concordance et discordance empirique lors du tirage aléatoire de deux observations indépendantes dans la population. Sur le plan asymptotique, l’estimateur de Kendall converge vers une distribution normale beaucoup plus rapidement que celui de Spearman, et son erreur-type est formulable de façon plus robuste sous l’hypothèse nulle d’indépendance, ce qui en fait l’outil d’élection pour les investigations cliniques à cohortes restreintes.
7.3 Le coefficient de corrélation à distance (Distance Correlation)
L’une des innovations les plus révolutionnaires des statistiques contemporaines pour résoudre définitivement la fracture théorique entre association et corrélation est l’introduction, par Gábor Székely et ses collaborateurs en 2007, de la corrélation à distance (Distance Correlation, notée $\mathrm{dCor}$ ou $\mathcal{R}$). Cette avancée majeure comble l’insuffisance séculaire des coefficients traditionnels :
$$\mathrm{dCor}(X,Y) = 0 iff X \text{ et } Y \text{ sont rigoureusement et stochastiquement indépendants}$$
Contrairement au coefficient de Pearson où $r = 0$ n’exclut aucunement une dépendance non linéaire violente, une corrélation à distance nulle garantit de façon absolue l’absence totale de n’importe quelle forme d’association fonctionnelle, probabiliste ou chaotique. La formulation mathématique de la corrélation à distance opère dans l’espace des distances euclidiennes intra-échantillon. Elle calcule la covariance de distance matricielle standardisée à partir des fonctions caractéristiques conjointes et marginales des variables :
$$\mathrm{dCor}(X,Y) = \frac{\mathrm{dCov}(X,Y)}{\sqrt{\mathrm{dVar}(X) \cdot \mathrm{dVar}(Y)}}$$
Ce coefficient varie harmonieusement dans l’intervalle $[0, 1]$. Il présente une sensibilité sans équivalent pour détecter sans modification de paramètres des structures paraboliques, des relations sinusoïdales, des distributions en croix ou des topologies fractales complexes. De surcroît, la corrélation à distance s’applique directement à des vecteurs de dimensions arbitraires ($\mathbb{R}^p$ et $\mathbb{R}^q$), permettant par exemple d’estimer en neuro-imagerie cognitive le lien d’association globale entre un ensemble multidimensionnel de voxels IRMf et un profil comportemental multivarié, ouvrant des perspectives méthodologiques inédites pour la recherche translationnelle.
8. L’association dans les variables catégorielles et qualitatives
8.1 Mesures de corrélation sérielle et bisérielle
Dans l’ingénierie des tests psychométriques et des épreuves standardisées, le chercheur est continuellement confronté à la nécessité d’évaluer le pouvoir de discrimination des items élémentaires. Dans ce cadre opérationnel, un item est fréquemment binaire ou dichotomique (succès codé 1 / échec codé 0, présence ou absence d’un symptôme), tandis que le critère global de performance ou l’estimation du trait latent s’exprime sous forme d’une variable métrique continue. Deux coefficients d’association hybrides répondent spécifiquement à cette configuration d’échelle.
Le coefficient de corrélation point-bisérielle ($r_{pb}$) est strictement l’équivalent algébrique du $r$ de Pearson appliqué à une variable continue $Y$ et une variable dichotomique $X$ représentant une dichotomie « vraie » ou naturelle (par exemple, être porteur ou non d’une mutation génétique spécifique). Sa formulation opérationnelle relie la différence des moyennes conditionnelles à l’écart-type total :
$$r_{pb} = \frac{\bar{Y}_1 – \bar{Y}_0}{s_Y} \sqrt{p(1-p)}$$
où $\bar{Y}_1$ et $\bar{Y}_0$ sont les moyennes de la variable continue pour chacune des deux catégories binaires, et $p$ est la proportion d’individus dans le groupe codé 1.
En revanche, lorsque la variable binaire découle de la segmentation artificielle d’un continuum sous-jacent que l’on postule normalement distribué (comme la réussite à un item d’arithmétique difficile, qui reflète en réalité un continuum latent d’aptitude cognitive générale), l’usage du coefficient point-bisérielle sous-estime systématiquement la force réelle du lien en raison de l’écrasement de la variance. Il convient alors de mobiliser le coefficient de corrélation bisérielle ($r_{b}$), qui introduit une correction fondée sur la hauteur de l’ordonnée de la courbe de densité normale standard ($u$) au point de troncature correspondant à la proportion $p$ :
$$r_b = \frac{\bar{Y}_1 – \bar{Y}_0}{s_Y} \cdot \frac{p(1-p)}{u} = r_{pb} \frac{\sqrt{p(1-p)}}{u}$$
Ce formalisme subtil rétablit mathématiquement la magnitude de l’association paramétrique latente à travers une lentille d’observation catégorielle imparfaite.
8.2 Corrélations tétrachorique et polychorique
Le problème de la distorsion métrique s’amplifie considérablement lorsque les deux variables observées sont simultanément catégorielles ordinales. C’est la situation prévalente dans l’immense majorité des instruments d’auto-évaluation psychologiques, où les items adoptent la forme d’échelles de Likert ordonnées (par exemple, une échelle graduée de « Pas du tout d’accord » à « Entièrement d’accord » sur 4 ou 5 échelons discrets).
Traiter directement ces données discrètes comme des grandeurs continues au moyen du coefficient de Pearson classique conduit à une sous-estimation systématique et sévère de la matrice de covariance. Les corrélations résultantes sont artificiellement atténuées, ce qui perturbe lourdement les analyses multivariées ultérieures, telles que l’analyse factorielle confirmatoire ou la modélisation par équations structurelles (SEM). Pour remédier à cette anomalie de mesure, la psychométrie moderne recourt systématiquement aux corrélations tétrachoriques (pour deux variables binaires dérivées de continuums normaux latents) et aux corrélations polychoriques (pour des variables ordinales polytomiques).
Le postulat théorique fondamental des modèles polychoriques affirme qu’à chaque variable ordinale observée $X$ et $Y$ correspond une variable latente inobservable distribuée selon une loi normale standard bivariée :
$$(X^*, Y^*) \sim \mathcal{N}_2\left(\begin{\pmatrix} 0 0 \end{\pmatrix}, \begin{\pmatrix} 1 &a\mp; \rho \rho &a\mp; 1 \end{\pmatrix}\right)$$
Les catégories discrètes visibles ne représentent que des intervalles délimités par des seuils ou points de coupure vectoriels latents ($\tau_x, \tau_y$). L’algorithme mathématique consiste à estimer simultanément, via le maximum de vraisemblance, ces seuils inconnus et le paramètre latent $rho$. Utiliser une matrice de corrélation polychorique au lieu d’une matrice de Pearson brute garantit l’adéquation structurelle des modèles psychométriques latents et évite l’extraction de pseudo-facteurs méthodologiques dérivés uniquement de la distribution asymétrique des items.
8.3 L’information mutuelle comme mesure universelle d’association
Pour s’émanciper totalement des contraintes distributionnelles paramétriques ou ordinales, il est possible d’aborder la question de la dépendance sous l’angle de la théorie de l’information formalisée par Claude Shannon en 1948. L’outil suprême de cette approche est le coefficient d’information mutuelle (noté $I(X; Y)$), fondé sur le concept d’entropie informationnelle $H(X)$, qui quantifie le degré moyen d’incertitude associé à une variable aléatoire :
$$H(X) = – \sum_{x in \mathcal{X}} P(X=x) \log_2 P(X=x)$$
L’information mutuelle mesure la réduction de l’incertitude quant à la variable $X$ induite par la connaissance empirique préalable de l’état de la variable $Y$, et vice-versa. Elle est définie formellement à partir de la divergence de Kullback-Leibler entre la distribution de probabilité conjointe et le produit des distributions marginales :
$$I(X; Y) = \sum_{x in \mathcal{X}} \sum_{y in \mathcal{Y}} P(x, y) \log_2 \left( \frac{P(x, y)}{P(x) P(y)} \right)$$
Les propriétés de l’information mutuelle en font la métrique d’association absolue par excellence :
- $I(X; Y)$ est strictement non négative ($I(X; Y) \geq 0$).
- $I(X; Y) = 0$ si et seulement si les variables $X$ et $Y$ sont rigoureusement indépendantes au sens de la théorie des probabilités.
- Elle capture indifféremment et avec la même précision les relations linéaires, sinusoïdales, cycliques, fractales ou catégoriellement discontinues.
- Elle est parfaitement invariante sous n’importe quelle transformation inversible et continue des variables d’intérêt.
Dans l’exploration computationnelle des mégadonnées en neurosciences et en génétique comportementale, où des millions d’interactions gène-environnement hautement complexes et non linéaires doivent être scannées sans a priori fonctionnel, l’information mutuelle s’impose comme un outil incontournable de détection exploratoire préliminaire.
9. Pièges interprétatifs : Confusion entre corrélation, association et causalité
9.1 Le postulat ‘Cum hoc ergo propter hoc’
L’adage latin « Cum hoc ergo propter hoc » (« avec ceci, donc à cause de ceci ») synthétise l’erreur épistémologique la plus répandue et la plus tenace de l’esprit humain : la confusion spontanée entre la simple concomitance temporelle ou spatiale de deux événements et l’existence d’une chaîne causale sous-jacente. L’esprit humain, biologiquement sélectionné pour détecter rapidement des régularités environnementales afin de maximiser sa survie, est une formidable « machine à inférer de la causalité », même au sein d’occurrences entièrement stochastiques.
En méthodologie de la recherche, il est constamment rappelé que la démonstration d’une association statistique — aussi robuste, significative et formellement quantifiée par un $r$ élevé soit-elle — constitue une condition strictement nécessaire, mais absolument pas suffisante, pour prétendre attester d’un lien de causalité. Déduire qu’une variable $X$ cause une variable $Y$ requiert la satisfaction conjointe de trois critères épistémologiques impératifs théorisés par John Stuart Mill :
- La précédence temporelle absolue de la cause sur l’effet (la manipulation ou la survenue de $X$ doit impérativement anticiper l’émergence de la variation sur $Y$).
- Une covariation empirique systématique (démontrée par l’association ou la corrélation).
- L’élimination totale de toute explication alternative plausible, notamment la neutralisation des tiers facteurs confondants par la randomisation expérimentale ou le contrôle contrefactuel.
Dans les designs observationnels transversaux couramment utilisés en sciences humaines, le critère temporel est fréquemment indécidable, rendant l’attribution causale arbitraire. L’histoire de la santé publique regorge d’erreurs coûteuses issues de cette confusion, comme l’assertion erronée persistante selon laquelle les traitements hormonaux substitutifs chez la femme ménopausée réduisaient substantiellement les pathologies coronariennes, avant que des essais randomisés contrôlés à double insu ne révèlent que l’association observée n’était qu’un sous-produit d’un statut socio-économique plus favorable chez les utilisatrices de ces traitements.
9.2 Corrélations fallacieuses et causalité commune
L’absence de causalité directe au sein d’une corrélation statistiquement significative renvoie dans une écrasante majorité des cas au mécanisme de la cause commune (common-cause confounder). Soient deux variables $X$ et $Y$ manifestant une corrélation substantielle. Cette interdépendance est fréquemment induite par l’action conjointe et non observée d’une troisième variable $Z$, appelée facteur de confusion (confounder), qui influence simultanément $X$ et $Y$ selon une structure triangulaire classique ($X \leftarrow Z \rightarrow Y$).
L’exemple canonique d’école est l’association positive robuste observée au sein des stations balnéaires entre le volume des ventes de glaces ($X$) et le nombre d’incidents par noyade ($Y$). Une lecture littérale conclurait de façon absurde que la consommation d’aliments glacés provoque la submersion aquatique. Il est évident que la température atmosphérique estivale ($Z$) constitue le facteur de confusion causal majeur qui régule simultanément l’appétence thermique des vacanciers et la fréquence globale des activités de baignade récréative.
Pour désenchevêtrer ces dépendances artificielles, l’expérimentateur utilise la technique analytique de la corrélation partielle ($r_{XY.Z}$). Cette méthode permet de quantifier l’intensité du lien linéaire subsistant entre $X$ et $Y$ une fois que l’impact et la variance attribuable à la variable confondante $Z$ ont été statistiquement purgés et neutralisés sur chacune des deux variables cibles :
$$r_{XY.Z} = \frac{r_{XY} – r_{XZ} r_{YZ}}{\sqrt{1 – r_{XZ}^2} \sqrt{1 – r_{YZ}^2}}$$
Si le coefficient résiduel de corrélation partielle s’effondre à zéro ($r_{XY.Z} \approx 0$), cela apporte la preuve formelle que la corrélation bivariée initiale était entièrement fallacieuse (spurious) et dérivait intégralement de l’action non contrôlée de la variable latente $Z$.
9.3 Le paradoxe de Simpson
Parmi les pièges les plus spectaculaires de l’agrégation de données quantitatives figure le redoutable paradoxe de Simpson (ou effet Yule-Simpson). Ce paradoxe désigne une anomalie mathématique au sein de laquelle une corrélation ou une association observée de manière stable au sein de plusieurs sous-groupes homogènes indépendants s’inverse totalement, disparaît ou change radicalement d’orientation directionnelle dès lors que l’on agrège l’ensemble de ces sous-groupes pour analyser l’échantillon composite global.
Supposons que nous étudions dans un contexte éducatif la relation unissant le nombre d’heures de pratique d’un logiciel d’entraînement cognitif ($X$) et les scores finaux obtenus à une épreuve cognitive standardisée ($Y$), au sein de deux cohortes distinctes : des enfants scolarisés au niveau élémentaire et des adolescents du secondaire. Analysée au sein de chaque groupe d’âge pris isolément, la corrélation est rigoureusement positive ($r = +0{,}45$ dans le groupe élémentaire, et $r = +0{,}50$ dans le groupe secondaire) : au sein d’une même tranche développementale, plus l’entraînement est soutenu, plus la performance s’élève.
Cependant, les adolescents réalisent globalement des scores beaucoup plus élevés aux tests en raison de leur maturité neurobiologique, mais consacrent paradoxalement beaucoup moins d’heures totales au logiciel d’entraînement en raison de contraintes académiques plus lourdes. Si un chercheur naïf regroupe l’ensemble des données des deux cohortes sans modéliser la variable de stratification « Âge », le nuage de points composite agrégé dessine une droite de pente négative : le coefficient global devient $r = -0{,}35$. Une interprétation basée sur ces données agrégées conclurait fallacieusement que l’usage du logiciel dégrade le potentiel cognitif des individus. La neutralisation du paradoxe de Simpson exige l’implémentation de modèles linéaires hiérarchiques (HLM) ou d’analyses de covariance (ANCOVA) capables de dissocier les effets intrasujets et intergroupes.
10. Applications pratiques en psychométrie et sciences comportementales
10.1 Validité et fidélité des instruments de mesure
L’évaluation métrologique de la qualité intrinsèque des instruments d’investigation psychologique constitue le domaine d’application privilégié du calcul des corrélations. Selon les standards scientifiques édités conjointement par l’AERA, l’APA et le NCME, la construction d’un test psychométrique valide requiert la démonstration empirique de sa fidélité et de sa validité de construit.
La fidélité de type test-retest — qui quantifie la stabilité temporelle des scores lors d’administrations répétées dans un intervalle chronologique où le trait est théoriquement stable — est mesurée via le calcul de coefficients de corrélation intraclasse (ICC). Contrairement au coefficient de Pearson qui ne détecte que la co-linéarité relative et tolère des biais systématiques de translation moyenne entre deux temps de mesure, l’ICC mesure la concordance absolue des scores individuels. L’analyse de la consistance interne, traditionnellement estimée par l’alpha de Cronbach ($\alpha$) ou l’oméga de McDonald ($\omega$), repose quant à elle mathématiquement sur la structure de la matrice de corrélations ou de covariances inter-items :
$$\alpha = \frac{k}{k – 1} \left( 1 – \frac{\sum_{i=1}^k \sigma_i^2}{\sigma_{\mathrm{total}}^2} \right)$$
En matière de validité de construit, la célèbre matrice multitraces-multiméthodes (MTMM) conceptualisée par Donald Campbell et Donald Fiske (1959) articule subtilement des hypothèses corrélatives exigeantes :
- La validité convergente est validée par l’observation de corrélations statistiques élevées et significatives entre des mesures distinctes prétendant évaluer un construit théorique homologue, y compris lorsqu’elles déploient des méthodologies hétérogènes (ex. auto-évaluation combinée à des observations comportementales).
- La validité discriminante requiert impérativement que les corrélations entre le construit cible et des dimensions théoriquement divergentes (par exemple, distinguer l’évaluation de l’anhédonie de l’évaluation de la fatigue physique générale) demeurent substantiellement inférieures et idéalement proches de zéro.
10.2 Analyse factorielle et réduction dimensionnelle
L’analyse en composantes principales (ACP) et l’analyse factorielle exploratoire (EFA) reposent entièrement sur la décomposition mathématique et la diagonalisation d’une matrice de corrélations ou de covariances empiriques. Ces techniques visent à synthétiser un large volume de variables observées manifestes ($p$) en un nombre restreint de facteurs latents synthétiques ($k ll p$) qui capturent le maximum de variance commune partagée.
La matrice de corrélations bivariées standardisée sert d’intrant direct aux algorithmes de factorisation. Cependant, le traitement mathématique de cette matrice impose des choix théoriques lourds de conséquences quant à la conception même des liens sous-jacents. Lorsque le psychologue applique une rotation orthogonale (de type Varimax), il contraint a priori les facteurs extraits à maintenir des corrélations rigoureusement nulles entre eux ($r = 0$), postulant l’indépendance structurelle des dimensions latentes de la psyché.
En revanche, lorsqu’il adopte une rotation oblique (de type Promax ou Oblimin), il autorise explicitement les facteurs latents sous-jacents à s’inter-corréler ($r \neq 0$). Cette seconde approche s’avère infiniment plus cohérente avec l’organisation systémique des processus psychologiques réels, où des construits comme l’anxiété, la dépression, le neuroticisme et l’auto-efficacité cognitive ne fonctionnent jamais en vases clos indépendants. Si le chercheur commet l’erreur méthodologique majeure d’alimenter une EFA avec une matrice de Pearson calculée sur des items ordinaux tronqués, l’algorithme générera des « facteurs de difficulté » parasitaires (facteurs de Guttman), trahissant une défaillance dans le choix des estimateurs d’association.
10.3 Psychopathologie et réseaux causaux
Au cours de la dernière décennie, la psychopathologie quantitative a opéré une véritable révolution paradigmatique sous l’impulsion des travaux de Denny Borsboom sur l’approche en réseau des troubles mentaux (Network Psychometrics). Rejetant le modèle médical classique de la maladie latente — qui postule qu’une entité causale invisible (ex. « le trouble dépressif majeur ») engendre de façon unilatérale un ensemble de symptômes observés —, cette théorie novatrice modélise les épisodes psychopathologiques comme des systèmes dynamiques complexes d’interactions réciproques directes entre les symptômes eux-mêmes.
Dans cette architecture de graphes formels, chaque symptôme constitue un nœud (node) et l’association conditionnelle entre deux symptômes est représentée par une arête (edge). Cependant, modéliser ce réseau par de simples corrélations marginales bivariées de Pearson engendrerait un graphe ultra-dense et illisible, saturé de liaisons fallacieuses induites par des cascades de dépendances indirectes. Pour extraire la structure véritable du réseau clinique, la psychométrie de pointe mobilise le formalisme des modèles graphiques gaussiens (GGM) couplés à l’algorithme de régularisation GLASSO (Graphical Least Absolute Shrinkage and Selection Operator).
Chaque arête du graphe régularisé représente ainsi le coefficient de corrélation partielle unissant deux symptômes spécifiques, conditionnellement à l’ensemble de tous les autres symptômes répertoriés dans le réseau. L’algorithme GLASSO applique une pénalisation de type norme $L_1$ qui contracte délibérément les corrélations partielles infinitésimales à zéro, ne conservant que les connexions causales putatives les plus robustes et parcimonieuses. Cette modélisation permet d’identifier les « symptômes centraux » du réseau (présentant la plus forte centralité de force ou d’intermédiarité), désignant ainsi les cibles d’intervention thérapeutique prioritaires pour désamorcer l’emballement d’une crise clinique.
11. Facteurs confondants et artéfacts méthodologiques
11.1 Biais d’échantillonnage et conditionnement sur un collisionneur
Dans l’arsenal méthodologique contemporain structuré autour des graphes acycliques dirigés (DAG, Directed Acyclic Graphs) développés par Judea Pearl, l’un des mécanismes les plus dévastateurs de génération d’associations fallacieuses est le conditionnement sur un collisionneur (collider conditioning), historiquement désigné en épidémiologie sous le nom de paradoxe de Berkson.
Un nœud $C$ est qualifié de collisionneur sur un chemin causal reliant deux variables $X$ et $Y$ si les flèches causales convergent simultanément vers lui : $X \rightarrow C \leftarrow Y$. Dans la population générale non sélectionnée, les variables $X$ et $Y$ peuvent être rigoureusement indépendantes et présenter une corrélation strictement nulle. Cependant, dès lors que l’échantillonnage de la recherche opère une sélection des participants fondée directement ou indirectement sur la valeur de la variable collisionneur $C$ (ce qui revient mathématiquement à stratifier ou à conditionner sur $C$), une association statistique négative artificielle d’une ampleur considérable est instantanément créée entre $X$ et $Y$.
Considérons l’exemple paradigmatique de la recherche psychiatrique hospitalière. Soit $X$ la sévérité d’un trouble anxieux panique, et $Y$ la présence d’une douleur chronique articulaire, deux affections largement indépendantes dans la population générale. Si le protocole expérimental recrute ses sujets au sein d’une clinique spécialisée dont le critère d’hospitalisation ($C$) dépend de la sévérité globale de la détresse médicale (induite soit par l’anxiété extrême, soit par la douleur intolérable, soit par les deux), l’admission agit comme un collisionneur conditionné. Au sein de cet échantillon hospitalisé spécifique :
$$\mathrm{Cov}(X, Y mid C = 1) < 0$$
Un patient admis souffrant d’une douleur articulaire bénigne doit obligatoirement présenter un niveau d’anxiété cataclysmique pour avoir franchi le seuil d’admission, et vice-versa. L’investigateur naïf observant ces données conclura à l’existence d’une robuste association négative inverse entre les deux pathologies, publiant un artéfact méthodologique total induit exclusivement par le biais de sélection de son protocole.
11.2 Hétérogénéité d’échantillon et écologie des données
Le transfert inconsidéré d’indices statistiques d’un niveau d’organisation macroscopique vers un niveau microscopique constitue une défaillance logique majeure désignée sous le terme d’erreur écologique (ecological fallacy). Ce phénomène se produit lorsqu’un chercheur observe une corrélation substantielle au niveau agrégé de groupes sociaux, de régions ou de nations, et en déduit fallacieusement que cette corrélation s’applique de manière isomorphe au niveau individuel.
Le sociologue William Robinson a magistralement formalisé cette dissociation dès 1950 en analysant les données du recensement américain. Au niveau agrégé des États fédéraux, il existait une corrélation positive très forte ($r = +0{,}53$) entre le pourcentage d’immigrants nés à l’étranger et le taux d’alphabétisation de la population. Une conclusion précipitée aurait consisté à affirmer que les individus immigrés maîtrisaient mieux la langue écrite que les citoyens nés aux États-Unis. Or, dès lors que l’analyse était menée au niveau des micro-données individuelles, la corrélation s’inversait pour devenir négative ($r = -0{,}11$) : au niveau individuel, les personnes immigrées présentaient un taux d’illettrisme moyen légèrement plus élevé. La corrélation agrégée macroscopique résultait uniquement du fait que les populations migrantes s’installaient préférentiellement dans les États industrialisés les plus riches disposant d’infrastructures scolaires hautement performantes pour l’ensemble des résidents.
Pour immuniser les recherches en sciences comportementales contre ces distorsions dévastatrices — tout particulièrement dans les protocoles modernes de recueil écologique de données en vie réelle (ESM, Experience Sampling Methodology) où les sujets sont évalués 10 fois par jour sur smartphone —, il est impératif de recourir à des modèles mixtes multi-niveaux. Ces architectures computationnelles partitionnent rigoureusement la variance totale en deux composantes mathématiquement distinctes : la dynamique interindividuelle (between-person correlation, reliant les moyennes globales des traits des participants) et la dynamique intra-individuelle (within-person correlation, reliant les fluctuations d’un individu par rapport à sa propre moyenne au fil des heures).
11.3 Biais de publication et p-hacking autour du coefficient r
L’estimation intègre des associations statistiques dans la littérature scientifique a été lourdement compromise par la crise de la réplicabilité qui a secoué la psychologie et les sciences médicales. L’un des moteurs cardinaux de cette altération réside dans le biais de publication combiné aux pratiques de recherche contestables regroupées sous le vocable de p-hacking.
Pendant des décennies, la probabilité d’acceptation d’un manuscrit empirique dans les revues académiques de premier rang a été conditionnée de façon disproportionnée à l’obtention d’un seuil magique arbitraire de significativité : $p < 0{,}05$. Confrontés à un coefficient de corrélation empirique préliminaire affichant une valeur de $r = 0{,}18$ pour $p = 0{,}07$, certains investigateurs se sont livrés à des ajustements a posteriori : élimination sélective de valeurs extrêmes selon des critères opportunistes, arrêt opportuniste de la collecte de données dès le franchissement du seuil de significativité, ou exploration matricielle de dizaines de construits jusqu'à dénicher une association fortuite franchissant le couperet canonique.
Cette sélection pernicieuse entraîne une inflation artificielle monumentale des tailles d’effet publiées, phénomène théorisé sous le nom de « malédiction du vainqueur » (winner’s curse). Les coefficients de corrélation trônant dans la littérature historique peuvent s’avérer deux à trois fois supérieurs à leur véritable amplitude populationnelle. Pour éradiquer ces dérives systémiques, la communauté académique a instauré le protocole du pré-enregistrement systématique (preregistration ou Registered Reports). Les chercheurs s’engagent formellement, avant toute collecte d’échantillons, sur leurs hypothèses directionnelles, leurs seuils d’exclusion et leur métrique analytique d’association, garantissant la publication des résultats quelle que soit la significativité terminale des coefficients observés.
12. Synthèse comparative et lignes directrices pour les chercheurs
12.1 Grille de décision pour le choix de la métrique appropriée
Face à la complexité des configurations méthodologiques, le choix de la métrique d’association ou de corrélation ne doit jamais découler d’un automatisme routinier, mais s’adosser à un arbre décisionnel probabiliste et métrologique rigoureux. La première étape diagnostique impose l’identification du niveau de mesure des variables aléatoires cibles :
- Variables purement catégorielles nominales : L’analyse de contingence s’impose. Déploiement du test d’indépendance du Chi-deux ($\chi^2$), associé au $V$ de Cramér ou au coefficient $Phi$ pour quantifier l’effet sans prétention directionnelle.
- Variables catégorielles ordinales : Recours exclusif aux mesures non paramétriques de rangs, en privilégiant le tau de Kendall ($\tau_b$) face à des échantillons réduits ou de multiples ex-æquo, ou le rho de Spearman ($rho$). Si les variables ordinales matérialisent des continuums psychologiques sous-jacents, l’extraction de matrices de corrélations polychoriques est obligatoire pour alimenter les modélisations multivariées.
- Variables continues d’intervalles ou de rapports : Avant d’appliquer l’estimateur de Pearson, le chercheur doit obligatoirement procéder à l’inspection graphique du nuage de points et au test formel des résidus (normalité bivariée via le test de Shapiro-Wilk univarié/Mardia multivarié, homoscédasticité via le test de Breusch-Pagan).
Dès lors que la structure géométrique présente une courbure fonctionnelle ou une relation cyclique, la corrélation linéaire de Pearson doit être immédiatement abandonnée au profit d’une régression polynomiale, d’un modèle additif généralisé (GAM), ou du coefficient universel de corrélation à distance de Székely. Enfin, dans les contextes de données massives asymétriques où aucun a priori fonctionnel n’est admissible, le calcul de l’information mutuelle constitue l’approche exploratoire la plus rigoureuse et impartiale.
12.2 Standards de rédaction scientifique selon l’APA
La communication académique des résultats empiriques exige une adhésion stricte aux normes formelles dictées par le manuel de style de l’American Psychological Association (APA, 7e édition). Pour une corrélation bivariée standard de Pearson, la notification textuelle ne peut se borner à mentionner une vague $p$-valeur ; elle doit obligatoirement rapporter les degrés de liberté exacts ($df = n – 2$), la valeur empirique arrondie au centième supérieur, la $p$-valeur exacte (sans zéro initial devant la virgule décimale), ainsi que l’intervalle de confiance à $95,%$ :
« Une corrélation linéaire statistiquement significative a été observée entre la mémoire de travail et les capacités de planification exécutive, r(118) = ,42, p < ,001, IC à 95 % [,26, ,56]. »
Pour les tests non paramétriques, la nomenclature prescrit la spécification adéquate des symboles : $r_s(118) = ,38$ pour Spearman, ou $tau(118) = ,29$ pour Kendall. Dans les tableaux synthétiques de corrélations multivariées, les matrices doivent impérativement être documentées en présentant sur la diagonale principale les indices de consistance interne des échelles (ex. oméga de McDonald ou alpha de Cronbach). De surcroît, le manuel de l’APA impose une vigilance éthique et lexicale absolue : l’usage de verbes d’action suggérant une dynamique causale unilatérale (tels que « impacter », « influencer », « provoquer » ou « déterminer ») est rigoureusement proscrit pour rapporter des analyses observationnelles d’association ou de corrélation, le chercheur devant s’en tenir strictement au lexique de la relation, de l’association, de la prédiction statistique ou de la covariation linéaire.
12.3 Perspectives futures en psychologie informatique
L’intersection contemporaine des sciences psychologiques, des neurosciences computationnelles et de l’intelligence artificielle repousse les frontières traditionnelles de la modélisation statistique des données bivariées et multivariées. L’intégration des architectures d’apprentissage automatique (Machine Learning) modifie en profondeur la façon dont les associations sont détectées et validées. Des algorithmes non paramétriques d’apprentissage supervisé, tels que les forêts d’arbres décisionnels (Random Forests) et les réseaux de neurones profonds, capturent d’emblée des surfaces de réponse multidimensionnelles saturées d’interactions non linéaires complexes et d’effets de seuil qui échappaient traditionnellement aux matrices corrélatives standards.
Parallèlement, la formalisation rigoureuse de l’inférence causale structurelle menée par Judea Pearl à travers le formalisme du « do-calculus » ($\mathrm{do}(X)$) permet désormais de dépasser définitivement la contemplation passive des matrices d’association observationnelles. En intégrant des modèles causaux explicites sous forme de graphes orientés validés a priori, les chercheurs peuvent identifier précisément quelles variables doivent être obligatoirement ajustées ou bloquées (critère de la porte arrière, backdoor criterion) et quelles variables ne doivent sous aucun prétexte être contrôlées (sous peine de créer un biais de collisionneur désastreux) pour convertir une simple mesure d’association empirique en une estimation causale non biaisée.
L’avenir de la discipline réside dans cette symbiose méthodologique harmonieuse : préserver la puissance de standardisation intuitive et la simplicité élégante des coefficients de corrélation linéaires pour les systèmes fonctionnant dans des régimes gaussiens de base, tout en adoptant sans frilosité les estimateurs non paramétriques avancés, la géométrie de la théorie de l’information et la modélisation graphique causale pour sonder la complexité intégrale de l’esprit humain dans ses manifestations les plus dynamiques et interconnectées.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Borsboom, D. (2017). A network approach to psychopathology. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202
- Galton, F. (1888). Co-relations and their measurement, chiefly from anthropometric data. Proceedings of the Royal Society of London, 45, 135–145. https://doi.org/10.1098/rspl.1888.0082
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press.
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Székely, G. J., Rizzo, M. L., & Bakirov, N. K. (2007). Measuring and testing dependence by correlation of distances. The Annals of Statistics, 35(6), 2769–2794. https://doi.org/10.1214/009053607000000505
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503