
Dans l’édifice des mathématiques appliquées et de l’inférence statistique moderne, la transition entre les modèles probabilistes théoriques purs et l’empirisme méthodologique constitue un défi permanent. Au cœur de cette articulation réside la question fondamentale de la représentativité et de la dynamique interne des échantillons probabilistes prélevés au sein de populations finies. Alors que la théorie élémentaire des probabilités postule très fréquemment l’indépendance mutuelle et stricte des observations — condition sine qua non de l’application directe des lois binomiales ou des versions canoniques du théorème central limite —, la réalité matérielle des protocoles de collecte de données confronte inévitablement les chercheurs à des populations finies au sein desquelles les tirages s’effectuent sans remise. Cet état de fait engendre mécaniquement une dépendance stochastique progressive entre les unités statistiques successivement observées, menaçant la validité formelle des procédures de test et d’estimation.
Pour surmonter cette aporie sans contraindre le praticien à manipuler systématiquement les équations combinatoires particulièrement rébarbatives de la loi hypergéométrique, les statisticiens ont formalisé des compromis opératoires rigoureusement encadrés. Parmi ces règles d’or méthodologiques, la condition dite des dix pour cent (ou « règle des 10 % ») occupe une place pivot dans les sciences quantitatives, depuis la psychométrie clinique jusqu’à l’épidémiologie et l’économétrie appliquée. Cette règle établit qu’aussi longtemps que la taille de l’échantillon extrait ne dépasse pas un dixième de la taille totale de la population cible, la dérive des probabilités conditionnelles consécutive à l’épuisement de ladite population demeure suffisamment infime pour que l’hypothèse d’indépendance puisse être maintenue sans compromettre l’intégrité des inférences subséquentes.
Le présent article propose une déconstruction épistémologique, théorique et opérationnelle exhaustive de la condition des 10 %. À travers l’analyse des propriétés axiomatiques de Bernoulli, la démonstration de la convergence asymptotique de la distribution hypergéométrique vers la loi binomiale, l’examen scrupuleux du facteur de correction pour population finie et l’étude d’exemples computationnels concrets, nous mettrons en lumière les mécanismes mathématiques qui sous-tendent ce seuil de tolérance standardisé. Nous explorerons également les conséquences structurelles de sa transgression, les fausses conceptions qui altèrent fréquemment sa mise en œuvre dans les protocoles de recherche contemporains, et les algorithmes d’ajustement requis lorsque les exigences de cette règle heuristique ne peuvent être satisfaites.
1. Introduction aux épreuves de Bernoulli et aux fondements de l’échantillonnage
1.1 Nature et propriétés fondamentales d’un essai de Bernoulli
L’unité fondamentale de la modélisation probabiliste discrète repose sur le concept théorisé originellement par Jacques Bernoulli dans son œuvre posthume Ars Conjectandi publiée en 1713 : l’essai de Bernoulli. Par définition formelle, un essai de Bernoulli est une expérience aléatoire dont l’espace d’échantillonnage fondamental est partitionné en exactement deux événements mutuellement exclusifs et conjointement exhaustifs, conventionnellement dénommés « succès » et « échec ». Dans le formalisme des variables aléatoires, une telle épreuve est modélisée par une variable indicatrice binaire prenant la valeur 1 lorsque l’événement désiré se réalise avec une probabilité théorique p comprise strictement entre 0 et 1, et la valeur 0 dans le cas contraire avec une probabilité complémentaire généralement notée q = 1 – p. La distribution de masse de cette variable possède une espérance mathématique égale à p et une variance canonique égale au produit p(1 – p), constituant le bloc structural minimal de toute théorie ultérieure de la dispersion binomiale.
La pérennité conceptuelle de l’épreuve de Bernoulli réside dans la constance théorique supposée de ce paramètre p à travers les réplications successives du protocole expérimental. Si l’archétype vulgarisé de ce processus demeure le jet d’une pièce de monnaie équilibrée où p = 0,5, la transposition de ce modèle aux sciences empiriques, telles que la psychologie expérimentale ou la recherche clinique, exige une abstraction rigoureuse. Qu’il s’agisse de mesurer la présence d’une rémission clinique après l’administration d’un principe actif, l’adhésion d’un sujet à un item dichotomique de personnalité, ou le comportement de vote lors d’un référendum, chaque unité observée est assimilée à une instanciation de cette variable binaire. Toutefois, cette assimilation théorique repose sur une hypothèse fondamentale et axiomatique : la stabilité immarcescible de la probabilité p et l’absence totale de corrélation temporelle ou causale entre les réalisations successives.
Cette hypothèse d’indépendance stochastique postule que la connaissance de l’issue d’un essai n’apporte strictement aucune information quant à l’issue de l’essai suivant. Lorsque cette condition d’invariance paramétrique et d’indépendance mutuelle est rigoureusement satisfaite, la sommation d’une série finie de n essais de Bernoulli indépendants et identiquement distribués donne naissance à la loi binomiale. Dès lors, toute la machinerie de l’inférence classique — calculs combinatoires de probabilités exactes, intervalles de confiance proportionnels et tests d’ajustement du chi deux — s’applique de manière directe. Néanmoins, la vulnérabilité de cette construction axiomatique transparaît immédiatement dès que les conditions empiriques de collecte s’écartent du modèle idéal d’un générateur aléatoire infini et immuable.
1.2 L’indépendance probabiliste dans la recherche quantitative
Dans l’édifice mathématique de la recherche quantitative, l’indépendance stochastique constitue le levier algorithmique essentiel autorisant la factorisation des lois conjointes. Formellement, deux événements aléatoires A et B définis sur un même espace de probabilité sont dits indépendants si et seulement si la probabilité de leur intersection conjointe est rigoureusement égale au produit algébrique de leurs probabilités marginales respectives, ce qui s’énonce par la relation P(A ∩ B) = P(A) × P(B). Par voie de corollaire immédiat en probabilité conditionnelle, l’indépendance implique que la probabilité conditionnelle de A sachant B est strictement identique à la probabilité a priori de A, soit P(A | B) = P(A), sous réserve que P(B) > 0. Dans l’écosystème inférentiel, cette propriété de factorisation permet de décomposer des problèmes d’une complexité multidimensionnelle inextricable en une simple multiplication de densités ou de masses de probabilités unidimensionnelles.
Le rôle opérationnel de cette indépendance est particulièrement saillant dans la théorie de l’estimation ponctuelle et par intervalle. Lorsque des observations sont mutuellement indépendantes, la variance de la somme d’un ensemble de variables aléatoires se réduit simplement à la somme arithmétique de leurs variances individuelles respectives, sans qu’il soit nécessaire de calculer ou d’estimer les termes de covariance croisée. En statistique appliquée, ce théorème d’additivité des variances permet d’établir sans détour que l’erreur type de la moyenne d’un échantillon ou d’une proportion empirique décroît proportionnellement à la racine carrée de la taille de l’échantillon. L’indépendance est par conséquent le socle sur lequel reposent l’efficience, la convergence et l’absence de biais des estimateurs classiques dérivés de la méthode du maximum de vraisemblance.
Cependant, dans la pratique de la collecte de données réelles, cette indépendance probabiliste s’avère être une hypothèse méthodologique extrêmement fragile. Dans les sciences sociales, médicales ou comportementales, les unités expérimentales n’évoluent pas dans un vide relationnel ou spatial et ne sont pas générées par un algorithme pseudo-aléatoire infini. Si une dépendance stochastique non contrôlée s’insinue au sein de l’échantillon — qu’elle soit induite par des corrélations intra-classes, des proximités géographiques ou, plus fondamentalement, par la nature même du processus de tirage —, les termes de covariance deviennent non nuls. L’omission de ces covariances dans les formules analytiques conventionnelles entraîne une sous-estimation systématique de la variance réelle des estimateurs, conduisant à des marges d’erreur artificiellement étroites, à des valeurs p trompeusement significatives et à une inflation incontrôlée de l’erreur de première espèce (rejet erroné d’une hypothèse nulle vraie).
1.3 Émergence de la problématique lors de l’échantillonnage sans remise
La confrontation la plus élémentaire, mais aussi la plus universelle, avec la rupture de l’indépendance probabiliste survient lors du passage de l’échantillonnage avec remise (tirage bernoullien strict) à l’échantillonnage sans remise (tirage représentatif standard). Dans un schéma théorique avec remise, chaque individu extrait de la population cible est consigné, mesuré, puis immédiatement réinjecté dans le vivier d’origine avant que la sélection de l’unité suivante n’intervienne. Sous ce protocole artificiel, la composition de la population demeure rigoureusement invariante du premier au dernier prélèvement : la proportion théorique de succès p reste absolue, chaque tirage constitue une épreuve de Bernoulli parfaitement autonome, et le nombre total de succès observés dans un échantillon de taille n suit de façon unimputable une loi binomiale formelle.
À l’inverse, l’immense majorité des enquêtes épidémiologiques, des essais cliniques et des sondages d’opinion s’exécute selon un protocole d’échantillonnage aléatoire simple sans remise (EASSR). Il serait en effet absurde, et méthodologiquement contre-productif, d’administrer deux fois le même inventaire de dépression au même patient, de biopsier deux fois le même organe, ou d’interroger à plusieurs reprises le même électeur au cours d’une même vague d’investigation. Or, l’action physique de prélever une unité statistique sans la restituer altère de manière irréversible et systématique la distribution paramétrique de la population résiduelle. Si le premier individu sélectionné au sein d’une population de taille N comptant K éléments cibles présente le statut « succès », la proportion résiduelle de succès pour le second tirage s’établit instantanément à (K – 1) / (N – 1), modifiant de facto la probabilité de survenue du second événement.
Ce glissement conceptuel marque l’abandon forcé du processus binomial au profit d’un processus stochastique régi par la loi hypergéométrique. Dans cette distribution, les tirages sont intrinsèquement interdépendants et conditionnés par l’historique complet des sélections préalables. Lorsque la taille de la population N est extrêmement modeste, la manipulation analytique de la loi hypergéométrique s’avère indispensable mais calculatoirement laborieuse. Dès lors, émerge un besoin pragmatique capital pour la statistique appliquée : déterminer avec précision le seuil critique d’épuisement de la population en deçà duquel cette altération conditionnelle est si marginale qu’elle peut être légitimement négligée, autorisant ainsi le maintien des formules simplifiées de la loi binomiale. C’est précisément à cette intersection entre rigueur mathématique et efficience méthodologique que s’enracine la condition des 10 %.
2. Définition formelle et cadre mathématique de la condition des 10 %
2.1 Énoncé canonique de la règle statistique
La condition des dix pour cent, régulièrement désignée dans les manuels académiques anglo-saxons sous le vocable de 10% Condition ou Independence Assumption for Finite Populations, constitue une règle heuristique régissant la validité de l’approximation binomiale lors d’un échantillonnage sans remise. Dans son énoncé canonique le plus strict, la règle stipule que la taille de l’échantillon extrait, notée n, ne doit pas excéder dix pour cent (soit un dixième) de la taille totale de la population finie sous-jacente, notée N. Formellement, l’inéquation s’écrit :
n ≤ 0,10 N ou, de manière rigoureusement équivalente : N ≥ 10 n
Le principe fondamental sous-jacent à cette formulation réside dans l’acceptation d’une distorsion infinitésimale et contrôlée des probabilités conditionnelles. Lorsqu’un chercheur extrait des observations successives sans remise au sein d’une population dont la fraction de sondage f = n / N respecte ce critère de modération relative, la composition globale du réservoir d’observations résiduel n’est pas modifiée de manière significative par les tirages antérieurs. En d’autres termes, l’écart entre la probabilité conditionnelle d’obtenir un événement au n-ième tirage sachant les (n – 1) tirages précédents et la probabilité marginale initiale p demeure confiné dans des marges de tolérance numérique qui n’altèrent en rien les décisions inférentielles subséquentes.
Il est impératif d’insister sur la nature éminemment relative de cette contrainte méthodologique. La condition des 10 % ne formule aucune exigence quantitative directe quant à la taille absolue de l’échantillon n, mais régit exclusivement le ratio d’épuisement de la population cible. Un échantillon de n = 500 sujets violera de manière flagrante la condition des 10 % s’il est extrait d’une collectivité locale restreinte de N = 2 000 habitants (car 500 / 2 000 = 0,25, soit 25 %), mais la satisfera de manière exemplaire s’il est prélevé au sein d’une métropole régionale de N = 500 000 résidents (où 500 / 500 000 = 0,001, soit seulement 0,1 %). Cette distinction conceptuelle entre volume absolu de données et fraction de sondage relative représente le premier écueil théorique que tout analyste doit impérativement assimiler.
2.2 Origine théorique et justification du seuil de 10 %
D’un point de vue épistémologique et historico-mathématique, le seuil de dix pour cent n’est pas une constante fondamentale de l’univers physique au sens de la constante de Planck ou de la vitesse de la lumière, mais une norme conventionnelle standardisée, validée empiriquement et analytiquement par des générations de théoriciens de l’échantillonnage, notamment William Cochran et Leslie Kish. Cette convention statistique procède d’une optimisation d’ingénierie mathématique visant à trouver le point d’équilibre parfait entre la rigueur analytique formelle et la faisabilité empirique des enquêtes d’envergure. Fixer un seuil excessivement conservateur, par exemple un pour cent (n ≤ 0,01 N), aurait pour conséquence de paralyser la recherche dans les populations de taille intermédiaire en imposant le recours systématique à des ajustements computationnels lourds.
La justification analytique de ce seuil spécifique de 10 % s’éclaire à travers l’étude du comportement de la variance de l’échantillonnage. Comme nous le formaliserons ultérieurement, la variance réelle d’un estimateur sans remise diffère de la variance sous indépendance stricte par un multiplicateur dénommé facteur de correction pour population finie, dont l’expression algébrique est (N – n) / (N – 1). Lorsque la fraction de sondage n / N s’établit précisément à la frontière des 10 %, ce facteur de réduction de variance prend une valeur approximative de 1 – 0,10 = 0,90. Si l’on s’intéresse à l’écart-type de l’échantillon (l’erreur type servant aux tests et aux marges d’erreur), l’ajustement est régi par la racine carrée de ce facteur, soit √0,90 ≈ 0,9486.
Ce résultat numérique révèle qu’à la limite maximale de la condition des 10 %, l’erreur type standard calculée sous l’hypothèse simplificatrice d’indépendance binomiale ne surestime l’erreur type réelle que d’environ 5,14 % (puisque 1 – 0,9486 ≈ 0,0514). Dans la communauté des statisticiens appliqués, une distorsion asymptotique relative de l’ordre de 5 % sur la largeur de l’intervalle de confiance est jugée comme une marge d’approximation parfaitement acceptable au regard des incertitudes inhérentes à la mesure empirique (erreurs de mesure, biais de non-réponse ou fluctuations d’échantillonnage). La règle des 10 % se présente ainsi comme le seuil de tolérance maximal au-delà duquel cette distorsion ne peut plus être considérée comme statistiquement bénigne.
2.3 Conditions d’application et prérequis méthodologiques
L’implémentation opérationnelle de la condition des 10 % ne saurait s’effectuer de manière aveugle ou décontextualisée. Elle exige la satisfaction préalable de réquisits méthodologiques stricts, au premier rang desquels figure la nécessité impérieuse de connaître avec un degré d’exactitude suffisant la taille globale de la population parente N. Si la population est infinie ou indéterminable de par sa nature physique (par exemple, la génération continue de pièces mécaniques sur une chaîne de montage industrielle ou l’ensemble théorique des réactions enzymatiques possibles), la notion même de fraction de sondage s’annihile, et l’indépendance des observations est assurée de fait, rendant la condition des 10 % intrinsèquement satisfaite.
En second lieu, la condition des 10 % exige impérativement que le plan d’échantillonnage mis en œuvre appartienne strictement à la catégorie de l’échantillonnage probabiliste aléatoire simple sans remise. Cela signifie axiomatiquement que chaque sous-ensemble de taille n au sein de la population N possède rigoureusement la même probabilité a priori d’être sélectionné, et que le processus d’inclusion de chaque individu est exempt de tout mécanisme d’auto-sélection ou de biais d’attrition. Si le devis de recherche recourt à des protocoles d’échantillonnage complexes — tels que l’échantillonnage stratifié disproportionnel, le sondage en grappes ou l’échantillonnage à plusieurs degrés —, l’inéquation n ≤ 0,10 N ne peut plus être appliquée de façon monolithique à l’échelle globale de l’échantillon brut, mais doit faire l’objet de calculs d’effets de plan (design effects) spécifiques à chaque strate ou unité primaire de sondage.
Enfin, il est épistémologiquement primordial de rappeler que la satisfaction de la condition des 10 % constitue une condition nécessaire, mais en aucun cas suffisante, pour valider l’ensemble des inférences statistiques habituelles. Valider la règle des 10 % garantit uniquement la quasi-indépendance des tirages successifs sans remise ; elle ne garantit en rien la normalité de la distribution d’échantillonnage, ni la robustesse des estimateurs face à des données fortement asymétriques. La condition des 10 % doit par conséquent être appréhendée comme un maillon constitutif d’un faisceau plus vaste de critères d’admissibilité méthodologique, interagissant en synergie avec les conditions d’effectifs minimaux et de représentativité structurale du cadre de sondage.
3. L’intuition mathématique : pourquoi 10 % est un seuil acceptable
3.1 Mécanique du tirage sans remise et dérive des probabilités
Pour forger une intuition mathématique inattaquable de la condition des 10 %, il convient d’analyser la dynamique séquentielle d’un tirage sans remise à travers l’évolution de ses probabilités conditionnelles. Considérons une population finie standard composée de N individus, parmi lesquels se trouvent exactement K individus présentant un attribut d’intérêt spécifique (les « succès »), de sorte que la proportion initiale de succès s’établit à p = K / N. Si l’on procède à un tirage successif sans remise, la probabilité que le premier individu sélectionné soit un succès est rigoureusement égale à P(S1) = K / N = p.
Supposons désormais que ce premier tirage ait effectivement produit un succès. Lors de la sélection du second individu, la population résiduelle ne comporte plus que N – 1 sujets au total, dont K – 1 succès. La probabilité conditionnelle d’observer un nouveau succès au second essai devient alors mathématiquement :
P(S2 | S1) = (K – 1) / (N – 1)
En développant l’expression de cette probabilité conditionnelle par rapport à la proportion initiale p, on obtient l’égalité algébrique suivante :
(K – 1) / (N – 1) = (N p – 1) / (N – 1) = p – (1 – p) / (N – 1)
Cette décomposition met immédiatement en lumière le mécanisme d’appauvrissement : la probabilité de succès au second tour est égale à la probabilité originelle diminuée d’une quantité de dérive quantitativement égale à (1 – p) / (N – 1). On constate sans équivoque que si la taille de la population N est imposante par rapport au nombre d’unités prélevées, le dénominateur (N – 1) prend une ampleur telle que cette quantité de dérive devient infinitésimale. Même après avoir extrait plusieurs dizaines d’unités, la modification subie par le numérateur et le dénominateur demeure marginale, maintenant les probabilités conditionnelles dans un voisinage infinitésimal de la constante théorique p.
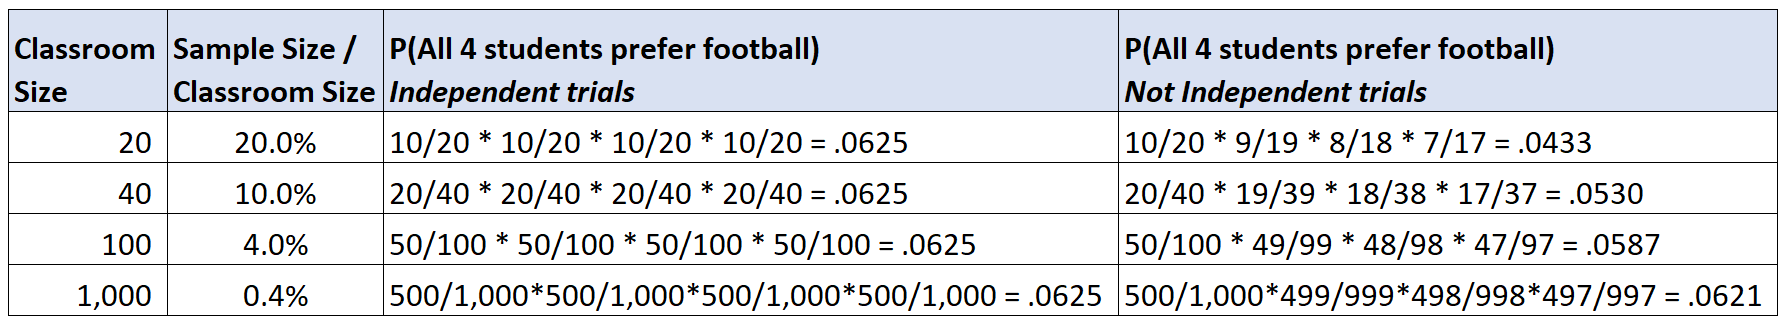
Ce phénomène s’illustre de manière limpide par la métaphore classique de l’urne d’échantillonnage. Si une urne contient 10 billes rouges et 10 billes blanches (soit N = 20 et p = 0,50), le retrait sans remise d’une seule bille rouge fait chuter instantanément la probabilité de tirer une seconde bille rouge à 9 / 19 ≈ 0,4737, soit une altération relative majeure de plus de 5,26 % dès le second prélèvement. En revanche, si l’urne contient 10 000 billes rouges et 10 000 billes blanches (N = 20 000 et p = 0,50), le prélèvement d’une première bille rouge ajuste la probabilité suivante à 9 999 / 19 999 ≈ 0,499975. Dans ce second scénario, il faudra prélever une fraction substantielle de l’urne avant que la dérive stochastique n’exerce une quelconque distorsion mesurable sur les probabilités d’occurrence.
3.2 Convergence de la loi hypergéométrique vers la loi binomiale
L’assise mathématique de la condition des 10 % réside dans le théorème classique d’approximation asymptotique reliant la distribution hypergéométrique à la distribution binomiale. Soit une variable aléatoire discrète X dénombrant le nombre de succès obtenus au cours de n tirages sans remise au sein d’une population de taille N renfermant K succès au total (avec p = K / N). La distribution de probabilité exacte de X est régie par la loi hypergéométrique de paramètres (N, n, p), dont la fonction de masse s’exprime par le formalisme combinatoire :
P(X = k) = [ C(K, k) × C(N – K, n – k) ] / C(N, n)
où C(a, b) désigne le coefficient binomial canonique « b parmi a », défini par a! / [ b! (a – b)! ] pour tout entier 0 ≤ b ≤ a. L’évaluation directe de cette fonction factorielle pose des défis calculatoires considérables dès que N s’élève à des valeurs substantielles. Cependant, si l’on examine le comportement limite de cette expression combinatoire lorsque la taille de la population N tend vers l’infini, tout en maintenant le rapport p = K / N et la taille d’échantillon n rigoureusement constants, on observe une convergence analytique remarquable.
En développant les factorielles et en regroupant les facteurs polynomiaux d’ordre supérieur, chaque terme combinatoire peut être décomposé sous la forme de produits séquentiels de fractions rationnelles. Par exemple, le ratio C(K, k) / [ Kk / k! ] tend asymptotiquement vers l’unité lorsque K → ∞. Par application systématique des règles de calcul sur les limites de produits finis, on démontre rigoureusement que :
limN → ∞ P(X = k) = C(n, k) × pk × (1 – p)n – k
Cette limite ultime n’est autre que la fonction de masse de la loi binomiale de paramètres (n, p). La question cruciale tranchée par la règle empirique des 10 % est celle de la vitesse de cette convergence : pour toute fraction de sondage telle que n / N ≤ 0,10, l’erreur absolue maximale entre la probabilité hypergéométrique exacte et l’évaluation binomiale approximée est confinée sous un seuil numérique si bas qu’elle n’induit aucun biais perceptible dans les inférences appliquées standard.
3.3 Impact sur le calcul des probabilités cumulées
L’intérêt de la quasi-invariance induite par le respect de la condition des 10 % prend tout son relief lorsqu’on examine non plus seulement les probabilités ponctuelles de masse P(X = k), mais les distributions de probabilités cumulées, lesquelles constituent le fondement direct du calcul des valeurs de significativité (valeurs p) dans les tests d’hypothèse. Une fonction de répartition unilatérale supérieure s’exprime par la sommation :
P(X ≥ kcritique) = ∑ P(X = j) pour j variant de kcritique jusqu’à n
Dans un protocole expérimental de décision statistique paramétrique, l’analyste cherche à déterminer si l’observation empirique se situe au-delà d’un quantile critique préalablement fixé par le seuil de significativité nominal α, conventionnellement fixé à 0,05 ou 0,01. La question méthodologique fondamentale est donc de vérifier si le remplacement de la fonction de répartition hypergéométrique par son homologue binomiale est susceptible de fausser la décision binaire de rejet ou de maintien de l’hypothèse nulle.
Les investigations analytiques sur les queues de distribution démontrent que tant que la condition n ≤ 0,10 N est respectée, les décalages de probabilités cumulées demeurent cantonnés au troisième ou quatrième chiffre après la virgule. Par voie de conséquence, une statistique de test générant une valeur p binomiale calculée à 0,048 (conduisant légitimement au rejet de l’hypothèse nulle au seuil de 5 %) correspondrait sous une modélisation hypergéométrique rigoureuse à une probabilité très marginalement inférieure, par exemple 0,046. La décision inférentielle substantielle demeure ainsi strictement inchangée.
De surcroît, la préservation de la puissance statistique des tests d’hypothèse bilatéraux est totale. La puissance d’un test statistique (définie par le complémentaire de l’erreur de seconde espèce, 1 – β) dépend intrinsèquement de l’erreur type de l’estimateur. Puisque, comme nous l’avons mis en évidence, l’écart-type n’est distordu que d’un facteur négligeable (≤ 5 %) lorsque la règle des 10 % est observée, la probabilité de détecter un effet expérimental réel d’une amplitude donnée n’est altérée que de manière totalement marginale, immunisant le chercheur contre tout artefact méthodologique majeur.
4. Exemple concret étape par étape : validation et calculs numériques
4.1 Présentation d’un scénario de recherche empirique
Afin d’illustrer de manière rigoureuse la portée opérationnelle de ces abstractions mathématiques, concevons une investigation épidémiologique et comportementale standard menée au sein d’une université européenne de taille moyenne. Les autorités universitaires souhaitent évaluer la prévalence de la détresse psychologique chez les étudiants inscrits au premier cycle. La population source, exhaustivement répertoriée par les services de scolarité centrale, comprend très exactement N = 10 000 étudiants immatriculés au cours de l’année académique courante.
Sur la base de la littérature épidémiologique nationale préexistante et d’études sentinelles comparables, il est postulé que la proportion de sujets présentant des manifestations d’anxiété clinique modérée à sévère s’élève à p = 0,20 (soit 20 % de la population globale). Par conséquent, au sein des effectifs totaux, le nombre absolu d’individus symptomatiques est de K = N × p = 10 000 × 0,20 = 2 000 étudiants, tandis que N – K = 8 000 étudiants sont exempts de cette symptomatologie clinique.
Dans l’impossibilité matérielle d’administrer une échelle psychométrique standardisée à l’ensemble du corps estudiantin pour des raisons logistiques et de coût de passation, l’équipe de recherche extrait, par le biais d’un algorithme générateur de nombres pseudo-aléatoires sans remise appliqué au registre matricule, un échantillon de n = 500 participants. L’objectif probabiliste spécifique assigné à l’analyse préliminaire consiste à déterminer la probabilité d’observer au sein de cet échantillon au moins 120 étudiants anxieux (ce qui correspondrait à une proportion d’échantillon p̂ ≥ 0,24), traduisant une élévation locale préoccupante de la morbidité psychologique.
4.2 Vérification explicite de la condition des 10 %
Avant d’engager le moindre calcul de probabilité d’échantillonnage ou de paramétrer une routine de test inférentiel, l’analyste de données a l’obligation méthodologique formelle de valider les conditions d’admissibilité de son modèle probabiliste. La première phase de ce diagnostic consiste à vérifier sans ambiguïté la condition des dix pour cent. Pour ce faire, calculons explicitement la fraction de sondage empirique, notée f :
f = n / N = 500 / 10 000 = 0,05 (soit précisément 5 %)
En confrontant ce résultat à la règle canonique formalisée dans notre cadre théorique, nous constatons de manière indiscutable que :
f = 0,05 ≤ 0,10 ou, sous la forme du produit équivalent : n = 500 ≤ 0,10 × 10 000 = 1 000
La fraction d’échantillonnage ne représentant que la moitié du plafond de tolérance autorisé par la convention méthodologique, la condition des 10 % est formellement respectée. L’analyste reçoit ainsi la garantie mathématique que la dépendance stochastique induite par l’épuisement sans remise de la population de 10 000 étudiants sera infinitésimale. Il est dès lors formellement autorisé à traiter l’ensemble des 500 observations comme des épreuves de Bernoulli mutuellement indépendantes, simplifiant de manière spectaculaire le calcul inférentiel par le recours à la loi binomiale.
Parallèlement, et par mesure de rigueur méthodologique préalable à tout traitement asymptotique normal, l’analyste vérifie également les critères d’effectifs attendus (règle des succès-échecs) :
- Nombre de succès théoriques attendus : n × p = 500 × 0,20 = 100 ≥ 10
- Nombre d’échecs théoriques attendus : n × (1 – p) = 500 × 0,80 = 400 ≥ 10
Les effectifs conjoints de succès et d’échecs dépassant très largement le seuil standard de robustesse, l’ensemble des prérequis à la modélisation asymptotique se trouve vérifié avec un niveau de rigueur optimal.
4.3 Résolution mathématique comparative : Binomiale vs Hypergéométrique
Procédons désormais à la résolution computationnelle du problème posé : calculer la probabilité cumulative P(X ≥ 120) sous les deux paradigmes méthodologiques en compétition. Dans le cadre de l’approximation binomiale simplifiée (autorisée par le respect strict de la condition des 10 %), la variable X est modélisée selon la distribution B(n = 500, p = 0,20). La probabilité cumulative supérieure s’obtient par la formule analytique :
Pbinom(X ≥ 120) = ∑ C(500, k) × (0,20)k × (0,80)500 – k pour k allant de 120 à 500
L’exécution numérique de cette sommation fournit la valeur hautement précise suivante :
Pbinom(X ≥ 120) ≈ 0,02203 (soit environ 2,203 %)
Calculons parallèlement la probabilité formellement exacte en modélisant le processus par la loi hypergéométrique H(N = 10 000, n = 500, K = 2 000). La formulation exacte de cette probabilité cumulative supérieure s’énonce selon la combinatoire stricte :
Phyper(X ≥ 120) = ∑ [ C(2 000, k) × C(8 000, 500 – k) ] / C(10 000, 500) pour k allant de 120 à 500
La résolution de cette équation combinatoire sur un moteur de calcul haute précision délivre le résultat exact suivant :
Phyper(X ≥ 120) ≈ 0,01931 (soit environ 1,931 %)
La confrontation directe de ces deux valeurs numériques met en évidence des enseignements majeurs. L’écart absolu entre le modèle binomial approximé et le modèle hypergéométrique exact est de seulement :
| Pbinom – Phyper | = | 0,02203 – 0,01931 | = 0,00272
Ce différentiel minime de moins de trois millièmes illustre avec une éloquence mathématique irréfutable l’extraordinaire efficience de la condition des 10 %. Sur le plan de la décision clinique ou de la politique de santé publique universitaire, la conclusion demeure strictement invariable : l’événement « observer 120 étudiants anxieux ou plus » constitue une anomalie statistique significative au seuil alpha canonique de 5 % (car p < 0,05 dans les deux modèles), mais ne franchit pas le seuil de significativité hautement conservateur de 1 % (car p > 0,01 dans les deux cas). L’analyste parvient ainsi à des déductions scientifiques impeccables tout en s’étant épargné la manipulation d’équations combinatoires d’une complexité computationnelle écrasante.
5. L’approximation normale de la distribution binomiale et la condition des 10 %
5.1 Articulation avec le Théorème Central Limite (TCL)
Dans l’arsenal méthodologique du chercheur, la loi binomiale n’est que rarement calculée par sa formule exacte lorsque la taille de l’échantillon n devient substantielle. Les praticiens s’appuient massivement sur le théorème central limite pour approximer la somme ou la proportion de variables de Bernoulli par une distribution normale continue (courbe de Gauss). Toutefois, l’articulation mathématique entre le théorème central limite et la condition des 10 % révèle une interdépendance théorique fondamentale qui échappe trop fréquemment aux utilisateurs profanes de logiciels d’analyse quantitative.
L’énoncé standard du théorème central limite de Lindeberg-Lévy repose sur une clause axiomatique incontournable : les variables aléatoires dont on étudie la somme normalisée doivent être obligatoirement « indépendantes et identiquement distribuées » (i.i.d.). Or, comme nous l’avons démontré dans nos sections introductives, tout échantillonnage sans remise au sein d’une population finie engendre structurellement des variables d’observation dépendantes entre elles. Rigoureusement parlant, le théorème central limite standard ne s’applique donc pas à un échantillonnage sans remise, puisque la condition d’indépendance mutuelle stricte est violée par construction.
C’est précisément ici que la condition des 10 % remplit son rôle de passerelle épistémologique indispensable. En garantissant que la dépendance stochastique est contenue dans des limites asymptotiques négligeables, le respect du critère n ≤ 0,10 N restaure une indépendance opérationnelle quasi-parfaite. C’est grâce à cette quasi-indépendance que le statisticien acquiert le droit formel d’invoquer les conclusions du théorème central limite et d’utiliser la distribution normale pour calculer des intervalles de confiance de proportions ou pour exécuter des tests univariés de type Z de Wald. En l’absence de cette condition de modération de la fraction de sondage, l’invocation de la normalité gaussienne standard devient formellement caduque et méthodologiquement illégitime.
5.2 La condition de succès-échec en tandem avec la condition des 10 %
L’utilisation de l’approximation normale pour une distribution d’échantillonnage de proportions exige le respect impératif d’un tandem méthodologique indissociable, composé d’une part de la condition des 10 % et d’autre part de la condition dite de « succès-échec » (ou condition d’effectifs attendus). Alors que la règle des 10 % veille à la préservation de la quasi-indépendance des tirages au regard de la population globale, la règle de succès-échec s’assure que la forme géométrique de la distribution binomiale sous-jacente est suffisamment symétrique pour autoriser son écrasement harmonieux sous une courbe gaussienne parfaitement symétrique.
La condition de succès-échec impose traditionnellement que l’échantillon contienne un nombre suffisant de réalisations pour chaque modalité de la variable binaire, ce qui se formule analytiquement par les deux inéquations simultanées :
n × p ≥ 10 et n × (1 – p) ≥ 10
Certains auteurs plus conservateurs élèvent ce seuil à 15 (exigeant np ≥ 15 et n(1 – p) ≥ 15), notamment lorsque le paramètre théorique p s’écarte substantiellement de la zone médiane 0,50 et approche des extrêmes tels que 0,05 ou 0,95. Si ces inéquations ne sont pas satisfaites, la distribution binomiale conserve une forte asymétrie résiduelle (un coefficient d’asymétrie de Pearson ou skewness non nul), ce qui provoque des distorsions sévères dans l’évaluation des surfaces sous la courbe normale, particulièrement dans les régions critiques des queues unilatérales.
Le chercheur est donc confronté à un triumvirat décisionnel d’une grande rigueur structurelle :
- Condition de représentativité probabiliste : Les données proviennent d’un échantillon aléatoire sans biais d’inclusion systématique.
- Condition des 10 % (n ≤ 0,10 N) : La fraction de sondage est suffisamment faible pour modéliser le prélèvement sans remise comme une série d’essais indépendants.
- Condition de succès-échec (np ≥ 10 et n(1-p) ≥ 10) : Le volume absolu de succès et d’échecs garantit une symétrie suffisante pour que la distribution d’échantillonnage de la proportion converge vers la normalité gaussienne.
Si l’une quelconque de ces trois exigences fondamentales fait défaut, l’application de la théorie normale canonique s’effondre, exposant la recherche empirique à des erreurs systématiques d’évaluation du risque statistique.
5.3 Calcul pratique de l’erreur type de la proportion
Lorsque la condition des dix pour cent et la règle de succès-échec sont conjointement et rigoureusement validées, le chercheur bénéficie d’une simplification analytique majeure dans l’estimation de la dispersion de son paramètre. L’erreur type de la proportion d’échantillon p̂ = X / n (qui quantifie l’écart-type de la distribution de toutes les proportions d’échantillon possibles de taille n autour de la véritable proportion populationnelle p) peut être formulée sous sa forme élémentaire classique :
σp̂ = √ [ p(1 – p) / n ]
Dans les contextes d’estimation où le paramètre populationnel p demeure inconnu par définition et doit être estimé à partir des données observées, on remplace le paramètre théorique par la proportion empirique p̂, ce qui donne l’erreur type estimée conventionnelle, notée SE(p̂) (pour Standard Error) :
SE(p̂) = √ [ p̂(1 – p̂) / n ]
Cette élégante simplicité algébrique élimine toute nécessité d’introduire des coefficients correcteurs pondérés ou des algorithmes itératifs lourds lors des phases d’analyse préliminaire. La construction d’un intervalle de confiance bilatéral classique au niveau de confiance asymptotique de 95 % s’exécute de manière directe par la célèbre formule de Wald :
IC95%(p) = p̂ ± Zcritique × SE(p̂) = p̂ ± 1,96 × √ [ p̂(1 – p̂) / n ]
Grâce au maintien de la condition des 10 %, ce calcul élémentaire conserve toute sa robustesse asymptotique. Le praticien s’assure ainsi que le taux de couverture nominal de l’intervalle de confiance (la probabilité que l’intervalle calculé englobe effectivement la véritable valeur du paramètre dans une répétition infinie du protocole) reste remarquablement proche des 95 % revendiqués, protégeant l’analyste contre les dérives méthodologiques sans requérir d’outillage computationnel sophistiqué.
6. Conséquences statistiques de la violation de la condition des 10 %
6.1 Impact de la sur-représentation de l’échantillon sur la variance
Que se produit-il sur le plan fondamental des mathématiques de l’échantillonnage lorsque la condition des dix pour cent se trouve violée, c’est-à-dire lorsque la fraction de sondage n / N excède significativement la borne de 0,10 pour s’établir à 20 %, 40 % ou 60 % de la population globale ? Contrairement à ce qu’une intuition superficielle pourrait suggérer, la transgression de la condition des 10 % n’introduit aucun biais au niveau de l’estimation ponctuelle de la moyenne ou de la proportion. L’espérance mathématique de la proportion d’échantillon E(p̂) demeure rigoureusement égale au paramètre populationnel p : l’estimateur reste strictement sans biais.
En réalité, la distorsion s’exerce de manière exclusive et spectaculaire sur la structure de variance de l’estimateur. Lorsque la taille de l’échantillon n commence à représenter une part substantielle de la population totale N, un phénomène d’information redondante et de « dépendance stochastique négative » s’installe. Chaque unité supplémentaire prélevée sans remise réduit drastiquement le nombre de configurations possibles pour les unités subséquentes. Dans le cas limite extrême où n = N (situation de recensement exhaustif complet), il n’existe plus la moindre incertitude statistique : la variance de l’échantillon doit s’annuler totalement (Var(p̂) = 0) puisque la totalité de la réalité empirique est désormais connue.
Dès lors, si l’on persiste à utiliser la formule standard de la variance binomiale p(1 – p) / n lorsque n > 0,10 N, on postule implicitement que la population continue de se renouveler à l’infini, traitant chaque nouveau tirage comme une découverte totale d’information. Cette hypothèse fallacieuse conduit à une surestimation systématique et artificielle de la véritable variance d’échantillonnage. En omettant de prendre en compte l’épuisement de la population finie, le statisticien calcule une dispersion d’échantillonnage démesurément large qui ne reflète aucunement la réalité physique du prélèvement.
6.2 Introduction au Facteur de Correction pour Population Finie (FCPF)
Pour restaurer la rigueur mathématique compromise par la violation de la condition des 10 %, la théorie classique de l’échantillonnage en population finie (développée formellement par William Cochran) impose l’introduction d’un multiplicateur analytique d’ajustement : le Facteur de Correction pour Population Finie (FCPF), universellement abrégé en FPC dans la littérature internationale (pour Finite Population Correction).
Au niveau de la variance de la distribution d’échantillonnage, ce facteur multiplicateur prend la forme exacte suivante :
FCPFvariance = (N – n) / (N – 1)
Puisque les inférences statistiques appliquées (marges d’erreur, intervalles de confiance et dénominateurs des tests Z ou de Student) opèrent sur l’échelle de l’écart-type (l’erreur type) et non sur celle de la variance quadratique, c’est la racine carrée de cette expression qui doit être appliquée comme coefficient de pondération réducteur sur l’erreur type standard. L’expression canonique du FCPF applicable à l’erreur type s’écrit donc :
FCPF = √ [ (N – n) / (N – 1) ] ≈ √ (1 – n / N) lorsque N est grand devant l’unité.
L’analyse structurelle des propriétés asymptotiques de ce facteur de correction éclaire avec une parfaite clarté mathématique la raison d’être de la condition des 10 % :
- Lorsque la fraction de sondage n / N tend asymptotiquement vers 0 (cas d’une population quasi-infinie), le ratio (N – n) / (N – 1) converge strictement vers 1. Par conséquent, FCPF → 1, et son omission n’a rigoureusement aucun impact numérique sur les estimations.
- Lorsque n / N ≤ 0,10, la valeur du FCPF demeure confinée entre √0,90 (≈ 0,9486) et 1,000, ce qui démontre analytiquement pourquoi la distorsion d’omission reste toujours inférieure à 5,14 %.
- En revanche, dès lors que la fraction de sondage dépasse 10 %, le terme correcteur chute de manière accélérée : pour n / N = 0,30, le FCPF s’abaisse à √0,70 ≈ 0,8366 (réduction de 16,3 % de l’erreur type) ; pour n / N = 0,50, il atteint √0,50 ≈ 0,7071 (réduction massive de 29,3 % de l’erreur type).
L’obligation méthodologique d’adjoindre le FCPF à l’erreur type binomiale devient donc une nécessité computationnelle incontournable dès que le seuil des 10 % est franchi.
6.3 Risques méthodologiques en cas de non-application du FCPF
L’omission non avisée ou ignorante du facteur de correction pour population finie dans un contexte de violation de la condition des 10 % engendre des distorsions méthodologiques sévères dans l’interprétation des résultats de la recherche empirique. La première répercussion immédiate concerne la largeur des intervalles de confiance. En surestimant artificiellement l’erreur type, le chercheur produit des marges d’erreur indûment hypertrophiées. Des intervalles de confiance artificiellement trop larges projettent une illusion d’imprécision expérimentale qui ne correspond à aucune réalité empirique, masquant la véritable netteté avec laquelle le paramètre a été mesuré grâce à l’exploration d’une fraction majeure de la population.
La seconde conséquence, hautement préjudiciable à la progression de la science expérimentale, réside dans l’accroissement artificiel du risque d’erreur de deuxième espèce (β). Dans le cadre d’un test d’hypothèse bilatéral ou unilatéral, la statistique de test observée Zobs est calculée en divisant l’écart entre l’observation et la valeur sous l’hypothèse nulle par l’erreur type. Si le dénominateur est artificiellement gonflé par l’omission du FCPF, la statistique Zobs résultante est mécaniquement sous-estimée, ce qui dérive vers une valeur p excessivement élevée. Le chercheur court alors le risque critique d’échouer à rejeter une hypothèse nulle pourtant totalement fausse (diminution drastique de la puissance statistique réelle du test).
Enfin, dans l’écosystème contemporain de la synthèse des données probantes, cette distorsion contamine lourdement les méta-analyses quantitatives. Dans une méta-analyse à effets fixes ou à effets aléatoires, le poids métrologique attribué à chaque étude primaire est fonctionnellement proportionnel à l’inverse de sa variance d’estimation (modèle de pondération par la précision inverse). Si une recherche primaire menée sur une fraction substantielle d’une cohorte spécifique n’applique pas le FCPF, sa variance sera arbitrairement surévaluée, conduisant les méta-analystes à sous-pondérer injustement les conclusions de cette étude au profit d’investigations potentiellement moins fiables. Les conclusions relatives à l’amplitude réelle de l’effet clinique ou pédagogique d’une intervention se trouvent ainsi gravement biaisées.
7. Pertinence et applications en psychométrie et sciences comportementales
7.1 Échantillonnage dans les populations cliniques rares
Si la problématique de la condition des dix pour cent est fréquemment ignorée dans les sondages socio-politiques d’envergure nationale (où les tailles de populations N se chiffrent en dizaines de millions d’individus, rendant tout échantillon de quelques milliers d’unités totalement infinitésimal en regard du ratio de sondage), elle constitue en revanche un défi quotidien dans les domaines de la neuropsychologie, de la psychiatrie spécialisée et de l’épidémiologie clinique des pathologies orphelines.
Considérons, à titre d’exemple clinique emblématique, la recherche psychométrique conduite sur des cohortes de patients victimes d’une lésion cérébrale focale extrêmement spécifique, telle qu’une atteinte bilatérale de l’amygdale consécutive à la maladie d’Urbach-Wiethe. À l’échelle d’un territoire national ou d’un consortium hospitalier interrégional, la population totale N de ces patients cliniquement stabilisés peut se limiter à quelques dizaines ou quelques centaines d’individus répertoriés (par exemple N = 80). Un chercheur clinicien qui parvient, au prix d’un investissement logistique majeur, à enrôler n = 30 de ces patients pour administrer une tâche expérimentale d’évaluation de la reconnaissance des expressions faciales de peur extrait de facto une fraction d’échantillonnage de :
f = n / N = 30 / 80 = 0,375 (soit 37,5 % de la population totale accessible)
Dans ce scénario de recherche clinique typique, la condition des 10 % est littéralement pulvérisée (37,5 % > 10 %). L’application aveugle des formules standard de la distribution binomiale ou des tests d’indépendance de Student classiques aboutirait à des inférences totalement faussées en surestimant de plus de 20 % la marge d’erreur des estimations comportementales. Les investigateurs en sciences cognitives et cliniques doivent donc obligatoirement intégrer le facteur de correction pour population finie ou basculer vers des paradigmes computationnels bayésiens prédictifs pour préserver l’intégrité formelle de leurs déductions scientifiques.
7.2 Psychologie du travail et des organisations : études intra-entreprises
Le second domaine comportemental où la condition des 10 % subit des violations structurelles massives et quotidiennes est celui de la psychologie du travail, du management des organisations et de la sociologie des ressources humaines. Lorsqu’un psychologue organisationnel ou un cabinet de conseil en santé au travail est mandaté pour ausculter le climat social, mesurer l’épuisement professionnel (syndrome de burn-out via l’inventaire de Maslach) ou quantifier les risques psychosociaux au sein d’une entreprise industrielle de taille intermédiaire, la population cible d’intérêt N est strictement délimitée par le registre du personnel de l’établissement.
Dans une manufacture employant N = 400 salariés, l’administration d’un questionnaire standardisé à un échantillon aléatoire représentatif de n = 150 collaborateurs produit une fraction de sondage de f = 150 / 400 = 0,375 (37,5 %). Les logiciels d’analyse de données utilisés couramment dans le secteur du conseil organisationnel exécutent quasi-systématiquement des régressions logistiques ou des tests d’ajustement de proportions sous le postulat par défaut d’une population mère infinie. L’erreur méthodologique est ici patente :
- L’erreur type de la proportion de salariés en souffrance psychique est artificiellement gonflée d’un facteur 1 / √(1 – 0,375) = 1 / √0,625 ≈ 1,265 (soit 26,5 % d’imprécision fallacieuse additionnelle).
- L’intervalle de confiance estimé pour une prévalence de burn-out observée à 30 % oscillera faussement entre 22,7 % et 37,3 %, alors qu’après application rigoureuse du FCPF, la véritable marge d’erreur rétrécit l’intervalle dans une fourchette beaucoup plus étroite de 24,2 % à 35,8 %.
- Ce gain de précision non exploité peut s’avérer lourd de conséquences pratiques lors des négociations sociales avec les instances représentatives du personnel ou dans le calibrage budgétaire des plans de prévention institutionnels.
7.3 Évaluation des interventions psychothérapeutiques en milieu institutionnel
L’évaluation des protocoles psychothérapeutiques et psychoéducatifs standardisés déployés au sein d’institutions closes ou semi-fermées — telles que les établissements pénitentiaires, les centres de réadaptation fonctionnelle pour adolescents ou les unités médico-sociales d’accueil pour personnes âgées dépendantes (EHPAD) — illustre de manière criante le cumul potentiel de la violation de la condition des 10 % et de dépendances comportementales directes.
Dans une maison d’arrêt regroupant une population carcérale de N = 250 détenus éligibles à un protocole de thérapie cognitive et comportementale axé sur la gestion des impulsions agressives, un échantillonnage aléatoire de n = 50 sujets pour tester l’efficacité d’un module thérapeutique génère un ratio d’épuisement de f = 50 / 250 = 0,20 (20 %). Ce prélèvement dépasse du double le seuil maximal de tolérance de la condition des 10 %. L’analyste clinique ne peut faire l’économie de l’application du FCPF sous peine d’écraser la significativité statistique réelle des progrès thérapeutiques mesurés.
Néanmoins, en milieu institutionnel, une complication méthodologique supplémentaire se superpose au biais de tirage sans remise : le phénomène d’interdépendance comportementale et de contagion sociale intra-groupe. Les sujets sélectionnés interagissent quotidiennement dans les cours de promenade, partagent leurs ressentis sur les exercices comportementaux et modifient mutuellement leurs schémas de pensée par apprentissage vicariant. Dès lors, le chercheur doit naviguer entre deux impératifs mathématiques distincts : d’une part, corriger la sur-représentation physique de l’échantillon au moyen du FCPF pour tenir compte de la finitude de l’effectif total carcéral, et d’autre part, ajuster les modèles d’analyse de covariance au moyen de régressions multiniveaux (ou modèles mixtes hiérarchiques) pour neutraliser les corrélations intra-grappes induites par l’environnement de vie partagé.
8. Analyse comparative rigoureuse : Loi binomiale vs Loi hypergéométrique
8.1 Confrontation structurelle des équations probabilistes
Pour mesurer la profondeur analytique de la condition des 10 %, il est formateur de confronter face à face l’architecture intime des équations qui décrivent respectivement la distribution binomiale et la distribution hypergéométrique. Soit l’observation d’exactement k succès au cours d’un tirage de n unités sans remise au sein d’une population finie N contenant initialement K succès (avec p = K / N).
L’équation de masse de la distribution hypergéométrique découle de l’axiomatique combinatoire laplacienne du dénombrement des cas favorables sur l’univers des cas possibles :
Phyper(X = k) = [ C(K, k) × C(N – K, n – k) ] / C(N, n)
Cette expression s’appuie sur trois coefficients combinatoires distincts. Le premier coefficient dénombre l’ensemble des manières de choisir k succès parmi le stock disponible K ; le second dénombre les manières de choisir les n – k échecs résiduels parmi le stock d’échecs N – K ; le dénominateur quantifie la totalité des combinaisons possibles de taille n configurables à partir de l’univers N. Cette formulation exacte lie indissolublement l’évaluation de chaque tirage au destin des tirages antérieurs et à l’état instantané du réservoir restant.
À l’opposé, la fonction de masse de la loi binomiale s’énonce selon une structure purement multiplicative et découplée :
Pbinom(X = k) = C(n, k) × pk × (1 – p)n – k
Ici, un seul coefficient binomial intervient pour dénombrer les permutations spatiales de l’occurrence des k succès au cours des n essais séquentiels, tandis que les probabilités élémentaires sont simplement élevées aux puissances respectives des effectifs observés, conformément au principe fondamental de multiplication des probabilités d’événements stochastiquement indépendants. Alors que la loi hypergéométrique exige de connaître simultanément N, K et n, la modélisation binomiale n’exige que la connaissance du ratio synthétique p et de la taille d’échantillon n. Cette tractabilité analytique supérieure rend la loi binomiale infiniment plus maniable pour la dérivation de fonctions de vraisemblance et la construction de tests statistiques généralisés.
8.2 Évolution de l’écart d’estimation selon les variations du ratio n/N
L’examen de l’erreur d’approximation en fonction de la montée en charge progressive de la fraction de sondage permet d’ancrer empiriquement la validité du seuil critique des 10 %. Considérons une population constante de N = 1 000 individus présentant une proportion intrinsèque de succès fixée à la valeur médiane p = 0,50 (soit K = 500). Évaluons la probabilité ponctuelle exacte et approximée d’observer un résultat parfaitement modal (c’est-à-dire exactement 50 % de succès dans l’échantillon, soit k = n / 2) au fur et à mesure que la taille d’échantillon n progresse de fractions marginales jusqu’à des proportions majeures de la population :
- Fraction de 1 % (n = 10, k = 5) :
- Probabilité binomiale : Pbinom(X = 5) ≈ 0,24609
- Probabilité hypergéométrique : Phyper(X = 5) ≈ 0,24729
- Écart absolu d’approximation : | Δ | ≈ 0,00120 (Erreur relative : 0,48 %)
- Fraction de 5 % (n = 50, k = 25) :
- Probabilité binomiale : Pbinom(X = 25) ≈ 0,11227
- Probabilité hypergéométrique : Phyper(X = 25) ≈ 0,11504
- Écart absolu d’approximation : | Δ | ≈ 0,00277 (Erreur relative : 2,41 %)
- Fraction frontière de 10 % (n = 100, k = 50) :
- Probabilité binomiale : Pbinom(X = 50) ≈ 0,07959
- Probabilité hypergéométrique : Phyper(X = 50) ≈ 0,08365
- Écart absolu d’approximation : | Δ | ≈ 0,00406 (Erreur relative : 4,85 %)
- Fraction de 20 % (n = 200, k = 100) :
- Probabilité binomiale : Pbinom(X = 100) ≈ 0,05635
- Probabilité hypergéométrique : Phyper(X = 100) ≈ 0,06290
- Écart absolu d’approximation : | Δ | ≈ 0,00655 (Erreur relative : 10,41 %)
- Fraction de 50 % (n = 500, k = 250) :
- Probabilité binomiale : Pbinom(X = 250) ≈ 0,03566
- Probabilité hypergéométrique : Phyper(X = 250) ≈ 0,05041
- Écart absolu d’approximation : | Δ | ≈ 0,01475 (Erreur relative : 29,26 %)
Cette trajectoire empirique illustre parfaitement le mécanisme de divergence. Tant que n / N ≤ 0,10, l’erreur relative reste confinée en dessous du plafond psychologique et méthodologique de 5 %. Mais dès que le ratio s’élève à 20 %, l’erreur relative double immédiatement pour dépasser 10 %, avant d’atteindre près de 30 % à la moitié de la population. Le seuil des 10 % constitue précisément le point d’inflexion au-delà duquel l’erreur d’approximation quitte le domaine du bruit de fond numérique pour devenir une distorsion substantielle de modélisation.
8.3 Arbitrage entre précision numérique et simplicité méthodologique
Face à cette démonstration de divergence numérique, une interrogation légitime se pose dans le paysage contemporain de la recherche : à une époque où la puissance computationnelle des ordinateurs personnels permet de calculer instantanément des fonctions factorielles de l’ordre de plusieurs dizaines de milliers, quel est l’intérêt persistant de maintenir la règle heuristique des 10 % au lieu d’imposer systématiquement le calcul hypergéométrique exact ?
La réponse réside dans un arbitrage épistémologique fondamental entre précision computationnelle brute et tractabilité conceptuelle. Si le calcul exact ponctuel d’une valeur p sous R ou Python est devenu une opération triviale, il n’en va pas de même pour l’ensemble des procédures d’ingénierie statistique qui gravitent autour de l’analyse empirique. La planification a priori de la taille de l’échantillon (calcul de puissance statistique avant collecte), la construction de modèles de régression multivariés, l’analyse factorielle confirmatoire ou la dérivation d’intervalles de confiance non asymétriques demeurent extraordinairement complexes sous une modélisation hypergéométrique complète.
La condition des 10 % fournit ainsi aux chercheurs un cadre formel de sécurité épistémologique. Elle assure que l’analyste peut déployer l’intégralité de la boîte à outils statistique classique — des tests de proportions aux modèles linéaires généralisés — avec l’assurance absolue que l’approximation n’introduit aucun artefact décisionnel. L’exactitude pure n’a de valeur que si elle apporte un gain substantiel à la compréhension du phénomène étudié ; lorsque ce gain est d’une fraction de millième, la simplicité analytique et l’interopérabilité des modèles binomial et normal constituent la démarche méthodologique la plus rationnelle.
9. Erreurs méthodologiques courantes et fausses conceptions
9.1 La confusion récurrente entre condition des 10 % et taille minimale d’échantillon
Parmi l’ensemble des heuristiques statistiques enseignées dans les cursus académiques universitaires, la condition des dix pour cent est paradoxalement l’une de celles qui génère les contresens les plus récurrents et les plus tenaces chez les jeunes chercheurs et les professionnels de terrain. Le contresens le plus dévastateur consiste à inverser la nature logique de l’inéquation en croyant fermement qu’un échantillon, pour être représentatif d’une population, doit impérativement représenter au moins 10 % de l’effectif de celle-ci.
Cette croyance fallacieuse résulte d’une confusion conceptuelle dramatique entre une borne supérieure de tolérance et une borne inférieure d’admissibilité. La condition des 10 % affirme solennellement que n ≤ 0,10 N (la taille de l’échantillon doit être au maximum égale à 10 % de la population parente) et non l’inverse ! Affirmer qu’un sondage national portant sur la population française (approximativement N = 68 000 000 d’habitants) nécessite d’interroger au moins 10 % de la population (soit 6,8 millions d’individus !) constitue une aberration méthodologique et financière absolue.
Dans la théorie de l’échantillonnage, la précision absolue d’un estimateur sans biais est déterminée presque exclusivement par le volume brut n de données observées (le nombre absolu de sujets dans l’échantillon) et nullement par le ratio n / N, pourvu que ce ratio demeure modéré. Un échantillon aléatoire simple de n = 1 000 électeurs extrait avec rigueur méthodologique produira une marge d’erreur d’environ ±3,1 % (au seuil de confiance de 95 %), que cet échantillon provienne d’une agglomération urbaine de 100 000 habitants ou d’un géant démographique continental de plusieurs centaines de millions de citoyens. La condition des 10 % ne vise donc aucunement à exiger un volume minimal pour la représentativité, mais à prévenir la surestimation de la variance lorsque l’échantillon prélève une portion excessivement vaste du vivier d’origine.
9.2 Ignorance de la dépendance spatiale ou relationnelle entre sujets
Une seconde illusion méthodologique fréquente réside dans la conviction naïve que le respect mathématique scrupuleux de l’inéquation n ≤ 0,10 N confère automatiquement et universellement une indépendance stochastique parfaite entre l’ensemble des données récoltées. Il s’agit là d’une erreur d’attribution causale majeure : la condition des 10 % neutralise exclusivement la dépendance induite par l’épuisement mathématique du tirage sans remise dans une population finie. Elle est structurellement impuissante face aux multiples autres sources de dépendance empirique qui menacent la validité d’une recherche quantitative.
En sciences comportementales, l’indépendance de sélection ne garantit en aucun cas l’indépendance comportementale. Si un chercheur respecte scrupuleusement la règle des 10 % en sélectionnant 500 élèves au sein d’une académie scolaire regroupant 50 000 collégiens (ratio de 1 %), mais que ces 500 élèves sont tous recrutés au sein de seulement dix établissements spécifiques (ou, pire, dans un nombre restreint de classes), des phénomènes majeurs de corrélation intraclasse se manifestent :
- Effets d’appartenance institutionnelle (pédagogie commune, climat d’établissement homogène).
- Effets de pairs et contagion émotionnelle au sein des groupes d’amis.
- Apprentissage social et mimétisme comportemental direct.
Dans une telle configuration de données hiérarchiques et imbriquées, l’indépendance des observations est brutalement violée, non pas en raison de la fraction d’échantillonnage (qui reste infinitésimale), mais en raison de la structure en grappes de la réalité sociale. Croire que la condition des 10 % immunise l’étude contre les biais de corrélation croisée relève d’un aveuglement théorique : le chercheur doit obligatoirement compléter son diagnostic par l’évaluation du coefficient de corrélation intraclasse (ICC) et ajuster ses variances via des modélisations hiérarchiques linéaires adaptées.
9.3 Mauvaise manipulation de la condition dans les sondages en ligne ouverts
L’avènement d’Internet et des plateformes sociales numériques a popularisé la prolifération de sondages et de questionnaires d’auto-évaluation administrés en ligne par diffusion ouverte (liens diffusés sur les réseaux sociaux, plateformes de recrutement participatif sans filtrage probabiliste strict). Dans ce type de recueil de données par convenance, de nombreux analystes profanes commettent la faute épistémologique de revendiquer la conformité de leur étude à la condition des dix pour cent au motif fallacieux que leur échantillon de quelques milliers de répondants ne représente qu’une fraction infime des utilisateurs mondiaux de la plateforme concernée.
Cette argumentation constitue une tromperie méthodologique intégrale. La condition des 10 % n’a de sens et de légitimité mathématique que si et seulement si l’opération d’échantillonnage s’effectue selon un protocole aléatoire simple au sein d’un cadre de sondage exhaustivement défini et numéroté, où chaque unité statistique dispose d’une probabilité d’inclusion non nulle et parfaitement calculable a priori. Dans un sondage en ligne ouvert :
- La population totale théorique N est indéterminable de façon rigoureuse (absence de cadre de sondage exhaustif).
- Les unités ne sont pas tirées au sort, mais s’auto-sélectionnent sur la base de leur motivation intrinsèque, de leur temps disponible ou de leur engagement idéologique envers le thème du questionnaire (biais d’auto-sélection massif).
- L’inéquation n ≤ 0,10 N perd toute portée opératoire, car la véritable population parente à laquelle appartiennent les répondants auto-sélectionnés n’est pas la population générale, mais le sous-ensemble inconnu et idiosyncrasique des individus exposés à l’algorithme de diffusion et ayant consenti à répondre.
Invoquer la condition des 10 % pour justifier l’indépendance des observations et la validité des inférences statistiques dans un échantillonnage non probabiliste de convenance relève d’une pure imposture scientifique.
10. Traitement des cas où la condition des 10 % est transgressée
10.1 Procédure systématique d’application du FCPF sur les erreurs types
Lorsqu’un protocole expérimental rigoureux conduit inéluctablement à prélever plus de dix pour cent de la population cible (ce qui survient fréquemment, nous l’avons vu, dans les milieux clos ou les cohortes cliniques rares), l’analyste ne doit nullement renoncer à son investigation. Il doit en revanche appliquer une procédure algorithmique systématique visant à intégrer le Facteur de Correction pour Population Finie (FCPF) au niveau de l’ensemble de ses estimateurs de dispersion standard.
La séquence opérationnelle pour ajuster l’estimation d’une proportion empirique s’articule comme suit :
- Calcul de l’erreur type non ajustée : L’analyste commence par évaluer l’erreur type classique sous l’hypothèse de répétition infinie : SEstd(p̂) = √ [ p̂(1 – p̂) / n ].
- Calcul du multiplicateur FCPF : Il calcule précisément la racine carrée du rapport d’épuisement : FCPF = √ [ (N – n) / (N – 1) ].
- Dérivation de l’erreur type corrigée : L’erreur type réelle de la distribution d’échantillonnage en population finie s’obtient par la multiplication : SEajustée(p̂) = SEstd(p̂) × FCPF.
- Actualisation de l’intervalle de confiance : L’intervalle de confiance à 95 % est recalculé avec cette erreur type affinée : IC95%(p) = p̂ ± 1,96 × SEajustée(p̂).
Le tableau suivant met en relief la trajectoire d’affinement des marges d’erreur pour un échantillon de n = 200 répondants présentant une proportion empirique de succès p̂ = 0,40, confronté à différentes configurations de populations parentes N :
| Taille de la population (N) | Fraction de sondage (n / N) | Statut Condition 10 % | Valeur exacte du FCPF | Marge d’erreur ± (95 %) |
|---|---|---|---|---|
| N = 20 000 | 1,0 % | Parfaitement respectée | 0,9950 | ± 6,86 % |
| N = 2 000 | 10,0 % | Seuil limite de tolérance | 0,9492 | ± 6,54 % |
| N = 800 | 25,0 % | Transgressée (FCPF requis) | 0,8666 | ± 5,97 % |
| N = 400 | 50,0 % | Transgressée (FCPF critique) | 0,7080 | ± 4,88 % |
| N = 250 | 80,0 % | Transgressée (Quasi-recensement) | 0,4481 | ± 3,09 % |
Cette synthèse tabulaire met en lumière le bénéfice immédiat de l’ajustement : lorsque la condition des 10 % est largement franchie (par exemple à n / N = 50 %), l’application du FCPF permet de réduire la marge d’erreur d’un quart (passant de ±6,54 % à ±4,88 %). Cette contraction légitime de l’incertitude confère à l’expérimentateur un gain substantiel de puissance statistique qu’il serait méthodologiquement impardonnable de négliger.
10.2 Recours aux modèles exacts et non paramétriques
Lorsque la taille d’échantillon n est non seulement substantielle par rapport à N (rupture de la condition des 10 %), mais que les effectifs absolus de succès ou d’échecs sont trop réduits pour satisfaire le critère de succès-échec (np < 10 ou n(1 – p) < 10), l’application du FCPF combiné à l’approximation normale cesse d’être mathématiquement viable. Dans ce scénario de double rupture méthodologique, l’analyste doit impérativement abandonner toute velléité d’approximation gaussienne et recourir aux distributions exactes ou à des démarches non paramétriques intensives.
Le premier réflexe opératoire consiste à exécuter le test exact basé directement sur la loi hypergéométrique, connu dans les tableaux de contingence deux par deux sous le nom de test exact de Fisher (ou son extension multidimensionnelle de Fisher-Freeman-Halton). Ce test calcule sans la moindre approximation la probabilité exacte d’observer la configuration de données empiriques obtenue, conditionnellement aux marges fixées du tableau d’effectifs. Dans l’écosystème de programmation statistique moderne, ce calcul est implémenté en standard par la fonction fisher.test() sous l’environnement R ou par les modules exacts sous IBM SPSS Statistics.
Une seconde alternative particulièrement robuste réside dans les protocoles de rééchantillonnage par bootstrap adapté aux populations finies (Finite Population Bootstrap). Contrairement au bootstrap standard de Bradley Efron, qui s’exécute par tirages avec remise au sein de l’échantillon de taille n (simulant une population infinie d’origine), le bootstrap pour population finie commence par reconstruire artificiellement une pseudo-population synthétique de taille N en dupliquant N / n fois les observations empiriques de l’échantillon, avant de prélever des sous-échantillons par tirages sans remise de taille n au sein de cette matrice élargie. Cette approche numérique intensive génère des distributions empiriques de substitution d’une fidélité exceptionnelle, émancipées de tout postulat paramétrique théorique.
10.3 Restructuration du devis de recherche et approches bayésiennes
Enfin, la transgression massive de la condition des 10 % offre une opportunité épistémologique majeure de reconsidérer globalement le paradigme inférentiel en basculant vers la statistique bayésienne appliquée aux populations finies. Dans la vision fréquentiste traditionnelle, les paramètres populationnels (comme le nombre total de succès K dans la population finie N) sont postulés comme des constantes fixes inconnues, tandis que l’échantillon est conceptualisé comme une variable aléatoire susceptible de se répéter à l’infini dans des univers parallèles.
Dans l’approche bayésienne des populations finies, initiée formellement par Ericson en 1969, la perspective s’inverse de manière particulièrement élégante :
- Les données observées dans l’échantillon de taille n sont considérées comme des certitudes absolues et fixes (elles ont été mesurées sans erreur).
- L’objet de l’inférence statistique ne porte plus sur un paramètre abstrait infini, mais sur la prédiction bayésienne des unités statistiques non observées de la population, dont le nombre est précisément égal à N – n.
- Le chercheur attribue une distribution a priori (souvent une loi bêta conjuguée) sur la proportion inconnue, intègre les données empiriques recueillies sur les n unités réelles pour obtenir une distribution a posteriori, puis dérive la distribution prédictive a posteriori (loi bêta-binomiale) pour dénombrer les succès présents au sein des N – n sujets résiduels non interrogés.
Cette approche prédictive bayésienne dissout littéralement la contrainte de la condition des 10 %. Plus l’échantillon n s’approche de N, plus l’incertitude prédictive sur la fraction résiduelle se réduit naturellement, sans jamais générer de paradoxes de variance ou de distorsions computationnelles. L’inférence sur la population finie trouve ainsi son accomplissement théorique le plus achevé.
11. Protocoles de diagnostic et implémentation dans les logiciels de données
11.1 Algorithme de décision méthodologique avant analyse
Pour immuniser le chercheur et l’analyste contre toute erreur de spécification lors du traitement de proportions ou de moyennes, il est hautement profitable de synthétiser le cheminement méthodologique sous la forme d’un algorithme séquentiel de décision rigoureux. Ce protocole systématique doit être déroulé de façon systématique en amont de toute phase d’inférence définitive :
Étape 1 : Identification du cadre de sondage et qualification de la finitude de N
L’analyste doit déterminer si la population parente fait l’objet d’un recensement fini dénombrable ou si elle relève d’un processus générateur infini. Si N est infini ou virtuellement inaccessible (ex. études de laboratoire sur des réactions chimiques), la condition d’indépendance binomiale est satisfaite par définition. Si N est fini et connu, passer immédiatement à l’Étape 2.
Étape 2 : Évaluation du ratio d’épuisement (Condition des 10 %)
Calculer précisément le ratio f = n / N. Deux branches décisionnelles s’ouvrent alors :
- Cas A (n ≤ 0,10 N) : La condition des 10 % est validée. L’analyste est formellement dispensé d’appliquer le FCPF. La loi binomiale (ou sa simplification normale) est autorisée. Aller à l’Étape 3.
- Cas B (n > 0,10 N) : La condition des 10 % est violée. L’application du facteur de correction pour population finie (FCPF) devient obligatoire sur l’ensemble des erreurs types, sous peine de surestimer l’imprécision des estimations. Aller à l’Étape 3.
Étape 3 : Contrôle de la normalité (Condition de succès-échec)
Vérifier si n × p̂ ≥ 10 et n × (1 – p̂) ≥ 10.
- Si la condition de succès-échec est satisfaite conjointement avec le Cas A : Déployer le test Z standard ou l’intervalle de Wald classique.
- Si la condition de succès-échec est satisfaite conjointement avec le Cas B : Déployer le test Z ajusté en multipliant le dénominateur de l’erreur type par le FCPF.
- Si la condition de succès-échec échoue : Abandonner l’approximation normale. Pour le Cas A, exécuter le test exact binomial. Pour le Cas B, exécuter obligatoirement le test exact hypergéométrique ou le test exact de Fisher.
11.2 Exécution sous R et SPSS : scripts et syntaxes comparatifs
L’opérationnalisation de ces principes au sein des environnements logiciels contemporains exige la maîtrise des commandes et packages dédiés à l’échantillonnage en population finie. Dans le logiciel de programmation statistique R, l’approche la plus rigoureuse consiste à mobiliser le package spécialisé survey (développé par Thomas Lumley), explicitement conçu pour traiter les plans d’échantillonnage complexes et les corrections de population finie.
Sous R, la déclaration d’un devis d’échantillonnage aléatoire simple sans remise avec intégration native du FCPF s’effectue au moyen de la syntaxe suivante :
Exemple de paramétrage de plan sous le package survey :
Pour spécifier un échantillon de données empiriques (mes_donnees) comprenant n = 400 lignes prélevées dans une population de N = 1 000 sujets, l’analyste crée une variable fpc_pop <- 1000 au sein de son bloc de données, puis configure l’objet de sondage :
mon_plan <- svydesign(ids = ~1, fpc = ~fpc_pop, data = mes_donnees)
L’interrogation subséquente des proportions et de leurs erreurs types via la commande :
svymean(~variable_binaire, mon_plan)
délivre instantanément des erreurs types affinées par l’application automatique du facteur √[(1000 – 400) / (1000 – 1)] ≈ 0,775, garantissant des intervalles de confiance parfaitement exacts.
Si l’on désire calculer manuellement les probabilités exactes cumulées sous R pour comparer la loi binomiale et la loi hypergéométrique, les fonctions canoniques natives sont :
– Modèle binomial : 1 - pbinom(q = 119, size = 500, prob = 0.20)
– Modèle hypergéométrique : phyper(q = 119, m = 2000, n = 8000, k = 500, lower.tail = FALSE)
Sous IBM SPSS Statistics, le traitement standardisé du FCPF requiert l’activation du module optionnel SPSS Complex Samples (Échantillons complexes). Dans le menu déroulant, l’analyste accède à Analyse > Échantillons complexes > Préparer pour l'analyse, génère un plan de sondage (fichier .csplan), renseigne la variable contenant la taille totale de la population N dans le champ d’ajustement de la strate d’échantillonnage sans remise, puis exécute les fréquences univariées via le sous-menu des échantillons complexes. L’omission de cette démarche sous SPSS conduit le logiciel à utiliser par défaut ses modules d’inférence générale, ignorant la transgression de la condition des 10 % et délivrant des erreurs types surévaluées.
11.3 Bonnes pratiques de reporting dans les normes de publication académique (APA)
La transcription des analyses quantitatives au sein des manuscrits scientifiques soumis aux revues à comité de lecture doit se conformer aux standards de transparence méthodologique les plus exigeants, tels que codifiés par l’American Psychological Association (normes APA, 7e édition). La section « Méthode » (sous-section Participants et échantillonnage) et la section « Résultats » doivent obligatoirement documenter la gestion de la fraction de sondage.
Les recommandations de rédaction académique imposent de respecter les trois directives suivantes :
- Déclaration explicite de la fraction de sondage : Dès lors que la population d’étude est restreinte et finie, les auteurs doivent déclarer conjointement la taille de l’échantillon n et la taille de la population parente N, en stipulant expressément la valeur du ratio d’échantillonnage (ex. « L’échantillon final de n = 350 soignants représente 28,0 % de l’effectif global des N = 1 250 soignants du centre hospitalier universitaire »).
- Justification formelle de l’inclusion ou de l’omission du FCPF : Si n ≤ 0,10 N, les auteurs doivent consigner en une phrase la validité de l’approximation binomiale (ex. « La fraction de sondage s’élevant à 4,5 % (≤ 10 %), les hypothèses d’indépendance de tirage ont été maintenues sans nécessité de correction pour population finie »). Si la fraction excède 10 %, les auteurs doivent formaliser l’emploi du FCPF (ex. « En raison d’un taux d’échantillonnage de 28,0 % excédant le seuil standard de 10 %, toutes les erreurs types et les marges d’erreur associées aux proportions ont été corrigées à l’aide du Facteur de Correction pour Population Finie [FCPF = 0,849] conformément aux recommandations de Cochran »).
- Précision du logiciel et des packages mobilisés : Afin de garantir une reproductibilité computationnelle absolue des calculs d’intervalles et des valeurs de significativité, le nom des fonctions informatiques ou des syntaxes de sondage complexe utilisées doit être transparentement mentionné dans le texte méthodologique.
12. Synthèse épistémologique et recommandations pour la recherche empirique
12.1 La condition des 10 % comme compromis pragmatique des statistiques appliquées
Au terme de cette exploration mathématique et méthodologique exhaustive, la condition des dix pour cent se révèle dans toute sa plénitude épistémologique : elle n’est pas une simple recette calculatoire destinée aux manuels de propédeutique, mais l’incarnation philosophique du compromis fondamental qui régit l’ensemble des sciences statistiques appliquées. L’activité scientifique ne consiste pas à poursuivre une idéalisation abstraite déconnectée des contingences matérielles, mais à construire des modèles formels capables de simplifier la réalité phénoménologique sans en trahir la structure essentielle.
Dans l’histoire des probabilités, l’émergence des règles heuristiques — à l’instar de la règle des 10 %, du seuil de normalité np ≥ 10, ou du seuil de significativité conventionnel α = 0,05 initié par Ronald Fisher — a joué un rôle moteur dans l’expansion des sciences empiriques. Sans ces seuils de robustesse universellement validés, le développement de la sociologie quantitative, de la psychométrie différentielle et des essais épidémiologiques aurait été considérablement freiné par des impasses calculatoires inextricables à l’ère pré-informatique.
Le statut épistémologique de l’approximation en statistique est un statut de noblesse méthodologique : une approximation n’est pas un calcul dégradé ou approximatif au sens péjoratif du terme, mais une modélisation optimisée où l’erreur maximale commise est rigoureusement bornée, quantifiée et reconnue comme inférieure au seuil de bruit expérimental inhérent à l’instrumentation humaine. La condition des 10 % garantit que la tractabilité analytique des distributions indépendantes peut être exploitée en toute sérénité intellectuelle, préservant à la fois la validité interne des conclusions et l’intelligibilité des procédures d’analyse.
12.2 Guide récapitulatif pour les chercheurs en sciences du comportement
Pour assister le chercheur, le clinicien et l’analyste de données dans sa pratique quotidienne, nous synthétisons les impératifs méthodologiques sous la forme d’un tableau d’orientation décisionnelle exhaustif, récapitulant les actions à entreprendre face aux différentes configurations expérimentales rencontrées sur le terrain empirique :
| Ratio de sondage (n / N) | Effectifs de succès / échecs | Modèle d’échantillonnage préconisé | Ajustement de dispersion requis | Conséquence si erreur |
|---|---|---|---|---|
| f ≤ 0,10 (Condition satisfaite) | np ≥ 10 et n(1-p) ≥ 10 | Approximation normale de Wald | Aucun ajustement (Erreur type standard) | Calculs inutilement complexes si FCPF employé |
| f ≤ 0,10 (Condition satisfaite) | np < 10 ou n(1-p) < 10 | Distribution binomiale exacte | Calculs exacts combinatoires discrets | Asymétrie non contrôlée si approximation normale |
| f > 0,10 (Condition violée) | np ≥ 10 et n(1-p) ≥ 10 | Approximation normale corrigée | Multiplication impérative par le FCPF | Intervalles de confiance indûment larges, perte de puissance |
| f > 0,10 (Condition violée) | np < 10 ou n(1-p) < 10 | Distribution hypergéométrique exacte / Fisher | Modélisation sans remise exacte directe | Erreurs massives d’inférence, faux négatifs critiques |
En observant scrupuleusement cette grille d’arbitrage méthodologique, l’investigateur se prémunit contre le double écueil de la sophistication calculatoire superflue lorsque la taille de la population parente autorise les approximations élémentaires, et du laxisme analytique lorsque la finitude du vivier d’origine impose des corrections correctives strictes.
12.3 Perspectives futures : l’analyse des mégadonnées et l’échantillonnage continu
À l’ère contemporaine des mégadonnées (Big Data), de l’apprentissage machine et du recueil continu de traces numériques comportementales, la place et le statut de la condition des 10 % connaissent des mutations conceptuelles fascinantes. Historiquement forgée pour des situations où les statisticiens recueillaient des données artisanales au sein de registres démographiques stables, la règle des 10 % se heurte aujourd’hui à des écosystèmes numériques où la distinction traditionnelle entre échantillon et population tend à s’estomper radicalement.
Lorsque des plateformes technologiques mondiales analysent les comportements d’utilisation d’algorithmes au sein de cohortes d’utilisateurs actifs dénombrant plusieurs millions d’individus, des expérimentations contrôlées à large échelle (devis de tests A/B continus) mobilisent fréquemment des échantillons n qui représentent 30 %, 50 % ou 80 % de la population totale d’intérêt sur une fenêtre temporelle donnée. Dans ces contextes algorithmiques de quasi-recensement continu, l’application de la théorie classique des tests d’hypothèse sans correction pour population finie génère des paradoxes majeurs, notamment l’apparition de significations statistiques purement triviales (valeurs p infinitésimales pour des tailles d’effet totalement négligeables en pratique).
Loin de rendre la condition des 10 % obsolète, l’ère des mégadonnées réaffirme avec une acuité renouvelée sa pertinence pédagogique et théorique fondamentale. Elle rappelle aux data scientists et aux chercheurs modernes que la taille d’un échantillon ne saurait être évaluée dans un vide métrologique absolu, mais doit toujours être contextualisée au regard de l’univers fini au sein duquel s’enracine la collecte de données. Que ce soit pour concevoir un essai clinique portant sur une cohorte médicale rare de cinquante patients ou pour ausculter les flux d’interactions de millions d’usagers sur une plateforme numérique, la maîtrise de l’épuisement des populations finies et de ses seuils de tolérance demeure l’une des marques les plus éclatantes de la véritable culture statistique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bernoulli, J. (1713). Ars conjectandi, opus posthumum. Impensis Thurnisiorum, Fratrum.
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press. https://doi.org/10.1201/9780429246593
- Ericson, W. A. (1969). Subjective Bayesian models in sampling finite populations. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 195-224. https://doi.org/10.1111/j.2517-6161.1969.tb00780.x
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Kish, L. (1965). Survey sampling. John Wiley & Sons.
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. John Wiley & Sons. https://doi.org/10.1002/9780470580066
- Moore, D. S., Notz, W. I., & Flinger, M. A. (2021). The basic practice of statistics (9th ed.). W. H. Freeman.
- Rice, J. A. (2007). Mathematical statistics and data analysis (3rd ed.). Duxbury Press.
- Särndal, C.-E., Swensson, B., & Wretman, J. (2003). Model assisted survey sampling. Springer Science & Business Media. https://doi.org/10.1007/978-1-4612-4378-6
- Thompson, S. K. (2012). Sampling (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118162934