
L’analyse de régression linéaire constitue incontestablement l’un des piliers méthodologiques les plus fondamentaux et les plus universellement appliqués au sein des sciences contemporaines, tout particulièrement dans le champ de la psychologie quantitative, des neurosciences cognitives et des sciences sociales empiriques. Dès lors qu’un chercheur formule l’hypothèse d’une dépendance fonctionnelle entre une variable explicative et une variable à expliquer, la modélisation linéaire s’impose comme l’outil privilégié permettant de cartographier la structure des relations observées. Néanmoins, l’observation brute d’une droite d’ajustement au sein d’un échantillon ne saurait suffire à fonder une conclusion scientifique pérenne : la variabilité inhérente à l’échantillonnage aléatoire introduit une incertitude radicale qui sépare la réalité empirique locale de la vérité théorique populationnelle.
C’est précisément à cette jonction critique entre la statistique descriptive et l’inférence probabiliste que se déploie le test t appliqué à la pente de régression. Conçu à l’origine pour pallier les contraintes drastiques des petits échantillons de mesures industrielles, le test développé par William Sealy Gosset sous le pseudonyme de « Student » s’est métamorphosé en un protocole universel de décision statistique. Dans le cadre de la modélisation linéaire, ce test évalue avec une rigueur analytique formelle si le taux d’accroissement observé entre deux variables reflète une véritable dynamique sous-jacente au niveau de la population parente, ou s’il ne représente qu’une simple chimère stochastique imputable aux fluctuations d’échantillonnage.
La compréhension approfondie de la mécanique mathématique, conceptuelle et épistémologique du test t de Student représente un impératif méthodologique incontournable pour quiconque aspire à conduire des analyses quantitatives rigoureuses. De la formalisation de la méthode des moindres carrés ordinaires jusqu’aux dilemmes contemporains liés à la crise de la reproductibilité, en passant par les subtilités de l’erreur type, de la puissance statistique et des diagnostics de colinéarité, ce traité propose une immersion exhaustive au cœur de l’inférence linéaire. L’objectif est de dépasser la simple lecture aveugle des sorties logicielles afin de restituer au chercheur l’entière maîtrise théorique et opérationnelle de son arsenal inférentiel.
1. Fondements théoriques de la régression linéaire et rôle de l’inférence statistique
1.1 Principes généraux du modèle de régression linéaire simple
Le modèle de régression linéaire simple repose sur l’hypothèse fondatrice selon laquelle une variable dépendante continue, conventionnellement notée Y (le critère ou la variable à prédire), peut être exprimée comme une fonction affine d’une variable indépendante continue ou dichotomique, notée X (le prédicteur ou la variable explicative), à laquelle s’adjoint une composante stochastique résiduelle. Sur le plan formel, le modèle probabiliste s’énonce selon l’équation canonique de population suivante :
Y = β0 + β1X + ε
Dans cette formalisation structurelle, β0 représente l’ordonnée à l’origine théorique (l’intercept de la population), qui désigne la valeur moyenne attendue de Y lorsque X adopte une valeur strictement nulle. Le paramètre β1 matérialise la pente théorique de la population, c’est-à-dire le coefficient de régression qui quantifie la variation attendue de Y pour chaque incrément d’une unité sur l’échelle de mesure de X. Le terme ε symbolise la variable d’erreur résiduelle, ou perturbation stochastique inobservable. Ce résidu ne traduit pas nécessairement une faute méthodologique, mais incorpore de manière globale trois dimensions inhérentes à la recherche empirique : l’erreur de mesure propre aux instruments psychométriques, l’influence non modélisée d’une myriade de facteurs externes régissant le phénomène étudié, et l’indéterminisme intrinsèque inhérent aux conduites humaines et aux processus biopsychologiques.
Il importe de distinguer avec acuité la finalité prédictive pure de la modélisation causale au sein des sciences comportementales. Dans une optique strictement pragmatique de prédiction statistique, l’ajustement du modèle vise l’optimisation de la concordance numérique entre les valeurs prédites et les valeurs observées, sans exiger que X soit le moteur étiologique direct de Y. À l’inverse, l’explication théorique et causale exige que le modèle reflète une dynamique asymétrique où les manipulations ou variations de X engendrent directement les altérations observées de Y. Cette dernière ambition ne découle jamais de la seule équation algébrique, mais dépend de la solidité du protocole expérimental, du contrôle rigoureux des variables parasites et de la cohérence interne du cadre théorique convoqué.
1.2 Le passage du descriptif à l’inférentiel en recherche quantitative
Dans la pratique de la recherche empirique, l’accès direct aux paramètres de la population globale (β0 et β1) s’avère matériellement et conceptuellement impossible, dans la mesure où les populations cibles comprennent des effectifs infinis ou inaccessibles dans leur intégralité. Le chercheur est donc contraint d’extraire un échantillon de taille finie n et d’estimer ces paramètres au moyen de statistiques d’échantillon, traditionnellement notées b0 pour l’intercept et b1 (ou simplement b) pour la pente de régression empirique. L’équation de prédiction appliquée à l’échantillon se condense sous la forme déterministe suivante :
Ÿ = b0 + b1X
Cette distinction entre le niveau populationnel (paramètres grecs invariants) et le niveau empirique (statistiques latines variables) constitue le pivot de la pensée inférentielle. Dès lors qu’une infinité d’échantillons aléatoires distincts de taille n peuvent être extraits d’une même population mère, la statistique b fluctue inévitablement d’une réplication à l’autre. Cette fluctuation engendre ce que la théorie mathématique désigne sous le vocable de variabilité d’échantillonnage de la pente.
La statistique purement descriptive se borne à acter la présence d’une valeur de b non nulle sur les données recueillies, constatant par exemple une pente de 0,45 au sein d’une cohorte particulière. Cependant, sans inférence statistique, il est rigoureusement impossible de déterminer si cette valeur de 0,45 reflète une tendance structurelle généralisable à l’ensemble de la population de référence, ou si elle découle simplement d’un artefact stochastique imputable à l’échantillonnage aléatoire. L’inférence statistique comble précisément ce fossé méthodologique en fournissant un ensemble de procédures probabilistes destinées à évaluer si l’estimation observée peut être légitimement considérée comme le reflet d’un paramètre β1 différent de zéro dans l’univers dont l’échantillon a été extrait.
1.3 La pente de régression comme indice d’association statistique
Sur le plan géométrique, la pente de régression b représente la tangente trigonométrique de l’angle que forme la droite des moindres carrés avec l’axe horizontal des abscisses. Elle exprime la raideur de l’inclinaison de l’ajustement linéaire et fournit une métrique directe du taux de transfert entre la variable indépendante et le critère étudié. Algébriquement, cette valeur synthétise le rapport existant entre la covariance conjointe des deux variables et la variance intrinsèque du prédicteur, formalisé selon l’égalité fondamentale :
b = Cov(X, Y) / Var(X)
Cette relation met en lumière le fait que la pente mesure l’amplitude du glissement concomitant de Y rapportée à l’échelle de dispersion de X. Par conséquent, la métrique de la pente est tributaire directe des unités de mesure concrètes utilisées pour coder X et Y. Si, dans le cadre d’une recherche psychométrique, la variable X quantifie l’anxiété sur une échelle allant de 0 à 10 points et que la variable Y mesure le rythme cardiaque en battements par minute, une pente b de 3,5 indique qu’une augmentation d’un point d’anxiété s’accompagne d’une élévation moyenne de 3,5 battements par minute. Si l’échelle d’anxiété était divisée par dix, la valeur numérique de la pente se verrait multipliée par dix sans que l’intensité fondamentale de la relation ne soit altérée d’aucune manière.
Il s’avère dès lors indispensable de souligner avec gravité qu’en dépit de son élégance descriptive, la pente de régression ne confère aucune garantie de causalité intrinsèque. Deux variables peuvent présenter une covariance élevée et une pente d’ajustement exceptionnellement prononcée en vertu de processus spurious, d’une corrélation fortuite ou de l’action non contrôlée d’une variable confondante sous-jacente. L’inférence statistique sur la pente permet d’affirmer la réalité de l’association probabiliste, mais le statut explicatif de l’effet exige impérativement un plan de recherche méthodologiquement verrouillé, à l’instar d’un essai randomisé contrôlé ou d’une modélisation quasi-expérimentale rigoureuse.
2. Formulation des hypothèses statistiques du test t pour la pente
2.1 L’hypothèse nulle (H0) et son interprétation conceptuelle
Le protocole de la théorie classique des tests d’hypothèses, héritier des formulations de Ronald Fisher, Jerzy Neyman et Egon Pearson, impose que toute démarche d’inférence prenne pour point de départ la formulation d’une hypothèse nulle d’invariance, désignée sous l’appellation formelle H0. Dans le cadre de l’évaluation de la pente de régression linéaire simple, l’hypothèse nulle postule que dans la population parente de laquelle provient l’échantillon, le paramètre structurel de pente est rigoureusement nul :
H0 : β1 = 0
La traduction conceptuelle de cette proposition algébrique est d’une portée substantielle majeure : postuler que β1 est égal à zéro équivaut à affirmer qu’il n’existe aucune relation fonctionnelle linéaire entre la variable explicative X et la variable dépendante Y au sein de la population. Sous H0, la connaissance de la valeur prise par X ne procure aucune information utile ou pertinente permettant de réduire l’incertitude quant à la valeur de Y. La variable X est déclarée statistiquement inopérante pour rendre compte des fluctuations de Y.
Sur le plan géométrique, l’acceptation de la validité de H0 implique que la droite de régression théorique au niveau de la population est parfaitement horizontale, son coefficient directeur étant nul. En vertu de cette horizontalité, l’ordonnée à l’origine β0 correspond exactement à la moyenne théorique de la variable dépendante dans la population, notée μY. Dès lors, le meilleur prédicteur linéaire de n’importe quel score individuel Yi, indépendamment du niveau observé de Xi, se résume purement et simplement à la moyenne empirique globale Ÿ (Ȳ). Tout raffinement du modèle visant à inclure X constitue, sous l’empire strict de l’hypothèse nulle, une complexification superflue incapable d’améliorer la modélisation du phénomène.
2.2 L’hypothèse alternative (HA) : approches bilatérales et unilatérales
Face à l’hypothèse nulle d’absence de relation, le chercheur formule une hypothèse alternative, notée H1 ou HA, qui définit l’espace des paramètres populationnels jugés plausibles dès lors que les données empiriques conduisent à répudier H0. Dans la majorité écrasante des protocoles en recherche quantitative, la formulation standard privilégie une hypothèse alternative bilatérale non directionnelle, s’énonçant comme suit :
HA : β1 ≠ 0
Cette spécification bilatérale stipule l’existence d’une association linéaire entre X et Y au sein de la population, tout en maintenant une neutralité épistémique a priori quant au signe positif ou négatif de cette relation. Le rejet de H0 intervient dès lors que la pente empirique s’écarte de zéro avec une amplitude suffisante, que cet écart se matérialise par une trajectoire ascendante fortement positive ou par une trajectoire descendante fortement négative. Cette approche constitue le choix méthodologique par défaut recommandé par la communauté scientifique, car elle préserve la capacité de détection du test face à des résultats inattendus ou contraires aux attentes théoriques initiales.
À l’inverse, l’approche unilatérale directionnelle exige que le chercheur restreigne son hypothèse alternative à un seul côté de la distribution théorique, posant de manière exclusive HA : β1 > 0 (prédiction d’une pente positive) ou HA : β1 < 0 (prédiction d’une pente négative). Bien que cette stratégie permette de concentrer la totalité de la zone de rejet dans une seule queue de la distribution — augmentant ainsi mécaniquement la puissance statistique locale —, elle soulève d’importants arbitrages méthodologiques. Si le chercheur observe une valeur fortement significative dans la direction opposée à son hypothèse unilatérale, il est formellement tenu par la logique mathématique du test de considérer le résultat comme un échec de rejet de H0. Pour cette raison, l’usage des tests unilatéraux exige une justification théorique préalable irréfutable, adossée à une littérature empirique consolidée, excluant logiquement toute possibilité d’un effet inverse.
2.3 Les implications épistémologiques du test d’hypothèse nulle (NHST)
L’application du test de signification de l’hypothèse nulle (Null Hypothesis Significance Testing, ou NHST) dans les modèles de régression s’inscrit au sein d’une structure logique directement inspirée de la vision falsificationniste formulée par Karl Popper. Selon cette perspective, un énoncé scientifique universel ne peut jamais être rigoureusement vérifié de manière définitive par l’accumulation d’observations empiriques favorables ; en revanche, il peut être réfuté par l’exhibition de données incompatibles avec ses prédictions fondamentales. Le NHST applique ce principe par l’absurde : plutôt que de chercher à valider directement la théorie substantive sous-jacente, il s’emploie à réfuter le postulat de l’absence totale d’effet représenté par H0.
Cette asymétrie logique engendre une distinction épistémologique cruciale que tout analyste quantitatif doit scrupuleusement respecter : l’absence de preuve statistique d’un effet ne constitue sous aucun prétexte une preuve de l’absence d’effet. Échouer à rejeter l’hypothèse nulle β1 = 0 signifie exclusivement que les données d’échantillon disponibles s’avèrent compatibles avec l’hypothèse d’invariance, sans que l’on puisse mathématiquement affirmer que le paramètre populationnel est rigoureusement équivalent à zéro. Cette incapacité à rejeter peut découler d’une absence réelle d’effet, mais elle peut tout aussi bien traduire une faiblesse de la puissance statistique due à un échantillon de taille insuffisante ou à un bruit de mesure excessif.
Par ailleurs, la pratique récurrente du NHST expose les sciences du comportement au risque insidieux de réification des seuils probabilistes arbitraires. La sacralisation de la barrière conventionnelle des 5 % a historiquement dérivé vers une dichotomisation simpliste de la réalité empirique, scindant artificiellement le savoir entre résultats « scientifiquement découverts » et « néants statistiques ». Replacer le test t dans son contexte épistémologique exact exige de le considérer non pas comme un verdict ontologique infaillible, mais comme un simple filtre probabiliste calibré pour modérer la propension naturelle du chercheur à discerner des structures régulières au milieu du bruit aléatoire.
3. Mécanique mathématique de la statistique de test t
3.1 Décomposition de l’estimateur de la pente (b ou β̂1)
L’obtention de la pente d’échantillon b découle de l’application de la méthode analytique des moindres carrés ordinaires (MCO). Cette méthode a pour vocation mathématique d’identifier l’unique droite qui minimise de manière globale la somme des carrés des écarts verticaux séparant chaque point empirique observé de sa valeur prédite sur la droite d’ajustement. Sur le plan matriciel et algébrique, cette opération de minimisation différentielle conduit à formuler l’estimateur de la pente sous la forme explicite du quotient de la somme des produits croisés centrés par la somme des carrés de la variable explicative centrée :
b = ∑((Xi – X̄)(Yi – Ȳ)) / ∑((Xi – X̄)2)
En vertu du célèbre théorème de Gauss-Markov, cet estimateur des moindres carrés bénéficie de propriétés formelles remarquables qui justifient son ubiquité en recherche quantitative. Dès lors que les postulats classiques du modèle linéaire sont satisfaits, l’estimateur b est qualifié de BLUE (Best Linear Unbiased Estimator, ou Meilleur Estimateur Linéaire Non Biaisé). Cela signifie formellement que son espérance mathématique coïncide exactement avec le paramètre de population sous-jacent [E(b) = β1], qu’il converge de manière asymptotique vers la vraie valeur à mesure que la taille de l’échantillon progresse vers l’infini, et qu’il présente une variance minimale parmi l’ensemble exhaustif des estimateurs linéaires sans biais envisageables.
Toutefois, cette perfection mathématique abstraite dissimule une fragilité géométrique notoire : l’estimateur b s’avère particulièrement vulnérable à la présence de valeurs aberrantes ou d’observations extrêmes dans le jeu de données. Étant calculé à partir de moments quadratiques centrés, un unique point d’échantillonnage cumulant un fort éloignement sur l’axe des X (point de levier élevé) et une déviation marquée sur l’axe des Y (résidu important) exerce un moment de force disproportionné susceptible de faire pivoter la trajectoire de la droite d’ajustement, altérant ainsi drastiquement l’estimation de la pente.
3.2 Calcul et signification de l’erreur type de la pente (SEb)
Pour soumettre la pente estimée b à une épreuve d’inférence, il est nécessaire de quantifier rigoureusement l’ampleur prévisible de sa dispersion d’échantillonnage. Cette dispersion théorique est captée par une grandeur fondamentale : l’erreur type de la pente, conventionnellement notée SEb (pour Standard Error of the slope) ou sb. Cette métrique représente l’écart type de la distribution d’échantillonnage théorique de b qui se déploierait si l’on procédait à un tirage infini d’échantillons aléatoires de même taille issus de la même population parente. Son équation calculatoire formelle s’exprime ainsi :
SEb = se / √(∑(Xi – X̄)2)
Dans cette structure mathématique, le numérateur se désigne l’erreur type des résidus (ou écart type résiduel de la régression), calculée par la racine carrée de la variance non expliquée du modèle :
se = √(∑(Yi – Ÿi)2 / (n – 2))
Cette expression explicite la façon dont trois composantes fondamentales modulent l’erreur type de la pente :
- La magnitude de la variance non expliquée (se) : Plus les données observées s’écartent avec dispersion autour de la droite d’ajustement (bruit résiduel important), plus l’erreur type SEb enfle, traduisant une estimation moins précise du paramètre.
- La dispersion intrinsèque de la variable explicative (∑(Xi – X̄)2) : Le dénominateur de l’erreur type intègre la somme des carrés de X. Par conséquent, plus les observations sont étalées et distantes sur l’échelle du prédicteur, plus le bras de levier mathématique est solide pour ancrer l’inclinaison de la droite, ce qui réduit mécaniquement SEb.
- La taille globale de l’échantillon (n) : À mesure que le nombre d’observations s’accroît, la somme des déviations quadratiques au dénominateur augmente cumulativement, ce qui resserre l’erreur type et confère à la statistique b une netteté de plus en plus chirurgicale.
3.3 Le ratio signal/bruit : anatomie de la formule t = b / SEb
L’articulation entre l’estimateur ponctuel de la pente et son erreur type permet de déduire la statistique de décision formelle du test t. En vertu du paradigme d’invariance stipulé par l’hypothèse nulle (selon laquelle le paramètre populationnel β1 est postulé égal à zéro), la statistique t observée se définit par la formule élémentaire suivante :
t = (b – β1, sous H0) / SEb = b / SEb
L’anatomie de cette fraction révèle immédiatement sa nature conceptuelle profonde : la statistique t s’apparente rigoureusement à un ratio signal/bruit standardisé. Au numérateur, la pente observée b incarne le « signal » empirique, c’est-à-dire l’amplitude matérielle du taux de liaison décelé entre les deux variables d’intérêt. Au dénominateur, l’erreur type SEb matérialise le « bruit » d’échantillonnage, soit la marge d’oscillation stochastique attendue sous le simple jeu du hasard de tirage.
Calculer la statistique t revient donc à formuler une question intuitive : à combien d’écarts types d’échantillonnage la pente observée se situe-t-elle par rapport à une absence totale de relation ? Si le signal dépasse largement le bruit de fond stochastique, la valeur absolue de t s’élève substantiellement, indiquant qu’il devient hautement invraisemblable que l’estimation constatée soit une banale coïncidence statistique. Sur le plan asymptotique, lorsque la variance résiduelle s’amenuise ou que l’échantillon croît vers de larges proportions, SEb converge vers zéro, propulsant le ratio t vers des amplitudes extrêmes qui forcent le rejet formel de l’hypothèse nulle.
4. Les degrés de liberté et la distribution de Student associée
4.1 Détermination des degrés de liberté (n – 2) dans la régression simple
Toute distribution de probabilité théorique de Student est paramétrée par un indice régulateur cardinal désigné sous le terme de degrés de liberté (noté dl ou df pour degrees of freedom). Dans le cadre strict de la régression linéaire simple comportant une variable dépendante et un unique régresseur quantitatif, le nombre de degrés de liberté assigné au test t de la pente équivaut invariablement à l’expression mathématique :
dl = n – 2
L’origine mathématique de cette soustraction de deux unités trouve sa justification dans les contraintes arithmétiques requises pour l’estimation conjointe des paramètres structurels du modèle. L’échantillon initial fournit n données brutes indépendantes, constituant autant de degrés de liberté d’information informationnelle non contrainte. Cependant, pour être en mesure de calculer l’erreur résiduelle se au sein de chaque écart (Yi – Ÿi), l’analyste doit préalablement estimer deux coefficients empiriques fondamentaux au moyen des équations normales des MCO : l’ordonnée à l’origine b0 et la pente b1.
Chacune de ces estimations impose une contrainte algébrique inviolable sur le vecteur des résidus empiriques ei = Yi – Ÿi. D’une part, l’estimation de l’ordonnée à l’origine contraint la somme des résidus à s’annuler strictement (∑ei = 0). D’autre part, l’ajustement optimal de la pente force la corrélation entre les résidus et les valeurs de la variable indépendante X à être parfaitement nulle (∑Xiei = 0). Ces deux restrictions structurelles consomment irrémédiablement deux unités d’information indépendante. Par voie de conséquence, seuls n – 2 résidus possèdent la liberté théorique de fluctuer sans contrainte une fois les deux paramètres calés, imposant d’utiliser ce dénominateur (n – 2) pour obtenir une estimation rigoureusement sans biais de la variance d’erreur résiduelle se2.
4.2 Propriétés de la distribution de Student selon la taille de l’échantillon
La distribution statistique sur laquelle se projette le ratio t d’échantillonnage ne suit pas rigoureusement la loi normale canonique de Laplace-Gauss à effectif modéré, mais la distribution dérivée formalisée par Gosset : la loi de Student. Cette densité de probabilité présente une morphologie en cloche symétrique centrée sur l’espérance mathématique zéro, rappelant l’allure générale de la loi normale, mais s’en distingue structurellement par des queues de distribution substantiellement plus épaisses et évasées (phénomène d’hyperkurticité relative).
Cette morphologie aux ailes relevées découle du fait que le dénominateur de la statistique t n’intègre pas le véritable écart type d’erreur de la population générale σ, mais son substitut empirique échantillonnal se, lui-même sujet à une variabilité stochastique d’échantillon en échantillon. Cette source supplémentaire d’incertitude induit une probabilité plus élevée d’obtenir des valeurs de t anormalement distantes de l’origine zéro sous la validité de H0. Cela rend les petits échantillons particulièrement sensibles aux fluctuations aléatoires et aux risques d’erreurs de décision si les seuils de référence ne sont pas ajustés en conséquence.
Toutefois, la géométrie de la distribution de Student présente une dynamique asymptotique fondamentale régie par le théorème central limite. À mesure que l’effectif n croît, le nombre de degrés de liberté n – 2 augmente parallèlement, ce qui a pour effet de réduire la variabilité d’estimation de se. Visuellement, les queues de la distribution s’amincissent progressivement et la loi de Student se transmue de manière continue pour converger à l’infini vers la loi normale centrée réduite Z. Dans les cohortes de recherche quantitatives excédant une centaine d’observations, la divergence pratique entre la loi de Student et la loi normale devient infinitésimale.
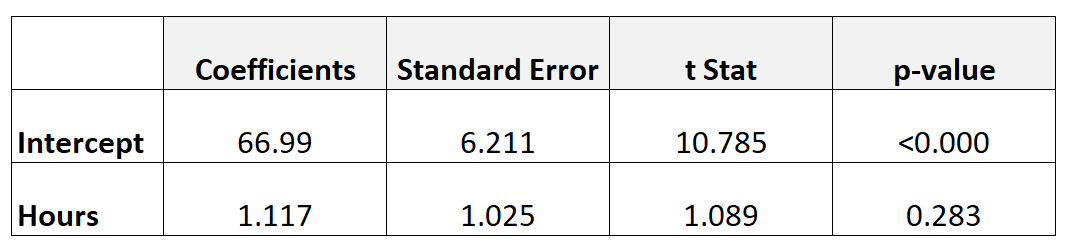
4.3 Définition des valeurs critiques et des régions de rejet
La mise en œuvre opérationnelle de la règle de décision statistique repose sur la détermination formelle de valeurs critiques d’exclusion, notées ±tcritique, qui opèrent une partition nette de l’espace de la distribution de Student entre une région centrale de non-rejet et deux régions périphériques de rejet (dans le cadre conventionnel d’un test bilatéral). La localisation spatiale précise de ces frontières critiques est dictée par deux paramètres conjoints : le seuil d’erreur alpha consenti (α) et le volume précis des degrés de liberté disponibles (n – 2).
Sur le plan géométrique, pour un seuil conventionnel fixé à α = 0,05, la surface totale délimitée par la courbe de la densité de probabilité de Student est partitionnée de telle sorte que 95 % de l’aire sous la courbe soit circonscrite à l’intérieur de l’intervalle symétrique [-tcritique ; +tcritique]. Les 5 % résiduels de probabilité d’erreur de faux positif sont ventilés à parts égales (2,5 % soit α/2) dans l’extrémité de la queue gauche et (2,5 %) dans l’extrémité de la queue droite. Par exemple, pour un effectif de 30 participants générant 28 degrés de liberté, la table statistique indique un seuil critique bilatéral t(0,05 ; 28) = ±2,048.
La règle décisionnelle formelle du test d’hypothèse se déploie selon une logique booléenne rigide :
- Si la valeur absolue du ratio calculé sur les données d’échantillon est strictement inférieure à la valeur critique, soit |tobservé| < tcritique, la statistique se loge au sein de la région de forte densité probabiliste sous l’hypothèse nulle. La décision statistique impose de ne pas rejeter H0.
- Si la valeur absolue calculée égale ou dépasse le seuil tabulé, soit |tobservé| ≥ tcritique, la statistique s’enfonce au cœur des zones de rejet aux marges extrêmes de la loi. La décision statistique commande de rejeter H0 au profit de l’hypothèse alternative HA, déclarant la pente observée statistiquement significative.
5. La valeur p (p-value) et les critères de décision statistique
5.1 Définition probabiliste exacte de la valeur p
La valeur p (communément désignée par l’anglicisme p-value) constitue l’indice probabiliste le plus universellement rapporté dans les articles de psychologie empirique, tout en représentant paradoxalement la grandeur conceptuelle la plus chroniquement mal interprétée par les praticiens de la recherche quantitative. Sur le plan de la théorie formelle des probabilités, la valeur p associée à un test t se définit rigoureusement comme suit :
p = P(|t| ≥ |tobservé| | H0 est vraie)
Cette formulation conditionnelle signifie que la valeur p correspond à la probabilité exacte d’observer, sous la supposition formelle que l’hypothèse nulle β1 = 0 soit rigoureusement vraie au niveau de la population, une statistique t dont l’amplitude s’avère au moins aussi déviante ou plus extrême que celle calculée à partir des données empiriques de l’échantillon. Géométriquement, elle représente l’intégrale de l’aire sous la courbe de la loi de Student s’étendant depuis les valeurs ±|tobservé| jusqu’aux confins des queues infinies de la distribution.
Il est impératif d’éradiquer les confusions conceptuelles récurrentes entourant cet indice : la valeur p ne mesure en aucun cas la probabilité que l’hypothèse nulle soit vraie dans l’absolu, pas plus qu’elle ne quantifie la probabilité que la théorie du chercheur soit exacte. De même, elle n’indique pas la probabilité que la réplication directe de l’expérience livre un résultat identique. La valeur p est une métrique de la compatibilité locale des données empiriques avec un modèle stochastique théorique d’absence totale d’effet. Plus la valeur p s’avère infinitésimale, plus la discordance entre le pattern de données observé et le modèle d’invariance devient éclatante.
5.2 Le seuil alpha (α = 0,05) : conventions historiques et débats contemporains
L’assise opérationnelle de la prise de décision en modélisation linéaire repose sur la confrontation de la valeur p calculée à un seuil décisionnel a priori désigné par la lettre grecque α. Historiquement, l’institutionnalisation de ce seuil à la valeur numérique α = 0,05 découle directement des travaux fondateurs de Sir Ronald Aylmer Fisher dans les années 1920. Fisher envisageait ce seuil non pas comme un dogme immuable, mais comme une démarcation pragmatique commode, correspondant grossièrement à une déviation équivalente à deux écarts types dans le cadre de la normalité, incitant le biologiste ou le psychologue à juger qu’un résultat méritait un réexamen approfondi.
Cependant, au fil des décennies, ce repère heuristique s’est pétrifié en une norme académique sacro-sainte régissant sans discernement la politique de publication des revues à comité de lecture. Cette dichotomie aveugle entre des résultats gratifiés du label « significatif » à p = 0,049 et des résultats relégués à l’insignifiance à p = 0,051 a nourri la sévère crise de la reproductibilité qui a ébranlé les sciences comportementales contemporaines. Cette dérive a stimulé des pratiques de sélection opportuniste de données (p-hacking) et la recherche effrénée de significativité artificielle.
Face à ces défaillances structurelles, des méthodologistes de premier plan, à l’image des propositions formulées par Daniel Benjamin et ses collaborateurs, ont vigoureusement milité pour abaisser le seuil d’alpha conventionnel pour la découverte d’effets inédits à α = 0,005, tout en qualifiant l’intervalle compris entre 0,05 et 0,005 de simple « preuve suggestive ». D’autres courants épistémologiques recommandent l’abandon pur et simple des seuils fixes au profit d’un étalonnage personnalisé du risque de décision, tenant compte de la taille globale de l’échantillon, de la vraisemblance théorique a priori de la relation postulée et de la gravité concrète des erreurs de décision, notamment dans les contextes de prise en charge clinique ou de politiques de santé publique.
5.3 Erreurs de type I, de type II et prise de décision opérationnelle
L’inférence statistique sur la pente d’un modèle de régression expose structurellement l’analyste à une matrice décisionnelle binaire régie par l’incertitude stochastique, dans laquelle deux catégories distinctes d’erreurs inférentielles peuvent advenir :
Le tableau ci-dessous explicite les quatre quadrants possibles de la décision inférentielle :
- L’erreur de type I (faux positif) : Cette erreur survient lorsque le chercheur rejette à tort l’hypothèse nulle alors que celle-ci est rigoureusement vraie dans la population (β1 = 0). La probabilité maximale consentie de commettre cette méprise méthodologique est précisément délimitée par le seuil de tolérance α fixé par l’expérimentateur (généralement 0,05). Commettre une erreur de type I en psychologie clinique conduit, par exemple, à affirmer l’efficacité thérapeutique d’un protocole cognitif ou pharmacologique sur la réduction de symptômes, alors que l’intervention est en réalité inopérante.
- L’erreur de type II (faux négatif) : Cette erreur advient lorsque le chercheur échoue à rejeter l’hypothèse nulle alors qu’elle est factuellement fausse dans la population (β1 ≠ 0). La probabilité d’occurrence d’un tel faux négatif est quantifiée par la lettre grecque β. Commettre une erreur de type II conduit à occulter une relation psychologique authentique en concluant à l’absence de preuve statistique d’une dynamique pourtant bien réelle dans le monde empirique.
Il existe un antagonisme dynamique structurel entre ces deux formes d’erreurs : la réduction unilatérale du risque d’erreur de type I (par exemple en resserrant drastiquement le seuil alpha de 0,05 à 0,001) entraîne automatiquement, toutes choses égales par ailleurs, une flambée mécanique du risque d’erreur de type II (β), affaiblissant la capacité de détection du test. La prise de décision opérationnelle équilibrée requiert dès lors un arbitrage conscient entre ces deux périls, dicté par le coût scientifique, social ou éthique respectif d’un faux triomphe par rapport à une opportunité manquée de découverte empirique.
6. Postulats fondamentaux requis pour la validité du test t de régression
6.1 Linéarité de la relation et normalité des résidus
L’édifice mathématique qui confère à la distribution de Student sa capacité prédictive exacte sur le ratio t de la pente repose sur une suite de postulats distributionnels contraignants, formalisés par le modèle classique de régression linéaire gaussienne. Le premier postulat constitutif concerne la linéarité structurelle de la relation unissant X et Y : le modèle postule que l’espérance mathématique conditionnelle de la variable dépendante sachant la variable explicative, notée E(Y|X), constitue une fonction strictement affine de X. Si la véritable trajectoire sous-jacente est en réalité quadratique, exponentielle ou asymptotique, l’estimation d’une pente linéaire constante dénature le phénomène, introduisant un biais conceptuel rendant le test t fallacieux.
Le second postulat cardinal exige que la composante d’erreur résiduelle ε suive, au sein de la population théorique, une distribution normale continue d’espérance nulle et de variance constante, notée de manière synthétique ε ~ N(0, σ2). Ce postulat ne porte pas sur la distribution marginale brute des variables brutes X ou Y considérées isolément, mais s’applique exclusivement à la dispersion des écarts conditionnels une fois le modèle ajusté. L’analyste doit contrôler ce comportement distributionnel au moyen d’outils diagnostiques rigoureux, tels que le tracé d’alignement quantile-quantile (Q-Q plot) confrontant la dispersion empirique des résidus standardisés aux quantiles de la loi normale, complété par des tests statistiques formels comme le test de Shapiro-Wilk.
En présence d’échantillons de taille restreinte (par exemple n < 30), une déviation marquée par rapport à la normalité résiduelle (forte asymétrie ou aplatissement extrême) altère significativement la forme des queues de distribution d’échantillonnage de la statistique t, faussant la précision de la valeur p associée. En revanche, pour des échantillons d’envergure plus substantielle, le théorème central limite confère au test t une robustesse relative face aux déviations modérées de la normalité, la distribution des estimateurs des moindres carrés convergeant asymptotiquement vers la loi normale.
6.2 Homoscédasticité et conséquences de l’hétéroscédasticité
Le postulat d’homoscédasticité stipule que la variance intrinsèque des résidus d’erreur conditionnels demeure rigoureusement constante et uniforme, quel que soit le niveau atteint par la variable explicative X sur son échelle de mesure :
Var(ε | X = x) = σ2 pour tout x
L’altération de cette condition donne naissance à l’hétéroscédasticité, un état pathologique récurrent dans les données en sciences humaines où la dispersion des résidus s’élargit ou se resserre systématiquement à mesure que la variable explicative progresse le long de son continuum (formant graphiquement une figure caractéristique en pavillon de trompette ou en éventail sur le diagramme de dispersion des résidus en fonction des valeurs prédites).
La présence d’hétéroscédasticité ne détruit pas la propriété de non-biaisance de l’estimateur de la pente des moindres carrés : l’espérance mathématique de b converge toujours fidèlement vers la vraie valeur populationnelle β1. En revanche, elle désintègre l’exactitude de l’estimation de l’erreur type SEb. Selon la configuration spatiale de l’hétéroscédasticité, la formule classique des MCO sous-estime ou surestime drastiquement la variabilité stochastique réelle de la pente. Lorsque SEb est artificiellement sous-estimée, le ratio t résultant se trouve artificiellement gonflé, conduisant à une inflation délétère du taux de faux positifs (erreurs de type I).
Face à la détection de cette pathologie — mise en évidence par des diagnostics visuels ou des tests formels d’hétéroscédasticité tels que le test de Breusch-Pagan ou le test de White —, le chercheur doit proscrire le test t conventionnel des MCO. Les voies de remédiation contemporaines consistent soit à recourir à des estimateurs de variance d’erreur robuste, couramment désignés sous le terme d’erreurs types robustes à l’hétéroscédasticité de White (ou estimateurs sandwich HC3/HC4), soit à modéliser structurellement la variance via la régression par moindres carrés pondérés (WLS).
6.3 Indépendance des observations et absence d’autocorrélation
De l’ensemble exhaustif des postulats requis pour l’inférence linéaire, l’hypothèse d’indépendance mutuelle des observations conditionnelles constitue l’exigence méthodologique la plus impérative et la plus intransigeante. Ce postulat pose que le terme d’erreur associé à une observation individuelle i ne présente aucune covariance ou relation de dépendance avec le terme d’erreur attaché à toute autre unité d’observation j :
Cov(εi, εj) = 0 pour tout i ≠ j
Ce postulat est typiquement violé dans deux contextes empiriques fréquents : les études longitudinales impliquant des mesures répétées dans le temps chez les mêmes sujets (donnant lieu à une autocorrélation sérielle temporelle des résidus) et les protocoles de recherche déployés au sein de structures imbriquées ou hiérarchiques, telles que des élèves évalués au sein de mêmes classes scolaires ou des patients suivis par un même praticien en thérapie (autocorrélation spatiale ou de groupe).
La violation du postulat d’indépendance exerce un effet dévastateur sur le comportement du test t. Lorsque les observations présentent une corrélation positive non modélisée, chaque point d’échantillonnage n’apporte plus une unité entière d’information nouvelle ; or, l’équation computationnelle standard du SEb continue de calculer l’erreur type sur la base illusoire d’un effectif indépendant de taille n. Il en résulte une sous-estimation systématique colossale de l’erreur type de la pente, provoquant une explosion incontrôlée du ratio t observé. La statistique de Durbin-Watson ou le calcul du coefficient de corrélation intraclasse (ICC) permettent de repérer ces dépendances résiduelles. En leur présence, le test t de régression simple ordinaire doit être formellement rejeté au profit de modélisations adaptées aux données corrélées, à l’instar des modèles linéaires mixtes hiérarchiques (HLM) ou des équations d’estimation généralisées (GEE).
7. Étude de cas empirique : Temps d’étude et performance académique
7.1 Présentation du jeu de données et contextualisation psychologique
Afin d’ancrer de manière opérationnelle les équations algébriques et les principes conceptuels exposés précédemment, examinons une étude empirique menée auprès d’une cohorte de n = 40 étudiants universitaires inscrits en licence de psychologie cognitive. L’investigateur se propose d’évaluer la pertinence d’un modèle d’apprentissage fondé sur l’investissement temporel délibéré. Pour chaque participant, deux variables quantitatives continues font l’objet d’un recueil standardisé :
- La variable explicative (X) : Le volume total d’heures consacrées aux révisions personnelles et aux lectures académiques dirigées durant les trois semaines précédant la session terminale d’examens (mesuré sur une échelle continue d’heures).
- La variable dépendante ou critère (Y) : La note globale obtenue lors d’une épreuve standardisée d’évaluation des compétences cognitives et statistiques, étalonnée sur une échelle de performance métrique variant théoriquement de 0 à 100 points.
L’interrogation théorique qui guide le protocole est la suivante : la quantité d’effort temporel consenti en phase de révision permet-elle de prédire de manière statistiquement significative et substantielle la performance cognitive finale à l’examen académique ? Les données ont été préalablement examinées sur le plan exploratoire : les distributions conditionnelles ne trahissent aucune rupture de linéarité apparente et les indices d’asymétrie et d’aplatissement résiduels se cantonnent dans des limites acceptables de normalité.
7.2 Calcul pas à pas de l’estimateur b, de l’erreur type et du test t
L’extraction des statistiques élémentaires descriptives calculées sur l’ensemble de la cohorte des 40 étudiants livre les valeurs de sommation et de dispersion suivantes :
- Taille de l’échantillon : n = 40
- Moyenne des heures d’étude : X̄ = 24,50 heures
- Moyenne des notes d’examen : Ȳ = 68,20 points
- Somme des carrés de X centrée : ∑(Xi – X̄)2 = 582,40
- Somme des produits croisés centrés : ∑((Xi – X̄)(Yi – Ȳ)) = 1 426,88
- Somme des carrés des erreurs résiduelles : ∑(Yi – Ÿi)2 = 2 345,74
En mobilisant les formules matricielles des moindres carrés ordinaires détaillées à la section 3, nous pouvons déterminer successivement les estimateurs du modèle linéaire :
Calcul de la pente non standardisée d’échantillon b :
b = ∑((Xi – X̄)(Yi – Ȳ)) / ∑(Xi – X̄)2 = 1 426,88 / 582,40 ≈ 2,450
Calcul de l’ordonnée à l’origine b0 :
b0 = Ȳ – bX̄ = 68,20 – (2,450 × 24,50) = 68,20 – 60,025 = 8,175
L’équation de régression empirique se déploie donc sous la formulation : Ÿ = 8,175 + 2,450X.
Calcul de l’erreur type résiduelle de la régression (se), avec n – 2 = 40 – 2 = 38 degrés de liberté :
se = √(∑(Yi – Ÿi)2 / (n – 2)) = √(2 345,74 / 38) = √(61,73) ≈ 7,857
Calcul de l’erreur type de la pente (SEb) :
SEb = se / √(∑(Xi – X̄)2) = 7,857 / √(582,40) = 7,857 / 24,133 ≈ 0,3256
Calcul de la statistique t observée pour le test de H0 : β1 = 0 :
tobservé = b / SEb = 2,450 / 0,3256 ≈ 7,525
7.3 Interprétation substantive des résultats et décision statistique
Pour statuer de manière formelle sur la significativité statistique de cette relation, il convient de confronter la statistique observée tobservé = 7,525 à la distribution théorique de Student dotée de 38 degrés de liberté. Pour un seuil conventionnel bilatéral α = 0,05, la table des quantiles de Student fournit une valeur critique d’exclusion égale à tcritique(0,05 ; 38) ≈ ±2,024.
La confrontation arithmétique met en évidence que la valeur absolue de notre statistique empirique (|7,525|) surpasse de manière spectaculaire le seuil critique requis (2,024). L’interrogation de la fonction de répartition de la loi de Student livre une valeur p asymptotique infinitésimale : p < 0,000000001 (notée selon les canons académiques p < 0,001). La décision statistique s’impose avec une force irréfutable : l’hypothèse nulle H0 postulant une absence de relation linéaire (β1 = 0) doit être catégoriquement rejetée au profit de l’hypothèse alternative bilatérale.
Sur le plan substantiel, la pente observée b = 2,450 signifie que dans cette cohorte d’étudiants, chaque heure supplémentaire investie dans les révisions académiques s’associe à un gain moyen de 2,45 points sur la note finale standardisée d’examen. L’ordonnée à l’origine b0 = 8,175 indique la note moyenne attendue pour un étudiant n’ayant consacré aucune heure de révision préalable. Cependant, l’analyste rigoureux doit assortir cette interprétation d’une mise en garde fondamentale contre le péril d’extrapolation : ce modèle linéaire n’est empiriquement fondé que sur le domaine d’observation documenté au sein de l’échantillon (par exemple des volumes d’étude variant entre 10 et 40 heures). Postuler qu’un étudiant révisant 100 heures obtiendrait une note de 253 points relèverait d’un contresens méthodologique total, ignorant la saturation cognitive et les rendements décroissants de l’apprentissage.
8. Intervalles de confiance pour la pente : Complément indispensable au test t
8.1 Construction mathématique de l’intervalle de confiance à 95%
Bien que le test de signification t constitue l’outil conventionnel de réfutation de l’hypothèse nulle, il ne fournit qu’une vision binaire et décontextualisée de l’effet. L’estimation par intervalle de confiance s’impose comme son prolongement incontournable, matérialisant sur l’échelle de mesure la précision stochastique de l’estimation ponctuelle. Dans le cadre de la régression linéaire simple, l’intervalle de confiance pour le paramètre de population β1, au seuil de confiance standardisé de 95 % (soit un risque d’erreur consenti de 1 – α = 0,95), se construit mathématiquement selon la formulation explicite :
IC95% = b ± (tcritique(0,025 ; n – 2) × SEb)
Dans cette expression analytique, b figure comme le centre de gravité de l’intervalle, tandis que le terme de produit (tcritique × SEb) définit la marge d’erreur empirique de part et d’autre de la moyenne d’échantillonnage. En réinjectant les données issues de notre cas pratique sur l’apprentissage académique (b = 2,450, SEb = 0,3256, tcritique(0,025 ; 38) = 2,024), le calcul arithmétique de la marge d’erreur livre :
Marge d’erreur = 2,024 × 0,3256 ≈ 0,659
Ce qui déploie les bornes de l’intervalle de confiance comme suit :
Borne inférieure = 2,450 – 0,659 = 1,791
Borne supérieure = 2,450 + 0,659 = 3,109
Soit formellement : IC95% [1,791 ; 3,109].
La largeur absolue de cette fenêtre d’estimation dépend directement de l’erreur type SEb : plus le volume d’échantillon est imposant et la variance des résidus compressée, plus l’intervalle se resserre, encadrant la valeur véritable du paramètre avec une acuité accrue.
8.2 Dualité conceptuelle entre intervalle de confiance et test d’hypothèse
Il existe une correspondance mathématique et conceptuelle rigoureuse — qualifiée de dualité formelle — unissant le test d’hypothèse bilatéral et la construction de l’intervalle de confiance à 1 – α. De manière générale, une hypothèse nulle stipulant H0 : β1 = c (où c représente n’importe quelle constante d’intérêt théorique, typiquement 0) sera formellement rejetée au niveau de significativité α = 0,05 par le test t si et seulement si la valeur postulée c est exclue de l’intervalle de confiance à 95 % calculé sur le même échantillon.
Cette congruence mathématique se vérifie instantanément dans notre illustration : l’intervalle de confiance à 95 % délimité par [1,791 ; 3,109] ne contient en aucune façon la valeur zéro. Par conséquent, nous savions avec une certitude absolue, avant même d’enclencher le calcul formel de la valeur p, que le test t conclurait à un rejet catégorique de H0 au seuil α = 0,05.
Cependant, l’intervalle de confiance apporte une plus-value informationnelle incomparablement plus riche que la simple décision dichotomique permise par le test d’hypothèse classique. Alors que le test t se borne à acter que l’hypothèse β1 = 0 est intenable au regard des données recueillies, l’intervalle de confiance dévoile l’ensemble continu des valeurs plausibles du paramètre. L’analyste peut ainsi évaluer si des hypothèses alternatives fortes formulées par la littérature concurrente (par exemple une théorie psychologique prédisant une pente minimale de β1 = 3,5) se trouvent corroborées ou réfutées par les données empiriques observées.
8.3 Interprétation probabiliste rigoureuse de l’intervalle de confiance
À l’instar de la valeur p, l’intervalle de confiance est fréquemment corrompu par des contresens téléologiques majeurs au sein de la littérature appliquée. L’erreur la plus répandue consiste à affirmer doctement qu’« il y a 95 % de chances que la véritable pente de la population β1 se situe entre 1,791 et 3,109 ». Dans le cadre de l’épistémologie fréquentiste orthodoxe qui sous-tend la régression linéaire classique, cette assertion est fausse. Au sein du paradigme fréquentiste, le paramètre de population β1 n’est pas une variable aléatoire dotée d’une fonction de densité, mais une constante fixe, immuable et déterministe. Dès lors que l’échantillon a été collecté et que les bornes numériques [1,791 ; 3,109] ont été calculées, le vrai paramètre est soit présent à l’intérieur de l’intervalle, soit absent : la probabilité a posteriori est de 1 ou de 0, mais en aucun cas de 0,95.
La définition fréquentiste exacte de l’intervalle de confiance à 95 % s’exprime en termes de comportement de couverture à long terme sur des réplications d’échantillonnage théoriques : si l’on devait extraire un nombre infini d’échantillons aléatoires indépendants de taille n = 40 de la même population, et calculer pour chacun d’eux un intervalle de confiance à 95 % selon la même formule mathématique, 95 % de ces intervalles recouvriraient effectivement le paramètre invariant β1, tandis que 5 % manqueraient la cible par excès ou par défaut.
Au-delà de cette rigueur de définition, l’intervalle informe l’analyste sur la portée clinique et substantielle de ses résultats. En examinant simultanément la borne inférieure et la borne supérieure, le chercheur s’assure que même dans le scénario empiriquement le plus pessimiste compatible avec les données (une pente de 1,791 point par heure d’étude), l’effet demeure suffisamment robuste pour justifier des interventions pédagogiques, dissipant ainsi l’incertitude quant à l’utilité pratique des conclusions.
9. Taille d’effet et puissance statistique dans l’analyse de régression
9.1 Signification statistique versus pertinence pratique et clinique
L’une des confusions les plus dommageables en méthodologie quantitative réside dans la confusion entre la significativité statistique d’un coefficient de régression et son importance substantielle pratique ou clinique. Le test t, par sa conception même, évalue exclusivement l’improbabilité des données empiriques sous l’égide du modèle nul stochastique, sans jamais fournir une estimation directe de l’ampleur fonctionnelle de l’effet découvert dans le monde réel.
Cette déconnexion structurelle découle de la sensibilité extrême du test t au volume de l’échantillon n. En vertu de la présence du terme de sommation quadratique au dénominateur de l’erreur type SEb, l’accroissement de la taille d’échantillon a pour effet de compresser indéfiniment l’erreur type vers zéro. Dès lors, au sein d’une méga-cohorte comprenant par exemple 50 000 participants, une pente empirique infinitésimale (telle qu’un gain moyen de 0,001 point d’humeur par tranche de dix heures de méditation) générera une statistique t hautement significative et une valeur p < 0,00001, forçant le rejet formel de H0.
Pour autant, cette association ténue ne possède aucune pertinence concrète pour le clinicien, le pédagogue ou le décideur politique. Les sciences du comportement doivent impérativement dissocier le constat probabiliste de l’existence d’une relation (garanti par le test t) de l’évaluation de son utilité écologique. Cette dernière exige la prise en compte conjointe de la magnitude du coefficient dans son unité naturelle, de la variabilité expliquée et des coûts réels associés au déploiement des interventions préconisées par le modèle.
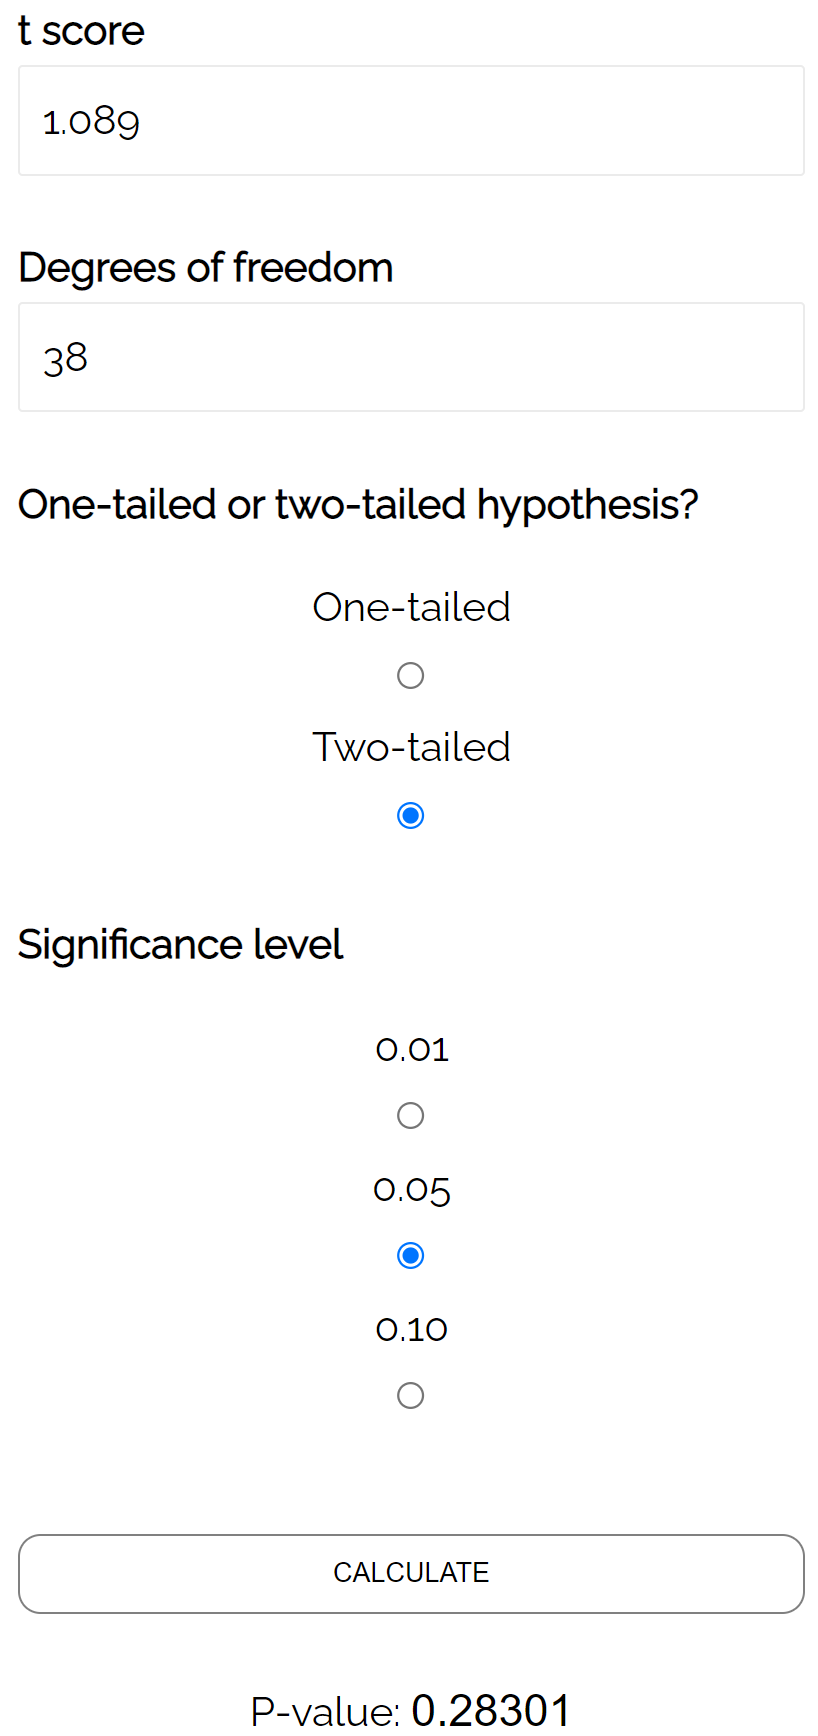
9.2 Le coefficient de détermination (R²) et le coefficient standardisé (β)
Pour standardiser l’évaluation de l’ampleur d’une relation au-delà des particularités métriques des instruments d’évaluation utilisés, l’analyse de régression convoque deux indices majeurs de taille d’effet : le coefficient de détermination R2 et le coefficient de pente standardisé β (parfois noté β* pour prévenir toute ambiguïté avec le paramètre populationnel non standardisé).
Le coefficient de détermination R2 quantifie la proportion de la variance totale observée sur la variable dépendante Y qui se trouve directement expliquée ou prédite par la droite de régression linéaire de X. Il se déduit de la décomposition canonique de la somme des carrés :
R2 = Somme des Carrés Modèle (SSM) / Somme des Carrés Totale (SST) = 1 – (SSE / SST)
Dans le cadre strict de la régression linéaire simple comportant un seul prédicteur, le R2 correspond rigoureusement au carré du coefficient de corrélation de Pearson entre X et Y (r2). Il existe d’ailleurs une passerelle algébrique directe unissant la statistique de test t de la pente et le R2 :
t2 = F = (n – 2) × R2 / (1 – R2)
Cette relation met en lumière le fait que la statistique t est une fonction composite directe de deux moteurs distincts : la force de l’association (traduite par R2) et le dimensionnement de l’échantillon (exprimé par n – 2).
D’autre part, le coefficient de pente standardisé β élimine les unités de mesure brutes en transformant préalablement les variables X et Y en scores centrés réduits (scores Z). Ce coefficient indique l’ampleur du déplacement moyen sur Y, exprimé en fractions d’écart type de Y, induit par une élévation d’un écart type complet sur la distribution de X. Dans la régression simple, le coefficient standardisé β coïncide rigoureusement avec la corrélation de Pearson r. Les lignes directrices conventionnelles de Jacob Cohen catégorisent les coefficients standardisés en effets faibles (β ≈ 0,10), modérés (β ≈ 0,30) et forts (β ≥ 0,50). Bien que ces repères fournissent une première grille de lecture, ils doivent être contextualisés au regard des standards méthodologiques de chaque sous-discipline psychologique.
9.3 Analyse de puissance statistique et dimensionnement de l’échantillon
La puissance statistique, conventionnellement formalisée par le complémentaire de l’erreur de type II (1 – β), représente la probabilité opérationnelle de rejeter formellement l’hypothèse nulle d’invariance (β1 = 0) sous la condition fondamentale qu’il existe bel et bien un effet réel d’une amplitude donnée dans la population d’intérêt. Tout protocole d’inférence s’insère dans un système d’interdépendance dynamique liant quatre paramètres statistiques fondamentaux :
- Le seuil de tolérance de l’erreur de type I (α), fixé généralement à 0,05 ;
- La taille globale de l’échantillon analysé (n) ;
- La magnitude minimale de l’effet théoriquement postulée (R2 ou coefficient β) ;
- La puissance statistique recherchée (1 – β), les standards académiques fixant le minimum acceptable à 0,80 (soit au moins 80 % de probabilité d’authentifier la relation si elle existe).
Dans la recherche contemporaine, la planification méthodologique préalable exige la conduite d’analyses de puissance a priori au moyen d’outils logiciels dédiés tels que G*Power. Un dimensionnement correct permet de calculer l’effectif minimal requis pour détecter une taille d’effet théoriquement pertinente, prévenant ainsi la mise en place d’études chroniquement sous-puissantes.
La conduite d’analyses de régression sur des cohortes sous-dimensionnées engendre des désordres méthodologiques graves documentés sous l’expression de « malédiction du gagnant » (winner’s curse). Dans une étude sous-puissante (dont la puissance plafonne par exemple à 0,25), la probabilité d’intercepter l’effet réel est faible ; si, au gré des fluctuations d’échantillonnage favorables, le ratio t parvient à franchir le seuil critique pour atteindre la significativité, l’amplitude de l’effet empirique b observé surpasse presque toujours la véritable magnitude du paramètre sous-jacent. Cet artefact conduit à polluer la littérature scientifique d’estimations d’effets artificiellement hypertrophiées qui résistent ensuite à toute tentative de réplication ultérieure.
10. Extension à la régression multiple : Les tests t partiels
10.1 Signification des coefficients de pente partielle
Lorsque la modélisation statistique s’enrichit pour embrasser la complexité multivariée des phénomènes psychologiques, le modèle s’élargit en intégrant simultanément un ensemble de k prédicteurs au sein de la même équation linéaire probabiliste :
Y = β0 + β1X1 + β2X2 + … + βkXk + ε
Dans ce cadre étendu, l’interprétation des estimateurs d’échantillon bj subit une mutation sémantique et mathématique majeure : ils cessent d’être de simples pentes bivariées pour devenir des coefficients de régression partielle. Le coefficient partiel bj quantifie la variation attendue sur la variable dépendante Y consécutive à l’augmentation d’une unité sur le régresseur spécifique Xj, sous la condition expresse de maintenir strictement invariantes et constantes les valeurs adoptées par l’ensemble exhaustif des autres covariables intégrées dans le modèle (raisonnement ceteris paribus).
Cette décomposition multivariée permet de répondre à une interrogation méthodologique fondamentale : quelle est la contribution informationnelle unique, spécifique et incrémentale de Xj pour rendre compte des fluctuations du critère Y, une fois expurgée toute la redondance partagée avec les autres variables du système ? Dès lors, les tests t individuels conduits au sein d’une régression multiple ciblent des hypothèses nulles spécifiques formulées pour chaque prédicteur distinct :
H0 : βj = 0 (sachant l’ensemble des autres variables contrôlées dans le modèle)
10.2 Ajustement des degrés de liberté et calcul de l’erreur type multivariée
L’adjonction de multiples prédicteurs dans la matrice de modélisation exerce un impact arithmétique direct sur les degrés de liberté résiduels associés à l’erreur type et aux distributions de Student. Avec k régresseurs quantitatifs distincts complétés par l’ordonnée à l’origine, le modèle consomme k + 1 degrés de liberté indépendants pour estimer l’ensemble des paramètres structurels. Par voie de conséquence, les degrés de liberté résiduels résignés à l’estimation de l’erreur type se et au test t s’établissent selon la formule :
dl = n – k – 1
Le calcul de l’erreur type associée à chaque coefficient de pente partielle SE(bj) ne s’opère plus par de simples déviations scalaires isolées, mais requiert l’inversion de la matrice de covariance des prédicteurs. Sur le plan matriciel, la matrice de variance-covariance des estimateurs est définie par le produit de l’erreur résiduelle quadratique moyenne avec l’inverse de la matrice de produit des observations centrées de prédicteurs :
Cov(b) = se2(X‘X)-1
Les erreurs types individuelles SE(bj) s’extraient directement de la racine carrée des éléments situés sur la diagonale principale de cette matrice inverse. Une formulation algébrique équivalente met en lumière la mécanique computationnelle sous-jacente :
SE(bj) = se / (√(∑(Xij – X̄j)2) × √(1 – Rj2))
Où Rj2 symbolise le coefficient de détermination issu de la régression auxiliaire prédisant le régresseur d’intérêt Xj par l’ensemble des k – 1 autres prédicteurs en lice. La statistique de test t partielle conserve sa morphologie classique :
tj = bj / SE(bj)
Elle se confronte à la loi de Student calibrée sur n – k – 1 degrés de liberté.
10.3 Articulation entre le test F global et les tests t individuels
L’analyse d’un modèle de régression linéaire multiple confronte le chercheur à deux épreuves d’inférence statistique hiérarchiquement articulées, qu’il convient de manier avec un ordre méthodologique scrupuleux :
En premier lieu intervient le test omnibus F de l’analyse de la variance de la régression. Ce test global évalue l’hypothèse nulle générale selon laquelle l’ensemble exhaustif des coefficients de régression associés aux variables indépendantes seraient simultanément nuls dans la population parente :
H0 : β1 = β2 = … = βk = 0
Si ce test F global ne parvient pas à franchir le seuil de significativité α = 0,05, le modèle s’avère dans son ensemble incapable de prédire le critère de manière statistiquement supérieure au hasard brut représenté par la simple moyenne générale de Y. Dans cette conjoncture d’échec global, l’exploration détaillée des tests t individuels doit être formellement suspendue afin d’endiguer l’inflation du risque de faux positifs résultant de comparaisons multiples.
Dès lors que le test F global est significatif, l’analyste est fondé à scruter les tests t partiels individuels pour identifier quelles variables spécifiques exercent une contribution unique robuste. Toutefois, des paradoxes analytiques majeurs peuvent se manifester : il est tout à fait possible d’observer un modèle doté d’un test F global significatif à p < 0,001 sans qu’aucun des tests t partiels pris individuellement ne parvienne à atteindre le seuil de significativité α = 0,05. Ce phénomène survient lorsque les prédicteurs partagent une colinéarité substantielle : le bloc des variables explique conjointement une part majeure de variance du critère, mais le degré de chevauchement informationnel est si marqué qu’il s’avère impossible d’attribuer de manière univoque cette explication à une variable plutôt qu’à une autre au sein des tests partiels.
11. Pièges diagnostiques et menaces à l’inférence du test t
11.1 Impact de la multicolinéarité sur l’erreur type et le test t
La multicolinéarité représente l’une des pathologies les plus insidieuses et déstabilisatrices pour l’inférence fondée sur le test t au sein des régressions multiples. Ce trouble analytique émerge dès lors que deux ou plusieurs variables indépendantes introduites simultanément dans l’équation de régression manifestent de fortes corrélations mutuelles, véhiculant des faisceaux d’informations redondants.
Pour mesurer ce phénomène de contamination redondante, l’analyste calcule deux indices diagnostiques complémentaires : la tolérance (notée Tolj = 1 – Rj2) et le facteur d’inflation de la variance, universellement désigné par son acronyme VIF (Variance Inflation Factor), défini algébriquement par l’inverse de la tolérance :
VIFj = 1 / (1 – Rj2)
Comme le révélait l’équation explicite de l’erreur type développée à la section 10.2, la racine carrée du VIF agit comme un multiplicateur direct de l’erreur type SE(bj). Par conséquent, à mesure que la redondance entre prédicteurs s’intensifie (engendrant des VIF supérieurs aux seuils critiques usuels de 5 ou 10), l’erreur type du coefficient partiel gonfle de manière artificielle et démesurée. Ce gonflement du dénominateur entraîne un effondrement mécanique du ratio t = b / SEb, précipitant la valeur p vers des zones non significatives.
La conséquence méthodologique de cette pathologie est sévère : le test t devient incapable d’identifier la contribution théorique d’un prédicteur pourtant substantiellement relié au critère dans la réalité psychologique sous-jacente, générant une vague d’erreurs de type II (faux négatifs). Face à des VIF alarmants, l’analyste doit impérativement intervenir en purgeant son modèle des variables redondantes, en procédant à une réduction dimensionnelle préalable via une analyse en composantes principales (ACP), ou en recourant à des méthodes d’estimation régularisées telles que la régression ridge ou Lasso.
11.2 Observations influentes, valeurs aberrantes et points de levier
L’inférence par le test t repose sur la fidélité de l’ajustement opéré par les moindres carrés ordinaires ; or, cette mécanique est hautement sensible à des observations singulières dont la localisation topologique au sein de l’espace multivarié peut altérer les conclusions d’un test. L’examen diagnostique rigoureux repose sur une distinction tripartite indispensable :
- Les valeurs aberrantes résiduelles (outliers) : Il s’agit d’observations dont la note observée Yi diverge dramatiquement de la prédiction établie par le modèle (Ÿi). Ces points sont repérés par l’inspection des résidus standardisés ou studentisés. Dès lors que ces résidus franchissent en valeur absolue des seuils de ±3 écarts types, ils témoignent d’une rupture d’ajustement locale.
- Les points de fort levier (leverage points) : Ces observations se caractérisent non pas par un mauvais ajustement sur Y, mais par un positionnement atypique ou isolé aux confins de la distribution multidimensionnelle des variables explicatives X. L’amplitude du levier est mesurée par la valeur hii issue de la diagonale de la matrice de projection chapeau (hat matrix). Un score dépassant le double de la valeur moyenne du levier [2(k + 1) / n] matérialise un ancrage excentrique capable d’agir comme un puissant point d’appui.
- Les observations influentes globales : Une observation est déclarée influente dès lors que sa présence ou sa suppression unitaire au sein du fichier de données modifie radicalement les estimations des coefficients de régression et, par voie de conséquence, fait basculer la statistique du test t de part et d’autre du seuil de significativité. L’évaluation de cette influence repose sur le calcul de la distance de Cook (notée Di) et des indicateurs de déviation partielle des coefficients (DFBETAS). Une distance de Cook excédant 1,0 (ou la valeur seuil 4/n dans les cohortes plus réduites) signale une altération grave du modèle induite par ce seul individu.
Lorsqu’une observation influente est diagnostiquée, l’analyste ne doit en aucun cas procéder à sa suppression arbitraire clandestine. La conduite scientifique prescrite commande de réaliser une analyse de sensibilité systématique, confrontant le modèle avec et sans l’observation litigieuse. Si les conclusions du test t (significativité ou non-significativité de la pente) dépendent exclusivement du maintien d’un unique participant extrême, les résultats ne peuvent prétendre à aucune généralisabilité solide et doivent être rapportés avec une entière transparence méthodologique.
11.3 Le problème de la significativité triviale dans les mégadonnées
L’essor contemporain des bases de données volumineuses (Big Data), des traces numériques d’apprentissage et des vastes cohortes épidémiologiques comprenant des dizaines ou centaines de milliers d’enregistrements pose un défi épistémologique inédit pour l’interprétation du test t de Student. Ce défi s’articule autour du paradoxe méthodologique de la significativité triviale.
Sur le plan mathématique, comme l’erreur type SEb est inversement proportionnelle à la racine carrée de l’effectif n, son amplitude tend vers zéro à mesure que la taille de l’échantillon croît vers l’infini. Il en résulte un comportement asymptotique implacable : pour des effectifs monumentaux (par exemple n = 100 000), tout coefficient de pente b, aussi infinitésimal, insignifiant et dépourvu de la moindre pertinence théorique soit-il (tel qu’une association de b = 0,0002 point de bien-être par heure d’exposition aux écrans), produit inéluctablement une statistique t écrasante et une valeur p s’effondrant sous le seuil critique des 0,001.
Le chercheur inexpérimenté risque alors de succomber à une illusion interprétative majeure, réifiant ce micro-effet stochastiquement détectable au rang de découverte théorique majeure dans le champ des sciences humaines. Or, dans les contextes de très larges données, le test t perd toute utilité sélective : il confirme simplement que l’univers empirique n’est pas mathématiquement rigide à zéro décimale absolue. La prise de décision doit alors s’émanciper totalement du fétichisme de la valeur p pour s’adosser exclusivement à l’évaluation critique de la taille d’effet standardisée et à la largeur informative de l’intervalle de confiance, afin de vérifier si l’amplitude décelée présente une substance matérielle tangible.
12. Bonnes pratiques de reporting et normes académiques APA
12.1 Format canonique de restitution des résultats selon l’APA
La publication scientifique en psychologie quantitative et en sciences sociales est strictement régie par les directives formelles édictées par l’American Psychological Association (APA, 7e édition). Ces standards imposent un protocole typographique et rédactionnel méticuleux lors du reporting d’un modèle de régression et des tests t afférents, interdisant toute troncature sélective des grandeurs inférentielles fondamentales.
Sur le plan textuel, la formulation canonique doit impérativement expliciter la valeur de la pente estimée non standardisée (b), son erreur type associée (SE), la statistique formelle t accompagnée de ses degrés de liberté résiduels entre parenthèses, la valeur exacte de la probabilité conditionnelle p, ainsi que l’intervalle de confiance encadrant le coefficient (généralement à 95 %). En appliquant ces directives aux résultats issus de notre cas pratique développé en section 7, la restitution s’énonce selon le gabarit normé suivant :
« L’analyse de régression linéaire simple indique que le volume d’heures consacrées aux révisions pré-examen prédit de manière positive et statistiquement significative la note finale obtenue par les étudiants, b = 2,45, SE = 0,33, t(38) = 7,53, p < 0,001, 95% IC [1,79 ; 3,11]. »
Lors de la restitution sous forme tabulaire — indispensable pour les modèles multivariés —, les tableaux standardisés doivent présenter de manière hiérarchisée :
- Les coefficients non standardisés (b ou B) assortis de leurs erreurs types respectives (SE) ;
- Les coefficients de pente standardisés (β) permettant la comparaison relative du poids des prédicteurs ;
- Les statistiques t individuelles et leurs valeurs p exactes (en proscrivant les mentions dichotomiques vagues telles que « p < 0,05 » sauf lorsque la valeur calculée est strictement inférieure à 0,001, où la mention « p < 0,001 » devient requise) ;
- Les bornes des intervalles de confiance à 95% pour chaque coefficient ;
- Les métriques synthétiques du modèle global en bas de tableau : R2, R2 ajusté, statistique F d’ANOVA, degrés de liberté du modèle et résiduels, et résidu d’erreur type se.
Sur le plan typographique, les symboles mathématiques et statistiques désignant des grandeurs d’échantillon ou de population (tels que b, t, p, F, R2, SE) doivent être systématiquement composés en italique, conformément aux conventions typographiques internationales de l’APA.
12.2 Transparence, science ouverte et reproductibilité computationnelle
L’affirmation d’une éthique méthodologique rigoureuse ne s’arrête plus aujourd’hui à la simple composition d’un manuscrit conforme aux normes formelles ; elle s’inscrit au sein du paradigme impérieux de la Science Ouverte (Open Science). Face aux dérives rétrospectives révélées par la crise de la reproductibilité, le reporting d’un test t de régression doit offrir les garanties d’une auditabilité computationnelle absolue.
Cette transparence computationnelle exige que les investigateurs rendent accessibles, au sein d’entrepôts de données pérennes et certifiés (tels que l’Open Science Framework [OSF] ou Zenodo), les jeux de données empiriques brutes dépersonnalisés, ainsi que l’ensemble des scripts d’analyse informatique ayant servi à générer les résultats (qu’il s’agisse de code écrit sous R, Python, de fichiers de syntaxe SPSS ou de pipelines Jamovi/JASP). Cette documentation publique permet à des chercheurs indépendants de reproduire à l’identique les résultats mathématiques, de vérifier la conformité des erreurs types calculées et de vérifier si les seuils de significativité des tests t ne résultent pas de manipulations opportunistes d’exclusion de données.
De surcroît, les hypothèses requises pour la validité du modèle linéaire (linéarité, homoscédasticité, normalité résiduelle) ne doivent plus être passées sous silence : les diagnostics visuels et numériques détaillés dans ce guide doivent figurer explicitement au sein des sections de méthode ou en annexes électroniques accessibles. Le pré-enregistrement des hypothèses (preregistration), spécifiant a priori l’orientation directionnelle des tests et la liste exhaustive des covariables introduites dans les modèles, constitue le rempart méthodologique le plus efficace contre le p-hacking, le découpage opportuniste de sous-groupes et l’hypothétisation a posteriori en fonction des résultats (HARKing).
12.3 Synthèse conclusive pour la recherche en psychologie quantitative
Au terme de cette exploration exhaustive, le test t de Student appliqué à la pente de régression se révèle pour ce qu’il est profondément : ni un verdict ontologique infaillible scellant l’existence d’une vérité psychologique absolue, ni un simple automatisme logiciel dénué de substance théorique. Il s’agit d’un instrument d’inférence stochastique élégant et rigoureux, calibré pour quantifier la plausibilité d’une déviation observée au regard du bruit d’échantillonnage inhérent à toute mesure humaine.
La validité des inférences qu’il autorise demeure tributaire du respect scrupuleux de ses postulats mathématiques sous-jacents, de la vigilance constante face aux pièges de la multicolinéarité et des points de levier, ainsi que de la modération épistémique face aux dérives de la significativité aveugle. Utilisé de concert avec l’estimation par intervalle de confiance, l’évaluation normalisée des tailles d’effet et la planification a priori de la puissance statistique, le test t prend toute sa dimension méthodologique au service de modèles empiriques transparents, robustes et reproductibles.
Enfin, l’analyste contemporain ne saurait ignorer les horizons théoriques complémentaires qui s’ouvrent au-delà de l’orthodoxie fréquentiste classique. Les approches bayésiennes de la régression, substituant au test d’hypothèse nulle l’estimation de distributions postérieures de plausibilité et le calcul de facteurs de Bayes (Bayes Factors), offrent une perspective féconde permettant de réconcilier l’évaluation des coefficients linéaires avec une quantification directe de la probabilité relative des hypothèses scientifiques en présence. Quelle que soit la trajectoire philosophique privilégiée, la maîtrise de la dynamique fonctionnelle unissant le signal empirique à l’erreur d’échantillonnage demeurera, pour tout chercheur en sciences humaines et comportementales, le fondement incontournable de toute inférence scientifique valide.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamin, D. J., Berger, J. O., Johannesson, M., Nosek, B. A., Wagenmakers, E. J., Berk, R., Bollen, K. A., Brembs, B., Brown, L., Camerer, C., Cesarini, D., Chambers, C. D., Clyde, M., Cook, T. D., De Boeck, P., Dienes, Z., Dreber, A., Kenny, D. A., & Johnson, V. E. (2018). Redefine statistical significance. Nature Human Behaviour, 2(1), 6–10. https://doi.org/10.1038/s41562-017-0189-z
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gelman, A., & Stern, H. (2006). The difference between « significant » and « not significant » is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006X152607
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Popper, K. (1959). The logic of scientific discovery. Hutchinson & Co.
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934