
Dans le paysage contemporain de la recherche quantitative en psychologie et en neurosciences cognitives, l’analyse de variance demeure l’un des piliers méthodologiques les plus mobilisés pour tester des hypothèses de causalité ou de différenciation intergroupes. Qu’il s’agisse d’évaluer l’efficacité différentielle de protocoles de psychothérapie cognitive et comportementale, de mesurer l’impact de charges cognitives distinctes sur les temps de réaction, ou d’explorer les modulations neurophysiologiques associées à divers états émotionnels, les chercheurs recourent quotidiennement à cette technique inférentielle. Pourtant, la validité des conclusions théoriques et cliniques tirées d’une telle modélisation repose sur une condition sine qua non souvent reléguée au second plan : la stricte vérification des postulats mathématiques sous-tendant le modèle linéaire général.
L’application machinale et automatisée des tests statistiques, catalysée par la convivialité des logiciels modernes, a progressivement instauré une illusion de sécurité méthodologique au sein de la communauté scientifique. Trop souvent, le ratio de variance issu de la statistique de Fisher-Snedecor est interprété sans examen préalable de la topologie distributionnelle des données ni de la dynamique de leurs erreurs résiduelles. Une telle omission ne constitue pas un simple manquement formel à l’orthodoxie statistique : elle altère directement la trajectoire des taux d’erreur de première et de seconde espèces, compromettant la reproductibilité des résultats, déformant l’estimation de la taille des effets et conduisant parfois à des inférences substantiellement erronées sur le fonctionnement psychologique humain.
Ce guide exhaustif a pour ambition d’offrir aux chercheurs, doctorants et praticiens des sciences comportementales un cadre de référence méthodique, rigoureux et opérationnel pour diagnostiquer, comprendre et traiter les violations des postulats de l’analyse de variance. En articulant les fondements théoriques des distributions d’échantillonnage avec les exigences empiriques des plans expérimentaux réels, nous détaillerons chaque étape du processus diagnostique. De l’évaluation de l’indépendance à la traque des hétéroscédasticités pernicieuses, en passant par l’auscultation graphique des résidus et l’arbitrage entre corrections analytiques modernes et approches robustes, ce traité constitue une feuille de route intégrale pour élever la rigueur analytique de vos protocoles de recherche.
1. Introduction méthodologique à l’analyse de variance et à ses postulats fondamentaux en psychologie
1.1 Cadre conceptuel de l’ANOVA dans la recherche quantitative en psychologie
L’analyse de variance, formulée à l’origine par le statisticien et généticien Sir Ronald Aylmer Fisher dans les années 1920, représente une extension probabiliste élégante et puissante du modèle linéaire général. Fondée sur la statistique F de Fisher-Snedecor, l’analyse procède à une décomposition algébrique rigoureuse de la dispersion totale observée au sein d’un ensemble de données quantitatives en composantes de variance orthogonales et mutuellement exclusives. Mathématiquement, la somme des carrés totale est partitionnée en une somme des carrés intergroupes, reflétant les fluctuations imputables aux manipulations expérimentales ou aux variables classificatoires, et une somme des carrés intragroupes, également qualifiée d’erreur résiduelle, traduisant la variabilité interindividuelle idiosyncrasique non expliquée par le modèle.
Dans les sciences du comportement, l’évaluation des différences entre plusieurs populations expérimentales ou cliniques ne peut se satisfaire de la simple itération de tests t de Student pour échantillons indépendants. Lorsqu’un devis de recherche implique la comparaison de trois groupes ou davantage — par exemple, un groupe contrôle sous placebo, un groupe bénéficiant d’une thérapie d’activation comportementale et un groupe soumis à un entraînement métacognitif —, la multiplication des comparaisons bivariées directes génère un phénomène délétère bien connu : l’inflation de l’erreur globale de type I. Si l’on fixe le seuil de signification nominal alpha à 0,05 pour chaque test unitaire, la probabilité d’observer au moins un résultat faussement positif au travers d’une famille de comparaisons augmente exponentiellement selon la formule probabiliste un moins le complémentaire d’alpha à la puissance k, où k représente le nombre de combinaisons possibles.
Le ratio F de l’analyse de variance surmonte cette entrave en proposant un test omnibus simultané. Ce test confronte l’estimation de la variance entre les moyennes de groupes à l’estimation de la variance résiduelle moyenne présente à l’intérieur de ces mêmes groupes. Cependant, la distribution théorique de la statistique F, tabulée selon deux paramètres de degrés de liberté distincts, ne conserve sa valeur probabiliste exacte que si le processus générateur de données satisfait scrupuleusement les axiomes mathématiques établis par les théorèmes de dérivation de Fisher. Négliger la vérification de ces conditions d’application mathématiques expose le chercheur à fonder ses inférences psychologiques sur des distributions d’échantillonnage déformées, réduisant à néant la validité interne du paradigme investigué.
1.2 Typologie des postulats essentiels de l’ANOVA à un facteur et plans factoriels
L’édifice mathématique de l’analyse de variance classique, qu’il s’agisse d’un devis unifactoriel inter-sujets ou de plans factoriels complexes impliquant des interactions d’ordre supérieur, repose invariablement sur un trépied de postulats fondamentaux. Le premier impératif, et de loin le plus intransigeant, réside dans l’indépendance statistique des observations et des termes d’erreur résiduels. Ce postulat stipule que la mesure recueillie auprès d’un participant ne doit en aucune manière être conditionnée, corrélée ou influencée par les scores des autres participants assignés à la même condition ou à des conditions différentes du plan expérimental.
Le second pilier concerne la normalité distributionnelle, laquelle s’applique formellement aux erreurs résiduelles du modèle conditionnellement à chaque modalité du facteur expérimental, et non à l’agrégat brut et hétérogène de la variable dépendante considérée sans distinction de groupe. Cette condition garantit que les sommes de carrés normalisées suivent rigoureusement des distributions de chi-deux indépendantes, condition préalable indispensable pour que leur ratio débouche sur la distribution F de Snedecor. Enfin, le troisième pilier correspond à l’homogénéité des variances, concept désigné sous le terme technique d’homoscédasticité. Ce postulat exige que les populations sous-jacentes d’où sont extraits les échantillons présentent une variance résiduelle théorique identique, permettant au modèle de calculer une estimation groupée unique de l’erreur d’échantillonnage commune.
Dans l’architecture de ces protocoles, il est impératif d’opérer une différenciation méthodologique nette entre la nature des variables en jeu. Les variables indépendantes doivent être strictement qualitatives ou catégorielles, définissant des partitions d’appartenance distinctes, tandis que la variable dépendante doit impérativement être continue, mesurée à l’aide d’échelles d’intervalles ou de rapports. Historiquement, l’attitude des psychologues quantitativistes vis-à-vis de ces postulats a oscillé entre une confiance aveugle accordée à une prétendue robustesse absolue et un perfectionnisme procédural paralysant. L’approche contemporaine préconise un diagnostic nuancé, s’appuyant sur une compréhension mécanique des répercussions qu’induisent des transgressions spécifiques sur la validité inférentielle globale.
1.3 Structure séquentielle du processus de vérification avant modélisation
L’évaluation des conditions d’application d’une analyse de variance ne saurait être envisagée comme une formalité hétéroclite ou un assemblage anarchique d’indices statistiques isolés. Elle exige au contraire une démarche diagnostique structurée, hiérarchisée et séquentielle. Ce processus débute bien avant la compilation des données et la génération des premiers résultats : il prend racine dans la conception même du devis de recherche et l’examen critique des modalités d’assignation expérimentale, garantes de l’indépendance structurelle des mesures.
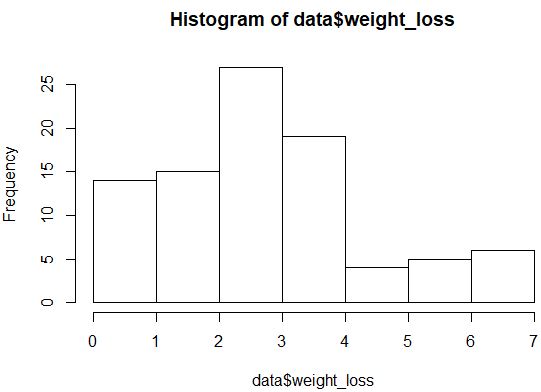
Une fois les données collectées, le protocole méthodologique impose d’ajuster formellement le modèle linéaire général envisagé afin d’en extraire les résidus mathématiques. Il existe en effet une confusion théorique récurrente au sein des laboratoires de sciences humaines, consistant à examiner la distribution de la variable dépendante globale sans tenir compte de la structuration imposée par les groupes. Une variable dépendante peut afficher une bimodalité ou une asymétrie marquée au niveau global, tout en présentant des résidus rigoureusement gaussiens à l’intérieur de chaque modalité une fois l’effet moyen du traitement contrôlé et soustrait. L’évaluation de la normalité et des valeurs extrêmes doit par conséquent s’opérer de manière préférentielle sur les résidus du modèle.
Cette trajectoire séquentielle d’investigation doit être explicitement inscrite dans les protocoles de recherche pré-enregistrés, limitant ainsi les degrés de liberté du chercheur et l’apparition de biais d’analyse opportunistes. En structurant l’exploration autour de jalons décisionnels transparents — examen de l’indépendance par le design expérimental, détection et contextualisation des observations atypiques, analyse conjointe de la normalité résiduelle puis auscultation de l’homoscédasticité —, le psychologue statisticien s’assure d’une modélisation intègre, respectueuse de la complexité psychométrique inhérente à l’étude des processus mentaux.
2. Le postulat d’indépendance des observations : Évaluation et implications expérimentales
2.1 Nature théorique et gravité de la violation du postulat d’indépendance
Parmi l’ensemble des conditions formelles conditionnant l’exactitude de l’analyse de variance, le postulat d’indépendance des observations représente le pivot le plus critique, le plus déterminant et le moins négociable. D’un point de vue mathématique, ce postulat stipule que la covariance entre deux résidus quelconques de l’échantillon doit être rigoureusement nulle. Toute violation de cette exigence fondamentale entraîne des répercussions dévastatrices sur la mécanique de l’inférence probabiliste, surpassant de très loin les distorsions modérées induites par des écarts de normalité ou de légères hétérogénéités de variance.
Lorsque des observations sont positivement corrélées au sein d’une même modalité — phénomène récurrent lorsque des participants interagissent ou partagent un environnement commun —, la variance observée entre les individus d’un même groupe sous-estime systématiquement la variance réelle de la population. Dès lors, le dénominateur du ratio de Fisher, qui est précisément le carré moyen de l’erreur, se trouve artificiellement comprimé. Cette diminution non justifiée gonfle de façon spectaculaire la valeur empirique du test F, provoquant une explosion catastrophique de l’erreur de type I. Comme l’ont démontré les travaux fondateurs de Scariano et Davenport, une corrélation intraclasse résiduelle aussi ténue que 0,05 peut élever le taux effectif de faux positifs à plus de 30 % ou 40 %, alors même que le seuil de signification est théoriquement fixé à 5 %.
La gravité de cette transgression s’accentue par le fait qu’il est rigoureusement impossible de corriger une absence d’indépendance a posteriori par le recours à des transformations mathématiques conventionnelles, telles que les conversions logarithmiques ou les racines carrées. La dépendance est une propriété inhérente à l’architecture structurelle du recueil de données, et non une simple propriété d’échelle. Dès lors, il convient d’opérer une distinction conceptuelle absolue entre les devis à mesures indépendantes, qui requièrent une étanchéité totale entre les unités expérimentales, et les protocoles longitudinaux ou à mesures répétées, qui exigent quant à eux une paramétrisation matricielle spécialisée, dédiée à la modélisation explicite de la covariance intra-sujet.
2.2 Évaluation du devis de recherche et contrôle méthodologique en amont
Étant donné l’absence de remède purement algorithmique permettant de rétablir la validité d’une analyse de variance classique face à des données interdépendantes, l’évaluation de ce postulat repose de façon prédominante sur une analyse critique du devis de recherche et du protocole expérimental. La pierre angulaire de cette prophylaxie réside dans l’assignation aléatoire intégrale et individualisée des participants aux différentes conditions expérimentales. Cette randomisation doit garantir que chaque sujet a une probabilité rigoureusement équivalente d’être alloué à un niveau factoriel donné, sans que cette assignation ne dépende d’une proximité spatiale, temporelle ou relationnelle préexistante.
La recherche en psychologie comportementale, développementale et organisationnelle est particulièrement vulnérable aux biais de regroupement. Lorsque les données sont collectées au sein de grappes naturelles — des écoliers regroupés au sein de classes scolaires spécifiques, des patients hospitalisés pris en charge par la même équipe soignante, ou encore des individus interagissant au sein de dyades amoureuses ou professionnelles —, les scores individuels partagent inévitablement une variance contextuelle commune. Les caractéristiques propres de l’enseignant, la dynamique de groupe ou la compétence singulière d’un thérapeute constituent des variables parasites partagées qui créent une dépendance statistique immédiate entre les observations.
Par ailleurs, les protocoles expérimentaux requérant des passations chronologiques successives sont exposés à des effets de série temporelle. Si les participants subissent une évaluation dans un laboratoire où la température dérive au fil des heures, si l’expérimentateur accumule de la fatigue au point d’altérer la neutralité de ses consignes, ou si les premiers sujets transmettent des informations relatives aux énigmes expérimentales aux cohortes suivantes, une dépendance séquentielle insidieuse s’infiltre dans les données. Le dépistage de ces biais exige une surveillance méthodologique rigoureuse, incluant la contre-balancement systématique des créneaux de passation et la standardisation informatisée des consignes pour couper tout canal de transmission interindividuelle non contrôlé.
2.3 Outils statistiques de dépistage des dépendances résiduelles
Bien que l’indépendance demeure avant tout une propriété de conception expérimentale, le chercheur dispose néanmoins d’instruments statistiques quantitatifs pour déceler des signaux d’alerte suggérant la présence de corrélations résiduelles non maîtrisées. L’un des indicateurs les plus couramment employés pour évaluer l’autocorrélation temporelle est la statistique de Durbin-Watson. Développé initialement pour l’analyse des séries temporelles en économétrie, ce test évalue si les termes d’erreur adjacents dans l’ordre de collecte manifestent une liaison séquentielle de premier ordre. Une statistique de Durbin-Watson fluctuant autour de la valeur centrale de 2,0 atteste de l’absence d’autocorrélation linéaire, tandis que des scores significativement inférieurs à 1,5 révèlent une corrélation sérielle positive inquiétante.
Face à des données hiérarchisées ou nichées dans des structures collectives, le recours au calcul du coefficient de corrélation intraclasse, abrégé sous l’acronyme ICC, s’avère indispensable. Dans le cadre d’un modèle à effets aléatoires simples, l’ICC représente le ratio de la variance attribuable à l’échelon supérieur — par exemple l’école ou le groupe d’intervention — sur la variance totale composée de la somme de la variance inter-grappes et de la variance intra-grappe. Dès lors que l’ICC dépasse un seuil conventionnel de 0,05, ce score indique que 5 % au moins de la variance de la variable dépendante découle de l’appartenance à la grappe, rendant l’analyse de variance à mesures indépendantes méthodologiquement illégitime en raison du risque inacceptable d’inflation de l’erreur alpha.
Enfin, une approche diagnostique hautement pragmatique consiste à ordonner les résidus selon la chronologie temporelle exacte d’acquisition des données et à cartographier cette séquence sous forme d’un graphique de dispersion temporelle. L’apparition d’oscillations périodiques, de dérives directionnelles continues au fil de la journée ou de regroupements compacts de résidus de même signe trahit instantanément l’existence d’effets d’apprentissage, d’usure des instruments de mesure ou de contamination d’ambiance, exigeant une révision structurelle de la stratégie d’analyse au profit de modèles mixtes ou hiérarchiques.
3. Le postulat de normalité : Fondements distributionnels et focus sur les résidus
3.1 Clarification conceptuelle : Distribution des scores versus distribution des résidus
Dans l’enseignement et la pratique quotidienne de la psychométrie, peu d’erreurs méthodologiques sont aussi répandues que l’analyse aveugle de la normalité sur les scores bruts de la variable dépendante sans différenciation des groupes. Il est conceptuellement erroné d’exiger que la distribution non découpée de la variable réponse d’une recherche psychologique se conforme à la courbe en cloche de Gauss. Si une intervention expérimentale produit un effet d’une amplitude substantielle entre plusieurs conditions, la distribution globale de la variable dépendante sera intrinsèquement plurimodale, aplatie ou asymétrique, reflétant précisément la divergence des moyennes induite par le traitement.
Le postulat de normalité de l’analyse de variance stipule formellement que ce sont les erreurs résiduelles du modèle — et non les scores bruts aggregated — qui doivent être issues d’une population normalement distribuée. Dans le cadre du modèle linéaire général, le résidu brut associé à la i-ème observation du j-ème groupe se formalise mathématiquement comme l’écart entre le score observé pour ce participant et la valeur prédite par le modèle, laquelle correspond exactement à la moyenne arithmétique de son groupe d’appartenance. Ce postulat équivaut à affirmer la normalité conditionnelle de la variable dépendante : à l’intérieur de chaque niveau du facteur expérimental, la distribution sous-jacente des scores doit suivre une loi normale de moyenne spécifique et de variance constante.
Il convient à cet égard de préciser le périmètre d’action du Théorème Central Limite. Ce théorème mathématique fondamental démontre que la distribution d’échantillonnage de la moyenne converge asymptotiquement vers une loi gaussienne à mesure que la taille de l’échantillon tend vers l’infini, quelle que soit la forme de la population mère, pourvu que sa variance soit finie. Toutefois, dans de nombreuses études en psychologie expérimentale où les effectifs oscillent entre 15 et 25 participants par cellule expérimentale, la vitesse de cette convergence demeure tributaire de l’éloignement initial par rapport à la loi normale. Si la distribution d’origine est fortement tronquée ou affectée de queues lourdes, invoquer mécaniquement le Théorème Central Limite pour s’affranchir du diagnostic de normalité des résidus relève d’une témérité méthodologique préjudiciable.
3.2 Impacts de l’asymétrie et de l’aplatissement sur la statistique F
La non-normalité d’une distribution résiduelle s’articule traditionnellement autour de deux dimensions mathématiques formalisées par les moments centrés d’ordre trois et d’ordre quatre : l’asymétrie, désignée dans la littérature internationale par le terme anglais de skewness, et l’aplatissement, qualifié de kurtosis. L’asymétrie mesure le degré de déséquilibre directionnel d’une distribution par rapport à sa valeur centrale. Une asymétrie positive indique un étalement prépondérant des valeurs vers les scores élevés créant une traîne à droite — profil récurrent des temps de réaction ou des scores de détresse psychologique —, tandis qu’une asymétrie négative reflète une accumulation de données au plafond avec une traîne orientée vers les valeurs minimales.
L’aplatissement, quant à lui, renseigne sur l’épaisseur relative des queues de distribution et la proéminence du sommet central comparativement à la distribution normale théorique. Une distribution leptokurtique présente des queues excessivement lourdes et denses en observations distantes, combinées à un pic central effilé, ce qui multiplie la probabilité d’enregistrer des écarts résiduels considérables. À l’inverse, une distribution platykurtique arbore des queues légères et un sommet arrondi, voire uniforme. Alors que les déviations de type platykurtique n’exercent qu’une influence très marginale sur la robustesse du modèle linéaire, les structures leptokurtiques déstabilisent profondément l’estimation de l’erreur quadratique moyenne.
La sensibilité du test F aux déviations de normalité s’avère particulièrement aiguë lorsque l’asymétrie opère en sens inverse selon les conditions expérimentales du devis. Si le groupe contrôle manifeste une asymétrie résiduelle positive marquée tandis que le groupe sous traitement présente une asymétrie résiduelle négative — traduisant une réorganisation fonctionnelle globale de la dynamique des réponses psychologiques —, la statistique F perd son calibrage probabiliste. Les taux d’erreur de première espèce s’écartent du seuil nominal, mais surtout, la puissance statistique réelle chute de manière dramatique par rapport aux projections initiales, rendant le chercheur incapable de détecter statistiquement des phénomènes cliniquement ou théoriquement majeurs.
4. Évaluation visuelle et graphique de la normalité des résidus
4.1 Construction et interprétation rigoureuse du diagramme quantile-quantile (Q-Q plot)
Pour apprécier la conformité empirique des résidus aux idéaux de la distribution gaussienne, l’inspection graphique instrumentée constitue la méthode de choix de tout psychologue statisticien rigoureux. Au sommet de cet arsenal sémiologique figure le diagramme quantile-quantile, universellement désigné sous le terme de Q-Q plot. Ce tracé cartographie avec une finesse analytique exceptionnelle les quantiles de la distribution empirique observée des résidus du modèle en vis-à-vis direct des quantiles théoriques attendus sous une loi normale standardisée parfaite de même moyenne et de même variance.
Sur le plan mécanique, si les résidus du modèle linéaire sont rigoureusement normaux, l’ensemble des points empiriques s’aligne fidèlement le long d’une droite diagonale de référence à 45 degrés. Toute altération systématique de la morphologie de la distribution se traduit instantanément par des signatures géométriques archétypales :
- Une courbure en forme de S inversé : indique des queues de distribution notablement plus lourdes que celles d’une loi normale, c’est-à-dire une structure leptokurtique où les points extrêmes s’écartent vers l’extérieur de la diagonale de référence.
- Une courbure en forme de S régulier : trahit une distribution platykurtique aux queues tronquées ou allégées, où les observations périphériques se resserrent vers le centre.
- Une concavité continue tournée vers le haut : sur l’intégralité du graphique, signe l’existence d’une asymétrie positive marquée, tandis qu’une convexité descendante reflète une asymétrie négative indéniable.
- Des points terminaux brutalement détachés : situés au-delà des projections linéaires à l’une ou l’autre des extrémités, isolent immédiatement des observations extrêmes et atypiques réclamant une investigation étiologique approfondie.
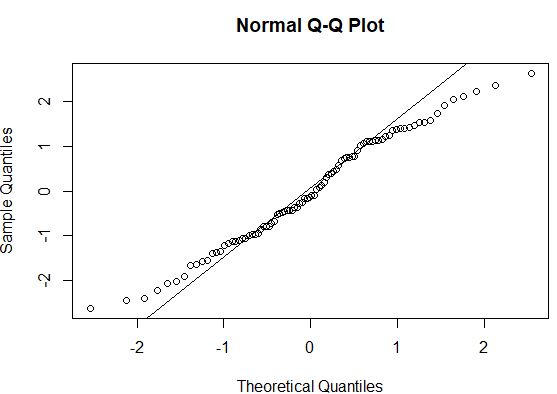
Pour optimiser l’objectivité de l’inspection visuelle, les environnements d’analyse contemporains incorporent des enveloppes de confiance à 95 %, modélisées par rééchantillonnage non paramétrique de type bootstrap ou par le calcul d’intervalles ponctuels de Fox. Ces fuseaux délimitent la marge de variabilité d’échantillonnage aléatoire acceptable : tant que la trajectoire des résidus demeure confinée à l’intérieur de ces bornes graphiques, l’hypothèse de normalité peut être considérée comme fonctionnellement satisfaite pour les besoins de l’analyse inférentielle.
4.2 Utilisation complémentaire des histogrammes et densités de probabilité
Bien que le diagramme quantile-quantile offre la résolution la plus discriminante pour sonder les queues de distribution, le recours complémentaire à des représentations spatiales alternatives permet de consolider l’intuition du chercheur quant à la morphologie globale de ses erreurs d’estimation. L’histogramme des résidus standardisés, enrichi de la superposition d’une courbe de densité gaussienne théorique ajustée sur les paramètres de l’échantillon, procure une lecture intuitive immédiate de la symétrie centrale et de la dispersion générale.
Néanmoins, l’histogramme souffre d’un biais technique inhérent à sa paramétrisation : la sensibilité de son profil morphologique au choix de la largeur des intervalles d’agrégation, désignée en modélisation computationnelle sous le nom de bin width. Une discrétisation trop large masque d’éventuelles bimodalités locales, tandis qu’un maillage excessivement fin engendre un bruit graphique fragmenté trompeur. Pour pallier cette instabilité, il est vivement préconisé de lui adjoindre une estimation de densité par noyau, connue sous le sigle KDE pour Kernel Density Estimation. En employant un noyau gaussien ou d’Epanechnikov, cette approche lisse mathématiquement la trajectoire des résidus et délivre une fonction de densité continue fidèle aux fluctuations réelles du phénomène.
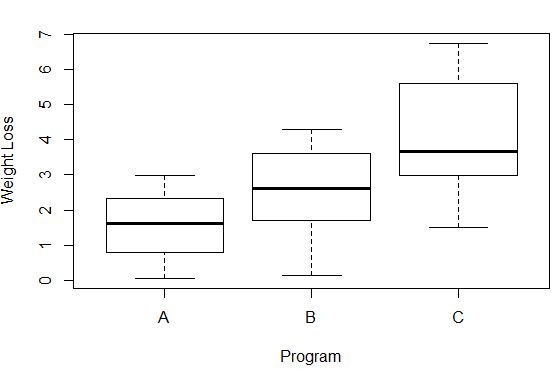
Dans cette même perspective descriptive, le recours à des représentations composites intégrant des diagrammes de dispersion à points dispersés aléatoirement le long d’un axe — appelés tracés jittered — combinés à des boîtes à moustaches de Tukey permet de contextualiser la distribution des résidus de manière contextualisée au sein de chaque groupe. Ces figures visualisent simultanément l’étendue interquartile, la médiane empirique, la présence d’asymétries locales au sein de chaque sous-groupe et la localisation exacte d’observations potentiellement discordantes sans jamais masquer la granularité unitaire de l’échantillon expérimental.
4.3 Limites inhérentes à l’interprétation purement subjective des graphiques
En dépit de leur richesse heuristique, les visualisations graphiques comportent des limites épistémologiques substantielles lorsqu’elles sont employées comme unique critère diagnostique. L’évaluation visuelle d’un tracé est par essence assujettie à une subjectivité interprétative non négligeable. Sous l’effet des fluctuations aléatoires d’échantillonnage, des échantillons de taille réduite tirés d’une population mère rigoureusement gaussienne peuvent afficher des distorsions visuelles déconcertantes simulant des asymétries ou des aplatissements factices.
De surcroît, le chercheur n’est jamais immunisé contre le biais de confirmation cognitif. Confronté à un Q-Q plot ambigu alors que la statistique de test principale approche le seuil fatidique de signification, l’observateur humain a naturellement tendance à rationaliser les déviations périphériques pour conclure au maintien du protocole initial. À l’inverse, face à des échantillons de très grande envergure excédant plusieurs centaines d’individus, l’œil humain tend à surinterpréter des ondulations millimétriques qui, bien qu’indubitables à l’affichage, s’avèrent totalement inoffensives quant à la validité numérique du ratio de variance.
Il est donc méthodologiquement indispensable de ne jamais scinder l’inspection graphique de l’analyse conjointe d’indices descriptifs quantitatifs standardisés et de métriques inférentielles rigoureuses. L’art du diagnostic réside dans la concordance de faisceaux d’indices convergents : une anomalie détectée sur un Q-Q plot ne prend toute sa gravité diagnostique que lorsqu’elle se reflète concomitamment dans les ratios de moments statistiques ou les tests formels d’adéquation distributionnelle.
5. Tests d’hypothèse formels de normalité : Procédures, métriques et seuils
5.1 Le test de Shapiro-Wilk : Standard d’excellence méthodologique
Parmi l’éventail des épreuves d’hypothèse dédiées à la validation formelle de la normalité, le test de Shapiro-Wilk, introduit en 1965, constitue la procédure de référence au sein de la littérature statistique internationale. Conçu spécifiquement pour sonder la structure gaussienne univariée, ce test repose sur le calcul de la statistique W, laquelle formalise le rapport entre la meilleure estimation linéaire sans biais de l’écart-type — dérivée de la corrélation linéaire entre les quantiles ordonnés de l’échantillon et les espérances de quantiles théoriques — et la somme des écarts quadratiques usuels par rapport à la moyenne.
La valeur numérique de la statistique W est bornée entre 0 et 1, une valeur unitaire reflétant une adéquation parfaite avec le profil normal. De multiples études comparatives de simulation de type Monte Carlo ont systématiquement démontré la supériorité de la puissance statistique du test de Shapiro-Wilk face à l’ensemble de ses concurrents historiques, notamment lorsque les effectifs se situent dans des plages intermédiaires courantes en psychologie, comprises entre 15 et 100 observations. Sous l’hypothèse nulle d’une distribution normale des résidus, une valeur p inférieure au seuil conventionnel de 0,05 conduit à rejeter formellement l’assertion de gaussianité.
Cependant, le test de Shapiro-Wilk présente le talon d’Achille de tous les tests de conformité : une sensibilité proportionnelle à l’effectif total d’échantillonnage. Lorsque la taille de l’échantillon excède 300 ou 500 sujets, le test acquiert une puissance statistique telle qu’il parvient à détecter des déviations infinitésimales et triviales, dénuées de tout impact néfaste sur le modèle d’analyse de variance. À l’inverse, dans les petits échantillons où l’ANOVA est précisément la plus vulnérable aux anomalies distributionnelles, le test souffre d’un manque criant de puissance, échouant fréquemment à signaler des non-normalités préjudiciables. Dès lors, le chercheur doit interpréter la p-valeur de Shapiro-Wilk en tandem avec la magnitude absolue du coefficient W, considérant généralement des valeurs de W supérieures à 0,95 ou 0,97 comme révélatrices d’une normalité pratique satisfaisante.
5.2 Tests alternatifs : Kolmogorov-Smirnov corrigé par Lilliefors et Anderson-Darling
Historiquement prégnant dans les formations initiales en méthodologie, le test d’adéquation de Kolmogorov-Smirnov est fréquemment utilisé par défaut dans certains logiciels généralistes. Néanmoins, son application mécanique au diagnostic des résidus d’une ANOVA repose le plus souvent sur une erreur théorique majeure : le test classique de Kolmogorov-Smirnov exige que les paramètres de la population — à savoir son espérance mathématique et son écart-type — soient connus a priori et fixés de manière exogène, et non estimés directement à partir des données de l’échantillon.
Lorsque ces paramètres sont extrapolés à partir des scores empiriques, le test de Kolmogorov-Smirnov originel devient excessivement conservateur, écrasant la p-valeur calculée et annihilant sa puissance de détection. Pour restaurer la validité inférentielle de cette approche, il est impératif d’adopter la correction de Lilliefors, laquelle réajuste les tables de probabilité critiques de la distance suprême en tenant compte de l’incertitude liée à l’estimation simultanée de la moyenne et de la variance de groupe. Même amendée de la sorte, l’épreuve de Kolmogorov-Lilliefors demeure notablement moins puissante que l’algorithme de Shapiro-Wilk pour déceler la plupart des déformations distributionnelles comportementales.
En revanche, le test d’Anderson-Darling mérite une attention soutenue de la part du chercheur en psychologie. Ce test constitue une modification sophistiquée du formalisme de Cramer-von Mises en intégrant une fonction de pondération quadratique inversée qui accorde un poids statistiquement accru aux écarts intervenant dans les queues de distribution. Dès lors que l’objectif méthodologique est d’identifier spécifiquement des anomalies leptokurtiques ou des contaminations sévères par des scores extrêmes susceptibles de déstabiliser les dénominateurs de variance, le test d’Anderson-Darling démontre une sensibilité exceptionnelle, surpassant ponctuellement le test de Shapiro-Wilk dans la caractérisation des queues de répartition.
5.3 Indices quantitatifs d’asymétrie et d’aplatissement standardisés
Pour s’affranchir de la dépendance excessive aux p-valeurs des tests d’hypothèse formels lors du travail sur des cohortes de grande envergure, le calcul direct des coefficients descriptifs d’asymétrie et d’aplatissement représente une alternative méthodologique indispensable. L’asymétrie de Fisher-Pearson et l’aplatissement de Fisher — ce dernier étant standardisé de manière à ce qu’une distribution gaussienne théorique présente une valeur exactement égale à zéro — offrent des métriques objectives pour apprécier l’ampleur et l’orientation des écarts distributionnels.
Une convention d’évaluation classique dans les manuels de psychologie expérimentale consiste à calculer des scores standardisés, couramment appelés ratios z, en divisant la valeur ponctuelle de l’indice par son erreur-type asymptotique respective :
$$z_{\text{asymétrie}} = \frac{\text{Skewness}}{SE_{\text{skew}}}$$
$$z_{\text{aplatissement}} = \frac{\text{Kurtosis}}{SE_{\text{kurt}}}$$
Ces ratios sont ensuite confrontés aux seuils critiques de la loi normale centrée réduite : une valeur absolue excédant 1,96 dénote une déviation significative au seuil alpha de 0,05, tandis qu’un score dépassant 2,58 atteste d’une violation au seuil de 0,01. Toutefois, à l’instar des tests formels, ces ratios z conservent une sensibilité élevée aux grands échantillons en raison du rétrécissement continu de l’erreur-type au dénominateur.
C’est pourquoi la méthodologie contemporaine — s’appuyant notamment sur les lignes directrices formulées par Kline dans le domaine de la modélisation statistique avancée — privilégie des seuils de tolérance empiriques absolus pour juger de la validité pratique des analyses paramétriques dans les échantillons larges. Ainsi, une valeur absolue d’asymétrie résiduelle inférieure à 2, combinée à une valeur absolue d’aplatissement inférieure à 7 (ou selon des critères plus conservateurs, asymétrie inférieure à 3 et aplatissement inférieur à 10), garantit que le ratio de variance de l’ANOVA conservera une stabilité robuste, les taux d’erreur de première espèce n’étant nullement corrompus par ces fluctuations d’échelle.
6. Le postulat d’homogénéité des variances (homoscédasticité) : Fondements théoriques
6.1 Compréhension mécanique de l’homosynthèse dans le calcul de la variance d’erreur
Le terme d’homoscédasticité, dérivé du grec signifiant littéralement « même dispersion », désigne le postulat statistique selon lequel la variance résiduelle de la variable dépendante doit être rigoureusement identique au sein de chacune des sous-populations définies par les modalités du facteur d’intérêt. Ce postulat structure l’ensemble de la logique de calcul de l’analyse de variance univariée. Dans le modèle linéaire, l’effet spécifique du traitement est modélisé comme un décalage moyen de la variable dépendante d’un groupe à l’autre, sans que ce traitement ne soit censé altérer la variabilité intrinsèque des sujets autour de ces nouvelles moyennes d’équilibre.
D’un point de vue calculatoire, le dénominateur de la statistique F repose sur le carré moyen résiduel — noté conventionnellement MS résiduel ou MS erreur. Ce terme correspond mathématiquement à la moyenne pondérée des variances calculées à l’intérieur de chaque échantillon unitaire :
$$MS_{\text{résiduelle}} = \frac{SS_{\text{résiduelle}}}{N – k} = \frac{\sum (n_j – 1) s^2_j}{N – k}$$
Cette mise en commun — formalisée sous l’appellation d’estimation de variance groupée — postule que chaque variance d’échantillon constitue un estimateur convergent d’un seul et unique paramètre sous-jacent universel, sigma carré. Si les véritables variances des populations diffèrent substantiellement entre les conditions expérimentales, cette estimation groupée perd sa cohérence théorique : elle amalgame des réalités distributionnelles distinctes en une valeur moyenne hybride qui ne correspond plus à l’erreur d’échantillonnage d’aucun des groupes investigués.
Les conséquences de cette rupture d’homoscédasticité demeurent intimement tributaires de la configuration des effectifs de l’étude. Si le plan de recherche est parfaitement équilibré — c’est-à-dire si le nombre de participants est strictement identique au sein de chaque niveau factoriel —, l’analyse de variance fait preuve d’une robustesse intrinsèque remarquable, l’impact sur le taux d’erreur de première espèce demeurant contenu tant que les disparités de variance ne dépassent pas un ordre de grandeur excessif. En revanche, dès lors que le plan expérimental devient déséquilibré — conséquence quasi inévitable de l’attrition des participants dans les protocoles cliniques longitudinaux ou du recueil de données sur le terrain —, l’interaction entre hétérogénéité des variances et disparité des effectifs engendre des distorsions statistiques d’une extrême dangerosité pour l’intégrité de l’inférence.
6.2 Le couplage des variances et des effectifs : Scénarios libéraux et conservateurs
L’interaction entre les effectifs de chaque groupe et leurs variances respectives engendre deux scénarios aux répercussions opposées sur le risque d’erreur de première espèce, universellement désignés par les psychologues méthodologistes sous les vocables de couplage direct et de couplage inverse :
Dans la configuration du couplage direct, les groupes hébergeant les plus grands effectifs d’échantillonnage s’avèrent être également ceux qui affichent les variances les plus volumineuses. Lors du calcul du carré moyen résiduel, la pondération par les degrés de liberté accorde un poids prépondérant aux variances de ces cohortes élargies. En conséquence, l’estimation groupée de l’erreur résiduelle au dénominateur du ratio F est massivement surestimée par rapport à ce qu’exigerait la dispersion des groupes réduits. Le test F devient excessivement conservateur : sa valeur empirique s’affaisse artificiellement et le taux réel d’erreur de type I s’effondre bien en deçà du seuil nominal de 0,05. Bien qu’une telle situation n’engendre pas d’inflation de faux positifs, elle détruit silencieusement la puissance statistique de l’expérience, rendant la détection d’effets thérapeutiques réels pratiquement impossible.
À l’extrême opposé se dessine le scénario du couplage inverse, de loin le plus délétère pour la crédibilité scientifique. Cette situation advient lorsque les sous-groupes dotés des effectifs les plus modestes présentent les variances les plus spectaculaires — phénomène typique de l’introduction d’un sous-groupe clinique hautement hétérogène comparé à un groupe témoin homogène et nombreux. Sous cette contrainte, les petits échantillons contribuent de manière marginale à la somme des carrés résiduels globale. Le dénominateur du test F se retrouve alors sous-estimé de manière drastique.
La statistique F s’envole alors vers des valeurs artificiellement gigantesques, induisant une explosion incontrôlée du risque d’erreur de type I. Dans des conditions de couplage inverse sévère, la probabilité de rejeter à tort l’hypothèse nulle d’égalité des moyennes peut culminer jusqu’à 30 %, 40 % voire 50 % ! Des chercheurs persuadés de travailler sous un risque alpha de 5 % publient alors des découvertes purement artefactuelles, alimentant directement la crise de la réplicabilité qui frappe la psychologie expérimentale contemporaine.
7. Procédures inférentielles pour vérifier l’égalité des variances
7.1 Le test de Levene et sa variante robuste de Brown-Forsythe
Pour statuer formellement sur l’homogénéité des variances au sein de leurs protocoles, les chercheurs recourent quasi systématiquement au test développé par Howard Levene en 1960. L’intuition mathématique sous-tendant le test de Levene originel se caractérise par une ingénieuse simplicité conceptuelle : le test consiste à transformer les scores bruts de la variable dépendante en calculant la valeur absolue des écarts de chaque observation par rapport à la moyenne arithmétique de son groupe d’appartenance :
$$z_{ij} = |Y_{ij} – \bar{Y}_j|$$
Une analyse de variance à un facteur classique est ensuite exécutée directement sur ces écarts absolus transformés. Si les variances intrinsèques des populations sont identiques, les déviations moyennes absolues au sein de chaque groupe doivent être équivalentes, ce qui conduit à une statistique F non significative.
Néanmoins, le test de Levene historique souffre d’une vulnérabilité non négligeable : il conserve une sensibilité résiduelle aux déviations de normalité de la variable initiale. Pour s’affranchir définitivement de cette dépendance, Morton Brown et Alan Forsythe ont proposé en 1974 une modification déterminante : substituer la médiane du groupe à la moyenne arithmétique lors du calcul des déviations absolues :
$$z_{ij}^* = |Y_{ij} – \tilde{Y}_j|$$
La médiane constituant l’estimateur de tendance centrale le plus résistant face à l’asymétrie et à l’irruption de valeurs aberrantes périphériques, le test de Brown-Forsythe — fréquemment libellé sous l’appellation générique de test de Levene basé sur la médiane dans les logiciels statistiques contemporains — s’impose comme le standard méthodologique absolu. Dès lors que l’évaluation préalable de la normalité des résidus révèle des asymétries même modérées, le psychologue quantitativiste doit impérativement privilégier la variante de Brown-Forsythe afin de ne pas confondre faussement une non-normalité univariée avec une authentique hétéroscédasticité.
7.2 Tests de Bartlett et de Fligner-Killeen : Usages et spécificités
En marge de la famille des tests de déviation absolue de Levene, d’autres procédures inférentielles jalonnent le répertoire diagnostique de la dispersion. Le test de Bartlett, fondé sur une formulation logarithmique du ratio de vraisemblance, a longtemps représenté l’alternative standard dans la tradition analytique anglo-saxonne. Ce test calcule une statistique approximée par une distribution de chi-deux évaluant l’homogénéité des variances de manière optimale lorsque la condition de normalité univariée est rigoureusement satisfaite au sein de chaque groupe expérimental.
Toutefois, la sensibilité du test de Bartlett aux entorses à la normalité gaussienne est si excessive que Box l’a jadis qualifié d’outil totalement inopérant pour discriminer l’hétérogénéité des variances. Confronté à des données simplement modérément leptokurtiques, le test de Bartlett rejette massivement l’hypothèse nulle d’égalité des variances, attribuant à la dispersion ce qui ne relève en réalité que de la structure des queues distributionnelles. Par conséquent, son utilisation en psychologie quantitative moderne doit être proscrite, sauf dans les contextes rarissimes où la normalité absolue des populations d’origine est formellement garantie par la physique de la mesure.
À l’autre extrémité du spectre méthodologique se déploie le test de Fligner-Killeen. Ce test d’homogénéité non paramétrique procède par assignation de rangs aux écarts médians absolus standardisés. Totalement insensible aux asymétries majeures, aux aplatissements excessifs et à l’influence distordante des valeurs extrêmes, le test de Fligner-Killeen constitue le choix le plus résistant et le plus robuste lorsque les données violent simultanément les postulats de normalité et de linéarité d’échelle. Face à des sorties statistiques divergentes entre ces épreuves, le chercheur doit toujours accorder sa confiance au test dont le profil de robustesse correspond à l’état de conformation distributionnelle constaté en amont.
7.3 Règles empiriques et rapports de variances (Variance Ratio F-max de Hartley)
En complément des épreuves inférentielles dont la sensibilité aux grands échantillons présente les mêmes écueils d’hyperréactivité que ceux détaillés pour la normalité, les statisticiens appliqués emploient fréquemment des règles de décision heuristiques fondées sur les rapports de variance empiriques. La plus documentée de ces approches est le ratio F-max de Hartley, lequel se définit tout simplement comme le quotient entre la variance d’échantillon la plus volumineuse constatée parmi l’ensemble des cellules du plan et la variance d’échantillon la plus faible :
$$F_{\text{\max}} = \frac{s^2_{\text{ma\ximum}}}{s^2_{\text{minimum}}}$$
Ce ratio peut être confronté à des tables de valeurs critiques établies par Hartley en fonction du nombre de groupes et des degrés de liberté de l’échantillon unitaire, fournissant ainsi un repère normé.
Toutefois, dans la pratique empirique contemporaine, une règle heuristique d’une grande robustesse a été popularisée par des auteurs de référence tels que Tabachnick et Fidell :
- Pour des plans factoriels équilibrés : (effectifs rigoureusement identiques dans chaque cellule, $n_1 = n_2 = dots = n_k$), l’analyse de variance classique demeure parfaitement fiable et préserve son taux d’erreur nominal tant que le ratio $F_{\text{\max}}$ demeure inférieur ou égal à 4:1 (certains auteurs recommandent un seuil plus strict de 3:1).
- Pour des plans factoriels déséquilibrés : la marge de tolérance s’effondre drastiquement : un ratio supérieur à 1,5:1 ou 2:1 suffit à disqualifier formellement l’utilisation du test F classique, imposant le basculement immédiat vers des procédures adaptées aux variances inégales.
8. Détection et gestion rigoureuse des valeurs aberrantes univariées
8.1 Identification mathématique des observations atypiques
L’auscultation des postulats de l’analyse de variance demeure indissociable de la recherche systématique des valeurs aberrantes, ou outliers, dont la présence unitaire suffit souvent à contaminer à la fois la distribution normale des résidus et l’homogénéité des variances de groupe. Une valeur aberrante univariée se définit comme une mesure qui s’écarte de façon disproportionnée de la masse centrale des observations recueillies au sein de la même modalité expérimentale.
La première technique d’identification repose sur la standardisation des données en scores z, calculés au sein de chaque groupe séparément afin de neutraliser l’effet de moyenne du traitement :
$$z_{ij} = \frac{Y_{ij} – \bar{Y}_j}{s_j}$$
Dans la littérature psychologique de référence, une observation présentant un score z supérieur en valeur absolue à 3,00 (ou 3,29 selon le seuil de probabilité bilatérale infinitésimal de p < 0,001 établi par Tabachnick et Fidell) est formellement catégorisée comme une anomalie statistique potentielle. Une seconde méthode, popularisée par John Tukey dans le cadre de l’analyse exploratoire des données, s’avère nettement plus robuste face aux biais de masquage : la règle de l’écart interquartile. En calculant l’intervalle séparant le premier quartile du troisième quartile, Tukey définit les valeurs aberrantes modérées comme celles franchissant une barrière située à 1,5 fois l’écart interquartile au-delà des quartiles, tandis que les valeurs extrêmes correspondent à des franchissements excédant 3 fois cet écart.
Dans le prolongement direct du modèle linéaire, il est hautement recommandé d’évaluer les résidus studentisés externes — obtenus en réajustant le modèle après omission temporaire de chaque observation ciblée — ainsi que la distance de Cook. Une distance de Cook excédant la valeur conventionnelle de 1,0 ou le seuil relatif formalisé par 4 divisé par l’effectif total N démasque des observations exerçant un levier démesuré sur les paramètres estimés du modèle, modifiant la structure des carrés moyens au détriment de l’ensemble de l’échantillon.
8.2 Diagnostic étiologique des observations aberrantes en psychologie
La détection purement algorithmique d’un point atypique ne constitue que le préambule d’une investigation substantielle indispensable. En psychologie, une valeur aberrante ne doit jamais être radiée d’un fichier de données de manière expéditive et automatisée. Le chercheur se doit d’accomplir un diagnostic étiologique rigoureux visant à élucider l’origine de cette discordance phénoménologique.
On distingue principalement trois grandes catégories de causes à l’origine de ces profils hors normes :
- Les erreurs instrumentales et de saisie : Une frappe erronée lors de l’encodage — un score d’anxiété de 77 enregistré au lieu de 7 sur une échelle de Likert bornée à 10 — ou une défaillance technique d’un capteur électrodermal constituent des anomalies artefactuelles manifestes qui justifient une correction immédiate ou une suppression documentée.
- Les défauts de conformité au protocole expérimental : Lors de passations de tâches cognitives chronométrées ou d’enquêtes psychométriques dématérialisées, certains participants s’engagent dans des stratégies de réponse aléatoire, devinant les stimuli sans lire les consignes, ou subissent des distractions massives attestées par des temps de réponse physiologiquement impossibles (inférieurs à 150 millisecondes). Ces comportements déviants attestent que le participant n’a pas été soumis au même processus psychologique que le reste de la cohorte.
- L’expression authentique d’une variabilité humaine extrême : Dans de nombreuses recherches cliniques, une valeur extraordinairement élevée sur une échelle de dépression ou d’impulsivité peut refléter la réalité symptomatique aigüe d’un patient n’ayant pas encore reçu de diagnostic comorbide. Considérer cet individu comme un déchet statistique à éliminer constitue une distorsion théorique inadmissible : son exclusion altère la représentativité écologique des résultats et biaise la portée des conclusions scientifiques.
8.3 Stratégies méthodologiques de traitement des données discordantes
Face à la persistance d’observations discordantes confirmées dont l’étiologie relève d’une variabilité comportementale réelle, trois voies méthodologiques s’offrent au psychologue quantitatif. La première stratégie consiste à procéder à une winsorisation des scores extrêmes. Cette technique d’estimation robuste consiste à remplacer les valeurs périphériques au-delà d’un percentile défini — par exemple les centiles 2,5 % et 97,5 % — par la valeur exacte de ce centile limitrophe. La winsorisation conserve l’intégralité de l’effectif expérimental ainsi que le rang ordinal des participants, tout en circonscrivant le pouvoir d’attraction de la valeur extrême sur la variance du groupe.
La seconde approche réside dans l’exclusion transparente et justifiée du cas atypique, conditionnée par une politique de traçabilité irréprochable. Le chercheur a l’obligation éthique d’expliciter dans la section « Méthode » de son manuscrit le critère mathématique d’exclusion arrêté a priori, le nombre précis de participants écartés, ainsi que la nature des conditions expérimentales affectées. Toute exclusion effectuée de manière sélective après observation de l’évolution des p-valeurs relève de la manipulation méthodologique frauduleuse, assimilable au p-hacking.
Enfin, la posture scientifique la plus élégante et la plus convaincante aux yeux des comités de lecture internationaux consiste à mener systématiquement une analyse de sensibilité. Cette procédure confronte l’exécution de l’analyse de variance sur le jeu de données intégrale avec celle opérée sur le jeu de données purgé des cas aberrants. Si la signification statistique, l’orientation vectorielle des effets et les tailles d’effet associées demeurent stables et congruentes d’un modèle à l’autre, le chercheur démontre de facto que ses conclusions scientifiques sont insensibles à la présence de ces perturbations locales.
9. Protocoles diagnostiques pas à pas sous les logiciels statistiques (R, SPSS, JASP)
9.1 Implémentation complète sous R
L’environnement statistique R offre le cadre computationnel le plus exhaustif et le plus souple pour instrumenter le diagnostic des résidus. La première étape opérationnelle requiert la spécification du modèle linéaire sous-jacent à l’aide de la fonction d’ajustement standardisée, modélisant la variable dépendante en fonction des niveaux factoriels du design expérimental :
Le chercheur extrait ensuite immédiatement les résidus bruts du modèle via la fonction générique d’extraction des résidus, ainsi que les résidus standardisés ou studentisés externes grâce aux fonctions d’estimation matricielle dédiées. L’évaluation formelle de la normalité s’exécute en soumettant directement le vecteur de ces résidus standardisés au test de Shapiro-Wilk, ce qui évite le fractionnement fastidieux des tests par sous-groupe.
Pour le postulat d’homoscédasticité, le package car met à disposition une implémentation rigoureuse du test de Levene. Par défaut, la commande applique le test robuste de Brown-Forsythe centré sur la médiane, mais permet de basculer sur la moyenne arithmétique si une fidélité au formalisme historique de 1960 est explicitement recherchée.
Sur le plan iconographique, l’évaluation visuelle moderne s’appuie sur la richesse de ggplot2 et l’automatisation proposée par le package performance. L’appel de la fonction de vérification globale du modèle génère un affichage multipanneau de haute volée scientifique : Q-Q plot assorti d’enveloppes de confiance bootstrap, tracé des résidus studentisés en fonction des valeurs ajustées pour repérer instantanément l’hétéroscédasticité par l’évasement de l’entonnoir des points, et calcul des distances de Cook pour isoler les influences individuelles excessives.
9.2 Procédure opérationnelle sous IBM SPSS Statistics
Au sein du logiciel propriétaire IBM SPSS Statistics, le protocole diagnostique des postulats mobilise principalement deux interfaces distinctes. L’exploration de la normalité et des valeurs aberrantes s’opère préférentiellement via le menu d’analyse descriptive, sous-rubrique « Explorer » (ou « Examiner » dans les versions francophones). Dans cette boîte de dialogue, la variable dépendante est insérée dans la liste des variables dépendantes, tandis que le facteur de traitement est spécifié dans la zone des facteurs.
Dans les options de graphiques associées, il convient impérativement de cocher la case relative aux graphiques de normalité avec tests. SPSS génère alors simultanément les tracés Q-Q plots détaillés par modalité factorielle, les boîtes à moustaches identifiant par un cercle les valeurs aberrantes modérées et par une astérisque les valeurs extrêmes, ainsi que le tableau inférentiel confrontant les résultats du test de Kolmogorov-Smirnov corrigé par Lilliefors et ceux du test de Shapiro-Wilk.
Pour l’homogénéité des variances, l’opérateur navigue vers le module de comparaison des moyennes dédié à l’analyse de variance à un facteur. Dans le sous-menu d’options, le chercheur sélectionne le test d’homogénéité de la variance (test de Levene) ainsi que les estimateurs de correction robuste de Welch et de Brown-Forsythe. Lors de la validation, SPSS délivre un tableau structuré exposant les statistiques de Levene calculées sur la moyenne, la médiane, la médiane avec ajustement des degrés de liberté, et la moyenne tronquée. Enfin, la boîte de dialogue d’enregistrement du modèle linéaire univarié permet de sauvegarder les résidus standardisés directement dans le fichier de données matriciel pour toute auscultation approfondie ultérieure.
9.3 Diagnostic visuel et intuitif sous JASP et Jamovi
Les interfaces logicielles libres de nouvelle génération que sont JASP — développé sous l’égide de l’Université d’Amsterdam — et Jamovi ont révolutionné l’ergonomie pédagogique et méthodologique de la vérification des postulats. Rompant avec la prolifération de fenêtres secondaires et le recours obligatoire à des lignes de syntaxe de commande, ces environnements intègrent nativement des sections de contrôle de validité directement incorporées au sein du volet d’exécution de l’ANOVA.
Dans JASP comme dans Jamovi, dès que le modèle d’analyse de variance classique est paramétré par glisser-déposer des variables, il suffit au chercheur de dérouler l’onglet intitulé « Assumption Checks » ou « Vérification des hypothèses ». D’un simple clic sur les sélecteurs dédiés, le logiciel injecte instantanément dans le rapport de résultats dynamique :
- Le test de Shapiro-Wilk calculé sur l’agrégat des résidus du modèle linéaire unifié.
- Le test d’homoscédasticité de Levene assorti du choix interactif du paramètre de centrage (médiane ou moyenne).
- Le diagramme Q-Q plot haute résolution des résidus avec sa droite de référence à 45 degrés.
- Des graphiques de dispersion confrontant les valeurs prédites aux résidus observés.
Ces outils se distinguent en outre par leur capacité à produire instantanément des sorties graphiques vectorielles prêtes pour la publication académique, conformes aux exigences typographiques des plus hautes instances de psychologie. En démocratisant un accès transparent et immédiat au diagnostic des erreurs résiduelles sans exiger d’expertise en programmation matricielle, JASP et Jamovi participent activement à l’élévation des standards de rigueur méthodologique au sein des laboratoires de sciences cognitives.
10. Robustesse de l’ANOVA face aux violations modérées des conditions théoriques
10.1 Résistance empirique aux écarts de normalité dans les devis équilibrés
La littérature relative à la robustesse des tests statistiques s’accorde largement à reconnaître que l’analyse de variance paramétrique de Fisher-Snedecor constitue une procédure robuste face à certaines transgressions spécifiques de ses axiomes théoriques. Les simulations systématiques initiées par George Box dès 1953, prolongées par les travaux de Glass, Peckham et Sanders dans les années 1970, ont abondamment démontré que le modèle d’ANOVA tolère des entorses notables à la normalité univariée pourvu que deux conditions d’ancrage soient satisfaites : la préservation stricte de l’indépendance des observations et l’équilibre quantitatif parfait des effectifs d’échantillon entre les cellules du plan factoriel.
Lorsque chaque cellule expérimentale comprend un effectif identique — par exemple trente participants assignés à chaque condition —, le taux d’erreur de première espèce demeure remarquablement confiné à proximité immédiate de la valeur nominale de 5 %, même sous des conditions d’asymétrie résiduelle modérée ou d’aplatissement platykurtique. La mécanique du calcul matriciel du ratio F compense mathématiquement les distorsions locales par une neutralisation symétrique des erreurs quadratiques moyennes. De même, les écarts de kurtosis modérés — tant que les distributions ne manifestent pas des profils leptokurtiques démesurés avec des queues hyper-denses — n’exercent qu’une influence très marginale sur la forme empirique de la distribution d’échantillonnage de F.
Ces éléments de résilience autorisent les chercheurs travaillant sur des protocoles expérimentaux strictement contrôlés et dotés d’effectifs égaux à maintenir l’analyse paramétrique classique, même en présence d’une p-valeur significative au test de Shapiro-Wilk, à la stricte condition que les représentations graphiques confirment une continuité morphologique générale sans points atypiques massifs.
10.2 Seuils critiques d’invalidation du modèle paramétrique standard
Cette tolérance méthodologique s’évanouit toutefois brutalement dès lors que plusieurs violations de postulats se combinent au sein d’un même jeu de données. La littérature quantitative identifie une « triade fatale » hautement destructrice qui disqualifie sans appel l’emploi du test F classique :
- Des micro-échantillons d’une taille inférieure à 12 ou 15 observations par cellule expérimentale.
- Une asymétrie résiduelle sévère ou orientée dans des directions opposées selon les conditions du plan.
- Une rupture flagrante d’homoscédasticité couplée à un déséquilibre prononcé des effectifs (plans inégaux).
Sous l’effet combiné de ces paramètres délétères, la distribution empirique du ratio F ne ressemble plus en rien à la distribution théorique de référence. Les tests de comparaisons multiples a posteriori traditionnels — tels que le test HSD de Tukey ou la méthode de Scheffé —, qui postulent tous l’exactitude sans faille de l’estimation groupée de la variance d’erreur résiduelle, voient leurs taux d’erreur de type I dégénérer totalement. L’intervalle de confiance estimé autour des différences de moyennes devient excessivement étroit ou indûment dilaté, induisant des prises de décision arbitraires.
Parallèlement, la puissance statistique réelle s’effondre de manière dramatique, privant l’investigateur de toute capacité à détecter des effets de taille moyenne — caractérisés par un d de Cohen oscillant autour de 0,5 —, même lorsque la substance psychologique sous-jacente est authentique. Dans ce contexte d’invalidation manifeste, s’entêter à publier le ratio F standard de Fisher sans correction relève d’une négligence scientifique coupable, imposant la mise en œuvre impérative des alternatives correctives modernes.
11. Stratégies alternatives et correctives en présence de postulats non satisfaits
11.1 Corrections d’hétéroscédasticité : ANOVA de Welch et test de Brown-Forsythe
Lorsqu’un protocole expérimental affiche une violation manifeste du postulat d’homogénéité des variances — attestée par un test de Levene ou de Brown-Forsythe statistiquement significatif ou un ratio de variance excédant les seuils de tolérance dans un plan déséquilibré —, le chercheur ne doit pas abandonner le cadre de la comparaison des moyennes continues. La statistique méthodologique contemporaine a forgé des solutions mathématiques robustes remarquables, au premier rang desquelles trône l’ANOVA de Welch.
Formulée par Bernard Lewis Welch en 1951, cette procédure élimine formellement le recours à l’estimation groupée de l’erreur résiduelle. Au lieu de postuler une variance commune artificielle, le formalisme de Welch pondère chaque moyenne d’échantillon par l’inverse de sa propre variance locale divisée par son effectif propre. La statistique résultante n’est plus distribuée selon les degrés de liberté usuels du modèle de Fisher, mais s’ajuste dynamiquement sur la base de l’approximation de Welch-Satterthwaite, générant des degrés de liberté fractionnaires qui corrigent précisément la distorsion induite par l’inégalité des dispersions.
Un ensemble convergent de méta-recherches computationnelles — menées notamment par Delacre, Lakens et Leys en 2017 — a démontré que l’ANOVA de Welch maintient un contrôle parfait de l’erreur de type I sous des conditions d’hétérogénéité de variance extrêmes, tout en conservant une puissance statistique rigoureusement identique à l’ANOVA classique lorsque les variances s’avèrent parfaitement égales. Pour cette raison, ces auteurs de référence recommandent formellement d’adopter l’ANOVA de Welch comme le test par défaut systématique pour toute comparaison de moyennes intergroupes univariée.
Lors de la mise en œuvre d’une ANOVA de Welch, les comparaisons post-hoc subséquentes doivent obligatoirement être adaptées : l’emploi du test de Tukey HSD doit être prohibé au bénéfice des procédures de Games-Howell ou de Dunnett T3, spécifiquement calibrées pour estimer les contrastes sous variances et effectifs inégaux.
11.2 Transformations mathématiques de la variable dépendante
Une démarche historiquement classique face à des résidus violant la normalité ou manifestant une hétéroscédasticité corrélée aux moyennes consiste à appliquer une transformation mathématique continue à l’ensemble des scores de la variable dépendante d’origine. L’objectif d’une telle opération est de remodeler l’échelle de mesure pour contracter les dispersions dissymétriques et stabiliser la variance globale.
Les transformations les plus éprouvées incluent :
- La transformation logarithmique (base 10 ou logarithme népérien) : particulièrement adaptée pour résorber l’asymétrie positive forte caractéristique des temps de réaction latents ou des scores de concentration hormonale salivaire.
- La transformation par racine carrée : idéale pour modéliser des variables de comptage comportemental discret — telles que le nombre d’erreurs commises dans un labyrinthe spatial — dont la distribution initiale approche une loi de Poisson où la variance est intrinsèquement liée à la moyenne.
- La transformation inverse : représentant la correction la plus drastique pour compresser les valeurs hautement divergentes.
- La famille de transformations paramétriques de Box-Cox : permet de balayer algorithmiquement un continuum de puissances lambda afin d’identifier la transformation exponentielle optimisant la normalité résiduelle.
Toutefois, la psychologie quantitative contemporaine porte un regard de plus en plus critique sur l’usage inconsidéré des transformations mathématiques. En altérant l’échelle d’origine, le chercheur modifie fondamentalement la substance psychométrique de sa variable : l’analyse n’évalue plus une différence de moyennes sur une échelle psychologique signifiante — par exemple des points d’anxiété clinique —, mais sur des logarithmes de points, rendant toute interprétation intuitive des intervalles de confiance et des tailles d’effet particulièrement ardue. De plus, une transformation non linéaire peut artificiellement créer ou détruire des interactions factorielles significatives, faussant les déductions théoriques relatives aux effets modérateurs.
11.3 Alternatives non paramétriques et approches par rééchantillonnage
Lorsque la variable dépendante se caractérise par une métrique ordinale ou viole si radicalement la normalité que toute modélisation linéaire s’avère proscrite, l’épreuve non paramétrique du test de Kruskal-Wallis s’impose comme l’alternative classique. En substituant aux scores métriques continus leurs rangs ordonnés au sein de l’échantillon global agrégé, le test de Kruskal-Wallis évalue si les distributions de rangs moyens divergent significativement entre les conditions. Toutefois, une clarification théorique s’impose : le test de Kruskal-Wallis ne constitue un véritable test d’égalité des médianes que si et seulement si les distributions au sein de chaque groupe partagent rigoureusement la même forme géométrique et la même dispersion ; en cas d’hétéroscédasticité sous-jacente, il teste uniquement une dominance stochastique globale.
Face à ces limitations, les méthodologies de rééchantillonnage par bootstrap offrent une flexibilité inférentielle supérieure. En tirant avec remise des milliers d’échantillons bootstrap à partir du jeu de données empirique originel, l’analyste reconstruit directement la distribution d’échantillonnage de la différence de moyennes sans formuler le moindre postulat paramétrique quant à la forme de la population mère. Les intervalles de confiance par bootstrap avec correction de biais et accélération (BCa) fournissent des estimations d’une fidélité exceptionnelle pour statuer sur l’existence d’effets substantiels sans risque de distorsion distributionnelle.
Enfin, la recherche de pointe privilégie de plus en plus l’implémentation des modèles statistiques robustes développés par Rand Wilcox, s’appuyant sur des moyennes tronquées à 20 % et des estimateurs de type M. Ces méthodes éliminent mécaniquement l’influence déstabilisatrice des queues lourdes et des observations aberrantes tout en préservant la métrique d’origine, surpassant tant l’ANOVA classique que les tests sur les rangs en matière de puissance statistique et de fidélité explicative.
12. Synthèse méthodologique, arbre décisionnel et directives de rapportage APA
12.1 Arbre décisionnel pour guider le chercheur pas à pas
Pour guider le chercheur à travers le labyrinthe des arbitrages analytiques, nous proposons une séquence logique standardisée, articulée autour de bifurcations décisionnelles rigoureuses :
Étape 1 : Vérification de l’indépendance des données
Le protocole implique-t-il une randomisation individuelle stricte et l’absence de regroupement contextuel ou sériel ? Si non, abandon immédiat de l’ANOVA au profit exclusif des modèles linéaires mixtes ou hiérarchiques (HLM). Si oui, passage à l’étape suivante.
Étape 2 : Ajustement du modèle et extraction des résidus
Calcul des résidus standardisés du modèle linéaire et recherche des observations aberrantes (scores z > 3,29, distance de Cook > 4/N). En présence d’outliers avérés : vérification de saisie, conduite systématique d’une analyse de sensibilité comparant les modèles avec et sans ces cas extrêmes.
Étape 3 : Évaluation de la normalité des résidus
Inspection conjointe du Q-Q plot avec enveloppes bootstrap et du test de Shapiro-Wilk (W > 0,95) ou vérification des indices absolus (|asymétrie| < 2, |aplatissement| < 7). Si la normalité est satisfaite, ou si N par groupe est supérieur à 30 dans un plan équilibré, progresser vers l’étape 4. Si la non-normalité est sévère sur de petits échantillons (N < 15) : privilégier l’ANOVA robuste sur moyennes tronquées de Wilcox, l’inférence par bootstrap, ou à défaut le test de Kruskal-Wallis.
Étape 4 : Évaluation de l’homogénéité des variances
Exécution du test de Levene centré sur la médiane (Brown-Forsythe) et examen du ratio F-max. Les variances sont-elles homogènes (p > 0,05 ou F-max < 3 dans un plan équilibré) ? Si oui, exécution et publication de l’ANOVA de Fisher standard (F). Si non (hétéroscédasticité avérée ou plan déséquilibré avec F-max > 1,5), rejet absolu du test de Fisher et exécution systématique de l’ANOVA de Welch assortie de comparaisons post-hoc de Games-Howell.
12.2 Directives de rédaction et standardisation selon les normes APA (7e édition)
La transparence méthodologique requise par l’American Psychological Association (normes APA, 7e édition) impose de documenter explicitement l’ensemble des étapes de vérification des postulats dans les sections « Méthode » et « Résultats » des publications scientifiques. Il est scientifiquement proscrit de se borner à affirmer lapidairement que « les postulats de l’ANOVA ont été vérifiés » sans étayer cette assertion par des métriques quantifiées et des justifications d’arbitrage.
Le chercheur doit énoncer précisément les épreuves diagnostiques mobilisées, en rapportant la statistique de test avec ses degrés de liberté exacts et sa p-valeur associée. S’il a été recouru à l’ANOVA de Welch en raison d’une rupture d’homoscédasticité, cette décision doit être formalisée et justifiée dans le corps du texte.
Voici un modèle de rédaction académique standardisé et pleinement conforme aux exigences des comités de lecture internationaux :
« Préalablement à l’évaluation des contrastes intergroupes, l’ensemble des postulats d’application du modèle linéaire général a été rigoureusement ausculté. L’examen du diagramme quantile-quantile (Q-Q plot) ainsi que l’exécution du test de Shapiro-Wilk appliqué aux résidus standardisés du modèle confirment la conformité globale de la distribution d’erreur au modèle gaussien, W = 0,984, p = 0,342, les indices d’asymétrie (0,21, SE = 0,18) et d’aplatissement (-0,34, SE = 0,36) demeurant bien en deçà des seuils critiques recommandés par Kline. Toutefois, le test d’homogénéité des variances de Brown-Forsythe — calculé sur les déviations médianes absolues — a révélé une hétérogénéité significative des dispersions à travers les trois conditions expérimentales, F(2, 87) = 5,42, p = 0,006. Le ratio des variances empiriques (F-max = 3,85) associé au déséquilibre structurel des cellules du plan factoriel interdisant le recours au modèle linéaire conventionnel, une ANOVA robuste de Welch a été appliquée par défaut. Les résultats indiquent une différence statistiquement significative entre les moyennes des groupes, Welch’s F(2, 48,63) = 8,76, p < 0,001, avec une taille d’effet substantielle estimée par l’oméga carré partagé robuste (omega² = 0,14). Les comparaisons a posteriori conduites à l’aide de la procédure de Games-Howell ont démontré que les participants soumis à l’intervention métacognitive manifestent des scores de flexibilité cognitive significativement plus élevés que ceux du groupe contrôle (Différence de moyennes = 4,23, IC à 95 % [1,45 ; 7,01], p = 0,002). »
12.3 Check-list finale de rigueur diagnostique pour le psychologue quantitatif
Avant de sceller définitivement les analyses statistiques d’un projet empirique et d’initier la diffusion de ses résultats, tout psychologue quantitativiste soucieux d’intégrité scientifique gagne à confronter sa démarche à cette check-list récapitulative :
- Validité du plan et indépendance : L’assignation aléatoire a-t-elle été scrupuleusement respectée ? Existe-t-il des regroupements institutionnels ou des facteurs de corrélation temporelle non contrôlés exigeant une modélisation multi-niveaux ?
- Nature des métriques : La variable dépendante s’inscrit-elle sur une échelle d’intervalle continue valide sur le plan psychométrique, exempte d’effets de plancher ou de plafond artificiels ?
- Extraction des résidus : Les diagnostics distributionnels ont-ils bien été exécutés sur les erreurs résiduelles conditionnelles du modèle unifié, et non sur la distribution brute globale ?
- Inspection visuelle instrumentée : Les diagrammes Q-Q plots enrichis d’enveloppes de confiance confirment-ils l’alignement satisfaisant des quantiles sans torsions pathologiques en S ?
- Traque des observations aberrantes : Les scores atypiques (scores z > 3,29, distance de Cook) ont-ils été analysés qualitativement, et une analyse de sensibilité a-t-elle attesté de la stabilité du modèle en leur présence ?
- Examen de la dispersion : Le test de Brown-Forsythe centré sur la médiane a-t-il été privilégié face à des données asymétriques pour évaluer l’homoscédasticité ?
- Adéquation du plan factoriel : En présence d’un plan d’échantillonnage déséquilibré associé à une hétérogénéité de variance, l’ANOVA de Welch a-t-elle systématiquement supplanté le ratio F de Fisher ?
- Sélection des procédures a posteriori : Les tests post-hoc ont-ils été ajustés en cohérence avec l’état de l’homoscédasticité (Games-Howell plutôt que Tukey HSD sous variances inégales) ?
- Transparence méthodologique (Science Ouverte) : Le script complet d’analyse — documentant explicitement les phases diagnostiques, les rééchantillonnages et les modèles alternatifs — est-il documenté et prêt à être archivé sur un répertoire de recherche public (OSF) afin de garantir la reproductibilité intégrale de l’étude ?
En ancrant ces principes et ces protocoles au cœur de vos pratiques de recherche, vous transformez l’exercice du diagnostic des postulats — jadis perçu comme une contrainte bureaucratique aride — en un formidable vecteur d’intégrité scientifique, d’élégance analytique et de puissance théorique pour l’avancement de la psychologie contemporaine.
Références
- Box, G. E. P. (1953). Non-normality and tests on variances. Biometrika, 40(3/4), 318–335. https://doi.org/10.2307/2333350
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch’s F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), 1–12. https://doi.org/10.5334/irsp.198
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Glass, G. V., Peckham, P. D., & Sanders, J. R. (1972). Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance. Review of Educational Research, 42(3), 237–288. https://doi.org/10.3102/00346543042003237
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
- Scariano, S. M., & Davenport, J. M. (1987). The effects of violations of independence assumptions in the one-way ANOVA. The American Statistician, 41(2), 123–129. https://doi.org/10.2307/2684223
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.