
L’analyse contemporaine des données au sein des environnements d’entreprises et des laboratoires de recherche exige une rigueur méthodologique croissante face à des volumes d’information toujours plus denses. Dans cet écosystème numérique, le tableur en nuage Google Sheets s’est imposé non pas simplement comme une interface d’enregistrement tabulaire rudimentaire, mais comme un moteur computationnel polyvalent, accessible et hautement collaboratif. La capacité à modéliser des flux décisionnels complexes directement au niveau de la cellule constitue le socle de toute architecture de données robuste, permettant de convertir des mesures brutes en indicateurs synthétiques immédiatement exploitables pour la gouvernance stratégique ou la validation empirique.
Au cœur de cette mécanique algorithmique se trouve l’évaluation conditionnelle, dont la fonction SI représente l’opérateur élémentaire fondamental. Cependant, la réalité empirique se plie rarement à une logique binaire simpliste où une cause unique produirait une alternative exclusive. Les phénomènes économiques, comportementaux ou opérationnels s’expriment à travers des continuums, des échelles multidimensionnelles et des régimes d’exception successifs qui imposent l’imbrication de multiples instructions conditionnelles. La maîtrise de ces architectures branchées, qu’il s’agisse de cascades de fonctions traditionnelles ou de constructions sémantiques plus modernes, est un prérequis indispensable pour tout analyste désireux de bâtir des modèles déterministes fiables, audités et pérennes.
Le présent traité propose une exploration exhaustive de l’ingénierie des conditions multiples au sein de Google Sheets. En parcourant les fondements théoriques de l’algèbre de Boole jusqu’aux techniques avancées de vectorisation matricielle, cet ouvrage détaille pas à pas les mécanismes d’évaluation interne, les protocoles d’arbitrage de performance, la gestion rigoureuse des valeurs limites et les méthodologies de maintenance collaborative. Grâce à une approche alliant rigueur formelle et cas d’application concrets, ce document a pour vocation d’établir un référentiel technique définitif pour la conception d’arbres décisionnels élégants, efficients et exempts d’incohérences logiques.
1. Introduction théorique à la logique conditionnelle dans Google Sheets
1.1 Fondements de l’algèbre booléenne appliquée aux feuilles de calcul
L’infrastructure décisionnelle de tout logiciel de traitement de données repose invariablement sur les axiomes formalisés par le mathématicien britannique George Boole au milieu du XIXe siècle. Au sein de l’environnement Google Sheets, l’algèbre booléenne se manifeste par l’intermédiaire d’un type de données primitif restreint à une dichotomie absolue : les valeurs logiques VRAI (représentant la véracité, codée numériquement par le scalaire 1 dans la plupart des contextes arithmétiques sous-jacents) et FAUX (représentant la fausseté, assimilée au scalaire 0). Toute formule conditionnelle, quelle que soit sa complexité apparente, converge inexorablement vers la réduction d’une assertion à l’un de ces deux états fondamentaux.
La formalisation des règles décisionnelles empiriques exige de traduire des propositions linguistiques parfois ambiguës en relations d’ordre strictes. Dans un contexte de modélisation industrielle, une consigne managériale stipulant qu’un délai de livraison est jugé acceptable si le transporteur met moins de trois jours ouvrés se traduira formellement par une proposition comparative reliant l’identifiant d’une cellule à une borne numérique. L’évaluation de cette proposition par le moteur de calcul n’est point une simple vérification passive ; il s’agit d’une opération déterministe qui conditionne l’exécution des branches d’instructions ultérieures.
L’évaluation séquentielle joue ici un rôle prépondérant. Dans une feuille de calcul, les expressions logiques sont interprétées de gauche à droite selon des règles de précédence rigoureuses. Dès lors qu’une proposition élémentaire est soumise au processeur, celui-ci résout d’abord les opérations arithmétiques internes, applique ensuite les opérateurs relationnels de comparaison, pour enfin délivrer la valeur booléenne résultante. Cette mécanique en cascade implique qu’aucune déviation probabiliste n’est admise : à données d’entrée identiques et stables, le résultat booléen demeure invariant, garantissant ainsi l’idempotence et la reproductibilité des analyses quantitatives.
1.2 Pertinence de la segmentation conditionnelle en recherche et analyse quantitative
Dans le domaine de l’analyse quantitative appliquée aux sciences sociales, cliniques ou managériales, la segmentation conditionnelle constitue la pierre angulaire de l’opérationnalisation des concepts théoriques. L’un des usages les plus critiques réside dans la catégorisation systématique de variables continues en échelles ordinales discrètes. À titre d’exemple, lors de l’administration d’inventaires psychométriques ou de questionnaires d’évaluation de la charge cognitive, les scores bruts continus doivent être discrétisés selon des classes de sévérité rigoureusement calibrées afin de permettre des diagnostics différentiels précis et standardisés.
Par ailleurs, l’automatisation du filtrage logique au sein d’échantillons volumineux minimise radicalement la variance d’erreur introduite par le facteur humain. Lorsque des milliers d’observations doivent être classifiées selon des critères combinatoires stricts, l’intervention manuelle d’un opérateur de saisie engendre inévitablement des dérives d’imputation, des biais de fatigue et des asymétries de jugement. En intégrant des règles décisionnelles formelles au sein de la feuille de calcul, l’analyste sanctuarise le protocole expérimental : chaque observation subit exactement le même traitement logique, éliminant de facto les discordances inter-juges.
Cette approche systématique optimise également l’hygiène globale de la base de données. En créant des colonnes de contrôle fondées sur des expressions logiques avancées, il devient aisé d’isoler instantanément les observations aberrantes, les contradictions logiques internes (telles qu’un âge négatif associé à une réponse positive) ou les données manquantes non déclarées. La structure conditionnelle n’agit plus uniquement comme un simple filtre d’affichage, mais s’érige en véritable pare-feu méthodologique garantissant la validité interne des inférences statistiques ultérieures.
1.3 Évolution structurelle des outils conditionnels dans Google Sheets
L’histoire computationnelle des tableurs électroniques témoigne d’une quête permanente d’équilibre entre expressivité sémantique et compacité syntaxique. Aux origines des premières versions de Google Sheets, calquées sur les standards hérités de logiciels historiques tels que Lotus 1-2-3 ou Microsoft Excel, l’instruction unitaire SI constituait l’unique passerelle pour bifurquer logiquement au sein d’un calcul. Pour gérer plusieurs conditions mutuellement exclusives, l’utilisateur n’avait d’autre choix que d’élaborer de fastidieuses structures imbriquées, souvent comparées à des poupées russes, dont l’illisibilité croissait de manière exponentielle avec le nombre d’intervalles à discriminer.
Face à la complexification croissante des modèles de données et aux réclamations de la communauté d’ingénierie, Google a procédé à une modernisation substantielle de son répertoire fonctionnel natif. L’introduction de fonctions spécialisées de nouvelle génération, au premier rang desquelles trônent SI.CONDITIONS (connue internationalement sous l’appellation IFS) et SWITCH, a marqué une rupture paradigmatique. Ces instructions contemporaines permettent de substituer des listes plates d’arguments par paires à l’arborescence pyramidale des parenthèses superposées, conférant ainsi au code de la formule une clarté comparable à celle d’un énoncé algorithmique moderne.
Néanmoins, la coexistence de ces différentes syntaxes impose une réflexion approfondie sur la compatibilité ascendante et la portabilité des modèles. Alors que les versions récentes des tableurs majeurs prennent en charge ces nouvelles fonctions, certains environnements patrimoniaux ou des moteurs d’exportation automatisés requièrent encore la structure classique des instructions SI imbriquées. L’analyste accompli doit dès lors faire preuve d’une double compétence : maîtriser les constructions ancestrales pour en assurer le débogage et l’interopérabilité sans faille, tout en exploitant judicieusement les paradigmes modernes pour optimiser la maintenabilité de ses architectures analytiques pérennes.
2. Anatomie et syntaxe fondamentale de l’instruction SI simple
2.1 Décomposition structurelle des arguments de base
Pour appréhender sereinement les architectures complexes, il est indispensable de disséquer la morphologie canonique de l’instruction SI unitaire. Au sein de la spécification francophone de Google Sheets, la fonction adopte la signature syntaxique standard : =SI(expression_logique; valeur_si_vrai; [valeur_si_faux]). Cette structure ternaire matérialise l’archétype universel du branchement conditionnel tel qu’on le retrouve dans les langages procéduraux de haut niveau, articulé autour d’un prédicat et de deux suites décisionnelles exclusives.
Le premier argument, désigné sous le terme d’expression_logique, constitue le cœur décisionnel de la fonction. Il s’agit obligatoirement d’une assertion qui, après évaluation par l’interpréteur de la feuille, renvoie un booléen strict, c’est-à-dire VRAI ou FAUX. Si une valeur purement numérique y est insérée, le tableur appliquera une conversion implicite héritée du langage C, où le zéro équivaut à un état faux et tout nombre différent de zéro est promu à l’état vrai. Le second paramètre, valeur_si_vrai, représente la sortie primaire qui sera instanciée et renvoyée dans la cellule si, et seulement si, l’expression logique est résolue à l’état VRAI.
Enfin, le troisième argument, valeur_si_faux, encapsule l’alternative d’échappement exécutée lorsque la condition évaluée s’avère non vérifiée. Cet argument, bien qu’optionnel dans la grammaire formelle du logiciel, s’avère dans la pratique analytique absolument déterminant. La relation d’exclusion entre ces deux sorties est absolue : jamais le moteur de calcul n’exécutera simultanément les arguments vrai et faux pour une même itération de cellule, ce qui protège le classeur de boucles d’évaluation concurrentes et préserve l’intégrité séquentielle du calcul.
2.2 Typologie des opérateurs de comparaison applicables
La formulation de l’expression logique requiert l’usage rigoureux d’opérateurs relationnels normalisés qui établissent un pont analytique entre deux grandeurs scalaires ou deux références de cellules. Google Sheets dispose d’une nomenclature universelle d’opérateurs de comparaison, dont la manipulation scrupuleuse conditionne la validité des tests logiques. Les opérateurs stricts comprennent l’infériorité stricte (<) et la supériorité stricte (>), lesquels excluent expressément la valeur pivot choisie comme seuil de référence dans l’évaluation.
Pour intégrer les valeurs frontières, l’analyste fait appel aux opérateurs d’inégalité large : inférieur ou égal (<=) et supérieur ou égal (>=). L’égalité mathématique s’exprime quant à elle par le signe unaire (=), tandis que la non-équivalence ou différence s’articule par la juxtaposition des deux chevrons opposés (<>). Une confusion classique consiste à juxtaposer ces symboles dans le mauvais ordre syntaxique, ce qui provoque immédiatement une erreur d’analyse lexicale signalée par le tableur sous le code d’anomalie typographique standard.
La gestion sous-jacente des formats de données constitue un piège redoutable lors de la manipulation de ces opérateurs. Si la comparaison numérique obéit aux règles universelles de l’arithmétique, la comparaison textuelle se conforme à un ordre lexicographique fondé sur la table des caractères Unicode. De plus, les dates étant converties en interne sous la forme de nombres sériels débutant au 30 décembre 1899, toute comparaison temporelle doit impérativement respecter cette granularité numérique continue sous peine de produire des aberrations d’arbitrage logique majeures lors de confrontations mixtes texte-date.
2.3 Flux d’exécution et renvoi des valeurs par défaut
L’omission intentionnelle ou accidentelle du troisième argument au sein de l’instruction SI engendre des comportements par défaut qu’il convient de cartographier avec la plus grande lucidité. Si un analyste omet de déclarer la valeur_si_faux, par exemple en rédigeant la syntaxe tronquée =SI(A1>100; "Objectif Atteint"), et que le contenu de la cellule A1 est strictement inférieur ou égal à 100, Google Sheets renverra d’autorité le booléen FAUX dans la cellule réceptrice. Ce renvoi implicite peut contaminer les chaînes de calcul dépendantes qui s’attendaient à recevoir une chaîne textuelle vide ou une valeur numérique neutre.
Le comportement du moteur de calcul face à des cellules sources non renseignées mérite une attention toute particulière. Dans la plupart des contextes comparatifs numériques simples, une cellule vide est implicitement assimilée à la valeur scalaire zéro. Dès lors, l’évaluation =SI(B1>=0; "Positif"; "Négatif") renverra inévitablement la chaîne « Positif » si la cellule B1 est entièrement vide, introduisant un biais statistique insidieux en agrégeant des absences réelles de données avec de véritables valeurs nulles mesurées sur le terrain.
Concernant le type de retour supporté par la fonction, la plasticité de Google Sheets autorise une grande liberté architecturale. Les sorties conditionnelles peuvent renvoyer des chaînes de caractères scalaires délimitées par des guillemets droits stricts, des valeurs numériques directes prêtes pour de futures opérations matricielles, ou des références directes à d’autres plages de cellules (ex. SI(A1=1; C1; D1)). Cette flexibilité offre la possibilité de dérouter dynamiquement les flux de consultation vers des répertoires entiers en fonction de critères logiques préalablement vérifiés.
3. Principes et mécanique des instructions SI imbriquées
3.1 Concept d’imbrication séquentielle en cascade
Dès lors qu’une situation analytique implique plus de deux états de sortie mutuellement exclusifs, l’instruction unitaire se révèle formellement insuffisante. Le paradigme de l’imbrication séquentielle en cascade repose sur un principe architectural simple mais puissant : substituer systématiquement l’argument valeur_si_faux de l’instruction mère par une sous-instruction SI fille totalement autonome. Ce déploiement récursif peut théoriquement se répéter jusqu’aux limites structurelles du processeur de calcul, formant ainsi un arbre décisionnel complet au sein d’une unique cellule.
Ce mécanisme opère rigoureusement à la manière d’un entonnoir décisionnel descendant. Le moteur de calcul interroge le premier prédicat logique ; si celui-ci s’avère vérifié, la branche d’évaluation s’interrompt sur-le-champ, la valeur correspondante est instanciée et l’ensemble de la formule résiduelle est purement et simplement ignoré. En informatique théorique, ce processus porte le nom d’évaluation en court-circuit (short-circuit evaluation). Ce n’est que dans l’éventualité où le premier test renvoie la valeur FAUX que le processeur consent à franchir le premier séparateur argumentaire pour engager l’évaluation de la seconde condition imbriquée.
Cette dynamique d’élimination séquentielle confère une élégance mathématique certaine à la formule, mais elle impose une vigilance architecturale sans faille. Chaque palier successif hérite implicitement de la négation de toutes les conditions qui l’ont précédé dans l’arbre d’exécution. Dès lors, il devient superflu de réaffirmer des contraintes déjà éliminées en amont, ce qui allège la complexité syntaxique globale tout en exigeant une compréhension aiguë du cheminement déterministe suivi par l’algorithme d’interprétation.
3.2 Rôle critique de la hiérarchie et de l’ordre d’évaluation
L’écueil méthodologique le plus dévastateur lors de l’élaboration de structures imbriquées réside dans la transgression des règles d’ordonnancement strict. Pour qu’une cascade de tests portant sur une même variable continue fonctionne sans distorsion, les seuils de démarcation doivent obligatoirement être agencés selon une séquence strictement monotone : soit dans un ordre strictement décroissant, soit dans un ordre strictement croissant. Toute oscillation ou rupture d’ordre logique au sein de la chaîne conduit inéluctablement à l’apparition de zones mortes dans l’arbre de décision.
Pour illustrer ce phénomène de biais induit par chevauchement d’intervalles non maîtrisé, considérons un barème où l’on souhaiterait attribuer le libellé « Majeur » au-delà de 50 points et « Exceptionnel » au-delà de 80 points. Si l’analyste écrit maladroitement la structure =SI(A1>50; "Majeur"; SI(A1>80; "Exceptionnel"; "Standard")), la seconde condition devient mathématiquement inaccessible. En effet, toute valeur supérieure à 80 étant par définition également supérieure à 50, le premier test sera immédiatement validé pour un score de 90, renvoyant l’étiquette « Majeur » et empêchant le processeur d’atteindre le palier supérieur « Exceptionnel ».
La rectification de cette incohérence structurelle exige une inversion stricte de la hiérarchie évaluative : il convient de tester d’abord la borne la plus sélective, à savoir A1>80, puis, dans la branche d’échappement, la borne intermédiaire A1>50. De manière analogue, si l’évaluation s’opère via des opérateurs d’infériorité (<), le balayage logique doit impérativement débuter par la valeur pivot la plus basse pour s’élever progressivement vers les limites supérieures. La rigueur de cette séquenciation garantit l’isomorphisme parfait entre l’intention d’analyse et la trajectoire de calcul.
3.3 Gestion des parenthèses et architecture syntaxique
Sur le plan purement formel, l’élaboration d’instructions SI profondément imbriquées expose l’analyste à un défi d’assemblage typographique récurrent : la gestion de la parité et de l’appariement des parenthèses délimitatrices. Chaque fonction conditionnelle ouverte par une parenthèse ouvrante doit trouver sa contrepartie exacte sous la forme d’une parenthèse fermante positionnée à l’extrémité droite de l’expression. Dans une formule comportant cinq niveaux d’imbrication séquentielle, l’accumulation finale de cinq parenthèses fermantes successives (...)))))) représente une zone d’extrême vulnérabilité syntaxique.
Pour juguler cette complexité visuelle et prévenir les erreurs d’inattention, il est hautement recommandé d’adopter des techniques d’indentation directement au sein de la barre de formule de Google Sheets. En utilisant la combinaison de touches Ctrl + Entrée (ou Cmd + Entrée sous macOS), l’analyste peut insérer des retours à la ligne physiques entre chaque sous-branche décisionnelle. En combinant ces sauts de ligne avec des espacements méthodiques, la formule prend l’apparence d’un script informatique indenté, rendant immédiatement perceptible la portée respective de chaque bloc logique et la fermeture correspondante de ses délimiteurs.
En outre, l’interface graphique moderne de Google Sheets propose une aide visuelle dynamique via la mise en surbrillance colorée des paires de parenthèses conjuguées. Lorsqu’un curseur se positionne sur une parenthèse fermante, la parenthèse ouvrante associée s’illumine brièvement d’une nuance chromatique identique. L’analyste rigoureux s’appuie systématiquement sur ce guidage colorimétrique pour s’assurer que le dernier délimiteur inséré clôture bel et bien l’instruction SI souche située à la racine de la formule, évitant ainsi les erreurs de type #ERROR! ou #FORMULA! lors de la validation.
4. Cas pratique d’ingénierie : Catégorisation de scores et d’échelles de performance
4.1 Modélisation d’une grille d’évaluation à paliers multiples
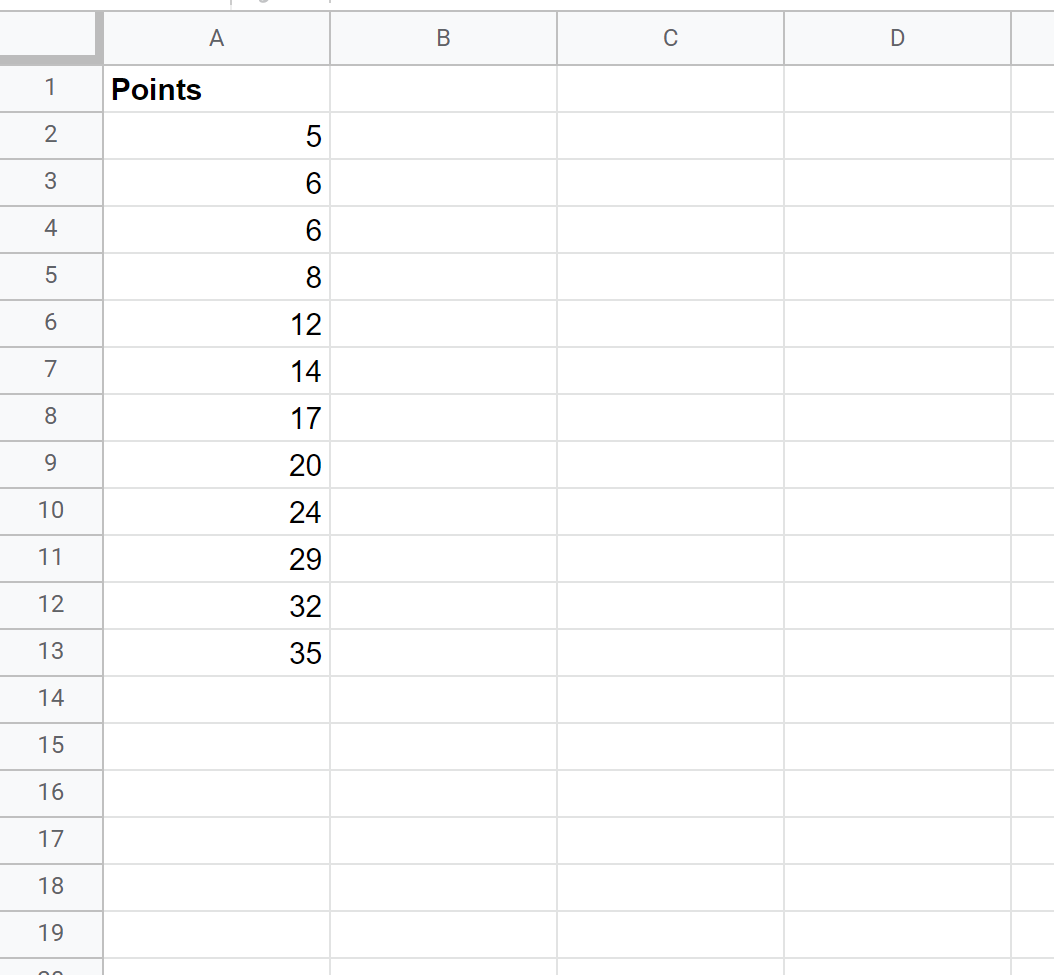
Afin de matérialiser ces concepts dans un scénario opérationnel réaliste, concevons un protocole d’évaluation de la performance académique ou athlétique standardisé. Imaginons un jeu de données quantitatives issu d’une cohorte d’individus ayant subi une batterie d’épreuves physiques normées. Chaque individu s’est vu attribuer un score de performance brut continu, enregistré dans la colonne A d’une feuille de travail, dont les valeurs s’étendent de 0 à 40 points. L’objectif analytique consiste à automatiser l’assignation d’un groupe qualitatif selon des seuils normatifs prédéterminés par un collège d’experts.
Le cahier des charges décisionnel s’articule autour de quatre strates de performance rigoureusement étanches :
- Un score strictement inférieur à 10 points est qualifié de « Mauvais » ;
- Un score compris entre 10 points inclus et 20 points exclus relève de la mention « Moyen » ;
- Un score compris entre 20 points inclus et 30 points exclus accède au palier « Bon » ;
- Tout résultat égal ou supérieur à 30 points atteint le niveau sommital « Excellent ».
Cette grille constitue une partition mathématique parfaite de l’ensemble des réels positifs : il n’existe aucune discontinuité entre les intervalles, et aucun score théorique ne peut simultanément appartenir à deux sous-ensembles distincts.
La conversion de cette grille en un modèle calculatoire requiert de transcrire ces intervalles continus sous la forme d’une succession de filtres logiques progressifs. En optant pour un balayage ascendant, nous nous appuierons sur l’élimination successive des valeurs par la borne inférieure, exploitant ainsi pleinement la dynamique d’entonnoir séquentiel détaillée précédemment sans avoir à alourdir la syntaxe par la vérification redondante des bornes déjà validées aux stades antérieurs.
4.2 Mise en œuvre pas à pas de la formule imbriquée
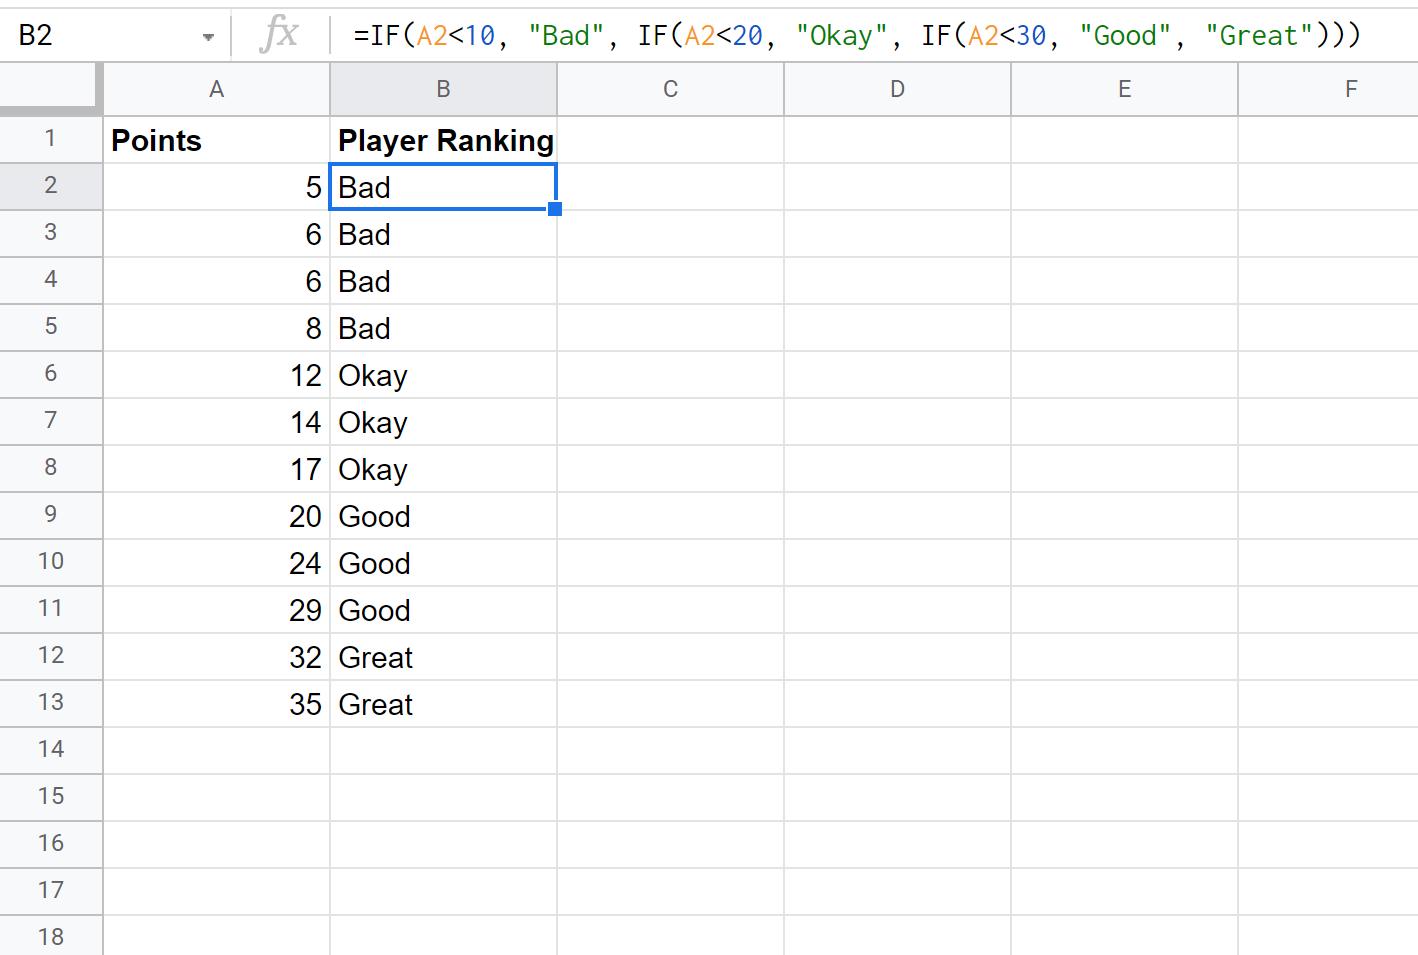
L’implémentation débute au niveau de la cellule B2, destinée à recevoir le diagnostic qualitatif de l’enregistrement situé en A2. La première étape consiste à filtrer la frange la plus défavorable de la distribution en formulant le test =SI(A2<10; "Mauvais"; ...). Si la valeur en A2 est égale à 7,5, le tableur valide l’assertion et renvoie sans délai la chaîne correspondante. En revanche, si la valeur excède ou égale 10, le flux d’exécution bascule vers l’argument faux, dans lequel nous instancions le second niveau d’évaluation.
Au deuxième palier, nous savons d’emblée que A2 >= 10 est garanti par l’échec du premier test. Par conséquent, il suffit de poser la condition SI(A2<20; "Moyen"; ...) pour capturer précisément l’intervalle semi-ouvert [10, 20[. Le raisonnement s’applique de manière symétrique pour le troisième palier : l’insertion de SI(A2<30; "Bon"; "Excellent") achève la construction en assignant directement la mention « Excellent » à toute valeur survivant à l’ensemble des tests précédents, sans qu’il soit requis de réécrire formellement un test A2>=30.
La formule synthétique définitive s’énonce ainsi : =SI(A2<10; "Mauvais"; SI(A2<20; "Moyen"; SI(A2<30; "Bon"; "Excellent"))). Une fois cette instruction saisie et éprouvée dans la cellule pilote B2, son déploiement vertical sur l’ensemble de la cohorte s’effectue au moyen de la poignée de recopie ou par double-clic sur le coin inférieur droit de la sélection. L’adressage relatif utilisé pour la référence A2 garantit la translation automatique de l’indice de ligne lors de la propagation matricielle, assurant un calcul individualisé pour chaque sujet de l’étude.
4.3 Contrôle d’intégrité empirique des résultats obtenus
Aucun modèle décisionnel ne doit être déployé sans un protocole d’audit expérimental strict destiné à tester la robustesse des sorties aux frontières de chaque domaine de validité. Ce contrôle débute par la vérification minutieuse des valeurs pivots, couramment désignées sous le vocable d’effets de bord. Dans notre cas de figure, les valeurs critiques à injecter manuellement au banc d’essai sont exactement 10, 20 et 30. Si la formule a été convenablement programmée avec l’opérateur strict <, la valeur 10 doit impérativement basculer en « Moyen » et non en « Mauvais », validant ainsi le respect scrupuleux du cahier des charges.
L’étape suivante consiste à examiner la cohérence de la distribution statistique des classes générées. En agrégeant temporairement la colonne des résultats par le truchement d’une fonction de comptage conditionnel telle que NB.SI, l’analyste peut tracer un histogramme de fréquence des mentions attribuées. Une distorsion flagrante dans la répartition des effectifs (par exemple, une absence anormale de sujets dans la catégorie « Bon » alors que la distribution d’origine des scores bruts suit une loi normale) constitue un indice infaillible d’une rupture de monotonicité ou d’une faute de frappe dans les seuils paramétrés.
Enfin, le modèle doit être éprouvé face à des entrées atypiques, erratiques ou aberrantes. Que se produit-il si un utilisateur renseigne un score négatif tel que -5 en raison d’une erreur d’acquisition d’un capteur ? La formule actuelle renverra la mention « Mauvais », ce qui peut paraître logiquement cohérent avec la borne <10, mais méthodologiquement inexact si l’échelle physique n’admet que des valeurs positives. L’analyste rigoureux identifiera alors la nécessité d’intercaler une condition garde-fou préalable afin de sanctuariser l’intégrité globale du flux analytique.
5. La fonction SI.CONDITIONS : Une alternative moderne et lisible
5.1 Structure syntaxique et arguments par paires
Face à la densité visuelle et à la complexité de maintenance inhérentes aux formules comportant de multiples niveaux d’instructions imbriquées, l’équipe d’ingénierie de Google a introduit une solution algorithmique d’une remarquable limpidité : la fonction SI.CONDITIONS. Disponible dans les versions récentes du tableur, cette instruction substitue l’arborescence pyramidale par une liste d’arguments séquentiels organisés strictement par paires associatives condition-résultat. Sa signature générale se formalise comme suit : =SI.CONDITIONS(condition1; valeur1; [condition2; valeur2]; ...).
Le fonctionnement interne de cette fonction repose sur une mécanique linéaire extrêmement intuitive. Le moteur de calcul examine tour à tour chaque prédicat logique impair (condition1, condition2, condition3, etc.). Dès que l’un de ces prédicats est évalué à l’état VRAI, la fonction renvoie instantanément la valeur paire qui lui est immédiatement associée (valeur1, valeur2, etc.) et stoppe net toute investigation ultérieure. Cette logique aplanie supprime définitivement l’empilement rébarbatif des parenthèses fermantes multiples en fin d’instruction.
Cette standardisation de la syntaxe procure un gain substantiel de lisibilité pour les équipes de collaborateurs pluridisciplinaires chargées d’auditer les classeurs d’analyse. Un auditeur n’a plus à scruter minutieusement l’alignement des sous-blocs conditionnels pour comprendre à quel niveau d’imbrication appartient telle ou telle clause d’échappement. Chaque règle métier s’affiche de manière explicite sous la forme d’un couple intelligible, rapprochant la rédaction sous Google Sheets des structures modernes d’évaluation de type match ou cond présentes dans les langages de programmation contemporains.
5.2 Conversion d’un SI imbriqué vers la fonction SI.CONDITIONS
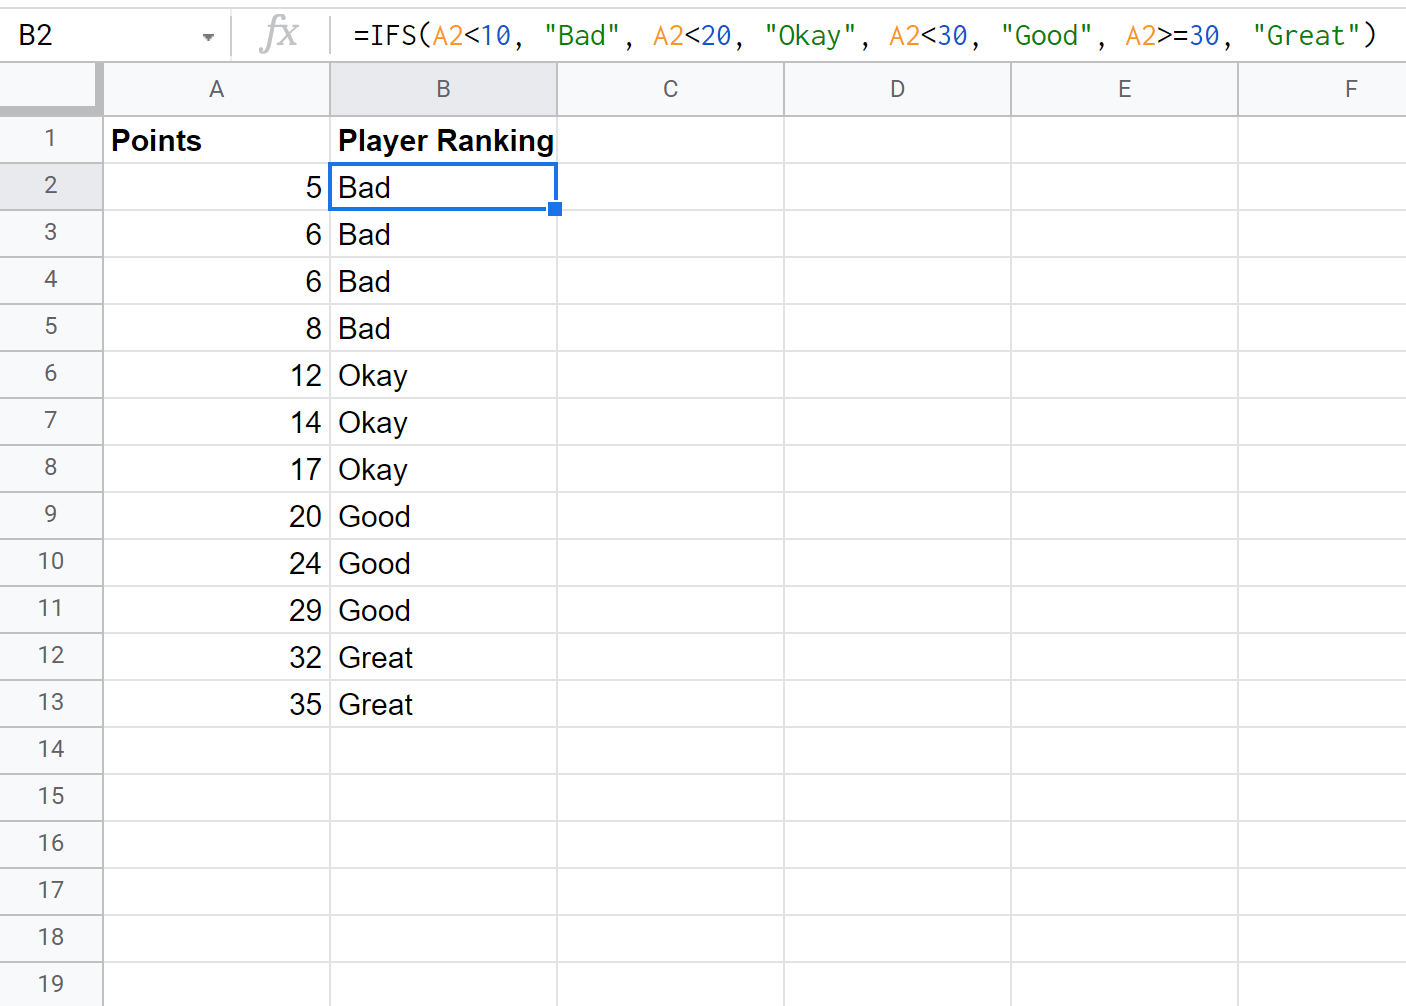
Pour apprécier la supériorité ergonomique de cette fonction, reprenons le cas concret de l’échelle de performance modélisée au chapitre précédent et procédons à sa transposition méthodique. Dans la structure classique, la condition d’échappement finale était implicitement prise en charge par le dernier argument faux de la dernière fonction imbriquée. Avec la fonction SI.CONDITIONS, l’approche se veut plus modulaire : nous allons déclarer chaque intervalle de manière autonome et ordonnée au sein d’une seule séquence plate.
L’implémentation de la transposition s’écrit de la manière suivante : =SI.CONDITIONS(A2<10; "Mauvais"; A2<20; "Moyen"; A2<30; "Bon"; VRAI; "Excellent"). Dans cette construction, les trois premières paires condition-résultat reproduisent fidèlement notre progression ascendante. L’élément hautement stratégique de cette syntaxe réside dans la dernière paire : l’assertion logique est délibérément fixée à la constante booléenne VRAI. Ce stratagème syntaxique permet d’émuler à la perfection la clause résiduelle universelle « SINON » (ou ELSE).
Si aucun des trois premiers prédicats n’a été vérifié (ce qui implique mathématiquement que la cellule A2 contient une valeur supérieure ou égale à 30), le processeur parvient à la quatrième condition. Celle-ci étant invariablement résolue à VRAI par définition, le résultat « Excellent » est immédiatement validé et délivré en sortie. Cette méthode de clôture constitue la bonne pratique canonique pour prémunir une formule SI.CONDITIONS contre tout risque de rupture de traitement lors de la confrontation avec des valeurs hors normes.
5.3 Limites inhérentes et gestion des cas d’échec d’évaluation
Bien que la fonction SI.CONDITIONS améliore grandement la lisibilité, elle impose des contraintes de rigueur plus drastiques que son équivalent imbriqué traditionnel. La limitation la plus critique réside dans son comportement face à une absence totale de correspondance logique. Si toutes les conditions déclarées sont évaluées à l’état FAUX et qu’aucune clause universelle de type VRAI; valeur_par_défaut n’a été prévue pour clore la série d’arguments, Google Sheets interrompt le calcul et affiche l’erreur rédhibitoire #N/A (signifiant Aucune valeur disponible).
Cette exigence d’exhaustivité absolue signifie que l’analyste ne bénéficie d’aucun filet de sécurité par défaut. Dans un SI imbriqué classique, l’omission d’un palier se traduit simplement par le renvoi silencieux de la valeur faux déclarée ou de la constante logique FAUX. Avec SI.CONDITIONS, la moindre faille dans la couverture des intervalles mathématiques provoque une rupture d’exécution visible qui altère la présentation des tableaux de bord et bloque la propagation des fonctions d’agrégation situées en aval (telles que SOMME ou MOYENNE).
En termes de flexibilité architecturale pure, la structure classique imbriquée conserve néanmoins un avantage marginal dans certaines configurations asymétriques très spécifiques. Le modèle SI.CONDITIONS oblige à répéter explicitement la référence de la cellule testée à chaque nouvelle condition (par exemple A2<10; ...; A2<20; ...), ce qui peut allonger inutilement la saisie lors de tests complexes impliquant des calculs intermédiaires lourds au sein même du prédicat. L’analyste averti choisira donc entre clarté déclarative et concision algorithmique selon la morphologie précise des données à traiter.
6. Combinaison des opérateurs logiques conjonctifs et disjonctifs (ET, OU)
6.1 Intégration de la fonction ET pour des conditions cumulatives
La simple comparaison d’une variable à un seuil unitaire s’avère fréquemment insuffisante pour traduire les exigences de la recherche empirique moderne. Dans de multiples protocoles expérimentaux, la validation d’une hypothèse ou l’assignation d’un statut exige la réalisation simultanée de plusieurs critères indépendants. Pour formaliser cette logique conjonctive au sein de Google Sheets, l’analyste recourt à l’intégration de la fonction ET, dont la syntaxe s’articule comme suit : ET(condition1; [condition2]; ...).
Le comportement de cette fonction est régi par la stricte intersection logique : la fonction ne délivrera la valeur VRAI que si, et seulement si, l’intégralité des propositions passées en arguments s’avère rigoureusement vérifiée. Dès lors qu’un seul prédicat échoue (renvoyant FAUX), l’ensemble du bloc conjonctif s’effondre et prend instantanément la valeur FAUX. L’insertion d’une telle construction au sein du premier argument d’une instruction conditionnelle s’illustre par l’exemple : =SI(ET(A2>=10; A2<20); "Conforme"; "Non Conforme").
Cette approche apporte une clarté conceptuelle incontestable lors de la validation d’intervalles stricts au sein d’environnements où l’ordre des lignes n’est pas garanti ou lors de modélisations non séquentielles. En explicitant à la fois la borne inférieure et la borne supérieure au sein d’un même bloc ET, l’analyste s’affranchit de la dépendance à l’évaluation en entonnoir : le test devient intrinsèquement étanche et auto-suffisant, éliminant tout risque d’effet de bord induit par une inversion accidentelle des lignes du classeur.
6.2 Intégration de la fonction OU pour des conditions alternatives
À l’inverse de la conjonction stricte, de nombreuses problématiques décisionnelles reposent sur une logique d’inclusions alternatives ou de redondance de sécurité : il suffit qu’au moins un critère parmi un ensemble donné soit validé pour déclencher l’action conditionnelle. Cette dynamique disjonctive est opérée au sein de Google Sheets par la fonction OU, dont la signature syntaxique est identique à celle de son homologue conjonctif : OU(condition1; [condition2]; ...).
D’un point de vue de l’algèbre booléenne, la fonction OU matérialise une union non exclusive. Elle délivre la valeur VRAI dès qu’au moins un de ses arguments internes est validé, indépendamment de l’état de véracité des autres prédicats. Elle ne retourne la valeur FAUX que dans le cas unique où l’intégralité absolue des propositions évaluées s’avère fausse. Cette fonction est typiquement mobilisée pour regrouper sous un label d’action commun des catégories d’événements disparates mais logiquement équivalents pour le gestionnaire.
Considérons l’évaluation d’un statut d’éligibilité pour un financement de recherche : un candidat peut être retenu soit si son score d’excellence dépasse 95 points, soit si son indice de publication internationale est supérieur à 10, soit encore s’il bénéficie d’une dérogation ministérielle matérialisée par un code d’exception en colonne C. L’encapsulation de ces alternatives au sein d’une instruction conditionnelle s’effectue avec une remarquable économie de moyens : =SI(OU(A2>95; B2>10; C2="DÉROGATION"); "Éligible"; "Ajourné"), simplifiant drastiquement ce qui aurait nécessité trois fonctions SI imbriquées redondantes.
6.3 Modélisation de structures composites hybrides (SI, ET, OU)
L’ingénierie avancée des feuilles de calcul culmine dans l’élaboration de structures composites hybrides, capables d’arbitrer des algorithmes décisionnels multidimensionnels extrêmement sophistiqués. Dans ces scénarios, des blocs conjonctifs et disjonctifs sont mutuellement imbriqués au sein d’instructions conditionnelles primaires et secondaires, créant un réseau logique capable de refléter des politiques d’entreprise hautement nuancées ou des critères d’inclusion épidémiologiques complexes.
Supposons qu’un protocole clinique impose d’administrer un traitement prioritaire à un patient si celui-ci a plus de 65 ans et présente un taux de glycémie supérieur à un seuil critique, ou bien si, quel que soit son âge, il manifeste à la fois une hypertension sévère et un antécédent cardiovasculaire identifié. La traduction formelle de ce prédicat au sein de Google Sheets s’agence par l’emboîtement harmonieux des opérateurs : =SI(OU(ET(Age>65; Glycemie>1,26); ET(Hypertension="OUI"; Antecedents="OUI")); "Prioritaire"; "Surveillance").
Toutefois, la manipulation de ces structures multidimensionnelles requiert d’infinies précautions méthodologiques pour éviter l’introduction de biais cognitifs lors de la conception ou de la relecture. L’analyste chevronné s’appuie sur les théorèmes de De Morgan pour simplifier et inverser méthodiquement les propositions négatives complexes, réduisant ainsi la charge mentale de débogage. De plus, il est crucial d’encadrer scrupuleusement chaque sous-groupe de conditions par des parenthèses dédiées afin d’empêcher toute ambiguïté sur la précédence des opérations logiques internes lors de l’évaluation par le processeur du tableur.
7. Gestion des valeurs manquantes, des erreurs et contrôle de validité
7.1 Traitement préventif des cellules vides et anomalies d’entrée
Dans tout flux de données réel, l’absence d’information représente un état récurrent qui ne saurait être confondu avec une valeur numérique nulle ou une chaîne de texte blanche. L’un des écueils majeurs lors de l’évaluation conditionnelle dans Google Sheets réside dans l’assimilation silencieuse d’une cellule vide au chiffre zéro lors des calculs d’inégalité. Si cette distorsion n’est pas neutralisée dès l’entame de la formule, des centaines de lignes non encore renseignées se verront attribuer des mentions d’évaluation erronées, faussant les tableaux de bord décisionnels.
Pour immuniser les calculs contre cette pollution méthodologique, la bonne pratique consiste à instaurer systématiquement un premier niveau d’échappement défensif chargé de détecter la vacuité des cellules cibles. À cet effet, l’analyste peut mobiliser la fonction spécialisée ESTVIDE(A2) ou recourir à la comparaison directe avec la chaîne vide normalisée : A2="". Dès lors que cette pré-condition s’avère vérifiée, la formule ordonne immédiatement le renvoi d’une cellule blanche ("") sans engager le moindre calcul substantiel sur les branches décisionnelles suivantes.
La structure type d’un modèle conditionnel hautement sécurisé adopte ainsi l’architecture préliminaire suivante : =SI(A2=""; ""; SI(A2<10; "Mauvais"; ...)). Cette précaution fondamentale garantit la parfaite propreté visuelle de la feuille de travail lors de l’application de la formule sur des plages de données prévisionnelles s’étendant vers le bas du classeur : les lignes en attente de collecte demeurent immaculées au lieu d’afficher prématurément des résultats aberrants générés sur la base d’une cellule vide travestie en valeur zéro.
7.2 Encapsulation défensive avec SI.ERREUR et SI.NON.DISP
L’exécution de formules conditionnelles avancées n’est pas à l’abri d’incidents computationnels inhérents à la nature même des opérations arithmétiques ou aux dysfonctionnements de liaisons externes. L’apparition intempestive de codes de rupture tels que #DIV/0! (tentative de division par zéro) ou #VALEUR! (incompatibilité de type d’argument) dégrade gravement la robustesse d’un tableau de bord et interrompt la chaîne de confiance des décideurs envers l’outil d’analyse.
Pour juguler ces désagréments techniques, Google Sheets offre une fonction d’encapsulation de haut niveau : SI.ERREUR. La syntaxe SI.ERREUR(formule; [valeur_si_erreur]) permet d’intercepter à la volée n’importe quelle interruption critique survenant au sein de l’expression encapsulée pour lui substituer un résultat de repli préalablement maîtrisé, tel qu’une valeur nulle, un message explicatif neutre ou une chaîne vide. De manière plus chirurgicale encore, la fonction SI.NON.DISP focalise son action protectrice exclusivement sur les codes d’erreur #N/A, généralement induits par l’absence d’une référence lors de croisements de données.
Cependant, l’encapsulation défensive doit être maniée avec un discernement méthodologique absolu. L’application indiscriminée et systématique de SI.ERREUR sur des formules complexes peut avoir pour effet pervers de masquer de véritables erreurs conceptuelles, des corruptions structurelles de la base ou des défaillances critiques de modélisation. L’analyste intègre doit impérativement réserver ces fonctions à la gestion prévisible des cas limites avérés, en veillant à ne point transformer un masque d’erreur cosmétique en un voile occultant des anomalies fonctionnelles profondes.
7.3 Validation des types de données pour prémunir les comparaisons
L’un des comportements les plus déroutants du moteur de calcul de Google Sheets découle de son système de typage dynamique laxiste, particulièrement lorsqu’il s’agit de distinguer des valeurs purement numériques de chaînes de caractères contenant des chiffres. Si un système d’information tiers exporte des relevés financiers ou statistiques en forçant un format texte sur les nombres (souvent identifiables à leur alignement spontané sur le bord gauche de la cellule), toute comparaison d’inégalité subséquente risque d’échouer de manière silencieuse et dramatique.
En effet, dans l’ordre de tri interne de Google Sheets, toute valeur de type texte est arbitrairement considérée comme strictement supérieure à n’importe quelle valeur numérique, quel que soit le chiffre représenté. Ainsi, l’assertion logique ="2" > 1000 sera résolue à l’état VRAI, car la chaîne textuelle « 2 » domine structurellement le scalaire numérique 1000 dans la hiérarchie des types de données. Il est aisé de mesurer les ravages qu’une telle distorsion peut provoquer au sein d’un barème décisionnel automatisé.
Pour assainir les flux d’entrée avant l’évaluation des conditions multiples, il est impératif d’intégrer des fonctions de typage préventives telles que ESTNUM(A2) pour vérifier formellement la nature numérique de l’argument, ou d’appliquer la fonction de coercition scalaire CNUM(A2) qui convertit formellement une chaîne textuelle chiffrée en véritable nombre exploitable. Par cette discipline d’ingénierie, l’analyste prémunit ses tests contre les ambiguïtés de formats induites par les importations hétérogènes de fichiers CSV ou les saisies d’opérateurs négligents.
8. Traitement conditionnel avancé de données textuelles et temporelles
8.1 Comparaisons de chaînes de caractères et sensibilité à la casse
L’application d’arbres décisionnels sur des variables qualitatives nominales nécessite une compréhension limpide des mécanismes de manipulation textuelle propres à Google Sheets. Par défaut, les opérateurs de comparaison universels tels que le signe d’égalité (=) ou l’inégalité (<>) s’exécutent de manière totalement insensible à la casse typographique. Ainsi, l’expression logique A2="PARIS" renverra immanquablement VRAI que la cellule contienne « Paris », « paris » ou « PARIS ». Dans la grande majorité des traitements de gestion, cette tolérance native constitue un atout précieux facilitant l’agrégation de libellés saisis de façon hétérogène.
Néanmoins, certains contextes de sécurité de données, de classification génétique ou de traitement d’identifiants de cryptographie exigent un contrôle rigoureux et binaire de la casse des caractères. Dans cette éventualité, l’opérateur standard d’égalité doit impérativement être abandonné au profit de la fonction spécialisée EXACT. L’instruction =SI(EXACT(A2; "Admin"); "Accès Autorisé"; "Refusé") s’avérera intraitable : la moindre variation typographique, telle que l’emploi d’une minuscule sur la lettre initiale, déclenchera immédiatement l’orientation vers la branche de rejet.
Au-delà de la correspondance exacte globale, la catégorisation conditionnelle exige fréquemment d’évaluer la présence d’une sous-chaîne spécifique enfouie au sein d’un texte plus dense, tel qu’un code d’inventaire ou une description d’incident clinique. L’analyste associe alors la fonction SI avec des fonctions de localisation textuelle comme CHERCHE (insensible à la casse) ou TROUVE (sensible à la casse). Encapsulées dans un prédicat de type ESTNUM(CHERCHE("URGENT"; A2)), ces constructions transforment la découverte d’un motif alphabétique en un signal booléen direct pour le branchement décisionnel.
8.2 Manipulation logique des dates et intervalles chronologiques
Les variables temporelles obéissent à des contraintes structurelles spécifiques qui méritent une formalisation conditionnelle adaptée. Comme souligné précédemment, Google Sheets matérialise l’écoulement du temps par l’incrémentation quotidienne d’un nombre sériel continu. Pour concevoir des alertes décisionnelles ou des cohortes de suivi temporel, l’analyste exploite fréquemment des fonctions calendaires dynamiques et volatiles, au premier rang desquelles trône AUJOURDHUI(), laquelle s’actualise à chaque réouverture du classeur ou modification de données.
La modélisation d’une gestion des créances clients ou du suivi d’échéances réglementaires s’articule couramment autour d’une soustraction arithmétique simple entre la date du jour et la date d’émission de la facture. L’intégration de cette métrique au sein d’une instruction conditionnelle imbriquée permet de ventiler automatiquement les dossiers en fonction de leur ancienneté : =SI(AUJOURDHUI()-A2>90; "Contentieux"; SI(AUJOURDHUI()-A2>30; "Relance"; "À jour")). Cette cascade dynamique assure un recalibrage automatique des priorités opérationnelles jour après jour.
Pour des calculs impliquant des décomptes plus granulaires (en mois révolus ou en années calendaires exactes), la fonction spécialisée DATEDIF constitue un auxiliaire analytique de choix. En combinant =SI(DATEDIF(DateNaissance; AUJOURDHUI(); "Y")>=18; "Majeur"; "Mineur"), le tableur délivre une segmentation démographique d’une fiabilité absolue, qui s’ajuste parfaitement aux règles juridiques sans subir les micro-distorsions induites par la variabilité de la durée des mois ou la récurrence des années bissextiles.
8.3 Utilisation des caractères génériques dans les contextes conditionnels
L’utilisation de caractères de substitution génériques, tels que l’astérisque (*, symbolisant une chaîne de longueur indéterminée) ou le point d’interrogation (?, représentant exactement un caractère individuel unique), est une technique extrêmement populaire au sein de certaines fonctions natives du tableur comme NB.SI ou RECHERCHEV. Cependant, une méprise largement répandue consiste à présumer que ces mêmes caractères génériques sont nativement pris en compte par les opérateurs d’égalité standards au sein de l’instruction SI.
Il est capital de souligner qu’une syntaxe telle que =SI(A2="FR*"; "France"; "Autre") ne produira jamais le résultat escompté : le moteur de calcul cherchera textuellement et littéralement la chaîne de deux lettres suivie du symbole typographique astérisque. Pour introduire un filtrage par motif au sein d’une condition logique, l’analyste moderne doit impérativement délaisser les opérateurs basiques et convoquer la puissance des expressions régulières via la fonction native REGEXMATCH.
En formulant le test conditionnel sous la forme =SI(REGEXMATCH(A2; "^FR"); "France"; "Autre"), le tableur déploie un moteur d’analyse lexicale conforme aux standards de l’ingénierie logicielle contemporaine. Cette approche permet de reconnaître avec une précision chirurgicale des formats complexes, tels que des structures de codes postaux, des adresses électroniques normalisées ou des identifiants d’échantillons de laboratoire répondant à des masques alphanumériques stricts, décuplant ainsi la portée fonctionnelle des instructions décisionnelles simples.
9. Optimisation des performances et réduction de la charge cognitive
9.1 Impact computationnel des arbres décisionnels profonds
Dans les classeurs d’entreprise ou les bases de recherche colossales regroupant des centaines de milliers de lignes, la performance du moteur de calcul devient une préoccupation centrale pour l’architecte de données. Chaque instruction conditionnelle imbriquée implique un coût algorithmique non négligeable lors de la recalculation en cascade du graphe de dépendance du document. Un modèle sous-optimal comportant des dizaines de niveaux de branches logiques démultipliés sur des dizaines de colonnes peut rapidement induire des latences insupportables pour les utilisateurs finaux.
L’optimisation des performances repose en premier lieu sur une stratégie probabiliste d’ordonnancement des tests logiques. En vertu du mécanisme d’évaluation en court-circuit évoqué au chapitre 3, le processeur s’arrête dès la première condition vérifiée. Par conséquent, il est hautement judicieux de concevoir l’arborescence décisionnelle de manière à tester en priorité absolue l’événement qui possède la probabilité d’occurrence statistique la plus élevée au sein de la population étudiée. En maximisant le nombre de résolutions précoces au premier palier, l’analyste décharge massivement le processeur de l’examen inutile des strates d’évaluation résiduelles.
Une autre règle d’or consiste à bannir l’usage répété de fonctions volatiles (telles que AUJOURDHUI(), MAINTENANT(), ou ALEA()) au cœur direct des prédicats logiques imbriqués. L’évaluation de telles fonctions force en effet le tableur à recalculer l’intégralité de la formule lors de la moindre modification de n’importe quelle cellule du classeur, anéantissant les mécanismes internes de mise en cache du processeur. La bonne pratique impose d’isoler la valeur volatile dans une cellule paramétrique unique et dédiée, puis de référencer celle-ci de manière absolue (ex. $Z$1) au sein des tests conditionnels.
9.2 Charge cognitive et maintenabilité collaborative des feuilles de calcul
L’ingénierie des feuilles de calcul ne se limite point à la simple production de résultats mathématiquement corrects ; elle englobe impérativement la dimension humaine de maintenabilité, d’auditabilité et de transmission intergénérationnelle du savoir technique au sein des organisations. Une formule conditionnelle monstrueuse, s’étendant sur dix lignes d’écran sans la moindre aération visuelle et imbriquant sept niveaux d’instructions SI, génère une charge cognitive écrasante pour quiconque est amené à en vérifier l’intégrité ou à en faire évoluer les seuils ultérieurement.
L’application du principe philosophique de parcimonie (le fameux Rasoir d’Ockham) doit guider chaque étape de la construction analytique : la meilleure formule n’est point celle qui étale la virtuosité technique la plus byzantine, mais celle qui parvient au résultat avec le minimum d’artifices syntaxiques nécessaires. Lorsqu’une structure conditionnelle devient trop absconse, le risque qu’un collaborateur introduise une régression logique majeure lors d’une simple mise à jour annuelle des seuils réglementaires avoisine la certitude statistique.
Pour prémunir l’organisation contre ces dérives opérationnelles, il est indispensable de documenter formellement les architectures décisionnelles. Google Sheets permet d’insérer des notes explicatives sur les en-têtes de colonnes détaillant la logique théorique sous-jacente. Mieux encore, le recours aux Plages nommées (via le menu Données > Plages nommées) permet de substituer à des coordonnées abstraites comme B12 des étiquettes éminemment sémantiques telles que Seuil_Admissibilite. L’écriture =SI(A2>Seuil_Admissibilite; "Admis"; "Refusé") transforme instantanément une formule hermétique en un document de spécification immédiatement compréhensible par tout auditeur externe.
9.3 Architecture modulaire : Fragmentation des calculs complexes
Face à des arbres décisionnels d’une complexité extrême impliquant des dizaines d’arbitrages conditionnels croisés, la tentative de tout résoudre au sein d’une formule unique et centralisée constitue une faute d’architecture classique. La décomposition modulaire, consistant à fragmenter le problème global en sous-problèmes élémentaires hébergés dans des colonnes d’étapes intermédiaires, représente la réponse méthodologique par excellence pour pérenniser le calcul.
Cette approche présente d’immenses vertus de contrôle qualité :
- Elle permet d’isoler chaque sous-condition logique dans une colonne distincte dédiée à un unique axe d’analyse (par exemple, une colonne pour la validation d’âge, une seconde pour l’ancienneté, une troisième pour le ratio budgétaire) ;
- Elle facilite l’audit unitaire en permettant d’examiner la distribution statistique intermédiaire de chaque sous-critère de manière totalement indépendante ;
- Elle simplifie radicalement l’instruction décisionnelle finale, qui se résume alors à une synthèse logique d’une grande sobriété agrégeant les états précalculés ;
- Elle accélère la localisation des anomalies lors des phases de débogage expérimental.
Bien que certains gestionnaires redoutent la prolifération spatiale des colonnes au sein de leurs interfaces, cet inconvénient visuel est aisément neutralisé par les fonctionnalités de masquage de colonnes ou la création de groupes réductibles (via le menu Afficher > Grouper). Le compromis entre compacité spatiale et transparence analytique penche systématiquement en faveur de la transparence : un modèle fragmenté et compréhensible demeurera toujours infiniment supérieur à un monolithe impénétrable source d’erreurs invisibles.
10. Vectorisation des conditions : Déploiement avec ARRAYFORMULA
10.1 Introduction au paradigme matriciel dans Google Sheets
L’un des traits de génie computationnels les plus distinctifs de Google Sheets réside dans sa prise en charge native du paradigme matriciel via la fonction fondamentale ARRAYFORMULA. Dans le paradigme scalaire traditionnel, une formule conditionnelle rédigée sur la ligne 2 doit être recopiée mécaniquement vers le bas sur l’ensemble des milliers de lignes de l’échantillon. Cette duplication de formules alourdit inutilement le fichier XML sous-jacent, consomme de la mémoire vive et expose l’analyste à des incohérences dramatiques si une modification locale n’est pas répercutée sur toute la hauteur de la colonne.
Le paradigme matriciel abolit complètement ce modèle archaïque. En encapsulant une instruction au sein de ARRAYFORMULA, l’analyste n’écrit la formule qu’une seule et unique fois dans la cellule d’en-tête ou la première cellule opérationnelle. La fonction prend alors en charge une plage unidimensionnelle entière (un vecteur) en entrée, applique l’algorithme conditionnel sur chaque coordonnée de manière itérative en mémoire vive, et déverse automatiquement l’intégralité du vecteur résultat sur les lignes correspondantes situées en dessous.
Cette expansion automatique confère une élégance architecturale absolue aux tableaux de bord contemporains. Non seulement le volume mémoire du classeur est drastiquement réduit, mais la maintenance logicielle s’en trouve sublimée : toute altération d’un seuil critique ou d’un libellé opérée sur la formule matricielle mère se diffuse instantanément sur des dizaines de milliers de lignes sans qu’aucune manipulation de recopie ne soit requise, garantissant une cohérence verticale irréprochable du jeu de données.
10.2 Intégration d’instructions SI multiples au sein de ARRAYFORMULA
L’hybridation entre l’instruction SI imbriquée et la fonction ARRAYFORMULA obéit à une rigueur syntaxique millimétrée. Pour que la vectorisation s’opère convenablement, toutes les références scalaires unitaires (ex. A2) doivent être transformées en références vectorielles ouvertes ou fermées (ex. A2:A). La signature canonique d’une telle formule d’ingénierie se présente sous la forme : =ARRAYFORMULA(SI(A2:A=""; ""; SI(A2:A<10; "Mauvais"; SI(A2:A<20; "Moyen"; SI(A2:A<30; "Bon"; "Excellent"))))).
Le premier niveau d’évaluation SI(A2:A=""; ""; ...) joue ici un rôle architectural vital. Étant donné que la plage A2:A s’étend jusqu’à la limite physique inférieure de la feuille de calcul (souvent plusieurs milliers de lignes au-delà des données réelles collectées), l’absence de ce garde-fou forcerait la formule matricielle à évaluer chaque cellule vide comme un zéro numérique, inondant le bas du document de milliers de libellés « Mauvais » indésirables. Cette pré-condition garantit que l’expansion matricielle s’interrompt visuellement dès la dernière ligne renseignée.
Le traitement des flux de calcul massifs s’en trouve considérablement accéléré. L’interpréteur de Google Sheets optimise l’exécution vectorielle en parallélisant les calculs au sein du moteur V8 sous-jacent. L’analyste bénéficie ainsi de temps de réponse nettement plus réactifs lors de l’actualisation dynamique des filtres ou des tables de consultation connectées, conférant au classeur une fluidité opérationnelle remarquable même face à des cohortes de taille industrielle.
10.3 Incompatibilité de SI.CONDITIONS, ET, OU et solutions vectorielles
L’accès au paradigme matriciel se heurte toutefois à une barrière technique majeure que tout analyste chevronné doit impérativement connaître pour éviter de sombrer dans des impasses de débogage stériles. Par conception historique et structurelle au sein du moteur Google Sheets, les fonctions logiques SI.CONDITIONS, ET, ainsi que OU sont catégoriquement incapables de s’exécuter sous forme vectorielle au sein d’une formule ARRAYFORMULA.
L’origine de cette incompatibilité fondamentale réside dans le fait que les fonctions ET et OU sont par nature des fonctions d’agrégation globale : confrontées à une plage de cellules telle que A2:A, elles cherchent à agréger l’ensemble absolu des valeurs de toute la colonne pour délivrer un unique booléen scalaire en sortie, au lieu de procéder à une confrontation ligne par ligne. Si l’on tente d’exécuter un bloc ET(A2:A>=10; A2:A<20) sous ARRAYFORMULA, le calcul échouera lamentablement ou produira un résultat global uniforme totalement absurde.
Pour contourner élégamment cette limitation sans renoncer à la puissance de la vectorisation, l’ingénierie des feuilles de calcul fait appel à la modélisation mathématique directe de la logique booléenne par l’algèbre linéaire arithmétique :
- L’opérateur conjonctif ET est fidèlement modélisé par l’opération de multiplication arithmétique (
*). La condition cumulative s’écrit alors vectoriellement :(A2:A>=10) * (A2:A<20). Le produit ne vaudra 1 (VRAI) que si les deux propositions valent simultanément 1 ; dès qu’un zéro apparaît, le produit s’annule ; - L’opérateur disjonctif OU est modélisé quant à lui par l’opération d’addition arithmétique (
+). L’assertion alternative se formalise ainsi :(A2:A="Paris") + (A2:A="Lyon"). Si au moins l’une des assertions est vérifiée, la somme sera strictement supérieure à zéro, activant le branchement conditionnel ; - L’intégration finale au sein de
ARRAYFORMULAprend alors la forme d’une prodigieuse formule hybride arithmético-logique :=ARRAYFORMULA(SI(A2:A=""; ""; SI((A2:A>=10)*(A2:A<20); "Conforme"; "Non Conforme"))).
11. Comparaison méthodique des alternatives : SWITCH, RECHERCHEV et TABLES
11.1 La fonction SWITCH pour les correspondances discrètes exactes
Lorsque la problématique décisionnelle ne concerne point l’analyse d’intervalles continus ou d’inégalités d’ordre, mais se concentre exclusivement sur la correspondance univoque de valeurs discrètes exactes, l’utilisation de multiples instructions SI imbriquées devient une hérésie stylistique. Google Sheets dispose d’une fonction dédiée inspirée de la programmation impérative classique : la fonction SWITCH, dont la structure générale s’articule ainsi : =SWITCH(expression; cas1; résultat1; [cas2; résultat2]; ...; [défaut]).
L’avantage conceptuel décisif de cette fonction repose sur l’évaluation unique de l’expression souche. Dans une suite de SI ou de SI.CONDITIONS, le processeur doit réévaluer la référence à la cellule cible à chaque nouvelle condition formulée (ex. A2=1, A2=2, etc.). Avec SWITCH, l’expression cible (par exemple A2 ou un calcul arithmétique complexe) n’est évaluée qu’une seule et unique fois au lancement de la fonction. Le moteur de calcul compare ensuite directement ce résultat fixe à la succession ordonnée des valeurs de cas déclarées.
L’ergonomie de saisie s’en trouve transcendée, particulièrement pour la gestion de tables de codification, de nomenclatures d’États ou de statuts opérationnels : =SWITCH(A2; "DEV"; "En Développement"; "PROD"; "En Production"; "TEST"; "En Phase de Test"; "Statut Indéterminé"). Le dernier argument fait automatiquement office de clause de repli universelle par défaut si aucune correspondance exacte n’est découverte. Cependant, la fonction s’avère totalement inopérante dès lors qu’il s’agit d’évaluer des comparaisons d’inégalité (>, <), son champ d’application demeurant strictement confiné à l’égalité exacte.
11.2 RECHERCHEV avec correspondance approximative (TRUE) comme substitut
Pour la catégorisation d’échelles continues à paliers multiples (telles que le cas pratique de notation athlétique modélisé au chapitre 4), l’alternative architecturale la plus noble, la plus performante et la plus pérenne face aux instructions conditionnelles multiples demeure indéniablement la fonction RECHERCHEV employée dans son mode de correspondance approximative (paramètre terminal positionné à VRAI ou 1).
Cette méthodologie repose sur l’externalisation complète des règles métier hors de la formule de calcul, au sein d’une table matricielle de barème ordonnée et dédiée. Cette table de consultation référence impérativement dans sa première colonne la borne inférieure minimale de chaque intervalle de score, classée dans un ordre strictement croissant, et dans sa seconde colonne l’étiquette qualitative correspondante :
- Ligne 1 :
0|"Mauvais" - Ligne 2 :
10|"Moyen" - Ligne 3 :
20|"Bon" - Ligne 4 :
30|"Excellent"
La formule d’attribution qualitative se résume dès lors à une concision spectaculaire : =RECHERCHEV(A2; $X$1:$Y$4; 2; VRAI). Confronté au paramètre VRAI, l’algorithme de Google Sheets exécute une recherche dichotomique d’une rapidité fulgurante : il balaie la première colonne jusqu’à identifier la valeur la plus élevée qui demeure inférieure ou égale au score cherché, renvoyant instantanément la classe correspondante. La maintenabilité devient totale : si un collège d’experts décide ultérieurement de faire passer le seuil d’excellence de 30 à 32 points, aucune formule n’a besoin d’être modifiée au sein des milliers de lignes de calcul ; une simple altération scalaire au sein de la table de barème répercute le changement sur l’ensemble du système d’information.
11.3 Matrice de décision méthodologique pour le choix de la fonction
Face à cet éventail d’instruments algorithmiques, le tableau comparatif ci-dessous formalise une matrice de sélection stratégique visant à guider le choix méthodologique de l’analyste en fonction des contraintes intrinsèques de son jeu de données :
Arbitrage comparatif des structures logiques de sélection :
- SI imbriqués traditionnels : Pertinents pour des flux décisionnels hautement asymétriques comportant de 2 à 4 niveaux de branchements non standardisés, ou lorsqu’une compatibilité descendante absolue avec des moteurs d’exportation de classeurs patrimoniaux est formellement requise. Inadaptés au-delà de 5 paliers sous peine d’effondrement de la lisibilité.
- SI.CONDITIONS moderne : Solution optimale pour des règles de segmentation plates comportant de 3 à 6 intervalles distincts portant sur des variables hétérogènes, à condition de clore scrupuleusement la déclaration par la clause universelle
VRAI; "Défaut"pour neutraliser les erreurs#N/A. Incompatible avec la vectorisation matricielle standard. - SWITCH : Instrument d’excellence pour l’arbitrage exclusif de variables qualitatives discrètes exactes fondées sur une valeur cible unique (codes nomenclatures, typologies fermées). Totalement inopérant face aux opérateurs d’inégalité ou aux découpages d’échelles continues.
- RECHERCHEV avec correspondance approximative : Le standard industriel indiscutable pour la classification d’échelles de valeurs continues denses comportant plus de 4 paliers. Offre la meilleure performance computationnelle et la maintenabilité collaborative la plus élevée grâce à la dissociation structurelle entre les formules de calcul et les tables de paramètres externes.
La sélection scrupuleuse de l’outil adapté conditionne la pérennité des structures analytiques. Un modélisateur d’élite ne se contente pas de produire une formule fonctionnelle ; il anticipe les cycles d’évolution futurs de la base de données, la charge mentale des futurs relecteurs et les contraintes computationnelles de l’infrastructure d’hébergement pour sélectionner l’architecture la plus sobre, robuste et pérenne possible.
12. Méthodologie d’audit, de débogage et bonnes pratiques d’implémentation
12.1 Protocole de débogage pas à pas d’une formule conditionnelle
La confrontation inévitable avec des comportements inattendus au sein d’arbres décisionnels complexes impose la mise en œuvre d’un protocole de débogage méthodique et rigoureux. L’erreur la plus répandue consiste à tenter de corriger empiriquement une formule d’une ligne entière en modifiant les opérateurs de comparaison de manière aléatoire. Une approche véritablement professionnelle exige au contraire de procéder à une décomposition chirurgicale de la chaîne logique afin d’identifier le point précis de rupture séquentielle.
L’une des techniques les plus expéditives consiste à procéder à une évaluation partielle des fragments logiques en exploitant l’interface interactive de Google Sheets. En sélectionnant un sous-ensemble d’une formule directement dans la barre d’édition (par exemple la sous-expression ET(A2>=10; A2<20)) et en observant l’infobulle d’évaluation flottante qui apparaît au-dessus du curseur, l’analyste visualise instantanément la valeur booléenne exacte (VRAI ou FAUX) que renvoie ce segment précis pour la ligne courante sans altérer l’intégrité de la cellule.
Si la formule résiste toujours à l’analyse, la méthode de rétro-ingénierie par isolation en cellules temporaires s’avère souveraine. L’analyste extrait chaque sous-instruction SI ou chaque prédicat individuel pour les transposer dans des colonnes adjacentes provisoires d’un banc d’essai. En observant la projection des résultats intermédiaires sur une variété d’échantillons critiques, il devient aisé de repérer la ligne précise où une valeur pivot franchit illicitement une barrière logique mal calibrée, permettant de rectifier l’architecture mère avec une certitude absolue.
12.2 Normalisation syntaxique et mise en forme esthétique
L’esthétique du code constitue l’un des remparts les plus efficaces contre l’introduction d’erreurs logiques silencieuses. La convention de normalisation syntaxique la plus fondamentale concerne l’indentation visuelle des formules à lignes multiples au sein de la barre de formule de Google Sheets. Tout bloc d’instructions conditionnelles dépassant deux niveaux d’imbrication doit être formatté par l’insertion systématique de retours à la ligne (Ctrl + Entrée) immédiatement après chaque séparateur d’argument ouvrant un nouveau sous-palier décisionnel.
Une attention méticuleuse doit également être accordée au séparateur d’arguments en vigueur selon la configuration régionale (la locale) du classeur. Dans la plupart des pays francophones (France, Belgique, Canada, Suisse), le séparateur décimal étant la virgule, Google Sheets emploie impérativement le point-virgule (;) comme délimiteur universel d’arguments au sein des fonctions. La copie servile de fragments de code glanés sur des documentations anglophones exploitant la virgule simple (,) déclenchera irrémédiablement une erreur d’analyse lexicale que l’analyste corrigera par une conversion rigoureuse de ses séparateurs.
Enfin, l’emploi exclusif et immuable des majuscules pour tous les noms de fonctions réservées (SI, ET, OU, SI.CONDITIONS, SWITCH) constitue un marqueur d’hygiène logicielle élémentaire. Non seulement cette discipline typographique renforce immédiatement la lisibilité en détachant visuellement les mots-clés algorithmiques des références de cellules et des constantes textuelles, mais elle permet également de vérifier la validité lexicale de la saisie : si l’interpréteur de Google Sheets ne normalise pas automatiquement le mot-clé saisi, c’est l’indice certain qu’une coquille orthographique a corrompu l’instruction.
12.3 Guide récapitulatif pour une gouvernance rigoureuse des classeurs
Avant d’autoriser la mise en production d’un classeur analytique intégrant des arborescences décisionnelles complexes, l’architecte de données doit soumettre son œuvre à une grille d’audit de gouvernance sans concession. Ce protocole final permet de sanctuariser le modèle contre les dérives opérationnelles futures induites par l’intervention de tiers ou les variations imprévues de volumétrie de données.
La checklist de vérification préalable au déploiement s’articule autour des préconisations cardinales suivantes :
- Vérification de l’étanchéité des frontières : Les opérateurs stricts et larges ont-ils été assignés sans ambiguïté sur chaque valeur pivot afin d’éviter tout chevauchement ou angle mort ?
- Présence systématique d’échappements aux cellules vides : Les colonnes de calcul ont-elles été prémunies contre l’assimilation d’une cellule blanche au zéro numérique via une clause
A2=""préalable ? - Neutralisation formelle des erreurs : Les fonctions de type SI.CONDITIONS disposent-elles obligatoirement d’une condition terminale universelle
VRAI; ...pour éradiquer l’apparition intempestive du code#N/A? - Protection des plages d’ingénierie : Les colonnes hébergeant les formules conditionnelles maîtresses ou les tables matricielles de barème ont-elles été rigoureusement verrouillées via l’option Données > Protéger les feuilles et les plages, interdisant toute altération accidentelle par des utilisateurs néophytes ?
- Parcimonie architecturale : Si l’arbre décisionnel excède cinq paliers séquentiels, l’opportunité d’une substitution par une table de consultation de type RECHERCHEV(…, VRAI) a-t-elle été scrupuleusement arbitrée ?
En observant scrupuleusement ces prescriptions méthodologiques, l’analyste élève la pratique du tableur au rang d’une véritable ingénierie logicielle déterministe. Les instructions conditionnelles multiples cessent d’être de fragiles assemblages d’opportunité pour devenir les rouages robustes, élégants et pérennes d’un système de traitement quantitatif de haute précision.
Références
Boole, G. (1854). An investigation of the laws of thought on which are founded the mathematical theories of logic and probabilities. Walton and Maberly.
Google LLC. (2024). SI (Fonction) – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3093364
Google LLC. (2024). SI.CONDITIONS (Fonction) – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/7014145
Google LLC. (2024). SWITCH (Fonction) – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/7014445
Google LLC. (2024). ARRAYFORMULA (Fonction) – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3093275
Microsoft Corporation. (2024). Utiliser des fonctions SI imbriquées. Support Microsoft. https://support.microsoft.com/fr-fr/office/utiliser-des-fonctions-si-imbriquées-bf582da5-4f7f-4771-b47a-7da4194f4886
Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
Winston, W. L. (2021). Microsoft Excel Data Analysis and Business Modeling (6e éd.). Microsoft Press.