
Dans le vaste champ de la modélisation probabiliste et de l’analyse stochastique, la distribution uniforme continue occupe une position paradoxale : conceptuellement élémentaire en apparence, elle constitue pourtant le socle fondamental sur lequel repose l’ensemble des techniques modernes de simulation numérique et d’échantillonnage aléatoire. Qu’il s’agisse d’évaluer le risque d’un portefeuille financier, de dimensionner les files d’attente d’une infrastructure logistique ou de structurer des protocoles expérimentaux stricts en psychométrie, la loi uniforme est le point d’ancrage incontournable de la génération de variables aléatoires. Son principe d’indifférence épistémique, formalisé dès les prémices du calcul des probabilités par Pierre-Simon de Laplace, stipule qu’en l’absence totale d’information asymétrique sur un intervalle borné, chaque sous-intervalle de même longueur possède rigoureusement la même probabilité d’occurrence.
Le logiciel Microsoft Excel demeure, au sein des organisations académiques, financières et industrielles, l’outil le plus universellement déployé pour le traitement quantitatif des données. Néanmoins, l’ingénierie statistique au sein de cet environnement tabulaire recèle des complexités techniques souvent sous-estimées. Contrairement à des distributions canoniques telles que la loi normale ou la loi de Poisson, qui bénéficient d’un arsenal complet de fonctions analytiques natives préprogrammées (à l’instar de LOI.NORMALE.N ou LOI.POISSON.N), la distribution uniforme continue ne possède pas de fonction dédiée directe portant son nom dans le moteur de calcul standard d’Excel. Cette absence apparente contraint le praticien, l’analyste et le chercheur à maîtriser les fondements algébriques de la distribution afin de concevoir eux-mêmes des architectures de calcul robustes, précises et auditables.
Ce guide exhaustif a pour vocation d’explorer l’intégralité du cycle de vie de la distribution uniforme au sein d’Excel, depuis ses démonstrations mathématiques formelles jusqu’à ses applications pratiques les plus pointues. Nous détaillerons les mécanismes internes du générateur de nombres pseudo-aléatoires du tableur, l’implémentation vectorielle des formules de densité et de probabilité cumulée, la mise en œuvre de simulations de Monte-Carlo massives, ainsi que les protocoles de tests statistiques d’adéquation garantissant la fiabilité des résultats. À travers des études de cas détaillées et des analyses méthodologiques approfondies, cet article offre une référence technique complète pour transformer un simple tableur en un laboratoire stochastique de haute précision.
1. Fondements théoriques et mathématiques de la distribution uniforme continue
1.1 Définition axiomatique et fonction de densité de probabilité (FDP)
La distribution uniforme continue, classiquement notée sous la forme synthétique U(a, b), est une loi de probabilité continue définie sur un espace probabilisable dont le support est restreint à un intervalle compact réel borné, noté classiquement [a, b], où les scalaires a et b vérifient la condition de régularité stricte a < b. L’amplitude ou la longueur du support fondamental de la variable est par conséquent quantifiée par la différence b – a. L’essence de cette loi réside dans l’équiprobabilité infinitésimale de ses réalisations : aucun point ou voisinage du support ne possède une densité d’attraction probabiliste supérieure à un autre. La théorie de la mesure de Borel-Lebesgue formalise cette propriété en stipulant que la probabilité qu’une variable aléatoire continue X prenne une valeur dans un borélien donné est proportionnelle à la mesure de Lebesgue de ce sous-ensemble.
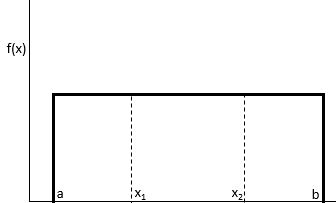
Sur le plan analytique, la fonction de densité de probabilité (FDP), que l’on note conventionnellement f(x), se formalise par une fonction par morceaux constante sur le support et strictement nulle au-delà. Son expression mathématique générale s’énonce comme suit :
Pour tout réel x appartenant à l’intervalle fermé [a, b], f(x) = 1 / (b – a). Pour toute valeur de x strictement inférieure à la borne a ou strictement supérieure à la borne b, f(x) = 0. La justification de la constante 1 / (b – a) découle immédiatement du deuxième axiome fondamental de Kolmogorov, imposant que l’intégrale de la densité sur l’ensemble de l’espace des réels soit rigoureusement égale à l’unité (condition de normalisation). En intégrant la constante c de a à b par rapport à la variable x, le calcul intégral élémentaire donne c * (b – a) = 1, ce qui impose de manière univoque la valeur c = 1 / (b – a).
Cette structure rectangulaire constante entraîne une conséquence fondamentale propre au calcul infinitésimal stochastique : pour tout point isolé x0 appartenant à [a, b], la probabilité ponctuelle exacte P(X = x0) est rigoureusement nulle. Cette propriété n’implique nullement l’impossibilité de l’événement au sens ontologique, mais traduit le fait qu’une intégrale définie sur un singleton de mesure nulle est égale à zéro. Dès lors, la quantification probabiliste n’a de sens opératoire que sur des intervalles de longueur non nulle. Les bornes du support fermé [a, b] peuvent d’ailleurs être ouvertes ou semi-ouvertes sans altérer en aucune manière les propriétés probabilistes globales de la loi.
1.2 Fonction de répartition cumulative (CDF)
La fonction de répartition cumulative, couramment désignée par l’acronyme anglophone CDF (Cumulative Distribution Function) et notée F(x), définit la probabilité pour que la variable aléatoire X prenne une valeur inférieure ou égale à un seuil réel spécifié x, soit F(x) = P(X ≤ x). D’un point de vue opératoire, cette fonction s’obtient par l’intégration de la fonction de densité de probabilité f(t) depuis l’infini négatif jusqu’au point d’évaluation x.
L’analyse de l’intégrale conduit à une fonction continue affine définie par morceaux. Si x < a, l’intégrande est identiquement nulle, conférant à la fonction de répartition la valeur F(x) = 0. Pour tout x compris dans l’intervalle [a, b], l’évaluation s’exécute selon l’intégrale de a à x de (1 / (b – a)) dt. La primitive immédiate de cette constante par rapport à t est t / (b – a). En appliquant le théorème fondamental de l’analyse entre les bornes d’intégration a et x, on dérive l’expression : F(x) = (x – a) / (b – a). Enfin, lorsque le seuil d’évaluation x dépasse strictement la borne supérieure b, l’événement {X ≤ x} devient l’événement certain, d’où F(x) = 1 pour tout x > b.
Géométriquement, la probabilité cumulée F(x) s’interprète comme l’aire géométrique d’un rectangle sous la courbe de densité. La base de ce rectangle s’étend du point a au point x, conférant une largeur égale à x – a, tandis que sa hauteur est fixée invariablement à 1 / (b – a). L’aire résultante correspond exactement au produit de la base par la hauteur, ce qui restitue sans ambiguïté la formule analytique. Cette linéarité absolue entre a et b confère à la fonction de répartition un taux de variation constant, ce qui signifie que l’accroissement de la probabilité cumulée est strictement proportionnel à l’incrément de la variable x, sans accélération ni décélération locale.
1.3 Distinction épistémologique entre lois uniforme continue et uniforme discrète
Il est impératif pour l’analyste de ne pas confondre la distribution uniforme continue avec son homologue, la distribution uniforme discrète. Cette divergence n’est pas une simple nuance formelle, mais engage des architectures computationnelles et mathématiques radicalement distinctes. La distribution uniforme discrète modélise une variable aléatoire susceptible de ne prendre qu’un ensemble fini de n valeurs numériques distinctes, typiquement un ensemble d’entiers consécutifs noté {k_min, k_min + 1, …, k_max}. Le cas paradigmatique est le jet d’un dé non biaisé à six faces, où l’univers des possibles est discret et dénombrable.
Dans le cas discret, chaque point d’évaluation individuel est porteur d’une masse de probabilité non nulle, valant uniformément P(X = k) = 1 / n, où n = k_max – k_min + 1. En revanche, dans le paradigme continu, le support de la variable aléatoire présente la puissance du continu (la cardinalité de l’ensemble des réels ℝ). Le nombre d’états accessibles est infini non dénombrable. Comme souligné précédemment, la masse de probabilité en chaque point ponctuel s’annihile, contraignant l’analyste à raisonner exclusivement en termes de densités et d’intégrales de surface.
Cette distinction conceptuelle dicte le choix des fonctions dans Microsoft Excel. Le traitement de la variable uniforme discrète fait appel à des algorithmes de combinatoire et de génération sur des entiers (tels que la fonction ALEA.ENTRE.BORNES), tandis que le traitement de la variable continue exige des générateurs à virgule flottante sur l’intervalle réel (la fonction ALEA) et l’implémentation manuelle des formules issues du calcul infinitésimal. Confondre ces deux régimes conduit inévitablement à des biais statistiques majeurs, particulièrement lors de l’estimation des probabilités de bordure et du calibrage de modèles de files d’attente ou de fiabilité industrielle.
2. Moments statistiques et propriétés formelles de la loi uniforme
2.1 Espérance mathématique et mesure de tendance centrale
L’espérance mathématique, ou moment d’ordre un centré à l’origine, représente la valeur moyenne théorique anticipée d’une infinité d’observations indépendantes d’une variable aléatoire. Pour une loi continue régie par sa densité f(x) sur le support [a, b], l’espérance E(X), communément symbolisée par la lettre grecque μ, est formellement définie par l’intégrale du produit de la variable par sa densité :
E(X) = ∫ [de a à b] x * f(x) dx = ∫ [de a à b] (x / (b – a)) dx
Le facteur 1 / (b – a) étant invariant par rapport à la variable d’intégration x, il s’extrait de l’opérateur intégral par linéarité. La détermination de la primitive de x donne x² / 2. En évaluant cette primitive aux bornes b et a, nous obtenons l’expression algébrique :
E(X) = (1 / (b – a)) * [(b² – a²) / 2]
L’application de l’identité remarquable relative à la factorisation de la différence de deux carrés, soit b² – a² = (b – a)(b + a), permet une simplification algébrique rigoureuse avec le dénominateur commun :
E(X) = [(b – a)(a + b)] / [2 * (b – a)] = (a + b) / 2
Cette formulation démontre avec élégance que l’espérance mathématique d’une distribution uniforme coïncide de manière absolue avec le milieu arithmétique de ses bornes extrêmes. En vertu de la symétrie axiale parfaite de la fonction de densité par rapport à la droite verticale d’équation x = (a + b) / 2, le centre de gravité de la masse de probabilité, la moyenne arithmétique théorique et la médiane (la valeur séparant l’univers en deux sous-ensembles de probabilité égale à 0,50) sont strictement superposés.
2.2 Variance et écart-type de la distribution
La variance, désignée par V(X) ou σ², mesure l’ampleur de la dispersion quadratique des réalisations de la variable stochastique autour de son espérance mathématique. D’après le théorème de König-Huygens, la variance s’exprime comme la différence entre l’espérance du carré de la variable et le carré de l’espérance de cette même variable : V(X) = E(X²) – [E(X)]².
L’évaluation du moment non centré d’ordre deux nécessite le calcul de l’intégrale suivante :
E(X²) = ∫ [de a à b] (x² / (b – a)) dx = (1 / (b – a)) * [(b³ – a³) / 3]
En factorisant la différence cubique b³ – a³ = (b – a)(a² + ab + b²), nous simplifions l’expression pour obtenir :
E(X²) = (a² + ab + b²) / 3
En substituant cette valeur ainsi que le carré de l’espérance [E(X)]² = ((a + b) / 2)² = (a² + 2ab + b²) / 4 dans l’équation de König-Huygens, nous obtenons par réduction au même dénominateur (égal à 12) :
V(X) = [4(a² + ab + b²) – 3(a² + 2ab + b²)] / 12 = (a² – 2ab + b²) / 12 = (b – a)² / 12
L’émergence du diviseur constant 12 constitue une caractéristique intrinsèque de la géométrie continue uniforme unidimensionnelle. L’écart-type, noté σ, s’obtient immédiatement en extrayant la racine carrée de la variance :
σ = √[(b – a)² / 12] = (b – a) / √12 = (b – a) / (2 * √3)
Ces développements analytiques prouvent que la dispersion d’une variable uniforme ne dépend exclusivement que de l’amplitude globale du support b – a, et demeure totalement invariante par translation horizontale des bornes de l’intervalle.
2.3 Moments d’ordre supérieur : asymétrie et aplatissement
La caractérisation fine de la géométrie d’une distribution statistique requiert l’examen des moments centrés normalisés d’ordre trois et quatre, respectivement dénommés coefficient d’asymétrie (skewness) et coefficient d’aplatissement (kurtosis). L’asymétrie, notée γ1, quantifie le degré de déséquilibre de la distribution autour de sa moyenne :
γ1 = E[(X – μ)³] / σ³
Dans le cas de la loi uniforme continue, la symétrie de la densité f(x) par rapport à μ = (a + b) / 2 est totale. Pour toute déviation δ, nous observons l’égalité f(μ + δ) = f(μ – δ). Par voie de conséquence, l’intégrale d’une fonction impaire sur un intervalle symétrique autour de zéro étant identiquement nulle, le moment centré d’ordre trois s’annule formellement : γ1 = 0. La distribution uniforme ne présente aucune traîne préférentielle vers la droite ou vers la gauche.
Le coefficient de kurtosis de Pearson, noté β2, s’établit quant à lui sur le rapport du quatrième moment centré sur le carré de la variance : β2 = E[(X – μ)⁴] / σ⁴. Le calcul analytique de l’intégrale du quatrième moment centré produit le résultat (b – a)⁴ / 80. Sachant que σ² = (b – a)² / 12, nous avons σ⁴ = (b – a)⁴ / 144. Le rapport structural s’établit ainsi :
β2 = [(b – a)⁴ / 80] / [(b – a)⁴ / 144] = 144 / 80 = 9 / 5 = 1,8
Si l’on adopte la convention du kurtosis excédentaire (ou excess kurtosis, mesuré classiquement par rapport à la valeur de référence de la distribution normale qui vaut 3), nous obtenons :
γ2 = β2 – 3 = 1,8 – 3 = -1,2
Cette valeur strictement négative démontre que la distribution uniforme est fortement platykurtique. Contrairement à une gaussienne qui présente des queues épaisses s’étendant à l’infini et un sommet resserré, la loi uniforme possède un profil totalement plat à sommet rectangulaire, dépourvu de queues de distribution au-delà de son support fini borné.
3. Formulation analytique des probabilités d’intervalle
3.1 Calcul de la probabilité entre deux bornes quelconques
L’objectif opérationnel fondamental de l’application de la loi uniforme réside dans la détermination de la masse de probabilité confinée entre deux seuils d’évaluation arbitraires, que l’on désignera par x1 et x2, sous la contrainte d’ordre x1 ≤ x2. En appliquant la définition axiomatique de la fonction de répartition cumulative, la probabilité que la variable continue X prenne une valeur au sein de cet intervalle fermé s’exprime par la différence de ses fonctions de répartition respectives :
P(x1 ≤ X ≤ x2) = F(x2) – F(x1)
Lorsque le sous-intervalle cible [x1, x2] est intégralement encapsulé au sein du support fondamental de la distribution, c’est-à-dire sous la condition conjointe a ≤ x1 ≤ x2 ≤ b, la substitution des expressions analytiques débouche sur la formulation standard :
P(x1 ≤ X ≤ x2) = [(x2 – a) / (b – a)] – [(x1 – a) / (b – a)] = (x2 – x1) / (b – a)
Ce résultat fondamental formalise le principe de proportionnalité géométrique : la probabilité est exactement égale au ratio entre la longueur de l’intervalle cible et la longueur totale de l’espace d’échantillonnage admissible. Par ailleurs, en raison de la continuité absolue de la mesure de probabilité, la nature des inégalités (strictes ou larges) n’exerce aucune incidence numérique sur le résultat final :
P(x1 ≤ X ≤ x2) = P(x1 < X ≤ x2) = P(x1 ≤ X < x2) = P(x1 < X < x2) = (x2 – x1) / (b – a)
Toutefois, la manipulation robuste de cette formule en ingénierie décisionnelle impose une vigilance formelle quant aux conditions aux limites. Si l’utilisateur spécifie une borne inférieure d’évaluation x1 située en deçà du minimum physique a (c’est-à-dire x1 < a), la valeur effective de départ doit être tronquée à a, car aucune densité n’existe dans le demi-espace ]-∞, a[. De manière parfaitement symétrique, si la borne supérieure spécifiée x2 dépasse le seuil b, l’évaluation doit être plafonnée à b. L’expression analytique universelle intégrant la troncature aux frontières s’énonce donc :
P(x1 ≤ X ≤ x2) = [max(a, min(b, x2)) – min(b, max(a, x1))] / (b – a) sous réserve que x1 ≤ x2.
3.2 Probabilités conditionnelles au sein d’une loi uniforme
L’introduction d’une information préalable ou d’une observation intermédiaire sur l’état d’un système modélisé par une loi uniforme modifie l’espace probabiliste via le théorème de conditionnement de Kolmogorov. Considérons l’interrogation analytique suivante : quelle est la probabilité que la variable X excède un seuil critique x2, sachant avec certitude que la variable a déjà franchi un seuil initial x1, avec a ≤ x1 < x2 ≤ b ?
Par application rigoureuse de la définition formelle de la probabilité conditionnelle, nous formulons :
P(X > x2 | X > x1) = P({X > x2} ∩ {X > x1}) / P(X > x1)
L’événement {X > x2} étant strictement inclus dans l’événement {X > x1} en raison de l’inégalité d’ordre x1 < x2, leur intersection logique se résume simplement à l’événement le plus restrictif : {X > x2} ∩ {X > x1} = {X > x2}. Dès lors, le ratio probabiliste s’exprime par le quotient des probabilités marginales de survie :
P(X > x2 | X > x1) = P(X > x2) / P(X > x1) = [(b – x2) / (b – a)] / [(b – x1) / (b – a)] = (b – x2) / (b – x1)
Ce résultat fondamental révèle une propriété mathématique majeure : la loi conditionnelle d’une variable uniforme X ~ U(a, b) restreinte à l’événement X > x1 est elle-même une loi uniforme continue parfaite, redéfinie sur le support tronqué [x1, b]. L’amplitude résiduelle devient b – x1, et l’équiprobabilité relative est intégralement préservée au sein de cette nouvelle fenêtre temporelle ou dimensionnelle. Contrairement à la distribution exponentielle, la loi uniforme ne jouit pas de la propriété d’absence de mémoire : le temps déjà écoulé ou l’incrément déjà consommé modifie substantiellement la probabilité de survenue future de l’événement.
3.3 Quantiles et fonction quantile inverse
L’inversion de la fonction de répartition cumulative constitue l’armature théorique indispensable à la fois pour le calcul des valeurs seuils stratégiques (telles que la Value-at-Risk en ingénierie financière) et pour la génération de variables aléatoires artificielles par simulation. La fonction quantile, notée Q(p) ou F⁻¹(p), prend en argument une probabilité cible normalisée p appartenant à l’intervalle unitaire fermé [0, 1] et retourne le scalaire réel unique x tel que F(x) = p.
En reprenant l’équation fondamentale de la CDF pour un point intérieur p = (x – a) / (b – a), l’isolation algébrique de la variable x aboutit directement à l’équation quantile de la loi uniforme :
x = Q(p) = a + p * (b – a)
Cette relation affine démontre que le quantile est simplement obtenu par l’interpolation linéaire entre la borne inférieure a et la borne supérieure b, pondérée par la probabilité cumulée p. À partir de cette équation structurelle, la détermination des quantiles d’intérêt statistique s’effectue sans aucune ambiguïté numérique :
- Le premier quartile (Q1), correspondant à la masse p = 0,25, s’établit à : Q1 = a + 0,25 * (b – a) = (3a + b) / 4.
- La médiane (Q2), pour p = 0,50, confirme le résultat de symétrie : Q2 = a + 0,50 * (b – a) = (a + b) / 2.
- Le troisième quartile (Q3), pour p = 0,75, s’établit à : Q3 = a + 0,75 * (b – a) = (a + 3b) / 4.
L’écart interquartile théorique, défini universellement par la différence métrique IQR = Q3 – Q1, s’obtient par la soustraction immédiate : IQR = [(a + 3b) / 4] – [(3a + b) / 4] = (2b – 2a) / 4 = (b – a) / 2. L’intervalle interquartile d’une loi uniforme capture donc invariablement la moitié exacte de l’étendue totale de la distribution.
4. Architecture et fonctions natives d’Excel dédiées aux lois uniformes
4.1 La fonction ALEA() et le générateur de nombres pseudo-aléatoires
L’ancrage de la modélisation stochastique dans Microsoft Excel repose sur la fonction native ALEA() (correspondant à RAND() dans les versions anglophones du tableur). Cette fonction ne prend aucun argument entre ses parenthèses et génère, à chaque évaluation, un nombre réel en virgule flottante distribué de manière uniforme sur l’intervalle semi-ouvert [0, 1[.
Historiquement, les premières itérations d’Excel (antérieures à la mouture Excel 2003) s’appuyaient sur des générateurs congruentiels linéaires simples qui présentaient des défauts d’équiprobabilité notables sur de grands volumes de données et une périodicité insuffisante (de l’ordre de 2³² – 1 tirages), induisant des corrélations spatiales identifiables lors de simulations tridimensionnelles. Depuis Excel 2003, et consolidé rigoureusement dans Excel 2010 et ses successeurs, Microsoft a modernisé son moteur de calcul en intégrant une variante robuste de l’algorithme du Mersenne Twister (précisément le modèle MT19937). Cet algorithme pseudo-aléatoire fournit une période titanesque de 2¹⁹⁹³⁷ – 1 tirages sans répétition de cycle et garantit une équidistribution statistique multidimensionnelle jusqu’à 623 dimensions, ce qui dépasse largement les exigences de la quasi-totalité des modélisations d’entreprises.
Une caractéristique opérationnelle critique de la fonction ALEA() réside dans sa nature strictement « volatile ». Dans la terminologie propre au moteur d’évaluation d’Excel, une fonction volatile est réexécutée systématiquement à chaque fois que la moindre modification intervient dans n’importe quelle cellule du classeur ouvert, ou lors du déclenchement d’un recalcul via l’appui sur les touches F9 ou Maj + F9. Cette instabilité dynamique présente le danger de recalculer involontairement l’intégralité des simulations stochastiques en cours d’analyse. Pour pérenniser et stabiliser un jeu de tirages aléatoires au sein d’une feuille de travail, il est dès lors impératif de figer les valeurs calculées en exécutant une opération de copie suivie d’un Collage spécial en valeurs sur la plage de cellules concernée.
4.2 La fonction ALEA.ENTRE.BORNES() pour les distributions discrètes
Pour répondre aux besoins de modélisation stochastique discrète, Microsoft Excel propose la fonction spécialisée ALEA.ENTRE.BORNES(bas; haut) (ou RANDBETWEEN(bottom, top) dans la version anglophone). Cette commande prend rigoureusement deux arguments scalaires obligatoires : le premier spécifie le seuil entier inférieur admissible (bas), tandis que le second détermine la limite entière supérieure inclusive (haut).
L’algorithme interne de cette fonction est conçu pour produire une variable aléatoire uniforme discrète où chaque entier k satisfaisant la relation bas ≤ k ≤ haut possède une probabilité théorique stricte d’apparition égale à 1 / (haut – bas + 1). L’erreur méthodologique récurrente commise par de nombreux analystes débutants consiste à tenter de discrétiser manuellement la fonction continue ALEA() au moyen de formules d’arrondi imbriquées du type ARRONDI(ALEA() * (haut – bas) + bas; 0). Cette approche naïve introduit un biais systématique majeur : les bornes extrêmes (bas et haut) ne collectent des réalisations que sur un demi-intervalle d’arrondi (d’amplitude 0,5), divisant par deux leur probabilité d’occurrence par rapport aux entiers centraux qui bénéficient d’un intervalle d’attraction de largeur unitaire (d’amplitude 1,0 allant de k – 0,5 à k + 0,5).
La fonction ALEA.ENTRE.BORNES élimine structurellement ce biais de distribution en appliquant un schéma de troncature fondé sur la fonction partie entière inférieure (floor), assurant une partition parfaitement équiprobable de l’intervalle discret sous-jacent. De surcroît, dans les versions modernes d’Excel (intégrant le moteur de calcul matriciel dynamique d’Office 365), la fonction plus récente TABLEAU.ALEAT(lignes; colonnes; min; max; [entier]) permet désormais de générer en une formule unique un tableau matriciel étendu de dimensions arbitraires, acceptant aussi bien la spécification d’un mode de génération continue que discrète via son cinquième argument booléen.
4.3 Absence de fonction spécifique continue native et création de formules personnalisées
Contrairement aux lois gaussienne (LOI.NORMALE.N), exponentielle (LOI.EXPONENTIELLE.N) ou de Student (LOI.STUDENT.N), le tableur Excel ne met à disposition aucune fonction native directe intitulée LOI.UNIFORME.N ou LOI.UNIFORME.CONTINUE. Cette omission architecturale s’explique par la simplicité algébrique intrinsèque de la loi uniforme continue, dont l’évaluation analytique ne fait appel à aucune fonction spéciale non élémentaire (contrairement aux polynômes d’approximation ou aux fractions continues requises pour approcher la fonction d’erreur de Gauss ou les intégrales eulériennes incomplètes de la loi Gamma).
Pour surmonter cette absence tout en évitant la redondance de formules complexes et sources d’erreurs au sein des feuilles de calcul, l’ingénieur statistique dispose de deux voies méthodologiques d’abstraction. La première consiste à formaliser des formules algébriques modulaires exploitant les fonctions logiques universelles du tableur, encapsulant la normalisation d’échelle dans des cellules dédiées. La seconde voie, plus structurée et pérenne dans les environnements de modélisation lourds, réside dans le développement d’une fonction personnalisée dite UDF (User Defined Function) écrite sous l’interpréteur Visual Basic for Applications (VBA).
Une fonction VBA rédigée selon les standards professionnels d’auditabilité s’implémente dans un module standard de classeur sous la syntaxe conceptuelle suivante :
La fonction LoiUniformeCDF(ByVal x As Double, ByVal a As Double, ByVal b As Double) As Double vérifie préalablement la cohérence géométrique b > a. Si cette condition est validée, elle renvoie la valeur 0 si x < a, la valeur 1 si x > b, et l’évaluation continue (x – a) / (b – a) lorsque x réside dans l’intervalle fermé. Cette modularisation évite la pollution visuelle des formules matricielles complexes et fiabilise les analyses de risques institutionnelles au sein de la plateforme Excel.
5. Méthodologie de calcul des probabilités dans une feuille Excel
5.1 Configuration matricielle des paramètres d’entrée
La conception d’un modèle stochastique rigoureux et vérifiable sous Excel obéit aux principes cardinaux du design de feuilles de calcul (notamment formalisés par les référentiels professionnels FAST et EuSpRIG). La première étape méthodologique consiste à isoler intégralement les paramètres structurels de la distribution uniforme au sein d’une zone d’entrée dédiée, totalement dissociée des zones de formules et de résultats.
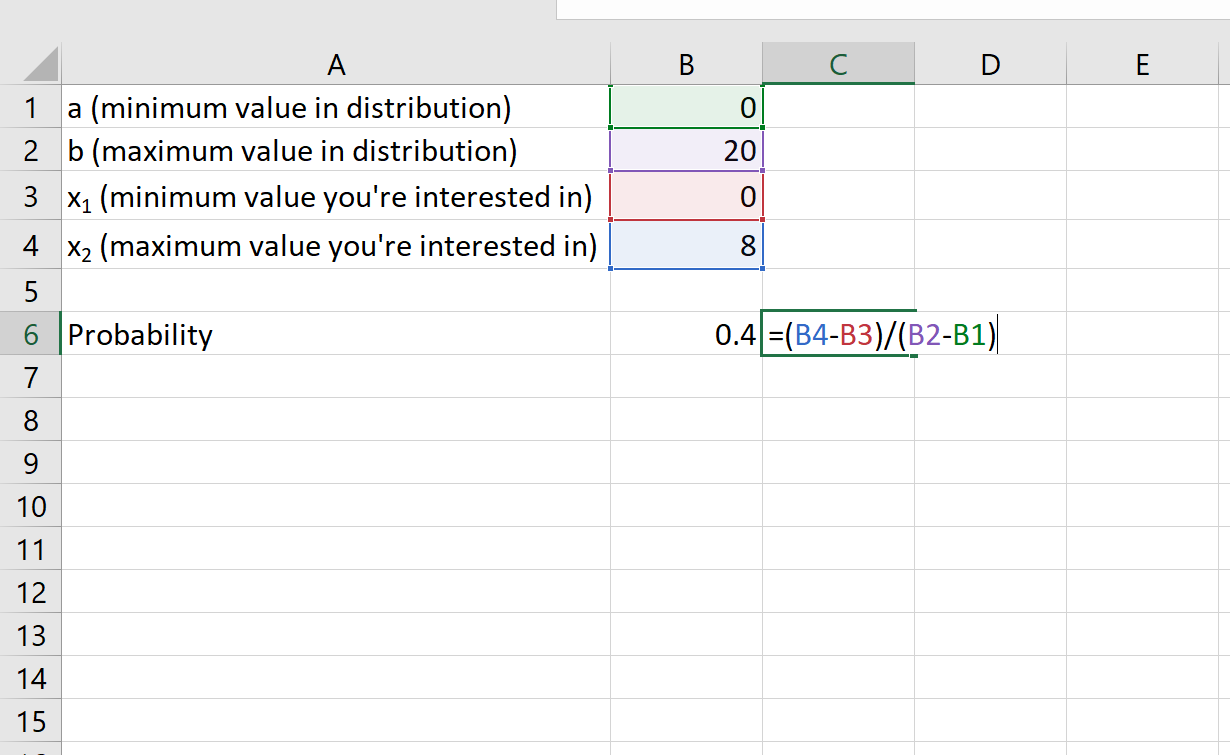
Pour implémenter cette architecture, nous configurons un bloc de paramètres fondamentaux au sein de la plage cellulaire standardisée :
- Cellule B1 : Borne inférieure théorique, identifiée par le label a.
- Cellule B2 : Borne supérieure théorique, identifiée par le label b.
- Cellule B4 : Borne d’évaluation inférieure d’intervalle, identifiée par x1.
- Cellule B5 : Borne d’évaluation supérieure d’intervalle, identifiée par x2.
Afin de prévenir toute altération fonctionnelle de l’adressage lors du déplacement ou de la duplication de formules, il est impératif d’utiliser le Gestionnaire de noms d’Excel pour attribuer des identifiants sémantiques explicites à ces cellules (par exemple nommer Param_a la cellule B1 et Param_b la cellule B2), ou de contraindre leur adressage au moyen de verrous absolus dollarisés ($B$1, $B$2). De surcroît, la robustesse d’un classeur d’ingénierie exige la mise en place d’une règle stricte de Validation des données (accessible via le ruban Données) sur la cellule B2, imposant la formule d’intégrité logique =B2>B1. Cette mesure de sécurité informatique bloque formellement la saisie d’un paramètre b inférieur ou égal à a, neutralisant ainsi en amont toute division par zéro ou inversion de signe au sein du moteur arithmétique.
5.2 Implémentation de la formule de probabilité d’intervalle
L’implémentation de la probabilité d’un intervalle quelconque P(x1 ≤ X ≤ x2) dans un environnement de production ne saurait se limiter à la soustraction naïve =(B5-B4)/(B2-B1). Une telle formule non régularisée produirait des aberrations statistiques notoires dès lors que les valeurs d’évaluation x1 ou x2 sortiraient des limites autorisées du support [a, b] (aboutissant à des probabilités négatives absurdes ou à des probabilités supérieures à 1,00, en violation directe des axiomes fondamentaux de probabilité).
Pour assurer une étanchéité mathématique totale face aux valeurs périphériques et aux inversions accidentelles, la formule d’évaluation de la probabilité cumulée sur un segment doit être construite en imbriquant des opérateurs d’encadrement logique. La formulation optimale et la plus élégante dans Excel s’écrit de la manière suivante :
=(MIN(Param_b; MAX(Param_a; B5)) – MIN(Param_b; MAX(Param_a; B4))) / (Param_b – Param_a)
Analysons la dynamique de cette structure de calcul. L’expression interne MIN(Param_b; MAX(Param_a; B5)) force le terme supérieur d’évaluation à être strictement borné entre le plancher a et le plafond b : si B5 est inférieur à a, l’opérateur renvoie a ; si B5 est supérieur à b, il renvoie b ; si B5 se situe dans l’intervalle nominal, sa valeur exacte est conservée intacte. Le même traitement symétrique est appliqué à la borne inférieure B4. En intégrant une condition logique globale supplémentaire prévenant l’inversion des bornes de requêtes via la structure SI(B4 > B5; 0; …), la formule devient totalement infaillible, produisant invariablement un résultat probabiliste strictement confiné au sein de l’intervalle [0, 1].
5.3 Calcul de la moyenne, de la variance et de l’écart-type dans Excel
Une fois les paramètres d’échelle calibrés, la détermination des moments statistiques théoriques s’exécute par des relations mathématiques explicites implémentées dans les cellules d’analyse descriptive du tableau :
- Espérance mathématique (μ) : Dans la cellule B7, la moyenne théorique se formule par l’écriture directe de son centre arithmétique : =(Param_a + Param_b) / 2.
- Variance théorique (σ²) : Dans la cellule B8, l’évaluation de la dispersion s’obtient par l’élévation au carré de l’amplitude divisée par la constante 12 : =((Param_b – Param_a)^2) / 12.
- Écart-type théorique (σ) : Dans la cellule B9, la dispersion s’exprime dans l’unité originale de la variable stochastique en appliquant la fonction de racine carrée : =RACINE(B8), ou directement par la formule =(Param_b – Param_a) / RACINE(12).
Il convient de souligner l’importance de la cohérence dimensionnelle lors de ces calculs. Si les bornes d’entrée a et b quantifient une grandeur physique exprimée en minutes, l’espérance calculée dans la cellule B7 et l’écart-type logé en B9 s’exprimeront rigoureusement en minutes, tandis que la variance obtenue en B8 s’exprime formellement en minutes au carré (min²). Cette distinction d’ingénierie statistique est critique pour éviter toute confusion lors de l’interprétation comparative avec des distributions expérimentales ou lors de l’agrégation de variances dans le cadre de modèles de propagation d’incertitudes.
6. Techniques de simulation de Monte-Carlo pour la loi uniforme dans Excel
6.1 La méthode de transformation inverse appliquée à [a, b]
La simulation probabiliste de Monte-Carlo repose sur la possibilité de synthétiser des trajectoires aléatoires artificielles d’une variable à partir de nombres pseudo-aléatoires canoniques. Le théorème universel de la transformation inverse stipule que si une variable aléatoire U suit rigoureusement une distribution uniforme continue standard sur l’intervalle unitaire [0, 1], alors pour toute fonction de répartition cumulative F continue et strictement croissante, la variable transformée définie par X = F⁻¹(U) suit exactement la loi de probabilité modélisée par F.
En appliquant ce théorème à la fonction quantile de la loi uniforme continue que nous avons formalisée à la section 3.3, l’inversion mathématique donne la relation linéaire de transport de mesure :
X = a + U * (b – a), avec U ~ U(0, 1)
La transposition de ce principe mathématique dans la syntaxe native d’Excel est d’une remarquable concision opérationnelle. Pour générer une observation synthétique de la variable uniforme X sur le support [a, b], il suffit d’insérer dans une cellule cible la formule de transformation :
=$B$1 + ($B$2 – $B$1) * ALEA()
En étendant cette formule sur une colonne matricielle de 1 000, 10 000 ou 100 000 lignes (par exemple de la cellule C1 à C10000), le tableur génère instantanément un échantillon empirique complet représentatif de la population théorique modélisée. Grâce aux capacités d’accélération multithread d’Excel, le temps de calcul d’une colonne de 50 000 observations uniformes par cette méthode ne requiert généralement qu’une fraction de seconde sur des architectures matérielles contemporaines.
6.2 Utilisation de l’outil Table de données pour automatiser les itérations
Si la méthode d’extension par colonnes convient pour des modèles légers, elle devient rapidement lourde et pénalisante en mémoire vive dès lors que le modèle de simulation comporte de nombreuses étapes intermédiaires de calcul matriciel. L’ingénierie Excel offre une technique de pointe pour industrialiser la simulation de Monte-Carlo sans requérir l’écriture de macros VBA : l’utilisation d’une Table de données à une variable (accessible via le menu Données > Analyse de scénarios > Table de données).
Le protocole opératoire se structure selon la séquence méthodique suivante :
- Construisez votre modèle stochastique complet dans une cellule récapitulative unique (par exemple la cellule E2), dont le calcul dépend directement d’une cellule source contenant la formule ALEA().
- Définissez une plage d’itérations verticale dans une zone vierge du classeur, en numérotant les lignes d’exécution de 1 à N (par exemple de la cellule G2 à G1001 pour exécuter 1 000 réplications d’échantillonnage).
- Liez l’en-tête de la colonne adjacente de résultats (la cellule H1) à votre cellule de résultat stochastique en écrivant =E2.
- Sélectionnez la matrice complète englobant la numérotation et la colonne de résultat (plage G1:H1001), ouvrez le menu Table de données, laissez le champ Cellule d’entrée en ligne totalement vide, et spécifiez dans le champ Cellule d’entrée en colonne l’adresse d’une cellule vierge neutre quelconque de votre feuille de calcul (par exemple $Z$100).
Dès la validation, le moteur de calcul d’Excel force le recalcul itératif du modèle pour chacune des 1 000 lignes sélectionnées, en injectant une nouvelle valeur pseudo-aléatoire à chaque pas de simulation. Cette méthodologie permet d’isoler les résultats dans une structure compacte, extrêmement performante et auditable, fournissant une batterie d’estimateurs empiriques dont la stabilité statistique converge vers les paramètres théoriques au rythme de la racine carrée de la taille de l’échantillon (1 / √N), conformément à la loi forte des grands nombres.
6.3 Génération via l’utilitaire d’analyse de données (Analysis ToolPak)
Pour les contextes scientifiques et industriels requérant une reproductibilité absolue et des jeux de données figés dès leur création, le recours aux fonctions dynamiques volatiles peut s’avérer contre-productif. Microsoft Excel intègre nativement un module d’ingénierie statistique avancée dénommé Utilitaire d’analyse (ou Analysis ToolPak), accessible sous l’onglet Données dans le groupe Analyse (nécessitant une activation préalable dans les options de compléments du logiciel).
L’utilitaire intègre un outil hautement spécialisé nommé Génération de nombres aléatoires. Son interface de paramétrage permet de choisir explicitement la distribution cible via un menu déroulant comportant l’option formelle Uniforme. Les paramètres à renseigner dans la boîte de dialogue sont les suivants :
- Nombre de variables : Indiquez le nombre de colonnes de données stochastiques indépendantes à produire en sortie.
- Nombre de points aléatoires : Spécifiez la taille d’échantillon désirée (par exemple 5 000 lignes).
- Paramètres de la loi : Renseignez directement la borne inférieure a et la borne supérieure b régissant l’intervalle continu cible.
- Valeur de départ aléatoire (Graine / Seed) : Ce paramètre constitue l’atout méthodologique déterminant de l’outil. En saisissant un entier fixe arbitraire (par exemple 12345), l’algorithme initialise son registre de congruence pseudo-aléatoire sur un état déterministe invariable.
La saisie d’une graine déterministe garantit que toute réexécution future de la procédure générera rigoureusement la même suite de valeurs aléatoires au bit près. Cette traçabilité est essentielle dans les processus d’audit réglementaire, la recherche clinique ou la validation de modèles financiers, où les examinateurs doivent pouvoir répliquer à l’identique l’échantillon empirique initial sans subir l’aléa dynamique du recalcul automatique du classeur.
7. Étude de cas 1 : Modélisation des temps d’attente aux transports
7.1 Présentation du problème stochastique du bus à passage régulier
Afin d’illustrer la pertinence empirique de la loi uniforme continue, examinons un problème classique d’ingénierie des flux de transport et d’optimisation de l’expérience usager. Soit un réseau de transport urbain où une ligne de bus à cadence élevée fonctionne selon une fréquence nominale stricte : un véhicule dessert un arrêt donné toutes les 20 minutes avec une régularité chronométrique absolue. Un voyageur se présente à cet arrêt à un instant totalement imprévisible de la journée, sans consultation préalable de l’horaire de passage en temps réel.
Sous l’hypothèse rationnelle que l’instant d’arrivée du voyageur est indépendant du cycle de rotation des véhicules, le temps d’attente résiduel X (exprimé en minutes) avant le passage du prochain véhicule constitue une variable aléatoire continue distribuée de manière parfaitement uniforme sur l’intervalle fermé borné entre a = 0 minute (le voyageur franchit l’arrêt au moment exact où le bus ouvre ses portes) et b = 20 minutes (le bus vient de refermer ses portes et démarre sous les yeux de l’usager, contraignant ce dernier à attendre l’intégralité du cycle de rotation inter-véhiculaire).
L’interrogation stochastique standard formulée par l’autorité organisatrice des transports est la suivante : quelle est la probabilité objective que le temps d’attente subi par cet usager n’excède pas 8 minutes (soit P(X ≤ 8)) ? Par ailleurs, quelles sont les métriques structurelles fondamentales régissant ce dispositif logistique en termes d’espérance de temps perdu et de dispersion statistique des temps d’attente ?
7.2 Mise en œuvre numérique pas à pas dans le tableur
La résolution analytique et empirique de ce problème s’articule méthodiquement dans une feuille Excel structurée de la façon suivante :
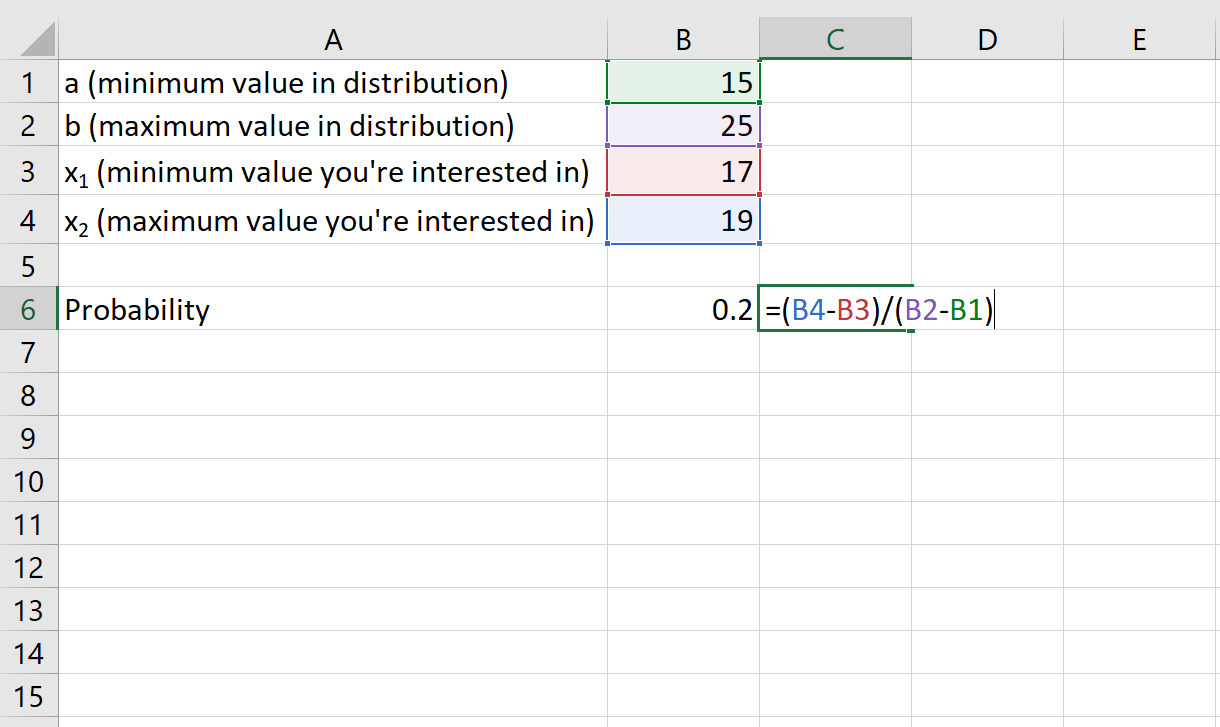
- En cellule A1, inscrivez le libellé Borne_Min_a et saisissez la valeur 0 en cellule B1.
- En cellule A2, inscrivez le libellé Borne_Max_b et saisissez la valeur 20 en cellule B2.
- En cellule A4, inscrivez le seuil d’évaluation Cible_x et saisissez la valeur 8 en cellule B4.
Le calcul de la probabilité cumulée P(X ≤ 8) est implémenté en cellule B6 par l’écriture directe de la fonction de répartition universelle :
=(MIN(B2; MAX(B1; B4)) – B1) / (B2 – B1)
L’évaluation numérique produit le ratio arithmétique rigoureux : (8 – 0) / (20 – 0) = 8 / 20 = 0,40, soit exactement 40,0 % de probabilité. L’usager possède donc quatre chances sur dix d’attendre 8 minutes ou moins à cet arrêt. Les indicateurs de synthèse se calculent concomitamment dans les cellules adjacentes :
- Temps d’attente moyen théorique (μ) : Calculé en cellule B8 par =(B1 + B2) / 2, fournissant rigoureusement 10,0 minutes.
- Variance du temps d’attente (σ²) : Calculée en cellule B9 par =((B2 – B1)^2) / 12, ce qui donne 400 / 12 = 33,333 min².
- Écart-type du temps d’attente (σ) : Calculé en cellule B10 par =RACINE(B9), aboutissant à 5,77 minutes (soit 5 minutes et 46 secondes d’incertitude moyenne autour de l’espérance mathématique).
7.3 Extensions analytiques du scénario de transport
Poussons l’investigation vers des scénarios opérationnels plus élaborés fréquemment rencontrés dans les études d’optimisation des services publics. Considérons en premier lieu la probabilité que le temps d’attente soit circonscrit dans une plage intermédiaire critique comprise entre 5 et 12 minutes (soit P(5 ≤ X ≤ 12)). L’application de la formule de probabilité d’intervalle développée à la section 3.1 produit : (12 – 5) / (20 – 0) = 7 / 20 = 0,35, soit une probabilité de 35,0 %.
Examinons ensuite une requête stochastique conditionnelle : supposons que l’usager ait déjà patienté durant 5 minutes sans qu’aucun bus ne se soit présenté. Quelle est la probabilité révisée que son temps d’attente total cumulé ne dépasse pas 12 minutes ? L’application du formalisme de Bayes et du conditionnement uniforme développé à la section 3.2 conduit à évaluer :
P(X ≤ 12 | X > 5) = P(5 < X ≤ 12) / P(X > 5)
Le numérateur correspond à l’intervalle [5, 12] dont la probabilité marginale vaut (12 – 5) / 20 = 7 / 20. Le dénominateur correspond à la probabilité de survie au-delà de 5 minutes, valant (20 – 5) / 20 = 15 / 20. Le rapport conditionnel s’établit par conséquent à :
(7 / 20) / (15 / 20) = 7 / 15 ≈ 0,4667, soit 46,67 %.
Cette élévation de la probabilité de 35 % à 46,67 % illustre parfaitement la réévaluation homothétique du support : sachant que les 5 premières minutes sont révolues, le support effectif résiduel de la variable s’est contracté à l’intervalle [5, 20], d’amplitude 15 minutes. Ce comportement met en lumière la divergence conceptuelle absolue avec un processus d’arrivée poissonnien sans mémoire régi par une distribution exponentielle, où la probabilité d’attendre encore un temps donné demeurerait strictement invariante quel que soit le passé temporel déjà accumulé à l’arrêt.
8. Étude de cas 2 : Variabilité biométrique et contrôle de pesée
8.1 Paramétrage d’un modèle d’échantillonnage biologique
La deuxième étude de cas explore l’utilisation de la distribution uniforme continue dans le cadre du contrôle qualité et de la modélisation biométrique exploratoire. Considérons un laboratoire d’écologie comportementale procédant à l’analyse pondérale d’une cohorte de spécimens d’une espèce de micromammifères au cours d’une phase de développement spécifique. Les observations biologiques préliminaires indiquent que la masse corporelle des individus matures est strictement comprise entre un minimum physiologique a = 15,0 grammes et un plafond adaptatif b = 25,0 grammes.
Durant les phases initiales d’investigation, lorsque les données physiologiques sont trop parcellaires pour justifier l’ajustement d’un modèle paramétrique complexe à cloche (telle qu’une distribution gaussienne ou log-normale), le principe d’entropie maximale de Jaynes stipule que la distribution uniforme constitue l’hypothèse d’inférence statistique la plus neutre et la moins biaisée qui soit, car elle maximise le désordre informationnel sur le support considéré sans introduire de préjugé morphologique indu.
Le protocole de recherche scientifique exige d’évaluer plusieurs segments de ségrégation phénotypique : identifier la proportion attendue de spécimens appartenant à une classe de masse moyenne standardisée comprise entre 18,0 g et 22,0 g, estimer le pourcentage de la population présentant un poids extrême supérieur à 23,5 g, et vérifier la stabilité de ces proportions par une simulation de validation à grande échelle sous Excel.
8.2 Résolution des requêtes probabilistes spécifiques dans Excel
Structurons notre modèle d’analyse biométrique au sein d’une nouvelle grille de calcul :
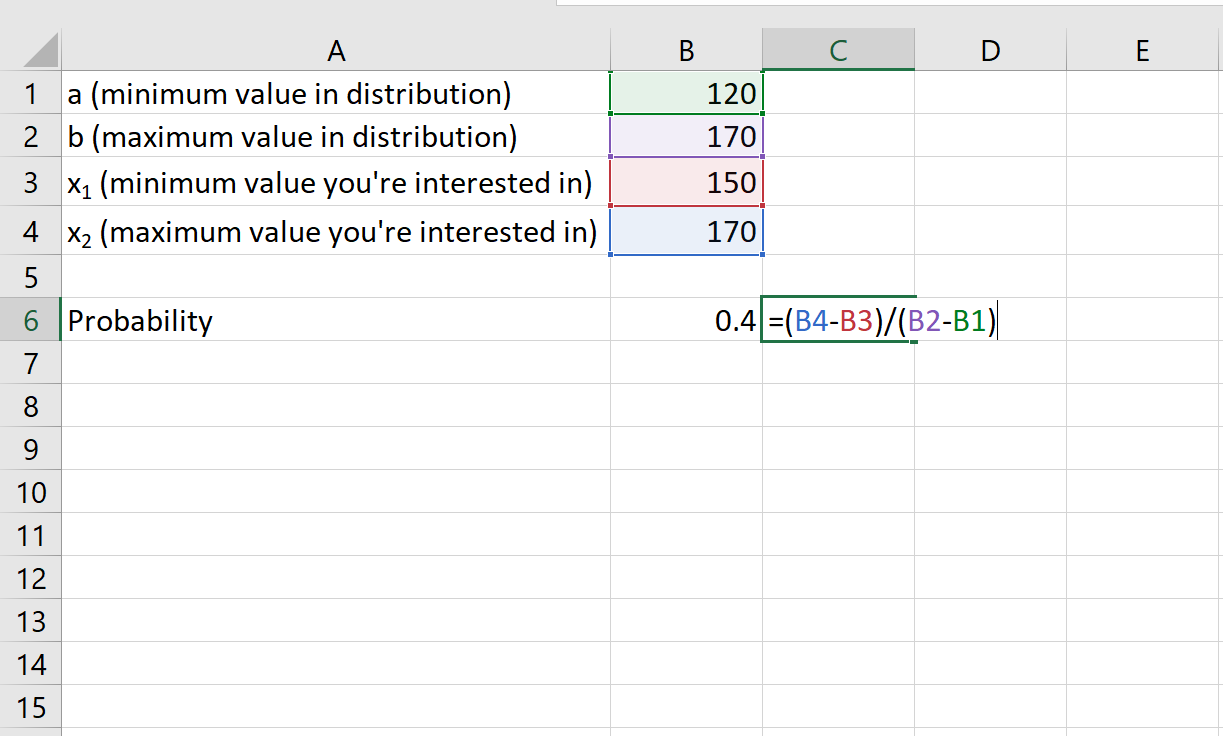
- En cellule D1, paramètre a : saisir 15,0.
- En cellule D2, paramètre b : saisir 25,0.
- En cellules D4 et E4, bornes du premier segment d’analyse : saisir respectivement 18,0 et 22,0.
- En cellule D5, seuil de masse haute : saisir 23,5.
Pour résoudre la première interrogation concernant la probabilité de l’intervalle pondéral [18,0 g ; 22,0 g], nous appliquons la formule en cellule F4 :
=(MIN(D2; MAX(D1; E4)) – MIN(D2; MAX(D1; D4))) / (D2 – D1)
Ce calcul débouche sur le résultat analytique : (22,0 – 18,0) / (25,0 – 15,0) = 4,0 / 10,0 = 0,40, soit une fréquence théorique de 40,0 % de la population au sein de cette tranche pondérale.
Pour la seconde interrogation portant sur la probabilité de dépassement du seuil pondéral extrême P(X > 23,5), la fonction de survie complémentaire s’implémente en cellule F5 par :
=(D2 – MIN(D2; MAX(D1; D5))) / (D2 – D1)
L’évaluation produit immédiatement : (25,0 – 23,5) / (25,0 – 15,0) = 1,5 / 10,0 = 0,15, soit 15,0 % d’individus présentant un gabarit supérieur à 23,5 grammes.
Pour valider empiriquement ces déductions analytiques, nous construisons un banc d’épreuve de Monte-Carlo au moyen de 5 000 tirages virtuels logés dans la plage cellulaire H1:H5000, en appliquant la formule vectorielle =15 + (25 – 15) * ALEA(). En utilisant la fonction de comptage conditionnel NB.SI.ENS, nous recensons le nombre de réalisations tombant dans l’intervalle [18 ; 22] via la formule =NB.SI.ENS(H1:H5000; « >=18 »; H1:H5000; « <=22 ») / 5000. Sur un tirage standard, cette formule renvoie une valeur empirique typiquement oscillant entre 0,392 et 0,408, confirmant de façon expérimentale la convergence vers la valeur théorique de 40,0 %.
8.3 Analyse de sensibilité et tolérance aux déviations de bornes
Dans tout dispositif expérimental réel, les bornes physiques a et b sont assujetties à des incertitudes métrologiques d’échantillonnage. Quelle est la robustesse des probabilités calculées face à une erreur d’estimation sur la borne supérieure b ? Supposons que la véritable limite supérieure de la population soit en réalité b = 26,5 g au lieu des 25,0 g postulés initialement.
Pour quantifier systématiquement l’élasticité du modèle sans briser sa structure, nous déployons le Gestionnaire de scénarios d’Excel (ruban Données > Analyse de scénarios > Gestionnaire de scénarios). Nous configurons trois états d’incertitude sur la cellule D2 (représentant la borne b) :
- Scénario Conservateur : b = 24,0 g (amplitude réduite de 9,0 g).
- Scénario Nominal : b = 25,0 g (amplitude de base de 10,0 g).
- Scénario Élargi : b = 26,5 g (amplitude dilatée de 11,5 g).
La génération automatique du rapport de synthèse des scénarios montre que la probabilité de capturer un spécimen dans l’intervalle [18 ; 22] passe respectivement de 44,4 % dans le scénario conservateur (4 / 9) à 40,0 % dans le scénario nominal (4 / 10), pour chuter à 34,8 % dans le scénario élargi (4 / 11,5). De même, la proportion de spécimens au-delà de 23,5 g bondit de 5,5 % (0,5 / 9) à 26,1 % (3 / 11,5). Cette analyse de sensibilité met en exergue la sensibilité critique des modèles uniformes aux fluctuations de leurs frontières d’échantillonnage : une variation marginale de l’amplitude du support produit un effet de dilution immédiat sur l’ensemble des probabilités locales.
9. Visualisation graphique avancée de la distribution uniforme dans Excel
9.1 Construction du tracé de la fonction de densité de probabilité
La restitution visuelle de la fonction de densité de probabilité (FDP) d’une loi uniforme dans Excel constitue un défi graphique classique : il s’agit de tracer une courbe en créneau parfait (fonction porte), caractérisée par des transitions verticales instantanées entre le niveau d’équiprobabilité 1 / (b – a) et le niveau de base nul situé en deçà de a et au-delà de b.
Pour construire ce tracé sans distorsion d’interpolation, il est nécessaire de générer une table d’abscisses et d’ordonnées comportant des points doubles aux frontières de discontinuité. Considérons une loi U(10, 30), dont la densité unitaire vaut 1 / (30 – 10) = 0,05. La structure tabulaire adéquate doit être encodée selon l’agencement méthodique suivant au sein des colonnes A (abscisses x) et B (densités f(x)) :
- Point 1 : x = 0 | f(x) = 0 (ancre de ligne de base gauche).
- Point 2 : x = 10 | f(x) = 0 (frontière basse externe).
- Point 3 : x = 10 | f(x) = 0,05 (frontière basse interne : création de la discontinuité verticale).
- Point 4 : x = 30 | f(x) = 0,05 (frontière haute interne : segment de plateau constant).
- Point 5 : x = 30 | f(x) = 0 (frontière haute externe : discontinuité verticale descendante).
- Point 6 : x = 40 | f(x) = 0 (ancre de ligne de base droite).
Sélectionnez cette plage de données puis insérez un Graphique en nuage de points avec lignes droites (sans aucun lissage cubique par splines, qui introduirait des ondulations parasites irréelles aux points d’inflexion). Pour mettre en valeur l’intégrale unitaire sous-jacente, il est particulièrement élégant de transformer ce nuage de points en graphique d’aire ou d’appliquer un remplissage semi-transparent sous le plateau horizontal, matérialisant ainsi graphiquement le rectangle d’aire unité dont la surface totale représente la certitude probabiliste absolue (1,00).
9.2 Représentation graphique de la fonction de répartition cumulative
La représentation de la fonction de répartition cumulative (CDF) nécessite quant à elle la restitution graphique d’une fonction continue affine par morceaux, se stabilisant à l’horizontale sur 0 avant la borne a, progressant de façon strictement linéaire jusqu’à la borne b, puis se stabilisant définitivement sur un plateau horizontal d’altitude 1,00.
Pour générer cette courbe avec une fluidité visuelle irréprochable, configurez une séquence d’abscisses régulièrement espacées couvrant largement le support d’étude. Dans la première colonne (colonne A), utilisez par exemple la fonction dynamique SEQUENCE(101; 1; 0; 0,4) pour créer 101 points d’abscisses s’étendant de 0 à 40 avec un pas de discrétisation fin de 0,4. Dans la colonne adjacente (colonne B), appliquez à chaque ligne la formule robuste de la fonction de répartition formalisée précédemment :
=(MIN(30; MAX(10; A2)) – 10) / (30 – 10)
Sélectionnez l’intégralité du tableau de points et insérez un Graphique en nuage de points avec lignes droites sans marqueurs. Le rendu visuel affiche impeccablement la signature géométrique de la distribution uniforme : un plateau d’altitude nulle jusqu’au point d’abscisse 10, suivi d’une rampe d’ascension oblique à pente constante 1 / (b – a) = 0,05 s’élevant jusqu’au point d’abscisse 30, prolongée enfin par un plateau horizontal parfaitement stabilisé à l’altitude unitaire 1,00. Des segments orthogonaux verticaux et horizontaux peuvent être ajoutés pour pointer visuellement la position des quantiles stratégiques Q1 (p=0,25 ; x=15), Médiane (p=0,50 ; x=20) et Q3 (p=0,75 ; x=25).
9.3 Création d’un histogramme de validation empirique
Le contrôle de la convergence d’une simulation stochastique vers sa distribution théorique s’effectue traditionnellement par la construction d’un histogramme empirique de fréquences. Supposons que nous ayons généré un échantillon synthétique de 10 000 observations d’une loi U(10, 30) dans la colonne F d’une feuille de travail.
Pour structurer cet histogramme de manière statistiquement rigoureuse, il convient de partitionner l’espace d’échantillonnage en un nombre optimal de classes (ou bins). L’application de la règle empirique de Freedman-Diaconis fournit la largeur de classe idéale h = 2 * IQR * N^(-1/3). Pour notre loi où IQR = 10 et N = 10 000, nous obtenons h ≈ 2 * 10 * 0,0464 ≈ 0,93. Nous pouvons ainsi retenir de manière pragmatique une largeur de classe de 1,0 unité, subdivisant le segment [10, 30] en exactement 20 classes consécutives de même largeur.
Implémentez les bornes supérieures de classes dans la colonne I (valeurs allant de 11 à 30). Dans la colonne adjacente J, insérez la puissante fonction matricielle native FREQUENCE(F1:F10000; I1:I20). Normalisez ensuite les effectifs bruts obtenus en les divisant par le produit de la taille de l’échantillon par la largeur de classe (N * h = 10 000 * 1 = 10 000) pour convertir les ordonnées en unités de densité de probabilité. En traçant un graphique combiné (histogramme à barres verticales pour les densités empiriques observées, superposé à une courbe linéaire pour la densité théorique constante fixée à 0,05), l’observateur constate l’ajustement empirique remarquable du générateur : les barres de l’histogramme oscillent étroitement autour de la ligne théorique de 0,05, matérialisant visuellement le principe de convergence asymptotique.
10. Tests d’adéquation et validation statistique de l’uniformité dans Excel
10.1 Implémentation du test du Khi-deux d’adéquation (Goodness-of-Fit)
L’évaluation visuelle d’un histogramme ne saurait suffire à garantir la validité scientifique d’un générateur stochastique ou d’une hypothèse de distribution. Il est impératif de recourir à des tests d’hypothèse formels d’adéquation. Le premier test canonique est le test du Khi-deux de Pearson (Goodness-of-Fit test), dont la finalité consiste à vérifier si les écarts constatés entre des effectifs observés et des effectifs attendus théoriques relèvent uniquement de fluctuations d’échantillonnage aléatoire ou traduisent un rejet franc de l’hypothèse nulle d’uniformité (H0).
Pour mettre en œuvre ce test sous Excel sur un échantillon de taille N = 1 000 issu d’une loi présumée U(a, b), procédons selon les étapes méthodologiques suivantes :
- Subdivisez le support [a, b] en k classes disjointes de même largeur (par exemple k = 10 sous-intervalles). En vertu de l’équiprobabilité théorique, chaque classe possède une probabilité élémentaire pi = 1 / k = 0,10.
- Déterminez l’effectif théorique attendu au sein de chaque classe, noté Ei. Celui-ci est rigoureusement constant pour toutes les classes et vaut Ei = N * pi = 1 000 * 0,10 = 100 observations.
- Dénombrez les effectifs empiriques réels Oi observés dans chaque classe à l’aide de la fonction FREQUENCE() ou de la commande NB.SI.ENS().
- Dans une colonne dédiée, calculez la contribution élémentaire de chaque classe à la statistique de divergence du Khi-deux via la relation algébrique canonique : =(Oi – Ei)^2 / Ei.
- Sommez l’ensemble de ces contributions pour obtenir la statistique d’épreuve globale : χ²_obs = Σ [(Oi – Ei)² / Ei].
Sous l’hypothèse nulle H0, cette statistique suit asymptotiquement une loi du Khi-deux à k – 1 – p degrés de liberté. Aucun paramètre n’ayant été estimé à partir de l’échantillon (les bornes a et b étant fixées a priori), le nombre de degrés de liberté s’établit à ddl = 10 – 1 – 0 = 9. La p-valeur du test se calcule immédiatement dans Excel via la fonction native LOI.KHIDEUX.DROITE(χ²_obs; 9). Si la p-valeur obtenue excède le seuil d’erreur standard de premier ordre α = 0,05, nous échouons à rejeter l’hypothèse nulle : la distribution de l’échantillon est considérée comme rigoureusement compatible avec une loi uniforme continue.
10.2 Approche du test de Kolmogorov-Smirnov dans un tableur
Bien que le test du Khi-deux soit robuste, il présente le désavantage structurel d’exiger une discrétisation arbitraire en classes, introduisant une perte d’information métrique sur les données continues. Le test non paramétrique de Kolmogorov-Smirnov (K-S) résout cet écueil en opérant directement sur les valeurs brutes individuelles non regroupées, en mesurant l’écart absolu maximal entre la fonction de répartition empirique Fn(x) et la fonction de répartition cumulative théorique F(x).
La mise en œuvre de l’algorithme de Kolmogorov-Smirnov sous Excel pour un échantillon de N observations (par exemple N = 100 valeurs logées dans la plage A2:A101) se formalise ainsi :
- Triez impérativement l’échantillon de données dans l’ordre croissant au sein de la colonne A.
- Attribuez à chaque ligne un indice de rang i s’échelonnant de 1 à N dans la colonne B.
- Calculez la fonction de répartition empirique en palier supérieur en colonne C : =i / N (soit =B2/100).
- Calculez la fonction de répartition empirique en palier inférieur en colonne D : =(i – 1) / N (soit =(B2-1)/100).
- Calculez la valeur théorique de la CDF en colonne E via l’équation uniforme : =(A2 – a) / (b – a).
- Déterminez les écarts verticaux absolus aux bornes de chaque palier dans les colonnes F et G via les formules =ABS(C2 – E2) et =ABS(D2 – E2).
La statistique suprémum du test, notée D, est extraite en appliquant la fonction =MAX(F2:G101). Cette valeur observée D_max quantifie la divergence géométrique maximale entre la réalité empirique et le modèle théorique. La valeur critique d’acceptation au seuil de significativité α = 0,05 s’estime, pour N > 35, par la formule asymptotique de Smirnov : D_critique = 1,36 / √N. Pour notre échantillon de 100 points, la valeur seuil est 1,36 / √100 = 0,136. Si la statistique D_max calculée demeure strictement inférieure à 0,136, l’adéquation à la loi uniforme continue est pleinement confirmée au niveau de confiance de 95 %.
10.3 Évaluation de la qualité du générateur de nombres aléatoires
L’intégrité des simulations d’entreprise repose sur l’absence totale de corrélations sérielles cachées au sein du générateur aléatoire employé. Même si l’algorithme d’Excel satisfait les tests fréquentiels classiques d’équiprobabilité univariée, il est indispensable de s’assurer que le tirage à l’instant t n’exerce aucune influence prédictive sur le tirage à l’instant t + 1.
Un outil diagnostique statistique d’une grande efficacité consiste à concevoir un graphique de dispersion retardé (communément désigné sous l’appellation de Lag Plot). Pour concevoir ce banc de contrôle :
- Dans la colonne A (cellules A1:A999), placez une série de 999 tirages successifs générés par la fonction ALEA(), représentant la série temporelle X(t).
- Dans la colonne B (cellules B1:B999), décalez la série d’une position vers le bas en copiant les valeurs de A2:A1000, modélisant ainsi la série retardée X(t + 1).
- Générez un graphique de type Nuage de points confrontant X(t) sur l’axe des abscisses et X(t + 1) sur l’axe des ordonnées.
L’analyse visuelle et analytique du nuage de points obtenu est révélatrice : si le générateur est de haute qualité statistique, les points doivent former un semis parfaitement homogène, saturant de manière uniforme le carré unitaire [0, 1] × [0, 1] sans former de grappes, de bandes diagonales, de zones de raréfaction ou de figures géométriques décelables. De plus, le calcul du coefficient de corrélation linéaire de Pearson entre les deux colonnes au moyen de la formule =COEFFICIENT.CORRELATION(A1:A999; B1:B999) doit retourner une valeur statistiquement indiscernable de zéro (typique de l’ordre de ± 0,01), confirmant l’absence totale d’autocorrélation linéaire d’ordre 1 au sein du moteur stochastique du tableur.
11. Applications méthodologiques en psychométrie et sciences comportementales
11.1 Randomisation et attribution aléatoire dans les plans expérimentaux
Dans la recherche expérimentale contemporaine en psychologie cognitive et en sciences comportementales, la validité interne d’une étude repose de manière incontournable sur l’assignation aléatoire stricte des participants aux différents groupes de traitement (par exemple groupe témoin sous placebo versus groupe expérimental recevant une intervention thérapeutique). Ce protocole d’assignation permet d’annihiler les biais de confusion systématiques liés à des variables idiosyncratiques non contrôlées (âge, niveau d’anxiété initial, traits de personnalité ou quotient intellectuel).
La distribution uniforme continue est l’instrument de prédilection pour matérialiser une allocation aléatoire équilibrée sans altérer l’aveuglement méthodologique. Considérons la mise en place d’un protocole devant assigner équitablement 100 participants répertoriés dans la colonne A (identifiants S001 à S100) en deux cohortes de 50 sujets :
- En colonne B, en regard de chaque participant, générez un score uniforme continu non biaisé en appliquant la formule =ALEA(). En vertu des propriétés de la loi uniforme, chaque sujet reçoit un score continu dont la probabilité d’ex-æquo parfait est rigoureusement nulle.
- Figez impérativement la colonne de scores aléatoires au moyen d’un Copier / Collage spécial en valeurs pour prémunir le dispositif contre tout reclassement fortuit ultérieur lors de la saisie des données cliniques.
- En colonne C, calculez le rang de chaque sujet au sein de la série aléatoire au moyen de la formule =RANG.EGAL(B2; $B$2:$B$101). Cela convertit l’échantillon uniforme en une permutation aléatoire rigoureusement équiprobable des entiers de 1 à 100.
- En colonne D, implémentez la règle d’assignation binaire : =SI(C2 ≤ 50; « Groupe Expérimental »; « Groupe Contrôle »).
Cette méthodologie garantit une randomisation d’une rigueur absolue : l’espérance mathématique d’inclusion dans chaque groupe est exactement de 50 %, tout en garantissant a priori un partitionnement déterministe parfait à effectifs strictement égaux, répondant aux exigences les plus contraignantes des protocoles de préenregistrement scientifique (tels que formalisés par les directives CONSORT et l’Open Science Framework).
11.2 Modélisation des intervalles inter-stimuli et temps de réaction de base
L’expérimentation chronométrique en neuropsychologie s’appuie fréquemment sur des paradigmes de temps de réaction simple ou de choix (tâches de type Go/No-Go ou tâche de Stroop). Un écueil expérimental redoutable dans ces protocoles réside dans le conditionnement temporel moteur : si l’intervalle temporel séparant l’avertisseur sonore de l’apparition du stimulus visuel cible (communément dénommé l’intervalle inter-stimuli ou ISI – Inter-Stimulus Interval) est constant ou prévisible, le sujet expérimental développe des stratégies d’anticipation motrice réflexe, invalidant la mesure du temps de traitement cognitif central réel.
Pour neutraliser totalement cette prévisibilité temporelle, les concepteurs de protocoles informatisés paramètrent l’ISI selon une distribution uniforme continue définie sur une fenêtre d’imprévisibilité sensorielle, par exemple U(1 200 ms, 2 800 ms). La génération de la table de séquençage des stimuli s’effectue dans Excel en appliquant pour chaque essai la formule de transformation inverse à l’échelle milliseconde :
=ARRONDI(1200 + (2800 – 1200) * ALEA(); 0)
L’utilisation de cette loi d’équiprobabilité temporelle garantit que le taux de hasard conditionnel perçu par le participant ne présente aucune accélération déterministe abrupte, inhibant ainsi efficacement la libération prématurée de la commande motrice. Par ailleurs, dans la phase d’apurement des données chronométriques recueillies, la loi uniforme est fréquemment mobilisée comme modèle théorique de bruit résiduel pour caractériser et filtrer les réponses ultra-rapides (temps d’appui inférieurs à 150 ms, physiologiquement incompatibles avec le délai minimal de conduction axonale et de traitement synaptique visuel), assimilées à des déclenchements accidentels distribués de manière uniforme le long de la session d’essai.
11.3 Distribution uniforme comme a priori non informatif en inférence bayésienne
L’analyse bayésienne des données s’est imposée comme un standard méthodologique majeur dans l’évaluation des modèles psychométriques modernes. Au cœur du formalisme bayésien réside le théorème éponyme : la distribution de probabilité a posteriori d’un paramètre psychologique θ (par exemple le niveau de compétence latent d’un individu ou l’efficacité d’un protocole cognitif) est proportionnelle au produit de la fonction de vraisemblance des données observées par la distribution de probabilité a priori de ce même paramètre :
P(θ | Données) ∝ P(Données | θ) * P(θ)
Lorsque le chercheur aborde une phase expérimentale exploratoire sans disposer de connaissances préalables validées ou de méta-analyses antérieures fiables, il est d’usage méthodologique d’assigner un a priori non informatif (ou prior plat) au paramètre sous investigation. Ce principe, initialement postulé par Thomas Bayes et Pierre-Simon de Laplace sous le vocable de « principe de raison insuffisante », se formalise mathématiquement par une distribution uniforme continue sur le domaine des valeurs théoriquement admissibles de θ, noté [a, b]. En fixant P(θ) = 1 / (b – a) pour tout θ, la densité a priori se comporte comme une constante scalaire multiplicative neutre.
La mise en œuvre de ce schéma inférentiel dans un tableur Excel permet d’exposer de manière pédagogique et transparente la mécanique d’actualisation bayésienne. Si l’on discrétise le support continu du paramètre θ sur 100 cellules de la colonne A avec une densité a priori uniforme constante inscrite en colonne B (valant systématiquement 0,01), le calcul de la vraisemblance en colonne C pondère directement chaque état possible. Le produit cellule par cellule B * C, normalisé ensuite par sa somme totale en colonne D, engendre directement la distribution de probabilité a posteriori. Dans cette configuration d’a priori uniforme, la distribution a posteriori se trouve être strictement proportionnelle à la fonction de vraisemblance, permettant au praticien d’observer l’impact exclusif des données observées sur l’estimation finale du paramètre psychométrique sans distorsion doctrinale exogène.
12. Erreurs courantes, écueils numériques et bonnes pratiques d’ingénierie Excel
12.1 Gestion des recalculs incontrôlés et volatilité des formules
L’un des pièges les plus déstabilisants lors de la mise en œuvre de modèles probabilistes dans Excel réside dans l’omniprésence du comportement volatil de la fonction ALEA(). Par défaut, le moteur de calcul d’Excel est configuré en mode de recalcul Automatique. Dans cet état opérationnel, toute action d’édition textuelle au sein d’une cellule quelconque, toute modification de format de cellule, tout filtrage de tableau ou toute opération de tri réexécute instantanément l’intégralité des fonctions volatiles du classeur actif.
Pour un modèle stochastique complexe comportant plusieurs dizaines de milliers de lignes de simulation de Monte-Carlo, cette réévaluation permanente et involontaire génère deux préjudices majeurs : d’une part, un effondrement dramatique des performances de calcul de la station de travail, gelant fréquemment l’interface graphique du tableur ; d’autre part, la modification perpétuelle des résultats de synthèse statistique (moyennes empiriques, quantiles, p-valeurs des tests d’adéquation), rendant strictement impossible toute phase d’audit, de présentation contradictoire ou de validation formelle des conclusions avec des pairs ou des régulateurs.
Pour maîtriser ce comportement, il est impératif d’adopter des règles de gouvernance de calcul rigoureuses. Dès que la phase de conception dynamique d’un modèle stochastique est achevée, accédez aux Options d’Excel > Formules > Options de calcul et cochez explicitement l’option Manuel (en désactivant l’option accessoire « Recalculer le classeur avant de l’enregistrer »). Dès lors, le classeur entre dans une phase de stabilité numérique totale. Le déclenchement des simulations stochastiques s’effectue alors exclusivement à la demande expresse de l’analyste au moyen de l’appui sur la touche de fonction F9 (recalcul de l’ensemble des classeurs ouverts) ou par la combinaison Maj + F9 (recalcul ciblé de la seule feuille active). Lorsque les tirages simulés constituent le jeu d’essai définitif d’un rapport, l’analyste doit impérativement opérer un Copier / Collage spécial en valeurs sur la plage de données pour pérenniser de façon immuable les données d’échantillonnage.
12.2 Incohérences de bornes et erreurs de logique conditionnelle
L’intégrité fonctionnelle d’une feuille de calcul probabiliste est constamment menacée par des erreurs humaines de paramétrage géométrique des bornes du support. L’erreur la plus fréquente réside dans la violation de l’hypothèse d’ordre fondamental a < b. Si un utilisateur saisit par mégarde une borne supérieure b inférieure à la borne inférieure a, le dénominateur b – a devient strictement négatif. Dès lors, les formules de probabilité retournent des valeurs probabilistes négatives et les formules de variance fournissent des grandeurs aberrantes.
Le second écueil logique réside dans le non-verrouillage des bornes de requêtes d’intervalle [x1, x2]. La saisie accidentelle d’une borne de début supérieure à la borne de fin (x1 > x2) produit instantanément une probabilité négative si la formule n’intègre pas de filtre logique. De même, l’omission d’une clause d’encadrement lorsque x2 > b peut conduire à des probabilités cumulées supérieures à 1,00 (100 %), en infraction flagrante avec l’axiome fondamental d’unitarité des probabilités.
Pour prémunir structurellement un modèle contre ces défaillances opérationnelles, le concepteur du classeur doit appliquer une stratégie défensive multicouche :
- Implémentez une règle de validation des données sur la cellule du paramètre b interdisant toute saisie où b ≤ a, assortie d’un message d’arrêt explicite.
- Encapsulez systématiquement vos calculs d’intervalles dans une fonction logique sécurisée intégrant la gestion des erreurs de bornes et de division par zéro :
=SI(Param_b ≤ Param_a; « Erreur : Paramètres b ≤ a invalides »; SI(B4 > B5; 0; (MIN(Param_b; MAX(Param_a; B5)) – MIN(Param_b; MAX(Param_a; B4))) / (Param_b – Param_a))) - Adjoignez un module de Mise en forme conditionnelle mettant immédiatement en surbrillance rouge vif toute cellule dont le résultat probabiliste dévierait de l’intervalle canonique strict [0, 1].
12.3 Écueils liés aux arrondis et à la discrétisation involontaire
La précision numérique d’Excel repose sur la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante double précision (64 bits). Cette norme confère au tableur une précision théorique d’environ 15 à 17 chiffres décimaux significatifs. Toutefois, cette puissance de calcul peut être gravement compromise par des erreurs d’ingénierie relatives à l’affichage cosmétique et à la discrétisation involontaire des variables continues.
L’écueil récurrent réside dans l’utilisation de l’option « Définir le calcul avec la précision au format affiché » au sein des options avancées d’Excel. Si cette option est imprudemment activée pour arrondir visuellement des probabilités à deux décimales, Excel altère définitivement le contenu des registres mémoire sous-jacents, transformant des calculs continus précis en approximations tronquées. Lors de calculs de probabilités d’événements rares ou de normalisation de segments d’intervalles infinitésimaux (Δx → 0), cette perte de précision machine engendre des erreurs d’annulation catastrophique par soustraction de nombres quasi-identiques, produisant des instabilités numériques massives.
Par ailleurs, une attention méthodologique absolue doit être portée au choix entre génération continue et discrète. Comme explicité à la section 4.2, l’arrondi naïf d’une distribution uniforme continue par le truchement de la fonction ARRONDI() ne produit pas une distribution uniforme discrète correcte, car les classes terminales subissent un écrasement de 50 % de leur poids d’échantillonnage théorique. Les modèles de calcul probabilistes professionnels doivent être rigoureusement documentés dans des fiches d’audit associées aux classeurs, consignant l’ensemble des hypothèses métrologiques, les formules analytiques sous-jacentes et les protocoles de vérification de l’intégrité arithmétique.
Références
- Evans, M., Hastings, N., & Peacock, B. (2000). Statistical Distributions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471722065
- Fishman, G. S. (1996). Monte Carlo: Concepts, Algorithms, and Applications. Springer-Verlag. https://doi.org/10.1007/978-1-4757-2553-7
- Gentle, J. E. (2003). Random Number Generation and Monte Carlo Methods (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b97336
- Kolmogorov, A. N. (1956). Foundations of the Theory of Probability (2nd English ed., N. Morrison, Trans.). Chelsea Publishing Company. (Ouvrage original publié en 1933).
- Laplace, P.-S. (1814). Essai philosophique sur les probabilités. Courcier. https://gallica.bnf.fr/ark:/12148/bpt6k1061988
- Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- Microsoft Corporation. (2023). Documentation sur les fonctions de feuille de calcul Excel : ALEA, ALEA.ENTRE.BORNES et TABLEAU.ALEAT. Microsoft Support. https://support.microsoft.com/fr-fr/office/
- Mood, A. M., Graybill, F. A., & Boes, D. C. (1974). Introduction to the Theory of Statistics (3rd ed.). McGraw-Hill.
- Robert, C. P., & Casella, G. (2004). Monte Carlo Statistical Methods (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-4145-2
- Winston, W. L. (2014). Microsoft Excel 2013: Data Analysis and Business Modeling. Microsoft Press.