
La modélisation stochastique et l’ingénierie de la décision financière reposent historiquement sur la quantification rigoureuse des aléas. Dans les environnements corporatifs contemporains, les analystes de risques, les gestionnaires de portefeuille et les ingénieurs d’affaires sont constamment confrontés à des situations où les séries chronologiques historiques se révèlent soit inexistantes, soit structurellement caduques en raison de ruptures de paradigme économique. Lorsque les méthodes inférentielles traditionnelles fondées sur la loi normale échouent faute d’un volume suffisant de données empiriques, la recherche opérationnelle et la statistique bayésienne préconisent le recours à des lois de probabilité subjectives capables de capturer l’expertise humaine sous forme de jugements d’intervalles et de valeurs préférentielles. C’est précisément dans ce cadre méthodologique que s’impose la loi triangulaire.
Pourtant, malgré son omniprésence dans les méthodologies de gestion de projet, l’évaluation des coûts d’ingénierie et l’analyse quantitative des risques de crédit, Microsoft Excel ne propose nativement aucune fonction dédiée à cette loi, à la différence des fonctions standardisées telles que LOI.NORMALE.N ou LOI.EXPONENTIELLE.N. Cette lacune fonctionnelle oblige les analystes financiers et les consultants en modélisation à dériver, formuler et programmer manuellement les équations de densité, de répartition cumulative et de quantiles au sein de leurs classeurs. L’absence de standardisation logicielle engendre fréquemment des approximations inadéquates, des erreurs de calcul matriciel ou des incohérences théoriques majeures, particulièrement lors de la transition entre la branche ascendante et la branche descendante de la distribution.
Ce guide propose un traité d’ingénierie quantitative sous Microsoft Excel, alliant rigueur statistique et techniques de modélisation financière. De la démonstration mathématique de ses moments d’ordre supérieur jusqu’à l’automatisation de simulations de Monte-Carlo à grande échelle sans macro, en passant par le développement de modules VBA optimisés et la conception de tableaux de bord graphiques interactifs, cet article décortique chaque dimension analytique de la distribution triangulaire. L’objectif est de doter les professionnels de la décision d’un cadre conceptuel complet et opérationnel pour maîtriser l’incertitude dans leurs feuilles de calcul.
1. Fondements théoriques de la distribution triangulaire
1.1 Définition mathématique et morphologie de la fonction de densité (PDF)
La distribution triangulaire est une distribution de probabilité continue définie formellement sur un support compact fermé noté [a, b], où les scalaires réels a et b représentent respectivement les bornes inférieure et supérieure du domaine de définition. Sa morphologie géométrique fondamentale se caractérise par une fonction de densité de probabilité (PDF, ou Probability Density Function) continue par morceaux, dont l’allure forme un triangle sur le plan cartésien. Contrairement aux distributions asymptotiques telles que la loi normale ou la distribution de Cauchy dont le domaine s’étend sur la droite réelle tout entière, la distribution triangulaire présente l’avantage analytique d’annuler strictement toute probabilité en dehors de son intervalle fondamental, garantissant ainsi l’impossibilité structurelle de générer des valeurs aberrantes ou théoriquement irréalisables.
Sur le plan de l’analyse mathématique, la fonction de densité f(x) est régie par deux équations linéaires distinctes qui se rejoignent en un point singulier noté c, communément désigné comme le mode de la distribution. L’expression analytique de f(x) est rigoureusement définie par la structure par morceaux suivante : pour toute valeur de x comprise entre la borne minimale a et le mode c (au sens large a ≤ x ≤ c), la densité s’accroît de manière affine selon l’équation f(x) = 2(x – a) / ((b – a)(c – a)). Inversement, sur le segment descendant reliant le mode c à la borne maximale b (au sens large c ≤ x ≤ b), la densité décroît linéairement selon l’expression f(x) = 2(b – x) / ((b – a)(b – c)). Enfin, pour tout x strictement inférieur à a ou strictement supérieur à b, la fonction f(x) est identiquement nulle.
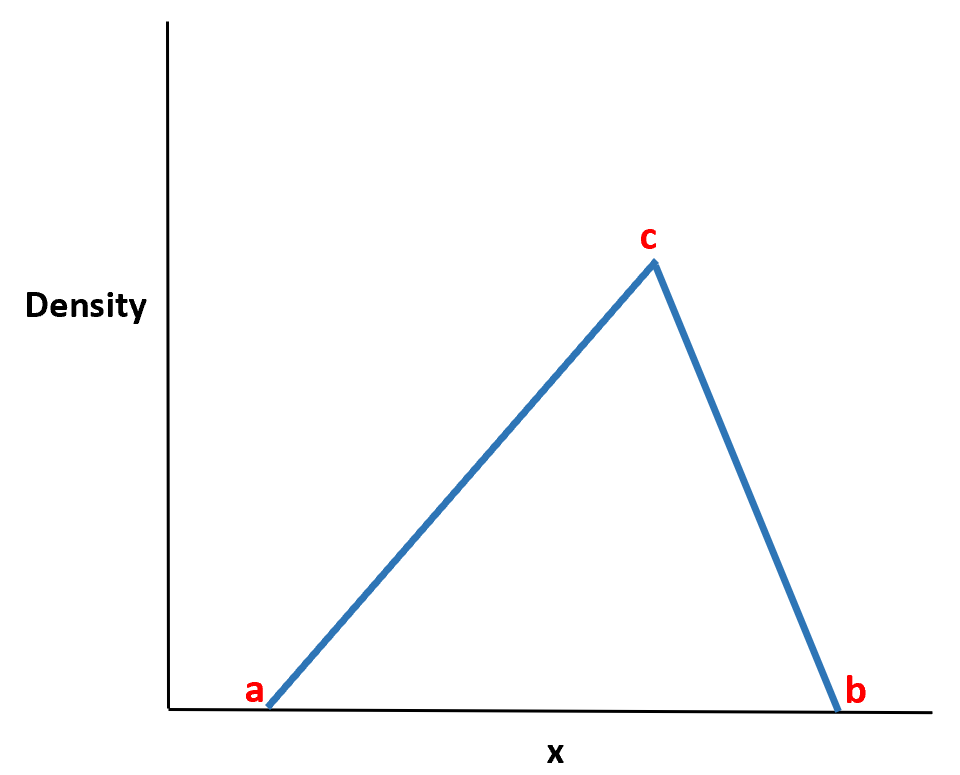
L’interprétation géométrique de cette formulation réside dans l’intégration de la surface sous la courbe, laquelle doit impérativement obéir au premier axiome de Kolmogorov stipulant que l’intégrale de la densité sur l’ensemble du support réel est égale à l’unité. La base du triangle présentant une longueur géométrique mesurée par l’écart (b – a), l’élévation au sommet c correspond nécessairement à la hauteur h du triangle. En appliquant la formule de l’aire d’un polygone triangulaire, Surface = (Base × Hauteur) / 2 = ((b – a) × h) / 2 = 1, on déduit par inversion directe que la hauteur de la densité au point modale atteint une valeur critique immuable égale à h = f(c) = 2 / (b – a). Cette propriété d’invariance d’échelle assure la continuité géométrique au sommet c, bien que la dérivée première de la fonction de densité présente en ce point une discontinuité de saut caractéristique.
1.2 Paramètres constitutifs fondamentaux : minimum (a), maximum (b) et mode (c)
L’architecture de la loi triangulaire repose intégralement sur une paramétrisation parcimonieuse à trois facteurs d’entrée scalaires notés usuellement a, b et c. Le paramètre a incarne la borne inférieure absolue du phénomène étudié. Dans le contexte de la gestion des risques et de l’ingénierie financière, il représente le scénario du pire envisageable (worst-case scenario) ou la frontière physique en deçà de laquelle le système ne peut matériellement pas évoluer. Loin d’être une simple construction abstraite, cette borne est souvent déterminée par des contraintes juridiques, des limites budgétaires infranchissables ou des seuils thermodynamiques stricts.
Le paramètre c constitue le mode ou la valeur la plus probable de la distribution. Sur le plan topologique, il localise l’abscisse correspondant à l’apex de la fonction de densité, c’est-à-dire le point où la concentration de probabilité marginale est maximale. Contrairement à la moyenne arithmétique qui subit l’influence mécanique des valeurs extrêmes, le mode traduit l’intuition centrale des experts métier quant à la trajectoire la plus plausible d’un événement opérationnel ou macroéconomique. Le paramètre b, quant à lui, formalise la borne supérieure maximale admissible, correspondant au scénario le plus optimiste ou à la capacité plafond théorique du système modélisé.
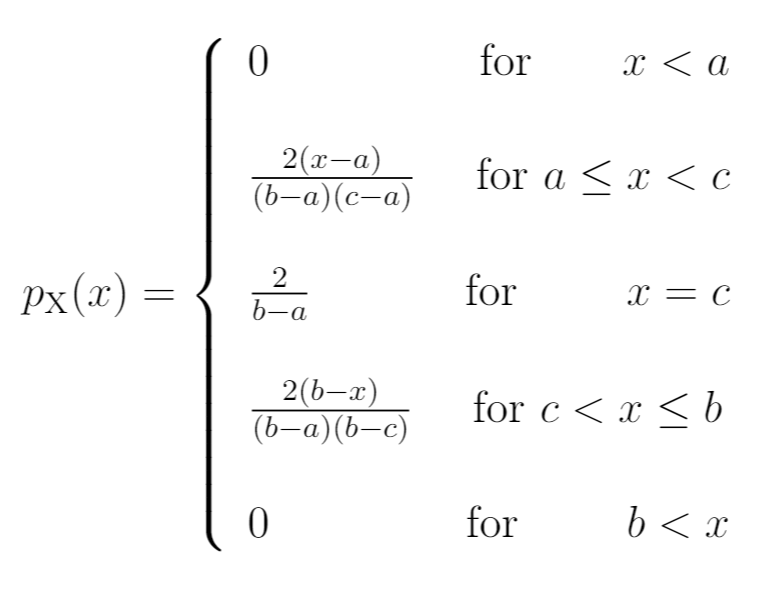
La validité mathématique du triplet de paramètres impose le respect strict de la condition d’ordre a ≤ c ≤ b. Deux cas d’inégalités doivent être méthodologiquement distingués. Lorsque l’on impose des inégalités strictes a < c < b, la distribution forme un triangle non dégénéré doté d’une phase d’accélération et d’une phase de décélération de probabilité. En revanche, lorsque les contraintes s’affaiblissent vers des égalités partielles, la distribution adopte des formes spécifiques remarquables : si le mode coïncide avec la borne inférieure (c = a), la distribution triangulaire devient strictement décroissante sur tout son support, formant un triangle rectangle orienté vers la droite ; symétriquement, si le mode s’aligne sur la borne supérieure (c = b), la distribution devient strictement croissante de a vers b, créant un triangle rectangle orienté vers la gauche.
1.3 Propriétés statistiques fondamentales : espérance, variance et asymétrie
L’exploitation opérationnelle d’une variable aléatoire continue X suivant une distribution triangulaire notée X ~ Triang(a, b, c) requiert l’évaluation analytique de ses moments statistiques d’ordre supérieur. L’espérance mathématique, notée E(X), représente le centre de gravité probabiliste de la distribution. Elle s’obtient par l’intégration de la fonction x × f(x) sur les deux sous-intervalles [a, c] et [c, b]. Au terme des simplifications algébriques, l’espérance s’exprime sous une forme synthétique élégante : E(X) = (a + b + c) / 3. Cette relation fondamentale démontre que l’espérance mathématique d’une loi triangulaire équivaut exactement à la moyenne arithmétique de ses trois paramètres constitutifs, accordant un poids identique d’un tiers à chaque estimation d’entrée.
Le moment centré d’ordre deux, correspondant à la variance théorique notée Var(X), quantifie la dispersion quadratique moyenne des réalisations aléatoires autour de l’espérance. Son calcul par l’intégrale du produit (x – E(X))² × f(x) conduit à la formulation polynomiale suivante : Var(X) = (a² + b² + c² – ab – ac – bc) / 18. L’écart-type théorique σ(X) s’en déduit par l’extraction de la racine carrée de cette quantité. Le diviseur 18, spécifique à la géométrie triangulaire continue, traduit une concentration de masse probabiliste structurellement plus élevée autour du centre de masse que celle observée au sein d’une distribution uniforme continue définie sur les mêmes bornes [a, b], dont le diviseur de variance s’établit à 12.
Le troisième moment centré normalisé permet d’évaluer le coefficient d’asymétrie de Pearson, ou skewness, dont le signe et l’amplitude régissent la déformation structurelle de la distribution. L’expression analytique du coefficient d’asymétrie s’établit selon le ratio suivant : Skewness = [sqrt(2) × (a + b – 2c) × (2a – b – c) × (a – 2b + c)] / [5 × (a² + b² + c² – ab – ac – bc)^(3/2)]. Si le mode c se positionne rigoureusement au centre géométrique des bornes, c’est-à-dire si c = (a + b) / 2, le terme (a + b – 2c) s’annule, rendant la distribution parfaitement symétrique avec un coefficient d’asymétrie nul. Dès lors que c s’écarte du point médian vers la gauche (c < (a + b) / 2), la distribution s’étire vers la droite et présente une asymétrie positive (right-skewed) ; inversement, lorsque c bascule vers la droite (c > (a + b) / 2), la distribution développe une queue allongée vers la gauche et affiche une asymétrie négative (left-skewed).
2. La fonction de répartition cumulative (CDF) et ses formulations
2.1 Comportement analytique pour le segment inférieur au mode (x ≤ c)
La fonction de répartition cumulative, universellement désignée sous l’acronyme CDF (Cumulative Distribution Function) et notée F(x), mesure la probabilité qu’une variable aléatoire continue X prenne une valeur inférieure ou égale à un seuil réel x donné, soit formellement F(x) = P(X ≤ x). Pour déterminer le comportement analytique de cette fonction sur le premier segment du support compact, il convient de procéder à l’intégration définie de la branche ascendante de la fonction de densité f(t) depuis la borne minimale a jusqu’à la valeur d’évaluation x, dans l’hypothèse où x demeure strictement inférieur ou égal au mode c.
L’intégration s’exécute selon l’expression : F(x) = ∫ [2(t – a) / ((b – a)(c – a))] dt, calculée entre les bornes a et x. En factorisant les constantes d’échelle situées au dénominateur et en appliquant le théorème fondamental de l’analyse sur la primitive élémentaire (t – a)² / 2, on obtient la formulation de la probabilité cumulée : F(x) = (x – a)² / ((b – a)(c – a)). Cette fonction présente une nature quadratique pure, ce qui lui confère une concavité dirigée vers le haut et une accélération strictement positive sur l’intervalle [a, c]. Au point d’inflexion morphologique où la variable x atteint exactement la valeur modale c, l’évaluation de la formule donne F(c) = (c – a)² / ((b – a)(c – a)) = (c – a) / (b – a). Ce ratio scalaire représente la proportion exacte de l’espace probabiliste total couverte par la branche ascendante.
Cette décomposition démontre que la probabilité cumulée au mode ne dépend aucunement de la hauteur absolue de la distribution, mais correspond exclusivement à la position relative du mode par rapport à l’envergure totale du support. Dans le cas d’une distribution symétrique où c = (a + b) / 2, la substitution algébrique confirme immédiatement que F(c) = ((a + b)/2 – a) / (b – a) = ((b – a)/2) / (b – a) = 0,5, signifiant que la médiane coïncide parfaitement avec le mode et l’espérance mathématique. Pour toute distribution asymétrique, la valeur F(c) constitue le point pivot déterminant le choix de la branche analytique lors des calculs d’inversion quantile.
2.2 Formulation mathématique pour le segment supérieur au mode (x > c)
Lorsque la variable d’évaluation x dépasse le mode c pour se positionner dans le segment supérieur du support [c, b], le calcul de la fonction de répartition cumulative nécessite l’intégration de la densité sur l’ensemble de la branche ascendante, complétée par l’intégration partielle de la branche descendante entre c et x. Sur le plan conceptuel et calculatoire, il est infiniment plus élégant et robuste d’opérer par soustraction probabiliste en exploitant le principe de la mesure complémentaire de la queue supérieure de distribution. En vertu des règles de l’analyse stochastique, la probabilité cumulée s’obtient en retranchant à l’unité la surface résiduelle située entre x et la borne supérieure b : F(x) = 1 – P(X > x).
L’intégrale de survie P(X > x) correspond à l’aire sous la courbe descendante calculée de x jusqu’à b : ∫ [2(b – t) / ((b – a)(b – c))] dt. L’évaluation de cette primitive produit le ratio géométrique direct (b – x)² / ((b – a)(b – c)). En réinjectant cette composante dans l’équation complémentaire, la fonction de répartition pour le segment supérieur prend la forme canonique : F(x) = 1 – (b – x)² / ((b – a)(b – c)). Cette expression quadratique inversée confère à la courbe de répartition une concavité orientée vers le bas, caractérisée par une croissance marginale décélérée au fur et à mesure que la variable x converge asymptotiquement vers la borne b.
La vérification des conditions aux limites confirme l’exactitude formelle du modèle mathématique : lorsque x tend vers b, le numérateur (b – x)² s’annule rigoureusement, assurant que F(b) = 1 – 0 = 1. De surcroît, la continuité globale de la fonction F(x) sur l’ensemble du domaine fermé [a, b] est préservée sans aucune discontinuité. En réévaluant l’expression de la branche supérieure au niveau du mode en posant x = c, on obtient F(c) = 1 – (b – c)² / ((b – a)(b – c)) = 1 – (b – c) / (b – a) = ((b – a) – (b – c)) / (b – a) = (c – a) / (b – a), ce qui confirme la concordance absolue avec le résultat obtenu via la branche inférieure.
2.3 Dérivation de la fonction quantile ou transformée inverse
Dans l’arsenal méthodologique de l’économétrie appliquée et des simulations stochastiques, la fonction quantile, également désignée sous le terme de fonction de répartition inverse notée Q(u) ou F^(-1)(u), joue un rôle prépondérant. Elle permet de déterminer avec une précision déterministe la valeur exacte de la variable aléatoire x correspondant à un niveau de probabilité cumulée fixé u ∈ [0, 1]. Pour dériver analytiquement cette fonction, il est indispensable d’inverser séparément les deux branches de la fonction de répartition cumulative F(x) en utilisant le seuil pivot u_critique = F(c) = (c – a) / (b – a) comme critère de bifurcation algorithmique.
Pour tout fractile de probabilité u vérifiant la condition 0 ≤ u ≤ (c – a) / (b – a), la variable x se situe nécessairement dans le segment inférieur [a, c]. En posant l’équivalence u = (x – a)² / ((b – a)(c – a)), on isole la variable x par multiplication scalaire du dénominateur suivie de l’extraction de la racine carrée positive, le domaine garantissant que (x – a) ≥ 0. L’équation quantile pour le régime inférieur s’écrit formellement : x = Q(u) = a + sqrt(u × (b – a) × (c – a)). Cette formulation quadratique inverse montre que le quantile croît avec une dérivée seconde positive sur ce premier sous-espace.
Réciproquement, pour tout niveau de probabilité u situé dans le régime supérieur, soit (c – a) / (b – a) < u ≤ 1, la variable x appartient au segment [c, b]. L’inversion de la formule complémentaire u = 1 – (b – x)² / ((b – a)(b – c)) débute par l’isolement du terme quadratique résiduel : 1 – u = (b – x)² / ((b – a)(b – c)). En extrayant à nouveau la racine carrée et en transposant la borne maximale b, on déduit l’expression de la fonction quantile supérieure : x = Q(u) = b – sqrt((1 – u) × (b – a) × (b – c)). Cette dérivation bi-régime constitue le moteur mathématique fondamental indispensable pour la programmation des générateurs aléatoires et le calcul des valeurs à risque (VaR) dans les logiciels de calcul matriciel.
3. Pertinence de la loi triangulaire dans la modélisation cognitive et décisionnelle
3.1 Représentation de l’incertitude subjective en psychologie mathématique
Dans les processus d’allocation de capital et d’ingénierie prévisionnelle, les décideurs opèrent fréquemment sous un régime d’incertitude knightienne, caractérisé par l’incapacité d’assigner des distributions de probabilité objectives basées sur des fréquences d’occurrence observées. En psychologie cognitive et en théorie de la décision, la collecte de jugements experts constitue la méthode primaire pour paramétrer les modèles d’anticipation. Or, solliciter d’un cadre dirigeant, d’un géologue pétrolier ou d’un chef de projet informatique qu’il explicite une variance statistique ou une distribution log-normale engendre presque systématiquement des distorsions conceptuelles et des erreurs d’incompréhension terminologique.
La distribution triangulaire résout ce défi cognitif en sollicitant des experts uniquement des notions immédiatement intuitives et perceptibles : une borne pessimiste (a), une valeur modale la plus fréquente (c), et une borne optimiste (b). En traduisant ces trois estimations scalaires en une distribution de probabilité continue cohérente et fermée, la loi triangulaire formalise un état de connaissance partielle sans introduire d’hypothèses injustifiées sur les queues de distribution infinies. Elle permet de structurer mathématiquement la mémoire épisodique et le jugement heuristique des spécialistes métier, transformant des intuitions qualitatives éparses en vecteurs numériques directement exploitables dans des calculs stochastiques complexes.
Cette approche est particulièrement vertueuse lors de l’élaboration de scénarios contrastés en planification stratégique. Plutôt que de contraindre la réflexion prédictive au sein d’une moyenne déterministe statique, l’expert est invité à explorer les limites extrêmes de son modèle mental tout en affirmant son ancrage opérationnel par l’intermédiaire du sommet modale. La loi triangulaire agit alors comme un réceptacle épistémologique structurant, fournissant un compromis mathématique optimal entre l’arbitraire complet d’une distribution uniforme et la complexité paramétrique d’une distribution bêta généralisée.
3.2 Biais cognitifs d’estimation : effet d’ancrage et surconfiance sur les bornes
Bien que la distribution triangulaire facilite grandement l’élicitation d’avis d’experts, son utilisation expose la modélisation à des distorsions psychologiques systématiques amplement documentées par l’économie comportementale. Le premier de ces écueils cognitifs est l’effet d’ancrage, théorisé par Daniel Kahneman et Amos Tversky. Dans la pratique, lorsqu’un éliciteur sollicite en premier lieu la valeur la plus probable (c), cette estimation initiale agit comme un point d’ancrage psychologique puissant. Par la suite, l’expert aura tendance à ajuster les bornes a et b de manière symétrique et trop resserrée autour de ce mode, sous-estimant dramatiquement l’éventail des possibles sous-jacent.
Le second écueil, encore plus critique dans la quantification financière, est le biais de surconfiance (overconfidence effect). Lorsqu’on demande à des spécialistes d’établir un minimum absolu et un maximum absolu, la recherche empirique démontre qu’ils fournissent en réalité des quantiles correspondant approximativement aux percentiles 10 % et 90 %, voire 20 % et 80 %, plutôt que les frontières réelles à 0 % et 100 %. Cette compression cognitive des intervalles réduit artificiellement la variance théorique du modèle, instillant un sentiment illusoire de maîtrise et occultant la vulnérabilité de l’organisation face aux événements rares mais dévastateurs.
Pour immuniser les classeurs Excel contre ces biais méthodologiques, il est fortement recommandé d’adopter des protocoles de calibration psychologique éprouvés. L’analyste doit impérativement forcer l’élicitation séquentielle en inversant l’ordre traditionnel : questionner d’abord la borne minimale absolue en incitant l’expert à imaginer des scénarios de crise systémique imprévus, questionner ensuite la borne maximale absolue en formulant des hypothèses de synergies exceptionnelles, et enfin, seulement après avoir borné l’espace d’états, solliciter le mode c. Des ajustements mathématiques correctifs, tels que l’extension proportionnelle des bornes déclarées par des facteurs multiplicatifs de sécurité de 10 % à 20 %, peuvent également être intégrés directement dans l’architecture des formules de calcul afin de compenser structurellement la surconfiance épistémique.
3.3 Comparaison critique avec la distribution Bêta-PERT dans l’élicitation d’experts
Dans l’ingénierie de modélisation quantitative, la distribution triangulaire est régulièrement mise en concurrence directe avec la distribution Bêta-PERT (Program Evaluation and Review Technique). Bien que ces deux lois de probabilité partagent exactement la même interface de paramétrisation par trois points (a, c, b), leurs fondements analytiques et leurs comportements morphologiques divergent significativement. La distribution Bêta-PERT représente une version restreinte et recalculée de la loi bêta continue sur support borné, caractérisée par une fonction de densité différentiable sur l’ensemble de son domaine, formant une cloche arrondie dénuée de tout sommet anguleux.
Sur le plan mathématique, l’espérance de la distribution Bêta-PERT classique s’établit selon l’expression pondérée E_PERT(X) = (a + 4c + b) / 6, alors que celle de la distribution triangulaire équivaut à E_TRIANG(X) = (a + c + b) / 3 = (2a + 2c + 2b) / 6. Cette divergence de pondération montre que la distribution Bêta-PERT accorde un coefficient d’influence quatre fois supérieur au mode c par rapport aux valeurs extrêmes, tandis que la loi triangulaire attribue une pondération strictement égale à chaque point d’estimation. Par conséquent, la distribution triangulaire accorde une probabilité substantiellement plus forte aux zones d’extrémités situées près des bornes a et b, ce qui en fait un outil plus conservateur et précautionneux pour l’évaluation des risques opérationnels sévères.
Le choix entre ces deux instruments mathématiques sous Excel repose sur des compromis de mise en œuvre. La distribution Bêta-PERT exige l’appel à la fonction complexe et numériquement exigeante LOI.BETA.N(), laquelle repose sur des calculs d’intégrales eulériennes incomplètes susceptibles de provoquer des ralentissements lors de simulations massives ou de générer des instabilités dans les versions antérieures d’Excel. En contrepartie, la distribution triangulaire se prête à une implémentation algébrique élémentaire basée exclusivement sur des opérations d’addition, de multiplication et de dérivation polynomiale, garantissant une clarté logique immédiate et une vitesse d’exécution computationnelle inégalable.
4. Implémentation manuelle des formules de la distribution triangulaire dans Excel
4.1 Structuration méthodologique de la feuille de calcul et nommage des plages
L’implémentation de modèles mathématiques dans un tableur professionnel exige une rigueur architecturale absolue afin de prévenir les erreurs d’adressage et de faciliter la maintenance logicielle par des tiers. La conception d’un module d’analyse de distribution triangulaire sous Microsoft Excel débute obligatoirement par la séparation hermétique entre le bloc des hypothèses exogènes et le bloc des calculs fonctionnels. Dans une feuille de travail dédiée, il convient de réserver les cellules B2, B3 et B4 pour recevoir respectivement les valeurs numériques des paramètres a, c et b, accompagnées de libellés clairs en colonne A.
L’utilisation de références absolues de cellules de type $B$2 au milieu de formules conditionnelles complexes alourdit considérablement la syntaxe et multiplie le risque d’omission du signe dollar lors des recopies incrémentales. Il est par conséquent impératif d’utiliser le Gestionnaire de noms d’Excel (accessible via le ruban Formules > Définir un nom ou le raccourci clavier Ctrl+F3) pour assigner une variable sémantique à chaque paramètre :
- Associer le nom Param_a à la cellule contenant la borne minimale (cellule B2).
- Associer le nom Param_c à la cellule contenant la valeur modale (cellule B3).
- Associer le nom Param_b à la cellule contenant la borne maximale (cellule B4).
- Associer le nom Variable_x à la cellule d’évaluation du seuil d’intérêt probabiliste (cellule B6).
Cette abstraction de nommage confère aux expressions de calcul une lisibilité comparable à celle d’un code source de haut niveau. Dès lors, les dénominateurs d’échelle (Param_b – Param_a) * (Param_c – Param_a) deviennent transparents, éliminant tout doute quant aux opérations sous-jacentes. En complément, il est fortement recommandé d’implémenter en cellule B5 une cellule de validation logique affichant un indicateur d’intégrité à l’aide d’un test booléen vérifiant la cohérence des paramètres d’entrée : =SI(ET(Param_a < Param_c; Param_c < Param_b); « VALIDÉ »; « ERREUR: Contraintes d’ordre violées »).
4.2 Traduction de la fonction de répartition avec la fonction SI() d’Excel
Pour calculer la fonction de répartition cumulative F(x) = P(X ≤ x) dans Excel sans utiliser de langage de script externe, il est impératif de traduire la formulation mathématique par morceaux à l’aide de la fonction conditionnelle SI() imbriquée. L’algorithme doit séquentiellement évaluer la position relative de la variable par rapport aux quatre zones de l’espace réel : la région extérieure inférieure (x < a), la branche ascendante (a ≤ x ≤ c), la branche descendante (c < x ≤ b), et la région extérieure supérieure (x > b).
En exploitant les plages nommées définies précédemment, la syntaxe exhaustive et robuste permettant de renvoyer la probabilité cumulée exacte sur l’ensemble de la droite réelle s’articule comme suit :
=SI(Variable_x < Param_a; 0; SI(Variable_x ≤ Param_c; (Variable_x – Param_a)^2 / ((Param_b – Param_a) * (Param_c – Param_a)); SI(Variable_x ≤ Param_b; 1 – (Param_b – Variable_x)^2 / ((Param_b – Param_a) * (Param_b – Param_c)); 1)))
Pour optimiser la maintenabilité et l’auditabilité de cette formule au sein de la barre de formule d’Excel, il est recommandé d’insérer des sauts de ligne explicites à l’intérieur de l’éditeur de formule en appuyant sur les touches Alt + Entrée immédiatement après chaque instruction de branchement logique. Cette mise en page aère la structure de l’algorithme : le premier test intercepte toute tentative d’évaluation sous la borne minimale en renvoyant strictement la valeur 0 ; le second palier applique l’intégration quadratique ascendante si la cible se situe sous le mode ; le troisième palier calcule la probabilité complémentaire descendante si la valeur demeure inférieure ou égale au maximum ; enfin, le dernier argument de repli attribue la probabilité absolue 1 (soit 100 %) à toute valeur dépassant le plafond b.
4.3 Formulation de la fonction de densité de probabilité (PDF) sous tableur
L’évaluation de la fonction de densité de probabilité f(x) est essentielle pour construire des courbes de distribution et des représentations graphiques analytiques au sein d’Excel. À l’instar de la fonction de répartition, f(x) est modélisée au moyen de conditions SI() imbriquées capturant la pente ascendante, la pente descendante, ainsi que la nullité stricte hors des frontières d’estimation [a, b]. La structure algorithmique doit impérativement respecter les équations affines définies dans les fondements théoriques.
La formule matricielle ou scalaire standard à saisir dans une cellule d’évaluation de la densité se transcrit ainsi dans la syntaxe francophone d’Excel :
=SI(OU(Variable_x < Param_a; Variable_x > Param_b); 0; SI(Variable_x ≤ Param_c; 2 * (Variable_x – Param_a) / ((Param_b – Param_a) * (Param_c – Param_a)); 2 * (Param_b – Variable_x) / ((Param_b – Param_a) * (Param_b – Param_c))))
Une attention mathématique particulière doit être portée au point de contact singulier où Variable_x = Param_c. Dans la formule ci-dessus, l’évaluation conditionnelle traite ce cas dans la première branche via l’opérateur ≤. Si l’on substitue Param_c à Variable_x dans cette équation, le terme (Variable_x – Param_a) s’annule algébriquement avec le facteur identique situé au dénominateur : 2 * (Param_c – Param_a) / ((Param_b – Param_a) * (Param_c – Param_a)) = 2 / (Param_b – Param_a). Ce résultat est strictement égal à la hauteur théorique h de la distribution triangulaire. De même, si le point avait été orienté vers la seconde branche, le terme (Param_b – Variable_x) se simplifierait à l’identique avec le dénominateur de droite. Cette convergence prouve l’absence d’ambiguïté au sommet modale.
5. Calcul pas à pas de la probabilité cumulée P(X < x) dans Excel
5.1 Décomposition du calcul pour la branche inférieure (x ≤ c)
Afin de fiabiliser les audits de modèles financiers et d’éliminer le phénomène de « boîte noire » souvent reproché aux formules conditionnelles complexes, il est vivement conseillé d’élaborer une grille de décomposition arithmétique étape par étape. Pour une évaluation se positionnant sous la valeur modale c, le calcul de la probabilité cumulée repose sur l’interaction entre une mesure d’écart quadratique locale et un facteur d’échelle globale du sous-domaine.
La première phase analytique consiste à isoler l’écart relatif entre la valeur cible x et l’origine minimale a, puis à élever cet écart à la puissance carrée. Dans Excel, si la cible est logée en cellule E4 et le minimum en B2, l’expression intermédiaire prend la forme =(E4 – $B$2)^2. Ce terme capture la progression d’accumulation géométrique de l’aire sous l’hypoténuse du premier triangle rectangle élémentaire.
La seconde phase requiert l’évaluation du dénominateur d’échelle normalisé, lequel correspond au produit cartésien de l’étendue globale par l’envergure du sous-segment ascendant, soit formellement =($B$4 – $B$2) * ($B$3 – $B$2). La troisième étape effectue le ratio entre le terme quadratique de la première phase et la constante de surface de la seconde phase. En appliquant un format de cellule en Pourcentage avec deux décimales, l’analyste obtient la probabilité exacte P(X ≤ x), tout en disposant de métriques intermédiaires transparentes permettant d’identifier immédiatement la cause d’une éventuelle anomalie de saisie.
5.2 Décomposition du calcul pour la branche supérieure (x > c)
Lorsque le seuil étudié dépasse l’apex de la distribution (x > c), le processus de décomposition arithmétique s’inverse pour privilégier la mesure de la surface résiduelle située dans la queue droite supérieure de la distribution. Cette technique évite la somme fastidieuse de trapèzes et garantit une précision numérique maximale sur les systèmes de calcul en virgule flottante.
Le premier terme intermédiaire calcule la distance quadratique résiduelle séparant la cible de la borne maximale admissible b, formalisée dans la grille de calcul par l’expression =($B$4 – E4)^2. Cette grandeur quantifie l’ampleur du risque d’extrémité qui n’a pas encore été couvert par la variable x au fur et à mesure de sa progression vers le plafond du système.
Le dénominateur de normalisation propre au segment décroissant est ensuite calculé via le produit =($B$4 – $B$2) * ($B$4 – $B$3), reliant l’étendue globale de la loi à la largeur résiduelle du segment modale-maximum. La division du premier terme par le second délivre la probabilité d’excursion supérieure P(X > x). Enfin, la probabilité cumulée P(X ≤ x) s’obtient par la simple soustraction complémentaire à l’unité : =1 – (Résultat_Intermédiaire). Cette approche par décomposition met en lumière la décroissance marginale de l’accumulation de probabilité à mesure que x s’approche de b.
5.3 Calculs des probabilités d’intervalles P(x1 < X < x2) et de dépassement P(X > x)
Les problématiques managériales se résument rarement à l’évaluation d’un unique point d’accumulation ; elles exigent le plus souvent d’estimer la probabilité qu’un phénomène se maintienne à l’intérieur d’un tunnel de performance prédéterminé, P(x1 ≤ X ≤ x2), ou au contraire qu’il franchisse un seuil critique d’intolérance réglementaire ou opérationnelle, P(X > x_seuil).
En vertu du deuxième axiome de la théorie des probabilités, la probabilité d’un intervalle délimité par deux bornes réelles x1 et x2 (avec x1 < x2) s’obtient rigoureusement par la différence algébrique de leurs fonctions de répartition respectives : P(x1 ≤ X ≤ x2) = F(x2) – F(x1). Dans Excel, si deux cellules adjacentes calculent indépendamment les valeurs de F(x1) et F(x2) selon la formule conditionnelle globale explicitée en section 4.2, la probabilité d’intervalle s’obtient simplement par l’opération de soustraction directe =Cellule_F_x2 – Cellule_F_x1. Cette relation demeure universellement exacte, que l’intervalle [x1, x2] soit entièrement localisé sous le mode, entièrement au-dessus, ou qu’il chevauche l’apex modale c.
Pour le calcul d’un risque de dépassement strict, ou probabilité de défaillance P(X > x), l’analyste applique le principe de l’événement complémentaire : =1 – F(x). Il est primordial de souligner que, pour toute variable aléatoire rigoureusement continue, la probabilité ponctuelle exacte P(X = x) est strictement nulle sur le plan théorique. Par conséquent, les inégalités larges ou strictes sont interchangeables dans les calculs d’intervalles : P(X ≤ x) = P(X < x) et P(x1 ≤ X ≤ x2) = P(x1 < X < x2). Cette propriété épargne à l’analyste la gestion des discontinuités aux frontières qui prévaut habituellement dans les lois discrètes telles que la loi binomiale ou la distribution de Poisson.
6. Exemple pratique 1 : Prévision des ventes d’un restaurant sous incertitude
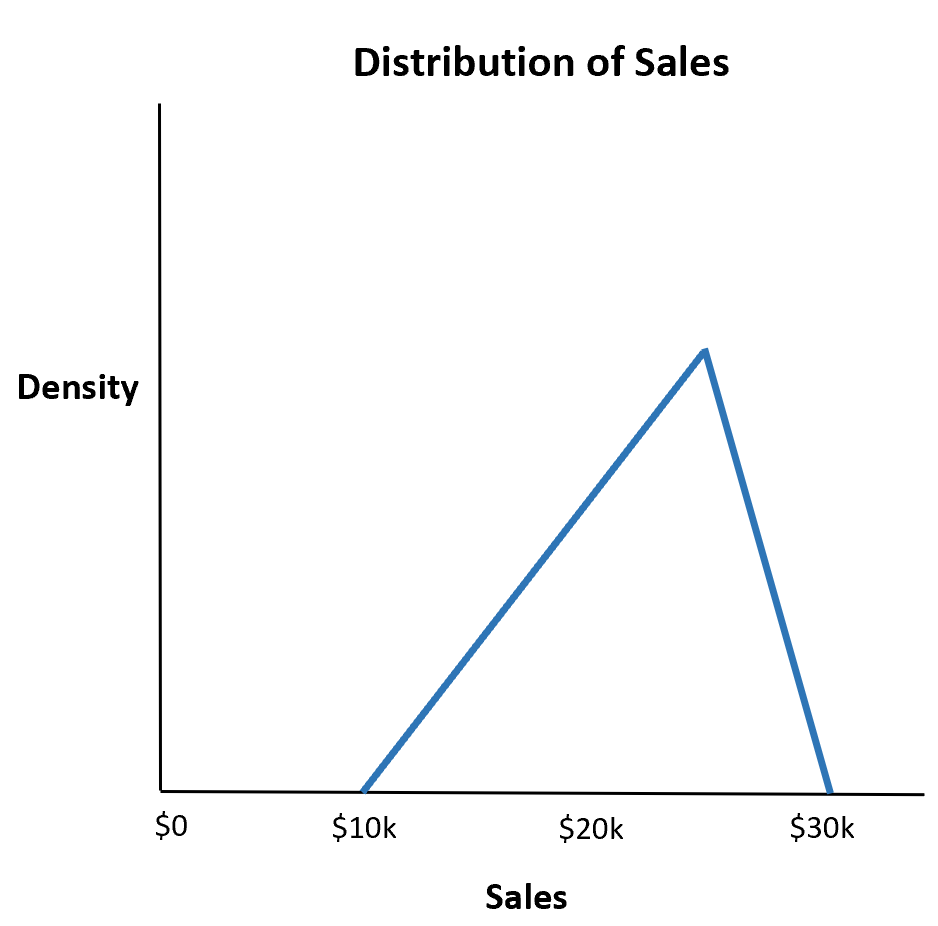
6.1 Paramétrage du cas d’étude : minimum 10 000 $, mode 25 000$, maximum 30 000 $
Pour illustrer la mise en œuvre pratique de ces concepts, considérons le cas d’une franchise de restauration commerciale haut de gamme s’implantant dans une zone d’affaires métropolitaine. Le directeur financier doit modéliser les prévisions de recettes hebdomadaires brutes soumises à une forte volatilité conjoncturelle. Après consultation des experts de l’immobilier commercial et analyse des données de franchises comparables, trois paramètres financiers directeurs sont arrêtés :
- Borne minimale pessimiste (Param_a) : 10 000 $ (recettes en période de creux d’activité estival sévère).
- Valeur la plus probable ou mode (Param_c) : 25 000 $ (affluence standard constatée en rythme de croisière).
- Borne maximale optimiste (Param_b) : 30 000 $ (saturation structurelle des capacités de couverts du restaurant).
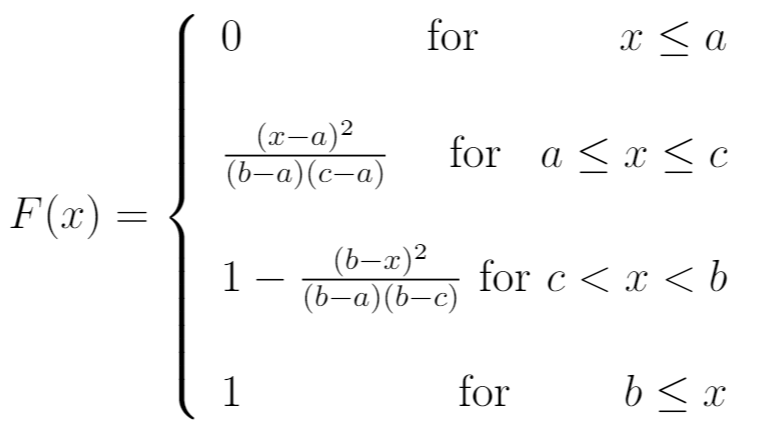
L’observation topologique de ce triplet met immédiatement en évidence une asymétrie négative prononcée (distribution étirée vers la gauche). En effet, le point médian géométrique entre le minimum et le maximum se situe à (10 000 + 30 000) / 2 = 20 000 $. Comme le mode rete\nu (25 000$) est strictement supérieur à ce centre médian, la branche descendante est extrêmement resserrée (sur une amplitude de 5 000 $), tandis que la branche ascendante s’étend sur une plage de 15 000$. L’espérance mathématique théorique des recettes hebdomadaires se calcule immédiatement via la formule d’ordre un : E(X) = (10 000 + 30 000 + 25 000) / 3 = 65 000 / 3 = 21 666,67 $. L’analyste constate que l’espérance mathématique est inférieure de plus de 3 333 $ au chiffre d’affaires le plus probable, illustrant l’impact pénalisant de la longue traîne des scénarios défavorables.
6.2 Calcul détaillé de la probabilité d’un chiffre d’affaires inférieur à 20 000 $
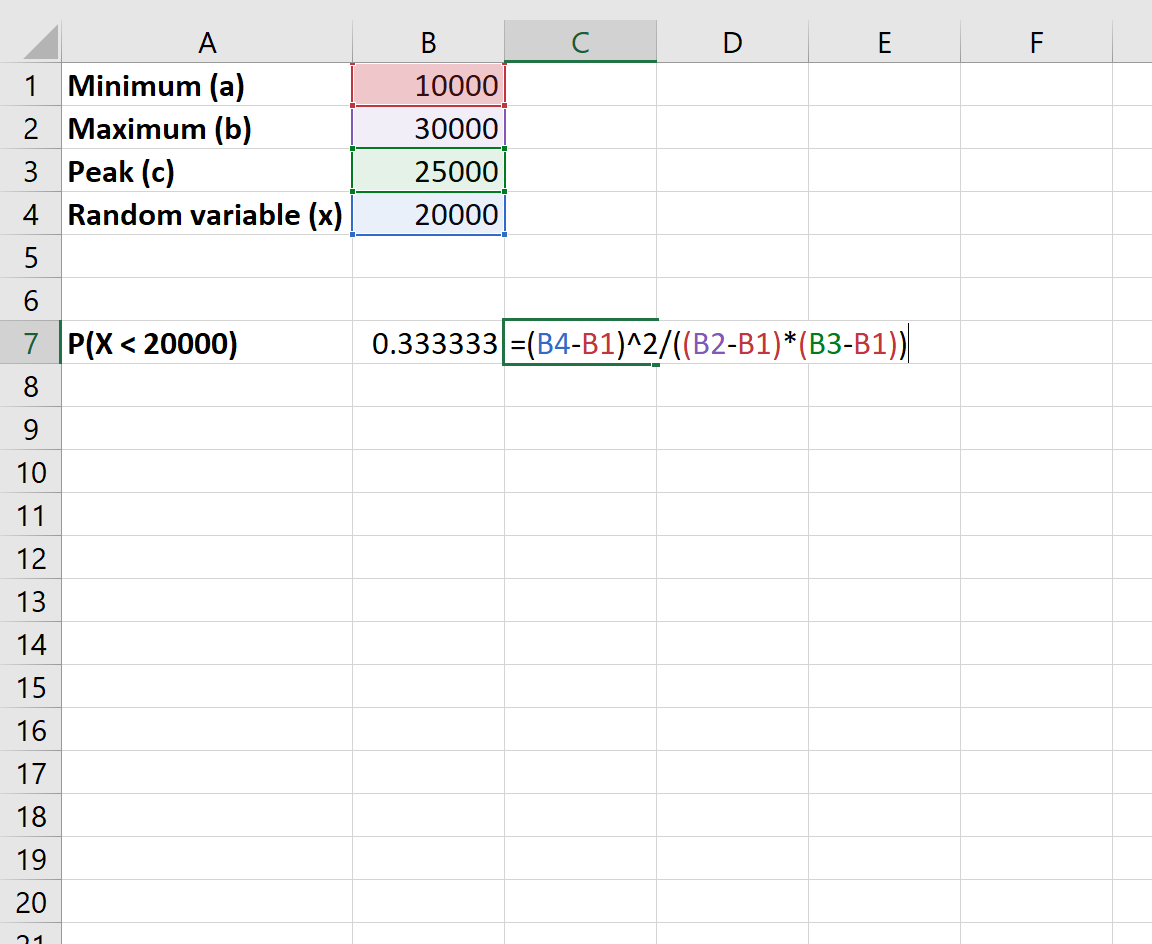
L’équipe de direction souhaite déterminer la probabilité que les ventes hebdomadaires ne parviennent pas à atteindre le seuil de 20 000 $, niveau jugé critique pour la rentabilité opérationnelle du trimestre. Dans cette configuration, la valeur cible x s’élève à 20 000$. En confrontant ce seuil aux paramètres initiaux, on constate formellement que : Param_a (10 000) ≤ Variable_x (20 000) ≤ Param_c (25 000). La valeur cible se positionne donc exclusivement sur la branche ascendante de la distribution de probabilité.
L’évaluation s’exécute par l’application de la formule quadratique du segment inférieur. Les calculs manuels et décomposés s’établissent comme suit :
- Écart au minimum : (x – a) = 20 000 – 10 000 = 10 000 $
- Numérateur quadratique : (x – a)² = (10 000)² = 100 000 000
- Étendue totale du support : (b – a) = 30 000 – 10 000 = 20 000 $
- Étendue du segment ascendant : (c – a) = 25 000 – 10 000 = 15 000 $
- Dénominateur d’échelle : (b – a) × (c – a) = 20 000 × 15 000 = 300 000 000
- Ratio de probabilité cumulée : F(20 000) = 100 000 000 / 300 000 000 = 1 / 3 ≈ 0,3333
Dans la feuille de calcul Excel, la formule standard =SI(20000 ≤ 25000; (20000 – 10000)^2 / ((30000 – 10000) * (25000 – 10000))) ou l’appel dynamique aux cellules équivalentes renvoie rigoureusement 33,33 %. Il existe donc précisément une probabilité d’un tiers que le restaurant réalise un chiffre d’affaires hebdomadaire inférieur ou égal à 20 000 $.
6.3 Interprétation managériale et analyse d’impact sur le seuil de rentabilité
La mise en évidence d’une probabilité de 33,33 % d’enregistrer des ventes inférieures à 20 000 $ constitue une information décisionnelle fondamentale pour le comité d’investissement. Si les charges de structure incompressibles du restaurant (loyer commercial, charges de personnel permanentes, leasing des équipements de cuisine et assurances) s’élèvent à un seuil de rentabilité hebdomadaire de 22 000 $, le management ne peut pas se contenter de comparer ce seuil au chiffre d’affaires le plus probable (25 000$), sous peine de biaiser dangereusement l’analyse de viabilité.
Calculons la probabilité que les ventes ne couvrent pas ce point mort d’exploitation de 22 000 $. Comme 22 000$ demeure inférieur au mode de 25 000 $, la formule de la branche ascendante s’applique à nouveau : F(22 000) = (22 000 – 10 000)² / ((30 000 – 10 000) × (25 000 – 10 000)) = (12 000)² / (20 000 × 15 000) = 144 000 000 / 300 000 000 = 48,00 %. Ce constat est saisissant : bien que le mode soit confortablement installé à 25 000 $ (soit 3 000 $ au-dessus du seuil de rentabilité), le restaurant présente en réalité près d’une chance sur deux (48 %) d’opérer en situation de perte d’exploitation hebdomadaire.
Cette analyse probabiliste modifie radicalement le pilotage stratégique de l’établissement. Elle contraint la direction financière à constituer un coussin de sécurité de trésorerie substantiellement supérieur aux anticipations initiales pour absorber la volatilité des premières semaines d’exploitation, et pousse la direction des opérations à flexibiliser la structure de coûts fixes, par exemple en indexant une fraction de la masse salariale ou du loyer sur le volume réel d’activité.
7. Exemple pratique 2 : Modélisation de l’achalandage et du flux de clientèle
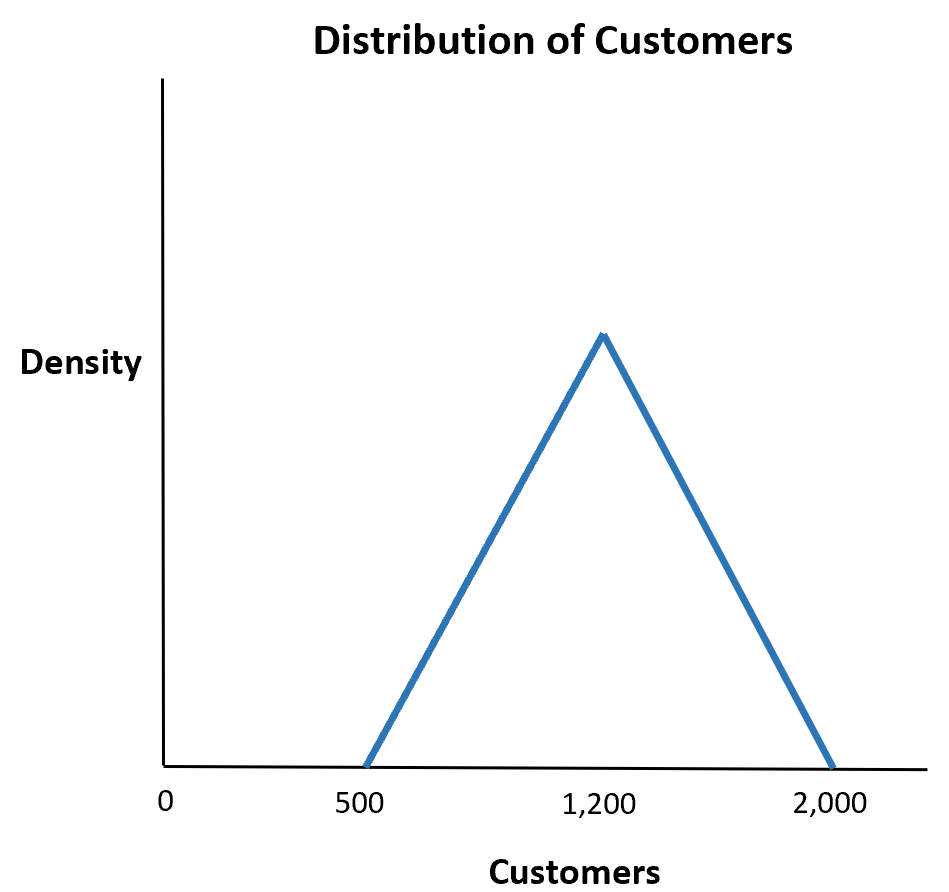
7.1 Établissement des hypothèses : affluence minimale de 500, mode de 1 200, maximale de 2 000
Le second cas pratique aborde le dimensionnement opérationnel des infrastructures de service au sein d’un grand magasin de distribution spécialisée planifiant une campagne de soldes saisonnières. La direction logistique cherche à anticiper le flux d’achalandage quotidien afin de calibrer les effectifs de sécurité, le nombre de caisses ouvertes et le personnel d’orientation en rayon. Le flux de fréquentation journalier, bien qu’exprimé en nombre entier d’individus, présente un volume suffisamment élevé pour autoriser son assimilation rigoureuse à une variable aléatoire continue modélisée par une loi triangulaire.
Les données empiriques issues des campagnes promotionnelles passées et les estimations des directeurs de magasin établissent les paramètres directeurs d’affluence suivants :
- Affluence minimale plancher (Param_a) : 500 clients par jour.
- Mode d’affluence le plus probable (Param_c) : 1 200 clients par jour.
- Affluence maximale de saturation (Param_b) : 2 000 clients par jour.
Examinons les caractéristiques intrinsèques de cette distribution. L’envergure globale du flux s’élève à (b – a) = 2 000 – 500 = 1 500 clients. Le centre géométrique s’établit à (500 + 2 000) / 2 = 1 250 clients. Le mode étant positionné à 1 200 clients, cette distribution présente une asymétrie positive très légère (presque symétrique, avec un étirement marginal vers la droite). L’espérance mathématique de la fréquentation journalière s’établit à E(X) = (500 + 1 200 + 2 000) / 3 = 3 700 / 3 ≈ 1 233,33 clients.
7.2 Calcul de la probabilité d’accueillir plus de 1 500 clients sous Excel
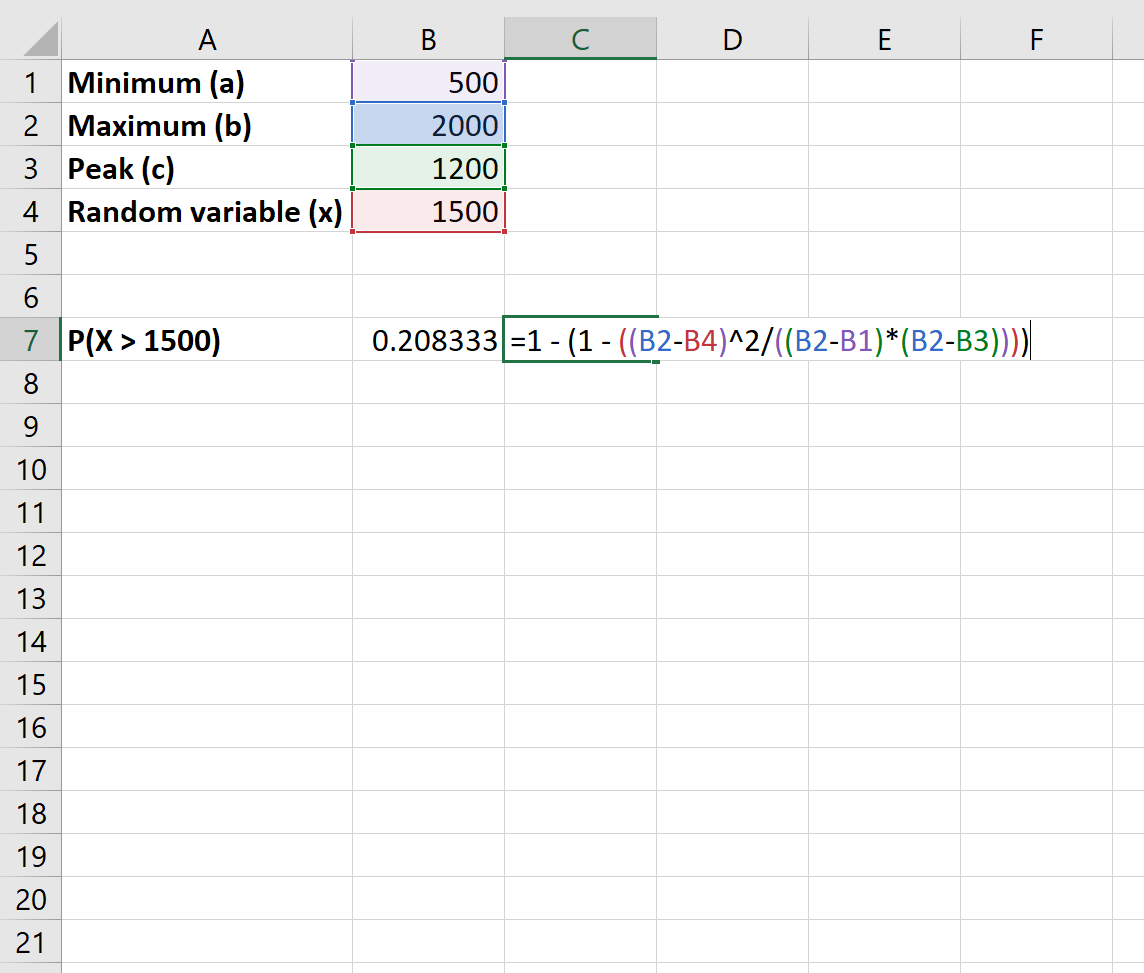
La problématique opérationnelle soumise par le responsable des opérations concerne le risque de saturation des lignes de caisse. Le système actuel peut traiter de manière fluide jusqu’à 1 500 passages par jour. Tout franchissement de ce seuil critique de 1 500 clients engendre des files d’attente excessives, des abandons de panier et une dégradation notable du score de satisfaction client (NPS). Il convient donc de calculer la probabilité d’excursion P(X > 1 500).
Le seuil d’évaluation x = 1 500 se situant strictement au-dessus du mode c = 1 200, l’analyse se déploie sur la branche descendante de la loi triangulaire. En exploitant la dérivation complémentaire directe formulée à la section 2.2, la probabilité de dépassement P(X > x) correspond précisément à la surface résiduelle de l’extrémité droite : P(X > x) = (b – x)² / ((b – a) × (b – c)).
L’évaluation arithmétique étape par étape s’effectue comme suit :
- Écart au plafond d’affluence : (b – x) = 2 000 – 1 500 = 500 clients
- Numérateur résiduel quadratique : (b – x)² = (500)² = 250 000
- Étendue totale du système : (b – a) = 2 000 – 500 = 1 500 clients
- Étendue de la branche descendante : (b – c) = 2 000 – 1 200 = 800 clients
- Dénominateur de normalisation supérieur : (b – a) × (b – c) = 1 500 × 800 = 1 200 000
- Probabilité de dépassement : P(X > 1 500) = 250 000 / 1 200 000 = 25 / 120 ≈ 0,2083
Dans Microsoft Excel, la formule directe =((2000 – 1500)^2) / ((2000 – 500) * (2000 – 1200)) délivre immédiatement le résultat de 20,83 %. L’analyste en conclut que le magasin présente un risque de congestion de ses caisses supérieur à un jour sur cinq durant la semaine promotionnelle.
7.3 Optimisation du dimensionnement des équipes de service selon les probabilités
Face à ce risque de 20,83 %, le directeur des ressources humaines souhaite dimensionner le dispositif d’accueil temporaire pour garantir une absorption des flux à un niveau de service contractuel de 90 % (soit une probabilité de rupture de service limitée à seulement 10 %). Cette exigence revient à déterminer le quantile x_0,90 tel que P(X ≤ x_0,90) = 0,90.
Pour résoudre ce problème d’ingénierie sans recourir au solveur d’Excel, nous appliquons directement la fonction quantile dérivée pour le régime supérieur établie à la section 2.3. Tout d’abord, vérifions le seuil critique d’inflexion : F(c) = (c – a) / (b – a) = (1 200 – 500) / (2 000 – 500) = 700 / 1 500 ≈ 0,4667. Comme le niveau de confiance ciblé (u = 0,90) est strictement supérieur à 0,4667, le quantile recherché se situe incontestablement dans le segment supérieur.
L’application de l’équation x = b – sqrt((1 – u) × (b – a) × (b – c)) permet de résoudre l’inconnue avec une rigueur analytique absolue :
- Complément de probabilité résiduelle : (1 – u) = 1 – 0,90 = 0,10
- Facteur d’échelle supérieur : (b – a) × (b – c) = 1 500 × 800 = 1 200 000
- Produit sous le radical : 0,10 × 1 200 000 = 120 000
- Extraction de la racine carrée : sqrt(120 000) ≈ 346,41 clients
- Quantile cible : x_0,90 = 2 000 – 346,41 ≈ 1 653,59 clients
Dans Excel, la formule à implémenter pour extraire directement cette capacité opérationnelle de pointe s’écrit : =2000 – RACINE((1 – 0,90) * (2000 – 500) * (2000 – 1200)). En arrondissant à l’entier supérieur via la fonction PLAFOND.MATH, l’organisation déduit qu’elle doit calibrer ses infrastructures de caisse et ses effectifs d’intérimaires pour absorber un pic de 1 654 clients par jour afin de satisfaire ses engagements de qualité de service à 90 %.
8. Simulation stochastique de Monte-Carlo par distribution triangulaire sous Excel
8.1 Théorie de l’échantillonnage par la méthode de la transformée inverse
La simulation de Monte-Carlo est une discipline de modélisation algorithmique consistant à reproduire artificiellement le comportement d’un système complexe par la génération répétée de dizaines de milliers de tirages pseudo-aléatoires. Lorsqu’il s’agit de simuler une variable suivant une distribution de probabilité continue non standard comme la loi triangulaire, la technique mathématique reine est la méthode de la transformée inverse (Inverse Transform Sampling), théorisée par Stanislaw Ulam et John von Neumann.
Le théorème fondamental sous-jacent stipule que si U est une variable aléatoire uniformément distribuée sur l’intervalle unité standard [0, 1], notée U ~ U(0, 1), alors la variable transformée X = F^(-1)(U) suit rigoureusement la distribution de probabilité dont la fonction de répartition cumulative est F. La démonstration repose sur le calcul direct de la probabilité cumulée de la variable transformée : P(X ≤ x) = P(F^(-1)(U) ≤ x). En appliquant la fonction strictement croissante F aux deux membres de l’inégalité, on obtient P(U ≤ F(x)). Or, par définition d’une loi uniforme continue sur [0, 1], la probabilité P(U ≤ y) est identiquement égale à y pour tout y ∈ [0, 1]. Par conséquent, P(U ≤ F(x)) = F(x), ce qui démontre sans équivoque la convergence distributionnelle de l’échantillon simulé vers la loi cible.
Pour la distribution triangulaire, le mécanisme d’échantillonnage s’articule donc autour d’un algorithme de décision déterministe à deux branches. L’algorithme tire un nombre pseudo-aléatoire uniforme u, le compare au ratio critique u_critique = (c – a) / (b – a), puis le transmet soit à la fonction inverse de la branche ascendante si u ≤ u_critique, soit à la fonction inverse de la branche descendante si u > u_critique. Cette méthode garantit une fidélité distributionnelle parfaite, sans distorsion ni biais de rejet.
8.2 Formule Excel autonome pour générer des valeurs aléatoires triangulaires
L’implémentation de ce générateur stochastique dans un environnement tableur soulève un défi algorithmique majeur spécifique à Microsoft Excel : la volatilité de la fonction native ALEA(). La fonction ALEA() génère un nombre pseudo-aléatoire uniforme sur [0, 1]. Cependant, si l’on tente d’écrire une formule naïve imbriquée de type SI(ALEA() ≤ (c – a)/(b – a); a + RACINE(ALEA() * …); b – RACINE((1 – ALEA()) * …)), Excel réévaluera la fonction ALEA() de manière totalement indépendante à chaque occurrence dans l’expression.
Cette réévaluation multiple est une erreur méthodologique fatale : le nombre aléatoire qui valide le test logique initial n’est plus le même que celui injecté sous le radical de calcul ! Ce phénomène détruit la cohérence de l’échantillonnage et génère une distribution déformée n’ayant plus aucun rapport avec la loi triangulaire théorique. Pour contourner cette contrainte technique sans faire appel à du code VBA, deux architectures de modélisation sont envisageables :
- L’architecture à deux colonnes (recommandée) : La colonne A génère et fige la réalisation uniforme via la formule simple =ALEA() logée en cellule A2. La colonne B calcule le tirage triangulaire en référençant systématiquement la cellule A2 :
=SI(A2 ≤ (Param_c – Param_a) / (Param_b – Param_a); Param_a + RACINE(A2 * (Param_b – Param_a) * (Param_c – Param_a)); Param_b – RACINE((1 – A2) * (Param_b – Param_a) * (Param_b – Param_c))) - L’architecture autonome utilisant LET() (Excel 365 / 2021) : Les versions modernes d’Excel permettent de déclarer des variables locales dynamiques au sein d’une unique cellule. La fonction LET() permet de stocker le tirage aléatoire dans une variable locale u réutilisée de manière cohérente :
=LET(u; ALEA(); p_pivot; (Param_c – Param_a) / (Param_b – Param_a); SI(u ≤ p_pivot; Param_a + RACINE(u * (Param_b – Param_a) * (Param_c – Param_a)); Param_b – RACINE((1 – u) * (Param_b – Param_a) * (Param_b – Param_c))))
La formulation via la fonction LET() représente l’état de l’art de la modélisation sous Excel moderne : elle garantit une étanchéité stochastique parfaite tout en maintenant l’intégralité du calcul encapsulée dans une cellule unique et réplicable.
8.3 Déploiement à grande échelle sans macro : utilisation des tables de données
Si l’étirement manuel d’une formule sur 10 000 lignes de calcul est techniquement possible, cette approche alourdit considérablement la taille du classeur binaire (.xlsx), ralentit les opérations d’ouverture et complique l’audit du modèle. Microsoft Excel intègre un moteur de simulation haute performance méconnu capable d’exécuter des itérations massives sans macro : la Table de données à une variable (What-If Analysis Data Table).
Le protocole de déploiement d’une simulation de Monte-Carlo de 5 000 itérations via les tables de données s’orchestre selon les étapes méthodologiques suivantes :
- Dans une feuille de calcul dédiée, configurer en cellule E2 le modèle de calcul déterministe de sortie (par exemple, le résultat financier net consolidé alimenté par une cellule source triangulaire autonome définie selon la section 8.2).
- Construire une colonne d’indices d’itérations en plage G2:G5001, numérotée séquentiellement de 1 à 5 000 (en utilisant la fonctionnalité Série de données).
- En cellule H1 (en tête de la colonne adjacente, immédiatement au-dessus de la première ligne de résultat), lier la formule de sortie du modèle en saisissant rigoureusement =E2.
- Sélectionner l’intégralité de la matrice de simulation couvrant la plage rectangulaire G1:H5001.
- Naviguer dans le ruban vers l’onglet Données > Analyse de scénarios > Table de données.
- Dans la boîte de dialogue contextuelle, laisser le champ Cellule d’entrée en ligne totalement vide, et renseigner dans le champ Cellule d’entrée en colonne une cellule quelconque totalement vierge de la feuille (par exemple $Z$1).
- Valider par Entrée. Excel applique automatiquement la fonction matricielle dynamique {=TABLE(;Z1)}.
Le moteur de calcul d’Excel force le recalcul complet du modèle stochastique 5 000 fois consécutives en substituant de manière factice chaque numéro d’itération dans la cellule vierge Z1. Les 5 000 résultats indépendants s’inscrivent instantanément dans la colonne H. L’analyste peut alors appliquer des fonctions statistiques descriptives globales sur la plage H2:H5001 : =MOYENNE(H2:H5001) pour valider la convergence vers l’espérance théorique, =ECARTYPE.STANDARD(H2:H5001) pour quantifier la volatilité empirique, ou encore =CENTILE.INC(H2:H5001; 0,05) pour déterminer avec une précision empirique la Value-at-Risk au seuil de 95 %.
9. Création de fonctions personnalisées avec VBA pour la loi triangulaire
9.1 Développement de la fonction personnalisée CDF_TRIANGULAIRE()
Pour les modélisations d’envergure institutionnelle où la lisibilité des classeurs constitue une priorité d’audit, la multiplication de formules conditionnelles SI() complexes dans des centaines de cellules nuit à la gouvernance des modèles. Le recours au langage Visual Basic for Applications (VBA) permet de compiler la logique de la distribution triangulaire au sein d’une fonction personnalisée (UDF, ou User Defined Function), réutilisable dans l’ensemble des feuilles à l’instar des fonctions natives d’Excel.
Pour implémenter la fonction de répartition cumulative, il convient d’ouvrir l’environnement de développement Visual Basic Editor (raccourci Alt + F11), d’insérer un module de code standard via le menu Insertion > Module, et de programmer l’algorithme suivant :
Function CDF_TRIANGULAIRE(ByVal x As Double, ByVal a As Double, ByVal c As Double, ByVal b As Double) As Variant
‘ Validation rigoureuse des contraintes d’ordre mathématique
If Not (a ≤ c And c ≤ b And a < b) Then
CDF_TRIANGULAIRE = CVErr(xlErrNum)
Exit Function
End If
‘ Traitement des régions situées en dehors du support compact
If x < a Then
CDF_TRIANGULAIRE = 0#
ElseIf x > b Then
CDF_TRIANGULAIRE = 1#
‘ Branche ascendante (x inférieur ou égal au mode)
ElseIf x ≤ c Then
If a = c Then
CDF_TRIANGULAIRE = 0#
Else
CDF_TRIANGULAIRE = ((x – a) ^ 2) / ((b – a) * (c – a))
End If
‘ Branche descendante (x supérieur au mode)
Else
If b = c Then
CDF_TRIANGULAIRE = 1#
Else
CDF_TRIANGULAIRE = 1# – ((b – x) ^ 2) / ((b – a) * (b – c))
End If
End If
End Function
Ce code intègre une barrière d’interception d’erreurs retournant l’erreur d’exécution native #NOMBRE! (via l’instruction CVErr(xlErrNum)) si l’utilisateur saisit des paramètres contradictoires violant la contrainte a ≤ c ≤ b. Une fois compilée, la fonction s’appelle directement dans la feuille de calcul via la syntaxe transparente =CDF_TRIANGULAIRE(E4; B2; B3; B4).
9.2 Programmation d’un générateur pseudo-aléatoire : RAND_TRIANG()
Pour exécuter des simulations de Monte-Carlo programmées ou intégrer des variables aléatoires au sein de macros automatisées, il est tout aussi pertinent de développer un générateur pseudo-aléatoire autonome en VBA basé sur la transformée inverse. Contrairement à la fonction ALEA() du tableur, l’instruction Rnd de Visual Basic présente l’avantage de s’exécuter de façon séquentielle et contrôlée au sein d’une variable typée locale.
Le module VBA s’enrichit de la fonction suivante :
Function RAND_TRIANG(ByVal a As Double, ByVal c As Double, ByVal b As Double) As Variant
Dim u As Double
Dim p_seuil As Double
‘ Contrôle de validité des paramètres
If Not (a ≤ c And c ≤ b And a < b) Then
RAND_TRIANG = CVErr(xlErrNum)
Exit Function
End If
‘ Tirage d’un nombre pseudo-aléatoire uniforme sur [0, 1[
u = VBA.Rnd()
p_seuil = (c – a) / (b – a)
‘ Application de la transformée inverse de façon déterministe sur u
If u ≤ p_seuil Then
RAND_TRIANG = a + Sqr(u * (b – a) * (c – a))
Else
RAND_TRIANG = b – Sqr((1# – u) * (b – a) * (b – c))
End If
End Function
L’utilisation de la variable locale u garantit que le tirage stochastique est rigoureusement unique pour chaque évaluation de la fonction. Pour réinitialiser le générateur d’aléa système et éviter la reproduction de suites pseudo-aléatoires identiques à l’ouverture du classeur, il est recommandé d’inclure l’instruction Randomize dans la routine d’ouverture du classeur (Workbook_Open).
9.3 Packaging et déploiement du module en macro complémentaire (.xlam)
Pour transformer ces développements VBA en une extension logicielle disponible universellement sur l’ensemble des classeurs d’une entreprise sans nécessiter de copier-coller de code, la méthode professionnelle consiste à packager le module sous la forme d’un complément Excel (Excel Add-In, format .xlam).
Le processus de déploiement s’articule comme suit :
- Dans un classeur vierge ne contenant que le module VBA documenté ci-dessus, naviguer vers Fichier > Enregistrer sous.
- Dans la liste déroulante des types de fichiers, sélectionner Complément Excel (*.xlam). Excel modifie automatiquement le répertoire de destination vers le dossier système standard des compléments utilisateur (généralement AppDataRoamingMicrosoftAddIns).
- Attribuer un nom explicite au module, par exemple BoiteAOutils_Triangulaire.xlam, puis enregistrer.
- Fermer le fichier, puis ouvrir un classeur de travail ordinaire. Naviguer vers Fichier > Options > Compléments.
- En bas de la fenêtre, dans le menu déroulant Gérer, sélectionner Compléments Excel et cliquer sur Atteindre…
- Cocher la case correspondant à BoiteAOutils_Triangulaire et valider par OK.
Dès cet instant, les fonctions =CDF_TRIANGULAIRE() et =RAND_TRIANG() sont reconnues nativement par le moteur de calcul d’Excel sur n’importe quel classeur existant ou nouveau. Les formules s’exécutent avec une transparence totale, sans nécessiter d’enregistrer les classeurs récepteurs sous le format contraignant prenant en charge les macros (.xlsm), simplifiant ainsi drastiquement les échanges de fichiers par courrier électronique et la validation par les systèmes de sécurité d’entreprise.
10. Visualisation graphique et représentations dynamiques dans Excel
10.1 Construction de la table de coordonnées pour la courbe en cloche triangulaire
La communication des résultats probabilistes auprès des directions générales requiert une restitution visuelle irréprochable. Pour tracer la fonction de densité f(x) sous la forme d’un profil géométrique continu, il est nécessaire de construire une grille de discrétisation fine comportant entre 50 et 100 points d’échantillonnage réguliers, complétée impérativement par les trois points cardinaux d’inflexion (a, c, b).
L’agencement méthodologique de la table de traçage s’opère selon les directives suivantes :
- Dans la colonne J, générer une échelle d’abscisses x débutant à Param_a – 0,1 × (Param_b – Param_a) et s’achevant à Param_b + 0,1 × (Param_b – Param_a) afin d’offrir des marges visuelles élégantes au graphique.
- Calculer le pas d’incrémentation régulier via la formule =(Param_b – Param_a) / 50.
- Insérer impérativement des lignes spécifiques dédiées aux coordonnées exactes des paramètres : la ligne de la borne minimale (Param_a ; 0), la ligne du mode (Param_c ; 2 / (Param_b – Param_a)), et la ligne de la borne maximale (Param_b ; 0). L’omission du mode exact Param_c produirait un sommet tronqué ou arrondi, altérant la géométrie de la distribution.
- Dans la colonne K adjacente, évaluer la densité f(x) pour chaque pas en utilisant la formule analytique explicitée à la section 4.3.
Une fois les coordonnées générées, il suffit de sélectionner l’intégralité de la plage J2:K55 et d’insérer un Graphique en nuage de points avec lignes droites (ou lignes lisses). L’affichage révèle immédiatement la silhouette triangulaire exacte de la distribution, permettant de visualiser instantanément son étendue et son asymétrie.
10.2 Conception d’un graphique en aires avec mise en évidence dynamique de P(X < x)
Pour illustrer de manière percutante la probabilité cumulée correspondant à un seuil cible x_seuil (par exemple, colorer en bleu l’intégralité de la surface sous la courbe comprise entre a et x_seuil), il convient de combiner un graphique en nuage de points avec une série graphique de type Aire dynamique conditionnelle.
La procédure technique sous Excel se déploie selon les étapes suivantes :
- Dans la table de traçage précédente, ajouter une troisième colonne intitulée « Aire Cumulée » en colonne L.
- Dans chaque cellule de cette colonne L, insérer une formule conditionnelle filtrant la densité en fonction du seuil cible saisi en cellule d’évaluation B6 : =SI(J2 ≤ $B$6; K2; 0). Cette formule recopie fidèlement la hauteur f(x) tant que l’abscisse se situe à gauche de la valeur cible, et impose une ordonnée nulle dès que le seuil est dépassé.
- Effectuer un clic droit sur le graphique existant, choisir Sélectionner des données, et ajouter une nouvelle série en affectant la colonne J pour les abscisses X et la colonne conditionnelle L pour les ordonnées Y.
- Modifier le type de graphique de cette nouvelle série via Modifier le type de graphique > Graphique combiné, et attribuer le type Aire (ou Nuage de points avec remplissage d’aire sous la courbe) à la série dynamique.
- Appliquer une mise en forme soignée : attribuer une couleur semi-transparente (par exemple bleu corporate avec 40 % de transparence) à la surface d’aire, et un contour plus sombre pour la courbe globale de densité.
Dès cet instant, la surface ombrée sous le triangle s’ajuste dynamiquement en temps réel dès que l’analyste modifie la valeur d’évaluation x_seuil en cellule B6, matérialisant visuellement le concept abstrait d’intégrale de probabilité cumulée lors des présentations ejecutées devant des auditoires non spécialistes des statistiques.
10.3 Intégration de contrôles de formulaire pour l’analyse de sensibilité interactive
Pour transformer cette feuille de travail en un tableau de bord d’aide à la décision hautement interactif, Microsoft Excel propose les Contrôles de formulaire. L’intégration de barres de défilement (curseurs dynamiques) permet de piloter visuellement la déformation de la loi triangulaire et d’observer instantanément les répercussions sur les probabilités de risque.
Le paramétrage des curseurs s’organise selon la séquence suivante :
- Activer l’onglet Développeur dans les options du ruban d’Excel si celui-ci n’est pas affiché.
- Cliquer sur Insérer dans la section Contrôles, puis sélectionner le contrôle de formulaire Barre de défilement. Dessiner le curseur horizontalement sous le graphique de distribution.
- Effectuer un clic droit sur le curseur et sélectionner Format de contrôle. Dans l’onglet Contrôle, définir la Valeur minimale (par exemple 0), la Valeur maximale (par exemple 1 000), le Changement de pas (par exemple 10), et affecter une cellule liée dédiée, par exemple la cellule Z10.
- Les barres de défilement d’Excel ne gérant nativement que des nombres entiers positifs, il convient d’appliquer une formule de mise à l’échelle dans la cellule du paramètre d’intérêt. Par exemple, pour faire varier le mode Param_c entre 10 000 $ et 30 000 $, la cellule B3 recevra la formule d’échelle dynamique :=10000 + (Z10 / 1000) * (30000 – 10000).
- Répéter l’opération en installant un second curseur relié à la cellule d’évaluation du seuil x_seuil.
Ce dispositif interactif confère au modèle une ergonomie remarquable. En manipulant le curseur du mode Param_c de gauche à droite, l’analyste observe en direct l’apex du triangle se déplacer sur l’axe horizontal, la cloche basculer d’une asymétrie positive à une asymétrie négative, et la surface de probabilité cumulée se recalculer instantanément, offrant un banc d’essai dynamique pour tester la robustesse des décisions d’investissement.
11. Diagnostic des erreurs courantes et vérification empirique des modèles
11.1 Gestion des violations de contraintes d’ordre et validation des données
La source la plus répandue de défaillance structurelle dans les classeurs modélisant des distributions triangulaires provient de la violation des contraintes d’inégalité liant les paramètres constitutifs. L’introduction par inadvertance d’une valeur modale strictement inférieure au minimum déclaré (c < a) ou strictement supérieure au maximum (c > b) engendre des dénominateurs négatifs dans les fonctions rationnelles, provoquant des probabilités absurdes, supérieures à 1 ou négatives, qui invalident silencieusement l’ensemble de la chaîne de décision.
Pour prévenir rigoureusement ces anomalies à la source, il est impératif d’imposer des règles de Validation des données (onglet Données > Outils de données > Validation des données) directement sur les cellules de saisie des paramètres :
- Sur la cellule du minimum (B2) : autoriser les nombres décimaux, et exiger la condition inférieur à =B3 (ou =B4).
- Sur la cellule du mode (B3) : autoriser les nombres décimaux, sélectionner la condition compris entre, et renseigner les formules minimales et maximales =B2 et =B4.
- Sur la cellule du maximum (B4) : autoriser les nombres décimaux, et exiger la condition supérieur à =B3.
- Personnaliser l’onglet Alerte d’erreur en configurant un style d’arrêt strict « Stop » accompagné du message explicite : « Erreur de cohérence géométrique : Les paramètres doivent impérativement respecter la relation fondamentale Minimum ≤ Mode ≤ Maximum ».
Concernant les cas théoriques limites où l’expert saisit un mode rigoureusement identique à l’une des bornes (a = c ou c = b, formant des triangles rectangles), les formules conditionnelles standardisées de la section 4.2 gèrent ces configurations sans planter, à la condition expresse d’utiliser des inégalités larges (≤) et d’ordonner scrupuleusement les tests conditionnels pour ne pas évaluer des dénominateurs nuls.
11.2 Résolution des erreurs arithmétiques et d’arrondi numérique
L’environnement Microsoft Excel, à l’instar de la quasi-totalité des architectures informatiques modernes, exécute ses calculs arithmétiques en stricte conformité avec le standard international IEEE 754 régissant la représentation des nombres en virgule flottante en double précision. Ce standard induit des approximations infinitésimales inhérentes à la conversion binaire des fractions décimales, pouvant générer des résidus d’arrondi de l’ordre de 10^(-16).
Dans les modèles stochastiques à seuils stricts, ces résidus peuvent provoquer des comportements inattendus lors des tests d’égalité binaire. Par exemple, si la variable x est censée égaler exactement la borne maximale b, une approximation binaire peut conduire le processeur à évaluer (b – x) comme valant -0,0000000000000001 au lieu de zéro strict. Dans une formule conditionnelle mal protégée, cette valeur infinitésimale négative peut orienter le calcul vers une branche inappropriée ou provoquer une division de type #DIV/0! si un dénominateur d’écart s’annule.
Pour immuniser les formules de calcul contre ces artefacts numériques, deux protocoles de sécurisation doivent être appliqués :
- Encapsuler les différences d’intervalles critiques dans la fonction ARRONDI() d’Excel pour tronquer les bruits de virgule flottante au-delà de la dixième décimale : par exemple, remplacer l’expression directe (Param_b – Param_a) par ARRONDI(Param_b – Param_a; 10).
- Sécuriser le test d’appartenance à la borne supérieure dans la fonction SI() en introduisant une tolérance d’erreur epsilon notée ε (typiquement 1E-12) : =SI(Variable_x ≥ Param_b – 1E-12; 1; …). Cette formulation garantit que toute valeur convergeant vers le plafond b à la limite de la précision machine se voit attribuer la probabilité unitaire exacte sans provoquer de discontinuité.
11.3 Tests de conformité statistique des tirages simulés de Monte-Carlo
L’implémentation d’un moteur de simulation de Monte-Carlo exige une validation de la représentativité statistique des échantillons générés. Il ne suffit pas de constater visuellement que l’histogramme des réalisations aléatoires « ressemble » à un triangle ; cette conformité empirique doit être validée par des métriques quantitatives formelles.
Le premier niveau de vérification s’opère par l’audit des moments empiriques. Sur un échantillon simulé de N = 10 000 itérations logé dans la plage H2:H10001, l’analyste compare la moyenne observée =MOYENNE(H2:H10001) avec l’espérance théorique (a + b + c) / 3. En vertu de la loi forte des grands nombres, l’erreur relative standardisée |Moyenne_Empirique – E(X)| / E(X) doit impérativement converger vers zéro et se situer sous le seuil d’intolérance de 0,5 % pour un échantillon de cette taille. Le même contrôle d’adéquation doit être exécuté sur la variance empirique calculée via =VAR.S(H2:H10001) en la confrontant à la formule théorique (a² + b² + c² – ab – ac – bc) / 18.
Le second niveau, plus approfondi, consiste à appliquer un test d’adéquation du Khi-deux d’ajustement (χ²). L’analyste discrétise l’espace [a, b] en k = 10 classes d’amplitudes égales. Pour chaque classe, il évalue l’effectif théorique attendu en multipliant la probabilité théorique de l’intervalle P(x_i ≤ X ≤ x_i+1) par la taille globale N = 10 000. Il dénombre ensuite l’effectif empirique réellement observé via la fonction matricielle =FREQUENCE(H2:H10001; Classes_Limites). Enfin, la statistique de test calculée =SOMME((Effectifs_Observés – Effectifs_Théoriques)^2 / Effectifs_Théoriques) est confrontée à la valeur critique de la loi du Khi-deux à (k – 1 – 3) degrés de liberté via la fonction =LOI.KHIDEUX.INVERSE(0,05; Degrés_Liberté). L’absence de rejet statistique confirme que le générateur stochastique est rigoureusement calibré.
12. Synthèse méthodologique et recommandations avancées de modélisation
12.1 Guide décisionnel : critères de sélection de la loi triangulaire
Au terme de cette analyse approfondie, il convient de formaliser les conditions méthodologiques régissant la sélection de la loi triangulaire dans les architectures décisionnelles. La loi triangulaire s’impose comme le choix d’ingénierie le plus adapté dans les contextes suivants :
- Absence ou pénurie avérée de séries historiques : Projets d’innovation de rupture, fusions-acquisitions non standard, chiffrage d’infrastructures pionnières ou contentieux juridiques hors normes où aucune base actuarielle n’est exploitable.
- Nécessité de bornes strictes et fermées : Modélisation de variables physiques, calendaires ou réglementaires où des valeurs négatives ou des dépassements de plafonds théoriques engendreraient des incohérences de calcul (impossibilité d’une durée de tâche négative, limitation d’une enveloppe budgétaire allouée).
- Communication auprès de comités non quantitatifs : Impératif de transparence méthodologique où chaque paramètre doit pouvoir être justifié intuitivement et défendu devant des conseils d’administration ou des auditeurs externes sans jargon mathématique abscons.
À l’inverse, l’analyste financier doit s’abstenir de recourir à la distribution triangulaire dans deux configurations identifiées :
- Présence d’un volume massif de données empiriques (Big Data) : Dès lors que des milliers d’observations historiques homogènes sont disponibles, il est impératif d’ajuster des lois paramétriques plus riches (loi log-normale, loi de Weibull, mélange de lois gaussiennes) ou d’exploiter directement des estimations non paramétriques par noyaux de densité (Kernel Density Estimation).
- Présence avérée de queues épaisses (Fat Tails) : Dans la modélisation des risques de marché extrêmes ou des crises financières systémiques, l’hypothèse de bornes fermées sous-estime tragiquement le risque de ruine. Les distributions à queues lourdes, telles que les lois de Student ou les lois de valeurs extrêmes de Fréchet et de Gumbel, doivent être privilégiées pour capturer adéquatement les cygnes noirs.
12.2 Bonnes pratiques de documentation et gouvernance des modèles Excel
La pérennité d’un modèle d’ingénierie financière sous Excel repose avant tout sur sa gouvernance documentaire. Trop de modèles stochastiques d’entreprise deviennent obsolètes ou sources de litiges à la suite du départ de leur concepteur initial, faute d’une traçabilité suffisante des hypothèses sous-jacentes. Pour prévenir ce risque opérationnel, plusieurs standards d’audit professionnel doivent être scrupuleusement appliqués :
- Standardisation du code couleur des cellules : Adopter une charte graphique universelle (par exemple la norme FAST standard) assignant un fond jaune pâle avec texte bleu pour les cellules d’hypothèses élicitées modifiables par l’utilisateur (Param_a, Param_c, Param_b), un fond blanc avec texte noir pour les formules de calcul intermédiaire, et un fond vert pâle avec texte gras pour les sorties décisionnelles et quantiles finaux.
- Traçabilité documentaire des paramètres d’élicitation : Intégrer systématiquement un commentaire de cellule ou une note explicative détaillée documentant l’origine précise de chaque paramètre (identité de l’expert interrogé, date de l’élicitation, compte rendu d’atelier, références des pièces comptables justificatives).
- Verrouillage structurel des formules : Protéger la feuille de calcul (onglet Révision > Protéger la feuille) en verrouillant l’ensemble des cellules de formules mathématiques de répartition et de densité, tout en laissant déverrouillées uniquement les cellules de saisie des paramètres. Cette précaution élémentaire interdit toute altération involontaire des expressions logiques par des tiers.
12.3 Perspectives d’extension vers des distributions généralisées et corrélées
Si la distribution triangulaire simple répond à la majorité des besoins opérationnels de base, les modélisations d’ingénierie avancée requièrent souvent de s’affranchir de ses limites structurelles, notamment l’imposition de segments strictement rectilignes. Des extensions théoriques remarquables ont été formalisées dans la littérature statistique, à l’instar de la Distribution Triangulaire Généralisée (GTD), qui intègre des paramètres de puissance supplémentaires permettant de courber les branches ascendante et descendante sous forme parabolique ou exponentielle tout en conservant le support borné tripartite originel.
Par ailleurs, dans les systèmes stochastiques multivariés réels, les variables aléatoires ne sont presque jamais indépendantes. Modéliser séparément le chiffre d’affaires et les coûts opérationnels par des lois triangulaires autonomes sans capturer leur corrélation sous-jacente conduit à une sous-estimation substantielle de la variance globale du système (effet de diversification fallacieux). Pour corriger ce biais, les modélisateurs Excel chevronnés peuvent implémenter des matrices de corrélation de rang de Spearman couplées à des algorithmes de décomposition de Cholesky ou des méthodes d’induction de dépendance par copules (notamment les copules gaussiennes ou les copules de Clayton).
Enfin, lorsque la complexité combinatoire dépasse les capacités de recalcul interactif de Microsoft Excel, la méthodologie documentée dans cet article constitue la passerelle conceptuelle idéale pour migrer les architectures de calcul vers des environnements de programmation scientifique de haute performance tels que Python (via les modules numpy et scipy.stats.triang) ou R (package EnvStats). La compréhension rigoureuse des mécanismes mathématiques de la loi triangulaire acquise sous tableur demeure le prérequis indispensable à toute démarche d’industrialisation algorithmique au service de la décision stratégique.
Références
- Evans, M., Hastings, N., & Peacock, B. (2000). Statistical Distributions (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Statistical+Distributions%2C+3rd+Edition-p-9780471371243
- Johnson, N. L., Kotz, S., & Balakrishnan, N. (1995). Continuous Univariate Distributions, Volume 2 (2nd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Continuous+Univariate+Distributions%2C+Volume+2%2C+2nd+Edition-p-9780471584940
- Kahneman, D., & Tversky, A. (1979). Prospect Theory: An Analysis of Decision under Risk. Econometrica, 47(2), 263–291. https://doi.org/10.2307/1914185
- Kotz, S., & van Dorp, J. R. (2004). Beyond Beta: Other Continuous Families of Distributions with Bounded Support and Applications. World Scientific Publishing. https://doi.org/10.1142/5555
- Microsoft Corporation. (2023). Documentation sur les fonctions de feuille de calcul Excel et le modèle objet VBA. Microsoft Learn. https://learn.microsoft.com/fr-fr/office/client-developer/excel/excel-home
- Mun, J. (2015). Modeling Risk: Applying Monte Carlo Risk Simulation, Strategic Real Options, Stochastic Forecasting, and Portfolio Optimization (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119199342
- Vose, D. (2008). Risk Analysis: A Quantitative Guide (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Risk+Analysis%3A+A+Quantitative+Guide%2C+3rd+Edition-p-9780470512845