
Dans le domaine de l’analyse quantitative appliquée aux sciences humaines, médicales et économiques, la maîtrise des outils de calcul probabiliste constitue un prérequis méthodologique fondamental. L’exploitation rigoureuse des données empiriques nécessite couramment de convertir des distributions de fréquences observées en grandeurs standardisées, ou réciproquement, d’isoler des frontières décisionnelles à partir d’un niveau d’incertitude préalablement fixé. Au cœur de cette démarche, la distribution normale — ou courbe de Gauss-Laplace — joue un rôle structurant en vertu du théorème central limite, servant de référence théorique pour une multitude de tests d’hypothèses paramétriques, d’étalonnages psychométriques et de modélisations prédictives. Dès lors que le chercheur ou l’analyste se trouve confronté à l’obligation d’extraire un quantile précis à partir d’une probabilité d’occurrence, les méthodes de calcul direct doivent céder le pas aux opérations d’inversion intégrale.
Pendant plusieurs décennies, l’évaluation de la fonction inverse de la loi normale a reposé sur l’utilisation de tables statistiques imprimées, réclamant des interpolations manuelles fastidieuses et introduisant des risques non négligeables d’erreurs d’approximation numérique. L’avènement des technologies de calcul formel et graphique, particulièrement incarnées par la gamme des calculatrices Texas Instruments TI-84, a profondément transformé la pratique de l’inférence statistique appliquée. L’implémentation de microprogrammes dédiés aux lois de probabilité au sein du système d’exploitation de ces machines permet désormais de déterminer instantanément, avec une précision atteignant quatorze chiffres significatifs, n’importe quelle valeur critique ou score de coupure clinique.
Cet article propose un examen exhaustif de l’instruction invNorm (loi normale inverse) disponible sur les machines de la série TI-84 (TI-84 Plus, TI-84 Plus Silver Edition et TI-84 Plus CE). En articulant rigueur mathématique, décomposition pas à pas de l’interface logicielle et études de cas empiriques issues de la psychologie quantitative et de la neuropsychologie, ce guide vise à doter les étudiants, cliniciens et chercheurs d’une méthodologie opératoire sans faille. Il s’agira non seulement de décrire le fonctionnement technique de la commande selon les versions d’ordinateurs de poche, mais également de consolider les bases théoriques sous-jacentes à la fixation des régions de rejet, tout en respectant scrupuleusement les exigences contemporaines de modélisation statistique et de publication académique.
1. Fondements théoriques de la loi normale et rôle de invNorm en analyse quantitative
1.1 Définition mathématique de la distribution normale standard
La distribution normale standard, conventionnellement symbolisée par la notation $\mathcal{N}(0, 1)$, représente la distribution continue canonique en statistique inférentielle. Sa fonction de densité de probabilité, souvent désignée par la lettre grecque $phi(z)$, est formellement définie sur l’ensemble des réels $\mathbb{R}$ par l’expression analytique :
$$\phi(z) = \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{z^2}{2}\right)$$
Cette courbe présente plusieurs propriétés géométriques et probabilistes majeures. Elle est rigoureusement unimodale et symétrique par rapport à son axe central $z = 0$, point où se confondent parfaitement la moyenne arithmétique, la médiane et le mode de la distribution. Ses deux points d’inflexion se situent exactement à un écart-type de part et d’autre de la moyenne, c’est-à-dire en $z = -1$ et $z = +1$. Par définition de la théorie de la mesure probabiliste, l’aire totale délimitée par la courbe et l’axe des abscisses est strictement égale à $1$.
La fonction de répartition cumulative, notée classiquement $Phi(z)$, calcule la probabilité qu’une variable aléatoire continue $Z$, suivant une loi normale standard, prenne une valeur inférieure ou égale à un score réel déterminé $z$ :
$$\Phi(z) = P(Z le z) = \int_{-\infty}^{z} \frac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} , dt$$
Comme cette intégrale ne possède aucune primitive exprimable sous forme d’une fonction élémentaire finie, son calcul nécessite le recours à des développements en séries entières ou à la fonction d’erreur de Gauss ($\mathrm{erf}$). L’inversion mathématique de cette relation — c’est-à-dire la recherche du score $z$ tel que $Phi(z) = p$ pour un quantile $p$ donné dans l’intervalle ouvert $]0, 1[$ — définit la fonction quantile ou fonction inverse de la loi normale, notée $\Phi^{-1}(p)$. Il est impératif d’établir une distinction conceptuelle claire entre la probabilité cumulée $p$ (qui traduit une aire sous la courbe comprise entre $0$ et $1$) et le score standardisé $z$ (qui représente une grandeur dimensionnelle sans unité, exprimant la déviation par rapport à la moyenne en fractions d’écart-type).
1.2 Utilité de la fonction inverse de la loi normale en recherche empirique
Dans la démarche hypothético-déductive qui caractérise l’analyse quantitative, le statisticien est fréquemment amené à inverser l’ordre traditionnel de la prédiction probabiliste. Alors que le calcul d’une valeur $p$ (par exemple via la commande normalcdf) consiste à déterminer la probabilité d’observer un résultat au moins aussi extrême qu’une statistique d’échantillon donnée, l’opération inverse consiste à identifier la frontière numérique délimitant une proportion d’observations prédéfinie. Ce processus de dérivation de seuils critiques est indispensable lors de la configuration a priori des tests d’inférence statistique sur l’hypothèse nulle ($H_0$). Dès lors qu’un chercheur fixe un risque d’erreur de première espèce $\alpha$ (généralement $0{,}05$ ou $0{,}01$), la fonction inverse de la loi normale permet de calculer avec exactitude la valeur critique $z_{\mathrm{crit}}$ au-delà de laquelle la région de rejet est proclamée.
Au-delà du strict paradigme des tests d’hypothèses de Neyman-Pearson, l’inversion de la distribution normale occupe une fonction cardinale dans la théorie des tests psychométriques et des traits latents. Dans le cadre de l’évaluation neuropsychologique, de la mesure de la personnalité ou de l’étalonnage de tests standardisés d’efficience intellectuelle, les performances brutes des participants sont typiquement distribuées de manière asymétrique ou soumises à des effets d’échelle arbitraires. La technique de normalisation par les rangs percentiles s’appuie directement sur la fonction $\Phi^{-1}(p)$ pour assigner à chaque rang centile un score standardisé normalisé (score $Z$, note T, ou score de quotient intellectuel dévié). Cette étape garantit la comparabilité internationale des profils cognitifs individuels en ancrant les observations empiriques sur une métrique universelle.
1.3 Présentation générale de la fonction invNorm sur la gamme TI-84
La commande invNorm constitue l’implémentation algorithmique de la fonction $\Phi^{-1}$ développée par Texas Instruments pour sa ligne de calculatrices graphiques. Si les premières générations de TI-83 et TI-84 Standard intégraient déjà cette commande sous une syntaxe minimale à trois arguments, l’architecture logicielle a connu des raffinements considérables au fil des évolutions matérielles. Les calculatrices TI-84 Plus Silver Edition, puis la version couleur TI-84 Plus CE dotée du processeur eZ80 cadencé à 48 MHz, ont enrichi la fonction d’interfaces utilisateur interactives et de paramètres de localisation directionnelle des queues de distribution.
Sur le plan mathématique interne, la TI-84 ne calcule pas une intégrale formelle, mais fait appel à des algorithmes d’approximation rationnelle minimax, dérivés des travaux d’Odeh et Evans ou de la méthode de Beasley-Springer-Moro. Ces algorithmes découpent le domaine de probabilité en sous-régions (notamment la région centrale et les deux régions asymptotiques extrêmes) et appliquent des polynômes rationnels de Tchebychev permettant d’atteindre un résidu d’erreur inférieur à $10^{-12}$. Par comparaison avec les tables statistiques traditionnelles — qui imposent une consultation fastidieuse sur des grilles papier limitées à deux décimales de précision et requièrent une interpolation linéaire sujette aux approximations —, la fonction invNorm offre un résultat instantané, continu et direct pour n’importe quel quantile arbitraire, sans nécessiter d’ajustements graphiques extérieurs.
2. Syntaxe, paramètres et structure formelle de la commande invNorm
2.1 Décomposition des arguments fondamentaux de invNorm
Dans sa structure matricielle native, la commande invNorm requiert au minimum un argument et peut en accepter jusqu’à quatre selon la génération de la machine et la configuration de son système d’exploitation (TI-OS). La signature fonctionnelle classique se présente sous la forme canonique :
invNorm(area, [μ, σ])
Le premier argument, obligatoirement désigné par le terme area (ou « aire » dans les versions francophones du logiciel), représente la masse de probabilité cumulée pour laquelle l’utilisateur cherche à déterminer l’abscisse correspondante. Dans la convention historique adoptée par Texas Instruments, cette aire s’entend impérativement comme l’intégrale cumulée s’étendant depuis l’infini négatif ($-\infty$) jusqu’au point de coupure désiré. Ainsi, saisir une valeur d’aire $p$ revient à résoudre l’équation intégrale $P(X le x) = p$.
Les deuxième et troisième arguments, respectivement notés $\mu$ (mu) et $\sigma$ (sigma), correspondent aux paramètres de localisation et d’échelle de la loi normale étudiée. Le paramètre $\mu$ symbolise l’espérance mathématique (la moyenne théorique) de la population cible, tandis que $\sigma$ représente son écart-type, qui doit être un nombre réel strictement positif ($\sigma > 0$). Lorsque ces deux arguments sont omis par l’utilisateur lors d’une saisie directe en ligne de commande, le système d’exploitation applique automatiquement les valeurs de configuration par défaut, à savoir $\mu = 0$ et $\sigma = 1$. Dans ce cas précis, la fonction calcule directement les quantiles de la loi normale centrée réduite standardisée $Z$.
2.2 Contraintes formelles et types de données acceptés
L’argument d’aire est assujetti à des restrictions de domaine rigoureuses découlant de la théorie axiomatique des probabilités de Kolmogorov. La valeur de area doit obligatoirement être un scalaire appartenant à l’intervalle ouvert réel $]0, 1[$. Tout argument inférieur ou égal à zéro ($area le 0$) ou supérieur ou égal à un ($area ge 1$) entraîne l’interruption immédiate du processus d’exécution de la calculatrice et l’émission d’une erreur bloquante de type ERR:DOMAIN. En effet, l’asymptote horizontale de la courbe de Gauss impliquant que la fonction de répartition ne converge vers $0$ qu’en $-\infty$ et vers $1$ qu’en $+\infty$, aucune abscisse finie ne peut être associée aux probabilités nulles ou certaines.
Le système d’exploitation de la TI-84 gère les calculs de invNorm avec une précision interne en virgule flottante codée sur quatorze octets (format BCD étendu), bien que l’affichage sur l’écran d’accueil soit tronqué à dix chiffres significatifs. En outre, la commande possède des propriétés vectorielles natives : il est tout à fait possible d’injecter une liste de probabilités délimitée par des accolades, telle que {0.05, 0.50, 0.95}, au sein de l’argument area. La TI-84 renvoie alors simultanément une liste dimensionnellement équivalente de scores $Z$ ou $X$, facilitant ainsi les calculs d’intervalles multiples ou la construction de tableaux d’étalonnage en une seule opération processeur.
2.3 Évolution syntaxique : apparition de l’argument Tail
L’une des innovations majeures introduites à partir des versions de système d’exploitation 5.x sur les modèles TI-84 Plus CE réside dans l’adjonction d’un quatrième argument formel désigné sous le terme Tail (queue de distribution). Cette fonctionnalité permet d’émanciper l’utilisateur de la contrainte historique du calcul exclusif par la gauche. La signature étendue devient :
invNorm(area, μ, σ, [tail])
Ce paramètre optionnel accepte trois spécificateurs distincts :
- LEFT (queue de gauche) : il s’agit du comportement conventionnel. La valeur saisie dans area est intégrée de $-\infty$ jusqu’au quantile recherché.
- RIGHT (queue de droite) : l’argument area est interprété comme la probabilité critique supérieure intégrée depuis le quantile recherché jusqu’à $+\infty$. Cela évite à l’utilisateur de calculer préalablement le complément mathématique $1 – \alpha$.
- CENTER (zone centrale) : l’argument area est interprété comme la masse centrale de probabilité bilatérale entourant symétriquement la moyenne $\mu$. Dans cette configuration, la calculatrice produit une paire de valeurs ordonnées sous forme d’une liste à deux éléments ${-x, +x}$, délimitant précisément la zone centrale spécifiée.
Il est fondamental de noter que les programmes rédigés pour des calculatrices TI-84 Plus plus anciennes (matériel monochrome) ne reconnaissent pas la chaîne ou le jeton mémoire associé à ce quatrième argument. Pour assurer une rétrocompatibilité absolue lors du partage de routines logicielles entre différentes générations d’équipements de laboratoire, l’utilisation de la syntaxe ternaire canonique invNorm(area, μ, σ) orientée à gauche par défaut demeure le standard algorithmique le plus sûr.
3. Guide étape par étape pour accéder au menu DISTR sur TI-84
3.1 Séquence de touches et navigation dans le système d’exploitation
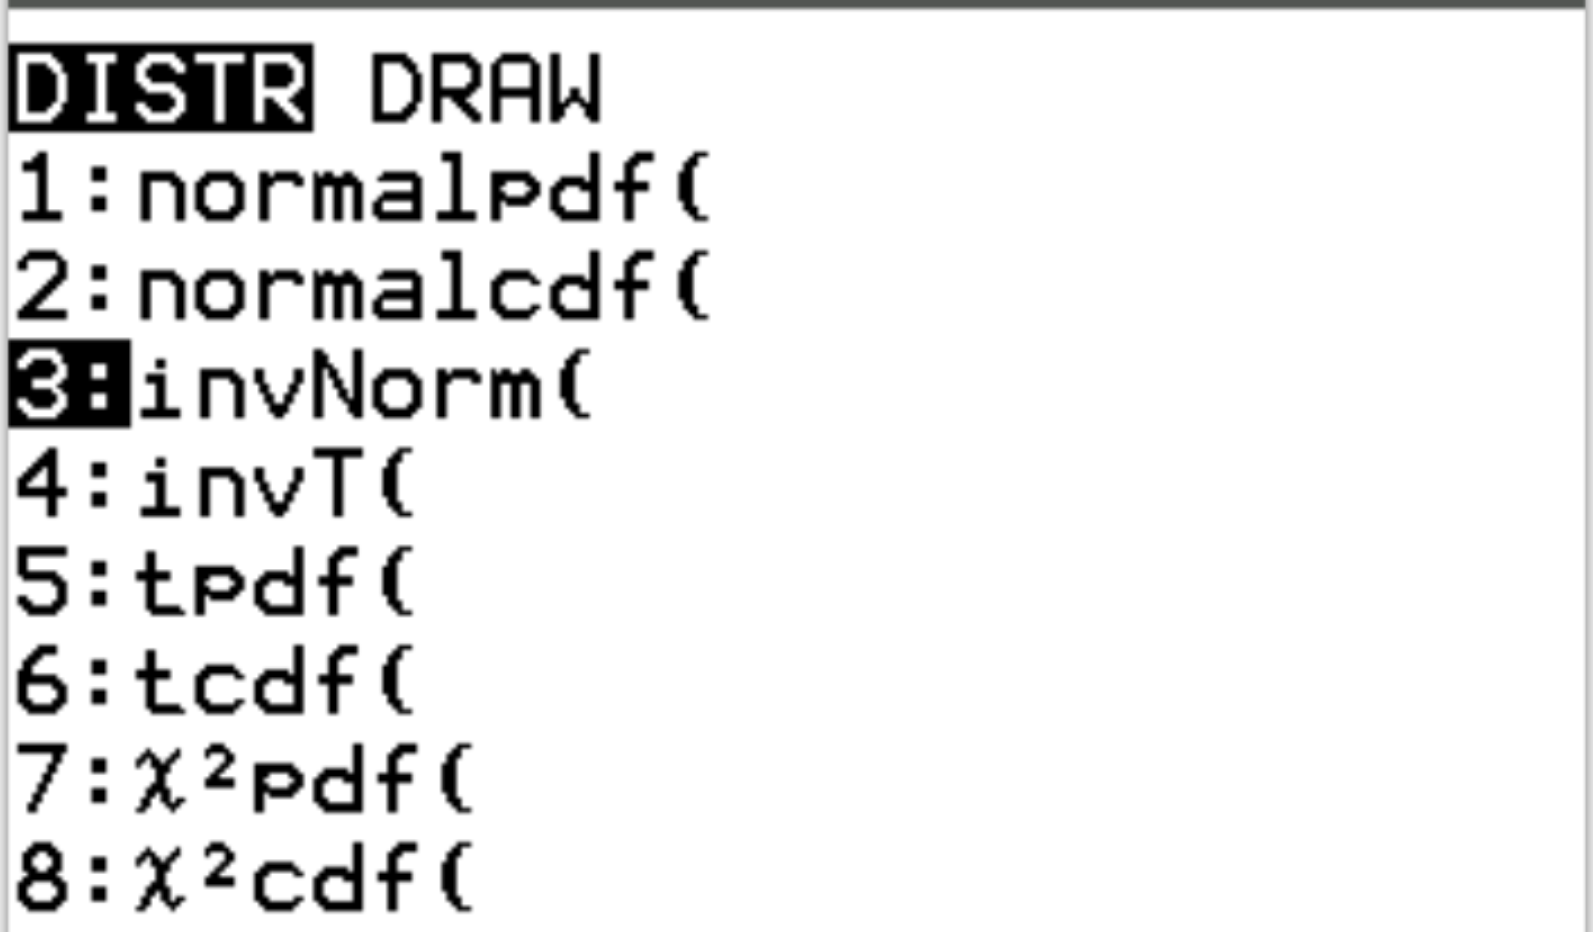
Pour appeler l’instruction invNorm sur n’importe quel modèle de la gamme TI-84, l’utilisateur doit accéder au sous-menu dédié aux distributions statistiques probabilistes, désigné par le libellé abrégé DISTR. Ce menu n’étant pas directement accessible par une touche unitaire du clavier physique, il convient d’exécuter la séquence de touches suivante depuis l’écran principal de calcul :
Dans un premier temps, appuyez sur la touche jaune ou bleue [2nd], située dans le coin supérieur gauche du clavier, afin de commuter la matrice des touches vers leurs fonctions secondaires imprimées au-dessus des touches physiques. Dans un second temps, pressez la touche [VARS], localisée juste en dessous des touches fléchées de navigation directionnelle. L’inscription jaune ou bleue « DISTR » est lisible immédiatement au-dessus de cette touche.
L’écran de la calculatrice affiche alors une liste hiérarchisée de fonctions probabilistes :
1: normalpdf(— densité de probabilité de la loi normale2: normalcdf(— fonction de répartition cumulative normale3: invNorm(— fonction inverse de la loi normale4: invT(— fonction inverse de la loi de Student
Pour valider la sélection de l’instruction invNorm, l’utilisateur dispose de deux approches ergonomiques équivalentes : soit presser directement la touche numérique [3] de son pavé, ce qui active instantanément l’élément correspondant sans nécessiter de parcours visuel, soit utiliser la touche fléchée orientée vers le bas pour surligner l’item 3: invNorm(, puis presser la touche d’exécution [ENTER].
3.2 Interaction avec l’écran d’assistance (Wizard Mode)
Sur les systèmes d’exploitation modernes configurés avec l’assistant de saisie statistique activé (le mode STAT WIZARDS), l’appel de la commande ne colle pas directement le mot-clé sur l’écran d’accueil, mais ouvre un formulaire de saisie guidé. Cette interface graphique interactive vise à éliminer les erreurs de ponctuation chez les utilisateurs débutants. L’écran présente une succession verticale de champs textuels préconfigurés :
Le premier curseur clignote en face du label area:. C’est ici que l’utilisateur doit saisir la valeur numérique de la probabilité cumulée désirée, sous forme décimale (par exemple 0.05). Il convient ensuite de descendre sur la ligne suivante au moyen de la flèche directionnelle basse pour atteindre le champ μ:. Par défaut, la calculatrice y pré-remplit la valeur 0. Si le problème porte sur une loi non centrée, la moyenne empirique de référence y est inscrite. La ligne suivante, σ:, contient par défaut la valeur 1, modifiable à volonté.
Sur les calculatrices de type TI-84 Plus CE, une quatrième ligne intitulée Tail: offre trois boutons radio virtuels textuels : LEFT, CENTER, RIGHT. Le positionnement s’effectue à l’aide des flèches droite et gauche, et la validation du choix requiert l’appui sur [ENTER]. Une fois tous les champs dûment renseignés, l’utilisateur navigue jusqu’à la dernière mention Paste et appuie de nouveau sur [ENTER]. L’assistant compile alors les informations saisies et les transfère sur l’écran d’accueil de calcul sous la forme syntaxique standardisée, prête pour l’évaluation.
Il est à noter que l’activation ou la désactivation de cet assistant graphique s’opère en pressant la touche [MODE], puis en faisant défiler l’affichage jusqu’à la ligne STAT WIZARDS pour commuter entre les options ON et OFF.
3.3 Saisie directe en ligne de commande (Classic Mode)
Lorsque le mode STAT WIZARDS est désactivé (option OFF), ou sur les versions logicielles de première génération, la sélection de l’élément 3 dans le menu DISTR imprime immédiatement la séquence invNorm( directement sur la ligne de commande active de l’écran principal. L’utilisateur doit alors composer manuellement la chaîne des arguments en respectant impérativement les règles syntaxiques du système d’exploitation.
Une confusion typographique fréquente doit être formellement évitée à cette étape : la TI-84 différencie rigoureusement le séparateur d’arguments — constitué par la virgule syntaxique située sur une touche dédiée, juste au-dessus du chiffre [7] — du point décimal qui se trouve sur la touche [.] au bas du pavé numérique. Tout usage du point en lieu et place de la virgule de séparation d’arguments conduira à une mauvaise interprétation mathématique de la chaîne d’instructions.
Ainsi, pour évaluer une borne standardisée relative à une probabilité de $0{,}05$, l’utilisateur composera :
invNorm(0.05,0,1)
ou plus simplement, en exploitant la configuration par défaut de la machine :
invNorm(0.05)
Bien que la fermeture finale de la parenthèse par la touche [ ) ] soit considérée comme une bonne pratique de programmation, le compilateur du système d’exploitation de la TI-84 tolère l’omission de cette dernière parenthèse en fin de ligne et calcule le résultat dès que la touche d’exécution [ENTER] est activée.
4. Détermination des valeurs critiques Z pour les tests unilatéraux à gauche
4.1 Fondements de l’hypothèse unilatérale inférieure
Dans l’architecture de la prise de décision statistique inférentielle, un test d’hypothèse est qualifié d’unilatéral à gauche (ou unilatéral inférieur) lorsque l’hypothèse alternative de recherche ($H_1$) postule formellement une diminution, un recul ou une infériorité du paramètre de population par rapport à la valeur assignée sous l’hypothèse nulle ($H_0$). La formulation mathématique de ce modèle de décision s’écrit conventionnellement :
$$\begin{\cases} H_0 : \mu ge \mu_0 H_1 : \mu < \mu_0 \end{\cases}$$
Dans cette configuration théorique, les observations empiriques qui viendraient réfuter la plausibilité de l’hypothèse nulle se situent exclusivement dans la région asymptotique inférieure de la distribution d’échantillonnage de la statistique de test. Dès lors, la totalité du risque d’erreur de première espèce, symbolisé par le niveau de signification $\alpha$, est concentrée dans l’extrémité gauche de la courbe normale.
Il existe par conséquent une correspondance mathématique directe et sans ambiguïté entre le risque nominal $\alpha$ et le paramètre area attendu par la calculatrice TI-84. La région de rejet est délimitée par une frontière unique, appelée valeur critique $z_{\mathrm{crit}}$, telle que la probabilité cumulée depuis l’infini négatif jusqu’à cette borne soit exactement égale à $\alpha$ :
$$P(Z le z_{\mathrm{crit}}) = \alpha iff z_{\mathrm{crit}} = \Phi^{-1}(\alpha)$$
La règle de décision statistique stipule alors que si la statistique de test calculée à partir des données de l’échantillon ($z_{\mathrm{obs}}$) est inférieure ou égale à $z_{\mathrm{crit}}$, l’hypothèse nulle doit être formellement rejetée au profit de l’hypothèse alternative.
4.2 Exemple d’application pas à pas avec seuil alpha = 0,05
Considérons le scénario classique où un chercheur souhaite établir la valeur critique $z$ pour un test unilatéral inférieur au seuil de confiance de $95,%$, ce qui correspond à un risque d’erreur de type I fixé classiquement à $\alpha = 0{,}05$.
Sur la calculatrice TI-84, la démarche opératoire s’exécute selon les étapes systématiques suivantes :
- Appuyez sur [2nd] puis sur [VARS] pour déployer le menu DISTR.
- Sélectionnez l’option
3: invNorm(en pressant la touche numérique [3]. - Si l’assistant de saisie (Wizard) s’affiche, saisissez
0.05dans le champarea:, laissez0pourμ:,1pourσ:, positionnez éventuellement l’optionTail:surLEFT, puis surlignezPasteet validez par [ENTER]. - Si la machine opère en mode ligne de commande classique, saisissez manuellement la séquence :
invNorm(0.05)ouinvNorm(0.05,0,1). - Pressez la touche finale d’exécution [ENTER].
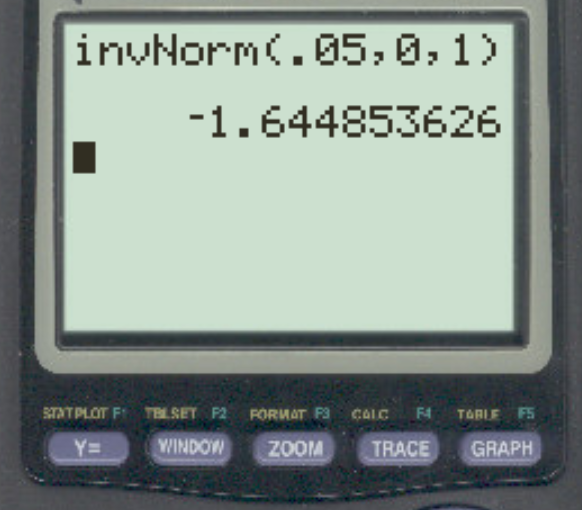
Le système renvoie immédiatement sur la partie droite de l’écran le résultat numérique :
-1.644853626
Ce résultat démontre sans ambiguïté que l’abscisse séparant les $5,%$ inférieurs du reste de la distribution normale standard correspond à $z \approx -1{,}645$. L’interprétation géométrique de ce résultat est immédiate : toute observation empirique standardisée dont le score se situe à gauche de $-1{,}645$ tombe dans la région de rejet de $H_0$, signifiant que la probabilité d’obtenir une telle déviation sous la simple action du hasard d’échantillonnage est strictement inférieure au seuil critique de $5,%$.
4.3 Variantes avec d’autres niveaux de signification usuels
Selon le niveau d’exigence méthodologique ou le cadre réglementaire d’une discipline, d’autres seuils de signification statistique sont communément employés. L’analyste doit être capable d’adapter immédiatement sa commande pour extraire les valeurs critiques correspondantes.
Dans les contextes expérimentaux requérant un contrôle drastique du risque de faux positif — comme les essais cliniques de phase III en pharmacologie ou les protocoles de détection en imagerie fonctionnelle cérébrale —, le seuil $\alpha$ est couramment abaissé à $0{,}01$ ($1,%$). En saisissant dans la TI-84 :
invNorm(0.01)
la machine génère la valeur critique :
-2.326347877
Le chercheur retiendra conventionnellement la valeur approchée $z_{\mathrm{crit}} = -2{,}326$. Pour qu’une baisse observée soit proclamée statistiquement significative à ce seuil conservateur, la statistique empirique calculée $z_{\mathrm{obs}}$ devra franchir cette borne négative extrême.
À l’inverse, lors d’investigations exploratoires préliminaires ou dans certaines études de screening où l’on cherche à minimiser le risque d’erreur de seconde espèce ($\beta$, non-détection d’un effet réel), un seuil plus libéral de $\alpha = 0{,}10$ ($10,%$) est parfois toléré. La commande :
invNorm(0.10)
produit alors :
-1.281551564
soit un seuil de rejet arrondi à $z_{\mathrm{crit}} = -1{,}282$. Ces calculs illustrent avec clarté la sensibilité de la frontière décisionnelle face aux variations imposées au risque d’erreur de première espèce.
5. Détermination des valeurs critiques Z pour les tests unilatéraux à droite
5.1 Spécificités de l’hypothèse unilatérale supérieure
À l’opposé de la situation précédente, un test unilatéral à droite (ou unilatéral supérieur) intervient lorsque l’hypothèse substantielle de recherche ($H_1$) postule de façon unidirectionnelle que le traitement, l’intervention clinique ou la condition expérimentale induit une augmentation ou une supériorité métrique du paramètre étudié. Les hypothèses statistiques formelles se traduisent par le système suivant :
$$\begin{\cases} H_0 : \mu le \mu_0 H_1 : \mu > \mu_0 \end{\cases}$$
Dans ce cadre décisionnel, les données corroborant l’hypothèse alternative se manifestent par des grandeurs numériques élevées, situées au tréfonds de la queue supérieure de la distribution de Gauss. Le niveau de signification $\alpha$ est par conséquent concentré en totalité dans l’extrémité droite de la courbe. L’objectif mathématique consiste donc à repérer une borne critique strictement positive, notée $+z_{\mathrm{crit}}$, telle que l’aire délimitée à droite de cette coordonnée représente une masse égale à $\alpha$ :
$$P(Z ge z_{\mathrm{crit}}) = \alpha$$
Sur les calculatrices de générations antérieures, ou sur les machines exploitant le mode syntaxique classique, cette formulation théorique nécessite une gymnastique arithmétique préalable découlant de la conception asymétrique native de l’algorithme.
5.2 Méthode du complément mathématique (1 – alpha)
Parce que la fonction de répartition universelle intégrée dans les ordinateurs calcule l’aire cumulative depuis $-\infty$ jusqu’à la borne $z$, spécifier directement la valeur de $\alpha$ au sein de invNorm conduirait inexorablement au calcul de la borne inférieure gauche, produisant un score négatif contraire à la logique du test unilatéral supérieur. Pour résoudre ce paradoxe sur les calculatrices TI-84 dépourvues de sélection de queue (ou fonctionnant en mode classique), l’utilisateur doit obligatoirement invoquer le principe fondamental des événements complémentaires de la théorie des probabilités.
L’aire totale sous la densité normale étant unitairement égale à $1$, la relation entre l’aire critique supérieure ($\alpha$) et l’aire cumulée inférieure à gauche s’exprime rigoureusement par :
$$\text{Aire à gauche} = 1 – P(Z ge z_{\mathrm{crit}}) = 1 – \alpha$$
Par conséquent, pour déterminer le seuil critique d’un test supérieur au niveau de risque $\alpha = 0{,}05$, la probabilité cumulée qu’il convient de soumettre à la machine est égale à $1 – 0{,}05 = 0{,}95$.
Sur la ligne de commande de la calculatrice TI-84, la saisie peut s’effectuer directement en intégrant l’opérateur arithmétique de soustraction au sein de l’argument de la fonction :
invNorm(1-0.05) ou invNorm(0.95)
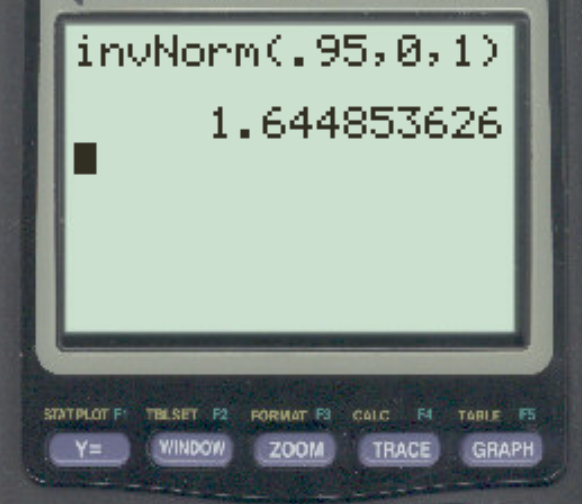
L’évaluation par la touche [ENTER] fournit instantanément :
1.644853626
On constate que le résultat généré présente exactement la même valeur absolue que la borne unilatérale inférieure calculée à la section précédente, mais affectée cette fois d’un signe positif ($z_{\mathrm{crit}} = +1{,}645$). La parfaite symétrie axiale de la courbe de Gauss par rapport à son origine $0$ garantit que $\Phi^{-1}(1 – \alpha) = -\Phi^{-1}(\alpha)$. L’hypothèse nulle sera dès lors rejetée si et seulement si la statistique observée de l’échantillon satisfait la condition : $z_{\mathrm{obs}} ge +1{,}645$.
5.3 Utilisation directe de l’option RIGHT sur les TI-84 modernes
Pour les utilisateurs de la TI-84 Plus CE disposant d’un système d’exploitation à jour, l’adjonction formelle du paramètre d’orientation de queue élimine complètement le besoin d’effectuer mentalement ou algébriquement l’opération du complément à un. Cette amélioration logicielle supprime l’une des sources les plus documentées d’erreurs de saisie chez les étudiants et chercheurs non mathématiciens.
La mise en œuvre pratique via l’assistant interactif s’articule comme suit :
- Ouvrez le menu DISTR via [2nd] [VARS] puis sélectionnez
3: invNorm(. - Dans le champ
area:, entrez directement la valeur nominale du seuil unilatéral supérieur :0.05. - Maintenez les paramètres d’échelle standardisés :
μ: 0etσ: 1. - Descendez sur la ligne
Tail:. Déplacez le curseur lumineux vers la droite pour surligner le mot-cléRIGHTet pressez [ENTER] pour valider ce positionnement. - Naviguez vers
Pasteet validez par [ENTER].
L’écran principal reproduit alors l’instruction enrichie :
invNorm(0.05,0,1,RIGHT)
La validation finale par [ENTER] produit immédiatement le score positif attendu :
1.644853626
Cette commodité logicielle garantit une cohérence absolue de traitement entre le libellé formel de l’hypothèse de recherche supérieure et sa transcription numérique au sein de l’environnement matériel Texas Instruments.
6. Calcul des valeurs critiques pour les tests d’hypothèses bilatéraux
6.1 Structure symétrique du test non directionnel
Dans la grande majorité des recherches expérimentales et cliniques fondamentales, l’état initial des connaissances théoriques ne permet pas d’anticiper avec certitude le sens de la variation induite par une variable indépendante. Le chercheur formule alors une hypothèse alternative non directionnelle (ou bilatérale), postulant simplement l’existence d’une différence statistique significative, sans préjuger de son signe positif ou négatif :
$$\begin{\cases} H_0 : \mu = \mu_0 H_1 : \mu ne \mu_0 \end{\cases}$$
Sous ce modèle mathématique, l’hypothèse nulle se trouve compromise aussi bien par l’obtention d’une statistique d’échantillon anormalement faible que par celle d’une statistique anormalement élevée. Par voie de conséquence, le risque d’erreur de première espèce global $\alpha$ ne peut plus être alloué à une seule extrémité de la loi de probabilité ; il doit être scrupuleusement fractionné en deux parts égales, assignées symétriquement aux deux régions asymptotiques de la distribution.
Chaque région critique d’extrémité absorbe ainsi une probabilité d’occurrence égale à $\alpha / 2$. Le cadre de décision ne repose plus sur une valeur critique unique, mais sur une paire de coordonnées géométriquement opposées : une valeur critique inférieure $-z_{\mathrm{crit}}$ et une valeur critique supérieure $+z_{\mathrm{crit}}$. L’espace probabiliste se partitionne en deux composantes disjointes :
$$P(Z le -z_{\mathrm{crit}}) = \frac{\alpha}{2} \quad \text{et} \quad P(Z ge +z_{\mathrm{crit}}) = \frac{\alpha}{2}$$
Le rejet de l’hypothèse nulle survient dès lors que l’amplitude absolue du score empirique franchit le seuil critique : $|z_{\mathrm{obs}}| ge z_{\mathrm{crit}}$.
6.2 Procédure standard pour un seuil global alpha = 0,05
Examinons l’étalonnage du test bilatéral canonique pour un niveau de signification global fixé à la convention habituelle de $\alpha = 0{,}05$. L’application rigoureuse du partitionnement probabiliste exige que chacune des deux queues de la distribution accueille une proportion d’erreur égale à :
$$\frac{\alpha}{2} = \frac{0{,}05}{2} = 0{,}025$$
Pour calculer la borne critique inférieure délimitant la queue gauche, il suffit d’entrer dans la commande invNorm de la TI-84 la masse cumulative de cette demi-région critique :
invNorm(0.05/2) ou invNorm(0.025)
Le microprocesseur de la machine restitue la coordonnée décimale :
-1.959963986
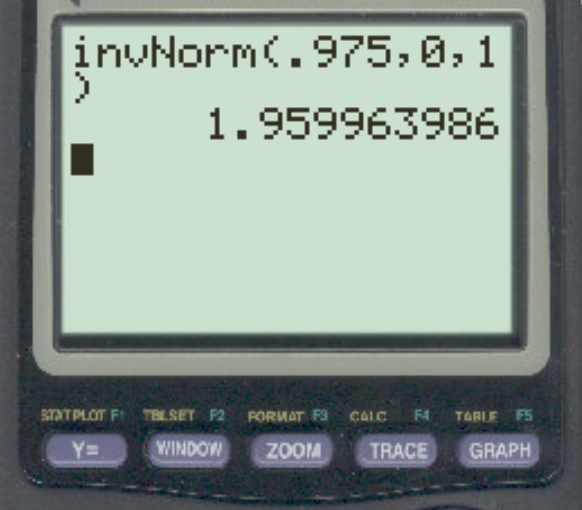
Pour déterminer réciproquement la borne critique supérieure, la démarche requiert d’intégrer l’ensemble de la masse probabiliste située en amont de cette seconde frontière, ce qui correspond à la somme de la zone centrale d’acceptation ($1 – \alpha = 0{,}95$) et de la queue inférieure gauche ($\alpha / 2 = 0{,}025$), soit une aire cumulative globale de $1 – (\alpha / 2) = 0{,}975$. En composant :
invNorm(1-0.05/2) ou invNorm(0.975)
la TI-84 affiche la valeur symétrique :
1.959963986
C’est de cette dérivation numérique que provient le fameux coefficient universel $z \approx \pm 1{,}96$, omniprésent dans la littérature scientifique internationale pour désigner l’intervalle de non-rejet de l’hypothèse nulle à $95,%$. Toute statistique empirique $|z_{\mathrm{obs}}| ge 1{,}96$ conduit au rejet formel de $H_0$ au niveau de confiance bilatéral de $95,%$.
6.3 Usage de l’option CENTER pour les intervalles de confiance
Dans les versions contemporaines de l’environnement TI-OS (modèles TI-84 Plus CE), la conceptualisation des régions bilatérales a été simplifiée par l’implémentation de la modalité CENTER du paramètre Tail. Cette approche fait coïncider le calcul des bornes de rejet bilatérales avec la mécanique d’estimation des intervalles de confiance.
Lorsque l’option centrale est mobilisée, l’argument formel area ne désigne plus la zone de rejet $\alpha$, mais bien la masse de probabilité interne encadrée par les deux bornes, soit précisément le coefficient de confiance $1 – \alpha$.
Pour obtenir simultanément les deux valeurs critiques associées à un niveau de risque bilatéral $\alpha = 0{,}05$ (niveau de confiance de $95,%$) :
- Appelez invNorm via le menu DISTR.
- Dans le champ
area:, renseignez la masse centrale :0.95. - Conservez les paramètres
μ: 0etσ: 1. - Sur la ligne
Tail:, positionnez le sélecteur sur l’option médianeCENTER. - Exécutez l’insertion via
Paste.
Sur l’écran d’accueil, la commande s’exprime sous la forme unifiée :
invNorm(0.95,0,1,CENTER)
Après validation par [ENTER], la calculatrice ne génère pas un scalaire isolé, mais une structure de données matricielle encadrée par des accolades (une liste TI-Basic) :
{-1.959963986, 1.959963986}
Cette sortie simultanée des deux frontières symétriques apporte un confort analytique exceptionnel pour la construction immédiate des intervalles de confiance autour d’une moyenne ou d’une proportion d’échantillon, évitant toute manipulation arithmétique manuelle du signe.
7. Utilisation de invNorm avec des distributions normales non standardisées
7.1 Conversion directe sans passage par la note Z
Dans les applications de terrain — qu’il s’agisse de métrologie industrielle, d’évaluation scolaire ou d’épidémiologie clinique —, les grandeurs mesurées s’expriment rarement sous une forme standardisée de moyenne nulle et d’écart-type unitaire. Les variables continues observées $X$ suivent plutôt une loi normale générale $\mathcal{N}(\mu, \sigma)$ caractérisée par une moyenne d’échelle $\mu ne 0$ et un étalement $\sigma ne 1$.
Traditionnellement, la détermination d’une valeur de coupure sur une distribution non standardisée réclamait une procédure séquentielle en deux étapes : premièrement, l’extraction de la valeur standardisée $z = \Phi^{-1}(p)$ au moyen d’une table ou d’une calculatrice, puis deuxièmement, la dé-standardisation algébrique manuelle de cette valeur au moyen de l’équation de transformation linéaire :
$$X = \mu + z \cdot \sigma$$
L’algorithme de la TI-84 résout cette transformation de manière transparente et native. En saisissant directement les valeurs numériques réelles de $\mu$ et $\sigma$ au sein des deuxième et troisième arguments de invNorm, le microprocesseur opère la dé-standardisation au niveau de ses registres internes avant de restituer la réponse. Cette intégration directe élimine les erreurs d’arrondi intermédiaires inhérentes à la manipulation d’un score $Z$ tronqué et diminue drastiquement le risque d’omission d’un facteur d’échelle lors des analyses d’urgence en laboratoire.
7.2 Application au repérage des centiles sur une échelle psychométrique
L’évaluation psychométrique de l’intelligence générale chez l’enfant et l’adulte (notamment par le biais des échelles d’intelligence de Wechsler comme le WISC-V ou la WAIS-IV) fournit une illustration paradigmatique de l’intérêt des distributions non standardisées. Par construction théorique internationale, les scores composites de quotient intellectuel (QI) sont calibrés selon une loi normale d’espérance $\mu = 100$ et d’écart-type standard $\sigma = 15$.
Supposons qu’un psychologue clinicien doive identifier le score seuil de QI à partir duquel un individu se classe parmi les $5,%$ les plus performants de sa classe d’âge (repérage d’un haut potentiel intellectuel selon un critère d’admissibilité fixé au $95^{\mathrm{e}}$ rang centile).
La probabilité cumulée inférieure associée au $95^{\mathrm{e}}$ centile correspond à $p = 0{,}95$. En appliquant la commande invNorm sans transformation préliminaire :
invNorm(0.95, 100, 15)
La TI-84 produit immédiatement la valeur brute :
124.6728044
L’analyse de ce résultat indique qu’un score standardisé de QI d’environ $124{,}67$ (arrondi cliniquement à $125$ points d’indice composite) marque la frontière inférieure du $95^{\mathrm{e}}$ centile supérieur. Si l’opérateur avait calculé manuellement :
$$X = 100 + (1{,}64485 \times 15) = 100 + 24{,}67275 = 124{,}67275$$
il serait parvenu à la même conclusion, mais au prix de manipulations calculatoires superflues. La TI-84 réalise cette opération de manière quasi instantanée tout en conservant la pleine fidélité de ses registres de précision décimale.
7.3 Calcul de tranches d’étalonnage et quartiles de performance
Une autre application fréquente réside dans la partition d’une population de référence en segments ordonnés de taille égale, appelés quartiles, fréquemment requis lors de la calibration d’épreuves de sélection ou dans la modélisation de sous-groupes cliniques (faible, moyen inférieur, moyen supérieur, élevé).
Les trois quartiles fondamentaux d’une loi normale sont découpés selon des aires cumulées respectives de $25,%$ ($0{,}25$), $50,%$ ($0{,}50$) et $75,%$ ($0{,}75$). Considérons une échelle de performance psychomotrice modélisée par une moyenne de $\mu = 50$ et un écart-type de $\sigma = 10$ (échelle classique en notes T) :
Pour identifier le premier quartile ($Q_1$, délimitant les $25,%$ des performances les plus faibles) :
invNorm(0.25, 50, 10) $long\rightarrow$ 43.2551025
Pour évaluer le deuxième quartile ($Q_2$ ou médiane distributionnelle) :
invNorm(0.50, 50, 10) $long\rightarrow$ 50
Comme attendu sur une courbe parfaitement symétrique, la médiane coïncide rigoureusement avec la moyenne théorique assignée.
Pour le troisième quartile ($Q_3$, frontière des $75,%$) :
invNorm(0.75, 50, 10) $long\rightarrow$ 56.7448975
À partir de ces sorties d’évaluation, l’écart interquartile théorique ($IQR = Q_3 – Q_1$) de cette population s’établit de façon rigoureuse à $56{,}745 – 43{,}255 = 13{,}490$ points d’échelle, fournissant aux équipes de recherche un indice de dispersion robuste face aux éventuelles observations aberrantes futures.
8. Études de cas appliquées en psychologie quantitative et neuropsychologie
8.1 Cas 1 : Diagnostic du déficit d’attention et repérage clinique
Dans le cadre du diagnostic neuropsychologique du Trouble du Déficit de l’Attention avec ou sans Hyperactivité (TDAH), les épreuves de performance continue (Continuous Performance Test ou CPT) mesurent la latence moyenne de réponse motrice lors de la présentation répétée de stimuli visuels cibles. L’un des marqueurs cognitifs majeurs de l’inattention réside dans l’allongement anormal du temps de réaction, reflétant des micro-décrochages de la vigilance attentionnelle soutenue.
Supposons que les données normatives standardisées pour une cohorte d’adolescents âgés de 12 à 14 ans suivent une distribution normale caractérisée par un temps moyen de réaction $\mu = 450$ millisecondes (ms) et un écart-type populationnel $\sigma = 60$ ms. Le consensus clinique international retient qu’une anomalie fonctionnelle de ralentissement attentionnel est suspectée dès lors que la latence d’un patient franchit le $95^{\mathrm{e}}$ rang centile des données normatives de son groupe d’appariement.
Le praticien doit déterminer le seuil critique temporel (en millisecondes) à partir duquel un patient est réputé pathologiquement ralenti. L’énoncé décrivant une dégradation unilatérale droite (temps anormalement élevés), la probabilité cumulative jusqu’à ce seuil s’élève à $0{,}95$. L’implémentation sur la calculatrice TI-84 s’effectue ainsi :
invNorm(0.95, 450, 60)
L’évaluation produit la valeur :
548.6912176
La règle décisionnelle clinique s’établit donc formellement à $548{,}69$ ms. Si un adolescent évalué présente un temps de réaction moyen mesuré à $562$ ms au protocole informatisé, son score dépasse le seuil critique du $95^{\mathrm{e}}$ centile ($562 > 548{,}69$). Le neuropsychologue peut en conclure avec un risque d’erreur diagnostique de première espèce inférieur à $5,%$ que la latence de traitement de ce patient est significativement atypique par rapport à sa cohorte de référence.
8.2 Cas 2 : Évaluation des seuils de précocité intellectuelle
La définition psychométrique classique du Très Haut Potentiel Intellectuel (THPI) adoptée par de nombreuses institutions de recherche repose historiquement sur l’atteinte d’un score de quotient intellectuel dévié situé à deux écarts-types au-dessus de la moyenne populationnelle. Sur une distribution d’efficience standard ($\mu = 100$, $\sigma = 15$), ce repère traditionnel correspond au score canonique bien connu de :
$$QI = 100 + 2 \times 15 = 130$$
Cependant, une question méthodologique symétrique et plus fine se pose fréquemment aux comités d’admission des programmes d’éducation enrichie : quel est le seuil exact de QI requis si l’on souhaite sélectionner rigoureusement les $2,%$ d’individus les plus avancés de la population générale (c’est-à-dire les candidats se situant strictement au $98^{\mathrm{e}}$ centile exact, et non à une déviation théorique arrondie de deux écarts-types) ?
Pour résoudre cette problématique, la masse de probabilité cumulée inférieure à considérer est de $1 – 0{,}02 = 0{,}98$. La commande saisie au clavier de la calculatrice s’écrit :
invNorm(0.98, 100, 15)
Le résultat obtenu à l’écran indique :
130.8062334
Cette analyse démontre qu’exiger un centile strict de $98,%$ impose un score de coupure de $130{,}81$ points, seuil légèrement plus exigeant que le simple palier conventionnel de $130$. En réalité, un QI de $130$ correspond exactement à un centile cumulé calculable par la fonction conjuguée normalcdf(-1E99, 130, 100, 15) égal à $97{,}72,%$, et non à $98,%$. Ce cas d’école met en lumière la puissance de l’outil invNorm pour affiner les standards de sélection psychométrique en s’affranchissant des approximations intuitives.
8.3 Cas 3 : Seuil de rejet dans une étude expérimentale sur le stress
Dans un protocole de recherche translationnelle en psycho-neuro-endocrinologie, une équipe teste l’efficacité d’un programme de réduction du stress basé sur la pleine conscience (MBSR). L’hypothèse de travail postule que la pratique intensive de la méditation induit une baisse significative de la concentration salivaire matinale de cortisol libre, biomarqueur de l’activité de l’axe hypothalamo-hypophyso-surrénalien.
Afin de parer aux variations métaboliques d’échelle, les données de variations de cortisol pré-post intervention sont converties en scores $Z$ standardisés de différence. Compte tenu des implications théoriques majeures du programme, les chercheurs choisissent de verrouiller leur test d’hypothèse unilatéral inférieur à un seuil d’exigence rigoureux fixé à $\alpha = 0{,}01$.
La valeur critique frontière $z_{\mathrm{crit}}$ au-delà de laquelle l’hypothèse nulle d’absence d’effet devra être rejetée est obtenue via :
invNorm(0.01, 0, 1)
ce qui génère la valeur critique négative standardisée :
-2.326347877
Après huit semaines d’intervention, l’analyse des prélèvements biologiques sur un échantillon apparié produit une statistique d’échantillon observée $z_{\mathrm{obs}} = -2{,}54$. En confrontant directement la grandeur calculée au seuil critique déduit sur la TI-84 :
$$-2{,}54 le -2{,}326 implies z_{\mathrm{obs}} le z_{\mathrm{crit}}$$
Les chercheurs constatent que la statistique empirique pénètre incontestablement dans la zone de rejet unilatérale. L’hypothèse nulle est rejetée au niveau de confiance de $99,%$, autorisant la publication de conclusions attestant formellement l’impact réducteur de l’entraînement méditatif sur les niveaux physiologiques de cortisol basilaire.
9. Comparaison méthodologique : invNorm face à normalcdf et aux tables de Gauss
9.1 Dualité conceptuelle entre invNorm et normalcdf
Pour tout praticien de l’analyse quantitative utilisant la TI-84, la compréhension des fonctions de distribution repose sur la maîtrise d’une réciprocité mathématique stricte liant normalcdf et invNorm. Ces deux instructions représentent les deux faces d’une bijection mathématique opérant sur la distribution normale continue :
D’un côté, normalcdf agit comme un opérateur direct d’intégration probabiliste : elle accepte en entrée deux coordonnées géométriques d’abscisse (une borne inférieure $a$ et une borne supérieure $b$, accompagnées des paramètres $\mu$ et $\sigma$) et retourne en sortie la masse scalaire de probabilité correspondante :
$$\text{normalcdf}(a, b, \mu, \sigma) = \int_{a}^{b} \phi(x; \mu, \sigma) , dx$$
D’un autre côté, invNorm effectue le processus fonctionnel exactement inverse : elle accepte en entrée une probabilité scalaire $p$ et renvoie l’abscisse de coupure unique $x$ satisfaisant l’intégrale cumulée depuis $-\infty$.
Cette relation de réciprocité offre un moyen idéal d’auto-validation des calculs en laboratoire ou en situation d’examen. Par exemple, si l’on évalue :
invNorm(0.975, 0, 1) $long\rightarrow$ 1.959963986
il est possible de réinjecter immédiatement ce résultat au sein de la fonction directe :
normalcdf(-1E99, 1.959963986, 0, 1)
L’évaluation restitue rigoureusement la probabilité initiale 0.975. La maîtrise conjointe de ces deux instructions garantit à l’analyste un contrôle parfait de la cohérence de ses estimations paramétriques.
9.2 Avantages de la calculatrice graphique sur les tables imprimées
Bien que l’enseignement traditionnel de la statistique descriptive conserve parfois l’usage des tables imprimées de la loi normale pour des motifs pédagogiques d’initiation, l’utilisation de invNorm sur calculatrice graphique confère des avantages méthodologiques écrasants qui disqualifient la table dans toute démarche professionnelle sérieuse.
En premier lieu, la résolution des tables papier est structurellement bridée : la quasi-totalité des documents publiés ne propose des entrées de scores $Z$ qu’avec deux décimales (par incréments de $0{,}01$). Dès lors que l’on cherche la valeur critique associée à un centile non tabulé avec exactitude (comme un risque $\alpha = 0{,}05$ dont la probabilité complémentaire $0{,}9500$ se trouve piégée à équidistance entre les scores de $1{,}64$ et $1{,}65$), l’utilisateur doit procéder à une interpolation linéaire d’approximation. La TI-84 calcule le quantile exact à l’ordre de $10^{-10}$, éliminant tout biais d’estimation numérique.
En deuxième lieu, les tables physiques sont totalement inopérantes pour l’exploration des queues de distribution très éloignées de la moyenne (au-delà de $|z| > 3{,}5$ ou pour des niveaux de risque extrême comme $\alpha = 0{,}0001$), où les valeurs cumulées sont uniformément écrasées à $0{,}9999$. L’algorithme numérique de la TI-84 maintient sa dynamique de convergence bien au-delà de ces frontières.
En troisième lieu, les tables imposent obligatoirement la standardisation manuelle préalable de toute distribution de moyenne $\mu$ et d’écart-type $\sigma$ arbitraires, multipliant les transcriptions manuscrites et donc les risques d’erreurs humaines de calcul.
9.3 Limites de l’outil dans les petits échantillons : invNorm vs invT
Une mise en garde fondamentale doit toutefois être formulée sur le plan épistémologique : l’utilisation de la commande invNorm n’est mathématiquement valide que si l’écart-type de la population cible $\sigma$ est formellement connu a priori, ou lorsque la taille de l’échantillon empirique étudié est suffisamment vaste ($N > 30$, voire $N > 100$) pour que le théorème central limite garantisse la convergence asymptotique de la distribution d’échantillonnage vers la normalité parfaite.
Dans la pratique réelle de la recherche quantitative en psychologie et en biologie, l’écart-type de la population $\sigma$ demeure le plus souvent inconnu et doit être estimé à partir de la variance de l’échantillon observé, notée $s$. Lorsque cette estimation intervient sur des petits échantillons ($N < 30$), la statistique de test ne se distribue plus selon une loi normale standard $\mathcal{N}(0, 1)$, mais suit rigoureusement la loi $t$ de Student à $\nu = n – 1$ degrés de liberté, dont les queues de distribution sont substantiellement plus épaisses (leptokurticité).
Dans cette situation méthodologique précise, continuer à exploiter invNorm conduirait à sous-estimer systématiquement la valeur critique réelle et, par conséquent, à gonfler artificiellement le taux d’erreur de première espèce en déclarant faussement significatifs des résultats imputables aux fluctuations d’échantillonnage. Le statisticien doit alors impérativement délaisser invNorm au profit de la commande invT, située à la quatrième ligne du menu DISTR de sa TI-84 :
invT(area, df)
où df symbolise les degrés de liberté ($n – 1$). Par exemple, pour un risque unilatéral gauche $\alpha = 0{,}05$ sur un groupe restreint de $n = 10$ sujets ($df = 9$) :
invNorm(0.05)produit $-1{,}645$invT(0.05, 9)produit $-1{,}833$
L’écart de près de deux dixièmes d’écart-type illustre la sévérité du biais qu’induirait l’usage aveugle de invNorm hors de son périmètre de légitimité mathématique.
10. Résolution des anomalies, messages d’erreur et pièges fréquents
10.1 Diagnostic de l’erreur d’exécution ERR:DOMAIN
L’incident logiciel le plus récurrent rencontré lors de l’exécution de la fonction inverse sur les calculatrices de la marque réside dans l’apparition inopinée de l’écran d’interruption :
ERR:DOMAIN
Cet arrêt brutal signifie que le processeur a reçu au moins un paramètre numérique dont la valeur est située en dehors de l’intervalle de définition mathématique formel de la fonction.
Dans plus de $90,%$ des cas observés, cette anomalie provient d’une confusion entre une notation en pourcentage et une écriture en fraction décimale de probabilité. Un utilisateur souhaitant paramétrer un seuil critique à $5,%$ est fréquemment tenté de saisir le chiffre entier 5 dans le champ area. Or, la théorie des probabilités imposant que la masse globale soit unitaire ($1$), toute aire supérieure ou égale à $1$ — tout comme toute aire négative ($area le 0$) — constitue une impossibilité mathématique absolue. Le traitement de l’erreur est immédiat : il suffit de diviser mentalement le pourcentage par $100$, en remplaçant la valeur erronée 5 par 0.05.
Une autre source documentée d’erreur de domaine concerne le paramètre d’écart-type $\sigma$. Si un utilisateur assigne par inadvertance une valeur négative ou strictement nulle à l’écart-type ($\sigma le 0$), la machine génère instantanément le message ERR:DOMAIN, la dispersion d’une loi normale ne pouvant être que strictement positive.
10.2 Diagnostic de l’erreur de syntaxe ERR:SYNTAX
Le message d’erreur ERR:SYNTAX signale quant à lui que la structure d’écriture de la commande viole la grammaire de traitement du système d’exploitation de la TI-84. Plusieurs maladresses de frappe en sont classiquement à l’origine :
La confusion entre le point décimal et la virgule séparatrice représente l’écueil prépondérant. Sur la TI-84, la virgule (située au-dessus de la touche 7) sert exclusivement à séparer les arguments d’une fonction, tandis que le point sert de séparateur décimal. Si un utilisateur compose invNorm(0,05) au lieu de invNorm(0.05), la calculatrice interprète la saisie comme une tentative de passage de deux arguments (aire $= 0$, $\mu = 05$), ce qui déclenche une erreur de domaine ou de syntaxe.
Un autre piège fréquent concerne l’usage du symbole négatif. La machine possède deux touches distinctes : la touche de l’opérateur arithmétique de soustraction [-] (située sur la colonne de droite) et la touche du signe unaire négatif d’inversion de polarité [(-)] (située en bas, à côté de la touche d’exécution). L’utilisation de l’opérateur de soustraction en tête d’un argument ou pour définir une valeur moyenne négative provoque irrémédiablement l’arrêt sur ERR:SYNTAX.
Enfin, en mode ligne de commande classique, l’omission d’un argument obligatoire au sein d’une chaîne complexe ou l’ajout d’une virgule terminale orpheline non suivie d’un paramètre (par exemple invNorm(0.05,0,)) conduit au même blocage syntaxique.
10.3 Pièges d’asymétrie et mauvaises interprétations des signes
Au-delà des erreurs logicielles matérielles qui bloquent le fonctionnement de la calculatrice, les méprises d’ordre conceptuel constituent les périls les plus insidieux pour l’analyste, dans la mesure où la machine produit un résultat calculatoire valide, mais conceptuellement faux par rapport à la question de recherche.
Le piège prééminent réside dans l’attribution erronée d’un signe pour les tests unilatéraux. Nombreux sont les étudiants qui, cherchant une valeur critique pour un test supérieur unilatéral droit au seuil de $5,%$, exécutent mécaniquement invNorm(0.05) et obtiennent $-1{,}645$. Constatant intuitivement que leur hypothèse porte sur une augmentation, ils suppriment simplement le signe négatif au stylo sur leur rapport pour écrire $+1{,}645$. Bien que cette manipulation empirique aboutisse par chance à la bonne valeur en raison de la symétrie de la courbe, ce raccourci traduit une incompréhension de la structure intégrale de l’outil et devient catastrophique lors de l’application à des lois asymétriques (comme la loi du Chi-deux ou de Fisher).
Un second piège récurrent concerne l’interprétation des seuils bilatéraux. Lors d’un test bilatéral à $\alpha = 0{,}05$, saisir invNorm(0.05) produit le seuil d’un test unilatéral à $5,%$, et non le seuil bilatéral recherché. Pour obtenir ce dernier en mode classique, il est indispensable de diviser le risque par deux : invNorm(0.025), sous peine de commettre une distorsion méthodologique majeure en testant les données contre un seuil trop laxiste.
11. Fonctions avancées de la TI-84 liées à invNorm : listes et représentations graphiques
11.1 Calcul simultané de multiples valeurs critiques à l’aide de listes
L’un des atouts computationnels majeurs du système d’exploitation de la TI-84 réside dans sa structure matricielle orientée tableau, qui autorise la vectorisation des calculs. Plutôt que d’évaluer de manière itérative et fastidieuse les valeurs critiques associées à une série de seuils de signification distincts, il est tout à fait possible d’injecter une liste globale de probabilités au sein du premier argument de invNorm.
Les listes personnalisées sont formellement encadrées par des accolades, accessibles par les combinaisons de touches [2nd] [(] (accolade ouvrante) et [2nd] [)] (accolade fermante). Les éléments internes sont séparés par la virgule syntaxique.
Supposons qu’un analyste souhaite obtenir en une seule instruction les valeurs critiques $Z$ relatives aux trois niveaux de risque unilatéraux conventionnels de la recherche expérimentale, à savoir $\alpha = 0{,}01$, $\alpha = 0{,}05$ et $\alpha = 0{,}10$. La ligne de calcul se configure ainsi sur l’écran d’accueil :
invNorm({0.01, 0.05, 0.10})
Dès validation par la touche [ENTER], la calculatrice génère instantanément la liste vectorielle des scores $Z$ correspondants :
{-2.3263 -1.6449 -1.2816}
Cette liste de résultats peut en outre être assignée et transférée directement dans l’une des mémoires de listes statistiques globales de la machine (de L1 à L6) au moyen de la touche d’assignation [STO $to$] :
invNorm({0.01, 0.05, 0.10}) $to$ L1
Cette approche offre un gain de temps inestimable lors de l’exécution d’analyses de sensibilité ou de procédures d’ajustement pour comparaisons multiples (comme les corrections de Bonferroni ou de Holm).
11.2 Visualisation graphique des aires sous la courbe normale
Pour ancrer la compréhension théorique des frontières de rejet sur le plan visuel, la calculatrice TI-84 dispose d’un outil graphique interactif capable de dessiner la courbe de Gauss et de colorer précisément la surface correspondant au quantile calculé par invNorm. Cette fonction s’intitule ShadeNorm( et se situe dans le sous-menu de dessin accessible par [2nd] [VARS], onglet horizontal DRAW, item 1: ShadeNorm(.
Pour assurer une visualisation claire, l’utilisateur doit impérativement ajuster au préalable la fenêtre d’affichage cartésien via la touche [WINDOW] afin de cadrer la dynamique de la distribution normale standard :
Xmin = -4Xmax = 4Xscl = 1Ymin = -0.1Ymax = 0.45Yscl = 0.1
Une fois cette fenêtre paramétrée, si l’on désire visualiser la région critique unilatérale gauche au seuil $\alpha = 0{,}05$, dont la valeur critique calculée par invNorm(0.05) est $-1{,}645$, l’opérateur appelle l’instruction :
ShadeNorm(-4, -1.645)
Sur l’écran graphique, la TI-84 trace avec précision la courbe en cloche et hachure intégralement la queue asymptotique inférieure gauche comprise entre $-4$ et la valeur critique $-1{,}645$. Sur les écrans couleur de la TI-84 Plus CE, cette surface se colore d’une teinte contrastée, faisant apparaître de manière éclatante la masse de $5,%$ soustraite au domaine d’acceptation. Pour effacer ce tracé avant un calcul ultérieur, la séquence de maintenance requiert d’activer la commande ClrDraw accessible via [2nd] [PRGM] (menu DRAW), item 1: ClrDraw.
11.3 Automatisation via des programmes TI-Basic pour la recherche
Pour les étudiants, assistants de recherche et cliniciens exécutant des protocoles normatifs répétitifs, l’écriture d’un micro-programme en langage TI-Basic permet de systématiser l’évaluation des seuils décisionnels tout en éliminant les aléas de navigation logicielle. L’éditeur de programmation est accessible nativement via la touche [PRGM].
Voici l’architecture algorithmique optimisée d’un sous-programme interactif dédié au calcul des scores critiques unilatéraux et bilatéraux :
:PROGRAM:VALCRIT

:Disp "TEST D'HYPOTHESE"

:Input "ALPHA: ",A

:Disp "1:UNILAT GAUCHE"

:Disp "2:UNILAT DROITE"

:Disp "3:BILATERAL"

:Input "CHOIX (1-3): ",C

:If C=1

:Then

:invNorm(A,0,1)$to$Z

:Disp "Z CRITIQUE:",Z

:End

:If C=2

:Then

:invNorm(1-A,0,1)$to$Z

:Disp "Z CRITIQUE:",Z

:End

:If C=3

:Then

:invNorm(1-A/2,0,1)$to$Z

:Disp "Z CRIT INF:",-Z

:Disp "Z CRIT SUP:",Z

:End

:Stop
Ce script rudimentaire mais extrêmement robuste structure la démarche d’inférence statistique. En sollicitant explicitement le risque de première espèce nominal et la nature directionnelle du test, il prémunit l’expérimentateur contre toute inversion de signe ou oubli de division par deux pour les situations bilatérales, garantissant une reproductibilité sans faille des calculs de terrain.
12. Bonnes pratiques de reporting statistique et rédaction académique (Normes APA)
12.1 Présentation formelle des scores Z et valeurs critiques
La transmission des analyses quantitatives au sein de la communauté scientifique internationale obéit à des normes typographiques et formelles rigoureuses édictées par le manuel de style de l’American Psychological Association (APA, 7e édition). La description des résultats issus de calculs probabilistes sur TI-84 ne déroge pas à ces impératifs de clarté.
Sur le plan typographique, les symboles statistiques désignés par une lettre latine doivent être impérativement formatés en caractères italiques. Ainsi, le score standardisé s’écrit scrupuleusement avec un « z » minuscule italique ($z$), tandis que la moyenne empirique est symbolisée par $M$ et l’écart-type d’échantillon par $SD$ (ou $s$). Les lettres grecques comme $\mu$, $\sigma$ ou $\alpha$ ne doivent jamais être mises en italique, conformément aux conventions typographiques internationales.
En ce qui concerne la précision décimale, les normes APA préconisent de rapporter les scores z et les valeurs critiques avec exactement deux ou trois décimales après la virgule (la pratique la plus répandue en psychométrie optant pour deux décimales, par exemple $z = -1{,}64$ ou $z = 1{,}96$). La formulation formelle d’un test doit systématiquement expliciter sa nature unilatérale (one-tailed) ou bilatérale (two-tailed), ainsi que le niveau de signification $\alpha$ prédéterminé, afin de permettre au lectorat de reconstituer immédiatement la logique décisionnelle adoptée par les auteurs.
12.2 Exemples de formulations pour mémoires et publications
La restitution textuelle des résultats de tests statistiques au sein d’une section « Résultats » d’une thèse de doctorat ou d’un manuscrit soumis à évaluation par les pairs doit intégrer avec fluidité la statistique de test calculée, le seuil de décision et la conclusion substantielle qui en découle.
Modèle de rédaction en cas de rejet formel de l’hypothèse nulle :
« Conformément à notre hypothèse de recherche unidirectionnelle, les analyses mettent en évidence un temps moyen de traitement significativement réduit au terme du protocole d’entraînement attentionnel ($M = 385$ ms, $SD = 42$ ms) par rapport à la moyenne normative populationnelle ($z_{\mathrm{obs}} = -2{,}14$). En fixant le seuil de signification a priori à $\alpha = {,}05$ pour un test unilatéral à gauche, la valeur critique théorique déduite via la distribution normale inverse s’établit à $z_{\mathrm{crit}} = -1{,}64$. La statistique observée étant strictement inférieure à cette limite critique ($z_{\mathrm{obs}} le -1{,}64$, $p = {,}016$), l’hypothèse nulle d’absence d’effet peut être formellement rejetée au profit de l’hypothèse alternative d’une amélioration des performances d’inhibition cognitive. »
Modèle de rédaction en cas de maintien de l’hypothèse nulle :
« L’évaluation de l’indice d’efficience globale chez les participants exposés n’indique aucune variation substantielle ($z_{\mathrm{obs}} = 1{,}48$). Pour un test bilatéral non directionnel au niveau de risque global $\alpha = {,}05$, les frontières décisionnelles symétriques d’acceptation issues de la fonction quantile normale correspondent à $z_{\mathrm{crit}} = \pm 1{,}96$. La statistique empirique observée demeurant confinée à l’intérieur de cet intervalle de non-rejet ($-1{,}96 < 1{,}48 < 1{,}96$, $p = {,}139$), les données recueillies ne permettent pas de réfuter l'hypothèse nulle d'équivalence au seuil de confiance bilatéral de $95,%$. »
12.3 Transparence méthodologique et réplicabilité
Dans le contexte actuel de la crise de réplicabilité qui traverse l’ensemble des sciences empiriques, l’exigence de transparence méthodologique impose une traçabilité totale des chaînes de traitement analytique. Les chercheurs ne peuvent plus se contenter d’asséner des conclusions sans expliciter les outils et paramètres algorithmiques employés pour produire leurs valeurs critiques.
Dans la section « Méthode / Analyses statistiques » des rapports académiques, il est impératif de déclarer explicitement les hypothèses distributionnelles qui ont guidé le choix des outils. L’auteur doit mentionner sans équivoque si la détermination des valeurs frontières ou des rangs percentiles a été opérée sous l’hypothèse théorique d’une normalité distributionnelle exacte, en précisant les paramètres de localisation ($\mu$) et d’échelle ($\sigma$) injectés dans le microprogramme invNorm de la calculatrice Texas Instruments ou dans les bibliothèques logicielles équivalentes (telles que la fonction qnorm du langage R ou la méthode scipy.stats.norm.ppf sous Python).
De surcroît, la cohérence épistémologique impose de maintenir une distinction étanche entre la phase de pré-spécification des seuils — qui doit obligatoirement intervenir en amont de toute collecte de données — et la phase de confirmation a posteriori. Recourir à l’ajustement opportuniste des seuils critiques calculés par invNorm après avoir pris connaissance des données d’échantillon constitue une pratique de recherche contestable (analogue au « p-hacking ») qui détruit toute validité statistique. La robustesse des conclusions scientifiques repose in fine sur l’ancrage indéfectible d’une règle de décision a priori, dont la fonction invNorm de la TI-84 demeure le garant computationnel le plus accessible et le plus fidèle.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Beasley, J. D., & Springer, S. G. (1977). Algorithm AS 111: The percentage points of the normal distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 26(1), 118-121. https://doi.org/10.2307/2346889
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- National Institute of Standards and Technology. (2010). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Texas Instruments. (2016). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com
- Wechsler, D. (2014). Wechsler intelligence scale for children—Fifth edition (WISC-V): Technical and interpretive manual. NCS Pearson.