
L’exploration visuelle des données constitue l’une des pierres angulaires de la démarche scientifique contemporaine, en particulier au sein des disciplines empiriques telles que la psychologie quantitative, les neurosciences cognitives et les sciences sociales computationnelles. Lorsqu’un chercheur tente de sonder la nature d’une relation bivariée, le nuage de points s’impose d’emblée comme le paradigme graphique de référence, offrant une projection intuitive des configurations structurelles, des tendances stochastiques et des anomalies d’échantillonnage. Cependant, la fidélité de cette projection cartésienne est fréquemment compromise par des contraintes inhérentes aux instruments de mesure, notamment la discrétisation forcée des réponses, le recours massif aux échelles ordinales et l’arrondi systématique des grandeurs continues.
Dans ce contexte méthodologique, le phénomène d’occlusion graphique, communément désigné sous l’anglicisme de sur-tracé ou overplotting, engendre une dégradation substantielle du signal perceptuel. Lorsque des dizaines, voire des centaines d’observations partagent des coordonnées strictement identiques, les points graphiques se superposent de manière imperceptible à l’œil nu, annihilant toute appréciation de la densité locale de l’échantillon et faussant dramatiquement le jugement clinique ou analytique. Pour pallier cette cécité visuelle sans recourir à des modèles de réduction paramétrique prématurés, l’environnement de programmation statistique R intègre une méthode élégante et fondamentale : l’injection contrôlée d’une composante aléatoire de dispersion, matérialisée par la fonction native jitter.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les mécanismes algorithmiques sous-jacents, les implémentations pratiques en R de base ainsi que les transpositions modernes au sein de l’écosystème ggplot2. En explorant les subtilités d’étalonnage de cette technique, ses implications déontologiques dans la diffusion des résultats empiriques et ses hybridations graphiques avancées, cet article propose une synthèse rigoureuse destinée aux chercheurs, psychométriciens et analystes soucieux d’allier intégrité statistique et acuité visuelle dans leurs restitutions scientifiques.
1. Introduction à la visualisation des données et à la fonction jitter dans R
1.1 Fondements de la dispersion graphique en psychométrie et sciences comportementales
Au sein des sciences comportementales, l’analyse exploratoire des données repose sur la capacité du chercheur à déceler des configurations relationnelles subtiles avant toute formalisation inférentielle. Le nuage de points, introduit dans la tradition statistique par John Herschel et popularisé par Francis Galton, joue un rôle fondamental dans cette quête en matérialisant chaque unité expérimentale sous la forme d’un élément géométrique ponctuel positionné dans un repère orthogonal. Cette figuration permet d’appréhender d’un seul coup d’œil l’homoscédasticité, la non-linéarité ou la présence de sous-structures agrégées au sein du collectif étudié.
Toutefois, la représentation bidimensionnelle conventionnelle rencontre une limite structurelle rédhibitoire dès lors que l’espace des coordonnées subit une quantification discrète. En psychométrie, où les paradigmes d’évaluation s’appuient continuellement sur des échelles composites, des questionnaires standardisés ou des protocoles de mesures répétées à pas temporels réguliers, la résolution spatiale des variables s’avère restreinte. Des sujets présentant des configurations de réponses identiques viennent alors occuper exactement le même pixel ou le même point d’ancrage vectoriel sur la planche graphique. Ce masquage de densité d’échantillonnage induit une distorsion cognitive sévère : l’observateur perçoit une unité géométrique isolée là où s’accumule en réalité une masse critique d’observations empiriques.
Il en découle une nécessité méthodologique impérieuse : restaurer l’intégrité de la distribution empirique sans pour autant dénaturer l’information contenue dans les données. La restitution fidèle des volumes d’échantillonnage locaux conditionne la validité des interprétations visuelles préliminaires. Sans un mécanisme capable de décoller visuellement les entités superposées, le praticien s’expose au risque de sous-estimer la prévalence de certains patterns psychologiques, de méconnaître des asymétries de distribution et d’orienter erronément les modélisations linéaires subséquentes.
1.2 Définition formelle et conceptuelle du jittering statistique
Sur le plan conceptuel et mathématique, le jittering, souvent traduit en français par l’adjonction d’un bruit de vacillement ou de tremblement stochastique, consiste à appliquer une perturbation aléatoire d’amplitude infinitésimale ou modérée aux coordonnées scalaires des observations. Formellement, pour une observation donnée caractérisée par un vecteur bidimensionnel de coordonnées réelles ou entières, l’opération consiste à substituer à chaque coordonnée initiale une variable aléatoire translatée. Cette perturbation est classiquement générée à partir d’une loi de probabilité continue, le plus souvent une distribution uniforme symétrique définie sur un intervalle fermé centré sur zéro.
Il convient de formuler une distinction épistémologique stricte entre l’altération substantielle des données brutes et l’artifice purement optique du procédé. Le jittering ne modifie en aucun cas la matrice des données stockée en mémoire destinée aux calculs mathématiques, aux régressions ou aux tests d’hypothèses. Il s’agit exclusivement d’une technique de rendu perceptuel destinée à désambiguïser les positions spatiales lors de la phase de projection graphique. L’objectif ultime réside dans l’optimisation de la transmission de l’information structurelle au système visuel humain, en convertissant une superposition aveugle en une densité de texture lisible.
Le domaine de validité de cette manipulation est intimement corrélé à la métrique des variables manipulées. Si l’application d’un bruit stochastique sur des variables continues à très haute résolution n’apporte aucun bénéfice et peut dégrader la précision de lecture, son emploi s’avère hautement légitime sur des variables catégorielles ordinales, des comptages discrets ou des grandeurs artificiellement tronquées. L’artifice visuel respecte la topologie générale des distributions tout en révélant la véritable cardinalité des agrégats sous-jacents.
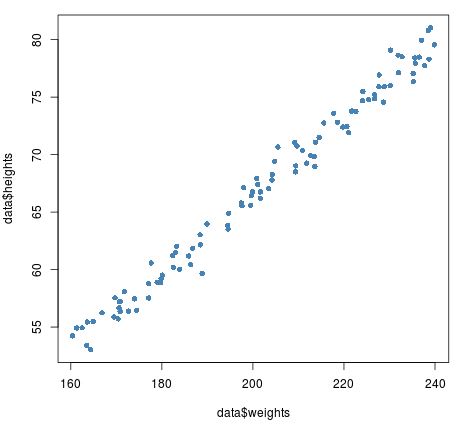
1.3 Historique et implémentation native dans l’environnement R
L’origine de la fonction jitter s’enracine dans les développements pionniers de l’analyse exploratoire des données impulsés par John Tukey dans les années 1970 aux Laboratoires Bell. La formalisation algorithmique de la commande a été initialement intégrée dans le langage S par Richard Becker, John Chambers et Allan Wilks, dans le cadre de leurs travaux fondateurs sur les environnements interactifs d’analyse de données. L’objectif était alors de fournir aux analystes un outil souple, capable de résoudre instantanément les congestions de tracés sans contraindre l’utilisateur à programmer manuellement des routines de génération aléatoire.
Lors de la transition historique du langage S vers le système open-source R au milieu des années 1990, Ross Ihaka et Robert Gentleman ont naturellement préservé et perfectionné cette routine au sein du package de base, consolidant ainsi sa présence au cœur des fonctions graphiques traditionnelles. Dans l’écosystème graphique historique, la commande est directement accessible et interagit harmonieusement avec les vecteurs numériques et les dispositifs d’affichage standard tels que les fenêtres graphiques X11 ou les terminaux vectoriels PDF.
Au fil des décennies, les pratiques de visualisation de données en psychologie quantitative ont progressivement intégré cette méthode comme une étape quasi obligatoire lors de l’examen exploratoire d’échantillons cliniques ou d’enquêtes psychosociales. L’évolution contemporaine a vu la logique du vacillement stochastique être reprise, raffinée et généralisée au sein d’extensions de haut niveau, démontrant la pérennité conceptuelle d’un algorithme simple mais indispensable à l’exercice lucide de la statistique appliquée.
2. Le problème théorique du chevauchement de points (overplotting)
2.1 Mécanismes générateurs du sur-tracé dans les protocoles expérimentaux
Dans la recherche expérimentale et observationnelle, la survenue de l’overplotting n’est pas un accident marginal mais une conséquence directe des choix de mesure imposés par le protocole scientifique. En premier lieu, la discrétisation forcée de variables intrinsèquement continues constitue un facteur prépondérant. Les chronomètres numériques arrondis au centième de seconde, le recueil d’âges exprimés uniquement en années révolues ou la quantification de seuils perceptifs par paliers discrets condensent une infinité théorique d’états réels en un ensemble fini et restreint d’étiquettes numériques distinctes.
En second lieu, l’utilisation omniprésente des échelles psychométriques à choix forcé, emblématisées par les échelles de Likert en 5 ou 7 points, produit une concentration massive de coordonnées identiques. Lorsque plusieurs centaines de participants complètent des inventaires évaluant l’anxiété-trait, l’estime de soi ou le sentiment d’auto-efficacité, la combinatoire des scores individuels sur deux items isolés ne permet qu’un nombre dérisoire d’emplacements cartésiens distincts. Si un item comporte cinq échelons et le second autant, seules vingt-cinq intersections spatiales sont disponibles pour représenter l’intégralité de la cohorte d’étude.
Ce resserrement géométrique forcé aboutit inévitablement à ce que les psychologues appellent un point d’accumulation aveugle. Sur le support visuel, les signaux lumineux émis par l’encre ou les pixels se superposent de manière destructive. L’observateur subit une perte totale de discrimination de l’effectif marginal et conjoint : une coordonnée partagée par une unique observation présente une signature graphique rigoureusement indiscernable de celle partagée par une cohorte de trois cents répondants, biaisant irrévocablement l’analyse sémiotique de l’image statistique.
2.2 Impacts négatifs de l’overplotting sur l’inférence visuelle
L’oblitération des densités par superposition graphique induit des distorsions cognitives majeures lors de l’inférence visuelle, étape préliminaire pourtant déterminante pour la formulation d’hypothèses et le choix des modèles structurels. Le premier biais cognitif documenté réside dans la sous-estimation dramatique de la densité locale au sein des catégories modales. En masquant l’ampleur numérique réelle du cœur de la distribution, le tracé conventionnel confère un poids visuel disproportionné aux observations périphériques ou marginales, qui, se trouvant isolées dans l’espace géométrique, attirent indûment l’attention perceptive de l’évaluateur.
Par ailleurs, cette occlusion systématique dissimule fréquemment l’existence de distributions multimodales asymétriques ou de sous-populations latentes au sein des échantillons cliniques. Un groupe de patients présentant des profils sémiologiques hétérogènes peut sembler uniformément réparti sur une surface d’évaluation, alors qu’en réalité, deux clusters massifs et compacts coexistent aux extrémités de la distribution. En l’absence de dispersion contrôlée ou d’indicateurs volumétriques, ces singularités structurelles demeurent totalement invisibles, privant l’investigateur d’une découverte diagnostique ou théorique potentielle.
Enfin, le sur-tracé corrompt gravement l’appréciation intuitive de l’intensité et du sens de la corrélation linéaire de Pearson. Un nuage de points affecté par une superposition centrale dense mais invisible peut donner l’illusion fallacieuse d’une absence d’association statistique, voire suggérer une relation purement aléatoire, en raison de la visibilité exclusive des points dispersés en périphérie. Ce décalage entre la configuration graphique perçue et les métriques réelles calculées engendre une méfiance cognitive et augmente le risque de décisions méthodologiques erronées en amont des régressions ou des analyses factorielles confirmatrices.
2.3 Typologie des variables exposées au chevauchement
Pour anticiper et traiter méthodiquement l’overplotting, il est impératif d’établir une typologie fine des structures de variables les plus vulnérables. La première catégorie englobe les variables de comptage issues de protocoles comportementaux. La mesure de la fréquence d’apparition d’un comportement opérant, le nombre de rechutes au cours d’un suivi longitudinal ou le décompte d’erreurs commises lors d’une tâche d’attention soutenue sont des données discrètes positives. Ces variables tendent à s’entasser massivement sur les valeurs nulles et les entiers faibles, générant des colonnes d’accumulation particulièrement denses à la base des graphiques.
La seconde catégorie correspond aux variables purement ordinales et pseudo-continues issues des instruments psychométriques standardisés. Il s’agit des scores bruts dérivés des sous-échelles d’inventaires de personnalité, des niveaux d’adhésion psychologique ou des classements hiérarchiques. Même lorsque ces scores résultent de la sommation de plusieurs items, le spectre des valeurs possibles demeure fini, granulaire et restreint, ce qui contraint les données à s’aligner sur des strates rectilignes parallèles propices à la dissimulation mutuelle des individus statistiques.
Enfin, une troisième catégorie regroupe les variables continues assujetties à des effets de plancher ou de plafond marqués, ou tronquées par des limites méthodologiques d’enregistrement. En neuropsychologie, par exemple, les scores à des tests de dépistage des troubles cognitifs légers montrent fréquemment une masse d’individus regroupée sur le score théorique maximal. Dans ces situations critiques de saturation instrumentale, le nuage de points standard échoue à traduire la stratification interne du groupe performant, transformant le sommet de l’axe en un segment indistinct où toute variance résiduelle devient illisible.
3. Syntaxe fondamentale et fonctionnement interne de la fonction jitter()
3.1 Anatomie de l’appel de fonction jitter() en R de base
L’environnement R de base met à disposition des analystes la fonction native jitter() via le package fondamental base, rendant son invocation immédiatement accessible sans nécessiter le chargement d’une bibliothèque tierce. L’anatomie formelle de cette fonction s’illustre à travers une signature d’arguments volontairement épurée mais conceptuellement très flexible. Le premier paramètre, impératif et central, est désigné par le vecteur numérique x, qui représente la collection des valeurs scalaires soumises à la perturbation aléatoire.
Outre ce vecteur obligatoire, la fonction admet deux arguments formels optionnels destinés à calibrer la morphologie du bruit stochastique : l’argument factor et l’argument amount. Par défaut, la signature canonique s’exprime selon la formule standard où le facteur prend conventionnellement la valeur unitaire, tandis que l’étendue du bruit demeure non définie a priori, laissant l’algorithme sous-jacent calculer de manière adaptative l’intensité optimale de la translation spatiale en fonction des propriétés de dispersion internes du vecteur soumis.
Lorsque la fonction est exécutée sans paramétrage explicite de ses arguments de contrôle, elle déploie un comportement d’inférence autonome. L’analyse détaillée de ce fonctionnement par défaut révèle que l’environnement R inspecte l’étendue numérique globale des données fournies, identifie la granularité minimale des écarts entre valeurs distinctes, et applique une dispersion calibrée de façon à éviter que les données modifiées n’empiètent de façon désordonnée sur les catégories voisines. Cette économie de syntaxe favorise une utilisation rapide en phase d’exploration préliminaire.
3.2 Calcul interne de la plage de bruit par R
L’élégance algorithmique de la fonction repose sur la procédure déterministe employée pour fixer la borne de variabilité aléatoire lorsque l’argument amount n’est pas renseigné par l’utilisateur. Pour expliciter cette logique, il convient de plonger dans le code source même de la routine interne de R. L’algorithme calcule d’abord l’étendue numérique brute du vecteur, c’est-à-dire la différence arithmétique entre la valeur maximale et la valeur minimale. Si cette étendue s’avère nulle, le bruit est calibré de manière triviale sur une proportion de la valeur absolue observée.
Dans les scénarios réguliers où le vecteur comporte une pluralité de modalités distinctes, l’algorithme procède à l’extraction des valeurs uniques ordonnées, puis détermine la plus petite différence absolue non nulle séparant deux valeurs consécutives. Cette valeur critique, fréquemment désignée sous l’appellation de pas élémentaire de discrétisation ou granularité intrinsèque, sert de balise fondatrice pour garantir que le bruit ne submergera pas la structure sous-jacente des données. L’amplitude de base est alors calculée comme étant égale à un cinquième de cette différence minimale, modulée par un facteur de sécurité dépendant de l’étendue globale.
Une fois cette borne maximale déterminée, l’adjonction stochastique s’opère par le biais du générateur pseudo-aléatoire interne de R. Pour chaque élément individuel du vecteur d’entrée, un tirage indépendant est réalisé selon une loi uniforme continue définie sur l’intervalle symétrique délimité par l’opposé et l’exacte valeur de cette borne calculée. Cette formulation garantit une espérance mathématique strictement nulle pour le terme d’erreur injecté, assurant la neutralité barycentrique de l’artifice visuel ainsi généré.
3.3 Comparaison entre données brutes et données traitées par jitter
L’inspection tabulaire rigoureuse d’un extrait de données avant et après le passage par la routine révèle avec acuité la nature de la transformation opérée sur le signal numérique. Si l’on observe un vecteur initial composé d’entiers discrets consécutifs issus d’une échelle ordinale, la version transformée présente des nombres réels dotés d’une expansion décimale spécifique à chaque ligne d’enregistrement. Deux occurrences initialement identiques, par exemple deux réponses fixées au niveau quatre d’un questionnaire, ressortiront de l’algorithme avec des valeurs disjointes comme 3.9421 et 4.0587.
D’un point de vue théorique et descriptif, il est primordial d’évaluer la conservation des moments statistiques fondamentaux lors de cette manipulation. L’espérance mathématique de la distribution uniforme utilisée étant rigoureusement égale à zéro, la moyenne arithmétique empirique du vecteur bruité converge de façon asymptotique vers la moyenne exacte du vecteur original. Sur des échantillons de taille modérée à large, la différence entre les deux moyennes s’avère totalement négligeable, n’affectant que les décimales éloignées sans incidence pratique sur l’évaluation globale de la tendance centrale.
Concernant le moment d’ordre deux, l’adjonction d’une variable aléatoire indépendante induit mathématiquement une inflation théorique de la variance globale, égale à la variance de la loi uniforme injectée. Toutefois, dans le cadre d’un paramétrage mesuré et rigoureusement étalonné, cette composante de variance additionnelle demeure confinée à un ordre de grandeur infinitésimal par rapport à la variance empirique originelle du phénomène étudié. Cette altération marginale de la dispersion numérique n’a d’autre vocation que de servir de support à la spatialisation cartésienne sans trahir les structures de distribution fondamentales.
4. Application pratique : Du nuage de points standardisé au nuage avec jitter
4.1 Création d’un jeu de données synthétique pour simulation psychologique
Afin de matérialiser la mise en œuvre empirique de ces principes méthodologiques, construisons un jeu de données synthétique reflétant une problématique classique en psychologie clinique et comportementale. Imaginons une étude interventionnelle investiguant l’efficacité d’un protocole de thérapie cognitivo-comportementale sur la réduction de l’anxiété sociale. Le protocole implique l’échantillonnage de deux cents patients suivis sur une période semestrielle dans divers centres de consultation hospitaliers.
La première variable de notre modèle synthétique quantifiera le nombre de séances thérapeutiques complétées avec succès par chaque participant. Cette variable discrète sera modélisée comme un nombre entier variant de manière contrainte entre zéro et dix sessions, capturée via un échantillonnage probabiliste. La seconde variable représentera le score résiduel d’anxiété, évalué au terme de l’intervention à l’aide d’un inventaire psychométrique validé s’étendant sur une échelle continue théorique, mais présentant une corrélation négative modérée avec l’assiduité thérapeutique des patients.
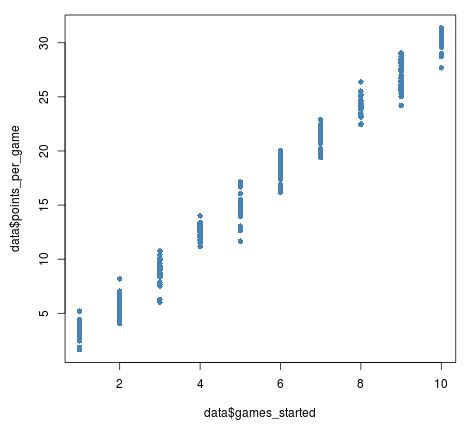
La programmation de ce jeu de données sous R s’opère par l’articulation des générateurs probabilistes habituels. Le recours combiné aux fonctions simulant la loi normale pour l’anxiété de base et aux tirages d’échantillonnage pour le volume de sessions permet de constituer un tableau de données rectangulaire au format standard de données relationnelles. La structure ainsi obtenue présente l’archétype parfait de la vulnérabilité au chevauchement graphique : une variable explicative strictement discrète croisée avec une variable réponse quasi continue mais fortement groupée sur des intervalles restreints.
4.2 Constat visuel de l’échec graphique du tracé conventionnel plot()
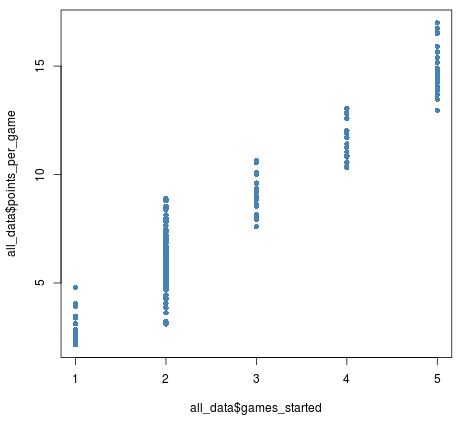
L’évaluation visuelle initiale de notre jeu de données synthétique via la fonction de base classique de R révèle immédiatement la faillite perceptive du tracé standard. Lorsque l’analyste exécute un appel direct combinant les deux variables sans artifice de dispersion, l’affichage obtenu se caractérise par une succession de colonnes verticales rigides et discontinues. Chaque colonne correspond à l’un des entiers représentant le nombre de sessions thérapeutiques suivies par les sujets de la cohorte.
À l’intérieur de ces colonnes artificiellement érigées sur l’axe des abscisses, les symboles géométriques circulaires se superposent de façon implacable. Bien que notre échantillon compte deux cents individus distincts, le spectateur non averti a l’illusion de ne contempler qu’un agrégat d’une cinquantaine de points dispersés. Toute la dynamique interne de l’échantillon clinique est oblitérée : les zones où se concentrent des grappes massives de patients répondant de manière similaire apparaissent visuellement équivalentes aux secteurs clairsemés occupés par des trajectoires atypiques isolées.
Le diagnostic empirique s’avère indiscutable : ce graphique conventionnel est méthodologiquement inopérant pour l’analyse exploratoire et scientifiquement trompeur pour une restitution académique. Il échoue à transmettre la véritable distribution conjointe des données empiriques et prive l’analyste d’une perception intuitive de l’hétérogénéité des réponses thérapeutiques, justifiant sans équivoque le recours immédiat à une technique de dégroupement spatial.
4.3 Implémentation de jitter() sur l’axe des abscisses
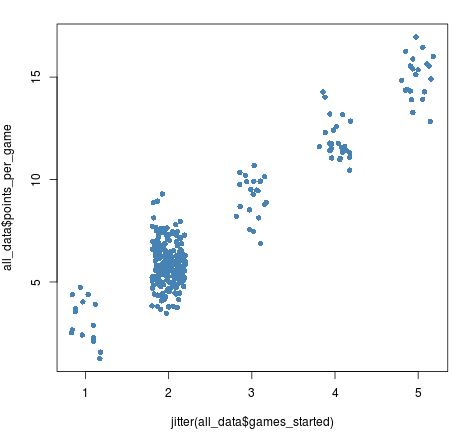
Pour remédier à cette oblitération graphique, la mise en œuvre de la fonction native jitter() constitue la réponse technique la plus directe et la plus élégante dans l’environnement de base de R. L’opération consiste à envelopper la variable discrète relative au nombre de séances thérapeutiques au sein de la fonction de perturbation avant de la transmettre en paramètre horizontal de la fonction d’affichage graphique, tout en maintenant rigoureusement intact le vecteur de la variable réponse d’anxiété sur l’axe vertical.
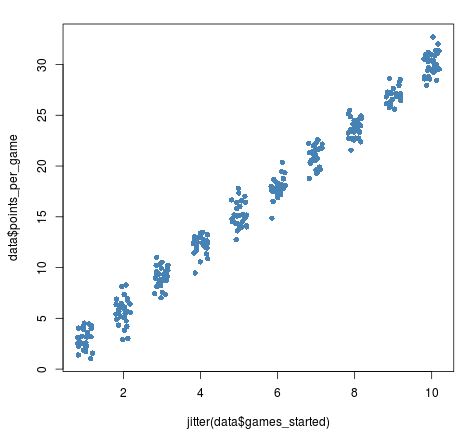
Dès l’exécution de cette commande révisée, la topologie du graphique subit une métamorphose spectaculaire. Les colonnes rigides et monolithiques se dissolvent pour laisser place à des bandes nébuleuses subtilement étalées autour de chaque coordonnée entière. Les points qui se masquaient mutuellement se séparent horizontalement, révélant avec une netteté remarquable les zones d’accumulation dense où de nombreux patients partagent des scores comparables, tout en mettant en relief la dispersion réelle aux extrémités de chaque modalité.
Cette première amélioration structurelle peut être avantageusement complétée par un raffinement des paramètres esthétiques du tracé de base. En sélectionnant un symbole de tracé adéquat à l’aide de l’argument typologique des points, et en lui associant une teinte chromatique nuancée ou une bordure contrastée, le praticien parachève la lisibilité de la figure. L’observateur dispose désormais d’un document graphique probe, permettant d’apprécier à la fois la trajectoire globale d’amélioration thérapeutique et la variance interindividuelle résiduelle sans déformation optique majeure.
5. Paramétrage avancé de jitter() : Contrôle précis des arguments factor et amount
5.1 Rôle et manipulation de l’argument factor
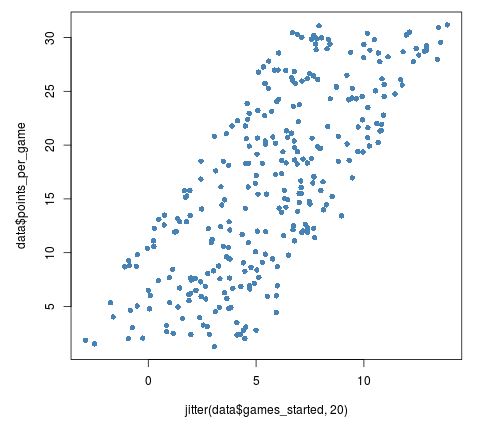
L’ajustement optimal de la dispersion stochastique ne saurait être laissé au seul hasard des paramètres automatisés, particulièrement lors de l’élaboration de figures destinées à l’évaluation par les pairs. Au cœur de la commande native de R se trouve l’argument factor, un multiplicateur scalaire sans dimension qui permet de moduler dynamiquement l’intensité globale du vacillement appliqué aux coordonnées. Par défaut, sa valeur est rigoureusement calée sur l’unité, ce qui correspond à la dispersion standard calculée à partir de la granularité minimale du vecteur.
L’accroissement de la valeur de ce facteur engendre un élargissement proportionnel de la fenêtre de tirage aléatoire uniforme. En doublant ou en triplant ce coefficient multiplicateur, l’analyste ordonne à l’algorithme d’étendre la projection latérale des points, ce qui s’avère particulièrement judicieux lorsque le volume de l’échantillon est colossal et que la dispersion unitaire par défaut s’avère encore insuffisante pour désamorcer l’overplotting persistant au sein des foyers d’agrégation denses.
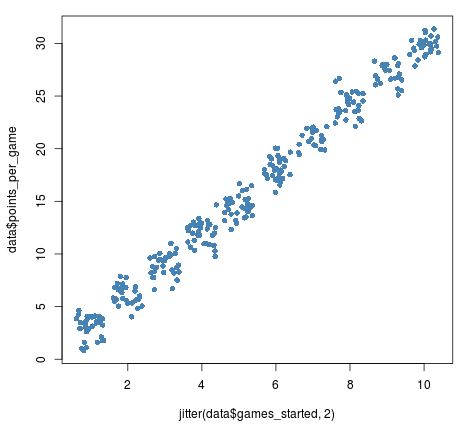
Cependant, le maniement du paramètre factor exige une circonspection méthodologique constante pour éviter le phénomène critique de surdosage visuel. Si l’amplitude du facteur est augmentée de manière disproportionnée, l’envergure du bruit finit par excéder la distance séparant deux échelons catégoriels consécutifs. Dans une telle dérive, les nuages de points associés à des modalités ordinales distinctes commencent à s’interpénétrer de façon confuse, oblitérant la structure sous-jacente et induisant une illusion fallacieuse de continuité empirique qui corrompt totalement la lisibilité du protocole.
5.2 Contrôle absolu de l’étendue avec l’argument amount
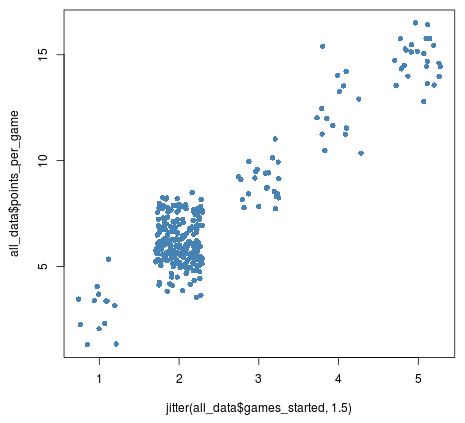
Tandis que le facteur opère comme un modulateur relatif dépendant de l’heuristique interne de calcul de R, l’argument amount octroie à l’expérimentateur une maîtrise absolue et déterministe sur l’amplitude maximale de la perturbation injectée. Lorsqu’il est explicitement renseigné par l’utilisateur, ce paramètre outrepasse complètement le calcul automatique basé sur la différence minimale et fixe impérativement le demi-intervalle de la loi uniforme appliquée aux données brutes.
L’utilisation concertée de l’argument amount requiert une analyse dimensionnelle rigoureuse de l’espace métrique dans lequel s’inscrivent les données. Si une variable psychométrique est codée sur une échelle d’intervalles entiers consécutifs dont le pas unitaire est rigoureusement égal à un, assigner à ce paramètre une valeur numérique précisément calibrée, telle que 0.15 ou 0.20, garantit de façon formelle et immuable que le déplacement stochastique individuel ne pourra jamais excéder cette marge stricte autour de la valeur nominale authentique.
Il existe un cas particulier remarquable dans le fonctionnement de la routine : l’assignation de la valeur zéro à l’argument amount. Dans cette configuration précise, l’algorithme désactive son mécanisme heuristique automatisé et annule purement et simplement toute injection stochastique. L’évaluation de ce comportement limite est fondamentale pour les développeurs de protocoles automatisés, car elle permet d’inhiber de façon paramétrique le jittering au sein de scripts génériques d’analyse sans avoir à réécrire la structure globale des appels graphiques.
5.3 Stratégies d’étalonnage pour les variables psychométriques discrètes
Dans le domaine spécialisé de la mesure psychométrique, l’application désordonnée de bruit graphique peut rapidement discréditer une figure scientifique. Pour étalonner méthodiquement la dispersion sur des échelles d’évaluation standardisées, à l’instar des inventaires fondés sur des échelles de Likert en 5 ou 7 ancrages, le chercheur doit adopter une stratégie de calibration proportionnelle systématique visant à préserver l’étanchéité sémiotique des différentes catégories de réponse.
Une règle heuristique robuste et largement éprouvée dans la communauté quantitative consiste à adopter la règle dite du tiers d’intervalle. Selon ce principe directeur, l’amplitude totale de la dispersion artificielle ne devrait en aucun cas excéder le tiers de l’espace numérique séparant deux modalités contiguës. Pour une échelle ordinale aux pas entiers réguliers de magnitude unitaire, l’amplitude totale du vacillement bilatéral sera donc bornée à un tiers d’unité, ce qui implique de paramétrer un demi-intervalle maximal d’environ 0.16 au niveau de l’argument amount.
Ce protocole de calibrage strict offre un compromis optimal entre dégroupement spatial et respect de l’ordonnancement théorique. Les nuages de points associés à chaque modalité se déploient suffisamment pour exposer la multiplicité et la densité des effectifs individuels, tout en maintenant un couloir de vide visuel net et incompressible entre les colonnes adjacentes. L’observateur conserve ainsi une distinction mentale parfaite entre les échelons nominaux de l’instrument psychométrique, sans jamais risquer d’attribuer une observation à une catégorie voisine erronée.
6. Dispersion bidimensionnelle : Application simultanée sur les axes X et Y
6.1 Contexte des croisements de deux variables discrètes
L’investigation empirique en sciences humaines est fréquemment confrontée au défi méthodologique majeur que représente le croisement analytique de deux variables simultanément discrètes ou catégorielles ordinales. Cette situation se manifeste couramment lors de l’étude des corrélations croisées entre deux items distincts d’un questionnaire d’attitude, ou lors de la comparaison d’évaluations cliniques croisées issues de deux juges indépendants cotant des symptômes sur des échelles ordonnées rigides.
Dans cette configuration bidimensionnelle, la projection cartésienne conventionnelle aboutit à une catastrophe visuelle totale : une grille orthogonale rigide de points isolés sur les nœuds de coordonnées entières. Chaque point graphique dissimule potentiellement des dizaines d’observations sous-jacentes partageant exactement la même combinaison de scores bivariés. Appliquer une dispersion unilatérale sur un seul des deux axes ne résout que très imparfaitement le problème, transformant simplement les points singuliers en segments linéaires horizontaux ou verticaux au sein desquels l’occlusion persiste de manière substantielle.
Pour dénouer ce blocage représentationnel, l’analyste doit nécessairement recourir à une dispersion bidimensionnelle intégrale. L’intervention implique de mobiliser simultanément la fonction de perturbation stochastique sur le vecteur horizontal et sur le vecteur vertical, conférant ainsi aux points géométriques la liberté spatiale nécessaire pour coloniser le plan bivarié dans toutes les directions radiales autour de leur nœud d’ancrage commun.
6.2 Mise en œuvre technique du double jittering en base R
La mise en œuvre de cette dispersion symétrique au sein du moteur graphique historique de R s’effectue avec une remarquable concision syntaxique. Il suffit d’encapsuler concomitamment la variable indépendante et la variable dépendante au sein d’appels distincts à la fonction de vacillement lors de l’instruction d’affichage. Cette approche offre une souplesse paramétrique remarquable, autorisant un contrôle différencié de la dispersion selon l’axe considéré.
Il est en effet fréquent que les deux variables investiguées ne partagent ni le même nombre d’échelons de mesure, ni la même amplitude d’échelle. Dans une telle éventualité, l’analyste averti paramétrera des arguments amount asymétriques pour chaque coordonnée, en adaptant rigoureusement la demi-largeur de perturbation horizontale aux spécificités de la première échelle, et la demi-hauteur de perturbation verticale aux caractéristiques de la seconde échelle psychométrique.
La résultante graphique de cette double transformation brise instantanément la rigidité de la grille orthogonale originelle. Autour de chaque intersection nominale émerge un îlot de dispersion stochastique dont la surface globale et la densité de tessiture reflètent de manière probante le nombre d’observations empiriques massées sur ce profil particulier de réponses. Les nœuds hautement fréquentés prennent l’aspect d’essaims compacts et étendus, tandis que les combinaisons de réponses anecdotiques se matérialisent sous la forme de points solitaires aisément repérables.
6.3 Interprétation visuelle de la forme conjointe résultante
L’exploitation analytique d’une figure issue d’une double dispersion exige toutefois une vigilance interprétative accrue de la part de l’investigateur statistique. Le premier écueil cognitif consiste à confondre l’artefact sphérique ou elliptique généré par le tirage uniforme bidimensionnel avec une véritable association structurelle entre les variables. L’arrondi nébuleux observable à l’intérieur de chaque îlot individuel n’est que la conséquence directe du générateur de nombres aléatoires et ne contient aucune signification clinique ou comportementale.
Cependant, lorsque l’observateur prend du recul perceptif par rapport à l’échelle locale de chaque cluster pour embrasser la configuration d’ensemble de la toile cartésienne, la véritable topologie globale de l’échantillon se révèle avec acuité. L’examen des densités comparées entre les différents agrégats permet de discerner immédiatement la présence de tendances monotones, d’asymétries bivariées et de corrélations ordinales fondamentales qui demeuraient insoupçonnables sur le tracé grillagé conventionnel.
L’évaluation de l’homoscédasticité apparente doit également être menée avec discernement critique. Un étalonnage asymétrique maladroit des paramètres de vacillement sur l’un des axes peut donner l’illusion d’une hétérogénéité de variance factice. L’analyste se doit de garder à l’esprit que la morphologie visuelle finale est le produit combiné de la structure latente des données empiriques et de l’enveloppe stochastique injectée par l’algorithme, ce qui requiert un entraînement spécifique à la lecture critique de ces représentations composites.
7. Utilisation moderne du jittering avec le package ggplot2
7.1 Introduction à la fonction geom_jitter() dans la grammaire des graphiques
Avec l’avènement et l’hégémonie contemporaine de l’écosystème Tidyverse, le traitement de l’overplotting s’est émancipé des fonctions de base pour s’inscrire harmonieusement dans les préceptes théoriques de la grammaire des graphiques développée par Leland Wilkinson et matérialisée dans R par Hadley Wickham. Au sein de cette architecture déclarative puissante, la dispersion des données discrètes trouve son incarnation privilégiée dans la couche géométrique dédiée geom_jitter().
Sur le plan structurel, cette fonction opère une abstraction élégante des mécanismes de calcul sous-jacents en offrant une interface déclarative d’une fluidité remarquable. Plutôt que de contraindre l’analyste à manipuler préalablement les vecteurs de données dans son tableau, la fonction encapsule intrinsèquement la transformation spatiale au moment même où les propriétés esthétiques sont mappées sur les dimensions géométriques du canevas cartésien.
Le paramétrage du vacillement sous cette approche repose sur deux arguments clés particulièrement intuitifs : width pour le contrôle de la dispersion horizontale, et height pour celui de la dispersion verticale. Par défaut, la couche applique une translation bidirectionnelle calibrée sur quarante pour cent de la résolution intrinsèque des données, évitant d’emblée les collisions entre catégories adjacentes tout en assurant une décongestion visuelle immédiate et hautement standardisée, parfaitement adaptée aux impératifs de la reproductibilité scientifique moderne.
7.2 L’alternative modulaire : geom_point(position = position_jitter())
Bien que la couche dédiée simplifie les écritures usuelles, la grammaire des graphiques de R révèle sa pleine puissance conceptuelle à travers son articulation modulaire. La formulation avancée consiste à dissocier explicitement l’objet géométrique ponctuel représenté de son ajustement spatial positionnel. Cette approche est implémentée en combinant la géométrie fondamentale geom_point() avec un modificateur de position spécifique instancié par la fonction position_jitter().
Cette distinction méthodologique présente des avantages analytiques considérables pour la manipulation avancée des couches graphiques. Elle permet notamment de mobiliser un argument critique pour la rigueur scientifique : l’argument seed directement encapsulé au sein de l’objet de position. En fournissant une graine d’initialisation pseudo-aléatoire locale à cet ajustement spatial, l’analyste garantit la reproductibilité absolue de la disposition des points dispersés, sans pour autant interférer avec l’état global du générateur de nombres aléatoires de la session de calcul R courante.
En outre, cette modularité structurelle autorise l’harmonisation visuelle parfaite de plusieurs couches graphiques distinctes superposées. Dans le cadre de protocoles expérimentaux complexes, il devient envisageable de synchroniser la dispersion spatiale de points individuels avec des étiquettes textuelles, des segments d’erreur ou des connecteurs spatiaux, conférant ainsi à l’ensemble du système graphique une cohérence interne inaccessible aux approches graphiques procédurales traditionnelles.
7.3 Optimisation esthétique complémentaire avec l’alpha-blending
Dans les configurations d’échantillonnage massives couramment rencontrées en psychologie numérique ou en épidémiologie comportementale, où la cohorte dépasse plusieurs milliers d’observations, l’application isolée du jittering ne suffit plus à résoudre intégralement l’overplotting. Les essaims de points vacillants finissent par saturer complètement l’espace visuel attribué à chaque catégorie, recréant une masse chromatique opaque au sein de laquelle la variation interne de densité demeure indéchiffrable.
Le saut qualitatif repose alors sur le couplage systématique du jittering spatial avec la technique de fusion d’opacité, universellement désignée sous le terme d’alpha-blending. En modulant la transparence intrinsèque de chaque marqueur géométrique via l’argument esthétique alpha, l’analyste confère à chaque point une capacité de transmission lumineuse partielle. Une valeur unitaire correspond à une opacité totale, tandis qu’une valeur fractionnaire, telle que 0.20 ou 0.05, autorise la superposition lumineuse cumulative.
La résultante optique de cette synergie méthodologique s’avère remarquable : les zones clairsemées n’accueillant que des observations isolées apparaissent comme des voiles diaphanes à peine perceptibles, tandis que les centres d’attraction denses où convergent des centaines de données individuelles gagnent en intensité chromatique par saturation progressive. Cette combinaison transforme un simple nuage de points dispersé en une véritable carte de densité optique continue, répondant avec une rigueur absolue aux canons graphiques les plus exigeants des revues internationales à comité de lecture.
8. Traitement spécifique des données cliniques et comportementales
8.1 Étude des temps de réaction et variables chronométriques discrétisées
L’expérimentation en psychologie cognitive et en neurosciences computationnelles mobilise continuellement la mesure chronométrique des temps de réaction face à des stimuli perceptifs ou sémantiques. Si le temps physique s’écoule de manière rigoureusement continue, son enregistrement numérique par le biais de logiciels d’expérimentation spécialisés tels que PsychoPy ou OpenSesame est inéluctablement assujetti aux contraintes d’échantillonnage temporel du matériel informatique, en particulier le taux de rafraîchissement vertical des moniteurs vidéo.
Dans un protocole expérimental usuel opérant sur un écran conventionnel cadencé à soixante hertz, les latences de réponse enregistrées ont tendance à se caler artificiellement sur des multiples discrets de l’intervalle de rafraîchissement d’environ seize millisecondes et demie. Sur un tracé cartésien croisant les temps de réponse avec la complexité d’une tâche, cette quantification matérielle provoque l’apparition de bandes horizontales ou verticales striées absolument artificielles, susceptibles d’égarer l’investigateur en lui faisant supposer l’existence d’une périodicité cognitive endogène.
L’application d’un micro-jittering précisément contrôlé permet de neutraliser cet artefact instrumenté sans compromettre la finesse des latences observées. En calibrant la perturbation stochastique sur une amplitude strictement inférieure au pas de rafraîchissement de l’écran, le chercheur réhabilite la fluidité chronométrique fondamentale du flux perceptif sous-jacent. Cette régularisation optique restaure une continuité d’affichage propice à l’appréciation fidèle des formes de distribution asymétriques typiques des processus attentionnels humains, telles que les lois ex-gaussiennes ou les distributions de Wald.
8.2 Données longitudinales et scores de suivi clinique
Les devis de recherche longitudinaux et les protocoles d’évaluation clinique pré-test versus post-test posent un problème d’affichage spécifique d’une grande complexité visuelle. Lorsqu’une batterie d’échelles symptomatiques standardisées est administrée à plusieurs reprises au cours d’un essai thérapeutique, l’analyste cherche traditionnellement à figurer à la fois l’évolution globale de la cohorte et les trajectoires individuelles singulières de chaque patient en reliant leurs scores respectifs par des traits géométriques continus.
Si la variable ordinale de score est soumise à un vacillement aléatoire non synchronisé entre les différentes sessions temporelles, les lignes individuelles de connexion se mettent à osciller de manière erratique, détruisant tout alignement structural et empêchant l’œil d’appréhender la pente clinique réelle des évolutions thérapeutiques. Pour préserver l’intégrité sémiotique du tracé, l’analyste doit impérativement veiller à ce que la translation spatiale de chaque patient soit rigoureusement coordonnée à travers les vagues temporelles d’enregistrement.
Cette coordination fine s’obtient sous R en injectant le déplacement aléatoire non pas de façon brute sur les colonnes temporelles d’affichage, mais en liant formellement l’aléa à l’identifiant unique de chaque participant au sein de la structure de données relationnelles. Cette synchronisation méthodique permet d’étaler avec clarté les points individuels superposés lors des temps de mesure fixes, tout en maintenant des trajectoires longitudinales parfaitement parallèles et lisibles. L’observateur peut ainsi distinguer sans ambiguïté les répondeurs positifs francs des trajectoires d’échec thérapeutique ou de stagnation clinique.
8.3 Scores d’inventaires de personnalité et effets d’ancrage
Dans le domaine de l’évaluation de la personnalité par le biais de modèles factoriels reconnus, tels que le modèle en cinq facteurs (Big Five Inventory), les scores composites résultent fréquemment de l’agrégation de plusieurs items ordinaux. Bien que ces sommes confèrent aux variables une résolution numérique supérieure à celle des items bruts, l’émergence d’effets d’ancrage psychologique provoque régulièrement des congestions d’observations sur des scores hautement typiques ou stéréotypés.
Les profils d’étudiants universitaires ou de populations normatives présentent une propension marquée à sélectionner des réponses modérées ou socialement désirables, aboutissant à une hyper-densité centrale sur les facettes d’Agréabilité ou de Stabilité émotionnelle. Un nuage de points croisant deux facettes de personnalité standard souffre ainsi d’un masquage préjudiciable exactement dans le secteur barycentrique où se concentre l’archétype comportemental dominant de la population investiguée.
Le déploiement du jittering, enrichi par l’affichage synchrone de distributions marginales sous forme de tapis de points (rug plots) ou d’estimations par noyau de densité aux bordures du graphique, constitue la réponse méthodologique la plus aboutie pour traiter ces configurations. Cette architecture composite désamorce la saturation centrale en découpant minutieusement les strates d’individus modaux, tout en garantissant une vision claire des profils psychologiques minoritaires situés aux confins de l’espace multivarié de la personnalité.
9. Préservation de la rigueur scientifique : Bruit statistique contre intégrité des données
9.1 Frontière éthique et déontologique de la manipulation visuelle
L’introduction d’un processus stochastique artificiel au sein d’une chaîne de traitement scientifique soulève d’inévitables interrogations d’ordre éthique et épistémologique relatives à l’authenticité de l’information divulguée. Il est primordial d’affirmer avec la plus intransigeante fermeté méthodologique la frontière infranchissable qui sépare l’optimisation perceptuelle d’un support de communication visuelle de la falsification délibérée des données empiriques brutes recueillies auprès des participants.
Le jittering est une prothèse cognitive exclusivement destinée à l’observateur humain : il vise à combler les défaillances de résolution intrinsèques de la projection bidimensionnelle sur écran ou sur papier. Sous aucun prétexte et dans aucune circonstance, les coordonnées perturbées par le bruit de vacillement ne doivent être réinjectées dans les modèles mathématiques d’analyse inférentielle, qu’il s’agisse de tests paramétriques, d’analyses de variance, de régressions ou de modélisations par équations structurelles. Toute modélisation quantitative doit impérativement et exclusivement reposer sur les matrices de données brutes intègres.
Dans le cadre de la publication académique évaluée par les pairs, la transparence déontologique la plus totale est exigée. Les auteurs ont l’obligation méthodologique de documenter explicitement dans la section consacrée aux analyses ou dans la légende accompagnant les documents iconographiques le recours au jittering, en précisant sans ambiguïté les paramètres numériques mobilisés. Cette traçabilité absolue garantit que la communauté scientifique puisse juger en toute connaissance de cause de la pertinence de la restitution graphique proposée.
9.2 Obligations de mention dans les légendes de figures académiques
La transcription des figures statistiques dans les manuscrits scientifiques doit se conformer aux standards éditoriaux internationaux les plus rigoureux, notamment ceux édictés par l’American Psychological Association dans son manuel de publication officiel. Selon les directives de l’APA (7e édition), toute figure comportant une distorsion intentionnelle, même à finalité de désocclusion visuelle, doit en expliciter la nature dans sa légende contextuelle.
L’énoncé de la légende doit spécifier de manière concise et formelle la présence d’une composante aléatoire de dispersion, en précisant sur quel axe dimensionnel celle-ci a été appliquée. Des formulations standardisées et universellement comprises doivent être privilégiées, indiquant par exemple que les points ont été soumis à un vacillement aléatoire d’amplitude contrôlée sur l’axe des abscisses pour révéler la superposition des observations multiples associées à des scores identiques.
Il est également hautement recommandé, dans une perspective de science ouverte et de reproductibilité, d’annexer entre parenthèses les valeurs exactes des paramètres de dispersion employés, tels que les coefficients d’étendue ou la valeur de la graine pseudo-aléatoire sélectionnée. Cette précision éditoriale élimine tout risque de suspicion quant à une tentative de manipulation cosmétique des faits scientifiques et confère à la publication un niveau d’excellence technique exemplaire.
9.3 Quand le jittering devient-il trompeur ?
Bien que la fonction apporte une contribution inestimable à l’analyse exploratoire, son utilisation aveugle ou non maîtrisée peut paradoxalement générer des artefacts de lecture tout aussi néfastes que le mal qu’elle prétend combattre. Le premier écueil méthodologique réside dans l’illusion fallacieuse de continuité conférée à une variable fondamentalement qualitative ou nominale. En dispersant de façon trop agressive des modalités distinctes sur un axe continu, l’analyste risque de tromper le lectorat non averti en suggérant l’existence d’états intermédiaires impossibles entre des catégories exclusives.
Le second danger, d’ordre mathématique et structurel, concerne la violation flagrante du domaine de définition théorique des instruments de mesure. Si un questionnaire d’évaluation de la dépression est rigoureusement borné par une valeur minimale de zéro et une valeur maximale de soixante-trois, l’injection mécanique d’un bruit symétrique non contraint sur des patients ayant obtenu un score plancher de zéro projettera inévitablement des points statistiques dans des valeurs négatives impossibles. Ce phénomène de fuite extra-domaine constitue une faute méthodologique majeure discréditant immédiatement la rigueur de la restitution scientifique.
Enfin, une dispersion stochastique excessivement étalée est susceptible d’altérer la pente perçue de la droite de régression chez le récepteur visuel. Bien que la trajectoire mathématique de la ligne d’ajustement demeure inchangée, la morphologie élargie de l’enveloppe extérieure des points modifie l’estimation intuitive de la force du lien statistique, pouvant inciter l’observateur à sous-estimer la corrélation réelle en raison de l’apparente dispersion artificielle du nuage. Le jittering doit donc toujours demeurer une intervention subtile et mesurée.
10. Combinaison du jitter avec des représentations synthétiques
10.1 Superposition sur boîtes à moustaches (boxplots)
L’un des apports méthodologiques les plus remarquables de la visualisation moderne réside dans l’hybridation féconde entre la synthèse statistique paramétrique ou non paramétrique et l’exposition scrupuleuse des données individuelles brutes. Dans ce paradigme, la boîte à moustaches de Tukey constitue un vecteur de synthèse universellement reconnu pour sa capacité à résumer d’un seul bloc la médiane, les quartiles et l’étendue interquartile d’une distribution empirique.
Cependant, le boxplot traditionnel souffre d’une cécité intrinsèque : il ne transmet aucune information quant à l’effectif total sous-jacent et masque totalement la présence éventuelle de trous de distribution ou de bimodalités internes au sein de la boîte centrale. En superposant une couche de points individuels traités par jittering directement par-dessus le tracé géométrique du boxplot, l’analyste transcende ces limitations structurelles, offrant simultanément le résumé synthétique et la preuve empirique sous-jacente.
Dans l’écosystème ggplot2, cette intégration exige une vigilance technique particulière relative au traitement des données considérées comme aberrantes au sens de Tukey. Si l’utilisateur superpose une géométrie de points vacillants sur une boîte à moustaches standard, les valeurs périphériques extrêmes risquent d’être tracées en double exemplaire : une première fois de manière rigide par l’algorithme du boxplot lui-même, et une seconde fois avec déplacement par la couche de jittering. L’analyste se doit impérativement de désactiver le traçage natif des valeurs aberrantes au sein du boxplot pour préserver la fidélité de l’effectif visualisé.
10.2 Hybridation avec les diagrammes en violon (violin plots)
L’évolution logique du boxplot réside dans le diagramme en violon, qui intègre une estimation continue de la densité de probabilité par le biais d’un noyau de lissage de part et d’autre de l’axe médian. Cette figuration séduisante excelle à mettre en lumière les distributions plurimodales, les asymétries prononcées ou les saturations aux extrémités, surpassant largement la rigidité des segments linéaires de la boîte à moustaches classique.
Néanmoins, le violon demeure une abstraction mathématique lissée, tributaire du choix de la fenêtre de bande passante du noyau d’estimation. Pour les cohortes restreintes, un noyau mal ajusté peut dessiner des courbures généreuses là où ne reposent en réalité que de rares observations isolées. L’hybridation du diagramme en violon avec un semis de points dispersés par jittering à l’intérieur même des parois du contour apporte une validation empirique immédiate à la courbe de densité mathématique.
Pour réussir cette articulation graphique complexe, la dispersion stochastique doit être strictement confinée à l’espace intérieur du violon. Cette prouesse technique peut être réalisée soit par un paramétrage minutieux de l’amplitude de dispersion, soit par le recours à des extensions spécialisées capables d’ajuster dynamiquement l’étendue du vacillement à la largeur instantanée du noyau de densité. Le lecteur dispose ainsi d’un outil d’inférence visuelle exceptionnel, reliant continuellement la modélisation statistique théorique à la matérialité de l’échantillon observé.
10.3 Intégration d’intervalles de confiance et courbes de tendance
L’enrichissement ultime d’une figure bivariée combinant dispersion et modélisation réside dans l’incrustation directe de courbes de tendance mathématiques adossées à leurs intervalles de confiance statistiques. L’objectif analytique est ici de guider la perception du lecteur en matérialisant explicitement l’espérance conditionnelle calculée par un modèle formel, tel qu’une régression linéaire ordinaire ou un modèle additif généralisé.
Il est impératif de souligner avec la plus grande rigueur technique que la droite de régression et la bande enveloppante matérialisant l’intervalle de confiance à 95 % doivent être rigoureusement estimées à partir des données brutes authentiques, et non sur les valeurs altérées par le jittering. La couche de modélisation mathématique vient se déployer comme une référence analytique immuable au sein du canevas cartésien, tandis que le semis de points dispersés gravite autour d’elle pour témoigner de la dispersion résiduelle réelle des observations.
Sur le plan de la hiérarchie visuelle, l’analyste veillera à ordonner soigneusement ses couches graphiques : les points dispersés traités avec un indice de transparence suffisant doivent être dessinés au premier ou au second plan, tandis que la ligne de prédiction statistique et son ruban d’incertitude doivent ressortir avec une netteté incontestable. Cet équilibre chromatique prévient toute confusion perceptive et permet de valider visuellement la qualité d’ajustement du modèle théorique aux données concrètes de l’expérience.
11. Reproductibilité scientifique : Gestion de l’aléa et des graines pseudo-aléatoires
11.1 L’impératif de réplicabilité computationnelle des figures
À l’ère de la crise de la réplicabilité qui traverse l’ensemble des sciences comportementales et biomédicales, la rigueur méthodologique ne saurait s’arrêter aux portes des calculs mathématiques pour ignorer l’étape de restitution graphique. Une figure scientifique publiée doit répondre aux mêmes exigences d’invariance et de réplicabilité computationnelle stricte que n’importe quelle valeur de p-value ou coefficient d’estimation statistique.
Or, par définition même, le recours à la fonction de vacillement sollicite le générateur de nombres aléatoires de la session de travail. Si aucune précaution informatique particulière n’est mise en place, chaque nouvelle exécution du script de tracé, chaque recompilation d’un document computationnel sous R Markdown ou Quarto, et chaque exportation vers un format vectoriel produira une disposition spatiale légèrement modifiée des points individuels. Bien que les propriétés macroscopiques demeurent stables, les micro-configurations individuelles fluctuent au gré des tirages.
Cette instabilité dynamique, bien qu’inoffensive sur le fond mathématique, s’avère hautement préjudiciable dans le cadre de la révision par les pairs et de l’archivage pérenne des productions scientifiques. Un relecteur méticuleux tentant de reproduire à l’identique une figure publiée doit pouvoir obtenir une superposition pixel par pixel absolue du document iconographique. La maîtrise rigoureuse de l’aléa algorithmique devient dès lors un impératif méthodologique incontournable.
11.2 Mise en œuvre de set.seed() en R de base
Dans l’environnement R de base, la commande maîtresse permettant d’assujettir le hasard stochastique à une reproductibilité déterministe parfaite est la fonction set.seed(). L’interpréteur R mobilise par défaut l’algorithme hautement performant de Mersenne-Twister pour générer des séquences pseudo-aléatoires d’une très longue période. En initialisant ce générateur avec une graine entière arbitraire mais documentée, l’analyste fige définitivement la suite séquentielle des tirages probabilistes subséquents.
Pour garantir la stabilité d’une figure exploitant la fonction native, il est indispensable de placer l’instruction d’initialisation de la graine immédiatement en amont de la commande de tracé graphique au sein du script d’analyse. Cette proximité séquentielle évite que des tirages intermédiaires réalisés au fil d’autres calculs exploratoires ne viennent modifier l’état interne du générateur et altérer inopinément la disposition spatiale des points lors de la phase d’exportation.
Dans le cadre d’un protocole de recherche formalisé, la valeur numérique entière assignée à cette graine pseudo-aléatoire doit être explicitement consignée au sein du code source partagé sur des dépôts ouverts de science reproductible, tels que l’Open Science Framework ou GitHub. Cette pratique rigoureuse permet à quiconque réexécutera la routine d’obtenir rigoureusement le même tracé cartésien, consacrant l’excellence déontologique de la démarche empirique.
11.3 Gestion native de la reproductibilité sous ggplot2
Si l’instruction globale de R résout le problème de l’instabilité, elle présente l’inconvénient théorique d’agir de manière globale sur l’ensemble de l’environnement de travail, affectant potentiellement d’autres procédures stochastiques distantes exécutées plus tard dans la session computationnelle. Pour pallier cette interférence systémique, l’architecture moderne de ggplot2 propose une solution modulaire d’une élégance informatique supérieure.
Au travers de l’instanciation de l’objet spatial via position_jitter(), l’environnement met à disposition des chercheurs un argument formel dédié nommé seed. En stipulant une valeur entière directement à l’intérieur de cette sous-routine de positionnement géométrique, le chercheur circonscrit l’initialisation de la graine pseudo-aléatoire à cette seule et unique couche graphique sans altérer l’état global du générateur de la session R.
Cette encapsulation locale garantit une isolation méthodologique totale : la figure est assurée de conserver sa reproductibilité spatiale millimétrique à travers toutes les plateformes logicielles, machines d’exploitation et recompilations futures, tout en protégeant les routines stochastiques subséquentes d’une réinitialisation indésirable de leurs propres séquences probabilistes. Cette pratique s’impose aujourd’hui comme le standard d’excellence dans le développement de pipelines de visualisation pérennes.
12. Alternatives computationnelles et recommandations pratiques de publication
12.1 Alternatives analytiques au jittering
En dépit de sa polyvalence manifeste, la méthode de dispersion aléatoire ne constitue pas une panacée universelle et doit être confrontée à d’autres alternatives computationnelles pertinentes dès lors que la nature des données ou le volume de l’échantillon le commande. La première alternative historique est le diagramme de tournesol, implémenté nativement en R via la fonction sunflowerplot(). Ce tracé classique quantifie les répétitions exactes en greffant des pétales géométriques distincts sur chaque point nodal, chaque pétale matérialisant de manière déterministe une observation supplémentaire superposée.
Une alternative moderne largement plébiscitée dans l’écosystème Tidyverse réside dans le codage par taille volumétrique, matérialisé par la géométrie geom_count(). Au lieu de dissocier spatialement les points conjoints, cette approche maintient les données sur leurs coordonnées cartésiennes intègres et module l’aire géométrique du marqueur proportionnellement au nombre effectif d’observations coïncidentes. Cette méthode offre une lecture quantitative immédiate et rigoureuse des effectifs nominaux, particulièrement adaptée aux tableaux de contingence croisant des échelles de Likert courtes.
Enfin, lorsque l’échantillonnage bascule dans le domaine des données massives comptant plusieurs centaines de milliers ou plusieurs millions d’entrées, le jittering devient totalement inopérant en raison de l’engorgement irrémédiable de l’espace graphique. Dans ce contexte mégadonnées, le recours aux représentations par compartimentage hexagonal (hexagonal binning) via geom_hex() ou aux grilles bidimensionnelles de densité geom_bin2d() devient impératif. Ces techniques découpent le plan cartésien en alvéoles régulières dont la luminance chromatique traduit de manière continue l’intensité du volume statistique hébergé.
12.2 Arbre décisionnel pour le chercheur en sciences humaines
Pour orienter le choix du chercheur face à la diversité des options de visualisation disponibles, il est opportun de formaliser un arbre décisionnel rationnel tenant compte de la taille de l’échantillon empirique, de la granularité des échelles de mesure et des objectifs de diffusion visés.
- Cas 1 : Échantillons restreints à modérés (N < 150)
- Variables purement discrètes : préconiser geom_count() ou le jittering léger avec des symboles pleins dotés d’un contour pour préserver la distinction individuelle.
- Variable discrète croisée avec une variable continue : utiliser systématiquement l’hybridation boxplot ou violin plot combinée à un semis de points sous geom_jitter().
- Cas 2 : Échantillons intermédiaires (150 ≤ N ≤ 2 000)
- Appliquer la dispersion stochastique bidirectionnelle couplée à un étalonnage d’opacité modéré (alpha compris entre 0.3 et 0.6).
- Recourir impérativement à la règle du tiers d’intervalle pour l’argument amount ou width afin d’interdire formellement le chevauchement inter-catégoriel.
- Cas 3 : Échantillons massifs (N > 2 000)
- Abandonner le jittering au profit des cartes de chaleur bidimensionnelles hexagonales ou des surfaces continues de densité de noyau bivariée pour éviter l’effet de boue visuelle saturée.
L’arbitrage doit également intégrer la sensibilité du lectorat ciblé. Dans le cadre d’une communication académique de pointe au sein d’une revue de psychométrie, l’affichage méticuleux des micro-variations individuelles par jittering sélectif est hautement valorisé. En revanche, pour une restitution vulgarisée destinée aux praticiens de terrain ou aux décideurs institutionnels, des représentations synthétiques consolidées évitant le flou visuel de l’aléa stochastique seront préférées pour maximiser l’intelligibilité immédiate des conclusions cliniques.
12.3 Guide synthétique des meilleures pratiques de codage
Pour conclure cette exploration approfondie, il convient de récapituler les règles fondamentales et les bonnes pratiques de programmation qui doivent guider tout analyste désireux de déployer le jittering dans un projet de recherche d’envergure. Une conformité stricte à cette check-list pré-publication garantit la probité méthodologique et l’élégance formelle de vos restitutions graphiques sous R :
- Étalonnage mesuré : Ne laissez jamais les valeurs de dispersion par défaut s’appliquer aveuglément lors de l’exportation finale. Testez méthodiquement plusieurs valeurs de l’argument width ou amount jusqu’à trouver le point de bascule exact où le chevauchement s’efface sans que les catégories ne se mélangent.
- Confinement dimensionnel : Si une seule de vos deux variables est de nature discrète, restreignez impérativement la dispersion stochastique à cet unique axe cartésien. Laissez l’axe continu totalement immaculé afin de ne pas injecter un flou arbitraire dans une dimension de mesure déjà parfaitement résolue.
- Verrouillage stochastique : Encapsulez systématiquement une graine pseudo-aléatoire via set.seed() ou par le biais du paramètre seed de position_jitter() pour garantir l’immutabilité rigoureuse de votre figure lors des compilations futures.
- Alliance de transparence : Associez systématiquement la dispersion spatiale à un ajustement de la transparence (alpha-blending). L’accumulation chromatique résultant de la superposition partielle de points transparents transforme un simple étalement géographique en une estimation volumétrique intuitive.
- Intégrité modélisatrice : N’appliquez jamais de modèles mathématiques régressifs ou inférentiels sur des coordonnées issues du jittering. Les modèles doivent être invariablement ajustés sur les données empiriques brutes non déformées, même si leur tracé graphique vient ensuite cohabiter harmonieusement avec le nuage dispersé.
- Perspective interactive : Pour les présentations sur support numérique, songez à transposer vos visualisations vers des environnements interactifs tels que Plotly ou des tableaux de bord Shiny. Ces technologies permettent de combiner la clarté spatiale du jittering à la possibilité offerte à l’utilisateur de survoler chaque point individuel pour faire apparaître instantanément, au sein d’une infobulle contextuelle, les coordonnées brutes exactes et les métadonnées spécifiques du participant.
En observant scrupuleusement ces principes directeurs, le chercheur s’assure d’exploiter la fonction jitter non comme un simple artifice cosmétique, mais comme un véritable instrument d’investigation statistique et de communication scientifique probante, réconciliant l’intégrité numérique des protocoles expérimentaux avec la puissance cognitive de la visualisation cartésienne.
Références
- Becker, R. A., Chambers, J. M., & Wilks, A. R. (1988). The New S Language: A Programming Environment for Data Analysis and Graphics. Wadsworth & Brooks/Cole. https://doi.org/10.1201/9781351074988
- Chambers, J. M., Cleveland, W. S., Kleiner, B., & Tukey, P. A. (1983). Graphical Methods for Data Analysis. Wadsworth International Group.
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3–30. https://doi.org/10.1145/272991.272995
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0