
Dans le domaine de l’ingénierie logicielle et de l’analyse computationnelle de données, la visualisation graphique constitue l’interface critique reliant le traitement algorithmique brut à l’interprétation cognitive humaine. Au sein de l’écosystème scientifique Python, la bibliothèque Matplotlib s’est imposée depuis plus de deux décennies comme la référence fondamentale pour la production de figures destinées à l’édition scientifique et à la recherche empirique. Toutefois, la maîtrise superficielle de ses interfaces procédurales de haut niveau dissimule fréquemment la sophistication de son architecture logicielle sous-jacente. Pour les chercheurs et ingénieurs confrontés à des ensembles de données multidimensionnels, l’ordonnancement précis de multiples visualisations hétérogènes sur un même canevas ne relève pas d’une simple considération esthétique, mais d’une exigence métrologique et sémiotique absolue.
Au cœur de cette architecture se trouve la méthode fig.add_subplot, véritable clé de voûte de la conception graphique orientée objet. Contrairement aux approches automatisées et souvent rigides offertes par les interfaces monolithiques, l’appel programmatique explicite à l’instanciation de sous-graphiques confère aux concepteurs un niveau de contrôle déterministe inégalé sur chaque composante topologique du canevas. Cette méthode permet non seulement d’assigner rigoureusement des axes cartésiens ou non cartésiens dans des configurations matricielles régulières, mais elle offre également le cadre théorique et pratique nécessaire à la genèse d’architectures asymétriques complexes, indispensables à la communication de résultats scientifiques à fort impact.
Le présent traité propose une déconstruction analytique et pédagogique exhaustive de la méthode fig.add_subplot. En explorant ses fondements architecturaux, sa grammaire syntaxique, ses mécanismes internes d’allocation spatiale et ses interactions avec les gestionnaires de grilles avancés, ce document offre aux praticiens les clés théoriques et techniques pour transcender les limitations des scripts conventionnels. De l’évaluation des compromis de performance mémoire à la résolution chirurgicale des artefacts typographiques, chaque étape du cycle de vie d’une figure composite sera rigoureusement disséquée selon les standards académiques les plus exigeants.
1. Introduction à l’architecture de Matplotlib et au paradigme orienté objet
1.1 Distinction fondamentale entre l’interface pyplot et l’approche orientée objet
L’écosystème de Matplotlib est historiquement structuré autour d’une dualité conceptuelle majeure, héritée de la volonté originelle d’émuler l’environnement de calcul matriciel de MATLAB. D’une part, le module pyplot expose une interface procédurale s’appuyant sur une machine à états implicite. Dans ce mode de fonctionnement, l’interpréteur conserve en mémoire globale une référence active vers la « figure courante » et « l’axe courant », redirigeant automatiquement les commandes de tracé vers ces entités sans nécessiter leur spécification explicite. Si cette approche offre une rapidité d’exécution appréciable pour le prototypage rapide ou l’exploration préliminaire de données dans des calepins interactifs, elle révèle de sévères limitations dès lors que la complexité logicielle s’accroît. La gestion d’états globaux induit des effets de bord imprévisibles, complique le débogage et interdit quasiment toute réutilisation de code au sein d’architectures modulaires ou de pipelines de calcul distribués.
À l’opposé, le paradigme orienté objet (souvent désigné par l’acronyme OO) repose sur l’instanciation déterministe et la manipulation directe d’arborescences d’objets logiciels. Dans cette approche, le programmeur conserve des références explicites et immuables vers chaque entité graphique, principalement les instances des classes matplotlib.figure.Figure et matplotlib.axes.Axes. Cette séparation stricte entre le conteneur global et les espaces de tracé individuels garantit la pureté fonctionnelle du code, autorisant l’injection de dépendances, le passage d’axes en arguments de fonctions analytiques et la parallélisation sécurisée des processus de génération graphique sans risque de collision d’états.
Dans le cadre de protocoles scientifiques rigoureux, l’approche orientée objet n’est pas une simple recommandation stylistique, mais un impératif de reproductibilité. En éliminant toute ambiguïté sur la cible d’une transformation géométrique ou d’une modification d’échelle, elle permet de construire des visualisations complexes dont le comportement demeure invariant, quel que soit le contexte d’exécution de la suite logicielle sous-jacente.
1.2 Le rôle central de l’objet Figure dans l’écosystème graphique
Dans la hiérarchie structurelle de Matplotlib, l’objet Figure incarne le sommet absolu de la composition graphique. Il ne doit pas être confondu avec la fenêtre de rendu d’un système d’exploitation ou avec une zone de tracé spécifique, mais doit être conceptualisé comme un canevas physique abstrait, un espace vectoriel continu sur lequel viendront s’ordonner l’ensemble des éléments visuels, textuels et géométriques. L’objet Figure détient l’autorité exclusive sur les dimensions globales du support, exprimées en pouces physiques conformément aux conventions typographiques internationales, ainsi que sur la densité de discrétisation spatiale désignée par la résolution en points par pouce (dots per inch ou DPI).
Cette distinction entre le support d’inscription et son contenu géométrique est fondamentale pour la métrologie de la visualisation. L’instance de Figure gère les mécanismes de transformation de coordonnées globales, le calcul des bordures structurelles (margins), la couleur de fond du subjectile (facecolor), ainsi que les éventuelles composantes d’affichage suprêmes telles que le titre global ou les légendes unifiées. Elle constitue le référentiel invariant au sein duquel des sous-espaces de projection indépendants vont pouvoir émerger et coexister sans interférer mutuellement.
Comprendre ce rôle de conteneur suprême permet de saisir la dichotomie essentielle entre la surface de tracé (Figure) et les zones réelles de projection de données (Axes). Alors que la Figure définit l’univers physique et typographique global, les objets de type Axes qui y sont attachés représentent des régions géométriques délimitées, dotées de leurs propres systèmes de coordonnées, métriques et transformations mathématiques. C’est précisément à l’interface de ces deux mondes que s’articule la commande d’allocation spatiale.
1.3 Émergence et nécessité de fig.add_subplot pour le contrôle granulaire
L’élaboration de figures scientifiques contemporaines exige fréquemment la juxtaposition de visualisations hétérogènes : profils spectraux, distributions marginales, cartes thermiques ou diagrammes de dispersion bivariés doivent souvent cohabiter au sein d’un même panneau de publication. Les fonctions d’automatisation globale de haut niveau, à l’instar de certaines routines monolithiques, imposent des hypothèses restrictives sur la symétrie et la régularité des grilles, rendant l’agencement de visualisations asymétriques particulièrement fastidieux ou sous-optimal.
C’est dans ce contexte de contraintes structurales complexes que la méthode fig.add_subplot s’impose comme un instrument d’une précision chirurgicale. Contrairement aux méthodes d’instanciation de masse qui construisent de manière rigide une matrice complète d’axes dès l’initialisation, fig.add_subplot adopte une philosophie de déclaration incrémentale et granulaire. Elle offre à l’ingénieur ou au chercheur la capacité d’adresser sélectivement des cellules virtuelles au sein de grilles de résolutions arbitraires, permettant l’émergence d’architectures spatiales sur mesure où chaque graphique occupe un espace dimensionné selon sa densité d’information intrinsèque.
Cette flexibilité programmatique s’avère vitale lors de la préparation de manuscrits académiques soumis aux grilles éditoriales strictes de revues de premier rang. La méthode permet de moduler les ratios spatiaux, de préserver l’alignement rigoureux des variables physiques entre sous-systèmes d’affichage, et d’intégrer de manière fluide des sous-graphiques aux comportements projectifs différenciés, tout en conservant une traçabilité parfaite au niveau du code source.
2. Syntaxe fondamentale et décorticage des paramètres de fig.add_subplot
2.1 Décomposition du format d’entier compressé à trois chiffres
L’une des spécificités syntaxiques les plus remarquables et pérennes de fig.add_subplot réside dans sa prise en charge d’un format d’argument condensé sous la forme d’un nombre entier unique composé de trois chiffres décimaux. Cette notation cryptique, directement empruntée aux conventions historiques de MATLAB, repose sur une encodage positionnel rigide où chaque chiffre possède une sémantique géométrique prédéfinie. Dans une expression telle que fig.add_subplot(231), le premier chiffre spécifie le nombre total de lignes composant la grille virtuelle (nrows = 2), le deuxième chiffre détermine le nombre de colonnes (ncols = 3), et le troisième chiffre désigne l’index séquentiel d’activation du sous-graphique ciblé (index = 1).
Le fonctionnement interne du moteur d’analyse lexicale de Matplotlib évalue cet entier en effectuant des divisions euclidiennes successives par dix pour extraire chaque composante vectorielle. Cette technique d’écriture compacte permet d’alléger considérablement l’encombrement syntaxique dans les scripts scientifiques comportant de multiples déclarations séquentielles. Elle confère au code une concision appréciée des analystes effectuant des visualisations rapides au clavier.
Néanmoins, cette concision s’accompagne d’une contrainte topologique infranchissable : le système décimal limitant chaque position à un chiffre compris entre 0 et 9, il est formellement impossible d’employer cette syntaxe compacte pour des partitions spatiales nécessitant 10 lignes, 10 colonnes, ou un index global égal ou supérieur à 10. Tenter de formuler un appel tel que fig.add_subplot(1011) conduirait inéluctablement à une erreur d’interprétation sémantique, le parseur échouant à isoler de manière univoque les dimensions de la grille et son positionnement d’accès.
2.2 Utilisation explicite des arguments positionnels séparés
Pour s’affranchir définitivement des limitations arithmétiques du format compressé et pour respecter scrupuleusement les recommandations de style logiciel édictées par la norme PEP 8, la signature formelle de la méthode fig.add_subplot prend en charge le passage d’arguments positionnels décomposés. Dans cette modalité explicite, l’appel adopte la forme canonique fig.add_subplot(nrows, ncols, index, **kwargs), où chaque dimension structurelle est passée en tant qu’entier indépendant au sein du flux d’évaluation.
Cette approche est impérative dès lors que le canevas de visualisation doit héberger des matrices de données à haute densité, par exemple lors du traçage de planches exhaustives de micro-réseaux biologiques, de spectrogrammes acoustiques multicanaux ou de grilles d’hyperparamètres en apprentissage profond. Dans ces configurations, l’instanciation de grilles de 12 lignes sur 16 colonnes s’opère de manière totalement transparente via l’instruction fig.add_subplot(12, 16, k), levant toute ambiguïté interprétative.
Au-delà de la suppression des contraintes d’échelle, l’utilisation d’arguments positionnels distincts accroît drastiquement la maintenabilité du code source dans les environnements de recherche collaborative. Elle permet l’affectation dynamique des dimensions de la grille à partir de variables d’environnement ou de calculs d’échelle dépendant directement de la taille des tenseurs de données injectés, facilitant ainsi l’automatisation intégrale des chaînes de traitement visuel.
2.3 Gestion de l’indexation basée sur 1 et pièges algorithmiques courants
L’un des écueils algorithmiques les plus fréquents rencontrés par les ingénieurs et data scientists lors de la manipulation de fig.add_subplot réside dans le principe d’indexation adopté par la bibliothèque. En parfaite discordance avec les conventions idiomatiques de l’écosystème Python — où l’indexation des séquences, listes, tuples et tableaux NumPy s’effectue systématiquement en base zéro (0-indexed) —, l’argument index de fig.add_subplot est strictement fondé sur une numérotation en base un (1-indexed).
Le balayage géométrique de la grille s’opère séquentiellement, ligne par ligne, de la gauche vers la droite et du sommet vers la base du canevas. Dès lors, pour une matrice virtuelle de dimensions (N times M), la cellule supérieure gauche porte invariablement l’indice (1), tandis que la cellule terminale inférieure droite est désignée par l’indice (N times M). La transmission accidentelle d’un indice nul, par exemple lors d’un appel généré par une boucle native fig.add_subplot(nrows, ncols, 0), déclenche immédiatement la levée d’une exception de type ValueError par le validateur interne de coordonnées de Matplotlib.
La mise en place de structures itératives automatisées nécessite donc une vigilance accrue et l’application systématique de corrections arithmétiques d’offset. Lorsque l’on itère sur des dimensions bi-indiciées à l’aide de boucles imbriquées exploitant les indices de ligne (i in [0, N-1]) et de colonne (j in [0, M-1]), la conversion mathématique rigoureuse permettant d’adresser la bonne cellule univariée s’établit selon la formule analytique :
$$\text{index} = i \times M + j + 1$$
L’omission de cette translation d’origine est l’une des causes prépondérantes de régressions logicielles silencieuses ou de visualisations tronquées au sein des pipelines de recherche.
3. Création de dispositions matricielles régulières et équilibrées
3.1 Implémentation d’une grille symétrique standard
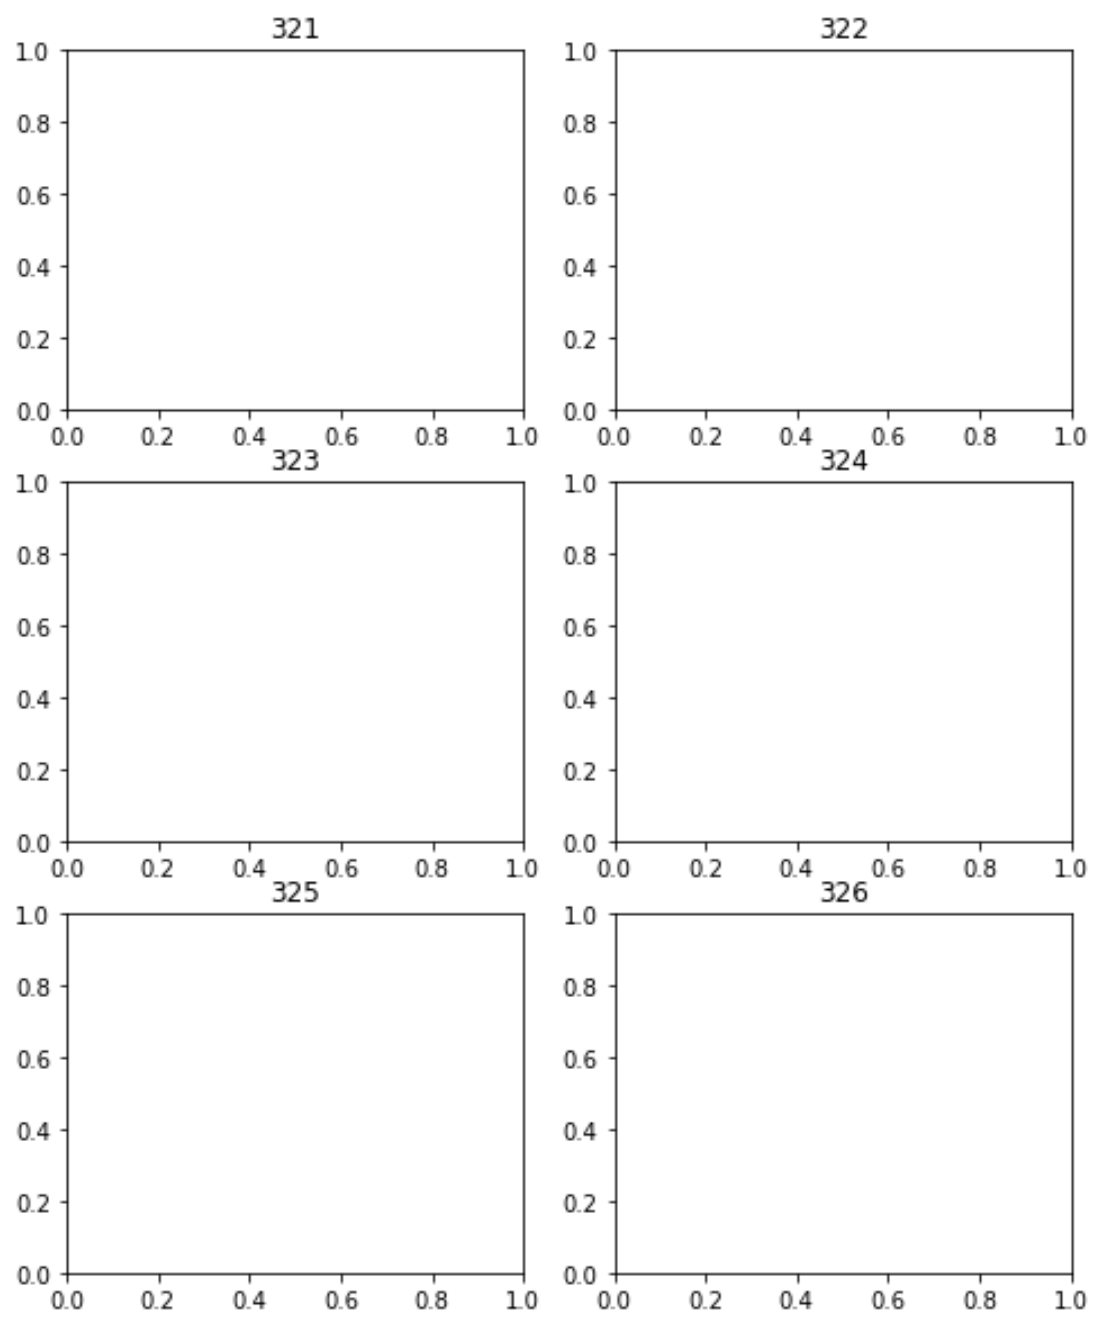
La mise en œuvre d’une topologie orthogonale régulière représente l’archétype fondamental de la présentation comparative de données. Lorsque plusieurs séries temporelles, densités spectrales ou réponses fréquentielles doivent être confrontées sous des angles d’observation équivalents, l’ordonnancement dans une matrice parfaitement symétrique — par exemple une configuration de 3 lignes par 2 colonnes — constitue la réponse ergonomique optimale pour minimiser l’effort cognitif du lecteur.
Dans ce cadre méthodologique, l’instanciation débute invariablement par la création d’un conteneur graphique maître via l’interface fondamentale plt.figure, en stipulant explicitement des proportions spatiales et une densité d’échantillonnage adaptées aux contraintes de diffusion. Une fois ce canevas alloué, les six instances d’axes sont créées successivement par des appels dédiés à fig.add_subplot, garantissant à chacune une délimitation géométrique parfaitement isotrope au sein de l’espace global.
Ce partitionnement déterministe assure que chaque unité visuelle hérite d’une surface projective rigoureusement identique. Cette identité dimensionnelle est un prérequis absolu pour que les yeux du lecteur puissent comparer les amplitudes, les pentes ou les variances sans être trompés par des artéfacts d’anamorphose géométrique induits par des déformations d’axes différentielles.
3.2 Itération programmatique et automatisation des sous-graphiques
Dans le développement d’applications scientifiques professionnelles, le codage manuel et répétitif de chaque assignation d’axe constitue un anti-patron de conception flagrant (code smell) qui nuit gravement à la concision et accroît les risques d’erreur humaine. L’élégance architecturale réside dans la délégation de cette tâche à des structures de contrôle itératives robustes, combinant harmonieusement la fonction native range ou l’énumérateur enumerate avec l’instanciation dynamique d’axes.
Il est particulièrement avantageux de collecter immédiatement les références d’objets Axes générées au sein de structures de données contiguës, telles que des listes d’adresses d’objets ou des dictionnaires sémantiques indexés par les noms des variables expérimentales. Cette approche permet de découpler totalement la phase de partitionnement spatial du canevas de la phase ultérieure d’injection des données empiriques et de rendu vectoriel.
Cette factorisation logicielle favorise également l’encapsulation de traitements génériques au sein de boucles secondaires d’homogénéisation graphique. Une fois le tableau d’axes constitué, il devient trivial d’appliquer des opérateurs vectorisés de stylisation, d’ajuster uniformément l’apparence des grilles cartésiennes ou de modifier de manière centralisée les propriétés rhéologiques des traits sur l’ensemble du composite graphique sans duplication de code.
3.3 Attribution des métadonnées textuelles et uniformisation des échelles
La rigueur de la transmission de l’information quantitative dépend de l’exactitude des métadonnées textuelles associées à chaque unité graphique. L’approche orientée objet induite par fig.add_subplot impose une modification fondamentale de la grammaire d’accès aux libellés : aux commandes procédurales globales telles que plt.title(), plt.xlabel() ou plt.ylabel() se substituent impérativement les méthodes mutatrices dédiées appartenant directement à la classe de l’axe, à savoir ax.set_title(), ax.set_xlabel() et ax.set_ylabel().
L’écueil majeur des visualisations matricielles non coordonnées réside dans l’auto-calibrage automatique et divergent des échelles dynamiques opéré par le moteur de rendu pour chaque tracé individuel. Si deux sous-graphiques adjacents illustrant des cohortes expérimentales distinctes adoptent des bornes d’ordonnées arbitraires basées sur leurs extrema locaux respectifs, toute comparaison visuelle instantanée devient erronée et introduit un biais cognitif significatif pour le chercheur.
Il est donc impératif de procéder à une synchronisation métrologique explicite en instaurant des bornes invariantes sur l’ensemble de la série de sous-graphiques, par l’application rigoureuse des primitives ax.set_xlim() et ax.set_ylim(). En forçant un référentiel spatial partagé, le scientifique garantit que la dispersion géométrique observée sur le panneau final traduit fidèlement la variance intrinsèque des données sous-jacentes, et non une distorsion projective algorithmique.
4. Conception de dispositions asymétriques et non uniformes
4.1 Principes de superposition conceptuelle de grilles hétérogènes
La véritable puissance expressive de fig.add_subplot se révèle dans sa capacité à transcender les structures matricielles régulières pour concevoir des mises en page asymétriques hautement complexes. Le fondement théorique sous-jacent repose sur la notion de maillages virtuels multiples coexistant de manière abstraite au sein de la même instance de Figure. L’utilisateur n’est nullement contraint de restreindre ses appels à une seule et unique définition de grille géométrique.
Chaque invocation de fig.add_subplot projette temporairement une trame de division spatiale fractionnaire sur le canevas global, calcule les coordonnées relatives normalisées de la zone d’affichage demandée par rapport aux bornes unifiées du canevas ([0, 1] en abscisse et en ordonnée), puis y ancre l’objet Axes de manière définitive. Dès lors, rien n’interdit au concepteur d’instancier un premier axe en se référant à une partition bipartite (par exemple une grille (1 times 2)), tout en peuplant l’espace adjacent en mobilisant une partition quadripartite ou tripartite (par exemple une grille (2 times 2) ou (3 times 2)).
Cette coexistence de topologies virtuelles requiert toutefois une planification géométrique méticuleuse en amont. L’ingénieur doit conceptualiser mentalement, ou esquisser graphiquement, les intersections nodales des différentes grilles afin d’éviter que les surfaces fonctionnelles des sous-graphiques ne se superposent anarchiquement, ce qui engendrerait des oblitérations visuelles destructrices de données.
4.2 Combinaison pratique de sous-graphiques de dimensions variables
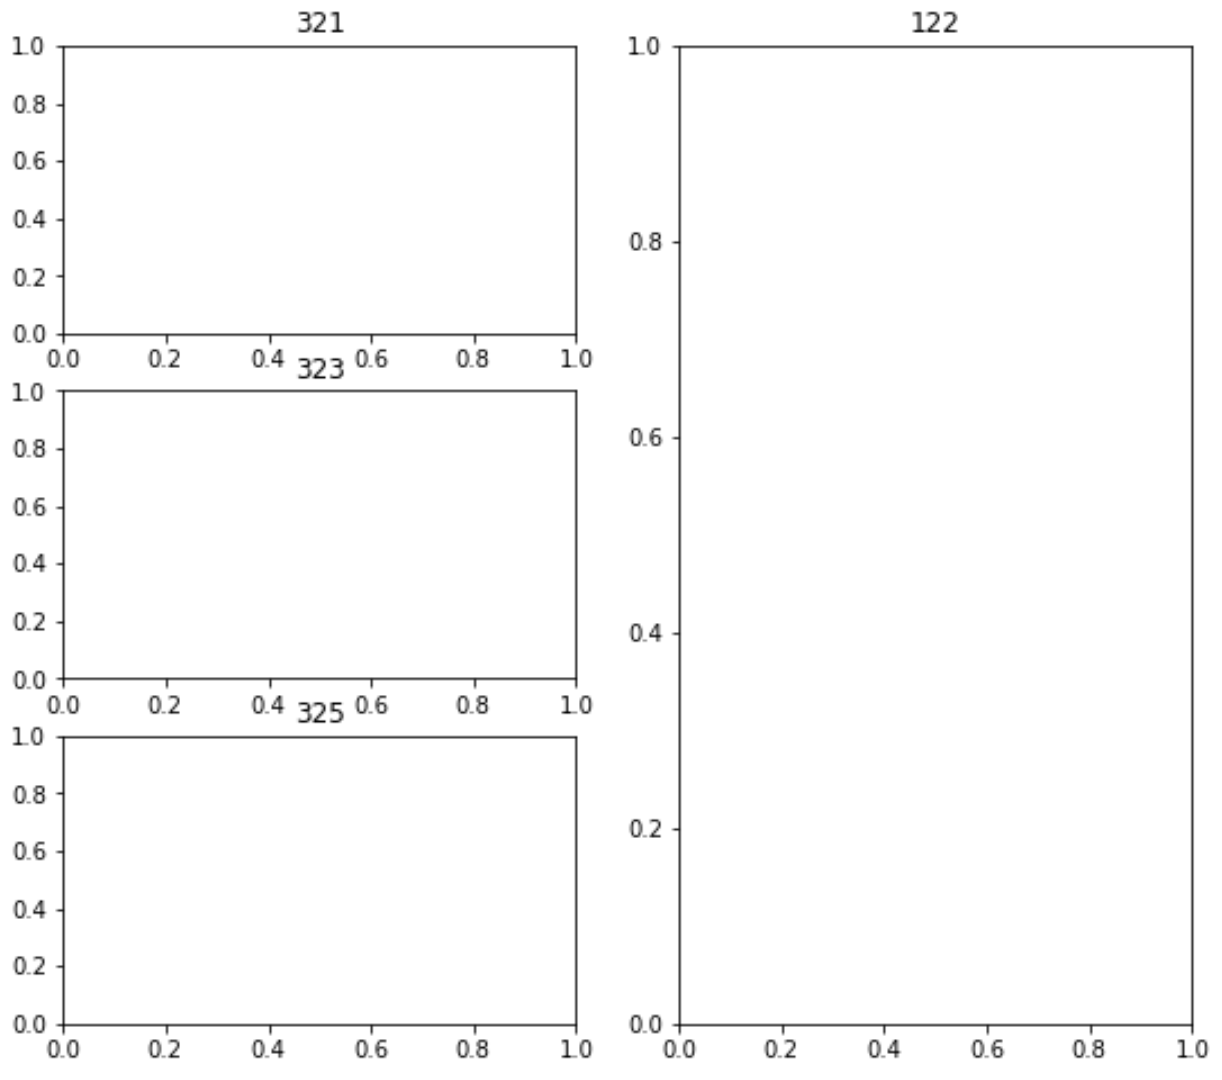
Considérons un scénario typique d’investigation expérimentale où une vue d’ensemble macroscopique, par exemple une trajectoire de phase multidimensionnelle, doit être contextualisée par trois séries temporelles complémentaires détaillant les projections axiales individuelles des variables d’état du système dynamique. La solution ergonomique par excellence consiste à scinder l’espace en deux colonnes d’inégales vocations : la moitié gauche accueille la vue d’ensemble unifiée, tandis que la moitié droite héberge une colonne stratifiée de trois visualisations compactes.
Une telle architecture se concrétise avec une élégance remarquable via fig.add_subplot sans exiger l’appel à des modules externes. Pour matérialiser la colonne de droite, l’analyste décrète conceptuellement une grille de 3 lignes par 2 colonnes, et mobilise sélectivement les emplacements pairs situés sur la seconde colonne, à savoir les positions (2), (4) et (6) (syntaxiquement transcrites par les indices (3, 2, 2), (3, 2, 4) et (3, 2, 6)). Simultanément, la moitié gauche du canevas est matérialisée en déclarant une grille globale de 1 ligne par 2 colonnes, au sein de laquelle on active le premier emplacement unitaire via l’appel fig.add_subplot(1, 2, 1).
Cette hétérogénéité spatiale permet d’optimiser l’économie d’attention du lecteur : le panneau dominant offre la résolution spatiale nécessaire à la détection de motifs topologiques globaux, tandis que les sous-panneaux satellites garantissent la précision chronologique micrométrique requise pour l’analyse locale des composantes spectrales ou temporelles.
4.3 Résolution des conflits d’espacement dans les architectures hybrides
L’assemblage de sous-graphiques issus de grilles virtuelles divergentes soulève inévitablement des défis d’ingénierie visuelle complexes au niveau de la gestion des espacements interstitiels. En effet, par construction, le moteur de calcul de positionnement de Matplotlib attribue des marges d’espacement par défaut optimisées pour des sous-graphiques partageant strictement le même dénominateur matriciel. Dès lors que des densités de cellules dissemblables sont juxtaposées sur la même surface, des distorsions spatiales notables peuvent survenir.
Ces conflits se manifestent principalement par des collisions spatiales entre les labels typographiques d’abscisses d’une grille dense et les titres supérieurs des sous-graphiques positionnés plus bas, ou par un désalignement horizontal flagrant des bordures extérieures des tracés. Pour pallier ces distorsions, il devient nécessaire d’exercer un contrôle chirurgical sur les métadonnées de positionnement en accédant aux propriétés de la boîte englobante (bounding box) de chaque axe.
L’arbitrage entre compacité de la mise en page et préservation de zones de silence visuel suffisantes conditionne directement la lisibilité de la figure scientifique. Une architecture hybride réussie doit garantir que les regards circulent naturellement d’une zone analytique à l’autre sans buter sur des superpositions d’encres typographiques ou des décalages d’axes incohérents qui dégraderaient l’autorité visuelle des travaux de recherche présentés.
5. Gestion avancée des projections et des systèmes de coordonnées
5.1 Définition de l’argument projection pour les tracés non cartésiens
L’espace physique et conceptuel des sciences contemporaines ne se limite que rarement au plan euclidien cartésien bidimensionnel standard. Qu’il s’agisse de modéliser la directivité d’antennes électromagnétiques, des flux de vents anémométriques, des cartographies géophysiques ou des structures macromoléculaires repliées dans l’espace, le système de représentation doit impérativement s’adapter à la topologie de la variété différentielle sous-jacente aux données.
La méthode fig.add_subplot répond à cette exigence fondamentale par l’intermédiaire de son argument nommé projection. Ce paramètre d’instanciation permet de dévier du modèle euclidien par défaut en spécifiant des registres géométriques spécialisés. En passant l’argument textuel projection='polar', le système substitue automatiquement à l’espace orthogonal affine un système de coordonnées polaires ((theta, r)), redéfinissant intrinsèquement le comportement des axes, des graduations angulaires et des algorithmes d’interpolation sous-jacents.
De manière similaire, l’accès à la représentation tridimensionnelle s’opère en stipulant projection='3d', ce qui déclenche l’initialisation transparente des classes spécialisées issues du module d’extension mpl_toolkits.mplot3d. L’instance d’Axes ainsi matérialisée ne relève plus de la classe de base bidimensionnelle, mais hérite de la classe Axes3D, octroyant l’accès direct aux primitives de calcul d’occlusion faciale, de transformation de caméra par angles d’Euler et de projection perspective ou axonométrique.
5.2 Transformations logarithmiques et échelles personnalisées
Dans de nombreuses disciplines empiriques — telles que la thermodynamique hors équilibre, l’acoustique, l’astrophysique ou la cinétique chimique —, les grandeurs mesurées s’étendent sur plusieurs décades de magnitude. La représentation cartésienne linéaire de telles données compresse irrémédiablement les faibles valeurs dans l’épaisseur du tracé tout en dilatant artificiellement les régimes asymptotiques, oblitérant toute capacité d’analyse fine des phénomènes de lois de puissance ou de comportements exponentiels.
Bien qu’il soit usuel de modifier le comportement des axes a posteriori à l’aide de méthodes telles que ax.set_xscale('log'), fig.add_subplot autorise la spécification programmatique précoce de ces contraintes via l’injection de paramètres de transformation dès l’allocation mémoire de l’axe. Matplotlib implémente une hiérarchie sophistiquée d’échelles mathématiques non linéaires, englobant les transformations purement logarithmiques, les échelles symétriques en log (symlog) capables de gérer rigoureusement les singularités de part et d’autre de zéro, ainsi que les échelles logistiques personnalisées pour l’analyse probabiliste.
L’ancrage d’une échelle non linéaire au moment précis de l’instanciation du sous-graphique optimise le calcul géométrique interne des graduations majeures et mineures, garantissant une affectation précise des formateurs numériques sans induire de cycles de rééchantillonnage graphique superflus lors du rendu final de la scène vectorielle.
5.3 Partage dynamique d’axes avec sharex et sharey
L’un des apports majeurs de la méthode fig.add_subplot réside dans sa capacité à lier structurellement plusieurs axes indépendants par le biais des arguments formels sharex et sharey. Cette fonctionnalité s’avère particulièrement précieuse dans la conception de panneaux stratifiés verticaux ou horizontaux destinés à l’analyse de signaux hautement résolus dans le temps ou l’espace.
En assignant une référence d’axe préexistante à l’argument sharex lors de la création d’un second sous-graphique (par exemple ax2 = fig.add_subplot(212, sharex=ax1)), les deux entités entrent dans un état de synchronisation bidirectionnelle rigoureuse. Toute modification apportée aux bornes de définition de l’abscisse sur l’un des axes — qu’elle découle d’un appel programmatique à set_xlim() ou d’une manipulation interactive d’agrandissement (zoom) et de translation (pan) opérée par l’analyste au sein de l’interface graphique — est instantanément répercutée de manière symétrique sur l’axe apparié.
Outre cette synchronisation dynamique, l’utilisation de sharex et sharey active des optimisations sémiotiques intelligentes. Le moteur d’affichage peut automatiquement inhiber l’étiquetage redondant des graduations sur les axes intermédiaires, réduisant considérablement la pollution visuelle globale et concentrant la charge cognitive du lecteur sur les variations relatives des courbes présentées.
6. Personnalisation esthétique et stylistique des objets Axes
6.1 Manipulation chirurgicale des bordures et délimitations
La théorie de la conception graphique scientifique contemporaine, largement inspirée des principes de rationalisation et de densification informationnelle théorisés par Edward Tufte, préconise l’élimination systématique de l’encre non porteuse d’information (data-ink ratio). Dans cette optique, les cadres rectangulaires lourds entourant par défaut les sous-graphiques cartésiens doivent souvent être allégés, segmentés, voire partiellement supprimés afin d’aérer la présentation et de valoriser les signaux empiriques.
Chaque instance d’axe générée par fig.add_subplot encapsule un dictionnaire spécialisé nommé spines, qui modélise les quatre segments de délimitation topologique du cadre : 'top', 'bottom', 'left' et 'right'. L’accès programmatique direct à ces composantes permet une micro-chirurgie de la structure visuelle :
- Inhibition de la visibilité des bordures supérieure et droite via l’instruction
ax.spines['top'].set_visible(False)pour éliminer le confinement de la zone de tracé. - Décalage spatial des axes vers l’extérieur au moyen de la méthode
set_position(('outward', offset)), détachant visuellement les axes de données du plan de projection pour éviter toute collision entre les points extrêmes et les segments noirs de démarcation. - Centrage absolu des délimitations au point d’origine des coordonnées cartésiennes ((0,0)) via
set_position('zero'), une configuration indispensable pour l’illustration canonique de portraits de phase ou d’ondes sinusoïdales à valeur moyenne nulle. - Modulation fine de la largeur de trait (linewidth), du style de tiret (linestyle) et de la nuance chromatique des segments résiduels pour instaurer une hiérarchie visuelle apaisée.
Cette maîtrise de la géométrie des bordures confère immédiatement aux figures produites une signature professionnelle et épurée, rompant radicalement avec l’aspect stéréotypé des sorties graphiques par défaut.
6.2 Graduations, marqueurs et étiquetage micrométrique
L’exactitude métrologique d’une figure réside dans la clarté et la pertinence de son système de graduation. L’objet Axes issu de fig.add_subplot offre un contrôle absolu sur ces éléments par le biais de la méthode polyvalente ax.tick_params(). Cette méthode permet de configurer simultanément ou sélectivement les échelles majeures et mineures sur chaque dimension spatiale.
Les concepteurs peuvent ainsi déterminer avec une grande précision l’orientation des encoches de graduation (qu’elles soient dirigées vers l’intérieur de la zone de données, vers l’extérieur pour ne pas interférer avec le signal tracé, ou centrées), leur longueur micrométrique, leur épaisseur vectorielle ainsi que les contrastes de couleur associés. L’introduction de graduations mineures non étiquetées, orchestrée conjointement avec les modules matplotlib.ticker.AutoMinorLocator, s’avère indispensable pour conférer aux représentations sur plusieurs ordres de grandeur une lecture quantitative immédiate.
Par ailleurs, la lisibilité des libellés numériques ou temporels denses peut être préservée grâce aux arguments d’orientation angulaire (rotation) et d’alignement typographique horizontal (ha='right'). L’intégration transparente du moteur d’analyse typographique LaTeX permet en outre de restituer des formules analytiques complexes, des symboles grecs et des notations exponentielles rigoureusement conformes aux règles de composition de l’imprimerie mathématique universelle.
6.3 Cohérence chromatique et application de thèmes académiques
L’attribution des nuances chromatiques au sein de figures multipanels composées via fig.add_subplot ne relève pas de préférences purement subjectives, mais de contraintes physiologiques d’accessibilité et de perception humaine des contrastes. L’utilisation de cartes de couleurs perceptuellement uniformes — à l’instar de viridis, magma, cividis ou plasma — garantit que des incréments quantitatifs égaux dans les données se traduisent par des incréments visuels perçus comme strictement équivalents par le système cognitif humain, tout en éliminant les artéfacts de faux contours inhérents aux palettes obsolètes de type jet ou arc-en-ciel.
Dans un contexte d’architecture orientée objet, il est particulièrement recommandé d’isoler la configuration stylistique globale en encapsulant les instructions de génération au sein d’un gestionnaire de contexte plt.style.context(). Cette approche évite toute contamination mutuelle entre différents scripts de tracé exécutés au sein du même noyau d’évaluation.
Il importe également de veiller scrupuleusement au contraste de luminance entre le fond des axes (défini par ax.set_facecolor()) et les glyphes graphiques représentés, afin de préserver une lisibilité intégrale lors de la reprographie papier monochrome courante dans les revues d’archives scientifiques.
7. Alignement typographique et résolution des chevauchements spatiaux
7.1 Mise en œuvre approfondie du moteur tight_layout
L’un des phénomènes les plus frustrants lors de l’agencement de sous-graphiques adjacents au moyen d’itérations de fig.add_subplot réside dans l’apparition récurrente de chevauchements typographiques intempestifs. Les étiquettes d’abscisses de la rangée supérieure viennent fréquemment percuter les titres de la rangée inférieure, tandis que les libellés d’ordonnées débordent sur les bordures droites des graphiques voisins. Pour remédier de manière algorithmique à cette déficience structurelle, Matplotlib intègre le gestionnaire d’optimisation spatiale tight_layout.
Ce moteur procède à une analyse cinématique statique en calculant les boîtes englobantes réelles (bounding boxes) de chaque glyphe typographique, graduation et titre associés à l’ensemble des instances d’Axes présentes sur la figure. Par résolution numérique sous contrainte géométrique, fig.tight_layout() ajuste automatiquement les coordonnées de placement des axes afin de maximiser la surface occupée par les données tout en sanctuarisant un espace interstitiel de sécurité minimal.
L’opérateur dispose de plusieurs leviers pour affiner ce comportement automatique grâce à des paramètres dédiés :
pad: module l’écartement global de capitonnage entre les frontières ultimes du canevas de la figure et l’ensemble des éléments typographiques périphériques.w_pad: calibre la tolérance de dégagement horizontal spécifiquement allouée entre les colonnes de sous-graphiques contiguës.h_pad: régit la marge de sécurité verticale séparant les étages successifs de sous-graphiques superposés.
Toutefois, sur des architectures très asymétriques issues de maillages virtuels concurrents, le moteur tight_layout peut échouer à converger vers une solution géométrique stable, exigeant alors le recours à un calibrage manuel déterministe.
7.2 Contrôle manuel et paramétrique via subplots_adjust
Lorsque les moteurs d’agencement automatique se heurtent à la complexité d’une composition non orthogonale, la méthode fig.subplots_adjust offre une alternative impérative et totalement déterministe pour calibrer la topologie de la surface de travail. Contrairement aux approches heuristiques, cette commande modifie directement les frontières globales normalisées régissant la zone d’implantation de tous les sous-graphiques déclarés au sein de l’objet Figure.
La syntaxe de cette méthode repose sur six paramètres géométriques adimensionnels, dont les valeurs sont impérativement bornées sur l’intervalle réel ([0.0, 1.0]), représentant les fractions scalaires des dimensions physiques globales du conteneur :
leftetbottom: assignent la distance absolue séparant l’origine inférieure gauche de la figure des premières bordures extérieures de sous-graphiques.rightettop: délimitent l’extension maximale autorisée pour les frontières opposées droite et supérieure du complexe graphique.wspace(width space) : exprime l’espacement horizontal interstitiel entre colonnes consécutives, formalisé sous la forme d’une fraction scalaire de la largeur moyenne des axes.hspace(height space) : spécifie l’espacement vertical interstitiel entre lignes superposées, rapporté à la hauteur moyenne des axes.
Cette commande fournit aux équipes de recherche un instrument mathématique rigoureux pour figer l’espacement d’une figure selon le gabarit typographique strict imposé par les éditeurs de presse scientifique (tels que l’IEEE, l’Elsevier ou la revue Nature), éliminant ainsi toute distorsion spatiale imprévisible lors de la compilation finale des documents.
7.3 Intégration de suptitle et hiérarchisation textuelle globale
L’adjonction d’un titre chapeautant l’ensemble d’un panneau scientifique multi-vues constitue une exigence éditoriale classique, résolue fonctionnellement par l’appel à la méthode de niveau figure fig.suptitle(). Toutefois, l’interaction spatiale entre ce titre suprême et les titres locaux des sous-graphiques supérieurs générés par fig.add_subplot représente une source notoire d’interférences visuelles.
Par défaut, l’application naïve subséquente de fig.tight_layout() recalcule les empiétements spatiaux sans toujours intégrer adéquatement la hauteur réservée pour le super-titre, positionnant régulièrement les graphiques du rang sommital par-dessus le libellé institutionnel de l’étude. La résolution algorithmique de ce conflit nécessite une coordination explicite entre les deux instructions : il convient de passer impérativement l’argument rect=[left, bottom, right, top] à tight_layout() (par exemple fig.tight_layout(rect=[0, 0, 1, 0.95])).
Cette restriction spatiale ordonne au moteur d’ajustement automatique de borner la réorganisation des sous-graphiques en deçà d’une frontière verticale stricte (ici fixée à 95% de la hauteur totale du canevas), sanctuarisant définitivement les 5% supérieurs de l’espace pour l’inscription sereine et non perturbée de la métadonnée textuelle globale.
8. Comparaison méthodologique : fig.add_subplot face aux approches alternatives
8.1 Analyse comparative : fig.add_subplot contre plt.subplot
D’un point de vue fonctionnel superficiel, les instructions plt.subplot et fig.add_subplot semblent souvent interchangeables pour le praticien débutant. Toutes deux partagent une syntaxe d’adressage similaire et génèrent en apparence des objets de tracé analogues. Pourtant, sur le plan de la rigueur épistémologique du génie logiciel, un gouffre fondamental les sépare.
La fonction plt.subplot opère au travers de l’interface d’état global du sous-système pyplot. À chaque appel, elle scrute l’état de l’interpréteur, vérifie si un axe identique existe déjà sur la figure active courante, et, le cas échéant, écrase ou sélectionne cet axe de manière silencieuse en modifiant au passage la variable d’état global pointant vers l’axe actif. Ce comportement procédural peut induire des erreurs insidieuses dans les boucles d’itération asynchrones ou complexes : si une routine secondaire modifie l’axe actif à l’insu de la fonction appelante, des données peuvent être injectées par erreur dans un panneau inadéquat, sans déclencher le moindre message d’avertissement logiciel.
À l’inverse, fig.add_subplot est une méthode orientée objet pure, directement encapsulée dans l’instance cible de Figure. Son comportement est intégralement déterministe : elle alloue formellement un nouvel axe géométrique sur l’objet propriétaire référencé, et renvoie explicitement cette nouvelle référence au programme sans altérer d’état global tiers. Cette absence d’effets de bord garantit une modularité totale du code, autorisant la refactorisation et les tests unitaires automatisés des fonctions graphiques au sein de systèmes logiciels scientifiques complexes.
8.2 Confrontation avec la méthode matricielle plt.subplots
L’utilitaire de fabrique plt.subplots (noter le pluriel terminologique distinctif) est fréquemment privilégié dans les tutoriels modernes d’analyse de données pour son ergonomie d’initialisation concise, formalisée par l’expression standardisée fig, axs = plt.subplots(nrows, ncols). Cette fonction offre l’avantage immédiat de créer simultanément le conteneur principal et l’intégralité d’un tableau structuré d’axes renvoyé sous la forme d’un conteneur matriciel NumPy multidimensionnel.
Néanmoins, cette concision s’accompagne d’un coût de flexibilité structurelle non négligeable :
- Rigidité topologique absolue :
plt.subplotsimpose obligatoirement une géométrie matricielle stricte et uniforme sur l’ensemble de la surface du canevas, interdisant nativement la création directe d’architectures asymétriques ou fractionnées complexes sans manipulations ultérieures tortueuses. - Allocation mémoire anticipée non modulaire : l’ensemble des axes est matérialisé immédiatement en mémoire, ce qui est incompatible avec des flux logiques où l’instanciation de certains sous-graphiques est conditionnée dynamiquement par l’évaluation statistique de distributions empiriques à l’exécution.
- Indirection d’accès : pour manipuler les sous-axes, l’utilisateur doit déballer ou indexer des tableaux de dimension variable (tableau 1D si une seule ligne, tableau 2D si plusieurs lignes et colonnes), ce qui exige fréquemment des vérifications de forme (shape assertions) fastidieuses pour assurer la généricité des scripts.
La méthode fig.add_subplot, fidèle à une instanciation progressive et modulaire (lazy approach), s’affranchit de ces entraves en permettant l’émergence granulaire de chaque axe au moment exact et à l’emplacement précis commandés par la logique métier de l’application.
8.3 Arbre de décision pour le choix de la méthode d’agencement
Afin de standardiser les pratiques de développement graphique au sein d’un laboratoire de recherche ou d’une direction technique, il est salutaire d’établir un arbre de décision méthodologique clair guidant la sélection entre ces différentes primitives d’agencement :
- Si la figure projetée est un panneau rigoureusement symétrique où chaque cellule partage des caractéristiques projectives strictement identiques (ex. (N times M) diagrammes de dispersion cartésiens équivalents) : privilégier l’expressivité compacte de
plt.subplots. - Si la figure exige une disposition asymétrique, non uniforme, ou si elle intègre des projections spatiales hétérogènes (ex. confrontation simultanée d’un tracé cartésien, d’un espace 3D et d’un diagramme en coordonnées polaires) : adopter impérativement
fig.add_subplot. - Si la construction s’inscrit dans un script interactif exploratoire à courte durée de vie au sein d’une console REPL : l’utilisation rapide de
plt.subplotdemeure tolérable, bien que déconseillée dans tout livrable pérenne. - Si l’architecture graphique exige la fusion de cellules composites couvrant de multiples portées d’intervalles matriciels : articuler
fig.add_subplotconjointement avec l’objet d’ordonnancement structurelGridSpec.
Cette standardisation garantit un équilibre optimal entre concision d’écriture et robustesse structurelle au fil du cycle de vie du code d’analyse.
9. Intégration avec GridSpec et SubplotSpec pour une modularité totale
9.1 Fondements et mécanique de matplotlib.gridspec.GridSpec
Lorsque les exigences de mise en page dépassent les capacités de composition offertes par la syntaxe standard de fig.add_subplot, Matplotlib propose un module de gestion topologique de bas niveau d’une puissance absolue : le module matplotlib.gridspec, articulé autour de sa classe maîtresse GridSpec. Cet objet incarne la dissociation conceptuelle totale entre la géométrie de partitionnement de l’espace et l’instanciation effective des récepteurs de tracé.
Une instance de GridSpec modélise une trame de discrétisation matricielle purement abstraite, indépendante de tout axe graphique réel. L’un de ses apports fonctionnels majeurs réside dans la capacité d’assigner des rapports d’échelle asymétriques via les arguments width_ratios et height_ratios. Par ce biais, l’ingénieur peut imposer que la première colonne d’une figure occupe une largeur relative trois fois supérieure à celle de la seconde colonne (par l’expression width_ratios=[3, 1]), introduisant un contrôle dimensionnel continu impossible à formuler avec les indices matriciels uniformes standard.
L’interface naturelle reliant ce gestionnaire géométrique au canevas graphique repose directement sur fig.add_subplot, qui accepte nativement dans sa signature une tranche d’allocation (slice) émanant de l’objet GridSpec en lieu et place des traditionnels triplets d’entiers.
9.2 Création de cellules composites et fusion d’intervalles
L’intérêt suprême du couplage entre fig.add_subplot et GridSpec réside dans l’exploitation directe de la syntaxe de découpage indiciel native de Python (slicing) pour créer des cellules composites issues de la fusion de multiples rangées ou colonnes d’une grille abstraite. Cette méthode émule avec une précision vectorielle la propriété colspan et rowspan des tableaux HTML standardisés.
Supposons la création d’un panneau analytique haute densité modélisé sur un canevas abstrait de dimension (3 times 3). Grâce à l’indexation de tranches, un axe majeur occupant l’intégralité des deux premières rangées sur les deux premières colonnes s’instancie avec une simplicité déconcertante par l’appel ax_main = fig.add_subplot(gs[0:2, 0:2]). Simultanément, des sous-graphiques marginaux d’investigation distributionnelle peuvent être alloués le long de ses bordures :
- Un graphique de distribution marginale supérieure étendu horizontalement via
ax_top = fig.add_subplot(gs[0, 2]). - Un graphique d’histogramme latéral résumant les densités de la projection verticale via
ax_right = fig.add_subplot(gs[1, 2]). - Un bloc informatif inférieur balayant toute la largeur de la base du canevas pour exposer des séries de contrôles résiduels via l’instruction unifiée
ax_bottom = fig.add_subplot(gs[2, :]).
Cette plasticité géométrique permet de concevoir des architectures graphiques hautement denses où chaque pixel du canevas physique concourt directement à l’élucidation des données scientifiques sans générer d’espaces interstitiels résiduels non maîtrisés.
9.3 Optimisation des architectures graphiques pour rapports scientifiques
L’intégration avancée de GridSpec avec fig.add_subplot permet aux équipes de recherche d’automatiser la génération de gabarits éditoriaux pérennes et réutilisables, parfaitement calibrés pour les formats d’impression multipages ou les rapports techniques normés. En encapsulant la définition d’un GridSpec complexe au sein de générateurs ou de classes d’usines graphiques modulaires, un laboratoire peut standardiser sa production visuelle de manière industrielle.
Cette rigueur de conception facilite considérablement l’intégration d’annotations globales ancrées directement dans le système de coordonnées de la figure (figure coordinates, normalisées entre 0 et 1). Des cartouches de titrage institutionnels, des indicateurs de conformité réglementaire ou des indices d’identification alphabétique des panneaux (couramment requis sous la forme de lettres capitales grasses telles que (A), (B), (C), (D) par les comités de lecture) peuvent être projetés sans risque d’être décalés par les modifications ultérieures des plages d’échelles de chaque axe individuel.
En découplant ainsi la matrice structurelle de l’espace de rendu des données, les praticiens confèrent à leurs scripts de visualisation une maintenabilité et une durabilité logicielles alignées sur les plus hauts standards de la science ouverte et reproductible.
10. Visualisation de données multidimensionnelles en recherche empirique
10.1 Représentation de profils psychométriques et analyses distributionnelles
La recherche empirique en sciences humaines, psychométrie et neurosciences computationnelles se heurte fréquemment à la nécessité d’illustrer la complexité distributionnelle de scores cliniques ou de temps de réaction comportementaux au travers de cohortes hétérogènes. L’utilisation d’une simple moyenne assortie d’un écart-type représente désormais une simplification inacceptable, souvent dénoncée par les statisticiens pour son opacité visuelle face aux phénomènes de bimodalité ou de dissymétrie.
L’application méthodique de fig.add_subplot autorise l’agencement chirurgical d’un panneau à facettes multiples orchestrant une décomposition analytique par niveau d’observation. L’espace supérieur peut héberger une série de sous-graphiques juxtaposés accueillant des diagrammes en violon (violin plots) croisés avec des représentations de nuages de points individuels jitterisés (strip plots), révélant la véritable morphologie des distributions empiriques pour chaque condition expérimentale.
Dans la section inférieure, alignée grâce à des subdivisions de grille coordonnées, des sous-graphiques complémentaires peuvent exposer les fonctions de répartition cumulée empiriques (eCDF) associées aux tests de Kolmogorov-Smirnov correspondants. Cette structuration logique en facettes délimitées permet d’appréhender d’un coup d’œil simultané la variabilité interindividuelle et les tendances centrales agrégées, satisfaisant ainsi aux critères de transparence méthodologique les plus sévères.
10.2 Tracés de séries temporelles longitudinales et mesures répétées
L’analyse de signaux biophysiques continus — tels que les tracés électroencéphalographiques (EEG), les relevés d’oxymétrie de pouls ou les données micro-météorologiques haute fréquence — impose une contrainte géométrique stricte : l’alignement temporel vertical absolu des dynamiques multiparamétriques. Tout décalage horizontal minime entre les graphiques composant la planche détruit la possibilité d’évaluer la synchronie temporelle ou la propagation causale d’événements discrets à travers les canaux d’enregistrement.
Grâce à fig.add_subplot et à l’exploitation de l’argument sharex, l’analyste instancie une pile de rubans graphiques verticaux continus. Chaque sous-graphique héberge un canal spectral ou physiologique spécifique. Les marges verticales interstitielles (hspace) peuvent être réduites à zéro, de sorte que les bordures inférieures de chaque trace touchent les bordures supérieures de la suivante, matérialisant une continuité visuelle parfaite.
Les graduations temporelles de l’abscisse sont automatiquement éteintes sur tous les panneaux supérieurs via plt.setp(ax.get_xticklabels(), visible=False), pour n’être explicitement rendues que sur la délimitation basse du tout dernier sous-graphique. Cette mutualisation temporelle élimine la dispersion attentionnelle, autorisant la superposition visuelle de marqueurs d’événements continus transversaux (à l’aide de primitives telles que ax.axvline) qui traversent l’ensemble de la composition de haut en bas sans la moindre discontinuité géométrique.
10.3 Matrices de corrélation et sous-graphiques de régression bivariée
L’investigation exploratoire des structures de covariance au sein de jeux de données multi-omiques ou d’économétrie appliquée nécessite l’intégration conjointe d’outils matriciels synthétiques et de visualisations microscopiques des associations sous-jacentes. La juxtaposition d’une carte thermique (heatmap) de corrélations de Pearson ou de Spearman et de sous-graphiques de régression bivariée détaillant les associations critiques constitue un archétype classique d’exploration empirique.
Par l’intermédiaire de fig.add_subplot, l’espace d’affichage se scinde pour allouer à la carte thermique une cellule dominante carrée préservant l’isotropie d’échelle (ax.set_aspect('equal')), tout en déployant sur la colonne adjacente une cascade de diagrammes de dispersion bivariés focalisés sur les paires de variables présentant les dépendances les plus significatives. Chaque sous-graphique de régression incorpore sa droite d’ajustement aux moindres carrés ordinaires, complétée par l’enveloppe de son intervalle de confiance à 95% calculé par rééchantillonnage bootstrap.
Cette articulation spatiale permet également d’intégrer avec précision les barres d’échelle colorimétrique (colorbars) au sein de sous-axes réservés, éliminant ainsi le phénomène classique de distorsion par lequel l’insertion automatique d’une barre de couleur redimensionne arbitrairement l’axe adjacent, rompant l’alignement millimétrique avec le reste du panneau analytique.
11. Erreurs fréquentes, débogage et bonnes pratiques logicielles
11.1 Diagnostic des anomalies d’indexation et chevauchements involontaires
La pratique quotidienne du développement avec Matplotlib expose même les analystes expérimentés à une catégorie spécifique d’erreurs d’exécution récurrentes liées à la manipulation des géométries matricielles. La plus emblématique demeure incontestablement l’erreur d’indice ValueError: num must be 1 <= num <= max_num, déclenchée instantanément lorsque l’argument d’index passé à fig.add_subplot sort de la plage admissible déterminée par le produit du nombre de lignes et de colonnes.
Un piège plus pernicieux, car n’entraînant aucune interruption du flux d’exécution, réside dans la ré-instanciation accidentelle d’un axe sur un emplacement déjà occupé. Si un script itératif appelle de manière redondante fig.add_subplot(2, 2, 1) sans avoir détruit ou nettoyé l’axe précédent, Matplotlib, selon les versions et contextes d’exécution, peut soit écraser l’ancien axe en invalidant ses liaisons d’événements, soit superposer un nouvel axe transparent directement au-dessus du premier. Il en résulte des superpositions illisibles de graduations et de textes, extrêmement complexes à diagnostiquer visuellement sans une inspection attentive de la liste interne fig.axes.
Pour immuniser les chaînes de production graphique contre ces anomalies, il est impératif d’intégrer des assertions formelles en amont de l’instanciation spatiale :
- Vérifier systématiquement par assertion que l’indice séquentiel respecte rigoureusement la condition (1 leq text{index} leq (N times M)).
- Valider l’intégrité de la liste d’axes hébergée par la figure via la consultation de
len(fig.axes)afin de détecter tout dédoublement fantôme d’entité géométrique. - Exécuter systématiquement un nettoyage ciblé à l’aide de
fig.delaxes(ax)lorsqu’une régénération dynamique d’un sous-espace graphique s’avère nécessaire à l’intérieur d’une session de calcul pérenne.
11.2 Gestion rigoureuse du cycle de vie des objets et de la mémoire vive
Dans les contextes de calcul intensif — tels que l’évaluation de simulations de Monte-Carlo sur des millions d’itérations ou la génération par lots de milliers de rapports graphiques automatisés pour des essais cliniques —, la mauvaise gestion du cycle de vie des figures Matplotlib constitue l’une des causes majeures de fuites de mémoire (memory leaks) sous Python.
Une incompréhension fondamentale réside dans le fait que la simple suppression d’une variable locale via l’instruction del fig ou del ax ne libère absolument pas la mémoire allouée par le système. En effet, le sous-système pyplot conserve en interne des références fortes (strong references) globales vers chaque instance de Figure instanciée au sein de son registre de gestionnaire de fenêtres d’affichage (Gcf), empêchant définitivement le ramasse-miettes automatique de Python (garbage collector) de désallouer les tampons de pixels matriciels et les arbres de primitives vectorielles.
L’élimination définitive de ces artefacts de saturation mémoire impose l’application d’un protocole d’extinction déterministe. Chaque figure conçue au travers de fig.add_subplot doit être formellement purgée dès l’achèvement de sa sérialisation sur disque ou de son transfert réseau, par l’appel explicite à la primitive de libération système plt.close(fig). Dans les architectures logicielles asynchrones de haut niveau, il est de bonne pratique d’encapsuler la production graphique dans des blocs d’exception contextuels try...finally pour garantir que la désallocation mémoire intervienne inconditionnellement, même en cas de levée inopinée d’erreurs numériques lors de la phase de tracé des données.
11.3 Encapsulation fonctionnelle et modularisation du code graphique
L’élévation de la qualité logicielle d’un projet scientifique passe impérativement par le refus systématique des scripts monolithiques géants (spaghetti code) où le chargement des fichiers de données, les transformations statistiques et les centaines d’instructions de mise en page Matplotlib sont entremêlés sans structure discernable. La bonne pratique architecturale cardinale repose sur le principe d’inversion de contrôle et l’injection explicite d’axes sous forme de dépendances fonctionnelles pures.
Selon ce paradigme de développement, toute routine de tracé spécifique doit être encapsulée dans une fonction unitaire recevant obligatoirement l’objet Axes cible en tant que paramètre d’entrée explicite, conformément à la signature canonique def plot_biomarker_distribution(ax, data_vector, **kwargs):. La responsabilité de la fonction se borne alors exclusivement à habiller cet axe récepteur (projection des primitives géométriques, ajustement des titres locaux, paramétrage des limites). Elle ignore délibérément tout de la topologie globale de la figure hôte.
Cette séparation étanche des responsabilités présente d’immenses vertus méthodologiques :
- Testabilité unitaire : les fonctions de tracé peuvent être testées unitairement au sein de harnais de tests automatisés (par exemple via le cadriciel pytest et son extension d’évaluation d’images de référence
pytest-mpl). - Composabilité totale : une même fonction analytique peut être déployée indifféremment dans un graphique unitaire isolé ou réinjectée au sein d’une matrice complexe générée par
fig.add_subplotsans exiger la moindre modification de son code source interne. - Découplage analytique : les mutations statistiques préalables des données demeurent hermétiques à la cinématique du moteur de rendu visuel, autorisant des optimisations algorithmiques indépendantes de la représentation graphique finale.
12. Cas pratiques d’application : Déploiement complet de visualisations académiques
12.1 Étude de cas 1 : Rapport expérimental à mise en page asymétrique complète
Pour illustrer la mise en œuvre pratique de l’ensemble des concepts théoriques développés jusqu’ici, concevons un rapport analytique asymétrique complet matérialisant l’évaluation comportementale d’un système cyber-physique expérimental. Le panneau graphique projeté doit orchestrer la coexistence harmonieuse de quatre zones visuelles interdépendantes : un moniteur temporel principal dominant la moitié supérieure du canevas, complété sur la moitié inférieure par trois cellules analytiques d’importance égale illustrant respectivement l’histogramme des résidus d’erreur, le spectre de densité de puissance, et un diagramme de dispersion des états de transition.
La concrétisation de cette architecture mobilise l’interopérabilité directe entre fig.add_subplot et le formalisme de conception modulaire. L’initialisation débute par l’allocation d’un canevas physique au format panoramique équilibré (12 par 8 pouces) doté d’une résolution de production fixée à 300 DPI. Le moniteur temporel supérieur est immédiatement matérialisé en déclarant conceptuellement une trame matricielle de 2 lignes par 1 colonne, activée sur son premier segment via ax_main = fig.add_subplot(2, 1, 1).
Pour façonner le socle inférieur sans générer de conflits géométriques, l’espace global est simultanément réinterprété sous la forme d’un second maillage virtuel comptant 2 lignes et 3 colonnes. L’ingénieur adresse alors successivement les trois cellules résolutives de la seconde ligne, correspondant formellement aux indices séquentiels (4), (5) et (6) (formulés explicitement par les appels fig.add_subplot(2, 3, 4), fig.add_subplot(2, 3, 5) et fig.add_subplot(2, 3, 6)).
Une fois l’ancrage spatial stabilisé, chaque sous-graphique reçoit son flux de données dédié. L’alignement typographique global est scellé par l’application conjointe de fig.subplots_adjust(hspace=0.35, wspace=0.25) pour prévenir tout télescopage entre les échelles d’abscisses de la vue maîtresse et les en-têtes des panneaux inférieurs, délivrant ainsi une planche visuelle prête pour l’évaluation par les pairs sans nécessiter la moindre retouche manuelle dans des logiciels de dessin vectoriel externes.
12.2 Étude de cas 2 : Tableau de bord analytique multi-projections
Examinons désormais un cas d’application avancé impliquant une hétérogénéité radicale des systèmes de projection mathématiques, situation typique rencontrée en robotique aérospatiale ou lors de l’étude de phénomènes magnétohydrodynamiques complexes. L’objectif consiste à structurer sur un canevas unique une vue tridimensionnelle de la trajectoire orbitale d’un vecteur d’exploration, flanquée d’un diagramme en coordonnées polaires exposant la directivité du signal radio-fréquence émis, et de deux graphiques cartésiens conventionnels documentant la consommation énergétique et l’évolution de la vitesse radiale.
Une telle disparité géométrique fait échouer la quasi-totalité des routines de haut niveau, mais se résout de manière fluide grâce à la flexibilité de l’argument projection intégré à fig.add_subplot. La figure est structurée sur une base orthogonale de 2 lignes par 2 colonnes :
- Le premier quadrant (haut gauche, index 1) accueille la variété spatiale tridimensionnelle via l’instruction explicite
ax_3d = fig.add_subplot(2, 2, 1, projection='3d'). Sur cet axe spécialisé, les routines de visualisation volumique projettent le vecteur de position tout en modulant dynamiquement l’azimut et l’élévation parax_3d.view_init(elev=28, azim=45). - Le second quadrant (haut droit, index 2) matérialise l’espace de directivité radioélectrique sous la forme d’une variété polaire native par
ax_polar = fig.add_subplot(2, 2, 2, projection='polar'), configurant immédiatement le réseau de coordonnées en coordonnées d’azimut et de distance radiale. - Les deux quadrants inférieurs (indices 3 et 4) sont instanciés selon le modèle cartésien euclidien standard par
ax_energy = fig.add_subplot(2, 2, 3)etax_speed = fig.add_subplot(2, 2, 4), en prenant soin d’apparier structurellement leur domaine temporel d’abscisse via l’argumentsharex=ax_energyinjecté dans le second axe.
L’application rigoureuse d’une palette chromatique sobre et d’un dimensionnement typographique harmonisé via matplotlib.rc_context assure l’unité sémiotique globale de ce tableau de bord hétérogène, prouvant la capacité de fig.add_subplot à fédérer des paradigmes géométriques radicalement divergents au sein d’une expérience de lecture visuelle cohérente et scientifiquement rigoureuse.
12.3 Exportation haute fidélité pour publication internationale
L’aboutissement ultime de tout pipeline de visualisation scientifique réside dans la phase de sérialisation physique du fichier graphique, destinée à l’intégration au sein de presses universitaires ou de plateformes d’archivage institutionnelles. La moindre négligence lors de cette étape finale peut anéantir l’ensemble des efforts de composition déployés en amont, en introduisant de la pixellisation, du crénelage ou des dérives de cadrage inacceptables.
La méthode d’exportation cardinale repose sur l’appel direct à fig.savefig(), dont la paramétrisation doit faire l’objet d’une sélection méticuleuse :
- Choix impératif de formats vectoriels sans perte pour les manuscrits finaux : le format de document portable (PDF) ou le graphisme vectoriel évolutif (SVG) doivent être systématiquement privilégiés afin de préserver l’infinité de résolution des contours typographiques et des tracés de données, quelle que soit l’échelle de grossissement appliquée par l’éditeur.
- Spécification stricte de
dpi=300oudpi=600lorsque les politiques éditoriales imposent formellement le dépôt de matrices de points au format TIFF sans compression (généralement exigé pour les planches photographiques ou les cartes thermiques à plusieurs millions de cellules discrètes). - Application de l’argument critique
bbox_inches='tight': cette instruction force le moteur d’exportation à recalculer dynamiquement la boîte englobante ultime de la figure au moment précis de l’écriture physique, rognant automatiquement les marges blanches périphériques superflues et prévenant le tronquage accidentel d’annotations ou d’étiquettes extérieures. - Préservation de la neutralité de fond au moyen de
transparent=Falseet d’un contrôle rigoureux de la facecolor du conteneur pour éviter l’apparition d’artefacts d’opacité lors de l’intégration dans des gabarits de mise en page composite.
En observant scrupuleusement ces règles d’ingénierie logicielle et typographique, le chercheur s’assure que la restitution physique finale de ses visualisations complexes, agencées avec précision par la méthode fig.add_subplot, demeurera parfaitement conforme à l’exigence d’exactitude et de clarté métrologique qui anime sa démarche scientifique.
Références
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Matplotlib Development Team. (2023). matplotlib.figure.Figure.add_subplot API Documentation. Matplotlib documentation. https://matplotlib.org/stable/api/figure_api.html#matplotlib.figure.Figure.add_subplot
- Matplotlib Development Team. (2023). Customizing Figure Layouts Using GridSpec and Other Tools. Matplotlib User Guides. https://matplotlib.org/stable/users/explain/axes/arranging_axes.html
- Rougier, N. P. (2021). Scientific Visualization: Python + Matplotlib. Nicolas P. Rougier. https://hal.inria.fr/hal-03427195
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Van Rossum, G., Warsaw, B., & Coghlan, N. (2001). PEP 8: Style Guide for Python Code. Python Enhancement Proposals. https://peps.python.org/pep-0008/
- VanderPlas, J. (2016). Python Data Science Handbook: Essential Tools for Working with Data. O’Reilly Media.