
Dans le paradigme contemporain de la science des données et du calcul scientifique, la communication visuelle ne constitue pas un simple artifice esthétique périphérique, mais bien le vecteur fondamental de la transmission du savoir empirique. Alors que les volumes de données s’accroissent de manière exponentielle, la capacité d’un analyste ou d’un chercheur à synthétiser des relations multidimensionnelles complexes dépend directement de la lisibilité sémiotique des artéfacts graphiques qu’il produit. Au cœur de cette architecture visuelle, le titre d’un graphique occupe une position hiérarchique éminente, agissant comme la clé de voûte cognitive qui arrime la structure géométrique des données à leur signification sémantique contextuelle.
L’écosystème Python s’est imposé comme l’environnement de référence pour l’analyse computationnelle, principalement grâce à l’intégration symbiotique entre la bibliothèque d’analyse tabulaire Pandas et le moteur de rendu graphique Matplotlib. Si l’accessibilité de la méthode intégrée d’affichage permet de matérialiser instantanément des distributions statistiques, la maîtrise du titrage exige une compréhension fine des interactions sous-jacentes entre ces deux couches logicielles. Trop souvent, des visualisations par ailleurs irréprochables sur le plan du calcul souffrent d’un titrage lacunaire, ambigu, voire inexistant, reléguant l’interprétation des résultats à un exercice de conjecture cognitive préjudiciable à la rigueur de la démarche scientifique.
Le présent traité propose une exploration exhaustive, didactique et méthodologique des techniques d’attribution et de personnalisation des titres aux représentations graphiques générées via Pandas. De la syntaxe élémentaire destinée aux explorations univariées rapides jusqu’aux configurations typographiques avancées exploitant la composition mathématique LaTeX et la manipulation fine des instances de figures, ce guide détaille chaque mécanisme sous le prisme conjoint de la rigueur technique et de l’ergonomie visuelle. À travers des cas d’application concrets et une décomposition méticuleuse des comportements du compilateur, nous fournissons aux praticiens les outils conceptuels et programmatiques indispensables à l’élaboration de figures conformes aux exigences les plus strictes de la publication académique et professionnelle.
1. Introduction à la visualisation de données avec Pandas et importance des titres
1.1 Le rôle fondamental de la visualisation dans l’analyse exploratoire de données
L’analyse exploratoire de données (dite EDA pour Exploratory Data Analysis), théorisée initialement par le statisticien John Tukey, positionne la visualisation comme un instrument heuristique primordial dans l’appréhension des distributions statistiques et des structures relationnelles sous-jacentes. Avant même d’envisager une modélisation inférentielle ou prédictive, le chercheur doit se confronter à la morphologie intrinsèque de son échantillon. Les représentations géométriques permettent de détecter quasi instantanément les asymétries de distribution, la bimodalité, la présence de valeurs aberrantes (outliers) ainsi que les ruptures de continuité ou les non-linéarités qu’un ensemble réducteur de métriques descriptives sommaires (telles que la moyenne ou l’écart-type) ne saurait révéler à lui seul, comme l’illustre classiquement le paradoxe du quartet d’Anscombe.
Dans ce contexte exploratoire, la bibliothèque Pandas offre une commodité opérationnelle remarquable en intégrant directement des méthodes de tracé au sein de ses structures de données matricielles canoniques, à savoir le DataFrame et la Series. Cette liaison intime entre la structure tabulaire et le pipeline de rendu graphique minimise la friction cognitive de l’analyste, lui permettant de basculer sans discontinuité de la manipulation relationnelle (filtrage, agrégation, transformation) à la projection visuelle. L’accessibilité immédiate de la commande d’affichage favorise une démarche itérative rapide, indispensable lors du défrichage de jeux de données massifs ou inconnus.
Cependant, cette fluidité opérationnelle porte en elle le risque d’une négligence de l’habillage contextuel de la figure. Une représentation graphique dénuée d’ancrage sémantique explicite égare l’observateur dans un labyrinthe de coordonnées cartésiennes abstraites. Contextualiser immédiatement les motifs empiriques dégagés n’est pas une simple exigence cosmétique, mais une condition sine qua non de la validité heuristique : le cerveau humain interprète les formes à travers le prisme des hypothèses qui lui sont soumises, et c’est précisément la fonction du titrage d’orienter cette focale cognitive vers l’objet légitime de l’investigation.
1.2 L’impact cognitif et communicatif d’un titrage rigoureux
D’un point de vue psychophysique et cognitif, la lecture d’un document graphique met en jeu la théorie de la charge cognitive élaborée par John Sweller. Lorsqu’un lecteur est confronté à une figure, sa mémoire de travail est simultanément sollicitée par l’encodage des canaux visuels (position, longueur, couleur, orientation) et par l’intégration conceptuelle de leur signification. Un titrage rigoureux, structuré et dépourvu d’ambiguïté opère une réduction drastique de la charge cognitive extrinsèque en fournissant une identification immédiate de la variable mesurée, de l’unité d’analyse et du périmètre observationnel. Il élimine le va-et-vient fastidieux entre la légende, les axes et le corps du texte explicatif.
Au-delà de la simple désignation descriptive, le titre constitue le vecteur privilégié de transmission univoque de l’hypothèse principale ou du résultat saillant que le graphique cherche à formaliser. Dans une communication scientifique moderne, un titre performatif ou analytique permet d’expliciter le message que l’auteur entend démontrer, prévenant ainsi les contresens interprétatifs. La précision de sa formulation détermine l’efficacité avec laquelle l’argumentation empirique s’articule avec l’appareil théorique sous-jacent.
Enfin, la rigueur du titrage conditionne l’adhésion aux standards internationaux de publication académique, à l’instar des normes édictées par l’American Psychological Association (APA) ou les comités éditoriaux des revues de rang mondial. Un graphique scientifique se doit d’être auto-suffisant (self-contained) : tout lecteur étranger au projet initial doit pouvoir en comprendre l’objet, la métrique et les conclusions fondamentales sans obligation de recourir immédiatement au corpus rédactionnel adjacent. Le titre représente l’affirmation inaugurale de cette autonomie documentaire.
1.3 Architecture sous-jacente : l’interaction entre Pandas et Matplotlib
Pour maîtriser pleinement l’adjonction de titres dans Pandas, il est indispensable de disséquer l’architecture sous-jacente qui régit le moteur de tracé. La méthode graphique standard de Pandas ne constitue pas un système de rendu autonome développé ex nihilo. Elle fonctionne fondamentalement comme une surcouche d’abstraction logicielle de haut niveau bâtie par-dessus l’API complexe de Matplotlib. Lorsque l’instruction de tracé est invoquée sur une structure de données Pandas, celle-ci encapsule et traduit les arguments fournis pour piloter le backend graphique de Matplotlib, instanciant de manière transparente des objets géométriques et typographiques de bas niveau.
Cette interaction repose principalement sur la transmission implicite ou explicite des paramètres de configuration vers l’objet canonique Axes de Matplotlib. Cet objet représente la surface concrète de traçage, délimitée par les axes de coordonnées, sur laquelle s’inscrivent les données ainsi que les éléments textuels périphériques. Lorsque l’argument d’attribution de titre est transmis au niveau de la commande Pandas, celle-ci délègue l’opération à la méthode interne correspondante de cet axe, effectuant une conversion des chaînes de caractères en conteneurs textuels (matplotlib.text.Text).
Cette conception architecturale implique un arbitrage permanent entre la concision d’écriture propre à l’interface de Pandas et l’extrême finesse de granularité offerte par Matplotlib. Si la syntaxe de Pandas privilégie la brièveté pour les visualisations d’exploration immédiate, la personnalisation avancée des propriétés physiques du texte (positionnement au micromètre, ancrage typographique, espacement vertical fin) nécessite de s’extraire de l’enveloppe de haut niveau pour manipuler directement l’objet Axes retourné. C’est précisément dans la maîtrise de cette charnière technique que réside l’expertise du concepteur de visualisations.
2. Préparation de l’environnement de travail et du jeu de données de référence
2.1 Configuration logicielle et importation des dépendances
L’exécution reproductible des protocoles de visualisation présentés tout au long de cet ouvrage exige un environnement d’exécution moderne et rigoureusement documenté. La compatibilité ascendante des méthodes de titrage nécessite une version de Python égale ou supérieure à la version 3.8, conjointement avec des distributions récentes de Pandas (version 1.5 ou ultérieure, idéalement 2.x) et de Matplotlib (version 3.5 ou supérieure). Ces exigences garantissent l’accès aux interfaces typographiques unifiées et éliminent les dépréciations d’arguments qui ont pu jalonner l’historique de ces bibliothèques.
Le protocole d’importation standard s’articule autour des alias conventionnels universellement adoptés au sein de la communauté scientifique internationale. On procède systématiquement à l’importation conjointe du module central de manipulation tabulaire et du sous-module fonctionnel de Matplotlib dédié à l’orchestration des figures interactives ou statiques. Ce couplage syntaxique s’écrit de manière canonique comme suit :
L’importation de pandas as pd et de matplotlib.pyplot as plt constitue la fondation de tout script d’analyse. En complément de ces importations matricielles, il est judicieux d’initialiser les paramètres globaux de style d’affichage via le gestionnaire de configuration matplotlib.rcParams ou via l’instruction plt.style.use(). L’activation d’un environnement graphique maîtrisé, tel que le style classique 'seaborn-v0_8-whitegrid' ou une palette contrastée rigoureusement étalonnée, assure que l’impact visuel des titres générés sera restitué de façon uniforme sur l’ensemble des systèmes d’exploitation et des architectures d’écrans.
2.2 Instanciation méthodique du DataFrame de démonstration
Afin de contextualiser nos expérimentations de titrage sur un ensemble d’observations représentatif des situations de la recherche ou du conseil, nous instancions un jeu de données synthétique, mais réaliste, emprunté au domaine de l’analyse de performance athlétique. Ce jeu de données formalise les statistiques individuelles de plusieurs entités au sein d’une compétition sportive, structurées autour de trois variables clés : une variable catégorielle nominale représentant l’équipe d’appartenance, et deux variables quantitatives continues ou discrètes à large dispersion, à savoir le volume de points marqués et le décompte des passes décisives octroyées.
L’instanciation s’opère rigoureusement au moyen de la structure de dictionnaire injectée dans le constructeur de Pandas. Le code ci-dessous illustre la matérialisation de cette matrice d’observations :
df = pd.DataFrame({'equipe': ['A', 'A', 'B', 'B', 'C', 'C', 'D', 'D', 'E', 'E'], 'points': [18, 22, 19, 14, 14, 11, 20, 28, 30, 25], 'passes': [5, 7, 7, 9, 12, 9, 9, 4, 3, 6]})
Le choix délibéré de cette structure répond à une double exigence didactique. D’une part, la coexistence d’attributs qualitatifs et de métriques numériques autorise la mise en œuvre aussi bien de visualisations univariées (histogrammes, diagrammes en barres) que bivariées (nuages de points relationnels). D’autre part, la granularité fine de l’échantillon permet une vérification manuelle immédiate de la véracité des projections graphiques obtenues, garantissant ainsi l’intégrité de la corrélation visuo-statistique lors de la lecture du titre assigné.
2.3 Analyse descriptive préliminaire des données manipulées
Préalablement à toute formulation d’un titre graphique, l’analyste doit impérativement auditer la structure intime de ses données afin d’en déduire les qualificatifs précis à inscrire dans la figure. L’inspection des métadonnées via l’appel de df.info() confirme la présence de dix enregistrements complets, exempts de toute valeur manquante (NaN), répartis entre le type textuel générique (object ou string pour la colonne ‘equipe’) et le type entier signé (int64 pour ‘points’ et ‘passes’). Cette intégrité typologique conditionne le choix des projections géométriques envisageables.
L’exploration des paramètres de distribution par l’entremise de la commande df.describe() fournit la base quantitative nécessaire à l’élaboration d’un titrage analytique rigoureux. L’analyse révèle que la variable ‘points’ s’échelonne d’un minimum de 11 unités à un plafond de 30 unités, avec une tendance centrale établie à une moyenne empirique de 20,1 points et un écart-type significatif reflétant l’hétérogénéité des performances individuelles. De son côté, la variable ‘passes’ présente une moyenne de 7,1 unités, comprise dans une amplitude plus resserrée de 3 à 12 unités.
Ces constatations numériques orientent directement la sémantique du titrage : un graphique portant sur les ‘points’ devra refléter une dispersion substantielle, tandis qu’un graphique confrontant les ‘points’ aux ‘passes’ permettra d’interroger visuellement l’existence d’une corrélation négative intuitive (un profil de joueur orienté vers la finalisation versus un profil axé sur la distribution tactique). Connaître ces dynamiques statistiques permet de substituer à un titre purement technique et générique une formulation conceptuelle de haute valeur informative.
3. Méthode fondamentale : Ajout d’un titre unique à un graphique univarié
3.1 Syntaxe de base via le paramètre ‘title’
La passerelle d’accès la plus immédiate et intuitive pour adjoindre un titre à une visualisation dans Pandas repose sur l’argument dédié title, exposé de manière native au sein de la signature de la méthode générique plot() du DataFrame ou de la Series. Conçue pour maximiser l’efficience du flux de travail exploratoire, cette approche dispense le développeur de recourir explicitement aux primitives d’instanciation de Matplotlib. Le paramètre accepte par défaut une chaîne de caractères scalaire qu’il applique directement au sommet de la zone de coordonnées rectangulaire.
D’un point de vue de la syntaxe d’appel, l’assignation s’effectue par passage d’argument nommé : title="Chaîne descriptive". Lors de l’interprétation de l’instruction, la méthode interne de Pandas intercepte cette variable textuelle, configure en arrière-plan l’objet matplotlib.axes.Axes généré pour l’occasion, et invoque silencieusement la méthode d’axe set_title() de Matplotlib en lui transmettant le contenu textuel sans altération.
Il importe de souligner que cette syntaxe compacte se distingue par son déterminisme : elle applique des paramètres typographiques par défaut stricts, prédéfinis dans la configuration globale du moteur de rendu. Bien que cette approche présente certaines limites quant à la flexibilité typographique, elle constitue le standard incontournable pour toute restitution graphique immédiate au sein d’un calepin d’analyse de type Jupyter Notebook ou lors de scripts de génération automatisée de rapports préliminaires.
3.2 Exemple pratique 1 : Histogramme univarié avec titre descriptif
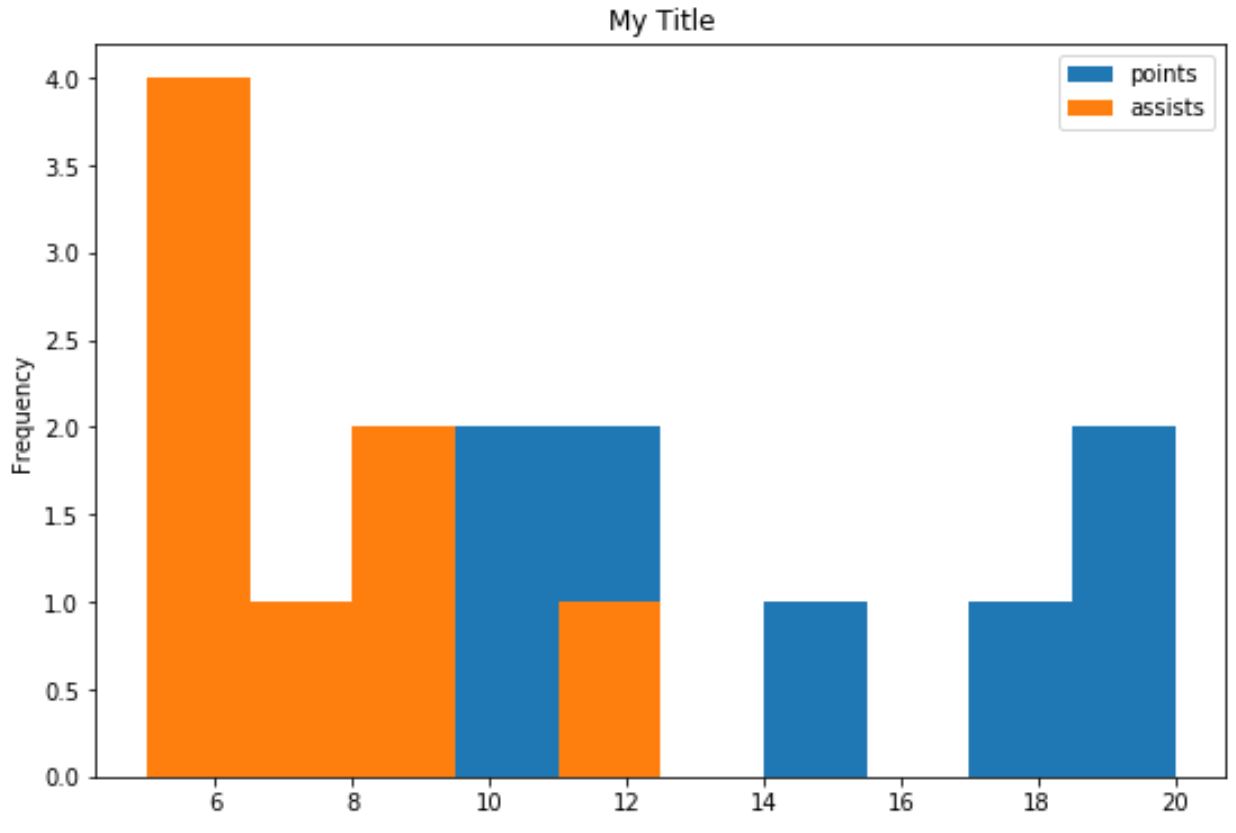
Afin d’illustrer la matérialisation de cette méthode fondamentale, considérons l’analyse de la distribution de fréquence empirique de la variable quantitative ‘points’ issue de notre jeu de données préalablement instancié. L’objectif est de projeter cette série sous la forme d’un histogramme discrétisé, tout en informant sans ambiguïté le lecteur sur la nature intrinsèque de l’axe des ordonnées (fréquences d’occurrence) et de l’axe des abscisses (intervalles de performance).
L’implémentation logicielle s’articule autour de l’extraction de la Series vectorielle correspondante et de l’invocation conjointe du paramètre de genre de tracé et de l’argument de titrage :
df['points'].plot(kind='hist', title='Distribution des points marqués par match')
plt.show()
À l’exécution de ce bloc de code, le moteur graphique compile la distribution en classes de valeurs discrètes et dispose la chaîne de caractères 'Distribution des points marqués par match' de manière strictement orthogonale au-dessus du cadre supérieur du canevas. L’alignement par défaut positionne le centre géométrique de la chaîne textuelle à équidistance exacte des bordures verticales gauche et droite de la boîte de délimitation de l’axe (bounding box), assurant un équilibre de symétrie visuelle fondamental pour une lecture rapide.
3.3 Évaluation du comportement graphique par défaut
L’examen minutieux du rendu produit par cette méthode élémentaire permet d’en apprécier à la fois les commodités et les lacunes intrinsèques. Par défaut, Matplotlib applique au texte du titre une police sans empattement (sans-serif) générique, configurée généralement sur une taille de corps nominale de 12 points, assortie d’une graisse typographique standard (normal weight) et d’une teinte chromatique noire absolue (#000000) ou gris anthracite profond selon la version employée. Ce rendu garantit une lisibilité satisfaisante sur écran standard, mais s’avère fréquemment sous-dimensionné dans le cadre d’un article scientifique multipages ou d’une projection en salle de conférence.
De surcroît, le positionnement automatique du titre le confine à une hauteur fixe au-dessus de la ligne d’axe supérieure, désignée techniquement sous le terme de marge d’espacement (pad). Dans les configurations graphiques comportant des valeurs statistiques élevées sur l’axe des ordonnées, ou lors de l’adjonction de notations exponentielles au sommet de celui-ci (par exemple 1e6), il n’est pas rare de constater une collision visuelle regrettable entre le libellé de l’axe Y et l’extrémité gauche du titre.
L’approche élémentaire via l’argument scalaire direct de Pandas révèle ainsi ses limites structurelles : elle ne permet pas d’intervenir chirurgicalement sur les attributs de micro-typographie, ni de moduler l’ancrage spatial selon des impératifs d’ergonomie cognitive avancée. Dès lors que l’analyste cherche à hisser sa production aux exigences formelles des revues scientifiques de premier rang, il devient impératif d’abandonner l’abstraction simplificatrice de Pandas pour dialoguer directement avec l’objet d’axe sous-jacent.
4. Personnalisation avancée du titre unique via l’objet Axes de Matplotlib
4.1 Récupération explicite de l’objet ‘Axes’
La transition vers un contrôle programmatique absolu de la typographie graphique impose une rupture méthodologique avec l’exécution aveugle des commandes de haut niveau. Dans l’architecture orientée objet de Matplotlib sur laquelle Pandas repose, la méthode plot() ne se contente pas de dessiner une forme à l’écran : elle retourne systématiquement une référence vivante vers l’instance de la classe matplotlib.axes.Axes sur laquelle le tracé vient d’être opéré. La captation de cette référence dans une variable dédiée constitue l’acte fondateur de toute personnalisation rigoureuse.
La syntaxe de captation s’écrit sous la forme idiomatique suivante :
ax = df['points'].plot(kind='hist')
Dès lors que la variable ax est déclarée et assignée dans l’espace de noms local, l’ensemble du répertoire des méthodes de bas niveau de Matplotlib devient immédiatement accessible à l’analyste. En lieu et place de l’argument contraint title de Pandas, nous mobilisons désormais la méthode native ax.set_title(). Cette méthode accepte un spectre particulièrement dense de paramètres optionnels régissant chaque nuance physique du composant textuel, affranchissant l’utilisateur de toute limitation préétablie par la surcouche logicielle de manipulation de données.
4.2 Contrôle typographique : police, taille, couleur et graisse
L’interface de la méthode ax.set_title() permet d’intervenir sur les variables typographiques fondamentales nécessaires à la création d’une hiérarchie d’information lisible et élégante. Le paramètre fontsize (ou son alias size) autorise la spécification de la dimension du corps du texte, soit par le biais de valeurs numériques absolues exprimées en points typographiques (par exemple fontsize=14), soit via des échelles relatives normalisées ('large', 'x-large', 'xx-large'). Cette modularité assure une mise en conformité immédiate avec les chartes graphiques éditoriales.
Parallèlement au corps, la graisse typographique s’ajuste via l’argument fontweight (ou weight), lequel admet des descripteurs nominaux tels que 'normal', 'bold', 'heavy', ou des valeurs numériques d’épaisseur allant de 100 à 900. L’application judicieuse d’un engraissement gras permet de focaliser l’attention sélective du lecteur sur l’intitulé conceptuel majeur du tracé. Conjointement, le paramètre color offre la liberté de rompre avec l’austérité du noir uniforme, acceptant des désignations en clair ('navy'), des triplets hexadécimaux stricts ('#1f77b4') ou des valeurs issues de palettes perceptuellement uniformes.
Le script suivant met en application l’ensemble de ces leviers de différenciation typographique au sein d’une séquence méthodologique cohérente :
ax = df['points'].plot(kind='hist')
ax.set_title("Distribution des points de performance", fontsize=15, fontweight='bold', color='#1A365D', fontfamily='sans-serif')
plt.show()
4.3 Positionnement spatial et espacement vertical
L’agencement géométrique d’un titre ne doit jamais être laissé au hasard. Bien que le centrage géométrique conventionnel demeure la norme la plus répandue, la littérature en psychologie ergonomique et en design de l’information préconise fréquemment l’alignement du titre sur le bord gauche de la zone de visualisation. En effet, dans les cultures occidentales assujetties au sens de lecture de gauche à droite, un alignement à gauche permet au regard de capter le contexte sémantique avant même d’amorcer l’exploration des données quantitatives portées par les axes verticaux.
Cet ajustement spatial s’opère sans difficulté par le truchement du paramètre loc au sein de l’instruction set_title(). L’argument accepte trois états discrets : loc='center' (configuration nominale par défaut), loc='left' (alignement rigoureux sur le zéro de l’axe horizontal intérieur) et loc='right' (alignement sur la bordure droite du cadre). Cette flexibilité permet d’équilibrer harmonieusement la composition d’ensemble selon la présence et la disposition des éléments de légende périphérique.
Un autre défi spatial réside dans la gestion chirurgicale de la distance verticale séparant le texte du sommet des barres ou des lignes de données. L’argument pad, exprimé en points typographiques flottants, module précisément cette hauteur de dégagement :
ax.set_title("Rendement offensif global", loc='left', pad=18.0)
L’introduction d’un espacement vertical adéquat (typiquement entre 15 et 25 points) élimine tout risque d’interférence visuelle avec les marques de graduation de l’axe supérieur ou les éventuelles annotations locales de points de données, aérant la composition et conférant à la figure un cachet d’édition haut de gamme.
5. Gestion des sous-graphiques : Attribution de titres multiples distincts
5.1 Principe de subdivision matricielle avec ‘subplots=True’
L’investigation de jeux de données multivariés conduit inévitablement à la nécessité d’isoler les variables au sein de canevas graphiques distincts afin de prévenir la surcharge visuelle et la superposition anarchique de courbes d’échelles disparates. Pour répondre à cet impératif de manière programmatique, Pandas intègre dans sa méthode plot() le paramètre booléen subplots=True. Lorsqu’il est activé, ce mécanisme décompose automatiquement la matrice de données en partitionnant chaque série numérique sur un système de coordonnées cartésiennes indépendant.
Sous le capot, Pandas orchestre la création d’une grille matricielle de sous-graphiques Matplotlib, configurant une disposition en lignes et colonnes proportionnée au volume de colonnes sélectionnées au sein du DataFrame source. Cette subdivision soulève immédiatement une problématique sémiotique fondamentale : chaque sous-graphique représentant une dimension statistique propre, l’assignation d’un titre unique et générique devient caduque et dommageable à la clarté de l’exposé.
Il devient dès lors indispensable d’adopter un protocole de titrage capable d’assigner à chaque cellule de cette matrice graphique un intitulé rigoureusement discriminé, adapté à la métrique représentée, tout en maintenant une parfaite harmonie formelle entre les différents volets de la planche comparative.
5.2 Exemple pratique 2 : Titrage individuel par transmission d’une liste
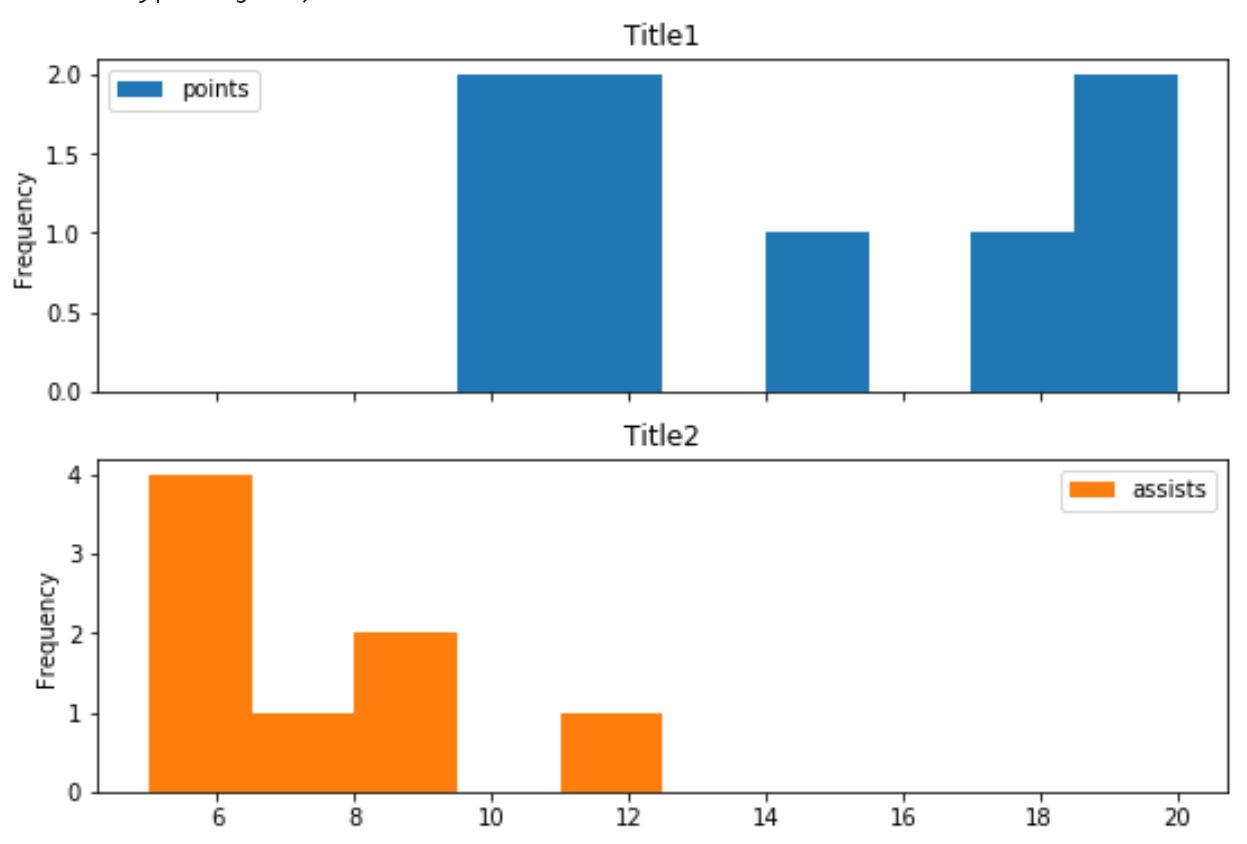
Pour résoudre l’attribution différentielle de titres à travers une grille multifenêtre, Pandas propose une déclinaison d’une grande élégance syntaxique : le paramètre title accepte nativement, en lieu et place d’une chaîne scalaire unique, une structure de données séquentielle de type liste ou tuple de chaînes de caractères. Le moteur de restitution procède alors à une liaison bijective ordonnée entre chaque élément de la séquence textuelle et chaque sous-graphique généré consécutivement.
Considérons l’analyse simultanée de nos deux métriques quantitatives, ‘points’ et ‘passes’. Nous souhaitons tracer leurs distributions d’occurrences respectives au sein d’une seule commande unifiée, tout en assignant à chaque axe un intitulé personnalisé et explicite :
titres_personnalises = ["Distribution des points inscrits", "Fréquence des passes décisives"]
axes = df[['points', 'passes']].plot(kind='hist', subplots=True, title=titres_personnalises, figsize=(8, 6))
plt.show()
Dans cette configuration, Pandas associe rigoureusement le premier titre de la liste à la première colonne traitée (‘points’), et le second titre à la colonne consécutive (‘passes’). Chaque sous-graphique reçoit son titre centré au-dessus de sa zone d’affichage dédiée, offrant une lecture compartimentée et immédiatement compréhensible de l’information univariée sans nécessiter l’écriture de boucles manuelles répétitives.
5.3 Règles syntaxiques et gestion des discordances de dimension
L’utilisation de séquences ordonnées pour le titrage multifenêtre obéit à des contraintes dimensionnelles strictes qu’il convient de ne jamais enfreindre sous peine d’interruption du processus de compilation graphique. La règle fondamentale réside dans l’exactitude de la cardinalité : le nombre d’éléments textuels contenus dans la liste passée à l’argument title doit correspondre scrupuleusement au nombre de sous-graphiques instanciés par l’argument subplots=True.
En cas de discordance dimensionnelle, le compilateur adopte des comportements problématiques. Si la liste est trop courte par rapport au nombre d’axes, Pandas ou Matplotlib lèvera une exception d’indexation (IndexError ou ValueError selon les versions) interrompant le tracé. À l’inverse, si une chaîne scalaire unique est fournie alors que subplots=True est actif, le comportement par défaut de certaines versions de Pandas consiste à répéter la même chaîne de manière tautologique au sommet de chaque sous-graphique, créant une redondance visuelle particulièrement indésirable.
Pour prémunir le code contre ces erreurs d’inadéquation dimensionnelle, notamment dans des pipelines d’analyse dynamique où le nombre de colonnes peut varier selon les filtres amont, il est fortement recommandé d’adopter des techniques de programmation défensive. L’automatisation par compréhension de liste basée sur les noms de colonnes nettoyés constitue une pratique exemplaire :
colonnes_cibles = ['points', 'passes']
titres_auto = [f"Analyse descriptive : {col.capitalize()}" for col in colonnes_cibles]
df[colonnes_cibles].plot(kind='hist', subplots=True, title=titres_auto)
6. Harmonisation globale : Intégration conjointe d’un super-titre et de sous-titres
6.1 Différenciation conceptuelle entre titre d’axe et super-titre de figure
L’architecture graphique de Matplotlib opère une distinction conceptuelle fondamentale entre deux entités spatiales hiérarchisées : l’objet Figure et l’objet Axes. La Figure représente le canevas global, la page blanche ou la fenêtre physique d’affichage qui encapsule l’ensemble des éléments tracés. L’Axes, quant à lui, est une subdivision géométrique locale de cette figure, délimitant un repère cartésien particulier doté de ses propres échelles numériques, graduations et courbes. Cette dichotomie architecturale se reflète directement dans la typologie du titrage.
Le titre d’axe (géré par ax.set_title() ou par l’argument title de Pandas) est circonscrit à la portée locale d’un sous-graphique spécifique. Il documente le comportement d’un sous-ensemble précis ou d’une variable isolée. En revanche, le super-titre de figure, couramment désigné par la primitive suptitle, intervient à l’échelon macroscopique. Sa fonction consiste à fédérer l’ensemble des sous-graphiques sous une thématique commune, énonçant le sujet unificateur de la planche graphique ou synthétisant la conclusion globale émergeant de la confrontation des visualisations individuelles.
Dans la composition d’une planche scientifique ou d’un tableau de bord de haute tenue, l’omission de cette double articulation hiérarchique engendre une confusion d’échelle. Les sous-titres doivent répondre aux critères de granularité et de précision analytique locale, tandis que le super-titre doit porter une ambition synthétique plus vaste, incarnant le niveau le plus élevé de la pyramide d’information visuelle.
6.2 Implémentation technique via l’objet Figure de Matplotlib
Étant donné que la méthode de tracé de Pandas opère prioritairement au niveau des axes, l’adjonction d’un super-titre fédérateur exige d’extraire la figure parente hébergeant ces axes. Lorsque df.plot(subplots=True) est exécuté, Pandas retourne un tableau unidimensionnel (numpy.ndarray) de références vers les différents objets Axes créés. L’accès à la figure parente s’effectue en interrogeant la méthode get_figure() sur l’une quelconque de ces instances d’axe.
Une fois l’instance de la classe matplotlib.figure.Figure récupérée, l’analyste peut solliciter la méthode fig.suptitle() pour composer le chapeau textuel supérieur. L’exemple suivant illustre l’intégration méthodique de cette hiérarchie à double niveau :
axes = df[['points', 'passes']].plot(kind='hist', subplots=True, title=["Distribution des points", "Volume de passes"], figsize=(9, 5))
fig = axes[0].get_figure()
fig.suptitle("Profil Statistique des Joueurs de l'Échantillon 2024", fontsize=16, fontweight='bold', color='#0F172A')
plt.show()
Dans ce schéma opératoire, l’harmonie stylistique est assurée par un contraste d’échelle maîtrisé : le super-titre s’impose immédiatement au regard par sa taille majorée (16 points) et sa graisse appuyée, tandis que les titres de sous-graphiques subordonnés adoptent une typographie plus discrète, organisant une progression logique dans l’exploration du document.
6.3 Résolution géométrique des chevauchements spatiaux
L’introduction conjointe d’un super-titre et de titres d’axes individuels induit de manière presque systématique un écueil de mise en page récurrent : le phénomène de collision ou de superposition spatiale. Par défaut, le gestionnaire de rendu de Matplotlib alloue des marges supérieures standard qui ne prévoient pas nécessairement l’encombrement vertical d’un super-titre proéminent. Il en résulte une imbrication désastreuse où le super-titre chevauche littéralement les titres des sous-graphiques situés sur la première rangée.
Pour remédier à cette anomalie géométrique, l’utilisation aveugle de l’instruction plt.tight_layout() s’avère insuffisante, car celle-ci calcule les espacements en optimisant exclusivement les limites des axes, ignorant fréquemment la présence du super-titre de la figure. La résolution experte impose d’ajuster paramétriquement le rectangle de disposition à l’aide de l’argument rect de tight_layout() :
fig.tight_layout(rect=[0, 0.03, 1, 0.93])
Ce quadruplet de coordonnées normalisées [gauche, bas, droite, haut] impose au moteur de mise en page de confiner la totalité des sous-graphiques dans une boîte englobante ne dépassant pas 93 % de la hauteur totale de la figure, sanctuarisant ainsi les 7 % supérieurs pour l’épanouissement exclusif du super-titre. Alternativement, l’invocation de plt.subplots_adjust(top=0.88) permet d’abaisser manuellement la limite supérieure de la matrice de coordonnées, garantissant une aération typographique impeccable, exempte de tout chevauchement d’éléments textuels.
7. Application du titrage à divers types de tracés statistiques dans Pandas
7.1 Titrage des diagrammes de dispersion (Scatter Plots)
Le diagramme de dispersion (ou scatter plot) constitue l’outil par excellence de l’investigation des dépendances relationnelles entre deux variables quantitatives continues. Contrairement à une série univariée où l’objet d’étude est confiné à une distribution isolée, la projection bidimensionnelle interroge une corrélation bivariée potentielle. Par conséquent, la formulation du titre d’un diagramme de dispersion doit impérativement rompre avec le simple titrage d’état pour formaliser l’interaction fonctionnelle observée.
D’un point de vue de la syntaxe Pandas, le tracé de dispersion requiert l’affectation explicite des colonnes aux abscisses et ordonnées via les arguments x et y. L’assignation du titre s’intègre au sein de la même instruction de base, comme en témoigne la formulation suivante :
ax = df.plot(kind='scatter', x='points', y='passes', title="Corrélation bivariée : Passes décisives vs Points marqués", color='#2563EB', s=60)
ax.set_title("Pression offensive : Relation entre volume de points et passes décisives", pad=12)
Sur le plan sémantique, la tradition académique recommande d’adopter la convention rigoureuse « Variable dépendante Y en fonction de la Variable indépendante X » ou d’opter pour une assertion analytique synthétique exposant la tendance mise en évidence (par exemple une décroissance monotone ou une dissociation structurelle). Un tel titrage éclaire immédiatement la lecture en indiquant à l’observateur quelle variable est postulée comme prédicteur et laquelle représente la réponse observée.
7.2 Titrage des diagrammes en barres et tracés linéaires
Les diagrammes en barres (bar plots) et les séries temporelles ou longitudinales (line plots) posent des défis sémiotiques distincts. Dans le cas des diagrammes en barres, qu’ils soient déployés de manière juxtaposée ou empilée, la dimension catégorielle devient prépondérante. Le titre doit spécifier sans équivoque l’unité d’agrégation statistique mobilisée (somme cumulative, médiane, moyenne arithmétique conditionnelle) sous peine d’induire le lecteur en erreur sur la nature de la hauteur géométrique représentée.
Prenons l’exemple du calcul de la moyenne de points par équipe. Le code de projection et de titrage doit expliciter la transformation sous-jacente :
df.groupby('equipe')['points'].mean().plot(kind='bar', title="Moyenne des points inscrits par formation sportive", color='#059669')
Pour les tracés linéaires séquentiels ou chronologiques, la problématique se déplace vers l’expression rigoureuse de la fenêtre temporelle et de la fréquence d’échantillonnage. Le titre doit systématiquement intégrer les bornes calendaires de la collecte de données (par exemple « Évolution temporelle des indices de performance (Janvier – Décembre 2023) »). De plus, il convient de veiller scrupuleusement à ne pas répéter dans le titre les intitulés textuels déjà présents sur les graduations des axes (tick labels), sous peine de surcharger inutilement la figure par des redondances lexicales stériles.
7.3 Titrage des diagrammes de distribution comparative (Boxplots)
Le diagramme en boîte à moustaches (boxplot ou diagramme de Tukey) constitue une représentation non paramétrique particulièrement robuste, synthétisant la médiane, les quartiles et les valeurs extrêmes d’une distribution. Dans Pandas, l’invocation de la méthode dédiée df.boxplot() obéit à une architecture interne spécifique, distincte de l’interface générale df.plot(kind='box'), ce qui engendre une anomalie notoire en matière de titrage automatique.
Lorsqu’un analyste utilise le paramètre de partitionnement catégoriel by au sein de df.boxplot(column='points', by='equipe'), la bibliothèque génère automatiquement un sous-titre standardisé disgracieux formulé sous la forme « Boxplot grouped by equipe », venant se superposer au titre principal de l’axe. Cette double hiérarchie non sollicitée dégrade sensiblement la qualité éditoriale du graphique.
Pour restaurer l’intégrité esthétique de la figure et imposer un titrage souverain, il convient de neutraliser ce comportement en supprimant le titre automatique ou en réassignant explicitement la figure parentale :
axes = df.boxplot(column='points', by='equipe')
fig = axes.get_figure()
fig.suptitle("Dispersion comparative des points selon l'équipe d'appartenance", fontsize=13, fontweight='semibold')
axes.set_title("")  # Suppression radicale du sous-titre générique Matplotlib
Cette manœuvre neutralise le libellé mécanique généré par le moteur sous-jacent et permet de rétablir une composition épurée, conforme aux réquisitions stylistiques des publications scientifiques de référence.
8. Génération dynamique et programmatique de titres analytiques
8.1 Utilisation des chaînes de formatage f-strings
Dans les environnements industriels de production de données ou au sein des chaînes d’analyse exploratoire itératives, les graphiques ne sont que très rarement générés de manière unitaire et figée. L’analyste se trouve confronté à l’automatisation de flux de travail où les jeux de données sont filtrés dynamiquement selon des critères géographiques, temporels ou démographiques. L’écriture manuelle de titres en dur (hardcoding) devient alors une source majeure d’obsolescence et d’erreurs méthodologiques.
L’introduction des chaînes de formatage littérales (dites f-strings) depuis Python 3.6 offre une réponse programmatique de premier ordre pour contextualiser dynamiquement les représentations graphiques. En encapsulant des variables contextuelles au sein de la chaîne de titrage, le libellé s’adapte instantanément à l’état des filtres appliqués aux données sans nécessiter d’intervention humaine dans le corps du texte :
selection_equipe = 'A'
donnees_filtrees = df[df['equipe'] == selection_equipe]
taille_echantillon = len(donnees_filtrees)
donnees_filtrees['points'].plot(kind='hist', title=f"Distribution des points - Équipe {selection_equipe} (n={taille_echantillon})")
Cette approche garantit une reproductibilité absolue des scripts de restitution : tout changement dans la variable de sélection en amont répercute de manière immédiate et traçable ses métadonnées au sommet de l’axe graphique, assurant la parfaite synchronisation entre le corpus empirique et son enveloppe sémantique.
8.2 Intégration d’indicateurs statistiques calculés en temps réel
L’un des apports majeurs de la génération dynamique réside dans la capacité à enrichir le titre d’indicateurs statistiques calculés à la volée directement sur le sous-ensemble de données représenté. Un graphique muet impose à l’observateur d’évaluer visuellement la tendance centrale d’une distribution. À l’inverse, l’adjonction dans le titre des métriques d’évaluation statistique fondamentales transforme la figure en un véritable condensé d’inférence analytique.
Il est ainsi possible d’extraire la moyenne arithmétique, l’écart-type ou la valeur médiane d’une série numérique, et de les formater rigoureusement à l’intérieur du titre via les spécificateurs de précision du formatage Python (tels que .2f pour limiter la restitution à deux décimales) :
moyenne_pts = df['points'].mean()
ecart_type_pts = df['points'].std()
ax = df['points'].plot(kind='hist', color='#475569')
ax.set_title(f"Distribution des scores individuels (μ = {moyenne_pts:.2f} | σ = {ecart_type_pts:.2f})", fontsize=12, fontweight='medium')
Cette technique confère à la visualisation une double portée informative : elle allie la lisibilité géométrique spatiale de la forme de la distribution à la précision numérique absolue des paramètres statistiques résumés, optimisant ainsi l’efficience de la transmission scientifique.
8.3 Automatisation des titres au sein de boucles itératives
Lors de l’analyse systématique de populations segmentées, il est fréquent de recourir au mécanisme de partitionnement par groupe offert par la méthode groupby() de Pandas. L’analyste est alors amené à parcourir une collection d’itérateurs pour instancier une série de figures destinées à être exportées individuellement sur le disque dur sous forme de fichiers vectoriels ou matriciels.
L’automatisation du titrage au sein de ces structures itératives constitue le garant de la cohérence opérationnelle de la chaîne de traitement. Le bloc de code suivant démontre l’articulation entre l’itération partitionnée, l’assignation dynamique d’un titre hautement spécifique et l’archivage automatisé cohérent du fichier résultat :
for identifiant, groupe in df.groupby('equipe'):
    fig, ax = plt.subplots(figsize=(6, 4))
    groupe['points'].plot(kind='hist', ax=ax, color='#3B82F6')
    ax.set_title(f"Profil Offensif - Segment Équipe {identifiant}", fontsize=13)
    ax.set_xlabel("Points marqués")
    plt.tight_layout()
    fig.savefig(f"rapport_performance_equipe_{identifiant}.png", dpi=300)
    plt.close(fig)
L’application rigoureuse de ce patron d’architecture logicielle garantit que chaque artéfact produit porte une empreinte nominale sans équivoque, tant dans son contenu textuel supérieur que dans sa nomenclature de stockage informatique, éradiquant tout risque de collision ou de confusion lors de l’intégration dans des synthèses managériales ou académiques.
9. Utilisation de symboles scientifiques et syntaxe mathématique LaTeX
9.1 Activation et principes de rendu de la syntaxe mathématique
Dans les disciplines quantitatives telles que l’économétrie, la biostatistique ou la physique computationnelle, le libellé des graphiques ne peut se satisfaire de simples approximations verbales pour désigner des grandeurs formelles. L’expression de variables théoriques, de paramètres estimés ou de modèles probabilistes requiert l’usage rigoureux du formalisme mathématique. Matplotlib intègre nativement un moteur autonome de composition mathématique, désigné sous le terme de mathtext, capable d’interpréter un vaste sous-ensemble des commandes de mise en page du système typographique standardisé LaTeX sans exiger l’installation préalable d’une distribution TeX complète sur la machine hôte.
Pour activer l’analyseur syntaxique mathématique au sein d’une chaîne de titrage dans Pandas ou Matplotlib, il suffit de délimiter l’expression formelle par le caractère typographique dollar ($). Tout segment textuel encapsulé entre deux symboles de cette nature est automatiquement extrait du flux textuel standard pour être confié au moteur de rendu géométrique d’équations.
Une précaution syntaxique capitale s’impose lors de l’écriture de ces instructions en langage Python : l’emploi systématique des chaînes de caractères brutes (raw strings), préfixées impérativement par la lettre r (par exemple r"$texte$"). Cette convention technique désactive l’interprétation native des séquences d’échappement de Python (telles que n ou t), prévenant ainsi la corruption accidentelle des commandes TeX débutant par une barre oblique inversée, à l’instar de nu, theta ou tau.
9.2 Insertion de symboles grecs, exposants et indices
L’exploitation de la syntaxe mathématique permet d’insérer avec une précision calligraphique parfaite l’ensemble des caractères de l’alphabet grec ainsi que les notations indicées et exponentielles qui structurent le discours quantitatif. Qu’il s’agisse d’exprimer des seuils de significativité statistique (alpha), des coefficients de régression théoriques (beta), des paramètres d’échelle (sigma) ou des tendances centrales (mu), la syntaxe s’intègre harmonieusement dans le fil du titre.
L’articulation des exposants et des indices s’opère via les opérateurs canoniques TeX, respectivement l’accent circonflexe (^) et le tiret de soulignement (_). Lorsque le champ d’application de l’opérateur excède un caractère unique, il convient de regrouper les glyphes au sein d’une paire d’accolades ({...}). Le script ci-après concrétise ces principes en associant un tracé Pandas élémentaire à un titre à forte densité symbolique :
ax = df['points'].plot(kind='density', color='#0D9488')
ax.set_title(r"Estimation de la densité empirique : $f(x) = \frac{1}{\sigma \sqrt{2\pi}} e^{-\frac{(x-\mu)^2}{2\sigma^2}}$", fontsize=12, pad=15)
La présence de ces formulations mathématiques enrichit considérablement la portée scientifique de la figure : le graphique cesse d’être une illustration muette pour devenir l’expression géométrique directe d’un modèle statistique formellement déclaré.
9.3 Formulation d’équations statistiques dans les titres
Au-delà de l’affichage de simples paramètres isolés, la maîtrise conjointe des f-strings et du balisage mathématique autorise la projection directe d’équations de régression achevées ou de bilans de tests d’hypothèses au sommet de l’espace visuel. Dans le cadre de l’évaluation d’un modèle d’ajustement linéaire, il est d’usage d’accompagner le nuage de points de son équation fonctionnelle et de son coefficient de détermination empirique ($R^2$).
Pour concaténer dynamiquement des valeurs numériques calculées au sein d’une chaîne brute TeX sans conflit d’échappement d’accolades, il suffit de doubler ces dernières dans la chaîne rf"...". La syntaxe opérationnelle s’agence selon le modèle d’excellence suivant :
coef_r2 = 0.8421
ax = df.plot(kind='scatter', x='points', y='passes')
ax.set_title(rf"Ajustement paramétrique : $Y_i = \beta_0 + \beta_1 X_i + \epsilon_i$ ($R^2 = {coef_r2:.3f}$)", fontsize=13, pad=12)
Toutefois, une réserve méthodologique s’impose quant à la charge informationnelle globale : la complexité de l’équation ne doit en aucun cas saturer la perception du lecteur au détriment des données brutes. L’analyste veillera à préserver une typographie lisible en limitant la longueur de l’expression mathématique afin de ne pas dépasser la largeur utile du graphique.
10. Résolution des problèmes fréquents et écueils de mise en page
10.1 Dépannage des titres tronqués ou rognés lors de la sauvegarde
L’un des dysfonctionnements les plus déconcertants et universellement rencontrés lors de l’automatisation de figures graphiques sous Pandas et Matplotlib réside dans le phénomène de tronquage ou d’amputation partielle du titre lors de l’exportation sur support physique de stockage (fichiers PNG, PDF, SVG) via la méthode savefig(). Il arrive fréquemment qu’une figure dont l’affichage interactif semble parfaitement équilibré à l’écran apparaisse amputée de la partie supérieure de son libellé une fois sérialisée sur disque.
Cette défaillance provient de la divergence entre le système de coordonnées de la fenêtre d’affichage interactive et la boîte englobante de canevas (bounding box) calculée lors de la restitution matricielle. Par défaut, la méthode de sauvegarde applique une zone d’exportation géométriquement rigide qui ignore les éléments typographiques flottant en dehors des marges théoriques de la figure.
Pour éliminer définitivement ce comportement préjudiciable, il est impératif d’intégrer systématiquement l’argument bbox_inches='tight' au sein de l’appel d’archivage :
ax = df['points'].plot(title="Distribution intégrale des métriques athlétiques")
fig = ax.get_figure()
fig.savefig("figure_haute_resolution.png", dpi=300, bbox_inches='tight')
L’activation de ce paramètre intime au moteur graphique de Matplotlib de recalculer dynamiquement le cadre d’exportation réel en intégrant la totalité des boîtes de délimitation des textes périphériques, garantissant ainsi l’intégrité intégrale du super-titre et des titres d’axes, quelle que soit la résolution par pouce (DPI) sélectionnée.
10.2 Traitement des caractères accentués et encodage typographique
Dans le cadre de la rédaction de travaux en langue française ou dans d’autres idiomes exploitant des signes diacritiques complexes (accents aigus, graves, circonflexes, cédilles), l’analyste peut se heurter à des anomalies de rendu se traduisant par l’apparition de glyphes rectangulaires vides (communément appelés symboles « tofu ») ou par des erreurs d’encodage de type UnicodeEncodeError. Ce problème tire généralement son origine de deux causes distinctes : la mauvaise interprétation du fichier source en encodage UTF-8 ou l’absence des glyphes requis au sein de la famille de polices d’écriture sélectionnée par défaut par le système hôte.
Pour prévenir toute altération des caractères accentués, il convient en premier lieu de vérifier que le script Python ou le calepin d’analyse déclare explicitement son encodage UTF-8. En second lieu, il est recommandé de configurer explicitement les paramètres globaux de police de Matplotlib afin de pointer vers des fontes contemporaines offrant une prise en charge typographique exhaustive des standards linguistiques internationaux :
plt.rcParams['font.family'] = 'sans-serif'
plt.rcParams['font.sans-serif'] = ['DejaVu Sans', 'Arial', 'Helvetica', 'Liberation Sans']
La bibliothèque logicielle libre DejaVu Sans, distribuée par défaut avec Matplotlib, intègre un jeu de glyphes universel particulièrement étendu qui garantit la préservation visuelle parfaite de la totalité des accents et caractères spéciaux de la langue française, éliminant ainsi toute distorsion de communication.
10.3 Écrasement involontaire des titres en cas d’appels multiples
Un autre écueil classique réside dans le phénomène d’écrasement involontaire ou de superposition fantôme de chaînes textuelles sur un axe unique lors de l’exécution séquentielle de plusieurs blocs d’instructions au sein d’un calepin interactif. Dans Matplotlib, les appels successifs à set_title() sur une même variable d’axe écrasent théoriquement la référence textuelle principale, mais si des primitives graphiques issues d’instances de figures non purgées sont réexécutées sans réinitialisation de la mémoire d’affichage, plusieurs couches de texte peuvent être restituées les unes sur les autres, créant un artefact illisible.
De surcroît, lorsque des légendes sont positionnées manuellement au sommet de la zone de traçage via l’argument loc='upper center', elles entrent fréquemment en collision frontale avec le titre principal de l’axe si aucun dégagement vertical n’a été spécifié via le paramètre pad. Pour assainir l’espace de tracé et lever ces conflits, il convient d’appliquer des protocoles de réinitialisation stricts :
plt.close('all')  # Purge intégrale de la mémoire des figures en amont
fig, ax = plt.subplots()
df['points'].plot(ax=ax)
ax.set_title("Titre souverain unique", pad=20)
ax.legend(loc='upper right', frameon=True)
La clôture explicite des contextes graphiques et la compartimentation spatiale rigoureuse entre la boîte de légende et l’emprise du titre assurent une lisibilité optimale, exempte de tout parasitage visuel résiduel.
11. Critères ergonomiques et académiques pour un titrage de haute qualité
11.1 Principes de clarté sémantique et de concision
L’acte d’attribution d’un titre ne relève pas exclusivement de la technicité informatique ; il engage avant tout la responsabilité éditoriale et rhétorique de l’auteur. Dans les traités classiques de sémiologie graphique, notamment ceux formalisés par Edward Tufte dans son ouvrage fondateur The Visual Display of Quantitative Information, la règle primordiale réside dans l’optimisation du ratio encre-données (data-ink ratio). Tout élément graphique ou textuel ne transmettant pas une information signifiante doit être impitoyablement élagué.
Cette exigence impose d’éradiquer systématiquement les pléonasmes visuels qui affligent fréquemment les productions novices. Les formulations de type « Graphique montrant l’histogramme de la variable points » constituent des tautologies préjudiciables à l’élégance du document : le lecteur constate de visu qu’il s’agit d’un histogramme. Le titre doit immédiatement porter le niveau de discours vers le domaine de l’interprétation empirique : « Distribution des points inscrits par match ».
L’auteur est ainsi confronté au choix entre un titre descriptif neutre (indiquant scrupuleusement la métrique, la population observée et le cadre spatial ou temporel) et un titre déclaratif ou conclusif (énonçant d’emblée la conclusion majeure, par exemple « Forte hétérogénéité des performances offensives individuelles »). Si le second style gagne en impact au sein de notes de synthèse destinées à des décideurs exécutifs, le premier demeure la norme attendue dans les manuscrits soumis à des revues académiques à comité de lecture, où l’objectivité du fait brut prévaut sur la rhétorique d’affirmation.
11.2 Accessibilité universelle, contrastes et choix chromatiques
La conception d’une visualisation scientifique doit impérativement s’inscrire dans les normes contemporaines de l’accessibilité universelle, telles que stipulées par les directives du World Wide Web Consortium (WCAG). Ces principes garantissent que l’information demeure pleinement intelligible pour des personnes présentant des déficiences visuelles ou des altérations de la perception des couleurs (daltonisme, protanopie, deutéranopie).
Sous ce prisme, le choix de la couleur du titre joue un rôle critique. Il est fondamental de garantir un ratio de contraste chromatique élevé entre la teinte typographique du titre et le fond du canevas de la figure. Pour un fond blanc conventionnel, l’emploi de textes gris clair ou de teintes pastel désaturées doit être rigoureusement banni au profit d’un noir profond ou de nuances sombres saturées (bleu marine profond #0F172A, anthracite #1E293B). Le ratio de contraste visuel mesuré doit atteindre au strict minimum la valeur de 4.5:1 pour satisfaire aux exigences du niveau AA.
Par ailleurs, la modulation typographique doit rester mesurée. La multiplication effrénée d’artifices visuels concurrents — tels que le mélange au sein d’un même titre de polices multiples, de passages en gras, d’italiques non justifiés et de couleurs hétérogènes — introduit une surcharge sensorielle qui pénalise précisément les lecteurs présentant des troubles de l’attention ou de la lecture. L’épure et l’uniformité constituent les plus sûrs garants de l’accessibilité cognitive.
11.3 Cohérence stylistique dans les rapports multipages
Dans la conduite de vastes programmes de recherche ou lors de la rédaction de thèses universitaires et de rapports d’évaluation institutionnels, la cohérence stylistique globale à travers l’ensemble des planches graphiques constitue le marqueur suprême du professionnalisme intellectuel. La confrontation à un document où la première figure arbore un titre aligné à gauche en police sans-serif bleue de 14 points, tandis que la seconde présente un titre centré en police serif noire de 11 points, perturbe le confort de lecture et fragilise la perception de rigueur méthodologique globale.
Pour instaurer une identité typographique unifiée et reproductible, l’analyste doit s’interdire de paramétrer manuellement chaque tracé de manière isolée. La démarche d’excellence consiste à centraliser l’ensemble des règles de titrage au sein d’une feuille de style globale réutilisable, matérialisée par un dictionnaire d’ajustements de plt.rcParams ou par la création d’un fichier de style Matplotlib (portant l’extension .mplstyle) :
configuration_typographique = {
    'axes.titlesize': 14,
    'axes.titleweight': 'bold',
    'axes.titlelocation': 'left',
    'axes.titlepad': 15.0,
    'figure.titlesize': 16,
    'figure.titleweight': 'bold'
}
plt.rcParams.update(configuration_typographique)
En injectant cette configuration en préambule de son calepin de calcul, l’analyste assure que l’intégralité des appels subséquents à df.plot() — qu’ils fassent usage de l’argument élémentaire de haut niveau ou des méthodes sophistiquées d’axes — produiront un alignement parfait de l’ensemble des caractéristiques typographiques, instaurant une rigueur visuelle sans faille d’un bout à l’autre de la publication.
12. Synthèse des méthodologies et comparaison avec les bibliothèques tierces
12.1 Tableau récapitulatif des approches de titrage dans Pandas
Au terme de cette exploration transversale des protocoles de titrage, il convient de dresser un bilan synthétique comparant les différentes stratégies logicielles étudiées. Chaque modalité d’assignation répond à un cas d’usage contextualisé, dicté par le compromis permanent entre la rapidité de prototypage et le degré d’exigence éditoriale imposé par la destination de l’artéfact graphique.
L’analyste dispose d’un triptyque opérationnel majeur. L’approche élémentaire directe via l’argument title de df.plot() demeure inégalable pour l’exploration rapide et le contrôle de flux univarié en calepin interactif. La manipulation intermédiaire par la méthode d’axe ax.set_title() constitue le socle indispensable pour toute publication statique nécessitant une personnalisation typographique (couleur, ancrage spatial, modulations LaTeX). Enfin, le pilotage par l’objet parent via fig.suptitle() représente l’unique standard recevable pour l’orchestration de matrices de sous-graphiques unifiées.
Ce continuum opérationnel démontre la plasticité remarquable de l’écosystème Python : loin de s’exclure mutuellement, ces approches s’intègrent au sein d’un continuum méthodologique où le chercheur fait glisser graduellement son code du prototypage immédiat vers l’édition savante à mesure que son analyse gagne en maturité.
12.2 Mise en perspective avec Seaborn et Plotly
Pour parfaire la culture méthodologique du scientifique de données, il est instructif de situer l’approche de titrage de Pandas en regard des paradigmes adoptés par deux bibliothèques tierces contemporaines majeures : Seaborn et Plotly.
Seaborn, bibliothèque statistique de haut niveau bâtie elle aussi sur Matplotlib, adopte une philosophie déclarative orientée vers la cartographie relationnelle de jeux de données tabulaires complexes. Lors de l’usage d’objets de partitionnement avancés tels que FacetGrid, pairplot() ou catplot(), Seaborn génère une structure matricielle enveloppante qui encapsule les axes. Le titrage ne s’opère plus via une méthode d’axe directe, mais par l’entremise de méthodes spécifiques de la classe enveloppante, telles que g.set_titles(template="..."), autorisant l’injection de patrons de formatage sophistiqués pour chaque facette conditionnelle. Pour le super-titre global, le recours à g.figure.suptitle() demeure cependant la règle immuable, attestant de la permanence du modèle sous-jacent de Matplotlib.
À l’opposé de ce paradigme statique, la bibliothèque Plotly repose sur un modèle de rendu interactif vectoriel au format Web (HTML/JavaScript D3.js). Sous Plotly, le titrage quitte totalement l’univers des instances d’axes Matplotlib pour être formalisé sous la forme d’un dictionnaire JSON au sein de la structure de mise en page (layout). L’attribution d’un titre s’y effectue via la méthode fig.update_layout(title_text="..."), acceptant des sous-propriétés imbriquées définissant la position relative en pourcentage normalisé de l’écran (coordonnées x et y) ainsi que le balisage typographique au format HTML standardisé (balises <b>, <i>, <span style="...">). Si Plotly excelle dans la restitution sur tableaux de bord numériques dynamiques, le couplage Pandas-Matplotlib demeure souverain et inégalé en matière d’intégration typographique de haute précision pour l’impression scientifique vectorielle et la composition LaTeX.
12.3 Protocole recommandé pour des analyses rigoureuses et reproductibles
Afin d’ancrer de manière pérenne les meilleures pratiques présentées dans cet ouvrage au sein de vos routines d’analyse computationnelle quotidiennes, nous proposons une grille de validation méthodologique standardisée en cinq points, à vérifier préalablement à toute diffusion ou archivage d’une figure :
- Sémantique de l’intitulé : Le titre est-il conceptuellement auto-suffisant ? Indique-t-il explicitement la métrique, l’unité de mesure et le périmètre d’observation sans verser dans la tautologie descriptive ?
- Positionnement et dégagement spatial : Le titre dispose-t-il d’une marge d’espacement (
pad) suffisante pour prévenir toute collision géométrique avec les graduations et annotations des axes ? L’alignement choisi (gauche ou centré) sert-il l’ergonomie visuelle globale ? - Hiérarchie typographique : En présence de sous-graphiques, la distinction structurelle entre le super-titre fédérateur (
suptitle) et les titres d’axes locaux est-elle formellement établie par des contrastes appropriés de taille et de graisse ? - Accessibilité et contraste : La palette chromatique retenue pour le texte offre-t-elle un ratio de contraste suffisant vis-à-vis de l’arrière-plan pour garantir une lisibilité optimale sur l’ensemble des supports d’affichage ?
- Intégrité d’exportation : L’archivage sur support physique via
savefig()intègre-t-il l’argumentbbox_inches='tight'afin d’écarter définitivement tout risque d’amputation mécanique du libellé ?
L’intégration systématique de ce protocole au sein de vos calepins de recherche assurera à vos travaux une rigueur démonstrative, une clarté sémiotique et une élégance typographique conformes aux standards d’excellence les plus stricts de la communauté scientifique internationale.
Références
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1922-00a
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/