
Dans le domaine de l’ingénierie des données et de l’analyse quantitative, la visualisation graphique ne constitue pas un simple artifice d’illustration mais s’impose comme une modalité cognitive fondamentale pour l’exploration, l’interprétation et la communication des structures relationnelles complexes. Au sein de cet écosystème computationnel, la bibliothèque Pandas, couplée à l’infrastructure de rendu Matplotlib, forme le socle instrumental de la majorité des scientifiques de données et des chercheurs. Toutefois, la puissance expressive d’une figure dépend intrinsèquement de sa lisibilité sémiotique, au sein de laquelle la légende joue le rôle de clé de déchiffrement essentielle, assurant la correspondance univoque entre les primitives géométriques tracées et les variables conceptuelles sous-jacentes.
Une mauvaise configuration de la légende engendre une friction cognitive immédiate : chevauchement sur les trajectoires de données critiques, ambiguïté des étiquettes générées automatiquement par inférence technique, troncature lors de l’exportation vectorielle ou rupture de contraste nuisant à l’accessibilité universelle. Maîtriser la création et la personnalisation avancée des légendes ne relève donc pas d’une préoccupation purement cosmétique, mais d’une exigence méthodologique garantissant l’intégrité, la reproductibilité et la portée scientifique des résultats présentés.
Ce guide encyclopédique propose une déconstruction systématique des mécanismes régissant l’affichage, le positionnement spatial, la typographie, l’esthétique et la gestion multi-axes des légendes dans l’environnement conjoint Pandas et Matplotlib. En explorant tant les abstractions de haut niveau offertes par les interfaces de tracé que les manipulations de bas niveau sur les conteneurs d’axes, cet article fournit l’ensemble des clés théoriques et pratiques nécessaires à l’élaboration de figures conformes aux standards de publication les plus rigoureux.
1. Introduction aux légendes dans l’écosystème Pandas et Matplotlib
1.1 Rôle sémiotique et cognitif de la légende en visualisation de données
D’un point de vue sémiotique, la visualisation de données opère une transposition systématique : des valeurs numériques et des catégories abstraites sont converties en attributs rétiniens tels que la position, la longueur, la couleur, la forme ou la texture. Dans cette chaîne de transmission, la légende remplit une fonction d’ancrage sémantique indispensable. Sans elle, le lecteur se trouve face à un système de signes désincarné où des variations de teintes ou de styles de tiretés ne renvoient à aucun référent déterminé. L’ancrage sémantique théorisé par les sciences de l’information garantit que l’interprétation du récepteur converge fidèlement vers la structure des données génératrices, éliminant l’arbitraire de la lecture.
Dans l’exploration de variables multidimensionnelles, où un même plan cartésien intègre simultanément des coordonnées spatiales, des gradations chromatiques et des différenciations morphologiques, la légende réduit drastiquement l’ambiguïté interprétative. Elle décharge la mémoire de travail de l’observateur en matérialisant un dictionnaire visuel immédiatement consultable. Chaque consultation de la légende correspond à une micro-opération cognitive de mise en correspondance ; son efficacité détermine la vitesse à laquelle les corrélations, les ruptures de tendance ou les regroupements catégoriels sont assimilés par l’esprit humain.
Cependant, l’intégration de ce composant requiert un équilibre délicat entre l’exhaustivité descriptive et la minimisation de la surcharge cognitive. Une légende surchargée d’informations triviales, de libellés redondants ou d’éléments graphiques disproportionnés obère la surface utile du tracé et génère une pollution visuelle contre-productive. Le concepteur d’une figure doit calibrer précisément le niveau de granularité textuelle nécessaire pour rendre la visualisation autonome sans rivaliser avec la lisibilité du signal statistique primaire mis en scène sur les axes cartésiens.
1.2 L’interfaçage structurel entre Pandas DataFrame.plot() et Matplotlib
L’architecture logicielle reliant Pandas à Matplotlib repose sur un modèle d’encapsulation élégant mais parfois source de confusion pour le praticien. Lorsque la méthode de haut niveau associée aux structures de données tabulaires est invoquée sur une instance de tableau de données, Pandas ne réimplémente pas un moteur de rendu vectoriel autonome. Au contraire, il délègue l’exécution matérielle du tracé graphique à l’infrastructure sous-jacente de la bibliothèque Matplotlib, spécifiquement à son interface orientée objet articulée autour de figures et de conteneurs d’axes.
Cette délégation s’opère par l’intermédiaire d’un adaptateur interne qui traduit les séries temporelles, les colonnes numériques et les index de la structure bidimensionnelle en primitives graphiques élémentaires. Lors de l’appel de ces routines de haut niveau, Pandas examine l’environnement courant de pyplot afin de déterminer si un objet d’axes préexiste ou s’il convient d’en instancier un nouveau au sein de la figure active. Cette dynamique implique que chaque primitive générée par l’instruction de tracé reçoit des métadonnées d’identification qui seront ultérieurement exploitées par le gestionnaire de légendes.
Le cycle de vie du conteneur d’axes est ainsi intimement lié à la chronologie des instructions. Lorsque l’instruction graphique est exécutée, elle peuple l’axe cible d’une collection d’objets dérivés de la classe générique des éléments graphiques fondamentaux. Pandas intercepte ces objets pour leur associer par défaut des étiquettes textuelles dérivées de la structure du tableau, puis invoque implicitement ou prépare la méthode responsable de l’affichage de la légende, établissant ainsi une passerelle directe entre la disposition tabulaire en mémoire et le système de rendu visuel.
1.3 Comportement par défaut de la génération de légendes dans Pandas
Le comportement prêt à l’emploi de Pandas en matière de légendes obéit à un ensemble de règles déterministes calibrées pour l’exploration rapide des données. Lors du tracé d’un tableau contenant plusieurs colonnes numériques en fonction d’un index, l’algorithme parcourt chaque série et affecte comme étiquette par défaut le nom de la colonne correspondante. Ce mécanisme d’inférence automatique élimine le besoin d’une configuration manuelle préliminaire et permet d’obtenir instantanément une séparation visuelle identifiable des différentes variables projetées sur l’axe des ordonnées.
Néanmoins, des mécanismes d’omission automatique interviennent en fonction des dimensions du tableau et des arguments transmis à la méthode de tracé. Par exemple, lorsqu’une série unique est tracée sans spécification explicite, Pandas peut estimer que le titre de l’axe ou la mention de la colonne rend la légende redondante, choisissant délibérément de désactiver son affichage. De même, lors de l’utilisation de sous-graphiques distribués sur plusieurs panneaux, la légende peut être automatiquement supprimée sur certains axes intermédiaires pour éviter la répétition monotone des mêmes descripteurs textuels sur l’ensemble de la grille d’affichage.
Cette configuration implicite présente toutefois des limites inhérentes majeures dans un contexte de publication professionnelle ou académique. Les noms de colonnes stockés dans les structures de données brutes adoptent fréquemment des conventions informatiques peu adaptées à la lecture humaine, telles que des acronymes hermétiques, des séparateurs de soulignement ou l’absence totale d’unités de mesure physiques. Se reposer aveuglément sur la génération par défaut conduit inévitablement à des graphiques dont la qualité éditoriale s’avère insuffisante, imposant une reprise en main programmatique intégrale de la légende.
2. Fondements syntaxiques de la fonction plt.legend()
2.1 Anatomie de la commande canonique plt.legend()
La commande canonique accessible via le module pyplot de Matplotlib constitue le point d’entrée historique et le plus répandu pour l’instanciation et l’ajustement d’une boîte de légende. Sa signature de base accepte une combinatoire riche d’arguments positionnels et nommés, permettant d’agir sur l’intégralité des composantes géométriques, textuelles et spatiales de l’objet. Lorsqu’elle est appelée sans le moindre argument, la fonction interroge le collecteur interne d’éléments graphiques associé à l’axe cartésien courant afin de rassembler l’ensemble des entités visuelles possédant une étiquette valide préalablement déclarée.
Ce mécanisme repose sur la distinction fondamentale entre arguments positionnels et arguments nommés. Les arguments positionnels sont historiquement réservés à l’injection directe des listes de poignées graphiques et de libellés textuels, tandis que les arguments nommés gouvernent les états de rendu, la localisation spatiale, les marges internes et la typographie. L’usage exclusif d’arguments nommés est aujourd’hui préconisé au sein des paradigmes modernes de développement afin de garantir une lisibilité optimale du code source et d’éviter les désalignements accidentels entre les structures de données sous-jacentes.
La synchronisation entre l’instruction de tracé émise depuis Pandas et l’appel de clôture de la légende est critique. Comme la méthode graphique du tableau de données applique sa propre logique de génération, un appel ultérieur non paramétré à la fonction globale de légende risque d’écraser les propriétés finement configurées lors de la première passe. Il est donc indispensable de comprendre l’état interne de l’axe au moment précis où l’instruction de légende est évaluée, sous peine de constater la réinitialisation silencieuse de certains attributs stylistiques ou la disparition de séries secondaires ajoutées séquentiellement.
2.2 Substitution explicite des étiquettes textuelles
Une pratique récurrente consiste à écraser les étiquettes natives dérivées du tableau de données en passant directement une collection séquentielle de chaînes de caractères lors de l’appel de la légende. Cette approche permet de transformer des désignations brutes en libellés explicites, dotés d’une typographie soignée et de leurs unités de mesure associées, sans devoir modifier la structure interne ou les en-têtes du tableau de données d’origine. Cette flexibilité syntaxique accélère la production de figures finalisées lors des phases ultimes de mise en page.
Cette technique impose cependant une contrainte absolue d’alignement ordinal strict entre l’ordre physique des colonnes tracées et l’ordre d’apparition des chaînes au sein de la liste injectée. Matplotlib associe les libellés séquentiellement à chaque élément graphique présent dans son registre interne. Si le tableau de données sous-jacent fait l’objet d’une réorganisation structurelle, telle qu’un tri alphabétique des colonnes ou l’insertion inopinée d’une variable intermédiaire, la correspondance sémantique se trouve brisée sans qu’aucun message d’erreur ni avertissement d’exécution ne soit émis par l’interpréteur.
Ce risque d’incohérence sémantique silencieuse représente un péril majeur pour la reproductibilité scientifique des analyses de données. Une inversion entre un groupe expérimental et un groupe de contrôle causée par un décalage d’indexation dans la liste des étiquettes peut conduire à des conclusions scientifiques diamétralement opposées à la réalité empirique. Par conséquent, bien que la substitution par liste brute demeure syntaxiquement valide, les environnements de production et de recherche rigoureux lui préfèrent systématiquement des approches explicites liant formellement chaque nom de variable à sa poignée graphique correspondante.
2.3 Gestion des poignées graphiques (handles) et des étiquettes (labels)
Pour maîtriser pleinement la composition d’une légende, il est nécessaire de manipuler formellement les objets artistiques représentant les poignées graphiques, désignées sous le terme technique de poignées ou handles, et leurs étiquettes associées, nommées labels. Dans la terminologie de Matplotlib, une poignée est une instance dérivée de la classe de base des éléments graphiques qui matérialise l’échantillon géométrique miniature inséré dans la légende : un segment de droite pour une courbe temporelle, un rectangle coloré pour un histogramme ou un marqueur ponctuel pour un nuage de points.
L’extraction programmatique de ces composantes s’effectue au moyen de la méthode dédiée accessible sur le conteneur d’axes, conventionnellement nommée selon la syntaxe d’extraction des poignées et étiquettes. Cette méthode retourne un tuple composé de deux listes synchronisées : la première regroupe les références directes aux instances d’objets graphiques présents sur l’axe, tandis que la seconde contient les chaînes textuelles associées. L’accès direct à ces deux collections ouvre la voie à des manipulations algorithmiques avancées avant la restitution finale de la légende sur le canevas d’affichage.
Grâce à cette extraction, le développeur acquiert la capacité d’effectuer un filtrage sélectif rigoureux des éléments représentés. Il devient trivial d’exclure certaines séries auxiliaires, telles que des lignes de tendance secondaires ou des intervalles de confiance, en supprimant simplement leurs poignées et étiquettes respectives des listes avant de réinjecter ces dernières dans l’appel final. Cette ségrégation manuelle garantit que seules les variables porteuses d’une signification conceptuelle majeure figurent dans la boîte de légende, préservant ainsi la clarté informative de l’ensemble de la composition visuelle.
3. Personnalisation sémantique et typographique du titre de légende
3.1 Attribution d’un titre explicite via l’argument title
L’attribution d’un titre formel à une légende répond à une exigence conceptuelle essentielle : identifier explicitement la dimension catégorielle ou la variable de regroupement dont les différentes séries constituent les modalités discrètes. Dans de nombreuses représentations générées par défaut, la légende énumère simplement des valeurs sans préciser la nature de la grandeur sous-jacente, contraignant le lecteur à déduire par recoupement contextuel la variable représentée. L’usage du paramètre dédié au titre au sein de la fonction de légende résout cette carence en ancrant catégoriellement les étiquettes.
Ce titre constitue l’emplacement privilégié pour consigner des métadonnées scientifiques cruciales, au premier rang desquelles figurent les unités de mesure conformes aux conventions internationales et les conditions expérimentales normalisées. Plutôt que de surcharger chaque étiquette individuelle en répétant l’unité physique après chaque modalité, le report de cette information directement dans le titre de la légende allège la charge visuelle globale et harmonise la présentation formelle de l’ensemble des éléments descriptifs du graphique.
Il importe de noter les divergences méthodologiques de traitement entre l’API procédurale de pyplot et l’interface orientée objet de Matplotlib. Alors que l’approche procédurale configure le titre de manière atomique lors de l’appel global, l’approche orientée objet permet d’accéder à l’instance sous-jacente de la légende pour ajuster dynamiquement la chaîne textuelle du titre à tout moment du cycle d’exécution, autorisant des enrichissements programmatiques différés en fonction de métadonnées calculées dynamiquement lors du traitement des données.
3.2 Ajustement de la taille et du style de police du titre
L’intégration d’un titre nécessite un étalonnage précis de ses attributs typographiques pour asseoir sa prééminence fonctionnelle sans déséquilibrer l’harmonie textuelle globale du document. Le paramètre spécifique gouvernant la dimension de la police du titre permet d’assigner une valeur scalaire exprimée en points typographiques ou d’employer des descripteurs scalaires standardisés. Une gradation inadéquate risque de reléguer le titre au rang d’artefact visuel secondaire ou, à l’inverse, d’écraser la lisibilité des modalités individuelles par une présence textuelle disproportionnée.
Au-delà du simple calibre dimensionnel, la différenciation stylistique joue un rôle prépondérant dans la vitesse d’assimilation cognitive de la hiérarchie informative. L’application d’une graisse accentuée ou d’un style typographique particulier permet de distinguer immédiatement le statut de variable maîtresse occupé par le titre de celui de modalité subordonnée propre à chaque étiquette de série. Cette scission formelle structure le parcours du regard et guide l’interprétation analytique de l’observateur avec une clarté immédiate.
Cette calibration locale doit s’inscrire dans le respect scrupuleux de l’échelle typographique de la figure globale. Il est impératif que la taille de la police du titre de légende demeure cohérente avec celle des titres d’axes et des annotations contextuelles. L’hétérogénéité des fontes au sein d’une même planche graphique trahit une conception empirique non maîtrisée et déprécie la perception de rigueur scientifique accordée aux résultats modélisés.
3.3 Alignement et hiérarchie visuelle
L’alignement spatial du titre vis-à-vis du corps textuel constitué par l’empilement des entrées de légende représente un paramètre de composition souvent sous-estimé. Par défaut, Matplotlib adopte un positionnement centré ou aligné à gauche selon les versions et les feuilles de styles appliquées. Le contrôle explicite de cet alignement horizontal permet de caler le titre sur la marge interne gauche de la boîte, créant ainsi une ligne de force verticale sur laquelle l’œil peut s’appuyer pour balayer l’ensemble des descripteurs catégoriels sans rupture d’axe optique.
Pour les visualisations impliquant des intitulés scientifiques verbeux ou des formulations protocolaires étendues, la gestion des retours à la ligne au sein du titre s’avère indispensable. L’insertion programmatique de caractères de saut de ligne permet de formater un titre descriptif sur plusieurs lignes compactes, évitant ainsi un étirement horizontal démesuré de la boîte de légende qui viendrait amputer la largeur disponible pour les axes de données proprement dits. Ce formatage textuel préserve la compacité de l’objet graphique sans sacrifier la précision du vocabulaire employé.
L’aboutissement de ces réglages réside dans l’établissement d’une hiérarchie de lecture limpide où le statut de chaque composant s’impose de lui-même : le titre catégorise l’ensemble, l’espacement vertical circonscrit le domaine de validité, et les étiquettes associées à leurs poignées respectives détaillent les modalités spécifiques. Cette architecture visuelle rationnelle garantit que le lecteur consacre son énergie mentale à l’évaluation des distributions statistiques plutôt qu’au décodage laborieux de l’appareil paratextuel de la figure.
4. Contrôle spatial : l’argument loc et l’évitement des chevauchements
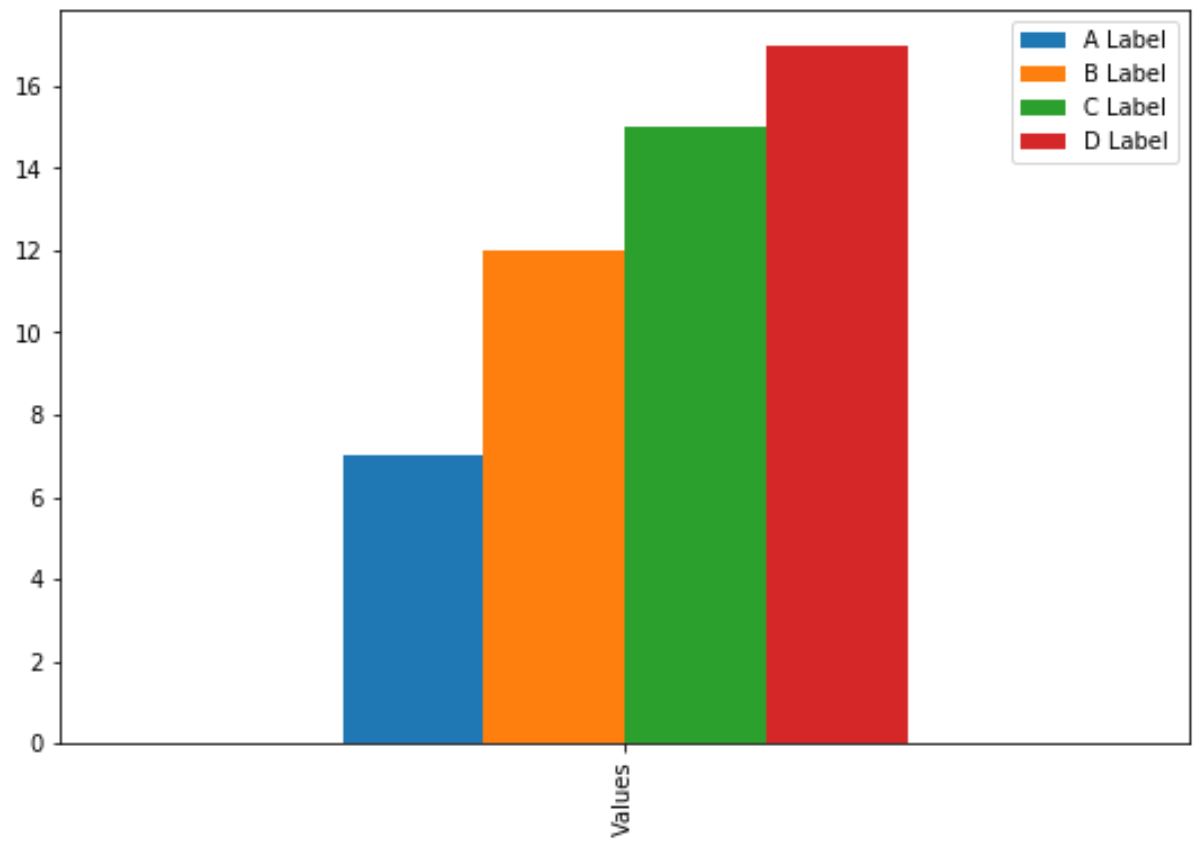
4.1 Nomenclature des positions prédéfinies par chaînes et codes entiers
La gestion du positionnement spatial de la légende au sein de la zone de tracé repose historiquement sur l’argument de localisation nommé de manière abrégée. Matplotlib propose une taxonomie normalisée articulée autour de neuf positions canoniques réparties selon les directions cardinales et ordinales du repère cartésien, complétées par une option de centrage absolu. Ces emplacements sont accessibles indifféremment par des chaînes descriptives en langue anglaise, telles que celles désignant les coins supérieurs ou inférieurs, ou par des identifiants numériques entiers strictement équivalents allant de un à dix.
La correspondance interne associe chaque chaîne à un entier selon une cartographie immuable : le coin supérieur droit correspond à l’entier un, le coin supérieur gauche à deux, le coin inférieur gauche à trois, et ainsi de suite jusqu’au centre de la boîte cartésienne représenté par l’entier dix. Bien que la concision des entiers puisse séduire les programmeurs chevronnés, l’emploi exclusif des chaînes de caractères littérales est unanimement encouragé par les chartes de programmation contemporaines en raison de leur expressivité intrinsèque et de la facilité d’audit du code qu’elles procurent lors des révisions collaboratives.
Sur le plan géométrique, le point de référence de la boîte englobante de la légende s’aligne automatiquement sur le point correspondant de la boîte d’axes sélectionnée. Ainsi, le choix de la position supérieure droite verrouille le coin supérieur droit de la boîte de légende sur le coin supérieur droit du cadre de données, en appliquant une marge de décalage interne calibrée par les paramètres généraux de configuration de la bibliothèque. Cette mécanique garantit une stabilité structurelle appréciable quel que soit le ratio d’aspect initial assigné à la fenêtre d’affichage.
4.2 Optimisation automatique via l’argument loc=’best’
Parmi les options d’affectation spatiale, la valeur magique désignant l’emplacement optimal constitue l’une des caractéristiques les plus distinctives de l’environnement graphique sous-jacent. Lorsqu’elle est activée, cette option confie à un algorithme interne le soin de déterminer dynamiquement l’emplacement de la zone de tracé qui minimise les risques de collision visuelle avec les données effectivement représentées. Ce mécanisme libère l’analyste de l’obligation de déterminer manuellement une position statique adaptée à chaque jeu de données.
Le fonctionnement de cette heuristique repose sur une discrétisation de la surface des axes cartésiens en une grille bidimensionnelle de cellules élémentaires. Pour chacune des neuf positions candidates standard, l’algorithme calcule une fonction de coût pénalisant le chevauchement avec les segments de courbes, les marqueurs dispersés ou les polygones de remplissage présents sur la scène graphique. L’emplacement affichant la note d’interférence la plus basse est ensuite automatiquement sélectionné pour accueillir la boîte englobante de la légende.
Cette commodité computationnelle s’accompagne toutefois d’un coût temporel non négligeable. Lors du rendu de graphiques contenant plusieurs dizaines de milliers de points ou des structures polygonales particulièrement denses, l’évaluation spatiale de non-recouvrement peut ralentir notablement la vitesse d’affichage de la figure. De surcroît, sur des jeux de données hautement dispersés occupant l’intégralité du plan cartésien, l’algorithme échoue fréquemment à trouver un espace vierge, aboutissant à des compromis visuels insatisfaisants qui justifient l’abandon de l’automatisme au profit d’un ancrage externe délibéré.
4.3 Stratégies d’évitement des collisions avec les séries tracées
L’évitement déterministe des collisions entre la légende et les séries temporelles ou distributionnelles requiert une analyse spatiale rigoureuse de la structure morphologique des données. Lorsqu’une variable présente une dynamique exponentielle croissante de gauche à droite, l’espace situé dans le quadrant supérieur gauche s’avère par définition le plus préservé des interférences matérielles. Inversement, une distribution décroissante libère naturellement le quadrant supérieur droit, faisant de l’anticipation empirique de la forme des courbes un guide infaillible pour le positionnement fixe de la légende.
L’impact psychologique d’une obstruction visuelle est particulièrement délétère sur la réception d’un travail de recherche. Lorsqu’une boîte de légende masque des points d’inflexion critiques, des valeurs aberrantes révélatrices ou des plateaux asymptotiques, elle suscite immédiatement chez le lecteur averti un sentiment de méfiance quant à la rigueur de l’analyste, voire le soupçon d’une dissimulation délibérée d’artefacts gênants. La légende doit éclairer le phénomène physique ou statistique modélisé, sans jamais faire écran physique aux observations empiriques.
Pour parer à ces interférences tout en conservant la légende à l’intérieur de la boîte cartésienne, il est souvent judicieux d’étendre artificiellement les limites des axes d’abscisses ou d’ordonnées par l’application d’un facteur de marge supérieur. En majorant délibérément la valeur maximale autorisée sur l’axe des ordonnées de quinze à vingt pour cent, on dégage une bande horizontale vierge au sommet de la figure, garantissant que même les pics extrêmes du signal n’entreront pas en collision avec une légende calée en bordure supérieure.
5. Positionnement absolu et déporté hors de la zone de tracé
5.1 Mécanisme de l’ancrage externe avec bbox_to_anchor
Lorsque la densité informationnelle d’une figure interdit tout compromis spatial à l’intérieur des axes, le déport de la légende vers l’extérieur de la zone de tracé s’impose comme la solution d’ingénierie visuelle par excellence. Cette opération s’articule autour de l’argument de délimitation par boîte d’ancrage, accessible sous le paramètre technique dédié. Ce paramètre redéfinit le référentiel géométrique de fixation de la légende en l’émancipant du cadre intérieur strict des axes cartésiens pour le projeter dans un système de coordonnées relatives normalisées.
La syntaxe canonique exploite un tuple de coordonnées exprimées dans le système de référence de l’axe, où l’origine de coordonnées zéro-zéro désigne le coin inférieur gauche de la boîte de tracé et les coordonnées unitaires un-un correspondent au coin supérieur droit. L’interaction géométrique entre l’argument de boîte d’ancrage et le paramètre de localisation classique est fondamentale : la position spécifiée par ce dernier définit quel point précis de la boîte de légende sera arrimé sur les coordonnées absolues dictées par l’ancrage. Cette logique vectorielle conjointe offre un contrôle micrométrique du positionnement.
Il est également possible de fournir un tuple étendu à quatre composantes décrivant successivement l’abscisse d’origine, l’ordonnée d’origine, la largeur relative et la hauteur relative de la boîte englobante. Dans cette configuration avancée, la légende est littéralement contrainte de s’étirer ou de se recomposer pour occuper l’espace géométrique virtuel délimité par ces bornes, permettant d’aligner rigoureusement la largeur de la légende sur celle de la figure ou de l’intégrer dans des compartiments sur mesure au sein de mises en page complexes.
5.2 Déplacement de la légende dans les marges latérales et supérieures
La disposition latérale externe, positionnant la légende immédiatement à la droite de la boîte de tracé, constitue le standard de facto de la publication académique pour les figures de proportion conventionnelle. En couplant une localisation orientée vers le centre ou le sommet gauche de la boîte de légende avec une coordonnée d’ancrage horizontale légèrement supérieure à l’unité, on repousse l’intégralité du bloc informatif dans la marge blanche extérieure droite, préservant la totalité de la surface utile pour le signal statistique.
Pour les figures adoptant un ratio d’aspect panoramique ou au sein de tableaux de bord horizontaux, l’agencement sous la forme d’une bannière supérieure externe s’avère particulièrement pertinent. En ancrant le bas de la légende au-dessus de la valeur unitaire de l’axe vertical et en l’associant à une distribution horizontale des étiquettes, la légende vient couronner le graphique à la manière d’un bandeau explicatif, laissant le champ de vision horizontal parfaitement libre pour l’observation des chroniques temporelles étendues.
Cette dissociation physique entre la géométrie du tracé et l’appareil descriptif clarifie radicalement la lecture analytique. Les axes cartésiens conservent leur stricte pureté dimensionnelle, les risques d’artefacts de lecture induits par des aplats de couleur parasites sont totalement éliminés, et la composition graphique globale gagne en élégance et en professionnalisme, répondant aux attentes des comités de lecture des revues scientifiques les plus exigeantes.
5.3 Gestion des débordements et recadrage de la figure
L’expulsion de la boîte de légende hors des limites natives du repère cartésien introduit une pathologie récurrente : la troncature partielle ou totale de la légende lors de l’enregistrement vectoriel ou matriciel de l’image. Par défaut, la commande de sauvegarde de la figure dimensionne le canevas d’exportation en se basant exclusivement sur la taille théorique de la figure et la boîte englobante des axes, sans tenir compte des éléments graphiques artificiellement déportés dans les marges extérieures, ce qui entraîne la disparition pure et simple des annotations situées au-delà des frontières nominales.
Pour résoudre ce dysfonctionnement structurel, l’invocation de la méthode d’ajustement automatique de la disposition globale constitue un premier niveau d’intervention classique. Cette routine réévalue les marges globales de la figure pour tenter d’accommoder les éléments périphériques tels que les étiquettes d’axes et les titres. Elle peut être complétée par un calibrage manuel précis des sous-espacements via l’ajustement explicite des marges périphériques de la fenêtre d’affichage, libérant ainsi un espace latéral calibré au millimètre près.
Cependant, la méthode la plus robuste et universellement préconisée lors de la phase de sauvegarde sur disque consiste à transmettre le paramètre explicite de boîte englobante ajustée au sein de la fonction d’enregistrement. Cette instruction ordonne au moteur de rendu d’inspecter l’intégralité des éléments graphiques présents sur la scène, y compris les légendes déportées et les textes flottants, et de recalculer dynamiquement les bornes de découpage du fichier résultant. Le fichier final ainsi produit encapsule l’intégralité du contenu visible sans la moindre troncature.
6. Configuration fine de la typographie et des échelles textuelles
6.1 Calibrage de la taille de police avec fontsize et le dictionnaire prop
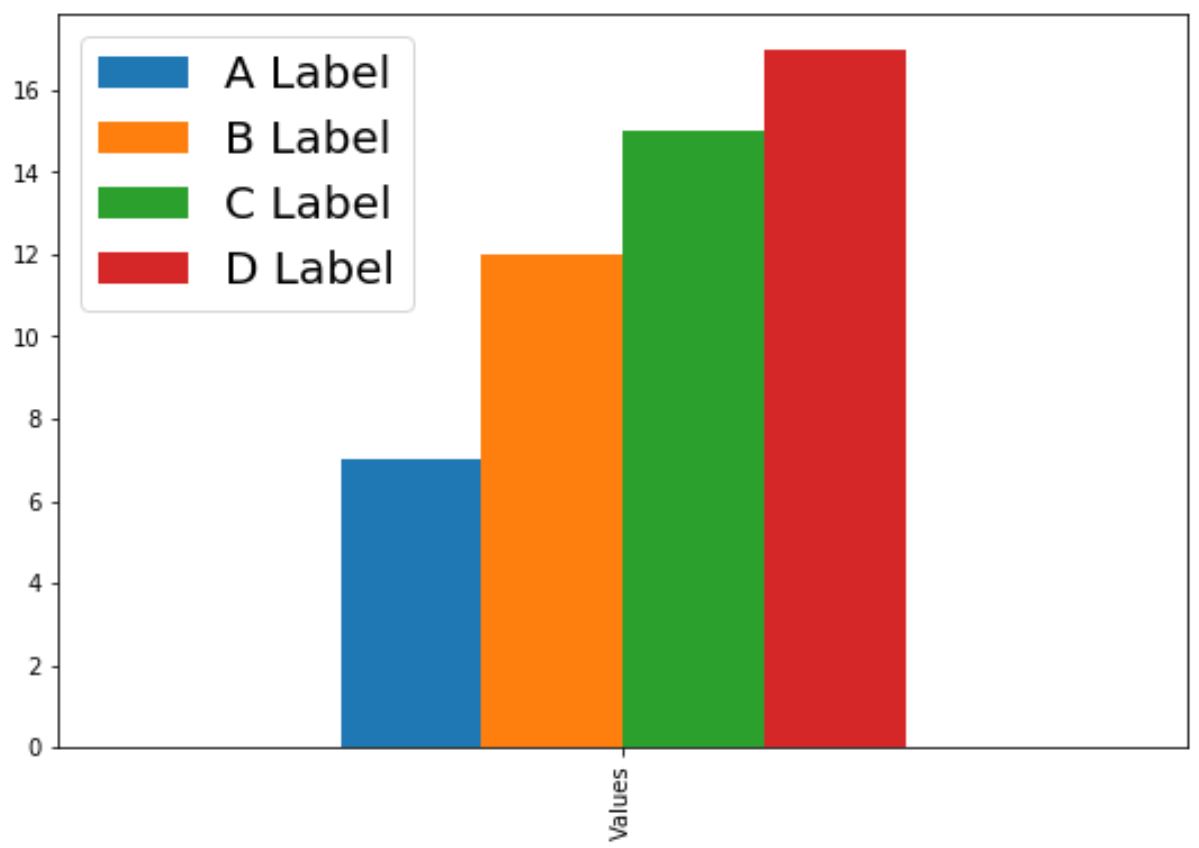
La lisibilité d’une légende repose avant tout sur un dimensionnement typographique judicieux. Le paramètre d’échelle de police permet de stipuler la hauteur des caractères textuels composant les étiquettes au moyen de deux formalismes distincts. D’une part, l’assignation d’une valeur scalaire numérique fixe la taille exacte en points typographiques réels, offrant une stabilité dimensionnelle absolue indépendamment des paramètres stylistiques globaux de l’environnement d’exécution.
D’autre part, l’utilisation de descripteurs sémantiques relatifs sous forme de chaînes de caractères permet d’adapter harmonieusement la taille du texte à la feuille de style générale de la figure. Ces qualifications relatives garantissent que si la police de base du document est ultérieurement redimensionnée pour les besoins d’une projection ou d’un tirage papier, la taille des entrées de légende modulera son gabarit proportionnellement, préservant ainsi la balance harmonique globale de la composition sans intervention manuelle supplémentaire.
Pour des personnalisations requérant un niveau de raffinement supérieur, Matplotlib propose le dictionnaire de propriétés typographiques. En encapsulant les directives au sein d’une structure de correspondances clés-valeurs, ce paramètre permet d’unifier la configuration de la taille, du poids et de la famille de police en un point d’entrée programmatique unique. Cette structuration s’avère particulièrement vertueuse au sein de pipelines de production de données où les chartes graphiques sont formalisées sous la forme de dictionnaires de configuration partagés et réutilisables.
6.2 Modification des attributs de fonte : graisse, style et famille
L’affirmation d’une identité visuelle professionnelle exige le contrôle des familles de fontes typographiques exploitées au sein de la figure. Matplotlib gère les grandes familles génériques standardisées, telles que les typographies avec empattements, les linéales sans empattements et les polices à espacement fixe. Selon que la figure est destinée à une insertion dans un rapport technique sous traitement de texte ou au sein d’un article composé sous le système de composition de documents TeX, le choix d’une famille adaptée garantit une continuité visuelle parfaite avec le texte courant environnant.
La modulation stylistique par l’application de graisses légères, normales ou accentuées, ainsi que le recours raisonné à l’italique, permettent de hiérarchiser l’importance informationnelle des différentes entrées. Il est par exemple possible de mettre en valeur une courbe expérimentale maîtresse en lui attribuant un libellé en caractères gras, tout en laissant les courbes de modélisation théorique ou les séries de bruit de fond sous une typographie ordinaire ou inclinée, guidant ainsi l’attention de l’auditoire vers la contribution empirique novatrice.
Pour les contextes industriels et éditoriaux aux chartes d’entreprise strictes, Matplotlib permet d’importer et d’instancier des polices vectorielles externes spécifiques au format TrueType ou OpenType par l’intermédiaire de son gestionnaire interne de polices de caractères. Cette capacité assure une conformité absolue avec les manuels de normes graphiques des institutions scientifiques ou des entreprises commanditaires, rehaussant l’impact visuel et la crédibilité des visualisations produites au plus haut niveau d’exigence institutionnelle.
6.3 Intégration de notations mathématiques et syntaxe TeX
La communication de résultats en physique, en économétrie ou en apprentissage statistique automatisé implique fréquemment l’utilisation d’un formalisme mathématique rigoureux au sein même des clés de légende. Matplotlib intègre nativement un moteur d’interprétation mathématique interne capable de restituer une vaste palette de commandes TeX sans exiger l’installation préalable d’une distribution externe sur la machine de calcul de l’analyste.
L’activation de cette fonctionnalité repose sur l’encapsulation des expressions au sein de délimiteurs monétaires dans des chaînes de caractères brutes d’échappement. L’utilisation du préfixe textuel brut est essentielle dans l’interpréteur Python : elle prévient l’interprétation accidentelle des barres obliques inversées comme des séquences d’échappement conventionnelles, permettant à la commande mathématique d’être transmise telle quelle au moteur de composition graphique pour un rendu parfait des indices, exposants et opérateurs différentiels.
Cette syntaxe ouvre la voie à l’affichage irréprochable de caractères grecs, de fractions intégrales, de vecteurs surmontés de flèches ou de symboles de sommation directement accouplés aux poignées de légende. Une modélisation physique gagne immensément en clarté lorsque sa courbe n’est pas identifiée par un libellé informatisé abrégé, mais par l’équation différentielle ou le paramètre stochastique exact qui la gouverne formellement, éliminant tout doute conceptuel chez le lecteur expert.
7. Personnalisation esthétique de la boîte de légende
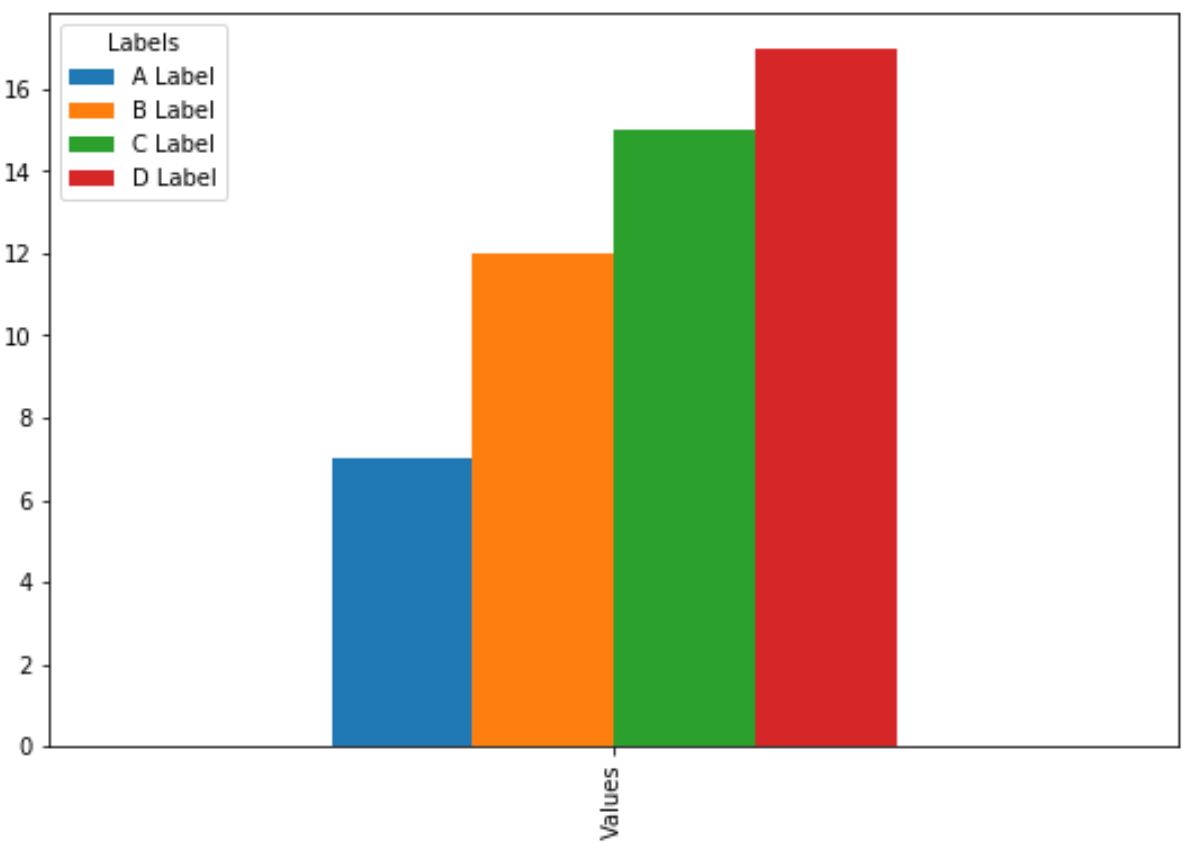
7.1 Gestion de la transparence et des bordures (frameon, framealpha, edgecolor)
La matérialité de la boîte englobante hébergeant la légende exerce un impact déterminant sur la texture perçue du graphique. Le paramètre booléen contrôlant l’activation du cadre offre la liberté d’afficher ou d’éliminer totalement le contour géométrique et l’arrière-plan de l’élément. La suppression volontaire du cadre architectural constitue un principe cardinal du design d’information contemporain épuré, permettant au texte et aux poignées de fusionner organiquement avec la scène graphique sans cloisonnement visuel artificiel.
Lorsque la préservation du cadre est requise pour assurer la lisibilité face à une grille cartésienne sous-jacente ou des trajectoires denses, la modulation de l’opacité d’arrière-plan intervient comme un outil d’arbitrage remarquable. En assignant au facteur de translucidité une valeur décimale comprise entre zéro et un, on autorise la trame des données et le quadrillage à transparaître subtilement sous le bloc informatif, garantissant que la boîte ne crée pas un angle mort béant au sein du repère cartésien.
La délimitation périphérique peut être ajustée via le contrôle direct de la couleur du contour et de l’épaisseur du trait de bordure. L’emploi d’une teinte de contour atténuée, telle qu’un gris neutre à faible contraste, confère à la figure une tonalité bien plus sobre et élégante que la bordure noire épaisse par défaut. Cette nuance technique atténue la lourdeur visuelle de la figure et focalise l’attention du spectateur sur les signaux analytiques primaires.
7.2 Teinte du fond et effets visuels (facecolor, fancybox, shadow)
L’harmonisation chromatique du réceptacle de légende avec la palette générale de la planche graphique implique la manipulation du paramètre de teinte de remplissage. L’attribution d’une nuance chromatique spécifique, qu’il s’agisse d’une référence textuelle standard, d’un code hexadécimal précis ou d’une composante vectorielle de rouge, vert et bleu, permet d’adapter la légende aux contextes d’affichage sur fond sombre ou d’intégrer des tons cassés adoucissant le contraste d’ensemble.
Pour briser la rigidité orthogonale des tracés vectoriels, l’argument booléen d’arrondissement des angles transforme la boîte de délimitation rectangulaire standard en un polygone aux sommets adoucis. Cet aménagement confère une touche contemporaine aux figures scientifiques. Il signale visuellement la boîte de légende comme un composant d’interface annotatif distinct des cadres de mesure stricts définis par les axes d’ordonnées et d’abscisses.
L’activation de l’effet d’ombrage tridimensionnel via le paramètre dédié projette une ombre portée subtile sous la face inférieure et latérale de la boîte englobante. Bien que cet artifice doive être employé avec discernement dans les contextes éditoriaux académiques stricts en raison de son caractère potentiellement ornemental, il apporte une séparation en profondeur utile sur des cartes de densité complexes ou des images matricielles polychromes où la légende risquerait autrement de se confondre avec le bruit de fond graphique.
7.3 Optimisation des contrastes selon la norme d’accessibilité WCAG
L’universalité de la communication graphique commande de concevoir des figures pleinement intelligibles pour l’ensemble des observateurs, y compris les personnes présentant des déficiences visuelles modérées ou sévères. L’application des principes édictés par les Règles pour l’accessibilité des contenus Web impose de vérifier rigoureusement le ratio de contraste de luminance entre la couleur des glyphes textuels et celle du fond de la boîte de légende. Un rapport minimal de quatre points cinq contre un doit être impérativement garanti pour le texte courant de taille conventionnelle.
Cette obligation normative s’étend à la relation visuelle unissant la boîte de légende elle-même au fond de la zone de tracé cartésienne sur laquelle elle vient éventuellement se superposer. Une boîte excessivement translucide ou parée d’une teinte de fond trop proche de celle du plan de données génère un éblouissement ou un estompage des poignées miniatures, interdisant la discrimination exacte des couleurs et des marqueurs pour les praticiens travaillant sur des écrans mal étalonnés ou sous de mauvaises conditions d’éclairage ambiant.
L’écueil récurrent de l’estompage esthétique, consistant à privilégier des gris pâles et des polices excessivement déliées au nom d’un minimalisme mal compris, doit être combattu avec vigueur. La rigueur scientifique requiert que l’accessibilité cognitive prime sur la fantaisie graphique : chaque trait, chaque étiquette et chaque poignée au sein de la légende doit offrir une vivacité de contraste garantissant une transmission de l’information quantitative sans fatigue oculaire ni ambiguïté sensorielle.
8. Structuration multi-colonnes et ajustement des espacements internes
8.1 Distribution des entrées sur plusieurs colonnes via ncol
Lorsque l’objet de l’étude implique la comparaison simultanée d’un nombre substantiel de séries de données, l’empilement vertical traditionnel de la légende devient une source majeure de déséquilibre architectural. Une longue colonne égrenant dix à quinze variables crée une bande verticale disproportionnée qui étouffe le graphique ou contraint à une réduction drastique de la taille des polices. Pour contourner cette impasse, la décomposition en plusieurs colonnes parallèles s’impose via l’utilisation du paramètre structural dédié au nombre de colonnes.
La transmission d’une valeur entière à cet argument réorganise instantanément la géométrie interne de la boîte en redistribuant la collection des entrées sur une matrice horizontale équilibrée. L’algorithme interne effectue une répartition automatique des éléments pour homogénéiser la hauteur relative de chaque colonne. Cette transformation compacte une nomenclature verticale encombrante en un rectangle horizontal ramassé qui s’insère idéalement sous l’axe des abscisses ou au zénith de la figure.
Ce format matriciel multi-colonnes constitue la configuration par excellence pour la réalisation de bannières inférieures horizontales. Disposée sous la ligne des abscisses, une légende étalée sur trois, quatre ou cinq colonnes de largeur identique respecte l’axe naturel de balayage visuel de gauche à droite propre aux cultures occidentales. Elle permet de conserver une emprise verticale minimale tout en documentant un vaste échantillon de modalités catégorielles de manière parfaitement aérée.
8.2 Micro-ajustement des marges et des intervalles (spacing arguments)
L’excellence typographique dans la visualisation de données se juge au contrôle méticuleux des micro-espacements séparant les différents constituants de la boîte de légende. Matplotlib expose une série d’arguments granulaires régissant les distances relatives, exprimées sous la forme de multiples de la taille de police courante. Le paramètre contrôlant l’espacement vertical des étiquettes permet de resserrer ou d’aérer la distance séparant deux entrées successives d’une même colonne, évitant les collisions de hampes et de jambages pour les polices à fort encombrement vertical.
L’intervalle horizontal dissociant le pictogramme graphique miniature de son libellé textuel correspondant est directement modulable via le paramètre de décalage entre la poignée et le texte. Dans les configurations où les marqueurs sont de dimension volumineuse ou lorsque des tiretés longs sont représentés, l’élargissement maîtrisé de cet espace évite tout contact accidentel entre le symbole et la première lettre de l’étiquette. Ce réglage confère une respiration salvatrice à chaque unité d’association sémiotique.
Enfin, lorsque la distribution multi-colonnes est activée, la gestion de l’écartement latéral inter-colonnes s’avère stratégique. Si ce jeu horizontal est laissé trop étroit, les étiquettes textuelles de la première colonne risquent de côtoyer dangereusement les poignées de la colonne adjacente, créant de fausses continuités de lecture transversale. L’amplification raisonnée de cet espacement latéral sépare nettement les colonnes en couloirs informatifs autonomes, garantissant un décodage séquentiel sans équivoque.
8.3 Dimensionnement des marqueurs et des segments de démonstration
Les dimensions physiques des poignées graphiques intégrées dans la légende doivent faire l’objet d’un calibrage méticuleux afin de refléter fidèlement la texture réelle des données projetées. Les arguments dédiés à la longueur et à la hauteur de la poignée permettent de dilater ou de contracter les segments de droite illustratifs. Une longueur de poignée insuffisante empêche souvent de distinguer convenablement un trait plein d’un trait pointillé ou tireté court, ruinant l’utilité du canal morphologique employé pour différencier les séries.
Par ailleurs, la question du dimensionnement des marqueurs ponctuels au sein des graphiques de dispersion revêt une importance capitale. Sur un nuage de points dense, les marqueurs tracés sur la figure sont fréquemment réduits à une taille infime pour pallier le phénomène de superposition massive. Si cette échelle microscopique était fidèlement dupliquée dans la légende, les symboles y deviendraient virtuellement invisibles à l’œil nu, privant l’observateur de sa grille de lecture.
Pour contrer cet inconvénient, le paramètre de facteur d’échelle des marqueurs dans la légende autorise l’application d’un coefficient multiplicateur ciblant sélectivement les pictogrammes d’illustration textuelle sans altérer d’un iota le rendu physique des observations sur les axes cartésiens. En grossissant de deux ou trois fois les symboles dans la légende, on offre une vue macroscopique nette de la morphologie du glyphe et de sa couleur, garantissant une identification instantanée de la modalité correspondante sur le canevas.
9. Gestion des légendes dans les visualisations multi-panneaux (Subplots)
9.1 Divergence conceptuelle : ax.legend() versus fig.legend()
L’extension d’une visualisation vers des structures multi-panneaux fait émerger un arbitrage architectural capital entre la portée locale d’une légende attachée à un axe cartésien individuel et la portée globale d’une légende rattachée à la figure mère dans son ensemble. L’appel de la légende sur une instance spécifique d’axes circonscrit son domaine de responsabilité aux seules séries hébergées dans cette cellule spatiale déterminée, adoptant les limites géométriques de cette dernière comme repère exclusif.
À l’inverse, l’invocation de la légende au niveau hiérarchique supérieur de la figure permet d’instancier un composant paratextuel transversal dont l’autorité sémiotique embrasse l’intégralité des sous-graphiques composant la planche d’analyse. Cette distinction conceptuelle conditionne la lisibilité des représentations factorielles en grille, où la même nomenclature de variables expérimentales est ventilée à travers différents traitements, cohortes ou fenêtres temporelles distinctes.
Multiplier aveuglément les légendes locales au sein de chaque panneau d’une grille factorielle engendre une répétition redondante toxique pour la clarté d’ensemble. En confisquant une fraction substantielle de l’espace utile au sein de chaque cellule cartésienne, cette prolifération encombre inutilement la scène graphique. Dans un tel contexte expérimental partagé, le recours méthodologique à une légende globale unique s’affirme comme l’unique démarche rigoureuse pour fédérer visuellement les données présentées.
9.2 Agrégation et déduplication des poignées sur une grille d’axes
La génération d’une légende globale centralisée unifiant une constellation de sous-graphiques impose une collecte algorithmique préalable des éléments graphiques disséminés sur les différentes cellules cartésiennes. Comme chaque panneau n’héberge potentiellement qu’un sous-ensemble des modalités étudiées, une boucle itérative programmatique doit parcourir l’ensemble de la matrice des conteneurs d’axes renvoyée par le constructeur de sous-graphiques pour inventorier les couples d’objets formés par chaque poignée et son étiquette textuelle.
Cette récolte exhaustive se heurte inévitablement à la problématique de la duplication des entrées : une modalité transversale tracée sur six sous-graphiques distincts fournira six poignées identiques dotées du même libellé nominal. Pour neutraliser cette redondance indésirable, l’emploi de structures de données associatives garantit un dédoublonnage parfait tout en préservant l’ordre chronologique d’apparition initial des séries, associant chaque libellé unique à sa première occurrence matérielle observée.
Les collections consolidées de poignées uniques et d’étiquettes dédupliquées peuvent ensuite être transmises directement à l’instance de légende de la figure mère. Ce processus d’agrégation systématique garantit une univocité sémiotique absolue : chaque facteur expérimental ne fait l’objet que d’une seule et unique entrée explicative, apportant une cohérence formelle maximale à la mise en page de la planche scientifique.
9.3 Agencement harmonieux d’une légende globale partagée
L’intégration spatiale réussie d’une légende unifiée partagée commande un recalibrage rigoureux de la géométrie de la figure globale pour éviter tout empiètement destructeur sur les sous-graphiques périphériques. Si une légende globale est positionnée par simple ancrage central sans aménagement préalable du maillage cartésien, le moteur de rendu viendra superposer brutalement la boîte paratextuelle sur les titres ou les axes médians de la grille de tracé.
Pour prévenir cette interférence, l’ajustement explicite des marges périphériques de la figure via la routine dédiée s’avère incontournable. Si la légende consolidée est destinée à être insérée sous forme de bannière au pied de la figure, il convient d’accroître délibérément la marge inférieure de la planche graphique en affectant une valeur rehaussée au paramètre d’espacement inférieur, réservant ainsi une bande horizontale libre de tout tracé pour y loger la légende.
Cette approche garantit que l’ensemble des sous-graphiques conservent une homogénéité dimensionnelle absolue et des proportions rigoureusement identiques entre eux, condition indispensable pour que les comparaisons optiques d’échelles et de pentes demeurent visuellement valides à travers l’ensemble des panneaux. La légende partagée trône alors comme un élément de cadrage harmonieux, parachevant la cohésion éditoriale de la composition globale.
10. Cas d’usage spécifiques selon les types de graphiques Pandas
10.1 Graphiques en barres groupées et empilées (kind=’bar’ / ‘barh’)
Le traitement des histogrammes et des graphiques en barres sous Pandas introduit des particularités notables relatives à l’ordonnancement matériel des éléments. Lors du traçage de diagrammes en barres empilées, la convention algorithmique native de Matplotlib consiste à accumuler les séries de bas en haut : la première colonne du tableau forme le socle de base, tandis que les colonnes subséquentes viennent s’ériger successivement par-dessus les segments précédents.
Or, la boîte de légende par défaut énumère les étiquettes selon l’ordre naturel descendant de la liste des colonnes, plaçant la première série en position sommitale dans la nomenclature textuelle. Il en résulte une dissonance cognitive immédiate : l’ordre de lecture vertical de la légende s’avère rigoureusement inversé par rapport à l’ordre physique d’empilement spatial des blocs colorés sur le plan cartésien, contraignant l’esprit à des contorsions d’interprétation continuelles pour associer un segment à sa modalité.
Pour restaurer une ergonomie visuelle sans faille, il est impératif d’inverser délibérément l’ordre des poignées et des étiquettes lors de la configuration finale de la légende. En inversant par manipulation séquentielle les listes extraites de l’axe, la série constituant le sommet physique de la pile de barres se retrouve positionnée au sommet de la boîte de légende, rétablissant une conformité mimétique directe entre l’architecture de la scène graphique et son appareil de décodage paratextuel.
10.2 Séries temporelles et graphiques linéaires continus (kind=’line’)
Les visualisations chronologiques continues mobilisent des variations fines d’épaisseur de trait, de teintes spectrales et de motifs de tiretés pour isoler des cohortes ou des dynamiques séquentielles. Lorsque des données temporelles présentent des amplitudes divergentes d’un ordre de grandeur substantiel, le recours méthodologique au dédoublement d’axes cartésiens partageant une même échelle d’abscisses temporelle constitue une technique exploratoire éprouvée.
Cependant, l’utilisation de cette méthode d’axes jumeaux disloque la gestion native des légendes : chaque axe cartésien gère son propre conteneur de manière totalement étanche, générant par défaut deux légendes superposées ou deux boîtes discordantes situées sur des bords opposés de la figure. Cette scission physique morcelle la lecture globale et affaiblit la perception des corrélations croisées entre les deux grandeurs temporelles synchronisées.
La résolution de cette discontinuité impose une réunification programmatique des poignées des deux axes au sein d’une boîte unique. En extrayant manuellement les poignées et libellés du premier axe d’ordonnées ainsi que ceux de l’axe jumeau secondaire, l’analyste concatène ces entités au sein d’une instruction de légende unique assignée sur l’un des deux axes. Cette fusion offre un inventaire clair et unifié de toutes les trajectoires dynamiques sur une seule interface synthétique.
10.3 Diagrammes de dispersion et distributions (kind=’scatter’, ‘hist’, ‘kde’)
Les diagrammes de dispersion matérialisant des observations individuelles posent des défis sémiotiques particuliers lorsque la couleur d’un point ne renvoie pas à une catégorie discrète, mais à une variable continue encodée au moyen d’une table de projection chromatique ou colormap. Dans cette configuration probabiliste, l’instanciation d’une légende à poignées géométriques discrètes perd toute pertinence sémiotique au profit d’une barre de graduation continue ou colorbar, dotée de ses propres graduations métriques calibrées.
En revanche, lorsque le nuage de points opère un encodage croisé combinant des variations morphologiques de forme de marqueur pour signifier une variable nominale et des variations de calibrage dimensionnel pour représenter un poids démographique, la légende doit être configurée avec un raffinement extrême. Elle doit alors ségréger ses entrées en sous-groupes thématiques distincts, proposant une première échelle de démonstration pour le calibrage des aires et une seconde pour l’identification des symboles discrets.
De façon similaire, lors de la superposition d’histogrammes de fréquence brute et d’estimations de densités par lissage à noyau, la légende doit rendre compte fidèlement de la dualité des représentations. La poignée du tracé distributionnel doit marier harmonieusement un rectangle semi-transparent illustrant l’empilement probabiliste volumique et un segment linéaire opaque figurant le profil fonctionnel de la densité théorique estimée, dissipant toute ambiguïté sur la modélisation sous-jacente.
11. Résolution des dysfonctionnements fréquents et pièges d’implémentation
11.1 Le piège de la réinitialisation silencieuse des styles
L’un des dysfonctionnements les plus déroutants rencontrés par les praticiens utilisant Matplotlib réside dans la perte inattendue des assignations chromatiques lors de la substitution empirique des étiquettes. Lorsqu’un analyste transmet imprudemment une simple liste de chaînes textuelles lors de l’invocation finale de la légende sans fournir préalablement les poignées correspondantes, Matplotlib lie aveuglément ces libellés aux premiers objets artistiques recensés dans la mémoire de l’axe.
Si la figure intègre des éléments géométriques auxiliaires non destinés à figurer dans la légende, tels que des grilles de fond, des axes zéro ou des polygones de soulignement, ces composants passifs peuvent se voir attribuer indûment les étiquettes textuelles au détriment des séries de données effectives. Il en résulte un déphasage visuel destructeur : les couleurs attribuées aux étiquettes de la légende ne correspondent plus aux teintes réelles des courbes tracées sur le plan d’ordonnées, propageant des contresens majeurs lors de l’analyse des figures.
Pour prévenir cette dérive silencieuse, la bonne pratique incontournable prescrit de toujours associer formellement les poignées explicites lors de toute modification des libellés nominaux. Alternativement, l’approche la plus saine sur le plan de l’architecture logicielle consiste à renommer rigoureusement les colonnes du tableau de données en amont de l’appel graphique via la méthode de renommage dédiée dans Pandas. Cette hygiène de programmation élimine le besoin de substitution différée et préserve l’intégrité de la chaîne de liaison sémiotique.
11.2 Conflit entre l’argument legend de Pandas et l’appel Matplotlib
Un écueil classique d’implémentation découle de l’interférence conflictuelle entre les automatismes de tracé de Pandas et les appels de personnalisation procéduraux de Matplotlib. Par défaut, la commande de tracé du tableau de données intègre un comportement autonome qui instancie immédiatement une légende dans la zone de tracé dès la fin de l’évaluation du tracé, sans attendre d’éventuelles instructions complémentaires de l’utilisateur.
Si le développeur enchaîne ensuite avec un appel explicite pour configurer un positionnement externe complexe sans avoir désactivé la première instance, il déclenche involontairement la cohabitation de deux boîtes de légende rivales au sein de la même figure : la légende native produite implicitement par Pandas demeure active à l’intérieur de la boîte cartésienne tandis que la seconde vient s’ancrer dans la marge extérieure, saturant la composition d’éléments redondants et disgracieux.
La neutralisation absolue de ce conflit impose d’inhiber systématiquement la génération native de Pandas en transmettant le paramètre booléen désactivant la légende directement au sein de l’instruction de tracé initiale. En dégageant le conteneur d’axes de cette construction prématurée, l’analyste s’arroge un contrôle total et exclusif sur l’instanciation de sa légende via l’API orientée objet de Matplotlib, évitant toute duplication involontaire de composants graphiques.
11.3 Légendes invisibles, tronquées ou écrasées par le redimensionnement
La disparition inopinée d’une légende à la suite d’une opération de redimensionnement de figure constitue une source récurrente de frustration. Ce problème survient particulièrement lors de l’utilisation de coordonnées d’ancrage déportées dont l’évaluation scalaire relative projette l’élément graphique bien au-delà de la zone de visibilité matricielle du système de rendu virtuel, conduisant le moteur à tracer l’objet dans un néant spatial invisible pour l’observateur.
Cette pathologie est particulièrement fréquente lors des transitions d’environnements d’exécution, notamment lorsqu’un flux de travail développé de manière interactive au sein d’un carnet computationnel type Jupyter Notebook est converti en script exécutable par lots sans interface d’affichage dynamique. Les backends de rendu headless adoptent des comportements d’écrêtage géométrique stricts qui expulsent impitoyablement tout élément non expressément inclus dans le calcul de la boîte englobante principale de la figure.
Le traitement définitif de ce dysfonctionnement combine l’application rigoureuse du paramètre de calcul serré de la boîte de découpage lors des sauvegardes automatisées et le dimensionnement proportionnel initial de la figure dès sa déclaration d’instanciation. En définissant des dimensions absolues de canevas aptes à accueillir la zone de données augmentée de la largeur attendue du panneau descriptif externe, on garantit une stabilité géométrique immuable quel que soit le moteur d’affichage sollicité par le script.
12. Standards académiques de publication et accessibilité graphique
12.1 Directives de publication pour les revues scientifiques
La diffusion de résultats dans des revues internationales de premier rang impose une conformité sans faille avec des directives éditoriales très contraignantes en matière d’art graphique. Les cahiers des charges scientifiques exigent en premier lieu une résolution matricielle minimale de trois cents à six cents points par pouce pour les figures pixellisées, voire une livraison sous format vectoriel exclusif afin de préserver l’intégrité chirurgicale des polices typographiques et des segments lors des opérations de mise en page professionnelle.
Un enjeu majeur réside dans la résistance de la légende aux réductions d’échelle massives inhérentes à l’impression sur deux colonnes standardisée dans la majorité des publications périodiques. Une boîte de légende parfaitement calibrée sur un écran d’ordinateur de haute résolution peut devenir microscopique et totalement indéchiffrable une fois réduite à une largeur de colonne d’environ huit centimètres, imposant de concevoir la taille relative des caractères et des poignées pour un facteur de réduction sévère.
Enfin, la normalisation linguistique et terminologique ne tolère aucun laxisme. Toutes les grandeurs physiques doivent impérativement mentionner leurs symboles conventionnels et leurs unités rattachées au Système International d’Unités, soigneusement délimitées entre crochets ou parenthèses selon les conventions disciplinaires en vigueur. Tout acronyme technique interne au code d’ingénierie doit être scrupuleusement banni au profit du concept scientifique formellement désigné.
12.2 Accessibilité universelle et conception pour déficiences chromatiques
L’éthique de la recherche moderne et les réglementations internationales imposent de concevoir des représentations visuelles accessibles à l’ensemble du lectorat, en prêtant une attention aiguë aux anomalies de vision chromatique affectant une part significative de la population mondiale, telles que la deutéranopie ou la protanopie. Fonder la seule distinction sémiotique d’une légende sur l’opposition chromatique de nuances de rouge et de vert constitue un manquement méthodologique grave qui interdit la discrimination visuelle des séries pour les personnes affectées.
Pour immuniser une figure contre ce déficit de lisibilité, le principe directeur réside dans la redondance obligatoire des canaux d’encodage sémiotique. Une nuance de teinte ne doit jamais opérer seule : elle doit impérativement être secondée par une modulation morphologique concomitante, qu’il s’agisse de l’alternance de motifs de tiretés sur les courbes ou de la diversification des glyphes géométriques employés pour ponctuer les séries d’observations continues.
Avant toute validation finale, il est impératif de soumettre la figure achevée à des algorithmes de simulation de daltonisme simulant fidèlement la dégradation perceptive sous diverses dyschromatopsies. Si sous une simulation monochrome intégrale la légende demeure capable de guider sans équivoque le lecteur vers la trajectoire correcte grâce à la structure de ses segments et de ses symboles, le document atteint le standard d’excellence requis pour une publication universelle pérenne.
12.3 Matrice de contrôle méthodologique pour la validation d’une figure
Avant d’intégrer une visualisation au sein d’un manuscrit soumis à évaluation par les pairs ou d’un rapport stratégique d’aide à la décision, il est salutaire de confronter systématiquement chaque figure à une grille d’audit méthodologique rigoureuse. Le premier critère de contrôle concerne l’univocité sémiotique absolue : pour chaque élément géométrique singulier tracé sur la scène cartésienne, il doit exister une poignée et une seule lui correspondant de manière univoque au sein de la légende de référence.
Le second volet de l’audit examine la concision informative et la chasse impitoyable aux fioritures superflues, qualifiées d’encre inutile par les théoriciens du design statistique. Toute mention textuelle redondante qui duplique inutilement un titre d’axe d’ordonnées ou une formulation évidente doit être impitoyablement élaguée. La légende doit synthétiser l’essence de la structuration des données sans consommer un seul millimètre carré qui ne soit directement porteur de sens pour le destinataire de la visualisation.
Le dernier critère, et sans doute le plus fondamental, réside dans l’autonomie conceptuelle complète de la figure. Une représentation scientifique accomplie doit être parfaitement intelligible par elle-même, permettant à un lecteur averti de décrypter l’intégralité du phénomène empirique consigné, de situer ses conditions d’échantillonnage et de mesurer ses écarts significatifs sans avoir besoin de se référer au corps de texte principal du manuscrit, la légende opérant comme la clé de voûte de cette émancipation cognitive.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 56-61). https://doi.org/10.25080/Majora-92bf1924-00a
- Rouhier, N., & Rougier, N. P. (2021). Scientific Visualization: Python + Matplotlib. Zenodo. https://doi.org/10.5281/zenodo.5194481
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2e éd.). Graphics Press.
- W3C. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. World Wide Web Consortium. https://www.w3.org/TR/WCAG21/
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3-28. https://doi.org/10.1198/jcgs.2009.07098