
L’analyse quantitative moderne repose fondamentalement sur la capacité des analystes et des chercheurs à segmenter des flux d’informations continus selon des dimensions spatio-temporelles précises. Dans l’écosystème des tableurs infonuagiques contemporains, Google Sheets s’est imposé comme un environnement de calcul distribué incontournable, offrant des abstractions fonctionnelles capables d’interroger des matrices de données hétérogènes sans nécessiter le déploiement immédiat d’une infrastructure de base de données relationnelle lourde. Au cœur de cette panoplie d’outils analytiques se trouve l’évaluation conditionnelle multidimensionnelle, matérialisée par des fonctions capables de filtrer, d’agréger et de dénombrer des observations selon des critères logiques conjonctifs.
Le traitement des variables chronologiques constitue l’un des défis méthodologiques les plus fréquents et les plus délicats lors de la structuration de modèles décisionnels. Contrairement aux variables catégorielles statiques, les dates représentent des grandeurs continues ordonnées, sujettes à des contraintes de granularité temporelle, d’encodage séquentiel et de conventions régionales de formatage. L’estimation précise du volume d’événements survenant au sein d’une fenêtre temporelle délimitée — qu’il s’agisse de cohortes d’utilisateurs, de transactions financières ou d’incidents logistiques — exige une maîtrise absolue des mécanismes d’évaluation relationnelle.
Cet article propose une exploration systématique, théorique et appliquée de la fonction COUNTIFS exploitée conjointement avec des plages temporelles bornées dans Google Sheets. À travers une démarche analytique rigoureuse, nous examinerons les fondements arithmétiques de la représentation temporelle dans les moteurs de calcul, la syntaxe d’encapsulation des opérateurs logiques, les compromis de performance sur les volumétries massives et les architectures alternatives offertes par les fonctions matricielles. L’objectif est de doter les praticiens de la modélisation de données d’un cadre conceptuel complet et immédiatement opérationnel pour fiabiliser leurs analyses longitudinales.
1. Introduction théorique et fondements de la fonction COUNTIFS dans Google Sheets
1.1 Définition formelle et rôle du dénombrement multicritère
Dans la théorie des ensembles appliquée aux bases de données tabulaires, le dénombrement conditionnel consiste à calculer le cardinal d’un sous-ensemble d’observations dont les attributs satisfont une proposition logique composée. La fonction COUNTIFS — désignée sous l’appellation francophone NB.SI.ENS dans la documentation officielle de Google Sheets — constitue l’extension multivariée directe de la fonction univariée COUNTIF (ou NB.SI). Tandis que cette dernière ne permet d’appliquer qu’un prédicat unique à un vecteur de données unidimensionnel, COUNTIFS autorise l’intersection simultanée de multiples prédicats appliqués à des plages distinctes ou superposées, opérant selon une conjonction logique stricte.
D’un point de vue méthodologique, l’analyse empirique contemporaine requiert rarement des agrégations fondées sur un facteur unique. Les jeux de données collectés dans le cadre de recherches quantitatives, d’études cliniques ou d’analyses de performance opérationnelle présentent une structure multidimensionnelle où les enregistrements doivent être filtrés simultanément selon leur appartenance catégorielle, leur amplitude quantitative et leur ancrage chronologique. L’évaluation de prédicats multiples au sein d’une même instruction matricielle évite le recours à des colonnes intermédiaires de filtrage booléen, préservant ainsi la pureté structurelle du modèle de données et minimisant la surcharge de calcul.
La différenciation entre le dénombrement univarié et multivarié s’avère particulièrement critique lors de la manipulation d’intervalles continus. Alors qu’une condition univariée peut aisément isoler les entités postérieures à un instant spécifique, la modélisation d’une période circonscrite — caractérisée simultanément par une borne inférieure et une borne supérieure — exige par essence la vérification simultanée de deux inégalités. Dès lors, le dénombrement d’occurrences au sein d’un segment temporel fini relève structurellement du domaine du dénombrement multicritère, conférant à COUNTIFS un rôle central dans l’analyse de données temporelles.
1.2 Typologie des données temporelles dans les tableurs infonuagiques
L’architecture interne des tableurs électroniques modernes, héritée des premiers développements de Lotus 1-2-3 et de Microsoft Excel, repose sur un modèle d’encodage séquentiel pour la manipulation des valeurs chronologiques. Dans le moteur d’exécution de Google Sheets, une date n’est fondamentalement pas stockée sous la forme textuelle qu’elle arbore à l’écran, mais sous la forme d’un nombre réel séquentiel (ou numéro de série). La partie entière de cette valeur scalaire quantifie le nombre de jours solaires écoulés depuis un point d’origine arbitraire, tandis que la fraction décimale représente la fraction écoulée de la journée, matérialisant ainsi l’horodatage en heures, minutes et fractions de seconde.
Cette abstraction mathématique produit des conséquences directes sur les opérations de comparaison logique. Lorsqu’une formule évalue si une date enregistrée se situe chronologiquement après une date de référence, le moteur procède à une comparaison d’inégalité arithmétique standard sur des valeurs à virgule flottante. Cependant, la présence d’une composante horaire non nulle dans un enregistrement modifie substantiellement le résultat de l’évaluation : un événement survenu le 15 mars à 14 heures 30 minutes correspond à une valeur décimale strictement supérieure à celle attribuée au 15 mars à 00 heure 00 minute. Tout protocole d’interrogation doit donc anticiper cette distinction entre date pure (entière) et horodatage composite (décimal).
Par ailleurs, la normalisation des représentations textuelles des dates représente une source pérenne d’ambiguïtés computationnelles. Les conventions régionales divergent significativement : la notation nord-américaine (mois/jour/année) s’oppose frontalement au standard européen (jour/mois/année). Le standard international ISO 8601 (AAAA-MM-JJ) a été conçu pour pallier cette confusion en établissant une hiérarchie lexicographique décroissante universelle. Dans Google Sheets, la mauvaise interprétation d’une chaîne de caractères due à un décalage de paramètres régionaux (locale) peut transformer silencieusement une date valide en une chaîne non reconnue ou inverser le jour et le mois, faussant irrémédiablement les agrégations de la fonction COUNTIFS.
2. Compréhension de la structure et de la syntaxe fondamentale de COUNTIFS
2.1 Décomposition mathématique de la signature de la fonction
La signature formelle de la fonction COUNTIFS se déploie à travers une suite ordonnée d’arguments disposés par paires alternées. La syntaxe canonique s’énonce comme suit : COUNTIFS(plage_critère1, critère1, [plage_critère2, critère2, …]). Dans cette modélisation fonctionnelle, chaque plage_critère représente un sous-ensemble vectoriel ou matriciel de cellules à inspecter, tandis que le critère associé spécifie le prédicat d’appartenance logique que chaque élément de la plage correspondante doit valider pour être retenu dans le décompte global.
Une exigence architecturale fondamentale imposée par le moteur de Google Sheets réside dans la symétrie dimensionnelle stricte de toutes les plages d’évaluation fournies en argument. Si le premier vecteur plage_critère1 correspond à un segment vertical de dimensions N lignes sur 1 colonne, l’ensemble des plages ultérieures (plage_critère2 jusqu’à plage_critèreK) doit obligatoirement posséder une topologie rigoureusement identique de N lignes sur 1 colonne. Toute déviation géométrique — par exemple la comparaison d’un vecteur de 100 lignes avec un vecteur de 99 lignes — provoque l’interruption immédiate de l’évaluation et renvoie une erreur de dimensionnalité de type #VALUE!.
Le moteur d’inférence de COUNTIFS applique un opérateur booléen d’intersection (ET logique implicite) sur l’ensemble des critères déclarés. Cela signifie qu’un enregistrement positionné à l’indice i ne contribue à l’incrémentation du compteur final que si, et seulement si, la condition 1 est vraie pour la cellule i de la plage 1, ET la condition 2 est vraie pour la cellule i de la plage 2, et ainsi de suite pour l’ensemble des paires définies. Cette logique ensembliste pure garantit que la fonction calcule précisément l’intersection des sous-espaces répondant à chaque contrainte individuelle, éliminant tout comportement disjonctif (OU logique) dans sa formulation standard.
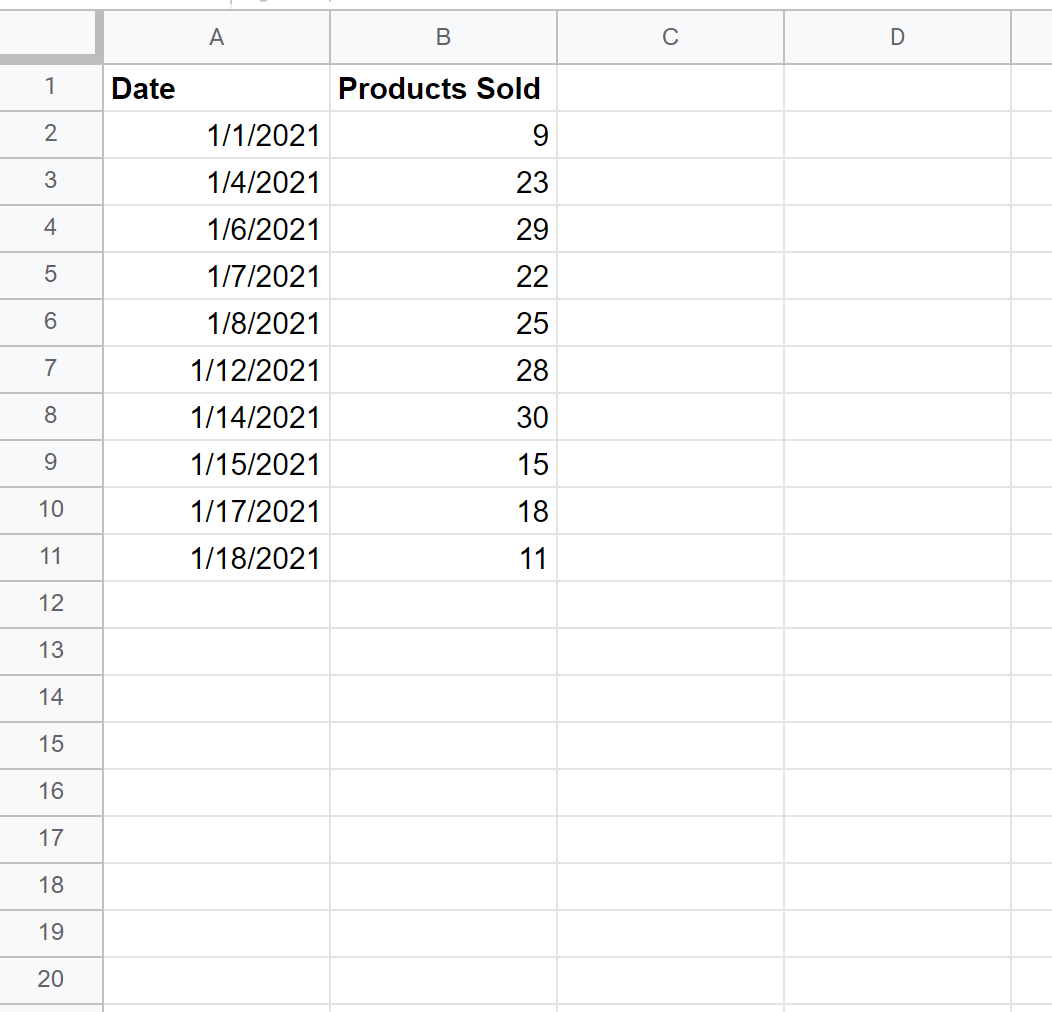
2.2 Traitement des critères et flexibilité syntaxique
L’évaluation des critères au sein de COUNTIFS s’appuie sur un analyseur syntaxique spécifique qui interprète des expressions textuelles pour configurer les comparateurs relationnels. Lorsqu’une condition requiert l’application d’un opérateur de comparaison arithmétique (égal, différent, strictement supérieur, strictement inférieur, supérieur ou égal, inférieur ou égal), l’opérateur doit impérativement être encapsulé sous la forme d’une chaîne de caractères délimitée par des guillemets doubles anglais. À titre d’exemple, pour évaluer la stricte supériorité par rapport à la constante numérique 100, la chaîne « >100 » doit être fournie en tant qu’argument de critère.
Le système autorise néanmoins le passage de valeurs scalaires directes lorsque l’opération visée est une stricte égalité d’identité. Ainsi, la fourniture du nombre 42 ou de la chaîne « Terminé » sans opérateur explicite est interprétée par le moteur comme équivalente aux expressions relationnelles « =42 » ou « =Terminé ». Toutefois, dès lors que l’inégalité intervient, le symbole comparateur doit être intégré à l’argument textuel. Cette spécificité syntaxique impose une rigueur particulière lors de la manipulation de références dynamiques, où la chaîne de l’opérateur doit être fusionnée avec la valeur contenue dans une cellule hôte.
En ce qui concerne les critères textuels, l’analyseur de Google Sheets intègre nativement la reconnaissance de métacaractères de substitution (wildcards). Le point d’interrogation (?) correspond à un caractère unique quelconque, tandis que l’astérisque (*) correspond à une séquence indéterminée de zéro, un ou plusieurs caractères textuels. Le tilde (~) opère quant à lui comme un caractère d’échappement permettant de rechercher littéralement un astérisque ou un point d’interrogation. Bien que ces caractères génériques soient réservés aux chaînes alphabétiques et s’avèrent inopérants sur les nombres de série purs des dates, leur existence souligne la nature polymorphe de l’analyseur de critères de COUNTIFS.
3. Mécanismes sous-jacents de la gestion des formats de dates dans Google Sheets
3.1 Représentation interne et valeur d’époque
Pour appréhender sans faille le dénombrement temporel, il est impératif d’examiner le référentiel chronologique fondamental sur lequel s’articule le moteur de calcul. Google Sheets synchronise son calendrier interne sur l’époque de référence fixée au 30 décembre 1899 à minuit. Cette date charnière correspond à la valeur séquentielle zéro (0,0). Chaque unité entière positive additionnée à cette valeur représente l’avancement d’un jour calendaire complet dans le temps futur, tandis que les valeurs négatives permettent de modéliser des époques antérieures à ce point zéro.
En vertu de cette modélisation mathématique, le 1er janvier 1900 est représenté par le numéro séquentiel 2, et une date contemporaine telle que le 1er janvier 2024 correspond au nombre séquentiel 45292. Cette conversion algorithmique sous-jacente signifie que toute inégalité formulée à l’égard d’une date constitue en réalité une simple comparaison d’ordre arithmétique sur l’ensemble des nombres réels. Lorsqu’un utilisateur formule la condition chronologique supérieure ou égale au 1er janvier 2024, le sous-système de calcul résout l’expression arithmétique sous la forme sous-jacente supérieure ou égale à 45292.
Cette abstraction élégante confère aux opérations temporelles une vélocité computationnelle maximale au sein du processeur, les comparaisons de chaînes de caractères étant considérablement plus gourmandes en cycles machine que les comparaisons d’entiers ou de flottants. Cependant, cette mécanique repose intégralement sur le postulat que les cellules contenant les dates ont fait l’objet d’une sérialisation valide au moment de leur saisie ou de leur importation dans le classeur, condition sine qua non de l’intégrité de toute formule d’agrégation.
3.2 Divergences entre affichage textuel et valeur séquentielle
L’une des anomalies les plus pernicieuses dans l’exploitation des fonctions d’agrégation conditionnelle réside dans la confusion entre l’affichage visuel d’une cellule et sa typologie interne de stockage. Une cellule affichant la séquence textuelle « 15/01/2024 » peut en réalité correspondre à deux états binaires fondamentalement distincts : un nombre séquentiel formaté selon le masque de présentation calendaire, ou une chaîne de caractères littérale (String) composée des dix glyphes graphiques composant la date. Pour approfondir la théorie de ces représentations, on consultera avec profit les travaux fondateurs sur les bases de données temporelles.
Si la date est stockée en tant que texte pur — événement survenant fréquemment lors de l’importation de fichiers CSV mal typés ou de l’extraction de données via des scripts externes — les opérateurs de comparaison arithmétique échouent silencieusement. Le moteur de Google Sheets applique en effet un ordre de tri interne dans lequel toute chaîne de caractères textuelle est arbitrairement considérée comme ayant une magnitude supérieure à n’importe quelle valeur numérique. Par conséquent, une condition arithmétique telle que « inférieure ou égale au 31/12/2024 » rejettera systématiquement les dates stockées sous forme de texte, ou produira des résultats aberrants lors des évaluations d’inégalité.
Pour garantir la robustesse des chaînes d’analyse, il est impératif d’implémenter des protocoles d’audit et de nettoyage préalable. La fonction native ISDATE permet de soumettre chaque cellule d’un échantillon à un test formel de validité temporelle, renvoyant la valeur booléenne VRAI uniquement lorsque le contenu est reconnu comme une entité chronologique exploitable. En cas d’altération généralisée des formats, le recours combiné aux fonctions DATEVALUE (qui convertit une chaîne textuelle conforme en son numéro de série équivalent) ou à des formules d’extraction par expressions régulières s’avère indispensable pour assainir les colonnes d’observation avant tout appel à COUNTIFS.
4. Construction de la formule élémentaire pour une plage temporelle fermée
4.1 Définition des bornes inclusives supérieure et inférieure
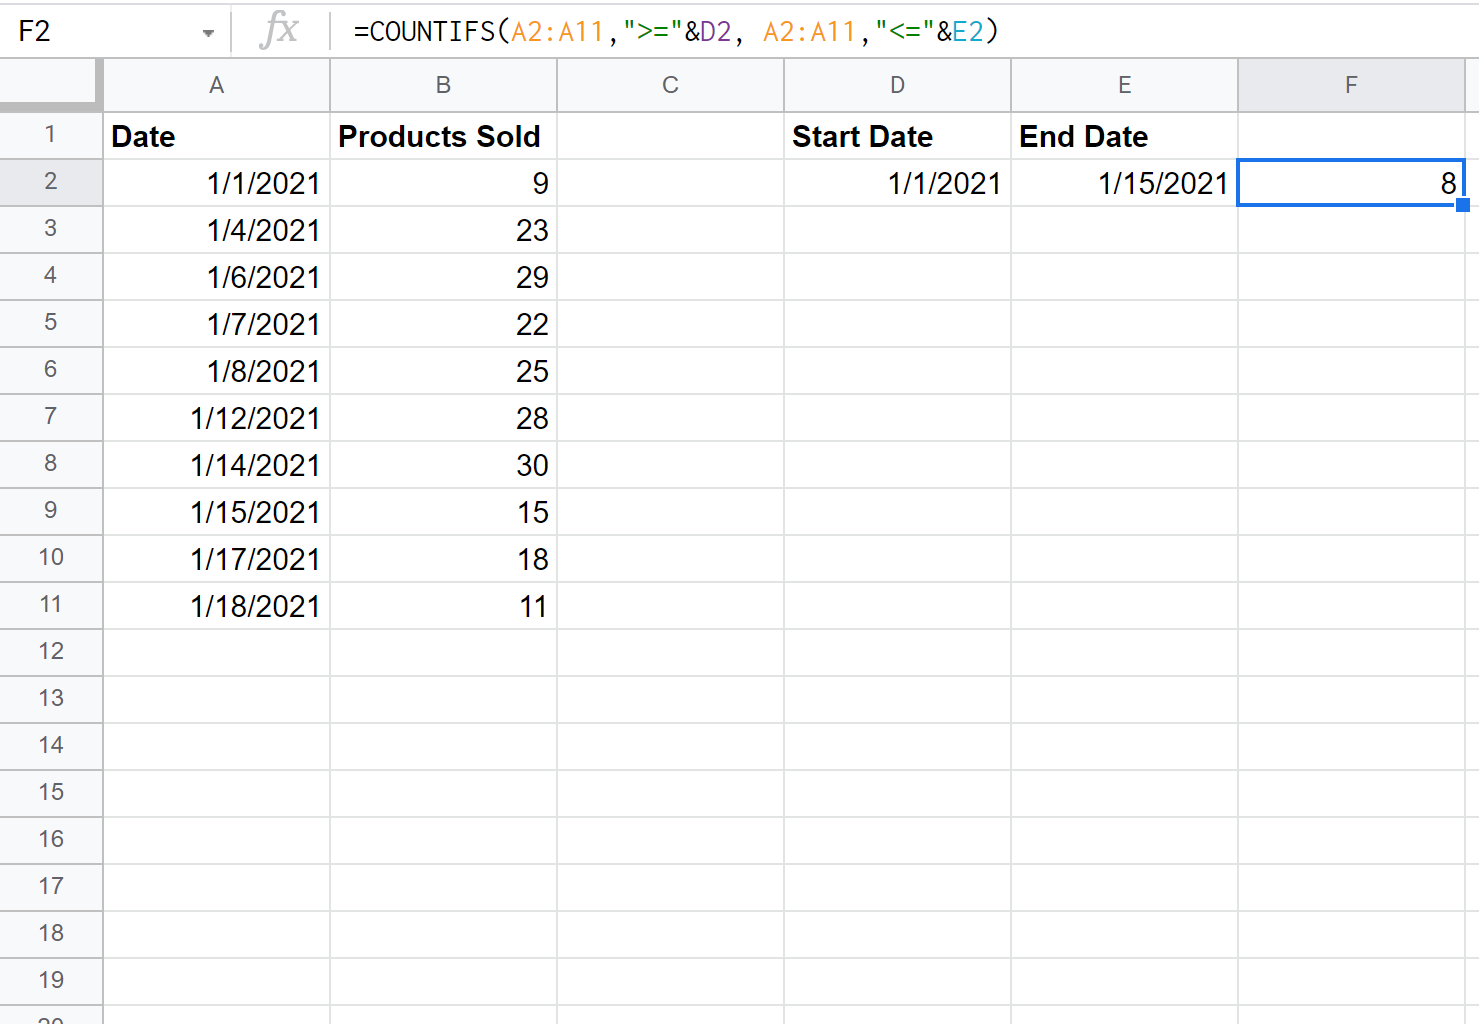
La délimitation d’une fenêtre chronologique fermée représente la configuration la plus classique en analyse de données tabulaires. Un intervalle fermé [T1, T2] exige la capture de tous les événements dont l’horodatage est simultanément postérieur ou égal à l’instant initial T1, et antérieur ou égal à l’instant final T2. Cette structure garantit que les observations coïncidant exactement avec les limites de la fenêtre sont rigoureusement incorporées dans l’agrégation, assurant ainsi la parfaite continuité mathématique des cohortes temporelles adjacentes.
Dans l’architecture de COUNTIFS, la formalisation de cet intervalle fermé nécessite la mobilisation d’un même vecteur de dates répété deux fois dans la liste des arguments, chacune des occurrences étant associée à une demi-droite d’inégalité distincte. La première condition établit la borne inférieure au moyen de l’opérateur relationnel supérieur ou égal (>=), matérialisant l’inclusion de tous les points temporels situés à droite de T1 sur l’axe chronologique. La seconde condition érige la borne supérieure par le biais de l’opérateur inférieur ou égal (<=), restreignant le spectre aux seuls points situés à gauche de T2.
L’agrégation conjonctive opérée par le moteur réalise l’intersection géométrique stricte de ces deux demi-droites, isolant de façon univoque le segment linéaire compris entre T1 et T2. Cette formulation garantit l’invariance du dénombrement, quelle que soit la densité des événements distribués au sein de la plage. Dès lors que les deux prédicats pointent vers la même colonne d’observation temporelle, chaque ligne subit consécutivement le double test d’encadrement arithmétique avant d’être validée par l’accumulateur de la fonction.
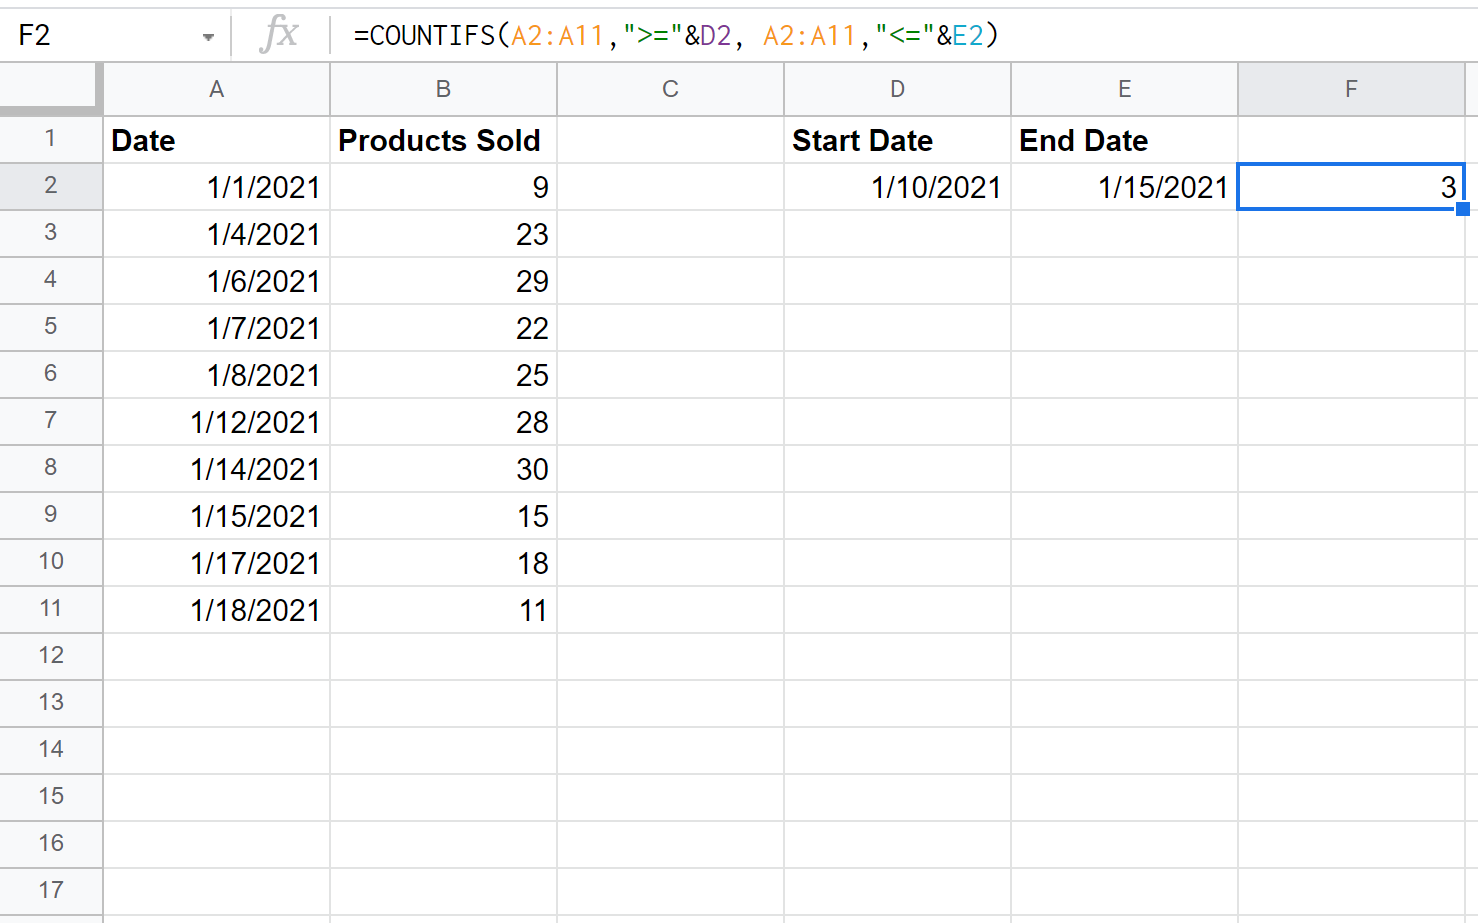
4.2 Anatomie de l’expression type : COUNTIFS(A2:A11, « >= » & D2, A2:A11, « <= " & E2)
L’expression fonctionnelle canonique matérialisant un encadrement temporel dynamique se structure rigoureusement selon la formule suivante : COUNTIFS(A2:A11, « >= » & D2, A2:A11, « <= " & E2). L'analyse détaillée de cette écriture révèle les mécanismes subtils de construction de requêtes propres à Google Sheets. La plage vectorielle A2:A11 constitue le champ d'observation primaire hébergeant la suite chronologique des données à quantifier. Les cellules D2 et E2 hébergent respectivement la date de départ et la date d'achèvement de la fenêtre d'investigation.
L’élément syntaxique déterminant de cette construction réside dans l’emploi de l’opérateur de concaténation typographique, matérialisé par l’esperluette (&). L’analyseur lexical de Google Sheets exige que le comparateur relationnel et la valeur de référence soient transmis au moteur de calcul sous la forme d’une entité textuelle unifiée. L’expression « >= » & D2 prend la chaîne de caractères statique contenant l’opérateur et y accole la valeur séquentielle résultant de l’évaluation dynamique de la cellule D2. Si la cellule D2 contient la date du 1er janvier 2024 (correspondant au numéro de série 45292), l’opération de concaténation engendre la chaîne textuelle formelle « >=45292 ».
Lors de la phase d’exécution, le moteur de calcul résout en premier lieu les adresses de cellules D2 et E2, effectue les concaténations respectives pour construire les chaînes de prédicats internes, puis initialise un pointeur d’itération sur la première ligne de la plage A2:A11. Pour chaque cellule Ai comprise dans l’intervalle, la valeur numérique sous-jacente est comparée au critère inférieur puis au critère supérieur. Si la double inégalité est satisfaite, le registre accumulateur est incrémenté d’une unité scalaire. Ce processus se poursuit de façon séquentielle jusqu’à la cellule A11, fournissant en sortie le cardinal absolu du sous-ensemble temporel recherché.
5. Gestion des opérateurs de comparaison et concaténation avec des références de cellules
5.1 Sémantique rigoureuse des opérateurs relationnels
Le choix des opérateurs arithmétiques au sein des prédicats gouverne la topologie ouverte ou fermée des frontières d’échantillonnage. La distinction conceptuelle entre une borne stricte (strictement supérieur > ou strictement inférieur = ou inférieur ou égal <=) revêt une importance capitale lors de la manipulation d'agrégats statistiques continus. L'omission accidentelle de l'égalité sur l'une des bornes entraîne l'éviction systématique des événements survenus précisément à la date charnière, induisant des biais d'échantillonnage substantiels lors des transitions périodiques.
Considérons à titre d’illustration le partitionnement d’un jeu de données annuel en douze cohortes mensuelles. Si l’analyste utilise une borne inclusive pour la clôture d’un mois (« = 31/01/2024 »), les observations enregistrées au jour charnière du 31 janvier subiront un double comptage non conservateur, corrompant la somme globale annuelle. Inversement, l’emploi exclusif d’opérateurs stricts sur les deux bornes consécutives exclura totalement la journée charnière de tout décompte. La modélisation rigoureuse exige une asymétrie contrôlée, typiquement de la forme [Date_Début <= Date < Date_Fin], garantissant que chaque quantum temporel appartient à une partition unique et disjointe.
Dans des configurations analytiques particulières, l’opérateur d’inégalité () s’avère indispensable pour exclure explicitement des jalons calendaires atypiques au sein d’une période donnée, tels que des jours fériés légaux ou des périodes d’interruption technique programmée. L’insertion du critère » » & F2 au sein de l’instruction COUNTIFS permet d’élaguer ponctuellement une date singulière référencée en cellule F2, tout en conservant l’intégrité de la fenêtre d’observation globale définie par les autres arguments conjonctifs de la formule.
5.2 Typologie des erreurs de concaténation syntaxique
La formulation des critères combinant opérateurs et références de cellules constitue la zone de vulnérabilité syntaxique la plus critique pour les utilisateurs de Google Sheets. L’erreur la plus ubiquitaire réside dans l’inclusion involontaire du libellé de la cellule à l’intérieur des guillemets doubles régissant la chaîne littérale, produisant une écriture de la forme COUNTIFS(A2:A11, « >=D2 », …). Dans ce cas de figure, l’analyseur ne résout pas la variable D2 vers sa valeur sous-jacente ; il recherche littéralement les cellules contenant la chaîne alphabétique brute « D2 », ce qui conduit invariablement à un résultat nul sans lever la moindre alerte d’erreur explicite.
Une autre anomalie syntaxique fréquente provient de l’omission pure et simple du symbole de concaténation (&), matérialisée par l’écriture invalide COUNTIFS(A2:A11, « >= » D2, …). Cette configuration déclenche immédiatement une erreur d’analyse structurelle (#ERROR!), le moteur étant incapable d’interpréter la juxtaposition d’un littéral textuel et d’un identifiant de cellule non liés par un opérateur grammatical reconnu. L’intégrité de la liaison exige la présence explicite du caractère esperluette, agissant comme connecteur binaire entre l’opérateur relationnel et la référence scalaire.
Enfin, l’insertion intempestive d’espaces typographiques au sein de l’opérateur composé lui-même représente un piège silencieux redoutable. Si l’écriture « >= » & D2 est parfaitement tolérée grâce à la flexibilité de l’analyseur qui ignore les espaces situés après l’opérateur de comparaison, l’introduction d’une césure entre les deux symboles d’inégalité — sous la forme « > = » & D2 — détruit la cohésion du jeton lexical. Le moteur ne parvient pas à réconcilier cette suite de caractères avec la table des opérateurs valides et neutralise l’évaluation logique du critère correspondant.
6. Insertion directe de dates sous forme de chaînes de caractères versus références dynamiques
6.1 Approche codée en dur (Hardcoding) et contraintes associées
L’insertion directe de constantes de date au sein des arguments de critères — pratique communément désignée sous le vocable de codage en dur (hardcoding) — consiste à inscrire textuellement la valeur temporelle complète entre les guillemets de l’opérateur, à l’exemple de COUNTIFS(A2:A11, « >=01/01/2024 », A2:A11, « <=31/12/2024"). Bien que cette approche présente un attrait immédiat lors de phases de prototypage rapide en raison de sa compacité textuelle, elle introduit de sévères vulnérabilités de maintenance et de portabilité algorithmique.
Le principal écueil du codage en dur réside dans sa sensibilité aiguë aux paramètres régionaux de la feuille de calcul. Une chaîne codée sous la forme « 05/06/2024 » sera interprétée comme le 5 juin 2024 dans un environnement configuré selon la locale française, mais sera silencieusement résolue comme le 6 mai 2024 dans un classeur paramétré selon les standards des États-Unis. Si le classeur est partagé entre des collaborateurs opérant sous des configurations régionales hétérogènes ou si les métadonnées de localisation de la feuille sont modifiées, l’intégralité des calculs temporels s’en trouve faussée sans qu’aucun message d’erreur ne vienne avertir l’utilisateur.
Pour immuniser les formules codées en dur contre les distorsions régionales, il est techniquement envisageable d’encapsuler la fonction DATE à l’intérieur de la concaténation, sous la structure formelle : COUNTIFS(A2:A11, « >= » & DATE(2024, 1, 1), A2:A11, « <= " & DATE(2024, 12, 31)). La fonction DATE(année, mois, jour) accepte des entiers stricts et élimine toute équivoque d’inversion entre jour et mois. Néanmoins, cette méthode conserve le défaut rédhibitoire de cristalliser les paramètres d’analyse au sein même du code de la formule, générant une dette technique substantielle dès lors que le modèle doit évoluer.
6.2 Paradigme de modélisation par cellules de contrôle dynamiques
En ingénierie des modèles financiers et décisionnels, l’adoption du principe de séparation stricte entre la couche de données, la couche de paramétrage et la couche d’agrégation analytique constitue une bonne pratique universelle. L’extériorisation des bornes temporelles au sein de cellules de contrôle dédiées — distinctes des matrices de calcul — permet de transformer une formule statique en un moteur d’interrogation dynamique hautement adaptable et auditable.
Dans ce paradigme de conception, des cellules spécifiques (telles que B1 pour la date initiale et B2 pour la date finale) sont formellement isolées et étiquetées pour accueillir les variables d’ajustement temporel. La formule COUNTIFS pointe exclusivement vers ces coordonnées spatiales par concaténation référentielle. Cette découplage structurel offre la possibilité d’itérer instantanément sur de multiples fenêtres d’observation par simple modification de la valeur saisie en cellule de contrôle, l’ensemble des dépendances en aval du graphe de calcul étant automatiquement réévalué par le moteur de propagation d’événements de Google Sheets.
De surcroît, ce modèle simplifie considérablement les protocoles d’audit et de vérification formelle de modèles de données complexes. Les auditeurs peuvent inspecter et valider les paramètres temporels d’entrée sans avoir à déconstruire les expressions internes imbriquées dans des centaines de formules matricielles. L’intégrité référentielle s’en trouve pérennisée, et l’intégration ultérieure de composants d’interface utilisateur — tels que des sélecteurs de date interactifs basés sur la validation des données — s’effectue sans aucune altération de l’infrastructure de calcul sous-jacente.
7. Traitement des plages de dates semi-ouvertes et filtres unilatéraux
7.1 Modélisation des fenêtres temporelles cumulatives unilatérales
Toutes les interrogations de séries chronologiques ne s’inscrivent pas dans le cadre de fenêtres bidirectionnelles fermées. L’analyse rétrospective et l’analyse de survie requièrent fréquemment l’observation de plages semi-ouvertes, au sein desquelles une seule frontière temporelle est imposée. Ces topologies correspondent conceptuellement à des rayons ou des demi-droites sur l’axe chronologique, permettant de dénombrer des événements cumulés depuis l’origine jusqu’à un instant pivot, ou inversement, l’ensemble des événements postérieurs à un jalon historique sans restriction de fin.
Pour modéliser une plage cumulative ouverte à droite (évaluant tous les enregistrements postérieurs ou égaux à une date seuil T1), la fonction COUNTIFS peut structurellement être simplifiée en réduisant ses arguments à une seule paire vecteur-critère, sous la forme : COUNTIFS(A2:A, « >= » & D2). Sur le plan théorique, cette opération équivaut strictement à l’utilisation de la fonction univariée COUNTIF(A2:A, « >= » & D2). Néanmoins, la conservation de la syntaxe COUNTIFS dans les architectures de modèles complexes est souvent préconisée pour des raisons d’homogénéité stylistique et de modularité, facilitant l’adjonction future de filtres dimensionnels supplémentaires sans restructuration intégrale de l’instruction.
Symétriquement, l’interrogation d’un passif historique s’exécute au moyen d’une plage ouverte à gauche, formalisée par l’inégalité unilatérale inférieure ou égale (« <= " & E2). Cette approche s'avère centrale pour le calcul de métriques cumulatives à date (To-Date metrics), telles que les indicateurs de type Year-To-Date (YTD) ou Month-To-Date (MTD), où le point focal d'observation capture l'exhaustivité des occurrences antérieures à la date de reporting tout en neutralisant toute fuite de données vers le futur.
7.2 Gestion des bornes manquantes ou optionnelles
Dans les interfaces décisionnelles interactives, il est fréquent qu’un utilisateur omette délibérément de renseigner l’une des bornes de filtrage temporel au sein des cellules de contrôle, exprimant ainsi implicitement le souhait de ne pas contraindre l’analyse sur cette dimension particulière. Si une formule COUNTIFS fermée classique pointe vers une cellule de borne supérieure laissée vide, le moteur interprète la valeur de cette cellule vide comme équivalente au scalaire zéro (0), correspondant au point d’origine séquentiel du 30 décembre 1899. La formule évaluera alors la condition « <=0", produisant un décompte nul ou totalement erroné.
Pour parer à cette défaillance opérationnelle, il convient d’encapsuler le dénombrement au sein d’une structure logique conditionnelle pilotée par la fonction IF (ou SI), capable d’arbitrer dynamiquement entre les différentes configurations d’entrées disponibles. La formule ci-dessous illustre ce mécanisme de sécurisation algorithmique :
IF(AND(ISBLANK(D2), ISBLANK(E2)), COUNT(A2:A), IF(ISBLANK(D2), COUNTIFS(A2:A, « = » & D2), COUNTIFS(A2:A, « >= » & D2, A2:A, « <= " & E2))))
Cette imbrication évalue systématiquement l’état d’occupation des cellules de contrôle. Si les deux bornes sont vacantes, l’expression retourne le dénombrement total non filtré via la fonction COUNT. Si seule la borne inférieure D2 est vide, la requête est commutée vers un filtre semi-ouvert à gauche. Si seule la borne supérieure E2 est absente, l’évaluation bascule en filtre semi-ouvert à droite. Ce n’est que lorsque les deux paramètres sont simultanément pourvus que la formule COUNTIFS fermée bidirectionnelle est sollicitée. Cette modélisation résiliente immunise le tableau de bord contre les comportements silencieux déviants induits par des saisies utilisateur partielles.
8. Intégration de critères qualitatifs et quantitatifs additionnels dans COUNTIFS
8.1 Croisement orthogonal entre calendrier et variables catégorielles
L’immense puissance analytique de COUNTIFS réside dans son aptitude à croiser de façon totalement orthogonale la dimension temporelle avec des attributs descriptifs discrets. Dans la quasi-totalité des architectures d’affaires, une analyse chronologique pure est insuffisante : le décompte d’activités doit être ventilé par canal d’acquisition, par typologie de produit, par statut opérationnel ou par zone géographique. La nature extensible de COUNTIFS autorise l’adjonction séquentielle de paires vecteur-critère additionnelles sans altérer la mécanique de filtrage temporel établie.
Considérons une structure tabulaire où la colonne A héberge la chronologie de création des dossiers, la colonne B le statut opérationnel de la demande (par exemple « Validé », « En attente » ou « Rejeté »), et la colonne C l’identifiant de la région géographique concernée. Le dénombrement des transactions dûment validées sur le territoire européen au cours du premier trimestre de l’exercice fiscal se formalisera par l’adjonction harmonieuse des contraintes catégorielles à la fenêtre de dates :
COUNTIFS(A2:A, « >= » & DATE(2024, 1, 1), A2:A, « <= " & DATE(2024, 3, 31), B2:B, "Validé", C2:C, "Europe")
L’intersection logique s’applique de manière symétrique à l’ensemble des quatre prédicats vectoriels. Par ailleurs, les critères textuels mobilisés conjointement aux dates peuvent tirer profit des caractères génériques mentionnés précédemment. La spécification de la condition « EUR* » pour la colonne C permettra d’agréger indifféremment les libellés « Europe_Nord », « Europe_Sud » ou « Europe_Centrale » au sein de la même enveloppe chronologique, démultipliant l’expressivité de l’interrogation sans alourdir la formule par des opérations disjonctives complexes.
8.2 Filtrage simultané sur des seuils numériques de métriques associées
Au-delà de la stratification par variables catégorielles, la modélisation de données quantitatives impose fréquemment l’application conjointe de seuils de magnitude sur des métriques scalaires associées aux événements temporels. Cette configuration se rencontre de façon typique lors de la détection d’anomalies, du filtrage de transactions d’une valeur marchande critique ou du suivi d’indicateurs de performance dépassant un plafond d’alerte sur un horizon temporel délimité.
Supposons qu’une colonne D contienne le montant unitaire des règlements financiers associés aux horodatages de la colonne A. Pour dénombrer exclusivement les règlements d’envergure majeure — arbitrairement définis comme excédant ou égalant la valeur de dix mille unités monétaires — survenus durant le second semestre civil, la formule intègre une condition numérique supplémentaire formulée avec les mêmes règles d’encapsulation relationnelle :
COUNTIFS(A2:A, « >= » & D2, A2:A, « =10000 »)
Cette approche unifiée présente un double avantage opérationnel. D’une part, elle permet d’isoler avec une concision mathématique exemplaire les segments de population répondant à des critères composites multidimensionnels. D’autre part, elle évite la prolifération de calculs d’étapes intermédiaires disséminés dans la feuille. La lisibilité de la formule demeure optimale sous réserve d’adopter une mise en forme rigoureuse, par exemple en procédant à des retours à la ligne contrôlés au sein de l’éditeur de formule de Google Sheets afin de juxtaposer visuellement chaque dimension d’observation.
9. Erreurs courantes, incohérences de types de données et protocoles de débogage
9.1 Diagnostic des décalages induits par les composants horaires
L’un des dysfonctionnements les plus déroutants observés lors de l’application d’un filtre temporel fermé découle de l’interférence masquée des composantes horaires (timestamps). Comme explicité dans notre socle conceptuel, une cellule contenant la date calendaire « 15/01/2024 » associée à une fraction temporelle « 18:30:00 » possède un numéro séquentiel valant approximativement 45292,7708. Si la borne supérieure de la formule COUNTIFS est construite à partir d’une cellule affichant la date pure « 15/01/2024 » sans spécification d’heure, sa valeur sous-jacente est rigoureusement égale à 45292,0000 (soit le 15 janvier à minuit pile).
Dès lors, l’évaluation du critère de borne supérieure (« <= " & E2) appliquera l'inégalité arithmétique 45292,7708 <= 45292,0000. Cette proposition logique étant formellement fausse, l'enregistrement intervenu dans la soirée du 15 janvier sera systématiquement et invisiblement rejeté du comptage, bien que son masque d'affichage visuel concorde en apparence avec la date limite. Ce décalage induit une sous-évaluation chronique des agrégations portant sur des données issues d'exports transactionnels automatisés, qui incorporent quasi-systématiquement des horodatages complets.
Deux architectures de remédiation permettent d’annihiler ce risque de sous-comptage :
- La troncature arithmétique à la source : Normaliser le vecteur de dates amont en éliminant la composante décimale au moyen de la fonction INT (ou ENT) appliquée à la colonne d’horodatage, ramenant chaque événement à minuit précis.
- L’extension asymétrique de la borne de clôture : Ajuster la borne supérieure au lendemain exclusif via un opérateur strict. Pour englober l’intégralité des événements du 15 janvier jusqu’à 23:59:59, la formule pose comme condition : COUNTIFS(…, A2:A, « < " & (E2 + 1)). En fixant la borne comme strictement inférieure au 16 janvier à 00:00:00, l'intégralité des micro-fractions de la journée du 15 janvier est arithmétiquement capturée avec une rigueur absolue.
9.2 Résolution des anomalies d’incompatibilité de dimensions et syntaxe
En dehors des altérations temporelles, l’écosystème d’exécution de Google Sheets est assujetti à des erreurs de cohérence structurelle qu’un protocole de débogage méthodique doit savoir identifier. L’erreur générique #VALUE! se manifeste quasi-exclusivement lorsque les plages vectorielles déclarées en arguments présentent des longueurs divergentes. Une formule stipulant COUNTIFS(A2:A100, « >= » & D2, B2:B99, « Validé ») avortera instantanément, le second vecteur comportant une cellule de moins que le premier. L’alignement dimensionnel doit être vérifié en priorité lors de toute levée d’exception de type valeur.
Un autre foyer récurrent d’incohérence provient des conflits de localisation linguistique régissant les séparateurs syntaxiques d’arguments. Selon que la feuille de calcul est paramétrée sous une locale francophone ou anglophone, le délimiteur d’arguments varie formellement entre le point-virgule (;) et la virgule (,). La tentative de copier-coller une formule rédigée selon les normes anglo-saxonnes (utilisant la virgule) dans un classeur configuré sous les paramètres régionaux français provoquera une erreur d’analyse structurelle (#ERROR!), le moteur attendant le point-virgule pour partitionner les paramètres.
Face à une formule complexe renvoyant un décompte inattendu (notamment un résultat nul suspect), la démarche diagnostique optimale consiste en une déconstruction analytique séquentielle. L’opérateur doit scinder l’instruction COUNTIFS en autant de formules COUNTIF individuelles qu’elle comporte de prédicats. L’évaluation isolée de la borne inférieure, puis de la borne supérieure, puis des critères catégoriels périphériques permet de localiser instantanément quel prédicat singulier engendre l’exclusion non anticipée des enregistrements, circonscrivant ainsi la zone de correction typologique ou syntaxique.
10. Optimisation des performances sur des ensembles de données massifs ou longitudinaux
10.1 Coût computationnel et impact sur la réactivité du classeur
Bien que Google Sheets dissimule la complexité de son infrastructure derrière une interface web fluide, le moteur de calcul JavaScript sous-jacent exécute ses processus sur des ressources distribuées allouées dynamiquement par les serveurs de calcul de Google. L’évaluation de fonctions de type COUNTIFS sur des matrices longitudinales denses — excédant plusieurs dizaines ou centaines de milliers d’enregistrements — génère une charge computationnelle dont la complexité temporelle algorithmique s’élève à l’ordre O(N * K), où N quantifie le volume de lignes analysées et K le nombre de critères conjonctifs appliqués.
L’une des dégradations de performance les plus massives résulte de l’utilisation indiscriminée de plages ouvertes infinies, telles que A:A ou B:B. Bien que très commode pour absorber de nouvelles lignes sans modifier les formules, cette pratique contraint le graphe de dépendances à dimensionner les vecteurs d’itération sur la capacité maximale de la feuille (pouvant atteindre des dizaines de milliers de lignes vierges allouées en mémoire tampon). Même si le moteur intègre des optimisations d’élagage pour les cellules vides de fin de matrice, la répétition de centaines de formules COUNTIFS pointant vers des colonnes intégrales induit une latence perceptible lors des recalculs en chaîne.
La règle d’or pour préserver une réactivité instantanée consiste à restreindre rigoureusement les plages de données aux limites physiques de la table d’observation occupée (par exemple A2:A15000), ou à recourir aux fonctionnalités natives de Tableaux structurés introduites récemment dans Google Sheets, qui ajustent automatiquement les références dimensionnelles à la taille effective des enregistrements sans surallocation mémoire inutile.
10.2 Stratégies alternatives de prétraitement et d’indexation
Lorsque l’architecture analytique exige le calcul simultané d’une vaste grille matricielle de synthèses temporelles — par exemple un tableau croisé calculant des décomptes hebdomadaires glissants sur des dizaines de catégories de produits —, la multiplication d’appels indépendants à COUNTIFS devient le goulet d’étranglement du classeur. Chaque formule relisant intégralement les mêmes colonnes de données pour évaluer ses propres prédicats, le système s’épuise en lectures redondantes de la mémoire matricielle.
Pour délester le processeur de calcul, la stratégie d’ingénierie préconisée repose sur la création de colonnes auxiliaires d’indexation et de partitionnement. L’insertion en amont d’une colonne calculant la clé de période unique d’un événement (par exemple via la fonction YEAR(A2) & « – » & TEXT(MONTH(A2), « 00 »)) déplace l’effort d’inférence temporelle continue vers un calcul scalaire exécuté une seule fois par ligne. Les cellules de synthèse en aval n’ont plus à évaluer une double inégalité chronologique complexe ( » >= Date_Début ET <= Date_Fin ") ; elles se bornent à un décompte catégoriel univarié rapide sur la chaîne de période précalculée ("= 2024-03").
De plus, le tri physique préalable des tables sources selon le vecteur chronologique principal constitue une optimisation d’architecture majeure. Bien que la fonction COUNTIFS n’exploite pas directement d’algorithmes de recherche dichotomique en raison de sa nature non ordonnée universelle, l’organisation séquentielle des flux de données optimise la mise en cache de l’interpréteur JavaScript et facilite le basculement éventuel vers des architectures de fonctions personnalisées hautement véloces.
11. Comparaisons méthodologiques : COUNTIFS face à FILTER, QUERY et SUMPRODUCT
11.1 COUNTIFS contre la fonction QUERY basée sur le langage SQL
L’arsenal analytique de Google Sheets intègre une fonction d’une puissance exceptionnelle sans équivalent direct dans les tableurs traditionnels : la fonction QUERY. Cette abstraction encapsule l’API de visualisation de Google pour soumettre des plages de données à des requêtes textuelles calquées sur la syntaxe du langage relationnel SQL. L’évaluation comparative entre COUNTIFS et QUERY constitue un jalon méthodologique fondamental pour tout architecte de données sur tableur.
Sur le plan des performances brutes lors d’agrégations univariées ou multivariées simples, COUNTIFS surpasse QUERY de manière constante. COUNTIFS est compilée nativement au sein du noyau d’exécution mathématique de la feuille de calcul, garantissant une vitesse de traitement optimale et une empreinte mémoire minime. À l’inverse, QUERY impose un coût d’initialisation non négligeable : le moteur doit analyser grammaticalement la chaîne de requête textuelle (parsing), construire un plan d’exécution relationnel temporaire, puis convertir les résultats dans le format de grille cible.
Toutefois, la gestion des dates dans la clause WHERE de QUERY s’avère particulièrement verbeuse et sujette à caution syntaxique. Le moteur SQL sous-jacent exige en effet un formatage strict selon le littéral temporel ‘yyyy-MM-dd’, imposant des concaténations lourdes fondées sur la fonction TEXT, comme l’illustre cette requête typique :
QUERY(A2:B, « SELECT COUNT(A) WHERE A >= date ‘ » & TEXT(D2, « yyyy-MM-dd ») & « ‘ AND A <= date '" & TEXT(E2, "yyyy-MM-dd") & "' LABEL COUNT(A) ''")
L’arbitrage est dès lors sans équivoque : pour des opérations d’agrégation pures disséminées dans un tableau récapitulatif, COUNTIFS s’impose impérativement pour des motifs de clarté syntaxique et d’efficience computationnelle. QUERY sera en revanche privilégiée lorsqu’il s’agit de générer en une instruction unique des tables d’extraction complètes agrégeant des regroupements multidimensionnels complexes via des clauses GROUP BY et ORDER BY.
11.2 Paradigme matriciel : SUMPRODUCT et FILTER combiné à ROWS
Dans l’arsenal des formulations avancées, deux autres approches concurrentes s’offrent au praticien pour résoudre l’encadrement temporel : la fonction matricielle SUMPRODUCT (SOMMEPROD) et l’association combinatoire de ROWS avec la fonction FILTER. Chacune répond à des contraintes logiques spécifiques que la signature rigide de COUNTIFS ne peut systématiquement combler.
La fonction SUMPRODUCT opère par arithmétique booléenne sur des matrices vectorielles sans nécessiter la validation matricielle explicite (ArrayFormula). Elle modélise l’intervalle temporel sous la forme d’un produit de matrices binaires, où chaque condition relationnelle renvoie un vecteur de booléens (VRAI/FAUX) converti en zéros et uns lors de la multiplication élément par élément :
SUMPRODUCT((A2:A >= D2) * (A2:A <= E2))
Le principal avantage théorique de SUMPRODUCT réside dans sa flexibilité expressive illimitée : elle autorise l’imbrication de transformations fonctionnelles directes sur le vecteur temporel (par exemple évaluer le mois calendaire à la volée via MONTH(A2:A) = 3) sans exiger de colonne intermédiaire, prouesse structurellement impossible avec COUNTIFS qui n’accepte que des plages physiques pures sans altération fonctionnelle de leur contenu. La littérature spécialisée en modélisation mathématique sur tableurs documente abondamment la polyvalence de ces calculs matriciels en algèbre relationnelle.
Quant à la combinaison ROWS(FILTER(…)), elle procède en deux temps distincts : la fonction FILTER partitionne le jeu de données pour ne conserver en mémoire vive que les lignes satisfaisant l’intersection temporelle, et la fonction ROWS calcule le nombre d’éléments du sous-ensemble ainsi matérialisé. Si cette méthode présente un intérêt pédagogique certain et permet d’inspecter visuellement l’échantillon extrait en supprimant simplement ROWS, elle consomme une quantité disproportionnée de mémoire dynamique sur de volumineuses matrices en devant instancier physiquement le tableau virtuel intermédiaire avant d’en calculer le cardinal.
12. Cas pratiques approfondis et modélisations appliquées d’analyse temporelle
12.1 Analyse longitudinale d’activités commerciales et de cohortes
Pour illustrer la mise en pratique opérationnelle de ces fondements, considérons la mise en place d’un tableau d’analyse longitudinale de performance commerciale au sein d’une organisation d’envergure. La base de données centrale, consignée sur la feuille « Transactions », référence plusieurs milliers de ventes. La colonne A recense la date d’émission de la facture, la colonne B matérialise l’identifiant commercial, et la colonne C consigne la division géographique opérationnelle.
L’objectif consiste à édifier un tableau récapitulatif annuel segmenté en périodes mensuelles strictes au sein d’une feuille de synthèse. La colonne X liste les dates d’ouverture de chaque mois (01/01/2024, 01/02/2024, etc.), tandis que la colonne Y liste les dates de clôture respectives (31/01/2024, 29/02/2024, etc.). L’architecte souhaite concevoir une formule unique, scalable et étirable horizontalement et verticalement, pour dénombrer le volume de transactions traitées par chaque agent commercial au cours de chaque fenêtre mensuelle.
La formule matricielle implantée en cellule Z2 pour le premier commercial (dont l’identifiant est stocké en en-tête de colonne Z$1) s’articulera a\vec un verrouillage rigoureux des références relatives et absolues au moyen du symbole dollar ($) :
COUNTIFS(Transactions!$A:$A, « >= » & $X2, Transactions!$A:$A, « <= " &$Y2, Transactions!$B:$B, Z$1)
Le positionnement stratégique des symboles dollar assure que lors de l’étirement de la formule vers le bas, les références temporelles s’incrémentent ligne par ligne ($X2 devient$X3) tout en conservant l’ancrage horizontal sur les colonnes de bornes. Inversement, lors de l’étirement latéral vers les colonnes des autres commerciaux, la référence à l’identifiant Z$1 glisse vers AA$1 tout en demeurant verrouillée sur la première ligne d’en-tête, et les vecteurs sources de la feuille « Transactions » demeurent immuables grâce au double ancrage absolu ($A:$A). Cette rigueur géométrique garantit l’invariance structurelle de la modélisation à grande échelle.
12.2 Suivi temporel dynamique basé sur la date courante
L’élaboration de tableaux de bord opérationnels de type Monitoring exige fréquemment un rafraîchissement dynamique des métriques par rapport à l’instant présent, sans dépendre de cellules de contrôle calendaires statiques devant être mises à jour manuellement par les gestionnaires. Les fonctions volatiles TODAY() (AUJOURDHUI()) et NOW() (MAINTENANT()) fournissent le point d’ancrage idéal pour automatiser ces fenêtres glissantes d’observation rétrospective ou prospective.
Supposons que la direction des opérations requière le suivi permanent du volume d’incidents informatiques enregistrés au cours des 30 derniers jours civils révolus, le jour courant étant exclu pour éviter les comptages partiels sur des journées non clôturées. Le vecteur d’observation des incidents se déploie sur la plage Incidents!A2:A. L’encadrement temporel dynamique se modélise par l’imbrication directe de l’arithmétique sur la fonction TODAY au sein des critères de COUNTIFS :
COUNTIFS(Incidents!A2:A, « >= » & (TODAY() – 30), Incidents!A2:A, « < " & TODAY())
L’expression TODAY() – 30 soustrait exactement 30 unités scalaires (jours) à la valeur de la date courante calculée lors de l’ouverture du classeur. Le premier critère isole ainsi la borne inférieure d’ouverture de la fenêtre glissante. Le second critère, formalisé au moyen de l’opérateur strict « < " & TODAY(), borne l'échantillon à la dernière fraction de seconde précédant le minuit du jour en cours. Dès lors, le tableau de bord recalcule automatiquement son périmètre temporel à chaque transition journalière sans aucune intervention humaine.
Il convient toutefois de manipuler les fonctions volatiles avec discernement au sein de modèles de grande envergure. Contrairement aux fonctions pures déterministes qui ne sont recalculées que si leurs antécédents directs subissent une mutation d’état, les fonctions volatiles telles que TODAY() forcent la réévaluation intégrale de toutes les formules dépendantes à chaque action d’édition sur le classeur ou à intervalle régulier paramétré dans les préférences de calcul. Une dissémination excessive de fonctions volatiles au cœur de milliers d’occurrences de COUNTIFS peut altérer significativement la réactivité générale du document.
Références
Google. (2024). Fonction NB.SI.ENS (COUNTIFS) – Centre d’aide Google Docs. Google Support. https://support.google.com/docs/answer/3256550?hl=fr
Google. (2024). Fonction DATE – Centre d’aide Google Docs. Google Support. https://support.google.com/docs/answer/3092969?hl=fr
International Organization for Standardization. (2019). Date and time — Representations for information interchange — Part 1: Basic rules (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
Snodgrass, R. T. (1999). Developing time-oriented database applications in SQL. Morgan Kaufmann Publishers.
Walkenbach, J. (2015). Excel 2016 formulas and functions. John Wiley & Sons.