
L’exploitation analytique contemporaine des données au sein des tableurs infonuagiques requiert des instruments algorithmiques à la fois souples, robustes et d’une rigoureuse expressivité formelle. Dans l’écosystème de la suite bureautique collaborative de Google, la fonction QUERY s’impose indéniablement comme la clef de voûte de la manipulation avancée des structures matricielles. Véritable moteur d’inférence basé sur le langage de requête de l’API de visualisation de données de Google, elle émule la sémantique déclarative du standard relationnel SQL tout en s’adaptant à l’élasticité et aux particularismes d’une feuille de calcul distribuée. Dès lors qu’il s’agit d’extraire, de ventiler ou d’agréger des enregistrements hétérogènes, la maîtrise de ses paramètres conditionnels devient un prérequis fondamental pour tout analyste de données, statisticien ou gestionnaire de systèmes d’information.
Cependant, la confrontation quotidienne avec des données issues du monde réel révèle rapidement l’inadéquation des critères d’appariement d’égalité absolue. Les corpus textuels, qu’ils procèdent de saisies manuelles, de flux transactionnels bancaires, d’extractions de protocoles réseau ou d’inventaires logistiques décentralisés, présentent une entropie intrinsèque. L’inconstance des dénominations, la variabilité des suffixes, la coexistence de préfixes catégoriels et l’occurrence intempestive de coquilles typographiques interdisent l’emploi exclusif d’opérateurs stricts d’égalité logique. Pour surmonter cet écueil fondamental sans contraindre les utilisateurs à la lourdeur syntaxique des langages impératifs externes ou des scripts personnalisés, le langage de requête de Google Sheets intègre le concept de filtrage par motif grâce aux caractères génériques, couramment désignés sous le terme de jokers textuels ou métacaractères.
L’incorporation de l’opérateur d’appariement textuel LIKE, adossé aux métacaractères de substitution universelle et unitaire, confère à l’analyste un levier décisionnel sans précédent pour circonscrire l’incertitude lexicale. En permettant la capture granulaire de chaînes débutant, s’achevant ou encapsulant une suite déterminée de graphèmes, cette approche concilie l’efficience algorithmique d’un moteur de base de données relationnelle avec la plasticité d’un environnement tabulaire interactif. Le présent traité a pour vocation d’exposer de manière exhaustive, systématique et académique la théorie computationnelle, la morphologie syntaxique et les applications industrielles des caractères génériques au sein de la fonction QUERY de Google Sheets, guidant le praticien depuis les fondements de l’algèbre relationnelle jusqu’aux architectures d’extraction les plus sophistiquées.
1. Introduction aux caractères génériques dans l’écosystème de la fonction QUERY de Google Sheets
1.1 Définition formelle et rôle des caractères génériques en analyse textuelle
Dans la théorie formelle des langages et la gestion des bases de données relationnelles, un caractère générique, communément désigné sous l’anglicisme wildcard, représente un symbole abstrait inséré au sein d’une chaîne de recherche pour désigner une classe indéterminée d’éléments lexicaux. Contrairement à un littéral alphanumérique immuable dont la valeur sémantique est restreinte à sa seule identité scalaire, le caractère générique agit comme un quantificateur ou un substitut logique capable d’absorber une cardinalité variable de caractères arbitraires. Son intégration répond à un besoin computationnel impérieux : permettre l’appariement flou ou structurel face à des gisements d’informations dont l’architecture typographique est imprévisible, incomplète ou partiellement normalisée. Dans les environnements relationnels historiques s’inspirant des standards établis par l’Organisation internationale de normalisation (ISO/IEC 9075), ces artefacts syntaxiques ont constitué la condition sine qua non de la flexibilité du traitement de texte algorithmique.
L’importance opérationnelle de ce mécanisme se manifeste de manière particulièrement éclatante dans la manipulation d’ensembles de données semi-structurées. Lorsqu’un analyste est confronté à des répertoires de clients où coexistent des variantes orthographiques, des abréviations sectorielles non normalisées ou des identifiants alphanumériques contenant des horodatages imbriqués, la comparaison stricte s’avère inopérante. Le caractère générique introduit une dimension probabiliste et probabiliste dans l’algèbre de Boole, autorisant la création de patrons morphologiques. Historiquement, l’implémentation de ces métacaractères au sein de l’API Google Visualization procède d’un arbitrage minutieux entre la complexité asymptotique des automates finis non déterministes et la fluidité d’un interpréteur asynchrone fonctionnant au sein d’une infrastructure infonuagique mutualisée. Google a fait le choix délibéré de transposer les métacaractères traditionnels du langage SQL vers son dialecte propriétaire de requête matricielle, garantissant une familiarité conceptuelle immédiate tout en optimisant le balayage des cellules en mémoire vive.
1.2 Architecture fonctionnelle de la fonction QUERY et du langage de requête Google
L’analyse formelle de la fonction matricielle requiert une décomposition structurelle de son invocation canonique : =QUERY(données; requête; [en-têtes]). Le premier argument désigne le tenseur matriciel d’origine, qu’il s’agisse d’une plage planaire statique ou du produit d’une composition dynamique de sous-fonctions. Le deuxième argument, de nature textuelle, encapsule la chaîne déclarative formulée dans le dialecte Google Visualization API Query Language. Le troisième argument, optionnel mais d’une importance capitale pour la stabilité de l’évaluation, précise le nombre de lignes d’en-tête consacrées aux métadonnées descriptives de l’ensemble matriciel. C’est à l’intérieur du second argument que se déploie toute la puissance analytique de la requête, matérialisée par des instructions délimitées par des mots-clés réservés calqués sur la grammaire relationnelle.
Au sein de cette grammaire déclarative, la clause conditionnelle WHERE occupe une fonction pivotale équivalente à l’opérateur de sélection unaire en algèbre relationnelle de Codd. Elle filtre les tuples constitutifs de la source en appliquant un prédicat logique d’évaluation unitaire à chaque ligne matricielle. Lors de l’exécution, l’instruction de filtrage textuel encapsulant des critères génériques n’est pas évaluée par le moteur usuel de calcul de formules de tableur, mais est entièrement transmise, sérialisée et compilée par le moteur sous-jacent d’interprétation des requêtes de Google. Ce compilateur interne convertit le prédicat textuel en un graphe syntaxique abstrait, optimisant l’ordonnancement des comparaisons de sous-chaînes avant d’instancier la sélection des lignes retenues dans la mémoire allouée à la feuille de calcul active.
1.3 Distinction entre l’égalité stricte et la comparaison par motif d’appariement
L’opérateur d’égalité stricte, matérialisé par le symbole de comparaison unaire =, souffre de limitations computationnelles et mathématiques intrinsèques dès lors qu’il est confronté à l’ambiguïté des données textuelles. En arithmétique relationnelle, la relation d’égalité postule une coïncidence binaire absolue et rigoureuse entre deux séquences d’octets : toute divergence, qu’elle résulte d’un espace insécable, d’une micro-variation typographique ou d’un caractère de contrôle non imprimable, conduit inéluctablement à l’évaluation du prédicat à faux. L’analyste se trouve alors contraint à multiplier les prédicats de disjonction ou à recourir à des phases préalables de manipulation de chaînes souvent dispendieuses en temps de traitement machine.
À l’opposé, l’opérateur sémantique LIKE se définit formellement comme un prédicat de comparaison par motif d’appariement morphologique. Plutôt que d’exiger une isométrie lexicale parfaite, il projette la chaîne évaluée contre une expression de structure qui tolère des zones d’indétermination sélective. L’impact ergonomique de ce paradigme sur les flux de travail en science des données et en gestion administrative est considérable. Il permet de s’abstraire d’un nettoyage préalable trop rigide, d’agréger à la volée des catégories conceptuelles étendues sans altérer l’intégrité de la source maîtresse, et de concevoir des règles d’extraction tolérantes aux anomalies mineures de saisie qui parasitent inévitablement les répertoires d’entreprises à forte composante humaine.
2. Fondements syntaxiques de l’opérateur LIKE et typologie des jokers
2.1 Morphologie de la clause WHERE combinée au mot-clé LIKE
L’implémentation opérationnelle de l’appariement par motif repose sur une syntaxe rigoureuse qui obéit aux conventions d’encapsulation littérale du dialecte Google Sheets. Dans une formule typique, l’association s’articule selon un ordonnancement déclaratif strict : le nom identificatoire de la colonne examinée (par exemple la lettre A, la désignation Col1 si l’on opère sur une matrice calculée, ou les identifiants structurels associés) est immédiatement suivi du mot-clé réservé LIKE, puis du motif textuel de comparaison. Ce motif doit impérativement être encapsulé entre des apostrophes simples droites, dites apostrophes simples de délimitation littérale, le tout étant contenu à l’intérieur de la paire de guillemets doubles régissant l’ensemble de la commande textuelle transmise à la fonction.
Cette articulation syntaxique exige une cohérence typologique absolue au regard du système de typage implicite de l’interpréteur de requêtes. Le moteur de visualisation applique une politique rigide d’interdiction de comparaison hétérogène : l’opérateur LIKE est ontologiquement réservé aux champs de nature strictement textuelle. Si un utilisateur tente d’appliquer l’opérateur LIKE à une colonne dont le type inféré majoritaire est constitué d’entiers scalaires, de flottants à virgule ou de structures temporelles pures sans coercition préalable, le compilateur lève immédiatement une exception d’incompatibilité de type. L’intégrité de la clause dépend donc de la pureté du type de données hébergé dans la dimension analysée, conditionnant la validité logique de toute extraction par motif.
2.2 Le symbole pourcentage (%) : sémantique de la multiplicité indéfinie
Dans la nomenclature universelle de l’opérateur LIKE héritée du standard Structured Query Language, le métacaractère matérialisé par le glyphe de pourcentage % incarne la sémantique formelle de la multiplicité indéfinie. D’un point de vue mathématique et relationnel, ce symbole correspond à la fermeture de Kleene restreinte au niveau des caractères textuels : il équivaut à la substitution d’une suite quelconque de symboles lexicaux d’une cardinalité égale à zéro, un ou n caractères arbitraires consécutifs. Sa présence au sein d’une séquence de test indique au moteur d’évaluation que la position occupée peut absorber indifféremment une absence totale de matière textuelle, un symbole unique ou une chaîne d’une longueur arbitrairement étendue.
Le comportement algorithmique de ce métacaractère face aux particularismes typographiques mérite une attention analytique rigoureuse. Face à une cellule contenant une chaîne de longueur nulle ou un caractère d’espacement insécable, le caractère pourcentage se comporte avec une flexibilité totale, intégrant l’intégralité de l’arborescence lexicale couverte par le patron. Il ne présume d’aucune restriction quant au sous-ensemble de caractères représenté, englobant sans discrimination les éléments alphanumériques, les diacritiques, la ponctuation et les symboles de formatage invisible. Cette polyvalence absolue en fait l’instrument de prédilection pour l’ensemble des opérations d’isolation thématique globale où seule une ancre lexicale partielle est connue avec certitude.
2.3 Le symbole tiret du bas (_) : sémantique de l’occurrence unitaire
À l’opposé de la nature expansive et cardinalement indéterminée du pourcentage, le métacaractère incarné par le tiret du bas ou tiret bas _ (souvent désigné sous l’anglicisme underscore) répond à une sémantique stricte de substitution unitaire. Dans la mécanique interne de l’interpréteur relationnel, ce symbole impose une contrainte arithmétique rigide : il doit être mis en correspondance avec exactement un, et un seul, caractère scalaire quelconque situé à la position orbitale exacte qu’il occupe dans le motif. Si aucune entité scalaire n’est présente à cet emplacement précis, ou si plusieurs caractères tentent d’occuper la position correspondant à ce marqueur individuel, la fonction de vérité du prédicat s’effondre et renvoie la valeur booléenne fausse.
Cette spécification d’occurrence isolée établit une frontière méthodologique nette entre les deux jokers. Tandis que le pourcentage dissout les frontières dimensionnelles d’une chaîne, le tiret du bas préserve fidèlement la métrique spatiale et le gabarit dimensionnel du champ inspecté. Dès lors, ses domaines d’application privilégiés englobent l’analyse des registres à formatage standardisé, tels que les nomenclatures de stocks manufacturiers, les codes postaux territoriaux, les identifiants d’immatriculation de transport ou les protocoles de routage d’adresses réseau privées. Dans tous ces cas d’usage, la variabilité lexicale est strictement délimitée au sein d’une enveloppe de longueur invariante.
3. Méthode 1 : Filtrer les cellules commençant par une séquence textuelle spécifique
3.1 Analyse formelle du patron syntaxique ‘préfixe%’
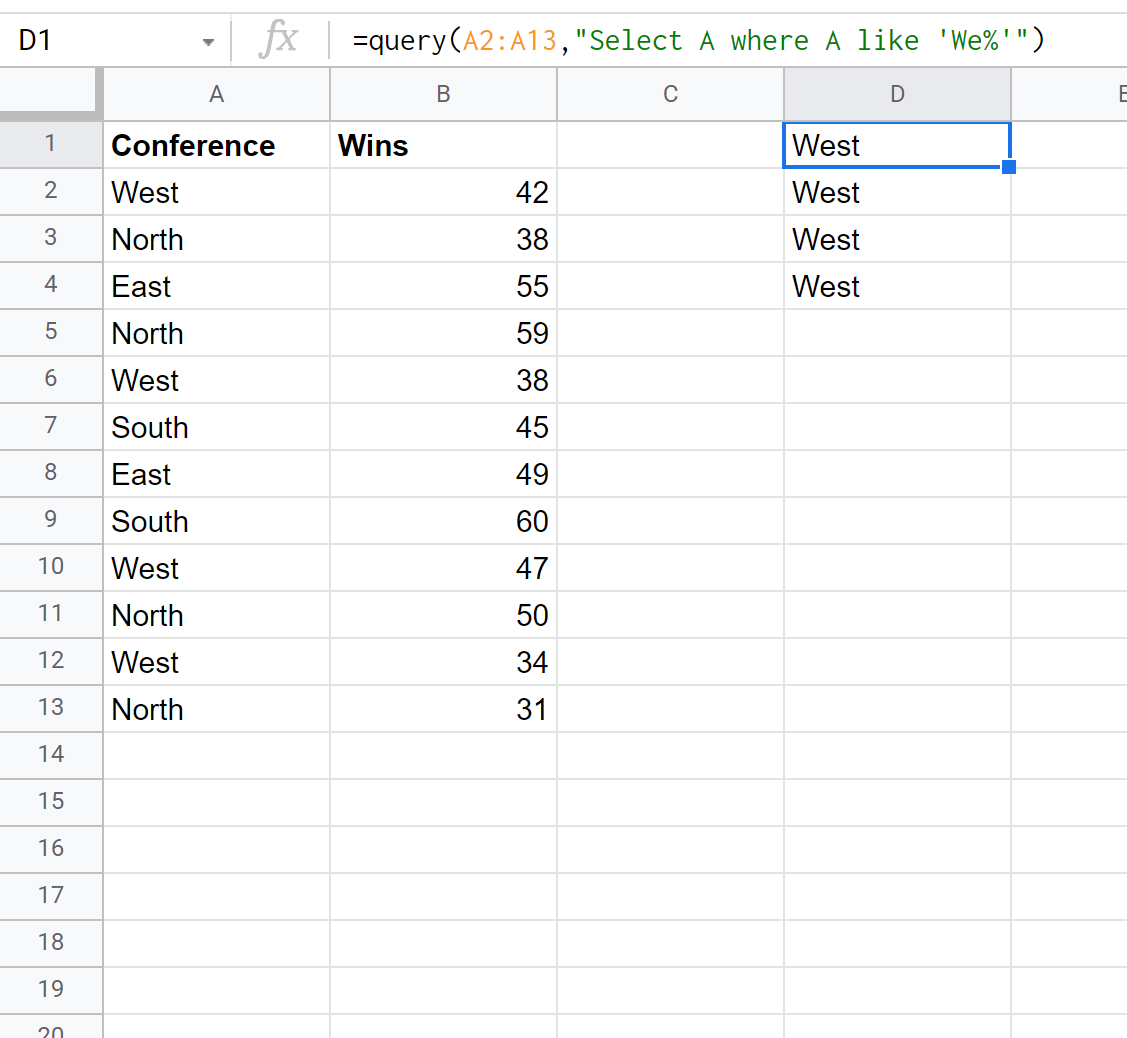
L’ancrage initial d’une requête de filtrage textuel représente l’une des architectures d’interrogation les plus courantes en matière de gestion de bases tabulaires. La formulation canonique s’énonce formellement sous la structure : =QUERY(A1:A10; « Select A where A like ‘texte%' »). Dans ce modèle, l’absence de caractère générique en amont du littéral textuel couplée à la présence immédiate du symbole pourcentage immédiatement après le dernier caractère alphabétique impose une contrainte directionnelle asymétrique à l’interpréteur de l’API de visualisation.
L’évaluation s’opère rigoureusement au niveau de l’index initial (l’octet de tête ou le premier point de code Unicode) de la chaîne de caractères encapsulée dans chaque cellule de la plage cible. L’interpréteur compare séquentiellement chaque élément du préfixe fourni avec les positions correspondantes du texte source. Si une concordance unitaire et continue est constatée sur l’ensemble de la longueur du préfixe, le caractère pourcentage final entre en action et valide l’ensemble du reste de la chaîne, indépendamment de son contenu lexical ultérieur ou de sa longueur globale. Par exemple, une instruction exigeant la correspondance avec le motif ‘We%’ sélectionnera instantanément des entrées hétérogènes telles que « Web », « Wednesday », « West-Side » ou même l’abréviation isolée « We », la longueur nulle étant mathématiquement satisfaite par la fermeture du joker.
3.2 Implications sur la performance d’indexation et d’évaluation
D’un point de vue informatique, les recherches opérant par préfixe fixe bénéficient d’un avantage comparatif notable en termes de charge computationnelle et d’efficacité algorithmique par rapport aux recherches décentralisées ou bilatérales. Lorsqu’une chaîne de recherche débute par un préfixe textuel déterminé non ambigu, le moteur d’exécution peut appliquer une heuristique de rejet précoce hautement optimisée. Dès que le premier caractère de la cellule inspectée diverge du premier caractère du motif prédéfini, l’algorithme interrompt l’analyse du reste de la cellule sans avoir à parcourir la suite de la séquence textuelle, élaguant ainsi substantiellement le nombre d’instructions exécutées par cycle machine.
Cependant, la taille relative de ce préfixe exerce une influence directe sur le comportement de l’interpréteur. Un préfixe multicaractère (tel que ‘CONTRAT-2024-%’) offre un pouvoir discriminant considérablement plus élevé qu’un préfixe à lettre unique (comme ‘C%’), ce dernier forçant l’algorithme à valider un sous-ensemble volumineux de données candidates avant d’exclure les divergences ultérieures. Lorsque la volumétrie matricielle franchit les dizaines de milliers de lignes dans Google Sheets, l’emploi de préfixes longs et hautement spécifiques réduit de manière sensible le temps global de calcul matriciel et la consommation de mémoire virtuelle dévolue au recalcul asynchrone des classeurs collaboratifs.
3.3 Scénarios appliqués et cas pratiques d’extraction par préfixe
L’exploitation pragmatique du filtrage par préfixe couvre une multitude d’activités névralgiques au sein des organisations modernes. L’un des cas les plus emblématiques réside dans la gestion logistique des nomenclatures d’inventaire industriel où les articles partagent un tronc commun hiérarchique désignant une famille de produits ou un site de production spécifique. L’extraction de sous-ensembles par une clause du type WHERE Col1 LIKE ‘SKU-ELEC-%’ permet de ventiler instantanément les composants de la filière électronique sans requérir l’adjonction d’une colonne de catégorisation secondaire au sein de la base de données brute.
Un autre champ d’application critique concerne l’analyse des journaux de navigation web et la cybersécurité des systèmes distribués. Les ingénieurs système exploitent régulièrement cette méthode pour ségréguer les protocoles d’adresses URL au sein de registres bruts. Une commande structurée sous la forme WHERE A LIKE ‘https://%’ garantit l’isolement exhaustif des flux chiffrés, écartant systématiquement les requêtes non sécurisées sans perturber la topologie des chemins de routage subséquents. De même, les nomenclatures administratives nationales, telles que les identifiants territoriaux de l’Institut national de la statistique et des études économiques (INSEE), exploitent cette logique pour regrouper les entités communales rattachées à un département déterminé par l’ancrage des deux premiers chiffres administratifs.
4. Méthode 2 : Filtrer les cellules se terminant par une séquence textuelle spécifique
4.1 Analyse formelle du patron syntaxique ‘%suffixe’
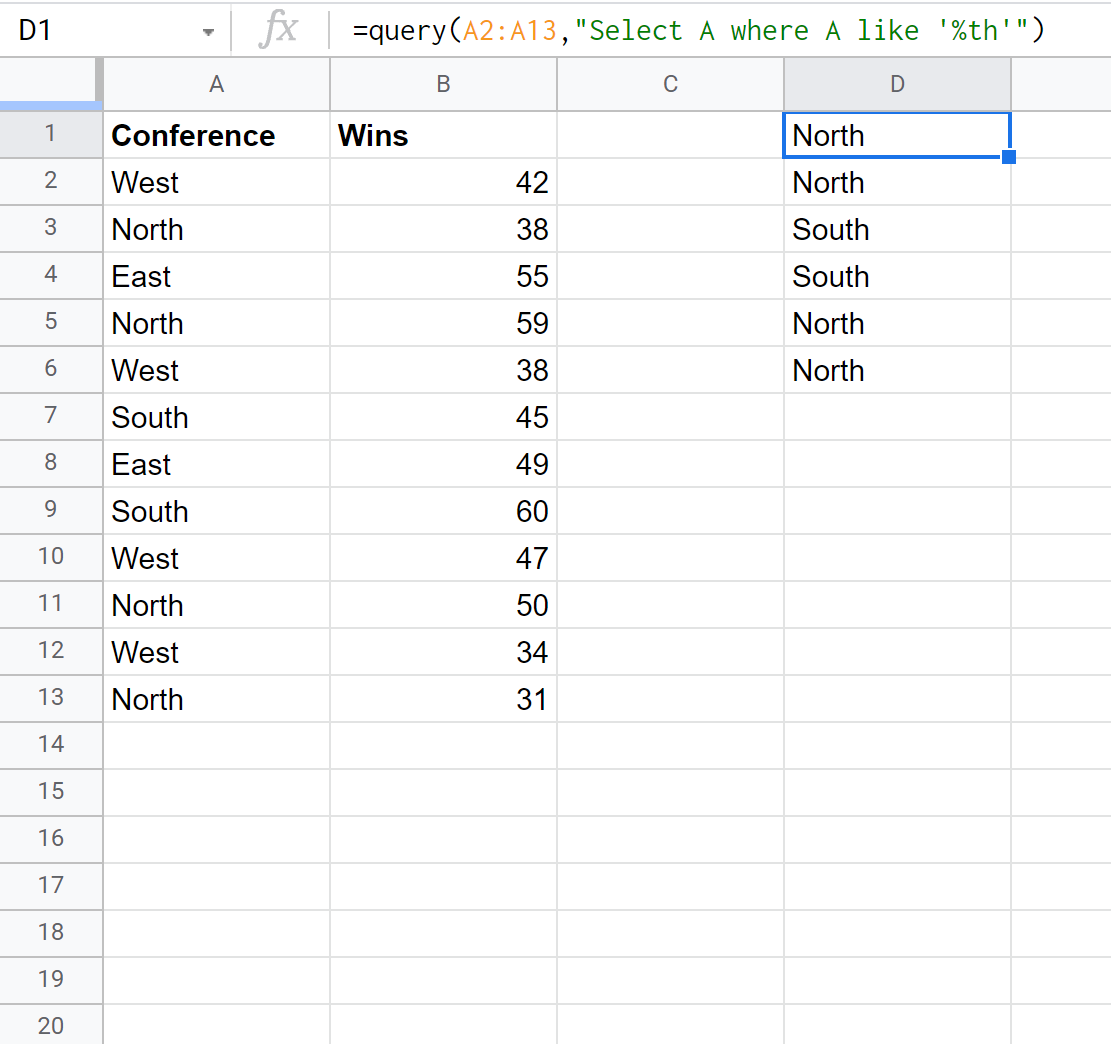
Le filtrage textuel rétrograde, ou recherche par terminaison morphologique, inverse la polarité structurelle de l’opération d’appariement. La formulation canonique de cette méthode s’établit selon le schéma suivant : =QUERY(A1:A10; « Select A where A like ‘%texte' »). Dans cette configuration, le métacaractère pourcentage est positionné en tête immédiate du motif de recherche, tandis que les caractères littéraux forment la terminaison absolue de la chaîne à comparer. Cette inversion impose au moteur de calcul une dynamique d’évaluation fondamentalement différente de celle mobilisée lors de la recherche par ancrage initial.
L’interpréteur de requêtes procède ici à une évaluation par ancrage terminal. Théoriquement, l’algorithme absorbe l’intégralité du segment textuel amont sous la juridiction du joker initial, puis tente de verrouiller la fin de la cellule cible avec le suffixe spécifié. Dans les architectures de traitement de chaînes les plus avancées, cette analyse s’effectue via une lecture rétrograde : le pointeur se positionne sur le dernier caractère de la cellule inspectée et remonte la séquence de droite à gauche en comparant les octets avec le suffixe attendu. Un patron tel que ‘%th’ permettra ainsi de capturer indifféremment des substantifs ou adjectifs tels que « Growth », « Path », « Zenith » ou « South », assurant l’extraction de structures morphologiques spécifiques.
4.2 Vulnérabilités liées aux espaces résiduels de fin de chaîne
L’usage de la clause de suffixe expose l’analyste à un écueil méthodologique omniprésent dans la pratique de la gestion tabulaire : la pollution invisible par des espaces résiduels d’extrémité, communément appelés trailing spaces. Dans la mesure où le langage de l’API de visualisation applique une correspondance binaire rigide sur l’extrémité absolue de la chaîne, la présence d’un seul espace typographique consécutif à la frappe manuelle (par exemple « Path » au lieu de « Path ») invalide totalement la correspondance avec le motif ‘%th’. Le caractère terminal étant un espace et non la lettre h, le prédicat LIKE bascule vers l’état faux, générant des exclusions arbitraires et silencieuses d’une dangerosité analytique extrême.
Pour immuniser les flux de traitement contre cette vulnérabilité structurelle, il est hautement recommandé de procéder à un prétraitement morphologique de la source ou d’encapsuler la matrice d’origine dans une routine d’épuration. L’emploi conjoint de la fonction SUPPRESPACE (ou TRIM dans les environnements anglophones) en amont de l’injection dans la fonction QUERY permet d’éliminer les caractères d’espacement superflus ainsi que les sauts de ligne intempestifs. De surcroît, le moteur de Google Sheets se heurte parfois à des caractères non imprimables encodés en Unicode (tels que l’espace insécable U+00A0) qui résistent aux nettoyages sommaires, imposant à l’ingénieur de données une vigilance redoublée sur l’hygiène typographique de la base analysée.
4.3 Applications empiriques du filtrage suffixe
Les déclinaisons pratiques du filtrage par suffixe s’avèrent indispensables dans de nombreux contextes d’ingénierie et d’audit administratif. Dans le domaine de la gouvernance des systèmes de fichiers numériques dématérialisés, cette méthode offre une procédure native pour segmenter les documents en fonction de leurs extensions techniques. Une requête articulée autour du critère WHERE A LIKE ‘%.pdf’ ou WHERE A LIKE ‘%.xlsx’ permet de répertorier instantanément les typologies d’actifs numériques stockés sur une plateforme sans nécessiter d’analyse heuristique du contenu binaire sous-jacent.
Dans l’univers du marketing opérationnel et de la gestion des relations clients, le filtrage par terminaison constitue la colonne vertébrale de l’audit des noms de domaine de messagerie électronique. Les gestionnaires de bases de données emploient fréquemment des critères de sélection de type WHERE Col2 LIKE ‘%@univ-paris1.fr’ ou WHERE Col2 LIKE ‘%.edu’ afin d’isoler précisément les cohortes universitaires ou institutionnelles au sein d’une liste de prospects amorphe. Enfin, en linguistique computationnelle et en traitement automatique des langues naturelles, cette technique autorise l’analyse distributionnelle de corpus lexicaux par l’extraction exhaustive de termes partageant des désinences grammaticales ou des suffixes dérivationnels analogues.
5. Méthode 3 : Filtrer les cellules contenant une sous-chaîne arbitraire
5.1 Analyse formelle du patron syntaxique d’inclusion ‘%sous-chaîne%’
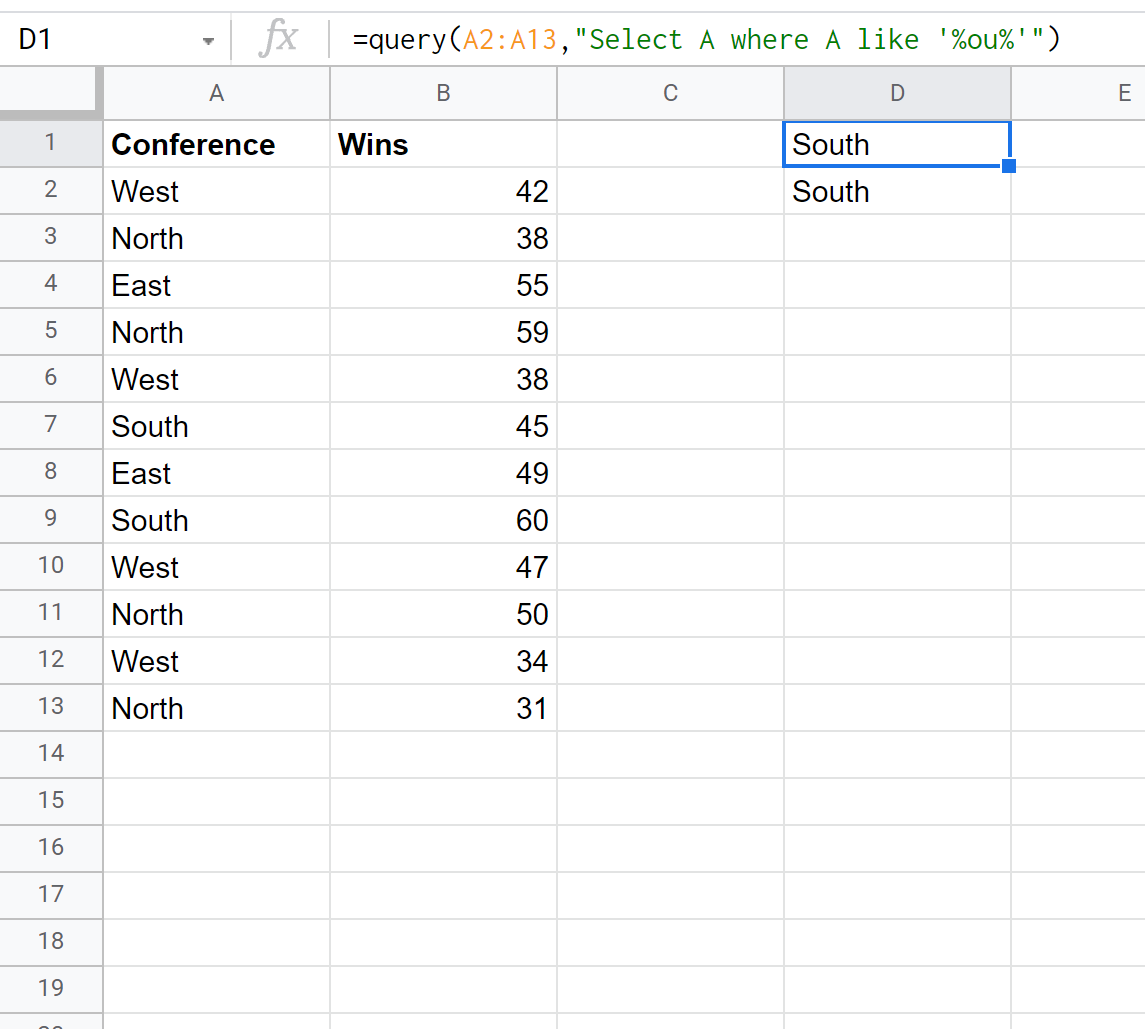
L’appariement non ancré, fondé sur la détection d’une sous-chaîne de caractères indépendamment de sa localisation orbitale au sein de la cellule cible, constitue le paradigme d’interrogation le plus polyvalent de la fonction QUERY. Sa codification syntaxique adopte la structure canonique suivante : =QUERY(A1:A10; « Select A where A like ‘%texte%' »). Dans ce cas de figure, le motif de recherche est enserré de part et d’autre par le métacaractère universel pourcentage, instituant une condition de recherche dite bilatérale ou flottante.
D’un point de vue structural, cette disposition mathématique stipule que la cellule valide le critère logique si et seulement s’il existe une séquence contiguë de caractères au sein de son contenu textuel qui correspond rigoureusement à l’argument littéral central. La partie précédant cette séquence peut posséder une longueur quelconque comprise entre zéro et l’infini lexical, et la portion succédant au motif est assujettie à une liberté dimensionnelle rigoureusement équivalente. Par exemple, l’introduction du digraphe ‘%ou%’ provoquera l’inclusion automatique d’enregistrements morphologiquement disparates tels que « Source », « Ouvrier », « Bijou », ou même de séquences isolées comme « Où » ou « Ouvert » (sous réserve du respect strict de la politique de casse et des diacritiques en vigueur).
5.2 Complexité algorithmique du balayage bilatéral
Bien que d’une commodité incontestable pour l’utilisateur final, l’évaluation d’un motif bilatéralement indéterminé impose une charge computationnelle considérablement plus lourde au sous-système de calcul de Google Sheets. Contrairement à l’ancrage de préfixe qui autorise l’élagage immédiat des chaînes non concordantes dès leur première lettre, le balayage d’une sous-chaîne non délimitée contraint le processeur à exécuter un algorithme de recherche textuelle à fenêtre glissante sur l’intégralité de chaque cellule du jeu de données.
Des mécanismes d’optimisation inspirés de l’algorithme de Knuth-Morris-Pratt ou de Boyer-Moore sont traditionnellement mobilisés en coulisses pour réduire le nombre d’opérations de comparaison unitaire, mais la complexité temporelle intrinsèque demeure proportionnelle à la somme des longueurs des chaînes inspectées. De surcroît, le risque de générer des faux positifs augmente de manière exponentielle avec la concision de la sous-chaîne sélectionnée. L’emploi d’un motif d’inclusion excessivement court, tel que ‘%an%’, risque de capturer des centaines d’occurrences incidentes au sein d’un texte descriptif sans rapport avec l’entité conceptuelle originellement convoitée par l’analyste, exigeant une qualification méthodique des données extraites.
5.3 Cas d’usage critiques en exploitation documentaire
En dépit de ces contraintes de charge mémoire, la recherche de sous-chaînes arbitraires s’avère indispensable pour l’exploration de corpus textuels libres et de données non formatées. Dans les contextes de conformité bancaire et de contrôle financier, les auditeurs exploitent quotidiennement des filtres de la forme WHERE Col3 LIKE ‘%VIREMENT%’ ou WHERE Col3 LIKE ‘%FRAIS%’ afin de repérer des typologies de mouvements spécifiques enfouies au cœur de libellés d’opérations particulièrement touffus et asymétriques émis par des systèmes interbancaires disparates.
Ce protocole est également fondamental pour l’interrogation des systèmes d’enregistrement d’incidents (tickets de support technique) et les registres de rétroaction d’utilisateurs. Les gestionnaires de produits numériques utilisent des requêtes de type WHERE Col4 LIKE ‘%erreur de connexion%’ pour quantifier la fréquence relative de dysfonctionnements applicatifs spécifiques rapportés dans les zones de commentaires textuels ouverts. De même, dans les activités d’analyse médico-légale de données numériques, l’extraction de signatures textuelles au sein de traces de journaux serveurs s’appuie massivement sur cette architecture de requêtes pour isoler les tentatives d’injection ou d’accès non autorisés.
6. L’utilisation conjointe du tiret du bas (_) pour les contraintes de longueur exacte
6.1 Syntaxe et principes de substitution unitaire
La substitution unitaire, gouvernée par l’utilisation du métacaractère tiret du bas _, offre un contrôle typographique d’une précision micrométrique souvent méconnu des praticiens du tableur de Google. La structure fondamentale d’une clause reposant sur ce joker exige une corrélation spatiale absolue entre chaque marqueur et la position du caractère substitué. Par exemple, la formulation déclarative WHERE A LIKE ‘A_C’ ordonne au moteur de filtrage de ne retenir que les cellules dont la chaîne débute impérativement par le caractère littéral A, se clôture rigoureusement par le caractère C, et présente exactement un caractère tiers non défini en position médiane.
Toute variation dimensionnelle se solde par un échec immédiat du test conditionnel : une cellule contenant « AC » (longueur deux) sera rejetée par manque de matière textuelle intermédiaire, tandis qu’un enregistrement matérialisé par « ABBC » (longueur quatre) sera écarté en raison d’une surabondance lexicale. Cette rigueur positionnelle permet de formuler des filtres calibrés pour isoler des mots d’une longueur arbitrairement déterminée en alignant une succession de tirets bas. Une instruction contenant WHERE A LIKE ‘_____’ (cinq tirets consécutifs) agira comme un tamis géométrique parfait, retenant exclusivement les entrées textuelles dont le décompte scalaire équivaut scrupuleusement à cinq caractères.
6.2 Combinaison hybride du symbole pourcentage et du symbole souligné
Le plein potentiel de l’opérateur LIKE émerge lors de la fusion architecturale du métacaractère d’indécision totale et du joker unitaire au sein d’un même motif de filtrage. Cette hybridation morphologique permet de circonscrire des règles d’appariement complexes combinant simultanément une variabilité spatiale et des contraintes positionnelles irréductibles. Considérons par exemple la structure de patron formulée sous la syntaxe WHERE A LIKE ‘A_%_Z’.
Une telle instruction stipule formellement que la chaîne valide doit obligatoirement commencer par le glyphe A, s’achever par le glyphe Z, et contenir un volume minimal incompressible de deux caractères intermédiaires (le premier étant matérialisé par le premier tiret du bas, le second par le tiret du bas terminal, tandis que le symbole de pourcentage autorise l’adjonction de zéro à une infinité de caractères supplémentaires entre les deux bornes). De façon corollaire, un motif tel que WHERE A LIKE ‘___%’ isole rigoureusement toutes les cellules comportant une longueur minimale de trois caractères, éliminant de facto les saisies embryonnaires ou tronquées issues d’erreurs de transfert de données sans avoir à solliciter la fonction de calcul de longueur LEN.
6.3 Applications aux identifiants normés et codes postaux
La mise en œuvre combinatoire du caractère unitaire trouve une justification immédiate dans le traitement de données régies par des normes géographiques et industrielles internationales. Les codes postaux du Royaume-Uni, par exemple, obéissent à des gabarits alphanumériques très spécifiques entrecoupés d’espaces. L’interrogation par motif unitaire permet d’extraire des sous-districts précis sans risquer d’inclure des codes régionaux voisins présentant des longueurs discordantes.
Dans l’industrie automobile et manufacturière, la validation des numéros d’identification de véhicules (codes VIN) ou des numéros de série d’appareils électroniques constitue un autre domaine de prédilection. Le code VIN étant mondialement normalisé sur une longueur fixe de dix-sept caractères alphanumériques, une requête de conformité formulée sous l’angle WHERE NOT A LIKE ‘_________________’ (dix-sept tirets du bas) permet d’isoler en un temps de calcul minime l’ensemble des enregistrements corrompus ou tronqués au sein d’une flotte industrielle. Ce mécanisme garantit une détection précoce des anomalies typographiques dans les processus d’intégration continue de données d’ingénierie.
7. Composition logique complexe : Enchaînement des opérateurs AND, OR et NOT
7.1 Conjonction booléenne (AND) appliquée aux caractères génériques
Lorsque les exigences de sélection dépassent la capacité expressive d’un motif unique, le compilateur de requêtes de Google autorise la composition booléenne avancée par le truchement du connecteur conjonctif AND. L’intersection de plusieurs prédicats fondés sur l’opérateur LIKE permet de circonscrire des topologies lexicales hautement restrictives. La syntaxe canonique d’une telle instruction s’énonce comme suit : WHERE A LIKE ‘A%’ AND A LIKE ‘%Z’.
Dans cette modélisation, le tuple n’est retenu dans la projection résultante que si et seulement si l’ensemble des conditions partielles converge vers la valeur de vérité unitaire. Sur le plan de la théorie des ensembles, cette opération réalise l’intersection géométrique de deux espaces vectoriels de chaînes : celui des entités débutant par la lettre A et celui des entités s’achevant par la lettre Z. Cette structure s’avère infiniment plus lisible et maintenable que les formulations alambiquées qui tenteraient d’agréger ces contraintes au sein d’une unique chaîne de substitution, tout en permettant au moteur d’évaluation d’interrompre l’analyse logique dès qu’une des branches de la conjonction s’avère fausse.
7.2 Disjonction inclusive (OR) et flexibilité des critères de recherche
À l’inverse de la conjonction restrictive, la disjonction booléenne matérialisée par le mot-clé OR permet de configurer des filtres inclusifs agrégateurs au sein d’une seule instruction de requête textuelle. Elle autorise la restitution d’un enregistrement dès lors que celui-ci satisfait à l’une quelconque des conditions atomiques énoncées. Une requête formulée selon le schéma WHERE A LIKE ‘Paris%’ OR A LIKE ‘Lyon%’ OR A LIKE ‘Marseille%’ opérera une consolidation instantanée des données relatives aux trois métropoles sans nécessiter l’exécution de requêtes disjointes ultérieurement regroupées.
Cependant, l’introduction de disjonctions multiples au sein d’une même clause conditionnelle impose une gestion méticuleuse de la précédence des opérateurs arithmétiques et logiques. Dans la grammaire de l’API Google Visualization, l’opérateur AND possède une précédence naturelle sur l’opérateur OR. Par conséquent, l’absence de parenthèses de délimitation structurelle au sein d’expressions mixtes est susceptible de dénaturer profondément la sémantique intentionnelle de la requête. L’analyste doit impérativement recourir à l’encapsulation par parenthèses pour expliciter ses regroupements logiques, adoptant une formulation rigoureuse telle que : WHERE (A LIKE ‘FR_%’ OR A LIKE ‘BE_%’) AND B > 1000.
7.3 Négation logique (NOT) pour l’exclusion méthodique de motifs
L’éviction systématique de catégories de données aberrantes, d’enregistrements d’essais ou de mentions provisoires est rendue possible grâce à l’opérateur unaire de négation booléenne NOT. Positionné immédiatement avant la référence de colonne ou devant l’opérateur de comparaison selon la variante acceptée par le dialecte, il inverse la polarité du prédicat textuel. L’architecture syntaxique recommandée par Google Sheets s’illustre par la clause : WHERE NOT A LIKE ‘%TEST%’.
Ce protocole d’exclusion méthodique s’avère crucial dans les opérations d’assainissement et d’épuration de bases transactionnelles. Il permet d’extraire les données opérationnelles réelles tout en éliminant les lignes de test, les démonstrations de formation ou les doublons artificiels contenant des mentions spécifiques. Néanmoins, une précaution théorique majeure s’impose quant à l’interaction de la négation avec les valeurs nulles ou manquantes. En logique ternaire (vrai, faux, inconnu/nul), l’évaluation d’un prédicat LIKE sur une cellule rigoureusement vide renvoie un état d’indétermination. Par conséquent, l’application de l’opérateur NOT à une valeur nulle ne convertit pas le résultat en vrai, mais maintient l’exclusion de la cellule du flux de sortie final, sauf si un prédicat de type OR A IS NULL est expressément formulé.
8. Sensibilité à la casse et typographie : Normalisation computationnelle des requêtes
8.1 Comportement natif de l’opérateur LIKE face à la casse
L’une des caractéristiques fondamentales du moteur de requête de l’API de visualisation de Google réside dans sa stricte sensibilité à la casse (Case Sensitivity) lors de l’évaluation de l’opérateur LIKE. Contrairement aux moteurs relationnels traditionnels configurés sous des collations insensibles à la casse (telles que Latin1_General_CI_AS sous Microsoft SQL Server), l’interpréteur de Google Sheets applique une discrimination binaire absolue fondée sur les valeurs numériques des points de code ASCII et Unicode. Dès lors, le motif ‘paris%’ et le motif ‘Paris%’ constituent deux entités sémantiques dissemblables qui renvoient des partitions de données totalement indépendantes.
Cette rigueur entraîne des dysfonctionnements majeurs dans les classeurs alimentés par des saisies hétérogènes. Si un groupe d’opérateurs administratifs renseigne alternativement les désignations « FACTURE », « Facture » et « facture », l’instruction unitaire WHERE A LIKE ‘Facture%’ n’extraira qu’une fraction marginale de la population cible, faussant irrémédiablement les agrégations comptables ultérieures. L’analyste doit donc systématiquement présumer l’instabilité de la casse au sein des bases distribuées et intégrer des mécanismes de normalisation au sein même de la grammaire de requête.
8.2 Techniques de neutralisation via les fonctions LOWER() et UPPER()
Pour neutraliser l’arbitraire de la casse typographique sans altérer les données sous-jacentes logées dans les cellules d’origine, le langage de requête de Google met à disposition deux fonctions scalaires de transformation textuelle intégrées : LOWER() et UPPER(). Ces primitives logiques permettent de coercer dynamiquement la valeur textuelle de la colonne examinée vers un état entièrement minuscule ou majuscule durant la phase d’évaluation du prédicat conditionnel.
La syntaxe canonique d’une recherche insensible à la casse exige la conversion synchronisée des deux composantes de la comparaison. L’expression s’énonce formellement sous la forme : =QUERY(A1:B10; « Select A where lower(A) like ‘mot%' »), ou plus académiquement : =QUERY(A1:B10; « Select A where lower(A) like lower(‘Mot%’) »). En appliquant la fonction lower(A), l’interpréteur convertit virtuellement chaque valeur textuelle de la colonne A en minuscules avant de la confronter au patron d’appariement lui-même rédigé en minuscules. Cette stratégie élimine instantanément toute friction liée aux aléas de frappe, garantissant une robustesse opérationnelle totale lors du traitement de gisements d’informations non calibrés.
8.3 Gestion des diacritiques et particularités de la langue française
Si la conversion par les fonctions LOWER et UPPER résout intégralement les disparités de casse, le traitement des signes diacritiques propres à la morphologie de la langue française (accents aigus, graves, circonflexes, trémas et cédilles) soulève une complexité algorithmique d’un ordre supérieur. Au sens de la table de codage Unicode, le caractère « é » (U+00E9) est radicalement distinct de son équivalent atone « e » (U+0065). Par conséquent, l’exécution d’une clause WHERE lower(A) LIKE ‘%electricite%’ échouera systématiquement à capturer les enregistrements comportant l’orthographe normative « électricité ».
Face à cette disjonction, deux stratégies computationnelles peuvent être déployées. La première, élégante mais circonscrite, exploite le métacaractère unitaire tiret du bas pour neutraliser les voyelles sujettes aux diacritiques : le patron ‘%_l_ctricit_%’ autorisera l’appariement indépendamment de la présence ou de l’omission des accents. La seconde stratégie, hautement recommandée pour les environnements de production industrielle à large échelle, consiste à créer une colonne auxiliaire transformant le texte d’origine par le biais d’expressions régulières de désaccentuation (mobilisant les fonctions REGEXREPLACE ou des scripts d’encodage ASCII) afin d’exécuter l’instruction QUERY sur un substrat phonétiquement et lexicalement normalisé.
9. Paramétrage dynamique : Injection de références de cellules dans les motifs génériques
9.1 Technique de concaténation de chaînes pour les requêtes dynamiques
L’intégration de valeurs scalaires statiques au sein d’une chaîne de requête QUERY limite drastiquement l’interactivité d’un modèle décisionnel. Pour bâtir des tableaux de bord dynamiques où les critères d’extraction s’adaptent instantanément aux choix d’un utilisateur, l’analyste doit maîtriser l’architecture de la concaténation de chaînes permettant d’injecter des références de cellules externes à l’intérieur du bloc de commande SQL. Cette opération s’appuie sur l’usage coordonné des guillemets doubles et du connecteur d’évaluation textuelle représenté par l’esperluette &.
L’anatomie d’une telle formule requiert une déconstruction rigoureuse pour en appréhender les seuils d’échappement. Considérons l’instruction canonique : =QUERY(A1:B10; « Select A, B where A like ‘% »&D1& »%' »). Dans ce schéma, la chaîne de requête est découpée en deux segments littéraux distincts : « Select A, B where A like ‘% » d’une part, et « %’ « d’autre part. La valeur dynamique contenue dans la cellule D1 est insérée à l’intersection exacte de ces deux blocs par le jeu des deux esperluettes. Lors de l’évaluation, le processeur de formule résout préalablement le contenu de la variable D1 avant de fusionner l’ensemble en une chaîne textuelle continue transmise au compilateur de l’API de visualisation.
9.2 Sécurisation et robustesse de l’injection dynamique
Bien que d’une efficience ergonomique remarquable, l’injection dynamique de critères textuels présente une vulnérabilité critique dès lors que la cellule de contrôle source (D1 dans notre exemple) se trouve vierge de toute saisie. En l’absence de saisie utilisateur, la formule se dégrade mécaniquement en une instruction contenant la séquence LIKE ‘%%’. Or, en vertu de la sémantique de multiplicité indéfinie du métacaractère pourcentage, le motif double %% équivaut à valider l’intégralité des cellules non vides de la plage, annulant de fait tout effet de filtrage sans en avertir l’utilisateur.
Pour prévenir cette réversion comportementale et garantir une étanchéité logique parfaite du système, il convient de conditionner l’évaluation de la requête à l’existence d’une entrée utilisateur effective. Cela se concrétise couramment par l’encapsulation de la commande au sein d’une structure conditionnelle : =IF(ISBLANK(D1); « »; QUERY(A1:B10; « Select A where lower(A) like ‘% »&LOWER(D1)& »%' »)). De surcroît, une attention particulière doit être portée à l’interception des caractères spéciaux saisis accidentellement par l’opérateur : la présence d’une apostrophe simple non échappée au sein de la cellule source briserait instantanément la syntaxe interne de la commande, provoquant un arrêt critique du moteur de calcul.
9.3 Création d’interfaces de recherche interactive pour utilisateurs métiers
L’aboutissement opérationnel du paramétrage dynamique réside dans l’édification de véritables interfaces de recherche interactives au sein de Google Sheets, découplant totalement l’utilisateur métier de la complexité syntaxique sous-jacente. En associant une cellule de saisie libre formatée, éventuellement combinée à des listes déroulantes de validation de données, l’analyste conçoit un panneau de contrôle ergonomique agissant comme un masque de saisie décisionnel.
Le moteur QUERY traite ces interactions de manière asynchrone : à chaque modification apportée à la cellule de saisie, un recalcul matriciel est déclenché en arrière-plan sans qu’aucune modification ne soit apportée à la base de données source protégée en écriture. Cette ségrégation architecturale entre l’entrepôt de données statique et la vue analytique dynamique garantit l’intégrité pérenne des enregistrements tout en autorisant une navigation intuitive et fluide au travers des millions de points de données de l’organisation.
10. Analyse comparative : Opérateur LIKE versus opérateur MATCHES
10.1 Différenciation conceptuelle entre caractères génériques et expressions régulières
Dans la boîte à outils d’analyse textuelle de la fonction QUERY, l’opérateur LIKE cohabite avec un instrument d’une expressivité computationnelle supérieure : l’opérateur MATCHES. La distinction entre ces deux opérateurs reflète la frontière théorique séparant le filtrage par caractères génériques traditionnels de l’univers des expressions rationnelles formelles, communément désignées sous l’abréviation RegEx. Alors que le prédicat LIKE se cantonne à une logique élémentaire de substitution unitaire ou universelle via deux symboles uniques, l’opérateur MATCHES implémente un analyseur syntaxique fondé sur le standard d’expressions régulières Java mis en œuvre par Google.
D’un point de vue conceptuel, tout patron formulé à l’aide de l’opérateur LIKE peut être fidèlement transposé vers l’opérateur MATCHES. L’instruction préfixée LIKE ‘mot%’ trouve son équivalence stricte dans la formulation régulière MATCHES ‘^mot.*’, de même que le motif suffixé LIKE ‘%mot’ correspond à MATCHES ‘.*mot$’, et l’inclusion LIKE ‘%mot%’ à MATCHES ‘.*mot.*’. Toutefois, cette équivalence fonctionnelle dissimule des disparités fondamentales en termes de ressources computationnelles et de gestion syntaxique :
- Opérateur LIKE : Utilise les métacaractères % (multiplicité indéfinie) et _ (occurrence unitaire). Syntaxe concise, lisible et directement accessible aux non-programmeurs. Faible consommation de cycles CPU.
- Opérateur MATCHES : Utilise la grammaire RegEx complète (classes de caractères, ancres de début et de fin de chaîne, quantificateurs arithmétiques, groupes de capture). Complexité d’écriture élevée mais puissance de capture quasi illimitée.
10.2 Scénarios où l’opérateur LIKE s’avère supérieur ou préférable
L’arbitrage en faveur de l’opérateur LIKE s’impose naturellement dans l’ensemble des scénarios où la simplicité, la lisibilité et la maintenance collective du code prévalent sur la complexité algorithmique. Dans un environnement de travail collaboratif où les modèles financiers et opérationnels sont audités par des équipes multidisciplinaires, l’intelligibilité immédiate d’une clause conditionnelle constitue un facteur d’atténuation des risques opérationnels. Une formule exploitant l’opérateur LIKE est compréhensible par tout utilisateur initié à la logique relationnelle sans exiger d’expertise avancée en compilation d’expressions régulières.
Sur le plan de la performance machine, l’opérateur LIKE s’avère également supérieur lors de l’exécution de requêtes simples sur de très volumineux jeux de données matriciels. Le coût d’instanciation de l’automate fini associé à une expression régulière est substantiellement plus élevé que le balayage linéaire opéré par l’algorithme de LIKE. De plus, LIKE élimine les risques d’erreurs syntaxiques générés par la présence fortuite de caractères réservés aux RegEx (tels que les parenthèses, les crochets, les barres verticales ou les points) qui obligent fréquemment les analystes à des manœuvres d’échappement fastidieuses sous MATCHES.
10.3 Scénarios imposant la transition impérative vers MATCHES
À l’inverse, la transition vers l’opérateur MATCHES devient incontournable dès lors que la règle de filtrage exige une quantification arithmétique rigide ou l’évaluation de classes disjointes complexes qui excèdent le champ sémantique de LIKE. Par exemple, isoler une séquence comportant précisément entre quatre et six chiffres consécutifs ne peut être modélisé sous LIKE qu’au prix d’une multiplication verbeuse de prédicats combinatoires, alors que l’expression MATCHES condense cette règle sous la syntaxe fluide ‘.*[0-9]{4,6}.*’.
De même, la validation formelle d’architectures textuelles hétérogènes complexes, telles que des adresses de courrier électronique respectant la norme RFC 5322, des numéros de sécurité sociale ou des identifiants bancaires internationaux (IBAN), réclame impérativement la puissance d’analyse de MATCHES. Enfin, sur le plan de la casse typographique, MATCHES propose une solution d’une élégance supérieure grâce au modificateur d’insensibilité (?i). L’instruction WHERE A MATCHES ‘(?i).*paris.*’ permet d’exécuter un appariement totalement neutre face à la casse sans nécessiter la surcharge syntaxique induite par l’invocation répétée des fonctions lower() ou upper().
11. Diagnostic des erreurs courantes et procédures de résolution systématique
11.1 Résolution de l’erreur d’analyse #VALUE! (Erreur de syntaxe de requête)
L’apparition de l’erreur générique #VALUE! (ou #VALEUR! dans l’interface francophone) signale l’échec critique du moteur d’analyse lexicale lors de la compilation de la chaîne de requête. Dans le contexte de l’opérateur LIKE, cette défaillance procède quasi systématiquement d’une rupture dans la continuité des délimitations typographiques. L’omission d’une apostrophe simple encadrant le motif littéral, son positionnement asymétrique ou la confusion visuelle entre apostrophes simples droites et apostrophes typographiques courbées (souvent insérées automatiquement par les correcteurs orthographiques des systèmes d’exploitation mobiles ou de traitement de texte) bloque instantanément l’exécution du compilateur.
La procédure de diagnostic méthodique requiert une vérification séquentielle par décomposition. L’analyste doit isoler le second argument de la fonction QUERY et l’injecter temporairement dans une cellule indépendante sans la commande QUERY afin de visualiser la chaîne littérale brute effectivement compilée par le tableur. L’examen minutieux de cette sortie permet de repérer immédiatement les anomalies d’échappement, les disparités de guillemets imbriqués ou les ruptures de concaténation induites par des esperluettes manquantes, garantissant une restauration rapide de la conformité syntaxique.
11.2 Gestion des résultats vides involontaires (retour uniquement des en-têtes)
L’un des comportements les plus déroutants de la fonction QUERY pour les praticiens réside dans la restitution d’une matrice ne comportant que la ligne d’en-tête descriptive, sans aucun enregistrement de données, alors même que des cellules cibles semblent visuellement concorder avec le critère textuel énoncé. Ce symptôme n’indique pas une erreur de syntaxe à proprement parler, mais trahit une incompatibilité de type de données sous-jacente régie par la règle dite de majorité typologique de l’API Google Visualization.
Le moteur d’inférence de Google analyse chaque colonne matricielle et impose un type de données unique fondé sur le type représenté majoritairement au sein des cent premières lignes. Si une colonne contient une prédominance de valeurs numériques scalaires aux côtés de quelques chaînes de caractères isolées, Google Sheets considérera l’ensemble de la dimension comme étant de nature numérique pure. Dès lors, toute application de l’opérateur LIKE sur cette colonne échouera silencieusement, le moteur ignorant purement et simplement les cellules textuelles minoritaires lors de l’évaluation du prédicat. Pour neutraliser ce phénomène, il est impératif de forcer la conversion préalable de la matrice en texte brut via l’application matricielle de la fonction TO_TEXT ou d’uniformiser la saisie à la source.
11.3 Échappement des caractères littéraux pourcentage et tiret du bas
Une aporie syntaxique majeure survient dès lors que l’analyste cherche à capturer, au sein d’une base de données, la présence littérale des symboles pourcentage ou tiret du bas eux-mêmes (par exemple, identifier des transactions financières étiquetées « Remise 10% » ou des fichiers dénommés « DATA_LOG »). Si ces caractères sont injectés de manière brute au sein d’une clause LIKE, le compilateur les interprète invariablement selon leur sémantique de métacaractères de substitution universelle ou unitaire, dénaturant totalement l’intention de la recherche.
Dans la norme SQL traditionnelle, l’interposition d’un caractère d’échappement spécifique, classiquement l’antislash ou barre oblique inversée , permet de désactiver temporairement la nature générique du symbole pour le contraindre à son identité scalaire pure. Toutefois, l’interpréteur de l’API Google Visualization présentant des limitations documentées dans la prise en charge uniforme de l’échappement natif au sein de LIKE, la stratégie de contournement la plus robuste consiste à basculer vers l’opérateur MATCHES. Grâce à la fonction d’échappement rigoureuse des expressions régulières, l’utilisation de séquences telles que MATCHES ‘.*10%.*’ ou MATCHES ‘.*_LOG.*’ (précédées d’une double barre oblique inversée d’échappement textuel) garantit une isolation parfaite du caractère typographique littéral sans ambiguïté interprétative.
12. Architectures avancées et optimisation des performances dans les grands volumes de données
12.1 Imbrication de requêtes QUERY avec caractères génériques au sein de fonctions matricielles
L’élévation de la fonction QUERY au rang d’outil de modélisation complexe culmine lors de son imbrication synergique au sein d’architectures matricielles avancées mobilisant des fonctions comme ARRAYFORMULA, REDUCE, ou l’écosystème fonctionnel de recherche INDEX/MATCH. L’une des constructions les plus fécondes consiste à utiliser une requête QUERY filtrée par des caractères génériques comme flux d’alimentation dynamique pour la création de tables virtuelles consolidées à la volée.
En exploitant la notation matricielle des accolades { }, l’ingénieur de données peut agréger verticalement ou horizontalement des sources hétérogènes réparties sur plusieurs feuilles avant de leur appliquer un prédicat unifié d’extraction par motif. Par exemple, l’instruction : =QUERY({Feuille1!A1:C; Feuille2!A1:C}; « Select Col1, Col2 where Col1 like ‘REF-%' ») unifie instantanément deux partitions distinctes en exécutant un filtrage continu sur la première dimension logique sans jamais générer de duplication physique sur le disque. De même, le chaînage d’une extraction QUERY dans une routine VLOOKUP (ou RECHERCHEV) permet d’effectuer des recherches vectorielles floues complexes au sein de structures relationnelles composites.
12.2 Stratégies d’optimisation du temps de recalcul dans les feuilles complexes
L’intégration de dizaines d’occurrences de la fonction QUERY armée de clauses LIKE au sein d’un même classeur collaboratif peut rapidement saturer le fil d’exécution JavaScript attribué par Google et dégrader dramatiquement le confort d’utilisation en induisant des temps de latence prolongés. Pour préserver une fluidité optimale, plusieurs principes d’architecture informatique doivent être scrupuleusement observés.
En premier lieu, il convient de bannir impérativement les références circulaires ou les plages indéfinies ouvertes démesurées telles que A:Z lorsqu’une borne dimensionnelle approximative est connue. Référencer A1:Z5000 restreint l’empreinte mémoire allouée par le moteur et dispense l’algorithme d’avoir à balayer des millions de cellules vides situées au-delà de la frontière effective des données. En second lieu, la séquence interne des expressions logiques au sein de la clause WHERE doit être scrupuleusement hiérarchisée : l’analyste doit placer les filtres d’égalité stricte ou les prédicats numériques en tête de clause (par exemple WHERE Col2 = 2024 AND Col1 LIKE ‘A%’) afin de maximiser l’élagage précoce des lignes avant que l’analyseur textuel par fenêtre glissante ne soit contraint de s’activer sur les données résiduelles.
12.3 Protocole méthodique pour un déploiement professionnel et pérenne
Le déploiement industriel de modèles tabulaires dans des contextes d’entreprise exige une gouvernance méthodologique stricte pour prémunir les organisations contre la dette technique et la fragilité applicative. Un modèle d’ingénierie professionnelle repose sur la standardisation rigoureuse des conventions de nommage et l’adoption systématique des plages de cellules nommées (Named Ranges). En substituant la syntaxe abstraite A1:E100 par des identifiants sémantiques tels que RegistreTransactions, l’analyste confère à ses formules QUERY une lisibilité immédiate qui simplifie l’audit de conformité : =QUERY(RegistreTransactions; « Select * where Col2 like ‘CONF-%' »).
Enfin, toute architecture décisionnelle complexe doit être documentée de manière exhaustive au sein de métadonnées internes ou de cellules dédiées de documentation architecturale. L’explicitation des choix opérés entre l’opérateur LIKE et l’opérateur MATCHES, la justification des règles d’échappement retenues et la formalisation des conventions typographiques attendues garantissent la maintenance pérenne et collaborative du système au fil des évolutions organisationnelles et des successions de collaborateurs.
Références
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
Google LLC. (2024). Google Visualization API Query Language. Google Developers. https://developers.google.com/chart/interactive/docs/querylanguage
Google LLC. (2024). QUERY function reference in Google Sheets. Google Workspace Support. https://support.google.com/docs/answer/3093343
International Organization for Standardization. (2016). Information technology — Database languages — SQL — Part 2: Foundation (SQL/Foundation) (ISO/IEC 9075-2:2016). https://www.iso.org/standard/63555.html
Knuth, D. E., Morris, J. H., & Pratt, V. R. (1977). Fast pattern matching in strings. SIAM Journal on Computing, 6(2), 323–350. https://doi.org/10.1137/0206024
The Unicode Consortium. (2024). The Unicode Standard, Version 15.1.0. Mountain View, CA: The Unicode Consortium. https://www.unicode.org/versions/Unicode15.1.0/