
Dans le domaine de l’analyse statistique appliquée et des sciences quantitatives contemporaines, la maîtrise des instruments de calcul informatique et graphique constitue un prérequis méthodologique fondamental. Qu’il s’agisse d’évaluer la variabilité des performances cognitives dans le cadre d’un protocole expérimental en neurosciences, de calibrer une échelle psychométrique standardisée ou d’analyser des distributions de scores universitaires, la dispersion des données constitue une source d’information aussi déterminante que la tendance centrale. L’erreur commune qui consiste à résumer une distribution empirique à sa seule moyenne arithmétique occulte la structure interne des phénomènes observés, masquant l’hétérogénéité des sujets et la variabilité intrinsèque des processus mesurés.
La calculatrice graphique Texas Instruments TI-84 Plus, déclinée en ses multiples versions incluant la Silver Edition et la version CE à écran couleur haute résolution, demeure la référence pédagogique et universitaire universelle pour l’apprentissage et l’application des biostatistiques et de la psychométrie. Cependant, une particularité ergonomique de cette machine suscite fréquemment la perplexité des étudiants et des chercheurs : le menu des statistiques descriptives à une variable n’affiche pas directement la variance de l’échantillon sous une forme explicite. L’utilisateur se retrouve confronté à deux symboles d’écart-type distincts, sans que la variance elle-même ne figure dans le tableau de synthèse initial.
Ce guide exhaustif a pour vocation d’élucider la totalité des démarches conceptuelles, algorithmiques et manuelles requises pour déterminer avec une précision absolue la variance d’un échantillon sur la calculatrice TI-84. En combinant la rigueur théorique des modèles inférentiels avec l’apprentissage minutieux des séquences de touches, ce traité explore les fondements mathématiques sous-jacents, détaille les protocoles de saisie séquentielle, explicite les méthodes vectorielles alternatives, et prévient les écueils métrologiques les plus sournois rencontrés lors du traitement des données empiriques.
1. Introduction aux fondements théoriques de la variance d’un échantillon en psychométrie et statistiques
1.1 Définition mathématique et conceptuelle de la variance d’échantillon
La variance d’échantillon constitue l’un des piliers cardinaux de l’analyse descriptive et inférentielle moderne. D’un point de vue conceptuel, elle mesure l’étendue avec laquelle les observations individuelles au sein d’une série de données s’écartent de leur barycentre arithmétique. Si la moyenne nous renseigne sur l’emplacement central d’une distribution de probabilité ou d’un nuage de points, la variance quantifie l’ampleur de la dispersion de ces données. Une variance nulle indiquerait une homogénéité absolue, c’est-à-dire une condition d’invariance où chaque sujet ou élément de l’échantillon présenterait exactement la même valeur métrique. À l’inverse, une variance élevée signale une grande diversité des scores, reflétant une forte variabilité interindividuelle ou la présence de fluctuations aléatoires majeures lors de l’acquisition des données.
Sur le plan formel, la formulation analytique standard de la variance d’un échantillon, universellement désignée par le symbole s², s’écrit sous la forme suivante :
s² = Σ (xᵢ – x̄)² / (n – 1)
Dans cette équation, le terme xᵢ représente chaque mesure individuelle observée, x̄ symbolise la moyenne arithmétique de l’échantillon, n désigne l’effectif total de l’échantillon considéré, et le symbole sommatoire Σ indique l’agrégation de l’ensemble des écarts à la moyenne calculés pour chaque observation allant du premier au n-ième individu. La soustraction de la moyenne à chaque score individuel génère ce que les statisticiens nomment des résidus ou des écarts. L’élévation de ces résidus à la puissance carrée remplit un double office : d’une part, elle neutralise les signes négatifs qui résulteraient des valeurs inférieures à la moyenne, empêchant ainsi une annulation arithmétique globale de la somme ; d’autre part, elle pénalise de manière non linéaire et disproportionnée les écarts majeurs, conférant une sensibilité accrue de l’indicateur aux déviations substantielles.
D’un point de vue métrologique, l’une des propriétés fondamentales de la variance réside dans sa dimensionnalité. En raison de l’opération d’élévation au carré, la variance s’exprime dans le carré de l’unité originale de la variable mesurée. Par exemple, si l’on mesure le temps de réaction de sujets à un stimulus visuel en millisecondes, la variance résultante s’exprimera en millisecondes au carré. Cette transformation dimensionnelle rend l’interprétation clinique directe de la variance complexe et peu intuitive, motivant l’extraction ultérieure de sa racine carrée pour obtenir l’écart-type, qui restaure l’unité de mesure primitive. Néanmoins, en psychométrie et dans la théorie classique des tests, la variance demeure la métrique irremplaçable pour décomposer la variabilité totale d’un instrument en composante de variance vraie et en variance d’erreur de mesure, condition indispensable à l’estimation de la fidélité des échelles psychologiques.
1.2 Distinction cruciale entre variance d’échantillon et variance de population
La confusion entre le paramètre d’une population et l’estimateur calculé sur un échantillon représente l’une des sources d’erreurs d’interprétation les plus pernicieuses dans l’enseignement supérieur et la pratique scientifique. Une population statistique comprend l’intégralité exhaustive des entités partageant une caractéristique définie (par exemple, l’ensemble des adultes francophones diagnostiqués avec un trouble anxieux généralisé). Lorsque l’on a accès à cette totalité théorique, la variance de population, universellement désignée par la lettre grecque σ² (sigma carré), est calculée en divisant la somme des carrés des écarts par l’effectif exhaustif N :
σ² = Σ (xᵢ – μ)² / N
où μ représente la moyenne paramétrique véritable de la population entière. Dans la quasi-totalité des contextes empiriques réels, il est matériellement, temporellement et financièrement impossible d’accéder à l’ensemble d’une population parente. Le chercheur est contraint de travailler avec un sous-ensemble fini, désigné sous le terme d’échantillon probabiliste ou non probabiliste. Le passage de la population à l’échantillon modifie radicalement le statut épistémologique du calcul : s² n’est plus la mesure descriptive directe d’un tout, mais un estimateur statistique chargé d’inférer la valeur inconnue de σ².
L’utilisation de la moyenne de l’échantillon x̄ en lieu et place de la moyenne paramétrique inconnue μ entraîne une modification substantielle des relations géométriques dans l’espace des données. Par définition de la méthode des moindres carrés, la somme des carrés des écarts des données par rapport à leur propre moyenne d’échantillon est strictement inférieure à la somme des carrés des écarts de ces mêmes données par rapport à n’importe quelle autre constante, y compris la moyenne réelle de la population μ. Par conséquent, si nous calculions la variance de l’échantillon en appliquant naïvement le dénominateur n, la valeur obtenue sous-estimerait systématiquement la véritable variance de la population. Cet estimateur serait alors mathématiquement qualifié de biaisé.
Il convient également de souligner la sensibilité différentielle de la variance face aux anomalies d’échantillonnage. En raison de sa structure quadratique, la variance est extrêmement vulnérable à la présence de valeurs aberrantes (ou outliers) et aux distributions fortement asymétriques. L’intégration d’un seul score extrême au sein d’un échantillon restreint de participants peut doubler ou tripler la variance calculée, créant une distorsion artificielle de l’estimation de dispersion. Cette caractéristique impose une vigilance accrue lors de la saisie des données sur les claviers numériques de nos instruments, ainsi qu’une vérification systématique de l’intégrité de la distribution avant toute conclusion définitive.
1.3 Le rôle des degrés de liberté et la correction de Bessel
La solution mathématique rigoureuse au problème du biais de sous-estimation évoqué précédemment est connue sous le nom de correction de Bessel, ainsi baptisée en l’honneur de l’astronome et mathématicien allemand Friedrich Wilhelm Bessel. Cette correction consiste à substituer le dénominateur n – 1 à la taille brute de l’échantillon n dans la formule du calcul de la variance de l’échantillon. Cette modification permet d’obtenir un estimateur sans biais, ce qui signifie formellement que l’espérance mathématique de la statistique s² est rigoureusement égale au paramètre de population sous-jacent :
E[s²] = σ²
Pour appréhender l’origine géométrique et logique de ce terme n – 1, il est nécessaire d’examiner le concept fondamental de degrés de liberté (notés communément dl ou df pour degrees of freedom). Dans une perspective multidimensionnelle, un échantillon de n observations indépendantes possède initialement n dimensions de variabilité libre. Cependant, pour calculer les écarts individuels (xᵢ – x̄), nous sommes obligés d’estimer préalablement la moyenne arithmétique x̄ à partir de ces mêmes données empiriques. Cette estimation impose une contrainte mathématique linéaire stricte sur l’ensemble de la série :
Σ (xᵢ – x̄) = 0
En vertu de cette égalité obligatoire, dès lors que n – 1 écarts ont été arbitrairement déterminés, le n-ième écart est mathématiquement verrouillé ; il ne dispose plus d’aucune liberté de variation puisqu’il doit impérativement compenser exactement la somme des autres écarts pour que le total soit nul. L’échantillon a donc « consommé » un degré de liberté pour estimer la moyenne arithmétique, ne laissant subsister que n – 1 composantes indépendantes pour estimer la dispersion autour de ce centre.
Cette distinction entre n et n – 1 a des répercussions directes sur l’ensemble des procédures d’inférence statistique. Les modèles de test d’hypothèses, tels que le test t de Student pour échantillons indépendants ou appariés, l’analyse de variance univariée et multivariée (ANOVA/MANOVA), ainsi que les techniques de régression linéaire, reposent tous explicitement sur le fractionnement de sommes de carrés divisées par leurs degrés de liberté respectifs pour dériver des carrés moyens. Omettre la correction de Bessel et utiliser la formule de population conduirait à un gonflement artificiel de la valeur des tests de significativité, augmentant drastiquement le risque de commettre une erreur d’inférence statistique de type I, c’est-à-dire le rejet erroné d’une hypothèse nulle pourtant exacte.
2. Configuration et préparation initiale de la calculatrice TI-84
2.1 Présentation de l’environnement matériel et des versions supportées
La gamme des calculatrices graphiques Texas Instruments TI-84 s’est enrichie de multiples révisions matérielles au cours des deux dernières décennies, maintenant néanmoins une continuité architecturale remarquable dans ses interfaces de calcul scientifique. Les protocoles algorithmiques présentés dans ce manuel s’appliquent sans aucune altération de logique aux modèles historiques fonctionnant sous écran LCD monochrome (tels que la TI-84 Plus standard et la TI-84 Plus Silver Edition, dotées d’un processeur Zilog Z80 cadencé à 15 MHz) ainsi qu’aux modèles modernes de dernière génération comme la TI-84 Plus CE, la TI-84 Plus CE-T et la TI-84 Plus C Silver Edition (animées par un microcontrôleur eZ80 et dotées d’écrans couleur rétroéclairés à haute densité de pixels).
L’interface utilisateur de la machine est agencée selon un partitionnement rationnel du clavier physique. Les touches primaires d’accès statistique se situent principalement au centre du pavé numérique supérieur, matérialisées par la touche STAT, encadrée par les touches de navigation directionnelle multidirectionnelle. Les opérations mathématiques de second ordre nécessitent l’utilisation systématique de la touche modificatrice jaune ou bleue 2nd, située dans le coin supérieur gauche du clavier, laquelle permet d’activer la fonction inscrite au-dessus de chaque touche physique.
Avant de s’engager dans des analyses empiriques critiques ou dans des sessions d’examens universitaires, une vérification rigoureuse de l’état fonctionnel de la machine s’avère indispensable. Sur les modèles monochromes, la gestion du contraste de l’affichage s’opère par une impulsion sur la touche 2nd suivie d’une pression maintenue sur la flèche multidirectionnelle HAUT (pour assombrir) ou BAS (pour éclaircir). Sur les modèles TI-84 Plus CE équipés d’accumulateurs au lithium-ion rechargeables, l’indicateur d’état de charge situé dans l’angle supérieur droit de l’écran d’accueil doit impérativement afficher au minimum trois barres d’énergie résiduelle, sous peine de voir l’appareil basculer en mode de veille forcée lors de calculs matriciels intensifs ou de tracés itératifs de distributions statistiques.
2.2 Réinitialisation et nettoyage des listes de données existantes
L’une des causes majeures d’erreur lors du calcul de la variance d’un échantillon sur calculatrice graphique réside dans la persistance involontaire de données numériques résiduelles issues d’exercices ou d’expérimentations antérieurs. Pour garantir l’intégrité absolue de la mémoire vive de travail, il est primordial d’exécuter une procédure formelle de réinitialisation des registres de listes statistiques.
La commande logicielle la plus sûre et la plus directe pour vider un conteneur de données spécifique consiste à utiliser l’instruction dédiée ClrList. Pour mobiliser cette routine :
- Appuyez sur la touche STAT pour ouvrir le menu principal de gestion statistique.
- Faites défiler le curseur vers le bas à l’aide de la flèche directionnelle pour sélectionner l’option 4: ClrList, puis appuyez sur ENTER.
- L’instruction ClrList s’affiche alors sur votre écran principal d’accueil de calcul. Vous devez lui spécifier la liste ciblée. Pour cibler la liste L1, appuyez sur la touche 2nd puis sur la touche numérique 1 (au-dessus de laquelle figure le symbole bleu ou jaune L1).
- Appuyez sur la touche ENTER pour exécuter la purge. La calculatrice valide l’opération en affichant l’indicateur textuel de réussite : Done (ou Fait sur les versions francisées).
Alternativement, il est tout à fait possible d’effectuer cette opération de nettoyage manuellement directement au sein de l’éditeur de tableaux matriciels. Lors de la navigation dans les colonnes de données (accessible via STAT > 1:Edit…), il suffit de positionner le curseur inverseur sur le nom même de l’en-tête de colonne (par exemple, en plaçant la surbrillance sur l’intitulé L1 au sommet de la colonne) et d’appuyer successivement sur la touche CLEAR puis sur la touche ENTER. Attention : il ne faut en aucun cas utiliser la touche DEL (supprimer) sur le nom de l’en-tête L1, sous peine d’effacer purement et simplement la colonne de l’interface visuelle de l’éditeur.
Dans l’éventualité où une liste fondamentale (de L1 à L6) aurait été accidentellement supprimée de l’éditeur matriciel suite à une mauvaise manipulation de la touche DEL, Texas Instruments a prévu un mécanisme de restauration de la configuration d’usine de l’affichage. Pour réhabiliter la disposition initiale des colonnes sans perdre les données enregistrées dans la mémoire profonde de l’appareil, appuyez sur la touche STAT, descendez jusqu’à l’option 5: SetUpEditor, appuyez sur ENTER deux fois consécutives. L’éditeur est alors réinitialisé avec ses six conteneurs standards natifs prêts pour l’analyse.
2.3 Vérification du mode d’affichage et de la précision numérique
La fidélité des calculs statistiques de variance dépend étroitement de la précision numérique interne et des paramètres de représentation typographique du moteur de rendu mathématique de la TI-84. La machine opère en interne avec une précision arithmétique de quatorze chiffres significatifs au format flottant à virgule binaire codée décimale (BCD), bien qu’elle limite généralement son rendu typographique à dix chiffres sur les écrans d’affichage par souci d’ergonomie visuelle.
Pour vérifier et verrouiller la configuration optimale du système, appuyez sur la touche MODE située sur la ligne supérieure des commandes système. Parcourez l’arborescence des réglages pour vérifier les éléments critiques suivants :
- Sur la deuxième ligne, relative au format décimal, assurez-vous impérativement que l’option FLOAT (flottant) est surlignée. Si un chiffre entier (par exemple 0, 2 ou 4) est sélectionné, la calculatrice arrondira de manière irréversible chaque affichage intermédiaire, tronquant les décimales ultérieures et induisant des erreurs de propagation désastreuses lors des calculs d’écarts quadratiques.
- Vérifiez que le mode général d’affichage est positionné sur NORMAL et non sur SCI (notation scientifique) ou ENG (notation ingénieur), sauf si l’ordre de grandeur de vos données expérimentales le requiert formellement (mesures microscopiques ou astrophysiques).
- Sur les modèles TI-84 Plus CE, assurez-vous que l’option d’affichage des fractions est positionnée de manière à privilégier les nombres décimaux réels lors de l’exécution de routines statistiques matricielles, ce qui évite la saturation visuelle sous forme de fractions rationnelles complexes non réductibles.
Une fois ces paramètres scrupuleusement confirmés, vous pouvez quitter l’environnement de configuration pour réintégrer l’écran principal d’accueil en exécutant la séquence combinatoire 2nd puis MODE (qui appelle la fonction secondaire QUIT). Votre calculatrice est désormais paramétrée de façon irréprochable pour garantir la traçabilité et l’exactitude des chaînes de calcul numérique les plus exigeantes.
3. Saisie rigoureuse des données dans les listes statistiques de la TI-84
3.1 Accès à l’éditeur de listes via la touche STAT
Le moteur d’analyse descriptive de la calculatrice Texas Instruments repose sur une structure matricielle de vecteurs unidimensionnels appelés couramment « Listes ». Le système intègre six listes prédéfinies identifiées par les étiquettes réservées L1, L2, L3, L4, L5 et L6, allouées de manière persistante dans la mémoire vive statique de l’équipement.
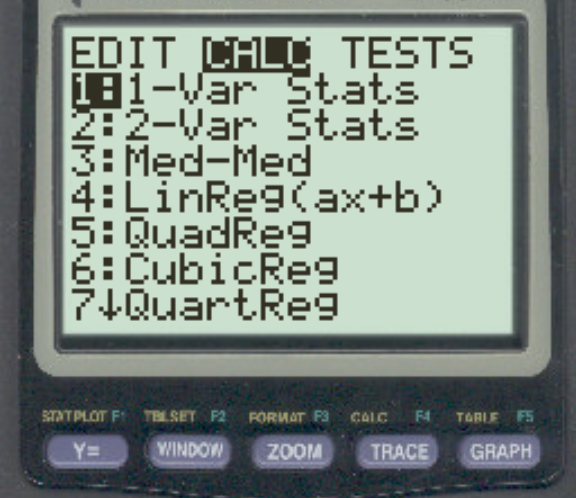
Pour pénétrer au cœur de cet environnement tabulaire, appuyez fermement sur la touche STAT située au centre du quadrant directionnel. L’écran de la machine se transforme pour présenter un menu contextuel horizontal articulé en trois sous-onglets principaux : EDIT, CALC et TESTS. L’onglet EDIT étant sélectionné par défaut à l’ouverture, vous constatez la présence immédiate de la commande 1: Edit….
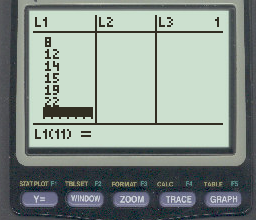
Pressez la touche ENTER (ou appuyez directement sur le chiffre 1 de votre clavier numérique) pour valider l’entrée dans l’éditeur. L’écran se convertit instantanément en un tableur à colonnes multiples. Les en-têtes supérieurs révèlent les noms respectifs des listes disponibles, tandis que le corps central est constitué de cellules d’encodage vierges ou garnies de données résiduelles. Le curseur clignotant s’immobilise par défaut sur la première cellule active située à la ligne 1 de la colonne L1 (désignée formellement par la coordonnée L1(1) sur la ligne d’état inférieure de la calculatrice).
3.2 Procédure d’encodage séquentiel de l’échantillon
L’introduction d’un échantillon numérique dans la liste L1 doit faire l’objet d’une rigueur méthodique absolue, car toute faute de frappe compromet irrémédiablement l’exactitude de la moyenne et, par répercussion exponentielle, celle de la variance d’échantillon. Pour encoder une valeur, l’utilisateur tape le nombre désiré sur le clavier numérique, puis appuie sur la touche ENTER pour entériner l’inscription du score.
Dès que la touche ENTER est pressée, deux phénomènes mécaniques se produisent simultanément : la valeur saisie est stockée dans le registre mémoire de la liste, et le curseur d’édition descend automatiquement d’un cran pour se positionner sur la cellule sous-jacente L1(2). L’opération est ainsi réitérée de manière strictement séquentielle pour l’ensemble des scores composant la cohorte d’observations :
- Pour encoder des valeurs fractionnaires ou décimales, employez exclusivement le point décimal standard situé sur la ligne inférieure du clavier à côté du chiffre zéro, et non une virgule textuelle.
- Pour introduire des mesures expérimentales négatives (par exemple, des différentiels thermiques ou des scores factoriels centrés-réduits négatifs), veillez à utiliser scrupuleusement la touche négative unaire notée (-), située tout en bas à droite à côté de la touche ENTER, et non la touche d’opération binaire de soustraction –, qui engendrerait immédiatement une erreur d’évaluation syntaxique à l’exécution.
Une règle ergonomique fondamentale pour vérifier la complétude de l’échantillon consiste à lire attentivement l’indicateur d’indice de positionnement présent sur la ligne d’état située tout en bas de l’écran matriciel. Si votre échantillon est supposé comporter exactement n = 10 observations, le curseur clignotant doit impérativement s’établir sur la ligne vide indexée L1(11) = lorsque vous avez terminé la saisie de votre dixième donnée. Cette correspondance d’indices fournit une assurance immédiate que le volume total d’unités expérimentales prévues a bien été consigné sans omission d’éléments.
3.3 Correction, modification et suppression des valeurs erronées
La pratique statistique sur le terrain est indissociable de la gestion des erreurs de frappe matérielles. La TI-84 propose un arsenal de commandes d’édition in situ permettant de rectifier n’importe quelle distorsion d’encodage sans être contraint d’annuler et de recommencer l’intégralité du processus de saisie.
Pour modifier une valeur mal retranscrite :
- Naviguez à l’aide des flèches multidirectionnelles HAUT et BAS jusqu’à ce que la cellule fautive apparaisse en surbrillance inversée.
- Tapez directement la nouvelle valeur numérique désirée. La saisie écrase automatiquement la valeur obsolète sur la ligne de commande inférieure.
- Pressez ensuite ENTER pour consigner la mise à jour au sein de la matrice.
Dans l’éventualité où une observation redondante ou superflue aurait été encodée par inadvertance, vous pouvez la retrancher unitairement de la série sans perturber le reste de la liste. Positionnez le curseur sur la cellule à détruire, puis appuyez simplement sur la touche DEL (située juste à côté de la touche fléchée gauche). La cellule ciblée est instantanément détruite, et l’ensemble des valeurs situées en dessous remonte d’un niveau d’incrémentation, réduisant la dimension totale de la liste d’une unité.
Inversement, si vous avez accidentellement omis une observation intercalaire dans la série séquentielle, vous n’êtes nullement contraint de la reporter tout à la fin de la liste (ce qui poserait des difficultés d’ordonnancement en cas de couplage temporel). Placez le curseur d’édition sur l’élément qui doit se situer immédiatement après l’observation omise, et exécutez la combinaison de touches 2nd puis DEL (qui sollicite l’ordre d’insertion INS). Une cellule vide s’ouvre instantanément à l’endroit désigné, repoussant l’ensemble de la distribution vers le bas. Vous n’avez plus qu’à renseigner la valeur manquante et à entériner l’opération par la touche ENTER.
4. Exécution de la commande 1-Var Stats pour l’analyse descriptive
4.1 Navigation dans le menu STAT CALC
Une fois les observations expérimentales minutieusement codées et validées au sein du vecteur de données matricielles, il convient de quitter l’environnement de l’éditeur tabulaire pour regagner la console de commande opérationnelle. Pour ce faire, exécutez la séquence d’interruption système standard en appuyant successivement sur la touche 2nd puis sur la touche MODE (commande QUIT). Votre affichage bascule alors sur l’écran d’accueil neutre de la machine.
L’initialisation du moteur algorithmique de calcul statistique descriptif s’effectue selon le protocole de navigation suivant :
- Appuyez sur la touche STAT pour réactiver le menu de pilotage.
- À l’aide de la touche directionnelle flèche DROITE, déplacez le sélecteur horizontal d’en-tête vers l’onglet central baptisé CALC.
- Cet écran liste les puissantes primitives de calcul statistique mises à disposition par Texas Instruments. La toute première fonction, référencée sous le label 1: 1-Var Stats (Statistiques à une variable), représente l’algorithme dédié à l’évaluation univariée des distributions d’échantillons ou de populations.
- Validez ce choix soit en pressant la touche ENTER lorsque la ligne 1 est surlignée, soit en pressant simplement le chiffre 1 sur le pavé numérique direct.
4.2 Configuration des paramètres List et FreqList
La présentation de l’interface qui succède à l’appel de la fonction 1-Var Stats dépend de la version matérielle et du microcode interne (firmware) qui pilote votre calculatrice TI-84. Sur les machines contemporaines (comme la TI-84 Plus CE ou les TI-84 Plus dotées d’un système d’exploitation égal ou supérieur à la version 2.55MP), le système présente un écran interactif d’assistant de configuration des arguments nommé Stat Wizards.
Cet assistant affiche une série de champs qu’il est indispensable de paramétrer avec la plus grande précision méthodologique :
- List : Ce champ désigne le réceptacle matriciel hébergeant vos observations brutes. Par défaut, la machine y préinscrit généralement la variable L1. Si un autre nom figure dans cette zone, repositionnez l’adresse sur L1 en pressant la combinaison de touches 2nd puis le chiffre 1.
- FreqList : Ce paramètre hautement sensible est destiné à la pondération fréquentielle des scores. Dans notre cas d’espèce, portant sur un échantillon d’observations individuelles brutes où chaque entrée représente une unité métrique indépendante singulière, ce champ doit impérativement demeurer totalement vierge et vide. Si une variable quelconque (comme L2) s’y trouve résiduellement inscrite, déplacez le curseur sur cette ligne et pressez impérativement la touche CLEAR pour la purger. La présence involontaire d’une liste de fréquences fausserait radicalement la totalité des sommes de carrés et de la métrique d’échantillon résultante.
- Calculate : À l’aide de la flèche directionnelle descendante, positionnez la surbrillance sur le mot Calculate, puis pressez la touche d’exécution ENTER.
Sur les calculatrices de génération antérieure fonctionnant sans l’assistant Stat Wizards, l’instruction 1-Var Stats apparaît directement sur la ligne de l’écran principal d’accueil. Dans ce cas de figure précis, la calculatrice assume implicitement par convention que le traitement s’opère sur la liste L1 non pondérée si aucun argument n’est spécifié à la suite de l’invite. Il vous suffit alors d’appuyer immédiatement sur la touche ENTER pour déclencher la compilation du moteur statistique.
4.3 Analyse globale de l’écran des résultats descriptifs
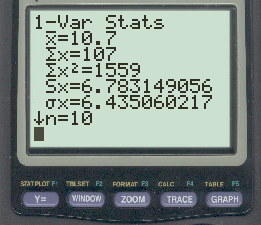
L’exécution de la commande 1-Var Stats prend une fraction de seconde, à l’issue de laquelle l’écran se peuple d’un ensemble complet de métriques descriptives indispensables à la description d’une série statistique. L’utilisateur averti doit savoir naviguer à travers cette nomenclature codifiée afin d’extraire les éléments clés indispensables à l’analyse de sa distribution :
- x̄ (x barre) : Représente la moyenne arithmétique rigoureuse calculée sur l’ensemble des scores composant votre échantillon.
- Σx (Somme de x) : Correspond au cumul arithmétique absolu de l’ensemble des valeurs numériques individuelles saisies dans la colonne d’analyse.
- Σx² (Somme des x carrés) : Renseigne la somme géométrique des carrés de chacune des valeurs de données brutes prises isolément. Cette métrique constitue l’ingrédient matériel de base utilisé par la formule développée de calcul de dispersion.
- Sx : Indique l’écart-type de l’échantillon (corrigé selon Bessel avec le dénominateur n – 1). C’est précisément cette valeur qui constitue le pivot opérationnel de notre démarche pour parvenir à la variance.
- σx (sigma x) : Représente l’écart-type de la population (calculé avec le dénominateur brut n).
- n : Confirme sans ambiguïté l’effectif total d’observations prises en compte lors de cette routine algorithmique.
Une petite flèche noire orientée vers le bas présente sur la bordure droite de l’écran signale la disponibilité de statistiques d’ordre complémentaires. En actionnant la flèche directionnelle BAS, l’utilisateur accède au résumé des cinq nombres de Tukey : la valeur minimale (minX), le premier quartile (Q1), la médiane d’échantillon (Med), le troisième quartile (Q3) et la valeur maximale observée (maxX), éléments fondamentaux pour dresser un diagramme en boîte à moustaches.
5. Extraction de l’écart-type d’échantillon (Sx) et dérivation de la variance
5.1 Localisation précise de l’écart-type d’échantillon Sx
L’examen minutieux de l’écran de sortie de la commande 1-Var Stats soulève immédiatement une interrogation légitime : pour quelle raison les concepteurs des calculatrices Texas Instruments n’ont-ils pas implanté une ligne affichant directement le symbole de la variance d’échantillon s² ? La réponse réside dans une décision d’ergonomie industrielle et d’économie d’espace d’affichage prise dès la conception de la lignée TI-81 au début des années 1990. L’écran LCD historique ne comportait que huit lignes de texte ; afficher simultanément les moyennes, sommes, deux types d’écarts-types, effectifs et paramètres d’ordre imposait un compromis structurel.
Les ingénieurs ont dès lors privilégié l’écart-type d’échantillon Sx, sachant que la relation formelle qui lie l’écart-type à la variance est une bijection analytique parfaite régie par la racine carrée :
s = √s² et par voie de conséquence : s² = (s)²
Face aux deux lignes concurrentes proposées par la machine :
Sx = ...
σx = ...
le choix méthodologique de l’étudiant ou du chercheur travaillant sur un échantillon expérimental doit se porter de manière absolue et sans aucune défaillance sur le paramètre Sx. Sélectionner σx (sigma de x) reviendrait à introduire un biais négatif dans l’analyse de dispersion, puisque cette ligne applique la division par la taille n de l’échantillon, présumant indûment que les données traitées couvrent l’intégralité cosmique ou populationnelle du phénomène étudié.
5.2 Conséquences néfastes de la recopie manuelle et des erreurs d’arrondi
Une pratique courante, mais méthodologiquement désastreuse, consiste pour l’étudiant à lire la valeur décimale de Sx affichée à l’écran, à en recopier les premiers chiffres significatifs sur une feuille de brouillon (ou directement sur l’écran d’accueil), pour ensuite élever ce nombre recopié au carré. Par exemple, si Sx vaut 6,783149056, l’utilisateur pourrait être tenté de taper naïvement 6.78² ou 6.783².
Cette troncature manuelle a des répercussions désastreuses sur la précision finale du résultat. En statistique appliquée, l’élévation au carré agit comme un amplificateur exponentiel d’imprécision. Considérons un écart-type réel de valeur :
s = 6,783149 dont le carré exact est s² = 46,011110
Si un individu tronque la valeur de base à deux décimales en écrivant 6,78, son carré produit alors 45,9684. L’erreur absolue générée est d’environ 0,0427. Dans le cadre de protocoles scientifiques de psychologie quantitative, de calibrations psychométriques ou de calculs de puissance d’effet statistique de Cohen, une telle discordance d’arrondi peut altérer le positionnement d’une valeur p (p-value) autour du seuil d’alpha critique de 0,05, conduisant potentiellement à une fausse découverte empirique ou au rejet immérité d’une publication académique.
Il est donc impératif de bannir la recopie manuelle et d’adopter la procédure automatisée de rappel dynamique des variables système de la TI-84, garantissant le maintien des quatorze chiffres de précision interne conservés dans les registres mémoire de la machine.
6. Utilisation des variables système (VARS) pour élever Sx au carré
6.1 Navigation vers le menu des variables statistiques
Pour exécuter un calcul de variance exempt de toute trace d’erreur d’arrondi, il convient d’exploiter l’architecture sous-jacente du système d’exploitation de la TI-84, qui consigne automatiquement les résultats de toute routine descriptive dans des variables système persistantes.
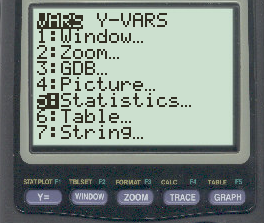
Pour accéder à ce registre dédié, assurez-vous tout d’abord d’être positionné sur l’écran de calcul principal d’accueil (en appuyant au besoin sur la séquence 2nd > MODE). Appuyez ensuite sur la touche VARS (Variables), située sur la rangée immédiatement en dessous des touches fléchées de navigation. L’écran présente alors une liste ordonnée de catégories de registres système :
- 1: Window…
- 2: Zoom…
- 3: GDB…
- 4: Picture…
- 5: Statistics…
- 6: Table…
- 7: String…
Sélectionnez sans hésitation l’option 5: Statistics… soit en descendant le curseur à l’aide de la flèche bas jusqu’au rang 5 puis en validant avec ENTER, soit en tapant directement le chiffre 5 sur votre clavier.
6.2 Sélection dynamique du paramètre Sx
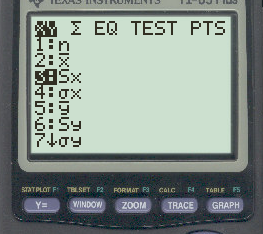
L’ouverture du menu des variables statistiques révèle une interface spécialisée subdivisée en plusieurs onglets horizontaux : XY, Σ, EQ, TEST et PTS. L’onglet par défaut XY regroupe l’ensemble des grandeurs de dispersion et de tendance centrale calculées lors de la dernière exécution des commandes d’analyse statistique :
- 1: n
- 2: x̄
- 3: Sx
- 4: σx
- 5: ȳ
- 6: Sy
- 7: σy
Pour désigner l’écart-type d’échantillon, descendez le curseur jusqu’à surligner la ligne 3: Sx et appuyez sur la touche ENTER (ou appuyez simplement sur la touche numérique 3). Cette manipulation a pour effet immédiat de rappeler la variable et d’imprimer la mention textuelle Sx directement sur la ligne de commande active de votre écran d’accueil.
Il est fondamental de comprendre que le symbole typographique Sx ainsi affiché à l’écran ne constitue pas un simple texte d’illustration, mais un pointeur mémoire dynamique. Il renvoie rigoureusement à l’adresse mémoire interne hébergeant la valeur de l’écart-type d’échantillon calculé lors du dernier appel de 1-Var Stats, conservant la plénitude de sa résolution mathématique interne sans la moindre troncature décimale.
6.3 Application de la puissance carrée et obtention de s²
Une fois le symbole système Sx positionné sur la ligne d’édition de l’écran d’accueil, l’étape terminale pour obtenir la variance de l’échantillon consiste à appliquer l’opérateur d’élévation à la puissance carrée. Texas Instruments a judicieusement pourvu le clavier d’une touche de fonction dédiée évitant d’avoir à composer des syntaxes d’exponentiation complexes :
- Repérez la touche x² située sur la colonne extrême gauche du clavier (au niveau de la cinquième rangée en partant du haut).
- Appuyez sur la touche x². L’écran de la calculatrice affiche désormais avec précision l’instruction suivante :
Sx². - Appuyez enfin sur la touche d’exécution terminale ENTER située dans le coin inférieur droit du pavé de commande.
La calculatrice exécute immédiatement la multiplication interne de la variable par elle-même et affiche, sur la partie droite de l’écran, le résultat décimal complet représentant la variance exacte de l’échantillon (s²). Cette valeur est exempte de tout biais d’estimation de Bessel et de toute contamination par erreur d’arrondi numérique.
7. Exemple empirique détaillé pas à pas sur la TI-84
7.1 Présentation du jeu de données expérimentales
Afin de concrétiser l’ensemble de ce protocole méthodologique dans des conditions réalistes d’expérimentation, considérons une série d’observations quantitatives recueillies lors d’un protocole d’évaluation de la flexibilité cognitive mesurée auprès d’un échantillon expérimental de participants adultes. La cohorte est constituée de dix individus (n = 10), dont les performances métriques brutes sont retranscrites dans la séquence numérique ordonnée suivante :
Série de données expérimentales : 2, 4, 4, 7, 8, 12, 14, 15, 19, 22
Avant d’initier la séquence de manipulation sur la calculatrice, nous pouvons anticiper manuellement la structure descriptive de cette série afin de consolider notre compréhension des étapes de traitement. La moyenne arithmétique de cet échantillon s’obtient par sommation élémentaire :
Σx = 2 + 4 + 4 + 7 + 8 + 12 + 14 + 15 + 19 + 22 = 107
x̄ = 107 / 10 = 10,7
L’enjeu va consister à confier l’analyse de cette série à la calculatrice TI-84 pour déterminer à la fois son écart-type d’échantillon Sx et sa variance d’échantillon non biaisée s².
7.2 Déroulement exhaustif des manipulations sur la calculatrice
Reprenons pas à pas la cinématique opératoire intégrale à partir de l’état vierge de la machine :
- Allumez la calculatrice en pressant la touche ON.
- Appuyez sur la touche STAT, puis validez le choix 1: Edit… en pressant ENTER.
- Si la colonne L1 n’est pas vierge, montez le curseur sur le label d’en-tête L1, appuyez sur CLEAR, puis descendez d’un cran avec la touche ENTER pour vider la liste.
- Procédez à la saisie ordonnée des dix données expérimentales en appuyant sur ENTER après chaque chiffre tapé :
- Tapez
2puis ENTER - Tapez
4puis ENTER - Tapez
4puis ENTER - Tapez
7puis ENTER - Tapez
8puis ENTER - Tapez
12puis ENTER - Tapez
14puis ENTER - Tapez
15puis ENTER - Tapez
19puis ENTER - Tapez
22puis ENTER
- Tapez
- Vérifiez que la ligne inférieure de l’écran affiche bien
L1(11) =, confirmant la présence de dix scores enregistrés. - Quittez l’éditeur en effectuant la combinaison 2nd suivie de MODE (QUIT).
- Appuyez sur STAT, actionnez la touche flèche DROITE pour illuminer le menu CALC, puis validez l’option 1: 1-Var Stats avec ENTER.
- Dans l’assistant, confirmez que la liste sélectionnée est
List: L1, assurez-vous queFreqListest rigoureusement vierge, positionnez le curseur surCalculateet appuyez sur ENTER. - L’écran d’analyse descriptive affiche immédiatement :
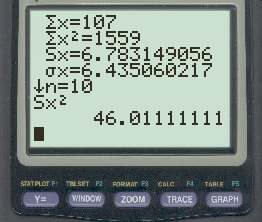
x̄ = 10.7Σx = 107Σx² = 1559Sx = 6.783149056σx = 6.435060217n = 10
- Pour dériver la variance d’échantillon sans recopie manuelle, appuyez sur la touche VARS.
- Sélectionnez l’option 5: Statistics… et validez.
- Sélectionnez la ligne 3: Sx et appuyez sur ENTER.
- Appuyez sur la touche fonctionnelle x² sur le clavier gauche.
- Appuyez enfin sur la commande terminale ENTER.
7.3 Validation du résultat final et analyse de conformité
Le calcul s’exécute instantanément, et la calculatrice renvoie la valeur d’affichage suivante :
Sx² = 46.01111111
La variance d’échantillon estimée pour notre série expérimentale s’établit donc formellement à s² ≈ 46,0111.
Pour attester de l’exactitude absolue de ce résultat d’ingénierie logicielle, menons en parallèle la démonstration analytique classique par le calcul des résidus individuels quadratiques :
- (2 – 10,7)² = (-8,7)² = 75,69
- (4 – 10,7)² = (-6,7)² = 44,89
- (4 – 10,7)² = (-6,7)² = 44,89
- (7 – 10,7)² = (-3,7)² = 13,69
- (8 – 10,7)² = (-2,7)² = 7,29
- (12 – 10,7)² = (1,3)² = 1,69
- (14 – 10,7)² = (3,3)² = 10,89
- (15 – 10,7)² = (4,3)² = 18,49
- (19 – 10,7)² = (8,3)² = 68,89
- (22 – 10,7)² = (11,3)² = 127,69
L’agrégation de cette série de déviations quadratiques donne la somme des carrés totale des écarts (notée classiquement SS pour Sum of Squares) :
SS = Σ (xᵢ – x̄)² = 75,69 + 44,89 + 44,89 + 13,69 + 7,29 + 1,69 + 10,89 + 18,49 + 68,89 + 127,69 = 414,10
En divisant désormais cette somme des carrés par les degrés de liberté théoriques selon la correction de Bessel (n – 1 = 10 – 1 = 9), nous obtenons :
s² = 414,10 / 9 = 46,01111111…
La concordance entre le modèle mathématique formel et la routine automatisée exécutée sur la TI-84 est absolue au dix-millième près. Cet exercice démontre avec éloquence la puissance et la robustesse de l’environnement matériel Texas Instruments dès lors que la syntaxe et les mécanismes de rappel mémoire sont convenablement orchestrés par l’utilisateur.
8. Méthode alternative : Calcul direct de la variance via les opérations sur listes
8.1 Calcul de la moyenne et soustraction vectorielle
Bien que la commande 1-Var Stats couplée à la variable Sx représente le chemin le plus rapide pour déterminer la variance, la TI-84 propose un moteur de calcul vectoriel d’une rare élégance permettant d’exécuter pas à pas la formule mathématique en manipulant des colonnes entières de données. Cette approche matricielle présente des vertus pédagogiques inestimables pour tout apprenant désireux de s’approprier intimement la mécanique interne de la variance.
Supposons que nos dix données expérimentales soient consignées dans la colonne L1. Il est possible d’utiliser la liste L2 pour héberger les écarts individuels à la moyenne arithmétique. La démarche s’opère comme suit :
- Rejoignez l’éditeur de données matricielles via STAT > 1:Edit….
- Positionnez le curseur directionnel vers le haut pour placer la zone de surbrillance noire sur l’étiquette même de l’en-tête de colonne L2.
- La ligne de commande inférieure affiche alors l’invite d’assignation fonctionnelle :
L2 =. - Nous allons ordonner à la calculatrice de soustraire la moyenne arithmétique de L1 à chaque élément de L1. Pour cela, saisissez le vecteur source en pressant 2nd puis le chiffre 1 (L1).
- Appuyez sur la touche d’opération arithmétique de soustraction –.
- Pour mobiliser la fonction calculant automatiquement la moyenne sans avoir à la saisir manuellement, appuyez sur la combinaison 2nd puis sur la touche STAT pour ouvrir le sous-menu réservé LIST.
- Actionnez la flèche fléchée DROITE à deux reprises pour sélectionner l’onglet MATH.
- Sélectionnez l’option 3: mean( et validez avec ENTER.
- Spécifiez la liste cible en pressant à nouveau 2nd puis 1 (L1), et refermez la parenthèse avec la touche ).
- La ligne inférieure affiche désormais rigoureusement l’expression vectorielle matricielle :
L2 = L1 - mean(L1). - Appuyez sur la touche d’affectation ENTER.
Instantanément, la colonne L2 se remplit des écarts individuels à la moyenne arithmétique (-8,7 ; -6,7 ; -6,7 ; -3,7 ; … ; +11,3). L’observation directe de ces résidus offre une perception immédiate de la dispersion des sujets autour de la tendance centrale, illustrant concrètement l’existence de scores situés en deçà et au-delà du barycentre de l’échantillon.
8.2 Élévation des écarts au carré et calcul de la somme des carrés (SS)
La deuxième étape de la démarche vectorielle consiste à élever au carré chacun des écarts individuels obtenus dans la colonne L2 pour générer la série des résidus quadratiques dans la colonne L3 :
- Déplacez le curseur sur l’en-tête supérieur de la colonne L3 de façon à activer l’invite de formule
L3 =. - Désignez la liste des résidus en pressant la combinaison de touches 2nd puis le chiffre 2 (qui appelle le conteneur L2).
- Appuyez sur la touche d’élévation au carré x². L’instruction formulée devient :
L3 = L2². - Appuyez sur la touche ENTER.
La colonne L3 s’emplit alors des déviations quadratiques positives (75,69 ; 44,89 ; … ; 127,69). Tous les signes négatifs ont été rigoureusement abolis par la propriété du carré arithmétique.
Il nous reste désormais à agréger cette totalité d’écarts quadratiques pour cristalliser la somme des carrés des écarts (SS). Pour réaliser cette sommation, quittez l’éditeur de tableaux matriciels en invoquant la routine de sortie 2nd > MODE (QUIT) pour revenir à l’écran principal d’accueil, puis procédez comme suit :
- Appelez le menu de calculs de listes en appuyant sur la combinaison 2nd puis STAT (LIST).
- Naviguez avec la flèche directionnelle vers l’onglet MATH.
- Sélectionnez la commande 5: sum( et validez avec ENTER.
- Désignez la colonne contenant les carrés des résidus en tapant 2nd puis le chiffre 3 (L3), puis refermez la parenthèse à l’aide de la touche ).
- Appuyez sur la touche ENTER.
La machine renvoie avec une limpidité parfaite la valeur scalaire globale : 414.1. Nous venons d’extraire la somme des carrés totale des écarts (SS) directement par manipulation vectorielle explicite.
8.3 Division par les degrés de liberté sur l’écran d’accueil
Pour clore cette démonstration mathématique et aboutir à la variance d’échantillon sans le moindre artifice boîte-noire, il nous suffit désormais de diviser cette somme des carrés (414,1) par les degrés de liberté correspondant à la taille de l’échantillon amputée d’une unité.
Pour conférer à cette démarche une portée totalement universelle et algorithmique, nous pouvons même solliciter la calculatrice pour qu’elle détermine elle-même la taille dimensionnelle du vecteur sans que nous ayons à dénombrer les lignes à la main. La fonction dim( (pour dimension de liste) est accessible via la séquence 2nd > STAT > OPS > 3:dim(.
Ainsi, il est possible de composer en une seule ligne continue sur l’écran d’accueil l’expression intégrale suivante :
sum(L3) / (dim(L1) - 1)
ou, de façon encore plus synthétique et directe, sans même recourir aux listes intermédiaires L2 et L3, en écrivant directement sur l’écran d’accueil :
sum((L1 - mean(L1))²) / (dim(L1) - 1)
En pressant la touche d’exécution ENTER, la calculatrice traite la chaîne vectorielle matricielle instantanément et renvoie sans surprise le résultat souverain : 46.01111111.
Cette méthodologie alternative présente un intérêt académique exceptionnel lors de séances de travaux dirigés de méthodologie de recherche ou de biomathématiques. Elle démythifie complètement le fonctionnement algorithmique de la machine, démontrant que la TI-84 n’est pas un oracle mystérieux produisant des indicateurs abstraits, mais une plateforme d’exécution programmable capable de manipuler les concepts formels les plus stricts de l’algèbre linéaire et des modèles linéaires généraux.
9. Gestion des données pondérées et tableaux de fréquences sur TI-84
9.1 Organisation des données groupées en listes jumelées
Dans de nombreuses applications concrètes en sociologie quantitative, en épidémiologie ou lors de dépouillements d’épreuves psychométriques administrées à de larges cohortes de participants, les données brutes ne se présentent pas sous la forme d’une simple séquence éparpillée d’observations individuelles. Elles sont souvent condensées au préalable sous la forme d’un tableau de distribution de fréquences ou de contingence univariée.
Considérons, à titre d’illustration, l’administration d’une échelle d’évaluation de la détresse psychologique graduée de 1 à 5 administrée à une promotion de 50 étudiants :
- Score de 1 : observé chez 6 participants
- Score de 2 : observé chez 14 participants
- Score de 3 : observé chez 18 participants
- Score de 4 : observé chez 9 participants
- Score de 5 : observé chez 3 participants
Encoder individuellement cinquante valeurs successives dans la liste L1 s’avérerait une procédure laborieuse, redondante et hautement propice aux erreurs de saisie. La TI-84 permet de gérer ce cas de figure par l’intermédiaire d’un couplage dynamique de listes jumelées au sein de l’éditeur statistique. La démarche d’agencement structurel s’articule comme suit :
- Accédez à l’éditeur tabulaire via STAT > 1:Edit….
- Purgez au préalable les listes L1 et L2 à l’aide de la commande CLEAR positionnée sur leurs en-têtes.
- Dans la colonne L1, enregistrez séquentiellement la modalité unique de chaque score métrique possible, soit dans notre cas :
1, 2, 3, 4, 5. - Déplacez ensuite le curseur horizontalement vers la droite pour vous positionner sur la première cellule de la colonne L2.
- Dans cette colonne L2, saisissez rigoureusement l’effectif ou la fréquence d’apparition correspondant à chaque modalité de score en respectant un alignement horizontal parfait :
6, 14, 18, 9, 3.
Une condition sine qua non de réussite logicielle réside dans la parité dimensionnelle absolue des deux vecteurs de données. Le nombre de lignes renseignées dans la liste des modalités (L1) doit être rigoureusement identique au nombre de lignes enregistrées dans la liste des fréquences associées (L2). Toute discordance dans le décompte des cellules entraînera l’interruption brutale de l’analyse et le déclenchement d’un message d’erreur système.
9.2 Paramétrage adapté de 1-Var Stats avec FreqList
Une fois les données groupées méticuleusement inscrites dans les deux colonnes associées, l’appel à la fonction descriptive univariée exige un ajustement stratégique de ses paramètres d’entrée afin que la calculatrice ne traite pas la colonne L2 comme une série indépendante, mais bien comme un multiplicateur de fréquence pondérant la colonne L1.
Revenez à l’écran d’accueil en composant 2nd > MODE (QUIT). Appelez l’instruction statistique en pressant STAT, déplacez le curseur vers le sous-menu CALC et validez le choix 1: 1-Var Stats. L’écran de paramétrage de l’assistant interactif se présente alors à nouveau :
- List : Spécifiez le réceptacle contenant les valeurs des scores expérimentaux, c’est-à-dire
L1(par pression de 2nd > 1). - FreqList : C’est ici que réside la divergence fondamentale avec la procédure des données brutes. Positionnez le curseur sur cette ligne et attribuez-lui formellement la liste des effectifs en appuyant sur la combinaison 2nd puis sur la touche numérique 2 (faisant apparaître le symbole
L2). - Calculate : Descendez le curseur jusqu’à surligner la commande de calcul et validez par ENTER.
Si votre calculatrice fonctionne sur une version plus ancienne ne disposant pas du menu Stat Wizards, l’instruction 1-Var Stats apparaît seule sur l’écran d’accueil. Il est alors impératif d’utiliser la syntaxe matricielle standardisée à virgule en tapant manuellement :
1-Var Stats L1, L2
La virgule séparatrice est mobilisée par une pression sur la touche virgule physique située sur la rangée médiane au-dessus de la touche du chiffre 7. Dès que la touche ENTER est actionnée, la TI-84 compile l’ensemble de la distribution pondérée en prenant en compte le poids démographique respectif de chaque valeur.
9.3 Dérivation de la variance pour distributions groupées
L’écran récapitulatif généré par l’analyse pondérée présente une architecture rigoureusement similaire à celle d’une distribution brute, mais les métriques intègrent l’expansion fréquentielle des effectifs. L’observateur attentif constatera immédiatement que la taille globale d’échantillon indique désormais :
n = 50
confirmant que la calculatrice a correctement sommé les effectifs inscrits dans la colonne L2 (6 + 14 + 18 + 9 + 3 = 50) et non le simple nombre de lignes matérielles (qui valait 5).
Pour extraire la variance d’échantillon pondérée de ce groupe de 50 sujets, nous appliquons exactement la même séquence de rappel dynamique des variables système de haute précision :
- Appuyez sur la touche VARS.
- Tapez le chiffre 5 pour solliciter le catalogue Statistics….
- Tapez le chiffre 3 pour sélectionner la variable système de l’écart-type d’échantillon Sx.
- Appuyez sur la touche d’élévation au carré x².
- Appuyez sur la touche ENTER.
La valeur numérique instantanément projetée à l’écran correspond à l’estimation sans biais de la variance d’échantillon s² calculée sur la totalité des 50 observations de la cohorte stratifiée. Cette méthode offre un gain de temps inestimable lors de l’analyse d’enquêtes psychosociales d’envergure ou d’inventaires de personnalité comportant plusieurs dizaines ou centaines d’administrations répétées.
10. Diagnostic et résolution des erreurs fréquentes sur la TI-84
10.1 Résolution des erreurs de dimension et de syntaxe
L’utilisation intensive de la calculatrice TI-84 en situation de stress académique ou d’analyse en laboratoire s’accompagne régulièrement de messages d’anomalies logicielles interrompant le flux de travail. L’identification rapide de l’étiologie de ces interruptions système conditionne l’efficacité et la sérénité de l’analyste.
Le message d’erreur le plus fréquemment rencontré lors de calculs statistiques sur données pondérées ou vectorielles est sans conteste l’alerte système :
ERR:DIM MISMATCH (Erreur : Discordance de dimension)
Cette interruption signifie sans ambiguïté que la machine a tenté d’exécuter une instruction statistique exigeant deux vecteurs de données de longueur strictement égale (comme la commande 1-Var Stats L1, L2 ou une soustraction vectorielle directe L1 – L2), mais que les listes sollicitées comportent un nombre d’éléments asymétrique (par exemple, dix valeurs dans L1 et seulement neuf valeurs dans L2). Pour résoudre cette anomalie :
- Sélectionnez l’option 2:Goto proposée sur l’écran d’erreur pour que la calculatrice vous positionne automatiquement sur la zone du conflit, ou appuyez sur 1:Quit.
- Ouvrez l’éditeur matriciel via STAT > 1:Edit….
- Parcourez la bordure inférieure des deux listes couplées pour repérer la cellule orpheline ou manquante, et réajustez la taille des séries jusqu’à obtenir un alignement horizontal parfait des deux colonnes.
Une autre anomalie courante est signalée par l’alerte :
ERR:DATA TYPE (Erreur : Type de données)
Cet écueil survient généralement lorsqu’un caractère textuel non convertible en quantité scalaire a été accidentellement saisi dans une cellule de liste réservée aux nombres réels, ou lorsque l’argument pointé par l’assistant FreqList fait référence à une variable matricielle multidimensionnelle ou à une chaîne de caractères alphabétiques au lieu d’un conteneur vectoriel standard.
Enfin, si lors de la consultation de l’éditeur tabulaire vous constatez la disparition tragique d’une colonne fondamentale (par exemple, la liste L1 a été involontairement détruite par l’action de la touche DEL au lieu de CLEAR sur l’en-tête), appliquez sans attendre la routine salvatrice : pressez la touche STAT, sélectionnez 5: SetUpEditor, appuyez sur ENTER deux fois de suite. L’environnement matriciel d’origine est instantanément reconstitué dans son intégrité structurelle.
10.2 Éviter la confusion conceptuelle entre Sx et σx
L’un des pièges les plus redoutables de l’épreuve statistique sur TI-84 réside dans le choix erroné entre les deux indicateurs de déviation affichés simultanément lors de l’exécution de l’analyse univariée : Sx et σx. Les répercussions d’une méprise sur ce point sont particulièrement sévères pour la validité des conclusions empiriques.
Pour graver définitivement cette frontière méthodologique dans l’esprit de l’utilisateur, examinons la matrice comparative des formules programmées par les ingénieurs dans le silicium de la machine :
- Symbole Sx : s = √[ Σ(xᵢ – x̄)² / (n – 1) ] — Conçu exclusivement pour les échantillons finis tirés d’une population plus vaste. Il applique systématiquement la correction de Bessel pour compenser la sous-estimation inhérente à l’échantillonnage empirique. C’est l’unique indicateur valide pour la recherche scientifique et la quasi-totalité des travaux universitaires.
- Symbole σx : σ = √[ Σ(xᵢ – μ)² / n ] — Conçu exclusivement pour les populations exhaustives. Il divise par l’effectif total n sans introduire de correction de dégrèvement. Son emploi sur un échantillon empirique engendre un estimateur biaisé sous-évaluant artificiellement la dispersion réelle.
Considérons une règle empirique infaillible : dans 99 % des contextes d’exercices universitaires, de laboratoires de psychologie expérimentale, de thèses médicales ou d’analyses de données de terrain, l’utilisateur manipule un échantillon de participants et cherche à inférer des propriétés générales. Dès lors, le symbole Sx est l’unique choix rigoureusement fondé. Le symbole σx ne doit être convoqué que dans la circonstance exceptionnellement rare où l’analyste détient l’ensemble de la population de référence (par exemple, l’intégralité exhaustive des notes attribuées aux 450 candidats d’un concours national clos dont on ne cherche nullement à généraliser les propriétés au-delà de cette cohorte fermée).
10.3 Gestion des pertes de précision et problèmes de mémoire vive
L’utilisation de la mémoire vive statique (RAM) de la TI-84 pour héberger les variables statistiques engendre une vulnérabilité opérationnelle souvent ignorée des praticiens : la volatilité des états système face à l’écrasement des registres.
Dès lors que vous exécutez une nouvelle commande d’analyse sur une autre série de données (par exemple, un appel à 2-Var Stats ou un ajustement de modèle par régression linéaire via LinReg(ax+b)), les registres mémoires associés aux symboles x̄, Σx, Sx et σx sont instantanément et irréversiblement écrasés par les nouveaux coefficients de la commande la plus récente. Si vous tentez de rappeler VARS > 5:Statistics > 3:Sx après avoir tracé une droite de régression, la valeur retournée ne correspondra plus à la variance de votre première distribution univariée, mais à l’écart-type de la variable résiduelle du modèle bivarié.
Par ailleurs, si la machine subit une décharge complète de son accumulateur ou si une réinitialisation accidentelle de la mémoire RAM est provoquée (suite à un blocage logiciel imposant un redémarrage système ou l’appui simultané sur certaines touches lors de tests de maintenance), l’ensemble du contenu des listes L1 à L6 ainsi que la totalité des variables statistiques temporaires sont instantanément anéantis.
Pour vous prémunir contre ces désagréments :
- Élevez Sx au carré pour consigner immédiatement la variance d’échantillon sur votre relevé d’observations dès l’obtention de l’écran 1-Var Stats, sans intercaler d’autres opérations complexes.
- Si un doute quelconque subsiste quant à l’antériorité de la dernière analyse statistique exécutée, prenez l’habitude de relancer systématiquement la commande
1-Var Stats L1avant d’extraire la variable Sx du menu VARS, afin de vous assurer que le registre actif reflète parfaitement les données visées.
11. Application pratique de la variance d’échantillon dans la recherche en psychologie
11.1 Évaluation de l’hétérogénéité des scores psychométriques
En psychométrie et en sciences du comportement, la variance d’échantillon ne constitue pas un simple intermédiaire algorithmique abstrait ; elle incarne la substance même de l’objet d’étude. La psychologie différentielle s’édifie tout entière sur la quantification des variations interindividuelles. Lorsqu’un chercheur administre une échelle d’évaluation de l’anxiété (telle que le STAI de Spielberger) ou un test d’intelligence standardisé (tel que l’échelle d’intelligence de Wechsler, WAIS-IV), la variance des scores observés au sein de l’échantillon normatif est le garant fondamental du pouvoir discriminant de l’instrument.
L’examen approfondi de la magnitude de la variance d’échantillon permet de diagnostiquer deux des anomalies métrologiques les plus destructrices affectant les instruments d’évaluation : l’effet plancher et l’effet plafond :
- Un effet plancher se manifeste lorsque les items d’une épreuve psychologique présentent un niveau de difficulté excessivement élevé, amenant la quasi-totalité des participants d’un échantillon à obtenir le score minimal envisageable. Les données se concentrent de manière compacte près de l’origine métrique, provoquant un effondrement artificiel de la variance d’échantillon s².
- Inversement, un effet plafond s’observe lorsque le test s’avère d’une simplicité triviale pour la population ciblée, conduisant une vaste majorité d’individus à saturer le score maximal possible. Là encore, la variabilité interindividuelle est écrasée et la variance d’échantillon se trouve artificiellement restreinte.
Dans l’un comme dans l’autre de ces cas de figure, l’observation d’une variance d’échantillon anormalement faible alerte immédiatement le clinicien ou le psychométricien : le test a échoué à capter l’hétérogénéité psychologique sous-jacente du groupe examiné. Par ailleurs, selon les postulats de la théorie classique des tests, le coefficient de fidélité d’une mesure (le fameux alpha de Cronbach) est structurellement proportionnel à la variance observée des scores totaux. Réduire artificiellement la variance d’un échantillon par des erreurs de sélection ou des biais d’échantillonnage engendre inévitablement une dégradation mathématique directe de l’estimation de la consistance interne de l’outil d’évaluation.
11.2 Articulation avec les tests d’hypothèses et les modèles inférentiels
La variance d’échantillon s² constitue le réactif chimique fondamental de la quasi-totalité des modèles de décision statistique inférentielle. Dès lors que l’on souhaite dépasser la simple description locale d’un groupe expérimental pour formuler des généralisations probabilistes quant à la population parente, la variance de l’échantillon intervient directement dans la construction des estimateurs d’incertitude.
L’application la plus élémentaire réside dans le calcul de l’erreur type de la moyenne (Standard Error of the Mean, notée SE ou σx̄), qui formalise l’amplitude des fluctuations d’échantillonnage attendues si l’on répétait l’expérience un nombre infini de fois avec des échantillons indépendants de même taille :
SE = s / √n = √(s² / n)
Comme l’illustre lumineusement cette formule, l’erreur type dépend directement de la variance de l’échantillon s². Cette métrique d’incertitude sert ensuite de dénominateur universel lors de l’exécution du test t de Student pour échantillon unique ou échantillons indépendants :
t = (x̄₁ – x̄₂) / √[ s²ₚ (1/n₁ + 1/n₂) ]
où s²ₚ représente la variance composite combinée (ou variance poolée) déduite des variances d’échantillons des deux groupes d’étude.
Au-delà du simple test t, l’ensemble de l’édifice de l’Analyse de Variance (ANOVA) conceptualisée par Ronald Fisher repose intégralement sur le partitionnement de la variance totale observée au sein de multiples échantillons. Le test statistique F de Fisher-Snedecor est littéralement défini comme le rapport de deux estimations distinctes de variances d’échantillons : la variance intergroupes (qui quantifie l’amplitude de l’effet d’un traitement expérimental) divisée par la variance intragroupe ou variance résiduelle (qui formalise le bruit de fond aléatoire et les différences individuelles non contrôlées). Sans une maîtrise parfaite du calcul et de l’extraction de la variance de chaque échantillon sur nos instruments informatiques, le déploiement de ces architectures inférentielles devient rigoureusement impossible.
11.3 Interprétation contextuelle de la dispersion dans les études de cas
Dans la pratique de la psychologie clinique, de la neuropsychologie et de l’analyse comportementale appliquée, la variance d’échantillon revêt une signification sémiologique directe lors de la conduite d’études de cas ou d’essais cliniques randomisés à effectifs restreints. L’analyste ne s’intéresse pas exclusivement au déplacement de la moyenne des symptômes au fil d’une prise en charge, mais scrute avec la même acuité l’évolution de la dispersion interne des comportements.
Considérons l’évaluation de l’efficacité d’un programme novateur de psychothérapie cognitive et comportementale (TCC) destiné à réduire les compulsions chez des patients souffrant de trouble obsessionnel-compulsif (TOC). Lors de la phase pré-thérapeutique (Baseline), l’administration de l’inventaire clinique à un échantillon pilote de douze patients peut révéler une moyenne de symptômes élevée associée à une variance d’échantillon substantielle, témoignant de profils symptomatiques hétérogènes. À l’issue des seize semaines de prise en charge thérapeutique, deux scénarios de dispersion peuvent se profiler :
- Une réduction conjointe de la moyenne arithmétique et de la variance d’échantillon : ce profil traduit une homogénéisation clinique bénéfique, signifiant que le protocole a produit des gains substantiels chez l’ensemble des participants du groupe de manière uniforme.
- Une diminution de la moyenne globale accompagnée d’une explosion de la variance d’échantillon : cette constellation statistique hautement critique signale l’existence d’une réponse clinique différentielle aiguë. L’augmentation de la variance révèle qu’une fraction des patients a remarquablement bénéficié de la prise en charge (scores très faibles), tandis qu’une autre sous-population a présenté une résistance thérapeutique voire une détérioration iatrogène (scores très élevés). La moyenne seule masquerait complètement cette dichotomie humaine essentielle.
Sur le plan de la communication scientifique, la rédaction des indices statistiques de dispersion au sein des manuscrits et des thèses obéit aux normes typographiques rigoureuses édictées par l’American Psychological Association (normes APA 7e édition). Bien que la coutume universitaire privilégie la citation conjointe de la moyenne et de l’écart-type sous la forme canonique M = 10,70, SD = 6,78 (où SD symbolise le Standard Deviation, correspondant formellement à Sx), les études psychométriques et les protocoles de modélisation structurelle exigent systématiquement la déclaration explicite de la variance d’échantillon (abrégée sous le symbole s² ou Var) sous la forme : s² = 46,01.
12. Bonnes pratiques, vérification manuelle et archivage des analyses sur TI-84
12.1 Sauvegarde et archivage des listes de données dans la mémoire ROM
L’une des hantises de tout expérimentateur de laboratoire ou de tout étudiant en situation d’examen réside dans l’effacement inopiné des séries de données patiemment encodées au sein des listes L1 à L6 suite à une fausse manipulation du clavier ou à un bug d’exécution d’une routine graphique. Pour neutraliser définitivement cette menace, Texas Instruments a intégré dans ses machines un mécanisme de protection par archivage déplaçant les données de la mémoire vive volatile (RAM) vers la mémoire morte flash d’archivage (Flash ROM), qui n’est affectée par aucune commande usuelle de réinitialisation.
Pour archiver une liste de données expérimentales hébergée dans la variable L1 :
- Rejoignez l’environnement de gestion de la mémoire système en appuyant sur la touche 2nd puis sur la touche + (qui active le sous-menu système MEM).
- Dans le menu contextuel qui s’affiche, sélectionnez l’option 2: Mem Management/Delete… et appuyez sur ENTER.
- Descendez jusqu’à la catégorie 4: List… et validez.
- L’écran dresse la nomenclature exhaustive de l’ensemble des conteneurs de listes hébergés dans l’appareil, accompagnée de la taille en octets de chacun. Positionnez le curseur en face de la liste à sécuriser (par exemple L1).
- Appuyez sur la touche ENTER. Un petit astérisque typographique (*) s’inscrit instantanément à la gauche immédiate du label de la liste.
La présence de cet astérisque indique que la liste est désormais formellement archivée dans la mémoire Flash protégée. Si vous retournez par mégarde dans le menu STAT > ClrList L1 ou si vous pressez une commande globale d’effacement de la RAM, le système d’exploitation refusera de purger cette variable protégée, préservant ainsi l’intégrité intégrale de votre série numérique.
Il importe néanmoins de noter qu’une liste archivée ne peut pas être modifiée directement au sein de l’éditeur tabulaire matriciel sans avoir été préalablement désarchivée. Pour restaurer la flexibilité d’écriture sur cette liste lors d’une analyse ultérieure, réitérez simplement la même procédure via 2nd > MEM > 2 > 4 et pressez une nouvelle fois ENTER sur le nom de la liste pour effacer l’astérisque de protection.
12.2 Méthodes de validation croisée des résultats obtenus
La rigueur scientifique impose de ne jamais accorder une confiance aveugle au résultat brut retourné par un instrument électronique sans exercer une démarche critique de validation croisée et de contrôle de cohérence métrologique.
La première technique de validation rapide, mobilisable en quelques secondes sur le terrain, repose sur la règle empirique de l’étendue divisée par quatre (ou règle du quart de l’étendue). Cette approximation heuristique stipule que pour toute distribution empirique unimodale et modérément symétrique se rapprochant d’une allure gaussienne, la quasi-totalité des observations se distribue dans un intervalle de quatre écarts-types (deux écarts-types de part et d’autre de la moyenne). Dès lors, nous pouvons approximer grossièrement l’écart-type attendu par la relation :
s ≈ (Valeur Maximale – Valeur Minimale) / 4
En reprenant les données de notre échantillon empirique exploré au chapitre 7, où le minimum valait 2 et le maximum 22, nous obtenons une étendue totale de 22 – 2 = 20. L’écart-type approché vaut donc environ 20 / 4 = 5. En élevant cette valeur au carré, nous anticipons un ordre de grandeur de variance d’environ 5² = 25. Notre calcul précis ayant fourni s² = 46,01 (en raison d’une distribution légèrement asymétrique et étalée vers les valeurs supérieures), cet ordre de grandeur conforte l’absence de toute erreur monumentale (telle qu’une variance de 450 ou de 0,4 qui signalerait une grave défaillance de virgule décimale).
La seconde méthode de contrôle visuel consiste à mobiliser l’environnement de tracé graphique statistique de la machine via la commande STAT PLOT (accessible par 2nd > Y=). En activant le premier tracé graphique sous la modalité du diagramme en boîte à moustaches modifiée (boxplot avec détection d’aberrations) pointant vers la liste L1, puis en pressant la touche ZOOM suivie de l’option 9: ZoomStat, la calculatrice dessine la géométrie spatiale de l’échantillon. L’absence de points isolés au-delà des moustaches confirme l’absence de valeurs aberrantes susceptibles d’avoir démesurément distordu le calcul de la variance.
Enfin, dans le cadre de recherches professionnelles publiables, la validation croisée des indicateurs de la TI-84 avec les cadriciels de calcul statistique standardisés du monde universitaire tels que R (via la primitive de base var()) ou IBM SPSS Statistics (via la commande Descriptives) confirme invariablement une convergence de calcul absolue au quatorzième chiffre significatif, attestant de la rectitude industrielle de l’architecture Texas Instruments.
12.3 Synthèse opérationnelle des raccourcis et recommandations méthodologiques
Pour condenser l’ensemble des connaissances procédurales développées tout au long de ce guide d’ingénierie statistique, nous mettons à votre disposition une fiche mémo opérationnelle synthétique, idéale pour les révisions rapides précédant les examens terminaux ou les sessions de terrain en laboratoire :
- Saisie des données : STAT > 1:Edit… > Renseigner les données brutes dans la colonne L1 en terminant chaque score par ENTER.
- Retour à l’écran neutre : 2nd > MODE (QUIT).
- Compilation de l’analyse descriptive : STAT > flèche DROITE (CALC) > 1: 1-Var Stats > Régler
List: L1, viderFreqList> Calculate > ENTER. - Extraction dynamique de la variance d’échantillon (s²) : Appuyer sur VARS > 5:Statistics… > 3:Sx > Appuyer sur la touche x² > Appuyer sur ENTER.
Sur le plan déontologique et méthodologique, la manipulation des données quantitatives sur calculatrice impose une transparence documentaire scrupuleuse. Il est fortement conseillé au chercheur de consigner systématiquement dans son cahier d’expérimentation non seulement la variance terminale obtenue, mais également la taille formelle de l’échantillon n, la somme des carrés SS ainsi que la moyenne arithmétique x̄. Cette traçabilité analytique permet de réviser a posteriori n’importe quel calcul en cas de divergence lors de la relecture par les pairs (peer-review) ou d’audit de données scientifiques.
La calculatrice Texas Instruments TI-84 Plus, loin de se limiter à un simple instrument d’arithmétique scolaire, constitue une plateforme d’investigation statistique performante, rigoureuse et pérenne. Dès lors que l’analyste maîtrise les arcanes de la correction de Bessel et le rappel des variables d’environnement système, elle offre une fiabilité d’évaluation de la dispersion d’échantillon rivalisant avec les stations de travail informatiques les plus sophistiquées du paysage scientifique contemporain.
Références
- Bessel, F. W. (1816). Untersuchungen über die scheinbare und wahre Bahn des im Jahre 1807 erschienenen grossen Kometen. Königlich Preußische Akademie der Wissenschaften, 201-204.
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric Theory (3rd ed.). McGraw-Hill.
- Texas Instruments. (2020). Guide de référence de la calculatrice graphique TI-84 Plus CE. Texas Instruments Incorporated. https://education.ti.com/fr/guidebook/details/fr/6EF1C333DA114A51BA19BEB57DC670EE/84ce