
Dans le paysage contemporain de la recherche scientifique et de l’analyse décisionnelle pilotée par les données, l’inférence statistique constitue la pierre angulaire permettant de distinguer les signaux empiriques authentiques du simple bruit stochastique. Au cœur de cet édifice méthodologique réside la valeur p (ou p-value), une métrique universellement employée pour quantifier la plausibilité d’une hypothèse expérimentale au regard des observations recueillies. Longtemps réservée aux spécialistes maîtrisant des environnements logiciels dédiés ou des langages de programmation complexes, l’évaluation de la significativité statistique s’est progressivement intégrée au sein d’outils plus flexibles et accessibles. Parmi ces plateformes, les tableurs infonuagiques ont profondément transformé la gestion quotidienne des données empiriques en associant rigueur algorithmique et puissance collaborative.
Google Sheets s’est imposé comme un environnement de travail incontournable pour les chercheurs, les analystes de données, les étudiants et les professionnels des sciences sociales et appliquées. Loin d’être un simple carnet d’adresses ou une grille de calcul comptable rudimentaire, ce tableur moderne intègre des bibliothèques de fonctions mathématiques sophistiquées capables d’exécuter des tests d’hypothèses paramétriques et non paramétriques avec une précision conforme aux exigences académiques. Comprendre comment extraire, calculer et interpréter rigoureusement une valeur p au sein de Google Sheets permet non seulement de démystifier les fondements de la statistique inférentielle, mais offre également un vecteur d’autonomie analytique considérable pour tout praticien soucieux de valider ses postulats expérimentaux sans recourir systématiquement à des progiciels spécialisés et onéreux.
Ce guide exhaustif et méthodique a pour vocation de vous accompagner pas à pas dans l’art et la science du calcul des valeurs p sous Google Sheets. De l’assimilation théorique des paradigmes fréquentistes aux subtilités de configuration de la fonction TEST.T, en passant par le traitement de l’hétéroscédasticité, la modélisation de régressions linéaires et la mise en conformité des résultats avec les normes éditoriales les plus strictes de l’American Psychological Association (APA), chaque section est conçue pour consolider vos compétences méthodologiques et analytiques. À travers des protocoles détaillés, des explications conceptuelles approfondies et des avertissements méthodologiques essentiels, vous disposerez de l’ensemble des leviers nécessaires pour mener des inférences statistiques robustes, transparentes et pleinement reproductibles.
1. Introduction aux valeurs p et à leur calcul dans Google Sheets
1.1 Importance de la valeur p dans l’évaluation quantitative
Dans l’arsenal de l’analyse quantitative, la valeur p occupe une position fonctionnelle hautement stratégique lors du processus d’arbitrage scientifique. Face à une série de données empiriques issues d’une expérimentation ou d’une observation de terrain, le chercheur est constamment confronté à une question existentielle : la divergence observée entre deux groupes ou la corrélation identifiée entre deux variables traduit-elle une réalité sous-jacente du phénomène étudié, ou n’est-elle que le produit fortuit des fluctuations inhérentes à l’échantillonnage aléatoire ? C’est précisément à cette intersection que la valeur p intervient comme un indicateur probabiliste continu, mesurant la probabilité d’obtenir une configuration de données au moins aussi extrême que celle effectivement recueillie, dans l’hypothèse où le phénomène mesuré serait en réalité totalement inexistant.
L’évaluation de la plausibilité de l’hypothèse nulle au regard des données d’échantillon constitue le pivot de l’inférence fréquentiste classique formalisée par Ronald A. Fisher au début du vingtième siècle. Lorsque cette probabilité s’avère extrêmement faible, le statisticien est fondé à remettre en cause la véracité de l’hypothèse nulle au profit de l’hypothèse expérimentale. Cependant, cette mécanique décisionnelle requiert une circonspection méthodologique constante. L’adoption généralisée de la valeur p dans les sciences quantitatives — de la biomédecine à l’économie comportementale — témoigne de son utilité pragmatique pour standardiser la communication des résultats de recherche au sein de la communauté scientifique mondiale.
Parallèlement, nous assistons à une transition technologique remarquable au sein des laboratoires universitaires et des centres de recherche d’entreprise. Si les progiciels statistiques lourds comme SPSS, SAS ou les bibliothèques spécialisées de R et Python ont historiquement monopolisé l’exécution des calculs inférentiels, les environnements collaboratifs basés sur le web, tels que Google Sheets, redéfinissent les pratiques de laboratoire. Cette transition vers le tableur ne dispense en aucun cas le chercheur d’une rigueur computationnelle absolue. Au contraire, le traitement des métriques comportementales, psychométriques ou cliniques au sein d’une interface dépouillée exige une compréhension intime des équations mathématiques sous-jacentes et des conditions de validité de chaque test exécuté.
1.2 Accessibilité et pertinence de Google Sheets pour la recherche empirique
La démocratisation des outils d’analyse statistique représente l’une des mutations structurelles les plus notables de la recherche contemporaine. Google Sheets, en s’affranchissant des barrières financières imposées par les licences commerciales de logiciels propriétaires et en supprimant les contraintes d’installation locale, permet à des équipes géographiquement dispersées de travailler simultanément sur un même corpus de données. Cette accessibilité universelle ne s’opère pas au détriment de la précision mathématique : les algorithmes internes de Google Sheets s’alignent sur les standards de calcul en virgule flottante définis par la norme IEEE 754, garantissant ainsi une précision numérique largement suffisante pour la quasi-totalité des investigations en sciences expérimentales et sociales.
Le tableur offre des fonctionnalités natives puissantes pour l’automatisation des formules de tests d’hypothèses. Qu’il s’agisse de comparer deux séries d’observations indépendantes, d’évaluer l’effet d’une intervention longitudinale sur une cohorte unique ou de calculer des matrices de corrélations croisées, l’application exécute ces routines analytiques de manière instantanée et dynamique. Chaque fois qu’une nouvelle observation est insérée ou modifiée dans la feuille de calcul, l’ensemble des dérivations statistiques et des valeurs p associées se met à jour en temps réel. Cette réactivité computationnelle s’avère particulièrement précieuse lors des phases de collecte de données continues, autorisant une surveillance rigoureuse des tendances empiriques au fur et à mesure de l’avancement des protocoles.
Toutefois, l’usage d’un tableur infonuagique pour l’analyse empirique implique d’adopter des précautions préalables rigoureuses. La collaboration en temps réel, bien que source d’une efficacité organisationnelle incomparable, expose le projet à des risques de modifications accidentelles des formules par des tiers si les autorisations de modification ne sont pas adéquatement compartimentées. De plus, Google Sheets ne dispose pas nativement de modules graphiques sophistiqués d’audit des postulats statistiques (tels que les tracés quantiles-quantiles pour la normalité), ce qui impose au chercheur de construire manuellement ses propres étapes de vérification diagnostique. L’instrumentation statistique sur tableur nécessite donc une vigilance accrue pour prévenir toute erreur de sélection de plage ou de typage de données.
2. Fondements statistiques : Comprendre la valeur p dans le cadre inférentiel
2.1 Définition formelle et signification de la valeur p
D’un point de vue mathématique et épistémologique, la valeur p est définie comme la probabilité conditionnelle, notée mathématiquement P(D+|H0), d’observer une statistique de test (telle qu’une valeur t de Student, un F de Fisher-Snedecor ou un khi-deux) au moins aussi déviante par rapport à la prédiction théorique que la valeur effectivement calculée à partir de l’échantillon, en supposant que l’hypothèse nulle (H0) soit strictement exacte. Cette formulation met en lumière une nuance conceptuelle critique fréquemment méconnue : la valeur p ne mesure en aucun cas la probabilité que l’hypothèse nulle soit vraie, pas plus qu’elle n’indique la probabilité que l’hypothèse de recherche alternative soit vérifiée. Elle quantifie exclusivement le degré d’incompatibilité statistique existant entre le modèle théorique sous-jacent à H0 et les données empiriques recueillies.
Il est impératif de maintenir une distinction catégorique entre la signification statistique attestée par une valeur p inférieure au seuil critique prédéterminé et la signification clinique ou pratique du résultat mis en évidence. Une différence de moyenne infime entre deux traitements peut s’avérer hautement significative sur le plan statistique (par exemple, p = 0,0001) si l’effectif de l’échantillon analysé est particulièrement massif, alors même que cette divergence demeure totalement dénuée de pertinence tangible dans le monde réel. Inversement, un effet thérapeutique substantiel peut échouer à atteindre le seuil de significativité statistique en raison d’une puissance d’échantillonnage insuffisante (taille d’échantillon trop modeste), engendrant un risque d’abandon prématuré d’une piste de recherche prometteuse.
Dans la pratique méthodologique usuelle, le chercheur fixe a priori un seuil de significativité nominal, désigné par la lettre grecque alpha (α), traditionnellement calibré à 0,05 (soit un niveau de confiance de 95 %) ou à 0,01 (confiance de 99 %). Cette convention tire ses racines de l’héritage historique de Fisher, qui proposait le seuil de 5 % comme un repère pragmatique d’alerte pour justifier des investigations complémentaires, combiné au cadre plus strict de décision binaire formalisé par Jerzy Neyman et Egon Pearson. Selon la dialectique de Neyman-Pearson, si la valeur p observée est strictement inférieure à α, l’analyste prend la décision formelle de rejeter H0 en assumant un taux d’erreur contrôlé de première espèce ; si la valeur p est supérieure ou égale à α, l’analyste conclut à l’absence de preuves statistiques suffisantes pour invalider l’hypothèse nulle.
2.2 Formulation des hypothèses nulle et alternative
L’édification de tout protocole de test inférentiel débute obligatoirement par la formalisation rigoureuse d’un couple d’hypothèses statistiques mutuellement exclusives et collectivement exhaustives : l’hypothèse nulle, désignée conventionnellement par H0, et l’hypothèse alternative, codifiée sous le symbole H1. L’hypothèse nulle incarne systématiquement le postulat conservateur du statu quo, postulant l’absence totale d’effet, d’association, de corrélation ou de divergence structurelle entre les populations sous-jacentes dont sont extraits les échantillons observés. Sur le plan algébrique, si l’on compare les moyennes μ1 et μ2 de deux cohortes expérimentales, l’hypothèse nulle s’énonce invariablement sous la forme d’une égalité stricte : H0 : μ1 = μ2, soit μ1 – μ2 = 0.
À l’opposé, l’hypothèse alternative H1 constitue la proposition théorique que le chercheur cherche activement à corroborer par le biais des données empiriques. La construction de cette hypothèse peut emprunter deux formes distinctes selon l’état des connaissances théoriques préalables : elle peut être bidirectionnelle (non directionnelle), posant simplement une non-équivalence générale entre les paramètres (H1 : μ1 ≠ μ2), ou directionnelle (unilatérale), stipulant expressément le sens de la divergence attendue, par exemple que la première moyenne surpasse la seconde (H1 : μ1 > μ2) ou qu’elle lui soit inférieure (H1 : μ1 < μ2). Le choix de cette configuration hypothétique exerce un impact déterminant sur la façon dont la distribution d’échantillonnage théorique sera scindée lors du calcul de la valeur p.
Ce processus décisionnel probabiliste s’accompagne structurellement de deux catégories d’erreurs d’inférence statistique fondamentales. L’erreur de type I, dont le risque est quantifié et borné par le seuil α, correspond au rejet intempestif d’une hypothèse nulle qui s’avérait pourtant mathématiquement vérifiée dans la population générale (phénomène communément désigné sous l’étiquette de « faux positif »). À l’inverse, l’erreur de type II, indexée par la lettre grecque β, survient lorsque le protocole statistique échoue à rejeter une hypothèse nulle qui est pourtant fondamentalement fausse au sein de la réalité empirique (le « faux négatif »). La puissance statistique d’un test, formalisée par la quantité 1 – β, dépend étroitement de la magnitude réelle de l’effet étudié, du seuil α retenu, de la variance des populations et de l’effectif des échantillons analysés.
2.3 Distinction entre tests unilatéraux et tests bilatéraux
La distinction opératoire entre une démarche de test unilatérale (à une queue) et bilatérale (à deux queues) repose sur la distribution spatiale de la zone de rejet critique de l’hypothèse nulle au sein de la fonction de densité de probabilité théorique. Lorsque l’analyste opte pour un test bilatéral, il postule a priori qu’une divergence empirique dans l’une ou l’autre direction constituerait un résultat pertinent et informatif sur le plan théorique. Par conséquent, la surface d’erreur de première espèce α est équitablement partitionnée entre les deux extrémités extrêmes de la courbe de distribution : une portion équivalente à α/2 (soit 0,025 pour un seuil global de 5 %) est allouée à la queue gauche de la distribution, tandis que la portion restante α/2 est affectée à la queue droite.
À l’inverse, l’application d’un test unilatéral implique la concentration intégrale du risque d’erreur α dans une seule et unique queue de la distribution statistique. Cette approche offre une puissance statistique théoriquement supérieure pour détecter une divergence orientée dans le sens spécifique prédéterminé par le chercheur, car la valeur t critique nécessaire pour franchir le seuil d’exclusion devient inférieure en valeur absolue à celle exigée dans le cadre bilatéral. Cependant, cette sensibilité accrue a pour corollaire un aveuglement complet à toute variation inverse : si les observations empiriques révèlent un effet substantiel mais de polarité rigoureusement opposée aux conjectures initiales, le cadre unilatéral oblige le praticien à conclure à la non-significativité, quelle que soit la magnitude absolue de la déviation constatée.
L’emploi d’un test unilatéral exige des justifications méthodologiques particulièrement strictes et documentées avant toute consultation des données (par exemple, lors de tests toxicologiques où seule l’augmentation de la mortalité présente un intérêt, ou dans le cadre de protocoles d’ingénierie où une déviation négative est structurellement impossible). Le recours à l’unilatéralité ne doit jamais servir d’artifice rétrospectif visant à abaisser artificiellement une valeur p récalcitrante (une valeur bilatérale de p = 0,08 devenant subitement p = 0,04 sous le filtre unilatéral). Une telle pratique d’ajustement a posteriori constitue une faute méthodologique grave qui double subrepticement le taux effectif d’erreur de première espèce et vicie l’intégrité de la littérature scientifique.
3. Analyse détaillée de la syntaxe de la fonction TEST.T dans Google Sheets
3.1 Structure générale et arguments requis
Dans l’écosystème fonctionnel de Google Sheets, l’outil computationnel primordial pour confronter les moyennes de séries d’observations continues est incarné par la fonction TEST.T (accessible également sous sa nomenclature anglophone universelle T.TEST, le moteur d’évaluation de Google prenant en charge les deux syntaxes de façon interchangeable). Cette fonction intègre sous un capot algorithmique unifié les équations analytiques développées historiquement par William Sealy Gosset, opérant sous le pseudonyme historique de Student. La structure syntaxique formelle requiert impérativement quatre paramètres ordonnés, séparés dans les versions francophones par un point-virgule :
=TEST.T(plage1; plage2; queues; type)
Le paramètre plage1 désigne le premier vecteur ou matrice de cellules hébergeant les données quantitatives de la première condition d’évaluation ou du premier sous-groupe expérimental (par exemple A2:A31). Symétriquement, l’argument plage2 identifie la plage de cellules hébergeant les observations relatives au second groupe ou à la seconde phase de mesure (par exemple B2:B31). Il est fondamental de veiller à ce que ces cellules soient formellement typées comme des valeurs numériques dans Google Sheets ; toute chaîne de caractères alphabétiques présente dans la sélection sera soit ignorée par le moteur de calcul, soit génératrice d’incohérences si elle contamine des plages dont l’alignement dimensionnel est strict.
Concernant le traitement des cellules vierges et des valeurs manquantes, la fonction TEST.T adopte un comportement algorithmique différencié en fonction de la topologie du test paramétré. Lorsque le test est configuré pour des échantillons indépendants, les cellules vides sont ignorées sans interrompre le traitement mathématique, chaque vecteur étant évalué sur la base de son effectif effectif réel. En revanche, lorsque le test est exécuté sur des séries appariées, la présence d’une cellule vide ou non numérique au sein de l’une des paires invalide la correspondance bilatérale de l’observation, ce qui requiert un filtrage exhaustif préalable pour éviter toute altération silencieuse des degrés de liberté du modèle.
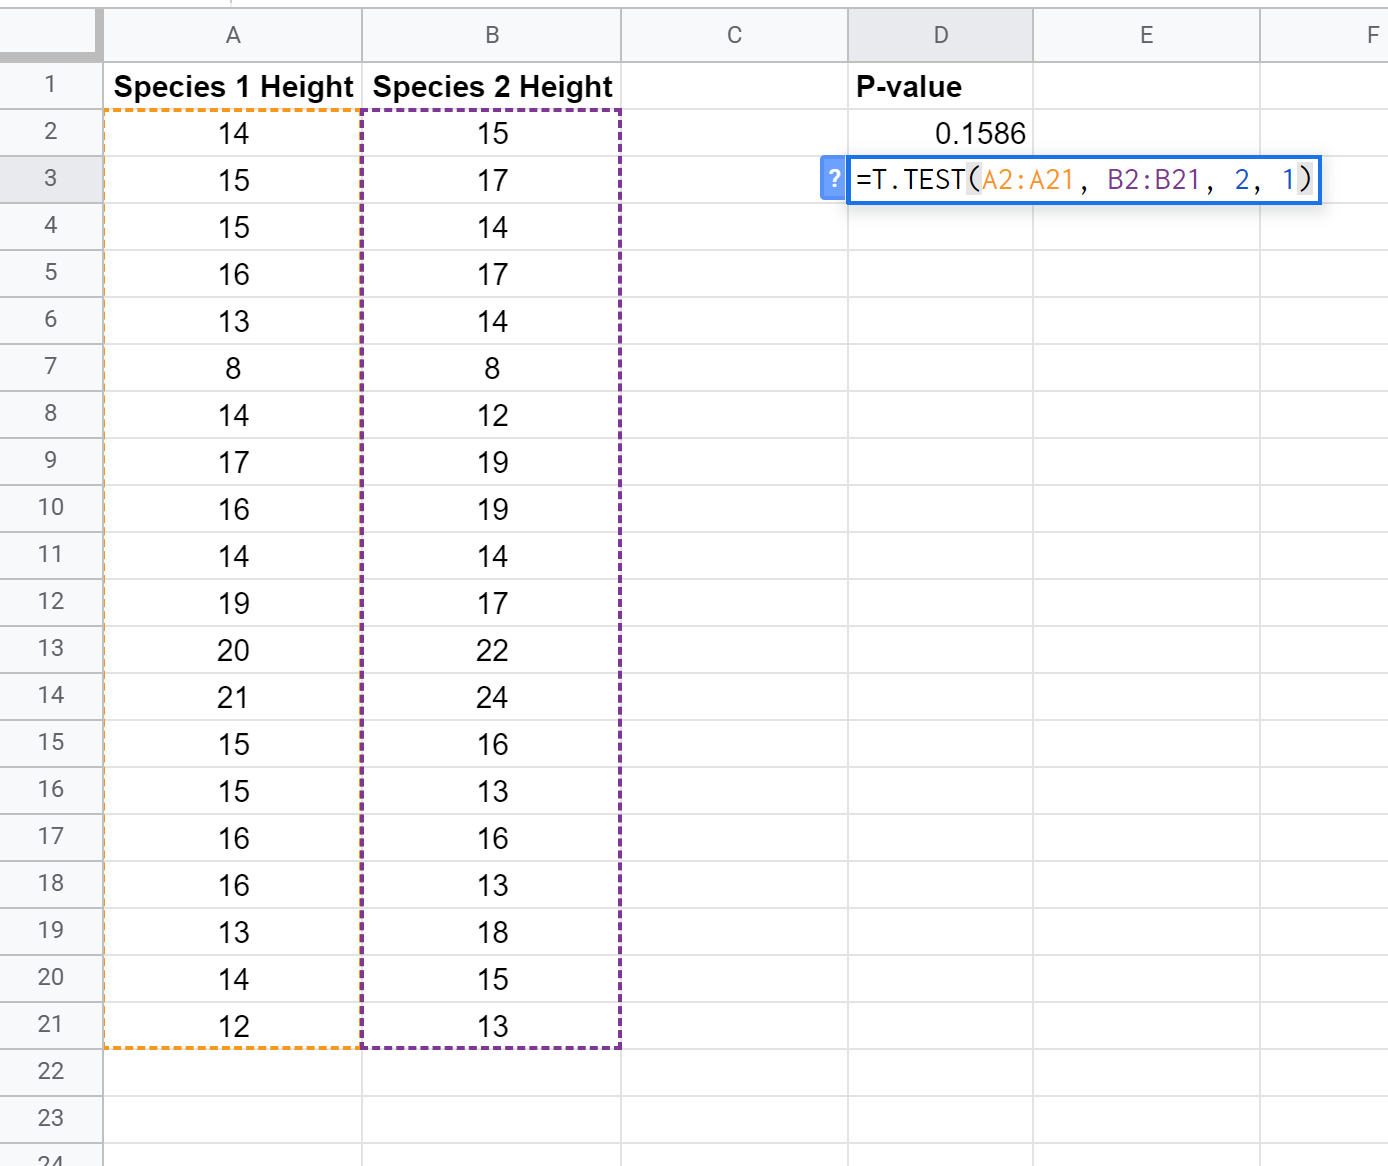
3.2 Paramétrage de l’argument des queues (tails)
Le troisième argument de la formule, intitulé queues (ou tails), dicte à l’algorithme sous-jacent la modalité géométrique selon laquelle l’intégrale de probabilité sous la courbe de densité de Student doit être calculée pour dériver la valeur p finale. Ce paramètre n’admet rigoureusement que deux valeurs discrètes entières : 1 ou 2. Toute tentative de spécifier un paramètre divergent déclenchera irrémédiablement une erreur d’exécution de type #NUM!, paralysant la chaîne computationnelle du tableur.
L’attribution de la valeur numérique 1 ordonne à Google Sheets d’exécuter un test unilatéral. Dans cette configuration, le moteur calcule l’aire sous la courbe d’un seul côté de la distribution de Student délimitée par la statistique t empirique. Cela implique obligatoirement que la direction de la différence observée (la polarité du signe algébrique résultant de la soustraction des moyennes) corresponde strictement au postulat formulé en amont de l’expérience. Si l’écart constaté s’inscrit en sens inverse de la prédiction directionnelle initiale, la valeur p affichée peut devenir trompeuse si elle n’est pas recadrée par l’analyste, soulignant une nouvelle fois l’exigence d’une grande prudence lors du choix de cette modalité.
À l’inverse, la spécification de la valeur 2 ordonne la conduite d’un test bilatéral, ce qui représente la convention de référence recommandée dans l’immense majorité des publications empiriques en psychologie, en sociologie et en recherche médicale. Sous cette option, le tableur calcule la probabilité cumulative dans la queue correspondant à la déviation observée, puis double mécaniquement cette valeur pour incorporer la possibilité symétrique d’une divergence de polarité opposée. En recherche quantitative moderne, l’usage de queues = 2 constitue la norme de probité méthodologique prévenant les dérives interprétatives et garantissant une transposabilité optimale des conclusions soumises à évaluation par les pairs.
3.3 Sélection rigoureuse du type de test t (type)
Le quatrième et dernier paramètre de la fonction, nommé type, constitue le sélecteur mathématique le plus sensible de l’analyse, car il détermine la formulation algébrique exacte de la statistique de Student et le calcul des degrés de liberté associés. L’argument accepte trois codes entiers distincts : 1, 2 ou 3. Choisir erronément ce paramètre revient à appliquer un modèle probabiliste inadapté à la nature intrinsèque du plan expérimental, ce qui compromet immédiatement la validité interne des inférences déduites de la valeur p.
Le code 1 configure un test t pour échantillons appariés (ou mesures répétées). Ce modèle suppose mathématiquement qu’il existe une corrélation intra-classe substantielle entre chaque élément de la première plage et son homologue correspondant dans la seconde plage, typiquement parce que les données proviennent d’un même individu interrogé à deux moments successifs (conception avant/après) ou de paires de sujets rigoureusement appariées sur des variables confondantes. Dans cette configuration, les deux plages vectorielles d’entrée doivent afficher une dimensionnalité absolument symétrique (même nombre de cellules non vides alignées ligne par ligne).
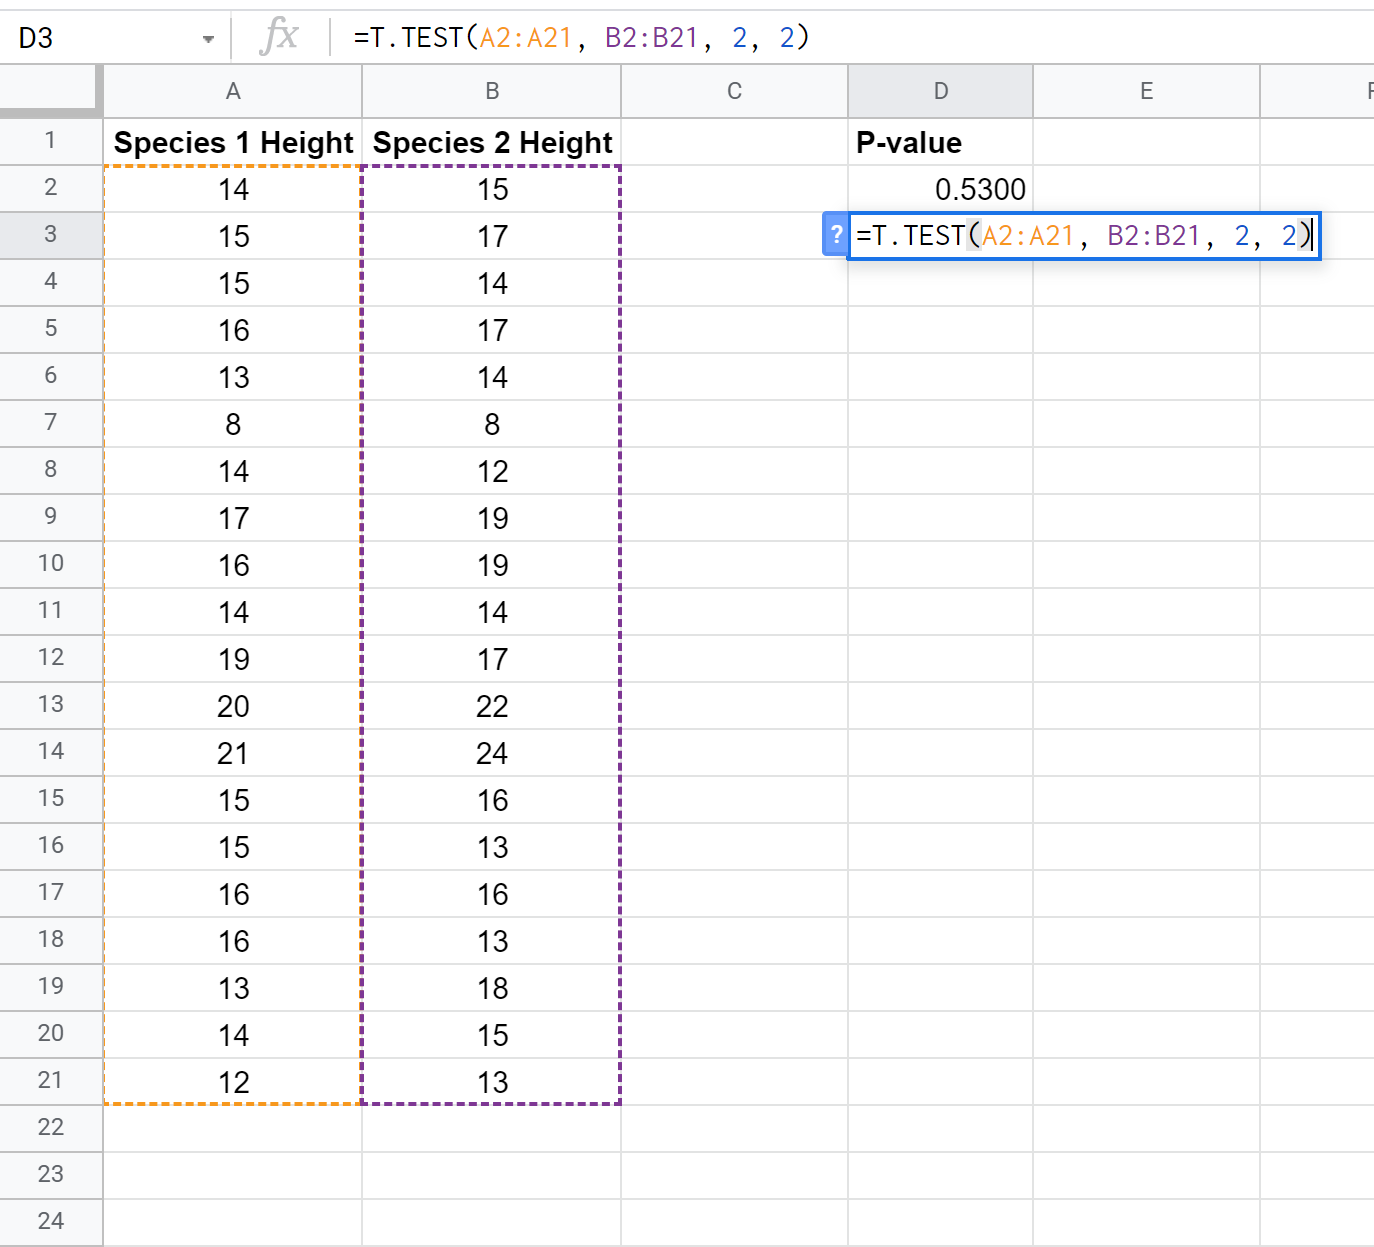
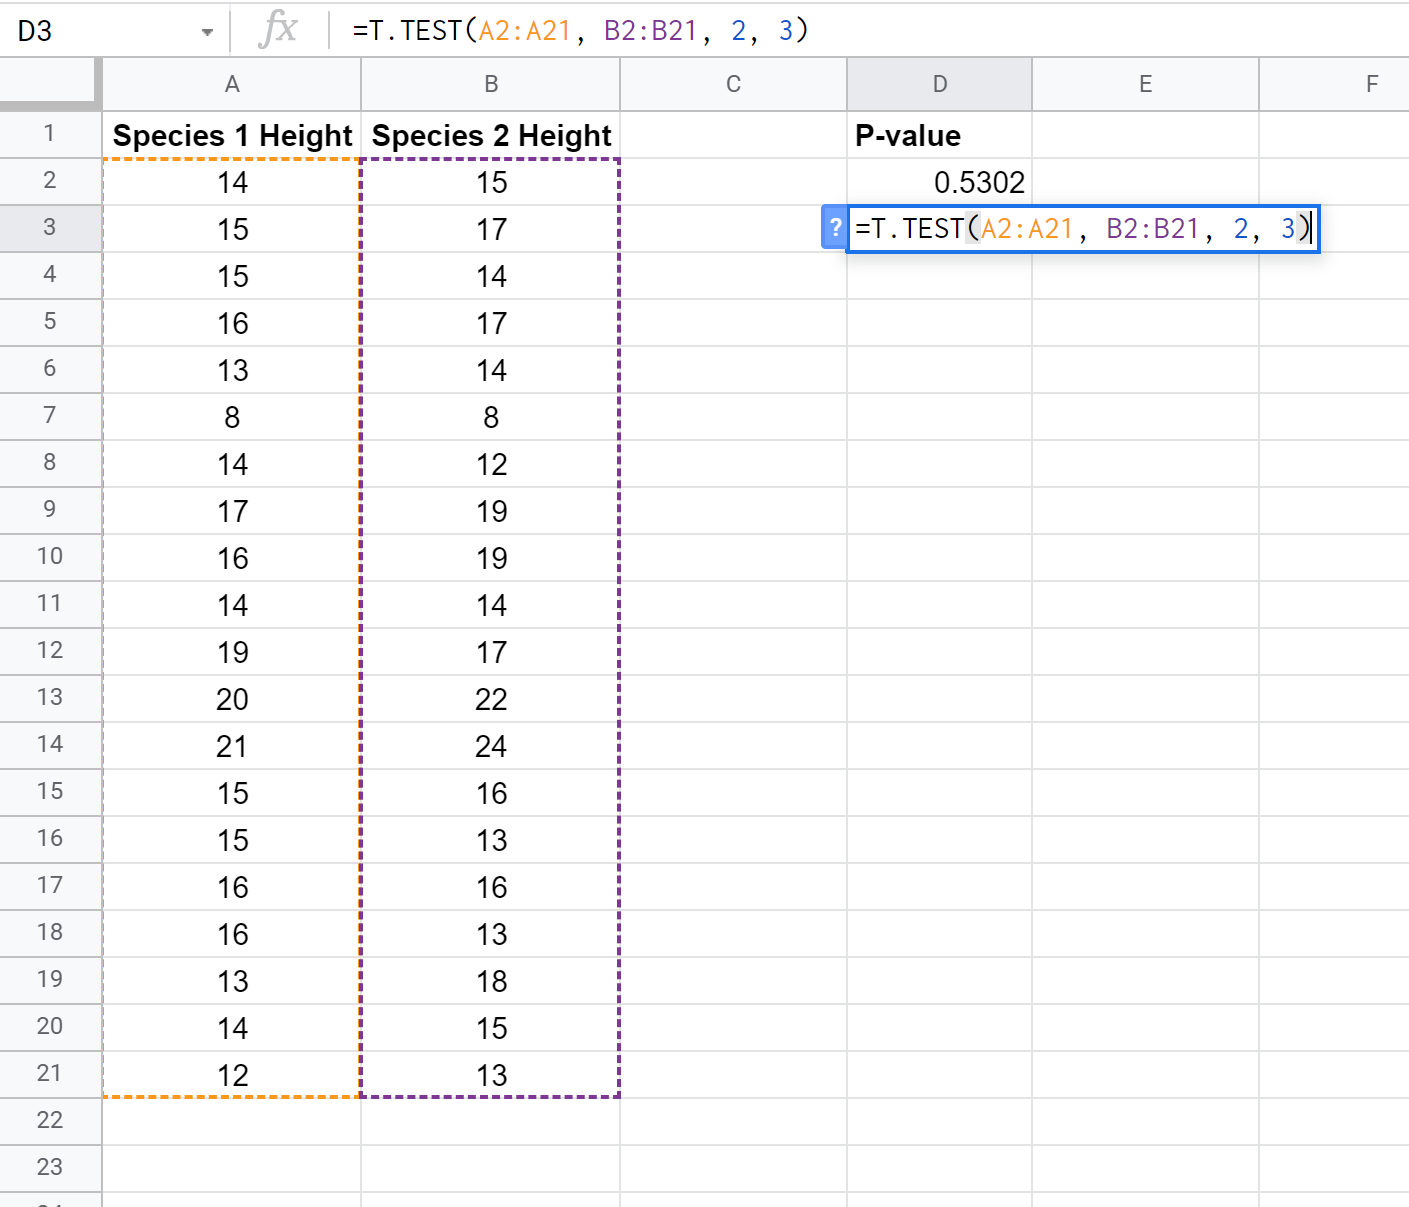
Le code 2 désigne le test t traditionnel de Student pour deux échantillons indépendants sous postulat d’homoscédasticité. Cette équation calcule une variance combinée (pooled variance) représentative de la dispersion globale supposée commune aux deux populations d’origine. Enfin, le code 3 active le test t de Welch pour deux échantillons indépendants sans postulat de variances égales (hétéroscédasticité). Cette variante hautement robuste réajuste le dénominateur de l’erreur type et substitue aux degrés de liberté classiques l’équation de correction non entière de Welch-Satterthwaite, protégeant ainsi l’analyste contre l’inflation pernicieuse des erreurs de type I lorsque les groupes affichent des dispersions hétérogènes.
4. Préparation et structuration des données expérimentales dans Google Sheets
4.1 Organisation tabulaire conforme aux normes méthodologiques
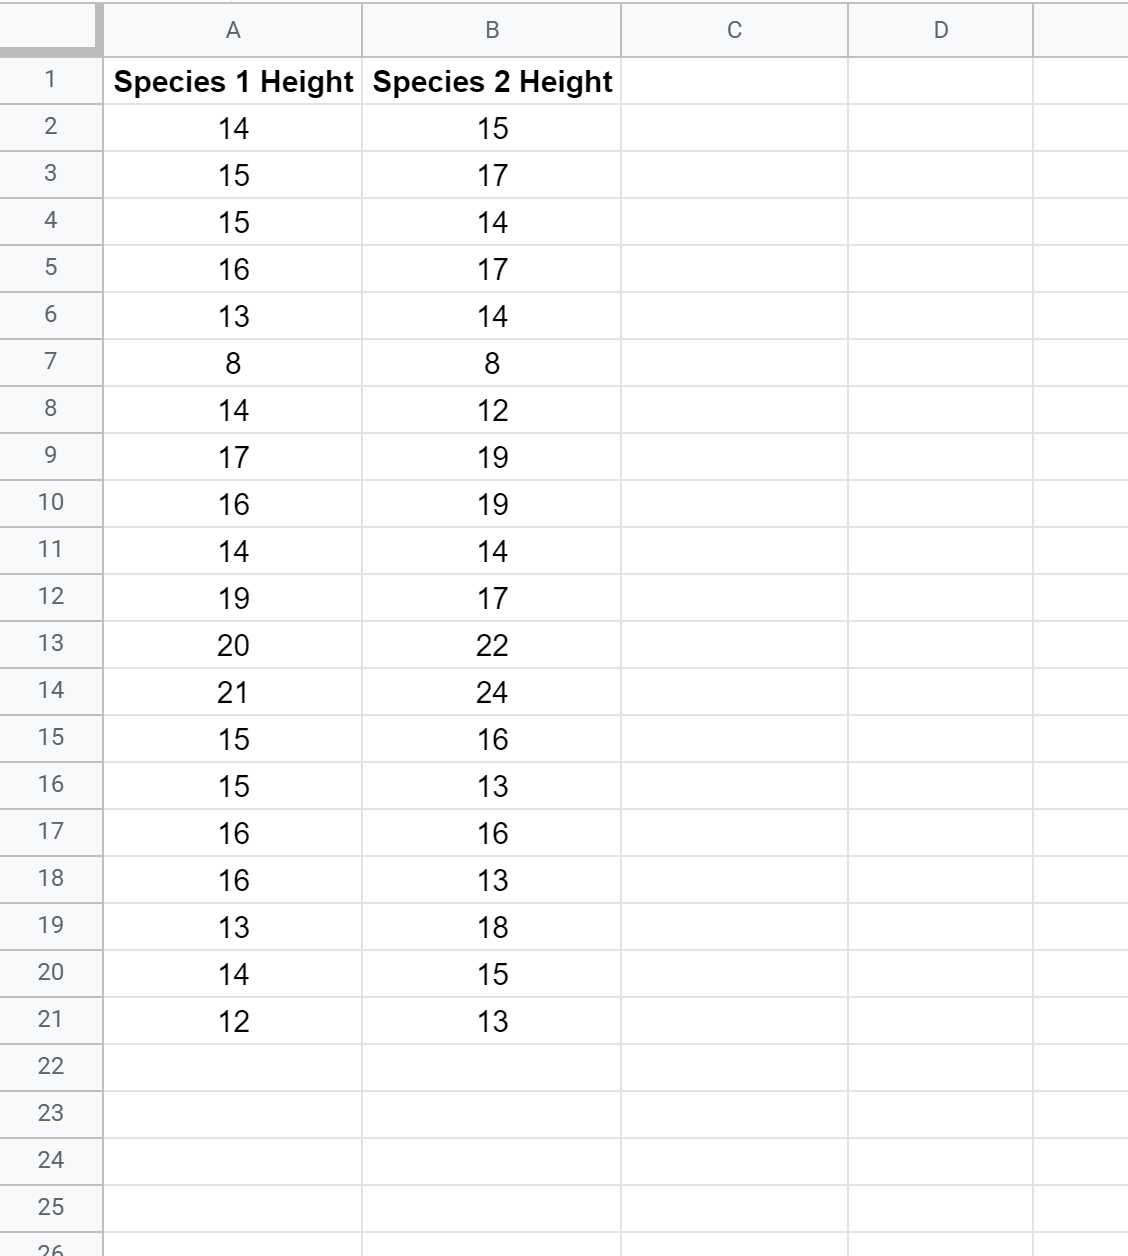
L’intégrité de toute inférence statistique sous Google Sheets est tributaire d’une architecture de stockage de données propre, claire et rigoureusement documentée. La disposition tabulaire adoptée doit immédiatement refléter la structure logique du plan d’échantillonnage employé. Dans le cas d’un plan factoriel intersujets impliquant deux groupes indépendants (par exemple, un groupe témoin recevant un placebo et un groupe expérimental recevant un traitement innovant), la configuration méthodologique standard consiste à organiser les métriques au sein de deux colonnes contiguës bien distinctes : la colonne A rassemblant l’ensemble des scores du groupe expérimental, et la colonne B regroupant ceux du groupe témoin.
Pour les plans expérimentaux longitudinaux ou intrajets fondés sur des mesures répétées, l’alignement horizontal rigoureux constitue un prérequis structural incontournable. Chaque ligne du tableur doit correspondre strictement à une unité statistique unique (un participant, un sujet animal ou un réplicat de laboratoire). Ainsi, pour un protocole d’évaluation des performances cognitives, la cellule A2 hébergera le score pré-interventionnel du sujet n°1, tandis que la cellule B2 contiendra impérativement le score post-interventionnel du même sujet n°1. Tout décalage vertical provoqué par l’omission d’une ligne détruirait la structure d’appariement des données, faussant irrémédiablement le calcul de la moyenne des différences intra-individuelles exécuté par le modèle de type 1.
Une bonne pratique de gestion consiste à exploiter systématiquement la fonctionnalité des plages nommées offerte par Google Sheets (accessible via le menu Données > Plages nommées). Attribuer des étiquettes sémantiques explicites, telles que Score_Controle et Score_Traitement, simplifie considérablement l’écriture ultérieure des syntaxes statistiques en remplaçant des coordonnées abstraites (ex. A2:A55) par des libellés intelligibles. Enfin, il convient de veiller à ce que la ligne sommitale (ligne 1) soit exclusivement réservée aux en-têtes textuels descriptifs, les observations numériques quantitatives débutant invariablement à partir de la ligne 2.
4.2 Vérification préliminaire des postulats d’application
L’application non critique de tests paramétriques sans examen préalable des postulats de distribution constitue l’une des lacunes méthodologiques les plus courantes dans le traitement empirique des données sur tableur. Le test t repose en effet sur trois hypothèses probabilistes fondamentales : l’indépendance statistique des observations (garantie par le plan d’échantillonnage), la distribution approximativement normale des résidus ou des scores au sein des populations mères, et l’homogénéité des variances populationnelles (homoscédasticité) lors des tests indépendants classiques.
Pour apprécier la normalité distributionnelle au sein de Google Sheets en l’absence de tests intégrés formels comme celui de Shapiro-Wilk, le praticien peut explorer les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). La commande =COEFFICIENT.ASYMETRIE(A2:A50) quantifie le degré d’asymétrie de la courbe : une distribution parfaitement symétrique affiche un coefficient nul, tandis que des valeurs oscillant au-delà de l’intervalle [-1, +1] signalent des déformations structurelles notables. Concomitamment, la fonction =KURTOSIS(A2:A50) mesure l’épaisseur des queues de distribution : un kurtosis fortement positif révèle la présence d’une distribution leptokurtique riche en valeurs atypiques, ce qui peut distordre l’estimation de l’erreur type.
L’identification des données aberrantes (outliers) représente le second jalon diagnostique indispensable. Le recours à l’écart interquartile via la fonction =ECART.INTERQUARTILE(A2:A50) permet d’isoler mathématiquement les observations situées au-delà de 1,5 fois cet intervalle par rapport aux premier et troisième quartiles (calculés à l’aide de QUARTILE.EXCLURE). Enfin, l’égalité des variances entre deux groupes indépendants doit faire l’objet d’un examen minutieux à l’aide de la fonction dédiée =TEST.F(A2:A50; B2:B45). Si le résultat du test de Snedecor retourne une valeur p inférieure à 0,05, le postulat d’homogénéité des variances est empiriquement réfuté, ce qui prescrit formellement le recours au test t de Welch (Type 3) au détriment du modèle classique de Student (Type 2).
4.3 Nettoyage et gestion des observations manquantes
Le traitement des données manquantes constitue une étape sensible qui conditionne directement l’exactitude des calculs matriciels subséquents. Dans le cas de plans à mesures répétées, une seule valeur absente au sein d’une paire d’observations compromet le calcul de la différence intra-sujet correspondante. Si l’on laisse subsister une cellule vide dans la colonne post-test alors que la cellule pré-test associée contient une valeur, les fonctions statistiques de certains tableurs risquent de désynchroniser les rangs ou d’exclure unilatéralement la donnée sans trace explicite pour l’analyste. Il est donc recommandé d’assainir structurellement la matrice en éliminant les paires incomplètes via des filtres dynamiques.
L’utilisation conjuguée des formules modernes FILTRE ou QUERY s’avère particulièrement efficace pour extraire des sous-ensembles de données parfaitement nettoyés sans altérer la matrice brute originelle. Par exemple, la syntaxe matricielle suivante génère instantanément un tableau d’échantillons appariés exempt de toute omission :
=FILTRE(A2:B100; ESTNUM(A2:A100); ESTNUM(B2:B100))
Cette approche garantit qu’aucune valeur textuelle résiduelle, espace invisible ou cellule vierge ne viendra corrompre le traitement de la formule TEST.T. Toute exclusion opérée au cours de cette phase doit être systématiquement consignée au sein d’un journal de modifications méthodologique pour préserver une traçabilité intégrale de la réduction de l’échantillon, conformément aux recommandations du standard CONSORT pour la transparence de la recherche expérimentale.
Par ailleurs, une maîtrise des codes d’erreur de Google Sheets est essentielle pour résoudre rapidement les blocages syntaxiques. L’affichage de l’erreur #VALEUR! signale presque systématiquement la présence inattendue d’un caractère non numérique au sein de la plage ciblée par le calcul statistique (souvent un espace dactylographique ou une apostrophe de formatage). L’erreur #DIV/0! apparaît généralement lorsque la variance de l’une des séries est rigoureusement égale à zéro (tous les scores d’un groupe étant parfaitement identiques), ce qui rend mathématiquement impossible la division par l’écart-type résiduel. Enfin, l’erreur #NUM! trahit une anomalie relative aux arguments paramétriques, comme la saisie d’un code de queue ou de type non répertorié par le logiciel.
5. Étape par étape : Test t pour échantillons appariés (Type 1)
5.1 Cadre d’application dans les protocoles avant/après
Le test t pour échantillons appariés, désigné par la sélection du paramètre type = 1 dans Google Sheets, représente l’outil d’élection pour analyser les protocoles méthodologiques fondés sur des mesures répétées. Dans ce schéma de recherche, chaque entité expérimentale sert de son propre témoin, ce qui permet de mesurer l’évolution d’une variable quantitative continue avant et après l’administration d’une intervention contrôlée (qu’il s’agisse d’un entraînement pédagogique, d’une thérapie cognitivo-comportementale ou d’un protocole pharmacologique). Ce protocole est mathématiquement structuré autour de la notion de différence individuelle directe : pour chaque participant i, le système calcule l’écart individuel direct Di = Yi – Xi.
Le bénéfice statistique majeur de ce design réside dans le contrôle intrinsèque de la variabilité interindividuelle. Dans une comparaison intersujets classique, les disparités congénitales, biologiques ou socio-économiques préexistantes entre les individus constituent une part importante de l’erreur type résiduelle. Dans un cadre apparié, cette variance parasite est éliminée de l’équation puisque l’analyse se focalise exclusivement sur la dynamique du changement intra-individuel. Cela confère au modèle une puissance statistique substantiellement supérieure pour détecter des variations d’ampleur modeste, même à partir de cohortes restreintes.
Cependant, ce formalisme exige l’existence d’une dépendance statistique forte entre les deux séries d’observations. Appliquer un test de Type 1 à deux groupes composés d’individus totalement distincts et sans correspondance univoque relève d’une erreur méthodologique manifeste. À l’inverse, traiter des données longitudinales dépendantes au moyen d’un test t pour échantillons indépendants (Type 2 ou 3) conduirait à sous-estimer la puissance du test en gonflant artificiellement le dénominateur de la statistique t, augmentant ainsi dangereusement le risque d’erreur de type II (ne pas observer une différence pourtant bien réelle).
5.2 Implémentation pas à pas de la formule dans le tableur
Pour mettre en œuvre concrètement ce test au sein de Google Sheets, suivons pas à pas un scénario didactique mesurant l’efficacité d’un programme de réduction de l’anxiété auprès d’un panel de 30 participants. La feuille de calcul est configurée comme suit :
- La colonne
A(cellulesA2:A31) héberge les scores d’anxiété mesurés lors du pré-test. - La colonne
B(cellulesB2:B31) consigne les scores correspondants obtenus par les mêmes sujets lors du post-test. - La cellule
C1reçoit le libellé textuelValeur p (Appariée, Bilatérale).
Dans la cellule C2, l’analyste saisit rigoureusement l’expression algorithmique suivante :
=TEST.T(A2:A31; B2:B31; 2; 1)
Dès la validation par la touche Entrée, Google Sheets exécute instantanément la séquence mathématique sous-jacente : il génère le vecteur des différences d’échantillons, calcule la moyenne de ces écarts (¯D), détermine l’écart-type des différences (SD), calcule l’erreur type de la moyenne des différences (S¯D = SD / √n), en extrait la statistique empirique t = ¯D / S¯D, puis intègre la fonction de probabilité de Student pour un nombre de degrés de liberté dl = n – 1 (soit 30 – 1 = 29 dans notre exemple) sur un schéma bilatéral (argument 2).
Il est indispensable de vérifier que les plages A2:A31 et B2:B31 possèdent rigoureusement le même nombre de lignes. Si une cellule demeure vide ou présente une valeur textuelle aberrante dans l’une des deux colonnes, le tableur ajustera sa structure ou renverra une erreur. Une façon efficace de valider l’intégrité de l’échantillon apparié consiste à insérer préalablement en cellule annexe la vérification logique =NB(A2:A31) = NB(B2:B31), qui doit impérativement retourner le booléen VRAI avant toute exploitation de la valeur p.
5.3 Interprétation quantitative et statistique du résultat obtenu
Considérons que la cellule C2 affiche la valeur numérique 0,0142 après l’évaluation de la formule. La première étape de l’analyse inférentielle consiste à confronter cette métrique au seuil critique fixé a priori. En retenant le standard académique α = 0,05, nous constatons immédiatement que p = 0,0142 < 0,05. Sur la base de cette constatation probabiliste, l’analyste prend la décision statistique formelle de rejeter l’hypothèse nulle (H0) d’équivalence des scores moyens d’anxiété avant et après l’administration du protocole.
Sur le plan sémantique et conceptuel, ce résultat démontre que si le programme d’intervention n’avait strictement aucun effet (H0 exacte), la probabilité d’observer un différentiel moyen au moins aussi marqué que celui constaté sur nos 30 sujets sous le seul effet des aléas d’échantillonnage ne serait que de 1,42 %. Cette éventualité étant jugée suffisamment improbable au regard du seuil de tolérance retenu, il est raisonnable de conclure à l’existence d’une évolution temporelle statistiquement significative des scores des participants.
Néanmoins, la rédaction des conclusions scientifiques associées doit être tempérée par l’examen de la métrique descriptive : la moyenne du post-test indique-t-elle effectivement une baisse (amélioration clinique) ou une augmentation inattendue de l’anxiété ? La valeur p issue d’un test bilatéral ne précise pas la polarité du résultat ; elle valide uniquement la présence d’une rupture d’équilibre significative. La formulation textuelle finale devra systématiquement intégrer les statistiques descriptives complètes : « Le score d’anxiété moyen a affiché une baisse significative entre la phase pré-test (M = 48,2, ÉT = 6,8) et post-test (M = 42,1, ÉT = 5,4), t(29) = 2,61, p = ,014 ».
6. Étape par étape : Test t pour deux échantillons indépendants avec variances égales (Type 2)
6.1 Contexte méthodologique du plan factoriel intersujets
Le test t pour deux échantillons indépendants fondé sur l’hypothèse de variances homogènes (homoscédasticité), assigné au paramètre type = 2, trouve son application reine dans l’évaluation des plans expérimentaux ou quasi-expérimentaux intersujets. Dans cette architecture, les unités d’observation sont strictement compartimentées en deux cohortes distinctes, mutuellement exclusives, ne partageant aucune corrélation sous-jacente. L’objectif analytique consiste à établir si les paramètres centraux des populations dont sont extraits ces groupes (notés μ1 et μ2) présentent une dissemblance quantitative réelle ou si l’écart constaté résulte de fluctuations d’échantillonnage normales.
Le postulat d’homoscédasticité stipule que les deux populations sous-jacentes partagent une variance identique (σ1² = σ2² = σ²), même si les moyennes μ1 et μ2 divergent. Sur le plan computationnel, cette hypothèse permet de réunir l’ensemble des informations de dispersion recueillies dans chaque sous-groupe au sein d’une métrique synthétique unique appelée variance combinée ou pondérée (pooled variance, notée Sp²). Cette estimation globale sert ensuite de dénominateur pour calibrer l’erreur type de la différence des moyennes d’échantillons selon la formule algébrique :
Sp² = [ (n1 – 1)S1² + (n2 – 1)S2² ] / (n1 + n2 – 2)
L’erreur type de la différence s’exprime alors comme : SE = √[ Sp² × (1/n1 + 1/n2) ]. Ce modèle requiert une vigilance particulière lorsque les tailles d’échantillons n1 et n2 sont asymétriques. Si les effectifs sont identiques (n1 = n2), le test de Student classique fait preuve d’une robustesse relative face à de légères entorses à l’égalité des variances. En revanche, si les effectifs sont substantiellement déséquilibrés et que le groupe le plus modeste présente la variance la plus forte, le test de Type 2 tend à sous-estimer l’erreur type réelle, entraînant une inflation majeure du risque de faux positifs (erreur de Type I).
6.2 Saisie pratique de la formule d’homoscédasticité
Examinons la mise en application d’un test t indépendant de Type 2 sous Google Sheets. Supposons une recherche évaluant l’impact d’une nouvelle interface logicielle sur la productivité de deux cohortes d’employés distinctes :
- La colonne
A(cellulesA2:A50) réunit les indicateurs de rendement de 49 utilisateurs ayant expérimenté la nouvelle interface (groupe expérimental). - La colonne
B(cellulesB2:B45) consigne les rendements de 44 utilisateurs travaillant sur l’ancienne interface (groupe témoin). - La cellule
C1est désignée pour accueillir la statistique de significativité.
Après s’être méthodologiquement assuré de l’homoscédasticité des deux distributions à l’aide d’un test d’égalité des variances (par exemple TEST.F(A2:A50; B2:B45) affichant une valeur p > 0,05), l’analyste implémente la formule en cellule C2 :
=TEST.T(A2:A50; B2:B45; 2; 2)
Dans ce modèle, Google Sheets gère sans difficulté le déséquilibre structurel entre le nombre de lignes de la première plage (49 observations) et de la seconde (44 observations). Le moteur d’évaluation calcule les degrés de liberté totaux selon la règle additive standard des modèles homoscédastiques : dl = n1 + n2 – 2, soit dans ce cas de figure 49 + 44 – 2 = 91 degrés de liberté. Toute addition ultérieure de données au sein des plages ciblées déclenchera une réévaluation dynamique instantanée de la variance combinée et de la valeur p associée.
6.3 Lecture critique de la valeur p sous condition de variances homogènes
Supposons que la commande renvoie en cellule C2 le résultat 0,0048. Ce chiffre atteste d’une significativité statistique hautement marquée au seuil conventionnel de 5 % (α = 0,05) et demeure même robuste sous un seuil plus strict de 1 % (α = 0,01). La marge d’erreur attribuable aux simples fluctuations aléatoires de l’échantillonnage ne représente ici qu’un risque de 0,48 % de commettre une erreur de Type I en concluant à l’inégalité des moyennes populationnelles de performance.
Cependant, l’interprétation scientifique ne s’arrête pas à la simple validation du dépassement de seuil. L’analyste doit impérativement documenter que l’hypothèse de travail relative à l’égalité des variances a fait l’objet d’une validation préalable. Si le ratio des variances d’échantillons S1² / S2² était supérieur à 1,5 ou 2 avec des tailles d’échantillons inégales, le choix du Type 2 deviendrait méthodologiquement vulnérable aux critiques lors de la soumission du manuscrit à un comité de lecture académique. En cas d’inégalité flagrante des variances, l’usage de ce modèle classique doit être systématiquement écarté au profit du test t de Welch, développé dans la section suivante.
7. Étape par étape : Test t de Welch pour variances inégales (Type 3)
7.1 Justification de la correction de Welch en situation d’hétéroscédasticité
Dans la pratique réelle de la recherche quantitative, la parfaite homogénéité des variances entre deux groupes indépendants relève souvent de l’illusion théorique. En effet, l’introduction d’un traitement expérimental puissant ne modifie pas uniquement la tendance centrale (la moyenne) des scores des sujets ; elle peut également accroître substantiellement leur dispersion, certains participants réagissant de manière spectaculaire tandis que d’autres demeurent insensibles à l’intervention. Face à ce phénomène d’hétéroscédasticité (σ1² ≠ σ2²), le modèle standard de Student (Type 2) perd sa neutralité mathématique et fournit des valeurs p biaisées, exposant l’expérimentateur à des risques d’inférence non contrôlés.
Pour surmonter cette impasse méthodologique, B. L. Welch a proposé une adaptation mathématique fondamentale qui ne présuppose aucune égalité des variances populationnelles. Dans le test t de Welch (accessible via le code type = 3), l’erreur type de la différence de moyennes n’utilise plus de variance combinée, mais agrège directement les erreurs types individuelles de chaque échantillon :
SE = √[ (S1² / n1) + (S2² / n2) ]
Pour compenser cette modification, le nombre de degrés de liberté de la distribution théorique de Student n’est plus calculé sous la forme entière élémentaire (n1 + n2 – 2), mais ajusté par la célèbre équation d’approximation de Welch-Satterthwaite :
dl = [ (S1² / n1) + (S2² / n2) ]² / [ ((S1² / n1)² / (n1 – 1)) + ((S2² / n2)² / (n2 – 1)) ]
Cette dérivation produit la plupart du temps un nombre de degrés de liberté non entier (décimal), qui s’avère inférieur ou égal aux degrés de liberté de Student classiques. Cet ajustement mathématique pénalise la statistique t de manière strictement proportionnelle au niveau de disparité des variances et au déséquilibre des tailles d’échantillons, empêchant mécaniquement toute sous-estimation de la valeur p finale. La littérature méthodologique moderne, notamment sous l’impulsion de statisticiens émérites comme Delacre, Lakens et Leys (2017), recommande d’adopter le test t de Welch comme modèle d’analyse par défaut pour toute comparaison de deux moyennes indépendantes, reléguant le test classique de Student à un usage restreint.
7.2 Mise en œuvre concrète du Type 3 dans Google Sheets
L’implémentation opérationnelle du test t de Welch dans Google Sheets s’avère d’une remarquable simplicité, l’intégralité de l’ajustement algorithmique complexe de Welch-Satterthwaite étant gérée de façon transparente par le moteur interne de la plateforme. Prenons l’exemple d’une cohorte médicale où l’on compare la concentration d’un biomarqueur entre un groupe de patients atteints d’une pathologie chronique et un groupe d’individus sains :
- Plage
A2:A40: Valeurs mesurées chez les patients pathologiques (n1 = 39, affichant une forte variabilité clinique, ÉT = 14,2). - Plage
B2:B35: Valeurs relevées chez les volontaires sains (n2 = 34, affichant une variance beaucoup plus étroite, ÉT = 4,1).
L’hétérogénéité des variances étant particulièrement marquée, l’analyste formule son instruction de calcul en sélectionnant impérativement le Type 3 :
=TEST.T(A2:A40; B2:B35; 2; 3)
Si l’on exécutait parallèlement sur les mêmes données la formule de Type 2 (TEST.T(A2:A40; B2:B35; 2; 2)), on constaterait souvent une discordance tangible au niveau de la valeur p résultante. Si l’échantillon le plus restreint présente la dispersion la plus faible, le modèle de Welch produira une valeur p légèrement plus libérale, tandis que si l’échantillon le plus réduit possède la variance la plus forte, la valeur p de Welch sera nettement plus conservatrice que celle de Student classique, évitant ainsi un faux positif pernicieux.
Pour valoriser ces résultats dynamiques dans Google Sheets, il est pertinent d’associer la cellule de calcul à un formatage conditionnel automatisé (accessible via le menu Format > Mise en forme conditionnelle). En paramétrant une règle établissant que toute valeur strictement inférieure à 0,05 colore automatiquement l’arrière-plan de la cellule en vert clair, l’analyste configure un tableau de bord analytique réactif capable d’identifier instantanément les axes de significativité au sein de vastes matrices de données empiriques.
7.3 Analyse comparative et inférence scientifique
L’examen approfondi des sorties générées par les Types 2 et 3 offre de riches enseignements didactiques et scientifiques. Le déplacement de la valeur p occasionné par le passage au modèle de Welch illustre la façon dont l’incertitude structurelle liée à l’hétérogénéité des variances est incorporée dans le jugement statistique. L’abaissement des degrés de liberté produit un élargissement des queues de distribution de Student, ce qui impose à la statistique t empirique un effort mathématique supplémentaire pour atteindre les zones de rejet critiques.
Dans un contexte de publication soumise à l’évaluation par les pairs, documenter l’usage délibéré du test de Welch témoigne d’une excellente rigueur méthodologique. Il est courant que des relecteurs méthodologistes contestent l’usage du test classique de Student (Type 2) en suspectant une violation non traitée de l’homoscédasticité ; en revanche, le recours au test de Welch (Type 3) est universellement accepté, puisqu’il offre une robustesse équivalente au test classique lorsque les variances sont parfaitement égales, tout en assurant une protection sans faille en cas de dispersion divergente. Choisir systématiquement le Type 3 constitue ainsi une démarche prudente et défendable pour sécuriser la reproductibilité de ses analyses.
8. Calculs alternatifs et complémentaires de la valeur p via la statistique t directe
8.1 Extraction manuelle de la statistique t et degrés de liberté
Bien que la fonction compacte TEST.T de Google Sheets procure une grande commodité d’exécution, elle fonctionne comme une boîte noire en occultant les étapes arithmétiques intermédiaires qui mènent à la valeur p finale. Or, pour la communication académique ou pour acquérir une compréhension approfondie de la distribution d’échantillonnage, il est souvent précieux de décomposer le calcul pour extraire manuellement la statistique empirique t ainsi que ses degrés de liberté précis. Cette décomposition didactique s’articule aisément à l’aide des fonctions mathématiques fondamentales du tableur.
Considérons la comparaison manuelle de deux groupes indépendants disposés en colonnes A (A2:A26, n1 = 25) et B (B2:B26, n2 = 25). La dérivation algébrique de l’estimateur t se formalise étape par étape comme suit :
- Moyenne du groupe 1 en
D2:=MOYENNE(A2:A26) - Moyenne du groupe 2 en
D3:=MOYENNE(B2:B26) - Variance d’échantillon du groupe 1 en
D4:=VAR.S(A2:A26) - Variance d’échantillon du groupe 2 en
D5:=VAR.S(B2:B26) - Effectifs effectifs n1 et n2 en
D6etD7:=NB(A2:A26)et=NB(B2:B26)
Sous condition de variances égales, l’analyste calcule la variance combinée (pooled variance) en cellule D8 via l’expression :
=((D6-1)*D4 + (D7-1)*D5) / (D6 + D7 - 2)
L’erreur type de la différence de moyennes est ensuite obtenue en cellule D9 :
=RACINE(D8 * (1/D6 + 1/D7))
La statistique t empirique de Student s’exprime enfin en cellule D10 par le quotient de la divergence des moyennes sur l’erreur type estimée :
=(D2 - D3) / D9
Les degrés de liberté (dl) associés s’obtiennent simplement en D11 par l’expression =D6 + D7 - 2 (soit 48 dans notre exemple). Cette décomposition modulaire permet de visualiser clairement comment chaque paramètre descriptif (différence brute de tendance centrale, dispersion résiduelle, taille d’échantillon) module la magnitude finale de la statistique t.
8.2 Conversion de la statistique t en valeur p avec LOI.STUDENT
Une fois la statistique t empirique et les degrés de liberté formellement établis au sein de cellules dédiées, Google Sheets met à disposition des fonctions spécifiques pour traduire cet indice géométrique en probabilité de dépassement (valeur p). La fonction maîtresse dédiée aux analyses bilatérales conventionnelles s’intitule LOI.STUDENT.BILATERALE (ou T.DIST.2T dans sa syntaxe anglophone internationale). Sa structure n’exige que deux arguments :
=LOI.STUDENT.BILATERALE(VALEUR_ABSOLUE_T; DEGRES_LIBERTE)
Il est impératif de souligner que cette fonction exige une valeur de test positive. Si la soustraction de vos moyennes a généré un indice t négatif (par exemple t = -2,45), l’insertion directe de cette valeur négative déclenchera une erreur #NUM!. Il convient donc de neutraliser le signe à l’aide de la fonction de valeur absolue :
=LOI.STUDENT.BILATERALE(ABS(D10); D11)
Pour un protocole reposant sur une hypothèse directionnelle justifiée où l’on souhaite calculer la probabilité associée à la queue droite de la distribution, le tableur propose la fonction LOI.STUDENT.DROITE(x; dl) (ou T.DIST.RT). En exécutant LOI.STUDENT.BILATERALE(ABS(D10); D11) sur nos calculs manuels, on constate une identité numérique parfaite, au dix-millième de décimale près, avec le résultat retourné par la fonction consolidée TEST.T(A2:A26; B2:B26; 2; 2). Cette convergence illustre la cohérence interne du moteur de calcul de Google Sheets et valide l’exactitude des chaînes algorithmiques mobilisées.
8.3 Compréhension des queues de distribution via LOI.STUDENT.N
Pour appréhender la topologie fonctionnelle de la courbe de Student de manière continue, Google Sheets intègre également la fonction cumulative générale LOI.STUDENT.N (homologue de T.DIST). Cette commande offre une flexibilité totale en acceptant des valeurs de t négatives ou positives, et permet de choisir entre la fonction de répartition cumulative ou la fonction de densité brute via un commutateur booléen :
=LOI.STUDENT.N(t; degres_liberte; cumulatif)
Lorsque le troisième argument est paramétré sur VRAI, la fonction calcule l’intégrale cumulative de la distribution depuis l’infini négatif jusqu’à la coordonnée t spécifiée (c’est-à-dire l’aire totale située à gauche de la statistique t). Si l’on obtient une statistique négative t = -2,10 avec 30 degrés de liberté, la formule =LOI.STUDENT.N(-2,10; 30; VRAI) retournera directement la valeur p unilatérale gauche correspondante (approximativement 0,0221).
Si l’on paramètre ce commutateur sur FAUX, la cellule renvoie la hauteur géométrique de la courbe (l’ordonnée de la fonction de densité de probabilité) pour la valeur t donnée, un paramètre utile pour tracer manuellement le graphique de la distribution théorique au sein du tableur. La maîtrise de ces fonctions spécialisées confère à l’expérimentateur une compréhension intime des intégrales de probabilité, lui permettant de s’affranchir des limitations des fonctions automatisées lors du traitement de designs expérimentaux non standards.
9. Calcul de la valeur p pour d’autres modèles statistiques courants dans Google Sheets
9.1 Valeur p d’un test d’indépendance ou d’ajustement du Khi-deux
L’inférence statistique ne se limite pas aux variables quantitatives continues et aux comparaisons de moyennes. Lorsque les observations sont de nature catégorielle (nominale ou ordinale), telles que des fréquences de réponses, des typologies de comportements ou des données d’adhésion clinique, le test d’indépendance ou d’ajustement du Khi-deux (χ²) de Karl Pearson constitue le cadre méthodologique universel. Google Sheets propose une fonction analytique directe dédiée à cette distribution :
=TEST.KHIDEUX(plage_observée; plage_théorique)
Pour exploiter cette formule, le chercheur doit structurer sur sa feuille deux tableaux croisés de dimensions strictement identiques. Le premier tableau regroupe les effectifs empiriques effectivement dénombrés sur le terrain (les fréquences observées, Oij). Le second tableau héberge les fréquences théoriques attendues (Eij), calculées selon le modèle d’indépendance stochastique : Eij = (Total Ligne i × Total Colonne j) / Total Général.
Dès la validation de la syntaxe =TEST.KHIDEUX(A5:B6; D5:E6), Google Sheets calcule la statistique empirique χ² = ∑ [ (Oij – Eij)² / Eij ], identifie les degrés de liberté de la grille dl = (Lignes – 1) × (Colonnes – 1), et calcule la valeur p issue de la distribution du Khi-deux. Il est méthodologiquement essentiel de s’assurer que les conditions de validité de Cochran sont scrupuleusement respectées : aucun effectif théorique Eij ne doit être inférieur à 1, et au moins 80 % des cases de la matrice théorique doivent présenter des effectifs attendus supérieurs ou égaux à 5. Si ces postulats ne sont pas tenus, la valeur p affichée devient mathématiquement suspecte, imposant des regroupements de modalités ou l’usage de tests exacts.
9.2 Valeur p du coefficient de corrélation de Pearson
L’évaluation des relations linéaires entre deux dimensions psychométriques, biologiques ou économiques continues mobilise le célèbre coefficient de corrélation produit-moment de Bravais-Pearson, noté r. Bien que Google Sheets calcule instantanément cette métrique d’association descriptive via la commande native =COEFFICIENT.CORRELATION(plage_X; plage_Y) ou son homologue =PEARSON(plage_X; plage_Y), l’application ne fournit pas directement de fonction unifiée renvoyant la valeur p de significativité de cette corrélation. Il incombe donc à l’analyste de modéliser cette dérivation inférentielle.
La conversion standardisée du coefficient empirique r en une statistique t de Student s’opère selon l’équation mathématique :
t = [ r × √(N – 2) ] / √(1 – r²)
Supposons que le coefficient de corrélation r soit calculé en cellule C2 et que le nombre de paires d’observations N soit stocké en cellule C3. La statistique t s’exprime en cellule C4 par la formule :
=C2 * RACINE(C3 - 2) / RACINE(1 - PUISSANCE(C2; 2))
Les degrés de liberté associés étant dl = N – 2, la valeur p bilatérale attestant de la significativité de l’association linéaire s’obtient élégamment en cellule C5 via la fonction de distribution :
=LOI.STUDENT.BILATERALE(ABS(C4); C3 - 2)
Ce calcul permet de réfuter l’hypothèse nulle d’orthogonalité (H0 : ρ = 0) lorsque p < 0,05, attestant que la corrélation observée ne provient pas d’une simple coïncidence au sein de l’échantillon analysé.
9.3 Valeur p associée au modèle de régression linéaire simple
Dans une perspective de modélisation prédictive ou d’explication causale, la régression linéaire univariée ou multiple permet d’analyser les variations d’une variable dépendante continue Y sous l’effet d’une ou plusieurs variables indépendantes prédictrices X. Google Sheets dispose d’une fonction matricielle d’une puissance remarquable pour extraire l’intégralité des paramètres du modèle : la fonction DROITEREG (ou LINEST).
Pour déployer ce module avec ses estimations statistiques complètes, l’analyste sélectionne une zone matricielle vierge de plusieurs colonnes et lignes, puis saisit la formule en paramétrant le quatrième argument sur VRAI :
=DROITEREG(plage_Y; plage_X; VRAI; VRAI)
La matrice résultante déploie un ensemble complet d’indicateurs : le coefficient de pente (b1), la constante d’ordonnée à l’origine (b0), leurs erreurs types respectives, le coefficient de détermination (R²), ainsi que la statistique globale F de Fisher-Snedecor accompagnée de ses degrés de liberté résiduels. À partir de cette statistique F (positionnée à la quatrième ligne, première colonne du bloc généré, notons-la E10) et de ses degrés de liberté associés (dl1 = 1 pour un modèle simple, dl2 résiduels en F11), le calcul de la valeur p globale du modèle s’obtient via la fonction de distribution de Fisher :
=LOI.F.DROITE(E10; 1; F11)
Cette valeur p quantifie avec une précision mathématique rigoureuse la significativité de la part de variance expliquée par le modèle face au résidu d’estimation stochastique, permettant de valider ou de rejeter l’utilité prédictive globale de l’équation linéaire formulée.
10. Interprétation critique, erreurs courantes et pièges méthodologiques
10.1 La fallacie de la valeur p et la confusion avec la taille d’effet
L’une des dérives épistémologiques les plus pernicieuses et les plus répandues dans l’analyse de données expérimentales réside dans l’assimilation erronée d’une valeur p hautement significative à la présence d’un effet d’une amplitude majeure. Cette illusion analytique procède d’une méconnaissance de la sensibilité de la valeur p à la taille de l’échantillon (problème des grands N). En effet, lorsque la taille de l’échantillon (N) tend vers des valeurs massives, l’erreur type s’effondre vers zéro au dénominateur ; par conséquent, la statistique de test croît mécaniquement vers l’infini, générant des valeurs p infinitésimales (ex. p < 0,00001) pour des variations d’une futilité pratique absolue.
C’est pourquoi les directives méthodologiques contemporaines, portées notamment par l’American Statistical Association (ASA), imposent de dissocier formellement la significativité statistique de la magnitude empirique de l’effet. Pour restituer une vision fidèle des données, le calcul de la valeur p doit impérativement être complété par l’estimation d’une mesure standardisée de la taille d’effet, au premier rang desquelles figure le d de Cohen pour les comparaisons de moyennes. Le d de Cohen quantifie l’ampleur du déplacement relatif entre deux distributions en exprimant la divergence brute des moyennes en unités d’écart-type combiné : d = (M1 – M2) / Sp.
Ce calcul complémentaire s’implémente très facilement dans Google Sheets. Si les moyennes respectives des deux groupes figurent en D2 et D3, et que la racine carrée de la variance combinée (l’écart-type combiné Sp) est stockée en D9, la commande permettant de déterminer le d s’écrit tout simplement :
=(D2 - D3) / D9
Selon les conventions d’étalonnage établies par Jacob Cohen, une valeur d’environ 0,20 traduit un effet modeste, 0,50 un effet d’ampleur moyenne, et 0,80 ou plus un effet massif. Intégrer conjointement la valeur p et le d de Cohen au sein de sa feuille de calcul protège le chercheur contre les interprétations naïves induites par des échantillons sur- ou sous-dimensionnés.
10.2 Erreurs courantes de paramétrage dans Google Sheets
L’utilisation de Google Sheets pour l’analyse inférentielle comporte plusieurs pièges opérationnels fréquemment rencontrés dans la pratique de laboratoire. Le premier écueil réside dans la confusion entre les codes du paramètre type. Affecter l’argument 1 (test apparié) à deux séries provenant de groupes indépendants produit un calcul dénué de toute cohérence théorique, réduisant arbitrairement les degrés de liberté et faussant le résultat final. Inversement, appliquer l’argument 2 à des mesures longitudinales détruit l’avantage de la réduction de la variance intra-sujet, affaiblissant inutilement la détection de l’effet.
Le deuxième écueil concerne la mauvaise sélection du paramètre des queues. Attribuer la valeur 1 (test unilatéral) par inadvertance ou par opportunisme divise mathématiquement la valeur p bilatérale par deux. Si ce choix n’est pas étayé par une décision théorique formulée préalablement à toute consultation des données, il expose le chercheur à un risque sévère d’erreur de première espèce en faisant passer arbitrairement un résultat limite (ex. p = 0,07) sous la barre convenue des 5 %.
Le troisième piège concerne la sélection accidentelle des en-têtes de colonnes au sein des plages de calcul. Si l’on écrit =TEST.T(A1:A50; B1:B50; 2; 2) alors que la ligne 1 héberge des libellés textuels, la plupart des versions de Google Sheets ignoreront silencieusement ces cellules textuelles. Cependant, dans certaines configurations ou lors de l’usage de formules matricielles imbriquées, cette pratique peut générer des erreurs #VALEUR! inattendues ou tronquer le décompte réel des effectifs analysés. Enfin, la sélection automatique du Type 2 sans validation préalable de l’homogénéité des variances constitue une négligence méthodologique classique pouvant être évitée par le recours systématique au test de Welch (Type 3).
10.3 Le fléau du p-hacking et de la multiplicité des tests
La flexibilité et la réactivité d’un tableur comme Google Sheets, où chaque modification de formule recalcule instantanément les résultats, constituent une arme à double tranchant qui favorise insidieusement des dérives méthodologiques connues sous le vocable de p-hacking ou d’exploration opportuniste des données. Cette pratique consiste à manipuler les seuils d’exclusion, à tester tour à tour différents sous-groupes ou à basculer unilatéralement du Type 2 au Type 1 jusqu’à ce que la valeur p descende magiquement sous la barre convoitée de 0,05.
Le problème sous-jacent est celui de la multiplication des tests d’hypothèses sans contrôle du taux d’erreur par famille (family-wise error rate). Si un chercheur conduit indépendamment 20 tests d’hypothèses distincts au sein de sa feuille de calcul avec un seuil α individuel fixé à 0,05, la probabilité globale d’obtenir au moins un faux positif (rejet à tort d’au moins une hypothèse nulle pourtant vraie) s’élève à :
αglobal = 1 – (1 – 0,05)²&sup0; ≈ 0,64
Il y a donc près de 64 % de chances d’identifier une association purement artificielle au sein du jeu de données ! Pour contrecarrer cette inflation des erreurs, il est impératif d’intégrer des procédures d’ajustement formelles au sein de son classeur. La correction la plus classique, bien que conservatrice, est la méthode de Bonferroni. Elle consiste à diviser le seuil α nominal par le nombre total de comparaisons planifiées k : αajusté = α / k. Si 5 comparaisons de moyennes sont menées de front, la significativité statistique ne sera accordée qu’aux valeurs p inférieures à 0,05 / 5 = 0,01. L’enregistrement préalable des protocoles d’analyse (pre-registration) et la transparence sur le nombre total de comparaisons réalisées demeurent les meilleures garanties contre ces distorsions scientifiques.
11. Visualisation graphique des résultats et des intervalles de confiance
11.1 Calcul et intégration des intervalles de confiance à 95%
L’inférence par la valeur p gagne immensément en clarté et en profondeur lorsqu’elle est complétée par la construction d’intervalles de confiance (IC). Alors que la valeur p fournit une métrique ponctuelle binaire quant à l’exclusion de l’hypothèse nulle, l’intervalle de confiance délimite la plage des valeurs plausibles du paramètre au sein de la population avec un degré de certitude prédéfini (usuellement 95 %). Il existe une relation mathématique étroite entre ces deux approches : si l’intervalle de confiance à 95 % de la différence entre deux moyennes ne comprend pas la valeur zéro, cela équivaut strictement à affirmer que le test bilatéral correspondant atteint une valeur p < 0,05.
Pour dériver les bornes d’un intervalle de confiance à 95 % pour la moyenne d’un échantillon, Google Sheets intègre la fonction INTERVALLE.CONFIANCE.STUDENT. Sa syntaxe requiert le seuil alpha (0,05 pour un intervalle à 95 %), l’écart-type d’échantillon et l’effectif :
=INTERVALLE.CONFIANCE.STUDENT(0,05; ECARTYPE.STANDARD(A2:A31); NB(A2:A31))
Cette commande retourne la marge d’erreur m. Les bornes inférieure et supérieure de l’intervalle de confiance se calculent alors par simple soustraction et addition autour de la moyenne de l’échantillon :
- Borne inférieure :
=MOYENNE(A2:A31) - INTERVALLE.CONFIANCE.STUDENT(...) - Borne supérieure :
=MOYENNE(A2:A31) + INTERVALLE.CONFIANCE.STUDENT(...)
La présentation conjointe de ces bornes offre une vision beaucoup plus riche que la seule valeur p, en renseignant immédiatement le lecteur sur le degré de précision de l’estimation expérimentale : un intervalle très large trahit un manque d’effectif ou une dispersion considérable, incitant à la prudence même en présence d’une valeur p inférieure à 0,05.
11.2 Création d’histogrammes et de diagrammes avec barres d’erreur
La transmission des données quantitatives culmine dans la mise en scène graphique des résultats expérimentaux. Google Sheets intègre un éditeur de graphiques performant permettant de convertir les tableaux de calculs inférentiels en figures synthétiques conformes aux attentes académiques. La représentation canonique d’une comparaison de moyennes repose sur le diagramme à colonnes ou le diagramme à points enrichi de barres d’erreur représentant les intervalles de confiance ou les erreurs types.
Pour implémenter cette visualisation dans Google Sheets :
- Organisez un mini-tableau récapitulatif contenant sur la première ligne le libellé des groupes (ex. Contrôle et Expérimental), sur la deuxième ligne leurs moyennes respectives, et sur la troisième ligne les marges d’erreur correspondantes issues de vos formules.
- Sélectionnez les données descriptives et accédez à Insertion > Graphique.
- Dans l’éditeur de graphiques latéral, choisissez la typologie Graphique à colonnes.
- Sous l’onglet Personnaliser, accédez à la sous-section Série. Cochez la case Barres d’erreur.
- Basculez le sélecteur de barres d’erreur sur la modalité Constante (en saisissant la valeur absolue calculée) ou liez-la dynamiquement aux cellules hébergeant les marges d’erreur calculées.
L’incorporation de barres d’erreur visuelles calibrées sur les intervalles de confiance à 95 % permet au lecteur d’appréhender instantanément la significativité du différentiel : l’absence visuelle de chevauchement entre les barres d’erreur des deux groupes signale le plus souvent une divergence hautement significative sur le plan statistique. Les graphiques ainsi générés peuvent être exportés au format vectoriel (PDF ou SVG) pour conserver une netteté irréprochable lors de leur intégration dans des rapports ou des manuscrits scientifiques.
12. Normes de présentation académique (APA 7e édition) et reproductibilité
12.1 Règles formelles de restitution de la valeur p selon l’APA
La valorisation des analyses menées dans Google Sheets au sein d’un article scientifique implique la mise en conformité stricte des sorties numériques avec les règles éditoriales internationales. L’American Psychological Association, dans sa septième édition (APA 7), établit un ensemble de normes typographiques et méthodologiques très rigoureuses régissant la communication des résultats inférentiels.
Sur le plan typographique formel :
- La lettre p doit être systématiquement composée en italique, qu’elle figure dans le corps du texte narratif, dans un tableau synthétique ou sur une légende de figure.
- Le zéro initial précédant la virgule (ou le point décimal anglophone) doit être impérativement omis pour la valeur p, car une probabilité ne peut par définition mathématique jamais dépasser la valeur 1. On écrira rigoureusement p = ,024 (ou p = .024 en anglais), et non p = 0,024.
- La précision standardisée impose une déclaration exacte arrondie à deux ou trois décimales. L’usage de mentions floues telles que « p = NS » (non significatif) est proscrit ; l’analyste doit indiquer la valeur décimale précise (ex. p = ,082).
- Pour les valeurs infinitésimales générées par le tableur (par exemple lorsque Google Sheets affiche
3,42E-07), il est formellement interdit d’écrire p = ,000. La notation standardisée impose dans ce cas d’indiquer le dépassement du seuil minimal : p < ,001.
L’intégration textuelle de la valeur p ne doit jamais s’effectuer de manière isolée. Elle doit s’inscrire au sein d’une phrase explicitant la direction empirique de l’effet et s’accompagner de la statistique de test associée, de ses degrés de liberté précis et de la mesure de la taille d’effet :
« Les participants soumis au programme d’entraînement ont obtenu des scores de performance significativement supérieurs (M = 78,4, ÉT = 8,2) comparativement aux sujets du groupe témoin (M = 65,1, ÉT = 9,4), t(58) = 5,84, p < ,001, d = 1,51. »
12.2 Assurer la pérennité et la reproductibilité de la feuille de calcul
La science contemporaine traverse une crise majeure de reproductibilité qui impose à tous les chercheurs une transparence absolue dans la gestion de leurs protocoles de calcul. Une feuille de calcul Google Sheets destinée à soutenir des publications scientifiques doit être pensée comme un instrument pérenne, auditable et résistant aux manipulations accidentelles.
La première mesure préventive consiste à verrouiller formellement les cellules hébergeant les formules analytiques maîtresses. Grâce à la commande Données > Protéger les feuilles et les plages, le propriétaire du fichier peut autoriser ses collaborateurs à saisir de nouvelles données brutes tout en leur interdisant toute modification des cellules de calculs statistiques. Cela prévient les destructions involontaires d’arguments ou les décalages de plages lors des sessions de saisie partagée.
La seconde exigence repose sur une documentation exhaustive au sein même du classeur. Chaque étape analytique intermédiaire, chaque exclusion d’observation aberrante et chaque choix de paramètre (justification du Type 1, 2 ou 3) doit être consigné au moyen de notes ou de commentaires de cellules explicites (raccourci Shift + F2). Dans une optique de science ouverte (Open Science), la feuille de données anonymisée peut être déposée sur des plateformes publiques d’archivage pérenne telles que l’Open Science Framework (OSF) ou Zenodo avec un identifiant numérique d’objet (DOI), autorisant un audit par la communauté scientifique mondiale.
Enfin, des audits réguliers de la chaîne computationnelle doivent être menés pour écarter tout risque de références circulaires ou de rupture d’alignement vectoriel. En articulant une compréhension théorique solide des fondements de l’inférence statistique et une maîtrise technique des outils de calcul de Google Sheets, tout chercheur ou analyste de données est à même de mener des explorations empiriques robustes, transparentes et pleinement conformes aux standards d’excellence académique les plus exigeants.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510