
L’inférence statistique constitue le socle épistémologique sur lequel repose l’ensemble de la recherche expérimentale et translationnelle en sciences humaines, particulièrement en psychologie quantitative, en neuropsychologie et en psychométrie. La transition opérée entre l’observation brute de comportements mesurés et la généralisation théorique d’un effet observé exige une formalisation mathématique rigoureuse de l’incertitude. Dans cet édifice probabiliste, le score standardisé, communément désigné sous le terme de score Z, et la valeur de probabilité associée, la valeur p (ou p-value), jouent le rôle de médiateurs analytiques indispensables. Ils permettent de quantifier avec exactitude dans quelle mesure un pattern empirique s’écarte des fluctuations purement stochastiques prévues sous une hypothèse d’absence d’effet.
Si des environnements de programmation statistique sophistiqués tels que le langage R, Python ou des logiciels propriétaires spécialisés comme SPSS occupent une place prépondérante dans les laboratoires universitaires, Microsoft Excel demeure un outil computationnel universellement répandu, tant dans les structures académiques que dans les milieux cliniques et organisationnels. Loin d’être un simple tableur administratif, Excel intègre des algorithmes d’approximation numérique de haute précision capables d’exécuter des calculs de distribution continue complexes. Toutefois, l’extraction correcte d’une valeur p à partir d’un score Z requiert une maîtrise approfondie de son architecture fonctionnelle interne, des paramètres de ses fonctions de distribution cumulative, ainsi que des spécificités directionnelles du test d’hypothèse déployé.
Le présent guide a pour vocation de fournir un cadre théorique exhaustif, méthodologique et technique guidant le chercheur, le clinicien et l’analyste de données à travers l’ensemble des étapes nécessaires pour dériver, automatiser et interpréter des valeurs p issues de scores Z dans Microsoft Excel. En explorant les fondements de la théorie de la décision de Neyman-Pearson, les subtilités algorithmiques de la loi normale centrée réduite, les impératifs des tests unilatéraux et bilatéraux, ainsi que les protocoles de reporting aux normes de l’American Psychological Association (APA 7e édition), ce traité se propose d’unifier la rigueur mathématique et l’application pratique au sein d’une interface logicielle du quotidien.
1. Cadre théorique de l’inférence statistique et rôle du score Z en psychologie quantitative
1.1 Fondements de l’évaluation d’hypothèses statistiques en psychométrie
L’évaluation rigoureuse des construits psychologiques repose sur le paradigme du test d’hypothèse nulle formalisé conjointement par Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans le domaine de la psychométrie et de l’étude des processus comportementaux, le chercheur formule initialement deux propositions mutuellement exclusives. L’hypothèse nulle, désignée conventionnellement par H0, postule l’absence de différence, de traitement effectif ou de corrélation au sein de la population parente ; elle postule que toute variation observée dans l’échantillon résulte exclusivement de l’erreur d’échantillonnage aléatoire. À l’opposé, l’hypothèse alternative, notée H1, soutient l’existence d’une divergence systématique traduisant un phénomène psychologique, cognitif ou comportemental tangible et reproductible.
La validité de cette démarche décisionnelle s’appuie sur la notion de distribution d’échantillonnage, articulée autour du théorème central limite. Selon ce théorème fondamental des probabilités, lorsque la taille de l’échantillon (n) augmente et dépasse un seuil conventionnel fixé à 30 observations indépendantes, la distribution des moyennes d’échantillonnage converge de manière asymptotique vers une distribution normale de Gauss, et ce, quelle que soit la forme de la distribution sous-jacente des scores bruts dans la population d’origine. Cette propriété mathématique permet aux psychomètres de modéliser avec précision le comportement théorique de statistiques d’échantillon et de quantifier le degré de conformité d’une observation empirique par rapport à une distribution théorique modélisée sous H0.
Pour arbitrer entre le rejet ou le non-rejet de l’hypothèse nulle, le statisticien définit a priori un seuil de significativité critique, noté alpha (α). Ce seuil représente le risque maximal toléré de commettre une erreur de type I, c’est-à-dire la probabilité de rejeter à tort H0 alors que celle-ci est fondamentalement vraie dans la réalité ontologique de la population. En sciences du comportement, les valeurs conventionnelles attribuées à alpha sont traditionnellement fixées à 0,05, 0,01 ou 0,001, selon le degré d’exigence méthodologique et les implications cliniques du test. Il est impératif de souligner la différenciation conceptuelle fondamentale entre la signification statistique, véhiculée par la valeur p, et l’importance pratique ou théorique de l’effet, quantifiée par des indices de taille d’effet tels que le d de Cohen ou le coefficient de détermination r2. Une valeur p infinitésimale témoigne de la faible plausibilité du modèle nul, mais ne garantit en aucun cas une portée clinique substantielle si l’effet mesuré s’avère trivial en amplitude.
1.2 Nature mathématique et utilité psychologique du score Z
Le score Z, ou score standardisé, constitue une transformation linéaire d’une variable aléatoire continue permettant de transposer un score brut dans une métrique standard universelle, exprimée en unités d’écart-type. Sur le plan formel, la métrique Z se calcule par l’équation canonique suivante : Z = (X – μ) / σ, où X représente la valeur empirique observée, μ correspond à la moyenne de la distribution de référence et σ désigne l’écart-type de cette même population. Lorsque l’inférence porte non pas sur un score individuel isolé mais sur la moyenne d’un groupe d’individus, la formule est ajustée pour incorporer l’erreur-type de la moyenne (σM = σ / √n), devenant alors : Z = (M – μ) / (σ / √n), où M est la moyenne empirique observée au sein de l’échantillon.
Cette transformation mathématique confère à la nouvelle distribution des propriétés structurales remarquables. Quelle que soit l’échelle métrique originale des instruments de mesure psychométriques (échelles d’intelligence de Wechsler, inventaires d’anxiété de Beck, temps de réponse en millisecondes), la distribution normale standardisée résultante, notée conventionnellement N(0, 1), présente impérativement une moyenne théorique égale à zéro (μ = 0) et une variance, ainsi qu’un écart-type, unitaires (σ2 = 1, σ = 1). La symétrie parfaite de cette cloche gaussienne autour de l’axe central implique que la médiane et le mode coïncident strictement avec la moyenne arithmétique.
Dans la pratique psychologique clinique et neuropsychologique, les scores Z fournissent une grille d’interprétation diagnostique immédiate. Un score Z s’écartant substantiellement de zéro reflète une position atypique au sein de la population de référence. Par convention sémiologique, une valeur Z excédant +2,00 ou inférieure à -2,00 signale une déviation présente chez moins de 2,28 % des individus situés dans la queue correspondante, orientant vers la suspicion d’une atypicité cognitive, d’un déficit fonctionnel ou, au contraire, d’un haut potentiel intellectuel. Le passage de cette métrique standardisée à une évaluation probabiliste formalise ce constat clinique : il ne s’agit plus seulement de repérer un écart spatial sur l’axe des abscisses, mais d’assigner une probabilité rigoureuse à l’occurrence d’un échantillon présentant une telle configuration sous l’action pure du hasard.
1.3 La valeur p comme mesure de plausibilité sous le modèle nul
La valeur p se définit mathématiquement comme la probabilité conditionnelle, calculée sous l’hypothèse stricte que H0 est vraie, d’obtenir une statistique de test (dans notre cas, un score Z) au moins aussi extrême, voire plus extrême, que la statistique empiriquement observée dans le jeu de données recueilli. Formellement, dans le cas d’un test unilatéral à droite, cette probabilité s’exprime par P(Z ≥ zobs | H0). La valeur p quantifie donc la compatibilité relative des données expérimentales avec la prédiction dérivée du modèle théorique nul. Plus la valeur p s’approche de zéro, plus l’observateur est confronté à un dilemme cognitif où l’occurrence conjointe de H0 et de données aussi déviantes apparaît invraisemblable.
Une incompréhension fréquente observée dans la littérature scientifique réside dans la confusion fallacieuse des probabilités conditionnelles inverses. La valeur p quantifie la probabilité des données sachant l’hypothèse nulle, notée P(Données | H0), et ne doit en aucun cas être interprétée comme la probabilité a posteriori que l’hypothèse nulle soit vraie au regard des données collectées, c’est-à-dire P(H0 | Données). Cette dernière inversion relève exclusivement de l’épistémologie de l’inférence bayésienne, laquelle nécessite la spécification préalable de distributions de probabilités a priori. De surcroît, la valeur p ne mesure en rien la probabilité que l’hypothèse alternative soit exacte, pas plus qu’elle n’indique la probabilité de réplication exacte de l’expérience à l’identique.
Cette rigueur définitoire impose une précision sans faille lors de l’implémentation numérique des calculs statistiques. Dans les environnements computationnels tels que les tableurs de bureau, l’obtention d’une valeur p à partir d’un score standardisé ne relève pas d’une simple lecture approximative dans des tables papier obsolètes annexées aux manuels de psychométrie. Elle nécessite l’intégration d’équations différentielles continues et le recours à des algorithmes numériques d’intégration convergente de l’intégrale de Gauss, sans quoi des approximations numériques fautives risquent de biaiser le seuil de décision et d’induire en erreur le processus d’inférence scientifique.
2. Architecture fonctionnelle d’Excel pour les distributions normales
2.1 Anatomie de la fonction LOI.NORMALE.N (NORM.DIST)
Au sein de Microsoft Excel, l’évaluation des propriétés d’une variable aléatoire continue distribuée selon une loi gaussienne s’articule historiquement autour de fonctions intégrées puissantes. La première fonction d’importance majeure est LOI.NORMALE.N, dont l’équivalent dans les versions anglophones du logiciel est NORM.DIST. Cette fonction généraliste est configurée pour traiter n’importe quelle distribution normale définie par sa propre moyenne (μ) et son propre écart-type (σ), sans exiger nécessairement une standardisation préalable manuelle par l’opérateur.
La syntaxe de cette fonction obéit à une séquence stricte de quatre arguments obligatoires :
- x : représente la valeur numérique brute observée ou le score Z pour lequel la fonction doit être évaluée.
- moyenne : désigne l’espérance mathématique de la distribution de référence. Dans le cadre spécifique de la loi normale standardisée où l’on injecte un score Z, ce paramètre doit impérativement être fixé à 0.
- écart_type : quantifie la dispersion des données autour de la moyenne. Pour l’analyse d’un score Z standardisé, cet argument doit obligatoirement recevoir la valeur 1.
- cumulatif : constitue un paramètre logique (booléen) déterminant la nature mathématique du résultat renvoyé par l’algorithme.
Le comportement de l’argument booléen cumulatif s’avère déterminant. Lorsque l’argument reçoit la valeur logique VRAI (ou le chiffre 1), Excel procède au calcul de la fonction de répartition cumulative (Cumulative Distribution Function ou CDF). Cela correspond à l’intégrale définie de la fonction de densité depuis l’infini négatif jusqu’à la borne d’évaluation x, renvoyant ainsi l’aire sous la courbe située à gauche du score considéré, ce qui est indispensable pour extraire une valeur p. En revanche, si l’argument est configuré sur FAUX (ou le chiffre 0), Excel évalue la fonction de densité de probabilité (Probability Density Function ou PDF), calculant la hauteur de la courbe de Gauss à l’abscisse x via l’équation :
f(x) = (1 / (σ √(2π))) × exp(-0,5 × ((x – μ) / σ)2)
L’utilisation de la valeur FAUX ne fournit pas une probabilité cumulée et ne peut donc jamais être employée directement pour estimer une valeur p, source d’erreurs fréquentes chez les praticiens non initiés.
2.2 Utilisation optimisée de la fonction LOI.NORMALE.STANDARD.N (NORM.S.DIST)
Bien que la fonction générique LOI.NORMALE.N permette d’arriver au résultat attendu en paramétrant manuellement la moyenne à 0 et l’écart-type à 1, Microsoft Excel met à disposition des chercheurs une fonction dédiée spécifiquement et exclusivement à la distribution normale centrée réduite : la fonction LOI.NORMALE.STANDARD.N (dont l’équivalent textuel dans les distributions anglophones est NORM.S.DIST). Cette fonction supprime tout risque d’erreur d’affectation des paramètres de centrage et de réduction en figeant nativement μ = 0 et σ = 1 dans son architecture computationnelle.
La structure syntaxique de cette fonction dédiée s’en trouve allégée et sécurisée :
- z : la valeur numérique scalaire du score Z dont on désire déterminer la probabilité associée.
- cumulatif : le commutateur booléen exigeant la valeur VRAI pour renvoyer la probabilité cumulative P(Z ≤ z).
Sur le plan de l’efficience algorithmique, le recours à LOI.NORMALE.STANDARD.N est vivement recommandé lors de l’analyse de jeux de données massifs (dépouillement de cohortes de plusieurs dizaines de milliers de lignes psychométriques). En court-circuitant le traitement des arguments de moyenne et de dispersion, le moteur de calcul d’Excel optimise les cycles processeur et minimise les temps de recalcul des classeurs de grande dimension. Pour les équipes de recherche collaborant à l’international, il convient de souligner que les classeurs rédigés avec les syntaxes francophones sont automatiquement traduits lors de leur ouverture sur des versions régionales différentes d’Excel : la formule =LOI.NORMALE.STANDARD.N(A1; VRAI) sera instantanément convertie en =NORM.S.DIST(A1, TRUE) sans déperdition d’information ni rupture syntaxique.
2.3 Prise en compte des versions historiques d’Excel
L’historique du développement logiciel de la suite Microsoft Office a généré des modifications substantielles dans la nomenclature et la précision arithmétique des fonctions de distribution statistique. Dans les versions antérieures à la mouture majeure d’Excel 2010, les analystes exploitaient les fonctions historiques LOI.NORMALE et LOI.NORMALE.STANDARD (sans le suffixe final « .N », correspondant en anglais à NORMDIST et NORMSDIST). Bien que ces anciennes fonctions soient maintenues par Microsoft à des fins strictes de compatibilité descendante au sein de la catégorie des fonctions de compatibilité, leur utilisation dans de nouvelles feuilles de travail de recherche doit être formellement proscrite.
Le motif de cette obsolescence programmée réside dans une refonte profonde des bibliothèques de calcul numérique sous-jacentes. Avant Excel 2010, les algorithmes implémentés pour approximer l’intégrale de la loi normale présentaient des limitations notables dans la gestion des queues extrêmes de distribution (typiquement pour des valeurs absolues de Z supérieures à 5). Les méthodes d’approximation polynomiale antérieures induisaient des artefacts de troncature prématurée et une dégradation mesurable du nombre de décimales exactes. Depuis la version 2010 et sur l’ensemble des itérations modernes (Excel 2016, 2019, 2021 et Microsoft 365), les fonctions suffixées en « .N » intègrent des approximations rationnelles de Tchebychev et des routines de calcul en précision double conformes au standard IEEE 754, garantissant une exactitude numérique allant jusqu’au quinzième chiffre significatif.
3. Calcul de la valeur p pour un test unilatéral à gauche (Left-Tailed Test)
3.1 Justification théorique et formulation de l’hypothèse directionnelle négative
Le choix d’un test directionnel unilatéral orienté vers la queue inférieure de la distribution, couramment désigné sous le terme anglo-saxon de left-tailed test, se justifie sur le plan épistémologique lorsque l’hypothèse de recherche opérationnelle postule sans équivoque une diminution, un ralentissement ou une réduction de la variable mesurée. En psychologie cognitive, en psychopharmacologie ou en psychopathologie clinique, cette configuration prévaut fréquemment : l’évaluation de l’efficacité d’une thérapie cognitivo-comportementale sur la réduction de l’intensité d’un affect dépressif, la mesure du raccourcissement des temps de latence motrice suite à l’administration d’un psychostimulant, ou encore l’atténuation du nombre d’erreurs d’inattention dans une tâche de vigilance continue constituent autant d’illustrations caractéristiques.
Dans ce cadre décisionnel, les hypothèses statistiques se formalisent rigoureusement selon les termes :
- H0 : μ ≥ μ0 (le traitement ne produit aucune réduction, ou engendre paradoxalement une augmentation de la moyenne observée par rapport à la norme de référence).
- H1 : μ < μ0 (le traitement provoque une diminution statistiquement significative de la moyenne).
La région critique de rejet de l’hypothèse nulle est alors confinée de manière exclusive dans la queue gauche de la distribution d’échantillonnage théorique. La valeur p associée correspond exactement à la probabilité cumulative d’obtenir un score Z aléatoire inférieur ou égal au score Z empiriquement calculé sur la cohorte expérimentale. Sur le plan formel, la valeur de probabilité recherchée se résume à l’expression mathématique : p = P(Z ≤ zobs).
3.2 Implémentation technique directe dans Excel
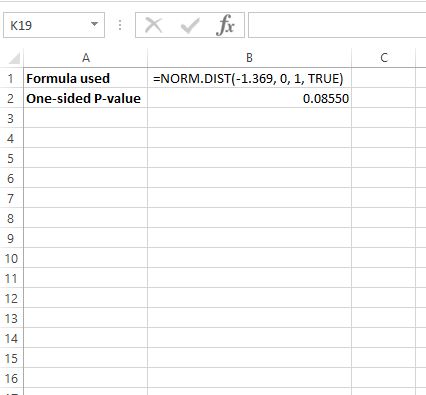
La structure algorithmique native des fonctions de répartition d’Excel évalue par définition l’intégrale cumulée allant de l’asymptote négative (-∞) jusqu’à l’abscisse spécifiée par l’utilisateur. En conséquence, le calcul de la valeur p pour un test unilatéral à gauche représente le scénario technique le plus direct et le plus intuitif dans le tableur, car la valeur renvoyée par le logiciel correspond immédiatement et sans modification algébrique à la probabilité recherchée.
Deux voies de formulation sont envisageables dans la feuille de calcul, la seconde devant être systématiquement privilégiée pour sa concision :
- En recourant à la fonction universelle :
=LOI.NORMALE.N(A1; 0; 1; VRAI) - En appliquant la fonction standardisée dédiée :
=LOI.NORMALE.STANDARD.N(A1; VRAI)
Dans ces formules, la cellule A1 héberge la valeur numérique du score Z empirique obtenu. Si la cellule A1 contient une valeur négative cohérente avec l’orientation de l’hypothèse (par exemple Z = -1,96), la formule renverra avec une extrême rapidité la valeur exacte de 0,024997895… Il est essentiel d’ajuster le format d’affichage de la cellule cible via l’onglet d’accueil d’Excel afin de ne pas tronquer l’affichage à deux décimales, ce qui afficherait un arrondi trompeur de « 0,02 », mais d’assurer un affichage scientifique comprenant au minimum quatre à six chiffres décimaux pour préserver la précision documentaire de l’analyse.
3.3 Exemple appliqué : Diminution du temps de réaction psychomoteur
Considérons une étude expérimentale menée par une équipe de neuropsychologues évaluant l’impact d’un entraînement de biofeedback assisté par ordinateur sur le temps de réaction psychomoteur (TRP) auprès de patients cérébrolésés. La norme de la population de référence établie lors d’une tâche de pointage visuel informatisée présente un temps de réaction moyen de 450 millisecondes (μ = 450) avec un écart-type connu de 40 millisecondes (σ = 40). L’équipe soumet une cohorte de 64 patients (n = 64) au protocole d’entraînement intensif durant six semaines consécutives. À l’issue de l’intervention, la moyenne d’échantillon enregistrée s’établit à 438 millisecondes (M = 438).
L’hypothèse clinique étant strictement orientée vers une accélération de la vitesse de traitement (et donc une réduction numérique du temps de réaction mesuré en millisecondes), le protocole impose un test unilatéral à gauche. Le calcul préliminaire de l’erreur-type de la distribution d’échantillonnage s’opère selon l’équation :
σM = σ / √n = 40 / √64 = 40 / 8 = 5 millisecondes.
Le score standardisé de l’échantillon se détermine ensuite au moyen du ratio :
Zobs = (M – μ) / σM = (438 – 450) / 5 = -12 / 5 = -2,40.
Dans le classeur Excel, l’analyste inscrit cette valeur dans la cellule B2 (-2,40) puis rédige la formule suivante dans la cellule adjacente C2 :
=LOI.NORMALE.STANDARD.N(B2; VRAI)
Le tableur calcule et affiche instantanément la valeur p exacte associée : 0,0081975. En confrontant ce résultat empirique au seuil de significativité conventionnel fixé a priori à α = 0,05 (ou même à un seuil plus conservateur de α = 0,01), le constat est univoque : dans la mesure où p = 0,0082 < 0,01, les chercheurs rejettent formellement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. La probabilité d’observer un tel raccourcissement du temps de réaction sous l’hypothèse d’une absence totale d’effet de l’entraînement n’étant que d’environ 0,82 %, l’inférence conclut à l’efficacité statistiquement significative de l’intervention de remédiation cognitive.
4. Calcul de la valeur p pour un test unilatéral à droite (Right-Tailed Test)
4.1 Justification théorique et orientation positive de l’effet
À l’opposé de la configuration précédente, un test unilatéral orienté vers la queue supérieure de la distribution normale (right-tailed test) est mobilisé lorsque le postulat scientifique prédit de manière univoque une progression, une élévation ou un accroissement quantitatif de la métrique observée. En psychologie du développement, en sciences de l’éducation ou en psychologie organisationnelle, de nombreuses situations expérimentales répondent à cette structure épistémique : l’évaluation des gains d’apprentissage suite à l’instauration d’un nouveau modèle pédagogique, le développement des capacités d’adaptation psychosociale consécutif à un coaching en résilience, ou encore l’élévation des scores de mémoire de travail induite par des exercices ciblés d’attention exécutive.
La formulation canonique des hypothèses statistiques prend la forme suivante :
- H0 : μ ≤ μ0 (le traitement n’induit aucun gain, ou génère une détérioration de la performance globale).
- H1 : μ > μ0 (le traitement engendre une hausse statistiquement significative de la performance).
Dans ce contexte précis, la région critique d’élimination du modèle nul se situe intégralement dans l’extrémité droite de la fonction de densité gaussienne. La valeur p équivaut à la probabilité d’obtenir une statistique standardisée au moins aussi élevée que le score Z empirique obtenu, soit formellement : p = P(Z ≥ zobs). Or, les lois continues étant normalisées à une intégrale totale d’aire égale à 1 sur l’ensemble de leur support réel, cette probabilité supérieure s’exprime par le principe mathématique fondamental du complément à l’unité : P(Z ≥ zobs) = 1 – P(Z ≤ zobs).
4.2 Transcription algorithmique dans la feuille de calcul
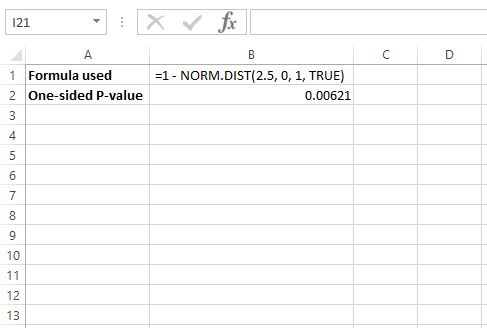
Puisque la fonction intégrée LOI.NORMALE.STANDARD.N cumule exclusivement les probabilités depuis l’asymptote négative (-∞) jusqu’au score spécifié, injecter un score Z positif directement dans la fonction sans modification renvoie l’aire de gauche, c’est-à-dire P(Z ≤ zobs). Pour extraire l’aire résiduelle de la queue supérieure représentant la valeur p unilatérale droite, il est nécessaire de soustraire ce résultat intermédiaire au nombre 1.
La formulation algorithmique maîtresse s’établit par conséquent comme suit :
=1 - LOI.NORMALE.STANDARD.N(A1; VRAI)
Une approche alternative, particulièrement élégante sur le plan conceptuel, exploite la propriété de symétrie absolue de la distribution normale autour de zéro. L’aire sous la courbe située à droite d’un score positif z est rigoureusement identique à l’aire sous la courbe située à gauche de son opposé négatif –z. Dès lors, la syntaxe suivante produit un résultat strictement indiscernable au niveau des calculs en virgule flottante :
=LOI.NORMALE.STANDARD.N(-A1; VRAI)
L’omission accidentelle du complément à l’unité (l’oubli du préfixe « 1 – ») représente l’une des bévues analytiques les plus dévastatrices dans l’usage d’Excel. Un chercheur évaluant un score très significatif de Z = +2,50 qui omettrait cette soustraction obtiendrait une valeur de probabilité erronée de 0,9938. S’il interprétait ce chiffre comme une valeur p, il conclurait faussement à une absence totale de significativité, commettant ainsi une erreur méthodologique majeure d’interprétation causée par une inadvertance syntaxique.
4.3 Exemple appliqué : Augmentation de la capacité de mémoire de travail
Une étude en psychologie ergonomique évalue l’impact d’une application d’entraînement de la mémoire de travail sur de jeunes adultes préparant des concours d’entrée hautement sélectifs. L’empan mnésique visuo-spatial complexe mesuré via une batterie informatisée standardisée possède dans la population générale une moyenne établie à 100 points (μ = 100) pour un écart-type de 15 points (σ = 15). Un groupe expérimental de 49 étudiants (n = 49) suit une routine d’entraînement quotidien basée sur des tâches de n-back adaptatives pendant 30 jours. À l’évaluation post-test, la cohorte obtient un score moyen de 104,2 points (M = 104,2).
L’hypothèse expérimentale prédisant une extension de la capacité de rétention d’informations, l’investigateur spécifie un test unilatéral supérieur. La première étape consiste à déterminer l’erreur-type de la moyenne :
σM = σ / √n = 15 / √49 = 15 / 7 ≈ 2,142857 points.
Le score standardisé de l’échantillon se calcule ensuite :
Zobs = (M – μ) / σM = (104,2 – 100) / 2,142857 = 4,2 / 2,142857 = 1,96.
Au sein du tableur Excel, la valeur 1,96 étant positionnée dans la cellule D4, l’utilisateur insère la formule standard de complémentation dans la cellule E4 :
=1 - LOI.NORMALE.STANDARD.N(D4; VRAI)
Le résultat généré avec exactitude par le tableur s’élève à 0,0249979 (soit approximativement 0,025). L’investigateur peut parallèlement vérifier ce calcul dans la cellule adjacente F4 via la méthode alternative par symétrie : =LOI.NORMALE.STANDARD.N(-D4; VRAI), qui restitue instantanément la même valeur numérique. Face à un seuil critique alpha prédéterminé de 0,05, la condition p < α est vérifiée (0,025 ≤ 0,05). L’hypothèse nulle H0 est par conséquent rejetée, confirmant l’existence d’une augmentation statistiquement significative des capacités de mémoire de travail suite au protocole expérimental.
5. Calcul de la valeur p pour un test bilatéral (Two-Tailed Test)
5.1 Cadre conceptuel de la non-directionnalité des hypothèses
Le test bilatéral, ou test à deux queues (two-tailed test), incarne l’approche la plus prudente et la plus conservatrice en matière d’inférence statistique. Il s’impose sur le plan déontologique dès lors que le cadre théorique ne permet pas de prédire formellement et univoquement la direction du changement provoqué par une variable indépendante, ou lorsque l’effet étudié est susceptible de se manifester sous la forme d’une fluctuation bidirectionnelle (bénéfique ou délétère). Dans de nombreuses recherches exploratoires en psychologie environnementale, en pharmacologie ou en dynamique de groupe, une intervention peut indifféremment optimiser le fonctionnement psychologique ou induire une surcharge cognitive délétère selon des processus d’interaction non anticipés.
Le système formel d’hypothèses s’écrit alors :
- H0 : μ = μ0 (la moyenne de la population expérimentale est rigoureusement identique à la moyenne théorique ou normative).
- H1 : μ ≠ μ0 (la moyenne observée diffère significativement de la norme, sans présomption préalable de positivité ou de négativité).
Sur le plan distributionnel, le risque d’erreur de première espèce alpha (α) n’est plus concentré sur une unique queue mais se trouve équitablement partitionné de part et d’autre des extrémités de la loi normale centrée réduite. Chaque queue héberge ainsi une surface critique de rejet équivalente à α / 2. Par conséquent, pour un seuil conventionnel global fixé à 0,05, une portion d’aire de 0,025 est allouée à la queue gauche (en deçà de Z = -1,96) et une portion identique de 0,025 est attribuée à la queue droite (au-delà de Z = +1,96). La valeur p bilatérale doit donc quantifier l’aire globale combinée des deux zones extrêmes plus déviantes que la valeur absolue du score standardisé observé : p = 2 × P(Z ≥ |zobs|).
5.2 Construction de formules robustes et indépendantes du signe de Z
L’écueil récurrent rencontré lors du calcul bilatéral dans Excel réside dans la variabilité du signe mathématique associé au score standardisé expérimental. Si le chercheur tente d’appliquer manuellement un calcul naïf fondé sur la soustraction ou sur une multiplication sans neutraliser la polarité du score Z, la feuille de calcul produira des résultats aberrants (valeurs de probabilité supérieures à 1 ou déductions inverses). La construction de formules analytiques robustes requiert l’incorporation de fonctions mathématiques d’encapsulation assurant une gestion dynamique et automatique du signe.
La première formulation canonique met en œuvre la fonction de valeur absolue ABS d’Excel, combinée avec le calcul de l’aire de la queue supérieure :
=2 * (1 - LOI.NORMALE.STANDARD.N(ABS(A1); VRAI))
Dans cette expression, quelle que soit la valeur initiale contenue dans la cellule A1 (positive ou négative), la fonction ABS(A1) convertit systématiquement le score en son module strictement positif. La fonction de distribution cumulative calcule la probabilité associée à ce score positif, son complément à l’unité en extrait la probabilité de queue droite, et la multiplication par deux agrège symétriquement les deux extrémités.
Une seconde approche algorithmique, tout aussi robuste mais computationnellement plus économe en instructions, exploite à nouveau la symétrie de Gauss en forçant la valeur absolue du score dans la queue inférieure gauche au moyen de l’opérateur de négation :
=2 * LOI.NORMALE.STANDARD.N(-ABS(A1); VRAI)
Dans ce modèle d’écriture, l’expression -ABS(A1) projette inconditionnellement l’argument vers l’asymptote négative. La fonction intégrée calcule immédiatement l’aire unilatérale gauche correspondante, qu’il suffit de multiplier par deux pour obtenir la valeur p bilatérale finale. Cette formule évite la double opération de soustraction et prévient toute instabilité numérique. Il convient de souligner que ces formules dynamiques rendent obsolète l’emploi de structures conditionnelles complexes de type =SI(A1>0; ...), simplifiant la maintenance et l’audit du classeur.
5.3 Exemple pratique : Évaluation de l’impact d’une modification environnementale sur l’attention
Une structure de recherche en psychologie du travail étudie l’influence du passage d’un aménagement de bureaux cloisonnés vers un modèle en open-space avec ambiance sonore continue sur les capacités attentionnelles d’opérateurs de saisie. Le niveau de performance attentionnelle soutenu est mesuré par un indice de précision standardisé dont la moyenne populationnelle historique est calibrée à 500 points (μ = 500) avec un écart-type de 50 points (σ = 50). L’hypothèse générale des chercheurs ne postule aucune orientation a priori : l’ambiance sonore stimulante pourrait potentiellement favoriser l’éveil cortical et accroître la vigilance, tout comme les interruptions conversationnelles imprévisibles pourraient saturer le contrôle exécutif et détériorer la performance.
À l’issue de six mois de collecte auprès de 100 collaborateurs volontaires (n = 100), la moyenne de performance attentionnelle enregistrée s’établit à 488 points (M = 488). L’absence de directionnalité impose un test bilatéral strict. Le calcul de la variabilité d’échantillonnage se déroule ainsi :
σM = σ / √n = 50 / √100 = 50 / 10 = 5 points.
Le score Z dérivé de cette observation empirique s’écrit :
Zobs = (M – μ) / σM = (488 – 500) / 5 = -12 / 5 = -2,40.
Le score standardisé obtenu étant négatif (-2,40), son traitement manuel unilatéral conduirait à sous-estimer le risque d’erreur. En intégrant cette valeur dans la cellule B5, l’analyste applique dans la cellule C5 la formule symétrique automatisée :
=2 * LOI.NORMALE.STANDARD.N(-ABS(B5); VRAI)
Le logiciel procède à l’évaluation : il identifie |-2,40| = 2,40, applique l’opposé soit -2,40, calcule l’aire cumulative unilatérale à gauche correspondant à ce score (approximativement 0,0082) et multiplie ce résultat par deux, ce qui renvoie la valeur p bilatérale définitive de 0,016395. Si le test avait été analysé avec un seuil de décision α = 0,01, le chercheur n’aurait pas pu rejeter l’hypothèse nulle (0,0164 > 0,01). Toutefois, sous le seuil usuel α = 0,05, la relation d’inégalité p < 0,05 est satisfaite. L’investigateur conclut avec rigueur méthodologique que l’aménagement en open-space modifie de manière statistiquement significative le fonctionnement attentionnel des employés, l’observation traduisant ici un déclin clinique objectif de la concentration.
6. Automatisation des tests d’hypothèses complets dans Excel
6.1 Intégration dynamique : Du score brut au calcul du score Z
Dans un contexte de traitement automatisé de données psychométriques ou cliniques, la saisie statique de scores Z précalculés à la main constitue une source de vulnérabilité analytique majeure. Une chaîne de traitement robuste doit lier dynamiquement les scores bruts fondamentaux jusqu’à l’obtention de la valeur de probabilité finale sans rupture de continuité numérique. Une telle architecture assure la mise à jour instantanée des indicateurs d’inférence statistique lors de toute modification, correction ou extension du jeu de données primaires.
Pour construire ce pipeline automatisé au sein d’une feuille de calcul, il convient de réserver des cellules spécifiques aux variables d’entrée fondamentales :
- Cellule
B1: Moyenne théorique de la population parente (μ). - Cellule
B2: Écart-type populationnel connu (σ). - Cellule
B3: Taille de l’échantillon expérimental (n). - Cellule
B4: Moyenne observée au sein de l’échantillon empirique (M).
La dérivation computationnelle s’effectue ensuite par étapes ordonnées au moyen de formules Excel interconnectées :
Dans la cellule B5, l’analyste implémente le calcul de l’erreur-type de la moyenne au moyen de la fonction racine carrée :
=B2 / RACINE(B3)
Puis, dans la cellule B6, le calcul du score standardisé Z est entièrement automatisé par l’expression du rapport :
=(B4 - B1) / B5
L’avantage cardinal de cette intégration systémique réside dans la propagation automatique des flux de données. Si un clinicien étend ultérieurement son échantillon expérimental de n = 50 à n = 100 individus, la simple mise à jour de la cellule B3 réévalue instantanément l’erreur-type en B5, recalcule le score Z en B6 et ajuste de facto la valeur p située en aval, éliminant tout délai de recalcul intermédiaire et tout risque de discordance numérique au fil des étapes d’analyse.
6.2 Création d’un sélecteur de test conditionnel
Afin de concevoir une feuille de calcul polyvalente capable de s’adapter aux différents paradigmes méthodologiques sans requérir la réécriture manuelle des formules probabilistes, il est opportun de structurer un module décisionnel conditionnel permettant de basculer dynamiquement entre un test unilatéral à gauche, un test unilatéral à droite et un test bilatéral.
Cette flexibilité opérationnelle s’implémente au moyen de la validation des données d’Excel. Dans une cellule dédiée au paramétrage du design d’étude (par exemple la cellule B7), l’analyste crée un menu déroulant restreint aux trois désignations textuelles explicites : « Unilatéral Gauche », « Unilatéral Droit » et « Bilatéral ». Cette standardisation textuelle neutralise les anomalies de casse ou les fautes de frappe de l’opérateur.
Dès lors, la formule maîtresse de dérivation de la valeur p, logée dans la cellule B8 et adossée au score Z positionné en B6, exploite une structure conditionnelle imbriquée via la fonction SI ou la fonction SI.CONDITIONS :
=SI(B7="Unilatéral Gauche"; LOI.NORMALE.STANDARD.N(B6; VRAI); SI(B7="Unilatéral Droit"; 1 - LOI.NORMALE.STANDARD.N(B6; VRAI); SI(B7="Bilatéral"; 2 * LOI.NORMALE.STANDARD.N(-ABS(B6); VRAI); "Erreur : Type de test invalide")))
Grâce à cette logique conditionnelle, le classeur adapte dynamiquement son algorithme d'intégration mathématique au modèle sélectionné. L'utilisateur peut tester l'impact d'une hypothèse directionnelle versus non directionnelle d'un simple clic de souris, observant instantanément la variation mathématique de la probabilité d'erreur de première espèce sans avoir à réécrire la syntaxe interne de la fonction statistique.
6.3 Automatisation du verdict statistique d'acceptation ou rejet
Le parachèvement d'un tableau de bord décisionnel automatisé réside dans la formulation autonome du verdict statistique, dictée par la stricte confrontation entre la valeur p calculée et le seuil de tolérance de l'erreur de type I préalablement arrêté (α). Cette étape évite toute hésitation humaine lors de l'application des règles de décision statistique.
En réservant la cellule B9 à la consigne du seuil de significativité critique (en y inscrivant par exemple la valeur décimale standardisée 0,05 ou 0,01), la cellule de verdict B10 peut accueillir la fonction décisionnelle logique suivante :
=SI(B8 < B9; "Rejet de H0 (Résultat statistiquement significatif)"; "Non-rejet de H0 (Résultat non significatif)")
Afin d'optimiser l'ergonomie visuelle et d'éviter les méprises lors de l'examen rapide de multiples contrastes, cette cellule d'arbitrage gagne à être couplée à une règle de mise en forme conditionnelle. L'opérateur paramètre une coloration de fond verte lorsque le texte contient le terme « Rejet de H0 » et une coloration grise ou rouge pâle dans le cas contraire. Par ailleurs, pour préserver la subtilité de l'analyse méthodologique et éviter le piège d'une vision binaire dogmatique, il est aisé d'enrichir la chaîne de conditions logiques pour faire apparaître des verdicts plus nuancés, à l'instar d'une mention « Tendance statistique (0,05 ≤ p < 0,10) » pour les scores se situant dans les zones d'indécision marginale.
7. Cas pratique étendu en psychométrie : Étalonnage d'une échelle d'anxiété
7.1 Présentation des données normatives et de l'échantillon clinique
Pour illustrer de manière concrète l'ensemble de la chaîne de calculs dans un contexte de psychologie clinique appliquée, examinons le protocole d'étalonnage et de validation empirique mené sur une nouvelle échelle standardisée d'anxiété situationnelle : l'Inventaire d'Anxiété Multidimensionnelle (IAM). Les études normatives nationales menées sur une vaste cohorte représentative de la population générale adulte ont permis de stabiliser les paramètres de référence métrique avec une moyenne normative fixée à 50 points (μ = 50) et un écart-type rigoureusement étalonné à 10 points (σ = 10), la distribution globale sous-jacente respectant les critères de normalité univariée.
Un centre hospitalier universitaire spécialisé dans les troubles de l'humeur évalue l'impact thérapeutique d'un protocole innovant d'intervention basée sur la pleine conscience (Mindfulness-Based Stress Reduction - MBSR) dispensé pendant une durée de huit semaines. Un groupe de 64 patients consécutifs (n = 64) présentant un diagnostic formalisé de trouble anxieux généralisé est assigné à ce protocole clinique. L'objectif de la recherche est de vérifier si le protocole engendre une diminution cliniquement et statistiquement significative du niveau d'anxiété mesuré par l'IAM par rapport aux normes générales de référence.
Compte tenu de la vulnérabilité de la population cible et de la nécessité d'établir des preuves robustes avant toute préconisation thérapeutique généralisée, le comité scientifique du laboratoire fixe a priori un seuil de significativité strict à α = 0,01. L'hypothèse de travail prédisant formellement un allègement de la charge symptomatique, l'inférence relève d'un modèle unilatéral orienté vers la queue gauche de la distribution normale.
7.2 Déroulement exhaustif des calculs sous Excel
À la fin du protocole thérapeutique de huit semaines, les 64 patients complètent l'inventaire psychométrique. La saisie des scores individuels et le calcul descriptif préliminaire font ressortir une moyenne d'échantillon post-intervention de 46,75 points (M = 46,75). L'analyste psychomètre configure alors sa feuille de calcul Excel selon une typologie rigoureuse pour mener le test statistique :
- Cellule
A1: Intitulé « Moyenne normative (Mu) » | CelluleB1:50 - Cellule
A2: Intitulé « Écart-type normatif (Sigma) » | CelluleB2:10 - Cellule
A3: Intitulé « Effectif clinique (n) » | CelluleB3:64 - Cellule
A4: Intitulé « Moyenne observée (M) » | CelluleB4:46,75 - Cellule
A5: Intitulé « Seuil de significativité (Alpha) » | CelluleB5:0,01
Le calcul de l'erreur-type de la moyenne est programmé dans la cellule B6 par la formule :
=B2 / RACINE(B3)
Le résultat intermédiaire renvoyé par Excel s'établit exactement à 1,25 (puisque 10 / √64 = 10 / 8 = 1,25 point).
Le score standardisé de l'échantillon clinique est calculé dynamiquement dans la cellule B7 au moyen de la formule :
=(B4 - B1) / B6
L'opération (46,75 - 50) / 1,25 donne un résultat de -3,25 / 1,25, produisant un score Z exact de -2,60. Ce score positionne nettement la moyenne clinique en dessous du centre de la distribution de référence.
Puisqu'il s'agit d'un test directionnel orienté vers la réduction des scores d'anxiété, la valeur p unilatérale gauche est extraite dans la cellule B8 par la formule dédiée :
=LOI.NORMALE.STANDARD.N(B7; VRAI)
Excel résout l'intégrale et renvoie une probabilité fine d'occurrence de 0,004661 (arrondie à six décimales).
7.3 Interprétation contextuelle des résultats obtenus
La valeur de probabilité empirique extraite de la feuille de calcul (p ≈ 0,0047) est confrontée au critère de décision prédéfini de α = 0,01. Le postulat décisionnel s'applique immédiatement : dans la mesure où p (0,0047) est strictement inférieure au seuil critique alpha arrêté (0,01), le rejet de l'hypothèse nulle H0 s'impose au niveau de confiance de 99 %. L'investigateur affirme avec un risque d'erreur d'échantillonnage inférieur à 0,47 % que la diminution des manifestations anxieuses observée dans cette cohorte n'est pas imputable aux fluctuations stochastiques usuelles de la population de référence.
Cependant, l'analyse d'un profil clinique ne peut s'arrêter au simple seuil de probabilité. Il incombe au psychomètre de rapporter l'ampleur métrique du phénomène en déterminant la taille d'effet d de Cohen populationnelle :
d = (M - μ) / σ = (46,75 - 50) / 10 = -3,25 / 10 = -0,325.
Cette taille d'effet se classe conventionnellement comme un effet d'ampleur petite à modérée (seuil conventionnel d'effet moyen fixé à |0,50|). Dès lors, la conclusion scientifique globale articulera ces deux facettes complémentaires de l'inférence : l'effet du protocole MBSR est indiscutablement avéré sur le plan statistique (p = 0,0047 < 0,01), mais son amplitude clinique absolue reste modérée à ce stade du déploiement, suggérant des gains thérapeutiques substantiels bien que nécessitant un suivi prolongé pour asseoir une amélioration plus marquée sur le plan fonctionnel.
8. Gestion des grands jeux de données et calculs matriciels de valeurs p
8.1 Déploiement vertical de formules sur de vastes cohortes
Dans l'exploitation de grandes bases de données psychométriques, issues d'enquêtes épidémiologiques ou de plateformes d'évaluation neuropsychologique en ligne, le statisticien traite fréquemment des fichiers contenant des dizaines de milliers de lignes individuelles. Le traitement de tels volumes requiert une structuration rigoureuse des formules de tableur afin d'assurer l'intégrité référentielle lors de la propagation verticale des calculs probabilistes.
La règle fondamentale d'ingénierie sous Excel repose sur l'utilisation stricte des références absolues (matérialisées par le symbole typographique $) pour stabiliser les paramètres invariants (moyenne normative μ, écart-type théorique σ), tout en préservant des références relatives sur la ligne courante du participant évalué. Supposons un tableau dans lequel la colonne A liste l'identifiant anonyme des participants (de la ligne 2 à la ligne 50000) et la colonne B consigne leur score brut respectif. Si la moyenne et l'écart-type de référence sont stockés dans les cellules fixes $E$1 et $E$2, la formule de score Z insérée dans la cellule C2 s'écrit :
=(B2 - $E$1) / $E$2
La valeur p bilatérale associée est alors implémentée dans la cellule D2 au moyen de la référence relative vers C2 :
=2 * LOI.NORMALE.STANDARD.N(-ABS(C2); VRAI)
Par un double-clic sur la poignée de recopie de la cellule D2, la syntaxe se propage instantanément sur les 49 999 lignes sous-jacentes. Sur de telles volumétries, la charge de calcul dynamique peut induire des latences matérielles perceptibles. Il est alors recommandé, via l'onglet « Formules » > « Options de calcul », de basculer temporairement le mode de calcul d'Excel sur « Manuel ». Les formules sont déployées sans exécution intermédiaire, puis l'analyste déclenche le calcul global synchrone en appuyant sur la touche F9 de son clavier, optimisant ainsi les allocations de mémoire tampon de son environnement de travail.
8.2 Exploitation des formules matricielles dynamiques modernes (Excel 365)
L'introduction du moteur de calcul matriciel dynamique au sein de Microsoft 365 et des itérations récentes d'Excel a transformé la manipulation des séries continues en éliminant la nécessité de copier-coller ou d'étirer des formules le long des colonnes. Ce paradigme autorise l'émission d'une formule unique dans une cellule d'origine, dont les résultats se propagent ou « débordent » (spill) automatiquement sur l'ensemble de la plage vectorielle cible.
Si l'ensemble des scores standardisés Z est localisé dans la plage continue C2:C10000, l'analyste n'a plus besoin de formuler 9 999 expressions individuelles. Il insère dans la seule cellule D2 la formule matricielle globale :
=2 * LOI.NORMALE.STANDARD.N(-ABS(C2:C10000); VRAI)
Le moteur d'Excel 365 identifie instantanément la nature vectorielle de l'argument d'entrée, traite l'opération matricielle en tâche de fond optimisée et remplit instantanément la plage D2:D10000 avec les valeurs p bilatérales correspondantes. Cette architecture supprime tout risque d'altération accidentelle d'une formule intermédiaire le long de la colonne, la plage de propagation étant verrouillée contre les modifications isolées de cellules filles.
Pour aller plus loin dans la standardisation modulaire, les chercheurs avancés peuvent définir des fonctions personnalisées réutilisables à l'aide de la fonction LAMBDA dans le gestionnaire de noms d'Excel. En créant un identifiant de formule personnalisé nommé VALEUR_P_Z, défini par l'expression =LAMBDA(score_z; type_test; ...), le classeur encapsule l'intégralité de la complexité algorithmique au sein d'une signature logicielle claire et auto-documentée.
8.3 Correction pour comparaisons multiples au sein d'Excel
L'analyse simultanée de multiples contrastes statistiques, sous-échelles de questionnaires ou sous-groupes de participants engendre une inflation stochastique majeure de l'erreur globale de type I, un phénomène désigné dans la littérature méthodologique sous le nom de multiplication des tests d'hypothèses (family-wise error rate). Si un psychologue quantitatif évalue indépendamment 20 scores Z au seuil nominal usuel de α = 0,05, la probabilité cumulée de déclarer au moins un faux positif purement imputable au hasard n'est plus de 5 %, mais s'élève théoriquement à :
αglobal = 1 - (1 - α)k = 1 - (0,95)20 ≈ 0,6415 (soit plus de 64 % de risque d'erreur).
Pour pallier cette dérive statistique au sein même du tableur, l'analyste doit intégrer des procédures de correction méthodologique post-hoc. La correction la plus classique, bien que conservatrice, est l'ajustement de Bonferroni. Elle consiste à diviser le seuil nominal alpha par le nombre total de comparaisons planifiées (k), ou de manière équivalente, à multiplier chaque valeur p brute observée par k. Dans la feuille de calcul, la valeur p ajustée de Bonferroni pour la cellule D2 s'implémente par la formule :
=MIN(1; D2 * NB(D$2:D$101))
L'emploi de la fonction MIN garantit que la multiplication arithmétique ne produise jamais de probabilité artificielle excédant la valeur unitaire de 1.
Pour des analyses exploratoires à haut débit nécessitant une puissance statistique plus élevée, l'opérateur peut déployer la procédure de Benjamini-Hochberg dédiée au contrôle du taux de fausses découvertes (False Discovery Rate ou FDR). La mise en œuvre dans Excel requiert d'ordonner préalablement l'ensemble des valeurs p non ajustées par ordre croissant à l'aide de la fonction TRIER, d'assigner à chaque contraste son rang séquentiel (i allant de 1 à m), puis de calculer le seuil critique corrigé pour chaque ligne au moyen de l'expression :
SeuilBH = (i / m) × α
L'inférence finale conserve comme statistiquement significatives toutes les valeurs p vérifiant la condition d'inégalité jusqu'au plus grand rang i satisfaisant le critère, fournissant ainsi une modération méthodologique robuste sans recourir à des logiciels statistiques externes.
9. Erreurs courantes, pièges méthodologiques et dépannage dans Excel
9.1 Erreurs de syntaxe et de typage de données
L'exécution de fonctions statistiques dans Excel est fréquemment compromise par des anomalies triviales de typage de données ou d'incompatibilités régionales. La source d'erreur la plus prévalente concerne la convention séparatrice des décimales. Sur les systèmes d'exploitation francophones, le séparateur décimal standard est la virgule (,), tandis que le point-virgule (;) agit comme séparateur d'arguments au sein des fonctions. Si un chercheur importe des données numériques générées par des instruments de mesure anglo-saxons utilisant le point (.) comme délimiteur décimal, Excel risque de classifier la cellule sous le format de données « Texte » sans générer d'alerte explicite immédiate.
Lorsque la fonction LOI.NORMALE.STANDARD.N reçoit en paramètre une chaîne de caractères textuels (par exemple "1.96" au lieu du nombre décimal 1,96), le moteur d'évaluation interrompt son intégration numérique et renvoie le message d'erreur rédhibitoire #VALEUR!. L'analyste peut diagnostiquer cette anomalie au moyen de la fonction de test logique =ESTNUM(A1). Pour résoudre ce problème sur des colonnes entières, il convient d'utiliser l'outil « Rechercher et remplacer » (remplacer le point par la virgule) ou d'encapsuler la référence de cellule dans la fonction de conversion arithmétique =CNUM(SUBSTITUE(A1; "."; ",")).
Un autre piège de configuration syntaxique réside dans l'attribution de l'argument cumulatif. La confusion entre l'instruction textuelle et l'instruction logique constitue une vulnérabilité : la saisie de l'argument logique FAUX en lieu et place de VRAI ne provoque pas d'erreur d'exécution logicielle apparente. Excel calcule scrupuleusement la hauteur de la densité de Gauss. Le chercheur recueille alors un chiffre décimal cohérent en apparence, mais dénué de toute signification décisionnelle quant à l'évaluation d'une hypothèse statistique.
9.2 Confusions conceptuelles fréquentes sur la distribution
L'exactitude computationnelle au sein d'une feuille de calcul ne saurait masquer les abus de modélisation statistique. Le test Z et le calcul de sa valeur p sous-jacente reposent sur des postulats probabilistes stricts que le chercheur ne doit jamais enfreindre sous prétexte de commodité logicielle. Le premier postulat fondamental concerne la connaissance préalable de la variance de la population parente (σ2). Si l'écart-type de la population n'est pas connu et doit être estimé à partir de l'écart-type de l'échantillon empirique (s), l'utilisation de la loi normale centrée réduite devient méthodologiquement invalide lorsque la taille de l'échantillon est restreinte (n < 30).
Dans ce cas de figure, l'incertitude sur l'estimation de la dispersion gonfle la variabilité d'échantillonnage, exigeant le déploiement de la loi t de Student au moyen des fonctions Excel LOI.STUDENT.N ou LOI.STUDENT.BILATERALE. Le recours injustifié au score Z en contexte de petits échantillons induit une sous-estimation systématique de la valeur p réelle, exposant le praticien à un taux d'erreur de type I très supérieur au seuil nominal déclaré.
Une seconde confusion distributionnelle concerne l'affectation des paramètres de dispersion dans la fonction générale LOI.NORMALE.N. L'interversion entre la variance (σ2) et l'écart-type (σ) constitue une erreur classique : insérer une variance de 100 dans un champ qui requiert un écart-type de 10 dilate artificiellement l'échelle de mesure par un facteur dix, anéantissant l'exactitude de l'inférence. Enfin, l'interprétation d'une valeur p unilatérale excédant 0,50 doit systématiquement alerter l'opérateur : une telle valeur indique presque toujours que le signe empirique du score Z se situe dans la direction rigoureusement opposée à celle stipulée par l'hypothèse de recherche.
9.3 Anomalies liées aux scores Z extrêmes et précision en virgule flottante
Bien que les routines de calcul introduites depuis Excel 2010 soient remarquablement robustes, le comportement du logiciel face à des scores Z d'une amplitude exceptionnelle (situés au-delà de 7 ou 8 écarts-types de la moyenne) nécessite une vigilance particulière. Ces scores extrêmes s'observent régulièrement lors du criblage génétique, de l'analyse computationnelle de temps de réaction en millisecondes ou lors d'études de neuro-imagerie fonctionnelle comportant des millions de voxels d'analyse.
Sous la norme arithmétique de virgule flottante en double précision (IEEE 754), Excel alloue 64 bits de stockage par nombre réel, ce qui borne sa capacité de discrimination infinitésimale. Lorsque l'on demande au tableur d'évaluer la fonction cumulative pour une valeur comme Z = 8,5 via =1 - LOI.NORMALE.STANDARD.N(8,5; VRAI), le résultat de la fonction cumulative est si infinitésimalement proche de l'unité que l'opération de soustraction subit une perte catastrophique de précision arithmétique : Excel affiche purement et simplement la valeur textuelle 0,00000000000000E+00.
Il est impératif que le praticien ne confonde pas cette limite de calcul machine avec une certitude absolue. Une valeur de probabilité empirique ne peut jamais égaler rigoureusement zéro dans une distribution de Gauss continue dont les queues sont infinies et asymptotiques à l'axe des abscisses. Lors de la communication scientifique de ces résultats dans un article ou un rapport d'audit, il est formellement interdit de retranscrire la formulation aberrante « p = 0,000 ». La formulation déontologique exigée consiste à consigner une relation d'inégalité stricte précisant la borne d'évaluation du logiciel, telle que « p < 10-15 » ou de manière plus conventionnelle « p < 0,001 », préservant ainsi la rigueur conceptuelle de l'aléa statistique.
10. Visualisation graphique de la valeur p et du score Z dans Excel
10.1 Construction de la courbe normale de Gauss théorique
L'appropriation cognitive de concepts probabilistes complexes est grandement facilitée par la visualisation graphique dynamique. Modéliser explicitement la courbe de Gauss et repérer spatialement la valeur p permet d'éviter les erreurs d'interprétation directionnelle et offre un support pédagogique précieux lors de présentations de résultats cliniques ou de comités de recherche.
Pour construire une courbe normale standardisée théorique dans Excel, la première phase consiste à tabuler la fonction de densité sur un intervalle représentatif, traditionnellement borné de Z = -4 à Z = +4 par pas incrémentaux réguliers de 0,1 :
- Dans la colonne
A(de la ligne 2 à la ligne 82), l'utilisateur génère la séquence de valeurs numériques continues de -4,0 à +4,0. - Dans la colonne
B, en face de chaque valeur Z, l'ordonnée de densité de probabilité est dérivée au moyen de la fonction standardisée configurée avec l'argument cumulatif FAUX :
=LOI.NORMALE.STANDARD.N(A2; FAUX)
En sélectionnant la plage de données A2:B82, l'analyste insère un graphique de type « Nuage de points avec lignes lisses » (en proscrivant les diagrammes en histogramme ou en barres, inaptes à restituer un continuum géométrique). L'esthétique visuelle gagne à être épurée selon les conventions de publication : suppression du quadrillage interne redondant, sélection d'un tracé de courbe noir d'une épaisseur de 1,5 point, et graduation explicite de l'axe horizontal avec des intervalles majeurs fixés à 1 unité d'écart-type.
10.2 Hachurage dynamique de l'aire sous la courbe correspondant à la valeur p
La puissance d'une feuille de calcul interactive réside dans la matérialisation de l'aire correspondant à la valeur p, se mettant à jour de manière réactive lors de toute modification du score Z empirique calculé dans la cellule de commande $E$1.
Pour concrétiser ce tracé d'ombrage sous la courbe, une troisième colonne conditionnelle (colonne C) doit être intégrée dans la structure de données graphique. Supposons le cas d'un test unilatéral à droite où l'aire de la valeur p correspond à l'intégrale supérieure au score empirique présent en $E$1. La cellule C2 accueille la formule logique :
=SI(A2 >= $E$1; B2; 0)
Cette expression renvoie la densité théorique dès lors que l'abscisse se situe dans la région critique de la valeur p, et renvoie la valeur zéro dans le cas contraire.
L'opérateur ajoute ensuite cette série conditionnelle à son graphique existant et modifie son type de traçage pour le convertir en « Graphique en aires » superposé. En configurant la couleur de remplissage de cette série avec une teinte semi-transparente (par exemple un rouge bordeaux à 40 % d'opacité) et une bordure nulle, l'aire sous la courbe se hachure automatiquement au-delà du seuil expérimental. Si le score Z en $E$1 passe de 1,50 à 2,30, la zone colorée se rétracte instantanément sur l'affichage, offrant une illustration saisissante de l'amenuisement de la probabilité empirique associée.
10.3 Représentation conjointe du seuil alpha et de la région de rejet
Pour finaliser cette infrastructure de visualisation scientifique, il convient d'ancrer sur le graphique le seuil décisionnel alpha sous la forme d'une ligne critique de démarcation verticale. Cette confrontation spatiale permet de juger immédiatement si la statistique empirique franchit ou non la frontière de rejet de l'hypothèse nulle.
Pour un test bilatéral au seuil conventionnel α = 0,05, la valeur critique standardisée est de Zcritique = ±1,96 (déterminable sous Excel via la fonction réciproque =LOI.NORMALE.STANDARD.INVERSE.N(0,975)). L'analyste matérialise cette démarcation en intégrant une série technique constituée de deux coordonnées définissant un segment vertical orthogonal : le premier point en (1,96 ; 0) et le second point en (1,96 ; 0,40), cette dernière valeur correspondant au sommet de la densité de Gauss.
Une fois formalisé, ce graphique peut être exporté vers des logiciels de mise en page documentaire. Pour préserver une résolution vectorielle optimale exempte de pixellisation (aliasing), l'utilisateur privilégiera un copier-coller avec l'option « Image vectorielle améliorée » (EMF) ou enregistrera la feuille au format PDF vectoriel avant son inclusion dans un traitement de texte professionnel.
11. Reporting académique et formalisation des résultats selon les normes de l'APA
11.1 Standards typographiques et rédactionnels de l'APA (7e édition)
La communication des analyses statistiques en psychologie et en sciences comportementales est régie de façon universelle par les directives du manuel de publication de l'American Psychological Association (APA 7e édition). Ce corpus fixe des exigences typographiques et arithmétiques très précises relatives à l'énonciation des indices déduits de distributions continues.
Les règles canoniques de reporting statistique comprennent notamment les impératifs suivants :
- Typographie des symboles : Toutes les lettres latines désignant des grandeurs statistiques ou des paramètres d'échantillon doivent être strictement composées en italique (par exemple : Z, p, M, SD, n). À l'inverse, les lettres grecques caractérisant les paramètres de population (μ, σ, α) demeurent impérativement en typographie romaine droite standard.
- Suppression du zéro initial pour la valeur p : Conformément aux conventions de l'APA, un chiffre zéro ne doit jamais précéder le séparateur décimal lorsque la grandeur rapportée ne peut mathématiquement excéder la valeur unitaire de 1. Dès lors, il convient d'écrire rigoureusement « p = .034 » et en aucun cas « p = 0.034 » ou « p = 0,034 ». En revanche, le score standardisé pouvant théoriquement dépasser 1, il conserve son zéro initial : « Z = 0.85 » ou « Z = -2.14 ».
- Règles d'arrondi décimal : Les valeurs de probabilité s'énoncent avec une précision arrêtée à deux ou trois décimales (trois décimales étant la norme d'usage courant pour les valeurs inférieures à .10). Les valeurs p infinitésimales ne doivent jamais être affichées comme nulles : toute valeur inférieure à .001 sera retranscrite sous la forme de l'inégalité stricte « p < .001 ».
11.2 Génération automatisée du texte de rapport via les formules Excel
La transcription manuelle des statistiques calculées dans un tableau vers le corps du texte d'un manuscrit de recherche est une source majeure de coquilles typographiques, d'erreurs d'inversion de chiffres et de discordances internes. Excel offre les capacités techniques d'automatiser intégralement la génération de chaînes de texte pré-formatées respectant au millimètre les contraintes de l'APA.
Pour opérer cette transformation au sein d'une cellule de synthèse textuelle, l'analyste exploite la fonction de concaténation conjointe aux capacités de mise en forme numérique de la fonction TEXTE. Supposons que le score Z soit localisé dans la cellule B6 et la valeur p bilatérale dans la cellule B8. La formule dynamique s'écrit alors :
="Z = " & TEXTE(B6; "0,00") & ", " & SI(B8 < 0,001; "p < .001"; "p = " & SUBSTITUE(TEXTE(B8; "0,000"); "0,"; "."))
Décomposons le mécanisme interne de cette formule :
- La fonction
TEXTE(B6; "0,00")force l'arrondi du score standardisé à exactement deux décimales. - La structure logique
SI(B8 < 0,001; ...)intercepte les résultats infinitésimaux pour injecter automatiquement la chaîne formelle"p < .001"sans laisser transparaître de résidus d'arrondi trompeurs. - Dans l'alternative, la fonction
SUBSTITUE(TEXTE(B8; "0,000"); "0,"; ".")extrait le nombre à trois décimales et ampute le zéro initial francophone (« 0, ») pour le convertir immédiatement en point décimal anglo-saxon (« . »), garantissant une stricte conformité aux critères typographiques de l'APA.
Le chercheur n'a plus qu'à copier la chaîne textuelle générée automatiquement par Excel pour l'insérer directement dans son manuscrit scientifique, éliminant tout risque d'erreur humaine de retranscription.
11.3 Articuler valeur p, intervalle de confiance et taille d'effet
La formalisation statistique contemporaine exige que l'énoncé d'une valeur p soit systématiquement contextualisé au sein d'un triptyque méthodologique indissociable comprenant : la statistique d'inférence (Z et sa probabilité associée), l'amplitude de la métrique observée matérialisée par sa taille d'effet standardisée, et la précision de l'estimation bornée par un intervalle de confiance à 95 %.
Le calcul des bornes de l'intervalle de confiance à 95 % autour de la moyenne observée d'un échantillon s'implémente facilement dans Excel au moyen de l'erreur-type. La borne inférieure s'écrit =Moyenne - (1,96 * Erreur_Type) et la borne supérieure s'énonce =Moyenne + (1,96 * Erreur_Type).
La synthèse académique rédigée dans le manuscrit adoptera alors une formulation exemplaire et exhaustive :
« Les analyses révèlent une diminution statistiquement significative des scores d'anxiété au terme des huit semaines d'intervention thérapeutique (M = 46,75, SD = 9,82) en comparaison des paramètres normatifs populationnels (μ = 50,00, σ = 10,00), Z = -2,60, p = .005 (unilatéral), IC 95 % [44,30, 49,20], d = -0,33. Cet ensemble d'indices atteste d'une efficacité mesurable du protocole, bien que son impact demeure d'une amplitude clinique modérée. »
12. Comparaison approfondie entre Excel et les logiciels statistiques dédiés
12.1 Confrontation computationnelle avec R, SPSS et Jamovi
La légitimité de Microsoft Excel comme outil d'analyse quantitative en milieu académique fait régulièrement l'objet de débats méthodologiques au regard des environnements statistiques spécialisés tels que le langage open-source R, le progiciel commercial IBM SPSS Statistics ou les plateformes modernes à interface graphique comme Jamovi et JASP.
Sur le plan de l'exactitude computationnelle pure relative au calcul de distributions d'échantillonnage standards, les disparités historiques entre Excel et ses concurrents ont été comblées depuis la refonte arithmétique d'Excel 2010. Une confrontation menée entre la formule Excel =LOI.NORMALE.STANDARD.N(1,95996398454005; VRAI) et la commande canonique de R pnorm(1.95996398454005) produit des résultats rigoureusement superposables jusqu'à la quatorzième décimale (renvoyant exactement 0,975). Les bibliothèques d'approximation algorithmiques actuelles employées par Microsoft offrent une précision numérique tout à fait suffisante pour l'immense majorité des applications en sciences humaines et biomédicales.
Les divergences fondamentales entre ces écosystèmes se situent en réalité sur le plan de la philosophie analytique et de la flexibilité modulaire :
- Accessibilité et ergonomie : Excel présente une transparence immédiate, chaque cellule affichant concrètement son contenu et ses liaisons fonctionnelles. Il dispense l'utilisateur de l'apprentissage complexe de lignes de code ou de syntaxes de scripts, rendant l'analyse statistique accessible à tout clinicien de terrain.
- Reproductibilité et traçabilité : Des logiciels scriptés tels que R ou Jamovi garantissent une auditabilité supérieure des analyses via l'exécution de syntaxes immuables et le contrôle de version. Dans Excel, la modification accidentelle d'une cellule non verrouillée peut altérer silencieusement une chaîne analytique complète sans avertissement visible.
- Modélisation statistique complexe : Excel atteint rapidement ses limites structurelles lors du passage à des modèles linéaires mixtes, des régressions logistiques multivariées ou des analyses factorielles confirmatoires, tâches nécessitant alors impérativement des environnements statistiques spécialisés.
12.2 Protocoles de validation et audit des feuilles de calcul en laboratoire
Pour conférer à Microsoft Excel une robustesse analytique compatible avec les exigences des principes de la science ouverte (Open Science) et des Bonnes Pratiques de Laboratoire (BPL), la conception de feuilles de calcul dédiées aux tests d'hypothèses statistiques doit obéir à des protocoles de contrôle qualité rigoureux.
Il incombe au responsable de la modélisation statistique d'instaurer des tests unitaires internes au sein du classeur. Cela consiste à insérer des lignes de contrôle évaluant des cas mathématiques limites dont le résultat probabiliste est universellement calibré (par exemple vérifier que pour Z = 0, la formule renvoie impérativement une valeur p bilatérale égale à 1,000000). Des formules de vérification conditionnelle de type =SI(ABS(LOI.NORMALE.STANDARD.N(0; VRAI) - 0,5) < 1E-14; "Validé"; "Alerte Anomalie") permettent d'auditer l'intégrité du moteur de calcul lors de l'ouverture du fichier sur différents environnements matériels ou versions de systèmes d'exploitation.
Enfin, la sécurisation matérielle du classeur constitue un impératif déontologique. L'accès aux cellules d'opérations et d'intégration statistique doit être strictement prohibé aux utilisateurs finaux en activant le verrouillage et la protection de la feuille de calcul par mot de passe, ne laissant libres d'édition que les seules cellules dédiées à l'encodage des scores bruts primaires. La documentation exhaustive des formules au sein d'une feuille de métadonnées dédiée garantit la pérennité, la transmissibilité et la reproductibilité totale des analyses quantitatives menées sur Excel.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Microsoft Corporation. (2024). Fonction LOI.NORMALE.STANDARD.N. Support technique Microsoft Office. https://support.microsoft.com/fr-fr/office/loi-normale-standard-n
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108