
L’inférence statistique moderne repose sur une dialectique constante entre les données empiriques recueillies sur le terrain et des modèles mathématiques probabilistes théoriques. Parmi ces outils d’évaluation quantitative, le test du khi-carré formulé initialement par le mathématicien et biométricien britannique Karl Pearson au tournant du vingtième siècle demeure l’un des piliers méthodologiques les plus omniprésents en sciences humaines, sociales et biomédicales. Utilisé aussi bien pour éprouver la conformité d’un échantillon à une distribution théorique que pour examiner l’indépendance de deux variables qualitatives catégorielles, ce test produit une statistique globale de divergence, notée conventionnellement X² ou χ². Toutefois, l’obtention de cette valeur numérique brute ne constitue que la première phase de l’analyse inférentielle : toute la démarche décisionnelle repose sur la détermination de la probabilité associée à cette statistique d’échantillonnage sous l’hypothèse nulle, une mesure fondamentale universellement désignée sous le nom de p-valeur (ou p-value).
Bien que l’avènement contemporain de suites logicielles puissantes telles que SPSS, R, JASP ou les bibliothèques scientifiques de Python permette d’extraire instantanément une p-valeur calculée jusqu’à la dixième décimale par intégration numérique continue, l’apprentissage de la lecture de la table statistique imprimée de la distribution du khi-carré conserve une valeur heuristique, épistémologique et didactique inestimable. La table matérialise physiquement l’espace probabiliste, contraignant le chercheur et l’étudiant à comprendre la géométrie sous-jacente de la loi de probabilité, la décroissance asymptotique de l’aire sous la courbe et l’impact direct du paramètre des degrés de liberté sur le comportement de la distribution. En outre, lors d’épreuves académiques, d’examens méthodologiques universitaires ou d’analyses préliminaires sur le terrain sans assistance informatique, la capacité à extraire et à borner avec précision une p-valeur manuellement constitue une compétence d’autonomie scientifique essentielle.
Le présent article propose un guide exhaustif, didactique et rigoureusement étayé sur le plan mathématique et appliqué, expliquant comment trouver la p-valeur à partir d’une table de distribution du khi-carré. Nous aborderons d’abord les fondements mathématiques de cette loi continue et ses usages paradigmatiques dans la recherche psychologique et sociale. Nous disséquerons ensuite minutieusement l’architecture matricielle des tables imprimées, les règles formelles de calcul des degrés de liberté, la technique pas à pas de repérage et d’encadrement de la probabilité, ainsi que les méthodes d’interpolation linéaire permettant de raffiner cette estimation manuelle. Enfin, nous explorerons les implications concrètes de ces procédures à travers des cas pratiques en psychométrie et psychologie clinique, tout en soulignant les pièges récurrents et les normes de publication académique les plus récentes édictées par l’American Psychological Association (normes APA 7).
1. Fondements théoriques de la distribution du khi-carré en psychologie
1.1 Définition et propriétés mathématiques de la loi du khi-carré
D’un point de vue strictement mathématique, la loi de probabilité continue du khi-carré, notée conventionnellement χ²(k), est définie comme la distribution de la somme des carrés de k variables aléatoires indépendantes et identiquement distribuées suivant une loi normale centrée réduite N(0, 1). Si l’on pose Z₁, Z₂, …, Z_k comme représentant k variables stochastiques gaussiennes indépendantes d’espérance nulle et de variance unitaire, la variable aléatoire Y définie par la somme Y = ∑(Z_i)² suit par construction une loi du khi-carré à k degrés de liberté. Cette genèse théorique explique directement l’une des caractéristiques fondamentales de son support mathématique : étant composée exclusivement d’une somme de termes quadratiques réels élevés au carré, une variable du khi-carré ne peut en aucun cas prendre de valeurs négatives. Son domaine de définition est strictement restreint à l’ensemble des nombres réels positifs ou nuls, soit l’intervalle [0, +∞[.
L’aspect de la fonction de densité de probabilité du khi-carré varie considérablement selon la valeur attribuée au paramètre unique qui la caractérise, à savoir le nombre de degrés de liberté (k ou ddl). Lorsque le nombre de degrés de liberté est très faible, notamment pour k = 1 ou k = 2, la distribution présente une allure fortement décroissante et concave, tendant asymptotiquement vers l’infini au voisinage immédiat de zéro pour k = 1. À mesure que k croît au-delà de 2, la courbe acquiert une morphologie unimodale présentant une asymétrie positive marquée, également désignée sous le terme d’étalement vers la droite (positive skewness). Le sommet de la courbe (le mode de la distribution) se situe alors exactement à la valeur k – 2, tandis que son espérance mathématique s’établit précisément à E(X) = k et sa variance théorique à Var(X) = 2k.
Une propriété centrale de la loi du khi-carré, découle directement du théorème central limite. Lorsque le nombre de degrés de liberté s’accroît de manière substantielle (généralement lorsque k dépasse 30 ou 50 selon les exigences de précision), l’asymétrie positive de la densité s’atténue progressivement au profit d’un profil symétrique en cloche. La distribution χ²(k) converge alors asymptotiquement vers une loi normale d’espérance k et d’écart-type √(2k). Cette dynamique mathématique sous-tend l’ensemble de la théorie de l’échantillonnage statistique : sous l’hypothèse nulle d’un test d’adéquation ou d’indépendance, la statistique d’écart calculée sur un échantillon empirique suit précisément cette distribution théorique, permettant d’associer de façon déterministe toute valeur observée à une probabilité d’occurrence sous le modèle du hasard pur.
1.2 Applications empiriques majeures en sciences psychologiques
Dans l’écosystème de la recherche en psychologie quantitative, la loi du khi-carré intervient comme l’instrument d’arbitrage par excellence pour traiter des données nominales et ordinales. Contrairement aux devis de recherche expérimentale fondés sur des échelles continues d’intervalles ou de rapports — qui autorisent l’utilisation de tests paramétriques tels que l’analyse de variance (ANOVA) ou le test t de Student —, les enquêtes épidémiologiques et comportementales génèrent fréquemment des distributions de fréquences catégorielles. C’est le cas lors de l’étude de l’indépendance entre des typologies comportementales (par exemple, les styles d’attachement insécure, évitant, anxieux ou sécure) et des catégories de troubles psychopathologiques ou de choix d’orientation professionnelle. Le test d’indépendance du khi-carré permet de déterminer si la répartition observée au sein d’un tableau de contingence croisé s’écarte significativement d’un pattern d’indépendance stochastique théorique.
Une deuxième application fondamentale réside dans les protocoles de psychométrie et d’évaluation standardisée, où les chercheurs cherchent à vérifier la conformité des fréquences observées d’un échantillon normatif par rapport à des distributions théoriques prédéterminées. Dans ce contexte, désigné sous le vocable de test d’adéquation (ou goodness-of-fit), le khi-carré permet d’examiner si la répartition des scores catégorisés à une échelle psychométrique reproduit fidèlement la répartition observée au sein de la population générale, identifiant ainsi d’éventuels biais d’échantillonnage ou des distorsions d’échantillonnage liées au recrutement des participants. Par ailleurs, dans le domaine de l’analyse d’items, le test permet d’éprouver l’équipotentialité des choix de réponses sur des distracteurs à choix multiples.
Enfin, à un niveau méthodologique plus avancé, la distribution du khi-carré sert d’indicateur pivot dans la modélisation par équations structurelles (SEM, pour Structural Equation Modeling) et dans les analyses factorielles confirmatoires (CFA). Dans ces paradigmes avancés, la statistique χ² quantifie la magnitude de l’écart global existant entre la matrice de covariance empirique observée à partir des réponses des sujets et la matrice de covariance théorique postulée par le modèle théorique sous-jacent. Une valeur non significative du khi-carré indique alors une adéquation satisfaisante du modèle aux données observées. De manière analogue, dans les protocoles cliniques transversaux, les tests d’homogénéité du khi-carré permettent de vérifier si différents sous-groupes cliniques présentent des répartitions identiques vis-à-vis de symptômes cardinaux, attestant ainsi de la comparabilité méthodologique des cohortes à l’étude.
1.3 Notions fondamentales : Statistique de test, p-valeur et hypothèse nulle
L’architecture de l’inférence statistique classique, issue de la synthèse opérée entre les paradigmes de Ronald Fisher et de Jerzy Neyman et Egon Pearson, repose sur l’énonciation initiale d’une hypothèse nulle, universally dénotée H₀. Dans le cadre d’un test du khi-carré, l’hypothèse nulle postule rigoureusement l’absence d’effet systématique, l’absence de différence entre les fréquences observées et les fréquences théoriques attendues, ou la parfaite indépendance stochastique entre les variables qualitatives examinées. Sous H₀, toute divergence numérique constatée entre les observations empiriques et les valeurs prédites par le modèle théorique est attribuée exclusivement aux fluctuations inhérentes à l’échantillonnage aléatoire.
La statistique de test observée, notée usuellement X² ou χ²_obs, fonctionne comme une métrique de distance normalisée multidimensionnelle. Elle condense l’intégralité des écarts constatés entre la réalité de l’échantillon et les attentes du modèle en une valeur scalaire unique. Plus les effectifs observés diffèrent des effectifs théoriques calculés sous l’hypothèse nulle, plus la statistique de test X² s’élève sur l’axe des réels positifs. Dès lors, la question scientifique centrale consiste à déterminer la probabilité d’obtenir une divergence d’une telle magnitude uniquement sous l’action du hasard d’échantillonnage : c’est précisément la définition de la p-valeur (probability value).
Formellement, la p-valeur correspond à la probabilité critique conditionnelle P(χ² ≥ X²_obs | H₀). Il s’agit de la probabilité d’observer, dans une population où l’hypothèse nulle est strictement vraie, une statistique du khi-carré au moins aussi extrême ou plus extrême que celle calculée à partir des données de l’échantillon. Une distinction conceptuelle d’une rigueur absolue doit être opérée entre le seuil de signification alpha (α), qui constitue une probabilité d’erreur de première espèce fixée a priori par le chercheur avant toute collecte de données (traditionnellement 0,05 ou 0,01), et la p-valeur, qui est une quantité continue calculée a posteriori à partir des données recueillies. Si la p-valeur s’avère inférieure ou égale au seuil alpha, le chercheur rejette formellement H₀ au profit de l’hypothèse alternative (H₁), concluant à l’existence d’une association statistiquement significative.
2. Structure et lecture de la table statistique de distribution du khi-carré
2.1 Organisation matricielle des lignes et des colonnes
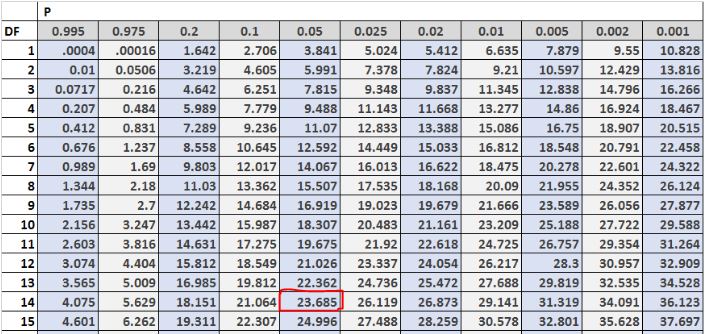
La table statistique de distribution du khi-carré se présente sous la forme d’un tableau à double entrée conçu pour répertorier des valeurs quantiles sélectionnées de la fonction de répartition de la loi χ². L’axe vertical de la matrice, situé le plus souvent dans la première colonne à l’extrême gauche du document, répertorie les degrés de liberté, désignés selon les manuels par les abréviations « ddl », « df » (pour le terme anglais degrees of freedom) ou par la lettre grecque nu (ν). Cette numérotation progresse de manière incrémentale, unité par unité, généralement de 1 jusqu’à 30 ou 40, avant d’adopter des paliers plus larges (par exemple 50, 60, 80, 100) pour les degrés de liberté élevés.
L’axe horizontal supérieur, constitué par la première ligne d’en-tête de la table, affiche une série ordonnée de probabilités de dépassement critique ou niveaux de signification unilatéraux, traditionnellement désignés par la lettre grecque α (alpha) ou par la notation P ou p. Ces valeurs décimales décroissent ou croissent selon la convention graphique adoptée par l’éditeur, balayant les probabilités usuelles telles que 0,995, 0,99, 0,95, 0,90, 0,50, 0,10, 0,05, 0,025, 0,01 et 0,001. À chaque intersection d’une ligne (représentant un degré de liberté spécifique) et d’une colonne (représentant un niveau de probabilité critique défini) se trouve la valeur critique X² correspondante, exprimée avec deux ou trois décimales de précision.
Il convient de noter que selon les manuels universitaires de psychométrie ou de biostatistique, des variations typographiques substantielles peuvent être observées. Certaines tables intègrent des séparateurs visuels pour isoler les colonnes associées aux seuils conventionnels de la recherche (notamment α = 0,05 et α = 0,01), tandis que d’autres adjoignent en bas de page des formules d’approximation asymptotique pour les degrés de liberté non répertoriés. La compréhension de cette géométrie bidimensionnelle constitue le prérequis indispensable à tout dépouillement manuel rigoureux.
2.2 Compréhension de l’aire sous la courbe et sens de lecture
L’étape la plus critique lors de l’appréhension d’une table statistique imprimée consiste à décrypter sans ambiguïté l’aire sous la courbe de densité qui se trouve effectivement tabulée. La très grande majorité des tables standardisées en sciences du comportement rapportent les probabilités de la queue supérieure droite (upper tail probability). Dans ce schéma de référence prépondérant, la probabilité α mentionnée en tête de colonne correspond à l’intégrale définie de la fonction de densité de probabilité depuis la valeur critique tabulée x_critique jusqu’à l’infini positif :
P(X² ≥ x_critique) = ∫_{x_critique}^{+∞} f(u) du = α
Toutefois, une minorité notable de tables statistiques — particulièrement celles issues de certains traités de mathématiques pures ou de manuels francophones anciens d’ingénierie — adoptent la convention inverse de la fonction de répartition cumulative unilatérale gauche (lower tail probability). Dans une telle configuration, la probabilité rapportée correspond à la surface située à gauche de la valeur critique, soit P(X² < x) = 1 – α. Pour éviter toute méprise méthodologique susceptible de fausser radicalement la prise de décision statistique, l’analyste doit impérativement examiner le schéma illustratif systématiquement imprimé dans l’en-tête de la table.
Si le graphique représente une courbe asymétrique du khi-carré dont la zone hachurée ou noircie se situe sur l’extrémité droite effilée (queue de distribution), la table rapporte bien l’aire de dépassement critique. Si la zone hachurée s’étend depuis l’origine zéro jusqu’à la valeur seuil, il s’agit d’une table cumulative gauche. Une erreur d’interprétation à ce niveau conduirait par exemple un chercheur à confondre un seuil hautement significatif (α = 0,05 à droite) avec une zone de conformité quasi-parfaite (0,95 à gauche), invalidant l’ensemble de l’inférence clinique ou expérimentale produite.
2.3 Seuils de signification conventionnels en recherche expérimentale
L’utilisation de la table de distribution du khi-carré s’articule autour de bornes probabilistes instituées par la tradition méthodologique en tant que repères cardinaux de la décision scientifique. Les colonnes les plus fréquemment scrutées correspondent aux risques d’erreur de première espèce α = 0,10, 0,05, 0,01 et 0,001. La justification épistémologique du seuil pivot de 0,05 — popularisé par Ronald Fisher dans les années 1920 — réside dans un arbitrage pragmatique entre le risque de commettre une erreur de type I (rejeter H₀ alors qu’elle est en réalité vraie) et le risque de commettre une erreur de type II (échouer à rejeter H₀ alors qu’il existe un effet réel dans la population parente).
Dans la recherche psychologique fondamentale et appliquée, le seuil nominal α = 0,05 est universellement adopté comme standard minimal requis pour revendiquer une découverte ou une association non aléatoire. Cependant, lors d’investigations cliniques confirmatoires portant sur des enjeux diagnostics majeurs, ou lors d’études psychométriques exigeant une haute fidélité de mesure, les chercheurs privilégient des seuils beaucoup plus conservateurs, tels que α = 0,01 ou α = 0,001. Le recours à ces colonnes de droite de la table vise à minimiser drastiquement les faux positifs scientifiques, assurant que la divergence constatée présente une plausibilité sous l’effet du hasard inférieure à un pour cent, voire un pour mille.
À l’opposé du spectre, la colonne correspondant à α = 0,10 est occasionnellement mobilisée dans le cadre d’études pilotes exploratoires ou de recherches qualitatives-quantitatives mixtes à visée générative. Une p-valeur comprise entre 0,05 et 0,10 y est couramment qualifiée de « marginalement significative » ou interprétée comme une « tendance statistique ». Bien que cette pratique fasse l’objet de vifs débats au sein de la communauté méthodologique quant à la reproductibilité des résultats, le repérage de cette colonne permet aux chercheurs de situer précisément la zone de transition entre la stricte conformité au modèle nul et l’émergence d’une divergence comportementale notable.
3. Calcul préalable des paramètres : Degrés de liberté et statistique de test
3.1 Formulation mathématique de la statistique de test X2
L’accès opérationnel à la table statistique du khi-carré requiert au préalable la dérivation rigoureuse de la valeur numérique de la statistique de test X² à partir des données brutes colligées. Établie par Karl Pearson en 1900, la formule d’adéquation globale s’écrit formellement :
X² = ∑_{i=1}^{k} frac{(O_i – E_i)²}{E_i}
Dans cette expression algébrique fondamentale :
- O_i désigne l’effectif ou la fréquence empiriquement observée dans la i-ème catégorie ou case du plan expérimental ;
- E_i (pour Expected en anglais) représente l’effectif théorique attendu ou espéré dans cette même cellule sous la condition stricte de validité de l’hypothèse nulle H₀ ;
- k symbolise le nombre total de cellules ou de modalités qualitatives analysées.
Le calcul impose d’élever au carré l’écart brut (O_i – E_i) afin de neutraliser les compensations de signes — la somme des écarts algébriques simples étant mathématiquement nulle — puis de diviser ce carré par l’effectif attendu E_i. Cette division opère une pondération statistique indispensable : une différence absolue de 10 observations ne possède pas la même portée sémiologique selon que l’effectif attendu s’élevait à 15 individus ou à 15 000 individus. La sommation de ces écarts standardisés produit la valeur globale X².
L’utilisation légitime de cette statistique d’échantillonnage est néanmoins assujettie au respect scrupuleux des conditions d’application asymptotiques énoncées par William Gemmell Cochran. La règle classique stipule qu’aucun effectif théorique E_i ne doit être inférieur à 1, et qu’au moins 80 % des cellules du tableau doivent présenter des effectifs théoriques supérieurs ou égaux à 5. De surcroît, une propriété intrinsèque de cette formule réside dans sa dépendance directe à la taille globale de l’échantillon (N) : multiplier par dix le volume de participants d’une cohorte sans modifier les proportions relatives observées multiplie exactement par dix la valeur finale de X², induisant une sensibilité accrue du test aux divergences les plus infimes.
3.2 Détermination des degrés de liberté pour un test d’indépendance
La validité de la consultation de la table repose entièrement sur l’exactitude de la valeur des degrés de liberté (ddl). Dans le cadre d’un test d’indépendance appliqué à un tableau de contingence croisant deux variables catégorielles comportant respectivement r rangées (lignes) et c colonnes, les degrés de liberté ne correspondent en aucun cas au nombre de sujets de l’étude (N), mais s’obtiennent par la formule matricielle :
ddl = (r – 1) × (c – 1)
Le fondement logique de cette équation réside dans la notion de contraintes mathématiques linéaires imposées par les totaux marginaux. Dans une table de dimensions r × c dont les totaux marginaux de chaque ligne et de chaque colonne sont fixés a priori par les données d’échantillonnage, seules (r – 1) × (c – 1) cellules possèdent la liberté de varier de façon autonome. Dès lors que ces cases libres reçoivent une valeur, le contenu de l’ensemble des cases restantes se trouve déterministement contraint et figé afin de satisfaire l’exactitude arithmétique des sommes marginales.
À titre d’illustration méthodologique :
- Pour un tableau croisé classique 2 × 2 (par exemple, Genre [F/H] × Présence d’un trouble anxieux [Oui/Non]), le calcul donne ddl = (2 – 1) × (2 – 1) = 1. Une seule cellule est libre, ce qui confère à la distribution une forte variance théorique.
- Pour une étude croisant deux groupes de traitement avec une échelle de Likert condensée en trois modalités (Insatisfait / Neutre / Satisfait), soit une table 2 × 3, les degrés de liberté s’établissent à ddl = (2 – 1) × (3 – 1) = 2.
- Pour une investigation explorant les relations entre quatre styles d’attachement et cinq catégories professionnelles (table 4 × 5), les degrés de liberté atteignent ddl = (4 – 1) × (5 – 1) = 3 × 4 = 12.
L’erreur la plus récurrente commise par les apprentis chercheurs consiste à confondre la taille de la cohorte d’étude avec le paramètre de la distribution. Utiliser N – 1 au lieu de (r – 1)(c – 1) conduirait à sélectionner une ligne de la table située à des dizaines ou centaines d’unités de la ligne adéquate, entraînant une sous-estimation dramatique de la p-valeur et une décision statistique totalement erronée.
3.3 Détermination des degrés de liberté pour un test de conformité
Dans le cas d’un test d’adéquation ou de conformité univarié — dans lequel une distribution observée sur une variable polytomique unique à k catégories mutuellement exclusives est comparée à une distribution théorique postulée —, la règle de dérivation des degrés de liberté s’exprime sous la forme canonique :
ddl = k – 1 – m
Dans cette relation, k représente le nombre total de classes ou modalités qualitatives de la variable. Le terme unitaire « – 1 » reflète la contrainte linéaire unique selon laquelle la somme de toutes les fréquences observées doit impérativement égaler l’effectif total N de l’échantillon. Si l’on connaît le total général et les effectifs de k – 1 catégories, l’effectif de la dernière classe est mécaniquement déterminé.
Le paramètre additionnel m désigne le nombre de paramètres distributionnels théoriques qui ont dû être préalablement estimés directement à partir des données de l’échantillon pour pouvoir calculer les fréquences attendues E_i. Si le modèle théorique est entièrement fixé a priori sans aucune estimation sur l’échantillon (par exemple, tester si un dé à six faces est équilibré, où la probabilité théorique de chaque face est 1/6, ou vérifier une proportion génétique mendélienne standard), aucun paramètre n’est estimé : m = 0, et l’équation se simplifie en ddl = k – 1.
En revanche, dans les protocoles de psychométrie où l’on cherche à éprouver l’adéquation d’un échantillon à une loi normale continue en discrétisant les scores en k classes d’intervalles, il est nécessaire d’estimer la moyenne empirique (m_score) et l’écart-type (s_score) sur l’échantillon pour calculer les bornes des aires sous la courbe de Gauss. Dans cette situation précise, deux paramètres sont soustraits (m = 2), et les degrés de liberté se réduisent à ddl = k – 1 – 2 = k – 3. Cette diminution directe des degrés de liberté déplace la distribution théorique vers la gauche, modifiant substantiellement les seuils critiques de dépassement sur la table statistique.
4. Procédure pas à pas pour déterminer la p-valeur via la table
4.1 Étape 1 : Localisation de la ligne des degrés de liberté correspondants
L’exécution de la procédure de détermination manuelle de la p-valeur débute par l’ancrage spatial sur la table imprimée. L’analyste doit diriger son regard le long de la première colonne marginale gauche répertoriant les degrés de liberté pour isoler la ligne unique dont l’indice équivaut exactement à la valeur ddl dérivée à la section précédente. Cette étape préliminaire requiert une vigilance rigoureuse : il n’est pas rare, sous la pression d’un examen ou lors de la lecture dense de micro-colonnes imprimées, de commettre une erreur de parallaxe visuelle en sélectionnant accidentellement la ligne immédiatement supérieure (ddl – 1) ou inférieure (ddl + 1).
Dans l’hypothèse où le plan expérimental génère un nombre important de degrés de liberté (par exemple, ddl = 47 ou ddl = 73) qui ne figure pas explicitement sur la table — les tables sautant fréquemment de 40 à 50, puis de 50 à 60 —, le chercheur dispose de deux conduites méthodologiques acceptables. La première, éminemment conservatrice sur le plan du contrôle de l’erreur de type I, consiste à retenir la ligne du degré de liberté immédiatement inférieur disponible (dans notre exemple, sélectionner la ligne 40 pour un ddl de 47). En augmentant artificiellement la valeur critique requise pour atteindre la significativité, cette approche prévient tout rejet abusif de l’hypothèse nulle.
La seconde modalité, privilégiée pour une rigueur analytique accrue lors de grands échantillons, réside dans l’usage des formules d’approximation asymptotique fournies par Karl Pearson ou Sir Ronald Fisher. Selon la transformation de Fisher, pour ddl > 30, la quantité √(2χ²) se distribue de manière approximativement normale avec une moyenne égale à √(2ddl – 1) et un écart-type unitaire, autorisant ainsi un calcul direct via la table de la loi normale centrée réduite si nécessaire.
4.2 Étape 2 : Balayage horizontal et repérage de la statistique calculée
Une fois la ligne correspondant aux degrés de liberté formellement identifiée et verrouillée, l’analyste procède à un balayage horizontal méthodique de gauche à droite le long de cette rangée unique. Les valeurs numériques compilées au sein des cellules de cette ligne augmentent de façon strictement monotone : plus l’on progresse vers la droite du tableau, plus les valeurs critiques du khi-carré sont élevées, reflétant des écarts d’échantillonnage de plus en plus rares et improbables sous l’hypothèse nulle.
L’objectif de cette étape consiste à localiser la position relative de la statistique de test empirique X² observée par rapport aux valeurs discrètes tabulées. Deux cas de figure géométriques peuvent alors se présenter :
- Dans un cas rare mais théoriquement envisageable, la statistique calculée coïncide au centième près avec l’une des valeurs critiques imprimées dans la ligne ;
- Dans l’immense majorité des applications empiriques en recherche psychologique, la statistique observée X² n’apparaît pas telle quelle, mais s’insère de manière continue entre deux valeurs critiques consécutives de la ligne.
L’analyste doit alors repérer avec précision :
- La valeur critique tabulée immédiatement inférieure à sa statistique calculée, que nous désignerons par X²_inf ;
- La valeur critique tabulée immédiatement supérieure à sa statistique calculée, désignée par X²_sup.
L’inégalité d’encadrement s’établit dès lors formellement sous la configuration structurelle : X²_inf < X²_obs < X²_sup.
4.3 Étape 3 : Déduction de l’intervalle encadrant la p-valeur
Ayant encadré avec succès la statistique de test entre deux bornes critiques adjacentes sur la rangée des degrés de liberté, l’analyste remonte verticalement le long des colonnes correspondantes pour lire les niveaux de probabilités α inscrits dans la ligne d’en-tête supérieure de la table. Une compréhension fondamentale de la relation géométrique inverse propre aux queues de distribution s’impose impérativement à ce stade du raisonnement.
Puisque la probabilité de dépassement critique unilatérale P(χ² ≥ x) est une fonction mathématique strictement décroissante de la valeur de la statistique x, une valeur critique plus élevée correspond obligatoirement à une surface sous la courbe plus petite, et donc à une p-valeur plus faible. Par conséquent, les en-têtes de colonnes associées aux bornes critiques subissent une inversion relationnelle directe :
- À la borne critique inférieure X²_inf correspond la probabilité de queue la plus forte (désignée par α_inf, située plus à gauche sur l’en-tête) ;
- À la borne critique supérieure X²_sup correspond la probabilité de queue la plus faible (désignée par α_sup, située plus à droite sur l’en-tête).
L’intervalle de déduction probabiliste s’écrit dès lors sous la forme d’une double inégalité rigoureuse :
α_sup < p-valeur < α_inf
Si, par exemple, la statistique observée se situe entre la valeur critique associée à la colonne 0,05 et celle associée à la colonne 0,01, l’analyste déduit avec une certitude absolue que la p-valeur de son test est comprise dans l’intervalle 0,01 < p < 0,05. Cette information est amplement suffisante pour trancher quant au rejet de l’hypothèse nulle au regard du seuil décisionnel prédéterminé α = 0,05.
5. Exemple concret détaillé : Statistique X2 de 27,42 avec 14 degrés de liberté
5.1 Mise en situation d’une étude expérimentale en psychologie
Afin de concrétiser l’application directe de ce protocole de lecture, considérons une recherche clinique translationnelle menée en psychologie de la santé. Une équipe de chercheurs s’intéresse à l’observance thérapeutique de patients souffrant d’anxiété généralisée, répartis selon différentes approches psychothérapeutiques et psychiatriques (Thérapie Cognitive et Comportementale, Thérapie d’Acceptation et d’Engagement, Psychanalyse brève, et Suivi pharmacologique standard) en fonction de cinq degrés gradués d’adhésion au traitement mesurés sur une échelle validée de suivi.
Ce protocole expérimental génère un tableau de contingence de dimensions 4 rangées × 5 colonnes. L’application scrupuleuse des règles relatives aux degrés de liberté établit :
ddl = (4 – 1) × (5 – 1) = 3 × 4 = 14
L’hypothèse nulle (H₀) formalisée a priori postule que l’observance thérapeutique est strictement indépendante de la modalité psychothérapeutique reçue par le patient. Le seuil de décision nominal est conventionnellement fixé à α = 0,05. Après la collecte rigoureuse des données sur une cohorte de 350 patients et la compilation des effectifs théoriques attendus (tous largement supérieurs au critère de sécurité de Cochran avec E_i > 12 sur chaque cellule), l’évaluation matricielle de la formule de Pearson produit une statistique de test empirique observée égale à :
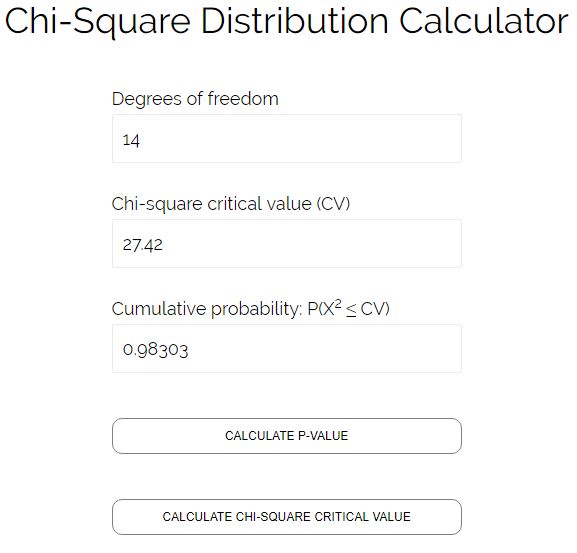
X²_obs = 27,42
Le chercheur se munit à présent de sa table statistique imprimée de la loi du khi-carré pour déterminer la p-valeur associée à cette divergence empirique.
5.2 Exploration méthodologique de la ligne ddl = 14 dans la table
L’analyste ouvre la table statistique et descend verticalement le long de la première colonne pour isoler sans ambiguïté la ligne ddl = 14. En balayant horizontalement cette rangée de gauche à droite à travers les différentes colonnes de dépassement unilatéral α, nous pouvons extraire la séquence de valeurs critiques standard suivantes :
- Pour α = 0,20 : valeur critique = 18,15
- Pour α = 0,10 : valeur critique = 21,06
- Pour α = 0,05 : valeur critique = 23,68
- Pour α = 0,025 : valeur critique = 26,12
- Pour α = 0,01 : valeur critique = 29,14
- Pour α = 0,001 : valeur critique = 36,12
L’examen comparatif de notre statistique observée X² = 27,42 le long de cette série ordonnée permet de retracer méthodologiquement sa trajectoire :
- La valeur 27,42 dépasse largement le seuil de 21,06 associé à la colonne α = 0,10 ;
- Elle excède également la valeur critique standard de 23,68 correspondant au seuil décisionnel classique de 0,05 ;
- Poursuivant sa course vers la droite, la valeur 27,42 dépasse la valeur critique 26,12 associée au niveau α = 0,025 ;
- En revanche, elle s’arrête net avant d’atteindre la valeur critique suivante de 29,14, qui correspond à la colonne α = 0,01.
La statistique observée X² = 27,42 se retrouve donc parfaitement et strictement encapsulée entre les bornes critiques discrètes 26,12 et 29,14.
5.3 Encadrement précis de la p-valeur et conclusion statistique
La remontée verticale depuis ces deux bornes vers la rangée d’en-tête de la table permet d’identifier directement les deux probabilités critiques qui encadrent notre résultat. La valeur inférieure 26,12 correspond à une probabilité de queue droite de 0,025, tandis que la valeur supérieure 29,14 correspond à une probabilité de 0,01. En vertu du principe de monotonie décroissante énoncé précédemment, la p-valeur empirique se trouve rigoureusement bornée au sein de l’intervalle :
0,01 < p < 0,025
Sur la base de cet encadrement probabiliste exact extrait de la table, le clinicien procède à l’arbitrage méthodologique. Étant donné que la limite supérieure de cet intervalle (0,025) est strictement inférieure au risque d’erreur de première espèce fixé a priori (α = 0,05), l’inégalité de décision p < α est indiscutablement satisfaite.
En conséquence, l’hypothèse nulle H₀ d’indépendance stochastique est formellement rejetée au seuil de signification de 5 %. Les chercheurs concluent qu’il existe une association statistiquement significative entre l’approche psychothérapeutique dispensée et le degré d’observance des patients souffrant de troubles anxieux généralisés (X²(14, N = 350) = 27,42, p < .025). La probabilité d’obtenir une telle divergence d’adhésion sous l’effet exclusif du hasard est inférieure à 2,5 %, démontrant un impact différentiel tangible des dispositifs thérapeutiques.
6. Comparaison entre l’approche par valeur critique et l’approche par p-valeur
6.1 Mécanisme de décision via le seuil critique absolu
Dans l’histoire du raisonnement inductif en statistique, l’approche préconisée par Jerzy Neyman et Egon Pearson s’articulait originellement autour de l’utilisation exclusive d’un seuil critique absolu. Dans cette perspective décisionnelle binaire, le chercheur sélectionne préalablement à l’expérimentation son risque d’erreur nominal (par exemple α = 0,05) et consulte la table du khi-carré pour extraire la valeur seuil unique X²_critique correspondant à ses degrés de liberté. Dès cet instant, l’espace des données se trouve partitionné de manière irrévocable en deux régions disjointes : la région de non-rejet (ou d’acceptation opérationnelle) et la région de rejet (également appelée région critique).
La règle décisionnelle est alors purement mécanique :
- Si X²_obs > X²_critique, on rejette catégoriquement H₀ au profit de H₁ ;
- Si X²_obs ≤ X²_critique, on ne rejette pas H₀ (ou l’on suspend son jugement).
Cette méthodologie possède l’avantage indéniable de la simplicité et d’une remarquable économie cognitive : elle ne réclame aucun calcul algorithmique élaboré et permet de trancher instantanément sans calculatrice. Cependant, elle présente une limitation épistémologique majeure : elle engendre une perte massive d’information quantitative en réduisant un continuum probabiliste riche à un verdict dichotomique simpliste. Elle traite avec une parfaite indifférence une statistique frôlant de justesse la frontière critique et une statistique qui pulvériserait cette même limite de plusieurs ordres de grandeur.
6.2 Apport informationnel supérieur de la p-valeur
Introduite avec force par Sir Ronald Aylmer Fisher, l’approche axée sur la p-valeur refuse l’enfermement dans une règle décisionnelle arbitrairement binarisée. La p-valeur offre une quantification continue et nuancée du degré de compatibilité ou de discordance existant entre les données de l’échantillon empirique et l’hypothèse nulle postulée. Elle répond directement à la question épistémologique : à quel point ce que nous venons d’observer est-il surprenant ou invraisemblable sous l’égide du hasard pur ?
Considérons deux études expérimentales indépendantes testant une même hypothèse avec 14 degrés de liberté sous un seuil α = 0,05 (où la valeur critique tabulée est 23,68) :
- La première étude collige une statistique X² = 23,80. L’encadrement par la table indique une p-valeur située juste en dessous de 0,05 (par exemple 0,049). Le résultat est formellement significatif, mais l’évidence empirique demeure précaire et particulièrement sensible aux variations d’échantillonnage ;
- La seconde étude obtient une statistique X² = 45,20. La lecture de la table montre que cette valeur excède largement le quantile à α = 0,001 (36,12). La p-valeur est donc infinitésimale (p < 0,001).
Alors que la méthode du seuil critique absolu qualifierait indifféremment ces deux résultats du même label monolithique « significatif », la p-valeur communique instantanément à la communauté scientifique que la seconde étude apporte une preuve méthodologique considérablement plus robuste et probante que la première. De surcroît, la p-valeur facilite les méta-analyses contemporaines et permet de combiner les niveaux d’évidence issus de multiples laboratoires indépendants.
6.3 Complémentarité des deux approches dans la recherche contemporaine
Loin de s’exclure mutuellement, ces deux visions méthodologiques s’articulent aujourd’hui de façon symbiotique dans la pratique des chercheurs en psychologie et en sciences biomédicales. Le recours préalable au seuil critique absolu permet de préserver la rigueur néo-pearsonienne du contrôle des erreurs de première espèce, prémunissant l’analyste contre la tentation de post-rationaliser ses découvertes en modifiant opportunément ses exigences décisionnelles au vu des résultats.
Concomitamment, le rapportage précis de la p-valeur ou de son encadrement analytique strict enrichit substantiellement l’interprétation des données psychologiques. Il permet aux évaluateurs par les pairs (peer reviewers) et aux lecteurs critiques d’évaluer par eux-mêmes la proximité des données vis-à-vis des frontières d’indécision. Cette complémentarité opérationnelle constitue la norme d’excellence au sein des revues scientifiques internationales indexées, où la double divulgation de la statistique de test exacte, de ses degrés de liberté associés et de la p-valeur déduite est systématiquement exigée pour garantir une transparence reproductible.
7. Technique d’interpolation linéaire pour affiner l’estimation de la p-valeur
7.1 Principes mathématiques sous-jacents à l’interpolation linéaire
La lecture standard de la table de distribution du khi-carré ne délivre intrinsèquement qu’un encadrement ordinal discontinu de la p-valeur sous la forme d’un intervalle délimité par deux colonnes prédéterminées. Lorsqu’un chercheur ou un étudiant en situation d’évaluation souhaite obtenir une approximation ponctuelle plus précise sans avoir recours à un ordinateur, la technique de l’interpolation linéaire locale offre une solution analytique élégante.
L’interpolation repose sur le postulat géométrique selon lequel, sur un segment extrêmement restreint de la courbe de distribution, l’arc de la fonction de répartition peut être assimilé avec une excellente tolérance à un segment de droite affine. Si l’on dispose de deux points de coordonnées connus sur la table, le point inférieur A(X²_inf ; α_inf) et le point supérieur B(X²_sup ; α_sup), la pente mathématique de la corde reliant ces deux coordonnées s’exprime par le ratio différentiel des probabilités sur les statistiques :
Pente (m) = frac{α_sup – α_inf}{X²_sup – X²_inf}
Cette pente est intrinsèquement négative, reflétant la relation inverse entre statistique et probabilité. L’estimation de la p-valeur approchée (p_interp) pour une statistique empirique X²_obs intermédiaire s’obtient alors par l’équation d’extrapolation linéaire directe :
p_interp = α_inf + left( frac{X²_obs – X²_inf}{X²_sup – X²_inf} right) × (α_sup – α_inf)
Il importe toutefois de garder à l’esprit les limites inhérentes à cette approximation : la véritable fonction de densité du khi-carré présentant une courbure convexe accentuée sur ses queues de distribution, l’interpolation linéaire tend à surestimer très légèrement la probabilité réelle par rapport à l’aire sous l’intégrale exacte, une erreur relative qui demeure néanmoins tout à fait négligeable sur les intervalles étroits.
7.2 Application calculatoire détaillée sur l’exemple pratique
Mettons en pratique cette formulation algébrique en reprenant les paramètres exacts développés dans notre exemple clinique antérieur à 14 degrés de liberté, où nous avions recueilli la statistique empirique X²_obs = 27,42. Rappelons les coordonnées extraites de la table de distribution :
- Point A (borne critique inférieure) : X²_inf = 26,12 correspondant à α_inf = 0,025 ;
- Point B (borne critique supérieure) : X²_sup = 29,14 correspondant à α_sup = 0,010.
Procédons par étapes ordonnées pour exécuter le calcul manuel :
- Calculons d’abord l’écart total séparant les deux valeurs critiques tabulées :
ΔX² = 29,14 – 26,12 = 3,02 - Calculons l’écart séparant notre statistique calculée de la borne inférieure :
δX² = 27,42 – 26,12 = 1,30 - Calculons la fraction ou ratio de progression de notre valeur au sein de l’intervalle :
Ratio = 1,30 / 3,02 ≈ 0,43046 (soit environ 43,05 % de la distance entre les bornes) - Calculons l’amplitude de la variation de probabilité entre les deux colonnes d’en-tête :
Δα = 0,010 – 0,025 = -0,015 - Appliquons la pondération linéaire pour ajuster la probabilité initiale :
p_interp = 0,025 + (0,43046 × (-0,015))
p_interp = 0,025 – 0,006457 = 0,018543
En arrondissant ce résultat selon les règles métrologiques habituelles, nous obtenons une p-valeur estimée par interpolation linéaire égale à p ≈ 0,0186 (ou 0,019). Cette modélisation manuelle permet donc de préciser drastiquement l’encadrement brut initial [0,010 ; 0,025], situant le résultat au voisinage direct de 1,9 %.
7.3 Comparaison de l’interpolation avec les calculs informatiques exacts
Pour évaluer la fiabilité opérationnelle et la fidélité de cette méthode d’approximation manuelle, confrontons la valeur issue de notre interpolation linéaire (p ≈ 0,0185) à la p-valeur algorithmique exacte calculée par un progiciel statistique moderne (tel que R ou SciPy) exécutant l’intégration continue de la fonction gamma incomplète. L’évaluation computationnelle exacte de la queue de distribution pour χ² = 27,42 avec 14 degrés de liberté fournit :
p_exact = 0,016987… (soit p ≈ 0,0170)
L’écart absolu entre notre estimation manuelle linéaire et le calcul informatique parfait est de seulement :
|0,0185 – 0,0170| = 0,0015
Une erreur résiduelle d’à peine 0,15 % de probabilité s’avère totalement insignifiante dans le cadre de la prise de décision scientifique standard. Dans les deux cas, le verdict méthodologique est rigoureusement identique : le chercheur rejette H₀ au seuil nominal α = 0,05. Cet exercice démontre que l’interpolation linéaire appliquée sur une table statistique papier offre un degré de précision tout à fait remarquable, permettant à l’analyste chevronné de s’affranchir ponctuellement de l’ordinateur sans compromettre la rigueur de son inférence.
8. Application au test d’adéquation (Goodness of Fit) en psychométrie
8.1 Particularités structurales du test d’adéquation
Le test d’adéquation de Pearson (ou goodness-of-fit) représente l’instrument canonique de validation d’hypothèses distributionnelles en psychométrie et en étalonnage de tests cognitifs. Contrairement aux devis d’indépendance matriciels, ce test analyse un vecteur unidimensionnel de données empiriques réparties sur k modalités qualitatives disjointes et le confronte à un ensemble de fréquences théoriques déterminées par un modèle théorique préexistant ou postulé a priori. L’objectif scientifique consiste à établir si l’échantillon observé peut être considéré comme extrait légitimement d’une population parente épousant cette structure idéale.
Les hypothèses statistiques se formulent de façon symétrique mais inversée par rapport aux tests expérimentaux de différence :
- L’hypothèse nulle (H₀) postule que les données empiriques s’ajustent de manière optimale au modèle théorique spécifié (les écarts ne sont dus qu’aux fluctuations d’échantillonnage) ;
- L’hypothèse alternative (H₁) affirme qu’il existe une distorsion structurelle significative entre la distribution de l’échantillon et le modèle théorique postulé.
Dans ce contexte précis, le chercheur ou le constructeur d’outils psychométriques espère le plus souvent ne pas rejeter l’hypothèse nulle. Un non-rejet conforte en effet l’idée que le test psychologique respecte la normalité attendue des traits latents ou que la cohorte recrutée reflète fidèlement la démographie nationale de référence sans distorsion sociologique.
8.2 Procédure d’extraction de la p-valeur pour un modèle psychométrique
Considérons un exemple concret portant sur la standardisation d’une nouvelle échelle de régulation émotionnelle administrée à une cohorte de 200 adolescents. Les auteurs postulent théoriquement que les scores globaux se distribuent selon une typologie comportementale équilibrée en cinq profils fonctionnels équiprobables (chacun devant représenter 20 % de la population, soit un effectif théorique attendu E_i = 200 × 0,20 = 40 individus par classe). Les effectifs empiriques colligés s’élèvent respectivement à : 48 pour le profil 1, 35 pour le profil 2, 32 pour le profil 3, 52 pour le profil 4 et 33 pour le profil 5.
Le calcul séquentiel de la statistique du khi-carré selon la formule sommative donne :
- Cellule 1 : (48 – 40)² / 40 = 64 / 40 = 1,60
- Cellule 2 : (35 – 40)² / 40 = 25 / 40 = 0,625
- Cellule 3 : (32 – 40)² / 40 = 64 / 40 = 1,60
- Cellule 4 : (52 – 40)² / 40 = 144 / 40 = 3,60
- Cellule 5 : (33 – 40)² / 40 = 49 / 40 = 1,225
- Statistique globale X² = 1,60 + 0,625 + 1,60 + 3,60 + 1,225 = 8,65
Le nombre de catégories étant k = 5 et aucun paramètre distributionnel n’ayant été estimé à partir des données, les degrés de liberté sont :
ddl = 5 – 1 = 4
L’analyste consulte la table à la ligne ddl = 4. En balayant les valeurs critiques tabulées :
- Pour α = 0,10 : valeur critique = 7,78
- Pour α = 0,05 : valeur critique = 9,49
Notre statistique calculée X² = 8,65 s’intercale strictement entre 7,78 et 9,49. La déduction immédiate de l’encadrement sur la table révèle que :
0,05 < p < 0,10
Puisque la p-valeur est supérieure au seuil usuel α = 0,05, les psychométriciens ne rejettent pas l’hypothèse nulle H₀ au niveau de confiance de 95 %. L’adéquation théorique aux cinq profils équiprobables est jugée acceptable sur le plan purement statistique, bien que la proximité du seuil de 10 % invite à examiner prudemment les écarts observés sur les profils 3 et 4.
8.3 Conséquences méthodologiques du non-rejet de l’hypothèse nulle
Le dénouement méthodologique exposé ci-dessus impose une vigilance épistémologique capitale : l’absence de preuve n’est pas la preuve de l’absence. Échouer à rejeter l’hypothèse nulle (parce que p > 0,05) ne valide pas de manière affirmative et définitive la conformité absolue du modèle au monde réel. Cette issue indique uniquement que la magnitude des données empiriques recueillies n’est pas suffisante pour déceler une divergence flagrante avec le modèle théorique sous le seuil d’erreur fixé.
Cette situation est tributaire de la puissance statistique du protocole expérimental, laquelle dépend intimement de la taille de l’échantillon N. Si l’étude précédente n’avait inclus que 50 sujets au lieu de 200, le test du khi-carré aurait affiché une puissance très médiocre, incapable de détecter une anomalie structurelle même prononcée (risque élevé de commettre une erreur de type II). Inversement, sur un échantillon normatif massif de 10 000 sujets, un écart infinitésimal et sans aucune portée clinique entre fréquences observées et attendues aurait produit un X² gigantesque et une p-valeur ultra-significative (p < 0,001), conduisant au rejet formel de l’adéquation.
C’est pourquoi la bonne pratique en psychométrie impose d’adjoindre systématiquement à la consultation de la table une analyse des résidus standardisés ajustés pour chaque modalité, garantissant qu’aucune cellule particulière ne s’écarte substantiellement des bornes de tolérance tolérées par la loi normale (résidus compris entre -1,96 et +1,96).
9. Application au test d’indépendance du khi-carré en psychologie sociale
9.1 Modélisation des tableaux de contingence complexes
Dans les paradigmes de la psychologie sociale et comportementale, les chercheurs déploient le test d’indépendance du khi-carré pour éprouver des relations entre variables d’attitudes, catégories culturelles ou comportements d’affiliation. Prenons l’exemple d’une investigation examinant la corrélation stochastique potentielle entre trois catégories de réactivité au stress (Hyperréactif, Normoréactif, Hyporéactif) et trois types d’adaptation socio-émotionnelle en contexte professionnel (Coopération active, Retrait social, Compétition agressive). Cette modélisation génère un tableau de contingence 3 × 3 complexe rassemblant 9 cellules d’interaction.
Sous l’hypothèse nulle d’indépendance H₀, la probabilité conjointe qu’un individu appartienne simultanément à la rangée i et à la colonne j est rigoureusement égale au produit de leurs probabilités marginales respectives :
P(Rangée_i ∩ Colonne_j) = P(Rangée_i) × P(Colonne_j)
Cette propriété mathématique permet d’établir les effectifs théoriques attendus de chaque case en multipliant la somme marginale de la ligne par la somme marginale de la colonne, le tout divisé par l’effectif global :
E_{ij} = frac{Total_Ligne_i × Total_Colonne_j}{N}
Pour cette matrice 3 × 3, le calcul structurel des degrés de liberté s’établit à :
ddl = (3 – 1) × (3 – 1) = 2 × 2 = 4
Le nombre de degrés de liberté étant identique au test d’adéquation analysé précédemment, les valeurs critiques à interroger sur la table seront identiques, mais leur signification conceptuelle portera cette fois sur la covariance de deux construits psychologiques distincts.
9.2 Extraction de la p-valeur et arbitrage décisionnel
Imaginons que les calculs de sommation quadratique appliqués aux 9 cellules de cette enquête menée auprès de 450 professionnels aboutissent à une statistique observée :
X²_obs = 10,45
Le chercheur se reporte à nouveau sur la ligne ddl = 4 de sa table de distribution du khi-carré pour dériver la p-valeur associée. La séquence des valeurs critiques pertinentes pour cette ligne indique :
- Pour α = 0,05 : valeur critique = 9,49
- Pour α = 0,025 : valeur critique = 11,14
- Pour α = 0,01 : valeur critique = 13,28
La statistique observée X² = 10,45 se situe clairement au-delà de 9,49 mais en deçà de 11,14. La lecture des en-têtes de colonnes correspondantes permet de déduire instantanément l’encadrement :
0,025 < p < 0,05
L’arbitrage décisionnel est sans équivoque : la p-valeur étant strictement inférieure au seuil alpha canonique de 0,05, l’hypothèse nulle d’indépendance statistique entre la réactivité au stress et le mode d’adaptation professionnelle est formellement rejetée. L’analyste conclut qu’il existe une association significative entre la dimension neuro-émotionnelle du stress et le pattern relationnel adopté au travail. Néanmoins, cet encadrement révèle que la p-valeur n’atteint pas le seuil de 0,01, signalant un niveau d’évidence empirique statistiquement valide mais modéré.
9.3 Distinction essentielle entre significativité statistique et clinique
L’obtention d’une p-valeur statistiquement significative (p < 0,05) extraite avec succès de la table ne saurait constituer l’épilogue de la démarche d’évaluation scientifique. L’un des écueils les plus pernicieux en sciences humaines réside dans la confusion entre la significativité statistique — qui renseigne exclusivement sur la probabilité que l’effet observé soit imputable aux fluctuations d’échantillonnage — et la pertinence théorique ou clinique concrète de l’association mise en évidence.
En vertu de la formulation de Pearson, la statistique X² croît de manière proportionnelle à l’effectif total N. Dès lors, sur un échantillon épidémiologique comprenant plusieurs dizaines de milliers de répondants, la divergence la plus triviale et dépourvue de toute utilité pratique engendrera invariablement une statistique astronomique débouchant sur une p-valeur infinitésimale (par exemple, p < 0,000001). À l’inverse, dans une étude clinique pilote portant sur 25 patients souffrant d’une pathologie rare, un effet thérapeutique massif peut échouer à atteindre la significativité statistique (p > 0,05) par simple déficit de puissance d’échantillonnage.
Pour cette raison fondamentale, la déduction de la p-valeur via la table doit impérativement s’accompagner du calcul d’un indicateur de taille d’effet standardisé, indépendant du volume de l’échantillon. Pour les tableaux de contingence de dimensions supérieures à 2 × 2, la métrique canonique est le V de Cramér, calculé selon la formule :
V = sqrt{frac{X²}{N × min(r – 1, c – 1)}}
Dans notre étude sur le stress (X² = 10,45, N = 450, ddl_min = 2) :
V = sqrt{frac{10,45}{450 × 2}} = sqrt{frac{10,45}{900}} = sqrt{0,01161} approx 0,108
Selon les conventions établies par Jacob Cohen, un coefficient V de 0,10 correspond à un effet de taille très faible (proche du plancher de détection). Ainsi, bien que le test soit statistiquement significatif au vu de la table, la magnitude clinique de l’association demeure marginale, ce qu’une lecture critique responsable doit impérativement expliciter dans la discussion des résultats.
10. Erreurs méthodologiques courantes lors de l’utilisation de la table
10.1 Erreurs de spécification des degrés de liberté
L’erreur la plus ubiquitaire et destructrice lors de la consultation des tables statistiques imprimées concerne la spécification erronée de la ligne des degrés de liberté. Ainsi que nous l’avons souligné, l’assimilation intuitive mais fallacieuse des degrés de liberté à l’effectif total de participants (N ou N – 1) constitue un réflexe fréquent chez les chercheurs néophytes habitués aux tests paramétriques simples de corrélation de Pearson ou au test t à un échantillon.
Considérons les ravages méthodologiques d’une telle confusion : pour notre étude clinique antérieure croisant 4 thérapies et 5 modalités d’observance sur 350 sujets, les vrais degrés de liberté sont ddl = (4 – 1) × (5 – 1) = 14, où la valeur critique à α = 0,05 s’établit à 23,68. Si l’analyste avait utilisé à tort la taille de l’échantillon (ddl = 350 – 1 = 349), la valeur critique requise sur une distribution asymptotique s’élèverait à plus de 393,0. Notre statistique observée de 27,42 aurait paru totalement dérisoire, conduisant à tort à déclarer le résultat non significatif (faux négatif majeur). Inversement, utiliser un nombre de degrés de liberté trop faible expose directement au risque de faux positif.
Une autre source majeure d’erreur structurelle réside dans l’oubli de la soustraction des paramètres distributionnels estimés (m) lors des tests d’adéquation psychométrique, ou encore dans le maintien artificiel de lignes ou de colonnes entièrement vides dans un tableau de contingence alors que certains sous-groupes n’ont recueilli aucune observation réelle. Tout mauvais décompte de la géométrie matricielle fausse irréversiblement l’ancrage horizontal sur la table.
10.2 Mauvaise lecture du sens des probabilités de queue
Une seconde catégorie d’erreurs méthodologiques provient de l’inversion d’axe ou d’une méprise sur le sens probabiliste des en-têtes de colonnes. Certaines personnes non formées aux subtilités des tables unilatérales appliquent par mimétisme la logique des tests bilatéraux de la loi normale (comme le test Z où l’on découpe le risque α en deux moitiés égales de 2,5 % réparties aux deux extrémités de la cloche). Or, dans l’écrasante majorité des applications du khi-carré, le test est fondamentalement unilatéral à droite (one-tailed), car la statistique X² étant une somme d’écarts quadratiques, seules les divergences positives extrêmes signalent une violation de l’hypothèse nulle.
Dédoubler artificiellement la p-valeur en la multipliant par deux (croyant corriger une bilatéralité) ou, pire encore, utiliser les colonnes de la distribution cumulative gauche (en retenant 1 – α, soit 0,95 au lieu de 0,05) débouche sur des contresens scientifiques absolus. Par exemple, si une table rapporte les valeurs cumulatives inférieures, la colonne 0,95 indique le seuil au-delà duquel se situent les 5 % les plus extrêmes. Si le chercheur lit la colonne 0,05 sur cette même table, il extrait le seuil délimitant les 5 % de valeurs les plus proches de zéro (zone d’adéquation quasi miraculeuse souvent suspecte de manipulation de données ou d’absence totale d’aléa).
Pour prévenir ces errements, une règle pratique élémentaire doit être appliquée systématiquement : sur la ligne des ddl, plus la statistique de test observée augmente numériquement, plus la p-valeur doit obligatoirement décroître vers zéro. Toute démarche d’encadrement qui aboutirait à associer une statistique observée plus grande à une p-valeur plus élevée trahit une inversion immédiate du sens de parcours de la table.
10.3 Mauvaises interprétations conceptuelles de la p-valeur
Au-delà de la manipulation mécanique de la table imprimée, les erreurs d’interprétation conceptuelle de la p-valeur demeurent tristement répandues dans la littérature scientifique contemporaine. La méprise la plus prégnante est connue sous le nom de sophisme de la conditionnelle inversée (ou fallacy of the transposed conditional). Il consiste à croire faussement que la p-valeur représente la probabilité que l’hypothèse nulle soit vraie au vu des données recueillies, soit l’illusion que p = P(H₀ | Données).
En réalité purement fréquentiste, la p-valeur quantifie exclusivement la plausibilité des données sachant que H₀ est vraie, soit l’expression mathématique :
p = P(Données ge Observées mid H_0)
Confondre ces deux termes revient à confondre la probabilité d’avoir de la fièvre si l’on a contracté une pathologie rare avec la probabilité d’avoir cette pathologie si l’on a de la fièvre. Par ailleurs, les raccourcis prétendant qu’une p-valeur de 0,03 indique que le traitement expérimental a 97 % de chances d’être efficace ou que les résultats ont 97 % de chances d’être réplicables sont des aberrations épistémologiques formelles.
Enfin, rappelons qu’une p-valeur extraite d’une table perd toute validité statistique si les postulats fondamentaux de la loi n’ont pas été respectés en amont, tout particulièrement si les observations de l’échantillon ne sont pas indépendantes entre elles (par exemple des mesures répétées sur les mêmes sujets analysées par un khi-carré standard) ou si la règle de Cochran sur les effectifs théoriques minimaux a été violée. Dans ce dernier cas, l’inflation artificielle de la statistique produit des p-valeurs illusoires ne reflétant en rien la réalité sous-jacente.
11. Passage de la table statique aux environnements logiciels modernes
11.1 Fonctions d’obtention de la p-valeur exacte sous R et Python
Bien que la table imprimée constitue un socle d’apprentissage irremplaçable, la pratique quotidienne de la recherche contemporaine s’opère majoritairement au sein d’environnements computationnels open-source hautement optimisés tels que R ou l’écosystème Python. Ces langages mobilisent des algorithmes d’intégration numérique continue permettant de calculer la p-valeur exacte associée à n’importe quelle statistique de test continue sans aucune contrainte de discrétisation de table.
Dans l’environnement de programmation statistique R, l’obtention de l’aire sous la queue supérieure de la distribution du khi-carré s’effectue via la fonction de répartition native. Pour interroger la probabilité de dépassement critique exacte correspondant à notre exemple clinique (X² = 27,42 avec ddl = 14), l’analyste fait appel à l’instruction :
pchisq(27.42, df = 14, lower.tail = FALSE)
L’argument lower.tail = FALSE indique explicitement à R d’intégrer l’aire située à droite de la valeur (queue supérieure), fournissant instantanément le résultat continu 0,016987. Parallèlement, pour exécuter l’ensemble du test d’indépendance directement depuis une matrice matricielle de contingence tab, la syntaxe chisq.test(tab, correct = FALSE) délivre simultanément la statistique, les degrés de liberté exacts et la p-valeur computationnelle sans risque d’erreur humaine de report.
Au sein de l’environnement Python, c’est la bibliothèque scientifique SciPy et son module scipy.stats qui fournissent les fonctionnalités équivalentes. La fonction de survie (survival function, qui correspond rigoureusement à 1 – CDF, soit l’intégrale de droite) s’exécute via la formulation :
scipy.stats.chi2.sf(27.42, df=14)
De manière globale, la fonction scipy.stats.chi2_contingency(matrice) gère de manière automatisée l’estimation des fréquences théoriques, le calcul des degrés de liberté et l’ajustement éventuel de la correction de continuité de Frank Yates pour les tableaux 2 × 2.
11.2 Lecture et extraction des p-valeurs sous SPSS et JASP
Pour les chercheurs et étudiants évoluant sous des environnements à interface graphique utilisateur (GUI) comme IBM SPSS Statistics ou le logiciel moderne open-source JASP développé par l’Université d’Amsterdam, la dérivation computationnelle est entièrement automatisée. Cependant, la lecture correcte des sorties logicielles générées nécessite une vigilance terminologique particulière.
Dans les tableaux récapitulatifs édités par SPSS lors de l’exécution de la procédure « Tableaux croisés » (Crosstabs), la ligne consacrée au khi-carré de Pearson comporte une colonne intitulée « Signification asymptotique (bilatérale) » ou en version anglaise « Asymptotic Significance (2-sided) ». Cette terminologie logicielle historique s’avère particulièrement trompeuse : elle ne signifie nullement que l’aire unilatérale droite de la distribution a été multipliée par deux, mais traduit maladroitement le fait que le test évalue les écarts dans les deux sens possibles (positifs comme négatifs) au sein de la table de contingence. La p-valeur rapportée dans cette case est précisément la p-valeur unilatérale de dépassement de l’intégrale du khi-carré.
De surcroît, lorsque les effectifs de l’échantillon sont réduits et que les conditions d’application asymptotiques de Cochran ne sont plus garanties, ces progiciels modernes offrent l’immense avantage de pouvoir basculer vers des méthodes d’estimation exactes (Test exact de Fisher étendu) ou des algorithmes de rééchantillonnage par simulations de Monte Carlo. Ces approches itératives contournent intégralement la loi continue théorique du khi-carré pour recalculer une p-valeur empirique non paramétrique d’une fidélité absolue.
11.3 Valeur pédagogique et heuristique persistante de la table papier
Face à cette débauche de puissance computationnelle instantanée, on pourrait être tenté d’interroger la légitimité du maintien de l’apprentissage de la table statistique imprimée dans les cursus universitaires contemporains de méthodologie et de psychométrie. Pourtant, l’expérience pédagogique démontre invariablement que la manipulation physique de la table joue un rôle d’ancrage conceptuel irremplaçable.
L’utilisation de la table force l’esprit du jeune chercheur à visualiser concrètement la non-linéarité de l’espace statistique. Elle brise l’illusion de la « boîte noire logicielle » dans laquelle des données brutes sont injectées pour produire magiquement un verdict d’acceptation ou de rejet sans que les principes fondamentaux sous-jacents ne soient assimilés. En arpentant physiquement les rangées des degrés de liberté, l’observateur perçoit de manière tangible comment l’exigence critique s’élève au fur et à mesure que le système intègre des contraintes multidimensionnelles.
En outre, la maîtrise de la lecture de la table confère un esprit critique indispensable lors de la relecture d’articles scientifiques révisés par les pairs. Il n’est pas exceptionnel d’identifier, dans des publications contemporaines, des incohérences typographiques majeures entre la statistique de test X² mentionnée, les degrés de liberté affichés et la p-valeur annoncée. L’analyste rompu à la consultation de la table est capable, d’un simple coup d’œil mental de contrôle, de déceler immédiatement une anomalie d’édition ou un résultat incohérent dans un manuscrit soumis à son évaluation.
12. Normes de rédaction scientifique (APA 7) et diffusion des résultats
12.1 Standardisation du rapportage textuel des résultats du khi-carré
L’aboutissement de toute démarche inférentielle réside dans la communication publique et transparente des conclusions scientifiques au sein de rapports de recherche ou d’articles académiques. Le manuel de publication de l’American Psychological Association, dans sa septième édition (normes APA 7), définit un protocole syntaxique et typographique d’une rigueur absolue pour rapporter les résultats issus d’un test du khi-carré.
La règle formelle impose de présenter séquentiellement :
- La lettre grecque du test (χ²) en italique ou la notation X² en italique ;
- Les degrés de liberté (ddl), insérés entre parenthèses immédiatement après le symbole du test, sans espace intermédiaire ;
- L’effectif total validé de l’échantillon analysé, précédé de la mention N = (également entre parenthèses ou séparé par une virgule selon les contextes éditoriaux) ;
- Le signe d’égalité typographique entouré d’espaces réguliers, suivi de la valeur numérique calculée de la statistique de test, arrondie strictement à deux décimales ;
- La p-valeur exacte précédée d’un espace, du signe d’égalité (ou d’inégalité) et rapportée avec trois décimales. Selon les règles de l’APA, la p-valeur ne doit jamais être précédée d’un zéro avant la virgule décimale (on note p = .017 et non p = 0.017), car une probabilité ne peut mathématiquement jamais être supérieure à 1.
Si la p-valeur a été dérivée manuellement par encadrement sur une table statistique sans interpolation numérique exacte, la formulation doit obligatoirement refléter cette réalité sous forme d’une inégalité stricte :
χ²(14, N = 350) = 27,42, p < .025
Si un calcul logiciel ou une interpolation exacte a été réalisé, le formatage académique s’exprimera sous la configuration :
χ²(14, N = 350) = 27,42, p = .017
Enfin, si la p-valeur computationnelle est extraordinairement infime (par exemple 0,0000004), la convention APA proscrit rigoureusement la notation aberrante émise par certains logiciels affichant « p = .000 ». La formulation scientifique correcte s’écrit obligatoirement sous la forme du seuil de plancher : p < .001.
12.2 Intégration obligatoire des mesures d’ampleur de l’effet
L’évolution épistémologique majeure entérinée par les normes APA 7 réside dans l’interdiction formelle de restreindre le rapportage méthodologique à la seule p-valeur. Consciente des dérives du mouvement du « p-hacking » et de la surévaluation systémique de la significativité purement stochastique, la communauté scientifique internationale exige que toute divulgation d’un khi-carré soit accompagnée concomitamment d’une mesure standardisée de la magnitude ou taille de l’effet (effect size).
Le choix de l’indice de taille d’effet doit être rigoureusement adapté à la topologie du protocole de recherche :
- Pour les tableaux de contingence 2 × 2, le coefficient Phi (noté φ en italique) ou le rapport des cotes (Odds Ratio, noté OR) constitue la métrique standardisée prescrite ;
- Pour les tableaux de contingence de dimensions plus larges (r × c), le coefficient V de Cramér (noté V en italique) s’impose comme l’indice universel de référence ;
- Dans les protocoles de conformité univariés, le coefficient w de Cohen est préférentiellement mobilisé.
De surcroît, les recommandations éditoriales de pointe préconisent d’associer à cette mesure ponctuelle un intervalle de confiance à 95 % (IC 95 %), permettant d’apprécier la précision métrologique de l’estimation empirique. Une restitution textuelle canonique conforme aux exigences de publication des plus grandes revues internationales s’articulera ainsi :
« Une analyse par test d’indépendance du khi-carré a révélé une association statistiquement significative entre le type de prise en charge psychothérapeutique et le degré d’adhésion au traitement, χ²(14, N = 350) = 27,42, p = .017, V de Cramér = .11, IC 95 % [.04, .18]. Cependant, bien que robuste au seuil conventionnel de 5 %, la taille d’effet observée demeure modeste selon les critères de référence, suggérant que d’autres variables modératrices individuelles influencent l’observance clinique des patients. »
12.3 Bonnes pratiques de reproductibilité et transparence méthodologique
Pour parachever l’inscription des recherches quantitatives dans le mouvement contemporain de la science ouverte (Open Science), les chercheurs doivent s’astreindre à une transparence documentaire intégrale lors de la restitution de leurs analyses au khi-carré. La simple communication de la p-valeur dans le corps du texte ne suffit plus à garantir la reproductibilité des résultats par la communauté scientifique internationale.
Les recommandations méthodologiques actuelles imposent :
- De publier systématiquement, sous forme de tableaux clairs intégrés dans le manuscrit ou au sein d’annexes numériques ouvertes (sur des dépôts certifiés tels que l’Open Science Framework), la matrice complète des effectifs empiriques observés ainsi que les effectifs théoriques attendus correspondants ;
- De mentionner explicitement si les p-valeurs ont été extraites manuellement à partir d’une table imprimée de distribution (en indiquant le cas échéant l’édition et l’auteur de l’ouvrage méthodologique source) ou générées algorithmiquement par un progiciel statistique spécifique (en renseignant scrupuleusement le nom, la version logicielle et les packages utilisés) ;
- De proscrire catégoriquement toute recombinaison ou fusion opportuniste de catégories qualitatives après analyse exploratoire préliminaire — pratique frauduleuse de « p-hacking » visant à gonfler artificiellement la valeur de X² pour forcer une p-valeur récalcitrante à passer sous la barre fatidique de 0,05.
En respectant scrupuleusement ces canons éthiques et méthodologiques, le psychologue, le sociologue ou le biostatisticien assure à ses investigations empiriques un niveau maximal de rigueur démonstrative, transformant la simple extraction d’une p-valeur sur une table en un acte d’inférence scientifique pleinement intelligible, valide, éthique et pérenne.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1954). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Greenwood, P. E., & Nikulin, M. S. (1996). A guide to chi-squared testing. John Wiley & Sons.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108