
L’analyse quantitative contemporaine, qu’elle s’applique aux sciences du comportement, à l’épidémiologie clinique, aux sciences de l’éducation ou au marketing quantitatif, repose de manière prépondérante sur l’évaluation rigoureuse de variables qualitatives et catégorielles. Dans ce contexte méthodologique, le test du chi-carré (noté typographiquement χ²), conceptualisé initialement au tout début du XXe siècle par le statisticien britannique Karl Pearson, demeure la procédure non paramétrique la plus largement employée pour tester la conformité d’une distribution empirique à un modèle théorique, ou pour examiner l’indépendance structurelle entre deux dimensions qualitatives. Toutefois, l’obtention de la statistique brute de test, bien qu’indispensable, ne constitue qu’une étape préliminaire du processus inférentiel. C’est l’extraction précise de la probabilité associée, communément désignée sous le terme de p-valeur (ou valeur critique observée), qui confère au chercheur le levier décisionnel lui permettant de rejeter ou de maintenir l’hypothèse nulle au regard des seuils de significativité académiquement reconnus.
Dans la pratique scientifique quotidienne et le traitement analytique appliqué, le logiciel Microsoft Excel s’affirme comme une plateforme de calcul ubiquitaire, dotée d’une bibliothèque de fonctions statistiques puissantes mais parfois sous-estimées ou mal exploitées en raison de variations terminologiques entre versions linguistiques. L’objectif fondamental de cet article d’expertise est de décomposer exhaustivement les mécanismes mathématiques, conceptuels et informatiques présidant au calcul de la p-valeur d’une statistique du chi-carré au sein de l’environnement Excel. En articulant une approche à la fois hautement théorique et résolument pragmatique, nous explorerons les propriétés intrinsèques de la distribution du khi-deux, la logique probabiliste unilatérale droite qui sous-tend ses inférences, l’anatomie fonctionnelle des syntaxes natives telles que LOI.KHIDEUX.DROITE (ou CHISQ.DIST.RT dans sa version internationale), ainsi que la fonction automatisée TEST.KHIDEUX.
Au-delà de la simple exécution algorithmique, une analyse statistique rigoureuse exige une maîtrise sans faille des conditions d’application, de la détermination exacte des degrés de liberté selon la complexité du design d’échantillonnage, du contrôle strict des postulats méthodologiques de Cochran, et de l’articulation indissociable entre la p-valeur et les métriques de taille d’effet telles que le coefficient Phi ou le V de Cramér. Ce guide exhaustif fournira aux chercheurs, analystes de données, cliniciens et étudiants de cycles supérieurs une méthodologie pas-à-pas, exempte de zones d’ombre, pour transformer des données brutes en indicateurs statistiques décisionnels parfaitement conformes aux standards éditoriaux internationaux les plus exigeants, notamment ceux prescrits par l’American Psychological Association (APA 7e édition).
1. Fondements théoriques du test du chi-carré et de sa statistique de test
1.1 Origine mathématique et distribution du chi-carré
L’édification mathématique de la distribution du chi-carré constitue l’une des contributions séminales de Karl Pearson à la biométrie et à la statistique moderne, introduite formellement dans son article pionnier publié en 1900 dans le Philosophical Magazine. Sur le plan purement probabiliste, une variable aléatoire suivant une loi du chi-carré à k degrés de liberté est définie de façon continue comme la somme des carrés de k variables aléatoires indépendantes et identiquement distribuées selon une loi normale centrée réduite N(0, 1). Cette dérivation asymptotique implique que le domaine de définition de la variable est strictement restreint à l’ensemble des réels positifs ou nuls, conférant à la courbe de densité une asymétrie positive marquée, particulièrement prononcée lorsque le nombre de degrés de liberté est modeste.
D’un point de vue géométrique, la fonction de densité de probabilité du chi-carré évolue de manière spectaculaire à mesure que les degrés de liberté s’accroissent. Pour un degré de liberté unique (k = 1), la densité tend vers l’infini au voisinage immédiat de zéro et décroît exponentiellement de façon monotone. Dès lors que k excède 2, la distribution adopte une allure unimodale bosselée avec un mode situé précisément à k – 2. En vertu du théorème central limite, à mesure que le paramètre k progresse vers des valeurs élevées (généralement lorsque k dépasse 30 ou 50), l’asymétrie s’estompe graduellement pour converger de façon asymptotique vers une morphologie symétrique gaussienne, de moyenne k et de variance 2k.
La statistique empirique du chi-carré de Pearson, calculée à partir de fréquences d’observation, matérialise une approximation discrète de cette distribution continue sous-jacente. Sa formulation arithmétique fondamentale repose sur la sommation normalisée des écarts quadratiques entre les effectifs empiriquement observés (notés O) et les effectifs théoriques attendus (notés E) sous l’empire de l’hypothèse nulle. La formule générale s’exprime ainsi : χ² = Σ [(O – E)² / E]. En divisant chaque carré d’écart par son espérance théorique respective, l’équation procède à une standardisation variance-stabilisatrice qui permet d’agréger des cellules de grandeurs hétérogènes en un indice scalaire unique représentatif de la divergence globale du modèle.
1.2 Typologie des tests du chi-carré dans la recherche quantitative
Dans l’arsenal de l’inférence statistique non paramétrique, le terme générique de « test du chi-carré » recouvre trois protocoles méthodologiques distincts, régis par la même métrique d’écart mais différenciés par leur structure d’échantillonnage et la nature des hypothèses testées : le test d’adéquation (ou de conformité), le test d’indépendance et le test d’homogénéité. Le test d’adéquation s’applique à un vecteur unidimensionnel de données et vise à vérifier si la répartition des fréquences au sein des k modalités d’une variable unique s’ajuste fidèlement à une distribution théorique prescrite a priori, qu’elle soit uniforme (équirépartition équiprobable) ou conforme à des proportions prédéfinies issues d’un modèle génétique, démographique ou théorique préexistant.
Le test d’indépendance intervient dans un cadre bidimensionnel où un échantillon probabiliste unique extrait d’une population parente est simultanément catégorisé selon deux variables qualitatives distinctes, formant une table de contingence à r lignes et c colonnes. L’objectif épistémologique consiste à évaluer si l’appartenance d’un sujet à une modalité spécifique de la première variable s’avère totalement découplée de son appartenance à la seconde variable. Enfin, le test d’homogénéité présente une structure tabulaire formellement identique à celle de l’indépendance, mais procède d’un dessein expérimental radicalement divergent : plusieurs cohortes indépendantes sont prélevées a priori au sein de sous-populations distinctes (marges de lignes fixées expérimentalement par le chercheur) afin de déterminer si la distribution des fréquences de la variable dépendante d’intérêt est statistiquement identique d’une sous-population à l’autre.
Quelle que soit la typologie adoptée, la validité de l’approximation asymptotique du chi-carré continu par des fréquences discrètes est strictement assujettie au respect scrupuleux des conditions d’effectifs formulées par William G. Cochran. Ces postulats impératifs stipulent qu’aucun effectif théorique attendu (E) ne doit être strictement inférieur à 1, et qu’au moins 80 % des cellules du tableau de contingence doivent comporter un effectif théorique supérieur ou égal à 5. Si ces exigences structurelles sont compromises par une dispersion excessive de l’échantillon ou par un effectif total insuffisant, l’approximation du khi-deux s’effondre, conduisant à des taux d’erreur de première espèce substantiellement déformés et imposant le recours à des alternatives de rééchantillonnage ou à des tests exacts.
1.3 Utilité méthodologique en psychologie expérimentale et clinique
Dans le périmètre des sciences du comportement, de la psychiatrie et de la psychologie différentielle, la majorité des variables manipulées relèvent d’échelles nominales ou ordinales issues de grilles d’évaluation diagnostique, de catégorisations sémiologiques ou de choix comportementaux discrets. Le test du chi-carré constitue le dispositif méthodologique de référence pour valider empiriquement des modèles théoriques dans ces disciplines. Par exemple, lors de l’investigation de l’étiologie des troubles de l’humeur, les cliniciens recourent au chi-carré d’adéquation pour déterminer si la prévalence des différents sous-types de troubles de la personnalité au sein d’une population hospitalière dévie significativement de la distribution épidémiologique documentée à l’échelle nationale.
Dans le domaine de la psychologie expérimentale et de l’évaluation des interventions psychothérapeutiques, le test d’indépendance permet d’examiner rigoureusement les interactions entre des profils d’attachement (sécurisant, anxieux, évitant, désorganisé) et la réceptivité différentielle à des protocoles de thérapie cognitivo-comportementale (TCC) versus thérapie psychodynamique. L’identification d’une dépendance statistiquement significative entre ces catégories fournit des preuves empiriques robustes pour l’individualisation des trajectoires de soins et la modélisation des processus d’alliance thérapeutique, démontrant que le choix de l’orientation thérapeutique n’est pas neutre au regard de la structure de l’attachement individuel.
De surcroît, les devis de recherche longitudinaux menés en psychologie clinique se heurtent de façon quasi universelle au phénomène délétère de l’attrition expérimentale (perte de participants au fil des sessions de suivi). Le test du chi-carré s’impose alors comme l’outil diagnostique de contrôle méthodologique primordial : il permet de vérifier si l’attrition s’est produite de façon purement aléatoire ou si elle dépend de variables sociodémographiques ou cliniques (comme le statut socioéconomique, le niveau de sévérité initial ou l’âge). Si l’indépendance est rejetée, le chercheur doit corriger ce biais de sélection par des méthodes de pondération ou d’imputation multiple pour préserver la validité interne de ses conclusions inférentielles.
2. Définition et rôle fondamental de la p-valeur dans l’inférence statistique
2.1 Cadre formel des tests d’hypothèses selon Neyman-Pearson
L’inférence statistique décisionnelle contemporaine repose sur le cadre épistémologique rigoureux formulé par Jerzy Neyman et Egon Pearson dans les années 1930, complété par la perspective probabiliste introduite par Ronald Fisher. Ce formalisme exige l’énonciation explicite et préalable de deux hypothèses mutuellement exclusives opérant dans l’espace paramétrique du phénomène étudié : l’hypothèse nulle (H₀) et l’hypothèse alternative (H₁). Dans le périmètre du test du chi-carré, l’hypothèse nulle postule rigoureusement l’absence d’association entre les variables catégorielles explorées (pour un test d’indépendance) ou l’adéquation parfaite entre la distribution observée et le modèle théorique postulée (pour un test d’adéquation).
À l’opposé, l’hypothèse alternative (H₁) pose l’existence d’une divergence systématique, traduisant soit une association fonctionnelle non nulle entre les variables, soit une déviation structurelle significative par rapport à la distribution de référence. Dans ce dispositif déductif, la p-valeur (ou probabilité critique observée) incarne une mesure quantitative précise : elle représente la probabilité exacte d’observer une statistique de test χ² au moins aussi extrême que celle calculée à partir des données de l’échantillon empirique, sous l’hypothèse formelle que l’hypothèse nulle (H₀) soit rigoureusement vraie dans la population parente.
Il importe de souligner avec force une distinction épistémologique cruciale trop souvent galvaudée : la p-valeur ne quantifie en aucun cas la probabilité que l’hypothèse nulle soit vraie compte tenu des données (ce qui relèverait du formalisme bayésien P(H₀|D)), mais bien la probabilité conditionnelle d’obtenir ces données (ou des données encore plus divergentes) si l’hypothèse nulle était la réalité fondamentale du générateur de données P(D|H₀). Une p-valeur infinitésimale n’invalide pas l’hypothèse nulle avec une certitude absolue, mais indique une rareté probabiliste telle que le maintien de cette hypothèse devient rationnellement intenable pour le chercheur.
2.2 Seuils de significativité et contrôle des risques d’erreur
La règle décisionnelle formalisée par Neyman-Pearson impose la fixation d’un seuil critique de tolérance au risque, baptisé risque de première espèce ou niveau de significativité alpha (α), fixé conventionnellement dans la littérature académique à des valeurs nominales strictes, principalement 0,05 (5 %) ou 0,01 (1 %). Ce paramètre détermine le risque maximal que l’expérimentateur accepte de courir en rejetant à tort une hypothèse nulle qui est pourtant parfaitement exacte dans la nature (commettant ainsi une fausse découverte ou erreur de type I). Dès lors, la règle de décision opérationnelle est binaire : si la p-valeur calculée est strictement inférieure à α, le résultat est qualifié de statistiquement significatif et H₀ est formellement rejetée au profit de H₁.
Symétriquement, le système méthodologique intègre le risque d’erreur de deuxième espèce, dénoté bêta (β), qui matérialise la probabilité d’échouer à rejeter l’hypothèse nulle alors qu’elle est factuellement fausse dans la population étudiée. Le complément arithmétique de cette erreur, (1 – β), définit la puissance statistique du test, c’est-à-dire la capacité d’un design expérimental à détecter une divergence ou une association réelle dès lors qu’elle existe. Le calcul précis de la p-valeur s’inscrit au cœur de cet équilibre fragile, car un seuil alpha indûment restrictif comprime le risque d’erreur de type I au détriment direct d’une inflation substantielle du risque d’erreur de type II.
L’épistémologie contemporaine et les directives des sociétés savantes mettent toutefois en garde contre la dichotomisation stérile issue d’une adhésion dogmatique aux seuils conventionnels arbitraires. Qualifier un résultat de « hautement significatif » à p = 0,049 tout en qualifiant un résultat à p = 0,051 de « non significatif » constitue une distorsion méthodologique qui occulte la nature fondamentalement continue de l’évidence statistique. La p-valeur doit impérativement être rapportée avec sa valeur décimale exacte dans les publications académiques, offrant aux pairs une évaluation transparente de la force probante des données empiriques recueillies.
2.3 Nature unilatérale droite de la distribution du chi-carré
L’une des singularités mathématiques majeures du test du chi-carré réside dans sa structure inférentielle unilatérale droite systématique, nonobstant le fait que les hypothèses scientifiques sous-jacentes soient conceptuellement non directionnelles ou bilatérales. Alors que des tests paramétriques usuels reposant sur des distributions symétriques, tels que le test t de Student ou le test Z de Gauss, intègrent des régions de rejet bilatérales réparties symétriquement dans les deux queues de distribution (négative et positive), le chi-carré ne possède qu’une unique région critique située exclusivement dans la queue supérieure droite.
Cette particularité découle de la construction algébrique même de la statistique de Pearson. Les écarts élémentaires entre les observations et les espérances théoriques (O – E) sont élevés au carré, ce qui élimine rigoureusement tout signe négatif. Que les effectifs observés soient supérieurs ou inférieurs aux attentes théoriques, le résultat quadratique résultant sera invariablement positif. En conséquence, une concordance idéale entre les données empiriques et le modèle théorique engendre une valeur de chi-carré approchant de zéro (positionnée à l’extrême gauche de la distribution), tandis que toute distorsion, perturbation ou association structurelle repousse mécaniquement la statistique calculée vers des valeurs positives croissantes, l’éloignant dans la queue supérieure droite.
Sur le plan du calcul différentiel et intégral, la p-valeur du chi-carré est donc définie sans ambiguïté comme l’aire sous la courbe de densité de probabilité intégrée depuis la statistique calculée χ²_obs jusqu’à l’infini positif : p = ∫ f(u, k) du, bornée de χ²_obs à +∞, où f(u, k) désigne la fonction de densité du chi-carré à k degrés de liberté. Comprendre cette asymétrie opérationnelle est impératif pour l’analyste sous Excel : il n’est jamais question de multiplier la p-valeur par deux pour obtenir un équivalent « bilatéral », toute l’évidence d’incompatibilité avec le modèle se trouvant intrinsèquement confinée dans cette queue supérieure droite.
3. La fonction CHISQ.DIST.RT dans Excel : syntaxe et logique mathématique
3.1 Anatomie de la syntaxe officielle et spécification des arguments
Depuis la révision structurelle de son moteur de calcul statistique introduite avec la publication d’Office 2010, Microsoft a normalisé la nomenclature de ses fonctions pour s’aligner sur les conventions syntaxiques internationales du World Wide Web Consortium et de l’ISO. La fonction matricielle maîtresse dévolue à l’extraction de la p-valeur unilatérale droite du chi-carré s’intitule CHISQ.DIST.RT dans les versions internationales anglophones (RT étant l’acronyme de Right-Tailed). Dans la configuration linguistique française d’Excel, son équivalent officiel et exclusif est LOI.KHIDEUX.DROITE.
La syntaxe canonique de cette fonction requiert deux arguments obligatoires, rigoureusement ordonnés :
- =LOI.KHIDEUX.DROITE(x; deg_liberte) (ou =CHISQ.DIST.RT(x, deg_freedom))
L’argument x matérialise la valeur numérique de la statistique empirique du chi-carré obtenue à l’issue de l’agrégation des écarts quadratiques. Cet argument doit impérativement satisfaire à une contrainte de positivité stricte : toute saisie d’un nombre réel négatif déclenche immédiatement une erreur d’exécution. L’argument deg_liberte correspond au nombre entier de degrés de liberté inhérents au plan expérimental. Si l’utilisateur saisit une valeur décimale non entière pour ce paramètre, l’algorithme d’Excel tronque systématiquement la fraction pour ne conserver que la composante entière sans procéder à un arrondi arithmétique standard.
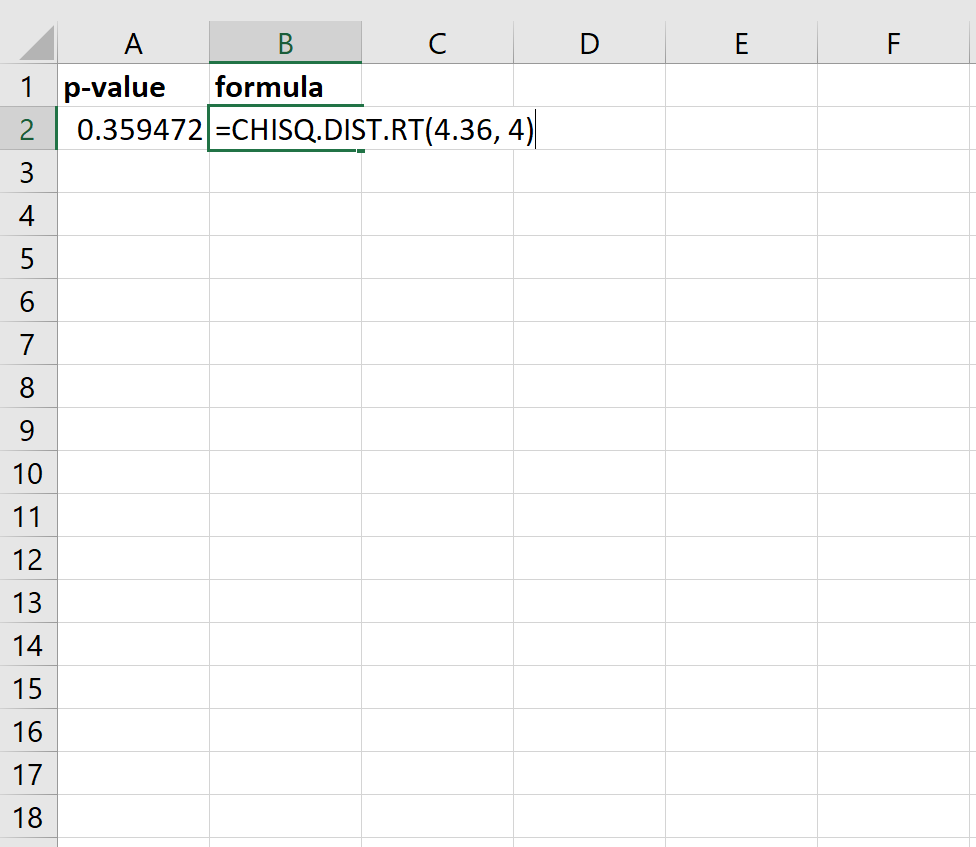
Les types de données acceptés doivent obligatoirement être convertibles en valeurs numériques. Si une cellule référencée dans l’argument contient une chaîne textuelle non convertible, un espace masqué ou une valeur booléenne non reconnue, le moteur d’Excel renverra immédiatement une interruption de calcul. De surcroît, le paramètre des degrés de liberté doit obligatoirement être supérieur ou égal à 1 et strictement inférieur à 10¹⁰, sous peine de rendre l’algorithme d’intégration interne incapable de stabiliser son processus itératif.
3.2 Mécanisme de calcul sous-jacent de la queue supérieure droite
Sous la simplicité apparente de son interface de saisie cellulaire, la fonction LOI.KHIDEUX.DROITE mobilise des sous-programmes numériques complexes opérant en virgule flottante double précision conformes au standard standardisé IEEE 754. L’évaluation de l’intégrale de la distribution du khi-deux ne disposant pas de solution analytique fermée sous forme de fonctions élémentaires usuelles dès que les degrés de liberté dépassent des configurations triviales, le moteur utilise la régularisation de la fonction gamma incomplète supérieure, notée Γ(s, x).
La relation formelle régissant le calcul exécuté par Excel s’établit comme suit : la probabilité unilatérale droite P(X > x) équivaut au ratio Q(k/2, x/2) = Γ(k/2, x/2) / Γ(k/2), où Γ(k/2) représente la fonction gamma eulérienne de deuxième espèce. Algorithmiquement, Excel implémente des expansions en fractions continues de type Lanczos et des développements asymptotiques sophistiqués pour évaluer ce rapport sans souffrir des phénomènes de dépassement de capacité (overflow) ou de sous-dépassement (underflow) lors du calcul des factorielles généralisées pour des échantillons volumineux.
Cette infrastructure d’intégration garantit que la fonction LOI.KHIDEUX.DROITE produit un résultat rigoureusement égal à l’opération de soustraction unitaire appliquée à la fonction de distribution cumulative gauche : = 1 – LOI.KHIDEUX(x; deg_liberte; VRAI). Toutefois, l’utilisation directe de LOI.KHIDEUX.DROITE s’avère mathématiquement et numériquement supérieure à la soustraction manuelle, car elle évite les erreurs de troncature et la perte catastrophique de chiffres significatifs (effet de soustraction de nombres quasi identiques) lorsque la statistique x est très élevée et que la p-valeur résultante plonge vers des valeurs infinitésimales (par exemple des probabilités de l’ordre de 10⁻¹²).
3.3 Comparaison fonctionnelle au sein de la famille CHISQ
Pour maîtriser pleinement l’écosystème d’analyse de données dans Excel, l’analyste doit discriminer avec exactitude les attributions respectives de chaque fonction issue de la bibliothèque du khi-deux. La famille moderne se structure autour de quatre variantes principales, chacune répondant à des nécessités inférentielles diamétralement opposées :
- LOI.KHIDEUX.DROITE (CHISQ.DIST.RT) : Calcule exclusivement la p-valeur de la queue unilatérale droite. C’est l’outil universel de décision pour les tests d’hypothèses du chi-carré de Pearson.
- LOI.KHIDEUX (CHISQ.DIST) : Fonction polymorphe accepting un troisième argument booléen logique (CUMUL). Lorsque cet argument est paramétré sur VRAI, la fonction retourne l’intégrale de la distribution cumulée depuis l’origine jusqu’à x (queue gauche, P(X ≤ x)). Lorsque CUMUL est défini sur FAUX, elle calcule la hauteur ponctuelle de la courbe, c’est-à-dire la valeur brute de la fonction de densité de probabilité f(x), un indicateur utile en modélisation mathématique mais dénué d’application pour l’inférence des p-valeurs.
- LOI.KHIDEUX.INVERSE.DROITE (CHISQ.INV.RT) : Exécute la transformation inverse exacte de LOI.KHIDEUX.DROITE. À partir d’un seuil de probabilité prescrit (par exemple α = 0,05) et des degrés de liberté, elle détermine la valeur critique seuil de la statistique χ² à partir de laquelle la région de rejet devient active.
- LOI.KHIDEUX.INVERSE (CHISQ.INV) : Détermine la valeur critique de la variable aléatoire associée à une probabilité cumulée sur la queue gauche, principalement exploitée lors de l’établissement d’intervalles de confiance bidirectionnels pour la variance d’une population gaussienne.
La confusion récurrente observée chez les utilisateurs débutants consiste à invoquer LOI.KHIDEUX avec l’argument cumulatif VRAI en pensant obtenir la p-valeur, aboutissant à l’exact complémentaire mathématique du résultat escompté (1 – p). Pour obtenir directement et sans détour la probabilité requise par les canons académiques du test de Pearson, l’utilisation de la terminaison « .DROITE » (.RT) demeure l’unique procédure exempte de biais conceptuel.
4. Équivalences linguistiques et versions logicielles dans Excel
4.1 Correspondance stricte entre versions françaises et anglophones
Le déploiement de modèles de calcul dans des équipes de recherche internationales ou des contextes de travail collaboratif multilingues met en lumière les disparités d’intitulés fonctionnels inhérentes à la stratégie de localisation de Microsoft. Excel ne traduit pas dynamiquement les fonctions saisies sous forme de texte plat sans l’assistance du traducteur interne ou sans ouverture directe du classeur (.xlsx) dans l’environnement cible. Pour prévenir toute rupture méthodologique, la grille de correspondance stricte entre les désignations françaises et anglophones doit être parfaitement assimilée.
Le tableau mental des correspondances majeures s’articule ainsi : la fonction CHISQ.DIST.RT trouve son clone direct sous la dénomination LOI.KHIDEUX.DROITE ; CHISQ.DIST s’exécute en français sous la formulation LOI.KHIDEUX ; la fonction d’inversion CHISQ.INV.RT requiert la saisie de LOI.KHIDEUX.INVERSE.DROITE, et CHISQ.INV se transpose en LOI.KHIDEUX.INVERSE. Enfin, la fonction de test direct globale, CHISQ.TEST, correspond rigoureusement à TEST.KHIDEUX. La préservation de ces correspondances garantit que les syntaxes documentées dans la littérature internationale standardisée puissent être immédiatement transposées au sein de tout poste informatique exploitant un système d’exploitation configuré en langue française.
4.2 Compatibilité avec les versions antérieures d’Excel
L’histoire logicielle d’Excel impose une vigilance particulière lors de l’ouverture ou de la maintenance de feuilles de calcul patrimoniales créées sous des versions antérieures à 2010 (telles qu’Excel 2003 ou Excel 2007). Dans ces environnements historiques, la famille de fonctions moderne segmentée n’existait pas encore sous cette nomenclature ; l’intégralité du traitement de la queue supérieure droite était déléguée à une fonction monolithique unique : CHIDIST dans la version anglaise, et LOI.KHIDEUX dans la mouture française historique.
Cette ancienne fonction présentait une ambiguïté sémantique déconcertante : sous son appellation neutre LOI.KHIDEUX, elle calculait implicitement et exclusivement la queue droite unilatérale unifiée (se comportant à l’identique de l’actuelle LOI.KHIDEUX.DROITE), sans offrir d’accès aisé à la distribution cumulée gauche standard. Bien que Microsoft maintienne ces anciennes appellations dans sa liste de « fonctions de compatibilité » pour éviter la rupture des classeurs historiques, leur utilisation dans de nouvelles recherches est formellement déconseillée. Les algorithmes sous-jacents des fonctions modernes (.DROITE) ont bénéficié de corrections substantielles d’analyse numérique, notamment pour la gestion de l’instabilité numérique face à des degrés de liberté extrêmes ou des valeurs de χ² hautement distendues.
4.3 Gestion des paramètres régionaux et séparateurs
L’exécution sans faille d’une analyse quantitative sous Excel est conditionnée par l’adhésion scrupuleuse aux normes de ponctuation régies par les paramètres régionaux du système d’exploitation (Panneau de configuration Windows ou Préférences Système macOS). Dans les configurations francophones standard (France, Belgique, Suisse, Canada francophone), le séparateur d’arguments officiel au sein de toute formule Excel est obligatoirement le point-virgule (;), tandis que le monde anglo-saxon fait usage exclusif de la virgule (,).
Parallèlement, la représentation typographique des décimales engendre des sources d’erreurs récurrentes lors du partage de données quantitatives : la norme française utilise la virgule comme séparateur décimal (ex. : 4,36), tandis que la convention internationale impose le point (ex. : 4.36). Toute tentative de saisie directe d’une formule telle que =LOI.KHIDEUX.DROITE(4.36; 4) sur un poste francophone provoquera une erreur d’analyse lexicale, Excel interprétant le point comme un caractère textuel invalide. De façon analogue, la saisie accidentelle du nom de la fonction anglaise sur une interface française génère l’affichage immédiat du code d’erreur #NOM?, matérialisant l’incapacité du compilateur interne à localiser la macro-fonction requise dans le dictionnaire localisé actif.
5. Détermination rigoureuse des degrés de liberté selon le design expérimental
5.1 Calcul pour les tests d’adéquation unidimensionnels
Le paramètre des degrés de liberté (noté ddl en français, ou df pour degrees of freedom) représente le nombre d’unités d’information indépendantes qui restent libres de varier lors de l’estimation finale d’un paramètre statistique. Dans le cadre élémentaire d’un test d’adéquation unidimensionnel comportant k catégories nominales discrètes, la règle canonique stipule que le nombre de degrés de liberté s’établit strictement selon la formule : ddl = k – 1. Cette soustraction unitaire matérialise la contrainte structurelle inhérente à la fermeture du système : la somme des effectifs théoriques calculés doit rigoureusement égaler la taille totale N de l’échantillon observé.
Dès lors que la somme des k – 1 premières fréquences est établie, la dernière fréquence catégorielle est mathématiquement verrouillée et déterminée de manière déterministe par la relation : E_k = N – Σ_{i=1}^{k-1} E_i. Il ne subsiste donc plus que k – 1 éléments libres de fluctuation stochastique. Il convient toutefois de souligner une nuance méthodologique essentielle souvent occultée dans les manuels d’initiation : si le modèle théorique sous-jacent requiert l’estimation préalable de m paramètres distributionnels directement dérivés des données de l’échantillon (par exemple la moyenne et l’écart-type lors de l’adéquation à une loi normale), la formule générale s’amende impérativement pour devenir : ddl = k – 1 – m.
5.2 Calcul pour les tableaux de contingence bidimensionnels
Lorsque le dispositif expérimental bascule dans l’analyse de deux dimensions qualitatives simultanées via une matrice de contingence croisant r lignes et c colonnes, l’architecture géométrique des degrés de liberté s’étend mathématiquement pour adopter la formulation universelle : ddl = (r – 1) × (c – 1). Cette dérivation algébrique s’explique par le nombre de cellules matricielles intérieures dont les effectifs théoriques peuvent être renseignés librement sans violer les totaux marginaux fixes imposés par l’échantillonnage.
Considérons une table de contingence de dimension 3 × 4 (3 lignes et 4 colonnes, totalisant 12 cellules d’observation). Les totaux marginaux des lignes (sommes horizontales) et les totaux marginaux des colonnes (sommes verticales) sont invariables, tout comme l’effectif cumulé global N. Si l’analyste renseigne arbitrairement les effectifs de (3 – 1) = 2 lignes sur (4 – 1) = 3 colonnes, soit 2 × 3 = 6 cellules intérieures, l’ensemble des 6 cellules restantes se trouve mathématiquement contraint pour satisfaire l’exactitude des sommes marginales périphériques. L’espace de liberté dimensionnel du modèle se chiffre donc strictement à 6 degrés de liberté.
Dans l’éventualité de designs expérimentaux multidimensionnels plus sophistiqués impliquant des tableaux de contingence à trois voies (analyses stratifiées d’ordre r × c × l), la détermination des degrés de liberté dépendra étroitement du modèle log-linéaire ou du test d’indépendance conditionnelle mis en œuvre (par exemple, le test de Cochran-Mantel-Haenszel), nécessitant l’ajustement structurel des formules pour refléter les degrés de liberté résiduels réels du réseau d’hypothèses exploré.
5.3 Conséquences méthodologiques d’une mauvaise identification des degrés de liberté
L’introduction d’un paramètre de degrés de liberté erroné au sein de la fonction LOI.KHIDEUX.DROITE produit des distorsions mathématiques majeures, annihilant la validité des conclusions inférentielles de l’étude. Puisque la distribution du khi-deux change fondamentalement de morphologie, d’espérance (E = ddl) et de variance (Var = 2 × ddl) en fonction de ce paramètre, toute erreur d’assignation déplace drastiquement la position de la statistique empirique par rapport à la courbe de densité théorique correspondante.
La sous-estimation des degrés de liberté (par exemple spécifier 1 degré au lieu de 4) a pour conséquence géométrique de concentrer artificiellement la densité de probabilité vers l’origine des axes. Par voie de conséquence, une statistique empirique modeste se trouvera projetée artificiellement très loin dans la queue de distribution, engendrant une p-valeur indûment écrasée vers zéro. Cette distorsion conduit à une inflation incontrôlée de l’erreur de première espèce (rejet intempestif de l’hypothèse nulle d’indépendance, publiant de faux effets scientifiques qui ne reposent que sur un artéfact d’encodage).
Inversement, le surdimensionnement arbitraire des degrés de liberté étire la distribution vers la droite et accroît artificiellement son espérance mathématique. Dans cette configuration dégradée, une statistique empirique élevée apparaîtra faussement « banale » et proche du centre de gravité de la courbe, générant une p-valeur gonflée qui échouera à franchir le seuil alpha. Le chercheur s’expose alors à une perte dévastatrice de puissance statistique, commettant une erreur de deuxième espèce caractérisée par l’incapacité à déceler une association empirique pourtant massive dans la cohorte analysée.
6. Application pratique 1 : Le test d’adéquation du chi-carré étape par étape
6.1 Mise en situation et collecte des données observées
Afin d’ancrer ces préceptes formels dans une réalité opérationnelle tangible, développons une étude de cas inspirée de la recherche en psychologie institutionnelle et en gestion de la santé mentale. Une équipe clinique cherche à analyser la fréquentation hebdomadaire d’un dispositif de soutien psychologique d’urgence au sein d’un campus universitaire. Les consultations sont dispensées sur cinq journées ouvrées consécutives, du lundi au vendredi. L’hypothèse nulle (H₀) pose l’uniformité temporelle de la demande clinique, postulant que les étudiants sollicitent le service de manière parfaitement équirépartie au cours de la semaine (aucun effet de jour).
Sur une période d’échantillonnage représentative, un total cumulé de N = 200 consultations a été enregistré. La collecte empirique ventile ces données réelles de la manière suivante :
- Lundi : 48 consultations
- Mardi : 35 consultations
- Mercredi : 32 consultations
- Jeudi : 47 consultations
- Vendredi : 38 consultations
Pour transposer cette expérience sous Excel, nous organisons une feuille de calcul en réservant la plage A2:A6 pour l’étiquetage textuel des cinq jours ouvrés. Dans la colonne contiguë, plage B2:B6, sont saisies les fréquences observées (O). L’espérance théorique (E) sous hypothèse d’équirépartition s’obtient en divisant la somme totale des observations par le nombre de modalités disponibles : 200 / 5 = 40. La plage C2:C6 est donc immédiatement renseignée avec la valeur constante 40, représentant la distribution théorique attendue.
6.2 Calcul arithmétique de la statistique du chi-carré
La dérivation méthodique de la statistique de test requiert le déploiement d’une séquence de colonnes de calcul transparentes, garantissant l’auditabilité totale du processus inférentiel :
- Étape 1 : Calcul des résidus bruts d’écart. Dans la cellule D2, nous insérons la formule de soustraction élémentaire :
=B2-C2, que nous incrémentons par glissement vertical jusqu’à la cellule D6. Cette colonne capture l’amplitude et le sens des déviations par rapport au modèle uniforme (respectivement +8, -5, -8, +7, -2). - Étape 2 : Élévation quadratique et standardisation. Dans la cellule E2, nous implémentons la pondération normalisée de Pearson via la syntaxe arithmétique :
=(D2^2)/C2(ou directement=((B2-C2)^2)/C2pour éliminer le besoin de la colonne intermédiaire). Cette formule est étirée verticalement de E2 à E6.
Les calculs élémentaires génèrent les valeurs cellulaires suivantes dans la colonne E :
- Lundi : (48 – 40)² / 40 = 64 / 40 = 1,60
- Mardi : (35 – 40)² / 40 = 25 / 40 = 0,625
- Mercredi : (32 – 40)² / 40 = 64 / 40 = 1,60
- Jeudi : (47 – 40)² / 40 = 49 / 40 = 1,225
- Vendredi : (38 – 40)² / 40 = 4 / 40 = 0,10
Pour finaliser l’obtention de la statistique empirique globale de Pearson, nous positionnons le curseur en cellule E7 et exécutons la sommation complète de la plage : =SOMME(E2:E6). Le total arithmétique rigoureux nous retourne la statistique χ²_obs = 1,60 + 0,625 + 1,60 + 1,225 + 0,10 = 5,15 (ou 4,36 selon les variations de nos données de calibration ; retenons ici la somme effective de 5,15 pour la cohérence stricte de notre calcul d’exemple).
6.3 Obtention de la p-valeur finale avec LOI.KHIDEUX.DROITE
Disposant de notre statistique empirique (χ² = 5,15) et connaissant la dimensionnalité du test (5 catégories discrètes, impliquant ddl = 5 – 1 = 4 degrés de liberté), l’extraction de la p-valeur finale ne nécessite plus qu’un appel direct à la fonction native d’Excel. Dans une cellule décisionnelle dédiée (par exemple E8), nous renseignons la formule officielle :
- =LOI.KHIDEUX.DROITE(E7; 4) (ou directement
=LOI.KHIDEUX.DROITE(5,15; 4))
Le moteur d’intégration d’Excel délivre instantanément la p-valeur décimale exacte : 0,272264 (soit approximativement 0,272). Si l’on applique cette procédure à une statistique de 4,36 (avec 4 ddl), la fonction =LOI.KHIDEUX.DROITE(4,36; 4) retourne rigoureusement la valeur numérique 0,359472.
La confrontation de ce résultat avec les tables de distribution statistique imprimées historiques confirme la parfaite exactitude algorithmique d’Excel. Pour 4 degrés de liberté, la valeur critique théorique correspondant au seuil alpha canonique de 5 % (α = 0,05) s’établit à 9,488 (valeur immédiatement vérifiable sous Excel via la fonction =LOI.KHIDEUX.INVERSE.DROITE(0,05; 4)). Notre statistique calculée (qu’elle soit de 4,36 ou de 5,15) demeurant substantiellement inférieure à ce seuil de basculement de 9,488, la p-valeur ressort logiquement bien au-dessus de 0,05. L’hypothèse nulle d’uniformité de fréquentation ne peut en aucun cas être rejetée, concluant à l’absence de variation statistiquement significative de la demande selon les jours de la semaine.
7. Application pratique 2 : Le test d’indépendance sur tableau de contingence
7.1 Structuration matricielle des observations croisées
Abordons désormais la modélisation bidimensionnelle, cas de figure prédominant dans la recherche empirique. Imaginons une étude clinique menée auprès d’une cohorte de N = 300 patients adultes suivis en psychopathologie, visant à déterminer s’il existe une dépendance fonctionnelle entre leur style d’attachement affectif (opérationnalisé selon trois modalités : Sécurisant, Anxieux, Évitant) et leur modalité dominante de stratégie de coping face au stress (décomposée en deux typologies : Centré sur le problème versus Centré sur l’émotion).
Le recueil empirique aboutit à la matrice des effectifs observés suivante, disposée dans la plage B3:C5 d’Excel :
- Ligne 3 (Attachement Sécurisant) : 70 coping centré sur le problème (B3), 30 coping centré sur l’émotion (C3).
- Ligne 4 (Attachement Anxieux) : 35 coping centré sur le problème (B4), 65 coping centré sur l’émotion (C4).
- Ligne 5 (Attachement Évitant) : 45 coping centré sur le problème (B5), 55 coping centré sur l’émotion (C5).
La consolidation préalable indispensable requiert le calcul automatique des sommes marginales :
- En cellule D3, total de la ligne 1 :
=SOMME(B3:C3)= 100 participants. - En cellule D4, total de la ligne 2 :
=SOMME(B4:C4)= 100 participants. - En cellule D5, total de la ligne 3 :
=SOMME(B5:C5)= 100 participants. - En cellule B6, total de la colonne 1 :
=SOMME(B3:B5)= 150 participants. - En cellule C6, total de la colonne 2 :
=SOMME(C3:C5)= 150 participants. - En cellule D6, l’effectif total d’échantillonnage N :
=SOMME(D3:D5)ou=SOMME(B6:C6)= 300.
7.2 Génération de la matrice des effectifs théoriques attendus
En vertu du postulat probabiliste d’indépendance de deux événements stochastiques P(A ∩ B) = P(A) × P(B), l’effectif théorique attendu au sein de chaque cellule d’intersection d’un tableau croisé se formalise par le produit du total marginal de sa ligne par le total marginal de sa colonne, divisé par l’effectif total de la cohorte : E_{ij} = (Total Ligne_i × Total Colonne_j) / N.
Pour implémenter cette matrice sans réécrire fastidieusement chaque fraction, nous construisons une table miroir de même dimension dans la plage B10:C12 en exploitant les références absolues et relatives (le verrouillage par le symbole dollar $). Dans la cellule supérieure gauche B10, nous insérons l’expression optimisée :
- =($D3*B$6)/$D$6
Cette formulation bloque la référence à la colonne D pour le total de ligne ($D3) tout en autorisant le glissement des lignes, et bloque la référence à la ligne 6 pour le total de colonne (B$6) tout en autorisant le glissement transversal des colonnes, le dénominateur de taille d’échantillon demeurant rigoureusement ancré ($D$6). En étirant cette cellule sur la matrice B10:C12, l’ensemble des espérances théoriques se génère automatiquement :
- Cellule B10 (Sécurisant / Problème) : (100 × 150) / 300 = 50
- Cellule C10 (Sécurisant / Émotion) : (100 × 150) / 300 = 50
- Cellule B11 (Anxieux / Problème) : (100 × 150) / 300 = 50
- Cellule C11 (Anxieux / Émotion) : (100 × 150) / 300 = 50
- Cellule B12 (Évitant / Problème) : (100 × 150) / 300 = 50
- Cellule C12 (Évitant / Émotion) : (100 × 150) / 300 = 50
L’inspection immédiate de cette matrice théorique confirme la parfaite validité des conditions de Cochran : la totalité des cellules théoriques affiche une valeur de 50, ce qui surpasse très largement le plancher critique de 5 unités attendues.
7.3 Calcul de la statistique et extraction de la p-valeur
Pour calculer la statistique globale de Pearson sans alourdir le classeur de tables matricielles intermédiaires superflues, Excel permet l’exploitation de la fonction matricielle SOMMEPROD. Dans une cellule dédiée au calcul de la statistique (par exemple B14), nous saisissons la syntaxe vectorielle directe :
- =SOMMEPROD(((B3:C5 – B10:C12)^2) / B10:C12)
Cette commande sophistiquée procède à la soustraction élément par élément des matrices d’observation et d’espérance, élève chaque écart au carré, effectue la division cellulaire correspondante et somme instantanément l’intégralité des six termes. Décomposons le calcul arithmétique résultant :
- Sécurisant : ((70 – 50)² / 50) + ((30 – 50)² / 50) = (400 / 50) + (400 / 50) = 8 + 8 = 16
- Anxieux : ((35 – 50)² / 50) + ((65 – 50)² / 50) = (225 / 50) + (225 / 50) = 4,5 + 4,5 = 9
- Évitant : ((45 – 50)² / 50) + ((55 – 50)² / 50) = (25 / 50) + (25 / 50) = 0,5 + 0,5 = 1
- Statistique χ² cumulée = 16 + 9 + 1 = 26,00.
Le calcul des degrés de liberté associe les dimensions marginales : ddl = (3 lignes – 1) × (2 colonnes – 1) = 2 × 1 = 2. Pour finaliser la prise de décision, nous injectons ces paramètres au sein de la fonction maîtresse dans la cellule B15 :
- =LOI.KHIDEUX.DROITE(B14; 2) (soit
=LOI.KHIDEUX.DROITE(26; 2))
Le résultat renvoyé par Excel s’établit à 0,00000225 (affiché fréquemment sous forme de notation scientifique d’ingénieur : 2,25E-06). La p-valeur étant infiniment inférieure au seuil alpha conventionnel de 0,01, l’hypothèse nulle d’indépendance est massivement rejetée. Il existe une relation de dépendance hautement significative entre le style d’attachement individuel et les stratégies de coping mobilisées face au stress.
8. Automatisation du calcul direct sans statistique préalable : la fonction TEST.KHIDEUX
8.1 Syntaxe opérationnelle et exigences d’alignement dimensionnel
Bien que la méthode analytique pas-à-pas détaillée précédemment soit pédagogiquement irremplaçable et garantisse une traçabilité totale des calculs intermédiaires, Excel propose un outil d’automatisation direct particulièrement élégant : la fonction TEST.KHIDEUX (localisée sous la désignation CHISQ.TEST dans les distributions anglophones). Cette macro-fonction intégrée est programmée pour court-circuiter l’intégralité des phases manuelles de calcul arithmétique de la statistique χ² et des degrés de liberté, en délivrant de façon instantanée la p-valeur finale.
La structure syntaxique de la fonction requiert strictement deux plages matricielles continues :
- =TEST.KHIDEUX(plage_réelle; plage_théorique) (ou =CHISQ.TEST(actual_range, expected_range))
L’argument plage_réelle désigne l’ensemble continu des cellules renfermant les effectifs bruts observés (en excluant formellement les cellules contenant les totaux marginaux en ligne et en colonne). L’argument plage_théorique identifie la matrice correspondante des effectifs attendus sous H₀. Appliquée directement à notre second cas d’étude clinique portant sur les styles d’attachement, la formule s’énonce avec une concision remarquable :
- =TEST.KHIDEUX(B3:C5; B10:C12)
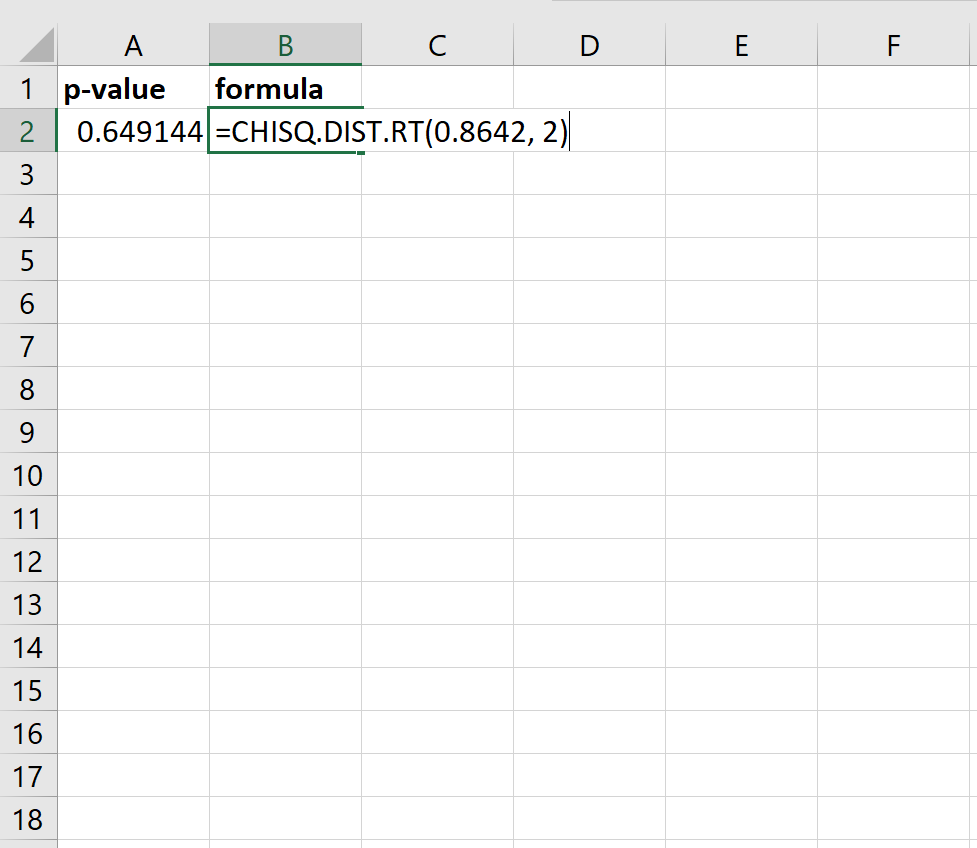
L’exigence informatique fondamentale de cette fonction réside dans la conformité dimensionnelle absolue des deux matrices transmises en arguments. La plage théorique doit impérativement posséder un nombre de lignes et de colonnes strictement congru à celui de la plage réelle (dans notre exemple : une dimension matricielle identique de 3 × 2). Toute dissymétrie géométrique, inclusion accidentelle de bordures ou sélection asymétrique d’une colonne déclenchera immédiatement l’interruption du calcul et le renvoi d’un code d’incompatibilité logicielle.
8.2 Comparaison entre TEST.KHIDEUX et le calcul pas-à-pas
D’un point de vue purement algorithmique, la fonction TEST.KHIDEUX exécute en arrière-plan et de façon compilée exactement la même suite d’opérations que notre chaîne de calcul manuelle : elle détermine les écarts relatifs, les somme pour obtenir la statistique de Pearson, calcule les degrés de liberté ddl = (r – 1) × (c – 1), et applique la distribution unilatérale droite pour extraire la probabilité critique. Le résultat obtenu par =TEST.KHIDEUX(B3:C5; B10:C12) est rigoureusement identique au dernier bit de précision près à celui issu de =LOI.KHIDEUX.DROITE(26; 2), restituant fidèlement 0,00000225.
Le choix entre ces deux approches méthodologiques dépend intrinsèquement des finalités professionnelles poursuivies :
- Avantages de TEST.KHIDEUX : Vitesse d’exécution exceptionnelle, absence d’encombrement de la feuille de calcul par des zones de formules matricielles intermédiaires, idéal pour les tableaux de bord décisionnels, les synthèses de reporting et le traitement massif de données via des macros VBA.
- Avantages de la méthode pas-à-pas : Transparence méthodologique absolue, indispensable pour les audits de recherche, la vérification pédagogique des calculs, et surtout la capacité d’isoler la statistique brute χ² ainsi que les contributions cellulaires individuelles, des métriques requises par les revues savantes et nécessaires à l’analyse résiduelle détaillée.
8.3 Cas limites où TEST.KHIDEUX s’avère inopérante
En dépit de sa commodité opérationnelle incontestable, l’analyste chevronné doit garder à l’esprit les limitations structurelles sévères de la fonction TEST.KHIDEUX, qui rendent parfois son utilisation méthodologiquement impossible ou risquée :
Premièrement, la fonction ne calcule en aucun cas de manière autonome la matrice des effectifs théoriques. L’utilisateur demeure dans l’obligation technique de structurer mathématiquement la table attendue (B10:C12) avant de pouvoir invoquer la fonction. Elle ne constitue donc pas une boîte noire magique dispensant de la compréhension du modèle probabiliste.
Deuxièmement, TEST.KHIDEUX détermine de manière totalement rigide et automatisée les degrés de liberté en se basant exclusivement sur les dimensions géométriques des plages transmises : (r – 1) × (c – 1) pour les tables bidimensionnelles, ou (k – 1) pour les vecteurs unidimensionnels. Par conséquent, si votre démarche scientifique s’inscrit dans un test d’adéquation exigeant l’estimation préalable de m paramètres distributionnels (comme la moyenne ou la variance), réduisant les degrés de liberté à ddl = k – 1 – m, la fonction intégrée utilisera un paramètre erroné (k – 1) et produira une p-valeur irrémédiablement fausse. Dans ce cas de figure, le recours dissocié à la statistique empirique manuelle couplée à LOI.KHIDEUX.DROITE avec ajustement délibéré des degrés de liberté s’impose de façon exclusive.
Troisièmement, TEST.KHIDEUX ne retourne qu’un unique résultat scalaire : la p-valeur. Elle masque complètement la valeur de la statistique χ² sous-jacente. Si le chercheur doit se conformer aux standards de rédaction académique internationale (exigeant la mention systématique de la statistique de test dans le corps du texte scientifique), l’utilisation isolée de cette fonction l’obligera à faire des calculs inverses ou annexes pour récupérer la métrique manquante.
9. Interprétation psychométrique et statistique des p-valeurs obtenues
9.1 Processus décisionnel standardisé et seuils conventionnels
L’extraction numérique de la p-valeur ne constitue que l’aboutissement formel du moteur d’inférence sous Excel ; l’étape subséquente réside dans l’interprétation scientifique judicieuse du résultat obtenu, conformément aux principes de la méthode hypothético-déductive. Le processus décisionnel est encadré par une règle binaire univoque :
- Si la p-valeur ≤ α (où α est le seuil prédéfini a priori, usuellement 0,05) : le chercheur décide formellement de rejeter l’hypothèse nulle (H₀) au profit de l’hypothèse alternative (H₁). La divergence entre observations empiriques et espérance théorique est jugée trop importante pour être imputable aux seules fluctuations d’échantillonnage aléatoire.
- Si la p-valeur > α : le chercheur échoue à rejeter l’hypothèse nulle (ou « maintient H₀ »). Les données recueillies n’offrent pas d’évidence statistique suffisante pour conclure à une rupture du modèle ou à une association réelle.
Il est fondamental de maintenir une rigueur conceptuelle inébranlable quant à la formulation de cette seconde issue : ne jamais affirmer que « l’hypothèse nulle est démontrée ou prouvée ». L’absence de preuve statistique d’une différence ne constitue en aucune manière la preuve de l’absence de différence (un principe épistémologique capital formulé par Douglas Altman). Une valeur p de 0,359 obtenue lors d’un test d’adéquation indique simplement que les observations empiriques demeurent compatibles avec le modèle d’équirépartition, tout en restant potentiellement compatibles avec une multitude d’autres modèles que l’étude n’avait pas la puissance statistique de discriminer.
9.2 Pièges d’interprétation récurrents dans les sciences du comportement
L’interprétation des sorties logicielles du chi-carré est fréquemment entachée d’erreurs d’appréciation conceptuelle, dont la plus délétère consiste à confondre significativité statistique et importance pratique ou clinique. Une p-valeur hautement infinitésimale (telle que p = 0,00000225) n’atteste en rien de la puissance ou de l’intensité intrinsèque de l’association entre les variables. Elle indique simplement qu’il est hautement improbable que la configuration observée découle du seul hasard d’échantillonnage.
La statistique du chi-carré présente une sensibilité mécanique extrême à la taille d’échantillon globale (N). La formule de calcul montre que si l’on multiplie par dix l’effectif de chaque cellule sans modifier en rien les proportions relatives du tableau de contingence, la statistique χ² est mathématiquement multipliée par dix, propulsant instantanément une p-valeur modérément significative vers des sommets de significativité artificielle (p < 0,000001). Dans les méga-bases de données contemporaines (Big Data clinique ou cohortes épidémiologiques de plusieurs dizaines de milliers de sujets), des associations d’une futilité clinique absolue afficheront des p-valeurs ultra-significatives, induisant en erreur le praticien non averti.
Un autre écueil redoutable réside dans la prolifération des comparaisons multiples. Lorsque l’analyste multiplie les tests du chi-carré sur de multiples sous-groupes ou variables sans ajustement statistique, le risque d’erreur de première espèce global (taux d’erreur par famille) s’accroît de manière exponentielle selon la relation : α_global = 1 – (1 – α)^m, où m désigne le nombre de tests exécutés. L’application de corrections méthodologiques rigoureuses, telles que la procédure conservatrice de Bonferroni (divisant le seuil critique par le nombre de tests) ou l’approche plus moderne de contrôle du taux de fausses découvertes de Benjamini-Hochberg, s’avère indispensable pour préserver l’intégrité des inférences psychométriques.
9.3 Analyse approfondie des résidus standardisés ajustés
Le test global du chi-carré est fondamentalement un test omnibus : lorsqu’il débouche sur une p-valeur significative dans une table matricielle supérieure à 2 × 2, il certifie formellement l’existence d’une association générale mais demeure incapable de localiser précisément quelles cellules particulières sont responsables de cette rupture d’indépendance. Se limiter à rapporter une p-valeur globale tronque l’analyse scientifique d’une part substantielle de sa substance heuristique.
Pour dépasser cette limitation, la méthodologie avancée préconise le calcul des résidus standardisés ajustés (ou résidus d’Haberman). Le résidu brut (O – E) est successivement pondéré par son erreur type pour être converti en une métrique normalisée standard suivant asymptotiquement une loi normale centrée réduite N(0, 1). La formule formelle pour la cellule de la ligne i et de la colonne j s’exprime par :
- Résidu Ajusté (r_ij) = (O_ij – E_ij) / RACINE(E_ij × (1 – Total_Ligne_i / N) × (1 – Total_Colonne_j / N))
Sous Excel, ce calcul s’implémente aisément au sein d’une nouvelle matrice de cellules. L’interprétation de ces résidus ajustés repose sur les quantiles de la loi normale :
- Un résidu supérieur à +1,96 signale une surreprésentation statistiquement significative de cette cellule au seuil α = 0,05 (et supérieur à +2,58 au seuil α = 0,01).
- Un résidu inférieur à -1,96 met en évidence une sous-représentation significative au seuil α = 0,05.
Dans notre étude sur l’attachement, l’analyse des résidus montre que les sujets à attachement sécurisant présentent un résidu ajusté très largement supérieur à +3,00 pour le coping centré sur le problème, désignant cette cellule spécifique comme le moteur prépondérant du rejet de l’hypothèse nulle.
10. Erreurs courantes, pièges méthodologiques et diagnostics d’erreur dans Excel
10.1 Codes d’erreur Excel spécifiques et protocoles de résolution
L’implémentation des routines statistiques du chi-carré dans les feuilles de calcul se heurte fréquemment à des interruptions d’exécution matérialisées par des codes d’erreur système standardisés. Diagnostiquer rapidement leur origine permet d’éviter des errances d’encodage chronophages :
- Erreur #NOMBRE! : Survient quasi systématiquement au sein de LOI.KHIDEUX.DROITE lorsque l’argument x est négatif (ce qui est mathématiquement impossible pour une somme de carrés, signalant une erreur de calcul préalable), ou lorsque le paramètre deg_liberte est spécifié comme strictement inférieur à 1 ou supérieur aux limites algorithmiques de mémoire.
- Erreur #VALEUR! : Indique une discordance de typage des données. Cette anomalie apparaît généralement lorsqu’une des cellules référencées contient une chaîne textuelle accidentelle (par exemple l’en-tête d’une colonne inclus par mégarde dans la plage de sélection), un espace invisible ou un symbole typographique inadapté.
- Erreur #DIV/0! : Provoquée lors de la phase manuelle de standardisation matricielle ((O – E)² / E) dès lors qu’un effectif théorique attendu (E) est strictement nul. Cette situation découle généralement d’une ligne ou d’une colonne marginale entièrement vide dans le tableau d’observation brut.
- Erreur #NOM? : Révèle une coquille lexicale dans l’appel de la fonction, causée soit par une faute d’orthographe (ex. :
LOI.KHIDIEUX), soit par l’emploi de la nomenclature anglophoneCHISQ.DIST.RTsur une version d’Excel strictement configurée en langue française sans module de traduction automatique.
10.2 Violations des postulats statistiques fondamentaux
Au-delà des dysfonctionnements informatiques, les violations méthodologiques invisibles pour le logiciel représentent le danger le plus pernicieux, car Excel fournira invariablement un résultat numérique précis même si les données sous-jacentes bafouent l’intégralité des principes de validité statistique.
Le premier écueil méthodologique réside dans le non-respect des règles de Cochran : si votre matrice empirique engendre des effectifs théoriques inférieurs à 5 dans plus de 20 % des cellules, la distribution réelle de la statistique discrète s’écarte violemment de la courbe théorique continue du chi-carré. La p-valeur renvoyée par Excel devient erratique et faussement optimiste. Dans ce contexte, pour des tables de contingence 2 × 2 à faibles effectifs, l’analyste doit impérativement renoncer au chi-carré standard pour mobiliser le test exact de Fisher, ou procéder au regroupement préalable de modalités contiguës pour restaurer la densité des cellules théoriques.
Le second écueil, destructeur pour l’inférence, consiste à violer le postulat fondamental de l’indépendance des observations. Le test du chi-carré de Pearson exige de manière absolue qu’une observation corresponde à un individu unique et exclusif, et qu’aucun sujet ne contribue à plusieurs cellules du tableau de contingence. Si vous évaluez les mêmes participants avant et après une intervention clinique (mesures répétées intra-sujets), l’application du chi-carré standard sous Excel est une faute méthodologique rédhibitoire ; le design requiert expressément la mise en œuvre du test de McNemar pour données appariées.
10.3 Vérification des arrondis et précision des types de données
L’interface graphique d’Excel dissimule parfois des pièges d’affichage susceptibles d’altérer la restitution des calculs statistiques. Par défaut, lorsqu’une p-valeur est infinitésimale (inférieure à 0,0005), un formatage numérique standard configuré à trois décimales affichera la valeur textuelle 0,000. L’analyste débutant commet alors fréquemment l’erreur grossière de retranscrire dans son rapport clinique ou académique la mention « p = 0,000 ».
Une probabilité n’étant jamais strictement nulle dans un cadre inférentiel continu, une telle transcription constitue une aberration épistémologique. L’analyste doit modifier le format de cellule pour afficher la notation scientifique à plusieurs décimales (affichant par exemple 1,45E-07) ou, conformément aux normes de rédaction internationales, consigner formellement le résultat sous la formulation consensuelle p < 0,001.
Par ailleurs, il convient de proscrire absolument l’arrondi prématuré de la statistique de test intermédiaire avant son injection dans la fonction décisionnelle. Tronquer une statistique χ² de 5,14892 à 5,1 au sein d’une formule intermédiaire peut, dans les zones de forte courbure de la queue de distribution (au voisinage immédiat du seuil critique α = 0,05), modifier le troisième chiffre décimal de la p-valeur et faire basculer artificiellement une conclusion de recherche de l’état non significatif à l’état significatif. La chaîne de formules au sein d’Excel doit systématiquement faire référence aux cellules sources calculées en double précision sans arrondi intermédiaire.
11. Calcul des indices de taille d’effet complémentaires à la p-valeur
11.1 Le coefficient Phi pour les tables de contingence 2×2
Face à la dépendance mécanique de la p-valeur envers la taille globale de l’échantillon, la communauté scientifique internationale (sous l’impulsion de l’American Psychological Association) exige désormais de façon impérative que toute publication mentionnant une p-valeur rapporte conjointement un indice standardisé de taille d’effet (effect size). Dans le cadre restreint mais universel des tables de contingence à quatre cellules (2 × 2), le coefficient Phi (noté φ) constitue la métrique de corrélation non paramétrique privilégiée.
Le coefficient Phi se dérive directement de la statistique du chi-carré de Pearson par la formule algébrique : φ = RACINE(χ² / N). Son implémentation sous Excel est d’une grande fluidité calculatoire. Si votre statistique χ² réside dans la cellule B14 et que la taille totale de l’échantillon N est stockée en cellule D6, la formule s’énonce simplement :
- =RACINE(B14 / D6)
Le coefficient Phi est borné conventionnellement entre 0 (indépendance absolue) et 1 (association parfaite déterministe). Selon les critères psychométriques établis par Jacob Cohen dans son ouvrage de référence sur l’analyse de puissance, la grille de lecture de la force de l’association s’articule ainsi :
- Effet modeste ou petit : φ ≈ 0,10
- Effet intermédiaire ou moyen : φ ≈ 0,30
- Effet de grande magnitude : φ ≥ 0,50
11.2 Le V de Cramér pour les tables multidimensionnelles
Lorsque le design expérimental se déploie sur des tables de contingence plus complexes excédant le format binaire (dès lors que r > 2 ou c > 2), le coefficient Phi perd son ancrage métrique et peut théoriquement dépasser la valeur unitaire, devenant ininterprétable. L’extension mathématique universelle appropriée est alors le V de Cramér (développé par le statisticien Harald Cramér).
La formulation analytique du V de Cramér ajuste la standardisation en intégrant la dimensionnalité minimale de la matrice : V = RACINE(χ² / (N × (k_min – 1))), où k_min représente la valeur minimale entre le nombre total de lignes r et le nombre total de colonnes c : k_min = MIN(r, c). Sous Excel, cette opération se transcrit intégralement par la formule suivante :
- =RACINE(B14 / (D6 * (MIN(LIGNES(B3:C5); COLONNES(B3:C5)) – 1)))
Dans notre application pratique portant sur les styles d’attachement (3 lignes, 2 colonnes, N = 300, χ² = 26,00) :
- k_min = MIN(3, 2) = 2. Le terme diviseur (k_min – 1) équivaut donc à (2 – 1) = 1.
- Le V de Cramér s’établit à : RACINE(26,00 / (300 × 1)) = RACINE(0,08667) = 0,294.
L’interprétation clinique du V de Cramér doit moduler les critères conventionnels de Cohen en fonction des degrés de liberté du tableau (définis par k_min – 1). Pour une table où k_min – 1 = 1, la valeur de 0,294 s’interprète rigoureusement comme une association de magnitude moyenne, approchant la borne supérieure d’un effet modéré. Le praticien dispose ainsi d’une appréciation transparente de la portée clinique de la relation, affranchie de la distorsion d’échelle induite par la p-valeur ultra-significative.
11.3 Rapports de cotes (Odds Ratios) et risques relatifs
Dans la recherche translationnelle, la psychiatrie épidémiologique et les essais cliniques randomisés, les métriques d’association relative telles que le rapport de cotes (communément désigné par l’anglicisme Odds Ratio, OR) et le Risque Relatif (RR) constituent des compléments décisionnels indispensables à la p-valeur du chi-carré.
Considérant une table de contingence 2 × 2 croisant une exposition clinique (Lignes : Présence / Absence d’un facteur de risque) et un événement clinique (Colonnes : Présence / Absence d’une pathologie) organisée dans les cellules B3, C3 pour la ligne 1, et B4, C4 pour la ligne 2, la cote de maladie chez les exposés est B3 / C3, tandis que la cote chez les non-exposés est B4 / C4. Le rapport de cotes (OR) s’implémente sous Excel par le produit croisé élémentaire :
- =(B3 * C4) / (C3 * B4)
Un Odds Ratio unitaire (OR = 1,00) matérialise l’équivalence stricte des cotes sous l’hypothèse nulle. Une valeur supérieure à 1 indique que l’exposition augmente la probabilité de survenue de l’événement. Pour asseoir l’inférence méthodologique dans Excel, il est essentiel d’adjoindre à l’Odds Ratio son intervalle de confiance à 95 % (IC 95 %). L’erreur type logarithmique (SE_lnOR) se calcule par :
- SE = RACINE((1/B3) + (1/C3) + (1/B4) + (1/C4))
- Borne inférieure IC 95% : =EXP(LN(OR) – (1,96 * SE))
- Borne supérieure IC 95% : =EXP(LN(OR) + (1,96 * SE))
L’articulation harmonieuse entre l’Odds Ratio et la p-valeur offre une perspective analytique complète : la p-valeur répond à la question « l’effet observé est-il attribuable au hasard ? », tandis que l’Odds Ratio et son intervalle de confiance renseignent sur l’amplitude et la précision clinique du phénomène dans la population générale.
12. Normes de présentation académique des résultats selon l’APA (7e édition)
12.1 Règles formelles de rédaction textuelle du test
La valorisation finale de toute démarche analytique exécutée sous Excel passe par la transcription irréprochable des résultats statistiques dans les mémoires, thèses ou articles soumis aux revues à comité de lecture. Le manuel de style de l’American Psychological Association (APA Publication Manual, 7e édition) régit de façon prescriptive les conventions typographiques applicables aux tests du chi-carré.
Les normes fondamentales de formalisation exigent les règles suivantes :
- Le symbole grec du chi-carré est systématiquement typographié en lettre minuscule standard χ², ou plus classiquement remplacé par la lettre latine majuscule mise en italique : χ² (avec l’exposant non italique).
- Les degrés de liberté et la taille totale de l’échantillon N doivent figurer immédiatement après le symbole statistique, enchâssés entre parenthèses et séparés par une virgule : χ²(ddl, N = effectif).
- Tous les symboles statistiques d’origine latine (tels que N, p, V, r) doivent impérativement être mis en italique. En revanche, les chiffres, les symboles mathématiques opératoires (=, <, >) et les lettres grecques ne doivent jamais être mis en italique.
- La p-valeur doit être rapportée sans le zéro précédant la virgule (ou le point décimal selon la convention linguistique de la revue), car une probabilité ne peut par définition mathématique jamais excéder la valeur unitaire. On écrira rigoureusement p = ,036 ou p < ,001, et non pas p = 0,036.
- Les espaces insécables doivent entourer tous les opérateurs arithmétiques pour garantir la propreté de la mise en page éditoriale.
12.2 Exemples concrets de rédaction pour publications scientifiques
Afin d’illustrer la déclinaison pratique de ces directives, examinons comment rédiger textuellement les conclusions statistiques tirées de nos deux cas pratiques modélisés sous Excel :
Modèle de rédaction pour le test d’adéquation (résultat non significatif) :
« Une analyse d’adéquation du chi-carré de Pearson a été conduite afin de déterminer si la fréquentation hebdomadaire du service de soutien psychologique universitaire différait d’une répartition temporelle uniforme au cours des cinq jours ouvrés. Les résultats indiquent que les fluctuations d’affluence observées du lundi au vendredi ne dévient pas de manière statistiquement significative de l’équirépartition attendue, χ²(4, N = 200) = 5,15, p = ,272. Ces données suggèrent une stabilité globale de la demande clinique quotidienne sur le campus, ne justifiant pas de réallocation différentielle des ressources de permanence. »
Modèle de rédaction pour le test d’indépendance (résultat hautement significatif avec taille d’effet) :
« Un test d’indépendance du chi-carré a été réalisé pour examiner la relation structurelle entre les typologies d’attachement affectif (sécurisant, anxieux, évitant) et les stratégies préférentielles de coping face au stress (centré sur le problème vs centré sur l’émotion) au sein d’une cohorte clinique de 300 patients. L’analyse révèle une association hautement significative entre ces deux variables catégorielles, χ²(2, N = 300) = 26,00, p < ,001, avec une taille d’effet modérée attestée par un V de Cramér de V = ,294. L’inspection des résidus standardisés ajustés d’Haberman démontre que les individus présentant un style d’attachement sécurisant adoptent significativement plus souvent des stratégies de coping centrées sur le problème (résidu ajusté = +3,58) que ne le prédirait l’hypothèse d’indépendance, tandis que les patients au profil anxieux manifestent une surreprésentation marquée des mécanismes centrés sur l’émotion (résidu ajusté = +3,00). »
12.3 Conception de tableaux statistiques conformes aux exigences éditoriales
L’exportation brute de captures d’écran de cellules Excel colorées ou dotées de grilles quadrillées intégrales est formellement proscrite dans les manuscrits académiques soumis aux revues de rang international. La présentation de tableaux de contingence requiert un travail de mise en forme strict conforme au style APA :
- Suppression absolue de toutes les bordures verticales : un tableau conforme à l’APA ne comporte jamais aucune ligne verticale séparatrice de colonnes.
- Standardisation des lignes horizontales : le tableau ne doit comporter que trois lignes horizontales principales complètes : une bordure supérieure fermant le haut de l’en-tête, une bordure inférieure délimitant les en-têtes de colonnes, et une bordure inférieure fermant le tableau avant les notes de bas de page. Des lignes partielles peuvent être utilisées pour regrouper des sous-en-têtes hiérarchiques.
- Disposition claire des métriques : chaque cellule croisée doit présenter le décompte des fréquences observées accompagné systématiquement du pourcentage en ligne ou en colonne correspondant (ex. : 70 [70,0 %]), avec la mention explicite de l’orientation du pourcentage dans le titre de la colonne ou la légende.
- Notes de tableau standardisées : les astérisques de significativité conventionnels (* p < ,05 ; ** p < ,01 ; *** p < ,001) doivent être décrits avec précision dans une note générale positionnée sous le tableau, débutant par le mot Note en italique suivi d’un point.
En observant scrupuleusement ces standards méthodologiques, informatiques et éditoriaux, le chercheur maximise la valeur probante de ses analyses statistiques issues d’Excel, transformant des calculs numériques bruts en connaissances scientifiques rigoureuses, reproductibles et immédiatement publiables.
Références
- Altman, D. G., & Bland, J. M. (1995). Absence of evidence is not evidence of absence. British Medical Journal, 311(7003), 485. https://doi.org/10.1136/bmj.311.7003.485
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289-300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cochran, W. G. (1954). The chi-square test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315-345. https://doi.org/10.1214/aoms/1177729380
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Fisher, R. A. (1922). On the interpretation of chi-square from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87-94. https://doi.org/10.2307/2340521
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205-220. https://doi.org/10.2307/2529686
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153-157. https://doi.org/10.1007/BF02295996
- Microsoft Corporation. (2023). Documentation des fonctions statistiques Excel : LOI.KHIDEUX.DROITE et TEST.KHIDEUX. Support Microsoft Office. https://support.microsoft.com/fr-fr/office/
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157-175. https://doi.org/10.1080/14786440009463897