
Dans le champ de l’inférence statistique moderne, l’estimation rigoureuse des paramètres d’une population à partir d’échantillons restreints constitue l’une des démarches méthodologiques les plus fondamentales. Que ce soit pour quantifier l’efficacité d’une nouvelle thérapie cognitive, évaluer l’impact d’une modification environnementale sur le temps de réaction neuromusculaire, ou mesurer les variations d’aptitudes psychométriques au sein d’une cohorte, le chercheur se heurte systématiquement à l’incertitude intrinsèque liée aux fluctuations d’échantillonnage. Pour dépasser la simple observation descriptive et formuler des jugements probabilistes valides, la statistique inférentielle s’appuie sur des distributions théoriques d’échantillonnage, parmi lesquelles la loi de Student occupe une position prééminente.
La détermination exacte de la valeur critique t alpha/2 représente l’étape pivot conditionnant l’ensemble des conclusions tirées lors d’un test d’hypothèse bilatéral ou lors de la construction d’un intervalle de confiance pour une moyenne. Cette valeur frontière, issue de la distribution t de Student, agit comme un arbitre mathématique impartial : elle délimite précisément la frontière entre les fluctuations aléatoires attendues sous l’hypothèse nulle et les variations statistiquement significatives qui justifient le rejet de cette dernière. Une mauvaise compréhension de sa dérivation, une confusion dans le calibrage des risques d’erreur ou une lecture erronée des outils de calcul risquent d’invalider la chaîne inférentielle, menant à des conclusions scientifiques trompeuses ou à des faux positifs dommageables pour la reproductibilité de la recherche.
Ce guide exhaustif a pour vocation de démystifier, d’analyser et de maîtriser sous tous ses aspects la recherche de la valeur critique t alpha/2. En abordant les fondements épistémologiques et mathématiques de la loi de Student, en détaillant pas à pas les procédures de consultation des tables statistiques traditionnelles, en explorant les syntaxes logicielles modernes au sein d’environnements tels que R, Python, Microsoft Excel ou les calculatrices graphiques, et en illustrant l’ensemble par des applications concrètes issues de la recherche expérimentale, cet ouvrage se présente comme une référence complète. L’analyse approfondie des erreurs courantes et des normes de publication académique permettra à tout praticien et chercheur d’asseoir ses déductions statistiques sur des bases inébranlables.
1. Introduction théorique et définition de la valeur critique t alpha/2
1.1 Définition formelle de la valeur critique t alpha/2
Dans l’arsenal méthodologique de la statistique décisionnelle, la notation t alpha/2 désigne formellement une valeur d’abscisse sur la distribution t de Student qui délimite, dans la queue supérieure de la fonction de densité, une probabilité exactement égale à la moitié du seuil de risque global consenti, noté alpha. L’inférence statistique repose sur l’arbitrage permanent entre le souhait d’identifier un effet réel et la nécessité de se prémunir contre les fluctuations stochastiques inhérentes à tout échantillonnage probabiliste. Lorsque le praticien retient une démarche bilatérale, il admet par hypothèse que la divergence entre la réalité empirique observée et l’espérance théorique formulée sous l’hypothèse nulle peut s’exprimer dans deux directions opposées : une moyenne empirique peut se révéler significativement supérieure ou, au contraire, significativement inférieure à la norme de référence établie.
Cette non-directionnalité impose une contrainte mathématique directe sur la topologie de la zone de rejet. Le risque total d’erreur de première espèce, conventionnellement fixé par le chercheur à un niveau globalisé alpha, doit être fragmenté en deux proportions parfaitement équivalentes en vertu des propriétés de symétrie de la distribution. Ainsi, une portion égale à alpha/2 est allouée à la queue de distribution droite, représentant les valeurs extrêmes positives, tandis qu’une portion strictement identique de surface alpha/2 est assignée à la queue de distribution gauche, traduisant les déviations négatives extrêmes. La valeur critique t alpha/2 correspond précisément au quantile positif qui laisse une surface de probabilité cumulée égale à 1 moins alpha/2 à sa gauche, et une surface d’extrusion de alpha/2 à sa droite.
D’un point de vue géométrique, l’aire totale sous la courbe de la fonction de densité de probabilité étant normalisée à l’unité, l’intervalle délimité par l’opposé de cette valeur et sa contrepartie positive concentre une masse probabiliste exactement égale à 1 moins alpha. Cette zone centrale constitue la région d’acceptation, ou plus rigoureusement la région de non-rejet de l’hypothèse nulle. La valeur t alpha/2 fonctionne donc comme une ligne de partage irrévocable : dès lors que la statistique empirique calculée à partir des données collectées dépasse ce seuil en valeur absolue, l’observateur est contraint de rejeter l’hypothèse d’une simple variation fortuite au profit de l’hypothèse alternative.
1.2 Le rôle fondamental de la distribution t de Student en psychologie
L’émergence de la distribution t trouve son origine historique dans les travaux pionniers de William Sealy Gosset, un chimiste et statisticien d’exception travaillant pour les brasseries Guinness au début du vingtième siècle. Contraint de publier sous le pseudonyme de « Student » en raison des clauses de confidentialité industrielle imposées par son employeur, Gosset s’est heurté à un obstacle mathématique récurrent : comment évaluer la variabilité d’ingrédients chimiques et le rendement de brassage à partir d’échantillons de taille extrêmement ténue sans connaître la variance exacte de la population mère ? À cette époque, la théorie statistique postulait la loi normale comme cadre universel, une présomption valide uniquement lorsque la dispersion de l’ensemble de la population était connue a priori ou lorsque la taille de l’échantillon devenait asymptotiquement infinie.
Dans la recherche contemporaine en psychologie cognitive, en neuropsychologie clinique ou en sciences du comportement, la situation méthodologique décrite par Gosset demeure la norme quotidienne. Les investigateurs travaillent presque invariablement sur des cohortes réduites pour des motifs d’accessibilité des patients, de coûts financiers ou de lourdeur des protocoles d’imagerie cérébrale. Dans ces contextes, l’écart-type de la population générale demeure une inconnue métaphysique. Le chercheur est contraint d’estimer ce paramètre à partir de l’écart-type de son propre échantillon empirique, introduisant une source supplémentaire d’incertitude dans la construction de la statistique de test. Remplacer l’écart-type vrai de la population par son estimateur non biaisé modifie en profondeur la distribution d’échantillonnage de la moyenne standardisée.
La distribution t de Student a précisément été développée pour absorber cette variabilité additionnelle. Par rapport à la loi normale centrée réduite de Gauss, la courbe de Student se caractérise par une morphologie dite leptokurtique, se matérialisant par un sommet plus aplati et, surtout, des queues de distribution notablement plus épaisses et étalées. Cette dispersion accrue reflète fidèlement le déficit d’information lié à la méconnaissance du véritable paramètre de dispersion de la population. L’adoption de la loi t garantit ainsi que les probabilités associées aux événements extrêmes ne soient pas sous-estimées, protégeant le psychologue chercheur contre des déductions téméraires qui découlerait de l’application illégitime d’une courbe normale trop étroite.
1.3 Distinction cruciale entre test unilatéral et test bilatéral
La distinction opératoire entre une démarche inférentielle unilatérale et un protocole bilatéral constitue l’une des décisions épistémologiques les plus lourdes de conséquences lors de la planification d’une étude scientifique. Dans un test unilatéral, l’investigateur avance une hypothèse théorique rigoureusement orientée a priori, soutenue par une littérature robuste ou des contraintes physiologiques strictes. L’hypothèse alternative postule explicitement la direction de l’effet : l’intervention ne peut que majorer les scores, ou alternativement ne peut que les minorer. Sous ce paradigme spécifique, l’intégralité du risque alpha est concentrée dans une seule et unique queue de la distribution. La valeur critique unilatérale se positionne alors de telle sorte que l’aire d’exclusion totale alpha se situe intégralement à droite ou à gauche de la courbe.
À l’opposé, le test bilatéral s’impose dès lors qu’il existe une incertitude théorique quant à la nature de la modification induite par le traitement, ou lorsque le protocole vise à vérifier une équivalence ou une altération sans préjuger de sa polarité. En psychologie clinique, administrer une molécule psychotrope innovante peut atténuer un symptôme anxieux mais pourrait tout aussi bien, en vertu d’effets paradoxaux indésirables, aggraver la détresse du patient. Formuler une hypothèse bilatérale constitue un impératif d’honnêteté intellectuelle : le chercheur recherche une différence, qu’elle soit positive ou négative. En conséquence, la surface de rejet totale alpha doit obligatoirement être scindée en deux parts congruentes de taille alpha/2, disposées symétriquement aux deux extrémités de la distribution théorique.
Cette fragmentation géographique de l’erreur induit une conséquence statistique directe sur l’amplitude numérique du seuil critique. À risque alpha équivalent et pour un nombre identique de degrés de liberté, la valeur critique bilatérale t alpha/2 s’avère systématiquement plus élevée en valeur absolue que la valeur critique issue d’un test unilatéral. Exiger un t bilatéral revient à durcir le niveau d’exigence de la démonstration expérimentale : l’effet empirique doit atteindre une magnitude supérieure pour franchir la ligne de démarcation statistique. Ce surcroît de rigueur épistémologique prévient efficacement la publication d’effets fortuits résultant d’explorations post-hoc non cadrées par un protocole rigoureux.
2. Les paramètres indispensables : seuil de signification et degrés de liberté
2.1 Compréhension conceptuelle du seuil d’erreur de type I (alpha)
Au cœur du formalisme de Neyman-Pearson se trouve la notion de seuil de signification, universellement désignée par la lettre grecque alpha. Ce paramètre correspond à la probabilité maximale tolérée par le chercheur de commettre une erreur de première espèce, c’est-à-dire le risque de rejeter indûment l’hypothèse nulle alors même que celle-ci est matériellement vérifiée dans la population parente. Dans le contexte de l’expérimentation, commettre une erreur de type I équivaut à déclarer une découverte illusoire : le clinicien conclurait à l’efficacité d’un protocole d’entraînement cérébral alors que les fluctuations mesurées ne résultent que du pur hasard d’échantillonnage. La maîtrise rigoureuse de ce risque constitue le socle éthique et qualitatif de la validation empirique.
Le choix numérique de ce seuil n’est pas dicté par une loi mathématique universelle mais par des conventions méthodologiques intériorisées par les communautés scientifiques. Dans le champ de la psychologie et des sciences humaines, la tradition instituée par Ronald Fisher consacre l’utilisation du seuil de cinq pour cent (alpha = 0,05) comme le standard de démarcation par excellence. Dans certaines configurations exploratoires ou lors d’essais préliminaires, un seuil plus libéral de dix pour cent (alpha = 0,10) est occasionnellement toléré pour ne pas étouffer prématurément des pistes émergentes. À l’inverse, dans les études génomiques associées aux traits cognitifs ou lors d’essais cliniques à fort enjeu de sécurité, un seuil conservateur d’un pour cent (alpha = 0,01), voire inférieur, s’avère indispensable pour minimiser drastiquement les faux positifs.
La sélection d’un seuil alpha engage directement la sévérité du t alpha/2 recherché. Plus le seuil retenu est faible, plus la fraction alpha/2 délimitée dans chaque queue de la distribution est minuscule, ce qui repousse mécaniquement la valeur critique vers des zones d’extrusion très éloignées du centre de la distribution. En élevant cette barrière d’acceptabilité, le chercheur s’assure d’une certitude quasi-totale avant de proclamer la validité de ses déductions, tout en acceptant délibérément le tribut corrélatif d’une réduction de la puissance statistique de son dispositif, augmentant ainsi le risque d’erreur de seconde espèce (bêta).
2.2 Calcul et signification des degrés de liberté selon le plan d’expérience
Le concept de degrés de liberté, communément abrégé sous les sigles ddl ou df pour l’anglais degrees of freedom, traduit la quantité d’informations indépendantes contenues dans l’échantillon qui demeurent libres de varier lors de l’estimation des paramètres populationnels. D’un point de vue algébrique, si l’on dispose d’un ensemble de n observations quantitatives indépendantes, ces n données possèdent initialement n degrés de liberté. Toutefois, dès lors qu’un paramètre intermédiaire doit être extrait de cet échantillon pour évaluer la dispersion du phénomène — en l’occurrence, le calcul de la moyenne empirique indispensable à la détermination de la variance d’échantillon —, une contrainte mathématique est imposée sur les données, confisquant instantanément un degré de liberté à la structure globale.
Le calcul effectif des degrés de liberté varie substantiellement selon l’architecture du plan expérimental déployé par l’investigateur. Dans le cas d’un test t sur échantillon unique ou d’un test t pour échantillons appariés reposant sur des mesures répétées sur les mêmes sujets, l’unité fondamentale d’analyse devient la différence individuelle ou l’écart à une constante. Pour un groupe de n participants, les degrés de liberté sont rigoureusement égaux à n moins un (df = n – 1). Cette déduction d’une unité découle du fait que si l’on connaît la moyenne de l’échantillon et que l’on a déterminé la valeur de n moins une observations, la dernière observation restante est parfaitement déterminée et n’apporte aucune liberté de variation statistique supplémentaire.
Dans la configuration classique d’une comparaison entre deux groupes d’individus totalement indépendants — par exemple un groupe expérimental recevant une prise en charge psychologique et un groupe témoin placé sur liste d’attente —, la démarche d’inférence nécessite l’estimation de deux moyennes distinctes. Si le premier groupe compte n1 sujets et le second n2 sujets, l’échantillon cumulé comporte n1 plus n2 observations. Dès lors que l’on postule l’homogénéité des variances entre les conditions, les degrés de liberté attribués à la statistique de Student s’élèvent exactement à la somme des deux effectifs amputée de deux unités (df = n1 + n2 – 2). Chaque paramètre central estimé pour chaque condition soustrait une unité à la masse informationnelle totale disponible pour le test.
2.3 Effet du nombre de degrés de liberté sur l’épaisseur des queues de distribution
La distribution t de Student ne constitue pas une courbe immuable unique, mais s’apparente plutôt à une famille infinie de lois continues, indexées chacune par leur paramètre de degrés de liberté respectif. L’impact de ce paramètre sur la morphologie géométrique de la fonction de densité est colossal : il gouverne directement l’épaisseur des queues d’extrusion de la loi. Lorsque le nombre de degrés de liberté est extrêmement faible, par exemple lorsque df est inférieur à dix, la distribution exhibe une lourdeur marquée de ses queues. Cela traduit le fait que l’estimateur de la variance calculé sur une poignée de sujets est lui-même sujet à d’importantes fluctuations d’échantillonnage, rendant l’apparition de valeurs t anormalement élevées bien plus fréquente que sous une loi normale pure.
Pour compenser cette incertitude fondamentale et maintenir le taux d’erreur de première espèce au niveau nominal alpha souhaité, la théorie statistique ajuste dynamiquement l’emplacement du quantile critique. Ainsi, pour un seuil bilatéral classique de 0,05 avec seulement 2 degrés de liberté, la valeur critique t alpha/2 s’élève à 4,303. Ce chiffre astronomique atteste qu’un effet doit atteindre un niveau de déviation spectaculaire pour être reconnu comme non fortuit lorsque l’échantillon est restreint. Si l’on augmente le nombre de sujets pour atteindre 30 degrés de liberté, le t alpha/2 correspondant descend promptement à 2,042, reflétant le gain de confiance substantiel accordé à l’estimation de la dispersion interne.
Au fur et à mesure que la taille de l’échantillon progresse et que les degrés de liberté tendent asymptotiquement vers l’infini, la variance d’échantillonnage converge en probabilité vers la variance vraie de la population selon les théorèmes de convergence stochastique. En conséquence, l’épaisseur résiduelle des queues de Student s’amenuise continûment pour s’ajuster parfaitement aux contours de la distribution normale centrée réduite. À l’infini, la loi t devient rigoureusement identique à la loi de Gauss, et la valeur critique t alpha/2 pour un seuil bilatéral de 0,05 se stabilise sur la valeur universelle z alpha/2 de 1,960. Comprendre cette dynamique d’amenuisement est essentiel pour percevoir à quel point la pénalisation imposée par la loi t protège la recherche contre les illusions méthodologiques.
3. Méthode pas à pas : lecture manuelle de la table statistique de Student
3.1 Organisation structurelle et conventions d’une table t
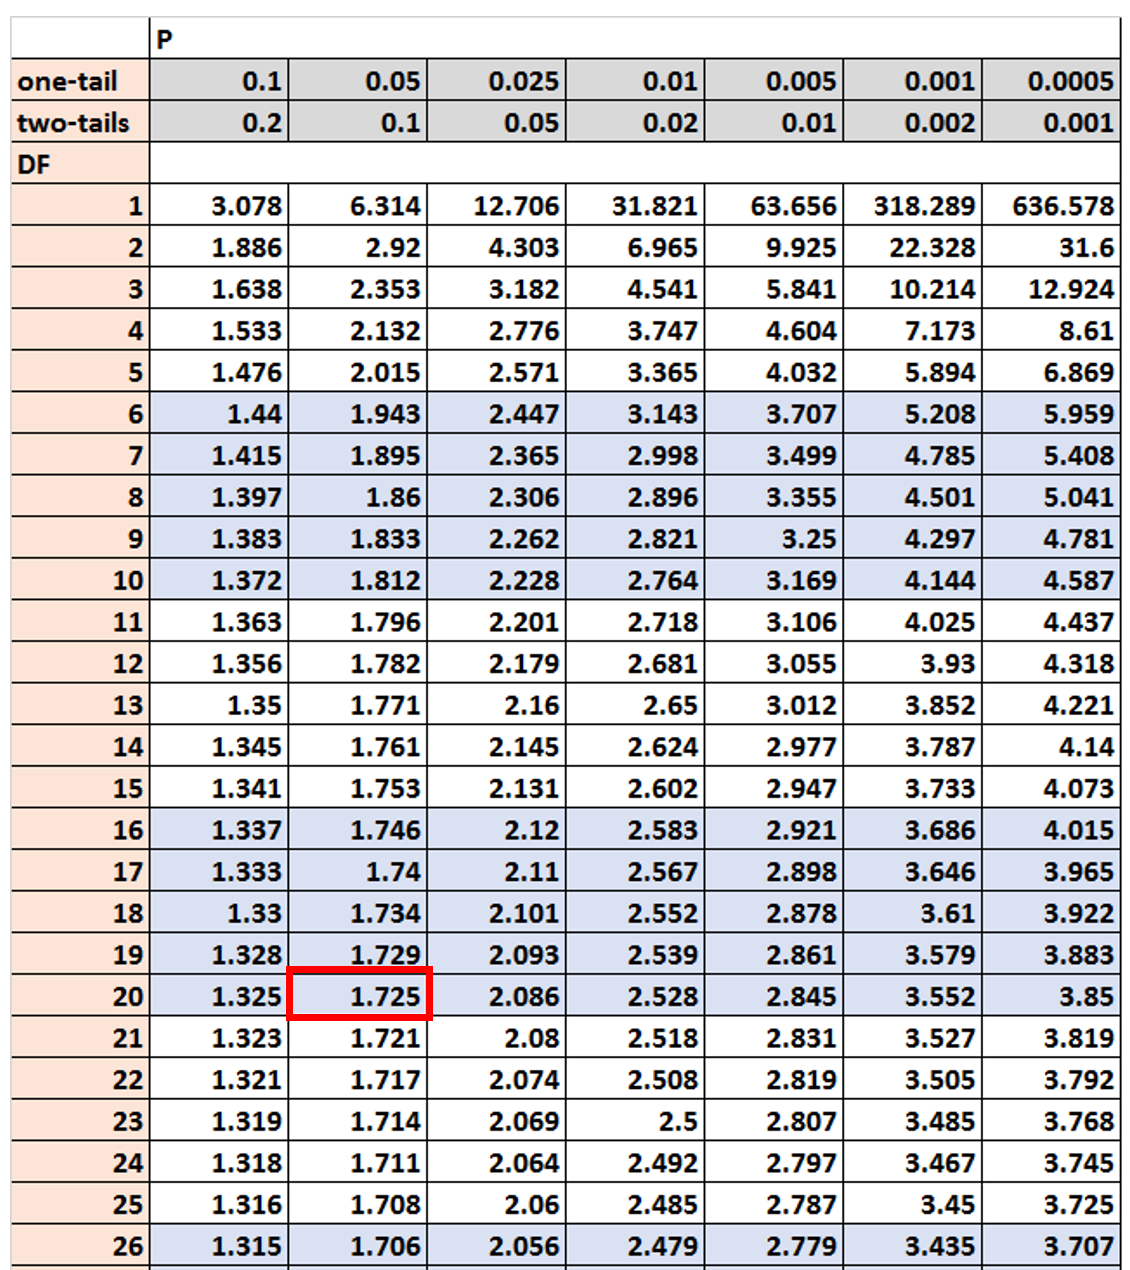
Bien que l’informatique moderne ait largement automatisé les procédures de calcul numérique, la consultation manuelle d’une table statistique imprimée demeure une compétence fondamentale pour tout chercheur ou praticien désireux de comprendre la logique sous-jacente de l’inférence. Une table t se présente sous la forme d’une matrice bidimensionnelle rigoureusement ordonnée. Les lignes horizontales correspondent systématiquement aux degrés de liberté de la distribution, disposés de manière strictement croissante à partir de la valeur un jusqu’à des paliers conventionnels (souvent de un en un jusqu’à trente ou quarante, puis par incréments de dix, cinquante ou cent, pour s’achever sur une ligne représentant l’infini ou la loi normale).
L’en-tête supérieur de la table comprend les colonnes qui référencent les niveaux de probabilité associés aux queues de distribution. C’est ici que réside la source majeure de confusion pour les utilisateurs non avertis. Selon les conventions typographiques adoptées par l’éditeur du manuel statistique, l’en-tête peut afficher des seuils pour un test unilatéral (indiquant souvent l’aire d’une seule queue, notée p ou alpha_1), des seuils pour un test bilatéral (notés 2p ou alpha_2), ou encore des probabilités cumulées depuis l’infini négatif (notées F(t) ou 1 – alpha). Certaines tables modernes et bien conçues intègrent une double rangée d’en-tête, explicitant simultanément le risque unilatéral et le risque bilatéral équivalent.
Avant d’extraire la moindre donnée chiffrée, il est impératif d’examiner le cartouche graphique situé en haut de la table. Ce schéma explicatif illustre la surface précisément hachurée sous la courbe de Student correspondant aux probabilités tabulées. Si la zone ombrée ne couvre que la pointe extrême droite de la cloche, la table est configurée selon une convention unilatérale de queue supérieure. Si les deux extrémités opposées sont simultanément hachurées, les en-têtes correspondent directement au risque bilatéral total alpha. Cette vérification liminaire constitue un rempart indispensable contre l’erreur de sélection d’une colonne erronée.
3.2 Repérage systématique de la colonne correspondant à alpha/2
Pour localiser avec certitude la valeur critique t alpha/2, le praticien doit convertir mentalement son risque bilatéral global en la coordonnée exacte requise par l’en-tête de la table à sa disposition. Si l’on applique un protocole avec un risque d’erreur consenti global de dix pour cent (alpha = 0,10) dans une optique bilatérale, la symétrie de la distribution impose que la zone de rejet soit constituée de deux aires extrêmes disjointes de cinq pour cent chacune (alpha/2 = 0,05). Si la table utilisée propose une rangée d’en-tête libellée « Test bilatéral » ou « Aire dans les deux queues combinées », l’utilisateur doit fixer directement son regard sur la colonne intitulée 0,10.
En revanche, si la table ne renseigne que les probabilités sous une convention unilatérale — ce qui est fréquemment le cas dans les annexes de nombreux traités académiques anglo-saxons —, l’utilisateur doit faire correspondre sa démarche à l’aire présente dans une seule queue. Dans cet exemple précis, pour un alpha bilatéral de 0,10, l’aire contenue dans la queue droite unique s’élève exactement à 0,05. Le praticien devra donc impérativement sélectionner la colonne affichant 0,05 pour le test unilatéral. Choisir accidentellement la colonne 0,10 unilatérale reviendrait à exécuter un test bilatéral au seuil global d’erreur de 0,20, ce qui doublerait illégitimement le risque d’erreur de type I.
Pour les tables qui tabulent l’intégrale cumulée à gauche depuis moins l’infini, la surface correspondant à la borne critique droite t alpha/2 englobe la totalité de la courbe à l’exception de la queue supérieure. Ainsi, la probabilité cumulée recherchée est égale à 1 moins alpha/2. Pour un seuil bilatéral global de 0,10, l’aire cumulée à gauche vaut 1 – 0,05 = 0,95. L’utilisateur devra donc repérer la colonne étiquetée 0,950. La cohérence entre ces différentes désignations repose sur une règle arithmétique simple qu’il convient de vérifier systématiquement avant toute lecture approfondie.
3.3 Exemple pratique guidé : cas d’un seuil à 0,10 avec 20 degrés de liberté
Afin de concrétiser cette méthodologie opératoire par un cheminement pratique sans équivoque, considérons une situation expérimentale dans laquelle un psychologue compare deux groupes indépendants composés chacun de onze participants. Le plan d’expérience requiert un test bilatéral au seuil alpha global de dix pour cent (alpha = 0,10). Le premier travail consiste à calculer le nombre de degrés de liberté associés au dispositif : df = n1 + n2 – 2 = 11 + 11 – 2 = 20. Le chercheur dispose désormais des deux coordonnées indispensables à la navigation sur la table : df = 20 et alpha = 0,10 en bilatéral (soit alpha/2 = 0,05 par queue).
Le chercheur prend en main sa table statistique de Student et parcourt verticalement la première colonne de gauche dédiée aux degrés de liberté jusqu’à positionner son index sur la ligne correspondant au chiffre 20. En maintenant son repère sur cette vingtième rangée, il déplace horizontalement son regard vers la droite jusqu’à croiser la colonne correspondant à un test bilatéral au niveau 0,10 (ou, de manière strictement équivalente, à la colonne unilatérale 0,05). À cette intersection exacte entre la ligne df = 20 et la colonne alpha/2 = 0,05, la table délivre un nombre décimal sans ambiguïté : 1,725 (ou 1,7247 selon le degré de précision des décimales du document).
Cette valeur de 1,725 représente la coordonnée du seuil critique supérieur. Puisque le test d’hypothèse formulé est bilatéral, la règle de décision symétrique s’applique immédiatement. Deux bornes critiques distinctes sont ainsi identifiées pour trancher le test : une frontière positive située à +1,725 et une frontière négative située exactement à son opposé géométrique, soit -1,725. La règle de décision s’énonce dès lors avec une limpidité absolue : si la statistique empirique t calculée sur les données des vingt-deux participants s’avère strictement supérieure à +1,725 ou strictement inférieure à -1,725, l’hypothèse nulle sera formellement rejetée au seuil de signification de 10 %. Si la statistique se trouve confinée entre ces deux valeurs, l’investigateur retiendra l’hypothèse nulle d’absence d’effet.
4. Détermination de la valeur t alpha/2 avec une calculatrice scientifique ou graphique
4.1 Utilisation de la fonction invT sur les calculatrices Texas Instruments
Dans la pratique académique contemporaine et lors des séances de modélisation sur le terrain, les calculatrices graphiques telles que les modèles de la série TI-83, TI-83 Premium CE ou TI-84 Plus de la marque Texas Instruments constituent des outils privilégiés pour obtenir instantanément des valeurs critiques avec une précision numérique remarquable. Sur ces machines, l’évaluation du quantile de Student ne requiert plus l’interpolation sur une table statique, mais s’effectue au moyen d’un algorithme numérique interne implémenté sous le nom de fonction invT (pour fonction inverse de la loi de Student).
Pour accéder à cette fonctionnalité, l’utilisateur doit solliciter le menu des distributions statistiques en pressant successivement la touche seconde (2nd) puis la touche des variables (VARS), ce qui fait apparaître à l’écran l’intitulé DISTR. En naviguant à l’aide des flèches directionnelles, l’utilisateur sélectionne l’item numéro 4, libellé invT(. La calculatrice bascule alors sur une interface d’invite de commande sollicitant deux arguments précis : l’aire sous la courbe (notée area) et les degrés de liberté (notés df). La compréhension de l’argument area est primordiale : par convention universelle chez Texas Instruments, la machine attend l’aire cumulée depuis l’infini négatif jusqu’au point critique recherché.
Par conséquent, pour un test bilatéral configuré à un seuil global alpha de 0,10 avec 20 degrés de liberté, la saisie ne doit pas porter sur la valeur brute de l’erreur. La borne critique positive t alpha/2 délimitant une queue supérieure de 0,05, la surface cumulée à gauche de cette valeur s’établit rigoureusement à 1 moins 0,05, soit 0,95 (ou formellement 1 – alpha/2). L’utilisateur saisit donc la séquence invT(0.95, 20) ou invT(1 - 0.10/2, 20). En validant l’opération par la touche entrer (ENTER), la calculatrice exécute son calcul d’intégration numérique et affiche immédiatement le résultat à haute résolution : 1,7247182… Cette valeur confirme avec une précision de laboratoire la lecture manuelle précédemment opérée sur la table papier.
4.2 Configuration sur calculatrices Casio et autres modèles graphiques
L’architecture logique des calculatrices de la marque Casio, telles que la Graph 35+, la Graph 75 ou les modèles innovants de la gamme fx-CG, se distingue de l’approche Texas Instruments par une ergonomie orientée vers le choix explicite de la queue de distribution. Pour initier le calcul sur un environnement Casio, l’étudiant ou le chercheur accède au menu principal STAT, sélectionne le sous-menu des distributions via la touche de fonction F5 (DIST), puis active la branche dédiée à la loi de Student en pressant F2 (t). À ce stade, la machine présente les différentes fonctions associées : il convient de choisir la commande Invt en pressant la touche de fonction F3.
L’interface Casio présente alors un paramétrage particulièrement pédagogique. La première ligne, intitulée Tail (queue), permet de choisir géométriquement la zone d’intégration parmi trois configurations : Left (queue à gauche), Right (queue à droite) ou Central (zone centrale symétrique). Si le praticien choisit la configuration Right, il lui suffit d’entrer directement l’aire de la queue supérieure, c’est-à-dire alpha/2 (soit 0.05 pour notre cas d’école), puis d’indiquer la valeur 20 sur la ligne df. La validation renvoie instantanément la valeur positive 1,7247. Cette flexibilité évite d’avoir à procéder mentalement à la soustraction du complément à l’unité.
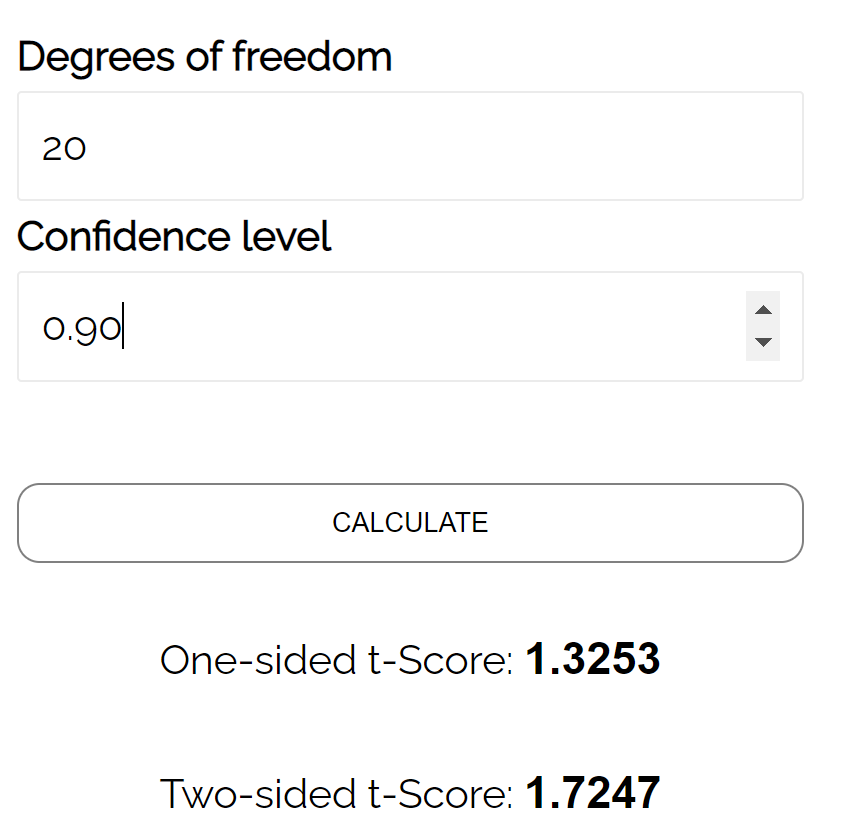
Si l’utilisateur opte pour le mode Central, l’algorithme demande la probabilité centrale retenue, qui équivaut très précisément au niveau de confiance du test, soit 1 moins alpha. En entrant la valeur 0.90 pour la surface centrale avec 20 degrés de liberté, la calculatrice Casio renvoie simultanément deux valeurs distinctes à l’écran : -1.7247 et +1.7247. Cette fonctionnalité graphique illustre visuellement la double borne de la zone d’acceptation, réduisant à néant les risques de méprise quant à la présence indispensable des deux seuils dans le protocole bilatéral.
4.3 Pièges d’encodage liés à la direction de l’aire cumulée
La source d’erreur la plus ubiquitaire lors de la programmation d’une calculatrice graphique réside dans la confusion entre l’aire de rejet et l’aire cumulée d’intégration. Un nombre impressionnant d’utilisateurs néophytes, confrontés à un test bilatéral à un seuil alpha de 0,05, introduisent machinalement l’expression invT(0.05, df) dans leur TI-84. Le système ne génère aucune alerte d’erreur car 0,05 est une probabilité parfaitement valide sur le plan mathématique. Toutefois, en opérant ainsi, l’utilisateur demande à la calculatrice d’identifier le point qui laisse une aire cumulée de seulement 5 % à sa gauche, ce qui correspond à la borne critique de la queue inférieure gauche d’un test unilatéral.
Le résultat affiché par la machine est alors affublé d’un signe négatif, par exemple -2,086 pour 20 degrés de liberté. Face à cette sortie, l’utilisateur mal informé est souvent dérouté par l’apparition de cette valeur négative alors qu’il recherchait la borne positive de son intervalle. Deux postures permettent de corriger ou d’exploiter convenablement ce phénomène. La première consiste à comprendre que, par pure symétrie géométrique de la distribution de Student autour de l’axe vertical zéro, la valeur absolue de cette sortie négative correspond rigoureusement à la borne critique supérieure d’un test dont le seuil unilatéral est de 0,05, ou dont le seuil bilatéral est de 0,10.
La seconde posture, infiniment plus vertueuse sur le plan de la rigueur algorithmique, impose de toujours formaliser mentalement la surface cumulée requise. Pour un test bilatéral au risque alpha, la queue supérieure rejette alpha/2. La masse probabiliste située en deçà de ce point est systématiquement égale à 1 – (alpha / 2). En prenant l’habitude systématique d’écrire invT(1 - alpha/2, df), le chercheur s’assure d’obtenir directement la valeur critique positive correcte sans dépendre d’ajustements empiriques a posteriori susceptibles de fausser les scripts ou les feuilles de calcul automatisées.
5. Calcul de t alpha/2 via les langages de programmation statistique R et Python
5.1 Implémentation sous l’environnement statistique R
Dans le monde de la recherche universitaire contemporaine, le langage de programmation statistique R s’est imposé comme l’environnement d’analyse et de modélisation par excellence. R intègre de manière native un ensemble complet et optimisé de fonctions dédiées à la manipulation des lois de probabilité. L’extraction des quantiles d’une distribution de Student est déléguée à la fonction canonique qt, dont la syntaxe de base s’articule autour de l’argument de probabilité cumulée p et du paramètre des degrés de liberté df. Pour garantir une reproductibilité irréprochable et écarter toute incertitude de calcul, R implémente des algorithmes de haute précision à convergence rapide.
Pour déterminer la valeur t alpha/2 associée à un seuil bilatéral de dix pour cent (alpha = 0,10) pour 20 degrés de liberté, la commande s’exécute selon l’expression suivante : qt(p = 1 - 0.10/2, df = 20). L’interpréteur R renvoie immédiatement le résultat 1.724718. La flexibilité de R permet également de manipuler l’argument logique lower.tail. Par défaut, cet argument est assigné à la valeur logique TRUE, ce qui signifie que la probabilité fournie est considérée comme cumulée depuis l’extrême gauche de la distribution. En configurant explicitement qt(p = 0.10/2, df = 20, lower.tail = FALSE), l’utilisateur demande directement à l’interpréteur de rechercher le point qui laisse une surface de 0,05 dans la queue supérieure droite, ce qui délivre exactement le même résultat positif sans calcul préalable du complément.
L’un des avantages fondamentaux du langage R réside dans sa capacité de vectorisation native. Le statisticien qui souhaite calculer simultanément les valeurs critiques bilatérales pour une série complète de seuils de signification usuels (par exemple 10 %, 5 % et 1 %) pour une cohorte de taille fixe peut formuler sa requête en une seule ligne de code concise : qt(p = 1 - c(0.10, 0.05, 0.01)/2, df = 20). R procède à l’évaluation élément par élément et retourne un vecteur numérique contenant les valeurs critiques correspondantes : 1.724718 2.085963 2.845340. Cette puissance d’expression algorithmique garantit une efficacité d’analyse inégalée lors du traitement automatisé de données psychométriques massives.
5.2 Calcul automatisé en Python avec Scipy
Python a conquis une place centrale dans les infrastructures de science des données et de neuro-informatique grâce à son écosystème de bibliothèques scientifiques hautement performantes. Le calcul des quantiles de Student repose principalement sur le module stats de la bibliothèque scipy. Au sein de cette bibliothèque, la loi de Student est représentée par l’objet scipy.stats.t, qui expose la méthode ppf, acronyme de percent point function, désignation mathématique synonyme de fonction quantile ou de réciproque de la fonction de répartition cumulée.
Pour reproduire notre calcul de référence dans un environnement Python standard, la séquence d’instructions requiert l’importation préalable du module avant l’évaluation numérique :
from scipy import stats
alpha = 0.10
df = 20
t_critique = stats.t.ppf(1 - alpha / 2, df)
print(t_critique)
L’exécution de ce script affiche dans le terminal de commande la valeur à double précision 1.7247182403684746. À l’instar des fonctions de R, la méthode ppf s’appuie sur la convention d’intégration à gauche. Pour obtenir directement la valeur en fonction de l’aire de la queue supérieure sans formuler 1 - alpha/2, l’utilisateur peut également exploiter la méthode isf, signifiant inverse survival function (fonction de survie inverse), en écrivant simplement stats.t.isf(alpha / 2, df), ce qui délivre une valeur positive rigoureusement identique.
Pour assurer la pérennité et la clarté des architectures de code déployées dans des études psychologiques longitudinales, il est recommandé d’encapsuler cette instruction dans une fonction réutilisable intégrant des vérifications de validité. Une routine logicielle robuste validera que le paramètre alpha est strictement compris entre zéro et un, et que les degrés de liberté constituent un entier strictement positif, prévenant ainsi les exceptions d’exécution ou les anomalies silencieuses lors du traitement par lots de centaines d’échelles comportementales.
5.3 Intégration dans des chaînes de traitement de données psychométriques
L’intégration de la dérivation automatique des valeurs t alpha/2 prend tout son sens au sein des pipelines modernes de traitement de données psychométriques et neurobiologiques. Lorsque des chercheurs analysent des signaux d’électroencéphalographie ou des matrices de corrélation issues de tests d’évaluation cognitive administrés à des milliers de participants, il est inconcevable de consulter manuellement des tables statistiques à chaque étape du diagnostic inférentiel. Les seuils de décision doivent être générés dynamiquement par le code en fonction des effectifs réels observés dans chaque groupe ou condition après élimination des données aberrantes ou artéfactées.
Dans un tel pipeline, la taille effective des sous-échantillons valides fluctue fréquemment en raison des données manquantes imprévues. L’implémentation logicielle calcule de manière adaptative les degrés de liberté effectifs pour chaque contraste d’intérêt, évalue instantanément la valeur t alpha/2 requise au niveau nominal spécifié, et injecte cette borne dans le moteur de décision qui catégorise les contrastes comme significatifs ou non. Ce mécanisme d’automatisation garantit que les règles d’inférence s’ajustent avec une fidélité mathématique absolue aux fluctuations d’effectifs propres à chaque variable mesurée.
Cette approche s’inscrit pleinement dans le mouvement mondial de la science ouverte et de la reproductibilité des résultats d’expérimentation. En associant au sein d’un même document de recherche reproductible — conçu sous Jupyter Notebook ou R Markdown — le code de calcul des valeurs critiques de Student, les visualisations graphiques de la statistique empirique et les tableaux de résultats inférentiels, les chercheurs fournissent à la communauté internationale les moyens de vérifier auditablement chaque étape de l’inférence. Cela élimine définitivement les erreurs de transcription manuelle entre une table papier consultée sur un coin de bureau et le manuscrit soumis pour publication.
6. Calcul sous tableur : Microsoft Excel et Google Sheets
6.1 Maîtrise de la fonction LOI.STUDENT.INVERSE.BILATERALE (T.INV.2T)
Les logiciels de type tableur, dont Microsoft Excel et Google Sheets sont les fers de lance universels, représentent les outils computationnels les plus largement répandus dans l’administration clinique, la recherche hospitalière et les laboratoires universitaires pour la gestion quotidienne des bases de données. Pour simplifier la démarche d’inférence, Microsoft a introduit dans les versions modernes d’Excel une fonction native dédiée spécifiquement et sans ambiguïté à l’extraction des valeurs critiques bilatérales : la fonction LOI.STUDENT.INVERSE.BILATERALE, dont l’identifiant syntaxique international s’énonce T.INV.2T.
La particularité structurelle remarquable de cette formule réside dans le fait qu’elle traite directement la probabilité bilatérale globale sans contraindre l’utilisateur à effectuer une division préalable du risque alpha par deux. Sa signature syntaxique s’écrit formellement sous la structure =LOI.STUDENT.INVERSE.BILATERALE(probabilité; degrés_liberté) dans la version francophone d’Excel, ou =T.INV.2T(probability, deg_freedom) dans Google Sheets ou sous environnement linguistique anglo-saxon. Pour évaluer notre cas standard d’un seuil bilatéral global de 0,10 avec 20 degrés de liberté, la saisie dans une cellule active se résume à l’expression : =LOI.STUDENT.INVERSE.BILATERALE(0,10; 20).
Dès la validation par la touche entrée, la cellule affiche avec une exactitude immédiate le nombre décimal 1,72471824. L’algorithme interne d’Excel intègre d’office la nature bilatérale du problème mathématique : il scinde automatiquement la probabilité de 0,10 entrée en deux aires d’extrusion de 0,05 chacune et renvoie systématiquement la coordonnée positive de la borne supérieure t alpha/2. Cette commodité d’emploi diminue considérablement les erreurs de saisie chez les professionnels peu rompus aux subtilités de l’intégration unilatérale de queue supérieure.
6.2 Utilisation alternative de la fonction LOI.STUDENT.INVERSE.N (T.INV)
Parallèlement à cette formulation bilatérale dédiée, les tableurs contemporains proposent une seconde fonction standardisée, intitulée LOI.STUDENT.INVERSE.N dans les déclinaisons françaises d’Excel, ou T.INV sous Google Sheets et les versions anglaises du logiciel. Contrairement à la fonction précédente, celle-ci opère sous une convention purement unilatérale et d’intégration cumulée à gauche, adoptant ainsi une logique strictement analogue à celle de la commande invT des calculatrices Texas Instruments ou de la fonction qt du langage R.
L’utilisation de cette formule pour extraire la borne positive t alpha/2 impose donc à l’opérateur une formalisation rigoureuse de son argument d’entrée. Si l’on applique le seuil bilatéral global de 0,10, la borne positive laisse une surface de 0,05 dans sa queue droite, et par conséquent une surface cumulative de 0,95 à sa gauche. L’utilisateur doit impérativement encoder dans le tableur la syntaxe suivante : =LOI.STUDENT.INVERSE.N(1 - 0,10/2; 20), ou plus explicitement =LOI.STUDENT.INVERSE.N(0,95; 20). Le tableur renverra instantanément la valeur positive 1,72471824.
Si l’analyste commet l’erreur d’entrer simplement le seuil bilatéral non corrigé ou l’aire de la queue gauche via la formule =LOI.STUDENT.INVERSE.N(0,05; 20), le résultat restitué prendra la valeur négative -1,72471824. Bien que la valeur absolue soit arithmétiquement exacte pour désigner la borne critique gauche symétrique, l’utilisation de cette valeur négative dans des formules en aval dédiées au calcul de la marge d’erreur d’un intervalle de confiance engendrerait des inversions de bornes préjudiciables. La compréhension intime de la divergence de conception entre T.INV et T.INV.2T est donc une condition sine qua non de fiabilité opérationnelle.
6.3 Construction d’une matrice dynamique de calcul de valeurs critiques
L’une des exploitations les plus enrichissantes du tableur réside dans la modélisation d’une matrice bidimensionnelle dynamique de calcul des quantiles t alpha/2, capable de servir de référence automatisée pour une équipe de recherche. Pour bâtir un tel tableau d’aide à la décision, l’analyste dispose par exemple sur la première ligne horizontale les différents niveaux conventionnels d’alpha bilatéral (cellules B1 à E1 recevant respectivement les valeurs 0,20, 0,10, 0,05 et 0,01). Dans la première colonne verticale (cellules A2 à A41), il insère la progression incrémentale des degrés de liberté allant de 1 jusqu’à 40.
Dans la cellule d’intersection B2, il suffit d’introduire une formule exploitant judicieusement les références relatives et absolues : =LOI.STUDENT.INVERSE.BILATERALE(B$1;$A2). En propageant cette formule par simple glisser-déposer sur l’ensemble de la plage de calcul B2:E41, le tableur génère instantanément une table complète de quantiles critiques t alpha/2. Toute modification ultérieure d’un seuil de risque dans la ligne d’en-tête recalcule de manière synchrone l’intégralité des valeurs de la matrice sans la moindre intervention humaine.
Il est en outre hautement pédagogique d’enrichir cette matrice dynamique de règles de mise en forme conditionnelle. Par exemple, l’analyste peut programmer une coloration progressive des cellules en fonction de l’élévation de la valeur t alpha/2, soulignant visuellement la pénalisation sévère imposée aux faibles échantillons. On peut également intégrer une alerte textuelle automatisée signalant les configurations pour lesquelles les degrés de liberté sont inférieurs à dix, avertissant ainsi les praticiens que l’instabilité de l’estimation de la variance d’échantillonnage impose des contraintes extrêmes sur la puissance du protocole expérimental.
7. Comparaison méthodologique : valeur critique t alpha/2 versus z alpha/2
7.1 Théorème central limite et convergence asymptotique
L’articulation théorique entre la valeur critique t alpha/2 issue de la loi de Student et la valeur critique z alpha/2 dérivée de la loi normale centrée réduite de Gauss s’éclaire à la lumière des grands théorèmes asymptotiques des probabilités, au premier rang desquels figure le théorème central limite. Ce principe fondamental énonce que la somme — et par conséquent la moyenne arithmétique — d’un ensemble de variables aléatoires indépendantes et identiquement distribuées d’espérance et de variance finies converge en loi vers une distribution normale lorsque le nombre d’observations tend vers l’infini, quelle que soit la morphologie distributionnelle de la variable d’origine dans la population parente.
Lorsque la taille d’un échantillon s’accroît, deux phénomènes convergent simultanément. D’une part, la distribution de la moyenne empirique s’ajuste avec une rigueur mathématique accrue aux contours de la cloche gaussienne. D’autre part, la variance calculée sur l’échantillon, notée s au carré, converge stochastiquement vers la variance véritable de la population parente, notée sigma au carré, en vertu de la loi des grands nombres. L’incertitude liée à l’estimation de la dispersion s’amenuise donc progressivement pour disparaître complètement à la limite asymptotique. En conséquence directe, le rapport de Student, dont le dénominateur incorpore cette variance estimée, perd sa variabilité propre pour se comporter rigoureusement comme une variable normale standardisée.
La transition entre la morphologie leptokurtique de la loi de Student et la courbe normale s’opère de façon continue. Pour un seuil d’erreur bilatéral de cinq pour cent (alpha = 0,05), la valeur z alpha/2 vaut invariablement 1,960. Pour df = 10, la valeur t alpha/2 s’établit à 2,228 ; pour df = 30, elle décroît à 2,042 ; pour df = 100, elle atteint 1,984, et pour df = 1000, elle converge à 1,962. Dès lors que l’échantillon dépasse la centaine de participants, l’écart numérique entre t alpha/2 et z alpha/2 devient minime dans la pratique courante. Toutefois, sur le plan formel, la substitution d’une valeur z à une valeur t ne peut être théoriquement justifiée que si la variance de la population parente est rigoureusement connue a priori.
7.2 Critères décisionnels de sélection entre table t et table z
Face à un jeu de données empiriques, le choix méthodologique d’utiliser une table t ou une table z obéit à un algorithme décisionnel strict qui ne laisse aucune place à l’arbitraire du praticien. Le premier critère, absolument cardinal et non négociable, réside dans le statut épistémique de l’écart-type de la population parente (sigma). Si cet écart-type populationnel est connu de manière incontestable — ce qui survient principalement lors de l’utilisation de tests standardisés d’intelligence ou de quotient intellectuel calibrés sur des populations nationales massives —, le chercheur doit obligatoirement fonder son inférence sur la statistique z et la table normale correspondante, sous réserve que la population d’origine soit normale ou que la taille de l’échantillon soit suffisante (conventionnellement n supérieur ou égal à 30).
À l’inverse, dès lors que l’écart-type de la population demeure inconnu — ce qui correspond à l’écrasante majorité des situations de recherche en psychologie clinique, expérimentale et sociale —, le recours à la distribution t de Student s’impose comme une nécessité mathématique absolue, indépendamment de la taille de l’échantillon collecté. Une légende urbaine méthodologique tenace postule parfois qu’au-delà d’un effectif de trente sujets, l’analyste serait fondé à abandonner la table t au profit de la table z. S’il est incontestable que les écarts numériques se réduisent au-delà de ce seuil empirique, l’utilisation de la loi normale reste une approximation, tandis que l’application de la distribution t constitue la démarche théoriquement exacte et optimale.
Dans la recherche contemporaine outillée par des logiciels statistiques, cette hésitation n’a plus lieu d’être. Les algorithmes modernes appliquent universellement la loi de Student dès que le paramètre de dispersion est estimé à partir des données d’échantillon, assurant une parfaite continuité méthodologique. La distribution z est ainsi confinée aux rares protocoles théoriques de standardisation ou aux modélisations asymptotiques spécifiques pour lesquelles les paramètres de dispersion sont réputés fixes et immuables.
7.3 Impact d’un mauvais choix sur l’erreur d’inférence
Substituer illégitimement la valeur critique z alpha/2 à la valeur critique t alpha/2 lorsque la variance de la population est inconnue et que l’échantillon est de taille modeste engendre des répercussions désastreuses sur la robustesse méthodologique des conclusions. Étant donné que la distribution normale est moins dispersée que la distribution de Student, la valeur critique z alpha/2 est invariablement plus basse en valeur absolue que la véritable valeur t alpha/2 requise. Pour un seuil bilatéral nominal de 5 % et un échantillon de 12 sujets (df = 11), le t critique s’élève à 2,201, tandis que le z critique s’affiche imperturbablement à 1,960.
Si l’expérimentateur utilise indûment la valeur 1,960 pour évaluer la significativité de ses données, il abaisse artificiellement le seuil d’admission dans la région de rejet de l’hypothèse nulle. Ce nivellement par le bas provoque une distorsion immédiate du taux d’erreur de première espèce : alors que l’investigateur affirme travailler avec un seuil de risque d’erreur consenti fixé à 5 %, son risque réel de déclarer à tort un effet inexistant grimpe fréquemment vers 7 %, 8 % voire 10 % selon l’étroitesse de l’échantillon. Cette inflation incontrôlée du risque alpha est l’une des causes majeures identifiées dans la prolifération des faux positifs qui alimentent la crise contemporaine de la reproductibilité scientifique.
Sur le plan éthique et sociétal, un tel laxisme mathématique peut avoir des conséquences dramatiques en psychologie médicale et en psychiatrie expérimentale. Conclure prématurément qu’une prise en charge non conventionnelle démontre une supériorité statistique par rapport à une prise en charge standard, sur la base d’un seuil critique z indûment assoupli, expose les patients à des protocoles inopérants et gaspille d’importantes ressources de recherche biomédicale. Le respect méticuleux du formalisme de Student n’est pas un purisme académique superflu : il garantit que les découvertes revendiquées reposent sur une réalité statistique incontestable.
8. Application concrète 1 : Construction d’un intervalle de confiance bilatéral
8.1 Formulation algébrique de l’intervalle de confiance pour une moyenne
L’estimation ponctuelle d’une moyenne empirique à partir d’un échantillon ne fournit aucune information quant à l’incertitude entourant cette valeur. Pour pallier cette lacune, l’inférence statistique préconise l’élaboration d’un intervalle de confiance, lequel définit une plage de valeurs plausibles à l’intérieur de laquelle le véritable paramètre populationnel inconnu, noté mu, a une probabilité formelle de 1 moins alpha de se situer au cours d’échantillonnages répétés. L’architecture algébrique de cet intervalle bilatéral repose entièrement sur le positionnement symétrique de la valeur critique t alpha/2.
L’expression mathématique formelle de l’intervalle de confiance pour une moyenne s’écrit conventionnellement sous la forme suivante : la moyenne d’échantillon x-barre plus ou moins une marge d’erreur globale. Cette marge d’erreur se structure comme le produit multiplicatif entre le facteur d’échelle critique t alpha/2, indexé sur le nombre adéquat de degrés de liberté (df = n – 1), et l’erreur standard de la moyenne empirique, formulée par le ratio entre l’écart-type de l’échantillon s et la racine carrée de la taille d’échantillon n. L’équation complète s’énonce ainsi :
Borne Inférieure = x̄ - [ t_(alpha/2; df) * (s / √n) ]
Borne Supérieure = x̄ + [ t_(alpha/2; df) * (s / √n) ]
D’un point de vue géométrique et conceptuel, la valeur critique t alpha/2 agit comme un amplificateur d’incertitude. Elle pondère directement l’erreur standard pour garantir que la surface couverte sous la distribution d’échantillonnage théorique englobe très exactement la proportion désirée d’intervalles conformes. Plus les exigences de certitude du chercheur augmentent — c’est-à-dire plus le risque alpha diminue —, plus la valeur t alpha/2 s’accroît, élargissant mécaniquement l’amplitude spatiale de l’intervalle de confiance pour garantir sa mission de couverture statistique.
8.2 Exemple appliqué : mesure de l’anxiété préopératoire
Pour illustrer de manière tangible le déploiement opérationnel de cette formulation, examinons une étude clinique menée au sein d’un service hospitalier de chirurgie pédiatrique. Une équipe de psychologues évalue le niveau d’anxiété préopératoire auprès d’une cohorte de 21 jeunes patients au moyen de l’inventaire standardisé de l’anxiété état (STAI). Les données recueillies après passation fournissent une moyenne d’échantillon x̄ = 46,2 points et un écart-type d’échantillon s = 8,4 points. L’objectif clinique consiste à déterminer un intervalle de confiance bilatéral au niveau de confiance de 90 % (ce qui correspond à un risque d’erreur alpha de 10 %, soit 0,10) pour situer le niveau moyen d’anxiété de l’ensemble de la population clinique de cet hôpital.
La première phase implique la dérivation des degrés de liberté associés à cet échantillon unique de 21 patients : df = n – 1 = 21 – 1 = 20. La recherche de la valeur critique t alpha/2 pour alpha = 0,10 et df = 20 dans la table de Student ou par un tableur (comme démontré dans nos sections précédentes) livre avec précision la valeur critique t_(0.05; 20) = 1,725. La deuxième phase consiste à calculer l’erreur standard de la moyenne empirique :
SE = s / √n = 8,4 / √21 = 8,4 / 4,582576 ≈ 1,833 points
La troisième phase réalise la fusion des paramètres pour établir la marge d’erreur globale :
Marge d'erreur = t_(alpha/2; df) * SE = 1,725 * 1,833 = 3,162 points
En retranchant puis en ajoutant cette marge d’erreur à la moyenne empirique observée de 46,2 points, l’équipe calcule les deux frontières de l’intervalle :
Borne Inférieure = 46,2 - 3,162 = 43,038 points
Borne Supérieure = 46,2 + 3,162 = 49,362 points
L’intervalle de confiance à 90 % pour l’anxiété moyenne de cette population est donc formellement borné entre 43,04 et 49,36 points.
8.3 Interprétation probabiliste et épistémologique du résultat
L’énonciation de cet intervalle de confiance nécessite une précaution épistémologique absolue, souvent transgressée par les praticiens non statisticiens. L’interprétation intuitive consistant à affirmer qu’« il y a 90 % de chances que la vraie moyenne de la population soit comprise entre 43,04 et 49,36 » est mathématiquement fautive dans le cadre de l’inférence fréquentiste classique. En effet, dans cette modélisation théorique, la moyenne vraie mu de la population est un paramètre fixe et immuable, bien qu’inconnu ; elle n’est pas une variable aléatoire. Elle est soit intégralement contenue dans cet intervalle précis, soit totalement en dehors.
L’interprétation probabiliste orthodoxe se fonde sur l’idée d’un processus itératif à long terme. La formulation rigoureuse s’énonce ainsi : si l’on répétait à l’infini ce protocole expérimental en prélevant des centaines d’échantillons indépendants de 21 patients issus de la même population, et que l’on calculait pour chacun d’eux un intervalle à 90 % selon cette même équation basée sur t alpha/2 = 1,725, alors exactement 90 % de l’infinité de ces intervalles construits renfermeraient la véritable moyenne de la population parente, tandis que 10 % la manqueraient.
Dans la pratique de la communication médicale et de l’aide à la décision thérapeutique, cet intervalle de confiance bilatéral fournit un éclairage précieux qui dépasse l’estimation ponctuelle. Il informe directement le clinicien sur la précision de son évaluation. Si la borne inférieure de 43,04 points se situe déjà au-delà du seuil pathologique de détresse psychologique conventionnellement admis pour cette échelle, l’équipe médicale peut anticiper légitimement qu’une prise en charge anxiolytique préopératoire systématique est cliniquement impérative pour l’ensemble des admissions hospitalières du service.
9. Application concrète 2 : Test d’hypothèses bilatéral pour deux groupes indépendants
9.1 Spécification formelle des hypothèses nulle et alternative
La comparaison de deux groupes indépendants constitue l’un des designs expérimentaux les plus emblématiques de la psychologie scientifique. Qu’il s’agisse de tester l’impact d’une remédiation cognitive par rapport à une condition placebo ou d’analyser les différences d’attachement émotionnel entre deux profils de personnalité, l’investigateur commence par poser deux hypothèses contradictoires et mutuellement exclusives. L’hypothèse nulle, notée conventionnellement H0, stipule l’absence totale de divergence entre les espérances mathématiques des deux populations étudiées : H0 : mu1 = mu2, ou de manière équivalente mu1 - mu2 = 0.
Dans un cadre méthodologique bilatéral, le chercheur formule l’hypothèse alternative, notée H1, sous une modalité purement non directionnelle. Il refuse de postuler a priori si le premier groupe surpassera le second ou si le schéma inverse s’observera : H1 : mu1 ≠ mu2, ou mu1 - mu2 ≠ 0. Cette modélisation impose la sélection d’un risque d’erreur de première espèce alpha, par exemple 0,05, qui doit être subdivisé en deux régions critiques symétriques de alpha/2 = 0,025 chacune, délimitées géométriquement par les bornes critiques -t alpha/2 et +t alpha/2.
La formulation de ces hypothèses conditionne l’ensemble de la mécanique du test. L’espace paramétrique est ainsi structuré de telle sorte que toute différence empirique observée entre les deux moyennes sera attribuée aux seules fluctuations de l’échantillonnage aléatoire, tant que la statistique empirique calculée demeurera captive de l’intervalle défini par les deux bornes t alpha/2 critiques. Ce formalisme garantit une neutralité méthodologique maximale face à des interventions expérimentales aux conséquences incertaines.
9.2 Calcul de la statistique de test empirique et règle de décision
Pour confronter les données de terrain aux hypothèses formalisées, le praticien calcule la statistique t de Student empirique. Sous le postulat d’homogénéité des variances (homoscédasticité), la démarche requiert préalablement l’estimation de la variance combinée ou poolée de l’ensemble de l’expérience, notée s_p au carré. Cette grandeur pondère les variances calculées sur chaque groupe en fonction de leurs degrés de liberté respectifs :
s_p² = [ (n1 - 1) * s1² + (n2 - 1) * s2² ] / (n1 + n2 - 2)
L’erreur standard de la différence entre les deux moyennes s’en déduit selon l’expression mathématique :
SE_(diff) = √( s_p² * (1/n1 + 1/n2) )
La statistique t empirique observée, notée t_obs, est ensuite obtenue en divisant la différence des moyennes d’échantillon par cette erreur standard :
t_obs = (x̄1 - x̄2) / SE_(diff)
La règle de décision statistique s’énonce dès lors avec une précision chirurgicale en confrontant la statistique empirique t_obs au seuil théorique t alpha/2 extrait de la loi de Student pour df = n1 + n2 – 2 degrés de liberté. Si la statistique t_obs se révèle supérieure ou égale à la borne positive +t alpha/2, ou inférieure ou égale à la borne négative -t alpha/2 (ce qui s’écrit de manière synthétique par l’inégalité de valeur absolue |t_obs| ≥ t alpha/2), le chercheur est formellement tenu de rejeter l’hypothèse nulle H0. Il conclut alors à l’existence d’une différence statistiquement significative entre les deux populations au seuil alpha. Dans le cas contraire, H0 ne peut être rejetée.
9.3 Cas d’étude : efficacité différentielle de deux thérapies comportementales
Appliquons concrètement cette démarche à un essai clinique comparant deux approches thérapeutiques de l’insomnie chronique : une thérapie cognitive et comportementale digitalisée (Groupe 1) et une thérapie classique en présentiel (Groupe 2). Les deux groupes comportent chacun un effectif de 15 patients (n1 = 15, n2 = 15). Le critère d’évaluation repose sur le score obtenu à l’indice de sévérité de l’insomnie (ISI) après huit semaines de suivi. Le chercheur retient un test bilatéral au seuil conventionnel alpha = 0,05.
Les degrés de liberté du test sont immédiatement déterminés : df = n1 + n2 – 2 = 15 + 15 – 2 = 28. Par consultation de la table statistique de Student à la ligne df = 28 et à la colonne bilatérale 0,05 (soit 0,025 par queue), le chercheur extrait la valeur critique t alpha/2 = 2,048. La région de rejet de l’hypothèse nulle est donc constituée par l’ensemble des valeurs empiriques t inférieures à -2,048 ou supérieures à +2,048.
Les calculs empiriques fournissent les résultats descriptifs suivants : Groupe 1 (digitalisé) : moyenne = 11,4, variance s1² = 6,2 ; Groupe 2 (présentiel) : moyenne = 13,8, variance s2² = 7,4. La variance combinée s’élève à :
s_p² = [ (14 * 6,2) + (14 * 7,4) ] / 28 = (86,8 + 103,6) / 28 = 190,4 / 28 = 6,8
L’erreur standard de la différence vaut :
SE_(diff) = √( 6,8 * (1/15 + 1/15) ) = √( 6,8 * 0,1333 ) = √( 0,9066 ) ≈ 0,952
La statistique de test observée s’établit à :
t_obs = (11,4 - 13,8) / 0,952 = -2,4 / 0,952 = -2,521
En confrontant cette grandeur empirique à la règle de décision, le constat est immédiat : la valeur t_obs de -2,521 est strictement inférieure à la borne critique inférieure de -2,048 (en valeur absolue, |-2,521| = 2,521 > 2,048). La statistique tombe incontestablement dans la zone de rejet critique. Le chercheur rejette donc formellement l’hypothèse nulle H0 au seuil alpha de 0,05. Il conclut qu’il existe une différence d’efficacité statistiquement significative entre les deux modalités thérapeutiques, le programme digitalisé s’accompagnant d’un score moyen de sévérité de l’insomnie substantiellement plus faible que le programme présentiel au sein de cet échantillon.
10. Application concrète 3 : Test t pour mesures répétées sur sujet unique ou apparié
10.1 Spécificités méthodologiques des plans d’expérience intra-sujets
Les plans d’expérience dits intra-sujets ou à mesures répétées constituent une avancée méthodologique majeure en psychologie expérimentale et en neurosciences. Contrairement aux dispositifs inter-sujets qui comparent des cohortes d’individus distincts, le protocole intra-sujets soumet chaque participant à l’ensemble des conditions expérimentales, ou suit les mêmes personnes longitudinalement à travers des étapes successives (par exemple une mesure initiale avant intervention suivie d’une mesure post-thérapeutique). Cette stratégie permet de neutraliser la variance interindividuelle résiduelle liée aux traits stables des sujets, chaque individu servant de son propre contrôle expérimental.
Sur le plan mathématique, cette structure de données appariées autorise une simplification élégante du problème inférentiel. Au lieu de traiter deux vecteurs distincts de données dépendantes, l’analyste soustrait terme à terme le score initial du score final pour chaque sujet. Cette opération produit une unique série unidimensionnelle de scores de différence, conventionnellement notés D (avec D = X_post – X_pre). L’analyse se ramène alors strictement à un test t de Student sur échantillon unique, dont l’objectif est d’évaluer si l’espérance mathématique de ces différences individuelles, notée mu_D, diverge significativement de zéro.
Cette simplification conceptuelle modifie substantiellement le calcul des degrés de liberté. Bien que deux mesures distinctes aient été enregistrées pour chaque sujet, la véritable unité d’échantillonnage indépendante est le couple de mesures ou la différence individuelle D. Dès lors, pour un protocole engageant un groupe de N participants appariés, les degrés de liberté disponibles pour le test ne sont pas calculés sur la somme des observations (qui vaudrait 2N), mais s’établissent rigoureusement à N moins une unité (df = N – 1). Cette déduction d’un degré de liberté découle de l’estimation préalable de la moyenne empirique de la différence au sein de la cohorte.
10.2 Dérivation du t alpha/2 adapté aux analyses pré-test post-test
La dérivation du seuil critique t alpha/2 dans le cadre des analyses pré-test post-test requiert une vigilance méthodologique sans faille lors de la consultation des tables ou des bibliothèques de calcul. Étant donné que le nombre de degrés de liberté est indexé sur le nombre de paires indépendantes (N – 1) et non sur le nombre total de relevés de données, commettre une méprise sur ce décompte reviendrait à artificiellement sous-estimer la valeur du seuil critique t alpha/2. Cette erreur de conception accorderait une puissance illusoire au test au mépris des postulats d’indépendance stochastique.
Pour fixer les frontières du test bilatéral d’efficacité d’une intervention, le chercheur pose l’hypothèse nulle H0 : mu_D = 0 (l’entraînement ne produit aucune modification moyenne) contre l’hypothèse alternative bilatérale H1 : mu_D ≠ 0 (l’entraînement produit une altération, positive ou négative). Le niveau de risque alpha global consenti, par exemple 0,05, est assigné pour moitié à l’amélioration et pour moitié à la détérioration, imposant une allocation de alpha/2 = 0,025 dans chacune des deux queues de la distribution de Student calibrée à N – 1 degrés de liberté.
La robustesse de ce test t pour données appariées repose en outre sur le respect de l’hypothèse de normalité de la distribution des différences D elles-mêmes, et non pas nécessairement sur la normalité des distributions brutes observées lors de chacune des phases prises isolément. Si la distribution des scores D dévie modérément de la courbe de Gauss, le théorème central limite confère une résilience appréciable à la procédure dès que N franchit le seuil d’une trentaine de participants, permettant de préserver la validité de la valeur critique t alpha/2 tabulée.
10.3 Illustration en neuropsychologie : évaluation d’un entraînement mnésique
Afin de mettre en pratique cette modélisation, considérons une expérimentation menée en neuropsychologie du vieillissement. Une cohorte de 16 personnes âgées présentant des plaintes cognitives légères participe à un programme informatisé de remédiation de la mémoire de travail s’étalant sur douze semaines. Les capacités mnésiques sont quantifiées au moyen de l’empan envers de chiffres avant le début de l’entraînement (pré-test) et à l’issue immédiate du protocole (post-test). Les neuropsychologues souhaitent vérifier au seuil bilatéral alpha = 0,05 si l’entraînement a provoqué une modulation statistiquement significative des capacités de rappel.
La configuration statistique se formalise ainsi : nous disposons d’un échantillon apparié de taille N = 16. Les degrés de liberté associés à cette recherche valent df = N – 1 = 16 – 1 = 15. Pour un seuil d’erreur bilatéral de 5 % (alpha = 0,05), la valeur critique t alpha/2 s’obtient instantanément en consultant la table t pour 15 degrés de liberté et une aire unilatérale de 0,025 : la valeur extraite est très exactement t_(0.025; 15) = 2,131. Les zones de rejet se déploient donc en deçà de -2,131 et au-delà de +2,131.
Le traitement des données empiriques des 16 participants fournit une moyenne des scores de différence D_barre = +0,875 item mnésique (témoignant d’une progression brute globale de l’empan) et un écart-type de ces différences individuelles s_D = 1,455. L’erreur standard de la moyenne des différences se calcule par la formule :
SE_D = s_D / √N = 1,455 / √16 = 1,455 / 4 = 0,36375
La statistique t empirique observée se déduit selon l’expression élémentaire :
t_obs = (D̄ - 0) / SE_D = 0,875 / 0,36375 = 2,405
En confrontant cette valeur de test t_obs = 2,405 au seuil critique t alpha/2 = 2,131, la conclusion s’impose : la statistique empirique franchit avec succès la borne critique supérieure (2,405 > 2,131). L’hypothèse nulle d’absence d’effet du programme mnésique est rejetée au seuil de signification de 5 %. L’intervention cognitive produit une majoration statistiquement démontrable des performances mnésiques, confortant l’indication clinique de cet outil chez les sujets âgés sans risque d’illusion statistique.
11. Erreurs fréquentes lors de la recherche de t alpha/2 et comment les éviter
11.1 Confusion fréquente entre risques unilatéral et bilatéral
Parmi les écueils récurrents observés dans les mémoires universitaires et les publications scientifiques préliminaires, la méprise entre seuil unilatéral et seuil bilatéral trône en première position. Cette confusion procède souvent d’une lecture hâtive des tables imprimées. L’investigateur, désireux d’appliquer un test bilatéral au niveau de signification usuel de 5 % (alpha = 0,05), recherche spontanément l’intitulé « 0,05 » dans la première ligne de sa table. Si celle-ci présente des probabilités unilatérales (notées couramment one-tail), l’utilisateur retient le quantile délimitant 5 % dans une seule queue, ce qui équivaut en réalité à exécuter un test bilatéral au seuil global d’erreur alpha de 10 %.
Cette faute de calibrage abaisse illégitimement le niveau d’exigence du test d’hypothèse. En retenant par exemple un t critique de 1,725 au lieu de 2,086 pour 20 degrés de liberté, l’expérimentateur s’expose à rejeter indûment l’hypothèse nulle pour des statistiques empiriques comprises entre 1,725 et 2,086, multipliant par deux son exposition réelle à l’erreur de première espèce. Pour prémunir tout praticien contre cette dérive, une règle mnémonique absolue doit être appliquée : dans un test bilatéral de niveau alpha, la valeur à chercher dans une table unilatérale est toujours et obligatoirement l’expression fractionnaire alpha divisé par deux.
Une vigilance égale est de mise lors de l’utilisation de routines logicielles. Si une commande informatique demande explicitement une probabilité pour un test bilatéral (à l’image de LOI.STUDENT.INVERSE.BILATERALE sous Excel), l’argument à fournir est le risque global alpha non divisé (par exemple 0,05). À l’inverse, si la fonction attend un quantile cumulé ou unilatéral (comme qt sous R ou invT sur calculatrice), l’utilisateur doit impérativement injecter la formule 1 - alpha/2. Documenter explicitement ces conversions dans les scripts d’analyse constitue la meilleure garantie de traçabilité méthodologique.
11.2 Erreurs de calcul relatives aux degrés de liberté
La seconde catégorie d’erreurs computationnelles réside dans l’attribution erronée des degrés de liberté. Une confusion largement répandue consiste à assimiler la taille totale de l’échantillon, universellement désignée par la lettre N, au paramètre df de la loi de Student. Oublier de soustraire les contraintes mathématiques liées aux paramètres estimés conduit systématiquement à surestimer les degrés de liberté, et par voie de conséquence, à sous-estimer légèrement la sévérité du seuil t alpha/2 critique. Si l’impact d’une erreur d’une ou deux unités est négligeable sur une cohorte de 500 sujets, il devient déterminant sur des groupes restreints de 8 à 15 participants.
L’autre écueil majeur concerne la distinction structurelle entre les plans inter-sujets et les plans intra-sujets. Dans une comparaison de deux groupes indépendants comportant chacun 12 individus, la taille cumulée N s’élève à 24, et les degrés de liberté véritables sont de n1 + n2 - 2 = 12 + 12 - 2 = 22. Si l’investigateur utilise par inadvertance la formule propre aux mesures répétées (df = N – 1 = 23), l’écart est mineur, mais l’incohérence mathématique est avérée. L’erreur inverse est plus grave : appliquer la formule d’échantillons indépendants à un protocole pré-test post-test impliquant 12 paires de données doublerait fictivement la masse informationnelle en postulant à tort l’existence de 24 sujets indépendants.
Enfin, une complexité singulière survient lors de la comparaison de deux groupes indépendants présentant des variances empiriques hétérogènes (violation de l’hypothèse d’homoscédasticité). L’application aveugle de la formule conventionnelle df = n1 + n2 - 2 devient mathématiquement fautive. Dans ce cas de figure, la théorie exige la mise en œuvre de la correction de Welch-Satterthwaite, laquelle recalcule des degrés de liberté ajustés, souvent non entiers et notablement réduits, afin de rehausser la valeur t alpha/2 et préserver le taux nominal d’erreur de type I face à la distorsion des variances.
11.3 Méprise sur la polarité et les bornes critiques d’un test bilatéral
Le troisième piège méthodologique découle d’une mauvaise compréhension de la dualité polaire inhérente aux tests bilatéraux. Un test bilatéral se caractérise géométriquement par la coexistence de deux zones critiques distinctes, situées de part et d’autre de l’origine zéro. Dès lors, il n’existe pas une unique valeur critique isolée, mais une paire de valeurs critiques jumelles strictement symétriques : -t alpha/2 et +t alpha/2. Omettre de considérer la borne négative dans la formalisation des règles de décision conduit fréquemment à des contresens d’analyse lors du dépouillement des résultats.
Il arrive régulièrement qu’un analyste obtienne une statistique empirique négative consécutivement à l’ordre arbitraire de soustraction de ses conditions (par exemple x̄1 - x̄2 = 12 - 15 = -3). Si le chercheur a simplement extrait de sa table papier le nombre positif t alpha/2 = 2,042 sans expliciter la règle de décision bilatérale en valeur absolue, il peut être tenté de conclure naïvement que, la valeur observée (-3) n’étant pas supérieure au seuil positif (+2,042), l’effet n’est pas significatif. Ce raisonnement est évidemment absurde : la statistique empirique se situe profondément ancrée dans la zone de rejet inférieure gauche.
Pour éradiquer définitivement cette confusion élémentaire mais destructrice, il est impératif d’adopter des formulations de décision standardisées. La règle de rejet d’un test bilatéral doit être systématiquement formalisée soit sous la condition disjonctive t_obs ≤ -t alpha/2 OU t_obs ≥ +t alpha/2, soit sous la forme condensée d’une inégalité en valeur absolue |t_obs| ≥ t alpha/2. Accompagner systématiquement le rapport d’analyse d’un schéma mental ou graphique situant l’estimateur ponctuel par rapport aux deux frontières de rejet assure une clarté inférentielle totale.
12. Normes de rédaction académique et bonnes pratiques pour les rapports de recherche
12.1 Rapportage des résultats d’un test t selon les normes de l’APA
La publication scientifique obéit à des règles de formalisation extrêmement rigoureuses, codifiées pour les sciences psychologiques et comportementales par la septième édition du manuel de l’American Psychological Association (normes APA). L’objectif de cette normalisation est de fournir aux lecteurs l’intégralité des informations nécessaires à l’évaluation critique de la démonstration expérimentale, excluant tout flou quant aux choix méthodologiques opérés.
Le rapportage textuel d’un test t de Student doit obligatoirement expliciter la lettre statistique t en italique, suivie immédiatement entre parenthèses du nombre exact de degrés de liberté associés au test. Cette mention est immédiatement suivie du signe d’égalité, de la valeur numérique de la statistique empirique observée arrondie à deux ou trois décimales, puis de la p-valeur exacte associée au test (ou de la mention de sa position par rapport au seuil alpha nominal si la valeur exacte n’est pas connue). Le caractère bilatéral du test doit être explicitement précisé dans le corps du texte ou dans l’intitulé des tableaux de synthèse.
Une rédaction conforme aux normes contemporaines ne saurait se cantonner à la seule significativité statistique. Elle exige l’adjonction systématique d’une mesure standardisée de la taille d’effet, le d de Cohen ou le g de Hedges, accompagnée obligatoirement de son intervalle de confiance bilatéral dérivé précisément à l’aide de la valeur t alpha/2 correspondante. Un exemple canonique de rédaction académique s’articulera ainsi : « L’analyse par test t de Student pour échantillons indépendants révèle une différence statistiquement significative entre le groupe expérimental et le groupe témoin, t(28) = -2,52, p = 0,018, bilatéral, avec une taille d’effet importante, d = -0,92, IC à 95 % [-1,68 ; -0,16]. »
12.2 Validation préalable des postulats d’application de la distribution t
La détermination et l’application légitimes de la valeur critique t alpha/2 reposent sur la vérification préalable de postulats mathématiques fondamentaux qui conditionnent la validité de l’inférence. Le premier d’entre eux est l’indépendance stochastique des observations au sein et entre les échantillons, garantie par un échantillonnage probabiliste rigoureux et une randomisation adéquate des conditions expérimentales. La violation de l’indépendance altère profondément la structure de variance et rend l’application des tables de Student totalement invalide.
Le deuxième postulat cardinal concerne la normalité de la distribution de la variable quantitative dans les populations d’origine. Si la loi de Student bénéficie d’une résilience relative face aux déviations modérées de la normalité en vertu du théorème central limite dès lors que les effectifs sont substantiels, des asymétries sévères ou une bimodalité prononcée faussent dangereusement la couverture probabiliste réelle de t alpha/2 sur de petits échantillons. Il incombe donc au chercheur de sonder visuellement ses distributions (via des diagrammes quantile-quantile ou diagrammes Q-Q) et de formaliser cette conformité par des tests d’adéquation tels que le test de Shapiro-Wilk.
Le troisième postulat, pour les plans inter-sujets classiques, réside dans l’homogénéité des variances entre les groupes comparés. La conformité à ce postulat doit être testée systématiquement, par exemple au moyen du test de Levene. En présence d’une hétéroscédasticité manifeste combinée à des tailles d’échantillons inégales, l’investigateur doit immédiatement abandonner le calcul du t classique au profit de la correction de Welch-Satterthwaite, ou s’orienter vers des alternatives non paramétriques de rééchantillonnage bootstrap ou le test de Wilcoxon-Mann-Whitney pour garantir la pérennité de ses conclusions inférentielles.
12.3 Arbre décisionnel synthétique pour la détermination de t alpha/2
Pour guider le praticien et le chercheur dans les méandres computationnels et méthodologiques de la recherche de t alpha/2, la formalisation d’un arbre décisionnel synthétique constitue un outil d’une remarquable efficacité procédurale. Cet algorithme séquentiel se déploie en quatre étapes indispensables, prévenant toute omission méthodologique avant la publication des analyses :
- Étape 1 : Spécification du design et des hypothèses. Le chercheur détermine si l’hypothèse est unilatérale ou bilatérale. Si elle est bilatérale, le risque alpha global retenu (souvent 0,05) est obligatoirement divisé par deux :
alpha/2 = 0,025. - Étape 2 : Quantification exacte des degrés de liberté (df).
- Pour un échantillon unique ou des mesures appariées (intra-sujets) :
df = N - 1. - Pour deux groupes indépendants à variances égales :
df = n1 + n2 - 2. - Pour deux groupes indépendants à variances inégales : calcul obligatoire des degrés de liberté corrigés par l’algorithme de Welch-Satterthwaite.
- Pour un échantillon unique ou des mesures appariées (intra-sujets) :
- Étape 3 : Sélection rigoureuse de l’outil de résolution.
- Sur table papier : repérer la ligne des df calculés, puis la colonne bilatérale
alpha(ou la colonne unilatéralealpha/2). - Sur calculatrice graphique (TI/Casio) : programmer
invT(1 - alpha/2, df). - Sous logiciel tableur : utiliser la formule
=LOI.STUDENT.INVERSE.BILATERALE(alpha; df)ou=T.INV.2T(alpha, df). - En programmation statistique (R / Python) : exécuter
qt(p = 1 - alpha/2, df)sous R ouscipy.stats.t.ppf(1 - alpha/2, df)sous Python.
- Sur table papier : repérer la ligne des df calculés, puis la colonne bilatérale
- Étape 4 : Validation finale et contextualisation. L’analyste intègre les deux bornes critiques symétriques
-t alpha/2et+t alpha/2dans la règle de décision inférentielle, calcule l’intervalle de confiance bilatéral correspondant et rapporte les résultats selon les standards académiques APA, garantissant une intégrité scientifique absolue à ses travaux de recherche.
La recherche et l’application rigoureuses de la valeur critique t alpha/2 ne se réduisent aucunement à une simple gymnastique calculatoire dénuée de sens. Elles incarnent au contraire la quintessence de la méthode scientifique : une articulation méticuleuse entre des postulats probabilistes exigeants, des choix épistémologiques éclairés et une exécution computationnelle irréprochable. En maîtrisant les subtilités théoriques de la loi de Student, en s’appropriant les outils contemporains d’extraction numérique et en évitant les multiples pièges inhérents aux degrés de liberté et à la polarité des tests, le chercheur s’assure que chaque conclusion qu’il livre à la communauté académique repose sur des fondations statistiques inattaquables.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110-114. https://doi.org/10.2307/3002019
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28-35. https://doi.org/10.2307/2332510