
L’analyse des séries quantitatives au sein des environnements d’entreprise et des laboratoires de recherche exige une rigueur méthodologique absolue lorsqu’il s’agit d’isoler des sous-ensembles remarquables. Dans le vaste champ de la statistique descriptive appliquée aux feuilles de calcul, l’identification des dix pour cent des valeurs les plus élevées d’une distribution constitue une opération cardinale. Qu’il s’agisse de déceler les clients générant l’essentiel du chiffre d’affaires selon le principe de Pareto, de repérer des performances boursières atypiques ou de circonscrire des anomalies biométriques dans une cohorte clinique, cette démarche ne saurait se réduire à une sélection empirique superficielle. L’utilisation du tableur Microsoft Excel offre un spectre étendu de solutions techniques, allant des mécanismes visuels directs aux algorithmes matriciels les plus avancés, chacun répondant à des contraintes computationnelles et statistiques précises.
Trop souvent, les praticiens confondent le comptage ordinal des dix premières observations d’une liste avec le seuil quantile qui sépare les quatre-vingt-dix pour cent inférieurs de la tranche sommitale de dix pour cent. Cette confusion engendre des biais décisionnels substantiels, fausse les extrapolations et compromet la reproductibilité des protocoles d’audit. La maîtrise de cette distinction repose sur une compréhension limpide du concept de centile et de sa transposition au sein du moteur de calcul d’Excel. En fonction de la nature des données, de leur cardinalité et des impératifs d’actualisation en temps réel, l’analyste doit arbitrer entre la flexibilité de la mise en forme conditionnelle, le déterminisme des fonctions statistiques natives, la puissance déclarative des formules matricielles dynamiques ou encore la robustesse industrielle de Power Query et du code Visual Basic for Applications.
Ce guide exhaustif a pour vocation d’exposer, avec une précision mathématique et opérationnelle sans concession, l’ensemble des protocoles permettant d’isoler avec exactitude les 10 % des valeurs supérieures d’une colonne Excel. À travers l’examen détaillé des fondements théoriques, l’assainissement préalable des données, la comparaison critique des fonctions de centile et l’exploration des architectures matricielles contemporaines, cet ouvrage fournit aux professionnels de la donnée le socle méthodologique indispensable pour transformer une simple colonne de mesures en un instrument d’analyse prédictive et décisionnelle irréprochable.
1. Fondements théoriques et statistiques du calcul du 90e percentile dans Excel
1.1 Définition mathématique du percentile et distribution continue
D’un point de vue statistique, le concept de centile ou percentile représente une mesure de position non paramétrique qui divise une distribution d’observations ordonnées en cent fractions équiprobables. Contrairement aux estimateurs de tendance centrale tels que la moyenne arithmétique ou la médiane, le centile s’affranchit des hypothèses fortes relatives à la normalité de la distribution sous-jacente. L’isolation des 10 % des valeurs les plus élevées équivaut formellement à identifier le seuil en deçà duquel se situent 90 % de la masse de distribution, seuil couramment désigné sous le terme de quatre-vingt-dixième percentile, noté P90. Ce point de coupure partitionne l’espace des données de manière asymétrique, concentrant l’analyse sur la queue supérieure de la distribution.
Dans le cadre théorique d’une variable aléatoire continue gouvernée par une fonction de répartition cumulative continue F(x), le 90e percentile correspond à la valeur singulière x satisfaisant rigoureusement l’égalité F(x) = 0,90. Néanmoins, lors de la manipulation de séries empiriques discrètes dans un tableur, la fonction de répartition prend la forme d’un escalier discontinu. L’estimation du quantile devient alors tributaire de techniques d’interpolation statistique destinées à combler l’intervalle entre les observations adjacentes. L’exactitude de cette estimation est intrinsèquement liée à la taille de l’échantillon. Pour une cohorte de taille réduite, l’incertitude entourant la position du quantile s’accroît considérablement, tandis que pour de grands volumes d’échantillonnage, la convergence vers la valeur théorique est garantie par la loi forte des grands nombres.
Le comportement des quantiles se distingue par une résilience remarquable face aux distributions asymétriques, présentant un étalement à droite prononcé ou des configurations bimodales. Dans de telles structures morphologiques, où la moyenne arithmétique est lourdement distordue par les valeurs extrêmes, le 90e percentile conserve une signification géométrique inaltérée : il marque sans ambiguïté la frontière séparant les 90 % des observations les plus basses du décile supérieur. Cette propriété d’invariance d’échelle pour les transformations monotones confère au calcul de centile une suprématie analytique sur les métriques basées sur l’écart-type lorsque les données s’écartent du modèle gaussien standard, comme l’illustrent fréquemment les distributions de revenus, les sinistres d’assurance ou les temps de réponse de serveurs informatiques.
1.2 Distinction essentielle entre valeurs absolues et rangs relatifs
L’une des défaillances analytiques les plus répandues dans le traitement de données sous Excel réside dans l’assimilation erronée des dix premières valeurs absolues aux dix pour cent supérieurs d’une série. Cette divergence conceptuelle induit des conséquences opérationnelles majeures selon la cardinalité du jeu de données exploré. Si une colonne comporte rigoureusement cent observations uniques, les dix premières valeurs ordonnées coïncident numériquement avec le décile supérieur. En revanche, dès lors que l’échantillon s’étend à dix mille enregistrements, les dix premières valeurs ne représentent qu’une fraction infinitésimale de 0,1 % de la population totale, négligeant de ce fait 990 observations appartenant légitimement aux 10 % supérieurs.
Réciproquement, sur un échantillon restreint de cinquante éléments, un filtrage fixé arbitrairement sur dix unités capturerait en réalité vingt pour cent de la série, altérant substantiellement la sélectivité du filtre statistique. Le choix d’un seuil proportionnel relatif s’impose dès l’instant où l’analyse ambitionne de préserver un ratio constant de sélection quelle que soit la dynamique d’expansion ou de contraction de la population observée. Cette approche est indispensable dans les protocoles de surveillance continue des processus industriels ou de notation financière, où les effectifs globaux fluctuent périodiquement sous l’effet des entrées et sorties de variables.
Les conséquences statistiques de la cardinalité ne se limitent pas à un simple enjeu d’échelle. Elles conditionnent la représentativité de l’ensemble résiduel sélectionné. Lorsque la distribution présente une forte concentration d’ex æquo au voisinage immédiat du seuil de coupure, la sélection relative requiert des règles d’arbitrage rigoureuses pour éviter une rupture de symétrie. Le passage d’un modèle d’échantillonnage discret à une sélection fractionnaire relative contraint ainsi l’analyste à formaliser avec minutie les critères d’inclusion et d’exclusion, garantissant que l’échantillon extrait reflète fidèlement la réalité stochastique du phénomène sous étude plutôt qu’un artifice de dimensionnement rigide.
1.3 Importance de la représentativité statistique dans le traitement de données
La délimitation d’un seuil de décile supérieur ne doit jamais être exécutée sans une compréhension épistémologique préalable de la structure des données sous-jacentes. Une mauvaise interprétation des seuils de coupure peut induire des biais d’échantillonnage dévastateurs, notamment le biais de survie ou l’effet de troncature non contrôlé. Isoler le décile supérieur sans procéder à une analyse exploratoire approfondie expose l’analyste au risque d’intégrer des artéfacts de mesure, des erreurs de saisie instrumentale ou des données aberrantes qui ne traduisent aucune réalité opérationnelle, mais tirent artificiellement le seuil vers des valeurs disproportionnées.
L’analyse exploratoire préalable s’impose pour valider la consistance interne de la série. Cette démarche implique le tracé d’histogrammes de fréquence, l’estimation des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis), ainsi que la vérification de la dispersion globale via l’écart interquartile. Cette phase préliminaire permet de déterminer si le seuil des 10 % supérieurs agit comme un séparateur de comportement pertinent ou s’il segmente arbitrairement une population hautement homogène où les écarts marginaux ne possèdent aucune significativité statistique. Par exemple, au sein d’une distribution uniforme, la frontière du 90e percentile n’incarne aucune discontinuité qualitative, contrairement aux phénomènes régis par des lois de puissance ou des dynamiques de Pareto.
Enfin, la question de l’inclusion ou de l’exclusion des valeurs limites constitue un enjeu méthodologique de premier ordre. Le statut de l’observation se situant exactement sur la frontière théorique du 90e percentile soulève la question de la stricte inégalité par rapport à l’inégalité large. Selon que l’on retient les valeurs strictement supérieures au seuil ou supérieures ou égales à celui-ci, la proportion empirique d’individus sélectionnés peut dévier sensiblement des 10 % théoriques visés, particulièrement au sein d’échantillons granulaires ou discrets. L’explicitation de ces hypothèses fondamentales dans la documentation analytique constitue le garant de l’intégrité scientifique des conclusions tirées du modèle Excel.
2. Préparation rigoureuse et assainissement de la colonne de données
2.1 Typage des variables et élimination des artefacts textuels
Avant d’engager tout calcul algorithmique ou statistique dans Excel, il est impératif d’auditer la pureté structurelle de la colonne concernée. Une défaillance récurrente réside dans la présence de données quantitatives stockées sous forme textuelle, fréquemment issues d’exports de systèmes d’information d’entreprise (ERP) ou de bases de données relationnelles mal configurées. Lorsqu’une cellule numérique est encodée comme texte, le moteur de calcul d’Excel l’exclut silencieusement de la majorité des fonctions statistiques d’agrégation, à l’instar de la fonction CENTILE.INC, ou applique un tri lexicographique destructeur faussant l’identification des valeurs dominantes.
L’assainissement requiert une détection méthodique des artefacts invisibles, au premier rang desquels figurent les espaces insécables identifiables sous le code de caractère 160 (correspondant à l’entité HTML ). Ces caractères, souvent utilisés comme séparateurs de milliers dans les formats de langue française, empêchent toute conversion arithmétique directe. La neutralisation de ces anomalies s’opère par l’application combinée des fonctions de manipulation textuelle, notamment via la formule =SUBSTITUE(A2; CAR(160); « »), associée au remplacement conventionnel des espaces simples. De même, les disparités régionales relatives au séparateur décimal — le point anglo-saxon opposé à la virgule continentale — nécessitent une standardisation rigoureuse au moyen de la fonction SUBSTITUE ou de l’outil natif de conversion de texte en colonnes.
Pour restaurer l’intégrité numérique d’une plage compromise, l’usage de la fonction CNUM s’avère particulièrement efficace en forçant le transtypage des chaînes textuelles vers un format numérique à virgule flottante double précision. Une vérification empirique consiste à observer l’alignement par défaut appliqué par le tableur : une donnée numérique pure s’aligne automatiquement sur le bord droit de la cellule, tandis qu’une chaîne textuelle demeure arrimée sur la gauche. L’analyste diligent confirmera cette cohérence au moyen de la fonction logique ESTNUM, assurant ainsi l’homogénéité intégrale de la colonne cible avant tout calcul matriciel.
2.2 Gestion méthodique des valeurs manquantes et des doublons
La présence d’enregistrements lacunaires, de cellules vides ou de doublons massifs au sein d’une série statistique constitue une source majeure de dérive pour l’évaluation du 90e percentile. Il convient d’établir une distinction opérationnelle stricte entre une cellule vide et une cellule hébergeant la valeur numérique zéro. Si le chiffre zéro représente une observation valide d’amplitude nulle qui participe pleinement au calcul de la fonction de répartition et tire le seuil quantile vers le bas, la cellule vide doit être rigoureusement ignorée afin de ne pas biaiser la cardinalité totale du dénominateur d’échantillonnage.
La problématique des doublons, ou ex æquo statistiques, requiert un arbitrage méthodologique fondé sur la phénoménologie des données traitées. Si deux observations identiques reflètent deux entités physiques distinctes présentant fortuitement la même mesure — par exemple deux transactions commerciales distinctes de montant identique —, leur conservation simultanée est un impératif de représentativité probabiliste. En revanche, si la répétition procède d’une duplication technique de lignes consécutive à une scission erronée d’enregistrements, la suppression immédiate via l’outil dédié d’Excel s’impose pour restaurer la neutralité de la distribution.
L’impact des ex æquo se révèle particulièrement critique lorsqu’ils s’accumulent au voisinage immédiat du point de coupure. Si le seuil théorique des 10 % supérieurs s’établit précisément sur une valeur répétée cinquante fois dans un ensemble de cinq cents lignes, l’inclusion de cette valeur critique peut faire basculer la sélection finale de 10 % à plus de 18 % du volume global. L’analyste doit dès lors formaliser son protocole : opte-t-il pour une inclusion tolérante quitte à élargir l’assiette du centile, ou met-il en œuvre une règle de départage fondée sur une variable secondaire, voire un tirage aléatoire contrôlé pour maintenir l’échantillon à son volume cible ? L’intégrité de l’analyse dépend de la clarté de ces arbitrages.
2.3 Conversion de la plage en tableau structuré Excel
L’optimisation des flux de travail contemporains dans Excel impose la dépréciation des plages de cellules standards non référencées au profit des tableaux structurés, techniquement désignés sous l’appellation d’objets ListObject dans le modèle d’objet Office. Cette transformation, opérée via le raccourci Ctrl+L ou le ruban Insertion > Tableau, confère à la série de données une robustesse computationnelle indispensable à toute analyse de centile pérenne et évolutive.
Les avantages architecturaux de cette structure sont prépondérants pour le calcul du 90e percentile :
- Référencement structuré et lisibilité : Les formules s’affranchissent des coordonnées de cellules fixes (ex. $A$2:$A$1000) pour adopter une syntaxe déclarative intelligible (ex. Tableau1[Mesure]), prévenant les erreurs de décalage de plage lors de l’insertion ultérieure de nouvelles observations.
- Dynamicité automatique : Toute nouvelle observation insérée au bas de la colonne est immédiatement intégrée dans le champ d’action des formules analytiques sans aucune intervention humaine, garantissant le recalcul en temps réel du seuil quantile.
- Propagation native des calculs : L’écriture d’un test logique sur la première ligne entraîne l’implémentation automatique d’une colonne calculée sur l’ensemble de la dimension, éliminant les disparités de formules au sein d’une même cohorte.
- Isolation des métadonnées : Les lignes d’en-tête et les lignes de totalisation sont gérées de manière découplée, évitant l’intégration accidentelle d’étiquettes textuelles ou de sommes partielles dans les vecteurs d’entrée des fonctions de calcul de centiles.
L’adoption du tableau structuré garantit ainsi une séparation étanche entre la couche de stockage des données et la couche d’évaluation mathématique, érigeant l’environnement de calcul en un système pérenne conforme aux meilleures pratiques de gouvernance de données sur tableur.
3. Méthode 1 : Identification visuelle immédiate via la mise en forme conditionnelle
3.1 Procédure opérationnelle des règles de valeurs les plus élevées
La mise en forme conditionnelle représente la passerelle la plus accessible pour mettre en évidence les dix pour cent supérieurs d’une série sans altérer la disposition spatiale des données ni recourir à des calculs intermédiaires. Cette fonctionnalité native du moteur graphique d’Excel analyse dynamiquement l’ensemble des cellules sélectionnées et applique un style chromatique distinctif aux observations satisfaisant le critère de rang proportionnel. Elle s’avère idéale pour les phases exploratoires rapides et les audits visuels préliminaires.
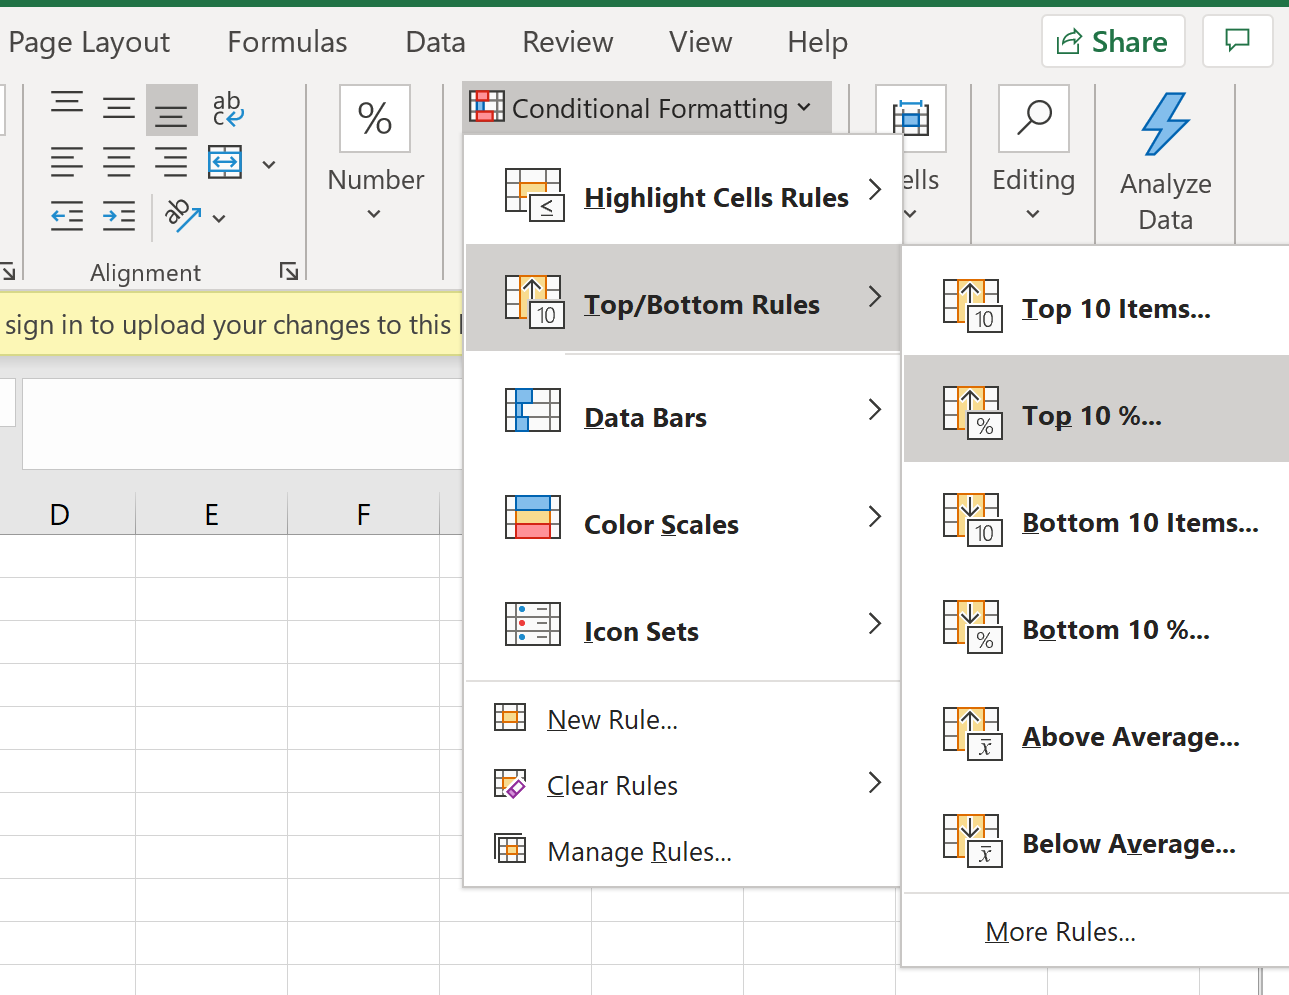
Pour déployer cette technique sur une colonne de données assainies, la séquence opératoire doit respecter un protocole rigoureux :
- Sélectionner l’ensemble de la plage numérique cible, en veillant scrupuleusement à exclure la cellule d’en-tête pour ne pas corrompre l’échantillon d’évaluation.
- Accéder au ruban principal Accueil, naviguer vers le groupe fonctionnel Style, puis cliquer sur l’icône Mise en forme conditionnelle.
- Déployer le sous-menu Règles des valeurs les plus/moins élevées, puis sélectionner expressément la commande intitulée 10 % les plus élevés….
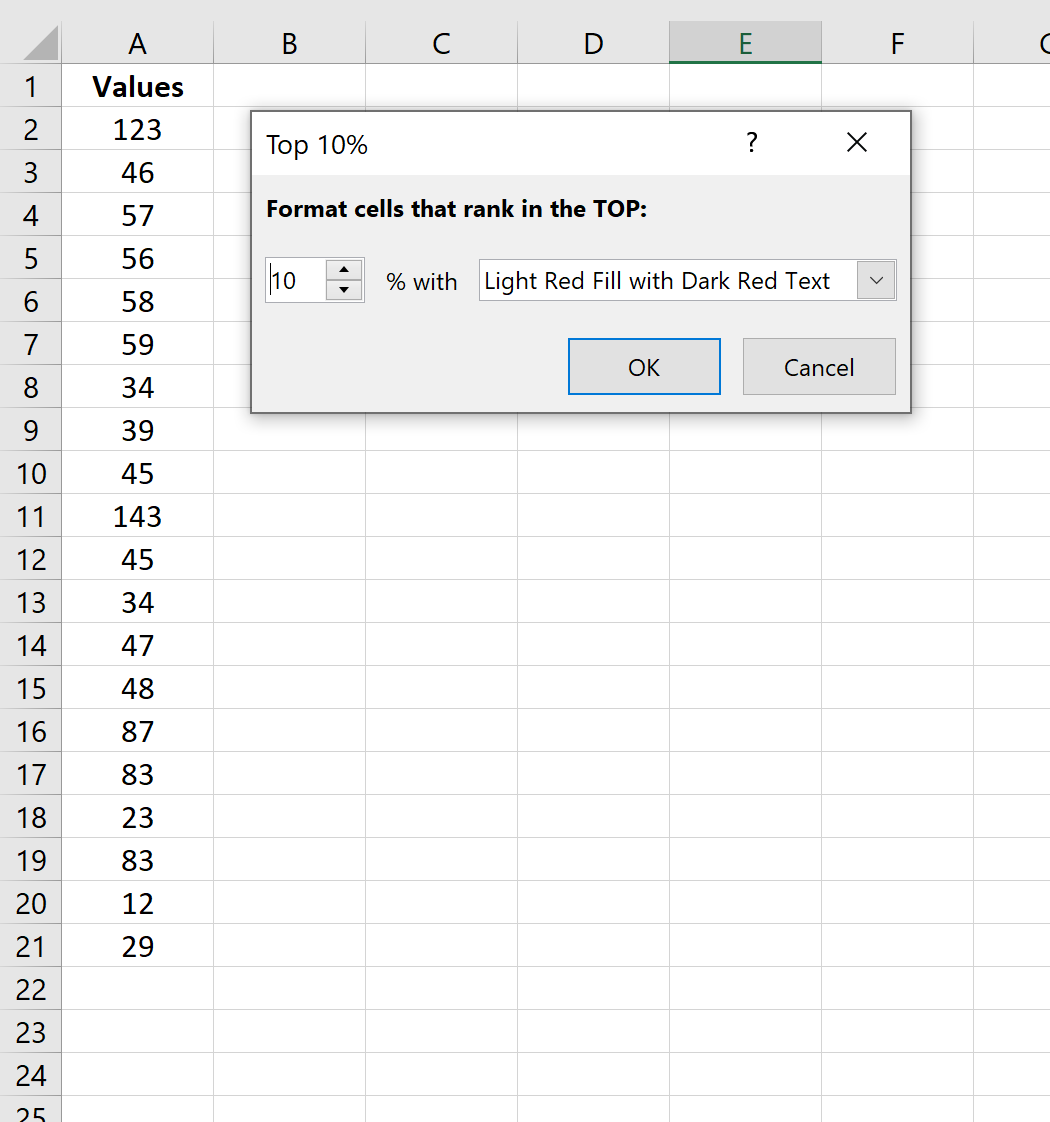
- Au sein de la fenêtre de dialogue modale qui s’affiche à l’écran, s’assurer que la valeur numérique du paramètre est précisément fixée à 10 et que l’unité contextuelle demeure bien configurée sur le mode pourcentage et non sur un comptage unitaire.
- Sélectionner un format de mise en surbrillance dans le menu déroulant préétabli ou définir un style personnalisé, puis valider en cliquant sur le bouton d’exécution.
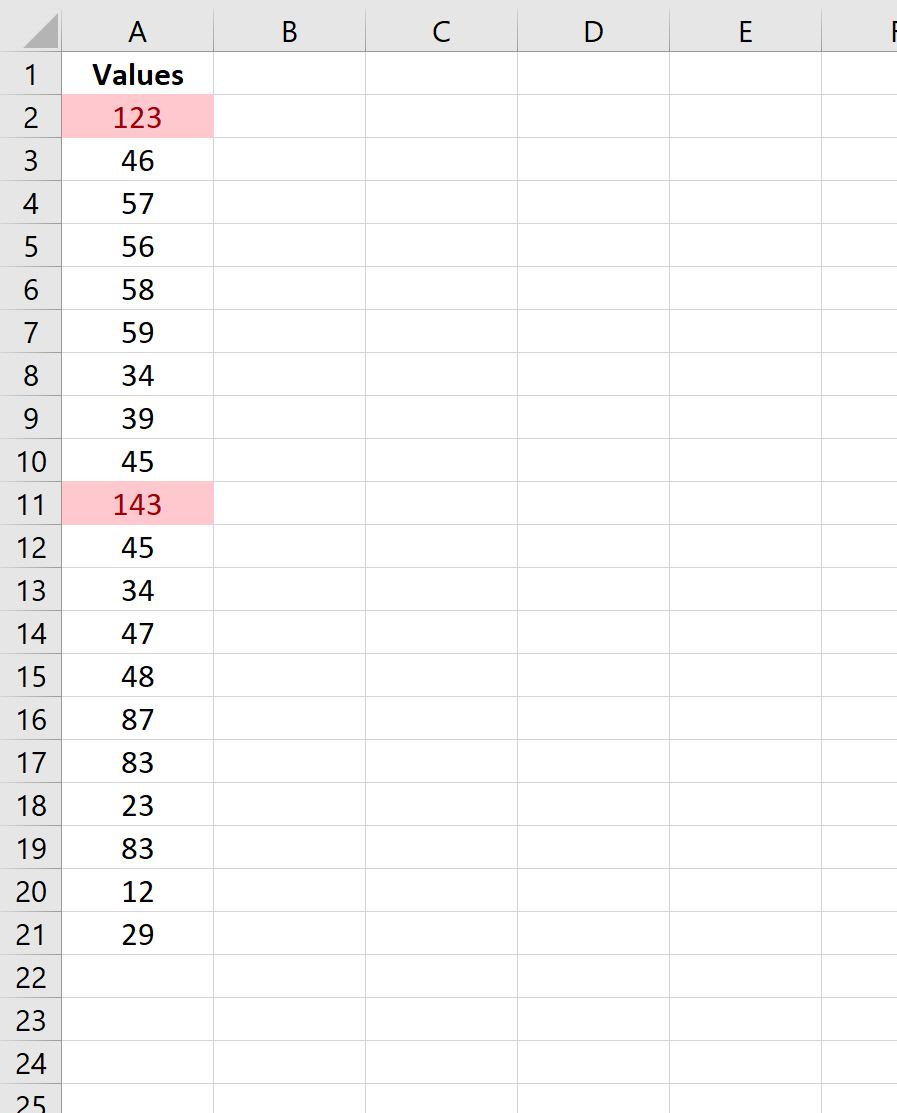
Le moteur d’Excel calcule alors de manière invisible le seuil de coupure correspondant et colore instantanément la tranche supérieure de la distribution, offrant une restitution cognitive immédiate de la répartition spatiale des extrêmes.
3.2 Personnalisation sémiotique et chromatique de l’affichage
La transcription graphique de l’information statistique ne doit pas être sous-estimée. L’adoption inconsidérée des styles de surbrillance proposés par défaut dans Excel — notamment le remplissage rouge clair avec texte rouge foncé — génère souvent une dissonance sémiotique dommageable. Dans la convention occidentale de visualisation des données, le rouge connote généralement le danger, l’erreur, le déficit ou l’écart négatif. Or, dans la vaste majorité des cas d’usage, identifier les dix pour cent des valeurs les plus élevées correspond à isoler des performances d’excellence, des marges bénéficiaires fortes ou des indicateurs d’efficacité industrielle méritant une valorisation positive.
Il est donc fortement recommandé d’opter pour une personnalisation chromatique réfléchie en créant un format personnalisé respectant les normes universelles d’accessibilité visuelle. L’utilisation d’une teinte verte sobre ou d’une nuance bleutée pastel, combinée à une typographie en graisse moyenne (semi-bold) et à une bordure discrète, assure un contraste suffisant selon les critères des directives WCAG (Web Content Accessibility Guidelines). Cette précaution préserve la lisibilité pour les personnes atteintes de déficiences de la vision des couleurs (daltonisme) et évite le phénomène de fatigue oculaire induit par les contrastes saturés.
En outre, la sobriété sémiotique garantit que la feuille de calcul demeure conforme aux standards de restitution académiques et managériaux de haut niveau. Une surcharge de couleurs criardes nuit à la perception analytique et détourne l’attention de l’observateur des nuances quantitatives sous-jacentes. La personnalisation doit ainsi magnifier la structure de la donnée sans transformer la matrice d’analyse en un artefact visuellement instable.
3.3 Interprétation des résultats et comportement face aux séries réduites
L’utilisation de la règle native des 10 % supérieurs masque un mécanisme algorithmique d’arrondi qu’il convient de décrypter pour interpréter convenablement les résultats. Lorsque la cardinalité de la plage sélectionnée n’est pas un multiple exact de dix, le tableur doit statuer sur le nombre entier de cellules à surligner. Excel implémente un système d’arrondi qui tend généralement à inclure l’entier le plus proche, ce qui peut engendrer des écarts proportionnels substantiels sur les petits effectifs d’échantillonnage.
À titre d’illustration concrète, sur une série expérimentale ne comprenant que 15 observations :
- Dix pour cent de 15 équivalent mathématiquement à 1,5 observation.
- Ne pouvant scinder physiquement une cellule, l’algorithme sous-jacent d’Excel arrondit cette valeur à 2 cellules.
- De ce fait, la mise en forme conditionnelle surligne les 2 valeurs les plus élevées de la série.
- La proportion réelle surlignée s’élève alors à 2 / 15 = 13,33 %, s’écartant sensiblement de la consigne nominale de dix pour cent.
Pour un échantillon témoin de 20 observations, le calcul retrouve une concordance théorique exacte (20 * 0,10 = 2 cellules surlignées, soit rigoureusement 10 %). Cette sensibilité dimensionnelle démontre que si la mise en forme conditionnelle s’avère un outil visuel performant, elle ne garantit en rien la rigueur mathématique sur des séries réduites et demeure impuissante à isoler physiquement les données sans manipulations annexes.
4. Analyse critique et limites de la mise en forme conditionnelle native
4.1 Problématique de la gestion des ex æquo au seuil de coupure
La limite structurelle majeure de la fonctionnalité visuelle réside dans son incapacité à fragmenter les blocs d’ex æquo se positionnant exactement à la charnière du seuil de sélection. Le moteur de rendu applique une règle d’inclusion inclusive : dès lors qu’une cellule affiche une valeur égale à celle de la dernière observation qualifiée pour le décile supérieur, cette cellule se voit attribuer la mise en forme distinctive, indépendamment du dépassement de quota que cette décision provoque mécaniquement.
Considérons un ensemble de données constitué de 100 observations où les 8 premières valeurs sont strictement distinctes et décroissantes, et où les cellules classées du 9e au 15e rang arborent rigoureusement la même valeur numérique Y. En vertu du paramètre des 10 % supérieurs, l’utilisateur s’attend légitimement à identifier exactement 10 valeurs. En pratique, le moteur conditionnel constate que la 10e valeur est égale à Y. Par cohérence logique élémentaire, il ne peut colorer la cellule du rang 10 sans colorer simultanément les cellules des rangs 11, 12, 13, 14 et 15 qui possèdent une valeur strictement identique.
Le résultat effectif aboutit donc au surlignage de 15 cellules au lieu des 10 attendues, matérialisant une sélection réelle de 15 % de la population. Si l’analyste procède ultérieurement à un comptage visuel ou utilise cette coloration pour allouer des primes de performance financière limitées à dix pour cent de l’effectif, l’illusion d’exactitude générée par le tableur induit une erreur de surallocation budgétaire non négligeable. Il est donc indispensable de valider par des tests fonctionnels complémentaires le volume exact de cellules mises en surbrillance.
4.2 Dégradation des performances de calcul sur les grands volumes
Sur le plan de l’architecture logicielle, les règles de mise en forme conditionnelle se comportent comme des formules volatiles soumises à une réévaluation quasi-permanente. À chaque modification d’une cellule du classeur, à chaque insertion de ligne ou simplement lors du défilement de l’écran (scrolling) nécessitant un rafraîchissement du tampon graphique, le sous-système de rendu d’Excel réexamine l’intégralité des règles appliquées pour recalculer les seuils et redessiner l’interface utilisateur.
Lorsque cette méthode est déployée sur des volumétries massives — par exemple des colonnes contenant plusieurs centaines de milliers de lignes —, ce cycle de recalcul perpétuel dégrade lourdement les performances de la machine. Les symptômes se traduisent par une latence perceptible lors de la navigation, des gels d’écran temporaires et une consommation disproportionnée de mémoire vive (RAM) et de cycles processeur. Ce coût computationnel s’accentue dramatiquement si la règle est appliquée sur des colonnes entières (ex. A:A) plutôt que d’être circonscrite à la plage utile réelle des données.
Pour prévenir cette dérive d’engorgement système, les bonnes pratiques de modélisation préconisent de restreindre strictement les plages d’application au périmètre des tableaux structurés et de proscrire la démultiplication des règles superposées. Toutefois, face à des jeux de données d’envergure industrielle, la mise en forme conditionnelle doit être écartée au profit de colonnes calculées déterministes, infiniment plus économes en ressources processeur.
4.3 Absence de persistance pour l’analyse statistique ultérieure
Une mise en forme conditionnelle est, par nature, un attribut de présentation cosmétique qui ne modifie aucunement la structure de l’information sous-jacente. Elle applique une couche de pixels colorés sans générer de descripteur de données exploitable par d’autres composants du modèle d’analyse. Par conséquent, il s’avère impossible d’utiliser directement cette mise en surbrillance comme variable d’entrée au sein de fonctions d’agrégation conditionnelle telles que SOMME.SI.ENS, MOYENNE.SI.ENS ou NB.SI.ENS sans recourir à des subterfuges techniques complexes.
L’analyste se heurte à une rupture de la chaîne de traitement : pour calculer la moyenne arithmétique ou la somme des transactions appartenant aux 10 % supérieurs ainsi identifiés visuellement, l’opérateur est contraint d’appliquer un filtre manuel par couleur, puis d’agréger les données via la fonction SOUS.TOTAL. Cette démarche fragmentée dépend entièrement de la manipulation humaine, détruisant tout espoir d’automatisation transparente au sein du classeur.
La pérennité d’un tableau de bord professionnel impose que chaque état statistique soit codifié sous forme d’une information logique binaire explicite (VRAI/FAUX ou 1/0) persistante en mémoire. La mise en forme conditionnelle ne saurait constituer l’étape terminale d’une démarche d’ingénierie des données ; elle doit être reléguée au rang d’accessoire cosmétique venant éventuellement souligner le résultat produit par des méthodes mathématiques et algorithmiques autonomes.
5. Méthode 2 : Calcul déterministe par les fonctions de centile
5.1 Syntaxe formelle et paramètres de la fonction CENTILE.INC
Pour instaurer un cadre d’analyse rigoureux et reproductible, l’évaluation du seuil de coupure doit être confiée aux fonctions statistiques natives du tableur. Depuis la refonte majeure de sa bibliothèque mathématique dans la version 2010, Excel propose la fonction CENTILE.INC, successeur direct et stabilisé de l’ancienne fonction générique CENTILE. Cette fonction implémente le modèle de calcul de centile inclusif, fondé sur une interpolation linéaire entre les rangs fractionnaires de l’échantillon.
La syntaxe canonique de la fonction se structure autour de deux arguments obligatoires :
=CENTILE.INC(matrice; k)
Dans cette formalisation :
- matrice : Représente la plage continue de cellules ou le vecteur de données quantitatives dont on souhaite évaluer la distribution.
- k : Désigne la valeur du centile cible, obligatoirement comprise dans l’intervalle fermé allant de 0 à 1 inclus. Pour isoler les 10 % des valeurs les plus élevées, l’argument k doit être rigoureusement fixé à 0,9 (ou 90 %), ce qui détermine la valeur en deçà de laquelle se situent 90 % des observations.
Sur le plan arithmétique, la fonction CENTILE.INC calcule le rang fractionnaire r correspondant à k * (N – 1) + 1, où N représente le nombre total d’observations numériques valides. Si r n’est pas un nombre entier, la fonction partitionne r en sa partie entière et sa partie décimale, puis opère une interpolation linéaire stricte entre les deux valeurs ordonnées entourant immédiatement cette position théorique. Ce comportement garantit une robustesse analytique remarquable et assure que la valeur de coupure calculée s’intègre harmonieusement dans le continuum de l’échantillon empirique.
5.2 Comparaison approfondie : CENTILE.INC versus CENTILE.EXC
Parallèlement à la fonction inclusive, Excel intègre la fonction CENTILE.EXC, laquelle formalise un paradigme d’exclusion des extrêmes. Le choix entre ces deux déclinaisons algorithmiques soulève des considérations statistiques théoriques fondamentales qui impactent directement la valeur seuil calculée, particulièrement au sein d’échantillons de dimension modeste.
La fonction CENTILE.EXC adopte pour base de calcul la formule de rang r = k * (N + 1). Dans ce modèle conceptuel, le percentile d’ordre k postule que les valeurs extrêmes de l’échantillon (le minimum et le maximum observés) ne constituent pas les bornes absolues de la population globale mère, mais simplement les points d’observation les plus reculés d’un échantillonnage borné. En conséquence, il devient impossible d’évaluer les centiles pour des valeurs de k inférieures à 1 / (N + 1) ou supérieures à N / (N + 1), la fonction retournant dans ces zones critiques une erreur d’argument #NOMBRE!.
À titre d’illustration méthodologique, sur une population restreinte de 8 observations (N = 8) :
- Pour évaluer le 90e percentile avec CENTILE.EXC, le rang requis serait r = 0,9 * (8 + 1) = 8,1.
- Le rang 8,1 dépassant l’effectif maximal de l’échantillon (N = 8), CENTILE.EXC refuse d’extrapoler au-delà des données observées et génère immédiatement une erreur computationnelle #NOMBRE!.
- À l’inverse, CENTILE.INC évalue le rang à r = 0,9 * (8 – 1) + 1 = 7,3, permettant une interpolation licite entre la 7e et la 8e valeur de la série ordonnée.
Dans la pratique scientifique et financière courante, la fonction CENTILE.INC est universellement privilégiée car elle garantit une opérabilité systématique quelle que soit la taille de l’échantillon, tout en demeurant compatible avec les normes historiques des logiciels de biostatistique (comme les protocoles standard du logiciel R ou de Python SciPy sous la méthode Weibull/NIST).
5.3 Création d’une colonne logique d’appartenance booléenne
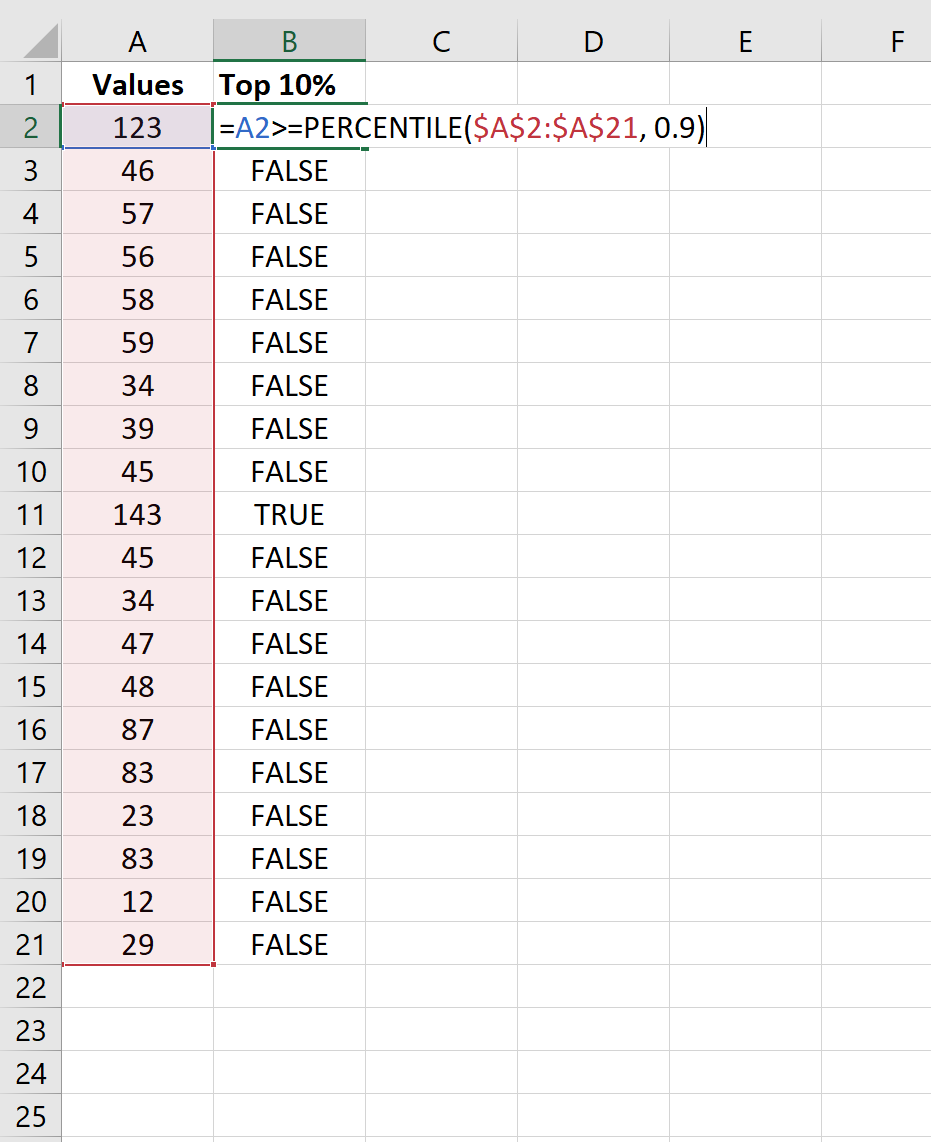
L’exploitation opérationnelle du seuil déterminé par la fonction de centile prend toute sa dimension par l’adjonction d’une colonne auxiliaire d’évaluation logique. Cette méthodologie consiste à associer à chaque observation un indicateur booléen explicite statuant sur son appartenance effective au décile supérieur. Cette approche confère une traçabilité intégrale à l’analyse et prépare le terrain pour les filtrages et segmentations ultérieurs.
Dans une feuille de calcul structurée où les données quantitatives sont stockées dans la plage B2:B101, la formule logique s’implémente au sein de la cellule adjacente C2 sous la syntaxe suivante :
=B2 >= CENTILE.INC($B$2:$B$101; 0,9)
L’analyse structurelle de cette formulation met en lumière plusieurs impératifs techniques fondamentaux :
- Référencement absolu de la matrice : L’application systématique du symbole dollar ($) sur les coordonnées de la plage matricielle ($B$2:$B$101) est vitale. Elle neutralise le décalage de la zone de référence lors du recopie de la formule vers les cellules inférieures, garantissant que chaque observation est confrontée au seuil global immuable.
- Sémantique de l’inégalité large : L’emploi de l’opérateur >= assure que toute observation dont l’amplitude coïncide rigoureusement avec la valeur seuil est intégrée dans le groupe cible, prévenant les évictions arbitraires.
- Production binaire native : La formule ne fait intervenir aucune fonction SI redondante. L’évaluation logique directe renvoie nativement la valeur booléenne VRAI lorsque l’observation intègre les 10 % supérieurs, et FAUX dans le cas contraire, optimisant ainsi la vitesse de traitement en mémoire.
Si la plage a préalablement été convertie en tableau structuré, la formule gagne en élégance et en résilience : =[@Mesure] >= CENTILE.INC([Mesure]; 0,9). La propagation devient instantanée sur toute la hauteur du tableau, immunisant le système contre les erreurs de manipulation humaine.
6. Intégration du filtrage logique et extraction des sous-populations
6.1 Application des filtres automatiques sur l’indicateur booléen
La génération de la colonne booléenne d’appartenance transforme l’opération d’extraction des dix pour cent supérieurs en une procédure de filtrage d’une simplicité et d’une fiabilité optimales. L’activation des filtres automatiques natifs d’Excel permet de modifier instantanément la granularité de la vue sans compromettre l’intégrité du tableau mère.
L’implémentation opérationnelle s’effectue selon la trajectoire suivante :
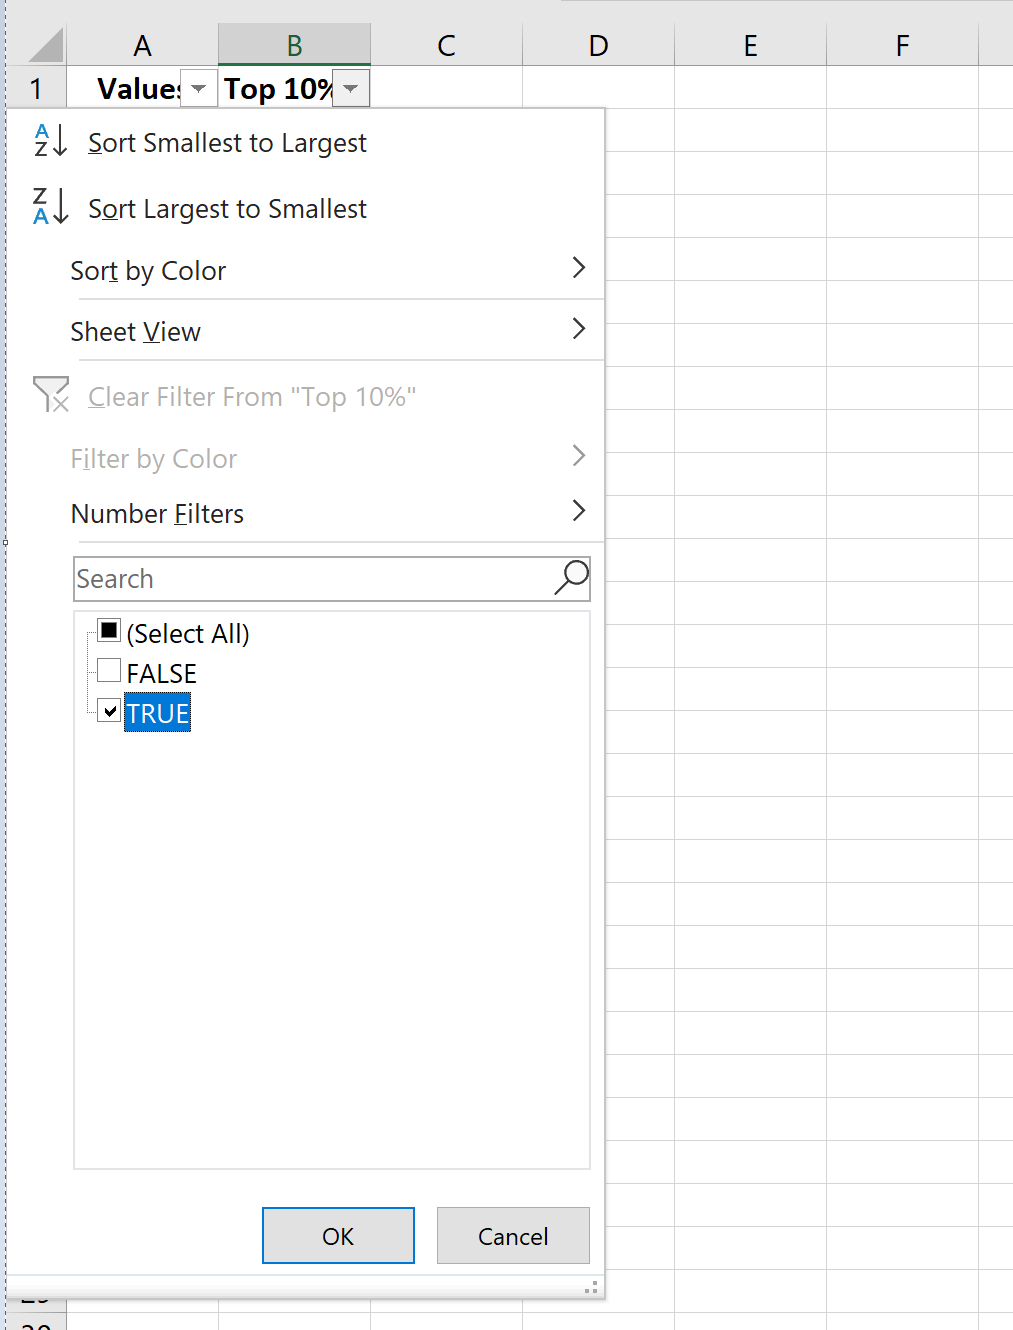
- Positionner le curseur actif au sein de la ligne d’en-tête du tableau et déployer les filtres automatiques à l’aide de la combinaison de touches Ctrl+Maj+L ou via le menu Données > Filtrer.
- Cliquer sur la flèche de déploiement située sur l’en-tête de la colonne booléenne nouvellement générée.
- Décocher l’option globale de sélection pour cocher exclusivement la modalité VRAI, puis valider la requête.
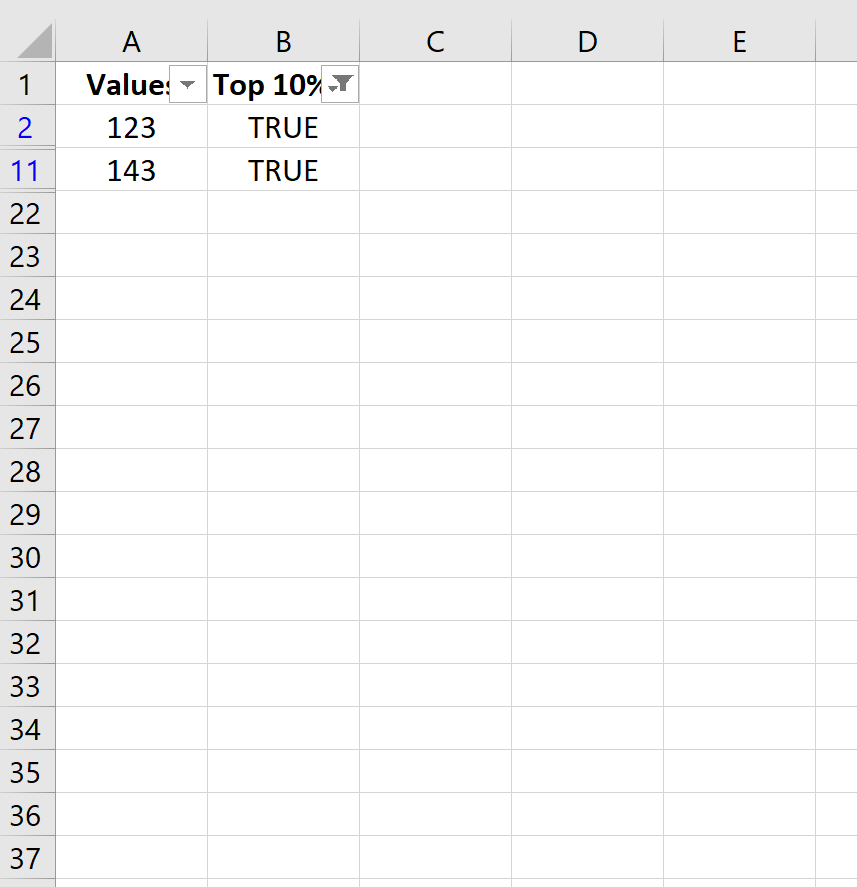
À l’issue de cette manipulation, le moteur de rendu d’Excel masque l’ensemble des lignes dont la valeur se situe sous le 90e percentile, laissant uniquement visibles les données constitutives du décile supérieur. Les numéros de ligne affichés sur le bord gauche de l’interface adoptent une coloration bleue distinctive, signalant que la feuille opère sous un mode d’affichage restreint. L’intégrité de la structure tabulaire est scrupuleusement préservée : aucune donnée n’est détruite, et le rétablissement de la vision intégrale s’opère instantanément par la réinitialisation du filtre.
6.2 Filtres numériques avancés sans colonne intermédiaire
Pour les contextes d’exploitation où l’analyste ne dispose pas de l’autorisation structurelle d’insérer une colonne auxiliaire au sein du classeur — contrainte fréquente dans le cadre de modèles financiers standardisés ou de bases de données normalisées —, Excel propose un mécanisme de filtrage dynamique intégré capable d’évaluer le seuil proportionnel en mémoire vive.
Cette approche tire parti du sous-menu contextuel des filtres numériques avancés. La procédure requiert les étapes suivantes :
- Activer les filtres automatiques sur la colonne de données quantitatives brutes.
- Déployer le menu de filtrage attaché à l’en-tête de cette colonne numérique et pointer le curseur sur la section Filtres numériques.
- Dans le menu contextuel secondaire, sélectionner l’option spécifique 10 premiers….
- Une boîte de dialogue modale intitulée Filtrer les 10 premiers se manifeste à l’écran. Elle comporte trois zones de paramétrage interactives.
- Dans la première liste déroulante, conserver le choix par défaut orienté sur Haut.
- Dans le champ numérique central, s’assurer que la valeur est paramétrée sur 10.
- Dans la dernière liste déroulante, commuter impérativement le mode d’évaluation en remplaçant la modalité Éléments par la modalité Pourcentage.
Cette sélection instruit le moteur de calcul d’Excel d’évaluer instantanément la distribution, de déterminer en tâche de fond le seuil proportionnel correspondant et de masquer toutes les lignes inférieures. Cette méthode présente l’avantage majeur de ne consommer aucun espace de stockage sur la grille de calcul et d’assurer une ségrégation physique immédiate des données sans générer de colonnes parasites.
6.3 Copie conforme et isolation des données extraites
Une fois la sous-population du décile supérieur isolée à l’écran par l’un des mécanismes de filtrage décrits précédemment, l’analyste doit fréquemment exporter ces observations vers un nouvel environnement de travail pour approfondir les investigations ou constituer une archive analytique autonome. Une erreur classique consiste à effectuer un simple copier-coller de la sélection apparente, au risque d’embarquer accidentellement les lignes masquées intercalaires si le logiciel gère imparfaitement le presse-papiers dans certaines configurations système.
Pour garantir une isolation étanche des seules valeurs filtrées, il est indispensable de forcer la sélection des cellules visibles au moyen d’un raccourci clavier dédié. La séquence opératoire optimale se déroule comme suit :
- Sélectionner l’ensemble de la plage filtrée affichée à l’écran.
- Exécuter la combinaison de touches Alt+Point-virgule (sur système Windows) ou solliciter la commande Rechercher et sélectionner > Atteindre > Cellules > Cellules visibles seulement.
- Cette action dessine un liseré blanc fugace autour de chaque bloc continu de cellules visibles, confirmant l’exclusion stricte des segments masqués.
- Effectuer la copie standard via Ctrl+C.
- Basculer vers la feuille de calcul de destination et opérer le collage via Ctrl+V.
L’échantillon supérieur se trouve dès lors totalement émancipé de la structure mère. Les liaisons de calcul volatiles et les dépendances structurelles sont éliminées, figeant les dix pour cent supérieurs dans une table dédiée, prête pour des traitements statistiques poussés ou des restitutions décisionnelles indépendantes.
7. Méthode 3 : Formules matricielles dynamiques modernes (Excel 365 et 2021)
7.1 Extraction automatisée avec la fonction FILTRE
L’avènement du moteur de calcul matriciel dynamique dans les déclinaisons modernes de Microsoft Excel (Microsoft 365 et Excel 2021) a révolutionné le traitement des données en rendant obsolètes les anciennes combinaisons contraignantes basées sur les validations matricielles Ctrl+Maj+Entrée. L’instrument privilégié de cette transformation algorithmique est la fonction FILTRE, qui permet d’extraire dynamiquement des sous-ensembles de données répondant à des critères mathématiques complexes et de propager nativement les résultats dans les cellules contiguës (mécanisme dit de spill ou de propagation matricielle).
Pour extraire l’intégralité des observations se hissant dans les 10 % supérieurs d’une série numérique positionnée dans la plage A2:B101 (où la colonne A contient un identifiant textuel et la colonne B la mesure quantitative), il suffit d’insérer dans une cellule cible vide la formule déclarative suivante :
=FILTRE(A2:B101; B2:B101 >= CENTILE.INC(B2:B101; 0,9); « Aucune observation »)
Le fonctionnement interne de cette formule matricielle dynamique mérite une exégèse détaillée :
- Le premier argument (tableau source) : Définit la matrice complète à restituer en sortie. Il peut s’étendre sur plusieurs colonnes, permettant de récupérer le contexte intégral de chaque individu statistique sélectionné.
- Le second argument (vecteur d’inclusion) : Évalue pour chaque ligne de la colonne B2:B101 le prédicat booléen d’appartenance en le confrontant au résultat scalaire de CENTILE.INC(B2:B101; 0,9). Ce vecteur génère une série de VRAI et FAUX en mémoire vive.
- Le troisième argument (si_vide) : Assure la gestion d’erreur native en renvoyant une chaîne prédéfinie dans l’hypothèse théorique où aucun enregistrement ne satisferait la condition, prévenant l’apparition de l’erreur disgracieuse #CALC!.
La puissance de cette architecture réside dans sa totale réactivité : si les valeurs du tableau source sont modifiées, le seuil quantile est instantanément réévalué et la matrice résultante ajuste automatiquement sa dimension sans aucune intervention manuelle.
7.2 Ordonnancement hiérarchique avec la fonction TRIER
L’extraction brute des dix pour cent supérieurs gagne considérablement en clarté analytique lorsqu’elle est assortie d’un ordonnancement décroissant rigoureux, propulsant les valeurs les plus éminentes au sommet de la matrice résultante. Plutôt que de procéder à un tri destructeur du tableau source — qui altérerait l’ordre chronologique ou séquentiel original des relevés —, la composition de fonctions modernes permet d’ordonner le flux matriciel de manière purement virtuelle.
Cet ordonnancement s’obtient en imbriquant harmonieusement la fonction FILTRE au sein de la fonction matricielle TRIER, selon la syntaxe formelle suivante :
=TRIER(FILTRE(A2:B101; B2:B101 >= CENTILE.INC(B2:B101; 0,9)); 2; -1)
Dans ce montage computationnel sophistiqué :
- La fonction interne FILTRE opère la ségrégation statistique préalable et renvoie la matrice épurée des observations appartenant au décile supérieur.
- La fonction englobante TRIER prend cette matrice en charge comme premier argument d’entrée.
- L’argument numérique 2 spécifie que le critère de classement porte sur la deuxième colonne de la matrice extraite, c’est-à-dire le vecteur quantitatif de mesure.
- L’argument -1 stipule expressément que le tri doit s’effectuer selon un ordre descendant (du plus grand au plus petit), garantissant la mise en exergue immédiate du maximum absolu de la série.
Cette approche sépare radicalement la couche de données brutes de la couche de restitution décisionnelle. L’intégrité du référentiel source est immunisée contre tout risque de corruption physique consécutif à un mauvais réordonnancement de lignes hétérogènes.
7.3 Calcul en mémoire sans colonne auxiliaire
La prévalence des architectures matricielles dynamiques sur les approches traditionnelles s’illustre avec éclat dans l’élimination totale du besoin de colonnes auxiliaires. Dans les versions antérieures d’Excel, la segmentation d’une série imposait la juxtaposition de multiples colonnes techniques hébergeant des formules de rang, des indicateurs logiques ou des calculs de seuils, alourdissant considérablement le schéma relationnel de la feuille de calcul et multipliant les risques de dysfonctionnements liés à des ruptures de cohérence de formules.
Le calcul exécuté intégralement en mémoire vive offre des gains substantiels à plusieurs niveaux opérationnels :
- Optimisation de l’empreinte mémoire : L’absence d’écriture physique de milliers de formules logiques au sein de la grille réduit drastiquement le poids du fichier (exprimé en mégaoctets) et accélère son ouverture et sa sauvegarde sur les serveurs de stockage d’entreprise.
- Propreté visuelle et maintenance logicielle : La feuille de calcul conserve une structure sobre et épurée. Les risques de suppression involontaire d’une formule par un utilisateur non averti sont anéantis, la propagation matricielle bloquant l’édition manuelle des cellules filles situées dans la zone de débordement.
- Performance des pipelines de calcul : Le processeur d’Excel optimise l’allocation des threads d’exécution (calcul multithread) lors de l’évaluation des fonctions matricielles vectorisées, surpassant largement le traitement itératif séquentiel cellule par cellule.
Ces avancées technologiques positionnent les formules matricielles dynamiques comme la méthodologie de référence pour concevoir des tableaux de bord académiques et managériaux automatisés, associant une robustesse mathématique irréprochable à une adaptabilité structurelle parfaite.
8. Méthode 4 : Approche par les fonctions de rang relatif et de quantification
8.1 Calcul de la position relative avec RANG.POURCENTAGE
En dehors des fonctions calculant directement la valeur scalaire d’un centile, l’infrastructure statistique d’Excel intègre des fonctions de quantification ordinale inversée, au sein desquelles la fonction RANG.POURCENTAGE.INC occupe une place de choix. Alors que la fonction CENTILE.INC répond à la question « Quelle est la valeur numérique qui coupe les données au 90e centile ? », RANG.POURCENTAGE.INC résout l’interrogation duale : « Quel est le pourcentage cumulé de la distribution se situant sous une valeur donnée ? ».
La syntaxe de cette fonction s’énonce comme suit :
=RANG.POURCENTAGE.INC(matrice; x; [précision])
Pour évaluer si une observation située dans la cellule A2 intègre le décile sommital d’une distribution couvrant la plage $A$2:$A$101, on formulera le test logique :
=RANG.POURCENTAGE.INC($A$2:$A$101; A2) >= 0,9
La fonction retourne une fraction décimale comprise entre 0 et 1, représentant le rang proportionnel de la valeur x par rapport à l’ensemble de la distribution. Toute cellule dont le résultat égale ou excède 0,90 appartient rigoureusement aux 10 % supérieurs. Cette fonction gère nativement l’interpolation linéaire pour les valeurs qui ne coïncident pas parfaitement avec un point de mesure empirique et résout avec une grande élégance la hiérarchisation des observations, bien qu’elle demeure calculatoirement plus lourde lors de son exécution sur des matrices volumineuses en raison de sa complexité algorithmique intrinsèque.
8.2 Utilisation conjointe des fonctions RANG et NB
Une alternative méthodologique robuste pour circonscrire le décile supérieur repose sur la quantification ordinale discrète au moyen des fonctions conjointes RANG.EQ (ou sa variante classique RANG) et NB. Cette approche s’avère particulièrement prisée dans les contextes où l’analyste souhaite imposer une sélection fondée sur un comptage cardinal strict dérivé du pourcentage global de la cohorte, s’affranchissant ainsi des subtilités d’interpolation des centiles continus.
La condition logique s’exprime alors par la formule combinatoire suivante, implémentée en ligne 2 :
=RANG.EQ(A2; $A$2:$A$101; 0) <= ARRONDI(NB($A$2:$A$101) * 0,1; 0)
La décomposition analytique de cette construction met en relief deux temps opératoires majeurs :
- Détermination du rang ordinal descendant : La fonction RANG.EQ(A2; $A$2:$A$101; 0) calcule la position hiérarchique absolue de la cellule au sein de la population classée par ordre décroissant (le paramètre 0 stipulant que la valeur la plus colossale reçoit le rang ordinal 1).
- Calcul de la borne cardinale proportionnelle : L’expression ARRONDI(NB($A$2:$A$101) * 0,1; 0) évalue dynamiquement le nombre total de cellules numériques peuplées via NB, multiplie ce volume par le ratio de 10 %, puis arrondit le résultat à l’entier arithmétique le plus proche pour fixer la limite supérieure du classement admissible.
Dans les situations impliquant des ex æquo fréquents, il convient de noter que RANG.EQ attribue le rang minimal identique à l’ensemble des doublons. Pour des protocoles exigeant une gestion probabiliste plus fine, la fonction alternative RANG.MOYENNE peut être sollicitée ; elle calcule la moyenne arithmétique des rangs que les observations identiques auraient occupés si elles avaient été légèrement dissociées, offrant ainsi un traitement mathématique particulièrement équitable des situations de concurrence statistique.
8.3 Comparaison méthodologique entre les centiles et les rangs relatifs
Le choix entre l’approche continue (fonctions CENTILE) et l’approche ordinale discrète (fonctions de RANG) soulève un débat méthodologique substantiel relatif à la granularité mathématique des algorithmes. Bien que ces deux voies convergent généralement vers des résultats identiques sur des séries amples et régulières, des divergences significatives se font jour en présence de distributions asymétriques, discontinues ou grevées d’ex æquo multiples.
Le modèle des centiles (CENTILE.INC) est un estimateur paramétrique indirect fondé sur l’hypothèse sous-jacente d’une continuité statistique : il détermine une valeur critique de coupure par interpolation linéaire, puis teste si les données franchissent cette ligne de démarcation continue. De son côté, la méthode du rang ordinal (RANG.EQ combiné à NB) est une technique purement non-paramétrique et discrète : elle ordonne les individus de manière séquentielle et tranche chirurgicalement à la k-ième observation admissible, sans formuler aucune hypothèse sur la distance d’échelle qui sépare les valeurs ordonnées.
Dans un contexte d’audit réglementaire, d’évaluation de la performance commerciale ou de conformité statistique, l’analyste doit expressément expliciter la méthode mobilisée. L’usage de CENTILE.INC sera privilégié lorsque la donnée est perçue comme la manifestation discrète d’un phénomène physique continu (ex. températures, tensions électriques, concentrations chimiques). En revanche, l’utilisation de RANG.EQ s’imposera dès lors que les données procèdent d’un inventaire intrinsèquement discret ou financier (ex. classements boursiers, concours de recrutement, attributions de quotas fixes de médailles) où la position ordinale brute prime sur l’interpolation d’échelle.
9. Automatisation du traitement des données via Power Query
9.1 Importation et profilage de la colonne dans le moteur Power Query
Pour le traitement de bases de données volumineuses ou l’intégration au sein de processus d’extraction, de transformation et de chargement (ETL) récurrents, le moteur Power Query intégré à Excel surpasse largement les formules de feuille de calcul classiques. Power Query isole l’ensemble des transformations au sein d’un pipeline déclaratif reproductible et immuable, garantissant que les données sources ne subissent aucune modification accidentelle.
La première phase opérationnelle consiste à importer la série de données dans l’environnement Power Query via la commande Données > À partir d’un tableau/d’une plage. Dès l’ouverture de l’éditeur de requêtes, il est fondamental de s’assurer du typage précis de la variable numérique. L’analyste cliquera sur l’icône de type logée dans l’en-tête de colonne pour sélectionner sans ambiguïté la modalité Nombre décimal ou Nombre entier.
Power Query déploie par ailleurs des outils de profilage avancés via l’onglet Affichage, notamment les fonctionnalités Qualité des colonnes, Distribution des colonnes et Profil de la colonne. Ces instruments analytiques révèlent instantanément le taux d’erreurs, la proportion de cellules vides, le nombre de valeurs distinctes et la présence de doublons structurels. Cette inspection visuelle prévient l’intégration de valeurs aberrantes susceptibles de fausser le calcul mathématique du centile supérieur lors des étapes ultérieures de la transformation M.
9.2 Calcul dynamique du quantile seuil en langage M
L’extraction des dix pour cent supérieurs dans Power Query requiert le calcul du 90e percentile directement au sein du langage d’évaluation sous-jacent (le langage M). Contrairement à l’interface graphique standard qui propose des filtres de lignes fixes, le recours à une fonction statistique M native garantit que le seuil de coupure est recalculé dynamiquement à chaque exécution du pipeline en fonction du volume réel des données ingérées.
La séquence algorithmique en langage M se structure autour des étapes suivantes :
- Extraction de la colonne numérique sous forme de liste native au moyen de l’expression : MaListe = Table.Column(EtapePrecedente, « NomColonne »).
- Évaluation déterministe du 90e percentile par la fonction native : Seuil90 = List.Percentile(MaListe, 0.9). Cette fonction implémente par défaut l’algorithme standard d’interpolation inclusive.
- Filtrage conditionnel de la table source via la fonction de sélection de lignes, en confrontant la colonne au scalaire préalablement instancié : LignesFiltrees = Table.SelectRows(EtapePrecedente, each [NomColonne] >= Seuil90).
Cette méthodologie présente l’avantage décisif d’encapsuler la valeur scalaire de référence au sein d’une variable éphémère du pipeline de calcul. Le modèle s’affranchit ainsi de toute référence circulaire, tandis que la lisibilité du flux de données demeure exemplaire grâce à l’enchaînement linéaire des étapes M documentées.
9.3 Chargement et actualisation transparente du modèle de données
La phase conclusive de la démarche Power Query réside dans la restitution contrôlée des données filtrées au sein du classeur Excel. L’analyste sollicitera la commande Fermer et charger dans…, logée sur l’onglet Accueil de l’éditeur, pour déterminer les modalités d’intégration du flux final.
Deux options architecturales principales s’offrent à l’utilisateur :
- Chargement sous forme de tableau : Les lignes correspondant aux dix pour cent supérieurs sont restituées sous la forme d’un tableau structuré autonome au sein d’une feuille de calcul dédiée. Ce tableau constitue une extraction propre, totalement découplée de la source brute.
- Chargement exclusif dans le modèle de données (Power Pivot) : Si le volume d’enregistrements excède la limite physique de la grille Excel (1 048 576 lignes), les données sont injectées directement dans le moteur tabulaire en mémoire xVelocity sous forme de connexion seule, autorisant des analyses sur des dizaines de millions d’observations.
Le bénéfice industriel d’une telle implémentation réside dans son actualisation transparente : dès lors que de nouvelles données sont versées dans le référentiel source, un simple clic droit sur le tableau de sortie suivi de la commande Actualiser (ou le raccourci Alt+F5) déclenche l’exécution complète du pipeline. Le seuil de décile est recalculé, les lignes sous-jacentes sont réévaluées et l’échantillon terminal est instamment mis à jour sans nécessiter la moindre intervention logicielle manuelle.
10. Exploitation des tableaux croisés dynamiques pour l’analyse des déciles
10.1 Structuration du tableau croisé dynamique pour l’analyse de fréquence
Le tableau croisé dynamique (TCD) constitue l’instrument d’exploration multidimensionnelle par excellence au sein de la suite bureautique d’Office. Bien que traditionnellement orienté vers l’agrégation comptable et le calcul de sommes ou de moyennes récapitulatives, le TCD peut être configuré de manière ingénieuse pour étudier la morphologie de dispersion d’une variable continue et observer la distribution de fréquence menant au décile supérieur.
Pour ériger cette matrice d’observation structurelle :
- Insérer un tableau croisé dynamique vierge pointant vers le tableau de données quantitatives source.
- Glisser la variable numérique étudiée au sein de la zone des Lignes de la disposition du TCD. Chaque valeur distincte forme ainsi une ligne unique ordonnée de la matrice.
- Glisser une seconde fois cette même variable numérique au sein de la zone des Valeurs.
- Modifier les paramètres du champ de valeur pour commuter le mode d’agrégation : remplacer la commande Somme par la fonction de comptage Nombre (ou Nb), révélant l’effectif unitaire attaché à chaque niveau d’amplitude.
- Déployer l’onglet Afficher les valeurs dans les paramètres du champ et sélectionner l’option % du total cumulé dans… en retenant la variable numérique comme champ de base.
Cette configuration génère instantanément la courbe empirique de distribution cumulative de la variable. L’analyste peut ainsi faire défiler la table pour identifier visuellement la ligne précise où le pourcentage cumulé franchit la borne des 90 %, matérialisant avec une clarté exemplaire la bascule vers les dix pour cent supérieurs de la série statistique.
10.2 Application des filtres d’étiquettes et de valeurs des 10 premiers
Au-delà de la simple analyse de fréquence cumulative, les tableaux croisés dynamiques incorporent un sous-système de filtrage contextuel d’une redoutable efficacité pour masquer instantanément la masse des données inférieures et ne restituer que les entités d’élite de la distribution.
Pour mettre en œuvre ce filtrage sélectif :
- Cliquer sur la flèche de déploiement de l’en-tête de ligne abritant la dimension d’intérêt.
- Pointer le curseur vers la catégorie de filtres intitulée Filtres s’appliquant aux valeurs.
- Dans l’arborescence contextuelle, sélectionner l’option 10 premiers….
- Dans la fenêtre de dialogue qui s’ouvre, configurer la triade de paramètres : conserver Haut, stipuler la valeur quantitative 10, puis basculer impérativement l’unité de mesure de droite sur Pourcentage.
- Vérifier dans le menu déroulant d’évaluation que le filtre s’applique bien sur l’indicateur métrique pertinent (somme du chiffre d’affaires, marge nette ou volume de production).
Le moteur d’agrégation du TCD restructure alors l’affichage pour n’exposer que les modalités dont l’accumulation contribue aux dix pour cent de l’indicateur sélectionné. Il convient néanmoins de prêter une attention rigoureuse à cette distinction : dans un TCD, le filtre des « 10 % » applique généralement un seuil sur la somme globale de la métrique (les éléments contribuant aux 10 % de la masse cumulée) plutôt que sur le comptage ordinal pur des individus, une nuance fondamentale qu’il convient de maîtriser pour ne pas biaiser les conclusions de l’étude.
10.3 Limites inhérentes à l’agrégation dans les tableaux croisés dynamiques
L’utilisation des tableaux croisés dynamiques traditionnels pour le calcul de centiles précis se heurte à une limitation logicielle historique du moteur d’analyse standard d’Excel. Dans les versions de TCD opérant sans le modèle de données sous-jacent, il n’existe aucune fonction native d’agrégation capable de calculer directement un percentile au niveau des champs de valeurs, la bibliothèque se cantonnant aux fonctions classiques (Somme, Nombre, Moyenne, Max, Min, Écart-type).
De surcroît, lorsque l’analyste applique des regroupements de classes numériques (via la commande Grouper pour créer des tranches d’amplitudes fixes de 10 en 10 ou de 100 en 100), la granularité de la distribution unitaire est irrévocablement dissoute dans l’intervalle agrégé. L’identification du 90e percentile devient alors dépendante de la largeur arbitraire de la classe de groupement, empêchant toute mesure de coupure fine au décimal près.
Pour s’émanciper de ce carcan fonctionnel, il s’avère indispensable d’activer l’environnement Power Pivot lors de la création du tableau croisé dynamique en cochant la case Ajouter ces données au modèle de données. Cette passerelle technologique autorise l’écriture de mesures personnalisées en langage d’analyse décisionnelle DAX (Data Analysis Expressions). Au moyen de fonctions avancées telles que PERCENTILE.INC ou PERCENTILEX.INC, l’analyste peut alors évaluer des centiles stricts au sein de TCD hautement dynamiques, fusionnant ainsi la puissance de calcul non-paramétrique avec la souplesse d’agrégation multidimensionnelle du tableau croisé.
11. Automatisation programmatique par macros et scripts VBA
11.1 Écriture d’une procédure standard de calcul de percentile
Dans le cadre de l’ingénierie logicielle appliquée aux classeurs Excel, l’automatisation par macros au moyen de Visual Basic for Applications (VBA) offre un contrôle total sur l’exécution des calculs, l’instanciation des variables système et la manipulation des structures de données. Le langage VBA permet d’appeler directement les fonctions statistiques de la bibliothèque du tableur via l’objet global WorksheetFunction.
Une implémentation standard dédiée au calcul du 90e percentile et à l’extraction de la valeur seuil se structure autour du paradigme algorithmique suivant :
L’analyste instancie une procédure nommée qui commence par dimensionner rigoureusement ses variables de travail : un objet Range destiné à pointer vers la colonne de mesures brutes, une variable de type Double pour stocker la valeur seuil du 90e percentile, et une variable de boucle Long pour parcourir les enregistrements. Le code pointe vers la plage active, puis exécute la fonction statistique via l’instruction : seuilQuantile = Application.WorksheetFunction.Percentile_Inc(plageSource, 0.9).
La robustesse de ce script repose sur une gestion méthodique des exceptions d’exécution via le bloc défensif On Error. En présence de cellules contenant des chaînes textuelles inattendues ou des valeurs d’erreur du type #DIV/0!, l’appel standard à WorksheetFunction provoque une rupture brutale du programme. L’interception de ces anomalies au moyen d’un gestionnaire d’erreur garantit la continuité de l’exécution et permet de notifier l’utilisateur de la présence d’artéfacts de données sans interrompre le cycle de traitement du classeur.
11.2 Application dynamique de surbrillance et de filtrage via le code
L’un des avantages majeurs de l’automatisation VBA réside dans sa capacité à opérer des ségrégations physiques ou visuelles sans alourdir le classeur d’objets conditionnels volatils persistants. Le code peut appliquer une surbrillance chromatique directe sur les cellules répondant au critère de manière ponctuelle et définitive, ou déclencher un filtrage automatique optimisé.
Sur le plan de la haute performance computationnelle, le parcours séquentiel cellule par cellule (via une boucle itérative For Each Cell In Range) doit être formellement banni sur les volumétries conséquentes en raison du coût prohibitif des accès récurrents au sous-système COM d’Excel. La meilleure pratique de programmation consiste à charger l’intégralité de la colonne source au sein d’un tableau vectoriel dimensionné en mémoire vive (un Variant Array). Le traitement arithmétique de comparaison face au seuil s’opère alors à la vitesse du processeur au sein de la structure de données volatile.
À l’issue de cette boucle en mémoire :
- Pour une application visuelle : Le script consolide les références des cellules qualifiées au sein d’un objet Range unifié via la méthode Application.Union, puis applique la coloration d’arrière-plan en un seul appel d’écriture global sur l’interface graphique.
- Pour un filtrage physique : Le script invoque directement la méthode AutoFilter sur la plage cible en lui assignant pour critère textuel : Criteria1:= »>= » & Replace(CStr(seuilQuantile), « , », « . »), adaptant dynamiquement le séparateur décimal à la locale du système pour masquer instantanément les lignes sous-jacentes.
Cette approche hybride garantit un temps d’exécution quasi-instantané, y compris sur des séries comportant plusieurs centaines de milliers d’enregistrements, éliminant tout ralentissement de l’application hôte.
11.3 Développement d’une fonction personnalisée (UDF)
Pour doter les utilisateurs finaux d’un instrument analytique sur mesure et standardiser l’évaluation des extrêmes au sein d’une organisation, le développement d’une fonction personnalisée — désignée sous l’acronyme d’UDF (User Defined Function) — constitue une architecture de choix. Cette méthodologie permet d’étendre le vocabulaire natif de la grille Excel en introduisant une fonction spécialisée dont la sémantique explicite l’objectif métier.
L’architecture d’une telle fonction, baptisée par exemple EST_DANS_TOP10, reçoit deux paramètres formels en entrée : la cellule singulière faisant l’objet de l’évaluation scalaire, et la plage globale constituant la population statistique de référence. Le corps fonctionnel de l’UDF procède de la manière suivante :
- Évaluation défensive : La fonction vérifie immédiatement que la cellule candidate et la matrice de référence abritent bien des grandeurs numériques, renvoyant l’erreur formelle CVErr(xlErrValue) en cas de non-conformité.
- Détermination en mémoire : L’algorithme calcule le seuil du 90e percentile sur la matrice transmise via l’appel sous-jacent Percentile_Inc.
- Attribution booléenne : Si la valeur de la cellule évaluée est supérieure ou égale au seuil calculé, la fonction retourne la valeur booléenne True ; dans le cas contraire, elle renvoie False.
Une fois compilée dans un module standard ou encapsulée au sein d’un complément d’extension Excel (.xlam) distribué sur le réseau d’entreprise, cette fonction personnalisée peut être appelée directement dans n’importe quelle cellule du classeur sous la syntaxe intuitive : =EST_DANS_TOP10(B2; $B$2:$B$1000). Cette abstraction logicielle masque la complexité algorithmique sous-jacente aux yeux des opérationnels, fiabilise les processus de contrôle de gestion et prévient les erreurs de retranscription des formules matricielles complexes.
12. Synthèse méthodologique, validation des résultats et bonnes pratiques académiques
12.1 Tableau comparatif des différentes approches présentées
Le choix de la méthode idoine pour isoler les 10 % des valeurs les plus élevées au sein d’une colonne Excel procède d’un arbitrage minutieux entre plusieurs critères opérationnels : le niveau de technicité requis, l’impact sur les performances computationnelles de la machine, la réactivité face aux mises à jour de données et la compatibilité descendante avec les versions historiques du tableur. Le tableau synthétique suivant structure cette évaluation croisée afin d’orienter les praticiens vers la solution la plus pertinente selon le contexte d’ingénierie rencontré.
Chaque méthodologie dispose d’un écosystème d’application préférentiel :
- Mise en forme conditionnelle native : Idéale pour l’audit exploratoire immédiat, la présentation visuelle informelle et les jeux de données restreints (< 5 000 lignes). Elle souffre néanmoins d’un coût computationnel prohibitif sur les grands volumes et ne garantit pas une extraction persistante des enregistrements.
- Colonne booléenne avec CENTILE.INC : Constitue le standard universel de l’analyste pour tous les classeurs de production. Alliant simplicité conceptuelle, transparence algorithmique et compatibilité intégrale avec l’ensemble des versions d’Excel depuis 2010, elle sert de socle fiable pour le filtrage et les agrégations conditionnelles ultérieures.
- Formules matricielles dynamiques (FILTRE/TRIER) : Représentent la solution d’excellence sur les versions contemporaines (Microsoft 365 et Excel 2021+). Elles permettent une ségrégation physique sans altération du tableau source, n’imposent aucune colonne parasite et recalculent instantanément l’assiette du centile en mémoire vive.
- Pipeline Power Query (Langage M) : Forme l’approche industrielle incontournable pour les volumétries d’envergure (> 100 000 lignes), les données issues de sources externes hétérogènes et les processus décisionnels récurrents exigeant une traçabilité d’audit inaltérable.
- Scripting et procédures VBA : Réservés aux environnements automatisés spécialisés où l’analyste doit piloter des flux de travail multi-applicatifs, appliquer des surbrillances non volatiles ou concevoir des outils d’entreprise sur mesure via des fonctions personnalisées.
Ce comparatif méthodique démontre qu’aucune approche ne détient une supériorité absolue universelle : l’ingénieur de données aguerri doit sélectionner son outil technique en parfaite adéquation avec les contraintes d’architecture logicielle et les objectifs analytiques finaux de son organisation.
12.2 Protocole de contrôle et d’audit de conformité statistique
L’implémentation d’une formule statistique sur une feuille de calcul ne dispense en aucun cas le praticien d’un contrôle de conformité systématique. La confiance aveugle accordée aux sorties automatisées d’Excel constitue l’une des causes prépondérantes d’erreurs dans les rapports décisionnels et scientifiques. Tout calcul de centile doit obligatoirement être validé par un protocole de test formel certifiant l’intégrité de la proportion retenue.
Le premier niveau de vérification consiste à implémenter une cellule de contrôle calculant le ratio réel de sélection. En supposant que les données d’origine occupent la plage A2:A101 et que la colonne booléenne d’appartenance réside en B2:B101, l’analyste formulera le contrôle suivant :
=NB.SI($B$2:$B$101; VRAI) / NB($A$2:$A$101)
Le résultat de ce quotient doit converger rigoureusement vers la valeur décimale 0,10 (soit 10 %). Tout écart supérieur à une marge de tolérance arithmétique acceptable — explicable par la division discrète de l’échantillon — doit déclencher un audit immédiat :
- Si le ratio s’effondre sous le seuil théorique de 10 %, il convient de vérifier si des cellules numériques ne sont pas corrompues par un encodage textuel ignoré par la fonction CENTILE.INC, ou si le filtre logique n’a pas été formulé avec une inégalité stricte erronée (> au lieu de >=).
- Si le ratio explose au-delà de 10 %, la présence massive d’ex æquo alignés précisément sur la valeur du seuil de coupure doit être immédiatement investiguée au moyen de la fonction NB.SI ciblant la valeur seuil calculée.
Dans un rapport de recherche ou une publication académique, il est impératif d’intégrer une note méthodologique explicitant l’algorithme d’interpolation retenu (ex. inclusivement linéaire selon la norme NIST/Weibull), le mode de départage des doublons à la frontière, ainsi que le volume exact d’observations sélectionnées rapporté à la population totale.
12.3 Préservation de l’intégrité et archivage des données d’analyse
L’ultime étape d’une analyse quantitative rigoureuse réside dans la pérennisation et l’archivage sécurisé des conclusions extraites. Les modèles de calcul dynamiques, bien qu’indispensables durant la phase de production et d’exploration, portent en eux une vulnérabilité temporelle : l’altération involontaire d’une cellule source, la modification d’un paramètre régional de calcul ou la réouverture du fichier sur une version logicielle divergente peut déclencher des recalculs imprévus et modifier l’échantillon des dix pour cent supérieurs a posteriori.
Pour immuniser les conclusions d’une étude contre ce risque d’instabilité, les règles de gouvernance des données préconisent d’opérer un gel définitif des données destinées à l’archivage réglementaire :
- Dupliquer la feuille de calcul active hébergeant les résultats filtrés ou matriciels.
- Sélectionner l’ensemble de la matrice résultante et appliquer la commande de conversion des formules en constantes statiques via le menu Copier > Collage spécial > Valeurs. Cette opération brise les dépendances mathématiques volatiles tout en préservant l’intégrité absolue des observations historisées.
- Documenter les métadonnées du classeur au sein d’un onglet d’en-tête dédié : y mentionner la date et l’heure précises de l’extraction, la version exacte d’Excel exploitée, l’empreinte de la formule algorithmique originale, ainsi que l’auteur de la modélisation.
- Protéger la feuille d’archivage contre toute édition ultérieure au moyen d’un mot de passe de verrouillage structurel (via le ruban Révision > Protéger la feuille), assurant la conformité du document avec les protocoles de traçabilité des données d’entreprise et les normes de publication scientifique.
En respectant scrupuleusement ces impératifs de rigueur, l’analyste garantit que la détermination des dix pour cent des valeurs les plus élevées d’une colonne Excel ne constitue pas une simple manipulation opportuniste de tableur, mais s’érige en un processus d’ingénierie analytique méthodique, reproductible et scientifiquement inattaquable.
Références
- Dodge, Y. (2007). Statistique : Dictionnaire encyclopédique (2e éd.). Springer Paris. https://doi.org/10.1007/978-2-287-47864-2
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Institut National de la Statistique et des Études Économiques. (2021). Définition des centiles et déciles. Insee. https://www.insee.fr/fr/metadonnees/definition/c1458
- Microsoft Corporation. (2024). Fonction CENTILE.INC. Support Microsoft 365. https://support.microsoft.com/fr-fr/office/centile-inc-fonction-centile-inc-680f9539-45eb-4107-9ea6-a39a750076d6
- Microsoft Corporation. (2024). Fonction FILTRE. Support Microsoft 365. https://support.microsoft.com/fr-fr/office/filtre-fonction-filtre-f4f7cb66-c82d-428b-8c47-4e5c47710829
- Microsoft Corporation. (2024). Fonction RANG.POURCENTAGE.INC. Support Microsoft 365. https://support.microsoft.com/fr-fr/office/rang-pourcentage-inc-fonction-rang-pourcentage-inc-de22a264-e18c-4f9d-a949-16526f29669a
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods: Percentiles. NIST. https://www.itl.nist.gov/div898/handbook/prc/section2/prc262.htm
- Saporta, G. (2011). Probabilités, analyse des données et statistique (3e éd.). Éditions Technip.
- W3C Web Accessibility Initiative. (2023). Web Content Accessibility Guidelines (WCAG) 2.2. World Wide Web Consortium. https://www.w3.org/TR/WCAG22/
- Winston, W. (2021). Microsoft Excel Data Analysis and Business Modeling (Office 2021 and Microsoft 365) (7th ed.). Microsoft Press.