
Dans le domaine de l’analyse quantitative et de la recherche en sciences comportementales, l’inférence statistique constitue le socle méthodologique sur lequel reposent la validation d’hypothèses et l’interprétation des données expérimentales. Qu’il s’agisse d’évaluer l’impact d’une prise en charge neuropsychologique, de mesurer l’évolution de traits latents à travers des batteries de tests standardisés ou de comparer les performances cognitives de cohortes cliniques, le recours aux tests d’hypothèses demeure une démarche incontournable. Au cœur de ce processus décisionnel se trouve la détermination rigoureuse de seuils d’acceptation et de rejet, formalisés par le calcul de valeurs critiques.
Parmi les distributions théoriques couramment mobilisées, la loi normale centrée réduite occupe une place centrale en raison de ses propriétés d’invariance et de convergence asymptotique. La valeur critique de Z, qui délimite la zone de rejet de l’hypothèse nulle pour un niveau de risque d’erreur consenti, requiert une précision numérique irréprochable. Si les tables statistiques imprimées ont longtemps constitué l’unique outil de référence pour les chercheurs et praticiens, l’intégration des fonctionnalités de calcul moderne au sein de logiciels généralistes a profondément transformé les pratiques de laboratoire. Microsoft Excel s’impose aujourd’hui comme un environnement accessible et puissant, capable de modéliser avec exactitude ces grandeurs probabilistes.
Cependant, la manipulation des fonctions statistiques dans un tableur nécessite une compréhension approfondie de leur architecture algorithmique sous-jacente, de leurs paramètres régionaux et des postulats théoriques qui régissent leur application. Une mauvaise appréciation de l’orientation d’un test, une confusion entre probabilité unilatérale et bilatérale, ou une méconnaissance de la syntaxe propre aux versions linguistiques du logiciel peuvent engendrer des biais décisionnels majeurs. Cet article propose un examen exhaustif, théorique et pragmatique, de la recherche et du calcul de la valeur critique de Z dans Excel, guidé par les exigences méthodologiques et académiques de la psychométrie et de la psychologie computationnelle.
1. Fondements théoriques de la valeur critique Z dans les tests d’hypothèses psychologiques
1.1 Définition de la statistique de test et du score Z standardisé
La statistique de test standardisée, communément désignée sous le terme de score Z ou valeur Z, représente une transformation mathématique fondamentale visant à convertir une mesure brute observée en un écart relatif exprimé en unités d’écart-type. Cette transformation linéaire, définie par la relation fondamentale reliant l’écart à la moyenne sur l’écart-type théorique, confère à la variable transformée des propriétés remarquables : une espérance mathématique strictement nulle et une variance égale à l’unité. En formalisant cette opération, la statistique de test extrait la mesure observée de son unité physique d’origine pour l’inscrire sur une échelle universelle et adimensionnelle, facilitant ainsi les calculs probabilistes subséquents.
Dans le cadre de l’inférence scientifique, le rôle de la statistique de test consiste à quantifier avec exactitude l’éloignement empirique existant entre les observations issues d’un échantillon expérimental et les prédictions dérivées d’un modèle théorique postulé sous l’hypothèse nulle. Plus l’écart absolu entre la métrique empirique et l’attente théorique est substantiel, plus la statistique de test adopte une magnitude extrême, suggérant que le hasard de l’échantillonnage ne saurait expliquer commodément la divergence constatée. Cette métrique devient ainsi l’indicateur central par lequel le chercheur jauge la plausibilité du statu quo.
En psychologie comportementale et en psychométrie, cette standardisation s’avère particulièrement précieuse. Elle autorise la comparaison immédiate de données recueillies au moyen d’échelles de mesure hétérogènes, telles que des scores d’anxiété évalués par le State-Trait Anxiety Inventory et des temps de réaction chronométriques mesurés en millisecondes. En affranchissant les distributions de leurs artéfacts métrologiques respectifs, le score Z permet une mise en perspective inter-études indispensable à l’agrégation méta-analytique des résultats de recherche.
Sur le plan épistémologique, il convient d’opérer une distinction rigoureuse entre la statistique observée, calculée à partir des données récoltées auprès d’un échantillon fini, et la valeur seuil théorique, ou valeur critique. Tandis que la première constitue une quantité empirique aléatoire dépendante de la variabilité d’échantillonnage, la seconde est une constante probabiliste déterministe, dérivée a priori de la distribution théorique choisie et du niveau de risque accepté par l’expérimentateur. La confrontation de ces deux grandeurs fonde la logique même du rejet ou du maintien de l’hypothèse nulle.
1.2 La loi normale centrée réduite en psychométrie et sciences comportementales
La mobilisation de la loi normale centrée réduite, également qualifiée de distribution gaussienne standard, repose en sciences humaines sur le postulat distributionnel de la normalité des traits latents. Dans les paradigmes de la théorie classique des tests comme dans les modèles de réponse aux items, les aptitudes cognitives, les dimensions de personnalité et les compétences mnésiques sont postulées comme étant réparties de manière continue et symétrique au sein des populations générales. Ce cadre théorique justifie l’utilisation des propriétés géométriques de la courbe en cloche pour formaliser la distribution des performances individuelles.
La distribution gaussienne standard se caractérise par des propriétés de symétrie axiale parfaite autour de son centre, où coïncident rigoureusement la moyenne, la médiane et le mode. De surcroît, elle présente un aplatissement mésokurtique théorique et une décroissance exponentielle de sa densité de probabilité au fur et à mesure que l’on s’écarte de l’origine. L’intégration de sa fonction de densité sur l’ensemble de la droite réelle converge asymptotiquement vers l’unité, propriété obligatoire pour satisfaire les axiomes fondamentaux des probabilités formulés par Kolmogorov.
L’assise formelle de cette distribution dans les protocoles expérimentaux découle directement du théorème central limite. Ce principe mathématique stipule que la somme ou la moyenne arithmétique d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées converge en loi vers une distribution normale, indépendamment de la forme des lois parentes initiales, dès lors que la variance sous-jacente demeure finie. Dans les recherches comportementales, où une multitude de déterminants génétiques, environnementaux et contextuels interagissent pour produire une performance mesurable, l’agrégation de ces micros-effets engendre tout naturellement des distributions empiriques hautement assimilables au modèle normal.
Néanmoins, les chercheurs doivent rester conscients des limites inhérentes à l’application aveugle de ce postulat. Certaines mesures cliniques, telles que les scores de dépression sévère dans une cohorte non clinique ou la latence de traitement face à des stimuli phobogènes, exhibent régulièrement une asymétrie positive marquée ou des structures bimodales. Dans de telles configurations, l’adhésion non critique au modèle de la loi normale centrée réduite risque de biaiser considérablement les inférences et impose le recours à des ajustements correctifs ou à des modélisations non paramétriques alternatives.
1.3 Le seuil de significativité alpha et le risque d’erreur de première espèce
Dans la formalisation probabiliste des tests d’hypothèses, le seuil de significativité, traditionnellement noté par la lettre grecque alpha, incarne la probabilité tolérée de rejeter à tort l’hypothèse nulle alors que celle-ci est fondamentalement vraie dans la population cible. Cette défaillance de jugement constitue l’erreur de type I, ou erreur de première espèce. Elle caractérise la fausse découverte scientifique, situation dans laquelle un expérimentateur conclut à l’existence d’une différence systématique ou d’un effet thérapeutique alors que la variation observée n’est que le fruit des fluctuations aléatoires d’échantillonnage.
Historiquement initiées par Ronald Fisher puis intégrées dans le cadre décisionnel strict de Jerzy Neyman et Egon Pearson, les conventions méthodologiques fixent fréquemment le seuil alpha à des niveaux prédéfinis : 0,05, 0,01 ou occasionnellement 0,10 lors d’études exploratoires. Dans la recherche expérimentale contemporaine, la convention alpha = 0,05 signifie que le chercheur consent à un risque maximal de 5 % de déclarer à tort un résultat statistiquement significatif. L’abaissement à 0,01 traduit une exigence de robustesse accrue, souvent requise dans les essais cliniques pharmacologiques ou les protocoles de génétique comportementale.
La fixation d’un seuil alpha impose invariablement un compromis statistique avec l’erreur de seconde espèce, notée bêta, qui représente la probabilité de ne pas rejeter l’hypothèse nulle alors qu’un effet réel existe effectivement. La puissance statistique d’une expérience, formalisée par l’expression 1 – bêta, mesure la capacité d’un protocole à déceler un phénomène substantiel. Réduire le seuil alpha sans accroître corrélativement la taille de l’échantillon détériore mécaniquement la puissance statistique, augmentant ainsi le risque d’occulter des avancées scientifiques légitimes au profit d’un conservatisme méthodologique excessif.
Sur le versant éthique et sociétal, la gestion du risque d’erreur de première espèce se situe au centre de la crise de la réplicabilité qui secoue les sciences comportementales depuis plus d’une décennie. La dissémination d’études rapportant des faux positifs a pollué la littérature de théories fragiles, incapables d’être reproduites de manière indépendante. La maîtrise algorithmique des seuils critiques et la stricte déclaration a priori du risque alpha s’avèrent indispensables pour préserver l’intégrité de la production scientifique et pérenniser la validité des protocoles de recherche clinique.
2. Architecture des fonctions statistiques d’Excel pour le calcul de la valeur critique Z
2.1 La fonction NORM.S.INV et son pendant francophone LOI.NORMALE.STANDARD.INVERSE
Le calcul de la valeur critique Z dans les éditions contemporaines de Microsoft Excel repose sur l’implémentation de la fonction d’inversion de la distribution normale standard cumulative, répertoriée sous l’appellation anglophone NORM.S.INV et traduite en français sous la nomenclature LOI.NORMALE.STANDARD.INVERSE. Cette fonction mathématique opère en tant que fonction quantile continue, acceptant en paramètre une mesure de probabilité cumulée et renvoyant la valeur scalaire précise de l’abscisse Z telle que l’intégrale de la fonction de densité de moins l’infini jusqu’à Z corresponde rigoureusement à ladite probabilité.
L’argument unique exigé par cette fonction est une valeur de probabilité comprise strictement dans l’intervalle ouvert ]0, 1[. L’insertion d’une valeur extérieure à ce domaine de validité, qu’elle soit négative, nulle ou supérieure ou égale à l’unité, provoque une interruption immédiate du calcul et génère le code d’erreur standardisé de domaine d’Excel. La fonction est conçue pour modéliser une intégration partant de la queue asymptotique gauche de la distribution jusqu’au point de coupure spécifié, ce qui implique une interprétation scrupuleuse de l’aire cumulative fournie en argument selon la nature unilatérale ou bilatérale du test projeté.
D’un point de vue algorithmique, le moteur de calcul d’Excel n’effectue pas une intégration numérique directe à chaque requête, car une telle démarche s’avérerait prohibitive en termes de ressources de calcul. Il fait plutôt appel à des approximations rationnelles sophistiquées, basées sur des polynômes minimisant les déviations absolues par rapport à la distribution théorique idéale. Ce procédé garantit un temps de réponse instantané au sein des feuilles de calcul, autorisant le traitement à la volée de vastes matrices de données quantitatives issues d’expérimentations psychologiques de grande ampleur.
Il est fondamental de noter que l’équivalence entre l’intitulé américain NORM.S.INV et la dénomination française LOI.NORMALE.STANDARD.INVERSE est absolue et biunivoque. Le tableur maintient une table de correspondance interne rigide qui assure que les classeurs compilés sous l’une des dénominations fonctionnent de façon transparente lorsqu’ils sont ouverts sur une session linguistique différente. Cette stabilité sémantique assure la transférabilité des classeurs entre équipes de recherche internationales.
2.2 Évolution historique des fonctions normales dans Microsoft Excel
L’architecture statistique de Microsoft Excel a fait l’objet d’une révision structurelle majeure à compter de la version 2010 du tableur. Avant cette transition technologique, le calcul de l’inverse de la loi normale reposait sur la fonction NORMSINV (ou LOI.NORMALE.STANDARD.INVERSE dans les déclinaisons francophones antérieures, sans la présence de points séparateurs). Si cette fonction originelle rendait des services indéniables, elle souffrait de limitations numériques chroniques documentées par de nombreux statisticiens professionnels, particulièrement lorsqu’elle était exploitée aux confins extrêmes de la distribution.
Les versions antérieures à 2010 employaient des algorithmes d’approximation qui engendraient des pertes de précision notables dans les queues de distribution, générant des écarts d’arrondi préjudiciables lorsque l’expérimentateur évaluait des probabilités infinitésimales (de l’ordre de 10⁻⁷ ou moins). Afin de hisser son moteur au niveau des standards industriels et scientifiques internationaux, Microsoft a substitué aux anciens algorithmes les méthodes développées par Peter J. Acklam, réputées pour leur stabilité numérique remarquable et leur précision relative uniforme sur l’ensemble du domaine de calcul.
Bien que Microsoft conserve les anciennes appellations au sein d’une bibliothèque de compatibilité ascendante, afin d’assurer l’ouverture des classeurs créés il y a plusieurs décennies, le recours à ces fonctions dépréciées est formellement déconseillé par les protocoles contemporains. Les fonctions historiques n’offrent pas les mêmes garanties de convergence et peuvent occasionner des divergences marginales lors d’audits méthodologiques rigoureux ou de vérifications d’intégrité par des revues scientifiques de premier plan.
La nouvelle standardisation repose sur une nomenclature avec points séparateurs (telle que NORM.S.INV ou NORM.DIST), structurée pour catégoriser logiquement la nature de la distribution (normale standard ou générale) et l’opération effectuée (distribution cumulative, densité ou inversion). Cette clarification syntaxique réduit les erreurs de manipulation des étudiants et des chercheurs débutants, en dissociant clairement les lois standardisées des lois nécessitant la spécification explicite des paramètres de moyenne et d’écart-type.
2.3 Précision algorithmique et traitement des décimales dans l’environnement Excel
L’exactitude des calculs statistiques sous Excel s’articule autour de la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante double précision. Cette norme octroie une précision de stockage d’environ 15 à 17 chiffres décimaux significatifs pour chaque valeur numérique enregistrée dans la mémoire vive de l’ordinateur. Par conséquent, lors de l’appel de LOI.NORMALE.STANDARD.INVERSE, la valeur critique de Z n’est pas limitée aux deux ou trois décimales conventionnelles des tables imprimées de la littérature, mais intègre une chaîne décimale étendue minimisant les résidus d’approximation.
Aux limites asymptotiques des quantiles, lorsque les risques alpha atteignent des niveaux extrêmement ténus (par exemple dans le criblage de données de neuro-imagerie fonctionnelle requérant des corrections massives pour comparaisons multiples), le comportement des fonctions d’Excel demeure d’une remarquable constance. Jusqu’à des probabilités proches de 10⁻¹⁵, l’inversion conserve une cohérence mathématique exempte de discontinuités brutales, évitant aux analystes de se heurter à des erreurs de dépassement de capacité arithmétique.
Un enjeu analytique majeur réside dans la dissociation systématique entre la valeur numérique réelle hébergée en mémoire et le rendu visuel au sein de la cellule de calcul. Le formatage de cellule (comme l’arrondi visuel à deux décimales affichant la valeur 1,96) masque les décimales sous-jacentes (1,95996398454005…). Si une formule ultérieure exploite cette cellule pour déterminer un seuil décisionnel ou établir un produit scalaire, elle utilisera la totalité de la précision interne, sauf si une fonction explicite telle qu’ARRONDI a été délibérément intercalée par le concepteur du modèle.
L’impact de cette gestion de la précision est déterminant lors de la confrontation d’une statistique de test empirique avec sa valeur seuil théorique. Si un Z empirique se positionne de façon marginale à la frontière du seuil critique (par exemple 1,95998), l’affichage tronqué peut donner l’illusion d’une égalité ou d’un franchissement de seuil, alors que la comparaison stricte en virgule flottante conclura au non-rejet de l’hypothèse nulle. La maîtrise de ces nuances numériques prévient les mauvaises interprétations décisionnelles dans les contextes de recherche hautement compétitifs.
3. Calcul de la valeur critique Z pour un test bilatéral dans Excel
3.1 Cadre conceptuel du test bilatéral en recherche cognitive et clinique
Le test bilatéral, ou test à deux queues, représente la modalité d’inférence par défaut adoptée dans la très grande majorité des investigations en sciences cognitives, en neuropsychologie et en psychiatrie expérimentale. Il s’applique lorsqu’une hypothèse alternative est dite non directionnelle, signifiant que le chercheur postule l’existence d’une divergence systématique entre les groupes ou les conditions expérimentales, sans pour autant préjuger du sens positif ou négatif de cette déviation. L’expérimentateur évalue si le traitement ou la variable indépendante altère le comportement, que ce soit par une facilitation ou une dégradation de la performance.
Sur le plan géométrique, l’absence de directionnalité a priori contraint la théorie probabiliste à partitionner de façon strictement symétrique la région de rejet de l’hypothèse nulle entre les deux extrémités distales de la distribution normale standard. Une performance anormalement élevée rejettera l’hypothèse nulle avec la même force épistémologique qu’une performance anormalement affaiblie. Cette division spatiale impose que l’intégrale totale de la région critique corresponde au risque alpha global tout en étant scindée en deux fractions égales à chacune des queues.
À titre d’illustration clinique, l’analyse comparative des performances d’attention soutenue entre des individus recevant une nouvelle molécule nootropique et un groupe sous placebo requiert une démarche bilatérale si les cliniciens envisagent la possibilité que la molécule induise paradoxalement une sédation cognitive ou, au contraire, une hyper-focalisation bénéfique. Adopter une perspective directionnelle exclusive dans un tel cadre relèverait d’une imprudence méthodologique susceptible d’occulter des effets délétères inattendus.
L’approche bilatérale présente des vertus conservatrices unanimement reconnues pour la prévention des faux positifs. En exigeant que la statistique empirique atteigne un degré d’extrémisme supérieur pour pénétrer une région critique deux fois plus restreinte sur chaque bord, elle prémunit la communauté scientifique contre l’enthousiasme prématuré suscité par des déviations marginales, consolidant ainsi la reproductibilité des corpus expérimentaux.
3.2 Formule de calcul avec répartition symétrique du risque alpha (alpha/2)
L’implémentation opérationnelle du calcul bilatéral sous Excel exige l’allocation rigoureuse de la moitié du risque d’erreur consenti à chacune des bornes de la distribution. Par conséquent, pour un seuil de significativité nominal désigné par la cellule A1 (contenant par exemple 0,05), la probabilité cumulée associée au quantile inférieur se formalise mathématiquement par l’expression alpha / 2. Pour isoler la borne supérieure, le raisonnement s’appuie sur le complémentaire de cette surface, à savoir 1 - (alpha / 2).
Pour extraire la valeur critique inférieure au sein de la feuille de calcul francophone, l’analyste formule l’instruction suivante :
=LOI.NORMALE.STANDARD.INVERSE(A1/2)
Pour la valeur critique supérieure, l’instruction symétrique s’écrit :
=LOI.NORMALE.STANDARD.INVERSE(1 - A1/2)
Dans un environnement de travail anglo-saxon, ces requêtes s’exécutent au moyen de =NORM.S.INV(A1/2) et =NORM.S.INV(1 - A1/2).
En vertu des propriétés d’antisymétrie axiale de la loi normale centrée réduite autour de zéro, la valeur issue du quantile supérieur est strictement l’opposée arithmétique de celle issue du quantile inférieur. Les seuils critiques bilatéraux sont ainsi toujours formulés par la paire ±Z_critique. L’utilisation conjointe de la fonction ABS() (valeur absolue) dans Excel permet fréquemment de ne conserver que la magnitude positive du seuil critique pour simplifier les arbres logiques de prise de décision ultérieurs.
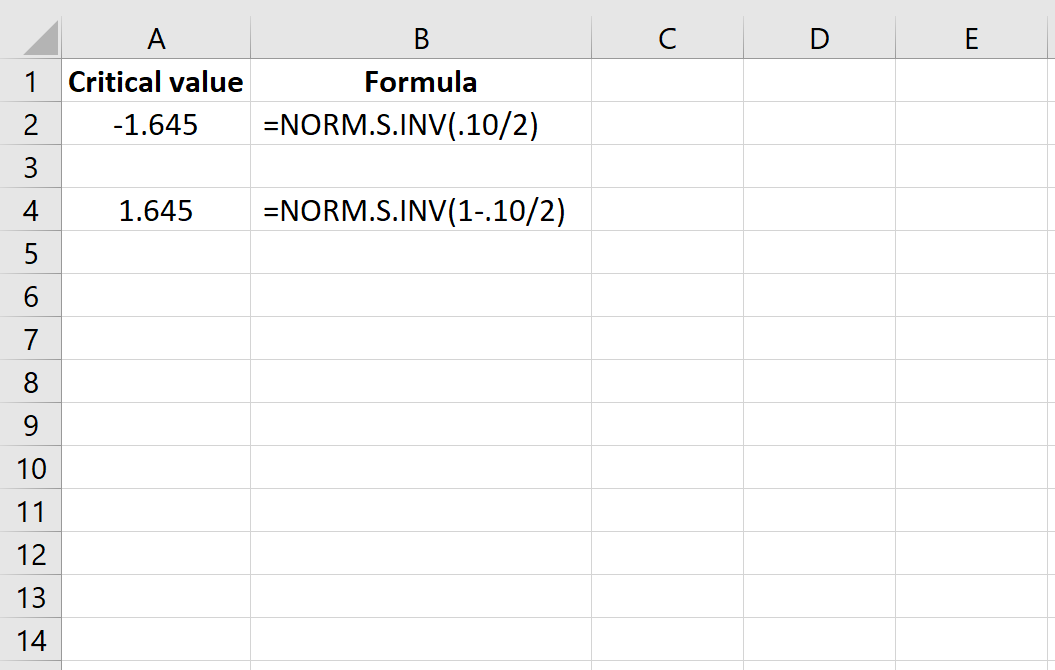
Le tableau théorique des correspondances met en lumière les seuils traditionnels de la littérature : pour un risque alpha fixé à 0,10, la valeur critique bilatérale s’établit à ±1,64485 ; pour le seuil standard de 0,05, la valeur critique s’élève à ±1,95996 (couramment arrondie à 1,96) ; enfin, pour un seuil rigoureux de 0,01, la valeur s’élève à ±2,57583 (usuellement arrondie à 2,58). Ces grandeurs constituent les étalons absolus de comparaison des scores expérimentaux.
3.3 Interprétation des zones de rejet et prise de décision statistique
La règle décisionnelle formelle d’un test bilatéral s’énonce selon une structure disjonctive rigoureuse. L’hypothèse nulle d’absence d’effet est rejetée au seuil alpha si et seulement si la statistique Z observée satisfait l’une des deux conditions d’inégalité suivantes :
Z_observé >= LOI.NORMALE.STANDARD.INVERSE(1 - alpha/2) ou Z_observé <= LOI.NORMALE.STANDARD.INVERSE(alpha/2).
En exploitant les propriétés de la valeur absolue, cette règle se synthétise élégamment sous la condition unifiée :
ABS(Z_observé) >= ABS(Z_critique).
D’un point de vue géométrique, l’espace des réalisations possibles de l’échantillonnage se subdivise en deux entités disjointes : d’une part, la vaste région centrale d’acceptation (ou plus exactement de non-rejet de l’hypothèse nulle), qui concentre une masse probabiliste égale à 1 - alpha (soit 95 % du volume sous la courbe pour un seuil classique) ; d’autre part, les deux zones critiques distales qui se partagent les 5 % restants. Toute statistique empirique chutant à l’intérieur de la zone centrale est interprétée comme compatible avec les variations aléatoires inhérentes au processus d’échantillonnage.
La formulation de la conclusion scientifique exige un respect méticuleux du formalisme académique standard préconisé par l’American Psychological Association (APA). Lorsque le seuil critique est franchi, le rapport de recherche stipule que la divergence observée est statistiquement significative au niveau alpha déclaré, attestant d’une variation non imputable au seul hasard d’échantillonnage. Dans le cas contraire, la rigueur épistémologique proscrit rigoureusement de conclure à « l’égalité des groupes » ou à « la preuve de l’absence d’effet » ; le chercheur doit uniquement déclarer qu’il échoue à rejeter l’hypothèse nulle au regard des données disponibles.
La gestion des cas limites, bien qu’extrêmement rare dans les variables continues, impose une convention opérationnelle préalable. Si la valeur Z observée coïncide à la décimale près avec la valeur critique théorique, l’usage probabiliste standard enjoint de rejeter l’hypothèse nulle, la zone de rejet étant définie sous la forme d’un intervalle fermé à sa frontière gauche ou droite (supérieur ou égal). Dans Excel, l’utilisation de comparateurs stricts ou larges (>= contre >) doit être anticipée pour assurer la cohérence des conclusions automatisées.
4. Détermination de la valeur critique Z pour un test unilatéral à droite dans Excel
4.1 Justification méthodologique des hypothèses directionnelles positives
L’application d’un test unilatéral à droite, ou test à queue supérieure, est méthodologiquement fondée lorsqu’un faisceau d’indices théoriques solides, des modélisations préexistantes ou des données empiriques antérieures permettent d’exclure formellement l’éventualité d’un effet négatif, ou lorsque seule une amélioration présente un intérêt pragmatique dans le paradigme exploré. L’hypothèse alternative postule alors expressément que le paramètre de la population expérimentale est supérieur à la référence fixée par l’hypothèse nulle.
La déclaration de la directionnalité de l’hypothèse doit impérativement précéder l’étape de collecte et d’exploration des données empiriques, idéalement dans le cadre d’un pré-enregistrement formel de protocole (par exemple sur l’Open Science Framework). Modifier a posteriori la nature du test d’une perspective bilatérale vers une orientation unilatérale à la vue des données constitue une altération méthodologique sévère assimilable à du p-hacking, ayant pour effet pervers de doubler artificiellement le risque réel d’erreur de première espèce encouru par l’analyse.
En concentrant l’intégralité de la zone de rejet dans la seule queue droite de la distribution normale, le test unilatéral alloue la totalité de la masse de probabilité alpha (5 %) à l’extrémité supérieure de l’axe réel. Cette géométrie asymétrique confère au protocole un net gain de puissance statistique comparativement au test bilatéral : la frontière critique nécessaire pour rejeter l’hypothèse nulle est moins éloignée du centre, rendant le dispositif expérimental plus sensible pour détecter un effet positif authentique avec un effectif de sujets restreint.
Toutefois, ce gain de sensibilité s’accompagne d’un coût épistémologique majeur : le chercheur se prive de facto de toute possibilité de tester formellement un effet qui s’exercerait dans le sens inverse. Si le traitement expérimental venait à dégrader massivement les scores des participants, le formalisme unilatéral à droite forcerait l’analyste à conclure au non-rejet de l’hypothèse nulle, le score se positionnant dans la région d’acceptation, masquant ainsi l’émergence d’effets secondaires ou d’altérations cognitives inattendues.
4.2 Modélisation sous Excel avec LOI.NORMALE.STANDARD.INVERSE(1 – alpha)
La fonction LOI.NORMALE.STANDARD.INVERSE d’Excel opère de manière cumulative de gauche à droite, accumulant les aires de probabilité depuis moins l’infini jusqu’au point de rupture recherché. Par suite, si l’objectif consiste à isoler une région critique située exclusivement dans la queue supérieure de surface alpha, l’aire cumulée située en amont de cette frontière correspond nécessairement au complémentaire à 1 de ce risque alpha.
Pour calculer la valeur critique d’un test unilatéral à droite avec un seuil de risque logé dans la cellule A1, la syntaxe requise sous une version française s’écrit formellement :
=LOI.NORMALE.STANDARD.INVERSE(1 - A1)
Dans les environnements configurés en langue anglaise, l’instruction correspondante prend la forme suivante :
=NORM.S.INV(1 - A1).
L’omission de l’expression 1 - constitue une erreur d’architecture fréquente qui déplace instantanément le seuil dans la queue inférieure opposée.
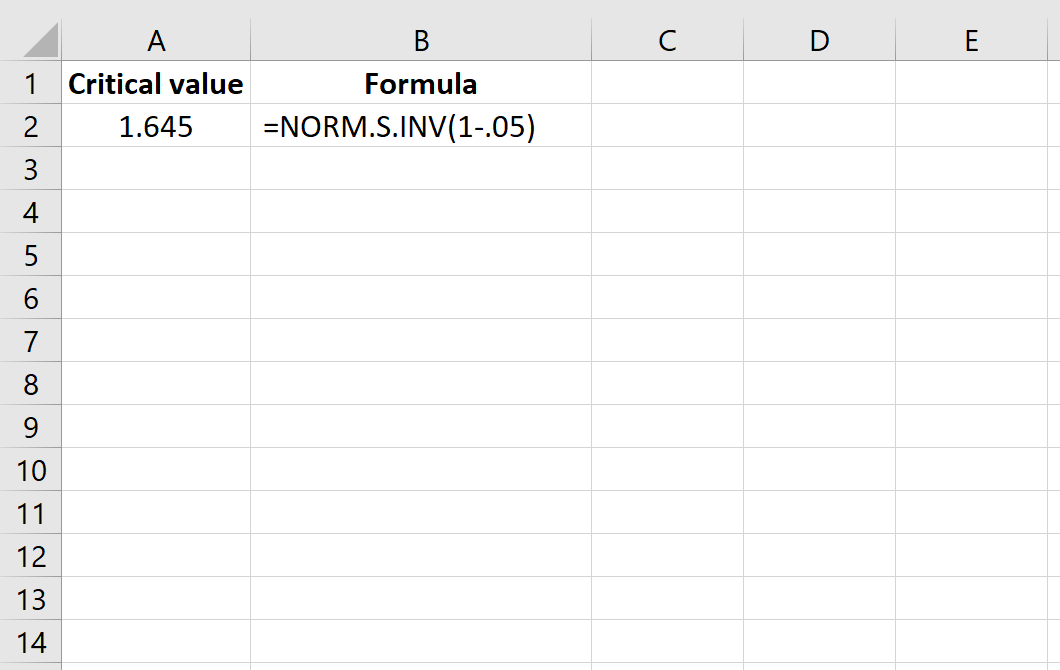
Sous ce modèle de calcul unilatéral droit, l’évaluation d’un risque d’erreur conventionnel de 5 % (alpha = 0,05) génère une valeur critique théorique égale à +1,64485. Comparé au seuil de +1,96 d’un test bilatéral de même niveau alpha, le seuil unilatéral à droite est sensiblement plus accessible, illustrant de manière tangible l’abaissement de l’exigence de preuve justifié par la directionnalité de l’hypothèse de départ.
Pour un niveau d’exigence méthodologique accru fixé à un risque alpha de 0,01, l’insertion de l’instruction =LOI.NORMALE.STANDARD.INVERSE(1 - 0,01) produit une valeur seuil positive égale à +2,32635. Cette modélisation garantit que seuls les 1 % supérieurs des scores standardisés parviendront à provoquer le rejet de l’hypothèse nulle sous ce paradigme conservateur.
4.3 Application empirique : évaluation de l’efficacité accrue d’une thérapie brève
Considérons une étude de psychologie clinique consacrée à l’évaluation d’une thérapie brève innovante ciblant le bien-être subjectif de patients souffrant de troubles de l’adaptation. Les instruments de mesure psychométrique standardisés fournissent une moyenne de base connue de 50 unités et un écart-type populationnel documenté de 10 unités. Les investigateurs postulent de façon exclusive que l’intervention thérapeutique entraînera une majoration des scores de bien-être, justifiant la planification d’un test unilatéral droit au seuil alpha de 0,05.
Au terme du protocole mené sur un effectif de 64 patients, la moyenne d’échantillon s’élève à 52,2 points. Le calcul de l’erreur standard de la moyenne donne : 10 / RACINE(64) = 10 / 8 = 1,25. La statistique de test Z empirique se déduit immédiatement par le rapport de la différence observée sur l’erreur standard : (52,2 - 50) / 1,25 = 1,76. En insérant dans le tableur Excel la formule =LOI.NORMALE.STANDARD.INVERSE(1 - 0,05), le chercheur extrait la valeur critique de Z égale à 1,645.
L’analyse comparative révèle immédiatement que la statistique de test empirique franchit le seuil critique théorique : Z_observé (1,76) > Z_critique (1,645). Il en découle une décision statistique formelle de rejet de l’hypothèse nulle au seuil de 5 %. Les cliniciens peuvent dès lors affirmer que la thérapie brève génère un gain statistiquement significatif sur le niveau de bien-être subjectif des participants, avec un risque consenti inférieur à 5 % d’émettre une conclusion erronée.
Si la statistique Z empirique avait abouti à un résultat opposé, par exemple un score moyen post-thérapeutique de 48 unités générant un Z observé de -1,60, le cadre unilatéral à droite imposerait un non-rejet catégorique de l’hypothèse nulle. Bien que la variation absolue soit marquée, elle s’inscrit en sens inverse de l’hypothèse alternative opérationalisée. L’expérimentateur ne saurait revendiquer une quelconque significativité sans réviser l’ensemble de son protocole conceptuel.
5. Détermination de la valeur critique Z pour un test unilatéral à gauche dans Excel
5.1 Hypothèses directionnelles négatives en psychopathologie expérimentale
Le paradigme du test unilatéral à gauche, ou test à queue inférieure, est couramment déployé en psychopathologie cognitive et en neuropsychologie clinique lorsque l’objectif expérimental réside dans la démonstration d’une réduction quantitative mesurable d’un paramètre défavorable. Qu’il s’agisse de documenter la diminution d’une symptomatologie dépressive, l’atténuation d’affects anxieux ou le raccourcissement des temps de latence motrice lors de tâches d’évitement attentionnel, l’hypothèse alternative stipule expressément que la moyenne du groupe expérimental se situe en deçà de la valeur de contrôle établie.
D’un point de vue probabiliste, cette formulation reporte l’intégralité de la masse critique alpha à l’extrême gauche de la fonction de densité de la loi normale centrée réduite. L’attention de l’analyste se polarise exclusivement sur les valeurs négatives extrêmes de la distribution. Les valeurs Z positives, même dotées d’une magnitude quantitative importante, sont d’emblée considérées comme non pertinentes pour l’inférence, n’apportant aucune preuve empirique au soutien d’une réduction du trouble analysé.
Ce cadre unilatéral inférieur présente les mêmes atouts et contraintes que son pendant supérieur. Il optimise la détection précoce d’effets thérapeutiques réducteurs en abaissant l’ampleur absolue du score nécessaire pour atteindre le statut de significativité statistique. Cependant, il impose une discipline intellectuelle stricte : dans l’hypothèse où le protocole expérimental induirait une exacerbation paradoxale des manifestations psychopathologiques (aggravation des symptômes), le chercheur serait contraint d’accepter l’hypothèse nulle, le test ne disposant d’aucune sensibilité pour caractériser formellement une dérive vers les valeurs supérieures.
Dans les essais cliniques contrôlés régis par des standards éthiques rigoureux, l’adoption d’un test unilatéral à gauche doit être rigoureusement explicitée dans le cahier d’observation avant toute inclusion de patients. Cette précaution neutralise les dérives interprétatives consistant à orienter le test après examen visuel des scores agrégés, pratique déviante qui compromet la validité interne des recherches interventionnelles.
5.2 Syntaxe directe sous Excel avec LOI.NORMALE.STANDARD.INVERSE(alpha)
L’implémentation d’un test unilatéral à gauche au sein de l’environnement Microsoft Excel se caractérise par une simplicité d’écriture syntaxique remarquable. Puisque la fonction LOI.NORMALE.STANDARD.INVERSE calcule par conception l’abscisse Z correspondant à l’aire cumulée depuis l’extrémité négative jusqu’au point ciblé, aucune transformation arithmétique complémentaire n’est requise. L’expérimentateur transmet directement le seuil de risque alpha en tant qu’argument unique de la fonction.
Pour un seuil alpha consigné dans la cellule A1 de la feuille de calcul, la formule s’énonce sous Excel francophone de la manière suivante :
=LOI.NORMALE.STANDARD.INVERSE(A1)
Pour les versions anglophones du logiciel, la formulation équivalente est :
=NORM.S.INV(A1).
En retour, l’algorithme génère obligatoirement une valeur critique pourvue d’un signe algébrique strictement négatif.
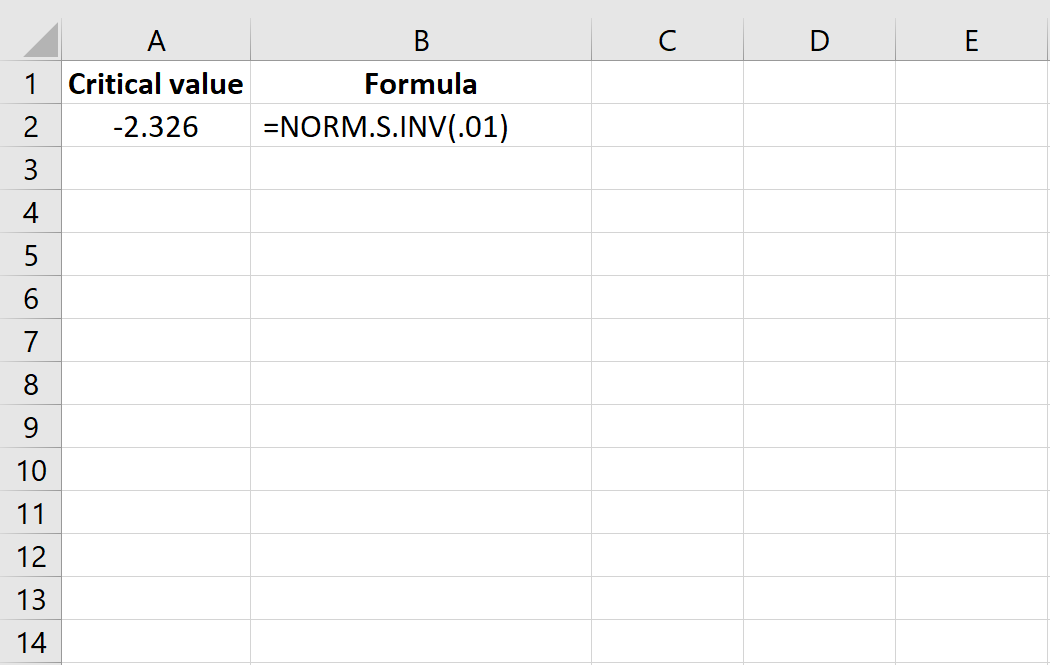
Dans le cadre d’un paramétrage standard à alpha = 0,05, l’application directe de la fonction renvoie la valeur critique universelle de -1,64485. Si le protocole élève son niveau de sévérité à un seuil alpha = 0,01, le seuil généré est de -2,32635. Ces coordonnées numériques sont rigoureusement symétriques à celles obtenues dans le cadre du test unilatéral supérieur, reflétant la parité mathématique de la courbe gaussienne.
La règle décisionnelle d’un test unilatéral à gauche s’exprime par une relation d’ordre direct : l’hypothèse nulle est rejetée si et seulement si la statistique de test Z empirique est inférieure ou égale à la valeur critique Z théorique :
Z_observé <= Z_critique.
Une attention scrupuleuse doit être portée au sens des inégalités dans les cellules logiques du tableur, l’emploi par inadvertance de l’opérateur supérieur générant un contresens logique complet dans la prise de décision automatisée.
5.3 Étude de cas : réduction mesurable du score de détresse émotionnelle
Afin de concrétiser l’analyse, examinons une étude clinique mesurant l’efficacité d’un protocole de remédiation cognitive sur le sentiment de détresse psychologique éprouvé par des soignants en milieu hospitalier. L’inventaire clinique utilisé présente une moyenne populationnelle stable de 80 points avec un écart-type connu de 12 points. Les investigateurs formulent l’hypothèse unilatérale selon laquelle le programme d’entraînement réduira significativement ce score. Le risque alpha retenu pour cette investigation est calibré à 0,05.
Un groupe de 36 soignants complète la prise en charge, affichant à son terme un score moyen de détresse de 76,2 unités. L’erreur standard associée à la distribution d’échantillonnage s’évalue selon le calcul : 12 / RACINE(36) = 12 / 6 = 2,0. La standardisation de la performance observée génère le score Z empirique suivant : (76,2 - 80) / 2,0 = -3,8 / 2,0 = -1,90. En sollicitant Excel via la formule unilatérale gauche =LOI.NORMALE.STANDARD.INVERSE(0,05), la valeur critique théorique obtenue est de -1,645.
La confrontation des grandeurs numériques montre clairement que le score empirique s’enfonce plus profondément dans la queue inférieure de distribution que le seuil de tolérance : Z_observé (-1,90) < Z_critique (-1,645). L’hypothèse nulle d’équivalence thérapeutique est donc rejetée avec confiance. Le protocole clinique a induit une baisse tangible et statistiquement significative de la détresse émotionnelle des participants au seuil de risque de 5 %.
La restitution de ces conclusions dans un mémoire ou un article scientifique conforme aux normes éditoriales de l’APA s’exprime selon le standard : « L’analyse unilatérale révèle une diminution statistiquement significative de la détresse psychologique post-intervention (Z = -1,90, p < 0,05), corroborant l’efficacité clinique du programme de remédiation cognitive proposé. » Cette formalisation condense l’ensemble des éléments analytiques indispensables au contrôle par les pairs.
6. Différences de syntaxe entre les versions régionales d’Excel
6.1 Équivalences syntaxiques entre versions anglophones et francophones
Le déploiement de modèles analytiques sur des postes informatiques hétérogènes expose fréquemment les équipes de recherche à des défaillances syntaxiques découlant de la localisation linguistique de la suite logicielle. Dans l’écosystème francophone de Microsoft Excel, l’ensemble des opérateurs et des fonctions de calcul natives bénéficie d’une traduction lexicale complète. Ainsi, la formule standard universelle NORM.S.INV est traduite par LOI.NORMALE.STANDARD.INVERSE, de même que NORM.S.DIST se mue en LOI.NORMALE.STANDARD.N.
Si un analyste insère textuellement la commande anglophone NORM.S.INV(0,05) au sein d’une installation configurée avec un pack linguistique strictement français, le tableur interrompt l’interprétation de la cellule et renvoie le code d’erreur lexical #NOM?. Ce dysfonctionnement signale que le compilateur interne d’Excel échoue à identifier la chaîne de caractères transmise comme une fonction valide répertoriée dans son dictionnaire d’exécution localisé.
Il importe de distinguer les fonctions modernes de leurs précurseurs historiques. Lors de la conversion de classeurs patrimoniaux, la syntaxe obsolète NORMSINV s’aligne en français sur LOI.NORMALE.STANDARD.INVERSE sans le suffixe moderne .N. Dans les versions modernes, il existe également une fonction générale LOI.NORMALE.INVERSE (équivalente à NORM.INV) qui requiert, outre la probabilité cumulée, la transmission explicite des paramètres de moyenne empirique et d’écart-type. L’oubli de la particule .STANDARD. modifie intégralement la signature de la fonction et provoque une inadéquation des arguments attendus.
En coulisses, le moteur de calcul d’Excel enregistre l’ensemble des instructions dans les structures sous-jacentes du format OpenXML sous leurs identifiants programmatiques uniques indépendants de la langue du système. Par conséquent, lorsqu’un classeur conçu en français est ouvert sur un poste configuré en langue anglaise, le tableur traduit dynamiquement les formules pour afficher NORM.S.INV sans altérer le fonctionnement des algorithmes décisionnels.
6.2 Gestion des séparateurs d’arguments et conventions numériques régionales
Au-delà de la dénomination textuelle des fonctions, la source de perturbation la plus pernicieuse lors du partage transfrontalier de feuilles de calcul réside dans la disparité des conventions typographiques relatives aux séparateurs de listes et aux marqueurs décimaux. Ces paramètres ne sont pas intrinsèques au fichier Excel lui-même, mais dépendent directement des préférences régionales configurées au sein du système d’exploitation hôte (Windows ou macOS).
Dans la configuration standard française et dans la majorité des pays de l’Union européenne continentale, la virgule (,) est réservée à la notation du séparateur décimal (par exemple 1,96). En conséquence mécanique, la syntaxe interne d’Excel doit employer le point-virgule (;) comme délimiteur obligatoire pour séparer les différents arguments insérés au sein d’une même formule mathématique :
=SI(A1 > 1,96; "Significatif"; "Non significatif").
L’omission de cette contrainte typographique corrompt l’interprétation logique de la ligne d’instructions.
À l’inverse, dans les configurations régionales anglo-saxonnes (notamment aux États-Unis, au Canada anglophone et au Royaume-Uni), le point (.) constitue le marqueur décimal universel (1.96). La virgule (,) est par conséquent libérée de son usage arithmétique et devient le séparateur officiel d’arguments :
=IF(A1 > 1.96, "Significant", "Not significant").
L’importation brute de lignes de code ou de formules depuis des manuels anglophones sans adaptation préalable des séparateurs déclenche une alerte de formule incorrecte bloquant la validation de la cellule.
Ce choc syntaxique intervient fréquemment lors du copier-coller de tutoriels en ligne internationaux. Pour s’en prémunir, les praticiens doivent inspecter les options avancées d’Excel (sous la rubrique Options > Options avancées > Délimiteurs système) ou standardiser les chaînes de saisie. Une vigilance particulière est requise lors de l’automatisation de scripts VBA ou de requêtes Power Query, qui requièrent conventionnellement des notations calquées sur le modèle anglo-saxon.
6.3 Portabilité des classeurs Excel entre laboratoires internationaux
La collaboration scientifique internationale exige une robustesse sans faille des outils d’analyse partagés. Si le mécanisme d’auto-traduction XML d’Excel résout une part substantielle des incompatibilités lors du transit des fichiers entre différents pays, plusieurs situations périphériques menacent l’intégrité calculatoire des protocoles psychométriques. L’intégration de macros rédigées en Visual Basic for Applications (VBA) constitue l’un des points de vulnérabilité les plus critiques.
Dans l’environnement éditeur de VBA, le langage de développement sous-jacent demeure rigoureusement standardisé en anglais américain. Un chercheur écrivant une routine d’automatisation doit impérativement employer la méthode Application.WorksheetFunction.NormSInv() ou Application.WorksheetFunction.Norm_S_Inv(), quand bien même son interface de tableur afficherait des libellés francophones. Tenter d’invoquer le nom français d’une formule au sein du compilateur VBA produit une erreur d’exécution immédiate avec interruption de la routine.
Une bonne pratique de laboratoire consiste à documenter rigoureusement les métadonnées du classeur au moyen d’un onglet spécifiquement dédié aux conventions de saisie. Ce volet doit stipuler les versions de logiciel supportées, les unités de mesure exploitées, ainsi que des cellules de validation témoins affichant des valeurs canoniques universellement admises (telles que le calcul de la valeur critique à 0,05 devant obligatoirement afficher 1,96). Cette vérification visuelle immédiate certifie à tout collaborateur étranger la viabilité computationnelle du fichier ouvert.
L’utilisation contemporaine des scripts Office basés sur TypeScript au sein de la version en ligne d’Excel (Microsoft 365) offre une alternative résiliente pour s’émanciper des aléas de localisation. Ces scripts s’exécutent de façon standardisée sur les serveurs distants en manipulant des structures typées universelles, évitant ainsi les pièges de décalage linguistique entre équipes multidisciplinaires dispersées géographiquement.
7. Automatisation de la décision statistique par formules conditionnelles dans Excel
7.1 Conception d’une matrice paramétrable de tests d’hypothèses
Pour prévenir les défaillances de transcription et fiabiliser la prise de décision statistique dans les laboratoires de recherche, la construction d’un tableau de bord paramétrable constitue une démarche méthodologique optimale. Cette approche consiste à ségréger les cellules de saisie de données brutes, les paramètres d’inférence modifiables et les moteurs de calcul automatique au sein de compartiments distincts, évitant ainsi toute altération involontaire des algorithmes au fil des saisies quotidiennes.
L’architecture matricielle s’articule autour de trois cellules pivots :
- Une cellule recevant le score Z empirique calculé à partir de l’échantillon expérimental ;
- Une cellule paramétrique accueillant le seuil de risque d’erreur alpha consenti (par exemple 0,05 ou 0,01) ;
- Une cellule de contrôle offrant un menu déroulant structuré via l’outil de validation de données, permettant de choisir l’orientation du test parmi trois modalités exclusives : « Bilatéral », « Unilatéral droit », « Unilatéral gauche ».
En aval de ces paramètres d’entrée, la cellule logeant la valeur critique devient pleinement dynamique. Au lieu d’adopter une formule statique, elle exploite une imbrication conditionnelle calculant la borne exacte requise selon le choix opéré dans le menu déroulant :
=SI(C1="Bilatéral"; LOI.NORMALE.STANDARD.INVERSE(1 - A1/2); SI(C1="Unilatéral droit"; LOI.NORMALE.STANDARD.INVERSE(1 - A1); LOI.NORMALE.STANDARD.INVERSE(A1))).
Cette structure ajuste immédiatement la valeur de référence sans manipulation de code par l’expérimentateur.
Pour parachever l’intégrité du dispositif, les cellules dévolues aux moteurs de décision statistique doivent faire l’objet d’un verrouillage logiciel (par le biais des fonctionnalités de protection de feuille d’Excel). Seules les cellules réservées à la saisie de l’échantillon et au paramétrage du seuil restent modifiables, prévenant toute écrasement accidentel des formules par un utilisateur tiers.
7.2 Implémentation de formules logiques imbriquées pour la décision automatique
L’automatisation formelle du rejet ou du maintien de l’hypothèse nulle se réalise en imbriquant des opérateurs logiques booléens (SI, ET, OU) articulés sur les règles de décision spécifiques à chaque typologie de test. Le moteur décisionnel compare la valeur Z empirique observée (cellule B1) avec la valeur critique dynamique ou applique les tests différentiels appropriés.
Une implémentation analytique complète se traduit par la formule algorithmique suivante :
=SI(C1="Bilatéral"; SI(ABS(B1) >= LOI.NORMALE.STANDARD.INVERSE(1 - A1/2); "Rejet de H0 (Significatif)"; "Non-rejet de H0"); SI(C1="Unilatéral droit"; SI(B1 >= LOI.NORMALE.STANDARD.INVERSE(1 - A1); "Rejet de H0 (Significatif)"; "Non-rejet de H0"); SI(C1="Unilatéral gauche"; SI(B1 <= LOI.NORMALE.STANDARD.INVERSE(A1); "Rejet de H0 (Significatif)"; "Non-rejet de H0"); "Paramètre invalide"))).
Cette syntaxe structure un aiguillage rigoureux garantissant une prise de décision conforme au sens du test sélectionné.
Afin de parfaire le niveau d’information délivré par le tableur, la décision binaire peut être assortie d’un retour qualitatif explicitant la direction de l’effet constaté. Par exemple, lors d’un test bilatéral significatif, la formule peut spécifier si le rejet procède d’une surperformance (statistique empirique positive) ou d’une sous-performance (statistique empirique négative), apportant une plus-value descriptive immédiate aux équipes soignantes ou éducatives.
Enfin, la résilience du modèle impose de blinder les formules contre les saisies aberrantes du seuil alpha. En introduisant un test préliminaire vérifiant que ET(A1 > 0; A1 < 1) est bien respecté, le modèle évite d’exécuter des calculs absurdes face à un utilisateur saisissant un risque exprimé en pourcentage entier (par exemple 5 au lieu de 0,05), affichant le cas échéant un message didactique invitant à rectifier le format de probabilité.
7.3 Mise en forme conditionnelle et alertes visuelles de significativité
L’ergonomie cognitive des environnements d’analyse concourt à l’abaissement des taux d’erreur de lecture. Dans cette optique, l’exploitation des fonctionnalités de mise en forme conditionnelle d’Excel permet de transcrire visuellement l’aboutissement de l’inférence statistique au moyen d’un système de signalisation chromatique universel.
La cellule hébergeant le statut de la décision statistique peut se voir assigner une règle de surbrillance dynamique fondée sur le texte généré :
- Si la cellule contient l’expression textuelle
"Rejet de H0", le fond s’illumine instantanément d’une teinte verte douce, signalant l’émergence d’un résultat statistiquement significatif au seuil spécifié ; - À l’inverse, l’apparition de la mention
"Non-rejet de H0"colore la cellule d’un ton neutre ou d’une nuance pastel d’ambre, prévenant toute extrapolation téméraire.
Ce protocole visuel peut être enrichi d’un échelonnement de significativité à plusieurs degrés, calqué sur les normes typographiques scientifiques :
- Une alerte chromatique standard pour les résultats significatifs à
p < 0,05; - Une coloration plus intense ou une bordure contrastée pour les niveaux de preuve hautement significatifs à
p < 0,01oup < 0,001; - Une mention typographique distincte (par exemple une couleur grise italique) pour qualifier les résultats marginaux ou tendanciels (
0,05 <= p < 0,10).
Ces indicateurs visuels facilitent la synthèse lors de l’examen de vastes batteries psychométriques comprenant des dizaines de dimensions parallèles. Les neuropsychologues peuvent identifier en un coup d’œil les domaines cognitifs où le patient s’écarte significativement de la norme populationnelle, optimisant ainsi l’élaboration de leurs synthèses diagnostiques.
8. Comparaison méthodologique entre la valeur critique Z et la p-valeur sous Excel
8.1 Calcul de la probabilité exacte associée via LOI.NORMALE.STANDARD.N
Tandis que la méthode de la valeur critique Z consiste à comparer une statistique de test empirique à un seuil géométrique statique déterminé a priori, l’approche par la p-valeur procède par la détermination de la probabilité exacte d’observer, sous l’hypothèse nulle, une valeur au moins aussi extrême que celle effectivement obtenue dans l’échantillon. Dans Microsoft Excel, l’extraction de cette probabilité exacte fait appel à la fonction de distribution cumulative LOI.NORMALE.STANDARD.N (ou NORM.S.DIST en anglais).
Cette fonction admet deux paramètres opérationnels : la valeur Z observée pour laquelle on souhaite évaluer la probabilité cumulée, et un indicateur booléen spécifiant si l’on désire la fonction de distribution cumulée (argument défini sur VRAI) ou la densité de probabilité ponctuelle (argument défini sur FAUX). Pour le calcul des p-valeurs, le paramètre cumulatif VRAI est obligatoirement requis.
Le calcul de la p-valeur exacte dépend de la directionnalité du test :
- Pour un test unilatéral à gauche, la probabilité cumulée s’obtient directement par :
=LOI.NORMALE.STANDARD.N(Z_obs; VRAI); - Pour un test unilatéral à droite, la p-valeur correspond à la surface résiduelle supérieure :
=1 - LOI.NORMALE.STANDARD.N(Z_obs; VRAI); - Pour un test bilatéral symétrique, le doublement de la surface distale s’opère au moyen de la formule combinée :
=2 * (1 - LOI.NORMALE.STANDARD.N(ABS(Z_obs); VRAI)).
Sur le plan mathématique, la concordance entre le critère du Z critique et celui de la p-valeur est absolue. Une statistique Z empirique dépassant le Z critique correspond systématiquement à une p-valeur inférieure au seuil de significativité alpha choisi. Les deux démarches constituent les deux faces géométriques et probabilistes d’un même phénomène d’inférence.
8.2 Confrontation épistémologique : Neyman-Pearson versus Fisher
La coexistence sous Excel du calcul de la valeur critique Z et de la p-valeur illustre le métissage historique de deux paradigmes épistémologiques rivaux de l’inférence statistique : l’approche par les tests de significativité de Ronald Fisher et le cadre décisionnel rigide formulé par Jerzy Neyman et Egon Pearson.
Dans la perspective de Neyman-Pearson, l’inférence statistique constitue une règle de décision binaire à seuil fixe, conçue pour minimiser les coûts d’erreurs sur le long terme dans une logique de contrôle de qualité ou de comportement inductif. L’analyste fixe impérativement ses risques alpha et bêta avant l’expérience, calcule la valeur critique Z correspondante, et accepte ou rejette mécaniquement l’hypothèse nulle sans accorder de considération particulière à l’amplitude du dépassement du seuil. Dans ce cadre, la valeur critique Z est le pivot de l’action rationnelle.
À l’opposé, la vision fisherienne conçoit la p-valeur comme une mesure continue et graduelle de la force de la preuve apportée par les données contre l’hypothèse nulle. Plus la p-valeur est infinitésimale, plus le modèle de l’hypothèse nulle apparaît invraisemblable pour expliquer les faits observés. Fisher récusait l’imposition de seuils couperets stricts et ne postulait pas d’hypothèse alternative mathématiquement paramétrée, privilégiant une interprétation souple de la plausibilité scientifique.
La pratique contemporaine en psychologie expérimentale combine ces deux approches dans une modélisation hybride. Les comités éditoriaux imposent généralement de formaliser la décision à l’aide d’un seuil critique tout en exigeant la mention de la p-valeur exacte calculée dans le tableur. Conserver simultanément sous Excel l’affichage du seuil Z critique et de la p-valeur permet aux chercheurs de vérifier la conformité stricte de leur règle décisionnelle tout en appréciant le poids quantitatif de la preuve empirique accumulée.
8.3 Standardisation du compte rendu des données selon les normes APA
La restitution éditoriale des tests statistiques d’inférence Z au sein des publications savantes est rigoureusement codifiée par les normes typographiques de l’American Psychological Association (7e édition). Une transcription conforme exige la réunion coordonnée de la statistique observée, de son sens, de son niveau d’exactitude probabiliste et d’une mesure standardisée d’effet, éléments aisément assemblables depuis les cellules d’un tableur Excel.
Les règles typographiques fondamentales imposent de styliser la lettre désignant la statistique par une mise en italique : Z. La valeur de la statistique est usuellement restituée avec deux décimales significatives (par exemple Z = 2,34), tandis que la p-valeur exacte s’exprime avec trois décimales (par exemple p = 0,019). Lorsque la p-valeur calculée par Excel descend sous le seuil de 0,001, les normes proscrivent l’écriture trompeuse p = 0,000 induite par les arrondis de cellules, imposant la notation relative p < 0,001.
En outre, le protocole rédactionnel exige d’expliciter sans ambiguïté dans le corps du texte la directionnalité du test pratiqué. Une formulation canonique s’énonce de la manière suivante :
« L’analyse comparative des performances cognitives révèle une supériorité statistiquement significative des sujets stimulés par rapport au groupe témoin, Z = 2,12, p = 0,034 (test bilatéral), d de Cohen = 0,53. » L’omission de la précision bilatérale ou unilatérale affaiblit la transparence méthodologique du rapport.
Excel facilite grandement cette formalisation grâce à la fonction de concaténation textuelle. En programmant une cellule dédiée agrégeant les libellés et les résultats issus des calculs précédents, le chercheur génère automatiquement une chaîne éditoriale prête pour le copier-coller :
="Z = " & TEXTE(B1; "0,00") & ", p = " & SI(P1 < 0,001; "< 0,001"; TEXTE(P1; "0,000")).
Ce processus élimine les erreurs de retranscription manuelle entre le tableur et le manuscrit scientifique.
9. Critères de distinction entre la distribution Z et la distribution t de Student dans Excel
9.1 Conditions strictes d’application du modèle Z en recherche psychologique
La validité théorique du recours à la valeur critique Z repose sur un postulat mathématique contraignant : la variance de la population générale (notée sigma carré, σ²) doit être une quantité connue de façon certaine et exacte par l’expérimentateur. Cette exigence est particulièrement ardue à satisfaire dans le champ de la recherche psychologique et clinique, où l’hétérogénéité biologique et socioculturelle interdit presque toujours d’appréhender la variance exhaustive des populations cibles.
En l’absence de variance théorique populationnelle certifiée, l’application du modèle Z ne peut se justifier que de façon asymptotique, en s’appuyant sur les garanties formelles du théorème central limite. Lorsque la taille de l’échantillon analysé devient très importante (conventionnellement fixée dans les manuels académiques à des effectifs dépassant 30, voire 100 individus selon les auteurs), la variance calculée à partir de l’échantillon converge de façon consistante vers la variance populationnelle inconnue, rendant l’écart entre la loi normale et la distribution de Student numériquement négligeable.
Cependant, dans la majorité des protocoles de recherche neuropsychologique, d’imagerie cérébrale fonctionnelle ou d’évaluation de psychothérapies intensives, les cohortes d’études n’intègrent que des échantillons réduits (souvent entre 10 et 25 participants par condition). Dans ces circonstances, considérer l’écart-type de l’échantillon comme un substitut parfait de l’écart-type théorique constitue une entorse méthodologique majeure déformant l’ensemble de l’inférence probabiliste.
L’utilisation injustifiée de la loi normale Z sur de petits effectifs débouche sur une sous-estimation systématique de l’erreur d’échantillonnage réelle. Les valeurs critiques de Z étant plus rapprochées de zéro que les valeurs critiques de Student correspondantes, le chercheur s’expose à rejeter l’hypothèse nulle avec une complaisance indue, gonflant le volume des faux positifs au sein de ses travaux expérimentaux.
9.2 Transition vers la loi de Student via LOI.STUDENT.INVERSE pour N inférieur à 30
Dès lors que la variance populationnelle σ² est inconnue et doit être estimée à partir de l’échantillon via la variance corrigée (s²), la distribution statistique rigoureuse qui gouverne l’échantillonnage n’est plus la courbe normale standard, mais la distribution de Student, introduite par William Sealy Gosset sous le pseudonyme historique de « Student ». Cette distribution s’ajuste mathématiquement en fonction de la taille de l’échantillon à travers le concept de degrés de liberté (ddl, usuellement égal à N - 1 pour une comparaison de moyenne simple).
Sur le plan géométrique, la loi de Student se caractérise par des queues de distribution notablement plus épaisses (structure leptokurtique) que celles de la loi normale standard. Cet épaississement reflète l’incertitude stochastique supplémentaire introduite par l’estimation simultanée de la moyenne et de la variance de la population. En conséquence directe, la valeur critique théorique requise pour déclarer la significativité statistique est repoussée plus loin sur l’axe des abscisses, rendant le test plus conservateur et mieux protégé contre l’erreur de type I.
Dans Microsoft Excel, le calcul de la valeur critique d’un test de Student bilatéral s’effectue au moyen de la fonction LOI.STUDENT.INVERSE.BILATERALE (ou T.INV.2T en anglais), qui attend deux arguments : le seuil alpha et les degrés de liberté :
=LOI.STUDENT.INVERSE.BILATERALE(alpha; ddl).
Pour un test unilatéral, l’analyste emploie la fonction LOI.STUDENT.INVERSE.N (ou T.INV) :
=LOI.STUDENT.INVERSE.N(1 - alpha; ddl).
Au fur et à mesure que la taille de l’échantillon croît, les degrés de liberté augmentent corrélativement et la distribution de Student se resserre de manière continue pour converger vers la loi normale. Ainsi, pour alpha = 0,05 en test bilatéral, le seuil critique t vaut 2,57 pour 5 ddl, 2,09 pour 20 ddl, 1,98 pour 100 ddl, rejoignant asymptotiquement la valeur Z de 1,96 lorsque les degrés de liberté tendent vers l’infini.
9.3 Erreurs d’inférence induites par une sélection erronée du modèle théorique
Le recours erroné à la valeur critique Z au lieu de la valeur critique de Student sur des cohortes restreintes a des répercussions concrètes sur l’intégrité des résultats publiés. À titre d’exemple, considérons une expérimentation psychologique pilote portant sur un échantillon restreint de 10 patients (soit 9 degrés de liberté), analysée au seuil conventionnel alpha = 0,05 bilatéral.
Si l’analyste utilise par méconnaissance la valeur critique de Z dans Excel, il retiendra le seuil standard de 1,96. En revanche, s’il applique rigoureusement la loi de Student appropriée au protocole via la formule =LOI.STUDENT.INVERSE.BILATERALE(0,05; 9), la valeur critique légitime s’élève à 2,262. Tout score empirique s’intercalant entre ces deux frontières (par exemple un score empirique de 2,10) sera déclaré significatif sous le modèle Z, alors qu’il est pleinement imputable aux aléas d’échantillonnage sous la modélisation de Student.
Cette substitution illégitime entraîne une inflation incontrôlée du risque réel d’erreur de première espèce. Le chercheur qui croit opérer à un risque consenti de 5 % travaille en réalité à un risque d’erreur effectif avoisinant fréquemment 10 à 15 % en raison du déficit de modélisation de l’incertitude de la variance. Les études pilotes en psychologie clinique, fréquemment conduites sur des effectifs limités par des contraintes budgétaires ou d’accès aux patients, sont particulièrement exposées à ces biais de modélisation.
Pour prévenir ces écueils méthodologiques, il est fortement recommandé d’implémenter au sein d’Excel une formule d’arbitrage automatique sélectionnant le modèle adéquat :
=SI(N >= 30; LOI.NORMALE.STANDARD.INVERSE(1 - alpha/2); LOI.STUDENT.INVERSE.BILATERALE(alpha; N - 1)).
Cette règle structurelle garantit l’adaptation du seuil critique à la volumétrie de l’échantillon, préservant ainsi la validité interne des conclusions diagnostiques ou de recherche.
10. Représentation graphique de la loi normale et des seuils critiques dans Excel
10.1 Génération de la distribution de Gauss discrétisée sur un continuum de scores
La modélisation géométrique de la courbe normale centrée réduite sous forme de diagramme cartésien enrichit l’analyse en offrant une matérialisation claire des zones critiques d’acceptation et de rejet. Pour construire cette visualisation dans Microsoft Excel, la première étape consiste à générer un tableau de discrétisation représentant le continuum de l’abscisse Z avec un pas d’incrément suffisamment fin pour assurer la régularité visuelle du tracé.
Sur le plan pratique, l’expérimentateur structure une colonne de coordonnées (par exemple la colonne A) initiée à la valeur de -4,0 et progressant de façon régulière par incrément constant de 0,1 jusqu’à la valeur de +4,0. Cette amplitude couvre plus de 99,99 % de la surface probabiliste totale sous la courbe gaussienne. Une telle progression génère une série séquentielle de 81 coordonnées couvrant l’ensemble du spectre d’intérêt psychométrique.
Dans la colonne contiguë (colonne B), l’analyste calcule la densité de probabilité normale standard associée à chaque coordonnée Z en sollicitant la fonction native :
=LOI.NORMALE.STANDARD.N(A2; FAUX).
La spécification du paramètre logique sur FAUX est essentielle : elle indique au compilateur d’extraire la hauteur ponctuelle de la fonction de densité de probabilité gaussienne (f(z)) et non son intégrale cumulative.
La cohérence géométrique de la série peut être validée par une approximation discrète de l’intégrale (méthode des trapèzes ou des rectangles). En multipliant la somme des densités obtenues par le pas d’incrément (0,1), la somme totale doit converger vers 1,00, attestant de la validité de la discrétisation avant de procéder à la génération des graphiques.
10.2 Tracé de la courbe et ombrage dynamique des aires de rejet critiques
La restitution visuelle de la distribution s’opère par l’insertion d’un graphique combiné de type Nuage de points avec lignes lissées (ou graphique en aires selon l’effet graphique souhaité), reliant les abscisses de la colonne A aux densités de probabilité de la colonne B. Ce tracé reproduit fidèlement la célèbre silhouette en cloche de Gauss.
Pour mettre en valeur de façon dynamique les régions critiques associées au seuil alpha, une série de données secondaire doit être adjointe au tableau de données. Cette colonne complémentaire (colonne C) isole sélectivement les densités associées aux zones de rejet au moyen d’un test logique conditionnel :
=SI(ABS(A2) >= $E$1; B2; 0),
où la cellule $E$1 héberge la valeur critique absolue calculée dynamiquement par LOI.NORMALE.STANDARD.INVERSE.
En superposant cette série secondaire sous forme d’un graphique en aires doté d’une couleur d’accentuation (par exemple un rouge translucide) sur le tracé lissé principal, les portions de la courbe excédant le seuil critique s’ombreront automatiquement. Si le praticien modifie son paramètre alpha de 0,05 à 0,01, les aires ombrées se contractent instantanément sur le graphique pour refléter la nouvelle géométrie décisionnelle.
Pour parfaire la lisibilité du tableau de bord, une barre verticale mobile représentant la statistique empirique observée (Z_obs) peut être ajoutée en insérant une série constituée d’une ligne d’erreur verticale reliant l’axe horizontal au sommet de la courbe. Cette signalétique permet de visualiser immédiatement la position du score de l’échantillon par rapport aux zones de rejet critiques ombrées.
10.3 Exploitation didactique des représentations visuelles en psychologie
La présence de ces graphiques dynamiques au sein des feuilles de calcul revêt une portée pédagogique majeure pour la restitution des résultats auprès de publics non spécialistes ou d’étudiants en formation aux méthodes quantitatives. La notion d’inférence probabiliste abstraite gagne immédiatement en intelligibilité lorsqu’elle est matérialisée par un positionnement spatial au sein d’une distribution bien identifiée.
Cette visualisation clarifie intuitivement la relation géométrique inverse qui lie le niveau de confiance souhaité et la surface de la région de rejet. Elle illustre concrètement pourquoi le passage d’un seuil alpha de 0,05 à 0,01 repousse les frontières critiques vers les marges extérieures, rendant visuellement palpable la sévérité accrue de l’exigence de preuve imposée au traitement expérimental.
Dans le cadre de colloques scientifiques ou de soutenances de thèses, l’intégration de figures soignées issues d’Excel et paramétrées sur les données observées facilite la compréhension des rapports d’essais cliniques par les comités d’éthique et les évaluateurs. Les auditeurs peuvent apprécier instantanément la proximité ou la distance d’un résultat empirique par rapport aux frontières du hasard.
L’automatisation du rafraîchissement visuel constitue enfin un outil d’expérimentation didactique précieux. En permettant aux apprenants de faire varier dynamiquement les curseurs de variance, de taille d’échantillon ou de niveau de risque, le tableur devient un simulateur interactif d’inférence statistique renforçant la maîtrise conceptuelle des tests d’hypothèses.
11. Diagnostic et résolution des erreurs courantes lors de l’extraction des valeurs Z
11.1 Erreurs de syntaxe et dépassement de domaine (#NOMBRE!, #VALEUR!)
L’extraction de valeurs critiques sous Microsoft Excel peut être entravée par l’apparition de messages d’erreur système bloquant le déroulement des calculs automatisés. Le code d’interruption le plus récurrent associé à l’appel de LOI.NORMALE.STANDARD.INVERSE est l’erreur de domaine d’argument #NOMBRE!. Ce signal indique formellement que l’argument transmis se situe en dehors de l’intervalle ouvert ]0, 1[ requis pour une probabilité cumulée.
Cette anomalie survient typiquement lors de trois maladresses de saisie :
- L’introduction accidentelle d’une probabilité nulle (
0) ou unitaire (1), pour lesquelles les asymptotes mathématiques de la loi normale tendent théoriquement vers moins et plus l’infini, grandeurs incalculables en arithmétique numérique standard ; - La saisie d’un risque d’erreur sous forme de pourcentage entier (en entrant
5pour signifier 5 %) sans le symbole afférent, amenant le compilateur à rejeter un argument supérieur à 1 ; - L’utilisation d’expressions arithmétiques complémentaires mal formées générant un argument négatif.
Le second dysfonctionnement régulier prend la forme de l’erreur #VALEUR!. Ce message signale une incohérence de type de données : la formule tente d’exécuter une opération mathématique sur une entrée interprétée comme une chaîne textuelle alphabétique. Cette défaillance découle fréquemment de l’usage d’un point décimal sur une version linguistique francophone attendant une virgule, d’espaces insécables invisibles issus d’un copier-coller Web, ou de guillemets résiduels englobant la valeur numérique.
Pour immuniser les feuilles de calcul contre ces interruptions d’affichage, il est méthodologiquement recommandé d’encadrer les formules d’inversion par des gardes d’assainissement logique à l’aide des fonctions SI.NON.DISP ou SI.ERREUR :
=SI.ERREUR(LOI.NORMALE.STANDARD.INVERSE(A1); "Paramètre de probabilité invalide [0-1]").
Cette précaution garantit un retour d’information explicite et préserve l’intégrité esthétique des tableaux de bord analytiques.
11.2 Confusion fréquente entre probabilités cumulées unilatérales et bilatérales
L’erreur la plus préjudiciable sur le plan méthodologique — car elle ne déclenche aucune alerte technique sous Excel — consiste à introduire le paramètre alpha dans la formule sans l’ajuster à la structure symétrique ou directionnelle du test envisagé. Cette confusion engendre un décalage substantiel des seuils critiques calculés, faussant insidieusement les conclusions statistiques de l’étude.
L’erreur classique réside dans l’attribution directe de la valeur alpha intégrale au lieu d’alpha divisé par deux au sein d’un test bilatéral. Par exemple, pour un risque nominal de 0,05, l’écriture fautive :
=LOI.NORMALE.STANDARD.INVERSE(1 - 0,05) renvoie la valeur de 1,645.
L’analyste pense appliquer un test bilatéral à 5 %, alors qu’il utilise en réalité un seuil bilatéral laxiste de 10 % (soit 5 % dans chaque queue), multipliant indûment par deux son risque réel d’erreur de première espèce.
Une dérive symétrique s’observe lors de l’omission de la soustraction complémentaire 1 - dans le calcul d’un test unilatéral supérieur :
L’écriture =LOI.NORMALE.STANDARD.INVERSE(0,05) génère la valeur critique négative de -1,645.
Si le chercheur omet d’interpréter le signe ou prend aveuglément la valeur absolue sans vérifier la cohérence logique du test, il risque de valider une hypothèse de supériorité avec une règle inversée.
Pour enrayer ces dérives au sein des unités de recherche, des protocoles de double vérification indépendante doivent être instaurés. Il est préconisé d’intégrer dans les modèles des cellules d’audit interne affichant en clair l’équivalence probabiliste réelle du test (par exemple en faisant recalculer par le tableur la p-valeur théorique associée au seuil généré pour confirmer son adéquation stricte avec le niveau alpha planifié).
11.3 Biais d’arrondi et incohérences dans l’évaluation des seuils limites
Les divergences d’évaluation observées aux frontières décisionnelles résultent très souvent d’une manipulation imprudente des fonctions d’arrondi au sein des étapes intermédiaires de modélisation. De nombreux utilisateurs ont pour réflexe d’appliquer la fonction ARRONDI(cellule; 2) directement sur la valeur critique calculée ou sur la statistique Z observée, dans le dessein d’aligner l’affichage sur la précision habituelle des manuels de référence.
Cette pratique d’arrondi prématuré déforme la rigueur du calcul en virgule flottante double précision. Supposons qu’un score Z empirique s’établisse à 1,9598 face à une valeur critique bilatérale à alpha = 0,05 (qui vaut réellement 1,95996...). Si les deux grandeurs sont préalablement arrondies à deux décimales, elles s’affichent toutes deux à 1,96, induisant une égalité artificielle qui peut inciter l’analyste à rejeter l’hypothèse nulle. Pourtant, à pleine précision numérique, le score Z empirique demeure rigoureusement inférieur au seuil critique théorique, commandant le non-rejet de l’hypothèse nulle.
La règle méthodologique fondamentale prescrit de conserver l’intégralité de la précision de stockage d’Excel tout au long de la chaîne analytique, et de réserver l’arrondi visuel au seul formatage de présentation des cellules via les options d’affichage de l’interface graphique. Aucune troncature arithmétique explicite ne doit s’intercaler en amont des tests de comparaison logique.
Enfin, il convient de souligner que les écarts occasionnellement constatés entre les résultats calculés sous Excel et ceux consignés dans les tables imprimées historiques ne constituent pas des erreurs logicielles. Ils témoignent au contraire de la supériorité algorithmique des tableurs modernes sur les tables papier traditionnelles, lesquelles ont été compilées il y a un demi-siècle avec des approximations manuelles ou des interpolations linéaires partielles.
12. Applications pratiques de la valeur critique Z à l’analyse de données psychologiques réelles
12.1 Test de comparaison de deux proportions indépendantes dans un cadre clinique
Une application clinique emblématique de la valeur critique Z concerne l’évaluation comparative de l’efficacité de deux protocoles thérapeutiques indépendants mesurée par des taux de rémission catégoriels (succès/échec). Dans cette configuration expérimentale, la variable dépendante est dichotomique, et le test vise à déterminer si la proportion de rémission au sein d’un groupe recevant une thérapie cognitive et comportementale (TCC) enrichie dépasse significativement celle observée sous TCC conventionnelle.
Soit un échantillon de 100 patients sous protocole enrichi affichant 70 rémissions (p₁ = 0,70) et une cohorte témoin de 100 patients sous traitement classique comptabilisant 50 rémissions (p₂ = 0,50). L’hypothèse nulle postule l’égalité des proportions populationnelles (p₁ = p₂). L’évaluation de l’erreur standard de la différence exige le calcul de la proportion combinée :
p_pool = (70 + 50) / (100 + 100) = 120 / 200 = 0,60.
La variance d’échantillonnage de la différence se déduit alors par :
SE = RACINE(0,60 * (1 - 0,60) * (1/100 + 1/100)) = RACINE(0,24 * 0,02) = RACINE(0,0048) = 0,06928.
Le calcul de la statistique de test Z empirique donne :
Z_obs = (0,70 - 0,50) / 0,06928 = 0,20 / 0,06928 = 2,887.
En paramétrant dans Excel un test bilatéral au seuil d’exigence alpha de 0,01 au moyen de la syntaxe :
=LOI.NORMALE.STANDARD.INVERSE(1 - 0,01/2),
le tableur renvoie une valeur critique Z de ±2,576.
La statistique observée excédant nettement la valeur critique théorique (2,887 > 2,576), l’hypothèse nulle est rejetée au seuil rigoureux de 1 %. Les cliniciens valident avec une forte robustesse la supériorité du protocole TCC enrichi sur l’obtention d’une rémission clinique, fournissant des données probantes pour l’orientation des politiques de santé mentale.
12.2 Standardisation et étalonnage des batteries de tests psychométriques
Dans l’évaluation psychologique et neuropsychologique standardisée (par exemple les échelles de Wechsler pour la mesure du quotient intellectuel ou les inventaires de personnalité de type MMPI), le recours à la valeur critique Z est indispensable pour délimiter les catégories normatives et diagnostiquer les fonctionnements cognitifs atypiques ou pathologiques.
L’étalonnage psychométrique procède par la segmentation de la courbe normale de référence en zones diagnostiques standardisées fondées sur les quantiles de la distribution. Par convention clinique, les performances s’écartant de plus de deux écarts-types de la moyenne populationnelle sont qualifiées d’atypiques, qu’elles traduisent un haut potentiel intellectuel ou un déficit neuropsychologique caractérisé. L’extraction de ces bornes sous Excel mobilise directement la fonction d’inversion.
Pour isoler les seuils délimitant les 2,5 % d’individus présentant les scores les plus affaiblis de la population (queue inférieure), la saisie de :
=LOI.NORMALE.STANDARD.INVERSE(0,025) identifie l’abscisse seuil de -1,96.
Pour convertir ce quantile Z en score de quotient intellectuel standard (caractérisé par une moyenne théorique fixée à 100 et un écart-type normé de 15 points), l’analyste applique dans le tableur la transformation linéaire canonique :
Score_QI = 100 + (Z_critique * 15).
Pour Z = -1,96, le seuil d’alerte clinique s’établit à 100 + (-1,96 * 15) = 70,6 points.
Grâce à ces modélisations, un tableau de bord Excel peut catégoriser automatiquement les profils des patients testés : toute performance brute inférieure à ce seuil calculé déclenche l’attribution du label clinique de « performance déficitaire », guidant l’orientation des bénéficiaires vers des dispositifs de soutien adaptés conformément aux critères nosographiques du DSM-5.
12.3 Construction des intervalles de confiance à 95% et 99% dérivés du Z critique
L’estimation par intervalle de confiance incarne le prolongement naturel et indispensable de l’inférence par test d’hypothèse. Recommandée par l’ensemble des comités éditoriaux internationaux, elle fournit une estimation de la plage de valeurs au sein de laquelle le paramètre populationnel inconnu a une probabilité déterminée (généralement 95 % ou 99 %) de se situer. La valeur critique Z bilatérale constitue la composante multiplicatrice directe permettant de dimensionner la marge d’erreur de cet intervalle.
La borne inférieure et la borne supérieure d’un intervalle de confiance pour une moyenne d’échantillon observée se formalisent sous Excel au moyen de l’expression mathématique unifiée :
Borne = Moyenne_observée ± Z_critique * (sigma / RACINE(N)).
Dans le tableur, pour une moyenne en cellule B1, un écart-type connu en B2, une taille d’échantillon en B3 et un seuil de confiance à 95 % (soit alpha = 0,05), la formule de la borne inférieure s’exécute ainsi :
=B1 - LOI.NORMALE.STANDARD.INVERSE(1 - 0,05/2) * (B2 / RACINE(B3)).
Symétriquement, la borne supérieure s’obtient en remplaçant la soustraction par une addition.
L’interprétation clinique des intervalles de confiance procure un avantage informatif majeur par rapport au test d’hypothèse ponctuel : elle renseigne directement sur la précision de la mesure. Un intervalle extrêmement large, même statistiquement significatif vis-à-vis du point zéro, traduit une incertitude substantielle sur l’ampleur réelle de l’effet, incitant les praticiens à la prudence avant toute généralisation clinique.
L’articulation entre l’intervalle de confiance et la valeur critique Z bilatérale permet une double lecture analytique : si l’intervalle de confiance à 95 % n’englobe pas la valeur postulée sous l’hypothèse nulle (usuellement zéro pour une différence de moyennes), le chercheur est mathématiquement garanti que le test d’hypothèse bilatéral correspondant conclura au rejet de H0 au seuil alpha de 0,05. Cette cohérence théorique renforce la robustesse de l’analyse exploratoire sous Excel.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Institute of Electrical and Electronics Engineers. (2019). IEEE standard for floating-point arithmetic (IEEE Std 754-2019). IEEE. https://standards.ieee.org/ieee/754/6210/
- Microsoft Corporation. (2023). Fonction LOI.NORMALE.STANDARD.INVERSE. Support Microsoft. https://support.microsoft.com/fr-fr/office/loi-normale-standard-inverse-f0eecb6f-44a9-43fb-8287-691bf37e6f65
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Weisstein, E. W. (2002). Standard Normal Distribution. MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/StandardNormalDistribution.html