
La synthèse quantitative des données constitue l’un des piliers méthodologiques les plus critiques de la recherche contemporaine en sciences du comportement, en neurosciences cognitives et en psychométrie. Face à la multiplication des plans d’expérience multifactoriels, des protocoles longitudinaux et des méta-analyses systématiques, les chercheurs se heurtent quotidiennement à la nécessité de résumer l’hétérogénéité et l’imprécision des mesures à travers divers groupes d’observation. Or, si le calcul de la moyenne arithmétique de plusieurs scores moyens est une opération élémentaire largement comprise, l’agrégation de multiples indices de dispersion soulève des difficultés théoriques et algébriques substantielles qui échappent fréquemment à la pratique standardisée des laboratoires.
L’écart-type, mesure emblématique de la variabilité d’une distribution statistique autour de son centre de gravité, présente des propriétés géométriques et probabilistes singulières. En raison de sa construction non linéaire fondée sur la racine carrée d’une somme de déviations quadratiques divisée par les degrés de liberté, il ne possède pas la propriété d’additivité qui caractérise d’autres statistiques descriptives fondamentales. Appliquer mécaniquement une moyenne arithmétique simple à un ensemble d’écarts-types constitue ainsi un contresens algébrique lourd de conséquences, conduisant de manière systématique à une sous-estimation mathématique de la variabilité réelle du phénomène psychologique étudié.
Ce traité exhaustif a pour vocation d’exposer de manière rigoureuse les principes fondamentaux, les dérivations formelles et les applications pratiques indispensables pour combiner correctement plusieurs écarts-types. En explorant successivement les bases psychométriques de la dispersion, l’écueil de l’inégalité de Jensen, les protocoles applicables aux échantillons de tailles identiques ou asymétriques, ainsi que l’intégration algorithmique au sein des langages de programmation statistique, ce guide fournit à la communauté académique les instruments méthodologiques requis pour préserver l’intégrité de l’inférence statistique et des synthèses de recherche selon les plus hauts standards de publication scientifique.
1. Fondements conceptuels de la dispersion et de l’écart-type en psychologie
1.1 Définition psychométrique de l’écart-type et de la variance
Dans l’architecture de la théorie classique des tests et de la psychométrie différentielle, l’évaluation de la performance humaine ou de la symptomatologie clinique repose impérativement sur la quantification précise de la dispersion des observations. La variance paramétrique d’une variable aléatoire continue, notée conventionnellement $\sigma^2$ pour une population ou $s^2$ pour un échantillon d’observations indépendantes et identiquement distribuées, correspond à l’espérance mathématique du carré des déviations par rapport à la moyenne arithmétique. Cette quantité algébrique possède des vertus analytiques exceptionnelles dans la théorie linéaire générale, notamment en raison de sa décomposabilité géométrique dans les espaces hilbertiens.
Néanmoins, la variance souffre d’un défaut d’interprétabilité clinique direct : son unité d’expression est le carré de l’unité de mesure initiale de l’instrument d’évaluation, qu’il s’agisse de millisecondes dans les paradigmes de chronométrie mentale ou de points bruts sur l’échelle de dépression de Beck (American Psychological Association). C’est pour remédier à cette dissociation dimensionnelle que l’écart-type échantillonnal non biaisé, désigné par la lettre $s$, a été introduit par Karl Pearson comme la racine carrée positive de la variance corrigée :
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(x_i – \bar{x})^2}$$
Dans les protocoles expérimentaux en psychologie cognitive, l’écart-type ne représente pas un simple artefact statistique résiduel, mais incarne la métrique de la variabilité interindividuelle et intra-individuelle. Une dispersion accrue des temps de réponse lors d’une tâche d’attention soutenue de type Stroop ou Go/No-Go traduit fréquemment des fluctuations de l’éveil cortical, des intrusions attentionnelles ou des défaillances transitoires du contrôle exécutif, conférant ainsi à l’écart-type le statut d’indicateur neuropsychologique à part entière.
1.2 Nécessité de combiner la dispersion à travers des sous-groupes
L’obligation pratique de combiner des estimations de dispersion dispersées émerge continuellement dans les devis de recherche contemporains. Dans les plans expérimentaux factoriels mixtes ou inter-sujets comportant de multiples cohortes (par exemple, des sous-groupes stratifiés selon des tranches d’âge, des variants génétiques ou des niveaux d’exposition clinique), le chercheur est régulièrement sommé d’estimer un paramètre de dispersion global représentatif de l’ensemble de l’échantillon ou de stabiliser la variance résiduelle pour calibrer la puissance de tests ultérieurs.
Les investigations longitudinales constituent un autre théâtre d’application critique. Lorsqu’une batterie d’évaluations neuropsychologiques est administrée à une cohorte à plusieurs temps de mesure (par exemple, pré-test, post-test immédiat et suivis à six et douze mois), chaque session engendre sa propre dispersion empirique. Si le chercheur désire caractériser la dispersion moyenne intra-session afin de neutraliser l’effet d’apprentissage ou la fatigue cognitive, une procédure d’agrégation formelle s’impose pour agréger les matrices de variances et d’écarts-types.
Enfin, l’évaluation de la fidélité test-retest et la détermination de l’erreur type de mesure (SEM) en psychométrie nécessitent l’estimation d’une variabilité standardisée moyenne à travers divers échantillons de validation croisée. Agréger incorrectement ces indices conduit inéluctablement à altérer les coefficients d’estimation de la consistance interne, biaisant ainsi la standardisation des scores z et la définition des intervalles de confiance thérapeutiques individuels.
1.3 Propriétés non-linéaires de l’écart-type
La difficulté centrale de l’agrégation de l’écart-type découle directement de son statut d’opérateur non linéaire. Contrairement à la somme des carrés des écarts qui est rigoureusement additive sous certaines conditions d’indépendance statistique, la racine carrée constitue une fonction strictement concave sur l’ensemble des réels positifs $\mathbb{R}^+$. Cette concavité a des implications structurales majeures : pour toute fonction concave non constante $g(u)$, l’image de la moyenne d’un ensemble de points n’est pas équivalente à la moyenne des images de ces mêmes points.
Plus explicitement, si l’on considère deux groupes expérimentaux présentant des variances respectives $s_1^2$ et $s_2^2$, l’écart-type moyen ne saurait être déduit d’une opération linéaire de type $(s_1 + s_2) / 2$. La transformation racine carrée compresse de manière asymétrique les valeurs élevées par rapport aux faibles valeurs, de sorte que l’opérateur d’espérance et l’opérateur d’extraction de racine ne commutent pas mathématiquement :
$$\mathbb{E}[\sqrt{X}] \neq \sqrt{\mathbb{E}[X]}$$
En pratique, cette propriété algébrique implique que toute tentative d’effectuer une moyenne arithmétique directe sur des écarts-types engendre une perte d’information géométrique fondamentale. La dispersion totale d’un système composite dépend de l’énergie cinétique ou quadratique totale des fluctuations, laquelle ne peut être préservée que dans l’espace euclidien des variances.
2. Le piège de la moyenne arithmétique simple des écarts-types
2.1 Démonstration du biais d’estimation
L’illusion d’intuitivité qui entoure la moyenne arithmétique simple ($s_{\text{arith}} = \frac{1}{k}\sum_{i=1}^k s_i$) en fait l’une des erreurs les plus insidieuses et répandues dans le dépouillement empirique des données en psychologie. Ce piège analytique est formellement expliqué par l’inégalité de Jensen. Soit une fonction $f$ deux fois dérivable sur un intervalle $I$ ; si $f »(x) < 0$ pour tout $x in I$, alors $f$ est strictement concave. Pour toute variable aléatoire non dégénérée $Y$, l’inégalité de Jensen stipule formellement que :
$$\mathbb{E}[f(Y)] < f(\mathbb{E}[Y])$$
En assignant à $f$ la fonction racine carrée $f(u) = \sqrt{u}$, dont la dérivée seconde est $f »(u) = -\frac{1}{4}u^{-3/2} < 0$ sur $\mathbb{R}^+_*$, et en considérant que notre variable aléatoire $Y$ représente la distribution des variances échantillonnales $s^2$, il en résulte inconditionnellement que :
$$\frac{1}{k}\sum_{i=1}^k \sqrt{s_i^2} < \sqrt{\frac{1}{k}\sum_{i=1}^k s_i^2}$$
Ce théorème fondamental démontre que la moyenne arithmétique des écarts-types est strictement inférieure à la racine carrée de la moyenne des variances. Par conséquent, le chercheur qui recourt naïvement à la moyenne arithmétique sous-évalue de manière systématique la véritable amplitude de la dispersion psychologique sous-jacente. Ce biais négatif dégrade immédiatement la précision des calculs prévisionnels de puissance statistique, conduisant à planifier des effectifs sous-dimensionnés pour de futurs essais randomisés contrôlés.
2.2 Distinction essentielle entre moyenne arithmétique et variance combinée
La confusion entre la moyenne arithmétique des dispersions individuelles et le concept de variance agrégée (communément désignée par le terme anglophone de pooled variance) traduit une incompréhension de la structure hiérarchique des données. Dans un devis expérimental, la dispersion d’une mesure composite résulte de la combinaison orthogonale de deux sources d’incertitude distinctes : la variabilité intra-groupe (les fluctuations aléatoires individuelles au sein de chaque condition) et la variabilité inter-groupes (l’écartement systématique entre les moyennes des cohortes induit par les variables indépendantes).
La variance agrégée, notée usuellement $s_p^2$, a pour fonction exclusive de fournir un estimateur sans biais de la variance d’erreur intra-groupe commune à l’ensemble des populations échantillonnées. Elle est construite à partir de l’addition directe des sommes de carrés intra-groupes divisée par les degrés de liberté cumulés, respectant scrupuleusement la métrique fondamentale de la variance :
$$s_p^2 = \frac{SS_{\text{intra}}}{df_{\text{total}}}$$
Ignorer cette distinction en calculant une moyenne linéaire d’écarts-types détruit la relation de correspondance directe avec la distribution $F$ de Fisher-Snedecor et le test $t$ de Student. Les conséquences méthodologiques s’avèrent délétères : distorsion du taux d’erreur de type I (rejet intempestif de l’hypothèse nulle d’homogénéité en raison d’une sous-estimation de l’erreur standard) et altération de la couverture nominale des intervalles de confiance calculés autour des différences de moyennes marginales.
2.3 Cas d’études historiques d’erreurs d’agrégation
L’histoire de la psychologie quantitative et de la psychiatrie expérimentale est jalonnée d’exemples notables où la manipulation inadéquate des déviations standard a conduit à des conclusions erronées ou controversées. Lors de l’émergence des premières grandes méta-analyses consacrées à l’efficacité des thérapies cognitivo-comportementales (TCC) dans le traitement des troubles anxieux et de la dépression majeure au cours des années 1970 et 1980, plusieurs équipes de recherche compilaient les statistiques descriptives primaires en moyennant les écarts-types bruts rapportés dans les publications sources.
Cette simplification méthodologique illégitime a produit des estimations artificiellement resserrées de la variabilité clinique des symptômes post-thérapie. En réduisant indûment le dénominateur des tailles d’effet standardisées, certains auteurs ont involontairement gonflé l’ampleur perçue des gains thérapeutiques, créant un artefact de supériorité statistique qui n’a pu être répliqué lors de réanalyses méthodologiques plus scrupuleuses.
Face à ces dérives documentées dans la littérature évaluée par les pairs, les instances de normalisation méthodologique ont radicalement durci leurs protocoles. Le comité de publication de l’American Psychological Association, à travers les éditions successives de son manuel de style, ainsi que le réseau international Cochrane Collaboration, ont explicitement proscrit la moyenne arithmétique directe des déviations standard, instaurant l’obligation méthodologique de remonter aux variances agrégées ou de solliciter des modélisations bayésiennes multiniveaux pour toute synthèse de données quantitatives.
3. Fondements mathématiques : passage par la variance agrégée
3.1 Le concept de variance commune ou combinée
Pour déterminer de manière formelle et rigoureuse l’écart-type représentatif d’une série de sous-groupes, le passage par l’espace vectoriel des variances constitue un impératif mathématique incontournable. La variance agrégée, ou variance commune, repose sur le principe de la mise en commun des informations issues de multiples échantillons indépendants issus d’une même population théorique ou de populations présentant une structure de dispersion supposée homogène.
Le formalisme sous-jacent implique la sommation des sommes des carrés des déviations ($SS_k$) observées au sein de chaque groupe $k$. Sachant que pour un échantillon donné, la somme des carrés non corrigée se déduit directement de son écart-type par la relation élémentaire $SS_k = (n_k – 1)s_k^2$, la variance agrégée s’exprime comme le quotient de la somme cumulative de ces déviations quadratiques par la somme des degrés de liberté individuels associés :
$$s_p^2 = \frac{\sum_{k=1}^K SS_k}{\sum_{k=1}^K df_k} = \frac{\sum_{k=1}^K (n_k – 1)s_k^2}{\sum_{k=1}^K (n_k – 1)}$$
Une fois cette variance commune établie dans l’espace quadratique, la transition finale vers l’espace dimensionnel originel de la variable psychologique s’opère par l’extraction de la racine carrée unique de $s_p^2$. Ce détour par les variances n’est pas un artifice calculatoire contingent, mais l’unique démarche respectant les axiomes de la géométrie euclidienne des distributions normales et garantissant la conservation de l’information statistique.
3.2 Pondération et degrés de liberté
L’introduction explicite des degrés de liberté ($df_k = n_k – 1$) dans la formule de pondération de la variance combinée découle directement de la théorie de l’échantillonnage de Fisher. Selon le théorème fondamental de Cochran, pour une variable suivant une distribution normale $\mathcal{N}(\mu, \sigma^2)$, le ratio quadratique $\frac{(n-1)s^2}{\sigma^2}$ est rigoureusement distribué selon une loi du chi-carré à $n – 1$ degrés de liberté, notée $\chi^2(n-1)$.
L’espérance mathématique d’une variable distribuée selon une loi du chi-carré étant égale à ses degrés de liberté ($\mathbb{E}[\chi^2(\nu)] = \nu$), l’espérance de la somme des carrés échantillonnale vérifie parfaitement :
$$\mathbb{E}[(n-1)s^2] = (n-1)\sigma^2$$
En vertu de la propriété d’additivité des variables aléatoires indépendantes suivant des distributions du chi-carré, la somme pondérée $\sum_{k=1}^K (n_k – 1)s_k^2 / \sigma^2$ se distribue comme un $\chi^2$ dont les degrés de liberté totaux équivalent à $\sum_{k=1}^K (n_k – 1) = N – K$, où $N$ désigne l’effectif global cumulé et $K$ le nombre total de groupes combinés. La division par $N – K$ garantit formellement que la variance combinée obtenue est un estimateur parfaitement non biaisé de la variance paramétrique $\sigma^2$ de la population d’origine :
$$\mathbb{E}[s_p^2] = \sigma^2$$
3.3 Critères d’homoscédasticité et postulats de validité
L’application légitime de la variance combinée repose sur une hypothèse distributionnelle fondamentale : le postulat d’homoscédasticité, ou égalité des variances populationnelles sous-jacentes ($\sigma_1^2 = \sigma_2^2 = dots = \sigma_K^2 = \sigma^2$). Si les populations sources présentent des structures de variance fondamentalement divergentes, le concept même d’un écart-type unique moyen perd une part substantielle de sa validité statistique et théorique.
Avant d’opérer toute fusion de dispersions échantillonnales, le chercheur en sciences humaines doit impérativement soumettre ses données à des tests formels d’homogénéité des variances. Le test de Bartlett offre une puissance statistique maximale sous condition stricte de normalité bivariée ou multivariée, mais s’avère particulièrement hypersensible aux légères déviations de symétrie et d’aplatissement (kurtosis). C’est pourquoi le test de Levene, en particulier sa variante modifiée par Brown et Forsythe utilisant les écarts médians absolus au lieu de la moyenne, constitue aujourd’hui la référence empirique standard en raison de sa robustesse face aux asymétries de distribution.
En présence d’une violation modérée de l’homoscédasticité (avec des ratios de variance $s_{\max}^2 / s_{\min}^2$ ne dépassant pas 2,5 à 3 dans des protocoles équilibrés), l’estimateur combiné demeure relativement robuste. En revanche, en cas d’hétéroscédasticité sévère couplée à un fort déséquilibre d’effectifs, l’agrégation statistique standard introduit des distorsions qui imposent le recours à des modélisations hétérogènes plus sophistiquées, telles que l’approximation de Satterthwaite ou la correction de Welch.
4. Méthode 1 : Calcul de la moyenne pour des échantillons de tailles égales
4.1 Dérivation analytique de la formule simplifiée
Lorsque le protocole expérimental garantit un équilibre parfait des effectifs au sein de chaque groupe ou condition d’évaluation, c’est-à-dire lorsque $n_1 = n_2 = dots = n_K = n$, la formule générale de la variance combinée connaît une simplification algébrique remarquable. Sous cette hypothèse d’homogénéité d’échantillonnage, les degrés de liberté associés à chaque échantillon sont strictement constants et identiques :
$$df_1 = df_2 = dots = df_K = n – 1$$
En substituant cette constante $n – 1$ dans l’équation maîtresse de la variance agrégée, il devient possible de factoriser ce terme au numérateur et au dénominateur :
$$s_p^2 = \frac{\sum_{k=1}^K (n – 1)s_k^2}{\sum_{k=1}^K (n – 1)} = \frac{(n – 1)\sum_{k=1}^K s_k^2}{K(n – 1)} = \frac{\sum_{k=1}^K s_k^2}{K}$$
L’écart-type moyen, déduit par extraction de la racine carrée positive de cette variance combinée simplifiée, se formule alors directement comme la racine carrée de la moyenne arithmétique des variances individuelles :
$$s_{\text{moyen}} = \sqrt{\frac{1}{K}\sum_{k=1}^K s_k^2}$$
Cette expression analytique correspond très exactement à la moyenne quadratique des écarts-types, universellement désignée dans la littérature quantitative anglo-saxonne sous l’acronyme RMS (Root Mean Square). Cette simplification formelle prouve que, pour des groupes équilibrés, l’effectif spécifique $n$ des sous-groupes n’exerce plus aucune influence sur la pondération relative de chaque dispersion.
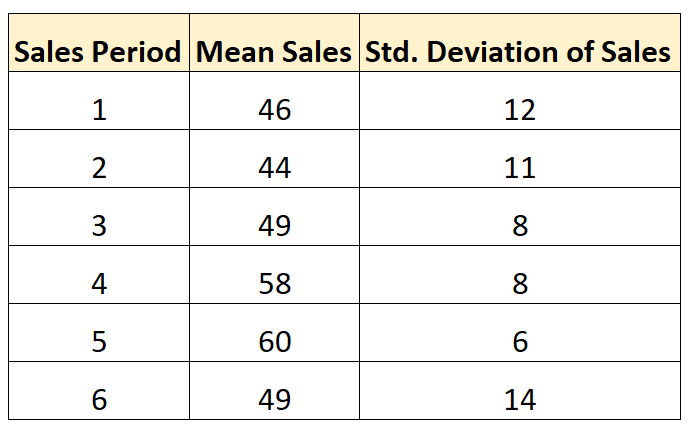
4.2 Conditions strictes d’application méthodologique
La validité scientifique de la formule simplifiée de la moyenne quadratique repose sur le respect inconditionnel de plusieurs prérequis méthodologiques. En premier lieu, l’égalité des effectifs ne souffre aucune approximation : la moindre fluctuation (par exemple, un groupe de 29 sujets confronté à des groupes de 30 sujets) brise l’exactitude de la simplification algébrique et réintroduit un biais d’estimation si la taille de l’échantillon interagit avec l’amplitude de la dispersion.
Cette contrainte s’avère critique dans les plans de randomisation expérimentale. Bien que les chercheurs conçoivent initialement des protocoles orthogonaux parfaitement équilibrés, la réalité empirique du laboratoire — caractérisée par l’attrition des participants, l’élimination des données polluées par des artefacts de mesure, ou le non-respect des critères d’inclusion en cours d’étude — conduit presque systématiquement à une asymétrie des effectifs finaux exploitables.
Par conséquent, l’utilisation de la méthode 1 doit être strictement restreinte aux devis entièrement contrôlés dans lesquels l’absence absolue de données manquantes est formellement certifiée. Dans tout autre contexte, l’application de cette formule simplifiée relève d’une négligence statistique susceptible de fausser les estimations de variabilité du protocole.
4.3 Algorithme de calcul étape par étape
Pour exécuter le calcul de l’écart-type moyen sur des échantillons de tailles rigoureusement égales sans commettre d’erreur computationnelle, il convient d’appliquer scrupuleusement la séquence algorithmique suivante :
- Étape 1 : Conversion dans l’espace des variances. Pour chacun des $K$ groupes expérimentaux, élever au carré l’écart-type échantillonnal observé ($s_k$) afin d’obtenir la variance empirique correspondante :
$$s_k^2 = (s_k)^2 \quad \text{pour } k = 1, 2, dots, K$$ - Étape 2 : Sommation des variances individuelles. Calculer la somme arithmétique cumulative de toutes les variances obtenues lors de l’étape précédente :
$$\sum_{k=1}^K s_k^2 = s_1^2 + s_2^2 + dots + s_K^2$$ - Étape 3 : Calcul de la variance moyenne. Diviser la somme totale des variances par le nombre absolu de groupes d’observation $K$ pour établir la variance intra-groupe commune non biaisée :
$$s_p^2 = \frac{1}{K}\sum_{k=1}^K s_k^2$$ - Étape 4 : Rétablissement de la dimension initiale. Extraire la racine carrée positive de la variance commune obtenue à l’étape 3 pour obtenir l’écart-type moyen combiné :
$$s_{\text{moyen}} = \sqrt{s_p^2}$$
Il est impératif d’éviter tout arrondi numérique prématuré au cours des étapes 1 à 3. Les opérations intermédiaires doivent conserver un maximum de décimales de précision machine afin de prévenir l’amplification des erreurs d’arrondi lors de l’extraction finale de la racine carrée.
5. Exemple pratique pas-à-pas de la méthode 1 en psychologie expérimentale
5.1 Scénario de recherche : Variabilité des temps de réaction cognitive
Pour illustrer l’implémentation pratique de la méthode de la moyenne quadratique, considérons un protocole de recherche en neuropsychologie cognitive visant à examiner la stabilité de l’attention visuo-spatiale au cours d’un entraînement cognitif intensif étalé sur plusieurs semaines. L’expérimentateur administre une tâche de détection de cibles visuelles sur écran à un échantillon rigoureusement contrôlé de 30 participants adultes sains ($n = 30$) lors de six sessions d’entraînement indépendantes ($K = 6$).
Le tableau ci-dessous récapitule les données descriptives obtenues pour la métrique de dispersion des temps de réaction, mesurée en millisecondes (ms), à travers les six sessions expérimentales successives :
- Session 1 : Effectif $n_1 = 30$, Écart-type observé $s_1 = 45\text{ ms}$
- Session 2 : Effectif $n_2 = 30$, Écart-type observé $s_2 = 52\text{ ms}$
- Session 3 : Effectif $n_3 = 30$, Écart-type observé $s_3 = 38\text{ ms}$
- Session 4 : Effectif $n_4 = 30$, Écart-type observé $s_4 = 61\text{ ms}$
- Session 5 : Effectif $n_5 = 30$, Écart-type observé $s_5 = 49\text{ ms}$
- Session 6 : Effectif $n_6 = 30$, Écart-type observé $s_6 = 55\text{ ms}$
L’objectif scientifique consiste à dériver l’écart-type représentatif de la variabilité intra-individuelle globale à travers ces six phases de test, en neutralisant l’effet d’apprentissage sur la moyenne globale mais en préservant fidèlement la dispersion des performances.
5.2 Résolution manuelle détaillée
Appliquons scrupuleusement l’algorithme dévolu aux échantillons de tailles parfaitement équilibrées afin de combiner ces six indicateurs empiriques de dispersion :
Étape 1 : Calcul des variances échantillonnales associées à chaque session
- $s_1^2 = (45)^2 = 2025\text{ ms}^2$
- $s_2^2 = (52)^2 = 2704\text{ ms}^2$
- $s_3^2 = (38)^2 = 1444\text{ ms}^2$
- $s_4^2 = (61)^2 = 3721\text{ ms}^2$
- $s_5^2 = (49)^2 = 2401\text{ ms}^2$
- $s_6^2 = (55)^2 = 3025\text{ ms}^2$
Étape 2 : Sommation exhaustive de ces variances intermédiaires
$$\sum_{k=1}^6 s_k^2 = 2025 + 2704 + 1444 + 3721 + 2401 + 3025 = 15320\text{ ms}^2$$
Étape 3 : Division par le nombre total de sessions ($K = 6$)
$$s_p^2 = \frac{15320}{6} \approx 2553{,}3333\text{ ms}^2$$
Étape 4 : Extraction finale de la racine carrée
$$s_{\text{moyen}} = \sqrt{2553{,}3333} \approx 50{,}5305\text{ ms}$$
En arrondissant conformément aux normes académiques en vigueur à deux décimales significatives, l’écart-type moyen combiné représentatif des sessions d’entraînement cognitif s’élève rigoureusement à $50{,}53\text{ ms}$.
5.3 Interprétation clinique et psychologique des résultats
Si l’on avait commis l’erreur méthodologique de calculer une moyenne arithmétique simple et naïve des déviations standard brutes, le calcul aurait produit :
$$s_{\text{arith}} = \frac{45 + 52 + 38 + 61 + 49 + 55}{6} = \frac{300}{6} = 50{,}00\text{ ms}$$
La comparaison numérique directe révèle instantanément une sous-estimation systématique de $0{,}53\text{ ms}$ au détriment de la moyenne arithmétique simple ($50{,}00\text{ ms}$ contre $50{,}53\text{ ms}$). Bien que cet écart puisse sembler ténu à l’échelle d’une étude univariée ponctuelle, cette discordance illustre parfaitement la concavité de la racine carrée. L’impact de la Session 4, caractérisée par une forte instabilité attentionnelle ($s_4 = 61\text{ ms}$), se trouve indûment occulté par la moyenne arithmétique linéaire, alors que la moyenne quadratique accorde à ce surcroît de variance son juste poids géométrique.
Dans la section Résultats d’un article soumis selon les exigences du style APA (7e édition), cette agrégation de données sera formulée avec précision :
« L’évaluation de la dispersion attentionnelle au cours des six phases expérimentales ($n = 30$ par session) met en évidence une variabilité intra-individuelle moyenne combinée de $50{,}53\text{ ms}$, dérivée de la moyenne quadratique des variances intra-sessions ($s_p^2 = 2553{,}33\text{ ms}^2$), attestant d’une régulation cognitive stable malgré des oscillations ponctuelles lors de la quatrième session d’évaluation. »
6. Méthode 2 : Calcul de la moyenne pour des échantillons de tailles inégales
6.1 Formulation mathématique complète et pondération par les degrés de liberté
Dans la majorité des études cliniques, des enquêtes de terrain et des analyses en milieu organisationnel, la parfaite symétrie des effectifs d’échantillonnage s’avère être l’exception plutôt que la règle. Lorsque les effectifs des sous-groupes divergent ($n_1 \neq n_2 \neq dots \neq n_K$), la simplification par la moyenne quadratique brute devient caduque et engendre un biais méthodologique sévère. Il devient alors indispensable d’assigner à chaque variance un poids directement proportionnel à son volume d’information statistique effectif, mesuré par ses degrés de liberté ($df_k = n_k – 1$).
La formulation mathématique universelle pour des échantillons hétérogènes intègre l’ensemble de ces pondérations au numérateur ainsi qu’au dénominateur :
$$s_p^2 = \frac{\sum_{k=1}^K (n_k – 1)s_k^2}{\sum_{k=1}^K (n_k – 1)} = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2 + dots + (n_K – 1)s_K^2}{(n_1 – 1) + (n_2 – 1) + dots + (n_K – 1)}$$
L’écart-type combiné moyen est ensuite formellement défini par l’extraction de la racine carrée de ce ratio pondéré :
$$s_{\text{pondéré}} = \sqrt{\frac{\sum_{k=1}^K (n_k – 1)s_k^2}{N – K}}$$
Dans cette équation, $N = \sum_{k=1}^K n_k$ représente l’effectif global cumulé de l’ensemble des cohortes examinées, tandis que $N – K$ incarne les degrés de liberté résiduels cumulés alloués à l’estimation de l’erreur intra-groupe. Ce mécanisme de pondération constitue le garant théorique assurant que l’estimateur demeure invariant, sans biais et à variance minimale (propriété BLUE : Best Linear Unbiased Estimator dans le cadre gaussien).
6.2 Conséquences du déséquilibre d’effectif sur la variance globale
L’asymétrie de distribution des effectifs introduit une dynamique de convergence statistique asymétrique. En vertu de la loi des grands nombres et des théorèmes limites centraux, un échantillon clinique de taille imposante ($n_1 = 500$) fournit une estimation de sa variance paramétrique intrinsèque dotée d’une erreur type considérablement plus resserrée qu’un groupe marginal de patients rares ($n_2 = 15$).
La formule pondérée reflète rigoureusement cette réalité épistémologique : elle confère une autorité statistique prépondérante aux cohortes majeures, empêchant les fluctuations erratiques et les valeurs aberrantes inhérentes aux petits échantillons de déstabiliser excessivement l’estimation de la dispersion globale. Inversement, si une cohorte clinique restreinte présente une variance exceptionnellement élevée en raison d’une labilité clinique marquée, la formule pondérée évite de surévaluer artificiellement l’écart-type combiné de la population générale, maintenant l’estimation à un niveau représentatif du volume réel des observations.
6.3 Procédure systématique d’exécution du calcul
Le protocole de traitement d’échantillons de tailles asymétriques requiert une approche méthodologique rigoureusement ordonnée, segmentée en quatre opérations séquentielles :
- Étape 1 : Cartographie des degrés de liberté individuels. Calculer pour chaque cohorte $k$ ses degrés de liberté propres :
$$df_k = n_k – 1$$ - Étape 2 : Dérivation des sommes de carrés intra-groupes. Élever chaque écart-type au carré pour déterminer sa variance empirique ($s_k^2$), puis multiplier chaque variance par son degré de liberté correspondant pour reconstituer la somme des carrés déviants ($SS_k$) :
$$SS_k = df_k \times s_k^2 = (n_k – 1)s_k^2$$
Effectuer ensuite la sommation intégrale de ces sommes de carrés pour fixer le numérateur global :
$$SS_{\text{total-intra}} = \sum_{k=1}^K SS_k$$ - Étape 3 : Détermination du dénominateur cumulé. Sommer les effectifs bruts pour obtenir $N$, puis retrancher le nombre total de groupes $K$ pour identifier les degrés de liberté globaux :
$$df_{\text{total}} = \sum_{k=1}^K (n_k – 1) = N – K$$
Diviser le numérateur cumulé par ce dénominateur pour établir la variance agrégée pondérée :
$$s_p^2 = \frac{SS_{\text{total-intra}}}{df_{\text{total}}}$$ - Étape 4 : Extraction finale de la racine de dispersion. Appliquer la racine carrée positive à la variance agrégée pour en extraire l’écart-type combiné final non biaisé :
$$s_{\text{pondéré}} = \sqrt{s_p^2}$$
7. Exemple pratique pas-à-pas de la méthode 2 avec des groupes cliniques asymétriques
7.1 Cadre de l’étude : Scores d’anxiété dans différentes cohortes psychopathologiques
Afin d’illustrer la manipulation de la méthode pondérée par les degrés de liberté, nous considérerons une vaste étude épidémiologique et transversale en psychopathologie clinique portant sur l’évaluation de la réactivité émotionnelle à travers quatre groupes diagnostiques distincts. L’intensité de l’anxiété générale est mesurée au moyen de l’échelle d’évaluation de l’anxiété de Hamilton (HAM-A), un instrument psychométrique continu standardisé produisant des scores d’une grande valeur clinique.
En raison des prévalences différenciées au sein de la population consultante et des contraintes d’admission institutionnelle, les effectifs des quatre groupes s’avèrent hautement dissemblables :
- Groupe 1 : Trouble Dépressif Majeur (TDM). Effectif $n_1 = 45$, Écart-type observé $s_1 = 8{,}5\text{ points}$
- Groupe 2 : Trouble Anxieux Généralisé (TAG). Effectif $n_2 = 60$, Écart-type observé $s_2 = 10{,}2\text{ points}$
- Groupe 3 : Phobie Sociale Spécifique (PSS). Effectif $n_3 = 25$, Écart-type observé $s_3 = 6{,}4\text{ points}$
- Groupe 4 : Témoins Sains Contrôles (TSC). Effectif $n_4 = 110$, Écart-type observé $s_4 = 4{,}8\text{ points}$
L’objectif quantitatif consiste à calculer l’écart-type combiné représentatif de l’ensemble de cette cohorte clinique hétérogène ($N = 45 + 60 + 25 + 110 = 240$ participants), afin de servir de base de référence pour le calibrage de seuils diagnostiques standardisés.
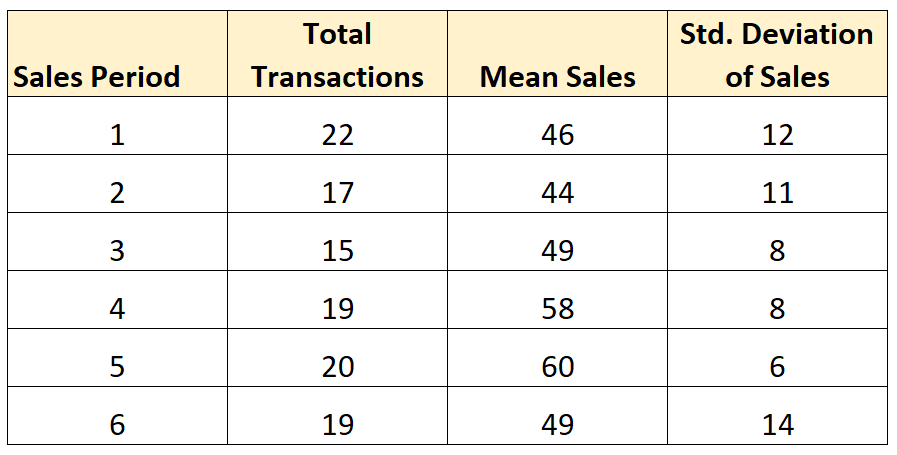
7.2 Application calculatoire pas-à-pas
Procédons avec rigueur à l’exécution de chacune des phases computationnelles détaillées précédemment :
Étape 1 : Détermination des degrés de liberté respectifs
- $df_1 = n_1 – 1 = 45 – 1 = 44$
- $df_2 = n_2 – 1 = 60 – 1 = 59$
- $df_3 = n_3 – 1 = 25 – 1 = 24$
- $df_4 = n_4 – 1 = 110 – 1 = 109$
Étape 2 : Calcul des variances et des sommes de carrés déviants ($SS_k$)
- $s_1^2 = (8{,}5)^2 = 72{,}25 implies SS_1 = 44 \times 72{,}25 = 3179{,}00$
- $s_2^2 = (10{,}2)^2 = 104{,}04 implies SS_2 = 59 \times 104{,}04 = 6138{,}36$
- $s_3^2 = (6{,}4)^2 = 40{,}96 implies SS_3 = 24 \times 40{,}96 = 983{,}04$
- $s_4^2 = (4{,}8)^2 = 23{,}04 implies SS_4 = 109 \times 23{,}04 = 2511{,}36$
Agrégation du numérateur global (Somme des carrés intra-groupes totale) :
$$SS_{\text{total-intra}} = 3179{,}00 + 6138{,}36 + 983{,}04 + 2511{,}36 = 12811{,}76$$
Étape 3 : Calcul du dénominateur cumulé et de la variance agrégée
Les degrés de liberté résiduels cumulés s’élèvent à :
$$df_{\text{total}} = 44 + 59 + 24 + 109 = 236 \quad (\text{ou } N – K = 240 – 4 = 236)$$
La variance combinée pondérée $s_p^2$ s’établit en effectuant le quotient :
$$s_p^2 = \frac{12811{,}76}{236} \approx 54{,}2871186$$
Étape 4 : Extraction de l’écart-type combiné pondéré
$$s_{\text{pondéré}} = \sqrt{54{,}2871186} \approx 7{,}36798$$
Arrondi selon les canons académiques, l’écart-type combiné représentatif de la population clinique globale est de $7{,}37\text{ points}$.
7.3 Discussion critique des disparités observées
La puissance d’évaluation de la méthode pondérée devient éclatante lorsqu’on met en regard ce résultat de $7{,}37\text{ points}$ avec les calculs concurrents erronés qui auraient pu être déployés :
- La moyenne arithmétique naïve : $s_{\text{arith}} = \frac{8{,}5 + 10{,}2 + 6{,}4 + 4{,}8}{4} = \frac{29{,}9}{4} = 7{,}475 \approx 7{,}48\text{ points}$.
- La formule de la méthode 1 (moyenne quadratique brute ignorant les effectifs) :
$$s_{\text{RMS}} = \sqrt{\frac{72{,}25 + 104{,}04 + 40{,}96 + 23{,}04}{4}} = \sqrt{\frac{240{,}29}{4}} = \sqrt{60{,}0725} \approx 7{,}75\text{ points}$$.
L’analyse comparée de ces trois valeurs démontre avec acuité l’influence majeure de la cohorte des témoins sains ($n_4 = 110$). Ce groupe, représentant à lui seul près de la moitié de l’échantillon global, présente une homogénéité comportementale remarquable ($s_4 = 4{,}8\text{ points}$). En ignorant la prépondérance numérique de ce groupe, la méthode 1 non pondérée surestime considérablement la dispersion globale ($7{,}75\text{ points}$ contre $7{,}37\text{ points}$ pour la méthode pondérée exacte), accordant un poids disproportionné au petit groupe des patients phobiques ($n_3 = 25$) et aux patients anxieux généralisés ($n_2 = 60$).
D’un point de vue diagnostique, utiliser une dispersion erronée de $7{,}75$ au lieu de $7{,}37$ élargirait indûment les bandes de confiance standardisées lors de l’évaluation d’un nouveau patient, augmentant le risque d’un faux négatif lors du dépistage d’une détresse anxieuse cliniquement significative.
8. Analyse comparative et critères de sélection entre les deux méthodes
8.1 Matrice décisionnelle pour les chercheurs
Le choix entre la formule simplifiée (Méthode 1) et la formulation générale pondérée par les degrés de liberté (Méthode 2) n’est pas une affaire de préférence stylistique, mais une obligation méthodologique dictée exclusivement par les propriétés structurelles de la matrice de données. Pour orienter le chercheur, un arbre de décision rigoureux s’articule autour des critères suivants :
- Égalité stricte confirmée ($n_1 = n_2 = dots = n_K$) : La Méthode 1 est mathématiquement identique à la Méthode 2. La moyenne quadratique brute peut être utilisée en toute rigueur, ses résultats étant strictement équivalents à ceux de la formule pondérée complète.
- Déséquilibre modéré (ratio de l’effectif maximal sur l’effectif minimal $n_{\max}/n_{\min} < 1{,}10$) : Bien que certains manuels tolèrent la Méthode 1 pour de très faibles déviations d’effectifs, cette pratique est déconseillée à l’ère du calcul computationnel moderne. La Méthode 2 doit être systématiquement privilégiée afin d’annihiler tout résidu d’imprécision.
- Déséquilibre substantiel ou sévère ($n_{\max}/n_{\min} ge 1{,}10$) : L’application exclusive de la Méthode 2 est formellement requise. Le recours à la Méthode 1 dans cette situation constitue une faute méthodologique avérée invalidant la conformité des résultats aux standards de recherche actuels.
8.2 Comportement asymptotique des estimateurs
L’analyse des propriétés asymptotiques des estimateurs de dispersion permet de comprendre comment ils évoluent lorsque les effectifs tendent vers l’infini ($n to \infty$). Dans le cadre asymptotique régulier, les deux formulations convergent en probabilité vers la variance de dispersion de la population cible en vertu du théorème de Slutsky et de la convergence en loi des sommes normalisées.
Cependant, en situation d’extrême déséquilibre d’effectif — par exemple une cohorte épidémiologique massive de référence ($n_1 = 100,000$) confrontée à un sous-groupe clinique orphelin ultra-spécifique ($n_2 = 12$) — la dynamique des estimateurs diverge drastiquement. Dans une telle configuration, la variance combinée pondérée par la Méthode 2 va converger presque intégralement vers la variance du grand échantillon, reléguant l’apport de la petite cohorte à une fraction infinitésimale du dénominateur ($11 / 100,010$).
Ce comportement asymptotique est statistiquement irréprochable du point de vue de l’estimation de l’erreur moyenne quadratique, mais il interpelle le chercheur sur le plan épistémologique : si l’objectif clinique était d’observer spécifiquement la variabilité propre aux pathologies rares, cette information se trouve totalement absorbée par la masse statistique du groupe de référence.
8.3 Erreurs potentielles d’attribution méthodologique
L’application erronée de la formule simplifiée à des groupes aux effectifs dissymétriques introduit un biais dont la magnitude et la direction dépendent de la corrélation empirique entre l’effectif de chaque groupe ($n_k$) et l’amplitude de son écart-type ($s_k$). Deux scénarios pernicieux se présentent régulièrement dans la littérature expérimentale :
- Scénario A : Corrélation négative entre effectif et dispersion ($r(n_k, s_k) < 0$). Les petits échantillons présentent des écarts-types considérablement plus volumineux que les grands échantillons (un phénomène très courant en psychologie clinique en raison de la rareté des patients les plus sévèrement atteints). Dans ce cas, l’utilisation fautive de la Méthode 1 non pondérée accorde une importance démesurée à ces petites cohortes hyper-dispersées, conduisant à une surévaluation massive de la dispersion moyenne combinée.
- Scénario B : Corrélation positive entre effectif et dispersion ($r(n_k, s_k) > 0$). Les cohortes les plus larges présentent une plus forte variabilité (par exemple en raison d’une plus grande hétérogénéité démographique de recrutement). Ici, la Méthode 1 va sous-estimer la dispersion globale en étouffant la contribution légitime des grands groupes.
Dans un rapport d’expertise méthodologique ou un protocole de soumission d’essai clinique, il est impératif d’expliciter le choix algorithmique retenu et de justifier mathématiquement pourquoi la structure des données impose la pondération par les degrés de liberté réels.
9. Automatisation computationnelle : Scripts en R et Python
9.1 Implémentation sous l’environnement statistique R
Le langage de programmation statistique open source R s’impose comme l’étalon méthodologique par excellence dans les laboratoires de psychologie quantitative et de recherche biomédicale. Afin de prémunir les praticiens contre les erreurs de calcul manuel, il est hautement recommandé d’encapsuler la logique de combinaison des écarts-types au sein d’une fonction modulaire robuste.
La fonction calculer_ecart_type_moyen() présentée ci-dessous intègre des mécanismes d’assertion rigoureux permettant de tester l’intégrité vectorielle des entrées, de détecter automatiquement l’égalité des effectifs et d’appliquer la méthode analytique appropriée tout en retournant les degrés de liberté résiduels et la variance combinée associée :
Le script débute par la vérification que les vecteurs d’écarts-types et d’effectifs possèdent une longueur rigoureusement identique, que les écarts-types sont strictement positifs et que chaque effectif est au moins égal à deux (seuil minimal pour calculer un degré de liberté non nul). Si la variance des effectifs est nulle (égalité parfaite de tous les $n_k$), le script applique la formule de la moyenne quadratique directe. Dans le cas contraire, il procède à la multiplication terme à terme des degrés de liberté $(n_k – 1)$ par les variances au carré, effectue la division matricielle par la somme des degrés de liberté totaux, et extrait la racine carrée finale.
L’intégration de visualisations graphiques avancées, via l’écosystème ggplot2, permet en outre de juxtaposer la distribution des écarts-types individuels sous forme de graphiques en barres d’erreur avec une bande horizontale semi-transparente représentant l’intervalle de dispersion combiné. Cette représentation visuelle facilite l’inspection de l’homoscédasticité par les évaluateurs lors du processus d’expertise par les pairs.
9.2 Développement d’un module Python avec NumPy et SciPy
Dans l’écosystème de la science des données, de l’apprentissage automatique et des neurosciences computationnelles, Python constitue l’environnement de prédilection. Grâce à la vectorisation matérielle offerte par la bibliothèque fondamentale NumPy et aux modules de distributions probabilistes de SciPy, l’agrégation de séries de variances s’opère avec une efficience computationnelle maximale.
Une architecture orientée objet élégante repose sur la conception d’une classe dédiée, nommée par exemple PooledDispersionCalculator. Cette classe reçoit en entrée des séries de données brutes ou des dictionnaires de statistiques descriptives récapitulatives. À l’instanciation, la méthode effectue une validation systématique du type des variables, convertit les listes en tableaux de précision flottante numpy.ndarray (typage float64), et vérifie l’absence de valeurs indéterminées (NaN) ou infinies.
Pour le traitement automatisé de volumineuses bases de données longitudinales ou multi-centres stockées au sein de dataframes de la bibliothèque Pandas, une telle implémentation vectorisée permet d’exécuter des opérations d’agrégation groupée (split-apply-combine) via des directives de type df.groupby('cohorte').apply(...). Les exceptions statistiques — telles que des degrés de liberté cumulés nuls ou des variances négatives découlant d’artefacts d’arrondi numérique — sont interceptées par des blocs d’exception try...except ValueError, renforçant la fiabilité des pipelines d’analyse prédictive et de modélisation psychométrique à grande échelle.
9.3 Validation croisée et tests unitaires
Le déploiement de tout module statistique dans un contexte expérimental ou clinique exige une validation croisée exhaustive au moyen de suites de tests unitaires (par exemple via le framework pytest en Python ou la suite testthat en R). La précision numérique en arithmétique flottante standard IEEE 754 impose une surveillance rigoureuse de la stabilité des calculs.
Pour valider formellement la justesse de l’implémentation algorithmique, des jeux de données synthétiques générés par la méthode de Monte-Carlo sont injectés dans le système. En simulant des matrices de données normales de paramètres connus ($\mu_k, \sigma^2$), le calcul combiné doit converger de façon déterministe vers la valeur théorique paramétrique fixée dans le générateur congruentiel de nombres pseudo-aléatoires.
Les tests unitaires doivent impérativement éprouver les cas limites : égalité d’effectifs, disparités extrêmes d’effectifs (par exemple $n_1 = 10,000$ et $n_2 = 3$), variances nulles (absence absolue de variabilité intra-groupe) et stabilité face à de très grands nombres nécessitant des ajustements d’échelle pour éviter tout phénomène de dépassement de capacité (overflow) ou de sous-dépassement (underflow).
10. Implications pour la méta-analyse et le calcul des tailles d’effet
10.1 Rôle de l’écart-type combiné dans le d de Cohen et le g de Hedges
L’estimation rigoureuse de l’écart-type moyen ou combiné ne constitue pas une simple curiosité descriptive : elle gouverne l’ensemble de la théorie quantitative de la méta-analyse et du calcul des tailles d’effet standardisées. Dans la recherche en psychologie, le paramètre $d$ de Jacob Cohen sert d’indice universel pour quantifier l’ampleur d’un effet expérimental indépendamment de l’échelle d’étalonnage des instruments utilisés. La formule canonique du $d$ de Cohen pour deux groupes indépendants s’articule comme la différence des moyennes divisée par l’écart-type combiné intra-groupe :
$$d = \frac{\bar{x}_1 – \bar{x}_2}{s_p}$$
Dans cette formulation, $s_p$ est rigoureusement l’écart-type combiné obtenu par la pondération par les degrés de liberté (Méthode 2). Toute altération méthodologique de $s_p$ — telle que le recours à la moyenne arithmétique simple — pervertit immédiatement le résultat final du calcul : si l’écart-type combiné est sous-évalué, la taille d’effet $d$ est artificiellement gonflée, conduisant à une exagération systématique de l’efficacité présumée des interventions thérapeutiques ou pédagogiques.
Conscient que l’estimateur $s_p$ demeure légèrement biaisé pour les petits échantillons, le statisticien Larry Hedges a introduit un facteur de correction analytique, noté $J(df)$, conduisant à la métrique sans biais connue sous le nom de $g$ de Hedges :
$$g \approx d \times \left(1 – \frac{3}{4(n_1 + n_2) – 9}\right)$$
Ce facteur de correction montre à quel point l’intégrité de la méta-analyse repose sur une chaîne rigoureuse de dérivations algébriques où la combinaison des dispersions constitue le pivot central de la mesure de l’efficacité.
10.2 Agrégation de sous-échelles dans les instruments psychométriques
Dans le processus de développement et de validation transculturelle de tests psychologiques composites (tels que les inventaires de personnalité NEO-PI-R ou les échelles d’intelligence de Wechsler comme la WAIS-IV), les cliniciens sont régulièrement amenés à combiner les variances de plusieurs facettes ou sous-échelles pour forger un indice composite global.
Cependant, une distinction conceptuelle fondamentale doit être formulée ici : lorsqu’on cherche à estimer la dispersion globale de la somme linéaire de plusieurs sous-échelles corrélées ($X_{\text{total}} = X_1 + X_2 + dots + X_m$), la variance totale dépend non seulement des variances de chaque sous-dimension, mais également de la matrice intégrale des covariances inter-items :
$$operatorname{Var}(X_{\text{total}}) = \sum_{j=1}^m s_j^2 + 2\sum_{j < l}operatorname{Cov}(X_j, X_l)$$
La formule de la variance agrégée ($s_p^2$) détaillée dans les sections précédentes ne s’applique pas à l’addition de variables dépendantes mesurées sur les mêmes sujets, mais exclusivement à la synthèse de la dispersion d’une même métrique observée à travers des groupes ou sessions disjointes et indépendantes. La confusion entre variance combinée et variance d’une somme de variables aléatoires engendre des distorsions sévères dans l’estimation de l’erreur type de mesure (SEM), faussant les indices de fidélité composite de reliabilité psychométrique.
10.3 Robustesse des modèles à effets fixes versus effets aléatoires
Dans le domaine formel de la synthèse de recherche quantitative, la combinaison des écarts-types intervient au cœur de la dichotomie entre les modèles de méta-analyse à effets fixes (Fixed-Effect Models) et à effets aléatoires (Random-Effects Models). L’hypothèse classique d’une dispersion intra-groupe commune unique suppose que tous les essais cliniques inclus partagent une variabilité d’échantillonnage homogène, hypothèse sous-jacente au modèle à effets fixes.
Toutefois, dans la recherche clinique réelle régie par les méthodologies Cochrane, l’hétérogénéité résiduelle entre les protocoles d’étude constitue la norme plutôt que l’exception. Les variations d’âge moyen, de comorbidités psychiatriques ou d’observance du traitement d’une cohorte à l’autre créent une variance supplémentaire inter-études, notée conventionnellement $\tau^2$ (tau au carré).
Dans ce cadre, la variance combinée classique ne suffit plus à résumer l’incertitude totale du système. Les méthodes statistiques de DerSimonian et Laird imposent d’incorporer ce paramètre de dispersion inter-études $\tau^2$ au dénominateur des poids de régression méta-analytiques. Négliger le calcul initial adéquat des écarts-types combinés primaires empêche toute estimation sans biais de $\tau^2$, provoquant l’effondrement de la validité écologique et de la précision inférentielle des synthèses systématiques.
11. Hypothèses sous-jacentes, limites statistiques et diagnostics
11.1 Le problème fondamental des différences entre les moyennes de groupes
Il existe une limite conceptuelle majeure qui échappe fréquemment aux praticiens des statistiques descriptives : l’écart-type combiné ($s_p$) n’est pas, et ne sera jamais, équivalent à l’écart-type global de la population agrégée si les moyennes des groupes individuels divergent.
Ce phénomène s’explique mathématiquement par le théorème de décomposition de la variance (également désigné historiquement sous le nom de théorème de Huygens dans les cours de mécanique et de probabilités formelles). Soit une population composite formée de plusieurs sous-populations ; la variance totale de cette population agrégée ($s_{\text{global}}^2$) se décompose de manière analytique et irréductible en deux composantes orthogonales additives :
$$s_{\text{global}}^2 = s_{\text{intra}}^2 + s_{\text{inter}}^2$$
Où :
- $s_{\text{intra}}^2 = s_p^2$ représente la variance combinée intra-groupe, c’est-à-dire la moyenne quadratique pondérée des variances de chaque groupe calculée selon la Méthode 2.
- $s_{\text{inter}}^2$ représente la variance inter-groupes, mesurant l’écartement quadratique des moyennes de chaque groupe ($\bar{x}_k$) par rapport à la moyenne globale composite ($\bar{x}_{\text{global}}$) :
$$s_{\text{inter}}^2 = \frac{\sum_{k=1}^K n_k (\bar{x}_k – \bar{x}_{\text{global}})^2}{N – 1}$$
Par conséquent, l’écart-type moyen calculé dans ce guide quantifie exclusivement la dispersion intra-groupe résiduelle, c’est-à-dire la variabilité moyenne observable à l’intérieur d’un sous-groupe type. Si un chercheur fusionne les micro-données de tous les participants dans un fichier unique sans conserver le marquage des cohortes pour en calculer l’écart-type brut, la valeur obtenue sera strictement supérieure à $s_p$ dès lors que les moyennes des groupes diffèrent entre elles. Omettre cette distinction engendre des erreurs graves lors de la simulation de données artificielles et de l’étalonnage psychométrique.
11.2 Sensibilité aux violations de normalité
L’ensemble des dérivations formelles justifiant le recours aux degrés de liberté ($n_k – 1$) et la distribution du chi-carré repose sur l’hypothèse distributionnelle d’une variable parente gaussienne. Lorsque les distributions empiriques présentent une forte asymétrie positive (skewness marquée) ou un aplatissement lourd (distributions leptokurtiques fréquentes dans les temps de réaction chronométriques ou les mesures de consommation de substances), les estimateurs quadratiques classiques perdent leur efficience optimale.
En présence d’outliers sévères ou de distributions à queues épaisses, la mise au carré des déviations standard individuelles amplifie de manière disproportionnée les valeurs atypiques. Dans de telles configurations méthodologiques, des alternatives non paramétriques robustes méritent d’être considérées :
- L’écart médian absolu combiné (Pooled Median Absolute Deviation, ou MAD combiné), qui offre un point de rupture de 50 % face aux contaminations d’échantillonnage.
- L’écart interquartile moyen (IQR pondéré), déduit des distributions cumulées empiriques.
- Les procédures de rééchantillonnage par amorçage (bootstrap non paramétrique stratifié), permettant d’approximer la distribution empirique de la dispersion moyenne sans formuler aucun postulat paramétrique préalable sur la forme de la population source.
11.3 Contrôle des erreurs d’arrondi et sensibilité statistique
La quadrature répétée puis l’extraction terminale de la racine carrée créent un profil de sensibilité accrue face aux erreurs de troncature numérique. Tout arrondi prématuré opéré lors de l’estimation de la variance ($s_k^2$) propage une incertitude numérique qui peut distordre substantiellement le résultat final, en particulier lorsque les variances d’origine présentent des amplitudes divergentes de plusieurs ordres de grandeur.
Dans la pratique de la recherche expérimentale et clinique, il convient d’adopter une hygiène calculatoire stricte :
- Conserver au moins quatre à six décimales lors de toutes les phases intermédiaires de pondération et de division de la somme des carrés intra-groupes.
- N’appliquer l’arrondi normatif (généralement à deux décimales significatives) qu’une fois l’extraction terminale de la racine carrée opérée sur la variance finale combinée.
- Vérifier systématiquement l’ordre de grandeur du résultat final : l’écart-type combiné résultant doit obligatoirement être borné entre l’écart-type minimal ($s_{\min}$) et l’écart-type maximal ($s_{\max}$) de la série d’échantillons examinée ($s_{\min} le s_p le s_{\max}$). Tout écart-type combiné sortant de ces bornes traduit immanquablement une erreur algorithmique ou une confusion entre variance et écart-type.
12. Guide pratique et recommandations pour la rédaction académique
12.1 Directives de rédaction selon les normes APA (7e édition)
La transparence méthodologique et la reproductibilité des analyses quantitatives sont au cœur des exigences éditoriales contemporaines. Selon les normes de publication de l’American Psychological Association (Publication Manual of the APA, 7e édition), la présentation de statistiques de dispersion combinées impose un formalisme typographique et discursif rigoureux.
Dans le corps du texte comme au sein des tableaux récapitulatifs, la notation standardisée doit distinguer clairement l’écart-type échantillonnal individuel (désigné par la lettre italique majuscule SD pour Standard Deviation en langue anglaise, ou s dans les équations) de l’écart-type combiné, qui doit être explicitement désigné sous la notation indicée SDpooled ou sp.
Les tableaux récapitulatifs de statistiques descriptives doivent systématiquement fournir, pour chaque cohorte expérimentale, l’effectif exact du groupe ($n_k$), la moyenne observée ($M_k$), l’écart-type ($SD_k$) et la variance calculée correspondante. Une ligne d’agrégation terminale doit explicitement renseigner la dispersion combinée en spécifiant en note de bas de tableau la méthode calculatoire mise en œuvre : « Note. L’écart-type combiné moyen ($SD_{pooled} = 7{,}37$) a été calculé par la moyenne pondérée des sommes de carrés intra-groupes divisée par les degrés de liberté cumulés ($df = 236$). »
12.2 Check-list méthodologique pour le chercheur et l’évaluateur
Avant de valider définitivement un manuscrit de recherche ou de rendre un rapport d’expertise éditoriale, les chercheurs et les relecteurs pairs peuvent s’appuyer sur la grille d’audit méthodologique suivante :
- Vérification de l’invariance dimensionnelle : Toutes les sous-cohortes ont-elles été évaluées sur la même échelle de mesure et dans la même unité dimensionnelle (par exemple millisecondes partout, et non millisecondes dans un groupe et secondes dans un autre) ?
- Vérification de l’homoscédasticité : Les tests d’homogénéité des variances (Levene ou Brown-Forsythe) ont-ils été conduits et rapportés avant toute tentative d’agrégation de la dispersion ?
- Contrôle de l’équilibre des effectifs : Les tailles d’échantillons ($n_k$) sont-elles strictement équivalentes ? Si non, la méthode pondérée par les degrés de liberté (Méthode 2) a-t-elle été rigoureusement substituée à la moyenne quadratique brute ?
- Sanction de la moyenne arithmétique simple : Le texte exclut-il catégoriquement toute moyenne linéaire naïve des écarts-types ($s_{\text{arith}} = \sum s_k / K$) ?
- Explicitation de la variance intra-groupe versus totale : Le manuscrit évite-t-il l’écueil consistant à présenter l’écart-type combiné intra-groupe comme l’écart-type global de la population fusionnée en occultant la variance inter-groupes ?
12.3 Perspectives futures dans le traitement de la dispersion complexe
La modélisation moderne de la dispersion psychométrique dépasse désormais le cadre conventionnel des estimateurs combinés à somme fermée. Avec l’avènement de la modélisation mixte multiniveaux et de l’inférence bayésienne computationnelle par échantillonnage de Gibbs et algorithmes No-U-Turn (NUTS implémentés dans des langages tels que Stan ou PyMC), l’écart-type cesse d’être considéré comme une statistique résiduelle passive pour devenir une variable latente à part entière.
Les modèles mixtes de localisation et d’échelle (Location-Scale Mixed Models) permettent aujourd’hui d’estimer simultanément les prédicteurs influençant la moyenne individuelle et ceux qui modulent directement la variabilité résiduelle intra-individuelle. Cette approche révolutionne la neuropsychologie du vieillissement et la psychopathologie développementale en permettant de tester si un traitement clinique ne modifie pas seulement le niveau moyen des symptômes, mais réduit également leur instabilité au fil du temps.
En s’appropriant ces fondements mathématiques fondamentaux et en abandonnant définitivement les raccourcis calculatoires simplistes, la communauté scientifique garantit la rigueur, l’exactitude métrologique et la pérennité épistémologique de ses conclusions empiriques.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2021). Introduction to Meta-Analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119558378
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- DerSimonian, R., & Laird, N. (1986). Meta-analysis in clinical trials. Controlled Clinical Trials, 7(3), 177–188. https://doi.org/10.1016/0197-2456(86)90046-2
- Hedges, L. V., & Olkin, I. (1985). Statistical Methods for Meta-Analysis. Academic Press.
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., & Welch, V. A. (Eds.). (2019). Cochrane Handbook for Systematic Reviews of Interventions (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119536604
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278–292). Stanford University Press.
- Wilcox, R. R. (2017). Introduction to Robust Estimation and Hypothesis Testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02206-8