
Dans l’édifice des sciences quantitatives, de la physique statistique à l’économétrie contemporaine en passant par la psychométrie et l’apprentissage automatique, la modélisation de l’incertitude constitue un défi fondamental. Une distribution de probabilité ne se résume jamais à une simple collection de valeurs potentielles associées à des chances d’occurrence : elle incarne la structure géométrique et stochastique sous-jacente à un phénomène aléatoire. Pour appréhender pleinement cette structure, la statistique mathématique a développé des indicateurs synthétiques capables de résumer la morphologie globale d’une loi. Si les mesures de tendance centrale, au premier rang desquelles figure l’espérance mathématique, indiquent le point d’équilibre ou le centre de gravité d’un système probabiliste, elles demeurent fondamentalement insuffisantes pour caractériser le comportement réel des trajectoires observées.
C’est précisément ici qu’intervient l’écart-type, désigné universellement par la lettre grecque sigma ($\sigma$). Mesure par excellence de la dispersion d’une distribution de probabilité, l’écart-type quantifie l’amplitude moyenne des fluctuations d’une variable aléatoire autour de sa valeur attendue. Contrairement à une simple dispersion empirique calculée sur un échantillon de données observées, l’écart-type d’une distribution théorique représente un paramètre déterministe absolu du modèle stochastique sous-jacent. Trouver cet écart-type exige de traverser une séquence rigoureuse d’opérations algébriques : la définition préalable du support et des probabilités associées, le calcul de l’espérance, l’évaluation quadratique des écarts individuels et l’extraction finale de la racine carrée de la variance.
Comprendre et maîtriser la détermination de l’écart-type d’une distribution de probabilité est un prérequis indispensable pour tout analyste, chercheur ou ingénieur confronté à des processus stochastiques. Ce guide exhaustif explore de manière approfondie les fondements théoriques, les justifications métrologiques, les algorithmes de calcul pas à pas, les théorèmes de simplification algébrique, ainsi que les généralisations continues et les applications pratiques de cette grandeur maîtresse de l’analyse décisionnelle et de l’inférence statistique.
1. Introduction aux distributions de probabilité et aux mesures de dispersion
1.1 Définition formelle d’une variable aléatoire et de sa loi de probabilité
Une variable aléatoire, traditionnellement notée par une lettre majuscule telle que $X$, n’est pas une simple variable au sens de l’algèbre élémentaire, mais une fonction mesurable définie d’un espace probabilisable vers l’ensemble des nombres réels. Cette fonction associe à chaque événement élémentaire d’un univers stochastique une valeur numérique déterminée. La loi de probabilité de cette variable décrit alors la répartition exhaustive de la masse de probabilité sur l’ensemble des valeurs que la variable est susceptible de prendre, ensemble que l’on nomme le support de la variable.
Il convient d’établir une dichotomie conceptuelle fondamentale entre les variables aléatoires discrètes et les variables aléatoires continues. Une variable aléatoire discrète ne peut prendre que des valeurs isolées, dénombrables ou finies, telles que le nombre de pannes sur un serveur informatique ou le résultat d’un lancer de dé. À l’inverse, une variable continue prend ses valeurs au sein d’un continuum non dénombrable, comme un intervalle de nombres réels, mesurant typiquement des grandeurs continues telles que la durée de vie d’un composant électronique ou la température ambiante.
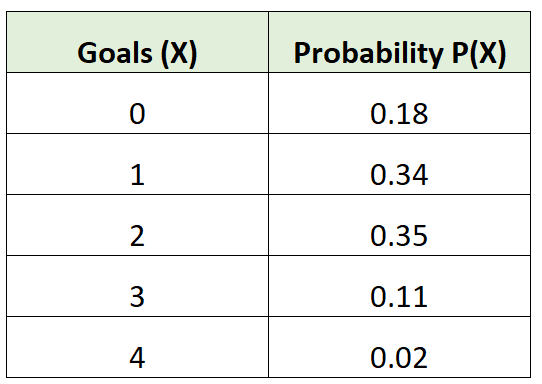
Dans le cadre des distributions discrètes, la loi de probabilité doit impérativement respecter les axiomes fondamentaux posés par le mathématicien Andreï Kolmogorov. D’une part, le principe de positivité impose que pour toute valeur réalisable $x_i$, la probabilité associée $P(X = x_i)$ soit strictement supérieure ou égale à zéro. D’autre part, l’axiome de certitude exige que la somme de toutes les probabilités associées à l’ensemble exhaustif des réalisations possibles soit rigoureusement égale à l’unité :
$$\sum_{i} P(X = x_i) = 1$$
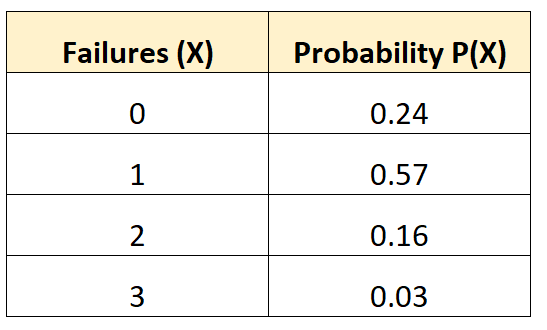
Ces probabilités sont généralement présentées sous une forme tabulaire associant chaque modalité à son poids probabiliste respectif, ou sous la forme d’une fonction de masse de probabilité analytique permettant d’attribuer instantanément une probabilité à tout élément du support.
1.2 Nécessité statistique d’évaluer la dispersion au-delà de la tendance centrale
L’erreur la plus fréquente dans l’analyse de données probabilistes consiste à réduire une distribution à sa seule mesure de tendance centrale, l’espérance mathématique. Bien que l’espérance fournisse une indication cruciale quant à l’emplacement moyen de la distribution sur l’axe réel, elle s’avère totalement aveugle à la structure de l’hétérogénéité interne du modèle. Deux distributions de probabilité peuvent posséder une espérance strictement identique tout en décrivant des réalités phénoménologiques radicalement opposées.
Considérons par exemple un placement financier $A$ qui offre un rendement garanti de 5 % avec une probabilité de 1, et un placement spéculatif $B$ qui offre soit un gain de 105 % avec une probabilité de 0,5, soit une perte sèche de 95 % avec une probabilité de 0,5. Les deux variables aléatoires possèdent rigoureusement la même espérance de rendement, à savoir 5 %. Pourtant, le profil de risque du placement $B$ est infiniment plus instable que celui du placement $A$. L’absence d’évaluation de la dispersion empêche de distinguer la certitude absolue de la volatilité extrême.
La quantification de la variabilité est donc un impératif méthodologique incontournable. Elle permet de mesurer l’incertitude prédictive inhérente à un modèle stochastique, de borner les risques d’erreur dans les processus de décision automatisés et d’évaluer la représentativité de l’espérance en tant qu’estimateur central. En physique, en épidémiologie ou en ingénierie de la fiabilité, la dispersion reflète la robustesse d’un système face aux perturbations aléatoires.
1.3 Origine historique et fondements conceptuels de l’écart-type
D’un point de vue historique, la conceptualisation formelle de l’écart-type découle directement des travaux du statisticien britannique Karl Pearson à la fin du dix-neuvième siècle. Avant les contributions fondamentales de Pearson, les astronomes et mathématiciens, notamment Carl Friedrich Gauss et Adolphe Quetelet, utilisaient couramment l’erreur probable ou l’écart moyen absolu pour quantifier la précision des instruments d’observation astronomique.
Karl Pearson introduisit en 1893 le terme « standard deviation » (écart-type en français) et en formalisa l’usage en démontrant la supériorité analytique de la déviation quadratique moyenne sur les approches fondées sur la valeur absolue. L’écart absolu moyen présentait en effet un obstacle mathématique majeur : la fonction valeur absolue n’est pas continûment dérivable en zéro, ce qui complique considérablement le développement de calculs différentiels et d’optimisations algébriques avancées.
Au-delà de sa commodité calculatoire, l’écart-type présente des propriétés métrologiques fondamentales, notamment la conservation stricte de l’unité de mesure d’origine de la variable aléatoire. Alors que la variance s’exprime dans le carré de l’unité de la variable (par exemple des mètres carrés ou des dollars au carré), l’écart-type rétablit l’échelle initiale, rendant l’indice directement comparable aux modalités du phénomène étudié. De plus, il vérifie une stricte propriété d’invariance d’échelle face aux transformations linéaires affines.
2. Le calcul préalable de la moyenne pondérée ou espérance mathématique
2.1 Formulation algébrique de l’espérance mathématique discrète
Le calcul de l’écart-type d’une loi de probabilité repose de manière inconditionnelle sur la connaissance préalable de son espérance mathématique, traditionnellement notée $\mu$ (mu) ou $E(X)$. Dans le cas d’une variable aléatoire discrète, l’espérance représente la moyenne pondérée de toutes les valeurs possibles que peut prendre la variable, chaque valeur étant pondérée par sa probabilité théorique respective.
L’expression algébrique canonique de l’espérance s’écrit formellement :
$$\mu = E(X) = \sum_{i=1}^{n} x_i \cdot P(X = x_i)$$
Sur le plan géométrique, l’espérance mathématique s’interprète rigoureusement comme le centre de gravité de la distribution probabiliste. Si l’on imagine l’axe des nombres réels comme une tige rigide sans masse sur laquelle sont disposés des poids proportionnels aux probabilités $P(X = x_i)$ aux positions $x_i$, le point d’équilibre parfait de ce système mécanique se situe exactement en $x = \mu$.
Il est impératif d’établir une distinction épistémologique nette entre la moyenne empirique (souvent notée $\bar{x}$), qui est calculée à partir d’un ensemble de réalisations concrètes issues d’un échantillon observé, et l’espérance théorique $\mu$. L’espérance est une constante mathématique déterministe propre au modèle probabiliste, exempte de tout aléa d’échantillonnage, alors que la moyenne empirique est elle-même une variable aléatoire susceptible de fluctuer d’une expérience à l’autre.
2.2 Procédure systématique d’évaluation numérique de l’espérance
Pour évaluer l’espérance mathématique sans commettre d’erreur d’inattention, la construction d’un tableau de calcul structuré est fortement recommandée. Cette matrice opératoire comprend au minimum trois colonnes : la première répertorie l’ensemble exhaustif des modalités $x_i$, la deuxième consigne la probabilité correspondante $P(X = x_i)$, et la troisième calcule le produit arithmétique élémentaire $x_i \cdot P(X = x_i)$.
Avant d’effectuer la moindre multiplication, une étape de vérification incontournable consiste à sommer l’intégralité de la colonne des probabilités. Si cette somme diffère de 1, ne serait-ce que de quelques centièmes, la distribution est soit incomplète, soit mal normalisée, ce qui vicierait irrémédiablement l’ensemble des calculs subséquents. Une fois la validité de la fonction de masse confirmée, la sommation des éléments de la troisième colonne livre directement la valeur exacte de $\mu$.
Durant cette phase de calcul, la gestion des arrondis numériques revêt une importance capitale. Tout arrondi prématuré de la moyenne pondérée introduit un biais systématique qui se propagera et s’amplifiera lors de l’élévation au carré des déviations dans le calcul de la variance. Il est donc préconisé de conserver l’espérance sous forme de fraction exacte ou avec une précision d’au moins quatre à six décimales lorsque les fractions deviennent indésirables.
2.3 Interprétation contextuelle de la valeur attendue
L’espérance mathématique doit être comprise à la lumière de la loi forte des grands nombres formalisée par Émile Borel. Elle représente la limite asymptotique vers laquelle converge la moyenne arithmétique d’une séquence infinie de tirages indépendants et identiquement distribués (i.i.d.) issus de cette loi de probabilité. En termes simples, il s’agit du résultat moyen que l’on observerait si l’on répétait l’expérience probabiliste un nombre infini de fois dans des conditions strictement identiques.
Néanmoins, une propriété fondamentale de l’espérance réside dans le fait qu’elle n’est pas nécessairement une modalité réalisable du système probabiliste étudié. Par exemple, le nombre de têtes obtenues lors de trois lancers consécutifs d’une pièce de monnaie équilibrée suit une distribution binomiale d’espérance 1,5. Bien qu’il soit matériellement impossible d’obtenir un résultat non entier lors d’une expérience unique, la valeur 1,5 constitue la seule ancre d’équilibre probabiliste du processus global.
Par ailleurs, l’analyste doit garder à l’esprit l’extrême sensibilité de l’espérance face aux valeurs extrêmes dans les distributions asymétriques. Une probabilité infinitésimale associée à une valeur gigantesque peut translater l’espérance vers une zone de l’espace d’états où la densité de probabilité est quasiment nulle, créant une illusion d’équilibre qui impose d’autant plus l’évaluation concomitante de la dispersion.
3. Fondements mathématiques de la variance probabiliste
3.1 Définition de l’écart à la moyenne et justification de l’élévation au carré
Une fois l’espérance mathématique solidement établie, la quantification de la variabilité impose d’examiner dans quelle mesure chaque valeur possible $x_i$ s’éloigne de ce centre. L’écart individuel, ou résidu théorique, se définit simplement par la différence algébrique :
$$d_i = x_i – \mu$$
L’intuition première consisterait à calculer la moyenne pondérée directe de ces écarts élémentaires. Or, en vertu de la linéarité même de l’espérance mathématique, cette sommation linéaire s’annule systématiquement :
$$\sum_{i} (x_i – \mu) \cdot P(X = x_i) = \sum_{i} x_i P(X = x_i) – \mu \sum_{i} P(X = x_i) = \mu – \mu(1) = 0$$
Les déviations positives situées à droite du centre de gravité compensent exactement les déviations négatives situées à sa gauche. Cette propriété démontre l’impossibilité d’utiliser la somme brute des écarts comme indicateur de dispersion.
Pour neutraliser le signe négatif des écarts tout en préservant l’amplitude des variations, deux opérations fondamentales sont envisageables : l’utilisation de la valeur absolue $|x_i – mu|$ ou l’élévation au carré $(x_i – \mu)^2$. Les mathématiciens ont massivement plébiscité l’élévation au carré. Ce choix mathématique assure la stricte différentiabilité de la fonction en tout point de l’espace, conférant à la variance des propriétés algébriques optimales, tout en exerçant une pénalisation quadratique qui amplifie géométriquement les déviations majeures au détriment des faibles fluctuations.
3.2 Formulation formelle de la variance théorique
La variance d’une distribution de probabilité discrète, notée $\sigma^2$ ou $Var(X)$, est formellement définie comme l’espérance mathématique du carré des écarts à la moyenne. Elle synthétise l’ensemble des fluctuations quadratiques pondérées par leurs probabilités de survenue respectives.
L’expression analytique constitutive de la variance s’écrit ainsi :
$$\sigma^2 = Var(X) = E[(X – \mu)^2] = \sum_{i=1}^{n} (x_i – \mu)^2 \cdot P(X = x_i)$$
Cette sommation intègre pleinement la double nature du risque : d’une part la sévérité de l’écart mesurée par son carré $(x_i – \mu)^2$, et d’autre part sa fréquence relative ou sa vraisemblance exprimée par la fonction de masse $P(X = x_i)$. Un événement très éloigné de la moyenne mais doté d’une probabilité infinitésimale contribuera modérément à la variance, tandis qu’une déviation moyenne mais récurrente exercera un impact structurel prépondérant.
Néanmoins, la variance souffre d’un handicap métrologique dirimant : la distorsion dimensionnelle. Si une variable aléatoire $X$ mesure des montants financiers exprimés en euros (€), la variance s’exprime en euros carrés (€²), une dimension physique dépourvue de signification concrète dans le monde phénoménal. La variance constitue une étape calculatoire intermédiaire indispensable mais s’avère impropre à une communication directe sans transformation supplémentaire.
3.3 Propriétés algébriques fondamentales de la variance
La variance probabiliste obéit à plusieurs théorèmes fondamentaux de l’algèbre stochastique qui facilitent grandement les manipulations théoriques et la modélisation de combinaisons de variables :
- Invariance par translation : L’ajout d’une constante certaine $c$ à une variable aléatoire décale l’ensemble de la distribution sans en altérer la dispersion. Par conséquent, $Var(X + c) = Var(X)$.
- Homogénéité quadratique par changement d’échelle : La multiplication d’une variable aléatoire par une constante multiplicative $a$ dilate la dispersion d’un facteur quadratique proportionnel à $a^2$, ce qui se traduit par $Var(aX) = a^2 Var(X)$. En combinant translation et dilatation linéaire, on obtient la propriété canonique : $Var(aX + b) = a^2 Var(X)$.
- Théorème d’additivité pour des variables indépendantes : Si deux variables aléatoires $X$ et $Y$ sont stochastiquement indépendantes (ou à tout le moins non corrélées, c’est-à-dire que leur covariance théorique est nulle), la variance de leur somme est strictement égale à la somme de leurs variances individuelles : $Var(X + Y) = Var(X) + Var(Y)$.
Cette dernière propriété constitue l’une des pierres angulaires de la théorie des probabilités et confère à la variance une supériorité absolue sur l’écart absolu moyen, qui ne possède aucune propriété d’additivité élémentaire sous l’effet de la sommation stochastique.
4. La formule maîtresse de l’écart-type pour une loi discrète
4.1 Transition analytique de la variance vers l’écart-type
Pour résoudre définitivement l’anomalie dimensionnelle générée par l’élévation au carré des résidus, l’écart-type est défini comme la racine carrée arithmétique positive de la variance théorique. Cette opération unilatérale rétablit une homogénéité dimensionnelle absolue entre la mesure de dispersion et la variable aléatoire sous-jacente.
L’expression maîtresse de l’écart-type d’une distribution de probabilité discrète s’énonce de la manière suivante :
$$\sigma = \sqrt{Var(X)} = \sqrt{\sum_{i=1}^{n} (x_i – \mu)^2 \cdot P(X = x_i)}$$
Sous cette forme canonique, l’écart-type s’exprime rigoureusement dans la même unité de mesure que la variable aléatoire initiale : des centimètres, des secondes, des volts ou des unités monétaires. Ce rétablissement de l’unité permet d’effectuer des comparaisons directes, de construire des intervalles de confiance standardisés et de communiquer de manière limpide sur l’amplitude prévisible des déviations.
4.2 Décomposition structurelle de chaque paramètre de la formule
L’analyse détaillée des composants de l’équation de l’écart-type met en lumière la mécanique interne de cette métrique maîtresse :
- Le terme $\mu$ : Représente l’origine relative à partir de laquelle toutes les déviations spatiales sont évaluées. Il ancre la métrique au centre de masse exact de la distribution.
- Le facteur $(x_i – \mu)^2$ : Agit comme une métrique de distance euclidienne à une dimension. En éliminant le signe, il quantifie le coût quadratique de l’éloignement d’une modalité particulière par rapport à la moyenne.
- Le coefficient probabiliste $P(X = x_i)$ : Joue le rôle d’un opérateur de pondération massique. Il dicte l’importance relative de chaque coût quadratique au sein de la somme totale.
- Le radical $\sqrt{phantom{x}}$ : Exerce une compression d’échelle globale ramenant la grandeur résultante au premier degré dimensionnel.
La sommation pondérée interne peut être comprise géométriquement comme le calcul d’une norme euclidienne pondérée dans un espace vectoriel à $n$ dimensions où chaque axe de coordonnées est contracté ou dilaté par la racine carrée de la probabilité qui lui est assignée.
4.3 Conditions de validité et d’existence du calcul
Le calcul de l’écart-type théorique ne s’applique pas universellement à toute distribution concevable de l’esprit. Pour que l’écart-type d’une loi discrète existe et possède une valeur finie, il est strictement nécessaire que le support soit fini ou que la série infinie définissant le moment d’ordre deux converge de manière absolue.
Dans les cas où le support de la variable aléatoire est infini dénombrable (comme pour une variable de Poisson ou une variable géométrique), la convergence de la somme $\sum_{i=1}^{\infty} x_i^2 P(X = x_i)$ conditionne l’existence même de la variance. Il existe des distributions pour lesquelles cette convergence fait défaut. La loi de Cauchy discrète ou certaines lois de Pareto à queue lourde possèdent des moments d’ordre un ou deux indéterminés ou infinis. Pour de telles distributions, l’espérance n’existe pas, et l’écart-type est par conséquent indéfini.
De plus, l’écart-type possède la propriété de stricte positivité : pour toute variable aléatoire non dégénérée, $\sigma > 0$. Le seul et unique cas où $\sigma = 0$ correspond à une variable aléatoire certaine ou dégénérée, c’est-à-dire une variable qui prend une unique valeur constante $c$ avec une probabilité rigoureusement égale à 1. Dans toute autre configuration probabiliste, l’incertitude induit nécessairement une valeur de dispersion strictement supérieure à zéro.
5. Algorithme détaillé pas à pas pour le calcul manuel de l’écart-type
5.1 Étape 1 et 2 : Structuration des données et détermination de la moyenne
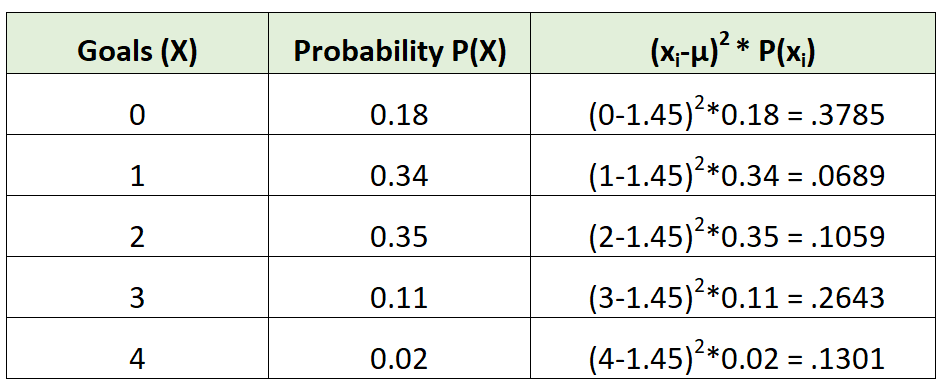
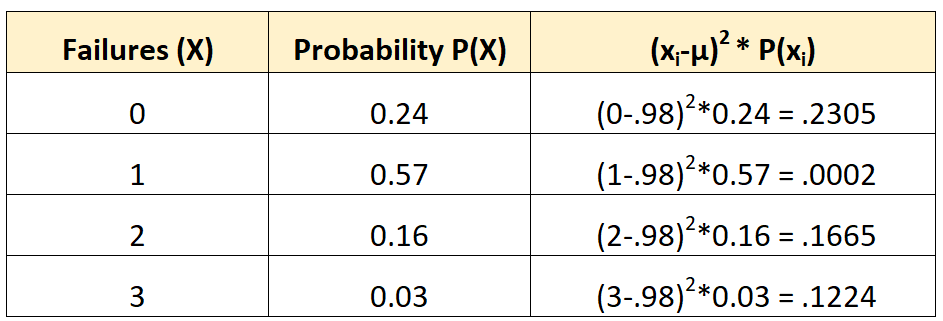
L’exécution manuelle d’un calcul d’écart-type sur une distribution discrète exige une méthode rigoureuse pour prémunir le calculateur contre les fautes arithmétiques. La première phase consiste à consigner le modèle dans une table de contingence mathématique comportant six colonnes distinctes :
- Colonne 1 : Les modalités réalisables de la variable aléatoire ($x_i$).
- Colonne 2 : Les probabilités théoriques correspondantes ($P(X = x_i)$).
- Colonne 3 : Le produit pondéré pour l’espérance ($x_i \cdot P(X = x_i)$).
- Colonne 4 : La déviation simple par rapport à l’espérance ($x_i – \mu$).
- Colonne 5 : Le carré de la déviation ($(x_i – \mu)^2$).
- Colonne 6 : La contribution quadratique pondérée ($(x_i – \mu)^2 \cdot P(X = x_i)$).
L’Étape 1 consiste à vérifier que la somme des éléments de la colonne 2 équivaut exactement à 1. L’Étape 2 calcule ensuite l’espérance en sommant l’ensemble des termes de la colonne 3. Dès cette étape, un test de cohérence logique s’impose : la valeur obtenue pour $\mu$ doit obligatoirement être comprise entre la plus petite et la plus grande modalité présente dans la colonne 1 :
$$\min(x_i) le \mu le \max(x_i)$$
Si la moyenne pondérée se situe en dehors de cet intervalle fermé, une erreur de calcul est survenue et doit être corrigée immédiatement avant de poursuivre.
5.2 Étape 3 et 4 : Évaluation des écarts individuels et calcul de leurs carrés
La deuxième phase algorithmique engage le traitement des déviations. À l’Étape 3, on soustrait systématiquement la valeur déterminée de $\mu$ de chaque modalité $x_i$ individuelle, consignant le résultat dans la colonne 4. Ces écarts peuvent être positifs, nuls ou négatifs. Pour vérifier la précision de cette étape, la somme pondérée des éléments de cette colonne 4 doit nécessairement être égale à zéro, ce qui confirme l’exactitude de l’ancrage gravitationnel.
L’Étape 4 consiste à élever au carré chacune des valeurs inscrites dans la colonne 4, le résultat étant reporté dans la colonne 5. Cette opération supprime définitivement tous les signes négatifs. Il convient ici d’être particulièrement scrupuleux sur la manipulation des signes lors de l’usage d’une calculatrice : le carré d’un nombre négatif est toujours rigoureusement positif. Par exemple, $(-3)^2 = +9$, et non $-9$.
Durant ces calculs intermédiaires, il est crucial de ne pas tronquer les décimales. Si $\mu$ est un nombre décimal périodique, l’utilisation de fractions rationnelles est vivement conseillée pour maintenir une précision absolue jusqu’au terme du protocole.
5.3 Étape 5 et 6 : Pondération probabiliste et extraction de la racine finale
La phase finale parachève l’évaluation de la dispersion. À l’Étape 5, on multiplie chaque écart quadratique figurant dans la colonne 5 par la probabilité d’occurrence d’origine correspondante issue de la colonne 2. Les valeurs résultantes, consignées dans la colonne 6, représentent la contribution marginale de chaque modalité à la variance totale du système.
En effectuant la sommation intégrale de la colonne 6, on obtient la variance théorique exacte $\sigma^2$ de la distribution :
$$\sigma^2 = \sum_{i=1}^{n} \left[ (x_i – \mu)^2 \cdot P(X = x_i) \right]$$
Enfin, l’Étape 6 consiste à appliquer la fonction racine carrée positive sur la variance obtenue afin d’extraire l’écart-type final :
$$\sigma = \sqrt{\sigma^2}$$
Le résultat doit toujours être formulé en précisant explicitement l’unité de mesure initiale de la variable étudiée, en limitant l’arrondi décimal uniquement à cette dernière étape d’extraction.
6. Formule simplifiée de calcul : le théorème de Koenig-Huygens
6.1 Démonstration mathématique de l’identité de calcul rapide
Le calcul manuel de l’écart-type via la formule canonique devient rapidement fastidieux et source d’erreurs lorsque l’espérance mathématique est un nombre décimal doté de nombreuses décimales. Pour contourner cet écueil opératoire, la théorie statistique s’appuie sur le théorème de Koenig-Huygens (souvent désigné sous le nom de formule de décomposition de la variance ou identité de calcul rapide).
La démonstration formelle procède du développement direct du binôme sous la sommation de la variance :
$$\sigma^2 = \sum_{i} (x_i – \mu)^2 P(X = x_i) = \sum_{i} (x_i^2 – 2\mu x_i + \mu^2) P(X = x_i)$$
En distribuant la probabilité $P(X = x_i)$ et en appliquant les propriétés de linéarité de la sommation discrète, l’expression se décompose en trois termes distincts :
$$\sigma^2 = \sum_{i} x_i^2 P(X = x_i) – 2\mu \sum_{i} x_i P(X = x_i) + \mu^2 \sum_{i} P(X = x_i)$$
En substituant $\sum_{i} x_i P(X = x_i)$ par sa définition qui est $\mu$, et en rappelant que $\sum_{i} P(X = x_i) = 1$, l’équation devient :
$$\sigma^2 = E(X^2) – 2\mu(\mu) + \mu^2(1) = E(X^2) – 2\mu^2 + \mu^2 = E(X^2) – \mu^2$$
Ce résultat fondamental stipule que la variance est égale à la moyenne des carrés moins le carré de la moyenne :
$$\sigma^2 = E(X^2) – [E(X)]^2$$
L’écart-type s’obtient alors immédiatement par l’expression alternative :
$$\sigma = \sqrt{E(X^2) – [E(X)]^2}$$
6.2 Avantages opérationnels de la méthode alternative
Cette formulation alternative apporte un allègement considérable de la charge calculatoire, tant en calcul mental ou manuel qu’en programmation algorithmique. Son avantage structurel majeur réside dans l’élimination de la phase de calcul des déviations individuelles $(x_i – \mu)$.
En pratique, l’analyste n’a plus besoin d’effectuer $n$ soustractions successives impliquant une valeur de $\mu$ potentiellement fractionnaire ou décimale avant d’élever les résultats au carré. Au lieu de cela, la procédure requiert uniquement :
- Le calcul direct du produit $x_i \cdot P(X = x_i)$ pour obtenir $E(X)$.
- Le calcul direct du produit $x_i^2 \cdot P(X = x_i)$ pour obtenir $E(X^2)$.
- Une simple soustraction terminale entre $E(X^2)$ et $\mu^2$.
Cette approche réduit de moitié le nombre total d’opérations élémentaires et évite la création de colonnes intermédiaires volumineuses dans les feuilles de calcul, optimisant ainsi substantiellement le temps de traitement.
6.3 Limites de précision numérique en arithmétique flottante
En dépit de son élégance et de son efficacité sur le papier, la formule de Koenig-Huygens présente un écueil majeur bien connu en analyse numérique : le phénomène d’annulation catastrophique lors de calculs informatiques en virgule flottante.
Lorsque la dispersion d’une distribution est extrêmement faible par rapport à la grandeur absolue de sa moyenne (c’est-à-dire quand $\sigma ll \mu$), le terme $E(X^2)$ et le terme $[E(X)]^2$ deviennent numériquement quasi identiques. Lors de la soustraction de deux nombres très grands et très proches dans un calculateur binaire à précision finie (standard IEEE 754), les bits de précision de poids fort s’annulent mutuellement.
Cette perte sévère de précision peut conduire à des erreurs de troncature considérables, et même, dans certains cas extrêmes, à l’obtention d’une variance négative due aux micro-arrondis machines. Dans un tel cas, l’algorithme échoue en tentant d’extraire la racine carrée d’un nombre strictement négatif. Ainsi, pour les implémentations informatiques critiques traitant des données massives avec des variances infimes, les algorithmes de sommation compensée de Welford ou la formule canonique centrée doivent impérativement être privilégiés.
7. Généralisation théorique aux distributions de probabilité continues
7.1 De la fonction de masse discrète à la fonction de densité continue
Lorsque l’on s’extrait du domaine des variables aléatoires discrètes pour aborder les variables aléatoires continues, la nature mathématique du support subit une transformation profonde. La probabilité ponctuelle pour une variable continue de prendre une valeur réelle exacte $x$ devient rigoureusement nulle : $P(X = x) = 0$. On ne peut plus définir la distribution par une fonction de masse discrète, mais par une fonction de densité de probabilité, notée usuellement $f(x)$.
La fonction de densité $f(x)$ décrit la concentration locale de la masse de probabilité sur le support continu. Pour être légitime au regard des axiomes de l’intégration probabiliste, la fonction $f(x)$ doit vérifier deux conditions mathématiques impératives :
- La non-négativité quasi-partout : $f(x) ge 0$ pour tout $x in \mathbb{R}$.
- La normalisation unitaire totale de son intégrale sur l’ensemble de son domaine de définition : $\int_{-\infty}^{+\infty} f(x) , dx = 1$.
Dans ce formalisme continu, la probabilité que la variable $X$ s’inscrive dans un intervalle infinitésimal $[x, x + dx]$ correspond à l’élément différentiel d’aire sous la courbe, noté $f(x) , dx$. Cet élément infinitésimal remplace rigoureusement le terme discret $P(X = x_i)$ dans toutes les formulations ultérieures.
7.2 Formalisme intégral de l’espérance et de la variance continue
La transition analytique du cadre discret au cadre continu s’opère par le remplacement systématique des opérateurs de sommation discrète $\sum$ par des intégrales impropres au sens de Riemann ou de Lebesgue. L’espérance mathématique d’une variable continue $X$ de densité $f(x)$ est ainsi définie par l’intégrale :
$$\mu = E(X) = \int_{-\infty}^{+\infty} x \cdot f(x) , dx$$
De manière parfaitement homologue, la variance s’obtient en intégrant le produit du carré des déviations pondéré par l’élément différentiel de probabilité :
$$\sigma^2 = Var(X) = \int_{-\infty}^{+\infty} (x – \mu)^2 \cdot f(x) , dx$$
L’écart-type d’une variable aléatoire continue découle alors directement de l’extraction de la racine carrée de cette intégrale convergente :
$$\sigma = \sqrt{\int_{-\infty}^{+\infty} (x – \mu)^2 \cdot f(x) , dx}$$
Le théorème de Koenig-Huygens conserve une validité intégrale dans l’analyse continue, se traduisant par :
$$\sigma = \sqrt{\int_{-\infty}^{+\infty} x^2 f(x) , dx – \left( \int_{-\infty}^{+\infty} x f(x) , dx \right)^2}$$
7.3 Applications classiques : loi normale et loi exponentielle
L’examen des lois continues fondamentales illustre le rôle central de l’écart-type comme paramètre intrinsèque d’échelle. Dans le cas de la loi normale (ou distribution de Gauss-Laplace), la fonction de densité dépend explicitement et directement de deux paramètres canoniques $\mu$ et $\sigma$ :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2}\left(\frac{x – \mu}{\sigma}\right)^2 \right)$$
L’écart-type $\sigma$ n’est pas ici une simple métrique calculée a posteriori : il gouverne directement la morphologie géométrique de la courbe en cloche. Le point d’inflexion où la courbure de la cloche s’inverse de concave à convexe se situe exactement à la distance $x = \mu + \sigma$ et $x = \mu – \sigma$. Une modification de $\sigma$ dilate ou compresse l’ouverture de la cloche sans déplacer son sommet horizontal.
Considérons à présent le cas de la loi exponentielle de paramètre d’intensité $lambda > 0$, qui modélise fréquemment les durées d’attente ou la défaillance de matériels sans mémoire. Sa densité s’écrit $f(x) = \lambda e^{-\lambda x}$ pour $x ge 0$. Par intégration par parties successives, on démontre que :
$$E(X) = \frac{1}{\lambda}, \quad E(X^2) = \frac{2}{\lambda^2}$$
En appliquant Koenig-Huygens :
$$\sigma^2 = \frac{2}{\lambda^2} – \left(\frac{1}{\lambda}\right)^2 = \frac{1}{\lambda^2} implies \sigma = \frac{1}{\lambda}$$
Pour une loi exponentielle, l’écart-type est donc rigoureusement égal à l’espérance mathématique, conférant à son coefficient de variation une constance absolue unitaire ($\sigma / \mu = 1$).
8. Étude de cas appliquée : modélisation de fréquences comportementales
8.1 Énoncé du protocole d’observation et distribution des occurrences
Afin d’ancrer de manière irréfutable l’ensemble de ces préceptes théoriques dans la réalité pratique de l’ingénierie et des sciences appliquées, développons une étude de cas détaillée. Imaginons un protocole d’évaluation psychologique et ergonomique au sein d’un laboratoire de surveillance du facteur humain. On enregistre le nombre d’occurrences d’un comportement d’inattention critique ($X$) émis par heure par un opérateur de contrôle aérien sur un simulateur de vol haute fidélité.
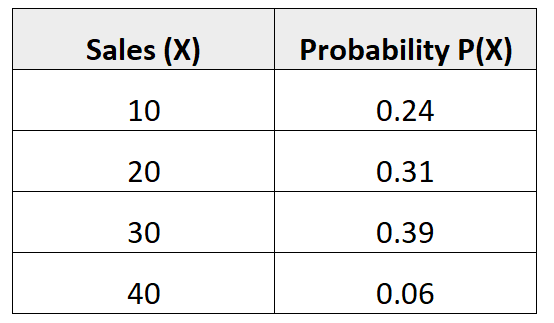
À la suite d’un étalonnage approfondi mené sur une très vaste population de contrôleurs, la loi de probabilité théorique discrète du nombre d’inattentions par heure a été modélisée et validée de la façon suivante :
- 0 inattention : $P(X = 0) = 0,15$
- 1 inattention : $P(X = 1) = 0,35$
- 2 inattentions : $P(X = 2) = 0,30$
- 3 inattentions : $P(X = 3) = 0,15$
- 4 inattentions : $P(X = 4) = 0,05$
La première démarche méthodologique consiste à valider la conformité de ce modèle avec les axiomes de Kolmogorov. Les probabilités sont toutes strictement positives, et leur somme donne :
$$\sum P(X) = 0,15 + 0,35 + 0,30 + 0,15 + 0,05 = 1,00$$
La distribution est complète, fermée et unitaire. Le support est strictement borné à l’ensemble ${0, 1, 2, 3, 4}$. L’objectif est d’extraire la variance exacte et l’écart-type de cette variable comportementale.
8.2 Exécution numérique complète du calcul pas à pas
Procédons méthodiquement au calcul de l’espérance mathématique $\mu$, centre gravitationnel du comportement d’inattention :
$$\mu = \sum x_i P(X = x_i) = (0 \cdot 0,15) + (1 \cdot 0,35) + (2 \cdot 0,30) + (3 \cdot 0,15) + (4 \cdot 0,05)$$
$$\mu = 0 + 0,35 + 0,60 + 0,45 + 0,20 = 1,60 \text{ inattention par heure}$$
L’espérance est de 1,60 inattention par heure. Nous construisons désormais la table complète des déviations quadratiques :
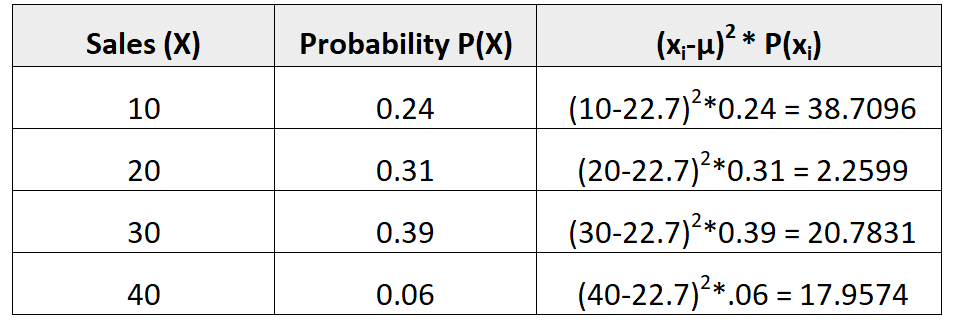
- Pour $x_0 = 0$ : écart $(0 – 1,6) = -1,6$ ; carré $(-1,6)^2 = 2,56$ ; produit $2,56 \cdot 0,15 = 0,384$
- Pour $x_1 = 1$ : écart $(1 – 1,6) = -0,6$ ; carré $(-0,6)^2 = 0,36$ ; produit $0,36 \cdot 0,35 = 0,126$
- Pour $x_2 = 2$ : écart $(2 – 1,6) = +0,4$ ; carré $(+0,4)^2 = 0,16$ ; produit $0,16 \cdot 0,30 = 0,048$
- Pour $x_3 = 3$ : écart $(3 – 1,6) = +1,4$ ; carré $(+1,4)^2 = 1,96$ ; produit $1,96 \cdot 0,15 = 0,294$
- Pour $x_4 = 4$ : écart $(4 – 1,6) = +2,4$ ; carré $(+2,4)^2 = 5,76$ ; produit $5,76 \cdot 0,05 = 0,288$
La sommation des contributions quadratiques de la colonne terminale fournit directement la variance théorique de la distribution :
$$\sigma^2 = 0,384 + 0,126 + 0,048 + 0,294 + 0,288 = 1,140 \text{ (inattention par heure)}^2$$
Pour déterminer l’écart-type, nous extrayons la racine carrée positive de cette variance :
$$\sigma = \sqrt{1,140} \approx 1,067707825…$$
En arrondissant à deux décimales significatives selon les standards psychométriques usuels, l’écart-type comportemental de cette population s’établit rigoureusement à 1,07 inattention par heure.
8.3 Contre-vérification par l’approche de Koenig-Huygens
Pour garantir une robustesse numérique sans faille, confrontons ce résultat à l’application directe du théorème de Koenig-Huygens. Évaluons d’abord l’espérance du carré de la variable, notée $E(X^2)$ :
$$E(X^2) = \sum x_i^2 P(X = x_i)$$
$$E(X^2) = (0^2 \cdot 0,15) + (1^2 \cdot 0,35) + (2^2 \cdot 0,30) + (3^2 \cdot 0,15) + (4^2 \cdot 0,05)$$
$$E(X^2) = (0 \cdot 0,15) + (1 \cdot 0,35) + (4 \cdot 0,30) + (9 \cdot 0,15) + (16 \cdot 0,05)$$
$$E(X^2) = 0 + 0,35 + 1,20 + 1,35 + 0,80 = 3,70$$
Nous reprenons la valeur de l’espérance $\mu = E(X) = 1,60$ et calculons son carré :
$$[E(X)]^2 = (1,60)^2 = 2,56$$
Nous soustrayons désormais $[E(X)]^2$ de $E(X^2)$ conformément à la formule algébrique :
$$\sigma^2 = E(X^2) – [E(X)]^2 = 3,70 – 2,56 = 1,14$$
L’extraction de la racine carrée reproduit la valeur exacte :
$$\sigma = \sqrt{1,14} \approx 1,0677 \approx 1,07$$
L’identité parfaite des décimales obtenues par les deux méthodes confirme l’infaillibilité du calcul et illustre la remarquable concision opérationnelle de la seconde démarche.
9. Applications psychométriques et interprétation des scores individuels
9.1 Rôle pivot de l’écart-type dans l’étalonnage des tests psychologiques
Dans les sciences comportementales et l’évaluation psychométrique, l’écart-type d’une distribution de scores ne constitue pas une simple curiosité descriptive : il forme l’étalon métrologique universel permettant de donner du sens à une performance individuelle. Un score brut issu d’une batterie d’évaluation (comme le nombre d’items réussis à un test de mémoire de travail) est intrinsèquement dénué de signification clinique ou diagnostique s’il n’est pas rapporté à la distribution théorique de la population d’étalonnage.
La transformation canonique fondamentale repose sur le centrage et la réduction de la variable aléatoire, convertissant un score brut $X$ en un score standardisé $Z$ (communément appelé z-score) :
$$Z = \frac{X – \mu}{\sigma}$$
Ce z-score exprime la distance exacte séparant l’individu de la moyenne en unités d’écart-type. Un score $Z = +1,5$ signifie sans ambiguïté que le sujet se situe à un écart-type et demi au-dessus de l’espérance de son groupe de référence.
Toutes les échelles psychométriques standardisées majeures sont des reparamétrisations affines directes du z-score s’appuyant sur un écart-type fixé conventionnellement. Ainsi, les échelles d’intelligence de Wechsler fixent arbitrairement $\mu = 100$ et $\sigma = 15$. Les échelles de personnalité de type MMPI emploient des scores T définis avec $\mu = 50$ et $\sigma = 10$. Enfin, les stanines structurent la dispersion avec $\mu = 5$ et $\sigma = 2$. Sans une détermination irréprochable de l’écart-type de la distribution de référence, l’étalonnage psychométrique s’effondre dans l’arbitraire le plus complet.
9.2 Interprétation probabiliste des intervalles autour de la moyenne
L’écart-type constitue la clé de voûte de la délimitation des intervalles de confiance et de l’identification de l’atypicité clinique ou statistique. Lorsqu’une distribution est présumée normale ou approximativement gaussienne, la règle empirique des trois sigmas permet de borner avec précision la distribution de la masse probabiliste :
- L’intervalle $[\mu – \sigma, \mu + \sigma]$ capture approximativement 68,27 % de la population.
- L’intervalle $[\mu – 2\sigma, \mu + 2\sigma]$ englobe précisément 95,45 % de la masse de probabilité.
- L’intervalle $[\mu – 3\sigma, \mu + 3\sigma]$ intègre 99,73 % des réalisations possibles.
Dans la pratique clinique, le seuil de significativité pathologique ou de haut potentiel est classiquement ancré à une distance de deux écarts-types de la moyenne ($|Z| ge 2$), marquant l’entrée dans les fractions marginales de la distribution (les 2,28 % supérieurs ou inférieurs).
Toutefois, lorsque la forme de la distribution sous-jacente s’écarte notablement de la courbe en cloche gaussienne, ou lorsque sa densité exacte demeure inconnue, l’inégalité de Bienaymé-Tchebychev fournit une borne mathématique universelle incontournable. Pour tout réel $k > 1$, la probabilité qu’une variable aléatoire $X$ s’écarte de son espérance d’une valeur supérieure ou égale à $k$ écarts-types est rigoureusement majorée par l’inverse du carré de $k$ :
$$P(|X – mu| ge k\sigma) le \frac{1}{k^2}$$
Cette inégalité universelle garantit, par exemple, qu’au minimum 75 % de n’importe quelle population stochastique se situe impérativement à moins de 2 écarts-types de sa moyenne ($k = 2 implies 1 – 1/4 = 0,75$), et ce, quelle que soit la dissymétrie de la loi de probabilité.
9.3 L’écart-type comme indicateur de fidélité et erreur type de mesure
Dans le cadre de la théorie classique des tests, le score observé d’un sujet ($X$) est conceptualisé comme la résultante linéaire de son score vrai inobservable ($V$) et d’une composante stochastique d’erreur de mesure non corrélée ($E$), soit $X = V + E$. En appliquant le principe d’additivité des variances pour des variables indépendantes, la variance observée se scinde en deux composantes :
$$\sigma_X^2 = \sigma_V^2 + \sigma_E^2$$
Le coefficient de fidélité théorique du test, noté $\rho_{XX’}$, est défini comme la proportion de la variance totale attribuable aux scores vrais :
$$\rho_{XX’} = \frac{\sigma_V^2}{\sigma_X^2} = 1 – \frac{\sigma_E^2}{\sigma_X^2}$$
À partir de cette relation maîtresse, on dérive l’écart-type de la distribution théorique de l’erreur de mesure, universellement désigné sous le vocable d’erreur type de mesure ($SEm$) :
$$\sigma_E = SEm = \sigma_X \sqrt{1 – \rho_{XX’}}$$
L’erreur type de mesure n’est autre que l’écart-type de la distribution d’échantillonnage des scores qu’un même individu obtiendrait s’il était testé une infinité de fois sous l’hypothèse de l’absence d’effet d’apprentissage. Cet écart-type d’erreur permet de tracer les intervalles de confiance métrologiques indispensables pour statuer sur la réalité d’une évolution clinique ou sur la différence significative entre deux candidats.
10. Erreurs conceptuelles courantes et écueils méthodologiques à éviter
10.1 Confusion entre écart-type d’échantillon et écart-type d’une distribution
L’un des écueils épistémologiques les plus destructeurs en statistique réside dans la confusion systématique entre l’écart-type empirique corrigé d’un échantillon fini et l’écart-type théorique d’une distribution de probabilité. L’écart-type d’échantillon, noté usuellement $s$ ou $s_n-1$, intègre la correction de Bessel au dénominateur sous la forme d’une division par $n – 1$ afin de compenser la perte d’un degré de liberté lors de l’estimation simultanée de la moyenne :
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i – \bar{x})^2}$$
Dans l’évaluation de l’écart-type d’une distribution de probabilité, aucun échantillonnage n’est à l’œuvre. Le modèle stochastique est présumé parfaitement et exhaustivement connu par sa loi de probabilité formelle. Il n’existe strictement aucun « degré de liberté » à retrancher, car on ne procède à aucune inférence d’estimateur. Introduire un diviseur de type $n – 1$ dans le calcul de la dispersion d’une fonction de masse théorique constitue un contresens théorique majeur.
L’analyste doit garder à l’esprit que l’écart-type d’une distribution théorique $\sigma$ est une constante idéale et immuable du modèle, alors que $s$ est une variable aléatoire fluctuante vouée à converger vers $\sigma$ lorsque la taille d’échantillon tend vers l’infini, en vertu du théorème de Glivenko-Cantelli.
10.2 Omission des pondérations probabilistes et erreurs d’équiprobabilité
Une bévue arithmétique extrêmement répandue chez les praticiens débutants consiste à calculer la variance et l’écart-type en effectuant la simple moyenne arithmétique des carrés des écarts, en omettant d’intégrer le facteur de pondération probabiliste $P(X = x_i)$. Cette faute équivaut à formuler l’hypothèse implicite et totalement erronée que toutes les modalités du support sont rigoureusement équiprobables :
$$P(X = x_i) = \frac{1}{n}, \quad \forall i$$
Si l’on reprend notre étude de cas sur les inattentions des contrôleurs aériens, appliquer une moyenne arithmétique simple conduirait à estimer l’espérance par :
$$\mu_{err} = \frac{0 + 1 + 2 + 3 + 4}{5} = 2,00$$
Cette valeur s’écarte radicalement de l’espérance mathématique réelle (qui est de 1,60), car elle attribue le même poids à la survenue rarissime de 4 inattentions ($P = 0,05$) qu’à la modalité modale de 1 inattention ($P = 0,35$). Cette déformation du centre de masse fausse immédiatement toutes les déviations résiduelles, aboutissant à un écart-type totalement fictif.
Pour prévenir cette erreur, un moyen mnémotechnique consiste à se rappeler que toute opération dans l’espace probabiliste doit impérativement être une sommation de termes formés du produit « valeur $\times$ probabilité ». L’intégrité de la pondération doit faire l’objet d’un audit systématique avant toute extraction de racine carrée.
10.3 Interprétation fallacieuse de l’écart-type en contexte asymétrique
L’écart-type synthétise l’ensemble de la dispersion en un scalaire scalairement symétrique unique. De ce fait, une tentation périlleuse consiste à toujours projeter mentalement un intervalle symétrique $\mu \pm \sigma$ ou $\mu \pm 2\sigma$ autour de la moyenne, comme si la distribution épousait fidèlement la courbe normale de Gauss. Cette pratique devient trompeuse dès lors que la loi de probabilité étudiée présente une asymétrie marquée (skewness prononcé) ou un aplatissement extrême (kurtosis élevé).
Considérons une distribution log-normale ou une distribution exponentielle : la masse de probabilité est concentrée à proximité de l’origine avec une longue queue s’étendant vers les valeurs positives. L’application mécanique de la formule $\mu – 2\sigma$ peut aboutir à des bornes négatives situées totalement en dehors du support réel de la variable. Pour une loi exponentielle où $\mu = 1/\lambda$ et $\sigma = 1/\lambda$, l’intervalle $\mu – 2\sigma = -1/\lambda$ désigne une région physiquement impossible puisque la variable ne peut prendre que des valeurs strictement positives.
De surcroît, face à des distributions bimodales ou multimodales (résultant souvent du mélange sous-jacent de sous-populations hétérogènes), l’écart-type peut donner une impression de variabilité homogène alors que les données se regroupent en réalité autour de deux attracteurs distincts, séparés par une zone de quasi-vacuité stochastique. Dans ces conditions, l’écart-type doit impérativement être complété par l’indice d’asymétrie de Fisher-Pearson, l’écart interquartile et l’examen direct du graphe de la distribution.
11. Automatisation computationnelle : R, Python et feuilles de calcul
11.1 Implémentation matricielle et vectorielle sous langage R
Le langage de programmation statistique R offre un environnement matriciel d’une rare élégance pour évaluer sans aucune boucle itérative l’écart-type d’une distribution discrète. Grâce à la vectorisation native des calculs, les opérations probabilistes s’exécutent par le biais de produits scalaires directs.
Pour implémenter ce calcul sous R, on commence par définir le vecteur des modalités $x$ et le vecteur des probabilités correspondantes $p$. Le produit scalaire `%*%` permet d’obtenir instantanément l’espérance et les moments d’ordre supérieur :
Le code analytique s’articule comme suit :
x <- c(0, 1, 2, 3, 4)
p <- c(0.15, 0.35, 0.30, 0.15, 0.05)
stopifnot(abs(sum(p) - 1) < 1e-9)
mu <- sum(x * p)
variance <- sum((x - mu)^2 * p)
sigma <- sqrt(variance)
Ce script intègre une assertion de sécurité (`stopifnot`) qui valide l’axiome de normalisation unitaire avant toute évaluation numérique. L’usage de `sum((x – mu)^2 * p)` garantit une stabilité numérique optimale en appliquant la formule canonique centrée plutôt que l’identité de Koenig-Huygens.
11.2 Modélisation numérique avec Python et la bibliothèque NumPy
Dans l’écosystème Python orienté vers la science des données, la bibliothèque NumPy offre des routines d’algèbre vectorielle hautement optimisées en langage C permettant de calculer la dispersion théorique en exploitant la fonction de moyenne pondérée `np.average` :
import numpy as np
valeurs = np.array([0, 1, 2, 3, 4])
probas = np.array([0.15, 0.35, 0.30, 0.15, 0.05])
assert np.isclose(np.sum(probas), 1.0), "La somme des probabilités doit valoir 1"
mu = np.average(valeurs, weights=probas)
variance = np.average((valeurs - mu)**2, weights=probas)
sigma = np.sqrt(variance)
L’utilisation judicieuse du paramètre `weights` au sein de `np.average` permet d’injecter la fonction de masse de probabilité à la fois pour le calcul de l’espérance et pour celui de la variance résiduelle quadratique. L’appel à `np.isclose` prémunit le script contre les erreurs d’arrondi binaire inhérentes aux représentations à virgule flottante.
Pour des distributions probabilistes continues ou des lois théoriques standardisées, le module spécialisé `scipy.stats` propose également des méthodes natives directes telles que `.mean()`, `.var()` et `.std()` applicables aux objets de lois de probabilité formellement instanciés.
11.3 Mise en place opérationnelle dans Microsoft Excel et Google Sheets
Pour les gestionnaires et analystes financiers évoluant sur tableurs bureautiques, le calcul rapide et sans erreur de l’écart-type d’une distribution discrète peut être entièrement condensé à l’aide de formules matricielles avancées, sans nécessiter la création de multiples colonnes de décomposition.
Supposons que les modalités $x_i$ soient saisies dans la plage de cellules A2:A6 et que leurs probabilités théoriques associées $P(X = x_i)$ occupent la plage B2:B6. La formule permettant d’extraire l’espérance mathématique en une cellule unique exploite la fonction SOMMEPROD :
=SOMMEPROD(A2:A6; B2:B6)
Si cette espérance réside désormais dans la cellule C1, la variance théorique complète se calcule instantanément via la formule matricielle :
=SOMMEPROD((A2:A6 - C1)^2; B2:B6)
Pour extraire directement l’écart-type théorique en une seule formule condensée n’exigeant aucune cellule intermédiaire, on imbriquera la racine carrée et la syntaxe matricielle de calcul de déviation :
=RACINE(SOMMEPROD((A2:A6 - SOMMEPROD(A2:A6; B2:B6))^2; B2:B6))
Cette expression matricielle calcule en interne l’espérance, détermine les résidus quadratiques correspondants, applique la pondération par les probabilités de la colonne B, effectue la sommation intégrale et applique la racine carrée terminale. Cette architecture évite l’écueil classique consistant à faire appel aux fonctions statistiques standards du tableur (comme ECARTYPE.STANDARD ou ECARTYPE.PEARSON), qui sont exclusivement destinées à des séries d’échantillons et ignorent totalement les pondérations probabilistes.
12. Synthèse mathématique et implications pour l’inférence statistique
12.1 Le théorème central limite et le rôle structural de l’écart-type théorique
L’écart-type théorique d’une distribution de probabilité ne constitue pas une simple métrique descriptive de variabilité interne : il s’impose comme le paramètre d’échelle universel gouvernant le comportement asymptotique des moyennes dans toute la théorie moderne de l’inférence statistique. Cette suprématie conceptuelle s’incarne dans le théorème central limite (TCL), formalisé dans sa forme moderne par Alexandre Liapounov et Paul Lévy.
Le théorème central limite stipule que si l’on extrait un échantillon aléatoire de taille $n$ composé de variables indépendantes et identiquement distribuées suivant une loi quelconque possédant une espérance $\mu$ et un écart-type théorique $\sigma$ fini, alors la distribution de la moyenne empirique $\bar{X}_n$ converge asymptotiquement en loi vers une distribution normale gaussienne :
$$\bar{X}_n x\rightarrow{\mathcal{L}} \mathcal{N}\left(\mu, \frac{\sigma^2}{n}\right) \quad \text{ou} \quad \frac{\bar{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} x\rightarrow{\mathcal{L}} \mathcal{N}(0, 1)$$
L’écart-type de la distribution théorique originale conditionne directement l’amplitude de l’erreur type de la moyenne, représentée par la quantité $\sigma / \sqrt{n}$. L’écart-type originel $\sigma$ mesure la variabilité intrinsèque du phénomène entre les entités individuelles, tandis que $\sigma / \sqrt{n}$ quantifie la précision métrologique de notre estimation de la moyenne globale. Connaître précisément l’écart-type de la distribution de base est ce qui permet de dimensionner de façon optimale les échantillons dans les essais cliniques, les sondages électoraux et les protocoles de contrôle qualité industriel.
12.2 Propagation des incertitudes et combinaisons linéaires de variables aléatoires
Dans la modélisation des systèmes complexes, qu’il s’agisse de chaînes d’assemblage micrométriques ou de portefeuilles d’actifs financiers diversifiés, les grandeurs étudiées résultent presque invariablement d’agrégations ou de combinaisons linéaires de multiples variables aléatoires fondamentales. Soit une variable composite $Y$ définie par :
$$Y = \sum_{j=1}^{m} a_j X_j$$
où les $a_j$ sont des coefficients constants déterministes et les $X_j$ des variables aléatoires admettant des écarts-types théoriques respectifs $\sigma_j$. La détermination de l’écart-type de la variable résultante dépend intimement du degré d’interdépendance stochastique unissant ces variables, mesuré par leurs coefficients de corrélation linéaire $\rho_{jk}$ :
$$\sigma_Y = \sqrt{\sum_{j=1}^{m} a_j^2 \sigma_j^2 + 2 \sum_{1 le j < k le m} a_j a_k \sigma_j \sigma_k \rho_{jk}}$$
Dans la situation particulière où toutes les composantes aléatoires sont mutuellement indépendantes ($\rho_{jk} = 0$), l’équation se contracte dans la célèbre formule de sommation quadratique des incertitudes :
$$\sigma_Y = \sqrt{\sum_{j=1}^{m} a_j^2 \sigma_j^2}$$
Cette relation fondamentale démontre l’effet de mutualisation et de diversification stochastique : l’écart-type d’une somme de risques indépendants croît beaucoup plus lentement (proportionnellement à la racine carrée du nombre de composants) que la valeur nominale de ces risques (qui croît linéairement avec $m$).
12.3 Récapitulatif méthodologique pour une rigueur analytique irréprochable
Pour assurer une rigueur analytique absolue dans toute investigation quantitative, la démarche méthodologique permettant de trouver et d’exploiter l’écart-type d’une distribution de probabilité peut être synthétisée sous la forme d’un protocole systématique :
- Identification de la nature du support : Déterminer sans équivoque si la variable est discrète ou continue afin de choisir entre la sommation pondérée discrète $\sum$ et l’intégration continue $\int$.
- Audit de cohérence axiomatique : Valider formellement la non-négativité des probabilités ou de la densité et s’assurer que la somme totale ou l’intégrale impropre converge rigoureusement vers 1.
- Vérification des conditions de moments finis : S’assurer que la queue de distribution décroît suffisamment rapidement pour garantir la convergence des intégrales ou des séries d’ordre 1 et d’ordre 2.
- Calcul non biaisé de l’espérance : Calculer le barycentre $\mu$, vérifier son inclusion stricte dans l’enveloppe du support et conserver sa précision sous forme fractionnaire ou décimale non tronquée.
- Sélection de la voie algorithmique : Privilégier la formule canonique centrée $\sum (x_i – \mu)^2 P(X=x_i)$ pour les calculs informatiques à faible dispersion, ou l’identité de Koenig-Huygens $E(X^2) – \mu^2$ pour les calculs analytiques ou manuels rapides.
- Extraction dimensionnelle finale : Extraire la racine carrée positive de la variance obtenue et toujours associer le scalaire numérique résultant à son unité physique ou psychométrique d’origine.
Sur le plan épistémologique, l’écart-type n’est pas un simple accessoire descriptif greffé sur l’espérance mathématique : il constitue l’autre versant indissociable de la réalité stochastique. Si l’espérance fixe l’horizon déterministe vers lequel tend la loi des grands nombres, l’écart-type délimite le champ des possibles, la marge des erreurs inévitables et l’amplitude souveraine de l’aléa dans le monde réel.
Références
- Bain, L. J., & Engelhardt, M. (1992). Introduction to probability and mathematical statistics (2nd ed.). Duxbury Press.
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Thomson Learning.
- DeGroot, M. H., & Schervish, M. J. (2012). Probability and statistics (4th ed.). Addison-Wesley.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons. https://archive.org/details/anintroductiontoprobabilitytheoryanditsapplicationsvol.1williamfeller_618_r
- Hogg, R. V., McKean, J. W., & Craig, A. T. (2019). Introduction to mathematical statistics (8th ed.). Pearson.
- Papoulis, A., & Pillai, S. U. (2002). Probability, random variables, and stochastic processes (4th ed.). McGraw-Hill.
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110. https://doi.org/10.1098/rsta.1894.0003
- Ross, S. M. (2014). A first course in probability (9th ed.). Pearson.
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7th ed.). Thomson Brooks/Cole.