
Dans le domaine de l’analyse statistique appliquée, de l’économétrie et de la psychométrie contemporaine, la caractérisation de la variabilité d’un ensemble de données constitue une étape tout aussi déterminante que l’estimation de sa tendance centrale. Alors que la moyenne arithmétique et l’écart-type demeurent les métriques canoniques au sein des distributions gaussiennes idéalisées, leur vulnérabilité intrinsèque face aux valeurs extrêmes ou aux contaminations d’échantillonnage impose le recours à des estimateurs dits robustes. Parmi ces outils de statistique exploratoire développés pour pallier les insuffisances de la métrologie paramétrique classique, l’écart interquartile (souvent désigné sous l’acronyme anglo-saxon IQR pour Interquartile Range) s’impose comme la mesure non paramétrique fondamentale de la dispersion des observations empiriques.
La calculatrice graphique Texas Instruments TI-84 Plus, déclinée en versions standard, Silver Edition et CE, constitue le standard informatique ubiquitaire dans l’enseignement supérieur, les laboratoires de recherche en sciences humaines et les protocoles d’expérimentation clinique. Bien que cette machine offre des routines automatisées sophistiquées pour dériver instantanément les paramètres descriptifs majeurs, l’extraction, la visualisation et l’exploitation inférentielle de l’écart interquartile requièrent une compréhension précise de ses algorithmes internes, de ses menus de calcul et de ses représentations graphiques dédiées. En effet, l’absence de commande directe étiquetée trivialement « IQR » sur le clavier de l’appareil déconcerte fréquemment les analystes néophytes, alors même que l’écosystème de programmation et de variables système de la TI-84 permet une automatisation d’une rare élégance.
Ce guide exhaustif a pour vocation d’articuler les fondements théoriques de l’écart interquartile avec la pratique instrumentée sur la TI-84 Plus. Nous examinerons successivement l’ancrage épistémologique de cette mesure en métrologie comportementale, les protocoles de configuration du système d’exploitation de la calculatrice, les méthodes de saisie et d’épuration des séries numériques, ainsi que les manipulations algébriques nécessaires à l’obtention sans erreur de l’IQR. Enfin, une attention scrupuleuse sera accordée à la détection formelle des données aberrantes selon les critères de John Tukey, à la résolution des anomalies logicielles et à l’automatisation de ces routines par l’intermédiaire de scripts programmés en TI-Basic.
1. Fondements théoriques de l’écart interquartile (IQR) en statistique et psychométrie
1.1 Définition formelle et partitionnement des quartiles
L’écart interquartile représente la distance mathématique séparant le 75e centile du 25e centile d’une distribution statistique ordonnée. D’un point de vue formel, si l’on considère une variable aléatoire réelle $X$ associée à une fonction de répartition cumulative $F(x) = P(X le x)$, les quartiles correspondent aux valeurs d’abscisse partitionnant l’espace probabilisé en quatre sous-ensembles d’aires équiprobables de 0,25. Le premier quartile, noté $Q_1$, satisfait la condition $F(Q_1) ge 0{,}25$ ; le deuxième quartile, noté $Q_2$, correspond rigoureusement à la médiane de la distribution telle que $F(Q_2) ge 0{,}50$ ; et le troisième quartile, désigné par $Q_3$, obéit à la relation $F(Q_3) ge 0{,}75$.
L’écart interquartile se définit alors de manière univoque par la différence algébrique absolue :
$$\text{IQR} = Q_3 – Q_1$$
Cette métrique circonscrit avec une parfaite exactitude l’étendue occupée par les 50 % centraux de la population ou de l’échantillon analysé. Contrairement à l’étendue brute qui intègre la totalité des fluctuations présentes entre la valeur minimale et la valeur maximale observées, l’IQR procède à un élagage symétrique délibéré des 25 % inférieurs et des 25 % supérieurs de la distribution. Ce filtrage géométrique confère à l’indicateur une stabilité remarquable dans l’évaluation de la dispersion interne.
Sur le plan méthodologique, la détermination concrète des quartiles sur un échantillon discret de taille finie $N$ soulève d’importantes divergences théoriques. Les statisticiens distinguent historiquement la méthode inclusive introduite par John Tukey (souvent associée aux charnières ou hinges de Tukey), les variantes exclusives recommandées par l’école anglo-saxonne, et les approches d’interpolation continue implémentées dans les grands progiciels contemporains. La méthode de Tukey inclut la médiane dans les sous-ensembles inférieur et supérieur lorsque $N$ est impair, tandis que les algorithmes exclusifs la bannissent strictement de ces sous-échantillons. Ces subtilités algorithmiques influent directement sur la valeur numérique finale calculée par la TI-84, dont le processeur applique une routine spécifique qu’il convient de maîtriser pour garantir la reproductibilité des analyses scientifiques.
1.2 Pertinence de l’IQR dans l’évaluation psychométrique
En psychométrie et en sciences du comportement, la quantification des construits latents repose quasi systématiquement sur des instruments de mesure ordinaux, tels que les échelles d’évaluation de type Likert, les inventaires d’anxiété de Spielberger ou les batteries d’évaluation de la personnalité comme le NEO-PI-3. Les données issues de ces épreuves dérogent fréquemment au postulat de continuité métrique stricte et présentent une vulnérabilité chronique aux biais de réponse, notamment les effets de plafond, de plancher et les réponses extrêmes dictées par la désirabilité sociale.
Dans un tel contexte métrologique, l’utilisation de la variance paramétrique ou de l’écart-type constitue une faute épistémologique majeure, dans la mesure où ces indices présupposent des intervalles rigoureusement égaux entre chaque échelon et une distribution normale sous-jacente. L’écart interquartile préserve la robustesse de l’évaluation psychologique en s’affranchissant totalement des déformations affectant les extrémités de la courbe. Par exemple, lors de l’étalonnage d’une échelle évaluant les symptômes dépressifs, quelques sujets manifestant des scores pathologiques massifs décaleraient artificiellement la moyenne et gonfleraient l’écart-type de la population témoin. L’IQR, quant à lui, demeure rigoureusement impassible face à ces manifestations marginales, reflétant fidèlement l’homogénéité ou l’hétérogénéité du groupe central.
En outre, l’IQR s’avère un instrument de choix dans la comparaison différentielle de cohortes cliniques face à des populations saines. Dans l’étude des troubles de l’attention ou de la régulation émotionnelle, les groupes pathologiques démontrent souvent une dispersion centrale élargie — témoignant d’une labilité cognitive accrue — sans que cette fluctuation ne puisse être correctement synthétisée par des paramètres gaussiens en raison d’une asymétrie positive prononcée. L’analyse conjointe de la médiane et de l’IQR fournit alors un cadre d’inférence non paramétrique scientifiquement irréprochable.
1.3 Propriétés statistiques fondamentales de la dispersion médiane
Sur le plan fonctionnel, l’écart interquartile forme un couple indissociable avec la médiane. De la même manière que l’écart-type constitue la mesure naturelle d’écartement associée à la moyenne arithmétique (dans le cadre de la minimisation de la somme des carrés des erreurs), l’écart interquartile opère comme l’estimateur de référence conjoint à la médiane, cette dernière minimisant la somme des déviations absolues simples. Cette complémentarité repose sur le caractère non paramétrique et ordinal de ces deux grandeurs.
Parmi les propriétés analytiques fondamentales de l’IQR, l’invariance par translation joue un rôle capital dans les procédures de standardisation de données. Soit un ensemble de mesures expérimentales $X = {x_1, x_2, dots, x_n}$ et une transformation affine $Y = aX + b$, où $a$ et $b$ sont des constantes réelles avec $a ne 0$. Si l’on applique une simple translation d’échelle (par exemple l’ajout d’une constante $b$ liée à un réétalonnage de zéro instrumental), la distribution spatiale des observations subit un glissement rigide sans modification de leurs distances relatives :
$$\text{IQR}(X + b) = \text{IQR}(X)$$
À l’inverse, sous l’effet d’une transformation d’échelle linéaire impliquant un multiplicateur $a$ (tel qu’un changement d’unités de mesure de secondes en millisecondes), l’écart interquartile évolue de façon strictement proportionnelle à la valeur absolue du coefficient scalaire :
$$\text{IQR}(aX) = |a| \cdot \text{IQR}(X)$$
Cette propriété garantit que l’indicateur conserve une fidélité absolue aux propriétés géométriques du nuage de points d’origine. L’absence de distorsion quadratique — contrairement à la variance qui s’accroît d’un facteur $a^2$ — simplifie l’interprétation dimensionnelle des résultats lors de l’application de barèmes de conversion ou de normalisations d’épreuves standardisées.
2. Avantages métrologiques de l’écart interquartile face aux valeurs aberrantes
2.1 Résistance statistique comparée à l’étendue simple
L’étendue classique d’une série statistique, définie par la différence élémentaire $R = X_{\text{\max}} – X_{\text{\min}}$, constitue l’indicateur de variabilité le plus intuitif mais également le plus instable de toute la théorie statistique. Sa vulnérabilité face aux artefacts métrologiques est absolue : il suffit d’une unique erreur d’encodage décimal, d’un dysfonctionnement matériel transitoire ou de la présence d’un individu atypique au sein de l’échantillon pour que l’étendue quadruple ou décuple instantanément, véhiculant une image totalement dévoyée de la dispersion du phénomène mesuré.
Le concept de résistance statistique, formalisé par Peter Rousseeuw et les théoriciens de la statistique robuste, quantifie la capacité d’un estimateur à maintenir sa validité en présence de données contaminées. Le « point de rupture » (breakdown point) représente la proportion maximale de données arbitrairement aberrantes qu’un échantillon peut tolérer avant que l’estimateur ne prenne une valeur infinie ou totalement erronée. Alors que l’étendue simple possède un point de rupture catastrophique de $1/N$ (tendant vers zéro lorsque la taille de l’échantillon augmente), l’écart interquartile affiche un point de rupture de 0,25 (soit 25 %).
Cette insensibilité opérationnelle signifie que jusqu’à un quart des observations situées aux extrémités les plus basses ou les plus hautes peuvent être corrompues ou déplacées à l’infini sans que la valeur de l’IQR ne subisse la moindre altération. Dans le cadre de protocoles expérimentaux impliquant des échantillonnages répétés, cette immunité confère à l’IQR une stabilité d’échantillonnage exceptionnelle, évitant aux chercheurs de rejeter à tort des hypothèses nulles en raison de fluctuations parasites confinées aux marges de la distribution.
2.2 Comparaison épistémologique avec l’écart-type et la variance
L’écart-type empirique standard, formalisé par la racine carrée de la variance corrigée :
$$s = \sqrt{\frac{1}{n-1}\sum_{i=1}^n (x_i – \bar{x})^2}$$
repose sur une métrique euclidienne assise sur le calcul des résidus quadratiques par rapport à la moyenne arithmétique. Cette pénalisation au carré confère à chaque point excentrique un effet de levier disproportionné sur la valeur finale de l’indice. Dans les distributions asymétriques à longue traîne droite (telles que les revenus, les temps d’accès mémoriel ou la charge virale), l’écart-type se trouve systématiquement étiré vers le haut, créant l’illusion d’une dispersion globale massive alors que l’immense majorité des données est en réalité fortement agglutinée autour d’un mode restreint.
D’un point de vue épistémologique, l’écart-type n’est l’estimateur d’échelle optimal qu’exclusivement sous l’hypothèse stricte de normalité (loi de Laplace-Gauss), en vertu du théorème de Gauss-Markov. Dès lors que la loi génératrice réelle des données s’éloigne de ce modèle théorique idéal — situation prévalant dans l’ensemble des sciences expérimentales et sociales —, l’efficacité statistique relative de l’écart-type s’effondre dramatiquement au profit des estimateurs basés sur les quantiles.
L’écart interquartile s’avère particulièrement fécond dans les distributions bimodales ou fortement asymétriques où la notion même de dispersion symétrique autour d’un centre de gravité unique perd tout son sens clinique. En s’affranchissant du calcul de résidus par rapport à une moyenne qui ne correspond à aucun sujet réel, l’IQR capture la géométrie interne de la masse centrale de façon agnostique vis-à-vis de la loi de probabilité sous-jacente, imposant de facto son usage dès que les tests de normalité (tels que ceux de Shapiro-Wilk ou de Kolmogorov-Smirnov) sont rejetés.
2.3 Application à la filtration des artéfacts en neurosciences comportementales
Le recueil de données chronométriques en neurosciences cognitives et en psychologie expérimentale illustre parfaitement la supériorité opérationnelle de l’écart interquartile. Dans les tâches informatisées mesurant les temps de réaction (par exemple le paradigme de Posner ou les protocoles d’amorçage sémantique), les séries temporelles sont inévitablement parasitées par deux classes d’artéfacts non modélisables : les anticipations motrices involontaires (générant des latences anormalement brèves inférieures à 150 ms) et les décrochages attentionnels transitoires (engendrant des latences disproportionnellement longues dépassant plusieurs secondes).
L’application aveugle de moyennes et d’écarts-types à ces chronométries altère substantiellement les estimations de la vitesse de traitement de l’information. L’écart interquartile permet d’isoler la variabilité authentique du processus cognitif sous-jacent en épurant mécaniquement les queues de distribution sans nécessiter d’élagage arbitraire susceptible d’introduire des biais d’amputation (trimming bias). La dispersion interquartile reflète avec une grande pureté l’instabilité neuromotrice intra-individuelle réelle, libre des défaillances circonstancielles du sujet expérimental.
De surcroît, lors d’acquisitions télémétriques continues par capteurs physiologiques (suivi de la conductance cutanée, électroencéphalographie ambulatoire ou actigraphie), les interruptions de contact et les interférences électromagnétiques injectent ponctuellement des signaux aberrants à très haute amplitude. L’usage de l’IQR comme métrique de variabilité du signal garantit la préservation de l’intégrité de l’analyse, rendant les chaînes de traitement insensibles aux micro-coupures techniques et aux perturbations d’enregistrement.
3. Configuration initiale et préparation de la calculatrice TI-84 Plus
3.1 Vérification des paramètres système et du système d’exploitation
Avant d’engager toute démarche de calcul statistique poussée sur la plateforme Texas Instruments TI-84 Plus (qu’il s’agisse de la version monochrome standard ou des déclinaisons TI-84 Plus CE dotées d’écrans couleur haute résolution), il est impératif d’auditer l’état du système d’exploitation interne, désigné sous le nom de TI-OS. Les versions de système supérieures à 2.55MP sur les modèles monochromes et 5.3+ sur les architectures CE intègrent le moteur de rendu MathPrint, qui modifie sensiblement la présentation syntaxique des commandes statistiques en substituant des formulaires interactifs aux anciennes syntaxes linéaires textuelles.
Pour vérifier la version courante de votre TI-OS, appuyez séquentiellement sur les touches 2nd puis + (pour appeler le menu MEM), puis sélectionnez l’option 1:About. L’écran affiche alors le numéro de révision du micrologiciel. Si votre appareil fonctionne sous un OS obsolète, certaines fonctionnalités ergonomiques de saisie des arguments pour les statistiques à une variable ne seront pas accessibles sous forme de menus déroulants guidés, contraignant l’opérateur à respecter une syntaxe stricte avec séparateurs par virgule.
Accédez ensuite au menu de configuration générale en pressant la touche MODE. Pour garantir un affichage optimal des sorties numériques statistiques sans instabilité de formatage, assurez-vous que les paramètres suivants sont rigoureusement sélectionnés sur les premières lignes de configuration :
- Ligne 1 (Format d’affichage) : Sélectionnez
Normalplutôt queSci(Scientifique) ouEng(Ingénieur), sauf si vos observations psychométriques s’échelonnent sur des puissances de dix extrêmes. - Ligne 2 (Arrondi décimal) : Paramétrez l’option sur
Float(Flottant). Cette configuration empêche la machine d’effectuer des arrondis prématurés sur les quartiles calculés, préservant ainsi une précision allant jusqu’à 10 chiffres significatifs. - Ligne des menus contextuels : Assurez-vous que l’option
STAT WIZARDSest positionnée surON. Cette activation garantit que l’appel aux routines de calcul statistique déploiera des écrans de dialogue explicites pour l’assignation des listes de données et de pondération.
Enfin, contrôlez l’espace mémoire libre via 2nd MEM > 2:Mem Management/Delete.... Une saturation de la mémoire vive (RAM) par des matrices volumineuses ou des programmes complexes peut provoquer des blocages système inopinés lors de l’exécution des algorithmes de tri nécessaires à la segmentation quartilaire.
3.2 Initialisation et nettoyage des registres de listes de données
L’architecture logicielle de la TI-84 Plus organise les données quantitatives unidimensionnelles au sein de registres dédiés désignés par les variables de liste système, numérotées par défaut de L1 à L6. L’encodage de nouvelles données expérimentales dans une liste contenant des résidus d’exercices antérieurs constitue la source d’erreur la plus banale et la plus dévastatrice en analyse quantitative. Une purge intégrale des registres de travail s’avère donc strictement obligatoire avant toute manipulation.
Deux méthodologies complémentaires permettent de réinitialiser ces registres. La première s’exécute directement depuis l’écran de calcul principal (Home Screen). Appuyez sur la touche STAT, puis, sous l’onglet EDIT, naviguez vers le bas pour sélectionner la commande 4:ClrList. La commande s’inscrit sur votre écran d’accueil. Il convient alors de spécifier la ou les listes à vider. Pour assigner la liste L1, pressez la combinaison de touches 2nd puis 1 (la mention L1 apparaissant en couleur secondaire au-dessus du chiffre 1). L’instruction complète se lit ainsi :
ClrList L1
En pressant la touche ENTER, la calculatrice exécute l’ordre et renvoie le message de confirmation Done. Vous pouvez purger simultanément plusieurs listes en séparant leurs désignations par des virgules (touche , située au-dessus de la touche 7) : ClrList L1, L2, L3.
La seconde procédure se réalise au sein même de l’éditeur de listes matriciel. Ouvrez l’éditeur en appuyant sur STAT puis 1:Edit.... À l’aide des flèches directionnelles du pavé de navigation, placez le curseur inverse directement sur l’en-tête de la colonne, de manière à surligner le libellé L1. Appuyez ensuite impérativement sur la touche CLEAR, puis sur la touche ENTER (ou descendez d’une case). La totalité de la colonne est immédiatement purgée de son contenu. Attention critique : ne pressez jamais la touche DEL lorsque l’en-tête L1 est surligné, car cette action n’efface pas les données mais supprime physiquement la colonne entière du visualiseur, provoquant la disparition de L1 de l’interface.
Si par mégarde une telle suppression de colonne survient, vous pouvez restaurer instantanément la structure d’affichage matricielle par défaut. Quittez l’éditeur, pressez la touche STAT, sélectionnez l’option 5:SetUpEditor, et validez par ENTER. Lorsque l’appareil confirme l’opération par Done, l’éditeur retrouve sa topologie canonique affichant les listes L1 à L6 dans l’ordre arithmétique standard.
3.3 Optimisation des variables d’affichage pour les statistiques
Pour exploiter pleinement la puissance analytique de la TI-84 Plus lors des explorations préliminaires, il est hautement profitable d’ajuster les drapeaux (flags) logiciels régissant le moteur de diagnostic et la présentation graphique. Bien que le calcul direct de l’écart interquartile n’en dépende pas de manière vitale, ces réglages évitent des interférences fonctionnelles majeures lors des étapes ultérieures de validation.
L’activation du mode DiagnosticOn s’effectue via le menu de catalogage universel de la machine. Appuyez sur la combinaison 2nd 0 pour ouvrir le CATALOG. Pressez la touche alphabétique D (touche $x^{-1}$) pour descendre rapidement dans la nomenclature alphabétique, puis faites défiler les commandes jusqu’à localiser DiagnosticOn. Pressez ENTER pour coller l’instruction sur l’écran d’accueil, puis ENTER à nouveau pour l’exécuter. Ce réglage force la machine à calculer et afficher de façon systématique les coefficients de détermination ($r^2$) et de corrélation linéaire de Pearson ($r$) lors des modélisations de régression conjointe.
Par ailleurs, contrôlez scrupuleusement l’inhibition des tracés fonctionnels résiduels. Si une équation algébrique demeure active dans l’interpréteur de fonctions de la calculatrice, elle sera superposée de force lors des visualisations par boîte à moustaches, saturant l’écran et déclenchant potentiellement des erreurs de calcul différentiel. Pressez la touche Y= située en haut à gauche du clavier. Inspectez la liste des équations de Y1 à Y9. Si une quelconque expression mathématique y figure, effacez-la à l’aide de la touche CLEAR ou désactivez son tracé en positionnant le curseur sur le signe d’égalité = correspondant et en pressant ENTER de sorte que le surlignage noir disparaisse.
4. Procédure d’encodage des données expérimentales dans l’éditeur de listes (L1)
4.1 Navigation et saisie pas à pas dans l’éditeur matriciel
L’encodage méthodique d’un jeu de données constitue la base sur laquelle repose l’ensemble de la chaîne de traitement statistique. Pour accéder à la matrice de saisie, pressez la touche STAT, ce qui ouvre par défaut l’onglet EDIT. Le premier choix, intitulé 1:Edit..., est surligné par défaut. Validez en pressant la touche ENTER ou le chiffre 1. Vous pénétrez alors dans l’environnement du tableur interne de la TI-84.
L’interface se structure sous la forme d’un tableau à double entrée. Les colonnes symbolisent les variables vectorielles (nommées L1, L2, etc.), tandis que les lignes numérotées entre parenthèses au bas de l’écran indiquent l’indice de l’élément actif, sous la forme explicite L1(n)= où $n$ matérialise le rang scalaire de l’observation au sein du vecteur de données.
Pour illustrer la démarche avec un réalisme psychométrique rigoureux, considérons une série de scores d’efficience cognitive recueillis auprès d’un échantillon expérimental de 15 sujets adultes soumis à une batterie informatisée d’évaluation des capacités de flexibilité mentale (scores standardisés sur une échelle continue) :
$${84, 76, 92, 68, 88, 79, 95, 81, 73, 85, 102, 70, 83, 89, 77}$$
Le protocole d’encodage séquentiel s’exécute ainsi :
- Positionnez le curseur sur la première cellule vide de la colonne
L1, indiquée au bas de l’écran parL1(1)=. - Tapez au clavier numérique la première valeur :
84, puis pressez impérativement la toucheENTER. La valeur est enregistrée et le curseur se déplace automatiquement sur la ligne immédiatement inférieure, étiquetéeL1(2)=. - Saisissez la valeur suivante :
76, suivie deENTER. - Poursuivez cette saisie rigoureuse de manière séquentielle pour l’ensemble des 15 scores du jeu de données.
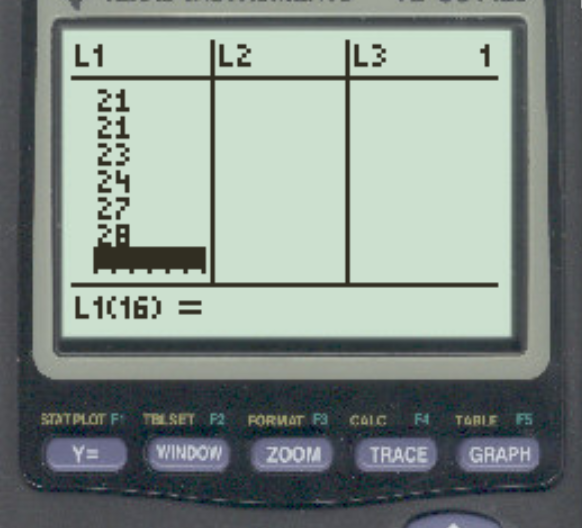
Après l’encodage de la dernière valeur (77), vérifiez scrupuleusement la ligne d’état au bas de la matrice. L’indicateur doit spécifier L1(16)=, ce qui atteste formellement que 15 valeurs distinctes ont été logées dans le registre matriciel sans omission de validation sur le dernier item.
4.2 Modification, correction et insertion de données
L’erreur de saisie humaine constitue l’un des écueils les plus récurrents en statistique pratique. La TI-84 Plus intègre des mécanismes d’édition textuelle permettant de rectifier une anomalie sans devoir ressaisir l’intégralité du tableau.
Si vous constatez qu’une valeur est erronée (par exemple, la saisie par inadvertance de 680 au lieu de 68 à la quatrième ligne), utilisez les touches fléchées du pavé directionnel pour naviguer verticalement dans la colonne L1 jusqu’à placer le curseur d’inversion directement sur la cellule incriminée. Tapez simplement la valeur correcte 68 par-dessus l’ancienne, puis appuyez sur ENTER. L’ancien enregistrement est immédiatement écrasé par la nouvelle entrée.
Dans l’éventualité où une observation empirique aurait été accidentellement omise dans la séquence chronologique d’encodage, le recours à la fonction d’insertion évite tout décalage fastidieux. Placez le curseur sur l’élément devant se situer immédiatement sous la valeur manquante. Pressez la touche bleue ou jaune 2nd, puis la touche DEL, au-dessus de laquelle figure l’inscription INS (pour Insert). La calculatrice décale instantanément l’ensemble des cellules inférieures d’un rang vers le bas et ouvre une cellule vierge initialisée à zéro : L1(i)=0. Tapez la valeur omise et validez par ENTER.
À l’inverse, si une cellule surnuméraire ou parasite a été intégrée par inadvertance, surlignez-la à l’aide des flèches directionnelles et appuyez simplement sur la touche DEL. La valeur est instantanément détruite et toutes les observations sous-jacentes sont translatées d’un rang vers le haut, comblant le vide créé sans altérer la cohérence d’indexation de la liste.
4.3 Tri préalable des données pour contrôle visuel
Bien que les algorithmes de la TI-84 soient conçus pour effectuer les opérations de tri en mémoire tampon lors du calcul des centiles sans modifier l’ordre initial de la liste, il est extrêmement profitable sur le plan pédagogique et analytique d’exécuter un tri croissant explicite sur la liste L1. Cette manipulation permet à l’expérimentateur d’inspecter physiquement l’ordonnancement de sa distribution et d’identifier intuitivement les rangs médians.
Pour trier votre liste par ordre croissant, quittez l’éditeur matriciel en exécutant la séquence d’échappement 2nd puis MODE (commande QUIT), ce qui vous ramène à l’écran d’accueil. Appuyez sur la touche STAT. Dans le menu EDIT, naviguez vers le bas pour sélectionner l’option 2:SortA( (le suffixe A signifiant Ascending ou tri ascendant). Validez par ENTER. L’instruction apparaît sur l’écran d’accueil :
SortA(
Indiquez le nom de la liste à trier en pressant 2nd puis 1 (pour coller L1), puis fermez éventuellement la parenthèse via la touche dédiée au-dessus du chiffre 9. L’écran affiche :
SortA(L1)
Pressez ENTER. La machine calcule l’ordonnancement en quelques millisecondes et affiche Done. Si vous retournez à présent dans l’éditeur via STAT > 1:Edit..., vous constaterez que la série de scores cognitifs a été rigoureusement réorganisée du plus petit au plus grand :
$${68, 70, 73, 76, 77, 79, 81, 83, 84, 85, 88, 89, 92, 95, 102}$$
Cette forme ordonnée facilite grandement le repérage visuel de la médiane (ici la 8e observation, soit la valeur 83) et permet d’anticiper la division en sous-groupes quartilaires, confirmant ainsi la validité matérielle des scores avant l’extraction algorithmique définitive.
5. Exécution de la commande 1-Var Stats pour l’extraction des quartiles
5.1 Paramétrage du menu statistique à une variable
La commande maîtresse pour l’extraction des paramètres de distribution univariée sur l’environnement Texas Instruments réside dans la routine 1-Var Stats (Statistiques à une variable). Ce sous-programme compile en une passe algorithmique unique l’ensemble des estimateurs paramétriques (moments d’ordre un et deux) et non paramétriques (statistiques d’ordre).
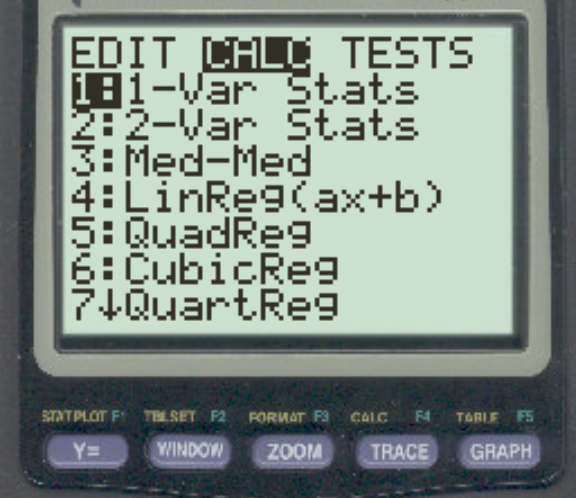
Depuis l’écran principal de la calculatrice, pressez la touche STAT, puis utilisez la flèche droite du pavé directionnel pour basculer sur l’onglet horizontal supérieur CALC. La première option disponible, intitulée 1:1-Var Stats, est sélectionnée par défaut. Pressez la touche ENTER pour engager le protocole de paramétrage.
Selon la génération de votre TI-84 Plus et l’état d’activation des assistants logiciels (Stat Wizards), deux interfaces distinctes peuvent se présenter à l’opérateur :
- Interface interactive moderne (Stat Wizards ON) : Un formulaire structuré s’affiche à l’écran avec trois champs explicites :
List:Ce champ doit spécifier la liste contenant vos observations. Par défaut, la machine propose généralementL1. Si un autre registre apparaît, effacez-le et pressez2nd1pour assigner rigoureusementL1.FreqList:Ce champ désigne la liste des fréquences associées aux observations (utilisée uniquement lorsque les données sont présentées sous forme de tableau d’effectifs condensé, où une liste contient les modalités et une seconde leurs poids respectifs). Pour des données brutes unitaires telles que celles de notre protocole cognitif, ce champ doit impérativement demeurer totalement vierge. Si une variable de liste y est inscrite, placez le curseur dessus et appuyez sur la toucheCLEAR.Calculate:À l’aide de la flèche directionnelle basse, positionnez le curseur inverse sur cette commande de déclenchement et pressezENTER.
- Interface classique en ligne de commande (Stat Wizards OFF) : La mention
1-Var Statsest directement collée sur l’écran d’accueil sans formulaire intermédiaire. Si vous avez encodé vos données dans le registre canoniqueL1, vous pouvez vous dispenser de tout argument et appuyer directement surENTER, la machine traitantL1par défaut avec une pondération unitaire. Si vous aviez utilisé une liste différente, telle queL2, la syntaxe textuelle exigerait d’écrire1-Var Stats L1(ou1-Var Stats L1,L2dans le cas d’une liste de fréquences pondérées) avant de valider.
5.2 Lecture et défilement du résumé à cinq nombres (Five-Number Summary)
Dès l’exécution de la routine de calcul, la TI-84 Plus affiche une première page de résultats synthétiques dominée par les estimateurs paramétriques gaussiens. On y observe au sommet la moyenne empirique de l’échantillon notée $\bar{x} = 81{,}8$, suivie de la somme des observations $\sum x = 1227$, de la somme des carrés $\sum x^2 = 101743$, de l’écart-type d’échantillon non biaisé $Sx = 9{,}351$ (divisé par $n-1$), de l’écart-type de population $\sigma x = 9{,}034$ (divisé par $n$), et de l’effectif total d’échantillon $n = 15$.
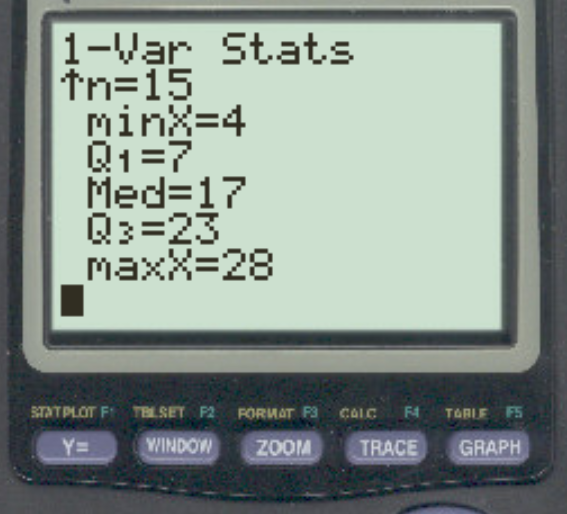
La présence d’une flèche noire pointant vers le bas sur le bord gauche de l’écran indique de manière formelle que d’autres indicateurs statistiques ont été générés en aval de la fenêtre d’affichage visible. À l’aide des flèches directionnelles du pavé de commande, faites défiler l’écran vers le bas. Vous accédez alors au segment non paramétrique de la sortie statistique, universellement désigné en métrologie sous le vocable de « résumé à cinq nombres » (Five-Number Summary), formalisé à l’origine par John Tukey pour caractériser les distributions indépendantes de toute hypothèse distributionnelle.
Ce bloc affiche consécutivement les cinq bornes quantilaires canoniques de la série :
minX = 68: La valeur minimale absolue constatée dans le vecteur ordonné.Q1 = 76: Le premier quartile, sous lequel se positionnent 25 % des observations.Med = 83: La médiane géométrique ($Q_2$), séparant la distribution en deux moitiés équiprobables.Q3 = 89: Le troisième quartile, sous lequel se trouvent 75 % des scores analysés.maxX = 102: La valeur maximale absolue identifiée dans la série d’observations.
Il est fondamental de constater ici la dissociation matérielle opérée par Texas Instruments : la calculatrice extrait de manière automatisée les bornes $Q_1$ et $Q_3$, mais ne procède pas spontanément à leur soustraction sur cet écran descriptif. La détermination de l’écart interquartile impose donc de recueillir ces deux bornes pour finaliser le traitement arithmétique.
5.3 Divergences méthodologiques de calcul des quartiles selon les systèmes
L’interprétation de la valeur Q1 = 76 et de Q3 = 89 obtenue sur notre série ordonnée de 15 éléments soulève une problématique statistique fondamentale relative aux algorithmes discrets de calcul quantilaire. Il existe en effet au moins neuf définitions mathématiques distinctes pour l’estimation des quantiles d’échantillon, répertoriées exhaustivement dans la typologie classique établie par Rob J. Hyndman et Yanan Fan en 1996.
L’architecture logicielle de la TI-84 applique rigoureusement la méthode dite de la « médiane des sous-listes avec exclusion de la médiane globale » (correspondant approximativement au Type 6 ou à la convention exclusive de Tukey). La logique opératoire de la machine procède de la façon suivante :
- Elle ordonne la liste globale de taille $N$. Si $N$ est impair ($N = 2k + 1$), la médiane se situe strictement au rang $(N+1)/2$. Pour notre échantillon de $N = 15$, la médiane correspond au 8e élément : $\text{Med} = x_{(8)} = 83$.
- Elle partitionne ensuite la série en deux sous-ensembles strictement étanches en excluant totalement la valeur médiane centrale :
- Sous-liste inférieure (les 7 éléments précédant la médiane) : ${68, 70, 73, 76, 77, 79, 81}$.
- Sous-liste supérieure (les 7 éléments succédant à la médiane) : ${84, 85, 88, 89, 92, 95, 102}$.
- Le premier quartile $Q_1$ est alors calculé comme la médiane formelle de la sous-liste inférieure. Cette sous-liste comptant 7 éléments (nombre impair), sa médiane est son 4e élément : $x_{(4)} = 76$.
- Le troisième quartile $Q_3$ est calculé comme la médiane de la sous-liste supérieure. Il s’agit de son 4e élément : $x_{(12)} = 89$.
Si la taille $N$ de l’échantillon initial avait été paire ($N = 2k$), la médiane globale aurait été obtenue par la demi-somme arithmétique des éléments aux rangs $k$ et $k+1$. Dans ce cas précis, la division se ferait naturellement en deux sous-listes de taille $k$ sans qu’aucun élément ne doive être exclu, et les quartiles correspondraient aux médianes de ces deux moitiés respectives.
Cette approche adoptée par Texas Instruments diverge sensiblement de l’algorithme par défaut implémenté dans des environnements tels que le logiciel R (qui applique par défaut la méthode de Hazen ou l’interpolation linéaire dite de Type 7), où les rangs quantilaires sont définis par des fonctions continues pondérées de type $p(n-1) + 1$. Selon les progiciels statistiques utilisés par un laboratoire universitaire (SPSS, SAS, Stata ou Excel via la fonction QUARTILE.INC vs QUARTILE.EXC), des variations de quelques dixièmes de points peuvent apparaître sur des échantillons de faible effectif. La maîtrise de l’algorithme interne de la TI-84 permet à l’analyste de justifier ces écarts métrologiques mineurs dans ses rapports de recherche sans imputer cette divergence à une quelconque anomalie logicielle de la machine.
6. Calcul arithmétique et extraction automatique de l’IQR sur TI-84
6.1 Calcul arithmétique standard sur l’écran d’accueil
La modalité la plus directe pour obtenir la valeur de l’écart interquartile consiste à exécuter la soustraction algébrique élémentaire des valeurs scalaires lues dans le rapport statistique 1-Var Stats. Cette approche est privilégiée lors des examens universitaires ou des sessions de travaux dirigés en raison de sa simplicité conceptuelle immédiate.
Après avoir visualisé les grandeurs Q1 et Q3 au bas du résumé statistique, quittez l’écran d’affichage des résultats en appuyant sur la combinaison de touches 2nd puis MODE (commande QUIT). Vous êtes immédiatement repositionné sur l’écran de travail interactif vierge (Home Screen).
À l’aide du pavé numérique de la calculatrice, saisissez directement la valeur relevée pour le troisième quartile, insérez le signe opératoire de la soustraction (touche - située sur la colonne de droite, à ne pas confondre avec le signe négatif d’affectation unaire (-) situé au bas du clavier), puis entrez la valeur du premier quartile. Dans le cadre de notre série d’efficience cognitive :
89 - 76
Pressez la touche ENTER. La TI-84 renvoie instantanément la valeur scalaire :
13
L’écart interquartile de la distribution est donc rigoureusement de 13 unités. Cette démarche manuelle, bien qu’élémentaire, comporte néanmoins un risque non négligeable d’erreur humaine par inadvertance lors de la retranscription de nombres décimaux longs ou d’échantillons complexes où les quartiles comporteraient plusieurs décimales tronquées à la lecture visuelle.
6.2 Utilisation des variables système pour un calcul sans ressaisie
Afin de garantir une rigueur métrologique absolue et d’éviter tout biais d’arrondi ou de transcription, la TI-84 Plus dispose d’un système hautement sophistiqué de stockage dynamique en mémoire tampon. Dès que la routine 1-Var Stats est exécutée, le processeur assigne automatiquement chaque métrique calculée à une variable système protégée accessible depuis les menus de programmation.
Pour exploiter cette architecture et calculer l’IQR sans la moindre ressaisie manuelle, appliquez le protocole suivant depuis l’écran d’accueil :
- Appuyez sur la touche
VARS(située sur la quatrième rangée du clavier, sous les flèches directionnelles). - Dans le menu contextuel qui s’affiche, descendez jusqu’à l’option
5:Statistics...et pressezENTER. - L’écran présente désormais une série d’onglets horizontaux répertoriant les différentes catégories de paramètres statistiques (
XY,Σ,EQ,TEST,PTS). Utilisez la flèche droite du pavé de navigation pour vous déplacer jusqu’à l’onglet intituléPTS(pour Points ou statistiques non paramétriques). - Faites défiler le curseur vers le bas au sein de cette sous-liste pour sélectionner la variable
4:Q3, puis appuyez surENTER. Le symbole textuelQ₃s’inscrit immédiatement sur votre écran d’accueil. - Pressez la touche de l’opérateur de soustraction arithmétique standard
-. - Retournez derechef dans le menu des variables : pressez
VARS>5:Statistics...> ongletPTS. - Sélectionnez cette fois la variable
2:Q1et pressezENTER. L’écran de la calculatrice affiche désormais l’équation symbolique :
Q₃ - Q₁
Pressez la touche d’exécution ENTER. La machine évalue instantanément la différence entre les deux registres système internes et affiche le résultat analytique exact : 13. Cette méthode élimine rigoureusement toute possibilité d’erreur de frappe et permet de manipuler des quartiles réels possédant un développement décimal infini avec la précision maximale garantie par le coprocesseur arithmétique (14 chiffres internes sous virgule flottante).
6.3 Stockage du résultat dans une variable dédiée pour réutilisation
Dans le cadre de protocoles d’analyse avancés, la valeur numérique de l’IQR ne constitue pas une fin en soi, mais sert de pivot arithmétique pour des calculs subséquents, notamment l’établissement des clôtures de Tukey ou la normalisation non paramétrique des scores individuels. Pour éviter d’avoir à recalculer continuellement cette différence ou à réécrire la syntaxe symbolique, il est fortement recommandé d’assigner l’IQR à une lettre mémoire persistante au moyen de l’opérateur d’affectation.
Immédiatement après avoir exécuté l’opération Q₃ - Q₁ sur l’écran principal, pressez la touche d’assignation mémorielle STO→ (située sur la colonne de gauche, immédiatement au-dessus de la touche ON). Une flèche d’affectation s’inscrit à l’écran, signifiant que la valeur scalaire temporaire présente dans le registre de réponse (Ans) va être injectée dans un registre persistant :
Ans →
Il convient alors de désigner la lettre alphabétique cible. Par convention mnémotechnique universelle, nous choisirons la lettre I (pour Interquartile). Appuyez sur la touche verte ALPHA, puis sur la touche de la fonction trigonométrique $x^2$ (au-dessus de laquelle figure la lettre I en vert). L’écran affiche désormais l’instruction formelle complète :
Ans → I (ou directement Q₃ - Q₁ → I)
Pressez ENTER. La calculatrice confirme l’assignation en réaffichant la valeur stockée (13). Désormais, la variable I conserve de façon pérenne la valeur numérique de l’écart interquartile en mémoire vive non volatile. Même si l’appareil est éteint ou que de nouvelles routines statistiques sont exécutées, la valeur réside dans le registre I jusqu’à sa réaffectation explicite. Vous pouvez désormais invoquer directement cette métrique au sein de n’importe quelle équation complexe (par exemple en saisissant 1.5*I) simplement en pressant ALPHA suivi de I.
7. Représentation graphique : Visualisation de l’IQR par la boîte à moustaches
7.1 Configuration du menu graphique STAT PLOT
L’écart interquartile trouve son incarnation géométrique la plus expressive dans la représentation graphique par boîte à moustaches (ou diagramme de Tukey, communément désigné sous le terme anglo-saxon de boxplot). La TI-84 Plus intègre dans son contrôleur vidéo un module dédié au traçage vectoriel direct de ces figures statistiques, permettant d’appréhender d’un seul coup d’œil l’ampleur de la dispersion interquartile et l’asymétrie de la distribution empirique.
Le paramétrage du tracé exige l’accès au menu de configuration des graphiques statistiques. Appuyez sur la touche jaune ou bleue 2nd, puis sur la touche de fonction graphique située à l’extrême gauche Y= pour appeler l’utilitaire STAT PLOT. L’écran liste alors les trois graphiques d’analyse programmables (Plot1, Plot2, Plot3) ainsi que la commande de coupure globale 4:PlotsOff. Pressez la touche ENTER pour configurer le premier tracé Plot1.
Dans la fenêtre de réglage de Plot1, configurez les options ligne par ligne selon la procédure suivante :
- Ligne 1 : Positionnez le curseur sur le commutateur d’état
Onet pressezENTERafin d’activer le rendu graphique pour ce tracé spécifique. - Ligne 2 (Type) : La ligne d’icônes présente six silhouettes graphiques distinctes représentant respectivement le nuage de points, la ligne polygonale, l’histogramme de fréquences, la boîte à moustaches modifiée avec détection d’outliers, la boîte à moustaches classique sans détection, et le tracé de probabilité normale. Naviguez horizontalement vers la droite jusqu’à la cinquième icône, qui matérialise la boîte à moustaches classique (deux moustaches continues s’étendant d’un bloc rectangulaire fermé sans points satellites extérieurs). Pressez
ENTERpour la verrouiller. - Ligne 3 (Xlist) : Indiquez la liste source des données observées. Pour notre protocole expérimental, spécifiez
L1en appuyant sur2ndpuis1. - Ligne 4 (Freq) : Pour des données brutes unitaires, ce paramètre d’incrément de fréquence doit impérativement être fixé au chiffre
1(saisie directe via le clavier numérique, et non pas la listeL1). - Ligne 5 (Color) : (Disponible exclusivement sur les architectures couleur TI-84 Plus C / CE). Vous pouvez sélectionner la couleur chromatique de rendu du contour de la boîte (par exemple
BLUEouNAVY) à l’aide des flèches latérales.
Avant de procéder au tracé effectif, il est prudent d’exécuter la commande PlotsOff pour les graphes 2 et 3, évitant ainsi la tentative de superposition d’un autre tracé statistique paramétré sur une liste aujourd’hui purgée.
7.2 Ajustement du cadre d’affichage via ZoomStat
L’affichage correct d’un objet statistique sur l’écran d’une calculatrice graphique dépend de l’ajustement géométrique de la fenêtre de projection cartésienne (définie par les bornes Xmin, Xmax, Ymin, et Ymax). Une tentative d’affichage via la touche standard GRAPH sans paramétrage préalable conduit presque inévitablement à un écran vide ou tronqué, la fenêtre géométrique standard étant usuellement fixée sur l’intervalle $[-10, 10]$ sur les deux axes, ce qui s’avère totalement inadapté pour nos scores cognitifs situés aux alentours de 80.
Pour éliminer tout dimensionnement manuel complexe, Texas Instruments a intégré un algorithme de fenêtrage automatique d’une remarquable puissance opérationnelle : la commande ZoomStat. Pour l’exécuter :
- Appuyez sur la touche centrale
ZOOM(située sur la rangée supérieure sous l’écran). - Faites défiler le menu vertical des méthodes de zoom vers le bas jusqu’à localiser l’option
9:ZoomStat. - Pressez la touche
ENTER(ou pressez directement la touche numérique9depuis le menu).
L’algorithme de la calculatrice scanne alors instantanément la liste L1 associée au tracé actif, extrait les valeurs scalaires extrêmes minX et maxX, et recalcule les limites de l’abscisse de telle sorte que la totalité de la distribution soit visualisée avec une marge de respiration visuelle d’environ 5 à 10 % de part et d’autre des extrémités. L’axe des ordonnées est quant à lui automatiquement calibré pour centrer la boîte horizontalement à mi-hauteur de l’écran.
Si lors de l’exécution de cette commande une courbe ondulatoire ou une droite diagonale vient parasiter le dessin de la boîte, cela indique qu’une fonction algébrique était restée active dans le sous-menu Y=. Pressez alors immédiatement la touche Y=, effacez l’équation résiduelle à l’aide de la touche CLEAR, puis pressez à nouveau la combinaison ZOOM > 9 pour assainir définitivement le champ d’observation graphique.
7.3 Exploration visuelle de la dispersion avec l’outil TRACE
Une fois le diagramme de Tukey déployé sur l’écran graphique, la TI-84 Plus offre un mode d’interrogation dynamique d’une exceptionnelle valeur ergonomique par l’intermédiaire de la fonction d’exploration TRACE. Appuyez sur la touche TRACE (située à droite de la touche ZOOM sur le bandeau supérieur). Immédiatement, un curseur clignotant sous forme de croix inverse vient se positionner physiquement sur la ligne médiane matérialisée à l’intérieur du rectangle central.
Au bas de l’écran d’affichage, la calculatrice fournit l’identification topologique du point ainsi que sa valeur arithmétique exacte :
Med=83
En utilisant les touches fléchées de déplacement latéral gauche et droite du pavé directionnel, vous pouvez déplacer ce curseur d’ancrage en ancrage le long de la structure anatomique du tracé :
- Déplacement vers la gauche : Une première pression déplace la croix sur l’arête gauche du rectangle central. La ligne d’état indique sans équivoque
Q1=76. C’est l’emplacement géométrique exact du premier quartile. - Seconde pression vers la gauche : Le curseur glisse le long de la moustache inférieure pour s’immobiliser sur son extrémité terminale gauche, affichant
minX=68. - Déplacement vers la droite : En pressant la flèche droite pour franchir la médiane, le curseur se verrouille sur l’arête droite du rectangle central, stipulant formellement
Q3=89. - Seconde pression vers la droite : La croix rejoint l’extrémité terminale de la moustache supérieure pour marquer la borne d’amplitude
maxX=102.
La dimension géométrique de l’écart interquartile s’incarne ici de manière lumineuse pour l’observateur : l’IQR correspond exactement à la largeur physique de la boîte centrale. Plus le rectangle délimité entre Q1 et Q3 est étiré horizontalement, plus l’hétérogénéité des 50 % centraux de la population est marquée. Inversement, une boîte compressée témoigne d’un resserrement dense des performances autour de la médiane.
De surcroît, cette lecture dynamique permet d’apprécier immédiatement l’asymétrie (ou skewness) de la distribution. En observant la position relative du segment médian Med à l’intérieur de la boîte, ainsi que la longueur respective des deux moustaches, le chercheur évalue si les données se distribuent de manière symétrique (médiane équidistante des arêtes) ou si la distribution accuse une dérive vers la gauche ou vers la droite. Dans notre cas d’étude, la distance séparant $Q_1$ de la médiane est de $83 – 76 = 7$, tandis que l’espace séparant la médiane de $Q_3$ est de $89 – 83 = 6$. Cette quasi-égalité spatiale révèle une distribution centrale remarquablement bien équilibrée.
8. Détection statistique des valeurs atypiques à l’aide de la règle de 1,5 x IQR
8.1 Formulation mathématique des frontières de Tukey
L’écart interquartile ne se cantonne pas à son rôle de descripteur d’échelle : il constitue la pierre angulaire de l’algorithme d’identification des observations aberrantes ou non représentatives le plus célèbre de la statistique moderne, formalisé par John Tukey sous l’appellation de « barrières » ou clôtures de clôture (inner and outer fences).
Dans cette modélisation robuste, les limites admissibles de fluctuation naturelle d’une distribution sont déduites directement de l’amplitude du corps central (l’IQR). Tukey postule qu’une valeur s’écartant au-delà de 1,5 fois la largeur de l’écart interquartile depuis les quartiles d’ancrage ne peut plus être raisonnablement imputée au hasard de l’échantillonnage d’une population homogène et doit être catégorisée comme « valeur atypique » ou modérément déviante (mild outlier).
Les frontières formelles de détection s’établissent rigoureusement par les deux équations fondamentales :
$$\text{Borne Inférieure (Lower Fence)} = Q_1 – 1{,}5 \times \text{IQR}$$
$$\text{Borne Supérieure (Upper Fence)} = Q_3 + 1{,}5 \times \text{IQR}$$
Les observations expérimentales satisfaisant la condition d’appartenance à l’intervalle fermé :
$$x_i in [Q_1 – 1{,}5 \cdot \text{IQR} ,;, Q_3 + 1{,}5 \cdot \text{IQR}]$$
sont déclarées statistiquement régulières. À l’inverse, toute observation franchissant ces clôtures intérieures fait l’objet d’un signalement d’anomalie.
Tukey a également instauré un second niveau de filtrage, désigné sous le terme de clôtures extérieures (outer fences), obtenu en substituant le facteur scalaire 3 au coefficient standard 1,5 :
$$\text{Clôture Extérieure Inférieure} = Q_1 – 3 \times \text{IQR}$$
$$\text{Clôture Extérieure Supérieure} = Q_3 + 3 \times \text{IQR}$$
Une observation se positionnant au-delà de ces frontières extrêmes est qualifiée d’aberrante sévère (extreme outlier). Dans les protocoles cliniques ou les chaînes de traitement automatisé de données psychophysiologiques, la survenue d’un outlier extrême requiert quasi systématiquement son exclusion analytique, car il traduit dans plus de 99 % des cas une défaillance instrumentale ou un non-respect patent des consignes expérimentales.
8.2 Calcul instrumenté des barrières de clôture sur la TI-84
La TI-84 Plus permet de formaliser et de calculer ces seuils de tolérance avec une rapidité déconcertante sur son écran principal en combinant les variables système précédemment extraites lors de la passe 1-Var Stats avec le registre mémoriel I dédié à l’IQR.
Pour déterminer analytiquement la borne inférieure d’exclusion :
- Depuis l’écran principal (
2ndMODE), appuyez sur la toucheVARS>5:Statistics...> ongletPTS>2:Q1. - Saisissez l’opérateur arithmétique de soustraction
-. - Tapez la constante scalaire de Tukey :
1.5. - Appelez l’opérateur de multiplication
*(ou collez directement la variable pour une multiplication implicite). - Insérez la variable d’IQR stockée :
ALPHAsuivi de la toucheI(ou tapez textuellement entre parenthèses(Q3 - Q1)via le menuVARS). - L’équation collée sur l’écran d’accueil se lit :
Q₁ - 1.5 * I
En pressant ENTER, la machine exécute l’évaluation : $76 – 1{,}5 \times 13 = 76 – 19{,}5 = 56{,}5$. La borne inférieure de non-aberrance est donc formellement fixée à 56,5. Toute valeur observée inférieure ou égale à 56,5 sera catégorisée comme pathologique ou atypique.
Pour calculer consécutivement la borne supérieure de non-aberrance :
- Appelez la variable $Q_3$ :
VARS>5:Statistics...> ongletPTS>4:Q3. - Insérez l’opérateur d’addition arithmétique
+. - Tapez le facteur de déviation :
1.5 * I. - L’expression totale se lit :
Q₃ + 1.5 * I
En validant par la touche ENTER, le système affiche : $89 + 1{,}5 \times 13 = 89 + 19{,}5 = 108{,}5$. La borne supérieure s’établit donc rigoureusement à 108,5.
L’espace d’admissibilité statistique de Tukey pour notre échantillon de scores cognitifs s’étend par conséquent sur l’intervalle continu $[56{,}5 ,;, 108{,}5]$. En inspectant les valeurs extrêmes de notre série ordonnée ($\text{minX} = 68$ et $\text{maxX} = 102$), nous constatons avec certitude que l’ensemble des observations s’inscrit confortablement à l’intérieur de ces clôtures théoriques. Notre distribution est donc formellement indemne de toute valeur aberrante au sens de Tukey.
8.3 Identification graphique automatique des valeurs aberrantes
Au-delà du calcul arithmétique des frontières, la TI-84 Plus possède la faculté exceptionnelle de procéder à l’identification, à l’isolement et à la représentation visuelle directe des données atypiques sans que l’utilisateur n’ait à programmer la moindre ligne de code conditionnel.
Cette fonctionnalité requiert l’activation d’un type de tracé hautement spécialisé au sein de l’environnement graphique : la boîte à moustaches modifiée (ou modified boxplot). Pour déployer cette analyse visuelle avancée :
- Accédez au panneau de configuration des tracés via la combinaison
2ndY=(menuSTAT PLOT), et validez sur1:Plot1. - Sur la ligne
Type:, positionnez le curseur inverse non pas sur la cinquième icône, mais sur la quatrième icône (représentant une silhouette de boîte à moustaches flanquée de deux petits points distincts dessinés à droite de la moustache terminale). PressezENTERpour la verrouiller. - Une nouvelle ligne de configuration intitulée
Mark:apparaît alors au bas du formulaire d’options. Elle permet de définir le glyphe typographique utilisé par la carte graphique pour matérialiser les points déviants : une boîte carrée ($Box$), une croix en croix ($+$) ou un simple point résolu ($\cdot$). Sélectionnez le premier symbole carré pour une lisibilité optimale sur les écrans à cristaux liquides. - Assurez-vous toujours que
Xlistrenvoie àL1et queFreqest fixé à1. - Appelez la mise à l’échelle automatique en pressant la commande
ZOOMpuis la touche9(ZoomStat).
Dans ce mode de rendu modifié, la structure mathématique de la boîte change profondément de comportement algorithmique. Contrairement au tracé classique où les moustaches se prolongent inconditionnellement jusqu’à la valeur minimale et maximale de l’échantillon, la boîte modifiée n’étend ses moustaches que jusqu’aux valeurs observées les plus extrêmes situées encore à l’intérieur des clôtures de Tukey. Toute valeur empirique franchissant les seuils $Q_1 – 1{,}5 \cdot \text{IQR}$ ou $Q_3 + 1{,}5 \cdot \text{IQR}$ est alors immédiatement exclue de la moustache et tracée sous la forme d’un point géométrique isolé dérivant dans l’espace vide.
Pour en faire l’expérience opérationnelle, injectons temporairement un score expérimental fortement corrompu dans notre registre L1 (par exemple, un sujet ayant obtenu un score résiduel de 125 par suite d’une défaillance d’encodage). Ouvrez STAT > 1:Edit..., descendez à la fin de la liste L1 et ajoutez la valeur 125. Réactualisez le graphique via ZOOM > 9.
L’affichage révèle instantanément la puissance de l’outil : la moustache supérieure s’interrompt désormais nettement sur la dernière observation valide de la distribution, tandis qu’un carré noir solitaire flotte à l’extrême droite du cadre. Pressez la touche TRACE : le curseur vous permet de naviguer de la médiane vers $Q_3$, puis vers le point d’arrêt de la moustache supérieure, et enfin d’effectuer un saut direct sur le point isolé en affichant en toutes lettres :
X=125
L’analyste dispose ainsi d’un protocole graphique et analytique instantané pour repérer, tracer et justifier l’isolement des anomalies expérimentales au sein de ses jeux de données.
9. Gestion des erreurs courantes et dépannage technique sur TI-84
9.1 Résolution des erreurs d’incompatibilité de dimensions (ERR:DIM MISMATCH)
L’erreur système affichée sous le code ERR:DIM MISMATCH (pour Dimension Mismatch, ou inadéquation des dimensions vectorielles) constitue incontestablement l’incident d’exécution le plus fréquent rencontré par les étudiants et les praticiens lors du lancement de la commande 1-Var Stats ou de l’actualisation des tracés graphiques statistiques.
Cette interruption logicielle survient obligatoirement lorsque l’algorithme sous-jacent tente d’exécuter un calcul matriciel ou vectoriel combinant deux registres de listes dont les cardinaux (le nombre total de cellules d’enregistrements) ne sont pas strictement identiques. Dans le cadre de l’extraction des quartiles à une variable, cette erreur est engendrée par deux situations typiques :
- La contamination du champ de fréquence : Dans le formulaire contextuel de
1-Var Statsou dans la configuration deSTAT PLOT, le paramètreFreqListouFreqest malencontreusement assigné à un registre secondaire (par exempleL2) contenant les résidus d’une analyse bivariée passée comprenant 20 valeurs, alors que votre liste principaleL1n’en comporte que 15. Le processeur tente d’apparier chaque observation de $X$ avec une fréquence $f$, et subit une rupture de mémoire dès la 16e cellule. - La saisie asymétrique en analyse conjointe : Si vous tentez de réaliser des tracés de comparaison ou des calculs simultanés sur deux séries sans avoir vérifié que les colonnes ont été saisies jusqu’au même indice de ligne.
Pour résoudre définitivement cette anomalie :
- Lorsque l’écran d’erreur bleu ou monochrome apparaît, sélectionnez l’option
2:Goto. Le système vous renvoie directement sur la ligne de paramétrage responsable du blocage. - Si vous vous trouvez dans le menu
1-Var Stats, inspectez scrupuleusement la ligneFreqList:. Si un quelconque libellé de liste y figure, effacez-le immédiatement à l’aide de la toucheCLEAR. Pour des données brutes élémentaires, la ligne doit être entièrement vide. - Si vous vous trouvez dans
STAT PLOT, vérifiez que le champFreq:contient bien la valeur constante scalaire1, et non la variable vectorielleL1ouL2. - Si le problème persiste, ouvrez l’éditeur matriciel via
STAT>1:Edit..., parcourez horizontalement les colonnes et contrôlez le nombre d’éléments renseignés dans chaque registre. Si une liste secondaire comporte des cellules surnuméraires orphelines, supprimez-les une à une via la toucheDELou purgez la colonne viaClrList.
9.2 Correction des erreurs d’arguments et de syntaxe graphique (ERR:INVALID DIM)
La seconde alerte logicielle majeure entravant les routines de traitement des quartiles s’intitule ERR:INVALID DIM (pour Invalid Dimension, dimension non valide). Bien que sémantiquement proche de la précédente, cette anomalie trouve son origine dans une rupture structurelle de la mémoire vectorielle de la machine.
La cause première de ce blocage réside dans la tentative par la commande 1-Var Stats ou par le sous-programme STAT PLOT d’adresser et de traiter une liste rigoureusement vide (contenant 0 élément). Par exemple, si vous avez configuré votre tracé de boîte à moustaches pour lire la liste L2 alors que vous n’avez encodé vos données que dans la liste L1, le processeur graphique ne peut pas instancier d’objets sur un espace géométrique nul et suspend l’exécution du système.
La seconde cause classique d’apparition du message ERR:INVALID DIM provient d’un conflit de fenêtrage cartésien incohérent au sein du menu WINDOW. Si un utilisateur a précédemment saisi manuellement une coordonnée d’abscisse minimale supérieure ou égale à la coordonnée maximale (condition d’absurdité géométrique où Xmin $ge$ Xmax), le moteur graphique est incapable de générer la trame d’affichage et lève une exception système.
Pour éradiquer ce problème, adoptez la démarche curative suivante :
- Appuyez sur la touche
2ndY=(menuSTAT PLOT). Sélectionnez l’option4:PlotsOffet pressezENTERdeux fois pour forcer la fermeture de tous les traceurs statistiques dormants. - Réouvrez
Plot1, assurez-vous de l’assignation de la bonne liste de données (contenant des scores réels) surXlist. - Ne pressez jamais directement la touche
GRAPHpour lancer le rendu : invoquez impérativement la routine de cadrage automatiqueZOOMsuivie de l’option9:ZoomStat. Cette commande écrase d’autorité toute incohérence géométrique préalable des registresWINDOWen redéfinissant un domaine de définition strictement valide où $X_{\text{\min}} < X_{\text{\max}}$.
9.3 Erreurs de données : typage, cellules omises et corruptions
L’intégrité du calcul de l’écart interquartile peut être compromise en amont par des corruptions de saisie au niveau de l’éditeur textuel de listes. L’interpréteur arithmétique de la TI-84 Plus opère une discrimination rigoureuse entre les types de données : un vecteur statistique ne peut agréger que des scalaires réels numériques.
L’erreur ERR:DATA TYPE se déclenche lorsqu’un caractère textuel (une chaîne de caractères alphabétiques générée involontairement par l’activation intempestive du mode ALPHA) a été inséré dans une cellule de liste. Inspectez visuellement votre colonne dans STAT > 1:Edit.... Les nombres doivent être rigoureusement alignés à droite de chaque cellule matricielle sans guillemets ni lettres isolées. Si un élément textuel est repéré, placez le curseur dessus et écrasez-le par la valeur numérique adéquate ou supprimez-le avec DEL.
Un autre dysfonctionnement pernicieux survient lorsqu’une case est laissée vide ou non initialisée à la suite d’un mauvais maniement de la commande d’insertion INS. La présence d’une cellule fantôme ou corrompue en fin de liste bloque le calcul des fréquences cumulées nécessaires à la segmentation quartilaire.
En situation de crise logicielle aiguë — par exemple lorsque la machine se fige ou renvoie des erreurs d’allocation mémoire indéterminées en dépit d’une vérification méticuleuse de vos données —, une réinitialisation partielle de la mémoire vive (RAM) s’avère salutaire sans pour autant compromettre les applications logicielles (Apps) protégées en mémoire flash. Pour exécuter cette réinitialisation curative :
- Appuyez sur la séquence
2ndpuis+pour entrer dans le menuMEM. - Sélectionnez l’option
7:Reset.... - Sous le sous-menu
RAM, pressez1:All RAM.... - La machine vous demande de confirmer l’effacement de la mémoire temporaire : sélectionnez
2:Resetet pressezENTER.
L’écran affiche alors le message rassurant RAM Cleared. Vos registres de listes, variables système et fenêtres de calcul sont restaurés dans leur état d’usine parfait, garantissant un environnement informatique immaculé pour la reprise de vos analyses quantitatives.
10. Comparaison de l’IQR avec d’autres indices de dispersion statistique
10.1 IQR versus écart absolu médian (MAD) sur TI-84
Si l’écart interquartile représente l’indicateur de dispersion robuste le plus démocratisé au sein de la littérature scientifique, la théorie métrologique moderne accorde une place privilégiée à un autre estimateur non paramétrique : l’écart absolu médian, universellement désigné par son acronyme anglophone MAD (pour Median Absolute Deviation). Formalisé dans sa rigueur mathématique par Peter Rousseeuw en 1984, le MAD mesure la déviation médiane des écarts absolus constatés par rapport à la médiane empirique de l’échantillon :
$$\text{MAD} = \text{médiane}(|x_i – \text{médiane}(X)|)$$
Sur le plan de l’efficacité asymptotique et de la théorie de la robustesse, le MAD surpasse substantiellement l’écart interquartile. Alors que l’IQR affiche un point de rupture de 25 % (puisqu’il suffit de contaminer un peu plus de 25 % des données d’un échantillon pour altérer de manière arbitraire soit $Q_1$ soit $Q_3$), le MAD atteint le plafond de robustesse théorique absolu de 50 %. Il peut ainsi tolérer qu’une moitié presque entière des observations soit totalement corrompue sans que son estimation de la dispersion de la fraction saine ne dérive à l’infini.
Bien que la TI-84 Plus ne propose pas de commande native préprogrammée pour le MAD dans le menu 1-Var Stats, son architecture vectorielle permet de le calculer avec une remarquable économie de moyens :
- Après avoir exécuté
1-Var Stats L1pour initialiser la médiane dans le registre systèmeMed, quittez vers l’écran principal. - Appliquez la formule du MAD sur la liste entière en saisissant l’expression vectorielle suivante à l’aide de la fonction valeur absolue
abs()(accessible viaMATH> ongletNUM>1:abs() :
abs(L1 - Med) → L2
Cette instruction soustrait la médiane scalaire de chaque observation de L1, en extrait la valeur absolue, et stocke ces résidus positifs dans la colonne L2. Il suffit alors de lancer un second calcul de statistiques univariées sur cette nouvelle liste :
1-Var Stats L2
La valeur de la médiane affichée (Med) sur ce second rapport représente alors formellement le MAD empirique de votre distribution.
L’arbitrage entre l’IQR et le MAD en modélisation psychométrique repose sur un compromis entre robustesse théorique pure et intuitivité communicationnelle. Le MAD présente le désavantage d’être d’une interprétation géométrique complexe pour les praticiens non statisticiens, tandis que l’IQR possède l’immense mérite didactique de borner visuellement l’enveloppe concrète des 50 % des sujets normatifs au sein des rapports psychologiques.
10.2 IQR versus étendue semi-interquartile
Dans de nombreuses publications académiques anglo-saxonnes et manuels de psychométrie appliquée, les auteurs font référence à l’étendue semi-interquartile (souvent notée $Q$ ou semi-interquartile range), plutôt qu’à l’IQR brut. Il convient de ne pas confondre ces deux entités mathématiques étroitement apparentées.
L’étendue semi-interquartile se définit formellement comme la simple moitié arithmétique de l’écart interquartile :
$$Q = \frac{\text{IQR}}{2} = \frac{Q_3 – Q_1}{2}$$
L’intérêt de cette déclinaison scalaire réside dans sa comparabilité conceptuelle directe avec l’écart-type. Dans une distribution parfaitement gaussienne et symétrique, la moyenne arithmétique coïncide avec la médiane, et l’espace s’étendant à $\pm 1$ écart-type autour du centre regroupe environ 68,2 % de la masse de probabilité. L’étendue semi-interquartile $Q$ quantifie quant à elle la distance moyenne séparant chaque quartile de la médiane dans une distribution équilibrée : $\text{Med} – Q_1 \approx Q_3 – \text{Med} \approx Q$. Elle représente donc le rayon théorique de dispersion médian autour du pivot central.
Sur votre calculatrice TI-84 Plus, le calcul de cette grandeur s’exécute trivialement sur l’écran d’accueil à l’aide de la variable I préalablement sauvegardée :
I / 2 (ce qui donne $13 / 2 = 6{,}5$ pour notre série empirique).
Pour convertir de façon rigoureuse cette étendue semi-interquartile en un équivalent asymptotique non biaisé de l’écart-type gaussien, les biostatisticiens appliquent un facteur correctif de normalisation :
$$\hat{\sigma}_{\text{robuste}} = \frac{\text{IQR}}{1{,}34898} \approx 0{,}7413 \times \text{IQR}$$
En programmant cette multiplication scalaire simple sur la TI-84 (0.7413 * I), le chercheur extrait une estimation robuste de l’écart-type affranchie de la distorsion des valeurs aberrantes de queue de distribution.
10.3 Comparaison quantitative sur échantillons normés et asymétriques
La confrontation de l’écart interquartile avec les estimateurs de dispersion paramétriques permet d’élucider la nature géométrique intime des données recueillies au sein d’un laboratoire de recherche.
Dans le cadre strict d’une distribution normale théorique $X \sim \mathcal{N}(\mu, \sigma^2)$, les quantiles se déduisent analytiquement de la fonction quantile de la loi normale centrée réduite $\Phi^{-1}(p)$. Les bornes quartilaires s’établissent rigoureusement à :
$$Q_1 = \mu – 0{,}67449 \cdot \sigma$$
$$Q_3 = \mu + 0{,}67449 \cdot \sigma$$
Il en découle la relation d’équivalence canonique reliant l’écart interquartile à l’écart-type :
$$\text{IQR} = 2 \times 0{,}67449 \cdot \sigma \approx 1{,}34898 \cdot \sigma$$
Cette égalité fournit un critère de diagnostic diagnostique majeur sur la TI-84 Plus. Après avoir extrait les statistiques complètes de votre échantillon via 1-Var Stats, évaluez le rapport suivant sur l’écran principal :
(Q₃ - Q₁) / Sx
Si la valeur numérique renvoyée par la machine oscille étroitement autour de la constante 1,35, l’hypothèse de quasi-normalité de la distribution empirique est fortement étayée. En revanche, si ce ratio diverge notablement vers le bas (par exemple $< 1{,}1$), cela trahit une distribution leptokurtique (à sommet aigu et queues lourdes) où les données centrales sont très resserrées tandis que les extrémités sont étirées. À l'inverse, un ratio substantiellement supérieur à 1,35 révèle une distribution platykurtique ou bimodale.
Par ailleurs, l’évaluation de l’asymétrie structurelle peut être instrumentée sans recourir aux coefficients complexes de Fisher ou de Pearson en calculant l’indice d’asymétrie quartilaire de Bowley (Bowley skewness), formulable sur la TI-84 au moyen des seules variables du sous-menu PTS :
$$B = \frac{(Q_3 – \text{Med}) – (\text{Med} – Q_1)}{Q_3 – Q_1} = \frac{Q_3 + Q_1 – 2\text{Med}}{Q_3 – Q_1}$$
Saisissez cette équation sur l’écran d’accueil de votre machine en appelant les variables système :
(Q₃ + Q₁ - 2*Med) / (Q₃ - Q₁)
L’indice $B$ évolue strictement sur l’intervalle continu $[-1, 1]$. Une valeur de 0 stipule une symétrie quartilaire parfaite. Un résultat positif indique une asymétrie à droite (longue traîne positive), tandis qu’un résultat négatif démontre une asymétrie vers les scores faibles. Pour notre jeu de scores d’efficience cognitive :
$$B = \frac{89 + 76 – 2(83)}{13} = \frac{165 – 166}{13} = -\frac{1}{13} \approx -0{,}077$$
Cette valeur infime confirme mathématiquement la quasi-symétrie parfaite de nos observations cliniques centrales.
11. Études de cas appliquées en psychologie comportementale avec la TI-84
11.1 Cas 1 : Temps de réaction à une tâche d’inhibition cognitive (Stroop)
Dans le cadre d’un protocole expérimental évaluant la capacité d’inhibition cognitive auprès d’une cohorte de 18 patients atteints de traumatismes crâniens légers, un chercheur enregistre les temps de latence motrice (en millisecondes) lors de la condition interférente du test de Stroop (nommer la couleur de l’encre d’un mot dont la signification sémantique désigne une couleur discordante). Les chronométries obtenues sont les suivantes :
$${612, 645, 658, 670, 684, 692, 705, 718, 730, 742, 765, 780, 810, 835, 890, 940, 1150, 1420}$$
Cette distribution temporelle manifeste une longue traîne asymétrique droite caractéristique des processus d’épuisement attentionnel, illustrée par les deux dernières latences massives de 1150 ms et 1420 ms.
Le chercheur encode ces 18 valeurs dans la liste L1 de sa TI-84 Plus, puis exécute la routine STAT > CALC > 1:1-Var Stats. Les métriques paramétriques affichent une moyenne déformée $\bar{x} = 791{,}4$ ms et un écart-type volumineux $Sx = 197{,}5$ ms. En faisant défiler l’écran vers le bas, le résumé à cinq nombres renvoie :
Q1 = 684msMed = 736msQ3 = 835ms
Le calcul de l’écart interquartile via les variables système Q₃ - Q₁ → I donne rigoureusement :
$$\text{IQR} = 835 – 684 = 151 \text{ ms}$$
L’IQR révèle ainsi que la variabilité de traitement central du groupe clinique s’établit à 151 ms autour d’une médiane de 736 ms, fournissant une description infiniment plus fidèle de la compétence cognitive réelle du groupe que l’écart-type empirique altéré de près de 200 ms.
Le calcul subséquent de la barrière de clôture supérieure de Tukey sur la TI-84 :
Q₃ + 1.5 * I = 835 + 1.5 * 151 = 1061.5 text{ ms}
démontre formellement que les observations à 1150 ms et 1420 ms excèdent le seuil critique de 1061,5 ms. En activant le tracé de la boîte à moustaches modifiée (icône 4 dans STAT PLOT), ces deux latences sont immédiatement isolées graphiquement sous la forme de points aberrants. Le chercheur peut ainsi légitimement décider d’imputer ces valeurs à des décrochages moteurs parasites et isoler l’IQR comme la métrique de référence pour comparer cette cohorte à un groupe témoin sain.
11.2 Cas 2 : Évaluation des scores de stress perçu en population clinique
Un essai clinique évalue l’efficacité d’un protocole de réduction du stress basée sur la pleine conscience (MBSR) auprès de cadres hospitaliers en état d’épuisement professionnel. L’instrument de mesure mobilisé est l’échelle validée PSS-10 (Perceived Stress Scale), générant des scores discrets étalonnés de 0 à 40 points. Le chercheur recueille les scores d’un groupe expérimental ayant suivi la thérapie ($N_1 = 12$) et d’un groupe témoin sur liste d’attente ($N_2 = 12$).
Les données sont encodées respectivement dans les listes L1 (groupe thérapie) et L2 (groupe contrôle) :
L1 (Thérapie): ${14, 16, 17, 18, 19, 20, 21, 22, 23, 24, 26, 31}$L2 (Contrôle): ${22, 24, 25, 27, 28, 29, 30, 31, 33, 34, 36, 38}$
Le praticien exécute l’instruction 1-Var Stats L1 sur sa TI-84. Le défilement fournit :
Q1 = 17.5 ; Med = 20.5 ; Q3 = 23.5. D’où $\text{IQR}_1 = 23{,}5 – 17{,}5 = 6{,}0$ points.
Il lance consécutivement la routine sur le second registre via 1-Var Stats L2 :
Q1 = 26 ; Med = 29.5 ; Q3 = 33.5. D’où $\text{IQR}_2 = 33{,}5 – 26 = 7{,}5$ points.
L’analyse bivariée par les diagrammes de Tukey permet une comparaison visuelle d’une éclatante limpidité. Dans le menu STAT PLOT, le chercheur active simultanément Plot1 (boîte modifiée connectée à L1, tracée en bleu) et Plot2 (boîte modifiée connectée à L2, tracée en rouge). En exécutant ZoomStat, la TI-84 superpose les deux boîtes parallèlement sur l’écran d’affichage.
L’inspection visuelle démontre immédiatement l’absence de chevauchement entre la boîte interquartile du groupe thérapie ($[17{,}5 ,;, 23{,}5]$) et celle du groupe contrôle ($[26 ,;, 33{,}5]$). Cette disjonction spatiale nette prouve que les trois quarts des sujets du groupe thérapie présentent des scores d’anxiété inférieurs au quart le plus calme du groupe témoin. De surcroît, le rétrécissement de l’IQR dans le groupe traité ($\text{IQR} = 6{,}0$ contre $7{,}5$) témoigne d’une plus grande homogénéisation de la régulation émotionnelle sous l’effet de l’intervention clinique, conclusion impossible à établir avec une telle force probante sur la base d’analyses paramétriques vulnérables aux petits effectifs.
11.3 Cas 3 : Analyse des données de fidélité test-retest en psychométrie
Lors de l’étalonnage psychométrique d’un subtest de mémoire de travail pour une nouvelle échelle d’intelligence, un laboratoire évalue la fidélité test-retest à trois semaines d’intervalle sur un échantillon normé de 14 participants. Pour quantifier l’amplitude de l’erreur absolue de mesure intra-individuelle sans présumer d’une distribution normale des fluctuations d’apprentissage, le métrologue calcule les différences arithmétiques absolues inter-sessions :
$$d_i = |\text{Score}_{\text{Session 2}} – \text{Score}_{\text{Session 1}}|$$
Les écarts absolus constatés sont consignés dans la colonne L1 :
$${0, 1, 1, 2, 2, 2, 3, 3, 4, 4, 5, 6, 8, 12}$$
L’existence d’un participant ayant fluctué de 12 points (phénomène pathologique lié à une indisposition physique temporaire documentée lors du second passage) gonfle artificiellement l’écart-type de différence à $Sx = 3{,}17$ points, ce qui conduirait à dégrader l’indice de fidélité théorique de l’instrument.
Le traitement univarié 1-Var Stats L1 sur la TI-84 Plus isole les indicateurs robustes :
Med = 3points de déviationQ1 = 2pointsQ3 = 5points
L’écart interquartile des écarts de mesure s’établit précisément à :
$$\text{IQR} = 5 – 2 = 3 \text{ points}$$
Le calcul de la frontière supérieure de clôture de Tukey donne :
Upper Fence = Q3 + 1.5 * IQR = 5 + 1.5 * 3 = 9.5 text{ points}
L’observation à 12 points est immédiatement identifiée comme franchissant cette clôture métrologique ($12 > 9{,}5$). Sur l’écran de la calculatrice, la boîte à moustaches modifiée affiche la moustache s’arrêtant proprement à 8 points, isolant la performance à 12 sous forme de point externe. Le psychométricien rapporte alors dans son dossier technique que 50 % des fluctuations test-retest normales s’inscrivent sur un intervalle restreint de 3 points d’amplitude ($\text{IQR} = 3$), fournissant aux neuropsychologues cliniciens une estimation robuste de l’erreur minimale détectable affranchie des artéfacts d’expérimentation.
12. Automatisation avancée : Création d’un sous-programme TI-Basic pour calculer l’IQR
12.1 Structure algorithmique et initialisation de l’environnement de programmation
Bien que les étapes manuelles détaillées dans les chapitres antérieurs s’exécutent avec fluidité, la répétition de ces manipulations lors du traitement de dizaines de séries expérimentales successives s’avère fastidieuse et source d’erreurs d’inattention. L’interpréteur de programmation embarqué TI-Basic offre l’opportunité de compiler l’ensemble de cette chaîne analytique — calcul univarié, extraction des quartiles, soustraction d’échelle, détermination des clôtures de Tukey et mise en forme textuelle élégante — au sein d’un exécutable dédié.
Pour engager la création de ce script automatisé, appuyez sur la touche PRGM (située sur la rangée centrale du clavier). À l’aide de la flèche droite, naviguez jusqu’à l’onglet horizontal NEW. La commande 1:Create New étant sélectionnée, appuyez sur ENTER.
La calculatrice vous invite alors à saisir le libellé identificatoire du programme au travers du prompt Name=. Le mode de verrouillage alphabétique (ALPHA-LOCK) étant automatiquement activé, saisissez un identifiant mnémotechnique clair et académique, par exemple IQRSTAT. Validez en pressant la touche ENTER. Vous êtes désormais au sein de l’éditeur de code de la TI-84, matérialisé par deux points verticaux (:) en tête de chaque ligne d’instruction.
La première exigence d’une programmation robuste réside dans l’assainissement de l’environnement d’affichage et l’interrogation interactive de l’opérateur pour cibler la liste de données à analyser. Nous allons initialiser le script en effaçant l’écran principal et en sollicitant la désignation du registre source. Saisissez les lignes suivantes en utilisant les touches de menus appropriées :
- Pressez
PRGM> ongletI/O(Input/Output) >8:ClrHome(Efface l’écran d’accueil). - À la ligne suivante, insérez un message d’invite en saisissant :
PRGM>I/O>1:Inputsuivi du libellé textuel entre guillemets (guillemets obtenus viaALPHA+) :Input "LISTE (EX L1):",L₁. Pour une approche universelle plus robuste évitant les erreurs de typage, nous pouvons programmer l’appel direct sur la liste de travail par défautL1en invitant l’utilisateur à y loger ses observations.
12.2 Codage de la séquence de traitement et d’extraction de données
Nous allons concevoir un code algorithmique universel, optimisé pour traiter automatiquement la liste L1 (ou toute liste assignée), exécuter l’analyse univariée en arrière-plan sans polluer l’écran, calculer l’IQR, stocker cette valeur dans la variable système I, et dériver simultanément les bornes de clôture inférieure ($LF$) et supérieure ($UF$) de Tukey.
Le listing complet des instructions TI-Basic se compose rigoureusement ainsi :
:ClrHome
:Disp "ANALYSE IQR..."
:1-Var Stats L1
:(Q3-Q1)→I
:(Q1-1.5*I)→L
:(Q3+1.5*I)→U
Pour insérer correctement ces instructions au clavier sans générer d’erreurs de syntaxe :
- La commande
Disps’obtient viaPRGM>I/O>3:Disp. - L’instruction
1-Var Statss’appelle via la toucheSTAT> sous-menuCALC>1:1-Var Stats. - La liste
L1s’insère par la combinaison2nd1. - Les variables
Q3etQ1s’extraient impérativement via le menu système :VARS>5:Statistics...> ongletPTS> sélectionner4:Q3ou2:Q1. Ne tentez jamais de taper la lettre Q suivie du chiffre 3 au clavier alphabétique, car la machine interpréterait cela comme la multiplication de deux variables inexistantes et non comme la lecture du registre statistique. - La flèche d’affectation
→s’obtient par une pression unique sur la toucheSTO→. - Les variables de stockage
I,L(pour Lower Fence) etU(pour Upper Fence) se tapent via la touche verteALPHAsuivie de la lettre respective.
Cette séquence centrale s’exécute de façon totalement transparente en mémoire en moins d’un dixième de seconde, effectuant le tri matriciel interne, extrayant les centiles réels et calculant les produits scalaires sans solliciter la moindre intervention manuelle.
12.3 Mise en page de l’affichage des résultats et validation du code
L’étape terminale du sous-programme consiste à concevoir une interface de sortie académique d’une clarté irréprochable, restituant sur un écran unique l’ensemble des indicateurs de dispersion non paramétrique nécessaires au compte-rendu de recherche.
Pour orchestrer cette présentation textuelle, nous mobiliserons la commande d’affichage formaté Output(ligne, colonne, texte) ou des successions harmonieuses d’instructions Disp. Poursuivez la saisie dans l’éditeur de programme :
:ClrHome
:Disp "--- DISPERSION ---"
:Disp "Q1 =",Q1
:Disp "MED=",Med
:Disp "Q3 =",Q3
:Disp "IQR=",I
:Disp "SEUILS DE TUKEY:"
:Disp "INF=",L,"SUP=",U
Pour clore l’édition et compiler le programme dans le système d’exploitation de la TI-84, appuyez sur la combinaison de touches d’échappement 2nd puis MODE (commande QUIT). Le programme est automatiquement archivé et prêt à l’emploi.
Pour exécuter et valider votre outil automatisé :
- Assurez-vous que vos données expérimentales sont correctement encodées dans la colonne
L1viaSTAT>1:Edit.... - Appuyez sur la touche
PRGM. Sous l’ongletEXEC, le libelléIQRSTATapparaît désormais en tête de liste. - Pressez
ENTERpour coller l’ordreprgmIQRSTATsur l’écran principal, puis pressezENTERpour lancer l’exécution.
En une fraction de seconde, l’écran de la calculatrice se nettoie intégralement pour afficher un rapport analytique complet et structuré :
Q1 = 76MED = 83Q3 = 89IQR = 13INF = 56.5SUP = 108.5
Ce sous-programme transforme votre TI-84 Plus en un véritable terminal d’analyse statistique robuste de laboratoire, éliminant tout risque d’erreur calculatoire, assurant une reproductibilité parfaite de vos évaluations et libérant un temps précieux pour l’interprétation théorique et clinique de vos résultats quantitatifs.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
- Texas Instruments. (2020). Guide de référence pour la calculatrice graphique TI-84 Plus CE. Texas Instruments Incorporated. https://education.ti.com/fr/guidebooks
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley. https://www.pearson.com
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02298-6