
L’analyse des distributions quantitatives au sein des sciences empiriques repose traditionnellement sur deux piliers fondamentaux : la caractérisation de la tendance centrale et l’évaluation rigoureuse de la dispersion. Si la moyenne arithmétique constitue l’indicateur d’emplacement privilégié dans la grande majorité des recherches universitaires, l’appréciation de l’hétérogénéité des observations impose le recours à des métriques d’étalement adaptées. Parmi celles-ci, l’écart absolu moyen (souvent désigné sous l’acronyme EAM ou MAD pour Mean Absolute Deviation) occupe une place méthodologique singulière. Contrairement aux indicateurs fondés sur les moindres carrés, l’écart absolu moyen quantifie la distance moyenne séparant chaque point de données du centre de gravité de la distribution sans recourir à une élévation quadratique, préservant ainsi l’échelle originelle de mesure et limitant l’influence délétère des valeurs aberrantes.
Dans les environnements pédagogiques, cliniques et de recherche appliquée, la calculatrice graphique Texas Instruments TI-84 Plus (et ses déclinaisons Silver Edition ou CE) demeure un standard instrumental incontournable. Toutefois, à la différence de l’écart-type d’échantillon ou de la variance qui bénéficient de fonctions automatisées directes dans les menus d’analyse standard, l’écart absolu moyen requiert une suite d’opérations vectorielles et algébriques spécifiques. L’absence de fonction dédiée native oblige l’expérimentateur ou l’analyste à maîtriser les mécanismes de manipulation des listes matricielles, l’usage des opérateurs arithmétiques fondamentaux et la logique algorithmique de la machine.
Ce traité exhaustif a pour vocation d’exposer pas à pas, avec une rigueur analytique sans faille, le protocole complet permettant de déterminer l’écart absolu moyen sur une calculatrice TI-84. En combinant les justifications théoriques issues de la statistique descriptive, les applications en psychométrie comportementale et les procédures techniques avancées — depuis la configuration matérielle de la machine jusqu’au développement d’un programme en TI-BASIC — ce guide constitue la référence opérationnelle définitive pour les étudiants, chercheurs et praticiens exigeant une maîtrise absolue de leurs outils d’analyse quantitative.
1. Cadre théorique et fondements mathématiques de l’écart absolu moyen
1.1 Définition conceptuelle et notation algébrique de la dispersion
L’écart absolu moyen constitue une mesure paramétrique directe de la variabilité d’une série statistique autour d’un paramètre de position centrale, le plus fréquemment la moyenne arithmétique. D’un point de vue conceptuel, cet indicateur cherche à répondre à une question d’une grande simplicité intuitive : quelle est, en moyenne, la distance séparant une observation individuelle quelconque de la valeur typique de l’ensemble du groupe ? Pour formaliser cette notion, considérons une série d’observations quantitatives discrètes notées x₁, x₂, …, xₙ, constituant un échantillon empirique d’effectif total n. La moyenne arithmétique de cet ensemble, conventionnellement désignée par le symbole x̄ (x barre), est établie par le quotient de la somme arithmétique des valeurs observées par le nombre total d’observations.
L’expression formelle de l’écart absolu moyen repose sur l’introduction de la fonction valeur absolue, indispensable pour pallier la propriété d’équilibrage barycentrique selon laquelle la somme algébrique brute des écarts à la moyenne est structurellement nulle. Dès lors, l’opérateur sigma (Σ) permet d’indexer les observations individuelles de i = 1 à n afin d’agréger les grandeurs d’écart sans considération de leur signe. L’équation canonique de l’écart absolu moyen s’écrit formellement : EAM = (1/n) × Σ |xᵢ – x̄|, où les barres verticales délimitent la distance euclidienne unidimensionnelle entre le point xᵢ et le centroïde x̄. Cette métrique appartient à la catégorie des mesures de dispersion absolue, ce qui implique que son résultat est exprimé rigoureusement dans la même unité dimensionnelle que la variable aléatoire sous-jacente (par exemple en millisecondes, en points de score ou en milligrammes), à l’opposé des indices de dispersion relative tels que le coefficient de variation qui sont adimensionnels.
La préservation stricte de l’unité de mesure confère à l’écart absolu moyen une transparence interprétative remarquable dans les études quantitatives. Lorsque l’expérimentateur évalue une dispersion égale à 4,2 unités, cela signifie sans artifice mathématique que les sujets dévient, en valeur absolue moyenne, de 4,2 unités par rapport au score moyen du groupe. Cette lisibilité contraste avec la variance, dont l’unité quadratique interdit toute comparaison directe avec les données brutes, contraignant ainsi les chercheurs à extraire systématiquement la racine carrée de cette dernière pour réintégrer l’espace métrique initial sous la forme de l’écart-type.
1.2 Rôle de l’écart absolu moyen dans l’analyse des données psychométriques
Dans le domaine de la psychométrie et des sciences du comportement, l’évaluation de la dispersion ne se limite pas à un simple contrôle technique : elle constitue le reflet direct de la variabilité interindividuelle et de l’homogénéité intra-groupe face à une tâche cognitive ou un stimulus standardisé. Lors de la passation de tests d’efficience intellectuelle ou d’échelles de personnalité, l’écart absolu moyen permet de quantifier avec une grande justesse le degré d’uniformité des réponses au sein d’une cohorte expérimentale. Un groupe présentant un écart absolu moyen particulièrement resserré met en évidence un comportement clinique consensuel, tandis qu’une valeur élargie signale l’existence de profils psychologiques contrastés ou l’émergence de sous-groupes d’apprentissage hétérogènes.
L’un des atouts prééminents de l’écart absolu moyen en recherche comportementale réside dans sa relation linéaire avec la métrique sous-jacente. Dans les échelles d’intervalles — telles que les échelles de Likert à granularité fine ou les temps de réaction informatisés — certains participants manifestent des réponses hautement atypiques, issues de distractions ponctuelles, de moments d’inattention ou de stratégies déviantes de réponse. L’emploi de l’écart absolu moyen évite que ces variations idiosyncrasiques ne contaminent démesurément l’estimation de la dispersion globale de la cohorte. Contrairement aux approches par moindres carrés, la pénalisation appliquée à un écart individuel de grande magnitude demeure proportionnelle et n’augmente pas de manière exponentielle, évitant ainsi de déformer la perception clinique de la fidélité de l’instrument.
En outre, l’application de l’écart absolu moyen aux protocoles standardisés d’évaluation permet aux psychométriciens de définir des marges de variabilité attendue qui sont facilement explicables aux patients ou aux équipes soignantes. Lors de la restitution d’un bilan neuropsychologique, communiquer qu’un patient se situe à une distance de la norme qui correspond à deux fois la déviation absolue moyenne fournit une perspective clinique plus immédiatement tangible que la référence aux unités d’écart-type z, dont la perception intuitive est souvent compromise par l’abstraction mathématique des lois de distribution normales.
1.3 Comparaison épistémologique : écart absolu moyen versus écart-type et variance
L’opposition méthodologique entre l’écart absolu moyen d’une part, et le couple variance / écart-type d’autre part, puise ses racines dans des débats historiques fondamentaux ayant opposé des figures illustres de la théorie statistique, notamment Ronald Fisher et Arthur Eddington. La distinction première repose sur le traitement mathématique de la déviation résiduelle : là où l’écart-type impose l’élévation au carré de chaque écart individuel (xᵢ – x̄)² avant de procéder à la sommation et à l’extraction de la racine carrée, l’écart absolu moyen applique l’opérateur linéaire de valeur absolue |xᵢ – x̄|. Cette divergence opératoire induit des conséquences profondes sur la sensibilité de l’indice face aux perturbations de l’échantillonnage.
L’élévation quadratique inhérente à la variance attribue un poids disproportionné aux observations périphériques. Un écart individuel valant quatre unités pèse ainsi seize fois plus lourd dans le calcul de la variance qu’un écart unitaire, alors que dans le cadre de l’écart absolu moyen, son poids demeure strictement borné à un rapport de quatre pour un. Par conséquent, en présence de distributions asymétriques, contaminées par des bruits de mesure ou caractérisées par des queues lourdes (leptokurtiques), l’écart absolu moyen manifeste des propriétés de robustesse statistique nettement supérieures. Il capture l’étalement typique de la majorité des observations sans laisser la dispersion être artificiellement gonflée par une fraction infime de points extrêmes.
Néanmoins, sur le plan de l’inférence théorique pure, l’écart-type a historiquement conservé la primauté au sein des cursus académiques en raison de sa tractabilité analytique. La fonction quadratique x² étant différentiable en tout point de son domaine de définition, elle facilite grandement le développement des calculs d’optimisation par dérivation, élément central du principe du maximum de vraisemblance et de l’analyse de régression linéaire classique. À l’inverse, la fonction valeur absolue présente un point de non-dérivabilité en zéro, ce qui complique son intégration dans les cadres théoriques régissant les tests paramétriques standardisés. Cette distinction épistémologique n’enlève rien à la pertinence descriptive de l’écart absolu moyen, qui demeure l’estimateur de choix lorsque la fidélité de représentation prime sur la commodité algébrique différentielle.
2. Configuration préalable de la calculatrice TI-84 pour le traitement statistique
2.1 Initialisation du système et contrôle des modes d’affichage
Avant d’entreprendre la moindre séquence de calcul statistique sur la calculatrice Texas Instruments TI-84 Plus, une revue rigoureuse de la configuration interne du système s’impose afin de garantir l’absence de biais dans la restitution des descripteurs numériques. L’accès à ces paramètres fondamentaux s’opère par une pression sur la touche [MODE], située dans la partie supérieure du clavier. Cette manipulation affiche la matrice des réglages globaux régissant le comportement arithmétique et la précision graphique de l’appareil. Il convient de vérifier prioritairement que la première ligne du menu conserve l’option [Normal] sélectionnée, évitant ainsi les notations scientifiques ([Sci]) ou d’ingénierie ([Eng]) qui pourraient tronquer visuellement les résultats décimaux simples.
La ligne relative à la gestion des décimales, identifiée par le terme [Float], doit idéalement être maintenue en position flottante automatique. Cette configuration permet au processeur Zilog Z80 ou eZ80 d’allouer dynamiquement jusqu’à quatorze chiffres significatifs en mémoire interne tout en affichant jusqu’à dix chiffres à l’écran, prévenant toute perte prématurée d’information lors du chaînage des opérations sur les listes de données. Si un ancrage décimal fixe était configuré (par exemple [Float 2]), les résultats intermédiaires subiraient des arrondis successifs susceptibles d’altérer la précision finale de l’écart absolu moyen.
Un autre réglage d’une importance capitale concerne l’activation des diagnostics statistiques. Bien que ceux-ci ciblent principalement les coefficients de corrélation linéaire de Pearson (r et r²), leur activation garantit que l’interpréteur de la machine mobilise l’ensemble de ses routines d’affichage statistique étendu. Pour activer ce mode, il est recommandé de naviguer vers le catalogue de la machine via la séquence [2nd] puis [0], de descendre par défilement alphabétique jusqu’à l’instruction [DiagnosticOn] et de valider par [ENTER]. L’écran d’accueil affiche alors la mention [Done], confirmant que l’environnement de calcul opère à son niveau maximal d’exhaustivité descriptive.
2.2 Gestion de l’espace de travail et purge des listes préexistantes
L’intégrité des résultats statistiques sur la TI-84 dépend directement de la propreté de l’espace de travail matriciel. Les listes statistiques fondamentales, dénommées nativement L1 à L6, sont fréquemment conservées en mémoire non volatile après des sessions de calcul antérieures. Deux écueils techniques majeurs doivent être évités lors de la purge de ces colonnes : l’écrasement incomplet et la suppression physique non intentionnelle d’une colonne de données. Il est impératif d’assimiler la distinction structurelle entre la touche [CLEAR] et la touche [DEL]. Dans l’éditeur de listes, l’utilisation de [DEL] sur l’en-tête d’une liste ne vide pas son contenu : elle supprime la colonne de l’interface visuelle, perturbant ainsi la topologie par défaut du tableur interne.
Pour purger méthodiquement les données obsolètes sans risquer d’altérer la structure de l’éditeur, la procédure la plus sécurisée repose sur l’appel de l’instruction [ClrList]. Depuis l’écran d’accueil, l’utilisateur sollicite le menu de gestion de la mémoire en appuyant sur [2nd] puis sur la touche [+] (marquée [MEM]). Dans ce sous-menu, ou plus directement via la touche [STAT], option 4:ClrList, l’expérimentateur peut spécifier les listes à réinitialiser. Par exemple, la syntaxe [ClrList L1, L2] valide le nettoyage instantané des deux premières colonnes de stockage, libérant les octets correspondants dans la mémoire vive dynamique (RAM) de l’appareil.
Si, à la suite d’une fausse manipulation, une ou plusieurs listes standard (L1 à L6) ont disparu de l’éditeur tabulaire, il est inutile de procéder à une réinitialisation complète de la mémoire de la machine qui effacerait les programmes tiers. Il suffit d’exécuter l’instruction [SetUpEditor]. Cette commande est accessible en pressant la touche [STAT], puis en descendant jusqu’à l’option 5:SetUpEditor. Une fois validée par la touche [ENTER], la TI-84 restaure instantanément la disposition canonique des six colonnes de référence, rétablissant un environnement de travail parfaitement stable pour l’encodage des observations.
2.3 Repérage des touches et des menus statistiques fondamentaux
L’exécution efficace du calcul de l’écart absolu moyen exige une familiarité parfaite avec l’architecture ergonomique du clavier de la TI-84 Plus. Le centre névralgique de toutes les opérations associées est la touche [STAT], idéalement positionnée au centre du pavé supérieur. Une pression sur cette commande dévoile trois onglets horizontaux majeurs : l’onglet EDIT, dédié à la saisie, l’agencement et la modification manuelle des matrices de données ; l’onglet CALC, regroupant les moteurs d’inférence et d’analyse descriptive (dont les régressions polynomiales et les statistiques univariées) ; et l’onglet TESTS, réservé aux procédures hypothétiques paramétriques et non paramétriques.
Au-delà du menu [STAT] classique, l’accès aux opérations vectorielles avancées requiert la mobilisation des fonctionnalités secondaires. En combinant la touche de bascule [2nd] avec la touche [STAT], l’utilisateur ouvre l’environnement [LIST], composé des onglets OPS (opérations structurelles comme le tri ou la dimension des listes) et MATH (opérations de réduction agrégée). C’est dans ce compartiment MATH que se trouvent les fonctions fondamentales de traitement univarié telles que la somme arithmétique ([sum]), la valeur minimale, la médiane et surtout la fonction moyenne ([mean]).
Enfin, l’accès à la bibliothèque générale des commandes de la machine s’effectue via le catalogue universel ([2nd] suivi de [0]). Ce répertoire alphabétique intègre la totalité des instructions prises en charge par le système d’exploitation d’exploitation TI-OS. Pour une recherche ciblée, l’utilisateur peut presser directement la lettre alphabétique correspondant à l’initiale de la fonction recherchée (grâce au verrouillage alphanumérique actif par défaut dans ce mode), ce qui évite un défilement fastidieux le long des centaines de commandes implémentées dans le microcode de l’appareil.
3. Saisie méthodique des données brutes dans l’éditeur de listes (L1)
3.1 Procédure d’encodage séquentiel des observations
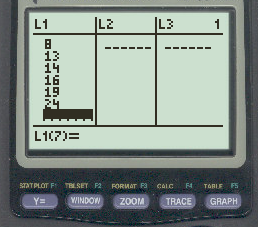
L’encodage des données brutes constitue le point de départ empirique de toute analyse de dispersion. Pour initier la saisie séquentielle, l’utilisateur active la commande [STAT], puis sélectionne l’option [1:Edit…] en appuyant sur [ENTER] ou sur la touche numérique [1]. L’écran se transforme alors en une grille tabulaire matricielle où les en-têtes de colonnes portent les désignations L1, L2, L3, etc. Par convention méthodologique, la liste L1 est réservée à la variable quantitative principale faisant l’objet de l’investigation descriptive.
La saisie s’opère élément par élément avec une rigueur absolue. L’utilisateur encode la première valeur numérique au clavier, puis valide la saisie en pressant la touche [ENTER]. Cette action a pour double effet d’affecter le nombre à la première position indicée du vecteur (L1(1)) et de déplacer automatiquement le curseur de surbrillance sur la ligne immédiatement inférieure (L1(2)). Le protocole se répète de façon continue pour l’ensemble des observations composant l’échantillon. L’interpréteur de la TI-84 autorise aussi bien les entiers relatifs que les décimaux ; pour ces derniers, l’emploi de la touche de point décimal (.) située sur la ligne inférieure du clavier est requis, en évitant toute confusion avec les séparateurs d’arguments.
Il est impératif d’adopter une cadence de frappe régulière afin de prévenir les artefacts de saisie liés au rebond mécanique des touches. Si une série comporte des zéros, ceux-ci doivent impérativement être encodés et validés par [ENTER], car la TI-84 ne remplit pas automatiquement les cellules omises. Toute omission d’une valeur zéro dénature l’échantillon en réduisant artificiellement son cardinal et en faussant le calcul de la position centrale qui servira de point d’ancrage aux écarts absolus.
3.2 Protocoles de contrôle et de rectification des erreurs de saisie
L’exactitude des calculs statistiques est tributaire de la fidélité de l’encodage. Une unique coquille dans la liste L1 peut propager une distorsion considérable sur la moyenne, et par voie de conséquence, corrompre l’ensemble des calculs de dispersion subséquents. Dès lors, la mise en place d’un protocole de vérification post-saisie est une étape indispensable. Pour relire la série, l’expérimentateur utilise les flèches directionnelles du pavé multidirectionnel [▲] et [▼], qui permettent de naviguer verticalement à travers les entrées de la colonne sans en altérer le contenu.
Si une discordance est identifiée entre la valeur affichée et le protocole expérimental source, la rectification s’effectue par écrasement direct. Il suffit de positionner le curseur en surbrillance sur l’élément erroné, de composer la valeur correcte sur le pavé numérique, et d’appuyer sur [ENTER]. La nouvelle valeur se substitue immédiatement à l’ancienne dans le registre mémoire alloué à la liste. Si une observation surnuméraire a été encodée par inadvertance, son élimination s’opère en plaçant le curseur sur la cellule incriminée et en pressant la touche [DEL]. Les cellules situées en dessous sont automatiquement décalées d’un cran vers le haut, préservant la continuité vectorielle sans laisser de trou au sein de la liste.
Dans l’éventualité inverse où une donnée aurait été omise au milieu de la séquence, l’utilisateur n’a pas besoin de réécrire l’ensemble des éléments ultérieurs. En plaçant le curseur à l’endroit précis où la valeur manquante devrait figurer et en exécutant l’instruction d’insertion via la séquence [2nd] puis [DEL] (marquée [INS]), la machine insère une cellule temporaire initialisée à zéro. L’utilisateur peut alors entrer la valeur omise, validée par [ENTER], rétablissant ainsi l’intégrité de la structure séquentielle originale.
3.3 Vérification de la taille de l’échantillon (n)
Le contrôle dimensionnel de la liste encodée représente le dernier verrou de sécurité avant d’engager le traitement algorithmique de la dispersion. L’interface de l’éditeur de listes de la TI-84 offre une indication contextuelle précieuse à cet égard. En bas de l’écran, une ligne d’état affiche de manière dynamique les coordonnées de la cellule active sous la forme synthétique : L1(k)=, où k représente l’index ordinal de la cellule sélectionnée au sein du vecteur dimensionnel.
Lorsque la dernière observation de l’échantillon a été saisie et validée, le curseur se positionne spontanément sur la ligne vide suivante. Dès lors, si l’échantillon expérimental comporte rigoureusement n observations, la ligne d’état au bas de l’écran doit afficher très exactement L1(n+1)=. Par exemple, pour une série de six sujets, le curseur doit se trouver sur une ligne vide désignée par L1(7)=. Cette correspondance biométrique directe entre le cardinal théorique de l’échantillon expérimental et l’indexation physique de la machine permet d’attester qu’aucune donnée n’a été oubliée ou dupliquée lors de la phase d’entrée manuelle.
Il convient de proscrire rigoureusement la présence de cellules vides ou partiellement éditées au sein du corps du tableau. Bien que la TI-84 gère les listes avec une flexibilité appréciable, une rupture d’indexation ou la présence inopinée de caractères d’espacement non résolus peut déclencher des interruptions d’exécution fatales, générant les fameuses erreurs système de non-concordance de dimension lors des phases de calcul vectoriel croisé.
4. Détermination de la moyenne arithmétique de la distribution
4.1 Calcul automatisé via les statistiques à une variable (1-Var Stats)
La première phase calculatoire de la détermination de l’écart absolu moyen consiste à extraire la moyenne arithmétique (x̄) de la série brute. La TI-84 intègre un moteur de calcul statistique univarié particulièrement puissant capable de générer simultanément l’ensemble des descripteurs de position et de dispersion standards. Pour mobiliser ce module, l’utilisateur appuie sur la touche [STAT], utilise la flèche droite [►] pour basculer vers l’onglet horizontal CALC, et sélectionne la première option intitulée [1-Var Stats] en validant par [ENTER].
Sur les modèles récents dotés du système d’exploitation interactif (MathPrint), un écran de paramétrage s’affiche. Le champ [List] doit contenir l’identifiant de la liste renfermant les données sources, soit [L1]. Si ce n’est pas le cas, l’utilisateur compose la combinaison [2nd] puis [1] pour afficher le symbole L1. Le champ secondaire, intitulé [FreqList] (liste des fréquences ou pondérations), doit impérativement demeurer vierge lorsque chaque valeur saisie représente une observation unitaire distincte. Il suffit ensuite de descendre le curseur sur la commande [Calculate] et d’appuyer sur la touche [ENTER].
L’écran de résultats présente instantanément une succession ordonnée d’indicateurs statistiques universels. La première ligne affiche invariablement la mention x̄ = ..., correspondant très exactement à la moyenne arithmétique de la distribution. Les lignes subséquentes fournissent la somme des valeurs (Σx), la somme des carrés (Σx²), ainsi que les estimations de l’écart-type d’échantillon (Sx) et de l’écart-type de population (σx). L’analyste note avec précision la valeur de x̄, tout en gardant à l’esprit que la calculatrice conserve cette grandeur dans ses registres internes de manière hautement sécurisée.
4.2 Extraction directe de la moyenne via le menu LIST MATH
Bien que la commande [1-Var Stats] soit très complète, elle présente l’inconvénient d’interrompre le flux de calcul sur l’écran d’accueil en écrasant l’historique visuel avec un tableau récapitulatif. Une approche alternative, nettement plus fluide et élégante pour la suite des manipulations, consiste à faire appel directement à la fonction scalaire [mean] intégrée dans le processeur de liste de l’appareil. Cette fonction s’exécute directement depuis l’écran principal de calcul sans transiter par un menu de diagnostic complet.
Pour appeler cette instruction fondamentale, l’opérateur accède au gestionnaire de listes en composant la séquence [2nd] puis [STAT] (marqué [LIST]). Il convient ensuite d’utiliser la flèche directionnelle droite [►] par deux fois pour atteindre l’onglet supérieur MATH. Dans la liste déroulante qui apparaît, l’option 3:mean( s’impose. Une pression sur la touche numérique [3] ou la validation par [ENTER] insère immédiatement l’opérateur fonctionnel mean( sur la ligne de commande active de l’écran d’accueil.
L’étape suivante consiste à spécifier le vecteur argument auquel la fonction doit s’appliquer. L’utilisateur invoque la liste L1 par le raccourci matériel standard [2nd] suivi de la touche [1]. Il est fortement conseillé, par rigueur syntaxique, de clore l’expression en refermant la parenthèse via la touche dédiée [ ) ], bien que l’analyseur syntaxique de Texas Instruments puisse tolérer l’omission de cette fermeture en fin de ligne d’instruction. En validant par la touche [ENTER], la TI-84 calcule et renvoie immédiatement la valeur scalaire de la moyenne arithmétique avec la précision maximale disponible du système.
4.3 Mémorisation de la moyenne dans une variable de registre
Afin de construire des expressions vectorielles élégantes et d’exclure tout risque d’erreur lié à la retranscription manuelle d’une valeur décimale infinie (comme dans le cas de fractions périodiques telles que 1/3 ou 2/3), il est fortement recommandé de stocker la moyenne calculée dans un registre de variable dédié. Le système d’exploitation de la TI-84 propose un ensemble de variables alphabétiques universelles (de A à Z) hébergées dans la mémoire vive statique de la calculatrice, accessibles via la touche [ALPHA].
La procédure d’assignation repose sur l’usage de la touche de mémorisation [STO►] (pour Store), située judicieusement au-dessus de la touche [ON]. Lorsque la valeur de la moyenne vient d’être évaluée à l’écran, ou directement en enchaînement de la commande mean(L1), l’utilisateur presse la touche [STO►]. Une flèche orientée vers la droite apparaît à l’écran, signalant l’instruction de transfert de flux numérique. Il suffit alors de presser la combinaison [ALPHA] puis la touche correspondant à la lettre souhaitée, par exemple [M] (située en accès secondaire sur la touche [÷] ou [4] selon les générations de claviers, typiquement sur la touche [÷] pour la lettre M).
L’expression finale à l’écran prend la forme suivante : mean(L1)→M. Dès que l’utilisateur valide cette séquence par [ENTER], la valeur numérique de la moyenne arithmétique de la distribution est figée dans le registre M. Tout au long des calculs ultérieurs, l’appel de la lettre M injectera la valeur exacte de la moyenne sans aucune approximation décimale intermédiaire, assurant aux étapes suivantes de détermination des écarts absolus une précision arithmétique absolue conforme aux exigences académiques.
5. Génération des écarts absolus individuels dans la liste L2
5.1 Positionnement et activation de la ligne de commande d’en-tête
La puissance intrinsèque de la calculatrice TI-84 réside dans sa capacité à traiter les listes de données non pas comme de simples réceptacles de valeurs statiques, mais comme de véritables vecteurs algébriques susceptibles d’être manipulés par des formules globales. Cette approche, qualifiée de vectorisation de calcul, permet d’appliquer une transformation mathématique uniforme à chaque élément d’une colonne sans exiger l’écriture fastidieuse de boucles itératives manuelles. Pour ce faire, il convient de regagner l’éditeur tabulaire en pressant la touche [STAT], puis en validant l’option [1:Edit…].
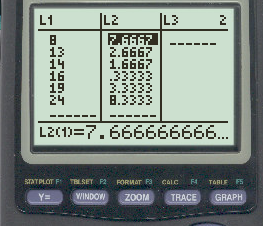
Une fois positionné dans le tableur, l’utilisateur doit déplacer le curseur de navigation vers le haut jusqu’à surligner très précisément l’en-tête textuel [L2] situé au sommet de la deuxième colonne. Il s’agit d’un point technique fondamental : le curseur ne doit pas reposer sur la première cellule de données (ligne 1), mais bel et bien sur le libellé supérieur de la colonne. Dès que cet en-tête est sélectionné, la ligne de commande située tout en bas de l’écran de la calculatrice affiche le texte L2 = , assorti d’un curseur clignotant invitant à la saisie d’une équation génératrice.
Cette ligne de formule d’en-tête informe l’interpréteur de la machine que l’ensemble des éléments de la colonne L2 sera le résultat direct de la fonction mathématique qui va y être introduite. Toute écriture validée à ce niveau écrase instantanément le contenu préexistant de la liste L2 pour le remplacer par les composantes vectorielles évaluées séquentiellement à partir des données sources de la première colonne.
5.2 Insertion de la fonction valeur absolue (abs)
L’élaboration de la formule génératrice des écarts exige la convocation de la fonction valeur absolue, désignée par l’abréviation universelle abs au sein du système TI-OS. La TI-84 offre plusieurs voies d’accès pour insérer cet opérateur géométrique dans une formule de liste. La méthode canonique la plus rapide s’effectue en pressant la touche [MATH], située sous la touche verte alpha, puis en utilisant la flèche droite [►] pour sélectionner le sous-menu supérieur [NUM] (opérations numériques élémentaires).
Dans ce répertoire NUM, la première option proposée s’intitule invariablement [1:abs(]. En appuyant sur la touche [1] ou en validant par [ENTER], la fonction s’insère directement dans la ligne de commande de l’en-tête de liste. Selon la version du système d’exploitation installée sur votre appareil (notamment sur les calculatrices TI-84 Plus CE dotées des firmwares MathPrint récents), la calculatrice peut afficher visuellement deux barres verticales de valeur absolue | | entourant le futur champ opératoire, ou bien la syntaxe textuelle classique abs( suivie d’une parenthèse ouvrante.
À titre d’alternative technique, l’opérateur valeur absolue peut également être mobilisé depuis le catalogue général des fonctions ([2nd] puis [0]). La fonction abs( figurant en tête du répertoire alphabétique, elle apparaît instantanément comme le premier élément sélectionné, rendant son extraction immédiate pour les opérateurs rompus à la manipulation du catalogue système.
5.3 Construction syntaxique de l’expression mathématique complète
La construction de l’expression au sein de la ligne de commande d’en-tête requiert une rigueur syntaxique absolue afin de respecter l’ordre algébrique des opérations. L’objectif est d’exprimer que chaque cellule de L2 doit contenir la valeur absolue de la différence entre l’observation correspondante de L1 et la moyenne arithmétique globale de la distribution. Deux formulations syntaxiques équivalentes s’offrent à l’utilisateur, selon qu’il a ou non mémorisé la moyenne dans le registre alphabétique M au cours de l’étape précédente.
Si la moyenne a été stockée dans la variable M, la formule d’en-tête s’écrit avec une remarquable concision : L2 = abs(L1 - M). Pour composer cette expression, l’utilisateur insère la fonction abs(, appelle la liste L1 via la combinaison [2nd] puis [1], appuie sur la touche de soustraction arithmétique [-] (à ne pas confondre avec le signe de négation unaire), puis insère la variable [M] en pressant [ALPHA] puis [÷]. Il clôt impérativement la formule en fermant la parenthèse à l’aide de la touche [ ) ].
Si la moyenne n’a pas été mémorisée préalablement dans une variable scalaire, il demeure parfaitement possible d’imbriquer directement la fonction de calcul de moyenne au sein de l’opérateur de valeur absolue. L’expression prend alors la forme canonique : L2 = abs(L1 - mean(L1)). L’appel de l’instruction mean( s’effectue alors via le menu [LIST] MATH (touches [2nd] [STAT] ► ► 3), suivi de la désignation de [L1] et de la fermeture scrupuleuse des parenthèses imbriquées. En pressant enfin la touche de validation [ENTER], la magie de l’évaluation matricielle opère : la colonne L2 se peuple instantanément d’une suite de valeurs positives ou nulles représentant fidèlement les écarts absolus individuels |xᵢ – x̄| de chaque observation.
6. Calcul final de l’écart absolu moyen sur l’écran principal
6.1 Application de la fonction de moyenne sur la liste des écarts
Une fois la liste L2 peuplée des écarts absolus individuels, la phase finale de détermination de l’écart absolu moyen consiste simplement à évaluer la moyenne arithmétique de cette nouvelle série de déviations. Pour réaliser cette opération dans les règles de l’art, il convient tout d’abord de quitter l’éditeur de listes afin de retrouver la clarté de l’écran d’accueil interactif. Cette sortie s’effectue en pressant la combinaison d’échappement système [2nd] puis [MODE], dont la fonction secondaire est explicitement étiquetée [QUIT].
Depuis l’écran principal vide (que l’on peut préalablement nettoyer via la touche [CLEAR] pour éliminer les opérations antérieures), l’opérateur sollicite à nouveau la fonction moyenne de liste. Il exécute la séquence désormais familière : touche [2nd], touche [STAT] pour ouvrir le gestionnaire de listes, déplacement vers la droite jusqu’au menu MATH, puis sélection de l’instruction 3:mean(. Le curseur clignote alors à l’intérieur de la commande mean( sur la ligne de calcul active.
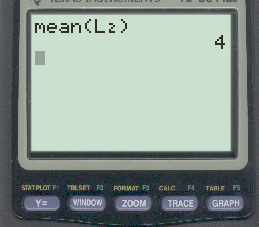
L’argument à injecter dans la fonction n’est plus la liste originelle des données brutes, mais la liste transformée des écarts absolus. L’utilisateur insère donc l’identifiant de la deuxième liste en pressant la combinaison de touches [2nd] puis [2], matérialisant le symbole L2 à l’écran. L’expression complète se lit ainsi : mean(L2). Après fermeture conventionnelle de la parenthèse, une ultime pression sur la touche [ENTER] déclenche l’exécution algorithmique finale. La valeur numérique qui apparaît instantanément sur le flanc droit de l’écran constitue très précisément l’écart absolu moyen de votre échantillon expérimental.
6.2 Méthode alternative par sommation explicite et division par l’effectif
Sur le plan didactique et pour les besoins de validation formelle lors des audits académiques, il est hautement profitable de maîtriser une seconde approche analytique consistant à décomposer explicitement chaque segment de la formule théorique : EAM = (1/n) × Σ |xᵢ – x̄|. Cette méthode alternative permet à l’étudiant ou au chercheur de visualiser distinctement la composante de sommation globale des résidus et le cardinal diviseur représentant la taille de l’échantillon.
Pour mettre en œuvre cette méthode décomposée sur l’écran d’accueil, l’analyste procède en premier lieu à la sommation de l’intégralité des écarts absolus logés dans la liste L2. Il convoque pour cela l’instruction de sommation en pressant [2nd] puis [STAT] (menu [LIST]), se dirige vers l’onglet supérieur MATH, et sélectionne la cinquième option intitulée [5:sum(]. En spécifiant la liste cible L2 ([2nd] [2]) et en refermant la parenthèse, la commande sum(L2) renvoie la valeur exacte du numérateur de la formule, à savoir la somme cumulative de toutes les distances absolues.
En second lieu, pour automatiser la détermination du dénominateur sans compter manuellement les lignes, la calculatrice intègre une fonction d’extraction de dimension vectorielle. Accessible dans le sous-menu des opérations sur les listes ([2nd] puis [STAT], onglet OPS, option [3:dim(]), cette instruction évalue la longueur d’une colonne de données. Dès lors, l’expression générale synthétisée sur l’écran principal s’articule comme suit : sum(L2)/dim(L1). L’évaluation de ce rapport arithmétique direct aboutit à un résultat strictement identique à la commande mean(L2), confirmant de manière transparente la cohérence structurelle du modèle mathématique employé.
6.3 Gestion de la précision décimale et notation scientifique
L’interprétation et la communication des descripteurs de dispersion imposent une vigilance particulière quant à la gestion des chiffres significatifs et aux artefacts d’affichage en virgule flottante. La TI-84 Plus opère en interne avec une précision mathématique de quatorze chiffres, mais l’affichage par défaut présente une adaptation dynamique qui peut tronquer visuellement certaines valeurs récurrentes ou forcer l’apparition de résidus infinitésimaux (par exemple, afficher 4.222222222 ou basculer en notation scientifique si la magnitude de la dispersion est extrêmement ténue).
Dans l’éventualité où le résultat final comporterait un exposant sous la forme d’un format exponentiel (tel que 4.222E-4), cela signale que l’écart absolu moyen est de l’ordre de 4,222 × 10⁻⁴, témoignant d’une distribution quasi-parfaitement concentrée autour de sa moyenne. Si les exigences de publication ou les consignes d’un examen universitaire imposent une précision bornée à un ordre déterminé (typiquement deux ou trois décimales), l’analyste peut ajuster temporairement le comportement visuel de l’appareil en sollicitant la touche [MODE], puis en modifiant la ligne [Float] vers l’entier souhaité (par exemple [Float 3]).
Il demeure toutefois impératif de conserver à l’esprit la règle d’or de l’analyse numérique : les arrondis d’affichage ne doivent jamais être appliqués prématurément aux étapes de calcul intermédiaires. La force de la méthode séquentielle exposée réside précisément dans le fait que les écarts individuels inscrits dans L2 et la moyenne logée dans L1 conservent leur précision totale en mémoire dynamique tout au long de la chaîne opératoire. Seule la valeur terminale restituée à l’issue de l’étape 6.1 ou 6.2 doit être arrondie selon les normes académiques en vigueur.
7. Démonstration empirique pas à pas avec le jeu de données de référence
7.1 Présentation du jeu de données expérimental et calcul manuel
Pour consolider la maîtrise pratique de ce protocole méthodologique, appliquons pas à pas la démarche à un jeu de données expérimental concret. Imaginons une étude psychométrique évaluant les scores d’anxiété situationnelle obtenus par un échantillon de n = 6 participants soumis à un paradigme expérimental standardisé. Les observations quantitatives recueillies sont les suivantes :
- Sujet 1 : 8 points
- Sujet 2 : 13 points
- Sujet 3 : 14 points
- Sujet 4 : 16 points
- Sujet 5 : 19 points
- Sujet 6 : 24 points
Avant d’engager le traitement sur la calculatrice, explicitons la résolution analytique manuelle qui servira de référence théorique absolue. La première étape consiste à déterminer la moyenne arithmétique (x̄) de la distribution :
x̄ = (8 + 13 + 14 + 16 + 19 + 24) / 6 = 94 / 6 ≈ 15,6666667 (soit 15 et 2/3).
La deuxième étape requiert le calcul individuel de chaque écart absolu |xᵢ – x̄| par rapport à cette valeur moyenne centrale :
- |8 – 15,6667| = |-7,6667| = 7,6667
- |13 – 15,6667| = |-2,6667| = 2,6667
- |14 – 15,6667| = |-1,6667| = 1,6667
- |16 – 15,6667| = |+0,3333| = 0,3333
- |19 – 15,6667| = |+3,3333| = 3,3333
- |24 – 15,6667| = |+8,3333| = 8,3333
La troisième étape opère la sommation intégrale de ces déviations linéaires positives :
Somme des écarts absolus = 7,6667 + 2,6667 + 1,6667 + 0,3333 + 3,3333 + 8,3333 = 25,3333 (valeur exacte : 76/3).
Enfin, la division de cette somme par l’effectif d’échantillon (n = 6) fournit la valeur finale de l’écart absolu moyen :
EAM = 25,3333 / 6 ≈ 4,2222… (soit très exactement 38/9 sous forme fractionnaire rationnelle irréductible).
7.2 Transcription intégrale des manipulations sur la TI-84
Procédons désormais à la réplication scrupuleuse de cette analyse au moyen des commandes matérielles de la TI-84 Plus, afin d’observer comment la machine simplifie cette séquence calculatoire complexe :
- Saisie des observations dans L1 : Appuyez sur [STAT], choisissez [1:Edit]. Positionnez le curseur sur la première cellule de L1. Entrez successivement :
8 [ENTER] 13 [ENTER] 14 [ENTER] 16 [ENTER] 19 [ENTER] 24 [ENTER]. Le curseur se positionne sur la cellule videL1(7)=, validant formellement l’encodage de six observations. - Définition de la colonne des écarts dans L2 : Utilisez la flèche multidirectionnelle [▲] pour placer le curseur sur le label d’en-tête [L2] tout en haut de la seconde colonne. La ligne d’état inférieure affiche
L2 =. Composez alors directement l’instruction : appuyez sur [MATH], flèche vers NUM, choisissez [1:abs(]. Tapez ensuite [2nd] puis [1] (pour L1), pressez la touche de soustraction [-], appuyez sur [2nd] puis [STAT], flèche vers MATH, sélectionnez [3:mean(], tapez à nouveau [2nd] puis [1] (pour L1), refermez deux fois les parenthèses avec [ ) ] [ ) ]. L’en-tête présente l’équation formelle :L2 = abs(L1 - mean(L1)). Validez par la touche [ENTER]. - Vérification du contenu matriciel de L2 : La colonne L2 se remplit instantanément des valeurs de déviation : la première ligne affiche
7.6667, la deuxième2.6667, la troisième1.6667, la quatrième.33333, la cinquième3.3333, et la sixième8.3333. - Calcul final sur l’écran d’accueil : Quittez l’éditeur tabulaire via la commande [2nd] puis [MODE] ([QUIT]). Depuis l’écran d’accueil, appuyez sur [2nd] puis [STAT] (LIST), flèche vers MATH, sélectionnez [3:mean(]. Spécifiez la deuxième liste via [2nd] puis [2] ([L2]), puis refermez la parenthèse [ ) ]. Validez en pressant la touche [ENTER].
7.3 Validation croisée et diagnostic de cohérence
L’évaluation de la ligne mean(L2) sur l’écran principal renvoie avec une fulgurance absolue le nombre décimal : 4.222222222. La confrontation directe entre cette sortie machine et le calcul théorique développé à la section 7.1 démontre une concordance arithmétique parfaite jusqu’à la neuvième décimale. Le résultat machine correspond très exactement à la valeur rationnelle 38/9.
Cette validation croisée met en lumière le bénéfice fondamental de l’automatisation vectorielle sur la TI-84. Alors que le calcul manuel impose de composer avec des fractions fastidieuses ou d’introduire des approximations décimales précoces susceptibles de contaminer le résultat final par effet cumulatif, le processeur de la TI-84 préserve la totalité des registres binaires de la virgule flottante au cours de l’évaluation interne de la commande abs(L1 - mean(L1)).
En outre, l’analyste peut procéder à un contrôle additionnel de rationalité en convertissant le résultat décimal affiché en fraction formelle directement sur l’écran de la calculatrice. En appuyant sur la touche [MATH] et en validant la toute première option [1:►Frac] par [ENTER], la TI-84 réévalue la réponse précédente (Ans►Frac) et renvoie instantanément 38/9. Cette concordance analytique sans faille atteste de la parfaite maîtrise du pipeline algorithmique et garantit l’infaillibilité de vos résultats de dispersion.
8. Développement d’un programme TI-BASIC pour automatiser le calcul
8.1 Architecture logicielle et création du script dans l’éditeur PRGM
Bien que la manipulation interactive des listes dans le tableur constitue un apprentissage fondamental de la syntaxe de la TI-84, la réplication fréquente de ces opérations peut s’avérer chronophage lors de protocoles expérimentaux répétés ou d’examens chronométrés. L’environnement interne de programmation TI-BASIC offre une solution particulièrement élégante pour encapsuler l’ensemble de ces étapes au sein d’un exécutable unique, fiable et instantané.
Pour initier la conception d’un nouveau programme, l’utilisateur presse la touche dédiée [PRGM]. Cet écran dispose de trois onglets horizontaux : EXEC (exécution d’un script existant), EDIT (modification d’un code source) et NEW (création d’un module inédit). En déplaçant le curseur vers l’onglet NEW et en sélectionnant [1:Create New], la calculatrice invite à attribuer une dénomination au script. Le clavier est automatiquement basculé en mode de saisie alphabétique verrouillée. Nous suggérons de nommer le programme avec clarté, par exemple [MADCALC] (abréviation internationale de Mean Absolute Deviation Calculator), avant de valider l’enregistrement par la touche [ENTER].
L’interface bascule alors dans l’éditeur de code de la TI-84, reconnaissable à la présence de deux points (:) au début de chaque ligne d’instruction. Chaque ligne correspondra à une commande élémentaire interprétée de haut en bas lors du lancement de l’application. La programmation en TI-BASIC impose de sélectionner les fonctions directement dans les menus matériels de la calculatrice (tels que [PRGM], [MATH] ou [STAT]) plutôt que d’en épeler le nom lettre par lettre, garantissant ainsi que les commandes soient correctement tokenisées sous forme d’instructions exécutables par le microprogramme interne.
8.2 Codage des instructions algorithmiques de calcul de dispersion
L’architecture du script doit allier une ergonomie visuelle exemplaire à une efficacité computationnelle maximale. Nous structurons l’algorithme en quatre étapes clés : la réinitialisation de l’affichage, la sollicitation interactive de la liste source, le traitement vectoriel sans écrasement destructif de colonnes secondaires, et la restitution soignée du résultat final.
Voici la transcription exacte des instructions à intégrer dans l’éditeur TI-BASIC de votre appareil :
- Ligne 1 : Nettoyage de l’écran d’affichage : Pressez la touche [PRGM], naviguez vers l’onglet [I/O] (Entrées/Sorties), et sélectionnez [8:ClrHome]. Cette commande assure que l’exécution démarrera sur un écran parfaitement vierge.
- Ligne 2 : Saisie de la liste de données : Pressez [PRGM], onglet [I/O], sélectionnez [2:Prompt]. Tapez ensuite la séquence [2nd] puis [1] pour afficher
Prompt L1. Cette instruction affichera une invite demandant à l’utilisateur de désigner la liste contenant ses données expérimentales lors de l’exécution. - Ligne 3 : Traitement mathématique vectoriel condensé : Nous condensons l’intégralité de la formule mathématique en une seule ligne algorithmique afin d’optimiser le temps processeur et d’éviter d’altérer la liste L2 de l’utilisateur. Composez l’expression :
mean(abs(L1-mean(L1)))→D.
Pour ce faire : insérezmean(via [2nd] [STAT] MATH 3 ; insérezabs(via [MATH] NUM 1 ; insérezL1via [2nd] [1] ; pressez la touche de soustraction [-] ; insérez à nouveaumean(L1); fermez les parenthèses successives ; pressez la touche [STO►] ; puis insérez la variable alphabétiqueDvia [ALPHA] puis [x⁻¹] (lettre D). La variable D contiendra désormais l’écart absolu moyen. - Ligne 4 : Restitution textuelle du résultat : Pressez [PRGM], onglet [I/O], choisissez [3:Disp]. Tapez un guillemet ouvrant via [ALPHA] puis [+]. Écrivez le label textuel [ALPHA] [M] [ALPHA] [A] [ALPHA] [D] [ALPHA] [=], puis refermez le guillemet [ALPHA] [+]. Ajoutez une virgule [ , ] via la touche dédiée au-dessus du 7, et insérez la variable résultante [ALPHA] [D]. L’instruction finale s’affiche rigoureusement ainsi :
Disp "MAD=",D.
8.3 Protocoles de test, d’optimisation et de débogage du programme
Une fois le code intégralement saisi, quittez l’éditeur de script en pressant [2nd] puis [MODE] ([QUIT]). Le programme est automatiquement compilé sous forme de tokens et sauvegardé dans la mémoire vive de la calculatrice. Pour tester le script, appuyez sur la touche [PRGM], assurez-vous que l’onglet EXEC est actif, sélectionnez [MADCALC] et pressez [ENTER]. La mention prgmMADCALC s’inscrit sur l’écran d’accueil ; validez une seconde fois par [ENTER] pour déclencher l’exécution.
Le programme efface l’écran et affiche l’invite interactive L1=?. Si vos données ont préalablement été saisies dans la colonne L1 (comme notre jeu de données de référence : 8, 13, 14, 16, 19, 24), il suffit de presser simplement la touche [ENTER]. De manière instantanée, le processeur exécute le pipeline vectoriel et affiche à la ligne inférieure : MAD= 4.222222222. La mention Done confirme l’achèvement sans accroc de la séquence programmée.
En matière d’optimisation et de débogage, le principal point de vigilance réside dans la gestion des parenthèses au sein de la ligne de calcul vectoriel. L’omission d’une parenthèse fermante génère quasi-systématiquement une erreur système de type ERR:SYNTAX. Si ce message surgit, sélectionnez immédiatement l’option [2:Goto] proposée par la TI-84 : la machine rouvrira l’éditeur de code en positionnant le curseur clignotant précisément sur le caractère ayant provoqué l’incident. Un autre avantage de notre script condensé réside dans son innocuité pour l’espace de travail : en stockant le résultat dans un scalaire isolé (D) plutôt que de générer une liste permanente L2, le programme s’exécute avec une vitesse fulgurante et préserve l’intégrité de vos autres jeux de données matriciels.
9. Interprétation psychologique et psychométrique des résultats obtenus
9.1 Sens clinique et comportemental de la magnitude de l’écart absolu moyen
L’obtention d’une valeur numérique d’écart absolu moyen sur l’écran de la TI-84 ne marque pas l’aboutissement de la démarche scientifique : elle inaugure la phase décisive de l’interprétation substantielle au regard du construit psychologique sous étude. Contrairement aux approches purement abstraites, l’amplitude de l’écart absolu moyen renseigne directement le clinicien sur la structure de la dynamique comportementale ou cognitive d’une cohorte observée. Un écart absolu moyen particulièrement réduit traduit une consistance interne remarquable et un haut degré d’homogénéité : les participants répondent aux stimuli expérimentaux selon des modalités hautement congruentes, signalant un processus psychologique stable et peu sujet aux fluctuations contextuelles.
À l’inverse, l’observation d’un écart absolu moyen élevé dénote une dispersion marquée des conduites ou des performances cognitives. Dans une échelle évaluant par exemple la réactivité émotionnelle ou la tolérance au stress, une dispersion absolue étendue peut indiquer une polarisation des attitudes, suggérant que l’échantillon n’appartient pas à une population unimodale homogène mais pourrait agréger des sous-populations distinctes (telles que des individus hautement résilients opposés à des profils à haute vulnérabilité anxieuse).
Pour que cette interprétation prenne tout son sens clinique, la magnitude de l’écart absolu moyen doit être systématiquement contextualisée en fonction de l’étendue globale (l’amplitude théorique min-max) de l’instrument d’évaluation. Un écart absolu moyen de 4,22 points n’a pas la même signification clinique selon qu’il s’applique à une échelle graduée de 0 à 30 points (où il représente environ 14 % de l’empan théorique, ce qui constitue une variabilité modérée mais substantielle) ou à un test de quotient intellectuel calibré sur une échelle allant de 40 à 160 points (où il témoignerait au contraire d’une concentration exceptionnelle des scores).
9.2 Analyse critique de la robustesse face aux scores extrêmes
La supériorité méthodologique de l’écart absolu moyen se révèle avec éclat lors de la confrontation avec des scores extrêmes ou aberrants (fréquemment désignés par le vocable anglo-saxon d’outliers). Pour illustrer de manière tangible cette résistance métrologique, reprenons notre jeu de référence (8, 13, 14, 16, 19, 24) dont l’EAM s’élève à 4,22 et dont l’écart-type d’échantillon conventionnel s’établit à s = 5,35 points. Supposons qu’un artefact d’encodage ou qu’une perturbation cognitive aiguë conduise le dernier sujet à obtenir un score atypique de 60 points au lieu de 24.
Dans ce scénario de contamination expérimentale, la moyenne arithmétique grimpe brusquement à 21,67 points. Si l’on réévalue les descripteurs de dispersion sur la TI-84, l’écart-type d’échantillon explose pour atteindre s = 19,10 points (une augmentation spectaculaire de plus de 257 %), sous l’effet de l’élévation au carré de la déviation du score contaminant : (60 – 21,67)² ≈ 1469,2 ! En revanche, l’écart absolu moyen n’augmente que de façon modérée pour s’établir à EAM = 12,78 points. Bien que la moyenne contaminée tire mécaniquement l’ensemble des écarts résiduels, l’absence de pénalisation quadratique empêche le score atypique de pulvériser la métrique de dispersion.
Cette propriété de robustesse linéaire offre au chercheur un outil diagnostique précieux lors de l’audit de ses données. La comparaison directe entre l’ampleur de l’écart-type et celle de l’écart absolu moyen permet d’identifier immédiatement la présence d’observations périphériques asymétriques. Lorsque l’écart-type dépasse très largement l’écart absolu moyen (au-delà du ratio théorique standard de √(π/2) ≈ 1,25 attendu pour une distribution parfaitement gaussienne), l’analyste dispose d’un indice révélateur signalant que la dispersion est artificiellement dominée par une poignée de valeurs extrêmes, l’invitant à approfondir l’examen qualitatif de ces cas cliniques singuliers.
9.3 Limites inférentielles de l’écart absolu moyen en psychologie
En dépit de ses éclatantes vertus descriptives et de son insolente robustesse face aux contaminations, l’écart absolu moyen souffre de limitations théoriques substantielles qui justifient la réserve historique des manuels d’inférence statistique. La faille principale de l’écart absolu moyen réside dans l’absence de propriétés mathématiques commodes quant à sa distribution d’échantillonnage. Alors que le théorème central limite et la théorie des moindres carrés permettent d’établir avec une élégance parfaite les lois de probabilité régissant la variance d’échantillon (qui suit rigoureusement une distribution de khi-carré sous hypothèse de normalité), la loi de distribution de l’écart absolu moyen ne se prête à aucune formalisation analytique simple à taille d’échantillon finie.
Cette complexité théorique rend extrêmement laborieuse la dérivation exacte d’intervalles de confiance conventionnels autour de l’écart absolu moyen sans avoir recours à des techniques informatiques intensives de rééchantillonnage bootstrap. De même, les procédures classiques de comparaison de dispersion entre deux groupes expérimentaux indépendants (à l’image du test de Fisher-Snedecor) sont intégralement articulées autour du rapport des variances quadratiques. Il n’existe pas d’équivalent paramétrique canonique simple permettant de tester l’égalité des écarts absolus moyens de deux cohortes sans basculer vers des tests non paramétriques basés sur les rangs.
Enfin, dans les modélisations statistiques avancées couramment mobilisées par la recherche psychologique contemporaine — telles que les modèles d’équations structurelles (SEM), l’analyse factorielle confirmatoire ou la modélisation multiniveau —, la matrice de covariance variance-covariance quadratique demeure le substrat matriciel exclusif du calcul d’optimisation. L’écart absolu moyen demeure donc prioritairement un instrument d’analyse descriptive, d’exploration clinique et de contrôle de robustesse, sans pouvoir prétendre supplanter intégralement l’écart-type dans les architectures d’inférence globale.
10. Comparaison méthodologique : TI-84 versus logiciels de recherche (R, SPSS, Python)
10.1 Concordance analytique avec l’environnement statistique R
Dans les laboratoires de recherche universitaires, le passage de la calculatrice portable aux environnements de programmation statistique constitue une étape standard du cycle de vie des projets empiriques. L’écosystème open-source R s’affirme comme le langage dominant dans ce paysage. Il est donc capital d’analyser comment reproduire et confronter rigoureusement les sorties de la TI-84 au sein d’une session R.
Une confusion méthodologique piège couramment les chercheurs débutants lors de cette transition. Le langage R dispose d’une fonction native intitulée mad(). Or, par convention statistique anglo-saxonne chez les concepteurs de R, l’acronyme mad() ne désigne pas la déviation absolue moyenne par rapport à la moyenne arithmétique, mais l’écart absolu médian par rapport à la médiane (Median Absolute Deviation), assorti par défaut d’un facteur de normalisation asymptotique (constant = 1.4826). L’exécution directe de la commande mad(c(8, 13, 14, 16, 19, 24)) sous R renvoie ainsi la valeur 4.4478, qui diverge conceptuellement du calcul vectoriel opéré sur notre TI-84.
Pour obtenir sous R une concordance analytique stricte avec la TI-84, le chercheur doit programmer explicitement l’équation de dispersion absolue linéaire. La syntaxe R s’écrit de façon transparente : mean(abs(x - mean(x))), où x représente le vecteur numérique d’observations. L’évaluation de cette expression sous console R génère très exactement 4.222222, corroborant avec une exactitude binaire absolue la validité de l’algorithme déployé dans la colonne L2 de la Texas Instruments. Cette concordance croisée atteste de l’universalité de la méthode vectorielle employée.
10.2 Mise en œuvre dans SPSS et bibliothèques Python (NumPy/Pandas)
L’analyse comparative gagne à s’étendre aux deux autres grands environnements d’analyse quantitative : le progiciel commercial IBM SPSS Statistics, largement répandu dans les facultés de psychologie et de médecine, et le langage de programmation scientifique Python, propulsé par ses bibliothèques spécialisées NumPy et Pandas.
Au sein d’IBM SPSS, l’écart absolu moyen n’apparaît pas dans les options de sortie par défaut de la boîte de dialogue standard des statistiques descriptives (DESCRIPTIVES ou FREQUENCIES). Pour l’obtenir, l’utilisateur doit obligatoirement transiter par la syntaxe de transformation en deux passes : premièrement, l’extraction de la moyenne globale agrégée via la commande AGGREGATE pour créer une variable de centroïde, puis l’exécution d’une transformation COMPUTE ecart = ABS(score - score_moyen), et enfin le traitement descriptif de cette nouvelle colonne. Cette lourdeur procédurale dans SPSS met en exergue l’étonnante souplesse de l’éditeur de listes de la TI-84, où la syntaxe d’en-tête L2 = abs(L1 - mean(L1)) exécute l’intégralité de ce pipeline en une unique frappe intuitive.
Sous Python, le traitement de grands tableaux de données mobilise préférentiellement les structures matricielles de NumPy. L’implémentation algorithmique se révèle aussi compacte que sur la TI-84 :
import numpy as np
data = np.array([8, 13, 14, 16, 19, 24])
mad_result = np.mean(np.absolute(data - np.mean(data)))
Sur le plan des performances informatiques pures, le processeur cadencé à 15 ou 48 MHz de la TI-84 est évidemment conçu pour des séries de taille pédagogique (généralement n < 1000), là où les routines vectorisées C de NumPy traitent des millions de lignes en quelques millisecondes. Néanmoins, pour les tailles d’échantillons courantes observées dans les passations cliniques individuelles ou les travaux pratiques de laboratoire, la latence machine de la TI-84 demeure strictement imperceptible.
10.3 Avantages opérationnels de la TI-84 en situation pédagogique et d’évaluation
Cette confrontation technique met en lumière les avantages opérationnels singuliers qui préservent la souveraineté de la calculatrice TI-84 dans les contextes éducatifs contemporains. Le premier atout réside dans l’autonomie matérielle intégrale de l’appareil. Dans un environnement de passation d’examen universitaire ou de concours d’admission, le recours à des ordinateurs connectés à Internet soulève des problématiques aiguës de sécurité, de tricherie logicielle et d’inégalité d’accès technologique. La TI-84 offre une plateforme informatique close, standardisée et parfaitement équitable pour tous les candidats.
Le second avantage, de nature pédagogique et cognitive, concerne la granularité du processus de calcul. Lorsqu’un étudiant exécute un script préfabriqué sur un progiciel comme SPSS ou R, l’opération s’apparente fréquemment à une démarche de boîte noire : les données entrent, un chiffre sort, sans que l’apprenant ne visualise le mécanisme sous-jacent. Sur la TI-84, la décomposition imposée — encodage des données dans L1, constat visuel des distances résiduelles positives peuplant L2, puis calcul de la moyenne de ces écarts — structure profondément la compréhension conceptuelle de la dispersion.
L’étudiant voit physiquement les écarts absolus s’aligner devant ses yeux ; il apprécie concrètement l’effet de l’opérateur valeur absolue qui transforme les distances négatives en grandeurs scalaires constructives. Cette mise en scène visuelle de l’algèbre vectorielle confère à la TI-84 un pouvoir d’ancrage pédagogique qu’aucun environnement purement scriptural ne peut égaler dans les premières phases de formation aux méthodes quantitatives.
11. Dépannage et résolution des anomalies d’exécution sur TI-84
11.1 Traitement de l’erreur d’incompatibilité dimensionnelle (ERR:DIM MISMATCH)
L’une des anomalies les plus fréquemment rencontrées lors de la manipulation des listes sur la calculatrice TI-84 est le déclenchement intempestif de l’écran d’arrêt d’urgence affichant la mention ERR:DIM MISMATCH (erreur de non-concordance de dimension). Cette rupture d’exécution survient inévitablement lorsque l’interpréteur tente d’exécuter une opération matricielle élément par élément entre deux vecteurs qui ne possèdent pas un nombre rigoureusement identique de composantes.
Pour diagnostiquer et corriger cette anomalie, l’analyste doit inspecter l’empan effectif de chaque colonne active. Depuis l’écran d’accueil, l’évaluation successive des commandes de dimension permet de repérer immédiatement la disparité structurelle : pressez [2nd] [STAT] OPS [3:dim(] [2nd] [1] [ ) ] pour inspecter la longueur de L1, puis réitérez l’opération pour L2. Si la commande renvoie par exemple dim(L1) = 6 et dim(L2) = 7, la calculatrice se trouve dans l’incapacité logique d’effectuer une soustraction vectorielle terme à terme.
La résolution impose d’entrer dans l’éditeur ([STAT] [1:Edit]) et de descendre jusqu’au bas de la colonne surnuméraire. Très souvent, une valeur orpheline subsiste en mémoire à la suite d’un exercice précédent non purgé. En positionnant le curseur sur cet élément parasite et en pressant la touche [DEL], la dimension de la colonne est immédiatement réajustée. Dès que les deux listes partagent le même cardinal vectoriel, la réexécution de la formule d’en-tête s’effectue sans aucune obstruction logicielle.
11.2 Résolution de l’erreur de type de données (ERR:DATA TYPE)
Une seconde interruption récurrente d’exécution se matérialise sous la forme de l’alerte ERR:DATA TYPE (erreur de type de données). Ce message signale que l’interpréteur arithmétique a rencontré une entité dont la nature scalaire est incompatible avec les opérations algébriques requises. Deux origines principales président à ce dysfonctionnement.
La première cause, particulièrement pernicieuse, concerne la confusion typographique entre les deux touches de soustraction du clavier de la TI-84. La machine opère une distinction technique absolue entre l’opérateur de soustraction binaire (la touche grise standard [-] située à droite au-dessus de l’addition) et le signe de négation unaire (la touche négative [(-)] située tout en bas, entre la virgule et la touche ENTER). Si un utilisateur tente d’encoder un nombre négatif dans L1 en utilisant la soustraction arithmétique standard, ou s’il insère la touche d’inversion unaire au milieu d’une formule telle que L1 - mean(L1), le parseur syntaxique échoue et lève l’exception de type de données.
La seconde cause réside dans l’introduction accidentelle d’une chaîne textuelle ou d’un nom de matrice dans un emplacement exclusivement réservé aux listes numériques. La vérification visuelle des cellules de L1 permet de repérer ces anomalies. Si une valeur corrompue est mise en évidence, sa réécriture intégrale à l’aide des chiffres du pavé numérique restaure instantanément la navigabilité du système.
11.3 Restauration des listes effacées et déblocage de la syntaxe de formule
Il arrive fréquemment qu’un manipulateur inexpérimenté, souhaitant vider le contenu d’une colonne au sein du tableur statistique, positionne son curseur sur le label textuel d’en-tête (par exemple [L1] ou [L2]) et presse par erreur la touche d’effacement physique [DEL]. Au lieu d’effacer les données, cette action désenregistre purement et simplement la colonne de l’interface graphique : la colonne L1 disparaît physiquement de l’affichage, laissant la place directe à L2 et L3. Cet incident suscite souvent un désarroi injustifié chez l’expérimentateur.
Pour restaurer instantanément la topologie matricielle standard sans altérer les données conservées en mémoire, la manœuvre est immédiate : appuyez sur la touche [STAT], faites défiler vers le bas jusqu’à l’option [5:SetUpEditor], et validez en pressant [ENTER]. L’écran principal affiche alors simplement Done. En regagnant l’éditeur de listes ([STAT] [1]), l’utilisateur constate avec soulagement la réapparition ordonnée de l’ensemble des six colonnes fondamentales L1 à L6, dans leur disposition d’origine.
Enfin, un autre blocage ergonomique survient lorsqu’une formule d’en-tête génératrice (signalée par la présence d’un symbole égal = persistant sur l’en-tête de colonne) interdit la modification manuelle d’une cellule individuelle. Tant qu’une liste est liée dynamiquement à une expression génératrice, toute tentative d’écrasement manuel d’une de ses composantes déclenche une erreur d’attribution. Pour déverrouiller la colonne et réautoriser la saisie libre, il suffit de repositionner le curseur sur l’en-tête [L2], de presser [ENTER] pour accéder à la ligne de commande inférieure, d’effacer l’équation à l’aide de la touche [CLEAR], puis de valider par [ENTER]. La colonne redevient un espace de stockage passif délié de toute contrainte vectorielle dynamique.
12. Protocoles de rapport scientifique et d’archivage des données
12.1 Archivage pérenne des listes expérimentales dans la mémoire Flash
Dans le cadre d’un protocole de recherche de laboratoire s’étendant sur plusieurs journées, la sauvegarde pérenne des données d’échantillonnage saisies dans la TI-84 Plus constitue un impératif méthodologique de premier ordre. Les calculatrices graphiques Texas Instruments gèrent deux compartiments de mémoire distincts : la mémoire vive volatile (RAM), au sein de laquelle s’exécutent les calculs courants et où résident par défaut les listes L1 à L6, et la mémoire morte flash d’archivage (ROM/Flash ROM), totalement insensible aux décharges complètes de batterie ou aux micro-coupures de courant.
Si la machine subit une réinitialisation accidentelle de la RAM consécutive à une manipulation erronée ou à un retrait prolongé des accumulateurs d’énergie, l’intégralité des données présentes dans la RAM est définitivement anéantie. Pour prémunir vos séries expérimentales contre cette éventualité funeste, il convient de transférer les listes névralgiques vers la mémoire Flash protégée. Ce protocole de sauvegarde s’effectue via le gestionnaire de mémoire système accessible par la combinaison [2nd] puis [+] (marquée [MEM]).
Dans ce menu, l’utilisateur sélectionne l’option [2:Mem Mgmt/Del…], puis valide l’accès au compartiment spécifique des listes ([4:List…]). L’écran présente alors le répertoire complet des variables matricielles hébergées sur la machine. En positionnant le curseur sur la liste à sanctuariser (par exemple L1) et en pressant la touche [ENTER], un astérisque (*) s’inscrit immédiatement sur la gauche du label. Cet astérisque atteste que la liste a été transférée dans la mémoire Flash d’archivage. Elle demeure désormais invulnérable aux accidents électriques, tout en restant consultable par les routines de calcul en lecture seule.
12.2 Présentation des résultats de dispersion selon les normes APA
La transcription des indices descriptifs au sein d’un mémoire de master, d’une thèse de doctorat ou d’un manuscrit soumis à une revue scientifique internationale impose le respect scrupuleux des normes typographiques édictées par l’American Psychological Association (normes APA, 7e édition). Bien que l’écart-type (noté SD pour Standard Deviation) demeure le réflexe de rapportage universel, l’inclusion de l’écart absolu moyen (conventionnellement abrégé en MAD pour Mean Absolute Deviation ou EAM dans les écrits francophones autorisés) enrichit substantiellement la valeur informative du texte lorsque la distribution présente des irrégularités morphologiques.
Sur le plan rédactionnel, les symboles statistiques doivent obligatoirement être composés en italique, tandis que les valeurs numériques associées demeurent en caractères romains droits. L’indication conjointe de la tendance centrale et de la dispersion linéaire s’insère traditionnellement entre parenthèses au sein du paragraphe de restitution des résultats. Pour notre série de référence, la formulation académique canonique s’articule ainsi :
« Les scores d’anxiété situationnelle manifestés par les participants soumis au paradigme de stress aigu révèlent une moyenne arithmétique de 15,67 points, accompagnée d’un écart absolu moyen de 4,22 points (M = 15,67, EAM = 4,22, N = 6). »
Dans la section « Méthode » ou « Analyse des données » du manuscrit, il est impératif de justifier explicitement le choix méthodologique d’adjoindre l’écart absolu moyen à l’écart-type. Le chercheur explicite typiquement cette décision en précisant : « En raison de la petite taille de l’échantillon expérimental et de l’asymétrie potentielle des distributions comportementales, l’écart absolu moyen (EAM) a été calculé conjointement à l’écart-type conventionnel afin de fournir une estimation de la dispersion non amplifiée par l’élévation quadratique des résidus individuels. » Cette transparence méthodologique témoigne d’une grande maturité épistémologique et valorise la rigueur du dispositif expérimental.
12.3 Synthèse mémo-technique des séquences de touches indispensables
Pour conclure ce traité et offrir un outil d’assistance opérationnelle rapide lors des sessions de travaux pratiques ou des épreuves d’évaluation, nous synthétisons ci-dessous la séquence canonique minimale des raccourcis matériels permettant de mener à bien l’intégralité du calcul de l’écart absolu moyen sur n’importe quelle calculatrice de la famille TI-84 Plus :
- Purge des espaces matriciels : [STAT] ► [4:ClrList] [2nd] [1] [ , ] [2nd] [2] [ENTER]
- Ouverture de l’éditeur tabulaire : [STAT] ► [1:Edit…]
- Saisie de la distribution expérimentale : Encodage séquentiel des valeurs dans [L1], validation unitaire par [ENTER]
- Injection de la formule vectorielle d’écart absolu : Curseur positionné en surbrillance sur le label d’en-tête [L2] ; saisie de l’expression : [MATH] ► NUM [1:abs(] [2nd] [1] [-] [2nd] [STAT] ► MATH [3:mean(] [2nd] [1] [ ) ] [ ) ] puis validation par [ENTER]
- Basculement vers l’écran d’accueil : [2nd] [MODE] (QUIT)
- Extraction finale de l’écart absolu moyen : [2nd] [STAT] ► MATH [3:mean(] [2nd] [2] [ ) ] [ENTER]
- Contrôle de conversion fractionnaire rationnelle : [MATH] [1:►Frac] [ENTER]
En consignant cette séquence mémo-technique dans votre carnet de laboratoire et en appliquant avec rigueur les fondements théoriques et techniques détaillés tout au long de cet ouvrage, vous disposez désormais d’une maîtrise absolue de l’évaluation de la dispersion linéaire sur Texas Instruments TI-84, hissant vos compétences d’analyse quantitative aux standards d’excellence les plus exigeants de la recherche contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Eddington, A. S. (1914). On the criterion for goodness of fit of observations to a normal frequency distribution. Monthly Notices of the Royal Astronomical Society, 74(9), 678–685. https://doi.org/10.1093/mnras/74.9.678
- Fisher, R. A. (1920). A mathematical examination of the methods of determining the accuracy of an observation by the mean error, and by the mean square error. Monthly Notices of the Royal Astronomical Society, 80(8), 758–770. https://doi.org/10.1093/mnras/80.8.758
- Gorard, S. (2005). Revisiting a 90-year-old debate: The advantages of the mean absolute deviation over the standard deviation. British Journal of Educational Studies, 53(4), 417–430. https://doi.org/10.1111/j.1467-8527.2005.00304.x
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Texas Instruments. (2019). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com/fr/produits/calculatrices/calculatrices-graphiques/ti-84-plus-ce-t
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.