
Dans l’arsenal des méthodes quantitatives appliquées aux sciences humaines, biomédicales et sociales, la distribution normale standard occupe une place prépondérante. Formalisée initialement par les travaux pionniers d’Abraham de Moivre, de Pierre-Simon de Laplace et de Carl Friedrich Gauss, cette loi de probabilité continue constitue le socle sur lequel repose une grande partie de l’inférence statistique moderne. Qu’il s’agisse d’évaluer la dispersion d’un trait psychologique au sein d’une cohorte, de déterminer un seuil diagnostique clinique ou d’éprouver la validité d’une hypothèse de recherche via un test paramétrique, la manipulation de la loi normale s’avère indispensable. La compréhension de sa géométrie intrinsèque ne relève pas d’une simple curiosité mathématique, mais d’une exigence méthodologique fondamentale pour tout praticien ou chercheur désireux d’interpréter des scores standardisés avec rigueur et exactitude.
Le défi central posé par la courbe de Gauss réside dans la transition conceptuelle entre une valeur scalaire discrète — le score standardisé ou cote z — et une probabilité continue représentée géométriquement par une portion de surface. Trouver l’aire indiquée sous la courbe normale standard revient à résoudre une intégrale de probabilité pour quantifier la fréquence relative d’un événement ou la proportion théorique d’une population répondant à des critères spécifiques. Contrairement aux distributions discrètes où les probabilités ponctuelles peuvent être sommées arithmétiquement, la nature continue de la fonction de densité gaussienne impose de raisonner exclusivement en termes d’intervalles et d’intégrales définies, délimitant des surfaces dont l’amplitude totale est rigoureusement égale à l’unité.
Ce guide exhaustif a pour vocation d’exposer avec une minutie académique les principes, les protocoles opératoires et les applications diagnostiques associés au calcul de l’aire sous la courbe normale standardisée. En articulant la théorie mathématique de la fonction de répartition avec des procédures pratiques d’utilisation des tables statistiques, des algorithmes informatiques et des études de cas cliniques issues de la psychométrie contemporaine, cet article offre une vue d’ensemble complète et méthodique. Les praticiens, chercheurs et étudiants y trouveront les clés nécessaires pour maîtriser l’ensemble des configurations géométriques possibles, surmonter les biais d’interprétation fréquents et automatiser avec précision leurs analyses quantitatives.
1. Fondements théoriques de la distribution normale standard en psychométrie et statistiques
1.1 Définition formelle de la variable normale centrée réduite
La variable aléatoire normale centrée réduite, universellement désignée par la lettre majuscule Z, est une entité mathématique abstraite caractérisée par des paramètres de localisation et de dispersion rigoureusement fixés. Par définition, sa moyenne arithmétique μ est nulle (μ = 0) et son écart-type σ est égal à l’unité (σ = 1), ce qui implique nécessairement une variance unitaire (σ² = 1). Cette configuration découle d’un processus de transformation linéaire appliqué à une variable aléatoire continue X qui suit initialement une distribution normale générale de moyenne μ et d’écart-type σ, notée conventionnellement X ~ N(μ, σ²). L’intérêt fondamental de cette transformation réside dans l’élimination des unités de mesure brutes, qu’il s’agisse de millisecondes lors d’une tâche de temps de réaction, de points bruts à une échelle d’évaluation de la dépression ou de centimètres dans des études biométriques.
La formule canonique de standardisation permettant de générer une cote z à partir d’un score brut x s’énonce de la manière suivante :
z = (x – μ) / σ
Dans cette équation, le numérateur (x – μ) effectue une opération de centrage en mesurant l’écart algébrique exact entre l’observation individuelle et le centre de gravité de la distribution parente. Le dénominateur σ opère quant à lui une réduction d’échelle en convertissant cet écart brut en unités d’écart-type. Ainsi, un score z exprime directement la distance d’une mesure par rapport à la moyenne du groupe de référence, orientée positivement lorsque l’observation excède la moyenne et négativement lorsqu’elle se situe en deçà. Cette standardisation garantit l’invariance distributionnelle et permet la comparaison directe de mesures issues de métriques initialement hétérogènes.
Sur le plan analytique, la distribution normale centrée réduite est formellement définie par sa fonction de densité de probabilité, souvent issue de la formulation de Gauss-Laplace :
φ(z) = (1 / √(2π)) × e(-z² / 2)
Dans cette expression fondamentale, π représente le nombre pi (approximativement 3,14159) et e désigne la base du logarithme népérien (environ 2,71828). La constante multiplicative 1 / √(2π) agit comme un coefficient de normalisation garantissant que l’intégrale impropre de la fonction sur l’intervalle infini allant de -∞ à +∞ soit exactement égale à 1. La composante exponentielle e(-z² / 2) dicte quant à elle l’allure symétrique caractéristique de la courbe en cloche, dont le sommet culmine précisément à l’abscisse z = 0, conférant à la distribution sa morphologie universelle.
1.2 Le concept d’aire sous la courbe comme mesure de probabilité
Dans le paradigme des probabilités continues, la notion de probabilité ponctuelle s’évanouit au profit exclusif de la notion de densité intégrée sur un intervalle donné. Contrairement à une variable aléatoire discrète où la somme des probabilités individuelles associées à chaque modalité distincte égale 1, la probabilité qu’une variable continue prenne une valeur numérique rigoureusement exacte est mathématiquement nulle, ce qui s’exprime formellement par l’égalité P(Z = z) = 0 pour tout z appartenant à l’ensemble des nombres réels. Cette particularité découle directement de la cardinalité infinie et non dénombrable du continuum réel : un point infinitésimal ne possède aucune épaisseur géométrique et ne sous-tend donc aucune surface sous la courbe de densité.
Par voie de conséquence, toute probabilité calculée dans le cadre de la distribution standardisée correspond de facto à une intégrale définie délimitant une aire sous la fonction de densité φ(z). L’aire totale circonscrite entre la courbe de Gauss, l’axe des abscisses et les asymptotes horizontales s’étendant à l’infini négatif et positif est obligatoirement égale à 1, ce qui traduit mathématiquement le postulat fondamental de l’espace probabilisé où la probabilité de l’univers des possibles est de 100 % :
∫-∞+∞ φ(z) dz = 1
Dès lors, lorsqu’un analyste cherche à déterminer la probabilité qu’un individu extrait au hasard d’une population présente un score Z inférieur ou égal à une valeur critique z, il calcule la probabilité cumulée P(Z ≤ z), laquelle correspond formellement à la fonction de répartition usuellement notée Φ(z) :
Φ(z) = P(Z ≤ z) = ∫-∞z φ(t) dt
Cette aire cumulée représente graphiquement la portion de surface s’étendant depuis l’extrême gauche de la distribution jusqu’à la droite verticale érigée au point d’abscisse z. La parfaite équivalence géométrique entre surface sous la courbe et probabilité théorique constitue la pierre angulaire de toutes les déductions quantitatives opérées sur les distributions continues.
1.3 Rôle de la distribution normale standard dans l’évaluation psychologique
Dans le domaine de la psychométrie contemporaine et de l’évaluation neuropsychologique, l’accès direct aux scores bruts s’avère souvent dépourvu de pertinence clinique ou diagnostique. Qu’indique réellement un score brut de 42 à une échelle d’évaluation de la mémoire de travail sans point de comparaison normatif ? Absolument rien d’exploitable. C’est précisément l’ancrage dans la distribution normale standard qui confère une signification interprétable à la performance individuelle en situant le sujet par rapport à une population d’étalonnage rigoureusement sélectionnée.
L’exemple le plus emblématique réside sans conteste dans les échelles d’intelligence développées par David Wechsler (telles que le WISC pour enfants ou l’WAIS pour adultes). Ces tests transforment les scores bruts en quotients intellectuels (QI) standardisés présentant une moyenne théorique fixée à 100 et un écart-type calibré à 15. Cette échelle s’articule directement sur la distribution Z par la relation linéaire QI = 100 + 15z. Ainsi, un QI mesuré à 130 correspond rigoureusement à un score z de +2,00. En déterminant l’aire située à gauche de ce seuil (qui s’élève à 0,9772), le clinicien peut affirmer que l’individu surpasse approximativement 97,7 % de sa classe d’âge, positionnant son fonctionnement cognitif au 98e rang centile.
Ce paradigme prévaut également dans l’évaluation de la personnalité à travers des modèles structuraux réputés, à l’instar du modèle en cinq facteurs (Big Five) ou des échelles cliniques comme le MMPI (Minnesota Multiphasic Personality Inventory). Ces inventaires ont fréquemment recours aux notes T (moyenne de 50, écart-type de 10), dérivées linéairement des scores z par l’équation T = 50 + 10z. La détection de scores cliniquement significatifs — qu’il s’agisse de traits pathologiques ou d’altérations cognitives majeures — s’appuie de manière quasi universelle sur des coupures probabilistes délimitées par des aires sous la courbe normale. Par exemple, un score situé à plus de deux écarts-types en dessous de la moyenne (z ≤ -2,00, correspondant à une aire résiduelle inférieure à 2,3 %) constitue l’un des critères conventionnels majeurs pour suspecter un déficit intellectuel ou un dysfonctionnement cognitif avéré.
2. Anatomie mathématique et propriétés géométriques de la courbe de Gauss
2.1 Symétrie parfaite et règle empirique
L’une des propriétés géométriques les plus remarquables de la courbe de Gauss standardisée est sa symétrie axiale rigoureuse par rapport à l’ordonnée érigée en z = 0. Sur le plan analytique, cette régularité géométrique se traduit par la parité stricte de la fonction de densité, formalisée par l’identité mathématique φ(z) = φ(-z) pour tout réel z. L’axe vertical z = 0 scinde donc la surface totale sous la courbe en deux régions parfaitement isométriques, possédant chacune une aire égale à exactement 0,5000 (soit 50 % de l’ensemble des observations théoriques). En conséquence directe, la moyenne, la médiane et le mode de la distribution normale standard sont strictement confondus en ce point central d’abscisse nulle.
Cette propriété de symétrie sous-tend des simplifications calculatoires substantielles. Elle implique notamment que l’aire située dans la queue gauche sous un score négatif –z est rigoureusement identique à l’aire confinée dans la queue droite au-delà du score positif symétrique +z, ce qui s’écrit formellement P(Z ≤ –z) = P(Z ≥ +z). De même, pour tout intervalle centré sur l’origine, la surface comprise entre –z et 0 équivaut parfaitement à celle comprise entre 0 et +z.
Cette géométrie symétrique fonde ce que les statisticiens désignent couramment sous l’appellation de règle empirique « 68-95-99,7 » (ou règle des trois sigmas) :
- L’intervalle borné par un écart-type de part et d’autre de la moyenne, c’est-à-dire [-1; +1], englobe une probabilité cumulée de ∫-1+1 φ(z) dz ≈ 0,6827, soit approximativement 68,27 % de la population totale.
- L’intervalle délimité par deux écarts-types, soit [-2; +2], concentre une aire d’≈ 0,9545, ce qui signifie que 95,45 % des valeurs observées s’inscrivent spontanément dans ces frontières.
- L’intervalle s’étendant à trois écarts-types, [-3; +3], couvre quant à lui une surface de ≈ 0,9973, ne laissant subsister à l’extérieur qu’une fraction marginale de 0,27 % des cas (0,135 % dans chaque queue extrême).
Enfin, la courbe présente un comportement asymptotique bilatéral : bien que la fonction φ(z) décroisse de façon extrêmement rapide à mesure que |z| s’accroît en tendant vers zéro, elle ne touche jamais l’axe horizontal des abscisses, quel que soit l’éloignement considéré vers -∞ ou +∞.
2.2 Points d’inflexion et dispersion géométrique
Au-delà de son sommet culminant à z = 0, où la dérivée première de la fonction s’annule (φ'(0) = 0) et où la densité atteint son apogée (φ(0) = 1 / √(2π) ≈ 0,3989), la morphologie de la courbe normale standard est gouvernée par ses points d’inflexion. Un point d’inflexion signale géométriquement l’endroit précis où la concavité de la courbe s’inverse, passant d’une courbure orientée vers le bas (concave) à une courbure dirigée vers le haut (convexe). Cette modification de la dynamique spatiale s’obtient mathématiquement en annulant la dérivée seconde de la fonction de densité, φ »(z) = 0.
Le calcul différentiel appliqué à la fonction de Gauss montre que la dérivée seconde s’exprime par :
φ »(z) = (z² – 1) × φ(z)
Puisque le terme exponentiel φ(z) demeure strictement positif pour toute valeur réelle de z, l’équation φ »(z) = 0 admet pour uniques solutions réelles z = -1 et z = +1. Les points d’inflexion de la courbe normale standardisée se situent donc rigoureusement à une distance géométrique équivalente à exactement un écart-type de part et d’autre du paramètre de position centrale. Ce résultat revêt une importance didactique capitale : l’écart-type n’est pas un concept statistique arbitraire, il possède une matérialité spatiale concrète observable directement sur le tracé de la distribution sous la forme du basculement structurel de la pente.
Dans la zone centrale comprise entre les deux points d’inflexion (-1 < z < +1), la courbe présente une forme en dôme concave, signalant une très forte concentration de la masse de probabilité au voisinage de l’espérance mathématique. Dès que l’on franchit le cap de |z| > 1, la courbe devient convexe et commence à s’étaler de manière fluide pour former les queues de distribution. La variance unitaire conditionne de façon invariable l’écartement des points d’inflexion : toute opération de standardisation impose une conformation géométrique rigoureusement uniforme, rendant la cloche standardisée identique pour n’importe quel phénomène mesuré dans le monde physique ou comportemental.
2.3 Les quatre scénarios géométriques fondamentaux de recherche d’aire
L’estimation quantitative d’aires sous la courbe normale standard se décline invariablement en quatre configurations spatiales élémentaires, dictées par la localisation des bornes critiques et l’orientation des hachures sur le graphique. Maîtriser ces quatre cas d’école constitue la condition sine qua non pour aborder sans ambiguïté les problématiques d’inférence statistique et de cotation diagnostique :
- L’aire cumulée unilatérale inférieure (à gauche d’une abscisse z) : Ce cas fondamental correspond à la probabilité P(Z ≤ z). Il s’agit de mesurer l’intégrale depuis -∞ jusqu’à une valeur seuil z. Dans les publications psychométriques, cette surface traduit immédiatement la notion de rang centile.
- L’aire unilatérale supérieure (à droite d’une abscisse z) : Définie par la probabilité P(Z ≥ z), cette région correspond à la queue de distribution supérieure. Elle est universellement employée dans la détermination des degrés de significativité statistique unilatéraux (p-valeurs critiques à droite) et dans l’identification des pourcentages de surdouance ou de pathologie aiguë.
- L’aire centrale comprise entre deux bornes finies : Formalisée par l’expression P(z1 ≤ Z ≤ z2), cette surface correspond au segment de population délimité par deux bornes numériques, le plus souvent ordonnées de sorte que z1 < z2. Cette topologie sert de matrice au calcul des intervalles de confiance et à la classification des scores qualifiés de « moyens » ou « typiques ».
- L’aire bilatérale extérieure située aux extrémités distales : Définie par l’union disjointe P(Z ≤ z1 ou Z ≥ z2), cette configuration représente la proportion de cas se situant hors d’une zone de normalité convenue, illustrant de façon par excellence les zones de rejet de l’hypothèse nulle lors de tests d’hypothèses bilatéraux au seuil α.
3. Comprendre et manipuler la table z standardisée
3.1 Structure typique d’une table normale cumulative (gauche à droite)
Bien que les environnements informatiques modernes calculent les probabilités normales de manière quasi instantanée, l’usage de la table statistique imprimée demeure un passage méthodologique incontournable pour appréhender l’articulation interne des scores standardisés. La version la plus répandue et la plus intuitive de la table de la loi normale est la table cumulative intégrale (souvent qualifiée de table de répartition de Laplace-Gauss « de gauche à droite »). Cette table fournit directement la valeur de l’aire cumulée depuis l’asymptote négative -∞ jusqu’à une coordonnée z donnée, correspondant rigoureusement à la fonction Φ(z) = P(Z ≤ z).
L’architecture matricielle d’une telle table s’organise selon une structure orthogonale bidimensionnelle à double entrée d’une grande rigueur :
- La colonne marginale verticale de gauche : Elle affiche la partie entière ainsi que la première décimale (les dixièmes) du score z. Les valeurs s’y égrènent typiquement de 0,0 à 3,4 ou 3,9 (pour les tables positives) ou de -3,4 à 0,0 (pour les tables complètes intégrant les scores négatifs).
- La ligne marginale horizontale supérieure : Elle répertorie la seconde décimale (les centièmes) du score z, s’étendant continûment de 0,00 à 0,09.
- Le corps central de la table : À l’intersection précise d’une ligne spécifique (déterminant la fraction z jusqu’au dixième) et d’une colonne spécifique (fournissant le centième), se trouve un nombre décimal compris obligatoirement entre 0 et 1, généralement exprimé avec quatre ou cinq décimales. Ce nombre correspond à la probabilité cumulée Φ(z).
Il est impératif d’examiner attentivement la notice ou le schéma explicatif figurant en en-tête de toute table imprimée. En effet, certains manuels utilisent des tables dites « de zéro à z » (qui ne fournissent que l’aire comprise entre l’axe central z = 0 et une borne positive, obligeant l’utilisateur à ajouter systématiquement 0,5000 pour obtenir l’aire cumulative globale), tandis que d’autres compilent uniquement la queue supérieure P(Z > z).
3.2 Gestion des scores z négatifs
Dans de nombreuses tables statistiques synthétiques, seules les valeurs positives du score z sont explicitement imprimées afin d’économiser l’espace typographique. Face à un score z négatif, l’utilisateur confronté à une telle table unilatérale doit impérativement mobiliser les propriétés géométriques de la distribution gaussienne pour extraire l’aire recherchée, sous peine de commettre des contresens méthodologiques majeurs.
La règle fondamentale régissant les scores négatifs repose directement sur la symétrie axiale de la fonction de densité. L’aire cumulée située à gauche d’un score négatif quelconque –z équivaut rigoureusement à l’aire située à droite de la valeur positive absolue correspondante +z. Or, en vertu du postulat de l’aire totale unitaire, l’aire à droite de +z s’obtient en retranchant de l’unité l’aire cumulée à gauche de +z. On en déduit l’identité algébrique universelle :
Φ(-z) = 1 – Φ(z)
Cette relation permet d’évaluer aisément n’importe quelle cote négative. Par exemple, si l’on cherche l’aire cumulée P(Z ≤ -1,50) à l’aide d’une table ne proposant que des scores positifs, la démarche s’effectue en deux temps :
- Localiser la ligne 1,5 et la colonne 0,00 pour trouver l’aire cumulée associée à la valeur absolue : Φ(1,50) = 0,9332.
- Appliquer le principe de complémentarité : Φ(-1,50) = 1 – 0,9332 = 0,0668.
Un mécanisme fondamental de contrôle cognitif consiste à vérifier la cohérence intuitive du résultat obtenu : la moyenne se situant à z = 0 avec une aire cumulée de 0,5000, tout score z négatif impose obligatoirement une probabilité cumulée strictement inférieure à 0,5000. L’obtention d’une aire supérieure à 0,5 pour un score négatif signale sans équivoque une erreur d’inversion algébrique.
3.3 Techniques d’interpolation pour les valeurs absentes
Bien que les tables standardisées couvrent la majorité des besoins quotidiens avec un découpage au centième près, le chercheur ou le psychométricien se trouve ponctuellement confronté à des scores z calculés avec trois décimales (par exemple z = 1,426) ou à des seuils critiques standardisés n’apparaissant pas rigoureusement au sein de la grille. Dans ce contexte, deux options méthodologiques s’offrent au calculateur : le recours à l’interpolation linéaire simple ou l’usage de conventions universelles.
L’interpolation linéaire part du postulat d’une progression proportionnelle locale de l’aire entre deux valeurs consécutives de la table. Si l’on souhaite estimer Φ(1,426), on isole d’abord les deux bornes au centième encadrant ce score :
- Φ(1,42) = 0,9222
- Φ(1,43) = 0,9236
La différence d’aire entre ces deux points s’élève à Δ = 0,9236 – 0,9222 = 0,0014 pour un accroissement de 0,01 sur z. La troisième décimale du score cible étant un 6, on pondère cet accroissement différentiel :
Φ(1,426) ≈ 0,9222 + (0,6 × 0,0014) = 0,9222 + 0,00084 = 0,92304 ≈ 0,9230
Toutefois, certains seuils probabilistes spécifiques font l’objet d’un consensus académique absolu dispensant d’une interpolation complète au cas par cas. Le cas le plus célèbre concerne la délimitation d’une aire de 0,9500 (pour un seuil unilatéral à 5 %). Dans la table, z = 1,64 génère 0,9495 et z = 1,65 donne 0,9505. La valeur cible 0,9500 se situant exactement à mi-chemin, la communauté scientifique a consacré le score z = 1,645 comme référence normative. De même, pour le seuil bilatéral classique de 95 % (laissant 2,5 % dans chaque queue), la valeur critique associée à l’aire 0,9750 est établie sans équivoque à z = 1,96.
Concernant les scores extrêmes situés au-delà de |z| > 3,49, les tables imprimées cessent fréquemment d’incrémenter leurs colonnes en raison de la proximité asymptotique avec les valeurs limites. La convention universelle impose alors de considérer que Φ(z) ≈ 0,9999 (ou 1,0000 à quatre décimales) pour tout z ≥ 3,50, et symétriquement que Φ(z) ≈ 0,0001 (ou 0,0000) pour z ≤ -3,50, l’erreur absolue induite devenant infinitésimale dans les contextes appliqués standards.
4. Cas n°1 : Calculer l’aire située à gauche d’un score z donné
4.1 Protocole pour un score z positif
Le calcul de l’aire située à gauche d’un score z positif constitue l’opération élémentaire par excellence lors de la lecture d’une table cumulative normale. Cette configuration correspond mathématiquement à la résolution de l’équation intégrale :
P(Z < z) = Φ(z), avec z > 0
Sur le plan géométrique, l’aire recherchée englobe la totalité de la moitié gauche de la distribution (de -∞ jusqu’à 0, soit exactement 0,5000) à laquelle s’agrège la tranche de surface comprise entre l’axe vertical central z = 0 et l’abscisse positive z. En vertu de cette addition spatiale, le résultat final d’une telle recherche doit impérativement excéder 0,5000.
Le protocole opératoire pour déterminer cette probabilité s’articule comme suit :
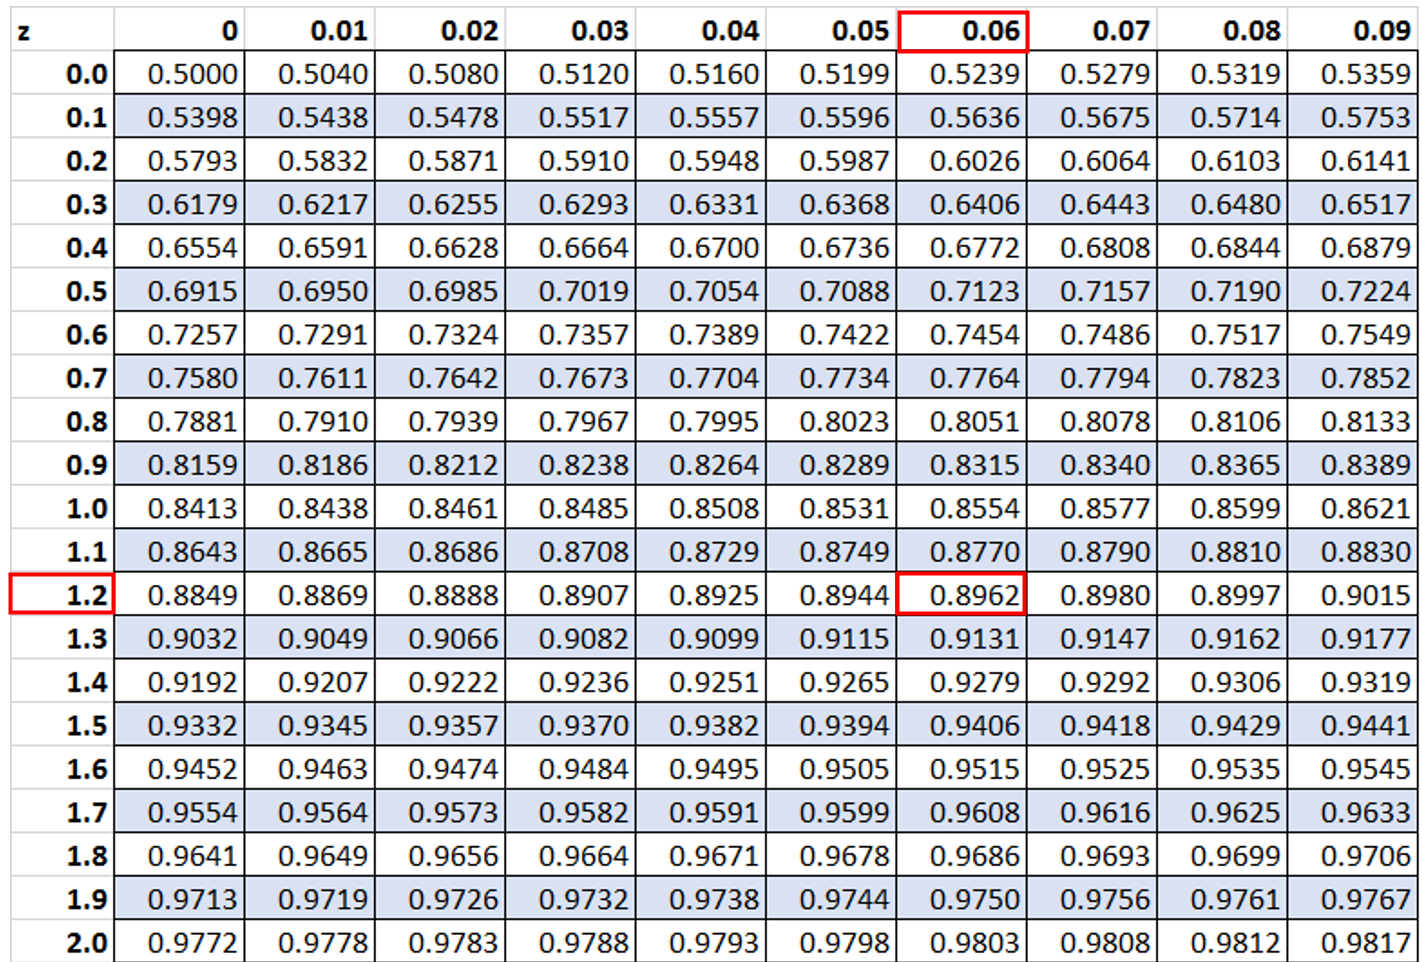
- Décomposer le score z considéré en extrayant la partie entière et le dixième d’un côté, et le centième de l’autre. Prenons l’exemple concret d’un score standardisé z = +1,26.
- Repérer dans la colonne de gauche de la table cumulative la ligne correspondant à la fraction 1,2.
- Faire glisser son regard horizontalement vers la droite jusqu’à croiser la colonne affichant l’en-tête 0,06.
- Lire la valeur inscrite à l’intersection : le tableau indique précisément 0,8962.
Sur le versant de l’interprétation psychologique ou clinique, cette donnée brute prend immédiatement un sens opérationnel : l’aire sous la courbe égale à 0,8962 signifie que 89,62 % de la population théorique de référence obtient un résultat inférieur ou égal à ce niveau de performance. Si cette métrique évalue par exemple une compétence de raisonnement verbal, l’individu testé surpasse près de neuf dixièmes de ses pairs, se situant de ce fait au 90e rang centile après arrondissement usuel.
4.2 Protocole pour un score z négatif
La recherche de l’aire cumulée s’étendant à gauche d’un score z négatif traduit la quantification de la pointe de la queue inférieure de distribution. La formalisation mathématique demeure :
P(Z < z) = Φ(z), avec z < 0
Puisque le score se positionne à gauche de l’axe de symétrie z = 0, la surface résultante doit obligatoirement être confinée dans un intervalle strict de probabilité compris entre 0,0000 et 0,5000. Deux cheminements procéduraux permettent d’aboutir à cette valeur, en fonction des tables dont dispose l’analyste.
Méthode 1 : Utilisation directe d’une table intégrant les scores négatifs. Si le support documentaire inclut une section consacrée aux valeurs négatives de z, la lecture s’effectue sans aucune manipulation arithmétique. Considérons la recherche de l’aire à gauche de z = -0,85 :
- Descendre le long de la colonne verticale jusqu’à la rangée étiquetée -0,8.
- Progresser vers la droite jusqu’à la colonne 0,05.
- Lire directement l’aire cumulée à l’intersection : Φ(-0,85) = 0,1977.
Méthode 2 : Recours à une table restreinte aux scores positifs via la règle de symétrie. Si la table ne répertorie que les grandeurs positives, le chercheur applique l’égalité Φ(-z) = 1 – Φ(|z|) :
- Isoler la valeur absolue du score : |-0,85| = +0,85.
- Lire l’aire associée à ce score positif dans la table : Φ(0,85) = 0,8023.
- Calculer le complément arithmétique à l’unité : 1 – 0,8023 = 0,1977.
Les deux protocoles mènent à un résultat identique : une aire de 0,1977 (ou 19,77 %). Le tracé visuel mental ou schématique d’une cloche dont la pointe gauche est noircie confirme la conformité spatiale de ce chiffre, qui demeure bien inférieur à la moitié de la surface totale de la courbe.
4.3 Sens clinique et diagnostic de l’aire cumulée inférieure
En psychométrie appliquée et en neuropsychologie clinique, la détermination de l’aire cumulée inférieure constitue l’outil diagnostique cardinal pour objectiver les déficits cognitifs, les retards développementaux ou les pertes fonctionnelles post-lésionnelles. Le calcul direct de P(Z < z) fournit l’équivalent direct du rang centile, paramètre normatif standard préconisé par les manuels de diagnostic internationaux tels que le DSM-5 (Manuel diagnostique et statistique des troubles mentaux).
Dans la pratique neuropsychologique standard, plusieurs seuils conventionnels s’articulent autour de l’aire inférieure :
- Le seuil d’alerte clinique (z ≤ -1,645) : Il correspond à une aire cumulative inférieure ≤ 0,0500 (le 5e centile). Une telle performance signale qu’au maximum 5 % des individus sains atteignent un niveau aussi bas, incitant le praticien à suspecter une fragilité neuropsychologique débutante.
- Le seuil du déficit avéré (z ≤ -2,00) : Il correspond à une aire cumulée de Φ(-2,00) = 0,0228 (approximativement le 2e centile). Ce critère quantitatif strict, caractérisant une observation située à deux écarts-types en deçà de la norme, est requis par la plupart des classifications médico-légales pour attester d’un handicap intellectuel ou d’un déclin cognitif majeur.
- Le seuil de sévérité critique (z ≤ -3,00) : L’aire cumulée résiduelle plonge sous 0,00135 (0,13e centile). Ce niveau d’effondrement atteste d’une atteinte cognitive massive, exceptionnellement observée au sein de la population générale saine.
L’utilisation rigoureuse de l’aire à gauche prémunit ainsi les équipes cliniques contre le risque d’erreur diagnostique en objectivant précisément la rareté statistique du comportement ou du déficit observé.
5. Cas n°2 : Calculer l’aire située à droite d’un score z donné
5.1 Application de la règle du complémentaire
Le calcul de la probabilité qu’une variable normale standardisée prenne une valeur supérieure à une coordonnée cible z, noté formellement P(Z > z), correspond géométriquement à la détermination de la surface comprise dans la queue de distribution droite, délimitée à gauche par l’abscisse z et s’étendant à droite vers +∞. La quasi-totalité des tables de référence étant construites sur le modèle cumulatif de gauche à droite (qui compile l’aire inférieure Φ(z)), ce calcul requiert l’application systématique de la règle de l’événement complémentaire.
En vertu de l’axiome fondamental selon lequel la probabilité de l’espace échantillonnal complet est rigoureusement égale à 1, la somme de l’aire située à gauche d’une valeur z et de l’aire située à sa droite forme obligatoirement l’unité totale :
P(Z ≤ z) + P(Z > z) = 1
Par transposition algébrique immédiate, on en déduit la règle maîtresse pour toute recherche d’aire supérieure :
P(Z > z) = 1 – P(Z ≤ z) = 1 – Φ(z)
L’erreur la plus répandue chez les étudiants et les analystes novices réside dans l’omission pure et simple de cette soustraction finale par 1. Oublier de retrancher la valeur extraite de la table conduit à attribuer à une queue de distribution supérieure étriquée la surface massive qui lui fait face à gauche, faussant l’évaluation statistique de manière critique.
5.2 Exemple guidé avec score z négatif
Supposons que nous souhaitions déterminer l’aire située à droite d’une cote standardisée négative, fixée à z = -1,81. Cette situation correspond formellement à l’expression probabiliste P(Z > -1,81). Sur le plan géométrique, l’abscisse z = -1,81 se situe nettement dans la portion gauche de la distribution. Par conséquent, l’aire s’étalant sur sa droite couvre l’intégralité de la moitié droite de la courbe (0,5000) ainsi qu’une portion majeure de la moitié gauche comprise entre -1,81 et 0. Le résultat attendu doit donc être très largement supérieur à 0,5000.
Deux méthodologies calculatoires permettent d’aboutir à la solution exacte :
Approche par le complément direct :
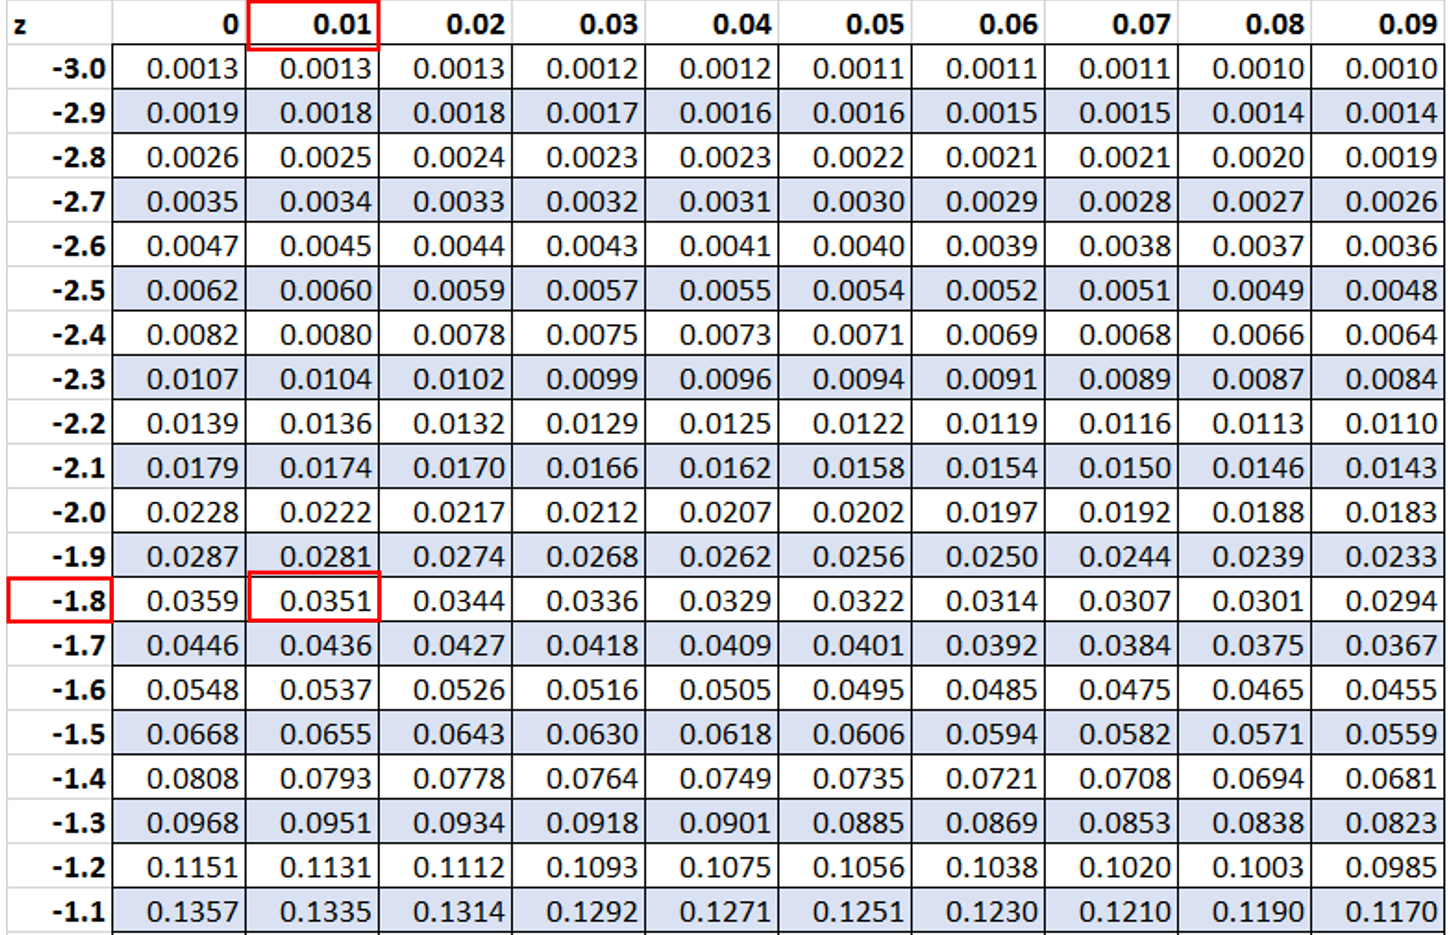
- Consulter la table cumulative pour identifier l’aire résiduelle inférieure associée à ce score négatif : à la ligne -1,8 et à la colonne 0,01, on extrait la valeur Φ(-1,81) = 0,0351.
- Appliquer la formule de complémentarité :
P(Z > -1,81) = 1 – Φ(-1,81) = 1,0000 – 0,0351 = 0,9649
Approche par symétrie axiale :
Parfaite illustration de l’élégance géométrique de la loi normale, l’aire située à droite du point z = -1,81 est rigoureusement identique, par retournement spéculaire le long de l’axe central, à l’aire située à gauche du point positif opposé z = +1,81. Ainsi, l’égalité suivante est vérifiée :
P(Z > -1,81) = P(Z < +1,81)
En cherchant directement la coordonnée z = +1,81 au sein de la table standardisée (ligne 1,8, colonne 0,01), on relève sans calcul intermédiaire la valeur 0,9649. Cette concordance parfaite valide la robustesse de l’analyse : 96,49 % de la distribution normale standard se déploie effectivement à droite du score z = -1,81.
5.3 Exemple guidé avec score z positif
Considérons à présent la détermination de l’aire s’étendant à droite d’un score z positif élevé, typiquement z = 2,15. Nous cherchons à quantifier l’expression P(Z > 2,15). La coupure s’opérant loin vers la droite, nous isolons une frange marginale de la queue supérieure. Le résultat doit donc être considérablement inférieur à 0,5000.
L’exécution de la procédure s’articule pas à pas selon les étapes suivantes :
- Localiser le score z = 2,15 dans la table cumulative standard : chercher l’intersection de la ligne 2,1 et de la colonne 0,05.
- Extraire la probabilité cumulée à gauche de cette coordonnée : Φ(2,15) = 0,9842.
- Soustraire cette valeur scalaire de l’unité intégrale afin d’extraire la portion droite :
P(Z > 2,15) = 1 – Φ(2,15) = 1,0000 – 0,9842 = 0,0158
Dans un contexte d’analyse psychologique ou de sélection organisationnelle, ce résultat revêt une portée concrète immédiate : seule une proportion infime de 1,58 % de la population générale est capable de produire une performance excédant un score standardisé de 2,15. Ce type de calcul intervient par exemple lorsqu’une institution académique prestigieuse ou une entreprise restreint son admission aux candidats surpassant ce seuil de sélection drastique.
6. Cas n°3 : Calculer l’aire comprise entre deux valeurs de score z
6.1 Méthode de soustraction des probabilités cumulées
L’estimation de l’aire sous la courbe normale confinée entre deux bornes finies z1 et z2 (conventionnellement ordonnées de telle sorte que z1 < z2) constitue l’une des requêtes statistiques les plus fréquentes dans la pratique de la recherche. Cette opération s’énonce mathématiquement sous la forme de l’intégrale définie suivante :
P(z1 ≤ Z ≤ z2) = ∫z1z2 φ(z) dz
En exploitant le théorème fondamental du calcul différentiel et intégral et les propriétés additives des intégrales de Riemann (relation de Chasles), cette intégrale définie se réécrit comme la différence exacte entre deux intégrales impropres partant de l’infini négatif :
P(z1 ≤ Z ≤ z2) = ∫-∞z2 φ(z) dz – ∫-∞z1 φ(z) dz
Sur le plan opérationnel, cette relation d’équivalence conduit à la formule maîtresse de la soustraction des probabilités cumulées :
P(z1 ≤ Z ≤ z2) = Φ(z2) – Φ(z1)
La représentation géométrique de ce théorème est limpide : pour déterminer la surface du segment intermédiaire, il suffit de prendre l’aire cumulée totale s’étendant depuis l’extrême gauche jusqu’à la borne la plus élevée z2, puis d’en retrancher chirurgicalement l’aire cumulée superflue qui s’étend depuis l’extrême gauche jusqu’à la borne inférieure z1. L’ordre de soustraction doit impérativement être respecté (la valeur la plus grande moins la valeur la plus petite) ; toute inversion aboutirait à une aire négative, ce qui constituerait une aberration mathématique dans un espace probabilisé normalisé.
6.2 Cas d’un intervalle chevauchant la moyenne (bornes de signes opposés)
Une configuration très fréquente en psychométrie correspond à un intervalle centré de part et d’autre de la moyenne, où la borne inférieure z1 est négative et la borne supérieure z2 est positive. Cette typologie encadre des populations présentant un fonctionnement intermédiaire régulier.
Soit l’exercice concret consistant à déterminer la proportion théorique d’individus dont le score standardisé est compris entre z1 = -0,75 et z2 = +1,40, ce qui s’écrit P(-0,75 ≤ Z ≤ 1,40). Le déploiement du protocole analytique s’effectue comme suit :
- Rechercher dans la table cumulative la probabilité cumulée associée à la borne supérieure z2 = 1,40. À la ligne 1,4 et à la colonne 0,00, on recueille :
Φ(1,40) = 0,9192
- Rechercher la probabilité cumulée associée à la borne inférieure z1 = -0,75. Dans une table négative (ligne -0,7, colonne 0,05) ou en calculant 1 – Φ(0,75) = 1 – 0,7734, on extrait :
Φ(-0,75) = 0,2266
- Opérer la soustraction différentielle entre les deux valeurs obtenues :
P(-0,75 ≤ Z ≤ 1,40) = Φ(1,40) – Φ(-0,75) = 0,9192 – 0,2266 = 0,6926
Le segment étudié englobe donc exactement 69,26 % de l’aire sous-jacente. Ce résultat s’avère parfaitement cohérent avec les repères théoriques connus : l’intervalle canonique [-1; +1] englobant environ 68,27 % des données, un intervalle asymétrique s’étendant de -0,75 à +1,40 (d’une largeur totale de 2,15 écarts-types) doit logiquement incorporer une proportion avoisinant les 69 à 70 %.
6.3 Cas d’un intervalle situé entièrement du même côté de la moyenne
Une complexité apparente survient lorsque l’intervalle d’intérêt se cantonne exclusivement d’un seul côté du centre de gravité de la distribution, n’incorporant pas la moyenne arithmétique z = 0. Deux variantes géométriques se présentent : l’intervalle strictement positif et l’intervalle strictement négatif.
Exemple d’un intervalle strictement positif : Déterminer l’aire comprise entre z1 = +0,50 et z2 = +1,80 :
- Extraction de l’aire supérieure : Φ(1,80) = 0,9641
- Extraction de l’aire inférieure : Φ(0,50) = 0,6915
- Calcul différentiel :
P(0,50 ≤ Z ≤ 1,80) = 0,9641 – 0,6915 = 0,2726 (soit 27,26 %)
Exemple d’un intervalle strictement négatif : Déterminer l’aire comprise entre z1 = -2,20 et z2 = -0,40 :
- Extraction de l’aire associée à la borne la plus élevée algébriquement (la plus proche de zéro) : Φ(-0,40) = 0,3446
- Extraction de l’aire associée à la borne la plus basse (la plus éloignée vers la gauche) : Φ(-2,20) = 0,0139
- Calcul différentiel :
P(-2,20 ≤ Z ≤ -0,40) = 0,3446 – 0,0139 = 0,3307 (soit 33,07 %)
L’analyse comparative de ces intervalles met en lumière un principe géométrique fondamental de la distribution normale : la non-linéarité de l’aire par rapport à l’amplitude du score z. Deux intervalles possédant exactement la même largeur métrique Δz n’abritent pas la même aire de probabilité. Plus l’intervalle se rapproche du centre modal z = 0, plus la densité de probabilité φ(z) est massive et plus l’aire comprise est volumineuse. À l’inverse, à mesure qu’un intervalle de même largeur s’aventure dans les queues de distribution, l’aire sous-tendue s’amenuise drastiquement en raison de la décroissance exponentielle de la fonction gaussienne.
7. Cas n°4 : Calculer l’aire située à l’extérieur de deux valeurs de score z
7.1 Définition de l’aire des queues bilatérales
Le quatrième scénario géométrique implique l’évaluation des surfaces disjointes situées aux extrémités périphériques de la distribution, au-delà de deux bornes conventionnelles z1 et z2 (avec z1 < z2). Ce cas survient lorsqu’un chercheur s’intéresse aux comportements atypiques ou aux scores atypiques dans les deux directions simultanément (par exemple, les individus extrêmement performants ou extrêmement défaillants). L’événement considéré s’exprime par la disjonction probabiliste :
P(Z < z1 ou Z > z2)
Puisque les deux événements « se situer sous z1 » et « se situer au-dessus de z2 » sont strictement mutuellement exclusifs (leur intersection est vide), le troisième axiome de Kolmogorov stipule que la probabilité de leur union équivaut à la somme arithmétique directe de leurs probabilités respectives :
P(Z < z1 ou Z > z2) = P(Z < z1) + P(Z > z2)
En appliquant les formules d’aires cumulées développées précédemment, cette relation se formalise par :
Aire extérieure = Φ(z1) + [1 – Φ(z2)]
Une voie alternative tout aussi valide repose sur la méthode du complémentaire appliquée à l’intervalle central. L’ensemble des valeurs extérieures constituant le complément direct de l’intervalle interne compris entre les deux seuils, il suffit de calculer d’abord l’aire centrale puis de la retrancher de l’unité globale :
Aire extérieure = 1 – P(z1 ≤ Z ≤ z2) = 1 – [Φ(z2) – Φ(z1)]
Les deux protocoles sont rigoureusement commutatifs et aboutissent à une précision numérique identique.
7.2 Cas particulier symétrique : les zones de rejet bilatérales
Dans la conduite des tests d’hypothèses statistiques classiques (notamment le test Z bilatéral pour la comparaison de moyennes d’échantillons), les bornes critiques sont délimitées de façon strictement symétrique autour de l’origine : z1 = –z et z2 = +z. La question posée se reformule alors : quelle est la probabilité d’observer une déviation absolue au moins aussi extrême que |z|, c’est-à-dire P(|Z| ≥ z) ?
En vertu de la parité de la courbe, l’aire confinée dans la queue gauche sous –z équivaut rigoureusement à l’aire logée dans la queue droite au-delà de +z. Par conséquent, le calcul s’allège en une multiplication élémentaire par deux d’une seule queue unilatérale :
P(|Z| ≥ z) = 2 × Φ(-z) = 2 × [1 – Φ(z)]
Cette configuration symétrique sous-tend les seuils décisionnels canoniques qui structurent la publication scientifique internationale :
- Le seuil bilatéral classique à α = 0,05 (5 %) : Lorsque les bornes sont fixées à z = ±1,96, l’aire cumulée inférieure Φ(-1,96) s’établit à 0,0250 (2,5 %). La queue droite supérieure 1 – Φ(1,96) s’élève de manière équivalente à 0,0250 (2,5 %). L’aire bilatérale extérieure cumulée totalise rigoureusement 2 × 0,0250 = 0,0500, soit 5,00 % des observations théoriques.
- Le seuil bilatéral strict à α = 0,01 (1 %) : Pour des bornes positionnées à z = ±2,576 (souvent arrondi à ±2,58), l’aire résiduelle dans chaque queue unilatérale s’établit à approximativement 0,0050 (0,5 %). L’aire extérieure conjointe représente exactement 1,00 % de la distribution globale, isolant les fluctuations d’échantillonnage hautement improbables.
7.3 Cas asymétrique d’aires extérieures disjointes
Bien que moins fréquente dans le cadre strict des tests d’hypothèses académiques, la recherche d’aires extérieures asymétriques constitue une nécessité fonctionnelle en évaluation psychologique spécialisée, par exemple lorsqu’une batterie clinique applique des critères d’inclusion et d’exclusion asymétriques. Imaginons que l’on recherche l’aire conjointe située à l’extérieur des bornes hétérogènes z1 = -1,20 et z2 = +2,05.
L’exécution de la procédure s’effectue méthodiquement par étapes séquentielles :
- Évaluer la probabilité unilatérale associée à la queue gauche :
P(Z < -1,20) = Φ(-1,20) = 0,1151
- Évaluer la probabilité unilatérale associée à la queue droite :
P(Z > 2,05) = 1 – Φ(2,05) = 1,0000 – 0,9798 = 0,0202
- Effectuer la sommation directe des deux aires disjointes :
Aire extérieure = 0,1151 + 0,0202 = 0,1353
La probabilité qu’un sujet aléatoire présente une performance tombant dans l’une ou l’autre de ces zones périphériques s’élève donc à 0,1353, soit 13,53 % de l’ensemble de la cohorte théorique. La démarche par le complément interne valide ce chiffre : l’aire centrale valant 0,9798 – 0,1151 = 0,8647, l’aire externe s’établit bien à 1 – 0,8647 = 0,1353.
8. Le problème inverse : Trouver le score z correspondant à une aire donnée
8.1 Démarche algorithmique de la recherche inverse
Jusqu’à présent, la logique méthodologique adoptée consistait à cheminer depuis une abscisse connue (le score z) vers une surface inconnue (la probabilité ou l’aire cumulée). Or, la pratique psychométrique et statistique quotidienne impose fréquemment de parcourir cette trajectoire en sens rigoureusement inverse. Ce problème, universellement qualifié de « recherche inverse de la cote standardisée » ou d’évaluation de la fonction quantile normale Φ-1(p), consiste à déterminer la coordonnée z exacte qui partitionne la courbe selon un ratio d’aire prédéterminé.
L’architecture algorithmique de la résolution inverse se déroule selon une séquence opérationnelle invariante :
- Conversion systématique en aire cumulée à gauche : Quelle que soit la question clinique formulée (qu’elle porte sur un pourcentage supérieur, une aire centrale ou un centile), la première manœuvre impérative consiste à convertir la consigne textuelle en une probabilité cumulée unilatérale inférieure équivalente, p = P(Z ≤ z).
- Balayage du corps interne de la table z : Contrairement à la méthode directe où l’on entre par les marges extérieures (lignes et colonnes), la lecture inverse impose de scruter les cellules internes de la table pour y localiser le nombre décimal à quatre ou cinq chiffres le plus proche possible de la probabilité cible p.
- Projection orthogonale vers les marges périphériques : Une fois la cellule identifiée au cœur du tableau, l’analyste projette son regard horizontalement vers la gauche pour lire la ligne (fournissant la partie entière et le dixième du score z), puis verticalement vers le haut pour extraire la colonne (fournissant le centième).
Cette approche requiert une grande vigilance perceptuelle, les chiffres du corps de table se succédant de manière compacte avec des incréments millésimaux.
8.2 Déterminer un score z pour un centile spécifique
L’étalonnage des épreuves psychologiques standardisées repose entièrement sur la conversion d’aires en scores z pour isoler des rangs centiles ou des quartiles de référence normatifs.
Exemple 1 : Identification du 90e centile. Trouver le score z délimitant les 90 % inférieurs de la population d’étalonnage.
L’aire cumulée à gauche recherchée est p = 0,9000.
En explorant le corps de la table normale standard, on observe les valeurs encadrantes :
Φ(1,28) = 0,8997 et Φ(1,29) = 0,9015.
La valeur 0,8997 se situant à seulement 0,0003 de la cible (contre 0,0015 pour 0,9015), on retient la coordonnée z ≈ +1,28. Un individu au 90e centile présente donc une performance standardisée d’environ +1,28 écart-type.
Exemple 2 : Détermination du premier quartile (Q1 / 25e centile). Trouver le seuil délimitant le quart inférieur de la cohorte.
L’aire cumulative inférieure ciblée est p = 0,2500.
Ce score étant inférieur à la moyenne de 0,5000, le score z associé sera obligatoirement négatif.
Dans une table cumulative complète, on localise les valeurs :
Φ(-0,67) = 0,2514 et Φ(-0,68) = 0,2483.
Une interpolation linéaire fine situe le premier quartile à z ≈ -0,674. Ainsi, le quart le moins performant de la cohorte obtient un score inférieur à -0,67 écart-type.
Exemple 3 : Isolement du centile d’excellence (Top 5 %). Identifier le score seuil requis pour appartenir aux 5 % les plus performants.
Appartenir aux 5 % supérieurs signifie laisser 95 % de la population en deçà. L’aire cumulative à gauche s’établit donc à p = 0,9500.
Comme explicité lors de l’analyse des interpolations, la valeur exacte se loge à mi-chemin absolu entre 1,64 (0,9495) et 1,65 (0,9505). On retient conventionnellement le score z = +1,645.
8.3 Déterminer les bornes symétriques d’un intervalle central
Une modalité fondamentale du problème inverse réside dans la détermination des frontières symétriques [-z, +z] encapsulant un pourcentage central prédéfini C de la population théorique. Ce schéma géométrique prévaut dans la construction intégrale des intervalles de confiance.
Le traitement analytique exige de convertir le pourcentage central en aires de queue périphériques selon la séquence logique suivante :
- Si la région centrale absorbe une proportion C de la masse de probabilité totale, la surface résiduelle dévolue aux deux queues cumulées s’élève à 1 – C.
- La courbe de Gauss étant rigoureusement symétrique, cette aire résiduelle se ventile de manière équitable entre les deux extrémités. L’aire dévolue à la seule queue gauche inférieure s’établit à :
Aire queue gauche = (1 – C) / 2
- La borne inférieure –z s’obtient directement en recherchant le score associé à cette probabilité cumulée unilatérale dans la table. La borne supérieure s’en déduit par simple changement de signe : +z = |-z|.
Illustrons cette méthodologie pour les trois configurations centrales majeures :
- Intervalle central à 80 % (C = 0,80) : L’aire résiduelle globale est de 1 – 0,80 = 0,20. Chaque queue unilatérale reçoit une aire de 0,20 / 2 = 0,1000. Au sein de la table, l’aire 0,1000 correspond au score z ≈ -1,28. L’intervalle central de 80 % est donc strictement circonscrit par les bornes [-1,28; +1,28].
- Intervalle central à 90 % (C = 0,90) : Chaque queue périphérique absorbe (1 – 0,90) / 2 = 0,0500. L’aire cumulée inférieure 0,0500 désigne sans ambiguïté le score z = -1,645. L’intervalle de 90 % est délimité par les frontières [-1,645; +1,645].
- Intervalle central à 99 % (C = 0,99) : Les queues résiduelles contiennent chacune (1 – 0,99) / 2 = 0,0050. Dans la table, la valeur cumulée la plus approchée de 0,0050 s’observe pour z ≈ -2,576. L’intervalle central de 99 % est donc borné par [-2,576; +2,576].
9. Applications pratiques en psychométrie et sciences du comportement
9.1 Conversion des scores bruts en aires de population
La puissance opérationnelle de la distribution normale standard se révèle pleinement lors de son application à des instruments cliniques concrets. Considérons l’administration de l’Inventaire de Dépression de Beck (BDI-II) au sein d’une cohorte de recherche en psychopathologie. Supposons qu’au terme d’une étude d’étalonnage sur un large échantillon normatif non clinique, la distribution des scores bruts suive de façon satisfaisante une loi normale caractérisée par une moyenne μ = 12,5 points et un écart-type σ = 6,2 points.
Un patient reçu en consultation d’évaluation obtient un score brut de 26 points. Le praticien cherche à déterminer la prévalence théorique d’un tel niveau de détresse psychologique dans la population générale, c’est-à-dire la proportion de sujets présentant un score égal ou supérieur à 26.
Le cheminement quantitatif se structure rigoureusement en deux phases successives :
- Standardisation du score brut en cote z :
z = (x – μ) / σ = (26 – 12,5) / 6,2 = 13,5 / 6,2 ≈ +2,18
Le score brut du patient se positionne ainsi à 2,18 écarts-types au-dessus de la moyenne de référence.
- Extraction de l’aire supérieure sous la courbe normale :
La prévalence recherchée équivaut à P(Z ≥ 2,18).
Dans la table cumulative, l’aire à gauche de z = 2,18 s’établit à Φ(2,18) = 0,9854.
L’application de la règle du complémentaire fournit l’aire supérieure :P(Z ≥ 2,18) = 1,0000 – 0,9854 = 0,0146
L’analyse met en lumière qu’à peine 1,46 % de la population générale saine présente une symptomatologie dépressive d’une intensité comparable ou supérieure à celle rapportée par ce patient. Cette rareté statistique fournit au clinicien un indice diagnostique majeur en faveur d’un épisode dépressif caractérisé sévère.
9.2 Normalisation et standardisation de tests psychologiques
Les concepteurs d’épreuves psychométriques recourent massivement à l’aire sous la courbe normale pour construire des échelles dérivées facilitant la communication des résultats entre professionnels et usagers. La plupart des distributions brutes observées sur le terrain présentant de légères asymétries naturelles, la méthode de « normalisation par les rangs centiles » (procédure de McCall) permet de régulariser la métrique en projetant les aires empiriques directement sur la courbe gaussienne théorique.
Cette démarche de calibrage sous-tend la création de multiples métriques standardisées classiques :
- Les notes T (T-scores) : Fréquemment utilisées dans les inventaires psychopathologiques (MMPI) et neuropsychologiques, les notes T fixent une moyenne arbitraire de 50 et un écart-type de 10 via l’équation T = 50 + 10z. Une note T de 70 correspond rigoureusement à z = +2,00, délimitant les 2,28 % supérieurs des profils les plus altérés.
- L’échelle des stens (Standard Tens) : Répandue dans les inventaires de personnalité appliqués aux ressources humaines (ex. 16PF de Cattell), cette échelle segmente la courbe en 10 intervalles ordonnés. Sa moyenne est fixée à 5,5 et son écart-type à 2,0. Les stens extrêmes (1 et 10) capturent précisément les aires de queue situées au-delà de ±2 écarts-types.
- L’échelle des stanines (Standard Nines) : Utilisée dans le milieu éducatif et militaire anglo-saxon, cette échelle subdivise la distribution normale standard en neuf bandes de largeur égale à 0,5 écart-type, la stanine centrale (5) absorbant les 20 % du centre de la distribution.
Le tableau ci-dessous illustre la correspondance parfaite entre ces différentes échelles psychométriques et les aires sous la courbe normale standard :
| Score Z | Rang Centile (Aire à gauche) | Quotient Intellectuel (μ=100, σ=15) | Note T (μ=50, σ=10) | Sten (μ=5,5, σ=2) |
|---|---|---|---|---|
| -3,00 | 0,13 % | 55 | 20 | 1 |
| -2,00 | 2,28 % | 70 | 30 | 1-2 |
| -1,00 | 15,87 % | 85 | 40 | 3-4 |
| 0,00 | 50,00 % | 100 | 50 | 5-6 |
| +1,00 | 84,13 % | 115 | 60 | 7-8 |
| +2,00 | 97,72 % | 130 | 70 | 9-10 |
| +3,00 | 99,87 % | 145 | 80 | 10 |
9.3 Liaison avec l’inférence statistique et les tests d’hypothèses
L’assimilation du calcul d’aire sous la courbe normale conditionne la compréhension des démarches d’inférence statistique, en particulier la notion omniprésente de p-valeur (degré de signification statistique). Lorsqu’un expérimentateur cherche à démontrer l’efficacité d’une nouvelle thérapie cognitive sur la réduction de l’anxiété, il formule une hypothèse nulle (H0) stipulant l’absence totale d’effet thérapeutique au sein de la population parente.
Sous la validité de l’hypothèse nulle, la statistique d’épreuve standardisée (notée Zobs) issue de l’échantillon expérimental suit théoriquement une distribution normale standard N(0, 1). La p-valeur représente alors très exactement l’aire sous la courbe normale située au-delà de la valeur observée Zobs. Cette démarche se décline selon la nature unilatérale ou bilatérale du protocole expérimental :
- Dans un test unilatéral directionnel : Si l’expérimentateur a postulé a priori un gain de performance (valeur positive) et obtient une statistique Zobs = 1,75, la p-valeur correspond strictement à l’aire de queue supérieure :
p = P(Z ≥ 1,75) = 1 – Φ(1,75) = 1 – 0,9599 = 0,0401
La valeur calculée étant inférieure au seuil alpha conventionnel (α = 0,05), l’hypothèse nulle est rejetée au profit de l’efficacité du traitement.
- Dans un test bilatéral non directionnel : Si l’expérimentateur n’a pas préjugé du sens de l’effet et recueille ce même score Zobs = 1,75, la règle décisionnelle impose de considérer l’aire bilatérale extérieure :
p = 2 × P(Z ≥ 1,75) = 2 × 0,0401 = 0,0802
Dans cette configuration bilatérale, la p-valeur excède le seuil de 0,05. L’expérimentateur est contraint de conclure au non-rejet de l’hypothèse nulle, illustrant la dépendance directe entre géométrie des aires sous-tendues et prise de décision statistique.
10. Résolution numérique : Outils logiciels et calculatrices modernes
10.1 Calcul de l’aire sous la courbe avec R et Python
À l’ère du traitement massif de données quantitatives (Big Data), les praticiens délaissent fréquemment les tables imprimées au profit de langages de programmation statistique open-source tels que R ou Python. Ces environnements intègrent des algorithmes d’approximation polynomiale de haute précision permettant d’obtenir l’aire sous la courbe normale standard avec une exactitude supérieure à dix décimales.
Dans l’environnement de programmation statistique R, le noyau natif propose une syntaxe intuitive reposant sur deux fonctions maîtresses fondamentales :
pnorm(q, mean = 0, sd = 1, lower.tail = TRUE): Cette fonction calcule la probabilité cumulée à gauche (l’aire de -∞ àq). L’argument optionnellower.tail = FALSEbascule instantanément l’algorithme vers l’aire de la queue supérieure à droite, évitant les erreurs manuelles d’arrondi lors des soustractions à l’unité.
Exemple pratique : Pour trouver l’aire à droite de z = 1,96, l’instructionpnorm(1.96, lower.tail = FALSE)retourne exactement0.0249979.qnorm(p, mean = 0, sd = 1): Cette fonction effectue la recherche inverse (la fonction quantile). Elle convertit n’importe quelle aire cumuléepen son score z équivalent.
Exemple pratique : L’exécution deqnorm(0.975)renvoie immédiatement le seuil critique1.959964.
Dans l’écosystème Python, les opérations statistiques sont prises en charge par la bibliothèque scientifique SciPy, et plus particulièrement son sous-module scipy.stats via la classe norm :
scipy.stats.norm.cdf(x): La fonction de répartition cumulative (Cumulative Distribution Function) équivaut rigoureusement à Φ(z).scipy.stats.norm.sf(x): La fonction de survie (Survival Function) calcule directement le complément à droite 1 – Φ(z).scipy.stats.norm.ppf(q): La fonction de point de pourcentage (Percent Point Function) implémente la recherche inverse quantile pour une aire cumulée donnée.
L’utilisation de ces scripts standardisés garantit une reproductibilité analytique absolue lors du traitement de volumineuses cohortes psychométriques.
10.2 Utilisation d’un tableur (Excel, Google Sheets) et de calculatrices graphiques
Pour des analyses rapides en milieu clinique ou pédagogique, les tableurs universels (tels que Microsoft Excel ou Google Sheets) mettent à la disposition des praticiens des fonctions statistiques prêtes à l’emploi. La compréhension de leur syntaxe permet de s’affranchir de toute manipulation manuelle de tables papier.
Les formules canoniques sous Excel et Google Sheets s’énoncent comme suit :
=LOI.NORMALE.STANDARD.N(z; VRAI): En passant le paramètre logiqueVRAI, la fonction retourne l’aire cumulée unilatérale inférieure depuis l’infini négatif jusqu’à la cotezspécifiée. Pour obtenir l’aire à droite d’un seuilz, il suffit d’écrire la cellule :=1 - LOI.NORMALE.STANDARD.N(z; VRAI).=LOI.NORMALE.STANDARD.INVERSE.N(probabilite): Cette fonction exécute la recherche inverse en convertissant une probabilité cumulée comprise entre 0 et 1 en son abscisse z correspondante.
Sur les calculatrices graphiques de référence (notamment la gamme Texas Instruments TI-83 / TI-84), les requêtes transitent par le menu DISTR (Distributions) :
normalcdf(borne_inf, borne_sup, μ, σ): Calcule l’intégrale définie exacte entre deux bornes. Pour déterminer l’aire cumulée à gauche d’un score z = 1,25, l’utilisateur renseigne une borne inférieure extrêmement éloignée simulant l’infini négatif :normalcdf(-1E99, 1.25, 0, 1), ce qui fournit instantanément0.89435. Symétriquement, l’aire supérieure au-delà de z = 2,00 s’obtient vianormalcdf(2.00, 1E99, 0, 1).invNorm(aire, μ, σ): Effectue le calcul quantile inverse. SaisirinvNorm(0.95, 0, 1)affiche sans délai la valeur1.64485.
10.3 Logiciels spécialisés en psychologie (SPSS, JASP)
Dans les laboratoires universitaires de psychologie cognitive et sociale, les logiciels intégrés comme IBM SPSS Statistics ou le logiciel open-source JASP automatisent intégralement l’analyse de normalité et la génération de scores normés. Ces outils évitent au chercheur de manipuler individuellement chaque observation tout en assurant une conformité rigoureuse aux standards de l’évaluation quantitative.
Sous SPSS, la transformation d’une variable brute en scores standardisés s’exécute en une commande élémentaire : Analyse > Statistiques descriptives > Descriptives, en cochant l’option systématique « Enregistrer les valeurs standardisées dans des variables ». Le logiciel crée instantanément dans la matrice de données une nouvelle colonne préfixée de la lettre Z, contenant les cotes réduites exactes de chaque sujet.
Pour calculer les aires sous la courbe correspondantes dans SPSS, le chercheur mobilise le module de calcul de variables (Transformer > Calculer la variable) en exploitant la fonction de distribution cumulative intégrée :
COMPUTE Aire_Gauche = CDF.NORMAL(Z_Score, 0, 1).
Cette commande génère automatiquement le rang centile théorique de chaque participant. Parallèlement, ces logiciels permettent de s’assurer de la validité de l’hypothèse de normalité empirique sous-jacente par l’affichage d’histogrammes ajustés d’une courbe de Gauss idéale et par l’exécution de tests d’adéquation distributionnelle (tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov avec correction de Lilliefors). Si ces tests révèlent une violation statistiquement significative de la normalité, l’inférence des aires gaussiennes théoriques perd de sa validité méthodologique.
11. Erreurs fréquentes et pièges d’interprétation des aires sous la courbe
11.1 Confusions conceptuelles courantes
La transmission didactique de la statistique en sciences humaines met en lumière des récurrences d’erreurs systématiques chez les apprenants et praticiens. La confusion la plus dommageable réside dans l’assimilation conceptuelle fautive entre l’abscisse (le score standardisé z) et l’ordonnée ou la surface (l’aire de probabilité). Un score z est une coordonnée spatiale d’écartement relatif pouvant osciller sur l’ensemble de la droite réelle, de -∞ à +∞. En revanche, une aire est une mesure d’espace probabilisé strictement bornée dans l’intervalle fermé [0, 1]. Confondre ces deux entités conduit à des formulations dénuées de sens, telles que l’attribution d’une « probabilité de 1,96 » ou d’une « cote z de 0,05 ».
Une autre méprise fréquente consiste à postuler qu’un score z négatif doit engendrer une « aire négative ». En mathématiques probabilistes, une aire sous une fonction de densité représente une probabilité continue ; elle est par essence rigoureusement non négative. Le signe négatif d’un score z indique exclusivement un positionnement spatial à gauche du centre de gravité μ = 0, mais la surface sous-tendue depuis l’asymptote négative demeure toujours un nombre réel strictement positif compris entre 0 et 0,5.
Enfin, lors de l’estimation de l’aire comprise entre deux valeurs de même signe, l’inversion des bornes dans la soustraction constitue un biais classique. L’analyste qui calcule Φ(-1,80) – Φ(-0,50) obtiendra un résultat négatif (-0,2726) qui traduit une simple faute d’ordonnancement opératoire. L’opération correcte requiert impérativement de soustraire la borne algébriquement inférieure de la borne algébriquement supérieure : Φ(-0,50) – Φ(-1,80) = +0,2726.
11.2 Pièges liés à la nature de la table de consultation
Le recours à la table imprimée constitue une source majeure d’erreurs instrumentales si l’analyste omet d’analyser rigoureusement la légende méthodologique de son support documentaire. Il existe trois grandes familles typologiques de tables de la loi normale distribuées dans les manuels universitaires :
- La table cumulative complète (de -∞ à z) : C’est le standard contemporain, fournissant directement Φ(z) pour des valeurs positives et négatives.
- La table cumulative positive (de -∞ à +z) : Ne débutant qu’à z = 0 avec une aire de 0,5000, elle impose à l’utilisateur de recourir manuellement au complément 1 – Φ(|z|) pour toute coordonnée négative.
- La table de « zéro à z » (demi-table) : Cette présentation historique, fréquente dans certains manuels d’ingénierie, n’intègre que l’aire comprise entre l’axe vertical central z = 0 et une borne positive z. Dans ce format, la valeur associée à z = 0 est 0,0000 et celle associée à z = 1,96 est 0,4750. L’analyste non averti qui lit directement cette table sans ajouter manuellement la constante 0,5000 (représentant la moitié gauche de la courbe) sous-estimera l’aire cumulative globale d’exactement 50 % !
Une vigilance constante est également requise lors de l’alignement visuel sur les colonnes de centièmes. Une lecture hâtive confond régulièrement la colonne 0,00 avec la colonne 0,01, induisant un décalage systématique sur l’ensemble des estimations probabilistes.
11.3 Mauvaises interprétations des hypothèses sous-jacentes
L’erreur la plus pernicieuse sur le plan de l’éthique scientifique consiste à projeter mécaniquement les propriétés de l’aire sous la courbe normale sur des données empiriques qui ne suivent absolument pas une distribution gaussienne. La standardisation formelle d’un ensemble de scores bruts via l’équation z = (x – μ) / σ est une opération arithmétique simple réalisable sur n’importe quel échantillon numérique, y compris sur des distributions bimodales, uniformes ou massivement dissymétriques.
Cependant, standardiser une variable ne la normalise pas ! Si la distribution parente initiale présente une asymétrie marquée (skewness) ou un aplatissement excessif (kurtosis), la forme globale de la distribution reste inchangée par cette transformation linéaire. Déduire des rangs centiles ou des probabilités de prévalence clinique à l’aide de la table normale sur des scores z issus d’une variable non gaussienne constitue une faute méthodologique majeure : les aires réelles observées sur le terrain divergeront radicalement des aires théoriques extrapolées.
Ce biais est particulièrement dangereux dans les échantillons cliniques de taille réduite (par exemple N < 30), où les fluctuations aléatoires d’échantillonnage suffisent à déformer la morphologie des queues de distribution. L’étiquetage diagnostique d’un patient fondé sur une aire théorique de 2,3 % alors que la distribution réelle sous-jacente est asymétrique expose à des faux positifs ou à des faux négatifs préjudiciables à la prise en charge thérapeutique.
12. Synthèse méthodologique et guide décisionnel pas à pas
12.1 Arbre de décision opérationnel pour tout problème d’aire normale
Pour systématiser la démarche de résolution face à n’importe quelle problématique probabiliste impliquant la loi normale standard, le chercheur ou l’évaluateur peut déployer un protocole décisionnel universel structuré en quatre étapes séquentielles :
Étape 1 : Représentation graphique préliminaire obligatoire.
Avant tout calcul numérique ou consultation documentaire, tracer une courbe en cloche schématique sur une feuille de brouillon. Ériger l’axe vertical central d’abscisse 0. Positionner approximativement le ou les scores z cibles selon leur valeur relative et hachurer visuellement la zone de surface réclamée par l’énoncé clinique (à gauche, à droite, entre deux seuils ou aux extrémités). Ce schéma constitue un garde-fou cognitif puissant contre les erreurs d’inversion ultérieures.
Étape 2 : Identification structurelle du scénario géométrique.
Qualifier la topologie de l’aire hachurée selon l’une des catégories fondamentales :
– S’agit-il d’une aire cumulée à gauche d’une borne unique ?
– S’agit-il d’une aire supérieure logée dans la queue droite ?
– S’agit-il d’un intervalle intérieur compris entre deux limites finies ?
– S’agit-il d’une zone périphérique disjointe s’étendant à l’extérieur de deux bornes ?
Étape 3 : Sélection de l’équation de transformation canonique.
Sélectionner la formule mathématique rigoureusement adaptée au profil spatial identifié à l’étape 2 (se référer au tableau récapitulatif ci-après).
Étape 4 : Extraction tabulaire et résolution arithmétique.
Relever les valeurs de probabilités cumulées Φ(z) requises au sein de la table standardisée, appliquer les opérations différentielles ou complémentaires prévues, puis confronter le résultat numérique final à l’esquisse graphique préliminaire pour vérifier sa cohérence spatiale globale (inférieur ou supérieur à 0,5000, ordre de grandeur plausible).
12.2 Tableau récapitulatif des formules canoniques
Le tableau méthodologique suivant compile de façon synthétique l’ensemble des équations analytiques indispensables à la détermination des aires sous la courbe normale standard, offrant une grille de lecture rapide pour la pratique clinique et de recherche :
| Configuration Spatiale Recherchée | Notation Probabiliste | Formule Opératoire Canonique | Règle de Validation Visuelle |
|---|---|---|---|
| Aire à gauche d’une borne positive | P(Z ≤ z), avec z > 0 | Aire = Φ(z) | L’aire résultante doit être > 0,5000 |
| Aire à gauche d’une borne négative | P(Z ≤ z), avec z < 0 | Aire = Φ(z) = 1 – Φ(|z|) | L’aire résultante doit être < 0,5000 |
| Aire à droite d’une borne positive | P(Z ≥ z), avec z > 0 | Aire = 1 – Φ(z) | L’aire résultante doit être < 0,5000 |
| Aire à droite d’une borne négative | P(Z ≥ z), avec z < 0 | Aire = 1 – Φ(z) = Φ(|z|) | L’aire résultante doit être > 0,5000 |
| Aire comprise entre deux bornes | P(z1 ≤ Z ≤ z2) | Aire = Φ(z2) – Φ(z1) | Toujours soustraire la plus petite de la plus grande |
| Aire extérieure bilatérale symétrique | P(|Z| ≥ z) | Aire = 2 × [1 – Φ(z)] = 2 × Φ(-z) | Multiplication par deux de la queue unilatérale |
| Aire extérieure bilatérale asymétrique | P(Z ≤ z1 ou Z ≥ z2) | Aire = Φ(z1) + [1 – Φ(z2)] | Somme des queues disjointes ou 1 – aire centrale |
12.3 Auto-évaluation : Exercices types appliqués à la psychologie
Afin de consolider les compétences méthodologiques développées au fil de cet article, trois cas d’étude pratiques représentatifs des problématiques psychométriques contemporaines sont proposés ci-après, assortis de leurs corrections détaillées pas à pas.
Exercice 1 : Évaluation neuropsychologique de l’attention sélective.
Un patient de 45 ans subit une épreuve d’attention sélective standardisée. Les normes pour sa tranche d’âge suivent une distribution normale d’espérance μ = 50 et d’écart-type σ = 8. Le patient obtient un score brut de 37 points. L’atteinte clinique est suspectée si la performance se situe parmi les 7 % les plus faibles de la population. Ce patient répond-il au critère d’alerte déficitaire ?
- Étape 1 : Standardisation du score brut :
z = (37 – 50) / 8 = -13 / 8 = -1,625 ≈ -1,63 (arrondi au centième)
- Étape 2 : Calcul de l’aire cumulative inférieure :
On cherche P(Z ≤ -1,63) = Φ(-1,63).
Dans la table standardisée, Φ(-1,63) = 1 – Φ(1,63) = 1 – 0,9484 = 0,0516 (soit 5,16 %). - Étape 3 : Conclusion clinique :
La performance du patient le situe au 5,16e centile. Cette valeur étant strictement inférieure au seuil critique des 7 % (0,0516 < 0,0700), le patient franchit le seuil d’alerte clinique, justifiant des investigations approfondies.
Exercice 2 : Segmentation de l’intelligence moyenne dans le milieu scolaire.
Au sein d’un district académique, on administre une échelle d’aptitudes cognitives présentant une métrique de QI classique (μ = 100, σ = 15). L’équipe pédagogique définit la catégorie de l’intelligence dite « moyenne typique » par l’intervalle de QI compris entre 90 et 115. Quelle proportion théorique d’élèves s’inscrit spontanément dans cette tranche normative ?
- Étape 1 : Standardisation des deux bornes brutes :
z1 = (90 – 100) / 15 = -10 / 15 ≈ -0,67
z2 = (115 – 100) / 15 = +15 / 15 = +1,00
- Étape 2 : Extraction des probabilités cumulées :
Pour la borne supérieure : Φ(1,00) = 0,8413.
Pour la borne inférieure : Φ(-0,67) = 0,2514. - Étape 3 : Calcul différentiel de l’aire intermédiaire :
P(-0,67 ≤ Z ≤ 1,00) = Φ(1,00) – Φ(-0,67) = 0,8413 – 0,2514 = 0,5899
- Étape 4 : Conclusion diagnostique :
Approximativement 58,99 % (soit près de six élèves sur dix) présentent un fonctionnement intellectuel typique compris dans cette tranche.
Exercice 3 : Détermination d’un seuil de résilience psychologique (Problème inverse).
Une organisation de secours d’urgence souhaite sélectionner des candidats démontrant un score de résistance au stress aigu situé dans les 10 % les plus élevés de la population générale. L’échelle de résilience employée présente une moyenne de 75 points et un écart-type de 12 points. Quel score brut minimal un candidat doit-il décrocher pour être sélectionné ?
- Étape 1 : Conversion en probabilité cumulée unilatérale inférieure :
Appartenir aux 10 % supérieurs implique de surpasser les 90 % inférieurs. L’aire cumulative à gauche ciblée est donc de 0,9000. - Étape 2 : Recherche inverse du score standardisé :
En consultant le corps de la table pour 0,9000, la coordonnée la plus approchée s’établit à z ≈ +1,28. - Étape 3 : Dénormalisation du score z en score brut x :
En réarrangeant l’équation fondamentale de standardisation :x = μ + (z × σ) = 75 + (1,28 × 12) = 75 + 15,36 = 90,36 points
- Étape 4 : Conclusion opérationnelle :
Pour intégrer le groupe des 10 % les plus résilients, un candidat doit obtenir un score brut minimal de 91 points (après arrondi pragmatique à l’entier supérieur).
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- De Moivre, A. (1738). The doctrine of chances: Or, a method of calculating the probabilities of events in play (2nd ed.). H. Woodfall.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Hogg, R. V., McKean, J., & Craig, A. T. (2018). Introduction to mathematical statistics (8th ed.). Pearson.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.