
Dans le champ des sciences humaines, de la biométrie et plus particulièrement de la psychométrie contemporaine, la modélisation probabiliste des conduites humaines repose sur un postulat fondamental : la variabilité interindividuelle tend à s’organiser autour d’une valeur centrale selon des régularités géométriques stables. Lorsque les cliniciens et les chercheurs administrent des épreuves standardisées — qu’il s’agisse de mesurer l’efficience cognitive, les dimensions de la personnalité ou les temps de réaction neuropsychologiques —, ils se heurtent immédiatement à l’hétérogénéité des unités de mesure brutes. Un temps exprimé en millisecondes ne possède aucune commensurabilité directe avec un nombre d’items réussis à un test de mémoire ou un score composite d’anxiété sur une échelle ordinale. C’est précisément à la croisée de cette exigence d’harmonisation métrologique et de la théorie probabiliste que s’impose la transformation en score standardisé, communément appelé score Z, dont l’exploitation culmine dans l’identification de l’aire située à sa gauche sous la courbe normale.
L’aire située à gauche d’un score Z ne constitue pas un simple artifice graphique ou un vestige des méthodes de calcul manuelles antérieures à l’informatique ubiquitaire. Elle incarne la fonction de répartition cumulative de la loi de Gauss-Laplace, matérialisant formellement la probabilité qu’un individu extrait aléatoirement d’une population de référence obtienne un résultat inférieur ou égal à une valeur critique donnée. En psychométrie différentielle, cette grandeur géométrique se transpose directement sous la forme d’un rang centile, pierre angulaire de l’interprétation diagnostique, du dépistage des anomalies neurodéveloppementales et de l’identification des profils cognitifs atypiques. Trouver l’aire à gauche d’un score Z revient ainsi à situer rigoureusement une performance singulière dans le continuum de la diversité humaine, en convertissant un écart arithmétique abstrait en une métrique d’abondance ou de rareté populationnelle.
La maîtrise opératoire de cette procédure exige cependant une compréhension approfondie des fondements mathématiques qui la sous-tendent, des mécanismes de transcription tabulaire et algorithmique, ainsi que des écueils méthodologiques inhérents aux violations des postulats de normalité. À travers ce traité exhaustif, nous détaillerons l’ensemble du cheminement conceptuel, analytique et appliqué permettant de déterminer et d’interpréter l’aire sous la courbe normale à gauche d’une coordonnée standardisée. De la formalisation de l’intégrale de Gauss aux cas cliniques concrets, en passant par les environnements computationnels modernes et les conversions nosographiques normalisées, ce guide constitue un manuel de référence rigoureux pour les chercheurs, praticiens et statisticiens désireux d’asseoir leurs inférences sur une métrologie irréprochable.
1. Fondements théoriques du score Z et de la loi normale en statistique psychologique
1.1 Définition et propriétés fondamentales de la loi normale centrée réduite
La distribution normale, souvent qualifiée de distribution gaussienne ou de courbe en cloche en référence aux travaux pionniers de Carl Friedrich Gauss et de Pierre-Simon de Laplace, constitue le modèle théorique prééminent pour décrire la dispersion des variables continues en psychologie. Sur le plan formel, la loi normale est définie par une fonction de densité de probabilité continue dont l’allure graphique présente une cloche parfaitement symétrique autour de son paramètre de position centrale. Dans sa forme générale, notée N(μ, σ²), la distribution est entièrement paramétrée par sa moyenne arithmétique populationnelle μ et son écart-type σ, ce dernier quantifiant la dispersion moyenne des observations autour du centre de gravité des données.
La particularité structurelle de cette distribution réside dans son point d’inflexion unique situé exactement à une distance d’un écart-type de part et d’autre de la moyenne, ainsi que dans son comportement asymptotique aux extrémités : les queues de distribution s’étendent indéfiniment vers l’infini négatif et l’infini positif sans jamais intercepter l’axe des abscisses. Lorsque cette distribution subit une translation et une mise à l’échelle pour adopter une moyenne rigoureusement égale à zéro (μ = 0) et une variance unitaire (σ² = 1, d’où σ = 1), elle accède au statut privilégié de loi normale centrée réduite, conventionnellement symbolisée par N(0, 1). Dans ce cadre formalisé, l’axe horizontal ne quantifie plus des unités physiques arbitraires, mais des unités d’écart-type universelles.
La prévalence de ce modèle en sciences du comportement n’est point fortuite ; elle trouve sa justification mathématique la plus robuste dans le théorème central limite. Ce principe fondamental énonce que la somme — ou la moyenne — d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées converge asymptotiquement vers une loi normale, quand bien même les variables individuelles sous-jacentes suivraient des distributions non gaussiennes. Dans la mesure où les aptitudes cognitives, les traits de personnalité et les manifestations émotionnelles résultent de l’agrégation complexe d’une infinité de micro-déterminants génétiques, neurobiologiques et environnementaux indépendants, leur distribution empirique au sein de larges populations tend naturellement à épouser le profil géométrique de la courbe normale.
1.2 Concept et signification psychométrique du score Z
En psychométrie et en évaluation clinique, les praticiens sont continuellement confrontés à la disparité des échelles de mesure : un score brut de 42 à un inventaire d’anxiété clinique ne possède aucun sens intrinsèque s’il n’est pas rapporté à la distribution des scores produits par la cohorte d’étalonnage. Le score Z, également désigné sous le vocable de score standardisé ou cote Z, constitue la solution algébrique à cette aporie métrologique. Il convertit une mesure brute individuelle en un indicateur invariant qui spécifie la distance directionnelle séparant ce score de la moyenne de la population, cette distance étant rigoureusement exprimée en multiples ou fractions de l’écart-type.
L’opération de standardisation confère au score Z une propriété mathématique inestimable : l’invariance d’échelle. Par ce mécanisme, le score brut d’un participant est dépouillé de son unité métrique d’origine — qu’il s’agisse de points d’items, de secondes de latence ou de millimètres de mercure — pour être projeté sur une droite numérique sans dimension dont l’origine 0 représente exactement la performance moyenne du groupe de référence. Un score Z positif indique sans ambiguïté que l’observation excède la moyenne, tandis qu’un score Z négatif signale une position située en deçà du centre de distribution. La magnitude absolue du score Z traduit l’intensité de cette divergence : une valeur de +1,00 correspond rigoureusement à un écart positif équivalent à un écart-type complet.
Cette standardisation métrique offre ainsi la possibilité d’effectuer des comparaisons intra-individuelles directes entre des domaines fonctionnels hautement disparates. Un neuropsychologue peut par exemple confronter immédiatement l’efficience de la mémoire verbale d’un patient à sa vitesse de traitement visuo-motrice, même si les tests administrés comportent des nombres d’items radically différents et des dispersions brutes incommensurables. En outre, la détection des tendances centrales et l’isolement des profils aberrants ou cliniquement déficitaires au sein d’échantillons cliniques deviennent des démarches directes, objectives et affranchies des biais d’ancrage liés aux métriques locales.
1.3 Notion d’aire sous la courbe et probabilité cumulée
Pour exploiter pleinement la portée diagnostique d’un score Z, il est impératif d’abandonner une conception purement discrète de la mesure pour adopter le cadre continu du calcul infinitésimal. Dans une distribution continue régie par une fonction de densité f(z), la probabilité associée à une valeur ponctuelle isolée est rigoureusement nulle : P(Z = z) = 0. Dès lors, la détermination de la probabilité s’effectue exclusivement sur des intervalles au moyen de l’intégration mathématique de la fonction de densité. Géométriquement, cette probabilité se matérialise par la surface, ou l’aire, délimitée par la courbe de Gauss, l’axe horizontal et les bornes de l’intervalle considéré.
L’aire située à gauche d’un score Z spécifique représente l’intégrale définie de la fonction de densité de probabilité gaussienne depuis la limite asymptotique inférieure, soit moins l’infini (-∞), jusqu’au point d’abscisse z. Formellement, cette grandeur correspond à la fonction de répartition cumulative, universellement désignée par la lettre grecque majuscule Phi, telle que :
$$\Phi(z) = P(Z le z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-\frac{t^2}{2}} , dt$$
En vertu de l’axiome fondamental de normalisation des probabilités de Kolmogorov, l’aire totale enserrée sous l’intégralité de la courbe de densité normale, de moins l’infini à plus l’infini, est strictement égale à l’unité (1,0000 ou 100 %).
Par conséquent, l’aire cumulée à gauche d’un score Z oscille nécessairement à l’intérieur de l’intervalle ouvert ]0, 1[. Cette valeur exprime avec une précision parfaite la proportion d’individus de la population parente dont le score standardisé est inférieur ou égal à la coordonnée z évaluée. La représentation graphique de cette distribution cumulée se traduit par une courbe sigmoïde caractéristique — l’ogive de Galton —, dont la pente maximale coïncide avec la moyenne (z = 0), illustrant que c’est au centre de la distribution que la densité de probabilité est la plus compacte et que l’accumulation des fréquences relatives s’opère avec la vélocité la plus marquée.
2. Formulation mathématique et procédure de standardisation
2.1 Équation standard du score Z pour une population
Le passage d’un score brut continu à son expression standardisée sur la loi normale s’opère au moyen d’un opérateur algébrique déterministe d’une élégante simplicité. Lorsque les paramètres caractérisant la population cible sont exhaustivement connus — situation canonique issue des grands programmes nationaux de standardisation psychométrique —, la formule mathématique liant le score individuel brut x à son homologue standardisé s’énonce comme suit :
$$z = \frac{x – \mu}{\sigma}$$
Dans cette formalisation structurelle, x désigne la réalisation empirique ou la performance quantitative brute obtenue par l’individu soumis à l’évaluation, μ symbolise la moyenne arithmétique de la population globale de comparaison, et σ incarne l’écart-type de cette même population, quantifiant la racine carrée de sa variance.
Le comportement de cette équation révèle la sensibilité fine du score Z aux variations respectives des paramètres normatifs. Le numérateur, (x – μ), effectue une translation d’origine qui soustrait l’ancrage central ; il détermine la direction de l’écart (positif si x > μ, négatif si x < μ, et nul si la performance coïncide rigoureusement avec l’attente moyenne). Le dénominateur, quant à lui, opère une contraction d’échelle par division : plus la population est hétérogène (grand écart-type σ), plus l’impact d’une déviation brute donnée sur la valeur finale de z se trouve atténué. Inversement, au sein d’une cohorte particulièrement homogène (faible écart-type σ), une déviation brute modeste engendre un score Z d’une amplitude substantielle, traduisant le caractère exceptionnel de la performance observée.
Il demeure méthodologiquement indispensable de distinguer les paramètres déterministes populationnels (μ et σ), qui relèvent de constantes théoriques invariantes associées à la loi, des statistiques descriptives d’échantillon. L’usage exclusif de cette formulation suppose que l’étalonnage psychométrique repose sur un recensement quasi-exhaustif ou un échantillonnage probabiliste d’une ampleur telle que les marges d’erreur associées à la moyenne et à la variance puissent être considérées comme asymptotiquement négligeables.
2.2 Adaptation pour les données d’échantillonnage clinique
Dans la pratique courante de la recherche neuropsychologique et clinique, l’accès aux paramètres exhaustifs d’une population s’avère souvent irréalisable en raison des contraintes d’échantillonnage inhérentes aux populations pathologiques rares. Les chercheurs doivent alors substituer aux paramètres théoriques μ et σ des estimateurs statistiques empiriques calculés à partir d’un échantillon représentatif de taille finie n. L’équation de standardisation subit alors une modification de ses composantes fondamentales :
$$z = \frac{x – \bar{x}}{s}$$
où x̄ représente la moyenne arithmétique de l’échantillon clinique et s symbolise l’écart-type d’échantillon corrigé, intégrant la correction de Bessel au dénominateur (division par n – 1 et non par n) afin de garantir le statut d’estimateur sans biais de la variance populationnelle.
Cette substitution paramétrique n’est pas neutre sur le plan inférentiel. Lorsque les effectifs de l’échantillon demeurent modestes (typiquement lorsque n < 30), la distribution de la quantité standardisée ne suit plus rigoureusement une loi normale unitaire, mais converge vers une distribution de Student à n – 1 degrés de liberté. Cette dernière possède des queues plus épaisses que la gaussienne, traduisant l’incertitude épistémique accrue liée à l’estimation concomitante de la variance. Utiliser les tables de la loi normale centrée réduite sans ajustement sur de petites cohortes conduit inévitablement à sous-estimer la probabilité des scores extrêmes et, par corollaire, à biaiser le calcul de l’aire à gauche.
De surcroît, les échantillons cliniques présentent fréquemment des asymétries de distribution prononcées — causées par des effets de plancher (items trop difficiles) ou des effets de plafond (items trop aisés) —, qui violent frontalement le postulat de symétrie sous-jacent. Dans de telles circonstances, l’application mécanique de la formule standardisée altère la validité de l’aire cumulative résultante : une déviation d’un écart-type vers le bas ne recouvre plus alors la même réalité probabiliste qu’une déviation symétrique vers le haut. Les cliniciens doivent donc s’assurer de la normalité empirique de leurs données au moyen d’épreuves d’ajustement, telles que le test de Shapiro-Wilk ou l’analyse des coefficients d’asymétrie et d’aplatissement, avant d’engager toute dérivation d’aire unilatérale.
2.3 Transformation inverse : de la probabilité cumulée à la valeur brute
Si la démarche analytique standard consiste à transposer un score brut en coordonnée Z pour en extraire l’aire cumulative à gauche, la pratique psychologique requiert tout aussi fréquemment la trajectoire épistémologique inverse. Dans le cadre de la construction de tests ou de l’application de critères de sélection psychométrique, il s’avère indispensable de déterminer le score brut seuil correspondant précisément à une probabilité cumulée cible, par exemple pour isoler les 5 % des performances les plus faibles au sein d’une épreuve d’attention soutenue.
Cette procédure de dé-standardisation repose sur l’inversion algébrique directe de l’équation fondamentale du score Z. En isolant la variable brute x dans l’égalité linéaire, nous dérivons l’expression suivante :
$$x = \mu + (z \cdot \sigma)$$
La résolution effective de cette équation exige préalablement d’extraire la valeur critique de z associée à l’aire à gauche spécifiée, ce qui s’accomplit par l’interrogation de la fonction quantile de la loi normale, traditionnellement notée Φ⁻¹(p). Par exemple, si un bilan neuropsychologique définit le seuil pathologique comme une performance inférieure au cinquième centile de la population (p = 0,0500), la consultation de la distribution normale inversée fournit un score Z critique d’approximativement z = -1,645. En substituant cette valeur dans l’équation linéaire avec les paramètres de l’étalonnage, le clinicien isole immédiatement la note brute en dessous de laquelle le diagnostic de fragilité cognitive est formellement suspecté.
Cette transformation inverse constitue le pivot opérationnel de la psychométrie d’étalonnage. Elle permet d’établir les barèmes de conversion qui ornent les manuels d’évaluation standardisée, garantissant que chaque praticien puisse associer instantanément une observation clinique concrète à un positionnement probabiliste univoque sur la courbe de densité gaussienne.
3. Mécanisme de lecture de la table statistique standard de la loi normale
3.1 Organisation structurelle de la table Z cumulative unilatérale
Avant l’avènement des calculateurs algorithmiques portables, la détermination numérique de l’intégrale de Gauss nécessitait le recours exclusif à des tables statistiques imprimées, dont l’architecture tabulaire demeure un chef-d’œuvre de concision ergonomique. La table de la loi normale standard cumulative unilatérale consigne les valeurs numériques de l’aire sous la courbe comprises entre moins l’infini et une borne supérieure z donnée, soit précisément P(Z ≤ z). L’exploitation de cet outil repose sur un système de coordonnées cartésiennes matricielles à double entrée.
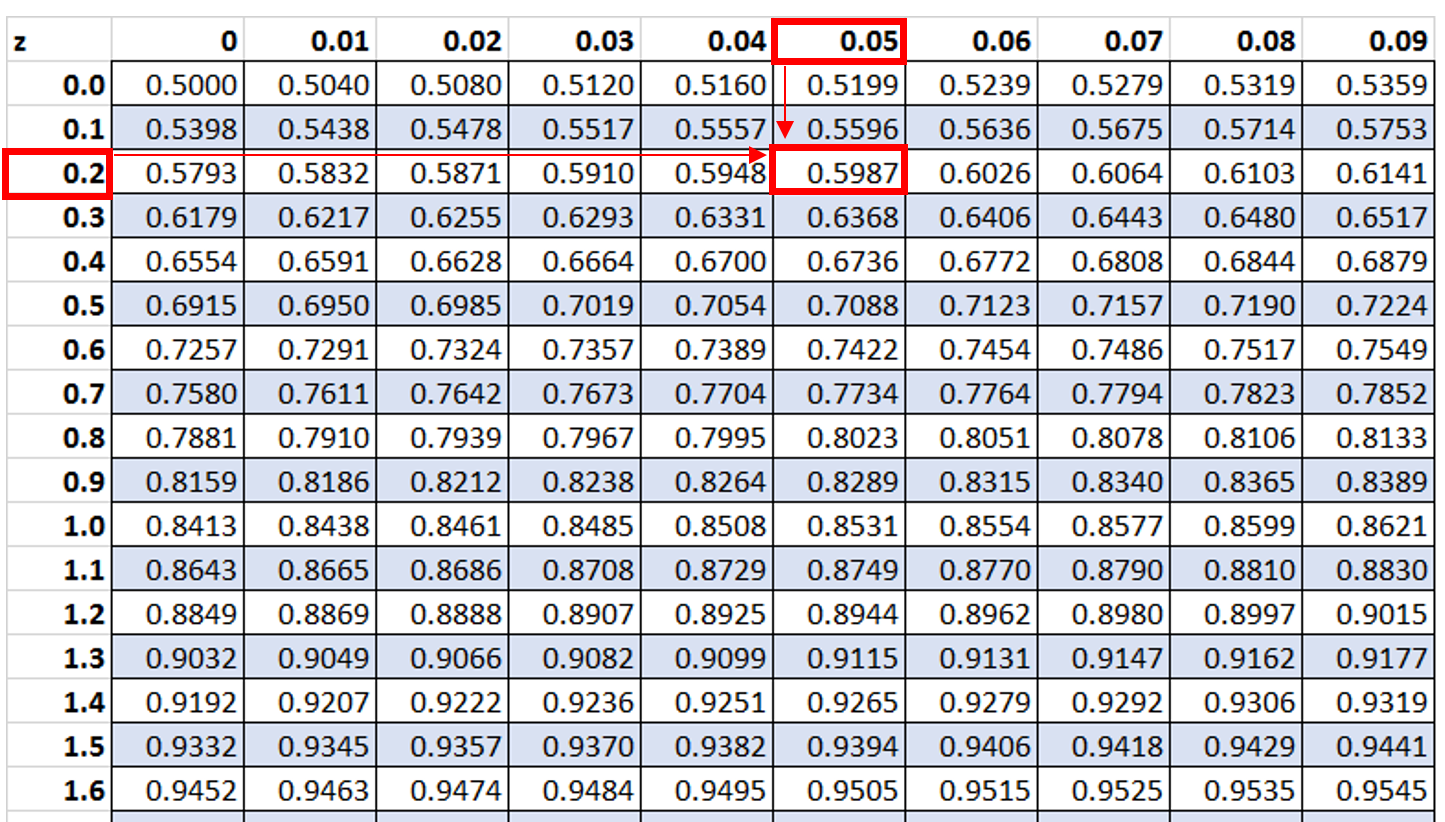
La colonne verticale située à l’extrême gauche de la matrice présente la partie entière du score Z suivie de sa première décimale (les dixièmes), s’échelonnant habituellement par incréments de 0,1 unité. Simultanément, la ligne d’en-tête horizontale située au sommet de la table affiche la seconde décimale du score Z (les centièmes), variant de 0,00 à 0,09. L’identification de la probabilité cumulée recherchée découle de l’intersection rigoureuse entre la rangée correspondant aux dixièmes et la colonne correspondant aux centièmes.
Il convient de souligner qu’il existe historiquement plusieurs typologies de tables de la loi normale dans la littérature académique francophone et internationale. Si les tables cumulatives intégrales (ou tables unilatérales de répartition) fournissent directement l’aire cumulée depuis -∞ jusqu’à z — affichant donc des probabilités oscillant théoriquement entre 0 et 1 —, d’autres tables, dites symétriques ou centrées sur la moyenne, n’expriment que l’aire comprise entre l’espérance mathématique (z = 0) et le score positif z, fournissant des valeurs contenues entre 0,0000 et 0,5000. Pour obtenir l’aire totale à gauche à partir de ce second format, l’analyste doit impérativement ajouter 0,5000 à la valeur lue dans le tableau. L’identification préalable du protocole éditorial de la table employée constitue ainsi une précaution élémentaire pour prévenir des erreurs d’interprétation massives.
3.2 Spécificités des tables pour valeurs Z positives et négatives
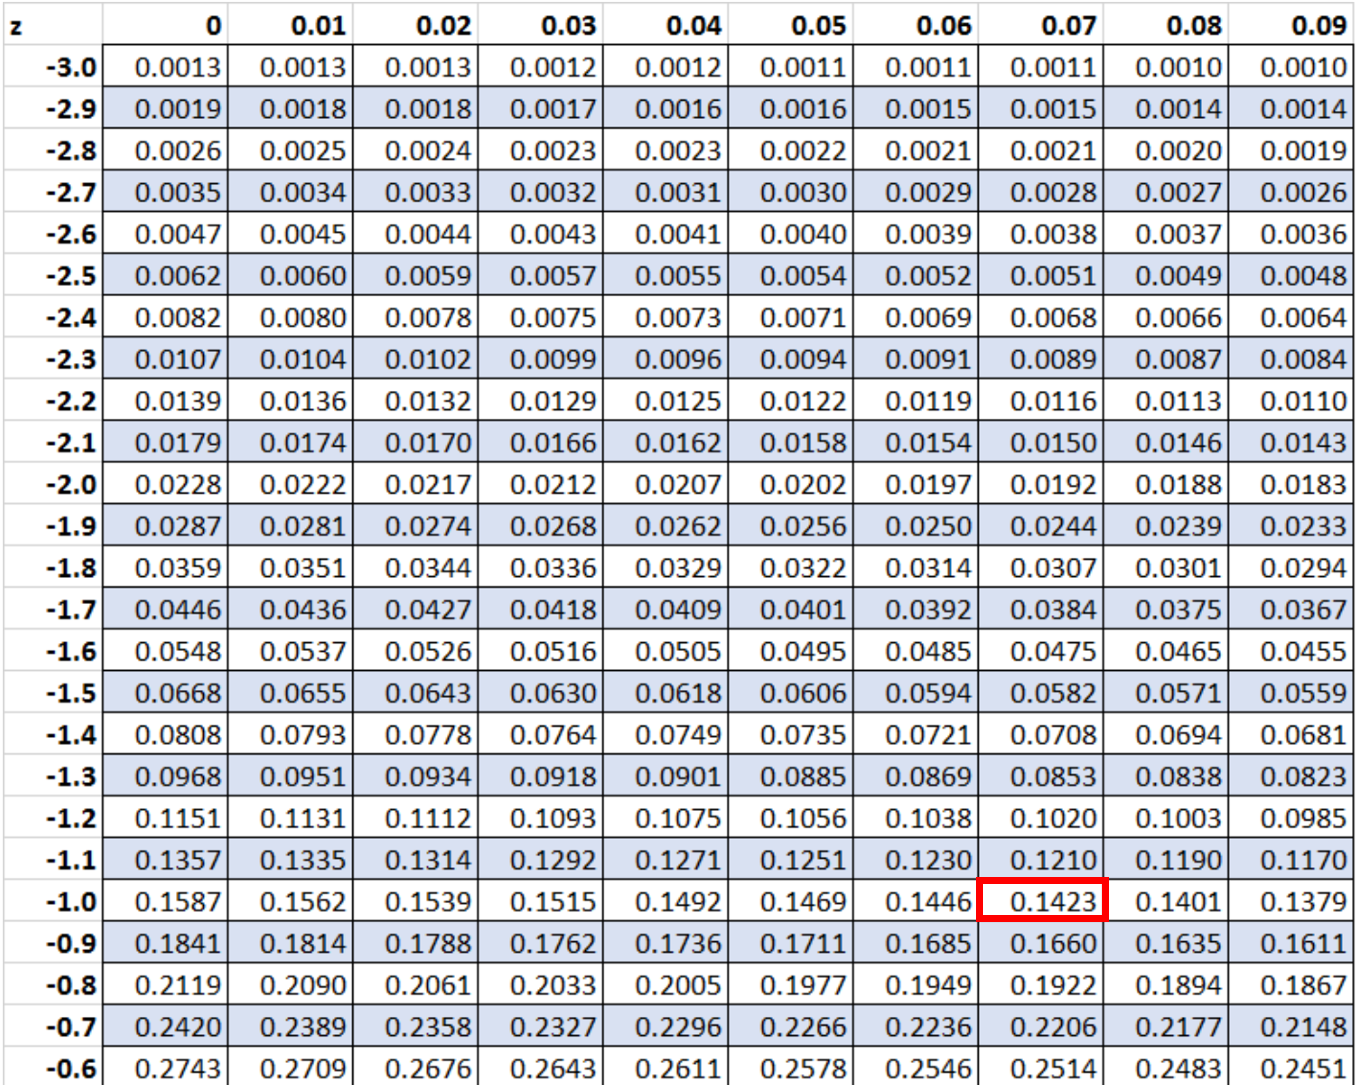
La plupart des fascicules statistiques modernes proposent deux volets distincts : une table dédiée aux scores Z négatifs et une table réservée aux scores Z positifs. La table des valeurs négatives délivre directement des valeurs d’aire cumulée strictement inférieures à 0,5000, illustrant graphiquement des surfaces cantonnées dans la queue inférieure de la distribution normale. Par exemple, pour un score de z = -1,50, l’intersection livre une probabilité de 0,0668, matérialisant le fait que seuls 6,68 % des cas se situent plus à gauche sur le continuum.
Néanmoins, certains manuels d’évaluation synthétiques n’impriment que la portion positive de la table normale unitaire, contraignant l’utilisateur à exploiter judicieusement la propriété de symétrie axiale parfaite de la courbe de Gauss autour de son axe médian vertical z = 0. En vertu de cette invariance géométrique par réflexion, l’aire située à gauche d’un score négatif quelconque –z est strictement équivalente à l’aire située à droite de son pendant positif +z. Or, puisque l’aire totale sous la courbe égale précisément l’unité, cette aire à droite correspond algébriquement au complément à 1 de l’aire cumulée à gauche du point positif :
$$P(Z le -z) = P(Z ge +z) = 1 – P(Z le +z)$$
Cette relation fondamentale exige une grande rigueur cognitive lors des calculs manuels. Omettre de soustraire la probabilité tabulée à 1 lors de la recherche de l’aire à gauche d’un score Z négatif dans une table positive induit une erreur de quadrant statistique gravissime : attribuer une probabilité de 0,9332 à un score de -1,50 au lieu de 0,0668 métamorphose une contre-performance clinique majeure en une réussite psychologique exceptionnelle.
3.3 Interpolation linéaire pour valeurs intermédiaires
Les tables statistiques imprimées sont structurellement limitées à un pas de discrétisation fixé au centième de point standardisé (deux décimales). Toutefois, les calculs arithmétiques issus des équations de standardisation génèrent fréquemment des scores Z comportant trois décimales ou davantage. Lorsqu’une précision accrue est requise sans recourir à un calculateur algorithmique, l’analyste doit employer la méthode de l’interpolation linéaire afin d’approximer la probabilité cumulée située entre deux cellules tabulaires adjacentes.
La formule d’interpolation linéaire repose sur l’hypothèse simplificatrice d’une variation proportionnelle et constante de l’aire sous la courbe sur le micro-intervalle considéré. Soit un score Z intermédiaire z compris entre z₁ et z₂, associés respectivement aux probabilités tabulées P₁ et P₂. L’approximation de l’aire cumulée P s’obtient au moyen de l’expression :
$$P = P_1 + \left( \frac{z – z_1}{z_2 – z_1} \right) \cdot (P_2 – P_1)$$
Considérons à titre d’illustration la recherche de l’aire à gauche pour un score standardisé précis de z = 0,544. La consultation de la table permet d’extraire :
- Pour z₁ = 0,54, P₁ = 0,7054
- Pour z₂ = 0,55, P₂ = 0,7088
L’écart de probabilité entre ces deux bornes atteint (0,7088 – 0,7054) = 0,0034. La fraction d’avancement du score Z au sein du centième est de (0,544 – 0,540) / 0,01 = 0,4. En appliquant la formule, nous obtenons :
$$P = 0{,}7054 + (0{,}4 \cdot 0{,}0034) = 0{,}7054 + 0{,}00136 = 0{,}70676$$
Arrondie au dix-millième usuel, la probabilité cumulée s’établit à 0,7068. Bien que la fonction de densité soit non linéaire en toute rigueur géométrique, la marge d’erreur relative induite par l’interpolation linéaire sur un intervalle aussi ténu qu’un centième d’écart-type est de l’ordre de 10⁻⁵, ce qui demeure largement inférieur au seuil de pertinence clinique.
4. Exemple pratique 1 : Aire à gauche d’un score Z négatif
4.1 Énoncé du cas psychométrique et contexte clinique
Afin d’illustrer la matérialité opératoire de la démarche face à un score négatif, examinons un protocole d’investigation en neuropsychologie clinique portant sur la vitesse d’intégration sensorimotrice. Une équipe hospitalière évalue le temps de réaction simple chez des patients atteints du syndrome de fatigue chronique (SFC). L’instrument d’évaluation informatisé mesure la latence séparant l’apparition d’un stimulus visuel sur écran de la dépression d’un bouton-poussoir de haute précision.
Les données normatives issues d’une vaste cohorte de contrôle saine, appariée selon l’âge et le niveau d’éducation, établissent que le temps de réaction se distribue selon une loi normale caractérisée par une moyenne populationnelle μ de 300 millisecondes (ms) et un écart-type σ de 15 ms. Dans ce paradigme chronométrique, une vitesse d’exécution supérieure à la moyenne se traduit mathématiquement par une latence plus courte, donc une valeur brute inférieure à 300 ms.
Un patient consécutivement admis dans le protocole réalise un temps de réponse moyen de 284 ms au terme de 50 essais randomisés. L’objectif diagnostique du neuropsychologue consiste à situer rigoureusement cette observation individuelle : quelle proportion exacte de la population saine de référence présente un temps de réaction inférieur ou égal à 284 ms ? Ce calcul d’aire à gauche permettra de quantifier la rapidité relative du sujet et de déterminer si sa performance cognitive échappe au profil de ralentissement usuellement documenté dans cette pathologie.
4.2 Calcul pas à pas du score standardisé
La première phase opératoire réside dans l’application méthodique de l’équation de standardisation unilatérale. En isolant les composantes numériques du problème clinique, nous identifions :
- Score individuel brut x = 284 ms
- Moyenne de référence μ = 300 ms
- Écart-type normatif σ = 15 ms
En injectant scrupuleusement ces valeurs au sein de l’équation standard :
$$z = \frac{x – \mu}{\sigma} = \frac{284 – 300}{15}$$
La soustraction arithmétique opérée au numérateur fournit :
$$284 – 300 = -16\text{ ms}$$
Cette divergence négative confirme immédiatement que la performance brute du sujet se positionne en deçà du centre de gravité de la cohorte d’étalonnage. La division de cette divergence brute par l’écart-type d’épreuvage donne :
$$z = \frac{-16}{15} \approx -1{,}066666…$$
En conformité avec les conventions de précision statistique pour l’interrogation manuelle des tables à deux décimales, la valeur décimale doit être arrondie au centième le plus proche. La troisième décimale étant un 6 (valeur supérieure ou égale à 5), le résultat s’arrondit par excès à :
$$z = -1{,}07$$
Ce score Z de -1,07 indique que la performance chronométrique du patient se situe rigoureusement à 1,07 écart-type en dessous de la moyenne populationnelle des sujets sains.
4.3 Recherche tabulaire et déduction de l’aire cumulative
Muni de cette coordonnée standardisée z = -1,07, le clinicien procède à la déduction de l’aire cumulative à gauche en consultant la section des scores négatifs de la table statistique standard de la loi normale centrée réduite :
- Étape 1 : Localiser la composante unitaire et le premier dixième le long de l’axe vertical des ordonnées, soit la ligne identifiée à -1,0.
- Étape 2 : Repérer le centième de complément le long de l’axe horizontal des abscisses en haut de tableau, soit la colonne identifiée à 0,07.
- Étape 3 : Projeter la convergence cartésienne des deux coordonnées au sein de la grille matricielle pour y prélever la cellule d’intersection.
La valeur numérique située au croisement exact de la ligne -1,0 et de la colonne 0,07 s’énonce comme suit :
$$\Phi(-1{,}07) = 0{,}1423$$
Pour transposer cette proportion géométrique continue en une métrique d’abondance sociale intelligible, l’analyste multiplie la probabilité par 100 :
$$\text{Pourcentage} = 0{,}1423 \times 100 = 14{,}23,%$$
Sur le plan de l’interprétation neuropsychologique, cette aire cumulée à gauche établit que seulement 14,23 % des individus de la population générale saine affichent une latence inférieure ou égale à 284 ms. Autrement formulé, le patient surpasse sur le plan de la vitesse de réaction 85,77 % (100 % – 14,23 %) de la cohorte d’étalonnage. Cette dérivation infirme formellement l’hypothèse d’une bradypsychie ou d’un ralentissement psychomoteur chez ce patient spécifique, son profil d’efficience motrice élémentaire se maintenant dans le quadrant supérieur des performances de sa classe d’âge.
5. Exemple pratique 2 : Aire à gauche d’un score Z positif
5.1 Mise en situation : Test d’efficience intellectuelle
Pour explorer symétriquement la situation d’une mesure excédant la moyenne, considérons le champ prévalent de l’évaluation intellectuelle standardisée chez l’adulte. L’évaluation repose sur les échelles d’intelligence de Wechsler (telles que la WAIS-IV), dont les épreuves composites agrégées fournissent le Quotient Intellectuel Total (QIT). Par convention métrologique historique, l’étalonnage du QIT est calibré pour suivre une distribution strictement normale dotée d’une moyenne populationnelle μ de 100 points et d’un écart-type σ de 15 points.
Lors d’un bilan d’orientation professionnelle et de prospective cognitive, une participante complète l’ensemble de la batterie d’évaluation et obtient un score brut standardisé d’efficience globale de 118 points de QIT. La problématique psychométrique soumise au praticien réside dans la caractérisation univoque de cette performance au sein de la distribution générale des aptitudes intellectuelles : quelle proportion exacte de la population présente une efficience cognitive globale inférieure ou égale à ce score de 118 ?
La résolution de cette interrogation implique l’identification directe de l’aire située à gauche du score Z correspondant sous la courbe normale. Cette démarche s’inscrit au cœur de la psychométrie différentielle, car elle conditionne l’attribution du rang centile, paramètre fondamental de communication des bilans psychologiques normés aux participants et aux institutions décisionnaires.
5.2 Calcul de la coordonnée Z
Le calcul de standardisation s’engage par l’extraction des paramètres formels du protocole d’étalonnage :
- Score brut observé x = 118
- Espérance mathématique de la métrique μ = 100
- Écart-type métrologique σ = 15
En injectant ces données dans l’opérateur de transformation normale :
$$z = \frac{x – \mu}{\sigma} = \frac{118 – 100}{15}$$
L’évaluation de l’écart arithmétique au centre fournit :
$$118 – 100 = +18\text{ points}$$
La présence d’un numérateur positif atteste indubitablement que la participante se situe au-dessus de la performance moyenne de l’échantillon de normalisation. Le rapport de cet écart brut à l’unité de dispersion livre :
$$z = \frac{18}{15} = 1{,}20$$
Le score Z résultant s’établit très exactement à +1,20, sans nécessiter d’arrondi approximatif complexe au-delà de sa deuxième décimale. Ce résultat indique que le niveau de fonctionnement cognitif global de la participante s’élève précisément à 1,20 écart-type au-dessus de la moyenne de ses pairs.
Sur le plan théorique, la positivité de ce score Z permet d’anticiper immédiatement la topographie de l’aire recherchée : puisque la moitié exacte de la distribution de Gauss se situe en deçà de z = 0, l’aire à gauche d’une coordonnée positive excédera nécessairement le seuil de 0,5000 (50 %).
5.3 Extraction de l’aire et interprétation cognitive
La lecture de la table standard de distribution normale unitaire pour les valeurs Z positives s’effectue suivant le protocole d’adressage cartésien :
- Étape 1 : Descendre le long de la colonne ordonnée de gauche jusqu’à la ligne désignant la valeur 1,2.
- Étape 2 : Parcourir la rangée horizontale supérieure des centièmes jusqu’à la colonne correspondant à 0,00.
- Étape 3 : Relever la cellule probabiliste à la jonction de ces deux vecteurs d’entrée.
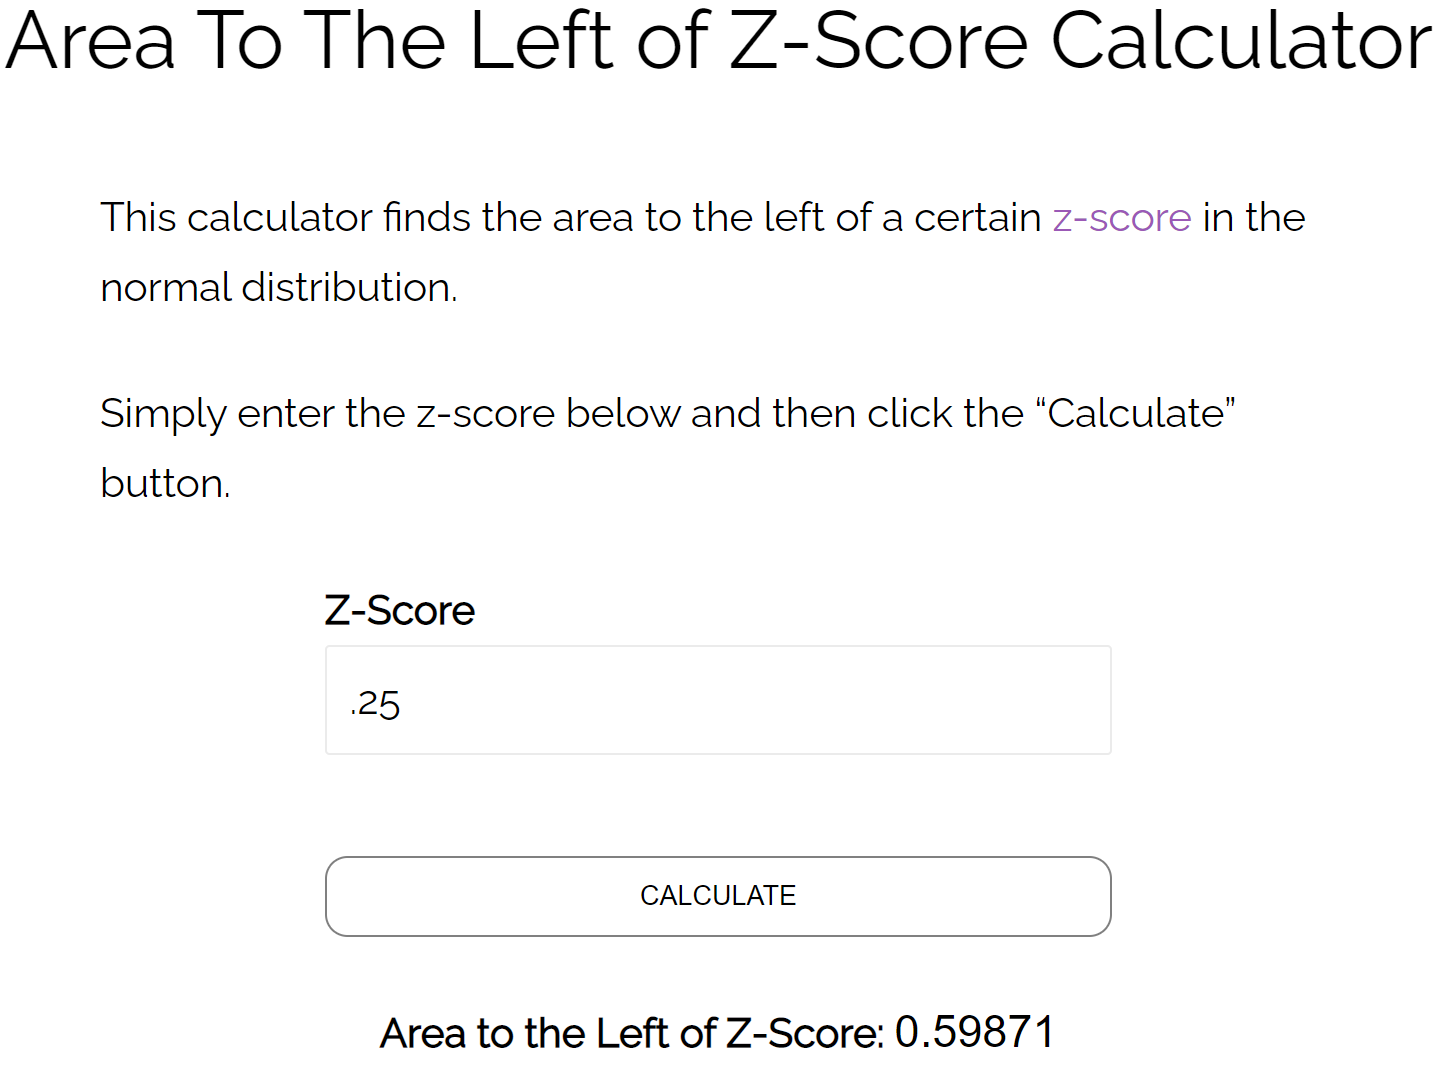
La consultation de la matrice livre la probabilité cumulative unilatérale suivante :
$$\Phi(1{,}20) = P(Z le 1{,}20) = 0{,}8849$$
En transposant cette proportion sous forme de pourcentage d’effectif :
$$\text{Pourcentage} = 0{,}8849 \times 100 = 88{,}49,%$$
Cette aire à gauche de 0,8849 signifie que 88,49 % des individus composant la population d’étalonnage obtiennent un score de QIT inférieur ou égal à 118 points. Dans la nomenclature standardisée de la psychométrie, cette participante se hisse précisément au 88e rang centile (conventionnellement arrondi à l’entier le plus proche). Réciproquement, la proportion d’individus surpassant cette performance n’est que de 11,51 % (1,0000 – 0,8849). Sur le plan clinique, une telle efficience intellectuelle est catégorisée selon la nosographie de Wechsler comme étant « moyenne supérieure » ou « d’un niveau au-dessus de la moyenne », témoignant de ressources cognitives solides et nettement au-delà de la norme médiane sans pour autant franchir le seuil conventionnel du haut potentiel intellectuel (qui requiert habituellement un score Z de +2,00, soit un QIT de 130 correspondant au 98e centile).
6. Méthodes informatisées et calculateurs logiciels de l’aire cumulative
6.1 Utilisation d’environnements de programmation statistique
À l’ère du traitement automatisé des données massives en sciences comportementales, l’extraction manuelle des probabilités via les tables en papier a cédé le pas aux environnements computationnels avancés. Les langages statistiques de pointe, tels que R et Python, intègrent des algorithmes d’intégration numérique d’une extrême rigueur mathématique, s’affranchissant des erreurs d’arrondi inhérentes aux tables imprimées tronquées à deux décimales.
Dans l’environnement de programmation R, la fonction native de référence pour le calcul de l’aire cumulative unilatérale sous la loi normale est pnorm(). Cette primitive implémente une approximation polynomiale de haute fidélité de la fonction de répartition de Gauss-Laplace. Sa syntaxe standard pour une coordonnée centrée réduite s’exécute de façon élémentaire :
pnorm(1.20, mean = 0, sd = 1, lower.tail = TRUE)
L’argument booléen lower.tail = TRUE garantit que l’algorithme intègre la densité de probabilité depuis moins l’infini jusqu’au score Z spécifié, restituant rigoureusement l’aire à gauche. En outre, la fonction autorise le passage direct des métriques brutes sans calcul intermédiaire de z : l’appel pnorm(118, mean = 100, sd = 15) produit directement le résultat 0,8849303 avec une précision machine à double précision (64 bits).
Au sein de l’écosystème Python, cette même opération mathématique s’articule autour du sous-module scipy.stats de la bibliothèque scientifique open-source. La fonction norm.cdf() (Cumulative Distribution Function) assume cette responsabilité computationnelle :
from scipy.stats import norm
aire_gauche = norm.cdf(1.20, loc=0, scale=1)
L’emploi de ces architectures de programmation permet d’automatiser le traitement probabiliste instantané de répertoires psychométriques comportant des dizaines de milliers de participants, tout en éliminant intégralement les risques d’omission du signe négatif ou d’inversion de table fréquents lors des lectures manuelles.
6.2 Procédure d’implémentation sur tableurs bureautiques
Dans le contexte des cabinets de consultation psychologique, des institutions scolaires ou des départements de ressources humaines, les tableurs bureautiques usuels tels que Microsoft Excel ou LibreOffice Calc demeurent les vecteurs d’analyse quantitative les plus universellement déployés. Ces outils disposent de fonctions intrinsèques dédiées à l’évaluation de la loi de Gauss.
Pour isoler l’aire à gauche d’un score Z préalablement dérivé, la fonction standardisée sous les versions modernes d’Excel s’énonce formellement comme suit :
=LOI.NORMALE.STANDARD.N(z; VRAI)
Dans cette syntaxe française, le premier argument z reçoit la coordonnée standardisée (par exemple -1,07 ou une référence de cellule telle que A2). Le second paramètre est un argument logique fondamental : la valeur booléenne VRAI enjoint impérativement au moteur de calcul de renvoyer la fonction de distribution cumulative, c’est-à-dire l’aire totale intégrée depuis -∞ jusqu’à la borne d’entrée. Si l’utilisateur commet la méprise d’inscrire la valeur FAUX, le tableur ne renverra point l’aire cumulée, mais la simple hauteur géométrique de la fonction de densité de probabilité au point z, une coordonnée d’ordonnée qui ne possède aucune signification probabiliste directe.
Il est tout aussi possible de court-circuiter l’étape arithmétique intermédiaire en exploitant la formule traitant directement le score brut :
=LOI.NORMALE.N(x; moyenne; ecart_type; VRAI)
En saisissant la chaîne =LOI.NORMALE.N(284; 300; 15; VRAI), le tableur affiche immédiatement 0,1423. Les praticiens doivent toutefois demeurer vigilants quant aux configurations régionales linguistiques de leur logiciel : dans les versions anglophones d’Excel, les fonctions se nomment respectivement NORM.S.DIST(z, TRUE) et NORM.DIST(x, mean, standard_dev, TRUE), et le séparateur d’arguments permute d’un point-virgule à une virgule.
6.3 Calculatrices graphiques et modules en ligne spécialisés
Dans les environnements pédagogiques, universitaires ou lors d’épreuves de certification clinique où l’usage d’ordinateurs connectés est proscrit, les calculatrices scientifiques programmables (de types Texas Instruments, Casio ou NumWorks) constituent le support privilégié de détermination de l’aire normale unilatérale.
Sur les architectures Texas Instruments (telles que la TI-83 ou la TI-84 Plus), le microcode statistique intègre la fonction d’intégration numérique normalcdf, logée dans le menu des distributions statistiques (accessible via la combinaison de touches 2nd puis VARS). La signature syntaxique requise pour calculer l’aire à gauche s’énonce :
normalcdf(borne_inférieure, borne_supérieure, [μ, σ])
Puisque la borne théorique inférieure de l’intégrale de Gauss réside en moins l’infini (-∞) — valeur que les registres mémoires d’une calculatrice ne peuvent stocker de façon littérale —, il est indispensable de spécifier un « infini négatif virtuel ». La convention opérationnelle éprouvée consiste à saisir une valeur conventionnellement démesurée par rapport à la variance de la distribution, usuellement -1E99 (-1 multiplié par 10 puissance 99). Ainsi, pour calculer l’aire à gauche d’un score z = -1,07, l’instruction programmée s’écrira :
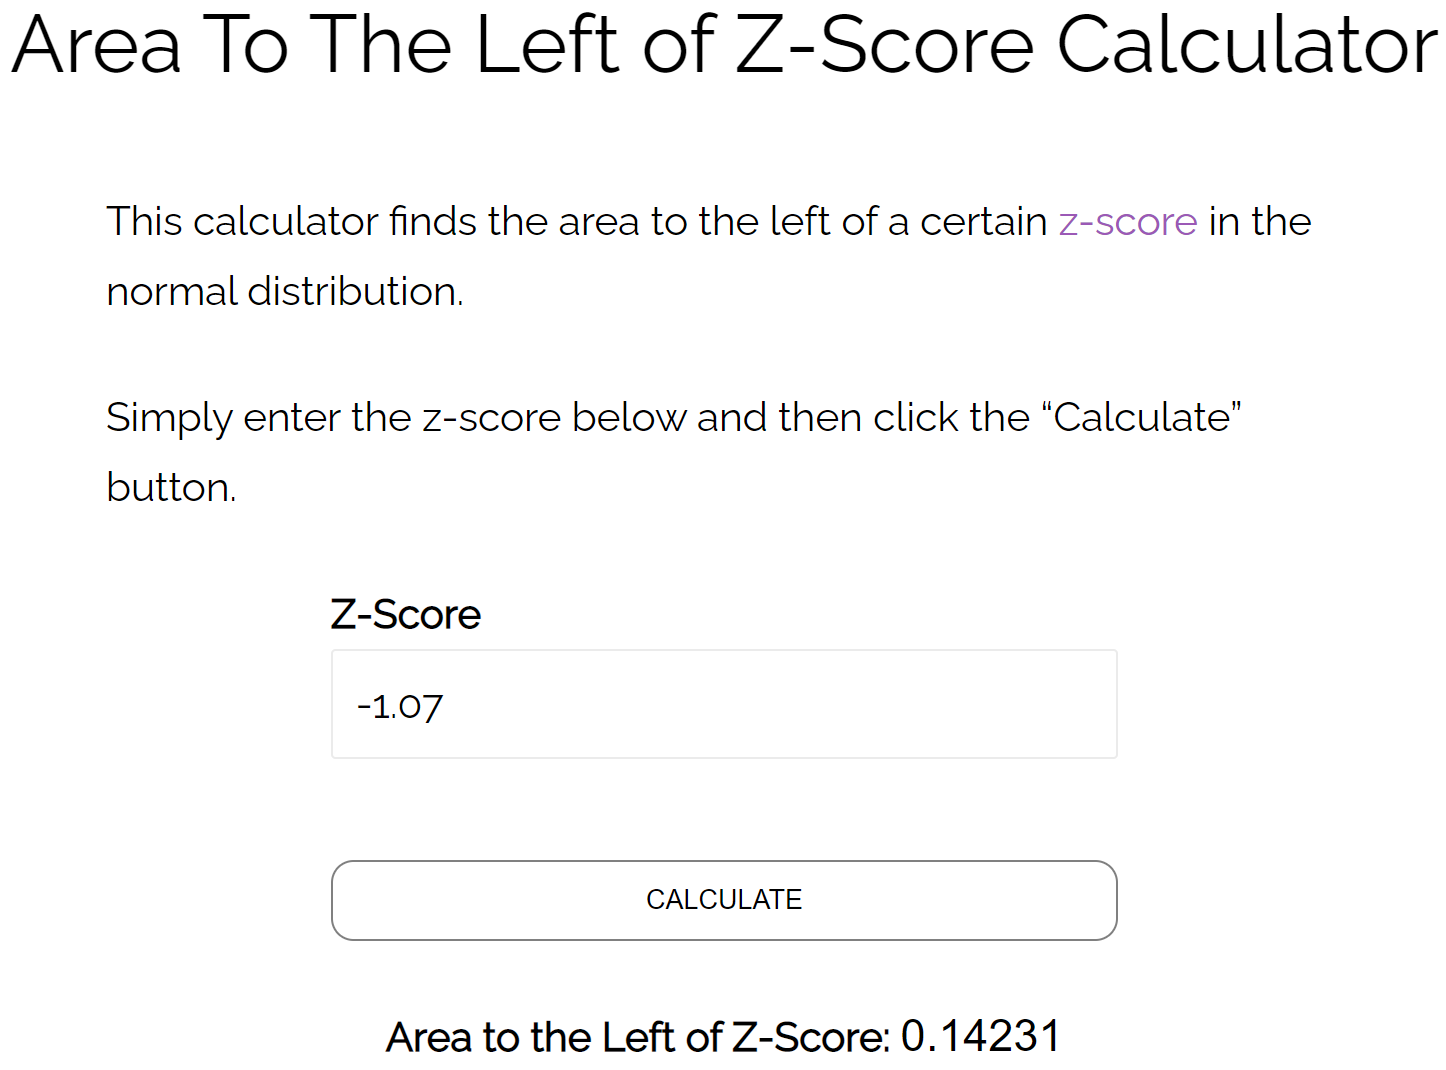
normalcdf(-1E99, -1.07, 0, 1)
La machine restituera la valeur numérique 0,14231… Sur les modèles Casio, la fonction correspondante est NormCD, accessible dans le module STAT via la séquence DIST puis NORM, imposant une définition similaire de la borne minimale (baptisée Lower).
Parallèlement, une multitude de calculateurs statistiques en ligne hébergés par des facultés de psychologie ou des consortiums scientifiques proposent des interfaces interactives dotées de visualisations graphiques dynamiques. Ces plateformes web offrent l’avantage pédagogique majeur d’ombrer instantanément la portion d’aire sous la courbe sélectionnée, permettant au chercheur de valider visuellement que l’opération numérique correspond bien à l’aire cumulative gauche et non à l’une des queues bilatérales.
7. Interprétation psychologique et conversion en rangs percentiles
7.1 Passage de l’aire géométrique au rang centile
Dans l’arsenal interprétatif de la psychométrie appliquée, l’aire géométrique à gauche d’un score Z trouve sa traduction sémiotique la plus fonctionnelle à travers le concept de rang centile (ou rang percentile). Bien que ces deux notions renvoient au même invariant probabiliste, leur usage linguistique répond à des impératifs distincts de communication clinique et scientifique.
Sur le plan analytique, la conversion s’avère mathématiquement directe : le rang centile est le produit scalaire de l’aire cumulée à gauche par une constante de cent (100) :
$$\text{Centile} = \Phi(z) \times 100$$
Le rang centile s’échelonne sur une échelle ordinale normée comprise théoriquement entre 0 et 100, désignant le pourcentage d’individus d’un groupe d’étalonnage dont la performance se situe en deçà d’une note donnée. Ainsi, un sujet dont le score Z atteint 0,00 se positionne exactement à une aire à gauche de 0,5000, ce qui correspond sans ambiguïté au 50e rang centile (la médiane de la distribution).
Il est fondamental de dissiper la confusion fréquente observée chez les étudiants entre le pourcentage de réussite à une épreuve et le rang centile. Le pourcentage de réussite quantifie une métrique absolue de maîtrise de contenu (par exemple, avoir répondu correctement à 80 questions sur 100 lors d’un examen). En revanche, le rang centile mesure une performance relative par rapport à autrui : obtenir un rang centile de 80 signifie que l’individu surpasse 80 % de la population parente, que le score brut absolu requis pour atteindre ce rang ait été hautement médiocre ou prodigieusement élevé en termes d’items validés. Dans l’exploration des inventaires de personnalité ou des échelles cliniques multidimensionnelles, l’aire à gauche convertie en centiles permet une cartographie intuitive des traits saillants d’un individu.
7.2 Concordance entre scores Z, scores T et notes étalonnées
Si le score Z constitue le standard de référence pour les modélisations inférentielles, son maniement en consultation clinique directe est fréquemment réprouvé en raison de deux écueils pédagogiques : la présence récurrente d’un signe arithmétique négatif (perçu à tort par les patients ou leurs familles comme une punition ou une perte de valeur) et l’usage de décimales fines. Pour pallier ces résistances, la psychométrie a développé une pluralité d’échelles dérivées par transformations affines du score Z, toutes conservant rigoureusement la même proportion d’aire cumulée à gauche.
L’échelle la plus renommée en évaluation de la personnalité (notamment au sein du Minnesota Multiphasic Personality Inventory, ou MMPI) est l’échelle T de McCall. La note T s’obtient par une translation et une dilatation d’échelle fixant la moyenne arbitraire à 50 et l’écart-type à 10 :
$$T = 50 + 10(z)$$
Dès lors, un score z de -1,07 (aire à gauche de 14,23 %) correspond rigoureusement à une note T de :
$$T = 50 + 10(-1{,}07) = 50 – 10{,}7 = 39{,}3$$
Le tableau ci-dessous illustre la concordance exacte entre les coordonnées Z canoniques, l’aire unilatérale à gauche, et les échelles étalonnées les plus courantes de la littérature psychologique :
| Score Z | Aire à gauche P(Z ≤ z) | Rang centile | Note T (μ=50, σ=10) | QI Wechsler (μ=100, σ=15) | Stanine (μ=5, σ=2) |
|---|---|---|---|---|---|
| -2,00 | 0,0228 | 2,3e | 30 | 70 | 1 |
| -1,00 | 0,1587 | 15,9e | 40 | 85 | 3 |
| 0,00 | 0,5000 | 50,0e | 50 | 100 | 5 |
| +1,00 | 0,8413 | 84,1e | 60 | 115 | 7 |
| +2,00 | 0,9772 | 97,7e | 70 | 130 | 9 |
La préservation mathématique de l’aire sous-jacente au fil de ces changements de repères assure que quelle que soit la métrique de restitution adoptée par le clinicien, la représentativité populationnelle demeure fondamentalement inchangée.
7.3 Seuils diagnostiques et classification nosographique
L’une des fonctions les plus critiques de l’aire située à gauche du score Z réside dans l’opérationnalisation des critères nosographiques guidant l’attribution des diagnostics de troubles spécifiques de l’apprentissage ou du développement. Dans les manuels de référence tels que le DSM-5 (Manuel diagnostique et statistique des troubles mentaux) ou la CIM-11 (Classification internationale des maladies de l’OMS), les entités cliniques sont fréquemment subordonnées à la démonstration d’un déficit fonctionnel significatif caractérisé statistiquement.
La convention internationale dominante dans le champ du retard mental (désormais qualifié de handicap intellectuel ou de trouble du développement intellectuel) exige la mise en évidence d’un déficit cognitif global situé au moins à deux écarts-types en dessous de la moyenne générale d’étalonnage. Cette délimitation correspond formellement à un score seuil z ≤ -2,00. En interrogeant l’aire sous la courbe normale pour cette borne :
$$\Phi(-2{,}00) = 0{,}0228$$
Ce seuil signifie que cette zone nosologique englobe rigoureusement 2,28 % des individus composant la population d’étalonnage général. En neuropsychologie pédiatrique, pour le repérage des troubles spécifiques du langage oral (dysphasies) ou de l’acquisition de la lecture (dyslexies), des critères un peu moins restrictifs sont fréquemment adoptés, plaçant le seuil d’alerte clinique à z = -1,65 (correspondant aux 5 % inférieurs de la distribution, aire = 0,0500) ou à z = -1,50 (environ 6,7 % inférieurs).
Cependant, l’interprétation diagnostique d’une aire à gauche atypique ne saurait être automatisée sans une analyse qualitative conjointe. Un clinicien averti doit impérativement contextualiser la mesure en intégrant l’erreur type de mesure (ETM) de l’épreuve, les intervalles de confiance probabilistes et l’évaluation de l’adaptation écologique du sujet. Réduire une démarche psychopathologique à la simple extraction mécanique d’une aire sous la courbe exposerait le praticien au péril du faux positif statistique, particulièrement chez des individus issus de minorités culturelles ou linguistiques dont le profil d’acculturation s’écarte des caractéristiques de l’échantillon normatif initial.
8. Distinction cruciale : Aire à gauche, aire à droite et zones bilatérales
8.1 Calcul de l’aire à droite par le principe de complémentarité
Bien que l’aire à gauche représente le paramètre canonique délivré par la quasi-totalité des fonctions de répartition modernes, certaines problématiques de recherche ou de diagnostic clinique nécessitent de déterminer la proportion d’individus surpassant un score spécifique, c’est-à-dire l’aire située à droite de la coordonnée Z (la queue supérieure de la distribution normale). C’est typiquement le cas lors du dépistage du haut potentiel intellectuel (HPI) ou dans l’évaluation des aptitudes exceptionnelles.
Le calcul de l’aire à droite repose formellement sur le postulat fondamental de normalisation probabiliste, selon lequel l’aire totale sous la densité gaussienne équivaut strictement à 1. Par voie de conséquence, la probabilité d’obtenir une valeur supérieure à une borne z donnée correspond exactement au complément à 1 de la probabilité cumulée à gauche de cette même coordonnée :
$$P(Z > z) = 1 – P(Z le z) = 1 – \Phi(z)$$
Prenons l’exemple clinique de l’identification d’un profil à haut potentiel intellectuel, défini par un score de QI au moins égal à 130 sur l’échelle de Wechsler. Ce score brut génère une coordonnée standardisée de :
$$z = \frac{130 – 100}{15} = +2{,}00$$
La consultation tabulaire délivre une aire cumulative à gauche de Φ(2,00) = 0,9772. Pour déterminer la prévalence exacte des individus présentant une aptitude égale ou supérieure à ce jalon d’excellence, le clinicien déduit l’aire à droite :
$$P(Z ge +2{,}00) = 1 – 0{,}9772 = 0{,}0228$$
Soit exactement 2,28 % de la population générale. L’erreur conceptuelle classique chez les néophytes consiste à prélever la valeur tabulée de Φ(z) et à la communiquer indistinctement, affirmant erronément que 97,72 % des individus sont surdoués, ce qui inverse tragiquement la queue de distribution étudiée.
8.2 Calcul de la surface comprise entre deux bornes Z distinctes
De nombreuses applications métrologiques exigent non point d’évaluer les extrêmes directionnels de la distribution, mais d’estimer la densité de population contenue à l’intérieur d’un couloir de performance spécifique, c’est-à-dire la surface délimitée entre deux bornes Z arbitraires, z₁ (borne inférieure) et z₂ (borne supérieure), avec z₁ < z₂.
L’algèbre probabiliste résout cette configuration géométrique par une opération de soustraction séquentielle directe. La probabilité que la variable aléatoire normale se réalise au sein de cet intervalle fermé s’exprime par la différence entre les deux aires cumulatives gauches respectives :
$$P(z_1 le Z le z_2) = P(Z le z_2) – P(Z le z_1) = \Phi(z_2) – \Phi(z_1)$$
Considérons à titre d’illustration l’évaluation de la cohorte d’individus situés dans la plage de fonctionnement intellectuel strictement qualifiée de « normale moyenne », définie conventionnellement en neuropsychologie par des scores bruts de QI compris entre 90 et 110. En convertissant ces deux seuils en scores standardisés :
$$z_1 = \frac{90 – 100}{15} = -0{,}67 \quad \text{et} \quad z_2 = \frac{110 – 100}{15} = +0{,}67$$
En extrayant les aires à gauche pour chacune de ces deux coordonnées standardisées :
- Pour z₂ = +0,67, la table donne Φ(0,67) = 0,7486
- Pour z₁ = -0,67, la table donne Φ(-0,67) = 0,2514
L’aire enserrée entre ces deux bornes s’obtient alors par soustraction :
$$P(-0{,}67 le Z le +0{,}67) = 0{,}7486 – 0{,}2514 = 0{,}4972$$
Ce calcul démontre qu’exactement 49,72 % de la population générale — soit quasiment un individu sur deux — évolue dans cette fenêtre de fonctionnement cognitif médian, illustrant la remarquable concentration des scores humains autour du point zéro de la distribution normale.
8.3 Lien fondamental avec les tests d’hypothèses unilatéraux et bilatéraux
La manipulation géométrique des aires sous la courbe normale ne se limite pas à la description statique d’échantillons psychométriques ; elle constitue l’armature logique de la statistique inférentielle et de la théorie des tests d’hypothèses initiée par Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans ce cadre épistémologique, l’aire située sous la courbe au-delà d’une statistique d’épreuve observée incarne la p-value, soit la probabilité d’obtenir une valeur au moins aussi extrême que celle mesurée sous l’hypothèse nulle (H₀).
L’aire à gauche se trouve intimement associée aux tests directionnels unilatéraux inférieurs (left-tailed tests). Dans un tel schéma inférentiel, le chercheur formule une hypothèse alternative (H₁) directionnelle postulant que le traitement expérimental abaisse le score mesuré (par exemple, la réduction d’un indice de symptomatologie dépressive). La région critique de rejet de l’hypothèse nulle, délimitée par un seuil de signification alpha (α) fixé usuellement à 0,05, est intégralement concentrée dans la queue inférieure gauche. Si l’aire à gauche du score Z expérimental s’avère inférieure à α, l’hypothèse nulle est rejetée avec un risque d’erreur contrôlé.
À l’inverse, lors d’un test non directionnel ou bilatéral (two-tailed test), le chercheur postule une différence sans préjuger du sens de l’écart. Dans cette éventualité, le risque d’erreur globale alpha est scindé de façon équidistante entre les deux extrémités de la distribution normale, allouant une aire de probabilité de α/2 (soit 0,025 pour α = 0,05) à la queue gauche et une aire de α/2 à la queue droite. La valeur critique délimitant l’aire gauche de rejet devient alors z = -1,96. Comprendre l’intégration des surfaces unilatérales sous la courbe constitue donc un prérequis indispensable pour maîtriser la mécanique de la décision statistique et la formulation des inférences scientifiques.
9. Gestion des valeurs extrêmes, cas atypiques et limites du modèle
9.1 Comportement des scores Z au-delà des bornes tabulaires classiques
Un dilemme analytique régulier surgit lorsque le clinicien ou le chercheur observe un score Z d’une magnitude quantitative excédant les limites éditoriales des tables imprimées usuelles, qui bornent généralement leurs entrées entre -3,49 et +3,49. De telles valeurs s’observent ponctuellement lors de bilans de traumatismes crâniens sévères ou dans l’identification de profils intellectuels prodigieux.
Ce phénomène découle de la nature asymptotique intrinsèque de la fonction de densité gaussienne. La fonction ne s’annulant jamais formellement pour des valeurs finies, l’aire à gauche pour un score extrêmement négatif (par exemple z = -4,20) n’est point strictement égale à zéro, mais converge vers une probabilité infinitésimale. Au seuil tabulaire classique de z = -3,49, l’aire cumulative à gauche ne représente déjà plus que 0,00024 (soit 2,4 individus sur 10 000). Pour un score z = -4,00, l’aire cumulée s’abaisse à environ 0,00003167 (environ 3 personnes sur 100 000).
Lorsque les calculs manuels se confrontent à de telles coordonnées au-delà des tables, il est d’usage d’adopter des approximations asymptotiques issues du développement en série de Mills :
$$P(Z le -z) \approx \frac{1}{\sqrt{2\pi} \cdot z} e^{-\frac{z^2}{2}}$$
Sur le plan psychologique, il est impératif de manier ces probabilités infinitésimales avec une circonspection scientifique aiguë. Prétendre qu’un individu se situe au « 99,999e centile » sur la foi d’un test psychométrique n’a bien souvent aucun sens clinique empirique : aucun instrument de mesure en sciences humaines ne dispose d’un échantillon normatif d’étalonnage suffisamment massif pour valider empiriquement des probabilités inférieures à un dix-millième sans être pollué par des erreurs de mesure résiduelles massives.
9.2 Impact des déviations de la normalité sur la précision de l’aire
La déduction de l’aire cumulative à gauche à partir du score Z repose sur une prémisse théorique incontournable : la variable empirique sous-jacente doit épouser rigoureusement une distribution normale. Or, dans la réalité clinique empirique, de multiples instruments psychométriques violent manifestement ce postulat en présentant des distorsions structurelles d’asymétrie (skewness) ou d’aplatissement (kurtosis).
L’asymétrie positive (étalement de la queue vers les valeurs supérieures) ou négative (étalement vers la gauche) détruit la symétrie axiale du modèle gaussien. Par exemple, sur une échelle évaluant les idéations suicidaires administrée en population générale, l’écrasante majorité des participants produit un score nul ou minime, engendrant une distribution hautement asymétrique à droite. Si un statisticien applique mécaniquement la formule du score Z sur une telle distribution pour en déduire l’aire à gauche via la table normale standard, les probabilités estimées seront lourdement erronées : le pourcentage réel d’individus situés sous un score Z donné différera substantiellement de l’aire théorique consignée dans la table.
De même, une distribution leptokurtique (queue épaisse et pic acéré) concentre une masse probabiliste disproportionnée dans ses extrémités par rapport à la courbe normale unitaire. Pour neutraliser ces distorsions métrologiques, il est recommandé de mettre en œuvre des transformations mathématiques stabilisatrices — telles que la transformation logarithmique, la racine carrée ou l’algorithme d’optimisation de Box-Cox — avant la dérivation des scores Z, ou de renoncer au modèle paramétrique au profit de rangs centiles empiriques directs non soumis aux postulats distributionnels.
9.3 Valeurs aberrantes et robustesse de l’estimation de l’aire
Un autre écueil méthodologique de première importance réside dans la vulnérabilité intrinsèque des paramètres classiques de calcul du score Z face aux observations extrêmes aberrantes (outliers). La moyenne arithmétique (μ ou x̄) et l’écart-type (σ ou s) constituent des estimateurs non robustes, dotés d’un point de rupture nul : une seule valeur hautement divergente résultant d’une erreur de saisie ou d’un défaut d’administration suffit à décaler artificiellement la moyenne et à gonfler exponentiellement l’écart-type.
Lorsqu’un échantillon normatif est contaminé par de telles anomalies, la métrique standardisée z s’en trouve biaisée pour l’ensemble des participants. Un écart-type artificiellement élargi par des valeurs extrêmes aura pour conséquence de comprimer l’ensemble des scores Z vers zéro, déformant par contrecoup l’évaluation de l’aire cumulative à gauche. Pour se prémunir contre ce péril métrologique, les statisticiens contemporains préconisent l’usage du score Z modifié (modified Z-score), fondé sur des estimateurs robustes insensibles aux extrêmes :
$$z_{\text{mod}} = \frac{0{,}6745 \cdot (x – \text{Médiane})}{\text{MAD}}$$
où MAD désigne la déviation absolue médiane (Median Absolute Deviation), soit la médiane des écarts absolus par rapport à la médiane de l’échantillon. La constante multiplicatrice 0,6745 assure que pour une distribution normale pure, la MAD équivaut exactement aux deux tiers de l’écart-type, rendant le score Z modifié parfaitement superposable au score Z canonique tout en neutralisant l’influence délétère des valeurs aberrantes sur la dérivation consécutive de l’aire cumulée.
10. Erreurs méthodologiques fréquentes et pièges d’interprétation
10.1 Confusion entre score brut, valeur Z et proportion d’aire
L’expérience pédagogique et la pratique de l’expertise médico-légale révèlent la récurrence chronique d’une triade de confusions métrologiques, particulièrement chez les professionnels non familiers avec la théorie de la mesure. Cette confusion articule de façon anarchique le score brut d’origine, le score standardisé Z et l’aire cumulative résultante.
L’aberration la plus fréquente réside dans la tentative d’assimilation directe du score Z à un pourcentage d’individus. Un praticien novice peut être tenté d’affirmer qu’un patient ayant obtenu un score Z de -1,50 se situe « au 1,5 % le plus faible de la population ». Une telle assertion révèle une méconnaissance radicale de la non-linéarité de la fonction de répartition de Gauss : comme nous l’avons établi, un score de z = -1,50 correspond en réalité à une aire cumulative à gauche de 0,0668 (soit le 6,68e centile). Le score Z est un multiple d’écart-type le long d’une droite numérique sans unité physique, tandis que l’aire à gauche représente une intégrale géométrique bornée comprise entre 0 et 1.
Une confusion symétrique consiste à omettre de rapporter l’unité d’origine lors de la transmission des bilans. Formuler une conclusion diagnostique en énonçant exclusivement que « le patient présente un score de 1,2 » sans expliciter s’il s’agit d’un score Z, d’un score brut ou d’une note étalonnée quelconque engendre des ambiguïtés préjudiciables à la prise en charge clinique. Une rigueur rédactionnelle absolue impose de stipuler systématiquement la métrique exploitée et sa correspondance probabiliste exacte en rang percentile.
10.2 Bévues associées à la gestion des signes arithmétiques
La manipulation des signes algébriques constitue indéniablement la source empirique majeure d’erreurs lors de la consultation des tables statistiques imprimées. L’esprit humain manifeste une propension documentée à négliger le signe négatif lorsqu’il est immergé dans des procédures de calculs matriciels complexes.
L’erreur typique survient lorsqu’un praticien confronté à un score négatif (par exemple z = -1,80) ouvre une table standard n’affichant que des valeurs positives, localise la coordonnée 1,80 et extrait sans précaution la probabilité correspondante : 0,9641. Si ce dernier omet de mobiliser la formule complémentaire par symétrie :
$$P(Z le -1{,}80) = 1 – P(Z le +1{,}80) = 1 – 0{,}9641 = 0{,}0359$$
il conclura que le sujet évalué surpasse 96,41 % de la cohorte d’étalonnage, alors que le patient se situe en réalité parmi les 3,59 % les plus vulnérables. Une telle méprise inverse radicalement l’évaluation clinique et peut conduire à priver un patient d’une prise en charge neuropsychologique indispensable ou, inversement, à diagnostiquer faussement un haut potentiel cognitif chez un sujet manifestant des lacunes sévères.
Pour immuniser les praticiens contre ces bévues arithmétiques, il convient d’enseigner une règle de contrôle spatial mnémotechnique systématique : tout score Z négatif impose impérativement une aire cumulative à gauche strictement inférieure à 0,5000. Dès lors qu’un calcul produit une probabilité cumulée excédant 50 % pour une coordonnée Z précédée du signe moins, l’analyste doit immédiatement identifier qu’une erreur d’inversion ou de complémentation a pollué sa chaîne opératoire.
10.3 Erreurs d’arrondi prématuré dans la chaîne opératoire
Dans la chaîne analytique conduisant d’une observation brute à l’aire sous la courbe, la manipulation des grandeurs décimales fait peser un risque d’instabilité numérique si les règles de l’arrondi statistique ne sont pas rigoureusement respectées. L’erreur la plus préjudiciable consiste à effectuer un arrondi prématuré lors de la détermination de la coordonnée Z avant son interpolation ou son traitement logiciel.
Considérons à titre d’exemple une tâche neuropsychologique complexe où la moyenne est de μ = 53,2 et l’écart-type de σ = 7,6. Un patient réalise un score brut x = 41,5. La division exacte livre :
$$z = \frac{41{,}5 – 53{,}2}{7{,}6} = \frac{-11{,}7}{7{,}6} \approx -1{,}53947368…$$
Si un clinicien procède à un arrondi hâtif à une seule décimale, tronquant la coordonnée à z = -1,5, la table délivre une probabilité unilatérale de 0,0668 (6,68e centile). Si, en revanche, le clinicien conserve rigoureusement deux décimales conformément à la règle de l’arrondi au plus proche, la valeur devient z = -1,54, fournissant une aire cumulée à gauche de 0,0618 (6,18e centile). La déviation induite par cet arrondi prématuré s’élève à un demi-centile d’écart, une amplitude qui peut suffire à faire basculer artificiellement un dossier au-dessus ou en dessous d’un seuil légal d’attribution d’allocations de compensation du handicap.
La règle d’or de l’analyse métrologique impose donc de conserver l’intégralité des décimales générées par les calculateurs tout au long des opérations intermédiaires, et de ne pratiquer l’arrondi statistique d’usage (généralement au dix-millième pour les aires et à l’unité pour les rangs centiles) qu’à l’étape ultime de formalisation du rapport d’évaluation.
11. Applications empiriques avancées en recherche psychologique
11.1 Étalonnage standardisé des instruments de mesure psychométrique
Au-delà du diagnostic individuel, le calcul de l’aire à gauche sous la courbe normale joue un rôle architectural déterminant dans la construction et l’étalonnage normatif des batteries psychométriques contemporaines. Lorsque les éditeurs de tests créent une nouvelle échelle d’évaluation, ils doivent découper l’espace continu des performances de l’échantillon normatif en tranches de rangs centiles harmonisées.
La procédure d’étalonnage normalisé, historiquement formalisée par Truman Lee Kelley, mobilise la technique de normalisation par rangs (rank-based inverse normal transformation). Cette approche consiste à classer l’ensemble des scores bruts d’un échantillon représentatif de calibration par ordre croissant, à leur assigner des fréquences cumulées empiriques relatives (équivalentes à l’aire à gauche sous la distribution empirique), puis à projeter ces aires empiriques sur la loi normale théorique au moyen de la fonction quantile Φ⁻¹(p). Par ce truchement, une échelle ordinale brute qui ne présentait initialement pas une forme parfaitement gaussienne se trouve transformée en une métrique d’intervalle rigoureusement normalisée.
Cette approche garantit une comparabilité internationale et transculturelle des instruments de mesure. Des pays employant des systèmes éducatifs très disparates peuvent ainsi standardiser un même test cognitif international en s’assurant que chaque centile de performance recouvre rigoureusement la même proportion géométrique d’individus sous la courbe normale de référence nationale.
11.2 Modélisation de la théorie de la détection du signal (TDS)
Dans les domaines de la psychophysique expérimentale, de la psychologie cognitive de la perception et de l’imagerie cérébrale fonctionnelle, la détermination de l’aire à gauche d’un score Z est au fondement de la Théorie de la Détection du Signal (TDS), développée initialement par David Green et John Swets.
Dans un paradigme expérimental standard de détection, un sujet doit discriminer la présence d’un signal discret au milieu d’un bruit de fond aléatoire. La performance du sujet est modélisée par deux distributions normales distinctes chevauchantes : la distribution du « Bruit seul » N(0, 1) et la distribution « Signal + Bruit » N(d’, 1), où d’ (d-prime) quantifie la sensibilité perceptive intrinsèque de l’observateur. L’observateur positionne un critère de décision interne arbitraire c le long de cet axe décisionnel :
- Le taux de fausses alarmes (FA) correspond à l’aire située à droite du critère c sous la distribution du Bruit, soit 1 – Φ(c), ce qui implique que l’aire à gauche Φ(c) représente la probabilité d’un rejet correct.
- Le taux de détections correctes (Hits) correspond à l’aire à droite du même critère sous la distribution Signal + Bruit, soit 1 – Φ(c – d’).
En recueillant expérimentalement les pourcentages de détections correctes et de fausses alarmes, le chercheur convertit immédiatement ces proportions en scores Z via la fonction quantile inverse. La sensibilité d’ s’isole alors par une élégante équation différentielle standardisée :
$$d’ = z(\text{Hits}) – z(\text{FA})$$
Cette méthodologie d’une exceptionnelle puissance permet de dissocier mathématiquement la finesse sensorielle pure d’un individu de ses biais cognitifs de réponse (conservatisme ou libéralisme décisionnel), une avancée méthodologique impensable sans la maîtrise de la correspondance biunivoque liant les aires cumulées de Gauss à leurs coordonnées standardisées.
11.3 Méta-analyses et standardisation de la taille d’effet
Dans la recherche translationnelle en psychologie clinique et en psychiatrie fondée sur les preuves (evidence-based practice), l’agrégation statistique d’études multiples au sein de méta-analyses repose sur la standardisation des amplitudes d’effet thérapeutique. L’indicateur prééminent est le d de Cohen, qui quantifie l’ampleur de la différence moyenne standardisée séparant un groupe clinique expérimental (recevant une psychothérapie) d’un groupe contrôle (sur liste d’attente ou recevant un placebo).
Or, pour conférer à un d de Cohen une signification clinique tangible et compréhensible pour les comités d’éthique et les décideurs de santé publique, les épidémiologistes transposent fréquemment cette statistique en une métrique d’aire sous la courbe normale, connue sous la désignation d’indice de non-chevauchement de Cohen (U₁) ou d’estimateur de supériorité probabiliste (Common Language Effect Size, CLES).
Si nous supposons que la distribution des scores de bien-être mental suit une loi normale d’écart-type homogène au sein des deux groupes, l’indice de supériorité probabiliste s’obtient directement par le calcul de l’aire à gauche sous la loi normale centrée réduite pour une coordonnée Z égale à :
$$z = \frac{d}{\sqrt{2}}$$
Ainsi, pour une psychothérapie présentant une taille d’effet substantielle de d = 0,80 (critère conventionnel d’effet fort selon Cohen), la coordonnée standardisée résultante s’énonce :
$$z = \frac{0{,}80}{1{,}4142} \approx 0{,}566$$
La déduction de l’aire cumulative à gauche sous la courbe de Gauss livre alors :
$$\Phi(0{,}566) \approx 0{,}714$$
Cette conversion probabiliste permet de formuler une conclusion d’une clarté exemplaire : un patient extrait aléatoirement du groupe bénéficiant de la psychothérapie manifestera un niveau de rétablissement supérieur à celui d’un patient extrait du groupe témoin dans exactement 71,4 % des appariements possibles. Ce passage de la métrique d’effet à l’aire sous la courbe incarne le vecteur privilégié de vulgarisation scientifique des avancées thérapeutiques.
12. Guide méthodologique synthétique et protocole opérationnel
12.1 Arbre de décision standardisé pour le calcul de l’aire à gauche
Afin de garantir une rigueur procédurale absolue et d’éliminer toute variabilité d’opérateur lors de l’analyse des données psychométriques, il est recommandé de formaliser les étapes analytiques au sein d’un arbre décisionnel standardisé en quatre phases consécutives :
- Étape 1 : Vérification de la compatibilité distributionnelle
Vérifier que la variable sous-jacente suit raisonnablement une distribution gaussienne au sein de la population parente. Contrôler l’asymétrie (critère : |Skewness| < 1,0) et l’aplatissement (|Kurtosis| < 1,5), ou recourir à des tests formels d’ajustement (Shapiro-Wilk) si la taille de cohorte le permet. En cas de violation patente, privilégier des rangs centiles empiriques directs. - Étape 2 : Standardisation arithmétique rigoureuse
Extraire le score brut x, l’espérance normée μ et la variance σ. Calculer la déviation relative selon l’équation standardisée :
z = (x – μ) / σ.
Conserver au minimum trois décimales intermédiaires et arrondir au centième d’unité le plus proche uniquement en cas d’usage de tables papier. Identifier immédiatement la polarité du signe (+ ou -). - Étape 3 : Sélection de la méthode de résolution et extraction de l’aire
Option A (Informatique) : Déployer la fonction native appropriée (pnorm()sous R,LOI.NORMALE.STANDARD.N(z; VRAI)sous Excel) pour recueillir l’aire à gauche avec une précision machine continue.
Option B (Table papier avec valeurs négatives) : Localiser la ligne (entier + dixième) et la colonne (centième) pour extraire directement l’aire cumulée.
Option C (Table papier positive unilatérale pour score négatif) : Localiser la valeur absolue |z|, extraire l’aire cumulée positive Φ(|z|), et appliquer formellement la transformation complémentaire : Aire = 1 – Φ(|z|). - Étape 4 : Contrôle de plausibilité et transposition interprétative
Vérifier la cohérence spatiale : le résultat doit être < 0,5000 pour un score Z négatif, et > 0,5000 pour un score Z positif. Multiplier l’aire par 100 pour consigner le rang centile dans le dossier clinique.
12.2 Matrice récapitulative des correspondances scores-aires
Pour l’estimation rapide au chevet du patient ou lors de sessions d’analyse exploratoire où l’usage d’outils informatiques est temporairement indisponible, le tableau mémoriel suivant synthétise les points d’ancrage canoniques de la loi normale centrée réduite. Ce tableau intègre les bornes cardinales issues de la fameuse règle empirique 68-95-99,7 réinterprétées sous le prisme unilatéral exclusif de l’aire à gauche :
| Point d’ancrage Z | Aire cumulée à gauche Φ(z) | Rang centile exact | Interprétation clinique standardisée |
|---|---|---|---|
| -3,00 | 0,0013 | 0,13e | Déficit gravissime / Exception statistique rare |
| -2,58 | 0,0049 | 0,49e | Seuil bilatéral classique α = 0,01 |
| -2,00 | 0,0228 | 2,28e | Seuil conventionnel du déficit pathologique (DSM) |
| -1,96 | 0,0250 | 2,50e | Seuil bilatéral critique α = 0,05 |
| -1,645 | 0,0500 | 5,00e | Seuil unilatéral critique α = 0,05 (Fragilité clinique) |
| -1,00 | 0,1587 | 15,87e | Limite basse de la moyenne normale |
| 0,00 | 0,5000 | 50,00e | Performance moyenne théorique (Médiane parfaite) |
| +1,00 | 0,8413 | 84,13e | Limite haute de la moyenne normale |
| +1,645 | 0,9500 | 95,00e | Seuil supérieur de performance remarquable |
| +1,96 | 0,9750 | 97,50e | Seuil de divergence supérieure (Top 2,5 %) |
| +2,00 | 0,9772 | 97,72e | Seuil conventionnel du haut potentiel (Wechsler) |
| +3,00 | 0,9987 | 99,87e | Aptitude exceptionnelle majeure |
Cette armature numérique fournit au clinicien un cadre d’estimation probabiliste instantané permettant de situer immédiatement n’importe quel score standardisé sans nécessiter d’interrogation tabulaire exhaustive.
12.3 Standards de conformité et de rédaction selon les normes de l’APA
La communication des résultats quantitatifs dans les publications académiques ou les comptes-rendus institutionnels est soumise aux directives typographiques rigoureuses de l’American Psychological Association (APA, 7e édition). La restitution d’une coordonnée standardisée et de l’aire unilatérale associée doit répondre à des canons formels immuables.
Sur le plan typographique, les lettres latines symbolisant des statistiques d’échantillon ou des variables standardisées doivent impérativement être composées en italique (par exemple z, p, d). En revanche, les abréviations métrologiques standard, les symboles grecs (tels que μ, σ ou Φ) et les opérateurs fonctionnels conservent une typographie romaine droite.
En conformité avec les conventions de précision de l’APA :
- Les scores Z doivent systématiquement être rapportés avec deux décimales après la virgule (ou le point selon la norme anglophone) : par exemple z = -1,07 ou z = 1,20.
- Les probabilités associées (aires à gauche) doivent être consignées avec trois ou quatre décimales. Lorsque la valeur ne peut théoriquement jamais excéder 1 (ce qui est le cas des proportions d’aire et des p-values), la règle de rédaction anglophone de l’APA omet le zéro initial précédant le séparateur décimal (par exemple, rapporter p = .036 ou aire = .1423), bien que la littérature francophone académique tolère l’écriture exhaustive avec la virgule (0,1423).
- Les rangs centiles doivent être mentionnés sous la forme d’entiers naturels sans décimale superflue lorsqu’ils sont communiqués aux patients (ex. : « se positionne au 88e centile »), mais peuvent admettre une décimale de précision dans les tableaux de recherche descriptive.
Une formulation rédactionnelle exemplaire d’une section de résultats clinico-scientifiques s’énoncera donc comme suit :
« L’analyse neuropsychologique individuelle révèle une latence sensorimotrice significativement écourtée (x = 284 ms, z = -1,07), correspondant à une aire cumulative sous la courbe normale de 0,1423. Ce positionnement situe le participant au 14e rang centile de la cohorte d’étalonnage sain, attestant de la préservation intégrale de sa vélocité de traitement élémentaire en dépit du diagnostic médical de fatigue chronique. »
Cette rigueur de signalement garantit la transparence méthodologique intégrale, la réplicabilité des déductions inférentielles et une communication clinique dénuée de toute ambiguïté sémiotique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kelley, T. L. (1939). The selection of upper and lower groups for the validation of test items. Journal of Educational Psychology, 30(1), 17-24. https://doi.org/10.1037/h0057123
- McCall, W. A. (1922). How to measure in education. Macmillan.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.