
Dans le domaine de l’analyse quantitative et de l’inférence statistique, la maîtrise de la distribution normale constitue le socle sur lequel reposent la plupart des méthodologies d’évaluation empirique. Qu’il s’agisse de mesurer des variables biométriques, des traits psychologiques ou des fluctuations financières, la capacité à transformer une observation brute en une valeur standardisée universellement interprétable — le score Z — représente une compétence méthodologique déterminante. Cette standardisation mathématique permet de transcender les unités arbitraires de mesure pour situer avec exactitude un individu, un échantillon ou un phénomène au sein d’une population de référence universelle régie par les lois du calcul probabiliste.
Cependant, le calcul du score Z ne constitue qu’une étape intermédiaire dans la chaîne du raisonnement analytique. L’intérêt fondamental de cette modélisation réside dans la détermination des surfaces géométriques sous la courbe de densité de probabilité, lesquelles correspondent directement aux probabilités d’occurrence des événements observés. Parmi les différentes configurations géométriques possibles, la recherche de l’aire située à droite d’un score Z — souvent qualifiée d’analyse unilatérale supérieure ou d’évaluation de la queue de distribution — s’avère particulièrement cruciale pour les chercheurs et les praticiens. Elle permet en effet de quantifier la probabilité qu’une observation excède un seuil déterminé, ouvrant ainsi la voie à l’identification de performances exceptionnelles, à la détection de pathologies sévères ou encore à la validation d’hypothèses scientifiques par le calcul de la p-valeur.
Ce guide exhaustif a pour vocation d’exposer en profondeur les fondements théoriques, les mécanismes computationnels et les applications empiriques de l’estimation de l’aire à droite d’un score Z. À travers une démarche progressive combinant rigueur mathématique, représentations graphiques, exemples numériques détaillés et implémentations logicielles modernes, cet article offre aux étudiants, aux chercheurs en sciences cognitives et aux statisticiens les outils méthodologiques indispensables pour maîtriser ce calcul statistique sans jamais succomber aux pièges d’interprétation les plus fréquents.
1. Introduction aux fondements de la loi normale et du score Z
1.1 Définition et rôle fondamental du score Z en statistique
Le score Z, également désigné sous le terme de note standardisée ou de valeur centrée réduite, constitue une mesure adimensionnelle traduisant l’écart d’une observation brute par rapport à la moyenne arithmétique de son groupe de référence, cet écart étant quantifié en unités d’écart-type. Sur le plan conceptuel, le score Z ne se contente pas de relater une position linéaire ; il fournit un indice relatif de rareté ou de типиcité d’une donnée au sein d’une distribution continue. Dans toute démarche de recherche empirique, les mesures brutes sont intrinsèquement tributaires d’unités hétérogènes : des millisecondes pour un temps de réaction cognitive, des points discrets pour un inventaire de personnalité ou des microgrammes par millilitre pour une concentration sérique. L’absence de référentiel commun empêche toute comparaison inter-domaines.
La transformation en score Z opère une normalisation linéaire qui affranchit la variable de son unité physique d’origine. Dès lors, un chercheur peut comparer rigoureusement des variables de natures radicalement disparates, telles que la performance verbale et la dextérité motrice d’un même sujet, en évaluant simplement leurs déviations relatives par rapport à leurs moyennes respectives. En psychométrie contemporaine et en modélisation quantitative, le score Z représente l’épine dorsale des étalonnages normatifs. Il permet de transformer des distributions empiriques parfois opaques en coordonnées immédiatement exploitables au regard de la loi de distribution normale standardisée.
Cette standardisation garantit la pérennité et la transférabilité des analyses descriptives et inférentielles. Sans cette réduction d’échelle, l’application de modèles linéaires généralisés, l’estimation des puissances statistiques et l’agrégation de résultats au sein de méta-analyses complexes se heurteraient à des distorsions mathématiques insurmontables. En convertissant la distance brute en un multiple d’écart-type, le statisticien installe l’observation sur une échelle universelle où chaque intervalle possède une signification probabiliste invariable.
1.2 Propriétés géométriques de la courbe normale centrée réduite
La courbe normale centrée réduite, matérialisée par la célèbre distribution en cloche de Carl Friedrich Gauss et d’Abraham de Moivre, se distingue par une architecture géométrique d’une régularité absolue. Sa première propriété cardinale réside dans sa symétrie axiale parfaite par rapport à la droite verticale d’abscisse z = 0, représentant la moyenne, la médiane et le mode conjoints de la population. Cette symétrie implique que la distribution se scinde rigoureusement en deux moitiés équiprobables de part et d’autre de cette origine centrale, conférant à chaque segment latéral une masse probabiliste de 0,5000, soit exactement 50 % de l’ensemble des événements possibles.
Sur le plan analytique, la fonction de densité de probabilité présente une allure continue qui décroît de manière exponentielle au fur et à mesure que la variable s’éloigne de l’axe central, sans toutefois jamais toucher l’axe des abscisses. Cette décroissance asymptotique vers l’infini positif et l’infini négatif signifie que, sur le plan strictement théorique, l’étendue de la variable s’étend de moins l’infini à plus l’infini, garantissant l’existence d’une probabilité non nulle, bien qu’infinitésimale, pour les déviations les plus extrêmes. L’aire géométrique totale comprise entre la courbe de densité et l’asymptote horizontale est rigoureusement égale à un, matérialisant ainsi l’axiome fondamental de l’espace probabilisé complet.
En outre, la distribution présente deux points d’inflexion caractéristiques situés précisément aux abscisses z = -1 et z = +1, marquant le basculement de la concavité de la courbe vers la convexité. Cette structure sous-tend les règles empiriques classiques de la statistique théorique : approximativement 68,27 % de la surface totale est circonscrite entre les coordonnées z = -1 et z = +1, environ 95,45 % entre z = -2 et z = +2, et plus de 99,73 % entre z = -3 et z = +3. Ces caractéristiques géométriques prévisibles transforment l’espace sous la courbe en un système de mesure spatiale directe des probabilités continues.
1.3 Importance de l’analyse unilatérale supérieure (aire à droite)
Dans l’arsenal des tests statistiques et de l’évaluation normative, une distinction conceptuelle majeure oppose la probabilité cumulative globale à l’évaluation de la queue supérieure. La probabilité cumulative ordinaire s’intéresse à l’aire intégrée depuis l’infini négatif jusqu’à une valeur seuil z, modélisant la probabilité qu’une variable aléatoire prenne une valeur inférieure ou égale à cette borne. À l’inverse, l’analyse unilatérale supérieure isole exclusivement la surface située à droite du score Z, c’est-à-dire l’intégrale définie depuis la borne d’évaluation z jusqu’à la limite asymptotique positive.
Cette aire à droite matérialise la proportion théorique d’une population qui surpasse un niveau de performance ou de symptomatologie spécifique. L’évaluation de cette queue de distribution est prépondérante dès lors que l’observateur cherche à documenter des phénomènes d’exception, qu’il s’agisse de compétences intellectuelles extraordinaires, de dépassements de seuils toxicologiques critiques en santé environnementale, ou de rendements financiers hors normes. Dans ces contextes, la masse probabiliste centrale et la queue inférieure s’avèrent non informatives quant à la nature de la singularité observée.
Dans le domaine des tests d’hypothèses statistiques, la détermination de l’aire à droite incarne directement le calcul de la valeur critique unilatérale, communément appelée la valeur p (p-value) supérieure. Lorsqu’un protocole expérimental formule l’hypothèse dirigée selon laquelle une intervention thérapeutique augmente significativement un biomarqueur ou améliore une capacité mnésique, l’évaluation du rejet de l’hypothèse nulle dépend entièrement de la probabilité résiduelle située à droite du score de test observé. Si cette aire est inférieure au seuil de signification alpha préalablement fixé (par exemple 0,05 ou 0,01), le résultat est déclaré statistiquement significatif.
2. La structure mathématique du score Z et son calcul
2.1 Décomposition algébrique de la formule du score Z
La formulation algébrique canonique du score Z repose sur un ratio d’une élégance mathématique parfaite, traduisant à la fois le positionnement d’une valeur individuelle et l’homogénéisation de l’échelle de dispersion :
z = (x – μ) / σ
Dans cette équation, le numérateur (x – μ) formalise l’écart brut entre l’observation empirique observée, notée x, et la moyenne arithmétique de la population mère de référence, symbolisée par la lettre grecque μ. Ce premier terme isole l’amplitude absolue de la divergence ainsi que son orientation spatiale : une différence arithmétique positive traduit un résultat situé au-delà de la tendance centrale du groupe, tandis qu’une valeur algébrique négative atteste d’une performance inférieure à ce référentiel moyen.
Le dénominateur, représenté par l’écart-type de la population σ, opère comme un facteur d’échelle régulateur. L’écart-type mesurant la dispersion moyenne des observations individuelles autour de la valeur centrale, son incorporation au dénominateur permet de relativiser la divergence brute. Diviser l’écart à la moyenne par σ revient à poser la question : « Combien de fois l’amplitude type des fluctuations individuelles est-elle contenue dans la déviation manifestée par ce sujet précis ? » Par conséquent, plus la population est hétérogène (c’est-à-dire caractérisée par un large écart-type σ), plus la déviation brute requise pour atteindre un score Z élevé sera substantielle.
2.2 Calcul opérationnel à partir de paramètres empiriques
L’application concrète de cette formulation statistique exige une distinction méthodologique rigoureuse entre les paramètres théoriques d’une population idéale et les statistiques issues d’un échantillon fini prélevé sur le terrain. Lorsque le statisticien travaille sur l’ensemble exhaustif d’une population ou sur des échelles psychométriques nationales standardisées, les paramètres μ et σ sont tenus pour fixes, stables et connus avec certitude. Le calcul s’exécute directement selon les normes universelles établies par les tables normatives de référence.
En revanche, dans les protocoles de recherche expérimentale où l’exhaustivité est inaccessible, le chercheur doit substituer la moyenne de l’échantillon (généralement notée x̄) et l’écart-type de l’échantillon corrigé (symbolisé par s) aux paramètres de population correspondants. Cette substitution transforme la relation linéaire :
z = (x – x̄) / s
L’effet d’une transformation linéaire sur la distribution des données brutes mérite une attention conceptuelle soutenue : soustraire une constante (la moyenne) et diviser par un facteur scalaire constant (l’écart-type) ne modifie aucunement la forme générale de la distribution. Les distances relatives séparant les différents points sont scrupuleusement conservées. Si la distribution d’origine est de morphologie normale, la distribution standardisée qui en découle conserve sans altération cette courbure symétrique en cloche. Le signe algébrique final du score Z synthétise de manière binaire l’appartenance à l’un ou l’autre des deux hémisphères de Gauss : un score Z négatif positionne le point dans le demi-plan inférieur, tandis qu’un score Z strictement positif valide un ancrage dans l’hémisphère supérieur.
2.3 Standardisation d’une mesure continue vers une variable N(0,1)
Le terme de standardisation exprime le passage formel d’une variable aléatoire continue X, obéissant à une loi normale caractérisée par une moyenne quelconque μ et une variance σ², notée conventionnellement X ~ N(μ, σ²), vers une variable aléatoire Z subordonnée à la loi normale standardisée, formalisée par l’expression Z ~ N(0, 1). Cette métamorphose mathématique implique impérativement que la nouvelle distribution possède une espérance mathématique E(Z) = 0 et une variance statistique Var(Z) = 1.
Cette réduction d’échelle garantit l’alignement absolu de la série statistique avec la table de distribution cumulative universelle. La standardisation abolit les contraintes liées aux singularités d’instrumentation métrologique. Qu’une épreuve psychométrique utilise une métrique brute allant de 0 à 50 points avec un écart-type de 7, ou qu’un examen d’aptitude quantitative s’étende de 200 à 800 points avec un écart-type de 100, la transformation conjointe de ces deux distributions vers l’espace N(0, 1) confère à leurs scores Z respectifs une comparabilité parfaite.
Dès lors, un individu affichant z = +1,50 dans le premier test et un individu obtenant z = +1,50 dans le second occupent des positions percentiles strictement indiscernables dans leurs populations normatives respectives. La transformation préserve scrupuleusement la hiérarchie des rangs (les percentiles) et l’espacement proportionnel des observations, tout en rendant possible l’application directe des algorithmes d’intégration de la densité de Gauss.
3. Compréhension probabiliste de l’aire située à droite d’un score Z
3.1 Expression intégrale de la queue supérieure de distribution
Sur le plan de l’analyse infinitésimale, la probabilité qu’une variable normale centrée réduite Z excède un seuil déterminé z se traduit formellement par l’intégrale définie de sa fonction de densité de probabilité φ(t), calculée depuis ce seuil z jusqu’à la limite asymptotique vers l’infini positif :
P(Z > z) = ∫z+∞ φ(t) dt = ∫z+∞ [1 / √(2π)] · exp(-t² / 2) dt
Dans cette formulation rigoureuse, la fonction φ(t) = [1 / √(2π)] exp(-t² / 2) représente la fonction de densité gaussienne de la loi normale centrée réduite. L’intégrale matérialise la somme continue des rectangles infinitésimaux de hauteur φ(t) et de largeur dt découpés sous la courbe entre le point z choisi et l’infini supérieur. Cette surface délimitée correspond sans aucune ambiguïté à la probabilité de survenue d’une valeur strictement supérieure au seuil z considéré.
Cependant, le calcul analytique direct de cette intégrale se heurte à une impossibilité théorique majeure formulée par Joseph Liouville : la fonction exponentielle de forme exp(-t²/2) ne possède aucune fonction primitive élémentaire exprimable à l’aide des fonctions usuelles (polynômes, exponentielles pures, logarithmes ou fonctions trigonométriques). Il est donc formellement impossible de résoudre cette intégrale par l’application naïve du théorème fondamental de l’analyse par soustraction de primitives élémentaires. Le recours à des méthodes d’approximation numérique, au développement en séries entières ou à des tables numériques précalculées devient, par nature mathématique, incontournable pour tout traitement pratique.
3.2 Le principe du complément à l’unité
Face à l’impossibilité de calculer directement une primitive élémentaire, la théorie des probabilités propose une dérivation opérationnelle fondée sur la décomposition de l’univers des possibles en événements complémentaires. L’ensemble de la surface délimitée sous la courbe de Gauss valant rigoureusement un, la partition de cette aire totale autour d’un score Z arbitraire obéit à une relation arithmétique élémentaire d’additivité spatiale :
P(Z ≤ z) + P(Z > z) = 1
En vertu de cette égalité axiomatique, l’aire unilatérale supérieure P(Z > z) peut être reformulée par le principe du complément à l’unité :
P(Z > z) = 1 – P(Z ≤ z)
Dans la littérature statistique internationale, la fonction de distribution cumulative — qui mesure la probabilité que la variable prenne une valeur inférieure ou égale à z (soit l’aire sous la courbe située à gauche du seuil) — est universellement symbolisée par la lettre grecque majuscule Phi, notée Φ(z). L’expression de la queue supérieure se réécrit donc sous sa forme canonique :
P(Z > z) = 1 – Φ(z)
Cette formulation constitue l’armature logique de l’immense majorité des démarches analytiques. Les tables statistiques standards ainsi que les moteurs de calcul algorithmique intègrent par convention la fonction de répartition cumulative Φ(z). Déterminer l’aire située à droite d’un score Z revient par conséquent à extraire la valeur cumulative de gauche Φ(z), puis à la retrancher mathématiquement du nombre entier 1.
3.3 Interprétation statistique et probabiliste du résultat
L’aire à droite, une fois quantifiée sous forme décimale, doit faire l’objet d’une traduction conceptuelle méthodique pour livrer toute sa valeur analytique. Une valeur décimale comprise entre 0 et 1 se convertit directement en un pourcentage de la population totale en multipliant le résultat arithmétique par 100. Par exemple, une aire supérieure calculée à 0,1587 signifie rigoureusement que 15,87 % de la population cible présente un score situé au-dessus de cette borne spécifique.
Cette grandeur probabiliste mesure simultanément la rareté relative de l’événement et sa fréquence d’occurrence théorique à long terme. Dans le cadre de l’inférence décisionnelle et de la théorie des tests statistiques formulée par Jerzy Neyman et Egon Pearson, cette aire à droite incarne la p-valeur unilatérale droite. Elle quantifie précisément la probabilité d’observer un résultat au moins aussi extrême que celui mesuré dans l’échantillon, sous la supposition formelle que l’hypothèse nulle d’absence de différence ou d’absence d’effet soit strictement vraie.
Si cette surface résiduelle s’avère inférieure au risque d’erreur consenti par le chercheur (le seuil α, fixé traditionnellement à 5 %, soit 0,05), le résultat sera considéré comme statistiquement improbable sous le régime du hasard pur, conduisant au rejet formel de l’hypothèse nulle en faveur de l’hypothèse de recherche.
4. Méthode 1 : Utilisation de la table statistique normale standard cumulative
4.1 Analyse de l’architecture d’une table Z standard
La table statistique de la loi normale centrée réduite, communément appelée table de Gauss ou table Z standard, constitue un outil imprimé dont la structure bidimensionnelle répond à des règles typographiques et arithmétiques très strictes. Une table Z cumulative standard présente une organisation matricielle où la dimension verticale (la colonne de marge située à l’extrême gauche) recense les valeurs du score Z jusqu’au premier chiffre décimal (les dixièmes). La dimension horizontale (la première ligne supérieure) détaille quant à elle le second chiffre décimal du score Z (les centièmes), s’étendant sans interruption de 0,00 à 0,09.
Avant d’engager toute consultation, le chercheur ou l’étudiant doit impérativement valider la convention cartographique adoptée par le concepteur de la table en examinant l’en-tête graphique situé au sommet de la page. Trois formats de tables coexistent dans la littérature scientifique :
- La table cumulative globale unilatérale gauche : le format le plus universellement répandu, qui consigne la valeur Φ(z), c’est-à-dire l’aire totale depuis -∞ jusqu’à z. Pour un score z = 0,00, cette table affiche invariablement 0,5000.
- La table cumulative centrée : elle quantifie uniquement l’aire comprise entre la moyenne 0 et le score z. Pour z = 0,00, la valeur affichée est 0,0000, et il convient d’ajouter 0,5000 pour obtenir la probabilité cumulative totale.
- La table de queue supérieure droite : plus rare dans les manuels de base, elle indique immédiatement l’aire à droite sans exiger de soustraction préalable.
La confusion entre ces trois formats structurels représente l’une des causes les plus dévastatrices d’erreur d’interprétation lors des examens universitaires et des expertises de données.
4.2 Extraction de la probabilité cumulative Phi(z)
L’extraction de la valeur cumulative Φ(z) au sein d’une table unilatérale gauche classique s’opère par une procédure de repérage cartésien à double entrée. Supposons que l’on recherche la probabilité cumulative associée à un score standardisé z = 1,46. L’opérateur segmente mentalement cette valeur en deux composantes scalaires : la troncature au premier dixième, soit 1,4, et le résidu centésimal, qui est de 0,06.
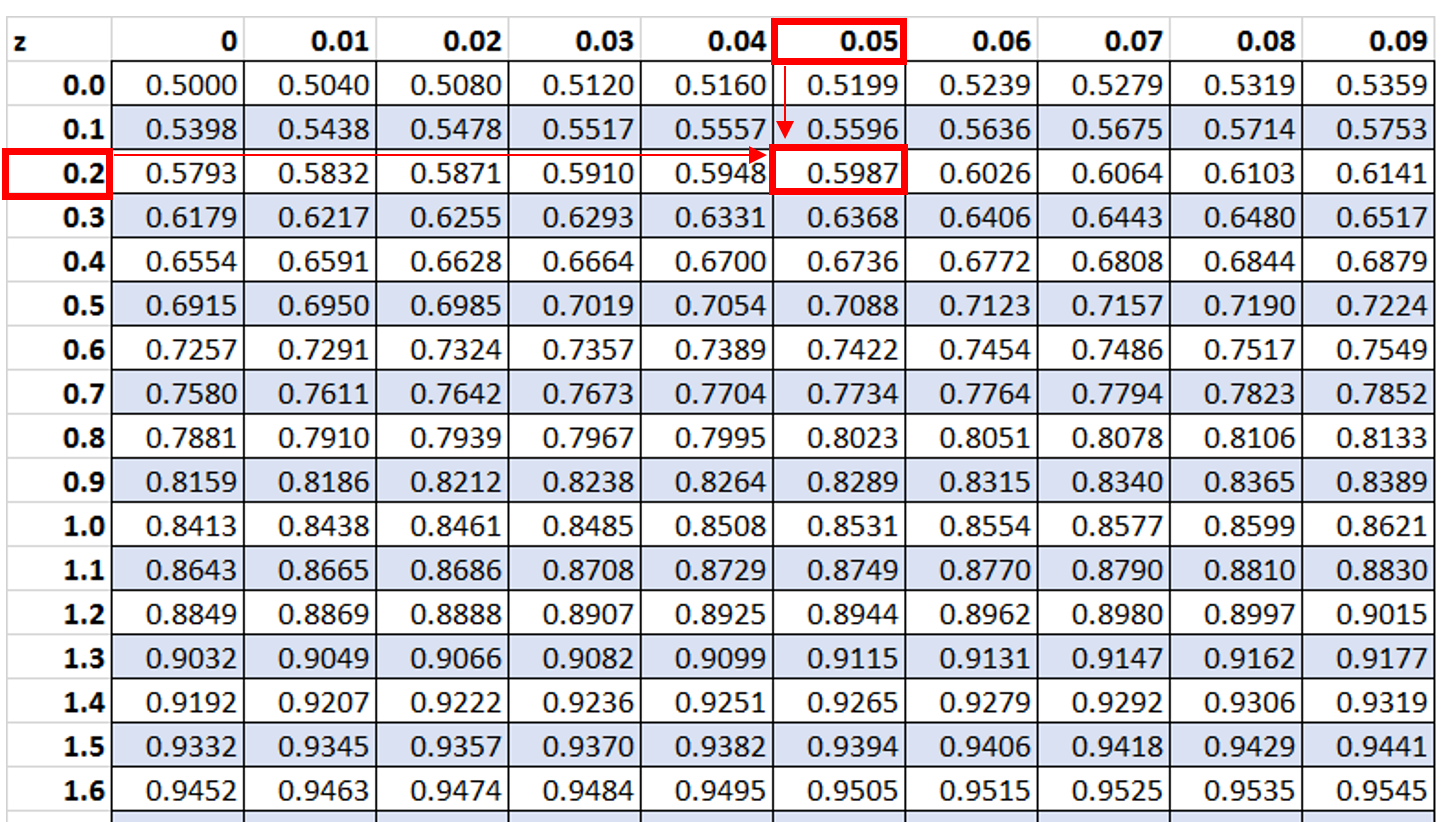
Le chercheur descend verticalement le long de la colonne de gauche jusqu’à intercepter la rangée étiquetée 1,4. Tout en maintenant cette ligne active, son regard balaie horizontalement le tableau vers la droite jusqu’à croiser la colonne indicée 0,06. La cellule située à l’intersection exacte de cette rangée 1,4 et de cette colonne 0,06 livre le coefficient probabiliste recherché : en l’occurrence, la valeur 0,9279.
Ce chiffre indique précisément que Φ(1,46) = 0,9279, soit une aire cumulative à gauche équivalente à 92,79 % de la surface totale de Gauss. Dans l’éventualité où le score Z comporterait trois décimales (par exemple z = 1,465), deux alternatives méthodologiques se présentent : procéder à un arrondi arithmétique conservateur au centième le plus proche (soit z = 1,47), ou exécuter une interpolation linéaire simple entre les cellules adjacentes Φ(1,46) = 0,9279 et Φ(1,47) = 0,9292 afin de capturer le millième avec une exactitude accrue.
4.3 Application de la soustraction du complément
Dès lors que la fonction cumulative Φ(z) a été extraite de la matrice numérique, l’étape ultime consiste à appliquer rigoureusement le théorème du complément pour isoler l’aire située à droite. En reprenant l’exemple précédent pour lequel z = 1,46 a conduit à l’identification de Φ(1,46) = 0,9279, le calcul arithmétique de la queue supérieure se déploie comme suit :
P(Z > 1,46) = 1 – Φ(1,46) = 1 – 0,9279 = 0,0721
Cette soustraction élémentaire révèle que la queue de distribution supérieure abrite 7,21 % de la surface probabiliste totale. La validation logique de ce résultat repose sur un auto-contrôle intuitif : puisque le score z = +1,46 est un nombre positif supérieur à zéro, le seuil se situe obligatoirement à droite du centre de gravité de la cloche de Gauss. L’aire résiduelle qui s’étend vers la droite doit par conséquent être strictement inférieure à la demi-surface de la courbe (0,5000).
L’obtention d’une valeur supérieure à 0,50 pour un score Z positif constitue le signe indiscutable d’une omission de la soustraction du complément à l’unité, signifiant que l’analyste a par inadvertance conservé l’aire à gauche Φ(z) en lieu et place de l’aire unilatérale supérieure.
5. Méthode 2 : Utilisation des calculateurs spécialisés et logiciels statistiques
5.1 Utilisation des calculateurs d’aire en ligne dédiés
L’avènement des calculateurs d’aire statistique en ligne et des applets interactives a profondément transformé la pédagogie et la pratique de l’inférence statistique. Ces outils numériques spécialisés, développés par des départements universitaires de statistique ou des éditeurs de logiciels éducatifs, permettent de contourner la manipulation manuelle des tables imprimées tout en offrant une interface visuelle immédiate.
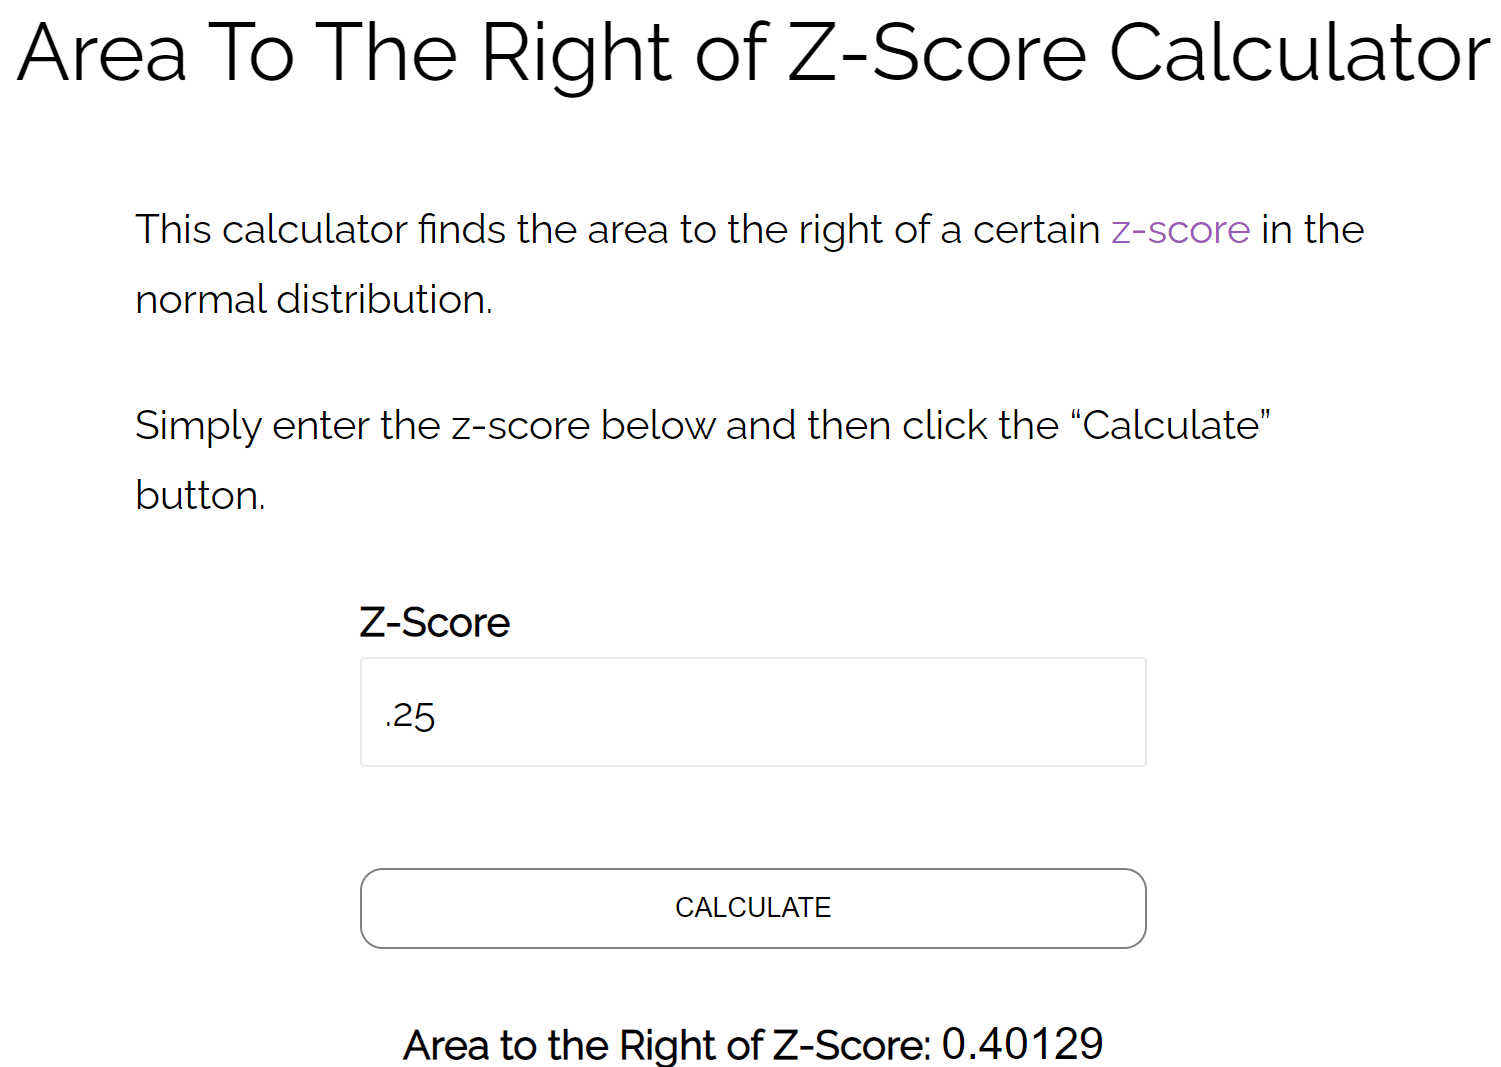
Leur utilisation opérationnelle s’articule autour d’une interface paramétrique épurée. L’utilisateur est invité à renseigner le score Z obtenu dans un champ dédié, puis à sélectionner l’orientation de l’aire par le biais de cases d’option directionnelles : « Queue gauche » (Left Tail / P(Z < z)), « Entre deux bornes » (Two Tails / Interval), ou précisément « Queue droite » (Right Tail / P(Z > z)). En sélectionnant l’option unilatérale supérieure, le moteur de rendu calcule instantanément la valeur numérique de l’aire avec une précision décimale configurable (souvent de 4 à 8 décimales) et actualise dynamiquement un tracé graphique de la courbe de Gauss.
Ce retour visuel, matérialisé par une coloration de l’aire sous la courbe à droite de la ligne verticale du score Z, procure un contrôle cognitif immédiat, confirmant à l’utilisateur que l’intervalle spatial évalué correspond point par point à la question de recherche posée.
5.2 Calculs automatisés via tableurs (Excel, Google Sheets)
Au sein des environnements d’entreprise et des laboratoires de recherche appliquée, les tableurs de référence tels que Microsoft Excel et Google Sheets offrent des fonctions internes hautement optimisées pour le calcul de l’aire de distribution normale. Historiquement, l’ancienne fonction LOI.NORMALE.STANDARD(z) a été remplacée dans les versions modernes par la fonction standardisée ISO LOI.NORMALE.STANDARD.N().
Pour déterminer directement l’aire à droite d’un score Z consigné dans la cellule A1 d’une feuille de calcul, la syntaxe arithmétique formelle s’écrit :
=1 - LOI.NORMALE.STANDARD.N(A1; VRAI)
Dans cette formule, l’argument logique VRAI est absolument fondamental. Il intime au moteur de calcul de renvoyer la fonction de distribution cumulative intégrée Φ(z) depuis l’infini négatif jusqu’à la valeur de la cellule A1. Si cet argument était omis ou renseigné avec la valeur FAUX, le tableur restituerait non pas une probabilité d’aire, mais la valeur de l’ordonnée de la fonction de densité φ(z), c’est-à-dire la hauteur physique de la courbe au point considéré, ce qui fausserait irrémédiablement l’analyse probabiliste.
L’immense avantage de l’implémentation sous tableur réside dans son potentiel d’automatisation matricielle : une colonne contenant des milliers de scores Z calculés en temps réel peut être convertie en probabilités de queues supérieures par un simple glissement de formule, avec un formatage conditionnel convertissant immédiatement les résultats en pourcentages d’une rigueur absolue.
5.3 Implémentation sous R et Python pour l’analyse scientifique
Dans le domaine de la recherche académique de pointe et de la science des données, le recours aux langages de programmation statistique R et Python constitue le standard méthodologique garantissant la reproductibilité computationnelle intégrale des calculs.
Dans l’environnement statistique R, la fonction de distribution cumulative de la loi normale est désignée par pnorm(). Bien qu’il soit possible d’écrire la formulation par soustraction 1 - pnorm(z), les développeurs du R Core Team ont introduit un argument direct d’une extrême élégance pour calculer nativement l’aire à droite :
pnorm(z, lower.tail = FALSE)
L’assignation du paramètre logique lower.tail = FALSE indique au logiciel de sommer les probabilités à partir de la queue supérieure (vers l’infini positif) plutôt qu’à partir de la queue inférieure. Sur le plan de la précision numérique de calcul en virgule flottante, cette commande native est nettement supérieure à la soustraction 1 - pnorm(z) pour les scores Z très élevés (par exemple z > 5). Elle préserve la précision numérique interne et évite l’annulation par soustraction de nombres infiniment proches de un.
Dans l’écosystème Python, ce même calcul s’exécute à travers la bibliothèque de référence pour les mathématiques et les statistiques, SciPy, plus précisément au sein de son module spécialisé scipy.stats :
from scipy import stats
# Méthode standard par complément :
aire_droite = 1 - stats.norm.cdf(z)
# Méthode optimale par la fonction de survie (Survival Function) :
aire_droite = stats.norm.sf(z)
L’utilisation de la méthode stats.norm.sf(z), désignée formellement sous le vocable de « Survival Function » (fonction de survie), modélise rigoureusement 1 – CDF et garantit une stabilité algorithmique maximale lors du traitement de jeux de données massifs.
6. Exemple pratique 1 : Calcul de l’aire à droite d’un score Z négatif
6.1 Énoncé du problème et contextualisation des variables
Afin d’ancrer ces développements théoriques dans une réalité clinique concrète, analysons une situation issue de la recherche en santé publique relative au suivi nutritionnel périnatal. Considérons une population générale de nouveau-nés à terme au sein de laquelle la variable continue « poids de naissance » obéit rigoureusement à une loi normale. Les paramètres démographiques exhaustifs de cette population mère ont été scientifiquement consolidés : la moyenne du poids est établie à μ = 3 000 grammes, et l’écart-type de la population est de σ = 150 grammes.
Un pédiatre chercheur évalue un sous-groupe de nourrissons issus d’un protocole environnemental spécifique et s’intéresse à un nouveau-né affichant un poids de naissance brut de x = 2 840 grammes. La question clinique et épidémiologique formulée est la suivante : « Quelle est la proportion théorique de nouveau-nés de cette population dont le poids de naissance est strictement supérieur au poids de ce nourrisson ? » Traduit en termes d’analyse probabiliste formelle, notre objectif est de déterminer l’aire située à droite du score correspondant à l’observation x = 2 840 grammes, soit P(X > 2 840).
6.2 Calcul du score Z et justification géométrique
L’étape préliminaire consiste à normaliser cette mesure brute continue en calculant son score Z canonique :
z = (x – μ) / σ = (2 840 – 3 000) / 150 = -160 / 150 = -1,0666…
Afin de permettre une exploitation au sein d’une table Z standardisée imprimée à deux décimales, nous appliquons un arrondi arithmétique conservateur au centième le plus proche, ce qui confère une valeur standardisée définitive de z = -1,07.
Avant d’engager le moindre calcul algorithmique, une analyse géométrique déductive s’impose. Le score Z obtenu affichant une valeur négative (z = -1,07), notre observation est située à gauche de l’axe central de symétrie (z = 0, représentant la moyenne de 3 000 grammes). La ligne verticale séparatrice coupe la distribution normale dans sa moitié inférieure. Par conséquent, la surface spatiale située à droite de cette démarcation englobe l’intégralité de l’hémisphère droit de la cloche (qui représente à lui seul 0,5000, soit 50 % de l’aire totale), plus la section centrale comprise entre le score z = -1,07 et la moyenne z = 0. Dès lors, le chercheur sait avec certitude que la probabilité finale recherchée doit obligatoirement dépasser 0,5000 (50 %).
6.3 Résolution par la table Z et par le calculateur
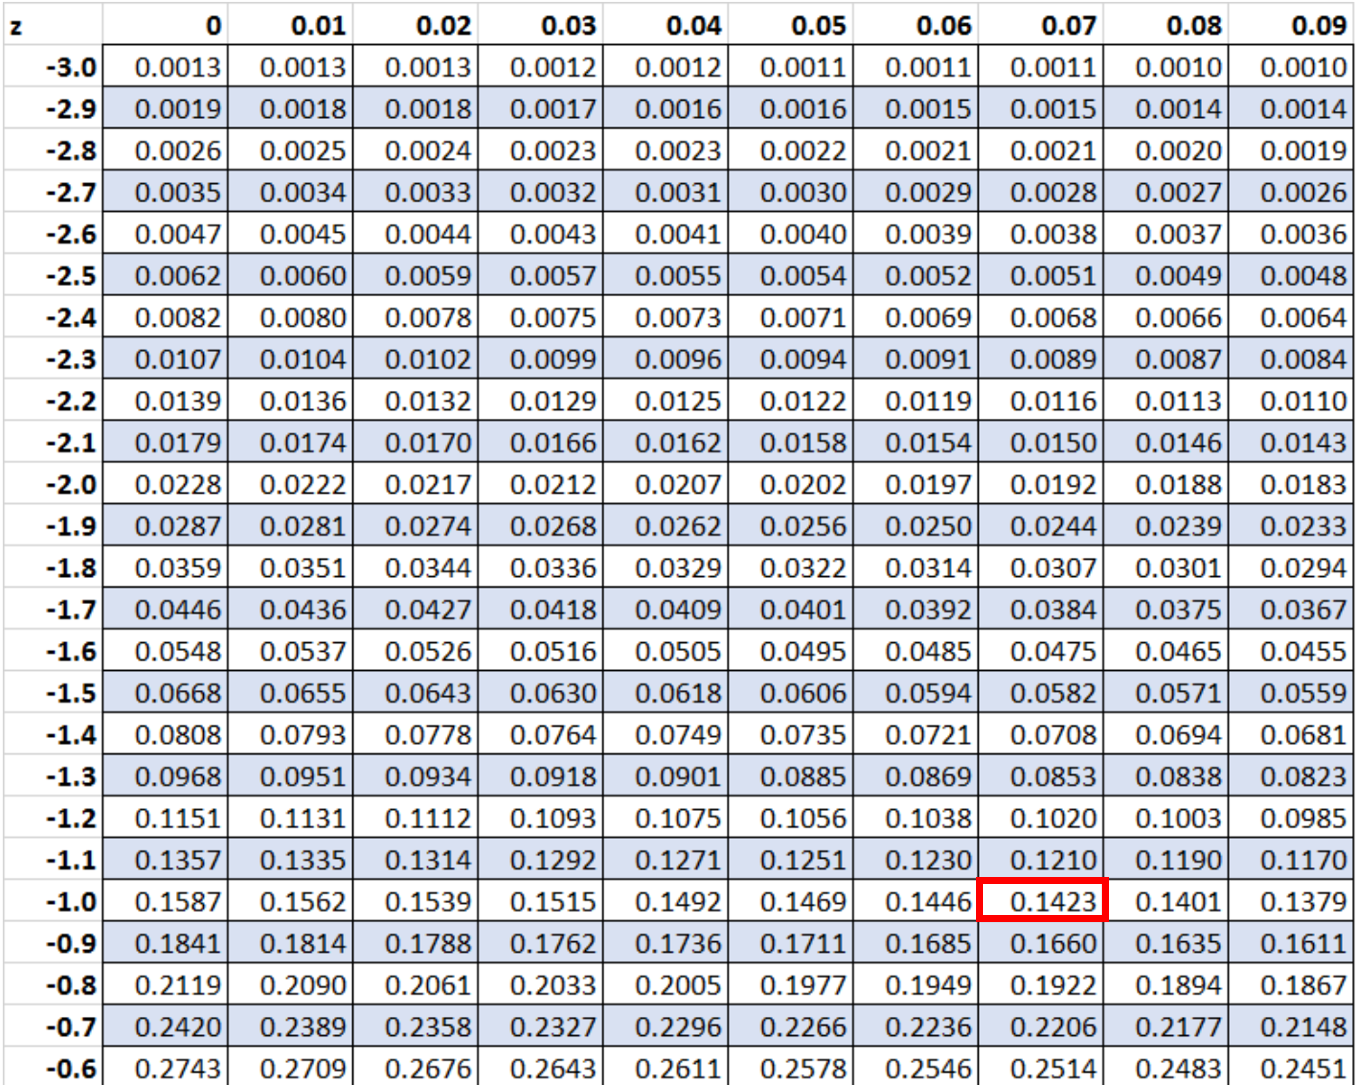
En consultant une table normale standard cumulative unilatérale gauche qui recense les scores négatifs, nous cherchons l’intersection de la ligne marquée -1,0 et de la colonne marquée 0,07. La table fournit la probabilité cumulative suivante :
Φ(-1,07) = 0,1423
Cette valeur de 0,1423 représente la surface située à l’extrême gauche de notre score seuil : elle nous informe que seuls 14,23 % des nouveau-nés ont un poids de naissance inférieur ou égal à 2 840 grammes. Pour obtenir l’aire unilatérale supérieure (à droite), nous mobilisons l’axiome du complément à l’unité :
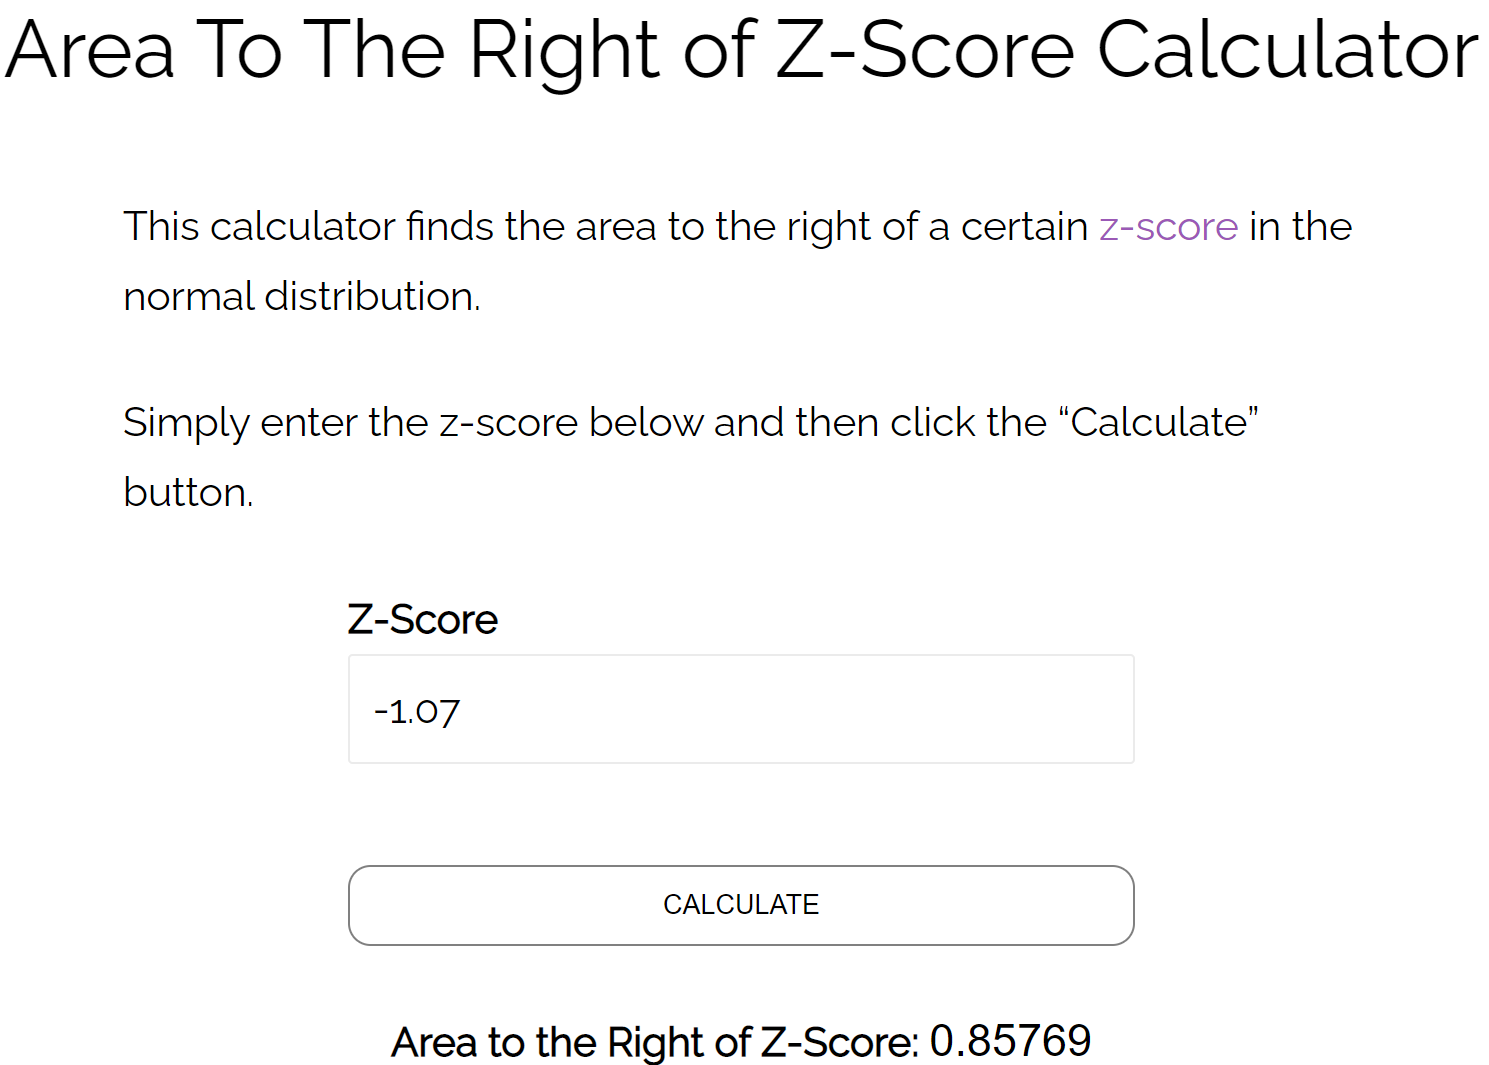
P(Z > -1,07) = 1 – Φ(-1,07) = 1 – 0,1423 = 0,8577
Si l’on exécute ce même calcul via un script sous R (pnorm(-1.07, lower.tail = FALSE)) ou sous Python (scipy.stats.norm.sf(-1.07)), le logiciel renvoie 0,8576903. En multipliant ce résultat par 100, le pédiatre peut conclure avec une absolue certitude scientifique que 85,77 % des nouveau-nés de la population de référence affichent un poids supérieur à 2 840 grammes. Ce résultat confirme remarquablement la prédiction géométrique formulée en amont, qui anticipait un résultat très nettement au-delà du seuil de 50 %.
7. Exemple pratique 2 : Calcul de l’aire à droite d’un score Z positif
7.1 Énoncé du problème et définition des seuils supérieurs
Examinons à présent un second problème empirique, cette fois issu du champ des neurosciences cognitives et de la psychologie différentielle. Dans le cadre de la standardisation d’un nouveau protocole d’évaluation de l’attention visuelle soutenue chez de jeunes adultes, les performances brutes sont quantifiées au moyen d’un score d’efficience globale. L’étalonnage normatif national a démontré que cette compétence cognitive obéit fidèlement à une loi normale caractérisée par une moyenne μ = 100 points et un écart-type σ = 15 points, adoptant une métrique analogue à celle des échelles de Wechsler.
Un candidat participant à une sélection de contrôleurs aériens se soumet à ce protocole et enregistre un score brut remarquable de x = 125 points. L’organisme recruteur applique une politique stricte de sélection des talents et souhaite identifier précisément la proportion de la population générale capable de surpasser cette performance. L’objectif analytique consiste à calculer formellement l’aire unilatérale située à droite du score brut x = 125, soit P(X > 125).
7.2 Standardisation et analyse de la zone critique
Nous convertissons sans délai cette observation empirique en une coordonnée normale centrée réduite en mobilisant la formule de transformation :
z = (x – μ) / σ = (125 – 100) / 15 = 25 / 15 = +1,6666…
En arrondissant cette mesure au centième le plus proche conformément aux exigences de projection sur table statistique standard, nous retenons un score de z = +1,67.
L’analyse géométrique déductive nous renseigne immédiatement sur la topologie de l’espace probabiliste. Le score z = +1,67 étant strictement positif, il s’enracine profondément dans l’hémisphère droit de la cloche de Gauss, bien au-delà de la médiane centrale z = 0. Le seuil sépare la courbe de telle sorte que l’immense majorité de la distribution (toute la moitié gauche de 50 %, augmentée de la région intermédiaire entre 0 et +1,67) se situe à gauche de la démarcation.
Par conséquent, l’aire résiduelle qui s’étend vers l’infini positif ne représente qu’une queue marginale d’excellence cognitive. Le résultat du calcul de l’aire à droite doit donc obligatoirement être un nombre décimal très inférieur à 0,5000, et même inférieur à 0,10 au regard de la règle empirique des deux écarts-types.
7.3 Procédure de calcul étape par étape et conclusion
La résolution manuelle méthodique à l’aide de la table de distribution cumulative normale se déroule selon l’enchaînement opératoire suivant :
- Étape 1 : Localisation de la valeur cumulative à gauche : nous parcourons la table de Gauss pour trouver la ligne 1,6 et la colonne 0,07. La cellule d’intersection révèle une valeur de Φ(1,67) = 0,9525. Cela signifie que 95,25 % des individus de la population de référence obtiennent une note inférieure ou égale à 125 points.
- Étape 2 : Application du théorème du complément à l’unité : nous retranchons cette masse cumulative de l’unité globale :
P(Z > 1,67) = 1 – Φ(1,67) = 1 – 0,9525 = 0,0475. - Étape 3 : Conversion en pourcentage démographique :
0,0475 × 100 = 4,75 %.
L’équipe d’évaluation neuropsychologique peut conclure que seuls 4,75 % des individus composant la population de référence démontrent un niveau d’attention soutenue supérieur à celui du candidat évalué. Sur le plan de la sélection professionnelle, ce candidat se positionne dans le 95e percentile supérieur, attestant d’une disposition cognitive rare qui justifie sa qualification pour les phases suivantes du processus de recrutement.
8. Applications en psychométrie, neuropsychologie et sciences cognitives
8.1 Diagnostic clinique et repérage du haut potentiel intellectuel
L’analyse de l’aire unilatérale supérieure trouve l’une de ses applications cliniques les plus codifiées dans l’évaluation psychométrique de l’efficience cognitive générale et le repérage formel du « Haut Potentiel Intellectuel » (HPI). Dans le modèle métrologique des échelles de l’intelligence pour enfants et adultes (WAIS-IV et WISC-V de David Wechsler), le quotient intellectuel global (QIT) est étalonné pour présenter une distribution normale théorique de moyenne μ = 100 et d’écart-type σ = 15.
Par consensus clinique international validé par les associations scientifiques de psychologie, le seuil d’admissibilité pour qualifier une douance cognitive ou un haut potentiel intellectuel est conventionnellement fixé à un score standardisé égal ou supérieur à deux écarts-types au-dessus de la moyenne démographique, ce qui se traduit par un score Z seuil de z ≥ +2,00. En appliquant la formule de calcul à l’échelle métrique du quotient intellectuel, cela correspond à :
x = μ + (z · σ) = 100 + (2 · 15) = 130 points
L’évaluation de l’aire unilatérale supérieure au-delà de z = +2,00 via l’intégration de la distribution de Gauss révèle une probabilité de P(Z > 2,00) = 1 – Φ(2,00) = 1 – 0,9772 = 0,0228, soit exactement 2,28 % de la population générale. Les praticiens spécialisés en neuropsychologie s’appuient sur cette quantification de la queue droite pour contextualiser les profils cognitifs singuliers : seule une fraction démographique résiduelle de 2,28 % présente une avance développementale de cette magnitude. Une maîtrise irréprochable de ce calcul garantit une interprétation éthique des bilans psychologiques, protégeant les cliniciens contre les diagnostics erronés et les faux positifs résultant d’une confusion entre percentiles et notes brutes.
8.2 Évaluation des échelles de psychopathologie et de détresse
À l’autre extrémité du champ d’application clinique, l’analyse de l’aire à droite constitue l’instrument prédictif de prédilection pour l’interprétation des échelles d’évaluation de la psychopathologie clinique, telles que l’Inventaire de personnalité multiphasique du Minnesota (MMPI) ou les échelles de dépression et d’anxiété de Beck (BDI, BAI). Ces instruments psychométriques convertissent généralement les réponses subjectives des patients en scores standardisés où les notes brutes élevées correspondent à une intensité symptomatique accrue.
Dans la standardisation des scores T utilisés dans le MMPI (caractérisés par une moyenne μ = 50 et un écart-type σ = 10), un score brut se traduisant par un score T ≥ 70 correspond rigoureusement à un score Z de z = (70 – 50) / 10 = +2,00. Là encore, le calcul de l’aire à droite permet au psychopathologue d’apprécier la prévalence théorique d’un tel niveau de souffrance psychologique ou de déviance comportementale :
P(T > 70) = P(Z > 2,00) = 2,28 %
Lorsque des scores atteignent des seuils encore plus critiques, tels que z = +3,00 (correspondant à un score T de 80, souvent symptomatique d’une décompensation psychotique aiguë ou d’un risque suicidaire imminent), l’aire à droite se restreint drastiquement :
P(Z > 3,00) = 1 – Φ(3,00) = 1 – 0,99865 = 0,00135, soit 0,135 %
Cette quantification de l’extrême rareté statistique du profil clinique fournit un indice d’alerte diagnostique puissant, permettant d’orienter les décisions thérapeutiques, l’indication d’hospitalisations d’urgence ou l’évaluation de la dangerosité psychiatrique.
8.3 Normalisation des batteries de tests neuropsychologiques
L’expertise neuropsychologique contemporaine repose sur des batteries d’évaluation approfondies explorant des fonctions cognitives distinctes : la mémoire épisodique, les fonctions exécutives, l’inhibition motrice et les capacités visuo-spatiales. L’un des défis méthodologiques majeurs auxquels font face les neuropsychologues réside dans l’hétérogénéité des scores bruts générés par ces différents tests, qui varient du nombre de mots correctement rappelés au temps d’exécution mesuré au chronomètre.
La normalisation de ces batteries implique l’étalonnage systématique des données brutes en notes standardisées Z, permettant d’établir ce que les cliniciens nomment un « profil neuropsychologique ». L’analyse de l’aire à droite intervient avec une grande pertinence théorique lors de l’investigation de ce que la littérature nomme la « réserve cognitive ». Des sujets âgés présentant des altérations structurales cérébrales visibles à l’imagerie par résonance magnétique (telles que des dépôts amyloïdes caractéristiques de la maladie d’Alzheimer) conservent parfois une efficience cognitive intacte.
En mesurant l’aire à droite occupée par ces patients sur des épreuves de réserve cognitive (vocabulaire, niveau culturel, fluence verbale complexe), les chercheurs documentent comment la persistance d’une performance située dans le décile supérieur (z > +1,28, correspondant à une aire droite de 10 %) compense activement la neurodégénérescence. Ces protocoles d’évaluation sont rigoureusement encadrés par les directives de l’American Psychological Association (APA) et de l’International Neuropsychological Society, qui exigent la mention systématique des scores Z et des rangs percentiles correspondants au sein des rapports de transmission clinique.
9. Exploitation de la symétrie de la courbe pour simplifier les calculs
9.1 La propriété fondamentale d’équivalence symétrique
La géométrie parfaitement symétrique de la fonction de densité de Gauss confère à la courbe normale une propriété arithmétique remarquable qui permet de simplifier considérablement les calculs et de s’affranchir de la soustraction du complément à l’unité. En raison de la symétrie axiale par rapport à zéro, la morphologie spatiale de la queue supérieure à droite d’une valeur positive z est le reflet spéculaire exact de la queue inférieure située à gauche de la valeur opposée -z :
P(Z > z) = P(Z < -z)
De manière rigoureusement réciproque, la probabilité d’obtenir une valeur supérieure à un score négatif -z est strictement équivalente à la probabilité cumulative d’obtenir une valeur inférieure à son homologue positif +z :
P(Z > -z) = P(Z < +z) = Φ(z)
Cette relation d’équivalence constitue une règle de substitution analytique majeure. Elle s’avère particulièrement précieuse dans deux contextes : d’une part, lorsque l’on manipule des tables statistiques historiques condensées qui ne consignent que les scores Z positifs ; d’autre part, pour accélérer les opérations mentales et réduire le risque d’erreur d’inversion lors de calculs sous contrainte de temps.
9.2 Cas concret de résolution symétrique pour un score Z négatif
Pour illustrer la puissance opérationnelle de cette propriété géométrique, réexaminons le cas traité dans notre premier exemple pratique, où nous devions déterminer l’aire à droite du score z = -1,07. La démarche séquentielle standard exigeait d’abord l’extraction de Φ(-1,07) = 0,1423, suivie du calcul de son complément arithmétique 1 – 0,1423 = 0,8577.
En mobilisant le principe de symétrie axiale, le problème se résout de façon directe sans aucune soustraction :
P(Z > -1,07) = P(Z < +1,07) = Φ(1,07)
Le statisticien n’a plus besoin d’accéder à une table des valeurs négatives ni d’effectuer une soustraction : il ouvre directement sa table cumulative standard positive, repère l’intersection de la ligne 1,0 et de la colonne 0,07, et lit immédiatement la valeur 0,8577. Le résultat définitif est obtenu en une seule étape de lecture directe. Cette démarche élimine tout risque d’erreur d’inversion lors de la soustraction par rapport à l’unité, tout en divisant par deux le temps de consultation.
9.3 Cas de résolution symétrique pour un score Z positif
Cette même propriété de symétrie s’applique avec une efficacité équivalente pour déterminer l’aire à droite d’un score Z strictement positif. Reprenons l’exemple de notre évaluation attentionnelle où nous cherchions l’aire unilatérale supérieure associée à z = +1,67. Selon la formulation de l’équivalence symétrique :
P(Z > +1,67) = P(Z < -1,67)
Si l’analyste dispose d’une table Z moderne proposant une page dédiée aux valeurs négatives (restituant directement la fonction cumulative Φ pour des coordonnées inférieures à zéro), la recherche directe de l’intersection de la ligne -1,6 et de la colonne 0,07 livre immédiatement la valeur 0,0475. Le recours à l’opération de complément (1 – 0,9525) est contourné.
Cette approche par double cheminement (voie cumulative standard avec complément versus voie par symétrie directe) offre une méthode de validation croisée d’une remarquable élégance : l’analyste peut vérifier la cohérence logique de ses calculs en comparant les deux résultats obtenus indépendamment, garantissant une fiabilité absolue lors de la communication de rapports décisionnels.
10. Erreurs courantes lors du calcul de l’aire à droite et comment les éviter
10.1 L’oubli de la soustraction par rapport à l’unité
L’omission de la soustraction du complément à l’unité constitue, d’après les données d’observation pédagogique dans l’enseignement universitaire de la statistique, l’erreur la plus ubiquitaire chez les praticiens et les étudiants. Cette méprise survient lorsque l’opérateur localise avec succès le score Z dans la table de Gauss, extrait la valeur cumulative Φ(z), puis la transcrit telle quelle en guise de résultat final sans retrancher ce nombre de l’entier 1.
La manifestation symptomatique la plus flagrante de cette défaillance réside dans l’obtention d’une probabilité unilatérale supérieure à 0,50 pour un score Z strictement positif. Considérons un analyste évaluant le seuil z = +2,15 : s’il rapporte que l’aire à droite vaut 0,9842 (soit 98,42 %), son affirmation est géométriquement absurde, car elle postule que la quasi-totalité de la population se situe au-delà d’un niveau d’excellence situé à plus de deux écarts-types au-dessus de la moyenne.
Le protocole d’auto-contrôle le plus performant pour éradiquer cette erreur consiste à tracer systématiquement à main levée, avant tout calcul numérique, une cloche de Gauss schématique. En dessinant l’axe central vertical à z = 0, en positionnant la ligne du score Z et en hachurant manuellement la surface étudiée à droite, l’analyste s’ancre dans une perception spatiale immédiate : si la surface hachurée représente un segment visuel étroit, tout résultat supérieur à 0,5000 doit être instantanément rejeté.
10.2 Confusion entre signe du score Z et sens de l’inégalité
Une confusion cognitive fréquente provient de l’association mentale erronée entre le signe arithmétique du score Z et l’orientation du symbole d’inégalité probabiliste. Beaucoup d’étudiants associent inconsciemment le signe algébrique négatif à l’obligation de calculer une aire à gauche (<), et le signe positif à la recherche exclusive d’une aire à droite (>).
Cette heuristique trompeuse conduit à des contresens majeurs face à des requêtes formulées sous la forme P(Z > -1,50). L’observateur novice, désarçonné par la présence du signe négatif, aura tendance à calculer P(Z < -1,50), confondant le positionnement géographique de la borne avec la direction de la zone d’intégration sous la courbe. Il est crucial d’assimiler les deux dimensions de manière strictement découplée :
- Le signe du score Z : indique exclusivement l’emplacement du seuil critique (à gauche ou à droite de la moyenne centrale z = 0).
- Le symbole d’inégalité (> ou <) : indique exclusivement la direction dans laquelle l’aire sous la courbe doit être balayée (vers la droite / plus l’infini, ou vers la gauche / moins l’infini).
Un score Z négatif peut être associé à une aire à droite (qui sera alors supérieure à 50 %), tout comme un score Z positif peut être associé à une aire à gauche (qui sera également supérieure à 50 %). Les deux paramètres sont mathématiquement indépendants.
10.3 Mauvaise lecture des axes et arrondis prématurés
La troisième famille d’erreurs méthodologiques regroupe les imprécisions instrumentales de lecture matricielle et les dégradations de précision consécutives à des arrondis prématurés. Lors de la manipulation d’une table imprimée, le basculement d’une colonne adjacente — par exemple lire la colonne 0,05 au lieu de la colonne 0,06 pour un score z = 1,26 — constitue un glissement visuel classique qui peut fausser une évaluation clinique ou un seuil d’admissibilité.
Par ailleurs, la gestion des arrondis lors des étapes intermédiaires de standardisation engendre fréquemment des biais cumulatifs non négligeables. Considérons une épreuve d’aptitude où μ = 40, σ = 7 et x = 49 points. Le score Z brut exact est :
z = (49 – 40) / 7 = 9 / 7 = 1,285714…
Si un étudiant tronque hâtivement ce score intermédiaire à z = 1,2, il extraira de sa table une aire cumulative Φ(1,20) = 0,8849, produisant une aire à droite estimée à 1 – 0,8849 = 0,1151 (11,51 %). En revanche, si l’on applique l’arrondi standard au centième le plus proche (z = 1,29), la table indique Φ(1,29) = 0,9015, générant une aire à droite de 1 – 0,9015 = 0,0985 (9,85 %). L’écart entre ces deux résultats s’élève à 1,66 point de pourcentage. Une telle divergence est inacceptable dans les expertises psychométriques ou judiciaires. Les protocoles scientifiques imposent de conserver au minimum quatre décimales tout au long des opérations intermédiaires et de n’appliquer l’arrondi qu’au stade de la formulation du score Z final.
11. Analyse comparative : Précision des tables manuelles versus outils computationnels
11.1 Limites inhérentes aux tables Z imprimées
Bien que les tables Z conservent une valeur didactique irremplaçable dans la formation universitaire, elles comportent des contraintes structurelles intrinsèques qui restreignent leur pertinence dans le cadre de la recherche quantitative contemporaine. La première contrainte réside dans la discrétisation imposée par un pas fixe de 0,01 unité. La réalité des mesures physiques, psychologiques ou biomédicales se déployant sur un continuum continu, un score Z empirique s’exprime rarement par un centième parfait. L’analyste se trouve contraint de tronquer sa donnée ou de se lancer dans des calculs d’interpolation linéaire fastidieux et sources potentielles d’erreurs.
La seconde limite majeure concerne la troncature de ces tables aux scores extrêmes. L’immense majorité des tables imprimées dans les manuels de référence arrêtent leurs colonnes à des valeurs de z comprises entre ±3,49 et ±3,99. Or, dans des disciplines telles que la génomique statistique (études d’association pangénomique – GWAS), l’analyse des risques financiers extrêmes (Value at Risk) ou les protocoles industriels Six Sigma, les seuils critiques atteignent fréquemment des amplitudes de z > 5 ou z > 6.
Face à de telles coordonnées extrêmes, la table imprimée affiche uniformément une aire cumulative de 0,9999 ou 1,0000, rendant impossible toute différenciation fine des p-valeurs résiduelles dans la queue supérieure de la distribution.
11.2 Puissance algorithmique des solutions logicielles
Les suites logicielles et les bibliothèques computationnelles modernes s’affranchissent radicalement de ces limitations structurelles en mobilisant des algorithmes d’intégration numérique d’une puissance mathématique remarquable. Au lieu de consulter des grilles précalculées, des environnements tels que SciPy (Python), le moteur mathématique de R ou les modules de SAS et SPSS utilisent des approximations polynomiales de haute précision pour la fonction d’erreur complémentaire, notée erfc(x), qui est directement reliée à la distribution normale cumulative par la relation :
Φ(z) = 0,5 · erfc(-z / √2)
L’implémentation de la fonction d’erreur complémentaire normalisée selon le standard matériel IEEE 754 de représentation des nombres en virgule flottante double précision garantit une stabilité algorithmique jusqu’à 53 bits de mantisse (soit environ 15 à 17 décimales significatives). Un chercheur peut ainsi évaluer l’aire unilatérale supérieure associée à un score Z exceptionnel de z = +8,0 sans rencontrer le moindre phénomène de saturation numérique :
P(Z > 8,0) ≈ 6,22 × 10⁻¹⁶
De surcroît, ces solutions logicielles intègrent la gestion native des distributions non standardisées : l’utilisateur peut renseigner directement la valeur brute x, la moyenne μ et l’écart-type σ sans devoir calculer manuellement le score Z intermédiaire, éliminant tout risque d’erreur de transmission arithmétique.
11.3 Critères de choix selon le contexte de recherche ou pédagogique
Le choix de l’instrumentation méthodologique dépend étroitement de la finalité de la démarche d’analyse et de son cadre opérationnel :
- Le cadre didactique et pédagogique initial : la consultation manuelle de la table statistique demeure une étape formative fondamentale. Elle contraint l’apprenant à visualiser spatialement les concepts de ligne, de colonne, d’intersection et de complément à l’unité, développant une intuition géométrique pérenne de la courbe de Gauss qu’aucun clic automatisé sur un logiciel ne saurait remplacer.
- La pratique clinique quotidienne de cabinet : pour le neuropsychologue ou le psychologue du travail recevant un patient en consultation individuelle, les calculateurs d’aire en ligne validés ou les tableurs préformatés offrent un compromis optimal entre vitesse opérationnelle, précision des rangs percentiles et confort ergonomique.
- La recherche scientifique, le Big Data et la publication académique : l’usage de scripts en langage R ou Python s’impose sans compromis. Il garantit non seulement une précision algorithmique absolue sur les queues lointaines, mais assure la reproductibilité intégrale de l’analyse, condition exigée par l’ensemble des revues scientifiques internationales à comité de lecture.
12. Guide méthodologique pas à pas et protocole de vérification
12.1 Protocole séquentiel d’analyse d’un problème de queue supérieure
Afin de garantir une rigueur constante et d’éliminer toute source d’erreur lors du traitement de l’aire unilatérale droite d’un score Z, nous formalisons ci-dessous un protocole méthodologique séquentiel universel, applicable à toute recherche quantitative :
- Étape 1 : Définition formelle de l’événement probabiliste : identifier avec précision la variable continue X, recueillir la moyenne μ et l’écart-type σ de la population parente, et formuler explicitement la question sous forme d’inégalité unilatérale droite : rechercher P(X > x).
- Étape 2 : Standardisation de l’observation brute : exécuter le calcul du score standardisé z = (x – μ) / σ en conservant impérativement un minimum de quatre décimales au stade intermédiaire, puis appliquer l’arrondi au centième le plus proche exclusivement lors de la sélection de la coordonnée z définitive.
- Étape 3 : Choix de la voie computationnelle :
- Option Table Z classique : extraire l’aire cumulative à gauche Φ(z) par croisement ligne-colonne, puis calculer le complément à l’unité 1 – Φ(z).
- Option Symétrie axiale : transformer directement P(Z > z) en son équivalent P(Z < -z) pour une lecture immédiate sans soustraction.
- Option Logicielle (R, Python, tableur) : exécuter la fonction de queue supérieure native (par exemple
pnorm(z, lower.tail = FALSE)).
- Étape 4 : Conversion et interprétation clinique ou scientifique : multiplier le résultat décimal obtenu par 100 pour convertir l’aire en pourcentage démographique représentatif de la population cible, et situer ce résultat au regard des hypothèses de recherche initiales.
12.2 Grille de contrôle de cohérence statistique
Avant d’intégrer tout résultat dans un compte-rendu d’évaluation ou un manuscrit de recherche, le chercheur doit obligatoirement soumettre son estimation à une grille de contrôle interne composée de quatre tests de cohérence logique :
- Test 1 : Vérification des bornes probabilistes : la valeur calculée est-elle rigoureusement confinée dans l’intervalle ouvert ]0 ; 1[ ? Tout résultat négatif ou supérieur à 1 signale une aberration mathématique dans l’algorithme ou l’équation de calcul.
- Test 2 : Vérification de vraisemblance géométrique liée au signe :
- Si le score Z est strictement positif (z > 0), l’aire unilatérale droite P(Z > z) doit obligatoirement être strictement inférieure à 0,5000 (50 %).
- Si le score Z est strictement négatif (z < 0), l’aire unilatérale droite P(Z > z) doit obligatoirement être strictement supérieure à 0,5000 (50 %).
- Si z = 0, l’aire droite est rigoureusement égale à 0,5000 (50 %).
- Test 3 : Épreuve de cohérence avec les règles empiriques : le résultat est-il compatible avec les repères standards ? Pour z = +1, l’aire droite doit avoisiner 15,87 % ; pour z = +2, environ 2,28 % ; pour z = +3, environ 0,13 %. Tout écart massif par rapport à ces ordres de grandeur signale une erreur d’échelle ou de lecture.
- Test 4 : Validation par double méthode croisée : comparer systématiquement le résultat obtenu par la méthode cumulative standard avec celui issu du calcul par symétrie axiale ou par l’outil logiciel. Les valeurs doivent concorder jusqu’à la dernière décimale significative autorisée par les tables.
12.3 Normes de rédaction et de restitution des résultats scientifiques
La présentation des résultats statistiques standardisés au sein de la littérature scientifique obéit à des normes typographiques et de contextualisation rigoureusement codifiées, notamment définies par le manuel de style de l’American Psychological Association (APA 7th edition). Une restitution scientifique rigoureuse ne doit jamais se limiter à mentionner une probabilité brute isolée.
Le rapport statistique doit impérativement articuler de concert les données brutes, les paramètres de dispersion de la population parente, la valeur standardisée Z, la directionnalité de l’intervalle probabiliste et le pourcentage démographique associé. Une formulation académique exemplaire s’articule selon le canevas suivant :
« La performance brute obtenue par le sujet à l’épreuve de fluence verbale catégorielle (x = 38 points) se situe significativement au-delà de la moyenne normative de la population de référence (μ = 26,00 ; σ = 6,00), correspondant à un score standardisé unilatéral z = +2,00. L’intégration de la distribution normale standardisée révèle que l’aire située à droite de ce seuil critique représente une probabilité unilatérale de P(Z > 2,00) = 0,0228. Par conséquent, seuls 2,28 % des individus composant la population de comparaison atteignent ou dépassent un tel niveau de performance verbale, ce qui situe le participant au sein du 98e percentile supérieur de la distribution. »
Cette rigueur de formulation prévient toute ambiguïté interprétative quant à la direction de la queue de distribution analysée et garantit une transmissibilité absolue des conclusions scientifiques au sein de la communauté internationale des chercheurs et des praticiens.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- De Moivre, A. (1738). The Doctrine of Chances: Or, A Method of Calculating the Probabilities of Events in Play (2nd ed.). H. Woodfall.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Neyman, J., & Pearson, E. S. (1933). On the Problem of the Most Efficient Tests of Statistical Hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Oliphant, T. E. (2007). Python for Scientific Computing. Computing in Science & Engineering, 9(3), 10–20. https://doi.org/10.1109/MCSE.2007.58
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental Algorithms for Scientific Computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.