
La psychométrie moderne, la neuropsychologie clinique et les sciences de l’éducation reposent sur une exigence fondamentale : transformer des observations brutes, souvent abstraites et arbitraires, en indicateurs standardisés directement interprétables et comparables au sein d’une population de référence. Qu’il s’agisse d’évaluer les compétences cognitives d’un enfant par une batterie d’efficience intellectuelle, de mesurer le degré de sévérité d’un trouble anxieux ou de quantifier les aptitudes professionnelles d’un candidat lors d’un processus de sélection, le score brut obtenu à une épreuve ne possède aucune signification intrinsèque s’il n’est pas rapporté à la distribution des performances d’un groupe d’étalonnage représentatif. Dans ce contexte, la conversion d’une performance en rang percentile constitue l’un des procédés de communication métrologique les plus puissants et les plus universellement compris par les professionnels de santé, les éducateurs et les bénéficiaires eux-mêmes.
Le calcul rigoureux des centiles à partir des deux paramètres descriptifs cardinaux que sont la moyenne (μ) et l’écart-type (σ) repose sur le postulat d’une loi de distribution théorique sous-jacente, le plus souvent la distribution normale ou courbe de Gauss-Laplace. Lorsque cette hypothèse de normalité distributionnelle est satisfaite, il devient mathématiquement possible de déterminer la position relative exacte de n’importe quel score individuel sans devoir recourir à un reclassement empirique fastidieux de l’ensemble de l’échantillon d’étalonnage. Cette opération mobilise la théorie des probabilités continues et s’articule autour de la notion de variable normale centrée réduite, matérialisée par la cote standardisée ou score z.
Le présent traité méthodologique et clinique a pour vocation d’exposer de manière exhaustive, systématique et analytique l’ensemble des fondements mathématiques, des démarches algorithmiques, des applications diagnostiques et des précautions psychométriques nécessaires à la dérivation sans faille des centiles à partir de la moyenne et de l’écart-type. Conçu tant pour les praticiens en exercice que pour les chercheurs et statisticiens appliqués, ce guide détaille chaque étape du processus, de l’inversion algébrique élémentaire jusqu’à la maîtrise des tables statistiques, la gestion de l’incertitude métrologique et l’implémentation de solutions logicielles automatisées.
1. Fondements théoriques : distribution normale et notion de centile en psychométrie
Avant d’aborder la mécanique calculatoire de la conversion, il est indispensable de maîtriser le cadre conceptuel qui légitime le passage d’une métrique d’intervalle à un indicateur ordinal de rang. L’ensemble de l’édifice psychométrique repose sur une modélisation probabiliste du comportement humain, où la régularité statistique permet d’ordonner et de quantifier la variabilité interindividuelle.
1.1 Propriétés mathématiques de la courbe de Gauss en sciences psychologiques
La distribution normale univariée, historiquement formalisée par Carl Friedrich Gauss et Pierre-Simon de Laplace, constitue le modèle probabiliste prédominant en psychométrie et en sciences humaines. Sa représentation géométrique adopte une forme caractéristique de cloche, rigoureusement symétrique par rapport à son axe vertical passant par son espérance mathématique. Cette symétrie parfaite implique que pour tout écart donné en amont de la valeur centrale, il existe une probabilité strictement identique d’observer un écart équivalent en aval. Du point de vue asymptotique, les extrémités de la courbe, appelées queues de distribution, se déploient à l’infini dans les directions positive et négative en s’approchant de l’axe des abscisses de manière tangentielle, sans jamais entrer en contact avec celui-ci, traduisant ainsi le fait qu’aucune performance humaine, aussi extrême soit-elle, ne possède une probabilité théorique rigoureusement nulle.
L’une des propriétés fondamentales de cette distribution est l’égalité stricte entre la moyenne arithmétique, la médiane et le mode. La valeur la plus fréquente (le mode) coïncide exactement avec le point qui scinde la population en deux moitiés équiprobables (la médiane) et avec le centre de gravité arithmétique des observations (la moyenne). Cette convergence tripartite simplifie considérablement les opérations de modélisation mathématique en fournissant un repère spatial et probabiliste unique au sommet de la densité de répartition.
La légitimité de l’application de la loi normale aux traits psychologiques et cognitifs s’enracine dans le théorème central limite. Selon ce postulat central de la statistique asymptotique, lorsqu’un phénomène continu observable résulte de la somme d’une multiplicité de facteurs causaux indépendants ou faiblement corrélés, ayant chacun une contribution élémentaire de faible amplitude, la distribution résultante converge inéluctablement vers une loi normale, indépendamment de la forme des distributions individuelles de ces facteurs. Ainsi, les aptitudes cognitives, les traits de personnalité stables ou les dimensions neuropsychologiques, étant influencés par des milliers de variants génétiques polygéniques et une infinité de modulations environnementales, présentent naturellement une répartition empirique très proche de l’idéalité gaussienne.
La fonction de densité de probabilité normale continue, notée f(x), est formellement définie sur l’intervalle de moins l’infini à plus l’infini par l’équation exponentielle faisant intervenir le nombre π et la constante népérienne e, pondérée par l’écart-type et la moyenne de la population. L’intégration de cette fonction sur un intervalle donné détermine avec exactitude l’aire sous la courbe, c’est-à-dire la probabilité qu’un sujet prélevé au hasard obtienne une note comprise entre ces deux bornes. L’intégrale de cette densité sur l’ensemble des réels est rigoureusement égale à 1, conférant à la courbe unitaire une représentativité probabiliste exhaustive de cent pour cent de la population mesurée.
1.2 Définition formelle des centiles et des rangs percentiles
Dans la taxonomie métrologique, il convient de distinguer avec une précision absolue les notions de centile, de pourcentage et de décile, dont la confusion altère fréquemment la rigueur des conclusions cliniques. Alors qu’un pourcentage reflète une proportion brute d’items réussis ou d’attributs présents par rapport à un ensemble total (par exemple, 75 % de bonnes réponses à un questionnaire), le rang percentile, fréquemment abrégé en centile, désigne une valeur positionnelle ordinale indiquant le pourcentage cumulé de la population d’étalonnage qui obtient un score strictement inférieur ou égal à une valeur déterminée. Les déciles divisent quant à eux la distribution ordonnée en dix tranches égales comprenant chacune dix pour cent des individus, le premier décile correspondant par définition au dixième centile, tandis que les quartiles segmentent les effectifs en quatre quarts égaux.
Mathématiquement, le rang percentile d’une valeur observée s’exprime comme la fonction de répartition cumulative unilatérale à gauche, c’est-à-dire la probabilité P(X ≤ x). Si une performance cognitive situe un individu au 75e centile, cette assignation ne signifie aucunement que le sujet a résolu trois quarts des items de l’épreuve, mais plutôt que son niveau de performance dépasse ou égale celui de 75 % des pairs composant son groupe de référence normatif, tandis que 25 % de cette même population réalise une performance supérieure.
Cette distinction met en exergue la nature fondamentalement ordinale des centiles, en opposition avec la nature d’intervalle des scores bruts ou des notes standardisées. Sur une échelle d’intervalle, la distance mathématique entre deux unités consécutives demeure constante : la différence entre un score de 40 et un score de 50 est arithmétiquement équivalente à celle séparant 90 de 100. En revanche, l’échelle des rangs percentiles présente une distorsion topologique non linéaire majeure, caractérisée par une compression intense des rangs au centre de la distribution et un étirement progressif et spectaculaire au niveau des queues.
Au cœur de la courbe normale, où la densité d’individus par unité métrique est maximale, un gain modeste de quelques points bruts permet de franchir un grand nombre de rangs percentiles ; à titre illustratif, le passage du 45e au 55e centile requiert une variation de score brut minime. À l’inverse, vers les extrêmes de la distribution, où les individus sont rarissimes, une progression d’un seul centile (par exemple du 98e au 99e centile) nécessite une augmentation substantielle de la note brute. L’interprétation clinique des rangs percentiles doit par conséquent toujours intégrer cette anamorphose de l’échelle sous-jacente.
1.3 Rôle structurel de la moyenne et de l’écart-type dans la normalisation
La normalisation psychométrique moderne repose sur l’exploitation combinée des paramètres de tendance centrale et de dispersion. La moyenne arithmétique de la population, traditionnellement symbolisée par la lettre grecque μ (mu), joue le rôle d’ancrage fondamental en agissant comme l’indice de position de référence absolue autour duquel s’organise l’ensemble de la variabilité mesurée. Elle correspond au centre de symétrie de la loi normale et fixe le seuil auquel correspond exactement, en théorie probabiliste, le 50e centile ou médiane distributionnelle. Sans la connaissance de cette moyenne, le score brut d’un individu flotte dans un vide contextuel qui interdit toute inférence normative.
L’écart-type, désigné par la lettre grecque σ (sigma), constitue le complément indispensable de la moyenne en faisant office d’étalon de mesure métrique universel. Dérivé de la racine carrée de la variance, l’écart-type quantifie la dispersion moyenne quadratique des observations autour du centre de gravité. Dans une modélisation gaussienne, l’écart-type n’est pas simplement un indice descriptif secondaire, mais la véritable unité de mesure de la distance psychologique. Il détermine le degré d’évasement ou d’acuité de la courbe en cloche : un écart-type faible traduit une grande homogénéité des performances autour de la moyenne, tandis qu’un écart-type élevé témoigne d’une dispersion considérable des aptitudes au sein du groupe étalon.
L’élégance et la puissance de la loi normale univariée résident dans le fait qu’elle est intégralement et exhaustivement définie par ces deux seuls paramètres. Dès lors que la moyenne et l’écart-type d’une population parente sont connus et que l’hypothèse de normalité est vérifiée, il devient théoriquement possible de prédire l’intégralité du comportement probabiliste de la variable, y compris la position exacte de chaque quantile, décile ou centile. Aucune information descriptive supplémentaire n’est requise pour modéliser le profil distributionnel dans son entièreté.
Toutefois, la validité métrologique de cette normalisation dépend de la robustesse des estimations d’échantillonnage de ces deux paramètres. Lorsque la moyenne et l’écart-type sont calculés à partir d’une cohorte de petite taille, les fluctuations d’échantillonnage introduisent un biais d’estimation qui fragilise la localisation précise des centiles théoriques. Plus la taille de l’échantillon normatif est substantielle, plus la variance d’échantillonnage de la moyenne et de la variance diminue, garantissant ainsi une stabilité asymptotique aux frontières percentiles calculées par voie paramétrique.
2. L’équation fondamentale de conversion : formulation mathématique et variables
Le passage d’une valeur théorique issue de la loi normale centrée réduite à une valeur métrique concrète s’opère par l’entremise d’une relation algébrique linéaire biunivoque. Cette équation de standardisation et de déstandardisation constitue la clé de voûte de la psychométrie paramétrique et permet de transposer n’importe quel seuil probabiliste dans l’unité de mesure native du test administré.
2.1 Dérivation analytique de la formule X = μ + zσ
L’équation fondamentale permettant de déterminer la valeur brute X correspondant à un centile déterminé prend la forme linéaire directe :
X = μ + z × σ
Pour comprendre la genèse de cette formulation, il est nécessaire de rappeler l’équation classique de centrage et de réduction, par laquelle on transforme un score brut observé en une cote standardisée z :
z = (X – μ) / σ
Dans cette relation primitive, le numérateur (X – μ) exprime l’écart arithmétique absolu entre la performance observée et la moyenne de la population, tandis que la division par le dénominateur σ permet d’exprimer cet écart en nombre relatif d’unités d’écart-type. L’inversion algébrique de cette fonction est immédiate : en multipliant d’abord les deux membres de l’équation par l’écart-type σ, nous obtenons z × σ = X – μ. L’isolement de la variable X par addition de la moyenne μ à chaque membre aboutit sans ambiguïté à l’équation de synthèse X = μ + zσ.
Sur le plan conceptuel, le score z agit comme un coefficient multiplicateur sans dimension d’unités de variance. Lorsqu’un praticien calcule z × σ, il quantifie l’amplitude exacte, exprimée dans l’unité de mesure du test (qu’il s’agisse de points d’efficience, de millisecondes de temps de réaction ou de scores d’auto-évaluation symptomatique), qu’il convient d’ajouter ou de retrancher à la moyenne centrale de référence pour atteindre le seuil correspondant au centile d’intérêt.
Cette transformation linéaire préserve scrupuleusement la structure géométrique de l’espace métrique d’origine. Contrairement à des transformations non linéaires (telles que les fonctions logarithmiques ou exponentielles), la multiplication par une constante positive (σ) suivie de l’addition d’une constante (μ) n’introduit aucune distorsion interne dans les rapports d’espacement entre les valeurs standardisées. L’échelle d’origine de la variable psychométrique est rigoureusement conservée, offrant ainsi une passerelle transparente entre la théorie abstraite de la loi normale unitaire et la pratique empirique de l’évaluation standardisée.
2.2 Nature et propriétés géométriques du score z
Le score z, également désigné sous le vocable de variable normale centrée réduite ou cote standard, est une variable aléatoire continue obtenue par une double opération arithmétique sur une variable distribuée normalement : le centrage, qui consiste à soustraire l’espérance mathématique afin de translater le centre de gravité à zéro, et la réduction, qui divise les écarts par l’écart-type pour ramener la variance à l’unité. Il en découle que la loi normale centrée réduite, universellement désignée par la notation standard N(0, 1), possède une moyenne rigoureusement nulle et un écart-type strictement égal à 1.
D’un point de vue spatial et géométrique le long de l’axe des réels, la valeur prise par le score z indique sans équivoque la direction et l’amplitude de l’écart à la moyenne :
- Un score z strictement égal à 0 se situe exactement au barycentre de la distribution, marquant l’axe de symétrie central où se croisent la moyenne, la médiane et le mode.
- Un score z positif traduit une position métrique située dans la moitié supérieure de la distribution, à droite du centre de symétrie, indiquant une performance supérieure à la moyenne du groupe étalon.
- Un score z négatif signale un positionnement dans la moitié inférieure de la courbe, à gauche du centre de symétrie, reflétant une performance inférieure à la moyenne normative.
L’avantage cardinal du score z réside dans son invariance d’échelle totale. Étant affranchi des unités de mesure d’origine du test (points bruts, temps, nombre d’erreurs), il constitue une métrique universelle permettant de comparer instantanément et équitablement des épreuves aux formats métrologiques hétérogènes. Un individu obtenant un score z de +1,50 à une épreuve de flexibilité cognitive et un score z de +1,50 à une tâche de rétention visuo-spatiale occupe une position de performance strictement équivalente vis-à-vis des populations de référence respectives, indépendamment du fait que la première épreuve soit notée sur 30 points et la seconde sur 150 points.
2.3 Correspondance probabiliste entre surface sous la courbe et centiles
La relation reliant le score standardisé z au rang percentile est intrinsèquement probabiliste et s’opère par l’entremise de la fonction de répartition cumulative unilatérale de la loi normale standard, conventionnellement notée par la lettre grecque majuscule Φ (Phi). Cette fonction associe à toute cote z réelle la probabilité cumulée qu’une variable normale centrée réduite Z prenne une valeur inférieure ou égale à cette cote spécifique :
Φ(z) = P(Z ≤ z)
Dans le formalisme du calcul infinitésimal, cette probabilité cumulée correspond à l’intégrale définie de la fonction de densité unitaire depuis la borne asymptotique inférieure jusqu’à la borne d’évaluation z :
Φ(z) = ∫-∞z (1 / √(2π)) × e-t2/2 dt
Cette intégrale mesure précisément l’aire sous la courbe située à gauche de l’ordonnée érigée au point d’abscisse z. La surface totale sous la courbe de Gauss étant normée à 1 (ou 100 %), la valeur décimale issue de cette intégration représente exactement la proportion d’individus dont les performances sont inférieures ou égales au seuil défini par z. Dès lors, le rang percentile P s’obtient par la simple multiplication de cette probabilité par cent :
P = Φ(z) × 100
Réciproquement, lorsqu’un clinicien ou un chercheur cherche à identifier le score brut correspondant à un centile cible P, il applique la fonction quantile, qui est la bijection inverse de la fonction de répartition cumulative, notée Φ-1. En convertissant préalablement le centile en probabilité cumulée (p = P / 100), l’application de la fonction inverse permet d’extraire la cote z exacte :
z = Φ-1(p)
Ce passage univoque et sans rupture de continuité entre une surface géométrique délimitée sous la fonction de densité, une probabilité cumulative et un rang percentile forme le pivot analytique permettant d’établir des normes d’étalonnage continues et rigoureuses.
3. Maîtrise de la table de distribution normale centrée réduite (Table Z)
Bien que l’informatique moderne permette aujourd’hui d’évaluer la fonction quantile normale de façon quasi instantanée, la maîtrise de la table statistique imprimée demeure un savoir-faire fondamental pour tout psychométricien. Elle garantit une compréhension intime des symétries mathématiques à l’œuvre et constitue une compétence indispensable pour vérifier rapidement la vraisemblance d’un résultat calculé ou conduire des expertises hors environnement informatisé.
3.1 Typologie et structure de lecture des tables statistiques standards
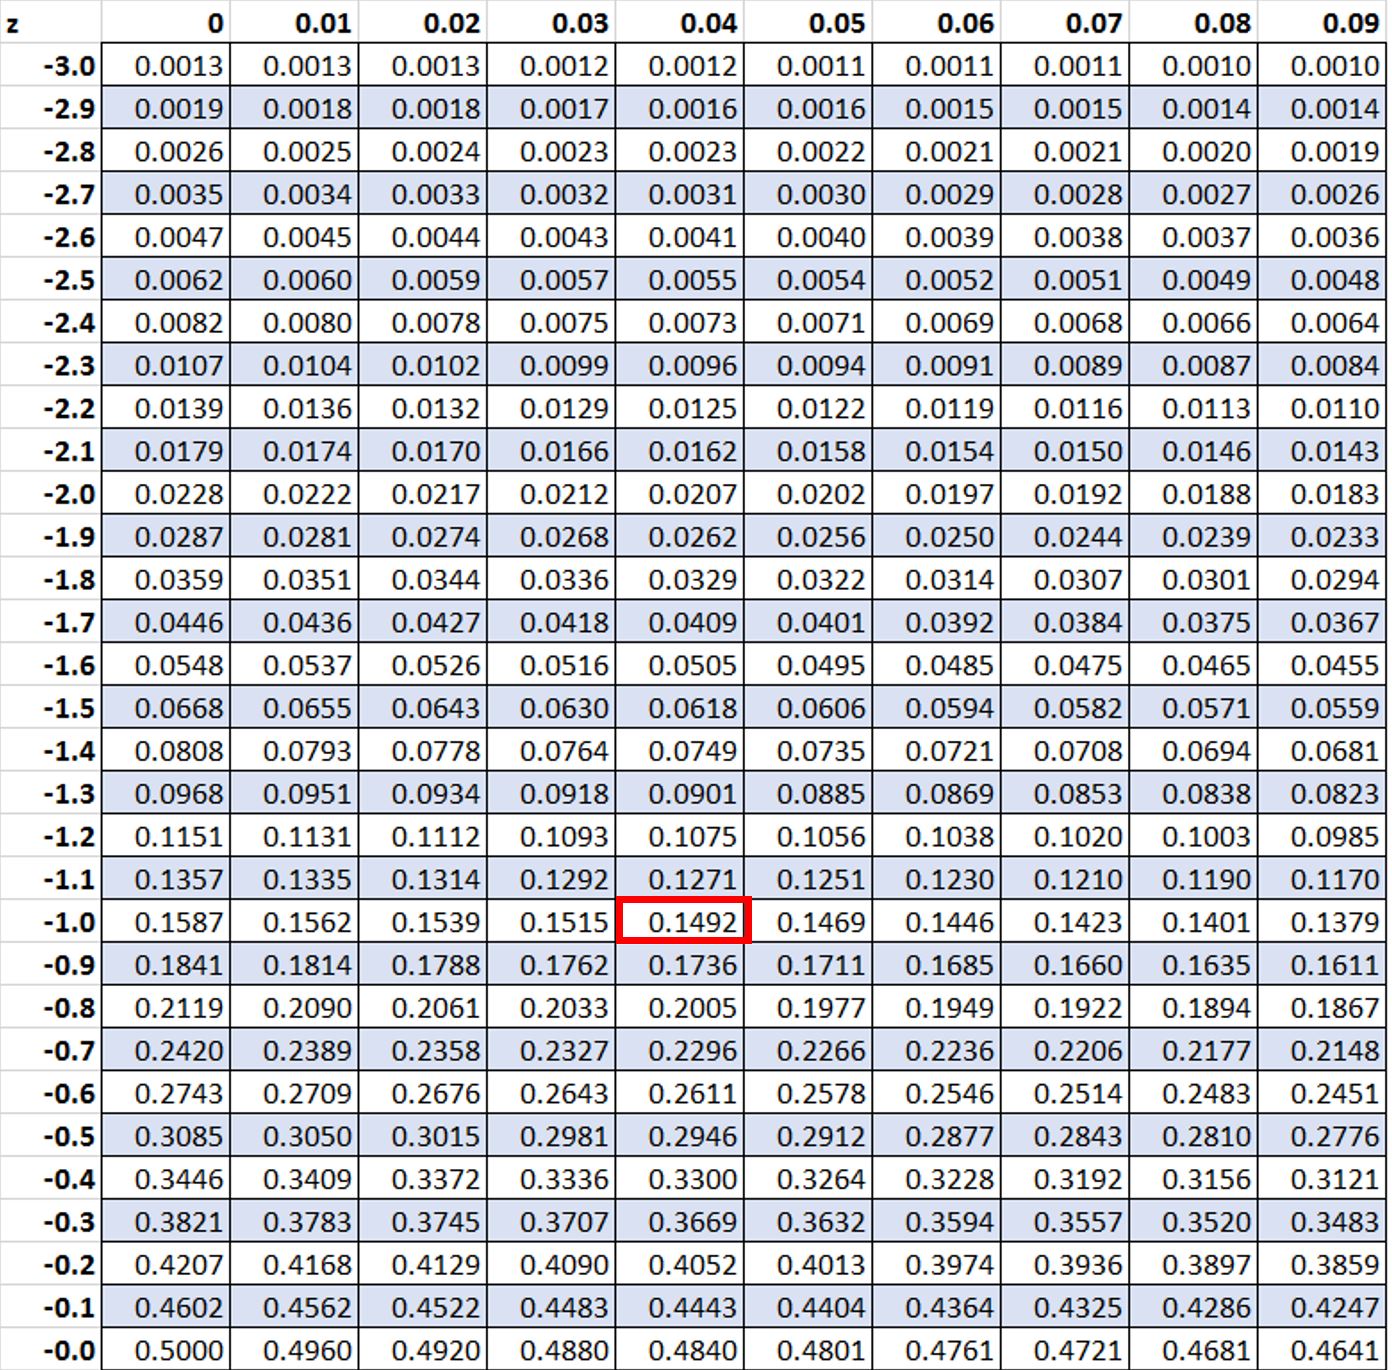
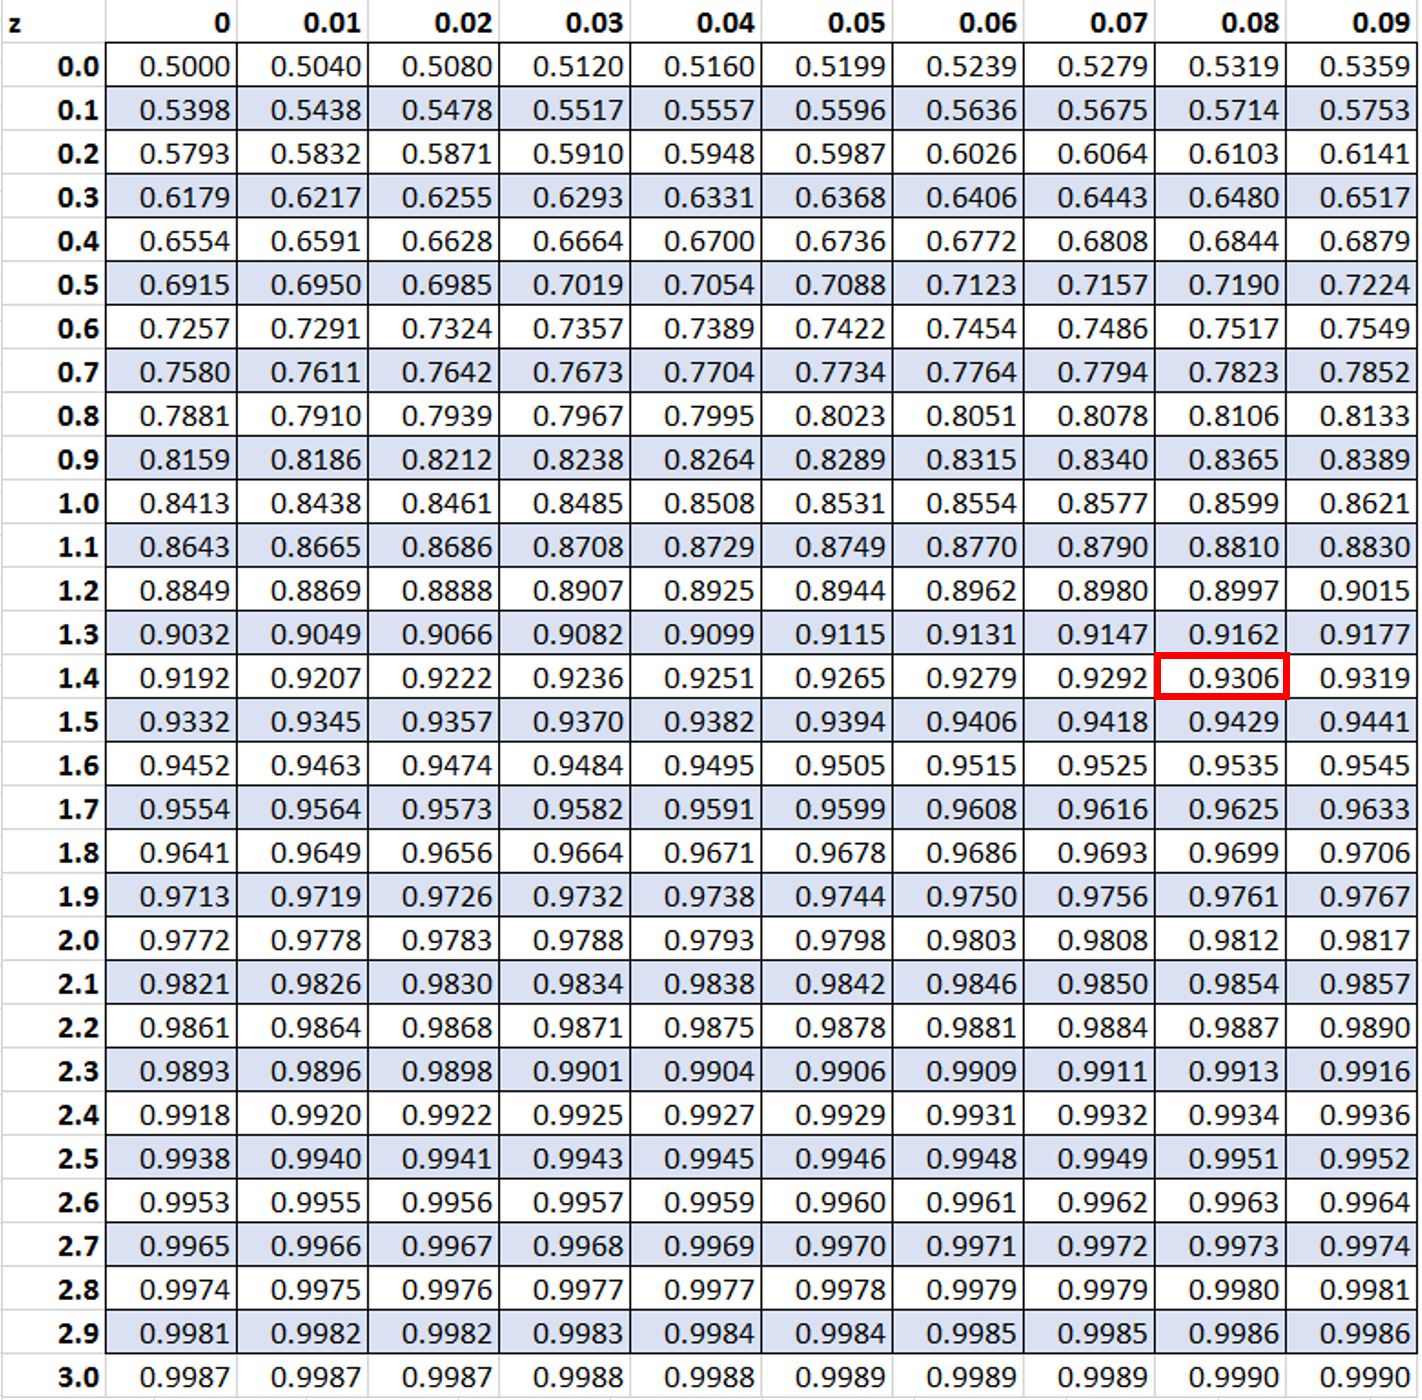
Les tables statistiques de la loi normale centrée réduite se présentent sous la forme d’un tableau matriciel à double entrée rigoureusement agencé pour consigner avec précision les décimales successives de la variable z. Dans la présentation la plus courante, la colonne située à l’extrême gauche répertorie les valeurs de z avec leur première décimale (du pas de 0,0 à 3,0 ou davantage), tandis que la première ligne horizontale supérieure affiche la deuxième décimale (allant de 0,00 à 0,09). L’intersection d’une ligne donnée et d’une colonne spécifique indique la probabilité cumulée correspondant à la cote z bidécimale ainsi formée.
Cependant, une source récurrente d’erreurs réside dans l’hétérogénéité des formats d’intégration retenus par les concepteurs de tables statistiques. On recense principalement trois grandes familles de tables dans la littérature :
- Les tables unilatérales cumulatives de moins l’infini à z : C’est la forme standardisée la plus directe, qui fournit immédiatement P(Z ≤ z). Pour z = 0,00, l’aire indiquée est rigoureusement de 0,5000, et pour z > 0, les probabilités s’échelonnent entre 0,5000 et 1,0000.
- Les tables d’aire centrale de zéro à z : Ces tables ne mesurent que la surface comprise strictement entre la moyenne centrale (0) et le score z positif considéré. Pour z = 0, la valeur affichée est 0,0000. L’utilisateur doit impérativement ajouter 0,5000 à la valeur lue dans le corps de la table pour reconstituer la probabilité cumulée totale à gauche nécessaire au calcul du centile.
- Les tables bilatérales ou unilatérales de dépassement à droite : Ces présentations répertorient l’aire de la queue supérieure P(Z > z). Dans ce cas, la probabilité cumulée à gauche s’obtient par soustraction de la valeur tabulée à l’unité (1 – P).
La règle d’or méthodologique impose par conséquent de procéder systématiquement à l’inspection de l’en-tête ou du schéma graphique accompagnant impérativement la table Z avant toute extraction de données numériques, afin d’identifier avec certitude la convention d’intégration mise en œuvre.
3.2 Recherche inverse du score z à partir d’une probabilité cumulée
Le calcul d’un centile requiert presque exclusivement une lecture inverse de la table de distribution. Contrairement à la démarche directe, qui consiste à partir d’une valeur z connue pour déterminer une probabilité, la recherche inverse impose de débuter par le rang percentile ciblé, de le convertir en proportion décimale, puis de scruter l’intérieur du corps de la table pour remonter vers les marges extérieures (abscisse et ordonnée).
Le processus opératoire s’articule comme suit :
- Diviser le rang percentile souhaité par 100 afin d’obtenir la probabilité cumulée cible p. Par exemple, pour isoler le 70e centile, la probabilité d’intérêt est p = 0,7000.
- Examiner les valeurs de probabilité situées à l’intérieur de la matrice pour repérer le nombre qui se rapproche le plus de cette probabilité cible. Dans les tables unilatérales standards, la valeur 0,6985 correspond à z = 0,52 et la valeur 0,7019 correspond à z = 0,53.
- Sélectionner la valeur la plus proche ou appliquer la règle du signe en fonction de la position du centile vis-à-vis de la médiane :
- Si le centile recherché est strictement supérieur à 50 (p > 0,50), la cote z extraite de la table positive conserve son signe positif.
- Si le centile recherché est strictement inférieur à 50 (p < 0,50), la plupart des tables ne détaillant que les valeurs positives, il convient d’invoquer le principe de symétrie. On calcule alors le centile symétrique complémentaire à droite en soustrayant p de 1 (p’ = 1 – p), on extrait le z correspondant dans la table positive, et on lui assigne impérativement un signe négatif.
Cette rigueur dans l’application de la règle du signe est essentielle, car l’omission d’un signe négatif pour un centile inférieur à la médiane conduirait à positionner le seuil du mauvais côté de la distribution, faussant radicalement l’évaluation.
3.3 Techniques d’interpolation linéaire pour une exactitude accrue
La lecture directe d’une table Z discrétisée au centième près engendre inévitablement de légères approximations lorsque la probabilité cumulée cible tombe entre deux cellules adjacentes du tableau. Bien que cette marge d’erreur soit souvent négligeable pour des usages pédagogiques généraux, les exigences de la standardisation de batteries neuropsychologiques de haute précision réclament le recours à l’interpolation linéaire pour approcher la valeur de z avec un degré de décimalisation supérieur.
L’interpolation proportionnelle repose sur le postulat local selon lequel, sur un intervalle infinitésimal entre deux cotes z très proches (par exemple séparées de 0,01 unité), la fonction de répartition cumulative se comporte de façon quasi linéaire. Si l’on désigne par p1 et p2 les probabilités tabulées encadrant la probabilité cible p, associées respectivement aux cotes z1 et z2, le score z interpolé se déduit de la formule suivante :
z = z1 + ((p – p1) / (p2 – p1)) × (z2 – z1)
Considérons à titre d’exemple la recherche du score z correspondant rigoureusement au 95e centile (p = 0,9500). Dans une table Z standard, nous constatons que pour z = 1,64, la probabilité cumulée est de 0,9495, tandis que pour z = 1,65, elle atteint 0,9505. La probabilité 0,9500 se situant exactement à mi-chemin entre 0,9495 et 0,9505, l’interpolation linéaire attribue le calcul :
z = 1,64 + ((0,9500 – 0,9495) / (0,9505 – 0,9495)) × (1,65 – 1,64) = 1,64 + (0,0005 / 0,0010) × 0,01 = 1,64 + 0,005 = 1,645
L’omission de cette interpolation et l’arrondi hâtif à 1,64 ou 1,65 induisent une déviation sur le score brut final qui, multipliée par un écart-type substantiel (par exemple σ = 15 sur une échelle d’intelligence), peut altérer l’assignation catégorielle diagnostique d’un sujet se trouvant à la lisière d’un seuil clinique.
4. Calcul pas à pas d’un centile inférieur à la médiane (P < 50)
Le calcul d’un centile situé dans la queue inférieure de la courbe constitue une procédure clinique critique, fréquemment sollicitée pour le repérage des troubles d’apprentissage, l’objectivation d’un déclin cognitif ou l’identification de profils pathologiques. L’exécution méthodique de chaque étape algorithmique prévient les erreurs de signe et les contresens interprétatifs.
4.1 Formulation du problème et recueil des paramètres descriptifs
Toute démarche d’évaluation paramétrique commence par l’inventaire rigoureux des données descriptives de la population de référence et la formulation non ambiguë de l’objectif métrologique. Le praticien doit collecter et consigner avec exactitude :
- La moyenne (μ) : Issue de l’échantillon d’étalonnage représentatif apparié selon les critères sociodémographiques pertinents (âge, niveau d’études, genre si applicable).
- L’écart-type (σ) : Issu du même échantillon d’étalonnage, exprimé strictement dans la même unité métrique que la moyenne.
- Le rang percentile cible (P) : Défini par les impératifs diagnostiques, devant satisfaire à la condition P < 50 pour appartenir au sous-espace inférieur de la distribution.
Il importe à ce stade d’effectuer une vérification scrupuleuse des unités de mesure. Si la métrique du test est temporelle, il faut s’assurer que la moyenne et l’écart-type sont tous deux exprimés en secondes (ou en millisecondes), et non dans un mélange hétérogène de minutes et de secondes, ce qui détruirait la cohérence dimensionnelle du calcul.
4.2 Détermination du score z négatif correspondant
La détermination du score z associé à un centile P < 50 exige le recours rigoureux aux propriétés de symétrie de la loi normale lorsque l’on utilise une table Z positive conventionnelle. Prenons pour illustration concrète la recherche du score seuil marquant le 15e centile (P = 15, soit une probabilité cumulée p = 0,1500).
La démarche logique se décompose ainsi :
- Constater que p = 0,1500 < 0,5000, ce qui signifie que le score recherché se situe dans la portion gauche de la courbe, en dessous de la moyenne arithmétique.
- Calculer la probabilité symétrique complémentaire dans la moitié supérieure : p’ = 1 – 0,1500 = 0,8500. Cette valeur correspond au point situé exactement à la même distance géométrique de la médiane, mais du côté positif.
- Explorer le corps de la table Z standard pour localiser la probabilité la plus proche de 0,8500. On identifie à l’abscisse 1,0 et à l’ordonnée 0,04 la valeur 0,8508, et pour 1,03 la valeur 0,8485. L’interpolation linéaire précise fournit :
z’ = 1,03 + ((0,8500 – 0,8485) / (0,8508 – 0,8485)) × 0,01 = 1,03 + (0,0015 / 0,0023) × 0,01 ≈ 1,0365
Arrondi au centième le plus proche pour un usage standard, nous obtenons z’ = 1,04.
- Rétablir la polarité directionnelle : le centile se trouvant sous la médiane, la cote standard critique est négative. Le score z officiel correspondant au 15e centile est donc rigoureusement :
z = -1,04
Ce résultat indique qu’une performance située au 15e centile se déploie précisément à 1,04 écart-type en deçà de la moyenne de la population de référence.
4.3 Application arithmétique et interprétation psychométrique
Dès lors que le score z négatif est solidement établi, il suffit de l’injecter dans la formule fondamentale de conversion X = μ + zσ. Supposons une batterie d’évaluation neuropsychologique de l’attention sélective dont la moyenne d’étalonnage est établie à μ = 50 points avec un écart-type de σ = 10 points. Pour isoler la valeur métrique brute délimitant le 15e centile, le clinicien résout :
X = 50 + (-1,04) × 10
X = 50 – 10,40 = 39,60 points
Le contrôle de cohérence élémentaire impose de vérifier sans délai que la valeur brute obtenue est strictement inférieure à la moyenne (μ = 50), ce qui est bien le cas ici avec 39,60. Si une inversion arithmétique avait été commise en négligeant le signe négatif, le praticien aurait obtenu 60,40, plaçant de manière absurde le seuil de déficit du 15e centile en pleine zone de supériorité normative.
Sur le versant de l’interprétation diagnostique, le seuil de 39,60 points ne doit pas être qualifié de façon péjorative sans discernement. En termes neuropsychologiques rigoureux, cela signifie qu’un patient obtenant un score brut inférieur ou égal à 39,60 points réalise une performance égale ou inférieure à celle de seulement 15 % des individus de sa classe d’âge. Il présente donc une fragilité relative sur le plan de l’attention sélective, se situant à l’orée de la zone de vigilance clinique généralement fixée entre le 10e et le 16e centile (c’est-à-dire au-delà d’un écart-type sous la moyenne).
5. Calcul pas à pas d’un centile supérieur à la médiane (P > 50)
L’évaluation des centiles supérieurs répond aux contextes où l’on cherche à objectiver des aptitudes remarquables, une haute efficience cognitive, ou, dans le registre de la psychopathologie dimensionnelle, un niveau d’élévation symptomatique sévère (comme une intensité dépressive extrême). La démarche calculatoire tire parti de la lecture directe des tables statistiques positives.
5.1 Extraction du score z positif pour les scores élevés
Lorsque le rang percentile visé est supérieur à 50 (P > 50), sa probabilité cumulée unilatérale associée p = P / 100 est par définition supérieure à 0,5000. Par voie de conséquence, le score standardisé z correspondant se situe inconditionnellement dans le domaine positif de l’axe réel.
Les seuils d’excellence ou de criticité clinique les plus fréquemment sollicités en psychologie contemporaine sont standardisés de longue date :
- 85e centile (p = 0,85) : z ≈ +1,036 (souvent arrondi à +1,04), marquant la frontière de supériorité légère.
- 90e centile (p = 0,90) : z ≈ +1,282 (arrondi à +1,28), délimitant le décile supérieur.
- 95e centile (p = 0,95) : z ≈ +1,645, représentatif des performances statistiquement rares (dépassées par seulement 5 % de la population).
- 98e centile (p = 0,98) : z ≈ +2,054, équivalent pratique du seuil canonique de plus deux écarts-types (+2,00σ correspondant rigoureusement au 97,72e centile).
- 99e centile (p = 0,99) : z ≈ +2,326, caractérisant une performance de très haut niveau, partagée par seulement un individu sur cent.
Une observation attentive de ces cotes standardisées met en lumière l’extrême non-linéarité de l’accroissement du score z au fur et à mesure que l’on progresse vers l’extrémité de la distribution : alors qu’il ne faut franchir que 0,24 écart-type pour passer du 85e au 90e centile, il faut déployer un effort métrique de 0,28 écart-type pour progresser du 98e au 99e centile, et un bond considérable de 0,75 écart-type supplémentaire pour atteindre le 99,9e centile (z ≈ +3,09).
5.2 Résolution de l’équation pour les zones de haut potentiel ou de sévérité
La résolution de l’équation X = μ + zσ dans le registre supérieur matérialise l’addition entre le point d’ancrage central et la marge d’élévation normative issue du produit z × σ. Examinons le cas d’une épreuve d’efficience intellectuelle globale calibrée sur l’échelle standardisée de David Wechsler, dont les paramètres normatifs universels sont une moyenne μ = 100 et un écart-type σ = 15.
Pour déterminer le seuil métrique brut requis pour satisfaire au critère diagnostique conventionnel du haut potentiel intellectuel (HPI), fixé au 98e centile de la distribution :
- Déterminer la probabilité cumulée : p = 98 / 100 = 0,9800.
- Extraire le score z exact à partir de la fonction quantile normale : z = Φ-1(0,9800) ≈ 2,0537 (que les tables d’étalonnage arrondissent traditionnellement à +2,05).
- Calculer la marge de dépassement de la moyenne :
Marge = z × σ = 2,0537 × 15 = 30,8055 points
- Sommer ce résultat à la moyenne normative :
X = 100 + 30,8055 = 130,8055 points
Dans les manuels psychométriques standardisés, les tables de conversion procèdent généralement à un arrondi à l’entier le plus proche ou retiennent le seuil théorique de deux écarts-types exacts (z = +2,00, ce qui correspond à 100 + 2 × 15 = 130, soit le 97,72e centile). Le score brut de 131 points d’indice de quotient intellectuel valide ainsi mathématiquement le dépassement effectif du 98e centile.
Cette approche mathématique est identique lorsqu’on évalue la sévérité d’un trouble sur une échelle clinique de dépression où un score élevé reflète une intensité pathologique accrue : un sujet positionné au 95e centile sur une échelle de dépression présente un niveau de détresse psychologique que 95 % des individus de la population générale ne manifestent pas.
5.3 Validation logique et contrôle d’erreur du résultat obtenu
La validation métrologique d’un résultat calculé ne s’achève pas à la dernière opération arithmétique. Le psychométricien doit appliquer des procédures de contrôle de cohérence formelle afin d’écarter toute altération de la validité de l’étalonnage. Le premier garde-fou réside dans le contrôle de conformité directionnelle : pour tout centile supérieur à 50, le score brut X obtenu doit impérativement être supérieur à la moyenne μ. Si le résultat est inférieur, une erreur fondamentale de transcription ou de signe s’est immiscée dans le calcul.
Le second contrôle analytique s’appuie sur la règle empirique universelle des distributions normales, dite règle des 68-95-99,7 :
- Environ 68,27 % des observations sont comprises dans l’intervalle [μ – 1σ ; μ + 1σ], ce qui situe les bornes de cet intervalle respectivement au 15,87e et au 84,13e centile.
- Environ 95,45 % des observations sont confinées dans l’intervalle [μ – 2σ ; μ + 2σ], borné par le 2,28e et le 97,72e centile.
- Environ 99,73 % des observations s’inscrivent dans l’intervalle [μ – 3σ ; μ + 3σ], délimité par le 0,135e et le 99,865e centile.
Cette grille de bornage mental rapide permet de confronter immédiatement la vraisemblance du score calculé. Si le calcul du 85e centile donne un score situé au-delà de deux écarts-types de la moyenne, le praticien sait instantanément qu’une anomalie algorithmique majeure est survenue, et que le résultat doit être rejeté et recalculé sans délai.
6. Méthodes computationnelles : automatisation sous logiciels statistiques
À l’ère du traitement massif de données et des protocoles d’évaluation numérisés, le calcul manuel des centiles cède le pas à l’automatisation logicielle. La compréhension des architectures algorithmiques au sein des environnements d’analyse de données modernes permet aux psychométriciens de construire des chaînes de normalisation automatisées d’une précision absolue.
6.1 Implémentation sous le langage R
Dans l’écosystème de programmation statistique R, référence mondiale en biostatistique et en psychométrie universitaire, le calcul d’un centile à partir de la moyenne et de l’écart-type s’effectue directement par l’appel de la fonction quantile de la distribution normale : qnorm(). Cette fonction implémente en interne des algorithmes polynomiaux de très haute précision (tels que l’approximation de Wichura) pour inverser la fonction de répartition cumulative gaussienne.
La syntaxe canonique de la fonction prend la structure suivante :
qnorm(p, mean = 0, sd = 1, lower.tail = TRUE)
Les paramètres s’interprètent de la façon suivante :
p: Le vecteur de probabilités cumulées cibles, exprimées sous forme de fractions décimales (par exemple 0.95 pour le 95e centile).mean: La moyenne arithmétique μ de la population de référence, fixée à 0 par défaut pour la loi standard.sd: L’écart-type σ de la population, fixé à 1 par défaut.lower.tail: Un booléen indiquant la direction d’intégration. Lorsque cet argument est paramétré surTRUE(valeur par défaut), la fonction calcule la probabilité unilatérale à gauche P(X ≤ x), ce qui correspond exactement à la définition stricte du rang percentile. Si l’argument est basculé surFALSE, la fonction calcule le quantile à partir de la queue supérieure à droite P(X > x).
La puissance de R réside dans sa nature vectorielle native : un chercheur peut calculer en une seule ligne d’instruction une matrice complète de centiles pour un test de mémoire étalonné avec une moyenne de 50 et un écart-type de 10 en passant un vecteur de probabilités :
centiles_cibles <- c(0.05, 0.10, 0.25, 0.50, 0.75, 0.90, 0.95)
scores_seuils <- qnorm(centiles_cibles, mean = 50, sd = 10)
Le résultat généré est un vecteur de valeurs numériques exactes, prêtes à être intégrées dans des grilles d’étalonnage psychométrique sans aucune intervention manuelle.
6.2 Traitement algorithmique sous Python (SciPy Stats)
Dans l’environnement de développement Python, de plus en plus prépondérant en intelligence artificielle appliquée et en neurosciences computationnelles, le calcul paramétrique des centiles s’appuie sur le sous-module spécialisé scipy.stats de la bibliothèque scientifique SciPy. La distribution normale continue y est modélisée par la classe d’objets norm.
Pour réaliser l’inversion d’une probabilité cumulée vers le score d’origine, on sollicite la méthode ppf (acronyme de Percent Point Function), qui constitue l’appellation computationnelle anglo-saxonne standard de la fonction quantile inverse :
from scipy.stats import norm
score_brut = norm.ppf(q, loc=0, scale=1)
Dans cette structure d’appel :
- L’argument
qreçoit la probabilité cumulée associée au centile (par exemple 0.98 pour le 98e centile). - L’argument
loc(pour location) spécifie le paramètre de position de la loi, c’est-à-dire la moyenne arithmétique μ. - L’argument
scalespécifie le paramètre d’échelle, à savoir l’écart-type σ.
L’utilisation de structures en virgule flottante double précision (format IEEE 754 sur 64 bits) garantit une exactitude numérique allant jusqu’à quinze décimales significatives, éliminant intégralement les erreurs d’arrondi inhérentes aux tables statistiques imprimées. Il est dès lors aisé de concevoir des classes et des fonctions modulaires réutilisables permettant de convertir automatiquement des scores de tests neuropsychologiques en rangs percentiles ou d’établir des grilles d’étalonnage complexes en automatisant l’extraction pour l’ensemble des déciles et centiles d’intérêt clinique.
6.3 Automatisation sous tableurs (Excel et LibreOffice Calc)
Pour la majorité des cliniciens et des professionnels de santé exerçant en cabinet libéral ou en institution hospitalière, le tableur bureautique (tel que Microsoft Excel ou LibreOffice Calc) représente l’outil d’analyse le plus accessible au quotidien. Les suites bureautiques modernes intègrent des fonctions statistiques internes capables d’effectuer ces opérations sans exiger de compétences en programmation informatique.
La formule matricielle de référence pour dériver directement un score brut à partir d’un centile, d’une moyenne et d’un écart-type est la fonction LOI.NORMALE.INVERSE (ou NORM.INV dans les versions anglophones d’Excel). Sa syntaxe opératoire s’articule comme suit :
=LOI.NORMALE.INVERSE(probabilité; moyenne; écart_type)
Si une cellule contient le centile sous forme de pourcentage ou de fraction décimale (par exemple la cellule A1 contenant 0,90), que la moyenne μ figure en B1 (100) et l’écart-type σ en C1 (15), l’inscription dans la cellule cible de la formule =LOI.NORMALE.INVERSE(A1; B1; C1) renverra immédiatement la valeur 119,22 points.
Une démarche alternative, décomposant l’opération en deux temps à des fins didactiques, consiste à mobiliser la fonction LOI.NORMALE.STANDARD.INVERSE(probabilité) pour extraire d’abord le score z standard, puis à appliquer manuellement dans une cellule connexe l’équation de transformation linéaire : = B1 + (score_z * C1).
Une vigilance particulière doit être portée aux conventions régionales de paramétrage des logiciels tableurs : l’usage de la virgule ou du point comme séparateur décimal et l’utilisation du point-virgule comme délimiteur d’arguments au sein des formules constituent la source la plus fréquente de dysfonctionnement ou de messages d’erreur de syntaxe rencontrés par les utilisateurs francophones.
7. Applications psychométriques aux échelles standardisées d’évaluation
Dans la pratique psychologique, les échelles standardisées recourent à des métriques artificielles spécifiques pour exprimer les résultats des sujets. La conversion de ces scores étalonnés en rangs percentiles offre une compréhension unifiée et élimine le risque de mauvaise interprétation lié à la multiplicité des formats d’échelle.
7.1 Étalonnage sur les échelles d’intelligence de Wechsler (QI)
Les échelles d’efficience intellectuelle développées initialement par David Wechsler (incluant le WISC pour les enfants et adolescents et la WAIS pour les adultes) constituent l’étalon-or international de l’évaluation cognitive. Les scores composites d’efficience globale (Quotient Intellectuel Total ou QIT) ainsi que les indices d’aptitude factoriels (Compréhension Verbale, Raisonnement Fluide, Aptitude Visuo-Spatiale, Mémoire de Travail, Vitesse de Traitement) sont standardisés sous la forme d’une distribution normale théorique paramétrée avec une moyenne universelle de μ = 100 et un écart-type de σ = 15.
Cette paramétrisation confère une correspondance fixe entre seuils d’écarts-types, scores de QI et centiles :
- QI = 70 (soit μ – 2σ) : Correspond exactement au 2,28e centile (souvent abrégé au 2e centile). Ce point d’inflexion constitue l’un des critères psychométriques majeurs pour poser le diagnostic de déficit intellectuel ou de trouble du développement intellectuel, attestant d’une performance cognitive significativement inférieure à celle de l’immense majorité de la population de référence.
- QI = 85 (soit μ – 1σ) : Correspond au 15,87e centile (16e centile), marquant la limite de la zone de normalité basse ou moyenne inférieure.
- QI = 100 (soit μ) : Correspond rigoureusement au 50e centile (médiane exacte de la population).
- QI = 115 (soit μ + 1σ) : Correspond au 84,13e centile (84e centile), seuil d’accès à la zone d’efficience supérieure.
- QI = 130 (soit μ + 2σ) : Correspond au 97,72e centile (arrondi conventionnellement au 98e centile), retenu internationalement comme le seuil clinique d’identification du haut potentiel intellectuel (HPI).
L’obligation clinique de convertir les scores indiciels en rangs percentiles s’avère particulièrement prégnante lors de la rédaction d’un bilan neuropsychologique destiné aux parents, aux équipes pédagogiques ou aux commissions médico-sociales. Indiquer à des interlocuteurs non avertis qu’un enfant présente un QI de 130 engendre fréquemment des projections fantasmées ou des incompréhensions métrologiques ; leur expliciter que ce résultat situe l’enfant au 98e centile, signifiant que 98 % des enfants du même groupe d’âge réalisent une performance inférieure ou équivalente, restitue immédiatement la dimension comparative et objective du profil cognitif mesuré.
7.2 Conversion des scores T et stanines en inventaires de personnalité
Dans l’évaluation de la personnalité et l’examen de la psychopathologie clinique (comme dans le cas du Minnesota Multiphasic Personality Inventory ou MMPI, et des inventaires factoriels dérivés du modèle en cinq facteurs tel que le NEO-PI), la métrique dominante est le score T. L’échelle en score T est une distribution normale transformée dont les paramètres de normalisation sont fixés à une moyenne de μ = 50 et un écart-type de σ = 10.
Dans ce cadre normatif :
- Un score T de 50 coïncide exactement avec la médiane ou 50e centile.
- Un score T de 60 (+1σ) correspond au 84,13e centile.
- Un score T de 65 (+1,5σ) correspond au 93,32e centile, seuil canonique marquant dans le MMPI-2 le début de l’élévation clinique significative.
- Un score T de 70 (+2σ) correspond au 97,72e centile, attestant d’une élévation clinique pathologique majeure.
D’autres dispositifs d’évaluation en contexte scolaire ou militaire exploitent l’échelle des stanines (contraction de standard nine). Cette échelle découpe la distribution gaussienne en neuf tranches ordinales standardisées ayant une moyenne théorique de μ = 5 et un écart-type de σ = 2. Chaque stanine englobe une bande définie de rangs percentiles :
- La stanine 5, bande centrale, regroupe les individus situés entre le 40e et le 59e centile (soit environ 20 % de la population).
- Les stanines 4 et 6 couvrent chacune 17 % des effectifs (respectivement les 23e-39e et 60e-76e centiles).
- Les stanines 1 et 9, situées aux extrémités absolues, ne rassemblent chacune que les 4 % d’individus les plus extrêmes (respectivement du 1er au 4e centile, et du 96e au 99e centile).
La conversion systématique des scores T et des stanines vers l’étalon universel des rangs percentiles permet de dissiper l’illusion de discontinuité propre aux découpages catégoriels et de replacer le sujet sur un continuum dimensionnel rigoureux.
7.3 Échelles de développement et batteries neuropsychologiques spécifiques
Dans la pratique clinique quotidienne de l’évaluation neuropsychologique et orthophonique, un grand nombre d’épreuves analytiques et de subtests individuels (présents par exemple dans l’Examen Clinique de la Mémoire de Wechsler – MEM, ou la batterie d’évaluation des fonctions exécutives NEPSY) ne recourent pas à l’échelle du QI mais à une métrique standardisée réduite désignée sous le terme de note standard ou note d’échelle. Cette distribution se caractérise par une moyenne normative fixée à μ = 10 et un écart-type paramétré à σ = 3.
La déclinaison des centiles sous cette métrique présente les équivalences suivantes :
- Une note standard de 10 correspond au 50e centile.
- Une note standard de 7 (μ – 1σ) s’aligne sur le 15,87e centile (16e centile).
- Une note standard de 4 (μ – 2σ) correspond au 2,28e centile (2e centile).
- Une note standard de 1 (μ – 3σ) correspond au 0,13e centile, témoignant d’une défaillance massive de la fonction instrumentale évaluée.
L’utilisation concertée des centiles devient primordiale pour l’homogénéisation des comparaisons inter-tests lors de bilans neuropsychologiques exhaustifs. Il est fréquent qu’un clinicien doive confronter, au sein d’un même dossier patient, des épreuves exprimées en scores de QI (μ = 100, σ = 15), des subtests codés en notes d’échelle (μ = 10, σ = 3), des inventaires comportementaux exprimés en scores T (μ = 50, σ = 10) et des indices moteurs bruts. Tenter de comparer ces scores bruts ou calibrés directement conduirait à des paralogismes diagnostiques majeurs. L’alignement systématique de l’ensemble des résultats sur l’échelle commune des rangs percentiles offre une lisibilité instantanée et scientifiquement irréprochable du profil cognitif, mettant en relief les forces et les faiblesses relatives de l’individu par-delà l’hétérogénéité des outils mobilisés.
Néanmoins, la validité de cette comparaison inter-instruments repose sur une condition méthodologique stricte : les centiles comparés doivent impérativement être issus d’échantillons normatifs équivalents ou comparables. Si un test d’attention a été étalonné sur un échantillon d’adultes jeunes hautement scolarisés et qu’un test de mémoire a été standardisé sur une population tout-venant hétérogène, la comparaison directe des rangs percentiles sera contaminée par ce biais de sélection initial.
8. Diagnostic de la normalité et validité des postulats statistiques
Le calcul des centiles par la relation X = μ + zσ repose sur un postulat mathématique formel : la variable étudiée doit suivre rigoureusement une loi normale au sein de la population parente. L’application aveugle de cette formule sans investigation préalable des propriétés distributionnelles empiriques expose le clinicien et le chercheur à des biais d’estimation métrologique sévères.
8.1 Évaluation formelle de l’asymétrie et de l’aplatissement
La normalité théorique impose des contraintes précises sur les moments d’ordre supérieur d’une distribution. Deux indicateurs statistiques fondamentaux permettent de quantifier les déviations morphologiques par rapport à la courbe de Gauss idéale :
- Le coefficient d’asymétrie (skewness) : Ce paramètre évalue le degré de distorsion unilatérale de la distribution par rapport à son centre. Une distribution parfaitement normale présente un skewness théorique de zéro. Un coefficient d’asymétrie positif (étirement de la queue vers la droite) indique une surreprésentation des scores faibles et une rareté des scores élevés, tandis qu’un coefficient négatif (étirement vers la gauche) traduit une accumulation de performances élevées avec une longue traîne de scores bas.
- Le coefficient d’aplatissement (kurtosis) : Cet indice mesure la lourdeur des queues de distribution et la concentration des valeurs autour du mode central. La distribution gaussienne possède un kurtosis théorique de 3 (ou un kurtosis excessif de 0 selon la normalisation de Fisher). Une distribution leptokurtique (kurtosis excessif largement positif) présente un pic central très aigu et des queues épaisses chargées en valeurs extrêmes, tandis qu’une distribution platykurtique (kurtosis excessif négatif) est aplatie, avec des queues fines et peu d’observations extrêmes.
Dans la pratique psychométrique courante, des tolérances empiriques sont admises : on considère généralement que des valeurs de skewness et de kurtosis excessif comprises entre -1,00 et +1,00 autorisent le maintien de l’approximation gaussienne pour les centiles centraux. En revanche, dès lors que ces indices s’écartent de ces bornes de tolérance, l’application de la formule paramétrique engendre des distorsions majeures, tout particulièrement au niveau des queues de distribution : un centile calculé comme étant le 99e centile théorique peut ne correspondre en réalité qu’au 92e ou 93e centile empirique si la queue de distribution réelle est tronquée ou asymétrique.
8.2 Tests d’adéquation et inspections graphiques
Pour statuer formellement sur l’adéquation d’une distribution empirique à la loi normale théorique, les statisticiens disposent d’un arsenal d’outils combinant tests d’hypothèses inférentiels et inspections visuelles qualitatives.
Parmi les tests d’adéquation statistiques formels :
- Le test de Shapiro-Wilk : Reconnu comme l’épreuve la plus puissante pour des échantillons de taille modeste ou intermédiaire (jusqu’à quelques centaines d’observations), ce test compare la corrélation empirique des quantiles observés avec ceux d’une loi normale. Un résultat statistiquement significatif (p < 0,05) conduit au rejet formel de l’hypothèse de normalité.
- Le test de Kolmogorov-Smirnov (avec correction de Lilliefors) : Utilisé pour quantifier la distance maximale absolue séparant la fonction de répartition cumulative empirique de la fonction théorique normale.
Toutefois, ces tests formels souffrent d’un paradoxe bien connu en métrologie : sur de très grands échantillons normatifs (comportant plusieurs milliers de sujets, comme c’est la règle pour les étalonnages d’échelles d’intelligence nationales), la puissance statistique devient si élevée que le test détecte des déviations infimes et sans aucune conséquence pratique, rejetant systématiquement la normalité. À l’inverse, sur de petits échantillons, le manque de puissance peut masquer des déviations majeures.
C’est pourquoi le diagnostic de normalité doit impérativement s’appuyer sur l’inspection graphique, au premier rang de laquelle figure le diagramme quantile-quantile (Q-Q plot normal). Ce graphique porte en ordonnée les quantiles de la variable empirique observée et en abscisse les quantiles théoriques attendus sous la loi normale. Si la distribution empirique est parfaitement gaussienne, les points s’alignent rigoureusement le long de la ligne diagonale bissectrice. Toute ondulation en « S » ou décollement marqué aux extrémités révèle visuellement et immédiatement une anomalie d’asymétrie ou d’aplatissement qui disqualifie l’utilisation naïve de la formule paramétrique directe.
8.3 Transformations correctives préalables au calcul des centiles
Lorsqu’une variable mesurée présente une violation patente du postulat de normalité, le statisticien ne peut calculer les centiles directement à partir de la moyenne et de l’écart-type bruts. Trois stratégies méthodologiques majeures s’offrent alors pour résoudre ce problème :
La première stratégie repose sur l’application d’une transformation mathématique non linéaire préalable visant à normaliser la distribution des scores bruts :
- La transformation logarithmique (naturelle ou décimale) : Particulièrement efficace pour corriger une asymétrie positive marquée, situation classique rencontrée lors de la mesure des temps de réaction ou des latences de réponse en chronométrie mentale.
- La transformation racine carrée : Idéale pour les distributions de comptage (nombre d’erreurs commises à une épreuve de barrage d’attention) présentant une asymétrie positive modérée.
- La famille de transformations de Box-Cox : Une procédure d’optimisation numérique paramétrique permettant d’identifier la puissance optimale λ (lambda) qui maximise la normalité de la série de données.
Lorsque cette transformation est opérée, le praticien calcule la moyenne et l’écart-type de la variable transformée, détermine le score seuil correspondant au centile d’intérêt dans l’espace transformé au moyen de l’équation Xtrans = μtrans + zσtrans, puis applique la fonction réciproque inverse pour restituer le score seuil dans l’unité de mesure native du test.
La seconde alternative méthodologique, universellement recommandée en présence de déviations distributionnelles sévères et irréductibles, consiste à abandonner totalement l’approche paramétrique au profit du calcul direct des rangs percentiles empiriques non paramétriques (par la méthode du rang cumulé ou l’algorithme de Weibull/Hazen sur la série ordonnée). Cette démarche s’affranchit de tout postulat sur la forme de la distribution et garantit une fidélité absolue à la topologie réelle des données observées.
9. Sources d’erreur métrologique et précautions de calcul
La rigueur apparente de l’algèbre statistique dissimule de multiples pièges conceptuels et arithmétiques dans lesquels basculent fréquemment les utilisateurs non avertis. L’identification systématique de ces écueils constitue une condition préalable à une pratique diagnostique éthique et scientifiquement solide.
9.1 Confusions conceptuelles récurrentes chez les praticiens
La première aberration métrologique, hélas courante en milieu scolaire et organisationnel, consiste à confondre le rang percentile avec le pourcentage de réussite aux items d’une épreuve. Obtenir un score de 60 % de bonnes réponses à une épreuve d’évaluation orthographique n’entretient aucune corrélation directe avec le 60e centile. Si l’épreuve s’avère particulièrement difficile, une note de 60 % d’exactitude peut très bien situer le sujet au 95e centile de sa cohorte (faisant de lui l’un des meilleurs orthographieurs) ; inversement, sur une épreuve de dépistage élémentaire d’une grande facilité où la majorité des pairs réalise un sans-faute, un score de 60 % de réussite peut reléguer l’individu au 5e centile, traduisant un retard d’acquisition majeur.
Une seconde confusion tenace réside dans l’assimilation erronée des centiles à des unités d’intervalle constantes. De nombreux praticiens commettent la maladresse d’affirmer qu’un gain de 5 rangs percentiles traduit une progression d’égale magnitude, qu’elle survienne au milieu ou à l’extrémité de la distribution. Comme nous l’avons théorisé à la section 1.2, franchir la distance séparant le 50e du 55e centile ne requiert qu’une fraction minime d’écart-type, tandis que gravir la distance entre le 94e et le 99e centile exige un saut métrique considérable. Additionner, soustraire ou moyenner des rangs percentiles entre eux constitue une faute méthodologique majeure, car les opérations arithmétiques fondamentales ne sont licites que sur des échelles de mesure d’intervalles ou de rapports.
Enfin, une erreur récurrente consiste à utiliser indifféremment l’écart-type d’échantillon (calculé avec un diviseur n – 1 au dénominateur de la variance pour corriger le biais d’échantillonnage) et l’écart-type populationnel (avec un diviseur N). Dans les manuels psychométriques d’envergure nationale, c’est l’estimation non biaisée issue de l’échantillon normatif qui sert de référence standardisée.
9.2 Erreurs arithmétiques et d’usage des tables Z
Sur le plan calculatoire pur, l’erreur la plus dévastatrice est l’omission du signe négatif pour les scores z correspondant aux centiles inférieurs à 50. Lorsqu’un clinicien traite le 10e centile, la lecture mécanique d’une table Z positive lui indique la cote 1,28. S’il omet d’assigner manuellement le signe négatif (z = -1,28), il aboutit à un score brut situé à plus d’un écart-type au-dessus de la moyenne au lieu de le positionner en deçà. Ce contresens aboutit à considérer comme très performant un sujet présentant en réalité un déficit marqué.
Le tableau suivant met en lumière les conséquences immédiates d’une telle omission sur une échelle standardisée (Moyenne = 100, Écart-type = 15) :
| Centile Cible | Cote z correcte | Calcul correct (X = μ + zσ) | Erreur de signe fréquente | Calcul erroné résultant | Conséquence diagnostique |
|---|---|---|---|---|---|
| 5e centile | -1,645 | 100 + (-1,645 × 15) = 75,3 | +1,645 | 100 + (+1,645 × 15) = 124,7 | Déficit majeur pris pour une haute performance |
| 10e centile | -1,282 | 100 + (-1,282 × 15) = 80,8 | +1,282 | 100 + (+1,282 × 15) = 119,2 | Difficulté clinique prise pour un score supérieur |
| 16e centile | -1,000 | 100 + (-1,000 × 15) = 85,0 | +1,000 | 100 + (+1,000 × 15) = 115,0 | Zone de fragilité prise pour un profil fort |
| 25e centile | -0,674 | 100 + (-0,674 × 15) = 89,9 | +0,674 | 100 + (+0,674 × 15) = 110,1 | Moyenne basse prise pour une moyenne haute |
Une autre bévue réside dans l’arrondi hâtif et prématuré des cotes standardisées au dixième d’unité près au lieu de conserver au minimum deux ou trois décimales au fil des calculs intermédiaires. Retenir z = 1,6 au lieu de 1,645 pour délimiter le 95e centile introduit un décalage métrique substantiel qui peut déformer la frontière diagnostique de façon arbitraire.
9.3 Effets de plancher et de plafond sur la validité des centiles
Les propriétés de la distribution normale théorique présupposent une métrique continue infinie, exempte de toute saturation artificielle aux extrémités. Or, les instruments psychométriques réels sont constitués d’un nombre fini d’items, introduisant inévitablement des limites physiques de mesure que l’on qualifie d’effets de plancher et de plafond :
- L’effet de plancher : Survient lorsque l’épreuve est excessivement ardue ou comporte trop peu d’items de faible difficulté pour discriminer les sujets les plus fragiles. De nombreux individus obtiennent le score brut minimal possible (souvent zéro). La distribution réelle se trouve alors brutalement tronquée à gauche, créant un empilement artificiel au niveau du score plancher. Tenter de calculer des centiles théoriques inférieurs (tels que le 1er ou le 2e centile) à partir de la moyenne et de l’écart-type paramétriques d’une telle distribution génère des valeurs théoriques mathématiquement négatives et cliniquement aberrantes.
- L’effet de plafond : Apparaît lorsqu’un test est trop facile pour la population évaluée, conduisant une proportion substantielle de sujets à atteindre la note maximale absolue de l’épreuve. La distribution se trouve tronquée à droite, rendant impossible toute discrimination valide des centiles supérieurs (tels que les 95e, 98e ou 99e centiles).
Pour prévenir ces écueils, le psychométricien doit vérifier la sensibilité discriminative de ses instruments en amont de toute démarche d’étalonnage. Lorsqu’un effet de plancher ou de plafond est avéré sur une population spécifique, l’usage de la normalisation paramétrique doit être formellement proscrit au profit d’outils complémentaires dotés d’une sensibilité appropriée au niveau d’aptitude des sujets examinés.
10. Incertitude d’échantillonnage et intervalles de confiance des centiles
Toute mesure en psychologie et en sciences de l’esprit est sujette à deux sources irréductibles d’imprécision : les fluctuations probabilistes liées à l’échantillonnage de la population d’étalonnage, d’une part, et l’erreur de mesure inhérente à la fidélité de l’instrument d’évaluation, d’autre part. L’affirmation péremptoire d’un centile ponctuel unique sans mention d’une marge d’incertitude statistique constitue une simplification abusive qu’une pratique déontologique rigoureuse se doit de corriger.
10.1 Propagation de l’erreur type d’échantillonnage
Les paramètres μ et σ exploités dans l’équation de standardisation ne sont pas des entités métaphysiques absolues, mais des estimations statistiques calculées à partir d’un échantillon fini d’individus. Par voie de conséquence, ces deux statistiques sont elles-mêmes affectées par une variance d’échantillonnage qui se propage directement sur l’estimation de la position des centiles.
Selon la théorie asymptotique statistique, l’erreur type associée à l’estimation d’un quantile gaussien Xp s’exprime en fonction de la taille de l’échantillon normatif N, de l’écart-type de la population σ, de la cote standard zp et de la valeur de la densité normale unitaire φ(zp) au point considéré :
SE(Xp) ≈ (σ / √N) × √[1 + (zp2 / 2)]
Cette relation analytique révèle une loi métrologique cruciale : l’erreur type d’estimation d’un centile s’accroît de façon exponentielle au fur et à mesure que l’on s’éloigne du centre de la distribution. Pour le 50e centile (où z = 0), le second terme sous la racine est égal à 1, et l’erreur type se réduit à l’erreur type classique de la moyenne arithmétique (σ / √N). En revanche, pour des centiles extrêmes comme le 99e centile (où z ≈ 2,33), le terme multiplicateur devient substantiel :
√[1 + (2,3262 / 2)] = √[1 + (5,41 / 2)] = √[3,705] ≈ 1,925
L’estimation du 99e centile présente ainsi une variabilité d’échantillonnage presque deux fois plus importante que celle de la médiane. Par conséquent, calibrer des centiles extrêmes sur des échantillons normatifs étriqués (par exemple N < 200) expose le praticien à une instabilité majeure des seuils critiques calculés, justifiant les préconisations psychométriques internationales qui exigent des cohortes de standardisation d’au moins plusieurs centaines, voire plusieurs milliers de sujets pour valider les bornes des queues de distribution.
10.2 Intégration de l’erreur type de mesure (ETM) de l’outil
Au-delà de la représentativité de l’échantillon normatif, le score brut d’un patient individuel à une passation d’épreuve ne reflète jamais fidèlement son niveau d’aptitude réel ou « score vrai » au sens de la théorie classique des tests (TCT). Toute passation est contaminée par des facteurs d’erreur transitoires aléatoires (fatigue du sujet, baisse attentionnelle momentanée, fluctuations environnementales, variabilité de cotation de l’examinateur). La précision intrinsèque d’un test est formalisée par son coefficient de fidélité ou de cohérence interne (noté rxx).
L’erreur type de mesure (ETM), souvent désignée sous son acronyme anglo-saxon SEM (Standard Error of Measurement), quantifie la dispersion des scores observés que l’on obtiendrait si le même individu était évalué une infinité de fois dans des conditions strictement équivalentes. Elle se déduit directement de l’écart-type du test et de son coefficient de fidélité par l’équation :
ETM = σ × √(1 – rxx)
Prenons l’exemple d’une échelle d’efficience globale (σ = 15) dotée d’une fidélité excellente de rxx = 0,96. Son erreur type de mesure est de :
ETM = 15 × √(1 – 0,96) = 15 × √0,04 = 15 × 0,20 = 3 points
Si la fidélité de l’outil chute à rxx = 0,75 (ce qui est fréquent pour des échelles de personnalité abrégées ou des tâches neuropsychologiques chronométrées courtes), l’erreur type de mesure s’élève immédiatement à :
ETM = 15 × √(1 – 0,75) = 15 × √0,25 = 15 × 0,50 = 7,5 points
Une telle marge d’imprécision instrumentale démontre qu’assigner un centile précis sans encadrement probabiliste relève d’une illusion scientiste qui compromet l’objectivité du diagnostic.
10.3 Établissement d’intervalles de confiance rigoureux
La déontologie psychologique et les recommandations des associations internationales de psychométrie (American Psychological Association, International Test Commission) imposent d’encadrer tout score standardisé et tout centile individuel d’un intervalle de confiance probabiliste explicite (généralement à 90 % ou 95 % de certitude statistique).
Pour construire un intervalle de confiance autour du score observé d’un individu à un niveau de certitude bilatéral de 95 % :
- Isoler la cote standard critique bilatérale pour 95 %, qui est zcrit = 1,96.
- Déterminer la marge d’erreur instrumentale : ME = 1,96 × ETM. Si ETM = 3 points, la marge d’erreur est de 1,96 × 3 = 5,88 points (souvent arrondie à 6 points).
- Délimiter l’intervalle de score brut : pour un sujet obtenant un score brut observé de 100 points, l’intervalle de confiance à 95 % s’étend de [100 – 5,88 ; 100 + 5,88], soit de 94,12 à 105,88 points.
- Convertir les bornes inférieure et supérieure de cet intervalle métrique en rangs percentiles par l’équation normale unilatérale :
- Pour la borne basse (94,12) : zbas = (94,12 – 100) / 15 = -0,392. La probabilité cumulée associée Φ(-0,392) donne un rang percentile de 35.
- Pour la borne haute (105,88) : zhaut = (105,88 – 100) / 15 = +0,392. La probabilité cumulée Φ(+0,392) donne un rang percentile de 65.
Cette démonstration prouve qu’un individu présentant un score observé correspondant rigoureusement au 50e centile ponctuel possède en réalité, à un niveau de confiance de 95 %, un positionnement normatif oscillant entre le 35e et le 65e centile. La formulation clinique doit obligatoirement restituer cette amplitude pour préserver la prudence diagnostique.
Une alternative contemporaine très performante repose sur l’approche par rééchantillonnage bootstrap. En simulant des milliers de rééchantillonnages avec remise au sein de la base d’étalonnage initiale, le statisticien peut construire des intervalles de confiance empiriques pour chaque quantile sans formuler d’hypothèse théorique a priori sur la normalité asymptotique, renforçant ainsi la robustesse métrologique des normes élaborées.
11. Atelier pratique : études de cas et exercices de calcul résolus
Afin de consolider l’ensemble des connaissances théoriques exposées, cette section propose trois études de cas cliniques détaillées, traitées pas à pas selon les règles de l’art psychométrique.
11.1 Étude de cas 1 : Évaluation de la mémoire de travail chez l’adulte
Dans le cadre d’un bilan d’aptitudes cognitives chez un patient de 42 ans se plaignant d’oublis fréquents sur son lieu de travail, le neuropsychologue administre une épreuve informatisée de mise à jour en mémoire de travail (n-back task). L’étalonnage de l’épreuve pour la tranche d’âge 40-49 ans indique une distribution des scores conformes à la loi normale, caractérisée par une moyenne arithmétique de μ = 50 points et un écart-type de σ = 10 points (métrique en score T).
Le praticien souhaite établir avec rigueur deux seuils métriques discriminants majeurs :
- Le seuil du 10e centile (marquant la zone de fragilité clinique justifiant une remédiation cognitive).
- Le seuil du 90e centile (marquant un niveau d’efficience mémoire remarquable).
Résolution détaillée du seuil du 10e centile :
Le centile recherché étant P = 10, la probabilité cumulée unilatérale est de p = 0,1000. Cette probabilité étant inférieure à la médiane (0,50), nous savons que le score z sera négatif. La probabilité symétrique supérieure complémentaire est de 1 – 0,1000 = 0,9000. La consultation de la table Z ou l’utilisation d’une commande logicielle identifie que le quantile normal pour 0,9000 correspond précisément à z = +1,2816. Par symétrie, la cote standardisée associée au 10e centile est :
z0,10 = -1,2816
L’application de la formule de conversion donne :
X0,10 = 50 + (-1,2816) × 10 = 50 – 12,816 = 37,184 points (soit un score arrondi à 37 points).
Résolution détaillée du seuil du 90e centile :
Pour P = 90, la probabilité cumulée est de p = 0,9000. Le score z se situe dans la portion supérieure de la courbe et correspond rigoureusement à la valeur positive calculée précédemment :
z0,90 = +1,2816
L’application de la formule fondamentale fournit :
X0,90 = 50 + (+1,2816) × 10 = 50 + 12,816 = 62,816 points (soit un score arrondi à 63 points).
Interprétation neuropsychologique comparée :
Les deux scores seuils (37 et 63 points) encadrent rigoureusement 80 % de la population générale adulte du même âge. Si le patient obtient un score brut de 35 points, il se situe sous le 10e centile ; le praticien conclut formellement à l’existence d’une altération de la mémoire de travail dépassant la variabilité interindividuelle standard, appuyant l’indication d’un accompagnement thérapeutique ciblé.
11.2 Étude de cas 2 : Diagnostic de douance intellectuelle
Une adolescente de 16 ans est reçue pour une évaluation psychométrique globale au moyen de la batterie WAIS-IV en raison de questionnements sur son adaptation scolaire. L’échelle globale de quotient intellectuel présente une moyenne normalisée de μ = 100 et un écart-type de σ = 15.
Le psychologue souhaite confronter les données empiriques aux deux seuils statistiques majeurs débattus dans la littérature spécialisée sur la douance intellectuelle :
- Le seuil classique de l’écart-type de +2,00σ (correspondant au 97,72e centile).
- Le seuil d’accès strict au 99e centile.
Calcul du seuil au 97,72e centile :
La cote standardisée z associée à une surface sous la courbe de 0,9772 est universellement fixée à :
z = +2,0000
L’application de l’équation fournit :
QI97,72 = 100 + (2,00 × 15) = 100 + 30 = 130 points.
Calcul du seuil au 99e centile :
Pour le 99e centile (probabilité cumulée p = 0,9900), l’inversion de la fonction de répartition cumulative normale fournit une cote z plus exigeante :
z = Φ-1(0,9900) ≈ +2,3263
En injectant cette cote standard dans l’équation :
QI99 = 100 + (2,3263 × 15) = 100 + 34,8945 = 134,89 points (arrondi conventionnellement à 135 points).
Discussion critique sur la relativité du seuil normatif :
Cette étude de cas illustre la sensibilité du diagnostic psychométrique au choix du critère normatif retenu. Si le praticien adopte le seuil conventionnel de Wechsler (QI ≥ 130), une performance brute correspondant à un QI de 131 valide l’identification d’un haut potentiel. En revanche, si une institution exige le dépassement du 99e centile strict (QI ≥ 135), ce même score de 131 s’avère insuffisant, bien qu’il témoigne d’un fonctionnement intellectuel situé dans les 2 % les plus efficients de l’humanité. Cette mise en perspective souligne le caractère conventionnel des frontières diagnostiques et l’importance d’une lecture clinique globale intégrant les indices qualitatifs et l’anamnèse du sujet.
11.3 Étude de cas 3 : Problème inverse (Déduction du rang percentile d’un score brut)
Lors d’une étude clinique sur la régulation émotionnelle, une participante obtient un score brut de X = 68 points à une échelle standardisée mesurant l’anxiété-trait. Le manuel technique de l’instrument stipule que les scores d’anxiété dans la population générale adulte s’ajustent de manière optimale à une distribution gaussienne de moyenne μ = 52 points et d’écart-type σ = 8 points. Le chercheur doit déterminer le rang percentile individuel exact de cette participante.
Démarche algorithmique résolue :
- Standardisation descendante : Il convient de transformer le score brut observé X en cote normale standardisée z par la formule de réduction :
z = (X – μ) / σ
z = (68 – 52) / 8 = 16 / 8 = +2,00 - Extraction de l’aire sous la courbe normale : Le score z étant de +2,00, nous interrogeons la fonction de répartition unilatérale standard Φ(2,00). La consultation de la table Z unilatérale cumulative de moins l’infini à z indique immédiatement à l’abscisse 2,0 et à l’ordonnée 0,00 la probabilité :
P(Z ≤ 2,00) = 0,97725
- Conversion en rang percentile : La multiplication par cent aboutit à :
Rang percentile = 0,97725 × 100 = 97,725e centile (que l’on arrondit usuellement au 98e centile).
Conclusion clinique :
Avec un score brut de 68 points, la participante présente un niveau d’anxiété-trait supérieur ou égal à celui de 98 % des adultes de la population de référence. Ce positionnement à deux écarts-types au-dessus de la moyenne centrale atteste d’une anxiété cliniquement significative nécessitant des investigations complémentaires.
12. Bonnes pratiques déontologiques et rédactionnelles du bilan psychologique
L’évaluation psychométrique ne se cantonne pas à une suite d’opérations mathématiques abstraites. Elle s’inscrit dans une relation humaine et clinique encadrée par des exigences déontologiques rigoureuses. La transmission des centiles et des scores standardisés exige une pédagogie métrologique sans faille pour garantir le respect et l’autonomie des personnes évaluées.
12.1 Communication transparente des centiles aux patients et tiers
Le compte-rendu d’évaluation psychologique constitue un document à valeur juridique et clinique qui s’adresse à des publics aux compétences statistiques contrastées : patients, parents, médecins traitants, directeurs d’établissements spécialisés ou magistrats. Le psychologue doit proscrire l’usage d’un jargon métrologique opaque qui obscurcit la compréhension des conclusions.
Dans cette perspective, le rang percentile est incontestablement l’indicateur le plus adapté à une vulgarisation éthique et rigoureuse. Il est toutefois impératif de désamorcer activement les biais interprétatifs récurrents :
- Démystifier explicitement la non-linéarité des centiles en expliquant qu’un saut métrique du 50e au 60e centile ne traduit pas la même progression qu’un passage du 89e au 99e centile.
- Rappeler avec bienveillance et fermeté qu’un centile ne mesure pas la valeur intrinsèque d’une personne, mais uniquement son positionnement relatif à une tâche standardisée donnée, à un instant t, face à une cohorte comparative spécifique.
- Présenter conjointement la moyenne, l’écart-type du groupe de référence, le score brut observé et le rang percentile assorti de son intervalle de confiance probabiliste.
Cette transparence préserve l’usager d’une vision fataliste de ses scores et favorise l’appropriation éclairée des préconisations formulées au terme de l’évaluation.
12.2 Check-list méthodologique pour la standardisation des bilans
Afin de prémunir les praticiens contre les omissions et les dérives métrologiques, l’adoption d’une grille de contrôle qualité systématique avant la clôture de tout rapport psychométrique est fortement recommandée :
| Étape d’audit | Vérification métrologique fondamentale | Critère de conformité |
|---|---|---|
| 1. Adéquation de l’échantillon | L’étalonnage sélectionné correspond-il précisément à la tranche d’âge et au profil culturel du sujet ? | Manuel technique à jour, stratification démographique documentée |
| 2. Forme distributionnelle | Le postulat de normalité gaussienne a-t-il été testé et documenté sur les données normatives ? | Skewness et kurtosis compris entre -1 et +1, ou transformation appliquée |
| 3. Intégrité des calculs | Les signes des cotes z ont-ils été respectés (négatif sous la médiane, positif au-dessus) ? | Score brut final cohérent avec la directionnalité du centile |
| 4. Gestion de l’erreur | L’intervalle de confiance est-il explicitement calculé à partir de l’Erreur Type de Mesure ? | Fourchette de scores et de centiles mentionnée au seuil de 90 % ou 95 % |
| 5. Pédagogie rédactionnelle | Le compte-rendu distingue-t-il expressément centile, note brute et pourcentage d’items ? | Formulation narrative claire, accessible aux non-statisticiens |
| 6. Effet Flynn et obsolescence | L’étalonnage utilisé date-t-il de moins de dix à quinze ans ? | Normes contemporaines évitant le biais de dérive séculaire des scores |
La formalisation explicite de ces points de contrôle dans les annexes méthodologiques du bilan psychologique témoigne du haut niveau de professionnalisme de l’évaluateur et immunise ses conclusions contre les contestations d’ordre technique.
12.3 Synthèse et tableau de correspondance rapide des valeurs remarquables
Pour accompagner les praticiens dans leurs estimations rapides au cabinet et faciliter la vérification instantanée de données normatives, le tableau récapitulatif ci-dessous synthétise les points d’ancrage universels de la distribution normale univariée, reliant le score standardisé z, l’écart-type σ, le rang percentile théorique exact et les équivalences sur les échelles métriques les plus courantes de la psychologie contemporaine :
| Écart à la moyenne | Score z exact | Probabilité unilatérale | Rang percentile | Échelle QI (μ=100, σ=15) | Échelle T (μ=50, σ=10) | Note standard (μ=10, σ=3) |
|---|---|---|---|---|---|---|
| -3,00 σ | -3,000 | 0,00135 | 0,1er | 55 | 20 | 1 |
| -2,33 σ | -2,326 | 0,01000 | 1er | 65 | 27 | 3 |
| -2,00 σ | -2,000 | 0,02275 | 2,3e (2e) | 70 | 30 | 4 |
| -1,65 σ | -1,645 | 0,05000 | 5e | 75 | 34 | 5 |
| -1,28 σ | -1,282 | 0,10000 | 10e | 81 | 37 | 6 |
| -1,00 σ | -1,000 | 0,15866 | 15,9e (16e) | 85 | 40 | 7 |
| -0,67 σ | -0,674 | 0,25000 | 25e (Q1) | 90 | 43 | 8 |
| 0,00 σ | 0,000 | 0,50000 | 50e (Médiane) | 100 | 50 | 10 |
| +0,67 σ | +0,674 | 0,75000 | 75e (Q3) | 110 | 57 | 12 |
| +1,00 σ | +1,000 | 0,84134 | 84,1e (84e) | 115 | 60 | 13 |
| +1,28 σ | +1,282 | 0,90000 | 90e | 119 | 63 | 14 |
| +1,65 σ | +1,645 | 0,95000 | 95e | 125 | 66 | 15 |
| +2,00 σ | +2,000 | 0,97725 | 97,7e (98e) | 130 | 70 | 16 |
| +2,33 σ | +2,326 | 0,99000 | 99e | 135 | 73 | 17 |
| +3,00 σ | +3,000 | 0,99865 | 99,9e | 145 | 80 | 19 |
Ce tableau constitue la matrice de référence cardinale à laquelle tout utilisateur de tests psychologiques et neuropsychologiques peut se référer pour naviguer d’une échelle à l’autre avec une rigueur absolue. La maîtrise intime de ces passerelles mathématiques consacre le passage d’une métrologie descriptive passive à une pratique diagnostique paramétrique experte, éclairée et éthiquement responsable.
Références
American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association.
Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Gregoire, J. (2019). L’évaluation clinique de l’intelligence de l’adulte : Guide pratique du praticien à la WAIS-IV. Mardaga.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
SciPy Community. (2023). Statistical functions (scipy.stats). SciPy documentation. https://docs.scipy.org/doc/scipy/reference/stats.html
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV) technical and interpretive manual. Pearson.
Wichura, M. J. (1988). Algorithm AS 241: The percentage points of the normal distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 37(3), 477-484. https://doi.org/10.2307/2347330