
L’analyse quantitative des données en sciences comportementales, cognitives et biomédicales repose très largement sur le paradigme du modèle linéaire général. Qu’il s’agisse de déployer des tests comparatifs de moyennes tels que le test t de Student, des analyses de variance factorielles ou des régressions linéaires multiples, la validité des conclusions inférentielles dépend directement du respect scrupuleux de plusieurs postulats mathématiques cardinaux. Parmi ces prérequis, la distribution normale des résidus occupe une position prépondérante. Or, dans les contextes empiriques réels — et plus particulièrement lors de l’investigation de variables psychologiques telles que les temps de réaction, la latence de traitement de l’information ou les fréquences d’erreurs comportementales —, les données observées manifestent presque systématiquement des déviations majeures par rapport à la courbe en cloche théorisée par Carl Friedrich Gauss. Ces déviations se traduisent le plus souvent par une asymétrie positive prononcée, caractérisée par une forte concentration d’observations dans les valeurs faibles et une longue traîne s’étirant vers les valeurs élevées.
Face à de telles distributions hétérogènes et asymétriques, l’analyste se trouve confronté à un dilemme fondamental. L’application brute de procédures paramétriques à des données violant manifestement l’hypothèse de normalité entraîne une altération substantielle du taux d’erreur de première espèce (taux alpha), tout en dégradant drastiquement la puissance statistique nécessaire à la détection d’effets réels. Bien que le recours à des méthodologies non paramétriques soit fréquemment envisagé, celles-ci présentent des limitations structurelles quant à l’estimation précise des tailles d’effet, à l’évaluation des interactions complexes entre variables et à la modélisation prédictive fine. C’est précisément à l’intersection de ces contraintes que se situe la pratique de la transformation mathématique des données. En opérant une modification fonctionnelle non linéaire de l’échelle de mesure, la transformation vise à symétriser la distribution empirique, à stabiliser la variance résiduelle et à rétablir la concordance entre la métrique empirique et les hypothèses du modèle statistique paramétrique.
Le présent article constitue un guide approfondi et exhaustif consacré à l’implémentation pratique, théorique et critique des trois transformations fondamentales de la famille des puissances de Tukey au sein du tableur Microsoft Excel : la transformation logarithmique, la transformation par racine carrée et la transformation par racine cubique. Chaque méthode fait l’objet d’une analyse détaillée de ses fondements mathématiques, de son champ d’application clinique et expérimental, de sa syntaxe exacte dans l’environnement Excel, ainsi que de ses protocoles de validation diagnostique par le biais de visualisations et de tests statistiques avancés tels que celui de Jarque-Bera. Par une approche rigoureuse et ancrée dans les exigences méthodologiques de la recherche académique contemporaine, ce guide fournit à l’expérimentateur les outils indispensables pour manipuler, normaliser et interpréter ses données sans dénaturer la structure sous-jacente des observations.
1. Introduction aux transformations de données en recherche psychologique et statistique
1.1 La nature des distributions de données en psychologie
L’étude empirique du comportement humain, de la cognition et des dynamiques affectives met en évidence une régularité frappante : la rareté absolue des distributions parfaitement gaussiennes au sein des échantillons bruts. En psychologie expérimentale, la variable dépendante reine est sans conteste le temps de réaction (TR), mesuré par chronométrie mentale lors d’épreuves perceptives, attentionnelles ou décisionnelles. Par définition, un temps de réaction ne peut descendre en dessous d’un seuil physiologique incompressible — correspondant au temps de conduction synaptique et à l’activation musculaire, soit environ cent millisecondes —, ce qui crée une barrière absolue sur la gauche de la distribution. Inversement, les fluctuations de l’attention, les lapsus cognitifs passagers ou la fatigue induisent des latences sporadiques considérablement allongées, étirant démesurément la queue droite de la série. Le résultat systématique de cette contrainte physiologique est une asymétrie positive sévère, modélisée avec une remarquable précision par des lois non gaussiennes telles que la loi log-normale ou la distribution ex-Gaussienne.
Cette divergence structurelle n’est pas cantonnée aux seules métriques chronométriques. L’évaluation psychométrique au moyen d’inventaires d’auto-évaluation clinique, d’échelles de dépression ou d’anxiété, ainsi que de batteries neuropsychologiques évaluant des atteintes cérébrales, produit fréquemment des données présentant des effets d’accumulation massive à l’une des extrémités du continuum. Dans une population générale ou un groupe contrôle sain, le niveau moyen d’idéation suicidaire, d’évitement agoraphobique ou d’amnésie antérograde est fondamentalement nul ou minime, engendrant un effet de plancher accentué. Dès lors, la variance n’est pas uniformément répartie autour d’un barycentre symétrique : les scores se massent contre la borne inférieure, tandis qu’un contingent restreint d’individus présente des scores hautement symptomatiques générant une queue de distribution effilée.
Les conséquences méthodologiques de cette non-gaussicité sont lourdes. Lorsqu’un jeu de données s’écarte structurellement de la symétrie idéale, la moyenne arithmétique subit une attraction disproportionnée vers les valeurs extrêmes de la queue droite, perdant ainsi sa représentativité en tant qu’indice de tendance centrale typique. Concomitamment, l’estimation de l’écart-type est artificiellement gonflée, ce qui compromet directement l’estimation des erreurs-types et produit un affaissement sévère de la puissance statistique lors des inférences formelles. L’expérimentateur court alors le risque manifeste de commettre une erreur de type II, échouant à mettre en évidence des différences intergroupes authentiques ou des modulations expérimentales significatives en raison de la distorsion d’échelle de ses instruments de mesure.
1.2 Définition et rôle fondamental de la transformation mathématique
D’un point de vue épistémologique et formel, une transformation mathématique consiste en l’application d’une fonction analytique continue, déterministe et strictement monotone à chaque valeur quantitative d’un ensemble de données. Le caractère strictement monotone de la fonction garantit une propriété indispensable à l’intégrité scientifique de l’analyse : la préservation absolue de l’ordre des observations initiales. Si un individu A présente un score supérieur à celui d’un individu B avant l’opération, cette inégalité stricte demeure inviolée après l’application de la transformation, ce qui empêche toute permutation artificielle de la hiérarchie des performances au sein du groupe étudié.
L’objectif primaire de cette intervention mathématique est d’aligner les propriétés distributionalistes de la variable dépendante sur les postulats théoriques du modèle linéaire général. Ce modèle stipule que la variable observée est une combinaison linéaire de prédicteurs additifs et d’un terme d’erreur aléatoire, indépendant et identiquement distribué selon une loi normale centrée en zéro et de variance homogène. Lorsque la métrique d’origine génère des relations d’échelle non linéaires ou des variances dépendantes du niveau de la moyenne, la transformation opère une reconfiguration de l’espace numérique afin de linéariser les relations sous-jacentes, d’homogénéiser la dispersion intra-groupe et de rapprocher les résidus de la morphologie gaussienne exigée par les tables de probabilité des tests conventionnels.
Il importe de clarifier une confusion fréquente dans la littérature méthodologique entre la normalisation par transformation et la standardisation par centrage-réduction (calcul des scores Z). La standardisation consiste à soustraire la moyenne arithmétique d’une série puis à diviser le résultat par son écart-type empirique. Bien que cette opération linéaire déplace le centre de gravité à zéro et étalonne la dispersion sur l’unité, elle ne modifie rigoureusement en rien la géométrie de la distribution : les coefficients d’asymétrie et d’aplatissement demeurent rigoureusement inchangés. En revanche, la transformation mathématique non linéaire modifie dynamiquement les distances relatives séparant les points le long du continuum, comprimant certains segments tout en étirant d’autres, ce qui altère profondément la courbure, la symétrie et l’aplatissement de la distribution empirique.
1.3 Présentation des trois transformations canoniques
Au sein de la célèbre famille des transformations de puissance formalisée par Box et Cox, trois fonctions occupent une place canonique et prépondérante dans l’arsenal analytique des sciences humaines et médicales : la transformation logarithmique, la transformation par racine carrée et la transformation par racine cubique. Chacune de ces fonctions possède une courbure analytique singulière et répond à un degré spécifique de déformation asymétrique de la distribution empirique initiale, fournissant ainsi une réponse graduée aux pathologies distributionnelles observées sur le terrain.
La transformation logarithmique constitue l’outil de correction le plus incisif parmi les trois fonctions traditionnelles. En convertissant une échelle arithmétique en une progression multiplicative, elle opère une compression drastique des valeurs élevées tout en étirant proportionnellement les valeurs situées au voisinage de zéro. Son action est spécifiquement dimensionnée pour contrecarrer les asymétries positives prononcées, réduisant les écarts considérables générés par les valeurs aberrantes ou les queues de distribution infiniment étirées, fréquentes dans les processus dynamiques exponentiels.
La transformation par racine carrée offre pour sa part une modération intermédiaire. Moins punitive que l’opérateur logarithmique envers les scores élevés, elle applique une déflation sub-linéaire qui se révèle optimale pour traiter les asymétries positives modérées. Elle constitue la solution mathématique de référence pour les variables issues de processus de comptage d’événements discrets, où la dispersion intrinsèque a naturellement tendance à croître au prorata de l’espérance mathématique du phénomène investigué.
Enfin, la transformation par racine cubique déploie des propriétés théoriques exceptionnellement avantageuses mais fréquemment sous-utilisées. Située sur un gradient d’inflexion intermédiaire, elle offre la caractéristique cruciale d’être intrinsèquement définie sur l’ensemble des nombres réels, incluant sans artifice arithmétique le zéro absolu et les valeurs négatives. Cette singularité mathématique lui confère une pertinence inégalée lorsqu’il s’agit de traiter des scores composites, des indices différentiels de changement ou des grandeurs bipolaires fortement polarisées, tout en neutralisant avec efficacité l’asymétrie positive ou négative sous-jacente.
2. Le postulat de normalité et ses implications méthodologiques
2.1 L’exigence de distribution normale dans les tests paramétriques
L’édifice statistique traditionnel bâti par Ronald Fisher, William Sealy Gosset et leurs contemporains s’articule autour du postulat central selon lequel les termes d’erreur résiduelle associés à l’observation des variables quantitatives suivent une loi normale d’espérance nulle et de variance constante. Les tests de comparaison univariés, tels que le test t de Student pour échantillons indépendants ou appariés, de même que les analyses de variance factorielles univariées et multivariées (ANOVA, MANOVA), dérivent directement leurs tables de décision critique de cette distribution gaussienne fondamentale. L’intégration mathématique qui sous-tend le ratio de variance F de Fisher repose explicitement sur le quotient de deux variables aléatoires indépendantes suivant chacune une distribution du Chi-deux, propriété qui n’est rigoureusement vérifiée que si la variable mère suit une loi normale.
Dans la pratique contemporaine, un argument récurrent s’appuie sur le théorème central limite pour justifier une négligence délibérée de la vérification de ce postulat dès lors que l’effectif de l’échantillon dépasse trente ou cinquante observations. Cette confiance aveugle constitue une méprise méthodologique substantielle. Si le théorème central limite garantit effectivement la convergence asymptotique de la distribution d’échantillonnage de la moyenne vers la normalité, il ne protège nullement les tests paramétriques contre la distorsion sévère du taux d’erreur de type I en présence de distributions résiduelles hautement asymétriques ou épaisses aux extrémités, tout particulièrement lorsque les effectifs entre groupes sont inégaux (plans non orthogonaux).
En outre, au sein des modèles de régression linéaire multiple et de modélisation par équations structurelles, l’hypothèse de normalité ne concerne pas uniquement les marges unidimensionnelles, mais implique formellement la normalité multivariée. La violation de cette condition engendre des estimations biaisées des erreurs-types des coefficients de régression partielle, conduisant à des intervalles de confiance erronés et à des conclusions fallacieuses quant à la significativité statistique de prédicteurs théoriques cruciaux. Ainsi, le rétablissement d’une forme distributionnelle aussi proche que possible de la normalité idéale demeure un prérequis méthodologique d’une impérieuse nécessité.
2.2 Caractérisation de l’asymétrie (Skewness) et de l’aplatissement (Kurtosis)
L’évaluation diagnostique formelle de la normalité d’un jeu de données exige une quantification précise des deux composantes fondamentales de la forme d’une distribution : le coefficient d’asymétrie (communément désigné sous le terme anglo-saxon de skewness) et le coefficient d’aplatissement (ou kurtosis). Le coefficient d’asymétrie de Fisher-Pearson correspond au moment centré d’ordre trois standardisé par l’écart-type élevé au cube. Mathématiquement, il s’exprime pour un échantillon de taille n par l’équation suivante :
S = [n / ((n – 1)(n – 2))] * Somme[((x_i – Moyenne) / Écart-Type)^3]
Une valeur strictement égale à zéro atteste d’une symétrie bilatérale absolue de la distribution autour de son espérance. Un coefficient d’asymétrie positif traduit un étalement de la queue de distribution vers les valeurs de droite (asymétrie dextre), où la moyenne se trouve supérieure à la médiane. Inversement, un coefficient négatif dénote une longue traîne orientée vers la gauche (asymétrie senestre), situation où la moyenne est inférieure à la médiane empirique.
Le coefficient d’aplatissement, quant à lui, repose sur le moment centré d’ordre quatre standardisé, diminué de la valeur 3 afin de définir le kurtosis excédentaire par rapport à la distribution gaussienne de référence :
K = {[n(n + 1) / ((n – 1)(n – 2)(n – 3))] * Somme[((x_i – Moyenne) / Écart-Type)^4]} – [3(n – 1)^2 / ((n – 2)(n – 3))]
Une distribution dite mésokurtique présente un kurtosis excédentaire nul. Une distribution leptokurtique (K > 0) est caractérisée par un pic central très aiguisé et des queues de distribution extrêmement épaisses, hébergeant une propension élevée à générer des valeurs distantes ou atypiques. Une distribution platykurtique (K < 0) exhibe un profil aplati aux épaules larges et aux queues minces. En méthodologie expérimentale rigoureuse, on considère traditionnellement que l’écart à la normalité devient problématique lorsque la valeur absolue de l’asymétrie excède 1,0, ou que le kurtosis excédentaire s’écarte de l’intervalle compris entre -2,0 et +2,0.
2.3 Risques associés à l’absence de correction des données asymétriques
L’omission délibérée ou accidentelle de correction face à des données fortement asymétriques induit une cascade d’erreurs d’estimation qui affecte directement la validité interne et la reproductibilité des recherches. Le premier préjudice concerne la validité des statistiques descriptives fondamentales. Dans une distribution asymétrique positive, la moyenne empirique ne représente plus le comportement modal des participants, mais se trouve tirée vers le haut par une minorité infinitésimale d’observations massives. Présenter de telles moyennes sans transformation ni mention de la médiane expose la communauté scientifique à des représentations fallacieuses de la réalité psychologique observée.
Sur le plan inférentiel, les risques se manifestent par une instabilité critique de la variance résiduelle, phénomène connu sous le vocable d’hétéroscédasticité. Les modèles paramétriques assument l’homogénéité stricte de la variance à travers l’ensemble des groupes expérimentaux. Or, dans les distributions asymétriques brutes, la variance empirique est fréquemment couplée de manière fonctionnelle au niveau moyen du groupe : les conditions expérimentales manifestant les moyennes les plus élevées exhibent quasi invariablement des variances considérablement supérieures à celles des groupes contrôles. Cette covariation directe entre moyenne et variance brise le postulat d’homoscédasticité, désactivant la robustesse du test F et induisant soit une inflation incontrôlée des faux positifs, soit une hécatombe méthodologique où des effets robustes demeurent indétectés.
Enfin, la généralisation des modèles explicatifs issus de données non régularisées vers des populations cibles se révèle hautement compromise. Les intervalles de confiance construits selon les formules paramétriques symétriques dépassent souvent les frontières physiques ou logiques du phénomène mesuré — par exemple en produisant des bornes inférieures négatives pour des temps de réaction ou des pourcentages de réussite. L’ajustement mathématique n’est donc pas un artifice cosmétique, mais un impératif épistémologique garantissant l’adéquation de l’outil analytique avec la géométrie intrinsèque des faits étudiés.
3. Cadre théorique de la transformation logarithmique
3.1 Mécanisme mathématique de l’échelle logarithmique
L’opérateur logarithmique est l’outil mathématique par excellence dédié à la linéarisation des phénomènes à croissance multiplicative et à la régulation des distributions exhibant une asymétrie dextre massive. Au sens fondamental, le logarithme en base b d’un nombre réel x strictement positif est l’exposant y auquel il faut élever la base b pour retrouver le nombre x :
y = log_b(x) équivaut à b^y = x
Dans la pratique analytique contemporaine, deux variantes logarithmiques dominent l’usage scientifique : le logarithme népérien ou naturel (utilisant la constante d’Euler e ≈ 2,71828 comme base, noté ln) et le logarithme décimal (utilisant la base 10, noté log10). D’un point de vue topologique, ces deux fonctions sont strictement proportionnelles par application de la règle du changement de base :
ln(x) = log10(x) * ln(10) ≈ 2,302585 * log10(x)
Cette proportionnalité constante implique que le choix entre le logarithme décimal et le logarithme népérien ne modifie en rien la courbure relative de la distribution après transformation, ni la valeur des coefficients d’asymétrie et d’aplatissement finaux. Le mécanisme régulateur du logarithme réside dans sa dérivée première, f'(x) = 1 / x, qui indique que le taux d’accroissement de la fonction décroît continuellement à mesure que x s’élève. Par conséquent, les écarts séparant les grandes valeurs numériques sont compressés de façon exponentielle, tandis que les écarts séparant les petites valeurs sont considérablement dilatés. Ce comportement fonctionnel réaligne la distribution vers le centre géométrique, neutralisant la traîne droite et stabilisant la variance lorsque celle-ci varie proportionnellement au carré de la moyenne.
3.2 Indications empiriques de la transformation log
L’application de la transformation logarithmique est particulièrement indiquée lorsque la distribution empirique initiale présente un coefficient d’asymétrie hautement positif, généralement supérieur à 1,0, voire excédant 2,0 ou 3,0. En psychologie cognitive, les données chronométriques représentent l’archétype absolu de cette structure distributionnelle. Le temps requis pour prendre une décision face à une charge mnésique croissante ne s’accroît généralement pas de manière arithmétique mais selon un ratio géométrique, faisant de la fonction logarithmique la traduction exacte de l’échelle de latence perceptive.
Un autre cas paradigmatique réside dans les variables psychophysiques respectant la célèbre loi de Weber-Fechner, stipulant que l’intensité perçue d’une sensation psychologique croît comme le logarithme de l’intensité physique du stimulus correspondant. Transformer les intensités lumineuses, acoustiques ou tactiles en échelle logarithmique ne constitue pas une simple manipulation numérique, mais une transcription fidèle de l’espace perceptif interne de l’organisme humain.
De surcroît, en neurosciences cognitives et en neurobiologie comportementale, de multiples paramètres de connectivité synaptique, de débits de tir neuronal ou d’amplitudes de potentiels évoqués suivent rigoureusement des distributions log-normales. Une variable log-normale se définit comme une grandeur aléatoire positive dont le logarithme naturel est distribué selon une loi normale standard. Dans ce cadre précis, l’application de la transformation logarithmique ne constitue pas un choix arbitraire parmi d’autres, mais représente le recouvrement exact de la métrique normale latente qui gouverne la génération probabiliste des observations empiriques.
3.3 Contraintes et gestion des valeurs nulles ou négatives
En dépit de sa remarquable puissance d’ajustement, la transformation logarithmique se heurte à une contrainte mathématique absolue : le domaine de définition de la fonction logarithmique est restreint à l’ensemble des réels strictement positifs, ]0, +∞[. La fonction n’est pas définie pour la valeur zéro — vers laquelle elle tend asymptotiquement vers l’infini négatif — et n’admet aucune solution dans le corps des réels pour les nombres strictement négatifs. Cette frontière pose un défi immédiat dans l’analyse de données empiriques comportant des absences de réponse (zéro erreur, zéro symptôme) ou des indices différentiels négatifs.
Pour contourner cet écueil sans sacrifier l’échantillon, la solution méthodologique consacrée consiste à opérer une translation linéaire de l’ensemble de la variable par l’adjonction d’une constante d’ajustement positive c, avant l’extraction du logarithme :
y’ = log(y + c)
Lorsque les données initiales sont constituées de dénombrements discrets incluant des zéros, la constante standard traditionnellement sélectionnée est c = 1, ce qui conduit à l’expression classique log(y + 1). Cette valeur présente l’élégance théorique d’ancrer les valeurs nulles initiales exactement à zéro sur la nouvelle échelle, puisque log(0 + 1) = log(1) = 0.
Toutefois, la sélection de cette constante d’ajustement exerce une influence sensible sur la forme finale de la distribution résultante, en particulier lorsque la variable contient des valeurs fractionnaires petites comprises entre 0 et 1. Une constante c excessivement grande dilue l’impact non linéaire du logarithme et affaiblit son pouvoir de correction d’asymétrie, tandis qu’une constante infinitésimale (telle que c = 0,0001) projette les valeurs nulles vers un pic isolé très lointain dans les négatifs, générant artificiellement une asymétrie gauche et un profil bimodal indésirable. Le choix de la constante doit donc être méthodologiquement justifié, rigoureusement documenté et proportionné à la résolution de la mesure.
4. Procédure d’application de la transformation logarithmique dans Excel
4.1 Syntaxe des fonctions LOG10 et LN dans Excel
L’environnement de calcul Microsoft Excel propose des fonctions intégrées hautement optimisées pour exécuter les calculs logarithmiques à travers de vastes plages de données. Les deux formules pivots sont :
=LOG10(nombre) pour le logarithme décimal en base 10.
=LN(nombre) pour le logarithme népérien fondé sur la constante népérienne e.
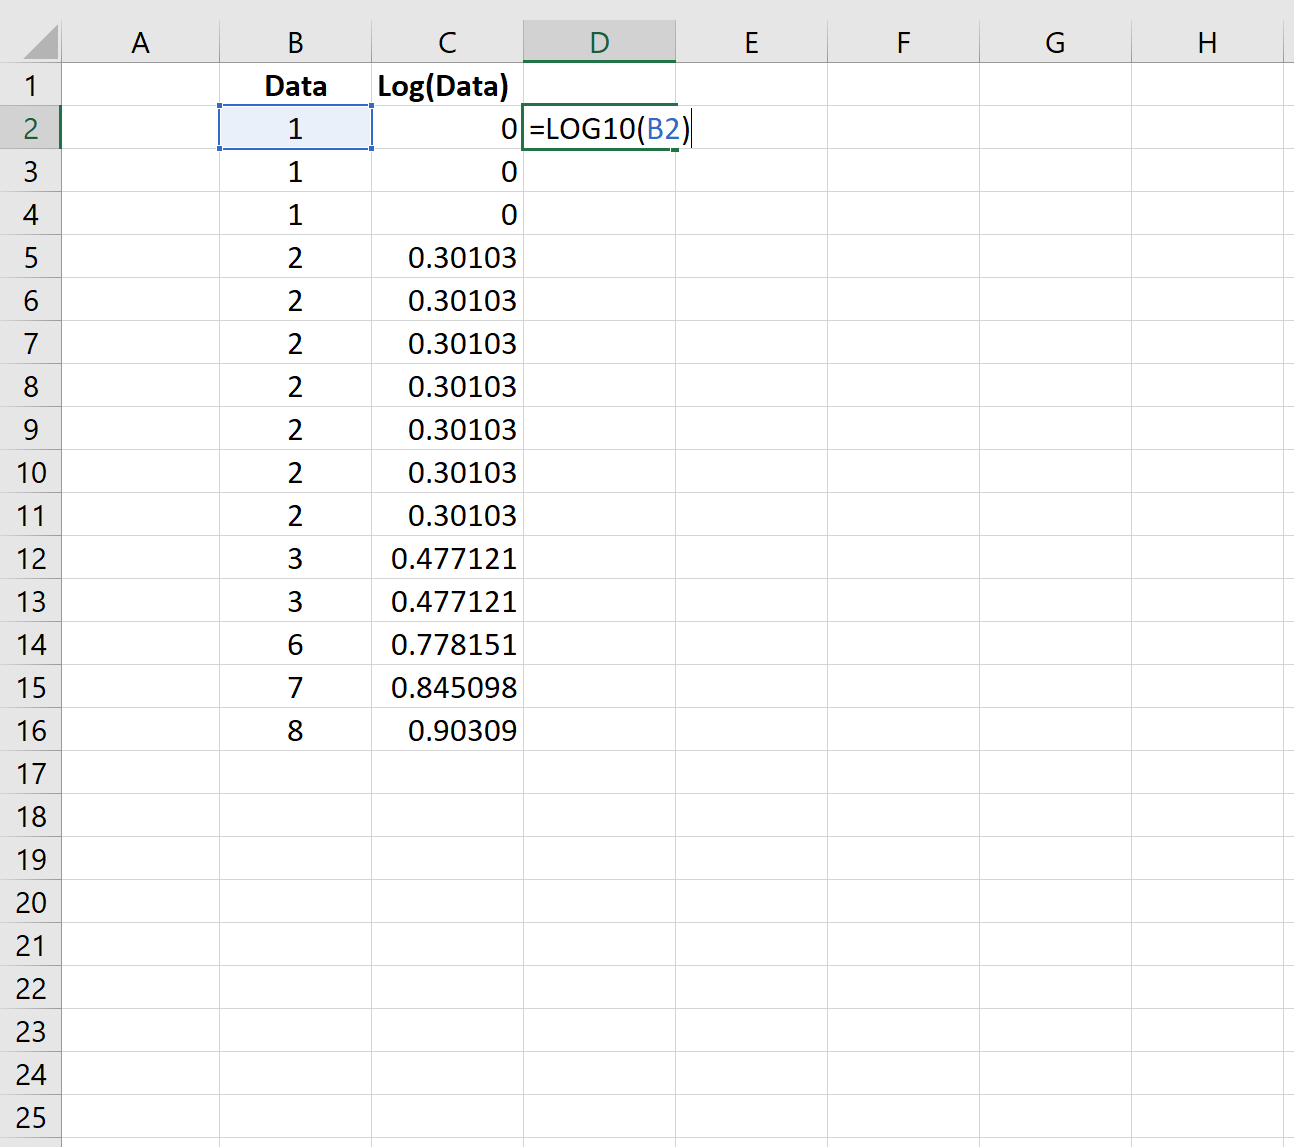
Pour appliquer cette transformation à une colonne de données expérimentales, l’expérimentateur doit structurer sa feuille de calcul de manière rigoureuse. Supposons que la variable brute « Temps_Reaction_ms » soit consignée dans la plage verticale A2:A250. Dans la cellule adjacente B2, destinée à accueillir la série transformée, l’opérateur introduit la formule relative suivante :
=LOG10(A2)
ou alternativement :
=LN(A2)
Une bonne pratique de modélisation dans Excel consiste à imbriquer l’instruction de calcul au sein d’une fonction de sécurisation afin de prémunir le tableur contre l’apparition d’erreurs d’exécution bloquantes — typiquement l’erreur #NOMBRE! générée lorsqu’une cellule source contient une valeur négative ou nulle, ou l’erreur #VALEUR! si un caractère textuel parasite s’est glissé dans la colonne. La formulation robuste s’écrit dès lors :
=SIERREUR(LOG10(A2); « »)
Cette précaution garantit que le flux analytique ne sera pas corrompu lors du déploiement de formules d’agrégation subséquentes (telles que le calcul de la moyenne générale ou de l’écart-type du groupe).
4.2 Implémentation d’une translation pour les zéros
Dans l’éventualité où la série de données comporte des zéros exacts, par exemple lors de l’analyse d’un nombre d’erreurs commises à une épreuve de Stroop ou de Wisconsin Card Sorting Test, l’application brute de la fonction =LOG10(A2) produit immédiatement une rupture sous la forme de l’erreur fatale #NOMBRE!. L’implémentation de la translation d’échelle par constante d’ajustement unitaire s’effectue en saisissant dans la cellule cible B2 la formule canonique :
=LOG10(A2 + 1)
Lorsque le jeu de données comporte des mesures continues de haute précision où les valeurs non nulles sont nettement inférieures à l’unité (par exemple des concentrations hormonales salivaires en microgrammes par décilitre oscillant entre 0,02 et 0,45), l’adjonction d’un incrément fixe de 1 masquerait l’intégralité de la dynamique de variance des scores réels. Dans une telle conjoncture, l’analyste doit déterminer une constante de translation c égale à la moitié de la plus petite valeur non nulle détectable dans la série expérimentale, ou égale au seuil de sensibilité nominal de l’appareil de mesure.
Pour assurer la traçabilité de cette manipulation, il est impératif d’enregistrer cette constante dans une cellule dédiée de la feuille de métadonnées, par exemple $D$1, et de formuler le calcul en référence absolue :
=LOG10(A2 + $D$1)
La documentation de cette constante dans l’en-tête de la colonne et dans le journal méthodologique de la recherche assure la réplicabilité absolue des calculs conformément aux principes directeurs de la science ouverte.
4.3 Vérification visuelle et contrôle d’intégrité
Une fois la formule propagée le long de la colonne par un double-clic sur la poignée de recopie inférieure droite de la cellule active, une étape cruciale de vérification de l’intégrité des résultats doit être immédiatement entreprise. La première démarche analytique consiste à scruter visuellement la colonne transformée pour confirmer l’absence intégrale de codes d’erreur système (#NOMBRE!, #VALEUR!, #N/A) ou de valeurs infinies textuelles.
La seconde démarche implique la construction d’une visualisation comparative directe via l’insertion d’histogrammes de distribution sous Excel. L’expérimentateur sélectionne tout d’abord la colonne des données d’origine A2:A250, accède à l’onglet « Insertion », sélectionne le groupe « Graphiques », puis opte pour l’« Histogramme ». Il réitère rigoureusement cette manipulation pour la nouvelle colonne transformée B2:B250, en positionnant les deux graphiques côte à côte pour un examen comparatif immédiat.
L’analyse visuelle du graphique transformé doit mettre en évidence une résorption nette de la longue traîne droite, un recentrage visible du sommet de distribution vers le milieu de l’axe d’abscisse et une régularisation de la décroissance symétrique des fréquences de part et d’autre du mode. Si la distribution transformée affiche désormais un aplatissement inverse avec une queue démesurément étirée vers la gauche, l’opérateur est confronté à un phénomène classique de surcorrection, signalant que la fonction logarithmique était excessivement puissante pour le niveau d’asymétrie modéré propre au jeu de données étudié.
5. Cadre théorique de la transformation par racine carrée
5.1 Propriétés mathématiques de la fonction racine carrée
La transformation par racine carrée consiste à extraire la racine d’ordre deux de chaque point de mesure, ce qui revient arithmétiquement à élever la variable dépendante à la puissance fractionnaire un demi :
f(x) = x^(1/2) = √x
Sur le plan de la théorie des fonctions d’une variable réelle, la racine carrée est une fonction concave définie sur l’intervalle semi-fermé des réels positifs ou nuls, [0, +∞[. Sa dérivée première, f'(x) = 1 / (2√x), indique que son pouvoir de compression décroît continuellement à mesure que la variable progresse, mais avec une décélération infiniment moins brutale que celle opérée par l’inverse de la fonction logarithmique.
Cette propriété mathématique fait de la racine carrée un outil de régularisation d’une intensité modérée. Elle comprime les valeurs supérieures et élargit les segments inférieurs sans projeter les observations basses dans des régions d’espacement disproportionné. Sur le plan de la théorie des probabilités et de l’inférence statistique, la racine carrée constitue la transformation stabilisatrice de variance par excellence pour les variables aléatoires suivant une loi de Poisson.
Dans une distribution de Poisson idéale régissant l’occurrence d’événements discrets et indépendants, la variance théorique d’un échantillon est intrinsèquement égale à son espérance mathématique : Var(X) = E(X) = λ. Dès lors que différentes conditions expérimentales induisent des moyennes inégales, les variances intra-groupes croissent au même rythme, violant directement l’hypothèse d’homoscédasticité requise par l’ANOVA. L’application de la transformation racine carrée sur une telle distribution opère une égalisation théorique parfaite : la variance de la variable transformée converge vers une valeur approximativement constante de 0,25 (ou 1 selon la normalisation retenue), indépendamment du niveau moyen du phénomène mesuré.
5.2 Scénarios d’usage en psychologie clinique et cognitive
Les caractéristiques opératoires de la racine carrée en font la méthode de choix pour une typologie spécifique de variables fréquemment recueillies dans les protocoles de psychologie clinique, de psychopathologie expérimentale et de psychologie ergonomique. Le cas d’application le plus emblématique concerne les données de comptage d’erreurs au sein de batteries d’attention soutenue ou de vigilance prolongée, telles que le test de performance continue (CPT pour Continuous Performance Test).
Dans ce type de paradigme expérimental, les participants sains ne commettent généralement qu’un nombre infime d’omissions ou de fausses alarmes (par exemple 0, 1, ou 2 erreurs au cours de la session), alors qu’une fraction clinique de sujets présentant un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH) ou un traumatisme crânien léger peut cumuler un total de 15, 20, voire 35 erreurs. Une telle variable exhibe une asymétrie positive modérée, couplée à une dispersion qui enfle dès que le niveau moyen d’erreurs augmente. La transformation par racine carrée rétablit la proportionnalité de ces dispersions tout en modérant l’asymétrie droite de façon remarquable.
Un scénario analogue se rencontre dans les études observationnelles éthologiques ou en psychologie sociale écologique, où les chercheurs quantifient le nombre d’interactions verbales proactives, la fréquence d’apparition d’épisodes d’agression verbale ou le nombre de fixations oculaires dirigées vers une zone d’intérêt déterminée sur un écran de capture du regard (eye-tracking). Lorsque la distribution présente une asymétrie positive nette mais non explosive (asymétrie comprise approximativement entre 0,5 et 1,2), la racine carrée permet de redresser la géométrie distributionnelle sans infliger la pénalisation sévère d’un logarithme, laquelle générerait presque immanquablement une asymétrie inverse vers la gauche.
5.3 Limites inhérentes à la racine carrée
Bien que particulièrement fluide et élégante à mobiliser, la transformation par racine carrée comporte des limitations analytiques que l’expérimentateur doit intégrer dans sa prise de décision. La première limite concerne l’inaptitude mathématique intrinsèque de la fonction à absorber les valeurs négatives. Si une échelle de mesure produit des nombres négatifs — situation fréquente lors de l’analyse d’indices d’efficience calculés sous forme de scores de différence temporelle ou de coordonnées spatiales centrées —, la fonction racine carrée devient indéfinie dans l’ensemble des nombres réels, renvoyant à des valeurs imaginaires non exploitables par les outils statistiques standards.
La seconde faiblesse réside dans son inertie face aux distributions hyper-asymétriques. Lorsque la variable dépendante s’étale sur plusieurs ordres de grandeur — par exemple, des temps de fixation visuelle pouvant varier de quelques millisecondes à plusieurs secondes sous l’effet de phénomènes de sidération perceptive —, l’inflexion d’une racine carrée s’avère nettement insuffisante pour juguler la queue de distribution. La persistance d’un coefficient d’asymétrie supérieur à 1,0 après extraction de la racine confirme l’incapacité de cette fonction modérée à combler le fossé géométrique induit par des dynamiques exponentielles sous-jacentes.
Enfin, la rétro-transformation des résultats finaux (moyennes, écarts-types, intervalles de confiance) vers l’échelle de métrique d’origine afin d’assurer l’interprétabilité clinique présente des écueils méthodologiques notables. L’élévation au carré de la moyenne transformée ne restitue pas la moyenne arithmétique d’origine, mais un estimateur spécifique dont la variance résiduelle réclame des corrections analytiques complexes (telles que le développement en séries de Taylor ou le delta method) pour éviter de biaiser la communication des données auprès des praticiens non statisticiens.
6. Procédure d’application de la transformation par racine carrée dans Excel
6.1 Utilisation de la fonction RACINE et de l’opérateur de puissance
L’exécution d’une transformation par racine carrée dans une feuille de calcul Microsoft Excel peut être réalisée par deux formulations mathématiquement équivalentes mais syntaxiquement distinctes. La méthode la plus intuitive mobilise la fonction native en langue française dédiée à l’extraction de la racine de degré deux :
=RACINE(nombre)
Supposons que la variable de comptage « Erreurs_Inattention » soit située dans la colonne B, précisément de la cellule B2 à la cellule B180. Dans la colonne adjacente C2, l’opérateur saisit la formulation canonique suivante :
=RACINE(B2)
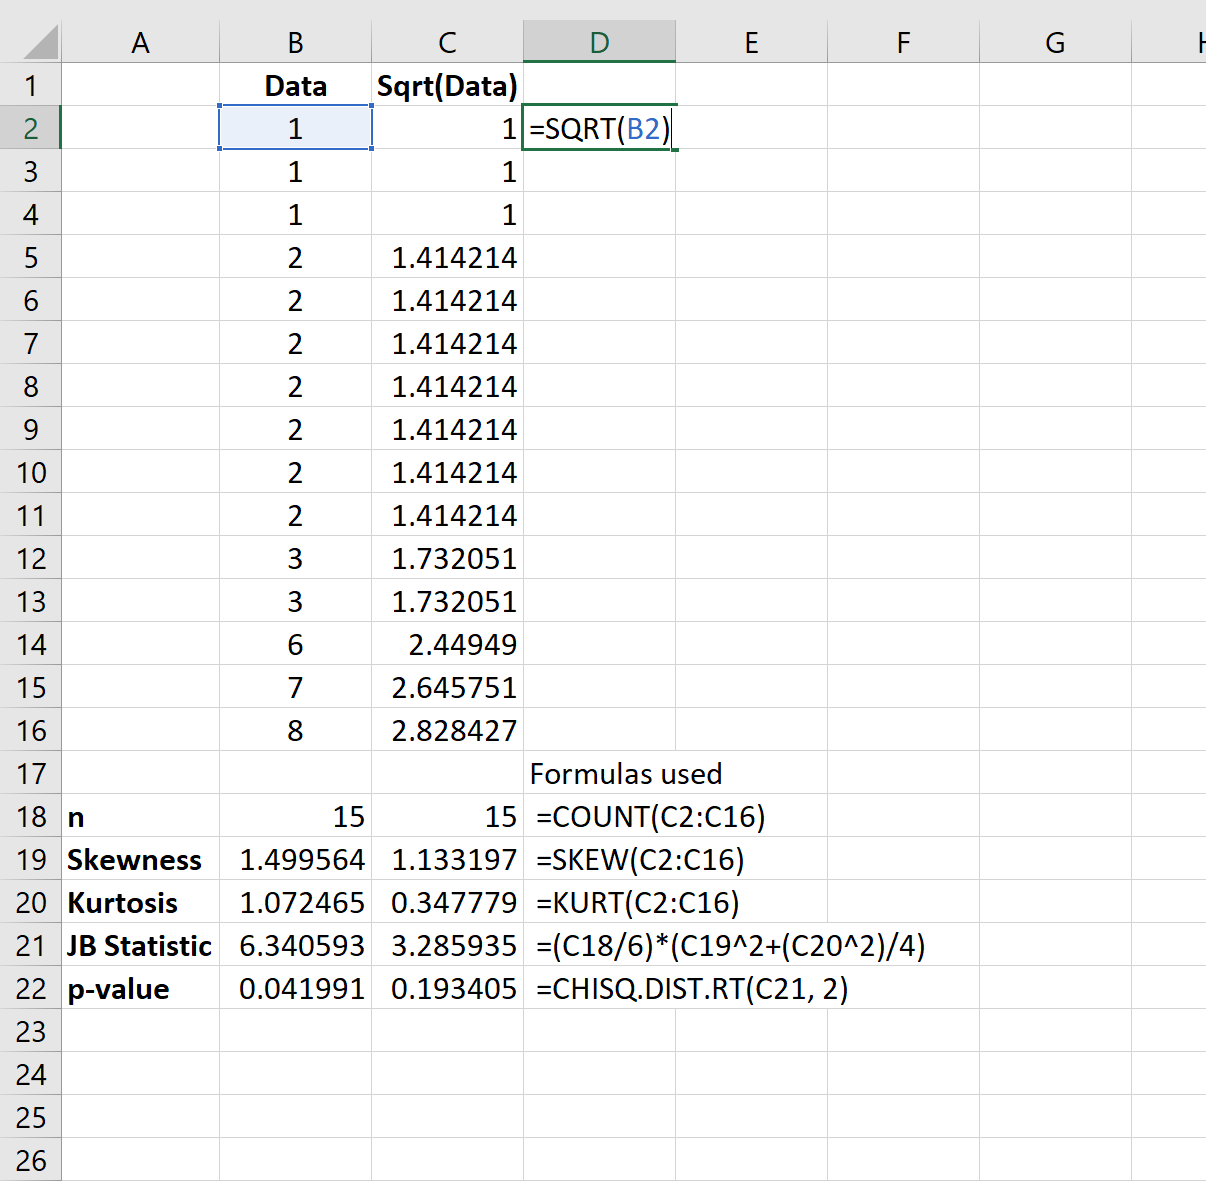
La seconde formulation, reposant sur l’opérateur arithmétique de puissance matérialisé par le symbole de l’accent circonflexe (^), permet d’exprimer l’extraction sous la forme d’une élévation à la puissance un demi. Il est impératif, lors de l’usage de cette syntaxe, d’encadrer scrupuleusement la fraction par des parenthèses afin de contraindre l’ordre des opérations arithmétiques d’Excel, qui octroie une priorité native à la puissance sur la division :
=B2^(1/2)
Si l’expérimentateur omettait les parenthèses en écrivant par inadvertance =B2^1/2, Excel élèverait tout d’abord la valeur de la cellule à la puissance 1 (la laissant identique), puis diviserait le résultat arithmétique par deux, ruinant entièrement la structure de la transformation mathématique. Pour propager la formule sélectionnée sur l’intégralité de l’échantillon, l’opérateur positionne le curseur de la souris sur le coin inférieur droit de la cellule C2 jusqu’à l’apparition de la croix noire de recopie, puis exécute un double-clic rapide, propageant instantanément la formule sur l’ensemble de la colonne jusqu’au dernier point de donnée consécutif.
6.2 Ajustement mathématique des valeurs négatives avant extraction
Bien que les données de dénombrement soient structurellement positives ou nulles, certains protocoles psychologiques génèrent des variables composites ou des indices d’interférence cognitive intégrant des valeurs négatives — par exemple, un indice d’effet Stroop calculé en soustrayant le temps de réaction en condition facilitatrice du temps en condition congruente. Dans cette configuration, l’insertion brute de la formule =RACINE(B2) aboutit immédiatement au déclenchement de l’erreur d’évaluation numérique #NOMBRE! dès la première valeur inférieure à zéro.
Pour régulariser cette situation sans corrompre la monotonicité de l’échelle, la procédure rigoureuse consiste à identifier la valeur minimale absolue de l’ensemble de la série expérimentale, puis à translater l’intégralité de la distribution d’une constante c garantissant que l’ensemble des scores résultants soit strictement supérieur ou égal à zéro. La formulation mathématique s’exprime alors sous la forme :
y’ = RACINE(y + |min(y)|)
ou plus prudemment, pour éviter qu’un résidu nul n’engendre des indéterminations dans des équations ultérieures :
y’ = RACINE(y + |min(y)| + 1)
Dans Microsoft Excel, cette procédure s’automatise intégralement en intégrant la fonction de détection du minimum dans une cellule de référence fixe, par exemple la cellule $E$1, via la formule suivante :
=MIN(B2:B180)
Puis, dans la colonne transformée C2, l’analyste introduit la formule dynamique intégrant les fonctions de valeur absolue :
=RACINE(B2 + ABS($E$1) + 1)
Cette architecture préserve la stricte continuité géométrique de l’échantillon tout en protégeant le tableur contre la génération de résidus non réels.
6.3 Analyse exploratoire des distributions résultantes
Dès l’achèvement du calcul de la nouvelle série par racine carrée, un diagnostic exploratoire approfondi s’impose afin de quantifier l’impact exact de la déflation d’échelle sur les paramètres structurels de la dispersion empirique. Ce protocole repose sur l’extraction simultanée des indicateurs de tendance centrale et de variabilité robuste avant et après transformation.
L’expérimentateur configure un tableau de synthèse statistique dans sa feuille Excel en utilisant les fonctions analytiques suivantes :
=MEDIANE(B2:B180) versus =MEDIANE(C2:C180)
=MOYENNE(B2:B180) versus =MOYENNE(C2:C180)
=MOYENNE.REDUITE(B2:B180; 0,05) versus =MOYENNE.REDUITE(C2:C180; 0,05)
L’examen comparatif doit mettre en lumière un rapprochement décisif de la moyenne arithmétique vis-à-vis de la médiane sur la série transformée, attestant du rééquilibrage de la symétrie centrale. Simultanément, l’évaluation de la dispersion s’opère par l’évaluation de l’intervalle interquartile (IQR), calculé par la différence entre le troisième quartile (percentile 75) et le premier quartile (percentile 25) au moyen des fonctions :
=QUARTILE.INC(C2:C180; 3) – QUARTILE.INC(C2:C180; 1)
Une transformation par racine carrée réussie se manifeste visuellement et numériquement par un resserrement substantiel de l’écart séparant le percentile 75 des valeurs extrêmes supérieures, tandis que l’intervalle séparant le percentile 25 du minimum demeure proportionnellement stable. Ce remodelage confirme que la variance anormale a été résorbée sans altérer la sensibilité de mesure dans la frange centrale du comportement évalué.
7. Cadre théorique de la transformation par racine cubique
7.1 Fondements et particularités analytiques de la racine cubique
La transformation par racine cubique, ou extraction de la racine d’ordre trois, consiste à assigner à chaque valeur observée x le nombre réel y dont l’élévation à la puissance trois équivaut exactement à x :
y = x^(1/3) = ∛x équivaut à y^3 = x
Sur le continuum de la famille des transformations de Tukey, la racine cubique occupe une coordonnée paramétrique fondamentale correspondant à la puissance λ = 1/3 (soit approximativement 0,333). Elle s’insère précisément entre la modération relative de la racine carrée (λ = 0,5) et la puissance de compression sévère du logarithme (qui correspond mathématiquement à la limite lorsque λ tend vers 0). Elle offre de ce fait un compromis opérationnel remarquable lorsque la racine carrée ne suffit pas à redresser l’asymétrie, mais que le logarithme s’avère excessif et génère une surcorrection platykurtique ou asymétrique négative.
Néanmoins, la caractéristique analytique la plus transcendante de la racine cubique réside dans sa parité fonctionnelle : il s’agit d’une fonction impaire, strictement croissante, continue et dérivable sur la totalité de la droite réelle, sans exception aucune :
(-x)^(1/3) = -(x^(1/3))
Le domaine de définition de la fonction racine cubique englobe rigoureusement l’intervalle ]-∞, +∞[. Contrairement au logarithme et à la racine carrée qui s’effondrent face aux nombres négatifs, la racine cubique d’un nombre négatif est une valeur réelle négative parfaitement définie (par exemple, la racine cubique de -8 est rigoureusement égale à -2). Cette propriété algébrique unique lui confère une immunité totale face au problème des observations négatives ou nulles, éliminant formellement l’impératif d’adjonction de constantes de translation arbitraires qui déforment souvent la structure intrinsèque des données.
7.2 Pertinence dans l’analyse de scores composites et différentiels
Cette propriété de continuité sur l’ensemble des réels fait de la racine cubique une méthode d’une valeur inestimable pour l’analyse des scores de gain, des mesures pré-test versus post-test et des indices différentiels de performance psychologique. Dans les essais cliniques randomisés ou les protocoles d’évaluation psychothérapeutique longitudinale, l’efficacité d’une intervention est couramment mesurée par la différence arithmétique brute entre le score initial d’un participant et son score terminal : Gain = Score_Post – Score_Pre.
Bien que la majorité des patients manifestent une amélioration clinique positive (Gain > 0), une fraction substantielle de l’échantillon demeure stationnaire (Gain = 0), tandis qu’un sous-groupe non négligeable subit une détérioration iatrogène ou spontanée de son état, engendrant des scores de gain négatifs (Gain < 0). Dès lors, la distribution de ces écarts temporels est typiquement bipolaire, caractérisée par une forte concentration autour de zéro et des queues asymétriques étendues dans les deux directions, avec une prépondérance fréquente vers les fortes améliorations. L’utilisation de la racine cubique dans ce cas précis permet de symétriser simultanément les deux queues de la distribution sans scinder l’échantillon ni modifier artificiellement le barycentre neutre représenté par le zéro clinique.
Un autre champ d’application privilégié réside dans le traitement des balances affectives ou motivationnelles en neuropsychologie. Lorsqu’un modèle opérationnalise la balance entre le système d’approche comportementale (BAS) et le système d’inhibition comportementale (BIS) sous la forme d’une soustraction de sous-échelles z-standardisées, le score composite résultant est intrinsèquement centré sur zéro avec un support mixte négatif-positif. La racine cubique régularise la variance extrême observée chez les individus hyper-réactifs sans violer la sémantique de l’inhibition (valeurs négatives) ou de l’activation (valeurs positives).
7.3 Avantages mathématiques majeurs face aux alternatives
L’avantage prépondérant de la racine cubique face aux transformations alternatives réside dans la préservation scrupuleuse de la structure relationnelle zéro-centrée des données. Dans toute procédure d’évaluation scientifique, translater une variable en lui ajoutant une constante arbitraire modifie la nature de l’échelle : une échelle d’intervalles peut ainsi perdre son point d’origine naturel, rendant la comparaison de ratios totalement caduque. En éliminant tout recours à une constante d’ajustement c, la racine cubique garantit que la neutralité mathématique du zéro demeure intacte : ∛0 = 0.
Par ailleurs, la racine cubique conserve intact le signe qualitatif des observations individuelles. Une performance déficitaire par rapport à la norme de référence demeure résolument dans le domaine négatif de la nouvelle métrique, tandis qu’une performance supérieure demeure positive. La transformation ne modifie que la distance métrique relative séparant les points extrêmes du centre de gravité.
Enfin, comparativement aux transformations paramétriques plus complexes telles que la transformation de Yeo-Johnson — qui généralise la méthode de Box-Cox aux nombres négatifs par le truchement de fonctions continues par morceaux —, la racine cubique offre une formulation unifiée, non segmentée, universellement reproductible et d’une transparence méthodologique totale. Elle présente un profil de robustesse exceptionnel face aux valeurs aberrantes résiduelles, atténuant leur influence délétère sur la matrice de covariance sans pour autant les effacer du modèle linéaire.
8. Procédure d’application de la transformation par racine cubique dans Excel
8.1 Formulation arithmétique pour valeurs strictement positives
À la différence de la racine carrée, Microsoft Excel ne possède pas de fonction native portant explicitement la dénomination =RACINECUBIQUE(). L’extraction de la racine de degré trois s’exécute par l’implémentation directe de sa définition exponentielle fractionnaire via l’opérateur d’élévation à la puissance (^).
Lorsque la série de données empiriques est constituée exclusivement de nombres réels strictement positifs, par exemple dans le cadre d’une variable « Temps_Inspection » localisée dans la plage D2:D300, la syntaxe arithmétique à introduire dans la cellule active E2 s’énonce simplement :
=D2^(1/3)
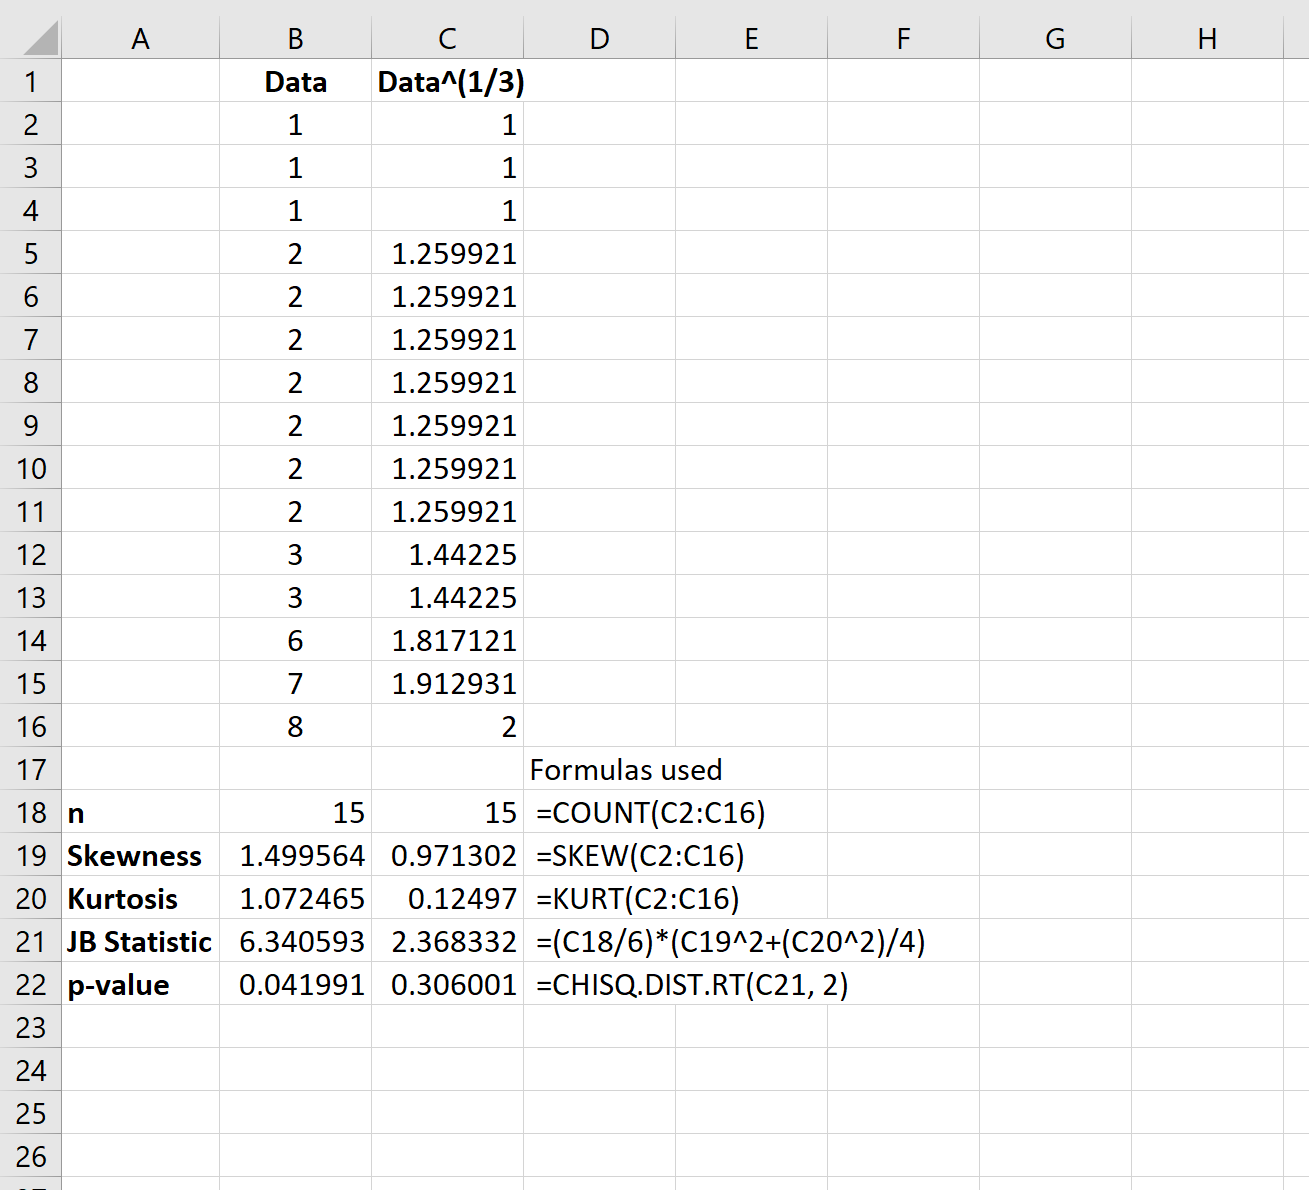
Il est fondamental de rappeler ici la règle stricte de précédence des opérateurs arithmétiques du moteur de calcul d’Excel. Si l’utilisateur omet les parenthèses en saisissant la formule erronée :
=D2^1/3
le tableur calculera dans un premier temps le terme D2^1 (qui équivaut simplement à la valeur initiale de la cellule D2), puis effectuera la division arithmétique de cette valeur par trois. L’utilisateur obtiendrait alors un tiers de la valeur d’origine au lieu d’extraire la racine cubique, introduisant une distorsion massive et indétectable au premier coup d’œil dans l’ensemble de la matrice de données. L’usage impératif des parenthèses encadrant le ratio fractionnaire (1/3) assure que l’exposant décimal périodique (0,333333333333333…) soit correctement évalué et appliqué à la base.
8.2 Formulation avancée pour variables contenant des nombres négatifs
L’implémentation de la racine cubique dans Excel soulève un défi algorithmique singulier lorsque la série contient des nombres négatifs. En dépit de la réalité mathématique attestant que la racine cubique d’un nombre négatif existe bel et bien dans le corps des réels, le moteur interne de calcul arithmétique de Microsoft Excel évalue l’opérateur d’élévation à une puissance fractionnaire non entière en mobilisant l’algorithme des logarithmes complexes :
x^y = exp(y * ln(x))
Dès lors que x est strictement négatif, la fonction logarithmique interne ln(x) échoue à s’évaluer dans le domaine des réels, et Excel renvoie instantanément et systématiquement le message d’erreur critique #NOMBRE!, même face à une expression parfaitement licite telle que =(-8)^(1/3).
Pour contourner cette limitation algorithmique du tableur et exploiter pleinement la parité de la racine cubique, l’analyste doit déployer une formule avancée exploitant conjointement la fonction de signe et la fonction de valeur absolue :
=SIGNE(D2) * ABS(D2)^(1/3)
La fonction =SIGNE(cellule) renvoie la valeur entière 1 si la cellule contient un nombre strictement positif, la valeur 0 si la cellule contient zéro, et la valeur -1 si la cellule héberge un nombre strictement négatif. La fonction =ABS(cellule) extrait quant à elle le module positif de la valeur, permettant au moteur d’Excel d’élever un nombre strictement positif à la puissance (1/3) sans déclencher d’erreur système. La multiplication finale par le signe originel rétablit instantanément la direction et la polarité de l’observation initiale. Cette formulation robuste est universelle : elle traite avec une égale précision les valeurs positives, le zéro exact et les valeurs négatives, sans exiger la moindre modification manuelle de la feuille de calcul.
8.3 Standardisation du format des cellules de calcul
La mise en œuvre de calculs exponentiels fractionnaires génère par essence des nombres irrationnels comportant un développement décimal infini. Dans une perspective de rigueur métrologique et de gestion optimale des ressources de calcul du tableur, l’expérimentateur doit standardiser la présentation numérique et la conservation des résultats.
Tout d’abord, il convient d’étalonner l’affichage visuel des cellules transformées. Par un clic droit sur la plage E2:E300, l’opérateur sélectionne « Format de cellule », accède à la catégorie « Nombre », et calibre l’affichage sur trois décimales fixes, ce qui est généralement conforme aux préconisations des normes internationales de publication scientifique (style APA). Cette modification d’affichage n’altère aucunement la précision interne d’Excel, qui continue de stocker les valeurs en virgule flottante double précision (conformément à la norme IEEE 754, soit environ 15 chiffres significatifs).
Toutefois, pour les volumétries de données considérables ou pour garantir l’archivage immuable des données avant modélisation statistique dans des logiciels tiers (tels que R, SPSS ou JASP), il est vivement recommandé de convertir ces colonnes de formules dynamiques en valeurs numériques statiques. Pour ce faire, l’analyste sélectionne l’intégralité de la colonne calculée, effectue une copie standard (Ctrl+C), puis, sur la même sélection ou dans une colonne de destination dédiée, applique un « Collage spécial » en sélectionnant l’option stricte « Valeurs » (ou la combinaison de touches Alt+E, S, V). Cette opération fige définitivement les résultats, émancipant la feuille de calcul de toute dépendance algorithmique et prévenant toute modification accidentelle subséquente des références cellulaires.
9. Évaluation empirique de la normalité des séries avant et après transformation
9.1 Calcul de l’asymétrie et de l’aplatissement dans Excel
Le contrôle rigoureux de l’efficacité d’une transformation mathématique exige le déploiement d’indicateurs numériques objectifs permettant de comparer la morphologie de la distribution avant et après l’opération. Le tableur Microsoft Excel intègre des fonctions statistiques d’échantillonnage hautement calibrées pour quantifier les moments d’ordre trois et d’ordre quatre.
Le coefficient d’asymétrie empirique de Fisher-Pearson se calcule au moyen de la fonction suivante :
=COEFFICIENT.ASYMETRIE(plage_de_donnees)
Cette fonction implémente automatiquement la correction des biais d’échantillonnage pour les échantillons de taille finie. Une valeur retournée comprise entre -0,5 et +0,5 indique une distribution approximativement symétrique, un intervalle compris entre 0,5 et 1,0 (en valeur absolue) caractérise une asymétrie modérée, tandis qu’un coefficient supérieur à 1,0 signale une asymétrie substantielle violant les présupposés gaussiens.
Pour évaluer l’épaisseur des queues de distribution et la hauteur du sommet central, l’analyste mobilise la fonction d’aplatissement :
=KURTOSIS(plage_de_donnees)
Il est fondamental de noter qu’Excel calcule ici le kurtosis excédentaire (excess kurtosis) en soustrayant automatiquement la constante 3 à la formule standard. De ce fait, une distribution normale parfaite renvoie rigoureusement la valeur 0. Une valeur positive indique un excès de leptokurticité (queues épaisses, risque élevé d’observations aberrantes), tandis qu’une valeur négative dénote une distribution platykurtique aplatie.
En disposant ces fonctions dans un tableau de synthèse comparatif en vis-à-vis pour la série brute (ex. A2:A250) et la série transformée (ex. B2:B250), l’expérimentateur mesure instantanément l’atténuation des coefficients. L’objectif recherché est d’obtenir, suite à la transformation retenue, un coefficient d’asymétrie ramené dans la zone d’acceptabilité méthodologique [-0,5 ; +0,5] et un kurtosis résiduel oscillant harmonieusement dans l’intervalle [-1,0 ; +1,0].
9.2 Construction de diagrammes Quantile-Quantile (Q-Q Plots) simplifiés
Bien que les indices numériques apportent une mesure globale, l’inspection visuelle de la distribution quantile par quantile (diagramme Q-Q) constitue le gold standard méthodologique pour diagnostiquer les anomalies locales de répartition, notamment au niveau des queues supérieure et inférieure. Bien qu’Excel ne propose pas d’outil automatisé en un clic pour générer des diagrammes Q-Q à l’instar des environnements statistiques spécialisés, il est aisé d’en construire une implémentation rigoureuse pas-à-pas.
La première phase exige le tri de la variable transformée par ordre strictement croissant. Une fois les valeurs classées dans une colonne dédiée, par exemple de la cellule F2 à F251 pour un échantillon de n = 250 observations, l’analyste génère dans la colonne adjacente G le rang centile i de chaque observation, allant de 1 à n.
La deuxième phase consiste à calculer la probabilité cumulée empirique p_i associée à chaque rang en appliquant la formule de traçage de Blom, reconnue pour son absence de biais dans l’estimation des quantiles normaux :
p_i = (i – 3/8) / (n + 1/4)
Dans la cellule G2, l’utilisateur saisit : =(LIGNE(F2) – LIGNE($F$2) + 1 – 0,375) / (250 + 0,25), et propage la formule.
La troisième phase convertit ces probabilités cumulées en quantiles théoriques d’une loi normale standardisée (scores Z théoriques) en utilisant la fonction intégrée de la loi inverse :
=LOI.NORMALE.STANDARD.INVERSE(G2)
Enfin, l’opérateur trace un diagramme de dispersion (Nuage de points X-Y) en positionnant les quantiles théoriques normaux sur l’axe horizontal des abscisses et les valeurs empiriques transformées de la colonne F sur l’axe vertical des ordonnées. L’alignement rectiligne rigoureux des points le long de la bissectrice atteste d’une adhésion idéale à la loi normale. Tout décrochement en forme de S ou de banane révèle respectivement des pathologies persistantes de kurtosis ou d’asymétrie, orientant l’analyste vers un ajustement de la fonction mathématique mobilisée.
9.3 Évaluation de la variance résiduelle entre conditions expérimentales
Le postulat de normalité des résidus est indissociable du postulat d’homogénéité des variances (homoscédasticité) dans les modèles factoriels. Une transformation mathématique efficace ne doit pas seulement rétablir la symétrie unimodale d’une colonne isolée, elle doit simultanément régulariser la dispersion relative entre les différents niveaux d’une variable indépendante manipulée au sein du protocole expérimental.
Pour contrôler cette dimension sous Excel, l’expérimentateur procède à la segmentation de la colonne transformée en sous-groupes correspondant aux modalités expérimentales (par exemple, Groupe Témoin versus Groupe Traitement A versus Groupe Traitement B). Il calcule ensuite l’écart-type empirique de chaque condition au moyen de la formule :
=ECART.TYPE.STANDARD(plage_du_groupe)
Dans les données physiologiques ou comportementales brutes, il est classique de constater un rapport d’hétéroscédasticité massif où l’écart-type du groupe le plus dispersé excède de trois, quatre ou cinq fois celui du groupe le plus homogène, violant la règle empirique de tolérance des tests d’analyse de variance (qui réclament typiquement un ratio d’écarts-types inférieur à 2,0, ou une égalité formelle vérifiée par le test de Levene). Suite à une transformation appropriée — qu’elle soit logarithmique pour des variances proportionnelles à la moyenne, ou par racine carrée pour des processus de Poisson —, le recalibrage des dispersions intra-groupes doit ramener le rapport des variances (le ratio F maximal entre groupes) à un niveau d’homogénéité compatible avec l’analyse de variance paramétrique standard.
10. Le test de normalité de Jarque-Bera dans Excel : Modélisation et calcul
10.1 Fondement mathématique et formulation du test de Jarque-Bera
Au-delà des inspections visuelles et des seuils heuristiques descriptifs, la validation méthodologique d’une distribution requiert l’administration d’un test d’hypothèse statistique formel. Le test d’adéquation de Jarque-Bera (JB) est particulièrement adapté pour évaluer si les données d’un échantillon continu proviennent d’une population gouvernée par une loi normale. Ce test paramétrique repose directement sur la quantification conjointe de l’asymétrie de Fisher-Pearson et du kurtosis excédentaire de la série.
La statistique de test de Jarque-Bera se définit par l’équation asymptotique suivante :
JB = (n / 6) * [ S^2 + ((K^2) / 4) ]
Dans cette expression formelle :
- n représente le nombre total d’observations valides au sein de l’échantillon expérimental.
- S désigne le coefficient d’asymétrie (skewness) de la série d’observations.
- K correspond au coefficient d’aplatissement excédentaire (excess kurtosis), théoriquement égal à zéro pour une loi gaussienne.
Sous l’hypothèse nulle fondamentale (H0) formulée par le test — stipulant que la distribution sous-jacente est rigoureusement normale —, les termes S et K convergent tous deux asymptotiquement vers zéro. L’élévation au carré de ces paramètres au sein de l’équation assure que toute déviation, qu’elle découle d’une asymétrie gauche ou droite, ou d’une distribution platykurtique ou leptokurtique, contribue additivement à gonfler la valeur scalaire de l’indice JB. Lorsque la taille de l’échantillon n tend vers l’infini, la statistique de Jarque-Bera converge en loi vers une distribution du Chi-deux possédant exactement deux degrés de liberté (d.d.l. = 2), correspondant aux deux restrictions imposées sur les moments d’ordre 3 et 4.
10.2 Mise en œuvre pas-à-pas de la statistique de test dans la feuille de calcul
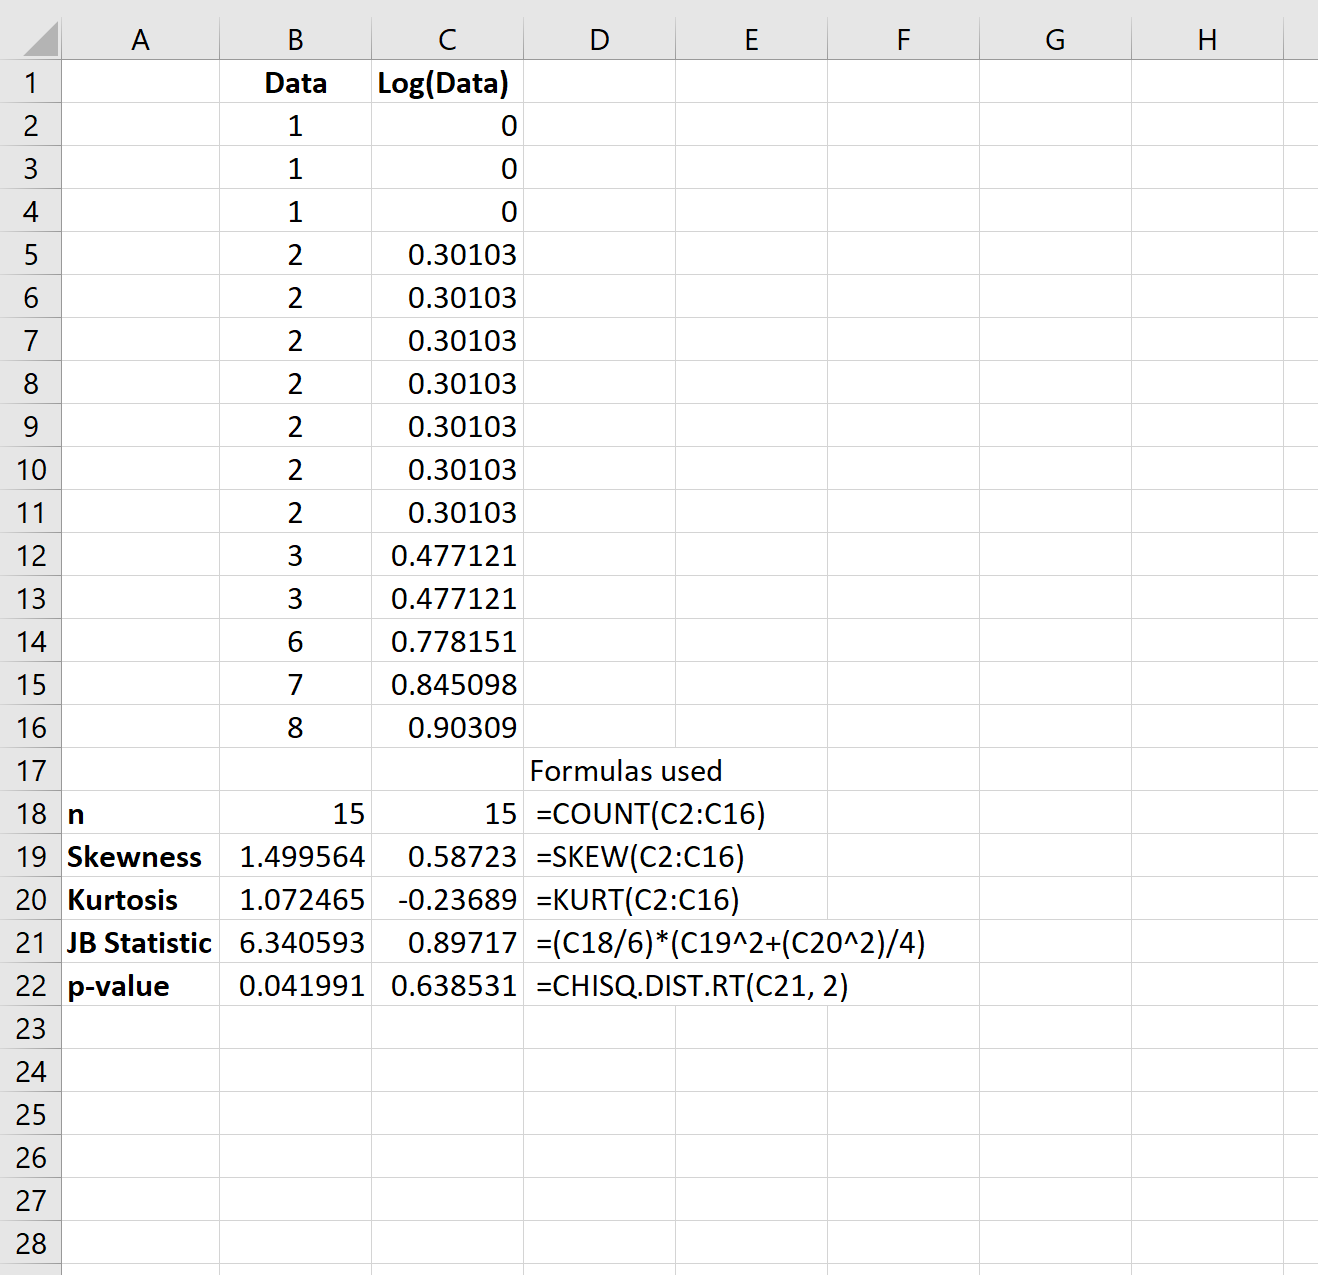
L’implémentation architecturale du test de Jarque-Bera dans Microsoft Excel s’avère d’une clarté méthodologique exemplaire lorsqu’elle est décomposée en cellules de calcul distinctes et auditables. Supposons que les données transformées à expertiser résident dans la plage continue C2:C251.
L’analyste structure son bloc de calcul dans une section dédiée de la feuille selon les formules suivantes :
- Cellule H2 (Taille de l’échantillon n) :
=NB(C2:C251) - Cellule H3 (Coefficient d’asymétrie S) :
=COEFFICIENT.ASYMETRIE(C2:C251) - Cellule H4 (Kurtosis excédentaire K) :
=KURTOSIS(C2:C251)
À partir de ces estimateurs fondamentaux, l’expérimentateur configure la cellule H5 afin d’assembler la statistique composite de Jarque-Bera via la saisie de l’équation algébrique :
=(H2 / 6) * ((H3^2) + ((H4^2) / 4))
Pour les utilisateurs souhaitant condenser l’intégralité de l’opération en une formulation unique, autonome et condensée sans faire appel à des cellules intermédiaires, Excel autorise l’imbrication complète des fonctions au sein d’une expression unique :
=(NB(C2:C251) / 6) * ((COEFFICIENT.ASYMETRIE(C2:C251)^2) + ((KURTOSIS(C2:C251)^2) / 4))
Le résultat généré dans la cellule représente la valeur observée de la statistique JB pour la variable soumise à vérification.
10.3 Détermination de la p-valeur et prise de décision statistique
L’obtention de la valeur scalaire JB ne constitue que l’étape préliminaire de l’inférence ; il s’agit à présent d’évaluer la probabilité critique (la p-valeur) d’observer une telle déviation sous l’hypothèse nulle de normalité. Puisque la statistique JB obéit asymptotiquement à une loi du Chi-deux à deux degrés de liberté, la p-valeur unilatérale à droite se calcule instantanément dans Excel au moyen de la fonction intégrée :
=LOI.KHIDEUX.DROITE(statistique_JB; degres_liberte)
En reprenant nos références cellulaires préalables, la formule à insérer dans la cellule H6 est la suivante :
=LOI.KHIDEUX.DROITE(H5; 2)
Le protocole de décision statistique s’applique dès lors de façon univoque au regard du seuil de significativité conventionnel fixé a priori (généralement alpha = 0,05) :
- Si la p-valeur calculée est strictement inférieure à 0,05 (p < 0,05), l’hypothèse nulle de normalité H0 est rejetée sans ambiguïté. L’analyste conclut formellement que la série de données s’écarte significativement d’une distribution gaussienne idéale.
- Si la p-valeur calculée est supérieure ou égale à 0,05 (p ≥ 0,05), l’hypothèse nulle ne peut être rejetée. L’expérimentateur retient que la variable analysée ne manifeste pas de divergence statistiquement significative par rapport au modèle gaussien de référence, autorisant l’application des tests paramétriques standardisés.
Une mise en garde épistémologique s’impose toutefois quant à l’interprétation aveugle de ce test au sein de grands échantillons (n > 500). À l’instar de l’ensemble des épreuves d’adéquation d’hypothèse nulle, la puissance du test de Jarque-Bera croît au prorata direct de la taille de l’échantillon n. Dans les cohortes massives, d’infimes déviations triviales sans la moindre conséquence sur la validité des modèles linéaires généraux conduiront mécaniquement à un rejet catégorique de H0 (p < 0,001). L’analyste éclairé doit donc toujours trianguler la p-valeur du test JB avec l’inspection visuelle du diagramme Q-Q et la magnitude absolue des coefficients d’asymétrie et de kurtosis.
11. Comparaison méthodologique et critères de sélection de la transformation idoine
11.1 Matrice décisionnelle selon l’intensité de l’asymétrie
Face à la pluralité des options mathématiques disponibles au sein de la boîte à outils du chercheur, le choix d’une fonction de transformation ne doit jamais être gouverné par le hasard ou par une succession d’essais-erreurs désordonnés. Il doit répondre à une matrice décisionnelle rationnelle, articulée autour de l’amplitude du coefficient d’asymétrie initial et de la nature structurelle de la variable dépendante investiguée.
Pour une variable quantitative continue ou discrète strictement positive présentant une asymétrie modérée, matérialisée par un coefficient de Fisher-Pearson compris approximativement entre +0,5 et +1,0, la transformation par racine carrée représente le choix canonique optimal. Son coefficient de courbure modéré permet de résorber harmonieusement la traîne droite sans contracter excessivement le centre de distribution, évitant ainsi le basculement vers une dissymétrie inverse.
Dès lors que l’asymétrie devient substantielle ou sévère, affichant un coefficient nettement supérieur à +1,0 (et pouvant s’élever jusqu’à +3,0 ou +4,0 comme dans les mesures de cortisol salivaire ou les chronométries de latence motrice), la transformation logarithmique (en base 10 ou népérienne) s’impose impérativement. Sa puissance de compression exponentielle est la seule capable de ramener les observations éloignées dans le corridor de dispersion gaussien.
Enfin, lorsque les données manifestent une asymétrie extrême, ou lorsque la variable intègre intrinsèquement des valeurs négatives, nulles et positives (scores de changement net, balances affectives, contrastes factoriels), la transformation par racine cubique s’impose de manière incontestable. Elle opère un compromis de courbure d’une remarquable stabilité géométrique tout en garantissant une totale immunité face aux indéterminations mathématiques sur les réels négatifs.
11.2 Comparaison directe des performances sur un jeu de données test
Afin d’illustrer concrètement la trajectoire comparative de ces trois approches, considérons un jeu de données simulé de n = 200 participants soumis à une tâche d’apprentissage associatif complexe, où la variable dépendante représente le nombre d’essais requis pour atteindre le critère de maîtrise (variable brute asymétrique positive avec valeurs minimales à 1). Le tableau synthétique suivant récapitule l’impact empirique des différentes transformations sur les métriques clés de normalité calculées sous Excel :
Données Brutes d’origine :
- Moyenne = 18,42 ; Médiane = 12,00
- Coefficient d’asymétrie (Skewness) = +2,14
- Kurtosis excédentaire = +5,87
- Statistique Jarque-Bera (JB) = 442,18 (p < 0,00001 — Violation massive de la normalité)
Application de la Racine Carrée [ =RACINE(A2) ] :
- Moyenne = 4,02 ; Médiane = 3,46
- Coefficient d’asymétrie (Skewness) = +1,12
- Kurtosis excédentaire = +1,48
- Statistique Jarque-Bera (JB) = 60,15 (p < 0,00001 — Amélioration nette mais rejet persistant de H0)
Application de la Racine Cubique [ =A2^(1/3) ] :
- Moyenne = 2,51 ; Médiane = 2,29
- Coefficient d’asymétrie (Skewness) = +0,76
- Kurtosis excédentaire = +0,32
- Statistique Jarque-Bera (JB) = 20,44 (p < 0,0001 — Progression remarquable de la symétrie)
Application du Logarithme Décimal [ =LOG10(A2) ] :
- Moyenne = 1,18 ; Médiane = 1,08
- Coefficient d’asymétrie (Skewness) = +0,08
- Kurtosis excédentaire = -0,41
- Statistique Jarque-Bera (JB) = 1,82 (p = 0,402 — Normalité pleinement rétablie)
Dans ce scénario empirique précis, la comparaison met en relief la supériorité absolue de la transformation logarithmique, qui parvient à neutraliser quasi intégralement l’asymétrie (+0,08) et ramène la statistique de Jarque-Bera sous le seuil critique du Chi-deux, conduisant au non-rejet de l’hypothèse de normalité (p > 0,05). La racine carrée et la racine cubique, bien qu’ayant substantiellement assaini la morphologie générale, se sont avérées insuffisantes face à l’amplitude initiale de la déviation (asymétrie d’origine supérieure à 2).
11.3 Règles de parcimonie scientifique dans le choix analytique
L’exercice de modélisation mathématique ne doit cependant pas verser dans l’hyper-optimisation artificielle des données. Le chercheur doit demeurer guidé par le principe épistémologique de parcimonie (le rasoir d’Ockham) : il convient de privilégier systématiquement la transformation la plus douce, la plus simple et la plus intuitivement intelligible qui parvient à ramener la distribution dans des limites statistiques théoriquement tolérables.
Le risque inhérent à l’usage inconsidéré de transformations trop radicales est l’induction d’un phénomène de surcorrection. Si un analyste applique aveuglément un algorithme logarithmique sur une distribution dont l’asymétrie positive initiale n’était que de +0,6, il constatera fréquemment que la nouvelle série se retrouve projetée dans une asymétrie négative sévère (ex. Skewness = -1,15) avec un écrasement platykurtique indésirable. L’analyste n’a alors fait que déplacer la pathologie distributionnelle d’un pôle vers l’autre, sans en résoudre la cause structurelle.
De surcroît, le choix d’une transformation doit être étayé par les usages méthodologiques établis au sein du champ disciplinaire spécifique. En psycholinguistique et en ergonomie cognitive, la transformation logarithmique des temps de réaction bénéficie d’une reconnaissance consensuelle et séculaire qui facilite l’intégration méta-analytique des résultats. À l’inverse, recourir à des transformations exotiques ou sur-calibrées pour atteindre à tout prix un seuil de significativité arbitraire (pratique assimilable au p-hacking) nuit gravement à la réplicabilité des inférences scientifiques.
12. Interprétation des résultats et communication scientifique des données transformées
12.1 Rétro-transformation et communication des métriques centrales
L’application d’une transformation non linéaire produit une modification ontologique de l’unité de mesure. Rapporter dans la section des résultats d’une thèse ou d’une publication internationale qu’un groupe clinique présente un temps moyen d’inhibition de 2,87 log(ms) ou de 24,1 √(erreurs) prive le lecteur de tout repère clinique intuitif sur la réalité du phénomène comportemental observé. La restitution de la clarté descriptive exige dès lors une rétro-transformation (back-transformation) des métriques statistiques fondamentales vers l’espace métrique d’origine.
Dans le cadre de la transformation logarithmique, l’opération inverse consiste à appliquer la fonction exponentielle correspondante. La rétro-transformation de la moyenne arithmétique calculée sur l’échelle logarithmique s’écrit sous Excel au moyen de l’une des formules suivantes :
=10^moyenne_log pour une transformation en log10.
=EXP(moyenne_ln) pour une transformation en logarithme népérien.
D’un point de vue mathématique strict, cette quantité rétro-transformée ne correspond pas à la moyenne arithmétique des données d’origine, mais restitue exactement la moyenne géométrique de la variable brute. La moyenne géométrique représente une mesure de tendance centrale remarquablement robuste et infiniment plus représentative du centre de gravité réel d’une distribution asymétrique que la moyenne arithmétique brute étirée par les extrêmes.
Toutefois, une vigilance absolue s’impose quant à la gestion des indices de dispersion. Il est formellement interdit de rétro-transformer l’écart-type calculé sur les données transformées par une simple exponentiation directe ou élévation au carré (par exemple, calculer 10^SD n’a strictement aucun sens statistique). La procédure rigoureuse consiste à construire tout d’abord l’intervalle de confiance paramétrique (à 95 %) sur l’échelle transformée, au moyen des formules conventionnelles :
Borne_Inf_Transf = Moyenne_Transf – (1,96 * Erreur_Type_Transf)
Borne_Sup_Transf = Moyenne_Transf + (1,96 * Erreur_Type_Transf)
L’analyste applique ensuite la fonction de rétro-transformation (ex. =10^Borne_Inf et =10^Borne_Sup) à chacune des bornes séparément. L’intervalle de confiance rétro-transformé ainsi obtenu présente une morphologie asymétrique autour de la moyenne géométrique (la barre d’erreur supérieure étant mécaniquement plus étendue que la barre inférieure), ce qui reflète fidèlement et élégamment la distribution asymétrique sous-jacente des données observées dans le monde réel.
12.2 Rédaction méthodologique conforme aux normes académiques (style APA)
La communication scientifique des résultats au sein de revues à comité de lecture adhérant aux normes de l’American Psychological Association (style APA 7e édition) requiert une transparence méthodologique absolue quant à la manipulation des échelles d’observation. L’omission d’explication ou la dissimulation d’une transformation mathématique constitue un manquement déontologique sévère.
Le protocole de rédaction dans la section « Méthode / Analyses statistiques » doit impérativement documenter :
- La justification empirique et théorique du recours à la transformation (mention explicite des indices de skewness initiaux et des résultats des tests de normalité).
- La désignation formelle de l’opérateur appliqué (par exemple, le logarithme décimal en base 10 plutôt que népérien).
- La valeur exacte de la constante de translation éventuellement mobilisée pour traiter les zéros ou valeurs négatives (ex. « en raison de la présence de valeurs nulles, une constante de translation unitaire a été ajoutée selon la formule log10(x + 1) »).
- Les métriques d’adéquation post-transformation attestant de la résorption effective du problème distributionnel.
Au sein de la section « Résultats », les inférences paramétriques (valeurs de t, de F, degrés de liberté, p-valeurs et tailles d’effet partiel êta-carré) doivent être formellement rapportées sur la base des calculs conduits sur les données transformées. Concomitamment, les tableaux descriptifs et les représentations graphiques doivent afficher les moyennes géométriques rétro-transformées accompagnées de leurs intervalles de confiance à 95 % asymétriques, en explicitant rigoureusement dans la légende du graphique la nature métrologique des barres d’erreur présentées.
12.3 Alternatives méthodologiques en cas d’échec des transformations classiques
Il advient des circonstances méthodologiques où aucune des trois transformations canoniques (logarithme, racine carrée, racine cubique) ne parvient à rétablir une normalité résiduelle acceptable. Cette impasse se produit fréquemment face à des distributions multimodales, des phénomènes à bimodalité prononcée induits par un mélange de sous-populations non identifiées, ou des distributions caractérisées par une masse discrète de zéros disproportionnée (phénomène de zéro-inflation excédant 40 ou 50 % de l’échantillon global).
Dans cette configuration, persévérer dans la manipulation mécanique d’échelles par des puissances mathématiques relève d’une faute analytique. L’expérimentateur doit alors migrer vers des cadres méthodologiques contemporains plus puissants et adaptés à la nature intrinsèque de ses mesures :
- Les Modèles Linéaires Généralisés (GLM / GLMM) : Au lieu de forcer les données à adopter une morphologie gaussienne par transformation artificielle, le paradigme des GLM permet de spécifier directement une loi de distribution appartenant à la famille exponentielle (loi Gamma pour les latences continues asymétriques positives, loi de Poisson ou Binomiale Négative pour les données de comptage avec surdispersion) couplée à une fonction de lien idoine (telle que le lien logit ou log).
- La famille paramétrique de Box-Cox et Yeo-Johnson : Ces algorithmes procèdent à une estimation itérative par maximum de vraisemblance pour déterminer le paramètre de puissance lambda optimal (λ) spécifique à l’échantillon, offrant une personnalisation mathématique supérieure aux puissances fixes canoniques.
- Les approches par rééchantillonnage (Bootstrap) et statistiques non paramétriques robustes : Le recours au rééchantillonnage non paramétrique avec remise (bootstrapping, généralement implémenté sur 5 000 à 10 000 itérations) permet de générer des intervalles de confiance robustes fondés sur la distribution empirique observée, s’affranchissant totalement du postulat de normalité sans requérir la moindre déformation mathématique de la métrique originale.
La maîtrise concertée de ces différents horizons méthodologiques garantit au chercheur une posture analytique lucide, rigoureuse et irréprochable, assurant à ses conclusions empiriques le plus haut degré de validité interne et de réplicabilité scientifique.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review / Revue Internationale de Statistique, 55(2), 163–172. https://doi.org/10.2307/1403192
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- Osborne, J. W. (2010). Improving your data transformations: Applying the Box-Cox transformation. Practical Assessment, Research, and Evaluation, 15(12), 1–9. https://doi.org/10.7275/qbpc-gk17
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Whelan, R. (2008). Effective analysis of reaction time data. The Psychological Record, 58(3), 475–482. https://doi.org/10.1007/BF03395630
- Yeo, I.-K., & Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. https://doi.org/10.1093/biomet/87.4.954