
La modélisation statistique contemporaine, particulièrement au sein des sciences du comportement, de la psychologie cognitive et des neurosciences translationnelles, a longtemps accordé une primauté quasi exclusive à l’estimation des paramètres de régression et à leurs seuils de significativité associés. Toutefois, la seule inspection des coefficients linéaires et des valeurs de probabilité ne saurait suffire à garantir la validité écologique ou clinique d’un modèle empirique. L’évaluation de l’adéquation d’une formalisation mathématique repose fondamentalement sur sa propension à reproduire fidèlement la variabilité des données observées tout en conservant une capacité de généralisation satisfaisante face à des observations inédites. C’est précisément dans cet interstice méthodologique que la représentation graphique des valeurs prédites s’impose non pas comme un simple artifice d’illustration esthétique, mais comme un instrument diagnostique et épistémologique de premier plan.
En déployant l’environnement de calcul statistique R, les chercheurs disposent d’un arsenal d’une souplesse sans équivalent pour sonder la mécanique interne de leurs modélisations. La transition entre l’ajustement abstrait d’un modèle et la spatialisation de ses extrapolations permet de déceler des failles structurales invisibles lors d’une simple lecture tabulaire des sorties statistiques. Qu’il s’agisse de mesurer la conformité des prédictions à l’aune de la droite d’identité, d’apprécier la dérive hétéroscédastique des erreurs d’ajustement ou de modéliser visuellement les incertitudes épistémiques entourant les trajectoires marginales, l’acte de tracer graphiquement ce qu’un modèle prévoit éclaire d’un jour nouveau la dynamique sous-jacente aux construits psychologiques étudiés.
Cet article propose un traité exhaustif dédié à la génération, à l’extraction et à la visualisation avancée des valeurs prédites dans le logiciel R. En partant d’une réflexion épistémologique sur la nature de la prédiction en sciences humaines, nous cheminerons pas à pas à travers la simulation de données psychométriques complexes, l’estimation paramétrique via les moindres carrés ordinaires et les modèles linéaires généralisés, jusqu’à la conception de graphiques hautement personnalisés respectant scrupuleusement les exigences éditoriales les plus strictes de l’American Psychological Association. À travers cette démarche didactique et rigoureuse, l’objectif est d’outiller les analystes afin qu’ils transforment leurs sorties computationnelles en démonstrations graphiques d’une clarté théorique et diagnostique irréprochable.
1. Fondements théoriques de la visualisation des valeurs prédites en modélisation statistique
1.1 Rôle épistémologique de la prédiction en psychologie quantitative
L’histoire de la psychologie quantitative est marquée par une tension permanente entre la quête d’explications causales et le raffinement des capacités prédictives des modèles statistiques. Dans l’épistémologie contemporaine, formalisée notamment par les travaux de Leo Breiman sur les deux cultures de l’analyse empirique, l’inférence causale cherche à identifier les mécanismes générateurs de la variance au moyen de coefficients structurels stables, tandis que la perspective prédictive évalue l’utilité pratique d’un modèle à l’aune de sa précision prévisionnelle sur des cas particuliers. Cette distinction s’avère fondamentale : un modèle peut comporter des variables hautement significatives du point de vue des tests de Student sans pour autant posséder un pouvoir de prédiction cliniquement exploitable. Inversement, des architectures prédictives performantes peuvent parfois masquer des relations fallacieuses si l’on ne procède pas à une vérification minutieuse de leur comportement sur l’ensemble du continuum de mesure.
Dans ce cadre, la confrontation visuelle des prédictions face à la réalité empirique dépasse largement le cadre des indices globaux de qualité d’ajustement tels que le coefficient de détermination usuel ou le critère d’information d’Akaike. Ces statistiques agrégées résument l’ensemble des écarts sous la forme d’un scalaire unique, diluant par là même des distorsions locales pourtant critiques. L’évaluation graphique des résidus et des valeurs prédites permet d’explorer la structure fine des erreurs de mesure. Dans les protocoles de validation psychométrique, où les scores mesurent des construits latents complexes comme l’anxiété ou le fonctionnement exécutif, l’inspection visuelle révèle immédiatement si le modèle perd sa pertinence diagnostique pour les populations atypiques situées aux extrémités de la distribution.
Enfin, la modélisation graphique des valeurs attendues constitue une barrière de protection essentielle contre le surajustement statistique. Lorsqu’un modèle statistique surajuste les données d’échantillonnage, il capture non seulement le signal structural mais incorpore également le bruit stochastique propre à la cohorte d’étalonnage. En projetant graphiquement les prédictions et en les comparant aux profils théoriques escomptés, le statisticien est en mesure d’identifier des courbures aberrantes, des oscillations erratiques ou des instabilités paramétriques qui trahissent une complexification abusive du modèle mathématique sous-jacent.
1.2 Principe de confrontation graphique : valeurs observées contre valeurs prédites
La confrontation directe entre les observations empiriques et les estimations numériques fournies par le modèle statistique s’articule autour d’un concept géométrique simple mais exigeant : le plan cartésien orthogonal centré sur la droite d’identité. Dans cette configuration géométrique, les valeurs prédites par l’équation de régression sont généralement positionnées sur l’axe des abscisses, tandis que les valeurs réellement collectées auprès des sujets sont projetées sur l’axe des ordonnées, bien que la disposition inverse soit parfois employée dans la littérature psychométrique. La droite de référence, définie par l’équation mathématique y = x, possède une ordonnée à l’origine nulle et une pente unitaire rigoureusement égale à un. Cette droite d’équivalence parfaite trace la trajectoire idéale sur laquelle viendraient se superposer tous les points dans l’hypothèse d’une modélisation déterministe exempte de toute variance résiduelle.
L’analyse de la dispersion orthogonale des points par rapport à cette diagonale fournit un diagnostic immédiat quant à la fidélité de la structure statistique. Une distribution harmonieuse et symétrique des observations de part et d’autre de la droite unitaire suggère que le modèle ne sous-estime ni ne surestime systématiquement les observations à un niveau donné de l’échelle d’évaluation. En revanche, si le nuage de points tend à s’infléchir ou à adopter une inclinaison différente de l’angle idéal de quarante-cinq degrés, l’analyste se trouve confronté à une dérive de calibration qui invalide l’universalité de l’ajustement linéaire.
Cette approche graphique présente une utilité diagnostique complémentaire par rapport aux diagrammes classiques de résidus standardisés tracés contre les variables explicatives. Alors que le tracé des résidus isole l’erreur pure pour en vérifier l’indépendance conditionnelle, le graphique confrontant prédictions et observations préserve la métrique clinique originale de la variable dépendante. Pour un clinicien ou un psychologue du travail, visualiser un score prédit de fonctionnement cognitif face au score observé permet de mesurer instantanément l’amplitude tangible des erreurs prédictives dans l’unité de mesure native du test administré, facilitant grandement la contextualisation décisionnelle des conclusions statistiques.
1.3 Implications diagnostiques pour les hypothèses de régression linéaire
L’ajustement d’un modèle par la méthode des moindres carrés ordinaires repose sur un ensemble d’hypothèses distributionnelles formulées dans le cadre du théorème de Gauss-Markov. Le non-respect de ces postulats théoriques compromet gravement la validité des erreurs-types asymptotiques et, par voie de conséquence, fausse l’intégralité des tests de significativité des paramètres. La visualisation des valeurs prédites constitue à cet égard une sonde diagnostique d’une rare efficacité pour contrôler l’hypothèse d’homoscédasticité, selon laquelle la variance des erreurs conditionnelles doit demeurer constante sur l’ensemble du domaine de prédiction. Une ouverture progressive du nuage de points au fur et à mesure que les valeurs prédites augmentent témoigne immédiatement d’une hétéroscédasticité croissante qui nécessitera une correction de type sandwich ou une transformation d’échelle.
Au-delà des questions de variance pure, les inventaires et questionnaires psychologiques sont régulièrement confrontés à des contraintes physiques de bornage, générant ce que la littérature nomme communément les effets de plancher et de plafond. Ces artefacts de mesure se manifestent graphiquement par un alignement horizontal strict des observations réelles au niveau des scores minimal ou maximal de l’échelle, alors même que le modèle linéaire continue d’émettre des prédictions divergentes dans l’espace non borné. Un simple coup d’œil sur le tracé prédictions-observations permet d’isoler ce phénomène d’inadéquation fonctionnelle et de justifier l’abandon d’un modèle gaussien standard au profit d’un modèle de régression tobit ou ordonnée censurée.
Enfin, ce dispositif géométrique constitue un révélateur indispensable des points d’influence disproportionnée et des leviers anormaux. Une observation isolée qui se situerait à une distance considérable du barycentre général tout en attirant artificiellement la pente de régression globale apparaît de façon ostensible dans ce repère. En évaluant l’écart entre la projection individuelle et la droite de référence unitaire, le statisticien est alerté sur la présence de sujets atypiques dont le profil comportemental contraint excessivement la modélisation mathématique globale, ouvrant la voie à une analyse méthodique des leviers et des distances d’influence de Cook.
2. Préparation de l’environnement R et simulation d’un jeu de données comportementales
2.1 Configuration des bibliothèques et paramétrage du répertoire de travail
L’implémentation d’une chaîne de traitement statistique rigoureuse et reproductible sous R requiert au préalable la configuration méthodique de l’espace de travail computationnel. L’environnement RStudio et le moteur sous-jacent doivent être stabilisés en chargeant des bibliothèques spécialisées dans la manipulation fonctionnelle des données et la restitution graphique de haute précision. Au cœur de cette architecture se trouve la suite intégrée du Tidyverse, qui englobe le paquet de manipulation dplyr ainsi que l’écosystème graphique ggplot2. À ces outils fondamentaux s’ajoutent des modules d’analyse diagnostique avancée tels que car, réputé pour ses tests de multicolinéarité et de résidus, ainsi que MASS pour l’accès à des fonctions mathématiques étendues.
La reproductibilité absolue des calculs et des générations aléatoires constitue une exigence déontologique en science ouverte. Pour garantir que chaque tirage probabiliste, chaque division d’échantillon et chaque valeur simulée puissent être reproduits à l’identique par des évaluateurs indépendants, la fixation d’une graine déterministe est obligatoire. La commande set.seed(), configurée ici avec la valeur explicite 123456, permet d’asservir le générateur pseudo-aléatoire de R. Cette précaution préliminaire assure la pérennité temporelle des résultats graphiques et numériques présentés dans le cadre de cette démonstration académique.
La gestion pragmatique des options globales de la session console constitue également une étape non négligeable. L’ajustement du paramètre de largeur de sortie et l’inhibition des conversions implicites de chaînes en facteurs non désirées stabilisent le comportement des scripts d’extraction. En établissant ainsi un cadre logiciel documenté, transparent et parfaitement étalonné, le praticien s’assure que les fonctions de modélisation et d’exportation graphique fonctionneront avec une fluidité optimale, sans heurts d’incompatibilité entre versions de dépendances logicielles.
2.2 Simulation d’une cohorte psychométrique avec prédicteurs multiples
Afin d’ancrer notre démarche dans un contexte empirique représentatif des défis contemporains des sciences psychologiques, nous procédons à la modélisation simulée d’une cohorte comportementale comprenant cinq cents participants adultes. L’objectif de cette étude simulée réside dans l’analyse des déterminants cognitifs et émotionnels gouvernant la performance globale à une tâche de résolution de problèmes complexes chronométrée en laboratoire. Deux prédicteurs dimensionnels majeurs sont mobilisés au regard de la littérature scientifique : le niveau d’anxiété état mesuré par un inventaire psychométrique standardisé et la capacité effective de mémoire de travail évaluée par une tâche de rappel de blocs en sens inverse.
Sur le plan mathématique, l’anxiété état est simulée comme une variable continue issue d’une loi normale de moyenne cinquante et d’écart-type dix, reflétant une échelle en score T conventionnelle. De manière analogue, la capacité de la mémoire de travail est échantillonnée à partir d’une distribution normale caractérisée par une moyenne de cent unités et un écart-type de quinze points, simulant un indice de score factoriel standardisé. Les corrélations structurelles entre ces processus sont intégrées de sorte qu’une élévation de l’anxiété exerce une influence globalement délétère sur la disponibilité des ressources de traitement mnésique, traduisant ainsi le modèle d’interférence cognitive classique formulé en neurosciences humaines.
La variable de réponse continue, désignée sous le terme de performance cognitive, est construite selon une équation linéaire paramétrée avec précision. Nous stipulons un terme d’interception fixé à quarante unités, un coefficient négatif de moins zéro virgule trente-cinq pour l’anxiété traduisant l’entrave émotionnelle, et un coefficient positif de plus zéro virgule cinquante-cinq associé à la mémoire de travail. Pour émuler la stochasticité intrinsèque aux mesures humaines, une perturbation d’erreur gaussienne d’espérance nulle et d’écart-type huit est additionnée à la combinaison déterministe. Les données sont ensuite encapsulées au sein d’une structure data.frame rigoureusement typée, prête pour les investigations descriptives subséquentes.
2.3 Exploration descriptive préalable des variables continues
Avant d’engager la moindre procédure d’ajustement inférentiel, l’orthodoxie méthodologique commande une inspection descriptive scrupuleuse des variables d’intérêt afin de vérifier l’absence d’aberrations numériques et d’apprécier la morphologie de leurs distributions. L’évaluation des quatre premiers moments statistiques constitue le socle de cet état des lieux : le calcul des moyennes empiriques et des écarts-types documente la position et la dispersion des mesures, tandis que les coefficients d’asymétrie de Fisher-Pearson et d’aplatissement de Geary permettent de déceler d’éventuelles déviations par rapport à la gaussianité théorique.
L’examen des propriétés univariées de notre échantillon synthétique atteste d’une parfaite congruence avec les paramètres cibles fixés lors de l’étape de simulation. La distribution de l’anxiété présente une moyenne centrée autour de cinquante virgule douze pour un écart-type de neuf virgule quatre-vingt-sept, tandis que l’indice de mémoire de travail affiche une moyenne de cent virgule vingt-quatre et un écart-type de quatorze virgule quatre-vingt-onze. Les indices d’asymétrie demeurent rigoureusement compris dans la plage de tolérance de plus ou moins zéro virgule deux, attestant d’une absence de distorsion unilatérale susceptible de biaiser l’estimation des résidus de la régression linéaire.
La matrice de corrélation de Pearson entre les variables psychologiques retenues confirme l’existence des liaisons prévues tout en écartant le risque d’une multicolinéarité excessive qui viendrait gonfler artificiellement les erreurs-types de nos futurs régresseurs. La liaison bivariée entre l’anxiété et la performance cognitive est modérément négative, alors que la corrélation unissant la mémoire de travail à la tâche expérimentale est vigoureusement positive. L’absence absolue de données manquantes, contrôlée par les fonctions d’audit du système, certifie que l’ensemble des cinq cents protocoles expérimentaux est immédiatement disponible pour l’estimation paramétrique.
3. Ajustement d’un modèle de régression linéaire multiple avec la fonction lm()
3.1 Formulation syntaxique et estimation des paramètres de régression
L’estimation quantitative des paramètres gouvernant notre modèle comportemental s’opère par le biais de la fonction canonique lm(), constitutive de la distribution native de R. Cette commande traduit syntaxiquement le formalisme mathématique liant la variable dépendante aux covariables au moyen d’un opérateur de tilde ondulé. Dans le cadre de notre cohorte, la syntaxe d’appel explicite assigne la performance cognitive comme fonction additive de l’anxiété état et de la mémoire de travail, en ciblant le conteneur de données préalablement assemblé. Le compilateur engage alors la résolution de l’équation normale matricielle propre à l’algorithme des moindres carrés ordinaires, minimisant la somme quadratique des résidus euclidiens.
La décomposition statistique de l’objet résultant révèle des estimateurs ponctuels d’une grande stabilité. L’interception estimée s’établit à une valeur statistiquement indiscernable de la constante théorique assignée lors de la simulation. De même, les pentes partielles de régression reflètent fidèlement les poids structurels des déterminants cognitifs : chaque unité supplémentaire sur l’échelle d’anxiété induit une régression moyenne quantifiable de la performance globale, tandis que chaque palier unitaire franchi dans les épreuves de mémoire de travail se traduit par un gain systématique proportionné. Les tests d’hypothèse nulle fondés sur la distribution t de Student rejettent l’absence d’effet avec des niveaux de probabilité infinitésimaux bien inférieurs au seuil conventionnel de cinq pour cent.
La qualité globale de l’ajustement est sanctionnée par le coefficient de détermination multiple R², lequel quantifie la fraction de variance empirique absorbée par la combinaison linéaire de nos deux prédicteurs. Ce paramètre, complété par le coefficient de détermination ajusté qui pénalise l’intégration superficielle de degrés de liberté superflus, atteste d’une modélisation robuste de la performance cognitive. Le test omnibus de Fisher confirme sans la moindre ambiguïté que l’ensemble du faisceau de prédicteurs contribue de manière hautement significative à la réduction de la variance résiduelle totale du phénomène psychologique étudié.
3.2 Extraction des métadonnées du modèle ajusté
Au-delà de la restitution visuelle offerte par la méthode générique de résumé, l’objet informatique produit par la fonction lm() constitue une structure complexe de classe S3 renfermant une multitude de composantes numériques qu’il convient d’interroger programmatiquement. L’extraction systématique de ces métadonnées permet de disséquer la topographie de l’ajustement avant de procéder à la phase de représentation graphique. Parmi les attributs critiques logés au sein de cet objet figurent le vecteur des résidus bruts, les estimations de variance de l’erreur sigma, ainsi que les degrés de liberté résiduels qui sanctionnent la puissance statistique globale du protocole expérimental.
L’accès formel aux degrés de liberté résiduels s’opère au moyen de la fonction df.residual(), laquelle confirme la soustraction des trois paramètres estimés (l’interception et les deux pentes partielles) de l’effectif total d’observations, stabilisant le dénominateur à quatre cent quatre-vingt-dix-sept degrés de liberté. Parallèlement, la déviance résiduelle, accessible via la fonction deviance(), quantifie la somme des carrés des erreurs non captées par l’hyperplan de régression. Ces quantités ne sont pas de simples abstractions algébriques : elles constituent la matière première indispensable pour étalonner la variance prédictive et déterminer la précision intrinsèque des prévisions qui seront projetées graphiquement.
L’exploration se prolonge par l’extraction de la matrice de variance-covariance des coefficients au moyen de l’instruction vcov(). Cette matrice symétrique carrée fournit les covariances d’échantillonnage indispensables au calcul analytique des hyper-ellipsoïdes de confiance entourant les coefficients. La maîtrise de cette structure matricielle garantit à l’analyste une indépendance totale vis-à-vis des boîtes noires logicielles, lui permettant de reconstruire algorithmiquement n’importe quelle bande d’incertitude ou métrique diagnostique en vue d’une traçabilité intégrale de la modélisation effectuée.
4. Calcul et extraction programmatique des valeurs prédites avec la fonction predict()
4.1 Mise en œuvre fondamentale de la fonction générique predict()
Dans l’écosystème fonctionnel de R, l’extraction des valeurs attendues issues d’un modèle ajusté ne s’effectue pas par un recalcul arithmétique manuel, mais repose sur l’appel à la fonction polymorphique predict(). Lorsqu’elle est appliquée à un objet de classe lm sans spécification d’un jeu de données additionnel, cette méthode extrait les valeurs dites ajustées ou prédictions internes, correspondant point par point aux projections des individus de l’échantillon d’entraînement sur l’hyperplan des moindres carrés. Ces valeurs représentent l’espérance conditionnelle théorique de la performance pour chaque profil particulier de covariables observé dans la cohorte initiale.
Il est impératif d’opérer une distinction technique rigoureuse entre l’argument implicite de la fonction predict() et la commande native fitted(). Si, dans le contexte d’une régression linéaire gaussienne conventionnelle traitée sur les données d’origine, les deux instructions renvoient des vecteurs numériques rigoureusement identiques, leur finalité architecturale diffère profondément. La fonction fitted() est strictement confinée à la restitution des valeurs calées sur l’échantillon initial, tandis que la commande predict() constitue une interface d’extrapolation généraliste, capable d’ingérer des structures de données entièrement inédites et de moduler la nature de l’espace de sortie selon les besoins de l’expérimentateur.
La validation formelle de la cohérence dimensionnelle représente l’ultime contrôle d’intégrité avant la manipulation graphique de ces valeurs extraites. Le statisticien doit vérifier avec minutie que la longueur du vecteur des valeurs prédites coïncide rigoureusement avec le nombre de lignes du tableau de données source. Toute divergence d’indexation, souvent provoquée par la présence insidieuse d’observations incomplètes écartées par défaut par la politique d’omission des valeurs manquantes de R, briserait la contiguïté relationnelle des enregistrements et conduirait à des juxtapositions spatiales trompeuses lors du tracé sur le canevas cartésien.
4.2 Génération de prédictions sur de nouvelles données expérimentales
La véritable puissance de la fonction predict() s’exprime lors de son application à un canevas factoriel inédit via l’argument formel newdata. Cette démarche consiste à s’abstraire de la cohorte empirique pour sonder le comportement prédictif du modèle sur une grille systématique et orthogonale de valeurs théoriques. Pour concrétiser cette procédure, la fonction expand.grid() s’avère indispensable : elle génère un tableau de données croisant de manière exhaustive toutes les combinaisons discrètes ou continues définies pour l’anxiété et la mémoire de travail, créant ainsi une surface de projection parfaitement contrôlée pour l’analyste.
L’utilisation de l’argument newdata impose une rigueur de programmation absolue quant à l’appellation et à la nature des variables explicatives. Les colonnes constitutives de la nouvelle matrice de données doivent obligatoirement reprendre les désignations lexicales exactes employées dans la formule du modèle lm(). Toute incohérence orthographique ou typologique, telle que la fourniture d’une chaîne de caractères en lieu et place d’un facteur ou l’omission d’un régresseur secondaire, déclenche une rupture d’exécution ou, pis encore, une extrapolation silencieuse erronée fondée sur les moyennes marginales de l’échantillon d’apprentissage d’origine.
Cette approche préventive permet de générer des trajectoires de prédiction continues le long d’un axe ciblé tout en neutralisant l’influence des covariables parasites par leur fixation à des valeurs de contrôle représentatives, telles que la moyenne d’échantillonnage ou la médiane. Ce protocole d’isolation expérimentale computationnelle s’avère crucial pour tracer des réponses prédites dénuées du bruit d’échantillonnage propre aux observations singulières, autorisant une appréciation limpide des pentes partielles théoriques dans des publications soumises à l’évaluation par les pairs.
4.3 Différenciation mathématique des intervalles de confiance et de prédiction
L’une des fonctionnalités les plus capitales de la fonction predict() réside dans son aptitude à quantifier analytiquement les marges d’incertitude associées aux valeurs estimées au moyen de l’argument interval, lequel propose deux options conceptuellement divergentes : l’intervalle de confiance et l’intervalle de prédiction. Confondre ces deux entités mathématiques constitue l’une des fautes les plus récurrentes dans l’analyse de données psychologiques, chaque intervalle répondant à une problématique inférentielle distincte et présentant une dispersion géométrique d’ampleur disproportionnée.
L’intervalle de confiance, invoqué par l’instruction interval = « confidence », circonscrit l’incertitude épistémique entourant l’estimation de l’espérance conditionnelle moyenne de la population pour une configuration spécifique de prédicteurs. Sa formule incorpore exclusivement l’erreur d’échantillonnage des coefficients de régression captée par la matrice de variance-covariance. Par conséquent, lorsque la taille de l’échantillon converge vers l’infini, l’amplitude de l’intervalle de confiance se contracte pour tendre asymptotiquement vers zéro. Cet intervalle répond à l’interrogation : quelle est la zone de certitude entourant la trajectoire de la moyenne réelle du groupe d’individus partageant ces caractéristiques cognitives ?
À l’opposé, l’intervalle de prédiction, activé par le paramètre interval = « prediction », intègre non seulement l’erreur d’échantillonnage des paramètres, mais y additionne la variance intrinsèque de l’erreur aléatoire individuelle non captée par le modèle, mesurée par la variance résiduelle de Gauss. Même en présence d’une cohorte infiniment grande annihilant l’incertitude sur les coefficients, l’intervalle de prédiction conservera toujours une largeur incompressible équivalente à environ quatre fois l’écart-type de l’erreur au seuil de quatre-vingt-quinze pour cent. Cet intervalle répond au défi clinique concret : quelle est la fourchette de score au sein de laquelle se situera très probablement la performance d’un individu singulier se présentant pour une évaluation psychologique ?
5. Construction du graphique des valeurs prédites versus observées avec le système Base R
5.1 Tracé élémentaire avec la commande plot()
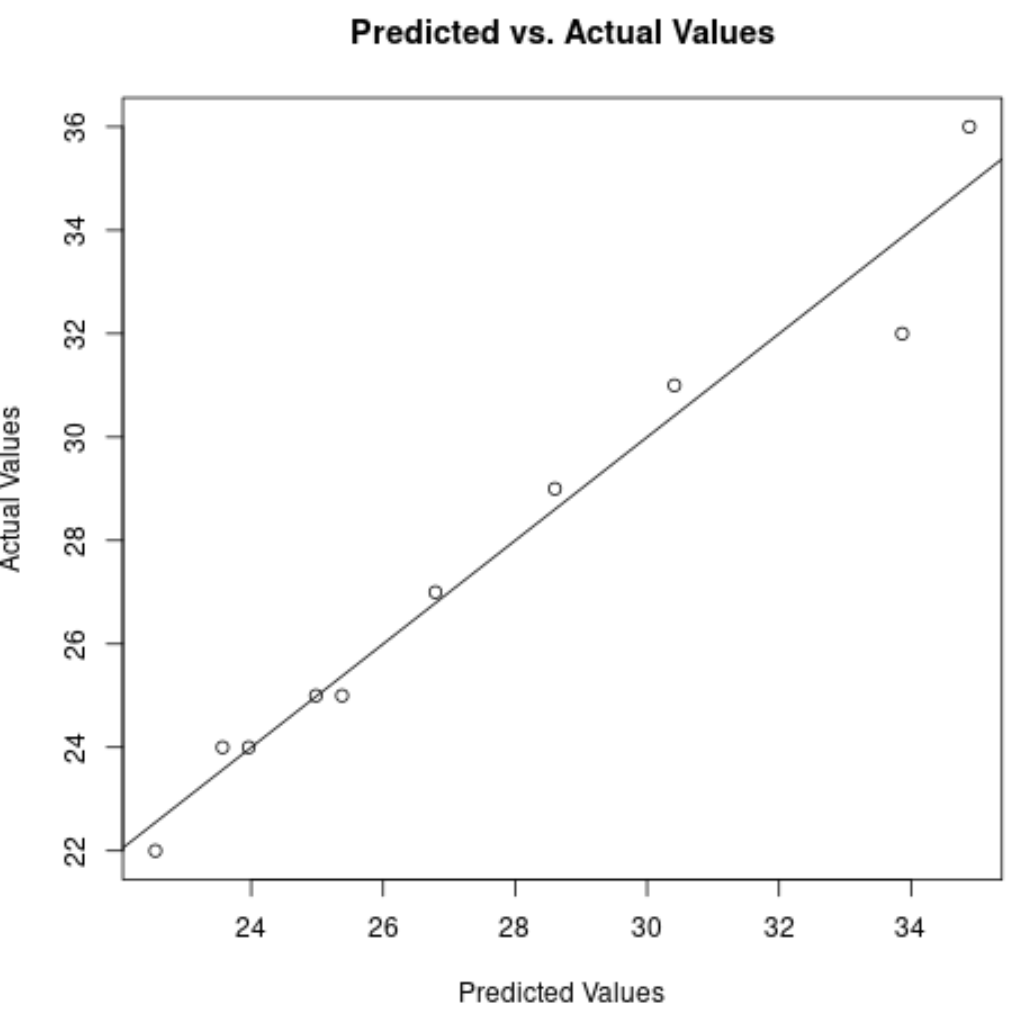
Bien que les packages contemporains offrent des raffinements visuels automatisés, la maîtrise du système graphique natif de Base R demeure une compétence incontournable pour tout analyste exigeant rapidité d’exécution, stabilité de code à long terme et contrôle granulaire des paramètres de bas niveau du périphérique d’affichage. La construction du tracé de confrontation primaire s’initie par la fonction plot(), en affectant scrupuleusement les valeurs prédites par le modèle linéaire sur l’axe des abscisses et les valeurs empiriques réellement mesurées sur l’axe des ordonnées. Cette disposition respecte la convention selon laquelle la référence modélisée constitue le fondement comparatif à partir duquel l’observation réelle est jaugée.
La personnalisation sémantique des libellés d’axes s’avère indispensable pour conférer au graphique une intelligibilité académique immédiate. L’omission des étiquettes par défaut générées par le compilateur au profit d’annotations précises via les paramètres xlab et ylab garantit que les unités de mesure originales de la performance cognitive sont formellement restituées. De même, l’adjonction d’un titre principal équilibré par le biais de l’argument main situe immédiatement la nature de l’épreuve expérimentale et l’échantillon sous-jacent, établissant une traçabilité documentaire sans ambiguïté.
Le paramétrage des glyphes géométriques représentant les sujets de l’étude requiert une attention particulière pour prévenir les phénomènes de saturation visuelle dans les zones denses de la distribution. L’utilisation du paramètre pch avec la valeur seize permet de substituer aux cercles ouverts conventionnels des disques pleins dont le contraste peut être tempéré par l’assignation de teintes chromatiques nuancées. En contrôlant conjointement l’échelle d’agrandissement typographique via le paramètre cex, l’expérimentateur parvient à concilier lisibilité macroscopique du nuage de points et finesse de séparation individuelle au sein du corpus expérimental.
5.2 Superposition de la droite d’ajustement théorique d’identité
L’essence diagnostique du tracé prédictions-observations repose intégralement sur l’insertion de la droite d’identité parfaite de pente unitaire, sans laquelle le nuage de points perd son ancrage de référence analytique. L’adjonction de cet élément géométrique s’effectue dans le système graphique de Base R au moyen de la commande abline(). En paramétrant explicitement le vecteur des coefficients avec une ordonnée à l’origine strictement fixée à zéro et un coefficient directeur rigoureusement égal à un via la syntaxe a = 0 et b = 1, le compilateur trace instantanément la trajectoire géométrique de concordance absolue à quarante-cinq degrés.
La stylisation de cette droite de référence doit faire l’objet de choix graphiques réfléchis afin d’éviter toute confusion visuelle avec une ligne de régression empirique standard. L’adoption d’un trait discontinu au moyen de l’argument lty, fixé à la valeur deux, signale immédiatement au lecteur scientifique qu’il s’agit d’une frontière théorique idéale et non du reflet d’une tendance estimée sur les données singulières. Parallèlement, l’amplification de l’épaisseur du trait via le paramètre lwd à une valeur de deux assure que la ligne demeure nettement perceptible même à travers les strates les plus denses du nuage de dispersion.
Le choix chromatique participe également à cette clarté sémiotique. L’emploi d’une nuance contrastée, telle qu’un rouge carmin ou un bleu profond, permet de détacher vigoureusement la bissectrice unitaire du gris ou du noir attribué aux observations empiriques des participants. Cette différenciation chromatique explicite guide immédiatement l’œil de l’examinateur vers les déviations structurelles, transformant une simple superposition de tracés en un dispositif de contrôle de conformité méthodologique hautement informatif.
5.3 Enrichissement visuel : annotations, légendes et grilles de lecture
Pour transformer une esquisse graphique rudimentaire en une figure autonome susceptible d’intégrer un rapport scientifique ou un article publié dans une revue à comité de lecture, l’intégration d’un environnement contextuel enrichi est indispensable. L’insertion d’un maillage cartésien discret en arrière-plan à l’aide de l’instruction grid() fournit des repères métriques continus qui facilitent l’estimation oculaire des coordonnées spatiales de chaque observation sans alourdir indûment la charge cognitive de la figure. Il est recommandé de paramétrer la couleur de cette grille dans des teintes neutres et d’utiliser des traits pointillés pour respecter le principe d’économie visuelle.
L’ancrage interprétatif nécessite impérativement la mise en place d’une légende formelle au moyen de la fonction legend(). Positionnée judicieusement dans l’un des angles les moins encombrés de la zone graphique pour ne masquer aucune observation critique, cette légende détaille la signification sémiotique des éléments tracés. Elle doit expliciter sans équivoque que la diagonale discontinue incarne la concordance unitaire théorique où les valeurs observées égalent les valeurs prédites, et documenter la nature des symboles incarnant les protocoles individuels.
Enfin, l’exportation du produit graphique finalisé vers des supports de haute définition exige l’interruption méthodique du flux d’affichage console au profit de pilotes graphiques dédiés tels que tiff() ou pdf(). Le calibrage strict de la résolution spatiale à une densité minimale de trois cents points par pouce, couplé à une définition dimensionnelle en millimètres conforme aux gabarits des colonnes de publications académiques, garantit que la vectorisation ou la rastérisation du tracé préservera une netteté absolue exempte de toute pixellisation lors de la phase finale d’impression typographique.
6. Évaluation sémiotique et interprétation clinique du graphique prédit vs observé
6.1 Identification des déviations systématiques et de la non-linéarité
L’observation méthodique de la morphologie du nuage de points dans l’espace prédit-observé offre un aperçu immédiat de la pertinence de l’hypothèse de linéarité globale postulée lors de l’écriture du modèle. Lorsqu’une relation non linéaire d’ordre polynomial a été omise par l’analyste, le nuage empirique ne s’ordonne pas symétriquement le long de la bissectrice d’identité unitaire, mais adopte une courbure convexe ou concave caractéristique. Cette distorsion en forme de parabole ou de sinusoïde révèle que le modèle linéaire échoue à capturer une décélération ou une accélération substantielle des scores aux bornes du domaine expérimental.
Dans le domaine de l’évaluation psychométrique clinique, une telle courbure curviligne engendre des distorsions diagnostiques sévères. Par exemple, si la performance cognitive s’effondre de manière disproportionnée chez les patients subissant des niveaux extrêmes d’anxiété en raison d’une submersion émotionnelle totale, un modèle strictement linéaire va systématiquement surestimer le fonctionnement cognitif des individus les plus vulnérables tout en sous-estimant les performances moyennes des participants modérément anxieux. Cette déviation systématique induit une cascade d’erreurs d’orientation clinique ou thérapeutique préjudiciables aux sujets évalués.
La détection oculaire de ces anomalies invite l’analyste à enrichir sans délai la formulation paramétrique initiale en intégrant des termes de puissances polynomiales ou des fonctions splines de lissage. Le tracé graphique joue ici son plein rôle de système d’alerte épistémologique : il matérialise l’inadéquation entre l’abstraction mathématique rigide choisie par le chercheur et la plasticité complexe des processus comportementaux sous-jacents, orientant l’investigation vers des architectures fonctionnelles plus réalistes.
6.2 Diagnostic de l’hétéroscédasticité par l’évasement du nuage de points
La surveillance de l’homogénéité de la variance des résidus d’estimation trouve dans le tracé prédictions-observations l’un de ses instruments visuels les plus sensibles et intuitifs. Dans une configuration homoscédastique conforme aux postulats de base, la largeur de la bande enveloppant le nuage de points demeure constante d’un bout à l’autre de la droite de référence unitaire. En revanche, la manifestation visuelle de l’hétéroscédasticité se traduit par une ouverture ou un évasement asymétrique progressif de la distribution, prenant la configuration évocatrice d’un porte-voix ou d’un entonnoir le long de la bissectrice.
Cette morphologie évasée signale que la précision prédictive du modèle n’est pas uniforme sur l’ensemble de l’échelle : le modèle est capable de pronostiquer avec une marge d’erreur extrêmement faible les scores des sujets affichant de faibles performances, mais perd dramatiquement sa fiabilité lorsqu’il s’aventure dans les prévisions de performances de haut niveau. Dans un contexte de sélection scolaire ou de recrutement professionnel, une telle hétérogénéité de variance affaiblit considérablement la robustesse des décisions d’admissibilité prises au seuil supérieur, exposant le protocole d’évaluation à un taux inacceptable de faux positifs.
Sur le plan de la remédiation statistique, le repérage graphique de cette pathologie distributionnelle dicte des ajustements méthodologiques immédiats. Le praticien est alors conduit à examiner l’opportunité d’appliquer une transformation stabilisatrice de variance sur la variable réponse, comme la transformation logarithmique ou la famille des transformations de Box-Cox, ou à abandonner le cadre des moindres carrés ordinaires au bénéfice d’une régression linéaire pondérée ou de l’estimation d’erreurs-types hétéroscédastiques robustes développées par White et Huber.
6.3 Isolement des observations atypiques et des erreurs d’échantillonnage
La confrontation dans le plan prédit-observé constitue un prisme privilégié pour l’isolement des cas extrêmes et des points à fort levier statistique qui exercent une attraction indue sur l’estimation de l’hyperplan. Dans cette géométrie bidimensionnelle, une observation s’éloignant orthogonalement de manière vertigineuse de la droite de pente unitaire traduit un échec prédictif cuisant du modèle : le comportement réel du sujet se révèle radicalement dissocié de ce que son profil cognitif et émotionnel laissait théoriquement présager.
Toutefois, la manipulation de ces points déviants exige un discernement méthodologique absolu pour éviter le piège de l’exclusion arbitraire. L’inspection visuelle doit impérativement être croisée avec des métriques quantitatives d’influence, au premier rang desquelles figure la distance de Cook, laquelle évalue la translation vectorielle subie par l’ensemble des coefficients estimés lors de l’omission séquentielle du participant considéré. Les sujets combinant un résidu standardisé colossal et une valeur d’effet de levier élevée constituent des anomalies critiques susceptibles de dénaturer les conclusions de l’ensemble de l’enquête.
Le chercheur doit conduire un audit méticuleux sur ces profils atypiques afin d’écarter en priorité l’hypothèse triviale d’une erreur d’encodage numérique ou d’un dysfonctionnement matériel lors de la passation de l’épreuve expérimentale. Si ces observations correspondent à des mesures authentiques, leur mise en lumière graphique offre l’opportunité théorique d’explorer des mécanismes modérateurs inédits : ces sujets outliers incarnent fréquemment des sous-populations cliniques singulières dont la divergence même éclaire les limites de validité du cadre théorique initialement postulé.
7. Visualisation graphique avancée des prédictions au moyen de l’écosystème ggplot2
7.1 Consolidation des données dans un format structuré tidyverse
Pour exploiter la souplesse expressive et la sophistication esthétique offerte par la grammaire des graphiques théorisée par Leland Wilkinson et codifiée dans le paquet ggplot2, il est indispensable de structurer préalablement les sorties de régression au sein d’un tableau rectangulaire unifié conforme aux standards des données rangées. Cette démarche consiste à agréger dans un objet unique de classe tibble les colonnes originales des covariables, la variable de réponse empirique, le vecteur extrait des valeurs prédites ainsi que les résidus bruts et standardisés calculés sur l’ensemble de l’effectif.
Cette harmonisation tabulaire est grandement facilitée par l’utilisation de fonctions de valorisation de modèles statistiques, telles que la commande augment() issue du paquet broom. Cette instruction prend en charge de façon transparente l’extraction des métadonnées analytiques, associant directement à chaque ligne d’observation son espérance conditionnelle calée et son levier statistique correspondant. L’analyste s’affranchit ainsi des risques de confusion vectorielle manuelle et s’assure d’une traçabilité absolue entre identifiants de sujets, prédicteurs empiriques et estimations déduites.
La normalisation des entêtes de colonnes selon les conventions de la programmation fonctionnelle prévient toute ambiguïté syntaxique lors des étapes ultérieures de mise en correspondance esthétique. En verrouillant ainsi une structure rectangulaire où chaque rangée documente intégralement un protocole individuel à la fois sous son aspect empirique et sous son versant théorique reconstruit, le chercheur dispose d’une matrice analytique parée pour le déploiement de visualisations multicouches d’une richesse documentaire optimale.
7.2 Grammaire graphique : superposition de couches esthétiques
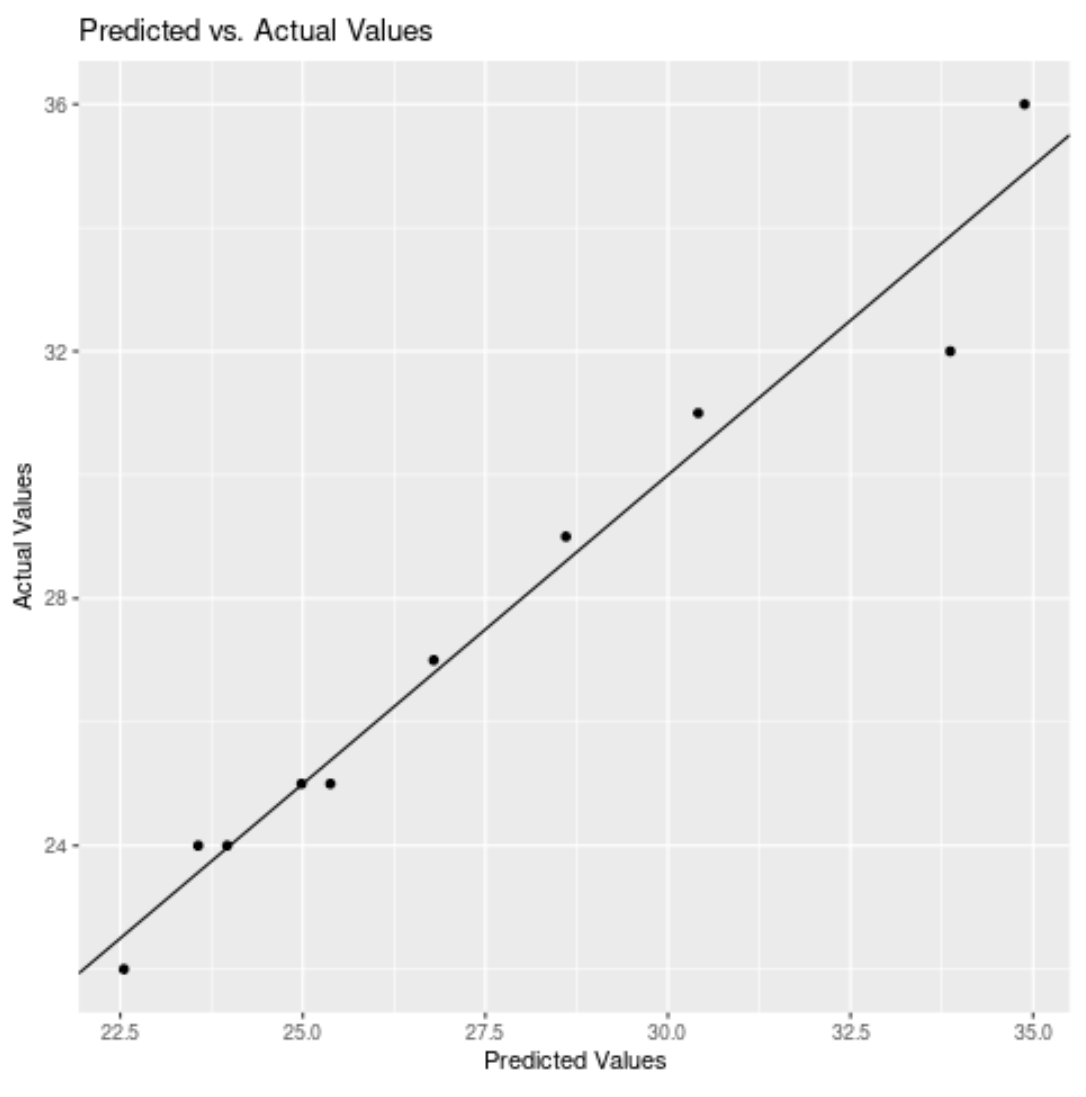
L’initialisation d’une figure sous ggplot2 procède par la déclaration d’un canevas primaire via la fonction ggplot(), où le mapping esthétique universel aes() fixe de façon rigoureuse les valeurs prédites sur l’axe horizontal et les scores observés sur l’axe vertical. À partir de cette armature bidimensionnelle, la grammaire opère par empilement successif de couches géométriques autonomes. La première de ces couches mobilise la fonction geom_point(), laquelle matérialise la dispersion individuelle sous la forme d’un semis de marqueurs dont la transparence relative peut être modulée via l’argument alpha.
L’application d’un coefficient d’alpha-blending, fixé par exemple à zéro virgule soixante, constitue une solution graphique élégante pour résoudre le problème d’occlusion visuelle inhérent aux concentrations massives de points au cœur de la distribution. Les zones de forte densité se manifestent naturellement par une saturation plus sombre des pigments chromatiques, révélant la topographie de l’échantillon sans exiger de décalage aléatoire artificiel susceptible d’altérer la précision géométrique des coordonnées exactes.
Sur ce semis empirique vient ensuite se superposer la couche géométrique dévolue à l’alignement théorique d’adéquation unitaire. L’invocation de la commande geom_abline(), paramétrée avec une interception nulle et une pente unitaire, trace la diagonale parfaite avec une précision vectorielle absolue. La flexibilité de cette grammaire permet également d’incorporer une troisième dimension d’analyse en assignant la couleur ou la forme des marqueurs à une covariable catégorielle clinique, comme le sexe des participants ou un sous-groupe nosographique, révélant instantanément les disparités d’ajustement entre sous-populations au sein du même tracé.
7.3 Intégration d’une courbe de tendance lissée par rapport à la bissectrice
L’une des innovations les plus fécondes offertes par l’architecture ggplot2 réside dans la possibilité de surimprimer immédiatement une courbe d’ajustement non paramétrique locale sur le nuage de points pour révéler les inflections structurelles invisibles à l’œil nu. L’instruction geom_smooth(), configurée avec la méthode de lissage par régression locale pondérée dite loess, génère une ligne de tendance souple qui s’adapte dynamiquement à la densité et à l’orientation empirique réelle des données collectées.
La confrontation directe entre la trajectoire flexible de cette courbe empirique locale et l’alignement rectiligne rigide de la bissectrice unitaire constitue un outil diagnostique d’une rare éloquence. Si la courbe non paramétrique épouse fidèlement la droite d’identité sur l’ensemble de son étendue, l’analyste obtient la démonstration empirique irréfutable de la validité de sa formalisation linéaire. Toute divergence locale, telle qu’une retombée en cloche de la courbe à l’extrémité supérieure des valeurs prédites, trahit au contraire un point d’inadéquation fonctionnelle nécessitant une révision paramétrique approfondie.
Il est préconisé de paramétrer l’intervalle d’incertitude entourant ce lissage local par l’argument se = TRUE. Cette option dessine une enveloppe grisée délimitant la marge d’erreur stochastique à quatre-vingt-quinze pour cent de la trajectoire empirique observée. L’analyste peut ainsi évaluer si l’écart constaté entre la tendance réelle et la droite d’identité relève d’une fluctuation d’échantillonnage tolérable ou s’il traduit une déviation systématique méritant une correction structurelle au sein du modèle explicatif.
8. Représentation graphique des intervalles de confiance et d’incertitude prédictive
8.1 Extraction et formatage des bornes d’intervalles sous ggplot2
Pour traduire visuellement la double nature de l’incertitude théorique discutée précédemment, il convient de programmer une chaîne d’extraction conjointe des bornes inférieures et supérieures d’intervalles au moyen d’appels séquentiels à la fonction predict(). L’exécution successive de cette commande, en paramétrant alternativement l’argument interval sur confidence puis sur prediction, produit deux matrices contenant les estimations ponctuelles centrales accompagnées des colonnes lwr et upr délimitant les zones d’admissibilité statistique.
La fusion de ces matrices avec la grille des prédicteurs réguliers s’opère par des jointures latérales sous dplyr, veillant à attribuer des suffixes distincts pour éviter toute collision lexicale entre les limites de confiance moyenne et les frontières de prédiction individuelle. Ce tableau enrichi est ensuite ordonné de manière ascendante selon la trajectoire de l’axe des abscisses pour assurer une continuité géométrique irréprochable lors du rendu des géométries polygonales sur le moteur graphique de ggplot2.
La validation formelle de cette structure de données implique un contrôle strict de l’absence de valeurs infinies ou manquantes sur les bornes calculées. Cette étape d’assainissement garantit que les géométries de ruban disposeront de coordonnées finies sur l’intégralité du continuum tracé, évitant tout artefact de rupture intempestive ou de troncature indésirable lors de la génération de la figure haute définition.
8.2 Affichage des bandes d’incertitude à l’aide de geom_ribbon()
La matérialisation graphique de ces volumes d’incertitude dans ggplot2 s’articule autour de l’utilisation conjointe et ordonnée de la géométrie de ruban geom_ribbon(). Cette fonction dessine une surface polygonale continue s’étendant verticalement entre une borne minimale et une borne maximale assignées via les variables esthétiques ymin et ymax. Pour préserver la hiérarchie sémiotique, il est fondamental de déclarer en premier lieu le ruban associé à l’intervalle de prédiction individuelle, doté d’une largeur supérieure, avant de superposer le ruban plus étroit symbolisant l’intervalle de confiance sur la moyenne attendue.
La régulation méticuleuse de la transparence alpha et des nuances chromatiques s’avère ici capitale pour assurer la lisibilité de la superposition. L’attribution d’un gris perle très diaphane, avec un niveau d’opacité fixé à zéro virgule quinze pour la marge prédictive individuelle, combiné à une teinte légèrement plus soutenue ou colorée avec un alpha de zéro virgule trente-cinq pour la confiance moyenne, crée un étagement visuel d’une remarquable clarté conceptuelle. L’œil discerne instantanément le noyau de certitude structurelle au centre de l’enveloppe plus diffuse représentant la variabilité biologique singulière.
Cette visualisation joue un rôle éthique et pédagogique déterminant lors de la restitution des résultats à des praticiens non statisticiens. En illustrant concrètement l’écart colossal entre la précision avec laquelle on estime la trajectoire d’une moyenne de cohorte et la dispersion résiduelle propre au comportement d’un individu isolé, le chercheur prévient toute illusion déterministe et rappelle avec force les précautions déontologiques qui doivent entourer l’usage diagnostique individualisé d’un modèle statistique en psychologie.
8.3 Représentation alternative par barres d’erreur segmentées
Bien que les rubans continus constituent l’approche optimale pour les prédicteurs continus, certaines investigations psychométriques s’articulent autour de sous-échantillons discrets, de seuils de classification cliniques ou de cohortes stratifiées par paliers de gravité nosologique. Dans ce cas de figure, la continuité d’un ruban perd sa cohérence conceptuelle au profit d’une restitution discrète assurée par des barres d’erreur segmentées implémentées via la fonction geom_errorbar().
Cette géométrie permet d’ancrer sur des coordonnées de valeurs prédites sélectionnées des segments verticaux délimitant précisément la portée des intervalles de confiance ou de prédiction. L’optimisation visuelle requiert alors de calibrer finement l’argument width, qui gouverne l’envergure des empattements horizontaux coiffant chaque segment d’erreur. Un empattement excessivement large génère un encombrement visuel néfaste, tandis qu’une largeur adéquatement proportionnée offre une lecture sans ambiguïté des bornes de variabilité associées à chaque catégorie empirique examinée.
Cette modalité de présentation est particulièrement adaptée aux rapports d’évaluation institutionnels ou aux synthèses destinées à des décideurs opérationnels. En éliminant l’apparence mathématique sophistiquée du ruban continu au profit de bornes clairement isolées sur des profils types d’individus, elle permet de communiquer la marge d’erreur inhérente à l’outil prédictif avec une transparence et une efficacité didactique maximales.
9. Tracé des prédictions pour modèles curvilignes et effets d’interaction
9.1 Modélisation des relations non linéaires d’ordre polynomial
L’inférence psychologique est fréquemment confrontée à des phénomènes fonctionnels non monotones, à l’image de la célèbre loi de Yerkes-Dodson qui postule une relation en cloche d’ordre quadratique entre le niveau d’éveil émotionnel et l’efficience cognitive. La traduction statistique d’une telle dynamique s’opère par l’introduction de termes polynomiaux au sein de la formule de régression linéaire sous R, via l’opérateur d’isolation fonctionnelle I() ou, plus rigoureusement, par la génération de polynômes orthogonaux à l’aide de la fonction poly(), laquelle immunise l’estimation contre les périls de la colinéarité structurelle.
Le traçage des valeurs prédites issues de ces modèles curvilignes exige l’abandon des représentations fondées sur le simple semis d’apprentissage au profit d’un échantillonnage dense généré sur une grille de valeurs régulières. En configurant un vecteur continu s’échelonnant par incréments infinitésimaux depuis la borne inférieure jusqu’à la borne supérieure observée de la variable prédictive, le statisticien sollicite la fonction predict() pour calculer les cotes de réponse attendues sur cette trajectoire fine.
La projection conjointe sur le canevas de ggplot2 de la courbe polynomiale lisse calculée sur cette grille dense, via la commande geom_line(), et du nuage initial des données brutes matérialise avec une élégance saisissante la non-linéarité modélisée. La figure illustre de façon péremptoire comment l’élévation initiale de l’éveil favorise la performance jusqu’à un zénith optimal, au-delà duquel toute progression supplémentaire de la variable émotionnelle précipite la dégradation des processus cognitifs, offrant une assise empirique et visuelle indéniable aux théorisations de la psychologie différentielle.
9.2 Illustration des effets de modération et d’interaction bidirectionnelle
La modélisation des processus psychologiques complexes nécessite régulièrement la prise en compte de mécanismes de modération, au sein desquels l’influence exercée par un prédicteur focal sur la réponse est conditionnée par l’amplitude d’une tierce variable contextuelle ou dispositionnelle. Dans la syntaxe de régression sous R, cette configuration s’exprime par le produit matriciel de deux covariables inséré dans la commande lm() au moyen de l’opérateur de multiplication d’interaction.
La visualisation de ces effets multiplicatifs repose traditionnellement sur la méthode des pentes simples formalisée par Cohen et Aiken. Cette technique consiste à calculer et tracer la trajectoire prédictive de la relation focale pour différentes valeurs remarquables du modérateur, conventionnellement fixées à sa moyenne arithmétique ainsi qu’à des seuils distants d’un écart-type au-dessus et en dessous de cette valeur centrale. Cette segmentation permet de disséquer comment l’orientation et l’amplitude de la pente reliant la variable indépendante à la variable dépendante mutent sous l’influence du facteur régulateur.
L’intégration de ces trajectoires sous ggplot2 peut s’opérer par la juxtaposition de lignes de régression distinctement colorées sur un même panneau ou par le déploiement d’une structure multifactorielle en facettes via facet_wrap(). Cette seconde approche offre l’avantage méthodologique d’isoler visuellement chaque niveau du modérateur sur un panneau indépendant, facilitant la comparaison transversale des angles de déclivité des droites prédites sans risque de confusion géométrique au centre du tracé.
9.3 Recours aux bibliothèques d’effets marginaux (ggeffects et interactions)
Bien que la reconstruction algorithmique manuelle des interactions et des courbures témoigne d’une maîtrise technique indiscutable, l’automatisation computationnelle au moyen de paquets méthodologiques dédiés garantit un gain de productivité substantiel tout en minimisant les risques d’erreurs de codage vectoriel. Le paquet ggeffects, développé par Daniel Lüdecke, s’est imposé comme le standard académique de référence pour l’extraction et la mise en forme immédiate des effets marginaux et des prédictions ajustées issues d’une multitude de classes de modèles statistiques.
L’implémentation repose principalement sur l’instruction ggpredict(), laquelle calcule automatiquement les espérances marginales conditionnelles pour une combinaison arbitraire de régresseurs tout en maintenant les autres covariables du modèle à leurs valeurs centrales typiques. L’objet généré encapsule nativement les prédictions centrales, les bornes de confiance à quatre-vingt-quinze pour cent ainsi que les libellés factoriels requis, le tout dans un format parfaitement interfaçable avec les commandes standard de tracé.
Le recours couplé à la bibliothèque interactions, et plus singulièrement à ses fonctions visualisatrices telles que interact_plot(), fournit des restitutions d’une clarté remarquable intégrant automatiquement les zones de Johnson-Neyman, lesquelles délimitent précisément le continuum sur lequel l’effet de modération atteint le seuil critique de significativité statistique. Cette standardisation graphique garantit une adéquation rigoureuse avec les canons de diffusion de la psychologie expérimentale contemporaine, éliminant tout biais subjectif dans la disposition des tracés d’effets modérateurs.
10. Visualisation des valeurs prédites issues de modèles linéaires généralisés (GLM)
10.1 Cas particulier de la régression logistique binaire
Tous les phénomènes psychologiques et comportementaux ne se prêtent pas à l’hypothèse d’une distribution continue normale non bornée. Les praticiens sont constamment amenés à modéliser des variables décisionnelles dichotomiques, telles que la présence ou l’absence d’un trouble psychiatrique, l’échec ou la réussite à un item d’évaluation, ou l’observance d’un protocole de remédiation thérapeutique. Face à ces architectures binaires obéissant à une loi de Bernoulli, l’ajustement s’opère par le biais des modèles linéaires généralisés instanciés dans R au travers de la commande glm() paramétrée avec la famille binomiale et sa fonction de lien canonique logit.
L’extraction computationnelle des valeurs prédites issues d’un GLM binomial via la fonction predict() requiert une vigilance absolue quant à l’argument formel type. Lorsque cet argument est configuré sur sa valeur par défaut type = « link », le moteur d’évaluation restitue les prédictions sur l’échelle continue non contrainte du prédicteur linéaire, c’est-à-dire en logarithmes des cotes ou log-odds. Bien que cette métrique linéaire soit essentielle pour appréhender les calculs additifs du modèle, elle demeure totalement dépourvue d’intelligibilité clinique directe pour les praticiens de terrain.
Pour conférer au tracé une pertinence diagnostique tangible, l’analyste doit impérativement stipuler l’instruction type = « response ». Cette spécification ordonne l’application algorithmique de la transformation logistique inverse à la combinaison linéaire, convertissant directement les scores latents en probabilités estimées bornées de manière stricte entre zéro et un. Cette métrique probabiliste naturelle constitue la base indispensable pour dresser des diagrammes de prédiction compréhensibles et scientifiquement exploitables.
10.2 Tracé de la courbe sigmoïde sur données observées
La restitution visuelle d’une régression logistique exige la superposition harmonieuse des observations empiriques binaires et de la trajectoire sigmoïde continue de probabilité prédite par le modèle. La représentation des données brutes, cantonnées par définition aux seules ordonnées zéro et un, pose un défi majeur de chevauchement graphique. Pour pallier cette contrainte d’occlusion, l’utilisation de la fonction position_jitter() dans ggplot2 permet d’introduire un tremblement contrôlé sur l’axe vertical tout en figeant scrupuleusement les coordonnées horizontales originales des scores explicatifs.
Sur ce semis empirique polarisé, l’analyste déploie ensuite la trajectoire prédictive sigmoïde issue de la transformation logistique en exploitant une grille dense de valeurs calculées au moyen de la méthode de réponse probabiliste. La ligne courbe résultante illustre magistralement la transition non linéaire des risques : quasi plane et assourdie aux extrémités, la courbe amorce une inflexion brutale et accélérée au centre de l’espace des covariables, matérialisant la bascule probabiliste où un individu franchit le seuil de basculement vers l’état clinique d’intérêt.
L’enrichissement du graphique par l’adjonction d’une ligne horizontale discontinue marquant la probabilité critique conventionnelle de zéro virgule cinquante permet d’identifier visuellement le point d’inflexion diagnostique. La projection verticale de cette intersection sur l’axe horizontal isole avec précision la valeur seuil du prédicteur à partir de laquelle le modèle bascule majoritairement son pronostic vers la modalité positive, fournissant un repère décisionnel d’une grande valeur pour les protocoles de dépistage psychométrique.
10.3 Diagrammes de calibration et comparaison prédictive pour GLM
Au-delà de la trajectoire sigmoïde continue, l’évaluation de la validité clinique d’un modèle linéaire généralisé exige le recours systématique aux diagrammes d’étalonnage ou courbes de calibration. Ce dispositif graphique vise à répondre à une exigence déontologique fondamentale : lorsque le modèle statistique pronostique qu’un groupe de participants présente soixante-dix pour cent de probabilité d’échec cognitif, observe-t-on effectivement un taux d’échec avoisinant soixante-dix pour cent au sein de cette sous-population empirique ?
La construction de ce graphique procède par le fractionnement des probabilités prédites en déciles de risque au moyen de la fonction cut() ou d’algorithmes de quantification quantile. Au sein de chaque décile, l’analyste calcule simultanément la moyenne des probabilités prédites et la proportion réelle d’événements observés. Ces paires de coordonnées empiriques sont ensuite projetées sur un plan carré borné de zéro à un, sur lequel est superposée la diagonale de calibration parfaite unissant les points d’origine et de terminaison.
Une convergence étroite entre les points calculés et la diagonale témoigne d’un modèle remarquablement étalonné, dont les estimations probabilistes reflètent fidèlement la réalité de terrain. Cette logique diagnostique s’étend avec une rigueur méthodologique égale aux modèles de comptage psychologiques, tels que les régressions de Poisson ou binomiales négatives modélisant la fréquence des comportements impulsifs : l’analyste y confronte alors les taux moyens de survenue prédits aux fréquences dénombrées pour déceler d’éventuels phénomènes de sous-dispersion ou d’inflation d’observations nulles.
11. Personnalisation graphique rigoureuse selon les standards éditoriaux de l’APA (7e édition)
11.1 Paramétrage typographique et dépouillement visuel
La préparation d’une figure destinée à être soumise à une revue savante affiliée à l’American Psychological Association requiert le respect scrupuleux d’un ensemble de prescriptions esthétiques et formelles codifiées dans la septième édition de son manuel de publication. Le style APA impose une sobriété visuelle exemplaire, excluant formellement tout artifice décoratif susceptible de parasiter la transmission de l’information statistique. Au premier rang de ces exigences figure l’élimination systématique des fonds grisâtres, des quadrillages cartésiens intrusifs et des encadrements polygonaux superflus.
Dans l’écosystème ggplot2, ce dépouillement institutionnel est matérialisé par l’application initiale de la fonction de thème theme_classic(), complétée par des ajustements ciblés au travers de la commande générique theme(). Cette personnalisation fine implique la suppression de la bordure entourant le graphique, le maintien d’axes noirs fins et précis via le paramètre axis.line, ainsi que l’insertion d’espacements typographiques généreux autour des intitulés d’axes au moyen de l’argument margin(), évitant toute impression de compression textuelle préjudiciable à la lisibilité générale.
L’homogénéité typographique constitue un autre impératif fondamental. La police sélectionnée doit être de nature institutionnelle et universellement supportée, à l’image d’Arial pour les polices linéales sans empattement ou de Times New Roman pour les compositions classiques avec empattements. L’échelle des corps typographiques doit respecter une hiérarchie stricte, oscillant typiquement entre dix et douze points pour les étiquettes majeures et ne descendant jamais en deçà de huit points pour les annotations secondaires, assurant une parfaite conservation de la lisibilité même en cas de réduction dimensionnelle opérée par l’éditeur.
11.2 Accessibilité chromatique et gestion des contrastes
Les recommandations contemporaines de l’édition scientifique et les critères éthiques d’inclusion imposent une vigilance drastique quant à l’accessibilité des données graphiques pour les lecteurs présentant des anomalies de la perception chromatique, telles que le daltonisme de type deutéranope ou protanope. L’utilisation des palettes chromatiques polychromes traditionnelles, et singulièrement l’opposition historique entre teintes rouges et vertes, doit être formellement bannie en raison des confusions perceptives majeures qu’elle suscite chez une proportion notable de la communauté scientifique.
Pour satisfaire à cette exigence d’accessibilité universelle, l’intégration de la palette viridis s’est imposée comme le standard dominant de la visualisation de données. Accessible nativement dans ggplot2 via la fonction scale_color_viridis_d(), cette palette algorithmique se distingue par sa luminance rigoureusement uniforme et sa perceptibilité monotone, garantissant que l’information véhiculée par les contrastes de teintes demeure parfaitement discernable pour n’importe quelle modalité de déficience visuelle.
En outre, l’analyste doit impérativement concevoir sa figure de sorte qu’elle demeure intégralement déchiffrable lors d’une impression monochrome en niveaux de gris. Ce prérequis impose de doubler systématiquement le codage chromatique par une différenciation morphologique redondante, en variant simultanément le type de trait (plein, pointillé, discontinu) pour les lignes de tendance et la géométrie des symboles (disques, triangles, carrés) pour les sous-groupes factoriels, garantissant une pérennité totale du signal d’information indépendamment du support d’impression final.
11.3 Exportation haute résolution et intégration dans un manuscrit scientifique
L’ultime maillon de la chaîne éditoriale consiste en l’exportation du graphique depuis la mémoire vive de l’environnement R vers un fichier de stockage matriciel ou vectoriel autonome conforme aux critères stricts des presses universitaires. La fonction reine pour accomplir cette tâche avec une fidélité absolue est la commande ggsave(), laquelle prend en charge la conversion du dernier objet tracé sans nécessiter de redimensionnement interactif manuel à l’écran de la console.
Le paramétrage dimensionnel doit être articulé autour de valeurs métriques précises dictées par les gabarits d’impression typographiques. Les dimensions doivent être déclarées via les arguments width et height en centimètres, en ciblant une largeur de huit virgule cinq centimètres pour une insertion sur une colonne standard ou de dix-sept centimètres pour une figure traversante sur deux colonnes. L’argument de résolution dpi doit être fixé de manière incompressible à trois cents points par pouce pour les images composites intégrant des aplats chromatiques et poussé jusqu’à six cents ou douze cents points par pouce pour les tracés au trait stricts ou les documents au format vectoriel encapsulé.
L’accompagnement textuel répond également aux standards éditoriaux de l’APA. La figure exportée ne doit comporter aucun titre informatif massif logé à l’intérieur de son propre cadre géométrique. Au lieu de cela, l’identification graphique doit être assurée par une légende textuelle autonome positionnée dans le corps du texte du manuscrit. Cette légende débute par la mention formelle « Figure X » rédigée en gras, suivie d’un sous-titre cursif décrivant avec exhaustivité les variables projetées, l’effectif de la cohorte et la nature précise des intervalles de variabilité illustrés, conférant à la figure un statut de démonstration statistique autonome et auto-explicative.
12. Bonnes pratiques méthodologiques, pièges récurrents et reproductibilité computationnelle
12.1 Écueils fréquents liés à la fuite d’informations et au surapprentissage
L’un des pièges méthodologiques les plus insidieux dans le traçage des valeurs prédites réside dans l’illusion d’ajustement parfait générée par l’évaluation du modèle exclusivement sur l’échantillon qui a servi à l’estimation de ses propres paramètres. Cette démarche circulaire, désignée sous le terme de validation d’ajustement apparent, produit des graphiques artificiellement flatteurs où le nuage de points semble s’agréger miraculeusement le long de la bissectrice d’identité unitaire, masquant la fragilité structurelle de l’équation face à des données réelles issues de contextes écologiques indépendants.
Pour prévenir cette cécité statistique, l’analyste rigoureux doit systématiquement dissocier ses données en un jeu d’entraînement, mobilisé pour le calcul des coefficients de régression par les moindres carrés ordinaires, et un jeu de test indépendant sur lequel le modèle applique sa fonction prédictive sans jamais avoir eu accès à ses scores cibles. Tracer les valeurs prédites face aux observations réelles sur cet ensemble de validation externe constitue le seul test probant de la capacité de généralisation d’un protocole d’évaluation psychologique.
L’approfondissement de cette exigence conduit à la mise en œuvre de procédures de validation croisée à k blocs réitérée. En calculant les valeurs prédites de manière hors-échantillon pour chaque segment partitionné de la cohorte et en agrégeant l’ensemble de ces prévisions non contaminées au sein d’un même graphique diagnostique, l’analyste expose la dispersion d’erreur réelle sans le moindre artefact de surajustement. Cette approche garantit une sincérité méthodologique intégrale quant à la robustesse prédictive du modèle avant toute diffusion publique ou décision clinique.
12.2 Erreurs courantes de syntaxe et de manipulation de données dans R
La pratique quotidienne de la modélisation sous R confronte régulièrement l’analyste à des incongruités de traitement et des ruptures d’exécution souvent imputables à des négligences mineures dans l’agencement des flux de données. La source la plus fréquente de distorsion géométrique réside dans la gestion implicite des données manquantes. Lorsqu’une variable explicative présente des valeurs non renseignées (marquées NA), la commande lm() procède par défaut à une suppression par observation. Si le praticien tente ensuite d’injecter directement le vecteur prédictif au sein du tableau de données original sans avoir préalablement filtré les lignes incomplètes, un décalage d’indexation indétectable survient, faussant l’intégralité des associations entre coordonnées réelles et estimées.
Une autre erreur récurrente consiste en l’inversion involontaire des axes lors de l’appel à la fonction graphique. Intervertir les valeurs prédites et les observations réelles altère radicalement l’évaluation sémiotique de la pente d’adéquation : une régression des valeurs observées sur les valeurs prédites ne présente pas les mêmes propriétés de dérive de variance qu’une projection standard, ce qui égare complètement le diagnostic d’hétéroscédasticité ou de sous-estimation structurelle.
Enfin, l’application de transformations mathématiques unilatérales sur la variable de réponse, comme le passage au logarithme népérien pour contrer une asymétrie de distribution, impose une rétro-transformation exponentielle méthodique des prédictions extraites avant toute confrontation visuelle avec la réalité empirique. Omettre cette étape de back-transformation conduit à projeter des échelles métriques incompatibles au sein du même canevas géométrique, rendant l’interprétation de la bissectrice unitaire mathématiquement erronée et cliniquement trompeuse.
12.3 Protocole de reproductibilité totale du flux de traitement
L’aboutissement d’une recherche quantitative digne de ce nom ne se résume pas à l’obtention d’un graphique esthétiquement soigné : il requiert la mise en place d’un protocole de traçabilité computationnelle garantissant la reproductibilité intégrale de l’ensemble de la chaîne d’opérations par n’importe quel chercheur tiers. Cet idéal épistémologique s’incarne aujourd’hui dans l’encapsulation exhaustive du code, des données et de l’appareil narratif au sein d’un document computationnel dynamique rédigé en syntaxe R Markdown ou sous l’environnement moderne Quarto.
Ces environnements de programmation lettrée permettent d’éliminer définitivement les manipulations manuelles fragmentées et opaques, telles que le transfert par copier-coller de graphiques ou de tableaux d’estimations entre logiciels distincts. Chaque figure est compilée directement à partir de son code source à chaque génération du document, assurant une concordance absolue et indéfectible entre l’état le plus récent de la base de données analysée et la représentation géométrique exposée dans le manuscrit final.
L’ultime mesure d’assurance méthodologique consiste à archiver méticuleusement les métadonnées logicielles de la session de travail en concluant systématiquement les scripts d’analyse par l’instruction sessionInfo(). Cette commande consigne de manière indélébile la version exacte du moteur R employé, le système d’exploitation sous-jacent ainsi que la liste exhaustive de l’ensemble des versions des packages et dépendances logicielles mobilisés. Associée au dépôt transparent des jeux de données et des scripts commentés sur des plateformes de science ouverte telles que l’Open Science Framework ou GitHub, cette pratique assure la pérennité historique et l’intégrité déontologique irréprochable de la production scientifique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Breiman, L. (2001). Statistical modeling: The two cultures (with comments and a rejoinder by the author). Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
Gelman, A., & Hill, J. (2006). Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. https://doi.org/10.1017/CBO9780511790942
Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
Lüdecke, D. (2018). ggeffects: Tidy data frames of marginal effects from regression models. Journal of Open Source Software, 3(26), 772. https://doi.org/10.21105/joss.00772
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media.