
L’analyse des séries temporelles constitue l’un des piliers méthodologiques les plus déterminants de la recherche empirique moderne. Qu’il s’agisse de scruter les fluctuations macroéconomiques, de quantifier les dynamiques climatiques à l’échelle séculaire, de modéliser les biorythmes physiologiques ou d’anticiper les comportements d’utilisateurs sur des plateformes distribuées, la dimension temporelle introduit une contrainte ontologique singulière : l’ordre séquentiel irréversible des événements. Dans cet espace analytique, l’environnement statistique The R Project for Statistical Computing s’est imposé comme une référence incontournable, offrant une richesse algorithmique et une expressivité visuelle hors du commun pour déchiffrer les structures sous-jacentes du changement sériel.
La visualisation graphique ne saurait être réduite à une simple opération cosmétique de restitution des résultats. Elle participe pleinement de l’acte heuristique, conditionnant la découverte de dynamiques imperceptibles par les seuls indicateurs d’agrégation numérique. Face à des chronologies denses et bruitées, l’œil humain, guidé par une sémiologie graphique rigoureuse, s’avère capable d’identifier des ruptures de pente, des hétéroscédasticités latentes, des périodicités enchevêtrées et des artéfacts d’enregistrement que les tests statistiques formels peinent parfois à diagnostiquer d’emblée. La maîtrise des outils graphiques sous R devient dès lors une compétence fondamentale pour tout chercheur ou analyste désireux de transformer une suite d’instants discrets en un narratif scientifique intelligible et reproductible.
Ce traité exhaustif se propose d’explorer méthodiquement l’art et la science du tracé des séries chronologiques sous R. En articulant les fondements théoriques de la modélisation longitudinale avec l’application pratique des bibliothèques de référence comme ggplot2 et l’écosystème étendu du Tidyverse, nous guiderons le lecteur à travers les méandres du typage calendaire, du contrôle micro-métrique des axes temporels, de la modélisation des composantes tendancielles et de la scénarisation comparative multivariée. Cette démarche d’apprentissage, ancrée dans une perspective académique rigoureuse, vise à conférer une autonomie technique totale pour convertir des données brutes hétérogènes en représentations visuelles de haute volée, publiables dans les revues internationales les plus exigeantes.
1. Fondements théoriques et pertinence des séries temporelles en sciences et méthodologie R
1.1 Définition épistémologique et structure d’une série chronologique
D’un point de vue épistémologique, une série temporelle se définit comme une séquence d’observations empiriques indicées par un ensemble ordonné dans le temps. Contrairement aux données transversales où les observations sont supposées indépendantes et identiquement distribuées, les séries chronologiques sont intrinsèquement marquées par une structure de dépendance sérielle ou autocorrélation. Cela signifie que la valeur observée à l’instant présent est, par nature, conditionnée par les réalisations antérieures du système étudié. Cette propriété fondamentale invalide la plupart des postulats d’indépendance requis par la théorie classique de l’échantillonnage et impose un cadre de traitement probabiliste spécifique où l’indice temporel n’est pas un attribut interchangeable, mais l’axe structural organisateur du phénomène.
La typologie des données longitudinales distingue schématiquement les processus continus des processus discrets, ainsi que les échantillonnages à pas régulier et les échantillonnages répétés à pas irrégulier. Les processus continus représentent des trajectoires théoriquement ininterrompues dans le temps physique, telles que le tracé d’un électrocardiogramme ou la variation de la température atmosphérique captée par un thermomètre à mercure. En pratique, l’instrumentation numérique procède à une discrétisation systématique par échantillonnage. La fréquence d’échantillonnage détermine la résolution de la série et fixe la frontière du théorème de Nyquist-Shannon au-delà de laquelle les variations haute fréquence deviennent indistinguables ou génèrent du repliement spectral. À l’inverse, de nombreux phénomènes sociaux, économiques ou comportementaux sont discrets par essence, mesurés à des intervalles conventionnels tels que le jour boursier, le mois civil ou le trimestre comptable.
L’importance de la visualisation graphique dans cette configuration se révèle prépondérante pour la détection précoce des artefacts méthodologiques. Avant toute tentative d’inférence, le tracé chronologique préliminaire permet de repérer les discontinuités matérielles causées par une modification des protocoles de mesure, les dérives d’étalonnage des capteurs, ou encore l’apparition brutale de valeurs aberrantes résultant d’erreurs de transmission ou de saisie. En l’absence d’un contrôle visuel rigoureux, l’inclusion non critique de tels artefacts dans des modèles autorégressifs ou structurels corrompt l’estimation des paramètres fondamentaux et débouche sur des conclusions fallacieuses.
Enfin, l’analyse exploratoire des séries chronologiques s’articule autour de trois objectifs directeurs : la décomposition du signal en sous-composantes explicatives, l’évaluation de la stationnarité et la mise en évidence des régularités sous-jacentes. Une série non stationnaire, dont la moyenne, la variance ou la structure d’autocovariance évolue au gré du temps, exige des transformations mathématiques préalables (différenciation, passage au logarithme) pour stabiliser sa dynamique. La visualisation exploratoire offre une première appréciation qualitative immédiate de cette stationnarité en dévoilant l’existence de dérives tendancielles manifestes ou de dilatations d’amplitude au fil des cycles d’oscillation.
1.2 L’écosystème R pour l’analyse temporelle et graphique
L’environnement statistique R a connu une évolution paradigmatique majeure dans sa manière d’aborder la restitution visuelle des données. Historiquement, le système graphique natif, couramment désigné sous le terme de Base R, reposait sur une métaphore mécanique de tracé sur une feuille de papier virtuel. Bien que la fonction générique plot() appliquée à des objets temporels natifs offre une rapidité d’exécution incontestable pour les inspections de routine, elle montre rapidement ses limites lorsqu’il s’agit d’édifier des visualisations complexes et stratifiées. Le manque d’abstraction conceptuelle du moteur graphique d’origine contraint l’utilisateur à gérer manuellement la mise à l’échelle, les collisions de texte, les marges de composition et la génération laborieuse des légendes.
L’émergence de la grammaire des graphiques, théorisée initialement par Leland Wilkinson puis implémentée de manière magistrale par Hadley Wickham au sein de la bibliothèque ggplot2, a profondément transformé cette approche. Ce cadre théorique postule qu’un graphique statistique n’est pas un assemblage de pixels arbitraire, mais une combinaison formelle d’éléments sémantiques universels : un jeu de données d’entrée, un système de coordonnées spatiales, des transformations statistiques, des objets géométriques et un mappage esthétique reliant les variables numériques ou factorielles aux attributs perceptuels du rendu (position, couleur, forme, taille). Cette formalisation garantit une reproductibilité scientifique irréprochable et favorise une maintenance modulaire du code graphique.
Au sein de cet écosystème contemporain, une remarquable complémentarité s’est instaurée entre les structures de données spécialisées dans la manipulation temporelle et les moteurs d’affichage graphique. Tandis que des bibliothèques telles que zoo, xts, tsibble ou lubridate gèrent la haute technicité arithmétique inhérente aux calendriers réels (irrégularités mensuelles, années bissextiles, fuseaux horaires), ggplot2 sert d’interface de projection sémiotique unifiée. Cette séparation rigoureuse des responsabilités algorithmiques assure que le calcul statistique de filtrage temporel reste décorrélé de la logique d’illumination visuelle sur l’écran.
Le rôle de la sémiologie graphique, telle que conceptualisée par Jacques Bertin, devient ainsi central dans la diffusion des résultats académiques. Un graphique temporel n’a pas seulement pour vocation d’exposer des données brutes, mais de guider l’activité cognitive du lecteur vers les invariants structuraux du système. En sélectionnant judicieusement les variables visuelles et en hiérarchisant l’information temporelle, le chercheur prévient la surcharge attentionnelle et garantit que l’interprétation des trajectoires dynamiques repose sur des bases de perception géométrique sans distorsion suggestive.
2. Préparation, conversion et manipulation des objets temporels dans R
2.1 Typologie des structures temporelles sous R : Date, POSIXct et POSIXlt
L’une des pierres d’achoppement les plus courantes lors du traitement des séries chronologiques sous R réside dans l’inadéquation entre les formats de stockage textuels et les types d’objets temporels internes au langage. Une chaîne de caractères représentant une date est opaque pour les opérateurs arithmétiques du moteur statistique ; pour calculer un écart de temps, déterminer une périodicité ou aligner des observations sur une échelle continue, R doit impérativement convertir cette écriture littérale en un type dédié. Les trois classes cardinales intégrées nativement sont Date, POSIXct et POSIXlt, chacune répondant à des exigences computationnelles précises.
La classe Date est conçue spécifiquement pour la représentation d’événements calendaires sans composante horaire intra-journalière. En coulisse, R code une variable de type Date sous la forme d’un nombre entier ou réel simple, correspondant au nombre exact de jours écoulés depuis une origine arbitraire fixée par convention au premier janvier 1970 (l’époque Unix). Cette représentation compacte la rend extrêmement véloce et économique en mémoire vive pour les séries quotidiennes, hebdomadaires ou mensuelles. La conversion basique s’effectue au moyen de la fonction as.Date(), qui requiert de spécifier explicitement le masque de lecture si la chaîne d’origine s’écarte de la norme internationale ISO 8601 (AAAA-MM-JJ).
Dès lors que l’échantillonnage s’opère à une échelle temporelle fine (heures, minutes, secondes, microsecondes), le recours aux standards POSIX devient obligatoire. La classe POSIXct (pour continuous time) matérialise l’horodatage comme un nombre flottant codant le nombre de secondes écoulées depuis le 1er janvier 1970 à minuit en temps universel coordonné (UTC). Cette compacité interne en fait le type privilégié au sein des tableaux de données volumineux et des algorithmes de filtrage. À l’inverse, la classe POSIXlt (pour logical time) décompose l’horodatage en une liste de vecteurs d’entiers nommés comprenant séparément l’année (comptée depuis 1900), le mois (indexé de 0 à 11), le jour du mois, l’heure, la minute, la seconde, le décalage de fuseau horaire et l’indicateur d’heure d’été. Si POSIXlt est précieux pour extraire instantanément une composante calendaire isolée, sa lourdeur structurelle proscrit son usage dans les colonnes de données volumineuses destinées au tracé graphique direct.
Pour s’affranchir de la syntaxe aride de la fonction standard strptime(), la bibliothèque lubridate propose une approche pragmatique reposant sur des fonctions mnémoniques dont le nom dérive de l’ordre d’apparition des composantes temporelles dans la chaîne d’entrée. Ainsi, les fonctions ymd(), dmy(), mdy_hms() permettent d’interpréter automatiquement les chaînes textuelles sans devoir renseigner des patrons de masquage verbeux. De surcroît, la prise en charge des fuseaux horaires (argument tz) s’avère capitale dans les études médicales multicentriques ou les analyses financières transcontinentales, car ignorer les écarts d’heures locales ou les basculements d’heure saisonnière génère des discontinuités temporelles fictives et fausse l’analyse d’autocorrélation.
2.2 Importation, nettoyage et validation de la structure du jeu de données
L’intégrité de la chaîne d’analyse graphique dépend directement de la rigueur appliquée lors de la phase de validation structurelle des données importées. Lors de la lecture d’un fichier plat (délimité par des virgules ou des tabulations), les fonctions d’ingestion automatisées ont tendance à classer par défaut les colonnes d’horodatage parmi les variables qualitatives de type facteur ou caractère littéral. Une inspection technique immédiate à l’aide des primitives de diagnostic de structure telles que class(), str() ou l’instruction glimpse() de la bibliothèque dplyr est indispensable. Constater qu’un axe chronologique est traité comme un simple facteur alphabétique est le signal d’une anomalie préalable : si l’on trace une telle colonne sans correction, R positionnera les dates par ordre alphabétique strict (plaçant par exemple le 10 janvier avant le 2 janvier), bouleversant irrémédiablement la topologie temporelle réelle.
L’ordonnancement chronologique rigoureux constitue la seconde condition opérationnelle sine qua non. Alors que certaines représentations en nuage de points tolèrent un désordre dans les lignes du tableau d’origine, le tracé de lignes continues sous ggplot2 via l’instruction géométrique geom_line() suppose par défaut que les observations consécutives doivent être reliées en fonction de l’ordre géométrique de leur abscisse, tandis que geom_path() relie les points selon leur ordre d’apparition séquentiel dans le tableau. Pour prévenir tout comportement erratique lors de calculs de lissage ou de décalages temporels (fonctions lag() et lead()), l’application de la commande arrange() sur la colonne d’horodatage normalisée doit faire partie intégrante du protocole systématique de nettoyage.
La recherche de doublons temporels constitue un autre jalon critique du processus de validation. Dans un protocole expérimental longitudinal rigoureux, deux observations distinctes ne sauraient théoriquement partager un horodatage identique pour une même unité d’observation. L’identification de telles collisions temporelles s’opère couramment en combinant les fonctions de regroupement et de filtrage conditionnel, révélant la présence de doublons stricts ou d’enregistrements contradictoires. Si ces conflits ne sont pas résolus par une agrégation déterministe (par exemple en calculant la médiane des valeurs partagées) ou par l’exclusion motivée des transmissions corrompues, le moteur graphique superposera des segments verticaux infinis sur l’abscisse correspondante, altérant la lisibilité du tracé.
Afin d’assurer la reproductibilité des simulations expérimentales et de faciliter l’enseignement méthodologique, il est d’usage de formaliser la création de jeux de données synthétiques au moyen de la primitive data.frame() ou de sa déclinaison moderne tibble(). En mobilisant la fonction seq.Date() ou seq.POSIXt() pour générer des séquences d’instants continus associées à des bruits gaussiens ou des marches aléatoires calculées avec cumsum() et rnorm(), le chercheur valide son pipeline de restitution graphique dans un environnement contrôlé avant de l’appliquer aux données de terrain.
2.3 Structuration au format long (tidy data) pour l’analyse visuelle
Le paradigme du Tidy Data, formalisé par Hadley Wickham, postule une équivalence biunivoque entre la géométrie d’une table d’analyse et les concepts de l’algèbre relationnelle : chaque variable mesurée doit constituer une colonne distincte, chaque observation élémentaire doit occuper une ligne unique, et chaque type d’unité d’échantillonnage doit former une table indépendante. Dans le champ des séries temporelles, cette exigence se traduit par une distinction opérationnelle majeure entre le format large (wide format) et le format long (long format).
Dans sa structure large historique, un tableau de données issu de suivis expérimentaux place souvent les dates d’observation en en-têtes de colonnes successives, ou consigne en colonnes juxtaposées les différentes variables mesurées simultanément (par exemple la température du réacteur A, du réacteur B et du réacteur C). Si cette disposition est intuitive pour la saisie manuelle dans un tableur bureautique, elle s’avère inexploitable directement par la grammaire de ggplot2. En effet, l’attribution des rôles graphiques repose sur le mécanisme de mappage esthétique aes(), qui exige de pointer vers un nom de colonne unique pour déterminer la position sur les ordonnées, et vers une autre colonne unique pour renseigner l’attribution chromatique ou stylistique des séries.
Le pivotement vers une morphologie longue s’opère avec une remarquable efficacité grâce à la fonction pivot_longer() de la bibliothèque tidyr. Cette commande rassemble les multiples colonnes de métriques sous deux attributs généralisés : une colonne clé désignant la série d’appartenance, et une colonne valeur hébergeant la mesure quantitative correspondante. L’opération préserve scrupuleusement les index d’horodatage et les identifiants d’échantillonnage longitudinaux. Ce réagencement s’impose non pas comme une contrainte technique superflue, mais comme le déclencheur fondamental permettant à ggplot2 de vectoriser la colorisation, le groupement et la stratification graphique sans recourir à des boucles impératives verbeuses.
3. Construction du graphique de base d’une série temporelle avec ggplot2
3.1 Mise en place de l’espace esthétique et de la couche géométrique initiale
L’élaboration d’une représentation graphique sous ggplot2 s’articule comme une superposition séquentielle de couches fonctionnelles indépendantes, connectées par l’opérateur d’addition unaire surchargé (+). L’étape initiale requiert l’appel à la fonction d’instanciation ggplot(), au sein de laquelle on transmet la référence du tableau de données préalablement validé, ainsi que la déclaration du mappage esthétique initial via la sous-fonction aes(). Pour une série chronologique fondamentale, ce mappage stipule que l’axe horizontal d’abscisse (x) accueille la variable temporelle convertie (de classe Date ou POSIXct), tandis que l’axe vertical d’ordonnée (y) reçoit la variable quantitative continue dont on se propose de suivre la dynamique.
À ce stade élémentaire d’instanciation, aucun signal n’apparaît encore sur la zone de rendu : l’objet graphique se borne à calculer les coordonnées spatiales limites et à tracer la grille cartésienne nue. La matérialisation physique de la trajectoire requiert l’adjonction explicite d’une couche géométrique élémentaire. La primitive geom_line() répond universellement à cette exigence pour les séries chronologiques régulières. Son algorithme prend en charge les observations successives selon l’ordre croissant de l’abscisse et trace entre chacune d’elles un segment de droite euclidien continu, dessinant ainsi la courbe d’évolution temporelle globale du processus.
Dans un contexte scientifique où la précision métrologique est primordiale, la seule présence d’une ligne continue peut induire en erreur en dissimulant la fréquence réelle d’acquisition des données sous-jacentes. Une droite continue reliant deux points séparés par plusieurs semaines peut donner l’illusion fallacieuse d’une dynamique stable et mesurée, alors qu’il ne s’agit que d’une interpolation linéaire aveugle comblant un vide d’information. Pour conjurer ce biais cognitif, la superposition combinée d’une couche géométrique de points discrets via geom_point() constitue une bonne pratique méthodologique élémentaire. Cette couche isole chaque mesure réelle, matérialisant visuellement la densité locale de l’échantillonnage sans équivoque possible.
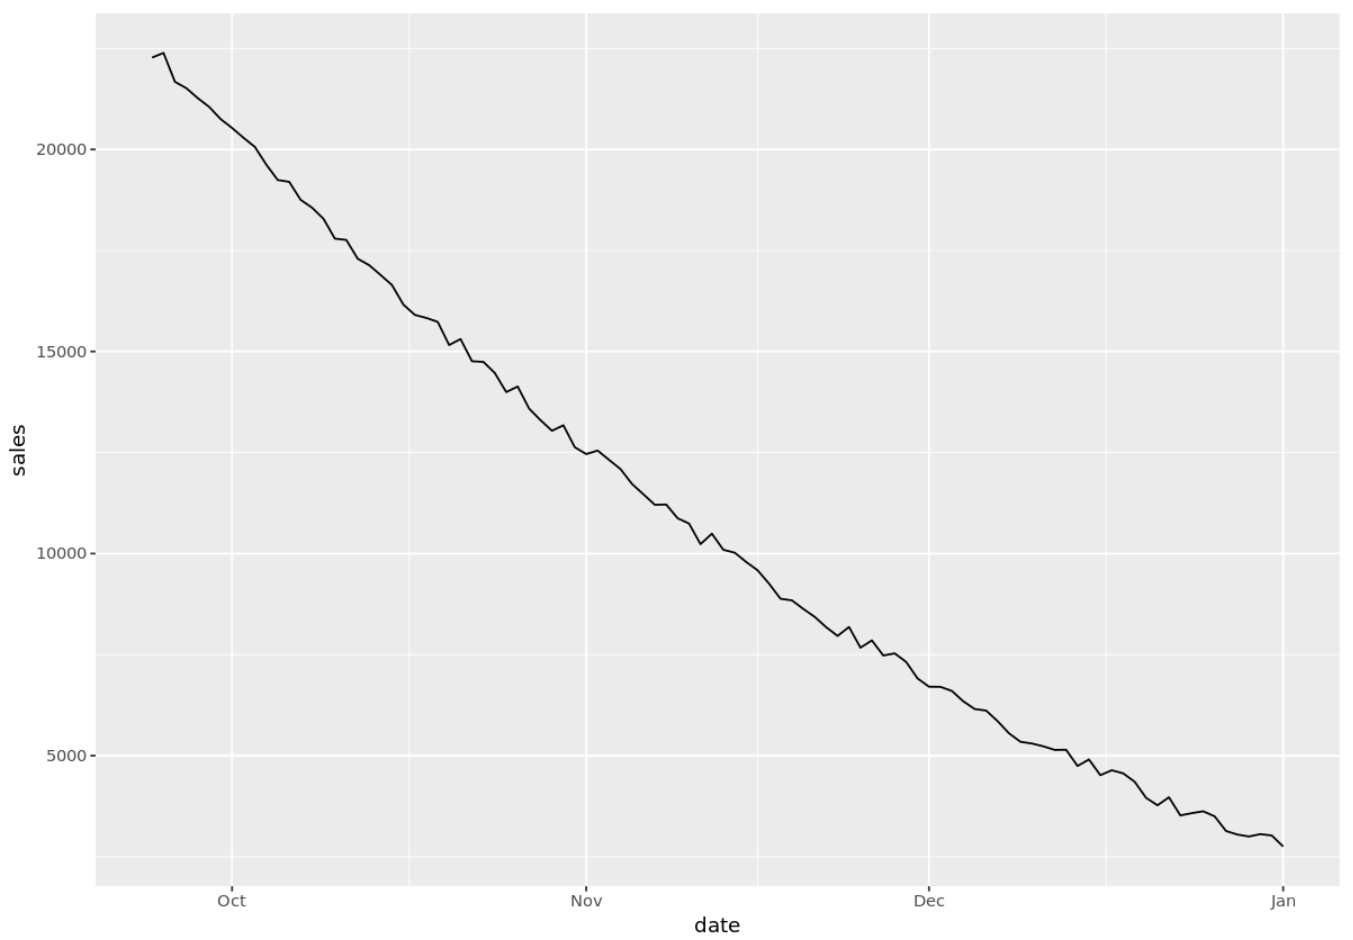
Le réglage des attributs physiques statiques au sein de ces primitives géométriques permet de moduler la hiérarchie visuelle. Il convient de souligner une distinction sémantique essentielle de la grammaire des graphiques : lorsqu’un paramètre (tel que la couleur, l’épaisseur ou la transparence) est fixé à une constante universelle pour tous les points sans dépendre d’une variable du tableau, sa valeur doit être définie à l’extérieur de la fonction aes(), directement au niveau des arguments de geom_line() ou geom_point(). Ainsi, l’épaisseur de ligne (linewidth), le type de tracé (linetype, acceptant des motifs solides, pointillés ou tiretés) et le coefficient de transparence (alpha, variant de 0 pour l’invisibilité totale à 1 pour l’opacité absolue) permettent de tempérer la force visuelle des bruits parasites tout en assurant une netteté de lecture irréprochable.
3.2 Interprétation visuelle de la dynamique sérielle fondamentale
La lecture analytique d’un tracé temporel primaire mobilise des mécanismes d’inférence visuelle complexes que le graphiste doit anticiper afin de ne pas induire de jugements erronés chez le récepteur. La première dimension évaluée réside dans l’amplitude globale des oscillations et l’identification visuelle des ruptures structurales de pente. Une série présentant des excursions brusques bien au-delà de l’enveloppe moyenne d’oscillation signale la présence probable de chocs exogènes ou d’erreurs de mesure sporadiques. À l’inverse, une dérive continue et monotone de l’axe central suggère un phénomène cumulatif sous-jacent requérant une formalisation mathématique de tendance déterministe ou stochastique.
La différentiation intuitive entre le signal systématique et le bruit résiduel aléatoire constitue le second enjeu de cette lecture exploratoire. Dans tout phénomène physique ou social réel, les mesures intègrent une part incompressible de variabilité non structurée (le bruit blanc gaussien) venant se superposer aux déterminants déterministes. Lorsque la variance locale du bruit aléatoire fluctue au cours du temps — manifestant un phénomène d’hétéroscédasticité conditionnelle —, l’enveloppe géométrique de la courbe s’épaissit ou se rétrécit localement. L’identification visuelle immédiate de ces dilatations de variance constitue une incitation heuristique décisive à recourir à des transformations stabilisatrices de type Box-Cox ou logarithmiques avant d’engager toute modélisation autorégressive.
Enfin, une attention épistémologique absolue doit être accordée au problème des distorsions perceptuelles induites par le ratio d’aspect géométrique (la proportion relative entre la largeur et la hauteur du cadre d’affichage). Ce problème, formalisé par William S. Cleveland sous le concept de banking to 45 degrees, postule que la perception de la vitesse de variation temporelle est optimisée lorsque l’angle absolu des segments d’orientation dominante est centré autour de 45 degrés. Un graphique artificiellement étiré en hauteur aura pour effet de dramatiser la sévérité des pentes ascendantes ou descendantes, transformant une fluctuation ordinaire en une rupture d’apparence catastrophique. Inversement, un graphique excessivement étiré en largeur aplatira artificiellement les variations réelles, étouffant visuellement des dynamiques pourtant critiques.
4. Formatage et contrôle avancé de l’axe temporel avec scale_x_date
4.1 Spécificateurs de conversion et nomenclature de mise en forme
Le moteur de mise à l’échelle de ggplot2 confère à l’abscisse un rôle spécifique lorsque la variable associée relève des classes temporelles standardisées. Dès qu’un vecteur de type Date est détecté, le logiciel déploie en arrière-plan la fonction scale_x_date(), laquelle prend en charge la graduation, la conversion textuelle et la projection linéaire du temps. L’une des exigences les plus impérieuses pour produire des graphiques respectant les canons éditoriaux consiste à dompter les spécificateurs de conversion alphanumériques dérivés de la norme POSIX, qui régissent la transcription des nombres calendaires en étiquettes lisibles par l’œil humain.
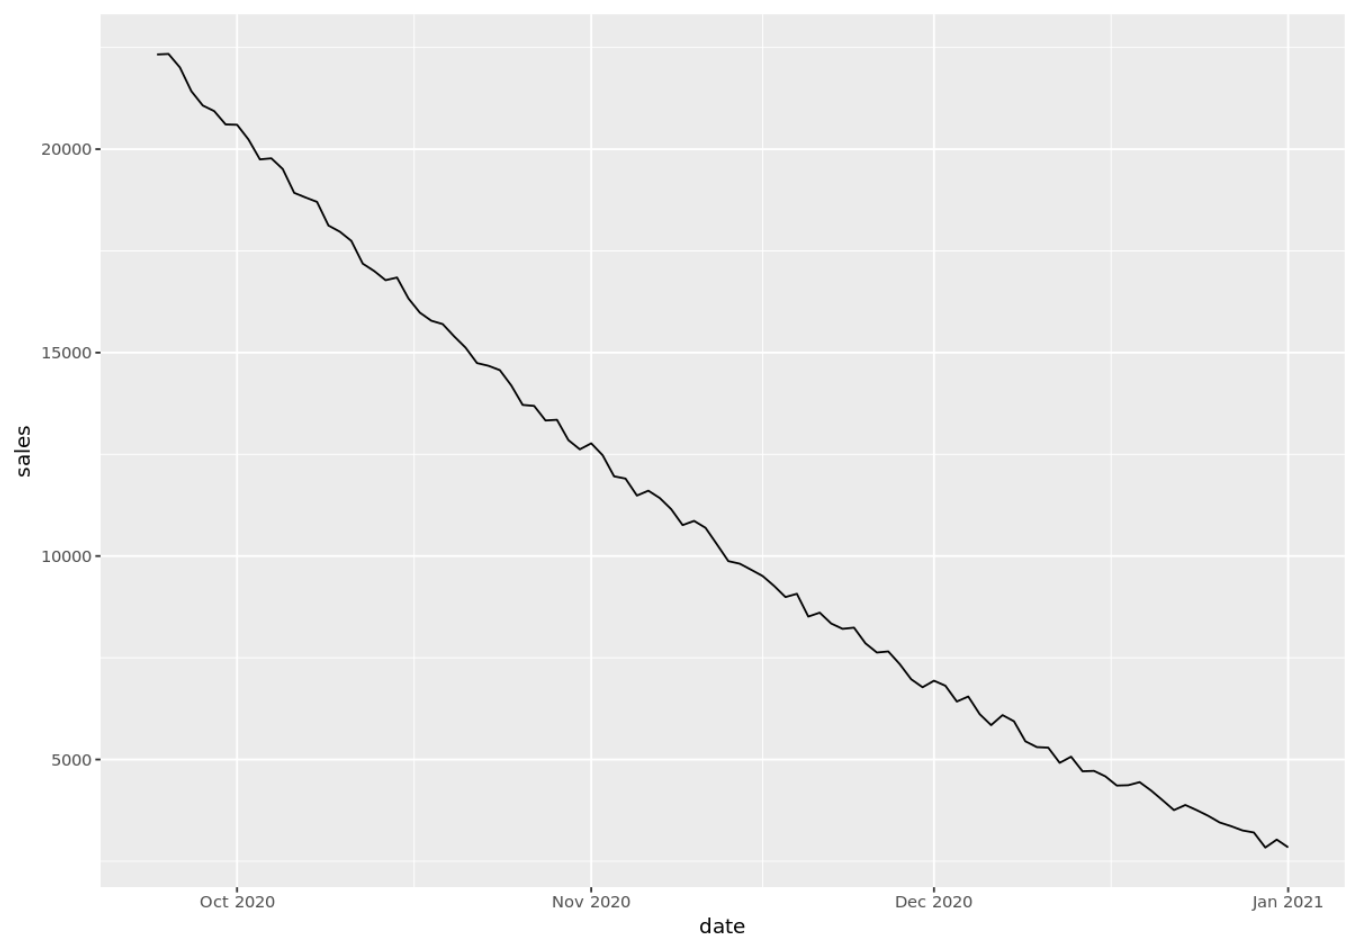
La composition de ces spécificateurs fait appel à des codes introduits par le caractère d’échappement pourcentage (%). Ainsi, %d permet d’afficher le jour du mois sous la forme d’un nombre à deux chiffres (de 01 à 31), tandis que %e supprime le zéro initial pour une typographie plus aérée. La manipulation des composantes mensuelles offre une grande variété stylistique : %m transcrit le mois sous forme numérique décimale (01 à 12), alors que %b et %B invoquent respectivement le nom abrégé et le nom complet du mois en langage naturel (par exemple « févr. » ou « février »). L’écriture de l’année s’articule classiquement autour de %y pour une notation condensée à deux chiffres et de %Y pour la transcription complète séculaire à quatre chiffres.
Pour des protocoles spécifiques requérant un calibrage plus spécialisé, il est possible d’accéder aux dénominations des jours de la semaine grâce aux séquences %a (forme abrégée) et %A (nom intégral). Dans les disciplines épidémiologiques et industrielles où le suivi opérationnel s’exécute à l’échelle hebdomadaire, la normalisation internationale impose l’usage de codes de numérotation de semaines calendaires tels que %W (commençant le lundi selon la convention européenne) ou %V (définissant la semaine conforme au standard ISO 8601). Le tableau ci-après synthétise les équivalences de conversion les plus couramment mobilisées dans les environnements de publication scientifique francophones :
- %d : Jour du mois sous forme numérique à deux chiffres (01 à 31).
- %b / %B : Nom abrégé / complet du mois selon les paramètres régionaux en vigueur.
- %m : Numérotation mensuelle ordinale (01 pour janvier à 12 pour décembre).
- %Y : Millésime calendaire intégral sur quatre chiffres (ex. 2024).
- %W : Numéro de la semaine dans l’année civile selon la norme ISO (00 à 53).
Un facteur critique de reproductibilité réside dans la gestion des paramètres régionaux (les fameuses locales du système d’exploitation). Si l’environnement de calcul R est configuré sous une session linguistique anglo-saxonne par défaut, la commande d’affichage calendaire générera immanquablement des étiquettes telles que « Jan », « Feb », « Mar » au lieu de leurs équivalents français « janv. », « févr. », « mars ». Pour remédier à cette asymétrie de restitution dans un document rédigé en langue française, il s’avère indispensable d’exécuter l’instruction système Sys.setlocale(« LC_TIME », « fr_FR.UTF-8 ») ou son équivalent sous l’architecture Windows hôte avant d’exporter les représentations graphiques vectorielles.
4.2 Graduation et espacement des repères chronologiques
La lisibilité d’un axe chronologique repose sur un dosage rigoureux de la densité de ses repères numériques ou textuels. Une abscisse encombrée d’une multitude d’étiquettes enchevêtrées devient totalement illisible, tandis qu’un axe excessivement dépouillé prive le récepteur de points d’ancrage temporels pour situer les dynamiques observées. L’argument date_breaks au sein de la primitive scale_x_date() permet de reprendre la maîtrise intégrale de ce rythme de graduation sans devoir recalculer manuellement les positions des marqueurs.
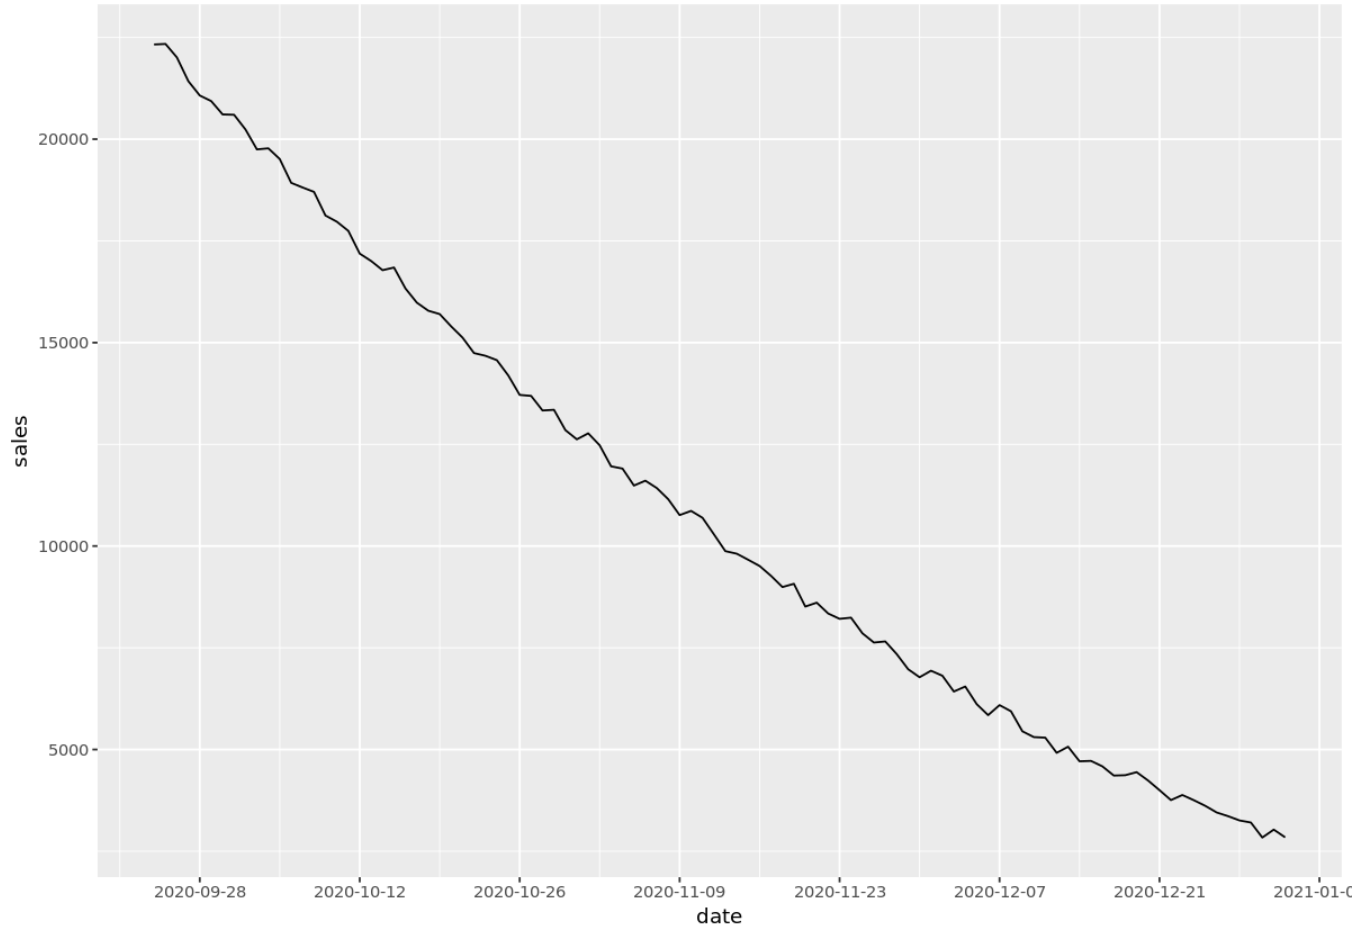
L’argument date_breaks accepte une expression textuelle intuitive formée d’un nombre entier suivi d’une unité de mesure temporelle standardisée (en anglais dans la syntaxe interne de la bibliothèque), telle que « 1 day », « 2 weeks », « 3 months » ou « 5 years ». Cette commande ordonne au moteur de calcul de contraindre l’intervalle entre chaque tiret d’axe majeur (major tick) au pas exact spécifié. De manière symétrique, l’argument date_minor_breaks introduit un second réseau de subdivisions plus fines à l’intérieur de la grille cartésienne en arrière-plan, facilitant le repérage géométrique sans surcharger visuellement l’axe horizontal d’étiquettes textuelles redondantes.
La formulation typographique exacte de ces tirets majeurs est ensuite déléguée au paramètre complémentaire date_labels. Ce dernier attend une chaîne de caractères formée par la combinaison des spécificateurs POSIX exposés précédemment. Ainsi, stipuler conjointement date_breaks = « 2 months » et date_labels = « %b %Y » garantit que R placera rigoureusement une annotation tous les deux mois en faisant figurer le nom abrégé du mois suivi du millésime à quatre chiffres, assurant une clarté de lecture constante sur l’intégralité du domaine d’observation.
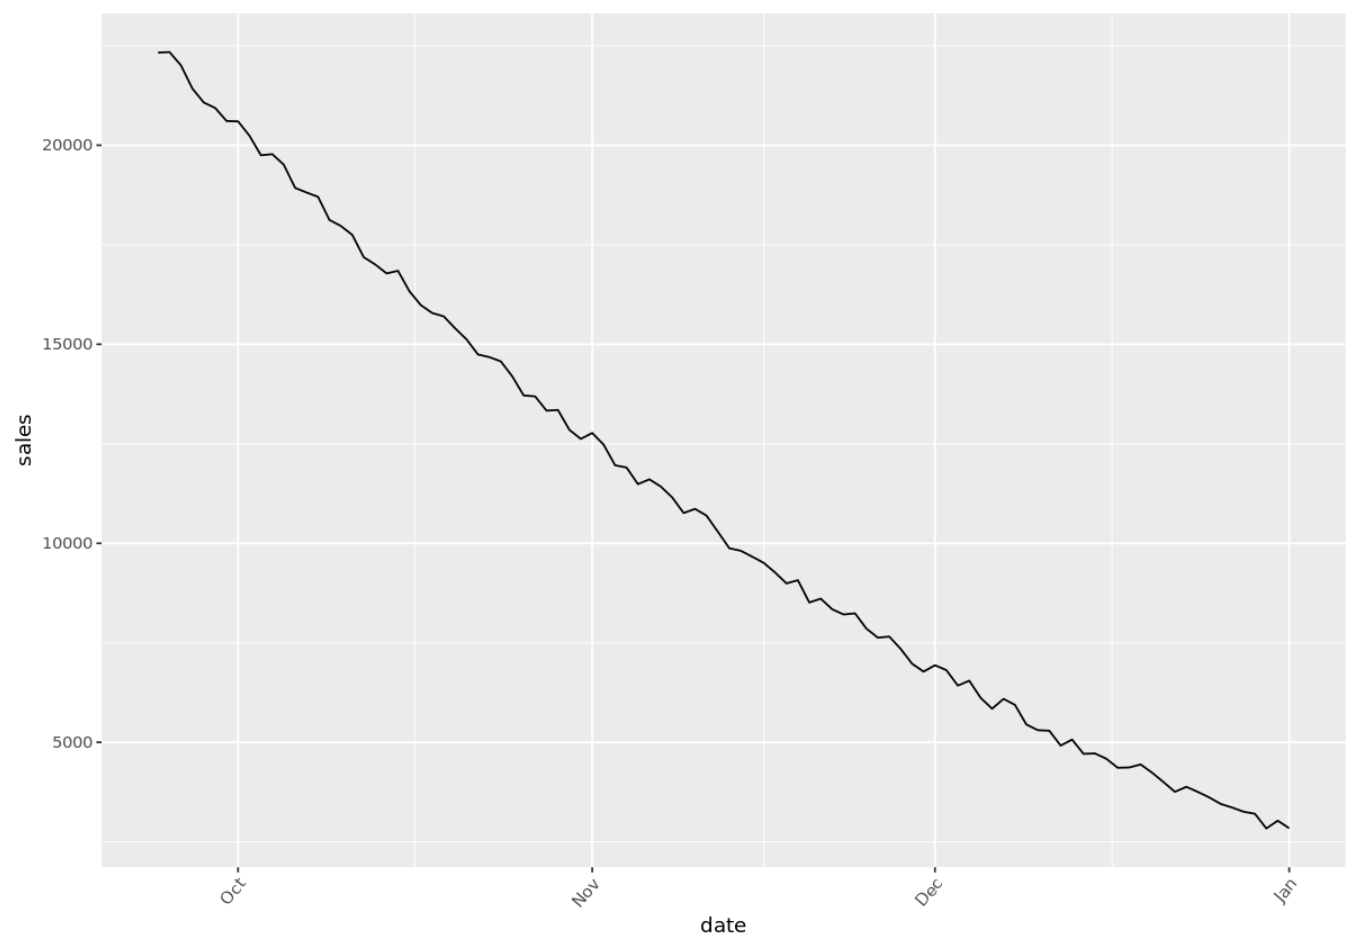
Malgré un espacement soigneusement choisi, la longueur textuelle des labels peut induire un chevauchement mutuel lors de tracés couvrant de longues périodes à fréquence resserrée. Pour pallier cette contrainte d’encombrement sans amputer le contenu informatif de la légende, la rotation angulaire contrôlée des étiquettes s’impose comme une alternative fonctionnelle élégante. Cette modification géométrique ne s’opère pas au sein de l’échelle elle-même, mais via l’interface de thématisation globale en utilisant l’instruction theme(axis.text.x = element_text(angle = 45, hjust = 1)). Le paramètre d’alignement horizontal (hjust = 1) assure que l’extrémité terminale de la chaîne de caractères inclinée à 45 degrés vienne s’aligner précisément au droit du tiret de graduation correspondant, éliminant ainsi toute ambiguïté sur le point temporel désigné.
4.3 Délimitation dynamique de la fenêtre temporelle
L’exploration scientifique d’une série temporelle exige fréquemment de resserrer l’attention analytique sur un sous-ensemble temporel spécifique, afin d’examiner une séquence d’événements singulière ou de neutraliser des périodes préliminaires de rodage expérimental. Sous R, la manipulation des limites de visualisation peut s’opérer selon deux logiques algorithmiques distinctes dont les conséquences statistiques diffèrent fondamentalement : le filtrage par échelle au sein de scale_x_date() et le recadrage spatial strict par le système de coordonnées avec coord_cartesian().
L’attribution explicite d’un vecteur de deux bornes temporelles (définies via as.Date()) à l’argument limits au sein de scale_x_date(limits = c(date_debut, date_fin)) ordonne au moteur de ggplot2 d’exclure structurellement du jeu de données toutes les observations chronologiquement situées en deçà de la borne inférieure ou au-delà de la borne supérieure. Si cette approche s’avère efficace pour restreindre l’affichage, elle entraîne un effet collatéral non négligeable : les calculs d’ajustement statistique subséquents (comme les régressions de tendance locale ou les lissages non paramétriques calculés par geom_smooth()) ne prendront plus en considération les points tronqués, ce qui peut distordre l’allure des estimations aux abords immédiats des marges de la fenêtre sélectionnée.
Pour opérer un véritable zoom optique qui circonscrit le champ d’observation sans altérer la masse statistique globale des calculs sous-jacents, il convient d’adopter l’instruction coord_cartesian(xlim = c(date_debut, date_fin)). Dans cette configuration, l’intégralité des observations est conservée en mémoire vive par les algorithmes d’ajustement géométrique, mais la caméra de projection visuelle se focalise exclusivement sur la sous-fenêtre désignée. De surcroît, la maîtrise des marges internes de décalage temporel s’obtient au moyen de l’argument expand de l’échelle d’abscisse. Par défaut, ggplot2 applique une dilatation proportionnelle de cinq pour cent pour éviter que les points extrêmes ne touchent physiquement les bords du tracé ; l’application de expand = expansion(mult = c(0, 0)) permet de supprimer cette bordure résiduelle afin d’ancrer le tracé de la série exactement à la ligne verticale marquant le seuil temporel inaugural.
5. Enrichissement esthétique, typographique et contextualisation sémantique
5.1 Personnalisation des titres, sous-titres et étiquetage scientifique
Un tracé de données chronologiques dépourvu d’ancrage textuel explicite perd l’essentiel de sa valeur probante dans une publication à comité de lecture. La contextualisation sémantique d’un graphique s’édifie au moyen de la fonction consolidée labs(), qui permet de déclarer en une seule instruction cohérente l’ensemble des titres, sous-titres, étiquettes d’axes et renvois méthodologiques indispensables à l’autonomie interprétative de la figure. Un graphique bien conçu doit s’auto-suffire et permettre à un lecteur averti de saisir la portée du phénomène sans devoir impérativement se reporter au corps du texte principal.
Le titre principal (argument title) se doit de résumer synthétiquement le processus dynamique sous-jacent plutôt que de se contenter d’une déclaration passive listant les axes en présence. Le sous-titre (argument subtitle) joue quant à lui un rôle de précision contextuelle : il accueille idéalement l’indication du pas d’échantillonnage temporel, le cadre institutionnel ou expérimental de l’observation et la période chronologique globale examinée. Parallèlement, l’argument caption placé au bas de la figure est le lieu dévolu aux mentions d’imputabilité méthodologique : sources d’origine des banques de données, identifiants de protocoles de recherche, ou rappels formels des conventions de calculs appliquées (taux déflatés, moyennes mobiles, corrections des jours ouvrés).
La précision de l’étiquetage de l’axe vertical des ordonnées (y) requiert une rigueur absolue quant à la mention des unités de mesure physiques ou abstraites et des ordres de grandeur manipulés. Omettre de spécifier si une variable exprime des milligrammes par litre, des pourcentages normalisés ou des flux financiers en millions de dollars constants introduit une incertitude scientifique intolérable. En outre, ggplot2 intègre une compatibilité native avec le moteur typographique mathématique de R grâce à la fonction expression(). Cette passerelle permet d’insérer au cœur des titres et des libellés d’axes des lettres grecques, des exposants, des indices ou des fractions intégrales (par exemple pour annoter un flux de matière en microgrammes par mètre cube : labs(y = expression(paste(« Concentration en « , mu, « g/ », m^3)))), assurant une conformité typographique stricte avec les normes de communication scientifique internationales.
5.2 Thématisation graphique rigoureuse pour supports académiques
Le rendu par défaut de ggplot2, caractérisé par son fond gris perlé quadrillé de blanc, a été conçu par ses créateurs pour équilibrer la perception des couleurs sur écran informatique. Cependant, ce rendu s’avère inadapté aux exigences strictes de l’impression académique et des revues spécialisées, qui imposent des contrastes élevés, une économie d’encre absolue et une typographie dépouillée. L’écosystème graphique propose une collection de thèmes clés en main permettant de métamorphoser instantanément la présentation d’une série temporelle.
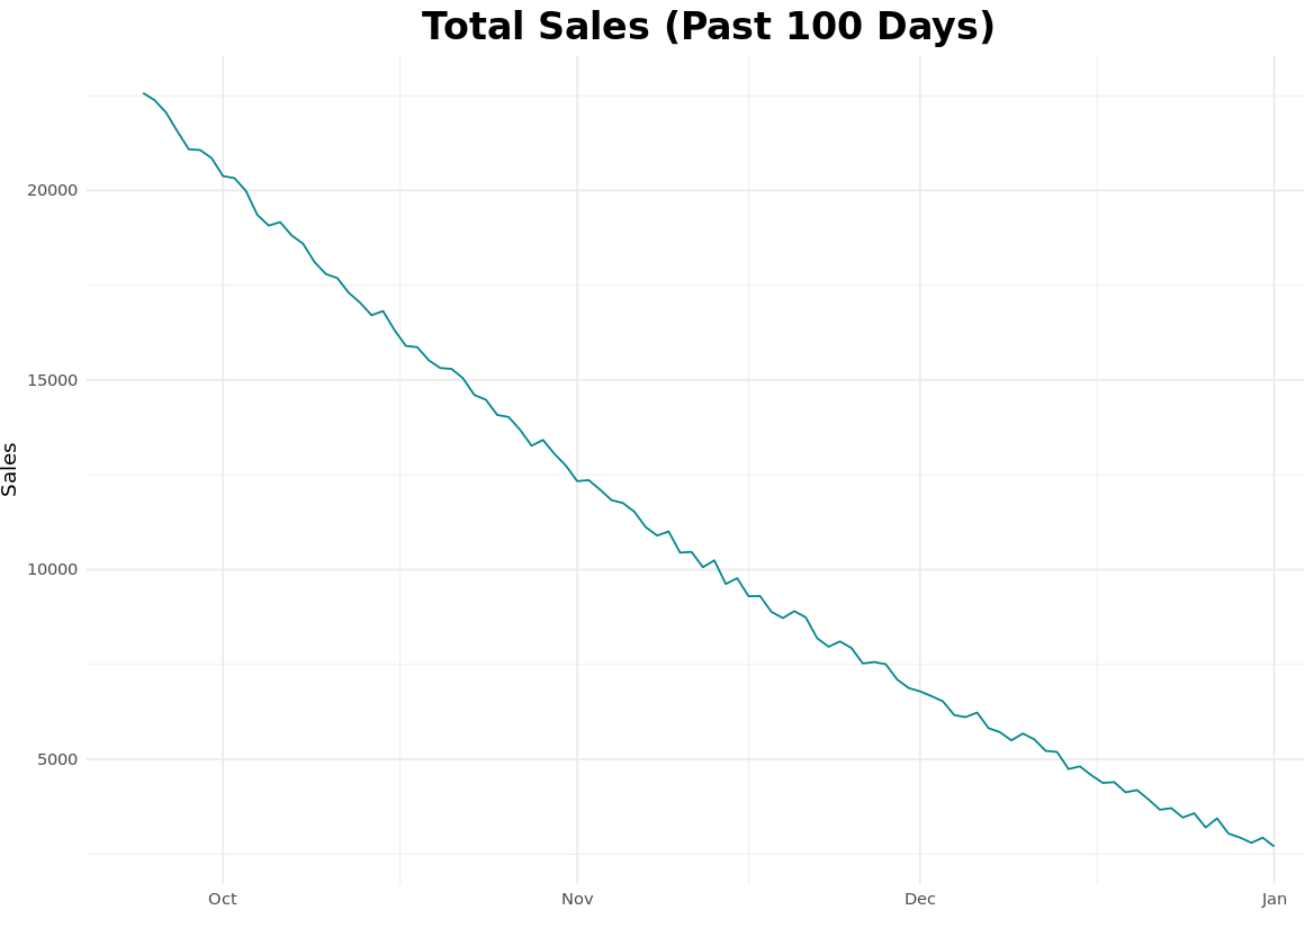
Le thème theme_bw() (pour black and white) remplace le fond gris par une toile blanche délimitée par un cadre rectangulaire fin, tout en conservant une grille cartésienne discrète idéale pour guider la lecture visuelle des coordonnées sans distraire l’attention du tracé de la série. Le thème theme_classic() pousse l’épuration encore plus loin en supprimant l’intégralité du quadrillage d’arrière-plan et en ne conservant que les deux axes orthogonaux d’origine (abscisse et ordonnée), reproduisant ainsi la convention séculaire des graphiques de laboratoire. Pour les publications numériques ou les présentations en milieu professionnel, theme_minimal() offre une solution équilibrée en supprimant le cadre extérieur tout en maintenant des lignes de grille éthérées pour faciliter la projection spatiale des points d’inflexion.
Au-delà de ces gabarits prédéfinis, la fonction modulaire theme() accorde un contrôle micro-typographique sur l’ensemble des éléments structuraux de la figure. Elle permet notamment d’harmoniser la police de caractères avec celle du corps de l’article scientifique en définissant le paramètre global base_family (par exemple en appelant une police à empattement de type « Times New Roman » ou une police linéaire sans empattement comme « Helvetica »). Elle autorise également le déplacement stratégique de la boîte de légende grâce à legend.position = « bottom » ou son inclusion directe à l’intérieur de la zone graphique non exploitée via un vecteur de coordonnées relatives normalisées legend.position = c(0.85, 0.20), libérant ainsi un espace horizontal précieux pour étirer la perspective temporelle.
5.3 Harmonisation des palettes de couleurs perceptuellement uniformes
Le choix des teintes pour matérialiser les séries temporelles répond à des contraintes sémiotiques et d’accessibilité universelle. Dans une communauté de recherche inclusive, une figure graphique doit demeurer parfaitement lisible et discriminante pour les personnes atteintes de déficits de la perception des couleurs (tels que la deutéranopie ou la protanopie, touchant une part significative de la population masculine). De surcroît, le tracé doit conserver son pouvoir de différenciation lors d’une impression photocopiée en noir et blanc ou en niveaux de gris sans générer d’ambiguïtés de contraste.
Pour répondre à ces exigences, le recours aux palettes de couleurs perceptuellement uniformes issues du projet Viridis (disponibles nativement dans ggplot2 via scale_color_viridis_d() pour les variables discrètes et scale_color_viridis_c() pour les variables continues) s’impose comme une référence incontournable. Ces échelles chromatiques sont construites algorithmiquement de sorte que la distance perceptuelle entre deux teintes soit rigoureusement proportionnelle à la distance numérique entre les valeurs sous-jacentes, tout en garantissant un gradient monotone de luminance qui préserve l’intégralité de l’information lors de la conversion monochromatique.
Une alternative largement éprouvée provient des travaux cartographiques de Cynthia Brewer implémentés dans la bibliothèque RColorBrewer (accessible via scale_color_brewer()). Selon la nature du phénomène chronologique représenté, l’analyste sélectionnera des palettes séquentielles (pour illustrer une gradation d’intensité), divergentes (pour faire ressortir des anomalies positives et négatives autour d’un seuil critique zéro ou d’une moyenne de référence), ou qualitatives (conçues pour distinguer des entités nominales sans hiérarchie implicite, telles que des pays ou des cohortes de patients distinctes). L’attribution intentionnelle des teintes vise ainsi à canaliser le regard vers les singularités du système dynamique plutôt qu’à séduire par un bariolage polychrome dénué de fondement sémiologique.
6. Représentation comparative de séries temporelles multiples
6.1 Superposition sur un axe unique par différenciation catégorielle
L’analyse scientifique d’un processus dynamique exige fréquemment de confronter plusieurs trajectoires simultanées sur un référentiel temporel commun. Cette approche permet d’évaluer la synchronisation de différents signaux, de comparer des groupes de traitement face à des groupes témoins, ou de mesurer la convergence de plusieurs indicateurs économiques. Sur le plan technique, la superposition sur un axe unique s’orchestre avec une grande élégance sous ggplot2 à condition que les données sources respectent le format long préalablement décrit.
L’assignation de la variable catégorielle distinctive au sein de l’argument de couleur esthétique aes(color = cohorte, group = cohorte) commande au moteur graphique de partitionner le calcul géométrique : au lieu de tracer un segment continu erratique reliant l’ensemble des points sans distinction, R isole chaque modalité de la variable de groupement et engendre autant de trajectoires continues indépendantes, associant à chacune d’elles une nuance chromatique issue de la palette sélectionnée. Pour garantir une accessibilité visuelle sans faille, il est recommandé de doubler cette différenciation par couleur d’une modulation géométrique du type de trait via l’argument esthétique complémentaire aes(linetype = cohorte), permettant ainsi de distinguer les trajectoires même sous un éclairage défavorable ou sur un support d’impression noir et blanc.
Toutefois, la superposition de trajectoires multiples se heurte rapidement à l’écueil visuel dit du spaghetti plot : dès lors que le nombre de séries concurrentes dépasse quatre ou cinq, l’enchevêtrement chaotique des courbes crée un bruit visuel indistinct où toute lecture individuelle devient impossible. Une stratégie sémiotique performante pour déjouer cet écueil consiste à pratiquer la mise en valeur sélective (highlighting). Dans cette configuration, l’ensemble des séries contextuelles secondaires est projeté en arrière-plan sous une couleur neutre (comme un gris discret) et une épaisseur de trait minimale, tandis que la trajectoire singulière méritant l’attention analytique est superposée au premier plan avec une teinte vive et un trait épaissi. Cette mise en page hiérarchise immédiatement l’information et focalise l’attention du lecteur sur l’hypothèse centrale examinée.
6.2 Segmentation en sous-graphiques avec facet_wrap et facet_grid
Lorsque le nombre de séries temporelles à comparer devient trop volumineux pour autoriser une superposition intelligible sur un plan unique, ou lorsque les dynamiques oscillent sur des échelles numériques très dissemblables, la technique des petits multiples (small multiples) théorisée par Edward Tufte apporte une réponse méthodologique remarquable. Cette approche consiste à décomposer la figure en une matrice de sous-graphiques partageant la même structure visuelle, chaque panneau étant dévolu à une modalité spécifique de la variable de segmentation.
L’instruction facet_wrap(~ entite, ncol = 3) déploie les panneaux selon une grille bidimensionnelle flexible, en réorganisant séquentiellement les sous-graphiques sur un nombre déterminé de colonnes ou de lignes. De manière plus rigide mais hautement analytique, facet_grid(facteur_ligne ~ facteur_colonne) dresse un tableau croisé complet permettant d’isoler l’intersection de deux conditions expérimentales distinctes le long du cours temporel. Cette standardisation matricielle facilite la comparaison transversale instantanée en réduisant la charge cognitive liée à la lecture d’une légende complexe.
L’un des choix de conception les plus déterminants lors de la facettisation réside dans la synchronisation des axes verticaux. Par défaut, ggplot2 impose des échelles strictement identiques à l’ensemble des panneaux (scales = « fixed »). Ce paramétrage standard est fondamental lorsqu’on souhaite comparer visuellement l’amplitude absolue des phénomènes sans biaiser le jugement. Cependant, si une série présente des variations oscillant entre 1 et 5 unités tandis qu’une autre fluctue entre 10 000 et 50 000, l’adoption d’échelles libres via scales = « free_y » devient inévitable pour éviter que les variations de la première ne soient totalement écrasées et invisibilisées. L’analyste prendra soin, le cas échéant, d’avertir explicitement le lecteur de cette rupture de comparabilité directe dans la légende de la figure.
6.3 Gestion et controverses autour du double axe des ordonnées
L’emploi d’un double axe vertical des ordonnées — superposant sur un même graphique temporel deux métriques différentes graduées respectivement sur les bords gauche et droit du cadre — constitue une pratique séduisante mais vivement controversée dans la littérature statistique spécialisée. Du point de vue de la syntaxe sous ggplot2, cette construction ne s’opère pas en déclarant deux échelles distinctes, mais en appliquant une transformation mathématique réversible au sein du paramètre sec.axis de la fonction scale_y_continuous().
La controverse méthodologique entourant cette technique repose sur le fait que la relation visuelle apparente entre les deux trajectoires dépend entièrement du coefficient multiplicateur et du décalage d’origine choisis par l’analyste pour ajuster la seconde échelle à la première. En modifiant arbitrairement ces paramètres d’échelle, on peut faire apparaître des croisements de courbes, des synchronisations ou des divergences factices qui n’ont aucune réalité physique ou statistique sous-jacente. Cette plasticité subjective expose l’expérimentateur au risque de manipulation involontaire ou de biais de confirmation visuel.
Pour parer à ces dérives interprétatives, des alternatives mathématiques plus rigoureuses doivent être privilégiées. La première consiste à normaliser les deux séries selon une convention indiciaire en base 100 à une date de référence déterminée (la valeur de chaque série devenant égale au ratio de sa valeur brute sur sa valeur initiale, multiplié par 100). Les deux trajectoires évoluent alors dans un espace sans dimension exprimant directement des pourcentages de variation relative, ce qui autorise leur tracé légitime sur une échelle commune. La seconde approche repose sur le calcul des scores centrés-réduits (z-scores), soustrayant à chaque série sa moyenne empirique et divisant le résultat par son écart-type d’échantillonnage. Les courbes représentent alors les déviations standard par rapport à la moyenne respective, garantissant une comparabilité statistique rigoureuse des profils dynamiques.
7. Modélisation de la tendance, lissage statistique et décomposition temporelle
7.1 Lissage non paramétrique et modélisation par régression locale
Les séries temporelles brutes sont régulièrement assaillies par des composantes de bruit à haute fréquence qui masquent la trajectoire de fond du système physique ou économique étudié. L’intégration d’un lissage non paramétrique permet d’extraire la tendance centrale sous-jacente sans formuler d’hypothèse fonctionnelle rigide a priori sur la forme globale de la courbe. La grammaire de ggplot2 automatise cette modélisation par l’entremise de la primitive geom_smooth(), apportant une appréciation analytique immédiate.
Par défaut, sur les jeux de données contenant moins d’un millier d’observations, geom_smooth() applique l’algorithme de régression locale pondérée connu sous l’acronyme LOESS (locally estimated scatterplot smoothing). Cet algorithme ajuste de manière glissante des polynômes de bas degré au voisinage de chaque instant de mesure, en accordant un poids statistique décroissant aux observations au fur et à mesure qu’elles s’éloignent du point d’évaluation sur l’axe temporel. Le contrôle de la souplesse de cet ajustement est régi par l’argument span : une valeur restreinte engendre un lissage réactif captant fidèlement les micro-inflexions mais sensible au bruit, tandis qu’une valeur élevée produit une courbe rigide approchant une trajectoire globale asymptotique.
Pour les séries temporelles manifestant une évolution globale continue et stable, le paramétrage explicite de la méthode par régression linéaire généralisée via geom_smooth(method = « lm ») permet de superposer la droite de régression des moindres carrés ordinaires. L’instruction calcule automatiquement l’enveloppe d’incertitude statistique sous-jacente et trace un intervalle de confiance ombré (paramétré par défaut à 95 % sous l’argument se = TRUE). Cet ombrage renseigne sur la précision de l’estimation de la trajectoire moyenne : un intervalle se dilatant aux extrémités de la fenêtre d’observation rappelle la vulnérabilité intrinsèque des extrapolations temporelles face à la raréfaction des degrés de liberté marginaux.
7.2 Moyennes mobiles et réduction de la volatilité à court terme
Dans la boîte à outils classique de l’analyse des séries chronologiques, le filtrage par moyennes mobiles occupe une place privilégiée pour lisser la volatilité de court terme et neutraliser les fluctuations saisonnières de périodicité connue. Contrairement au lissage LOESS qui opère un ajustement polynomial local pondéré, la moyenne mobile remplace la valeur instantanée par la moyenne arithmétique simple ou pondérée des observations situées à l’intérieur d’une fenêtre temporelle coulissante glissant le long du signal.
La bibliothèque spécialisée zoo fournit la fonction de calcul glissant rollmean(), particulièrement adaptée pour s’intégrer au sein d’un pipeline de manipulation avec dplyr. Deux configurations de calcul s’offrent au modélisateur : la moyenne mobile centrée (qui calibre le résultat au point médian exact de la fenêtre, éliminant tout déphasage temporel mais générant des données indéfinies aux bords de la série) et la moyenne mobile unilatérale retardée (qui agrège exclusivement les instants passés et présents, cruciale pour les prévisions en temps réel mais introduisant un retard de phase systématique sur le graphique tracé).
Le choix de la largeur de la fenêtre coulissante (argument k) doit être motivé par la nature phénoménologique de la série sous peine de dénaturer le signal. Par exemple, sur une série de températures journalières manifestant une rythmique hebdomadaire d’activités anthropiques, une fenêtre glissante de sept jours permet d’annihiler l’artéfact du week-end pour révéler la dynamique de fond. La superposition graphique sous ggplot2 de la trajectoire brute semi-transparente (avec un faible alpha) et de la courbe de moyenne mobile plus épaisse et contrastée matérialise visuellement la décomposition entre l’aléa instantané et l’inertie structurelle du processus.
7.3 Décomposition structurelle : tendance, saisonnalité et résidus
La théorie classique de l’analyse temporelle postule que toute série chronologique empirique peut être décomposée en la somme (modèle additif) ou le produit (modèle multiplicatif) de trois composantes fondamentales : une tendance de fond séculaire (trend), un schéma oscillatoire périodique d’intervalle fixe (seasonal) et une perturbation aléatoire résiduelle stationnaire (remainder ou bruit blanc). Lorsque l’amplitude des oscillations saisonnières demeure stable indépendamment du niveau de la tendance, le modèle additif est approprié ; si cette amplitude s’accroît proportionnellement à la hausse du niveau moyen, le cadre multiplicatif s’impose.
L’algorithme de décomposition robuste STL (Seasonal and Trend decomposition using Loess), mobilisable sous R via la fonction stl(), applique des lissages itératifs non paramétriques pour isoler ces différentes strates sans se laisser déstabiliser par la présence éventuelle de valeurs aberrantes isolées. Les architectures modernes intégrées dans le méta-package fable et la structure tsibble permettent de convertir instantanément les résultats d’une décomposition formelle en tableaux de données manipulables par la grammaire des graphiques.
La visualisation classique d’une décomposition structurelle fait appel à un ensemble multi-panneaux vertical comprenant quatre segments alignés temporellement : la série brute observée au sommet, suivie successivement de la trajectoire tendancielle extraite, de la composante saisonnière périodique isolée, et enfin de la chronique des résidus non expliqués à la base. Cette décomposition graphique fournit une vue d’ensemble diagnostique immédiate : elle permet d’attester la régularité du cycle périodique et de contrôler que les résidus finaux se comportent bien comme un processus stochastique dénué de structure informative résiduelle.
8. Annotation contextuelle, seuils théoriques et mise en valeur d’événements
8.1 Insertion de lignes de repère verticales et horizontales
Un tracé quantitatif abstrait prend toute sa dimension démonstrative lorsqu’il s’articule autour de jalons physiques, réglementaires ou historiques explicites. L’injection d’annotations géométriques structurelles s’exécute avec une grande simplicité dans l’écosystème ggplot2 au moyen des primitives de référence orthogonales geom_vline() et geom_hline().
L’introduction d’une ligne verticale via geom_vline(xintercept = as.Date(« 2020-03-17 »), linetype = « dashed », color = « red ») permet d’ancrer visuellement le moment exact d’un changement de paradigme, de l’application d’un traitement expérimental, d’une rupture réglementaire ou d’une crise macroéconomique. Le choix d’un tracé discontinu (en pointillés ou tirets) évite la confusion avec un saut instantané de la série temporelle elle-même, tout en signifiant clairement qu’il s’agit d’un repère exogène introduit par l’analyste.
De manière complémentaire, l’insertion de lignes horizontales via geom_hline(yintercept = seuil_critique) matérialise des seuils théoriques, des normes toxicologiques, des cibles d’inflation ou des moyennes d’échantillonnage de référence calculées sur une période historique témoin. Ces lignes offrent un point d’ancrage visuel immédiat pour évaluer si la série se maintient dans des marges de contrôle acceptables ou si elle franchit des paliers de basculement critiques.
8.2 Mise en évidence de périodes spécifiques par zones ombrées
Certains phénomènes ne se réduisent pas à des points d’inflexion temporels discrets, mais s’étendent sur des plages de temps continues : phases de confinement épidémiologique, cycles de récession économique documentés, saisons végétatives ou périodes d’administration médicamenteuse. L’illustration de telles durées d’intérêt s’obtient au moyen de la couche géométrique rectangulaire geom_rect().
La déclaration d’une zone ombrée requiert de renseigner les coordonnées spatiales de ses quatre limites : xmin et xmax reçoivent les dates d’ouverture et de clôture de la séquence historique ciblée, tandis que ymin et ymax sont généralement fixés à moins l’infini (-Inf) et plus l’infini (+Inf) afin que le bandeau s’étende verticalement sur toute la hauteur disponible sans devoir réajuster manuellement les coordonnées en cas d’évolution de l’échelle des ordonnées.
Pour ne pas masquer les courbes chronologiques sous-jacentes, ces bandes d’arrière-plan doivent être insérées au tout début de la pile d’instructions de tracé (juste après l’appel initial à ggplot()), garantissant ainsi que les tracés géométriques ultérieurs viennent se superposer au-dessus de la zone ombrée. De surcroît, le paramètre de transparence (alpha) doit être calibré à un niveau bas (souvent entre 0.1 et 0.2) avec une teinte feutrée pour suggérer le contexte sans surcharger l’équilibre chromatique général de la figure.
8.3 Étiquetage textuel précis de points critiques
La simple présence d’un marqueur géométrique ne suffit pas toujours à rendre explicite la portée d’une anomalie ou d’un sommet historique ; l’adjonction d’une étiquette textuelle descriptive devient alors nécessaire. L’outil d’annotation universel annotate(geom = « text », x = date_point, y = valeur_point, label = « Rupture de charge ») permet de fixer un bloc de texte directement dans l’espace cartésien en le liant à une coordonnée temporelle exacte.
Néanmoins, l’étiquetage manuel de points multiples dans des zones à forte densité de données engendre souvent des superpositions inesthétiques entre le texte, les lignes de la série et les marqueurs voisins. Pour résoudre ce problème typographique récurrent, la bibliothèque spécialisée ggrepel fournit des fonctions avancées telles que geom_text_repel() et geom_label_repel(). Celles-ci intègrent un algorithme d’optimisation physique par répulsion électrostatique simulée : les étiquettes se repoussent mutuellement et s’écartent des données tout en maintenant un trait de rappel fin orienté vers le point temporel exact qu’elles documentent.
L’utilisation raisonnée de ces étiquettes textuelles impose une grande discipline sémiotique pour préserver la clarté visuelle. L’expérimentateur évitera d’annoter l’ensemble des points d’observation, préférant cibler méthodiquement les extremums locaux (minima et maxima absolus de la série) ou les points d’inflexion correspondant à des événements dûment identifiés. Cette approche sélective allège la charge cognitive tout en maximisant la portée explicative du graphique.
9. Traitement des irrégularités, données manquantes et ruptures de rythme
9.1 Visualisation et diagnostic des lacunes temporelles
Dans les applications réelles de collecte de données, l’existence de lacunes dans les séries chronologiques constitue une réalité fréquente : pannes sporadiques de capteurs environnementaux, protocoles hospitaliers interrompus, ou suspensions temporaires des cotations boursières. Du point de vue computationnel, R modélise ces manques par la constante dédiée NA (Not Available). La manière dont ces lacunes sont encodées dans la structure du tableau modifie considérablement le comportement du moteur de rendu graphique.
Il est fondamental de distinguer les valeurs manquantes explicites des données manquantes implicites. Une donnée manquante explicite se matérialise par une ligne existante dans le tableau où la colonne temporelle contient un horodatage valide, mais dont la mesure associée indique NA. Lorsqu’il rencontre cette configuration au cours de l’évaluation d’un geom_line(), R interrompt le tracé du segment continu à l’approche de la lacune et ne le reprend qu’au point valide suivant. Cette rupture de continuité géométrique signale honnêtement au lecteur l’absence de mesure durant l’intervalle.
À l’inverse, une donnée manquante implicite correspond à une omission pure et simple de la ligne temporelle correspondante dans la base de données. Si l’enregistrement passe directement du 1er mai au 15 mai sans ligne intermédiaire pour la période intercalaire, geom_line() reliera aveuglément les deux observations par une ligne droite continue, dissimulant complètement le vide de mesure de deux semaines. Le diagnostic préventif de ces failles structurelles requiert l’usage de la fonction complete() de la bibliothèque tidyr, qui regénère l’intégralité du maillage chronologique à pas constant et injecte explicitement les valeurs NA requises pour préserver l’intégrité sémiotique du tracé.
9.2 Stratégies d’imputation et impact sur la dynamique tracée
Face à des séries chronologiques fragmentées par des valeurs manquantes, l’analyste peut être contraint d’appliquer des méthodes d’imputation numérique pour rétablir une trajectoire continue avant d’engager des modélisations spectrales ou autorégressives. Les approches mathématiques varient de la simple interpolation linéaire d’ordre un aux ajustements par splines cubiques ou modèles d’état-espace de type Kalman, mobilisables sous la bibliothèque spécialisée imputeTS.
D’un point de vue éthique et scientifique, toute valeur interpolée ne saurait être présentée au lecteur sous la même forme graphique qu’une mesure empirique réelle. Une bonne pratique méthodologique consiste à générer une colonne factorielle de statut (« Observé » versus « Imputé ») lors de la phase de reconstruction des données. Cette typologie est ensuite transmise à l’esthétique graphique de ggplot2 via le paramètre aes(linetype = statut, color = statut).
Cette distinction permet de superposer les segments interpolés en pointillés discrets ou sous une couleur différenciée, tandis que les données réelles sont tracées en traits pleins rehaussés de points discrets. Cette transparence visuelle prévient toute surinterprétation des segments reconstruits : le lecteur discerne immédiatement les zones où la dynamique reflète une observation directe de celles où elle découle d’une hypothèse de lissage mathématique.
9.3 Séries temporelles irrégulièrement espacées
De nombreux protocoles d’échantillonnage ne répondent pas à une grille calendaire régulière : protocoles de médecine ambulatoire recueillant des données lors d’épisodes symptomatiques aléatoires, études comportementales fondées sur l’échantillonnage de l’expérience, ou transactions de marché haute fréquence déclenchées par des flux d’ordres asynchrones. Ces chronologies à pas variable soulèvent des défis de représentation spécifiques.
Tracer de telles séries sous la forme d’une ligne continue peut donner l’illusion d’une régularité de processus là où l’intervalle d’acquisition est hautement instable. Pour les variables d’état qui restent constantes par paliers jusqu’à l’enregistrement d’une nouvelle valeur (comme un niveau de posologie médicale ou un prix d’équilibre de carnet d’ordres), le recours à la primitive geom_step() constitue le choix géométrique le plus rigoureux. Contrairement à geom_line() qui interpole une pente entre deux états, geom_step() trace un segment horizontal constant suivi d’une transition verticale instantanée au moment exact de l’observation suivante, traduisant fidèlement la dynamique du phénomène.
La combinaison de ce tracé en escalier avec une couche de points explicites via geom_point() permet de visualiser simultanément la stabilité de l’état mesuré et les instants discrets d’acquisition. Par ailleurs, la modulation de l’espacement des graduations temporelles au moyen de scale_x_date() doit être ajustée pour tenir compte de cette hétérogénéité, en veillant à ce que les axes ne masquent pas les alternances de phases de forte densité et de silences d’échantillonnage.
10. Interactivité et dynamisation graphique des séries chronologiques
10.1 Conversion immédiate vers le Web interactif avec plotly
Si la figure statique demeure le format de référence pour les publications imprimées traditionnelles, la diffusion des travaux scientifiques sur les plateformes numériques et les rapports reproductibles bénéficie grandement de l’interactivité. La bibliothèque plotly s’est imposée comme une passerelle d’extension naturelle grâce à sa fonction ggplotly(), capable de convertir un objet graphique ggplot2 statique en une interface web interactive riche basée sur le standard JavaScript.
Cette conversion préserve l’intégralité du travail de composition préalable tout en y adjoignant des fonctionnalités d’exploration dynamique. L’utilisateur peut ainsi faire glisser son curseur sur la série temporelle pour faire apparaître une infobulle (tooltip) affichant la date exacte et la valeur précise de chaque observation. L’argument tooltip au sein de ggplotly() permet de personnaliser le contenu informationnel de ces cartouches textuelles, par exemple pour y intégrer des variables secondaires ou des identifiants d’échantillons sans encombrer la lisibilité globale de la figure.
L’interface interactive offre également des fonctions de recadrage par sélection rectangulaire (box zoom), de translation temporelle le long de l’axe horizontal (pan) et de réinitialisation automatique du champ d’observation par double-clic. Cette flexibilité s’avère particulièrement utile lors de la présentation de chronologies très denses s’étendant sur plusieurs décennies, permettant au lecteur d’appréhender d’abord la tendance séculaire globale avant de zoomer sur un trimestre particulier pour en analyser les micro-fluctuations.
10.2 Visualisations temporelles haute performance avec dygraphs
Lorsque les volumes d’enregistrement atteignent des centaines de milliers, voire des millions de points de mesure (comme dans les flux de télémétrie de capteurs industriels ou les données financières haute fréquence), les moteurs de rendu fondés sur le standard vectoriel SVG montrent leurs limites de performance. Dans ce contexte de données massives, le package dygraphs, interfaçant la bibliothèque JavaScript éponyme, offre une solution graphique optimisée pour les flux chronologiques à haute densité.
La bibliothèque dygraphs requiert que les données soient préalablement structurées sous la forme d’un objet de série temporelle extensible de classe xts. Grâce à son moteur de rendu basé sur l’élément Canvas HTML5, elle garantit une fluidité de manipulation et de rafraîchissement visuel même en présence de jeux de données massifs qui satureraient les capacités de rendu d’un navigateur standard.
Parmi ses fonctionnalités distinctives figure l’intégration d’un sélecteur d’intervalle temporel inférieur (range selector). Activé par une simple ligne de commande, ce sélecteur place au bas du tracé principal une vue miniature panoramique de l’ensemble de la série surmontée de deux poignées coulissantes interactives. L’utilisateur peut ainsi moduler intuitivement la fenêtre d’observation principale tout en conservant une vision d’ensemble du profil chronologique global.
11. Cas pratiques appliqués : Du protocole expérimental à la figure scientifique
11.1 Cas 1 : Suivi longitudinal d’un indicateur continu en recherche
Pour ancrer ces concepts dans la pratique du laboratoire, examinons un premier cas pratique simulant un protocole de recherche clinique appliquée : le suivi longitudinal de la concentration d’un biomarqueur sérique au sein d’une cohorte d’individus suivis sur une période continue de douze semaines. Le modèle sous-jacent postule une trajectoire globale moyenne caractérisée par une décrue progressive sous l’effet d’un traitement, tout en intégrant une variabilité interindividuelle marquée et un bruit de mesure aléatoire gaussien.
La structuration du jeu de données synthétique fait appel à la fonction expand.grid() ou au verbe tidyr::expand() afin de croiser un vecteur de dates d’échantillonnage régulières avec un identifiant pour chaque sujet de l’étude. Le niveau de biomarqueur est ensuite calculé en combinant une trajectoire asymptotique moyenne décroissante, un décalage aléatoire propre à chaque individu tiré selon une loi normale centrée, et une composante résiduelle instantanée simulant les imprécisions instrumentales.
La composition de la figure scientifique finale fait appel à une superposition élégante : les courbes individuelles de chaque sujet sont tracées à l’aide de geom_line() sous une teinte grise discrète avec un fort degré de transparence (alpha = 0.3), matérialisant l’éventail de dispersion biologique interindividuelle sans focaliser l’attention. Par-dessus cette trame contextuelle, on superpose la trajectoire centrale d’ensemble ajustée au moyen d’un modèle non linéaire calculé par geom_smooth(method = « gam »), tracée en trait épais bleu nuit et encadrée de son intervalle de confiance à 95 %. L’application conjointe de theme_classic(), d’un formatage des dates au format abrégé en français via scale_x_date(), et de libellés d’axes rigoureux incluant les unités physiques conforme la figure aux standards de soumission des revues biomédicales internationales.
11.2 Cas 2 : Analyse d’une série chronologique avec rupture institutionnelle
Le second cas pratique relève de l’économétrie et de l’évaluation des politiques publiques à travers une analyse de série chronologique interrompue (interrupted time series design). L’objectif consiste à modéliser et visualiser l’évolution hebdomadaire d’un indicateur de fréquentation ou d’activité économique avant et après l’introduction brutale d’une réforme réglementaire, afin de quantifier visuellement à la fois le changement de niveau immédiat et la modification ultérieure de la pente de la tendance.
Le jeu de données reproduit un suivi étendu sur deux années pleines à raison d’un relevé par semaine. La date de l’intervention institutionnelle est fixée exactement au milieu de l’intervalle d’observation. La formulation mathématique simule une tendance linéaire d’évolution ascendante initiale, suivie au moment exact de l’intervention par un décrochage instantané vers le bas (changement de niveau) accompagné d’une inflexion de la pente ultérieure qui devient stagnante ou décroissante.
La représentation graphique s’édifie en segmentant la variable chronologique en deux périodes distinctes (« Avant réforme » et « Après réforme »). Au lieu d’ajuster une régression globale continue qui gommerait la rupture, on appelle la primitive geom_smooth(method = « lm », aes(group = periode)), ordonnant à R d’estimer et de tracer deux droites de régression indépendantes de part et d’autre du seuil. Une ligne verticale discontinue rouge est insérée via geom_vline() au point chronologique exact de la bascule institutionnelle, rehaussée d’une annotation textuelle descriptive positionnée grâce à la commande annotate(). Cette mise en page met en évidence le différentiel d’évolution induit par la politique publique et permet une interprétation univoque de l’effet d’intervention.
12. Diagnostic des erreurs fréquentes, optimisation et reproductibilité
12.1 Résolution des pièges techniques récurrents sous R
Même les praticiens confirmés de R se heurtent régulièrement à des comportements inattendus lors de la construction de visualisations temporelles. L’un des pièges les plus universels réside dans l’omission de la conversion explicite de la variable temporelle vers la classe Date ou POSIXct. Lorsqu’un vecteur de dates importé reste stocké sous la forme d’un simple facteur ou d’une chaîne de caractères alphabétiques, le moteur de ggplot2 traite l’abscisse comme une variable ordinale discrète : les points d’observation sont répartis à équidistance spatiale sans tenir compte des écarts réels de temps qui les séparent, et l’ordre d’affichage suit la collation lexicographique plutôt que la flèche du temps chronologique. Le diagnostic de cette erreur s’effectue immédiatement en inspectant le type de la variable à l’aide de l’instruction class(donnees$date).
Un autre désordre géométrique déconcertant survient lors de la confusion entre la primitive geom_line() et la primitive geom_path(). Tandis que geom_line() prend soin d’ordonner automatiquement les observations selon l’ordre croissant de l’axe des abscisses avant de tracer les segments reliant les points, geom_path() relie quant à elle les données selon leur ordre séquentiel exact d’apparition dans le tableau de données d’origine. Si le tableau n’a pas été rigoureusement trié par ordre chronologique préalable au moyen de l’instruction dplyr::arrange(date), l’appel à geom_path() produit un gribouillage inextricable de lignes revenant en arrière dans le temps.
Enfin, la gestion des fuseaux horaires (time zones) recèle des pièges d’autant plus insidieux qu’ils sont souvent invisibles à l’œil nu lors d’une inspection superficielle. Lors de l’utilisation conjointe de fonctions de conversion de bas niveau et de fonctions d’agrégation temporelle, une mauvaise interprétation du décalage UTC peut conduire au glissement systématique de l’horodatage de quelques heures. Pour une série quotidienne, ce décalage horaire invisible peut suffire à faire basculer artificiellement l’enregistrement au jour calendaire précédent ou suivant, faussant l’alignement des repères de graduation d’un jour entier. Il convient dès lors de spécifier explicitement le fuseau de référence lors de chaque conversion ou parsing temporel.
12.2 Exportation vectorielle et standards de reproductibilité computationnelle
L’aboutissement de toute recherche scientifique réside dans l’exportation et l’intégration de figures graphiques de haute qualité au sein des manuscrits finaux. L’environnement ggplot2 met à disposition la fonction dédiée ggsave(), conçue pour décharger l’analyste des contraintes d’ouverture et de fermeture manuelles de périphériques graphiques virtuels (tels que pdf() ou png()).
Pour les figures destinées à l’impression typographique ou à la mise en page sous des moteurs de composition scientifique comme LaTeX, le recours exclusif aux formats vectoriels (PDF ou SVG) est fortement préconisé. Contrairement aux images matricielles constituées d’une grille finie de pixels, le tracé vectoriel encode chaque ligne, courbe, texte et point sous forme d’instructions géométriques scalaires mathématiques, garantissant une netteté absolue et une absence totale de pixellisation, quel que soit le facteur d’agrandissement lors de l’impression finale. Pour les besoins du web ou des supports imposant des formats d’image matriciels (PNG, TIFF), il est impératif de calibrer la résolution de rendu à un seuil d’au moins 300 points par pouce (dpi = 300) pour préserver la netteté des plus fines inscriptions de l’axe temporel.
La reproductibilité computationnelle exige enfin que les dimensions physiques d’affichage soient figées directement dans le code source d’exportation (arguments width, height et units au sein de ggsave(), par exemple en fixant une largeur de 16 centimètres pour une hauteur de 9 centimètres) plutôt que redimensionnées manuellement à la souris dans l’interface de développement intégré. De surcroît, la fixation explicite des graines de générateurs pseudo-aléatoires au moyen de set.seed() lors de l’usage de simulations, et l’archivage rigoureux des versions des packages au sein d’un environnement de gestion des dépendances tel que renv, garantissent que le tracé graphique pourra être réexécuté et répliqué à l’identique au fil des années, répondant ainsi aux plus hauts standards de la science ouverte et vérifiable.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Box, G. E., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons.
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S., McGill, M. E., & McGill, R. (1988). The shape parameter of a two-variable graph. Journal of the American Statistical Association, 83(402), 289–300. https://doi.org/10.1080/01621459.1988.10478600
- Grolemund, G., & Wickham, H. (2011). Dates and times made easy with lubridate. Journal of Statistical Software, 40(3), 1–25. https://doi.org/10.18637/jss.v040.i03
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0
- Zeileis, A., & Grothendieck, G. (2005). zoo: S3 infrastructure for regular and irregular time series. Journal of Statistical Software, 14(6), 1–27. https://doi.org/10.18637/jss.v014.i06