
La modélisation stochastique des durées de vie, des temps d’attente et des intervalles inter-événements constitue un pilier fondamental de l’analyse statistique moderne, trouvant des applications cruciales tant en ingénierie de la fiabilité qu’en neurosciences computationnelles, en économétrie ou en psychologie expérimentale. Au cœur de cette modélisation se trouve la distribution exponentielle, loi continue caractérisée par sa remarquable simplicité analytique et sa propriété unique d’absence de mémoire. Comprendre la dynamique géométrique et probabiliste de cette distribution nécessite non seulement une maîtrise de ses fondements mathématiques rigoureux, mais également une capacité à la représenter visuellement de manière fidèle, élégante et reproductible au sein d’environnements computationnels dédiés.
Le logiciel d’analyse statistique et de programmation vectorielle R s’est imposé comme l’étalon-or international pour l’exploration quantitative des données et la communication graphique de haut niveau scientifique. Grâce à son moteur graphique natif d’une extraordinaire précision conceptuelle et à l’avènement de paradigmes modernes portés par le métapaquetage du tidyverse et la grammaire des graphiques de ggplot2, R offre aux chercheurs et aux analystes un spectre complet d’outils pour disséquer, visualiser et comparer des modèles théoriques continus avec des distributions empiriques observées sur le terrain expérimental.
Cet article propose une exploration encyclopédique, théorique et appliquée de la visualisation graphique de la distribution exponentielle dans l’environnement R. À travers l’examen approfondi des fonctions de densité, de répartition, de survie, des quantiles et des graphiques de diagnostic diagnostique, ce guide détaille pas à pas les instructions syntaxiques, les choix de paramétrisation, les nuances d’interprétation et les standards éditoriaux de publication scientifique requis pour traduire avec une rigueur absolue la morphologie de cette loi de probabilité majeure.
1. Fondements théoriques et mathématiques de la loi exponentielle
1.1 Définition formelle et fonction de densité de probabilité (PDF)
La loi exponentielle est une distribution de probabilité continue principalement employée pour modéliser le temps écoulé jusqu’à la survenue d’un événement donné, au sein d’un processus ponctuel homogène dit processus de Poisson. Sur le plan formel, une variable aléatoire continue notée majuscule X suit une loi exponentielle paramétrée par un taux strictement positif, généralement désigné par la lettre grecque lambda (λ). Le domaine de définition ou support de cette distribution est strictement confiné à l’ensemble semi-infini des réels positifs ou nuls, c’est-à-dire l’intervalle fermé à gauche [0, +∞). Toute valeur strictement négative possède une densité rigoureusement nulle, reflétant l’impossibilité temporelle d’observer des durées de transition négatives.
La formulation analytique exacte de la fonction de densité de probabilité, communément abrégée sous l’acronyme PDF pour Probability Density Function, s’exprime mathématiquement pour toute valeur positive de x par la relation suivante : f(x; λ) = λ e^(-λx). Pour toute valeur de x inférieure à zéro, la fonction prend la valeur f(x; λ) = 0. Dans cette équation, le paramètre de taux λ gouverne intégralement la pente de décroissance de la courbe exponentielle ainsi que son ordonnée à l’origine. En effet, lorsque la variable x tend vers zéro par valeurs positives, la densité atteint son point culminant maximal précisément égal à la valeur de λ. Ainsi, une augmentation substantielle de λ engendre simultanément une élévation abrupte de la valeur initiale à l’origine et une contraction sévère de la distribution vers les faibles valeurs, caractérisée par une chute verticale vertigineuse de la queue de probabilité.
Sur le plan fondamental de la théorie de la mesure, la fonction de densité satisfait scrupuleusement la condition sine qua non d’intégrabilité unitaire sur son support. L’intégrale définie de la fonction f(x; λ) évaluée entre zéro et l’infini positif équivaut rigoureusement à l’unité. Cette propriété géométrique implique que l’aire totale délimitée sous la courbe de densité et l’axe des abscisses représente l’espace probabiliste complet. Sur le plan des moments statistiques fondamentaux, la loi exponentielle se distingue par une relation déterministe stricte entre son premier moment centré et sa dispersion. L’espérance mathématique, représentant la moyenne théorique du temps d’attente, est exactement égale à l’inverse arithmétique du paramètre de taux, soit E(X) = 1/λ. De manière analogue, la variance, quantifiant l’écartement quadratique moyen autour de cette espérance, est formulée par Var(X) = 1/λ², d’où il découle que l’écart-type théorique est rigoureusement identique à l’espérance, c’est-à-dire σ(X) = 1/λ. Cette égalité structurelle entre la moyenne et l’écart-type constitue une signature d’identification empirique primordiale lors des phases exploratoires de modélisation.
1.2 Fonction de répartition cumulative (CDF) et fonction de survie
La compréhension dynamique de la loi exponentielle exige l’étude conjointe de sa fonction de répartition cumulative, désignée sous l’appellation CDF pour Cumulative Distribution Function. Par définition, la fonction de répartition notée F(x; λ) associe à tout seuil réel x la probabilité intégrée que la variable aléatoire X prenne une valeur inférieure ou égale à cette borne, traduisant l’événement probabiliste P(X ≤ x). L’obtention de cette fonction s’effectue par l’intégration de la fonction de densité de probabilité depuis l’origine jusqu’au point d’évaluation x. Le calcul de la primitive de λ e^(-λu) conduit immédiatement à l’expression analytique exacte : F(x; λ) = 1 – e^(-λx) pour tout x supérieur ou égal à zéro. Cette trajectoire monotone strictement croissante démarre précisément à l’origine avec la valeur 0 et progresse de manière concave en direction de l’asymptote horizontale d’ordonnée 1 lorsque x croît indéfiniment vers l’infini positif.
Dans de nombreux champs méthodologiques orientés vers l’analyse de survie biomédicale, l’ingénierie prédictive de défaillance des systèmes industriels ou l’étude des temps de réaction cognitifs, l’attention se porte préférentiellement sur la fonction complémentaire de la CDF, universellement désignée comme la fonction de survie ou fonction de fiabilité, notée S(x) ou R(x). Cette fonction modélise la probabilité qu’un système, un individu ou un stimulus conserve son état opérationnel au-delà d’un temps critique x. Mathématiquement, elle s’énonce par la différence complémentaire unitaire S(x) = P(X > x) = 1 – F(x; λ) = e^(-λx). Cette formulation particulièrement épurée met en évidence le déclin purement géométrique de la probabilité résiduelle en fonction du temps écoulé.
Cette structure analytique confère à la distribution exponentielle une propriété probabiliste unique parmi l’ensemble des lois continues : l’absence totale de mémoire, ou amnésie stochastique. Énoncée formellement à travers les probabilités conditionnelles, cette propriété garantit que pour tous réels strictement positifs s et t, la condition suivante est rigoureusement vérifiée : P(X > s + t | X > s) = P(X > t). En d’autres termes, le fait qu’un composant ou qu’un processus ait déjà survécu ou attendu pendant une durée préalable s n’altère en aucune manière la distribution probabiliste du temps résiduel d’attente t avant la survenue de l’événement terminal. Le système se comporte à chaque instant infinitésimal comme s’il était neuf, dépourvu de tout vieillissement physique, de fatigue mécanique ou d’accumulation de latence comportementale. Cette caractéristique explique pourquoi la modélisation exponentielle s’avère hautement pertinente pour des événements survenant sous l’effet de chocs aléatoires externes exogènes, mais totalement inappropriée pour décrire des processus biologiques ou mécaniques soumis à une dégradation endogène temporelle cumulative.
1.3 Distinction cruciale entre paramètre d’échelle et paramètre de taux
L’une des sources majeures d’ambiguïté conceptuelle, d’erreurs computationnelles et de divergences entre logiciels statistiques réside dans l’existence de deux formulations canoniques pour paramétrer la distribution exponentielle : la paramétrisation par le taux et la paramétrisation par l’échelle. La première approche, privilégiée de manière universelle au sein de l’environnement de programmation R, emploie le taux λ, désigné par le terme anglophone rate. Dans cette optique, l’unité de mesure de λ est l’inverse d’une unité temporelle, par exemple le nombre d’occurrences par seconde ou par heure. À l’opposé, d’autres plateformes analytiques telles que Matlab, le package SciPy de Python ou certains logiciels d’ingénierie industrielle adoptent préférentiellement le paramètre d’échelle, fréquemment symbolisé par la lettre grecque bêta (β) ou le terme scale, qui est défini comme l’inverse strict du taux, soit β = 1/λ. Dans cette seconde convention, le paramètre d’échelle s’exprime directement dans l’unité physique de la variable observée, traduisant de facto l’espérance mathématique de la distribution.
Les conséquences computationnelles et graphiques d’une méprise entre ces deux paradigmes paramétriques sont considérables. Si un chercheur exploitant l’écosystème R introduit un argument numérique destiné à représenter une échelle temporelle moyenne en omettant d’en prendre l’inverse arithmétique, la courbe de densité générée subira une déformation morphologique catastrophique. Par exemple, si l’on souhaite modéliser des temps de latence cognitive présentant une moyenne de 200 millisecondes, le paramètre de taux correct à déclarer dans R est λ = 1 / 200 = 0.005. Si l’analyste renseigne par inadvertance la valeur 200 en guise d’argument de taux, R produira une fonction de densité s’effondrant verticalement avec une ordonnée à l’origine de 200 et devenant indiscernable de zéro dès une fraction infinitésimale de milliseconde, corrompant irrémédiablement l’échelle visuelle du graphique.
Le tableau comparatif suivant synthétise les équivalences théoriques et les désignations employées afin de prémunir le statisticien contre toute confusion lors du codage informatique :
- Paramétrisation par le taux (Convention R) : Paramètre noté λ (rate). Densité : f(x) = λ e^(-λx). Espérance : 1/λ. Utilisation dans R : argument explicite
rate = lambda. - Paramétrisation par l’échelle (Convention alternative) : Paramètre noté β ou θ (scale). Densité : f(x) = (1/β) e^(-x/β). Espérance : β. Conversion nécessaire pour R : spécifier
rate = 1/beta.
Cette standardisation impérative implique qu’avant tout tracé graphique ou ajustement inférentiel dans R, l’analyste doit formellement vérifier la nature dimensionnelle des coefficients manipulés afin de garantir la concordance stricte entre les hypothèses probabilistes sous-jacentes et le moteur d’évaluation numérique.
2. L’écosystème R pour la distribution exponentielle
2.1 La famille des fonctions exponentielles natives : dexp, pexp, qexp, rexp
L’architecture interne du langage R intègre de manière native un ensemble hautement optimisé de quatre fonctions élémentaires dédiées à la manipulation sous tous ses aspects de la loi exponentielle. Cet ensemble respecte la nomenclature canonique préfixée mise en place dès les premières versions du langage S, dans laquelle une lettre initiale descriptive est systématiquement apposée devant le radical désignant la distribution, à savoir exp. Cette symétrie d’implémentation offre une cohérence fonctionnelle absolue, garantissant à l’utilisateur une transition transparente entre le calcul des densités locales, l’intégration cumulative des probabilités, l’inversion quantile et la génération de nombres pseudo-aléatoires pour la simulation de Monte-Carlo.
La première composante de cette famille est la fonction dexp(), dont le préfixe d renvoie à l’évaluation de la densité de probabilité (density). Prenant comme argument principal un vecteur de coordonnées réelles positives et un paramètre de taux rate, cette fonction calcule la hauteur théorique instantanée de la courbe de densité f(x; λ) en chaque point spécifié. Elle constitue le fondement computationnel sur lequel repose le tracé des courbes de distribution continue dans les systèmes graphiques de base ou avancés. La seconde fonction, pexp(), correspond au calcul des probabilités cumulées (probability), matérialisant l’évaluation numérique exacte de l’intégrale F(x; λ). Elle accepte des options additionnelles fondamentales telles que lower.tail = TRUE par défaut pour évaluer P(X ≤ x), ou lower.tail = FALSE pour calculer instantanément la probabilité de survie complémentaire P(X > x) avec une précision arithmétique supérieure à celle d’une simple soustraction manuelle.
La troisième fonction, qexp(), implémente la fonction quantile théorique, correspondant à la réciproque formelle ou inverse fonctionnelle de la fonction de répartition. Prenant en entrée des probabilités comprises rigoureusement dans l’intervalle semi-ouvert [0, 1), elle calcule les valeurs scalaires des abscisses associées aux percentiles désirés, résolvant analytiquement l’équation x = -ln(1 – p) / λ. Elle s’avère indispensable pour positionner des repères verticaux représentant la médiane théorique ou des intervalles de confiance précis sur des figures scientifiques. Enfin, la fonction rexp() matérialise le générateur de nombres pseudo-aléatoires (random generation), permettant d’extraire des échantillons i.i.d. (indépendants et identiquement distribués) selon une loi exponentielle de taux spécifié. Utilisant l’algorithme d’inversion directe ou des méthodes de rejet accélérées, cette routine constitue le socle des expérimentations numériques et des comparaisons graphiques entre profils théoriques et données synthétiques simulées.
2.2 Configuration de l’environnement de travail et reproductibilité
La production d’illustrations graphiques de niveau professionnel publiables dans des revues scientifiques à comité de lecture exige une structuration rigoureuse de la session de travail sous R, plaçant la reproductibilité algorithmique au premier rang des exigences techniques. Lorsqu’une figure intègre des données générées de manière pseudo-aléatoire via rexp(), la variabilité stochastique inhérente au générateur de congruence linéaire ou de Mersenne-Twister peut altérer la morphologie précise des histogrammes d’un rendu à l’autre. Il est donc impératif d’initialiser explicitement la graine computationnelle à l’aide de la primitive set.seed(), en sélectionnant un entier fixe arbitraire. Cette démarche assure que toute personne réexécutant le script obtiendra une superposition visuelle strictement identique à l’originale.
Au-delà de la graine aléatoire, la précision du tracé continu dépend de la discrétisation spatiale du vecteur d’évaluation sous-jacent. L’utilisation conjointe de la fonction seq() permet de configurer des grilles d’abscisses à haute résolution. En fixant un pas d’incrémentation extrêmement fin ou en requérant un grand nombre de points d’interpolation, par exemple au moyen de l’argument length.out = 1000, l’analyste s’assure que le tracé restituera fidèlement la courbure exponentielle abrupte localisée aux abords de l’origine sans faire apparaître d’artefacts polygonaux ou de segments brisés visibles à l’œil nu.
Enfin, la maîtrise de l’environnement graphique de base impose une gestion fine des paramètres typographiques et spatiaux globaux au moyen de la fonction par(). Cette fonction centrale permet d’ajuster les marges intérieures du canevas graphique exprimées en lignes de texte via l’argument vectoriel mar = c(bas, gauche, haut, droite), d’harmoniser la taille relative des polices vectorielles avec cex.axis, cex.lab et cex.main, et de configurer la boîte délimitant l’espace cartésien à l’aide de bty = « l » afin de respecter les critères esthétiques épurés prescrits par les manuels de style éditoriaux internationaux tels que les normes de l’American Psychological Association (APA).
3. Tracer la fonction de densité de probabilité (PDF) avec le moteur R de base
3.1 Utilisation de la fonction curve() pour une représentation directe
Pour matérialiser instantanément la morphologie d’une distribution exponentielle sans devoir instancier préalablement de structures de données vectorielles en mémoire, le moteur graphique standard de R met à disposition la fonction hautement expressive curve(). Cette routine prend comme premier argument une expression algébrique univariée dépendant d’une variable formelle notée textuellement x. Le moteur graphique évalue de manière dynamique cette expression sur un continuum déterminé par les arguments obligatoires from et to, calculant automatiquement un maillage régulier de coordonnées cartésiennes et traçant la ligne correspondante dans le périphérique actif.
Pour tracer la fonction de densité de probabilité d’une loi exponentielle ayant un paramètre de taux λ fixé à 0.5 sur l’intervalle temporel allant de 0 à 10 unités arbitraires, la syntaxe fondamentale prend la forme curve(dexp(x, rate = 0.5), from = 0, to = 10). Par défaut, la fonction optimise l’ordonnée maximale en positionnant le sommet à 0.5 sur l’axe des ordonnées. Néanmoins, pour hisser le graphique au rang de figure scientifique, une paramétrisation esthétique avancée s’impose. L’argument lwd = 2.5 garantit une épaisseur de trait assurant une excellente visibilité lors de la conversion du tracé en format vectoriel ou matriciel haute résolution. Le choix d’une teinte chromatique contrastée via col = « navyblue » ou un code hexadécimal renforce l’impact visuel.
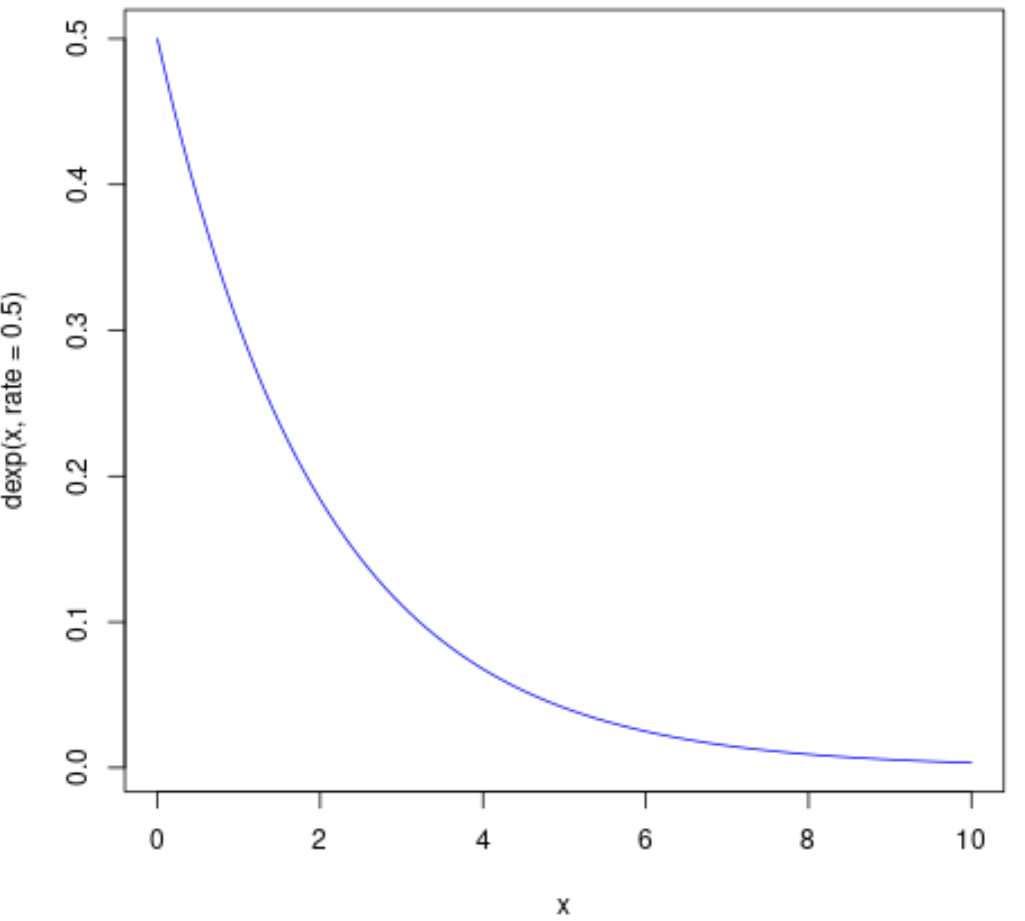
De surcroît, le raffinement des étiquettes textuelles périphériques requiert une attention particulière. Il convient de neutraliser les libellés génériques automatisés de R en spécifiant explicitement xlab = « Temps d’attente (t) » et ylab = « Densité de probabilité f(t) », complétés par un intitulé formel à l’aide de l’argument main = « Fonction de densité de probabilité exponentielle (λ = 0.5) ». La fonction curve() constitue le vecteur d’exploration préliminaire le plus ergonomique et le plus rapide pour vérifier les propriétés asymétriques d’une distribution sans encombrer l’espace de travail global d’objets intermédiaires éphémères.
3.2 Approche alternative vectorielle avec plot() et lines()
Bien que la fonction curve() offre une concision appréciable, l’approche vectorielle reposant sur la combinaison classique des primitives plot() et lines() demeure la méthode de référence pour le praticien chevronné souhaitant exercer un contrôle déterministe absolu sur la chaîne de traitement graphique. Cette méthodologie repose sur une dissociation conceptuelle claire entre deux étapes computationnelles : d’une part, l’échantillonnage discret d’un domaine mathématique continu dans un vecteur numérique explicite, et d’autre part, la projection cartésienne de ces coordonnées appariées.
La première étape s’exécute par la création d’un vecteur d’abscisses au moyen de l’instruction x_vals <- seq(0, 8, length.out = 1000). La sélection d’un millier de coordonnées équidistantes permet de capturer avec une fluidité géométrique irréprochable la courbure vertigineuse qui caractérise la transition de la fonction exponentielle à proximité immédiate de l’ordonnée à l’origine. Ensuite, l’analyste génère le vecteur des densités théoriques correspondantes via l’appel vectorisé y_vals <- dexp(x_vals, rate = 0.8). L’ossature graphique initiale est alors matérialisée par l’invocation de plot(x_vals, y_vals, type = « l », lwd = 2, col = « darkgreen », …), où la spécification impérative de l’argument type = « l » intime au moteur graphique l’ordre de relier l’ensemble des points consécutifs par des segments continus plutôt que de projeter des glyphes ponctuels individuels.
Cette approche vectorielle déploie toute sa puissance fonctionnelle lorsqu’il devient nécessaire d’adjoindre des segments graphiques complémentaires ou d’insérer ultérieurement des éléments morphologiques interactifs via la primitive complémentaire lines(). Contrairement à plot() qui réinitialise intégralement le canevas en écrasant les tracés préexistants, lines() opère par surimpression directe sur la fenêtre de visualisation active. Cette modularité permet de partitionner le script en blocs logiques distincts, facilitant le calcul préalable de seuils d’optimisation complexes, l’intégration de séries temporelles superposées ou la gestion conditionnelle de tracés adaptatifs au sein de boucles de traitement itératives complexes.
3.3 Mise en valeur des zones critiques et calcul d’aires sous la courbe
La communication statistique exige fréquemment de rendre visuellement palpables des concepts théoriques abstraits tels que la probabilité cumulée associée à un intervalle temporel donné, la position exacte de l’espérance mathématique ou le franchissement de seuils percentiles critiques. Pour parvenir à une telle mise en relief au sein du moteur graphique de base de R, la commande primitive polygon() constitue l’instrument d’ombrage géométrique par excellence. Cette fonction permet de délimiter et de remplir d’une teinte chromatique ou de hachures régulières un périmètre polygonal défini par une séquence ordonnée de coordonnées bidimensionnelles fermées.
Supposons que l’analyste cherche à visualiser la probabilité théorique qu’une variable exponentielle de taux λ = 0.5 soit comprise dans l’intervalle spécifique [1, 3]. La procédure consiste à extraire un sous-vecteur d’abscisses restreint à ce segment, à évaluer ses ordonnées via dexp(), puis à fermer artificiellement la structure géométrique en adjoignant les points d’ancrage situés sur l’axe des abscisses aux bornes d’évaluation. L’appel à polygon(c(1, x_zone, 3), c(0, y_zone, 0), col = rgb(0.2, 0.4, 0.8, 0.4), border = NA) génère alors un aplat translucide du plus bel effet sous la courbe de densité. L’utilisation du format de couleur avec canal alpha transparent via la fonction rgb() empêche l’occultation des axes ou des grilles de repérage sous-jacents.
Parallèlement au remplissage des aires probabilistes, l’enrichissement sémantique du tracé s’effectue par l’adjonction de marqueurs verticaux désignant les paramètres centraux de la loi. L’instruction abline(v = 1/lambda, col = « red », lty = 2, lwd = 1.5) permet de tracer la ligne en pointillé marquant l’espérance mathématique théorique, tandis que abline(v = log(2)/lambda, col = « darkorange », lty = 3, lwd = 1.5) positionne la médiane théorique. Pour parachever la lisibilité didactique, des annotations textuelles ciblées sont inscrites dans le corps même du graphique grâce à l’instruction text(), positionnant des descriptions succinctes à des coordonnées cartésiennes judicieusement choisies pour éviter tout chevauchement graphique préjudiciable à la clarté d’interprétation.
4. Superposition et comparaison de multiples densités exponentielles
4.1 Superposition technique de courbes avec l’argument add = TRUE
L’exploration analytique de la sensibilité d’un modèle statistique requiert presque invariablement la juxtaposition directe de plusieurs configurations paramétriques au sein d’un repère cartésien unifié. Pour comparer visuellement la dynamique de déclin temporel associée à différentes intensités stochastiques λ, R propose une mécanique d’itération graphique directe grâce à l’argument logique add = TRUE au sein de la fonction native curve(). Cette directive instruit le moteur de rendu de conserver la fenêtre cartésienne préalablement initialisée et de projeter la nouvelle courbe théorique sur le plan préexistant sans réinitialiser les axes gradués.
La mise en œuvre technique de cette superposition impose une vigilance mathématique aiguë lors de la construction du tracé initial de référence. La première courbe invoquée sans l’argument d’addition dicte de manière irrévocable les limites dimensionnelles de la boîte graphique, matérialisées par les intervalles xlim et surtout ylim. Si l’analyste trace en premier lieu une densité dotée d’un taux faible tel que λ = 0.5, l’ordonnée maximale calibrée automatiquement par R avoisinera 0.5. Si l’on tente d’ajouter subséquemment une courbe caractérisée par un paramètre λ = 2.0, le pic initial de cette dernière, culminant à 2.0 à l’origine, subira une troncature drastique au niveau du bord supérieur de la figure. Pour neutraliser cet écueil récurrent, il est impératif d’évaluer a priori la valeur maximale parmi l’ensemble des taux comparés et de la déclarer explicitement lors de l’appel inaugural, par exemple via ylim = c(0, max(taux_vector)).
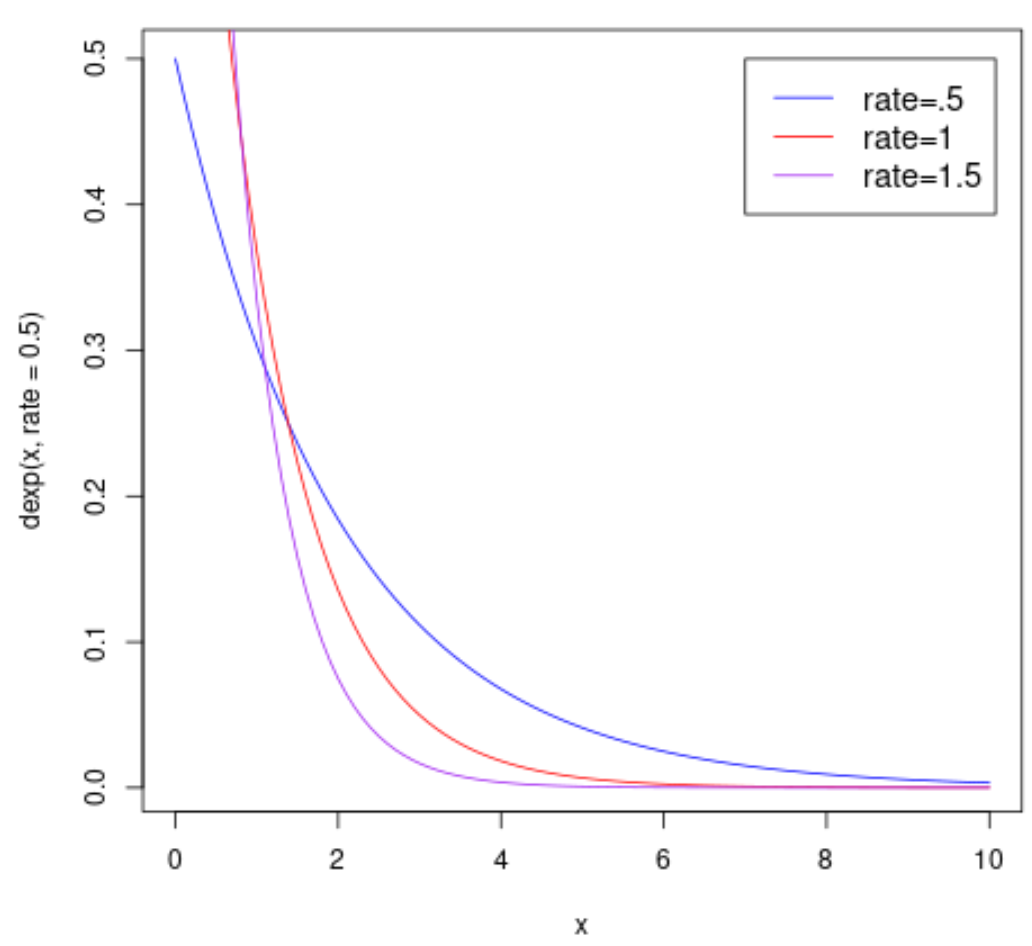
Pour assurer une discrimination perceptuelle parfaite entre les différentes trajectoires théoriques, particulièrement lorsque la figure est destinée à être reproduite sous forme imprimée ou en niveaux de gris, il est vivement recommandé de conjuguer deux vecteurs de différenciation sémiotique : le contraste chromatique et le style de trait. Ainsi, l’analyste associera à chaque valeur de λ une couleur distincte issue de palettes perceptuellement uniformes et un indicateur de type de ligne lty distinct, alternant par exemple entre le trait plein (lty = 1), le tireté long (lty = 2), le pointillé serré (lty = 3) et le tiret-point (lty = 4). Cette redondance visuelle garantit l’accessibilité universelle du graphique quelle que soit la modalité finale de restitution typographique.
4.2 Conception d’une légende scientifique rigoureuse
Une figure scientifique comparant de multiples distributions théoriques ne saurait prétendre à l’exhaustivité académique sans l’intégration d’une légende cartographique formelle répondant à des standards typographiques d’une extrême précision. Dans l’écosystème de base de R, la commande legend() constitue le réceptacle dédié à cette fonction. Son ancrage dans l’espace graphique peut s’effectuer de manière relative par l’emploi de mots-clés d’alignement géographique universels tels que « topright », « topleft » ou « bottomright », ou par l’indication directe de coordonnées cartésiennes absolues au format x, y pour un ajustement millimétrique.
La valeur ajoutée majeure de R réside dans sa capacité native à formater des expressions typographiques mathématiques complexes au moyen de la directive interne expression(), s’appuyant sur les conventions du moteur de composition mathématique formelle plotmath. Plutôt que de consigner de simples chaînes de caractères brutes telles que « lambda = 0.5 », l’analyste encodera scrupuleusement une séquence vectorielle d’expressions : legend_labels <- c(expression(lambda == 0.5), expression(lambda == 1.0), expression(lambda == 2.0)). Cette commande garantit la restitution typographique fidèle du symbole grec minuscule λ assorti d’un espacement typographique irréprochable conforme aux critères des maisons d’édition scientifiques internationales.
Par ailleurs, la configuration esthétique de la boîte de légende exige une synchronisation rigoureuse avec les paramètres physiques des courbes tracées. Les arguments col, lwd et lty de la légende doivent refléter en tout point les attributs géométriques attribués séquentiellement aux différentes fonctions de densité. L’argument cex = 0.85 permet d’ajuster l’échelle globale de la police de caractères afin de préserver l’équilibre visuel sans masquer les trajectoires de décroissance rapide dans le quadrant supérieur droit. Enfin, l’attribution de l’argument bty = « n » pour supprimer intégralement la bordure encadrant la légende, ou bty = « o » combiné à un fond opaque blanc via bg = « white », prévient toute collision visuelle disgracieuse avec les données cartésiennes d’arrière-plan.
5. Tracer la fonction de répartition cumulative (CDF) dans R de base
5.1 Représentation graphique de pexp()
L’observation isolée de la fonction de densité de probabilité dissimule fréquemment la cinétique globale d’accumulation des probabilités dans le temps, laquelle s’avère pourtant déterminante pour appréhender le comportement d’un système à long terme. Le tracé de la fonction de répartition cumulative via la primitive pexp() offre une perspective géométrique complémentaire indispensable. Contrairement à la densité qui converge inexorablement vers le néant à mesure que l’abscisse s’étire vers l’infini, la CDF amorce sa trajectoire au point d’origine rigoureusement nul (0,0) pour s’élever selon une trajectoire concave vers un seuil de saturation absolu représenté par l’asymptote horizontale d’ordonnée unitaire y = 1.
La mise en œuvre graphique de cette fonction s’exécute avec une remarquable fluidité au moyen de la syntaxe curve(pexp(x, rate = λ), from = 0, to = max_x, …). Dans ce contexte d’évaluation, le paramétrage du domaine d’observation longitudinal sur l’axe des abscisses revêt une importance capitale. Si l’intervalle sélectionné s’avère excessivement étriqué, le graphique échouera à mettre en lumière l’aplatissement asymptotique caractéristique vers 1.0, induisant l’observateur en erreur quant à la complétude du processus stochastique sous surveillance. Inversement, une échelle temporelle d’une amplitude disproportionnée contractera l’ensemble de la transition dynamique initiale dans un liseré vertical indéchiffrable collé à l’axe des ordonnées.
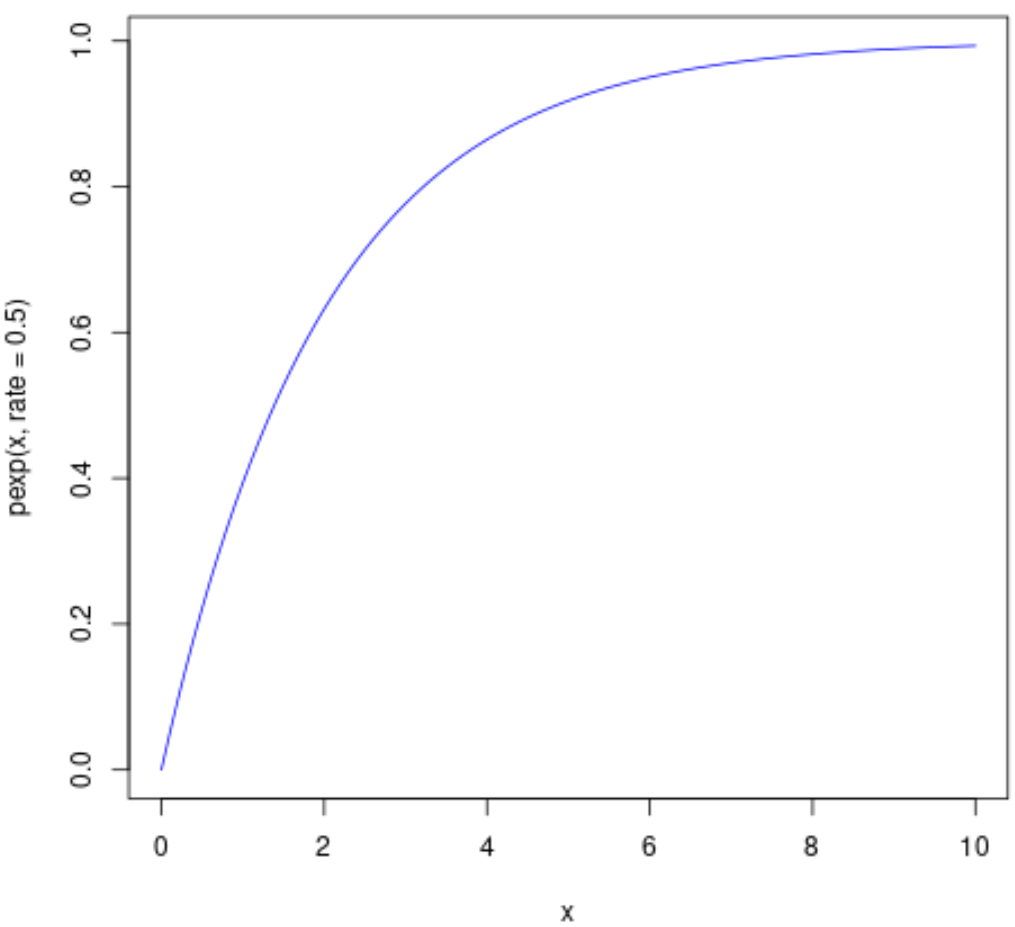
Pour matérialiser graphiquement le principe de fermeture probabiliste, il est hautement méthodique d’incorporer une ligne de démarcation asymptotique horizontale en invoquant la primitive abline(h = 1, lty = 2, col = « grey50 », lwd = 1.2). Cette démarcation discrète rappelle visuellement le plafond probabiliste indépassable régi par les axiomes fondamentaux de Kolmogorov. Sur le plan de l’interprétation expérimentale, cette figure permet d’appréhender d’un coup d’œil la vitesse de réalisation de l’événement terminal : par exemple, repérer l’abscisse correspondant à la valeur 0.5 sur l’axe vertical permet d’identifier visuellement la demi-vie ou médiane du processus, qui pour une loi exponentielle s’établit analytiquement à la coordonnée exacte ln(2) / λ ≈ 0.693 / λ.
5.2 Superposition de plusieurs fonctions de répartition
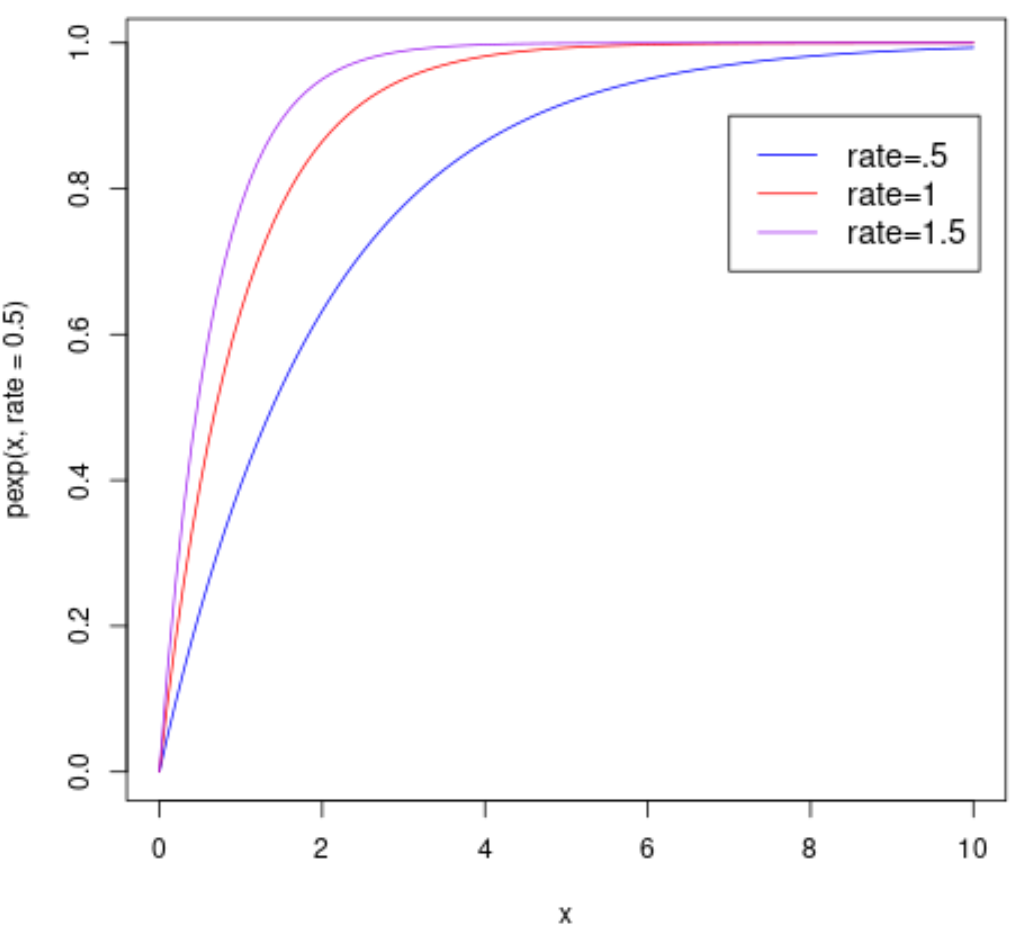
La comparaison multiparamétrique des fonctions de répartition cumulative constitue un exercice méthodologique crucial, en particulier lors de l’évaluation de la fiabilité différentielle entre divers matériels industriels ou de l’analyse comparative de la vitesse d’apprentissage entre cohortes expérimentales soumises à des protocoles de conditionnement distincts. En superposant les courbes issues de plusieurs valeurs croissantes du paramètre de taux λ, l’analyste met en lumière la disparité temporelle d’atteinte du plateau de saturation unitaire.
Une valeur élevée du taux λ engendre une courbe de répartition présentant une cambrure extraordinairement prononcée, atteignant quasi instantanément les percentiles de probabilité supérieurs à 90 %, matérialisant un processus où la quasi-totalité des défaillances ou des transitions comportementales se concentre dans les fractions initiales de l’observation. À l’inverse, un taux résiduel faible génère une rampe d’accumulation étirée, progressant lentement sur une vaste étendue temporelle avant de fléchir vers son asymptote. Cette superposition graphique s’exécute avec la même logique que celle décrite pour la densité, en initialisant un canevas principal délimité strictement par ylim = c(0, 1) et en déployant des appels itératifs successifs configurés avec add = TRUE.
Afin de structurer le fond cartésien et de faciliter la lecture croisée directe des quantiles sans exiger de l’observateur un effort d’extrapolation mentale complexe, l’intégration d’un quadrillage orthonormé s’impose. La primitive grid(), judicieusement paramétrée avec des arguments de discrétisation tels que nx = NULL et ny = NULL pour épouser automatiquement les graduations majeures des axes, projettera en arrière-plan une résille géométrique discrète sous forme de traits pointillés fins (lty = 3, col = « lightgray »). Cette pratique de mise en page garantit une efficacité d’extraction cognitive maximale lors de l’évaluation comparative des probabilités cumulées sur l’ensemble de la gamme paramétrique exposée.
6. Visualisation avancée de la loi exponentielle avec ggplot2
6.1 Architecture fondamentale de ggplot2 appliquée aux fonctions théoriques
Bien que le système graphique traditionnel de R offre une souplesse incontestable, la bibliothèque ggplot2, conçue par Hadley Wickham sur la base des principes formalisés par Leland Wilkinson dans son ouvrage fondateur The Grammar of Graphics, transcende la composition graphique en introduisant une abstraction déclarative de haut niveau. Dans ce paradigme, un graphique n’est plus envisagé comme une juxtaposition artisanale de primitives de dessin vectoriel sur une toile vierge, mais comme une articulation structurelle stricte reliant un ensemble de données sous-jacent, des représentations géométriques discrètes ou continues (geoms), des transformations statistiques (stats) et un système cartésien ordonné.
Pour matérialiser la fonction de densité de probabilité d’une loi exponentielle théorique dans l’écosystème ggplot2 sans recourir à l’injection préalable de tables massives de points discrétisés, l’analyste s’appuie sur la combinaison synergique de la couche de base ggplot() et de l’opérateur statistique stat_function(). L’instanciation de l’environnement graphique s’opère en fournissant un objet conteneur minimal délimitant le domaine de calcul sur l’abscisse : ggplot(data.frame(x = c(0, 8)), aes(x = x)). Cette directive installe le cadre esthétique fondamental sans charger de mémoire superflue.
L’adjonction de la composante géométrique continue s’exécute en greffant l’opérateur analytique via l’opérateur d’addition unaire : + stat_function(fun = dexp, args = list(rate = 0.5), color = « royalblue », linewidth = 1.2). Dans cette instruction épurée, le moteur interne de ggplot2 prend en charge de façon totalement transparente le calcul sous-jacent de l’échantillonnage numérique en subdivisant l’intervalle spécifié en une multitude de segments infinitésimaux réguliers. Le paramètre d’évaluation mathématique args transmet directement à la primitive dexp() le vecteur des paramètres analytiques requis. Cette architecture confère une extensibilité sans précédent, permettant d’associer en une seule expression déclarative le calcul mathématique, le calibrage automatique des dimensions spatiales et l’application d’un rendu lissé exempt du moindre artefact géométrique.
6.2 Génération simultanée de courbes multiples par structure ‘tidy’
Le plein potentiel descriptif de ggplot2 se manifeste avec éclat lorsqu’il s’agit de projeter simultanément une multiplicité de distributions exponentielles régies par différentes valeurs du paramètre λ. Pour s’inscrire harmonieusement dans la philosophie architecturale du tidyverse, la démarche d’excellence ne consiste pas à empiler séquentiellement des couches géométriques manuelles disparates, mais à structurer les données théoriques selon un modèle tabulaire longitudinal ou format long, universellement qualifié de structure tidy data.
La préparation computationnelle débute par l’orchestration d’une grille factorielle complète combinant un maillage dense de valeurs d’abscisses et le vecteur discret des paramètres de taux λ que l’on souhaite soumettre à l’analyse comparative. Cette opération s’effectue avec élégance via la combinaison de expand.grid() ou des fonctions modernes du package tidyr. Pour chaque combinaison croisée d’abscisse et de paramètre, la densité théorique correspondante est calculée de manière vectorisée au moyen de l’expression dexp(x, rate = lambda), consolidant l’ensemble des métriques au sein d’un tableau unique comportant trois colonnes dédiées : la coordonnée spatiale, l’identifiant paramétrique et la valeur d’intensité résultante.
Une fois cette table structurée transmise au constructeur ggplot(), l’analyste associe la dimension paramétrique à la couleur du tracé via le mappage esthétique aes(x = x, y = densite, color = factor(lambda), linetype = factor(lambda)). Dès cet instant, le moteur graphique automatise l’intégralité des opérations d’ingénierie visuelle : attribution ordonnée des nuances chromatiques selon des palettes perceptuellement optimisées, modulation synchronisée des motifs de tirets pour chaque courbe, et génération spontanée d’une légende contextuelle unifiée intégrant la variable catégorisée. Pour hisser la qualité visuelle aux standards des plus prestigieuses revues scientifiques, il suffit d’adjoindre des échelles spécialisées telles que scale_color_viridis_d(option = « D », end = 0.85) garantissant une lisibilité absolue même pour les lecteurs atteints de déficiences de la vision des couleurs, tout en convertissant les étiquettes de légende en notations mathématiques via l’argument labels = scales::parse_format().
6.3 Application des thèmes académiques stricts et standardisés
L’une des signatures visuelles caractéristiques de ggplot2 dans sa configuration d’origine réside dans la présence d’un fond d’écran teinté d’un gris neutre strié d’un quadrillage blanc dense. Bien que ce choix graphique initial ait été théorisé pour faciliter la localisation spatiale selon les préceptes de la théorie psychophysique de la perception des formes, les conventions éditoriales académiques internationales, notamment celles édictées par les comités de rédaction des revues de psychologie mathématique et de biostatistique, proscrivent catégoriquement ces fonds saturés au profit de formats épurés et austères assurant une clarté typographique maximale.
Pour satisfaire à ces exigences de publication rigoureuses, ggplot2 propose une collection de thèmes intégrés complets dont les plus usités dans la littérature scientifique sont theme_classic() et theme_bw(). L’application directe de + theme_classic() élimine instantanément tout artefact de fond superficiel, supprime le quadrillage intrusif et trace deux axes perpendiculaires nets et sobres délimitant le quadrant inférieur gauche, restituant exactement le standard intemporel des publications de l’APA. Alternativement, le recours à theme_bw() conserve un quadrillage discret en traits grisés ultrafins, circonscrit dans une boîte rectangulaire fermée préservant l’alignement cartésien périphérique.
Pour parachever la configuration stylistique, l’opérateur déclaratif labs() prend en charge l’orchestration exhaustive des chaînes textuelles contextuelles. Il permet de renseigner un titre principal concis mais informatif, un sous-titre contextualisant les hypothèses expérimentales, la désignation exhaustive des axes assortie de leurs unités physiques de mesure entre parenthèses, ainsi que le libellé formel de la légende paramétrique. Par l’entremise de la fonction de surchage theme(), le praticien peaufine les attributs typographiques au moyen de directives comme element_text(family = « serif », size = 12, face = « plain »), harmonisant la police de la figure avec la typographie globale du manuscrit destiné à la soumission éditoriale.
7. Représentation conjointe de données empiriques et ajustement exponentiel
7.1 Tracé d’un histogramme de fréquences avec mise à l’échelle de densité
L’exploration empirique des phénomènes stochastiques réels implique inévitablement la confrontation directe entre un échantillon de mesures quantitatives collectées sur le terrain et la trajectoire théorique idéalisée déduite des axiomes de la loi exponentielle. Pour visualiser adéquatement cette mise en miroir au sein d’une même composition graphique, l’instrument visuel de référence demeure l’histogramme empirique. Toutefois, une erreur méthodologique gravissime commise avec une régularité troublante consiste à tenter de superposer une courbe continue de densité de probabilité sur un histogramme calibré sur les fréquences d’occurrence brutes, exprimées sous forme de décomptes entiers d’observations par classe.
Sur le plan mathématique, une fonction de densité possède une surface totale sous-tendue rigoureusement normalisée à unitaire, alors que la surface cumulée des barres d’un histogramme d’effectifs correspond à la taille de l’échantillon N multipliée par l’amplitude des intervalles de discrétisation. Toute superposition de ces deux entités mathématiquement hétérogènes génère une aberration géométrique totale où la courbe théorique se trouve écrasée de manière invisible sur l’axe horizontal, ou l’histogramme projeté à des altitudes disproportionnées. Pour rétablir l’homogénéité dimensionnelle absolue, il est impératif d’ajuster l’axe vertical de l’histogramme afin qu’il exprime une densité empirique de probabilité, dont la somme des surfaces des rectangles équivaut scrupuleusement à 1.
Dans l’écosystème graphique natif de R, cette conversion fondamentale s’exécute en renseignant explicitement l’argument freq = FALSE au sein de la primitive hist(), ou son équivalent sémantique probability = TRUE. Dans l’architecture de ggplot2, l’opération se matérialise au sein de la couche géométrique dédiée via le mappage esthétique spécialisé : geom_histogram(aes(y = after_stat(density)), binwidth = …, fill = « grey80 », color = « white »). Le choix raisonné de la largeur des intervalles ou classes (binwidth) constitue un arbitrage critique : un découpage excessivement large masque la décroissance brutale près de l’origine, tandis qu’un découpage microscopique déchiquette la distribution en une multitude d’arêtes bruitées sans représentativité statistique.
7.2 Superposition de la courbe théorique estimée par le maximum de vraisemblance
Une fois l’histogramme empirique adéquatement normalisé à l’échelle unitaire de densité, l’étape analytique subséquente consiste à estimer le paramètre optimal de taux λ qui caractérise au mieux la population sous-jacente ayant engendré l’échantillon observé, puis à projeter la courbe théorique résultante directement sur les barres de distribution observées. Sur le plan de la théorie statistique de l’inférence asymptotique, l’estimateur privilégié en vertu de ses propriétés d’invariance, de convergence et d’efficacité asymptotique est l’estimateur du maximum de vraisemblance, universellement désigné par l’acronyme anglo-saxon MLE pour Maximum Likelihood Estimator.
Dans le cadre strict d’une distribution exponentielle univariée, la résolution analytique des équations de score dérivées de la fonction de log-vraisemblance démontre de façon élégante que l’estimateur du maximum de vraisemblance, noté formellement λ̂ (lambda chapeau), est rigoureusement égal à l’inverse arithmétique de la moyenne empirique observée sur l’échantillon : λ̂ = 1 / mean(X). Cette relation d’une stupéfiante simplicité computationnelle permet à l’analyste d’extraire instantanément la valeur optimale du paramètre à partir du vecteur des données empiriques sans recourir à des algorithmes d’optimisation non linéaire itératifs complexes.
Pour automatiser ce processus et accéder conjointement à l’estimation de l’erreur-type asymptotique et de la matrice de variance-covariance des paramètres, l’utilisation du package spécialisé fitdistrplus s’avère particulièrement judicieuse. L’instruction fit <- fitdist(donnees, « exp ») extrait le paramètre optimal tout en confirmant la convergence des algorithmes numériques. La courbe théorique calibrée sur ce paramètre estimé est ensuite intégrée dans ggplot2 par l’adjonction de la couche stat_function(fun = dexp, args = list(rate = lambda_chapeau), color = « firebrick », linewidth = 1.2). Parallèlement, l’ajout d’une estimation non paramétrique par noyau de densité empirique via geom_density(color = « darkblue », linetype = « dashed », linewidth = 1) fournit un diagnostic visuel croisé d’une extraordinaire richesse, confrontant simultanément le modèle paramétrique rigide aux inflexions réelles des données d’observation.
7.3 Diagnostic visuel de la qualité d’ajustement
La projection simultanée de l’histogramme empirique, de la courbe théorique paramétrique estimée et du noyau de densité empirique non paramétrique permet de conduire une inspection sémiotique poussée des pathologies d’ajustement. Cette évaluation visuelle qualitative précède impérativement les tests formels d’adéquation probabiliste tels que le test de Kolmogorov-Smirnov, le test d’Anderson-Darling ou les critères d’information d’Akaike (AIC) et bayésien (BIC).
Le premier point d’attention diagnostique se situe à la racine même de la distribution, dans la région infinitésimale contiguë à l’abscisse x = 0. Dans les processus stochastiques idéaux modélisés par la loi exponentielle, la densité maximale théorique doit impérativement coïncider avec l’origine. Or, dans une immense majorité de données comportementales, physiologiques ou technologiques réelles, un temps physiologique minimal d’incompressibilité ou une latence instrumentale d’activation empêche toute observation d’événements à proximité immédiate de zéro. Ce phénomène se traduit graphiquement par un déficit massif de densité empirique à l’origine, où l’histogramme démarre avec des barres plates avant d’atteindre un sommet décalé vers la droite, révélant une incompatibilité structurelle rédhibitoire avec le modèle exponentiel pur.
Le second foyer diagnostique concerne la morphologie de la queue de distribution située aux valeurs élevées des abscisses. Les déviations persistantes où l’histogramme conserve des barres substantielles à des horizons temporels où la courbe exponentielle théorique est devenue depuis longtemps infinitésimale et indiscernable de zéro signalent la présence d’une queue lourde ou sous-exponentielle. Ces discordances visuelles indiquent sans équivoque que le taux de défaillance instantané n’est pas constant dans le temps, ruinant l’hypothèse de mémoire nulle et contraignant le modélisateur à délaisser la loi exponentielle au profit de distributions plus flexibles dotées de paramètres de forme adaptatifs.
8. Tracer la fonction quantile et la fonction de survie (CCDF)
8.1 Visualisation de la fonction quantile qexp()
La fonction quantile théorique, calculée dans l’environnement R par l’intermédiaire de la commande qexp(), représente la transformation inverse de la fonction de répartition. Alors que la CDF associe à une échelle temporelle d’abscisse une probabilité d’occurrence comprise entre 0 et 1, la fonction quantile réalise la projection inverse : elle prend comme domaine d’entrée l’intervalle unitaire de probabilité cumulative p ∈ [0, 1) et renvoie sur l’axe des ordonnées la durée d’attente critique exacte t_p pour laquelle la probabilité d’avoir observé l’événement est rigoureusement égale à p.
La représentation graphique de cette fonction s’exécute nativement par la commande curve(qexp(x, rate = λ), from = 0, to = 0.99, …). Il importe de proscrire l’évaluation de la borne unitaire exacte to = 1.0, celle-ci correspondant à la limite asymptotique infinie de la distribution exponentielle, ce qui provoquerait un débordement numérique ou l’apparition d’une coordonnée infinie inexploitable graphiquement. La courbe quantile ainsi produite présente une convexité caractéristique spectaculaire, s’élevant très modérément sur le premier tiers du domaine de probabilité, avant d’amorcer une ascension hyperbolique quasi verticale à mesure que p s’approche des quantiles extrêmes supérieurs.
Cette visualisation graphique revêt une utilité méthodologique de premier ordre lors de la calibration des seuils d’intervention décisionnelle ou de la définition des limites de tolérance opérationnelle au sein de protocoles d’investigation clinique ou de contrôle industriel. La projection sur la courbe de lignes directrices orthogonales pointillées au moyen de segments() ou de geom_segment() permet de repérer instantanément la valeur de la médiane théorique au point p = 0.50, ainsi que les percentiles de coupure standardisés p = 0.90, 0.95 ou 0.99, fournissant aux expérimentateurs des repères temporels concrets pour décider de l’interruption planifiée d’un essai ou de la censure à droite d’une étude longitudinale.
8.2 Tracer la fonction de survie ou de fiabilité complémentaire (CCDF)
La fonction de répartition cumulative complémentaire, désignée en littérature internationale sous le sigle CCDF pour Complementary Cumulative Distribution Function, ou plus usuellement fonction de survie S(t) = P(X > t) = e^(-λt), possède une signification physique et cognitive d’une puissance analytique exceptionnelle. Elle matérialise la proportion théorique d’une cohorte initiale qui persiste dans son état opérationnel d’origine au-delà d’une borne temporelle t. Le tracé de cette fonction sur une échelle cartésienne linéaire standard restitue fidèlement l’allure d’une courbe en déclin exponentiel strict, démarrant à l’ordonnée 1 pour s’évanouir graduellement vers 0.
Cependant, la pleine supériorité méthodologique du tracé de la CCDF émerge lors de l’application d’une transformation logarithmique sur l’axe des ordonnées. Sur le plan algébrique, si l’on applique le logarithme népérien à la fonction de survie théorique, on obtient la simplification linéaire remarquable : ln(S(t)) = ln(e^(-λt)) = -λt. Il en découle que sur une échelle semi-logarithmique où l’axe vertical est gradué en échelle logarithmique tandis que l’axe horizontal demeure strictement linéaire, la fonction de survie d’un processus stochastique régi par une loi exponentielle pure se métamorphose en une droite parfaite d’une linéarité absolue, dont la pente géométrique négative est rigoureusement égale à l’opposé arithmétique du paramètre de taux -λ.
Dans l’environnement de programmation ggplot2, cette mise en évidence graphique s’opère avec une efficacité saisissante en adjoignant à la couche de calcul de survie stat_function(fun = function(x) 1 – pexp(x, rate = lambda)) la commande de transformation dimensionnelle scale_y_log10() ou coord_trans(y = « log »). Cette conversion sémiotique fournit à l’analyste un test visuel impitoyable : toute déviation manifeste par rapport à la rectitude linéaire sur papier semi-logarithmique trahit sans ambiguïté une violation de l’hypothèse de taux de défaillance instantané constant. Une courbure concave vers le haut indique une distribution à taux de hasard décroissant (durabilité accrue avec l’âge), tandis qu’une courbure convexe vers le bas révèle un processus à taux de hasard croissant traduisant une fatigue temporelle cumulative manifeste.
9. Graphiques de diagnostic et validation du modèle : Q-Q Plots et P-P Plots
9.1 Construction d’un diagramme Quantile-Quantile (Q-Q Plot) exponentiel
Au-delà de la confrontation visuelle directe entre histogrammes empiriques et courbes théoriques, la validation rigoureuse de la conformité d’un jeu de données empiriques vis-à-vis d’une hypothèse de distribution exponentielle requiert la construction de diagrammes de diagnostic bivariés hautement spécialisés, au premier rang desquels figure le diagramme Quantile-Quantile ou Q-Q plot. Le principe structural fondamental de ce graphique d’inspection consiste à projeter en abscisse les quantiles théoriques déduits de la distribution exponentielle calibrée sur le paramètre estimé, et en ordonnée les quantiles empiriques observés au sein de l’échantillon expérimental trié par ordre croissant.
Si la variable aléatoire sous-jacente respecte scrupuleusement le comportement probabiliste dicté par la loi exponentielle théorique, les couples de coordonnées ordonnées doivent s’agréger de façon continue le long d’une droite de référence idéale d’équation y = x, matérialisant l’identité parfaite entre attentes théoriques et mesures factuelles. Dans le moteur graphique de base de R, la routine générique qqplot() permet de juxtaposer un échantillon aléatoire théorique généré via rexp() aux observations empiriques, mais la rigueur académique commande de calculer les quantiles théoriques de manière déterministe en appliquant la fonction qexp() sur une séquence ordonnée de probabilités de traçage associées au rang des observations, selon des formules de positionnement éprouvées telles que celle de Weibull ou de Hazen.
Le recours à des bibliothèques spécialisées telles que car ou des extensions graphiques dédiées à ggplot2 comme qqplotr permet d’enrichir ce tracé de bandes d’intervalles de confiance ponctuels ou simultanés à 95 %, calculées par rééchantillonnage de bootstrap paramétrique ou approximations asymptotiques. L’inspection sémiotique des anomalies morphologiques le long de la ligne de repère apporte des renseignements diagnostiques inestimables : un décrochement progressif vers le haut dans le quadrant supérieur droit caractérise un phénomène d’étirement en queue lourde où les valeurs observées dépassent largement les prédictions exponentielles, tandis qu’une ondulation en forme de S signale une asymétrie bimodale ou une contamination structurelle par un mélange latent de lois.
9.2 Construction d’un diagramme Probabilité-Probabilité (P-P Plot)
Complément direct et indispensable du diagramme Quantile-Quantile, le diagramme Probabilité-Probabilité, universellement abrégé en P-P plot, aborde la vérification de l’adéquation d’un modèle sous un angle perceptuel différent. Alors que le Q-Q plot amplifie la sensibilité de détection des anomalies dans les régions extrêmes et les queues de distribution en raison de la projection non linéaire sur l’échelle des quantiles réels, le P-P plot focalise sa résolution discriminante sur le corps central de la distribution, dans les plages de densité maximale où s’accumule le gros de la masse probabiliste.
La construction computationnelle d’un P-P plot repose sur l’évaluation conjointe des probabilités cumulées théoriques et empiriques. Pour chaque observation ordonnée de rang i au sein d’un échantillon de taille N, la probabilité cumulée empirique est approximée par le ratio standardisé p_emp = (i – 0.5) / N. Parallèlement, la coordonnée théorique correspondante est calculée en injectant la valeur réelle observée au sein de la fonction de répartition paramétrique estimée, soit p_theo = pexp(x_i, rate = lambda_chapeau). L’espace cartésien résultant est délimité par une boîte carrée strictement bornée sur l’intervalle bivarié unitaire [0, 1] × [0, 1].
La ligne de référence fondamentale correspond ici à la diagonale d’équipartition parfaite reliant l’origine (0,0) au sommet opposé (1,1), projetée au moyen de abline(0, 1, lty = 2, col = « red ») ou geom_abline(intercept = 0, slope = 1). Si le modèle exponentiel s’ajuste avec pertinence aux dynamiques observées, l’ensemble des points empiriques chemine en adhérence étroite avec cette trajectoire diagonale. Tout écartement morphologique significatif, matérialisé par exemple par une courbure en arche concave ou convexe au centre du tracé, atteste d’un décalage persistant entre la vitesse théorique d’accumulation probabiliste régie par le paramètre λ et le rythme effectif de transition observé sur le terrain expérimental.
10. Techniques avancées de personnalisation graphique pour la publication
10.1 Composition multipanneaux et facettage
L’argumentation scientifique moderne repose rarement sur la présentation d’une figure isolée ; elle exige la juxtaposition raisonnée de plusieurs panneaux visuels interconnectés permettant de comparer différents groupes cliniques, conditions expérimentales ou horizons temporels au sein d’une mise en page unifiée et cohérente. Dans le système graphique natif de R, la commande d’orchestration par excellence est par(mfrow = c(lignes, colonnes)), qui partitionne l’espace d’affichage en une grille matricielle de fenêtres cartésiennes indépendantes traversées séquentiellement par les instructions de tracé ultérieures.
Toutefois, la manipulation de matrices graphiques complexes via le moteur standard souffre d’un écueil méthodologique majeur : la disparité des échelles d’axes. Si chaque panneau calibre ses dimensions spatiales sur ses propres données locales, toute comparaison visuelle transversale directe devient cognitivement biaisée et méthodologiquement trompeuse. Dans le formalisme de ggplot2, cette limitation structurelle est élégamment résolue par les opérateurs de facettage automatisé facet_wrap() et facet_grid(). En associant une variable catégorielle factorielle aux arguments de partitionnement, ggplot2 engendre une série de sous-graphiques homogènes partageant des échelles d’axes coordonnées d’une rigueur mathématique sans faille, assurant la comparabilité immédiate de la morphologie des lois exponentielles d’un sous-groupe à l’autre.
Pour orchestrer des architectures multipanneaux encore plus sophistiquées combinant des types de visualisations hétérogènes — par exemple en adossant une courbe de densité théorique en panneau supérieur à un Q-Q plot de diagnostic et une courbe de survie semi-logarithmique en panneaux inférieurs —, l’intégration de métapaquetages modernes tels que patchwork ou cowplot transcende les contraintes habituelles. Par une syntaxe algébrique d’une extraordinaire fluidité reposant sur les opérateurs +, / et |, patchwork permet de fusionner des objets graphiques distincts, d’harmoniser automatiquement leurs marges d’alignement typographique et de numéroter les sous-figures (A, B, C) selon les critères stricts de la composition éditoriale internationale.
10.2 Annotation mathématique avancée et symbolique grecque
La transmission efficace de la complexité conceptuelle inhérente aux modèles probabilistes exige l’incorporation directe, au cœur même du canevas graphique, de métadonnées textuelles enrichies combinant typographie littérale et formalisme mathématique rigoureux. L’insertion de formules analytiques détaillées intégrant des intégrales définies, des fractions, des exposants et des caractères grecs transcende le statut d’une figure, la métamorphosant en un support d’instruction scientifique autosuffisant dispensant le lecteur de fastidieux renvois au corps du texte.
Le moteur d’annotation de R supporte une implémentation intégrale de la syntaxe plotmath. Pour projeter une formulation mathématique complexe dans un tracé ggplot2, l’analyste fait appel à l’instruction déclarative annotate() en spécifiant geom = « text » et en activant le moteur d’analyse syntaxique via l’argument impératif parse = TRUE. Une formulation telle que annotate(« text », x = 4, y = 0.3, label = « f(t) == lambda * e^{-lambda * t} », parse = TRUE, size = 4.5, family = « serif ») restitue la formule de densité sous une forme typographique absolument irréprochable.
Cette puissance d’annotation vectorielle est avantageusement complétée par l’adjonction d’éléments géométriques directeurs, tels que des flèches indicatrices à segments courbes pointant précisément vers des anomalies de distribution ou des singularités fonctionnelles critiques. L’emploi de annotate(« curve », x = …, y = …, xend = …, yend = …, arrow = arrow(length = unit(0.2, « cm »)), curvature = 0.3) guide l’attention sémiotique de l’observateur vers la zone exacte du tracé nécessitant une interprétation probabiliste pointue, érigeant la figure graphique en un instrument de démonstration théorique d’une rare éloquence visuelle.
10.3 Exportation haute résolution et formats vectoriels
La dernière étape du cycle de traitement computationnel, trop souvent négligée par les praticiens, concerne l’enregistrement et l’exportation du rendu graphique sur un support de stockage physique. Un tracé d’une grande perfection esthétique projeté sur l’écran d’un environnement de développement intégré comme RStudio peut se trouver irrémédiablement dégradé lors de son incorporation dans un document final s’il a été exporté sous la forme d’un fichier matriciel compressé de faible résolution, générant des effets de crénelage disgracieux et rendant les polices de caractères illisibles à l’impression.
Les maisons d’édition scientifique exigent de manière universelle la soumission de figures sous deux formats exclusifs : soit sous forme de graphismes vectoriels encapsulés totalement indépendants de toute contrainte de résolution d’affichage, soit sous forme d’images matricielles compressées sans perte bénéficiant d’une résolution spatiale minimale de 300 à 600 points par pouce (DPI pour dots per inch). Pour la restitution vectorielle directe dans l’écosystème R standard, l’ouverture d’un périphérique dédié via pdf() ou svg() garantit une extensibilité infinie du dessin, les lignes et caractères étant encodés comme des équations géométriques autonomes et non comme des grilles de pixels.
Dans l’écosystème ggplot2, l’automatisation de l’exportation haute fidélité s’exécute avec une rigueur paramétrique totale grâce à la directive ggsave(). Cette fonction centrale décharge l’utilisateur de toute incertitude quant au calibrage dimensionnel en exigeant la spécification conjointe des dimensions physiques réelles et de la résolution spatiale ciblée. L’instruction exemplaire s’illustre par l’appel ggsave(« figure1_distribution_exponentielle.png », plot = last_plot(), width = 18, height = 12, units = « cm », dpi = 600, device = « png »), produisant un document graphique de qualité muséale, parfaitement adapté aux contraintes de calibrage des colonnes typographiques des revues internationales les plus rigoureuses.
11. Applications empiriques en psychologie quantitative et sciences comportementales
11.1 Modélisation des latences et des temps de réaction simples
Au sein des sciences comportementales, de la psychophysique et des neurosciences cognitives quantitatives, l’analyse de la distribution temporelle des temps de réaction simples (TR) représente l’un des paradigmes expérimentaux les plus féconds pour sonder l’architecture élémentaire du traitement de l’information dans le système nerveux central. Depuis les investigations pionnières de Franciscus Donders, il est empiriquement établi que les distributions chronométriques observées lors de tâches d’initiation motrice rapide manifestent une asymétrie positive persistante, caractérisée par une montée fulgurante vers un mode d’occurrence précoce suivie d’un étirement graduel vers les latences prolongées.
Bien que la loi exponentielle pure constitue le modèle formel le plus direct pour décrire la survenue stochastique d’un influx neuronal au-delà d’un état de repos, son application directe aux temps de réponse moteurs se heurte à une impossibilité physiologique fondamentale : l’impossibilité biologique d’observer des réponses motrices à des latences nulles ou infinitésimales. La conduction axonale périphérique, la transmission synaptique à travers les voies afférentes et la dépolarisation biomécanique des plaques motrices imposent un délai incompressible de transport biophysique. Pour résoudre cette contradiction fondamentale tout en préservant l’élégance analytique du processus de Poisson sous-jacent, les psychométriciens recourent à la distribution exponentielle décalée, connue en littérature anglo-saxonne sous la désignation de shifted exponential distribution ou loi exponentielle à deux paramètres.
Cette distribution incorpore un paramètre spatial additionnel de localisation ou seuil de décalage temporel, universellement désigné par t_0 ou gamma, délimitant le seuil absolu de latence en deçà duquel la probabilité d’occurrence demeure strictement nulle. Sur le plan formel, sa densité s’énonce par f(t; λ, t_0) = λ e^(-λ(t – t_0)) pour tout t ≥ t_0. Dans l’environnement de programmation R, la visualisation graphique de cette distribution adaptée s’opère aisément en programmant une fonction personnalisée encapsulée dans curve() ou stat_function(), exploitant la condition vectorisée ifelse(x ≥ t0, dexp(x – t0, rate = lambda), 0). Cette figure permet d’isoler visuellement la part du temps consacrée aux processus sensorimoteurs périphériques incompressibles (représentée par la distance vierge entre l’axe vertical d’origine et la rupture de la courbe à t_0) de la dynamique stochastique centrale de prise de décision (reflétée par le paramètre de décroissance λ).
11.2 Analyse de la persistance comportementale et des temps d’abandon
Un autre champ d’application empirique majeur de la modélisation exponentielle réside dans l’analyse chronométrique de la persévérance comportementale, mesurée par la durée pendant laquelle un sujet humain ou animal persiste volontairement dans l’exécution d’une tâche cognitive astreignante, d’un jeu vidéo expérimental ou d’une quête d’exploration écologique avant de décider unilatéralement l’abandon ou la réorientation de son effort attentionnel. Dans ce cadre méthodologique, l’événement terminal d’intérêt n’est plus un temps d’initiation réactif, mais la rupture volontaire de l’engagement fonctionnel.
La représentation graphique comparative des courbes de survie ou de persistance entre différentes cohortes cliniques fournit des indicateurs phénotypiques d’une finesse discriminante exceptionnelle. Supposons qu’un protocole expérimental évalue la résistance à la frustration chez des populations témoins par rapport à des cohortes diagnostiquées avec un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH). En traçant conjointement la fonction de survie S(t) = e^(-λt) pour chaque groupe, l’analyste visualise instantanément la divergence des pentes de décroissance temporelle.
Dans ce cadre d’analyse décisionnelle, le paramètre de taux λ est rigoureusement interprété comme un indicateur d’instabilité attentionnelle ou de susceptibilité stochastique à l’extinction comportementale. Une valeur élevée de λ, se traduisant visuellement par une chute vertigineuse de la courbe de survie sur le graphique, signale une propension accrue à l’abandon prématuré de la tâche à chaque fraction de seconde écoulée. À l’opposé, une courbe étirée traduisant un λ affaibli reflète une persistance tonique résiliente face au coût cognitif accumulé. La restitution graphique vectorielle de ces dynamiques sous forme de courbes de survie enrichies d’intervalles de confiance calculés à partir des estimateurs de Kaplan-Meier offre aux investigateurs une cartographie clinique transparente facilitant l’évaluation des interventions thérapeutiques ou pharmacologiques visant la stabilisation attentionnelle.
12. Dépannage, pièges courants et bonnes pratiques computationnelles
12.1 Erreurs fréquentes d’échelle et anomalies de représentation
L’implémentation algorithmique de la distribution exponentielle dans les logiciels statistiques s’accompagne d’un corpus d’erreurs récurrentes dont l’impact graphique peut complètement vicier l’interprétation des résultats empiriques. L’écueil computationnel le plus fréquemment documenté dans la pratique analytique concerne la confusion fondamentale entre le paramètre de taux rate et le paramètre d’échelle scale, déjà théorisée dans la première section de cette étude. Déclarer au sein d’une routine R une espérance brute en croyant renseigner le taux génère une contraction d’échelle destructrice ; pour un temps moyen d’attente théorique évalué à 50 unités, l’invocation erronée de dexp(x, rate = 50) condense la totalité de la surface de probabilité dans un microfilm graphique contigu à l’axe des ordonnées, produisant une ligne plate sur l’immense majorité du plan cartésien.
Une seconde anomalie de représentation graphique couramment observée découle d’une discrétisation spatiale déficiente lors de l’interpolation numérique sur l’abscisse. Lorsqu’un praticien configure une séquence vectorielle de points via seq() avec un pas d’échantillonnage trop lâche dans une zone où le paramètre de taux est particulièrement élevé, l’intervalle entre les points d’évaluation ne parvient pas à échantillonner la chute quasi verticale initiale. Le moteur de tracé vectoriel relie alors linéairement l’ordonnée à l’origine au premier point discret disponible, transformant la courbure exponentielle concave en un biseau anguleux artificiel. Pour prémunir le tracé contre tout artefact de discrétisation, il est impératif d’ajuster dynamiquement la densité de la grille spatiale en concentrant un grand nombre de points d’interpolation dans le premier demi-écart-type de la distribution.
Enfin, le calibrage erroné des fenêtres de normalisation lors du tracé conjoint d’un histogramme empirique et d’une courbe continue représente le piège le plus insidieux. Oublier de déclarer freq = FALSE dans le moteur de base ou omettre la transformation interne aes(y = after_stat(density)) dans les couches géométriques de ggplot2 engendre un effondrement d’échelle visuelle immédiat, la courbe théorique se trouvant écrasée sur la ligne zéro en raison de l’amplitude démesurée des décomptes bruts de l’axe vertical. Une vigilance méthodologique absolue sur la conformité des unités d’ordonnée s’avère la condition première de la validité de toute superposition scientifique.
12.2 Gestion des valeurs aberrantes et limites du modèle exponentiel
Un modèle statistique n’est jamais qu’une approximation idéalisée d’une réalité phénoménologique complexe. Face à des jeux de données empiriques bruts, le statisticien est régulièrement confronté à la présence de valeurs aberrantes, universellement désignées sous le terme anglais d’outliers. Ces mesures atypiques, pouvant résulter d’erreurs d’enregistrement instrumentales, d’inattentions passagères des participants lors d’une tâche de réaction motrice ou de perturbations environnementales sporadiques, exercent une influence déstabilisatrice massive sur l’ajustement exponentiel classique.
L’estimateur du maximum de vraisemblance de la loi exponentielle λ̂ = 1 / Moyenne est d’une extrême vulnérabilité face aux données extrêmes, son point de rupture asymptotique étant rigoureusement égal à zéro. L’inclusion accidentelle d’une poignée de temps d’attente disproportionnellement gigantesques gonfle artificiellement la moyenne empirique de l’échantillon, ce qui provoque par ricochet un effondrement drastique du paramètre de taux estimé λ̂. Graphiquement, cette contamination se traduit par une courbe théorique ajustée dont l’ordonnée à l’origine est sévèrement sous-estimée par rapport au véritable pic de concentration des données, écrasant l’ajustement sur la majorité du domaine utile d’observation.
De surcroît, le praticien doit être en mesure d’identifier avec lucidité les limites ontologiques du modèle exponentiel lui-même. L’hypothèse régulatrice fondamentale de cette loi repose sur l’invariance absolue de sa fonction de taux de hasard instantané, définie par le ratio h(t) = f(t) / S(t) = λ. Cette constance postule que la probabilité conditionnelle d’apparition de l’événement terminal au cours de l’instant infinitésimal suivant est rigoureusement indépendante du temps déjà consommé par le système. Lorsque l’analyse empirique révèle, à travers les graphiques de survie ou les diagrammes de diagnostic décrits aux sections précédentes, que le taux de hasard varie en fonction de l’âge (phénomènes de fatigue, d’usure, d’apprentissage ou de récupération d’énergie), le cadre exponentiel doit être impérativement révoqué.
Dans ces configurations dynamiques non stationnaires, le chercheur basculera méthodologiquement vers des familles paramétriques plus flexibles intégrant des paramètres de forme modulant le vieillissement temporel :
- La distribution de Weibull : Dotée d’un paramètre de forme k, elle permet de modéliser des taux de hasard strictement croissants (k > 1) ou strictement décroissants (k < 1), englobant la loi exponentielle comme cas particulier limite lorsque k = 1.
- La distribution Gamma : Également paramétrée par un facteur de forme, elle s’avère particulièrement appropriée pour modéliser des temps d’attente cumulés issus d’une succession séquentielle de multiples sous-étapes exponentielles indépendantes.
- La distribution Ex-Gaussienne : Fusionnant par convolution une composante normale gaussienne et une composante exponentielle, elle constitue la référence absolue pour modéliser avec un réalisme physiologique indépassable les temps de réponse cognitifs intégrant un temps de traitement moteur périphérique et une latence décisionnelle centrale.
12.3 Synthèse procédurale et script type pour l’analyste
Pour pérenniser les démarches méthodologiques développées au fil de cette monographie et doter l’analyste quantitatif d’un canevas immédiatement transposable à ses propres protocoles de recherche, cette sous-section synthétise les étapes fondamentales du pipeline d’analyse sous la forme d’un protocole opérationnel standardisé. De la préparation stochastique à l’exportation vectorielle haute définition, la démarche s’articule autour d’une progression linéaire séquentielle :
- Initialisation et reproductibilité : Déclaration de la graine computationnelle via la commande set.seed() et configuration globale des options de l’environnement de travail.
- Extraction ou importation des données : Nettoyage des séries empiriques, traitement raisonné des valeurs manifestement aberrantes et vérification rigoureuse de la positivité stricte du support d’évaluation.
- Estimation paramétrique : Détermination de l’estimateur du maximum de vraisemblance λ̂ via l’inverse de la moyenne d’échantillon ou par optimisation automatisée via le package fitdistrplus.
- Construction de l’ossature empirique : Tracé de l’histogramme de fréquences avec conversion impérative sur l’axe unitaire de densité de probabilité au moyen des commandes graphiques adaptées.
- Superposition théorique et non paramétrique : Injection de la courbe de densité théorique calibrée sur λ̂ et adjonction conjointe d’une estimation de densité par noyau pour l’inspection des écarts morphologiques.
- Diagnostic structural formel : Réalisation synchronisée d’un diagramme Quantile-Quantile (Q-Q plot) et d’un tracé de fonction de survie semi-logarithmique pour éprouver la validité de l’hypothèse de taux de hasard constant.
- Finition typographique et publication : Application d’un thème scientifique conforme aux normes académiques (ex. theme_classic()), annotation des formules mathématiques formelles et exportation au format vectoriel ou matriciel haute résolution (DPI ≥ 300) via ggsave().
Ce protocole systématique garantit que chaque visualisation issue de la programmation sous R ne constitue pas une simple ébauche graphique contemplative, mais s’affirme comme un acte de démonstration statistique d’une rigueur absolue, capable de résister aux expertises méthodologiques les plus exigeantes des comités de lecture internationaux.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
Delignette, D. (2015). Modèles à temps de réaction et dynamique cognitive. Éditions Universitaires Européennes.
Luce, R. D. (1986). Response times: Their role in inferring elementary mental organization. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780195036107.001.0001
Murrell, P. (2018). R graphics (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429490217
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Ross, S. M. (2014). Introduction to probability models (11th ed.). Academic Press. https://doi.org/10.1016/C2012-0-06487-7
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0