
Dans le vaste univers de la théorie des probabilités et de la modélisation statistique appliquée, la loi uniforme occupe une place singulière et matricielle. Souvent qualifiée de modèle d’équiprobabilité par excellence, elle incarne la formalisation mathématique d’un état d’ignorance préalable ou d’indifférence cognitive parfaite, où aucun point d’un intervalle défini ne bénéficie d’une vraisemblance supérieure à ses congénères. Bien que sa simplicité apparente puisse la reléguer au rang d’outil purement didactique dans certains cursus introductifs, elle constitue en réalité la clé de voûte de la simulation stochastique moderne, de la cryptographie computationnelle, de l’échantillonnage de Monte-Carlo et de la psychométrie quantitative. Dans ces disciplines, la possibilité de générer, d’examiner et de visualiser rigoureusement des variables aléatoires uniformes représente un impératif méthodologique de premier ordre.
L’environnement statistique R, reconnu internationalement comme l’un des standards les plus puissants pour l’analyse computationnelle et la visualisation de données, offre une infrastructure native et modulaire particulièrement adaptée à l’exploration de cette loi. À travers ses moteurs graphiques fondamentaux et ses extensions modernes telles que l’écosystème ggplot2, R permet de transposer les axiomes abstraits de Kolmogorov et les intégrales de Riemann en représentations visuelles nettes, reproductibles et conformes aux exigences éditoriales académiques les plus strictes. Tracer la fonction de densité, cartographier la fonction de répartition cumulative ou confronter des histogrammes d’échantillons finis à leurs limites asymptotiques constituent des démarches pédagogiques et scientifiques incontournables.
Ce guide exhaustif a pour vocation d’explorer l’intégralité du spectre théorique, computationnel et graphique lié à la loi uniforme dans R. De l’analyse rigoureuse des propriétés mathématiques sous-jacentes à la création de tracés multivariés de haute précision, en passant par les diagnostics d’adéquation et les applications spécifiques aux sciences humaines et cognitives, ce document détaille chaque concept avec une profondeur académique maximale. L’objectif est d’équiper le chercheur, l’étudiant avancé et le biostatisticien d’une boîte à outils pérenne, garantissant une maîtrise absolue des primitives graphiques et des distributions probabilistes continues.
1. Fondements théoriques et mathématiques de la loi uniforme
1.1 Définition formelle de la loi uniforme continue
La distribution uniforme continue est définie sur un sous-ensemble compact ou semi-ouvert de la droite réelle, couramment délimité par deux réels finis notés a et b, sous la condition fondamentale que a soit strictement inférieur à b. Cette distribution modélise une variable aléatoire réelle X dont la caractéristique intrinsèque réside dans une densité invariante sur l’ensemble de son intervalle support. L’expression analytique de sa fonction de densité de probabilité, conventionnellement désignée par la notation f(x), se formule de manière univoque par f(x) = 1 / (b – a) dès lors que la variable x appartient à l’intervalle fermé [a, b], et prend une valeur identiquement nulle dès que x se situe en dehors de ces bornes. Cette formulation garantit que l’intégrale de Lebesgue de la fonction f sur l’ensemble des réels soit strictement égale à l’unité, respectant ainsi le second axiome des probabilités de Kolmogorov.
L’étude des moments statistiques de la loi uniforme continue met en lumière sa parfaite symétrie. Le moment d’ordre un, correspondant à l’espérance mathématique E(X), se calcule par l’intégration du produit de x par sa densité sur l’intervalle [a, b]. Le résultat de cette intégration aboutit à l’expression E(X) = (a + b) / 2, ce qui coïncide rigoureusement avec le centre géométrique de l’intervalle support. La variance, notée Var(X), mesure l’étalement quadratique moyen autour de ce centre de gravité stochastique. Sa dérivation, obtenue par la différence entre l’espérance du carré de la variable et le carré de son espérance, donne Var(X) = (b – a)^2 / 12. Cette valeur souligne que la dispersion de la distribution dépend exclusivement de la longueur totale de l’intervalle support et s’avère totalement indépendante de la position de ce dernier sur l’axe des réels.
La notion d’équiprobabilité stricte sur un continuum mesurable est l’élément qui distingue profondément la loi uniforme continue des lois discrètes. Pour tout point individuel c appartenant à l’intervalle support, la probabilité ponctuelle P(X = c) est rigoureusement égale à zéro, en dépit du fait que l’événement soit structurellement possible dans l’espace échantillon. La mesure de probabilité n’acquiert une valeur non nulle que lorsqu’elle est évaluée sur un sous-ensemble mesurable de Borel possédant une longueur positive. Cette spécificité mathématique requiert un soin conceptuel particulier lors de la restitution graphique sous R, dans la mesure où le tracé ne représente pas des probabilités d’occurrences ponctuelles isolées, mais bien une densité continue dont la surface sous la courbe constitue la seule grandeur interprétable en termes probabilistes.
1.2 Fonction de répartition et calculs d’intervalles
La fonction de répartition cumulative, notée F(x), constitue l’intégrale définie de la fonction de densité de probabilité depuis l’infini négatif jusqu’à une valeur seuil x. Dans le cadre de la loi uniforme continue sur l’intervalle [a, b], cette primitive prend une forme linéaire affine par morceaux. Lorsque x est strictement inférieur à la borne inférieure a, la probabilité cumulée est rigoureusement égale à zéro. Pour tout x appartenant à l’intervalle [a, b], la fonction s’exprime sous la forme F(x) = (x – a) / (b – a). Enfin, dès que x dépasse la borne supérieure b, F(x) atteint et conserve la valeur absolue de un. Cette transition continue mais non différentiable aux points de raccordement a et b confère à la courbe de répartition une morphologie caractéristique de rampe linéaire uniforme.
Le calcul de la probabilité qu’une observation se situe à l’intérieur d’un intervalle spécifique délimité par x1 et x2, avec la condition d’ordre a ≤ x1 < x2 ≤ b, découle directement de la formule d’accroissement fini de la fonction de répartition. En vertu du théorème fondamental de l’analyse, cette probabilité s’écrit P(x1 < X < x2) = F(x2) – F(x1) = (x2 – x1) / (b – a). Il apparaît ainsi avec une clarté évidente que la mesure de probabilité est strictement proportionnelle à la longueur euclidienne du sous-intervalle considéré. Deux segments de même dimension spatiale au sein du support se voient attribuer une masse de probabilité rigoureusement identique, quelle que soit leur localisation proximale ou distale vis-à-vis des bornes a et b.
D’un point de vue géométrique, cette propriété se traduit par l’évaluation de l’aire d’un polygone rectangulaire. La fonction de densité étant une constante de hauteur h = 1 / (b – a), la surface délimitée par la courbe au-dessus du sous-segment [x1, x2] correspond exactement au produit de la base (x2 – x1) par cette hauteur constante. Cette géométrisation limpide facilite grandement les représentations didactiques sous R, où l’aire intégrée peut être matériellement illustrée par des aplats de couleur polygonaux, rendant immédiatement perceptibles les concepts abstraits d’intégration stochastique aux yeux de l’analyste ou du chercheur en sciences empiriques.
1.3 Distinction fondamentale entre loi uniforme continue et discrète
Bien que partageant le même principe épistémologique d’indifférence probabiliste, la distribution uniforme continue et sa contrepartie discrète reposent sur des fondations mathématiques et combinatoires profondément divergentes. La loi uniforme discrète s’applique à un ensemble dénombrable et fini de k éléments distincts, souvent modélisés par les entiers successifs d’un ensemble fini. La fonction de masse de probabilité attribue à chaque modalité singulière une valeur strictement égale à 1 / k. Dans ce schéma, les probabilités ponctuelles sont non nulles, et la fonction de répartition cumulative présente une morphologie en escalier rigide, ponctuée de sauts discrets d’amplitude 1 / k à chaque nœud d’observation.
Ces divergences de structure impliquent des conséquences computationnelles majeures lors de la modélisation et du tracé dans l’écosystème R. La représentation d’une variable uniforme discrète nécessite l’usage d’outils visuels adaptés à la discontinuité des données, tels que des diagrammes en bâtons, des graphiques à barres ou des segments verticaux disjoints créés via la primitive plot avec le paramètre de type adapté. Tenter de visualiser une loi uniforme discrète sous l’apparence d’une ligne continue conduirait à une erreur d’interprétation grave, suggérant que des états intermédiaires non définis possèdent une densité de probabilité effective.
Inversement, le tracé de la distribution uniforme continue impose d’échantillonner un continuum numérique à une résolution suffisamment fine pour simuler visuellement la planéité et la régularité sans introduire de crénelage perceptible. L’analyste doit choisir entre la modélisation théorique exacte, reposant sur une grille de valeurs continues calculées analytiquement, et la modélisation empirique fondée sur des tirages pseudo-aléatoires générés par ordinateur. La maîtrise de cette dichotomie théorique permet d’éviter les pièges visuels fréquents lors de la communication de résultats scientifiques, en assurant que la nature continue ou discrète de l’espace d’échantillonnage soit fidèlement transcrite dans chaque pixel du graphique final.
2. Configuration de l’environnement R et écosystème statistique
2.1 Vérification et initialisation de l’interpréteur R
Avant d’entreprendre toute séquence de visualisation statistique avancée, il est indispensable de stabiliser et de documenter avec rigueur l’état de la session R. L’intégrité des résultats graphiques et numériques dépend de la version du moteur d’exécution et de l’état de l’espace de travail. L’exécution de la commande de diagnostic sessionInfo permet d’obtenir un rapport exhaustif mentionnant la version de base de R, le système d’exploitation hôte, ainsi que les packages attachés. Une pratique méthodologique saine consiste à débuter tout script de tracé par le nettoyage ciblé des objets résiduels en mémoire, évitant ainsi que des variables obsolètes ne viennent altérer les calculs vectoriels subséquents.
La reproductibilité computationnelle constitue l’un des piliers cardinaux de la recherche scientifique contemporaine. Étant donné que la simulation de variables uniformes implique des générateurs de nombres pseudo-aléatoires, il est impératif d’initialiser explicitement la graine stochastique au moyen de la fonction set.seed. L’algorithme standard employé par défaut dans R moderne est le générateur de Mersenne Twister, réputé pour sa période phénoménale de 2^19937 – 1 et ses excellentes propriétés d’équidistribution multidimensionnelle. L’assignation d’un entier spécifique au sein de set.seed assure que toute personne exécutant le code obtiendra exactement la même séquence de nombres pseudo-aléatoires et, par conséquent, une réplique visuelle strictement identique des graphiques d’échantillonnage.
Parallèlement, la configuration globale des paramètres graphiques via la primitive par permet d’optimiser l’ergonomie visuelle du moteur standard de R. Ce sous-système régule des dimensions critiques telles que les marges périphériques de la figure, les espacements d’étiquettes, le comportement des polices typographiques et les dispositifs de coupure d’axes. Définir des marges équilibrées via l’argument mar évite le tronquage des labels d’axes ou des titres scientifiques complexes contenant des expressions mathématiques sophistiquées, garantissant ainsi une présentation immédiatement exploitable pour l’édition académique.
2.2 Présentation des quatre fonctions canoniques dédiées à l’uniformité
L’architecture interne du langage R met à disposition une nomenclature modulaire d’une rare cohérence pour le traitement des distributions statistiques. Pour la loi uniforme, cette interface se déploie à travers un quatuor de fonctions dont le radical commun unif est préfixé par quatre lettres directrices : d, p, q et r. Chacune de ces fonctions encapsule une facette fondamentale du modèle probabiliste et requiert la spécification rigoureuse des bornes inférieure et supérieure via les arguments formels min et max, qui prennent respectivement pour valeurs par défaut 0 et 1 dans la distribution standard.
La fonction dunif représente l’opérateur de densité de probabilité. Elle évalue la hauteur théorique de la fonction de densité pour chaque élément d’un vecteur numérique fourni en entrée. Si la valeur transmise se situe à l’intérieur de l’intervalle délimité par min et max, dunif retourne la quantité scalaire 1 / (max – min) ; dans le cas contraire, elle renvoie la valeur zéro. La fonction punif, quant à elle, calcule la fonction de répartition cumulative, fournissant l’intégrale de la probabilité depuis l’origine négative jusqu’au quantile spécifié, délivrant ainsi une réponse comprise impérativement entre zéro et un.
Pour effectuer l’opération inverse de la probabilité cumulée, R met à disposition la fonction qunif, communément appelée fonction quantile ou inverse généralisée de la fonction de répartition. Lorsqu’on lui transmet une probabilité p comprise dans l’intervalle [0, 1], qunif renvoie la coordonnée réelle correspondante x telle que F(x) = p. Enfin, la primitive runif constitue le moteur de simulation stochastique par excellence. Elle génère un vecteur de réalisations pseudo-aléatoires indépendantes et identiquement distribuées selon la loi uniforme continue spécifiée, servant de substrat algorithmique indispensable pour toute vérification expérimentale ou méthode d’échantillonnage de Monte-Carlo.
2.3 Sélection des bibliothèques d’affichage graphique
Le chercheur ou l’ingénieur de données dispose dans R de deux paradigmes majeurs pour la création d’artéfacts visuels : le moteur graphique de base, désigné sous le terme de base graphics, et la bibliothèque avancée ggplot2, ancrée dans la philosophie de la grammaire des graphiques théorisée par Leland Wilkinson. Le système graphique standard se distingue par sa vélocité computationnelle remarquable, son absence totale de dépendances logicielles tierces et son adéquation parfaite pour les scripts d’exploration rapide ou les procédures nécessitant des millions d’appels vectoriels directs. Il repose sur un modèle d’assemblage procédural où les couches graphiques successives viennent s’inscrire sur une toile préalablement ouverte.
À l’opposé de cette approche séquentielle, l’extension ggplot2 propose une modélisation déclarative hautement structurée. Elle sépare rigoureusement la source des données, les associations esthétiques d’axes et de nuances chromatiques, et les formes géométriques de rendu graphique. Cette abstraction permet de concevoir des représentations d’une élégance typographique exceptionnelle tout en minimisant les risques d’incohérence d’échelles. De surcroît, ggplot2 intègre nativement des mécanismes d’évaluation fonctionnelle continue permettant de tracer des densités théoriques sans avoir à générer manuellement des vecteurs de données volumineux au sein du flux de travail principal.
En complément de ces deux moteurs essentiels, certaines bibliothèques spécialisées viennent enrichir l’éventail méthodologique. Les packages tels que scales apportent des fonctions de formatage précis pour les axes de coordonnées, facilitant la transition entre proportions décimales et pourcentages réels. Des modules d’algèbre vectorielle et de manipulation de tableaux comme dplyr ou tibble garantissent par ailleurs une transformation fluide des échantillons simulés en structures de données tabulaires parfaitement optimisées pour les moteurs graphiques modernes, assurant une chaîne de traitement robuste et exempte de distorsions numériques.
3. Tracé de base de la fonction de densité avec dunif()
3.1 Génération de la grille d’abscisses
La première phase de la construction d’un tracé de densité théorique dans R consiste à élaborer une grille numérique dense sur l’axe des abscisses. Contrairement à des environnements de calcul formel qui manipulent des fonctions continues sous forme symbolique pure, le moteur graphique de R fonctionne par interpolation linéaire discrète entre des nœuds de coordonnées numériques. La primitive seq s’avère l’outil idoine pour engendrer une telle séquence vectorielle régulière. L’utilisateur doit spécifier l’origine du balayage temporel ou spatial, sa terminaison et le pas d’incrémentation ou, plus rigoureusement, le nombre total d’observations équidistantes souhaitées via le paramètre length.out.
Il est fondamental d’étendre la grille de coordonnées bien au-delà des strictes limites de l’intervalle théorique [a, b]. Si une loi uniforme est paramétrée sur le support standard débutant à 2 et culminant à 8, restreindre la grille d’abscisses à cet intervalle fermé masquerait la propriété essentielle de la densité, à savoir son caractère strictement nul hors du support. Un choix méthodologique optimal consiste à élargir le balayage d’une fraction substantielle de l’étendue totale, par exemple en explorant l’intervalle débutant à 0 et se terminant à 10. Cette amplitude périphérique met en valeur le saut discontinu caractéristique qui singularise cette distribution par rapport aux densités asymptotiques gaussiennes.
La résolution de cette grille d’abscisses conditionne directement la qualité géométrique du tracé. L’allocation d’un nombre insuffisant de points, tel qu’un vecteur de quelques dizaines de valeurs, introduit des artefacts visuels grossiers, notamment une atténuation factice des discontinuités ou un arrondi intempestif des angles vifs du rectangle de densité. À l’inverse, une partition comportant plusieurs milliers de points permet d’obtenir un rendu visuel parfait tout en maintenant une charge mémoire parfaitement négligeable pour les processeurs modernes, matérialisant ainsi un continuum visuel optimal.
3.2 Calcul vectoriel des ordonnées de densité
Dès lors que la grille d’abscisses est convenablement instanciée, le calcul des ordonnées correspondantes s’effectue au moyen d’un unique appel vectoriel à la fonction dunif. La vectorisation native du langage R permet d’évaluer la densité de chaque point du vecteur sans recourir à des boucles itératives manuelles explicites, garantissant des temps d’exécution optimaux. Il convient de renseigner explicitement les paramètres min et max au sein de la fonction afin de faire correspondre précisément l’opérateur probabiliste aux hypothèses du modèle statistique investigué.
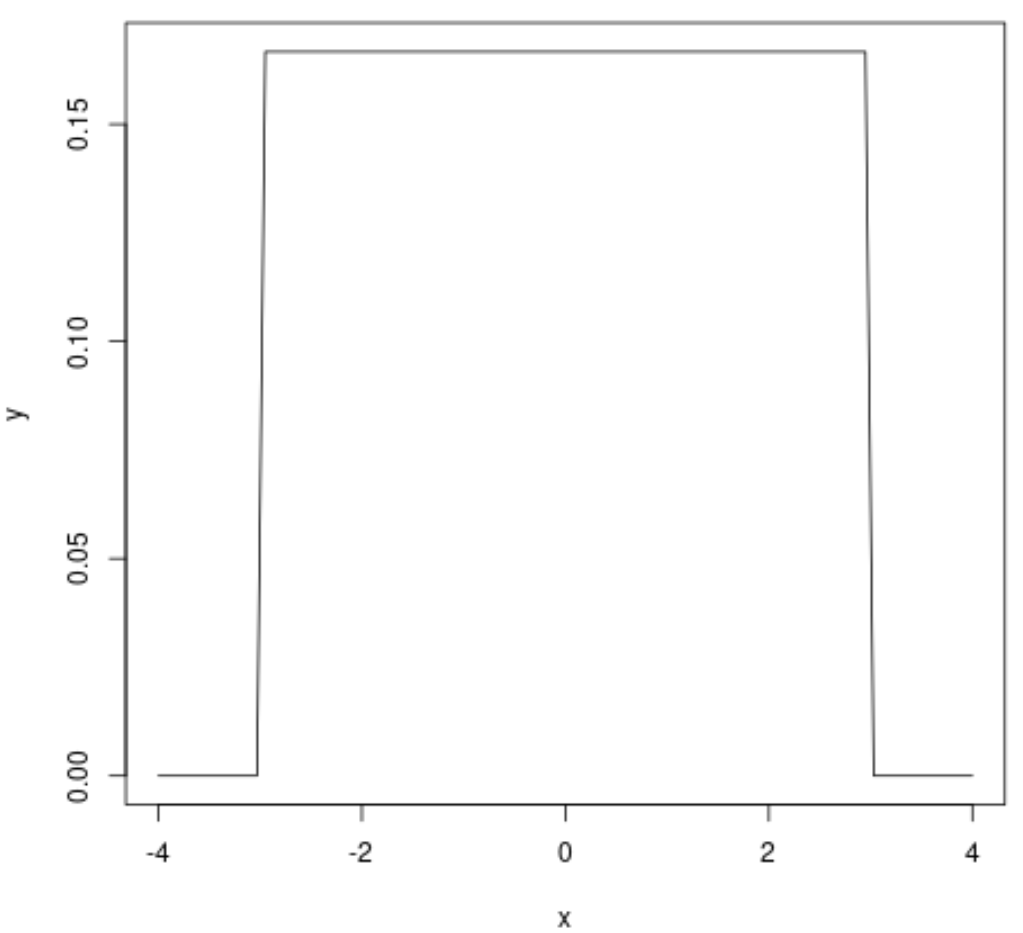
L’analyse du vecteur de résultats ainsi généré révèle la mécanique interne de dunif. Pour l’ensemble des coordonnées de la grille d’abscisses qui se situent rigoureusement en deçà de la borne inférieure min ou au-delà de la borne supérieure max, la fonction retourne impérativement la valeur numérique zéro. Dès que l’abscisse franchit la frontière du support, la valeur attribuée passe instantanément à l’inverse scalaire de la largeur de l’intervalle support. L’inspection des données calculées permet de vérifier la conformité absolue avec le théorème de la conservation de l’aire totale, chaque segment élémentaire d’ordonnée positive reflétant exactement la valeur théorique calculée manuellement.
Une vigilance particulière doit être accordée au comportement de la fonction dunif précisément au niveau des bornes limites a et b. Du point de vue de la théorie de la mesure de Lebesgue, la valeur ponctuelle d’une densité sur un ensemble de mesure nulle n’altère en rien la validité des probabilités calculées par intégration. Dans R, dunif renvoie conventionnellement la hauteur positive 1 / (b – a) sur les bornes fermées de l’intervalle. Ce comportement algorithmique assure la cohérence des tracés et prévient les erreurs de troncature lors de l’interpolation des coordonnées graphiques par le moteur de rendu.
3.3 Construction du tracé linéaire fondamental
L’élaboration matérielle de la représentation graphique mobilise la fonction primitive plot du système graphique de base de R. En fournissant le vecteur d’abscisses étendu et le vecteur d’ordonnées résultant de l’appel à dunif, on obtient l’armature générale du graphe. L’argument capital à spécifier dans cette instruction est type = ‘l’, qui ordonne au moteur de relier les coordonnées successives par des segments linéaires continus plutôt que de disposer des points isolés. Sans cette précision, la figure résultante perdrait sa lisibilité fonctionnelle en devenant un nuage de points sans cohérence géométrique apparente.
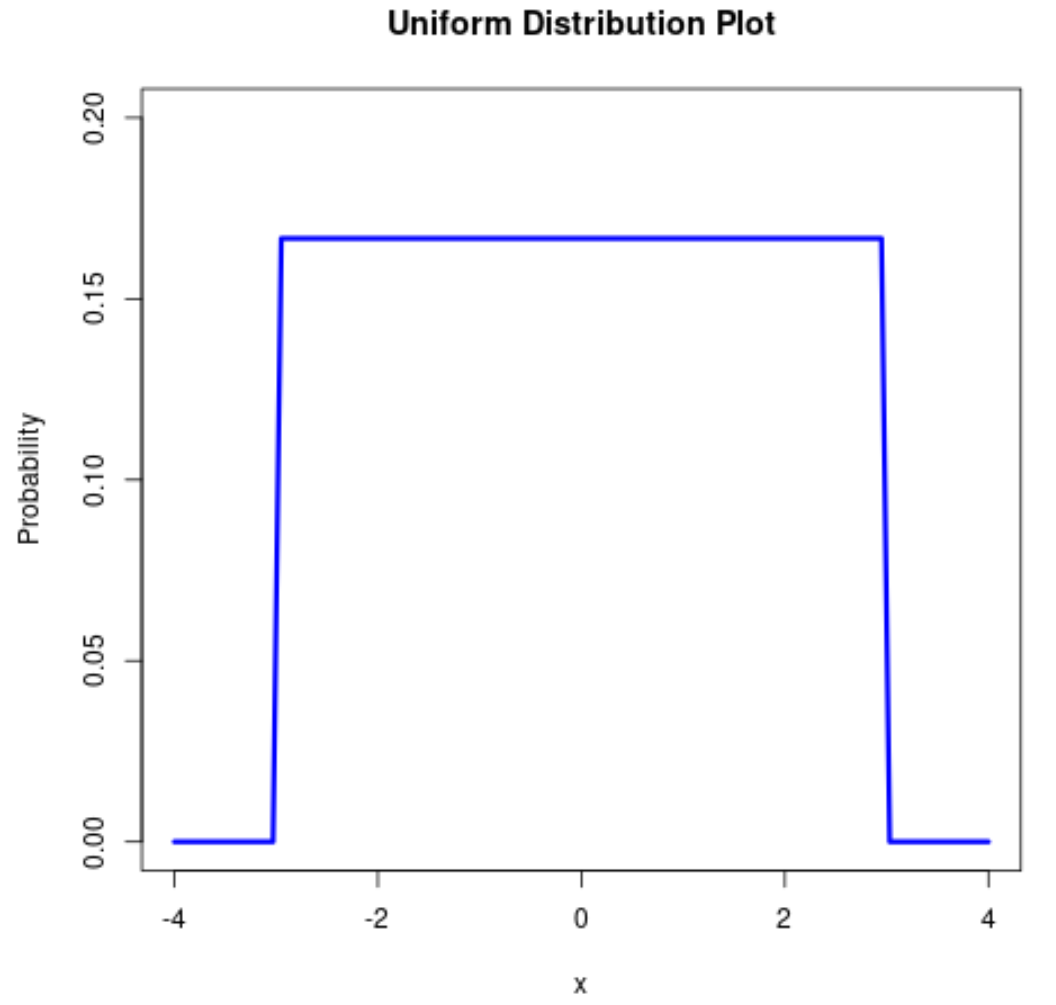
La personnalisation sémantique des axes et des métadonnées contextuelles s’avère indispensable pour satisfaire aux critères de diffusion académique. Les paramètres xlab et ylab doivent être rigoureusement documentés afin d’expliciter sans ambiguïté la nature des variables représentées, typiquement en désignant l’axe horizontal par la variable aléatoire x et l’axe vertical par la mention de densité de probabilité f(x). L’argument main permet de coiffer la représentation d’un titre formel mentionnant explicitement les paramètres intrinsèques de la loi, tels que la valeur de a et la valeur de b.
Toutefois, le recours à un simple tracé linéaire continu engendre un artefact graphique méthodologiquement contestable : le moteur graphique trace une droite quasi verticale oblique pour connecter le zéro périphérique au sommet du rectangle de densité. Cette ligne de transition, bien que matérialisant visuellement la discontinuité, ne correspond à aucune réalité probabiliste formelle puisque la fonction f(x) ne prend jamais de valeurs intermédiaires entre 0 et 1 / (b – a). L’analyste averti peut remédier à cette imprécision de rendu en fragmentant le tracé en plusieurs segments disjoints ou en utilisant des options de dessin adaptées pour représenter des sauts stricts, thématique qui sera approfondie dans les sections consacrées aux corrections méthodologiques avancées.
4. Représentation graphique de la fonction de répartition cumulative
4.1 Calcul de la probabilité cumulée via punif()
L’exploration visuelle d’un processus stochastique ne saurait être complète sans l’examen approfondi de sa fonction de répartition cumulative. Alors que la densité fournit une indication locale sur l’intensité probabiliste instantanée, la fonction de répartition documente la sédimentation progressive de la masse de probabilité sur la totalité de l’axe des réels. Dans R, cette trajectoire intégrale s’obtient avec une efficacité mathématique absolue grâce à la fonction punif, appliquée directement sur la grille d’abscisses préalablement construite pour l’étude de la densité.
L’exécution de la commande punif sur un vecteur s’étendant au-delà des bornes théoriques a et b permet de mettre graphiquement en exergue le comportement asymptotique stationnaire de la fonction. L’analyste constate que la trajectoire demeure strictement horizontale au niveau zéro tant que l’abscisse n’a pas atteint la frontière a. Dès l’instant où la borne a est franchie, la courbe quitte l’axe horizontal pour amorcer une ascension rigoureusement rectiligne et continue, caractérisée par une pente constante de valeur scalaire égale à 1 / (b – a). Cette inclinaison constante atteste graphiquement de l’uniformité du taux de croissance probabiliste sur l’ensemble du support.
Lorsque la coordonnée x atteint précisément la valeur maximale b, la fonction atteint l’asymptote horizontale d’ordonnée un et y demeure indéfiniment pour tout x supérieur à b. Cette saturation unitaire témoigne du caractère exhaustif de la mesure de probabilité. L’absence totale de courbure parabolique ou sigmoïdale non linéaire entre a et b différencie sans ambiguïté la fonction de répartition de la loi uniforme de celle des distributions issues de la famille exponentielle, traduisant visuellement l’équipartition parfaite des chances de réalisation sur le segment étudié.
4.2 Visualisation comparative de la densité et de la répartition
Pour appréhender dans toute sa cohérence la dynamique d’une loi statistique continue, la mise en relation synoptique de la fonction de densité et de la fonction de répartition cumulative constitue une démarche pédagogique d’une remarquable efficacité. Le moteur de base de R autorise une telle juxtaposition architecturale grâce à la modification des paramètres globaux de la fenêtre graphique via l’instruction par(mfrow = c(1, 2)). Cette configuration sépare l’espace d’affichage en une matrice de deux panneaux contigus, permettant d’observer simultanément les deux facettes mathématiques complémentaires du modèle.
Dans le panneau de gauche, le tracé de la densité dessine le profil en créneau typique, caractérisé par son plateau horizontal invariable d’ordonnée 1 / (b – a) et ses chutes abruptes vers zéro. Dans le panneau de droite, aligné sur des abscisses rigoureusement synchronisées, la fonction de répartition trace sa rampe diagonale continue reliant le seuil nul au plafond unitaire. La correspondance visuelle entre ces deux entités devient immédiatement saisissante pour le chercheur : la pente constante observée sur le panneau de droite correspond rigoureusement à la hauteur du rectangle exhibé sur le panneau de gauche.
Cette double visualisation permet également de souligner visuellement les propriétés analytiques fondamentales aux points singuliers. Aux bornes a et b, là où la fonction de densité subit des ruptures de continuité de première espèce, la fonction de répartition présente des points anguleux où la dérivée première n’est pas définie au sens strict, bien que la fonction elle-même demeure parfaitement continue au sens topologique. La synchronisation spatiale des deux tracés rend ces concepts de calcul différentiel immédiatement perceptibles sans ambiguïté analytique.
4.3 Mise en évidence graphique des probabilités d’intervalles
L’application concrète du calcul des probabilités implique fréquemment la détermination de la probabilité associée à un sous-intervalle restreint, compris entre une limite inférieure x1 et une limite supérieure x2, toutes deux englobées dans l’intervalle support [a, b]. Sur le plan géométrique, cette probabilité s’incarne matériellement par l’aire de la sous-région rectangulaire délimitée par ces deux bornes, l’axe des abscisses et le sommet de la fonction de densité. La mise en exergue graphique de cette surface au moyen d’un aplat chromatique contrasté permet de donner une matérialité visuelle limpide au concept d’intégrale définie.
Dans l’environnement de base R, cette coloration s’opère de manière idéale à l’aide de la fonction polygon. Cette primitive vectorielle prend pour arguments une séquence fermée de coordonnées horizontales et verticales définissant le périmètre de la surface à remplir. Pour colorer la tranche de probabilité entre x1 et x2, il suffit de concevoir un vecteur horizontal assemblant consécutivement les points x1, x2, x2 et x1, apparié à un vecteur vertical reliant successivement 0, 0, la hauteur de densité 1 / (b – a) et de nouveau cette même hauteur. L’application d’une teinte translucide via un code de couleur adapté évite de masquer les lignes d’axes sous-jacentes.
L’enrichissement du graphique peut être parachevé par l’inscription d’annotations textuelles explicites directement au cœur ou au-dessus de la zone polygonale colorée. L’usage combiné des fonctions text et segments permet de tracer une flèche indicatrice pointant vers l’aire ombrée, accompagnée de l’évaluation numérique exacte du calcul P(x1 < X < x2) = (x2 – x1) / (b – a). Ce dispositif visuel transforme une figure statique en un diagramme démonstratif d’une grande valeur pédagogique, démontrant sans équivoque que la masse de probabilité équivaut strictement à la surface géométrique mise en relief.
5. Simulation d’échantillons et diagnostic par histogramme
5.1 Génération de variables aléatoires par runif()
La théorie asymptotique et les propriétés déterministes des distributions continues prennent tout leur sens pratique lorsqu’elles sont confrontées à la réalité empirique de l’échantillonnage aléatoire. La fonction runif permet d’instancier ce pont méthodologique en générant des échantillons de variables pseudo-aléatoires distribuées selon la loi uniforme continue. Le paramètre fondamental n spécifie la taille de la cohorte synthétique à produire, tandis que les paramètres min et max circonscrivent le champ de tirage des réalisations numériques.
L’exploration empirique de la distribution gagne à être conduite à travers différents ordres de grandeur de taille d’échantillon afin d’observer visuellement les manifestations concrètes de la convergence stochastique. En instanciant successivement des échantillons de dimensions réduites, tels que N = 100, intermédiaires à N = 1 000, et massives à N = 100 000, l’analyste constate l’impact direct de la variabilité d’échantillonnage. Pour des cohortes réduites, l’aléa produit des regroupements locaux de points et des zones de vide apparentes, créant une impression trompeuse de non-uniformité au sein du continuum support.
C’est à travers l’accroissement substantiel de la taille d’échantillon que se manifeste de manière éclatante le théorème de Glivenko-Cantelli, souvent qualifié de théorème fondamental de la statistique mathématique. Ce théorème postule que la fonction de répartition empirique converge presque sûrement et uniformément vers la fonction de répartition théorique sous-jacente lorsque N tend vers l’infini. Observer la régularisation progressive des distributions simulées au fur et à mesure que N s’élève constitue une validation empirique saisissante de la robustesse des algorithmes d’échantillonnage implémentés dans le socle algorithmique de R.
5.2 Construction d’histogrammes normalisés
L’histogramme demeure l’outil graphique par excellence pour apprécier empiriquement la distribution de densité d’un échantillon continu. Cependant, l’usage de la primitive hist de R requiert une précaution méthodologique capitale : le paramètre freq doit être impérativement configuré sur la valeur logique FALSE. Par défaut, la fonction hist comptabilise les effectifs bruts au sein de chaque classe sur l’axe vertical, ce qui rend toute superposition avec une fonction de densité théorique formellement erronée, les grandeurs scalaires n’évoluant pas dans le même espace dimensionnel.
Lorsque le paramètre freq est fixé à FALSE, R procède à une normalisation rigoureuse de l’histogramme en divisant les fréquences absolues par le produit de la taille de l’échantillon et de la largeur de chaque classe. L’ordonnée représente dès lors une véritable densité empirique, conférant à la somme totale des aires de tous les rectangles de l’histogramme une valeur exactement égale à un. Cette homogénéisation des unités constitue la condition sine qua non pour autoriser une comparaison directe et visuellement valide entre les observations échantillonnées et le modèle continu continu.
Le choix du nombre et de la largeur des intervalles d’échantillonnage, piloté par l’argument breaks, exerce une influence critique sur la morphologie visuelle de l’uniformité. Un partitionnement trop grossier, induit par un nombre excessivement restreint de classes, lisse artificiellement les variations locales et dissimule d’éventuelles anomalies d’échantillonnage. À l’opposé, une fragmentation microscopique avec un nombre excessif de classes engendre un bruit visuel intense caractérisé par de nombreuses classes dépeuplées ou vides, occultant la planéité globale recherchée. L’application judicieuse d’algorithmes de discrétisation optimisés, tels que la règle de Freedman-Diaconis ou de Sturges, permet d’atteindre un équilibre visuel optimal adapté au volume de données disponible.
5.3 Superposition de la densité théorique sur l’histogramme
L’évaluation diagnostique de l’adéquation d’un échantillon à la loi uniforme sous-jacente culmine lors de la superposition géométrique de la courbe théorique de densité par-dessus l’histogramme de densité normalisé préalablement généré. Dans l’écosystème de base R, cet ajout séquentiel s’opère sans ouvrir de nouveau dispositif graphique grâce à l’appel de la primitive lines. En transmettant à cette fonction la grille d’abscisses analytique et les ordonnées calculées par dunif, une ligne continue vient se plaquer directement sur les barres de l’histogramme.
Pour garantir une comparaison visuelle sans ambiguïté, il est nécessaire d’ajuster l’échelle de l’axe vertical de l’histogramme dès son initialisation. Les fluctuations d’échantillonnage conduisent fréquemment certaines classes expérimentales à dépasser légèrement la hauteur théorique 1 / (b – a). Si l’argument ylim de la fonction hist n’a pas été calibré pour intégrer une marge supérieure de sécurité, le sommet des classes les plus hautes ou la ligne théorique de densité risquent d’être tronqués par le cadre du tracé. L’incorporation d’un facteur d’expansion sur l’ordonnée maximale résout définitivement ce désagrément de mise en page.
Cette superposition offre un diagnostic immédiat des fluctuations d’échantillonnage stochastiques. Sur un échantillon modeste, les irrégularités de hauteur des rectangles par rapport à l’horizontale analytique illustrent la variance inhérente à l’estimateur de densité empirique. Sur des cohortes massives, la parfaite tangence de la ligne théorique avec le sommet moyen de la mosaïque rectangulaire confirme avec une éloquence visuelle saisissante la validité du tirage pseudo-aléatoire et la congruence du modèle probabiliste théorique avec l’observation expérimentale.
6. Tracé de la loi uniforme à l’aide de ggplot2
6.1 Approche fonctionnelle avec stat_function()
Le basculement vers l’écosystème ggplot2 introduit une rupture méthodologique élégante dans la manière de représenter des objets mathématiques continus. Au lieu de manipuler directement des vecteurs numériques disjoints, ggplot2 privilégie une approche déclarative où les courbes sont générées de manière dynamique à partir de structures fonctionnelles. Pour tracer la densité théorique de la loi uniforme sans créer manuellement de volumineuses grilles d’abscisses dans l’environnement global, l’analyste peut s’appuyer sur la couche spécialisée stat_function.
La mise en œuvre de cette technique débute par l’initialisation d’un canevas vierge au moyen de la fonction ggplot, couplée à un jeu de données symbolique délimitant l’amplitude de l’axe des abscisses, typiquement un tableau de données rudimentaire restreint aux deux bornes d’affichage souhaitées. Dès lors, l’adjonction de stat_function permet de déléguer au moteur interne de ggplot2 l’échantillonnage et l’évaluation de la distribution. En spécifiant l’argument fun = dunif et en transmettant les paramètres de la distribution sous la forme d’une liste nommée via args = list(min = a, max = b), l’opérateur génère automatiquement la courbe requise.
L’immense avantage de cette approche réside dans sa vectorisation automatique et son adaptabilité à la géométrie de la fenêtre d’affichage. Le paramètre n de stat_function permet de fixer arbitrairement la finesse de l’échantillonnage interne, garantissant une netteté vectorielle irréprochable sans alourdir le script de code. Cette modularité conceptuelle favorise une écriture concise, réduisant substantiellement les lignes de code nécessaires tout en intégrant nativement la gestion des légendes et des propriétés esthétiques globales propres à l’écosystème Tidyverse.
6.2 Visualisation de distributions empiriques avec geom_histogram()
Lorsqu’il s’agit de visualiser des données d’échantillonnage uniformes générées via runif au sein de ggplot2, l’approche déclarative requiert de convertir préalablement le vecteur de valeurs simulées en une structure tabulaire formelle, de type data.frame ou tibble. Cette structuration préalable permet d’exploiter pleinement le système de correspondances esthétiques de la fonction aes. La géométrie geom_histogram constitue l’entité centrale pour la restitution sous forme de classes de densité.
À l’instar de la précaution requise dans le système de base avec l’argument freq = FALSE, il est indispensable sous ggplot2 de spécifier explicitement que l’ordonnée doit refléter la densité et non le simple décompte absolu des occurrences. Cette opération s’effectue en associant l’esthétique y à la variable calculée interne fournie par la syntaxe after_stat(density). Par cette commande, chaque barre de l’histogramme voit sa hauteur automatiquement ajustée pour que l’intégration globale de l’aire totale corresponde strictement à l’unité.
Le contrôle de la largeur des intervalles au sein de geom_histogram s’opère avec une flexibilité chirurgicale au moyen de l’argument binwidth, ou alternativement par la spécification directe du nombre de coupures via bins. Ajuster ce paramètre permet d’exhiber la planéité empirique de la distribution sans masquer les variations stochastiques naturelles propres à la taille de l’échantillon analysé. En combinant un contour net grâce à l’argument color et un remplissage chromatique sobre via fill, l’analyste produit un rendu visuel d’une qualité immédiatement diffusable dans des publications de rang académique.
6.3 Superposition élégante de couches graphiques
La puissance paradigmatique de ggplot2 culmine dans son aptitude à empiler harmonieusement des strates géométriques d’abstractions diverses au sein d’un repère orthonormé unifié. La superposition conjointe d’un histogramme empirique généré par geom_histogram et d’une courbe fonctionnelle analytique projetée par stat_function s’effectue par une simple concaténation d’instructions reliées par l’opérateur d’addition standard. Ce mécanisme permet de confronter le réel simulé à la perfection mathématique sur un unique tableau de bord visuel.
L’optimisation visuelle de cet assemblage repose sur une gestion raffinée de la transparence chromatique au travers du paramètre alpha. En attribuant à l’histogramme une opacité partielle, l’analyste assure que la ligne analytique théorique, positionnée préférentiellement au sommet de la pile d’affichage avec une épaisseur renforcée via le paramètre linewidth, demeure parfaitement discernable sur l’ensemble du profil sans jamais être éclipsée par le volume des barres expérimentales.
Pour parachever ce dispositif diagnostic, il est particulièrement pertinent d’adjoindre une géométrie complémentaire sous la forme de geom_rug. Cette primitive projette une série de fines encoches linéaires directement sur l’axe des abscisses, matérialisant individuellement chaque observation du jeu de données synthétique. Ce complément visuel enrichit l’analyse en offrant une vue univariée directe de la densité ponctuelle le long du support, révélant la régularité spatiale des tirages et la présence éventuelle de conglomérats aléatoires locaux le long de l’intervalle.
7. Personnalisation esthétique et typographie académique
7.1 Contrôle des axes et de l’habillage graphique
La production de figures destinées à l’évaluation par les pairs ou à des monographies scientifiques exige un contrôle absolu sur chaque élément de mise en page, bannissant les configurations graphiques implicites ou génériques. Sous le moteur de base R, ce niveau d’exigence implique souvent de désactiver le traçage par défaut des axes via l’argument axes = FALSE dans la primitive plot, pour reconstruire ensuite sur mesure chaque composant à l’aide de la fonction dédiée axis. Cette stratégie permet de spécifier précisément les graduations majeures et mineures aux abscisses exactes des bornes a et b, garantissant une rigueur visuelle maximale.
Dans l’univers ggplot2, cette personnalisation avancée est orchestrée par les fonctions de la famille scale_x_continuous et scale_y_continuous. Ces directives permettent de délimiter formellement l’étendue visible grâce au paramètre limits, de définir la position précise des graduations d’échelle via l’argument breaks, et d’affiner la nomenclature textuelle associée au moyen de vecteurs d’étiquettes personnalisés. L’intégration de ces spécifications prévient toute distorsion de perspective en ancrant fermement le zéro d’origine au croisement exact des axes de coordonnées.
L’habillage typographique et structurel de la figure bénéficie grandement de l’application de thèmes épurés préconfigurés. L’abandon du fond grisâtre standard de ggplot2 au profit de chartes minimalistes, telles que theme_classic() ou theme_bw(), élimine les bruits visuels périphériques non porteurs de sens statistique. Le calibrage de la grille orthogonale interne, la suppression des bordures superflues et l’harmonisation des proportions dimensionnelles confèrent à l’artéfact graphique une sobriété et une clarté indispensables pour une lecture analytique exempte de distractions esthétiques.
7.2 Insertion de formules mathématiques et légendes
L’intégration formelle de la théorie au sein de la visualisation s’accomplit par l’adjonction d’équations mathématiques rigoureuses directement intégrées dans le canevas graphique. R dispose d’un moteur typographique interne particulièrement sophistiqué nommé plotmath, capable de restituer fidèlement la syntaxe mathématique universelle, incluant les alphabets grecs, les fractions, les symboles d’intégrales et les indices ou exposants, sans recourir à des logiciels externes de retouche d’image.
Pour insérer une équation au sein d’une figure, qu’il s’agisse du titre principal ou d’une étiquette flottante, l’analyste emploie la commande expression. L’écriture d’une formulation explicitant la densité formelle f(x) = 1 / (b – a) ou la variance Var(X) = (b – a)^2 / 12 se trouve ainsi instantanément transmutée en une gravure typographique impeccable, répondant aux standards esthétiques des publications imprimées. Dans ggplot2, cette même fonctionnalité est exploitée au sein des couches d’annotation textuelle via l’adjonction de l’argument parse = TRUE dans la fonction annotate.
Le positionnement de légendes explicatives constitue le complément logique de ce dispositif typographique. L’agencement minutieux d’une légende contextuelle, calibrée pour expliciter sans ambiguïté les conventions de couleurs associées aux densités théoriques et aux distributions simulées, renforce considérablement l’autonomie conceptuelle du graphique. L’ajout de repères géométriques ponctuels, tels que des lignes verticales tiretées créées via abline ou geom_vline pour matérialiser visuellement la moyenne centrale E(X) ou les limites du support, guide instantanément le regard de l’observateur vers les propriétés clés du modèle statistique.
7.3 Exportation en haute résolution pour manuscrits
L’aboutissement de tout travail de visualisation statistique réside dans son exportation sous la forme d’un fichier numérique préservant rigoureusement l’intégrité de ses composants vectoriels et typographiques. L’affichage au sein de l’environnement interactif de RStudio ne préjuge en rien du comportement du tracé lors de son impression sur papier couché ou de son intégration dans des revues savantes exigeant une conformité technique intransigeante, notamment une résolution minimale de 300 à 600 points par pouce (DPI).
Deux voies techniques s’offrent à l’analyste pour matérialiser cette conservation de fidélité : les formats vectoriels purs et les formats matriciels haute densité. Pour une soumission académique standard, l’exportation vectorielle demeure la solution privilégiée par excellence. L’initialisation d’un périphérique vectoriel tel que cairo_pdf() ou svg() permet d’encoder chaque tracé sous la forme de directives géométriques indépendantes de la résolution d’affichage. Les polices de caractères, les contours et les aplats chromatiques peuvent ainsi être agrandis indéfiniment sans qu’aucun phénomène de pixellisation ou d’altération de contour n’apparaisse.
Lorsque des contraintes éditoriales imposent la transmission d’images matricielles ou rastérisées, l’usage de ggsave sous ggplot2 ou de la primitive tiff dans le système de base permet de fixer avec une précision absolue la largeur, la hauteur, l’unité métrique physique et la densité de points par pouce de la matrice résultante. Il est impératif d’ajuster simultanément le ratio d’aspect dimensionnel et l’échelle d’agrandissement global des polices, afin de s’assurer que les caractères demeurent parfaitement lisibles une fois l’image réduite aux dimensions d’une colonne de texte standard dans une revue internationale.
8. Visualisation de la distribution uniforme multivariée
8.1 Génération de variables uniformes bidimensionnelles
L’extension de la loi uniforme vers des espaces à dimensions multiples constitue le socle indispensable pour l’analyse spatiale, la physique statistique et les plans d’échantillonnage de Monte-Carlo multivariés. Dans sa forme continue bidimensionnelle la plus classique, la loi uniforme est définie sur un domaine rectangulaire compact résultant du produit cartésien de deux intervalles unidimensionnels, formalisé par le pavé [a, b] x [c, d]. La condition d’indépendance stochastique stricte entre les deux variables aléatoires constituantes X et Y simplifie l’architecture théorique du modèle.
En vertu du principe d’indépendance probabiliste, la fonction de densité conjointe de probabilité, désignée par f(x, y), s’exprime rigoureusement comme le produit direct des densités marginales respectives. Dès lors, pour tout couple de coordonnées (x, y) appartenant au rectangle spatial délimité par les bornes [a, b] et [c, d], la densité conjointe est constante et prend pour valeur scalaire 1 / ((b – a) * (d – c)). En dehors de ce domaine pavé, la densité s’annule strictement. La matrice de variance-covariance associée présente une covariance théorique identiquement nulle, attestant d’une orthogonalité statistique absolue entre les deux axes de variation.
Pour simuler computationnellement une telle structure sous R, il suffit de procéder à deux appels distincts et consécutifs à la primitive runif, en configurant séparément les tailles et les bornes requises pour chaque coordonnée dimensionnelle. L’assemblage de ces deux vecteurs au sein d’une matrice à deux colonnes ou d’un tableau structuré permet de générer un échantillon d’observations spatiales équiprobables. Cette structure matricielle constitue le point de départ pour l’exploration graphique bidimensionnelle et la vérification visuelle de l’absence totale de motifs directionnels ou de regroupements privilégiés dans l’espace échantillonné.
8.2 Tracés en deux dimensions : diagrammes de dispersion et cartes de chaleur
La première technique de restitution visuelle d’une distribution uniforme bidimensionnelle repose sur le diagramme de dispersion cartésien classique, matérialisé par la fonction plot ou la géométrie geom_point de ggplot2. Dans un scénario théorique idéal d’uniformité spatiale continue, les points générés doivent saturer le rectangle de support de manière homogène, sans révéler d’axes privilégiés, de trajectoires de corrélation oblique ou de concentrations centrales. Cependant, lorsque le volume d’échantillons devient très important, la superposition dense de points opaques génère un phénomène de sur-traçage qui obère l’estimation visuelle de la régularité locale.
Pour surmonter cette limitation perceptive, le recours à des géométries d’agrégation spatiale régulière apporte une plus-value diagnostique déterminante. L’utilisation conjointe de geom_bin2d ou de geom_hex permet de subdiviser le plan euclidien en une mosaïque de compartiments réguliers rectangulaires ou hexagonaux, et de quantifier précisément le dénombrement d’observations contenues dans chaque maille spatiale. La palette chromatique appliquée à ces mailles matérialise une véritable carte de chaleur de la densité expérimentale.
L’analyse visuelle d’une telle carte de chaleur permet d’apprécier immédiatement la qualité de l’équipartition spatiale. Dans le cas d’une simulation uniforme idéale à grand volume, la palette chromatique doit afficher une quasi-uniformité de teinte sur l’ensemble de la grille délimitée, les micro-variations de couleur résiduelles n’étant que le reflet de la variance poissonnienne inhérente aux processus de comptage aléatoire par compartiment. Tout gradient de couleur systématique ou toute concentration chromatique asymétrique mettrait en évidence un biais flagrant dans le générateur pseudo-aléatoire utilisé.
8.3 Tracés tridimensionnels de la surface de densité
La représentation intégrale de la fonction de densité conjointe nécessite d’élever la modélisation vers un repère spatial tridimensionnel, où l’altitude verticale de l’axe z correspond formellement à la hauteur f(x, y). Sur le plan théorique, cette fonction s’apparente à un pavé architectural aux parois abruptes, présentant un plateau supérieur horizontal rigoureusement plan culminant à l’altitude constante 1 / ((b – a) * (d – c)). La reproduction visuelle de cette topologie cubique permet de saisir immédiatement le concept de volume unitaire sous-jacent à la distribution conjointe.
Dans l’environnement graphique de base R, cette matérialisation en relief s’accomplit au travers de la fonction persp. La procédure nécessite l’élaboration préalable d’une matrice d’ordonnées spatiales au moyen de la primitive outer, qui croise l’évaluation de deux vecteurs d’abscisses orthogonaux selon la règle de multiplication matricielle des densités de dunif. En transmettant cette matrice d’altitudes à persp, l’opérateur génère une surface tridimensionnelle filaire ou ombrée. Les arguments de perspective theta et phi autorisent une rotation interactive de l’angle d’observation pour visualiser la verticalité des flancs et la planéité du plateau sommital.
Pour des environnements de recherche contemporains nécessitant une manipulation visuelle dynamique, des packages avancés tels que plotly permettent de transposer cette surface volumique sous une forme vectorielle interactive exécutable au sein d’un navigateur web. L’utilisateur peut ainsi faire pivoter le pavé volumique, zoomer sur les zones frontalières de discontinuité et vérifier numériquement que le volume géométrique intégral délimité par cette surface spatiale au-dessus du rectangle support correspond avec une exactitude arithmétique absolue à la valeur scalaire de un.
9. Comparaison visuelle entre la loi uniforme et d’autres distributions
9.1 Confrontation avec la loi normale de même variance
Une démarche heuristique majeure pour comprendre les singularités morphologiques de la loi uniforme consiste à la juxtaposer visuellement à la distribution reine de la statistique inférentielle : la loi normale de Laplace-Gauss. Pour rendre cette confrontation mathématiquement et graphiquement rigoureuse, il est indispensable de calibrer la distribution gaussienne de comparaison de telle sorte qu’elle partage exactement la même espérance mathématique et la même variance que la loi uniforme de référence sur l’intervalle [a, b].
En mobilisant les équations théoriques des moments de la loi uniforme continue, l’analyste configure la moyenne gaussienne mu sur la valeur (a + b) / 2 et l’écart-type sigma sur la racine carrée de la variance uniforme, c’est-à-dire (b – a) / sqrt(12). La superposition des deux courbes de densité sur un même canevas graphique au moyen de ggplot2 ou du système de base met instantanément en lumière les divergences structurelles profondes qui séparent ces deux architectures probabilistes, bien qu’elles partagent des caractéristiques de dispersion quadratique strictement équivalentes.
Cette comparaison visuelle éclaire de manière éclatante les concepts de curtosis ou coefficient d’aplatissement. La distribution uniforme est dite platykurtique par excellence, exhibant une valeur de curtosis d’excès rigoureusement égale à -1,2, ce qui se traduit graphiquement par l’absence totale de cloche centrale prononcée et l’inexistence de queues de distribution étirées vers l’infini. Alors que la courbe normale s’évase à l’infini en concentrant sa masse au voisinage immédiat de sa moyenne, la densité uniforme maintient une intensité invariante avant de s’effondrer brutalement à zéro, soulignant ainsi la compacité stricte de son support spatial.
9.2 Transformation intégrale de probabilité (Probability Integral Transform)
La transformation intégrale de probabilité, souvent désignée par le vocable anglais de Probability Integral Transform, représente l’un des théorèmes les plus profonds et les plus élégants de la théorie moderne des probabilités. Ce théorème stipule que si une variable aléatoire continue X possède une fonction de répartition cumulative continue notée F(X), alors la variable aléatoire transformée définie par Y = F(X) suit impérativement et universellement une loi uniforme standard sur le segment [0, 1], quelle que soit la complexité ou l’asymétrie de la distribution d’origine de la variable X.
L’illustration graphique de ce principe fondamental sous R constitue une expérience pédagogique d’une rare clarté. En générant un échantillon massif issu d’une distribution hautement asymétrique, telle qu’une loi exponentielle ou une loi log-normale, et en appliquant à ce vecteur empirique sa propre fonction de répartition théorique (respectivement pexp ou plnorm), l’analyste obtient un nouveau vecteur de données. Le tracé de l’histogramme normalisé de cette variable transformée révèle alors un profil parfaitement rectangulaire et plan, conforme à l’uniformité standard attendue.
Ce mécanisme théorique et visuel trouve son application concrète majeure dans deux domaines vitaux de la statistique appliquée. D’une part, il constitue le socle algorithmique de la méthode d’inversion par échantillonnage, employée pour simuler n’importe quelle variable aléatoire complexe à partir d’un simple générateur de nombres uniformes en exploitant l’inverse de la fonction de répartition. D’autre part, il explique pourquoi, sous l’hypothèse nulle d’un test statistique continu rigoureux, la distribution des p-valeurs observées doit nécessairement épouser une loi uniforme sur [0, 1], faisant du diagnostic visuel d’uniformité un outil d’audit fondamental de l’intégrité expérimentale.
9.3 Convergence de la somme de variables uniformes (Théorème Central Limite)
Le tracé de la somme de variables aléatoires indépendantes et identiquement distribuées selon une loi uniforme offre l’une des illustrations visuelles les plus spectaculaires de l’universalité du Théorème Central Limite. La distribution analytique exacte résultant de la sommation de n variables uniformes indépendantes sur [0, 1] porte le nom de distribution d’Irwin-Hall. L’exploration graphique de cette distribution pour des valeurs successives et croissantes de n permet de visualiser la métamorphose continue d’un profil rectangulaire pur vers la cloche gaussienne canonique.
Pour n = 2, la sommation de deux tirages uniformes indépendants génère la célèbre distribution triangulaire de Simpson. Sur le plan visuel, le plateau horizontal cède instantanément la place à une structure anguleuse pyramidale, culminant en son centre à la coordonnée unitaire et s’éteignant linéairement à ses extrémités zéro et deux. Dès l’adjonction d’une troisième composante (n = 3), la composition par morceaux s’adoucit considérablement, les discontinuités anguleuses de première dérivée disparaissant pour laisser place à une courbure parabolique continue d’une remarquable fluidité visuelle.
En atteignant une sommation de n = 12 variables uniformes standard, l’analyste observe un phénomène computationnel historique fascinant. L’espérance mathématique de la somme étant égale à 12 * 0,5 = 6 et sa variance étant égale à 12 * (1/12) = 1, la variable soustraite de la constante 6 produit une approximation de la loi normale centrée réduite si parfaite que les représentations graphiques contemporaines ne permettent de déceler aucun écart perceptible à l’œil nu. Ce mécanisme a longtemps constitué l’algorithme standard de génération des nombres normaux dans les architectures informatiques pionnières du vingtième siècle.
10. Applications de la loi uniforme en méthodologie psychologique
10.1 Modélisation des temps de réponse et des processus d’attention
Dans le champ de la psychologie cognitive et des neurosciences comportementales, la loi uniforme est fréquemment sollicitée pour formaliser des états d’attente neutres ou des paradigmes d’incertitude temporelle maximale. Lors de protocoles expérimentaux mesurant des temps de réaction simples ou de choix forcé, les chercheurs introduisent des intervalles préparatoires aléatoires, communément désignés sous le terme d’intervalles avant-période (ou foreperiods), séparant le signal d’avertissement de l’apparition effective du stimulus cible.
L’utilisation d’une distribution uniforme continue pour calibrer ces intervalles préparatoires permet de modéliser un environnement temporel où, a priori, aucune fenêtre temporelle spécifique n’est privilégiée par le participant pour déclencher son attention focalisée. Cependant, la visualisation comparative entre la distribution uniforme théorique du temps d’attente et la fonction de taux de hasard subjective perçue par le sujet humain révèle un paradoxe fondamental : au fur et à mesure que le temps s’écoule sans que le stimulus n’apparaisse, la probabilité conditionnelle que l’événement survienne dans l’instant immédiatement suivant croît de manière hyperbolique.
Parallèlement, au sein du cadre méthodologique de l’inférence bayésienne appliquée aux sciences cognitives, la distribution uniforme continue sur un intervalle borné incarne l’archétype de la distribution a priori non informative, ou prior d’indifférence. Tracer graphiquement cette distribution a priori rectangulaire et la superposer à la distribution de vraisemblance empirique permet aux chercheurs d’illustrer la manière dont les données expérimentales collectées viennent actualiser les croyances initiales du modèle sans qu’aucun biais préalable d’ancrage n’ait été introduit dans l’estimation paramétrique.
10.2 Étalonnage psychométrique et distribution des rangs percentiles
Le domaine de la psychométrie et de la mesure des aptitudes psychologiques recourt de manière intensive aux propriétés mathématiques de l’uniformité lors des procédures de standardisation et d’étalonnage des instruments psychologiques. Alors que les scores bruts issus d’un questionnaire d’évaluation de la personnalité ou d’une échelle cognitive globale suivent traditionnellement une distribution approximativement gaussienne au sein de la population générale, la transformation de ces scores en rangs percentiles produit une altération délibérée de la métrique sous-jacente.
En vertu directe de la transformation intégrale de probabilité, l’attribution à chaque individu de son rang centile sur une échelle graduée de 0 à 100 induit théoriquement une distribution uniforme de la métrique au sein de l’échantillon de référence normatif. La visualisation graphique de cette distribution des percentiles permet aux psychométriciens de diagnostiquer immédiatement la présence d’anomalies structurelles au sein du panel de test, telles que des effets de plafond ou de plancher prononcés, qui se manifestent visuellement par des accumulations aberrantes d’effectifs sur les colonnes terminales de l’histogramme.
De surcroît, le tracé conjoint de la courbe des scores bruts originaux et de la ligne des percentiles standardisés met en lumière la distorsion métrique inhérente à cette transformation. La pente de conversion n’étant pas linéaire, elle a pour effet graphique d’étirer artificiellement les écarts interindividuels situés au centre de la distribution tout en comprimant drastiquement les différences de compétences situées aux extrémités de l’échelle. Visualiser avec précision ces non-linéarités est indispensable pour prémunir les cliniciens et les praticiens contre des erreurs d’interprétation diagnostique majeures lors de l’évaluation standardisée.
10.3 Randomisation dans les protocoles expérimentaux
La validité interne des inférences causales dans les devis expérimentaux en psychologie et en recherche médicale repose intégralement sur la neutralité des mécanismes d’allocation des sujets aux conditions expérimentales. L’attribution des participants aux groupes témoins et aux groupes d’intervention thérapeutique nécessite une procédure de randomisation exempte de tout biais de sélection systématique, tâche pour laquelle le générateur uniforme runif de R constitue l’instrument informatique standardisé par excellence.
Le contrôle diagnostique de ces protocoles d’assignation s’effectue idéalement au moyen d’analyses graphiques rigoureuses. En représentant la séquence sérielle des tirages stochastiques sous forme de diagrammes de dispersion ou de cartes thermiques longitudinales, l’expérimentateur peut vérifier visuellement l’absence de tendances d’autocorrélation temporelle ou de périodicités accidentelles pouvant résulter d’une mauvaise initialisation du générateur aléatoire ou d’une taille de bloc inadaptée lors d’une randomisation par blocs permutés.
De même, dans les paradigmes psychophysiques avancés requérant la présentation pseudo-aléatoire de centaines de stimuli sensoriels, la cartographie visuelle de la distribution spatio-temporelle des occurrences de stimuli assure que chaque condition expérimentale a bénéficié d’une équipartition spatiale rigoureuse sur l’écran d’affichage. Les visualisations graphiques issues de R garantissent ainsi une traçabilité méthodologique complète, attestant que l’équiprobabilité théorique postulée dans le protocole de recherche a bien été fidèlement transposée dans l’implémentation algorithmique de laboratoire.
11. Tests d’adéquation et outils de diagnostic graphique de l’uniformité
11.1 Diagramme quantile-quantile (Q-Q Plot) pour loi uniforme
Le diagramme quantile-quantile, universellement désigné sous le terme de Q-Q plot, constitue l’un des outils de diagnostic les plus sensibles et les plus élégants pour apprécier visuellement la fidélité d’un échantillon expérimental vis-à-vis d’un modèle probabiliste théorique donné. Contrairement à l’histogramme, dont le profil visuel est tributaire de la largeur arbitraire des classes retenues, le Q-Q plot exploite individuellement chaque point de données en mettant directement en correspondance les quantiles empiriques observés avec les quantiles théoriques attendus de la loi considérée.
Dans l’environnement R, la conception d’un Q-Q plot adapté à la loi uniforme nécessite une instanciation méthodique, la fonction standard qqnorm étant exclusivement calibrée pour la référence gaussienne. L’analyste extrait les quantiles empiriques en ordonnant de manière croissante le vecteur d’échantillon au moyen de la primitive sort. En parallèle, les quantiles théoriques équivalents sont calculés à l’aide de la fonction qunif, appliquée sur un vecteur de probabilités de traçage déterminé par la formule standard (1:n – 0.5) / n, où n représente la taille totale de la cohorte analysée.
La projection de ces couples de coordonnées sur un graphique cartésien produit un ensemble de points qui, sous l’hypothèse d’une conformité parfaite avec la loi uniforme, doivent s’aligner de manière strictement rectiligne le long de la droite d’équation y = x ou de la droite reliant les bornes (min, min) et (max, max). Toute incurvation systématique en forme de S ou de banane met immédiatement en lumière une déviation morphologique structurée, révélant la présence de queues de distribution asymétriques, d’un excès de kurtosis ou d’une concentration anormale de valeurs centrales incompatibles avec l’équiprobabilité théorique postulée.
11.2 Visualisation de la fonction de répartition empirique (ECDF)
La visualisation de la fonction de répartition empirique, conventionnellement abrégée sous l’acronyme ECDF (Empirical Cumulative Distribution Function), constitue un instrument d’évaluation non paramétrique d’une puissance méthodologique majeure. Elle associe à toute valeur scalaire x la proportion exacte des observations de l’échantillon qui lui sont inférieures ou égales. Dans le système graphique de R, cette modélisation s’obtient instantanément au travers de la primitive plot(ecdf(donnees)).
Le profil géométrique de l’ECDF dessine une trajectoire en escalier rigide, ponctuée de sauts verticaux discrets d’amplitude constante 1 / n à chaque observation observée dans le vecteur de mesures. Pour ausculter graphiquement l’uniformité sous-jacente, il est d’usage d’ajouter sur ce graphique en escalier la droite théorique calculée analytiquement par la fonction punif. Cette juxtaposition visuelle directe permet d’évaluer la proximité de la fonction expérimentale avec la rampe rectiligne idéale caractéristique de la loi uniforme.
L’examen minutieux des écarts verticaux entre la trajectoire empirique en escalier et la droite analytique permet d’apprécier matériellement la statistique de test de Kolmogorov-Smirnov. Cette dernière correspond formellement à la borne supérieure absolue de la distance verticale séparant l’ECDF de la fonction théorique. La détection visuelle de la divergence maximale le long de l’axe des abscisses localise précisément le domaine du support spatial où l’échantillon s’éloigne le plus nettement des prédictions d’indifférence équiprobable.
11.3 Couplage des tracés aux tests d’hypothèses formels
Bien que la restitution visuelle constitue une étape exploratoire et diagnostique irremplaçable, elle ne saurait s’affranchir d’une validation inférentielle quantitative rigoureuse. L’œil humain présente en effet une tendance cognitive innée à surinterpréter les motifs d’agrégation aléatoire au sein de petits échantillons, percevant fréquemment des déviations factices au sein de cohortes pourtant rigoureusement uniformes. Il est donc indispensable de coupler systématiquement les diagnostics graphiques à des tests d’hypothèses formels dédiés à l’adéquation de l’uniformité.
Le test non paramétrique de Kolmogorov-Smirnov univarié, exécuté sous R via l’instruction ks.test, représente l’étalon statistique pour cette évaluation confirmatoire. En transmettant au test le vecteur d’échantillon et la référence fonctionnelle punif accompagnée de ses arguments de bornage, l’analyste obtient la statistique D et la p-valeur associée. L’inscription formelle de ces deux paramètres métriques au sein même de la fenêtre graphique, au moyen d’un encadré textuel superposé via text ou annotate, confère à la visualisation une rigueur scientifique optimale en documentant explicitement le rejet ou le non-rejet de l’hypothèse d’uniformité.
En alternative ou en complément, le test d’adéquation du Chi-deux de Pearson peut être mobilisé après avoir discrétisé le continuum au moyen d’un partitionnement régulier via la fonction cut. La confrontation des dénombrements observés par classe avec les effectifs théoriques constants attendus permet de vérifier l’homogénéité globale du tirage stochastique. L’articulation coordonnée de ces indices quantitatifs formels avec l’observation visuelle des histogrammes normalisés et des Q-Q plots assure une assise méthodologique indéboulonnable à toute conclusion scientifique touchant à la loi uniforme.
12. Erreurs méthodologiques fréquentes et recommandations pratiques
12.1 Artefacts visuels liés aux discontinuités
L’une des erreurs computationnelles et méthodologiques les plus omniprésentes lors du tracé de la loi uniforme dans R réside dans l’apparition d’artefacts d’interpolation linéaire au droit des discontinuités frontalières de première espèce situées en a et en b. Lorsqu’un analyste utilise la primitive plot(…, type = ‘l’) sur une grille d’abscisses comprenant des points extérieurs et intérieurs au support sans précaution structurelle, le moteur graphique relie mécaniquement le point périphérique d’ordonnée zéro au point intérieur d’ordonnée 1 / (b – a) par un segment oblique erroné.
Cette droite oblique constitue une aberration statistique absolue : elle attribue faussement des valeurs de densité intermédiaires et un gradient d’accroissement progressif à des zones où la fonction subit en réalité un saut discontinu vertical instantané. Pour bannir cet artéfact des productions académiques, plusieurs stratégies algorithmiques s’imposent. L’une d’entre elles consiste à fractionner le vecteur de tracé en trois segments indépendants exécutés par des instructions lines disjointes : une première ligne horizontale reposant sur l’axe d’ordonnée nulle de l’origine jusqu’à la borne a, un segment sommital horizontal isolé reliant exclusivement le point a au point b à l’altitude 1 / (b – a), et un troisième segment reprenant l’altitude zéro à partir de b.
Au sein de l’écosystème ggplot2, ce raffinement graphique peut être orchestré sans recourir à des fractionnements manuels lourds en tirant profit de la géométrie geom_step. Cette fonction impose un tracé par paliers orthogonaux rigides, éradiquant nativement les liaisons diagonales parasites. L’adoption systématique de ces configurations avancées atteste de la rigueur de l’analyste et garantit la conformité mathématique intégrale de la représentation produite.
12.2 Biais d’échelle et distorsions de perception
La perception humaine des proportions géométriques est hautement vulnérable aux distorsions d’échelle sur les axes de coordonnées. Un biais méthodologique particulièrement pernicieux concerne la troncature de l’axe vertical lors de la représentation de la densité ou de l’histogramme de données uniformes. Si l’axe des ordonnées est arbitrairement compressé ou si son origine inférieure ne débute pas strictement à zéro, de minuscules fluctuations aléatoires d’échantillonnage se trouvent amplifiées visuellement au point de créer l’illusion trompeuse de vallées profondes ou de pics d’asymétrie majeurs au sein de l’intervalle.
Pour immuniser l’observateur contre ces distorsions de lecture cognitive, il est formellement impératif d’ancrer l’origine verticale à la valeur scalaire zéro dans toute représentation de fonction de densité. Dans ggplot2, cette consigne s’applique via l’argument limits = c(0, NA) au sein de scale_y_continuous, complété par le réglage expand = expansion(mult = c(0, 0.1)) afin de supprimer l’interstice d’espacement inutile sous l’axe des abscisses tout en préservant une marge de confort au-dessus du plateau sommital.
Le ratio d’aspect dimensionnel entre la largeur et la hauteur du canevas graphique global conditionne également l’interprétation de la planéité. Une figure excessivement étirée verticalement accentuera artificiellement le relief des fluctuations d’échantillonnage, tandis qu’un format excessivement aplati horizontalement masquera des anomalies structurelles significatives. L’application de la fonction coord_fixed ou le réglage explicite du rapport largeur-hauteur lors de l’exportation du fichier garantit une restitution fidèle des proportions géométriques théoriques du pavé probabiliste.
12.3 Synthèse de bonnes pratiques pour la reproductibilité
L’excellence méthodologique en science des données et en statistique computationnelle requiert l’établissement de protocoles de programmation normalisés, pérennes et entièrement reproductibles. Pour que les visualisations de la loi uniforme continuent de produire des résultats invariables à travers le temps et sur des architectures matérielles hétérogènes, l’encapsulation de l’ensemble du pipeline graphique au sein de scripts R modulaires et rigoureusement documentés s’avère indispensable.
Il est vivement conseillé d’encapsuler les blocs de tracés récurrents au sein de fonctions logiques personnalisées dédiées, prenant explicitement pour arguments la taille d’échantillon souhaitée n, les bornes d’intervalles a et b, ainsi que la valeur d’initialisation de la graine pseudo-aléatoire. Une telle modularité logicielle prévient les erreurs de copier-coller, favorise la réutilisation au sein de projets d’envergure et garantit que les mêmes chartes graphiques de couleurs, de thèmes et de typographies de formules soient appliquées de manière uniforme sur l’ensemble d’une monographie ou d’un manuscrit de recherche.
Enfin, l’archivage systématique de l’environnement computationnel doit accompagner tout artéfact graphique destiné à la publication. La consignation de l’entier d’initialisation de set.seed, la journalisation de la version du moteur R et la fixation stricte des versions de bibliothèques tierces au moyen d’outils de gestion de dépendances tels que renv parachèvent la chaîne de confiance scientifique. En respectant scrupuleusement ces impératifs techniques et formels, le statisticien s’assure que chaque tracé de distribution uniforme élaboré dans R reflète la plus haute intégrité scientifique et graphique possible.
Références
Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und verwandte Gebiete, 57(4), 453-476. https://doi.org/10.1007/BF01025868
Murrell, P. (2018). R graphics (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429445477
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Ross, S. M. (2014). Introduction to probability models (11th ed.). Academic Press. https://doi.org/10.1016/C2012-0-03820-2
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0