
La modélisation probabiliste des phénomènes discrets constitue l’un des piliers méthodologiques les plus robustes de la recherche contemporaine, en particulier dans les sciences quantitatives, la biométrie et les sciences du comportement. Lorsqu’un protocole expérimental engendre des issues catégorielles binaires répétées sous des conditions contrôlées, la distribution binomiale s’impose naturellement comme la structure stochastique de référence. Maîtriser sa représentation visuelle au sein de l’environnement de calcul statistique R ne constitue pas seulement une habileté de visualisation technique élémentaire ; il s’agit d’une compétence fondamentale pour inspecter empiriquement l’adéquation des modèles théoriques aux données observées, diagnostiquer des anomalies d’échantillonnage et communiquer des inférences statistiques selon les plus hauts standards académiques.
L’environnement statistique R, grâce à son architecture logicielle orientée vers la manipulation vectorielle et ses moteurs de rendu graphique éprouvés, offre un cadre idéal pour explorer la distribution binomiale. Des fonctions graphiques primitives intégrées jusqu’aux écosystèmes graphiques déclaratifs sophistiqués de dernière génération, R permet de disséquer chaque facette analytique de la fonction de masse de probabilité et de sa fonction de répartition cumulative. La compréhension approfondie de ces outils exige toutefois une articulation rigoureuse entre les fondements mathématiques sous-jacents et les choix computationnels d’implémentation, afin d’éviter les erreurs classiques de représentation qui faussent fréquemment l’interprétation des résultats empiriques.
Cet ouvrage analytique propose une déconstruction systématique, didactique et exhaustive des protocoles de traçage de la distribution binomiale dans R. En parcourant les axiomes de Bernoulli, les particularités de l’écosystème algorithmique des fonctions probabilistes, les subtilités du moteur graphique de base, les adaptations comparatives face aux variations paramétriques, jusqu’aux standards de publication et de reproductibilité, ce guide exhaustif fournit aux chercheurs, analystes de données et biostatisticiens l’ensemble des connaissances nécessaires pour transformer des formulations abstraites en visualisations scientifiques rigoureuses, informatives et esthétiquement irréprochables.
1. Fondements théoriques de la distribution binomiale en modélisation statistique
1.1 Définition mathématique et axiomes du processus de Bernoulli
La distribution binomiale repose de manière exclusive sur la formalisation rigoureuse d’une séquence finie d’épreuves de Bernoulli. Un essai de Bernoulli représente une expérience aléatoire fondamentale n’admettant que deux issues mutuellement exclusives et collectivement exhaustives, conventionnellement qualifiées de succès et d’échec, souvent codées respectivement par les valeurs scalaires un et zéro. Pour qu’une série de répétitions donne naissance à une loi binomiale valide, deux axiomes fondamentaux et intangibles doivent être rigoureusement satisfaits : l’indépendance statistique absolue des essais successifs et l’invariance stricte de la probabilité de survenue du succès tout au long de la séquence expérimentale.
Sur le plan mathématique, l’espace d’échantillonnage d’une telle expérience est discret. La variable aléatoire d’intérêt, conventionnellement notée X, représente la somme arithmétique de ces variables binaires indépendantes et identiquement distribuées, ce qui correspond au comptage brut du nombre de succès k observés au terme de n épreuves. La fonction de masse de probabilité, notée P(X = k), quantifie la probabilité exacte d’observer précisément k réalisations positives. Cette probabilité est formulée analytiquement par le produit du coefficient binomial, de la probabilité de succès élevée à la puissance k, et de la probabilité d’échec élevée à la puissance n – k.
Le coefficient binomial, souvent exprimé sous la forme de combinaisons de k éléments parmi n, joue ici un rôle combinatoire déterminant. Il dénombre la multiplicité des arrangements séquentiels distincts permettant d’obtenir exactement k succès au cours des n tirages indépendants. Sans cette composante combinatoire, la formulation ne décrirait que la probabilité d’une trajectoire spécifique unique ; son intégration assure la prise en compte exhaustive de toutes les permutations possibles au sein de l’arbre probabiliste de l’expérience, conférant à la loi binomiale son universalité mathématique dans l’analyse combinatoire discrète.
1.2 Paramètres fondamentaux : taille d’échantillon et probabilité de succès
Le comportement stochastique de la distribution binomiale est intégralement gouverné par un doublet de paramètres fondamentaux : la taille d’échantillon n, appartenant à l’ensemble des entiers naturels strictement positifs, et la probabilité individuelle de succès p, confinée dans l’intervalle réel fermé allant de zéro à un. Le paramètre n conditionne directement la cardinalité de l’espace des états accessibles, puisque la variable aléatoire ne peut prendre que des valeurs entières comprises entre zéro et n inclusivement. L’accroissement de n dilate l’horizon des réalisations possibles et étend la dispersion spatiale de la distribution le long de l’axe des abscisses.
Le paramètre p, pour sa part, régule l’asymétrie intrinsèque de la fonction de masse. Lorsque p s’écarte de la valeur médiane d’un demi, la répartition des masses de probabilité subit une déformation morphologique substantielle. Une valeur de p strictement inférieure à un demi concentre la masse de probabilité sur les valeurs faibles de l’abscisse tout en étirant une queue de distribution vers les valeurs élevées. Inversement, une valeur de p strictement supérieure à un demi engendre une asymétrie négative, caractérisée par une accumulation des probabilités vers l’extrémité droite de l’intervalle de définition.
L’espérance mathématique de la variable aléatoire binomiale, notée E(X), est établie par le produit analytique simple n * p. Elle représente le barycentre théorique ou le centre de gravité probabiliste de la distribution. La variance théorique, notée Var(X), est quant à elle formulée par l’expression n * p * (1 – p). Cette relation analytique met en lumière une propriété critique : la variabilité interne de la distribution atteint son maximum absolu lorsque p est rigoureusement égal à un demi pour une taille d’échantillon donnée, et s’amenuise de manière symétrique à mesure que le paramètre s’approche des frontières déterministes zéro ou un.
1.3 Pertinence empirique en sciences du comportement et psychologie
En psychologie expérimentale et dans les neurosciences cognitives, l’application de la distribution binomiale s’avère indispensable pour modéliser les paradigmes de choix forcé à deux alternatives. Dans ces protocoles psychophysiques classiques, un observateur doit discriminer un signal sensoriel noyé dans du bruit ou identifier la présence d’un stimulus en sélectionnant l’une de deux options exclusives. La modélisation de la performance sous l’hypothèse d’une absence totale de perception repose sur un processus de Bernoulli où le paramètre p est théoriquement calibré à un demi, incarnant le niveau de devinette aléatoire pure.
Au-delà de la psychophysique, la psychométrie standardisée exploite largement cette distribution pour concevoir et étalonner des épreuves d’évaluation cognitive, des tests d’intelligence ou des inventaires de connaissances composés d’items dichotomiques évalués en termes de réussite ou d’échec. La détermination de la validité d’un score individuel requiert une analyse probabiliste visant à estimer si le nombre de réponses correctes observées chez un sujet surpasse substantiellement le seuil stochastique imputable aux simples fluctuations du hasard. La distribution binomiale offre le cadre probabiliste formel indispensable pour calculer cette valeur critique.
L’analyse des taux d’erreur dans les paradigmes de temps de réaction ou les tâches motrices sérielles bénéficie également de cette approche formelle. Lorsque les chercheurs souhaitent comparer des cohortes cliniques présentant des déficits attentionnels à des groupes témoins, la formalisation des erreurs d’omission ou de commission sous forme de réalisations d’un processus binomial permet d’estimer avec précision si les divergences observées reflètent une altération réelle des processus cognitifs sous-jacents ou relèvent de la simple variabilité intrinsèque liée à un nombre limité d’essais expérimentaux.
2. L’écosystème R et la fonction fondamentale dbinom()
2.1 Syntaxe formelle et mécanismes de calcul de dbinom()
Au sein du langage R, le calcul de la fonction de masse de probabilité de la distribution binomiale est dévolu à la fonction native nommée dbinom(). Cette routine algorithmique intègre une architecture formelle articulée autour de trois arguments positionnels ou nommés obligatoires : x, size et prob. L’argument x désigne le vecteur des quantiles discrets, c’est-à-dire le nombre de succès dont on souhaite évaluer la probabilité d’occurrence. L’argument size correspond à la taille de l’échantillon ou au nombre total d’essais indépendants n, tandis que prob spécifie la probabilité de succès p associée à chaque tentative individuelle.
L’environnement R se distinguant par sa gestion vectorielle native, la fonction dbinom() traite instantanément des vecteurs de n’importe quelle longueur pour l’argument x. Si un analyste transmet une séquence numérique complète s’étendant de zéro à n, la fonction évalue de manière simultanée la totalité des probabilités de masse correspondantes sans nécessiter l’implémentation manuelle de boucles itératives. Cette vectorisation garantit une rapidité computationnelle optimale, le moteur d’évaluation interne étant codé en langage C de bas niveau pour maximiser les performances de calcul numérique.
Un quatrième argument optionnel, nommé log et prenant par défaut la valeur logique FALSE, peut être basculé sur TRUE pour contraindre la fonction à retourner directement le logarithme népérien des probabilités calculées. Cette fonctionnalité s’avère particulièrement précieuse dans le cadre des calculs d’inférence statistique avancée, comme l’estimation du maximum de vraisemblance. Elle permet de contourner les limitations matérielles d’arrondi et d’éviter les phénomènes délétères de sous-dépassement arithmétique lorsque la taille n devient extrêmement volumineuse et que les probabilités individuelles descendent à des échelles infinitésimales.
2.2 Distinction essentielle au sein de la famille dbinom, pbinom, qbinom et rbinom
Pour exploiter avec rigueur le modèle binomial dans R, il est impératif de dissiper toute confusion conceptuelle entre les quatre fonctions fondamentales constituant le noyau stochastique du langage : dbinom, pbinom, qbinom et rbinom. La fonction dbinom() calcule exclusivement la densité ou masse ponctuelle de probabilité, répondant à la question précise de la probabilité exacte d’observer un événement X = k. En revanche, la fonction pbinom() évalue la distribution cumulative, calculant la somme des probabilités pour toutes les valeurs inférieures ou égales à un seuil donné, formalisant ainsi la quantité P(X ≤ k).
La fonction qbinom() opère comme la réciproque formelle de la fonction de distribution cumulative, incarnant la fonction quantile. Elle prend en entrée une valeur de probabilité comprise entre zéro et un et détermine le plus petit entier k tel que la probabilité cumulative atteigne ou surpasse cette valeur de probabilité renseignée. Cet outil s’avère capital pour délimiter les seuils statistiques d’acceptation ou de rejet d’une hypothèse nulle lors des procédures de tests inférentiels unilatéraux ou bilatéraux, permettant aux chercheurs d’isoler sans ambiguïté les bornes critiques de décision empirique.
Enfin, la fonction rbinom() sert à la génération de nombres pseudo-aléatoires distribués selon la loi binomiale paramétrée. Contrairement aux trois fonctions précédentes qui délivrent des valeurs théoriques déterministes et analytiques, rbinom() produit des cohortes synthétiques simulant la réalisation empirique d’expériences stochastiques répétées. Son usage est omniprésent dans les protocoles de validation méthodologique fondés sur des simulations de Monte-Carlo, permettant de confronter des estimateurs statistiques à des jeux de données artificiels dont les paramètres réels sont strictement maîtrisés.
2.3 Optimisation numérique et gestion des notations scientifiques
Lors de la manipulation de distributions binomiales caractérisées par des valeurs de n élevées ou des paramètres p asymétriques, la console de R a tendance à convertir automatiquement les nombres décimaux extrêmement petits en notation scientifique exponentielle standardisée. Bien que mathématiquement exacte, cette notation nuit fréquemment à l’intelligibilité visuelle immédiate des probabilités discrètes lors de l’affichage tabulaire préliminaire ou de l’annotation directe des axes graphiques, compliquant la lecture pour un public non mathématicien.
Pour juguler cette propension et contraindre R à conserver un affichage en virgule fixe conventionnel, il est d’usage d’ajuster l’option globale du système via la commande options(scipen = 999). L’argument scipen applique une pénalité numérique à l’activation de la notation exponentielle, forçant le système d’affichage à présenter les probabilités sous leur forme décimale standardisée, à condition que le nombre de chiffres après la virgule n’excède pas les limites physiques allouées au format de stockage double précision.
Parallèlement à la modification de cette option globale, la manipulation précise des arrondis décimaux s’effectue au moyen de la commande round(). Appliquée aux vecteurs générés par dbinom(), cette fonction assure une normalisation de la précision visuelle, réduisant par exemple les estimations à trois ou quatre décimales significatives. Cette étape prévient la propagation d’artefacts visuels et garantit que les métadonnées textuelles associées aux visualisations graphiques conservent une clarté typographique optimale, en harmonie avec les normes éditoriales académiques internationales.
3. Tracé élémentaire de la fonction de masse avec les fonctions graphiques de base
3.1 Génération de la séquence des valeurs de succès
Le protocole d’élaboration d’un graphique représentant la fonction de masse binomiale débute impérativement par la construction rigoureuse du support discret des valeurs admissibles. Contrairement aux variables aléatoires continues qui nécessitent l’échantillonnage d’un continuum sous la forme d’une grille dense de points infinitésimaux, la variable aléatoire binomiale ne peut prendre que des valeurs entières positives closes dans l’intervalle zéro à n. L’omission de la valeur zéro constitue l’une des erreurs d’initialisation les plus répandues chez les analystes novices.
Pour générer ce support numérique dans l’environnement R, on utilise l’opérateur séquentiel deux-points pour instancier un vecteur discret contenant l’intégralité des réalisations théoriques possibles, de 0:n. Cette séquence vectorielle garantit la préservation absolue de l’exhaustivité de l’espace d’échantillonnage de la variable. Si un utilisateur définit arbitrairement un vecteur démarrant à l’unité, il introduit une troncature structurelle qui invalide le modèle statistique et génère un décalage horizontal dommageable sur l’ensemble de la représentation visuelle.
Une fois le vecteur discret des succès instancié et assigné à une variable, il convient de calculer le vecteur dépendant des probabilités associées en transmettant directement ce support à la fonction dbinom(), conjointe aux paramètres size et prob prédéfinis. Il est méthodologiquement recommandé de vérifier l’adéquation dimensionnelle stricte entre les deux vecteurs au moyen de la fonction length(), confirmant que la structure vectorielle sous-jacente au tracé graphique comporte rigoureusement n + 1 éléments coordonnés.
3.2 Usage critique du paramètre graphique type = ‘h’
La commande graphique élémentaire de R, nommée plot(), requiert un paramétrage scrupuleux de son argument morphologique type pour traduire fidèlement la nature d’une loi de probabilité. L’argument par défaut produit un nuage de points isolés sans liaison géométrique, ce qui disperse l’attention de l’observateur. En revanche, l’application irréfléchie de l’argument type = ‘l’, qui relie les coordonnées consécutives par des segments linéaires continus, constitue une faute épistémologique majeure : elle suggère visuellement l’existence de probabilités pour des valeurs fractionnaires ou décimales de succès, ce qui est strictement impossible au sein d’une distribution discrète.
Pour transcrire visuellement la discontinuité intrinsèque de la fonction de masse de probabilité, l’argument optimal au sein de la fonction de base est indiscutablement type = ‘h’, abréviation du terme anglais désignant les diagrammes en bâtons ou aiguilles verticales. Cette instruction ordonne au moteur graphique de projeter, pour chaque valeur entière discrète de l’axe horizontal, un segment rectiligne vertical partant de l’ordonnée zéro jusqu’à la hauteur exacte correspondant à la probabilité calculée P(X = k).
Ce choix de représentation par aiguilles verticales ancre immédiatement dans l’esprit de l’observateur la nature ponctuelle et isolée de chaque masse probabiliste. Aucun segment horizontal ou oblique ne vient suggérer de transition continue entre deux entiers successifs. La hauteur de chaque ligne verticale représente fidèlement l’intégralité de la masse de probabilité attribuée au point considéré, respectant ainsi scrupuleusement la sémiologie graphique propre aux variables aléatoires discrètes définie dans les traités fondateurs de statistique théorique.
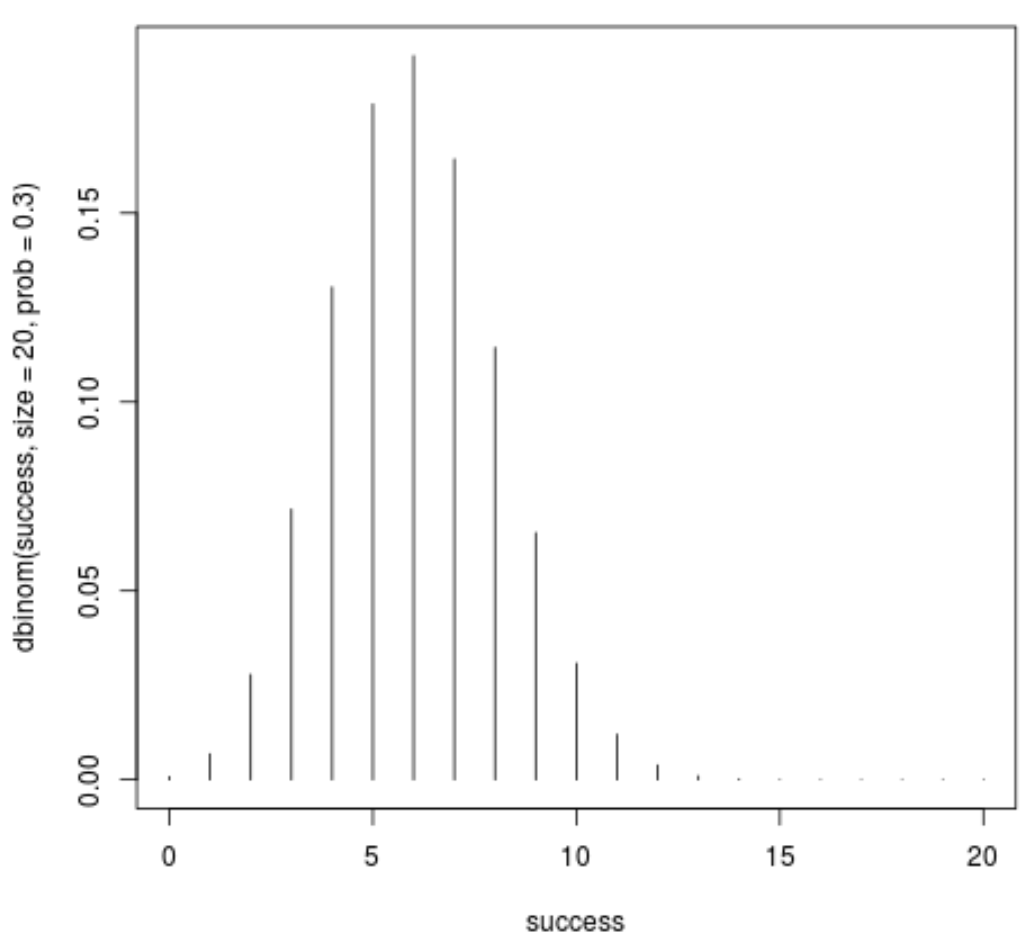
3.3 Lecture immédiate et interprétation du graphique brut
L’affichage initial résultant d’une commande telle que plot(0:n, dbinom(0:n, size = n, prob = p), type = ‘h’) autorise une inspection empirique instantanée de la morphologie distributionnelle globale. Le premier élément visuel frappant réside dans l’identification sans équivoque du mode de la distribution, qui correspond à la valeur discrète de l’abscisse au-dessus de laquelle s’élève le bâton vertical atteignant la hauteur maximale. Cette localisation spatiale informe directement sur la réalisation la plus vraisemblable lors de l’exécution de l’expérience stochastique.
L’axe des ordonnées permet simultanément d’évaluer la densité de cette probabilité modale. Si le pic vertical s’élève à des valeurs modestes, cela traduit une forte dispersion de la masse de probabilité sur une multiplicité de valeurs adjacentes. Inversement, une aiguille culminant à des niveaux d’ordonnées élevés indique une focalisation stochastique étroite, traduisant une faible variabilité du processus sous-jacent. Cette lecture intuitive permet aux analystes de valider la plausibilité de leurs modèles avant même d’engager des calculs numériques formalisés.
Enfin, l’étalement global de la forêt d’aiguilles et leur disposition spatiale relative fournissent un diagnostic visuel immédiat concernant la symétrie ou l’asymétrie du processus. L’observateur avisé détecte d’un simple coup d’œil si la masse d’information se concentre symétriquement au centre de l’intervalle des abscisses ou si elle présente une longue traîne unidirectionnelle s’étirant vers les valeurs marginales, confirmant visuellement la conformité du graphique avec les valeurs paramétriques injectées dans la fonction de calcul.
4. Personnalisation esthétique et rigueur académique du graphique de base
4.1 Normalisation des libellés et métadonnées graphiques
Bien que le moteur graphique standard de R permette de produire des visualisations exploitables en quelques lignes de commande, le tracé brut présente des insuffisances notoires qui empêchent son intégration directe dans un article scientifique ou un rapport de recherche institutionnel. Les intitulés des axes par défaut reprennent textuellement les expressions de programmation saisies en argument, affichant des formulations rébarbatives telles que la séquence d’indices ou l’appel de fonction intégral. Il est donc indispensable de normaliser ces métadonnées textuelles pour garantir la conformité académique.
L’argument main permet d’attribuer un titre global informatif qui doit stipuler sans ambiguïté la nature du modèle tracé ainsi que les paramètres structurels gouvernant la loi représentée, notamment la taille d’échantillon n et la probabilité élémentaire p. Parallèlement, l’argument xlab doit être méticuleusement renseigné afin de caractériser l’axe horizontal par une étiquette explicite, par exemple le nombre de succès observés ou le nombre d’occurrences positives. Cette labellisation rigoureuse élimine toute équivoque quant à la signification concrète de l’abscisse.
De façon symétrique, l’axe vertical doit impérativement être documenté au moyen de l’argument ylab en employant une formulation probabiliste normalisée, telle que la probabilité de masse ou l’expression mathématique standardisée P(X = k). Cette démarche d’explicitation typographique assure l’autonomie conceptuelle de la figure graphique, permettant à un lecteur spécialisé d’en appréhender le contenu empirique et la portée méthodologique sans avoir à se reporter de façon continue au corps du texte principal.
4.2 Ajustement de l’épaisseur et stylisation des lignes de probabilité
Le tracé par défaut généré par l’argument type = ‘h’ produit des lignes verticales d’une finesse extrême, réduites à une épaisseur unitaire d’un pixel. Lors de l’insertion de ces figures dans des documents imprimés ou au sein de présentations projetées en amphithéâtre, cette finesse excessive engendre des artefacts visuels perceptibles, tels que des effets de crénelage ou une atténuation dramatique de la lisibilité des bâtons probabilistes périphériques. Il s’avère donc impératif d’ajuster l’épaisseur physique de ces segments verticaux.
L’argument lwd, acronyme de largeur de ligne, offre le contrôle paramétrique nécessaire pour amplifier la présence visuelle des bâtons de probabilité. L’assignation d’une valeur supérieure, généralement comprise entre deux et cinq selon la résolution physique du périphérique de sortie, confère aux aiguilles une densité géométrique satisfaisante. Les bâtons se transforment alors en barres nettes et parfaitement visibles, dont la projection spatiale traduit fidèlement l’amplitude des masses stochastiques sous-jacentes.
Sur le plan chromatique, l’abandon du noir uniforme par défaut au profit d’une palette chromatique sobre et contrastée répond aux exigences des publications scientifiques internationales. L’utilisation de l’argument col permet de spécifier des teintes telles que le bleu cobalt, le gris anthracite ou des nuances calibrées issues de palettes perceptuellement uniformes. L’ajout éventuel de points terminaux au sommet de chaque segment vertical, au moyen d’un appel combiné à la fonction points() avec un symbole plein circulaire, adoucit l’agencement géométrique tout en focalisant l’attention visuelle sur l’amplitude discrète exacte.
4.3 Ajustement des échelles et des limites d’axes
Le moteur graphique standard de R calibre les limites d’axes en appliquant un algorithme d’ajustement automatique qui optimise le cadrage spatial mais engendre fréquemment des effets de bord dommageables. Sur l’axe des ordonnées, la limite inférieure par défaut est souvent positionnée légèrement en dessous de zéro pour prévenir le chevauchement des données avec la bordure inférieure, tandis que la limite supérieure effleure le sommet de la probabilité maximale. Ce calibrage tronque l’espace d’interprétation et complique la comparaison visuelle directe entre plusieurs graphiques juxtaposés.
La fixation manuelle de l’étendue verticale via l’argument ylim = c(0, max_val) s’impose dès lors comme une règle méthodologique fondamentale. En verrouillant impérativement l’origine inférieure à zéro strict, le chercheur préserve l’intégrité sémiotique du diagramme en bâtons, dont la signification repose sur la proportionnalité directe entre la longueur absolue du segment et la probabilité représentée. La limite supérieure doit quant à elle être calculée dynamiquement, par exemple en majorant la probabilité maximale observée d’une fraction de dix à quinze pour cent pour offrir un dégagement visuel suffisant aux futures annotations textuelles.
Sur l’axe des abscisses, l’utilisation de l’argument xlim combinée à la désactivation des graduations automatisées permet un contrôle total de la typographie numérique. L’appel à la fonction axis(side = 1, at = 0:n) permet de forcer le moteur graphique à imprimer explicitement l’ensemble des entiers discrets constituant le support de la loi, évitant ainsi que R n’omette certains entiers pairs ou impairs en tentant d’espacer artificiellement les étiquettes numériques pour prévenir les chevauchements visuels.
5. Exploration comparative de la variation du paramètre de probabilité
5.1 Modélisation de l’asymétrie positive (p < 0.5)
L’exploration graphique approfondie de la distribution binomiale révèle des transformations géométriques spectaculaires dès lors que l’on module la valeur du paramètre de succès p. Lorsque ce paramètre est fixé à une valeur strictement inférieure à un demi, la distribution manifeste une asymétrie positive marquée, également désignée sous le terme d’asymétrie étalée à droite. Ce profil stochastique modélise avec une fidélité remarquable les processus expérimentaux caractérisés par des événements à faible probabilité d’occurrence ou des phénomènes d’échec prédominant.
Sur le plan visuel, la masse de probabilité prépondérante se trouve fortement comprimée contre l’origine de l’axe des abscisses. Le mode de la distribution se localise sur des valeurs de succès très faibles, voire sur l’abscisse zéro si le produit n * p est inférieur à l’unité. Les bâtons verticaux s’élèvent de façon abrupte à l’extrémité gauche du graphique, formant un pic acéré qui s’effondre de manière exponentielle à mesure que le nombre de succès progresse vers des valeurs élevées.
La queue de distribution qui s’étire vers la droite le long des abscisses illustre le principe fondamental de rareté relative des événements cumulés. Bien que la survenue d’un grand nombre de succès demeure théoriquement possible au sein de l’espace combinatoire, les hauteurs des bâtons correspondants deviennent visuellement imperceptibles sur l’échelle linéaire conventionnelle. Cette configuration asymétrique sert couramment à illustrer la modélisation de pathologies rares ou de taux de mutation génétique résiduels au sein d’échantillons démographiques restreints.
5.2 Modélisation de la symétrie parfaite (p = 0.5)
L’assignation de la valeur exacte d’un demi au paramètre de succès p induit une métamorphose géométrique complète de la distribution binomiale, la contraignant à adopter une symétrie axiale parfaite. Dans cette configuration probabiliste spécifique, qui matérialise l’archétype des jeux de hasard équilibrés de type pile ou face ou les conditions de choix forcé sans biais sensoriel, la probabilité d’obtenir k succès équivaut rigoureusement à la probabilité d’observer n – k succès.
L’axe de symétrie miroir de la figure graphique se situe précisément sur l’abscisse correspondant à l’espérance mathématique, c’est-à-dire au point central n / 2. Lorsque la taille d’échantillon n est un entier pair, le mode distributionnel coïncide de manière unique avec cette valeur centrale, formant une aiguille prééminente parfaitement équilibrée par la décroissance symétrique des bâtons situés de part et d’autre. Si n est impair, la distribution devient bimodalement symétrique, présentant deux sommets jumeaux de hauteurs rigoureusement identiques encadrant le centre exact du domaine.
En méthodologie expérimentale et en recherche comportementale, cette configuration symétrique joue le rôle fondamental de condition témoin stochastique. L’inspection visuelle d’un tracé binomial symétrique permet d’évaluer la dispersion naturelle des réponses lorsque le comportement des sujets expérimentaux est dicté par l’indétermination décisionnelle pure. Toute divergence empirique substantielle par rapport à ce profil en cloche discrète symétrique constitue un indice visuel probant d’un biais cognitif, d’une sensibilité perceptive ou d’un apprentissage opérant chez le sujet testé.
5.3 Modélisation de l’asymétrie négative (p > 0.5)
La situation sémiotique et probabiliste s’inverse intégralement dès lors que le paramètre individuel de succès franchit le seuil médian pour s’établir à des valeurs strictement supérieures à un demi. La distribution binomiale adopte alors une asymétrie négative, couramment qualifiée d’asymétrie étalée à gauche. Cette morphologie décrit les paradigmes expérimentaux au sein desquels l’issue positive constitue la norme comportementale attendue, comme l’exécution de tâches cognitives élémentaires chez des participants neurotypiques hautement entraînés.
Sur le tracé graphique, la concentration des masses de probabilité migre massivement vers l’extrémité droite de l’abscisse, au voisinage immédiat de la valeur maximale n. Le pic modal se juxtapose contre la frontière supérieure de l’espace d’échantillonnage, matérialisant visuellement le fait que l’observation de taux de réussite exceptionnellement élevés devient l’événement le plus vraisemblable. Les aiguilles de probabilité s’érigent vigoureusement à droite, tandis que le flanc gauche s’affaisse pour former une longue traîne s’amenuisant progressivement vers l’origine.
Pour mettre en valeur ces variations morphologiques au sein d’une démonstration scientifique, il est particulièrement élégant de faire appel à la fonction de partitionnement graphique par(mfrow = c(1, 3)). Cette commande permet de juxtaposer sur un même plan horizontal les trois déclinaisons paramétriques d’une même expérience sous une taille d’échantillon invariante, offrant une comparaison visuelle directe et pédagogique de la transition continue de la masse probabiliste sous l’effet de la translation du paramètre de Bernoulli.
6. Impact de la taille de l’échantillon et théorème central limite
6.1 Évolution graphique du profil discret avec l’augmentation de n
L’accroissement méthodique de la taille d’échantillon n, toutes choses égales par ailleurs, induit une reconfiguration profonde de la géométrie visuelle de la distribution binomiale. Lorsque n est restreint, par exemple fixé à une valeur de dix, le tracé se caractérise par une faible densité de bâtons verticaux largement espacés, dont les amplitudes individuelles sont substantiellement élevées, la somme totale unitaire des probabilités se distribuant sur un nombre restreint d’états discrets accessibles.
À mesure que l’analyste fait progresser la taille d’échantillon vers des valeurs intermédiaires telles que trente, puis des dimensions volumineuses atteignant ou dépassant cent, la structure visuelle subit une métamorphose spectaculaire. Le support des abscisses se densifie considérablement, les valeurs entières se resserrant spatialement sur le tracé. Corolairement, la hauteur individuelle maximale de chaque bâton probabiliste s’abaisse de manière inexorable, puisque la même unité de masse probabiliste globale doit désormais se ventiler entre des dizaines, voire des centaines de valeurs entières concurrentes.
Cette densification progressive transforme visuellement l’aspect crénelé et haché du diagramme en aiguilles initial en une enveloppe continue aux contours d’une remarquable fluidité géométrique. La dispersion relative diminue par rapport à l’étendue totale des abscisses, et le profil général adopte la silhouette universelle de la courbe en cloche symétrique, manifestant visuellement les prémisses de l’un des principes les plus fondamentaux de la statistique mathématique : le théorème central limite formulé par Laplace et Gauss.
6.2 Superposition de l’approximation normale continue
L’aboutissement théorique de l’expansion de la taille n réside dans la convergence en loi de la variable binomiale standardisée vers la distribution gaussienne standard. Pour matérialiser graphiquement ce principe mathématique dans R, il est d’un grand intérêt pédagogique de superposer directement la courbe de densité normale théorique ajustée sur le diagramme en bâtons discrets de la distribution binomiale préalablement tracé. Les paramètres de cette loi normale continue sont dictés de manière déterministe par l’espérance et la variance binomiales exactes : une moyenne fixée à n * p et un écart-type rigoureusement égal à la racine carrée de n * p * (1 – p).
La mise en œuvre computationnelle s’effectue avec une remarquable simplicité en recourant à la fonction curve(), conjointement à l’argument logique add = TRUE pour contraindre le moteur graphique à surimprimer la courbe continue sur le système d’axes existant sans effacer le tracé sous-jacent. La fonction d’évaluation continue appelée est dnorm(), paramétrée avec les coordonnées théoriques calculées. Il convient d’appliquer une couleur distinctive et contrastée, telle qu’un rouge écarlate ou un orange vif, pour distinguer visuellement la densité continue de l’armature discrète sous-jacente.
Cette confrontation graphique rend immédiatement palpables les célèbres conditions empiriques de validité de l’approximation normale, souvent résumées par les règles heuristiques stipulant que le produit n * p et le produit complémentaire n * (1 – p) doivent tous deux excéder simultanément la valeur de cinq ou de dix selon la sévérité des auteurs. Lorsque ces conditions sont enfreintes, la superposition visuelle dénonce instantanément l’inadéquation de la courbe normale, qui déborde de manière illégitime sur les valeurs négatives ou échoue à épouser l’asymétrie résiduelle des bâtons discrets.
6.3 La correction de continuité en représentation visuelle
L’approximation d’une loi discrète définie sur des entiers par une loi continue intégrant des densités sur un intervalle infini introduit une distorsion géométrique intrinsèque qui requiert une correction formelle : la correction de continuité. Sur le plan conceptuel, une probabilité discrète ponctuelle P(X = k) correspond, au sein du modèle continu substitutif, à l’intégrale de la densité normale calculée sur une tranche d’intervalle unitaire s’étendant formellement de k – 0.5 à k + 0.5.
En matérialisant visuellement cette zone géométrique sous la courbe normale au moyen de la commande polygon(), l’analyste offre une démonstration éclatante de la logique de conservation de l’aire sous-jacente. L’aire délimitée par cette tranche polygonale sous la courbe continue compense les zones triangulaires résiduelles résultant de la divergence entre le sommet plat théorique de la tranche discrète et la courbure continue de la fonction gaussienne. Cette compensation graphique illustre pourquoi la simple lecture ponctuelle d’une densité normale au point entier k constitue une approximation imparfaite en comparaison du calcul d’aire sur l’intervalle corrigé.
L’impact pratique de cette correction devient particulièrement saillant lors de l’estimation visuelle des probabilités cumulées au niveau des queues de distribution. Sans l’adjonction graphique de ce demi-entier correctif, l’aire calculée sous la courbe gaussienne sous-estime ou surestime systématiquement la somme discrète des probabilités des bâtons binomiaux inclus dans la région critique, introduisant des distorsions préjudiciables lors de la fixation des seuils d’erreur de première espèce dans les tests d’adéquation empiriques.
7. Tracé de la fonction de répartition cumulative (CDF)
7.1 Formulation du cumul discret via la fonction pbinom()
Tandis que la fonction de masse de probabilité s’attache à décomposer l’aléa en événements élémentaires disjoints, la fonction de répartition cumulative, couramment désignée par l’acronyme anglo-saxon CDF, répond à l’impératif d’évaluer la probabilité globale d’observer une réalisation ne franchissant pas un seuil quantitatif déterminé. Mathématiquement formalisée par l’expression F(k) = P(X ≤ k), elle traduit l’accumulation progressive des masses stochastiques à mesure que l’on balaie le support numérique des succès potentiels de gauche à droite.
Dans l’écosystème algorithmique de R, cette grandeur stochastique est calculée de manière native par la fonction pbinom(). En transmettant le même vecteur d’entiers s’étendant de zéro à n à cette routine de sommation discrète, l’utilisateur obtient un vecteur de probabilités cumulées caractérisé par des propriétés mathématiques rigides : une monotonie strictement croissante au sens large, une origine initiale non nulle correspondant à la masse ponctuelle au point zéro, et une convergence asymptotique déterministe qui atteint rigoureusement la valeur unitaire pour la borne supérieure n.
L’intérêt de la fonction cumulative réside dans sa capacité à fournir instantanément les valeurs critiques nécessaires au calcul de la signification statistique et à l’extraction des quantiles empiriques. Dans les protocoles de psychométrie clinique, l’analyste ne s’intéresse que rarement à la probabilité ponctuelle d’un score isolé, privilégiant la détermination de la probabilité cumulée que le sujet obtienne un score inférieur ou égal au score constaté, ce qui conditionne le calcul de son rang percentile au sein de la population de référence.
7.2 Visualisation graphique sous forme d’escalier avec type = ‘s’
La représentation graphique de la fonction de répartition d’une variable aléatoire discrète impose des contraintes géométriques particulières qui prohibent formellement le tracé d’une courbe continue ou d’un simple nuage de points sans lien structurel. Puisque la variable aléatoire ne peut prendre que des valeurs entières, la probabilité cumulée demeure rigoureusement constante sur chaque intervalle semi-ouvert à gauche de la forme [k, k + 1[, avant de subir une discontinuité de première espèce au point entier suivant, se traduisant par un saut vertical abrupt dont l’amplitude exacte équivaut à la masse de probabilité P(X = k + 1).
Pour matérialiser avec une fidélité mathématique absolue cette typologie discontinue dans R, la fonction plot() doit impérativement être configurée avec l’argument spécialisé type = ‘s’, qui commande le traçage d’une fonction en escalier. Cette option ordonne au moteur graphique de prolonger horizontalement l’ordonnée courante jusqu’au quantile entier suivant avant d’opérer une transition verticale instantanée, dessinant ainsi la succession caractéristique de marches d’escalier qui caractérise la théorie de la mesure discrète.
L’utilisation de type = ‘s’ confère au graphique une lisibilité conceptuelle exemplaire. L’observateur visualise immédiatement que la probabilité cumulative stagne entre deux entiers successifs et perçoit d’un seul regard l’ampleur des sauts marginaux. Les marches les plus hautes correspondent visuellement aux régions de plus forte densité de probabilité, c’est-à-dire au voisinage immédiat du mode distributionnel, tandis que les marches s’aplatissent imperceptiblement à l’approche de l’asymptote horizontale unitaire au sommet de la figure.
7.3 Exploitation clinique et seuils diagnostiques
Dans les contextes d’évaluation diagnostique, de dépistage épidémiologique ou d’expertise neuropsychologique, la visualisation de la fonction de répartition cumulative constitue l’outil analytique par excellence pour isoler les performances atypiques ou pathologiques. Les praticiens s’appuient couramment sur des seuils statistiques conventionnels, tels que le percentile cinq pour identifier les déficits sévères ou le percentile quatre-vingt-quinze pour isoler les profils surdoués ou exceptionnels au sein d’une distribution de compétences standardisée.
L’adjonction de repères visuels formalisés sur le tracé en escalier s’exécute avec fluidité au moyen de la commande abline(h = 0.95, col = ‘red’, lty = 2), qui projette une ligne de référence horizontale discontinue matérialisant visuellement le niveau critique choisi. L’intersection spatiale entre cette droite horizontale et la trajectoire en escalier de la distribution cumulative binomiale isole sans ambiguïté l’abscisse entière à partir de laquelle un score observé peut être considéré comme statistiquement atypique au seuil alpha prédéterminé.
L’intégration de tels repères permet d’enrichir la restitution des bilans psychométriques d’un support graphique indiscutable. En positionnant le score singulier d’un patient sur cette trajectoire cumulative, le clinicien démontre visuellement la rareté stochastique de la performance constatée, apportant une assise probabiliste irréfutable à la décision diagnostique finale, tout en prévenant les erreurs d’interprétation fréquemment générées par la manipulation exclusive de scores standardisés abstraits.
8. Représentation moderne et publication-ready avec le package ggplot2
8.1 Structuration des données sous forme de tibble ou data.frame
Si le système graphique de base de R excelle par son immédiateté et sa légèreté computationnelle, la confection de visualisations destinées aux revues internationales de premier rang s’oriente aujourd’hui quasi universellement vers l’écosystème graphique déclaratif fondé sur la grammaire des graphiques et implémenté au sein du package spécialisé ggplot2. Ce paradigme algorithmique impose un prérequis structurel fondamental : les données à cartographier doivent être préalablement encapsulées au sein d’un objet bidimensionnel structuré de type data.frame ou tibble, en parfaite harmonie avec les règles du tidy data.
Pour préparer le pipeline de données en amont de l’instanciation de la figure, l’analyste crée un tableau structuré associant deux colonnes numériques synchronisées : la première consignant la séquence ordonnée des succès discrets de zéro à n, et la seconde stockant les masses de probabilités homologues générées vectoriellement par la fonction dbinom(). L’attribution de noms explicites et normalisés à ces variables facilite considérablement la clarté des déclarations esthétiques ultérieures dans les fonctions de cartographie graphique.
Cette structuration préalable en tableau de données offre en outre une flexibilité incomparable pour adjoindre des métadonnées factorielles ou des colonnes catégorielles calculées. Il devient ainsi trivial d’intégrer une troisième colonne sous forme d’indicateur logique binaire ou polytomique, marquant par exemple les réalisations stochastiques tombant dans la région de rejet d’un test statistique, ouvrant la voie à des manipulations chromatiques conditionnelles d’une grande puissance expressive au sein de la syntaxe déclarative de ggplot2.
8.2 Construction géométrique avec geom_col() et geom_segment()
La transcription géométrique de la distribution binomiale dans le paradigme ggplot2 s’articule autour de deux couches géométriques fondamentales selon la métaphore visuelle privilégiée par le chercheur : geom_col() ou geom_segment(). L’utilisation de geom_segment() représente la transposition la plus rigoureuse et la plus fidèle du diagramme en aiguilles de base. Elle exige la déclaration explicite des coordonnées de départ et d’arrivée, reliant le point d’abscisse x et d’ordonnée zéro au point homologue d’abscisse x et d’ordonnée P(X = k), conférant au graphique une sobriété géométrique optimale.
Alternativement, l’opérateur peut opter pour la fonction geom_col(), qui génère des colonnes verticales ou des barres massives dont la base repose sur l’axe horizontal. Pour préserver l’intégrité sémiotique propre aux variables aléatoires strictement discrètes et éviter la confusion visuelle avec un histogramme de densité continue, il est impératif de contraindre la largeur géométrique relative de ces barres en ajustant l’argument width à une valeur resserrée, comprise par exemple entre 0.15 et 0.30, garantissant un espace d’interruption net entre deux colonnes consécutives.
L’harmonisation de l’identité visuelle s’exécute en raccordant ces couches géométriques à des échelles de nuances éprouvées issues de packages réputés pour leur robustesse perceptuelle, tels que viridis ou RColorBrewer. L’application d’échelles de couleurs continues ou discrètes perceptuellement uniformes assure une distinction sans faille des gradients de probabilité, tout en garantissant la parfaite accessibilité visuelle du document aux lecteurs présentant des anomalies de la vision des couleurs comme le daltonisme.
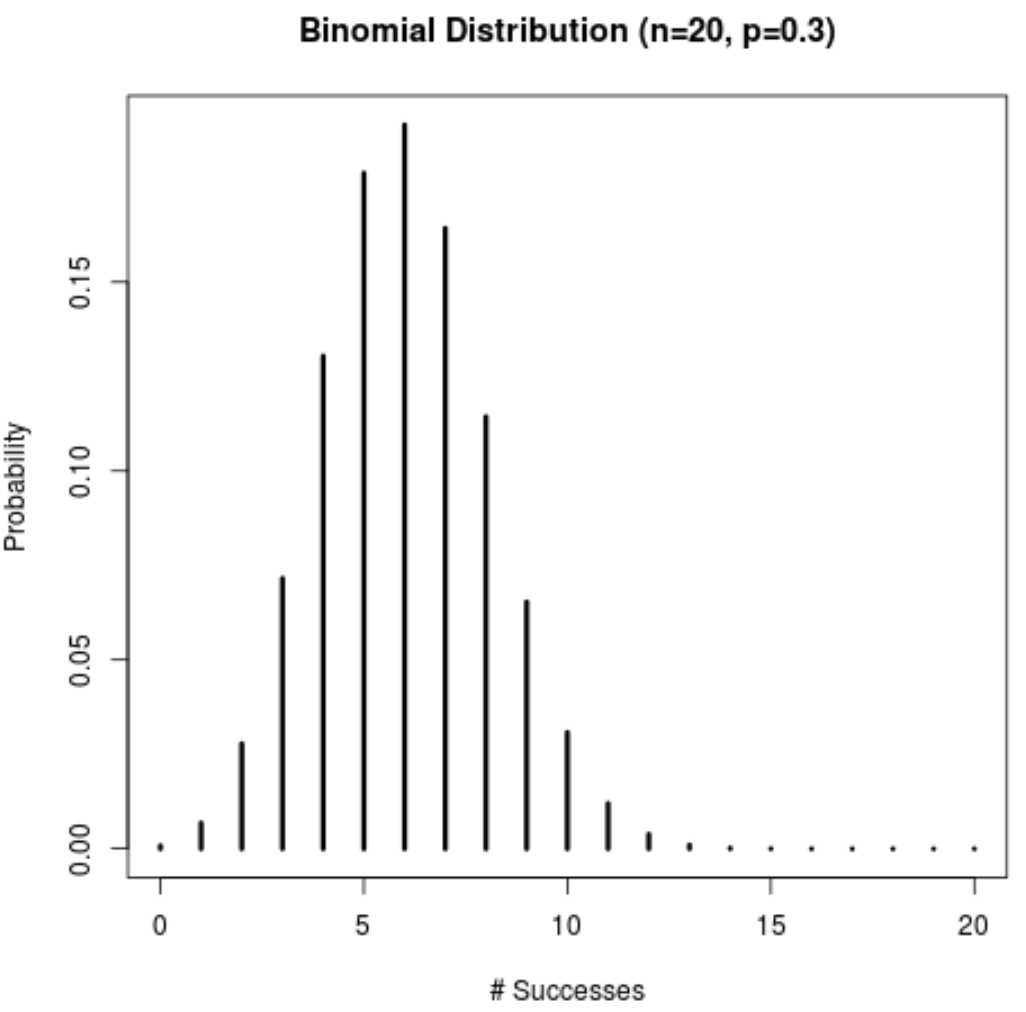
8.3 Application des standards éditoriaux académiques
L’esthétique graphique par défaut générée par le package ggplot2, reconnaissable à son arrière-plan quadrillé grisâtre et ses bordures épaisses, ne correspond pas aux normes de sobriété formelle exigées par les comités éditoriaux des périodiques scientifiques internationaux. La transformation d’un graphique brut en un visuel publiable requiert donc une refonte drastique de ses composantes thématiques non informationnelles, conformément au principe d’optimisation du ratio encre-données formulé par Edward Tufte.
L’application du thème clé en main theme_classic() ou theme_minimal() permet d’éliminer instantanément le fond grisâtre pour instaurer un fond blanc pur, tout en supprimant le maillage orthogonal superflu pour ne conserver que les axes cartésiens essentiels. L’adjonction de la fonction générique theme() offre quant à elle un contrôle microscopique sur l’ensemble de la scénographie typographique : sélection d’une police sans empattement normalisée, agrandissement mesuré des corps textuels des étiquettes d’axes pour assurer la lisibilité en réduction typographique, et réglage fin de l’espacement des marges externes.
Le pipeline de labellisation s’achève par l’appel à la fonction labs(), qui orchestre la hiérarchie informative textuelle : attribution d’un titre formel précis, désignation d’un sous-titre optionnel récapitulant les coordonnées stochastiques n et p, formulation rigoureuse des légendes d’axes avec notations mathématiques enrichies via la fonction expression(), et incorporation en pied de figure d’une note descriptive stipulant explicitement la signification statistique des représentations géométriques, satisfaisant ainsi aux exigences des manuels de style de l’American Psychological Association (APA).
9. Annotations scientifiques et zones critiques sur le tracé
9.1 Mise en exergue de l’espérance mathématique
Un tracé de distribution probabiliste acquiert une valeur heuristique décuplée dès lors qu’il intègre visuellement les moments statistiques fondamentaux régissant la variable étudiée. Le premier de ces indicateurs n’est autre que l’espérance mathématique ou valeur moyenne attendue, formalisée par le scalaire mu = n * p. Sur le plan sémiologique, positionner explicitement cette grandeur sur le graphique offre à l’observateur un ancrage cognitif immédiat, permettant d’évaluer la dispersion de l’aléa autour de son centre d’attraction gravitationnel.
Pour matérialiser cet équilibre au sein du moteur graphique standard de R, la commande abline(v = n * p, col = ‘firebrick’, lty = 2, lwd = 2) trace instantanément une droite verticale discontinue coupant l’axe des abscisses exactement à la coordonnée moyenne. Dans l’écosystème ggplot2, cette opération s’exécute de manière déclarative par l’adjonction de la couche geom_vline(xintercept = n * p, linetype = ‘dashed’, color = ‘firebrick’), préservant la modularité du pipeline de rendu graphique.
Cette démarcation géométrique gagne à être enrichie d’une annotation textuelle explicative positionnée avec minutie dans l’espace vierge du tracé au moyen de la fonction text() ou de son équivalent moderne annotate(geom = ‘text’, …). L’intégration d’une étiquette alphanumérique affichant l’espérance théorique calculée garantit une intelligibilité absolue de la figure, dissipant toute incertitude lors de l’examen visuel de distributions discrètes asymétriques où la moyenne arithmétique ne coïncide pas nécessairement avec le sommet modal entier de la distribution.
9.2 Coloration conditionnelle des zones de rejet d’hypothèse
Dans les démarches d’inférence statistique confirmatoire, la distribution binomiale sert fréquemment de distribution d’échantillonnage sous l’hypothèse nulle pour tester si un taux de conformité ou une fréquence comportementale s’écarte significativement du hasard. La délimitation visuelle des régions critiques, qui correspondent à l’ensemble des réalisations extrêmes dont la probabilité cumulée sous l’hypothèse nulle est inférieure au risque d’erreur consenti de première espèce alpha, constitue un vecteur pédagogique d’une efficacité remarquable.
Dans l’environnement de programmation R, cette ségrégation visuelle s’opère élégamment par la construction vectorielle d’une variable logique d’appartenance. En évaluant quelles valeurs de succès du vecteur 0:n possèdent une probabilité cumulative strictement inférieure à alpha / 2 pour la queue inférieure, ou strictement supérieure à 1 – (alpha / 2) pour la queue supérieure dans le cas d’un test bilatéral symétrique, on engendre un vecteur booléen qui discrimine instantanément la zone de rétention d’hypothèse de la zone de rejet critique.
Ce vecteur logique est ensuite immédiatement injecté dans l’argument chromatique col de la fonction plot() ou au sein de l’esthétique fill de ggplot2 au moyen de structures conditionnelles telles que ifelse(). Les bâtons de probabilité appartenant à la région de non-rejet s’affichent par exemple dans une teinte ardoise discrète, tandis que les aiguilles critiques tombant dans la région de rejet s’illuminent d’un carmin éclatant. L’observateur appréhende ainsi d’un seul coup d’œil les frontières de décision statistique et la probabilité totale associée aux événements disqualifiant l’hypothèse de travail.
9.3 Intégration d’une légende explicative normalisée
L’incorporation d’indicateurs visuels multiples, tels que des lignes de référence, des moyennes théoriques et des codes chromatiques conditionnels, génère une complexité visuelle qui impose l’adjonction d’une boîte de légende rigoureusement calibrée. Une figure dépourvue de légende exhaustive transfère la charge cognitive de déchiffrement sur le lecteur, ce qui déroge aux principes fondamentaux de la communication scientifique formalisée dans les directives méthodologiques internationales.
Au sein des fonctions graphiques de base de R, la commande legend() permet d’implanter manuellement ce cadre informatif en spécifiant ses coordonnées cartésiennes ou en utilisant des mots-clés positionnels standardisés tels que ‘topright’ ou ‘topleft’. L’analyste doit veiller avec le plus grand soin à choisir une localisation topologique qui n’entre pas en conflit spatial avec le déploiement des bâtons verticaux de probabilité, préservant l’intégrité de la zone informative principale du graphique.
Dans le package ggplot2, la construction de la légende est gérée de manière automatisée par le moteur de cartographie esthétique, mais sa personnalisation demeure indispensable. Il convient d’épurer l’apparence de cette boîte en ajustant les arguments thématiques via theme(legend.position = …) et d’affiner la précision des intitulés via guides() ou scale_color_manual(). L’élimination systématique des bordures parasites et des fonds opaques assure un rendu visuel aéré, parfaitement conforme aux canons typographiques des publications scientifiques de référence.
10. Applications pratiques : protocoles expérimentaux en psychologie cognitive
10.1 Modélisation de tâches de détection du signal en psychoacoustique
Dans le domaine empirique de la psychoacoustique expérimentale, les chercheurs explorent les limites absolues du système perceptif humain en soumettant les auditeurs à des séquences d’essais calibrés au cours desquels un stimulus acoustique d’intensité infinitésimale est aléatoirement inséré dans une trame de bruit blanc continu. L’observateur est contraint de répondre de manière dichotomique en signalant la perception effective du signal ou son inaudibilité totale. La distribution binomiale constitue le socle mathématique sur lequel repose l’intégralité de la modélisation statistique de ces sessions de détection.
Sous l’hypothèse nulle d’une imperceptibilité physiologique totale du stimulus, les réponses de l’auditeur sont assimilées à des tirages aléatoires purs gouvernés par un processus de Bernoulli où p s’établit rigoureusement à 0.5 dans le cadre d’un protocole binaire équilibré. En traçant la fonction de masse binomiale pour une session comportementale de cent essais indépendants, le psychoacousticien configure la cartographie théorique de la performance attendue par devinette pure, centrée de manière déterministe sur l’espérance mathématique de cinquante détections.
L’annotation visuelle de ce tracé par une ligne verticale délimitant le seuil alpha unilatéral à 5 % permet de fixer immédiatement le nombre minimal de détections réussies requises pour rejeter l’hypothèse de la chance et attester statistiquement d’une sensibilité sensorielle réelle chez le sujet. Si le nombre de détections observées se situe au-delà de cette frontière stochastique, le chercheur dispose d’une démonstration graphique indiscutable attestant que la performance perceptive émerge significativement du bruit sensoriel de fond.
10.2 Évaluation de questionnaires psychométriques à items dichotomiques
Les épreuves d’aptitude psychologique, les inventaires de personnalité administrés en milieu clinique ou les questionnaires d’évaluation pédagogique reposent fréquemment sur des batteries de questions fermées admettant des réponses dichotomiques de type vrai ou faux. Lors de l’administration d’un questionnaire standardisé comportant par exemple vingt items indépendants, la préoccupation centrale du psychométricien réside dans la dissociation formelle entre la maîtrise réelle d’une compétence et la réussite artificielle imputable à des réponses émises au hasard.
Le traçage dans R d’une distribution binomiale paramétrée par une taille d’échantillon fixée à vingt et une probabilité de succès stochastique calibrée à 0.5 permet d’objectiver avec une précision mathématique absolue le profil de réponse d’un répondeur totalement ignorant. La visualisation révèle instantanément que la probabilité d’obtenir par simple hasard un score supérieur ou égal à quinze sur vingt est infinitésimale, isolant ainsi la frontière numérique à partir de laquelle une inférence de compétence peut être scientifiquement revendiquée.
Par ailleurs, cette approche graphique facilite l’illustration didactique des intervalles de confiance binomiaux exacts dérivés de la méthode de Clopper-Pearson pour un participant spécifique. En superposant sur la figure les limites de confiance associées au score empirique brut constaté, le praticien visualise immédiatement l’amplitude de l’erreur d’échantillonnage inhérente à la brièveté du test, prévenant ainsi les erreurs de surinterprétation diagnostique fondées sur des variations minimes de performance.
10.3 Analyse de puissance et estimation visuelle de la taille d’effet
La planification méthodologique d’un protocole de recherche requiert une calibration rigoureuse de la puissance statistique afin d’assurer que l’expérience possède une probabilité raisonnable de détecter un effet expérimental réel s’il existe effectivement dans la population générale. La superposition graphique de deux distributions binomiales distinctes offre une visualisation remarquablement limpide de cette mécanique inférentielle, réconciliant théorie probabiliste et pratique expérimentale.
L’analyste trace sur un même système d’axes cartésiens la distribution binomiale modélisée sous l’hypothèse nulle, caractérisée par une probabilité de référence p = 0.5, et la distribution concurrente postulée sous l’hypothèse alternative, matérialisée par exemple par un taux de succès accru p = 0.75 reflétant l’ampleur postulée de l’effet cognitif induit par une intervention thérapeutique. La démarcation préalable du seuil critique de décision statistique issu de la distribution nulle révèle visuellement les deux risques d’erreur fondamentaux.
L’erreur de première espèce, notée alpha, s’incarne graphiquement dans la somme des masses de probabilité de la distribution sous hypothèse nulle s’étendant au-delà du seuil critique dans la région de rejet. L’erreur de seconde espèce, notée bêta, correspond géométriquement à la fraction de la masse de probabilité de la distribution sous hypothèse alternative qui demeure en deçà de ce même seuil critique. La puissance statistique n’est autre que l’aire complémentaire 1 – bêta. La manipulation interactive de la taille n met alors visuellement en évidence la séparation spatiale progressive des deux profils distributionnels, démontrant graphiquement comment l’accroissement des cohortes expérimentales maximise la probabilité de réplication empirique.
11. Diagnostic et résolution des anomalies de programmation fréquentes
11.1 Incohérence dimensionnelle et erreurs de bornage d’indices
Parmi les écueils algorithmiques récurrents rencontrés lors de l’implémentation de visualisations stochastiques dans l’environnement R, les erreurs de dimensionnement vectoriel et d’omission d’indices figurent au premier rang des causes de dysfonctionnement computationnel. La source de distorsion la plus pernicieuse résulte de l’initialisation du support des abscisses à l’unité plutôt qu’à zéro, c’est-à-dire en générant la séquence via l’instruction 1:n au lieu de la formulation exhaustive obligatoire 0:n.
Cette omission de la valeur zéro prive non seulement le modèle de son état initial légitime, qui possède une probabilité mathématique d’occurrence non nulle égale à (1 – p)^n, mais génère en outre un décalage dimensionnel dramatique si l’utilisateur transmet simultanément le vecteur discret tronqué à l’argument x et un calcul d’ordonnées complet évaluant la fonction de masse sur n + 1 points. R interrompt alors l’exécution du code en retournant un message d’erreur explicite signalant une incompatibilité de longueur entre les coordonnées horizontales et verticales.
La résolution de cette anomalie requiert une rigueur procédurale constante lors de l’instanciation des structures de données. L’analyste doit systématiquement contrôler la stricte conformité vectorielle avant tout appel graphique au moyen de la clause logique stopifnot(length(x) == length(y)). Cette précaution algorithmique garantit que chaque probabilité calculée est spatialement et sémantiquement appariée à son entier ordinal exact, immunisant le code contre tout glissement indiciaire susceptible de fausser l’intégralité de l’interprétation empirique des tracés générés.
11.2 Choix erroné de l’interpolation continue
Un travers visuel couramment observé chez les praticiens issus de disciplines non mathématiques consiste à recourir aveuglément à des tracés linéaires interpolés continus en renseignant l’argument type = ‘l’ au sein de la fonction graphique de base plot(), ou en appliquant sans précaution la couche geom_line() dans l’environnement ggplot2. Cette pratique traduit une confusion méthodologique substantielle entre la notion de variable aléatoire continue et celle de variable discrète à support dénombrable.
L’interpolation linéaire trace des segments obliques arbitraires reliant les probabilités ponctuelles associées aux entiers discrets consécutifs. Ce rendu visuel suggère de manière trompeuse à l’observateur qu’il existe une masse de probabilité intermédiaire attribuable à des réalisations fractionnaires, comme l’obtention de 3.4 succès ou de 7.8 réponses correctes. Or, dans un cadre expérimental standardisé, une telle occurrence est rigoureusement inexistante et dépourvue de tout fondement mathématique ou physique.
Pour éradiquer cette déviance de représentation, la communauté méthodologique préconise de contraindre strictement la sémiologie graphique aux formes discontinues éprouvées : le diagramme en bâtons d’aiguilles via type = ‘h’, les diagrammes en barres étriquées via geom_col(), ou le tracé ponctuel disjoint combiné à des segments verticaux. Le bannissement des courbes continues pour représenter une fonction de masse discrète constitue une exigence éditoriale universelle qui conditionne l’acceptabilité méthodologique des manuscrits soumis aux revues de statistiques appliquées.
11.3 Débordements d’échelle et troncature des sommets
Une anomalie visuelle fréquente affectant les visualisations de distributions binomiales réside dans la troncature accidentelle du sommet modal de la distribution ou le découpage involontaire des barres latérales, phénomène consécutif à une mauvaise gestion de l’étendue cartésienne des axes d’ordonnées et d’abscisses. Lorsque le moteur graphique standard ajuste les échelles sans contrainte manuelle, l’extrémité supérieure du bâton le plus élevé vient fréquemment heurter la ligne de cadre supérieure de la figure, dégradant la lisibilité esthétique de la composition.
Pour prévenir cette dégradation spatiale, l’ingénierie du script doit intégrer une règle d’évolutivité dynamique lors de la définition de la borne supérieure d’ordonnées. Il est vivement conseillé de calculer programmatiquement cette limite au moyen de l’expression ylim = c(0, max(dbinom(0:n, size = n, prob = p)) * 1.15). Ce coefficient multiplicateur de sécurité alloue un dégagement vertical de quinze pour cent au sommet du graphique, garantissant que le pic de masse s’épanouisse dans l’espace utile sans restriction et offrant la surface indispensable à l’insertion de symboles ou d’annotations textuelles sans risque de chevauchement.
Parallèlement, la mauvaise calibration des marges périphériques de la figure via le paramètre global mar de la fonction par() engendre régulièrement la disparition partielle des étiquettes des axes ou des valeurs numériques des graduations. La configuration méthodique d’un vecteur de marges équilibré, traditionnellement calibré sur par(mar = c(5, 5, 4, 2) + 0.1), garantit que les dénominations textuelles et les expressions formelles bénéficient d’un espace topologique adéquat, assurant une présentation visuelle d’une netteté professionnelle irréprochable.
12. Exportation haute résolution et pérennité pour publication
12.1 Comparatif des périphériques graphiques vectoriels et matriciels
La finalisation d’un protocole de visualisation stochastique impose de s’extraire de l’interface interactive de RStudio pour transférer la production visuelle vers un périphérique d’exportation pérenne capable de générer des fichiers de qualité typographique supérieure. Deux familles technologiques distinctes s’offrent alors au chercheur : les formats graphiques vectoriels et les formats matriciels ou points par point, chacun répondant à des contraintes éditoriales spécifiques.
Les périphériques vectoriels, dont les représentants les plus éminents sont les fonctions natives pdf() et svg(), constituent le standard d’excellence absolue pour les revues scientifiques et les presses universitaires internationales. En encodant les composantes du graphique sous forme d’instructions géométriques et typographiques indépendantes de toute grille physique de pixels, ces formats autorisent des agrandissements infinis sans la moindre dégradation de netteté. Les segments verticaux, les textes annotés et les symboles stochastiques conservent des contours microscopiquement tranchés, quelle que soit la résolution de l’équipement de photocomposition utilisé.
À l’opposé, les périphériques matriciels tels que png() ou tiff() figent le tracé au sein d’une matrice bidimensionnelle de pixels prédéfinie. Si leur usage est parfois requis pour l’intégration web ou pour respecter certaines directives strictes d’éditeurs interdisant les fichiers vectoriels complexes, leur initialisation exige une rigueur extrême quant au calibrage du paramètre de densité de points par pouce, couramment désigné par le sigle DPI. L’omission de ce réglage produit des visualisations floues et pixelisées inacceptables pour une publication académique sérieuse.
12.2 Dimensionnement physique et calibration typographique
Lors de l’activation programmatique d’un périphérique de sortie haute résolution matriciel, tel que png(filename = « figure_binomiale.png », width = 2400, height = 1800, res = 300), l’utilisateur force le système à générer une image répondant aux critères standard de l’impression professionnelle, fixés à trois cents points par pouce. Toutefois, cette modification drastique de la densité modifie profondément les rapports de proportions géométriques internes si elle n’est pas compensée de manière adéquate.
Le piège récurrent réside dans l’effondrement visuel de la taille relative des polices de caractères et de l’épaisseur des tracés verticaux, qui apparaissent microscopiques au sein de la volumineuse matrice de pixels générée. Pour restaurer l’harmonie typographique, il est indispensable de manipuler l’argument scalaire pointsize au sein de la fonction d’exportation. En augmentant proportionnellement cette valeur de base, le moteur de rendu redimensionne l’intégralité des éléments textuels, rétablissant une lisibilité parfaite des graduations, des titres et des annotations explicatives.
Dans l’écosystème spécialisé de ggplot2, cette opération d’exportation dimensionnée bénéficie de la concision et de la puissance de la commande unifiée ggsave(). Cette routine dédiée permet de stipuler les grandeurs physiques directes de l’image finale en centimètres ou en pouces via les arguments explicites width, height et units, tout en verrouillant la résolution cible via l’argument dpi = 300. Le moteur interne recalcule automatiquement les facteurs d’échelle scalaires, garantissant que la figure exportée s’intègre harmonieusement sur la largeur d’une colonne de texte dans une mise en page éditoriale standardisée.
12.3 Reproductibilité computationnelle et encapsulation de scripts
L’exigence contemporaine de reproductibilité scientifique impose que toute visualisation publiée puisse être régénérée de manière totalement déterministe et identique par n’importe quel chercheur tiers disposant du code source et de l’environnement logiciel initial. Cette transférabilité repose sur une architecture algorithmique modulaire, propre et documentée, isolant le script de tracé binomial des contingences interactives de la machine hôte.
Un script de visualisation binomiale rigoureusement conçu s’ouvre par la fixation des méta-paramètres au sein d’un bloc de configuration initial isolé en en-tête. Les valeurs expérimentales de la taille d’échantillon n et de la probabilité de succès p y sont explicitement déclarées sous forme de scalaires nommés, assurant que toute modification ultérieure de ces valeurs se propage automatiquement à l’ensemble du pipeline de calcul et de rendu graphique sans nécessiter de fastidieuses retouches manuelles dans le corps du code.
Le protocole de pérennisation s’achève par l’ancrage des métadonnées logicielles relatives à la session de travail. L’inclusion systématique en queue de script de l’instruction sessionInfo() permet d’archiver la version exacte de R mobilisée, les architectures matérielles sous-jacentes ainsi que les numéros de version précis des packages externes invoqués. Cette documentation exhaustive immunise la recherche contre les ruptures de compatibilité ascendante futures, transformant un simple exercice graphique en un livrable scientifique durable, pérenne et universellement vérifiable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Macmillan, N. A., & Creelman, C. D. (2005). Detection theory: A user’s guide (2nd ed.). Lawrence Erlbaum Associates.
- Murrell, P. (2018). R graphics (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429490279
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4